Diese Studie schlägt ein hybrides Kostenprognosemodell für Stromnetze vor, das physikalische Kostenquoten mit dynamischen makroökonomischen und technologischen Anpassungen sowie einer XGBoost-basierten Restkompensation kombiniert. Mit einem MAPE von 2,34 % bietet es eine Balance zwischen Genauigkeit und Interpretierbarkeit und trägt damit den Anforderungen an regulatorische Transparenz bei der Tarifgestaltung Rechnung.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Retrospektive Prognose unter Verwendung von Provinzgitterdaten und einem quotenbasierten hybriden Physikalisch-KI-Modell
In diesem Artikel
Zusammenfassung
Zusammenfassung
Der globale Energieübergang und die laufenden Reformen des Strommarktes erfordern, dass Stromnetzbetreiber eine zuverlässige Stromversorgung mit immer strengeren Vorgaben zu Übertragungs- und Verteiltarifen in Einklang bringen. Traditionelle Budgetierungsverfahren, die auf historischen Extrapolationen basieren, spiegeln oft nicht die physikalische Grundlage des Anlagenbetriebs wider, während datengetriebene maschinelle Lernmodelle eine hohe Vorhersagegenauigkeit erreichen, aber an Transparenz mangeln, die für die regulatorische Kostenprüfung erforderlich ist. Um den Kompromiss zwischen Vorhersagegenauigkeit und Interpretierbarkeit zu überwinden, schlägt diese Studie ein hybrides Kostenprognosemodell auf Basis von Kostenkontingenten vor. Der Ansatz verwendet standardisierte Betriebskontingente als physikalische Budgetierungsgrundlage und integriert einen dynamischen Mechanismus zur Weiterentwicklung der Kontingente, der von makroökonomischen Bedingungen und technologischem Fortschritt gesteuert wird. Extreme Gradient Boosting (XGBoost) wird eingesetzt, um nichtlineare Residuen jenseits der kontingentbasierten Schätzungen abzubilden, während SHAP (Shapley Additive exPlanations) zur Interpretation des Beitrags wesentlicher Kostenfaktoren verwendet wird. Das Modell wurde anhand von 16 Jahren anonymisierter Betriebsdaten eines Provinzstromnetzes in China evaluiert. Es erreichte einen mittleren absoluten prozentualen Fehler (MAPE) von 2,34 % und reduzierte die Prognosefehler um 61,8 %, 46,6 % bzw. 34,1 % im Vergleich zu SARIMAX-, eigenständigen XGBoost- und Attention-LSTM-Modellen. Der vorgeschlagene Ansatz verbindet ingenieurtechnische Kostenkontingentprinzipien mit erklärbarer künstlicher Intelligenz und liefert sowohl genaue langfristige Kostenprognosen als auch ein transparentes Entscheidungsunterstützungsinstrument für die regulatorische Genehmigung von Kosten.
Einleitung
Der globale Energiewandel verändert das Anlagenmanagement und die Betriebspraktiken von Stromnetzen durch die Integration verteilter erneuerbarer Erzeugung, zunehmende Extremwetterereignisse und den flächendeckenden Einsatz von IoT-Technologien, wodurch insgesamt eine größere betriebliche Flexibilität und mehr Wartungsressourcen erforderlich sind, um die Systemzuverlässigkeit sicherzustellen1,2. Gleichzeitig haben die Stromregulierungsbehörden die Aufsicht über Übertragungs- und Verteiltarife durch Rahmenbedingungen wie das britische RIIO-Modell und die Renditeprüfungen der US Federal Energy Regulatory Commission verstärkt und dabei die Transparenz bei der Kostenrechtfertigung betont3. Auch China hat einen Regulierungsmechanismus nach dem Prinzip „zugelassene Kosten plus angemessene Rendite“ eingeführt, der von den Energieversorgungsunternehmen verlangt, klare Zusammenhänge zwischen technischen Maßnahmen und finanziellen Aufwendungen nachzuweisen4. Viele Versorger verfügen jedoch häufig über keine transparenten quantitativen Werkzeuge, die physische Anlagenbetriebsdaten mit Kostenvorhersagen verknüpfen, was die Wirksamkeit der regulatorischen Kostenüberprüfung einschränkt5.
Bestehende Prognoseansätze weisen in diesem Umfeld wichtige Einschränkungen auf6. Traditionelle Methoden, darunter inkrementelle Budgetierung und ARIMA-basierte Modelle, gehen von relativ stabilen historischen Mustern aus und erzielen bei strukturellen Veränderungen, die durch wirtschaftliche Schwankungen oder extreme Wetterbedingungen verursacht werden, häufig schlechte Ergebnisse7. Im Gegensatz dazu bieten moderne maschinelle Lernmodelle wie LSTM- und Transformer-Architekturen eine hohe Vorhersagegenauigkeit für kurzfristige Prognosen, weisen jedoch die für regulatorische Entscheidungsfindung erforderliche ingenieurstechnische Interpretierbarkeit nicht auf8,9. Obwohl neuere hybride Prognoseansätze statistische Verfahren mit Techniken des maschinellen Lernens kombinieren, wird dabei in der Regel die standardisierte ingenieurstechnische Kostenkalkulation, die den Buchhaltungssystemen von Stromnetzen zugrunde liegt, außer Acht gelassen10. Um diese Einschränkungen zu überwinden, schlägt diese Studie einen quotenbasierten hybriden Prognoseansatz vor, der die dynamische Entwicklung von Quoten mit einer auf maschinellem Lernen basierenden Residualkorrektur verbindet und dabei die ingenieurstechnische Interpretierbarkeit erhält, gleichzeitig aber die Prognosegenauigkeit verbessert.
Eine wichtige Forschungsrichtung ergibt sich aus der Anreizregulierung in natürlichen Monopolbranchen, einschließlich des britischen RPI-X-Mechanismus und des chinesischen Rahmens zur Überprüfung zulässiger Kosten11. Diese Studien bewerten die betriebliche Effizienz hauptsächlich mithilfe der Data Envelopment Analysis (DEA) und der Stochastic Frontier Analysis (SFA)12. Bisherige Untersuchungen haben langfristige Zusammenhänge zwischen Kapitalaufwendungen (CAPEX), Betriebsaufwendungen (OPEX) und Kosteneffizienz analysiert, um die Tarifregulierung zu unterstützen13,14. Obwohl diese Ansätze wertvolle makroökonomische Erkenntnisse liefern, werden ihre Ergebnisse in der Regel als relative Effizienzwerte und nicht als monetäre Prognosen dargestellt, die für die jährliche Budgetplanung geeignet wären15,16. Darüber hinaus setzen Grenzmodellansätze im Allgemeinen relativ stabile physische Anlagenstrukturen und Betriebsbedingungen voraus, was ihre Fähigkeit einschränkt, plötzliche Kostenänderungen infolge von Anlagenalterung, Infrastrukturaustausch oder schnellem Nachfragewachstum abzubilden17,18.
Eine zweite Forschungsrichtung konzentriert sich auf statistische und auf künstlicher Intelligenz basierende Prognosemodelle. Frühe Studien verwendeten multiple lineare Regression sowie Modelle mit autoregressiver Integration und gleitendem Durchschnitt mit exogenen Variablen (ARIMAX) zur Kostenprognose19. In jüngerer Zeit haben Support-Vektor-Regression, Zufallswälder, XGBoost, LSTM- und Transformer-Modelle die Prognosegenauigkeit deutlich verbessert, indem sie nichtlineare Zusammenhänge und hochdimensionale Merkmalsräume ausnutzen20,21,22. Diese Ansätze integrieren häufig makroökonomische Indikatoren wie den Stromverbrauch, Erzeugerpreisindizes (PPI) und klimatische Variablen23. Die Betriebskosten von Stromnetzen ergeben sich jedoch aus ingenieurtechnischen Tätigkeiten, dem Verschleiß von Anlagen, der Wartungsplanung und Managemententscheidungen und nicht allein aus makroökonomischen Variablen24. Daher wirken rein datengetriebene Modelle oft wie „Black Boxes“, was die Erklärung prognostizierter Kosten im Rahmen behördlicher Prüfungen oder der Überprüfung genehmigter Kosten erschwert25,26.
Das Management von Ingenieurkostenquoten bietet eine mögliche Lösung für diese Herausforderung27. Die auf Aktivitäten basierende Kostenrechnung (Activity-based costing, ABC) stützt sich seit langem auf standardisierte betriebliche Quoten, um den Bedarf an Arbeitskraft, Material, Ausrüstung und Wartung für routinemäßige Netzoperationen abzuschätzen28. Große chinesische Versorgungsunternehmen haben umfassende Quotendatenbanken entwickelt, die Inspektion, Wartung, Prüfung, Reparatur und den Austausch von Geräten abdecken. Diese ingenieurtechnischen Standards werden jedoch hauptsächlich für Projektabrechnungen und Prüfungen genutzt, nicht aber für dynamische Langzeitprognosen29,30. Zudem werden Quotenstandards typischerweise nur alle paar Jahre überarbeitet, wodurch sie unzureichend auf sich ändernde Rohstoffpreise, technologische Fortschritte und veränderte Betriebspraktiken reagieren können31. Die Anwendung von Quotensystemen auf Millionen verteilter Anlagen stellt außerdem erhebliche rechentechnische Herausforderungen für Prognosen im großen Maßstab dar32.
Trotz erheblicher Fortschritte bei statistischen Prognosen, maschinellem Lernen und der Kostenmanagement-Methodik existiert bisher kein Rahmenmodell, das standardisierte ingenieurtechnische Kostenquoten, dynamische makroökonomische Anpassungen und erklärbares maschinelles Lernen effektiv in ein einheitliches Prognosemodell für die regulatorische Kostenüberprüfung integriert. Es wurde die Hypothese aufgestellt, dass die Kombination sich dynamisch weiterentwickelnder Kostenquoten mit einem XGBoost-basierten Residual-Learning-Ansatz die Genauigkeit langfristiger Prognosen verbessern kann, gleichzeitig aber die für regulatorische Entscheidungsfindung erforderliche ingenieurtechnische Transparenz bewahrt. Um diese Hypothese zu überprüfen, wurde ein hybrides, quotenbasiertes Prognosemodell entwickelt, das physikalisches Kostenmodellieren, Mechanismen zur makroökonomischen und technologischen Anpassung, XGBoost-basierte Kompensation von Residuen sowie die Modellinterpretation mittels SHAP integriert. Der vorgeschlagene Ansatz zielt darauf ab, sowohl genaue langfristige Kostenprognosen als auch transparente Belege zur Unterstützung der Überprüfung genehmigter Kosten im Rahmen der modernen Elektrizitätsmarktregulierung bereitzustellen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie verwendete anonymisierte Betriebs- und Finanzdaten, die von einem Provinz-Stromnetz in Ostchina gesammelt wurden. Alle Daten wurden vor der Analyse aggregiert und anonymisiert, und es wurden keine personenbezogenen oder sensiblen individuellen Informationen einbezogen. Daher war keine ethische Genehmigung erforderlich. Der Zugriff auf die Daten und deren Analyse erfolgten in Übereinstimmung mit den geltenden Datenschutzvorschriften und institutionellen Vereinbarungen zur Regelung von Informationen im Stromsektor.
Überblick über den Prognoseansatz
Um physikbasierte und datengetriebene Prognoseansätze zu verbinden, wurde ein hybrider Prognoserahmen entwickelt, der ingenieurtechnische Kostenansätze mit maschinellem Lernen kombiniert. Anstatt lediglich mehrere Algorithmen zusammenzuführen, folgt der Rahmen dem Prinzip, dass physikalische Modelle die Basisprognose liefern, während maschinelles Lernen die verbleibenden Fehler ausgleicht. Diese Gestaltung stellt sicher, dass der Prognoseprozess auf den physikalischen Mechanismen beruht, die den Erzeugungs- und Betriebsabläufen im Stromnetz zugrunde liegen, anstatt allein auf der Extrapolation historischer Kosten.
Der Rahmen schafft zunächst eine hierarchische Zuordnung zwischen Anlagen des Stromnetzes, standardisierten Betriebsaktivitäten und finanziellen Kostenstellen. Produktions- und Betriebskosten werden als monetäre Darstellung der Ressourcen betrachtet, die von physischen Anlagen – einschließlich Umspannwerken, Übertragungsleitungen, Verteilungssträngen, Messgeräten und digitalen Inspektionsgeräten – bei routinemäßigen Tätigkeiten wie Inspektion, Wartung, Prüfung, Reparatur und Ersetzung verbraucht werden. Kostenkontingente dienen als Verbindung zwischen messbaren technischen Arbeitsmengen und den entsprechenden finanziellen Ausgaben.
Wie in Abbildung 1 veranschaulicht, fungieren Kostenkontingente als standardisierte Recheneinheiten, die in den gesamten Betriebs- und Wartungsprozess von Vermögenswerten integriert sind, anstatt als abstrakte finanzielle Zuweisungsregeln. Arbeitseinsätze auf unterster Ebene der Vermögenswerte werden in standardisierte Betriebskontingente umgewandelt und anschließend Kostenkategorien zugeordnet, darunter Arbeitskraft, Materialien, Baumaschinen, ausgelagerte Dienstleistungen und Notfallvorräte. Diese hierarchische Zuordnung erhält die ingenieurstechnische Interpretierbarkeit und behördliche Nachvollziehbarkeit während des Prognoseprozesses bei und bildet die physikalische Grundlage für die Erstellung des statischen Basis-Kontingentmodells.
Überblick über den methodischen Arbeitsablauf
Der vorgeschlagene Prognoseansatz umfasst drei aufeinanderfolgende Stufen: (1) die Erstellung einer physikalischen Basislinie anhand von Workload-Quoten auf Asset-Ebene, (2) die dynamische Anpassung der Kostenquoten durch makroökonomische und technologische Korrekturen und (3) eine auf maschinellem Lernen basierende Restkompensation zur Erfassung systematischer nichtlinearer Effekte. Wie in Abbildung 1 veranschaulicht, schafft der Ansatz eine hierarchische Zuordnung von Assets und standardisierten Betriebsaktivitäten auf unterster Ebene hin zu Prognosen für Produktions- und Betriebskosten. Die Implementierungsdetails jeder Stufe werden in den folgenden Unterkapiteln beschrieben.
Physikalisches Basiskostenmodell basierend auf werksspezifischen Arbeitslasten
Die Erzeugungs- und Betriebskosten eines Stromnetzes, Ctotal, umfassen Ausgaben, die mit mehreren geschäftlichen Aktivitäten verbunden sind, darunter der Betrieb von Umspannwerken, die Wartung von Übertragungsleitungen, das Management von Verteilnetzen, Kundenservice und unterstützende Systeme. In dieser Studie wird angenommen, dass die grundlegenden Betriebskosten durch die Arbeitslast bestimmt werden, die durch jede standardisierte Betriebsaktivität erzeugt wird, sowie durch die entsprechende Kostenquote.
Die statische Grundkosten werden wie folgt berechnet:
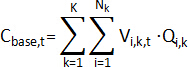 (1)
wobei Vi,k,t die mit der i-ten Anlage oder Betriebsaufgabe innerhalb der Geschäftskategorie k im Zeitraum t verbundene Arbeitslast bezeichnet und Qi,k die entsprechenden standardisierten Stückkosten darstellt, die durch das ingenieurtechnische Kostenquotensystem festgelegt sind. Die Geschäftskategorie umfasst wesentliche Betriebsfunktionen wie die Unterhaltsarbeiten an Umspannwerken, die Inspektion von Übertragungsleitungen, den Betrieb des Verteilnetzes und den Kundenservice. Die Doppelsumme aggregiert die Kosten aller standardisierten betrieblichen Aktivitäten, um den theoretischen Grundbedarf an Ausgaben abzuschätzen, der erforderlich ist, um den normalen Netzbetrieb aufrechtzuerhalten.
Gleichung (1) stellt den physikalischen Zusammenhang zwischen technischen Arbeitslasten und finanziellen Ausgaben her, indem standardisierte Betriebsaktivitäten direkt Kostenkonten zugeordnet werden. Im Gegensatz zu rein statistischen Prognosemodellen bietet diese Formulierung eine interpretierbare technische Grundlage, die als Fundament für nachfolgende dynamische Kontingentanpassungen und eine auf maschinellem Lernen basierende Korrektur von Residuen dient. Die Gleichung wurde aus den betrieblichen Praktiken und dem Kostenkontingent-System abgeleitet, das von provinziellen Stromnetzunternehmen in China angewandt wird. Tabelle 1 fasst die in Gleichung (1) verwendete Notation zusammen, einschließlich der Arbeitslast (Vi,k,t), der standardisierten Einheitskosten (Qi,k), der Anzahl der Betriebsaufgaben (Nk) und des Geschäftssegment-Index (k).
Dynamischer Evolutionsmechanismus von Quoten unter externen Umweltstörungen
Standardisierte Kostenquoten (Qi,k) liefern eine physikalisch interpretierbare Basis, berücksichtigen jedoch keine Änderungen der makroökonomischen Bedingungen oder des technologischen Fortschritts. Um ihre Langzeitanwendbarkeit zu verbessern, wurde ein dynamischer Entwicklungsmechanismus eingeführt, um die Basisquoten als Reaktion sowohl auf Preisinflation als auch auf technologiebedingte Effizienzsteigerungen anzupassen.
Die erste Anpassung berücksichtigt Änderungen der Beschaffungskosten aufgrund makroökonomischer Inflation. Der Betrieb und die Wartung von Stromnetzen hängen stark von Massenmaterialien ab, darunter Kupfer, Aluminium und Siliziumstahl, deren Preise eng mit Schwankungen des Erzeugerpreisindex (EPI) verknüpft sind. Da  ein Index mit einem Basiswert von 100 ist, wird er zunächst in eine standardisierte Inflationsrate umgerechnet:
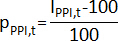 (2)
Darauf basierend wird die Preis-Korrektur-Funktion  wie folgt definiert:
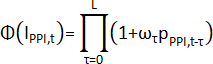 (3)
wobei  ein Lag-Gewichtsvektor der Länge L ist, der folgende Bedingung erfüllt
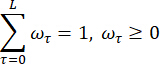
Die Verzögerungsstruktur stellt die verzögerte Übertragung der makroökonomischen Inflation auf die Beschaffungskosten innerhalb der Stromnetz-Lieferkette dar. Die Umrechnung des PPI-Index in eine standardisierte Inflationsrate bewahrt den kumulativen Effekt von Preisänderungen und vermeidet gleichzeitig Skalierungsverzerrungen, die mit der direkten Verwendung von Indexwerten verbunden sind. Die Gleichungen (2) und (3) wurden aus etablierten makroökonomischen Modellen zur Inflationsanpassung übernommen, wobei die Verzögerungsstruktur auf die Beschaffungszyklen des Stromsektors kalibriert wurde33,34.
Der technologische Fortschritt wurde über einen Kostenreduktionsfaktor berücksichtigt, der Verbesserungen der betrieblichen Effizienz widerspiegelt, die sich aus Fortschritten wie der Inspektion mittels unbemannter Luftfahrzeuge, intelligenter Robotik und digitaler Wartungstechnologien ergeben. Der Technologieanpassungsfaktor ist definiert als:
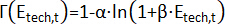 (4)
In diesem Teil sind α und β empirische Elastizitätskoeffizienten, die anhand historischer Paneldaten mittels nichtlinearer Kleinster-Quadrate-Schätzung ermittelt wurden. Um sicherzustellen, dass der technologische Fortschrittsfaktor stets eine plausible Verringerung der Stückkosten der Quoten darstellt, beschränkt der Parameterschätzprozess 0 < Γ(Etech,t) ≤ 1. Es ist darauf hinzuweisen, dass dieser Faktor vor allem die langfristige Effizienzsteigerung widerspiegelt, die sich aus der Substitution ausgereifter Technologien ergibt. Gleichung (4) ist neu in dieser Arbeit und übernimmt das Konzept der Lernkurve aus der Literatur zu den Kosten energietechnischer Systeme35,36 auf die Netzwartungsoperationen. Zusätzliche Kosten, die in der Anfangsphase der Einführung digitaler Geräte entstehen können, wie beispielsweise der parallele Betrieb alter und neuer Systeme, die Plattformintegration, die Kommunikationstests sowie zusätzliche Wartungsarbeiten, werden nicht zwangsläufig von der Basisquote abgezogen; stattdessen werden sie durch das nachfolgende Modul zur Kompensation von Residuen mittels maschinellen Lernens erfasst:
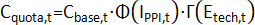 (5)
wobei Cbase,t die statische Basislastkosten bezeichnet, die aus den Arbeitsschwerpunkten der untersten Ebene und standardisierten Betriebskostenquoten berechnet werden; den Übertragungseffekt makroökonomischer Preisschwankungen auf Material-, Ausrüstungs- und Außenkostenpreise erfasst; und Γ(Etech,t) die effizienzbezogene Senkung der Einheitsbetriebs- und Wartungskosten nach Erreichen der technologischen Reife widerspiegelt. Durch den oben beschriebenen dynamischen Evolutionsmechanismus bleibt die Quotenbasis nicht länger auf einer statischen Buchhaltungsbasis, sondern kann sich adaptiv an Veränderungen in den wirtschaftlichen Rahmenbedingungen und technologischen Gegebenheiten anpassen. Gleichung (5) stammt ursprünglich aus dieser Arbeit und stellt die neuartige Integration von Preis- und Technologiekorrekturen in das Rahmenwerk der Quotenbasis dar.
Systematische nichtlineare Restmengenerfassung unter Quotenbeschränkungen
Trotz komplexer evolutionärer Korrekturen erzeugt das Quotenmodell zwangsläufig systematische Abweichungen, wenn unvorhersehbare wetterbedingte Störungen infolge von Katastrophen oder plötzliche politische Vorgaben auftreten, beispielsweise erhöhte Kosten für die Bearbeitung von Kundenreklamationen während vorübergehender Tarifsenkungsphasen. Diese Abweichung bildet das Residuum auf beiden Seiten der Gleichung:
Rt=Cactual,t-Cquota,t (6)
Da herkömmliche physikalische Gesetze diesen Aspekt nicht erklären können, kann maschinelles Lernen diese Einschränkungen beheben. Um dem Fluch der Dimensionalität, der durch hochdimensionale Merkmale verursacht wird, entgegenzuwirken, verwendet diese Studie den XGBoost-Algorithmus, der auf Entscheidungsbaum-Ensembles basiert, um die nichtlineare Beziehung Rt37,38 zu modellieren. Es wird eine Merkmalsmatrix Xt mit starken Störungen definiert, die meteorologische Merkmale wie jährliche extreme Frosttage Dice sowie die Intensität makropolitischer Maßnahmen umfasst.
Für einen nichtlinearen Kompensator, der aus Regressionsbäumen besteht, kann die Erzeugungslogik des vorhergesagten Residuums  ausgedrückt werden als39:
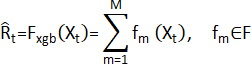 (7)
wobei F den Raum aller möglichen Klassifizierungs- und Regressionsbaumstrukturen bezeichnet. Um die Anpassungsgenauigkeit und die Verhinderung von Überanpassung auszugleichen, wird eine regularisierte Zielfunktion konstruiert und in der m-ten Iteration minimiert, die einen Strafterm für strukturelle Komplexität enthält:
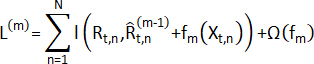 (8)
wobei  eine konvexe Verlustfunktion ist, die den Unterschied zwischen dem tatsächlichen Rest und dem vorhergesagten Rest misst. In dieser Arbeit wird der Huber-Verlust verwendet, um die Robustheit des Modells gegenüber abnormalen Spitzenausgaben zu erhöhen. Der Regularisierungsterm
 dient zur Beschränkung der Komplexität der Baumstruktur und ist definiert als:
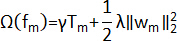 (9)
wobei Tm die Anzahl der Blattknoten im m-ten Baum darstellt, wm den entsprechenden Blattgewichtsvektor darstellt und γ und λ den Bestrafungskoeffizienten für die Anzahl der Blattknoten bzw. den Regularisierungskoeffizienten für das Gewicht bezeichnen.
Die endgültige Prognosegleichung lautet:
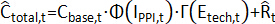 (10)
Weitere Erweiterung als:
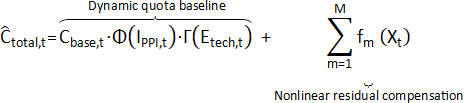 (11)
Die obige Formel stellt mathematisch die geschlossene Struktur des vorgeschlagenen Prognosemodells dar. Die endgültige Nachfrage nach Produktions- und Betriebskosten wird nicht direkt vom maschinellen Lernmodell erzeugt, sondern ergibt sich durch Überlagerung der durch das Modul des maschinellen Lernens identifizierten nichtlinearen Restkompensation auf die dynamische Mengenrahmenbasis. Dabei spiegeln die Faktoren Preis und Technologie hauptsächlich die dynamische Entwicklung der Mengenrahmenbasis wider, während Faktoren, die sich nur schwer explizit durch Regeln beschreiben lassen – wie Klimastöße, politische Störungen und plötzliche Anstiege von Reparaturereignissen – durch das Modul zur Restkompensation mittels maschinellem Lernen erfasst werden. Die Gleichungen (10) und (11) sind neu in dieser Arbeit und verbinden die physikalische Basislinie mit der auf maschinellem Lernen basierenden Erfassung von Residuen zu einem einheitlichen Prognoserahmenwerk.
Abbildung 2 zeigt, dass die Prognoseergebnisse des vorgeschlagenen Modells eine klare hierarchische Generierungslogik aufweisen. Einerseits bietet die Baseline-Quote eine stabile, transparente und überprüfbare physikalische Grundlage für die Kostennachfrage; andererseits ermöglichen Preisänderungen, technologische Effekte und Restgrößen externer Schocks dem Modell, sich an dynamische Veränderungen unter komplexen Umweltbedingungen anzupassen. Im Vergleich zu Black-Box-Modellen, die direkt prognostizierte Werte ausgeben, kann diese dekomponierte Struktur klar aufzeigen, „warum Kosten steigen oder fallen“, wodurch die Interpretierbarkeit der Modelleergebnisse bei der Haushaltsprüfung sowie bei der Regulierung von Netznutzungsentgelten verbessert wird.
Datenquellen und Sammelverfahren
Theoretische Modelle müssen durch empirische Daten streng validiert werden, um ihre praktische Nützlichkeit nachzuweisen. Da die Kernfinanzdaten des Stromsektors sensible Informationen zu den Betriebsabläufen nationaler Infrastrukturen enthalten, extrahiert diese Studie hochpräzise, anonymisierte monatliche Buchhaltungsdaten aus einem typischen Provinz-Stromnetz in Ostchina, das der Einfachheit halber als E-Grid bezeichnet wird, über einen Zeitraum von 16 aufeinanderfolgenden Kalenderjahren von 2010 bis 2025. Diese Provinz hat einen typischen Wirtschaftszyklus durchlaufen, der sich von einem wachstumsgetriebenen traditionellen Schwerindustrie-Modell hin zur hochwertigen Fertigung verlagert hat, wobei die durchschnittliche jährliche Wachstumsrate des Netzzellenvolumens 7,4 % erreichte. Die komplexe Entwicklung ihrer Kostenstruktur ist daher möglicherweise auch für andere sich schnell entwickelnde Netzzellen-Systeme von Bedeutung. Die Daten stammen aus drei Hauptquellen: (1) internen Betriebs- und Wartungsprotokollen, die arbeitsspezifische Lasten, Inspektionshäufigkeiten und Reparaturereignisse auf Ebene der Anlagen erfassen; (2) Finanzbuchhaltungssystemen, die monatliche Kostenberichte über Arbeitskräfte, Materialien, Ausrüstung und ausgelagerte Dienstleistungen bereitstellen; und (3) externen Umweltdatenbanken, einschließlich Wetteraufzeichnungen des Chinesischen Wetteramtes und makroökonomischer Indikatoren des Nationalen Statistikamtes.
Qualitätskontrolle und Umgang mit fehlenden Daten
Für über 130 anfängliche Indikatoren, die aus mehrquelligen Systemen integriert wurden, wurde ein strenges Verfahren zur Qualitätskontrolle angewandt. Fehlende Datenpunkte, die weniger als 3 % der Gesamtbeobachtungen ausmachten, wurden mithilfe linearer Interpolation bei kontinuierlichen Variablen mit zeitlichen Trends sowie durch Modus-Imputation bei kategorialen Indikatoren behandelt. Ausreißer wurden anhand der Interquartilsabstandsmethode (IQR) identifiziert; Werte, die das 3,0-Fache des IQR über dem dritten Quartil überschritten, wurden auf das 99. Perzentil winsorisiert, um die Datenintegrität zu bewahren und Verzerrungen durch Extremwerte zu verringern.
Überlegungen zur Stichprobengröße
Der Datensatz umfasst 192 monatliche Beobachtungen (Januar 2010–Dezember 2025), wobei 156 Beobachtungen (2010–2022) für Training und Validierung verwendet werden und 36 Beobachtungen (2023–2025) für Out-of-Sample-Tests reserviert sind. Obwohl diese Stichprobengröße für Deep-Learning-Anwendungen relativ gering ist, eignet sie sich gut für den XGBoost-Algorithmus, der speziell dafür entwickelt wurde, aufgrund seiner Regularisierungs- und Baum-Pruning-Mechanismen gut mit kleinen bis mittleren tabellarischen Datensätzen zu arbeiten. Um potenzielle Überanpassungsrisiken zu verringern, wurden (1) strenge Regularisierungsstrafen angewendet (γ = 0.1, λ = 1.0), (2) ein Early Stopping mit einer Geduld von 50 Runden und (3) konservative Beschränkungen der Baumtiefe (maximale Tiefe = 5). Diese Maßnahmen gewährleisten gemeinsam die Stabilität und Generalisierungsfähigkeit des Modells trotz der begrenzten Stichprobengröße.
Datensegmentierung und Integration heterogener Datenquellen
Für eine gründliche Überprüfung wurden die Daten von Januar 2010 bis Dezember 2022 dem Trainings-Validierungszeitraum zugeordnet, der 156 Beobachtungen umfasst und zur Schulung der Quotenentwicklungs-Faktoren sowie des Quotenausgleichs-Residualnetzwerks verwendet wird. Der Zeitraum Januar 2023–Dezember 2025 ist als separater Out-of-Sample-Testdatensatz reserviert, der 36 Beobachtungen enthält. Warum wurde dieser Zeitraum als abschließende Testphase gewählt? Der Grund liegt darin, dass diese drei Jahre mit der Beschleunigung des Aufbaus eines neuen Typs von Stromnetzsystem zusammenfielen, verstärkt durch großflächige, mit El Niño verbundene Extremereignisse mit hohen Temperaturen sowie das schnelle und ungleichmäßige Wachstum der dezentralen Erzeugung erneuerbarer Energien. Das Stromnetz stand dabei vor beispiellosem Druck hinsichtlich der Materialversorgungsketten und der Zuteilung von Reparaturpersonal.
Die wissenschaftliche Auswahl und quantitative Definition kostenbestimmender Faktoren bildet die Grundlage dafür, dass das maschinelle Lern-Residualnetzwerk systematische Schwankungen effektiv erfassen kann. Basierend auf der Managementlogik der standardmäßigen Betriebskosten in Stromnetzen durchbricht diese Studie die eindimensionale traditionelle Finanzprognose, die allein auf historischen Cashflows beruht, und rekonstruiert stattdessen das Feature-Engineering anhand von vier zentralen Dimensionen: physischer Anlagenumfang, Betriebs- und Wartungsbedingungen, makroökonomische Entwicklung sowie externes Klimaumfeld, unter Verwendung ursprünglicher Betriebsprotokolle und externer Systembuchführungen. Im eigentlichen Modellierungsprozess werden für mehr als 130 ursprüngliche Indikatoren, die aus der Integration mehrerer Quellsysteme resultieren, mittels Pearson-Korrelationstests stark kollineare, redundante Variablen mit einem Schwellenwert von |r| > 0,85 eliminiert. Auf Grundlage des Vorwissens erfahrener Stromnetzexperten werden letztendlich 42 zentrale Eingangsmerkmale ausgewählt, um die Merkmalsmatrix Xt zu bilden. Um die zugrundeliegende Datenstruktur und Verteilung des Eingabetensors klar darzustellen, wählt Tabelle 2 12 repräsentative Kernmerkmale aus den vier oben genannten Bewertungsdimensionen aus und fasst deren deskriptive Statistiken über den Beobachtungszeitraum zusammen.
Um die räumlich-topologische Grundlage des Mehrquellen-Merkmalsystems weiter zu veranschaulichen, zeigt Abbildung 3 eine anonymisierte schematische Topologie des untersuchten provincialen Stromnetzes. Die Abbildung überlagert Umspannwerke verschiedener Spannungsebenen, Übertragungskorridore, dezentrale regenerative Energieanlagen, Lastzentren sowie repräsentative Zonen umweltbedingter Störungen. Die Topologie hilft zu erklären, warum Produktions- und Betriebskosten gemeinsam von der Anlagengröße, der Netzstruktur, der Intensität von Notfallreparaturen und externen klimatischen Schocks beeinflusst werden. Zudem liefert sie eine räumliche Interpretationsgrundlage für die im XGBoost-Kompensationsmodul verwendeten residualtreibenden Variablen.
Tabelle 2 zeigt, dass erklärende Variablen aus verschiedenen Geschäftsbereichen deutlich unterschiedliche statistische Formen aufweisen. Variablen für physische Vermögenswerte, die endogene Unternehmensentwicklungsprozesse widerspiegeln, wie beispielsweise Umspannwerkskapazität und Leitungslänge, weisen relativ stabile Standardabweichungen auf, und ihre Schiefe-Werte liegen konzentriert zwischen 0,1 und 0,8. Ihre gesamte Datenstruktur ist annähernd normalverteilt und spiegelt objektiv das Merkmal einer stabilen Stromnetzentwicklung im Infrastrukturbauzyklus wider. Im starken Gegensatz dazu stehen die meteorologischen und externen Umweltstörvariablen am unteren Ende der Tabelle. Beispielsweise weisen die kumulierte Anzahl von warnstufenrelevanten Hitzetagen der letzten 90 Tage sowie der Leitungsabschaltungs-Impakt-Index eine extrem starke Rechtsschiefe auf, mit Schiefe-Werten von 2,15 bzw. 2,45. Diese typische Verteilung mit schwerem Tail bestätigt einen nicht zu vernachlässigenden, objektiven Engpass in der praktischen Betriebs- und Instandhaltung von Stromnetzen: Obwohl extreme Wetterereignisse im Jahresverlauf relativ selten auftreten, führen sie bei Eintreten oft zu exponentiellen Anstiegen beim Arbeitsaufwand für Reparaturen und beim Verbrauch von Ersatzteilen. Aus einer anderen Perspektive offenbaren die hohe Inhomogenität und die Extremwertschiefe in der Verteilung dieser multimodalen Merkmale die theoretischen Grenzen traditioneller linearer Zeitreihenmodelle wie ARIMAX, die auf den Annahmen der Normalverteilung und Homoskedastizität basieren, wenn es darum geht, komplexe Stromnetzkosten nachzuvollziehen. Dies unterstreicht nicht nur weiter die Rationalität, ein maschinelles Lernmodul über die physische Buchhaltungsbasis hinaus einzuführen, sondern liefert auch fundierte statistische Argumente für die in dieser Arbeit getroffene Auswahl des XGBoost-Baummodells, das in der Lage ist, spärliche Merkmalsverteilungen und nichtlineare Abbildungen effizient zu verarbeiten, um Kostenresiduen zu approximieren.
Einrichtung des Hyperparameter-Optimierungs- und Evaluierungssystems
Nach der Bestimmung des Merkmals-Eingaberaums beeinflusst die Festlegung der Modell-Hyperparameter direkt die Anpassungsgüte des Residual-Approximationsnetzwerks. Da das XGBoost-Kompensationsnetzwerk mehrere Parameter umfasst – darunter die Baumtiefe (max depth), die Lernrate und Regularisierungsstrafterme – und diese Parameter nichtlineare Wechselwirkungen aufweisen, weist die herkömmliche Gitterrastersuche (Grid Search) nicht nur eine hohe Rechenkomplexität auf, sondern neigt zudem dazu, in hochdimensionalen Räumen in lokalen Minima stecken zu bleiben. Daher führt diese Studie den Tree-structured Parzen Estimator (TPE), ein bayessches Optimierungsverfahren, in den Parameterabstimmungsprozess ein. Der TPE-Algorithmus kann mithilfe von Rückmeldungen der Verlustfunktion aus vorherigen Bewertungen die nachfolgenden Stichprobenrichtungen dynamisch steuern. Durch die Erstellung einer posterioren Kerndichteschätzung (KDE) der Zielvariablen verengt er adaptiv den Parameter-Suchraum, wodurch das Modell die global optimale Hyperparameter-Konfiguration annähern kann, ohne hohe Rechenkosten zu verursachen. Das Optimierungsziel von TPE bestand darin, den Validierungs-RMSE über 100 Iterationen zu minimieren, mit einer vorzeitigen Beendigung nach 50 Runden ohne Verbesserung.
Nach der Parameteroptimierung anhand des internen Validierungssatzes erfolgt zur objektiven Bewertung der endgültigen Leistung jedes Modells auf dem Out-of-Sample-Testdatensatz und zur Erfüllung der regulatorischen Anforderungen an die quantitative Bewertung der Kostenverifizierung die Verwendung des mittleren absoluten prozentualen Fehlers (MAPE), um die relative Abweichung der vorhergesagten Sequenz zu quantifizieren. Gleichzeitig wird zur Berücksichtigung des praktischen Bedarfs, extreme Fehler bei der Kostenprognose im Betrieb zu kontrollieren, der Root-Mean-Square-Fehler (RMSE) hinzugezogen, der größere Abweichungen stärker bestraft. Schließlich quantifiziert das Bestimmtheitsmaß R2 die gesamte Erklärungskraft der Regression im Verhältnis zur tatsächlichen Zielvarianz.
Die mathematischen Definitionen der Indikatoren lauten wie folgt:
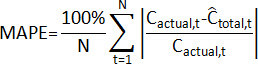 (12)
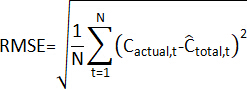 (13)
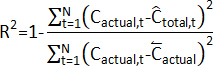 (14)
wobei  die tatsächlichen Produktions- und Betriebskosten im Zeitraum t darstellt,
 die vom Modell vorhergesagten Kosten darstellt,
 die durchschnittlichen tatsächlichen Kosten in der Teststichprobe darstellt und N die Anzahl der Proben im Testdatensatz ist.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Vergleich der Vorhersagegenauigkeit in panaromatisch reduzierter Dimension
Als alle mit dem baumstrukturierten Parzen-Schätzer (TPE) optimierten Modelle auf dem außerhalb der Stichprobe liegenden Testdatensatz aus den Jahren 2023–2025 bewertet wurden, der Erholungsschwankungen nach der Pandemie sowie Extremereignisse mit sehr hohen Temperaturen umfasste, konnte die Leistungsfähigkeit gängiger Prognosealgorithmen objektiv verglichen werden. Zur strengen und umfassenden Bewertun...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Diese Studie zeigt, dass die Integration industrieller Kostenquoten mit maschinellem Lernen einen interpretierbaren und genauen Rahmen für die langfristige Kostenprognose von Stromnetzen bietet. Die Ergebnisse zeigen, dass klimabedingte Variablen, insbesondere Tage mit extremen Hochtemperaturen und Leitungsabschalt-Einflussindizes, die Haupttreiber der Kostenresiduen sind, wodurch der zunehmende Einfluss externer Störungen auf die Betriebsausgaben von Versorgungsunternehmen verdeutlicht wird. Diese Erkenntnisse legen nah...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Alle Autoren geben an, dass kein Interessenkonflikt besteht.
BEITRAG DER AUTOREN:
Xiaohui Wang hat die Studie konzipiert und entworfen, die Methodologie entwickelt, die formale Analyse durchgeführt und den ursprünglichen Manuskriptentwurf verfasst. Tong Li trug zur Datenpflege, Software-Implementierung und Validierung bei. Yanchao Lu beteiligte sich an der Entwicklung der Methodologie, Durchführung der Untersuchungen und Interpretation der Daten. Quanfeng Lv stellte Ressourcen bereit, überwachte die Datenerfassung und überprüfte das Manuskript kritisch. Fan Liu leitete das Projekt, trug zur Konzeption und Interpretation der Ergebnisse bei, sicherte die Finanzierung und überarbeitete das Manuskript kritisch. Alle Autoren haben die endgültige Version des Manuskripts geprüft und genehmigt.
Danksagungen
Diese Arbeit wurde unterstützt durch das Technologieprojekt der State Grid Corporation of China mit dem Titel „Forschung zur Analyse der Zuweisung von Produktions- und Betriebskosten und zur asynchronen Optimierungstechnologie“ (Projektnummer: 520600250029-183-ZN).
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Anonymisierte monatliche Abrechnungsdatensatz E-Grid | Provinziales Stromnetz in Ostchina | N/V | Anonymisierter monatlicher Datensatz zur Erzeugung und Betriebskosten (2010–2025) mit 192 Beobachtungen, einschließlich Daten zu physischen Anlagen, Instandhaltung, makroökonomischen und Umwelteinflüssen. Verwendet zur Modellentwicklung (156 Beobachtungen) und zur Out-of-Sample-Testung (36 Beobachtungen). |
| Matplotlib-Plotting-Bibliothek | Matplotlib-Entwicklungsteam | 3.5.2 | Wird zur Erstellung der Abbildungen und grafischen Ausgaben in der Manuskripterstellung verwendet, einschließlich Modellleistungsdiagrammen, Visualisierungen der Topologie, Residualdiagnosen, Radar-Diagrammen und zusammenfassenden Darstellungen im Zusammenhang mit SHAP. |
| NumPy-Bibliothek für numerisches Rechnen | NumPy-Entwickler | 1.22.3 | Wird für numerische Array-Operationen, Matrixberechnungen und die Kontrolle der Reproduzierbarkeit verwendet. Bei Bedarf wurde ein fester Zufallsstartwert (Seed) von 42 angewendet. |
| Pandas-Bibliothek zur Datenmanipulation | pandas-Entwicklungsteam | 1.4.2 | Wird zum Import, zur Integration, Umstrukturierung, Filterung und Vorverarbeitung von Daten verwendet, einschließlich der Imputation fehlender Werte, der Ausrichtung von Zeitreihen und der Vorbereitung der Eingabevariablen für das Modell. |
| Python-Programmierumgebung | Python Software Foundation | 3.9.13 | Programmierumgebung, die zur Implementierung des gesamten Prognosearbeitsablaufs verwendet wurde, einschließlich Daten-Vorverarbeitung, Merkmalsentwicklung, Modelltraining, Hyperparameter-Optimierung, Vorhersage, statistischer Tests und Leistungsbewertung. |
| Scikit-learn-Bibliothek für maschinelles Lernen | scikit-learn-Mitwirkende | 1.0.2 | Wird für die Daten-Vorverarbeitung, Aufteilung in Trainings- und Validierungsdaten, ergänzende Modellbewertung und statistische Verfahren verwendet, einschließlich der Pearson-Korrelationsanalyse und der Berechnung ausgewählter Leistungskennzahlen. |
| SciPy-Bibliothek für wissenschaftliches Rechnen | SciPy-Mitwirkende | 1.9.0 | Wird für statistische Berechnungen verwendet, einschließlich der Pearson-Korrelationsanalyse sowie unterstützender Verfahren zur Behandlung von Ausreißern und Winsorisierung. |
| Implementierung des baumstrukturierten Parzen-Estimators | Optuna-Mitwirkende | 3.1.0 | Bayessche Optimierungsmethode zur Anpassung der Hyperparameter von XGBoost, einschließlich maximaler Baumtiefe, Lernrate und Regularisierungsparameter. Der baumstrukturierte Parzen-Estimator wurde über das Open-Source-Paket Optuna implementiert. |
| XGBoost-Softwarebibliothek | DMLC / XGBoost-Mitwirkende | 1.7.1 | Ensemble-Lernbibliothek auf Basis von Entscheidungsbäumen, die zur nichtlinearen Restkompensation verwendet wird. Das Modell implementierte eine regularisierte Zielfunktion mit Huber-Verlust und Bestrafung der Baumkomplexität, wie in den Gleichungen 7–9 beschrieben. |
Referenzen
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.