Dieses Protokoll beschreibt einen reproduzierbaren quanten-klassischen hybriden Workflow zur Klassifizierung der Parkinson-Krankheit aus menschlichen Sprachaufnahmen, einschließlich Datenvorverarbeitung, Implementierung von Quantenschaltungen, Modelltraining und Kreuzvalidierung für unabhängige Replikation.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Ein reproduzierbares quanten-klassisches Hybridprotokoll zur Klassifizierung der Parkinson-Krankheit anhand menschlicher Sprachaufnahmen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Parkinson-Krankheit ist eine fortschreitende neurodegenerative Erkrankung, für die verfügbare, kostengünstige Screening-Methoden weiterhin begrenzt sind. Aufzeichnungen der anhaltenden Vokalstimme enthalten messbare akustische Biomarker, die mit krankheitsbedingter Dysphonie assoziiert sind und ohne spezielle Geräte erworben werden können. Dieses Protokoll beschreibt ein vier-Qubit-Quanten-klassisches hybrides konvolutionales neuronales Netzwerk (QI-HCNN), das eine parametrisierte Quantenschaltung mit einer flachen klassischen Klassifikationsschicht kombiniert, um die Parkinson-Krankheit mittels dimensionsreduzierter akustischer Stimmmerkmale zu klassifizieren. Das Protokoll vergleicht den vorgeschlagenen Ansatz außerdem mit einem dimensionsangepassten klassischen neuronalen Netzwerk und gradientenverstärkten Baumklassifikatoren, die sowohl auf den reduzierten als auch auf den vollständigen Funktionssätzen trainiert sind. Mit einem öffentlich verfügbaren, deidentifizierten Datensatz mit 195 Sprachaufnahmen von 31 Personen erreichte das QI-HCNN unter der Empfänger-Betriebscharakteristik 0,78 mittels dreifacher stratifizierter Kreuzvalidierung, verglichen mit 0,87 für das abgestimmte klassische neuronale Netzwerk und 0,94–0,95 für die gradient-boosted Baselines, die jeweils auf den reduzierten und vollständigen Feature-Sets trainiert wurden. Eine kontrollierte Ablationsanalyse zeigte, dass eine der beiden Verschränkungsoperationen in der Schaltung die gemessene Ausgabe nicht beeinflussen konnte, während die verbleibende Verschränkungsoperation die Klassifikationsleistung im Vergleich zu einer nicht verschränkten Variante verringerte statt verbesserte. Patientengruppierte Kreuzvalidierung zeigte zudem, dass Leistungsschätzungen je nach den zugeordneten Personen erheblich variierten und die begrenzte Kohortengröße widerspiegelten. Dieses Protokoll bietet daher eine vollständig spezifizierte und unabhängig reproduzierbare quanten-klassische Basis sowie eine datengestützte Bewertung der Stärken und Grenzen des aktuellen Schaltungsdesigns und bildet so eine methodische Grundlage für zukünftige Untersuchungen statt der Unterstützung diagnostischer Bereitschaftsbehauptungen.
Einleitung
Die Parkinson-Krankheit ist eine chronische neurodegenerative Erkrankung, die durch den fortschreitenden Verlust dopaminergerer Neuronen in der Substantia nigra verursacht wird, die weltweit mehr als 10 Millionen Menschen betrifft und eine erhebliche sowie wachsende öffentliche Gesundheitsbelastung darstellt. Die Krankheit verursacht sowohl motorische Symptome, darunter Zittern, Steifheit und Bradykinesie, als auch nicht-motorische Symptome wie Schlafstörungen und Anosmie. Die klinische Diagnose basiert hauptsächlich auf neurologischer Untersuchung mit standardisierten motorischen Bewertungsskalen, die gegebenenfalls durch Dopamintransporter-Bildgebung ergänzt werden; Beide Ansätze erfordern jedoch spezialisierte Fachkenntnisse und Infrastruktur, die nicht einheitlich zugänglich sind, und die klinische Bewertung in der frühen Phase bleibt subjektiv2. Da derzeit keine krankheitsmodifizierende Therapie verfügbar ist, ist die Früherkennung vor allem deshalb wertvoll, weil sie eine frühere Symptomtherapie und longitudinale Überwachung ermöglicht. Dieser Bedarf hat die Entwicklung kostengünstiger, skalierbarer und nicht-invasiver Screening-Ansätze motiviert, die die klinische Bewertung ergänzen und nicht ersetzen können.
Stimmliche Beeinträchtigung gehört zu den frühesten messbaren Veränderungen im Zusammenhang mit Parkinson und geht häufig offenen motorischen Symptomenvoraus. Die anhaltende Phonation eines gehaltenen Vokals liefert ein kontrolliertes Signal, aus dem akustische Merkmale wie Jitter, Schimmer, Harmonisch-Rausch-Verhältnis, Dichtenentropie der Rekurrenzperiode und Analyse von detrendierten Fluktuationen extrahiert werden können. Diese Merkmale haben wiederholt diagnostisch relevante Informationen enthalten und können mit Verbraucheraufnahmegeräten 4,5 erschlossen werden. Ein öffentlich zugänglicher Benchmark-Datensatz, der aus solchen Aufzeichnungen abgeleitet ist, ist zu einem Standardtestfeld für diese Aufgabe geworden, und klassische maschinelle Lernmethoden, die auf den gesamten Funktionssatz angewendet werden, einschließlich Support-Vector-Machines, Zufallswäldern und gradientenverstärkten Bäumen, haben Flächenwerte unter dem Empfänger-Betriebscharakteristikkurvenwert von etwa 0,99 6,7,8 gemeldet, was darauf hindeutet, dass die Klassifikationsaufgabe nahezu gelöst ist, wenn der gesamte Funktionssatz und geeignete Strategien zur Behandlung des Klassenungleichgewichts verwendet werden. Quantenmaschinelles Lernen hat sich als alternatives rechnerisches Paradigma für biomedizinische Klassifikationsaufgaben etabliert, bei dem parametrisierte Quantenschaltkreise Superposition und Verschränkung verwenden, um Merkmalswechselwirkungen mit vergleichsweise wenigen trainierbaren Parametern darzustellen, und Schaltungsgradienten analytisch mit der Parameterverschiebungsregel statt mit endlichen Differenzenapproximationen berechnet werden können9. Viele veröffentlichte Studien, die "Quanten"- oder "quanteninspirierte" neuronale Netze für biomedizinische Anwendungen beschreiben, implementieren jedoch vollständig klassische Architekturen, die quanteninspirierte mathematische Formalismen verwenden, ohne eine tatsächlich parametrisierte Quantenschaltung auf einem Simulator oder Quantenhardwareauszuführen. Jüngste Entwicklungen bei der Erkennung der Parkinson-Krankheit umfassen auch hybride konvolutionelle neuronale Netzwerk-Transformator-Architekturen11, aufmerksamkeitsbasierte Deep-Learning-Methoden für Magnetresonanztomographie (MRT)12 und leichte konvolutionelle neuronale Netzwerke, die für eine rechnergestützt effiziente Diagnose entwickelt wurden13, was die rasche Ausweitung künstlicher Intelligenz-Ansätze über mehrere Datenmodalitäten hinweg veranschaulicht. Im weiteren Sinne wurde die nicht-invasive computergestützte Diagnose erfolgreich auf andere biomedizinische Anwendungen ausgeweitet, darunter hybride maschinelles Lernen und Deep-Learning-Pipelines für medizinische Bildgebung14. Vergleichende Bewertungen von Deep-Learning-Architekturen auf demselben öffentlichen Sprachdatensatz zeigen zudem die starke Leistung, die mit konventionellen, vollfunktionsfähigen klassischen Modellen15 erreicht werden kann.
Diese Entwicklungen verdeutlichen einen spezifischen methodologischen Bedarf an einem reproduzierbaren quanten-klassischen hybriden konvolutionalen neuronalen Netzwerk (QI-HCNN)-Modell, das (i) eine echte, vollständig spezifizierte parametrisierte Quantenschaltung ausführt; (ii) mit identischen Eingabemerkmalen sowohl gegen ein architektonisch abgestimmtes klassisches neuronales Netzwerk als auch gegen eine starke klassische Basislinie verwertet wird; und (iii) wird mit einem Protokoll bewertet, das explizit die Hauptquellen von Verzerrungen in kleinen biomedizinischen Datensätzen untersucht, einschließlich Klassenungleichgewicht, demografische Störungen und Datenlecks auf Patientenebene während der Kreuzvalidierung.
Das übergeordnete Ziel dieses Protokolls ist es, einen vollständig reproduzierbaren QI-HCNN-Workflow für die Klassifikation der Parkinson-Krankheit unter Verwendung menschlicher Sprachaufnahmen bereitzustellen. Das Protokoll beschreibt eine vier-Qubit-parametrisierte Quantenschaltung, die Winkelkodierung, zwei auf kontrolliert NICHT basierende Verschränkungsschichten und eine trainierbare Variationsschicht verwendet, die mit der Parameterverschiebungsregel optimiert ist, gekoppelt mit einem flachen klassischen Klassifikationskopf und auf eine vierkomponentenige Hauptkomponentenrepräsentation eines öffentlich zugänglichen Sprachaufnahmedatensatzes angewendet wird. Der Workflow spezifiziert, auf einem für unabhängige Replikation ausreichenden Niveau, alle Vorverarbeitungsverfahren, den vollständigen Schaltkreisaufbau, die klassische Trainingskonfiguration und Evaluationsverfahren, einschließlich Vergleichen mit einem dimensionsangepassten klassischen neuronalen Netzwerk, dimensionsangepassten und vollständigen Feature-Gradienten-Boosted-Baumbasislinien, kontrollierten Schaltungskomponentenablationen, patientengruppierten Kreuzvalidierungen zur Bewertung der Sensitivität gegenüber zurückgehaltenen Teilnehmern sowie expliziter statistischer Signifikanzprüfung. Anstatt nur günstige Ergebnisse zu präsentieren, ist das Protokoll so konzipiert, dass es transparent berichtet, wenn einzelne Schaltungskomponenten die Leistung nicht messbar verbessern, und so einen reproduzierbaren methodischen Rahmen bietet, der zukünftige Entwicklung der QI-HCNN-Architektur für biomedizinische Klassifikationsaufgaben kleiner Kohorten unterstützen kann.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Dieses Protokoll verwendet einen öffentlich verfügbaren, de-identifizierten Datensatz für Sprachaufzeichnungen von Drittanbietern. Die Autoren erhoben keine neuen Daten von menschlichen Probanden und für diese Studie war keine zusätzliche Genehmigung durch das Institutional Review Board (IRB) erforderlich. Der im Unterabschnitt Dataset Acquisition and Participant-Level Data Handling beschriebene Datensatz wurde ursprünglich unter institutioneller ethischer Genehmigung von Little et al. 3 erhoben, enthält keine direkt identifizierenden Teilnehmerinformationen (nur anonymisierte Aufzeichnungsidentifikatoren) und ist öffentlich für Forschungszwecke zugänglich. Bestätigen Sie gemäß Ihren institutionellen Richtlinien, ob eine sekundäre Analyse dieses öffentlich zugänglichen Datensatzes eine ethische Überprüfung erfordert. An der Institution der Autoren wurde eine retrospektive sekundäre Analyse dieses vollständig freigegebenen, öffentlich archivierten Datensatzes als von der vollständigen IRB-Überprüfung ausgenommen.
Datensatzerfassung und Datenverarbeitung auf Teilnehmerebene
Der Parkinson's Disease Classification Dataset (UCI Machine Learning Repository, Dataset ID 174), ursprünglich beschrieben von Little et al.3, wurde heruntergeladen. Der Datensatz enthielt 195 Aufzeichnungen der anhaltenden Vokal-/a/phonation von 31 Personen (23 mit Parkinson-Diagnose und 8 gesunde Kontrollpersonen; Altersgruppe 46–85 Jahre). Da das Repository kein versioniertes DOI bereitstellt, wurde das genaue Downloaddatum in der Materialtabelle verzeichnet und angegeben. Der Datensatz wurde als CSV-Datei (parkinsons.csv CSV) bereitgestellt. Eine Dekompression oder Dateikonvertierung war nicht erforderlich, und die Datei wurde direkt mit der read_csv-Funktion aus der Pandas-Bibliothek importiert (siehe Materialtabelle).
Der heruntergeladene Datensatz wurde auf 195 Zeilen und 24 Spalten verifiziert, bestehend aus einer Aufzeichnungs-Identifikationsspalte (Format: phon_R01_S  Subjekt
 _ Aufnahme), 22 kontinuierlichen akustischen Merkmalspalten (Tabelle 1) und einer binären Klassenlabel-Spalte (Status: 1 = Parkinson-Krankheit; 0 = gesunde Kontrolle). Tabelle 1 diente als Referenz für alle akustischen Merkmale und Merkmalskategorien im gesamten Protokoll.
| Kategorie | Repräsentative Merkmale | Klinische Bedeutung |
| Grundfrequenz | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | Durchschnitts-, Maximal- und Minimalgrundfrequenz der Phonation; spiegelt die Stabilität der Stimmlippenvibration wider. |
| Jitter (Frequenzstörung) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | Wechsel von Zyklus zu Zyklus in der Tonhöhe, was eine beeinträchtigte Kehlkopfmotorik widerspiegelt. |
| Schimmer (Amplitudenstörung) | MDVP:Shimmer, MDVP:Shimmer(dB), Shimmer:APQ3, Shimmer:APQ5, MDVP:APQ, Shimmer:DDA | Zyklus-zu-Zyklus-Variation der Signalamplitude, was eine atemlose oder instabile Phonation widerspiegelt. |
| Lärmmaße | NHR, HNR | Verhältnis von Rauschen zu harmonischen (tonalen) Komponenten des Sprachsignals. |
| Nichtlineare Dynamik / fraktale Skalierung | RPDE, D2, DFA, spread1, spread2, PPE | Maße der nichtlinearen Stimmdynamik, Periodizität und langfristiger zeitlicher Korrelationen, die mit der Schwingung der Stimmlippen verbunden sind. |
Tabelle 1: Akustische Merkmalskategorien, die für die Klassifikation der Parkinson-Krankheit verwendet werden. Die 22 akustischen Stimmmerkmale, die aus dem Parkinson's Disease Classification Datensatz extrahiert wurden, sind in fünf Merkmalskategorien eingeteilt: Grundfrequenz, Jitter, Schimmer, Rauschmessungen und nichtlineare Dynamik. Repräsentative Merkmale werden für jede Kategorie zusammen mit ihrer entsprechenden klinischen Bedeutung aufgeführt. MDVP, Multidimensionales Sprachprogramm; RAP, relative durchschnittliche Störung; PPQ, Störungsquot der Tonfallperiode; APQ, Amplitudenstörungsquotienten; DDP, Differenz der Periodenunterschiede; DDA, durchschnittliche absolute Amplitudendifferenz; NHR, Rausch-Harmonik-Verhältnis; HNR, Harmonik-Rausch-Verhältnis; RPDE, Entropie der Wiederholungszeitdichte; D2, Korrelationsdimension; DFA, Detrended Fluctuation Analysis; PSA, Tonzeitentropie.
Für jede Aufnahme wurde eine Teilnehmerbekennung extrahiert, indem die Teilzeichenkette vor dem letzten Unterstrich im Aufnahmenamen geparst wurde. Zum Beispiel wurden phon_R01_S01_1 und phon_R01_S01_2 dem Teilnehmer S01 zugewiesen. Teilnehmer-Identifikatoren wurden anstelle von Aufzeichnungs-Identifikatoren anschließend für alle im Unterabschnitt Evaluation Protocol beschriebenen Gruppen- oder Leave-One-Participant-Out-Validierungsverfahren verwendet, da Aufnahmen desselben Teilnehmers akustisch korreliert sind. Nach der Extraktion wurde eine Frequenztabelle der Identifikatoren erstellt und überprüft, um zu bestätigen, dass alle 195 Aufzeichnungen genau 31 eindeutigen Teilnehmern zugeordnet waren, dass keine Aufzeichnung unzugeordnet war und dass die Anzahl der Aufzeichnungen pro Teilnehmer mit der Quelldokumentation übereinstimmte.
Die Klassenverteilung wurde sowohl auf Aufzeichnungsebene (147 Parkinson-Aufnahmen, 75,4 %; 48 gesunde-Kontroll-Aufzeichnungen, 24,6 %) als auch auf Teilnehmerebene (23 von 31 Teilnehmern, 74,2 %, diagnostiziert mit Parkinson) tabelliert. Beide Verteilungen wurden berichtet, weil das Klassenungleichgewicht auf Aufzeichnungs- und Teilnehmerebene nicht identisch ist und die nachgelagerte Bewertung beeinflusst.
Das Fehlen alters- oder geschlechtsspezifischer Parkinson- und gesunder Kontrollgruppen im Quelldatensatz wurde als Studienbeschränkung dokumentiert und in die Diskussion übernommen, da dieses Merkmal die ursprüngliche Datenerhebung widerspiegelt und nicht durch nachgelagerte Vorverarbeitung korrigiert werden kann.
Vorverarbeitungspipeline
Alle Vorverarbeitungsverfahren wurden unabhängig innerhalb jedes Trainingsrahmens des im Unterabschnitt Evaluation Protocol beschriebenen Kreuzvalidierungsverfahrens durchgeführt. Sowohl Min–Max-Normalisierungsschritte als auch die Hauptkomponentenanalyse (PCA) wurden nur mit der Trainingspartition jeder Faltung angepasst. Die angepassten Transformationen wurden anschließend auf die entsprechende ausgewiesene Testpartition angewendet, ohne neu angepasst zu werden, um Informationslecks von der Testpartition in die Vorverarbeitungsparameter zu verhindern.
Die 22 rohen akustischen Features in jeder Trainingspartition wurden mit einem Min–Max-Skalierer mit einem Ausgangsbereich von [0, π] normalisiert. Der angepasste Scaler wurde dann sowohl auf die Trainings- als auch auf die Testpartitionen der entsprechenden Faltung angewendet (Gleichung 1). Gleichung 1 folgt der Standardformulierung der Min–Max-Normalisierung und wurde für das vorliegende Protokoll definiert. Die Min–Max-Normalisierung wurde mit der MinMaxScaler-Klasse aus scikit-learn (Version 1.8.0) mit feature_range=(0, π), copy=True und clip=False durchgeführt.
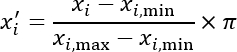 (1)
Ein PCA-Modell mit n_components = 4 wurde ausschließlich mit den normalisierten Trainingsdaten angepasst. Die angepasste PCA-Transformation wurde dann sowohl auf die Trainings- als auch auf die Testpartitionen angewendet. Der Anteil der Gesamtvarianz, der durch die vier erhaltenen Hauptkomponenten erklärt wurde, wurde für jede Falte aufgezeichnet. In den hier berichteten Analysen erklärten die vier erhaltenen Hauptkomponenten 81,5 % der Gesamtvarianz (50,3 %, 16,3 %, 9,4 % und 5,5 %). PCA wurde mit der PCA-Klasse mit n_components=4, svd_solver="voll", whiten=False und random_state=42 durchgeführt.
Da PCA negativwertige Komponentenwerte erzeugen kann, wurde ein zweiter Min–Max-Scaler mit einem Ausgabebereich von [0, π] mittels der PCA-transformierten Trainingspartition installiert. Anschließend wurde der angepasste Scaler sowohl an der Ausbildungs- als auch an der Testtrennwand angebracht. Jeder transformierte Test-Partition-Wert, der außerhalb des Intervalls [0, π] lag, wurde an die nächstgelegene Grenze geclippt, weil der Skalierer nur mit der Trainingspartition angepasst worden war. Im Datensatz waren keine Nullvarianzmerkmale vorhanden. Die Bandbreite jedes Features über alle 195 Aufnahmen hinweg war streng positiv; daher trat keine Teilungsbedingung durch Null auf. Dies wurde bestätigt, indem überprüft wurde, dass die skalierte Ausgabe weder NaN noch unendliche Werte enthielt.
Die vier re-normalisierten Hauptkomponenten wurden während des im Unterabschnitt Quanten-Schaltkreiskonstruktion beschriebenen Winkel-Verfahren sequentiell als Rotationswinkel für die Qubits 0, 1, 2 und 3 zugewiesen. Die erste Hauptkomponente wurde Qubit 0 zugewiesen, die zweite Qubit 1, die dritte Qubit 2 und die vierte Qubit 3. Damit wurde die Vorverarbeitungspipeline abgeschlossen und die verarbeiteten klassischen Features auf die Quantenschaltung übertragen. Nach dem zweiten Min–Max-Skalierungsschritt wurden bestätigt, dass alle Ausgabewerte innerhalb des Intervalls [0, π] liegen. Testpartitionswerte, die aufgrund von Gleitkomma-Rundung marginal außerhalb dieses Bereichs lagen, wurden mit der Clip-Funktion aus NumPy (Version 2.4.4) an die nächstgelegene Grenze geclippt. Dieses Verfahren stellte sicher, dass alle vier Eingaben der winkelkodierenden Schicht gültige Rotationswinkel innerhalb des Intervalls waren [0, π].
Quantenschaltungskonstruktion
Die Vier-Qubit-Schaltung wurde mit dem Zustandsvektor-Simulator in der Materialtabelle und der unten beschriebenen Gate-Sequenz konstruiert. Supplementary Coding File 1 wurde als vollständige ausführbare Schaltungsimplementierung verwendet, einschließlich aller Hilfsfunktionen für die Gatterkonstruktion und die Berechnung von Parameterverschiebungsgradienten. Abbildung 1 zeigt den vollständigen Arbeitsablauf von der Sprachaufnahme-Vorverarbeitung über die vier Schaltungsschichten, den klassischen Nachbearbeitungskopf bis hin zur endgültigen Klassifikation.
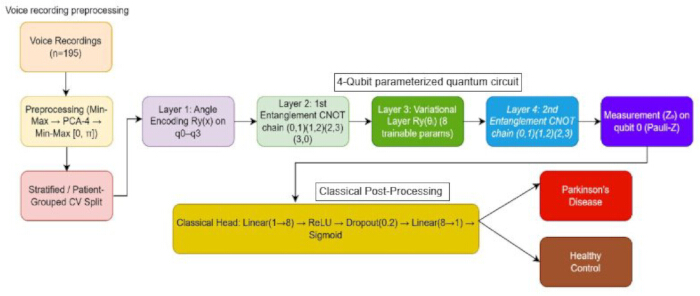
Abbildung 1. Systemarchitektur und Quantenschaltungs-Workflow. Arbeitsablauf zur Klassifikation der Parkinson-Krankheit anhand menschlicher Sprachaufnahmen. Das Diagramm zeigt die Sprachaufnahme-Vorverarbeitung, geschichtete oder patientengruppierte Kreuzvalidierung, vier-Qubit-parametrisierte Quantenschaltkreisausführung, Einzelqubit-Pauli-Z-Messung auf Qubit 0, klassische Nachbearbeitung und die endgültige binäre Klassifikation als Parkinson-Krankheit oder gesunde Kontrolle. CNOT, Controlled-NOT-Gate; PCA, Hauptkomponentenanalyse; ReLU, gleichgerichtete lineare Einheit. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Ein Vier-Qubit-Register wurde im Berechnungsbasiszustand ∣0000 initialisiert.
Für die winkelkodierende Schicht wurde ein R, y (xi) Rotationgatter auf das Qubit i angewendet, wobei i = 0,1,2,3 gilt, wobei die vier Winkel verwendet werden, die durch die Vorverarbeitungspipeline erzeugt wurden (Gleichung 2). Gleichung 2 beschreibt das Standard-Winkelkodierungsverfahren, das in parametrisierten Quantenschaltungen verwendet wird, im Einklang mit dem parametrisierten Quantenschaltungslernrahmen von Mitarai et al.9, und wurde hier in der spezifischen Vier-Qubit-Konfiguration angewandt, die für das vorliegende Protokoll definiert ist.
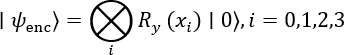 (2)
Für die erste Verschränkungsschicht wurde eine kreisförmige Kette von kontrollierten NICHT-Gattern in folgender Kontroll-Ziel-Reihenfolge angewendet: (0,1), (1,2), (2,3) und (3,0).
Für die Variationsschicht wurden die acht trainierbaren Parameter w0 bis w7 durch unabhängige Stichproben aus einer Normalverteilung mit einem Mittelwert von 0 und einer Standardabweichung von 0,3 initialisiert. Der zufällig verwendete Seed wurde in der Materialtabelle festgehalten. Die acht variationalen Quantenparameter wurden mit numpy.random.default_rng(42 + fold_index).normal(0, 0,3, Size = 8) initialisiert, wobei fold_index die nullbasierte Faltungszahl ist, wodurch falt-spezifische, aber reproduzierbare Initialisierungen bereitgestellt werden. Für jedes Qubit i = 0,1,2 und 3 wurde ein Rz(wi)-Gatter angewendet, gefolgt von einem Ry(wi+4)-Gatter (Gleichung 3). Gleichung 3 beschreibt eine variationale (trainierbare) Quantenschicht, die mit dem allgemeinen parametrisierten Quantenschaltungs-Lernrahmen übereinstimmt, das von Mitarai et al.9 eingeführt wurde und hier unter Verwendung der spezifischen Gattersequenz und Parametrisierung für das vorliegende Protokoll instanziiert wurde.
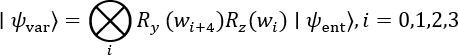 (3)
Für die zweite Verschränkungsschicht wurde eine offene Kette von kontrollierten NICHT-Gattern in folgender Kontroll-Ziel-Reihenfolge angewendet: (0,1), (1,2) und (2,3). Diese Kette wurde nicht auf Qubit 0 zurückgeschlossen.
Der Erwartungswert des Pauli-Operators nur auf Qubit 0,  , wurde mit einem Zustandsvektor-Innenprodukt berechnet. Die Schaltungsausführung verwendete einen benutzerdefinierten Zustandsvektorsimulator, der mit Standard-Numeric-Array-Operationen implementiert wurde (Supplementary Coding File 1; qhcnn.py). Complex128 Precision (numpy.complex128) wurde durchgehend verwendet. Die Erwartungswerte wurden analytisch aus dem Zustandsvektor-Innenprodukt berechnet; daher wurde keine schussbasierte Probenahme durchgeführt. Ein Drittanbieter-Quantencomputing-Framework war nicht erforderlich. Wäre anstelle des Zustandsvektorsimulators ein samplingbasierter Simulator oder ein Quantengerät verwendet worden, wären wiederholte Rechenbasismessungen von Qubit 0 durchgeführt worden und die resultierenden Bitfrequenzen in einen Erwartungswert umgewandelt worden (Gleichung 4). Gleichung 4 ist die standardmäßige quantenmechanische Erwartungswertformel und wurde hier auf die für das vorliegende Protokoll definierte Einzelqubit-Pauli-Observable angewendet. Da keine schussbasierte Stichprobe durchgeführt wurde, war keine Fehlerminderung erforderlich. Der Simulator verwendete Big-Endian-Qubit-Indizierung, wobei Qubit 0 dem bedeutendsten Bit des Zustandsvektorindex entspricht. Diese Konvention wurde explizit bei der Konstruktion des Pauli-Observables berücksichtigt, um sicherzustellen, dass der korrekte Erwartungswert gemessen wurde.
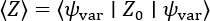 (4)
Der Gradient von bezüglich jedes der acht Variationsparameter wurde mit der Parameterverschiebungsregel berechnet. Die Schaltung wurde bei jeder Gradientenberechnung zweimal für jeden Parameter ausgewertet, einmal bei θ + π/2 und einmal bei θ - π/2 (Gleichung 5). Gleichung 5 ist die Standard-Parameterverschiebungsregel, die von Mitarai et al. 9 eingeführt wurde und hier ohne Modifikation angewendet wurde.
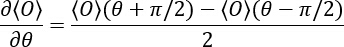 (5)
Die zweite Verschränkungsschicht, wie oben angegeben, hat nie ein kontrolliertes NICHT-Gatter mit Qubit 0 als Ziel angewendet. Da ein kontrolliertes NICHT-Gatter den reduzierten Zustand seines Steuerqubits unverändert lässt, könnte die zweite Verschränkungsschicht , unabhängig von den trainierbaren Parameterwerten, nicht verändern . Damit die zweite Verschränkungsschicht die gemessene Ausgabe in einem modifizierten Protokoll beeinflussen kann, müsste Qubit 0 als Ziel einbezogen werden, zum Beispiel indem die Kette mit einem zusätzlichen (3,0) kontrollierten NICHT-Gatter geschlossen wird, oder eine Multiqubit-Observable, die statt eines Erwartungswerts mit einem einzelnen Qubit gemessen werden müsste. Die ursprünglich festgelegte zweite Verschränkungsschicht wurde in diesem Protokoll beibehalten, und ihr gemessener Beitrag wurde explizit im Ergebnis-Abschnitt berichtet, anstatt still korrigiert zu werden, da dieses Schaltungsverhalten Teil der aktuellen Ergebnisse ist.
Klassische Nachbearbeitungsschicht
Die klassische Nachbearbeitungsphase bestand aus einem Vorwärts-neuronalen Netzwerk, das mit den standardisierten arraybasierten numerischen Operationen aus der Materialtabelle implementiert wurde. Der einzelne skalare Schaltkreisausgang,  , wurde mit einer vollständig verbundenen Schicht auf acht versteckte Einheiten abgebildet, gefolgt von einer rectified linear unit (ReLU)-Aktivierung. Während des Trainings wurde eine Dropout-Schicht mit einer Retentionswahrscheinlichkeit von 0,8 (Dropout-Rate = 0,2) angewendet. Die acht versteckten Einheiten wurden dann mit einer zweiten vollständig verbundenen Schicht auf eine einzelne Ausgangseinheit abgebildet, und eine sigmoidische Aktivierungsfunktion wurde angewandt, um die endgültige Klassenwahrscheinlichkeit ŷ zu erzeugen (Gleichung 6). Gleichung 6 definiert die spezifische klassische Nachbearbeitungsarchitektur, die im vorliegenden Protokoll verwendet wird, und umfasst standardmäßige lineare, rectifizierte lineare Einheiten (ReLU) und sigmoidale Operationen.
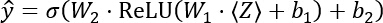 (6)
Die Gewichtsmatrizen der ersten und zweiten Schicht wurden durch unabhängige Stichproben aus einer Normalverteilung mit einem Mittelwert von 0 und einer Standardabweichung von 0,5 initialisiert, während alle Bias-Terme auf 0 initialisiert wurden. Die gleiche Zufallszahlengenerator-Instanz und der Seed für die Initialisierung der quantenmechanischen Variationsparameter wurden ebenfalls für die klassische Schicht verwendet, um die Run-to-Run-Reproduzierbarkeit zu gewährleisten. Konkret wurden die klassischen Gewichtsmatrizen mit numpy.random.default_rng(42 + fold_index).normal(0, 0,5, Size=...) initialisiert, während alle Bias-Terme auf null initialisiert wurden. Eine einzelne Seeded-Random-Number-Generator-Instanz, initialisiert mit 42 + fold_index, wurde zu Beginn jeder Cross-Validierungs-Falte erstellt und sequentiell für die Quantenparameterinitialisierung, klassische Gewichtsinitialisierung, Mini-Batch-Shuffling und Dropout-Maskengenerierung wiederverwendet, anstatt für jeden Prozess separate unabhängige Seed-Streams zu verwenden.
Während des Trainings wurde der Dropout angewendet, indem bei jedem Vorwärtsdurchgang eine neu abgetastete binäre Maske unter Verwendung der invertierten-Dropout-Konvention erzeugt wurde, bei der überlebende Einheiten um 1/0,8 skaliert wurden. Während der Validierung und des Tests wurde der Dropout vollständig deaktiviert und das vollständige, nicht skalierte Netzwerk für die Inferenz verwendet.
Das kombinierte QI-HCNN-Modell enthielt 33 trainierbare Parameter: acht quantenmechanische Variationsparameter aus der Quantenschaltung und 25 klassische Parameter. Die klassische Komponente bestand aus acht Gewichten und acht Vorspannungen in der ersten vollständig verbundenen Schicht, zusammen mit acht Gewichten und einer Vorspannung in der zweiten vollständig verbundenen Schicht. Die Gewicht- und Bias-Tensormaße waren 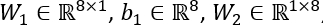 und
 . Die klassische Nachbearbeitungsschicht wurde vollständig mit standardisierten numerischen Array-Operationen ohne zusätzliches maschinelles Lernen implementiert. Alle klassischen Berechnungen wurden mit float64-(Doppelpräzisions-)Arithmetik durchgeführt.
Modellausbildung
Die im Unterabschnitt Quantenschaltungskonstruktion beschriebenen Quantenschaltkreis und die klassische Nachbearbeitungsschicht im Unterabschnitt Klassische Nachbearbeitungsschicht wurden zu einem einzigen, end-zu-ende-trainierbaren Modell zusammengefasst. Alle 33 trainierbaren Parameter wurden gemeinsam mit dem Adam-Optimierer optimiert, mit einer anfänglichen Lernrate von 0,01 und Gewichtsabnahme, implementiert als L2-Strafe von , angewandt nur auf die klassischen Gewichtsmatrizen. Der Adam-Optimierer wurde manuell mit Standard-Numeric-Array-Operationen mit folgenden Einstellungen implementiert: Lernrate = 0,01, β1 = 0,9, β2 = 0,999, ∈ = 1 × 10⁻⁸ und Gewichtsabfall = 1 × 10⁻⁴, angewendet nur auf die klassischen Gewichtsmatrizen und nicht auf die Verzerrungsterme oder quantenvariablen Parameter.
Als Verlustfunktion wurde binäre Kreuzentropie verwendet. Für das im Unterabschnitt Evaluation Protocol beschriebene Klassenausgleichsverfahren nach der Split-Trennung wurde der Verlustbeitrag jeder Trainingsprobe nach der umgekehrten Häufigkeit ihrer Klasse innerhalb der Trainingspartition des aktuellen Folds gewichtet. Für das unsymmetrische Protokoll wurden einheitliche Stichprobengewichte zugewiesen. Die binäre Kreuzentropie wurde als mittlerer Verlust über alle Proben innerhalb jeder Mini-Charge unter Verwendung der standardmäßigen binären Kreuzentropie-Formulierung berechnet.
Das Modell wurde über 30 Epochen mit Mini-Chargen von 16 Proben trainiert. Trainingsproben wurden zu Beginn jeder Epoche zufällig gemischt, wobei numpy.random.default_rng(42 + fold_index).permutation(n) verwendet wurde, um eine zufällige Stichprobenreihenfolge zu erzeugen. Wenn die Anzahl der Trainingsproben nicht gleichmäßig durch 16 teilbar war, wurde die letzte kleinere Mini-Charge behalten und in ihrer tatsächlichen Größe verarbeitet, anstatt verworfen zu werden.
Während der Ausbildung wurde ein Stufenlern-Tempo-Plan angewendet. Die Lernrate wurde nach jeweils 10 abgeschlossenen Epochen, insbesondere zu Beginn der Epochen 11 und 21, mit 0,7 multipliziert.
Gradienten für die acht quantenmechanischen Variationsparameter wurden mit der im Unterabschnitt Quantenschaltungskonstruktion beschriebenen Parameterverschiebungsregel berechnet. Die Gradienten für die 25 klassischen Parameter wurden ausschließlich mit der Standard-Differenzierung der Umkehrmodus durch die klassische Schicht berechnet. Die Quantenschaltungsausgabe , , und ihre Parameterverschiebungsgradienten dienten als Schnittstelle zwischen der Quantenschaltung und der klassischen Schicht. Alle 33 Parameter wurden mit derselben Adam-Optimizer-Instanz aktualisiert.
Validierungsbasierte Frühstopps wurden nicht verwendet. Jedes Modell wurde für den festen 30-Epochen-Zeitplan trainiert, und die anhaltende Testpartitionsleistung wurde nach Abschluss der letzten Epoche gemeldet. Alle Modellparameter (Quantenvariationsparameter, klassische Gewichtungsmatrizen und Bias-Terme) wurden zu Beginn jeder Kreuzvalidierungsfalte unabhängig mit dem fold-spezifischen Zufallsseed (42 + fold_index) neu initialisiert. Die Parameter wurden nicht zwischen Folds oder Baseline-Runs geteilt.
Die Rechenumgebung, einschließlich Prozessor, Speicher, Softwareversionen und ungefährer Wanduhr-Trainingszeit pro Falt, wurde in der Materialtabelle festgehalten.
Bewertungsprotokoll
Die Modellleistung wurde sowohl mit Protokoll- als auch auf Teilnehmerebene-Crossvalidierungsverfahren bewertet, zusammen mit Baseline-Modellvergleichen, Klassenabgleichsanalysen, Schaltungsablationsexperimenten, statistischen Signifikanztests und Merkmalswichtigkeitsanalysen.
Für die primäre Untersuchung wurden die 195 Sprachaufnahmen in drei geschichtete Falten unter Verwendung eines festen Zufallssamens aufgeteilt, wobei das aufzeichnungsstarke Parkinson-Krankheits-/gesunde-Kontroll-Verhältnis von 75,4 %/24,6 % innerhalb jeder Falte erhalten blieb. Das in den vorangegangenen Abschnitten beschriebene Modell wurde mit zwei Falten trainiert und auf der verbleibenden gehaltenen Faltung ausgewertet; dieses Verfahren wurde wiederholt, bis jede Faltung einmal als Testpartition diente. Genauigkeit, Präzision, Rückruf, F1-Wert und Fläche unter der Empfänger-Betriebscharakteristiekkurve (AUC–ROC) wurden für jede Faltung berechnet und als Mittelwert ± Standardabweichung über die drei Faltungen angegeben. Die primäre dreifache stratifizierte Kreuzvalidierung wurde mit der StratifiedKFold-Klasse mit n_splits=3, Shuffle=True und random_state=42 implementiert.
Binäre Klassenvorhersagen wurden erzeugt, indem eine feste Wahrscheinlichkeitsschwelle von 0,50 auf die vorhergesagte Klassenwahrscheinlichkeit ŷ angewendet wurde, die von der klassischen Nachbearbeitungsschicht erzeugt wird. Genauigkeit, Präzision, Rückruf und F1-Wert wurden aus diesen Schwellenwerte berechnet, während AUC–ROC direkt aus den kontinuierlichen Wahrscheinlichkeitswerten ohne Schwellenwert berechnet wurde. Präzision, Abruf und F1-Wert wurden mit den Metrikfunktionen mit zero_division=0 berechnet, wobei jeder undefinierten Metrik ein Wert von 0,0 zugeordnet wurde. Während der berichteten Experimente trat keine solche undefinierte Bedingung auf.
Baseline-Modelle wurden mit identischen Fold-Partitionen und identischer vier-komponenten vorverarbeiteter Merkmalsrepräsentation ausgewertet, die von der Preprocessing-Pipeline erzeugt wurden. Ein klassisches mehrschichtiges Perzeptron, das eine versteckte Schicht von acht ReLU-aktivierten Einheiten enthält, architektonisch auf die klassische Komponente des Hybridmodells abgestimmt, aber ohne die Quantenschaltung, wurde mit dem Adam-Optimierer trainiert, mit einer L2-Strafe von 1 × 10⁻⁴. Ein gradient-boosted Tree Classifier wurde ebenfalls mit derselben vierteiligen Darstellung trainiert, mit 200 Bäumen, einer maximalen Baumtiefe von 3, einer Lernrate von 0,1 und einer Klassengewichtung, die der inversen Klassenfrequenz innerhalb jeder Trainingsfalte entspricht. Zusätzlich wurde ein zweiter, gradientenverstärkter Baumklassifikator mit der vollständigen 22-Feature-Darstellung trainiert, die nach der initialen Min–Max-Normalisierung erzeugt wurde, ohne PCA oder Quantenfeature-Codierung anzuwenden. Dieses Modell verwendete 300 Bäume, eine maximale Baumtiefe von 4, eine Lernrate von 0,05 und dieselbe inverse Trainings-Fold-Klassengewichtungsstrategie. Die klassische mehrschichtige Perzeptron-Baseline wurde mit MLPClassifier mit hidden_layer_sizes=(8), Aktivation="relu", Solver="Adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0,001, max_iter=500, early_stopping=False, shuffle=True und random_state=42 implementiert. Die Standard-Glorot (Xavier)-Gleichgewichtsinitialisierung, die von der Implementierung bereitgestellt wurde, wurde verwendet. Die gradient-boosted Tree Baselines wurden mit XGBoost 3.3.0 implementiert, mit Objective = "binary:logistic", eval_metric = "logloss", tree_method = "auto", Subsample = 1.0, colsample_bytree = 1.0, reg_alpha = 0, reg_lambda = 1 und random_state = 42.
Zur Bewertung des Effekts der Klassenausgleichung nach der Aufteilung wurde das primäre Kreuzvalidierungsverfahren für das QI-HCNN-Modell mit aktivierter Stichprobengewichtung wiederholt. Die Ausgleichsgewichte wurden ausschließlich aus der Trainingspartition jeder Faltung nach Zug-/Testaufteilung berechnet und nicht aus der entsprechenden gehaltenen Testpartition.
Schaltungskomponenten-Ablationsexperimente wurden durchgeführt, indem der gesamte Vorverarbeitungs-, Trainings- und Auswertungsablauf viermal wiederholt wurde, wobei nur die beiden Verschränkungsschichten der Quantenschaltung modifiziert wurden. Die vier Schaltungsvarianten umfassten: (i) die vollständige Schaltung, die beide Verschränkungsschichten enthält; (ii) der Stromkreis, bei dem die erste Verschränkungsschicht entfernt und die zweite erhalten bleibt; (iii) der Stromkreis, bei dem die erste Verschränkungsschicht erhalten bleibt und die zweite entfernt wird; und (iv) die Schaltung mit entfernten beiden Verschränkungsschichten. Identische Fold-Partitionen, zufällige Seeds und Trainingskonfigurationen wurden in allen vier Experimenten beibehalten, sodass beobachtete Leistungsunterschiede ausschließlich auf die Entanglement-Layer-Konfiguration zurückzuführen sind.
Als Robustheitsbewertung wurde die Teilnehmergruppen-Kreuzvalidierung durchgeführt, indem die 31 Teilnehmer statt der 195 Aufzeichnungen in fünf Gruppen mit jeweils sechs bis sieben Teilnehmern aufgeteilt wurden. Während jeder Iteration wurde das Modell mit Aufzeichnungen von Teilnehmern aus vier Gruppen trainiert und anhand von Aufnahmen der verbleibenden Gruppe bewertet, wobei sichergestellt wurde, dass kein Teilnehmer Aufnahmen sowohl zu den Trainings- als auch zu Test-Partitionen desselben Folds beisteuerte. Genauigkeit, Präzision, Erinnerung, F1-Score und AUC–ROC wurden als Mittelwert ± Standardabweichung über die fünf teilnehmergruppierten Faltungen für das QI-HCNN-Modell, das klassische Mehrschicht-Perzeptron und das Vier-Feature-Gradient-Boosted Baseline berichtet. Die teilnehmergruppierte Kreuzvalidierung wurde mit der GroupKFold-Klasse mit n_splits=5 implementiert, wobei die Teilnehmerkennungen als Gruppierungsvariable dienten. Da GroupKFold die Gruppen nicht mischt, wurden die Teilnehmer nach der standardmäßigen deterministischen Reihenfolge der Implementierung zugeordnet, was zu Falten mit jeweils sechs oder sieben Teilnehmern führte.
Die statistische Signifikanz wurde bewertet, indem gepaarte Wilcoxon-Signed-Rank-Tests auf die pro Falt erhaltenen AUC–ROC-Werte für die primären Evaluations- und Basismodelle angewendet wurden. Exakte p-Werte und die entsprechenden Anzahl gepaarter Beobachtungen wurden angegeben, da die statistische Leistungsfähigkeit dieses Tests begrenzt ist, wenn nur eine geringe Anzahl von Faltungen verfügbar ist. Vier paarweise AUC–ROC-Vergleiche wurden a priori definiert: (1) QI-HCNN versus das klassische Multilayer-Perzeptron; (2) QI-HCNN im Vergleich zum PCA-angepassten, gradient-boosted Tree Baseline; (3) dem klassischen mehrschichtigen Perzeptron gegenüber dem PCA-angepassten, gradient-boosted Tree Baseline; und (4) das unsymmetrische QI-HCNN-Modell im Vergleich zum post-split-balancierten QI-HCNN-Modell. Es wurde keine Mehrfachvergleichskorrektur angewandt, da die Analysen explorativ waren und die begrenzte Anzahl von Falten die statistische Stärke erheblich verringerte.
Die Analyse der Merkmalswichtigkeit wurde mit dem gradient-boosted Tree Classifier durchgeführt, der auf der vollständigen 22-Feature-Darstellung trainiert wurde. Gain-basierte Feature-Importance-Scores wurden extrahiert und für alle ursprünglichen akustischen Features bewertet. Separat wurde PCA dem vollständigen Datensatz nur zu Berichtszwecken zugeordnet und während der Modellbewertung nicht verwendet. Für jedes ursprüngliche akustische Merkmal wurden die absoluten Lasten über die vier erhaltenen Hauptkomponenten addiert, und die Merkmale wurden entsprechend diesen Werten bewertet. Sowohl Rangfolgemethoden als auch deren Überschneidungen wurden berichtet. Für die gain-basierte Feature-Importance-Analyse erzeugte die gradient-boosted tree-Implementierung eindeutige Gleitkomma-Gewinnwerte, und es traten keine Gleichheiten auf. Für die Hauptkomponenten-Laderangfolge wurden Gleichstellungen in den summierten absoluten Lastwerten gemäß der ursprünglichen Feature-Spaltenreihenfolge im Datensatz aufgelöst.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Alle im Text angegebenen Zahlenwerte sind mit denen in den Abbildungen 2–8 und Tabellen 2–4 abgestimmt und identisch mit denen. Jede Abbildung wurde direkt aus dem im Supplementary Coding File 1 bereitgestellten Code generiert, anstatt manuell vorbereitet zu werden, um eine Konsistenz zwischen den gemeldeten Zahlenwerten und den geplotten Daten sicherzustellen.
Primäre Kreuzvalidierungsleistung
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Dieses Protokoll spezifiziert eine vollständig reproduzierbare QI-HCNN-Architektur für die Klassifikation der Parkinson-Krankheit anhand von Sprachaufnahmen, bei der jedes Gatter, jede Parameterinitialisierungswahl, jeder Vorverarbeitungsschritt und jedes Bewertungsverfahren auf einem ausreichenden Niveau für eine unabhängige Implementierung beschrieben wird. Die vorgeschlagene Schaltung wird mit identischen Eingabefunktionen und identischen Cross-Validierungs-Fold-Partitionen mit einem ...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Interessenkonflikt:
Die Autoren erklären, dass sie keine konkurrierenden finanziellen oder nicht-finanziellen Interessen in Bezug auf dieses Werk haben.
Danksagungen
Diese Arbeit wurde weder technisch noch finanziell von einer Agentur oder Organisation finanziert. Die Autoren danken den Betreuern des UCI Machine Learning Repository dafür, dass sie dem öffentlichen Zugang zum in dieser Studie verwendeten Sprachaufzeichnungsdatensatz ermöglicht haben.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Adam-Optimierer | Standard numerische Optimierungsimplementierung | Benutzerdefinierte Implementierung; NumPy 2.4.4 | Gemeinsame Optimierung von Quanten- und klassischen Parametern; Modelltraining |
| Implementierung der binären Kreuz-Entropie-Verlustfunktion | Benutzerdefinierte Implementierung mit NumPy | NumPy 2.4.4; Verlust gemittelt (mittlere Reduktion) über jedes Mini-Batch | Trainingsverlustfunktion; Modelltraining |
| Gradient-Boosted-Baumklassifikator | XGBoost Open-Source Gradient-Boosting-Bibliothek | XGBoost 3.3.0; objective="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | PCA-angepasste und vollständige Merkmalsklassische Baselines; Evaluierungsprotokoll |
| Maschinelles Lernbibliothek | scikit-learn Open-Source-Maschinelles Lernbibliothek | scikit-learn 1.8.0 | Min–Max-Skalierung, Hauptkomponentenanalyse, geschichtete Kreuzvalidierung, teilnehmergruppierte Kreuzvalidierung, mehrschichtige Perzeptron-Baseline und Bewertungsmetriken |
| Numerische Rechenbibliothek | NumPy Open-Source-Numerische Rechenbibliothek | NumPy 2.4.4 | Kernarrayoperationen, Zustandsvektorsimulation, Parameterinitialisierung und manuelle Gradientenberechnung |
| Parkinson-Klassifikationsdatensatz | Little, McSharry, Roberts, Costello und Moroz; verteilt durch das UCI Machine Learning Repository | UCI-Datensatz-ID 174; 195 Aufnahmen von 31 Teilnehmern; abgerufen am 19. Juni 2025 | Quelle für den Datensatz mit anhaltenden Vokalaufnahmen; https://archive.ics.uci.edu/dataset/174 |
| Wissenschaftliche Rechenbibliothek | SciPy Open-Source-Wissenschaftliche Rechenbibliothek | SciPy 1.17.1 | Wilcoxon-Vorzeichen-Rang-Test zur statistischen Signifikanz; Evaluierungsprotokoll |
| Zustandsvektorsimulator | Benutzerdefinierter Zustandsvektorsimulator (Ergänzendes Codierungsdatei 1; qhcnn.py) | Reine NumPy-Implementierung; complex128 (double) Präzision; kein externes Backend erforderlich | Ausführung des Vier-Qubit-Quantenschaltkreises; Quantenschaltkreiskonstruktion |
| Tabellendatenbibliothek | Pandas Open-Source-Datenanalysebibliothek | Pandas 3.0.2 | Datensatzladen, Inspizieren und Tabellenmanipulation |
| Rechenumgebung für Workstations | Lokale CPU-Workstation (Cloud-gehosteter Linux-Container) | x86_64 CPU; Ubuntu Linux; Python 3; keine GPU oder Quantenhardware verwendet; ungefähre Wanduhr-Trainingszeit von 30–60 Sekunden pro Falte | Für alle Trainings und Auswertungen verwendete Rechenumgebung; CPU-basierte Zustandsvektorsimulation; keine GPU oder Quantenhardware erforderlich |
Referenzen
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.