Diese Studie untersucht den Zusammenhang zwischen systemischem Lupus erythematodes und wiederholtem Schwangerschaftsverlust und identifiziert IFI27 als potenziellen Biomarker für zukünftige Untersuchungen.
Forschungsartikel
Mendelsche Randomisierung und Bioinformatik identifizieren IFI27 als potenziellen Biomarker für wiederholte Fehlgeburten bei systemischem Lupus erythematodes
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Systemischer Lupus erythematodes (SLE) ist mit ungünstigen Schwangerschaftsverläufen assoziiert, doch der kausale Zusammenhang mit rezidivierenden Schwangerschaftsverlusten (RPL) sowie deren gemeinsame molekulare Merkmale sind weiterhin unklar. Diese Studie kombinierte eine bidirektionale zweistichprobenbasierte Mendelsche Randomisierung (MR) mit transkriptomischen bioinformatischen Analysen, um diesen Zusammenhang zu untersuchen und gemeinsame Biomarker-Kandidaten zu identifizieren. FinnGen und die UK Biobank wurden ausgewählt, da sie umfangreiche, nicht überlappende, populationsbasierte genomweite Assoziationsstudien (GWAS) mit europäischem Hintergrund bereitstellen. Differenziell exprimierte Gene (DEGs) wurden aus GSE61635 (Blut; |log₂-Faltungsänderung| > 1) und GSE165004 (Endometrium; |log₂-Faltungsänderung| > 0,5) unter Verwendung eines adjustierten P < 0,05 identifiziert, gefolgt von funktioneller Anreicherung, Protein-Protein-Interaktions-(PPI-)Analyse, Hub-Gen-Screening, Regressionsanalyse mit dem Verfahren der kleinsten absoluten Schrumpfung und Auswahl (LASSO), externer Validierung mittels GSE50772 und GSE198700, ROC-Analyse (Receiver Operating Characteristic) und der single-sample Gen-Set-Enrichment-Analyse (ssGSEA). Genetisch vorhergesagter SLE war mit einer statistisch signifikanten, aber quantitativ geringfügigen Zunahme spontaner Fehlgeburten assoziiert (inverse-varianzgewichtete [IVW] Odds Ratio [OR] = 1,01, 95%-Konfidenzintervall [CI] = 1,00–1,02; P < 0,001). Die Instrumentenstärke war ausreichend, und Sensitivitätsanalysen ergaben keine wesentliche Heterogenität, keine direktionale Pleiotropie oder einen einzelnen einflussreichen Varianten. Neunundfünfzig gemeinsame DEGs waren angereichert in antiviralen Immunantworten, Zelladhäsion und apoptosebezogenen Prozessen. IFI27 war bei SLE im Blut konstant überexprimiert, jedoch bei RPL im Endometrium und in Chorionzotten unterexprimiert, während CXCL11 keine konsistente externe Validierung zeigte. Retrospektive ROC-Analysen ergaben Flächen unter der Kurve (AUCs) von 0,822 für SLE und 0,872 für RPL. Rechnerisch abgeleitete ssGSEA-Scores zeigten Korrelationen zwischen der Expression von IFI27 und mehreren Immunzell-Signaturen, einschließlich T-Helfer-2-(Th2-)Zellen. Diese Ergebnisse identifizieren IFI27 als gemeinsamen Biomarker-Kandidaten für SLE und RPL; prospektive klinische und experimentelle Studien sind jedoch erforderlich, um seine biologische und klinische Bedeutung zu validieren.
Einleitung
Systemischer Lupus erythematodes (SLE) ist eine komplexe Autoimmunerkrankung, die durch eine Beteiligung mehrerer Organsysteme und eine chronische Immunregulationsstörung gekennzeichnet ist1. Die pathologischen Veränderungen beim SLE werden hauptsächlich auf gestörte adaptive Immunantworten und die Ablagerung von Antigen-Antikörper-Komplexen zurückgeführt, die zu autoimmunvermittelter Gewebeschädigung und Organbefall führen2,3. Die weltweite Inzidenz von SLE beträgt etwa 5,14 (1,4–15,13) Fälle pro 100.000 Personenjahre, wobei bei Frauen eine geschätzte Inzidenz von 8,82 (2,4–25,99) Fällen pro 100.000 Personenjahre vorliegt4. SLE betrifft Menschen jeden Alters, tritt jedoch vorwiegend bei Frauen im gebärfähigen Alter auf5,6. Schwangere Patientinnen mit SLE haben ein erhöhtes Risiko für ungünstige Schwangerschaftsverläufe, einschließlich rezidivierender Fehlgeburten, Totgeburten, Frühgeburten und intrauteriner Wachstumsretardierung7,8. Rezidivierender Schwangerschaftsverlust (RPL) wird als zwei oder mehr Fehlgeburten vor der 20.–24. Schwangerschaftswoche definiert9. Die berichtete Prävalenz liegt bei etwa 2,6 %10 und macht RPL zu einer klinisch signifikanten reproduktiven Komplikation. Etwa 20 % der schwangeren Patientinnen mit SLE erleiden eine Fehlgeburt11, und SLE gilt als wichtiger Risikofaktor für RPL12. Vorgeschlagene Mechanismen umfassen hormonelle Veränderungen und Immunregulationsstörungen. Biomarker wie Antikardiolipin-Antikörper und Lupusantikoagulans wurden als mögliche Prädiktoren für ungünstige Schwangerschaftsverläufe bei Patientinnen mit SLE untersucht11. Diese Autoantikörper können Plazentatrophoblasten binden, die Trophoblastensignalübertragung, -proliferation und -invasion beeinträchtigen, die Sekretion von Hormonen und Zytokinen modulieren und die Apoptose erhöhen, wodurch ungünstige Schwangerschaftsverläufe begünstigt werden13. Zusätzlich wird Beta-2-Glykoprotein I (β2-GPI), ein wichtiges Antigen beim Antiphospholipid-Syndrom, im Plazentagewebe exprimiert. Die Bindung von anti-β2-GPI-Antikörpern an β2-GPI hemmt das Wachstum und die Differenzierung von Trophoblasten und führt zu Plazentadefekten. Diese Wechselwirkung fördert zudem ein proinflammatorisches Milieu, das durch die Produktion zerstörerischer Zytokine und Komplementaktivierung gekennzeichnet ist, und trägt so zur Plazentathrombose und rezidivierenden Fehlgeburt bei14,15. Frühere Studien enthielten jedoch oft keine umfassende Analyse lokaler Fortpflanzungsgewebe wie der Decidua, was die Korrelation systemischer Biomarker mit lokalen pathologischen Veränderungen erschwert. Außerdem bleibt die Behandlung von Schwangerschaften, die durch SLE kompliziert sind, sowie die Prävention ungünstiger Schwangerschaftsverläufe eine Herausforderung. Die genetische Anfälligkeit trägt zur Entstehung von SLE bei, und genetische Variationen wurden ebenfalls in die Pathogenese von RPL einbezogen16,17. Ob jedoch eine kausale Beziehung zwischen SLE und RPL besteht, sowie die molekularen Mechanismen und gemeinsam genutzten Gene, die ihrem gleichzeitigen Auftreten zugrunde liegen, ist weiterhin unklar.
Die Mendelsche Zufallsstichprobe (MR) ist ein etablierter Ansatz zur kausalen Schlussfolgerung, bei dem genetische Varianten als instrumentelle Variablen verwendet werden, um die kausalen Effekte von Expositionen auf Krankheitsausgänge zu schätzen18. Durch die Nutzung des Zusammenhangs zwischen Genotyp und Phänotyp verringert die MR im Vergleich zu herkömmlichen Beobachtungsstudien Verzerrungen durch Störvariablen und umgekehrte Kausalität. Parallel dazu haben Fortschritte bei genomischen Mikroarray-Plattformen und Hochdurchsatz-Sequenzierung bioinformatische Analysen ermöglicht, um mittels transkriptomischer Profilierung vielversprechende diagnostische Biomarker und therapeutische Zielstrukturen zu identifizieren. Die Integration dieser komplementären Ansätze könnte ein umfassenderes Verständnis des Zusammenhangs zwischen SLE und RPL ermöglichen, indem kausale genetische Hinweise mit krankheitsassoziierten Genexpressionsmustern kombiniert werden. Daher hatte diese Studie das Ziel, den potenziellen kausalen Zusammenhang zwischen SLE und RPL zu untersuchen, gemeinsame Kandidaten-Biomarker und biologische Signalwege zu identifizieren sowie Zielstrukturen für zukünftige Validierungen zu priorisieren. Um diese Ziele zu erreichen, wurde der analytische Arbeitsablauf wie folgt vorab festgelegt: bidirektionale MR zur Bewertung der kausalen Richtung; unabhängige differentielle Genexpressionsanalysen, gefolgt von transkriptomischer Integration; Protein-Protein-Interaktions-(PPI-)Netzwerkanalyse und Regressionsanalyse mit dem Verfahren der kleinsten absoluten Schrumpfung und Auswahl (LASSO) zur Priorisierung von Biomarkern; externe Expressionsvalidierung und ROC-Analyse (Receiver Operating Characteristic); sowie die single-sample Gene Set Enrichment Analysis (ssGSEA), um Assoziationen mit Immunzell-Signaturen zu bewerten. Dieser schrittweise Arbeitsablauf ist in Abbildung 1 zusammengefasst.
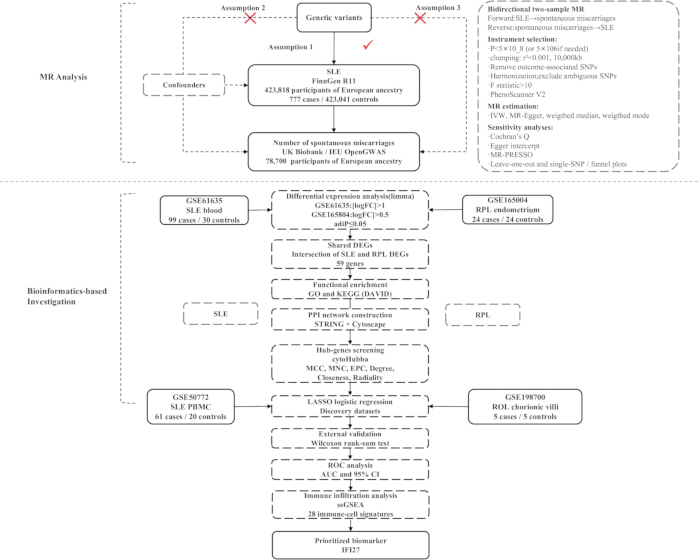
Abbildung 1. Studiendesign und analytischer Arbeitsablauf.
Das obere Panel veranschaulicht die bidirektionale zweistichprobige Mendelsche Randomisierung (MR) zur Bewertung des Zusammenhangs zwischen systemischem Lupus erythematodes (SLE) und der Anzahl spontaner Fehlgeburten mithilfe von Zusammenfassungsstatistiken aus genomweiten Assoziationsstudien (GWAS). Die Instrumentenauswahl, die Kopplungsungleichgewichts-Clustering, die Mendelsche Randomisierungsanalyse (MR) sowie die Sensitivitätsanalysen werden zusammengefasst. Das untere Panel skizziert den bioinformatischen Arbeitsablauf, einschließlich der differentiellen Expressionsanalyse, der Identifizierung gemeinsam differentiell exprimierter Gene (DEGs), der funktionalen Anreicherungsanalyse, des Aufbaus von Protein-Protein-Interaktionsnetzwerken (PPI), der Hub-Gen-Screening, der LASSO-Regression (Least Absolute Shrinkage and Selection Operator), der externen Validierung, der ROC-Analyse (Receiver Operating Characteristic), der single-sample Gene Set Enrichment Analyse (ssGSEA) sowie der Priorisierung des Kandidaten-Biomarkers IFI27. IVW, inverse-variance weighted; KEGG, Kyoto Encyclopedia of Genes and Genomes; GO, Gene Ontology. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Protokoll
Für die vorliegende Studie war keine ethische Genehmigung erforderlich, da ausschließlich sekundäre Analysen öffentlich zugänglicher, anonymisierter Zusammenfassungsstatistiken von Genomweiten Assoziationsstudien (GWAS) und transkriptomischer Datensätze durchgeführt wurden. Es wurden keine neuen Teilnehmer rekrutiert, keine biologischen Proben gesammelt und keine identifizierbaren individuellen Informationen eingesehen. Bei den ursprünglichen Studien FinnGen, UK Biobank und Gene Expression Omnibus wurde berichtet, dass die ethische Genehmigung und die informierte Einwilligung gemäß den jeweiligen institutionellen, nationalen und datenbankspezifischen Anforderungen eingeholt worden waren. Auf alle in der vorliegenden Studie verwendeten Datensätze wurde unter Einhaltung der geltenden Nutzungsrichtlinien der Datenbanken, der Bedingungen für den Datenzugriff und der ethischen Leitlinien zugegriffen und diese wurden analysiert. Die Autoren versuchten nicht, Teilnehmer erneut zu identifizieren. Daher war keine zusätzliche schriftliche informierte Einwilligung für diese sekundäre Analyse erforderlich. Der Inhalt dieser Studie umfasst zwei Teile: MR-Analyse und bioinformatische Analyse (Abbildung 1). Diese Studie war vollständig rechnergestützt und nutzte öffentlich zugängliche, zusammengefasste GWAS- und transkriptomische Datensätze. Es wurden keine Reagenzien oder Verbrauchsmaterialien für nasse Labore verwendet.
MR-Analyse
Datenquellen, Erfassung und Vorverarbeitung der GWAS-Zusammenfassungsstatistiken:
Die Zusammenfassungsstatistiken der GWAS für Lupus erythematodes stammten aus FinnGen Release 11 (finngen_R11_L12_LUPUS; RRID:SCR_022254), einer populationsbasierten finnischen Kohorte. Das Phänotyp wurde anhand des ICD-10-Codes L93 definiert und umfasste 423.818 Teilnehmer, darunter 777 Fälle und 423.041 Kontrollen. Die Zusammenfassungsstatistikdatei von FinnGen wurde vom öffentlichen FinnGen-Datenportal im komprimierten tabulatorgetrennten Format heruntergeladen und mithilfe der Funktion read_exposure_data() oder read_outcome_data() in TwoSampleMR in R importiert, je nachdem, ob der Datensatz als Exposition oder Outcome verwendet wurde. Es wurden folgende Angaben beibehalten: rsID, Chromosom, genomische Position, Effektallel, anderes Allel, Effektallelfrequenz, Beta-Koeffizient, Standardfehler und der P-Wert der Assoziation.
Zusammenfassende Statistiken zur Anzahl spontaner Fehlgeburten wurden über die IEU OpenGWAS-Ressource (ukb-b-419; RRID:SCR_012815) aus dem UK Biobank abgerufen, bestehend aus 78.700 Teilnehmern. Bei der Vorwärtsanalyse wurden Assoziationen der ausgewählten FinnGen-Einzel-Nukleotid-Polymorphismen (SNPs) mit dem Outcome mittels extract_outcome_data(outcomes = "ukb-b-419", proxies = FALSE) extrahiert. Bei der Rückwärtsanalyse wurden SNPs, die mit Lupus erythematodes assoziiert sind, mittels extract_instruments(outcomes = "finngen_R11_L12_LUPUS", clump = FALSE) abgerufen, woraufhin die entsprechenden SNP-Assoziationen aus der Zusammenfassungsstatistik-Datei des UK Biobank extrahiert wurden. Die Merkmale der in den bidirektionalen MR-Analysen verwendeten GWAS-Datensätze sind in Tabelle 1 zusammengefasst.
| Merkmalsausprägung | Stichprobengröße | Abstammung | Konsortium | Jahr | GWAS-Datensatz-ID |
| Lupus erythematodes | 4,23,818 | europäisch | FinnGen (RRID: SCR_022254) | 2024 | finngen_R11_L12_LUPUS |
| Anzahl spontaner Fehlgeburten | 78.700 | europäisch | UK Biobank (RRID: SCR_012815) | 2018 | ukb-b-419 |
Tabelle 1: Zusammenfassende Statistiken aus genomweiten Assoziationsstudien (GWAS), die für die bidirektionale Mendelsche Randomisierungsanalyse verwendet wurden.
Die Tabelle fasst die öffentlich verfügbaren Datensätze aus genomweiten Assoziationsstudien zusammen, die als Quellen für Exposition und Ergebnis in den Vorwärts- und Rückwärts-Analysen der Mendelschen Randomisierung dienten, einschließlich Stichprobengröße, Herkunft, Datenquelle, Jahr der Datenveröffentlichung und Datensatzkennung.
FinnGen und die UK Biobank wurden ausgewählt, da sie große, öffentlich zugängliche Datensätze hauptsächlich europäischer Herkunft bereitstellen, die aus nicht überlappenden Quellpopulationen stammen und eine ausreichende Abdeckung von Varianten für eine Two-Sample-MR-Analyse bieten. Es wurde über keinen Überlapp zwischen Expositions- und Outcomesamples berichtet. Da ausschließlich zusammengefasste Daten verwendet wurden, erfolgte kein Zugriff auf genotypische Einzelpersonendaten, keine zusätzliche normalisierende Bearbeitung auf Teilnehmerebene und wurden keine Teilnehmer durch die vorliegenden Untersucher ausgeschlossen. Wir stützten uns auf die Qualitätskontrollverfahren auf Proben- und Variantenebene, die von den ursprünglichen GWAS-Konsortien implementiert wurden. Während der vorliegenden Analyse wurde eine zusätzliche Qualitätskontrolle auf Variantenebene durch Signifikanzfilterung, Linkage-Disequilibrium-Clumping, Allel-Harmonisierung, Beurteilung der Instrumentenstärke sowie Pleiotropie-Screening durchgeführt, wie unten beschrieben.
FinnGen Release 11 gibt genomische Positionen gemäß GRCh38/hg38 an, während die harmonisierten Datensätze von IEU OpenGWAS und die Referenzressource für das Kopplungsungleichgewicht Variantenannotationen verwenden, die mit GRCh37 kompatibel sind. Daher wurden Expositions- und Outcome-Varianten vorrangig anhand stabiler rsIDs und nicht anhand chromosomaler Positionskoordinaten abgeglichen. Es wurde kein direkter positionsbasierter Abgleich zwischen den Genomversionen durchgeführt. Varianten ohne eindeutige rsID oder mit inkonsistenten Allelinformationen zwischen den Datensätzen wurden vor der MR-Analyse ausgeschlossen. Die Zusammenfassungsstatistiken von FinnGen Release 11 basieren auf GRCh38, während die OpenGWAS-Daten an die Referenzsequenzkonvention von Build 37 harmonisiert wurden. Die Abstimmung anhand der rsID ist daher wichtig, wenn beide Ressourcen kombiniert werden.
Studiendesign der MR:
Wir hielten uns strikt an die STROBE-MR-Richtlinien (Ergänzende Datei 1)19. Ein bidirektales Two-Sample-MR-Design wurde verwendet, um den Zusammenhang zwischen genetisch vorhergesagtem Lupus erythematodes und der Anzahl spontaner Fehlgeburten zu untersuchen. In der Vorwärtsanalyse wurde Lupus erythematodes als Exposition und die Anzahl spontaner Fehlgeburten als Zielgröße betrachtet. In der Rückwärtsanalyse wurden Exposition und Zielgröße vertauscht, und der gesamte Workflow zur Instrumentenauswahl, Kopplungsungleichgewichts-Clumping, Datenausrichtung, kausalen Schätzung und Sensitivitätsanalyse wurde wiederholt. Single-Nukleotid-Polymorphismen (SNPs) wurden als instrumentelle Variablen (IVs) verwendet. Der gesamte Workflow wurde in der folgenden Reihenfolge durchgeführt: Beschaffung und Aufbereitung der GWAS-Zusammenfassungsstatistiken; Auswahl von expositionsassoziierten SNPs; Entfernung von duplizierten oder unvollständig annotierten Varianten; Kopplungsungleichgewichts-Clumping; Extraktion der entsprechenden Zielgrößenassoziationen; Ausschluss von SNPs, die direkt mit der Zielgröße assoziiert sind; Harmonisierung der Expositions- und Zielgröllen-Alelle; Berechnung der Instrumentenstärke; Screening auf potenzielle störende Phänotypen; Schätzung kausaler Effekte; Beurteilung von Heterogenität und horizontaler Pleiotropie; Ausreißererkennung mittels Mendelian Randomization Pleiotropy RESidual Sum and Outlier (MR-PRESSO); sowie Leave-one-out- und Single-SNP-Sensitivitätsanalysen. Alle MR-Analysen wurden mit R-Version 4.4.2 (RRID:SCR_001905), TwoSampleMR-Version 0.6.6 (RRID:SCR_019010), MRPRESSO-Version 1.0 (RRID:SCR_023697) und forestploter-Version 1.1.2 durchgeführt. Die MR-Analyse basierte auf drei zentralen Annahmen. Erstens muss gemäß der Relevanzannahme der ausgewählte SNP stark mit der Exposition assoziiert sein. Zweitens müssen gemäß der Unabhängigkeitsannahme die ausgewählten SNPs unabhängig von Faktoren sein, die die Expositions-Zielgrößen-Assoziation stören. Drittens müssen gemäß der Ausschluss-Restriktionsannahme die ausgewählten SNPs die Zielgröße nur über die Exposition beeinflussen20 (Abbildung 1).
Methoden zur SNP-Auswahl:
Die Instrumentenwahl erfolgte in der folgenden Reihenfolge: (1) Auswahl der mit der Exposition assoziierten SNPs bei P < 5 × 10⁻⁸; falls die Anzahl der Instrumente unzureichend war, Verwendung von P < 5 × 10⁻⁶; (2) Anwendung der Funktion clump_data() zur Durchführung der Kopplungsungleichgewichts-Clustering (Linkage Disequilibrium Clumping) bei R2 < 0,001 und einem genetischen Abstand von 10.000 kb; die Kriterien wurden nur dann gelockert auf R2 < 0,01 innerhalb von 5.000 kb, wenn dies notwendig war, um eine analysierbare Instrumentensatz beizubehalten; (3) Ausschluss von SNPs, die signifikant mit dem Outcome assoziiert waren, anhand einer Schwelle von P = 5 × 10⁻⁵; (4) Anwendung der Funktion harmonise_data() zur Harmonisierung der Allele für Exposition und Outcome sowie Ausschluss palindromer oder anderweitig mehrdeutiger Varianten; (5) Berechnung der Instrumentenstärke als F = β2/SE2 und Ausschluss von SNPs mit F < 10; sowie (6) Überprüfung der verbliebenen SNPs in PhenoScanner V2 auf Phänotypen, die die Beziehung zwischen SLE und Schwangerschaftsverlust verfälschen könnten21. Antiphospholipid-Antikörper (aPL) könnten ein gemeinsamer Risikofaktor für SLE und die Anzahl spontaner Fehlgeburten sein. Individuelle SNPs wurden in PhenoScanner V2 durchsucht. Alle Kandidaten-SNPs wurden in PhenoScanner V2 mithilfe des standardmäßigen GWAS-Katalogs abgefragt, um alle berichteten genomweiten Assoziationsstudien (GWAS) zu ermitteln. Die Signifikanzschwelle wurde auf P < 1 × 10⁻5 festgelegt, und der standardmäßige Referenzgenom-Assembly (GRCh37) wurde verwendet. Da die Studienpopulation europäischer Herkunft war, wurde die Suche nach Proxy-Varianten unter Verwendung des europäischen Referenzpanels (proxies = "EUR") aktiviert, mit einer LD-Schwelle von R2 > 0,8 innerhalb eines 1.000-kb-Fensters. Alle übrigen Suchparameter blieben auf ihren Standardeinstellungen. SNPs, die signifikante Assoziationen mit dem vorab festgelegten Störfaktor, den Antiphospholipid-Antikörpern (aPL), zeigten, galten als potenziell pleiotrop und wurden aus dem endgültigen Instrumentalvariablensatz ausgeschlossen, um Verstöße gegen die Ausschlussrestriktionsannahme der Mendelschen Randomisierung zu minimieren. Die für die vorwärts- und rückwärtsgerichtete MR-Analyse verwendeten Instrumental-SNPs sind in den ergänzenden Tabellen 1 und 2 aufgeführt.
Statistische Analyse:
Nach der Auswahl der Instrumente und der Allel-Harmonisierung wurden kausale Schätzungen mithilfe der mr()-Funktion in TwoSampleMR berechnet. Der analytische Workflow wurde in der folgenden Reihenfolge durchgeführt. Zunächst wurde der gesamte kausale Effekt mit vier MR-Methoden geschätzt: inverse Varianzgewichtung (IVW), MR-Egger-Regression, gewichteter Median und gewichteter Modus. Die Effektschätzungen für die Anzahl spontaner Fehlgeburten und SLE wurden als Odds Ratios mit entsprechenden 95 %-Konfidenzintervallen und P-Werten angegeben. Die IVW-Methode wurde als primäre Analyse festgelegt, da sie eine hohe statistische Power bietet, wenn alle enthaltenen SNPs gültige instrumentelle Variablen sind und keine horizontale Pleiotropie vorliegt. Allerdings kann die IVW-Schätzung verzerrt sein, wenn horizontale Pleiotropie vorhanden ist22. Die MR-Egger-Regression wurde hauptsächlich verwendet, um kausale Schlussfolgerungen bei potenziell vorliegender horizontaler Pleiotropie zu bewerten23. Der gewichtete Medianansatz setzt voraus, dass mindestens 50 % des analytischen Gewichts von gültigen instrumentellen Variablen stammen. Diese Methode ist optimal, wenn Heterogenität vorliegt, aber keine horizontale Pleiotropie besteht24. Der gewichtete Modus identifiziert Gruppen von instrumentellen Variablen mit ähnlichen kausalen Effekten und schätzt den Effekt anhand der größten Gruppe25. Die mit den vier MR-Methoden erhaltenen Effektschätzungen sind in Abbildung 2 dargestellt. Zweitens wurde die Heterogenität zwischen den SNP-spezifischen kausalen Schätzungen mithilfe des Cochran-Q-Tests bewertet, der über die mr_heterogeneity()-Funktion implementiert wurde. Die Q-Statistik stellt die gewichtete Summe der quadrierten Abweichungen der einzelnen SNP-Schätzungen von der gesamten kausalen Schätzung dar. Ein Q-Test P-Wert < 0,05 wurde als Hinweis auf Heterogenität gewertet; in diesem Fall wurde ein Zufallseffekte-IVW-Modell angewendet. Bei fehlender signifikanter Heterogenität wurde ein Festeffekte-IVW-Modell verwendet26. Drittens wurde die gerichtete horizontale Pleiotropie mithilfe des MR-Egger-Intercept-Tests, implementiert mit der mr_pleiotropy_test()-Funktion, überprüft. Ein vom Nullwert signifikant abweichender Intercept bei P < 0,05 wurde als Hinweis auf gerichtete horizontale Pleiotropie betrachtet. Viertens wurde das MR-PRESSO-Verfahren mithilfe der mr_presso()-Funktion im MRPRESSO-Paket (RRID:SCR_023697) durchgeführt, um SNPs mit ausreißerhaften pleiotropen Effekten zu identifizieren27. Bei Identifizierung von Ausreißern wurden diese entfernt, und die kausale Analyse wurde mit den verbleibenden Instrumenten wiederholt. Der MR-PRESSO-Globaltest wurde verwendet, um die gesamte horizontale Pleiotropie zu bewerten, und der Verzerrungstest wurde herangezogen, um zu prüfen, ob die Entfernung der Ausreißer die kausale Schätzung wesentlich veränderte. Fünftens wurde eine Leave-one-out-Sensitivitätsanalyse mithilfe der mr_leaveoneout()-Funktion durchgeführt. Dabei wurde jedes SNP nacheinander ausgeschlossen, und die gepoolte kausale Schätzung wurde mit den verbleibenden SNPs neu berechnet. Die Ergebnisse wurden mithilfe von mr_leaveoneout_plot() visualisiert, um festzustellen, ob die Gesamtassoziation übermäßig durch ein einzelnes Instrument beeinflusst wurde. Sechstens wurden individuelle SNP-spezifische Schätzungen mithilfe der mr_singlesnp()-Funktion erstellt. Diese Schätzungen wurden verwendet, um mit mr_funnel_plot() Tropfenplots zu konstruieren, um asymmetrische Verteilungen zu visuell beurteilen, die möglicherweise auf gerichtete horizontale Pleiotropie zurückzuführen sind. Zusammenfassende Waldplots wurden mit forestploter (Version 1.1.2) erstellt, um die Effektschätzungen und Konfidenzintervalle der verschiedenen MR-Methoden darzustellen. Der forward-MR-Streudiagramm, der SNP-spezifische Waldplot, die Leave-one-out-Analyse und der Tropfenplot sind in Ergänzende Abbildungen 1–4 dargestellt.
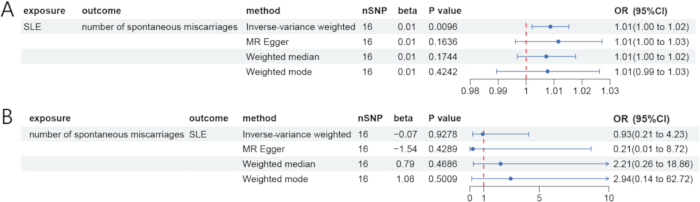
Abbildung 2. Ergebnisse der bidirektionalen Mendelschen Zufallsbeziehungsanalyse.
(A) Waldplot der vorwärts gerichteten Mendelschen Zufallsbeziehungsanalyse (MR) mit systemischem Lupus erythematodes (SLE) als Exposition und der Anzahl spontaner Fehlgeburten als Zielgröße. (B) Waldplot der umgekehrten MR-Analyse mit der Anzahl spontaner Fehlgeburten als Exposition und SLE als Zielgröße. Die Effektschätzungen werden als Odds Ratios (ORs) mit 95 % Konfidenzintervallen (CIs) für die Methoden der inversen Varianzgewichtung, MR-Egger, gewichteten Median und gewichteten Modus dargestellt. SNP, Einzelnukleotid-Polymorphismus. Klicken Sie bitte hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Eine kausale Assoziation galt als gestützt, wenn die IVW-Schätzung statistisch signifikant bei P < 0,05 war, die MR-Egger-, gewichtete Median- und gewichtete Modus-Schätzungen eine mit der IVW-Schätzung übereinstimmende Richtung zeigten und die Ergebnisse durch Heterogenität, Pleiotropie, MR-PRESSO oder Leave-one-out-Sensitivitätsanalysen nicht wesentlich verändert wurden. Alle statistischen Tests waren zweiseitig.
Bioinformatische Analyse
Microarray-Daten:
Die transkriptomischen Datensätze wurden aus der Gene Expression Omnibus (GEO; RRID:SCR_005012)-Datenbank bezogen28. Die verarbeiteten Series-Matrix-Dateien, Probendaten und Plattform-Anmerkungsdateien wurden für GSE61635, GSE165004, GSE50772 und GSE198700 heruntergeladen. Plattform, Gewebekomponente, Stichprobengröße und Analysekategorie jedes Datensatzes sind in Tabelle 2 zusammengefasst. Da die Datensätze aus unterschiedlichen Geweben und Microarray-Plattformen stammten, wurde jeder Datensatz separat vorverarbeitet und analysiert. Expressionsmatrizen aus verschiedenen Datensätzen wurden nicht direkt zusammengeführt, und es wurde keine plattformübergreifende Batch-Korrektur durchgeführt. Die Integration über mehrere Datensätze hinweg erfolgte erst auf Ebene der Gen-Symbole, und zwar ausschließlich nach Abschluss der differentiellen Expressionsanalyse in jedem einzelnen Entdeckungsdatensatz.
| GEO-Datensatz | Erkrankung | Plattform | Gewebe (Homo sapiens) | Fälle | Kontrollen | Experimenttyp | Beitragender | Datensatzkategorie |
| GSE61635 | Systemischer Lupus erythematodes (SLE) | GPL570 | Ganzblut | 99 | 30 | Expressions-Mikroarray | Greidinger EL | Entdeckungsdatensatz |
| GSE165004 | Rezidivierender Schwangerschaftsverlust (RPL) | GPL16699 | Endometrium | 24 | 24 | Expressions-Mikroarray | Keleş ID29 | Entdeckungsdatensatz |
| GSE50772 | Systemischer Lupus erythematodes (SLE) | GPL570 | Periphere mononukleäre Blutzellen (PBMCs) | 61 | 20 | Expressions-Mikroarray | Kennedy WP30 | Validierungsdatensatz |
| GSE198700 | Rezidivierender Schwangerschaftsverlust (RPL) | GPL13534 | Chorionzotten | 5 | 5 | Expressions-Mikroarray | Li Y31 | Validierungsdatensatz |
Tabelle 2: Transkriptomische Datensätze, die für die bioinformatischen Analysen verwendet wurden.
Die Tabelle fasst die in den Entdeckungs- und Validierungsanalysen verwendeten transkriptomischen Datensätze aus der Gene Expression Omnibus (GEO)-Datenbank zusammen, einschließlich Krankheit, Microarray-Plattform, Gewebeprobe, Stichprobengröße, Experimenttyp, ursprünglicher Studienverfasser und Datensatzkategorie.
GSE61635 wurde unter Verwendung der Affymetrix Human Genome U133 Plus 2.0 Array-Plattform (GPL570) generiert und umfasste 99 Ganzblut-Arrays von Patienten mit SLE, einschließlich Wiederholungsuntersuchungen einiger Patienten, sowie 30 Arrays von unabhängigen gesunden Kontrollpersonen. Die hinterlegte Expressionsmatrix war bereits durch die ursprünglichen Forscher einer robusten multiarraydurchschnittlichen Hintergrundkorrektur, quantilen Normalisierung, Zusammenfassung der Probe-Sets und log2-Transformation unterzogen worden. Daher wurde keine erneute Hintergrundkorrektur oder quantile Normalisierung durchgeführt. Die Patientenidentifikatoren wurden aus den GEO-Metadaten extrahiert und für die Modellierung wiederholter Messungen beibehalten.
GSE165004 wurde unter Verwendung der Agilent SurePrint G3 Human Gene Expression v2 8×60K Microarray-Plattform (GPL16699) erstellt. Der vollständige Datensatz enthielt 24 fruchtbare Kontrollen, 24 Patientinnen mit RPL und 24 Patientinnen mit unerklärter Unfruchtbarkeit. Es wurden nur die 24 RPL-Proben und 24 Proben von fruchtbaren Kontrollen, die an den Tagen 19–21 des Menstruationszyklus gesammelt wurden, einbezogen; die 24 Proben mit unerklärter Unfruchtbarkeit wurden ausgeschlossen, da sie außerhalb des vorab definierten Vergleichs lagen29. Es wurde die vom Einreicher normalisierte Expressionsmatrix verwendet, und nach Überprüfung vergleichbarer Stichprobenverteilungen mittels Boxplots und Dichtediagrammen wurde keine zusätzliche Normalisierung zwischen den Arrays durchgeführt.
GSE50772 wurde als unabhängiger SLE-Validierungssatz verwendet und umfasste Proben peripherer mononuklearer Blutzellen von 61 Patienten mit SLE sowie 20 gesunden Kontrollen, die mit GPL57030 generiert wurden. GSE198700 wurde mit GPL13534 generiert und enthält Chorionzottenproben von fünf Patienten mit RPL und fünf Kontrollen nach elektiver Abtreibung31. Die hinterlegte Expressionsmatrix wurde vollständig importiert und einmalig mittels log2(x + 1) transformiert, da die hinterlegten Expressionswerte auf einer nicht-logarithmischen Skala vorlagen. Diese Transformation wurde auf die gesamte Expressionsmatrix vor der Qualitätskontrolle auf Proben-Ebene, der Probennotation, der Zusammenfassung auf Gen-Ebene, der Validierung von Kandidatengenen, der differentiellen Expressionsanalyse, den Gruppenvergleichstests und der ROC-Analyse angewendet. Kandidatengene wurden nicht separat transformiert, und während nachfolgender Validierungsanalysen erfolgte keine zusätzliche logarithmische Transformation. Bei allen Datensätzen wurden Probenidentitäten, Krankheitsstatus, Gewebeherkunft und Gruppenbezeichnungen vor der Analyse mit den entsprechenden GEO-Metadaten abgeglichen. Die Qualitätskontrolle umfasste die Beurteilung der Bibliotheksgrößen oder Expressionsverteilungen, boxplots pro Probe, Hauptkomponentenanalyse, hierarchisches Clustering und Heatmaps der Probenabstände. Nach der Qualitätskontrolle wurden keine weiteren Proben ausgeschlossen.
Analysen der differentiellen Expression:
Die Analysen der differentiellen Expression wurden unabhängig für GSE61635 und GSE165004 unter Verwendung von limma Version 3.60.6 (RRID:SCR_010943) durchgeführt. Alle Expressionsmatrizen wurden mit Genen in Zeilen und Proben in Spalten organisiert. Die Schwelle für die differentielle Expression wurde für GSE61635 bei |log₂-Fold-Change| > 1 und für GSE165004 bei |log₂-Fold-Change| > 0,5 festgelegt, jeweils mit einem nach Benjamini–Hochberg (BH) adjustierten P-Wert < 0,05. Die Volcano-Plots wurden mit ggplot2 Version 3.5.1 (RRID:SCR_014601) erstellt. Heatmaps der 50 signifikantesten differentiell exprimierten Gene (DEGs), sortiert nach dem adjustierten P-Wert, wurden mit pheatmap Version 1.0.12 (RRID:SCR_016418) generiert. Gemeinsame DEGs wurden identifiziert, indem die offiziellen Gensymbole aus den signifikanten SLE- und RPL-DEG-Listen mithilfe der Basis-R-Funktion intersect() geschnitten wurden, und visualisiert mit ggvenn Version 0.1.16 (RRID:SCR_025300). Die Heatmaps zur differentiellen Expression, die Volcano-Plots sowie der Schnitt der SLE- und RPL-DEG-Listen sind in Abbildung 3 dargestellt.
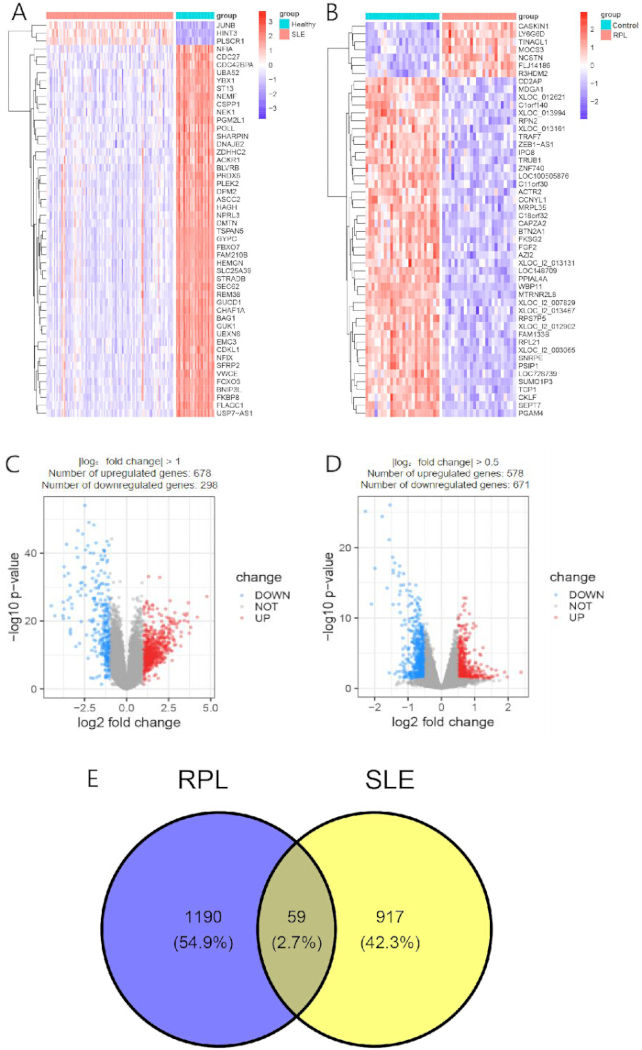
Abbildung 3. Differenziell exprimierte Gene bei systemischem Lupus erythematodes und rezidivierendem Schwangerschaftsverlust.
(A) Heatmap der 50 signifikantesten differenziell exprimierten Gene (DEGs) zwischen Patienten mit systemischem Lupus erythematodes (SLE) und gesunden Kontrollen in GSE61635. (B) Heatmap der 50 signifikantesten DEGs zwischen Patienten mit rezidivierendem Schwangerschaftsverlust (RPL) und fruchtbaren Kontrollen in GSE165004. (C) Volcano-Plot der differentiellen Genexpression in GSE61635. (D) Volcano-Plot der differentiellen Genexpression in GSE165004. (E) Venn-Diagramm zur Darstellung der Überschneidung zwischen den signifikanten DEG-Listen aus den SLE- und RPL-Erkenntnisdatensätzen. DEGs, differenziell exprimierte Gene. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Funktionsanreicherungsanalyse der gemeinsamen DEGs:
Zur molekularen Analyse der Funktionen der DEGs wurde das Online-Tool DAVID (Version 2021; RRID:SCR_001881)32 verwendet, um eine Anreicherungsanalyse der Genontologie (GO) und des Kyoto Encyclopedia of Genes and Genomes (KEGG) durchzuführen. Als Identifikatortyp wurden offizielle humane Gensymbole hochgeladen und Homo sapiens als Spezies ausgewählt. Die benutzerdefinierte Hintergrundpopulation bestand aus dem Durchschnitt aller Gene, die die Sondenannotation und Qualitätskontrolle bestanden hatten und in beiden Datensätzen GSE61635 und GSE165004 messbar waren. Die minimale Genanzahl wurde auf 2 festgelegt, und der maximale EASE-Score, der den modifizierten einseitigen Fisher-Exaktheits-P-Wert von DAVID darstellt, wurde auf 0,05 gesetzt. Mehrfachvergleiche wurden mittels des in der DAVID-Spalte „Benjamini“ angegebenen Benjamini–Hochberg-Verfahrens kontrolliert. Funktionelle Begriffe galten als statistisch signifikant, wenn der EASE-Score < 0,05 und der Benjamini-korrigierte P-Wert < 0,05 war. Die vollständige DAVID-Ausgabe, einschließlich Begriffsbezeichnungen, Genanzahlen, EASE-Scores, Benjamini-korrigierter P-Werte, Zuordnungen der Eingabegene und der Hintergrundgene, wurde als tabulatorgetrennte Datei exportiert. Die CNSknowall-Website wurde zur Visualisierung der gefilterten DAVID-Ergebnisse verwendet. Die Ergebnisse der GO- und KEGG-Anreicherungsanalyse sind in Abbildung 4A dargestellt.
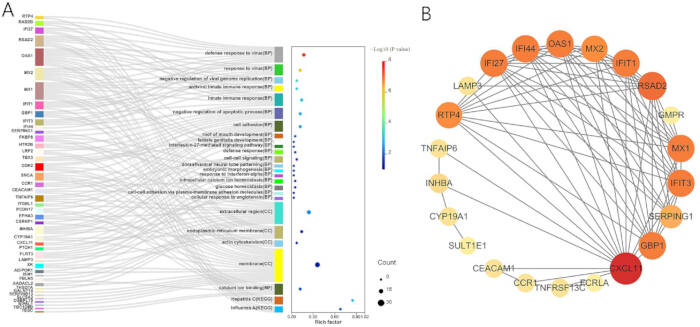
Abbildung 4. Funktionsanreicherungsanalyse und Protein-Protein-Interaktionsnetzwerk der gemeinsam differenziell exprimierten Gene.
(A) Genontologie (GO) und Kyoto-Enzyklopädie für Gene und Genome (KEGG) Anreicherungsanalysen der 59 gemeinsam differenziell exprimierten Gene (DEGs). Das Sankey-Diagramm veranschaulicht die Beziehungen zwischen Genen und angereicherten GO-Termen, und das zugehörige Blasendiagramm fasst angereicherte GO- und KEGG-Terme gemäß Anreicherungsfaktor, Genanzahl und statistischer Signifikanz zusammen. (B) Protein-Protein-Interaktionsnetzwerk (PPI), erstellt aus den 59 gemeinsamen DEGs mittels STRING und in Cytoscape visualisiert. Knotengröße und -farbe spiegeln die Netzwerkkonnektivität wider, und Kanten zeigen vorhergesagte Protein-Protein-Assoziationen. BP, biologischer Prozess; CC, zelluläre Komponente; MF, molekulare Funktion. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
PPI-Netzwerk und Identifizierung von Kerngenen:
Die gemeinsamen DEGs wurden in STRING Version 11.0 (RRID:SCR_005223)33 hochgeladen, wobei Homo sapiens als Organismus ausgewählt wurde (taxonomische Kennung: 9606). Es wurde das vollständige STRING-Netzwerk verwendet, wodurch sowohl funktionelle als auch physikalische Proteinassoziationen berücksichtigt wurden. Alle verfügbaren Beweiskanäle wurden aktiviert, einschließlich experimenteller Nachweise, kuratierter Datenbanken, Co-Expression, Textmining, Gen-Nachbarschaft, Genfusion und gemeinsamen Auftretens von Genen.
Der minimal erforderliche Interaktionsscore wurde auf 0,400 festgelegt, was einer mittleren Zuverlässigkeit entspricht. Es wurden keine zusätzlichen Interaktoren der ersten oder zweiten Schale hinzugefügt; daher enthielt das Netzwerk nur Proteine, die von den übermittelten gemeinsam differentiell exprimierten Genen (DEGs) kodiert wurden. Netzwerkverbindungen wurden im Zuverlässigkeitsmodus dargestellt und als tabulatorgetrennte Datei mit den interagierenden Proteinen und den kombinierten STRING-Scores exportiert. Die STRING-Zuverlässigkeitswerte geben die Sicherheit dafür an, dass eine Assoziation existiert, und nicht die Stärke oder Bindungsintensität der Interaktion.
Die STRING-Netzwerkdatei wurde in Cytoscape Version 3.10.0 (RRID:SCR_003032)34 importiert. Knoten ohne Interaktion mit einem anderen übermittelten Protein wurden vor der Analyse der Netzwerktopologie entfernt35. Das verbleibende Netzwerk wurde als ungerichtetes Netzwerk behandelt. Die kombinierten STRING-Scores wurden als Kantenattribute zur Visualisierung beibehalten, während die cytoHubba-Rangfolgen mit den standardmäßigen, ungewichteten topologischen Definitionen erzeugt wurden. Das resultierende PPI-Netzwerk ist in Abbildung 4B dargestellt.
Hauptgene wurden mit cytoHubba Version 0.1 (RRID:SCR_017677) unter Verwendung von sechs Algorithmen rangsortiert: Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness und Radiality36. Für jeden Algorithmus wurden die Gene in absteigender Reihenfolge sortiert, und die jeweils 10 bestplatzierten Gene behalten. Kandidaten für Netzwerk-Hubs wurden anhand des strengen Durchschnitts der sechs Top-10-Listen definiert. Ein Gen wurde daher nur dann als Netzwerk-Hub berücksichtigt, wenn es in allen sechs Top-10-Listen enthalten war. Die Rangfolgen und der Schnittmengenprozess wurden exportiert und archiviert. Die mit jedem cytoHubba-Algorithmus ermittelten Top-10-Gene sind in Tabelle 3 dargestellt.
| Rang | Maximale Cliquenzentralität (MCC) | Maximale Nachbarschaftskomponente (MNC) | Kantenperkolationskomponente (EPC) | Grad | Zentralität nach Closeness | Radialität |
| 1 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 |
| 2 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 |
| 3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 |
| 4 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 |
| 5 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 |
| 6 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 |
| 7 | MX1 | MX1 | MX1 | MX1 | MX1 | MX1 |
| 8 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 |
| 9 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 |
| 10 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 |
Tabelle 3: Die 10 wichtigsten Hub-Gene, ermittelt mittels sechs cytoHubba-Bewertungsalgorithmen.
Gemeinsam differenziell exprimierte Gene wurden mittels sechs Netzwerk-Topologie-Algorithmen, die im cytoHubba-Plugin von Cytoscape implementiert sind, eingestuft. Die jeweils 10 höchstrangigen Gene, die von jedem Algorithmus ermittelt wurden, werden zum Vergleich für Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness und Radiality dargestellt.
LASSO-Regression zur Identifizierung zentraler Gene:
Die logistische LASSO-Regression wurde unabhängig in den Entdeckungs-Datensätzen für SLE und RPL mit glmnet Version 4.1-8 (RRID:SCR_015505) durchgeführt. Die Prädiktormatrix enthielt die normalisierten Expressionswerte der Kandidaten für Netzwerknodes, wobei Proben in Zeilen und Gene in Spalten angeordnet waren. Der Krankheitsstatus wurde als 1, der Kontrollstatus als 0 codiert. Ein generalisiertes lineares Modell mit binomialer Verteilung und einer reinen LASSO-Strafe wurde mit family = "binomial" und alpha = 1 angepasst. Prädiktorvariablen wurden intern standardisiert, indem standardize = TRUE verwendet wurde, und ein Achsenabschnitt wurde eingeschlossen. Klassengestützte 10-fache Aufteilungen wurden separat für die SLE- und RPL-Datensätze mithilfe eines benutzerdefinierten Basis-R-Codes erstellt. Innerhalb jedes Krankheitsstatus-Stratums wurden die Probenindizes zufällig permutiert und so gleichmäßig wie möglich auf die 10 Folds verteilt, unter Verwendung von sample(rep(seq_len(10), length.out = n)). Ein Zufalls-Seed von 123 wurde vor der Erzeugung der Fold-Zuordnungen für jeden Datensatz festgelegt, um die Reproduzierbarkeit zu gewährleisten. Da jede Gruppe des Krankheitsstatus mehr als 10 Proben enthielt, enthielt jeder Cross-Validation-Fold sowohl Fälle als auch Kontrollen. Die resultierenden ganzzahligen Vektoren (foldid_sle und foldid_rpl) wurden dem Argument foldid von cv.glmnet() übergeben, und dieselben Fold-Zuordnungen wurden für alle evaluierten λ-Werte innerhalb des entsprechenden Datensatzes verwendet.
Die Modelle wurden mit family = „binomial“, alpha = 1, nfolds = 10, type.measure = „deviance“, standardize = TRUE, intercept = TRUE, nlambda = 100, thresh = 1 × 10⁻7 und maxit = 100000 angepasst. Der Strafparameter wurde mithilfe von lambda.min ausgewählt, definiert als der Lambda-Wert, der die minimale mittlere binomiale Abweichung bei Kreuzvalidierung ergibt. Der konservativere Wert lambda.1se, definiert als der größte Lambda-Wert innerhalb einer Standardabweichung des minimalen Kreuzvalidierungsfehlers, wurde als Sensitivitätsresultat erfasst. Das LASSO-Verfahren wurde separat auf GSE61635 und GSE165004 angewandt. Gene mit von null verschiedenen Koeffizienten in beiden krankheitsspezifischen Modellen wurden als gemeinsame, durch LASSO ausgewählte Kandidatengene definiert. Durch Einführung des L1-Regularisierungsterms reduziert die Methode die Koeffizienten weniger aussagekräftiger Gene effektiv auf null und führt somit eine Merkmalsauswahl durch37. Die Koeffizientenprofile und die Kurven der 10-fachen Kreuzvalidierung für die SLE- und RPL-Entdeckungsdatensätze sind in Abbildung 5 dargestellt.
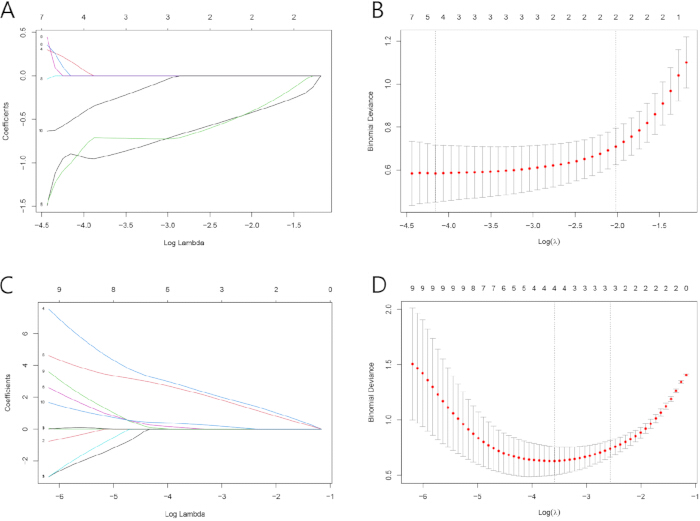
Abbildung 5. Regressionsanalyse der Netzwerk-Hub-Gene mittels Least Absolute Shrinkage and Selection Operator (LASSO).
(A) Koeffizientenprofile, erzeugt durch die logistische Regression mit Least Absolute Shrinkage and Selection Operator (LASSO) für den Entdeckungsdatensatz zur systemischen Lupus erythematodes (SLE) (GSE61635). (B) Zehnfache Kreuzvalidierungskurve zur Bestimmung des optimalen Strafparameters (λ) für das SLE-Modell. (C) Koeffizientenprofile, erzeugt durch die logistische LASSO-Regression für den Entdeckungsdatensatz zum rezidivierenden Schwangerschaftsverlust (RPL) (GSE165004). (D) Zehnfache Kreuzvalidierungskurve zur Bestimmung des optimalen Strafparameters (λ) für das RPL-Modell. Die Zahlen entlang der oberen x-Achse geben die Anzahl der nicht-null Regressionskoeffizienten bei jedem Wert von λ an. Die vertikalen gestrichelten Linien zeigen λ_min und λ_1se. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Überprüfung des diagnostischen Werts der Kerngene:
Die Expressionsmuster der mittels LASSO ausgewählten Kandidatengene wurden im unabhängigen SLE-Datensatz GSE50772 und im unabhängigen RPL-Datensatz GSE198700 bewertet. Externe Datensätze wurden erst verwendet, nachdem die Auswahl der Kandidatengene in GSE61635 und GSE165004 abgeschlossen war. In den Validierungsdatensätzen erfolgte keine zusätzliche Merkmalsauswahl oder Modellanpassung. Der Vergleich der Expression der Kandidatengene zwischen Fällen und Kontrollen wurde mittels des zweiseitigen Wilcoxon-Rangsummentests durchgeführt. Wenn mehr als ein Kandidatengen innerhalb eines Datensatzes getestet wurde, wurden die resultierenden P-Werte mittels der Benjamini-Hochberg-Methode korrigiert. Ein Kandidatengen galt als extern repliziert, wenn sich seine Expression nach Korrektur für Mehrfachvergleiche signifikant zwischen Fällen und Kontrollen unterschied und die Richtung mit dem entsprechenden Entdeckungsdatensatz übereinstimmte. Die Expressionsmuster der Kandidatengene in den Entdeckungs- und Validierungsdatensätzen sind in Abbildung 6 dargestellt.
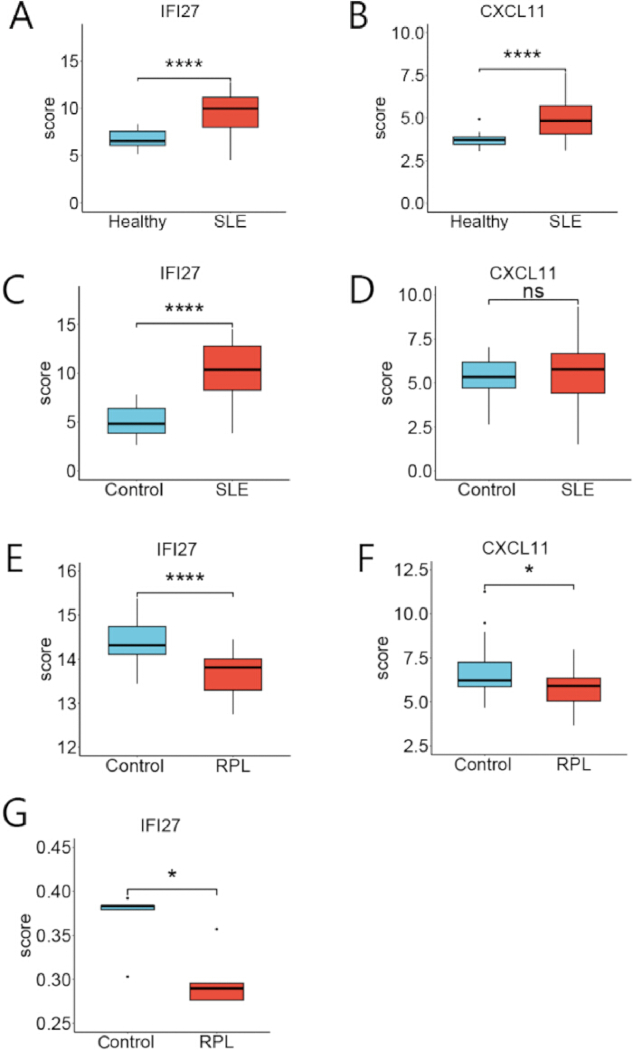
Abbildung 6. Expression von IFI27 und CXCL11 in den Entdeckungs- und Validierungsdatensätzen.
(A,B) Expression von IFI27 bzw. CXCL11 im systemischen Lupus erythematodes (SLE)-Entdeckungsdatensatz (GSE61635). (C,D) Expression von IFI27 bzw. CXCL11 im unabhängigen SLE-Validierungsdatensatz (GSE50772). (E,F) Expression von IFI27 bzw. CXCL11 im Rezidivierenden-Schwangerschaftsverlust (RPL)-Entdeckungsdatensatz (GSE165004). (G) Expression von IFI27 im unabhängigen RPL-Validierungsdatensatz (GSE198700). Der Genexpressionsvergleich zwischen den Gruppen erfolgte mittels zweiseitigem Wilcoxon-Rangsummentest. P-Werte wurden bei Tests mehrerer Kandidatengene innerhalb desselben Datensatzes nach der Methode von Benjamini–Hochberg korrigiert. P < 0,05; **** P < 0,0001; ns, nicht signifikant. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Die Analyse der Receiver-Operating-Characteristic (ROC) wurde mit pROC Version 1.18.5 (RRID:SCR_024286)38 durchgeführt. Für jedes Kandidatengen in jedem Entdeckungsdatensatz wurden separate ROC-Kurven erstellt. Die Fläche unter der ROC-Kurve (AUC) und ihr zweiseitiges 95 %-Konfidenzintervall wurden nach der Methode von DeLong berechnet. Die explorative diagnostische Schwelle wurde anhand des maximalen Youden-Index bestimmt. Konfidenzintervalle für die Schwelle, Sensitivität und Spezifität wurden mithilfe von 2.000 stratifizierten Bootstrap-Wiederholungen berechnet, wobei der Zufallsstartwert auf 123 festgelegt wurde. Die AUC diente als schwellenwertunabhängiges Maß der Diskriminierung39. Da die Datensätze retrospektiv waren und unter Verwendung unterschiedlicher Gewebe, Plattformen und Normalisierungsverfahren generiert wurden, wurden die auf dem Youden-Index basierenden Schwellenwerte separat innerhalb jedes Datensatzes berechnet und als explorative, datensatzspezifische Schwellen betrachtet. Sie galten nicht als standardisierte klinische Schwellenwerte und wurden nicht direkt zwischen Plattformen übertragen. Die externen ROC-Ergebnisse stellen eine transkriptomische Validierung dar, keine prospektive klinische Validierung. pROC unterstützt DeLong-Konfidenzintervalle für AUCs und die Optimierung nach dem Youden-Index über coords(), während Konfidenzintervalle für ROC-Koordinaten mittels stratifizierter Bootstrap-Stichprobenziehung geschätzt werden können. Die ROC-Kurven und Zusammenfassungen der Diskriminierungsleistung der Kandidatengene in den Entdeckungsdatensätzen zu SLE und RPL sind in Abbildung 7 dargestellt.
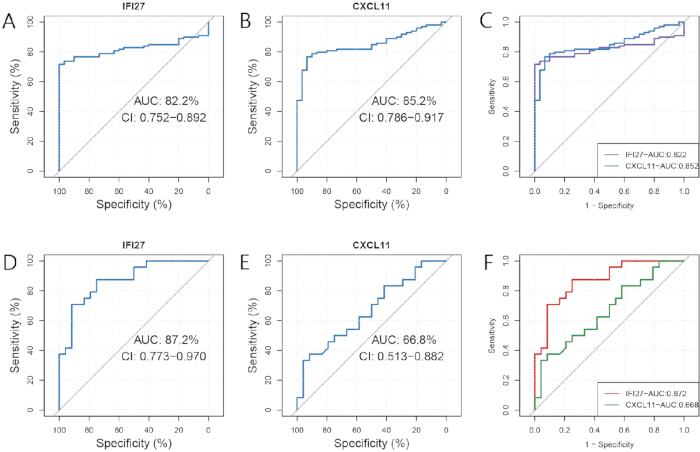
Abbildung 7. Analyse der Betriebskennmerkmale des Empfängers (ROC) für die Kandidatengene.
(A) Betriebskennlinie (ROC-Kurve) für IFI27 im Entdeckungsdatensatz für systemischen Lupus erythematodes (SLE). (B) ROC-Kurve für CXCL11 im SLE-Entdeckungsdatensatz. (C) Zusammenfassung der diagnostischen Leistung von IFI27 und CXCL11 im SLE-Entdeckungsdatensatz. (D) ROC-Kurve für IFI27 im Entdeckungsdatensatz für rezidivierenden Schwangerschaftsverlust (RPL). (E) ROC-Kurve für CXCL11 im RPL-Entdeckungsdatensatz. (F) Zusammenfassung der diagnostischen Leistung von IFI27 und CXCL11 im RPL-Entdeckungsdatensatz. Die Flächen unter der Kurve (AUC) sind mit 95 % Konfidenzintervallen (CIs) angegeben. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
ssGSEA-Immuninfiltration:
Unter Berücksichtigung der Rolle einer Dysregulation von Immunzellen bei der Pathogenese von SLE und RPL40,41 wurde die Anreicherung von Immunzellen rechnerisch in den Entdeckungsdatensätzen GSE61635 und GSE165004 abgeleitet. Die Analyse wurde separat innerhalb jedes Datensatzes durchgeführt, und die Datensätze wurden nicht zusammengeführt. Die Sammlung der Gen-Signaturen für Immunzellen bestand aus den Marker-Gen-Sets für 28 Immunzellpopulationen, wie sie von Charoentong et al.42 beschrieben wurden. Die ursprüngliche ergänzende Tabelle der Gen-Signaturen wurde in eine benannte Liste von Gen-Sets unter Verwendung offizieller menschlicher Gen-Symbole umgewandelt. Doppelte Symbole innerhalb jedes Gen-Sets wurden entfernt. Gene, die in der entsprechenden Expressionsmatrix fehlten, wurden verworfen, und Gen-Sets mit weniger als fünf zugeordneten Genen nach der Identifizierungszuordnung wurden aus diesem Datensatz ausgeschlossen. Die single-sample Gene Set Enrichment Analysis (ssGSEA) wurde mithilfe von GSVA Version 1.52.3 (RRID:SCR_021058) und GSEABase Version 1.66.0 durchgeführt. In GSVA Version 1.52.3 ist ein methodenspezifisches Parameterobjekt erforderlich. Folgende Parameter wurden verwendet: minSize = 5, maxSize = 500, alpha = 0.25, normalize = TRUE und checkNA = "yes.“
Der Alpha-Parameter wurde auf 0,25 festgelegt, und die endgültige ssGSEA-Score-Normalisierung wurde aktiviert. Die Gen-Sets wurden nach der Zuordnung zur Expressionsmatrix auf 5–500 Gene beschränkt. Es wurde eine Single-Thread-Ausführung verwendet, um eine konsistente Berechnung über verschiedene Systeme hinweg sicherzustellen. Der kcdf-Parameter wurde nicht verwendet, da er kein Parameter der ssgseaParam()-Prozedur in GSVA Version 1.52.3 ist. ssGSEA liefert relative, auf Proben-Ebene basierende Anreicherungsscores für Gen-Sets, keine experimentell gemessenen Zellzahlen für Immunzellen oder absoluten Zellanteile43. Der GSVA 1.52.3-Arbeitsablauf erfordert ein methodenspezifisches Parameterobjekt, und die ssGSEA-Parameter umfassen Alpha, Score-Normalisierung und Grenzwerte für die Größe der Gen-Sets.
Für jede Immunzell-Signatur wurden die ssGSEA-Scores zwischen Krankheits- und Kontrollgruppen mithilfe des zweiseitigen Wilcoxon-Rangsummentests verglichen. P-Werte für die 28 Zelltyp-Vergleiche wurden innerhalb jedes Datensatzes separat mittels der Benjamini-Hochberg-Methode angepasst. Immunzell-Signaturen mit einem angepassten P-Wert < 0,05 galten als unterschiedlich angereichert.
Spearman-Rangkorrelationen wurden zwischen der Expression der Kandidatengene und dem ssGSEA-Score jeder Immunzell-Signatur innerhalb jedes Datensatzes berechnet. Die Korrelations-P-Werte wurden mittels der Benjamini-Hochberg-Methode für alle Kombinationen aus Kandidatengen und Immunzelle innerhalb des jeweiligen Datensatzes angepasst. Korrelationen wurden als statistisch signifikant angesehen, wenn der angepasste P-Wert < 0,05 betrug. Korrelationsmatrizen wurden mit ggcorrplot Version 0.1.4.1 visualisiert, und Gruppenvergleichsdiagramme wurden mit ggplot2 Version 3.5.1 erstellt.
Für alle statistischen Tests wurden rohe normalisierte ssGSEA-Scores verwendet. Heatmaps und gestapelte Darstellungen dienten ausschließlich der beschreibenden Präsentation. Die Scores wurden nicht als direkte Anteile von Immunzellen beschrieben, und beobachtete Assoziationen wurden als rechnerische Korrelationen interpretiert, nicht als experimentell nachgewiesene Zell-Gen-Interaktionen. Die Anreicherungsprofile für Immunzellsignaturen, Gruppenvergleiche sowie Korrelationen mit der Expression von Kandidatengenen sind in Abbildung 8 dargestellt.
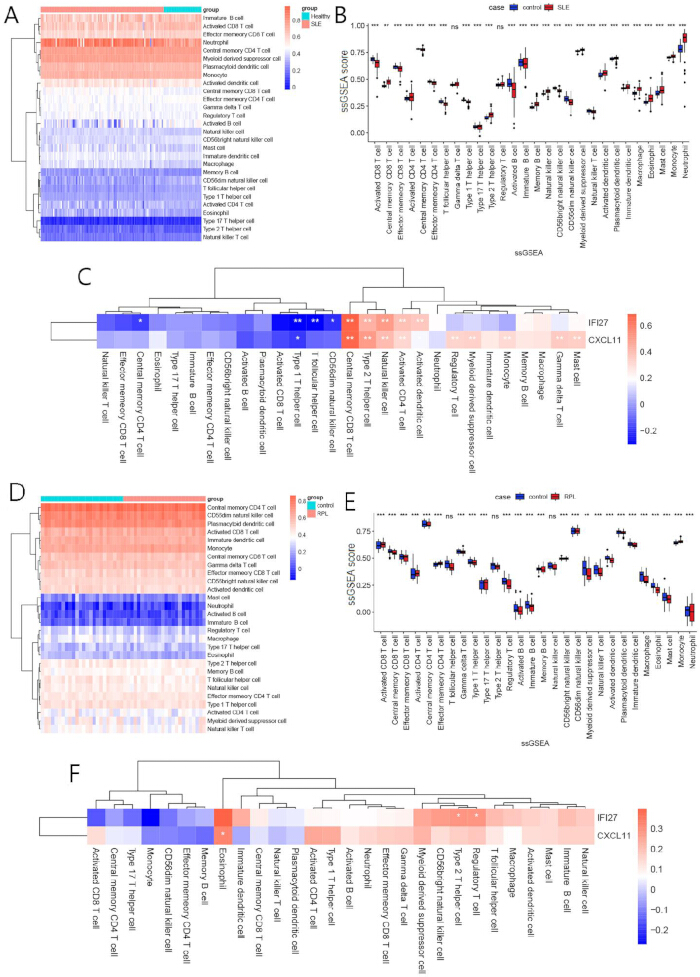
Abbildung 8. Anreicherung von Immunzell-Signaturen und deren Korrelationen mit den gemeinsamen Kandidatengenen bei systemischem Lupus erythematodes und rezidivierendem Schwangerschaftsverlust.
(A) Hierarchische Cluster-Heatmap der Single-Sample-Gene-Set-Enrichment-Analyse (ssGSEA)-Scores für 28 Immunzell-Signaturen im Entdeckungsdatensatz zum systemischen Lupus erythematodes (SLE). (B) Vergleich der ssGSEA-Scores der Immunzell-Signaturen zwischen SLE-Patienten und gesunden Kontrollen. (C) Spearman-Korrelations-Heatmap, die die Assoziationen zwischen der Expression von IFI27 und CXCL11 sowie den ssGSEA-Scores der 28 Immunzell-Signaturen im SLE-Entdeckungsdatensatz zeigt. (D) Hierarchische Cluster-Heatmap der ssGSEA-Scores für 28 Immunzell-Signaturen im Entdeckungsdatensatz zum rezidivierenden Schwangerschaftsverlust (RPL). (E) Vergleich der ssGSEA-Scores der Immunzell-Signaturen zwischen RPL-Patienten und fruchtbaren Kontrollen. (F) Spearman-Korrelations-Heatmap, die die Assoziationen zwischen der Expression von IFI27 und CXCL11 sowie den ssGSEA-Scores der 28 Immunzell-Signaturen im RPL-Entdeckungsdatensatz zeigt. Die Korrelationen wurden mittels Rangkorrelation nach Spearman berechnet, und die P-Werte wurden mit der Methode von Benjamini–Hochberg angepasst. P < 0,05; ** P < 0,01; *** P < 0,001; ns, nicht signifikant. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Ergebnisse
MR analysis
After instrument selection and data harmonization, 16 SNPs were retained for the forward MR analysis, in which SLE was treated as the exposure and the number of spontaneous miscarriages as the outcome. Detailed information on the instrumental variables is provided in Supplementary Table 1. All retained SNPs had F statistics greater than 10, indicating that weak-instrument bias was unlikely. Each retained SNP was also screened using PhenoScanner V2, and no SNP associated with aPL was identified. MR-PRESSO analysis identified no outliers. Cochran’s Q test showed no significant heterogeneity among the SNP-specific estimates (Q = 16.12, P = 0.31); therefore, a fixed-effects IVW model was applied. The MR-Egger intercept test did not indicate directional horizontal pleiotropy (P = 0.69). The IVW analysis showed a statistically significant but quantitatively modest positive association between genetically predicted SLE and the number of spontaneous miscarriages (odds ratio [OR] = 1.01, 95% confidence interval [CI] = 1.00–1.02, P < 0.01; Figure 2A). The effect estimates obtained using MR-Egger regression (OR = 1.01, 95% CI = 1.00–1.03, P = 0.16), the weighted median method (OR = 1.01, 95% CI = 1.00–1.02, P = 0.17), and the weighted mode method (OR = 1.01, 95% CI = 0.99–1.03, P = 0.42) were directionally consistent with the IVW estimate, although they did not individually reach statistical significance. Leave-one-out analysis showed that exclusion of any single SNP did not materially alter the pooled estimate, and the approximately symmetrical funnel plot provided no visual evidence that the result was driven by marked directional pleiotropy. The corresponding scatter plot, SNP-specific forest plot, leave-one-out analysis, and funnel plot are presented in Supplementary Figures 1–4.
In the reverse MR analysis, 16 SNPs were retained after instrument selection, and all had F statistics greater than 10 (Supplementary Table 2). MR-PRESSO analysis identified no outliers. Cochran’s Q test showed no significant heterogeneity (Q = 13.41, P = 0.50), and the MR-Egger intercept test provided no evidence of directional horizontal pleiotropy (P = 0.41). The IVW estimate did not support an association between the genetically predicted number of spontaneous miscarriages and SLE risk (OR = 0.93, 95% CI = 0.21–4.23, P = 0.93; Figure 2B). Together, the MR results support a modest association in the forward direction, from genetically predicted SLE to the number of spontaneous miscarriages, whereas the reverse analysis did not support an association from the genetically predicted number of spontaneous miscarriages to SLE risk.
Bioinformatics analysis
Differential expression analysis:
Differential expression analysis of GSE61635 identified 976 DEGs between the SLE and healthy-control groups, including 678 upregulated and 298 downregulated genes (Figure 3C). Analysis of GSE165004 identified 1,249 DEGs between the RPL and control groups, including 578 upregulated and 671 downregulated genes (Figure 3D). Heatmaps showing the 50 most significant DEGs in the two discovery datasets are presented in Figure 3A and Figure 3B. In addition, 59 shared DEGs were identified across the two datasets (Figure 3E). These shared DEGs provided the gene set used for the subsequent functional enrichment and network analyses.
Functional enrichment analysis of intersection DEGs:
The 59 shared DEGs were subjected to GO and KEGG pathway enrichment analyses using DAVID. Within the biological process category, the shared DEGs were enriched in defense response to virus, response to virus, negative regulation of viral genome replication, antiviral innate immune response, negative regulation of the apoptotic process, and cell adhesion. Enriched cellular component terms included extracellular region, endoplasmic reticulum membrane, actin cytoskeleton, and membrane. Calcium ion binding was identified among the enriched molecular function terms. KEGG analysis showed enrichment in pathways related to hepatitis C and influenza A (Figure 4A). These findings indicate that the shared DEGs were predominantly associated with antiviral and immune-related biological processes, providing functional context for the genes common to the SLE and RPL discovery datasets.
PPI network and identification of hub genes
The 59 shared DEGs were uploaded to STRING to construct a PPI network using a minimum interaction confidence score of 0.400. The resulting network contained 59 nodes and 80 edges. The network was imported into Cytoscape version 3.10.0 for visualization, and isolated nodes were removed before topological analysis (Figure 4B). Hub-gene ranking was performed using the cytoHubba plugin. Six algorithms were applied: Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness, and Radiality. The same 10 genes were identified among the top-ranked genes generated by all six algorithms: RSAD2, RTP4, IFIT3, IFI27, IFI44, GBP1, MX1, OAS1, IFIT1, and CXCL11 (Table 3). These genes were therefore retained as candidate network hubs for subsequent LASSO regression.
LASSO regression identified IFI27 and CXCL11 as shared candidate genes
The 10 candidate hub genes were subjected to LASSO regression analysis in the SLE and RPL discovery datasets. In the SLE dataset, four genes retained nonzero coefficients at the selected lambda value: IFIT3, IFI27, IFI44, and CXCL11, with coefficients of 2.575, 0.057, 2.359, and 0.307, respectively (Figure 5A,B). In the RPL dataset, four genes retained nonzero coefficients: IFI27, GBP1, OAS1, and CXCL11, with coefficients of −0.897, 0.167, −1.007, and −0.519, respectively (Figure 5C,D). Comparison of the genes selected by the two disease-specific models identified IFI27 and CXCL11 as the shared LASSO-selected candidate genes. These two genes were subsequently evaluated in the discovery and external validation datasets.
External validation of IFI27 and CXCL11 expression
The expression patterns of the two candidate genes were evaluated using the independent GSE50772 and GSE198700 validation datasets obtained from the GEO database. In GSE61635, both IFI27 and CXCL11 were significantly upregulated in the SLE group compared with healthy controls (Figure 6A,B). In the independent SLE validation dataset (GSE50772), IFI27 remained significantly upregulated (Figure 6C), whereas CXCL11 did not differ significantly between the groups (Figure 6D). In the RPL discovery dataset (GSE165004), both IFI27 and CXCL11 were significantly downregulated in the RPL group compared with controls (Figure 6E,F). In the independent RPL validation dataset (GSE198700), IFI27 remained significantly downregulated in the RPL group (Figure 6G), whereas CXCL11 was not detected. Overall, IFI27 showed consistent differential expression across both the SLE and RPL discovery and validation datasets. In contrast, CXCL11 was not consistently replicated in the external validation datasets. Accordingly, IFI27 was prioritized as the shared candidate biomarker for subsequent analyses.
Exploratory evaluation of diagnostic discrimination
Receiver operating characteristic (ROC) analysis was performed to evaluate the ability of IFI27 and CXCL11 expression to distinguish disease samples from controls in the analyzed retrospective transcriptomic datasets. For SLE, IFI27 yielded an area under the ROC curve (AUC) of 0.822 (95% CI = 0.752–0.892; Figure 7A), whereas CXCL11 yielded an AUC of 0.852 (95% CI = 0.786–0.917; Figure 7B). A comparison of the ROC curves for the two candidate genes in the SLE dataset is shown in Figure 7C. For RPL, IFI27 yielded an AUC of 0.872 (95% CI = 0.773–0.970; Figure 7D), whereas CXCL11 yielded an AUC of 0.668 (95% CI = 0.513–0.882; Figure 7E). A comparison of the ROC curves for the two candidate genes in the RPL dataset is shown in Figure 7F. IFI27 demonstrated AUC values greater than 0.80 in both disease datasets and showed more consistent external validation than CXCL11 across the expression datasets. These findings support IFI27 as a candidate biomarker for further evaluation. However, because the ROC analyses were performed using retrospective public transcriptomic datasets, the results should be interpreted as exploratory evidence of transcriptomic discrimination rather than prospective clinical diagnostic validation.
Computational assessment of immune infiltration
ssGSEA was performed to evaluate the enrichment of 28 immune-cell signatures in the GSE61635 and GSE165004 discovery datasets. The immune-cell enrichment heatmaps for the SLE and RPL datasets are shown in Figure 8A,D, respectively, whereas the corresponding group comparisons of ssGSEA scores are presented in Figure 8B,E. In the SLE dataset, multiple immune-cell signatures differed significantly between patients with SLE and healthy controls, including those representing CD8+ T cells, CD4+ T cells, B cells, dendritic cells, type 1 helper T (Th1) cells, type 2 helper T (Th2) cells, type 17 helper T (Th17) cells, natural killer cells, macrophages, eosinophils, mast cells, monocytes, and neutrophils (Figure 8B). In the RPL dataset, the ssGSEA scores for activated CD8+ T cells, activated CD4+ T cells, effector memory CD4+ T cells, Th17 cells, and monocytes were higher in the RPL group than in the control group. In contrast, the ssGSEA scores for regulatory T cells (Treg) and macrophages were lower in the RPL group than in the control group (Figure 8E). Correlation analysis showed that, in the SLE dataset, IFI27 and CXCL11 expression was positively correlated with the ssGSEA scores of activated CD4+ T cells, natural killer cells, Th2 cells, and central memory CD8+ T cells and negatively correlated with the Th1-cell ssGSEA score (Figure 8C). In the RPL dataset, IFI27 expression was positively correlated with the ssGSEA scores of Treg and Th2 cells, whereas CXCL11 expression was positively correlated with the eosinophil ssGSEA score (Figure 8F).
Data Availability:
No new primary human participant data were generated in this study. All analyses were based exclusively on publicly available genome-wide association study (GWAS) summary statistics and transcriptomic datasets. The SLE GWAS summary statistics were obtained from FinnGen Release 11 (accession: finngen_R11_L12_LUPUS). Summary statistics for the number of spontaneous miscarriages were obtained from the IEU OpenGWAS resource (accession: ukb-b-419), which is based on UK Biobank data. The transcriptomic datasets were obtained from the National Center for Biotechnology Information Gene Expression Omnibus (GEO) under accession numbers GSE61635, GSE165004, GSE50772, and GSE198700. The publicly available datasets can be accessed at the following repositories:
-- FinnGen Release 11: https://r11.finngen.fi/
-- IEU OpenGWAS: https://gwas.mrcieu.ac.uk/
-- Gene Expression Omnibus (GEO): https://www.ncbi.nlm.nih.gov/geo/
The processed data supporting the findings of this study are included in the article and its Supplementary Materials. No individual-level or personally identifiable participant data were accessed or retained. The analytical workflow was performed using publicly available software and packages as described in the Protocol.
Supplementary File 1. Completed STROBE-MR reporting checklist.
Completed Strengthening the Reporting of Observational Studies in Epidemiology Using Mendelian Randomization (STROBE-MR) checklist indicating where each recommended reporting item is addressed in the manuscript. Please click here to download this file.
Supplementary Figure 1. Scatter plot of the forward Mendelian randomization analysis.
Scatter plot showing the associations between the genetic effects of the instrumental single-nucleotide polymorphisms (SNPs) on systemic lupus erythematosus (SLE) and the number of spontaneous miscarriages. Each point represents one SNP, with horizontal and vertical error bars indicating the standard errors of the SNP effect estimates. Regression lines correspond to the inverse-variance weighted, MR-Egger, weighted median, and weighted mode Mendelian randomization methods. Please click here to download this file.
Supplementary Figure 2. Single-nucleotide polymorphism-specific causal estimates from the forward Mendelian randomization analysis.
Forest plot showing the causal effect estimate for each instrumental single-nucleotide polymorphism (SNP) on the association between systemic lupus erythematosus (SLE) and the number of spontaneous miscarriages. Black points represent the SNP-specific effect estimates with 95% confidence intervals. Red points represent the overall causal effect estimates obtained using the inverse-variance weighted and MR-Egger methods. The vertical dashed line indicates the null effect. Please click here to download this file.
Supplementary Figure 3. Leave-one-out sensitivity analysis of the forward Mendelian randomization analysis.
Forest plot showing the results of the leave-one-out sensitivity analysis evaluating the association between systemic lupus erythematosus (SLE) and the number of spontaneous miscarriages. Each black point represents the overall inverse-variance weighted causal effect estimate after sequential exclusion of one instrumental single-nucleotide polymorphism (SNP), with horizontal lines indicating the corresponding 95% confidence intervals. The red point represents the overall inverse-variance weighted estimate obtained using all instrumental SNPs. The vertical dashed line indicates the null effect. Please click here to download this file.
Supplementary Figure 4. Funnel plot of the forward Mendelian randomization analysis.
Funnel plot showing the distribution of the SNP-specific causal effect estimates for the association between systemic lupus erythematosus (SLE) and the number of spontaneous miscarriages. Each point represents one instrumental single-nucleotide polymorphism (SNP). The vertical lines indicate the overall causal effect estimates obtained using the inverse-variance weighted and MR-Egger methods. The y-axis represents the inverse of the standard error (1/SE). Please click here to download this file.
Supplementary Table 1. Instrumental single-nucleotide polymorphisms selected for the forward Mendelian randomization analysis.
The table lists the instrumental single-nucleotide polymorphisms (SNPs) used for the forward Mendelian randomization analysis of systemic lupus erythematosus and the number of spontaneous miscarriages, including the nearest annotated gene, chromosome, genomic position, effect allele, effect allele frequency, effect size (Beta), standard error (SE), P value, and F statistic. Chromosomal positions are based on the source genome assembly used in the genome-wide association study. The F statistic was calculated as Beta2/SE2. Please click here to download this file.
Supplementary Table 2. Instrumental single-nucleotide polymorphisms selected for the reverse Mendelian randomization analysis.
The table lists the instrumental single-nucleotide polymorphisms (SNPs) used for the reverse Mendelian randomization analysis with the number of spontaneous miscarriages as the exposure and systemic lupus erythematosus as the outcome, including the nearest annotated gene, chromosome, genomic position, effect allele, effect allele frequency, effect size (Beta), standard error (SE), P value, and F statistic. Chromosomal positions are based on the source genome assembly used in the genome-wide association study. The F statistic was calculated as Beta2/SE2. Please click here to download this file.
Diskussion
Mithilfe einer bidirektionalen MR-Analyse in Kombination mit mehrdimensionalen bioinformatischen Analysen identifizierte diese Studie einen positiven kausalen Zusammenhang zwischen SLE und RPL sowie systematisch gemeinsame transkriptomische Biomarker. Soweit bekannt, ist dies die erste Studie, die eine bidirektionale MR-Analyse, transkriptomische Analysen und Analysen der Immuninfiltration integriert, um diesen Zusammenhang zu untersuchen. Obwohl die beobachtete MR-Effektgröße gering war (IVW OR = 1,01), wurde die Assoziation konsistent durch mehrere komplementäre MR-Methoden und Sensitivitätsanalysen gestützt, ohne Hinweise auf erhebliche Heterogenität, horizontale Pleiotropie oder einflussreiche Ausreißer, was darauf hindeutet, dass der beobachtete Zusammenhang statistisch robust, aber quantitativ gering ausgeprägt ist. Die vorliegenden Ergebnisse sollten daher als Hinweis auf einen geringen genetischen Beitrag von SLE zur Anfälligkeit für RPL verstanden werden, nicht jedoch als Beleg für eine große klinische Wirkung. Durch die Integration kausaler Inferenz mit transkriptomischer Validierung und Analysen der Immuninfiltration liefert diese Studie einen reproduzierbaren Rahmen zur Priorisierung von Kandidaten-Biomarkern für komplexe, immunvermittelte Fortpflanzungsstörungen. Eine in Ägypten zwischen 2007 und 2021 durchgeführte Studie, an der 123 Frauen mit SLE und insgesamt 201 Schwangerschaften teilnahmen, berichtete, dass 20,4 % der Schwangerschaften bei Frauen mit SLE zu einem fetalen Verlust führten44. Frühere Studien haben ebenfalls darauf hingewiesen, dass SLE ein wichtiger Risikofaktor für RPL ist, da eine Immunstörung die Wahrscheinlichkeit eines Schwangerschaftsverlusts erhöhen kann12.
Bioinformatische Analysen zeigten, dass die 59 gemeinsamen differentiell exprimierten Gene (DEGs) vorwiegend in Signalwegen angereichert waren, die mit antiviralen Immunantworten, Zelladhäsion und Regulation der Apoptose assoziiert sind. Virusinfektionen könnten zur Pathogenese des SLE beitragen. Patienten mit SLE weisen häufig eine Dysfunktion sowohl der angeborenen als auch der adaptiven Immunantwort auf45,46, wodurch sie anfälliger für Virusinfektionen sind. Diese erhöhte Anfälligkeit könnte durch Mechanismen wie Plazentainflammation und Schädigung plazentaler Zellen zum Schwangerschaftsverlust beitragen47. Als wesentlicher Bestandteil der Plazenta wurden Veränderungen der Autophagie und des biologischen Verhaltens von Trophoblastenzellen ebenfalls mit dem Auftreten von RPL assoziiert48,49. Insgesamt legen diese Beobachtungen nahe, dass eine mit dem SLE assoziierte Immunregulationsstörung die Schwangerschaftsergebnisse beeinflussen könnte, indem sie die Funktion von Trophoblastenzellen beeinträchtigt. Weitere Analysen identifizierten IFI27 und CXCL11 als potenzielle zentrale Gene, die von SLE und RPL gemeinsam genutzt werden. IFI27 wurde jedoch für nachfolgende Analysen bevorzugt, da es eine höhere biologische Konsistenz über unabhängige Datensätze hinweg aufwies. Obwohl beide Gene vom LASSO-Modell ausgewählt wurden, zeigte nur IFI27 eine konsistente differentielle Expression sowohl im Entdeckungs- als auch im externen Validierungsdatensatz, während CXCL11 in den Validierungsdatensätzen nicht konsistent repliziert wurde. Darüber hinaus wies IFI27 eine stärkere diagnostische Trennschärfe für RPL auf und blieb über Blut- und reproduktive Gewebedatensätze hinweg signifikant dysreguliert. Insgesamt stützen diese Ergebnisse IFI27 als robusteren Kandidatenbiomarker im Vergleich zu CXCL11, obwohl zusätzliche experimentelle Validierungen erforderlich sind. Die Validierung anhand des SLE-Datensatzes GSE50772 und des RPL-Datensatzes GSE198700 zeigte, dass die Expression von IFI27 über die Validierungsdatensätze hinweg konsistent dysreguliert blieb. Bemerkenswerterweise war IFI27 in Blutproben von Patienten mit SLE überexprimiert, was mit früheren Studien übereinstimmt50, während es in Endometrium- und Chorionzottenproben von Patienten mit RPL herunterreguliert war. Dieses entgegengesetzte Muster könnte Unterschiede zwischen systemischer Immunstörung und der lokalen Immunumgebung an der materno-fetalen Grenzfläche bei SLE mit RPL widerspiegeln.
IFI27 ist ein interferonstimuliertes Gen, das an der antiviralen Immunität, der Interferonsignalübertragung und den Immunantworten des Wirts nach Virusinfektion beteiligt ist51,52. Bei normalen Schwangerschaften ist die Expression von IFI27 in Trophoblastenzellen deutlich erhöht53, was auf eine wichtige physiologische Rolle bei der Aufrechterhaltung der Trophoblastenfunktion hindeutet. Im Gegensatz dazu zeigten unsere Analysen eine verminderte Expression von IFI27 im Endometrium und in den Chorionzotten von Patientinnen mit RPL. Obwohl dieses Ergebnis von einigen früheren Berichten abweicht54, sollte es mit Vorsicht interpretiert werden, da die vorliegende Studie transkriptomische Datensätze integrierte, die aus verschiedenen Geweben stammten, anstatt aus gepaarten mütterlich-fötalen Proben. Eine mögliche Erklärung könnte sein, dass eine chronische systemische Aktivierung von Typ-I-Interferon bei SLE eine anhaltende Interferonsignalübertragung in zirkulierenden Immunzellen hervorruft, gleichzeitig jedoch eine Desensibilisierung der Rezeptoren, eine Immunauslastung oder kompensatorische Mechanismen der negativen Rückkopplung an der mütterlich-fötalen Grenzfläche begünstigt. Alternativ könnten gewebespezifische epigenetische Regulationen oder Unterschiede in der zellulären Zusammensetzung zwischen peripherem Blut und reproduktiven Geweben die lokale Expression von IFI27 unterdrücken, trotz systemischer Interferonaktivierung. Diese Hypothesen bleiben spekulativ und erfordern eine mechanistische Validierung unter Verwendung gepaarter Proben von mütterlichem Blut, Endometriumgewebe und Trophoblasten, idealerweise auf Einzelzell-Ebene, um gewebespezifische und zelltypspezifische Regulationsmechanismen zu unterscheiden55.
Die Analyse der Immuninfiltration zeigte signifikante Unterschiede in den Immunzell-Signaturen sowohl bei SLE als auch bei RPL, die hauptsächlich durch Veränderungen in CD4+-T-Zell-assoziierten Populationen gekennzeichnet sind. Die Expression von IFI27 war bei beiden Erkrankungen positiv mit der Anreicherung von Th2-Zellen korreliert; diese Befunde stellen jedoch rechnergestützte Korrelationen dar, die aus der ssGSEA abgeleitet wurden, und nicht experimentell verifizierte biologische Interaktionen. Frühere Studien haben gezeigt, dass peripheres Blut von Patienten mit SLE verminderte Anteile an Th1- und Treg-Zellen, aber erhöhte Anteile an Th2-Zellen enthält56,57, was mit unseren Ergebnissen übereinstimmt. Während einer normalen Schwangerschaft verschiebt sich das Th1/Th2-Immungleichgewicht an der mütterlich-fötalen Grenzfläche in Richtung eines Th2-dominanten Zustands58. Daher könnte eine verminderte IFI27-Expression in reproduktiven Geweben Veränderungen in der lokalen Immunhomöostase widerspiegeln, die mit einer beeinträchtigten mütterlich-fötalen Toleranz assoziiert sind, ob IFI27 diesen Prozess jedoch direkt reguliert, muss experimentell noch geklärt werden.
Mehrere Einschränkungen sollten berücksichtigt werden. Erstens, obwohl die MR-Analysen eine kausale Assoziation unterstützten, war der geschätzte genetische Effekt relativ gering, was darauf hindeutet, dass SLE nur eine Komponente der multifaktoriellen Pathogenese von RPL darstellt. Zweitens umfasste die transkriptomische Integration Datensätze, die aus verschiedenen Geweben (peripheres Blut, Endometrium und Chorionzotten), unterschiedlichen Microarray-Plattformen und unabhängigen Kohorten stammten, was biologische und technische Heterogenität einführen könnte, trotz der konsistenten Validierung von IFI27. Drittens enthielt die externe Validierungskohorte für Chorionzotten nur eine begrenzte Anzahl von Proben, was die statistische Power und die Generalisierbarkeit verringert haben könnte. Viertens konnten aufgrund der begrenzten klinischen Informationen in den öffentlich zugänglichen Datensätzen wichtige Faktoren wie Krankheitsaktivität, Status der Antiphospholipid-Antikörper, Medikamentenexposition, Schwangerschaftsphase und andere klinische Kovariaten nicht vollständig bewertet werden. Schließlich kann, obwohl die PhenoScanner-Screening-Analyse potenzielle pleiotrope Störungen in den MR-Analysen minimiert hat, eine verbleibende Störung nicht vollständig ausgeschlossen werden.
Aus translationsmedizinischer Sicht sollte IFI27 derzeit als Kandidatenbiomarker und nicht als klinisch validierter diagnostischer Marker betrachtet werden. Vor einer klinischen Anwendung sind prospektive multizentrische Studien erforderlich, um die diagnostische Leistungsfähigkeit von IFI27 in unterschiedlichen Populationen zu validieren, standardisierte Testplattformen und diagnostische Schwellenwerte festzulegen und zu ermitteln, wie Schwangerschaftsphase, Krankheitsaktivität und immunsuppressive Therapie die Expression von IFI27 beeinflussen. Funktionelle Experimente sowie räumliche Transkriptomik und Einzelzell-Transkriptom-Analysen werden ebenfalls unerlässlich sein, um zu klären, ob IFI27 aktiv zur maternal-fetalen Immunregulation beiträgt oder lediglich eine interferongetriebene Immunaktivierung widerspiegelt.
Offenlegungen
Interessenkonflikt:
Die Autoren erklären, dass sie keine konkurrierenden finanziellen oder nichtfinanziellen Interessen haben.
Danksagungen
Diese Arbeit wurde unterstützt durch das Schwerpunktprojekt der Stadtverwaltung Peking für traditionelle chinesische Medizin zur Integration der traditionellen chinesischen und westlichen Medizin bei schweren Erkrankungen (2023BJSZDYNJBXTGG-003), den nationalen gemeinnützigen Forschungsfonds für die Grundlagenforschung von Instituten (ZZ16-XRZ-038) und das Projekt zur Förderung von Spitzenmedizinischen Einrichtungen in China (HLCMHPP2023087). Die Finanzierungsquellen hatten keinerlei Einfluss auf das Studiendesign, die Datensammlung, die Datenanalyse, die Dateninterpretation, die Vorbereitung des Manuskripts oder die Entscheidung zur Einreichung zur Veröffentlichung. Die Autoren danken den Forschern und Teilnehmern der FinnGen-Studie, der UK Biobank sowie dem Genexpression-Omnibus (GEO) des Nationalen Zentrums für Biotechnologieinformation (NCBI), die ihre Datensätze öffentlich zugänglich gemacht haben. Die Autoren danken zudem dem FinnGen-Konsortium, das finnische Biobankproben mithilfe von Kooperationen zwischen finnischen Forschungseinrichtungen, Biobanken und internationalen Partnern mit landesweiten Gesundheitsregisterdaten verknüpft.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| 28 Immunzellen-Gen-Signatur-Sammlung | Veröffentlichte ergänzende Gen-Signatur-Ressource | Zusätzliche Liste von Immunzell-Marker-Genen, beschrieben von Charoentong et al. (Referenz 42) | Nicht zutreffend RRID: Nicht verfügbar Zweck / Anmerkungen: Immunzell-Signaturen, die für die ssGSEA verwendet wurden. |
| CNSknowall | CNSknowall-Webplattform | DAVID-Ausgabedateien | Nicht zutreffend RRID: Nicht verfügbar Zweck / Anmerkungen: Visualisierung gefilterter funktioneller Anreicherungsergebnisse. |
| Computerarbeitsplatz | Institutionelle Computergestützte Umgebung | Nicht zutreffend | Nicht zutreffend RRID: Nicht zutreffend Zweck / Anmerkungen: Computergestützte Analysen. |
| Verbrauchsmaterialien | Nicht zutreffend | Nicht zutreffend | Nicht zutreffend RRID: Nicht zutreffend Zweck / Anmerkungen: Es wurden keine Verbrauchsmaterialien für nasschemische Laborarbeiten verwendet. |
| Cytoscape | Cytoscape-Konsortium | Nicht zutreffend | 3.10.0 RRID: SCR_003032 Zweck / Anmerkungen: Protein–Visualisierung von Proteininteraktionsnetzwerken und topologische Analyse |
| cytoHubba | Cytoscape-App-Store | Nicht zutreffend | 0.1 RRID: SCR_017677 Zweck / Anmerkungen: Rangfolge der Hub-Gene basierend auf MCC, MNC, EPC, Degree, Closeness und Radiality. |
| DAVID Funktionsanmerkungswerkzeug | Nationales Institut für Gesundheitswesen / Nationales Krebsinstitut | Hochgeladene geteilte DEG- und Hintergrund-Genlisten | 2021 RRID: SCR_001881 Zweck / Anmerkungen: Genontologie- und KEGG-Pfad-Enrichment-Analyse |
| europäisches LD-Referenzpanel | 1000 Genomes Projekt / IEU OpenGWAS | Phase-3-Europäisches Panel (GRCh37-kompatible Varianten) | Phase 3 RRID: Nicht angegeben Zweck / Anmerkungen: Kopplungsungleichgewicht-Clustering mittels des OpenGWAS/TwoSampleMR-Workflows. |
| FinnGen | FinnGen-Konsortium | finngen_R11_L12_LUPUS | Version 11 RRID: SCR_022254 Zweck / Anmerkungen: Zusammenfassungsstatistiken von GWAS für Lupus erythematodes. |
| forestploter | CRAN | Nicht zutreffend | 1.1.2 RRID: Nicht verfügbar Zweck / Anmerkungen: Visualisierung eines Forest-Plots der Mendelschen Zufallsgrößen |
| Gene Expression Omnibus (GEO) | Nationales Zentrum für Biotechnologieinformation | GSE61635; GSE165004; GSE50772; GSE198700 | Nicht zutreffend RRID: SCR_005012 Zweck / Anmerkungen: Quelle der Entdeckungs- und Validierungs-Transkriptomdatensätze. |
| Genontologie | Gene Ontology Consortium | GO-Terms abgerufen über DAVID | DAVID 2021 Anmerkungen RRID: SCR_002811 Zweck / Anmerkungen: Annotierung biologischer Prozesse, zellulärer Komponenten und molekularer Funktionen |
| ggcorrplot | CRAN | Nicht zutreffend | 0.1.4.1 RRID: Nicht verfügbar Zweck / Anmerkungen: Visualisierung eines Kandidatengens–Korrelationsmatrizen der Immunzellen |
| ggplot2 | CRAN | Nicht zutreffend | 3.5.1 RRID: SCR_014601 Zweck / Anmerkungen: Vulkan-Diagramme, Box-Plots und andere statistische Grafiken. |
| ggvenn | CRAN | Nicht zutreffend | 0.1.16 RRID: SCR_025300 Zweck / Anmerkungen: Visualisierung gemeinsam differentiell exprimierter Gene |
| glmnet | CRAN | Nicht zutreffend | 4.1-8 RRID: SCR_015505 Zweck / Anmerkungen: LASSO-Logistische Regression und Kreuzvalidierung. |
| GSE165004 | NCBI GEO | GSE165004 / GPL16699 | Verarbeitete Serienmatrix RRID: SCR_005012 Zweck / Anmerkungen: RPL-Endometrium-Entdeckungsdatensatz |
| GSE198700 | NCBI GEO | GSE198700 / GPL13534 | Verarbeitete Serienmatrix RRID: SCR_005012 Zweck / Anmerkungen: Unabhängiger RPL-Chorionzotten-Validierungssatz |
| GSE50772 | NCBI GEO | GSE50772 / GPL570 | Verarbeitete Serienmatrix RRID: SCR_005012 Zweck / Anmerkungen: Unabhängiger Validierungsdatensatz von peripheren mononukleären Blutzellen bei SLE |
| GSE61635 | NCBI GEO | GSE61635 / GPL570 | Verarbeitete Serienmatrix RRID: SCR_005012 Zweck / Anmerkungen: SLE-Ganzblut-Entdeckungsdatensatz |
| GSEABase | Bioconductor | Nicht zutreffend | 1.66.0 RRID: Nicht verfügbar Zweck / Anmerkungen: Verwaltung von Gen-Set-Listen für Immunzellen für die ssGSEA |
| GSVA | Bioconductor | Nicht zutreffend | 1.52.3 RRID: SCR_021058 Zweck / Anmerkungen: Einzelprobe-Analyse der Gen-Set-Enrichment (ssGSEA). |
| IEU OpenGWAS | MRC Integrative Epidemiology Unit | ukb-b-419; finngen_R11_L12_LUPUS | Nicht zutreffend RRID: Nicht angegeben Zweck / Anmerkungen: Abruf von GWAS-Zusammenfassungsstatistiken und harmonisierten genetischen Assoziationsdaten. |
| Kyoto-Enzyklopädie der Gene und Genome (KEGG) | Kanehisa Laboratories | KEGG-Wegstrecken über DAVID abgerufen | DAVID 2021 Anmerkungen RRID: SCR_012773 Zweck / Anmerkungen: Anreicherungsannotation von Signalwegen |
| limma | Bioconductor | Nicht zutreffend | 3.60.6 RRID: SCR_010943 Zweck / Anmerkungen: Differenzielle Expressionsanalyse |
| MRPRESSO | Verbanck et al. | Nicht zutreffend | 1 RRID: SCR_023697 Zweck / Anmerkungen: Nachweis horizontaler Pleiotropie und ausreißender Instrumentalvariablen. |
| pheatmap | CRAN | Nicht zutreffend | 1.0.12 RRID: SCR_016418 Zweck / Anmerkungen: Expressions-Heatmaps |
| PhenoScanner V2 | PhenoScanner-Konsortium | Phänotyp-Anfragen auf SNP-Ebene | Version 2 RRID: Nicht verfügbar Zweck / Anmerkungen: Screening der behaltenen SNPs auf mögliche phänotypische Assoziationen mit störenden Einflüssen. |
| pROC | CRAN | Nicht zutreffend | 1.18.5 RRID: SCR_024286 Zweck / Anmerkungen: ROC-Kurven, AUCs, DeLong-Konfidenzintervalle, Youden-Index-Schwellenwerte und Bootstrap-Konfidenzintervalle. |
| R | R Foundation for Statistical Computing | Nicht zutreffend | 4.4.2 RRID: SCR_001905 Zweck / Anmerkungen: Statistische Rechenumgebung |
| Reagenzien | Nicht zutreffend | Nicht zutreffend | Nicht zutreffend RRID: Nicht zutreffend Zweck / Anmerkungen: Es wurden keine Reagenzien im Nasslabor verwendet. |
| STRING | STRING-Konsortium | Homo sapiens (Taxon 9606); minimaler Interaktionsscore 0,400 | 11 RRID: SCR_005223 Zweck / Anmerkungen: Protein–Konstruktion eines Proteininteraktionsnetzwerks |
| TwoSampleMR | MRC Integrative Epidemiology Unit | Nicht zutreffend | 0.6.6 RRID: SCR_019010 Zweck / Anmerkungen: Bidirektionale Zweistichproben-Mendelsche Randomisierung, Datengewinnung, Harmonisierung, kausale Schätzung und Sensitivitätsanalysen. |
| UK Biobank | UK Biobank | ukb-b-419 | Zusammenfassungsdatensatz 2018 RRID: SCR_012815 Zweck / Anmerkungen: Zusammenfassungsstatistiken von GWAS für die Anzahl spontaner Fehlgeburten. |
Referenzen
- Petri M. Pregnancy and systemic lupus erythematosus. Best Pract Res Clin Obstet Gynaecol. 2020;64:24-30.
- Zhao X, et al. Advances in drug therapy for systemic lupus erythematosus. Curr Med Chem. 2021;28(7):1251-1268.
- Stanescu II, et al. Salivary biomarkers of inflammation in systemic lupus erythematosus. Ann Anat. 2018;219:89-93.
- Tian J, Zhang D, Yao X, Huang Y, Lu Q. Global epidemiology of systemic lupus erythematosus: A comprehensive systematic analysis and modelling study. Ann Rheum Dis. 2023;82(3):351-356.
- Palma Dos Reis CR, et al. Prediction of adverse pregnancy outcomes in women with systemic lupus erythematosus. Clin Rev Allergy Immunol. 2020;59(2):287-294.
- Venne K, Scott S, Bernatsky S, Vinet E. Induced abortions in women with systemic lupus erythematosus. Lupus. 2021;30(4):484-488.
- Kim JW, et al. Lupus low disease activity state achievement is important for reducing adverse outcomes in pregnant patients with systemic lupus erythematosus. J Rheumatol. 2021;48(5):707-716.
- Braga A, et al. Systemic lupus erythematosus and pregnancy: A Portuguese case-control study. Clin Rev Allergy Immunol. 2022;62(2):324-332.
- Dimitriadis E, Menkhorst E, Saito S, Kutteh WH, Brosens JJ. Recurrent pregnancy loss. Nat Rev Dis Primers. 2020;6(1):98.
- Quenby S, et al. Miscarriage matters: The epidemiological, physical, psychological, and economic costs of early pregnancy loss. Lancet. 2021;397(10285):1658-1667.
- Valeff NJ, Ventimiglia MS, Diao L, Jensen F. Lupus and recurrent pregnancy loss: The role of female sex hormones and B cells. Front Endocrinol (Lausanne). 2023;14:1233883.
- Gao R, Zeng X, Qin L. Systemic autoimmune diseases and recurrent pregnancy loss: Research progress in diagnosis and treatment. Chin Med J (Engl). 2021;134(17):2140-2142.
- Pantham P, Abrahams VM, Chamley LW. The role of anti-phospholipid antibodies in autoimmune reproductive failure. Reproduction. 2016;151(5):R79-R90.
- Meroni PL, et al. Updating on the pathogenic mechanisms of antiphospholipid antibody-associated pregnancy loss. Clin Rev Allergy Immunol. 2008;34(3):332-337.
- Blank M, Shoenfeld Y. Antiphospholipid antibody-mediated reproductive failure in antiphospholipid syndrome. Clin Rev Allergy Immunol. 2010;38(2–3):141-147.
- Babker A, et al. Frequency of ACE I/D and PAI-1 4G/5G polymorphisms in women with recurrent pregnancy loss in Sudan. Biomed Pharmacol J. 2025;18(3):1953-1961.
- Babker AM, et al. Detection of human platelet antigen polymorphisms (HPA-1 and HPA-3) and factor XIII mutation in Sudanese women with recurrent pregnancy loss. BMC Res Notes. 2024;17(1):66.
- Grover S, Del Greco MF, Stein CM, Ziegler A. Mendelian randomization. Methods Mol Biol. 2017;1666:581-628.
- Skrivankova VM, et al. Strengthening the reporting of observational studies in epidemiology using Mendelian randomization: The STROBE-MR statement. JAMA. 2021;326(16):1614-1621.
- Emdin CA, Khera AV, Kathiresan S. Mendelian randomization. JAMA. 2017;318(19):1925-1926.
- Burgess S, Thompson SG, CRP CHD Genetics Collaboration. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764.
- Hemani G, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408.
- Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314.
- Hartwig FP, Davey Smith G, Bowden J. Robust inference in summary data Mendelian randomization via the zero modal pleiotropy assumption. Int J Epidemiol. 2017;46(6):1985-1998.
- Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665.
- Verbanck M, Chen CY, Neale B, Do R. Detection of widespread horizontal pleiotropy in causal relationships inferred from Mendelian randomization between complex traits and diseases. Nat Genet. 2018;50(5):693-698.
- Barrett T, et al. NCBI GEO: Archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(Database issue):D991-D995.
- Keleş İD, et al. Gene pathway analysis of the endometrium at the start of the window of implantation in women with unexplained infertility and unexplained recurrent pregnancy loss: Is unexplained recurrent pregnancy loss a subset of unexplained infertility? Hum Fertil (Camb). 2023;26(5):1129-1141.
- Kennedy WP, et al. Association of the interferon signature metric with serological disease manifestations but not global activity scores in multiple cohorts of patients with SLE. Lupus Sci Med. 2015;2(1):e000080.
- Matsumoto Y, et al. Characteristic DNA methylation profiles of chorionic villi in recurrent miscarriage. Sci Rep. 2022;12(1):11673.
- Sherman BT, Lempicki RA. Systematic and integrative analysis of large gene lists using DAVID bioinformatics resources. Nat Protoc. 2009;4(1):44-57.
- Szklarczyk D, et al. STRING v11: Protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607-D613.
- Shannon P, et al. Cytoscape: A software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504.
- Jia P, Zheng S, Long J, Zheng W, Zhao Z. dmGWAS: Dense module searching for genome-wide association studies in protein–protein interaction networks. Bioinformatics. 2011;27(1):95-102.
- Chin CH, et al. cytoHubba: Identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11.
- Mohammadi M. A projection neural network for the generalized Lasso. IEEE Trans Neural Netw Learn Syst. 2020;31(6):2217-2221.
- Kumar R, Indrayan A. Receiver operating characteristic (ROC) curve for medical researchers. Indian Pediatr. 2011;48(4):277-287.
- de Hond AAH, Steyerberg EW, van Calster B. Interpreting area under the receiver operating characteristic curve. Lancet Digit Health. 2022;4(12):e853-e855.
- Xu H, et al. Single-cell transcriptomics reveals CCL3+ classical monocyte subset linked to autoimmune pathogenesis. J Inflamm Res. 2025;18:16273-16291.
- Zych M, et al. Surface immune checkpoints as potential biomarkers in physiological pregnancy and recurrent pregnancy loss. Int J Mol Sci. 2024;25(17):9378.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-262.
- Liu J, Lu J, Wang G, Gu L, Li W. Prognostic characteristics of a six-gene signature based on ssGSEA in sarcoma. Aging (Albany NY). 2024;16(2):1536-1554.
- Mokbel A, et al. Pregnancy outcomes among Egyptian women with systemic lupus erythematosus: A prospective cohort study. Lupus. 2023;32(4):521-530.
- Illescas-Montes R, Corona-Castro CC, Melguizo-Rodríguez L, Ruiz C, Costela-Ruiz VJ. Infectious processes and systemic lupus erythematosus. Immunology. 2019;158(3):153-160.
- Banko A, et al. Epstein-Barr virus infection as a potential indicator of the occurrence and clinical presentation of systemic lupus erythematosus. Front Immunol. 2023;14:1307589.
- Nigro G, et al. Role of infections in recurrent spontaneous abortion. J Matern Fetal Neonatal Med. 2011;24(8):983-989.
- Yang D, et al. YY1-PVT1 affects trophoblast invasion and adhesion by regulating mTOR pathway-mediated autophagy. J Cell Physiol. 2020;235(10):6637-6646.
- Guan D, et al. Immunologic insights in recurrent spontaneous abortion: Molecular mechanisms and therapeutic interventions. Biomed Pharmacother. 2024;177:117082.
- Zhao X, et al. Identification of key biomarkers and immune infiltration in systemic lupus erythematosus by integrated bioinformatics analysis. J Transl Med. 2021;19(1):35.
- Villamayor L, et al. The IFN-stimulated gene IFI27 counteracts innate immune responses after viral infections by interfering with RIG-I signaling. Front Microbiol. 2023;14:1176177.
- Lim FY, et al. High-frequency home self-collection of capillary blood correlates IFI27 expression kinetics with SARS-CoV-2 viral clearance. J Clin Invest. 2023;133(23):e173715.
- Apps R, et al. Genome-wide expression profile of first-trimester villous and extravillous human trophoblast cells. Placenta. 2011;32(1):33-43.
- Li Y, et al. RNA sequencing of decidua reveals differentially expressed genes in recurrent pregnancy loss. Reprod Sci. 2021;28(8):2261-2269.
- Dankers W, et al. Failing maternal-fetal tolerance in SLE (FaMaLE): A prospective cohort study for finding the molecular mechanisms behind pregnancy complications. Lupus Sci Med. 2025;12(1):e001668.
- Xiang S, et al. Imbalance of helper T cell type 1, helper T cell type 2, and associated cytokines in patients with systemic lupus erythematosus: A meta-analysis. Front Pharmacol. 2022;13:988512.
- Tu J, et al. UC-BSC exosomes regulate Th17/Treg balance in patients with systemic lupus erythematosus via miR-19b/KLF13. Cells. 2022;11(24):4123.
- Wang W, et al. T helper (Th) cell profiles in pregnancy and recurrent pregnancy loss: Th1/Th2/Th9/Th17/Th22/Tfh cells. Front Immunol. 2020;11:2025.