Diese Arbeit untersucht einen dynamischen Optimierungsalgorithmus für die Ablaufplanung, der Transformer und die Verstärkungslernmethode PPO integriert, und konzentriert sich dabei auf häufige Ressourcenkonflikte und Reaktionsverzögerungen bei der Planung von Vereinsaktivitäten.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Dynamischer Planungs- und Ressourcenoptimierungsalgorithmus für gewerkschaftliche Aktivitäten durch Integration von Transformern und verstärkendem Lernen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Um das Problem der verringerten organisatorischen Effizienz aufgrund häufiger Ressourcenzuweisungskonflikte und verzögerter Planungsreaktionen bei der Verwaltung von Gewerkschaftsaktivitäten zu lösen, schlägt dieser Artikel einen dynamischen Planungsalgorithmus vor, der Transformer und PPO (Proximal Policy Optimization) integriert. In der konkreten Implementierung wird zunächst eine einheitliche Modellierungsstruktur für Planungsszenarien entworfen, um Aktivitäts-, Personal- und Ressourcenzustände in Tensoreingaben umzuwandeln und so eine Integration mehrdimensionaler Einschränkungen zu erreichen. Anschließend wird der Multi-Head-Attention-Mechanismus des Transformers verwendet, um die Zeitreihe historischer Aktivitätsanfragen und Ressourcenstatus zu kodieren, mehrdimensionale räumlich-zeitliche Merkmale zu extrahieren und die Wahrnehmung von Konfliktrisiken zu verbessern. Danach werden basierend auf den Kodierungsergebnissen und dem PPO-Strategienetzwerk Planungsentscheidungen aus dem aktuellen Zustand heraus generiert, um die Anpassungsfähigkeit der Strategie an komplexe Umgebungen zu erhöhen. Schließlich werden durch das Pruning-Update und den Mechanismus zur Korrektur der Vorteilsfunktion die Stabilität der Strategie während der Iteration sowie eine verbesserte Planungsleistung sichergestellt. Experimente haben gezeigt, dass bei einer Aufgabendichte von 1000 die durchschnittliche Entscheidungszeit des Planungsalgorithmus 0,72 s und die durchschnittliche Antwortverzögerung 1,59 s beträgt, was auf eine hohe Reaktionsgeschwindigkeit und Entscheidungseffizienz hinweist. Bei sieben Aktivitätstypen und Komplexitätsstufen liegt die Ressourcenkonfliktrate zwischen 0,05 und 0,12; die durchschnittliche Ressourcennutzungsrate liegt zwischen 0,75 und 0,86; und der Planungsstabilitätsindex beträgt 0,8 bis 0,91, wodurch häufige Ressourcenzuweisungskonflikte effektiv reduziert und eine hohe Planungsstabilität erreicht wird. Unter Bedingungen hoher Parallelität betragen der Ressourcenbilanzindex und der Robustheitsindex für Strategieübertragung jeweils 0,88 und 0,85, was auf eine gute Anpassungsfähigkeit an parallele Aufgabenlasten hinweist.
Einleitung
Die Planung von Vereinsaktivitäten umfasst die komplexe Koordination mehrerer Aufgaben und Ressourcen, weshalb das System über effiziente dynamische Reaktionsfähigkeiten verfügen muss1,2. Die Anforderungen an die Aktivitäten ändern sich häufig, und die Verteilung von Personal- und Veranstaltungsortressourcen ist komplex, was leicht zu Planungskonflikten und Ressourcenverschwendung führen kann3,4. Die präzise Erfassung der Aktivitätsverläufe und des Echtzeit-Status der Ressourcen sowie die Verbesserung der Fähigkeit, potenzielle Konflikte zu erkennen und darauf zu reagieren, sind entscheidend, um die betriebliche Effizienz der Organisation zu steigern5,6. Die Integration fortschrittlicher Technologien zur Zeitreihenmodellierung und Algorithmen des Verstärkungslernens kann ein tiefes Verständnis komplexer Planungsumgebungen ermöglichen und eine intelligente Optimierung unterstützen, wodurch die Ressourcennutzung maximiert, die Reaktionsgeschwindigkeit bei der Planung beschleunigt und die intelligente Weiterentwicklung des Managements von Vereinsaktivitäten gefördert wird.
Bestehende Planungsmethoden in der Praxis basieren jedoch größtenteils auf festen Regeln und sind statisch, wodurch sie nicht in der Lage sind, sich an häufige Aufgabenänderungen und Schwankungen bei den Ressourcen anzupassen. Dies führt oft zu verlängerten Reaktionszeiten und schwerwiegenden Ressourcenkonflikten. Bei der Planung von Gewerkschaftsaktivitäten ist die Vielfalt der Aufgabentypen sehr groß; die Nutzung von Ressourcen ist stark eingeschränkt und unterliegt häufigen Änderungen; zudem bilden die Abhängigkeiten zwischen den Aktivitäten sowie die Konkurrenz um Ressourcen eine komplexe Planungsstruktur7,8. In der Praxis lässt sich der Aktivitätsplan nur unzureichend mit den verfügbaren Zeitfenstern von Ressourcen wie Personal und Veranstaltungsorten abstimmen9,10, was häufig zu Konflikten führt und die Gesamtkohärenz der organisatorischen Abläufe beeinträchtigt11,12. Das Planungssystem steht nicht vor einem einzelnen Optimierungsziel, sondern muss ein Gleichgewicht zwischen mehrdimensionalen Indikatoren finden, wie der Minimierung von Ressourcenkonflikten, der Maximierung der Reaktionsgeschwindigkeit, der Stabilität der Planungsstrategie und der Aufgabenabschlussrate13,14, wodurch typische Merkmale einer mehrzieligen Optimierung gegeben sind. Außerdem weisen Gewerkschaftsaktivitäten deutliche Phasen und Zyklen auf, sodass sich die Planungsstrategien dynamisch an die sich verändernden Strukturen des Ressourcenbedarfs in verschiedenen Aufgabenphasen anpassen müssen. Ein einmal erstellter statischer Plan kann die Ausführungsumgebung mit ihren häufigen Änderungen nicht unterstützen15,16. Die bisherige Planungslogik untersucht das historische Verhalten von Aufgaben und Muster von Ressourcenänderungen nicht ausreichend tiefgreifend. Sie ist daher nicht in der Lage, genaue Vorhersagen und strategische Ableitungen für die Zukunft zu liefern17,18. Die Reaktionsgeschwindigkeit der Planungsstrategie auf plötzlich auftretende Aufgaben und temporäre Ressourcenänderungen ist gering, was die Gesamtnachhaltigkeit des Betriebs beeinträchtigt19,20. Die Entwicklung eines Planungssystems mit Vorhersagefähigkeit, Flexibilität und Stabilität ist daher zu einer zentralen technischen Anforderung in praktischen Anwendungen geworden. Dazu muss das Modell über Fähigkeiten zur Wahrnehmung hochdimensionaler Informationen, zur Sequenzspeicherung und zur Strategieübertragung verfügen sowie robuste Entscheidungsfindung und Ressourcenbilanzierung in einer Umgebung mit mehreren Aufgaben gewährleisten, um eine intelligente und optimale Koordinierung der Planung von Gewerkschaftsaktivitäten zu ermöglichen.
Zahlreiche Studien haben verschiedene Lösungen für das Problem der dynamischen Planung vorgeschlagen. Dabei hat sich die Kombination aus Deep Learning und Verstärkendem Lernen als besonders anpassungsfähig und leistungsfähig bei der Optimierung erwiesen. Einige Forscher verwenden LSTM (Long Short-Term Memory)21,22, um Zeitreihendaten zu modellieren, und kombinieren diese mit Strategien des Verstärkenden Lernens, um das Planungsverhalten zu optimieren, wobei bereits gewisse Erfolge erzielt wurden. Eine weitere Forschungsrichtung nutzt eine auf einem Greedy-Algorithmus basierende heuristische Methode, die die Einfachheit und Effizienz von Planungsentscheidungen betont und sich für Szenarien mit klaren Regeln eignet23,24. Andere Arbeiten haben die Anwendung von Deep Q-Networks (DQN) für die Planung untersucht und verbesserte Strategien durch Wertfunktionsapproximation erreicht25,26. Diese Methoden weisen jedoch Probleme wie eine unzureichende Erfassung langfristiger Abhängigkeiten, instabile Strategieaktualisierungen und große Reaktionsverzögerungen auf, insbesondere bei komplexen und sich ständig verändernden Szenarien, wodurch die Anforderungen an die Planung von dichten und vielfältigen Aufgaben nur schwer erfüllt werden können. Daher stellt die Entwicklung eines Planungsalgorithmus mit effizienter Merkmalsextraktion und stabiler Strategieaktualisierung derzeit eine Hauptschwierigkeit dar, die überwunden werden muss.
In der Forschung zum mehrdomänigen Scheduling wurde die Transformer-Architektur aufgrund ihres Multi-Head-Self-Attention-Mechanismus, der langfristige zeitliche Abhängigkeiten effektiv erfasst, auf verschiedene Aufgaben der Zeitreihenvorhersage und der Optimierung von Abläufen angewandt27,28. In Kombination mit dem PPO-Algorithmus im Verstärkungslernen wird die Strategie durch Beschneiden der Zielfunktion stabil und effizient aktualisiert, wobei dieser Ansatz in Bereichen wie der Robotiksteuerung und der intelligenten Fertigung gute Leistung gezeigt hat29,30,31. Einige Studien haben versucht, den Transformer mit Verstärkungslernen zur komplexen Ressourcenplanung zu kombinieren32. Bei der dynamischen Planung von Vereinsaktivitäten befassen sich jedoch nur wenige Arbeiten mit der Kombination unterschiedlicher Aktivitätstypen und komplexer Ressourcenbeschränkungen. Einige Studien haben die Beziehung zwischen Ressourcen und Aufgaben mithilfe von Graph-Neural-Networks modelliert, um die Genauigkeit bei der Identifizierung von Konflikten zu verbessern33,34. Andere Forscher haben die Ressourcenplanung basierend auf Edge-Computing optimiert, um die Effizienz und Leistung des Modells zu steigern35,36. Solche Methoden weisen jedoch nach wie vor begrenzte Fähigkeiten bei der Modellierung des zeitlichen Kontexts auf. Vor diesem Hintergrund schlägt diese Arbeit vor, einen Transformer zur Kodierung historischer Aktivitäts- und Ressourcenstatussequenzen einzusetzen und diesen mit dem PPO-Police-Netzwerk zu kombinieren, um eine hohe Wahrnehmung von Konfliktrisiken sowie eine stabile Aktualisierung von Planungsstrategien zu erreichen, um den sich wandelnden und komplexen Anforderungen bei der Planung von Vereinsaktivitäten gerecht zu werden.
Aktuellere Studien haben die Optimierung der Ressourcenplanung aus verschiedenen Perspektiven untersucht, beispielsweise die VM-Konsolidierung zur Energieeffizienz im Cloud-Computing37, Authentifizierungsalgorithmen in Mobilfunknetzen38, verbesserte VM-Konsolidierung mit Live-Migration für nachhaltiges Cloud-Computing39, Verkehrsoptimierung mithilfe von Wartezeitvorhersage und evolutionären Algorithmen40 sowie blockchainbasierte Cloud-Speicherung mit verbesserter Optimierung und Integritätserhaltung41. Obwohl diese Arbeiten wertvolle Einblicke in die Ressourcenverteilung und Optimierungsalgorithmen liefern, konzentrieren sie sich vorrangig auf Cloud-Infrastrukturen, Telekommunikation oder Speichersysteme und berücksichtigen nicht speziell die mehrfachen Aktivitätstypen, dynamischen Konflikte zwischen Personal und Veranstaltungsorten sowie die Echtzeit-Anforderungen an die Planung, die für die Organisation von Gewerkschaftsaktivitäten charakteristisch sind. Dieser Unterschied unterstreicht weiterhin die Notwendigkeit eines dedizierten Planungsrahmens, der auf den organisatorischen Kontext von Gewerkschaftsaktivitäten zugeschnitten ist.
Bestehende Planungsmethoden für Gewerkschaftsaktivitäten erfassen häufig nicht die langfristigen räumlich-zeitlichen Abhängigkeiten und bewahren keine Policy-Stabilität inmitten dynamischer Veränderungen, was zu langsamen Reaktionszeiten und hohen Ressourcenkonflikten führt. Um diese Forschungslücken zu schließen, schlägt diese Studie ein Planungsoptimierungsmodell vor, das auf dem Prinzip basiert, dass die Multi-Head-Attention-Mechanismen von Transformern historische Sequenzen effektiv kodieren können, um Konflikte vorherzusagen, und dass die Proximale Policy-Optimierung (PPO) mit einer begrenzten Zielfunktion stabile und adaptive Policy-Updates gewährleistet. Konkret wird der Transformer eingesetzt, um Aktivitäts- und Ressourcenstatussequenzen zu kodieren und wichtige räumlich-zeitliche Merkmale zu extrahieren, um die Konflikterkennung im Voraus zu verbessern, und PPO wird kombiniert, um effiziente Planungsentscheidungen zu generieren und stabile Aktualisierungen zu ermöglichen. Eine einheitliche Einschränkungsmatrix wird entworfen, um Aktivitäten, Personal und Veranstaltungsorte abzubilden und die Erkennung komplexer Abhängigkeiten zu verbessern. Zu den zentralen Innovationen dieser Arbeit gehören: (1) die Integration von zeitlicher Kodierung und Verstärkendem Lernen speziell für die Planung von Gewerkschaftsaktivitäten; (2) ein konfliktorientierter Attention-Mechanismus, der die Wahrnehmung von Risiken priorisiert; und (3) ein Pruning-Update mit Korrektur der Advantage-Funktion, um die Robustheit der Strategie bei hoher Parallelität sicherzustellen. Umfangreiche Experimente unter verschiedenen Aufgabendichten und -komplexitäten belegen die Überlegenheit des Modells gegenüber bestehenden Methoden hinsichtlich Reaktionsgeschwindigkeit, Ressourcennutzung und Stabilität und bieten eine praktikable und skalierbare intelligente Planungslösung für das Management von Gewerkschaftsaktivitäten.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Abbildung 1 zeigt die Struktur eines Systems zur Planung von Vereinsaktivitäten, das Zeitreihenmodellierung und Verstärkendes Lernen integriert. Die Eingabeschicht kombiniert Aktivitätspläne, Ressourcenverfügbarkeit und Zeitfensterinformationen des Personals und erstellt mithilfe des Constraint-Graph-Moduls eine mehrdimensionale Matrix zur Darstellung von Aufgaben- und Ressourcenkonflikten. Der Transformer führt eine Multi-Head-Attention-Codierung über die historische Abfolge von Aktivitäts- und Ressourcenzuständen durch und erzeugt so verdeckte Zustände mit zeitlichen Abhängigkeiten. Das Policy-Modul nutzt die Codierungsergebnisse, um Aktionsverteilungen und Zustandsschätzungen zu generieren, und trifft Planungsentscheidungen durch Stichprobenziehung von Aktionen. Die Ausführungsergebnisse werden an die Umgebung zurückgegeben, wodurch der Ressourcenstatus aktualisiert und unmittelbare Belohnungen generiert werden. Auf dieser Grundlage erstellt das Optimierungsmodul eine beschnittene Zielfunktion, bewertet die Vorteilsfunktion und korrigiert die Schätzung des Wertnetzwerks, um eine Abdrift der Politik einzuschränken und stabile Aktualisierungen der Planungsstrategien sicherzustellen. Zwischen den Modulen entsteht eine geschlossene Datenschleife, die eine hochsensible Wahrnehmung von Ressourcenkonflikten und adaptive Strategieanpassungen in dynamischen Umgebungen ermöglicht und dadurch die Intelligenz der Reaktion sowie die Effizienz der Ressourcenverteilung im System zur Planung von Vereinsaktivitäten in Szenarien mit vielen Aufgaben und hohen Restriktionen verbessert.
Szenariomodellierung der Planung von Gewerkschaftsaktivitäten
Alle Aktivitätsanfragen im Planungssystem werden basierend auf Zeitschritten in diskrete Planungssequenzen unterteilt. Jede Aktivität ist durch klar definierte Start- und Endzeiten, Ressourcenkategorien, Phasen und Prioritätsstufen festgelegt. Der Standortnutzungsstatus wird als zweidimensionale Zeit-Slot-Matrix modelliert, wobei die horizontale Achse die standardisierte Zeiteinheit und die vertikale Achse die Anzahl der räumlichen Ressourcen darstellt. Der Ressourcenstatus wird als verfügbar oder belegt markiert, wodurch eine initiale Ressourcenverteilungskarte mit statischer Struktur entsteht. Die Personaleinsatzplanungs-Informationen werden in der Zeit-Identitäts-Dimension erweitert, um einen kontinuierlichen Zeitfenster-Vektor zu konstruieren, der jeweils den Aufgaben- oder Leerlaufstatus sowie die Abteilungsnummer des Personals erfasst. Alle Eingabedaten werden in einer dreidimensionalen Tensorstruktur zusammengeführt, wobei den diskreten Zeitschritt, die Anzahl der Ressourceneinheiten und den entsprechenden Ressourcennutzungs-Attributcode bezeichnet (z. B. ob die Ressource belegt ist, die Aktivitätsnummer, die Nutzungspriorität usw.). Diese Struktur ermöglicht es dem Planungssystem, die Ressourcenkonfiguration zu jedem beliebigen Zeitpunkt auszulesen und gewährleistet eine einheitliche Darstellung verschiedener Ressourcenstatus-Typen.
Nachdem die Aufgabeninformationen mit dem Modell verknüpft wurden, wird der Aufgabenintensitätsvektor basierend auf der Aktivitätspriorität und der Ressourcennutzungsdauer festgelegt. Die Kombinationen von Aufgaben, die zu Konflikten führen können, werden mithilfe der Überlappungserkennung von Zeitfenstern markiert. Konflikthafte Kombinationen werden in Knotenmengen umgewandelt, und Kantenmengen werden basierend auf gemeinsamen Ressourcentypen und -zeiträumen konstruiert, um implizite Abhängigkeiten explizit darzustellen. Der abschließend erstellte Aufgabengraph enthält Grenzinformationen zur zeitlichen Abfolge, Ressourcenüberlappung oder Beschränkungskonflikten und bietet eine strukturelle Grundlage für die anschließende Konflikterkennung und die Erzeugung von Planungsstrategien. Diese Struktur bewahrt den dynamischen Charakter der Aufgabenplanung und die kontinuierlichen Änderungen im Ressourcenstatus und unterstützt die Echtzeiterfassung von Änderungen in den Planungsbeschränkungen.
Die Konflikterkennung nutzt die spärlichen überlappenden Bereiche der Zeit- und Ressourcendimensionen in der Tensordarstellung als Ausgangsbedingungen für die Beurteilung. Sie führt eine statische Beziehungs-Codierung für Aufgabenpaare mit überlappenden Planungszielen durch. Es wird eine Graphstruktur G=(V,E,C) konstruiert, wobei V die Menge der aktiven Knoten, E die aufgrund von Ressourcenkonflikten entstandenen Kanten und C die Konfliktgewichtungs-Codierungsmatrix für die Kanten darstellt. Die Konfliktgewichtungsfunktion ist in der folgenden Form definiert:
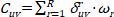 (1)
Dabei ist Cuv das Konfliktgewicht zwischen den Aktivitäten u und v; u, v sind Aktivitätsindizes; R ist die Gesamtanzahl der Ressourcentypen; δuvr ∈ {0,1} gibt an, ob sich die Zeitfenster der Aktivitäten u und v bezüglich der Ressource r überlappen; ωr ist das Konfliktempfindlichkeitsgewicht der Ressource r. Diese Funktion führt eine gewichtete Summe der Konfliktintensitäten durch, wobei Unterschiede in der Bedeutung von Ressourcenkonflikten für die Ergebnisse der Terminplanung berücksichtigt werden, und behält gleichzeitig einen quantifizierbaren Ausdruck der Verteilung der Konfliktstärke bei.
Die oben genannte Konfliktgraph-Struktur wird durch eine dünn besetzte Matrixdarstellung in eine Beschränkungsgrenz-Matrix umgewandelt. Jeder Eintrag in der Matrix enthält das Ausmaß des Ressourcenkonflikts. Die Matrix wird in den Planungsentscheidungsprozess integriert, um zu bestimmen, ob Aufgaben parallel geplant werden können, während die Aktionsabschirmlogik im Politik-Netzwerk liegt. Um mit periodischer Aktivitätsaggregation und Aufgabenbursts mit hoher Dichte umzugehen, wird ein dynamischer Aktualisierungsmechanismus implementiert, der Änderungen im Aufgabenstatus überwacht und den Matrixinhalt in Echtzeit anpasst, sobald Ressourcen freigegeben oder hinzugefügt werden, um die Kontinuität und Konsistenz der Planungsgrenze während der gesamten Aufgabenentwicklung sicherzustellen.
Die Anwendung dieser Konfliktgraphstruktur ermöglicht es dem Planungssystem, potenzielle Ressourcenengpässe und Muster von Aufgabenüberschneidungen visuell abzubilden, wodurch die Effizienz der Entkopplungsanalyse des Entscheidungsnetzwerks bei komplexen Randbedingungsszenarien verbessert wird. Das Planungsverhalten basiert nicht länger auf regelbasiertem logischem Abgleich. Stattdessen wird der optimale Pfad im Beschränkungsraum gesucht, wodurch die Fähigkeit gestärkt wird, lokale Ressourcenkonflikte dynamisch mit der globalen Aufgabenübersicht auszugleichen. Das System kann die Stabilität der Planung und die Kohärenz der Aufgaben in einer Umgebung aufrechterhalten, in der sich Ressourcen verändern und Aufgaben häufig hinzugefügt oder entfernt werden.
Abbildung 2 zeigt ein Netzwerkstrukturdiagramm, das auf der Gewichtungsbeziehung von Aufgabekonflikten basiert. Jeder Knoten in der Abbildung repräsentiert eine zu planende Aufgabe, und die Linien zwischen den Knoten zeigen Ressourcennutzungskonflikte an. Die Dicke der Kante spiegelt das Gewicht des Konflikts wider. Je schwerwiegender der Konflikt, desto dicker ist die Linie. Die Gewichtungsberechnung integriert die Ressourcenüberlappung und kombiniert die Konfliktempfindlichkeit verschiedener Ressourcen, um eine zusammengesetzte Konfliktintensität zwischen Aufgaben zu bilden. Die Graphstruktur zeigt, dass einige Aufgaben eng verbundene Bereiche bilden, was auf einen erheblichen Wettbewerb um die Ressourcennutzung hinweist. Dieses Phänomen der lokalen Konfliktaggregation ist die Hauptursache für Ressourcenengpässe und Aufgabenverzögerungen im Planungsprozess, sodass der Planungsalgorithmus entsprechend Prioritäten für Konfliktbearbeitung festlegen kann. Die Anordnung der Knoten verwendet eine kraftbasierte Layoutstrategie, um Aufgaben mit hohen Konflikten automatisch zu gruppieren, wodurch das Planungssystem Schlüsselaufgabengruppen identifizieren und die Strategieverteilung optimieren kann, was die Gesamtkohärenz der Planung und die Ressourcenabstimmung verbessert.
Codierung der historischen Zustandssequenz
Basierend auf dem erstellten Konfliktgraphen und der Beschränkungsmatrix besteht der nächste Schritt darin, die historischen Aktivitätsabläufe und Ressourcenzustände zu kodieren, um die zeitlichen Muster, die diesen Beschränkungen zugrunde liegen, für nachfolgende Entscheidungsprozesse extrahieren zu können. Die Kerndaten des Planungsszenarios bestehen aus Aktivitätsanfragen, Änderungen des Ressourcenstatus und Rückmeldedaten zu Aufgaben. Diese Informationen bilden mehrere heterogene Zeitreihen, die verschiedenen Attributen entsprechen, wie etwa Zeitpunkten von Ereignissen, Kennungen der Ressourcennutzung und dem Status der Aktivitätsausführung. Um die Verarbeitungsstruktur zu vereinheitlichen, wird jeder Eingabetyp als Sequenz gleich langer Vektoren kodiert, und ein einheitlicher Zeitindex wird etabliert, um eine Zustandsausrichtung unter zeitlicher Synchronisation sicherzustellen. Die Eingabeeinheit zu jedem Zeitpunkt wird durch die Konkatenation dreier Gruppen von Merkmalsvektoren repräsentiert: Der Aktivitätsmerkmalsvektor beschreibt den Aufgabentyp, die Priorität und die Stufennummer; der Ressourcenmerkmalsvektor erfasst die aktuelle Ressourcenbelegung, die verbleibende Kapazität und die Position des verfügbaren Zeitfensters; der Rückmeldemerk-malsvektor gibt an, ob die Aufgabe im vorherigen Zeitpunkt reibungslos ausgeführt wurde und ob ein Ressourcenkonflikt oder eine Verzögerung aufgetreten ist.
Alle Merkmale werden linear transformiert und in denselben mehrdimensionalen Raum abgebildet, um eine standardisierte Embedding-Matrix X ∈ ℝT×d zu erhalten, wobei T die Anzahl der Zeitschritte und d die einheitliche Embedding-Dimension darstellt. Um die zeitliche Struktur beizubehalten, wird die Eingabematrix elementweise zur Positions-Codierungsmatrix P addiert, um die positionsbewusste Eingabe zu bilden:
Z = X + P (2)
Z ist die endgültige Eingabesequenz, die als Eingabe für den nachfolgenden Attention-Mechanismus dient. Das Design der Positions-Codierung verwendet eine feste Sinus- und Kosinusfunktion als Vorlage, um einen Informationsleak über zukünftige Werte zu verhindern und sicherzustellen, dass die kausalen Bedingungen während der Codierung strikt eingehalten werden. Die oben beschriebene Struktur ermöglicht es dem Modell, Aufgabenmerkmale, Ressourcenstatus und Zeitposition gleichzeitig wahrzunehmen. Sie verfügt über eine vollständige Zustandsspeicher-Basis und bietet eine hochauflösende, einheitliche Struktur für den nachfolgenden Attention-Mechanismus.
Das Attention-Modul verarbeitet die Eingabesequenz, um mögliche Beziehungen zwischen mehreren Zeitpunkten zu erfassen. Mehrere Gruppen von Attention-Köpfen werden verwendet, um die Sequenz separat zu verarbeiten und dadurch die Empfindlichkeit des Modells gegenüber verschiedenen Arten von Zustandsentwicklungsverläufen zu erhöhen. Jeder Attention-Kopf erzeugt aus der Eingabesequenz eine Query-Matrix Q, eine Key-Matrix K und eine Value-Matrix V, berechnet die Gewichtungsverteilungsmatrix und erzeugt eine gewichtete Repräsentation. Die Ausgabe eines einzelnen Attention-Kopfes lautet:
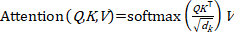 (3)
dk ist die Anzahl der Merkmalsdimensionen pro Kopf. In dieser Formel repräsentiert QK⊤ die Ähnlichkeit zwischen Zeitpunkten, √dk dient der numerischen Stabilität, und die Softmax-Funktion stellt die Gewichtsnormierung sicher. Unterschiedliche Attention-Köpfe konzentrieren sich auf verschiedene Kombinationen von Zeitintervallen, und die dynamischen Abhängigkeiten, die sie erfassen, sind ebenfalls vielfältig, wodurch implizite Regeln wie Vorläufer von Aufgabenkonflikten, Muster des Ressourcenverbrauchs und auffällige Trends in der Rückmeldung aufgedeckt werden können.
Alle Ausgaben der Attention-Heads werden verkettet und über eine lineare Transformationschicht geleitet, um eine einheitliche Kodierungssequenz zu erzeugen, die als Zustandseingabe für das Netzwerk zur Generierung von Planungsstrategien dient. Diese Sequenz kodiert die Verhaltensspur der Aufgabe, die Merkmale von Ressourcenänderungen sowie die Auswirkungen vorangegangener Ausführungsabweichungen im aktuellen Planungsfenster und löst damit effektiv das Problem der hohen historischen Abhängigkeit des Planungsverhaltens und der spärlichen Merkmalsdarstellung. Residuelle Verbindungen und Layer-Normalisierungsmoduln sind in die Kodierungsausgabeschicht integriert, um die Stabilität des Trainingsprozesses und die Fähigkeit zur Erhaltung von Darstellungen im tiefen Netzwerk zu verbessern.
Die Folge der verborgenen Ausgabezustände behält nicht nur die zeitliche Entwicklungsinformation bei, sondern reagiert auch auf Änderungen, die durch plötzliche Aufgaben oder vorübergehende Ressourcenmismatches entstehen, und zeigt damit eine starke Anpassungsfähigkeit. Dieser strukturelle Ansatz verzichtet auf die explizite Definition von Regeln, ermöglicht eine strukturierte Modellierung dynamischer Planungsumgebungen und unterstützt nachfolgende Policy-Module dabei, Planungslösungen mit globaler Konsistenz und lokaler Anpassungsfähigkeit unter Mehrzielbedingungen zu erzeugen.
Generierung von dynamischen Planungsstrategien
Die codierten Sequenzen der versteckten Zustände, die sowohl zeitliche Abhängigkeiten als auch Informationen zu Ressourcenkonflikten enthalten, werden anschließend in das Politik-Netzwerk eingespeist, um Planungsentscheidungen zu generieren, die sich an die aktuelle Umgebung anpassen. Die vom Kodiermodul ausgegebene Sequenz der verborgenen Zustände wird als Eingabe für das Netzwerk der Planungsstrategie verwendet. Der Zustandsvektor, der zu jedem Zeitpunkt festgelegt wird, bildet die aktuelle Beobachtungsdarstellung der Umgebung ab und erfasst die Entwicklung von Aufgabenmerkmalen, Ressourcennutzungstrends sowie historischen Feedback-Trajektorien. Die Dimension der Zustandsdarstellung und die Länge des Zeitfensters sind festgelegt, wobei die Kontinuität von Zustandsänderungen über einen Schiebeaktualisierungsmechanismus erfasst wird. Bevor der Zustandsvektor an das Politiknetzwerk übermittelt wird, erfolgen eine Normalisierung und eine Neugliederung der Merkmale, um sicherzustellen, dass die Eingabe eine stabile numerische Verteilung im hochdimensionalen Raum beibehält, wodurch Gradientenexplosionen und Konvergenschwankungen reduziert werden.
Die Struktur des Politik-Netzwerks verwendet ein zweigeteiltes Ausgabemodul, bei dem ein Zweig die Aktionsverteilung erzeugt und der andere die Schätzung der Zustandswertfunktion ausgibt. Der Aktionsraum umfasst alle planbaren Aufgaben und zuweisbaren Ressourcen. Der Kandidatenauswahlmechanismus filtert unzulässige oder überflüssige Kombinationen von Operationen heraus, um eine begrenzte, zulässige Menge von Aktionen zu bilden. Der Politik-Zweig gibt eine Wahrscheinlichkeitsverteilung π(at|st) aus, wobei at die Planungsaktion zum Zeitpunkt des Zeitschritts und st den aktuellen Zustandseingang darstellt. Zum Auswählen von Aktionen aus der Verteilung für die tatsächliche Planung wird eine standardisierte Gaußsche Stichprobe oder eine Softmax-Stichprobenstrategie verwendet. Die andere Ausgabe ist die Schätzung der Zustandswertfunktion, die die Erwartung des langfristigen Belohnungswerts im gegebenen Zustand repräsentiert und für die Bewertung und Aktualisierung der Politik verwendet wird.
Im Richtliniennetzwerk wendet die versteckte Schicht Aktivierungsfunktionen und Batch-Normalisierung an, um den nichtlinearen Ausdruck zu verbessern und die Netzwerkkonvergenz zu beschleunigen. Im Entscheidungsprozess werden die Ausführungspriorität, die Ressourcenplanungskosten und die historische Leistung verschiedener Aufgaben als Aufmerksamkeitsfaktoren berücksichtigt und über eine spezifische Gewichtungsmatrix in den Aktionsauswahlmechanismus integriert, um einen adaptiv einstellbaren Rahmen für die Richtlinienausgabe zu schaffen. Dieses Design vermeidet die Abhängigkeit von festen Regeln und erhöht somit die Flexibilität der Strategie bei der Bewältigung plötzlicher Konflikte und struktureller Engpässe.
Die Planungsstrategie verwendet einen Zufallsstichproben-Mechanismus, um die eigentliche Aktionssequenz zu erzeugen. In jedem Planungszyklus wird eine ausführbare Aktion aus der aktuellen Aktionsverteilung gezogen, und der Ressourcenstatus sowie die Markierung des Aufgabenknotens werden aktualisiert. Nach Ausführung der Aktion berechnet das System die unmittelbare Belohnung basierend auf den Änderungen der Ressourcen und dem Fortschritt der Aufgabe, um die Auswirkung dieser Planungsrunde auf das Gesamtziel zu messen. Die Belohnungskonzeption berücksichtigt mehrere Dimensionen, darunter die Aufgabenabschlussrate, die Effizienz der Ressourcennutzung und das Ausmaß der Konfliktdämpfung. Sie liefert dem Strategie-Update-Modul über umfassende Indikatoren Rückmeldung.
Der gesamte Planungsprozess erstellt eine Markov-Entscheidungskette und verwendet die empirische Trajektorien-Stichprobenerhebungsmethode, um die Zustands-Aktions-Belohnungs-Sequenz, bezeichnet als (st, at, rt, st+1), aufzuzeichnen. Die Strategieoptimierung beruht auf der Konstruktion der Vorteilsfunktion, wobei die Vorteilsschätzung in der folgenden Form definiert ist:
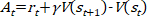 (4)
At steht für den Vorteilswert, rt ist die aktuelle Sofortbelohnung, γ ist der Diskontfaktor für Belohnungen und V(st) sowie V(st+1) sind die Ausgaben der Zustandswertfunktion im aktuellen bzw. nächsten Zustand. Die Vorteilsfunktion spiegelt das Ausmaß wider, in dem die aktuelle Aktion gegenüber der durchschnittlichen Leistung der Strategie überlegen ist. Sie dient dazu, die nachfolgende Verbesserung der Strategie zu steuern. Wenn At > 0 gilt, bedeutet dies, dass die aktuelle Aktion besser ist als die durchschnittliche Erwartung, und ihre Wahrscheinlichkeit sollte erhöht werden; andernfalls sollte ihre Auswahlneigung verringert werden.
Während des Strategie-Update-Prozesses wird ein Trunkierungsmechanismus für die Zielverteilung angewandt, um Strategieoszillationen aufgrund übermäßiger Update-Amplituden zu vermeiden. Dieser begrenzt den Änderungsbereich zwischen neuen und alten Strategien und gewährleistet somit die Kontinuität und Stabilität der Netzwerkausgabe. Eine enge Kopplung zwischen der Aktionsverteilung und der Rückmeldung des Belohnungssignals ermöglicht es der Strategie, unmittelbar auf Veränderungen komplexer Randbedingungen zu reagieren. Der Mechanismus erhält die Stabilität der Entscheidungsfindung und eine rationelle Ressourcenplanung in Situationen, in denen sich Aufgaben häufig ändern oder Ressourcen plötzlich nicht mehr passend zur Verfügung stehen, und verhindert effektiv Probleme wie doppelte Zuweisungen, Ressourcenstaus oder Anstauungen in der Aufgabenwarteschlange. Das Planungssystem kann unter wechselnden Aufgabendichten und Ressourcenengpässen einen besseren Betriebszustand beibehalten und zeigt damit starke adaptive Fähigkeiten.
Strategie-Iteration und stabiler Aktualisierungsmechanismus
Um sicherzustellen, dass die generierten Planungsstrategien stabil bleiben und sich über wiederholte Trainingsrunden hinweg nicht verschlechtern, wird in diesem Abschnitt ein iterativer Aktualisierungsmechanismus mit Clipping und Vorteils-Korrektur eingeführt. Das Trunkierungs-Update-Intervall zwischen der alten und der neuen Strategie wird festgelegt, und die Clipping-Zielfunktion wird verwendet, um die Strategieabweichung einzuschränken und so einen Planungsschock während des Strategie-Update-Prozesses zu verhindern. Das Bewertungsnetzwerk wird in Kombination mit der Vorteilsfunktion korrigiert, um die Genauigkeit der langfristigen Planung zu verbessern.
Die Wahrscheinlichkeitsverteilung der Aktionsausgabe des Policy-Netzwerks neigt während kontinuierlicher Planungsiterationen zu starken Schwankungen, was zu instabilem Verhalten oder ungeordneter Ressourcenverteilung führen kann. Um den durch Policy-Drift verursachten Planungsschock zu verringern, wird ein abgeschnittenes Aktualisierungsintervall konzipiert, um den Änderungsbereich zwischen der neuen und der alten Policy zu begrenzen, und ein Restriktionsterm wird eingeführt, um die Zielfunktion zu verfeinern. Die Wahrscheinlichkeit der historischen Policy wird in der Abtastphase aufgezeichnet, und der Verhältnisterm wird mit der aktuellen Policy-Wahrscheinlichkeit gebildet. Das Ziel der Policy-Aktualisierung wird festgelegt als:
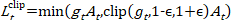 (5)
Hier bezeichnet gt = πθ(at|st)/πθold(at|st) das Verhältnis der Wahrscheinlichkeiten zwischen der neuen und der alten Strategie; ε ist die Abschneide-Schwelle, die den Bereich der Strategieaktualisierung begrenzt. Wenn das Verhältnis die Grenze überschreitet, wird stattdessen der abgeschnittene Wert verwendet, um zu verhindern, dass die Strategie übermäßige Gradienten aus extremen Stichproben erzeugt, wodurch sichergestellt wird, dass die Anpassung der Netzwerkparameter innerhalb des vorgegebenen Bereichs bleibt. Diese Struktur beschränkt dynamisch den Änderungsbereich der Ausgabestrategie in jeder Planungsrunde, bewahrt die Glattheit und Konsistenz der Strategieausgabe bei dichten Aufgabenverteilungen und reduziert signifikant die Schwankungsrate des Planungsverhaltens.
Die Ziel-Funktion der Politik wird während des Aktualisierungsprozesses um Regularisierungs- und Entropiebelohnungsterme erweitert, um die Diversität der Aktionsverteilung zu erhöhen und eine vorzeitige Konvergenz zu unterdrücken. Jede Runde der Politikaktualisierung nutzt mehrere Batches von Erfahrungstrajektorien-Stichproben für das schrittweise Training, wodurch eine breite Abdeckung im Zustandsraum erhalten bleibt. Wenn die Wahrscheinlichkeitsverteilung der ausgegebenen Aktionssequenz vor und nach der Aktualisierung verglichen wird, wird die Abweichungsrate der Verteilung berechnet, und eine feste Schwelle filtert den akzeptablen Störungsbereich der Politik heraus. Dieser Mechanismus bietet eine Grenzkontrolle für die Übertragung von Planungspolitiken über Zyklen hinweg und unterdrückt so Überanpassung aufgrund drastischer Änderungen im Ressourcenstatus.
Strategieaktualisierungen basieren auf der Zustandsbewertung, die von der Wertfunktion bereitgestellt wird. Abweichungen bei der Zustandswertschätzung können die Korrektheit der Advantage-Funktion direkt beeinflussen und dadurch die Richtung der Strategieiteration verändern. Um die Genauigkeit der Bewertung zu verbessern, wird ein Mehrfach-Zeitreihen-Backtracking-Mechanismus konstruiert, und der diskontierte kumulative Wert zukünftiger Belohnungen wird verwendet, um den aktuellen Zustandswert zu korrigieren. Die Backtracking-Belohnung verwendet die Struktur der Generalized Advantage Estimation (GAE), die wie folgt definiert ist:
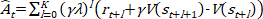 (6)
Ât ist der korrigierte Vorteilswert; λ ist der Rückverfolgungsbilanzkoeffizient; rt+l repräsentiert die unmittelbare Belohnung des (t+l)-ten Schritts; V(st+l) ist der vom Bewertungsnetzwerk ausgegebene Zustandswert. Diese Struktur integriert kurzfristiges, unmittelbares Feedback und langfristige Erwartungen an den Zustand, um Abweichungen in den Reaktionsvorhersagen der Strategie hinsichtlich zukünftiger Ressourcenkonflikte, Spitzenlasten und Aufgabenanhäufung zu korrigieren. λ steuert die Tiefe der Rückverfolgung und passt sich automatisch während Phasen starker dynamischer Ressourcenschwankungen an, um die Robustheit der Reaktion des Bewertungsnetzwerks auf plötzliche Ereignisse zu erhöhen.
Die in der Vorteilsfunktion eingebettete zeitabhängige Struktur auf mehreren Skalen ermöglicht es dem Bewertungsnetzwerk, langfristige Ressourcentrends zu modellieren. Bei der Erkennung von Abweichungen in der Politikausgabe wird der Index zur Konsistenz des Politikverhaltens verwendet, um zu bewerten, ob das Netzwerk übermäßig auf den Bewertungsfehler reagiert. Rückkopplungs-Differenz-Restterme überwachen das Verhalten der Politikaktualisierung, und das Trainingsziel sowie die Amplitude der Gewichtsaktualisierung der Wertefunktion werden dynamisch korrigiert. Das Wertnetzwerk und das Politiknetzwerk werden gemeinsam optimiert, um sicherzustellen, dass die Wertabschätzung nicht vom Ziel der Aufgabenerfüllung abweicht, und um gleichzeitig zu verhindern, dass eine hochfrequente Planung den Status von Ressourcenkonflikten falsch einschätzt.
Dieser stabile Mechanismus zur Aktualisierung von Strategien kann die Steuerbarkeit und Konsistenz von Verhaltensaktualisierungen effektiv in einer hochdimensionalen dynamischen Aufgabenumgebung aufrechterhalten, wodurch die Effizienz der Aufgabenabdeckung und die Flexibilität der Ressourcennutzung verbessert werden und sich eine kontinuierlich iterative, intelligente Planungsstruktur ergibt. Das Planungsverhalten verhindert, dass die langfristige Entwicklung in eine lokale Optimalität gerät, und erhöht die gesamte Anpassungsfähigkeit an Änderungen in den Aufgabenmustern sowie Schwankungen in den Ressourcenzyklen.
Abbildung 3A zeigt den Trend des Zielfunktionswerts in Abhängigkeit von der Anzahl der Trainingsiterationen unter verschiedenen Abschneidegrenzwerten. Die horizontale Achse stellt die Anzahl der Trainingsiterationen dar, die vertikale Achse den numerischen Wert der begrenzten Zielfunktion. ε wird auf 0,1, 0,2 und 0,3 festgelegt, was unterschiedliche Grade der Stärke der Steuerung des Politikdrifts repräsentiert. Die Kurve, die einem kleineren ε-Wert entspricht, schwankt weniger, und die Zielfunktion bleibt stabil. Bei ε = 0,1 liegt der Gesamtwert der Zielfunktion zwischen 0,8 und 1 und zeigt die schrittweise Anpassung und Stabilität der Strategieaktualisierung. Ein größerer ε-Wert hingegen führt zu deutlichen Schwankungen. Bei ε = 0,3 liegt der Gesamtwert der Zielfunktion zwischen 0,65 und 0,95, und die Kurve der Zielfunktion weist eine größere Oszillationsamplitude auf, was das Risiko einer starken Abweichung im Strategieaktualisierungsprozess widerspiegelt. Je kleiner der Schwellenwert, desto stabiler ist die Strategie, was sie für stark eingeschränkte Planungsumgebungen geeignet macht. Abbildung 3B zeigt die Veränderungen der verallgemeinerten Vorteilsschätzung unter verschiedenen Koeffizienten zur Rückverfolgungsbilanzierung. λ wird jeweils auf 0,8, 0,9 und 1,0 gesetzt, um die Tiefe der Rückverfolgung zukünftiger Belohnungen zu steuern. Die Kurve zeigt, dass bei höherem λ die GAE-Schwankungen geringer sind, der langfristige Trend glatter verläuft und der potenzielle Einfluss von Planungsverhalten über mehrere Schritte hinweg genauer erfasst wird. Die Kurve mit λ = 0,8 weist deutliche periodische Schwankungen auf, was darauf hinweist, dass sie stärker auf unmittelbare Belohnungen reagiert und sich besser für kurzfristige, plötzliche Aufgaben eignet. Im Gegensatz dazu konzentriert sich ein λ von 1,0 stärker auf die Modellierung langfristiger Trends und ist für periodische Aufgabenszenarien geeignet.
Analysen zur Rechenkomplexität und Skalierbarkeit
Die Rechenkomplexität des vorgeschlagenen Transformer-PPO-Frameworks ergibt sich aus zwei Hauptkomponenten: dem Transformer-Encoder und der PPO-Richtlinienoptimierung.
Für den Transformer-Encoder mit L Schichten, H Attention-Köpfen, einer Embedding-Dimension d und einer Eingabesequenzlänge T (dem historischen Zeitfenster) beträgt die Zeitkomplexität pro Vorwärtsdurchlauf O(L·T2·d + L·T·d2), wobei der Term T2 aus dem Selbst-Attention-Mechanismus resultiert. In der Implementierung gilt L = 3, H = 4, d = 128, und T ist auf 100 Zeitschritte festgelegt, was einen überschaubaren Rechenaufwand ergibt. Bei längeren historischen Fenstern wird der quadratische Term T2 zum dominierenden Faktor; in der Praxis umfasst die Planung von Gewerkschaftsaktivitäten jedoch typischerweise begrenzte historische Zeiträume (z. B. gleitende Fenster von einem Quartal oder einem Jahr), und die zeitliche Auflösung kann angepasst werden, um Genauigkeit und Effizienz auszugleichen.
Für die PPO-Komponente handelt es sich bei dem Policy-Netzwerk und dem Wert-Netzwerk um leichte MLPs (256 bzw. 128 Neuronen pro versteckter Schicht), deren Inferenzkomplexität O(d·m) beträgt, wobei m die Anzahl der versteckten Einheiten ist und im Vergleich zum Transformer-Encoder vernachlässigbar ist. Die Aktualisierung der Policy während des Trainings umfasst mehrere Epochen von Mini-Batch-Gradientenaktualisierungen mit einer Komplexität von O(B·E·d2), wobei B die Batch-Größe und E die Anzahl der Aktualisierungsepochen angibt.
Hinsichtlich der Skalierbarkeit weist das Framework drei vorteilhafte Eigenschaften auf. Erstens kann der Attention-Mechanismus über Zeitschritte hinweg parallelisiert werden, was eine effiziente GPU-Beschleunigung ermöglicht. Zweitens ist die Modellgröße unabhängig von der Anzahl der Aktivitäten oder Ressourcen, da die Nebenbedingungsmatrix bei jedem Planungsschritt dynamisch erstellt und nicht als feste Parameter eingebettet wird. Dadurch kann dasselbe trainierte Modell ohne erneutes Training in Verbänden unterschiedlicher Größe eingesetzt werden. Drittens kann bei extrem groß angelegten Szenarien die Länge des historischen Zeitfensters T und die Einbettungsdimension d als Kompromiss reduziert werden, oder die Variante mit spärlicher Attention (sparse attention) kann verwendet werden, um die O(T2)-Komplexität auf O(T log T) oder O(T) zu verringern.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Experimentelle Daten
Um die Leistung des in dieser Arbeit vorgestellten Transformer-PPO-Dynamischen-Zeitplanungs-Algorithmus umfassend zu bewerten, verwendet das Experiment als Benchmark-Datensatz Aktivitätsverwaltungsdaten einer großen Unternehmensgewerkschaft aus den letzten drei Jahren. Dieser Datensatz enthält über 5.000 Aktivitätsaufzeichnungen, die verschiedene Typen umfassen, darunter Sitzungen, Schulungen und Unterhaltungsveranstaltungen, sowie Planungsinformationen für mehrere Ressourcen wie...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die experimentellen Ergebnisse zeigen, dass der vorgeschlagene Transformer-PPO-Algorithmus die Baseline-Methoden (LSTM-PPO, Greedy-Suche und DQN) bei allen Evaluierungsmetriken konsistent übertrifft. Die überlegene Leistung ist auf zwei entscheidende Faktoren zurückzuführen. Erstens erfasst der Multi-Head-Self-Attention-Mechanismus des Transformers effektiv langreichweitige zeitliche Abhängigkeiten in Aktivitäts- und Ressourcenstatussequenzen, wodurch potenzielle Konflikte proaktiv identifiziert werden können. Dies erklä...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass sie keine finanziellen Interessenkonflikte haben.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Kernprogrammiersprache |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Tiefenlern-Framework (Implementierung von Transformer/PPO) |
| NumPy 1.23 | NumPy-Entwickler | https://numpy.org/doc/stable/release/1.23.0-notes.html | Bibliothek für numerische Berechnungen |
| Matplotlib 3.5 | Matplotlib-Entwicklungsteam | https://matplotlib.org/stable/users/installing.html | Visualisierung der Ergebnisse |
| Datensatz zur Terminplanung von Gewerkschaftsaktivitäten | Interner Datenbestand eines kooperierenden Unternehmens (anonymisiert) | Nicht öffentlich zugänglich aufgrund einer Vertraulichkeitsvereinbarung; Forschende können den korrespondierenden Autor für den Zugang kontaktieren | Mehr als 5.000 Aktivitätseinträge (Besprechungen, Schulungen, Unterhaltung) aus einer großen Unternehmensgewerkschaft über einen Zeitraum von drei Jahren |
| NVIDIA A100 GPU | |||
| PyTorch |
Referenzen
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.