Diese Studie identifiziert acht mit der mitotischen Katastrophe assoziierte prognostische Gene (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) beim Lungenadenokarzinom, erstellt ein Risikomodell mit akzeptabler Vorhersageleistung und zeigt deutliche Unterschiede in den Merkmalen des immunologischen Mikromilieus zwischen den Risikogruppen auf.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Identifizierung prognostischer Gene im Zusammenhang mit mitotischer Katastrophe bei Lungenadenokarzinomen mittels Transkriptomanalyse
In diesem Artikel
Zusammenfassung
Zusammenfassung
Lungenadenokarzinom (LUAD), die häufigste Unterart des Lungenkrebses, weist eine schlechte Prognose auf. Obwohl in LUAD eine mitotische Katastrophe ausgelöst werden kann, die zum Zelltod führt, bleibt die prognostische und biologische Bedeutung mitotischer katastrophbezogener Gene (MCRGs) bei dieser Erkrankung unklar. Differenziell exprimierte Gene (DEGs), die mit LUAD assoziiert sind, wurden aus dem TCGA-LUAD-Kollektiv herausgefiltert, und überlappende Gene wurden durch den Schnitt von DEGs mit MCRGs definiert. Mithilfe maschinellen Lernens wurden prognostische Kandidatengene ausgewählt, woraufhin ein multigenes prognostisches Modell erstellt wurde. Eine prognostische Signatur aus acht Kandidatengenen, bestehend aus PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 und S100B, wurde etabliert und zeigte in der Trainingsgruppe akzeptable Vorhersagezuverlässigkeit mit Flächen unter der Kurve (AUCs) von 0,723, 0,715 bzw. 0,625 für 2-, 3- und 5-Jahres-Zeiträume (bootstrap-korrigierter C-Index: 0,699, 95 % KI: 0,657–0,742) sowie konsistente Validierung in GSE31210 (AUCs: 0,812, 0,766 und 0,814). Patienten mit niedrigem Risiko wiesen signifikant bessere Überlebensresultate, eine stärkere Immuninfiltration, höhere Immun- und Stromawerte, erhöhte Immunphänotypscores sowie aktivere Krebsimmunitätszyklen auf. Zwischen den Gruppen mit hohem und niedrigem Risiko zeigten sich signifikante Unterschiede hinsichtlich der Tumormutationslast und der Empfindlichkeit gegenüber Medikamenten. Die quantitative Polymerase-Kettenreaktion (qPCR) bestätigte die transkriptomischen Profile von sechs prognosebezogenen Kandidatengenen in klinischen Proben. Ein Nomogramm, das den Risikoscore und den klinischen Stadiumsgrad integriert, zeigte eine gute Vorhersageleistung. Diese Ergebnisse zeigen, dass die acht MCRG-bezogenen Kandidatengene ein hohes Potenzial besitzen, das Patientenoutcome vorherzusagen und das Risiko bei LUAD zu stratifizieren, wobei zwischen den Risikogruppen deutliche Unterschiede im immunologischen Mikromilieu bestehen.
Einleitung
Lungenkrebs gehört weltweit weiterhin zu den häufigsten und tödlichsten Krebserkrankungen1,2. Das nicht-kleinzellige Lungenkarzinom (NSCLC) wird vor allem durch das Lungenadenokarzinom (LUAD) geprägt, das etwa 40 % aller Lungenkrebsfälle ausmacht3,4. Obwohl bedeutende Fortschritte bei operativen Verfahren, molekular gezielten Therapien, Immun-Checkpoint-Inhibitoren und Kombinationsregimen erzielt wurden, bleibt die klinische Prognose für LUAD-Patienten ungünstig5,6. Obgleich pathologische und bildgebende diagnostische Ansätze bei LUAD weit verbreitet sind, weisen sie inhärente Grenzen bei der Erfassung der Tumorheterogenität und molekularen Eigenschaften auf. Im Gegensatz dazu kann die Analyse von Tumorgewebe anhand molekularer Biomarker umfassendere Informationen über die Tumorbiologie liefern und zur prognostischen Beurteilung sowie zu individualisierten Behandlungsstrategien beitragen7. Daher ist die Identifizierung zuverlässiger molekularer Biomarker weiterhin wichtig, um die prognostische Vorhersage und das biologische Verständnis von LUAD zu verbessern.
Die Mitose, ein essenzieller Mechanismus der zellulären Replikation, gewährleistet die korrekte Verteilung replizierter Chromosomen auf zwei Tochterzellen8. Eine Fehlregulation mitotischer Prozesse kann eine unkontrollierte Zellproliferation, genomische Instabilität und Tumorprogression begünstigen. Der Begriff Mitotischer Kataklysmus (MC) beschreibt einen Zelltod-Weg, der durch das Versagen des Abschlusses der Mitose ausgelöst wird, typischerweise infolge einer Schädigung des Spindelapparats oder defekter Zellzyklus-Checkpoints9. Auf morphologischer Ebene zeigt sich MC durch zelluläre Auffälligkeiten wie Multinukleation, Mikrokernbildung, multipolare Spindelkonfigurationen und Polyploidisierung10. Als Mechanismus zur Eliminierung von Zellen mit schwerwiegenden mitotischen Defekten könnte MC zur Hemmung der Tumorprogression beitragen9. Die Deletion von p53 in A549-LUAD-Zellen kann einen mitotischen Kataklysmus und letztlich Zelltod induzieren11, was auf einen möglichen Zusammenhang zwischen MC und LUAD-assoziierten zellulären Prozessen hindeutet. Dennoch sind die prognostische Bedeutung und die biologischen Funktionen von MC-bezogenen Genen (MCRGs) bei LUAD bisher unzureichend geklärt.
In dieser Studie wurde die prognostische Bedeutung und die mögliche biologische Relevanz von MCRGs bei LUAD systematisch anhand von Daten aus TCGA und GEO untersucht. Kandidaten-MCRGs wurden zunächst durch differentielle Expressions- und Schnittmengenanalysen identifiziert. Mehrere maschinelle Lernverfahren dienten der Selektion der Kandidatengene und der Erstellung einer prognostischen Risikosignatur, die anschließend extern validiert wurde. Ein Nomogramm, das den Risikoscore zusammen mit klinischen Merkmalen integriert, wurde weiterentwickelt, um die Überlebensvorhersage zu verbessern. Zusätzlich dienten die Charakterisierung der immunen Mikroumgebung, die Bewertung somatischer Mutationen sowie die Analyse der Chemosensitivität der Untersuchung der biologischen Implikationen und klinischen Nützlichkeit der identifizierten Gene. Insgesamt belegen diese Ergebnisse das prognostische Potenzial von MCRGs bei LUAD und könnten die Entwicklung von Biomarkern sowie die individualisierte Therapie beeinflussen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Die Studie wurde gemäß der Deklaration von Helsinki durchgeführt, und das Protokoll wurde am 22. April 2025 vom Ethikkomitee des Anhui Chest Hospital (K2025-007) genehmigt. Von allen an der Studie beteiligten Probanden wurde informierte Einwilligung eingeholt.
Datenextraktion und Normalisierung
Transkriptomprofile und entsprechende klinische Datensätze für LUAD wurden aus den TCGA- und GEO-Kohorten bezogen. Der TCGA-LUAD-Datensatz wurde als Trainingsset festgelegt, wobei GSE72094, GSE31210 und GSE26939 als Kohorten zur externen Validierung dienten (Tabelle 1). Zusätzlich wurden 900 MCRGs aus einer früheren Studie gesammelt12 (Ergänzende Tabelle 1). Transkriptomdaten wurden mithilfe von GENCODE v36 oder den entsprechenden GPL-Plattform-Annotationsdateien annotiert. Die Probe-IDs wurden in Gen-Symbole umgewandelt, doppelte Gene mittels der avereps-Funktion zusammengeführt, und nur protein-kodierende Gene wurden beibehalten, um Gen-Ebene-Expressionsmatrizen zu erstellen. Für das TCGA-LUAD-Trainingsset wurden Gene mit Fragments per kilobase of exon model per million mapped fragments (FPKM) < 1 in mehr als 50 % der Proben herausgefiltert, und die verbleibenden Expressionswerte wurden log2-transformiert (log2[FPKM+1]). Für die GEO-Validierungskohorten wurden rohe Expressionsdaten heruntergeladen, die Probe-IDs mithilfe der jeweiligen Plattform-Annotationsdateien den Gen-Symbolen zugeordnet, und mehrere Proben, die demselben Gen entsprachen, wurden durch Mittelung ihrer Expressionswerte zusammengefasst. Diese Datensätze wurden gegebenenfalls log2-transformiert. Zwischen TCGA und GEO wurde keine korrekte Bereinigung von plattformübergreifenden Batch-Effekten vorgenommen, da wir eine kohortenweise Standardisierungsstrategie anwandten, um eine relative Vergleichbarkeit sicherzustellen. Konkret wurden für Trainings- und Validierungskohorten die Genexpressionswerte mittels des jeweiligen Mittelwerts und der Standardabweichung jedes Datensatzes zentriert und skaliert (z-Wert-Transformation). Die gleichen aus dem Trainingsset abgeleiteten Cox-Regressionskoeffizienten wurden anschließend verwendet, um Risikoscores für alle Kohorten zu berechnen. Um die klinische Anwendbarkeit zu bewahren und eine Überanpassung an irgendeinen Validierungssatz zu vermeiden, wurde der mediane Risikoscore der Trainingskohorte als fester Schwellenwert verwendet, um Patienten in Hoch- und Niedrigrisikogruppen über alle externen Validierungskohorten hinweg einzuteilen. Klinische Informationen, einschließlich Alter, Geschlecht, pathologisches Stadium, Tumor-Node-Metastase-(TNM-)Stadium, histologischer Typ, Überlebenszeit, Überlebensstatus und Gewebetyp, wurden bei Verfügbarkeit extrahiert. Der Endpunkt war das Gesamtüberleben (OS). Proben mit unvollständigen Überlebensinformationen oder einer Überlebenszeit < 30 Tagen wurden ausgeschlossen. Die Überlebenszeit wurde in Jahre umgerechnet, und der Überlebensstatus wurde als 0 für lebendig und 1 für verstorben kodiert.
Identifizierung und funktionelle Analyse von Kandidatengenen
Das Limma-Paket identifizierte differentiell exprimierte Gene (DEGs) zwischen LUAD-Tumor- und Normalproben im Trainingsset13. Die folgenden Kriterien definierten die DEGs: |log2FC| > 0,5 und adjustierter p-Wert < 0,05. Anschließend wurde der mfuzz-Fuzzy-Clustering-Algorithmus im R-Paket ClusterGVis verwendet, um die DEGs in unterschiedliche Expressionscluster zu unterteilen. Die Genontologie–biologischer Prozess (GO-BP)-Analyse wurde an den fünf repräsentativsten Genen jedes Clusters basierend auf ihren Zugehörigkeitsscores durchgeführt. Eine Menge gemeinsam exprimierter Gene ergab sich aus dem Durchschnitt der DEGs mit den MCRGs. Die funktionelle Anreicherungsanalyse mittels Genontologie/Kyoto Encyclopedia of Genes and Genomes (GO/KEGG) bewertete die biologische Relevanz der überlappenden Gene. Protein-Protein-Interaktionsnetzwerke (PPI) stammten aus der STRING-Datenbank14. Nur Interaktionen mit Konfidenzwerten > 0,7 blieben erhalten, um die Netzwerkzuverlässigkeit zu verbessern.
Screening prognostischer Gene
Mit dem Survival-Paket wurde eine univariate Cox-Regressionanalyse durchgeführt, um mögliche Gene zu identifizieren, die mit dem Gesamtüberleben bei LUAD15 assoziiert sind. Gene mit einem p-Wert < 0,05 wurden als potenzielle prognostische Indikatoren betrachtet. Die TCGA-LUAD-Trainingskohorte umfasste 500 Patienten mit vollständigen Überlebensdaten, von denen 216 (43,2 %) während der Nachbeobachtungszeit ein Todesereignis erlitten. Das Verhältnis von Kandidatengenen (n = 108) zu Ereignissen (n = 216) betrug etwa 1:2, was für eine Cox-Regressionanalyse akzeptabel ist. Anschließend erfolgte eine weitere Merkmalsauswahl mittels Least-Absolute-Shrinkage-and-Selection-Operator-(LASSO-)Regressionsanalyse und eines Extreme-Gradient-Boosting-(XGBoost-)Modells. Die Cox-Proportional-Hazards-Modelle wurden mit family = „cox“ mithilfe der cv.glmnet-Funktion des glmnet-Pakets erstellt. Der optimale Regularisierungsparameter wurde mittels 10-facher Kreuzvalidierung bestimmt, wobei der λ.min-Wert den minimalen Kreuzvalidierungsfehler repräsentierte und als optimaler λ-Wert ausgewählt wurde. Gene mit nicht-null Regressionskoeffizienten wurden als Kandidatenmerkmale extrahiert. Für das XGBoost-Modell wurden Überlebenszeit und Überlebensstatus zur Zielvariablen kombiniert, wobei positive Werte den Todesereignissen und negative Werte den zensierten Fällen zugeordnet wurden. Die Parameter wurden wie folgt festgelegt: objective = „survival:cox“ und eval_metric = „cox-nloglik“, mit 100 Iterationen und einer Lernrate von 0,1. Nach dem Modelltraining wurden die Wichtigkeitsscores der Gene anhand der Feature-Gain-Werte berechnet. Die 20 am höchsten bewerteten Gene wurden nach absteigender Sortierung der Wichtigkeitsscores beibehalten, um die Merkmalsdimensionalität und die Modellkomplexität zu reduzieren. Gemeinsame Gene aus den Ergebnissen von LASSO und XGBoost wurden als prognostische Kandidatengene identifiziert.
Konstruktion und Bewertung eines prognostischen Modells
Ein prognostisches Modell wurde mithilfe einer multivariaten Cox-Regressionanalyse der identifizierten Kandidatengene entwickelt. Die Risikoscores wurden individuell wie folgt berechnet:
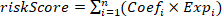 .
Dabei bezeichnet Coefi den Koeffizienten für das Gen i und Expi den entsprechenden Genexpressionswert. Die Individuen wurden anschließend anhand des medianen Risikoscores als Trennwert in zwei Gruppen eingeteilt: hohe Risikogruppe und niedrige Risikogruppe. Danach wurden zeitabhängige Receiver-Operating-Characteristic-(ROC)-Kurven erstellt. Um das Potenzial für eine Überanpassung zu bewerten, wurde eine interne Bootstrap-Validierung mit 1.000 Resampling-Durchgängen durchgeführt, um den biaskorrigierten C-Index und die zeitabhängigen AUCs mit 95 %-Konfidenzintervallen zu berechnen. Kalibrierungskurven wurden generiert, um die Übereinstimmung zwischen den vorhergesagten und beobachteten Überlebenswahrscheinlichkeiten nach 2, 3 und 5 Jahren zu bewerten. Außerdem wurde eine Entscheidungskurvenanalyse (DCA) mit dem ggDCA-Paket in R durchgeführt, um den klinischen Nettovorteil des Modells zu den Zeitpunkten 2, 3 und 5 Jahre zu bewerten und den potenziellen Nutzen des Risikoscores in klinischen Entscheidungsprozessen über verschiedene Schwellenwahrscheinlichkeiten hinweg zu quantifizieren. Überlebensunterschiede zwischen den risikostratifizierten Gruppen sowie zwischen anderen klinischen Kategorien wurden mittels Kaplan-Meier-(KM)-Überlebenskurven mit Log-Rank-Test verglichen. Um die Beiträge einzelner Gene zur Modellleistung aufzuklären, wurde eine Shapley-Additive-exPlanations-(SHAP)-Analyse zur nachträglichen erklärbaren Interpretation herangezogen.
Entwicklung und externe Validierung eines Nomogramms
Die Zusammenhänge zwischen den berechneten Risikoscores und verschiedenen klinischen Merkmalen (einschließlich Geschlecht, Alter und TNM-Stadium) wurden mithilfe des Wilcoxon-Rangsummentests oder des Kruskal-Wallis-Tests untersucht, um die klinische Anwendbarkeit des Modells zu bewerten. Um zu prüfen, ob der Risikoscore als unabhängiger prognostischer Faktor fungierte, wurden klinische Variablen zusammen mit dem Risikoscore in eine multivariate Cox-Regression eingebunden. Anschließend wurde ein prognostischer Nomogramm, das die unabhängigen klinischen Risikofaktoren (z. B. Stadium) und den genetischen Risikoscore vereint, mithilfe des regplot-R-Pakets erstellt, um die Vorhersage der Überlebenswahrscheinlichkeit zu individualisieren. Kalibrierungskurven dienten der Beurteilung der Übereinstimmung zwischen den vom Nomogramm vorhergesagten und den tatsächlich beobachteten Überlebensraten. Schließlich wurde die endgültige Vorhersagekraft und Generalisierbarkeit des integrierten Nomogramm-Systems durch zeitabhängige ROC-Kurven und umfassende KM-Analysen klinischer Subgruppen in den Kohorten streng validiert.
Analysen der Immuninfiltration und der Immunsubtypen
CIBERSORT wurde unter Verwendung der Leukozyten-Gen-Signaturmatrix (LM22) verwendet, um die relativen Anteile von 22 Immunzelltypen zur Beurteilung der Immunzellinfiltration bei LUAD-Patienten zu schätzen. Die Beziehungen zwischen prognostischen Genexpressionsniveaus und immunologischer Infiltration wurden mittels Spearman-Korrelationsanalyse bewertet. Immune-, Stromal-, Tumorreinheits- und ESTIMATE-Scores wurden über den ESTIMATE-Algorithmus abgeleitet, und Unterschiede zwischen Risikogruppen wurden mittels Wilcoxon-Test analysiert. LUAD-Patienten wurden mithilfe des ImmuneSubtypeClassifier-Pakets16 sechs Immunsubtypen zugeordnet. Der Wilcoxon-Test wurde zusätzlich verwendet, um die Verteilung der Immunsubtypen zwischen Risikogruppen zu vergleichen.
Analysen der Immun-Checkpoint, des Immunphänotypscores und des Krebsimmunzyklus
In dieser Studie diente der Wilcoxon-Rangsummentest zur Bewertung von 21 Immun-Checkpoint-Genen17 in risikostratifizierten Gruppen, um die immunologische Landschaft von LUAD zu charakterisieren. Die Spearman-Korrelation verknüpfte vielversprechende prognostische Gene mit Immun-Checkpoint-Genen. Um Unterschiede in der Reaktion auf Immun-Checkpoint-Inhibitoren (ICIs) bei LUAD-Patienten mit unterschiedlichem Risiko zu bewerten, wurden Immunphänotypisierungsscores (IPS) für Anti-PD-1- und Anti-CTLA-4-Behandlungen aus dem Cancer Immunome Atlas (TCIA)18 bezogen, und die Datenbank Tracking Tumor Immunophenotype (TIP)19 wurde verwendet, um die Aktivität des Krebs-Immunzyklus zu evaluieren und die entsprechenden Scores zwischen den Risikogruppen zu vergleichen.
Analyse von somatischen Mutationen und Arzneimittelsensitivität
Das TCGA-Mutations-Tool erhielt somatische Mutationsprofile für TCGA-LUAD-Fälle, um die Variation der Mutationsmuster zwischen Risikogruppen zu untersuchen. Das maftools-Paket verarbeitete und visualisierte die Mutationsdaten. Die Tumor-Mutationslast (TMB) wurde für jede Probe bestimmt und zwischen den beiden Risikokategorien verglichen. Eine pharmakogenomische Sensitivitätsanalyse wurde mithilfe des pRRophetic-Pakets gemäß der Genomics of Drug Sensitivity in Cancer (GDSC)-Datenbank20 durchgeführt. Die halbmaximale inhibitorische Konzentration (IC50) von Antikrebsmedikamenten wurde für jeden LUAD-Patienten vorhergesagt, und die Unterschiede zwischen den Risikogruppen wurden mittels des Wilcoxon-Rangsummentests quantifiziert.
Beurteilung der Expressionsniveaus prognostischer Gene
Jeder Datensatz diente der Beurteilung der Transkriptmengen ausgewählter potenzieller, ergebnisbezogener Gene. Um die Genexpression mit der Patientenprognose zu verknüpfen, wurden optimale Cutoff-Werte mithilfe der Funktion surv_cutpoint im R-Paket survminer ermittelt. Basierend auf diesen Schwellenwerten wurden die Fälle von LUAD in Subgruppen mit hoher und niedriger Expression eingeteilt, die anschließend einer Überlebenszeitanalyse unterzogen wurden.
Außerdem wurden fünf gepaarte Proben von Lungenadenokarzinom (LUAD)-Tumoren und angrenzendem Normalgewebe vom Anhui Chest Hospital bezogen, und anschließend erfolgte die Validierung mittels qPCR. Jeder Teilnehmer gab eine schriftliche, informierte Einwilligung ab. Sechs prognostische Kandidatengene (PDGFB, LDHA, ZEB2, FKBP4, DMD und S100B) wurden für die qPCR-Validierung ausgewählt. RNA wurde aus homogenisierten Gewebeproben mittels RNA-Extraktionsreagenz, gefolgt von Chloroform-Extraktion und Isopropanol-Fällung, isoliert. Mithilfe eines Spektrophotometers wurde die RNA-Konzentration und -reinheit gemessen. Die qPCR-Validierung der sechs prognostischen Kandidatengene erfolgte mit einem SYBR-Green-basierten PCR-Mastermix auf einem Echtzeit-PCR-System: zunächst eine Denaturierung bei 95 °C für 30 s, gefolgt von 40 Zyklen mit jeweils 20 s bei 95 °C, 20 s bei 55 °C und 20 s bei 72 °C. Die relative Expression wurde berechnet und mit der 2-ΔΔCt-Methode auf Glyceraldehyde-3-Phosphate Dehydrogenase (GAPDH) standardisiert. Alle Einzelheiten zu Reagenzien und Instrumenten sind in der Tabelle der Materialien angegeben.
Statistische Analyse
Die statistischen Analysen wurden mit Software für statistisches Rechnen und Visualisierung durchgeführt. Das Protein-Protein-Interaktionsnetzwerk wurde mithilfe von Software zur Netzwerkanalyse dargestellt. Nach der Beurteilung der Normalverteilung wurde der Student-t-Test für normalverteilte kontinuierliche Variablen und der Mann-Whitney-U-Test für nicht normalverteilte Variablen verwendet.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Identifizierung von Kandidatengenen und funktionelle Analyse
Insgesamt wurden 4.915 DEGs detektiert, darunter 2.485 down-DEGs und 2.430 up-DEGs (Abbildung 1A). Die funktionelle Modul-Clustering-Analyse klassifizierte diese DEGs in sechs Expressionsmodule (C1–C6), wobei die Module C1, C2, C3 und C5 in Tumorproben relativ höhere Expression aufwiesen (Abbildung 1B). Die funktionelle Annotation zeigte, dass diese Module m...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
LUAD gehört zu den häufigsten Formen des Lungenkrebses und stellt weiterhin eine erhebliche Belastung für die öffentliche Gesundheit dar21. Die MC ist ein zelltodbezogener Prozess, der zur Eliminierung von Zellen mit schwerwiegenden mitotischen Anomalien und zur Hemmung der Tumorprogression beitragen kann22. Daher könnte die Untersuchung der potenziellen Rolle von MCRGs bei LUAD helfen, prognostische Biomarker zu identifizieren und das Verständnis der LUAD-Biologie zu verbe...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren geben keine Interessenkonflikte an.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| ClusterGVis | CRAN | Version 0.1.2 | Genexpressions-Clustering und Visualisierung |
| Cytoscape | Cytoscape Consortium | Version 3.9.1 | Visualisierung von Proteininteraktionsnetzwerken RRID:SCR_003032 |
| CFX384 Real-Time Quantitative Fluorescent PCR System | Bio-Rad | CFX384 Touch | qPCR-Reagenz |
| DMD-Primer | Tsingke | N/V | Forward: 5’-GCTCAACCATCGATTTGCAGCC-3’ Reverse: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| FKBP4-Primer | Tsingke | N/V | Forward: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Reverse: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Online-Tool | Bezug des externen Validierungsdatensatzes für LUAD RRID:SCR_005012 |
| GAPDH-Primer | Tsingke | N/V | Forward: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Reverse: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | Version 4.1-8 | Merkmalsauswahl bei LASSO-Regression RRID:SCR_015505 |
| LDHA-Primer | Tsingke | N/V | Forward: 5’-GGATCTCCAACATGGCAGCCTT-3’ Reverse: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | Version 3.60.6 | DEG-Screening RRID:SCR_010943 |
| maftools | Bioconductor | Version 2.20.0 | Visualisierung somatischer Mutationsdaten RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Vorhersage von Wirkstoff-IC50-Werten RRID:SCR_024417 |
| PDGFB-Primer | Tsingke | N/V | Forward: 5’-GAGATGCTGAGTGACCACTCGA-3’ Reverse: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | qPCR-Reagenz |
| R-Software | R Foundation | Version 4.2.2 | Bioinformatische Analyse |
| regplot | CRAN | Version 1.1 | Erstellung von Liniendiagrammen |
| survival | CRAN | Version 3.8-3 | Überlebensanalyse und Cox-Regression RRID:SCR_021137 |
| STRING | STRING Consortium | Online-Tool | Analyse von Proteininteraktionsnetzwerken RRID:SCR_005223 |
| S100B-Primer | Tsingke | N/V | Forward: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Reverse: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | Version 0.5.0 | Erstellung und Optimierung von Überlebenskurven RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | qPCR-Reagenz |
| TCGA | NCI | Online-Tool | Erwerb von LUAD-Transkriptom- und klinischen Daten RRID:SCR_003193 |
| ZEB2-Primer | Tsingke | N/V | Forward: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Reverse: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Referenzen
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Nachdrucke und Genehmigungen
Dieser Artikel wurde veröffentlicht
Video demnächst verfügbar