Dieses Protokoll beschreibt, wie ein Multiview-Vision Mamba U-shaped Network-Framework für medizinische Bildsegmentierung gebaut, trainiert und bewertet werden kann, wodurch eine reproduzierbare Segmentierung von Hautläsionen und Bauchorganen durch standardisierte Datensatzvorbereitung, Modellimplementierung und Leistungsbewertung möglich ist.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Multi-View Vision Mamba U-shaped Network Framework für medizinische Bildsegmentierung
In diesem Artikel
Zusammenfassung
Zusammenfassung
Medizinische Bildsegmentierung erfordert rechnerische Methoden, die globalen Kontext, lokale Grenzen und multiskalige anatomische Strukturen genau erfassen und gleichzeitig in verschiedenen Anwendungen reproduzierbar bleiben. Dieser Artikel stellt ein Protokoll zur Konstruktion, zum Training und zur Bewertung eines Multi-view Vision Mamba U-Shaped Network-Frameworks für zweidimensionale medizinische Bildsegmentierung vor. Das Protokoll bietet einen reproduzierbaren Workflow, der öffentliche Datensatzerfassung, Bild- und Maskenvorverarbeitung, Netzwerkaufbau, Modelltraining, Checkpoint-Auswahl sowie quantitative und qualitative Leistungsbewertung umfasst. Das Framework integriert Multiview-Feature-Scanning, um komplementäre räumliche, Kontur-, Skalierungs- und Randinformationen zu erfassen, und wendet mehrstufige Feature-Fusion innerhalb einer U-förmigen Encoder-Decoder-Architektur an, um die Feature-Integration während der Segmentierung zu verbessern. Das Protokoll wird mithilfe öffentlich zugänglicher Datensätze zur Hautläsion und der Segmentierung von Bauchorganen demonstriert. Unter dem beschriebenen Implementierungsworkflow erreicht das Framework eine wettbewerbsfähige Segmentierungsleistung mittels standardisierter Bewertungskennzahlen. Durch die Befolgung der in diesem Protokoll vorgestellten Verfahren können Forscher die Modellimplementierung reproduzieren, das Netzwerk mit definierten experimentellen Umgebungen trainieren, die Segmentierungsleistung bewerten und den Arbeitsablauf für verwandte medizinische Bildsegmentierungsaufgaben anpassen, die reproduzierbare, auf Deep-Learning-Basis basierende Analyse erfordern.
Einleitung
Medizinische Bildsegmentierung ist eine grundlegende Aufgabe in den Bereichen Computer Vision und medizinische Bildanalyse 1,2,3. Dabei wird ein Bild in mehrere Bereiche oder Objekte unterteilt, um es weiter zu analysieren und zu verarbeiten. Diese Technologie ist besonders wichtig in der medizinischen Bildgebung, da sie Klinikern hilft, pathologische Regionen zu identifizieren und zu lokalisieren, wodurch die diagnostische Genauigkeit und Behandlungsplanung verbessert werden. Mit dem Fortschritt medizinischer Bildgebungstechnologien wie Magnetresonanztomographie (MRT), Computertomographie (CT) und Positronenemissionstomographie (PET) ist die Nachfrage nach präzisen medizinischen Bildsegmentierungstechniken weiter gestiegen. Aktuelle Methoden zur Segmentierung medizinischer Bilder lassen sich grob in drei Hauptansätze einteilen: konvolutionelle neuronale Netzwerke (CNN)-basierte Methoden4, Transformer-basierte Methoden5 und Zustandsraummodell-(SSM)-basierte Methoden 6,7. CNN-basierte Methoden verwenden typischerweise U-förmige Netzwerkarchitekturen für die Segmentierung medizinischer Bilde. Die am weitesten verbreitete Architektur in dieser Kategorie ist U-Net8, die die Wirksamkeit einer U-förmigen Encoder-Decoder-Architektur für biomedizinische Bildsegmentierung demonstrierte. U-Net3+ kombiniert dichte Skip-Verbindungen von UNet++9 mit vollmaßstäblichen Skip-Verbindungen, um die Multiscale-Feature-Aggregation zu verbessern. CNN-basierte Methoden haben jedoch nur begrenzte Fähigkeit, Langstreckenabhängigkeiten zu erfassen, und modellieren daher möglicherweise nicht effektiv langfristige kontextuelle Informationen.
Transformatorbasierte Methoden erfassen langfristige Abhängigkeiten effektiv durch den Selbst-Aufmerksamkeitsmechanismus, der parallele Berechnungen ermöglicht und unterschiedliche Aufmerksamkeitsgewichte für verschiedene Interessensgebiete zuweist. UNETR++10 führt das Modul Efficient Paired Attention (EPA) ein, um die Anzahl der Parameter und die Rechenkosten zu reduzieren. nnFormer11 kombiniert ineinandergreifende Faltungs- und Selbstaufmerksamkeitsoperationen und führt einen lokal–globalen, volumenbasierten Selbst-Aufmerksamkeitsmechanismus zum Erlernen volumetrischer Darstellungen in dreidimensionaler (3D) medizinischer Bildsegmentierung ein. H2Former12 schlägt einen effizienten hierarchischen hybriden Vision Transformer vor, der Aufmerksamkeitsmechanismen mit CNN-basierter Merkmalsextraktion im Encoder kombiniert. Transformatorbasierte Methoden zeigen jedoch quadratische Rechenkomplexität mit zunehmender Sequenzlänge, was zu deutlich höheren Rechenkosten führt. Abbildung 1 veranschaulicht die Motivation für MVM-UNet und vergleicht die vorgeschlagene Multiview-Scan-Strategie mit bestehenden SSM-basierten Segmentierungsrahmen.
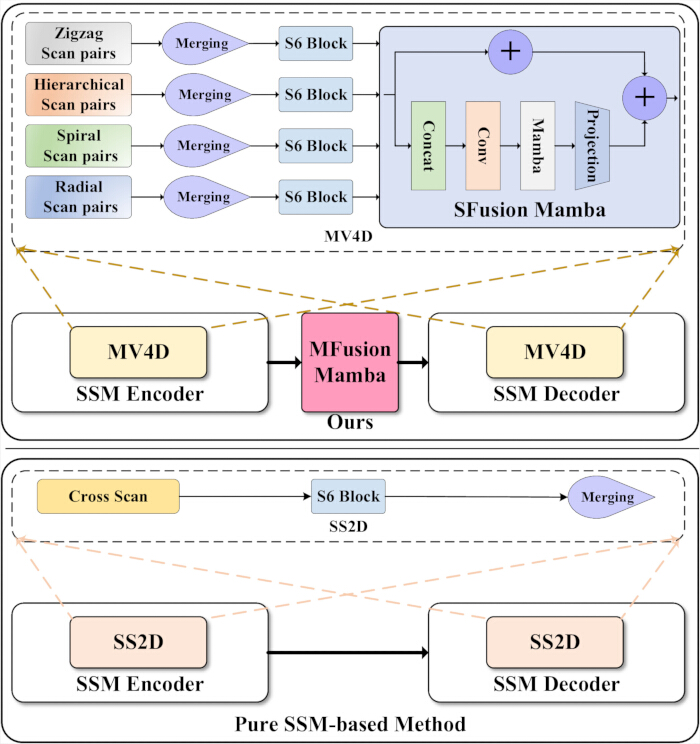
Abbildung 1. Vergleich von MVM-UNet mit bestehenden reinen Zustandsraummodell-(SSM)-basierten Segmentierungsarchitekturen. Vergleich zwischen einem konventionellen, auf reinem Zustandsraummodell (SSM)-basierten Segmentierungsrahmen und der vorgeschlagenen Multi-View Mamba U-Net (MVM-UNet)-Architektur. Das obere Panel zeigt MVM-UNet, in dem das Multi-View 4-Directional (MV4D) Modul komplementäre Merkmale mithilfe von Zickzack-, Hierarchische-, Spiral- und Radialscan-Paaren extrahiert, die durch Spatial Fusion Mamba (SFusion Mamba) integriert werden, während Multistage Fusion Mamba (MFusion Mamba) Multiscale-Encoder-Features vor der Dekodierung aggregiert. Das untere Panel zeigt eine repräsentative, reine SSM-basierte Architektur, die Selective Scan 2-Dimensional (SS2D) Module mit Cross-Scanning verwendet. Die Abbildung hebt die architektonischen Unterschiede zwischen konventionellen SSM-basierten Segmentierungsnetzwerken und dem vorgeschlagenen MVM-UNet hervor. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
SSM-basierte Methoden kombinieren die globale Modellierungsfähigkeit von Transformatoren mit linearer Rechenkomplexität. Die Mamba-Architektur verarbeitet Eingabeinformationen selektiv mittels eines selektiven Zustandsraummodells (Selective-SSM), wodurch das Modell seine Parameter dynamisch entsprechend der Eingabe anpassen kann, während irrelevante Informationen gefiltert und informative Funktionen hervorgehoben werden. Vim13 und VMamba14 passen die Mamba-Architektur für Computer-Vision-Aufgaben an. U-Mamba15 verwendet eine hybride CNN–SSM-Architektur, um die Anwendung von SSMs in der Segmentierung medizinischer Bilder zu erforschen, während Mamba-UNet16 eine vollständig SSM-basierte Encoder-Decoder-Architektur für die Segmentierung medizinischer Bilder verwendet. Diese Methoden erzielen wettbewerbsfähige Leistungen bei deutlich weniger Parametern. Derzeit extrahieren SSM/Mamba-basierte Methoden jedoch hauptsächlich Bildmerkmale mittels einfacher Bildpatches und SS2D-Scanningsstrategien, die mehrere Einschränkungen für die medizinische Bildsegmentierung mit sich bringen. Erstens sind SS2D- und patchbasierte Techniken hauptsächlich für allgemeine Computer-Vision-Aufgaben konzipiert. Local Mamba17 und Motion Mamba18 haben vorgeschlagen, dass die SS2D-Scan-Strategie für alle visuellen Aufgaben unzureichend ist, da verschiedene Scan-Strategien unterschiedliche Arten visueller Informationen erfassen. Zweitens ist die SS2D-Scanstrategie relativ einfach und verlässt sich nur auf horizontale und vertikale Scanrichtungen. Folglich erfasst sie möglicherweise nicht ausreichend komplexe räumliche Beziehungen und feine strukturelle Details. Die Segmentierung medizinischer Bilder erfordert eine gleichzeitige Modellierung sowohl des globalen räumlichen Kontexts als auch präziser lokaler anatomischer Merkmale. Darüber hinaus bieten aktuelle SSM/Mamba-basierte Methoden eine begrenzte Funktionsfusion zwischen Encoder und Decoder. Architekturen wie UNet++ und FATNet verbessern die Segmentierungsgenauigkeit durch verbesserte Feature-Fusion und unterstreichen die Bedeutung einer effektiven Feature-Integration für die Segmentierung medizinischer Bilder.
Um diese Einschränkungen zu beheben, schlägt dieses Papier ein neuartiges, auf Mamba basierendes medizinisches Bildsegmentierungssystem vor, das MVM-UNet genannt wird. Wie in Abbildung 1 dargestellt, dient das vorgeschlagene Multi-View Four-Directional (MV4D)-Modul als Kernkomponente zur Feature-Extraktion von MVM-UNet und ist speziell für die Segmentierung medizinischer Bilder konzipiert, indem Informationen aus vier unterschiedlichen Scanstrategien integriert werden. Jede Scan-Strategie extrahiert komplementäre Bildmerkmale und stellt eine andere Ansicht des Eingabebildes dar. Zickzack-Scanning19 wechselt die Durchlaufrichtung am Ende jeder Reihe oder Spalte ab und balanciert so lokale und globale räumliche Informationen aus. Im Gegensatz dazu bieten spiralförmige und radiale Scanschemata20 eine umfassende Abdeckung, indem sie entweder vom Zentrum nach außen oder vom Rand nach innen erstrecken. Hierarchisches Scannen18 erfasst sowohl lokale als auch globale Merkmale auf mehreren Skalen. Um die Robustheit jeder Scan-Strategie zu verbessern, werden die Scanpaare zusammengeführt, bevor sie in den S6-Block eingegeben werden. Das Scan-view Fusion Mamba (SFusion Mamba)-Modul integriert anschließend die aus den vier Scanmodalitäten extrahierten Merkmale. Um Multiscale-Encoder-Funktionen effektiv zu nutzen, schlägt dieses Paper außerdem ein Multiscale-Mamba-Fusionsmodul (MFusion Mamba) vor, das die Ausgänge jeder Encoderstufe sammelt und fusioniert, bevor die fusionierten Features an den Decoder weitergeleitet werden. MVM-UNet wurde auf den Datensätzen ISIC 2017, ISIC 2018 und Synapse ausgewertet. Experimentelle Ergebnisse zeigen, dass MVM-UNet auf den ISIC 2017, ISIC 2018 und Synapse-Datensätzen eine wettbewerbsfähige Segmentierungsleistung erzielt.
Repräsentative Segmentierungsarchitekturen haben die Segmentierung medizinischer Bilder weiter vorangebracht. U-Net wurde auch erfolgreich für biomedizinische Bildanalyseaufgaben wie Zellzählung, -erkennung und Morphometrie21 eingesetzt. Aufmerksamkeitsverstärkte CNN-Architekturen wie CA-Net22 verbessern die Merkmalsrepräsentation durch umfassende Aufmerksamkeitsmechanismen. Repräsentative, transformatorbasierte Segmentierungsrahmen, darunter TransUNet23, Pyramid Medical Transformer24, Swin U-Net25, TransAttUNet26 und TransCUNet27, demonstrieren zudem die Wirksamkeit aufmerksamkeitsbasierter globaler Merkmalmodellierung für medizinische Bildsegmentierung.
Das Design von MVM-UNet wird durch zwei Einschränkungen bestehender SSM/Mamba-basierter Segmentierungsmethoden motiviert. Erstens basieren viele aktuelle Vision Mamba-Modelle auf einfachen zweidimensionalen Scan-Strategien, die für medizinische Bilder mit unregelmäßigen Läsionsgrenzen, kleinen Zielregionen und multiskaligen anatomischen Strukturen möglicherweise unzureichend sind. Zweitens übertragen konventionelle U-förmige Encoder-Decoder-Architekturen hauptsächlich Funktionen über entsprechende Skip-Verbindungen, was die direkte Nutzung von mehrstufigen Encoderinformationen während der Dekodierung einschränkt. Daher führt MVM-UNet MV4D ein, um die Multiview-Raummodellierung zu verbessern, und MFusion Mamba, um explizit mehrstufige Encoderfunktionen zu aggregieren. Dieses Design soll die auf Mamba basierende Langstreckenmodellierung an die spezifischen Anforderungen der medizinischen Bildsegmentierung anpassen.
Obwohl MVM-UNet auf dem allgemeinen Encoder-Decoder-Paradigma und der Mamba-basierten Sequenzmodellierung basiert, liegt seine Neuheit darin, wie diese Komponenten für die medizinische Bildsegmentierung angepasst und integriert werden. Anstatt einfach einen Standard-Mamba-Block in ein U-förmiges Netzwerk-Backbone zu integrieren, gestaltet das vorgeschlagene Framework den räumlichen Modellierungsprozess durch mehrere aufgabenorientierte Scan-Pair-Zweige neu, führt SFusion Mamba ein, um scan-spezifische Darstellungen zu integrieren, verbessert den MVV-Block mit Rest- und Projektionspfaden und fügt MFusion Mamba zwischen Encoder und Decoder ein, um mehrstufige Encoder-Funktionen vor der Dekodierung zu aggregieren. Dieses Design auf Architekturebene zielt darauf ab, die unregelmäßigen Grenzen, kleinen Zielregionen und multiskaligen anatomischen Strukturen zu adressieren, die häufig in medizinischen Bildern beobachtet werden.
Dieses Protokoll eignet sich am besten für Segmentierungsaufgaben, die eine gleichzeitige Modellierung von Fernkontextinformationen, unregelmäßigen Objektgrenzen und multiskaligen anatomischen Strukturen in zweidimensionalen medizinischen Bildern erfordern. Im Vergleich zu CNN-basierten Segmentierungsmethoden bietet das Mamba-basierte Encoder-Decoder-Design einen effektiven Kontextmodellierungsmechanismus, während ein U-förmiger Arbeitsablauf beibehalten bleibt, der medizinischen Bildsegmentierungsforschern vertraut ist. Im Vergleich zu Transformer-basierten Methoden vermeidet das vorgeschlagene Framework die direkte Nutzung quadratischer Selbstaufmerksamkeit und richtet sich an Forscher, die globale kontextuelle Modellierung mit einem relativ effizienten Sequenzmodellierungsmechanismus suchen. Dementsprechend eignet sich dieses Protokoll für Hautläsionsegmentierung, Segmentierung von Bauchorganen und ähnliche zweidimensionale medizinische Bildsegmentierungsaufgaben, bei denen sowohl globale strukturelle Informationen als auch lokale Randdetails wichtig sind.
Dieses Protokoll hat zudem Einschränkungen, die vor der Anwendung berücksichtigt werden sollten. Für relativ einfache Segmentierungsaufgaben, bei denen ein leichtes CNN bereits ausreichende Leistung bietet, ist es möglicherweise nicht notwendig. Außerdem ist sie nicht direkt für eine vollständige dreidimensionale volumetrische Segmentierung ohne architektonische Anpassung konzipiert. Forscher mit sehr begrenzten annotierten Daten, begrenzten Ressourcen der Grafikeinheit (GPU) oder einem Bedarf an hochinterpretierbaren klassischen Modellen sollten diese Einschränkungen ebenfalls berücksichtigen, bevor sie das Protokoll anwenden. Insgesamt ist diese Methode für Forscher gedacht, die ein Mamba-basiertes, U-förmiges Segmentierungsframework reproduzieren und evaluieren möchten, das Langzeitkontextmodellierung, lokale Randdarstellung und mehrstufige Merkmalsfusion ausbalanciert.
Die wichtigsten Beiträge sind wie folgt:
1. Dieses Papier präsentiert ein neuartiges, auf Mamba basierendes medizinisches Bildsegmentierungs-Framework, das MVM-UNet genannt wird. Im Gegensatz zu Ansätzen, die bereits bestehende SS2D-basierte oder Standard-Mamba-Blöcke direkt integrieren, führt MVM-UNet MV4D ein, um medizinische Bildmerkmale aus vier komplementären Scanpaar-Ansichten zu modellieren, darunter Zickzack-, hierarchische, spiral- und radiale Scans.
2. Dieses Paper entwirft SFusion Mamba und den MVV-Block, um scan-spezifische Darstellungen zu integrieren und die Feature-Transformation zu verbessern. SFusion Mamba fusioniert die aus verschiedenen Scanpaar-Zweigen extrahierten Merkmale, während die Residual- und Up-Down-Projektion-Zweige im MVV-Block komplementäre Merkmalswege bieten, die die Merkmalsrepräsentationen stabilisieren und bereichern.
3. Dieses Paper führt MFusion Mamba als intermediäres mehrstufiges Fusionsmodul zwischen Encoder und Decoder ein. Im Gegensatz zu herkömmlichen Skip-Verbindungen, die hauptsächlich korrespondierende Stufenmerkmale übertragen, aggregiert MFusion Mamba explizit mehrstufige Encoderfunktionen durch grobe bis feine Fusion und liefert erweiterte Informationen für die Dekodierung.
4. Umfangreiche experimentelle Ergebnisse zeigen, dass das vorgeschlagene MVM-UNet eine wettbewerbsfähige Segmentierungsleistung auf den ISIC 2017- und ISIC 2018-Datensätzen sowie eine starke Leistung auf dem Synapse-Multiorgan-Segmentierungsdatensatz erzielt. Darüber hinaus validieren umfassende Ablationsstudien den Beitrag jeder einzelnen Komponente innerhalb von MVM-UNet.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie nutzte ausschließlich öffentlich zugängliche und de-identifizierte medizinische Bilddatensätze, darunter ISIC 2017, ISIC 2018 und Synapse. In dieser Studie wurden keine neuen menschlichen Teilnehmer, Tierprobanden oder identifizierbare private medizinische Unterlagen gesammelt. Der in dieser Studie verwendete ISIC-2017-Datensatz war der ISIC 2017 Challenge Skin Lesion Segmentation Dataset, der aus dem offiziellen International Skin Imaging Collaboration Challenge Data Repository (https://challenge.isic-archive.com/data/#2017) stammt. Die in dieser Studie verwendete Datensatzversion entspricht der ISIC-Läsionssegmentierungsaufgabe 2017, einschließlich der offiziellen Trainings-, Validierungs- und Testpartitionen. Der Datensatz wurde am 15. März 2024 heruntergeladen. Der in dieser Studie verwendete ISIC 2018-Datensatz war der ISIC 2018 Challenge Task 1 Lesion Boundary Segmentation Dataset, der aus dem offiziellen International Skin Imaging Collaboration Challenge-Datenrepository (https://challenge.isic-archive.com/data/#2018) stammt. Die in dieser Studie verwendete Datensatzversion entspricht der ISIC 2018 Aufgabe 1: Segmentierung von Läsionsgrenzen. Der Datensatz wurde am 8. Juli 2024 heruntergeladen.
Der in dieser Studie verwendete Synapse-Datensatz war der Multi-Atlas Labeling Beyond the Cranial Vault abdominale CT-Datensatz, der aus dem Synapse-Repository unter der Zugangskennnummer syn3193805 (https://www.synapse.org/Synapse:syn3193805) stammt. Der in dieser Studie verwendete Datensatz entspricht dem häufig verwendeten 30-Fälle umfassenden abdominalen CT-Multiorgansegmentierungsdatensatz. Das heruntergeladene Archiv war Abdomen/RawData.zip, verfügbar unter Accession syn3193805. Zum Zeitpunkt des Downloads gab das Repository keine separate Versionsnummer, kein Veröffentlichungsetikett oder datiertes Veröffentlichungsetikett an. Nach der in früheren Studien verwendeten Standardaufteilung wurden 18 Fälle für die Ausbildung und 12 Fälle für Tests verwendet. Die Datenaufteilung folgte der Fallliste, die von TransUNet23 verwendet wurde. Konkret waren die Trainingsfälle case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0023, case0040, case0010, case0021, case0006, case0027, case0028 und case0037, während die Testfälle case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 und case0035 waren. Der Datensatz wurde am 9. Juli 2024 heruntergeladen. Da diese Studie ausschließlich öffentlich zugängliche, de-identifizierte Datensätze verwendete und keine neuen Daten von Menschen oder identifizierbare private Informationen sammelte, war für die in diesem Protokoll beschriebenen rechnergestützten Experimente keine Genehmigung des institutionellen Überprüfungsausschusses erforderlich. Es wurde keine formelle schriftliche institutionelle Ausnahmeregelung erwirkt. Wenn es die lokale institutionelle Richtlinie verlangt, sollten Forscher vor der Durchführung von Sekundäranalysen öffentlich zugänglicher Datensätze eine institutionelle Ausnahmeregelung einholen. Für diese Studie lagen keine institutionelle Ethik-Ausnahme-Referenznummer oder formelle Ausnahmedokumentation vor.
1. Vorbereitung von Datensätzen
- Laden Sie den ISIC-Datensatz zur Hautläsionsegmentierung 2017 aus dem offiziellen International Skin Imaging Collaboration-Repository herunter. Nutzen Sie die offiziellen Trainings-, Validierungs- und Testpartitionen. Überprüfen Sie, dass der Datensatz 2.000 Trainingsbilder, 150 Validierungsbilder und 600 Testbilder enthält.
- Laden Sie den ISIC 2018 Hautläsionssegmentierungsdatensatz aus dem offiziellen International Skin Imaging Collaboration-Repository herunter. Nutzen Sie die offiziellen Trainings-, Validierungs- und Testpartitionen. Überprüfen Sie, dass der Segmentierungsdatensatz 2.594 Trainingsbilder, 100 Validierungsbilder und 1.000 Testbilder enthält.
- Laden Sie den Synapse-Multiorgan-Segmentierungsdatensatz herunter. Verwenden Sie die Standardaufteilung, bestehend aus 18 Fällen (2.212 axiale Schnitte) für das Training und 12 Fällen (1.567 axiale Schnitte) zum Testen. Führen Sie kein separates Validierungsset ein.
- Reservieren Sie die 12 Testfälle ausschließlich für die Endbewertung. Verwenden Sie die Testfälle nicht für Modelltraining, Hyperparameter-Tuning oder Modellauswahl. Die Segmentierungsaufgabe umfasst acht Bauchorgane: Aorta, Gallenblase, Milz, linke Niere, rechte Niere, Leber, Bauchspeicheldrüse und Magen.
- Verwenden Sie die folgende Synapse-Datensatzaufteilung. Die 18 Trainingsfälle waren case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 und case0037. Die 12 Testfälle waren case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 und case0035.
- Organisieren Sie jeden Datensatz in separate Image- und Maskenordner. Stellen Sie sicher, dass jedes Bild eine entsprechende Segmentierungsmaske mit derselben Fallkennung besitzt.
- Jede Hautläsionsmaske in eine binäre Vordergrund-Hintergrund-Segmentierungskarte umwandeln. Behalte die ursprünglichen Multiclass-Organ-Labels für den Synapse-Datensatz bei.
- Für die ISIC 2017 und ISIC 2018 Datensätze weisen Sie nach der Binärmaskenkonvertierung einen Label-Wert von 0 auf Hintergrundpixel und 1 auf Läsions-(Vordergrund-)Pixel zu. Pixel mit ursprünglichen Maskenwerten höher als 0 werden als Vordergrund behandelt und in 1 umgewandelt, während Pixel mit ursprünglichen Maskenwerten von 0 als Hintergrund behandelt und als 0 beibehalten werden. Für den Synapse-Datensatz werden die ursprünglichen ganzzahligen Label-Werte beibehalten, wobei 0 die Hintergrundklasse und 1–8 die acht Vordergrundorganklassen darstellt.
- Vergrößern Sie ISIC 2017 und ISIC 2018 Bilder und Masken auf 256 × 256 Pixel, ohne das ursprüngliche Seitenverhältnis zu erhalten. Verwenden Sie keine Beschneidung oder Polsterung.
- Skalieren Sie jeden Synapse-CT-Schnitt und das entsprechende Label auf 224 × 224 Pixel. Verwenden Sie bilineare Interpolation für RGB-Bilder, Spline-Interpolation dritter Ordnung für CT-Schnitte und nächstgelegene Nachbarinterpolation für Segmentierungsmasken.
- Bildgröße in Python anpassen.
- Für die ISIC 2017 und ISIC 2018 Datensätze verwenden Sie die benutzerdefinierte myResize-Transformation, die in utils.py implementiert ist und torchvision.transforms.functional.resize aufruft, um sowohl Bild- als auch Maskentensoren auf 256 × 256 Pixel zu vergrößern. Spezifizieren Sie in dieser Transformation keinen expliziten Interpolationsmodus oder Anti-Aliasing-Argument.
- Für den Synapse-Datensatz verwenden Sie scipy.ndimage.zoom in Datasets/dataset.py. Die CT-Bildschnitte werden auf 224 × 224 Pixel mit der Interpolation dritter Ordnung der Spline (Ordnung = 3) geändert und die Label-Maps mit nächster Nachbar-Interpolation (Ordnung = 0) angepasst. Wenden Sie beim Größenändern keine separate Anti-Aliasing-Operation oder eine anti_aliasing=True-Einstellung an.
- Normalisieren Sie jedes ISIC-RGB-Bild vor der Tensorumwandlung mit dem datensatzspezifischen Mittelwert und der Standardabweichung (SD) mit Gleichung 1 wie folgt:
 (1)
Dann skalieren Sie das normalisierte Bild mit Min–Max-Normalisierung auf den Bereich 0–255 neu.- Verwenden Sie μ = 159,922 und σ = 28,871 für das ISIC 2017 Training Set sowie μ = 148,429 und σ = 25,748 für die ISIC 2017 Validierungs- und Testsets. Verwenden Sie μ = 157,561 und σ = 26,706 für das ISIC 2018 Training Set sowie μ = 149,034 und σ = 32,022 für die ISIC 2018 Validierungs- und Testsätze.
- Wandeln Sie jedes normalisierte Bild in einen Tensor der Form 3 × 256 × 256 um. Wandeln Sie jede binäre Maske in einen Tensor der Form 1 × 256 × 256 um.
- Führen Sie eine Min–Max-Normalisierung unabhängig für jedes Bild nach der datensatzspezifischen Mittelwert- und Standardabweichungsnormalisierung durch. Konkret subtrahiert man den datensatzspezifischen Mittelwert von jedem Bild und teilt durch die entsprechende Standardabweichung.
- Berechnen Sie die Minimal- und Maximalintensitätswerte aus dem normalisierten Bild und skalieren Sie das Bild mit diesen Minimal- und Maximalwerten pro Bild auf den Bereich 0–255 neu. Verwenden Sie für diesen Min–Max-Reskalierungsschritt keine datensatzweiten Mindest- und Maximalwerte.
- Bereiten Sie jeden Synapse-CT-Schnitt als zweidimensionales Graustufenbild vor. Konvertiere jede CT-Scheibe in float32 und füge eine Singleton-Kanaldimension hinzu, um einen Eingabetensor mit Form 1 × 224 × 224 zu erhalten.
- Jede Synapse-Label-Abbildung wird als Einzelkanal-Ganzzahl-Maske mit Form 224 × 224 beibehalten. Wenden Sie keine zusätzliche Mean-SD-Normalisierung auf Datensatzebene im Datenlader an.
- Verwenden Sie die im .npz-Format bereitgestellten vorverarbeiteten Synapse-Dateien zum Training von Slices und .npy.h5 zum Testen der Volumes. Laden Sie die Bild- und Label-Arrays direkt aus jeder .npz-Datei während des Trainings und direkt aus jeder .npy.h5-Datei während des Tests. Wenden Sie im freigegebenen Datenloader kein zusätzliches Intensitätsclipping, CT-Fenster, Datensatz-Level-Normalisierung oder Rohvolumen-Resampling an.
- Während des Modelltrainings wird jeder geladene zweidimensionale Schnitt in float32 umgewandelt, mit scipy.ndimage.zoom mit Ordnung = 3 für Bildschnitte und Ordnung = 0 für Label-Karten auf die Zielraumgröße angepasst, und anschließend die umgestalteten Arrays in Tensoren mit Singleton-Kanaldimension umgewandelt.
- Wenden Sie Datenaugmentation nur auf das Trainingsset an. Für ISIC 2017 und ISIC 2018 wenden Sie zufälliges horizontales Flipping (p = 0,5), zufälliges vertikales Flipping (p = 0,5) und zufällige Rotation (p = 0,5) mit einem Winkel von 0° bis 360° an.
- Wende dieselbe geometrische Transformation auf jedes Bild-Masken-Paar an. Während der Validierung und Tests wenden Sie nur Größenänderung, Normalisierung und Tensorkonvertierung an.
- Für den Synapse-Datensatz wenden Sie während des Trainings zufällige Rotation und zufälliges Umdrehen an. Drehen Sie jedes Bild-Label-Paar zufällig um k × 90°, wobei k ∈ {0,1,2,3}, drehen Sie das Bild-Label-Paar zufällig entlang einer räumlichen Achse oder drehen Sie das Bild-Label-Paar zufällig um einen Winkel von −20° bis 20°.
- Wenden Sie während der Tests keine stochastische Augmentation an.
- Wenden Sie die Datenerweiterung auf den Synapse-Datensatz an, indem Sie die im RandomGenerator-Transform implementierten gegenseitig ausschließenden Verzweigungen verwenden.
- Für jede Trainingsstichprobe wird zunächst die Bedingung random.random() > 0,5 bewertet. Wenn diese Bedingung erfüllt ist, wenden Sie random_rot_flip an, bestehend aus einer zufälligen 90°-Rotation (k = 0, 1, 2 oder 3), gefolgt von einer zufälligen Umdrehung entlang einer räumlichen Achse.
- Wenn der erste Ast nicht ausgewählt wird, wird eine zweite Bedingung bewertet, random.random() > 0,5. Wenn diese Bedingung erfüllt ist, wenden Sie random_rotate mit einem zufällig ausgewählten Rotationswinkel zwischen −20° und 20° an. Wenn keine der Bedingungen erfüllt ist, wenden Sie keine stochastische Augmentation auf die Probe an.
- Wende dieselbe Transformation sowohl auf das Eingabebild als auch auf die entsprechende Label-Abbildung an.
- Setze den zufälligen Seed vor dem Laden, Vorverarbeiten und Training des Datensatzes. Verwenden Sie für die Hauptvergleichsexperimente zufällige Samen 1, 52 und 100 und verwenden Sie Samen 100 für Ablationsstudien, sofern nicht anders angegeben.
- Initialisieren Sie die Zufallsgeneratoren Python, NumPyPy, PyTorch CPU, PyTorch CUDA und cuDNN, bevor Sie den Datenloader erstellen. Behalten Sie die Datensatzpartitionen, Vorverarbeitungsverfahren, Augmentationseinstellungen, Normalisierungsparameter, Größenänderungsstrategie und Evaluationsvorverarbeitung über alle Seed-Runs hinweg unverändert.
- Setzen Sie num_workers = 0 für sowohl das ISIC- als auch das Synapse-Experiment, um im Hauptprozess Daten zu laden. Bevor Sie den Datensatz erstellen und den DataLoader erstellen, initialisieren Sie den globalen Zufallsseed mit der set_seed-Funktion, um die Zufallszahlengeneratoren Python, NumPy, PyTorch CPU, PyTorch CUDA und cuDNN zu seeden. Definieren Sie keinen separaten worker_init_fn- oder DataLoader-spezifischen Zufallsgenerator, da diese in der veröffentlichten Implementierung nicht verwendet werden.
2. Bau der MVM-UNet-Architektur
- Baue die vorgeschlagene Multi-View Vision Mamba UNet (MVM-UNet) mit einer U-förmigen Encoder-Decoder-Architektur.
- Setze die Eingabebilddimension auf H × W × 3. Führe das Eingabebild durch die Patch-Embedding-Schicht.
- Implementiere die Patch-Embedding-Schicht mittels einer 2D-Faltung mit einer Kernelgröße von 4 × 4, Stride von 4, drei Eingangskanälen und 96 Ausgangskanälen.
- Transformieren Sie die Eingangsfunktion in eine räumliche Auflösung von H/4 × W/4 mit C = 96 Ausgangskanälen.
- Baue vier Encoder-Stufen und vier Decoder-Stufen. Reduziere die räumliche Auflösung nach jeder Encoderstufe um die Hälfte und verdoppele die Kanaldimension.
- Verwenden Sie eine symmetrische Encoder-Decoder-Konfiguration. Stellen Sie die Anzahl der MVV-Blöcke sowohl im Encoder als auch im Decoder auf {2, 2, 2, 2} ein.
- Setze zwei MVV-Blöcke in jede Encoder-Stufe und zwei MVV-Blöcke in jede Decoder-Stufe.
- Fügen Sie einen MVV-Block in jede Encoder- und Decoder-Stufe ein. Verwenden Sie das MV4D-Modul als Kernmodul zur Extraktion der Funktionen in jedem MVV-Block.
- Fügen Sie das MFusion Mamba-Modul zwischen Encoder und Decoder ein. Verwenden Sie dieses Modul, um mehrstufige Encoder-Funktionen vor der Dekodierung zu fusionieren.
- Konfigurieren Sie den gesamten MVM-UNet-Workflow. Verwenden Sie MV4D zur Feature-Extraktion im gesamten Encoder.
- Behalte die Encoder-Ausgänge als Skip-Verbindungen. Leiten Sie die Encoder-Ausgänge an die entsprechenden Decoder-Stufen weiter.
- Gib die Encoder-Funktionen vor dem Dekodieren an MFusion Mamba weiter. Sample die fusionierte Darstellung schrittweise durch den Decoder und erstelle die endgültige Segmentierungskarte mit dem Segmentierungskopf.
- Führe das Eingabebild I ∈ RB×H×W×3 durch die Patch-Einbettungsschicht, um Hier ist C = 96 zu erhalten
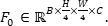 .
- Generiere Encoder-Feature-Maps: E1 ∈ RB×H/4×W/4×C, E2 ∈ RB×H/8×W/8×2C, E3 ∈ RB×H/16×W/16×4C und E4 ∈ RB×H/32×W/32×8C. Verwenden Sie in jeder Encoder-Stufe MVV-Blöcke, die MV4D enthalten.
- Bewahren Sie jede Encoder-Funktion für die entsprechende Skip-Verbindung. Geben Sie alle Encoder-Funktionen an MFusion Mamba für eine mehrstufige Funktionsfusion weiter.
- Richten Sie die Encoder-Features vor der groben und feinen Fusion innerhalb von MFusion Mamba auf einen gemeinsamen Merkmalraum aus. Gib die gefusionierte Darstellung an den Decoder weiter.
- Erweitern Sie schrittweise die Decoder-Darstellung. Fusionieren Sie die Decoder-Funktionen mit E3 bei H/16 × W/16, E2 bei H/8 × W/8 und E1 bei H/4 × W/4.
- Upgrade der End-Decoder-Funktion auf die ursprüngliche Bildauflösung. Erzeugen Sie die Vorhersagekarte
 ∈ RB×H×W×K. Hier gilt K = 1 für binäre Läsionssegmentierung und K = 8 für Synapse-Multiorgansegmentierung.
- Siehe Abbildung 2 für die Gesamtarchitektur des Netzwerks und die ergänzende Tabelle 1 für die vollständige Schicht-für-Schicht-Architekturspezifikation, einschließlich der Operationen, Hauptparameter und Ausgabemerkmale-Dimensionen für jede Stufe
- Encoder-Decoder-Übergangsschichten
- Erproben Sie Encoder-Funktionen unter Verwendung von Patch-Merging-Übergangsschichten. Für jeden Übergang werden vier räumlich ineinander verschlungene Merkmalsgruppen aus einer 2 × 2 Nachbarschaft ausgewählt, entlang der Kanaldimension verkettet, die Schichtnormalisierung (LayerNorm) angewendet und das resultierende 4C-dimensionale Merkmal mit einer biasfreien linearen Schicht auf 2C-Kanäle projiziert. Diese Operation verringert die räumliche Auflösung um den Faktor 2 und verdoppelt die Kanaldimension.
- Upsample-Decoder-Funktionen mit patch-expandierenden Übergangsschichten. Wenden Sie eine biasfreie lineare Projektion an, ordnen Sie die erweiterten Merkmale räumlich um, um die Auflösung um den Faktor 2 zu erhöhen, und wenden Sie nach räumlicher Expansion LayerNorm an. Wiederholen Sie diese Operation, um die Merkmalskarten von H/32 × W/32 bis H/16 × W/16, H/8 × W/8 und H/4 × W/4 schrittweise zu rekonstruieren.
- Richten Sie die Encoder-Features innerhalb des MFusion Mamba-Moduls aus, indem Sie sie mit bilinearer Interpolation (align_corners = False) auf die räumliche Zielauflösung anpassen und anschließend eine lernbare lineare Kanalprojektion vor der Merkmalsfusion anwenden.
- Segmentierungskopf
- Upsample Sie die endgültige Decoder-Feature-Map von H/4 × W/4 auf die ursprüngliche Bildauflösung (H × W) mithilfe der finalen patch-expandierenden Schicht. Wende lineare Projektion an, führe räumliche Neuordnung mit einem Expansionsfaktor von 4 durch und wende LayerNorm an.
- Projizieren Sie die rekonstruierte Merkmalsabbildung auf K-Ausgangskanäle mit einer 1× 1-Faltung, nachdem Sie den Tensor in das Kanal-zuerst-Format umgewandelt haben.
- Die endgültige Vorhersage während der Bewertung wird generiert, indem man eine sigmoidale Aktivierungsfunktion für binäre Läsionsegmentierung oder eine Softmax-Aktivierung gefolgt von argmax für die Synapse-Multiorgansegmentierung anwendet. Wenden Sie keine Aktivierungsfunktion direkt im Segmentierungskopf an.
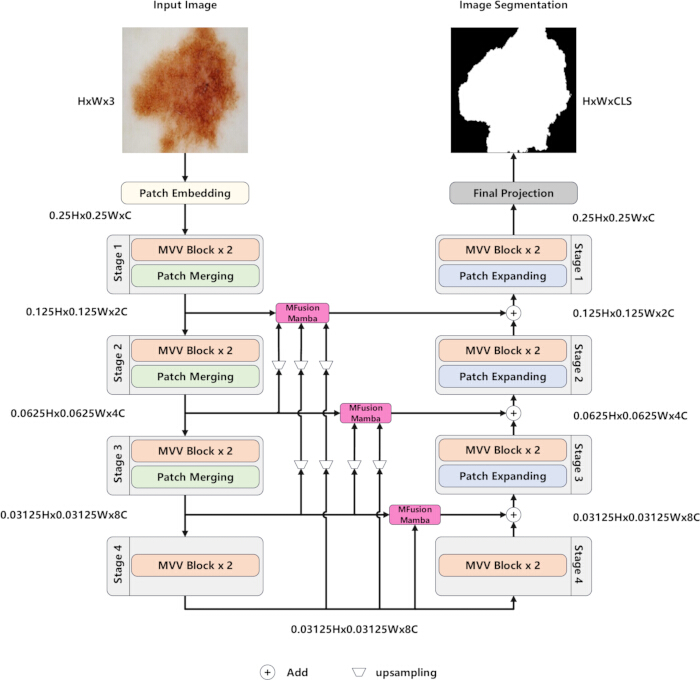
Abbildung 2. Gesamtarchitektur von Multi-View Mamba U-Net (MVM-UNet). Überblick über die vorgeschlagene Multi-View Mamba U-Net (MVM-UNet)-Architektur. Das Eingabebild wird in Patch-Embeddings umgewandelt und durch vier Encoder-Stufen verarbeitet, die aus Multi-View Vision (MVV)-Blöcken bestehen, die durch Patch-Merging-Operationen getrennt sind. Encoder-Features werden durch Multi-stage Fusion Mamba (MFusion Mamba) aggregiert und über Skip-Verbindungen zum Decoder weitergegeben. Der Decoder stellt die räumliche Auflösung schrittweise durch Patch-Erweiterungsoperationen wieder her und erzeugt die endgültige Segmentierungskarte über die Projektionsschicht. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
3. Bau des MV4D-Moduls
- Verwenden Sie das MV4D-Modul als grundlegende Feature-Extraktionseinheit im MVV-Block. Geben Sie die Eingabefeature-Patches in vier Scan-Pair-Zweige ein. Siehe Algorithmus 1, Supplementary File 1 für den vollständigen Pseudocode der räumlichen Abflachung, Scan-Pair-Index-Konstruktion, Sequenzerfassung, S6/Mamba-Verarbeitung, inverse räumliche Neuordnung, Scan-Pair-Fusion, SFusion Mamba-Fusion, Projektion und Ausgabe-Umformung.
- Verwenden Sie die exakten Zickzack-, hierarchischen, Spiral- und radialen Scan-Index-Generierungsverfahren, die in Models/mvmunet/core.py implementiert sind. Für jede Scan-Strategie verwenden Sie die Vorwärtsscan-Reihenfolge und deren Rückwärts-Reihenfolge als ein bidirektionales Scan-Paar.
- Konstruiere das Zickzack-Scan-Paar. Durchqueren Sie die Bildmerkmale in abwechselnden Richtungen am Ende jeder Reihe oder Spalte. Nutzen Sie dieses Scan-Muster, um lokale und globale räumliche Informationen auszubalancieren.
- Konstruiere das hierarchische Scan-Paar. Erfassen Sie Merkmale auf mehreren räumlichen Skalen. Nutzen Sie dieses Scan-Muster, um die Extraktion sowohl lokaler als auch globaler Darstellungen zu stärken.
- Konstruiere das Spiralscan-Paar. Scannen Sie die Bildmerkmale vom Zentrum zur Grenze oder vom Rand zum Zentrum. Verwenden Sie dieses Scan-Muster, um die Extraktion globaler Konturinformationen zu verbessern.
- Konstruiere das radiale Scan-Paar. Scannen Sie Bildmerkmale entlang mehrerer radialer Richtungen. Verwenden Sie dieses Scan-Muster, um die Extraktion lokaler Rand- und Kantendetails zu verbessern.
- Fügen Sie jedes Scan-Paar zusammen, bevor Sie die zusammengeführte Sequenz in den S6-Block eingeben. Nutzen Sie das gepaarte Design, um die Robustheit jeder Scanstrategie zu verbessern und gleichzeitig die Recheneffizienz zu erhalten.
- Geben Sie die Ausgangssequenz jedes Scan-Paar-Zweigs in einen S6-Block ein. Erhalten Sie vier Merkmalsrepräsentationen, die den Zickzack-, hierarchischen, Spiral- und radialen Scan-Ansichten entsprechen.
- Fusionieren Sie die vier extrahierten Merkmalsrepräsentationen mit dem SFusion Mamba-Modul. Verwenden Sie zwei parallele Fusionswege. Im ersten Weg integrieren Sie die vier Merkmale durch elementweise Addition.
- Im zweiten SFusion Mamba-Pfad werden die vier Merkmale miteinander verbunden. Verarbeiten Sie die verkettete Darstellung mit Conv1d und Mamba. Reduziere die Kanaldimension mit einer Projektionsschicht, um der S6-Blockausgabe gerecht zu werden.
- Konfigurieren Sie den S6/Mamba-Block unter Verwendung der Merkmalsdimension C als Modelldimension. Verwenden Sie eine Projektionsschicht, um jedes zusammengeführte Scanpaar-Merkmal vor der Fusion auf die Kanaldimension C zurückzubilden.
- In SFusion Mamba führen Sie elementweise Addition im ersten Pfad aus. Verkette die vier Scan-View-Merkmale im zweiten Pfad vor Conv1d, Mamba und linearer Projektion. Verwenden Sie die Normalisierungs-, lineare Projektion, tiefenseparable Faltung und Aktivierungsoperationen rund um MV4D, wie in Schritt 4 beschrieben.
- Addieren Sie die Ausgaben der beiden Fusionswege, um die endgültige Ausgabe des MV4D-Moduls zu erhalten.
- Konstruiere vier komplementäre Scanpaar-Zweige, anstatt nur horizontale und vertikale Scanrichtungen zu verwenden. Verwenden Sie Zickzack-Scanning, um kontinuierliche räumliche Durchquerung zu betonen, hierarchisches Scannen zur Stärkung der multiskaligen Darstellung, Spiralscanning zur Erfassung von Zentrum-zu-Rand-Konturinformationen und radiales Scannen zur Verbesserung der grenzorientierten lokalen Detailermittlung.
- Bearbeiten Sie jeden Scan-Paar-Zweig unabhängig. Fusioniere die resultierenden Features mit SFusion Mamba. Jede verarbeitete Sequenz wird wieder auf ihre ursprüngliche räumliche Reihenfolge vor der Fusion abgebildet.
- Gegeben eine Eingabe-Merkmalsabbildung X ∈ RB×H×W×C, flache sie zu Xseq ∈ RB×L×C, wobei L = H × W gilt.
- Ordne die abgeflachte Sequenz entsprechend den Scan-Indizes für jeden Scan-Paar-Zweig neu an. Verarbeiten Sie jede neu geordnete Sequenz mit dem S6-Block. Stelle die verarbeitete Sequenz in die ursprüngliche räumliche Reihenfolge wieder her.
- Fusionieren Sie die vier Scan-View-Funktionen über den additiven Pfad und den SFusion Mamba-Pfad, um den endgültigen MV4D-Ausgang zu erhalten. Siehe Abbildung 3 für die MV4D-Architektur und Algorithmus 1, Supplementary File 1 für den vollständigen Tensor-Level-Implementierungsworkflow.
- Verwenden Sie die komplette Softwareimplementierung in models/mvmunet/core.py. Diese Datei enthält die Scan-Index-Generatoren PairwiseScanMamba, SequenceS6, SFusion Mamba und das MV4D-Wrapper-Modul.
- Erzeugen Sie Multiview-Scan-Indizes
- Generiere die Scan-Indizes durch Folgen der veröffentlichten Implementierung in models/mvmunet/core.py. Für eine Eingabe-Merkmalsabbildung mit räumlicher Größe H × W flachen Sie jede Pixelposition zu einem eindimensionalen Index aus: index = r × W + c, wobei r und c jeweils die Zeilen- und Spaltenkoordinaten darstellen.
- Erzeugen Sie den Zickzack-Scan, indem Sie Bilddiagonalen mit konstanter r + c durchlaufen. Sammeln Sie die gültigen Pixelindizes für jede Diagonale und wechseln Sie die Durchlaufrichtung, indem Sie die Reihenfolge jeder geraden Diagonalen umkehren.
- Generiere den hierarchischen Scan, indem du das Bild rekursiv in vier Quadranten unterteilst. Besuchen Sie die Quadranten oben links, oben rechts, unten links und unten rechts nacheinander, bis die Höhe oder Breite des Unterbereichs nicht größer als 2 Pixel ist, und durchqueren Sie dann die restlichen Pixel in Reihen-Haupt-Reihenfolge.
- Erzeugen Sie den Spiralscan, indem Sie die äußere Bildgrenze von links nach rechts entlang der oberen Reihe, nach unten entlang der rechten Spalte, von rechts nach links entlang der unteren Reihe und nach oben entlang der linken Spalte durchlaufen, während die Begrenzung schrittweise zum Bildzentrum hin verkleinert wird.
- Erzeugen Sie den radialen Scan, indem Sie jedes Pixel nach seinem quadrierten Abstand zum Bildzentrum sortieren und dann nach seinem Polarwinkel, berechnet mit der Funktion atan2.
- Erzeugen Sie den Rückwärtsscan für jede Scan-Strategie, indem Sie die entsprechende Vorwärtsscan-Reihenfolge umkehren. Kombinieren Sie die Vorwärts- und Rückwärtsscan-Sequenzen, um für jede Scan-Strategie ein Scanpaar zu bilden, bevor die Scanpaare an das MV4D-Modul weitergegeben werden.
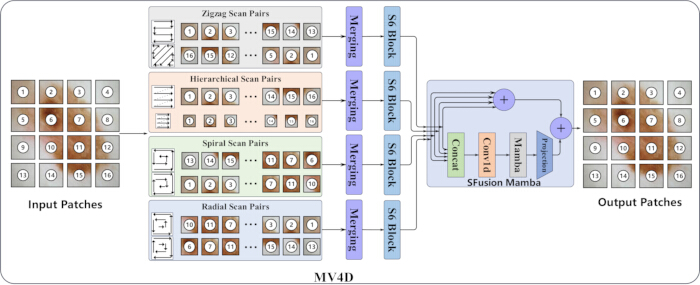
Abbildung 3. Architektur des Multi-View 4-Directional (MV4D) Moduls. Struktur des Multi-View 4-Directional (MV4D) Feature-Extraktionsmoduls. Eingabe-Patches werden über vier komplementäre Scan-Pair-Zweige verarbeitet, darunter Zickzack-, hierarchische, spiral- und radiales Scannen. Features, die aus den vier Zweigen extrahiert werden, werden zusammengeführt, mit Zustandsraumblöcken verarbeitet und von Spatial Fusion Mamba (SFusion Mamba) integriert, um die Ausgabefeature-Darstellung zu erzeugen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
4. Bau des MVV-Blocks
- Baue den MVV-Block mit einem Hauptzweig und zwei Hilfszweigen. Verwenden Sie die in Abbildung 4 gezeigte Gesamtstruktur.
- Wende die Schichtnormalisierung auf die Eingabefunktion im Hauptzweig an. Führe das normalisierte Merkmal in eine lineare Schicht ein. Übergebe das transformierte Merkmal zur tiefenseparablen Konvolution.
- Verarbeiten Sie das transformierte Merkmal mit der tiefenseparablen Faltung. Wenden Sie die GELU-Aktivierungsfunktion an. Führe die aktivierte Funktion in das MV4D-Modul ein.
- Konstruiere den ersten Hilfszweig als identitätsrestliche Verbindung. Verbinde die Eingangsfunktion direkt mit dem Endausgang. Nutzen Sie diesen Zweig, um die ursprüngliche Repräsentation zu erhalten und das Training zu stabilisieren.
- Konstruiere den zweiten Hilfszweig als Projektion nach unten nach oben. Komprimiere die Eingabefunktion mit einer Abwärtsprojektionsschicht. Stellen Sie die Merkmalsdimension mit einer Hochprojektionsschicht wieder her.
- Führen Sie die Ausgaben des Hauptzweigs und beider Hilfszweige zusammen. Erhalten Sie die endgültige MVV-Block-Ausgabe. Siehe Abbildung 4 für die vollständige Architektur.
- Setze die verborgene Dimension des Hauptzweigs gleich der Eingangskanaldimension Cs. Wende LayerNorm(Cs) vor der Hauptlinearprojektion an und verwende eine lineare Schicht mit den Maßen Cs→Cs. Verwenden Sie eine tiefenweise separable Faltung, bestehend aus einer 3×3 tiefenweisen Faltung mit Auffüllung 1, Gruppen = Cs und ohne Verspannung, gefolgt von einer punktweisen 1×1 Faltung ohne Verspannungen.
- Wenden Sie die Gelu-Aktivierungsfunktion nach der tiefenseparablen Faltung an. Führe die aktivierte Funktion in MV4D ein und wende eine lineare Ausgangsprojektion mit den Maßen Cs→Cs an. Konfigurieren Sie den Projektions-Down-Up-Ast mit LayerNorm(Cs), einem Projektionsverhältnis von 4, einer Abwärtsprojektion Cs→Cs/4, GELU-Aktivierung und einer Aufwärtsprojektion Cs/4→Cs.
- Kombinieren Sie den Identitätszweig, den Projektions-Down-Up-Zweig und den Drop-Path-Processing-Hauptzweig mittels elementweiser Addition, um die endgültige MVV-Blockausgabe zu erhalten.
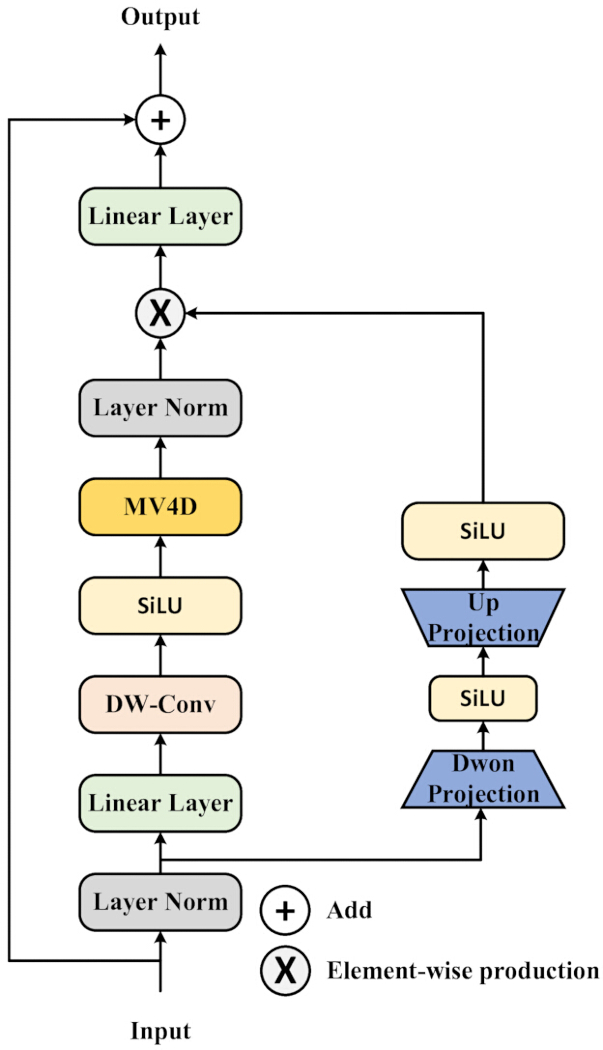
Abbildung 4. Architektur des Multi-View Vision (MVV)-Blocks. Struktur des Multi-View Vision (MVV)-Blocks. Der Block besteht aus einem Hauptelement-Extraktionszweig, der das Multi-View 4-Directional (MV4D) Modul sowie Tiefenfaltungs-, Normalisierungs- und lineare Projektionsschichten enthält. Ein Hilfs-Up-Down-Projektionszweig bietet eine gesperrte Merkmalsmodulation durch elementweise Multiplikation vor der Restaddition, um die Ausgabe-Merkmalsrepräsentation zu erzeugen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
5. Bau der MFusion Mamba
- Sammle die Feature-Karten aus allen Encoder-Stufen. Richten Sie die Encoder-Features auf einen einheitlichen Darstellungsraum aus, indem Sie sie bei Bedarf anpassen oder projizieren. Siehe Algorithmus 2, Supplementary File 1 für den vollständigen Tensor-Level-Implementierungsworkflow.
- Bei Bedarf werden die Encoder-Funktionen auf die räumliche Auflösung des Ziels angepasst. Projektfunktionen mit unterschiedlichen Kanaldimensionen in dieselbe Kanaldimension. Richten Sie alle Encoder-Funktionen vor der mehrstufigen Fusion aus.
- Geben Sie die ausgerichteten Encoder-Features in die Coarse-Fusion-Komponente ein. Führen Sie grobe Fusion mit dem Hadamard-Produkt durch. Generiere die grobe fusionierte Darstellung.
- Gib die grobe fusionierte Darstellung in die Feinfusionskomponente ein. Konstruiere zwei parallele Feinfusionswege. Behandle beide Wege unabhängig voneinander.
- Verarbeiten Sie den ersten Feinfusionsweg mit einer linearen Schicht. Verarbeiten Sie den zweiten Feinfusionsweg mit Aufwärtsprojektion, Conv1d, Mamba und Abwärtsprojektion. Stelle die Merkmalsdimension nach der Abwärtsprojektion wieder her.
- Führen Sie die Ausgaben der beiden Feinfusionswege mit dem Hadamard-Produkt zusammen. Trage die letzte lineare Schicht auf. Erhalten Sie die MFusion Mamba-Ausgabe.
- Speise die MFusion Mamba-Ausgang in den Decoder. Entschlüsseln Sie die fusionierte mehrstufige Darstellung zusammen mit den Encoder-Decoder-Skip-Funktionen. Generiere die endgültige Segmentierungskarte.
- Encoder-Features aus verschiedenen Phasen in einen einheitlichen Feature-Bereich ausrichten, bevor die grobe Fusion durchgeführt wird. Verarbeiten Sie die ausgerichteten Merkmalsrepräsentationen mit den groben und feinen Fusionsstufen. Siehe Abbildung 5 für die MFusion Mamba-Architektur und Supplementary Algorithm 2 für den vollständigen Tensor-Level-Implementierungsworkflow.
- Verwenden Sie die Implementierungsparameter von MFusion Mamba wie folgt. Für jedes Encodermerkmal Ei projizieren Sie die Kanaldimension von Ci auf Ct. Die projizierten Merkmale auf die räumliche Zielgröße mit bilinearer Interpolation mit align_corners=Falsch anpassen, wenn nötig.
- Wenden Sie das Hadamard-Produkt an, um eine grobe Fusion über die ausgerichteten Encoder-Funktionen durchzuführen. Konfigurieren Sie den ersten Feinfusionsweg mit einer linearen Schicht mit den Maßen Ct → Ct. Konfigurieren Sie den zweiten Feinfusionsweg mit einer Aufwärtsprojektion Ct → 2Ct, Conv1d, einem Mamba/S6-Block mit Modelldimension 2Ct, einer Scanrichtung, Zustandsdimension 16 und einer Abwärtsprojektion von 2Ct → Ct.
- Fusionieren Sie die Ausgaben der Feinfusionswege mit dem Hadamard-Produkt. Wenden Sie eine endgültige lineare Projektion mit den Maßen Ct auf Ct an. Führe die fusionierte mehrstufige Darstellung in den Decoder ein.
- Mehrstufige Encoder-Funktionen mit MFusion Mamba
- Sammeln Sie die Encoder-Funktionen aus allen vier Encoder-Stufen (E1, E2, E3 und E4) und verwenden Sie sie als Eingang für das MFusion Mamba-Modul. Wählen Sie nicht nur die entsprechende Stufen-Encoderfunktion für die Decoderfusion aus.
- Richten Sie alle Encoder-Funktionen auf die räumliche Auflösung aus, die für die aktuelle Decoder-Stufe erforderlich ist. Dimensionieren Sie die Encoder-Features auf die Zielauflösung und projizieren Sie sie auf die erforderliche Kanaldimension vor der Feature-Fusion.
- Wiederholen Sie das Feature-Ausrichtungsverfahren für jede Decoder-Stufe. Wenn der Decoder bei H/16 × W/16, H/8 × W/8 und H/4 × W/4 arbeitet, wird E1, E2, E3 und E4 auf den entsprechenden Ziel-Merkmalsraum angepasst und projiziert.
- Fusionieren Sie die ausgerichteten Mehrstufe-Encoder-Features mithilfe der Coarse Fusion- und Fine-Fusion-Operationen des MFusion Mamba-Moduls und kombinieren Sie die fusionierte Darstellung mit den Decoder-Funktionen auf entsprechender Skala.
- Führen Sie die Feature-Projektion, Größenanpassung und Fusion gemäß der veröffentlichten Implementierung in Models/mvmunet/core.py durch.
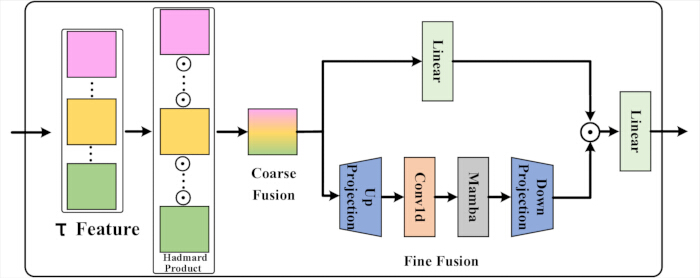
Abbildung 5. Architektur des Multi-stage Fusion Mamba (MFusion Mamba) Moduls. Struktur des Multi-stage Fusion Mamba (MFusion Mamba) Moduls. Mehrskalige Encoder-Features werden zunächst durch grobe Fusion kombiniert und anschließend durch das Fine Fusion-Modul verfeinert, das aus linearer Projektion, eindimensionaler Faltung (Conv1d), einem Mamba-Block und Merkmalprojektionsschichten besteht, bevor die vom Decoder verwendete Fused-Feature-Darstellung erzeugt wird. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
6. Modelltraining
- Trainiere MVM-UNet auf Ubuntu 22.04.1 mit Linux-Kernel-Version 6.8.0. Verwenden Sie eine Arbeitsstation mit einer Intel Core i9-13900K CPU der 13. Generation und einer NVIDIA A800 GPU. Verwenden Sie während der gesamten Schulung und Bewertung die gleiche Hardwarekonfiguration.
- Implementiere und trainiere das Modell mit PyTorch 2.0.1 und CUDA 11.8. Installiere alle erforderlichen Softwareabhängigkeiten vor dem Training.
- Verwenden Sie den AdamW-Optimierer mit einer anfänglichen Lernrate von 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸ und einem Gewichtsabfall von 0,01. Setze die Chargengröße auf 32, sofern nicht anders angegeben.
- Trainiere jedes Modell für 300 Epochen. Verwenden Sie einen Cosinus-Annealing-Lernratenplan mit ηmin = 1 × 10⁻⁵. Stellen Sie die Eingangsbildgröße auf 256 × 256 für ISIC 2017 und ISIC 2018 sowie auf 224 × 224 für Synapse ein.
- Verwenden Sie drei unabhängige zufällige Seeds (1, 52 und 100) für die Hauptvergleichsexperimente. Wiederholen Sie das vollständige Trainings- und Bewertungsverfahren für jeden Samen. Geben Sie die endgültigen quantitativen Ergebnisse als Mittelwert ± SD über die drei Läufe hinweg.
- Verwenden Sie für alle Ablationsstudien einen festen zufälligen Seed von 100, sofern nicht anders angegeben. Halte die Datensatzpartitionen, die Vorverarbeitungsstrategie, die Netzwerkarchitektur, den Optimierer, die Lernrate, die Batchgröße und die Anzahl der Trainingsphasen über alle Ablationsexperimente hinweg unverändert.
- Verwenden Sie den BCE-Dice-Verlust für binäre Läsionssegmentierung auf ISIC 2017 und ISIC 2018. Setze die BCE- und Würfelgewichtsverluste auf 1,0. Nutze den CE-Würfelverlust für Synapse und setze sowohl das Kreuzentropie- als auch das Würfelverlustgewicht auf 1,0.
- Formatiert, normalisieren und ergänzen Sie die ISIC 2017 und ISIC 2018 Trainingsbilder mit dem in Schritt 1 beschriebenen Vorverarbeitungsverfahren. Wenden Sie Größenänderung, zufällige Rotation und zufälliges Flipping auf Synapse-Trainingsbilder an, wie in Schritt 1 beschrieben. Verwenden Sie während aller Trainingsläufe identische Vorverarbeitungseinstellungen.
- Wählen Sie Modell-Checkpoints gemäß dem datensatzspezifischen Validierungsprotokoll aus. Speichere den Checkpoint mit der besten Validierungsleistung für ISIC 2017 und ISIC 2018 und führe alle 30 Epochen eine Validierung durch. Trainiere Synapse über 300 Epochen ohne Validierungsset und nutze den finalen Trainings-Checkpoint für Tests.
- Verwenden Sie das offizielle Validierungsset nur für die Modellauswahl auf ISIC 2017 und ISIC 2018. Verwenden Sie das Synapse-Testset nicht für Training, Hyperparameter-Abstimmung oder Checkpoint-Auswahl. Reservieren Sie alle Testdaten ausschließlich für die Endbewertung.
- Verwenden Sie die folgenden Trainingsparameter zur Reproduzierbarkeit. Setze die Batch-Größe für alle Datensätze auf 32. Verwenden Sie AdamW mit einer anfänglichen Lernrate von 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸ und einem Gewichtsabfall von 1 × 10⁻².
- Konfigurieren Sie den Cosinus-Annealing-Lernrate-Scheduler mit Tmax = 50 und ηmin = 1×10⁻⁵ für ISIC 2017 und ISIC 2018. Konfigurieren Sie den Scheduler mit Tmax = 100 und ηmin = 1×10⁻⁵ für Synapse. Lassen Sie die Scheduler-Konfiguration für alle wiederholten Experimente unverändert.
- Trainieren Sie alle Modelle mit vollpräziser FP32-Arithmetik. Deaktivieren Sie automatisches Mixed-Precision-Training. Wenden Sie während der Optimierung kein Gradientenclipping an.
- Halten Sie die Präzisionseinstellungen, die Gradienten-Update-Strategie, die Optimierungskonfiguration, den Lernratenplan und das Zufalls-Seed-Protokoll über alle Vergleichsexperimente, Ablationsstudien und Reproduzierbarkeitsläufe hinweg unverändert.
- Wählen Sie den besten Modell-Checkpoint aus
- Bewerten Sie das Modell anhand des Validierungssets nach jeder Trainingsphase für die ISIC 2017 und ISIC 2018 Datensätze.
- Berechnen Sie den binären Kreuzentropie-(BCE)-Würfelverlust für jede Validierungscharge und berechnen Sie den mittleren Validierungsverlust über das gesamte Validierungsset.
- Speichern Sie das aktuelle Modell als besten Kontrollpunkt, wenn der mittlere Validierungsverlust niedriger ist als der zuvor dokumentierte minimale Validierungsverlust.
- Zeichnen Sie den mittleren Intersection over Union (mIoU), den Würfelähnlichkeitskoeffizienten (DSC), die Genauigkeit (Acc), Spezifität (Spe) und die Sensitivität (Sen) während der Validierung nur zur Leistungsüberwachung auf. Verwenden Sie diese Metriken nicht als Kriterium für die Auswahl von Kontrollpunkten.
7. Modellbewertung
- Bewerten Sie das trainierte Modell anhand des offiziellen Testsets für jeden Datensatz. Verwenden Sie das Testset nur für die abschließende Leistungsbewertung.
- Für ISIC 2017 und ISIC 2018 berechnen Sie die mIoU, DSC, Acc, Sen und Spe. Verwenden für alle Berechnungen Pixel-Wahr-Positive (TP), Falsch-Positive (FP), Wahr-Negative (TN) und Falsch-Negative (FN).
- Wenden Sie eine sigmoidische Aktivierungsfunktion auf die Modellausgabe von ISIC 2017 und ISIC 2018 an. Konvertiere die Wahrscheinlichkeitsabbildung in eine binäre Segmentierungsmaske mit einem Schwellenwert von 0,5. Berechnen Sie die Bewertungsmetriken mit den Gleichungen 2–6:
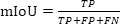 (2)
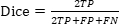 (3)
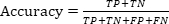 (4)
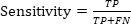 (5)
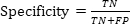 (6)
- Für Synapse wenden Sie die Softmax-Aktivierungsfunktion auf die Modellausgabe an. Weisen Sie jedem Pixel oder Voxel der Klasse mit der höchsten Wahrscheinlichkeit mithilfe der argmax-Operation zu. Berechnen Sie den DSC und den Hausdorff-Abstand im 95. Perzentil (HD95) für jedes Vordergrundorgan und geben Sie die Durchschnittswerte über alle Testfälle an.
- Vergleichen Sie MVM-UNet mit repräsentativen CNN-basierten, Transformer-basierten und Zustandsraummodell-(SSM)-basierten Segmentierungsmethoden. Verwenden Sie identische Datensatzpartitionen, Vorverarbeitungsverfahren, Eingabeauflösungen und Auswertungsmetriken für alle Methoden.
- Nutzen Sie die offiziellen Trainings-, Validierungs- und Testpartitionen für ISIC 2017 und ISIC 2018. Verwenden Sie die Standardaufteilung von 18 Trainingsfällen und 12 Testfällen für Synapse. Stellen Sie die Eingabeauflösung für ISIC-Datensätze und für Synapse ein.
- Reproduzieren Sie Basismethoden mit deren offiziellen Implementierungen, wann immer verfügbar. Der Bericht reproduzierte Ergebnisse als Mittelwert ± SD über wiederholte Durchläufe. Beziehen Sie sich auf literaturberichtete Werte wie ursprünglich veröffentlicht und unterscheiden Sie sie in den entsprechenden Tabellennotizen.
- Führen Sie Ablationsstudien mit dem festen zufälligen Seed von 100 durch, sofern nicht anders angegeben. Behalten Sie die Datensatzpartitionen, das Vorverarbeitungsverfahren, die Eingabeauflösung, den Optimierer, den Lernratenplan, die Batchgröße, die Anzahl der Epochen, die Verlustfunktion und die Bewertungsmetriken in allen Ablationsexperimenten unverändert.
- Bewerten Sie die Beiträge von MV4D, SFusion Mamba, dem Up-Down-Projektionszweig im MVV-Block, MFusion Mamba, Eingabebildgröße, Dropout-Wert und Konfiguration der Encoder-Decoder-Schicht. Ändern Sie in jedem Ablationsexperiment nur die Zielkomponente oder den Parameter.
- Führen Sie den Wilcoxon-Signed-Rank-Test mit gepaarten Pro-Bild-Ergebnissen für ISIC 2017 und ISIC 2018 sowie gepaarten Pro-Fall-Ergebnissen für Synapse durch. Betrachten wir einen p-Wert kleiner als 0,05, um die statistische Signifikanz anzuzeigen.
- Bewerten Sie die Recheneffizienz unter Verwendung derselben Hardwareumgebung und Eingabeauflösung für alle Methoden. Messen Sie die Trainingszeit pro Epoche, die Inferenzzeit pro Bild, den maximalen GPU-Speicherverbrauch während des Trainings, die Anzahl der Modellparameter und Gleitkommaoperationen (FLOPs). Berechnen Sie FLOPs mit einem einzigen Vorwärtspass.
- Wählen Sie repräsentative qualitative Beispiele nur nach Abschluss der Modellbewertung aus dem Testset aus. Vergleichen Sie das Originalbild, die Ground-Truth-Maske und die vorhergesagte Maske mit identischen Testfällen über alle Methoden hinweg. Wählen Sie repräsentative Beispiele aus, die kleine Ziele, unregelmäßige Grenzen, mehrdeutige Grenzen und repräsentative Multiorgan-Strukturen umfassen.
- Berechnen Sie Bewertungskennzahlen und führen Sie statistische Analysen durch
- Berechnen Sie die Segmentierungsmetriken für die ISIC 2017 und ISIC 2018 Datensätze in Python mit NumPy und sklearn.metrics.confusion_matrix. Schwelle die vorhergesagte Wahrscheinlichkeitsabbildung bei 0,5, erziele die pixelartigen TP, FP, TN und FN und berechne die mIoU, DSC, Acc, Sen und Spe aus diesen Werten.
- Berechnen Sie DSC und HD95 für den Synapse-Datensatz mit medpy.metric.binary.dc bzw. medpy.metric.binary.hd95. Wende Softmax gefolgt von argmax auf die Modellausgabe an, bevor du die Evaluationsmetriken berechenst.
- Berechnen Sie die Anzahl der FLOPs und trainierbaren Parameter mit thop.profile mit einem einzigen Vorwärtspass.
- Führen Sie den Wilcoxon-Signed-Rank-Test in Python mit scipy.stats.wilcoxon durch. Verwenden Sie gepaarte Metrikwerte pro Bild für die ISIC 2017 und ISIC 2018 Datensätze sowie gepaarte Metrikwerte pro Fall für den Synapse-Datensatz.
8. Definition der Verlustfunktion
- Verwenden Sie den Standard-Cross-Entropy-(CE)-Verlust für die Mehrklassensegmentierung und den Standard-BCE-Verlust für binäre Segmentierung. Verwenden Sie die Standard-Würfelverlustformel für die Segmentierung. Die Gleichungen 7–11 definieren die in diesem Protokoll verwendeten Verlustfunktionen.
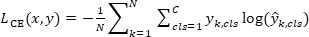 (7)
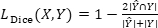 (8)
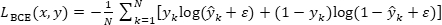 (9)
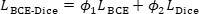 (10)
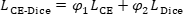 (11)
- Setzen Sie die BCE- und Würfelverlustgewichte für ISIC 2017 und ISIC 2018 auf 1,0, sodass
 1 = 1,0 und 2 = 1,0 gilt. Setze die CE- und Dice-Verlustgewichte für Synapse auf 1,0, also φ1 = 1,0 und φ2 = 1,0.
- Implementiere die Verlustfunktionen in utils.py. Benutze nn. BCELoss für den BCE-Begriff und nn. CrossEntropyLoss für den CE-Begriff. Berechnen Sie den binären Würfelverlust, indem Sie jede vorhergesagte Maske und jede Ground-Truth-Maske abflachen, den Würfelverlust für jede Probe berechnen und den Verlust über den gesamten Batch durchschneiden. Berechnen Sie den Multiclass-Würfelverlust, indem Sie die Ziel-Label-Karte in ein One-Hot-Format umwandeln, Softmax auf die Modellausgabe anwenden, den Dice-Verlust für jede Klasse berechnen und den Verlust über alle Klassen hinweg gemittelt werden.
- Setze die Glättungskonstante auf 1 für den binären Würfelverlust und auf 1×10⁻⁵ für den Mehrklassen-Würfelverlust. Implementiere den BCE-Dice-Verlust mit der BceDiceLoss-Klasse mit wb = 1 und wd = 1. Implementiere den CE-Dice-Würfelverlust mit der CeDiceLoss-Klasse mit loss_weight = [1, 1]. Lassen Sie die Glättungskonstanten, die Reduktionsstrategie und die Softwareimplementierung für alle Datensätze, zufälligen Seeds und Experimente unverändert.
- Konfigurieren Sie die Verlustreduktion
- Instanziere nn. BCELoss() und nn. CrossEntropyLoss(), ohne das Reduktionsargument explizit anzugeben.
- Verwenden Sie für beide Verlustfunktionen die Standardeinstellung PyTorch (Reduktion = "Mittelwert"). Verwenden Sie keine Reduktion = "Summe" oder eine unreduzierte Verlustausgabe.
9. Reproduzierbarkeitseinstellungen und Ausführung
- Laden Sie die veröffentlichte Implementierung von https://github.com/LIXUEGUANG002/MVM-UNet herunter. Verwenden Sie das Repository zusammen mit den Softwarepaketen, Datensätzen, Hardwarespezifikationen und Rechenressourcen, die in der Materialtabelle aufgeführt sind.
- Klone das Repository und betritt das Projektverzeichnis, indem du Git Clone https://github.com/LIXUEGUANG002/MVM-UNet.git ausführst, gefolgt von cd MVM-Unet.
- Konfigurieren Sie das ISIC 2017- oder ISIC 2018-Experiment, indem Sie den Datensatznamen, den Datensetpfad, die Eingabegröße, die Batchgröße, die Anzahl der Epochen, die Verlustfunktion, den Optimierer, den Lernraten-Scheduler und den zufälligen Seed in den Konfigurationen/config_setting.py einstellen. Führe das Trainingsskript aus dem Repository-Root mit Python train.py.
- Konfigurieren Sie das Synapse-Experiment, indem Sie den Datensatznamen, den Trainingsdatenpfad, den Testvolumenpfad, das Listenverzeichnis, die Eingabegröße, die Anzahl der Klassen, die Batchgröße, die Anzahl der Epochen, die Verlustfunktion, den Optimierer, den Lernraten-Scheduler und den Zufallsseed in den Konfigurationen/config_setting_synapse.py eingeben. Führe das Trainingsskript vom Repository-Root aus mit Python train_synapse.py.
- Führen Sie eine reine Inferenzbewertung durch, indem Sie only_test_and_save_figs = True, best_ckpt_path auf den trainierten Checkpoint und img_save_path auf das Ausgabeverzeichnis in der entsprechenden Konfigurationsdatei setzen. Führe Python train.py für ISIC 2017 oder ISIC 2018 aus oder führe Python train_synapse.py für Synapse aus, um Vorhersageergebnisse und qualitative Zahlen zu generieren.
- Verwenden Sie die veröffentlichte Quellcode-Version
- Klonen Sie das veröffentlichte GitHub-Repository und überprüfen Sie commit ee891b42c2f083c4990eed72f1d4463adc5e103e im Master-Branch, bevor Sie die Datensätze, Trainingsskripte und Evaluationseinstellungen konfigurieren.
- Verwenden Sie dieses Commit, um die in dieser Studie berichteten Experimente zu reproduzieren. Zum Zeitpunkt der Manuskriptüberarbeitung war keine getaggte Version für das Repository verfügbar.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Erwartete Ergebnisse und Interpretation
Wenn dieses Protokoll korrekt implementiert ist, wird erwartet, dass das trainierte MVM-UNet-Modell eine stabile Segmentierungsleistung über wiederholte Durchläufe hinweg liefert, mit nur geringen Unterschieden zwischen verschiedenen Zufalls-Seeds für die meisten Evaluationsmetriken. Für ISIC 2017 und ISIC 2018 spiegeln sich erfolgreiche Ergebnisse in hohen DSC-, mIoU-, Acc-, Sen- und Spe-Werten wider, zusammen mit vorhergesagte...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Dieses Protokoll beschreibt MVM-UNet, ein auf Mamba basierendes medizinisches Bildsegmentierungs-Framework. Die Methode wurde entwickelt, um zwei Einschränkungen bestehender Segmentierungsmodelle zu adressieren. Erstens haben konventionelle CNN-basierte Methoden eine begrenzte Fähigkeit, Langstreckenabhängigkeiten und hierarchische kontextuelle Informationen in komplexen medizinischen Bildern zu modellieren43. Zweitens können Transformer-basierte Methoden den glob...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass sie keine konkurrierenden finanziellen Interessen haben.
Danksagungen
Diese Forschung erhielt keine externe Finanzierung.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 mit Linux Kernel 6.8.0; Intel Core i9-13900K CPU; NVIDIA A800 GPU; 128 GB RAM; 512 GB lokaler Speicher. | Berechnungsplattform für Training-, Validierungs-, Test-, Ablations- und Inferenz-only-Experimente. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | NVIDIA A800 GPU (80 GB Speicher). | GPU-beschleunigte Modelltrainings- und Inferenz. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | 13th Gen Intel Core i9-13900K CPU. | Host-Prozessor für Datenladen, Vorverarbeitung und Experimentausführung. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB System-RAM | Speicher für Datensatzladen, Vorverarbeitung und Training. |
| Hardware - Storage | Institutional computing platform / local workstation | 2 TB NVMe Solid-State-Laufwerk. | Speicher für Datensätze, Checkpoints, Logs und generierte Vorhersagefiguren. |
| Software environment - Operating system | Canonical Ltd. | Empfohlen: Ubuntu 22.04.1 LTS | Betriebssystem für die Berechnungsumgebung. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Umgebungsname: mvmunet | Python-Umgebung, die zum Installieren und Isolieren von Abhängigkeiten verwendet wird. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Programmiersprache, die für Implementierung und Experimentausführung verwendet wird. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | GPU-Computing-Backend, das von PyTorch und Mamba-bezogenen Paketen benötigt wird. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | GPU-beschleunigte Deep-Learning-Primitive, die über PyTorch verwendet werden. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Deep-Learning-Framework für Modelltraining, Verlustberechnung, Optimierung und Inferenz. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Bild-Transformations-Utilities, die bei der Vorverarbeitung und Augmentation verwendet werden. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Installiert mit der empfohlenen PyTorch-Umgebung. |
| Python package - timm | timm developers | timm == 0.4.12 | Modellkomponenten- oder Dienstprogramm-Abhängigkeit, die in den Repository-Umgebungsanweisungen aufgeführt ist. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Abhängigkeit, die von GPU-beschleunigten Sequenzmodellierungskomponenten verwendet wird. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Effiziente kausale Faltungsabhängigkeit, die für die Mamba-Implementierung benötigt wird. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | Zustandsraum-Sequenzmodellierungspaket, das für Mamba/S6-bezogene Komponenten verwendet wird. |
| Python package - NumPy | NumPy developers | NumPy Version 1.24.3. | Numerische Berechnung und Array-Operationen. |
| Python package - SciPy | SciPy developers | SciPy Version 1.10.1. | Wissenschaftliche Berechnung; scipy.ndimage.zoom wird in utils.py importiert. |
| Python package - SimpleITK | Insight Software Consortium | SimpleITK Version 2.2.1. | Medizinische Bildeingabe/-ausgabe- und Vorverarbeitungsdienstprogramm, das in utils.py importiert wird. |
| Python package - MedPy | MedPy developers | MedPy Version 0.4.0. | Medizinische Bildmetrik-Berechnungspaket, das in utils.py importiert wird. |
| Python package - scikit-image | scikit-image developers | scikit-image Version 0.21.0. | Bildverarbeitungsabhängigkeit, die in README aufgeführt ist. |
| Python package - scikit-learn | scikit-learn developers | scikit-learn Version 1.3.2. | Maschinelles Lern-Dienstprogrammpaket, das in README aufgeführt ist. |
| Python package - matplotlib | Matplotlib developers | Matplotlib Version 3.7.2. | Verwendet zum Speichern qualitativer Visualisierungsfiguren. |
| Python package - h5py | h5py developers | h5py Version 3.9.0. | HDF5-Dateiunterstützung für Synapse-Testvolumina. |
| Python package - thop | THOP developers | THOP Version 0.1.1.post2209072238. | Verwendet bei der Berechnung von FLOPs und parameterbezogenen Berechnungskosten. |
| Python package - packaging | Python Packaging Authority | packaging Version 23.1. | Abhängigkeit, die in README aufgeführt ist. |
| Python package - pytest | pytest developers | pytest Version 7.4.0. | Abhängigkeit, die in README aufgeführt ist. |
| Python package - chardet | chardet developers | chardet Version 5.2.0. | Abhängigkeit, die in README aufgeführt ist. |
| Python package - yacs | YACS developers | yacs Version 0.1.8. | Konfigurationsdienstprogramm-Abhängigkeit, die in README aufgeführt ist. |
| Python package - termcolor | termcolor developers | termcolor Version 2.3.0. | Logging/Terminal-Dienstprogramm-Abhängigkeit, die in README aufgeführt ist. |
| Python package - submitit | submitit developers | submitit Version 1.4.5. | Experiment-/Job-Dienstprogramm-Abhängigkeit, die in README aufgeführt ist. |
| Python package - tensorboardX | tensorboardX developers | tensorboardX Version 2.6.2.2. | Trainingsprotokoll-Visualisierungsdienstprogramm, das in README aufgeführt ist. |
| Python package - ml-collections | ml_collections developers | ml-collections Version 0.1.1. | Importiert von configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | ISIC 2017 Hautläsionssegmentierungsdatensatz | Öffentliche, anonymisierte dermoskopische Hautläsionsbilder und Masken, die für binäre Segmentierung verwendet werden. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Läsionsgrenzsegmentierung | Öffentliche, anonymisierte dermoskopische Hautläsionsbilder und Masken, die für binäre Segmentierung verwendet werden. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Zugangskennung: syn3193805 | Öffentlicher abdominaler CT-Multiorgan-Segmentierungsdatensatz. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Erwarteter lokaler Ordner mit Trainings- und Validierungsbildern/Masken. |
| Data organization - ISIC 2018 data folder | Authors / repository layout | data/isic2018/ | Erwarteter lokaler Ordner mit Trainings- und Validierungsbildern/Mask |
Referenzen
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.