Diese Querschnittsuntersuchung untersuchte die Zusammenhänge zwischen der Nutzung generativer künstlicher Intelligenz, Unterrichtsstil, digitaler Kompetenz, Motivation, Angst und Kreativität bei saudischen Studierenden im Fach Englisch als Fremdsprache und identifizierte die Motivation als wichtigen Mediator der beobachteten Beziehungen.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Generative Künstliche Intelligenz, Motivation, Angst und Kreativität in saudischen Englisch-als-Fremdsprache-Klassenzimmern: Eine Querschnittsumfrage
In diesem Artikel
Zusammenfassung
Zusammenfassung
Künstliche-Intelligenz-(KI-)Werkzeuge wie ChatGPT werden zunehmend in den Englisch-als-Fremdsprache-(EFL-)Unterricht integriert; es liegen jedoch begrenzte Erkenntnisse darüber vor, wie deren Nutzung mit Unterrichtsstil, digitaler Kompetenz, Motivation, Fremdsprachenunterrichtsangst (FLCA) und Kreativität im saudi-arabischen Kontext zusammenhängt. Diese Studie untersuchte die Beziehungen zwischen diesen Konstrukten und analysierte die vermittelnde Rolle der Motivation innerhalb eines einheitlichen konzeptionellen Rahmens. Eine quantitative Querschnittsumfrage wurde an 280 Studierenden im Bachelorstudium, die EFL an einer staatlichen Universität in Saudi-Arabien belegen, mithilfe validierter Fragebogeninstrumente durchgeführt. Die vorgeschlagenen Zusammenhänge wurden mittels partieller kleinster-Quadrate-Strukturgleichungsmodellierung (PLS-SEM) analysiert. Die Ergebnisse zeigten, dass die Nutzung von ChatGPT, der Unterrichtsstil und die digitale Kompetenz positiv mit der Motivation der Studierenden verbunden waren. Eine höhere Motivation war mit geringeren FLCA-Werten und höherer Kreativität assoziiert. Die Motivation vermittelte zudem die Zusammenhänge zwischen der Nutzung von ChatGPT, dem Unterrichtsstil, der digitalen Kompetenz und der FLCA. Diese Befunde legen nahe, dass die motivationalen Erfahrungen der Studierenden eng mit den Beziehungen zwischen Unterrichtspraktiken, Technologienutzung und Ergebnissen des Spracherwerbs verknüpft sind. Die Studie liefert Belege dafür, dass die Integration geeigneter Unterrichtsstrategien, generativer KI-Werkzeuge und digitaler Kompetenz im Englischunterricht sinnvoll ist, und unterstreicht gleichzeitig die Bedeutung, die motivationalen und emotionalen Erfahrungen der Lernenden bei der Gestaltung technologiegestützter Lernumgebungen zu berücksichtigen.
Einleitung
Das Königreich Saudi-Arabien befindet sich im Zuge der Vision 2030 inmitten einer umfassenden Bildungsreform, die die Entwicklung von Fähigkeiten des 21. Jahrhunderts, digitale Kompetenz sowie innovative pädagogische Ansätze auf allen Bildungsebenen in den Vordergrund stellt1. In diesem nationalen Kontext sieht sich der Englisch-als-Fremdsprache-Unterricht (EFL) nach wie vor anhaltenden Herausforderungen gegenüber, darunter eine prüfungsorientierte Unterrichtskultur, die auswendig gelerntes Wissen und Testleistungen über kommunikative Kompetenz stellt2,3. Eingeschränkte Möglichkeiten für authentische englische Sprachinteraktion außerhalb des Klassenzimmers sowie hohe Ausprägungen von Fremdsprachenunterrichtsangst (FLCA) beeinträchtigen zusätzlich die Bereitschaft der Lernenden, sich aktiv und sinnvoll mit der Zielsprache auseinanderzusetzen4. Vor diesem Hintergrund suchen Lehrkräfte und Bildungspolitiker nach innovativen Ansätzen, um motivationalen Defiziten, emotionalen Hürden und kreativem Sprachgebrauch entgegenzuwirken. Künstliche Intelligenz (KI) hat sich dabei als vielversprechender Weg erwiesen, um den Spracherwerb zu unterstützen und den Unterricht zu verändern5. Unter den KI-Anwendungen im Englischunterricht (ELT) hat ChatGPT, ein konversationelles generatives KI-Modell, besondere Aufmerksamkeit erhalten, da es interaktive Sprachübungen und unmittelbares, individuelles Feedback in Echtzeit-Konversationen ermöglicht6. Solche Funktionen sind besonders relevant im saudischen EFL-Unterricht, wo lehrergeleitete Methoden und begrenzte Schülerinteraktion die kreative Sprachproduktion weiterhin einschränken7. ChatGPT könnte dabei helfen, diese Einschränkungen zu überwinden, indem es Möglichkeiten für authentische, angstfreie Sprachpraxis mit einem KI-Gesprächspartner bietet8.
Aktuelle bildungspolitische Reformen in Saudi-Arabien haben einen Übergang hin zu einer lernzentrierten Pädagogik gefördert und dadurch Möglichkeiten geschaffen, KI-Technologien zu integrieren, die aktive Beteiligung, kritisches Denken und selbstgesteuertes Lernen fördern9,10. Wenn sie angemessen eingesetzt wird, kann ChatGPT diesen Übergang unterstützen, indem sie die Sprachpraxis über traditionelle Unterrichtsaktivitäten hinaus erweitert11. Die Wirksamkeit der KI-Integration hängt jedoch teilweise von der digitalen Kompetenz der Studierenden ab, die definiert ist als deren Fähigkeit, digitale Technologien für das Lernen effektiv zu bewerten, zu nutzen und damit zu interagieren12. Digitale Kompetenz ermöglicht es Lernenden, KI-Werkzeuge produktiv einzusetzen und gleichzeitig potenzielle Risiken wie übermäßige Abhängigkeit und Fehlinformationen zu minimieren13. Diese Kompetenz ist besonders wichtig in der saudi-arabischen Hochschulbildung, in der sich der digitale Wandel im Rahmen der Vision 2030 beschleunigt hat14.
Obwohl frühere Untersuchungen KI-Werkzeuge, Unterrichtsstil, digitale Kompetenz, Motivation, Angst und Kreativität getrennt voneinander betrachtet haben, gibt es nur begrenzte Erkenntnisse darüber, wie diese Konstrukte in nicht-westlichen Fremdsprachenlernkontexten wie Saudi-Arabien innerhalb eines einheitlichen Modells zusammenwirken. Die Motivation wurde durchgängig als wichtiger Vermittlermechanismus identifiziert, der Unterrichtspraktiken mit Lernergebnissen verbindet, einschließlich geringerer Angst, höherer Kreativität und anhaltender Lernbeteiligung15. Die Zusammenhänge zwischen der Nutzung von ChatGPT, Unterrichtsstil, digitaler Kompetenz, Motivation, Fremdsprachenlernangst (FLCA) und Kreativität wurden jedoch im saudischen Fremdsprachenunterricht bisher nicht umfassend untersucht16. Die Schließung dieser Forschungslücke könnte theoretische und praktische Erkenntnisse liefern, um technologiegestützte Sprachlernumgebungen zu konzipieren, die die motivationale, emotionale und kreative Entwicklung der Lernenden unterstützen. Entsprechend untersucht diese Studie die Zusammenhänge zwischen der Nutzung von ChatGPT, Unterrichtsstil, digitaler Kompetenz, Motivation, FLCA und Kreativität bei saudischen Studierenden im Fremdsprachenunterricht. Konkret werden untersucht: (1) die Beziehungen zwischen der Nutzung von ChatGPT, Unterrichtsstil und digitaler Kompetenz einerseits und der Motivation der Lernenden andererseits; (2) die Zusammenhänge zwischen Motivation und Fremdsprachenlernangst (FLCA) sowie Kreativität; und (3) die vermittelnde Rolle der Motivation bei den Beziehungen zwischen der Nutzung von ChatGPT, Unterrichtsstil, digitaler Kompetenz und den Ergebnisvariablen Angst und Kreativität.
Diese Studie leistet einen Beitrag zur Fremdsprachendidaktik und zum technologiegestützten Lernen, indem sie die Nutzung von KI-Werkzeugen in bestehende Modelle der Motivation und des Sprachlernens integriert und damit das Verständnis des technologieunterstützten Sprachlernens in zeitgenössischen Bildungskontexten erweitert. Zudem liefert sie Belege, die Lehrenden, Curriculum-Entwicklern und politischen Entscheidungsträgern helfen können, KI-Werkzeuge in den saudischen Englisch-als-Fremdsprache-Unterricht zu integrieren. Indem die Studie Motivation als vermittelnden Faktor untersucht, der Technologienutzung und Unterrichtspraktiken mit Fremdsprachenlernangst (FLCA) und Kreativität verbindet, bietet sie kontextspezifische Hinweise zur Unterstützung einer lernzentrierten Sprachausbildung, die mit den bildungspolitischen Reformzielen Saudi-Arabiens übereinstimmt.
Die Selbstbestimmungstheorie (SDT) bietet einen theoretischen Rahmen, um die Beziehung zwischen Lehrpraktiken und der Motivation von Studierenden in Bildungskontexten zu verstehen17. Laut der SDT werden intrinsische Motivation und autonome Formen der extrinsischen Motivation gefördert, wenn die drei grundlegenden psychologischen Bedürfnisse der Lernenden – Autonomie, Kompetenz und Verbundenheit – im Lernumfeld erfüllt werden18. Der Lehrstil ist daher ein entscheidender kontextueller Faktor, der die Motivation und das Engagement der Studierenden beeinflusst19. Lehrpraktiken, die Autonomie unterstützen, indem sie sinnvolle Wahlmöglichkeiten bieten, die Perspektiven der Studierenden anerkennen und Lernaktivitäten erklären, fördern die intrinsische Motivation und ein selbstbestimmtes Engagement20. Im Kontext des Englisch-als-Fremdsprache-Unterrichts (EFL) wurden lernzentrierte Ansätze, einschließlich der Rollen des Vermittlers und Delegators im Lehrstil, mit größerer Studierendenzugehörigkeit, aktiverer Teilnahme und stärkerem Interesse am Sprachenlernen in Verbindung gebracht21,22. Umgekehrt kann ein lehrerzentrierter Unterricht die Motivation verringern, indem er die Teilhabe und Autonomie der Studierenden einschränkt und extrinsische Belohnungen über das intrinsische Interesse stellt23,24. Im saudischen EFL-Kontext, in dem traditioneller Unterricht historisch auf Auswendiglernen und lehrerzentrierte Vermittlung abzielte25, könnte die Übernahme stärker lernzentrierter Lehransätze die Motivation der Studierenden unterstützen26. Auf Grundlage dieser theoretischen und empirischen Grundlage wird die folgende Hypothese aufgestellt: H1: Der Lehrstil beeinflusst die Motivation von EFL-Studierenden positiv.
Der Zusammenhang zwischen Bildungstechnologie und Lernermotivation wurde umfassend untersucht27,28. Das Technology Acceptance Model (TAM) besagt, dass die Motivation der Lernenden, Bildungstechnologien zu nutzen, von der wahrgenommenen Nützlichkeit und der wahrgenommenen Leichtigkeit der Bedienung beeinflusst wird, was wiederum das Verhalten und die Nutzung der Technologie prägt29. Angewandt auf ChatGPT legt dieser Ansatz nahe, dass Studierende, die das Tool als nützlich und einfach zu bedienen empfinden, eher bereit sind, es für das Sprachenlernen einzusetzen30. Empirische Studien berichten von positiven Zusammenhängen zwischen KI-gestütztem Sprachunterricht und der Motivation der Studierenden, wobei interaktive Funktionen, unmittelbares Feedback und personalisiertes Üben zu anhaltender Lernbeteiligung beitragen31,32. ChatGPT kann zudem Barrieren im Zusammenhang mit Sprachangst verringern, indem es Möglichkeiten für entspanntes Sprachtraining bietet, was die kontinuierliche Nutzung der Sprache fördern kann33. Dieses Potenzial ist besonders im saudischen Kontext relevant, wo die Fremdsprachenlernangst (FLCA) als wesentliche Hürde für Motivation und sprachliche Leistung identifiziert wurde34. Auf Grundlage dieser theoretischen und empirischen Erkenntnisse wird die folgende Hypothese aufgestellt: H2: Die Nutzung von ChatGPT beeinflusst die Motivation von Studierenden im Englisch-als-Fremdsprache-Unterricht positiv.
Digitale Kompetenz ist zu einem wichtigen Faktor für die Motivation von Studierenden in heutigen Fremdsprachenlernumgebungen geworden35. Sie bezeichnet die Fähigkeit, digitale Technologien und Medien effektiv zum Lernen zu suchen, zu bewerten und anzuwenden36. Im Kontext des Fremdsprachenerwerbs ermöglicht digitale Kompetenz den Lernenden, digitale Ressourcen – einschließlich ChatGPT, Lernmanagementsystemen und Multimedia-Tools – effizient zur Unterstützung des Spracherwerbs und der Motivation einzusetzen37. Studierende mit einem höheren Grad an digitaler Kompetenz nutzen Lern-Technologien selbstbewusster, wodurch Kompetenzgefühl und Autonomie gestärkt werden, was wiederum mit intrinsischer Motivation assoziiert ist38. Zudem sind sie besser gerüstet, digitale Werkzeuge für eigenständige Sprachpraxis, Feedback und langfristiges Lernengagement zu nutzen39. Auf Grundlage dieser Literatur wird die folgende Hypothese aufgestellt: H3: Die digitale Kompetenz von Fremdsprachenlernenden beeinflusst deren Lernmotivation positiv.
FLCA und Kreativität sind eng miteinander verbundene Konstrukte im Bereich des fremdsprachlichen Englischunterrichts, obwohl ihr Verhältnis komplex bleibt40. Angstzustände können die Leistung von Lernenden bei Aufgaben beeinträchtigen, die Kreativität, kognitive Flexibilität, divergentes Denken und Selbstausdruck erfordern41. FLCA spiegelt die Angst der Lernenden vor Fehlern, vor negativer Beurteilung und vor geringem Selbstvertrauen wider, Faktoren, die alle die kreative Sprachproduktion beeinträchtigen können42. Kreativität ist jedoch eine wichtige Kompetenz beim Erlernen von Englisch als Fremdsprache, da sie kontextgerechten und innovativen Sprachgebrauch fördert31. Frühere Studien haben berichtet, dass Lernende mit stärkerer Angst weniger bereit sind, an kreativen Schreibaufgaben und mündlichen Kommunikationsaktivitäten teilzunehmen43,44. Auf Grundlage dieser Literatur werden die folgenden Hypothesen aufgestellt: 1) H4: Die Motivation von Lernenden im Englisch als Fremdsprache-Unterricht steht in negativer Beziehung zu ihrer Angst, und 2) H5: Die Angst von Lernenden im Englisch als Fremdsprache-Unterricht beeinträchtigt negativ ihre Kreativität.
Die Motivation bietet einen theoretischen Mechanismus, über den Lehrstil, die Nutzung von ChatGPT und digitale Kompetenz mit der Fremdsprachenunterrichtsangst (FLCA) in Zusammenhang stehen könnten45. Motivierte Lernende neigen eher dazu, aktiv teilzunehmen, Herausforderungen zu bewältigen und geringere Ängste im Kommunikationsprozess zu empfinden46. Unterstützende Lehrpraktiken, KI-gestütztes Sprachenlernen sowie eine ausgeprägte digitale Kompetenz wurden jeweils mit einer höheren Motivation und geringerer Angst im Englisch-als-Fremdsprache-Unterricht (EFL) assoziiert47,48,49. Frühere Studien deuten außerdem darauf hin, dass eine stärkere Motivation mit geringerer Klassenraumangst und erhöhter Kreativität verbunden ist, was die Motivation als möglichen Mediator zwischen Unterrichtsmethoden, Technologienutzung und Lernergebnissen stützt50,51,52. Auf Grundlage dieser Literatur werden folgende Hypothesen aufgestellt: 1) H6: Motivation vermittelt den Zusammenhang zwischen Lehrstil und der Angst von EFL-Schülern; 2) H7: Motivation vermittelt den Zusammenhang zwischen der Nutzung von ChatGPT und der Angst von EFL-Schülern; und 3) H8: Motivation vermittelt den Zusammenhang zwischen der digitalen Kompetenz von EFL-Schülern und ihrer Angst. Abbildung 1 veranschaulicht das postulierte Modell, in dem Lehrstil, ChatGPT-Nutzung und digitale Kompetenz mit der Motivation von EFL-Schülern verknüpft sind, die wiederum deren Beziehungen zu FLCA und Kreativität vermittelt.
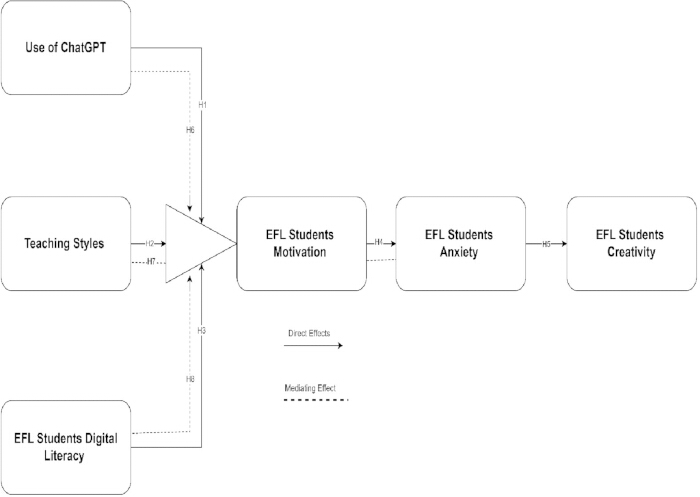
Abbildung 1. Hypothetisches Forschungsmodell. Das Modell zeigt die postulierten Zusammenhänge zwischen der Nutzung von ChatGPT, Lehrstil, digitaler Kompetenz, Motivation, Fremdsprachenunterrichtsangst und Kreativität bei Studierenden im Englisch-als-Fremdsprache-Unterricht (EFL). Durchgezogene Linien stellen direkte postulierte Beziehungen dar, gestrichelte Linien vermittelnde Beziehungen, wie in der Abbildung angegeben. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Obwohl die Studie aufgrund ihres nicht-experimentellen, anonymen Umfrageformats, das keine physischen Eingriffe, Manipulationen oder Täuschungen der Teilnehmer beinhaltete, keine formelle ethische Genehmigung durch eine institutionelle Prüfkommission erforderte, wurden alle Verfahren im Einklang mit den ethischen Grundsätzen der Deklaration von Helsinki und den Leitlinien der American Psychological Association für Forschung mit menschlichen Versuchspersonen durchgeführt. Von allen Teilnehmern wurde vor der Datenerhebung eine informierte Einwilligung eingeholt. Die Institution verlangte für diese Art von Studie keine formelle ethische Genehmigung oder Befreiung und stellte diese auch nicht aus. Alle Befragten wurden ausdrücklich über den Forschungszweck, die freiwillige Teilnahme, ihr Recht, sich jederzeit ohne negative Konsequenzen zurückzuziehen, sowie über die strengen Vertraulichkeitsmaßnahmen, die für ihre Daten gelten, informiert. Es wurden weder personenbezogene Daten erhoben noch berichtet, und alle Daten wurden ausschließlich für aggregierte akademische Analysen verwendet. Besonderes Augenmerk lag auf einer nicht-intrusiven und respektvollen Formulierung, um sicherzustellen, dass die Umfrage die akademischen Aktivitäten oder das psychologische Wohlbefinden der Teilnehmer nicht beeinträchtigte. Die Vorlage für die informierte Einwilligung finden Sie in Supplementary File 1. Darüber hinaus sind die in dieser Studie verwendeten Materialien in der Table of Materials aufgelistet.
Forschungsdesign
Dieser Abschnitt beschreibt das Forschungsdesign, die Verfahren zur Datenerhebung sowie die Stichprobendetails, die in der Studie verwendet wurden, um die Zusammenhänge zwischen Unterrichtsstil, ChatGPT-Nutzung, digitaler Kompetenz, Motivation, Angst und Kreativität bei EFL-Schülern zu untersuchen. Die Studie verwendete ein quantitatives, querschnittliches Forschungsdesign, um die vermittelnde Rolle der Motivation bei den Zusammenhängen zwischen Unterrichtsstil, ChatGPT-Nutzung, digitaler Kompetenz und Angst bei EFL-Schülern zu untersuchen und zu ermitteln, wie diese Variablen gemeinsam mit der Kreativität verbunden sind. Zur Erfassung der Primärdaten wurde eine strukturierte Umfrage verwendet, um Standardisierung und Zuverlässigkeit bei der Messung der Konstrukte sicherzustellen. Die Studie nutzte validierte Skalen zur Bewertung aller Variablen, einschließlich Unterrichtsstil, ChatGPT-Nutzung, digitale Kompetenz, Motivation, FLCA und Kreativität.
Daten und Probe
Die Daten für diese Studie wurden von EFL-Studierenden erhoben, die an der Universität von Dschidda eingeschrieben sind, einer staatlichen Hochschule in Saudi-Arabien, die für ihren Schwerpunkt auf Sprachbildung und die Integration von Technologie im Unterricht bekannt ist. Die Teilnehmenden wurden mittels einer gezielten Stichprobenziehung ausgewählt, die für diese Studie als angemessen erachtet wurde, da spezifische Einschlusskriterien bestanden, nach denen die Teilnehmenden aktive Erfahrung mit KI-Werkzeugen wie ChatGPT in ihrem Lernumfeld aufweisen mussten. Dieser Ansatz der Nicht-Wahrscheinlichkeitsstichprobe war notwendig, da sich die Forschungsfragen der Studie auf eine bestimmte Population konzentrierten – EFL-Studierende, die sowohl traditionellen als auch technologiegestützten Lernmethoden ausgesetzt waren – und eine Zufallsstichprobe nicht die Einbeziehung von Teilnehmenden mit diesen Kriterien garantiert hätte. Obwohl die gezielte Stichprobenziehung die Übertragbarkeit der Ergebnisse auf die breitere Population einschränkt, war sie für diese explorative Untersuchung gerechtfertigt, um sicherzustellen, dass die Teilnehmenden über die erforderlichen Erfahrungen und Sichtweisen verfügten, um die Forschungsziele zu adressieren. Um die Einschränkungen der gezielten Stichprobenziehung abzumildern, wurden Anstrengungen unternommen, Teilnehmende mit unterschiedlichen akademischen Hintergründen und verschiedenen Kompetenzniveaus im Umgang mit Technologie einzubeziehen, wodurch die Repräsentativität der Stichprobe innerhalb der Zielgruppe verbessert wurde. Die endgültige Stichprobe umfasste 280 EFL-Studierende im Bachelorstudium, eine Größe, die als ausreichend für die verwendeten statistischen Methoden erachtet wurde.
Die Beurteilung der Angemessenheit der Stichprobengröße basierte auf etablierten Leitlinien für die Strukturgleichungsmodellierung (Structural Equation Modeling, SEM). Forschende empfehlen für die SEM ein Mindestratio von 10 Fällen pro geschätztem Parameter, wobei konservativere Leitlinien 20 Fälle pro Parameter für die Partial-Least-Squares-SEM (PLS-SEM) vorschlagen. Das Messmodell umfasste 29 Items zur digitalen Kompetenz, 25 Items zum Unterrichtsstil und 32 Items zur FLCA sowie zusätzliche Items zur Nutzung von ChatGPT, Motivation und Kreativität. Die Leitlinien für die PLS-SEM empfehlen außerdem eine Mindeststichprobengröße, die dem Zehnfachen der größten Anzahl an formativen Indikatoren oder der größten Anzahl an strukturellen Pfaden entspricht, die auf ein bestimmtes Konstrukt gerichtet sind. Daher übertraf die Stichprobe von 280 Teilnehmenden diese Mindestanforderungen. Zudem zeigte eine post-hoc-Power-Analyse mit G*Power53, dass eine Stichprobe von 280 Teilnehmenden eine statistische Power von über 0,95 zur Detektion mittlerer Effektstärken (f2 = 0,15) bei α = 0,05 bietet, was über der üblicherweise empfohlenen Schwelle von 0,80 liegt. Diese Stichprobengröße ermöglicht zuverlässige Parameterschätzungen und ausreichende statistische Power, um bedeutungsvolle Zusammenhänge zwischen den untersuchten Variablen zu erkennen, und berücksichtigt dabei die Komplexität der vorgeschlagenen Mess- und Strukturmodelle.
Teilnehmer und Verfahren
Die Teilnehmer waren EFL-Studierende im Alter zwischen 18 und 25 Jahren, wobei die Mehrheit Erst- und Zweitsemester-Studenten in Englischkursen waren. Die Umfrage wurde zwischen September und Oktober 2025 durchgeführt, wobei die Studierenden zur freiwilligen Teilnahme aufgefordert wurden. Der Rekrutierungsprozess umfasste die Ansprache über offizielle universitäre Kanäle, darunter E-Mails und Ankündigungen in Lehrveranstaltungen. Die Teilnehmer waren EFL-Studierende im Alter von 18–25 Jahren, die als Erst- oder Zweitsemester-Studenten in Englischsprachkursen eingeschrieben waren. Die Zulassungsberechtigung wurde anhand vorab definierter Einschluss- und Ausschlusskriterien festgelegt. Teilnahmeberechtigt waren Studierende, wenn sie (a) offiziell in grundständigen Englischkursen an der Universität von Dschidda eingeschrieben waren, (b) im Alter von 18–25 Jahren waren und (c) als Erst- oder Zweitsemester-Studenten registriert waren. Ausgeschlossen wurden Studierende, wenn sie (a) fortgeschrittene Studierende oder Studierende höherer Semester außerhalb der Grundkurssequenz waren, (b) außerhalb des festgelegten Altersbereichs lagen oder (c) an der Vorprüfung des Fragebogens beteiligt waren. Um informierte Einwilligung sicherzustellen, wurden die Teilnehmer über den Zweck der Studie, den freiwilligen Charakter ihrer Teilnahme sowie die Vertraulichkeit ihrer Antworten informiert. Das Instrument zur Datenerhebung war ein strukturierter, selbstausgefüllter Fragebogen, der physisch und elektronisch über eine sichere Online-Plattform verteilt wurde. Validierte Skalen wurden angepasst, um den Unterrichtsstil, die Nutzung von ChatGPT, digitale Kompetenz, die Motivation der Studierenden, FLCA und Kreativität zu messen. Die Teilnehmer wurden gebeten, ihre Antworten auf einer 5-Punkte-Likert-Skala zu bewerten, die von 1 (Stimme völlig nicht zu) bis 5 (Stimme völlig zu) reichte. Eine Vorprüfung des Fragebogens wurde mit einer kleinen Gruppe von 30 Studierenden durchgeführt, um Klarheit und Zuverlässigkeit sicherzustellen. Basierend auf den Ergebnissen der Vorprüfung wurden geringfügige sprachliche Anpassungen vorgenommen, um die Verständlichkeit der Items zu verbessern; es wurden keine wesentlichen Probleme hinsichtlich der Reliabilität oder Validität der Skalen festgestellt. Um die Datenintegrität zu wahren und ehrliche Antworten zu fördern, wurde Anonymität garantiert, und den Teilnehmern wurde versichert, dass ihre Daten ausschließlich für Forschungszwecke verwendet würden. Von den ursprünglich erfassten 300 Antworten wurden nach Prüfung auf unvollständige oder inkonsistente Daten 280 als gültig eingestuft, was einer Rücklaufquote von 93 % entspricht. Die Datenscreening-Verfahren beinhalteten die Überprüfung von Antwortmustern auf Geradlinigkeit, übermäßige fehlende Daten (mehr als 10 %) und multivariate Ausreißer mithilfe der Mahalanobis-Distanz. Dieser methodische Ansatz bildet eine solide Grundlage für die Analyse der Beziehungen zwischen den untersuchten Variablen und liefert wertvolle Erkenntnisse über die Rolle von Unterrichtsstil, KI-Tools und digitaler Kompetenz bei der Gestaltung der Motivation, Angst und Kreativität von EFL-Studierenden.
Nach der Datenerhebung wurden 20 Antworten aus dem ursprünglichen Pool von 300 basierend auf vorab festgelegten Kriterien ausgeschlossen: 12 Antworten wurden aufgrund eines zu hohen Anteils fehlender Daten (mehr als 10 % der Fragebogenitems) entfernt, 5 wurden aufgrund von geradlinigen Antwortmustern (einheitliche Antworten bei allen Items, was auf fehlende Beschäftigung hindeutet) eliminiert, und 3 wurden als multivariate Ausreißer mittels Mahalanobis-Distanz (p < 0,001) identifiziert und anschließend entfernt, um eine Verzerrung der SEM-Ergebnisse zu verhindern. Fehlende Werte bei den beibehaltenen Fällen wurden durch Mittelwert-Imputation behandelt, wenn die fehlenden Daten minimal waren (weniger als 5 % pro Fall), da dieser Ansatz bei geringen Anteilen an fehlenden Werten in großangelegten Umfrageuntersuchungen akzeptabel ist. Die endgültige Rücklaufquote von 93 % (280 gültige Antworten von 300 gesammelten Fragebögen) stellt den Anteil der verwendbaren Antworten dar, die von der Gesamtanzahl der eingesammelten Fragebögen beibehalten wurden; dieser Wert sollte jedoch nicht als tatsächliche Antwortquote interpretiert werden, da die genaue Anzahl der eingeladenen Teilnehmenden nicht ermittelt werden konnte, weil die kombinierte physische und elektronische Verteilung über offizielle universitäre Kanäle eine präzise Nachverfolgung der Gesamtanzahl der Einladungen ausschloss. Diese Einschränkung wird anerkannt, und die Zahl von 93 % wird daher als Anteil gültiger Antworten bezogen auf die eingesammelten Fragebögen und nicht als Antwortquote im Verhältnis zur gesamten eingeladenen Population angegeben.
Werkzeuge und Messverfahren
In dieser Studie wurden bewährte und validierte Skalen verwendet, die sorgfältig an den Kontext des Fremdsprachenunterrichts (EFL) angepasst wurden, um die zentralen Konstrukte zu erfassen: Unterrichtsstil, digitale Kompetenz, ChatGPT-Nutzung, Fremdsprachenlernangst (FLCA), Motivation und Kreativität. Jede Skala wurde aufgrund ihrer Relevanz und ihres umfassenden Charakters bei der Erfassung der jeweiligen Variablen ausgewählt. Die digitale Kompetenz wurde mithilfe einer adaptierten Skala gemessen, die auf Rodríguez-de-Dios et al.54 basiert und aus sechs Dimensionen mit insgesamt 29 Items besteht. Diese Dimensionen umfassen Technologische Fähigkeiten, Sicherheitskompetenz im persönlichen Bereich, Kritische Fähigkeiten, Sicherheitskompetenz bei Geräten, Informationskompetenz und Kommunikationskompetenz und ermöglichen eine umfassende Beurteilung der Studierenden in Bezug auf digitale Fähigkeiten, die für moderne Bildungskontexte unerlässlich sind. Die Nutzung von ChatGPT wurde anhand einer 8-Item-Skala erfasst, die auf Abbas et al.55 basiert und auf die Interaktion der Studierenden mit dem KI-Tool im Rahmen von Sprachlernaufgaben fokussiert. Der Unterrichtsstil wurde mithilfe einer angepassten Version des Grasha Teaching Style Inventory56 bewertet. Dieses Instrument misst fünf Dimensionen von Unterrichtsstilen: Autorität, Experte, Vorbild, Moderator und Delegierer. Diese Dimensionen spiegeln unterschiedliche didaktische Ansätze wider, die die Lernerfahrungen von EFL-Studierenden beeinflussen. Die Fremdsprachenlernangst (FLCA) wurde anhand einer adaptierten Skala gemessen, die auf Briesmaster und Briesmaster57 basiert. Das Instrument untersucht die Angst in drei Dimensionen: Kommunikationsangst (10 Items), Prüfungsangst (10 Items) und Angst vor negativer Bewertung (7 Items). Die Motivation der Studierenden wurde mithilfe einer Skala erfasst, die auf Kanoksilapatham et al.58 basiert, und misst drei Dimensionen: Instrumentalität – Förderung und Vermeidung, Ethnozentrismus und Integrativität sowie Einstellung zum Englischlernen. Die Skala umfasst insgesamt 20 Items. Die Kreativität von EFL-Studierenden wurde anhand einer Skala gemessen, die auf Govindasamy et al.59 basiert und vier Dimensionen erfasst: Originalität, Flexibilität, Flüssigkeit und Ausführlichkeit. Jede Dimension wurde mit jeweils drei Items gemessen. Um die kulturelle und kontextuelle Eignung der Instrumente für den EFL-Kontext sicherzustellen, wurde ein systematisches Anpassungsverfahren angewandt. Da die ursprünglichen Skalen auf Englisch verfasst waren, überprüften und vereinfachten zwei zweisprachige EFL-Experten die Sprache, um die Verständlichkeit für Studierende mittlerer Sprachkenntnisse zu verbessern, wobei die ursprüngliche Bedeutung jedes Konstrukts erhalten blieb. Die angepassten Versionen wurden anschließend von einem unabhängigen Übersetzer in die Muttersprache der Teilnehmenden zurückübersetzt, um sprachliche und konzeptionelle Äquivalenz zu überprüfen; etwaige Abweichungen wurden im Forschungsteam diskutiert und behoben. Danach bewerteten drei erfahrene EFL-Lehrende die adaptierten Instrumente hinsichtlich inhaltlicher Relevanz, kultureller Angemessenheit und Klarheit der Items, was zu geringfügigen sprachlichen Überarbeitungen und gegebenenfalls zum Austausch kulturell unvertrauter Beispiele führte. Schließlich wurden die überarbeiteten Instrumente in einer Vorstudie mit 30 Studierenden getestet (siehe Abschnitt „Verfahren“), und das Feedback der Teilnehmenden wurde genutzt, um weitere kleine sprachliche Verbesserungen vorzunehmen, um die Verständlichkeit zu erhöhen. Dieser mehrstufige Prozess gewährleistete, dass die adaptierten Instrumente ihre ursprünglichen psychometrischen Eigenschaften beibehielten und gleichzeitig für die Zielgruppe der EFL-Studierenden geeignet waren. Die vollständige angepasste Fragebogenversion finden Sie in Supplementary File 2.
Methoden der Datenanalyse
Die für diese Studie erhobenen Daten wurden mit dem Statistical Package for the Social Sciences (SPSS 26) und SmartPLS 4 unter Anwendung der PLS-SEM analysiert. Dieser zweigleisige Ansatz gewährleistete eine umfassende Datenauswertung, bei der sowohl beschreibende als auch schließende Aspekte berücksichtigt wurden, sowie die Überprüfung der postulierten Zusammenhänge und der vermittelnden Effekte im Forschungsmodell. Zunächst wurde SPSS zur Durchführung der vorläufigen Datenanalyse verwendet, einschließlich Datensäuberung, deskriptiver Statistik und Zuverlässigkeitstests. Die Datensichtung umfasste die Prüfung auf fehlende Werte, Ausreißer und Normalverteilung, um die Qualität und Integrität des Datensatzes sicherzustellen. Deskriptive Statistiken wie Mittelwert, Standardabweichung und Häufigkeitsverteilungen wurden berechnet, um die Stichprobenmerkmale zusammenzufassen. Die Hauptanalyse erfolgte mit SmartPLS 4. Die PLS-SEM wurde aufgrund ihrer Eignung zur Analyse komplexer Modelle mit mehreren Konstrukten sowie ihrer Robustheit bei kleinen bis mittleren Stichprobengrößen gewählt. Die Analyse wurde in zwei Phasen durchgeführt: Bewertung des Messmodells und Bewertung des Strukturmodells. Bei der Beurteilung des Messmodells wurden die Indikatorzuverlässigkeit, die interne Konsistenz (mittels kompositen Reliabilität [CR]), die konvergente Validität (mittels durchschnittlich erklärter Varianz [AVE]) und die diskriminante Validität (mittels des Heterotrait–Monotrait-Verhältnisses [HTMT]) überprüft.
Nach der Validierung des Messmodells wurde das Strukturmodell bewertet, um die postulierten Beziehungen zwischen Lehrstil, ChatGPT-Nutzung, digitaler Kompetenz, Motivation, Angst und Kreativität zu überprüfen. Pfadkoeffizienten wurden analysiert, um Stärke und Signifikanz der direkten und indirekten Effekte zu bestimmen, wobei die Signifikanz mittels Bootstrapping mit 5.000 Resampling-Schritten bewertet wurde. Zur Beurteilung der Signifikanz direkter, indirekter und vermittelter Effekte wurden bias-korrigierte (BC) Bootstrap-Konfidenzintervalle mit 5.000 Bootstrap-Stichproben und einem Konfidenzniveau von 95 % berechnet. Die vermittelnden Effekte der Motivation auf die Beziehungen zwischen Lehrstil, ChatGPT-Nutzung, digitaler Kompetenz und Angst wurden ebenfalls mithilfe von Bootstrap-Konfidenzintervallen untersucht. Die Modellanpassung und Vorhersagekraft wurden anhand des Determinationskoeffizienten (R2), der Vorhersagerelevanz (Q2) und des standardisierten quadratischen Mittelwerts der Residuen (SRMR) bewertet.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Deskriptive Statistik
Deskriptive Statistiken liefern einen Überblick über die Merkmale der Stichprobe sowie über die Verteilung, zentrale Tendenz und Variabilität der Untersuchungsvariablen. In dieser Studie wurden deskriptive Analysen durchgeführt, um die Teilnehmerstichprobe zu charakterisieren und die zentralen Variablen zusammenzufassen, bevor die strukturellen Analysen durchgeführt wurden.
Tabelle 1 fasst die demografischen Me...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Diese Studie untersuchte die Zusammenhänge zwischen Lehrstil, ChatGPT-Nutzung, digitaler Kompetenz, Motivation, FLCA und Kreativität bei saudischen EFL-Studenten, wobei insbesondere die vermittelnde Rolle der Motivation im Fokus stand. Die Ergebnisse liefern Belege für die Beziehungen zwischen pädagogischen Praktiken, Technologieeinsatz und Lernereigenschaften im technologiegestützten Sprachenlernen. Die positive Assoziation zwischen Lehrstil und der Motivation von EFL-Studierenden (H1 bestätigt) steht im Einklang mit de...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Interessenkonflikt:
Der Autor erklärt, dass kein Interessenkonflikt besteht.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| ChatGPT-Nutzungsskala (angepasst) | Autoren; angepasst nach Abbas et al. | N/V | Achtteilige Fragebogenerhebung zur Beurteilung der Nutzung von ChatGPT durch Studierende für das Sprachenlernen. |
| Kreativitätsskala (angepasst) | Autoren; angepasst nach Govindasamy et al. | N/V | Zwölftteilige Fragebogenerhebung zur Beurteilung von Originalität, Flexibilität, Flüssigkeit und Ausführlichkeit. |
| Digital-Kompetenz-Skala (angepasst) | Autoren; angepasst nach Rodríguez-de-Dios et al. | N/V | Neunundzwanzigteilige Fragebogenerhebung zur Messung von sechs Dimensionen der digitalen Kompetenz. |
| Angstskala im Fremdsprachenunterricht (FLCA) (angepasst) | Autoren; angepasst nach Briesmaster & Briesmaster | N/V | Siebenundzwanzigteilige Fragebogenerhebung zur Messung von Kommunikationsangst, Prüfungsangst und Angst vor negativer Bewertung. |
| G*Power | Heinrich-Heine-Universität Düsseldorf | Version 3.1.9.7; RRID: SCR_013726 | Software zur Durchführung der post-hoc-Statistischen-Power-Analyse. |
| IBM SPSS Statistics | IBM Corp. | Version 26; RRID: SCR_002865 | Statistiksoftware zur Datensäuberung, deskriptiven Statistik, Reliabilitätsanalysen und vorläufigen Analysen. |
| Mahalanobis-Distanz-Analyse | IBM SPSS Statistics | Version 26; RRID: SCR_002865 | Statistisches Verfahren in IBM SPSS Statistics zur Identifizierung multivariater Ausreißer. |
| Motivationsskala (angepasst) | Autoren; angepasst nach Kanoksilapatham et al. | N/V | Zwanzigteilige Fragebogenerhebung zur Beurteilung der Lernermotivation. |
| Papierfragebogen | Autoren | N/V | Gedruckte Version des strukturierten, selbstausgefüllten Fragebogens zur persönlichen Datenerhebung. |
| Sichere Online-Umfrageplattform | Google LLC | N/V | Google-Forms-Plattform zur elektronischen Verteilung des Fragebogens. |
| SmartPLS | SmartPLS GmbH | Version 4; RRID: SCR_036419 | Software zur Durchführung der partiellen kleinsten-Quadrate-Strukturgleichungsmodellierung (PLS-SEM), einschließlich Bewertung des Messmodells, Analyse des Strukturmodells, Bootstrapping (5.000 Neustichproben) und Mediationsanalyse. |
| Strukturierter selbstausgefüllter Fragebogen | Autoren | N/V | Fragebogen, der in gedruckter und elektronischer Form mittels einer 5-Punkte-Likert-Skala (1 = Stimme völlig nicht zu bis 5 = Stimme völlig zu) erhoben wurde. |
| Lehrstil-Inventar (angepasst) | Autoren; angepasst nach Grashas Teaching Style Inventory | N/V | Fragebogen zur Messung der Lehrstile Autorität, Experte, Vorbild, Moderator und Delegierender. |
| Universitäre Kommunikationskanäle | Universität von Dschidda | N/V | Offizielle E-Mails und Klassenansagen zur Rekrutierung der Teilnehmenden. |
Referenzen
- Ansa H. Exploring the role of artificial intelligence (AI) in enhancing EFL education in Saudi Arabia: A review of opportunities, obstacles, and future directions. Educ Sci. 2026;16(6):981.
- Alshehri A, Aldossary S, Jamshed M, Banu S. Incorporating ChatGPT in Saudi EFL classrooms: Oscillating between expectations and anxiety. J Lang Teach Res. 2025;16(5):1673-81.
- Alzubi AA, Alelaiwi AS. Exploring EFL university teachers’ perceptions of AI-generative tools in Saudi Arabia: A mixed-methods study. Discov Comput. 2025;28(1):282.
- Alzubi AA, Nazim M, Alyami N. Do AI-generative tools kill or nurture creativity in EFL teaching and learning? Educ Inf Technol. 2025;30(11):15147-84.
- Allehyani FS, Albedah F, Jamshed M, Warda WU. Exploring Saudi EFL learners’ engagement with AI generative tools in educational settings: Perceptions, practices, and pedagogical outcomes. Theory Pract Lang Stud. 2025;15(6):1959-66.
- Almusharraf A, Bailey D. Generative AI use among Saudi and Korean language learners in higher education: Examination through a modified TAM framework. SAGE Open. 2025;15(4):21582440251387804.
- Alharbi MA, Hassan Al-Ahdal AA. Exploring Saudi EFL learners’ engagement with ChatGPT: A mixed-methods study of perceptions, attitudes, and intentions. SAGE Open. 2025;15(4):21582440251392080.
- Khoso AK, Honggang W, Darazi MA. Empowering creativity and engagement: The impact of generative artificial intelligence usage on Chinese EFL students’ language learning experience. Comput Hum Behav Rep. 2025;18:100627.
- Alalwi FS, Alqahtani N, Jamshed M, Ahmmed MF. AI-driven feedback for pedagogical innovation: Assessing ChatGPT’s impact on Saudi EFL learners’ writing proficiency. World. 2026;16(5).
- Alshehri N. Speaking with AI: Exploring EFL learners’ attitudes, engagement, and satisfaction through ChatGPT conversations. 2026. 10.2139/ssrn.6595190
- Metwally AA, Bin-Hady WR. Probing the necessity and advantages of AI integration training for EFL educators in Saudi Arabia. Cogent Educ. 2025;12(1):2472462.
- Elmahdi OE, et al. AI-Driven Vocabulary Acquisition in EFL Higher Education: Interdisciplinary Insights into Technological Innovation, Ethical Challenges, and Equitable Access. Forum Linguist Stud. 2025;7(4):477–491.
- Al-Nofaie H, Alwerthan TA. Appreciative inquiry into implementing artificial intelligence for the development of language student teachers. Sustainability (Basel). 2024;16(21):9361.
- Alshayban A. Exploring EFL learners’ use of AI outside the classroom. J Lang Teach Res. 2026;17(1).
- Abdelhalim SM, Alsehibany RA. Integrating AI-powered tools in EFL pronunciation instruction: Effects on accuracy and L2 motivation. Comput Assist Lang Learn. 2025;38:1-25.
- Khoso AK, Honggang W, Darazi MA. Trust and attitude towards AI as pathways to creativity: A TAM model study of EFL students’ digital literacy and AI acceptance. Humanit Soc Sci Commun. 2025;13(1):69.
- Xiong X. Influence of teaching styles of higher education teachers on students’ engagement in learning: The mediating role of learning motivation. Educ Chem Eng. 2025;51:87-102.
- Bartholomew KJ, et al. Beware of your teaching style: A school-year-long investigation of controlling teaching and student motivational experiences. Learn Instr. 2018;53:50-63.
- Wiangga IA. The impact of educators’ teaching styles on secondary school learners’ motivation in English. J Educ Manag Strategy. 2024;3(2):136-44.
- Sheikh A, Mahmood N. Effect of different teaching styles on students’ motivation towards English language learning at secondary level. Sci Int (Lahore). 2014;26:825-30.
- Marina I, Natalia M, Tatiana K, Nataliya S. The influence of the teaching style of communication on the motivation of students to learn foreign languages. J Lang Educ. 2019;5(2):67-77.
- Zalukhu FS, Laoli A, Zebua EP, Daeli H. The influence of teacher teaching styles on English learning motivation of eighth-grade students at SMP Negeri 1 Afulu. J Pembelajaran Bahasa dan Sastra. 2026;5(2):1545-54.
- Yue X, Hou X, Zhang J, Li M. The impact of controlling teaching style on student engagement and academic achievement: Differences across varied motivation profiles. Teach Teach Educ. 2026;176:105479.
- Idhaufi NL, Ashari ZM. Relationship between motivation and teachers’ teaching style among secondary school students in Kulai. Man India. 2017;97(12):299-307.
- Zolfaghari M, Janghorbanian Z, Krevan Brojerdi K, Aghaziarati A. Investigation of the role of teaching styles and student-teacher interaction in students’ academic achievement motivation. Educ Strateg Med Sci. 2020;13(3):220-8.
- Avecilla PA, Capiña XE, Javier AY. Teachers’ teaching style as perceived by students and its influence on students’ level of self-regulation and motivation in learning psychology. Technium Soc Sci J. 2023;43:213-24.
- Khoso AK, et al. The dual forces of AI: How generative AI and perceived AI dependency influence fear of missing out (FoMO) and EFL students’ vocabulary acquisition. J Vis Exp. 2025;(226):e69637.
- Ali JK, Shamsan MA, Hezam TA, Mohammed AA. Impact of ChatGPT on learning motivation: Teachers’ and students’ voices. J Engl Stud Arabia Felix. 2023;2(1):41-9.
- Song C, Song Y. Enhancing academic writing skills and motivation: Assessing the efficacy of ChatGPT in AI-assisted language learning for EFL students. Front Psychol. 2023;14:1260843.
- Khoso AK, et al. Integrating Sustainable Development Goals (SDGs) and generative AI to enhance language digital literacy and creativity in EFL learning environments. J Vis Exp. 2026;(228):e69445.
- Balcı Ö. The role of ChatGPT in English as a foreign language (EFL) learning and teaching: A systematic review. Int J Curr Educ Stud. 2024;3(1):66-82.
- Yamaoka K. ChatGPT’s motivational effects on Japanese university EFL learners: A qualitative analysis. Int J TESOL Stud. 2024;6(3).
- Afkarin MY, Asmara CH. Investigating the implementation of ChatGPT in English language education: Effects on student motivation and performance levels. Journey J Engl Lang Pedagogy. 2024;7(1):57-66.
- Alrabai F. The influence of teachers’ anxiety-reducing strategies on learners’ foreign language anxiety. Innov Lang Learn Teach. 2015;9(2):163-90.
- Kang S, Kim Y. Examining the quality of mobile-assisted video-making task outcomes: The role of proficiency, narrative ability, digital literacy, and motivation. Lang Teach Res. 2024;28(6):2326-53.
- Honggang W, Khoso AK, Althubyani AR. Technostress, digital fatigue, and AI dependency as antecedents of burnout and SDG-4 achievement in EFL classrooms. Sci Rep. 2026;16:15412.
- Sari AA, Ningsih SK. The influence of digital literacy in social media use on high school students’ intrinsic motivation in EFL learning. IDEAS J Engl Lang Teach Learn Linguist Lit. 2025;13(2):6634-51.
- Zhang Y. Impact of digital literacy on college students’ English proficiency: The mediating role of learning motivation and the moderating effect of technological self-efficacy. Acta Psychol (Amst). 2025;259:105452.
- Bender SM. Awareness of artificial intelligence as an essential digital literacy: ChatGPT and Gen-AI in the classroom. Changing Engl. 2024;31(2):161-74.
- Khoso AK, et al. The impact of ESL teachers’ emotional intelligence on ESL students’ academic engagement, reading and writing proficiency: Mediating role of ESL students’ motivation. Int J Early Child Spec Educ. 2022;14:3267-80.
- He M, Abbasi BN, He J. AI-driven language learning in higher education: An empirical study on self-reflection, creativity, anxiety, and emotional resilience in EFL learners. Humanit Soc Sci Commun. 2025;12(1):1-20.
- Wang HC. Exploring the relationships of achievement motivation and state anxiety to creative writing performance in English as a foreign language. Think Skills Creat. 2021;42:100948.
- Khan MA, Mahjabeen AN, Hussain F, Ur Rehman M. Investigating the correlation between writing anxiety and English creativity in Pakistani ESL students. Russ Law J. 2021;9(1):214-24.
- McDonough K, Crawford WJ, Mackey A. Creativity and EFL students’ language use during a group problem-solving task. TESOL Q. 2015;49(1):188-99.
- Rubino C, Luksyte A, Perry SJ, Volpone SD. How do stressors lead to burnout? The mediating role of motivation. J Occup Health Psychol. 2009;14(3):289-304.
- Halbesleben JRB, Bowler WM. Emotional exhaustion and job performance: The mediating role of motivation. J Appl Psychol. 2007;92(1):93-106.
- van Emmerik IJH, et al. The route to employability: Examining resources and the mediating role of motivation. Career Dev Int. 2012;17(2):104-19.
- Dana LP, et al. The impact of entrepreneurial education on technology-based enterprise development: The mediating role of motivation. Adm Sci (Basel). 2021;11(4):105.
- Kholifah N, Nurtanto M, Mutohhari F, et al. The mediating role of motivation and professional development in determining teacher performance in vocational schools. Cogent Educ. 2024;11(1):2421094.
- Güngör P. The relationship between reward management system and employee performance with the mediating role of motivation: A quantitative study on global banks. Procedia Soc Behav Sci. 2011;24:1510-20.
- Danish RQ, Khan MK, Shahid AU, et al. Effect of intrinsic rewards on task performance of employees: Mediating role of motivation. Int J Organ Leadersh. 2015;4:33-46.
- Mavhungu D, Bussin MH. The mediation role of motivation between leadership and public sector performance. SA J Hum Resour Manag. 2017;15(1):1-11.
- Faul F, Erdfelder E, Buchner A, Lang AG. Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behav Res Methods. 2009;41(4):1149-60.
- Rodríguez-de-Dios I, Igartua JJ, González-Vázquez A. Development and validation of a digital literacy scale for teenagers. In: Proceedings of the Fourth International Conference on Technological Ecosystems for Enhancing Multiculturality; 2016. p. 1067-72.
- Abbas M, Jam FA, Khan TI. Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students. Int J Educ Technol High Educ. 2024;21(1):10.
- Grasha AF. Teaching with style: The integration of teaching and learning styles in the classroom. Alliance Publishers; Pittsburgh (PA); 1996.
- Briesmaster M, Briesmaster-Paredes J. The relationship between teaching styles and NNPSETs’ anxiety levels. System. 2015;49:145-56.
- Kanoksilapatham B, et al. Motivation of Thai university students from two disciplinary backgrounds using a hybrid questionnaire. LEARN J Lang Educ Acquis Res Netw. 2021;14(1):455-91.
- Govindasamy P, Cumming TM, Abdullah N. Validity and reliability of a needs analysis questionnaire for the development of a creativity module. J Res Spec Educ Needs. 2024;24(3):637-52.
- Hair JF, Risher JJ, Sarstedt M, Ringle CM. When to use and how to report the results of PLS-SEM. Eur Bus Rev. 2019;31(1):2-24.
- Zhang R, et al. Mediating effect of learning motivation and engagement on the relationship between generative artificial intelligence implementation and English as a foreign language proficiency. 2026. https://doi.org/10.21203/rs.3.rs-9075280/v1.
- Almira NF, Almira ZF, Vircavani C, Agustina E. A systematic review of teachers’ teaching styles and their impact on EFL student learning outcomes. J Appl Linguist Engl Educ. 2025;3(1):1-5.
- Reeve J. Teachers as facilitators: What autonomy-supportive teachers do and why their students benefit. Elem Sch J. 2006;106(3):225-36.
- Huang S, Dong L, Wang W, et al. Language is not all you need: Aligning perception with language models. In: Advances in Neural Information Processing Systems. 2023;36:72096-109.
- Liu L. An international graduate student’s ESL learning experience beyond the classroom. TESL Can J. 2011;29(1):77-92.
- van Laar E, van Deursen AJAM, van Dijk JAGM, De Haan J. The relation between 21st-century skills and digital skills: A systematic literature review. Comput Hum Behav. 2017;72:577-88.
- Al-Kahtani N. A survey assessing health science students’ perceptions of online learning at a Saudi higher education institution during the COVID-19 pandemic. Heliyon. 2022;8(9):e10688.
- Dewaele JM, Chen X, Padilla AM, Lake J. The flowering of positive psychology in foreign language teaching and acquisition research. Front Psychol. 2019;10:2128.
- Liu W, Li Y. A qualitative study of question-posing anxiety in Chinese postgraduates in UK TESOL programs. Sci Rep. 2025;16(1):2081.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.