Diese Studie stellt einen leichtgewichtigen Ansatz zur Verringerung von Halluzinationen in großen Sprachmodellen durch die Verifikation auf Ebene einzelner Aussagen und adaptive statistische Schwellenwertbestimmung vor. Durch die gezielte Korrektur nicht gestützter Aussagen mittels natürlicher Sprachinferenz verbessert das Verfahren die faktische Genauigkeit, während gleichzeitig eine geringe Antwortlatenz und eine praktikable Einsatzeffizienz erhalten bleiben.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Adaptive NLI-gestützte Behauptungsverifizierung mit statistischer Entscheidungsmodellierung zur Reduzierung von Halluzinationen bei geringer Latenz in großen Sprachmodellen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Große Sprachmodelle (LLMs) weisen eine kritische Tendenz auf, faktisch falsche, aber sprachlich flüssige Ausgaben zu erzeugen – ein Phänomen, das als Halluzination bezeichnet wird –, das in anwendungsbezogenen Bereichen mit hohen Präzisionsanforderungen erhebliche Risiken birgt. Bestehende Minderungsstrategien, darunter die abrufverstärkte Generierung und die Stichprobenziehung mittels Selbstkonsistenz, führen entweder zu erheblichen Verzögerungen während der Inferenz oder sind von externer Wissensinfrastruktur abhängig, was ihre Anwendbarkeit in Echtzeitanwendungen einschränkt. In dieser Arbeit wird ein leichtgewichtiger zweistufiger Rahmen für die Überprüfung von Aussagen vorgeschlagen, der LLM-Antworten in atomare Faktenbehauptungen zerlegt und jede extrahierte Behauptung unabhängig anhand eines separat generierten Referenztexts verifiziert, der durch eine isolierte Faktenabruffrage erzeugt wird. Obwohl Generator und Verifier auf demselben zugrundeliegenden Sprachmodell basieren, reduziert die Trennung von Antwortgenerierung und Faktenabruf die direkte Antwortbedingtheit und verringert Bestätigungsfehler während der Verifikation, wobei die natürliche Sprachinferenz (Natural Language Inference, NLI) verwendet wird, und setzt eine adaptive statistische Schwelle ein – definiert als τ = µ + kσ über die Verteilung der NLI-Zuverlässigkeitswerte –, um gezielt nur widersprüchliche Behauptungen zu korrigieren. Im Gegensatz zu früheren NLI-basierten Methoden, die auf festen Entscheidungsgrenzen beruhen, passt der vorgeschlagene Rahmen seine Verifizierungsschwelle dynamisch an die Zuverlässigkeitsverteilung jeder einzelnen Antwort an und zeigt dabei konsistente Leistung über alle evaluierten Benchmarks hinweg, ohne dass eine erneute Modelltrainierung erforderlich ist. In den Evaluierungen auf TruthfulQA und FEVER verringert der Rahmen die Halluzinationsrate von 28 % auf 9 % bei TruthfulQA – eine relative Reduktion um 67,9 % – und verursacht dabei lediglich eine zusätzliche Latenz von 160 ms gegenüber dem Basis-LLM, während er SelfCheckGPT und FActScore hinsichtlich der Genauigkeit bei der Halluzinationsdetektion übertrifft. Diese Ergebnisse deuten darauf hin, dass der Rahmen ein günstiges Gleichgewicht zwischen faktischer Zuverlässigkeit und Antwortlatenz auf den evaluierten Benchmarks bieten kann, wobei jedoch weitere Validierungen über verschiedene Domänen und Einsatzszenarien hinweg erforderlich sind.
Einleitung
Große Sprachmodelle (LLMs) haben sich als grundlegende Bestandteile moderner künstlicher Intelligenzsysteme etabliert und beeindruckende Fähigkeiten in einem breiten Spektrum natürlicher Sprachaufgaben gezeigt, einschließlich Textgenerierung, Fragebeantwortung, Zusammenfassung und komplexer Schlussfolgerungen1Ihre Fähigkeit, flüssige und kontextuell kohärente Antworten zu generieren, hat die Einführung in hochwirksamen Bereichen wie der klinischen Entscheidungsunterstützung, der juristischen Analyse, dem Software-Engineering und der Bildungstechnologie beschleunigt.2Ein kritisches und anhaltendes Manko beeinträchtigt jedoch ihre Zuverlässigkeit in diesen Anwendungsbereichen: Halluzinationen, bei denen Modelle sprachlich flüssige, aber faktisch falsche, nicht belegte oder vollständig erfundene Antworten generieren. Empirische Studien berichten über Halluzinationsraten zwischen 15 % und über 40 %, abhängig von der Aufgabe und dem Modell, wobei selbst modernste Systeme wie GPT-4 bei fachspezifischer Bewertung messbare faktische Inkonsistenzen aufweisen.2,3Diese Einschränkung birgt erhebliche Risiken in anwendungsbezogenen Bereichen, die hohe Präzision erfordern, da fehlerhafte Ergebnisse zu Fehlinformationen, Fehldiagnosen oder fehlerhaften Entscheidungen führen können.4Halluzinationen entstehen grundsätzlich aus der probabilistischen Natur der Sprachmodellierung – große Sprachmodelle generieren Token, indem sie statistisch wahrscheinliche Fortsetzungen von Eingabesequenzen vorhersagen, anstatt verifiziertes Faktenwissen abzurufen oder darauf zu schließen.5Als Konsequenz können die generierten Ausgaben plausibel erscheinende, aber ungenaue Behauptungen enthalten, unbegründete Aussagen einführen oder semantisch verwandte, jedoch faktisch unterschiedliche Konzepte verwechseln.6.
Bestehende Minderungsstrategien begegnen diesem Problem durch mehrere Paradigmen, die jeweils erhebliche Einschränkungen aufweisen. Die abrufbasierte Generierung (Retrieval-Augmented Generation, RAG) verringert Halluzinationen, indem Antworten auf extern abgerufene Dokumente gestützt werden, verursacht jedoch erhebliche Latenzkosten, erfordert Zugriff auf gepflegte Wissensdatenbanken und bleibt anfällig für Abrufausfälle in spezialisierten oder ressourcenarmen Bereichen7,8,9.
Obwohl der Antwortgenerator und der Referenzgenerator auf dem gleichen zugrundeliegenden GPT-3.5-Turbo-Modell basieren, arbeiten sie mit unterschiedlichen Vorgaben und Ausführungskontexten. Der Antwortgenerator erzeugt eine uneingeschränkte Antwort auf die Nutzeranfrage, während der Referenzgenerator eine isolierte Faktenabrufaufgabe durchführt, ohne Zugriff auf die zuvor generierte Antwort. Diese Trennung verringert direkte, antwortbedingte Effekte und begrenzt Bestätigungsfehler während der Prüfung von Aussagen. Daher betrachtet das Framework die generierte Referenz als prozedural unabhängig, nicht jedoch als statistisch unabhängig.
Aktuelle Forschungsarbeiten haben zudem leichtgewichtige Dekodierstrategien untersucht, um Halluzinationen bei der Textgenerierung zu reduzieren, ohne auf externe Abrufverfahren oder wiederholte Überprüfungen angewiesen zu sein. Ein repräsentativer Ansatz ist das Decoding by Contrasting Layers (DoLA), das die Faktentreue verbessert, indem Repräsentationen aus Zwischen- und finalen Transformer-Schichten während des Dekodierens gegenübergestellt werden. Im Gegensatz zu Überprüfungsansätzen nach der Generierung greifen solche Methoden direkt während der Token-Generierung ein und optimieren somit eine andere Phase des Sprachgenerierungsprozesses. Diese komplementären Strategien zeigen, dass die Minderung von Halluzinationen entweder während des Dekodierens oder durch nachträgliche Generierungsüberprüfung erreicht werden kann, wobei jeder Ansatz unterschiedliche Kompromisse hinsichtlich des rechnerischen Aufwands, der Implementierungskomplexität und der faktischen Zuverlässigkeit bietet.
Methoden zur Selbstkonsistenz verbessern die faktische Zuverlässigkeit, indem sie mehrere Antworten abtasten und die am häufigsten vorkommende oder kohärenteste Ausgabe auswählen; ihre Rechenkosten steigen jedoch linear mit der Anzahl der Stichproben an, wodurch sie für latenzsensitive Anwendungen ungeeignet werden8. Ansätze zur iterativen Verbesserung überarbeiten die Ausgaben wiederholt mithilfe von Selbstrückkopplungsschleifen und verringern so schrittweise die Fehlerquoten, verlängern jedoch die Inferenzzeit erheblich mit jedem zusätzlichen Durchlauf9. Verifizierungsmethoden basierend auf natürlicher Sprachinferenz (NLI) bieten eine gezieltere Alternative, indem sie die semantische Implikation zwischen generierten Aussagen und Referenztexten bewerten, doch bestehende Implementierungen stützen sich auf feste Entscheidungsschwellen, die nicht an unterschiedliche Konfidenzverteilungen, Domänen oder Modellverhalten anpassbar sind10,11. Insgesamt bringen diese Ansätze entweder unannehmbare Rechenlast mit sich, sind auf externe Infrastruktur angewiesen oder weisen einen Mangel an Anpassungsfähigkeit auf, der für eine allgemeine Bereitstellung erforderlich ist. Ein Vergleich der wichtigsten Merkmale dieser Halluzinationsverifizierungsansätze ist in Zusatztabelle 1 dargestellt.
In diesem Artikel wird ein leichtgewichtiger, zweistufiger Rahmen für die Überprüfung von Behauptungen vorgeschlagen, der darauf abzielt, Halluzinationen in den Ausgaben von LLMs zu reduzieren, während eine geringe Antwortlatenz beibehalten wird. Im ersten Schritt erzeugt das LLM eine anfängliche Antwort, die anschließend in atomare Faktenbehauptungen zerlegt wird. Im zweiten Schritt wird jede Behauptung mittels natürlicher Sprachinferenz (Natural Language Inference) gegenüber einer separat erzeugten faktischen Referenz überprüft, die durch einen isolierten Schlussfolgerungsdurchlauf generiert wird, der nicht auf die ursprünglich erzeugte Antwort zugreift; eine statistisch abgeleitete Konfidenzschwelle regelt die Entscheidung über Annahme oder Korrektur auf Ebene der einzelnen Behauptung. Die Hauptbeiträge dieser Arbeit sind wie folgt: (1) Eine zweistufige Verifizierungspipeline auf Ebene einzelner Behauptungen, die die Antwortgenerierung von der faktischen Validierung entkoppelt und dadurch eine unabhängige und gezielte Bewertung jeder atomaren Behauptung ermöglicht, ohne externe Abrufverfahren oder vollständige Neugenerierung der Antwort zu erfordern; (2) Ein adaptiver statistischer Schwellenwertmechanismus, der auf der Verteilung der NLI-Konfidenzwerte basiert (τ = µ + kσ), wodurch die Grenzen für Annahme und Korrektur dynamisch festgelegt werden, anstatt auf festen Entscheidungsregeln zu beruhen, was die Robustheit über unterschiedliche Konfidenzverteilungen hinweg verbessert; (3) Eine selektive Korrekturstrategie, die die Neugenerierung auf ausschließlich als widersprüchlich klassifizierte Behauptungen beschränkt und dadurch den Rechenaufwand im Vergleich zu Methoden mit vollständiger Neugenerierung oder iterativer Verbesserung erheblich reduziert; (4) Eine empirische Evaluation anhand eines auf Halluzinationen ausgerichteten Benchmarks, die zeigt, dass der vorgeschlagene Rahmen die Halluzinationsrate von 28 % auf 9 % senkt, während die Antwortlatenz innerhalb praktisch nutzbarer Grenzen für den Einsatz bleibt.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie umfasste keine menschlichen Teilnehmer, Tiere, biologischen Proben oder Patientendaten. Daher waren eine institutionelle ethische Genehmigung und eine informierte Einwilligung nicht erforderlich.
Überblick über den Studiendesign
Ein zweistufiges Verifizierungsframework wurde implementiert, um die faktische Zuverlässigkeit der Ausgaben von großen Sprachmodellen (LLM) zu verbessern. Das Verfahren bestand aus der Erzeugung von Antworten, der Extraktion von Aussagen, der konstruierten isolierten Referenz, der verifizierung basierend auf natürlicher Sprachinferenz (NLI), der adaptiven statistischen Entscheidungsfindung, der selektiven Korrektur und der endgültigen Zusammenstellung der Antwort. Das Framework wurde anhand der Benchmark-Datensätze TruthfulQA und FEVER evaluiert.
Gesamtarbeitsablauf
Benutzeranfrage → Erste Antwortgenerierung → Aussageextraktion → Unabhängige Referenzgenerierung → NLI-Verifizierung → Statistische Schwellwertberechnung → Aussagenkorrektur → Endgültige verifizierte Antwort. Der gesamte Arbeitsablauf des adaptiven Rahmenwerks zur Aussagenüberprüfung ist in Abbildung 1 dargestellt.
Datensatzvorbereitung
Der TruthfulQA-Datensatz12, der 817 faktenbasierte Fragen enthält, wurde heruntergeladen und für die Auswertung vorbereitet. Der FEVER-Datensatz13 umfasst 185.445 annotierte Behauptungen, die als Unterstützt, Widerlegt oder Nicht genügend Informationen gekennzeichnet sind; für die Auswertung wurden die gekennzeichneten Entwicklungsdaten mit ihren Feldern Behauptung, Beweis und Ground-Truth-Label verwendet. Jede Behauptung wurde anhand des bereitgestellten Beweises bewertet, während das ursprüngliche FEVER-Label als Referenzergebnis zur Verifizierung beibehalten wurde. Der FEVER-Datensatz, der Paare aus Behauptungen und Beweisen zur Faktenüberprüfung enthält, wurde bezogen und vorverarbeitet. Eingabefragen und -behauptungen wurden in ein standardisiertes Textformat umgewandelt. Doppelte Einträge und unvollständige Beispiele wurden vor den Experimenten entfernt. TruthfulQA wurde in Validierungs- und Testteilmengen aufgeteilt. Etwa 20 % der TruthfulQA-Beispiele (164 Fragen) dienten der Schwellenwertanpassung, während die verbleibenden 653 Fragen für die Leistungsbewertung reserviert blieben. Für FEVER wurden die vom Benchmark bereitgestellten Behauptungen direkt als Verifizierungseinheiten verwendet und durchliefen nicht den Prozess der Antwortgenerierung und Behauptungsextraktion, der bei TruthfulQA angewandt wurde. Die Merkmale der für die Entwicklung und Bewertung des Frameworks verwendeten Benchmark-Datensätze sind in Tabelle 1 zusammengefasst.
Erzeugung der anfänglichen Antwort
Jede Abfrage wurde dem Basis-Sprachmodell übermittelt. Die Antworten wurden mithilfe von Nucleus-Sampling mit einer Temperatur von 0,7 und einem Top-p-Wert von 0,9 generiert. Die maximale Ausgabelänge war auf 256 Token begrenzt. Generierte Antworten wurden ohne Nachbearbeitung oder manuelle Änderungen gespeichert. Der generierte Text wurde direkt an die Phase der Aussageextraktion weitergeleitet.
Extraktion von Behauptungen
Jede generierte Antwort wurde in unabhängig überprüfbare Faktaussagen zerlegt. Es wurde ein strukturierter Zerlegungsansatz verwendet, um atomare Aussagen zu identifizieren. Zusammengesetzte Aussagen wurden in minimale Fakteinheiten aufgeteilt. Subjektive Meinungen, stilistische Ausdrücke und konversationelle Füllphrasen wurden entfernt. Jede extrahierte Aussage wurde als eigenständige Verifizierungseinheit gespeichert.
Beispiel:
Ursprüngliche Antwort:
„Marie Curie war eine gebürtige Polin und Physikerin sowie Chemikerin, die bahnbrechende Forschungsarbeiten zur Radioaktivität durchführte.“
Extrahierte Aussagen: (1) Marie Curie war polnischer Herkunft; (2) Marie Curie war Physikerin und Chemikerin; (3) Marie Curie führte Forschungen zur Radioaktivität durch.
Konstruktion isolierter Referenzen:
Für jede extrahierte Behauptung wurde eine unabhängige sachliche Referenz erstellt. Dem Verifizierungsmodell wurde lediglich die ursprüngliche Nutzeranfrage zur Verfügung gestellt. Der Zugriff auf die ursprünglich generierte Antwort wurde eingeschränkt, um Bestätigungsfehler zu vermeiden. Es wurde eine Faktenerinnerungs-Aufforderung verwendet, um prägnante, evidenzbasierte Antworten zu fördern. Die generierten Referenzen wurden zur anschließenden Überprüfung gespeichert.
Überprüfung der natürlichsprachlichen Inferenz
Jedes Paar aus Behauptung und Referenz wurde einem vortrainierten NLI-Modell übermittelt. Das NLI-Modell klassifizierte die Beziehung als: Bestätigung, Neutralität oder Widerspruch. Konfidenzwahrscheinlichkeiten für alle drei Klassen wurden aufgezeichnet. Es wurde eine vorzeichenbehaftete Verifizierungsscore zugewiesen: ein positiver Wert bei Bestätigung, null bei Neutralität und ein negativer Wert bei Widerspruch. Alle Verifizierungsscores wurden zur Schwellenwertberechnung gesammelt.
Berechnung adaptiver statistischer Schwellenwerte
Das Verifizierungsvertrauen, das vom NLI-Modell erzeugt wird, variiert zwischen den Antworten erheblich, da unterschiedliche Anfragen verschiedene Anzahlen von Aussagen, unterschiedliche semantische Komplexitätsgrade und verschiedene Verteilungen des Vertrauens hervorrufen. Eine feste globale Schwelle setzt voraus, dass alle Antworten einem ähnlichen Vertrauensprofil folgen, was in der Praxis selten beobachtet wird. Um diese Variabilität zu berücksichtigen, schätzt das vorgeschlagene Framework die Entscheidungsgrenze für jede Antwort einzeln anhand des Mittelwerts und der Standardabweichung ihrer Verifizierungsergebnisse. Der Mittelwert spiegelt das allgemeine Vertrauensniveau der Antwort wider, während die Standardabweichung die Streuung der Vertrauenswerte unter den extrahierten Aussagen erfasst. Diese adaptive Formulierung ermöglicht es, das Akzeptanzkriterium an die unspezifische Unsicherheit jeder einzelnen Antwort anzupassen, anstatt auf eine einzige Schwelle für alle Eingaben zu vertrauen.
Der Mittelwert (µ) und die Standardabweichung (σ) aller signierten Verifizierungsscores wurden berechnet.
Die adaptive Entscheidungsschwelle wurde wie folgt berechnet:

wobei τ die adaptive Schwelle, µ den mittleren Verifizierungswert, σ die Standardabweichung und k den Empfindlichkeitsparameter bezeichnet.
Der Empfindlichkeitsparameter wurde mit 0,7 initialisiert. Behauptungen, die als Folgerung mit Werten größer oder gleich +τ klassifiziert wurden, wurden akzeptiert. Behauptungen, die als Widerspruch mit Werten kleiner oder gleich −τ klassifiziert wurden, wurden zur Korrektur markiert. Behauptungen mit Werten innerhalb des Intervalls (−τ, +τ) wurden als neutral beibehalten.
Selektive Anspruchskorrektur
Eine Behauptung wurde nur dann zur Korrektur weitergeleitet, wenn das NLI-Modell das Paar aus Behauptung und Referenz als Widerspruch klassifizierte und die entsprechende vorzeichenbehaftete Verifizierungsscore das adaptive Schwellenwertkriterium si ≤ -τ erfüllte. Die Entscheidung zur Korrektur ergab sich somit aus der Klassenbezeichnung des NLI und der reaktionsspezifischen statistischen Schwelle. Behauptungen, die als Folgerung klassifiziert wurden und für die si ≥ τ galt, wurden akzeptiert, während Behauptungen, deren Werte im Intervall -τ < si < τ lagen, als neutral behandelt und ohne Korrektur beibehalten wurden. Dieses kombinierte Kriterium stellte sicher, dass eine Korrektur nur auf Behauptungen angewandt wurde, die sowohl einen semantischen Widerspruch aufwiesen als auch ausreichend starke negative Verifizierungsbeweise lieferten.
Rekonstruktion der Antwort
Akzeptierte und korrigierte Aussagen wurden in ihrer ursprünglichen Reihenfolge angeordnet. Die Satzgrenzen wurden wiederhergestellt, um die Lesbarkeit zu gewährleisten. Gegebenenfalls wurden geringfügige grammatische Anpassungen vorgenommen. Die zusammengestellte Ausgabe wurde als endgültige verifizierte Antwort gespeichert.
Leistungsbeurteilung
Der Rahmen wurde anhand von vier Metriken bewertet: (1) Genauigkeit: Der Anteil der Antworten, die nach der Überprüfung faktisch korrekt blieben; (2) F1-Score: Das harmonische Mittel aus Präzision und Sensitivität bei der Halluzinationsdetektion; (3) Antwortlatenz: Die gesamte Verarbeitungszeit von der Abgabe der Anfrage bis zur Generierung der überprüften Antwort; (4) Halluzinationsrate
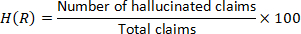
Die Latenz wurde als mittlere Ausführungszeit über wiederholte Messungen hinweg angegeben. Da die individuellen Latenzwerte pro Durchlauf nicht gespeichert wurden, wurden Standardabweichungen und Konfidenzintervalle nicht berechnet.
Bewertung der korrekten Ergebnisse je Benchmark
Bei TruthfulQA wurde die endgültige überprüfte Antwort mit den menschlich validierten Referenzantworten des Benchmarks sowie mit Listen falscher Antworten verglichen. Eine Antwort galt als korrekt, wenn ihre faktischen Aussagen mit den akzeptierten Antwortinformationen übereinstimmten und keine Inhalte enthielt, die den identifizierten Mustern falscher Antworten entsprachen. Bei FEVER wurde jede Behauptung in der endgültigen Ausgabe anhand des zugehörigen Beweismaterials und der ursprünglichen FEVER-Anmerkung bewertet; Unterstützte Behauptungen wurden als faktisch verifiziert angesehen, während widerlegte Behauptungen als falsch gewertet wurden. Fälle mit „Nicht genügend Informationen“ wurden als unbestimmt beibehalten, anstatt als positiver faktischer Hinweis gewertet zu werden. Die resultierenden entscheidungen auf Ebene der einzelnen Behauptungen wurden für jeden Benchmark zusammengefasst, um die angegebene Genauigkeit und Halluzinationsrate zu berechnen.
Experimentelles Umfeld
Der Rahmen wurde mithilfe von Python 3.9 implementiert. Datenverarbeitungsoperationen wurden mit numerischen und tabellarischen Analysebibliotheken durchgeführt. Das NLI-Modell arbeitete im Inferenzmodus, ohne zusätzliche Feinabstimmung. Die Experimente wurden auf einer Workstation mit einem Intel Core i5-Prozessor, 16 GB RAM und einem 64-Bit-Betriebssystem ausgeführt. Alle Bewertungen erfolgten im Einzeldurchlauf-Inferenzmodus, um einen Betrieb mit geringer Latenz zu gewährleisten. Alle Experimente wurden mit identischer Hardware- und Softwarekonfiguration durchgeführt, um eine konsistente Bewertung über Datensätze und Baseline-Methoden hinweg sicherzustellen.
Erwartetes Ergebnis
Das Protokoll dient dazu, entscheidungsrelevante Verifizierungen auf Anspruchsebene zu erzeugen, indem potenziell unbegründete Behauptungen identifiziert und gezielt stark widersprüchliche Behauptungen zur Korrektur weitergeleitet werden. Die erwartete Ausgabe ist eine verifizierte Antwort mit reduzierten faktischen Inkonsistenzen und begrenztem zusätzlichem Verarbeitungsaufwand, abhängig von der Leistung, die während der experimentellen Evaluierung beobachtet wurde.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Erzeugung der anfänglichen Antwort
Das Basismodell erzeugte flüssige und kontextuell relevante Antworten auf Fragen aus beiden Benchmark-Datensätzen. Bei genauerer Untersuchung zeigten sich jedoch mehrere Antworten mit unbegründeten und faktisch unrichtigen Aussagen. Auf dem TruthfulQA-Datensatz wies das Basissystem eine Halluzinationsrate von 28 % auf, während auf dem FEVER-Datensatz eine Halluzinationsrate von 26 % beobachtet wurde. Diese Ergebnisse bestätigten, dass die rei...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Der vorgeschlagene Ansatz verbesserte die Leistung bei der Faktenüberprüfung, ohne wiederholte Stichprobenziehung oder externe Abrufverfahren zu benötigen. Bei TruthfulQA sank die Halluzinationsrate von 28 % beim Baseline-LLM auf 9 % mit dem vollständigen Framework, während die Genauigkeit von 0,72 auf 0,87 anstieg. Bei FEVER verringerte sich die Halluzinationsrate von 26 % auf 10 %, wobei die Genauigkeit von 0,74 auf 0,89 stieg. Diese Vergleiche sollten im Kontext der in dieser Studie verwendeten experimentellen Bedingu...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass keine Interessenkonflikte bestehen.
Danksagungen
Die Autoren möchten ihrer Institution aufrichtig dafür danken, dass sie die akademische Umgebung und die Rechenressourcen bereitgestellt hat, die für die Durchführung dieser Forschung erforderlich waren. Die Autoren danken außerdem den Entwicklern und Betreuern der öffentlich zugänglichen Benchmark-Datensätze, die in dieser Studie verwendet wurden und eine umfassende Bewertung des vorgeschlagenen Frameworks ermöglichten. Anerkennung gilt auch Kollegen und Gutachtern für ihr konstruktives Feedback, das dazu beigetragen hat, die Qualität und Klarheit dieser Arbeit zu verbessern. Die Autoren danken weiterhin der Open-Source-Forschungsgemeinschaft für die Bereitstellung der Softwarebibliotheken und Werkzeuge, die Experimente, Datenanalysen und die Visualisierung der Ergebnisse erleichtert haben. Ihre anhaltenden Bemühungen haben die Forschung im Bereich der natürlichen Sprachverarbeitung und des vertrauenswürdigen künstlichen Intelligenz erheblich vorangebracht. Die Autoren erklären, dass für diese Forschung keine externe finanzielle Unterstützung oder Fördermittel eingeworben wurden.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| FEVER-Benchmark-Datensatz | FEVER Shared Task (Thorne et al.) | https://fever.ai/dataset/fever.html | Öffentlich zugänglicher Faktenüberprüfungsdatensatz mit Behauptungs-Evidenz-Paaren, der zur Evaluierung verwendet wird |
| GPT-3.5 Turbo (großes Sprachmodell B10+2:12:12 | OpenAI | Modell-ID: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Wird sowohl als Antwortgenerator als auch als unabhängiger Referenzgenerator verwendet und über die OpenAI-API abgerufen |
| NumPy | NumPy-Entwickler (Open Source) | https://numpy.org/ | Bibliothek für numerische Berechnungen, verwendet für statistische Analysen, einschließlich Mittelwert und Standardabweichung der NLI-Verifizierungsscores |
| Openai (Python-API-Client-Bibliothek) | OpenAI | https://github.com/openai/openai-python | Python-Client-Bibliothek zum Senden von Prompts und Abrufen von Antworten von GPT-3.5 Turbo |
| pandas | Entwicklungsteam von pandas (Open Source) | https://pandas.pydata.org/ | Bibliothek zur Analyse tabellarischer Daten, verwendet für die Datensatz-Vorverarbeitung und Ergebnisverarbeitung |
| Vortrainiertes Natural-Language-Inference- (NLI-)Klassifizierungsmodell | Hugging Face Model Hub (Modell basierend auf der DeBERTa-v3-large-Architektur von Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Wird im Inferenzmodus ohne Feinabstimmung verwendet, um jedes Behauptungs-Referenz-Paar als Folgerung, neutral oder Widerspruch zu klassifizieren |
| Python | Python Software Foundation | Version 3.9; https://www.python.org/downloads/release/python-390/ | Kernprogrammiersprache zur Implementierung des Verifizierungsframeworks |
| SciPy | SciPy-Entwickler (Open Source) | https://scipy.org/ | Wissenschaftliche Rechenbibliothek zur Unterstützung der statistischen Analyse der experimentellen Ergebnisse |
| Transformers (Hugging Face Transformers-Bibliothek) | Hugging Face | https://github.com/huggingface/transformers | Python-Bibliothek zum Laden und Ausführen des vortrainierten NLI-Modells |
| TruthfulQA-Benchmark-Datensatz | Ursprünglich veröffentlicht von Lin, Hilton und Evans | https://github.com/sylinrl/TruthfulQA | Öffentlich zugänglicher Benchmark mit 817 faktenbasierten Fragen, verwendet zur Schwellenwertanpassung und Evaluierung |
| Arbeitsplatzrechner | Im Manuskript nicht spezifiziert (bitte Hersteller/Modell bestätigen) | Intel Core i5-Prozessor; 16 GB RAM; 64-Bit-Betriebssystem | Hardware, auf der alle Experimente unter identischen Konfigurationen ausgeführt wurden |
| Hinweis: Alle oben aufgeführten URLs wurden auf Aktivität geprüft und zum Zeitpunkt dieser Tabelle bestätigt. |
Referenzen
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Nachdrucke und Genehmigungen
Dieser Artikel wurde veröffentlicht
Video demnächst verfügbar