Dieser Artikel stellt einen erklärbaren, auf CNNs basierenden Ansatz für die Klassifizierung von Hautläsionen vor, der hohe diagnostische Genauigkeit mit Modellinterpretierbarkeit verbindet. Er klassifiziert Bilder von Läsionen und erzeugt visuelle Erklärungen für seine Vorhersagen. Die Ergebnisse zeigen eine starke Leistungsfähigkeit und verbesserte Transparenz, was die klinische Entscheidungsfindung unterstützt und Dermatologen bei der Früherkennung von Hauterkrankungen hilft.
Forschungsartikel
Ein erklärbares computergestütztes Framework zur Klassifizierung von Hautläsionen mittels Deep Learning
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Nutzung tiefer faltender neuronaler Netze zur Diagnose von Erkrankungen im Bereich der Haut hat in verschiedenen Studien eine vergleichbare Genauigkeit wie die von Dermatologen erzielte Genauigkeit nachgewiesen. Dennoch bestehen weiterhin zahlreiche Herausforderungen, darunter in einigen Fällen Unterperformance und schlechte Generalisierungsfähigkeit sowie eine geringe Interpretierbarkeit aufgrund der Verwendung von Black-Box-Modellen. Dies schafft erhebliche Hindernisse für die praktische Umsetzung, da neben einer genauen Diagnostik auch Erklärbarkeit erforderlich ist, weshalb eine Lösung gefunden werden muss. Um die genannten Schwierigkeiten zu überwinden, wird in dieser Studie ein erklärbares Deep-Learning-Framework zur Klassifizierung von Hautläsionen (EDLF-SLC) entwickelt. Das Framework nutzt verschiedene Ansätze des maschinellen Lernens und der erklärbaren künstlichen Intelligenz (XAI), um in drei Stufen sowohl die Genauigkeit als auch die Interpretierbarkeit zu verbessern. In der ersten Stufe werden tiefe Darstellungen, die aus mehreren vortrainierten CNN-Architekturen extrahiert wurden, fusioniert, um komplementäre diskriminative Informationen zu bewahren, die von unterschiedlichen Netzwerkarchitekturen gelernt wurden, bevor die Klassifizierung mithilfe eines SVM mit einem radialen Basisfunktionskern erfolgt. Anschließend werden Support-Vektor-Maschinen (SVM) mit einem radialen Basisfunktionskern zur Klassifizierung der gewonnenen Merkmale verwendet. Schließlich werden die vom Modell getroffenen Vorhersagen mittels lokaler interpretierbarer, modellunabhängiger Erklärungen (LIME) interpretiert. Die experimentellen Ergebnisse zeigen, dass EDLF-SLC eine Genauigkeit von 88,0 %, eine Präzision von 89,0 %, einen Recall von 87,0 % und einen F1-Score von 88,0 % erreicht und somit im Vergleich zu mehreren kürzlich publizierten Methoden unter den in dieser Studie betrachteten experimentellen Bedingungen wettbewerbsfähige Leistung erbringt.
Einleitung
Hautläsionen sind in der Dermatologie und Onkologie von großer Bedeutung, da sie von gutartigen Veränderungen bis hin zu malignen Krebserkrankungen wie dem Melanom, der tödlichsten Form von Hautkrebs, reichen. Im Jahr 2020 gab es weltweit schätzungsweise 325.000 neue Melanom-Fälle und über 57.000 Todesfälle1. Obwohl Fortschritte bei der Früherkennung und Therapie die Behandlungsergebnisse für Patienten verbessert haben, tragen verzögerte Diagnosen und eingeschränkter Zugang zur medizinischen Versorgung weiterhin zu einer hohen Mortalität und zu verlorenen Lebensjahren bei, insbesondere in jüngeren Bevölkerungsgruppen2,3.
Die herkömmliche Diagnose stützt sich hauptsächlich auf die visuelle Untersuchung und Dermatoskopie, wodurch der Prozess von der Expertise der Ärztinnen und Ärzte abhängt und anfällig für Subjektivität, interindividuelle Variabilität, unnötige Biopsien sowie verlängerte Untersuchungszeiten ist4,5,6. Um diese Einschränkungen zu überwinden, hat sich das Deep Learning, insbesondere CNNs, als effektive Lösung für die automatisierte Klassifizierung von Hautläsionen etabliert. CNN-basierte Modelle, darunter DDCNN-F7, YOLOv7-XAI8 und mehrere andere Architekturen9,10,11,12,13, haben eine hohe diagnostische Genauigkeit gezeigt, indem sie diskriminierende Bildmerkmale automatisch erlernen. Trotz ihres Erfolgs funktionieren die meisten Deep-Learning-Modelle wie „Black Boxes“, was das Vertrauen der Ärztinnen und Ärzte einschränkt und ihre Einführung in die routinemäßige medizinische Praxis behindert. Aus diesem Grund wurden Techniken der erklärlichen künstlichen Intelligenz (Explainable Artificial Intelligence) eingeführt, um die Transparenz der Modelle zu erhöhen, indem sie visuelle Erklärungen der Vorhersagen bereitstellen. Eine dieser Methoden, die Lokalen interpretierbaren modellunabhängigen Erklärungen (Local Interpretable Model-Agnostic Explanations), erzeugt nachvollziehbare lokale Erklärungen, indem sie die Bildbereiche identifiziert, die die Modellentscheidungen am stärksten beeinflussen14.
Die Klassifizierung von Hautläsionen hat sich aus der traditionellen klinischen Beurteilung heraus zu fortschrittlichen, auf künstlicher Intelligenz basierenden Diagnosesystemen entwickelt, getrieben durch die Notwendigkeit einer genauen, zuverlässigen und frühen Erkennung von Hautkrebs. Diese Entwicklung durchlief fünf Hauptphasen – traditionelle Diagnosemethoden, computergestützte Diagnose (CAD), maschinelles Lernen (ML), Deep Learning (DL) und, in jüngerer Zeit, erklärbares KI-System (XAI) und föderiertes Lernen (FL) –, was kontinuierliche Bemühungen widerspiegelt, die diagnostische Genauigkeit, Konsistenz, Skalierbarkeit und klinische Vertrauenswürdigkeit zu verbessern und gleichzeitig die Grenzen herkömmlicher Untersuchungen zu überwinden. Frühe rechnergestützte Methoden versuchten, die klinische Schlussfolgerung durch manuell erstellte Bildmerkmale nach dem ABCD-Regel-System zu imitieren, einschließlich Asymmetrie, Randunregelmäßigkeit, Farbunterschieden und Läsionsdurchmesser. Diese Merkmale wurden mit Bayesschen Netzwerken, Entscheidungsbäumen, Expertensystemen und Modellen mit unscharfer Logik kombiniert, um die Diagnose von Melanomen zu unterstützen, wobei mehrere Studien Klassifizierungsgenauigkeiten von über 90 % meldeten15,16,17. Obwohl diese Methoden eine wichtige Grundlage für die computergestützte Diagnose bildeten, waren sie vollständig von manuell konstruierten Merkmalen und vorgegebenen diagnostischen Regeln abhängig. Folglich zeigten sie eine begrenzte Robustheit gegenüber Variationen in der Bildqualität, Läsionsmorphologie, Beleuchtung und Aufnahmebedingungen.
Um diese Nachteile zu beheben, entstanden klassische CAD-Systeme als Zwischenschritt zwischen der konventionellen Bildanalyse und modernen, auf KI basierenden Frameworks. CAD-Systeme kombinierten manuell konstruierte Merkmalsextraktion mit herkömmlichen Klassifizierern, um die diagnostische Konsistenz zu verbessern und die klinische Entscheidungsfindung zu unterstützen. Verschiedene hybride Ansätze integrierten hierarchisches Clustering mit rekurrenten neuronalen Netzen und Langzeit-Kurzzeit-Gedächtnis-Architekturen und erreichten Klassifizierungsgenauigkeiten von nahezu 99,5 %18. Andere CAD-basierte Frameworks nutzten Gradient-Boosting-Klassifizierer mit SHAP-basierten Erklärungen und zeigten dabei wettbewerbsfähige diagnostische Genauigkeit, während sie gleichzeitig die Modelltransparenz verbesserten19. Obwohl diese Systeme eine deutliche Verbesserung gegenüber rein regelbasierten Ansätzen darstellten, waren sie weiterhin stark von manuell konstruierter Merkmalsextraktion, umfangreicher Vorverarbeitung, sorgfältig annotierten Datensätzen und mehrstufigen Verarbeitungspipelines abhängig.
Maschinelle Lernverfahren haben die automatisierte Klassifizierung von Hautläsionen weiter vorangetrieben, indem sie ein datengestütztes Lernen anstelle der expliziten Regelerstellung ermöglichten. Hybride Frameworks, die konvolutionelle neuronale Netze mit herkömmlichen maschinellen Klassifikatoren wie logistischer Regression und k-nächsten Nachbarn kombinierten, zeigten eine hohe Klassifizierungsleistung auf etablierten Datensätzen und erreichten Genauigkeiten von über 95 %9. Selbstüberwachtes multimodales Lernen verbesserte die Merkmalsrepräsentation weiter, indem es dermatoskopische und klinische Bilder gemeinsam nutzte, wodurch die Abhängigkeit von umfangreichen manuellen Annotationen verringert und gleichzeitig die Klassifizierungsleistung gesteigert wurde20. Weitere Studien kombinierten CNNs mit verallgemeinerter Diskriminanzanalyse, SURF-Deskriptoren und Optimierungsalgorithmen, um die Merkmalsdiskriminierung und Klassifizierungsgenauigkeit zu verbessern21. Automatische Verfahren zur Merkmalsauswahl, die DenseNet-201, InceptionV3 und binäre Baumoptimierungsalgorithmen verwendeten, verbesserten die Merkmalsrepräsentation weiter, während sie gleichzeitig eine wettbewerbsfähige diagnostische Leistung beibehielten22. Ansätze des Transferlernens, die vortrainierte Architekturen wie AlexNet und GoogLeNet nutzten, zeigten trotz begrenzter Trainingsdaten vielversprechende Klassifizierungsfähigkeiten23. Dennoch blieben die meisten ML-Methoden weiterhin von sorgfältig entworfenen Vorverarbeitungsverfahren, manuell erstellten Optimierungsstrategien, ausgewogenen Datensätzen und umfangreichem Hyperparameter-Tuning abhängig. Ihre begrenzte externe Validierung und Empfindlichkeit gegenüber Klassenungleichgewichten schränkten zudem ihre praktische Anwendbarkeit in unterschiedlichen klinischen Umgebungen ein.
Die Einführung des Deep Learning hat die automatisierte Klassifizierung von Hautläsionen grundlegend verändert, indem sie das Ende-zu-Ende-Lernen direkt aus rohen Bilddaten ermöglichte. Faltungsneuronale Netze (CNNs) machten manuelles Merkmals-Engineering überflüssig und verbesserten gleichzeitig die diagnostische Leistung deutlich über mehrere Benchmark-Datensätze hinweg. Die meisten auf CNNs basierenden Ansätze zeigten signifikante Verbesserungen bei der Läsionsklassifizierung durch zunehmend anspruchsvolle Architekturen. Symmetrieorientierte CNN-Modelle untersuchten klinisch relevante Läsionsmerkmale, erreichten jedoch lediglich eine moderate ausgewogene Genauigkeit24. Andere integrierten EfficientNet-Architekturen mit LIME- und SHAP-Erklärungen, um die Interpretierbarkeit zu verbessern, und führten gleichzeitig quantitative Maße für Vertrauenswürdigkeit ein25. Hybride Deep-Learning-Systeme, die Läsionssegmentierung, Ensemble-Learning und CNNs kombinierten, erzielten hervorragende Ergebnisse auf mehreren ISIC-Datensätzen, blieben jedoch empfindlich gegenüber der Segmentierungsgüte und Klassenungleichgewichten26.
In jüngerer Zeit haben zunehmend anspruchsvollere hybride Architekturen die Klassifizierungsgenauigkeit weiter verbessert, indem sie komplementäre Deep-Learning-(DL-)Techniken integrierten. Bedingte generative adversariale Netzwerke in Kombination mit YOLOv5 und der Analyse unabhängiger Komponenten erreichten Klassifizierungsgenauigkeiten von über 99 %, wobei ihre hohe Rechenkomplexität die praktische Anwendung jedoch einschränkte27. Ebenso lernten hybride LSTM–ResNet-Architekturen effektiv räumlich-zeitliche Darstellungen, benötigten aber erheblich mehr Rechenressourcen28. Auf Transformatoren basierende Modelle wie Sap-Former nutzten globale Kontextinformationen, um die Merkmalsrepräsentation zu verbessern, erforderten jedoch umfangreiche Vorverarbeitung, groß angelegte annotierte Datensätze und erhebliche Rechenleistung29. Leichtgewichtige Alternativen wie S-MobileNet versuchten, Rechenleistungseffizienz mit diagnostischer Genauigkeit in Einklang zu bringen30, während Methoden der unbeaufsichtigten Domänenanpassung die Generalisierung über Domänen hinweg verbesserten, trotz verringerter Effektivität, wenn nur begrenzte Trainingsbeispiele verfügbar waren31. Durch Aufmerksamkeitsmechanismen verbesserte hybride Netzwerke, die modifizierte konvolutionale Aufmerksamkeitsmodule und Snapshot-Ensemble-Lernen integrieren, zeigten ebenfalls vielversprechende Leistung bei der Klassifizierung von Hautläsionen durch Affenpocken, obwohl Herausforderungen im Zusammenhang mit Klassenungleichgewicht, Bildvielfalt und begrenzter Erklärbarkeit weiterhin ungelöst blieben32. Angepasste Residualarchitekturen, die tiefere Netzwerkstrukturen und hybride Verlustfunktionen verwenden, steigerten die Klassifizierungsgenauigkeit über 99 % hinaus, gingen jedoch mit deutlich höherem Rechenaufwand und längeren Trainingszeiten einher33. Umfassende Übersichtsarbeiten kamen übereinstimmend zu dem Schluss, dass DL-Methoden traditionelle manuelle Ansätze deutlich übertrafen, indem sie diskriminative Bildrepräsentationen automatisch lernten, und gleichzeitig persistierende Herausforderungen im Hinblick auf Bildartefakte, Beleuchtungsvariabilität, Rechenkomplexität und begrenzte klinische Generalisierbarkeit identifizierten34.
Obwohl die tiefe Lernverfahren (DL) die diagnostische Genauigkeit erheblich verbessert haben, haben Bedenken hinsichtlich Modelltransparenz, Unsicherheitsschätzung und vertrauenswürdigen klinischen Einsatz ein wachsendes Interesse an erklärbarer KI (XAI) und verteiltem Lernen (Federated Learning) ausgelöst. Mehrere Studien haben Techniken zur Quantifizierung von Unsicherheiten untersucht, darunter konforme Vorhersage, Monte-Carlo-Dropout und evidenzbasiertes tiefes Lernen, wobei sich zeigte, dass eine zuverlässige Konfidenzschätzung die Entscheidungsunterstützung erheblich verbessern kann, auch wenn dadurch zusätzliche rechentechnische und datenbezogene Einschränkungen entstehen35. Es wurden ebenfalls mutual learning-basierte Transformer-Frameworks vorgeschlagen, um das Problem der Klassenungleichgewichte zu adressieren und gleichzeitig die Effizienz des Merkmalslernens zu verbessern36. Andere Ansätze kombinierten vollauflösende CNNs mit graphenbasierten Optimierungstechniken, um die Segmentierung und Klassifizierung von Läsionen zu verbessern37, während hybride Deep-Learning-Frameworks, die mehrere komplementäre Merkmalsdarstellungen integrieren, Klassifizierungsgenauigkeiten von nahezu 99,5 % erreichten, jedoch umfangreiche Vorverarbeitung erfordern38.
Aktuelle Forschungsarbeiten konzentrieren sich zunehmend darauf, Erklärbarkeit direkt in Deep-Learning-Frameworks zu integrieren, um das Vertrauen von Ärzten zu stärken und die praktische klinische Anwendung zu erleichtern. Erklärbare Systeme, die mehrere Architekturen aus faltenden neuronalen Netzen in Kombination mit Grad-CAM und Score-CAM nutzen, lokalisierten diagnostisch relevante Läsionsbereiche erfolgreich und erzielten gleichzeitig wettbewerbsfähige Klassifizierungsleistungen sowohl auf internen als auch externen Datensätzen39. Hybride CNN–Transformer-Modelle, die dermatoskopische Bilder mit klinischen Metadaten kombinieren, verbesserten die Vorhersagegenauigkeit weiter und nutzten SHAP sowie Grad-CAM, um klinisch aussagekräftige visuelle Erklärungen zu erzeugen40. Zusätzliche, auf Transformatoren basierende hybride Architekturen, die EfficientNetV2S, Swin-Transformer, modifizierte Xception-Netzwerke und Graph-Attention-Mechanismen integrieren, erfassten effektiv komplementäre globale und lokale Läsionseigenschaften, wobei ihre hohe Anzahl an Parametern und die begrenzte Leistung bei Minderheitenklassen die praktische Anwendbarkeit einschränkten41. Ebenso zeigten hybride YOLOv8–Vision-Transformer-Modelle durch adaptive Datenaugmentierung sowie Erklärungen mittels SHAP und Grad-CAM eine verbesserte Lokalisation von Läsionen, multiklassige Klassifizierung und visuelle Interpretierbarkeit; diese Verfahren stützten sich jedoch weiterhin hauptsächlich auf Benchmark-Datensätze und wiesen eine begrenzte Robustheit bei Minderheiten-Läsionskategorien auf42. Mehrere Übersichtsarbeiten haben diese Entwicklungen zusammengefasst und betonen sowohl die bemerkenswerten Fortschritte moderner Deep-Learning-Verfahren als auch die anhaltenden Herausforderungen hinsichtlich Recheneffizienz, Erklärbarkeit, Abhängigkeit von Datensätzen und klinischer Validierung43,44,45. Tabelle 1 fasst einige kürzlich veröffentlichte Arbeiten zusammen, die Deep-Learning-Algorithmen zur Klassifizierung von Hautläsionen nutzen.
Trotz der bemerkenswerten Fortschritte, die neuere DL-Methoden bei der Klassifizierung von Hautläsionen erzielt haben, sind die meisten bestehenden Ansätze weiterhin durch hohe Rechenkomplexität, Abhängigkeit von großen annotierten Datensätzen, begrenzte Modellinterpretierbarkeit und unzureichende Validierung in unterschiedlichen, realen klinischen Umgebungen eingeschränkt. Um diese Einschränkungen zu überwinden, schlägt dieser Artikel den EDLF-SLC-Rahmen vor, der komplementäre Merkmale, die aus mehreren CNN-Architekturen extrahiert wurden, mit einem SVM-Klassifikator kombiniert, um eine robuste und genaue Klassifizierung zu ermöglichen. Der Rahmen verwendet außerdem ein verbessertes Preprocessing, um die Bildqualität zu steigern und Klassenungleichgewichte auszugleichen, und integriert die LIME-Technik, um visuelle Erklärungen für individuelle Vorhersagen bereitzustellen, wodurch die Transparenz des Modells sowie das klinische Vertrauen erhöht werden.
Die Beiträge dieser Studie sind dreifach. Erstens schlagen die Autoren einen robusten Rahmen, EDLF-SLC, vor, der fortschrittliche faltende neuronale Netze (CNNs) mit einem Support-Vektor-Maschinen-(SVM-)Klassifikator kombiniert, um eine genaue und zuverlässige Klassifizierung von Hautläsionen zu erreichen. Zweitens setzen die Autoren verbesserte Vorbereitungstechniken ein, um Klassenungleichgewicht auszugleichen und Bildrauschen zu reduzieren, wodurch die Qualität der Eingabebilder sowie die Gesamtleistung des Klassifizierungsmodells verbessert wird. Drittens integrieren die Autoren die Methode der Lokal Interpretierbaren Modell-agnostischen Erklärungen (LIME), um individuelle Modellvorhersagen zu visualisieren und zu interpretieren, indem sie die Bildbereiche hervorheben, die die Klassifizierungsentscheidungen am stärksten beeinflussen, wodurch die Transparenz und Interpretierbarkeit des vorgeschlagenen Ansatzes erhöht wird.
Protokoll
Diese Studie beinhaltete keine Rekrutierung menschlicher Teilnehmer oder die Erhebung identifizierbarer Patientendaten. Alle Experimente wurden unter Verwendung des öffentlich zugänglichen ISIC-2020-Hautläsions-Datensatzes durchgeführt, der aus dem Kaggle-Repository bezogen wurde; daher waren eine Genehmigung durch einen institutionellen Ethikausschuss und eine informierte Einwilligung nicht erforderlich. Alle in dieser Studie verwendeten Materialien sind in der Tabelle der Materialien aufgeführt.
Extraktion und Fusion von Merkmalen
Hautläsionsbilder wurden mithilfe mehrerer vortrainierter CNN-Modelle verarbeitet. Die aus den ausgewählten vortrainierten CNN-Architekturen extrahierten tiefen Merkmalsvektoren werden verkettet, um eine einheitliche Merkmalsrepräsentation für jedes Hautläsionsbild zu erstellen. Die verwendete Fusionsstrategie bewahrt komplementäre visuelle Informationen, die von unterschiedlichen CNN-Architekturen gelernt wurden, wodurch der nachfolgende SVM-Klassifikator sowohl texturbasierte Eigenschaften auf niedriger Ebene als auch semantische Repräsentationen auf höherer Ebene nutzen kann. Obwohl Dimensionsreduktionsverfahren wie die Hauptkomponentenanalyse oder die auf mutualer Information basierende Merkmalsauswahl die Dimensionalität der Merkmale verringern könnten, wurde die vollständige fusionierte Repräsentation bewusst beibehalten, da der fusionierte Merkmalsraum für den verwendeten RBF-SVM-Klassifikator rechentechnisch handhabbar bleibt und gleichzeitig komplementäre diagnostische Informationen bewahrt, die aus den heterogenen CNN-Backbones extrahiert wurden.
Klassifizierung
Die fusionierten Merkmalsvektoren wurden verwendet, um einen SVM-Klassifikator mit einem RBF-Kern zu trainieren. Es kamen Techniken zur Hyperparameter-Optimierung zum Einsatz, um die optimalen Klassifizierungseinstellungen zu bestimmen. Anschließend kategorisierte der Klassifikator die Hautläsionen in ihre jeweiligen Klassen ein.
Erklärbarkeit
Zur Verbesserung der Interpretierbarkeit wurde LIME angewendet, um visuelle Erklärungen zu generieren, die die Bildbereiche hervorheben, die am stärksten zu den Klassifizierungsergebnissen beitragen. Diese Erklärungen würden Kliniker dabei unterstützen, die Entscheidungen des Modells nachzuvollziehen und zu validieren.
Evaluierungsplan
Der vorgeschlagene Ansatz wurde anhand eines etablierten Datensatzes für Hautläsionen evaluiert. Die Leistung wurde anhand von Genauigkeit, Präzision, Sensitivität und F1-Score bewertet. Vergleichende Experimente wurden gegenüber bestehenden maschinellen Lern- und Deep-Learning-Verfahren durchgeführt, um die Wirksamkeit des vorgeschlagenen Ansatzes zu belegen.
Erwartete Ergebnisse
Die Studie sollte ein genaues und interpretierbares Klassifizierungssystem für Hautläsionen hervorbringen. Vorläufige experimentelle Ergebnisse deuten darauf hin, dass EDLF-SLC eine Genauigkeit von 88,0 %, eine Präzision von 89,0 %, einen Recall von 87,0 % und einen F1-Score von 88,0 % erreicht und damit mehrere konkurrierende Methoden übertrifft. Es wurde erwartet, dass die Integration von LIME-Erklärungen die Vertrauenswürdigkeit erhöht und die Einführung von KI-unterstützten Diagnosesystemen in der klinischen Praxis erleichtert.
Bedeutung
Diese Forschung leistet einen Beitrag zum wachsenden Bereich der erklärbareren KI im Gesundheitswesen, indem sie sowohl Leistungs- als auch Transparenzherausforderungen bei der Diagnose von Hautläsionen angeht. Der vorgeschlagene Ansatz hat das Potenzial, Dermatologen bei zuverlässigeren und nachvollziehbareren diagnostischen Entscheidungen zu unterstützen und dadurch letztlich die Patientenversorgung zu verbessern. Darüber hinaus geben die Autoren in diesem Abschnitt Informationen zu den Materialien und der Methodik an, die in dieser Studie angewandt wurden. Insbesondere beginnen die Autoren mit der Beschreibung des für die Experimente verwendeten Datensatzes und führen dies weiter in eine detaillierte Darstellung des Erklärbaren Tiefenlern-Frameworks für die Klassifizierung von Hautläsionen.
Datensatz
Die vorgestellte Arbeit basiert auf dem öffentlich verfügbaren ISIC-2020-Datensatz (International Skin Imaging Collaboration), auf den über die Kaggle-Website zugegriffen werden kann (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). Das ISIC-Repository gilt als eine der besten Ressourcen auf dem Gebiet der dermatologischen Bildgebung, da es eine große Vielfalt an dermatoskopischen Bildern verschiedener Arten von Hautläsionen bereitstellt, wie in Abbildung 1 gezeigt. Wichtig ist, dass der Datensatz Bilder sowohl gutartiger als auch bösartiger Erkrankungen enthält, was ihn für binäre Klassifizierungsaufgaben bei Hautkrebs geeignet macht 46. Der aktuelle Datensatz umfasst 3.297 Bilder, darunter 1.800 gutartige und 1.497 bösartige. Für effizientere Experimente mussten die Daten in einen Trainings- und einen Testdatensatz aufgeteilt werden. Insbesondere umfasst der Trainingsdatensatz 2.637 Bilder, darunter 1.440 gutartige und 1.197 bösartige, während der Testdatensatz aus 660 Bildern besteht, davon 360 gutartige und 300 bösartige. Eine Zusammenfassung des Datensatzes ist in Tabelle 2 dargestellt.
Das vorgeschlagene EDLF-SLC-Modell
In dieser Arbeit wird eine effiziente und verständliche Lösung zur Klassifizierung von Hautläsionen in gutartige und bösartige Kategorien vorgestellt, die auf einer neuartigen erklärbaren Deep-Learning-Technik basiert und einen hybriden Ansatz verfolgt, der die Vorteile mehrerer vortrainierter Convolutional-Neural-Network-Modelle kombiniert. Convolutional Neural Networks haben sich als äußerst effektiv bei der Extraktion semantischer Merkmale auf hohem Niveau aus medizinischen Bildern erwiesen. Unter Nutzung dieser Fähigkeit nutzt das vorgeschlagene erklärbare Deep-Learning-Framework zur Klassifizierung von Hautläsionen (EDLF-SLC) mehrere vortrainierte CNN-Modelle, um eine überlegene Leistung zu erzielen. Um die notwendige Transparenz des medizinischen Entscheidungsprozesses sicherzustellen, wurde im vorgeschlagenen Ansatz LIME eingesetzt, um lokale, für Menschen verständliche Erklärungen für die Ergebnisse zu generieren. Der gesamte Rahmen lässt sich in drei Hauptphasen unterteilen, wie in Abbildung 2 dargestellt, nämlich (1) Daten-Präprozessing, (2) Merkmalsextraktion und -klassifizierung sowie (3) Interpretierbarkeit.
Modellarchitektur und Integration
Als vorbereitende Maßnahme wurden sieben verbreitete Deep-Learning-Modelle (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge und MobileNet) ausgewählt und separat anhand des Validierungsdatensatzes bewertet. Für die Merkmalsextraktionsphase wurden die vier effektivsten Modelle (ResNet50, EfficientNetB0, MobileNet und Xception) ausgewählt. In dem vorgeschlagenen Framework wird jedes Eingabebild x unabhängig durch die ausgewählten vortrainierten Modelle geleitet. Die letzte vollverknüpfte Schicht wurde aus jedem dieser Modelle entfernt, und Merkmalsvektoren wurden aus den vorhergehenden Schichten gewonnen. fResNet50(x), fEfficientNetB0(x), fMobileNet(x) und fXception(x) bezeichnen die Ausgabe-Merkmalsvektoren der oben genannten Modelle. Durch Verkettung dieser Merkmalsvektoren ergibt sich ein neuer aggregierter Merkmalsvektor F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
Anschließend wurde F(xi) einem SVM-Klassifikator mit einem radialen Basisfunktionskern (RBF) zugeführt, um das Klassifikationsergebnis zu erhalten. Der gesamte Algorithmus für das vorgeschlagene Framework ist in Supplementary File 1 dargestellt.
Der vorgeschlagene Ansatz verwendet eine direkte Fusion auf Merkmalsebene, da jede vortrainierte CNN-Architektur unterschiedliche diskriminative Merkmale von Hautläsionen durch ihre jeweils spezifische Netzwerkarchitektur und hierarchische Merkmalslernung erfasst. Daher bewahrt die Verkettung dieser heterogenen Merkmalsdarstellungen komplementäre Informationen auf, die zu einer umfassenderen Charakterisierung der Läsionen vor der Klassifizierung beitragen. Obwohl Dimensionsreduktionsverfahren wie die Hauptkomponentenanalyse (PCA) oder die auf mutualer Information basierende Merkmalsauswahl die Dimensionalität der fusionierten Darstellung verringern können, wurde der vollständige fusionierte Merkmalsvektor absichtlich beibehalten, da seine Dimensionalität für den verwendeten RBF-SVM-Klassifikator rechentechnisch handhabbar bleibt und gleichzeitig die komplementären diagnostischen Informationen erhalten bleiben, die von den verschiedenen CNN-Backbones extrahiert wurden. Dieses Design priorisiert somit die Beibehaltung komplementärer tiefer Darstellungen gegenüber der Eliminierung potenziell informativer Merkmale vor der Klassifizierung.
Datenaufbereitung
Die Datenaufbereitung umfasste die Vorverarbeitung und die Aufteilung des Datensatzes in Trainings- und Testmengen. Die Vorverarbeitung zielt darauf ab, die Datenqualität zu verbessern, indem Inkonsistenzen beseitigt, doppelte Elemente entfernt, Eingabebilder formatiert und eine Merkmalsskalierung zur stabilen Erstellung eines guten Modells durchgeführt wird. Alle Bilder wurden mithilfe der Z-Score-Normalisierung auf den Bereich [−1, 1] normalisiert:
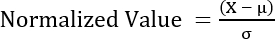 (2)
wobei µ und σ für den Mittelwert und die Standardabweichung des entsprechenden Bildes stehen. Der Datensatz wurde in zwei Teilmengen aufgeteilt, und zwar in einen Trainingsdatensatz (70,0 %) und einen Testdatensatz (30,0 %).
Datenaugmentierung
Um eine Überanpassung zu vermeiden und die Verallgemeinerungsfähigkeit des Modells zu verbessern, wurden einige Erweiterungen für den Trainingsdatensatz verwendet. Bei der Bildaugmentierung werden Bilder verändert, um den Datensatz künstlich zu erweitern, ohne wesentliche Merkmale medizinischer Zustände zu verändern. Die Augmentierungspipeline wurde mithilfe der Keras Sequential-API erstellt. Dabei wurden Transformationen wie zufälliges horizontales Spiegeln, Drehung um einen kleinen Winkel, Änderung der Bildgröße, Skalierung, Anpassung von Helligkeit und Kontrast, Zoomen sowie einige geringfügige Verschiebungen angewendet. Repräsentative Beispiele augmentierter Bilder sind in Abbildung 3 dargestellt.
Vortrainierte Modelle
Mehrere vortrainierte Deep-Learning-Modelle wurden in dem vorgeschlagenen Framework zur Merkmalsextraktion aus Eingabebildern verwendet. Zu diesen Modellen gehören MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 und MobileNetV2. MobileNet und MobileNetV2 sind leichte Deep-Learning-Modelle, die aufgrund ihrer effizienten Berechnungen auf tiefenweisen separablen Faltungen basieren. ResNet50 verwendet das Prinzip residueller Verbindungen, um das Modell zu trainieren und somit das Problem verschwindender Gradienten während des Trainings zu vermeiden. EfficientNetB0 erreicht durch die Methode der zusammengesetzten Skalierung ein Gleichgewicht zwischen Effizienz und Genauigkeit. Xception erweitert das Inception-Netzwerk unter Verwendung tiefenweiser separabler Faltungen. NASNetLarge nutzt eine neuronale Architekturentwicklung, um optimale tiefe neuronale Netzwerkstrukturen zu erstellen, während Inception-ResNet-v2 eine Hybridstruktur aus dem Inception-Modell und dem Mechanismus residueller Verbindungen bildet. Die aus ResNet50 (1.024 Merkmale), EfficientNetB0 (1.280 Merkmale), MobileNet (1.024 Merkmale) und Xception (2.048 Merkmale) extrahierten Merkmalsvektoren werden verkettet, um eine einheitliche, 5.376-dimensionale Repräsentation zu erzeugen. Diese Fusionsstrategie wurde gewählt, um komplementäre Repräsentationen zu erhalten, die von den verschiedenen CNN-Architekturen gelernt wurden, anstatt die Repräsentation vor der Klassifizierung zu reduzieren. Der resultierende Merkmalsvektor wird anschließend dem RBF-SVM-Klassifikator zugeführt, der die optimale nichtlineare Entscheidungsgrenze im fusionierten Merkmalsraum bestimmt.
Erklärbares KI-Modell (LIME)
Um eine lokale Interpretierbarkeit der Modellvorhersagen zu ermöglichen, verwenden die Autoren die Methode zur Erzeugung lokaler, menschenlesbarer Erklärungen für jede einzelne Modellvorhersage, bekannt als LIME47. Für jedes Eingabebild unterteilt LIME dieses zunächst in kleinere Einheiten, sogenannte Superpixel. Anschließend werden Störungen (Perturbationen) aus dem ursprünglichen Bild erzeugt, und die Vorhersagen des tiefen neuronalen Modells werden für jede dieser Störungen geschätzt. Danach wird ein gewichtetes lineares Modell auf die Störungen angepasst, wobei die Gewichtung von deren Nähe zur ursprünglichen Eingabeinstanz abhängt. Nach der Anpassung des linearen Modells werden die Wichtigkeitsscores der Merkmale geschätzt, die die Rolle jedes Superpixels bei der Vorhersage der endgültigen Kategorie anzeigen. Diese Wichtigkeitsscores werden visuell in dem endgültigen Erklärungsbild hervorgehoben. Der LIME-Algorithmus ist in Supplementärdatei 2 dargestellt.
Ergebnisse
Die Leistungsbeurteilung des entwickelten Klassifizierungsrahmens basiert auf traditionellen Evaluationsmaßen, die sich aus der Konfusionsmatrix ergeben. Eine Konfusionsmatrix ermöglicht ein vollständiges Verständnis der Klassifiziererleistung, indem sie die Anzahl der richtigen und falschen Klassifizierungen für jede definierte Klasse darstellt. Auf diese Weise können alle Fehlerarten analysiert werden. Beispielsweise sind sowohl falsch positive als auch falsch negative Ergebnisse bei der Diagnose von Krankheiten besonders wichtig. Hohe Werte bei falsch positiven Ergebnissen können auf eine hohe Empfindlichkeit des Klassifizierers hinweisen, während gleichzeitig eine große Anzahl falsch negativer Ergebnisse auf eine geringe Sensitivität hindeutet und potenzielle Gesundheitsrisiken darstellt. In dieser Arbeit werden die folgenden Leistungskennzahlen verwendet: Genauigkeit, Präzision, Sensitivität (Recall), F1-Score, Spezifität, True-Positive-Rate (TPR) und False-Positive-Rate (FPR). Die Formeln dieser Kennzahlen sind unten aufgeführt:
Genauigkeit=(TP+TN)/(TP+TN+FP+FN) (3)
Präzision = TP/(TP+FP) (4)
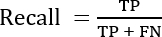 (5)
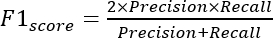 (6)
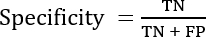 (7)
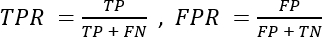 (8)
In diesem Fall zeigt TP die Anzahl der vom Framework erkannten bösartigen Hautkrebsfälle an, während TN die Anzahl der gutartigen Läsionen angibt. FP zeigt hingegen die Anzahl falscher Entscheidungen an, bei denen Läsionen als bösartig klassifiziert werden, obwohl sie tatsächlich gutartig sind. FN spiegelt die Anzahl falsch als gutartig erkannter Proben wider. Bei der Klassifizierung von Hautkrebs ist die Minimierung von falsch negativen Ergebnissen äußerst wichtig, da dies potenziell schwerwiegende Folgen haben kann.
Leistung der Baseline-Modelle
Alle rechnergestützten Experimente wurden in der cloudbasierten Umgebung von Google Colab durchgeführt. Dabei ist hervorzuheben, dass diese Plattform das Ausführen von virtuellen Maschineninstanzen ermöglicht, die ein vordefiniertes Ubuntu 20.04 als Betriebssystem verwenden. Zum Trainieren der Baseline-Modelle kamen Python-Version 3.9 und das PyTorch-Framework in Version 2.3.1 zum Einsatz. Zudem verfügten alle Recheneinheiten über identische Spezifikationen, nämlich eine Intel Xeon CPU mit einer Taktfrequenz von 2,2 GHz, eine NVIDIA Tesla T4 GPU, 16 GB RAM und eine Speicherkapazität von 70 GB. Dadurch konnte die durch unterschiedliche Hardwareplattformen verursachte Variabilität verringert und die Zuverlässigkeit sowie Reproduzierbarkeit der Ergebnisse erhöht werden. Eine vollständige Übersicht über die experimentelle Umgebung ist in Tabelle 3 enthalten.
Abbildung 4 zeigt Lernkurven, die 100 Trainingsepochen für die ResNet-50-Architektur entsprechen. Das Training wurde anhand eines Datensatzes mit 2.110 Bildern durchgeführt, während die Größe des Validierungsdatensatzes 660 Bilder betrug. Wie man sehen kann, stieg die Genauigkeit während des Trainings kontinuierlich auf nahezu 90,0 % an. Gleichzeitig wurde eine Verbesserung der Genauigkeit in den ersten 50 Epochen beobachtet; danach blieb die Genauigkeit nahezu konstant, was als Zeichen für die Konvergenz des Modells angesehen werden kann. Bei der Validierung erreichte das Modell einen AUC-Wert von 86,0 %, wodurch es angemessene diskriminative Eigenschaften zeigte.
Die in Abbildung 5 dargestellte Konfusionsmatrix beschreibt die Leistung des ResNet-50-Modells hinsichtlich der Klassifikationsgenauigkeit anhand eines Testdatensatzes mit 660 Bildern. Während der Auswertung erkannte das Modell 310 von 360 gutartigen Proben korrekt sowie 239 von 300 bösartigen Proben. Allerdings wurden vergleichsweise viele bösartige Proben falsch klassifiziert, was zu einem relativ hohen Anteil an falsch negativen Ergebnissen führte. Dieses Ergebnis sollte aufgrund der schwerwiegenden Konsequenzen dieser Fehlerart bei praktischer Anwendung des Klassifikators genauer betrachtet werden. Insgesamt erreichte das Modell eine Genauigkeit von 83,0 %, eine Präzision von 83,3 %, einen Rückruf von 83,3 % und einen F1-Score von 83,3 %.
Tabelle 4 enthält eine detaillierte Beschreibung der Leistungsmerkmale des ResNet-50-Modells bezüglich beider Klassen. Der Klassifikator zeigte ein relativ ausgewogenes Verhalten hinsichtlich der Präzision: Bei gutartigen Proben betrug der Wert 83,0 %, während bösartige Proben eine Präzision von 84,0 % aufwiesen. Ebenso erreichten die Sensitivitätswerte 88,0 % für gutartige Läsionen und 78,0 % für bösartige. Die Angabe „Support“ in der Tabelle stellt die Anzahl der Proben dar, die jeder Klasse entsprechen.
Vorgeschlagenes EDLF-SLC-Modell
Abbildung 6 zeigt die Trainings- und Validierungs-AUC des vorgeschlagenen Modells über 300 Epochen hinweg. Die AUC-Metrik spiegelt die Fähigkeit des Modells wider, zwischen benignen und malignen Klassen zu unterscheiden, wobei höhere Werte eine bessere Diskriminierungsleistung anzeigen. Wie zu erkennen ist, steigt die Trainings-AUC während des gesamten Trainingsprozesses stetig an und erreicht einen maximalen Wert von 1,00 bei etwa der 200. Epoche. Die Validierungs-AUC verbessert sich ebenfalls progressiv in den anfänglichen Trainingsphasen; sie beginnt jedoch nach etwa 150 Epochen zu stagnieren, was auf eine Konvergenz des Modells hindeutet. Die endgültige Validierungs-AUC von 0,95 demonstriert eine starke Generalisierungsfähigkeit und effektive Klassentrennbarkeit.
Die in Abbildung 7 dargestellte Konfusionsmatrix des vorgeschlagenen Modells zeigt, dass das Modell 299 gutartige Proben und 272 bösartige Proben korrekt klassifizierte, während 28 gutartige Fälle fälschlicherweise als bösartig und 61 bösartige Fälle fälschlicherweise als gutartig klassifiziert wurden. Insgesamt erzielte das Modell 571 korrekte Vorhersagen und 89 Fehlklassifikationen. Auffällig ist die höhere Anzahl an falsch-negativen Ergebnissen (bösartige Fälle, die fälschlicherweise als gutartig klassifiziert wurden), die eine entscheidende Einschränkung darstellt, da solche Fehler erhebliche klinische Auswirkungen haben können. Dennoch bleibt die Gesamtleistung der Klassifizierung robust. Im Gegensatz zu Ansätzen zur Merkmalsauswahl, bei denen Dimensionen vor der Klassifizierung gezielt entfernt werden, bewahrt das vorgeschlagene Framework die vollständige fusionierte, tiefe Repräsentation, die von mehreren heterogenen CNN-Architekturen erzeugt wird. Dieser Ansatz wurde gewählt, weil jeder Backbone komplementäre Läsionsmerkmale extrahiert, und die Beibehaltung der vollständigen Repräsentation es dem SVM-Klassifikator ermöglicht, die kombinierten diskriminativen Informationen zu nutzen, ohne potenziell informative Merkmale auszuschließen. Folglich priorisiert die verwendete Strategie zur Merkmalsfusion das Lernen komplementärer Repräsentationen, während gleichzeitig die rechnerische Machbarkeit gewahrt bleibt.
Abbildung 8 zeigt repräsentative Beispiele für Klassifizierungsergebnisse, die vom vorgeschlagenen Modell erzeugt wurden. Die Ergebnisse zeigen, dass das Modell korrekt klassifizierten Fällen hohe Konfidenzwerte zuweist. Insbesondere weisen gutartige Fälle hohe vorhergesagte Wahrscheinlichkeiten auf (z. B. 99,84 % und 99,85 %), während auch maligne Fälle starke Konfidenzniveaus aufweisen (z. B. 99,98 % und 99,96 %). Diese Befunde deuten darauf hin, dass das Modell gutartige und maligne Läsionen effektiv voneinander unterscheiden kann, selbst in visuell anspruchsvollen Szenarien. Zur Verbesserung der Interpretierbarkeit wird das LIME-Framework verwendet, um lokalisierte Erklärungen für Modellvorhersagen zu generieren, wie in Abbildung 9A–D dargestellt. LIME approximiert die komplexe Entscheidungsgrenze des Modells mithilfe eines lokal interpretierbaren linearen Modells. Für jedes Eingabebild erzeugt die Methode gestörte Stichproben, indem selektiv Superpixel maskiert und die entsprechenden Vorhersagen ausgewertet werden. Anschließend wird ein gewichtetes lineares Modell an diese Stichproben angepasst, wobei die Gewichte basierend auf der Nähe zum ursprünglichen Eingangssignal mithilfe eines radialen Basisfunktionskernels bestimmt werden. Die resultierenden Koeffizienten repräsentieren den Beitrag jedes Superpixels zur endgültigen Vorhersage und sind definiert als:
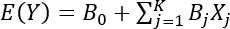 (9)
wobei Xj ∈ {0, 1} das Vorhandensein oder Fehlen des j-ten Superpixels bezeichnet, Bj das entsprechende Gewichtungsgewicht darstellt und B0 die Baseline-Vorhersage ist. Positive Koeffizienten (Bj > 0) weisen auf Bereiche hin, die zur malignen Klasse beitragen, während negative Koeffizienten (Bj < 0) benignen Merkmalen entsprechen. Die auf LIME basierenden Visualisierungen, dargestellt in Abbildung 9B, D, heben die einflussreichsten Regionen hervor, die zu jeder Klassifizierungsentscheidung beitragen. Bei benignen Läsionen betont das Modell Bereiche, die sich durch gleichmäßige Pigmentierung und klar definierte Grenzen auszeichnen. Im Gegensatz dazu entsprechen die hervorgehobenen Bereiche bei malignen Fällen klinisch signifikanten Merkmalen wie unregelmäßigen Grenzlinien, Farbheterogenität und atypischen Texturen. Die Intensität der hervorgehobenen Bereiche spiegelt die Größe der entsprechenden Koeffizienten Bj wider.
Diese Ergebnisse zeigen, dass das EDLF-SLC-Modell auf klinisch bedeutsame Merkmale fokussiert, die mit etablierten dermatologischen Kriterien wie der ABCD-Regel übereinstimmen. Diese Übereinstimmung erhöht die Interpretierbarkeit und Vertrauenswürdigkeit des Modells und macht es besser für die Unterstützung klinischer Entscheidungsfindung geeignet. Darüber hinaus zeigt Abbildung 10 vergleichende Visualisierungsergebnisse, die mithilfe zusätzlicher Erklärbarkeitstechniken gewonnen wurden, darunter Grad-CAM, HiResCAM, GradCAM++, XGradCAM, LayerCAM, EigenGradCAM und EigenCAM, wodurch die Konsistenz der identifizierten aussagekräftigen Bereiche über verschiedene Methoden hinweg weiter bestätigt wird. Hinsichtlich der Leistung des vorgeschlagenen EDLF-SLC-Modells und sieben Baseline-Modellen nach dem Training über 100 Epochen ist ein Vergleich in Tabelle 5 ersichtlich. EDLF-SLC erzielte im Vergleich zu den Baseline-Architekturen im Rahmen des experimentellen Kontexts bei jeder evaluierten Metrik eine wettbewerbsfähige Leistung von 0,88. EfficientNetB0 und ResNet50 erzielten ebenfalls gute Ergebnisse mit Genauigkeiten von 0,85 bzw. 0,83. Umgekehrt wies Inception-ResNetV2 die schlechteste Klassifikationsleistung aller evaluierten Modelle auf. Dennoch war seine Recheneffizienz trotz relativ niedrigerer Klassifikationsgenauigkeit mit der der Baseline-Modelle vergleichbar. Das vorgeschlagene EDLF-SLC-Modell zeigte unter den verwendeten experimentellen Bedingungen eine wettbewerbsfähige Leistung im Vergleich zu den evaluierten Baseline-Modellen.
Um die Leistung des vorgeschlagenen Frameworks im Vergleich zu bestehenden Ansätzen zu bewerten, zeigt Tabelle 6 einen Vergleich mit repräsentativen Methoden des aktuellen Forschungsstandes zur Klassifizierung von Hautläsionen. Beispielsweise47 wurde eine Genauigkeit von 0,86 berichtet, während48 ein ensemblebasiertes Modell verwendete, das eine ähnliche Genauigkeit, jedoch geringere Präzision, Sensitivität und F1-Score erreichte. Neuere Studien, die auf Ensemble-Learning und mehreren CNN-Architekturen basieren25,49, berichteten Genauigkeiten von bis zu 0,87. Unter den verwendeten experimentellen Bedingungen erreichte das vorgeschlagene EDLF-SLC-Framework eine Genauigkeit von 0,88, wobei es eine einheitliche, erklärbare Architektur nutzt, ohne zusätzliche Komponenten wie Läsions-Segmentierungsmodelle zu benötigen.
VERFÜGBARKEIT VON DATEN
Die Daten, die die Ergebnisse dieser Studie unterstützen, sind öffentlich in Kaggle unter https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign verfügbar.
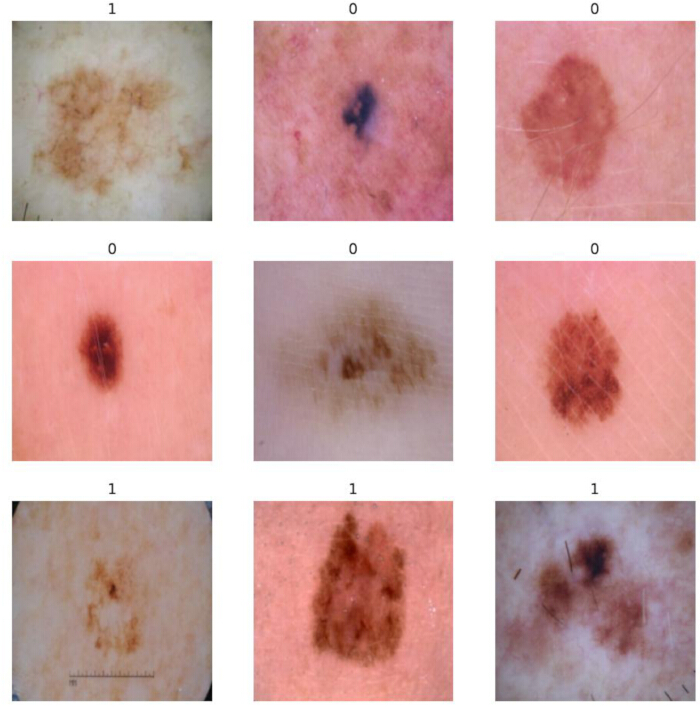
Abbildung 1: Repräsentative dermatoskopische Bilder aus dem ISIC-Datensatz, die die beiden diagnostischen Klassen veranschaulichen, die in dieser Studie verwendet wurden. Die Proben sind als gutartig (0) und bösartig (1) gekennzeichnet und zeigen die Variabilität der Läsionsmorphologie, -farbe und -textur innerhalb des Datensatzes auf. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
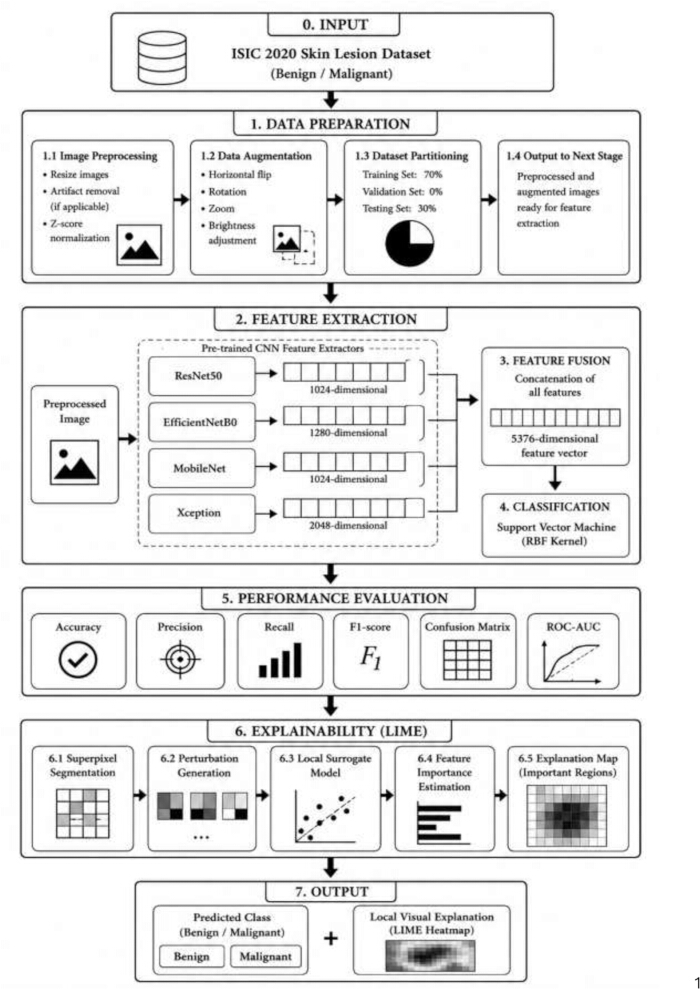
Abbildung 2: Vollständiger Workflow des vorgeschlagenen EDLF-SLC-Frameworks. Das Protokoll beginnt mit der Bildakquise aus ISIC 2020, gefolgt von der Vorverarbeitung, Datenaugmentierung, Aufteilung des Datensatzes, tiefen Merkmalsextraktion mithilfe von vier vortrainierten CNN-Architekturen, Merkmalsfusion, SVM-Klassifizierung, Leistungsbewertung und der Erzeugung von Erklärungen basierend auf LIME. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
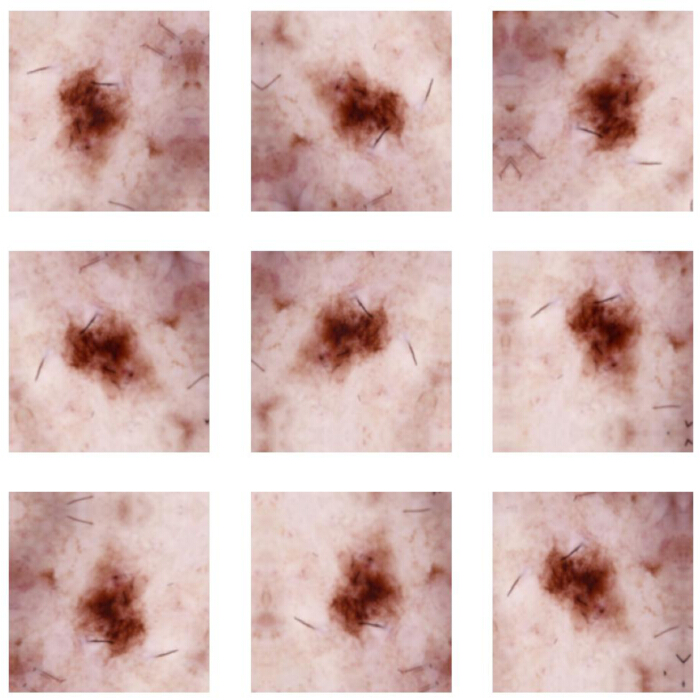
Abbildung 3: Beispiele erweiterter Hautläsionsbilder, die mithilfe von Datenaugmentierungstechniken erzeugt wurden. Dazu gehören horizontales und vertikales Spiegeln, Drehung, Skalierung sowie Helligkeitsanpassung. Diese Transformationen erhöhen die Vielfalt des Datensatzes, verbessern die Robustheit des Modells und verringern das Risiko einer Überanpassung während des Trainings. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
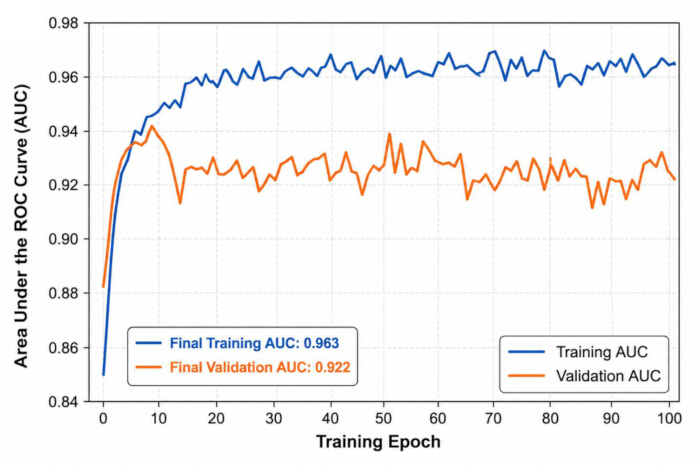
Abbildung 4: Trainings- und Validierungs-Receiver-Operating-Characteristic-Fläche unter der Kurve (ROC-AUC) des ResNet-50-Modells über 100 Trainingsepochen. Die blaue Kurve stellt die Trainings-AUC dar, während die orangefarbene Kurve die Validierungs-AUC darstellt. Die Kurven zeigen eine schnelle Konvergenz in den ersten Trainingsepochen, gefolgt von einer stabilen Optimierung mit durchgängig hoher Validierungsleistung, was auf effektives Lernen und zufriedenstellende Generalisierung auf dem Validierungsdatensatz hinweist. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
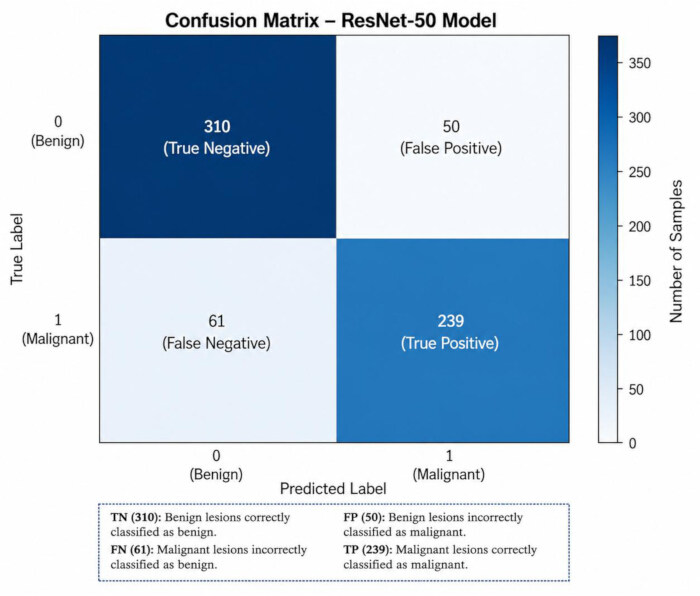
Abbildung 5: Konfusionsmatrix des ResNet-50-Modells auf dem Testdatensatz. Die Zeilen repräsentieren die tatsächlichen Klassenbezeichnungen (0 = gutartig, 1 = bösartig), während die Spalten die vorhergesagten Klassenbezeichnungen darstellen. Die Elemente auf der Diagonalen zeigen korrekt klassifizierte Proben an (310 gutartige und 239 bösartige), während die Elemente außerhalb der Diagonalen falsch klassifizierte Proben darstellen, darunter 50 falsch positive und 61 falsch negative Ergebnisse. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
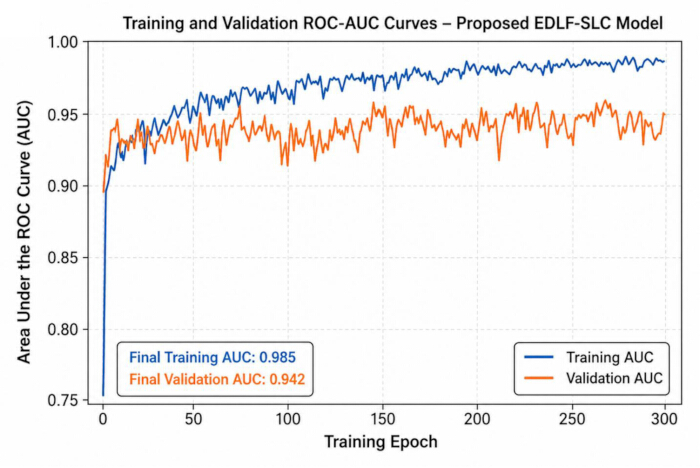
Abbildung 6: Trainings- und Validierungs-Receiver-Operating-Characteristic-Fläche unter der Kurve (ROC-AUC) des vorgeschlagenen EDLF-SLC-Modells über 300 Trainingsepochen. Die blaue Kurve stellt die Trainings-AUC dar, während die orangefarbene Kurve die Validierungs-AUC darstellt. Das Modell zeigt eine schnelle Konvergenz in den ersten Trainingsepochen, gefolgt von einer stabilen Optimierung mit durchgängig hohen AUC-Werten sowohl im Training als auch in der Validierung über die verbleibenden Epochen hinweg. Die anhaltend gute Validierungsleistung demonstriert die gute Generalisierungsfähigkeit und stabiles Lernverhalten des vorgeschlagenen EDLF-SLC-Frameworks auf dem Validierungsdatensatz. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
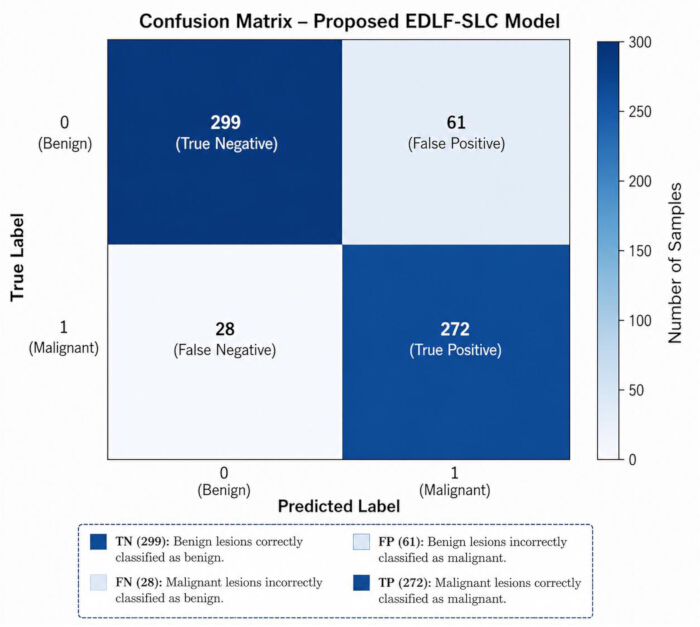
Abbildung 7: Konfusionsmatrix des vorgeschlagenen EDLF-SLC-Modells auf dem Testdatensatz. Die Zeilen repräsentieren die tatsächlichen Klassenbezeichnungen (0 = gutartig, 1 = bösartig), während die Spalten die vorhergesagten Klassenbezeichnungen darstellen. Die Elemente auf der Diagonalen zeigen korrekt klassifizierte Proben an (299 gutartige und 272 bösartige), während die Elemente außerhalb der Diagonalen falsch klassifizierte Proben entsprechen, darunter 61 falsch positive und 28 falsch negative Ergebnisse. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
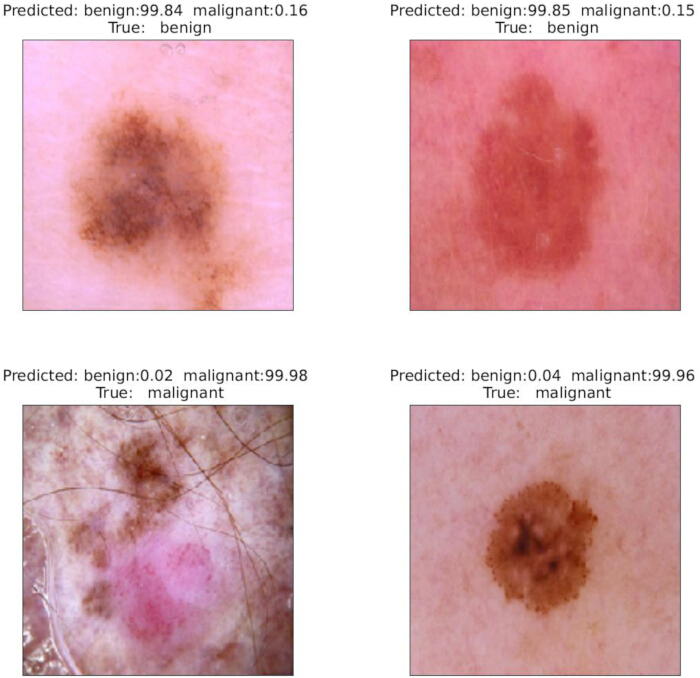
Abbildung 8: Beispielhafte Vorhersagen, erzeugt durch das vorgeschlagene EDLF-SLC-Modell. Diese Abbildung veranschaulicht die Konfidenzniveaus der Klassifizierung für gutartige und bösartige Läsionen und demonstriert die Unterscheidungsfähigkeit des Modells. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
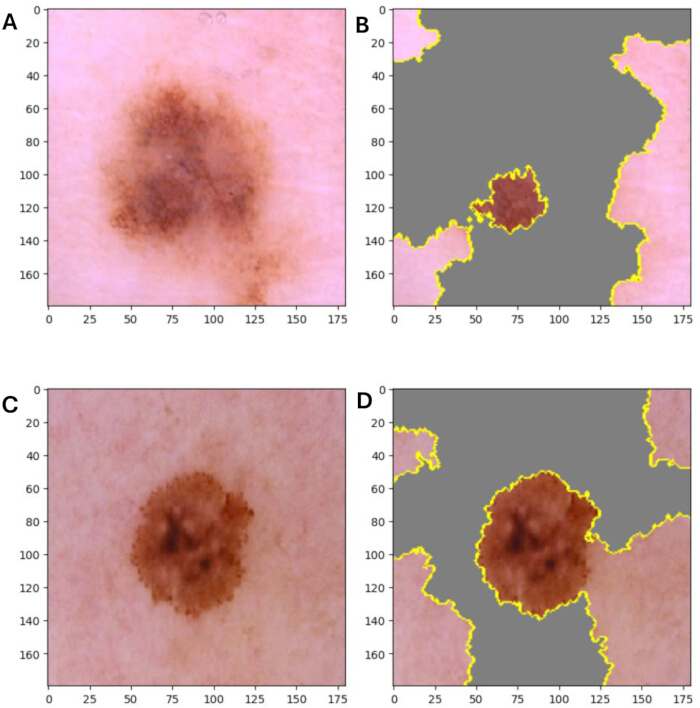
Abbildung 9: Lokale Erklärungen des vorgeschlagenen EDLF-SLC-Modells basierend auf LIME. Die Abbildung zeigt die einflussreichsten Superpixel-Bereiche, die zu den Klassifizierungsentscheidungen des Modells beitragen. (A) Ursprüngliches dermatoskopisches Bild einer benignen Hautläsion. (B) LIME-Erklärung für die benigne Läsion, wobei hervorgehobene Superpixel die Bereiche anzeigen, die am stärksten zur benignen Vorhersage beigetragen haben. (C) Ursprüngliches dermatoskopisches Bild einer malignen Hautläsion. (D) LIME-Erklärung für die maligne Läsion, die die diskriminativen Superpixel-Bereiche zeigt, die maßgeblich die maligne Klassifizierung beeinflusst haben. Gelbe Ränder grenzen die von LIME identifizierten einflussreichen Superpixel ab, während graue Bereiche Regionen mit geringem Beitrag zur Vorhersage darstellen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
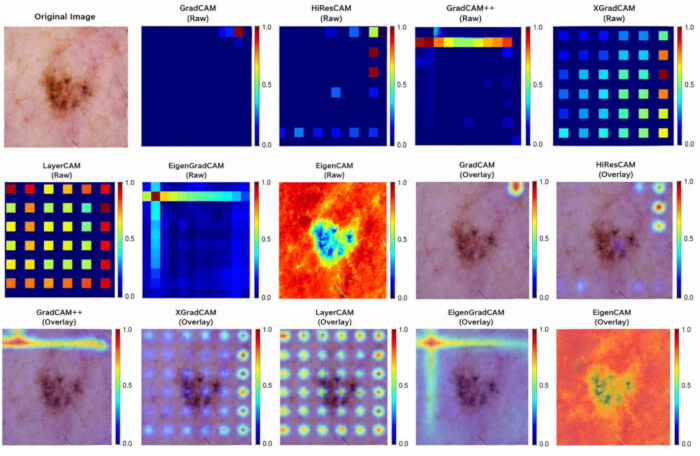
Abbildung 10: Vergleich von auf Klassenaktivierungskartierung (CAM) basierenden Erklärbarkeitsmethoden, angewendet auf das vorgeschlagene EDLF-SLC-Modell. Die Abbildung vergleicht die von GradCAM, HiResCAM, GradCAM++, XGradCAM, LayerCAM, EigenGradCAM und EigenCAM erzeugten Lokalisierungskarten für dasselbe dermoskopische Bild. Im ersten Feld ist das ursprüngliche Eingabebild dargestellt, gefolgt von den entsprechenden rohen Aktivierungskarten und Heatmap-Überlagerungen, die von jeder Erklärbarkeitsmethode erzeugt wurden. Die Visualisierungen verdeutlichen die Unterschiede in der räumlichen Lokalisierung und heben die Bildbereiche hervor, die am stärksten zur Klassifizierungsentscheidung des vorgeschlagenen EDLF-SLC-Frameworks beitragen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Ref. | Jahr | Datensatz | Datengröße | Merkmalsextraktion | Methode | Genauigkeit |
| 9 | 2022 | HAM10000-Datensatz | 10015 Bilder von Hautläsionen | Farb- und Formmerkmale | ML-Algorithmen und faltungsneuronale NN-Modelle | 95,1 % |
| 19 | 2023 | PH2-Datensatz | 200 annotierte Bilder | Asymmetrie, Striche, Punkte/Globuli, Regressionsareal-Merkmale | ML-Modelle | 94,0 % |
| 30 | 2024 | HAM10000-Datensatz | 10.000 Bilder | Farb- und Formmerkmale | S-MobileNet | 97,7 % |
| 28 | 2025 | ISIC2020- und HAM10000-Datensätze | ISIC2020 (12.670 Bilder) und HAM10000 (10.015 Bilder) | Farbe und Form | Residualnetzwerk mit langem Kurzzeitgedächtnis (R-LSTM50) | 95,7 % (ISIC2020); 94,2 % (HAM10000) |
| 32 | 2026 | Monkeypox-Hautläsions-Datensatz (MSLD) | 770 Bilder | Kontext und Textur | DenseNet121, Xception, InceptionV3 und CBAM | 88 % (DenseNet121) |
| 39 | 2025 | HAM10000 | 38.569 Bilder | Kontext und Textur | MobileNet, ResNet50, InceptionV3 und EfficientNet | 93,6 % (MobileNet) |
| 40 | 2025 | ISIC 2019 | 2.357 Bilder | Kontext und räumliche Merkmale | mehrmodales Deep Learning basierend auf CNN-Transformer | 98,71 % |
| 41 | 2026 | ISIC 2019 | 25.000 Bilder | Kontext und Textur | TransXV2S | 95,26 % |
| 42 | 2025 | HAM10000 | 10.015 Bilder | Farbe und Form | ViT mit YOLOv8 | 93 % |
Tabelle 1: Literaturvergleich. Zusammenfassung einiger kürzlich veröffentlichter Arbeiten, in denen Deep-Learning-Algorithmen zur Klassifizierung von Hautläsionen verwendet wurden.
| Datensatz | Benigne | Maligne | Gesamt |
| Trainingsdaten | 1440 | 1197 | 2637 |
| Testdaten | 360 | 300 | 660 |
| Gesamtdaten | 1800 | 1497 | 3297 |
Tabelle 2: Datensatzverteilung. Verteilung gutartiger und bösartiger Proben im ISIC-2020-Datensatz, einschließlich der Aufteilung in Trainings- und Testdatensätze.
| Komponente | Spezifikation |
| Betriebssystem | Ubuntu 20.04 |
| Programmiersprache | Python 3.9 |
| Tiefe-Lern-Plattform | PyTorch 2.3.1 |
| Optimierer | Adam |
| Lernratenanpassung | 1e−3 |
| Anzahl der Epochen | 100/300 |
| CPU | 2 vCPU 2,2 GHz |
| GPU | Tesla T4 (16 GB) × 1 |
| Arbeitsspeicher (RAM) | 16 GB |
| Trainierbare Parameter | 2.430.353 (9,27 MB) |
| Nicht-trainierbare Parameter | 133.434.397 (509,01 MB) |
Tabelle 3: Systemspezifikationen. Detaillierte Spezifikationen der Rechenumgebung, einschließlich der Software-Frameworks und Hardware-Ressourcen, die für das Training und die Bewertung des Modells verwendet wurden.
| Klasse | Präzision | Recall | F1-Score | Unterstützung |
| gutartige Klasse | 0.83 | 0.88 | 0.85 | 360 |
| bösartige Klasse | 0.84 | 0.78 | 0.81 | 300 |
| Genauigkeit | - | - | 0.832 | 660 |
| Macro-Durchschnitt | 0.84 | 0.83 | 0.83 | 660 |
| gewichteter Durchschnitt | 0.84 | 0.83 | 0.83 | 660 |
Tabelle 4: Klassifizierungsbericht. Klassifizierungsleistung des ResNet-50-Modells auf dem Testdatensatz, einschließlich Präzision, Sensitivität, F1-Score und Support für jede Klasse.
| Modell | Genauigkeit | Präzision | Erinnerung | F1-Wert | Zeit (s) |
| NASNetLarge | 0.77 | 0.76 | 0.77 | 0.76 | 2002.47 |
| EfficientNetB0 | 0.85 | 0.85 | 0.85 | 0.85 | 734.8 |
| Xception | 0.8 | 0.81 | 0.8 | 0.8 | 732.23 |
| ResNetV2 | 0.63 | 0.64 | 0.63 | 0.611 | 1072.34 |
| MobileNet | 0.79 | 0.8 | 0.79 | 0.79 | 629.29 |
| MobileNetV2 | 0.77 | 0.79 | 0.77 | 0.77 | 660.5 |
| ResNet50 | 0.83 | 0.83 | 0.83 | 0.83 | 749.77 |
| EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 | 3279.77 |
Tabelle 5: Modellleistung im Vergleich. Vergleichende Leistung des vorgeschlagenen EDLF-SLC-Modells und der Baseline-Deep-Learning-Modelle hinsichtlich Genauigkeit, Präzision, Sensitivität, F1-Score und Rechenzeit.
| Modell | Genauigkeit | Präzision | Recall | F1-Score |
| ResNet-18 [25] | 0.85 | 0.85 | 0.85 | 0.85 |
| ResNet-50 mit SVM [50] | 0.87 | 0.88 | 0.98 | 0.93 |
| Hybride DL-Modelle + SVM [48] | 0.86 | 0.84 | 0.8 | 0.84 |
| Hybride DL-Modelle + SVM [49] | 0.86 | 0.8 | 0.6 | 0.68 |
| Vorgeschlagenes EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 |
Tabelle 6: Metriken zum Modellvergleich. Vergleich der Leistung zwischen dem vorgeschlagenen EDLF-SLC-Framework und aktuellen modernen Ansätzen zur Klassifizierung von Hautläsionen.
Zusatzdatei 1: Algorithmus 1. Arbeitsablauf des vorgeschlagenen EDLF-SLC-Frameworks, der die Datenvorverarbeitung, die Extraktion tiefer Merkmale mithilfe mehrerer CNN-Architekturen, die SVM-basierte Klassifizierung und die LIME-basierte Erklärbarkeit für die Vorhersage von Hautläsionen darlegt. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatzdatei 2: Algorithmus 2. Arbeitsablauf des LIME-basierten lokalen Erklärungsverfahrens, der die Generierung von Superpixeln, die Stichprobenerhebung durch Perturbation, den Aufbau des Surrogatmodells und die Visualisierung der Bildbereiche veranschaulicht, die am stärksten zur Klassifizierungsentscheidung beitragen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Der vorgeschlagene erklärbare Deep-Learning-Ansatz zur Klassifizierung von Hautläsionen (EDLF-SLC) zeigt, dass die Kombination komplementärer, tiefer Merkmalsdarstellungen mit erklärbarer künstlicher Intelligenz sowohl die Klassifizierungsleistung als auch die Transparenz des Modells verbessern kann. Durch die Integration mehrerer vorab trainierter CNN-Architekturen (ResNet50, EfficientNetB0, MobileNet und Xception) zur Merkmalsextraktion sowie den Einsatz einer Support-Vektor-Maschine (SVM) zur endgültigen Klassifizierung nutzt das Framework die Stärken verschiedener Merkmalsextraktoren, um reichere und stärker unterscheidende Darstellungen der Läsionen zu erzeugen, als dies mit einem einzelnen Backbonenetzwerk möglich wäre. Darüber hinaus ermöglicht die Einbindung lokaler, modellunabhängiger interpretierbarer Erklärungen (LIME) lokalisierte visuelle Erklärungen, wodurch Ärzte nachvollziehen können, welche Bildbereiche am stärksten zur jeweiligen Vorhersage beitragen, und somit das Vertrauen in die diagnostischen Entscheidungen des Modells steigt.
Experimentelle Ergebnisse zeigen, dass EDLF-SLC im Vergleich zu Baseline-CNN-Modellen wie MobileNet, Xception und ResNet50 eine wettbewerbsfähige Leistung erzielt und somit die Wirksamkeit der fusionierten komplementären Merkmale sowie der SVM-basierten Klassifizierung unterstreicht. Der Vergleich mit aktuellen modernsten Ansätzen bestätigt zudem die Wettbewerbsfähigkeit des vorgeschlagenen Frameworks weiter. Beispielsweise berichteten zwei Studien48,49 über Genauigkeiten von etwa 0,86 unter Verwendung ensemblebasierter Methoden, während andere hybride CNN-SVM-Frameworks25,50,51,52,53 Genauigkeiten von bis zu 0,87 erreichten, jedoch auf komplexeren Architekturen sowie zusätzlichen Vorverarbeitungs- oder Segmentierungsmodulen basierten. Im Gegensatz dazu erreicht das vorgeschlagene Framework eine Genauigkeit von 0,88 unter Verwendung einer vergleichsweise vereinfachten Architektur, ohne dass eine explizite Läsionensegmentierung erforderlich ist, und liefert gleichzeitig interpretierbare Vorhersagen mittels LIME. Diese Ergebnisse deuten darauf hin, dass die Kombination komplementärer CNN-Merkmalsextraktoren vor der SVM-Klassifizierung die diagnostische Leistung verbessern kann, während gleichzeitig die architektonische Einfachheit und Transparenz erhalten bleibt.
Obwohl der vorgeschlagene Ansatz die Klassifungsgenauigkeit und Interpretierbarkeit verbessert, geht diese Verbesserung auf Kosten erhöhter Rechenkosten. Die gesamte Trainingszeit von EDLF-SLC beträgt etwa 3279,77 s, deutlich höher als bei einzelnen CNN-Modellen wie ResNet50 (749,77 s) und MobileNet (629,29 s). Dieser zusätzliche Rechenaufwand entsteht durch das Training mehrerer vortrainierter CNNs und die Durchführung der Merkmalsfusion vor der Klassifizierung. Ein solcher Kompromiss wird häufig bei hybriden und Ensemble-Lernansätzen beobachtet, bei denen eine verbesserte Vorhersageleistung auf Kosten höherer Rechenanforderungen erreicht wird. Dennoch werden in klinischen Entscheidungsunterstützungssystemen Diagnosegenauigkeit, Robustheit und Zuverlässigkeit im Allgemeinen als wichtiger angesehen als Trainings-Effizienz, da sie die Patientenergebnisse direkt beeinflussen.
Ein weiterer wichtiger Vorteil des vorgeschlagenen Frameworks ist seine Erklärbarkeit. Im Gegensatz zu herkömmlichen Deep-Learning-Modellen, die oft wie Black-Box-Systeme funktionieren, integriert EDLF-SLC LIME, um fallbezogene visuelle Erklärungen des Vorhersageprozesses bereitzustellen. Diese Erklärungen helfen Kliniker:innen zu überprüfen, ob das Modell auf klinisch relevante Läsionsbereiche fokussiert, wodurch Transparenz verbessert, die klinische Interpretation unterstützt und das Vertrauen in die KI-gestützte Diagnose gefördert wird. Folglich bietet das vorgeschlagene Framework ein praktikables Gleichgewicht zwischen Vorhersagegenauigkeit und Modellinterpretierbarkeit und stellt damit ein vielversprechendes computergestütztes Entscheidungsunterstützungswerkzeug für die Klassifizierung von Hautläsionen dar.
Trotz dieser ermutigenden Ergebnisse sollten mehrere Einschränkungen berücksichtigt werden. Erstens wurde das Framework nur anhand des öffentlich verfügbaren ISIC-Datensatzes evaluiert, und seine Fähigkeit zur Verallgemeinerung auf Bilder, die unter unterschiedlichen klinischen Bedingungen, mit verschiedenen Bildgebungsgeräten und bei verschiedenen Patientengruppen aufgenommen wurden, bleibt noch zu validieren. Zweitens erhöht der Einsatz mehrerer vortrainierter CNN-Architekturen zwangsläufig die rechnerische Komplexität und die Trainingszeit im Vergleich zu Modellen mit einzelner Backbone-Architektur. Drittens wurden während der Experimente feste Hyperparameter-Einstellungen verwendet, und eine weitere Optimierung könnte die Leistung und Anpassungsfähigkeit über verschiedene Datensätze hinweg verbessern. Schließlich verbessert LIME zwar die Transparenz des Modells, doch die Erklärungen sind lokal und von der Perturbation abhängig, was bedeutet, dass die Konsistenz der Erklärungen zwischen einzelnen Durchläufen variieren kann und vor einem routinemäßigen klinischen Einsatz durch Experten für Dermatologie weiter validiert werden sollte.
Künftige Forschungsarbeiten werden sich auf die Validierung des vorgeschlagenen Frameworks mithilfe mehrerer groß angelegter und multizentrischer Datensätze von Hautläsionen konzentrieren, die Optimierung der Recheneffizienz durch leichtgewichtige Merkmalsfusion und Modellkomprimierungstechniken, die Untersuchung fortschrittlicher Strategien zur Hyperparameter-Optimierung sowie die Erweiterung des Frameworks auf die multiklassige Klassifizierung von Hautläsionen. Darüber hinaus wird die Integration zusätzlicher erklärbarer KI-Methoden und die Durchführung prospektiver klinischer Bewertungen mit Dermatologen die Zuverlässigkeit, Interpretierbarkeit und praktische Anwendbarkeit des vorgeschlagenen Frameworks in realen klinischen Umgebungen weiter stärken.
Offenlegungen
Die Autoren erklären, dass kein Interessenkonflikt besteht.
Danksagungen
Die Autoren möchten der Taif University aufrichtig dafür danken, dass sie das Forschungsumfeld und die institutionelle Unterstützung bereitgestellt hat, die zur Fertigstellung dieser Arbeit beigetragen haben.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| ISIC 2020 Hautläsions-Datensatz | International Skin Imaging Collaboration (ISIC) | ISIC 2020 Challenge-Datensatz | Dermoskopischer Bilddatensatz zur Modellentwicklung und -evaluierung verwendet. |
| Keras | Keras-Team | Integration mit TensorFlow | Erstellung und Training von Deep-Learning-Modellen. |
| LIME (Local Interpretable Model-Agnostic Explanations) | Ribeiro et al. | Python-Paket | Erzeugung lokaler visueller Erklärungen für Modellvorhersagen. |
| Matplotlib | Matplotlib-Entwickler | Neueste kompatible Version | Visualisierung von Lernkurven, Konfusionsmatrizen und Evaluationsdiagrammen. |
| NumPy | NumPy-Entwickler | Neueste kompatible Version | Numerische Berechnungen und Array-Manipulation. |
| NVIDIA Tesla T4 GPU | NVIDIA Corporation | 16 GB VRAM | Beschleunigung von Modelltraining und Inferenz. |
| Pandas | Pandas-Entwicklungsteam | Neueste kompatible Version | Datenverarbeitung und Verwaltung experimenteller Ergebnisse. |
| Vortrainierte CNN-Modelle | TensorFlow/Keras Applications | ResNet50, EfficientNetB0, MobileNet, Xception | Tiefen Merkmalsextraktion aus dermoskopischen Bildern. |
| Python | Python Software Foundation | Version 3.9 | Programmiersprache für die Implementierung verwendet. |
| PyTorch | PyTorch Foundation | Version 2.3.1 | Deep-Learning-Framework für Merkmalsextraktion und Modellimplementierung. |
| Scikit-learn | Scikit-learn-Entwickler | Neueste kompatible Version | Support Vector Machine (SVM), Evaluationsmetriken und Daten-Preprocessing. |
| Support Vector Machine (RBF-Kernel) | Scikit-learn | SVC | Klassifizierung fusionierter tiefen Merkmalsrepräsentationen. |
| TensorFlow | Google LLC | Version 2.x | Deep-Learning-Framework für Modelltraining und Inferenz. |
| Ubuntu-Betriebssystem | Canonical Ltd. | Ubuntu 20.04 | Experimentelles Betriebsumfeld. |
Referenzen
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.