Dieser Artikel schlägt ein neuartiges Modell vor, die linearen Gated-Slot-Attention-Graph-Neuronalen-Netzwerke für die empfehlungsbasierte Sitzung, das eine Gated-Slot-Linear-Attention-basierte Methode auf einem dual konstruierten Sitzungsgraphen verwendet. Es verbessert die Genauigkeit und Effizienz der Empfehlung und übertrifft den aktuellen Stand der Technik (SOTA) auf drei öffentlichen Datensätzen.
Forschungsartikel
Gated-Slot Linear Attention Graph Neural Networks für sessionsbasierte Empfehlungen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Empfehlungssysteme basierend auf Sitzungen (Session-based Recommendation, SBR) zielen darauf ab, das nächste Element vorherzusagen, mit dem ein Benutzer wahrscheinlich interagieren wird, basierend auf der Verhaltenssequenz innerhalb der aktuellen Sitzung. Neuere Ansätze, die den Transformer-Attention-Mechanismus nutzen (z. B. GC-SAN), haben eine überlegene Leistung gegenüber traditionellen Methoden gezeigt; sie leiden jedoch unter einem hohen Rechenaufwand und einer hohen Platzkomplexität aufgrund der quadratischen Kosten der Selbst-Attention. Um diese Einschränkungen zu überwinden, wird ein neuartiges Modell namens GSLA4Rec (gated-slot linear attention graph neural networks for session-based recommendation) vorgeschlagen, das lineare Attention mit einem lernfähigen Gating-Mechanismus und einer auf Slots basierenden Speicheraktualisierungsstrategie kombiniert, die sich an der Gated-Slot-Attention orientiert. Konkret konstruiert GSLA4Rec zunächst zwei Graphen: einen Sitzungsgraphen, um Übergänge zwischen Elementen innerhalb einer Sitzung abzubilden, und einen Nachbarglobalgraphen, um kollaborative Signale über Sitzungen hinweg zu kodieren, wodurch sowohl lokale als auch globale Kontextinformationen modelliert werden. Der vorgeschlagene Ansatz konzentriert sich auf den Gated-Slot-Linear-Attention-Mechanismus, der (1) Gating-Einheiten verwendet, um Rauschen aus irrelevante oder redundante Interaktionen in langen Sitzungen zu unterdrücken, (2) Slot-Einheiten nutzt, um kompakte Sitzungsrepräsentationen dynamisch zu speichern und zu aktualisieren – wodurch der Speicherbedarf reduziert wird, und (3) die Selbst-Attention durch lineare Attention ersetzt, um eine lineare Zeitkomplexität zu erreichen. Zusammen verbessern diese Komponenten signifikant die Vorhersagegenauigkeit und Effizienz des Modells bei der Erfassung sich verändernder Benutzerinteressen. Umfangreiche Experimente auf mehreren öffentlichen Benchmark-Datensätzen, darunter Diginetica, Tmall und NowPlaying, zeigen, dass GSLA4Rec die Leistung von SOTA-SBR-Methoden konsistent übertrifft, was die Wirksamkeit des GSLA-Mechanismus bestätigt.
Einleitung
Mit der rasanten Entwicklung von Online-Diensten (wie E-Commerce, Kurzvideoplattformen und Nachrichtenfeeds) ist das Problem der Informationsüberlastung zunehmend prominent und gravierend geworden. Empfehlungssysteme1,2 bieten personalisierte und präzise Informationsverbreitungsdienste, indem sie Nutzerverhaltensdaten tiefgehend analysieren. In vielen praktischen Anwendungen, die durch anonymen Zugriff, nicht angemeldete Nutzer, Datenschutz und kurze Interaktionsdauern gekennzeichnet sind, beschränken herkömmliche Empfehlungsmethoden wie Collaborative Filtering3 und Matrixfaktorisierung4,5 jedoch stark die Anwendbarkeit von Empfehlungsalgorithmen. Um diese Herausforderungen zu bewältigen, hat sich die SBR6,7,8,9-Methode herausgebildet. SBR konzentriert sich auf die Interaktionssequenzdaten innerhalb der aktuellen Sitzung der Nutzer, um den nächsten möglichen Interessenpunkt vorherzusagen. Dieses Paradigma vermeidet nicht nur die Abhängigkeit von langfristigen Nutzerhistoriendaten, sondern erfasst auch kurzfristige dynamische Interessenänderungen präzise und zeigt dadurch einen einzigartigen Anwendungswert in Szenarien wie E-Commerce, Kurzvideos, Musikempfehlungen und ähnlichen Bereichen.
Frühe Methoden stützten sich hauptsächlich auf Markov-Ketten5,10,11,12, um Übergangswahrscheinlichkeiten zwischen Elementen in Sitzungssequenzen zu modellieren. Obwohl diese Methoden erste Abhängigkeiten erster Ordnung erfassen konnten, bleibt die Beschreibung komplexer Abhängigkeiten höherer Ordnung und nichtlinearer Dynamiken der Nutzerinteressen begrenzt, was die Modellleistung in komplexen Szenarien einschränkt. Mit der Entwicklung der Deep-Learning-Technologie13,14 wurden auf neuronalen Netzen basierende Verfahren breit in der Sitzungsbasierten Empfehlung (SBR) angewandt. GRU4REC15 war die erste Methode, die rekurrente neuronale Netze14 (RNNs) für sitzungsbasierte Empfehlungen nutzte und dabei zeitliche Abhängigkeiten in Sequenzen effektiv erfasste; NARM16 verbesserte die Fähigkeit, zentrale Nutzerinteressen zu extrahieren, indem es Aufmerksamkeitsmechanismen mit RNNs kombinierte; STAMP17 verwendete mehrschichtige Perzeptronen (MLPs) in Kombination mit Aufmerksamkeitsmechanismen, um gezielt kurzfristige Nutzerinteressen abzubilden. Obwohl diese Methoden Fortschritte bei der Sequenzmodellierung erzielten, blieben Herausforderungen wie die Schwierigkeit, langfristige Abhängigkeiten zu verarbeiten, sowie Anfälligkeit gegenüber Rauschen bestehen.
In den letzten Jahren haben Graph-Neuronale Netze (GNNs)18,19,20,21 eine neue Perspektive für die SBR-Aufgabe eröffnet. Modelle wie SR-GNN22 bilden komplexe Übergangsbeziehungen explizit ab, indem sie einen Sitzungsgraphen (SG) konstruieren, und erzielen dadurch deutliche Verbesserungen bei der Empfehlungsgenauigkeit. Die meisten bestehenden, auf GNNs basierenden Methoden führen jedoch die Graphkonstruktion und Nachrichtenweiterleitung innerhalb einzelner Sitzungen durch und nutzen dabei keine globalen Informationen über Item-Korrelationen effektiv. Um dieses Problem zu lösen, integriert GCE-GNN23 globale Semantik und Sitzungsgraphen mittels eines Self-Attention-Mechanismus, um durch Konstruktion eines Nachbarglobalgraphen (NGG) die Wichtigkeit von Items adaptiv zu gewichten und so beträchtliche Leistungssteigerungen zu erreichen. Dennoch stehen bestehende, auf GNNs basierende Methoden weiterhin vor zwei wesentlichen Engpässen: Erstens steigt die Komplexität des Self-Attention-Mechanismus quadratisch mit der Länge der Sitzung an, was bei der Verarbeitung langer Sitzungen zu erheblichem Rechenaufwand führt; zweitens fehlt traditionellen GNNs die Fähigkeit, die Wichtigkeit von Items während der Informationsaggregation dynamisch zu regulieren, wodurch es schwierig wird, zwischen Rauschen und entscheidenden Verhaltensweisen zu unterscheiden, was die Qualität der Repräsentation beeinträchtigt.
Um diese Herausforderungen zu bewältigen, schlägt diese Arbeit ein Gated-Slot-Linear-Attention-Graph-Neuronales-Netzwerk für die empfehlungsbasierte Sitzungsverarbeitung (GSLA4Rec) vor: (1) Entwicklung eines Gated-Slot-Mechanismus, der Rauschen durch Gating-Steuerung herausfiltert und wesentliche semantische Informationen in Sitzungs-Slots speichert, wodurch die Robustheit des Modells erhöht und der Speicheraufwand reduziert wird; (2) Einführung des Linear-Attention-Mechanismus, der die Berechnungskomplexität von O(N2) auf O(N) senkt (wobei N die Länge der Sitzung ist), während die Fähigkeit zur Modellierung langer Abhängigkeiten erhalten bleibt; (3) Durchführung umfangreicher Experimente auf drei öffentlichen Benchmark-Datensätzen (Diginetica, Tmall und NowPlaying), die zeigen, dass GSLA4Rec bestehende SOTA-Methoden deutlich übertrifft und insbesondere klare Vorteile in Szenarien mit langen Sitzungen und geringer Datendichte aufweist.
Protokoll
Erleben der empfehlungsbasierten Sitzung
Die empfehlungsbasierte Sitzungsanalyse kann aus drei Perspektiven untersucht werden: SBR, globales Kontextlernen und GSLA (siehe Tabelle der Materialien). An dieser Studie waren keine menschlichen Teilnehmer oder Tiere beteiligt. Alle in dieser Arbeit verwendeten experimentellen Datensätze sind öffentlich zugänglich und als Zusatzdatei: GSLA4Rec.zip eingereicht.
Empfehlung basierend auf Sitzungen
Die empfehlungsbasierte Sitzung (SBR) war ein Künstliche-Intelligenz-System, das über mehrstufige natürlichsprachliche Dialoge mit Benutzern interagierte, um deren Präferenzen dynamisch zu erfassen und personalisierte Empfehlungen bereitzustellen. SBR entwickelte sich von traditionellen Methoden hin zu Deep-Learning-basierten und hybriden Ansätzen und schritt anschließend zu Lösungen auf Basis von großen Sprachmodellen (LLM) fort.
Traditionelle, auf Sitzungen basierende Empfehlung
Traditionelles SBR wurde typischerweise durch Methoden basierend auf Markov-Ketten und durch Collaborative Filtering repräsentiert. Erstere erzeugten Empfehlungen durch die Zerlegung nutzerspezifischer probabilistischer Übergangsmatrizen. Beispielsweise schlug Guy Shani24 eine auf dem Markov-Entscheidungsprozess basierende Empfehlungsmethode vor, die Empfehlungen durch Zerlegung entsprechender Matrizen erzeugte; Wanrong Gu25 verbesserte die Empfehlungsleistung, indem er Markov-Ketten mit Kaufzeitintervallen kombinierte. Letztere generierten Empfehlungen, indem sie verborgene sequenzielle Beziehungen zwischen benachbarten interaktiven Elementen mittels Matrixfaktorisierung extrahierten. Zum Beispiel berechnete Sarwar B1 die Ähnlichkeit zwischen Elementen basierend auf dem historischen Nutzerverhalten (wie Bewertungen und Klicks), um Elemente vorzuschlagen, die den früheren Präferenzen der Nutzer entsprechen. Wenn Nutzer A das Element a mochte und Element c dem Element a stark ähnelte, empfiehlt das System c an A; Rendle S5 schlug FPMC vor, ein Sequenz-Empfehlungsmodell, das Matrixfaktorisierung mit Markov-Ketten kombiniert, um verborgene sequenzielle Beziehungen zwischen benachbarten interaktiven Elementen abzubilden. Solche traditionellen SBR-Ansätze konzentrierten sich jedoch auf sequenzielle Beziehungen zwischen benachbarten Elementen, wodurch die Modellierung komplexer Abhängigkeitsbeziehungen erschwert wurde.
Deep-Learning-basierte Empfehlung nach Sitzungen
Die Deep-Learning-empfohlene Sitzungsempfehlung hat sich über Stufen entwickelt, die Faltungsneuronale Netze (CNNs)26,27,28,29, RNNs und GNNs beinhalten. Die auf CNNs basierende SBR nutzte Operationen wie Faltung und Pooling, um Darstellungen jedes Sitzungskontexts zu erlernen, die anschließend für nachfolgende Empfehlungen verwendet wurden. Caser30 wandelte die L zuletzt von einem Nutzer genutzten Elemente mithilfe einer Einbettungsschicht in d-dimensionale Vektoren um und bildete so eine Einbettungsmatrix, die als „Bild“ interpretiert wurde, das in Zeit- und latenter Raumdimension abgebildet ist. Anschließend wurden drei faltungs-basierte sequenzielle Musterfilter – auf Punkt-Ebene, auf Vereinigungsebene ohne Überspringen und auf Vereinigungsebene mit einmaligem Überspringen – verwendet, um sequenzielle Muster zu erlernen und die SBR-Leistung zu verbessern. Tuan et al.31 modellierten Sitzungs-Klickströme und Inhaltsmerkmale einheitlich mittels 3D-Faltungskernen, um gemeinsame räumlich-zeitlich-inhaltliche Darstellungen zu bilden.
RNNs waren eine Klasse neuronaler Netzwerkarchitekturen, die speziell zur Verarbeitung sequenzieller Daten entwickelt wurden. Der Kerngedanke bestand darin, zeitliche Abhängigkeiten durch rekurrente Strukturen wie Long Short-Term Memory-Netzwerke (LSTM)13 und Gated Recurrent Units (GRUs)32 abzubilden, und sie wurden weithin in Bereichen wie Natural Language Processing (NLP)33, Spracherkennung34, Textübersetzung35, Reiseverkehr36,37, Kriminalität38, und Vorhersage zukünftiger Trends39 (z. B. Verkehr40, Aktienmärkte41,42 und Meteorologie43) eingesetzt. GRU4Rec, vorgeschlagen von Hidasi et al., stellte einen Meilenstein in der SBR-Forschung dar und führte erstmals RNNs in die SBR ein, um mittels GRU die sequenziellen Verhaltensmuster von Nutzern zu erfassen und personalisierte Empfehlungen zu ermöglichen.
GNNs44 zeigten eine starke Ausdruckskraft bei der Modellierung komplexer Beziehungen in graphbasierten Daten, weshalb einige Forscher GNNs zur Modellierung komplexer Übergänge innerhalb oder zwischen Sitzungen eingeführt haben. Abhängig von verschiedenen GNN-Architekturen wurden GNN-basierte Methoden für SBR im Allgemeinen in Gated-Graph-Neural-Networks (GGNNs)45, Graph-Convolutional-Networks (GCNs)46 und Graph-Attention-Networks (GATs)47 kategorisiert. SR-GNN war die erste Methode, die GNNs auf SBR anwendete, indem Sitzungssequenzen als gerichtete Graphen dargestellt und GGNNs genutzt wurden, um komplexe Übergangsbeziehungen zwischen Elementen innerhalb einer Sitzung abzubilden, kombiniert mit Attention-Mechanismen zur Erzeugung der finalen Sitzungsembedding, wodurch die Empfehlungsleistung verbessert wurde. Chen L48 schlug ein Multiview-GNN-Framework vor, das strukturierte Attribute und unstrukturierte Schlüsselwörter kombiniert, um mehrdimensionale Produktzusammenhänge abzubilden und die Genauigkeit von SBR zu erhöhen. Driss E49 entwickelte ein innovatives System zur Sitzungsempfehlung, das Capsule-Graph-Neural-Networks verwendet, um komplexe Merkmale von Elementen zu erfassen und die Vorhersagegenauigkeit für SBR zu verbessern.
Die oben genannten Deep-Learning-Techniken hatten den Forschungsumfang von SBR bereichert und die Leistung effektiv verbessert, wiesen jedoch weiterhin bestimmte Einschränkungen auf, die sich hauptsächlich darin äußerten: 1) Bei neu auftretenden Elementen oder sehr spärlichen Sitzungen war es für die Modelle aufgrund des Fehlens eines globalen Kontexts schwierig, genaue Vorhersagen zu treffen; 2) Sie konnten die globalen Muster, die in allen historischen Sitzungen enthalten waren, nicht nutzen.
Hybride empfehlungsbasierte Sitzung
Hybride, auf Sitzungen basierende Empfehlungen integrierten die Stärken verschiedener Techniken, wie der kollaborativen Filterung, des Deep Learnings und von Attention-Mechanismen, um die Leistung von SBR zu verbessern. GC-SAN50 integrierte einen Self-Attention-Mechanismus basierend auf SR-GNN, um Interaktionsinformationen wichtiger Elemente innerhalb einer Sitzung besser erfassen zu können. FGNN51 aggregierte zusätzlich Informationen von benachbarten Elementen mithilfe eines Multi-Head-Attention-Mechanismus, um mehrere Beziehungen des Zielobjekts zu erlernen. SR-HetGNN52 gehörte zu SBR mit heterogenen Graphen; durch die Einführung von mehreren Elementtypen (Nutzer, Element, Sitzung) und mehreren relationalen Kanten (Klick, Kauf, gemeinsames Auftreten, Attributzuordnung) wurde ein globales Wissensnetz konstruiert, wodurch die Beschränkung auf einzelne Elementsequenzen überwunden wurde. Dieses Verfahren stellt in den letzten Jahren eine wichtige Methode zur Modellierung des Verhaltens anonymer Nutzer und zur Erfassung von Interessenüberlappungen über mehrere Sitzungen hinweg dar. KGSR-SAP53 konstruierte einen Wissensgraphen, indem Elemente über Kanten mit mehrfachen Beziehungen verbunden wurden, um verschiedene Nutzer-Element-Interaktionen abzubilden und das Problem des Informationsverlusts zu lösen, das entsteht, wenn der globale Graph nur Kanten eines Typs (Nutzer-Element-Interaktion) enthält. Wang ZH54 schlug DiffSBR vor, ein diffusionsbasiertes Empfehlungsmodell für Sitzungen. Es erzeugt verlässliche Vorlieben für das nächste Element, indem es die Rauschunterdrückung simuliert, und verbessert so die Modellierung dynamischer Nutzer-Klicksequenzen. Qiao ST55 entwickelte ein SBR-Framework, das das Lernen aus mehreren Blickwinkeln der Nutzerabsicht mit der Anpassung an Sprachmodelle (LLM) kombiniert. Es identifizierte implizite Nutzerabsichten aus verschiedenen Perspektiven und nutzte Sprachmodelle, um semantische Merkmale anzugleichen und die Empfehlungsleistung weiter zu verbessern.
Globale Einordnung
Um den Nachteil der „isolierten Betrachtung von Sitzungen“ zu überwinden, erkannten Forscher, dass globale Informationen genutzt werden könnten, um die Repräsentationsfähigkeit der aktuellen Sitzung zu verbessern, um so Probleme wie Datensparsamkeit, Cold-Start und semantische Lücke in traditionellen SBR-Ansätzen zu lösen. Gleichzeitig war bei der Erstellung des globalen Kontexts erforderlich, globale Informationen in eine einzelne Sitzung zu integrieren und dabei Störungen durch Rauschen möglichst gering zu halten. CSRM56 optimierte die Sitzungsrepräsentation auf Ebene der Sitzung, indem kollaborative Informationen zwischen der aktuellen Sitzung und benachbarten Sitzungen integriert wurden, wobei ein äußerer Speicher-Encoder (OME) verwendet wurde, um kollaborative Absichten aus diesen Informationen zu extrahieren. CA-TCN57 schlug ein zeitliches Faltungsschicht-Netzwerkmodell mit Berücksichtigung mehrerer Sitzungen (cross-session aware temporal convolutional network) vor, das globale Graphen und Sitzungskontext-Graphen erstellt, um den Einfluss über mehrere Sitzungen hinweg auf Elemente und Sitzungen zu simulieren, während das zeitliche Faltungsschicht-Netzwerk (TCN) durch dilatierte Faltungen das Rezeptivfeld erweitert, wobei die Anzahl der Schichten Sequenzen exponentieller Länge abdeckt (Rezeptivfeld = ), wodurch das Problem des verschwindenden Gradienten bei RNNs gelöst wird. Chen58 schlug eine SBR-Methode basierend auf Hypergraph-Neuronalen-Netzwerken (SR-HGNNs) vor, die gemischte Ordnungen (niedrige und hohe Ordnungen) der Propagation und Aufmerksamkeitsmechanismen integriert, um das Überglättungsproblem traditioneller GNNs in kurzen Sitzungen zu lösen und die Wichtigkeit verschiedener Propagationsordnungen zu unterscheiden, und somit Abhängigkeiten genauer erfassen und Störungen durch Rauschen vermeiden kann. GCE-GNN verwendete Item-Paare mit mehrfachem gemeinsamem Auftreten, um einen ungerichteten gewichteten Graphen zu konstruieren, wobei die Häufigkeit des gemeinsamen Auftretens von Items erfasst wurde, um die Wichtigkeit der Items in der Sitzung widerzuspiegeln; AGNN-GC59 nutzte über Sitzungen hinweg bestehende Item-Übergangsbeziehungen, um einen globalen kollaborativen Graphen aufzubauen, und berechnete die Item-Übergangswahrscheinlichkeiten im globalen Graphen, um Interessenänderungen innerhalb der Sitzung abzubilden; DA-GCN60 verwendete den kürzesten Pfad, um die Adjazenzmatrix zu aktualisieren und einen dynamisch gewichteten Graphen zu konstruieren, wobei die globale Koauftretenshäufigkeit und die Pfaddistanz zwischen Items berechnet wurden. Angeregt durch die oben genannte Literatur schlägt diese Arbeit vor, einen globalen Graphen mithilfe einer nachbarschaftsbasierten Methode zu konstruieren, d. h., den Jaccard-Ähnlichkeitskoeffizienten zur Berechnung ähnlicher Sitzungen zu verwenden, was nicht nur globale Informationen nutzt, sondern auch Rauschen filtert (durch Ausschluss irrelevanter Items), um so das Ziel einer präzisen Konstruktion des globalen Kontexts zu erreichen und eine solide Grundlage für den nachfolgenden SBR-Algorithmus zu schaffen.
Geöffneter linearer Schlitz-Algorithmus
Traditionelle Transformer61 verursachten aufgrund der Notwendigkeit vollständig verbundener Attention-Operationen über die gesamte Sequenz hinweg eine hohe räumliche und zeitliche Komplexität wie folgt:
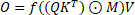 (1)
Dabei waren Q, K, V ∈ RN×d lineare Transformationen der Eingabeelemente, M = {Mij = 1, falls i ≥ j, andernfalls −∞} die kausale Maske zur Verhinderung von Informationslecks aus der Zukunft, ⊙ bezeichnete die elementweise Multiplikation und f bezeichnete die Aktivierungsfunktion Softmax.
Um eine lineare Aufmerksamkeit62 zu erreichen, war die naheliegendste Idee, die Aktivierungsfunktion Softmax zu entfernen. Wenn jedoch die Aktivierungsfunktion Softmax direkt entfernt wird, führt die lineare Aufmerksamkeit zwangsläufig zu einigen potenziellen Problemen: dem Verlust der starken Ausdruckskraft neuronaler Netze und der Unfähigkeit, komplexe reale Probleme zu lösen.
Slot-lineare Aufmerksamkeit mit begrenzter Speichersteuerung
Unter der Annahme, dass die Aktivierungsfunktion Softmax beibehalten werden musste, wurden K und V separat in K̃, Ṽ ∈ Rm×d komprimiert. Aus Sicht des Speicher-Netzes besaßen K̃ und Ṽ Speicherplätze, deren Länge mit der Sequenz wächst, das heißt, die Anzahl der Plätze m = N. Falls m festgelegt war, war eine Linearisierung offensichtlich möglich. Angeregt durch Bounded-memory Control63, musste jedes Token in den Eingabeelementen mit einer Länge von N konkurrierend in m Plätze geschrieben werden.
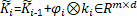 ,
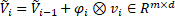 ,
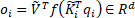 (2)
Dabei war f die Aktivierungsfunktion Softmax und φi der Vektor zur Steuerung der effektiven Eingabe zur Kontrolle des Schlüsselwerts ki, wie folgt.
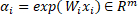 ,
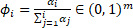 (3)
Hierbei repräsentierte (φi)j die Schreibintensität des iten Tokens im jten Slot und wurde mithilfe einer kumulativen Softmax-Funktion ermittelt.
Um eine effiziente lineare Berechnung zu erreichen, wurde Formel (2) als Formel (4) neu formuliert, die οi aus qi, ki und vi (Glg. 4) berechnete durch {οi|i=1T, qi, ki, vi)|i=1T} und eine zweipassige sequenzielle Berechnung verwendete:
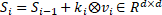 ,
 (4)
Daher konnten SLA-Operationen abgeleitet werden:
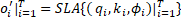 ,
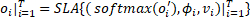 (5)
Wobei oi′ ∈ ℝm, οi ∈ ℝd. Daher könnte SLA eine hardware-effiziente, linearzeitige, abschnittsweise Schulung erwerben64.
Linearer Gated-Slot-Algorithmus
Die Slot-Linear-Attention mit begrenzter Speichersteuerung könnte die rechnerische und räumliche Komplexität verringern. Allerdings könnte die Anhäufung von Informationen auch Rauschinformationen in die Sitzungsinteraktion einbringen, weshalb eine datenabhängige Abklingung wichtig war, um Informationen selektiv zu behalten oder zu vergessen. Dieser selektive Mechanismus war kürzlich in selektiven Zustandsraummodellen wieder aufgegriffen worden65. GSLA mit datenabhängiger Abklingung ließe sich wie folgt ausdrücken:
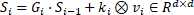 ,
 (6)
Hier wurden Abklinggatter in Form eines äußeren Produkts parametrisiert als Gi = αi ⊗ βi, mit αi, βi ∈ [0,1]d. Im Folgenden könnte GSLA auch in der folgenden äquivalenten Form geschrieben werden, wobei typischerweise βt = 1 gesetzt wird und Matrizenmultiplikation wie in64 verwendet wird:
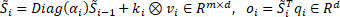 (7)
Wobei αi und ki separat das Vergess-Tor und das Eingabe-Tor bezeichnen, könnten die beiden Tore gekoppelt werden als ki = 1 − αi, inspiriert von der Literatur zu geteilten RNNs. Es zeigte sich, dass GSLA mit einer zweipassigen sequenziellen Berechnung formuliert werden könnte, wie in Gleichung (8) dargestellt. Die Struktur zweiter Ordnung ermöglichte ein blockweises paralleles Training zur Verbesserung der Trainingseffizienz, und die Einfügung der Softmax-Operation in der Mitte der Struktur zweiter Ordnung verbesserte die Modellierungsfähigkeit des endlichen Slot-Gedächtnisses.
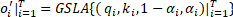 ,
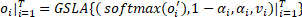 (8)
Umwandlung von Sitzungsdaten
Problembeschreibung
Es sei die gegebene Sitzungssequenz S = {v1s, v2s, ⋯, vns}, wobei vis das i-te angeklickte Element bezeichnet. Durch die Analyse des Klickverhaltens des Benutzers innerhalb dieser Sequenz prognostizierte das System das nächste Element, an dem der Benutzer interessiert sein könnte, vn+1s.
Graphkonstruktion
Konstruktion des Sitzungsgraphen
Für eine Sitzung S = {v1s, v2s, ⋯, vns} wurde ein gerichteter Graph Gs = (Vs, εs) konstruiert, wobei Vs die Artikelmenge der gegebenen Sitzung S war und εs = {eijlocal|vi, vj, vi, vj ∈ Vs} die Kantenmenge der gegebenen Sitzung S war. ε(vi-1s, vis) repräsentierte die aufeinanderfolgend angeklickten Artikel in dieser Sitzung. Die Kante eijlocal konnte in vier Typen unterteilt werden: ein, eout, ein-out, eself. Da dasselbe Element möglicherweise mehrfach in der Sequenz auftreten konnte, wurde der gewichtete Wert für jede Kante gezählt.
Die aktuelle Sitzung s = [v1, v2, v4, v2, v3] wurde in ein SG umgewandelt, wie in Abbildung 1A. dargestellt
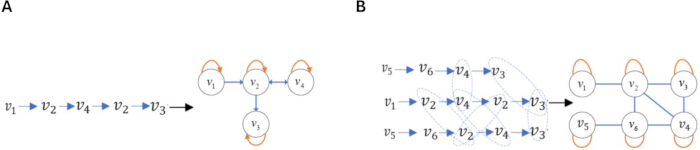
Abbildung 1: Interaktive Elemente in Graphstrukturen umwandeln. (A) Veranschaulichung der Sitzungsgraph-(SG-)Konstruktion durch Umwandlung einer Sitzung in einen Graphen. (B) Veranschaulichung der Konstruktion des Nachbarglobalgraphen (NGG) durch Kombination vieler Sitzungen zu einem Graphen. Diese Abbildung wurde selbstständig mit Visio unter Verwendung vollständig angepasster Elemente erstellt. Es wurden keine urheberrechtlich geschützten externen Grafikressourcen verwendet, daher war keine zusätzliche Drittlizenzierung erforderlich. Das Urheberrecht an der Abbildung liegt bei den Autoren und wird den Urheberrechtsregeln der Zeitschrift bei Annahme entsprechen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Konstruktion des globalen Nachbargraphen
Basierend auf der aktuellen Sitzung S wurde der entsprechende NGG Gg = (Vg, εg) konstruiert, um das Repräsentationslernen der aktuellen Sitzung auf querschnittlicher Ebene anzureichern. Vg war die Elementmenge, die alle Elemente in Gg enthält, und εg = {eijglobal|vi, vj, vi, vj ∈ Vg} war die Kantenmenge von Gg. ε(vi-1g, vig) repräsentierte die direkt wechselwirkenden Elemente vi-1g und vig im NGG Gg. Dieser Prozess bestand aus zwei Schritten: der Erfassung benachbarter Sitzungen und der NGG-Konstruktion.
Erwerb der Nachbarsitzung
Für den gesamten Datensatz wurden Sitzungen gesucht, die die maximale Anzahl gemeinsam auftretender Elemente mit der aktuellen Sitzung aufweisen. Die N besten Sitzungen mit den höchsten Co-Occurrence-Zahlen wurden ausgewählt, um eine Menge möglicher Nachbar-Sitzungen S aufzubauen. Anschließend wurde der Jaccard-Ähnlichkeitskoeffizient verwendet, um die Ähnlichkeit zwischen der aktuellen Sitzung cu und einer Sitzung Sr ∈ S aus der Kandidatenmenge S gemäß Gleichung (9) zu berechnen.
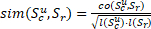 (9)
Hier bezeichnete co(Scu, Sr) die Anzahl der Elemente, die sowohl in Scu als auch in Sr gemeinsam auftreten, während l(Scu) und l(Sr) jeweils die Längen von Scu und Sr angaben, und Scu sowie Sr die aktuelle Sitzung und eine benachbarte Sitzung bezeichneten. Sitzungen mit einer Ähnlichkeit unterhalb einer bestimmten Schwelle (die als Hyperparameter festgelegt werden könnte) wurden herausgefiltert, und die verbleibenden Sitzungen bildeten die Menge der benachbarten Sitzungen Ns für die aktuelle Sitzung.
Konstruktion eines globalen Nachbargraphen
Basierend auf der Nachbarsitzungs-Menge Ns wurde der NGG konstruiert, wie in Abbildung 1B veranschaulicht. Während der Erstellung der Adjazenzmatrix wurde der entsprechende Eintrag Aij auf 1 gesetzt, wenn zwischen zwei Elementen (vi, vj) eine Interaktion bestand, andernfalls auf 0. Zusätzlich wurden die Interaktionen zwischen den Elementen als ungerichtet behandelt und mit Selbstrückkopplungen ausgestattet, gefolgt von einer Normalisierung, wie in Tabelle 1 dargestellt.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tabelle 1: Normalisierte Adjazenzmatrix des Nachbarglobalgraphen. Die Tabelle zeigt die normalisierte Adjazenzmatrix, die die gewichteten Verbindungen zwischen den Knoten im konstruierten Nachbarglobalgraphen beschreibt.
Entwurf eines empfehlungsbasierten Algorithmus für Sitzungen
Dieser Abschnitt erläutert das vorgeschlagene innovative Modell GSLA4Rec, das die SBR-Leistung verbessert, indem es den GSLA-Mechanismus über die gemeinsame Merkmalsdarstellung von SG und NGG einführt.
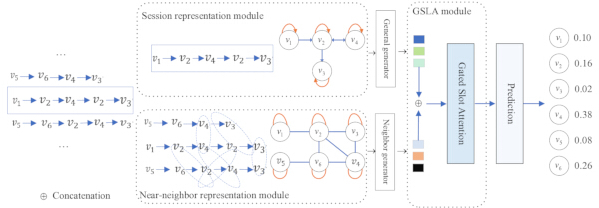
Abbildung 2: GSLA4Rec-Framework. Dieses Framework integrierte das Lernen von Sitzungsgraphen und der globalen Nachbargraphstruktur, filterte Interaktionsrauschen mithilfe eines Gating-Mechanismus, balancierte Speicherbedarf und Effizienz durch einen Memory-Slots-Mechanismus und erfasste die Relevanz von Elementen mittels eines linearen Attention-Mechanismus, um die nächste Klickpräferenz des Nutzers vorherzusagen. Diese Abbildung wurde selbstständig mit Visio unter Verwendung vollständig angepasster Elemente erstellt. Es wurden keine urheberrechtlich geschützten externen Grafikressourcen verwendet, daher war keine zusätzliche Drittlizenzierung erforderlich. Das Urheberrecht an der Abbildung liegt bei den Autoren und wird bei Annahme den Urheberrechtsregeln der Zeitschrift entsprechen. GSLA4Rec steht für „gated-slot linear attention“-Graph-Neuronale-Netzwerke für SBR. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Abbildung 2 zeigt das Framework von GSLA4Rec, das aus vier Hauptkomponenten bestand: 1) Sitzungsebene-Item-Darstellung. Es verwendete ein GNN-Modell auf dem SG, um Sitzungsebene-Item-Embeddings innerhalb der aktuellen Sitzung zu lernen; 2) Nachbar-Global-Ebene-Item-Darstellung. Es lernte Global-Ebene-Item-Embeddings über alle Sitzungen hinweg, indem es ein GRU verwendete, um rekursiv die Nachbar-Embeddings jedes Items basierend auf dem NGG einzubeziehen; 3) GSLA. Es modellierte die Benutzerpräferenz der aktuellen Sitzung, indem es die gelernten Item-Darstellungen auf Sitzungs- und Global-Ebene aggregierte; 4) Vorhersageschicht. Sie gab die vorhergesagten Wahrscheinlichkeiten für die Kandidaten-Items aus. Die vier Komponenten werden im Folgenden detailliert beschrieben.
Darstellung der Sitzung
In SBR war das Verständnis der Interaktionsverhalten der Nutzer von entscheidender Bedeutung. Zu diesem Zweck wurden ein SG und ein NGG zur Lernens der Sitzungsdarstellung konstruiert, um die Interaktionsverhalten der Nutzer umfassend zu verstehen und dadurch die authentischeren Absichten der Nutzer zu erfassen.
Darstellung von Elementen auf Sitzungsebene
Basierend auf dem SG in Abbildung 1A wurde eine gewichtete bidirektionale Graph-Aufmerksamkeitsmethode (Weighted Bidirectional Graph Attention, WBGAT) angewandt, um Merkmale des SG zu extrahieren. Diese Methode führte Kantengewichtungen und Elementrichtungen (In-Nachbarn und Out-Nachbarn) basierend auf dem Standard-GAT-Mechanismus ein, verstärkte dadurch wichtige Kanten und erfasste bidirektionale Abhängigkeiten. Auf diese Weise wurden die Schwächen des herkömmlichen GAT bezüglich asymmetrischer Elementbeziehungen und Interaktionsstärken behoben. Der Berechnungsprozess sah wie folgt aus:
Zunächst Berechnung der Normalisierungsgewichte für den Eingangsgrad des Elements.
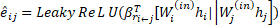 (10)
wobei eij das Gewicht der erststufigen Einbarnbeziehung der Merkmale des Elements j zum Element i angab,  die Beziehung zwischen Element i und Element j darstellte, β* ∈ ℝd die Gewichtsvektoren waren, hi und hj jeweils die Repräsentationen der Elemente i und j darstellten, Wi(in) ∈ ℝd*d und Wj(in) ∈ ℝd*d trainierbare Parameter waren und || die Verkettungsoperation repräsentierte. Um verschiedene Ein-Grad-Beziehungen zu unterscheiden, wurden zwei Gewichtsvektoren, nämlich rin und rin-self, trainiert. Als Aktivierungsfunktion wurde LeakyReLU verwendet.
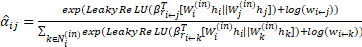 (11)
Um Koeffizienten über verschiedene Elemente hinweg vergleichbar zu machen, wurden die Aufmerksamkeitsgewichte mittels der Softmax-Funktion normalisiert. Dabei war Ni(in) die Menge der erststufigen eingehenden Nachbarn des Elements i,  das Gewicht der eingehenden Kante (i←j) im SG; dieses Verfahren ermöglichte es dem Modell, Merkmalskorrelationen der Elemente zu lernen und gleichzeitig die inhärente Verbindungsstärke der Graphstruktur zu bewahren, indem der Logarithmus der Kantengewichte genommen und zur ursprünglichen Aufmerksamkeitsscore eij addiert wurde.
Zweitens die Berechnung der Item-Out-Degree-Normalisierungsgewichte.
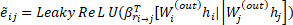 (12)
wobei ẽij das Gewicht der Out-Neighbor-Beziehung erster Ordnung der Merkmale des Elements j zum Element i angab,  die Beziehung zwischen den Elementen i und j darstellte und zwei Gewichtsvektoren, nämlich rout und rout-self, trainiert wurden.
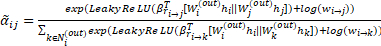 (13)
Dabei war Ni(out) die Menge der Out-Neighbors erster Ordnung des Elements i, und  das Gewicht der ausgehenden Kante (i→j) im gerichteten Graphen SG.
Drittens, die Informationsaggregation. Die aktualisierte Einbettung des Elements konnte ermittelt werden, nachdem die Einbettungen des ein- und ausgehenden Grad erster Ordnung des Elements i gewichtet und summiert wurden.
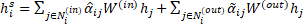 (14)
Wobei  und α̃ij respectively die Gewichte des Eingangs- und Ausgangsgrads des Elements i bezeichnen,
 die aktualisierte Darstellung des Elements i bezeichnet.
Darstellung des benachbarten globalen Elementes
Aktuelle Forschungsergebnisse waren sich einig, dass die Erstellung eines globalen Graphen die Datenrepräsentation verbessern und somit die SBR-Leistung steigern könnte, daran bestand kein Zweifel. Allerdings könnte eine globale Verbesserung der Daten auch irrelevante Informationen wie Rauschen einführen. Im vorgeschlagenen Modell wurde, um eine globale Datenaugmentierung zu erreichen und gleichzeitig das Rauschen so weit wie möglich zu minimieren, ein Nachbar-Global-Graph konstruiert.
Basierend auf dem NGG in Abbildung 1B und der normalisierten Adjazenzmatrix in Tabelle 1 wurden die aktuelle Sitzung und ihre benachbarten Sitzungen in ein NGG umgewandelt, und eine GGNNs45-Methode wurde angewendet, um Merkmale des NGG zu extrahieren. Der Lernprozess der Item-Vektoren im NGG ist in Gleichung (15) dargestellt.
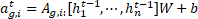
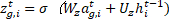
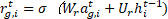
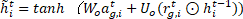
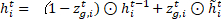 (15)
W ∈ ℝd×2d bezeichnete die Steuergewichte, zg,i und rg,i stellten das Aktualisierungs- und das Reset-Gate dar. [h1t-1, ⋯, hnt-1] repräsentierte die Liste aller Item-Vektoren in der Sitzung s. σ(x) = 1/(1 + e-x) war die logistische Sigmoidfunktion, ⊙ bezeichnete die elementweise Multiplikation und hi ∈ ℝd repräsentierte den Vektor nach der Gated-Aktualisierung. Die Adjazenzmatrix As ∈ ℝn×n zeigte die Verbindungen zwischen den Items in benachbarten Sitzungen an, und As,i: ∈ ℝ1×n repräsentierte einen Spaltenblock von As, der dem Item vs,i in der Adjazenzmatrix entsprach. Für die aktuelle Sitzung s = [v1, v2, v4, v2, v3] waren das NGG und die normalisierte Adjazenzmatrix in Abbildung 1B und Tabelle 1 dargestellt.
Objektdarstellung
Die Elementdarstellung wurde durch Summierung des Elementvektors auf Sitzungsebene und des Nachbarn-Global-Elementvektors auf globaler Ebene erhalten, wie in Gleichung (16) dargestellt:
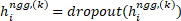
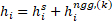 (16)
Wo Dropout auf globaler Ebene bei den Nachbar-Item-Darstellungen angewendet wurde, um Überanpassung zu vermindern.
Linearer Gated-Slot-Algorithmus
Die in diesem Artikel vorgestellte Gated-Slot-Linear-Attention (GSLA) kombiniert lineare Attention mit einer begrenzten Speichersteuerung und einem datenabhängigen Gating-Mechanismus. Einerseits übernahm sie den endlichen Speicher-Slot-Mechanismus des Attention-basierten Controller-(ABC-)Modells, bei dem die ursprünglich mit der Sequenzlänge wachsenden Key-Value-Paare auf eine feste Anzahl von Slots komprimiert werden, wobei jeder Slot über ein Competitive Writing aktualisiert wird, wodurch das Problem der hohen Rechenkomplexität der globalen Attention im Transformer angegangen wird. Andererseits führte sie einen feinabgestuften Gating-Mechanismus ähnlich dem von GLA ein, bei dem die Eingabedaten das Retentionsverhältnis der historischen Informationen über ein Vergessensgate αi dynamisch anpassen, wodurch das durch das Fehlen eines Vergessensmechanismus im ABC verursachte Rauschproblem gelöst wird.
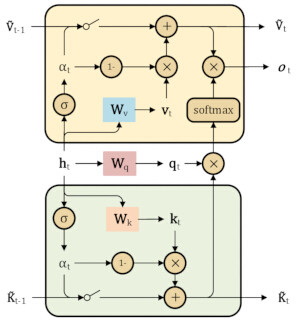
Abbildung 3: Schematisches Diagramm der GSLA. Der Eingabevektor wurde jeweils auf den Abfragevektor, Schlüsselvektor und Wertvektor abgebildet und anschließend mittels linearer Aufmerksamkeit mit begrenzter Speichersteuerung und einer datenabhängigen Gating-Mechanismus verarbeitet, um den aktualisierten Abfragevektor, Schlüsselvektor, Wertvektor und Ausgabevektor zu erhalten. Diese Abbildung wurde selbstständig mittels Visio mit vollständig angepassten Elementen erstellt. Es wurden keine urheberrechtlich geschützten externen Grafikressourcen verwendet, daher war keine zusätzliche Lizenzierung durch Dritte erforderlich. Das Urheberrecht an der Abbildung liegt bei den Autoren und wird den Urheberrechtsregeln der Zeitschrift bei Annahme entsprechen. GSLA steht für gated-slot lineare Aufmerksamkeit. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Wie speziell in Abbildung 3 dargestellt, wurde der Eingabevektor separat in den Query-Vektor, den Key-Vektor und den Value-Vektor64 abgebildet:
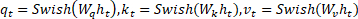 (17)
Dabei repräsentierten Wq, Wk, Wv ∈ ℝd×d die Transformations-Gewichtsmatrizen, die jeweils der Abfrage, dem Schlüssel und dem Wert entsprachen, und ht bezeichnete den Einbettungsvektor zum t-ten Zeitschritt in der Eingabesequenz der Sitzung. Die Swish-Funktion war definiert als Swish(x) = x · σ(x) und stellte eine selbstgesteuerte Aktivierungsfunktion dar, wobei σ die Sigmoid-Funktion war; sie zeigte bei mehreren Deep-Learning-Aufgaben eine bessere Leistung als die traditionelle ReLU-Aktivierungsfunktion.
GSLA verwendete ein Vergessungstor αi und ein Eingangstor 1 − αi, abhängig von den Eingabedaten, um die Informationen im iten Speicherplatz dynamisch zu aktualisieren. Der Prozess war wie folgt64:
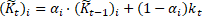 (18)
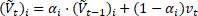 (19)
Hier repräsentierten K̃t und Ṽt die Schlüsselvektor-Slots und Wertvektor-Slots zum Zeitpunkt t, während K̃t-1 und Ṽt-1 die Schlüsselvektor-Slots und Wertvektor-Slots zum Zeitpunkt t−1 repräsentierten. Das Vergess-Tor αi = σ(Wαht)1/τ, wobei Wα ∈ ℝd die Transformationsgewichtsmatrix war, σ die Sigmoid-Funktion war und τ der Dämpfungskoeffizient war (typischerweise auf 8 gesetzt), diente zur Steuerung der Weichheit des Vergess-Tors. Dadurch konnte GSLA die Vergessensrate historischer Informationen kontinuierlich anpassen: je größer das αi, desto stärker bezog sich GSLA auf historische Informationen; je kleiner das αi, desto stärker konzentrierte sich GSLA auf die aktuelle Eingabe.
Die Schlüssel-Vektor-Slots K̃t und Wert-Vektor-Slots Ṽt der Slots im t-ten Schritt wurden in Matrixform wie in den Gleichungen (20) und (21) dargestellt65 geschrieben:
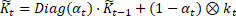 (20)
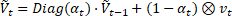 (21)
Anschließend wurde die GSLA mit Eigenschaften zweiter Ordnung (siehe Gleichung (8)) verwendet, um den Ausgabewert oi |i=1T für jeden Zeitschritt i ∈ [1, …, T] zu berechnen. Auf die Ausgabe jedes Zeitschritts wurde eine lineare Transformation angewendet, um das Ergebnis h̃t zu erhalten. Schließlich wurde der Mittelwert der Darstellungen aller Elemente in der Sitzungssequenz berechnet, um das Sitzungs-Embedding S̃e mit dynamischen Speicheraktualisierungen zu erzeugen:
 (22)
 (23)
Hier repräsentierte ot die Ausgabe des Gated-Slot zum Zeitpunkt t, h̃t bezeichnete das Ergebnis der linearen Transformation von ot. S̃e bezeichnete den Mittelwert von h̃t über alle Zeitpunkte.
Vorhersageschicht
Basierend auf der erhaltenen Sitzungsrepräsentation S̃e und der anfänglichen Einbettung des Elements i wurde eine Punktprodukt-Operation durchgeführt, um den Score für jedes kandidierende Element hi zu berechnen. Anschließend wurde die Softmax-Funktion verwendet, um die Empfehlungswahrscheinlichkeiten des kandidierenden Elements i zu ermitteln:
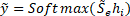 (24)
Hier repräsentierte ỹ die Empfehlungswahrscheinlichkeiten des in Frage kommenden Elements, hi bezeichnete den Vektor des in Frage kommenden Elements, und die Cross-Entropy-Verlustfunktion wurde für das Modelltraining verwendet.
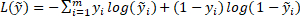 (25)
Hier war y die One-Hot-kodierte Darstellung der Ground-Truth.
Ergebnisse
Datensätze und Vorverarbeitung
In den Experimenten wurden drei öffentliche SBR-Datensätze, die aus echten Transaktionsdaten praktischer Anwendungsszenarien abgeleitet wurden, zur Bewertung der Modellleistung ausgewählt: Diginetica, das aus dem CIKM Cup 2016 stammt und Transaktions- sowie Klickdatensätze von Nutzern enthält, Tmall, das Nutzerprotokolle von der Tmall-Plattform umfasst und das Surf- sowie Kaufverhalten der Nutzer dokumentiert, und Nowplaying, das Musikdatensätze über die Abspielhistorie der Nutzer auf Musikplattformen beinhaltet. Diese Datensätze werden häufig in der SBR-Forschung verwendet und ermöglichen eine umfassende Bewertung der Effektivität und Anwendbarkeit des Modells.
In der Phase der Datenvorverarbeitung wurden die Datensätze standardisiert, um eine konsistente Datenqualität sicherzustellen. Konkret wurden alle Sitzungen mit einer Länge von weniger als 2 herausgefiltert und Elemente, die weniger als 5-mal vorkamen, entfernt. Darüber hinaus wurden für jede Sitzung S = {v1, v2, ..., vn} mehrere Teilsequenzen zur Modelltrainierung und -testung generiert. Diese Teilsequenzen hatten die Form: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Nach Abschluss der oben genannten Vorverarbeitung wurden statistische Analysen an den Datensätzen durchgeführt, detaillierte Informationen sind in Tabelle 2 dargestellt.
| Datensatz | Diginetica | Tmall | Nowplaying |
| Klicks | 982961 | 818479 | 1367963 |
| Training | 719470 | 351268 | 825304 |
| Test | 60858 | 25898 | 60417 |
| Artikel | 43097 | 40728 | 60417 |
| durchschn. Länge | 5.12 | 6.69 | 7.42 |
Tabelle 2: Datensatzbeschreibung. Die Tabelle fasst die Statistiken der Datensätze Diginetica, Tmall und Nowplaying zusammen, einschließlich der Anzahlen von Klicks, Trainings- und Testbeispielen, Artikeln sowie der durchschnittlichen Sitzungslänge.
Experimentelle Einstellungen
Parameterkonfiguration
Um die Fairness des Experiments sicherzustellen, wurden Vorverarbeitungsmethoden angewandt, um drei Datensätze zu verarbeiten, und gleichzeitig die Parameter des GSLA4Rec-Modells vorab festgelegt. Für die Datensätze Diginetica und Nowplaying wurde die Batch-Größe auf 150 festgelegt, für den Tmall-Datensatz auf 300. Die Parameter dieses Modells wurden mittels einer Gaußschen Verteilung mit einem Mittelwert von 0 und einer Standardabweichung von 0,1 initialisiert, und die Dimension wurde auf 100 gesetzt. Als Optimierer kam Adam zum Einsatz, wobei die anfängliche Lernrate auf 0,001 festgelegt wurde. Die Lernrate wurde alle 3 Epochen mit 0,1 multipliziert. Das Training wurde insgesamt 30 Epochen lang auf einer NVIDIA TITAN V-GPU und mit PyTorch 1.11.0 mit cu113 durchgeführt (siehe Tabelle der Materialien), wobei der beste Wert ausgewählt wurde. Die Schwelle zur Filterung benachbarter Sitzungen wurde auf 0,5 festgelegt, und im Experiment wurde eine L2-Regularisierung angewandt. Für jeden Datensatz wurden die letzten 10 % der nach Handelszeit sortierten Daten als Testmenge ausgewählt, während die verbleibenden 10 % und 80 % zufällig als Validierungs- bzw. Trainingsmenge ausgewählt wurden. Die Anzahl der Speicherplätze in GSLA wurde auf einen Wert aus {0, 1, 2, 3, 4, 5} festgelegt.
Evaluierungsmetriken
In dieser Arbeit wurden P@N (Präzision@N, N = 10/20) und MRR@N (mittlere reziproke Rangfolge@N, N = 10/20) verwendet. P@N diente zur Messung des Anteils korrekter Empfehlungen unter den ersten N Empfehlungsergebnissen; MRR@N wurde verwendet, um die durchschnittliche reziproke Position korrekter Projekte zu berechnen. Je höher der MRR-Wert, desto besser die Sortierleistung.
Leistung analysieren
Die Wirksamkeit des GSLA4Rec-Modells wurde im Vergleich zu Baseline-Methoden bewertet, die unterschiedliche Entwicklungsstufen der Technologie repräsentieren. In frühen Ansätzen kamen maschinelle Lernverfahren für die SBR zum Einsatz, beispielsweise wurde FPMC5 verwendet, um den sequenziellen Effekt basierend auf Markov-Ketten vorherzusagen. Anschließend fanden tiefe Lernverfahren mit der Entwicklung der künstlichen Intelligenz breite Anwendung in der SBR. GRU4Rec10 basierte beispielsweise auf RNNs, modellierte die SBR durch das Stapeln mehrerer GRU-Schichten und verwendete speziell entwickelte Verlustfunktionen zur Optimierung der SBR. NARM16 führte die Aufmerksamkeitsmechanismen (AM) ein, um die Hauptinteressen der Nutzer zu erfassen, und erzeugte eine endgültige Embedding-Darstellung des nächstmöglichen Empfehlungsitems. STAMP17 setzte AM-erweiterte mehrschichtige Perzeptronen ein, um sowohl das allgemeine als auch das unmittelbare Interesse der Nutzer gleichzeitig zu erfassen. In den letzten Jahren wurden Graph-Neuronale Netzwerke aufgrund ihrer leistungsstarken Fähigkeit zum Lernen nicht-euklidischer Daten ebenfalls häufig in der SBR eingesetzt. So wandte beispielsweise SR-GNN22 GNNs erstmals in der SBR an, erfasste komplexe Item-Übergangsbeziehungen mithilfe von GGNNs und konzentrierte sich in Kombination mit AM auf das unmittelbare Interesse der Nutzer. GCE-GNN23 nutzte GATs, um Item-Transfer-Beziehungen im lokalen und globalen Kontext zu erfassen, und generierte Sitzungsdarstellungen durch RPE und Soft-AM. S2-DHCN66 transformierte die Sitzungsdaten in einen Hypergraphen und einen Linien-Graphen und nutzte selbstüberwachendes Lernen, um die SBR zu verbessern.
Kürzlich wurde ein umfassender Ansatz zur Verbesserung der Leistung von SBR verfolgt. Beispielsweise kombinierte GC-SAN50 GNNs mit mehrschichtigen Selbst-Aufmerksamkeitsnetzwerken, um die Empfehlungsleistung durch Modellierung kurz- und langfristiger Abhängigkeiten zu steigern; TASRec67 integrierte zeitliche Informationen, indem eine Abfolge dynamischer Graph-Schnappschüsse zu verschiedenen Zeitpunkten konstruiert wurde; CT-GNN68 verwendete GNNs mit kombinierten zeitlichen Informationen, um zusätzliche zeitliche Assoziationen zwischen Elementen zu erfassen; CORE69 verschmolz Ko-Okkurrenz- und zeitliche Informationen der Elemente, um die endgültige Sitzungsrepräsentation zu erhalten; RESTC70 schlug räumlich-zeitliche Interaktionsmuster vor, inspiriert von den Eigenschaften der Gleichförmigkeit und Ausrichtung des kontrastiven Lernens; COTRec66,71 setzte selbstüberwachtes Lernen auf zwei Ansichten von Sitzungsgraphen sowie Co-Training ein, um das Problem der Daten-Sparsamkeit bei SBR zu lösen; RAIN71 nutzte Kantenmaskierung und strukturelle Rekonstruktion und trainierte gleichzeitig einen Kantenindikator, um gezielt verrauschte Kanten zu identifizieren und zu eliminieren, was die Genauigkeit und Robustheit von SBR erheblich verbesserte.
| Datensätze | Diginetica | Tmall | Nowplaying | ||||||||||
| Methodenklassi- fizierung | Metriken | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Machine-Learning | FPMC | 15,42 | 22,10 | 6,20 | 6,66 | 13,12 | 16,05 | 7,10 | 7,30 | 5,28 | 7,35 | 2,66 | 2,82 |
| Deep-Learning | GRU4REC | 17,92 | 30,80 | 7,73 | 8,20 | 9,47 | 10,93 | 5,78 | 5,89 | 6,74 | 7,92 | 4,40 | 4,48 |
| Deep-Learning | NARM | 35,44 | 48,32 | 15,12 | 16,00 | 19,16 | 23,30 | 10,40 | 10,70 | 13,60 | 18,59 | 6,62 | 6,92 |
| Deep-Learning | STAMP | 33,97 | 46,62 | 14,26 | 15,13 | 22,63 | 26,47 | 13,10 | 13,35 | 13,20 | 17,65 | 6,57 | 6,88 |
| GNNs | SR-GNN | 38,42 | 51,26 | 16,89 | 17,76 | 23,41 | 27,57 | 13,46 | 13,72 | 14,17 | 18,86 | 7,15 | 7,47 |
| GNNs | S2 -DHCN | 40,21 | 53,66 | 17,59 | 18,51 | 26,22 | 31,42 | 14,60 | 15,05 | 17,35 | 23,50 | 7,87 | 8,18 |
| GNNs | GCE-GNN | 41,16 | 54,22 | 18,15 | 19,04 | 28,01 | 33,42 | 15,08 | 15,42 | 16,94 | 22,37 | 8,03 | 8,40 |
| GNNs+Att | TASRec | 39,85 | 52,53 | 17,19 | 18,22 | 25,72 | 29,58 | 14,22 | 14,51 | 16,35 | 20,52 | 7,30 | 7,78 |
| GNNs+Att | GC-SAN | 38,40 | 51,30 | 16,80 | 17,80 | 23,50 | 27,60 | 13,50 | 13,80 | 14,20 | 18,90 | 7,20 | 7,50 |
| GNNs+Tem | CT-GNN | 39,40 | 52,71 | 17,50 | 18,56 | 25,95 | 31,42 | 14,52 | 15,00 | 16,55 | 22,28 | 7,75 | 8,06 |
| GNNs+Tem | CORE | 41,03 | 52,84 | 17,95 | 18,47 | 32,97 | 39,16 | 18,72 | 19,16 | 17,65 | 21,81 | 7,92 | 7,35 |
| GNNs+Tem | RESTC | 42,35 | 55,93 | 18,75 | 19,65 | 35,57 | 42,47 | 18,05 | 18,52 | 18,39 | 24,79 | 8,31 | 8,72 |
| GNNs+COT | COTRec | 39,87 | 54,18 | 17,53 | 19,07 | 30,62 | 36,35 | 17,65 | 18,04 | - | - | - | - |
| GNNs+ReStr | RAIN | - | 55,50 | - | 19,20 | - | 38,73 | - | 19,12 | - | 24,17 | - | 8,47 |
| GNNs+Gated-Slot | GSLA4Rec | 43,35 | 56,47 | 19,38 | 19,98 | 36,56 | 43,60 | 19,46 | 19,96 | 19,80 | 27,10 | 8,86 | 9,32 |
| SD | ±0,0009 | ±0,0011 | ±0,0008 | ±0,0009 | ±0,0018 | ±0,0021 | ±0,0016 | ±0,0018 | ±0,0028 | ±0,0031 | ±0,0024 | ±0,0026 | |
| p-Wert | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,01 | |
| Tinference | 0,294 | 0,296 | 0,295 | 0,297 | 0,168 | 0,169 | 0,169 | 0,171 | 0,472 | 0,478 | 0,475 | 0,479 | |
Tabelle 3: Leistungsvergleich anhand von drei Datensätzen. Die Tabelle vergleicht GSLA4Rec mit Methoden zur Empfehlung basierend auf maschinellem Lernen, Deep Learning, GNNs, Attention-Mechanismen, zeitlichen Modellen und anderen Ansätzen anhand der Datensätze Diginetica, Tmall und Nowplaying unter Verwendung von P@10, P@20, MRR@10 und MRR@20. SD und p-Werte für GSLA4Rec werden ebenfalls angegeben.
Um die Leistung des GSLA4Rec-Modells zu überprüfen und die Zufälligkeit von Leistungssteigerungen aufgrund zufälliger Faktoren auszuschließen, wurden am Testdatensatz mehrfache Gruppierungsexperimente sowie statistische Analysen durchgeführt. Konkret wurde der Testdatensatz in Gruppen mit jeweils 150 Sitzungen pro Batch unter Verwendung der Zufallszahlnmethode 30-mal wiederholt. Die durchschnittlichen Ergebnisse und die benötigte Zeit aller gruppierten Experimente wurden als Modellleistung bzw. Inferenzzeit des GSLA4Rec-Modells berechnet. Die Standardabweichung (SD) sowie der statistische Signifikanz-t-Test des GSLA4Rec-Modells wurden ermittelt, um Stabilität und Zuverlässigkeit der Leistungssteigerung des Modells weiter zu überprüfen. Tabelle 3 zeigt die Leistung, SD, p-Wert und Tinference des vorgeschlagenen Empfehlungsmodells GSLA4Rec im Vergleich zu den Baseline-Verfahren auf den drei Datensätzen. Die unterstrichenen Zahlen kennzeichnen die beste Baseline-Methode, und die jeweils beste Leistung pro Evaluierungsmetrik ist fett und schwarz markiert.
Empfehlungsmethoden auf Basis von Machine Learning: Bei SBR-Aufgaben zeigte die traditionelle FPMC-Methode die schlechteste Leistung, hauptsächlich weil Markov-Ketten-Modelle nicht in der Lage waren, komplexe Übergangsmuster zwischen Elementen zu erfassen. 2) Empfehlungsmethoden auf Basis von Deep Learning: Modelle wie GRU4REC, NARM und STAMP nutzten Ansätze des Sequenzmodellings und erreichten gewisse Leistungssteigerungen. Dabei erzielten NARM und STAMP bessere Empfehlungsergebnisse als GRU4REC, vor allem weil NARM einen Attention-Mechanismus einführte, um die primären Interessen der Nutzer abzubilden. 3) Empfehlungsmethoden auf Basis von GNNs: Der Einsatz von GNNs im Bereich SBR führte zu deutlichen Leistungsverbesserungen. Beispielsweise übertraf SR-GNN, das als erstes die Umwandlung von Sitzungssequenzen in Graphstrukturen vorantrieb, um räumliche Strukturinformationen der Elemente zu erfassen, Deep-Learning-Methoden, repräsentiert durch STAMP, um 0,36–4,64 %, was den räumlichen Vorteil von Graphstrukturen bei der Verarbeitung sequenzieller Daten belegt. S2-DHCN verwendete eine zweikanalige Hypergraph-Convolution, um Abhängigkeiten höherer Ordnung zwischen Elementen abzubilden, und kombinierte diese mit selbstüberwachtem kontrastivem Lernen, um die Darstellungen zu verbessern. Damit konnte es die Einschränkung traditioneller GNNs überwinden, die nur paarweise Beziehungen und unzureichende Informationen modellieren, und übertraf Deep-Learning-Methoden, repräsentiert durch STAMP, um 1,30–7,04 %. GCE-GNN übertraf durch die effektive Integration von Informationen aus Einzelsitzungen und globalen Sitzungen die Deep-Learning-Methoden, repräsentiert durch STAMP, um 1,46–7,60 % und SR-GNN um 0,88–5,85 %, was darauf hinweist, dass Graphstrukturmethoden, die globale Kontextinformationen einbeziehen, die SBR-Leistung signifikant verbessern können. 4) Empfehlungsmethoden mit GNNs und Attention-Mechanismus: TASRec zielte darauf ab, kurzfristige und langfristige Präferenzen in Nutzerverhaltenssequenzen präziser abzubilden, indem ein zeitbezogener Mechanismus eingeführt wurde. Seine Leistung übertraf Deep-Learning-Methoden um 0,73–5,91 % und das SR-GNN-Modell um 0,30–2,31 %, blieb jedoch hinter dem GCE-GNN-Modell um 0,59–3,84 % zurück. GC-SAN kombinierte aus Sitzungssequenzen umgewandelte Graphstrukturen mit Multi-Head-Self-Attention-Mechanismen, um lokale und langfristige Abhängigkeiten innerhalb von Sitzungen erfolgreich abzubilden. Seine Leistung war vergleichbar mit oder leicht besser als die des SR-GNN-Modells, lag aber unter den Modellen TASRec und GCE-GNN. Dies legt nahe, dass die Einführung von Attention-Mechanismen die SBR-Leistung effektiv verbessern kann, der Zuwachs jedoch geringer ausfällt als bei der Nutzung globaler Informationen, was die Bedeutung globaler Kontextinformationen bestätigt. 5) Empfehlungsmethoden mit GNNs und Zeitkodierung: CT-GNN war das erste Modell, das Graphstrukturen mit zeitlicher Kodierung kombinierte, um „räumliche Struktur“ und „zeitliche Dynamik“ gleichzeitig abzubilden, und übertraf damit das GC-SAN-Modell um 0,55–3,82 %. CORE erfasste langfristige Präferenzen und kurzfristige Intentionen, indem es die Koinzidenzhäufigkeiten von Elementen in globalen Sitzungen statistisch analysierte und eine zeitliche Positions-Gewichtung für aktuelle Sitzungen entwarf, und fusionierte diese Koinzidenz- und Zeitinformationen, um die endgültige Sitzungsrepräsentation zu erhalten. Seine Leistung übertraf das TASRec-Modell um 0,25–9,58 % und das GC-SAN-Modell um 0,67–11,56 %, wobei auf dem Tmall-Datensatz eine signifikante Verbesserung von 3,64–5,74 % gegenüber dem GCE-GNN-Modell erzielt wurde. RESTC führte ein kontrastives Lernmodell auf Basis von raum-zeitlichen GNNs ein, um Probleme traditioneller GNNs zu adressieren, wie die alleinige Fokussierung auf räumliche Graphstrukturen, das Ignorieren zeitlicher Informationen und unzureichende raum-zeitliche Fusion. Seine Leistung übertraf das CORE-Modell um 0,39–3,31 % und das GCE-GNN-Modell um 0,28–7,56 %, was zeigt, dass sowohl zeitliche Kodierung als auch kontrastives Lernen die SBR-Leistung effektiv verbessern. RAIN nutzte Edge-Masking- und Struktur-Rekonstruktions-Techniken, um einen Edge-Indikator gemeinsam zu trainieren, der explizit verrauschte Kanten identifiziert und entfernt, und erreichte damit eine Leistung, die der des RESTC-Modells nahekommt.
Das vorgeschlagene Modell GSLA4Rec integrierte globale kontextuelle Informationen und einen Gated-Slot-Linear-Attention-Mechanismus, um kontextuelle Informationen der Nutzer effektiv zu erfassen, Störungen herauszufiltern und den Rechenaufwand zu reduzieren. Es zeigte Leistungsverbesserungen in allen Datensätzen und übertraf dabei die beiden besten Baseline-Modelle – das RESTC-Modell um 0,54–2,31 % und das GCE-GNN-Modell um 0,83–10,18 %. Dies war besonders deutlich bei der Verarbeitung sequenzieller Abhängigkeiten in Langsitzungszenarien im SBR (insbesondere Verbesserungen von 10,18 % und 4,73 % gegenüber GCE-GNN sowie von 1,44 % und 2,31 % gegenüber RESTC auf den Datensätzen Tmall und Nowplaying). Kurz gesagt, integrierte das vorgeschlagene GSLA4Rec-Modell eine effiziente Graphkonstruktion, um Nutzerkontexte zu erfassen und Rauschen zu filtern; seine Leistung war in allen Datensätzen durchgängig besser als die von SOTA.
Effizienz analysieren
Wie in Abbildung 4 gezeigt, zeigten experimentelle Ergebnisse auf dem Diginetica-Datensatz, dass der vorgeschlagene GSLA4Rec eine schnellere Trainingsgeschwindigkeit als die Baseline-Modelle hinsichtlich der Trainingszeit pro Epoche erreichte, wobei alle Experimente auf einer NVIDIA TITAN V-GPU durchgeführt wurden und ungefähr 9300 MB Speicher verbrauchten. Deep-Learning-Modelle wie STAMP, NARM und GRU4Rec liefen effizient, erzielten jedoch die schwächste Leistung; TASRec- und GC-SAN-Modelle, die auf GNNs und dem Self-Attention-Mechanismus basieren, verbesserten die Leistung, litten jedoch unter erheblichem Zeitverbrauch. Obwohl S2-DHCN und CORE, die auf GNNs basieren, einen leichten Anstieg der Rechenzeit verursachten, wurde eine bemerkenswerte Verbesserung der Gesamtleistung erzielt, insbesondere beim vorgeschlagenen GSLA4Rec-Modell, das eine deutliche Leistungssteigerung aufwies. Der Hauptgrund war, dass das GSLA4Rec-Modell weniger Zeit für die Graphkonstruktion benötigte als die Baseline-Modelle; außerdem verwendete es einen zweiphasigen, gegatterten linearen Attention-Mechanismus mit festen Speicherplätzen m, was zu einer linearen Zeitkomplexität O(Ldm) führte. Diese Architektur war deutlich effizienter als die Standard-Self-Attention mit O(L2d), behielt aber gleichzeitig eine starke Speicherkapazität durch Softmax-verstärktes Slot-Lesen bei. Leistungstests auf dem Testdatensatz zur Synchronisierung der statistischen Inferenzzeit, wie in der letzten Zeile von Tabelle 3 dargestellt, verdeutlichten den Effizienzvorteil des GSLA4Rec-Modells, vermieden „falsch hohe Genauigkeit, aber Unverfügbarkeit“ und erreichten tatsächlich einen Kompromiss zwischen Wirksamkeit und Effizienz.
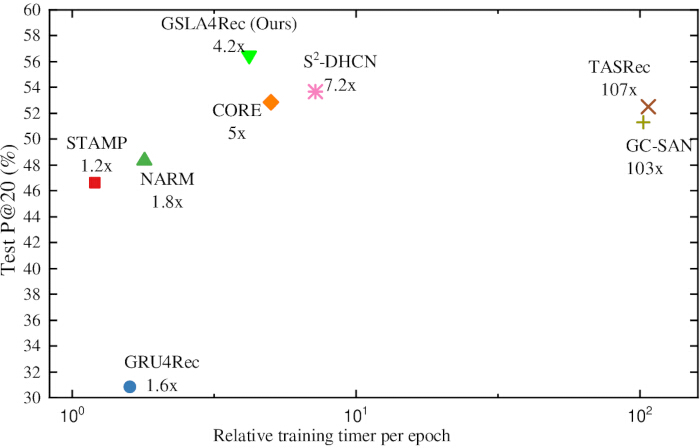
Abbildung 4: Leistung über die Laufzeit von GSLA4Rec auf Diginetica. Die Abbildung zeigt, dass unser vorgeschlagenes GSLA4Rec-Modell und die Baseline-Modelle auf einer NVIDIA TITAN V-GPU mit Diginetica hinsichtlich der relativen Trainingszeit pro Epoche getestet wurden und dass GSLA4Rec eine schnellere Trainingsgeschwindigkeit als die Baseline-Modelle erreichte. Diese Abbildung wurde selbstständig mit OriginPro unter vollständiger Anpassung der Elemente erstellt. Es wurden keine urheberrechtlich geschützten externen Grafikressourcen verwendet, daher war keine zusätzliche Drittlizenz erforderlich. Das Urheberrecht an der Abbildung liegt bei den Autoren und wird den Urheberrechtsregeln der Zeitschrift bei Annahme entsprechen. GSLA4Rec steht für Gated-Slot-Linear-Attention-Graph-Neuronale-Netzwerke für SBR. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zusammenfassend übertraf die Effizienz des vorgeschlagenen GSLA4Rec-Modells mit linearer Komplexität und Gated-Slot-Attention konsequent die aktuell besten Methoden (SOTA) in allen Datensätzen. Insbesondere erzielte GSLA4Rec deutliche Leistungssteigerungen bei der Empfehlung in langen Sitzungen auf den Datensätzen Tmall und Nowplaying und zeigte eine überlegene Fähigkeit zur Modellierung sequenzieller Abhängigkeiten.
Analyse von Ablationsversuchen
Auswirkungen von SG und NGG sowie GSLA
Um die Auswirkungen des SG, des NGG, des Gating-Mechanismus, der Speicherblöcke und der linearen Aufmerksamkeit auf die aktuelle SBR zu bewerten, wurden Ablationsstudien an den Datensätzen Diginetica, Tmall und Nowplaying durchgeführt. GSLA4Rec‑NotSG enthielt die SG-Funktionscodierung nicht, behielt jedoch die NGG-Codierung bei, GSLA4Rec‑NotNGG verwendete keine NGG-Codierung und führte die Merkmalsextraktion ausschließlich basierend auf SG durch, GSLA4Rec‑NotGM entfernte lediglich den Gating-Mechanismus innerhalb von GSLA, GSLA4Rec‑NotMS eliminierte ausschließlich die Speicherblöcke von GSLA, und GSLA4Rec‑NotLA ließ nur das lineare Aufmerksamkeitsmodul in GSLA weg.
| Datensatz | Diginetica | Tmall | Nowplaying | |||
| Maße | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54,28 | 18,87 | 31,40 | 15,11 | 22,48 | 7,45 |
| GSLA4Recs-NotNGG | 52,65 | 17,67 | 28,90 | 14,61 | 20,17 | 7,74 |
| GSLA4Rec-NotGM | 53,82 | 18,21 | 39,26 | 16,52 | 23,14 | 7,62 |
| GSLA4Rec-NotMS | 53,40 | 17,60 | 38,05 | 15,65 | 22,55 | 7,40 |
| GSLA4Rec-NotLA | 51,86 | 16,92 | 29,12 | 13,96 | 20,82 | 7,28 |
Tabelle 4: Leistung der GSLA4Rec-Ablationsversuche. In der Tabelle wird die Ablationsleistung von GSLA4Rec nach Entfernung einzelner Modulkomponenten auf den Datensätzen Diginetica, Tmall und Nowplaying gemeldet, bewertet mit P@20 und MRR@20.
Tabelle 4 zeigte die Ergebnisse der Ablationsstudie an verschiedenen Datensätzen, wobei alle Leistungsmetriken im Vergleich zum vollständigen Modell abnahmen. Der Leistungsabfall bei Entfernung der globalen Sitzungsgraph-Codierung für nahe Nachbarn (GSLA4Rec-NotNGG) war stärker als bei Entfernung der Merkmalscodierung des Sitzungsgraphen (GSLA4Rec-NotSG). Das Löschen eines beliebigen Teilmoduls in GSLA führte zu einer Leistungsminderung, wobei die Abstufung der Minderung von hoch nach niedrig durch lineare Aufmerksamkeit, Speicherplätze und Gating-Mechanismus erfolgte. Der Grund lag darin, dass die Bedeutung jedes Elements in SBR eindeutig unterschiedlich war und eine assoziative Speicherung zwischen den Elementen erforderlich war. Daraus ließ sich schließen, dass GSLA ein wesentlicher Bestandteil des in dieser Arbeit vorgestellten Modells darstellt.
Auswirkungen verschiedener Aggregationsmethoden
Um die Auswirkungen verschiedener Methoden zur Informationsaggregation auf die Leistung des GSLA4Rec-Modells zu bewerten, wurden die folgenden drei klassischen Methoden untersucht: 1) Durchschnittspooling: Durchführung einer Durchschnittspooling-Operation auf den Vektoren, die vom SG und vom NGG erzeugt wurden; 2) Vektorverkettung: Verkettung der vom SG und NGG erzeugten Vektoren; 3) Vektorsummation: Addition der vom SG und NGG erzeugten Vektoren. Die Ergebnisse sind in Tabelle 5 dargestellt. GSLA4Rec mit Vec-Sum erzielte die beste Leistung auf Diginetica, Tmall und Nowplaying. Im Gegensatz dazu lieferte Mean-pooling bei allen Datensätzen schlechte Ergebnisse. Die schlechtere Leistung der Mittelwertaggregation und der Verkettungsaggregation könnte auf eine durch übermäßige Parameter verursachte Überanpassung zurückzuführen sein, die die Gesamtleistung des Modells beeinträchtigte.
| Datensatz | Diginetica | Tmall | Nowplaying | |||
| Maße | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Mittelwert-Pooling | 45,26 | 15,63 | 38,84 | 16,3 | 23,56 | 7,55 |
| Vec-Konkatenation | 51,77 | 17,24 | 39,83 | 18,24 | 24,06 | 8,88 |
| Vec-Summe | 56,47 | 19,98 | 43,6 | 19,96 | 27,1 | 9,32 |
Tabelle 5: Auswirkungen verschiedener Aggregationsmethoden. Die Tabelle vergleicht die Auswirkungen von Mittelwert-Pooling, Vektor-Konkatenation und Vektor-Summation auf die GSLA4Rec-Leistung über die Datensätze Diginetica, Tmall und Nowplaying hinweg anhand von P@20 und MRR@20.
Analysieren von Hyperparameter-Einstellungen
Wirkungen unterschiedlicher Speicherplatzgrößen
Speicherplätze speicherten Informationen aus vorherigen Zeitschritten, was besonders wichtig für Aufgaben mit zeitlichen Abhängigkeiten war. In diesem Abschnitt wurde der Einfluss der Speicherplatzgrößen m = [0, 1, 2, 3, 4, 5] auf die SBR-Leistung untersucht. Die in Tabelle 6 dargestellten experimentellen Ergebnisse zeigten, dass die Metriken P@20 und MRR@20 bei einer Speicherplatzgröße m = 3 auf den drei Datensätzen optimal abschnitten. Dies deutet darauf hin, dass eine moderate Speicherplatzgröße die Empfehlungsgenauigkeit und die Qualität der Rangfolge des Modells effektiv verbesserte. Kleinere Speicherplätze konnten nicht ausreichend historische Informationen speichern und konzentrierten sich stärker auf kurzfristige Benutzerinteressen. Wenn hingegen die Speicherplatzgröße auf 4 oder mehr anstieg, speicherte das Modell zu viele historische Informationen, wodurch es übermäßig auf frühere Interessen vertraute und dabei kritischere aktuelle Eingabedaten vernachlässigte, was die Empfehlungsleistung beeinträchtigte.
| Datensatz | Diginetica | Tmall | Nowplaying | |||
| Maße | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53,40 | 17,60 | 38,05 | 15,65 | 22,55 | 7,40 |
| GSLA4Rec-m1 | 55,43 | 18,92 | 41,55 | 17,12 | 25,60 | 8,43 |
| GSLA4Rec-m2 | 56,02 | 19,35 | 42,90 | 18,25 | 26,62 | 8,95 |
| GSLA4Rec-m3 | 56,47 | 19,98 | 43,60 | 19,96 | 27,10 | 9,32 |
| GSLA4Rec-m4 | 53,96 | 19,25 | 43,06 | 19,09 | 26,34 | 8,35 |
| GSLA4Rec-m5 | 52,18 | 18,03 | 42,12 | 17,56 | 24,86 | 8,85 |
Tabelle 6: Auswirkungen verschiedener Speicherplatzgrößen. Die Tabelle zeigt die Leistung von GSLA4Rec mit unterschiedlichen Speicherplatz-Konfigurationen (m0–m5) auf den Datensätzen Diginetica, Tmall und Nowplaying anhand von P@20 und MRR@20.
Auswirkungen verschiedener Dropout-Raten
Um eine Überanpassung zu verhindern, wurde eine Dropout-Regularisierung eingeführt. Vor der Summation des sektionsspezifischen Item-Vektors und des globalen Nachbar-Item-Vektors wurden die Ausgaben der Neuronen im globalen Nachbar-Item-Vektor hingg,(k) zufällig entfernt, um die Robustheit und Verallgemeinerungsfähigkeit des GSLA4Rec-Modells zu verbessern.
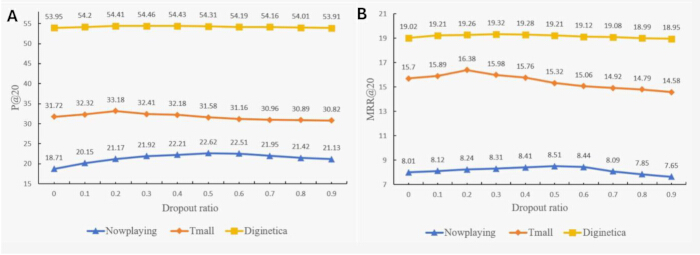
Abbildung 5: Leistung von GSLA4Rec bei unterschiedlichen Dropout-Raten. (A) P@20 und (B) MRR@20 von GSLA4Rec bei unterschiedlichen Dropout-Raten auf den Datensätzen Nowplaying, Tmall und Diginetica. Die Leistung stieg zunächst an und nahm anschließend mit steigender Dropout-Rate ab, was die Robustheit und Generalisierungsfähigkeit des Modells zeigt. GSLA4Rec, gated-slot linear attention graph neural networks für sessionbasierte Empfehlungen (SBR). Diese Abbildung wurde selbst mit OriginPro unter Verwendung vollständig angepasster Elemente erstellt. Es wurden keine urheberrechtlich geschützten externen Grafikressourcen verwendet; daher war keine zusätzliche Lizenzierung durch Dritte erforderlich. Das Urheberrecht an der Abbildung liegt bei den Autoren und wird bei Annahme den Urheberrechtsregeln der Zeitschrift entsprechen. Klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Abbildung 5A–B zeigte die Auswirkung verschiedener Dropout-Raten in Gleichung (16) auf die Modellleistung. Die experimentellen Ergebnisse zeigten, dass das Modell schlecht abschnitt, wenn die Dropout-Rate niedrig war; mit steigender Dropout-Rate verbesserte sich die Leistung jedoch schrittweise, bis ein optimales Niveau erreicht war. Konkret betrug die optimale Dropout-Rate 0,3 im Diginetica-Datensatz, 0,2 im Tmall-Datensatz und 0,5 im Nowplaying-Datensatz. Wenn die Dropout-Rate diese optimalen Werte überschritt, begann die Modellleistung abzunehmen, hauptsächlich weil ein übermäßiger Neuronenausfall verhinderte, dass das Modell wichtige Merkmale aus den Sitzungsdaten effektiv erlernen konnte.
Einflüsse der Größe der Einbettung
Um den Rechenaufwand so gering wie möglich zu halten, während gleichzeitig eine optimale Modellleistung gewährleistet bleibt, wurde die Auswirkung unterschiedlicher Embedding-Dimensionen d wurde an der Leistung des GSLA4Rec-Modells untersucht. Wie in Abbildung 6A–B, auf drei öffentlichen Datensätzen – Diginetica, Tmall und Nowplaying – zeigte das GSLA4Rec-Modell eine schlechte Leistung, wenn die Einbettungsdimension d lag bei 10–40, stieg die Leistung des Modells jedoch rasch an, wenn der Wert von d stieg, zeigten die Leistungskennzahlen eine Stabilisierung, wenn der Wert von d lag im Bereich von 80 bis 120, danach nahm die Leistung tatsächlich ab, wenn d stieg kontinuierlich an, möglicherweise aufgrund von Überanpassung, verursacht durch eine große Einbettungsdimension. Daher wurde die Dimension des Item-Embedding-Vektors abschließend auf 100 festgelegt.
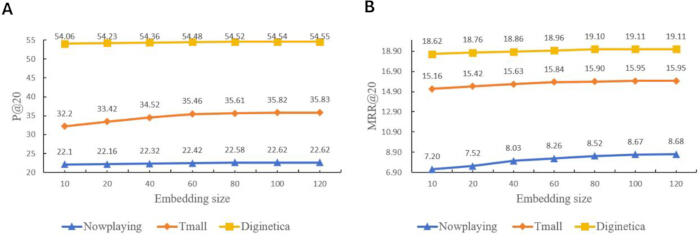
Abbildung 6: Leistung von GSLA4Rec bei unterschiedlichen Einbettungsgrößen. (A) P@20 und (B) MRR@20 von GSLA4Rec bei unterschiedlichen Einbettungsgrößen auf den Datensätzen Nowplaying, Tmall und Diginetica. Die Modellleistung stieg mit zunehmender Einbettungsgröße kontinuierlich an und erreichte schließlich ein Plateau. GSLA4Rec, gated-slot linear attention graph neural networks für sessionbasierte Empfehlungen (SBR). Diese Abbildung wurde selbstständig mit OriginPro unter vollständiger Anpassung der Elemente erstellt. Es wurden keine urheberrechtlich geschützten externen Grafikressourcen verwendet; daher war keine zusätzliche Drittlizenzierung erforderlich. Das Urheberrecht an der Abbildung liegt bei den Autoren und wird den Urheberrechtsregeln der Zeitschrift bei Annahme entsprechen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Wirkungen unterschiedlicher Sitzungslängen
Es war allgemein bekannt, dass die Länge jeder Sitzung in den drei realen SBR-Datensätzen (Diginetica, Tmall und Nowplaying) variiert. Um die Robustheit des GSLA4Rec-Modells im Vergleich zu Baseline-Methoden bei unterschiedlichen Sitzungslängen zu überprüfen, wurden alle Sitzungen in Diginetica und Tmall jeweils in drei Gruppen unterteilt: kurze Gruppe (S), mittlere Gruppe (M) und lange Gruppe (L), entsprechend den Bereichen von 1 bis 6, 7 bis 12 und größer als 12. MRR@20 wurde verwendet, um die Leistung der Methoden anstelle von P@20 zu bewerten, da MRR die Rangqualität korrekter Ergebnisse besser widerspiegelt. Abbildung 7A–B zeigten, dass das GSLA4Rec-Modell die sequenzbasierte Baseline-Methode NARM, die auf GNNs basierende Baseline-Methode SR-GNN, die durch kontrastives Lernen erweiterte GNNs-Baseline S2-DHCN sowie die räumlich-zeitliche Baseline RESTC bei unterschiedlichen Sitzungslängen übertraf. Gleichzeitig wurde ebenfalls beobachtet, dass die Leistung aller Methoden mit zunehmender Sequenzlänge abnimmt, da langreichweitige Item-Übergänge es erschweren, die Präferenzen der Nutzer zu erfassen. Das vorgeschlagene GSLA4Rec-Modell wies jedoch im Vergleich zu den Baselines die geringste Abnahmegeschwindigkeit auf, da der Gated-Slot-Mechanismus irrelevante Items herausfiltern konnte. Die Leistung von GSLA4Rec übertraf die des NARM-Modells in den langen Gruppen von Diginetica und Tmall jeweils um 6,3 und 8,85.
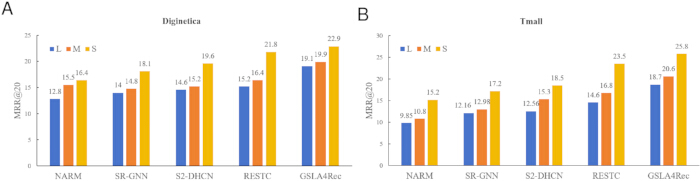
Abbildung 7: Leistung von GSLA4Rec bei unterschiedlichen Sitzungslängen. Leistung von GSLA4Rec und Baseline-Modellen bei verschiedenen Gruppen von Sitzungslängen in den Datensätzen (A) Diginetica und (B) Tmall, bewertet mittels MRR@20. Die Gruppen der Sitzungslänge werden als L, M und S bezeichnet. GSLA4Rec, gated-slot linear attention graph neural networks für die empfehlungsbasierte Sitzungsverarbeitung (SBR). Diese Abbildung wurde selbst mit OriginPro unter Verwendung vollständig angepasster Elemente erstellt. Es wurden keine urheberrechtlich geschützten externen Grafikressourcen verwendet; daher war keine zusätzliche Lizenzierung von Drittanbietern erforderlich. Das Urheberrecht an der Abbildung liegt bei den Autoren und wird den Urheberrechtsregeln der Zeitschrift bei Annahme entsprechen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Schlussfolgerung
In dieser Arbeit wird ein globaler Kontext-gegatterter Slot-Lineare-Aufmerksamkeits-Netzwerk für SBR vorgeschlagen. Durch die Kombination von SG und NGG sowie die Einführung eines gegatterten Slot-Lineare-Aufmerksamkeits-Mechanismus ermöglicht es diese Methode, sich auf Schlüsselelemente in der Sitzungssequenz zu konzentrieren, lang- und kurzfristige Abhängigkeiten zu erfassen, Störgrößen effektiv zu reduzieren und den Rechenaufwand zu verringern. Experimentelle Ergebnisse bestätigen, dass diese Methode auf drei öffentlichen Datensätzen eine hervorragende Empfehlungsgenauigkeit und -effizienz aufweist und sich insbesondere bei Aufgaben zur Modellierung langfristiger Abhängigkeiten auszeichnet.
VERFÜGBARKEIT VON DATEN:
Drei gängige öffentliche Datensätze (Diginetica, Tmall und Nowplaying, deren URLs in der Tabelle der Materialien zu finden sind), die die Ergebnisse dieser Studie unterstützen, sind im Internet öffentlich zugänglich. Gleichzeitig wurden drei weit verbreitete öffentliche Datensätze sowie der Quellcode für diese Arbeit als Ergänzungsordner: GSLA4Rec.zip eingereicht. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Compared with baselines, the GSLA4Rec model achieves dual improvements in performance and efficiency for three core reasons. First, applying gating mechanisms to NGG alleviates data sparsity and filters noise effectively. Second, the memory slots mechanism balances storage capacity and efficiency via hyperparameter m adjustment. Third, the linear attention mechanism computes item correlations at an O(N) complexity, far lower than the O(N2)61. The GSLA4Rec model overly relies on users' interaction sequences and ignores the multimodal properties of items48. Meanwhile, the NGG construction uses a fixed Jaccard threshold without dynamic adjustment function, and the memory slots m cannot achieve adaptive adjustability65.
The GSLA4Rec model, which builds SG&NGG and adopts gated-slot linear attention, especially fits anonymous session recommendation39 across e-commerce and online streaming platforms. In e-commerce platforms, this model recommends matching products to users by capturing their browsing, clicking, or adding behaviors to their shopping cart, without relying on user characteristic attributes. The datasets Diginetica and Tmall used in this paper are e-commerce recommendation datasets. For short-video and music streaming platforms, this method analyzes users' playback sequences to infer their implicit preferences, updates content summaries to retain users, and extends viewing time. The dataset Nowplaying used in this paper is the music recommendation dataset.
There are alternative solutions that can replace the gated slot linear attention architecture. The emerging Mamba65 based state space model, as an alternative, has the characteristics of selective state storage space and linear computational complexity, balancing linear complexity and long sequence fitting ability, and combined with the LLM55 enhancement framework, it extracts the users' implicit intent from the original interaction log, thereby achieving good recommendation performance and efficiency. Future work can optimize GSLA4Rec from multiple perspectives: building dynamic NGG to replace fixed Jaccard filtering, implementing variable memory slots to automatically match sessions of different lengths, and incorporating user multimodal information to improve recommendation accuracy. In addition, with the help of LLM-augmented models55, users' implicit intentions can be mined from interaction sequences, and noisy conversation data can be filtered more accurately72.
Offenlegungen
Die Autoren erklären, dass sie keine bekannten konkurrierenden finanziellen Interessen oder persönlichen Beziehungen haben, die die in dieser Arbeit beschriebenen Ergebnisse beeinflusst haben könnten.
Danksagungen
Der Autor dankt den Gutachtern für ihre sorgfältigen Rückmeldungen und Anregungen während des Begutachtungsprozesses sowie Professor Jiang Nan, meinem Doktorvater, für seine gewissenhafte Betreuung. Diese Studie wurde teilweise durch die Nationale Naturwissenschaftliche Stiftung Chinas im Rahmen der Förderkennzeichen Nr. 6217072713 und Nr. 62061019 unterstützt, sowie teilweise durch offene Forschungsthemen des Ingenieur- und Forschungszentrums für unbemannte Sensorsysteme und Künstliche-Intelligenz-Technologie der Provinz Jiangxi im Jahr 2025 und teilweise durch das Key Laboratory of Advanced Electronic Materials and Devices der Provinz Jiangxi (Nr. 2024SSY03012).
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | NONE | CUDA 11.3 ist eine parallele Computerplattform und Programmiermodellversion, die 2021 von NVIDIA veröffentlicht wurde und darauf abzielt, die Leistung und Entwicklungsflexibilität von GPU-beschleunigten Anwendungen zu verbessern. |
| Diginetica | Diginetica | NONE | Diginetica ist der offizielle Wettbewerbsdatensatz des CIKM-Cups (International Information Retrieval Conference) 2016, der im CIKM-Algorithmuswettbewerb zur Lösung des Problems der personalisierten Produktsuche im E-Commerce mit Suchkontext verwendet wurde. Er gilt mittlerweile als der gängigste Standard-Benchmark-Datensatz für e-Commerce im Bereich der empfehlungsbasierten Sitzungen (Session based Recommendation, SBR). |
| Nowplaying | Zenodo | NONE | Es handelt sich um einen groß angelegten Datensatz zum Musiknutzungsverhalten, der auf der Analyse von Tweets mit dem Hashtag „#nowplaying“ basiert und hauptsächlich für Musikempfehlungen in Gesprächen, kontextbasierte Empfehlungen und die Analyse von Stimmungskorrelationen verwendet wird. |
| OriginPro 2024 (64-Bit) SR1 | OriginLab Corporation | NONE | OriginPro ist eine kommerzielle, professionelle Software für wissenschaftliche Grafiken und Datenanalyse, die von der OriginLab Corporation entwickelt wurde und häufig zur Erstellung von publikationsreifen Diagrammen, Datenstatistiken, Kurvenanpassungen, Signalverarbeitung usw. verwendet wird. In diesem Artikel wird OriginPro zur Erstellung von experimentellen Vergleichsdiagrammen, Liniendiagrammen und Balkendiagrammen verwendet. |
| PyTorch 1.11.0 | PyTorch Foundation | NONE | PyTorch ist ein Open-Source-Framework für maschinelles Lernen und Deep Learning, das 2016 von Facebook veröffentlicht wurde. Es realisiert vor allem die automatische Differenzierung und führt dynamische Berechnungsgraphen ein, um die Modellentwicklung flexibler zu gestalten. |
| TITAN V GPU | NVIDIA | NONE | NVIDIA TITAN V ist eine Flaggschiff-Grafikkarte, die NVIDIA Ende 2017 vorgestellt hat und hauptsächlich auf den Bereichen Hochleistungsrechnen und Künstliche Intelligenz ausgerichtet ist. |
| Tmall | Tmall | NONE | Aus dem IJCAI 2015 Alibaba Tmall Empfehlungswettbewerb hat Alibaba Tianchi desensibilisierte echte Online-Protokolle von Tmall öffentlich freigegeben. Es ist einer der drei Standarddatensätze im SBR-Bereich (Diginetica, Yoocoose, Tmall) und das bevorzugte Evaluationsset für chinesische E-Commerce-Szenarien. |
| visio 2021 | Microsoft | NONE | Visio ist eine Vektorzeichnungssoftware von Microsoft, die zur Erstellung von Modellstrukturdiagrammen, Flussdiagrammen, Rahmendiagrammen, Netzwerktopologiediagrammen in wissenschaftlichen Fachartikeln und zur Ausgabe von Vektordiagrammen für Abbildungen verwendet wird |
Referenzen
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.