Dieses Protokoll beschreibt die Erstellung eines wetterbasierten Datensatzes und die systematische Bewertung von Machine-Learning-, Deep-Learning- und Hybridmodellen zur Vorhersage der atmosphärischen Dämpfung in Freiraum-Optikkommunikationssystemen unter unterschiedlichen irakischen Umweltbedingungen, einschließlich Staubstürme, Nebel, Regen und Schnee.
Forschungsartikel
Maschinelles Lernen übertrifft Deep Learning bei der Vorhersage der atmosphärischen Dämpfung in der Freiraum-Optikkommunikation unter irakischen Wetterbedingungen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Systeme der optischen Freiraumkommunikation bieten hohe Bandbreite, erhöhte Sicherheit und lizenzfreien Betrieb, sind jedoch stark von Leistungsverlusten betroffen, die durch atmosphärische Dämpfung infolge Streuung und Absorption verursacht werden. Die genaue Vorhersage der Dämpfung ist im Irak noch bedeutender, wo die Umweltbedingungen zufällig heiß, staubig, neblig und regnerisch sind. Ziel dieser Studie ist es, die Leistungsfähigkeit von Machine-Learning-, Deep-Learning- und hybriden Modellierungstechniken zur Vorhersage der atmosphärischen Dämpfung in Freiraum-Optikkommunikationssystemen unter verschiedenen irakischen Wetterbedingungen zu bewerten. Ein synthetischer Datensatz mit 1500 Stichproben wurde mithilfe etablierter physikalischer Ausbreitungsmodelle für fünf Wetterregime erstellt: klare Luft, Nebel, Regen, Staubstürme und Schnee. Fünfzehn Vorhersagemodelle wurden systematisch evaluiert, bestehend aus sechs Machine-Learning-Verfahren (Random Forest [RF], Extreme Gradient Boosting, Light Gradient Boosting Machine, Support Vector Regression, Lineare Regression und K-Nächste-Nachbarn), sechs Deep-Learning-Architekturen (Mehrschichtiges Perzeptron, Tiefes Neuronales Netzwerk, Long Short-Term Memory [LSTM], Eindimensionales Faltungsneuronales Netzwerk [CNN], CNN–LSTM und Attention-basiertes Netzwerk) sowie drei hybriden Ansätzen. Die Ergebnisse zeigten, dass RF die beste Leistung erbrachte (R2 = 0,9654, Wurzel des mittleren quadratischen Fehlers = 1,324 dB/km) im Vergleich zu Deep-Learning-Ansätzen (bestes R2 = 0,7766) und hybriden Methoden (bestes R2 = 0,9571). Die Merkmalswichtigkeit wurde mittels Shapley Additive exPlanations analysiert, wobei die Staubkonzentration (67,3 %) und die Sichtweite (21,2 %) als die einflussreichsten Faktoren identifiziert wurden. Obwohl RF deutlich schnellere Trainings- und Inferenzzeiten aufwies, ergab ein statistischer Test keinen signifikanten Unterschied zwischen RF und dem leistungsstärksten hybriden Ansatz (p = 0,083). Die Leistungsfähigkeit herkömmlicher Machine-Learning-Verfahren erweist sich als hoch effizient für die Abschätzung der atmosphärischen Dämpfung in FSO-Kommunikationssystemen unter widrigen Umweltbedingungen, was mit bekannten physikalischen Ausbreitungstheorien übereinstimmt. Wir betonen jedoch, dass diese Schlussfolgerungen auf synthetischen Daten basieren und durch reale atmosphärische Messungen validiert werden müssen, bevor sie in betrieblichen FSO-Systemen eingesetzt werden können.
Einleitung
Freiraum-Optik-Kommunikationsnetzwerke bieten im Allgemeinen eine höhere Kapazität und bessere Sicherheit, doch die atmosphärische Dämpfung aufgrund von Streuung und Absorption ist ein wesentlicher begrenzender Faktor für die Kommunikationsdistanz1. In dieser Arbeit stellen wir eine detaillierte Analyse von maschinellen Lern-, Deep-Learning- und hybriden Ansätzen2 zur Bewertung der Signaldämpfung in Freiraum-Optik-Systemen in der anspruchsvollen Umgebung des Irak mit hohen Temperaturen, Staubstürmen und unregelmäßigen Niederschlägen bereit.
Die FSO-Kommunikationssysteme haben sich als eine der vielversprechenden Lösungen für drahtlose Hochdurchsatzverbindungen3 mit Datenraten von über 100 Gbps über Distanzen von mehreren hundert Metern bis hin zu mehreren Kilometern4 herauskristallisiert. Im Gegensatz zu herkömmlichen Funkfrequenzsystemen arbeiten FSO-Verbindungen im sichtbaren und infraroten Spektrum und bieten Vorteile wie lizenzfreien Betrieb, Unempfindlichkeit gegenüber elektromagnetischen Störungen, verbesserte Sicherheit durch geringe Strahldivergenz sowie große Bandbreitenkapazität5. Diese Eigenschaften machen FSO zu einer attraktiven Technologie für Backhaul-Anwendungen, Verbindungen zwischen Gebäuden, Notfallkommunikationsnetze und die letzte Meile, wo der Einsatz von Glasfaserkabeln zu kostspielig ist6. Die Kommunikation ist jedoch stark von Umweltbedingungen hinsichtlich Verfügbarkeit und Leistung abhängig, da Streuung, Strahlablenkung und Absorption7,8 auftreten können. Diese Herausforderung stellt eine der wesentlichen Einschränkungen freiraumoptischer Kommunikationssysteme dar. Wetterbedingungen führen zu starken Schwankungen der Dämpfungswerte (dB/km). Bei klarem Himmel kann die Dämpfung unter 0,5 dB/km liegen, während schwere Nebelbedingungen eine Dämpfung von ≥50 dB/km bei 1550 nm verursachen können (basierend auf dem Kim-Nebelmodell, das Dämpfungswerte bis zu 50 dB/km bei Sichtweiten unter 50 m bei 1550 nm vorhersagt)9,10. Starke Regenfälle können je nach Niederschlagsintensität Dämpfungen von bis zu 20–30 dB/km hervorrufen (nach der Vorhersage des Carbonneau-Modells)11. Daher ist eine genaue Vorhersage der Dämpfung für zuverlässige Link-Planung, Netzwerkgestaltung und adaptive Übertragungsstrategien erforderlich. Die herkömmlichen Methoden basieren auf physikalischen Ausbreitungsmodellen, wie dem Kim-Modell für Nebel12, dem Carbonneau-Modell für Regen13 und der Mie-Streuungstheorie für Aerosolpartikel14. Obwohl diese Modelle eine solide theoretische Grundlage bieten, hängen sie häufig von genauen atmosphärischen Parametern ab, die in der Praxis nicht immer verfügbar sind, und berücksichtigen oft nicht die komplexen Wechselwirkungen zwischen gleichzeitig auftretenden meteorologischen Phänomenen15.
Die extremen Umweltschwankungen im Irak stellen erhebliche Herausforderungen für den Einsatz von Freiraum-Optikkommunikationssystemen dar. Die Übertragungsbedingungen werden zusätzlich durch geringe Niederschläge und vereinzelte Nebelphasen erschwert, während die Wintertemperaturen unter den Gefrierpunkt sinken und die Sommertemperaturen über 50 °C ansteigen können16. Bei üblicherweise genutzten Spektren wie 1550 nm in normalen Wellenlängen können Sandstürme, lokal als „al-haboob“ bezeichnet, die Sichtweite auf weniger als 100 Meter reduzieren und zu Dämpfungswerten führen, die 20 dB/km überschreiten17. Um FSO-Systeme erfolgreich im Irak und anderen Ländern des Nahen Ostens einzusetzen, ist es notwendig, verlässliche Vorhersagemodelle zu entwickeln, die die Systemleistung unter diesen unterschiedlichen Umweltbedingungen genau abschätzen können18.
Neue Entwicklungen im maschinellen Lernen bieten praktikable Alternativen zu herkömmlichen physikbasierten Modellierungsverfahren. Die Fähigkeit von Verfahren des maschinellen Lernens, komplexe nichtlineare Zusammenhänge zwischen Dämpfung und atmosphärischen Faktoren direkt zu erfassen, ermöglicht die Erkennung feiner Wechselwirkungen, die traditionelle analytische Modelle möglicherweise übersehen19. Bei einer Vielzahl klimatologischer Vorhersageaufgaben haben Random-Forest- (RF-) und Gradient-Boosting-Verfahren eine hohe Leistungsfähigkeit gezeigt20. Ebenso haben Deep-Learning-Verfahren bemerkenswerte Erfolge in der natürlichen Sprachverarbeitung, der Computer Vision und der Zeitreihenvorhersage erzielt21. Diese Ansätze sind jedoch für die Vorhersage von FSO-Dämpfung bisher wenig erforscht, insbesondere bei begrenzten Datensätzen und stark wechselnden Wetterbedingungen22. Um diese Lücke zu schließen, präsentiert diese Arbeit eine umfassende Untersuchung von Machine-Learning-, Deep-Learning- und hybriden Ansätzen zur Vorhersage der FSO-Signaldämpfung unter irakischen atmosphärischen Bedingungen. Dies wird durch die Erstellung eines sorgfältig konzipierten synthetischen Datensatzes auf Grundlage etablierter physikalischer Ausbreitungsmodelle erreicht23. Wir vermuten, dass bei mittelgroßen, tabellarischen Umweltdatensätzen mit nur wenigen dominierenden prädiktiven Variablen die Vorhersageleistung baumbasierter Ensemble-Methoden komplexen Deep-Learning-Architekturen überlegen sein wird. Die primären Ziele sind: (1) eine Basismethodik für den Vergleich von Prognoseverfahren in einer kontrollierten Simulationsumgebung zu etablieren, (2) die besten algorithmischen Strategien zur Vorhersage atmosphärischer Dämpfung zu identifizieren und (3) die Merkmalswichtigkeit und Modellinterpretierbarkeit zu bewerten, um Einblicke in diejenigen Umweltfaktoren zu gewinnen, die die Dämpfung am stärksten beeinflussen. In dieser Arbeit werden synthetische Daten verwendet, doch wird die Grundlage für eine spätere Validierung mit realen experimentellen Messungen gelegt, die für zukünftige Arbeiten vorgesehen ist. Darüber hinaus werden Analysen zur Merkmalswichtigkeit und Interpretierbarkeit integriert, um die wichtigsten Umweltfaktoren zu ermitteln, die die Dämpfung beeinflussen.
Protokoll
Diese Studie umfasste keine menschlichen Probanden oder Wirbeltiere und keine Gewebeproben. Alle für diese Forschung verwendeten Daten wurden synthetisch mithilfe physikalischer Ausbreitungsmodelle und öffentlich zugänglicher meteorologischer Parameter generiert. Daher war keine Genehmigung durch eine Ethikkommission (Institutional Review Board, IRB) oder eine Kommission für den Umgang mit Versuchstieren (Institutional Animal Care and Use Committee, IACUC) erforderlich.
Datensatzerzeugung basierend auf der physikalischen Ausbreitungstheorie. Der Datensatz wurde erstellt, um stündliche atmosphärische Bedingungen für ein Freiraum-Optikkommunikationssystem über ein gesamtes Kalenderjahr (2024) unter irakischen atmosphärischen Bedingungen nachzuahmen. Wir erstellten eine synthetische Datenbank mit 1.500 Stichproben pro Stunde.
Zunächst wurden Wetterbedingungen basierend auf regionalen Trends zufällig zugewiesen: klare Himmel (54,3 %), Staub (24,9 %), Nebel (10,5 %), Regen (7,4 %) und Schnee (2,8 %). Zweitens wurde das entsprechende physikalische Dämpfungsmodell für jede Probe basierend auf der Wetterbedingung angewandt, d. h. das Beer-Lambertsche Gesetz für klare Himmel, das Kim-Modell für Nebel, die Carbonneau-Theorie für Regen und die Mie-Streutheorie für Staubstürme. Drittens wurden die Parameter des FSO-Systems wie folgt festgelegt: Sendeleistung von 20 dBm, Wellenlänge von 1550 nm, Übertragungsentfernung von 3 km, Sendeapertur von 2,5 cm und Empfangsapertur von 20 cm. Viertens wurde die Dämpfung in dB/km für jede Probe berechnet. Schließlich wurde der vollständige Datensatz zufällig in 1.200 Trainingsproben (80 %) und 300 Testproben (20 %) aufgeteilt. Die simulierten Bedingungen umfassen hohe Staubkonzentrationen in Verbindung mit Sandstürmen, Regenstürmen und Temperaturschwankungen von −4,89 °C bis 47,99 °C. Die Wetterbedingungen und Parameterverteilungen wurden basierend auf den Klimaaufzeichnungen des Irak für den Zeitraum 2020–2024 ausgewählt. Die fünf Wetterregime (klarer Himmel, Nebel, Regen, Staubstürme und Schnee) wurden gewählt, da sie das gesamte Spektrum atmosphärischer Bedingungen abdecken, die die FSO-Dämpfung im Irak beeinflussen, wobei Staubstürme im Nahen Osten besonders verbreitet sind. Die historischen meteorologischen Daten, die in verschiedenen irakischen Regionen gesammelt wurden, dienten zur Erstellung der Wahrscheinlichkeitsverteilung für jede Wetterbedingung. Die resultierende Verteilung war wie folgt: 54,3 % klarer Himmel (der vorherrschende Zustand), 24,9 % Staub (repräsentativ für das Sandsturmproblem im Irak), 10,5 % Nebel (häufig in den nordirakischen Wintern), 7,4 % Regen (typisch geringe Niederschlagsmengen im Irak) und 2,8 % Schnee (gelegentlich in den nördlichen Bergregionen). Die relevanten meteorologischen Parameter wurden mithilfe von Wahrscheinlichkeitsverteilungen für jede Wetterbedingung wie folgt modelliert: Die Temperatur wurde mittels einer Normalverteilung (Mittelwert 28,55 ± 11,18 °C) zwischen −4,89 °C und 47,99 °C basierend auf den saisonalen Extremen im Irak modelliert; die Luftfeuchtigkeit wurde mittels einer Gleichverteilung (Mittelwert 42,01 ± 25,56 %) von 0 % bis 100 % modelliert; die Sichtweite wurde mittels einer logarithmischen Normalverteilung zwischen 0,05 km und 29,99 km (Mittelwert 13,10 ± 10,91 km) modelliert, um die häufigen Ereignisse mit geringer Sichtweite während Staubstürme zu berücksichtigen; die Staubkonzentration wurde mittels einer Exponentialverteilung zwischen 0 und 4,96 mg/m3 (Mittelwert 0,74 ± 1,30 mg/m3) modelliert, mit höheren Wahrscheinlichkeiten für niedrige Konzentrationen und langen Ausläufern bei extremen Staubereignissen.
Das Kommunikationssystem wurde mit einer Sendeleistung von 20 dBm, einer Wellenlänge von 1550 nm, einer Übertragungsdistanz von bis zu 3 km, einer Sendeapertur von 2,5 cm und einer Empfangsapertur von 20 cm konzipiert, um den Divergenzverlust auszugleichen. Die Parameter des FSO-Systems wurden in zwei Gruppen unterteilt: feste Parameter, die für alle Proben unverändert blieben, und variable Parameter, die während der Erstellung des Datensatzes verändert wurden. Für alle 1.500 Proben wurden folgende Parameter festgelegt: Sendeleistung (20 dBm), Betriebswellenlänge (1550 nm), Sendeapertur (Durchmesser 2,5 cm, Effizienz 0,7) und Empfangsapertur (Durchmesser 20 cm, Effizienz 0,7). Diese Parameter blieben konstant, da sie die physikalischen Spezifikationen der FSO-System-Hardware darstellen und sich nicht mit den Wetterbedingungen ändern. Der Datensatz wurde mit 1.500 Proben erstellt, wobei folgende Parameter variiert wurden: Temperatur (−4,89 °C bis 47,99 °C), Luftfeuchtigkeit (0 % bis 100 %), Sichtweite (0,05 km bis 29,99 km), Staubkonzentration (0 bis 4,96 mg/m3) und Wetterbedingung (klarer Himmel, Nebel, Regen, Staub, Schnee). Diese Parameter wurden gemäß Wahrscheinlichkeitsverteilungen angepasst, die aus Klimaaufzeichnungen des Irak für die Jahre 2020–2024 abgeleitet wurden. Für jede Probe wurde der Dämpfungswert (dB/km) mithilfe des entsprechenden physikalischen Dämpfungsmodells berechnet, basierend auf der spezifischen Kombination aus Wetterbedingungen und variablen Parametern.
Die physikalische Dämpfung wurde mithilfe des Carbonneau-Modells für Regen, des Beer-Lambert-Gesetzes für klare Luft, der Mie-Streutheorie für Staub und des Kim-Modells für Nebel modelliert24. Das Beer-Lambert-Gesetz gilt für klare Himmelsbedingungen, bei denen die Dämpfung hauptsächlich durch molekulare Streuung und Absorption verursacht wird, die exponentiell mit der Distanz abnimmt25. Der Extinktionskoeffizient α bei 1550 nm resultiert aus der Rayleigh-Streuung durch Luftmoleküle und der Absorption durch atmosphärische Gase26. Das Kim-Modell ist ein nebel-spezifisches Modell, das die Dämpfung über empirische Koeffizienten, die aus der Größenverteilung von Nebeltropfen abgeleitet sind, mit der Sichtweite verknüpft. Der wellenlängenabhängige Exponent q berücksichtigt die Mie-Streuung27. Der Hauptparameter des Carbonneau-Modells ist die Niederschlagsrate R, da die Regendämpfung von der Größe und Dichte der Regentropfen abhängt; die Koeffizienten wurden empirisch bei 1550 nm ermittelt und speziell für optische Wellenlängen kalibriert28. Die Mie-Streutheorie ist auf staubige Bedingungen anwendbar, da die Größe der Staubpartikel (0,1–100 μm Radius) vergleichbar mit der Wellenlänge (1550 nm) ist, und der komplexe Brechungsindex m = 1,55–0,005i für mittelöstlichen Staub sowohl Streuung als auch Absorption umfasst29. Die folgenden physikalischen Dämpfungsmodelle wurden mit ihren jeweiligen Gleichungen und Parametereinstellungen implementiert.
Für klare Himmelsbedingungen wurde das Beer-Lambertsche Gesetz verwendet:
Aclear = 10×log₁₀(e(α×d)) (1)
wobei α der Extinktionskoeffizient ist (variiert mittels einer Normalverteilung mit Mittelwert bei 0,02 dB/km und einer Abweichung von ±0,005 dB/km bei 1550 nm unter klaren Bedingungen) und d die Übertragungsdistanz ist (festgelegt auf 3 km). Für Nebelbedingungen wurde das Kim-Modell unter Verwendung der folgenden Gleichung implementiert:
Afog = 10×ln(10)/V×(λ/550)−q (2)
wobei V die Sichtweite in Kilometern ist (variiert von 0,05 km bis 10 km), λ ist die Wellenlänge in Nanometern (festgelegt bei 1550 nm) und q der Partikelgrößenverteilungskoeffizient, berechnet als: q = 1,6 für V>50 km, q=1,3 für 6<V<50 km, q=0,585×V(1/3) für 1 <V<6 km, q = 0 für 0,5<V<1 km und q = 0,5 für V<0,5 km. Für Regenbedingungen wurde das Carbonneau-Modell verwendet:
Arain=0.023×R0.93 (3)
wobei R die Niederschlagsraten in mm/h sind (variierend zwischen 0,25 und 50 mm/h gemäß irakischen Niederschlagsaufzeichnungen). Der Zusammenhang der Extinktionseffizienz wurde für die Bedingungen eines Sandsturms unter Verwendung der Mie-Streuung verwendet:
Adust=10×log₁₀(e(τ×L)) (4)
wobei τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r der Partikelradius ist (0,1–100 μm gemäß der Zusammensetzung irakischen Staubs), Qext die Extinktionswirkungsgrad nach der Mie-Theorie berechnete Extinktionswirkungsgrad ist, λ=1550 nm, m=1,55–0,005i der komplexe Brechungsindex für mittelöstlichen Staub ist und N(r) die Partikelgrößenverteilung beschreibt, die mittels einer logarithmischen Normalverteilung mit einem geometrischen mittleren Radius von 2,5 μm und einer Standardabweichung von 2,0 modelliert wurde. Das Dämpfungsmodell wurde wie folgt für Schneeverhältnisse implementiert:
Asnow = 0.1×S0.75 (5)
wobei S die Schneefallrate in mm/h (0,5–15 mm/h) ist. Diese empirische Gleichung wurde basierend auf Literaturdaten ausgewählt30, wobei Dämpfungsmodelle für die optische Ausbreitung durch Schnee mithilfe der Mie-Streutheorie entwickelt wurden, angewendet auf Größenverteilungen von Schneeflocken. Die Gleichung gilt für Schneefallraten zwischen 0,5 und 15 mm/h und setzt trockene Schneeverhältnisse voraus mit typischen Schneeflockendurchmessern von 1–10 mm. Der Koeffizient 0,1 und der Exponent 0,75 wurden durch Anpassung an Mie-Streuungsberechnungen30 für Schnee bei 1550 nm ermittelt. Die Gleichung berücksichtigt keine feuchten Schneeverhältnisse oder kombinierte Niederschläge, die variable Dämpfungseigenschaften aufweisen können, obwohl sie für trockenen Schnee eine brauchbare Schätzung liefert. Da dieser Ansatz recheneffizient ist, häufig in Veröffentlichungen zur freien Raumoptik (FSO) zitiert wird und für die erwarteten Schneeverhältnisse im nördlichen Irak (Region Kurdistan im Januar und Februar) geeignet ist, wurde er für diese Untersuchung ausgewählt. Unter Verwendung von Numpy für numerische Berechnungen wurden alle Modelle in Python 3.9 implementiert. Das passende Modell wurde auf die zufällig ausgewählten Wetterbedingungen und die erfassten Umgebungsdaten angewandt, um den Dämpfungswert für jede Probe zu berechnen. Die ermittelte Wetterverteilung umfasste 814 wolkenfreie Bedingungen (54,27 %), 375 Staubereignisse (25,00 %), 157 Nebelereignisse (10,47 %), 111 Regenereignisse (7,40 %) und 43 Schneefälle (2,87 %).
Die Untersuchung historischer meteorologischer Daten, die von irakischen Wetterstationen in verschiedenen Regionen (Bagdad, Basra, Mossul und Ramadi) zwischen 2020 und 2024 gesammelt wurden, diente der Ermittlung der Anteile unterschiedlicher Wetterlagen. Die ursprünglichen Daten wurden vom irakischen Ministerium für Verkehr sowie der Irakischen Meteorologischen Organisation und Seismologie (IMOS) bereitgestellt. Die Datensätze enthielten tägliche Wetteraufzeichnungen, die die jeweils aktuellen atmosphärischen Bedingungen für jeden Tag dokumentierten. Aus diesen Aufzeichnungen wurden spezifische Merkmale wie Temperatur (tägliches Minimum, Maximum und Mittelwert), relative Luftfeuchtigkeit, Sichtweite, Niederschlagsmenge und das Auftreten von Staubstürmen extrahiert. Über das Open-Data-Portal der irakischen Regierung (https://www.motrans.gov.iq/) ist ein Teil der IMOS-Daten zugänglich; die in dieser Studie verwendeten spezifischen Aufzeichnungen sind jedoch nicht öffentlich in einem zentralen Archiv gespeichert. Die zur Berechnung der prozentualen Anteile der Wetterbedingungen und der Parameterwerte verwendeten Klimadaten sind in Tabelle 1 zusammengefasst. Als klare Himmelstage wurden Tage definiert, an denen kein Niederschlag auftrat, die Sichtweite größer als 10 km betrug und keine Staubaktivität vorlag; sie machten 54,27 % der insgesamt 1.825 erfassten Tage aus. Tage mit Staubsturm (einschließlich vollständigem Staubsturm (Sichtweite < 1 km) und teilweisem Staubsturm (Sichtweite 1–10 km)) machten zusammen 20,05 % der Tage aus. Bewölkte Tage (bedeckter Himmel ohne Staubaktivität und ohne Niederschlag) stellten 14,30 % der Tage dar, während regnerische Tage (mit Niederschlag unabhängig von Bewölkung oder Staub) 11,37 % der Gesamtanzahl ausmachten. < 1 km) und suspendiertem Staub (Sichtweite 1–5 km)) entfielen auf 25,00 % der Tage, was auf die hohe Häufigkeit von Sandsturmereignissen im ariden und semiariden Klima des Irak hinweist. Tage mit einer Sichtweite unter 1 km, verursacht durch die Suspension von Wassertropfen (ohne durch Staub bedingte Sichtweitenverringerung), wurden als Nebeltage klassifiziert. Der Anteil der Nebeltage betrug 10,47 %, wobei Nebeltage hauptsächlich im Winter in den nördlichen Regionen des Irak auftraten. Regentage, Tage mit messbaren Niederschlägen >0,1 mm, lagen bei 7,40 % und entsprechen dem geringen durchschnittlichen Jahresniederschlag in Irak von 150–200 mm pro Jahr. Schneetage (Tage mit Ansammlung gefrorener Niederschläge) machten 2,87 % der Tage aus und waren auf die bergigen nördlichen Gebiete (Region Kurdistan) im Januar und Februar beschränkt. Diese Anteile wurden später als Wahrscheinlichkeitsgewichte für die Zufallsstichprobe bei der Datensatzerstellung verwendet. Somit spiegelt der synthetische Datensatz die reale Häufigkeit der jeweiligen Wetterbedingungen im irakischen Umfeld wider.
Überlegungen zur Verzerrung bei der Erzeugung synthetischer Daten
Um mögliche Verzerrungen zu verringern, wurden mehrere Schritte unternommen:
(1) Verteilung auswählen: Die statistischen Eigenschaften der klimatologischen Quelldaten wurden verwendet, um Wahrscheinlichkeitsverteilungen auszuwählen. Die Temperatur war normalverteilt mit einem Mittelwert und einer Standardabweichung, wie sie vom IMOS erfasst wurden. Die Luftfeuchtigkeit war über den gesamten beobachteten Bereich (0–100 %) gleichverteilt. Für die Sichtweite wurde angenommen, dass sie einer logarithmischen Normalverteilung folgt, um das häufige Auftreten von schlechten Sichtverhältnissen während Staubstürme zu berücksichtigen. Die Staubkonzentration folgte einer exponentiellen Verteilung, bei der niedrige Konzentrationen wahrscheinlicher sind und extreme Staubereignisse lange Ausläufer bilden31. Dies steht im Einklang mit der beobachteten Häufigkeit von Staubereignissen im Irak32.
(2) Anteile der Wetterbedingungen: Die Analyse der IMOS-Datensätze für die Jahre 2020–2024, die 1.825 tägliche Beobachtungen aus allen vier Regionen umfassen, ergab folgende Anteile: 54,3 % klarer Himmel, 24,9 % Staub, 10,5 % Nebel, 7,4 % Regen und 2,8 % Schnee. Als klare Himmeltage wurden Tage definiert, an denen keine Niederschläge auftraten, die Sichtweite >10 km betrug und keine Staubaktivität vorlag. Tage mit Stürmen umfassten sowohl voll ausgeprägte Staubstürme (Sichtweite <1 km) als auch suspendierten Staub (Sichtweite 1–5 km). Ein Nebeltag wurde als ein Tag definiert, an dem die Sichtweite unter 1 km lag und die Ursache die Suspension von Wassertropfen (nicht Staub) war. Regentage wurden als Tage mit messbaren Niederschlägen >0,1 mm definiert. Schneetage wurden als Tage mit akkumuliertem gefrorenem Niederschlag33 definiert.
(3) Parameterbereiche: Die Parameterbereiche basierten auf den beobachteten Extremwerten in den IMOS-Aufzeichnungen: Die Temperatur reichte von −4,89 °C (Mossul, Winter) bis 47,99 °C (Basra, Sommer), die Sichtweite von 0,05 km (schwere Staubstürme) bis 29,99 km (klare Bedingungen) und die Staubkonzentration von 0 bis 4,96 mg/m3 (basierend auf der beobachteten maximalen Staubkonzentration während schwerer Haboob-Ereignisse)34.
(4) Unabhängigkeitsannahmen: Es wurde angenommen, dass die Umweltparameter unabhängig voneinander abgetastet wurden, was eine Vereinfachung realer Bedingungen darstellt, unter denen atmosphärische Variablen miteinander korrelieren (z. B. korreliert eine hohe Staubkonzentration oft mit geringer Sichtweite). Um eine kontrollierte Simulationsumgebung für den methodischen Modellvergleich bereitzustellen, wurde diese Unabhängigkeitsannahme getroffen 35. Die Auswirkungen dieser Annahmen werden in der Diskussion behandelt.
(5) Geschichtete Aufteilung: Die Aufteilung in Trainings- und Testdatensatz erfolgte geschichtet nach der Wetterbedingungskategorie (klarer Himmel, Nebel, Regen, Staub, Schnee), um sicherzustellen, dass der Anteil jeder Wetterbedingung in den Trainings- und Testdatensätzen der Verteilung im ursprünglichen Datensatz entsprach. Auf diese Weise ist der Testdatensatz hinsichtlich seltener Wetterbedingungen (insbesondere Schnee mit 2,87 %) nicht verzerrt36.
Anerkennung der deterministischen Zielgenerierung
Es ist wichtig darauf hinzuweisen, dass die hier beobachtete gute Vorhersageleistung teilweise darauf zurückzuführen sein kann, dass das Modell die deterministischen physikalischen Gleichungen erlernt oder annähert, die zur Erzeugung der synthetischen Zielwerte verwendet wurden37. Im Gegensatz zu realen experimentellen Messungen, die Messrauschen, Instrumentenfehler und nicht modellierte physikalische Phänomene enthalten, bietet der synthetische Datensatz eine saubere, rauschfreie Beziehung zwischen den Eingangsmerkmalen und dem Dämpfungsziel. Dies liegt daran, dass die Dämpfungswerte direkt aus den physikalischen Ausbreitungsmodellen (Beer-Lambertsches Gesetz, Kim-Modell, Carbonneau-Modell und Mie-Streuungstheorie) basierend auf den Eingabeparametern berechnet wurden. Die quantitativen Leistungskennzahlen (R2, RMSE, MAE) stellen daher die Leistung auf Gleichungen basierenden synthetischen Daten dar und sollten nicht als erwartete Leistung bei verrauschten Beobachtungs- oder Experimentaldaten interpretiert werden. Die Ergebnisse sollten vor allem als vergleichende Bewertung von Modellierungsansätzen in einer kontrollierten Simulationsumgebung betrachtet werden38.
Vollständiger Merkmalsatz für das Modelltraining
Der Trainingsdatensatz enthielt 10 Eingabemerkmale für das Modelltraining:
1. Temperatur (°C)
2. Luftfeuchtigkeit (%)
3. Sichtweite (km)
4. Staubkonzentration (mg/m3)
5. Niederschlagsrate (mm/h)
6. Schneefallrate (mm/h)
7. Windgeschwindigkeit (m/s)
8. Luftdruck (hPa)
9. Monat (numerisch, 1–12)
10. Jahreszeit (einfach kodiert: Frühling, Sommer, Herbst, Winter)
Wichtige Klarstellung: Wetterbedingungen (klarer Himmel, Nebel, Regen, Staub, Schnee) wurden als kategoriale Variable zur Stratifikation während der Datensatz-Aufteilung verwendet und nicht als Eingabemerkmale für irgendein Modell einbezogen. Die SHAP-Analyse umfasst nur die oben aufgeführten 10 Merkmale. Die Jahreszeiten-Variable wurde als One-Hot-codierte Variable (4 Kategorien: Frühling, Sommer, Herbst, Winter) dargestellt, und für die SHAP-Analyse wurden die Beiträge der one-hot-kodierten Jahreszeiten-Variablen über alle Jahreszeiten hinweg summiert, um einen einzigen saisonalen Beitragswert zu erzeugen. Dieser kombinierte Wert repräsentiert den Gesamtbeitrag aller saisonbezogenen Variablen zur Vorhersage der Dämpfung. Vor der Erstellung der Zusammenfassungsgrafik wurden die vier one-hot-kodierten Spalten für die Jahreszeiten identifiziert, und ihre SHAP-Werte wurden für jede Probe addiert. Diese Methode gewährleistet, dass die Verwendung der Jahreszeit durch das Modell als zusammengesetzte kategoriale Variable mit der SHAP-Analyse übereinstimmt.
Die wichtigsten Umweltfaktoren, die die optische Dämpfung durch physikalische Mechanismen direkt beeinflussten, waren die Merkmale 1–6. Die Hinzunahme der Merkmale 7 und 8 (Windgeschwindigkeit und Luftdruck) als zusätzliche meteorologische Faktoren könnte indirekt die Dämpfung beeinflussen, indem sie die Luftstabilität und die Aerosolverbreitung verändern. Um saisonale Schwankungen der atmosphärischen Bedingungen zu berücksichtigen, wurden die Merkmale 9–10 (Monat und Jahreszeit) als zeitliche Deskriptoren einbezogen. Der Dämpfungswert (dB/km) diente als Zielvariable für alle Modelle. Zu den wichtigsten Datensatzstatistiken gehörte die Temperatur (28.55°C ± 11.18°C), Luftfeuchtigkeit (42,01 % ± 25,56 %), Sichtbarkeit (13,10 %) ± 10.91 km; Bereich: 0,05–29,99 km), Staubkonzentration (0,74 ± 1.30 mg/m3; Maximum: 4,96 mg/m3), Dämpfung (4,80 ± 7.20 dB/km; Bereich: 0,09–50,93 dB/km), Betriebsbereich (5,74 ± 1.97 km) und Signal-Rausch-Verhältnis (64,88 ± 15.07 dB). Der Betriebsbereich und das Signal-Rausch-Verhältnis (SNR) wurden anhand der Dämpfungswerte unter Verwendung standardmäßiger FSO-Link-Budget-Gleichungen berechnet.
Berechnung des Betriebsbereichs
Die Betriebsreichweite (in km) wurde mithilfe der Link-Budget-Gleichung berechnet:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
wobei: Prx = empfangene Leistung (auf die minimale Empfindlichkeit von −30 dBm eingestellt); Ptx = Sendeleistung (festgelegt auf 20 dBm); Gt = Sendergewinn (berechnet aus den Aperturgrößen); Gr = Empfängergewinn (berechnet aus den Aperturgrößen); λ = Wellenlänge (1550 nm); R = Reichweite in km; A = atmosphärische Dämpfung in dB/km (berechnet aus den physikalischen Modellen).
Sende- und Empfangsverstärkung: Die Sendeverstärkung (Gt) wurde wie folgt berechnet: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44,2 dBi. Die Empfangsverstärkung (Gr) wurde berechnet als: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62,3 dBi. Die Sendeblende hatte einen Durchmesser von 2,5 cm und einen Wirkungsgrad von 0,7. Die Empfangsblende hatte einen Durchmesser von 20 cm und einen Wirkungsgrad von 0,7. Die Gleichung wurde iterativ nach R aufgelöst, um die maximal erreichbare Verbindungsentfernung für jeden Dämpfungswert zu bestimmen.
Berechnung des Signal-Rausch-Verhältnisses
Das SNR (Signal-Rausch-Verhältnis) in dB wurde mit der folgenden Gleichung berechnet:
SNR=Prx−10×log₁₀(kTB)−NF (7)
wobei: Prx = empfangene Leistung in dBm (berechnet aus dem Link-Budget); k = 1,38×10⁻23 J/K (Boltzmann-Konstante); T = 290 K (Empfängertemperatur); B = 109 Hz (Empfängerbandbreite, 1 GHz); NF = 3 dB (Rauschzahl des Empfängers). Die Rauschuntergrenze wurde wie folgt berechnet:
10 × log10(kTB) ≈ −84 dBm (8)
Für jede Probe wurde nach der Berechnung der Dämpfung A unter Verwendung des geeigneten physikalischen Modells die Betriebsreichweite ermittelt, indem die Link-Bilanz nach R aufgelöst wurde, und das SNR wurde aus der resultierenden Empfangsleistung Prx bei dieser Reichweite berechnet.
Wetterbedingte Betriebsbereichswerte: Der Betriebsbereich variierte je nach Wetterbedingungen: klare Himmel (7,12 ± 1,85 km), Nebel (5,81 ± 1,92 km), Schnee (5,42 ± 1,56 km), Regen (3,81 ± 0,98 km) und Staub (3,72 ± 1,08 km). Ein 3 dB-Margin wurde bei den aktuellen Berechnungen nicht angewendet; der Betriebsbereich stellt die theoretische maximale Reichweite ohne Systemreserve dar. Die angegebene Betriebsreichweite (5,74 ± 1,97 km) ist der Gesamtmittelwert über alle Wetterbedingungen hinweg39.
Feste Übertragungsdistanz: Die Übertragungsdistanz in den physikalischen Dämpfungsmodellen wurde auf 3 km festgelegt. Dies ist die Distanz der Verbindung, für die die Dämpfungsberechnungen durchgeführt wurden. Die angegebene Betriebsreichweite ist die theoretische maximale Distanz, die mithilfe der Link-Budget-Gleichung berechnet wurde und sich von der festen Übertragungsdistanz von 3 km unterscheiden kann. Wetterabhängige Dämpfungswerte wurden für klare Bedingungen (0,27±0,06 dB/km), Nebel (1,88±1,92 dB/km), Schnee (6,45±2,54 dB/km), Regen (13,58±6,32 dB/km) und Staub (13,10±7,32 dB/km) erfasst. Alle in dieser Arbeit angegebenen quantitativen Werte werden als Mittelwert ± Standardabweichung (SD) angegeben, sofern nicht anders angegeben40.
Das Kreuzvalidierungs-R2 für Random Forest beträgt 0,960±0,007. In bestimmten Fällen, wie bei der Temperatur (−4,89 bis 47,99 °C), der Sichtweite (0,05 bis 29,99 km), der Staubkonzentration (0 bis 4,96 mg/m3) und der Dämpfung (0,09 bis 50,93 dB/km), wird der Bereich (von niedrigster zu höchster Messung) verbal angegeben. Der Datensatz wurde in Untergruppen für Testen (300 Stichproben; 20 %) und Training (1.200 Stichproben; 80 %) aufgeteilt. Zur Durchführung der Aufteilung in Trainings- und Testmenge wurde eine stratifizierte Zufallsstichprobe verwendet. Um sicherzustellen, dass der Anteil jeder Wetterbedingung im Trainingsdatensatz (80 %) und im Testdatensatz (20 %) der Verteilung im ursprünglichen Datensatz entspricht, erfolgte die Stratifikation basierend auf der Kategorie der Wetterbedingung (klarer Himmel, Nebel, Regen, Staub und Schnee). Insbesondere wurden 1.200 (80 %) der 1.500 Stichproben dem Lernsatz und 300 (20 %) dem Testsatz zugewiesen. Die Stichproben wurden zufällig für jede Kategorie meteorologischer Bedingungen ausgewählt, wobei die ursprünglichen Anteile beibehalten wurden: von den 814 Stichproben bei klarem Himmel (54,27 %) wurden 651 dem Training und 163 dem Test zugewiesen; von den 375 Staubstichproben (25,00 %) 300 dem Training und 75 dem Test; von den 157 Nebelstichproben (10,47 %) 126 dem Training und 31 dem Test; von den 111 Regenstichproben (7,40 %) 89 dem Training und 22 dem Test; von den 43 Schneestichproben (2,87 %) 34 dem Training und 9 dem Test. Die Zufallsstichprobe innerhalb jedes Stratum wurde mit einem Zufallsstartwert (Random Seed) von 42 durchgeführt, um Reproduzierbarkeit zu gewährleisten. Dieser stratifizierte Ansatz wurde gewählt, um eine unausgeglichene Repräsentation seltener Wetterbedingungen (insbesondere Schnee mit 2,87 %) im Testdatensatz zu vermeiden, was andernfalls zu einer unzuverlässigen Leistungsbewertung für diese Bedingungen führen könnte.
Beurteilung von Maschinenlernmodellen
Sechs Methoden des maschinellen Lernens wurden evaluiert, darunter die Support-Vektor-Regression (SVR) mit einem radialen Basisfunktionskern (C = 100), die k-nächsten Nachbarn (KNN; k = 10, abstandsgewichtet), RF (200 Bäume, maximale Tiefe = 20), Extreme Gradient Boosting (XGBoost; 200 Schätzer, maximale Tiefe = 10, Lernrate = 0,1), Light Gradient Boosting Machine (LightGBM; 200 Schätzer, maximale Tiefe = 10, Lernrate = 0,1) sowie eine lineare Regressions-Baseline. Für alle Modelle des maschinellen und des tiefen Lernens wurde eine Hyperparameter-Optimierung für die kritischsten Parameter durchgeführt, während für nicht spezifizierte Parameter die Standardwerte beibehalten wurden. Für die Modelle des maschinellen Lernens wurden die folgenden Parameter explizit mittels Gitter-Suche mit 5-facher Kreuzvalidierung auf dem Trainingsdatensatz optimiert: 1) Zufallswald: Anzahl der Bäume (getestet: 50, 100, 150, 200, 250) und maximale Tiefe (getestet: 10, 15, 20, 25, keine Begrenzung), wobei die optimalen Werte 200 Bäume und Tiefe 20 ausgewählt wurden. 2) XGBoost: Anzahl der Schätzer (getestet: 100, 150, 200, 250), maximale Tiefe (getestet: 6, 8, 10, 12) und Lernrate (getestet: 0,05, 0,1, 0,2), wobei die optimalen Werte 200 Schätzer, Tiefe 10 und Lernrate 0,1 festgelegt wurden. 3) LightGBM: Es wurden identische Optimierungsbereiche verwendet, was zu 200 Schätzern, Tiefe 10 und Lernrate 0,1 führte. 4) SVR: Der Regularisierungsparameter C (getestet: 1, 10, 50, 100) und der Kernkoeffizient gamma (getestet: „scale“, „auto“, 0,1, 0,01) wurden optimiert, wobei die optimalen Werte C = 100 und der RBF-Kern gewählt wurden. 5) KNN: Die Anzahl der Nachbarn k (getestet: 3, 5, 7, 10, 15) wurde optimiert, wobei der optimale Wert k = 10 und eine abstandsgewichtete Abstimmung aktiviert wurde.
Alle anderen Parameter für diese Modelle wurden gemäß der in scikit-learn festgelegten Standardeinstellungen belassen (siehe Tabelle der Materialien für die Version; z. B. Zufallswald: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1,0, colsample_bytree=1,0, gamma=0). Bei den Deep-Learning-Modellen wurden die Architektur (Anzahl der Schichten und Neuronen pro Schicht) sowie die Dropout-Rate (20 %) manuell durch iterative Experimente am Validierungsset optimiert, während der Optimierer (Adam), die anfängliche Lernrate (0,001), die Geduld für die vorzeitige Beendigung (20 Epochen) und die Parameter zur Reduzierung der Lernrate (Faktor 0,5, Geduld 10) gemäß gängiger Praxis aus der Literatur festgelegt und für alle Deep-Learning-Experimente unverändert beibehalten wurden.
Klimadatenquellen
Die historischen meteorologischen Daten, die zwischen 2020 und 2024 an irakischen Wetterstationen an mehreren Orten (Bagdad, Basra, Mossul und Ramadi) gesammelt wurden, dienten zur Berechnung der Anteile der Wetterzustände und der Verteilungen der Variablen. Die Rohdaten wurden vom irakischen Verkehrsministerium und der Irakischen Meteorologischen Organisation und Seismologie (IMOS) bereitgestellt. In die Datensätze wurden tägliche Wetteraufzeichnungen einbezogen, die den vorherrschenden atmosphärischen Zustand für jeden Tag beschreiben. Zu den spezifischen aus diesen Aufzeichnungen gewonnenen Variablen gehörten Temperatur (tägliches Minimum, Maximum und Mittelwert), relative Luftfeuchtigkeit, Sichtweite, Niederschlagsmenge und das Auftreten von Staubstürmen. Die IMOS-Daten sind teilweise über das Open-Data-Portal der irakischen Regierung (https://www.motrans.gov.iq/) zugänglich, obwohl die in dieser Studie verwendeten spezifischen Aufzeichnungen nicht öffentlich in einem zentralen Archiv gespeichert sind. Eine Zusammenfassung der Klimadaten, die zur Bestimmung der Anteile der Wetterbedingungen und der Parameterbereiche verwendet wurden, ist in Tabelle 1 dargestellt.
Eine fünffache Kreuzvalidierung wurde auf dem Trainingsdatensatz (1.200 Stichproben) verwendet, um Hyperparameter zu optimieren und die Leistung aller Machine-Learning-Modelle abzuschätzen. Alle Eingabevariablen (Temperatur, Luftfeuchtigkeit, Sichtweite, Staubkonzentration, Regenintensität, Schneefallrate, Windgeschwindigkeit, Druck) wurden durch Standardisierung (Z-Score-Normalisierung) skaliert: x_scaled = (x − μ)/σ, wobei μ und σ der Mittelwert und die Standardabweichung des Trainingsdatensatzes sind. Wir führten die Standardisierung innerhalb jedes Kreuzvalidierungs-Folds ausschließlich mit den Statistiken aus dem Trainings-Fold durch, um Datenlecks zu vermeiden. Baum-basierte Modelle (Random Forest, XGBoost, LightGBM) sind skaleninvariant, aber zur Konsistenz wurde dieselbe Standardisierung für alle Machine-Learning-Modelle angewendet. Für Deep-Learning-Modelle wurde eine Min-Max-Normalisierung verwendet: x_scaled = (x−x_min)/(x_max−x_min), bei der die Merkmale basierend auf den Minimal- und Maximalwerten des Trainingsdatensatzes auf den Bereich [0, 1] skaliert werden. Begrenzte Eingaben führen zu einer schnelleren Konvergenz neuronaler Netze, weshalb sie gewählt wurden. Der Testdatensatz wurde mit den aus dem Trainingsdatensatz ermittelten Parametern skaliert und nicht für die Modellauswahl oder Hyperparameterabstimmung verwendet.
Es wurden vollständige Leistungsmetriken erfasst, einschließlich des Test-Bestimmtheitskoeffizienten (R2), des Wurzels der mittleren quadratischen Abweichung (RMSE), des mittleren absoluten Fehlers (MAE), des Cross-Validierungs-R2 und der Trainingszeit. Die Trainingszeiten für alle Modelle des maschinellen Lernens und des Deep Learnings werden für die schnelleren Modelle (Lineare Regression, KNN, SVR, Random Forest, XGBoost, LightGBM) in Sekunden (s) und für die langsameren Modelle (Deep-Learning-Architekturen) in Minuten (min) angegeben. Alle Modelle wurden in derselben Rechenumgebung trainiert, um einen fairen Vergleich zu gewährleisten41.
Die Trainingszeit wurde mithilfe des Python-Moduls time gemessen, also die vergangene Echtzeit vom Beginn bis zum Ende der Modellanpassungsfunktion, ausgenommen die Zeit für das Laden und Vorverarbeiten der Daten. Die Trainingszeit eines Deep-Learning-Modells ist die Dauer, die benötigt wird, um alle Epochen bis zum vorzeitigen Abbruch abzuschließen. Dazu gehören Vorwärtspropagation, Rückwärtspropagation und Validierungsprüfungen. Alle Experimente wurden durchgeführt, während auf dem System keine anderen rechenintensiven Prozesse liefen, um konsistente Zeitmessungen zu erhalten. Die angegebenen Zeiten stellen den Durchschnitt aus 5 unabhängigen Durchläufen dar (Standardabweichungen)42.
Auswertung des Deep-Learning-Modells
Sechs Deep-Learning-Architekturen wurden unter Verwendung einer GPU-Beschleunigung evaluiert, darunter ein Multilayer-Perzeptron (MLP; 64-32-16), ein tiefes neuronales Netzwerk (DNN) mit Batch-Normalisierung (128-64-32-16), ein Long-Short-Term-Memory-Netzwerk (LSTM; 64-32 Einheiten, Sequenzlänge = 10), ein eindimensionales faltendes neuronales Netzwerk (1D-CNN), ein hybrides CNN–LSTM-Modell sowie ein Netzwerk mit Attention-Mechanismus. Alle Deep-Learning-Modelle wurden mit TensorFlow und der Keras-API implementiert und mit GPU-Beschleunigung ausgeführt (siehe Tabelle der Materialien für Hardware-/Software-Versionen). Die 1D-CNN-Architektur bestand aus drei Faltungsschichten (64, 128 und 256 Filter, Kernelgröße 3, ReLU-Aktivierung, padding=’same’), zwei MaxPooling1D-Schichten (Poolgröße 2), einer GlobalAveragePooling1D-Schicht, einer Dense-Schicht mit 128 Einheiten und ReLU-Aktivierung, einer Dropout-Schicht (0,2) und einer Dense-Ausgabeschicht (1 Einheit, lineare Aktivierung), insgesamt etwa 245.000 trainierbare Parameter. Die CNN-LSTM-Hybridarchitektur akzeptierte Eingabesequenzen mit 10 Zeitschritten und 5 Merkmalen und verwendete zwei Conv1D-Schichten (64 und 128 Filter, Kernelgröße 3, ReLU, padding=’same’), eine MaxPooling1D-Schicht (Poolgröße 2), zwei LSTM-Schichten (64 und 32 Einheiten, return_sequences=False), Dropout-Schichten (0,2), eine Dense-Schicht (32 Einheiten, ReLU) und eine Dense-Ausgabeschicht (1 Einheit, lineare Aktivierung), insgesamt etwa 198.000 trainierbare Parameter. Das Attention-basierte Netzwerk verwendete einen Multi-Head-Attention-Mechanismus mit 4 Heads (Schlüssel- und Wertdimensionen von 64), wobei die Eingabe auf 64 Dimensionen projiziert wurde, gefolgt von skalierten Skalarprodukt-Attention (Formel: Attention(Q, K, V) = softmax(QKT/√d_k)V), Residualverbindungen, Layer-Normalisierung, einem Feedforward-Netzwerk (128→64 Einheiten), globaler Durchschnittspooling, Dropout (0,2), einer Dense-Schicht (32 Einheiten, ReLU) und einer Dense-Ausgabeschicht (1 Einheit, lineare Aktivierung), insgesamt etwa 167.000 trainierbare Parameter43.
Alle Modelle verwendeten eine frühzeitige Unterbrechung (patience = 20), eine Reduzierung der Lernrate (Faktor = 0,5, patience = 10), Dropout (20 %) und den Adam-Optimierer (Lernrate = 0,001). Bei allen Deep-Learning-Modellen wurde die Batch-Größe auf 32 Stichproben festgelegt, die maximale Anzahl an Trainingsepochen betrug 200 mit frühzeitiger Unterbrechung (patience = 20, Rückstellung der besten Gewichte), und die Verlustfunktion war der mittlere quadratische Fehler (MSE). Die Aufteilung in Trainings- und Validierungsdatensatz war wie folgt: Von den ursprünglichen 1.200 Trainingsstichproben (nach der 80/20-Aufteilung in Trainings- und Testdatensatz) wurden 80 % (960 Stichproben) zum Training und 20 % (240 Stichproben) zur Validierung verwendet. Die Aufteilung in Trainings- und Validierungsdatensatz wurde nach Wetterbedingungen stratifiziert, um die Verteilung beizubehalten. Der Validierungsdatensatz diente ausschließlich der frühzeitigen Unterbrechung, der Reduzierung der Lernrate und der Überwachung einer Überanpassung; er wurde niemals für die Modellauswahl oder die Feinabstimmung von Hyperparametern über diese automatisierten Verfahren hinaus verwendet. Für die maschinellen Lernmodelle wurde kein separater Validierungsdatensatz zurückgehalten; stattdessen verwendeten wir eine fünffache Kreuzvalidierung an den 1.200 Trainingsstichproben, um Hyperparameter abzustimmen und die Leistung zu schätzen44.
Begründung für die Bewertung der LSTM- und CNN-LSTM-Architektur
Der Hauptdatensatz besteht aus unabhängig generierten Wetterproben, doch wir testeten auch LSTM- und CNN-LSTM-Architekturen aus folgenden Gründen: (1) reale atmosphärische Bedingungen weisen eine zeitliche Autokorrelation auf, und die Untersuchung sequenzbasierter Modelle ermöglicht es uns zu bestimmen, ob die Erfassung solcher Abhängigkeiten die Vorhersagegenauigkeit verbessern könnte; (2) aktuelle Forschungsergebnisse zur atmosphärischen Vorhersage haben den potenziellen Nutzen sequenzieller Architekturen bei der Modellierung der zeitlichen Entwicklung meteorologischer Parameter gezeigt34; (3) die Untersuchung einer breiten Palette an Architekturen gewährleistet einen umfassenden Vergleich methodischer Ansätze, was einen zentralen Beitrag dieser Studie darstellt; und (4) die hybride CNN-LSTM-Architektur kombiniert die räumliche Merkmalsextraktion mit der zeitlichen Modellierung, was vorteilhaft sein könnte, um die komplexen Wechselwirkungen zwischen mehreren atmosphärischen Variablen zu erfassen45.
Datenformatierung für die sequenzielle Modell-Eingabe
Für die sequenziellen Architekturen (LSTM und CNN–LSTM) wurden die Eingabedaten von unabhängigen Stichproben in Pseudo-Sequenzen mithilfe eines Gleitfenster-Ansatzes umstrukturiert. Insbesondere wurden die 1.200 Trainingsstichproben zunächst nach Wetterbedingungskategorien gruppiert, um die physikalische Kohärenz zu bewahren. Innerhalb jeder Wetterkategorie wurden die Stichproben nach ihren Erzeugungszeitstempeln geordnet (simulierte stündliche Beobachtungen für das Kalenderjahr 2024). Anschließend wurde ein Gleitfenster der Länge 10 angewendet, um Eingabesequenzen aus 10 aufeinanderfolgenden Zeitpunkten zu erzeugen (jeweils mit 5 Merkmalen: Temperatur, Luftfeuchtigkeit, Sichtweite, Staubkonzentration und Niederschlagsrate), um die Dämpfung zum 11ten Zeitpunkt vorherzusagen. Diese Methode erhält die zeitliche Abfolge der simulierten Beobachtungen bei und ermöglicht es sequenziellen Modellen, zeitliche Abhängigkeiten zu lernen. Die Struktur des Testdatensatzes war identisch, mit gleicher Fenstergröße und Merkmalsmenge. Wir erkennen an, dass diese Pseudo-Sequenz-Strukturierung eine methodische Vereinfachung darstellt und keine realen zeitlichen Dynamiken widerspiegelt. Dies wurde in der Diskussions-Sektion als Limitation benannt.
Auswertung hybrider Ansätze
Es wurden drei hybride Ansätze untersucht. Der erste Ansatz war ein Abstimmungs-Ensemble, das die Vorhersagen der Modelle Random Forest, XGBoost und Deep Neural Network mit gleichen Gewichten (jeweils ein Gewicht von 1/3) mittelte, wobei die endgültige Vorhersage wie folgt berechnet wurde:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
Es wurde eine gleichmäßige Gewichtung gewählt, um zusätzliche Hyperparameter zu vermeiden und die Baseline-Ensemble-Performance ohne Bias gegenüber einem einzelnen Modell zu bewerten. Der zweite Ansatz verwendete ein Ridge-Meta-Learner-Stacking. Die Basislerner waren Random Forest, XGBoost und ein tiefes neuronales Netzwerk (basierend auf Attention). Das Stacking-Verfahren umfasste zwei Schritte: Zunächst wurde jeder Basislerner auf dem gesamten Trainingsdatensatz mit 1.200 Stichproben unter Verwendung einer 5-fachen Kreuzvalidierung trainiert, um Out-of-Fold-Vorhersagen zu generieren, wodurch eine neue Meta-Merkmalsmatrix der Größe 1.200×3 entstand (eine Vorhersage pro Basismodell und Stichprobe). Anschließend wurde ein Ridge-Regression-Meta-Learner (L2-Regularisierungsparameter alpha=1,0) auf diesen Meta-Merkmalen trainiert, wobei die ursprünglichen Dämpfungswerte als Zielvariable dienten, um optimale Kombinationsgewichte für die Basislerner zu erlernen. Die endgültige Stacking-Vorhersage lautete:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
wobei die Gewichte w durch den Ridge-Meta-Lerner gelernt wurden. Der dritte Ansatz war ein physikbasiertes neuronales Netzwerk, das 70 % der Vorhersagen des neuronalen Netzwerks mit 30 % der Vorhersagen des Kim-Modells für Nebelzustandsproben kombinierte. Die Kombination erfolgte durch festgelegtes gewichtetes Mitteln mithilfe der folgenden Formel:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
wobei ŷneural die Ausgabe des aufmerksamkeitsbasierten neuronalen Netzwerks ist und ŷKim die aus dem Kim-Nebelmodell basierend auf der Sichtweite berechnete Dämpfung darstellt. Für Proben ohne Nebel wurde der physikalische Teil auf 0 gesetzt, und das Modell wurde als reines neuronales Netzwerk ausgeführt. Die Gewichte (70 % neuronal und 30 % physikalisch) wurden basierend auf Vorversuchen am Validierungsset (nicht am Testset) festgelegt, bei denen wir die Gewichtskombinationen 90:10, 80:20, 70:30, 60:40 und 50:50 testeten. Die Aufteilung 70:30 wurde gewählt, da sie das beste Validierungs-R2 lieferte und gleichzeitig ausreichend physikalische Einschränkung durch das Kim-Modell beibehielt, um die Vorhersagen zu regulieren und physikalisch unplausible Ergebnisse zu vermeiden, insbesondere bei Nebel, wo das Kim-Modell etablierte theoretische Dämpfungsgrenzen bereitstellt.
Analysen zur Merkmalswichtigkeit und Interpretierbarkeit
Das Random-Forest-Modell mit auf Unreinheit basierender Merkmalswichtigkeit (Varianzreduktion) wurde verwendet, um alle 10 Ränge der Eingabemerkmale hinsichtlich ihrer Wichtigkeit zu ermitteln. Die Analyse zeigte, dass die Staubkonzentration (67,3 %) und die Sichtweite (21,2 %) die wichtigsten Prädiktoren waren und gemeinsam 88,5 % der gesamten Vorhersagebedeutung erklärten. Das drittwichtigste Merkmal war die Regenintensität (6,0 %), gefolgt von der Windgeschwindigkeit (2,1 %), der Temperatur (1,5 %), der Luftfeuchtigkeit (0,9 %), dem Monat (0,5 %), der Jahreszeit (0,3 %), der Schneefallrate (0,1 %) und dem atmosphärischen Druck (0,1 %). Die geringen Wichtigkeitswerte für die zeitlichen Merkmale (Monat und Jahreszeit) deuten darauf hin, dass saisonale Schwankungen der atmosphärischen Dämpfung hauptsächlich durch zugrundeliegende Umweltparameter erfasst werden und nicht allein durch zeitbasierte Muster.
Eine SHAP-Analyse (Shapley Additive exPlanations) wurde durchgeführt, um die Beziehungen zwischen Umweltfaktoren und Dämpfung zu bewerten. Als SHAP-Implementierung wurde das TreeExplainer-Modul aus der SHAP-Bibliothek verwendet, das speziell für baumbasierte Modelle wie Random Forest, XGBoost und LightGBM optimiert ist (siehe Tabelle der Materialien für die Version). Die Konfiguration der SHAP-Analyse war wie folgt: Das trainierte Random-Forest-Modell wurde an den TreeExplainer übergeben, der SHAP-Werte mithilfe des interventionsbasierten (marginalen) Ansatzes zur Merkmalszuschreibung berechnete, basierend auf dem bedingten Erwartungswert der Modellausgabe. SHAP-Werte wurden für alle 300 Testdatensätze berechnet, wodurch eine Matrix der Größe 300 × 10 entstand (ein SHAP-Wert pro Merkmal und Probe). Für jedes Merkmal repräsentierte der SHAP-Wert dessen Beitrag zur Vorhersage im Vergleich zur Basislinie (der durchschnittlichen Modellvorhersage). Negative SHAP-Werte zeigten eine Absenkung an, während positive SHAP-Werte darauf hinwiesen, dass das Merkmal die Dämpfungsvorhersage verstärkte. Die Stärke des Beitrags wurde durch den Betrag des SHAP-Werts angegeben. Die Verteilung der SHAP-Werte für jedes Merkmal (mittels Beehive-Diagrammen), die Richtung des Einflusses (die Korrelation zwischen Merkmalswerten und SHAP-Werten) sowie die Rangfolge der Merkmalswichtigkeit wurden alle mithilfe von Zusammenfassungsdiagrammen visualisiert. Zur Erstellung sämtlicher SHAP-Visualisierungen wurden die integrierten Plotfunktionen der SHAP-Bibliothek verwendet – shap.summary_plot() für das Beehive-Diagramm und shap.bar_plot() für die globale Merkmalswichtigkeit.
Behandlung von One-Hot-kodierten Variablen: Vier binäre Spalten (Frühling, Sommer, Herbst und Winter) wurden zunächst verwendet, um die Saisonalitätsvariable zu kodieren. Um einen einzelnen „Saison“-Beitrag pro Probe für die SHAP-Analyse zu erstellen, wurden die Beiträge dieser vier One-Hot-kodierten Variablen kombiniert, indem die SHAP-Werte jeder Saisonkategorie addiert wurden. Zur Durchführung dieser Gruppierung wurden alle Spalten identifiziert, die den One-Hot-kodierten Saisongruppen entsprachen, ihre SHAP-Werte für jede Probe extrahiert und anschließend elementweise summiert. Die resultierenden kombinierten SHAP-Werte stellen den Gesamtbeitrag der Saison zur Dämpfungsvorhersage dar. Dieses Verfahren ermöglicht eine einzelne „Saison“-Zeile im SHAP-Zusammenfassungsdiagramm und gewährleistet Konsistenz mit der Verwendung der Saison als zusammengesetzte kategoriale Variable im Modell. Da die kombinierte Zahl eine verständlichere Darstellung des Gesamtbeitrags der Saison bietet, wurden die SHAP-Werte der Saison nicht separat für jede Saisonkategorie angezeigt.
Ergebnisse
Die Merkmale des synthetischen Datensatzes sind in Abbildung 1A–F zusammengefasst. Der Datensatz umfasste Bedingungen mit klarem Himmel, Staub, Nebel, Regen und Schnee (Abbildung 1A) sowie Proben aus den heißen, trockenen und den kühlen, feuchten Jahreszeiten (Abbildung 1B) und aus Tages- sowie Nachtzeiträumen (Abbildung 1C). Die Verteilungen von Temperatur, Luftfeuchtigkeit und Sichtweite unter verschiedenen Wetterbedingungen sind in Abbildung 1D–F dargestellt.
Die maschinellen Lernmodelle zeigten eine starke Vorhersageleistung bei der Abschätzung der atmosphärischen Dämpfung (Abbildung 2A–D; Tabelle 3). RF erzielte die beste Gesamtleistung unter den bewerteten Modellen mit einem Test-R2 von 0,9654 und einem RMSE von 1,324 dB/km (Abbildung 2A; Tabelle 3). RF erklärte 96,54 % der beobachteten Variation, während der Vorhersagefehler unter 1,5 dB/km blieb. XGBoost schnitt ebenfalls gut ab (Abbildung 2C), gefolgt von LightGBM (Abbildung 2B). Die Robustheit des Modells wurde durch eine fünffache Kreuzvalidierung bestätigt, wobei RF einen Kreuzvalidierungs-R2 von 0,960 ± 0,007 erreichte (Abbildung 2D). Im Gegensatz dazu zeigten die k-nächsten Nachbarn Anzeichen einer Überanpassung, mit einem Trainings-R2 von 1,000 und einem Test-R2 von 0,7341, während die lineare Regression eine moderate Vorhersageleistung erzielte (Abbildung 2A; Tabelle 3).
Die Analyse der Merkmalswichtigkeit der oben genannten 10 Eingabemerkmale ist in Abbildung 3A dargestellt. Die relativen Wichtigkeitsscores sind wie folgt geordnet: Staubkonzentration (67,3 %), Sichtweite (21,2 %), Niederschlagsrate (6,0 %), Windgeschwindigkeit (2,1 %), Temperatur (1,5 %), Luftfeuchtigkeit (0,9 %), Monat (0,5 %), Jahreszeit (0,3 %), Schneefallrate (0,1 %) und Luftdruck (0,1 %). Die Variable „Wetterbedingung“ wird zur Datensatz-Stratifizierung verwendet, ist jedoch nicht in der Analyse der Merkmalswichtigkeit enthalten, da es sich um eine kategoriale Zusammengesetzte Variable handelt, die mehrere zugrundeliegende physikalische Parameter repräsentiert, und deren Einfluss durch die einzelnen Umweltmerkmale erfasst wird. Analysen zur Merkmalswichtigkeit und Interpretierbarkeit identifizierten die Umweltvariablen, die am stärksten mit der Dämpfung assoziiert sind (Abbildung 3A,B). Staubkonzentration (67,3 %), Sichtweite (21,2 %) und Niederschlagsrate (6,0 %) entfielen zusammen 94,4 % der gesamten Vorhersagebedeutung (Abbildung 3A). Die SHAP-Analyse zeigte zudem, dass eine zunehmende Staubkonzentration und eine abnehmende Sichtweite mit höheren Dämpfungsvorhersagen verbunden sind (Abbildung 3B).
Tiefenlernmodelle wiesen eine geringere Vorhersagegenauigkeit auf als die maschinellen Lernverfahren (Abbildung 4A–D). Das leistungsstärkste Tiefenlernmodell, das aufmerksamkeitsbasierte Netzwerk, erreichte ein Bestimmtheitsmaß (R2) von 0,7766 und einen RMSE-Wert von 3,362 dB/km (Abbildung 4A). Rekurrente Architekturen zeigten besonders schlechte Leistungen, wobei sowohl die LSTM- als auch die CNN–LSTM-Modelle nahezu null betragende R2-Werte und RMSE-Werte über 7,19 dB/km ergaben (Abbildung 4B). Die vergleichsweise schlechte Leistung der LSTM- und CNN-LSTM-Architekturen (R2 = 0,0110 bzw. 0,0109; RMSE = 7,193 dB/km und 7,196 dB/km) lässt sich teilweise durch die pseudo-sequenzielle Natur der Eingabedaten erklären, die die tatsächlichen zeitlichen Dynamiken atmosphärischer Bedingungen nicht vollständig erfasst.
Im Gegensatz zu Echtzeit-Zeitreihenanwendungen, bei denen die sequenziellen Abhängigkeiten stark und klar definiert sind, bestand unser Datensatz hauptsächlich aus unabhängigen Stichproben mit einer künstlich vorgegebenen zeitlichen Ordnung. Die geringe Vorhersagegenauigkeit dieser Architekturen legt nahe, dass die durch den Gleitfensteransatz gewonnene zeitliche Information entweder unzureichend war oder die reale atmosphärische Entwicklung nicht repräsentativ widerspiegelte (Abbildung 4C). Dies untermauert unsere Schlussfolgerung, dass für Datensätze dieser Art einfachere maschinelle Lernverfahren besser geeignet sind als komplexe, sequenzbasierte Deep-Learning-Modelle. Die Validierungsgenauigkeit aller Deep-Learning-Architekturen ist in Abbildung 4D zusammengefasst.
Die Leistung von Machine-Learning-, Deep-Learning- und hybriden Ansätzen ist in Abbildung 5A,B und Tabelle 3 zusammengefasst. Unter den hybriden Methoden erreichte das Voting-Ensemble ein R2 von 0,9340 und einen RMSE von 1,827 dB/km (Abbildung 5A,B; Tabelle 3). Das Ridge-Meta-Learner-Stacking erreichte ein R2 von 0,9571 und einen RMSE von 1,473 dB/km (Abbildung 5A,B; Tabelle 3) und näherte sich damit der Leistung des RF-Verfahrens an, benötigte jedoch deutlich längere Trainingszeiten. Das physikinformierte neuronale Netzwerk erreichte ein R2 = 0,8269 und RMSE = 2,960 dB/km (Abbildung 5A,B; Tabelle 3) und schnitt besser ab als die Deep-Learning-Modelle, jedoch nicht so gut wie die besten Machine-Learning-Ansätze. Ein statistischer Vergleich zwischen den RF- und Stacking-Ensemble-Modellen zeigte keinen signifikanten Unterschied in der Vorhersageleistung (Tabelle 3; gepaarter t-Test: t = −1,74, p = 0,083). Obwohl RF den höchsten numerischen R2-Wert erreichte, war der Unterschied zum besten hybriden Ansatz daher statistisch nicht signifikant.
Insgesamt unterstützen die Ergebnisse die Hypothese, dass maschinelle Lernverfahren die atmosphärische Dämpfung unter irakischen Wetterbedingungen genau vorhersagen können. Der Zufallswald (RF) erzielte durchgängig die höchste Vorhersagegenauigkeit (Abbildung 2A,B; Tabelle 3), während Analysen zur Merkmalswichtigkeit und SHAP-Analysen die Staubkonzentration und die Sichtweite als dominierende Umweltfaktoren identifizierten, die die Dämpfung beeinflussen (Abbildung 3A,B).
Validierungsdatenangabe: Alle Modellevaluierungen wurden anhand des in der Methodik beschriebenen synthetischen Datensatzes durchgeführt. Bei der Modellvalidierung wurden keine experimentellen oder beobachteten Daten zur atmosphärischen Dämpfung verwendet. Der synthetische Datensatz wurde mithilfe etablierter physikalischer Ausbreitungsmodelle (Beer-Lambertsches Gesetz, Kim-Modell, Carbonneau-Modell und Mie-Streutheorie) erstellt, wobei meteorologische Parameter aus Wahrscheinlichkeitsverteilungen basierend auf klimatischen Aufzeichnungen des Irak ausgewählt wurden. Wie im Methodikabschnitt erwähnt, könnte die hohe Vorhersagegenauigkeit teilweise darauf zurückzuführen sein, dass das Modell die deterministischen physikalischen Gleichungen, die zur Generierung der Zielwerte verwendet wurden, erlernt oder angenähert hat. Die quantitativen Leistungskennzahlen (R2, RMSE, MAE) stellen daher die Leistung an gleichungsabgeleiteten synthetischen Daten dar und sollten als relative Vergleiche zwischen Modellierungsansätzen in einer kontrollierten Simulationsumgebung interpretiert werden, nicht jedoch als absolute Leistungsgarantien für betriebliche FSO-Systeme. Dieser Ansatz bietet eine kontrollierte Umgebung zur vergleichenden Bewertung von Vorhersagemodellierungsverfahren (wie in Tabelle 2 aufgelistet), ersetzt jedoch nicht die Validierung mit realen FSO-Dämpfungsmessungen unter tatsächlichen Wetterbedingungen im Irak.
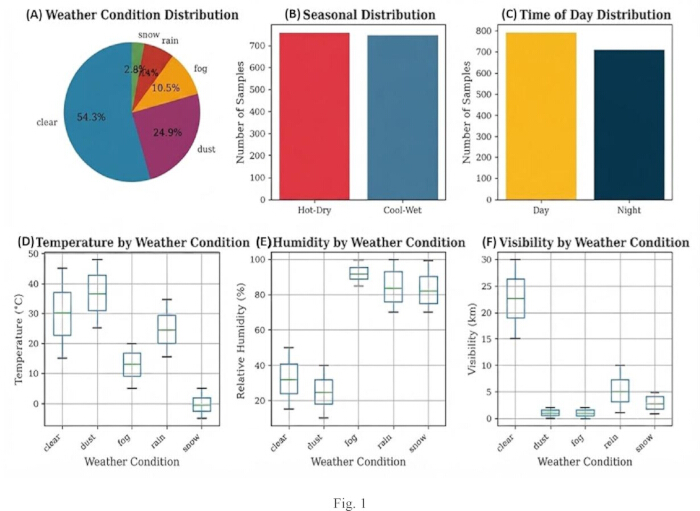
Abbildung 1: Merkmale des synthetischen Datensatzes und der für die Modellierung der atmosphärischen Dämpfung verwendeten Umweltvariablen. (A) Verteilung der im Datensatz dargestellten meteorologischen Bedingungen, einschließlich klarer Himmel, Staub, Nebel, Regen und Schneefall. (B) Saisonale Verteilung der Proben über heiße-trockene und kühle-feuchte Perioden hinweg. (C) Verteilung der tagsüber und nachts gesammelten Proben. (D) Temperaturverteilungen für jede Wetterbedingung. (E) Feuchtigkeitsverteilungen für jede Wetterbedingung. (F) Sichtweitenverteilungen für jede Wetterbedingung. Die Boxplots zeigen den Median (mittlere Linie), den Interquartilsabstand (Box), sowie die minimalen und maximalen Werte (Whiskers). Die Temperatur wird in °C, die Luftfeuchtigkeit in % und die Sichtweite in km angegeben. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
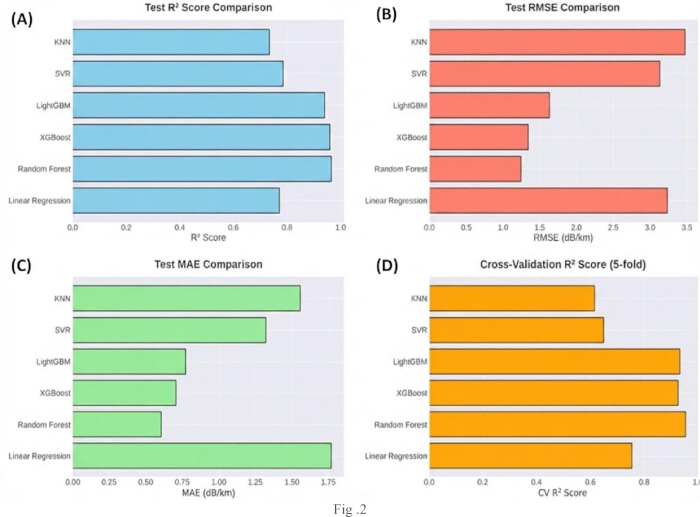
Abbildung 2: Leistungsvergleich von maschinellen Lernmodellen zur Vorhersage der atmosphärischen Dämpfung. (A) Bestimmtheitsmaß (R2) der Testdaten für die bewerteten Modelle des maschinellen Lernens, einschließlich Linearer Regression, Random Forest, Extreme Gradient Boosting (XGBoost), Light Gradient Boosting Machine (LightGBM), Support Vector Regression (SVR) und K-Nächste-Nachbarn (KNN). (B) Wurzel des mittleren quadratischen Fehlers (RMSE) der Testdaten für jedes Modell des maschinellen Lernens. (C) Mittlerer absoluter Fehler (MAE) der Testdaten für jedes Modell des maschinellen Lernens. (D) Bestimmtheitsmaß (R2) der Kreuzvalidierung, ermittelt mittels fünffacher Kreuzvalidierung. Höhere R2-Werte sowie niedrigere RMSE- und MAE-Werte weisen auf eine verbesserte Vorhersageleistung hin. RMSE und MAE sind in dB/km angegeben. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
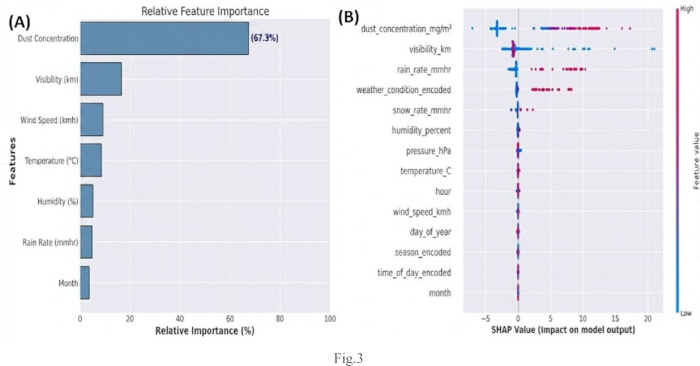
Abbildung 3: Analyse der Merkmalswichtigkeit und Modellinterpretierbarkeit für die Vorhersage der atmosphärischen Dämpfung. (A) Rangfolge der relativen, auf Unreinheit basierenden Merkmalswichtigkeit aus dem Random-Forest-Modell, die den Beitrag aller 10 Umwelt- und Zeitvariablen zur Dämpfungsvorhersage zeigt. Das einflussreichste Merkmal war die Staubkonzentration (67,3 %), gefolgt von Sichtweite (21,2 %), Niederschlagsrate (6,0 %), Windgeschwindigkeit (2,1 %), Temperatur (1,5 %), Luftfeuchtigkeit (0,9 %), Monat (0,5 %), Jahreszeit (0,3 %), Schneefallrate (0,1 %) und atmosphärischem Druck (0,1 %). Die relative Wichtigkeit ist ein Prozentsatz der gesamten Modellwichtigkeit. (B) SHAP-Zusammenfassungsdiagramm (SHapley Additive exPlanations), das den Einfluss einzelner Merkmale auf die Modellvorhersagen veranschaulicht. Die SHAP-Matrix wurde für 300 Testmengenproben (300 × 10 Merkmale) berechnet. Für die als One-Hot-kodierte Jahreszeitenvariable (ursprünglich vier binäre Spalten: Frühling, Sommer, Herbst, Winter) wurden die SHAP-Werte durch Summierung über die vier Kategorien hinweg kombiniert, um pro Probe einen einzelnen „Jahreszeit“-Beitragswert zu erhalten. Jeder Punkt repräsentiert eine Probe, und die Farbskala gibt den Merkmalswert an, der von niedrig (blau) bis hoch (rot) reicht. Positive SHAP-Werte deuten eine Erhöhung der vorhergesagten Dämpfung an, während negative SHAP-Werte eine Verringerung der vorhergesagten Dämpfung anzeigen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
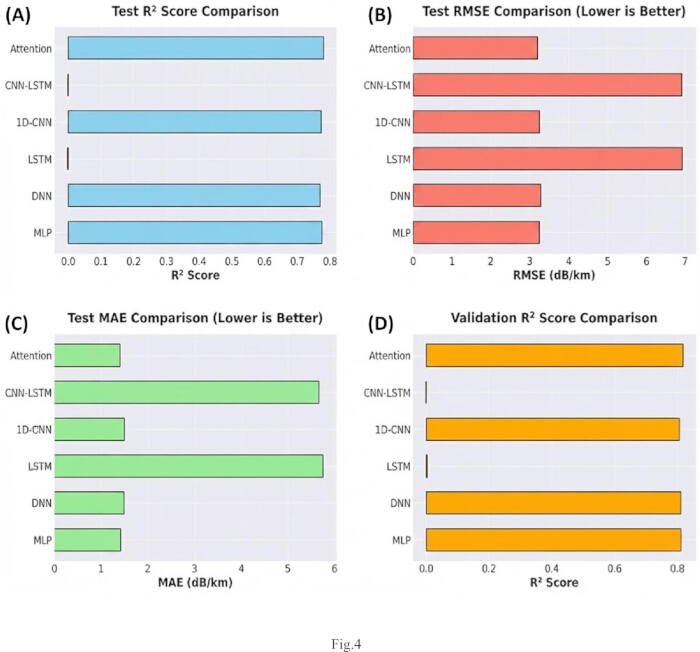
Abbildung 4: Leistungsvergleich von Deep-Learning-Modellen zur Vorhersage atmosphärischer Dämpfung. (A) Test-Koeffizienten der Bestimmung (R2) für die bewerteten Deep-Learning-Architekturen, einschließlich Multilayer-Perzeptron (MLP), Tiefes Neuronales Netzwerk (DNN), Long Short-Term Memory (LSTM), eindimensionales faltendes neuronales Netzwerk (1D-CNN), Faltendes Neuronales Netzwerk–Long Short-Term Memory (CNN–LSTM) und Modellen mit Aufmerksamkeitsmechanismus. (B) Testwerte des Wurzelmittelfehlerquadrats (RMSE) für jedes Deep-Learning-Modell. (C) Testwerte des mittleren absoluten Fehlers (MAE) für jedes Deep-Learning-Modell. (D) Validierungs-Koeffizienten der Bestimmung (R2) für die bewerteten Deep-Learning-Modelle. Höhere R2-Werte sowie niedrigere RMSE- und MAE-Werte deuten auf eine verbesserte Vorhersageleistung hin. RMSE und MAE sind in dB/km angegeben. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
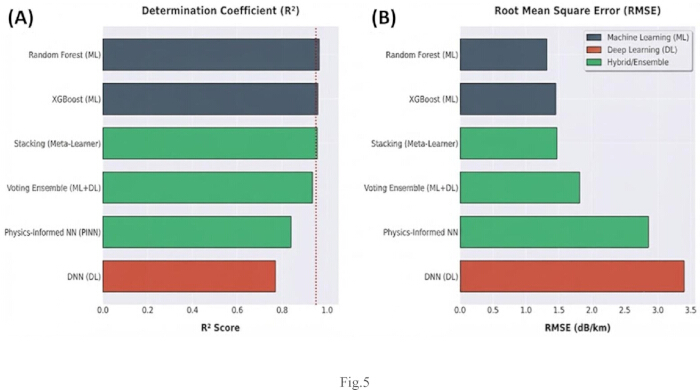
Abbildung 5: Vergleichende Leistung von Machine-Learning-, Deep-Learning- und Hybridmodellen zur Vorhersage der atmosphärischen Dämpfung. (A) Bestimmtheitsmaß (R2)-Werte für repräsentative Machine-Learning-, Deep-Learning- und Hybridansätze, einschließlich Random Forest, Extreme Gradient Boosting (XGBoost), Deep Neural Network (DNN), Voting Ensemble, Stacking und Physics-Informed Neural Network-Modelle. (B) Wurzel des mittleren quadratischen Fehlers (RMSE) für dieselben Modelle. Machine Learning (ML), Deep Learning (DL) und Hybrid- bzw. Ensemble-Techniken sind die drei Kategorien, nach denen die Modelle farblich codiert sind. Höhere R2- und niedrigere RMSE-Werte deuten auf eine verbesserte Vorhersageleistung hin. Der RMSE ist in dB/km angegeben. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Wetterbedingung | Anteil | Temperaturbereich | Luftfeuchtigkeitsbereich | Sichtweitenbereich | Hauptparameterbereich |
| klarer Himmel | 54,27 % (814 Proben) | −4,89 bis 47,99 °C | 0–100 % | >10 km | — |
| Staub | 25,00 % (375 Proben) | 10–45 °C | 10–60 % | 0,05–5 km | Staub: 0–4,96 mg/m3 |
| Nebel | 10,47 % (157 Proben) | −5 bis 20 °C | 70–100 % | 0,05–1 km | — |
| Regen | 7,40 % (111 Proben) | 5–30 °C | 60–100 % | 1–10 km | Regen: 0,25–50 mm/h |
| Schnee | 2,87 % (43 Proben) | −10 bis 5 °C | 50–100 % | 0,5–5 km | Schnee: 0,5–15 mm/h |
Tabelle 1: Leistungskennzahlen von Machine-Learning-Modellen zur Vorhersage der atmosphärischen Dämpfung.
| Modell | Test-R2 | RMSE (dB/km) | MAE (dB/km) | CV-R2 | Trainingszeit (s) |
| Random Forest | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| Support Vector Regression (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| Lineare Regression | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-Nächste-Nachbarn (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
Tabelle 2: Vergleichende Bewertung spezifischer Deep-Learning-, Hybrid- und Machine-Learning-Modelle.
| Modell | Kategorie | Test-R2 | RMSE (dB/km) | Rang |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking-Ensemble | Hybrid | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting-Ensemble | Hybrid | 0.934 | 1.827 | 5 |
| Physikbasiertes neuronales Netzwerk | Hybrid | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
Tabelle 3: Vergleich der Recheneffizienz (Training und Inferenz) der jeweils bewerteten Modelle.
VERFÜGBARKEIT VON DATEN :
Der vollständige synthetische Datensatz mit 1.500 Proben, der alle Eingangsmerkmale (Temperatur, Luftfeuchtigkeit, Sichtweite, Staubkonzentration, Niederschlagsrate, Schneefallrate, Windgeschwindigkeit, atmosphärischer Druck, Monat, Jahreszeit und Wetterbedingung) sowie die Zielvariable (Dämpfung in dB/km) umfasst, wird als ergänzende Datei zusammen mit diesem Manuskript unter https://doi.org/10.5281/zenodo.21792999 bereitgestellt. Der Datensatz ist so formatiert, dass jede Probe eine eigene Zeile besitzt, einschließlich aller berechneten Variablen (Betriebsbereich und SNR).
Der vollständige Implementierungscode, einschließlich: Datengenerierungsskripte (Implementierungen physikalischer Modelle); Funktionen zur Vorverarbeitung und Merkmalsskalierung; alle Implementierungen von Machine-Learning-Modellen; alle Implementierungen von Deep-Learning-Modellen; Skripte zur Auswertung und Visualisierung; sowie Verfahren zur Hyperparameterabstimmung und Kreuzvalidierung, soll ebenfalls als ergänzende Datei bereitgestellt werden.
Klimadatenquelle: Die zur Definition der Verteilungen der synthetischen Daten verwendeten Klimadaten stammen von der Irakischen Meteorologischen Organisation und Seismologie (IMOS) und dem Irakischen Ministerium für Verkehr und umfassen den Zeitraum 2020–2024. Eine Zusammenfassung der Klimadaten, die zur Bestimmung der Anteile der Witterungsbedingungen und der Parameterbereiche verwendet wurden, ist in Supplementär-Tabelle 1 enthalten. Die spezifischen IMOS-Datensätze, die in dieser Studie verwendet wurden, sind nicht öffentlich in einem zentralen Archiv hinterlegt, können jedoch direkt bei IMOS angefragt werden. Die Zusammenfassungsstatistiken und abgeleiteten Wahrscheinlichkeitsverteilungen werden in den ergänzenden Materialien bereitgestellt, um die Reproduzierbarkeit zu ermöglichen.
Angaben zum Repository: Der Quellcode und der Datensatz sind in einem öffentlichen Repository (Zenodo) mit https://doi.org/10.5281/zenodo.21792999 hinterlegt.
Diskussion
Um die Luftdämpfung in Freiraum-Optik-Kommunikationssystemen (FSO) unter irakischen Wetterbedingungen vorherzusagen, bewertete die vorliegende Studie maschinelle Lernverfahren, Deep-Learning- und hybride Techniken. Da atmosphärische Einflüsse weiterhin eines der Hauptprobleme darstellen, die die Leistung und Verfügbarkeit der Verbindung beeinträchtigen, haben neuere Untersuchungen die zunehmende Bedeutung prädiktiver Modellierung für FSO-Systeme hervorgehoben21. Die Ergebnisse zeigten, dass klassische Ansätze des maschinellen Lernens, insbesondere RF und XGBoost, eine hohe Vorhersagegenauigkeit erzielten und in einigen Fällen numerisch besser abschnitten als Deep-Learning- und hybride Methoden. Statistische Tests ergaben jedoch keinen signifikanten Unterschied (p=0.083) zwischen RF und dem besten hybriden Ensemble (Stacking), was bedeutet, dass beide Ansätze mit diesem Datensatz vergleichbare Ergebnisse erzielen können. Unsere Ergebnisse deuten darauf hin, dass baumbasierte Ensemble-Methoden für tabellarische Umweltdaten mit moderaten Stichprobengrößen und einer geringen Anzahl dominanter Prädiktorvariablen nach wie vor sehr leistungsfähig sind. Die Analyse der Merkmalswichtigkeit zeigte, dass Staubkonzentration und Sichtweite die Haupttreiber der Dämpfung waren und zusammen den Großteil der Vorhersagekraft erklären. Dieses Ergebnis stimmt mit früheren Untersuchungen überein, die den wichtigen Einfluss von Nebel, Staub, Aerosolen und atmosphärischer Verschmutzung auf die Ausbreitung des optischen Signals belegen22,23,24,25. Ähnliche Befunde wurden in Anwendungen des Umweltmonitorings berichtet, bei denen Modelle des maschinellen Lernens oft von Datensätzen mit einer geringen Anzahl hochinformativer Variablen profitieren26,27,28,29,30,31,32. Die SHAP-Analyse verbesserte die Modellinterpretierbarkeit weiter, indem sie den Einfluss einzelner Umweltparameter auf die Dämpfungsvorhersagen quantifizierte.
Die geringere Leistungsfähigkeit der Deep-Learning-Modelle lässt sich auf mehrere Faktoren zurückführen. Der Datensatzumfang war relativ bescheiden für das Training komplexer neuronaler Architekturen (in https://doi.org/10.5281/zenodo.21792999), und die Umweltvariablen wiesen eine stark konzentrierte Merkmalswichtigkeit auf. Frühere Studien haben gezeigt, dass Deep-Learning-Methoden im Allgemeinen von großen Datensätzen, hierarchischen Merkmalsstrukturen und komplexen nichtlinearen Repräsentationen profitieren33,34,35,36,37. Im Gegensatz dazu enthielt der in dieser Studie verwendete Dämpfungsdatensatz nur eine begrenzte Anzahl dominanter Prädiktoren und wies nicht die zeitlichen Abhängigkeiten auf, die für rekurrente Architekturen erforderlich sind. Die schlechte Leistung der LSTM- und CNN–LSTM-Modelle legt nahe, dass sequenzielle Lernmechanismen für diese Anwendung keine wesentlichen Vorteile bieten.
Die Dominanz der Staubkonzentration (67,3 %) und der Sichtweite (21,2 %) als Prädiktoren der atmosphärischen Dämpfung lässt sich auf mehrere Faktoren zurückführen. Erstens die molekulare Streuung und Absorption bei 1550 nm werden von der Mie-Streuung durch Staubpartikel überlagert. Nach der Mie-Theorie ist die Extinktionswirkungsgrad Q_ext stark von der Partikelkonzentration abhängig, und die Dämpfung skaliert im mittleren bis hohen Konzentrationsbereich nahezu linear mit der Staubkonzentration. Zweitens ist der Irak häufigen Staubstürmen ausgesetzt (25,00 % der Tage in unseren Klimaaufzeichnungen), die Dämpfungswerte von 4–30 dB/km verursachen. Dies steht im Gegensatz zu Nebel (10,47 %, 0,5–10 dB/km) und Regen (7,40 %, 2–25 dB/km). Die größere Variabilität der Staubdämpfung führt zu stärkeren Signalen, aus denen die Modelle lernen können. Drittens folgt die Staubkonzentration einer exponentiellen Verteilung (0,4–4,96 mg/m3) erzeugt eine breite Palette von Dämpfungswerten. Der lange Schwanz bei extremen Staubereignissen führt zu hohen Dämpfungswerten, die für eine genaue Vorhersage wichtig sind. Viertens weist das Mie-Streumodell eine einfachere (annähernd lineare) Abhängigkeit von der Staubkonzentration auf, die für baumbasierte Modelle leichter zu approximieren ist als der komplexere Zusammenhang zwischen Sichtweite und Nebeldämpfung im Kim-Modell. Fünftens ist dieses Ergebnis von praktischer Bedeutung, da Staubstürme eine der herausforderndsten Umweltbedingungen für Freiraum-Optik (FSO) im Nahen Osten darstellen. Eine genaue Vorhersage während Staubereignisse ist entscheidend für den zuverlässigen Betrieb des Systems.
Die Ergebnisse tragen zur Erforschung der Freiraum-Optik-Kommunikation bei, indem sie praktische Anleitungen zur Auswahl von Algorithmen für die Vorhersage atmosphärischer Dämpfung bereitstellen. Eine genaue Vorhersage der Dämpfung ist entscheidend für die Netzwerkplanung, adaptives Link-Management und die zuverlässige Implementierung optischer Kommunikationssysteme in anspruchsvollen Umgebungen wie dem Nahen Osten23,28,30,36. Darüber hinaus könnte die Methodik auf andere Umweltvorhersageprobleme anwendbar sein, die Luftausbreitung, atmosphärische Überwachung und die Bewertung der Leistung optischer Netzwerke betreffen38,39,40. Größere reale Datensätze, fortschrittliche Ensemble-Lernverfahren, Transfer-Learning-Strukturen oder komplexere physikbasierte Architekturen sind weitere Ansätze, um diese Idee zu untersuchen41,42,43,44,45.
Umfang der Schlussfolgerungen und Probleme der Verallgemeinerbarkeit
Die Schlussfolgerungen dieser Arbeit basieren hauptsächlich auf einem synthetischen Datensatz, der aus etablierten physikalischen Ausbreitungsmodellen generiert wurde (Beer-Lambertsches Gesetz, Kim-Modell, Carbonneau-Modell und Mie-Streuungstheorie). Dieser methodische Ansatz hat Auswirkungen auf den Umfang und die Verallgemeinerbarkeit unserer Ergebnisse:
Schlussfolgerungen aus simulierten Daten: (1) Vergleichende Leistungsbeurteilung von maschinellen Lernverfahren, tiefen neuronalen Netzen und hybriden Ansätzen zur Vorhersage der atmosphärischen Dämpfung. (2) Identifizierung der Staubkonzentration und Sichtweite als dominierende Umweltfaktoren für die optische Dämpfung unter den modellierten Bedingungen. (3) Recheneffizienzvorteil von baumbasierten Ensemble-Methoden gegenüber Architekturen des tiefen Lernens. (4) Interpretierbarkeit der Merkmalswichtigkeit und SHAP-Analysen zur Erklärung der Modellvorhersagen.
Schlussfolgerungen, die eine Bestätigung unter realen Bedingungen erfordern: (1) Die absoluten Werte von R2 und RMSE, die von den evaluierten Modellen erzielt wurden, hängen von den spezifischen Eigenschaften des synthetischen Datensatzes ab und könnten widerspiegeln, dass die Modelle die deterministischen physikalischen Gleichungen erlernt haben, die zur Generierung der Zielgrößen verwendet wurden. (2) Es bleibt noch zu beweisen, dass das beste Modell, Random Forest, auf unbekannte reale atmosphärische Bedingungen angewendet werden kann. (3) Eine Validierung vor Ort ist erforderlich, damit die Ergebnisse auf betriebliche FSO-Einheiten, die im Irak installiert sind, übertragbar sind. (4) Es muss bestätigt werden, dass die ermittelten Rangfolgen der Merkmalswichtigkeit unter Bedingungen realer Feldmessungen robust sind.
Es ist wichtig, die Leistung bei auf Gleichungen basierenden synthetischen Daten von der Leistung bei verrauschten Beobachtungs- oder Experimentaldaten zu unterscheiden. Der synthetische Datensatz liefert einen sauberen, rauschfreien Zusammenhang zwischen den Eingangsmerkmalen und dem Abschwächungsziel, was möglicherweise zu höheren Vorhersageleistungskennzahlen führt, als sie mit realen Daten unter Berücksichtigung von Messrauschen, Instrumentenfehlern und nicht modellierten physikalischen Phänomenen erzielbar sind. Wir empfehlen, zukünftige Arbeiten auf die Gewinnung realer FSO-Abschwächungsmessungen unter den Wetterbedingungen im Irak auszurichten, um die hier vorgestellten Ergebnisse zu validieren und die tatsächliche Verallgemeinerbarkeit der vorgeschlagenen Methoden zu bewerten.
Auswirkungen synthetischer Daten auf die Generalisierbarkeit von Modellen
Die Auswirkungen der Verwendung synthetischer Daten in dieser Studie sollten sorgfältig hinsichtlich der Übertragbarkeit der Modelle berücksichtigt werden:
Vorteile des synthetischen Ansatzes Der Datensatz ist physikalisch konsistent und basiert durch die Verwendung etablierter physikalischer Ausbreitungsmodelle auf anerkannten theoretischen Rahmenbedingungen. Meteorologische Parameter wurden aus meteorologischen Aufzeichnungen des Irak extrahiert, um sicherzustellen, dass der Datensatz die statistischen Eigenschaften der tatsächlichen Wetterbedingungen im Irak widerspiegelt. Zusätzlich zu der Vermeidung von störenden Variablen bei Feldmessungen (wie Messfehlern, Gerätekalibrierung oder unzureichenden Datenaufzeichnungen) ermöglicht diese kontrollierte Umgebung eine systematische Untersuchung von Modellierungsansätzen.
Einschränkungen der Übertragbarkeit Der synthetische Datensatz weist Einschränkungen hinsichtlich der Erfassung der vollen Komplexität der realen atmosphärischen Dämpfung auf, einschließlich: (1) der Wechselwirkung mehrerer gleichzeitig auftretender atmosphärischer Phänomene; (2) des nichtlinearen und nichtstationären Verhaltens atmosphärischer Parameter; (3) der langfristigen klimatischen Variabilität, die durch die Stichprobenverteilungen nicht erfasst wird; (4) lokal begrenzter mikroklimatischer Effekte, die die FSO-Ausbreitung erheblich beeinflussen können; und (5) des Rauschens und der Unsicherheiten, die der Datenerfassung in der realen Welt inhärent sind.
Biasüberlegungen bei der Erzeugung synthetischer Daten: Die Annahme einer unabhängigen Stichprobenziehung von Umweltparametern (siehe Methoden) stellt eine Vereinfachung realer Bedingungen dar, bei denen atmosphärische Variablen tendenziell korreliert sind (z. B. sind hohe Staubkonzentrationen oft mit geringer Sichtweite verbunden). Eine Unabhängigkeitsannahme wurde getroffen, um eine kontrollierte Simulationsumgebung für einen systematischen Modellvergleich zu schaffen. Diese Methode könnte jedoch die volle Komplexität der Wechselwirkungen zwischen atmosphärischen Parametern nicht erfassen. Wir verwenden ein geschichtetes Aufteilungsverfahren (bei dem die Verhältnisse der Wetterbedingungen in Trainings- und Testmengen erhalten bleiben), um die Wahrscheinlichkeit einer unausgewogenen Repräsentation seltener Bedingungen in der Testmenge (insbesondere Schnee mit 2,87 %) zu minimieren.
Deterministische Zielgenerierung: Die in dieser Studie beobachtete hohe Vorhersagegenauigkeit lässt sich teilweise dadurch erklären, dass die Modelle die deterministischen physikalischen Gleichungen erlernt haben, die zur Erzeugung der Zielwerte verwendet wurden. Im Gegensatz dazu enthalten reale experimentelle Daten Messrauschen, Instrumentenfehler und nicht modellierte physikalische Phänomene, die die Vorhersage erschweren. Daher sollten die quantitativen Leistungsmetriken (R2, RMSE, MAE) als relative Vergleiche zwischen Methoden in einer kontrollierten Simulationsumgebung interpretiert werden und nicht als absolute Leistungsgarantien für betriebliche FSO-Systeme.
Daher sollten die absoluten Leistungsmetriken (R2, RMSE, MAE) nicht als Hinweis auf die erwartete Leistung in betrieblichen FSO-Systemen verstanden werden, obwohl die vergleichenden Ergebnisse zur Modellleistung wahrscheinlich robust sind (aufgrund der physikalischen Konsistenz der synthetischen Daten). Es ist notwendig, die Generalisierbarkeit des Modells auf reale Bedingungen anhand experimenteller Luftdämpfungsmessungen zu überprüfen, die unter verschiedenen Wetterbedingungen im Irak gewonnen wurden.
Es gibt einige Einschränkungen, die berücksichtigt werden sollten. Erstens basierte die Studie nicht auf Feldbeobachtungen, sondern auf einem synthetischen Datensatz, der mithilfe bekannter physikalischer Ausbreitungsmodelle erstellt wurde. Wie bereits erwähnt, sollten die quantitativen Leistungskennzahlen (R2, RMSE, MAE) nicht als absolute Leistungsgarantien für betriebliche FSO-Systeme verstanden werden, sondern vielmehr als relative Vergleiche von Ansätzen in einer kontrollierten Simulationsumgebung. Zweitens könnten Standard- und Deep-Learning-Modelle aufgrund des Umfangs des Datensatzes möglicherweise keine robusten Merkmalsdarstellungen erlernen. Drittens wurden andere FSO-Leistungsindikatoren wie Verbindungserreichbarkeit, Ausrichtungsfehler und durch Turbulenzen verursachte Signalabschwächung zugunsten der Abschwächungsvorhersage nicht berücksichtigt. Viertens wurden historische Aufzeichnungen aus den Jahren 2020 bis 2024 verwendet, um die Anteile der Wetterbedingungen zu berechnen, was möglicherweise keine genaue Abbildung der jährlichen klimatischen Schwankungen im Irak darstellt. Fünftens stellt die pseudo-sequentielle Eingabedatenstruktur der CNN–LSTM- und LSTM-Modelle eine methodische Vereinfachung dar, die die zeitlichen Dynamiken realer Anwendungen möglicherweise nicht ausreichend erfasst. Diese Einschränkungen sollten bei der Bewertung der Ergebnisse berücksichtigt werden, da sie die Übertragbarkeit der Ergebnisse beeinflussen könnten.
Empfohlene Priorität: Überprüfung in der realen Welt. Die Erfassung und Analyse tatsächlicher FSO-Abschwächungsmessungen unter irakischen Wetterbedingungen ist der wichtigste zukünftige Forschungsansatz. Dies sollte umfassen: (1) den Aufbau von FSO-Testbetten in verschiedenen Regionen des Irak (z. B. Bagdad, Basra, Mossul, Ramadi), um regionale klimatische Unterschiede zu erfassen; (2) die gleichzeitige Messung atmosphärischer Parameter (Temperatur, Luftfeuchtigkeit, Sichtweite, Staubkonzentration) an den FSO-Standorten mithilfe kalibrierter Instrumente; (4) die Dokumentation der Abschwächung während extremer Wetterereignisse (Staubstürme, dichter Nebel, starker Regen); (5) die öffentliche Bereitstellung der erhobenen Daten, um Reproduzierbarkeit und vergleichende Forschung zu ermöglichen; sowie (3) die kontinuierliche Überwachung über mindestens einen vollständigen Jahreszyklus, um saisonale Schwankungen zu erfassen. Eine solche praktische Validierung böte die Möglichkeit, die Übertragbarkeit des Modells zu bewerten und die in dieser Studie entwickelten Vorhersagetechniken weiterzuentwickeln.
Um die erstellten Modelle zu validieren und zu verbessern, sollte sich zukünftige Forschung darauf konzentrieren, tatsächlich unter irakischen Wetterbedingungen gewonnene FSO-Messungen einzubeziehen. Weitere Untersuchungen könnten Transferlernstrategien untersuchen, die relevante atmosphärische Datensätze nutzen, Online-Lernverfahren, die sich an wechselnde Umweltbedingungen anpassen, sowie hybride experimentell-simulationsbasierte Ansätze, die gemessene Daten mit physikalischen Modellen kombinieren. Zusätzliche Forschung zu erklärbarer Künstlicher Intelligenz und fortschrittlichen, physikbasierten Lernverfahren könnte zudem weitere Einblicke in die Mechanismen der Luftdämpfung gewähren und die Robustheit zukünftiger Vorhersagesysteme stärken.
Offenlegungen
Interessenkonflikt: Die Autoren geben an, dass kein Interessenkonflikt besteht.
Danksagungen
Die Autoren erklären, dass für diese Forschung keine externe Förderung erhalten wurde. Wir danken dem Internationalen Zentrum für Angewandte und Theoretische Forschung (IATRC), Bagdad-Viertel, Irak.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | Bibliothek zur GPU-Beschleunigung für das Training von Deep Learning-Modellen |
| cuDNN | NVIDIA Corporation | 8.6.0 | GPU-beschleunigte Bibliothek für tiefe neuronale Netze |
| GPU (Graphics Processing Unit) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | Verwendet für GPU-beschleunigtes Deep-Learning-Training |
| CPU (Central Processing Unit) | Intel Corporation | Core i9-13900K, 24 Kerne/32 Threads | Workstation-Prozessor für das Training und die Evaluierung aller Modelle |
| Arbeitsspeicher (RAM) | nicht verfügbar | 64 GB DDR5, 5200 MHz | Arbeitsspeicher der Workstation |
| Keras API | Open Source (Teil von TensorFlow) | im Lieferumfang von TensorFlow 2.11.0 enthalten | Hochwertige Deep-Learning-API, verwendet für alle DL-Architekturen |
| LightGBM | Open Source (Microsoft) | 3.3.5 | Gradient-Boosting-Framework |
| NumPy | Open Source (NumFOCUS) | 1.23.5 | Bibliothek für numerische Berechnungen |
| Betriebssystem | Canonical Ltd. | Ubuntu 22.04 LTS | Betriebssystem der Workstation |
| Python | Python Software Foundation | 3.9 | Programmiersprache für die gesamte Datenerzeugung und Modellierung |
| scikit-learn | Open Source | 1.2.2 | Machine-Learning-Bibliothek (RF, SVR, KNN, Lineare Regression, Kreuzvalidierung, Skalierung) |
| SHAP (SHapley Additive exPlanations) | Open Source | 0.41.0 | Bibliothek zur Modellinterpretierbarkeit, TreeExplainer-Modul |
| TensorFlow | Open Source (Google) | 2.11.0 | Deep-Learning-Framework, verwendet für alle sechs DL-Architekturen |
| XGBoost | Open Source | 1.7.5 | Extreme Gradient Boosting-Bibliothek |
Referenzen
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.