Hier stellen wir ein Protokoll zur Anreicherung von mitochondrieller DNA aus einzelnen menschlichen Eizellen mittels Exonuclease V und zur Herstellung von Duplex-Sequenzierbibliotheken für den hochgenauen Nachweis von Varianten der mitochondrialen DNA unter Verwendung mit Illumina kompatibler Sequenzierplattformen vor.
Methodenartikel
Protokoll für das Duplex-Sequenzing mitochondrialer DNA in einzelnen menschlichen Oozyten
In diesem Artikel
Zusammenfassung
Zusammenfassung
Oozyten sind dicht mit Mitochondrien gefüllt, den energieproduzierenden Organellen, die über ein eigenes Genom, die mitochondriale DNA (mtDNA), verfügen. Jede Zelle enthält mehrere Kopien der mtDNA, wobei die Kopienzahl zwischen verschiedenen Gewebetypen variiert. Oozyten weisen die höchste mtDNA-Kopienzahl auf und enthalten Hunderttausende von mtDNA-Molekülen pro Zelle. Da Mitochondrien ausschließlich über die mütterliche Linie vererbt werden, ist die genaue Detektion von mtDNA-Varianten entscheidend für Studien zur Vererbung, Alterung und Krankheit. Die Anwesenheit mehrerer mtDNA-Kopien ermöglicht es, dass Wildtyp- und Mutantenmoleküle innerhalb derselben Zelle koexistieren, ein Zustand, der als Heteroplasmie bekannt ist, bei dem Varianten mit geringer Häufigkeit und de-novo-Varianten mit Frequenzen unter 1 % auftreten können. Die konventionelle Next-Generation-Sequenzierung (NGS) weist nicht ausreichende Genauigkeit auf, um diese seltenen Varianten zuverlässig von Fehlern zu unterscheiden, die während der Bibliotheksherstellung und Sequenzierung eingeführt werden. Hier stellen wir ein Protokoll zur Anreicherung der mtDNA aus einzelnen menschlichen Oozyten mithilfe von Exonuclease V zur Entfernung linearer DNA vor, gefolgt von der Herstellung einer Duplex-Sequenzierungsbibliothek für eine hochgenaue mtDNA-Analyse. Dieser Arbeitsablauf ermöglicht die fehlerkorrigierte Sequenzierung einzelner Oozyten und erleichtert die zuverlässige Detektion von mtDNA-Varianten mit geringer Häufigkeit sowie die Analyse von Heteroplasmie und de-novo-Mutagenese. Das Protokoll bietet einen reproduzierbaren Ansatz zur Untersuchung der Variation des mitochondrialen Genoms in einzelnen Oozyten unter Verwendung mit Illumina kompatibler Sequenzierplattformen.
Einleitung
Mitochondrien spielen grundlegende Rollen bei essentiellen zellulären Prozessen, darunter Energieproduktion, Apoptose, Signalübertragung und Calcium-Homöostase1. Sie verfügen über ein eigenes Genom, die mitochondriale DNA (mtDNA), ein kreisförmiges, doppelsträngiges Molekül mit einer Länge von etwa 16,6 kb bei Säugetieren. Obwohl die meisten ursprünglichen mitochondrialen Gene während der Endosymbiose auf das nukleäre Genom übertragen wurden, enthält die mtDNA weiterhin 37 Gene, die für 13 oxidative Phosphorylierungs-(OXPHOS)-Polypeptide, 22 Transfer-RNAs (tRNAs) und zwei ribosomale RNAs (rRNAs) kodieren2. Mutationen in der mtDNA können die mitochondriale Genexpression und Funktion beeinträchtigen und zu schweren Erkrankungen führen3. Da Mitochondrien ausschließlich über die mütterliche Linie vererbt werden, spielt die mtDNA der Oozyten eine entscheidende Rolle bei der Befruchtung, embryonalen Entwicklung und Gesundheit der Nachkommen4. Daher sind die Detektion und Charakterisierung von mtDNA-Mutationen sowie deren Häufigkeiten von erheblichem Interesse. Beispielsweise ist das Verständnis der Keimbahn-Mutagenese im Zusammenhang mit Alterung und Krankheit eine wichtige Voraussetzung für die Entwicklung therapeutischer Strategien bei weiblicher Unfruchtbarkeit.
Im Gegensatz zur nukleären DNA ist die mtDNA in mehreren Kopien pro Zelle vorhanden, wobei die Anzahl je nach Gewebetyp zwischen einigen hundert und mehreren tausend Kopien in somatischen Zellen variiert und in reifen Oozyten über 100.000 Kopien überschreiten kann4. Diese hohe mtDNA-Kopienzahl macht Oozyten besonders geeignet, um mitochondriale Mutagenese auf Einzelzell-Ebene zu untersuchen. Die Detektion neu entstandener mtDNA-Mutationen, insbesondere solcher mit sehr geringer Häufigkeit, bleibt jedoch herausfordernd, da die Fehlerraten herkömmlicher Next-Generation-Sequenzierungsverfahren (NGS) die Häufigkeiten vieler echter Varianten übersteigen5. Daher sind fehlerkorrigierende Sequenziermethoden erforderlich, um echte Mutationen von Artefakten zu unterscheiden, die während der Bibliotheksherstellung, Amplifikation und Sequenzierung entstehen. Ein solches Verfahren ist die Duplex-Sequenzierung (DS)6,7. Bei der DS werden DNA-Fragmente vor der Amplifikation an Adapter mit doppelsträngigen, zufällig generierten 12-Nukleotid-Molekularmarkern ligiert. Diese eindeutigen molekularen Identifikatoren markieren jedes ursprüngliche DNA-Molekül an beiden Enden, wodurch Sequenzierungsreads, die von demselben Vorlagestrang stammen, basierend auf ihrer gemeinsamen Markierungssequenz zu Familien zusammengefasst werden können. Aus jeder Lese-Familie wird eine Einzelstrang-Konsenssequenz (SSCS) generiert, woraufhin komplementäre SSCSs, die vom ursprünglichen DNA-Duplex stammen, kombiniert werden, um eine Duplex-Konsenssequenz (DCS) zu erzeugen. Nur Varianten, die in der Mehrheit der Reads innerhalb beider komplementärer SSCSs nachgewiesen werden und in der resultierenden DCS bestätigt sind, gelten als echte Mutationen, wodurch Fehlerraten erreicht werden, die um mehrere Größenordnungen niedriger liegen als bei herkömmlichen NGS-Verfahren8. Diese Strategie ist besonders vorteilhaft für die Detektion von mtDNA-Varianten mit geringer Häufigkeit und Heteroplasmie in Einzelzellen.
Eine wesentliche Einschränkung der meisten veröffentlichten Duplex-Sequenzierungsprotokolle ist die Notwendigkeit vergleichsweise großer Mengen an Input-DNA während der Bibliotheksherstellung, wodurch diese Methoden für Einzelzell-Anwendungen ungeeignet sind6,7,9. Das übergeordnete Ziel dieses Protokolls besteht darin, eine hochgenaue Duplex-Sequenzierung der mtDNA aus einzelnen menschlichen Oozyten durch einen optimierten Arbeitsablauf für die Anreicherung der mtDNA, die Bibliotheksherstellung und die Sequenzierung zu ermöglichen. Um die Sequenzierung nuklearer mitochondrialer DNA-Abschnitte (NUMTs) zu minimieren und die Sequenzierungseffizienz zu verbessern, beinhaltet dieses Protokoll einen Anreicherungsschritt auf Basis von Exonuklease V, der linearer DNA selektiv abbaut, während zirkuläre mtDNA erhalten bleibt. Der resultierende Arbeitsablauf bietet einen praktikablen Ansatz für die genaue Detektion von mtDNA-Varianten in einzelnen Oozyten und eignet sich für Studien zur Heteroplasmie, de-novo-Mutagenese, Alterung und mitochondriellen Erkrankungen.
Protokoll
Die Gewinnung und Verarbeitung menschlicher Oozyten wurde von der Ethikkommission der Johannes Kepler Universität Linz genehmigt (Genehmigungsnummer 1293/2020). Führen Sie alle Verfahren gemäß den institutionellen Richtlinien durch, einschließlich informierter Einwilligung, Anonymisierung der Proben und aller geltenden Vorschriften zum Umgang mit menschlichem Gewebe.
HINWEIS: Obwohl dieses Protokoll für humane Oozyten beschrieben ist, passen Sie die artenspezifischen Primer an, um den Arbeitsablauf auf andere Arten zu übertragen. Verwenden Sie während des gesamten Protokolls Verbrauchsmaterialien mit geringer DNA-Bindungskapazität (z. B. Röhrchen und Pipettenspitzen), um Probenverluste zu minimieren. Führen Sie alle Schritte bis zur ersten Reinigung im ursprünglichen Low-Binding-Oozyten-Sammelröhrchen durch. Vortexen Sie die Proben nicht, da dies die DNA-Stränge beschädigen könnte. Mischen Sie die Reaktionsbestandteile stattdessen durch vorsichtiges Auf- und Abpipettieren oder sanftes Anflicken des Röhrchens, gefolgt von einer kurzen Zentrifugation. Führen Sie nach Möglichkeit die DNA-Isolierung, die Herstellung der Master-Mix-Lösung und die Reaktionsansätze in dedizierten Polymerase-Kettenreaktions-(PCR-)Arbeitsstationen oder räumlich getrennten Laborbereichen durch, um Kontaminationen zu minimieren.
1. Herstellung von Puffern und Reagenzien
- Stellen Sie den Oozyten-Lysepuffer (OLB), 10 mM Tris-HCl, TE-Puffer, TElow-Puffer und 10 mM Tris-NaCl gemäß Tabelle 1 her, indem Sie die angegebenen Volumina der Stammlösungen kombinieren und jede Lösung mit wasserfreier Molekularbiologie-Grad-Wasser auf das vorgesehene Endvolumen auffüllen. Portionieren Sie 1 mL der hergestellten Puffer ab, lagern Sie die Aliquots bei 4 °C und verwenden Sie sie innerhalb eines Jahres.
Tabelle 1: Zusammensetzung der Puffer, die im gesamten Protokoll verwendet werden. Pufferzusammensetzungen und Endkonzentrationen zur Herstellung von 10 mM Tris-HCl, TE-Puffer, TElow-Puffer, 10 mM Tris-NaCl und Oozyten-Lysepuffer (OLB). Bereiten Sie alle Puffer mit wasserfreier Molekularbiologie-Grad-Wasser zu. Stellen Sie den pH-Wert der Tris-HCl- und EDTA-Stammlösungen gegebenenfalls gemäß den Herstellerempfehlungen vor der Pufferherstellung ein. OLB wird unmittelbar vor der Probelyse, wie im Protokoll beschrieben, mit thermolabiler Proteinase K ergänzt. Bitte klicken Sie hier, um diese Datei herunterzuladen.
2. Einzelne Oozytensammlung
HINWEIS: Die in diesem Protokoll verwendeten menschlichen Oozyten wurden von Patientinnen gewonnen, die sich in der Kinderwunsch-Zentrum (Fertilitätszentrum) des Kepler Universitätsklinikums in Linz, Österreich, für eine intrazytoplasmatische Spermieninjektion (ICSI) angemeldet hatten. Die Ovarialstimulationsprotokolle basierten auf der vorhergesagten ovariellen Antwort der Patientin, und die Dosierungen wurden entsprechend individuellen Merkmalen wie Alter, Spiegel des anti-Müller'schen Hormons (AMH) und Körpergewicht gemäß den Empfehlungen der Europäischen Gesellschaft für Humanreproduktion und Embryologie (ESHRE)10 angepasst. Die Hypophysensuppression wurde entweder mittels Gonadotropin-freisetzendem Hormon (GnRH)-Agonist oder mittels GnRH-Antagonist-Protokoll in Kombination mit einer gonadotropen Stimulation zur Förderung der follikulären Reifung erreicht. Das follikuläre Wachstum wurde regelmäßig mittels transvaginaler Sonographie überwacht, bevor der Eisprung ausgelöst wurde. Die Oozyten wurden anschließend durch transvaginale Follikelaspiration entnommen, und die Follikelflüssigkeit, die die Cumulus-Oozyten-Komplexe (COCs) enthielt, wurde gesammelt11. Für die Forschung standen ausschließlich unreife oder nicht befruchtete Oozyten zur Verfügung, die nicht für die ICSI-Behandlung der Patientin verwendet werden konnten und andernfalls verworfen worden wären, nachdem eine informierte Einwilligung eingeholt worden war. Patientinnen mit höheren Antralfollikelzahlen (AFCs) wurden bevorzugt um Spende von Oozyten gebeten, da sie voraussichtlich mehr unreife oder nicht befruchtete Oozyten produzierten, die sich für Forschungszwecke eigneten. Alle vor der Auswahl der Oozyten für die Forschung durchgeführten Verfahren müssen den nationalen Vorschriften zur In-vitro-Fertilisation und zur Verwendung menschlichen Gewebes entsprechen. Alle Materialien sind unter sterilen Bedingungen in einer laminarer Luftströmungswerkbank zu handhaben. Stellen Sie sicher, dass alle mit den Oozyten in direkten Kontakt kommenden, CE-zertifizierten Materialien und Kulturmedien steril sind, auf 37 °C vorgewärmt und auf einem pH-Wert von 7,20–7,40 gehalten werden.
- Sammeln Sie COCs aus dem Follikelflüssigkeit und überführen Sie sie unter steriler Mineralkurzöl in 750 µL GM501 Kulturmedium nach kontrollierter ovarieller Hyperstimulation und transvaginaler Oozytenentnahme.
- Entfernen Sie die umgebenden Cumuluszellen von der Zona pellucida (ZP) durch enzymatische Verdauung mit Hyaluronidase. Inkubieren Sie die Oozyten für 30–60 s bei 37 °C in 500 µL GM501 Hyaluronidase (80 U/mL), gefolgt von drei Waschschritten in jeweils 750 µL GM501 Kulturmedium. Entfernen Sie alle verbleibenden Cumuluszellen vorsichtig mechanisch mithilfe von Denudationspipetten.
- Öffnen Sie bei Oozyten in Telophase I (TI) oder Metaphase II (MII) die ZP durch eine Serie von Laserimpulsen neben dem Polkörper und entfernen Sie den ersten Polkörper mittels Mikromanipulatoren. Passen Sie die Laserparameter entsprechend der Dicke der ZP an (1–3 Impulse; Impulsdauer 1,5–2,6 ms; Spotdurchmesser 16–20 µm). Nutzen Sie den Laser, um verbleibende Cumuluszellen zu entfernen, um eine Kontamination der Oozyte mit somatischer Zell-DNA zu minimieren.
- Überführen Sie jede Oozyte einzeln in 2–3 µL 1× phosphatgepufferte Kochsalzlösung (PBS) in ein 200 µL Low-Bind-Röhrchen. Gefrieren Sie das Röhrchen unverzüglich bei −20 °C ein. Für die Langzeitlagerung überführen Sie die gefrorenen Oozyten in −80 °C.
HINWEIS: Führen Sie nach dem Auftauen den restlichen Protokollschritt kontinuierlich und ohne Unterbrechung bis zum Abschluss des ersten Amplifikationsschritts durch. - Um mögliche Umwelt-DNA-Kontaminationen während des gesamten Protokolls zu überwachen, fügen Sie eine negative Kontrolle aus 2 µL 1× PBS ohne Oozyte während der Bibliotheksvorbereitung (ab Schritt 4) hinzu. Verarbeiten Sie die negative Kontrolle identisch zu allen Oozytenproben. In der negativen Kontrolle sollte zu keinem Zeitpunkt des Protokolls nachweisbare DNA auftreten.
3. Synthese von Adaptern
HINWEIS: Bereiten Sie die Adapter vor Beginn der Bibliotheksherstellung vor. Lagern Sie synthetisierte Adapter bei −80 °C bis zu 3 Monate lang. Stellen Sie Aliquote her, um wiederholte Einfrier- und Auftauzyklen zu vermeiden, und frieren Sie die Adapter nach dem Auftauen nicht erneut ein. Alle in diesem Protokoll verwendeten Oligonukleotidsequenzen sind in Tabelle 2 aufgeführt.
Tabelle 2: Im Protokoll verwendete Oligonukleotide und Primer. Die Tabelle enthält alle Oligonukleotide, die für die Adapter-Synthese, die Bibliotheksverstärkung, die quantitative Polymerase-Kettenreaktion (qPCR), die Bibliotheksquantifizierung und die Schätzung der Anreicherung von mitochondrieller DNA (mtDNA) verwendet wurden, zusammen mit ihren Sequenzen, Reinigungsmethoden, gelieferten Mengen oder empfohlenen Stammlösungskonzentrationen sowie dem Hersteller. Die angegebene Träger-Oligonukleotidsequenz stellt die im Protokoll verwendete Beispielsequenz dar. Das Sternchen (*) innerhalb der Primersequenzen kennzeichnet eine Phosphorothioatbindung. Die randomisierten Nukleotide (N) im mws55-Adapter repräsentieren den eindeutigen molekularen Identifikator (UMI), während Y die degenerierte Pyrimidinbase (C oder T) bezeichnet. Sofern nicht anders angegeben, wurden die Oligonukleotide mittels Standard-Entsalzungsreinigung synthetisiert. Bitte klicken Sie hier, um diese Datei herunterzuladen.
- Bereiten Sie eine Aliquotportion von 96 % Ethanol (EtOH) vor und lagern Sie sie bei −20 °C für nachfolgende Reinigungsschritte. Bereiten Sie 80 % EtOH unmittelbar vor der Verwendung frisch zu.
- Mischen Sie jeweils 20,5 µL von 100 µM mws51_short und 100 µM mws55 Oligonukleotiden in einem 200 µL Low-Binding-Röhrchen, um ein Gesamtvolumen von 41 µL (2.000 pmol jedes Oligonukleotids) zu erhalten.
- Inkubieren Sie die kombinierten Oligonukleotide 5 min bei 95 °C in einem Thermocycler mit einer Deckeltemperatur von 110 °C. Starten Sie den Timer, nachdem die Probe 95 °C erreicht hat, schalten Sie den Thermocycler nach 5 min aus und lassen Sie die Röhrchen 1 h im Thermocycler, um eine langsame Abkühlung auf Raumtemperatur (RT) und die Annealing-Reaktion zu ermöglichen („annealed adapter“).
- Bereiten Sie eine Extension-Master-Mix durch Mischen von 1× NEB Puffer 2 (5,6 µL von 10×-Stammlösung), 3,5 mM Desoxynukleosidtriphosphaten (dNTPs; 5,6 µL von 10 mM Stammlösung), 11,5 U Klenow-Fragment (2,3 µL von 5 U/µL Stammlösung) und 2,5 µL wasserfreiem Molekularbiologie-Grad-Wasser zu einem Endvolumen von 16 µL vor.
- Entnehmen Sie 1 µL des in Schritt 3.3 hergestellten annealed adapters, verdünnen Sie diesen 1:20 in TElow-Puffer, kennzeichnen Sie die Aliquotportion als „annealed“ und lagern Sie sie bei 4 °C für die Agarose-Gelelektrophorese.
- Geben Sie 16 µL der Extension-Master-Mix zu den verbleibenden 40 µL annealed Oligonukleotiden und mischen Sie gründlich.
- Inkubieren Sie die Reaktion 1 h bei 37 °C mit einer Deckeltemperatur des Thermocyclers von 47 °C.
- Reinigen Sie die verlängerten Oligonukleotide durch EtOH-Fällung. Geben Sie 28 µL Ammoniumacetat (NH4OAc) zur 56 µL Reaktionsmischung und mischen Sie gründlich.
- Überführen Sie die gesamte Reaktion in ein 1,5 mL Low-Binding-Röhrchen und geben Sie 168 µL eiskaltes 96 % EtOH hinzu.
- Wenden Sie das Röhrchen mehrmals um und inkubieren Sie 30 min bei −20 °C, um die DNA auszufällen.
- Bereiten Sie 1 mL frisches 80 % EtOH vor und kühlen Sie es auf −20 °C ab. Kühlen Sie die Zentrifuge im Voraus auf 4 °C vor.
- Zentrifugieren Sie 30 min bei 14.000 × g.
- Entfernen Sie vorsichtig den Überstand, ohne das Pellet zu stören. Geben Sie 1 mL eiskaltes 80 % EtOH hinzu, ohne das Röhrchen zu mischen oder umzudrehen.
- Zentrifugieren Sie 5 min bei 14.000 × g.
- Entfernen Sie sämtliches restliche EtOH und trocknen Sie das DNA-Pellet 10–15 min an der Luft, bis keine sichtbare Flüssigkeit mehr vorhanden ist und das Pellet transparent erscheint. Trocknen Sie die Oligonukleotide nicht übermäßig aus.
- Lösen Sie das Pellet in 41 µL wasserfreiem Molekularbiologie-Grad-Wasser wieder auf.
- Entnehmen Sie 1 µL, verdünnen Sie es 1:20 in TElow-Puffer, kennzeichnen Sie die Aliquotportion als „extended“ und lagern Sie sie bei 4 °C.
- Bereiten Sie eine Restriktions-Master-Mix durch Mischen von 47 µL wasserfreiem Molekularbiologie-Grad-Wasser, 1× CutSmart Puffer (10 µL von 10×-Stammlösung) und 15 U HpyCH4III (3 µL von 5 U/µL Stammlösung) zu einem Endvolumen von 60 µL vor.
- Geben Sie 60 µL der Restriktions-Master-Mix zu 40 µL gereinigten Oligonukleotiden und mischen Sie gründlich.
- Inkubieren Sie die Reaktion 16 h bei 37 °C mit einer Deckeltemperatur des Thermocyclers von 47 °C.
- Bereiten Sie 6,5 mL frisches 80 % EtOH vor und kühlen Sie es auf −20 °C ab. Kühlen Sie die Zentrifuge im Voraus auf 4 °C vor.
- Überführen Sie die gespaltenen Adapter in ein 1,5 mL Low-Binding-Röhrchen und geben Sie 900 µL wasserfreies Molekularbiologie-Grad-Wasser hinzu.
- Geben Sie 500 µL NH4OAc hinzu und mischen Sie gründlich.
- Teilen Sie die Lösung in sechs Aliquoten zu je 250 µL in 1,5 mL Low-Binding-Röhrchen auf. Geben Sie in jedes Röhrchen 500 µL eiskaltes 96 % EtOH.
- Wenden Sie die Röhrchen mehrmals um und inkubieren Sie 30 min bei −20 °C, um die DNA auszufällen.
- Zentrifugieren Sie 30 min bei 14.000 × g. Entfernen Sie vorsichtig den Überstand, ohne das Pellet zu stören. Geben Sie in jedes Röhrchen 1 mL eiskaltes 80 % EtOH, ohne zu mischen oder umzudrehen. Zentrifugieren Sie 5 min bei 14.000 × g.
- Entfernen Sie sämtliches restliche EtOH und trocknen Sie die Adapter-Pellets an der Luft.
- Lösen Sie jedes Pellet in 6,7 µL Tris-NaCl-Puffer wieder auf und vereinigen Sie alle sechs Suspensionen, um ein Endvolumen von 41 µL zu erhalten. Entnehmen Sie 1 µL, verdünnen Sie es 1:10 in TElow-Puffer, kennzeichnen Sie die Aliquotportion als „cut“ und lagern Sie sie bei 4 °C.
- Bereiten Sie Aliquoten der Adapter-Stammlösung vor und lagern Sie sie bei −80 °C. Messen Sie die Adapter-Konzentration und bestimmen Sie die Absorptionsverhältnisse A260/280 und A260/230 der „cut“-Aliquotportion mittels eines Spektrophotometers. Die erwartete Adapter-Konzentration liegt bei 30–50 µM, mit einem A260/280-Verhältnis von >1,7 und einem A260/230-Verhältnis von >1,9.
- Laufen Sie die „annealed“, „extended“ und „cut“ Aliquoten auf einem 2 %igen Agarosegel 45 min bei 125 V, um die Adapterbildung und vollständige Restriktionsverdauung zu überprüfen (Abbildung 1).
HINWEIS: Die „annealed“-Aliquotportion sollte zwei Banden enthalten, die die annealed und unannealed Fraktionen darstellen. Der annealed Adapter sollte bei etwa 90 bp wandern und besteht aus einem 13 bp langen doppelsträngigen Bereich mit einem 68 nt langen Einzelstrangüberhang, während die unannealed Oligonukleotide bei etwa 60 bp wandern. Nach der Verlängerung besteht der Adapter aus einem 37 bp langen doppelsträngigen Bereich mit einem 44 nt langen Y-förmigen Überhang und sollte bei etwa 110 bp wandern. Nach der Restriktionsverdauung wird ein 8 bp langes Fragment aus dem Adapter entfernt. Drei Banden sollten sichtbar sein: eine dominante Bande bei etwa 100 bp (endgültiger Adapter) sowie zwei schwache Banden bei etwa 60 bp (verbleibende unannealed Oligonukleotide) und 8 bp (Restriktionsfragment).
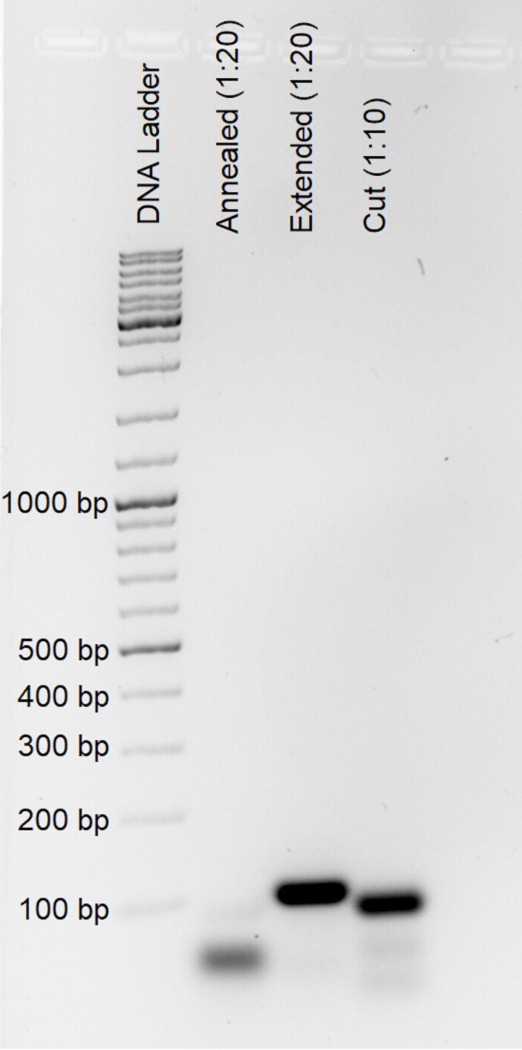
Abbildung 1. Repräsentative Analyse der Fragmentgrößen von Zwischenprodukten und endgültigen Duplex-Sequenzierungs-Adaptern. Aliquots, die während der Adapter-Synthese nach dem Annealing von Oligonukleotiden („annealed“, 1:20 verdünnt), der Auffüllungsverlängerung („extended“, 1:20 verdünnt) und dem Schnitt mit der Restriktionsendonuklease HpyCH4III („cut“, 1:10 verdünnt) entnommen wurden, wurden mittels 2%iger Agarose-Gelelektrophorese analysiert, um die korrekte Bildung der Duplex-Sequenzierungs-Adapter zu überprüfen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
4. Lyse einzelner Oozyten
- Bereiten Sie OLB vor, das mit thermostabilem Proteinase K (OLB+) ergänzt ist, indem Sie 1 µL thermostabiles Proteinase K (0,120 U/µL) zu 99 µL OLB hinzufügen, um eine Endkonzentration von 0,0012 U/µL Proteinase K zu erreichen.
- Tauen Sie die Oozyten bei RT auf. Geben Sie sofort 4 µL OLB+ zu jedem Oozyten hinzu. Spülen Sie mehrmals die Ränder des Röhrchens mit dem Lysepuffer, um die vollständige Übertragung des Oozyten in den Puffer sicherzustellen und zu verhindern, dass die Probe an der Röhrchenwand haften bleibt.
- Vortexen Sie die Probe gründlich, zentrifugieren Sie sie kurz, um den Inhalt am Boden des Röhrchens zu sammeln, und inkubieren Sie sie 16 h bei 37 °C in einem Thermocycler mit einer Deckeltemperatur von 47 °C.
HINWEIS: Vor der Fragmentierung wird keine eigenständige Beurteilung der Oozytenlyse durchgeführt. Eine 16-stündige Inkubation unter den angegebenen Lysebedingungen ist im Allgemeinen ausreichend für die vollständige Lyse eines einzelnen Oozyten. Die Menge an gewonnener DNA kann dennoch aufgrund von Probenverlusten während der Handhabung und Unterschieden in der mtDNA-Kopienzahl zwischen den Oozyten variieren. - Inaktivieren Sie das thermostabile Proteinase K durch eine 15-minütige Inkubation der Proben bei 55 °C in einem Thermocycler mit einer Deckeltemperatur von 75 °C.
HINWEIS: Führen Sie die nachfolgenden Arbeitsschritte ohne Unterbrechung nach der Lyse und der Inaktivierung von Proteinase K durch, es sei denn, ein späterer Schritt des Protokolls gibt ausdrücklich einen möglichen Unterbrechungspunkt an.
5. Exonuklease-V-Degradation
- Lassen Sie die Proben vor Fortsetzung auf Raumtemperatur (RT) einstellen.
- Stellen Sie eine Exonuklease-V-Master-Mix her, indem Sie 4 µL 25 mM Magnesiumchlorid (MgCl₂), 1 µL 10 mM Tris-HCl, 1 µL 10 mM Adenosintriphosphat (ATP) und 1 µL Exonuklease V (10 U/µL-Stammlösung) kombinieren, um ein Endvolumen von 7 µL zu erhalten.
- Bereiten Sie eine 1 mg/mL Ribonuklease-A-(RNase-A-)Arbeitslösung vor, indem Sie 1 µL 10 mg/mL RNase-A-Stammlösung mit 99 µL wasserfreiem Wasser für die Molekularbiologie verdünnen. Geben Sie etwa 0,1 µL der verdünnten RNase-A-Lösung zu jeder lysierten Oozytenprobe hinzu.
ANMERKUNG: Verwenden Sie für diesen Schritt einen geeigneten Pipettierer. Bei der gleichzeitigen Bearbeitung mehrerer Proben kann ein geeigneter Mehrkanalpipettierer verwendet werden, sofern Maßnahmen zum Vermeiden einer Kreuzkontamination zwischen den Proben getroffen werden. Da die Pipettiergenauigkeit bei der Dosierung solch kleiner Volumina mit einem Mehrkanalpipettierer abnehmen kann, überprüfen Sie alle Kanäle sorgfältig. Alternativ genügt ein kurzes Eintauchen der Pipettenspitze in die verdünnte RNase-A-Lösung, um etwa 0,1 µL zu übertragen. Geringfügige Abweichungen von diesem Volumen beeinträchtigen die Leistung des Protokolls nicht. Überprüfen Sie das ungefähre übertragene Volumen vorab mit einem Einzelkanalpipettierer. - Geben Sie 7 µL der Exonuklease-V-Master-Mix zu jeder lysierten Oozytenprobe hinzu und mischen Sie gründlich. Inkubieren Sie die Proben 1 h bei 37°C in einem Thermocycler mit einer Deckeltemperatur von 47°C.
- Geben Sie 38 µL TE-Puffer zu jeder Probe hinzu, um ein endgültiges Reaktionsvolumen von etwa 51 µL zu erhalten. Inaktivieren Sie die Enzyme durch eine 30-minütige Inkubation bei 70°C in einem Thermocycler mit einer Deckeltemperatur von 75°C.
- Fahren Sie unmittelbar mit der Bibliotheksherstellung fort.
6. Fragmentierung
- Scheren Sie die DNA durch Sonikation auf eine durchschnittliche Fragmentgröße von etwa 550 Basenpaaren (bp).
ANMERKUNG: Dieses Protokoll beschreibt die DNA-Fragmentierung mittels eines Covaris M220 Fokussiert-Ultraschall-Geräts, im Folgenden als Sonikator bezeichnet; gleichwertige Systeme können jedoch ebenfalls verwendet werden. Da die Proben nach der Lyse neben der DNA auch zelluläre Bestandteile enthalten, optimieren Sie die Fragmentierungsbedingungen für das jeweilige Gerät und Probentyp, um eine relativ enge Fragmentgrößenverteilung zu erzielen, die um die gewünschte Fragmentgröße zentriert ist. - Geben Sie das gesamte Probenvolumen (etwa 51 µL) in ein 50-µL-Fokussiert-Ultraschall-Röhrchen.
- Scheren Sie die DNA für 70 s bei einem Tastverhältnis (Duty Factor) von 10 %, einer Spitzenleistung (Peak Incident Power) von 75 W und 200 Zyklen pro Burst bei 20 °C.
- Überführen Sie unverzüglich jede gescherete Probe (etwa 50 µL) aus dem Scherröhrchen in ein 200-µL-Niedrigbindungs-Röhrchen, da die Scherröhrchen keine Niedrigbindungs-Röhrchen sind. Das ursprüngliche Sammelröhrchen für die Oozyten kann hierfür wiederverwendet werden. Überprüfen Sie den Deckel des Scherröhrchens auf verbliebene Flüssigkeit und gewinnen Sie ggf. verbliebene Probe zurück, um die Probenausbeute zu maximieren.
- Fahren Sie unmittelbar mit der Endreparatur und A-Tailing fort.
7. Endreparatur/A-Anhängen
- Stellen Sie eine Endreparatur/A-Tailing-Master-Mischung her, die 7 µL End-Präparations-Reaktionspuffer und 3 µL End-Präparations-Enzymmischung enthält.
- Geben Sie 10 µL der Endreparatur/A-Tailing-Master-Mischung zu jeder Probe hinzu, um ein endgültiges Reaktionsvolumen von 60 µL zu erhalten. Mischen Sie gründlich durch 10-maliges Auf- und Abpipettieren.
- Inkubieren Sie die Proben 30 Minuten bei 20 °C mit ausgeschaltetem Thermocycler-Deckel, gefolgt von einer Inkubation 30 Minuten bei 65 °C mit der Deckeltemperatur auf 75 °C eingestellt.
- Fahren Sie unverzüglich mit der Adapterligation fort.
8. Adapterligation
- Stellen Sie eine Ligations-Master-Mischung her, die 30 µL Ligationsmischung und 1 µL Ligationsverstärker enthält.
- Tauen Sie eine Aliquot des synthetisierten Adapters auf und verdünnen Sie ihn 1:4000 in Tris-NaCl-Puffer.
- Geben Sie 1,5 µL des verdünnten Adapters zu jeder endreparierten und A-schwanzhaltigen DNA-Probe hinzu. Fügen Sie 31 µL der Ligations-Master-Mischung hinzu und mischen Sie gründlich.
- Inkubieren Sie die Proben 15 min bei 20 °C. Geben Sie 1 µL des verdünnten Adapters zu jeder Probe hinzu, um ein endgültiges Reaktionsvolumen von 93,5 µL zu erhalten. Mischen Sie gründlich und inkubieren Sie 16 h bei 4 °C.
- Fahren Sie unverzüglich mit der Reinigung fort.
9. Reinigung von Adapter-ligierter DNA
- Lassen Sie die magnetischen Perlen und den TElow-Puffer mindestens 30 min bei RT equilibrieren. Bereiten Sie in dieser Zeit frisches 80 %iges EtOH vor. Bereiten Sie eine Träger-Oligonukleotidlösung zu, indem Sie 1 µL des Träger-Oligonukleotids (Sequenz, die nicht im menschlichen Genom vorkommt; siehe Tabelle 2) zu 99 µL TElow-Puffer hinzufügen, um eine Endkonzentration von 1 nM zu erhalten.
- Überführen Sie 74,8 µL magnetische Perlen, was einem 0,8×-Perlen-zu-Probe-Verhältnis entspricht, in ein 1,5-mL-Niedrigbindungsgefäß. Geben Sie das gesamte Volumen von 93,5 µL adapterligierter DNA hinzu und mischen Sie gründlich.
- Incubieren Sie die Perlen-Probe-Mischung 15 min bei RT. Nach 7,5 min mischen Sie die Suspension vorsichtig und zentrifugieren das Gefäß kurz.
- Zentrifugieren Sie das Gefäß kurz, stellen Sie es auf einen Magnetständer und incubieren Sie 5 min, um eine vollständige Trennung der Perlen zu ermöglichen. Entfernen und verwerfen Sie vorsichtig den klaren Überstand und verschließen Sie das Gefäß anschließend sofort.
- Geben Sie 400 µL 80 %iges EtOH hinzu, incubieren Sie 30 s und entfernen Sie das EtOH. Fügen Sie 200 µL 80 %iges EtOH hinzu, incubieren Sie 30 s und entfernen Sie das EtOH.
- Nehmen Sie das Gefäß vom Magnetständer und zentrifugieren Sie es kurz. Stellen Sie das Gefäß zurück auf den Magnetständer, entfernen Sie restliches EtOH und lassen Sie die Perlen weniger als 5 min an der Luft trocknen.
- Geben Sie 50 µL TElow-Puffer, ergänzt mit Träger-Oligonukleotiden, hinzu. Nehmen Sie das Gefäß vom Magnetständer und resuspendieren Sie die Perlen gründlich durch Pipettieren.
- Incubieren Sie die Suspension 5 min bei RT, gelegentliches Mischen. Zentrifugieren Sie das Gefäß kurz, stellen Sie es auf den Magnetständer zurück und incubieren Sie weitere 5 min.
- Während der letzten 5 min der ersten magnetischen Trennung bereiten Sie ein neues 1,5-mL-Niedrigbindungsgefäß mit 40 µL magnetischen Perlen vor. Überführen Sie 50 µL des Eluats in das vorbereitete Gefäß, um die zweite Reinigung bei einem 0,8×-Perlen-zu-Probe-Verhältnis durchzuführen.
- Mischen Sie gründlich und incubieren Sie 15 min bei RT. Nach 7,5 min mischen Sie die Suspension vorsichtig und zentrifugieren das Gefäß kurz.
- Stellen Sie das Gefäß auf den Magnetständer und incubieren Sie 5 min, um eine vollständige Trennung der Perlen zu ermöglichen. Entfernen und verwerfen Sie vorsichtig den klaren Überstand und verschließen Sie das Gefäß anschließend sofort.
- Geben Sie 400 µL 80 %iges EtOH hinzu, incubieren Sie 30 s und entfernen Sie das EtOH. Fügen Sie 200 µL 80 %iges EtOH hinzu, incubieren Sie 30 s und entfernen Sie das EtOH.
- Nehmen Sie das Gefäß vom Magnetständer und zentrifugieren Sie es kurz. Stellen Sie das Gefäß zurück auf den Magnetständer, entfernen Sie restliches EtOH und lassen Sie die Perlen weniger als 5 min an der Luft trocknen.
- Geben Sie 15,5 µL Tris-HCl zu jeder Probe hinzu. Nehmen Sie das Gefäß vom Magnetständer und resuspendieren Sie die Perlen gründlich durch Pipettieren.
- Incubieren Sie die Suspension 5 min bei RT, gelegentliches Mischen. Zentrifugieren Sie das Gefäß kurz, stellen Sie es auf den Magnetständer zurück und incubieren Sie weitere 5 min.
- Überführen Sie 15 µL des Eluats in ein neues 200-µL-Niedrigbindungsgefäß. Entnehmen Sie 1 µL des Eluats und verdünnen Sie es 1:10 in Tris-HCl für attomolare quantitative PCR (qPCR) und mitochondriale DNA (mtDNA)-Anreicherungs-qPCR-Analysen.
10. Attomol-Bestimmung
HINWEIS: Bestimmen Sie die ungefähre Menge an Adapter-ligierter DNA, um die DNA-Menge und die Anzahl der Zyklen in den nachfolgenden Amplifikations- und Indexierungs-PCR-Reaktionen anzupassen. Da die Probenmenge begrenzt ist, können direkte Konzentrationsmessungen unzuverlässig sein; schätzen Sie daher die DNA-Menge mittels qPCR. Analysieren Sie die Amplifikationsprodukte durch Agarose-Gelelektrophorese, um die Verteilung der Fragmentgrößen zu beurteilen und verbleibende Adapter-Dimere nachzuweisen. Cq-Werte können je nach verwendeten Reagenzien und Echtzeit-PCR-Gerät variieren. Anpassungen der Cq-Werte basierend auf dem Nachweis von Adapter-Dimeren sowie der eingesetzten DNA-Menge und der Anzahl der PCR-Zyklen erfolgen hauptsächlich aufgrund empirischer Beobachtungen und erfordern möglicherweise eine Optimierung für individuelle Bibliotheksherstellungen.
- Bereiten Sie eine Attomol-qPCR-Master-Mix-Lösung vor, die pro Reaktion 5 µL 2× KAPA HiFi HotStart Reaktionsmix (im Folgenden als 2× hochfidelitäts-PCR-Mix bezeichnet), 1 µL des Dual-NEBNext Universal PCR Primers für Illumina (10 µM; im Folgenden als universeller Bibliotheksprimer bezeichnet), 1 µL des mws20-Primers (10 µM), 0,5 µL 20× EvaGreen und 0,5 µL wasserfreiem Molekularbiologie-Grad-Wasser enthält.
- Geben Sie 8 µL der Master-Mix-Lösung in jedes vorgesehene Loch einer qPCR-kompatiblen 96-Loch-Platte. Fügen Sie 2 µL der 1:10 verdünnten Probe hinzu, um ein Endvolumen von 10 µL pro Reaktion zu erreichen.
- Versiegeln Sie die Platte und zentrifugieren Sie sie kurz, bevor Sie sie in das Echtzeit-PCR-Gerät einlegen.
- Führen Sie die qPCR mit folgenden thermischen Zyklenbedingungen durch: 45 s bei 98 °C, gefolgt von 45 Zyklen mit jeweils 15 s bei 98 °C, 30 s bei 65 °C und 45 s bei 72 °C.
- Bestimmen Sie den Quantifizierungszyklus (Cq), indem Sie die Fluoreszenzschwelle auf 1.000 relative Fluoreszenzeinheiten (RFU) einstellen.
ANMERKUNG: Wählen Sie eine Fluoreszenzschwelle, die mit dem Echtzeit-PCR-Gerät kompatibel ist, und verwenden Sie in allen Experimenten dieselbe Schwelle, um den Vergleich der Cq-Werte zu ermöglichen. - Trennen Sie die qPCR-Amplifikationsprodukte in einem 1,5%igen Agarosegel bei 125 V für 40 Minuten auf.
- Überprüfen Sie das Gel auf verbleibende Adapter-Dimere. Adapter-Dimere wandern bei etwa 130 bp (Abbildung 2).
- Falls Adapter-Dimere sichtbar sind, passen Sie den Cq-Wert unter Verwendung des entsprechenden attomolaren Cq-Korrekturfaktors (ACF) an, wie in Abbildung 2 dargestellt. Wählen Sie den ACF entsprechend der Intensität des im Agarosegel beobachteten Adapter-Dimer-Bandes unter Bezugnahme auf die repräsentativen Beispiele in Abbildung 2. Ein ACF-korrigierter attomolarer Cq-Wert von 22–26 ist optimal; jedoch sind Werte <29 im Allgemeinen akzeptabel.
ANMERKUNG: Anstelle einer Cq-Korrektur kann gegebenenfalls eine zusätzliche Reinigung durchgeführt werden; dies kann jedoch zu erheblichen Bibliotheksverlusten führen. Proben mit starken Adapter-Dimer-Banden weisen typischerweise hohe attomolare qPCR-Cq-Werte auf, was auf eine geringe DNA-Eingabemenge hinweist. Proben mit Cq-Werten ≥29 erzeugen in der Regel große Familiengrößen und geringe mitochondriale DNA-Sequenzierungstiefen (<100×) und sollten daher von der Sequenzierung ausgeschlossen werden. Da die Cq-Werte von dem verwendeten Echtzeit-PCR-Gerät und den Assay-Bedingungen abhängen, sollten laborspezifische Grenzwerte beim Einsatz dieses Protokolls festgelegt werden.
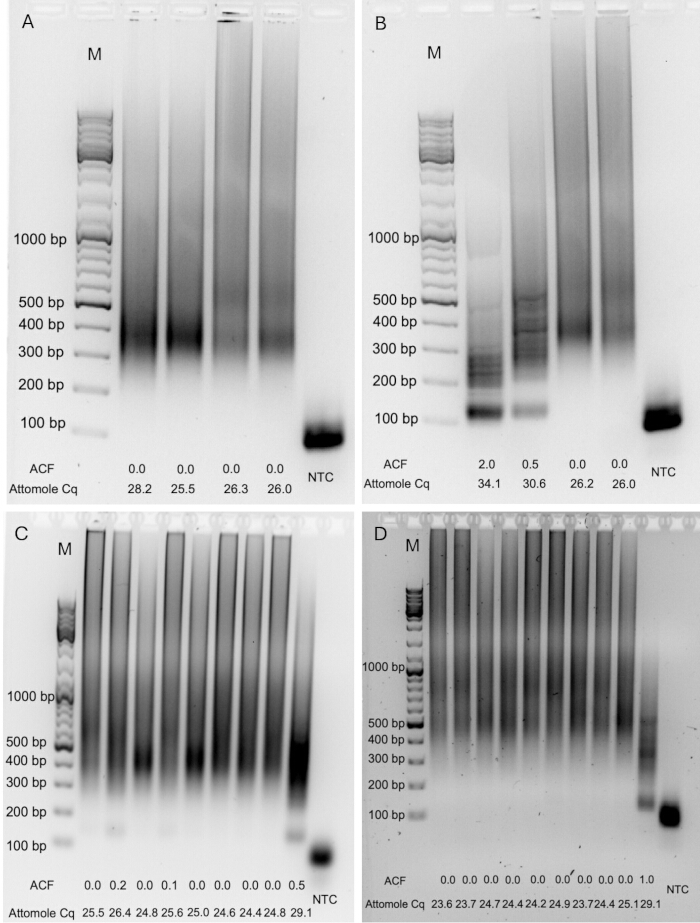
Abbildung 2. Repräsentative attomol-Quantitative-PCR-(qPCR)-Produkte zur Abschätzung der Bibliothekseingabemenge und zur Identifizierung von Adapter/Primer-Dimeren. Amplifizierte attomol-qPCR-Produkte wurden mittels 1,5 %iger Agarose-Gelelektrophorese analysiert, um die Fragmentgrößenverteilung zu beurteilen und verbleibende Adapter/Primer-Dimere nachzuweisen. (A–D) Repräsentative Beispiele, die Bibliotheken mit unterschiedlichen Mengen an adapterligierter DNA und variierenden Gehalten an Adapter/Primer-Dimeren zeigen. Der attomol-Cq-Korrekturfaktor (ACF) sowie der entsprechende nicht korrigierte Quantifizierungszyklus (Cq) sind für jede Probe angegeben. M, DNA-Größenmarker; NTC, Kontrolle ohne Matrize. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
11. Schätzung der Anreicherung von mitochondrieller DNA (optional)
HINWEIS: Schätzen Sie die Anreicherung von mitochondrieller DNA (mtDNA) mittels qPCR unter Verwendung von Primern, die das mitochondriale ND6-Gen und nukleare Alu-Elemente targeten. Berechnen Sie die Differenz der Cq-Werte zwischen den nuklearen und mitochondrialen Targetsequenzen, um die mtDNA-Anreicherung abzuschätzen. Verwenden Sie den absoluten Cq-Wert des mitochondrialen Targets, um die Menge an mtDNA in der Probe abzuschätzen. Die Cq-Werte können je nach verwendeten Reagenzien, Verbrauchsmaterialien und Echtzeit-PCR-Gerät variieren. Passen Sie die Primersequenzen für andere Arten entsprechend an. Weitere Informationen zu spezies-spezifischen Primern für Maus und Makaken finden Sie in früheren Publikationen12,13. Dieser Schritt ist optional und liefert eine grobe Schätzung der mtDNA-Anreicherung vor der Sequenzierung.
- Bereiten Sie separate Master-Mixes für die mitochondrialen und nuklearen Zielsequenzen vor. Kombinieren Sie für jede Reaktion 5 µL 2× PowerUp SYBR Green Mix, 0,4 µL jedes Primers des jeweiligen Primerpaares (jeweils 10 µM) und 2,1 µL wasserfreies Molekularbiologie-Wasser.
- Geben Sie 8 µL des entsprechenden Master-Mixes in jedes vorgesehene Loch einer qPCR-kompatiblen 96-Loch-Platte. Fügen Sie 2 µL der 1:10 verdünnten Probe hinzu, um ein Endvolumen von 10 µL zu erreichen.
- Versiegeln Sie die Platte und zentrifugieren Sie sie kurz, bevor Sie sie in das Echtzeit-PCR-Gerät einlegen.
- Führen Sie die qPCR mit folgenden thermischen Zyklenbedingungen durch: 2 min bei 95 °C, gefolgt von 45 Zyklen mit jeweils 15 s bei 95 °C, 20 s bei 56 °C und 30 s bei 72 °C.
- Bestimmen Sie den Cq-Wert, indem Sie die Fluoreszenzschwelle auf 100 RFU einstellen.
HINWEIS: Wählen Sie eine Fluoreszenzschwelle, die mit dem Echtzeit-PCR-Gerät kompatibel ist, und verwenden Sie in allen Experimenten dieselbe Schwelle, um den Vergleich der Cq-Werte zu ermöglichen. Korrelieren Sie die Cq-Werte nach der Sequenzierung mit den aus der Sequenzierung abgeleiteten Anreicherungseffizienzen und verwenden Sie diese Werte als Referenz für nachfolgende Bibliotheksherstellungen. - Berechnen Sie den anreicherungsassoziierten ΔCq, indem Sie den Cq-Wert des nuklearen Ziels vom Cq-Wert des mitochondrialen Ziels subtrahieren (CqmtDNA − CqnDNA). Sobald erste Sequenzierungsdaten verfügbar sind, erstellen Sie eine laborinterne Standardkurve, um den Anteil der aus mtDNA stammenden Sequenzierungsreads abzuschätzen.
HINWEIS: Falls noch keine Sequenzierungsdaten vorliegen, kann Gleichung 1 verwendet werden, um eine grobe Schätzung des erwarteten Prozentsatzes der aus mtDNA stammenden Sequenzierungsreads anhand einer beispielhaften Standardkurve aus sieben Oozyten-Bibliotheken zu erhalten (ΔCq = −0,8, 16,83 %; ΔCq = −2,1, 33,62 %; ΔCq = −3,0, 45,57 %; ΔCq = −3,9, 60,34 %; ΔCq = −5,0, 77,98 %; ΔCq = −6,2, 89,25 %; ΔCq = −8,4, 95,09 %). Ein ΔCq-Wert <−1 sollte erreicht werden, um eine effiziente Entfernung der nuklearen DNA sicherzustellen. Geringere Anreicherungseffizienzen können durch Zuweisung zusätzlicher Sequenzierungsreads ausgeglichen werden, um eine ausreichende mtDNA-Sequenzierungstiefe zu erzielen; dies kann jedoch die Kontamination durch nukleäre mitochondriale DNA-Sequenzen (NUMT) erhöhen. Da die Beziehung zwischen ΔCq und mtDNA-Gehalt von Reagenzien, Verbrauchsmaterialien, Geräten und experimentellen Bedingungen abhängt, sollte Gleichung 1 lediglich als Beispielkalibrierung betrachtet werden, und möglichst sollten laborinterne Standardkurven erstellt werden.
Geschätzter mtDNA-Anteil (%) = −11,006 × ΔCq + 13,776 (1)
12. Bibliotheksverstärkung
HINWEIS: Führen Sie die erste Amplifikation in zwei aufeinanderfolgenden PCR-Schritten durch. Führen Sie die erste PCR mit einem einzelnen Primer durch, um eine lineare Amplifikation zu erzeugen. Fügen Sie anschließend den zweiten Primer hinzu, um während der zweiten PCR eine exponentielle Amplifikation zu ermöglichen.
- Bestimmen Sie die DNA-Menge für die erste Amplifikations-PCR anhand der Ergebnisse der Attomol-qPCR.
- Verwenden Sie für Einzel-Oozyten-Bibliotheken Proben mit einem Cq-Wert der Attomol-qPCR, der typischerweise über 22 liegt. Falls eine Probe einen niedrigeren Cq-Wert aufweist, verdünnen Sie sie entsprechend Tabelle 3 auf einen Cq-Wert von etwa 22. Bibliotheken mit Cq-Werten ≥29 erzeugen in der Regel große Familiengrößen und geringe mtDNA-Sequenzierungstiefen und sind daher für die weitere Bibliotheksherstellung oder Sequenzierung nicht empfehlenswert.
- Stellen Sie eine Amplifikations-Master-Mix her, die pro Reaktion 20 µL 2× High-Fidelity-PCR-Mix und 4 µL des mws20-Primers (10 µM) enthält.
- Geben Sie 24 µL des Amplifikations-Master-Mix zu 14 µL der verdünnten Probe hinzu.
- Führen Sie die lineare Amplifikations-PCR mit folgenden thermischen Zyklenbedingungen durch: 45 s bei 98°C, gefolgt von 12 Zyklen mit jeweils 15 s bei 98°C, 30 s bei 60°C und 45 s bei 72°C, gefolgt von 2 min bei 72°C.
- Geben Sie 4 µL des universellen Bibliotheksprimers (10 µM) hinzu und mischen Sie gründlich.
- Führen Sie die exponentielle Amplifikations-PCR mit folgenden thermischen Zyklenbedingungen durch: 45 s bei 98°C, gefolgt von 9 Zyklen mit jeweils 15 s bei 98°C, 30 s bei 65°C und 45 s bei 72°C, gefolgt von einer 2-minütigen Verlängerung bei 72°C.
ANMERKUNG: Nach Abschluss der ersten Amplifikation können die Proben bei 4°C gelagert und das Protokoll später fortgesetzt werden, falls erforderlich. Führen Sie alle vorhergehenden Schritte, von der Oozytenlyse bis zur ersten Amplifikation, ohne Unterbrechung durch. - Geben Sie 10 µL wasserfreies Molekularbiologie-Wasser zu jeder Probe hinzu.
- Reinigen Sie die amplifizierte DNA mithilfe von 40 µL magnetischen Partikeln (0,8× das Probenvolumen), gemäß dem zweiten Verfahren zur magnetischen Partikelreinigung in den Schritten 9.9–9.15. Waschen Sie die Partikel zweimal mit jeweils 200 µL 80 %igem EtOH, eluieren Sie die DNA in 15,5 µL Tris-HCl und überführen Sie 15 µL des Eluats in ein neues 200-µL-Low-Bindungsgefäß.
ANMERKUNG: Dies ist ein geeigneter Haltepunkt. Lagern Sie die gereinigte DNA bei 4°C oder fahren Sie unmittelbar mit der Indexierung fort.
Tabelle 3: Verdünnungsfaktoren und entsprechende Korrekturfaktoren für die quantitative Polymerase-Kettenreaktion (qPCR), die zur Standardisierung der DNA-Menge für die erste Bibliotheksverstärkungs-Polymerase-Kettenreaktion (PCR) verwendet wurden. Proben mit attomolaren qPCR-Cq-Werten unterhalb des Zielwerts wurden vor der ersten Amplifikations-PCR mit wasserfreiem Molekularbiologie-Wasser verdünnt. Der korrigierte Cq-Wert wurde ermittelt, indem der jeweils passende Verdünnungskorrekturfaktor zum experimentell gemessenen Cq-Wert addiert wurde, und diente anschließend zur Bestimmung der Anzahl der Zyklen in der Indexierungs-PCR sowie der geplanten Sequenziertiefe (Tabelle 4). Die angegebenen Probenvolumina und Wasservolumina ergeben ein Endvolumen von 14 µL für die erste Amplifikations-PCR. Das Sternchen (*) zeigt an, dass der aufgeführte Verdünnungskorrekturfaktor zum experimentell gemessenen attomolaren qPCR-Cq-Wert addiert werden muss, um den korrigierten Cq-Wert zu erhalten. Die Korrekturfaktoren wurden für diesen Arbeitsablauf empirisch ermittelt. Bitte klicken Sie hier, um diese Datei herunterzuladen.
13. Indexierung
- Bestimmen Sie die Anzahl der Indexierungs-PCR-Zyklen anhand des dimeren- und verdünnungskorrigierten Attomol-qPCR-Cq-Werts gemäß Tabelle 4.
- Stellen Sie eine Indexierungs-Master-Mix her, die für jede Probe 25 µL 2× High-Fidelity-PCR-Mix und 10 µL eines 10 µM einzigartigen dualen Indexprimer-Paars enthält.
- Geben Sie 35 µL des Indexierungs-Master-Mix zu 15 µL jeder amplifizierten Probe hinzu.
- Führen Sie die Indexierungs-PCR mit den folgenden thermischen Zyklenbedingungen durch: 45 s bei 98°C, gefolgt von der geeigneten Anzahl Zyklen, bestehend aus 15 s bei 98°C, 30 s bei 65°C und 45 s bei 72°C, gefolgt von einer abschließenden Verlängerung bei 72°C für 2 min.
- Reinigen Sie die indexierten Bibliotheken mit 40 µL magnetischen Beads (0,8× Probenmenge). Waschen Sie die Beads zweimal mit 80 % EtOH und eluieren Sie die DNA in 21 µL TElow-Puffer.
- Überführen Sie das Eluat in ein DNA-low-binding-Gefäß.
- Messen Sie die DNA-Konzentration mithilfe eines Qubit High Sensitivity DNA Assay oder eines äquivalenten fluorometrischen Assays.
- Lagern Sie die Bibliotheken vor der Sequenzierung bei 4°C oder langfristig bei −80°C.
HINWEIS: Dies ist ein sicherer Haltepunkt.
Tabelle 4: Bestimmung der Zyklenanzahl für die Index-PCR und der angestrebten Sequenzierungstiefe basierend auf dem korrigierten attomolaren qPCR-Quantifizierungszyklus (Cq). Der korrigierte Cq-Wert berücksichtigt den experimentell gemessenen attomolaren qPCR-Cq-Wert sowie gegebenenfalls einen Korrekturfaktor für Adapter-Dimer-Bildung (Abbildung 2) und einen Verdünnungskorrekturfaktor (Tabelle 3). Anhand des korrigierten Cq-Werts wurden sowohl die Anzahl der Zyklen für die Index-PCR als auch die empfohlene Anzahl an Paired-End-Sequenzierungsreads pro Bibliothek für die Poolbildung bestimmt. Die angegebenen Zielwerte für die Sequenzierungsreads dienen als erster Leitfaden und erfordern möglicherweise eine an das jeweilige Labor angepasste Optimierung, abhängig vom eingesetzten Echtzeit-PCR-Gerät, der Sequenzierplattform, der Multiplexing-Strategie und den experimentellen Anforderungen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
14. Qualitätskontrolle
- Beurteilen Sie die Bibliotheksqualität, die Verteilung der Fragmentgrößen und das Vorhandensein von verbleibenden Adapter- oder Primerdimeren mithilfe eines Bioanalyzer, TapeStation oder eines äquivalenten Instruments zur Nukleinsäure-Fragmentanalyse. Die Fragmentgrößen sollten ungefähr zwischen 300 und 1.000 bp liegen. Kleine Restspitzen (<5 % der Fluoreszenzintensität [RFU] der Probe im Bioanalyzer-Chromatogramm) waren im Allgemeinen akzeptabel (Abbildung 3A–D). Verbleibende Adapter- oder Primerdimer zeigen sich als deutliche Spitzen bei etwa 70–150 bp (Abbildung 3E–H). Die endgültige Bibliothekskonzentration sollte mindestens 5 ng/µL betragen. Weisen Sie auf ergänzende Datei 1 (Fehlerbehebungsanleitung) hin, falls eines dieser Qualitätskriterien nicht erfüllt ist.
- (Optional) Falls Adapter- oder Primerdimer nachgewiesen werden (Abbildung 3E–H), stellen Sie das Bibliotheksvolumen mit wasserfreiem Wasser der Molekularbiologie-Qualität auf 50 µL ein, geben 40 µL magnetische Partikel (0,8× Probenmenge) hinzu und führen eine zusätzliche Reinigung durch. Waschen Sie die Partikel zweimal mit 80 %igem EtOH und eluieren Sie die gereinigte Bibliothek in 21,5 µL TElow-Puffer.
- (Optional) Wiederholen Sie die Qualitätskontrolle (Schritt 14.1), um die vollständige Entfernung von Adapter- und Primerdimeren zu bestätigen.
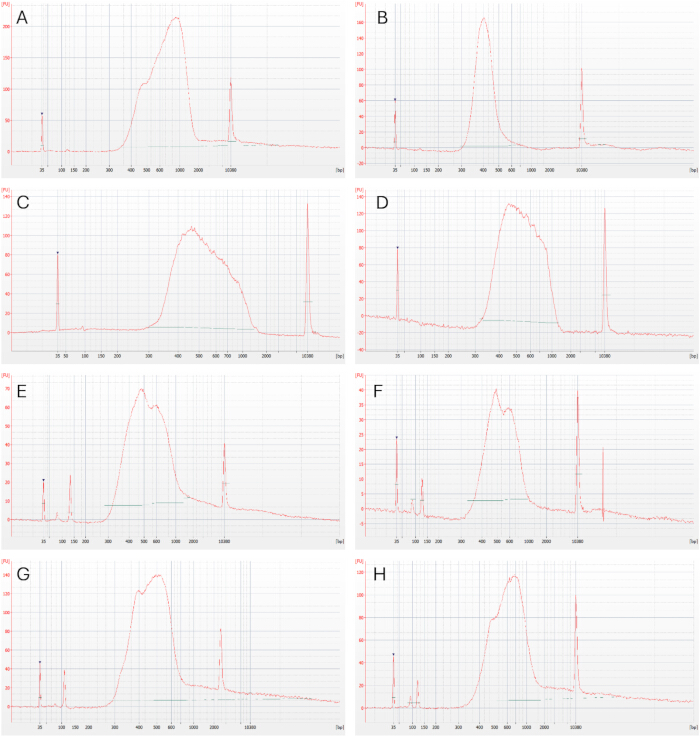
Abbildung 3. Repräsentative Fragmentanalyse indizierter Sequenzierbibliotheken. Repräsentative Elektropherogramme, erzeugt durch Fragmentanalyse mit dem Bioanalyzer, zur Beurteilung der Bibliotheksqualität nach der Index-PCR. (A–D) Bibliotheken mit der erwarteten Fragmentgrößenverteilung (ca. 300–1000 bp) und ohne nachweisbare Adapter-/Primer-Dimere, geeignet für die Sequenzierung ohne zusätzliche Aufreinigung. (E–H) Bibliotheken mit verbliebenen Adapter- und/oder Primer-Dimeren, die eine zusätzliche Aufreinigung mittels magnetischer Beads vor der Sequenzierung erfordern. Die Peaks bei etwa 35 bp und 10.380 bp entsprechen dem unteren bzw. oberen internen Marker. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
15. Zusammenführung und Sequenzierung
- Messen Sie die Konzentration jeder indizierten Bibliothek mithilfe eines qPCR-basierten Bibliotheksquantifizierungsassays, der mit Illumina-präparierten Bibliotheken kompatibel ist, wie beispielsweise dem Collibri Library Quantification Kit, gemäß der Anleitung des Herstellers. Verdünnen Sie jede Bibliothek 1:100.000 im mitgelieferten Bibliotheksverdünnungspuffer und analysieren Sie jede Probe mindestens im Duplikat; Triplikatmessungen werden empfohlen. Analysieren Sie die Standards im Triplikat.
- Berechnen Sie den mittleren Quantifizierungszyklus (Cq)-Wert für jede Probe und jeden Standard. Erstellen Sie eine Standardkurve aus den mittleren Cq-Werten der Standards und berechnen Sie die Konzentration jeder Bibliothek gemäß den Anweisungen des Herstellers.
- Mischen Sie die Bibliotheken entsprechend der geplanten Anzahl an Paired-End-Lesungen, die auf Grundlage des in Schritt 10 ermittelten, korrigierten Attomol-qPCR-Cq-Werts unter Berücksichtigung von Adapter-Dimeren und Verdünnung sowie der in Tabelle 4 angegebenen Allokationen bestimmt wurde.
HINWEIS: Das Mischverhältnis hängt vom korrigierten Cq-Wert jeder Oozyten-Bibliothek und der entsprechenden Zielanzahl an Paired-End-Lesungen ab. Die Werte in Tabelle 4 sind annähernd und können je nach Echtzeit-PCR-Gerät variieren. Legen Sie gerätespezifische Werte für eine optimale Leistung fest. - Berechnen Sie den relativen Anteil jeder Bibliothek am Gesamtmischansatz, indem Sie deren Zielanzahl an Paired-End-Lesungen durch die Summe aller Ziel-Lesungen aller Bibliotheken teilen. Ermitteln Sie die benötigte Menge jeder Bibliothek, indem Sie diesen Anteil mit der gesamten molaren Menge des Endansatzes multiplizieren, und berechnen Sie anschließend das entsprechende Volumen der Bibliothek anhand ihrer gemessenen molaren Konzentration. Kombinieren Sie die berechneten Volumina, um den endgültigen Pool zu erzeugen.
- Sequenzieren Sie die gemischten Bibliotheken mithilfe einer Illumina-Sequenzierplattform oder einer anderen Plattform, die mit Illumina-Adaptersequenzen kompatibel ist. Verwenden Sie eine Paired-End-Konfiguration mit einer Mindestleselänge von 2 × 150 bp. Längere Lesungen, wie beispielsweise 2 × 250 oder 2 × 300 bp, werden empfohlen, da sie die Identifizierung und Filterung von Lesungen verbessern, die von kürzeren nukleären mitochondrialen DNA-Abschnitten (NUMTs) stammen.
- Sequenzieren Sie die gemischten Bibliotheken beispielsweise auf einer Illumina NovaSeq 6000-Plattform mit zweikanaliger Sequenzierung durch Synthese-Chemie unter Verwendung eines SP Reagent Kit v1.5 (500 Zyklen) und einer Paired-End-Konfiguration von 2 × 250 bp, einschließlich eines 5 %igen PhiX-Spike-Ins. Laden Sie die Bibliothek auf und führen Sie die Sequenzierung gemäß den Anweisungen des Herstellers durch. Die repräsentative Sequenzierleistung sollte ≥75 % der Basen mit einem Qualitätswert von ≥Q30 und ≥60 % der Cluster, die den Filter passieren, erreichen.
16. Bioinformatische Analyse
HINWEIS: Der folgende Arbeitsablauf beschreibt die Datenanalyse in Galaxy unter Verwendung der Du Novo-Analysewerkzeuge8,14,15. Die Analyse kann auch mit einer lokalen Installation von Du Novo oder anderer Software, die für Duplex-Sequenzierungsdaten entwickelt wurde, durchgeführt werden.
- Laden Sie die mit BCL Convert oder einem entsprechenden Demultiplexing-Tool erzeugten demultiplexierten paired-end-FASTQ-Dateien auf eine lokale Galaxy-Installation oder eine öffentlich verfügbare Galaxy-Instanz hoch14.
- Beurteilen Sie die Qualität der Sequenzierungsreads mithilfe von FastQC (Galaxy-Version 0.72+galaxy1). Untersuchen Sie mindestens die Module „Per Base Sequence Quality“, „Per Sequence GC Content“ und „Adapter Content“.
- Erzeugen Sie Einzelstrang-Konsenssequenzen (SSCSs) und DCSs aus den demultiplexierten paired-end-FASTQ-Dateien unter Verwendung der Du-Novopipeline (Galaxy-Version 3.0.2). Verwenden Sie eine minimale Familiengröße von drei Reads zur SSCS-Bildung und rufen Sie ein konsensuelles Nukleotid ab, wenn es in mindestens 70 % der Reads vorhanden ist15. Aktivieren Sie die Barcode-Fehlerkorrektur mit bis zu drei Mismatches. Weitere detaillierte Anweisungen zur Nutzung der Pipeline finden Sie im Du-Novotutorial des Galaxy Training Network16.
- Entfernen Sie mittels Sequence Content Trimmer (Galaxy-Version 0.2.3) Basen, die durch „NRYSWKMBDHV“ repräsentiert werden, und verwerfen Sie Reads, die kürzer als 10 bp sind.
- Entfernen Sie die ersten 10 Nukleotide am 5′-Ende jedes DCS mithilfe von FASTQ Trimmer (Galaxy-Version 1.1.5), um eine durch Endreparatur verursachte Bias zu reduzieren. Alignieren Sie die gekürzten DCS-Reads an das humane Referenzgenom, beispielsweise GRCh38.p14, das die überarbeitete Cambridge-Referenzsequenz (rCRS; NC_012920.1) enthält, unter Verwendung von BWA-MEM (Galaxy-Version 0.7.17.1).
HINWEIS: Es können auch andere humane Genom-Assemblys verwendet werden, einschließlich T2T-CHM13v2.0 oder neuere Assemblys. - Filtern Sie die BAM-Dateien mithilfe von BAMTools Filter BAM datasets on a variety of attributes (Galaxy-Version 2.5.2+galaxy1). Behalten Sie Reads mit einer Mapping-Qualität >20 bei, die auf chrM abbilden, primäre Alignments darstellen, gepaart sind, korrekt gepaart sind und einen abgebildeten Partner besitzen. Diese Kriterien reduzieren potenzielle, von NUMTs stammende Alignments17.
- Linienausrichtung der Reads mithilfe von Bam Left Align (Galaxy-Version 1.3.1). Schneiden Sie überlappende Bereiche gepaarter DCS-Reads mithilfe von BAMUtil clipOverlap (Galaxy-Version 1.0.15+galaxy1) ab.
- Rufen Sie Einzelnukleotidvarianten (SNVs) und Insertionen/Deletionen (Indels) mithilfe von Call variants with LoFreq (Galaxy-Version 2.1.5+galaxy2) mit Standardeinstellungen ab.
- Ausschluss gepaarter DCS-Reads, die mehr als zwei Varianten enthalten, sofern vorhanden, um eine potenzielle NUMT-Kontamination zu reduzieren. Proben mit effizienter mtDNA-Anreicherung sind typischerweise frei von nachweisbaren, von NUMTs stammenden Reads; eine unzureichende Depletion nukleärer DNA kann jedoch zu von NUMTs stammenden Sequenzen führen.
- Überprüfen Sie jede Bibliothek auf potenzielle Kreuzkontamination mithilfe donor-spezifischer mtDNA-Sequenzunterschiede, einschließlich fixierter Varianten und heteroplasmischer Varianten mit hoher Frequenz. Falls Kreuzkontamination festgestellt wird, wenden Sie die in Ergänzende Datei 1 (Fehlerbehebungsanleitung) beschriebenen Vorsichtsmaßnahmen an. Falls die Fragmentgrößenverteilung den empfohlenen Bereich überschreitet oder die durchschnittliche Fragmentgröße >900 bp beträgt, führen Sie eine doppelte, größenselektive Reinigung wie zuvor beschrieben durch18.
- Führen Sie downstream-Analysen der detektierten Varianten gemäß den Studienzielen durch.
- Nur Proben mit einer mittleren mitochondriale DCS-Sequenzierungstiefe von ≥100× für die downstream-Analyse berücksichtigen. Für die Anzahl gepaarter Reads oder die Ausbeute an SSCSs bzw. DCSs wurden keine festen Mindestschwellenwerte festgelegt.
Ergebnisse
Duplex-Sequenzierbibliotheken wurden aus menschlichen Oozyten hergestellt, die verschiedene Reifungsstadien repräsentieren, einschließlich Keimvesikel (GV), Metaphase I (MI), MII, pronukleares Stadium (0PN) und TI-Oozyten. Erfolgreich hergestellte Bibliotheken wurden auf einer Illumina NovaSeq 6000-Plattform mit einer SP-Flowcell und 2 × 250 bp Paired-End-Lesungen sequenziert. Die Datenanalyse wurde in Galaxy mithilfe der Du-Novo-Pipeline zur Gruppierung von Read-Familien und Erzeugung von Konsens-Reads durchgeführt8,14,15. Repräsentative Sequenziermetriken für erfolgreich verarbeitete Bibliotheken sind in Supplementary Table 1 zusammengefasst, während Proben, die während der Bibliotheksherstellung suboptimale Ergebnisse lieferten und von der Sequenzierung ausgeschlossen wurden, in Supplementary Table 2 aufgelistet sind.
Während der Bibliotheksherstellung wurden mehrere Qualitätskontrollschritte durchgeführt, um die Menge an Adapter-ligierter DNA, die mtDNA-Anreicherung, die Bibliothekskonzentration und die Fragmentgrößenverteilung zu bewerten. Der erste Qualitätskontrollschritt war der Attomol-qPCR-Test, der zur Abschätzung der Menge an Adapter-ligierter DNA verwendet wurde (Abbildung 4A,B). Der berechnete Quantifizierungszyklus (Cq)-Wert wurde angepasst, wenn Adapter- oder Primer-Dimere durch Agarose-Gelelektrophorese der qPCR-Amplifikationsprodukte nachgewiesen wurden (Abbildung 2A–D). Adapter- oder Primer-Dimere wurden typischerweise in Proben mit höheren Cq-Werten beobachtet, was auf geringere Mengen an Adapter-ligierter DNA hindeutet. Unter Verwendung der in diesem Protokoll beschriebenen Bedingungen wurde ein mittlerer angepasster Cq-Wert von 25,8 im Attomol-qPCR erzielt (Zusätzliche Tabelle 1). Basierend auf dem korrigierten Cq-Wert wurde die DNA-Menge für die erste Amplifikations-PCR gemäß dem in Tabelle 3 dargestellten Verdünnungsschema angepasst. Proben mit korrigierten Cq-Werten von ≥22 wurden ohne Verdünnung verwendet, während Proben mit korrigierten Cq-Werten von <22 vor der Amplifikation verdünnt wurden. Diese Anpassung wurde vorgenommen, um die Read-Familien-Größe zu optimieren und die erforderliche Anzahl an Sequenzierungsreads zu reduzieren. Proben mit korrigierten Cq-Werten von >28 produzierten im Allgemeinen größere Read-Familien (mittlere Familien-Größe: 21,8), was zu weniger DCSs und einer mittleren mtDNA-Sequenzierungstiefe von <200× führte (Zusätzliche Tabelle 1). Eine Anpassung des korrigierten Cq-Werts auf 22–28 führte zu einer mittleren Familien-Größe von 7,91, was der zuvor als optimal für die Duplexsequenzierung berichteten Familien-Größe von etwa sechs nahekommt6,7. Größere Familien-Größen können dennoch für Proben mit sehr geringer DNA-Menge, wie beispielsweise einzelnen Oozyten, vorteilhaft sein, da sie die Sequenzierungstiefe erhöhen können.
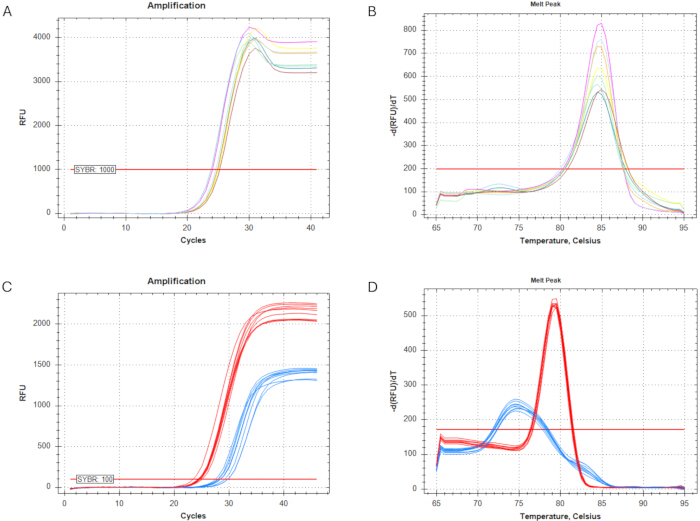
Abbildung 4. Quantitative PCR (qPCR)-Analysen zur Bibliotheksquantifizierung und Schätzung der Anreicherung von mitochondrialer DNA (mtDNA). Die gereinigte, adapterligierte DNA wurde vor der qPCR-Analyse 1:10 verdünnt. (A) Amplifikationskurven aus dem Attomol-qPCR-Assay zur Abschätzung der Menge an adapterligierter DNA. Die Fluoreszenzschwelle wurde auf 1.000 relative Fluoreszenzeinheiten (RFU) festgelegt. (B) Schmelzkurvenanalyse des Attomol-qPCR-Assays. (C) Amplifikationskurven aus dem qPCR-Assay zur Bestimmung der mtDNA-Anreicherung. Die Fluoreszenzschwelle wurde auf 100 RFU festgelegt. Die Amplifikation des mitochondriale NADH-Dehydrogenase-Untereinheit-6-(ND6)-Ziels ist rot dargestellt, und die Amplifikation des nuklearen Alu-Wiederholungselement-Ziels ist blau dargestellt. (D) Schmelzkurvenanalyse der mitochondrialen und nuklearen qPCR-Produkte. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Vor dem Pooling der Bibliotheken wurden alle Bibliotheken mittels Bioanalyzer oder TapeStation analysiert, um die Verteilung der Fragmentgrößen zu bewerten und verbleibende Adapter- oder Primer-Dimere zu erkennen. In Abbildung 3A–H sind repräsentative Beispiele optimaler Bibliotheken sowie Bibliotheken mit verbleibenden Adapter- oder Primer-Dimeren dargestellt. Adapter- oder Primer-Dimere zeigten sich als Peaks bei etwa 70–150 bp (Abbildung 3E–H); bei deren Nachweis wurden die Bibliotheken vor der Sequenzierung einer zusätzlichen magnetischen Bead-Reinigung unterzogen. Da eine Größenselektion absichtlich weggelassen wurde, um Probenvolumenverlust zu minimieren, wiesen die sequenzierten Bibliotheken eine mittlere Insertgröße von 275 bp auf (Ergänzende Tabelle 1).
Die Anreicherung der mtDNA wurde mittels qPCR unter Verwendung mitochondrialer und nuklearer Zielloci geschätzt, wodurch der Anteil der Sequenzierungsreads, die voraussichtlich auf das mitochondriale Genom abgebildet werden, vorhergesagt werden konnte (Abbildung 4C,D). Die mittleren Cq-Werte betrugen 25,2 für das mitochondriale Ziel und 29,7 für das nukleare Ziel (Zusätzliche Tabelle 1), was einem mittleren ΔCq (CqmtDNA − CqnDNA) von −4,5 entspricht. Im Durchschnitt wurden 67,5 % der paired-end-Sequenzierungsreads auf das mitochondriale Referenzgenom abgebildet. Sowohl die Schätzung der mtDNA-Anreicherung als auch der korrigierte Attomol-qPCR-Cq-Wert wurden bei der Bibliotheken-Poolung berücksichtigt. Bibliotheken mit höheren korrigierten Cq-Werten und effizienterer mtDNA-Anreicherung erhielten gemäß dem in Tabelle 4 dargestellten Sequenzierungszuweisungsschema anteilig weniger Sequenzierungsreads, um eine ausgewogene Sequenzierungsausbeute über alle Proben hinweg zu gewährleisten.
Basierend auf den korrigierten Attomol-qPCR-Cq-Werten wurde jedem Librarys eine durchschnittliche Zielzuweisung von 4 Millionen Paired-End-Lesungen zugewiesen (Tabelle 4). Aufgrund einer ineffizienten Clustererzeugung wurden nach der Sequenzierung durchschnittlich 1,3 Millionen Paired-End-Lesungen pro Library erhalten; diese Sequenzierausbeute reichte jedoch für die nachgeschaltete Duplex-Sequenzieranalyse aus (ergänzende Tabelle 1). Die Zuordnung der DCSs zum mitochondrialen Referenzgenom ergab eine mediane Sequenzierungstiefe von 567× über das gesamte mitochondriale Genom (Abbildung 5A,B,D; ergänzende Tabelle 1). Im Durchschnitt wurden pro Library 344.554 SSCSs und 96.322 DCSs generiert (ergänzende Tabelle 1). Die resultierenden Librarys wiesen eine durchschnittliche Read-Familiengröße von 8,32 auf, wobei größere Familiengrößen im Allgemeinen in Librarys mit höheren korrigierten Attomol-qPCR-Cq-Werten beobachtet wurden (Abbildung 5C,E; ergänzende Tabelle 1). Diese Ergebnisse stimmen mit denen einer früheren Studie unter optimaler Clusterdichte überein, in der eine mediane mtDNA-Sequenzierungstiefe von 1.440× erreicht wurde19.
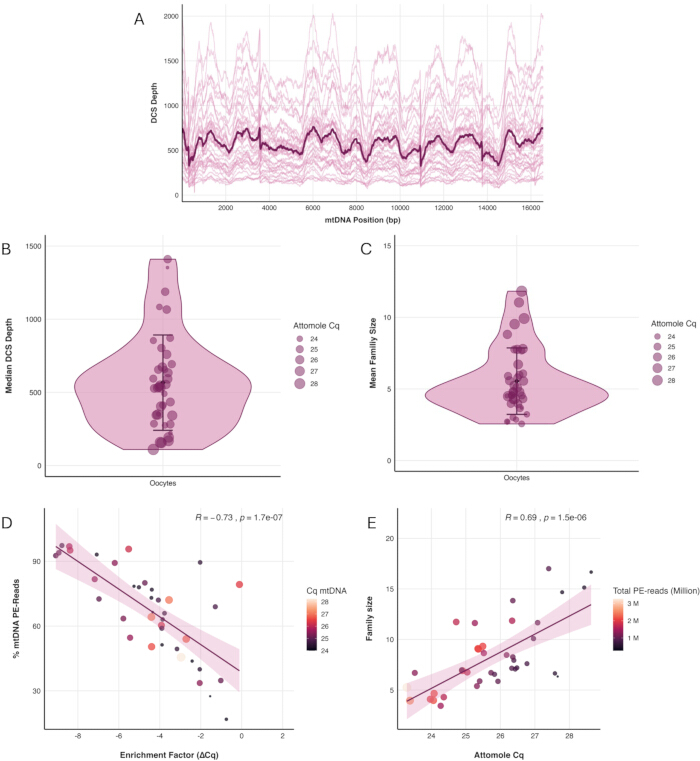
Abbildung 5. Sequenzierleistung von Duplex-Sequenzierbibliotheken einzelner Oozyten. (A) Tiefe der Duplex-Konsenssequenz (DCS) entlang des mitochondrialen Genoms. Dünne Linien repräsentieren einzelne Bibliotheken, und die fett gedruckte Linie zeigt die mittlere Tiefe über alle Bibliotheken hinweg. (B) Verteilung der medianen DCS-Tiefe für einzelne Bibliotheken. (C) Verteilung der mittleren DCS-Familiengröße für einzelne Bibliotheken. In (B) und (C) repräsentiert jeder Punkt eine Bibliothek, und die Punktfarbe gibt den attomol-qPCR-Quantifizierungszyklus (Cq) an. (D) Pearson-Korrelation zwischen der mtDNA-Anreicherungsschätzung (ΔCq) und dem Anteil der auf das mitochondriale Referenzgenom alignierten Sequenzierreads. (E) Pearson-Korrelation zwischen dem attomol-qPCR-Cq-Wert und der mittleren DCS-Familiengröße. In (D) und (E) repräsentiert jeder Punkt eine Bibliothek; die Punktfarbe zeigt den attomol-qPCR-Cq-Wert an, und die Punktgröße repräsentiert die Gesamtanzahl der für diese Bibliothek erhaltenen paired-end-Reads. n = 39 Bibliotheken. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Erweiterte Tabelle 1. Sequenzierungs- und Bibliotheksqualitätsmetriken für optimale Duplexsequenzierungsbibliotheken menschlicher Oozyten. Diese Tabelle fasst Metriken zur Qualitätsbeurteilung vor der Sequenzierung, quantitative Polymerase-Kettenreaktions-(qPCR-)Messungen, Sequenzierungsleistung und Ergebnisse der Duplexsequenzierungsanalyse für Bibliotheken zusammen, die die Qualitätskontrolle bestanden haben und in nachgeschaltete Analysen einbezogen wurden. Zu den berichteten Parametern gehören das Entwicklungsstadium des Oozyten, qPCR-Ergebnisse zur Anreicherung der mitochondrialen DNA (mtDNA), qPCR-Messungen in Attomol, Korrekturfaktor für Adapter-Dimer (ACF), Anzahl der Indexierungs-PCR-Zyklen, geplante Paired-End-Sequenzierungstiefe, Bibliothekskonzentration, Sequenzierungsertrag, mtDNA-Anreicherung, Anzahl der Reads für einzelsträngige Konsenssequenzen (SSCS) und Duplex-Konsenssequenzen (DCS), Statistiken zur Familiengröße, Sequenzierungstiefe und Verteilung der Insertgrößen. Die Probenidentifikatoren wurden vor der Analyse anonymisiert. Die geplanten Anzahlen an Paired-End-Reads wurden basierend auf dem korrigierten quantitativen qPCR-Zyklusschwellenwert (Cq) zugewiesen (Tabelle 4). Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle 2. Qualitätskennzahlen vor der Sequenzierung für suboptimale humane Oozyten-Bibliotheken, die von nachfolgenden Duplex-Sequenzierungsanalysen ausgeschlossen wurden. Diese Tabelle fasst die Ergebnisse der Qualitätskontrolle vor der Sequenzierung für Bibliotheken zusammen, die nicht die Kriterien für die Einbeziehung in nachfolgende Sequenzierungsanalysen erfüllten. Berichtete Parameter umfassen die Probenidentifikation, den Entwicklungsstadium des Oozyten, Ergebnisse der quantitativen Polymerase-Kettenreaktion (qPCR) zur Anreicherung der mitochondriellen DNA (mtDNA), den Korrekturfaktor für Adapter-Dimer (ACF), den korrigierten attomol-qPCR-Quantifizierungszyklus (Cq), die Anzahl der Zyklen in der Indexierungs-Polymerase-Kettenreaktion (PCR) sowie die Bibliothekskonzentration, gemessen mittels des Qubit High Sensitivity DNA Assay. Die Bibliotheken wurden gemäß den in der Anleitung beschriebenen Qualitätskontrollkriterien ausgeschlossen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatzdatei 1. Fehlersuchanleitung für die Bibliotheksvorbereitung zur Duplex-Sequenzierung der mitochondriale DNA einzelner Oozyten. Diese Zusatzdatei enthält Empfehlungen zur Fehlersuche bei kritischen Arbeitsschritten des Workflows, einschließlich der Vermeidung von Probenverlust, der Vorbereitung und Qualitätsbewertung von Adaptern, der magnetischen Bead-Reinigung, der Qualitätskontrolle der Bibliothek, der Sequenzierleistung, der Kontamination zwischen Proben sowie der Kontamination durch nukleäre mitochondriale DNA-Abschnitte (NUMT). Die Anleitung ergänzt das Hauptprotokoll und sollte konsultiert werden, wenn die Qualitätskennzahlen der Bibliothek oder die Sequenzierleistung außerhalb der empfohlenen Bereiche liegen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
In Oozyten identifizierte mtDNA-Varianten spiegeln eine Kombination aus de-novo-Mutagenese, Heteroplasmieverschiebungen über Generationen hinweg sowie den Auswirkungen des Alterns und von Erkrankungen auf die weibliche Keimbahn wider. Dieses Protokoll beschreibt eine Methode zur Anreicherung von mtDNA aus einzelnen Oozyten, gefolgt von der Herstellung einer Duplex-Sequenzierbibliothek und der Sequenzierung, wodurch eine hochgenaue Detektion und Analyse von mtDNA-Mutationen ermöglicht wird. Obwohl die Kopienzahl der mtDNA in Oozyten hoch ist, erfordert dieser Arbeitsablauf die Vorbereitung einer vollständigen Sequenzierbibliothek aus einer einzigen Zelle. Daher ist ein sorgfältiges Probenumgehen während des gesamten Verfahrens unerlässlich, wie auch im Zusatzmaterial 1 (Fehlerbehebungsanleitung) ausführlich beschrieben. Trotz sorgfältigen Probenumgehens können etwa 5 % der Bibliotheksherstellungen aufgrund des Verlusts von Oozyten in den ersten Handhabungsschritten oder des Probenverlusts während der Bibliotheksherstellung fehlschlagen.
Die Qualitätskontrolle während und nach der Bibliotheksherstellung ist entscheidend, um eine erfolgreiche Adapterligation zu überprüfen, die Anreicherung der mtDNA zu bewerten, die DNA-Menge für die Amplifikation zu optimieren, verbleibende Adapter- oder Primer-Dimere zu erkennen und festzustellen, ob zusätzliche Reinigungs- oder Amplifikationsschritte erforderlich sind. Die Verwendung desselben Echtzeit-qPCR-Geräts über mehrere Bibliotheksherstellungen hinweg gewährleistet konsistente Reaktionsbedingungen und verbessert die Vergleichbarkeit, Reproduzierbarkeit und Zuverlässigkeit der Messungen, die für die nachgeschaltete Qualitätskontrolle und die Optimierung des Protokolls verwendet werden. Die in diesem Protokoll angegebenen PCR-Zyklenzahlen für die Bibliotheksverstärkung und die Indexierung müssen möglicherweise angepasst werden, wenn andere Geräte, Enzyme oder Reagenzien verwendet werden. Der erste Amplifikationsschritt gliedert sich in eine lineare Amplifikationsphase mit einem einzelnen Primer, gefolgt von einer exponentiellen Amplifikation nach Zugabe des zweiten Primers. Diese Strategie minimiert die Wahrscheinlichkeit, dass Fehler, die während des ersten Amplifikationszyklus eingeführt werden, auf ein Niveau propagiert werden, bei dem sie kaum noch von echten DNA-Mutationen zu unterscheiden sind. Die empfohlenen Zyklenzahlen wurden gewählt, um eine optimale Read-Familien-Größe für die Duplex-Sequenzierungsanalyse zu erreichen; sie müssen jedoch möglicherweise je nach Menge und Qualität der eingesetzten DNA optimiert werden. Proben mit geringerer DNA-Menge benötigen möglicherweise zusätzliche Amplifikationszyklen, während Proben mit höherer DNA-Menge weniger Zyklen benötigen, um eine Überamplifikation zu vermeiden und die Komplexität der Bibliothek zu erhalten.
Obwohl dieses Protokoll an einzelnen menschlichen Oozyten demonstriert wird, ist der Arbeitsablauf nicht auf menschliche Proben beschränkt. Wir haben denselben Ansatz bereits erfolgreich zur Untersuchung der Keimbahn-Mutagenese bei Mäusen und Makaken12,13 eingesetzt, was zeigt, dass die Herstellung von Duplex-Sequenzierbibliotheken nach Optimierung spezies-spezifischer Primersequenzen und gegebenenfalls weiterer experimenteller Parameter auch auf Oozyten mehrerer Spezies übertragbar ist. Trotz der breiten Anwendbarkeit der Duplexsequenzierung ist der hier beschriebene Arbeitsablauf zur Anreicherung der mtDNA und zur Bibliotheksherstellung nicht ohne Weiteres auf einzelne somatische Zellen übertragbar, da deren mtDNA-Kopienzahl in der Regel um mehrere Größenordnungen niedriger liegt als die der Oozyten, was die Menge an für die Bibliotheksherstellung verfügbaren Eingangs-DNA begrenzt. Dennoch können Duplexsequenzierbibliotheken aus Gesamtproben somatischer Zellen erzeugt werden, wenn sie mit einer optimierten mtDNA-Anreicherung vor der Bibliotheksherstellung kombiniert werden. Eine weitere Einschränkung der Duplexsequenzierung ist die Notwendigkeit der DNA-Fragmentierung, die artefizielle Fehler, insbesondere in der Nähe der Fragmentenden, verursachen kann. Daher werden Basen an den Fragmentenden typischerweise von nachfolgenden Analysen ausgeschlossen, und auch die Detektion sowie Charakterisierung von Insertionen und Deletionen kann durch den Fragmentierungsprozess beeinträchtigt werden. Jüngste Fortschritte bei Langstreckensequenzierungstechnologien, insbesondere solche von Oxford Nanopore Technologies, könnten langfristig eine hochgenaue Sequenzierung ganzer mitochondrialer DNA-Moleküle ohne Fragmentierung ermöglichen. Derzeit hängt die Erreichung der für eine zuverlässige Mutationsdetektion erforderlichen Genauigkeit jedoch von der Analyse nativer, nicht amplifizierter DNA-Moleküle ab. Da die in einem einzelnen Oozyt vorhandene DNA-Menge für diese Ansätze unzureichend ist, ist ihre Anwendung auf diesen Probentyp derzeit nicht praktikabel.
Im Vergleich zu Ansätzen früherer Studien, einschließlich Langstrecken-PCR und konventioneller massiv paralleler Sequenzierung20,21,22, bietet dieses Protokoll mehrere Vorteile. Jeder Amplifikationsschritt birgt das Risiko, artifizielle Mutationen einzuführen, die die Detektion von Varianten mit geringer Häufigkeit erschweren und oft die Anwendung von Schwellenwerten für die Frequenz seltener Allele von mindestens 1 % erforderlich machen. Demgegenüber verbessert die deutlich niedrigere Fehlerrate der Duplexsequenzierung die Genauigkeit bei der Identifizierung von Mutationen und übertrifft diejenige konventioneller Sequenziermethoden5. Folglich stellt diese Methode einen zuverlässigeren Ansatz zur Detektion und Quantifizierung seltener mtDNA-Mutationen bereit. Mithilfe dieses Workflows konnten wir bereits zeigen, dass Oozyten im Gegensatz zu den meisten somatischen Geweben weitgehend der altersbedingten Anhäufung von mtDNA-Mutationen entgehen19. Ob dieser offensichtliche Schutzeffekt in Krankheitszuständen, die das ovarielle Mikromilieu verändern – wie beispielsweise Endometriose – und die Oozytenqualität beeinträchtigen, aufrechterhalten bleibt, ist derzeit unbekannt und bedarf weiterer Untersuchungen.
Offenlegungen
Die Autoren geben keine Wettbewerbsinteressen an.
Danksagungen
Wir danken herzlich dem Team des In-Vitro-Fertilisationszentrums des Kepler Universitätsklinikums Linz für die Unterstützung bei der Eizellentnahme. Wir danken außerdem N. Stoler und A. Nekrutenko für die Entwicklung der Duplex-Sequenzierungsanalyse-Instanz auf Galaxy und für die Anleitung zur Datenanalyse. Diese Arbeit wurde durch das Österreichische Wissenschaftsfonds (FWF) Schrödinger-Stipendium (DOI: 10.55776/J4096; BA) und das FWF Einzelprojekt (DOI: 10.55776/P36928; BA) unterstützt. KDM wurde teilweise durch ein Zuschuss des National Institutes of Health R01GM116044 und durch das Willaman-Stiftungsfonds des Eberly College of Science an der Pennsylvania State University unterstützt.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| 96 eindeutige duale Index-Primer-Paare | New England Biolabs | E6440S/L | Einzigartige Dual-Index-Primer-Paare zur Indexierung von PCR |
| Absolutethanol, molekularbiologische Qualität, 96 % | Fisher BioReagents | 15518181 | Frisches 80%iges Ethanol mit wasserfreiem Wasser der Molekularbiologiestufe herstellen |
| Agarose, niedrige Elektroendosmose | Biozym | 840000 | Zur Herstellung von 1,5 % und 2 %igen Agarosegelen |
| Ammoniumacetatlösung, 5 M | Thermo Fisher Scientific | J60688.AD | Zur Ethanolpräzipitation verwendet |
| ATP, 10 mM | New England Biolabs | P0756S/L | Zur Verdauung mit Exonuklease V verwendet |
| Automatisiertes Elektrophoresegerät | Agilent Technologies | G2992AA | Der eingestellte Agilent 2100 Bioanalyzer wurde verwendet; alternativ kann ein 4150 TapeStation oder ein gleichwertiges Instrument zur Fragmentanalyse von Nukleinsäuren eingesetzt werden. |
| Bioanalyzer High Sensitivity DNA Kit | Agilent Technologies | 5067-4626 | Zur Beurteilung der Bibliotheksgrößenverteilung sowie von Adapter- und Primerdimern |
| Träger-Oligonukleotid | Integrated DNA Technologies (IDT) | Maßgeschneiderte Synthese | Sequenz, die nicht komplementär zum menschlichen Genom ist. Ein Beispiel für eine solche Sequenz ist in Tabelle 2 angegeben. Bereiten Sie eine Stammlösung mit 100 nM vor und verdünnen Sie diese auf eine Endkonzentration von 1 nM. |
| CFX96 Touch Echtzeit-PCR-Detektionssystem | Bio-Rad | 12011319 | Das in dieser Studie verwendete Gerät ist nicht mehr im Handel erhältlich; ein CFX Opus 96 oder ein gleichwertiges Echtzeit-PCR-Gerät kann verwendet werden, wobei jedoch die Cq-Werte variieren können. |
| Collibri Library Quantification Kit | Invitrogen | A38524100 | Zur Quantifizierung der indizierten Bibliotheken vor dem Pooling |
| Medium zur Entfernung von Cumuluszellen, das Hyaluronidase (80 U/mL) enthält | Gynemed | 4 HY 0010 | GM501 Hyaluronidase |
| DNA-armes PCR-Röhrchen 200 µL | Corning | PCR-02-L-C | Axygen Maximum Recovery-Röhrchen |
| DNA-low-bind-Röhrchen, 0,5 mL | Biozym | 710136 | |
| DNA-low-bind-Röhrchen, 1,5 mL | Biozym | 710176 | |
| DNA-Polymerase I, großes (Klenow-)Fragment (5 U/µL) | New England Biolabs | M0210S/L | Wird während der Adapterverlängerung verwendet |
| dNTP-Mix (äquimolar dATP, dCTP, dGTP und dTTP), 10 mM | New England Biolabs | N0447S/L | Wird während der Adapterverlängerung verwendet |
| EDTA, 0,5 M (pH 8,0) | Fisher BioReagents | 10628203 | Bestandteil der TE- und TElow-Puffer |
| EvaGreen-Farbstoff, 20× | Biotium | 31077-T | Wird in attomol-qPCR verwendet |
| Exonuklease V (RecBCD), 10 U/µL | New England Biolabs | M0345S/L | Zur Verdauung von linearer DNA verwendet |
| Kamm mit fester Höhe | Bio-Rad | 1704446EDU | Für die Agarosegelelektrophorese |
| Fokussiertes Ultraschall-Gerät | Covaris | 500295 | M220 fokussierter Ultraschallhomogenisator |
| Fokussierte-Ultraschallprobengefäß, 50 µL | Covaris | 520166 | microTUBE-50 AFA Fiber Schraubverschluss |
| Gel-Ladefarbstoff, 6× | Thermo Fisher Scientific | R1161 | TriTrack DNA-Ladefarbstoff |
| GM501 Mineralöl | Gynemed | 4 MO 0100 | Wird verwendet, um das Oozyten-Sammelmedium zu überlagern, um Verdunstung zu verhindern und stabile sterile Kulturbedingungen, einschließlich Temperatur, Osmolalität und pH-Wert, während der Oozytenmanipulation aufrechtzuerhalten |
| High-Fidelity-PCR-Mix, 2× | KAPA Biosystems | KK2602 | KAPA HiFi HotStart ReadyMix |
| Kits für fluorometrische DNA-Analysen mit hoher Empfindlichkeit | Invitrogen | Q32854 | Qubit dsDNA High Sensitivity Assay Kit |
| HpyCH4III Restriktionsenzym (5 U/µL) | New England Biolabs | R0618S/L | Wird für die Restriktionsverdauung von Adaptern verwendet |
| Laborzentrifuge, gekühlt | Eppendorf | 5406000313 | Muss 14.000 unterstützen × g bei 4 °C |
| Lasersystem zur Öffnung der Zona pellucida | Vitrolife | 19310/0146 | Wird zur Polkörperentnahme verwendet |
| Kit zur Bibliotheksherstellung | New England Biolabs | E7645S/L | NEBNext Ultra II DNA Library Prep Kit; enthält Reagenzien für Endreparatur/A-Anhängung und Ligationsreagenzien |
| Magnesiumchloridlösung, 25 mM | New England Biolabs | B9021S/L | Zur Verdauung mit Exonuklease V verwendet |
| Reagenz zur Reinigung mit magnetischen Kügelchen | Beckman Coulter | A63881 | AMPure XP-Kügelchen |
| Magnetständer | Invitrogen | 12-321-D | Für die Trennung mit magnetischen Kügelchen |
| Mikromanipulator | Luigs & Neumann GmbH | SM II/2 | Wird zur Polkörperentnahme verwendet |
| Mikroskop | Olympus | IX51 | Wird zur Entfernung des Polkörperchens verwendet |
| Wasser in Molekularbiologie-Qualität | Thermo Fisher Scientific | 327290010 | Zur Reagenzherstellung und Verdünnungen verwendet |
| Oozytenkulturmedium | Gynemed | 4 GM 501H-20 | GM501 Kulturmedium |
| PCR-Platte, 96-Loch | Biozym | AF4TI-0960-C | Klare Vertiefungen, klarer Rahmen, flaches Profil, umrandet |
| PCR-Plattenversiegelung | Bio-Rad | MSB1001B | Kompatibel mit dem Echtzeit-PCR-Gerät |
| Phosphatgepufferte Kochsalzlösung (PBS), 20× | Cell Signaling Technology | 9808S | Verdünnen auf 1× mit wasser in molekularbiologischer Qualität |
| Pipetten zur Manipulation und Übertragung von Cumulus–Oozyten-Komplexe (COCs) und Oozyten | CooperSurgical | MXL3-150 (150 µm) | Zur mechanischen Entfernung von Cumuluszellen sowie zum Transfer von COCs und Oozyten verwendet. Weitere Pipettengrößen sind auf der Website des Herstellers verfügbar. |
| Stromversorgung für die Gelelektrophorese | Bio-Rad | 1645050 | PowerPac Basic Netzteil |
| PowerUp SYBR Green Master Mix, 2× | Applied Biosystems | 15350929 | Wird für mitochondriale und nukleäre qPCR-Assays verwendet |
| Qubit-Fluorometer | Invitrogen | Q33238 | Der eingestellte Qubit 1-Fluorometer wurde verwendet; eine neuere Version oder ein gleichwertiges fluorometrisches Instrument zur Nukleinsäurequantifizierung kann verwendet werden. |
| RNase A, 10 mg/mL | Thermo Fisher Scientific | 10753721 | Vor Gebrauch auf 1 mg/mL verdünnen |
| Spektralphotometer | Thermo Fisher Scientific | NDULTRAGL | Das eingestellte Gerät NanoDrop OneC wurde verwendet; eine neuere Version oder ein äquivalentes Mikrovolumen-Spektrophotometer kann verwendet werden. |
| SYBR Safe DNA-Gel-Färbemittel | Invitrogen | S33102 | Für die Agarose-Gelelektrophorese |
| Thermocycler | Bio-Rad | 1861096 | T100 Thermocycler |
| Thermolabile Proteinase K (0,120 U/µL) | New England Biolabs | P8111S/L | Wird zur Lyse einzelner Oozyten verwendet |
| Tris-Acetat-EDTA (TAE)-Puffer, 50× | Fisher Scientific | BP1332-1 | Verdünnen auf 1× für die Agarosegelelektrophorese |
| Tris-HCl (pH 8,0), 1 M | Fisher BioReagents | 10336763 | Zur Reagenzherstellung und Verdünnungen verwendet |
| Tween 20 | Fisher BioReagents | 11417160 | Bestandteil der Oozyten-Lysepufferlösung |
| Universeller DNA-Größenstandard | Thermo Fisher Scientific | SM0333 | GeneRuler Ready-to-Use DNA-Ladder (100–1.000 bp |
| Wide Mini-Sub Cell GT Zelle | Bio-Rad | 1704468EDU | Für die Agarose-Gelelektrophorese |
| Breite Mini-Sub-Cell GT UV-transparente Gelaufnahmewanne (15 × 7 cm | Bio-Rad | 1704426 | Für die Agarosegelelektrophorese |
Referenzen
- Dyall SD, Brown MT, Johnson PJ. Ancient invasions: from endosymbionts to organelles. Science. 2004;304:253-257. doi:10.1126/science.1094884.
- Pakendorf B, Stoneking M. Mitochondrial DNA and human evolution. Annu Rev Genomics Hum Genet. 2005;6:165-183. doi:10.1146/annurev.genom.6.080604.162249.
- Ng YS, Turnbull DM. Mitochondrial disease: genetics and management. J Neurol. 2016;263:179-191. doi:10.1007/s00415-015-7884-3.
- Shoubridge EA, Wai T. Mitochondrial DNA and the mammalian oocyte. In: St John JC, editor. Current Topics in Developmental Biology. Vol. 77: The Mitochondrion in the Germline and Early Development. San Diego (CA): Academic Press; 2007. p. 87-111. doi:10.1016/S0070-2153(06)77004-1.
- Fox EJ, Reid-Bayliss KS, Emond MJ, Loeb LA. Accuracy of next generation sequencing platforms. Next Gener Seq Appl. 2014;1:1000106. doi:10.4172/jngsa.1000106.
- Kennedy SR, et al. Detecting ultralow-frequency mutations by Duplex Sequencing. Nat Protoc. 2014;9:2586-2606. doi:10.1038/nprot.2014.170.
- Schmitt MW, et al. Detection of ultra-rare mutations by next-generation sequencing. Proc Natl Acad Sci U S A. 2012;109:14508-14513. doi:10.1073/pnas.1208715109.
- Stoler N, et al. Family reunion via error correction: an efficient analysis of duplex sequencing data. BMC Bioinformatics. 2020;21:96. doi:10.1186/s12859-020-3419-8.
- Abascal F, et al. Somatic mutation landscapes at single-molecule resolution. Nature. 2021;593:405-410. doi:10.1038/s41586-021-03477-4.
- The ESHRE Guideline Group on Ovarian Stimulation, Ata B, Bosch E, Broer S, Griesinger G, Grynberg M, et al. ESHRE guideline: ovarian stimulation for IVF/ICSI: an update in 2025. Hum Reprod. 2026;41:498-514. doi:10.1093/humrep/deag018.
- The ESHRE Working Group on Ultrasound in ART, et al. Recommendations for good practice in ultrasound: oocyte pick up. Hum Reprod Open. 2019;2019:hoz025. doi:10.1093/hropen/hoz025.
- Arbeithuber B, et al. Age-related accumulation of de novo mitochondrial mutations in mammalian oocytes and somatic tissues. PLoS Biol. 2020;18:e3000745. doi:10.1371/journal.pbio.3000745.
- Arbeithuber B, et al. Advanced age increases frequencies of de novo mitochondrial mutations in macaque oocytes and somatic tissues. Proc Natl Acad Sci U S A. 2022;119:e2118740119. doi:10.1073/pnas.2118740119.
- The Galaxy Community. The Galaxy platform for accessible, reproducible, and collaborative data analyses: 2024 update. Nucleic Acids Res. 2024;52:W83-W94. doi:10.1093/nar/gkae410.
- Stoler N, Arbeithuber B, Guiblet W, Makova KD, Nekrutenko A. Streamlined analysis of duplex sequencing data with Du Novo. Genome Biol. 2016;17:180. doi:10.1186/s13059-016-1039-4.
- Nekrutenko A, Stoler N. Calling very rare variants. Galaxy Training Network. Available from: https://training.galaxyproject.org/training-material/topics/variant-analysis/tutorials/dunovo/tutorial.html. Accessed July 25, 2026.
- Barnett DW, et al. BamTools: a C++ API and toolkit for analyzing and managing BAM files. Bioinformatics. 2011;27:1691-1692. doi:10.1093/bioinformatics/btr174.
- Illumina. Double sided size selection and bead clean up. Illumina Knowledge Base. Available from: https://knowledge.illumina.com/library-preparation/general-library-prep/library-preparation-general-library-prep-reference_material-list/000006157. Accessed July 25, 2026.
- Arbeithuber B, et al. Allele frequency selection and no age-related increase in human oocyte mitochondrial mutations. Sci Adv. 2025;11:eadw4954. doi:10.1126/sciadv.adw4954.
- Mertens J, et al. Mitochondrial DNA variants segregate during human preimplantation development into genetically different cell lineages that are maintained postnatally. Hum Mol Genet. 2022;31:3629-3642. doi:10.1093/hmg/ddac059.
- Mertens J, et al. Children born after assisted reproduction more commonly carry a mitochondrial genotype associating with low birthweight. Nat Commun. 2024;15:1232. doi:10.1038/s41467-024-45446-1.
- Van Der Kelen A, et al. The interplay between mitochondrial DNA genotypes, female infertility, ovarian response, and mutagenesis in oocytes. Hum Reprod Open. 2025;2025:hoae074. doi:10.1093/hropen/hoae074.
Nachdrucke und Genehmigungen
Dieser Artikel wurde veröffentlicht
Video demnächst verfügbar