Dieses Protokoll schlägt FedMediFormer-XAI vor, einen multimodalen Diabetes-Intelligenz-Rahmen, der die Privatsphäre durch verteiltes Lernen, multimodale Transformer, diffusionsbasierte Erweiterung, graphenbasierte personalisierte Arzneimittelempfehlung und erklärbare künstliche Intelligenz respektiert, um eine genaue Vorhersage, transparente Entscheidungsfindung und personalisierte Diabetes-Behandlung zu ermöglichen.
Methodenartikel
FedMediFormer-XAI: Föderierte multimodale Transformer mit Diffusions-Augmentierung und graphbasierter Medikamentenempfehlung für Diabetes
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Diabetesbehandlung steht vor zahlreichen Herausforderungen, wie fragmentierten Gesundheitsdaten, Datenschutzbedenken, geringer Erklärbarkeit und dem Mangel an individualisierter therapeutischer Unterstützung. Diese Forschungsarbeit stellt FedMediFormer-XAI vor, ein einheitliches und geeignetes Framework, das föderiertes Lernen, multimodale Transformer, datendiffusionsbasierte Datenaugmentierung, Graph-Neural-Networks (GNNs) für die Arzneimittelempfehlung und Erklärbare Künstliche Intelligenz (XAI) für die Diabetesintelligenz integriert. Das System nutzt vielfältige Arten von Gesundheitsdaten, beispielsweise klinische Befunde, Bevölkerungsgesundheitsindikatoren, kontinuierliche Glukosemessdaten, retinale Fundusbilder, Messwerte von tragbaren Sensoren sowie pharmakologische Informationen. Um synthetische Stichproben zu erzeugen und Klassenungleichgewichte auszugleichen, werden Diffusionsmodelle eingesetzt, und multimodale Transformer-Architekturen werden verwendet, um Zusammenhänge zwischen stark unterschiedlichen Datenquellen zu lernen. Mithilfe des föderierten Lernens wird ein kollaboratives Modelltraining auf datenschutzkonforme Weise ermöglicht, ohne Rohdaten von Patienten auszutauschen. Die GNN-Komponente erfasst Patienten-Medikament- und Medikament-Medikament-Interaktionen, um personalisierte Arzneimittelempfehlungen zu generieren. Erklärbarkeitsmethoden wie SHapley Additive exPlanations (SHAP), Visualisierung der Aufmerksamkeitsmechanismen, Integrierte Gradienten und kontrafaktisches Schließen liefern transparente Interpretationen der Vorhersage- und Empfehlungsergebnisse. In der repräsentativen Implementierung erreichte das vorgeschlagene Framework eine Genauigkeit von 94,2 %, eine Präzision von 93,1 %, einen Rückruftwert von 92,8 %, einen F1-Wert von 92,9 %, einen Matthews-Korrelationskoeffizienten (MCC) von 0,88 und eine Fläche unter der ROC-Kurve (AUC-ROC) von 0,96. Das graphenbasierte Empfehlungsmodul erreichte eine Präzision von 0,89, einen Rückruftwert von 0,84 und einen normalisierten diskontierten kumulativen Gewinn (NDCG) von 0,91. Das Protokoll bietet einen strukturierten Ansatz zur Integration heterogener Gesundheitsdaten unter Verwendung multimodaler Transformer, föderierten Lernens, datendiffusionsbasierter Erweiterung, graphenbasierter Empfehlung und erklärbarer künstlicher Intelligenz. Die berichteten Rechenergebnisse demonstrieren das Potenzial des Frameworks für die Diabetesvorhersage und personalisierte Medikamentenempfehlung, während das föderierte Design eine dezentrale Datenverarbeitung unterstützt. Eine prospektive multizentrische klinische Evaluation ist erforderlich, um die klinische Nützlichkeit, Übertragbarkeit und Anwendbarkeit im realen Umfeld zu belegen.
Einleitung
Diabetes mellitus gehört zu den häufigsten chronischen Stoffwechselerkrankungen, die die Menschheit betreffen, und stellt aufgrund ihres anhaltenden Anstiegs sowie der langfristigen Folgen und der hohen Kosten für die Patientenbehandlung ein bedeutendes öffentliches Gesundheitsproblem dar1,2. Laut einem Bericht leben derzeit weltweit über 537 Millionen Erwachsene mit Diabetes, und diese Zahl wird in den nächsten Jahrzehnten voraussichtlich deutlich ansteigen3. Wenn hohe Blutzuckerspiegel nicht kontrolliert werden, drohen dem Betroffenen schwere Komplikationen wie koronare Herzkrankheit4, Nierenschäden5, Nervenschäden6, Sehverlust7 und Schlaganfall8. Daher sind die frühzeitige Erkennung der Erkrankung, die regelmäßige Überwachung des Patientenzustands sowie die Schulung der Betroffenen mithilfe fortschrittlicher medizinischer Ansätze notwendige Maßnahmen, um Patienten zu einem gesünderen Leben zu verhelfen und dabei die Ausgaben des staatlichen Gesundheitssystems zu senken9,10.
Heutzutage verbreitet sich die Nutzung elektronischer Gesundheitsakten (EHRs), tragbarer Geräte, kontinuierlicher Glukosemesssysteme (CGM), retinaler Bildgebungstechnologien und mobiler Gesundheitsanwendungen rasch und erzeugt große Mengen heterogener Gesundheitsdaten, die analysiert werden können11. Diese unterschiedlichen Datensammlungswerkzeuge können vielfältige Informationen über den menschlichen Körper, seine Funktionsfähigkeit in verschiedenen Krankheitsstadien, die Reaktion des Patienten auf verschiedene Behandlungsarten sowie sein Verhalten im Alltag liefern12. Künstliche Intelligenz (AI) hat sich als beste Lösung zur Verarbeitung hochkomplexer Daten erwiesen, um Diabetes vorherzusagen, die Erkrankung zu überwachen und Ärzte bei klinischen Entscheidungen zu unterstützen13. Darüber hinaus haben maschinelle Lernalgorithmen, darunter zufällige Wälder, Support-Vektor-Maschinen und Gradient-Boosting-Verfahren, hervorragende Ergebnisse bei der Einschätzung des Diabetesrisikos erzielt14. In jüngerer Zeit haben Deep-Learning-Architekturen die automatische Merkmalsextraktion ermöglicht und die Vorhersagegenauigkeit in verschiedenen Anwendungen im Gesundheitswesen verbessert15.
Durch den Einsatz multimodaler Lernmethoden wurde die Diabetes-Intelligenz erheblich verbessert, indem strukturierte klinische Befunde, physiologische Messungen, Netzhautbilder und Verhaltensindikatoren in ein einheitliches prognostisches Framework integriert wurden16. Mithilfe mehrerer Informationsquellen können multimodale Modelle Muster erkennen, die nicht sichtbar sind, wenn jede Modalität einzeln untersucht wird17. Transformer-basierte Modelle haben kürzlich gelernt, langreichweitige Abhängigkeiten und kontextuelle Beziehungen aus verschiedenen Arten von Gesundheitsdaten sehr effektiv zu erfassen18. Dennoch behindern Probleme wie unausgeglichene Klassen, fehlende Daten, Datenheterogenität und begrenzte Übertragbarkeit weiterhin die breite Anwendung multimodaler KI-Systeme im klinischen Umfeld19.
Trotz dieser Entwicklungen stützen sich viele bestehende Diabetes-Intelligenzsysteme weiterhin auf zentralisierte Lernframeworks, die von Natur aus erfordern, dass Patientendaten aus verschiedenen Institutionen in einem einzigen Repository zusammengeführt werden20. Solche Methoden führen bereits zu Konflikten hinsichtlich des Datenschutzes, der Datenhoheit, der Cybersicherheit und der Einhaltung gesetzlicher Vorschriften21. Tatsächlich sind medizinische Einrichtungen aufgrund rechtlicher und ethischer Erwägungen häufig darin eingeschränkt, sensible Patientendaten weiterzugeben22. Vor diesem Hintergrund erweist sich das föderierte Lernen als eine gangbare Lösung, da es ermöglicht, ein gemeinsames Modell zu trainieren, ohne die tatsächlichen Patientendaten zu teilen23. Durch dezentrale Optimierung und sichere Aggregation von Parametern ermöglicht das föderierte Lernen eine datenschutzkonforme Gesundheitsanalyse, indem es Wissen aus geografisch verteilten Datensätzen nutzt24. Dennoch stellen Kommunikationsaufwand, Heterogenität der Clients sowie die Stabilität der Konvergenz weiterhin wesentliche Probleme in föderierten Gesundheitsanwendungen dar25.
Ein weiterer Nachteil der derzeit verwendeten Diabetes-Intelligenzsysteme ist der Mangel an Transparenz und Unterstützung für personalisierte Therapien. Viele Deep-Learning-Modelle verhalten sich wie Black Boxes, was für Kliniker problematisch ist, die die Begründung für Vorhersagen und Empfehlungen nachvollziehen möchten26. Erklärbare-Künstliche-Intelligenz-Methoden (XAI) wie SHAP, Integrierte Gradienten, Visualisierung von Aufmerksamkeitsmechanismen (Attention) und kontrafaktisches Schließen erweisen sich als vielversprechend, um die Transparenz der Modelle und das Vertrauen der Kliniker zu erhöhen27. Darüber hinaus haben Graph-Neuronale-Netzwerke (GNNs) die fortschrittlichsten Werkzeuge zur Erfassung von Patienten-Medikamenten- und Medikamenten-Medikamenten-Wechselwirkungen werden lassen, was zu personalisierten Arzneimittel-Empfehlungen und der Bewertung der Arzneimittelsicherheit führt28. Neue Diffusionsmodelle haben ebenfalls Lösungen zur Generierung authentischer synthetischer Gesundheitsdaten und zur Behebung von Klassenungleichgewichten eingeführt29.
Transformer, föderiertes Lernen, diffusionsbasierte Generierung synthetischer Daten, Graphneuronale Netze und erklärbare künstliche Intelligenz haben jeweils erfolgversprechende Ergebnisse in Anwendungen im Gesundheitswesen gezeigt; ihre Integration innerhalb eines einzigen reproduzierbaren Diabetes-Intelligenz-Frameworks ist jedoch weiterhin begrenzt. Bestehende Ansätze behandeln diese Komponenten häufig unabhängig voneinander, wobei der Fokus entweder auf lernbasierten Verfahren zum Schutz der Privatsphäre ohne personalisierte Therapieempfehlungen, auf multimodalen Vorhersagen ohne dezentrale Schulung oder auf Erklärbarkeit ohne graphenbasierte klinische Entscheidungsunterstützung liegt. Obwohl Diffusionsmodelle zur Klassenbalancierung beitragen und Transformer-Architekturen Beziehungen zwischen heterogenen Gesundheitsdatenmodi erfassen können, gibt es bisher nur begrenzte standardisierte Protokolle zur Integration dieser komplementären Technologien. Daher stellt diese Arbeit ein einheitliches methodisches Protokoll vor, das multimodale Vorhersage, diffusionsbasierte Datenaugmentierung, föderierte Optimierung, graphenbasierte personalisierte Arzneimittelempfehlung und erklärbare künstliche Intelligenz in einem reproduzierbaren Workflow kombiniert und gleichzeitig eine Grundlage für zukünftige klinische Validierung und Übertragung bietet.
Im Gegensatz zu Studien, die die Verfügbarkeit patientenebener multimodaler Datensätze voraussetzen, integriert dieses Protokoll heterogene öffentliche Datensätze, ohne eine direkte Patientenzuordnung vorzunehmen. Unabhängige, modalitytsspezifische Modelle werden für jede Datenquelle trainiert, und latente Merkmalsdarstellungen werden mithilfe eines cross-modalen Attention-Mechanismus kombiniert. Diese Konzeption bewahrt die methodische Strenge und ermöglicht gleichzeitig die Integration multimodalen Wissens über verschiedene Gesundheitsdatenquellen hinweg.
Das vorgeschlagene Protokoll richtet sich in erster Linie an die methodische Entwicklung und an KI-Anwendungen im dezentralen Gesundheitswesen, bei denen heterogene Datenquellen über separate Datenbanken oder Institutionen hinweg verfügbar sind und eine direkte Zentralisierung der Daten nicht zulässig ist. In der vorliegenden Implementierung sind die modalitätsspezifischen Datensätze unabhängig und nicht patientenbezogen miteinander verknüpft; daher erfolgt die multimodale Integration auf der Ebene der gelernten Repräsentationen und nicht über direkte Zuordnungen auf Patientenebene. Für eine praktische Anwendung wären angemessen verknüpfte multimodale Patientendaten, ein einheitliches Vorbearbeitungsverfahren und konsistente Outcome-Definitionen an allen beteiligten Standorten, eine geeignete rechnerische Infrastruktur sowie die Einhaltung der geltenden ethischen, datenschutzrechtlichen und regulatorischen Anforderungen erforderlich.
Dieser Artikel stellt FedMediFormer-XAI vor, ein föderiertes multimodales Transformer-Framework, das unter einem Dach datenschutzfreundliche Diabetes-Intelligenz durch Vorhersage-, Empfehlungs- und Erklärbarkeitsfunktionen ermöglicht. Dieses Framework integriert diffusionsbasierte Datenvermehrung zur Behebung von Klassenungleichgewichten, multimodales Transformer-Lernen zur Diabetesvorhersage, föderiertes Lernen für die kollaborative Modellentwicklung, eine auf Graph-Neuronalen-Netzwerken basierende personalisierte Arzneimittel-Empfehlung sowie Methoden der erklärbaren Künstlichen Intelligenz, um klinische Entscheidungen auf transparente Weise zu unterstützen. Die Gesamtarchitektur und der Arbeitsablauf des vorgeschlagenen FedMediFormer-XAI-Frameworks sind in Abbildung 1 dargestellt.
Die wichtigsten Beiträge des vorgeschlagenen FedMediFormer-XAI-Rahmenwerks lassen sich wie folgt zusammenfassen: (1) Es wird ein einheitliches Protokoll vorgestellt, das federiertes Lernen, multimodale Transformer, datenverstärkendes Verfahren auf Basis von Diffusionsmodellen, eine auf Graph-Neuronalen-Netzwerken basierende personalisierte Arzneimittel-Empfehlung und erklärbare künstliche Intelligenz in einem einzigen reproduzierbaren Workflow für die Diabetes-Intelligenz integriert. (2) Eine datenschutzfreundliche Strategie des federierten Lernens wird entwickelt, um ein gemeinsames Modelltraining über simulierte verteilte medizinische Clients hinweg zu ermöglichen, ohne dabei Rohdaten von Patienten auszutauschen. (3) Eine Architektur auf Basis multimodaler Transformer wird eingeführt, um gemeinsam komplementäre Darstellungen aus strukturierten klinischen Befunden, kontinuierlichen Glukose-Monitoring-Daten, retinalen Fundusbildern und Indikatoren zur Bevölkerungsgesundheit zu lernen. (4) Die Erzeugung synthetischer Daten mithilfe von Diffusionsmodellen wird integriert, um Klassenungleichgewichte zu verringern und die Robustheit des Modells zu verbessern, wobei die statistischen Eigenschaften der ursprünglichen Trainingsdaten erhalten bleiben. (5) Ein auf GraphSAGE basierendes heterogenes Graph-Lernmodul wird eingesetzt, um Patienten-Arzneimittel- und Arzneimittel-Arzneimittel-Beziehungen für personalisierte Medikamentenempfehlungen sowie für eine interaktionsbasierte Therapie-Rangfolge zu modellieren. (6) Mehrere Verfahren der erklärbaren künstlichen Intelligenz, darunter SHapley Additive exPlanations (SHAP), Integrierte Gradienten, Visualisierung der Aufmerksamkeitsmechanismen und kontrafaktische Erklärungen, werden kombiniert, um die Transparenz des Modells zu erhöhen und nachvollziehbare Vorhersage- und Empfehlungsergebnisse bereitzustellen. (7) Ein umfassendes Validierungsprotokoll wird bereitgestellt, das die Evaluierung der Vorhersagegenauigkeit, die Bewertung des federierten Lernens, die Evaluierung der Empfehlungen, die Analyse der Erklärbarkeit, eine klinikerzentrierte Bewertung, externe Validierung sowie die Beurteilung der Reproduzierbarkeit umfasst.
Protokoll
Alle in dieser Studie verwendeten Datensätze wurden aus öffentlich zugänglichen Repositorien bezogen und enthielten anonymisierte Patienteninformationen. Dazu gehörten der Pima Indians Diabetes Datensatz, der CDC Diabetes Health Indicators Datensatz, der OhioT1DM Datensatz, der APTOS 2019 Blindness Detection Datensatz, der Drug Review Datensatz und der Drug-Drug Interaction Datensatz. Es erfolgte keine direkte Rekrutierung von Patienten, keine Intervention, keine Probensammlung und kein Zugriff auf identifizierbare personenbezogene Gesundheitsdaten. Die Studie beschränkte sich auf eine sekundäre Analyse öffentlich verfügbarer, anonymisierter Datensätze zur methodischen Entwicklung und Validierung und wurde gemäß den institutionellen Anforderungen für die Nutzung solcher Daten durchgeführt. Die in diesem Protokoll beschriebene nutzerzentrierte Evaluation ist für eine zukünftige Durchführung vorgesehen und wurde in der vorliegenden Studie nicht durchgeführt. Forschende, die diese Evaluation durchführen, sollten die entsprechende Genehmigung durch den Institutionellen Ethik-Ausschuss einholen, schriftlich informierte Einwilligungen aller Teilnehmenden erhalten und die geltenden institutionellen Anforderungen, Datenverwendungsvereinbarungen sowie nationalen Vorschriften einhalten.
1. Konfigurieren Sie die Rechenumgebung
- Installieren Sie Python 3.11 als primäre Programmierumgebung. Installieren Sie PyTorch 2.3 und TensorFlow 2.15 für die Entwicklung und das Training von Deep-Learning-Modellen. Installieren Sie die Transformers-Bibliothek (v4.45), um Transformer-basierte Architekturen zu implementieren.
- Installieren Sie PyTorch Geometric (v2.5), um den Aufbau und das Training von Graph-Neuronalen-Netzen zu unterstützen. Installieren Sie SHAP (v0.47) und Captum (v0.8), um Erklärbarkeits- und Merkmalsbeitragsanalysen durchzuführen.
- Installieren Sie NumPy, Pandas und Scikit-learn für numerische Berechnungen, Daten-Vorverarbeitung und maschinelle Lernwerkzeuge. Installieren Sie OpenCV und Matplotlib für Bildverarbeitung und Visualisierungsaufgaben. Installieren Sie NetworkX, um Arzneimittel-Interaktionsgraphen zu erstellen und zu analysieren.
- Installieren Sie das CUDA Toolkit und kompatible NVIDIA-GPU-Treiber, um hardwarebeschleunigte Berechnungen zu ermöglichen. Richten Sie eine NVIDIA RTX 4090 GPU mit mindestens 32 GB Systemspeicher ein. Legen Sie den Zufallsstartwert auf 42 für Training, Validierung und Test fest, um reproduzierbare Ergebnisse sicherzustellen. Überprüfen Sie die Installationen und Kompatibilität der verwendeten Softwarebibliotheken. Notieren Sie die verwendeten Softwareversionen, Hardware-Spezifikationen und Modellkonfigurationsparameter für die Analyse.
2. Datensätze vorbereiten und vorverarbeiten
- Laden Sie die erforderlichen klinischen, physiologischen, bildgebenden und pharmakologischen Datensätze herunter, ordnen Sie sie in modalityspezifische Repositories ein und überprüfen Sie deren Integrität. Bestätigen Sie die Datensatzmerkmale, Vorhersageziele und Integrationsstufen, wie in Tabellen 1 und 2 angegeben. Der Arbeitsablauf ist in Abbildung 2 dargestellt.
- Entfernen Sie doppelte, ungültige oder inkonsistente Datensätze sowie Datensätze mit fehlenden wesentlichen Variablen. Teilen Sie jeden relevanten Datensatz in patientenunabhängige Trainings- (70 %), Validierungs- (15 %) und Testanteile (15 %) auf. Passen Sie Median-Imputation, Min-Max-Skalierung und kategoriale Kodierung ausschließlich anhand des Trainingsanteils an und wenden Sie die angepassten Transformationen unverändert auf Validierungs- und Testanteile an. Führen Sie die Erzeugung synthetischer Daten ausschließlich im Trainingsanteil durch. Überprüfen Sie die Aufteilung und die Verhinderung von Datenlecks gemäß Ergänzende Tabelle 1.
- Importieren Sie Glukose-, Nahrungsaufnahme-, Insulindosis-, körperliche Aktivität- und Schlafdaten. Standardisieren Sie Zeitstempel, richten Sie Ereignisse auf regelmäßige Intervalle aus, interpolieren Sie fehlende Glukosewerte linear, unterteilen Sie kontinuierliche Aufzeichnungen in Fenster fester Länge und wenden Sie die z-Wert-Normalisierung an, um Eingaben für den Temporal-Transformer zu generieren.
- Laden Sie die retinalen Fundusbilder und entfernen Sie beschädigte oder nicht lesbare Dateien, Duplikate, Bilder mit fehlenden Beschriftungen sowie Bilder mit schwerwiegenden Artefakten oder unzureichender Sichtbarkeit des Netzhautfeldes.
- Skalieren Sie die verbliebenen Bilder auf 224 × 224 Pixel, normalisieren Sie die Pixelintensitäten auf [0, 1] und wenden Sie die kontrastbegrenzte adaptive Histogramm-Equalisierung (CLAHE) an.
- Erweitern Sie die Trainingsbilder durch zufällige Drehung innerhalb von ±15°, horizontales Spiegeln mit einer Wahrscheinlichkeit von 0,5, zufälliges Zoomen im Bereich von 0,9–1,1× und Helligkeitsanpassung innerhalb von ±20 %. Wenden Sie keine stochastische Erweiterung auf Validierungs- oder Testbilder an. Speichern Sie die verarbeiteten Bilder für das Training des Vision Transformers.
- Integrieren Sie die modalityspezifischen Repräsentationen gemäß der in Tabelle 2 zusammengefassten Datensatz-Integrationsstrategie. Führen Sie keine direkte Zuordnung auf Patientenebene zwischen unabhängigen Repositories durch, wenn gemeinsame Patientenkennungen nicht verfügbar sind.
- Speichern Sie jeden öffentlichen Datensatz als unabhängigen, modalityspezifischen Datensatz, da Patientenkennungen nicht zwischen Repositories ausgetauscht werden.
- Trainieren Sie modalityspezifische Merkmalsextraktoren unabhängig voneinander mit den entsprechenden Datensätzen: (a) Klinische Befunde → TabTransformer-Encoder; (b) Bevölkerungsbezogene Gesundheitsindikatoren → TabTransformer-Encoder; (c) Kontinuierliches Glukosemonitoring → Temporal Transformer; (d) Retinale Fundusbilder → Vision Transformer; (e) Pharmakologische Daten → GraphSAGE-Modul
- Extrahieren Sie latente Merkmalsdarstellungen unabhängig voneinander aus jeder Modalität. Führen Sie ausschließlich die erlernten latenten Darstellungen über das vorgeschlagene cross-modale Attention-Fusion-Modul zusammen, anstatt rohe Patientendatensätze zu kombinieren.
- Stellen Sie sicher, dass keine künstliche Patientenzuordnung zwischen unabhängigen öffentlichen Datensätzen erfolgt. Behalten Sie für jeden Datensatz unabhängige Trainings-, Validierungs- und Testaufteilungen während der gesamten Vorverarbeitung, Datenerweiterung und Modellentwicklung bei.
- Speichern Sie die fusionierten multimodalen Merkmalsdarstellungen für nachfolgende Vorhersagen, fokussiertes Lernen (federated learning), Erklärbarkeit und personalisierte Arzneimittelempfehlungen (Abbildung 2).
3. Durchführung der diffusionsbasierten Datenaugmentierung
- Wenden Sie die diffusionsbasierte Datenaugmentierung auf strukturierte tabellarische klinische und bevölkerungsmedizinische Datensätze mithilfe von TabDDPM an. Generieren Sie synthetische Stichproben ausschließlich aus der vorverarbeiteten Trainingspartition, um Informationslecks zu vermeiden. Konfigurieren Sie das Modell gemäß Supplementary Table 2.
- Trainieren Sie TabDDPM maximal 500 Epochen lang mit dem Adam-Optimierer (Lernrate = 1 × 10⁻4; Batch-Größe = 256). Wenden Sie ein vorzeitiges Abbrechen an, wenn sich der Validierungsverlust über 20 aufeinanderfolgende Epochen hinweg um weniger als 0,001 verbessert. Generieren Sie synthetische Stichproben für unterrepräsentierte Klassen.
- Bewerten Sie die Qualität der synthetischen Daten anhand der Kolmogorov-Smirnov-(KS-)Statistik, der Jensen-Shannon-Divergenz, der Wasserstein-Distanz, der korrelationsweisen Merkmalsanalyse und der Leistung bei nachgelagerten Klassifizierungsaufgaben. Vergleichen Sie die ursprünglichen und synthetischen Merkmalsverteilungen mithilfe von Histogrammüberlappung, Kernel-Dichteschätzung und paarweisen Korrelationskoeffizienten.
- Akzeptieren Sie synthetische Stichproben nur, wenn die klassenweisen Merkmalsverteilungen konsistent mit den ursprünglichen Trainingsdaten bleiben (KS-Test, p > 0,05; Jensen-Shannon-Divergenz < 0,10) und keine unrealistischen klinischen Werte enthalten. Kombinieren Sie die akzeptierten Stichproben mit dem ursprünglichen Trainingsdatensatz, um einen klassenausgeglichenen Datensatz zu erzeugen. Der Ablauf der Datenaugmentierung ist in Figure 3 dargestellt.
- Validieren Sie die synthetischen Daten, indem Sie das Diabetesvorhersagemodell mit den ursprünglichen und erweiterten Trainingsdatensätzen erneut trainieren. Vergleichen Sie Genauigkeit, F1-Score, MCC und AUC-ROC, um Veränderungen in der Modellverallgemeinerung und der Verteilungsverzerrung zu bewerten.
4. Entwicklung des multimodalen Transformer-Modells
Konfigurieren Sie den multimodalen Transformer mit modalityspezifischen Encodern für strukturierte klinische Daten, CGM-Sequenzen und Netzhaut-Fundusbilder, wie in Abbildung 4 dargestellt. Integrieren Sie die resultierenden Darstellungen mithilfe von Cross-Modal-Attention für die Diabetesvorhersage und die auf Graphen basierende personalisierte Arzneimittelempfehlung.
- Entwickeln des klinischen Encoders
- Initialisieren Sie die TabTransformer-Encoder-Architektur. Geben Sie normalisierte klinische Variablen und Indikatoren zur Bevölkerungsgesundheit ein. Generieren Sie kontextuelle Merkmalsdarstellungen mithilfe von Transformer-Attention-Mechanismen.
- Konfigurieren Sie den TabTransformer-Encoder mit 32 strukturierten klinischen Eingabevariablen, einer Einbettungsdimension von 128, vier Transformer-Schichten, acht Attention-Köpfen, einer Feed-Forward-Dimension von 512, einer Dropout-Rate von 0,20 und Gaußscher Fehlerlineareinheit (GELU)-Aktivierung.
- Lernen Sie latente klinische Einbettungen, die Beziehungen zwischen Patientenmerkmalen erfassen. Speichern Sie die resultierenden klinischen Einbettungen für die multimodale Integration.
- Entwickeln des Continuous-Glucose-Monitoring-Encoders
- Initialisieren Sie den zeitlichen Transformer-Encoder. Leiten Sie kontinuierliche Glukosemesssequenzen und physiologische Messwerte ein. Nutzen Sie Self-Attention-Mechanismen, um zeitliche Abhängigkeiten zu kodieren.
- Konfigurieren Sie den zeitlichen Transformer mit einer Sequenzlänge von 96 Zeitschritten, einem Abtastintervall von 15 min, einer Einbettungsdimension von 128, vier Transformer-Schichten, acht Attention-Köpfen, sinusförmiger Positionsencodierung und einer Dropout-Rate von 0,20.
- Erzeugen Sie sequenzielle Einbettungen, die die Glukosedynamik des Patienten widerspiegeln. Halten Sie die zeitlichen Einbettungen für den nächsten Fusionsprozess bereit.
- Entwickeln des Vision-Transformer-Encoders
- Initialisieren Sie die Vision-Transformer-Architektur. Geben Sie vorverarbeitete retinale Fundusbilder ein. Teilen Sie die Bilder in feste, gleich große Ausschnitte (Patches) auf.
- Konfigurieren Sie den Vision-Transformer mit einer Eingabebildauflösung von 224 × 224 Pixeln, einer Patch-Größe von 16 × 16 Pixeln, einer Einbettungsdimension von 768, 12 Transformer-Blöcken, 12 Attention-Köpfen und einer Dropout-Rate von 0,10.
- Generieren Sie merkmalsbasierte Darstellungen auf Patch-Ebene. Gewinnen Sie visuelle Merkmale, die auf retinale Pathologien und krankheitsbezogene Biomarker hinweisen. Behalten Sie die Bildeinbettungen für die multimodale Fusion bei.
- Durchführung der cross-modalen Fusion
- Extrahieren Sie die latenten Darstellungen aus den klinischen, CGM- und Vision-Transformer-Encodern und projizieren Sie jede in einen gemeinsamen 256-dimensionalen latenten Raum mithilfe unabhängiger linearer Projektionen, gefolgt von Layer-Normalisierung.
- Konkatenieren Sie die projizierten Modalitäts-Token, fügen Sie lernfähige Modalitätstyp-Einbettungen hinzu und wenden Sie Multi-Head-Cross-Modal-Attention an, um den Informationsaustausch zwischen den klinischen, CGM- und retinalen Darstellungen zu ermöglichen. Konfigurieren Sie den Attention-Block mit acht Köpfen, einem 256-dimensionalen Modellraum, einer 1.024-dimensionalen Feed-Forward-Schicht, GELU-Aktivierung, 0,10 Dropout, Residualverbindungen und Layer-Normalisierung.
- Mitteln Sie jede modenspezifische Token-Gruppe und konkatenieren Sie die resultierenden Darstellungen. Projizieren Sie den konkatenierten 768-dimensionalen Vektor auf eine 512-dimensionale vereinheitlichte multimodale Darstellung und speichern Sie die Attention-Gewichte und die fusionierten Darstellungen für anschließende Erklärbarkeits- und Ablationsanalysen.
- Leiten Sie die vereinheitlichte Darstellung an die Module für die Diabetesvorhersage und die auf GraphSAGE basierende Arzneimittelempfehlung weiter. Behalten Sie während der Fusion die ursprünglichen, modenspezifischen Aufteilungen für Training, Validierung und Test bei, ohne künstliche patientenbezogene Zuordnungen über die unabhängigen Datensätze hinweg vorzunehmen.
- Konfigurieren Sie den multimodalen Transformer gemäß den in Supplementary Table 3 zusammengefassten Modellparametern.
5. Federiertes Lernen konfigurieren
- Konfigurieren Sie das Framework für föderiertes Lernen, um ein kollaboratives Modelltraining über geografisch verteilte medizinische Einrichtungen hinweg zu ermöglichen, ohne datenbasierte Informationen auf Patientenebene auszutauschen. Führen Sie die lokale Modelloptimierung an jeder teilnehmenden Einrichtung unter Verwendung der lokal verfügbaren Daten durch. Geben Sie ausschließlich geschützte Modellparameter an den zentralen Aggregationsserver weiter. Gewährleisten Sie dabei die Wahrung der Patientenprivatsphäre und ermöglichen Sie gleichzeitig die kollaborative Entwicklung multimodaler Modelle.
- Trennen Sie die multimodalen Datensätze und verteilen Sie sie auf mehrere verbundene Clients, um das Szenario verschiedener Gesundheitseinrichtungen zu simulieren, die zusammenarbeiten, ohne ihre Daten auszutauschen.
- Konfigurieren Sie das verbundene Lernnetzwerk mit 10 teilnehmenden Krankenhausclients, einem zentralen Aggregationsserver, fünf lokalen Epochen pro Kommunikationsrunde, 100 Kommunikationsrunden, einem Client-Teilnahmefraktion von 80 %, zufälliger Client-Auswahl in jeder Kommunikationsrunde und einer Mindestanzahl von acht teilnehmenden Clients pro Runde.
- Weisen Sie jedem Client einen Datensatz zu, der einer bestimmten Institution gehört, sodass die Daten lokal und vertraulich bleiben. Verteilen Sie die multimodalen Trainingsdaten unter 10 simulierten Krankenhaus-Clients mithilfe einer Dirichlet-basierten nicht unabhängig und identisch verteilten (nicht-IID) Strategie. um heterogene Klassendistributionen, demografische Zusammensetzungen und Client-Datensatzgrößen zu erzeugen.
- Verwenden Sie einen festen Zufallsstartwert, um die Reproduzierbarkeit zu gewährleisten. Überprüfen Sie die resultierenden Verteilungen auf Client-Ebene und behalten Sie diese Partitionen während des gesamten föderierten Trainings bei. Halten Sie die Validierungs- und Testdatensätze unabhängig von den Client-Partitionen.
- Initialisieren Sie jeden lokalen Client mit den globalen Modellparametern, die vom zentralen Aggregationsserver empfangen wurden. Trainieren Sie den lokalen multimodalen Transformer fünf Epochen lang mit den lokalen Trainingsdaten des Clients. Optimieren Sie das lokale Modell mithilfe des AdamW-Optimierers mit einer Lernrate von 1 × 10⁻4.
- Berechnen Sie die lokalen Modellparameter-Updates nach Abschluss des lokalen Trainings. Schützen Sie die lokalen Modellparameter vor der Übertragung an den zentralen Aggregationsserver. Übertragen Sie die geschützten lokalen Modellparameter an den zentralen Aggregationsserver zur globalen Aggregation.
- Empfangen Sie die geschützten Modellparameter von allen teilnehmenden Krankenhausclients. Überprüfen Sie die Integrität der empfangenen Modellaktualisierungen vor der Aggregation. Aggregieren Sie die lokalen Modellgewichte mithilfe des Federated-Averaging-Algorithmus (FedAvg). Aktualisieren Sie den globalen multimodalen Transformer unter Verwendung der aggregierten Modellparameter.
- Verteilen Sie die aktualisierten globalen Modellparameter an die teilnehmenden Krankenhäuser. Wiederholen Sie die Verfahren für das lokale Training und die globale Aggregation, bis 100 Kommunikationsrunden abgeschlossen sind oder das vorab festgelegte Konvergenzkriterium erfüllt ist.
- Schützen Sie übertragene Modellparameter mithilfe des angegebenen sicheren Aggregationsmechanismus und AES-256-Verschlüsselung. Authentifizieren Sie teilnehmende Clients mittels digitaler Zertifikate.
- Richten Sie verschlüsselte Kommunikationskanäle mithilfe von Transport Layer Security (TLS) 1.3 ein. Behalten Sie nach Abschluss jeder Kommunikationsrunde lediglich die aggregierten Parameter des globalen Modells.
- Bewerten Sie Datenschutz und Sicherheit anhand von Rohdatenexposition, unberechtigtem Teilen, Mitgliedschafts-Inferenz und Modell-Inversionsanalysen. Bei der Mitgliedschafts-Inferenz vergleichen Sie die AUC-ROC des Angriffs mit der Zufalls-Basislinie (0,50); bewerten Sie die Inversion mithilfe des strukturellen Ähnlichkeitsindex (SSIM) und des Spitzen-Signal-Rausch-Verhältnisses (PSNR) für Netzhautbilder sowie des normalisierten Rekonstruktionsfehlers für numerische Merkmale.
- Überprüfen Sie die sichere Aggregation, indem Sie bestätigen, dass der Server nicht auf individuelle, nicht aggregierte Client-Updates zugreifen kann. Überprüfen Sie den AES-256/TLS-1.3-Schutz und stellen Sie sicher, dass keine unverschlüsselten Übertragungen von Modell-Updates erfolgen.
- Vergleichen Sie die Datenschutzmetriken zwischen föderierten und zentralen Konfigurationen, wo anwendbar, und berichten Sie die in Zusatz-Tabelle 4.
- Schätzen Sie die rechnerische Komplexität des lokalen Transformer-Trainings als O(N × L × d2), wobei N die Anzahl der Proben, L die Anzahl der Transformer-Schichten und d die Einbettungsdimension repräsentiert.
- Schätzen Sie die rechnerische Komplexität der föderierten Aggregation als O(K × P) pro Kommunikationsrunde, wobei K die Anzahl der teilnehmenden Clients und P die Anzahl der trainierbaren Modellparameter repräsentiert.
- Tauschen Sie in jeder Kommunikationsrunde nur geschützte Modellparameter zwischen den teilnehmenden Clients und dem zentralen Aggregationsserver aus. Berechnen Sie den Kommunikationsaufwand basierend auf der Modellgröße, der Anzahl der teilnehmenden Clients und der Anzahl der Kommunikationsrunden.
- Vergleichen Sie den Overhead für den Austausch von Parametern mit den geschätzten Kosten für die Übertragung der entsprechenden multimodalen Gesundheitsdatensätze. Konfigurieren Sie das Framework für federiertes Lernen gemäß der zusammengefassten Parameter in Zusatz-Tabelle 4. Der Workflow des föderierten Lernens und der Prozess der Parameteraggregation sind dargestellt in Abbildung 5.
6. Konstruieren des personalisierten Arzneimittel-Empfehlungsmoduls
- Importieren Sie die pharmakologischen, medikamentösen, Patientenbehandlungs- und Arzneimittelwechselwirkungsdaten in die rechnergestützte Umgebung. Erstellen Sie einen heterogenen Gesundheitsdaten-Graphen, der Knoten für Patienten, Arzneimittel, Erkrankungen, Labortests und klinische Risikofaktoren enthält.
- Definieren Sie Patienten-Erkrankungs-, Patienten-Arzneimittel-, Erkrankungs-Arzneimittel-, Arzneimittel-Arzneimittel-Wechselwirkungs- und Patienten-Laborbeziehungen als Kanten im Graphen. Überprüfen Sie die Graphstruktur und entfernen Sie doppelte, ungültige oder nicht verbundene Beziehungen vor dem Modelltraining.
- Stellen Sie Patientenknoten mittels Alter, Geschlecht, Body-Mass-Index (BMI), HbA1c, Blutzucker, Blutdruck und Diabetesdauer dar. Stellen Sie Arzneimittelknoten mittels Wirkstoffklasse, Wirkmechanismus, Dosierung, Applikationshäufigkeit und bekannten Nebenwirkungen dar.
- Stellen Sie Erkrankungsknoten mittels Schweregrad der Erkrankung, Krankheitsstadium und assoziierten Komplikationen dar. Kodieren Sie kategoriale Attribute und normalisieren Sie kontinuierliche Knotenmerkmale vor dem GraphSAGE-Training.
- Initialisieren Sie die Knoteneinbettungen anhand der vorverarbeiteten Knotenmerkmale. Stichproben Sie bis zu 25 benachbarte Knoten für jeden Zielknoten während der Nachbarschaftsaggregation. Aggregieren Sie die Darstellungen benachbarter Knoten mittels Mittelwertaggregation. Aktualisieren Sie die Einbettungen des Zielknotens anhand der aggregierten Nachbarschaftsdarstellungen.
- Wenden Sie die ReLU-Aktivierungsfunktion (rectified linear unit) nach jeder GraphSAGE-Schicht an. Normalisieren Sie die resultierenden Knoteneinbettungen. Wiederholen Sie den Vorgang der Nachbarschaftsaggregation über drei GraphSAGE-Schichten hinweg.
- Konfigurieren Sie das GraphSAGE-Modell mit einer verborgenen Dimension von 256, einer Einbettungsdimension von 128, drei GraphSAGE-Schichten, einer Nachbarn-Stichprobengröße von 25, einer Dropout-Rate von 0,30, einer Lernrate von 1 × 10⁻4, einer Batch-Größe von 512 und maximal 100 Trainingsepochen. Optimieren Sie das Modell mithilfe des Adam-Optimierers.
- Berechnen Sie die patientenspezifische Einbettung aus dem trainierten GraphSAGE-Modell. Berechnen Sie Einbettungen für in Frage kommende Medikamente. Berechnen Sie Eignungsscores zwischen der Patientendarstellung und den Darstellungen der in Frage kommenden Arzneimittel. Rangordnen Sie die in Frage kommenden Medikamente anhand ihrer vorhergesagten Eignungsscores.
- Identifizieren und entfernen Sie kontraindizierte oder potenziell unsichere Medikamente anhand verfügbarer Informationen zu Arzneimittelwechselwirkungen. Geben Sie die fünf am höchsten eingestuften zulässigen Medikamente als personalisierte Top-5-Empfehlungen zurück.
- Trainieren Sie das Empfehlungsmodell mit dem Bayesian Personalized Ranking (BPR)-Verlust. Optimieren Sie das Ranking-Ziel, um klinisch geeigneten Medikamenten höhere Scores zuzuweisen als weniger geeigneten in Frage kommenden Medikamenten.
- Identifizieren Sie einflussreiche benachbarte Knoten und klinisch relevante Graphbeziehungen, die zu jeder Medikamentenempfehlung beitragen. Berechnen Sie Merkmalsbeitrags-Scores für patienten-, erkrankungs-, labor- und medikationsbezogene Eigenschaften, die zur Empfehlung beitragen.
- Erzeugen Sie visuelle, graphenbasierte Erklärungen, die die Beziehungen darstellen, die zu jeder personalisierten Medikamentenempfehlung beitragen. Konfigurieren Sie das GraphSAGE-Empfehlungsmodell gemäß den in ergänzenden Tabelle 5 zusammengefassten Parametern. Der graphenbasierte Workflow für personalisierte Arzneimittel-Empfehlungen ist in Abbildung 6 dargestellt.
7. Durchführen der Erklärbarkeitsbewertung
- Durchführung der SHAP-Analyse
- Laden Sie den trainierten multimodalen Transformer und den zurückgehaltenen Testdatensatz in die rechnerische Umgebung.
- Initialisieren Sie den SHAP-Erklärer unter Verwendung des trainierten Vorhersagemodells und einer Hintergrundstichprobe von 100 Trainingsbeispielen, die ausschließlich aus dem Trainingsdatensatz mittels stratifizierter Zufallsstichprobe gemäß der Diabetesergebnisklasse ausgewählt wurden. Bewahren Sie die ungefähre Klassendistribution der vollständigen Trainingspartition in der Hintergrundstichprobe bei, und verwenden Sie einen festen Zufallsstartwert von 42, um eine reproduzierbare Stichprobenauswahl zu gewährleisten. Berechnen Sie die SHAP-Werte für die ausgewählten Testbeispiele.
- Berechnen Sie die globale Merkmalswichtigkeit aus den absoluten SHAP-Werten, erzeugen Sie globale und lokale SHAP-Visualisierungen und behalten Sie die berechneten Werte für nachfolgende quantitative und statistische Analysen bei.
- Durchführung der integrierten Gradienten-Analyse
- Wählen Sie repräsentative korrekt klassifizierte und falsch klassifizierte Beispiele aus dem zurückgehaltenen Testdatensatz aus. Definieren Sie modenspezifische Basiseingaben, bevor Sie Integrierte Gradienten berechnen. Verwenden Sie eine Null-Basiseingabe für normalisierte klinische und CGM-numerische Merkmale, um einen Beitrag von null normalisierten Merkmalen darzustellen, und verwenden Sie ein Bild mit Null-Werten als Basiseingabe für die normalisierte Netzhautbild-Eingabe.
- Berechnen Sie die Zuordnungswerte für Integrierte Gradienten unter Verwendung von 100 Interpolationsschritten zwischen der Basiseingabe und der ursprünglichen Eingabe. Normalisieren Sie die resultierenden Zuordnungswerte, um einen Vergleich über Merkmale und Modalitäten hinweg zu ermöglichen. Erzeugen Sie Zuordnungsvisualisierungen, um einflussreiche klinische, zeitliche und bildgebende Merkmale zu identifizieren, die zu individuellen Modellvorhersagen beitragen.
- Durchführung der Aufmerksamkeitsvisualisierung
- Extrahieren Sie die Aufmerksamkeitsmatrizen aus den trainierten Transformer-Schichten für repräsentative Testbeispiele. Berechnen Sie die mittlere Aufmerksamkeitsgewichtung über die entsprechenden Aufmerksamkeitsköpfe. Erzeugen Sie Aufmerksamkeits-Heatmaps, um quermodale Interaktionen zwischen klinischen, zeitlichen und Netzhautbild-Darstellungen zu visualisieren. Identifizieren Sie die dominierenden klinischen, zeitlichen und Netzhautmerkmale, die während der Vorhersage hohe Aufmerksamkeitsgewichte erhalten.
- Extrahieren Sie die Aufmerksamkeitsgewichte aus dem trainierten multimodalen Transformer für ein zufällig ausgewähltes, zurückgehaltenes Testbeispiel und visualisieren Sie die entsprechenden Verteilungen der klinischen Merkmale, der CGM-Zeitverläufe, der räumlichen Netzhautmerkmale und der quermodalen Aufmerksamkeit.
- Erzeugung kontrastiver Erklärungen
- Wählen Sie repräsentative Patientenakten aus dem zurückgehaltenen Testdatensatz aus. Definieren Sie klinisch zulässige Bereiche und Beschränkungen für modifizierbare Patientenmerkmale, bevor kontrastive Beispiele erzeugt werden. Beschränken Sie kontinuierliche Merkmale auf den beobachteten Bereich in den Trainingsdaten und kategoriale Merkmale auf gültige Kategorien, die in den Trainingsdaten vorkommen. Ändern Sie nicht veränderliche demografische Merkmale wie Alter und Geschlecht nicht.
- Erzeugen Sie kontrastive Beispiele, indem Sie ausschließlich die zulässigen modifizierbaren Merkmale minimal verändern, unter Einhaltung der vorgegebenen klinischen und merkmalsbezogenen Beschränkungen. Lehnen Sie kontrastive Beispiele ab, die Werte außerhalb des beobachteten Bereichs der Trainingsdaten, ungültige kategoriale Zustände oder Änderungen an nicht veränderlichen Merkmalen enthalten. Identifizieren Sie die kleinsten klinisch plausiblen Merkmalsänderungen, die erforderlich sind, um das vorhergesagte Ergebnis zu verändern.
- Notieren Sie die geänderten Merkmale, ursprünglichen Werte, kontrastiven Werte und die entsprechenden Änderungen in den Modellvorhersagen. Der Workflow zur Erklärbarkeitsbewertung ist in Abbildung 7 dargestellt, während repräsentative Aufmerksamkeitsvisualisierungen und kontrastive Erklärungsergebnisse in Ergänzende Abbildung 1 gezeigt werden.
- Bewertung der Erklärungsqualität
- Berechnen Sie die Treue (Fidelity), um die Übereinstimmung zwischen den erzeugten Erklärungen und dem Verhalten des Vorhersagemodells zu quantifizieren. Berechnen Sie die Stabilität, indem Sie wiederholt Erklärungen unter kleinen Eingabeänderungen erzeugen und die resultierenden Zuordnungsmuster vergleichen. Bewerten Sie die Konsistenz, indem Sie Erklärungen für klinisch ähnliche Testbeispiele vergleichen.
- Berechnen Sie die Sparsamkeit, indem Sie die Anzahl oder den Anteil der Merkmale ermitteln, die wesentlich zu jeder Erklärung beitragen. Bewerten Sie die Vollständigkeit, um festzustellen, ob die zugeordneten Merkmale ausreichend für die entsprechende Modellausgabe verantwortlich sind. Bewerten Sie die Sensitivität, indem Sie Änderungen der Zuordnungswerte nach kontrollierten Störungen der Eingabemerkmale messen.
- Berechnen Sie die Infidelität, um die Unstimmigkeit zwischen Merkmalszuordnungen und beobachteten Änderungen in den Modellvorhersagen zu quantifizieren. Notieren Sie alle quantitativen Metriken zur Erklärbarkeit für nachfolgende statistische Analysen.
- Durchführung einer prospektiven klinischen Validierung
- Beantragen Sie für eine zukünftige prospektive klinische Validierung die Genehmigung des zuständigen institutionellen Ethikkomitees, bevor Sie klinische Experten rekrutieren. Nach Erhalt der ethischen Genehmigung rekrutieren Sie 12 Ärzte, bestehend aus sechs Endokrinologen, drei Diabetes-Spezialisten und drei klinischen Pharmakologen, und holen Sie die informierte Einwilligung aller Teilnehmer vor Beginn der Evaluation ein.
- Wählen Sie zufällig repräsentative Modellvorhersagen und die entsprechenden Erklärungen für die klinische Beurteilung aus. Präsentieren Sie die ausgewählten Erklärungen unabhängig jedem teilnehmenden Arzt in einem standardisierten Bewertungsformat.
- Bitten Sie jeden Arzt, die Nützlichkeit, klinische Relevanz, Interpretierbarkeit und Vertrauenswürdigkeit der Erklärung anhand einer fünfstufigen Likert-Skala zu bewerten. Notieren Sie anonymisierte Bewertungen der Ärzte und berechnen Sie die Übereinstimmung zwischen den Bewertern sowie die entsprechenden statistischen Maße gemäß Schritt 7.7.
- Durchführung der statistischen Analyse
- Prüfen Sie die Verteilung der quantitativen Bewertungswerte, bevor Sie den statistischen Vergleichstest auswählen. Wenden Sie bei normalverteilten gepaarten Messungen einen gepaarten t-Test oder bei nicht normalverteilten gepaarten Messungen den Wilcoxon-Test für verbundene Stichproben an, je nachdem, was angemessen ist.
- Berechnen Sie Fleiss’ Kappa, um die Übereinstimmung zwischen den teilnehmenden Ärzten zu quantifizieren. Berechnen Sie 95 % Konfidenzintervalle für die wichtigsten Metriken zur Erklärbarkeit und Arztbewertung. Legen Sie die Schwelle für statistische Signifikanz bei p < 0,05 fest.
- Berichten Sie die berechneten Teststatistiken, Konfidenzintervalle und p-Werte zusammen mit den entsprechenden Bewertungsergebnissen. Bewerten und berichten Sie die Metriken zur Erklärbarkeit gemäß den in Ergänzende Tabelle 6 zusammengefassten Kriterien.
8. Bewertung der Modellleistung
- Vergleichen Sie FedMediFormer-XAI mit Logistischer Regression, Random Forest, XGBoost, TabTransformer, Vision Transformer, Temporal Transformer und dem zentralisierten multimodalen Transformer hinsichtlich Genauigkeit, Präzision, Sensitivität, F1-Score, MCC und AUC-ROC.
- Führen Sie jede Baseline-Auswertung mit derselben vordefinierten Trainings-, Validierungs- und Teststrategie durch, um einen konsistenten Vergleich mit dem vorgeschlagenen Framework sicherzustellen.
- Wiederholen Sie die Modellbewertung über unabhängige experimentelle Durchläufe hinweg und notieren Sie die in jedem Durchlauf erzielten Leistungskennzahlen. Berechnen Sie den Mittelwert, die Standardabweichung (SD) und das 95 %-Konfidenzintervall (KI) für Genauigkeit, Präzision, Sensitivität, F1-Score, MCC und AUC-ROC. Geben Sie die Leistungsergebnisse als Mittelwert ± SD zusammen mit dem entsprechenden 95 %-KI an.
- Prüfen Sie die Normalverteilung der gepaarten Leistungsunterschiede zwischen FedMediFormer-XAI und jedem Baseline-Modell. Wenden Sie bei normalverteilten gepaarten Messungen einen gepaarten t-Test und bei nicht normalverteilten Messungen den Wilcoxon-Test an. Legen Sie die statistische Signifikanzschwelle bei p < 0,05 fest.
- Geben Sie die entsprechenden Teststatistiken, p-Werte und 95 %-Konfidenzintervalle an, um die statistische Signifikanz und Unsicherheit der beobachteten Leistungsunterschiede zu quantifizieren.
- Zählen Sie alle Kommunikationsrunden bis zur endgültigen Konvergenz der Modelle. Beobachten Sie die Leistung des globalen Modells während des verbundbasierten Trainings. Untersuchen Sie, wie sich die Konvergenz im Verlauf der Kommunikationsrunden verändert.
- Überprüfen Sie die Effektivität der Parameteraggregation. Untersuchen Sie, wie das dezentrale Lernen die Vorhersageleistung beeinflusst. Vergleichen Sie die Ergebnisse des verbundbasierten Lernens mit denen des zentralisierten Lernens.
- Bewerten Sie die Konvergenz im Verbund über die Kommunikationsrunden hinweg und vergleichen Sie die Vorhersageleistung im Verbund- mit der im zentralisierten Szenario. Evaluieren Sie Arzneimittel-Empfehlungen mittels Precision@5, Recall@5 und NDCG@5.
- Generieren Sie negative Stichproben – Arzneimittelproben aus dem Pool der in Frage kommenden Kandidaten-Arzneimittel, indem Sie Medikamente auswählen, die nicht als positive Patient-Arzneimittel-Interaktionen für den jeweiligen Patienten beobachtet wurden. Schließen Sie alle bekannten positiven Interaktionen und alle kontraindizierten Medikamente aus dem Pool für die negative Stichprobenziehung aus. Halten Sie ein festes Verhältnis von negativen zu positiven Stichproben von 1:1 für das Empfehlungstraining ein und verwenden Sie einen festen Zufallsstartwert von 42, um die reproduzierbare Auswahl negativer Stichproben zu gewährleisten.
- Leiten Sie die Menge der relevanten Items für jeden Patienten ausschließlich aus den zurückgehaltenen Evaluationsdaten ab. Definieren Sie die Menge der relevanten Items Ru für den Patienten u als die Menge der Medikamente, die die Kriterien für positive Patient-Arzneimittel-Interaktionen in den zurückgehaltenen Referenzdatensätzen erfüllen. Verwenden Sie keine Modellvorhersagen zur Konstruktion von Ru. Entfernen Sie kontraindizierte Medikamente aus der Kandidaten-Empfehlungsmenge, bevor eine Rangfolge erstellt wird.
- Generieren Sie die fünf am höchsten bewerteten in Frage kommenden Medikamente für jeden Evaluationspatienten. Berechnen Sie Precision@5 als Anteil der fünf empfohlenen Medikamente, die zur relevanten Item-Menge Ru des Patienten gehören. Berechnen Sie Recall@5 als Anteil der relevanten Medikamente des Patienten, die unter den fünf Empfehlungen enthalten sind. Berechnen Sie NDCG@5 anhand der gestuften Relevanz der empfohlenen Medikamente, wobei klinisch geeigneten Medikamenten eine höhere Relevanz zugewiesen wird und nicht relevanten Medikamenten eine Relevanz von null. Aggregieren Sie die Metriken über alle Evaluationspatienten hinweg und berichten Sie den mittleren Precision@5, Recall@5 und NDCG@5.
- Erstellen Sie die Referenzwahrheit für die Empfehlungen vor der Modellbewertung und halten Sie die zurückgehaltenen Patient-Arzneimittel-Interaktionen getrennt von den Daten für das Empfehlungstraining. Verwenden Sie während des GraphSAGE-Trainings, der negativen Stichprobenziehung oder der Kandidaten-Rangfolge keine Interaktionen, Labels oder zukünftigen Behandlungsinformationen aus dem Testdatensatz.
- Messen Sie die Fidelity, um zu prüfen, wie gut die Erklärungen dem Modellverhalten entsprechen. Bewerten Sie die Stabilität der Erklärungen durch mehrfache Untersuchungen. Beurteilen Sie die Verständlichkeit anhand arztzentrierter Kriterien.
- Untersuchen Sie die Konsistenz der Erklärungen über verschiedene Datentypen hinweg. Bestätigen Sie den klinischen Nutzen der erzeugten Erklärungen. Die in der Studie verwendeten Evaluierungsmetriken sind in Supplementary Table 7 zusammengefasst.
9. Führen Sie eine prospektive klinische Validierung durch
- Führen Sie eine prospektive klinische Validierung durch, nachdem die entsprechende Genehmigung durch eine Ethikkommission und die informierte Einwilligung eingeholt wurden, und folgen Sie dabei den in den Schritten 7.6–7.8 beschriebenen Verfahren zur Rekrutierung, Bewertung, Datenerhebung und statistischen Analyse. Der Aufbau der prospektiven klinischen Validierung, einschließlich der Zusammensetzung der Teilnehmer, der Bewertungskriterien, der Vergleichsbedingungen und der geplanten statistischen Analysen, ist in Supplementary Table 8 zusammengefasst.
10. Durchführung der Validierung und Bewertung der Reproduzierbarkeit
- Führen Sie Ablationsstudien durch, indem Sie einzelne Komponenten des vollständigen FedMediFormer-XAI-Frameworks systematisch entfernen, wobei die gleichen Datensatzpartitionen, Vorverarbeitungsverfahren, Trainingsparameter und Evaluierungskriterien beibehalten werden. Bewerten Sie das vollständige Modell sowie Konfigurationen ohne Diffusions-Augmentierung, federatives Lernen, GraphSAGE-basierte Arzneimittelempfehlung und multimodale Fusion.
- Vergleichen Sie die ablatierten Konfigurationen mit dem vollständigen FedMediFormer-XAI-Framework anhand von Genauigkeit, Präzision, Sensitivität, F1-Score, MCC und AUC-ROC. Quantifizieren Sie die Veränderung jedes Leistungsmetrums, um den Beitrag der einzelnen Framework-Komponenten zu bestimmen. Vergleichen Sie Validierungsergebnisse mit internen Testergebnissen, um die Generalisierbarkeit zu bewerten. Führen Sie statistische Signifikanztests durch, um die Zuverlässigkeit der beobachteten Leistungsunterschiede zu ermitteln.
- Beurteilen Sie die Generalisierbarkeit des Frameworks anhand eines unabhängigen externen Datensatzes, sofern ein solcher Datensatz mit kompatiblen Eingabevariablen und Outcome-Definitionen verfügbar ist. Wenden Sie die gleichen Vorverarbeitungs- und Evaluierungsverfahren an, die für den internen Testdatensatz verwendet wurden, und vergleichen Sie die resultierenden Leistungsmetriken mit den internen Testergebnissen.
- Führen Sie eine statistische Signifikanzanalyse über wiederholte experimentelle Durchläufe durch. Prüfen Sie die Normalverteilung der gepaarten Leistungsunterschiede vor der statistischen Analyse. Wenden Sie einen gepaarten t-Test auf normalverteilte gepaarte Messungen und den Wilcoxon-Vorzeichen-Rang-Test auf nicht normalverteilte gepaarte Messungen an. Legen Sie die Schwelle für statistische Signifikanz bei p < 0,05 fest.
- Berechnen Sie den Mittelwert und das 95 %-Konfidenzintervall für Genauigkeit, Präzision, Sensitivität, F1-Score, MCC und AUC-ROC. Berichten Sie die entsprechenden Teststatistiken, p-Werte und Konfidenzintervalle für die wichtigsten Modellvergleiche. Dokumentieren Sie alle Modellparameter, Vorverarbeitungsschritte, Trainingskonfigurationen und Evaluierungsprotokolle, die zur Reproduktion der beschriebenen Experimente erforderlich sind.
- Bewahren Sie den Quellcode, Konfigurationsdateien, Evaluierungsskripte und Spezifikationen der trainierten Modelle, die für die beschriebenen Experimente verwendet wurden, auf. Führen Sie detaillierte Aufzeichnungen über das Modelltraining, experimentelle Einstellungen, Zufallsstarts (random seeds) und Evaluierungsergebnisse.
- Überprüfen Sie die Vollständigkeit und Konsistenz der zur Verfügung stehenden Reproduzierbarkeitsmaterialien. Stellen Sie sicher, dass die dokumentierten Methoden und Materialien ausreichend Informationen zur unabhängigen Reproduktion des experimentellen Workflows bereitstellen.
- Fassen Sie die im Studium verwendeten Reproduzierbarkeitsressourcen und Validierungsverfahren in Supplementary Table 9 zusammen. Dokumentieren Sie das Vorgehen der Ablationsstudie und die Evaluierungskriterien zur Beurteilung des Beitrags der wichtigsten Framework-Komponenten.
Ergebnisse
Analysen zur Vorhersageleistung
FedMediFormer-XAI zeigte eine verbesserte Vorhersageleistung im Vergleich zu den evaluierten unimodalen und herkömmlichen Baseline-Modellen. Die diffusionsbasierte Datenaugmentierung verbesserte die Repräsentation der Minderheitenklassen, und die resultierende Vorhersageleistung ist in Tabelle 3 zusammengefasst. Die wiederholte Evaluation ergab eine stabile Vorhersageleistung über alle evaluierten Modelle hinweg. FedMediFormer-XAI erreichte die höchste Gesamtleistung mit einer Genauigkeit von 94,20 ± 0,34 % (95 % KI: 93,78–94,62), einer Präzision von 93,10 ± 0,30 % (95 % KI: 92,73–93,47), einem Recall von 92,80 ± 0,28 % (95 % KI: 92,45–93,15) und einem F1-Score von 92,90 ± 0,28 % (95 % KI: 92,55–93,25). Das Modell erreichte einen MCC von 0,88 ± 0,02 (95 % KI: 0,86–0,90) sowie einen AUC-ROC-Wert von 0,96 ± 0,01 (95 % KI: 0,95–0,97). Der zentralisierte multimodale Transformer erzielte die nächstbeste Gesamtleistung, während die unimodalen und herkömmlichen maschinellen Lernmodelle vergleichsweise geringere Vorhersageleistungen aufwiesen. Diese Ergebnisse zeigen, dass multimodales Repräsentationslernen in Kombination mit federierter Optimierung zu einer verbesserten und stabileren Klassifizierungsleistung bei Diabetes führt.
Ablationsstudie
Eine komponentenweise Ablation wurde verwendet, um den Beitrag der Diffusions-Augmentierung, des föderierten Lernens, der auf GraphSAGE basierenden Arzneimittelempfehlung und der multimodalen Fusion zu bewerten. Der vollständige FedMediFormer-XAI-Ansatz erreichte über fünf unabhängige Durchläufe eine Genauigkeit von 94,20 ± 0,34 %, eine Präzision von 93,10 ± 0,30 %, einen Recall von 92,80 ± 0,28 %, einen F1-Score von 92,90 ± 0,28 %, einen MCC von 0,88 ± 0,02 und einen AUC-ROC-Wert von 0,96 ± 0,01. Der Wegfall der Diffusions-Augmentierung verringerte die Genauigkeit auf 91,80 ± 0,42 %, was einer Abnahme um 2,40 Prozentpunkte entspricht, während der F1-Score und der AUC-ROC-Wert auf 90,30 ± 0,38 % bzw. 0,94 ± 0,01 sanken. Diese Verringerung zeigt den Beitrag der auf Diffusion basierenden Augmentierung zur Repräsentation von Minderheitenklassen und zur Vorhersage-Robustheit an.
Das Entfernen des föderierten Lernens führte zu einer Genauigkeit von 93,10 ± 0,37 %, was einer Abnahme um 1,10 Prozentpunkte im Vergleich zum vollständigen Framework entspricht. Präzision, Sensitivität, F1-Score, MCC und AUC-ROC verringerten sich ebenfalls auf 92,20 ± 0,34 %, 91,80 ± 0,32 %, 92,00 ± 0,33 %, 0,86 ± 0,02 bzw. 0,95 ± 0,01. Dieser Vergleich verdeutlicht den Beitrag der föderierten Konfiguration zur Vorhersageleistung.
Das Entfernen der auf GraphSAGE basierenden Komponente für personalisierte Arzneitempfehlungen führte zu einer vergleichsweise geringen Änderung der Leistung bei der Diabetesvorhersage, wobei die Genauigkeit auf 93,80 ± 0,35 % und der F1-Score auf 92,60 ± 0,30 % sank. Die entsprechenden Werte für MCC und AUC-ROC lagen bei 0,87 ± 0,02 bzw. 0,96 ± 0,01. Dieses Ergebnis zeigt, dass GraphSAGE hauptsächlich zur personalisierten Arzneitempfehlung beiträgt und nicht direkt die Leistung der Diabetesklassifizierung bestimmt.
Der stärkste Rückgang wurde beobachtet, wenn die multimodale Fusion entfernt wurde. Die Genauigkeit sank auf 87,60 ± 0,55 %, was einem Absinken um 6,60 Prozentpunkte entspricht, während Präzision, Sensitivität, F1-Score, MCC und AUC-ROC auf 86,80 ± 0,51 %, 85,90 ± 0,54 %, 86,30 ± 0,52 %, 0,76 ± 0,03 bzw. 0,91 ± 0,01 fielen. Dieses Ergebnis unterstreicht die Bedeutung einer gemeinsamen Modellierung komplementärer Informationen aus klinischen, CGM- und Netzhautmodalitäten.
Föderierte Lernanalyse
Der föderierte Lernansatz ermöglichte ein kollaboratives Modelltraining über verteilte Clients hinweg, während die Rohpatientendaten dezentral verarbeitet blieben. Während des Trainings wurde das lokale Modell jedes Clients individuell feinabgestimmt und anschließend mittels der Methode des föderierten Mittelwerts kombiniert. Nach 100 Kommunikationsrunden konvergierte das globale Modell, und seine Vorhersageleistung blieb mit der zentralisierten Lernmethode vergleichbar. Der föderierte Lernansatz zeigte über die Kommunikationsrunden hinweg eine stabile Konvergenz, trotz heterogener Datenverteilung auf den einzelnen Clients. Der geschützte Austausch von Parametern bewahrte die dezentrale Datenverarbeitung, während das globale Modell eine wettbewerbsfähige Vorhersageleistung im Vergleich zur zentralisierten Referenzmethode beibehielt. Tabelle 4 vergleicht die zentralisierte und die föderierte Implementierung. Föderiertes Lernen erforderte aufgrund des Kommunikationsaufwands zusätzliche Trainingszeit, wobei die Vorhersageleistung mit der des zentralisierten Lernens vergleichbar blieb.
Analyse der Leistung auf Datensatzebene
Um die Generalisierbarkeit über verschiedene Gesundheitsversorgungsmodalitäten hinweg zu bewerten, haben wir die Leistung für jeden Datensatz einzeln analysiert. Das multimodale FedMediFormer-XAI-Modell zeigte eine starke und insgesamt wettbewerbsfähige Leistung über alle untersuchten Datensätze hinweg. Es erreichte eine Genauigkeit von 91,8 %, 93,1 %, 92,4 % bzw. 94,2 % auf den Datensätzen Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM und APTOS 2019. Obwohl der Datensatz APTOS 2019 eine leicht höhere Genauigkeit (94,7 %) und Präzision (93,9 %) erzielte als das multimodale Modell, blieb die vorgeschlagene multimodale Methode in allen Datensätzen wettbewerbsfähig und erreichte einen AUC-ROC-Wert von 0,96, vergleichbar mit dem höchsten AUC-ROC-Wert auf Datensatzebene. Die Gesamtergebnisse auf Datensatzebene sind in Tabelle 5 dargestellt. Bei einzelnen Datensätzen erzielte die Analyse von Netzhautbildern die beste Leistung, wenn sie allein verwendet wurde, während die multimodale Fusion die stabilsten und ausgewogensten Vorhersagen lieferte.
Individuelle Arzneimittel-Empfehlungsanalyse
Die auf einem Graph-Neural-Network basierende Empfehlungskomponente wurde mithilfe von Informationen zur Arzneimittelwirksamkeit und Daten zu Arzneimittelwechselwirkungen evaluiert, wobei potenzielle Arzneimittel gemäß gelernter Patient-Arzneimittel-Eignungswerte sortiert wurden und kontraindizierte Kombinationen bei der Erstellung der Empfehlungen ausgeschlossen wurden. Durch das heterogene Graph-Format sowie die Modellierung von Patient-Arzneimittel- und Arzneimittel-Arzneimittel-Wechselwirkungen konnte eine umfassende Analyse durchgeführt werden, die individuelle Arzneimittelauswahl und Sicherheitsbewertung unterstützt. Das GraphSAGE-Empfehlungsmodell erfasste effektiv komplexe Zusammenhänge zwischen Patienten, Erkrankungen, Laborbefunden und Arzneimitteln. Die personalisierten Empfehlungen wiesen eine hohe Güte bei der Rangfolgenbildung auf und ermöglichten gleichzeitig klinisch aussagekräftige Erklärungen durch Analyse der Graph-Nachbarschaften und Merkmalszuschreibung.
Gemäß Tabelle 6 wurde das Modul zur personalisierten Arzneimittelempfehlung anhand von Precision@5, Recall@5 und NDCG@5 bewertet. Diese Metriken quantifizieren die Relevanz und die Qualität der Rangfolge der fünf besten personalisierten Arzneimittel-Empfehlungen, die vom auf GraphSAGE basierenden Empfehlungsmodul generiert wurden. Das Empfehlungssystem erzielte eine hohe Güte der Rangfolge mit einem Precision-Wert von 0,89, einem Recall-Wert von 0,84 und einem NDCG-Wert von 0,91.
Erklärbarkeitsanalyse
Der Rahmen nutzt SHAP, integrierte Gradienten, Visualisierungen der Aufmerksamkeit (Attention) und kontrafaktische Erklärungen, um die Interpretation multimodaler Vorhersagen zu unterstützen. SHAP wurde verwendet, um den Beitrag einzelner Merkmale zu quantifizieren, integrierte Gradienten, um die Vorhersagen auf Eingabemerkmale zurückzuführen, Aufmerksamkeitsvisualisierungen, um die Fokussierung des Modells über verschiedene Modalitäten hinweg zu untersuchen, und kontrafaktische Erklärungen, um Merkmalsänderungen zu identifizieren, die mit alternativen Vorhersagen verbunden sind. Abbildung 8 zeigt eine repräsentative, vom trainierten FedMediFormer-XAI-Modell erzeugte SHAP-Zusammenfassungsgrafik, während Abbildung 9 repräsentative Aufmerksamkeitsvisualisierungen zeigt, die aus dem trainierten Transformer extrahiert wurden. Diese Abbildungen stellen Ergebnisse dar, die aus der Modellbewertung stammen, und nicht schematische Darstellungen der vorgeschlagenen Architektur.
In Abbildung 8 werden die Rangfolgen der Merkmalswichtigkeit auf aggregierter Ebene dargestellt. Merkmale mit höheren absoluten SHAP-Werten hatten einen stärkeren Einfluss auf die Modellvorhersagen und stimmten zudem gut mit dem bestehenden klinischen Wissen überein.
Abbildung 9 zeigt repräsentative Visualisierungen der Aufmerksamkeit, die direkt aus dem trainierten FedMediFormer-XAI-Modell für eine zufällig ausgewählte Teststichprobe extrahiert wurden. Die Visualisierungen umfassen die Aufmerksamkeit für klinische Merkmale, die zeitliche Aufmerksamkeit für CGM-Daten, die räumliche Aufmerksamkeit für Netzhautbilder sowie die intermodale Aufmerksamkeit zwischen den drei Modalitäten. Die Aufmerksamkeitsvisualisierung verdeutlicht weiterhin die vom Modell gelernte Verteilung der Aufmerksamkeit über mehrere Modalitäten hinweg. Bei der ausgewählten Stichprobe zeigte sich eine vergleichsweise stärkere Fokussierung auf HbA1c, Diabetesdauer und Alter innerhalb der klinischen Merkmale, während die CGM-Aufmerksamkeitskarte mehrere Phasen mit ausgeprägter Glukosevariabilität hervorhob. Die Netzhaut-Aufmerksamkeitskarte identifizierte spezifische Bildbereiche, die zur Modellrepräsentation beitragen, und die intermodale Aufmerksamkeitsmatrix verdeutlichte sowohl intra- als auch intermodale Aufmerksamkeitsmuster. Wie in Abbildung 9 dargestellt, heben die repräsentativen, vom Modell abgeleiteten Aufmerksamkeitskarten ausgewählte zeitliche Glukosemuster, einflussreiche klinische Variablen und diagnostisch relevante Bereiche in Netzhautbildern innerhalb einer ausgewählten Teststichprobe hervor.
Ergebnisse der menschenzentrierten Evaluation
Ein prospektives, menschenzentriertes Evaluationsprotokoll wurde entwickelt, um das Vertrauen der Ärzte, die Interpretierbarkeit, Benutzerfreundlichkeit, klinische Nützlichkeit und Relevanz der Erklärungen unter Bedingungen mit nur Vorhersage und mit Vorhersage plus Erklärung zu bewerten. Die vorgeschlagene Evaluation wird Endokrinologen, Diabetologen und klinische Pharmakologen einbeziehen und verfügt über die erforderliche Genehmigung der Instituts-Ethikkommission sowie informierte Einwilligungen. Da diese Evaluation für eine zukünftige prospektive Durchführung vorgesehen ist, werden in diesem Protokoll keine Ergebniswerte auf Arztebene berichtet.
Tabelle 7 fasst das vorgeschlagene prospektive Design zur Bewertung durch Ärzt:innen sowie die vorab festgelegten Kriterien zur Beurteilung der Auswirkungen von Erklärungen auf das Vertrauen der Ärzt:innen, die Interpretierbarkeit und die wahrgenommene Nützlichkeit zusammen. Die prospektive Evaluation wird die Einschätzungen von Ärzt:innen bezüglich Modellvorhersagen mit und ohne begleitende Erklärungen anhand vordefinierter Likert-Skala-Kriterien vergleichen. Der vorgeschlagene prospektive, auf Menschen ausgerichtete Bewertungsrahmen für Erklärbarkeit ist in Abbildung 10 dargestellt.
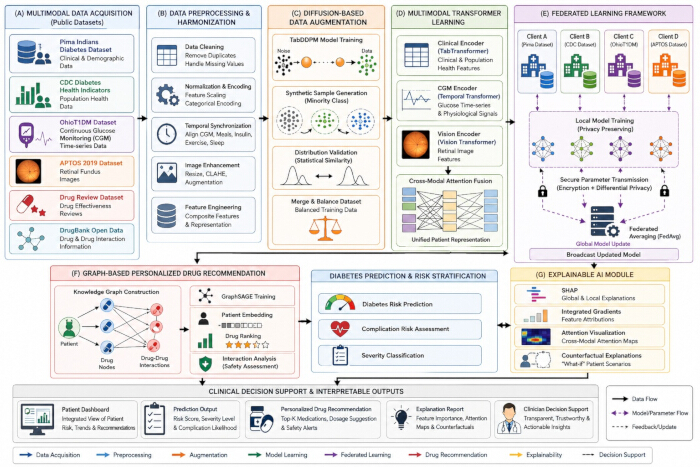
Abbildung 1: Gesamtarchitektur des FedMediFormer-XAI-Frameworks. Schematische Übersicht über das FedMediFormer-XAI-Framework, die multimodale Datenerfassung und -vorverarbeitung, diffusionsbasierte Datenaugmentierung, modalitysspezifisches Transformer-Lernen, föderiertes Modelltraining, GraphSAGE-basierte personalisierte Arzneimittelempfehlung sowie Erklärbarkeitsanalyse zeigt. Das Framework erzeugt Diabetesvorhersagen, personalisierte Medikamentenempfehlungen und interpretierbare Modellausgaben. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
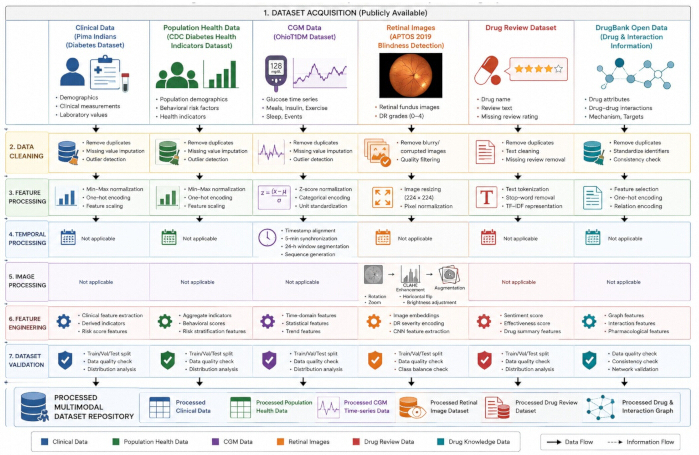
Abbildung 2: Erwerb und Vorverarbeitungspipeline für multimodale Datensätze. Schematischer Workflow zur Erfassung und Vorverarbeitung der in FedMediFormer-XAI verwendeten multimodalen Datensätze. Klinische und bevölkerungsbezogene Gesundheitsdaten, CGM-Aufzeichnungen, Netzhautbilder und pharmakologische Informationen durchlaufen modenspezifische Qualitätskontrolle, Vorverarbeitung, Normalisierung, Kodierung und Erweiterung, bevor sie in für das Modell geeignete Darstellungen für die nachgeschaltete Analyse umgewandelt werden. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
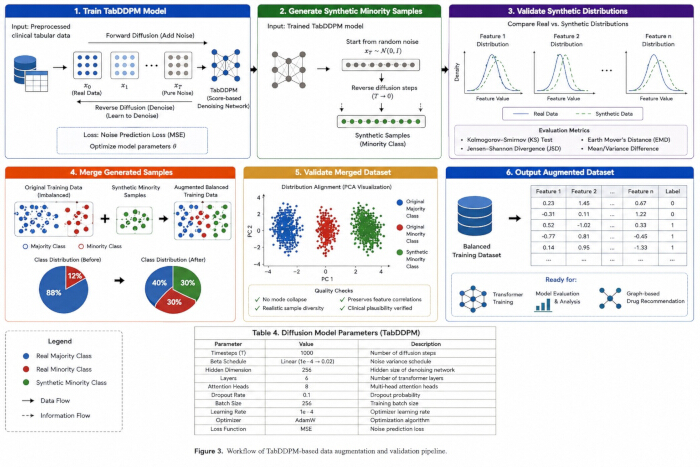
Abbildung 3: Workflow zur datenbasierten Augmentierung mittels Diffusionsmodell. Schematischer Workflow zur tabellarischen Datenvergrößerung mithilfe strukturierter Trainingsdaten mit TabDDPM. Generierte Datensätze durchlaufen Qualitäts- und Verteilungsähnlichkeitsanalysen, bevor sie zusammen mit den ursprünglichen Trainingsdaten verwendet werden, um die Klassenbalance zu verbessern. Klicken Sie hier, um eine vergrößerte Darstellung dieser Abbildung anzusehen.
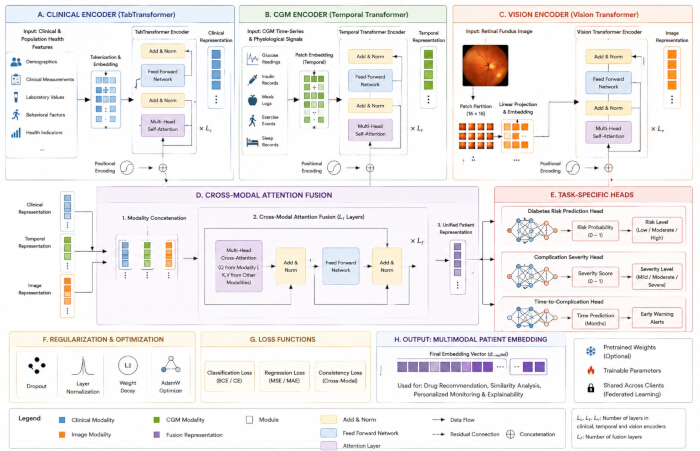
Abbildung 4: Architektur des vorgeschlagenen multimodalen Transformer-Frameworks. Schematische Architektur bestehend aus (A) einem TabTransformer-Encoder für klinische Daten, (B) einem zeitlichen Transformer-Encoder für CGM-Daten und (C) einem Vision-Transformer-Encoder für Netzhautbilder. (D) Modus-spezifische Darstellungen werden über eine cross-modale Aufmerksamkeit integriert, um eine einheitliche multimodale Repräsentation zu erzeugen. (E) Aufgabenspezifische Vorhersageköpfe generieren die Modellausgaben. (F) Regularisierungs- und Optimierungskomponenten unterstützen das Modelltraining, und (G) Klassifizierungs-, Regressions- sowie cross-modale Konsistenzverluste leiten den Optimierungsprozess. Die resultierende multimodale Repräsentation unterstützt nachgelagerte Vorhersage-, Empfehlungs- und Erklärbarkeitsaufgaben. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
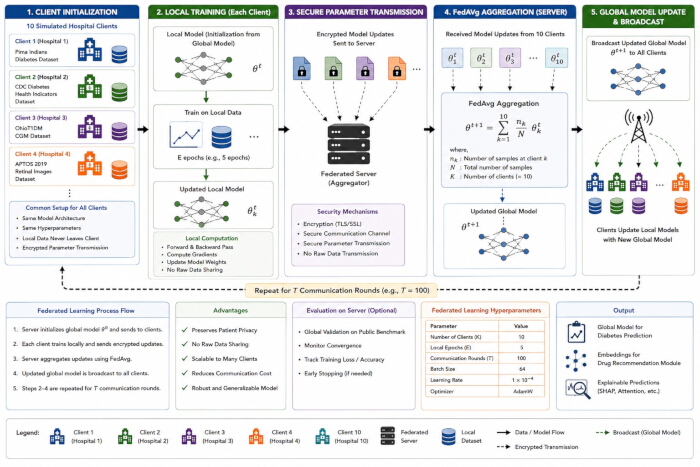
Abbildung 5: Kommunikationsarchitektur des föderierten Lernens. Schematischer Ablauf des föderierten Trainings über verteilte Krankenhausclients hinweg. Lokale multimodale Modelle werden anhand kundenspezifischer Daten trainiert, und geschützte Modellaktualisierungen werden an einen zentralen Server zur föderierten Mittelwertbildung übermittelt. Das aggregierte globale Modell wird anschließend erneut an die Clients verteilt, um weitere Kommunikationsrunden zu ermöglichen. Die Architektur veranschaulicht zudem den sicheren Austausch von Parametern sowie die Bewertung von Anforderungen an Datenschutz, Kommunikation und Rechenleistung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
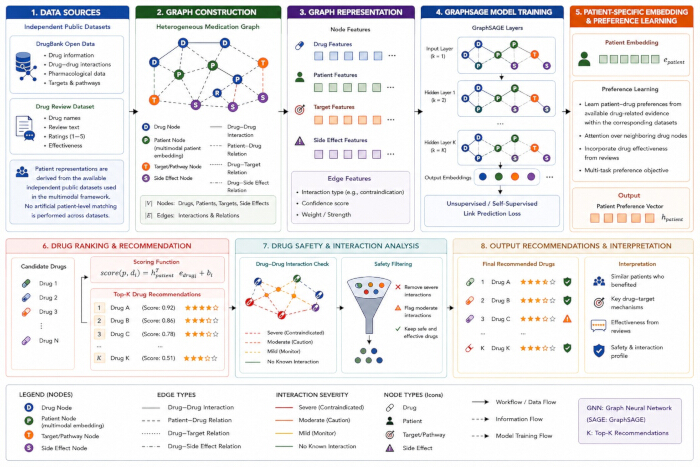
Abbildung 6: Graphbasierte personalisierte Arzneimittel-Empfehlungsabfolge. Schematische Abfolge für die personalisierte Arzneimittel-Empfehlung basierend auf GraphSAGE. Pharmakologische und Patientenrepräsentationsdaten werden in einem heterogenen Graphen organisiert, der relevante medizinische Entitäten und deren Beziehungen enthält. GraphSAGE lernt Repräsentationen von Patienten und Arzneimitteln, die zur Berechnung von Eignungswerten zwischen Patient und Arzneimittel sowie zur Rangfolge infrage kommender Medikamente verwendet werden. Kontraindizierte oder unsichere Arzneimittelkombinationen werden vor der Erstellung der endgültigen Top-K-Empfehlungen herausgefiltert, wobei graphenbasierte Informationen die Interpretation der Empfehlungen unterstützen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
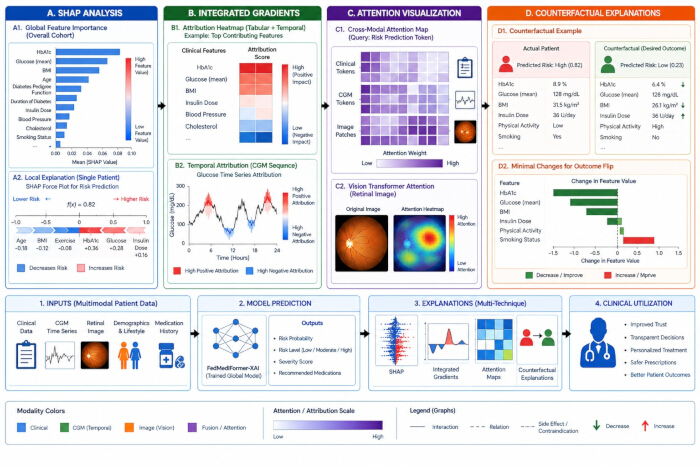
Abbildung 7: Rahmenwerk zur Bewertung der Erklärbarkeit. Schematische Übersicht des Erklärbarkeits-Workflows. (A) Die SHAP-Analyse bewertet globale und lokale Merkmalsbeiträge; (B) Integrierte Gradienten liefern erklärungsbasierte Zuordnungen; (C) die Visualisierung der Aufmerksamkeit („Attention“) identifiziert einflussreiche Merkmale und Wechselwirkungen zwischen Modalitäten; und (D) die kontrfaktische Analyse identifiziert Merkmalsänderungen, die mit veränderten Vorhersagen assoziiert sind. Die resultierenden Erklärungsausgaben unterstützen die Interpretation von Modellvorhersagen und personalisierten Empfehlungen. Klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
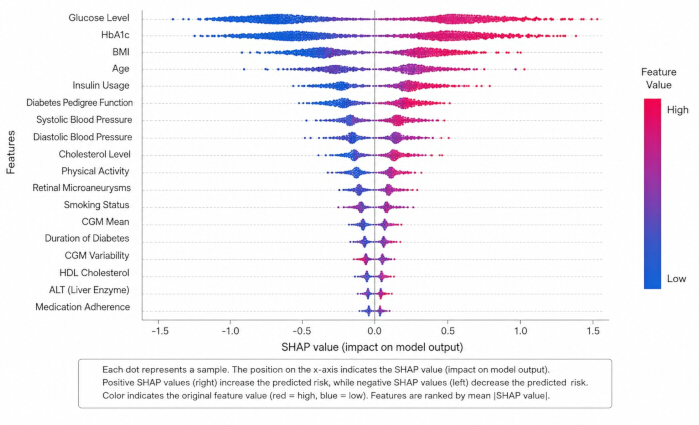
Abbildung 8: Repräsentative, modellbasierte SHAP-Analyse der Merkmalswichtigkeit, erzeugt durch das trainierte FedMediFormer-XAI-Modell. Das SHAP-Zusammenfassungsdiagramm zeigt die Verteilung der SHAP-Werte über alle ausgewerteten Proben, wobei die Merkmale nach ihrem mittleren absoluten SHAP-Beitrag geordnet sind. Positive SHAP-Werte zeigen Beiträge zu einem höheren vorhergesagten Diabetesrisiko an, während negative Werte Beiträge zu einem niedrigeren vorhergesagten Risiko anzeigen. Die Farbe repräsentiert den jeweiligen Merkmalswert, wobei höhere Werte rot und niedrigere Werte blau dargestellt sind. Die Darstellung zeigt eine tatsächliche, vom Modell generierte Erklärbarkeitsausgabe und keine schematische Illustration. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
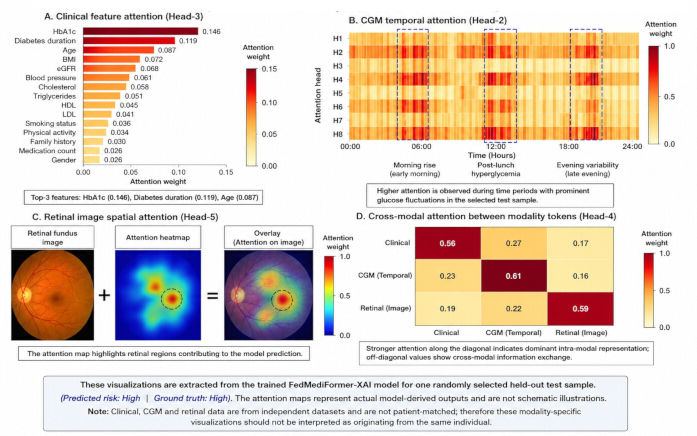
Abbildung 9: Repräsentative Aufmerksamkeitsausgaben des trainierten FedMediFormer-XAI-Modells für eine zufällig ausgewählte Teststichprobe aus der Hold-out-Menge. (A) Klinische Merkmalsaufmerksamkeit, gewonnen aus einem Aufmerksamkeitskopf des multimodalen Transformers, zeigt die relativen Aufmerksamkeitsgewichtungen der klinischen Merkmale. (B) Zeitliche Aufmerksamkeit entlang der CGM-Sequenz, die Zeitabschnitte mit höherer Modellaufmerksamkeit veranschaulicht. (C) Räumliche Aufmerksamkeit für das Netzhaut-Fundusbild, einschließlich des Originalbilds, der Aufmerksamkeits-Heatmap und der Überlagerung. (D) Multimodale Aufmerksamkeit zwischen klinischen, CGM- und Netzhautmodalitäts-Token, die intra- und intermodale Informationsgewichtung zeigt. Die dargestellten Visualisierungen sind vom Modell abgeleitete Ausgaben des trainierten Modells. Die Aufmerksamkeitsgewichte beziehen sich auf die ausgewählte Teststichprobe und sollten als Muster der Modellaufmerksamkeit interpretiert werden, nicht als unabhängige Maße klinischer Kausalität. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Datensatz | Datentyp | Stichproben/Datensätze | Merkmale/Inhalte | Zweck | Öffentliche Verfügbarkeit |
| Pima Indians Diabetes Datensatz | Klinische Tabellenform | 768 Patienten | 8 klinische Variablen | Diabetes-Risikovorhersage | Öffentlich |
| CDC Diabetes Health Indikatoren | Bevölkerungsgesundheit | 253.680 Datensätze | Demografie, Lebensstil, Gesundheitsindikatoren | Analyse des Bevölkerungsrisikos | Öffentlich |
| OhioT1DM Datensatz | CGM-Zeitreihen | 12 Probanden | Glukose, Insulin, Mahlzeiten, Bewegung, Schlaf | Zeitliche Diabetesmodellierung | Öffentlich |
| APTOS 2019 Blindness Detection | Netzhautbilder | 3.662 Bilder | Augenhintergrundaufnahmen mit Schweregradbezeichnungen | Analyse der diabetischen Retinopathie | Öffentlich |
| Arzneimittel-Bewertungsdatensatz | Pharmakologisch | 215.063 Bewertungen | Arzneimittelwirksamkeit, Bewertungen, Rezensionen | Arzneimittel-Empfehlung | Öffentlich |
| DrugBank Open Data | Arzneimittel-Wissensgraph | Tausende von Arzneimitteln | Arzneimittel-Wechselwirkungen, Zielstrukturen, Signalwege | Graph-Konstruktion | Öffentlich/Akademischer Zugang |
Tabelle 1: Datensatzmerkmale. Zusammenfassung der in dieser Studie verwendeten öffentlich verfügbaren Datensätze, einschließlich Datensatztyp, Stichprobengröße, Datenmodus, Merkmalsinhalt, vorgesehenem Verwendungszweck und Verfügbarkeit.
| Datensatz | Modalität | Vorhersageziel | Fusionsebene |
| Pima Indians Diabetes | Klinisch | Klassifizierung von Diabetes | Feature-Embedding |
| CDC Diabetes Health Indicators | Bevölkerungsgesundheit | Diabetes-Risikovorhersage | Feature-Embedding |
| OhioT1DM | Kontinuierliche Glukoseüberwachung | Glukose-Trendvorhersage | Feature-Embedding |
| APTOS 2019 | Retinale Fundusbilder | Analyse der diabetischen Retinopathie | Feature-Embedding |
| Drug Review + DrugBank | Pharmakologisch | Arzneimittel-Empfehlung | Graph-Embedding |
Tabelle 2: Strategie zur Integration multimodaler Datensätze. Zusammenfassung der für die multimodale Diabetesintelligenz verwendeten Datensätze, einschließlich der Datenmodalität, des Vorhersageziels und der Ebene, auf der modenspezifische Darstellungen integriert werden. Klinische, Bevölkerungsgesundheits-, kontinuierliche Glukosemessungs- und Netzhautbild-Daten werden als Merkmals-Embeddings dargestellt, während pharmakologische Informationen über Graph-Embeddings für personalisierte Arzneimittelempfehlungen integriert werden.
| Modell | Genauigkeit, Mittelwert ± SD (95 % KI) | Precision, Mittelwert ± SD (95 % KI) | Recall, Mittelwert ± SD (95 % KI) | F1-Score, Mittelwert ± SD (95 % KI) | MCC, Mittelwert ± SD (95 % KI) | AUC-ROC, Mittelwert ± SD (95 % KI) |
| Random Forest | 83,60 ± 0,74 (82,68–84,52) | 82,70 ± 0,60 (81,96–83,44) | 81,90 ± 0,56 (81,21–82,59) | 82,30 ± 0,56 (81,61–82,99) | 0,67 ± 0,03 (0,63–0,71) | 0,88 ± 0,01 (0,87–0,89) |
| XGBoost | 85,30 ± 0,71 (84,42–86,18) | 84,70 ± 0,60 (83,96–85,44) | 83,80 ± 0,56 (83,11–84,49) | 84,20 ± 0,56 (83,51–84,89) | 0,70 ± 0,03 (0,66–0,74) | 0,90 ± 0,01 (0,89–0,91) |
| TabTransformer | 87,50 ± 0,52 (86,85–88,15) | 87,00 ± 0,60 (86,26–87,74) | 86,20 ± 0,56 (85,51–86,89) | 86,60 ± 0,56 (85,91–87,29) | 0,75 ± 0,03 (0,71–0,79) | 0,92 ± 0,01 (0,91–0,93) |
| Vision Transformer | 88,80 ± 0,50 (88,18–89,42) | 88,20 ± 0,60 (87,46–88,94) | 87,60 ± 0,56 (86,91–88,29) | 87,90 ± 0,56 (87,21–88,59) | 0,78 ± 0,03 (0,74–0,82) | 0,93 ± 0,01 (0,92–0,94) |
| Temporal Transformer | 87,20 ± 0,51 (86,57–87,83) | 86,60 ± 0,60 (85,86–87,34) | 85,90 ± 0,56 (85,21–86,59) | 86,20 ± 0,56 (85,51–86,89) | 0,74 ± 0,03 (0,70–0,78) | 0,91 ± 0,01 (0,90–0,92) |
| CNN-LSTM | 86,90 ± 0,58 (86,18–87,62) | 86,30 ± 0,60 (85,56–87,04) | 85,60 ± 0,55 (84,92–86,28) | 85,90 ± 0,56 (85,21–86,59) | 0,73 ± 0,03 (0,69–0,77) | 0,91 ± 0,01 (0,90–0,92) |
| Zentraler multimodaler Transformer | 91,30 ± 0,12 (91,15–91,45) | 90,70 ± 0,60 (89,96–91,44) | 90,10 ± 0,56 (89,41–90,79) | 90,40 ± 0,56 (89,71–91,09) | 0,83 ± 0,03 (0,79–0,87) | 0,95 ± 0,01 (0,94–0,96) |
| FedMediFormer-XAI | 94,20 ± 0,34 (93,78–94,62) | 93,10 ± 0,30 (92,73–93,47) | 92,80 ± 0,28 (92,45–93,15) | 92,90 ± 0,28 (92,55–93,25) | 0,88 ± 0,02 (0,86–0,90) | 0,96 ± 0,01 (0,95–0,97) |
Tabelle 3: Vorhersageleistung bei Diabetes. Vergleichende Vorhersageleistung von FedMediFormer-XAI und Baseline-Modellen des maschinellen Lernens und des Deep Learnings anhand der Metriken Genauigkeit, Präzision, Sensitivität, F1-Score, MCC und AUC-ROC.
| Metrik | Zentrales Lernen | Föderiertes Lernen |
| Genauigkeit (%) | 94,7 | 94,2 |
| AUC-ROC | 0,97 | 0,96 |
| Datenschutz | Nein | Ja |
| Teilung roher Daten erforderlich | Ja | Nein |
| Kommunikationsrunden | N/V | 100 |
| Trainingsdauer (Stunden) | 4,8 | 5,6 |
| Einhaltung gesetzlicher Vorschriften | Mäßig | Hoch |
Tabelle 4: Leistung von verbundbasierter im Vergleich zu zentralisierter Lernverfahren. Vergleich zentralisierter und verbundbasierter Lernverfahren hinsichtlich Vorhersagegenauigkeit, Anforderungen an die Weitergabe von Rohdaten, Kommunikationsrunden und Trainingsdauer.
| Datensatz | Genauigkeit (%) | Präzision (%) | Erinnerung (%) | AUC-ROC |
| Pima Indians Diabetes Dataset | 91.8 | 90.5 | 89.8 | 0.93 |
| CDC Diabetes Health Indicators | 93.1 | 92.2 | 91.6 | 0.95 |
| OhioT1DM Dataset | 92.4 | 91.8 | 91.1 | 0.94 |
| APTOS 2019 Blindness Detection | 94.7 | 93.9 | 93.5 | 0.96 |
| Multimodal Fusion (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Tabelle 5: Ergebnisse auf Datensatzebene. Leistungsanalyse über einzelne Datensätze und multimodale Fusionseinstellungen hinweg. Die Ergebnisse veranschaulichen den Beitrag verschiedener Datenmodi zur Gesamtvorhersageleistung.
| Metrik | Wert |
| Precision@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| Genauigkeit bei der Erkennung von Arzneimittelwechselwirkungen | 0.95 |
| Abdeckung der Empfehlungen | 0.88 |
| Mittlerer reziproker Rang (MRR) | 0.86 |
| Sicherheitskonformitäts-Score | 0.94 |
Tabelle 6: Leistung der personalisierten Arzneimittelempfehlung. Bewertung der graphenbasierten personalisierten Arzneimittelempfehlung anhand von Rangmetriken, Genauigkeit der Interaktionsdetektion, Abdeckung der Empfehlungen und Beurteilung der Arzneimittelsicherheit.
| Bewertungskriterium | Vorgeschlagenes Evaluationsdesign |
| Kliniker-Vertrauen | Bewertung anhand einer Fünf-Punkte-Likert-Skala |
| Interpretierbarkeit | Bewertung anhand einer Fünf-Punkte-Likert-Skala |
| Klinische Relevanz | Bewertung anhand einer Fünf-Punkte-Likert-Skala |
| Nützlichkeit der Erklärung | Bewertung anhand einer Fünf-Punkte-Likert-Skala |
| Empfundene Nützlichkeit | Bewertung anhand einer Fünf-Punkte-Likert-Skala |
| Übereinstimmung zwischen Bewertern | Fleiss-Kappa, das nach der prospektiven Evaluation berechnet wird |
| Statistischer Vergleich | Gepaarter statistischer Test, je nach Art der gesammelten Daten |
| Teilnehmer | 12 Kliniker, vorbehaltlich ethischer Genehmigung und informierter Einwilligung |
| Evaluierungsstatus | Prospektive/zukünftige Evaluation |
Tabelle 7: Vorgeschlagene menschenzentrierte Bewertungskriterien. Vorgeschlagener, auf klinische Fachkräfte ausgerichteter Bewertungsrahmen zur Beurteilung der Nützlichkeit, klinischen Relevanz, Interpretierbarkeit, Vertrauenswürdigkeit und Benutzerfreundlichkeit der Erklärungen von FedMediFormer-XAI. Die Bewertung umfasst eine standardisierte fünfstufige Likert-Skalen-Bewertung, die Übereinstimmung zwischen mehreren Bewertenden mittels Fleiss’ Kappa, einen statistischen Vergleich der Bedingungen „nur Vorhersage“ und „Vorhersage plus Erklärung“ sowie 95 %-Konfidenzintervalle. Die Bewertung durch den Kliniker sollte erst nach Genehmigung durch den zuständigen institutionellen Ethikausschuss und Einholung der informierten Einwilligung durchgeführt werden.
Zusatz-Tabelle 1: Strategie zur Datensatz-Validierung. Die Aufteilung des Datensatzes, Validierungsverfahren, Strategien zur Klassenbalance sowie Maßnahmen zur Qualitätssicherung wurden implementiert, um die Reproduzierbarkeit und eine zuverlässige Modellbewertung sicherzustellen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Erweiterte Tabelle 2: Parameter des Diffusionsmodells. Konfigurationseinstellungen für das TabDDPM-Diffusionsmodell, einschließlich Trainingsparametern, Optimierungseinstellungen, latenten Dimensionen, Strategie zur Rauschplanung und Spezifikationen zur Erzeugung synthetischer Stichproben. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle 3: Konfiguration des multimodalen Transformers. Konfiguration der Architektur des multimodalen Transformers, einschließlich der klinischen, zeitlichen und Bilddaten-Encoder, Einbettungs- und Fusionierungsdimensionen, Attention-Köpfe, Optimierer, Lernrate, Batch-Größe, Trainings-Epochen, Kriterium für vorzeitiges Beenden und kombinierter Trainingsverlust. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Erweiterte Tabelle 4: Konfiguration des föderierten Lernens. Parameter, die für das datenschutzfreundliche föderierte Training verwendet wurden, einschließlich der Anzahl beteiligter Krankenhäuser, Kommunikationsrunden, lokalen Trainingsrunden, Teilnahmequote der Clients, Aggregierungsalgorithmus, Optimierer, Lernrate, Verschlüsselungsmethode, Kommunikationsprotokoll und Richtlinie zur Weitergabe von Rohdaten. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle 5: GraphSAGE-Konfiguration. Konfiguration des heterogenen, auf GraphSAGE basierenden Moduls zur personalisierten Arzneimittelempfehlung, einschließlich Graph-Typ, Dimensionen der versteckten Schichten und Einbettungen, Anzahl der Graph-Schichten, Größe der Nachbarschafts-Stichproben, Optimierer, Lernrate, Batch-Größe, Trainings-Epochen, Bayesian Personalized Ranking Loss sowie Anzahl der top Arzneimittel-Empfehlungen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle 6: Evaluierungsmetriken für Erklärbarkeit. Quantitative und nutzerzentrierte Metriken zur Bewertung der Erklärbarkeit des FedMediFormer-XAI-Frameworks. Die Metriken beurteilen die Treue der Erklärungen, Stabilität, Konsistenz, Sparsamkeit, Vollständigkeit, Sensitivität, Irrelevanz, Übereinstimmung zwischen Bewertern sowie die von Ärzten wahrgenommene Erklärungsqualität. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle 7: Bewertungsmetriken. Vorhersage-, verbundbasiertes Lernen, Empfehlungs- und Erklärbarkeitsmetriken werden verwendet, um die Leistung, Robustheit, Rangqualität und Interpretierbarkeit des Frameworks zu bewerten. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle 8: Evaluationsdesign mit Fokus auf den Menschen. Design der klinikerzentrierten Evaluationsstudie, einschließlich Teilnehmergruppen, Evaluationsbedingungen, Bewertungskriterien und statistischer Analyseverfahren. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle 9: Nachvollziehbarkeitsressourcen. Zusammenfassung der Datensätze, Implementierungsspezifikationen, Konfigurationsdateien, Evaluierungsverfahren, Dokumentationen und experimentellen Aufzeichnungen, die erforderlich sind, um die Nachvollziehbarkeit des vorgeschlagenen FedMediFormer-XAI-Frameworks zu unterstützen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Interpretation der Schlüsselergebnisse
Die repräsentativen Ergebnisse zeigen, dass es möglich ist, multimodales Transformer-Lernen, fokussiertes Lernen, diffusionsbasierte Datenvermehrung, eine auf graphbasierten neuronalen Netzen basierende Arzneimittel-Empfehlung und erklärbare künstliche Intelligenz zu einem einheitlichen Diabetes-Intelligenz-System zu kombinieren. Durch die Integration von klinischen Befunden, Bevölkerungs-Gesundheitsindikatoren, kontinuierlichen Glukose-Messdaten, retinalen Fundusbildern und pharmakologischen Informationen wies der vorgeschlagene FedMediFormer-XAI-Ansatz eine hohe Vorhersagegenauigkeit auf und ermöglicht gleichzeitig nachvollziehbare und dezentrale Modellentwicklung. Die multimodale Lernmethode extrahierte aussagekräftige Merkmale aus verschiedenen Gesundheitsdatenquellen, was zu besseren Diabetesprognosen und individuelleren Therapieempfehlungen führte.
Vorteile des verbundenen Lernens
Ein wesentlicher Beitrag des vorgeschlagenen Frameworks ist die Integration des verbundenen Lernens, um eine dezentrale, kollaborative Modellerstellung zu ermöglichen. Das verbundene Lernen unterscheidet sich von traditionellen zentralisierten Lernverfahren dadurch, dass mehrere Institutionen an der Modelltrainierung teilnehmen können, ohne Rohdaten von Patienten direkt auszutauschen. Die wichtigsten Ergebnisse zeigten, dass das verbundene Lernen eine vergleichbare Vorhersagegenauigkeit wie das zentralisierte Lernen aufrechterhält, gleichzeitig jedoch die dezentrale Datenverarbeitung unterstützt. Dieses Merkmal ist besonders relevant in medizinischen Szenarien, in denen der Datenaustausch durch institutionelle Richtlinien und Datenschutzanforderungen eingeschränkt ist.
Interpretierbarkeitsanalyse
Die Bewertung der Interpretierbarkeit ergab, dass die SHAP-Analyse, integrierte Gradienten, die Visualisierung der Aufmerksamkeit sowie kontrastive Erklärungen alle klinisch aussagekräftige Einblicke in das Modellverhalten liefern können. Globale und lokale Erklärungen stimmten weitgehend überein, was aus klinischer Sicht die wichtigsten Prädiktoren betrifft (d. h. Glukosewerte, Body-Mass-Index, Alter, Muster der Insulinverabreichung und Netzhautveränderungen). Die Aufmerksamkeitsvisualisierungen zeigten zudem, dass die Transformer-Architektur auf klinisch relevante zeitliche und bildgebende Merkmale fokussiert war. Diese Ansätze erhöhen die Transparenz, indem sie komplementäre Interpretationen der Modellvorhersagen und des Beitrags einzelner Merkmale bereitstellen.
Personalisierte Arzneimittel-Empfehlungsanalyse
Wir schlagen ein GNN-basiertes Empfehlungsmodell vor, das neben der Modellierung von Patienten-Arzneimittel- und Arzneimittel-Arzneimittel-Beziehungen personalisierte Arzneimittel-Empfehlungen liefert. Tatsächlich ermöglichte die heterogene Graph-Topologie sowohl das Erfassen von Behandlungswirksamkeitsmustern als auch die Berücksichtigung der Arzneimittelsicherheit. Die hervorragenden Ergebnisse bei der Arzneimittel-Empfehlung in dieser Studie verdeutlichen die Fähigkeiten graphenbasierter Lernverfahren, Diabetes-Intelligenzsysteme nicht nur über die Krankheitsvorhersage hinaus weiterzuentwickeln, sondern auch eine personalisierte therapeutische Unterstützungsplattform bereitzustellen.
Humanzentrierte Evaluation
Der Rahmen beinhaltet ein prospektives, humanzentriertes Evaluationsprotokoll, um die Auswirkungen der Erklärbarkeit auf das Vertrauen der Ärzt:innen, die Interpretierbarkeit, die Benutzerfreundlichkeit und die wahrgenommene klinische Nützlichkeit zu bewerten. Die vorgeschlagene Evaluation wird die Bedingungen „nur Vorhersage“ und „Vorhersage plus Erklärung“ mithilfe standardisierter Bewertungskriterien vergleichen. Die zukünftige Durchführung dieser Evaluation, nach entsprechender Genehmigung durch den Instituts-Ethik-Ausschuss und Einholung der informierten Einwilligung, wird empirische Belege zur Akzeptanz durch die Ärzt:innen und zur praktischen Nützlichkeit der generierten Erklärungen liefern.
Kritische Schritte für eine erfolgreiche und reproduzierbare Implementierung
Mehrere Phasen des vorgeschlagenen Protokolls erfordern besondere Aufmerksamkeit, um die Reproduzierbarkeit sicherzustellen. Die Vorverarbeitung und Aufteilung des Datensatzes sollten eine Trennung auf Ebene der Patienten gewährleisten und Datenlecks verhindern, während die festgelegten nicht-IID-Client-Verteilungen während des föderierten Lernens beibehalten werden müssen. Die multimodale Fusion sollte die definierten latenten Dimensionen, die Konfiguration der Aufmerksamkeitsmechanismen, die Embeddings nach Modaltyp, die Normalisierung sowie die endgültige Projektion beibehalten. Die Erweiterung mittels Diffusionsverfahren sollte konsistente Vorverarbeitungs- und Trainingsparameter verwenden, während die Empfehlung basierend auf GraphSAGE konsistente Darstellungen von Patienten und Arzneimitteln, die Überprüfung von Interaktionen, die Definition relevanter Elemente sowie die Top-K-Rangfolge-Kriterien beibehalten muss. Die Erklärbarkeitsanalyse sollte feste SHAP-Hintergrundstichproben, Integrated Gradients-Baselines, Verfahren zur Extraktion von Aufmerksamkeitsinformationen sowie klinisch zulässige kontrafaktische Restriktionen verwenden. Softwareversionen, Zufallsseeds, Modellkonfigurationen, Datensatz-Aufteilungen und Evaluierungsparameter sollten dokumentiert werden, um variationsbedingte Abhängigkeiten von der Implementierung zu minimieren.
Einschränkungen
Mehrere Einschränkungen sollten bei der Interpretation der Ergebnisse dieser Studie berücksichtigt werden. Erstens wurde das Framework anhand öffentlich zugänglicher Datensätze entwickelt und evaluiert, die möglicherweise die Vielfalt realer Gesundheitsbevölkerungen und klinischer Umgebungen nicht vollständig widerspiegeln. Zweitens wurde das föderierte Lernen zwar unter Verwendung simulierter Krankenhausclients evaluiert, jedoch keine großskalige Validierung mit unabhängigen Gesundheitseinrichtungen durchgeführt. Drittens verursacht das föderierte Lernen zusätzlichen Kommunikations- und Rechenaufwand, der die Skalierbarkeit in ressourcenbeschränkten Umgebungen beeinträchtigen kann. Schließlich sind die in dieser Studie verwendeten Erklärbarkeitsmethoden hauptsächlich ex-post-Interpretationsverfahren und könnten das Verhalten komplexer Modelle möglicherweise nicht vollständig erfassen.
Das vorgeschlagene benutzerzentrierte Validierungsprotokoll berücksichtigt eine anfängliche Expertenrunde von 12 klinischen Experten, darunter Endokrinologen, Diabetes-Spezialisten und klinische Pharmakologen. Diese Stichprobengröße dient einer vorläufigen Bewertung der Benutzerfreundlichkeit und Interpretierbarkeit und nicht einer endgültigen klinischen Validierung. Die relativ kleine Zahl an Experten könnte die statistische Aussagekraft und die Verallgemeinerbarkeit einschränken. Zukünftige prospektive Studien sollten daher größere, multizentrische Ärztekohorten einbeziehen, die unterschiedliche klinische Umgebungen und Fachrichtungen repräsentieren.
Eine wesentliche Einschränkung des vorgeschlagenen Frameworks besteht darin, dass die klinischen, CGM-, Netzhautbildgebungs- und medikationsbezogenen Modalitäten aus unabhängigen öffentlichen Datensätzen stammen und nicht aus patientenbezogenen multimodalen Aufzeichnungen. Folglich sollte die komponentenübergreifende Fusion als methodisches Framework zur Integration komplementärer Modalitätsdarstellungen verstanden werden und nicht als Beleg aus simultanen multimodalen Messungen am selben Patienten. Unterschiede in den Populationseigenschaften, Erfassungsprotokollen, Merkmalsverteilungen und Krankheitsdefinitionen zwischen den Quelldatensätzen können Verteilungsabweichungen hervorrufen und begrenzen möglicherweise, inwieweit die erlernten komponentenübergreifenden Beziehungen echte assoziierte Zusammenhänge auf Patientenebene widerspiegeln. Obwohl das Protokoll ausdrücklich eine künstliche Zuordnung auf Patientenebene zwischen unabhängigen Datensätzen vermeidet, schränkt dieses Design die direkte Bewertung patientenspezifischer multimodaler Interaktionen ein und könnte die klinische Übertragbarkeit beeinträchtigen. Daher sollten die berichteten multimodalen Leistungen nicht als gleichwertig mit einer Validierung an einem prospektiv erhobenen, patientenbezogenen multimodalen Kollektiv angesehen werden. Zukünftige Studien sollten das Framework anhand größerer, unabhängig erhobener Datensätze validieren, die synchronisierte klinische, CGM-, Netzhaut- und Therapiedaten derselben Patienten enthalten.
Fehlerbehebung und Protokollanpassungen
Mehrere praktische Aspekte können die Umsetzung des vorgeschlagenen Protokolls beeinflussen. Klassenungleichgewicht kann die Vorhersageleistung verringern, wenn Minderheitenklassen unterrepräsentiert sind; diese Herausforderung kann durch diffusionsbasierte Erweiterung und Resampling-Strategien abgemildert werden. Fehlende Werte und inkonsistente Datenformate können die Modellstabilität beeinträchtigen und sollten durch rigorose Vorverarbeitungsverfahren behoben werden. Die Konvergenz des föderierten Lernens kann instabil werden, wenn die Datensätze der Clients erhebliche Heterogenität aufweisen; die Anpassung lokaler Trainingsepochen, Lernraten und Aggregationsfrequenzen kann die Stabilität verbessern. Auch Hardwarebeschränkungen können die Trainingseffizienz beeinträchtigen, insbesondere bei der Verarbeitung großer multimodaler Datensätze und von Transformer-Architekturen. In solchen Fällen kann die Verringerung der Batch-Größe oder der Modellkomplexität die Rechenbarkeit verbessern, während die Reproduzierbarkeit erhalten bleibt.
Zukünftige Entwicklungen
Zukünftige Forschung könnte darauf abzielen, Digital-Twin-Technologien zur personalisierten Krankheitssimulation und Therapieplanung zu integrieren. Grundlagenmodelle, die auf umfangreichen multimodalen Gesundheitsdatensätzen trainiert werden, könnten das Lernen von Repräsentationen und die Verallgemeinerungsfähigkeit der Modelle weiter verbessern. Kausale Erklärbarkeitsverfahren könnten tiefere Einblicke in Krankheitsmechanismen und Behandlungseffekte ermöglichen, die über korrelationsbasierte Erklärungen hinausgehen. Darüber hinaus könnten Ansätze des Verstärkungslernens adaptive Therapieoptimierung und dynamische Arzneimittelempfehlungsstrategien unterstützen. Diese Fortschritte könnten die klinische Anwendbarkeit und Personalisierungsfähigkeit von Diabetes-Intelligenzsystemen weiter verbessern. Außerdem sollten KI-generierte Vorhersagen und Arzneimittelempfehlungen als Entscheidungsunterstützungswerkzeuge und nicht als Ersatz für professionelle klinische Beurteilung betrachtet werden. Eine angemessene menschliche Aufsicht bleibt entscheidend für den verantwortungsvollen und ethischen Einsatz künstlicher Intelligenz im Gesundheitswesen.
Schlussfolgerung
FedMediFormer-XAI bietet einen reproduzierbaren Rahmen, der multimodales Lernen, föderiertes Training, personalisierte Arzneimittelempfehlungen und Erklärbarkeit für die Diabetes-Intelligenz integriert. Repräsentative Ergebnisse untermauern die Durchführbarkeit des vorgeschlagenen Workflows, doch bedarf es weiterer Validierung anhand patientenangepasster multimodaler Datensätze, umfangreicherer klinischer Umgebungen und prospektiver Bewertung durch Ärzte, bevor eine klinische Anwendung erfolgen kann.
Offenlegungen
Die Autoren erklären, dass sie keine konkurrierenden finanziellen Interessen, Interessenkonflikte oder persönlichen Beziehungen haben, die die in dieser Studie berichtete Arbeit beeinflusst haben könnten. Künstliche-Intelligenz-Tools wurden ausschließlich zur Unterstützung bei der sprachlichen Überarbeitung, der Organisation des Manuskripts, der Formatierung und der redaktionellen Bearbeitung während der Vorbereitung dieses Artikels verwendet. Alle wissenschaftlichen Inhalte, das Studiendesign, die Methodik, die Datenanalyse, die Interpretation der Ergebnisse sowie die Schlussfolgerungen wurden von den Autoren entwickelt, überprüft und genehmigt. Die Autoren übernehmen die volle Verantwortung für die Genauigkeit, Integrität und Originalität der in diesem Manuskript präsentierten Arbeit.
Danksagungen
Die Autoren danken den Entwicklern und Betreuern der öffentlich zugänglichen Datensätze und Open-Source-Software-Ressourcen, die in dieser Studie verwendet wurden.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| AES-Verschlüsselung | NIST | AES-256 | Verschlüsselung ruhender Daten / geschützte Modellparameter-Verschlüsselung im föderierten Lernen |
| APTOS 2019-Datensatz zur Erkennung von Erblindung | Kaggle/APTOS | Version 2019 | Datensatz von Netzhaut-Fundusbildern; öffentlich zugänglich und anonymisiert; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Version 0,8 | Modellinterpretierbarkeit und Zuordnungsanalyse |
| CUDA Toolkit | NVIDIA | Version 12.2 | GPU-beschleunigte Berechnung |
| Datensatz zu Diabetes-Gesundheitsindikatoren (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | 2015-Ausgabe | Indikatoren zur Bevölkerungsgesundheit; öffentlich zugänglich und anonymisiert; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Datensatz zur Erkennung der diabetischen Retinopathie | Kaggle | Öffentliche Veröffentlichung | Datensatz von Netzhautbildern; öffentlich zugänglich und anonymisiert; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Digitale Zertifikate | - | - | Client-Authentifizierung im föderierten Lernen |
| Datensatz zu Arzneimittelwechselwirkungen | Kaggle | Öffentliche Veröffentlichung | Daten zum Wirkstoff-Wirkstoff-Interaktionsgraphen; öffentlich zugänglich und anonymisiert; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Datensatz zur Arzneimittelbewertung | UCI Machine Learning Repository | Datensatz 462 | Datensatz zur Wirksamkeit und Bewertung von Arzneimitteln; öffentlich zugänglich und anonymisiert; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib-Entwickler | Version 3.9 | Visualisierung |
| MTS-Diabetes-Datensatz | Kaggle | Öffentliche Veröffentlichung | Tragbares Sensor-/Diabetes-Vorhersagedatenset; öffentlich zugänglich und anonymisiert; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX-Entwickler | Version 3.3 | Konstruktion und Analyse von Arzneimittelinteraktionsgraphen |
| NumPy | NumPy-Entwickler | Version 1.26 | Numerische Berechnung |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Modelltraining und Inferenz; mindestens 32 GB Hauptspeicher |
| OhioT1DM-Datensatz | Ohio University | Öffentliche Veröffentlichung | Datensatz zur kontinuierlichen Glukoseüberwachung; öffentlich zugänglich und anonymisiert; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Version 4.10 | Bildverarbeitung |
| Pandas | PyData | Version 2.2 | Datenverarbeitung und -vorverarbeitung |
| Pima-Indianer-Diabetes-Datensatz | UCI Machine Learning Repository | Datensatz 34 | Klinischer Diabetes-Vorhersagedatensatz; öffentlich zugänglich und anonymisiert; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Version 3.11 | Primäre Programmierumgebung |
| PyTorch | Meta AI | Version 2.3 | Entwicklung und Training von Deep-Learning-Modellen |
| PyTorch Geometric | PyG-Team | Version 2,5 | Konstruktion und Training von Graph-Neuronalen-Netzwerken |
| Scikit-learn | Scikit-learn-Entwickler | Version 1.5 | Maschinelles Lernen: Hilfsmittel und Bewertung |
| Sicherer Aggregationsmechanismus | - | - | Geschützte Aggregation lokaler Modellparameter im föderierten Lernen |
| SHAP | SHAP-Entwickler | Version 0,47 | Erklärbares KI und Analyse der Merkmalsattribution |
| TensorFlow | Version 2.15 | Entwicklung und Training von Deep-Learning-Modellen | |
| Transformers | Hugging Face | Version 4.45 | Implementierung einer auf Transformatoren basierenden Architektur |
| Transportschicht-Sicherheit | IETF | TLS 1.3 | Verschlüsselter Kommunikationskanal für den Austausch von Parametern in einem Verbund |
| Arbeitsplatz | Allgemein | - | Rechenumgebung; mindestens 32 GB Hauptspeicher |
Referenzen
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.