Diese Studie kombiniert ein Szenarioexperiment mit Elektroenzephalogrammen, um zu untersuchen, wie die Rollenrahmung von Experten und Begleitpersonen im Zusammenhang mit Vertrauen in verschiedenen medizinischen Aufgabenkontexten steht.
Methodenartikel
Rollenformulierung und Vertrauen in medizinische KI: Belege aus einem Szenarioexperiment und EEG
In diesem Artikel
Zusammenfassung
Zusammenfassung
Online-medizinische KI hat sich von Back-End-Analysewerkzeugen zu patientenorientierten Dienstleistungsschnittstellen entwickelt, wodurch kalibriertes Vertrauen zu einem zunehmend wichtigen Gestaltungs- und Governance-Problem wird. Basierend auf der Rollen-Kongruenz-Theorie untersuchte diese Studie, wie die Rahmung in Experten- und Begleitrollen mit Vertrauen über verschiedene medizinische Aufgabenkontexte hinweg verknüpft ist. Studie 1 verwendete ein Szenarioexperiment mit 2 (Rolle: Experte vs. Begleiter) × 2 (Aufgabe: Krankheitsberatung vs. Gesundheitsberatung) (N = 300). Die Rahmung als Experte steigerte die wahrgenommene Professionalität, während die Rahmung als Begleiter die soziale Präsenz erhöhte; beide Wahrnehmungen waren unabhängig voneinander mit dem Gesamtvertrauen assoziiert, wenn sie simultan berücksichtigt wurden. Die indirekte Assoziation über die Professionalität wurde durch den Aufgabenkontext bedingt, aber ein direkter Bootstrap-Vergleich zeigte nicht, dass sich die beiden moderierten Mediationseffekte bezüglich des Gesamtvertrauens unterschieden. Messdiagnostik wies auf erhebliche Überschneidungen zwischen wahrgenommener Professionalität und kognitivem Vertrauen sowie zwischen sozialer Präsenz und affektivem Vertrauen hin, was eine vorsichtige Interpretation erfordert. Studie 2 verglich Experten- und Begleiter-gerahmte Aussagen mittels EEG in 39 gepaarten Beobachtungen. Die Rahmung als Experte war mit einer höheren fronto-medianen Theta-ERS und einer weniger negativen basislinienkorrigierten FCz-F6 Theta-ΔPLV verbunden, während das verhaltensbezogene Ergebnis auf Bedingungsebene keinen zuverlässigen Unterschied in der Vertrauensrate, Reaktionszeit oder Rate fehlender Antworten zeigte. Diese EEG-Befunde stellen explorative prozessuale Korrelate dar, nicht jedoch eine neuronale Validierung des bedingten indirekten Modells. Insgesamt scheinen Rollenhinweise nicht ausschließliche kompetenz- und beziehungsorientierte Bewertungen zu formen. Die Rollengestaltung sollte ein kalibriertes Vertrauen durch klare Fähigkeitsgrenzen, Kommunikation von Unsicherheiten, risikobasierte Warnhinweise und angemessene Eskalationswege unterstützen, anstatt Vertrauen einfach zu maximieren.
Einleitung
Medizinische KI umfasst heute Anwendungen im Hintergrund wie die Bilderkennung, die Analyse von Pathologiedaten und die Arzneimittelforschung sowie patientenorientierte Service-Schnittstellen. Branchenanalysen prognostizieren ein anhaltendes Wachstum des KI-Marktes im Gesundheitswesen bis 20331. Große Sprachmodelle ermöglichen es medizinischen KI-Systemen, Gesundheitsfragen zu beantworten, Testergebnisse zu interpretieren, Informationen zusammenzufassen und Empfehlungen in natürlicher Sprache auszugeben2. Dieser Wandel verändert die Beziehung des Nutzers zur Technologie. Ein analytisches Hintergrundsystem wird von Ärzten und Organisationen bewertet, während eine patientenorientierte Schnittstelle ihre Rolle, die zugrundeliegenden Belege, Unsicherheiten und Grenzen gegenüber den Nutzern kommunizieren muss. Medizinische KI kann als diagnostischer Assistent, als Schnittstelle im Stil eines Hausarztes oder als Begleiter zur Gesundheitsverwaltung auftreten, und jede dieser Erscheinungsformen kann beeinflussen, wie Nutzer die Dienstleistungsidentität des Systems wahrnehmen. Da solche Systeme zunehmend an Krankheitsberatungen und der alltäglichen Gesundheitsverwaltung beteiligt sind, wird Vertrauen mehr als nur eine Haltung gegenüber der Technologie. Es beeinflusst, ob Nutzer persönliche Informationen preisgeben, Empfehlungen als glaubwürdig erachten, mit dem System interagieren und Gesundheitsempfehlungen befolgen. Vertrauen ist daher ein zentrales Gestaltungs- und Steuerungskriterium für digitale Gesundheitsplattformen.
Die technische Leistungsfähigkeit allein bestimmt nicht, ob medizinische KI von Nutzern als glaubwürdig und akzeptabel angesehen wird. Übersichten zu sprachbasierten Gesundheitsassistenten zeigen, dass die Implementierung von der Interaktionsqualität, klinischen Relevanz, Transparenz und den Einsatzbedingungen abhängt3. Aktuelle Arbeiten zu glaubwürdigen Nachweisen für medizinische KI argumentieren ebenfalls, dass die Modellleistung unzureichend ist, sofern die Behauptungen nicht durch für den beabsichtigten Einsatz geeignete Evidenz gestützt werden4. Transparenz ist entscheidend, da Patienten die Grenzen der Fähigkeiten, Unsicherheiten und die Grundlage einer Empfehlung erkennen müssen, anstatt die Zuverlässigkeit allein anhand flüssiger Sprache abzuleiten5. Die Forschung zu Informationssystemen beschreibt die Einführung von KI-gestützten Diagnosen ähnlich als ein Vertrauenskonfigurationsproblem, bei dem Interpretierbarkeit, Datenschutz und Hinweise in der Benutzeroberfläche gemeinsam die Akzeptanz beeinflussen6. Diese Aspekte sind wichtig für Sprachmodell-Schnittstellen. Flüssigkeit kann eine Antwort leicht verständlich machen, lässt dabei aber unbeantwortet, ob das System über klinisches Wissen verfügt, ob die Empfehlung auf die individuelle Situation des Nutzers zutrifft und wann eine Eskalation an einen qualifizierten Arzt notwendig ist. Die entscheidende Frage ist nicht nur, ob medizinische KI eine Antwort generieren kann, sondern ob Nutzer diese mit angemessenem Vertrauensgrad bewerten können.
Das Vertrauen in medizinische KI hängt empfindlich vom Aufgabenkontext ab. Untersuchungen zur Resistenz gegenüber medizinischer KI zeigen, dass Nutzer algorithmische Empfehlungen bei entscheidungsträchtigen Aufgaben zurückweisen können, weil sie glauben, ein Algorithmus könne ihre Individualität nicht berücksichtigen7. Diese Resistenz ist jedoch nicht universell. Forschung zur Wertschätzung von Algorithmen zeigt, dass Menschen algorithmische Urteile bevorzugen können, wenn Aufgaben objektiv sind und klare Regeln gelten8. Bei Online-Gesundheitsberatungen beeinflussen Personalisierung und Sorgfalt in der von KI generierten Beratung das Vertrauen und die Akzeptanz9. Diskrete Wahluntersuchungen, die herkömmliche, digitale und KI-basierte Beratungsformen vergleichen, zeigen ebenfalls, dass Präferenzen und Erwartungen an Vertrauen je nach Format variieren10. Mensch-KI-Zusammenarbeit kann die Resistenz auch durch Vertrauensübertragung von menschlicher Expertise auf eine KI-gestützte Dienstleistungsform verringern11. Das Vertrauen in medizinische KI entsteht daher aus dem Zusammenspiel wahrgenommener Risiken, Aufgabenanforderungen, Kommunikationsstils und Systembewertung. Bei Krankheitsberatungen treten Unsicherheit, möglicher Verlust, diagnostische Konsequenzen und die Kosten von Fehlern besonders hervor. Gesundheitsberatungen betreffen dagegen häufiger Ernährung, Bewegung, Schlaf, Therapietreue und präventive Gesundheitssteuerung, bei denen kontinuierliche Interaktion und relationale Zugänglichkeit mehr Gewicht haben können. Ein und derselbe Interface-Hinweis kann daher unterschiedlich interpretiert werden, je nachdem, ob ein Nutzer Hilfe bei einer möglichen Erkrankung oder bei der langfristigen Gesundheitsvorsorge sucht.
Die Rollenrahmung ist eine Schnittstelleneigenschaft, über die diese Erwartungen vermittelt werden können. Medizinische KI kann als Experte dargestellt werden, der berufliche Autorität, strukturierte Argumentation, klinische Grenzen und Nachweise der Leistungsfähigkeit betont, oder als Begleiter, der Empathie, Beruhigung, soziale Unterstützung und Kontinuität in den Vordergrund stellt. Diese Unterscheidung bezieht sich auf Kompetenz und Wärme, die beiden Dimensionen der sozialen Wahrnehmung, stellt jedoch nicht einfach eine Wahl zwischen einem kompetenten und einem warmen System dar12. Kommunikationsstil und die Rahmung von Handlungsfähigkeit beeinflussen die Bewertung von Gesprächspartnern13. In mobilen medizinischen Anwendungen wirken soziale Hinweise und Datenschutzbedenken gemeinsam auf das Vertrauen und die Verhaltensintention14. Anthropomorphe Hinweise in medizinischen Gesprächspartnern können soziale Präsenz, Vertrauen und Akzeptanz erhöhen, können jedoch auch Erwartungen schaffen, die die Systemleistungen übertreffen15. Forschung zu Mensch-KI-Teams zeigt zudem, dass Wärme und Kompetenz unterschiedliche Formen der Rezeptivität vorhersagen16. Bei risikoreichen Aufgaben hängt das Vertrauen von der Passung zwischen Teamrolle, Aufgabenkontext und Leistungsverletzung ab17. Die Konsistenz zwischen der sozialen Rolle eines Chatbots und seiner Leistung beeinflusst ebenfalls den Auf- und Wiederaufbau von Vertrauen18. Experten- und Begleiter-Hinweise machen daher unterschiedliche Bewertungsmaßstäbe deutlich, anstatt lediglich den Gesprächston zu verändern.
Es bestehen zwei Lücken. Erstens haben Forschungsarbeiten bisher nicht erklärt, wie sich die Relevanz von kompetenz- und beziehungsorientierten Hinweisen mit den Anforderungen medizinischer Aufgaben verändert. Übersichtsarbeiten zum Vertrauen des Menschen in KI betonen die Kontextabhängigkeit, klären jedoch nicht, wie Hinweise auf Experten- und Begleitrollen im Rahmen von Krankheits- und Gesundheitsberatungen wirken19. Zweitens stützen sich Studien zum Vertrauen in medizinische KI hauptsächlich auf Selbstberichte, wodurch nur begrenzte Erkenntnisse über die kognitiven Verarbeitungsprozesse im Zusammenhang mit rollenbezogenen Bewertungen gewonnen werden. Auch Datenschutz, Transparenz, Rechenschaftspflicht und Verzerrungen schränken die Interpretation der Hinweise auf der Benutzeroberfläche bezüglich der Rolle ein20,21. Um diese Lücken zu schließen, stützt sich die vorliegende Studie auf die Theorie der Rollenkonkordanz, die Bewertungen anhand der Übereinstimmung zwischen Rollenhinweisen und kontextuell relevanten Anforderungen erklärt22. Studie 1 verwendet ein randomisiertes Szenarioexperiment mit einem 2 (Rolle: Experte vs. Begleiter) × 2 (Aufgabe: Krankheitsberatung vs. Gesundheitsberatung)-Design (N = 300), um Rollenrahmung, Aufgabenkontext sowie parallele indirekte Zusammenhänge über wahrgenommene Professionalität und soziale Präsenz zu untersuchen. Studie 2 verwendet ein separates EEG-Experiment mit within-subjects-Design (N = 39), um die Theta-Band-Aktivität als Reaktion auf rollenbezogene Aussagen im Experten- und Begleiterkontext zu vergleichen. Studie 1 bewertet Verhaltenszusammenhänge und kontextuelle Moderation; Studie 2 liefert einen explorativen, prozessbezogenen Vergleich, jedoch keine neuronale Validierung des bedingten indirekten Modells.
Theoretischer Rahmen und Hypothesenentwicklung
Rahmenbedingungen für die Rolle von medizinischer KI
Künstliche Intelligenz im medizinischen Bereich agiert in hochsensiblen Kontexten, die Krankheitsrisiken, Therapieempfehlungen, Haftungsfragen und ethische Grenzen betreffen23. Die Rollendefinition ist daher von Bedeutung, da die verwendete Sprache an der Benutzeroberfläche die Grenzen von Fähigkeiten, wissenschaftlicher Evidenz und Verantwortung für Nutzer stärker oder weniger deutlich macht. Auch aus der Transparenzforschung ist bekannt, dass medizinische KI-Systeme ihre Leistungsgrenzen und evidenzbasierten Grundlagen klar kommunizieren sollten5. Antworten im Expertenstil vermitteln Kompetenz durch formale Fachbegriffe, strukturierte Argumentation, Abgrenzungen und Handlungsempfehlungen, während Antworten im Begleiterstil durch Empathie, Zusicherungen und kollaborative Formulierungen Beziehungssupport ausdrücken. Diese Hinweise sind nicht bloß eine gestalterische Oberflächlichkeit: Sie beeinflussen die Maßstäbe, die Nutzer bei der Bewertung eines Systems anlegen24,25. Anthropomorphe Gestaltung kann soziale Reaktionen hervorrufen, birgt jedoch auch die Gefahr unrealistischer Erwartungen und verschwommener Haftungsgrenzen26,27. Untersuchungen zu Mensch-KI-Teams und Chatbots zeigen zudem, dass Wärme, Kompetenz, Passung der Rolle zum Kontext sowie Konsistenz zwischen sozialer Rolle und tatsächlicher Leistung die Akzeptanz und das Vertrauen beeinflussen16,17,18. In dieser Studie bezeichnet Rollenkonkordanz die Übereinstimmung zwischen den durch eine KI-Antwort vermittelten Hinweisen und den für die Beratungsaufgabe relevanten Bewertungserfordernissen22.
Doppelter Pfad des Vertrauens: Wahrgenommene Professionalität und soziale Präsenz
Die Rollenkonformität wird aus der beobachteten Interaktion zwischen Rolle und Aufgabe abgeleitet, anstatt als separates subjektives Konstrukt gemessen zu werden. Die Interpretation ist daher an die experimentelle Interaktion gebunden und impliziert nicht, dass die Teilnehmer bewusst ein Gefühl der Rollenpassung berichteten. Vertrauen umfasst kognitive Urteile über Kompetenz und Zuverlässigkeit sowie affektive Urteile über relationale Sicherheit und Wohlbefinden28,29,30. Bei der Nutzung medizinischer KI beurteilen Nutzer sowohl, ob das System eine Gesundheitsentscheidung unterstützen kann, als auch, ob die Interaktion damit ausreichend sicher und zugänglich erscheint. Eine Expertenrahmung sollte die kompetenzorientierte Bewertung hervorheben. Befunde aus der Forschung zu klinischen Entscheidungsunterstützungssystemen zeigen, dass Erklärungen und Informationen zur Systemlogik Vertrauen und Verlagerung beeinflussen31. Bei Online-Gesundheitsberatungen sind Personalisierung und Fürsorge ebenfalls mit Vertrauen und Akzeptanz assoziiert9. Die wahrgenommene Professionalität erfasst eine kompetenzorientierte Bewertung, die für das Vertrauen relevant ist25. Studien zur Online-Gesundheitsberatung identifizieren zudem die Glaubwürdigkeit der Informationsquelle als relevant für die Akzeptanz von Gesundheitsempfehlungen durch Nutzer32. Die vorliegende Studie prüft daher, ob eine Expertenrahmung mit einer höheren wahrgenommenen Professionalität assoziiert ist.
H1: Begleitrollen führen im Vergleich zu medizinischen KI-Systemen im Expertenstil zu einer geringeren wahrgenommenen Professionalität.
Der begleitende Rahmenkontext sollte die relationale Bewertung deutlicher machen. Soziale Präsenz bezieht sich auf die wahrgenommene zwischenmenschliche Qualität vermittelter Interaktionen, nicht auf die Überzeugung, dass das System menschlich ist33. Sie ist mit der Qualität der Interaktion, Vertrauen und Akzeptanz bei Online-Diensten und gesundheitsbezogenen Konversationsassistenten verbunden15,34.
Soziale Präsenz kann die psychologischen Kosten der Selbstoffenbarung verringern und den Informationsaustausch während einer Online-Beratung unterstützen32. Die vorliegende Studie prüft daher, ob eine Begleiter-Rahmenbedingung mit einer höheren sozialen Präsenz verbunden ist.
H2: Fachmännische Rollen führen im Vergleich zu begleitenden medizinischen KI-Systemen zu einer geringeren sozialen Präsenz.
Die wahrgenommene Professionalität und soziale Präsenz werden als parallele, nicht ausschließliche Assoziationen mit Vertrauen betrachtet. Eine angemessene Nutzung von sicherheitskritischer Automatisierung hängt von den Systemfähigkeiten, Grenzen und den Anforderungen der Aufgabe ab und nicht allein von der Maximierung des Vertrauens35.
H3: Wahrgenommene Professionalität und soziale Präsenz sagen jeweils positiv das Vertrauen voraus, wenn sie gleichzeitig modelliert werden.
Modierender Effekt des Aufgabenkontexts
Derselbe Rollenhinweis kann bei verschiedenen medizinischen Aufgaben ein unterschiedliches psychologisches Gewicht haben. Die Aufgaben-Technologie-Passung bietet eine kontextuelle Begründung dafür, ob Rollenhinweise den Anforderungen der Aufgabe entsprechen36. Bei der Beratung zu Erkrankungen spielen Unsicherheit, Verlustrisiko und die Kosten von Fehlern eine größere Rolle, wodurch Professionalität, Genauigkeit und klare Grenzen besonders wichtig werden7,37. Fachliche Hinweise sollten daher stärker auf diese Anforderungen abgestimmt sein als begleitende Hinweise. Die Gesundheitsberatung konzentriert sich auf das langfristige Gesundheitsmanagement, die Aufrechterhaltung von Verhaltensweisen und die Kontinuität der Interaktion. Übersichtsarbeiten zu KI-basierten klinischen Entscheidungsunterstützungssystemen und gesundheitsbezogenen Konversationsassistenten unterstreichen die Bedeutung von Kontextinformationen, Handlungsorientierung, Interaktion und Implementierungsbedingungen3,38,39.
Diese Studie sagt voraus, dass der Unterschied zwischen Experten und Begleitpersonen hinsichtlich der wahrgenommenen Professionalität bei Krankheitskonsultationen größer sein wird als bei Gesundheitskonsultationen. Ein nicht signifikanter Interaktionseffekt bezüglich der sozialen Präsenz wird nicht als Beleg für Invarianz gewertet. Die Hypothese wird wie folgt formuliert:
H4: Der Aufgabenkontext moderiert den Einfluss von Expertenrollen auf die wahrgenommene Professionalität erheblich. Dieser Einfluss ist bei Krankheitsberatung stärker ausgeprägt als bei Gesundheitsberatung.
Protokoll
Forschungsübersicht
Die Studie wurde gemäß der Deklaration von Helsinki durchgeführt und vom Ethikkomitee der Huaqiao-Universität (M2025021) genehmigt, das sowohl das Online-Szenarioexperiment als auch das EEG-Experiment abdeckte. Alle Teilnehmer gaben ihre informierte Einwilligung ab und erhielten nach Abschluss eine Aufwandsentschädigung.
Dieser Artikel enthält zwei komplementäre Studien (siehe Abbildung 1). Studie 1 ist ein randomisiertes 2 × 2-Szenarioexperiment, das Effekte der Rollenrahmung und des Aufgabenkontexts schätzt, die Messstruktur bewertet und parallele bedingte indirekte Zusammenhänge über wahrgenommene Professionalität und soziale Präsenz prüft. Studie 2 ist ein EEG-Experiment mit within-subjects-Design, das die Aktivität im Theta-Frequenzband unter experten- und begleiter-gerahmten Aussagen vergleicht und als explorativer vergleich auf Prozessebene interpretiert wird. Die Studien liefern Verhaltens- und neuronale Belege auf unterschiedlichen Ebenen; sie werden nicht als ein einziger progressiver Mechanismus behandelt.
Studie 1: Szenario-Experiment
Teilnehmer und Studiendesign
Studie 1 verwendete ein balanciertes 2 × 2-Zwischensubjektdesign mit Rollenrahmung (Experte vs. Begleiter) und Aufgabenkontext (Krankheitsberatung vs. Gesundheitsberatung). Die ursprüngliche G*Power-Berechnung ging von einem mittleren omnibus-ANOVA-Effekt (f = 0,25), α = ,05 und einer Teststärke von ,80 aus und ergab eine Mindeststichprobengröße von 128 Teilnehmern40. Da diese Berechnung nicht auf bedingte indirekte Effekte zugeschnitten war, wird sie als ursprüngliche Rekrutierungsgrundlage und nicht als Beleg für die Teststärke bezüglich moderierter Mediation angegeben. Bei N = 300 und vier balancierten Zellen zeigte eine Sensitivitätsanalyse eine Teststärke von 80 %, um eine Interaktion von f = 0,162 (partielles η2 = ,026) bei α = ,05 nachzuweisen.
Zusätzlich führten wir eine nachträgliche, simulationsbasierte Power-Analyse für die moderierten Mediationseffekte anhand des SPSS-Fragebogendatensatzes mit 300 Fällen durch. Die Simulation erzeugte 1.000 ausgewogene 2 × 2-Stichproben aus dem angepassten Parallel-Mediator-Modell, indem empirische Residuen erneut gezogen wurden; jeder simulierte Datensatz verwendete 500 prozentilbasierte Bootstrap-Konfidenzintervalle, die durch Neuziehen der Fälle gewonnen wurden. Die geschätzten Wahrscheinlichkeiten, dass das Konfidenzintervall den Wert null ausschloss, betrugen .698 für den Professionalitätsindex, .157 für den Sozialpräsenzindex und .279 für die direkte Differenz zwischen den beiden Indizes. Diese Analyse setzt die beobachteten Koeffizienten, Residualverteilungen und Modellspezifikation voraus und stellt keine a-priori-Begründung der Stichprobengröße dar. Die vollständige nachträgliche, simulationsbasierte Power-Analyse ist in Supplementary Table S1 dargestellt.
Dreihundert Teilnehmer wurden über Credamo rekrutiert und zufällig vier Bedingungen zugewiesen (n = 75 pro Zelle). Die Stichprobe umfasste 109 Männer (36,3 %) und 191 Frauen (63,7 %); 43,7 % waren 21–30 Jahre alt, 41,3 % waren 31–40 Jahre alt, und 69,7 % verfügten über einen Bachelor-Abschluss. Alle erforderlichen Fragebogenitems wurden vollständig ausgefüllt. Es wurde kein dediziertes Aufmerksamkeitscheck-Item und keine vorab registrierte Ausschlusskriterium basierend auf der Bearbeitungsdauer verwendet, und kein Teilnehmer wurde ausgeschlossen. Die mediane Bearbeitungsdauer betrug 268 s (Spanne = 67–1.894 s). Eine nachträgliche Robustheitsanalyse, die Antworten unterhalb des fünften Perzentils der Bearbeitungsdauer ausschloss (<125 s; verbleibend n = 285), prüfte die Empfindlichkeit gegenüber ungewöhnlich schnellen Antworten. Detaillierte Statistiken zur Überprüfung der Manipulation sowie Analysen zur Sensitivität der Bearbeitungsdauer sind in Supplementary Table S2 angegeben.
Experimentelle Reize und Vorgehensweise
Die Stimulusmaterialien bestanden aus einer Aufgabenszenario-Einleitung und einer Dialogantwort eines KI-Arztes und bildeten vier vollständige experimentelle Sätze. Im Krankheitsberatungsszenario wurden die Teilnehmer gebeten, sich wiederkehrende nächtliche Brustenge und Herzklopfen vorzustellen sowie die Sorge, ob unverzügliche Krankenhausbehandlung erforderlich sei. Im Gesundheitsberatungsszenario sollten sich die Teilnehmer vorstellen, generell guter Gesundheit zu sein und einen personalisierten Ernährungs- und Bewegungsplan zu suchen. Jede Aufgabenkategorie wurde durch ein Szenario repräsentiert; die Schlussfolgerungen sind daher auf diese beiden Szenarien beschränkt und nicht auf alle Arten von Krankheits- und Gesundheitsberatungen übertragbar.
Alle vier Fragebogen-Screenshots verwendeten dasselbe Symbol und zeigten den Systemnamen Medical AI (DiagnosPro) an, wodurch die dargestellte Identität über alle Bedingungen hinweg konstant blieb. Antworten im Expertenrahmen enthielten strukturierte Analysen, Risiko- oder Evidenzaussagen, direkte Sprache und explizite Handlungsempfehlungen. Antworten im Begleiterrahmen nutzten Empathie, beruhigende Formulierungen, kollaborative Ausdrucksweise und flexible Vorschläge. Die experimentelle Manipulation repräsentierte somit ein Bündel von rollenkonformen kommunikativen und informativen Hinweisen; sie isolierte die Rollenrahmung nicht von Spezifität, Handlungsorientierung, Gewissheit, medizinischen Details oder emotionaler Unterstützung. Der gemeinsame Name DiagnosPro mag zudem in allen Bedingungen einen Expertenhinweis vermittelt haben. Der vollständige Stimulussatz ist in Supplementary File 1 enthalten.
Die Teilnehmer lasen zunächst das Einwilligungsformular und wurden anschließend nach dem Zufallsprinzip einer von vier experimentellen Bedingungen zugewiesen. Nachdem sie den Szenario- und Dialogreiz gelesen hatten, füllten sie den Fragebogen basierend auf ihren Antworten aus. Der Fragebogen begann mit Kontrollfragen zur Manipulationsüberprüfung, gefolgt von Maßen für wahrgenommene Professionalität, soziale Präsenz, Vertrauen und demografische Angaben. Das Verfahren dauerte etwa 15 min.
Alle Skalen verwendeten eine 7-Punkt-Likert-Skala, wobei 1 „stimme überhaupt nicht zu“ und 7 „stimme voll zu“ bedeutete. Die wahrgenommene Professionalität wurde mit drei Items gemessen: „Diese medizinische KI ist in der Lage, medizinische Ratschläge zu geben“, „Diese medizinische KI wirkt sehr professionell“ und „Diese medizinische KI ist ein Experte auf dem medizinischen Gebiet“ (α = .883)41. Die soziale Präsenz wurde mit drei Items erfasst: „Bei der Interaktion mit dieser medizinischen KI hatte ich das Gefühl einer menschlichen Note“, „Die Interaktion mit dieser medizinischen KI ließ mich Verbundenheit empfinden“ und „Diese medizinische KI wirkte während der Interaktion kontaktfreudig“ (α = .932)42. Kognitives Vertrauen bestand aus drei Items: „Ich kann auf diese medizinische KI vertrauen, da sie über die erforderlichen Fähigkeiten verfügt, um Ratschläge zu geben“, „Ich bin mir der Genauigkeit der von dieser medizinischen KI gegebenen Ratschläge sicher“ und „Diese medizinische KI verfügt über ausreichende Kompetenz, um mein Gesundheitsproblem zu bewältigen“ (α = .837). Affektives Vertrauen umfasste drei Items: „Diese medizinische KI vermittelt mir Wärme und Fürsorge“, „Das Vertrauen in diese medizinische KI gibt mir Sicherheit, weil sie mein Wohl zu berücksichtigen scheint“ und „Ich glaube, dass diese medizinische KI mir niemals absichtlich etwas Schädliches antun würde“ (α = .700). Das Gesamtvertrauen ergab sich als Mittelwert aller sechs Vertrauensitems (α = .784). Diese Messungen wurden als kompetenzorientierte, zwischenmenschliche, kognitiv-vertrauensvolle, affektiv-vertrauensvolle und Gesamtvertrauens-Ergebnisse analysiert, nicht als voneinander unabhängige Konstrukte.
Die Analyse erfolgte in vier Schritten. Zunächst wurde mittels konfirmatorischer Faktorenanalyse das vorgeschlagene Vier-Faktoren-Modell mit Zwei-Faktoren- und Ein-Faktoren-Alternativen verglichen; dabei wurden die zusammengesetzte Reliabilität, die durchschnittlich erklärte Varianz, latente Korrelationen sowie Heterotrait-Monotrait-Verhältnisse untersucht. Zweitens wurden vollständige 2 × 2-Faktormodelle verwendet, um Haupteffekte und Interaktionseffekte für wahrgenommene Professionalität, soziale Präsenz, kognitives Vertrauen, affektives Vertrauen und Gesamtvertrauen zu schätzen, inklusive Zellenmittelwerten, Konfidenzintervallen und partiellem η2. Die geschätzten Randmittelwerte und 95-%-Konfidenzintervalle sind in Abbildung 2 dargestellt. Drittens wurden wahrgenommene Professionalität und soziale Präsenz gleichzeitig als parallele Mediatoren im PROCESS 4.2 beta Modell 7 mit 5.000 Perzentil-Bootstrap-Stichproben43 eingegeben. Die Rollenrahmung wurde kodiert als 1 = Experte und 2 = Begleiter, der Aufgabenkontext als 1 = Krankheitsberatung und 2 = Gesundheitsberatung. Ein gemeinsamer Resampling-Bootstrap verglich direkt die beiden Indizes moderierter Mediation. Viertens wurden kognitives und affektives Vertrauen getrennt als explorative Ergebnisvariablen analysiert. Da Mediatoren und Ergebnisvariablen zeitgleich erhoben wurden, werden die Schätzungen als indirekte Assoziationen im Einklang mit Mediation interpretiert, nicht jedoch als kausale psychologische Mechanismen.
Studie 2: EEG-Experiment
Teilnehmer
Studie 2 rekrutierte 40 Teilnehmer. Ein Teilnehmer wurde ausgeschlossen, da die durch Artefakte beeinträchtigten Durchläufe in mindestens einer experimentellen Bedingung 30 % überschritten, sodass 39 Teilnehmer in die endgültige EEG-Analyse eingingen. Dieses Kriterium stellte sicher, dass jeder berücksichtigte Teilnehmer in jeder Bedingung mindestens 70 % der Durchläufe beitrug. Alle Teilnehmer gaben eine schriftliche informierte Einwilligung und erhielten nach dem Experiment eine Vergütung. Demografische Informationen konnten nicht mit allen verbleibenden EEG-Aufzeichnungen verknüpft werden und werden daher für die endgültige EEG-Stichprobe nicht zusammengefasst.
Experimentelle Reize und Vorgehensweise
Das Experiment wurde in einem standardmäßigen EEG-Labor mithilfe eines Within-Subjects-Designs durchgeführt, wobei die Reize in E-Prime 2.1 präsentiert wurden. Den Teilnehmern wurde die Aufgabe gestellt, sich eine Interaktion mit einem medizinischen KI-System vorzustellen und ihr Vertrauen in das System für jedes Szenario einer medizinischen Konsultation einzuschätzen. Im Experiment wurde die wahrgenommene Rolle des medizinischen KI-Systems variiert, wozu expertentypische und begleitertypische Varianten gehörten.
Insgesamt wurden 40 chinesische Satzreize erstellt. Die Bedingung „Experten-Typ“ enthielt 20 Reize, die mit „Medizinischer KI-Experte“ begannen, während die Bedingung „Begleiter-Typ“ 20 parallele Reize enthielt, die mit „Medizinischer KI-Begleiter“ begannen. Die medizinischen Szenarien umfassten sowohl professionelle diagnostische Funktionen wie das Erfragen der Krankengeschichte, die Analyse von Untersuchungsberichten, die Beurteilung von Herzfrequenzdaten, die Interpretation genetischer Tests, die Einschätzung des Krankheitsrisikos und die Empfehlung von Behandlungsplänen als auch unterstützende Gesundheitsmanagementfunktionen wie das Zeigen von Sorge um den körperlichen Zustand, das Erfragen der Schlafqualität, die Minderung von Angstzuständen, das Erfassen von Gesundheitsdaten, die Förderung der Therapietreue und die Bereitstellung täglicher Gesundheitstipps. Die Bedingungen unterschieden sich somit auch hinsichtlich ihres semantischen Gehalts und ihrer Komplexität; eine unabhängige Reizanpassung oder Vortestung lag nicht vor.
Vor dem eigentlichen Experiment absolvierten die Teilnehmer einen kurzen Übungsblock. Jeder Durchgang begann mit einem Fixierungskreuz für 500 ms, gefolgt von einem zufällig variierten Leerintervall von 300–500 ms und einer medizinischen KI-Aussage, die 1.600 ms lang präsentiert wurde. Anschließend gaben die Teilnehmer ein binäres Vertrauensurteil in ihrem eigenen Tempo ab, indem sie die Taste F drückten, um Vertrauen anzugeben, oder die Taste J, um kein Vertrauen anzugeben (siehe Abbildung 3). Aussagen im Experten- und Begleiterrahmen wurden in zufälliger Reihenfolge präsentiert. Die Aufgabenprotokolle von E-Prime zeigten 80 formale Durchgänge pro Aufzeichnung: 40 Experten- und 40 Begleiterrundengänge, wobei jede der 20 einzigartigen Aussagen pro Rolle zweimal präsentiert wurde.
Verhaltensaufgabendaten
Die Verhaltensdaten waren für 38 der 39 Teilnehmer der endgültigen EEG-Stichprobe verwendbar; die E-Prime-Aufzeichnung eines Teilnehmers war unbrauchbar. Die verhaltensbezogenen Analysen verwendeten daher N = 38. Detaillierte Ergebnisse zum Verhalten sowie eine Aufstellung der Stichprobe finden sich in Supplementary Table S3. Vertrauen wurde als Tastenbetätigung der F-Taste kodiert; Tastenbetätigungen der J-Taste deuteten auf Misstrauen hin. Leere Antworten oder eine aufgezeichnete Reaktionszeit von 0 ms wurden als fehlend kodiert. Die Vertrauensrate wurde anhand der beantworteten Durchgänge berechnet, und die Reaktionszeit wurde über die beantworteten Durchgänge zusammengefasst. Die zur Analyse verfügbaren neuronalen Daten enthielten bedingungsaggregierte Maße, jedoch keine ereignisbezogenen EEG-Indizes oder verifizierten Identifikatoren, die jede Verhaltensaufzeichnung mit ihrer EEG-Aufzeichnung verknüpften; daher wurde kein gemischtes Modell auf Ereignisebene für EEG und Vertrauensurteile berechnet.
EEG-Aufzeichnung und -Analyse
Zur Aufrechterhaltung einer Elektroden-Haut-Impedanz unterhalb von 5 kOhm wurde ein leitfähiges Elektrolytgel (Quik-Gel) verwendet. FCz diente als standardmäßige Online-Referenz des Geräts, und die Abtastrate betrug 1.000 Hz. Die Offline-Umreferenzierung auf den Mittelwert der bilateralen Mastoiden erfolgte mithilfe der integrierten Umreferenzierungsfunktion von CURRY; FCz wurde beibehalten und automatisch relativ zur neuen Referenz rekonstruiert, wobei kein benutzerdefinierter Rekonstruktionsbefehl oder Skript verwendet wurde. Die anschließende Offline-Verarbeitung wurde in MATLAB R2020b mit EEGLAB44 und ICLabel45 durchgeführt. Die Daten wurden auf 500 Hz heruntergerechnet und mit einem Bandpassfilter von 0,1 bis 40 Hz gefiltert. Schlechte Kanäle und stark artefaktbelastete Datensegmente wurden visuell identifiziert und entfernt; es wurde weder eine automatische Interpolation noch eine automatische Segmentausschluss-Schwelle angewendet. Anschließend wurde die standardmäßige EEGLAB-Implementierung von runica (Infomax-ICA) verwendet, und Komponenten wurden entfernt, wenn ICLabel ihnen eine Wahrscheinlichkeit von mindestens 0,70 für eine Artefaktklasse zuordnete (z. B. Augen-, Muskel-, Herz-, Netzbrumm- oder Kanalrauschen). Teilnehmer mit mehr als 30 % artefaktbelasteter Durchgänge in einer der beiden Bedingungen wurden ausgeschlossen, um eine Mindestbeibehaltung von 70 % der Durchgänge pro Bedingung sicherzustellen. Die Epochen erstreckten sich von −1.000 bis 1.996 ms. Für die Analyse der funktionellen Konnektivität wurden die vorverarbeiteten Daten zusätzlich auf 250 Hz heruntergerechnet, und periphere Elektroden, einschließlich P7, P8, F7 und F8, wurden vor der Schätzung der Phasensynchronität ausgeschlossen.
Die an frontomedialen Kopfhautstellen aufgezeichnete Theta-Aktivität wurde mit Berechnungen in Verbindung gebracht, die durch kognitive Kontrollanforderungen ausgelöst werden46. Die Phasensynchronisation im Theta-Band zwischen medialen und lateralen frontalen Elektrodenpositionen wurde ebenfalls mit der Koordination während kontrollbezogener Verarbeitung assoziiert47. Insbesondere eine verstärkte Phasensynchronisation im Theta-Band zwischen Positionen wie FCz und F6 wurde nach Konflikt- oder Fehlererkennung beobachtet48. Da diese Kopfhautmessungen nicht eindeutig spezifisch für kognitive Kontrolle sind, werden sie hier als konvergente Prozessindikatoren und nicht als direkte Messgrößen eines einzelnen kognitiven Mechanismus behandelt.
Zunächst wurde die fronto-mediane Theta-Ereignis-bezogene Synchronisation (ERS) im Frequenzband von 4–8 Hz innerhalb des Zeitfensters 800–1.000 ms nach dem Stimulus quantifiziert. Die ERS wurde mittels Zeit-Frequenz-Analyse berechnet, wobei die relative Leistungsänderung im Vergleich zur prästimulus-Basislinie von −500 bis −200 ms ermittelt wurde. Positive Werte weisen auf eine Leistungssteigerung (Synchronisation) hin, während negative Werte eine Leistungsunterdrückung (Desynchronisation) anzeigen. Zweitens wurde die funktionelle Konnektivität geschätzt, nachdem die vorverarbeiteten Daten zusätzlich auf 250 Hz heruntergerechnet und periphere Elektroden, einschließlich P7, P8, F7 und F8, ausgeschlossen wurden. Vor der Berechnung des Theta-Band-Phasenkopplungswerts (PLV) zwischen FCz und F6 wurde eine Kurzzeit-Fourier-Transformation (STFT) angewandt. Die basislinienkorrigierte PLV-Änderung (ΔPLV) wurde relativ zur prästimulus-Basislinie von −600 bis −200 ms berechnet. Der rohe PLV-Wert liegt zwischen 0 und 1; negative ΔPLV-Werte zeigen daher eine Abnahme gegenüber der Basislinie an, nicht jedoch eine negative Phasenkopplung. Diese Ableitungsparameter werden als explorative Muster im Zusammenhang mit kontrollbezogener Verarbeitung und präfrontaler Koordination interpretiert; sie identifizieren jedoch nicht direkt einen spezifischen kognitiven Prozess oder eine neuronale Quelle.
Ergebnisse
Studie 1: Ergebnisse des Szenario-Experiments
Messmodell. Das Vier-Faktoren-Modell zeigte eine bessere Anpassung als die Alternativen mit zwei bzw. einem Faktor, jedoch war die absolute Modellanpassung uneinheitlich: χ2(48) = 223,93, p < .001; CFI = .935; TLI = .911; RMSEA = .111; SRMR = .140. Die standardisierten Loadings lagen zwischen .382 und .937. Die zusammengesetzte Reliabilität betrug .886 für wahrgenommene Professionalität, .932 für soziale Präsenz, .840 für kognitives Vertrauen und .709 für affektives Vertrauen; die entsprechenden AVE-Werte lagen bei .722, .821, .636 und .474. Die diskriminante Validität war eingeschränkt: Die HTMT-Werte betrugen .935 zwischen wahrgenommener Professionalität und kognitivem Vertrauen sowie .926 zwischen sozialer Präsenz und affektivem Vertrauen. Die Befunde zur bedingten Prozessanalyse werden daher vorsichtig interpretiert, und die dimensionsspezifischen Vertrauensanalysen sind explorativer Natur (Tabelle 1).
Manipulationskontrollen. Die Teilnehmer in der Expertenrahmung (n = 150, M = 5,57, SD = 1,18) stuften die medizinische KI als eher expertenähnlich ein als die Teilnehmer in der Begleitrahmung (n = 150, M = 3,21, SD = 1,76). Da sich die Varianzen unterschieden, F = 47,42, p < .001, wurde der Welch-Test verwendet, t(259,90) = 13,63, p < .001, mittlere Differenz = 2,36, 95 % KI [2,02, 2,70]. Die Teilnehmer in der Krankheitsbedingung (n = 150, M = 2,51, SD = 1,53) gaben niedrigere Bewertungen zur präventiven Gesundheitsorientierung an als die Teilnehmer in der Gesundheitsbedingung (n = 150, M = 5,98, SD = 1,22), F = 10,96, p = .001; Welch’s t(284,11) = −21,70, p < .001, mittlere Differenz = −3,47, 95 % KI [−3,79, −3,16]. Die Welch-Freiheitsgrade entsprechen nicht N − 2, wenn die Varianzen ungleich sind; alle Analysen verwendeten N = 300.
Beschreibende Statistiken nach experimenteller Bedingung. Bei der Expertenrahmung ergaben sich für die Krankheits- und Gesundheitsberatung Mittelwerte der wahrgenommenen Professionalität von 5,69 (SD = 0,83) und 5,85 (SD = 0,63), Mittelwerte der sozialen Präsenz von 4,28 (SD = 1,54) und 4,25 (SD = 1,64) sowie Mittelwerte des Gesamtvertrauens von 5,45 (SD = 0,86) und 5,28 (SD = 0,87). Bei der Begleitrahmung lagen die entsprechenden Mittelwerte für Krankheit und Gesundheit bei 4,52 (SD = 1,47) und 5,25 (SD = 0,94) für die wahrgenommene Professionalität, bei 5,68 (SD = 1,07) und 5,93 (SD = 0,74) für die soziale Präsenz sowie bei 5,30 (SD = 1,02) und 5,61 (SD = 0,64) für das Gesamtvertrauen. Tabelle 2 enthält alle bedingungsspezifischen Konfidenzintervalle und die vollständigen faktoriellen Tests.
Vollständige faktorielle Ergebnisse. Die wahrgenommene Professionalität zeigte einen Haupteffekt der Rollenrahmung, F(1, 296) = 56,92, p < .001, partielle η2 = .161, einen Haupteffekt des Aufgabenkontexts, F(1, 296) = 14,37, p < .001, partielle η2 = .046, sowie eine Wechselwirkung zwischen Rolle und Aufgabe, F(1, 296) = 5,89, p = .016, partielle η2 = .020. Die soziale Präsenz zeigte einen Haupteffekt der Rollenrahmung, F(1, 296) = 105,57, p < .001, partielle η2 = .263, weder der Haupteffekt der Aufgabe, F(1, 296) = 0,59, p = .442, noch die Wechselwirkung, F(1, 296) = 0,84, p = .359, war jedoch signifikant. Dieses letztere Ergebnis zeigt, dass keine Moderation nachgewiesen wurde; es belegt nicht die Gleichwertigkeit zwischen den Aufgaben. Bei kognitivem Vertrauen war die Wechselwirkung zwischen Rolle und Aufgabe signifikant, F(1, 296) = 5,60, p = .019, partielle η2 = .019; die entsprechende Wechselwirkung war bei affektivem Vertrauen nicht signifikant, F(1, 296) = 3,48, p = .063, partielle η2 = .012. Das Gesamtvertrauen zeigte weder einen Haupteffekt der Rollenrahmung, F(1, 296) = 0,81, p = .369, noch einen Haupteffekt der Aufgabe, F(1, 296) = 0,55, p = .459, die Wechselwirkung zwischen Rolle und Aufgabe war jedoch signifikant, F(1, 296) = 5,78, p = .017, partielle η2 = .019. Bei der Krankheitsberatung unterschied sich das Gesamtvertrauen nicht zwischen der Begleiter- und der Expertenrahmung, mittlere Differenz = −0,15, SE = 0,14, t(296) = −1,06, p = .288, 95 % KI [−0,42, 0,13]. Bei der Gesundheitsberatung war das Gesamtvertrauen unter der Begleiterrahmung höher, mittlere Differenz = 0,33, SE = 0,14, t(296) = 2,34, p = .020, 95 % KI [0,05, 0,60].
Parallele bedingte indirekte Assoziationen. Wenn wahrgenommene Professionalität und soziale Präsenz gleichzeitig eingegeben wurden, zeigten sich beide positiv assoziiert mit dem Gesamtvertrauen: b = 0.4872, SE = 0.0258, p < .001, 95 % KI [0,4294; 0,5460] bzw. b = 0,3293, SE = 0,0208, p < .001, 95 % KI [0,2762; 0,3829]. Die direkte Verbindung zur Rollenrahmung war nicht signifikant, b = 0,0119, SE = 0,0680, p = ,861, 95 % KI [−0,1071; 0,1361]. Die indirekten Assoziationen über Professionalität betrugen −0,5695 bei Krankheitsberatung, 95 % Bootstrap-KI [−0,7687; −0,3851], und −0,2923 bei Gesundheitsberatung, 95 % Bootstrap-KI [−0,4288; −0,1634]. Die indirekten Assoziationen über soziale Präsenz betrugen 0,4625 bei Krankheitsberatung, 95 % Bootstrap-KI [0,3165; 0,6091], und 0,5532 bei Gesundheitsberatung, 95 % Bootstrap-KI [0,3855; 0,7383] (Tabelle 3). Der Index der moderierten Mediation über wahrgenommene Professionalität betrug 0,2772, 95 % Bootstrap-KI [0,0594; 0,5035], während der Index über soziale Präsenz bei 0,0907 lag, 95 % Bootstrap-KI [−0,0984; 0,3008]. Der direkte Bootstrap-Vergleich zwischen den Indizes war nicht signifikant, Differenz = 0,1864, 95 % Bootstrap-KI [−0,0856; 0,4447]. Die Ergebnisse unterstützen daher eine kontextuelle Moderation der indirekten Assoziation über Professionalität, weisen aber keine statistisch unterschiedliche kontextuelle Moderation der beiden Assoziationen nach.
Explorative Analysen der Vertrauensdimensionen. Bei kognitivem Vertrauen war der Unterschied zwischen den indizierten moderierenden Mediationseffekten für Professionalität und soziale Präsenz positiv, Differenz = 0,3707, 95 % Bootstrap-KI [0,0493, 0,6996]. Für affektives Vertrauen wurde der entsprechende Unterschied nicht bestätigt, Differenz = 0,0022, 95 % Bootstrap-KI [−0,3421, 0,3127]. Beide Mediatoren zeigten positive Zusammenhänge mit beiden Vertrauensdimensionen, was auf Quereffekte statt auf ausschließliche Wirkungen hindeutet. Angesichts der hohen HTMT-Werte sollten diese Ergebnisse nicht als eindeutige Trennung kognitiver und affektiver Mechanismen interpretiert werden.
Post-hoc-Power für moderierte Mediation. Unter dem angepassten Modell und den Annahmen der Residuen-Resampling ergab sich eine geschätzte Wahrscheinlichkeit von 0,698, dass das prozentuale Bootstrap-Konfidenzintervall die Null ausschloss, für den Professionalismus-Index, von 0,157 für den Sozialpräsenz-Index und von 0,279 für deren direkten Unterschied (1.000 Simulationen; 500 Bootstrap-Stichproben pro Simulation). Diese schätzbasierten Designergebnisse erklären, warum der unterstützte Professionalismus-Index und der nicht signifikante direkte Vergleich nicht als schlüssiger Beleg für unterschiedliche kontextuelle Moderation interpretiert werden sollten.
Robustheit bezüglich der Abschlusszeit. Nach Ausschluss der 15 Antworten unterhalb von 125 s verblieben 285 Fälle. Die Interaktion bezüglich des Gesamtvertrauens blieb signifikant, p = .029; der Professionalitätsindex wurde weiterhin gestützt, 95% Bootstrap-KI [0,0242, 0,4827]; und der Kontrast zwischen den moderierten Mediationsindizes blieb nicht signifikant, 95% Bootstrap-KI [−0,1027, 0,4506]. Die Hauptschlüsse hingen nicht von den schnellsten 5 % der Antworten ab.
Studie 2: EEG-Ergebnisse
Frontal-medianes Theta-ERS. In der endgültigen analytischen Stichprobe (N = 39) war das Theta-ERS im Frequenzbereich von 4–8 Hz und im Zeitfenster von 800–1.000 ms unter der Expertenrahmung (M = 0,2948, SD = 0,8218) höher als unter der Begleitpersonenrahmung (M = −0,0422, SD = 1,2155), mittlere Differenz = 0,3369, 95 % KI [0,0125, 0,6614], t(38) = 2,10, p = ,042, Cohens dz = 0,337, partielles η2 = ,104. Der nach Holm adjustierte p-Wert für die beiden berichteten gepaarten EEG-Ergebnisse betrug ,042. Dieser Unterschied weist auf eine differenzielle Verarbeitung im Theta-Band in diesem Aufgabenfenster hin; allein das Theta-ERS identifiziert jedoch keinen spezifischen psychologischen Prozess.
FCz-F6 basiskorrigierte Änderung der Theta-PLV (ΔPLV). In der endgültigen analytischen Stichprobe (N = 39) war die Theta-ΔPLV unter der Expertenrahmung (M = −0,0111, SD = 0,0546) weniger negativ als unter der Begleitpersonenrahmung (M = −0,0350, SD = 0,0473), mittlere Differenz = 0,0239, 95 % KI [0,0058, 0,0420], t(38) = 2,68, p = ,011, Cohens dz = 0,429, partielles η2 = ,159. Der Holm-korrigierte p-Wert für die beiden berichteten gepaarten EEG-Ergebnisse betrug ,022. Dieses Muster deutet auf eine geringere Abnahme der Theta-Phasenkonsistenz gegenüber dem Ausgangswert unter der Expertenrahmung hin; es belegt allein jedoch nicht eine stärkere präfrontale Kontrolle oder einen spezifischen kognitiven Mechanismus (siehe Abbildung 4 und Tabelle 4).
Ergebnisse der Verhaltensaufgabe. Bei den 38 analysierten Aufzeichnungen der Aufgabe betrug die Vertrauensreaktionsrate 83,1 % (SD = 15,8 %) unter Expertenrahmen und 82,4 % (SD = 17,5 %) unter Begleitrahmen, mittlere Differenz = 0,7 Prozentpunkte, 95 % KI [−0,9, 2,4], t(37) = 0,91, p = ,371, dz = 0,147. Die mittlere Reaktionszeit betrug jeweils 828,7 ms (SD = 204,6) und 826,1 ms (SD = 208,9), mittlere Differenz = 2,5 ms, 95 % KI [−14,0, 19,1], t(37) = 0,31, p = ,758, dz = 0,050. Die Raten fehlender Antworten betrugen jeweils 6,3 % (SD = 7,4 %) und 5,2 % (SD = 6,3 %), mittlere Differenz = 1,1 Prozentpunkte, 95 % KI [−1,0, 3,1], t(37) = 1,05, p = ,302, dz = 0,170.
Datenverfügbarkeitsaussage:
Die anonymisierten Fragebogendaten der Studie 1, vorverarbeiteten EEG-Dateien und aggregierten EEG-Ergebnisdateien, die Studie 2 unterstützen, sind öffentlich im Open Science Framework (OSF) unter https://doi.org/10.17605/OSF.IO/JKSP7 verfügbar. Zu den ergänzenden Materialien gehören die vollständigen experimentellen Stimuli (Zusatzdatei 1), Manipulationskontrollen, zusätzliche Verhaltensanalysen, post-hoc-Potenzanalysen und unterstützende methodische Informationen.
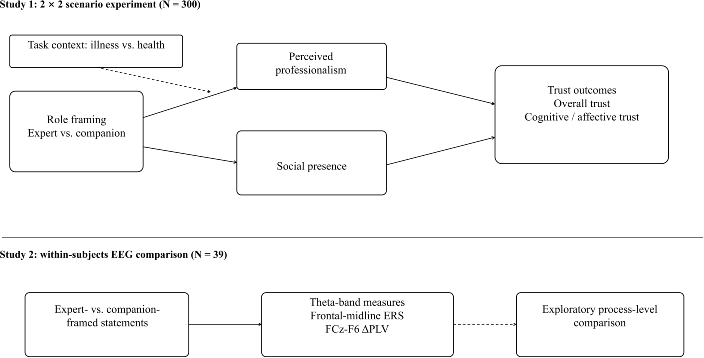
Abbildung 1. Forschungsrahmen. Studie 1 ist ein 2 × 2-Szenarioexperiment (N = 300), das die Einflüsse der Rollendarstellung und Aufgabenkontexts sowie parallele indirekte Zusammenhänge über die wahrgenommene Professionalität und soziale Präsenz untersucht. Studie 2 bietet einen explorativen Elektroenzephalogramm-Vergleich von Aussagen mit Experten- und Begleiter-Rahmen (N = 39); diese prüft jedoch nicht direkt das konditionale indirekte Modell. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
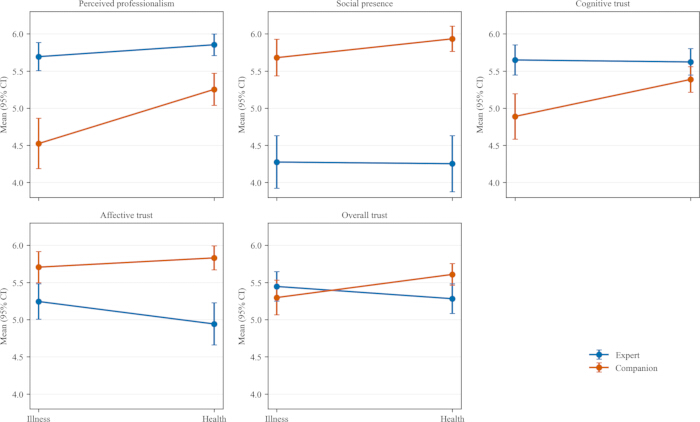
Abbildung 2. Darstellungen der Rollenrahmenbedingungen × Aufgabenkontext für wahrgenommene Professionalität, soziale Präsenz, kognitives Vertrauen, affektives Vertrauen und Gesamtvertrauen. Die Punkte zeigen die Zellenmittelwerte, und die Fehlerbalken zeigen 95 % Konfidenzintervalle (n = 75 pro Zelle). Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
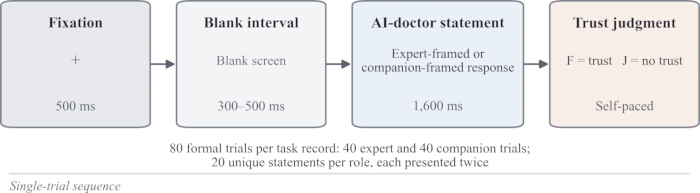
Abbildung 3. Einzeldurchgangssequenz in Studie 2. Jeder Durchgang bestand aus einer 500 ms dauernden Fixation, einem variablen 300–500 ms langen Leerintervall, einer 1.600 ms dauernden Aussage des KI-Arztes im Experten- oder Begleiter-Rahmen und einer selbstgesteuerten binären Vertrauensbewertung. Die Aufzeichnungen der E-Prime-Aufgabe zeigten 80 formale Durchgänge pro Aufgabendatensatz, mit 40 Durchgängen pro Rollenrahmenbedingung und zwei Darbietungen jeder der 20 einzigartigen Aussagen pro Bedingung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
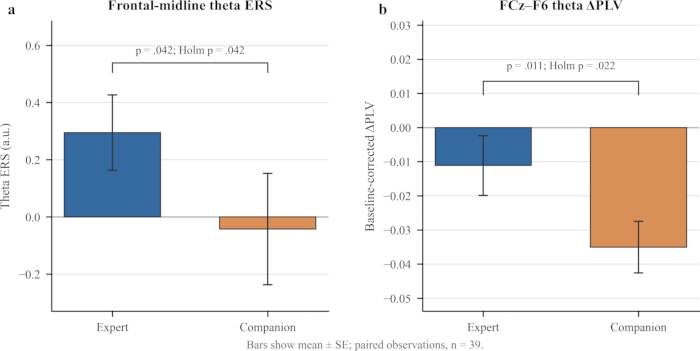
Abbildung 4. Wirkung der Rollendarstellung von medizinischer KI auf die frontomediale Theta-ERS und den FCz-F6 Theta-Delta-PLV. (A) Ereignisbezogene Synchronisation im Theta-Band an der frontomedialen Elektrode. (B) Baseline-korrigierte Änderung des Phasenkoppelsignals (ΔPLV) im Theta-Band zwischen FCz und F6; negative Werte zeigen eine Abnahme gegenüber der prästimulativen Baseline an. Die Balken zeigen Mittelwert ± Standardfehler (SE) für n = 39. Gepaarte t-Tests ergaben p = .042 für die Theta-ERS und p = .011 für ΔPLV; die nach Holm adjustierten p-Werte für diese beiden Ergebnisse betrugen jeweils .042 und .022. Abkürzungen: Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Tabelle 1: Messmodell-Diagnose für Studie 1. Die Tabelle zeigt standardisierte Faktorladungen, Cronbachs α, komposite Reliabilität, durchschnittlich erklärte Varianz, latente Korrelationen und HTMT-Werte für wahrgenommene Professionalität, soziale Präsenz, kognitives Vertrauen und affektives Vertrauen an. N = 300. Das Vier-Faktoren-Modell passte besser als die Alternativen, aber RMSEA und SRMR wiesen auf eine schwache absolute Modellpassung hin, und zwei HTMT-Werte lagen über 0,90. Abkürzungen: CR = komposite Reliabilität; AVE = durchschnittlich erklärte Varianz; HTMT = Heterotrait-Monotrait-Verhältnis. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 2: Deskriptive Statistiken für die vier Bedingungen und vollständige 2 × 2-Faktoranalysen für Studie 1. Die Tabellenzellen enthalten Angaben zu n, Mittelwert, Standardabweichung und 95 %-Konfidenzintervall; die Faktoranalysen enthalten F, p und partielles η2. N = 300; n = 75 pro Zelle. Die Rollenrahmung wurde kodiert als 1 = Experte und 2 = Begleiter; der Aufgabenkontext wurde kodiert als 1 = Krankheitsberatung und 2 = Gesundheitsberatung. Die Koeffizienten und Konfidenzintervalle sind nicht standardisiert. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 3: Parallele bedingte indirekte Assoziationen in Studie 1. N = 300. Die Rollenrahmung wurde kodiert als 1 = Experte und 2 = Begleiter; der Aufgabenkontext wurde kodiert als 1 = Krankheitsberatung und 2 = Gesundheitsberatung. Wahrgenommene Professionalität und soziale Präsenz wurden gleichzeitig berücksichtigt. Die Schätzungen sind nicht standardisiert, und die Prozentil-Bootstrap-Konfidenzintervalle basierten auf 5.000 Neustichproben. Die Tabelle enthält bedingte indirekte Assoziationen, beide Indizes moderierter Mediation sowie deren direkten Bootstrap-Vergleich. Der direkte Vergleich zwischen den beiden Indizes der moderierten Mediation bezüglich des Gesamtvertrauens betrug 0,1864, 95 % KI [-0,0856, 0,4447]. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Tabelle 4: Gekoppelte EEG-Ergebnisse in Studie 2. N = 39 gepaarte Beobachtungen in der endgültigen analytischen Stichprobe. Die Tabelle zeigt die Mittelwerte pro Bedingung, die gepaarten Mittelwertdifferenzen, 95 %-Konfidenzintervalle, gepaarte t-Tests, Cohens dz, partielles η2 und nach Holm adjustierte p-Werte für die fronto-mediane Theta-ERS sowie die basislinienkorrigierte Theta-ΔPLV an FCz-F6. Die Holm-Korrektur bezieht sich ausschließlich auf die beiden berichteten gekoppelten EEG-Ergebnisse und rekonstruiert keinen unberichteten umfassenderen Suchraum hinsichtlich Elektroden, Frequenzbändern oder Zeitfenstern. Bitte klicken Sie hier, um diese Tabelle herunterzuladen.
Zusatzdatei 1: Experimentelle Stimuli, verwendet in Studie 1. Die Datei enthält den vollständigen Text der medizinischen KI-Antworten im Experten- und Begleiter-Rahmen, die in den Szenarien zur Krankheits- und Gesundheitsberatung verwendet wurden. Sowohl der ursprüngliche chinesische Text als auch die englische Übersetzung sind enthalten.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle S1. Post-hoc-Simulationsbasierte Power-Analyse für das moderierte Mediationsmodell. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle S2. Statistiken zur Überprüfung der Manipulation und Analysen zur Empfindlichkeit der Bearbeitungsdauer für Studie 1. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle S3. Verhaltensaufgaben-Ergebnisse, Stichprobenbilanzierung und beschreibende Statistiken für Studie 2. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Theoretische Implikationen
Die beiden Studien liefern Belege auf unterschiedlichen Ebenen. Studie 1 identifiziert Rollen-aufgabenbezogene Assoziationen und parallele indirekte Assoziationen in einem randomisierten Szenarioexperiment, während Studie 2 einen explorativen, prozessbezogenen EEG-Vergleich bietet. Die Studien stützen somit eine begrenzte Konzeption der rollenbezogenen Bewertung statt eines einzelnen progressiven Mechanismus. Die Ergebnisse erweitern die Theorie der Rollenkonkordanz auf medizinische KI, indem Konkordanz als Übereinstimmung zwischen Rollenhinweisen und aufgabenbezogen hervorgehobenen evaluativen Anforderungen verstanden wird22. Diese Interpretation unterscheidet sich von Kompetenz-Wärme-Inhalten und der Aufgaben-Technologie-Passung. Befunde zur Algorithmenablehnung und Algorithmenwertschätzung können als kontextabhängige Bewertungen verstanden werden, ob Rollen- und Fähigkeitshinweise zur Aufgabe passen49,50.
Die Ergebnisse stützen zudem parallele, nicht ausschließliche Zusammenhänge zwischen Rollenrahmung, wahrgenommener Professionalität, sozialer Präsenz und Vertrauen. Da sich Professionalität mit kognitivem Vertrauen und soziale Präsenz mit affektivem Vertrauen überschneiden, sprechen die Befunde für differenzierte evaluative Inhalte, jedoch nicht für zwei klar getrennte Mechanismen. Die Wechselwirkung zwischen Rolle und Aufgabe bezüglich der wahrgenommenen Professionalität entspricht dem vorgeschlagenen rollenkonformen Erklärungsansatz. Die Befunde stützen eine kontextuelle Moderation des Zusammenhangs mit Professionalität, belegen jedoch nicht statistisch asymmetrische kontextuelle Mechanismen oder Invarianz im Pfad der sozialen Präsenz.
Die EEG-Befunde liefern eine erkenntnisorientierte Perspektive auf Prozessebene. Aussagen, die von Experten formuliert wurden, gingen mit charakteristischen Muster im Theta-Frequenzband einher, doch die Bedingungen unterschieden sich zudem in semantischer Aussagekraft und Komplexität, und auf Bedingungsebene zeigte sich kein verlässlicher Unterschied im Vertrauen. Die EEG-Messungen belegen daher keinen eindeutigen Mechanismus kognitiver Kontrolle oder des Vertrauens. Die neuronalen Befunde sollten als hypothetisch generierend betrachtet werden. Studie 2 manipulierte den Aufgabenkontext nicht, erfasste weder die wahrgenommene Professionalität noch soziale Präsenz und stellte keinen Zusammenhang zwischen EEG-Indizes auf Versuchsebene und Vertrauensurteilen her; die EEG-Ergebnisse ergänzen daher das bedingte indirekte Modell, statt es zu validieren.
Die Ergebnisse sind vereinbar mit einer angemessenen statt maximalen Verlagerung der Verantwortung. Die Inanspruchnahme automatisierter Systeme sollte an die Fähigkeiten, Grenzen und Aufgabenanforderungen des Systems angepasst sein35. In verwandten Arbeiten werden adaptive kognitive Mechanismen beschrieben, die eine abgestimmte Vertrauensbildung und Verlagerung der Verantwortung unterstützen könnten51. Die NeuroIS-Perspektive befürwortet den Einsatz neuronaler Messungen als Ergänzung zu Verhaltensdaten bei der Untersuchung zeitlich aufgelöster Prozesse52. Frühere fMRT-Studien zeigen zudem, dass die neuronale Aktivität während Online-Vertrauensentscheidungen je nach Zielobjekt und Kontext variiert53.
Ableitungen für das Management
Für Online-Medizinplattformen bedeutet dies eine abgestimmte Verlässlichkeit statt einer einfachen Maximierung des Vertrauens. Rollenhinweise sollten an die Anforderungen der jeweiligen Aufgabe angepasst und mit der Kommunikation von Unsicherheiten, expliziten Angaben zu Leistungsgrenzen, risikobasierten Warnungen sowie der Eskalation an qualifizierte Ärzte kombiniert werden.
In Modulen mit hohem Risiko, die Diagnose, Interpretation abnormaler Ergebnisse, medizinische Beratung oder Triagen betreffen, können kompetenzorientierte Hinweise den Nutzern helfen, die Grenzen von Evidenz und Handlung zu erkennen, ohne unberechtigte Autorität zu verleihen. In Modulen mit geringerer Dringlichkeit, wie Ernährung, Bewegung, Schlaf, Therapietreue und emotionale Unterstützung, können beziehungsorientierte Hinweise das Engagement fördern, ohne falsche Sicherheit oder unangemessene Anthropomorphisierung zu erzeugen.
Die Rollengestaltung sollte modular und szenariobasiert sein, anstatt auf einer festen Persönlichkeitseinstellung zu beruhen. Die Rollenkonfiguration sollte mit Erklärungen, Datenschutzhinweisen, Risikokennzeichnungen und Eskalationsmechanismen verknüpft werden. Forschungen zum Governance-Aspekt betonen, dass Transparenz, Rechenschaftspflicht, Verzerrungsmanagement und Datenschutz gemeinsam konzipiert werden müssen, damit glaubwürdige Frontend-Rollenhinweise keine Backend-Risiken verbergen6,20,21.
Forschungsgrenzen und zukünftige Forschungsrichtungen
Studie 1 ist ein Szenarioexperiment und keine echte Beratung. Die Bedingungen wurden nicht unabhängig hinsichtlich Dauer, Wortfrequenz, Lesbarkeit, Genauigkeit, Handlungsorientierung, emotionaler Valenz, Erregung, Risiko, Vertrautheit oder Komplexität vorgetestet. Zukünftige Studien sollten mehrere Szenarien, neutrale Systemnamen, inhaltsmäßig abgestimmte Reize, unabhängige Manipulationen oder zeitlich getrennte Messungen sowie Zufallseffekte auf Teilnehmer- und Stimulus-Ebene verwenden.
Studie 2 lieferte EEG-Beweise auf Prozessebene, jedoch war die abschließende demografische Verknüpfung mit 39 Personen unvollständig, die EEG-Aussagen wurden nicht unabhängig hinsichtlich Satzlänge, Wortfrequenz, Lesbarkeit, emotionaler Valenz, Erregung, wahrgenommener Risikobereitschaft, Vertrautheit und Komplexität abgeglichen oder vorab getestet, und explizite Rollenbezeichnungen könnten Erwartungseffekte hervorgerufen haben. Die vorliegende Studie verwendete den baseline-korrigierten Phase-Locking-Wert (ΔPLV) als vordefinierte Messgröße für funktionelle Konnektivität. Obwohl der gewichtete Phasen-Lag-Index (wPLI) weniger empfindlich gegenüber Volumenleitung ist, wurde er nicht in die ursprüngliche Analysepipeline einbezogen. Zukünftige Studien sollten untersuchen, ob die vorliegenden Ergebnisse mit wPLI oder anderen komplementären Konnektivitätsmaßen repliziert werden können. Die verfügbaren neuronalen Ausgangsdaten sind nach Bedingungen aggregiert und können nicht mit vertrauensbezogenen Urteilen auf Versuchsebene verknüpft werden; daher wurde kein gemischtes EEG-Verhaltensmodell auf Versuchsebene berechnet. Der PLV vom Skalp ist außerdem empfindlich gegenüber Gemeinsamkeitsreferenz- und Volumenleitungseffekten. Diese Einschränkungen bedeuten, dass die neurologischen Befunde vorerst als explorativ gelten sollten und nicht als Beleg für einen einzigartigen kognitiven Kontroll- oder Vertrauensmechanismus interpretiert werden dürfen.
Offenlegungen
Die Autoren erklären, dass keine Interessenkonflikte bestehen.
Während der Vorbereitung dieser Arbeit nutzten die Autoren ChatGPT, um die Sprache zu verbessern. Nach der Nutzung dieses Tools/Dienstes überprüften und bearbeiteten die Autoren den Inhalt nach Bedarf und übernehmen die volle Verantwortung für den Inhalt der Veröffentlichung.
Danksagungen
Dieses Forschungsprojekt wurde von den allgemeinen Projekten des Nationalen Fonds für Sozialwissenschaften, VR China (Zuschussnummer 22BGL006), unterstützt.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Online-Umfrageplattform Credamo | Credamo (Jianshu), China | Nicht zutreffend | Online-Fragebogen-, Zufallszuordnungs- und Probandenrekrutierungsplattform, die in Studie 1 verwendet wurde. |
| CURRY-Umbezugsfunktion | Compumedics Neuroscan, USA | Version nicht angegeben | Integrierte Offline-Umbezugung vom FCz-Onlinereferenz zu dem Mittelwert der bilateralen Mastoiden; FCz wurde automatisch relativ zur neuen Referenz rekonstruiert. |
| EEG-Elektrodenkappe, 64-Kanal | Compumedics Neuroscan (Compumedics Limited), Australien | Modell-/Katalognummer nicht angegeben | 64-Kanal-Ag/AgCl-Elektrodenkappe zur kontinuierlichen EEG-Aufzeichnung verwendet. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 2023.0 | MATLAB-Toolbox zur EEG-Vorverarbeitung und Durchführung der unabhängigen Komponentenanalyse. |
| E-Prime | Psychology Software Tools, Inc., USA | Version 2.1 | Präsentation der Reize und Erfassung der Antworten in Studie 2. |
| G*Power | Heinrich-Heine-Universität Düsseldorf, Deutschland | Version 3.1.9.7 | Ursprüngliche a-priori-Stichprobengrößenberechnung, Interaktionsempfindlichkeitsanalyse und post-hoc modellbasierte Power-Analyse für Studie 1. |
| IBM SPSS Statistics | IBM Corp., USA | Version 27 | Statistische Umgebung zur Ausführung des PROCESS-Makros. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 1.7 | EEGLAB-Plugin zur Klassifizierung artefaktbehafteter unabhängiger Komponenten. |
| MATLAB | The MathWorks, Inc., USA | Release R2020b | Berechnungsumgebung für die EEG-Verarbeitung und -Analyse. |
| PROCESS-Makro für SPSS | Andrew F. Hayes, Kanada | Version 4.2 beta | Modell 7 mit wahrgenommener Professionalität und sozialer Präsenz, die gleichzeitig als parallele Mediatoren eingegeben wurden, unter Verwendung von 5.000 Perzentil-Bootstrap-Stichproben in Studie 1. |
| Quik-Gel leitfähiges Elektrolytgel | Compumedics Neuroscan (Compumedics Limited), Australien | Katalognummer nicht angegeben; 32 oz | Leitfähiges Gel zur Verringerung der Elektroden-Haut-Impedanz während der EEG-Aufzeichnung. |
| SynAmps2 EEG-Verstärker | Compumedics Neuroscan (Compumedics Limited), Australien | SynAmps2; Katalognummer nicht angegeben | 64-256-Kanal-EEG-Verstärker, konfiguriert für 64-Kanal-Aufzeichnung. |
Referenzen
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.