Dieses longitudinale Protokoll kombiniert wiederholte Assessments der Pflegeabhängigkeitsskala mit einer Growth-Mixture-Modellierung, um unterschiedliche Verläufe der Pflegeabhängigkeit nach einem akuten Myokardinfarkt zu identifizieren und demografische, klinische sowie psychosoziale Faktoren zu bewerten, die mit der Zugehörigkeit zu bestimmten Verlaufsgruppen assoziiert sind.
Forschungsartikel
Latente Klassen von Trajektorien der pflegerischen Abhängigkeit und assoziierte Faktoren bei Patienten mit akutem Myokardinfarkt
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Diese Studie hatte zum Ziel, latente Klassen von Pflegeabhängigkeitstrajectorien bei Patienten mit akutem Myokardinfarkt (AMI) zu identifizieren und Faktoren zu untersuchen, die mit der Zugehörigkeit zu einer Trajektorienklasse assoziiert sind. Diese einzentrische, longitudinale Beobachtungsstudie umfasste 260 Patienten mit AMI, die zwischen Januar 2024 und Januar 2026 in das Linquan County People’s Hospital aufgenommen wurden. Der Studien-Basiszeitpunkt wurde als der Zeitpunkt nach erfolgreicher Notfallbehandlung und Wiedererlangung der Bewusstseinslage definiert. Die Pflegeabhängigkeit wurde mittels der Care Dependency Scale (CDS) zum Basiszeitpunkt (T1), am 3. Tag nach Aufnahme (T2), bei Entlassung (T3) und 1 Monat nach Entlassung (T4) erhoben. Mithilfe der Growth-Mixture-Modellierung wurden unterschiedliche longitudinale Trajektorienklassen identifiziert. Klinische und psychosoziale Merkmale wurden anschließend mittels multinomialer logistischer Regression evaluiert, um unabhängig mit der Trajektorienklassenzugehörigkeit assoziierte Faktoren zu ermitteln. Vier unterschiedliche Pflegeabhängigkeitstrajectorien wurden identifiziert: Typ mit hoher Selbstständigkeit und langsamer Verbesserung (C1, n = 66, 25,4 %), Typ mit mittlerer Abhängigkeit und rascher Verschlechterung (C2, n = 54, 20,8 %), Typ mit hoher Abhängigkeit und signifikanter Verbesserung (C3, n = 90, 34,6 %) sowie Typ mit hoher Abhängigkeit und langsamer Verschlechterung (C4, n = 50, 19,2 %). Alter, Familienstand, depressive und angstbezogene Symptome, soziale Unterstützung sowie Vorerkrankungen zeigten unabhängige, klassenspezifische Assoziationen mit der Trajektorienklassenzugehörigkeit. Die Pflegeabhängigkeit wies bei Patienten mit AMI eine erhebliche interindividuelle Heterogenität auf, wobei vier deutlich unterschiedliche longitudinale Trajektorien identifiziert wurden. Mit der Trajektorienklassenzugehörigkeit assoziierte Faktoren könnten helfen, Patienten zu identifizieren, die eine intensivere Pflegebeurteilung und individuelle Nachbetreuung benötigen; die Wirksamkeit von Interventionen, die auf diese Faktoren abzielen, bedarf jedoch einer prospektiven Evaluation.
Einleitung
Ein akuter Myokardinfarkt (AMI) wird gewöhnlich durch eine plötzliche Okklusion der Koronararterie verursacht, die zu einer deutlichen Verringerung oder Unterbrechung des myokardialen Blutflusses und anschließender myokardialer Nekrose führt. AMI bleibt eine schwerwiegende lebensbedrohliche kardiovaskuläre Erkrankung, da eine beeinträchtigte myokardiale Funktion und akute Komplikationen die kurz- und langfristigen Behandlungsergebnisse erheblich beeinträchtigen können1. Reperfusionsstrategien, einschließlich perkutaner koronarer Intervention und thrombolytischer Therapie, können den koronaren Blutfluss wiederherstellen und die akute Behandlung von AMI erheblich verbessert haben. Dennoch leiden einige Patienten auch nach erfolgreicher akuter Therapie weiterhin unter Einschränkungen bei der Selbstversorgung und den Aktivitäten des täglichen Lebens und benötigen infolgedessen unterschiedliche Grade an pflegerischer Unterstützung2.
Pflegeabhängigkeit kann die Lebensqualität, die soziale Teilhabe, die funktionelle Erholung und den gesamten Rehabilitationsprozess der Patienten beeinträchtigen3. Bisherige Forschungsarbeiten zum akuten Myokardinfarkt (AMI) konzentrierten sich vorwiegend auf diagnostische und therapeutische Strategien, die Prävention und das Management von Komplikationen sowie prognostische Faktoren. Frühere Querschnittsstudien bei Patienten mit koronarer Herzkrankheit nach perkutaner koronarer Intervention haben Gebrechlichkeit, Selbstwirksamkeit und psychologischen Status als mit der Pflegeabhängigkeit assoziierte Faktoren identifiziert; allerdings kann eine einmalige Erfassung zeitlich begrenzter Veränderungen innerhalb eines Patienten nicht abbilden oder heterogene Erholungsverläufe im Zeitverlauf unterscheiden4. Durch die wiederholte Beurteilung der Pflegeabhängigkeit zu vier Zeitpunkten und die Anwendung der Growth-Mixture-Modellierung erweitert die vorliegende Studie bisherige statische Analysen, indem latente Patientensubgruppen mit unterschiedlichen longitudinalen Verläufen identifiziert werden. Die Identifizierung dieser heterogenen Muster könnte Kliniker dabei unterstützen, Patienten mit verschiedenen Rehabilitationsprofilen zu erkennen, und eine Grundlage für individualisierte pflegerische Beurteilung, Nachverfolgung und unterstützende Versorgung bieten.
Dementsprechend zielte diese Studie darauf ab, unterschiedliche longitudinale Klassen der Pflegeabhängigkeit vom Basiszeitpunkt nach der Notfallbehandlung bis zu einem Monat nach der Entlassung bei Patienten mit einem akuten Myokardinfarkt (AMI) zu identifizieren und demografische, klinische sowie psychosoziale Faktoren zu untersuchen, die mit der Zugehörigkeit zu bestimmten Verlaufsgruppen assoziiert sind. Aufgrund des explorativen Charakters der Studie wurden keine gerichteten Hypothesen bezüglich spezifischer Verlaufsgruppen im Voraus festgelegt.
Protokoll
Die Studie wurde in der Abteilung für Notfallmedizin des Linquan County People’s Hospital in Fuyang, Anhui, China, durchgeführt. Das Studienprotokoll wurde vom Ethikkomitee des Linquan County People’s Hospital geprüft und genehmigt (Genehmigungsnummer: 24XNLC-HL1015). Von allen Teilnehmern wurde vor der Einschreibung eine schriftliche informierte Einwilligung eingeholt. Alle Verfahren an menschlichen Teilnehmern wurden gemäß den institutionellen ethischen Anforderungen und anwendbaren ethischen Grundsätzen durchgeführt.
Studieneinstellung und Teilnehmeridentifizierung
Die Studie wurde als eine single-center, longitudinale Beobachtungsuntersuchung in der Abteilung für Notfallmedizin des Linquan County People’s Hospital in Fuyang, Anhui, China, durchgeführt. Die Rekrutierung der Teilnehmer erfolgte zwischen Januar 2024 und Januar 2026, und die Nachbeobachtung erstreckte sich vom Basiszeitpunkt nach der Notfallbehandlung bis zu einem Monat nach der Entlassung.
Zur Identifizierung von in Frage kommenden Patienten, die wegen eines akuten Myokardinfarkts (AMI) aufgenommen wurden, wurde eine Convenience-Stichprobe verwendet. Auf alle potenziellen Teilnehmer wurden dieselben Einschlusskriterien und Screening-Verfahren angewandt. Da die Convenience-Stichprobe eine Selektionsbias verursachen kann, wurde diese mögliche Bias-Quelle bei der Interpretation der Übertragbarkeit der Ergebnisse berücksichtigt.
Insgesamt wurden 287 Patienten untersucht, von denen 27 nicht eingeschlossen wurden. Bei acht Patienten hatte bereits ein Myokardinfarkt stattgefunden, sechs konnten die Studienuntersuchungen aufgrund beeinträchtigter Bewusstseinslage oder kognitiver Funktion nicht abschließen, fünf wiesen andere organische Herzkrankheiten auf, vier hatten maligne Tumoren, ein Multiorganversagen oder andere schwere systemische Erkrankungen, und vier lehnten die Teilnahme ab. Die verbleibenden 260 Patienten wurden in die Studie eingeschlossen.
Ein- und Ausschlusskriterien und Baseline-Definition
Eingeschlossen wurden Patienten, wenn sie eine bestehende klinische Diagnose eines akuten Myokardinfarkts (AMI) hatten, einen ersten Myokardinfarkt erlitten, mindestens 18 Jahre alt waren, bei klarem Bewusstsein und ausreichender kognitiver Funktion zur Verständigung und Teilnahme an den Studienuntersuchungen waren und schriftlich informierte Einwilligung erteilt hatten. Ausgeschlossen wurden Patienten mit anderen organischen Herzerkrankungen, bösartigen Tumoren, Multiorganversagen oder anderen schweren systemischen organischen Erkrankungen.
Die Einschreibung war auf Patienten mit erstmaligem Myokardinfarkt beschränkt, um die Heterogenität durch vorangegangene Infarkte, frühere Revascularisierungen, chronische Funktionsstörungen nach Infarkt und bereits bestehende Anpassungen in der Selbstpflege oder Rehabilitation zu verringern, da all diese Faktoren unabhängig die basale Pflegeabhängigkeit und die anschließenden Verlaufsprofile beeinflussen könnten.
T1 wurde als der Zeitpunkt definiert, der auf die erfolgreiche Notfallbehandlung und das Wiedererlangen der Bewusstheit folgte, zu dem der Proband die erforderlichen Assessments zuverlässig abschließen konnte.
Erhebung demografischer und kardiovaskulärer klinischer Daten
Ein studienspezifischer allgemeiner Fragebogen wurde verwendet, um Alter, Geschlecht, Body-Mass-Index (BMI), Familienstand, kardiale Funktionsklasse, Typ des Myokardinfarkts, Reperfusionsbehandlungsstrategie und Vorerkrankungen zu erfassen. Demografische und psychosoziale Informationen wurden je nach Eignung durch Befragung und Überprüfung der Krankenakten gewonnen. Kardiovaskuläre klinische Merkmale, einschließlich kardialer Funktionsklasse, Myokardinfarkttyp, Reperfusionsstrategie und Vorerkrankungen, wurden anhand vordefinierter Kriterien aus den Krankenakten für den Indexaufenthalt extrahiert. Die kardiale Funktionsklasse wurde aus der Krankenakte des Indexaufenthalts entnommen und für die Analyse als Klasse I–II oder Klasse III–IV gruppiert. Der Myokardinfarkttyp wurde basierend auf der Diagnose während des Indexaufenthalts als ST-Strecken-Hebungs-Myokardinfarkt (STEMI) oder Nicht-ST-Strecken-Hebungs-Myokardinfarkt (NSTEMI) klassifiziert. Die Anamnese bezüglich Vorerkrankungen wurde dichotom als nein (0) oder ja (1) kodiert, wobei „ja“ bedeutete, dass mindestens eine vordefinierte chronische Komorbidität in der Krankengeschichte dokumentiert war.
Die perkutane koronare Intervention (PCI) und die thrombolytische Therapie wurden entsprechend der tatsächlich während des Indexaufenthalts verabreichten Behandlung erfasst, nicht gemäß dem ursprünglich geplanten Behandlungsansatz. Die ursprünglichen kontinuierlichen Werte für Alter und BMI wurden für die statistische Analyse beibehalten.
Wiederholte Pflegebedürftigkeitsbeurteilung
Die Pflegeabhängigkeitsskala (CDS5) wurde zum Zeitpunkt T1 erhoben. Die Skala umfasst 15 Items. Jedes Item wurde von 1 (vollständig abhängig) bis 5 (fast unabhängig) bewertet, was zu einem Gesamtwert zwischen 15 und 75 führt. Höhere Werte zeigen eine größere Selbstständigkeit und geringere Pflegeabhängigkeit an. Gemäß der etablierten CDS-Klassifikation weisen Werte zwischen 60 und 69 einen begrenzten Grad an Pflegeabhängigkeit auf, während Werte zwischen 70 und 75 eine nahezu vollständige Unabhängigkeit anzeigen; daher wurde im vorliegenden Studie ein Gesamtwert der CDS <70 als Hinweis auf Pflegeabhängigkeit gewertet4,5.
Die CDS-Beurteilung wurde am Tag 3 nach der Aufnahme (T2), beim Entlassungstermin (T3) und 1 Monat nach der Entlassung (T4) wiederholt. Bei allen Beurteilungen wurden dieselben Anweisungen, Item-Reihenfolge, Bewertungsregeln und Hilfeprozeduren angewendet, um Messinkonsistenzen zu minimieren. Die T4-Beurteilung erfolgte im Rahmen der geplanten 1-Monats-Follow-up-Kontrolle nach der Entlassung, entweder persönlich in der Ambulanz oder telefonisch, wenn ein persönlicher Besuch nicht möglich war. In beiden Fällen führte ein geschulter Mitarbeiter des Forschungsteams alle CDS-Items unter Verwendung derselben standardisierten Anweisungen, Item-Reihenfolge und Bewertungskriterien durch.
Alle 260 eingeschlossenen Teilnehmer absolvierten die CDS zu allen vier Zeitpunkten, und es ging kein Teilnehmer während des einmonatigen Beobachtungszeitraums verloren.
Psychosoziale Basisauswertung
Die 17-Item-Hamilton-Depressionsrating-Skala (HAMD-17)6 wurde einmalig zum Zeitpunkt T1 erhoben. Die Items 1–3, 7–11, 15 und 17 wurden von 0 bis 4 punktiert, während die Items 4–6, 12–14 und 16 von 0 bis 2 bewertet wurden. Die Item-Punktzahlen wurden summiert, um eine Gesamtpunktzahl zwischen 0 und 54 zu erhalten, wobei höhere Werte auf schwerere depressive Symptome hinweisen.
Die Generalized Anxiety Disorder-7 (GAD-7)7 wurde einmalig zum Zeitpunkt T1 erhoben. Jedes der sieben Items wurde von 0 (überhaupt nicht) bis 3 (fast jeden Tag) bewertet, was zu einer Gesamtpunktzahl zwischen 0 und 21 führte. Höhere Werte deuteten auf schwerwiegendere Angstsymptome hin.
Die Skala zur Bewertung sozialer Unterstützung (Social Support Rating Scale, SSRS)8 wurde einmalig zum Zeitpunkt T1 erhoben. Die Skala bestand aus 10 Items. Die Items 1–4 und 8–10 wurden auf einer 4-stufigen Skala von 1 bis 4 bewertet; Item 5 wurde je nach angegebenem Unterstützungsgrad von 1 bis 4 punktiert; die Items 6 und 7 wurden entsprechend der Anzahl verfügbarer Unterstützungsquellen bewertet. Die Gesamtpunktzahl lag zwischen 12 und 66, wobei höhere Werte für eine stärkere soziale Unterstützung stehen.
Alle CDS- und psychosozialen Beurteilungen wurden von geschulten Mitgliedern des Forschungsteams durchgeführt oder überwacht. Vor der Teilnehmerrekrutierung erhielten die Beurteiler eine standardisierte Schulung zur Befragungsdurchführung, zur Interpretation der Items, zur zulässigen Unterstützung und zu den Bewertungsverfahren. Während der gesamten Studie wurden dieselben standardisierten Anweisungen, Itemreihenfolgen und Bewertungskriterien verwendet. Es war nicht erforderlich, dass derselbe Beurteiler einen bestimmten Teilnehmer zu jedem Zeitpunkt untersuchte; die Konsistenz zwischen den Beurteilern wurde durch standardisierte Schulung und einheitliche Beurteilungsverfahren gewährleistet. Die Teilnehmer wurden nach Möglichkeit gebeten, die Fragebögen selbstständig auszufüllen. Wenn Teilnehmer Schwierigkeiten beim Lesen, Verstehen oder Schreiben hatten, wurde standardisierte Einzelhilfe geleistet, ohne Antworten vorzuschlagen, Items im Sinne des Teilnehmers zu interpretieren oder die Antworten des Teilnehmers zu verändern.
Datenqualitätskontrolle und Umgang mit fehlenden Daten
Vor der Durchführung des Fragebogens wurden die Teilnehmer über den Studienzweck, die Ausfüllverfahren und die Anforderungen an die Vertraulichkeit informiert. Für alle Teilnehmer wurden standardisierte Anweisungen und identische Erhebungsverfahren verwendet. Abgeschlossene Fragebögen wurden unverzüglich auf fehlende oder offensichtlich ungültige Angaben überprüft. Wurde ein Fragebogenpunkt nicht beantwortet, wurde der Teilnehmer gebeten, den ausgelassenen Punkt erneut zu prüfen und, falls gewünscht, eine Antwort zu geben. Wenn Unterstützung beim Ausfüllen des Fragebogens erforderlich war, schlugen die Studienmitarbeiter keine Antworten vor, deuteten sie nicht und gaben sie auch nicht im Namen des Teilnehmers an. Klinische Variablen wurden mithilfe vorab definierter Kriterien extrahiert, und die ausgefüllten Formulare wurden vor der Dateneingabe verifiziert.
Alle 260 Teilnehmer absolvierten die CDS-Beurteilungen zu den Zeitpunkten T1–T4, es gab keine Verluste im Follow-up. Die longitudinalen CDS-Daten sowie die in den berichteten Analysen enthaltenen demografischen, klinischen und psychosozialen Variablen waren vollständig. Daher wurden alle 260 Teilnehmer in die Analysen eingeschlossen, und es war keine Datenimputation erforderlich.
Wachstums-Mischmodellierung longitudinaler CDS-Scores
Die Wachstumsmischungsmodellierung (GMM) wurde mit Mplus Version 8.3 durchgeführt. Ein bedingungsloses GMM ohne Kovariaten wurde berechnet, wobei CDS_T1, CDS_T2, CDS_T3 und CDS_T4 als kontinuierliche manifeste Variablen eingegeben wurden.
Eins- bis Fünf-Klassen-Lösungen wurden nacheinander mithilfe der robusten Maximum-Likelihood-Schätzung (MLR) angepasst. Um das Risiko einer Konvergenz zu einem lokalen Maximum zu verringern, wurden 1.000 zufällige Sätze von Startwerten generiert, und die besten 200 wurden für die abschließende Optimierung beibehalten. Für jede Lösung wurde ein normales Ende, die Reproduzierbarkeit des besten Log-Likelihood-Werts über verschiedene Zufallsstarts hinweg sowie das Fehlen inadäquater Parameterschätzungen überprüft.
Das Akaike-Informationskriterium (AIC), das Bayessche Informationskriterium (BIC), das an die Stichprobengröße angepasste BIC (aBIC), die Entropie, der Lo-Mendell-Rubin-Test mit angepasstem Likelihood-Quotienten (LMR-LRT) und der Bootstrap-Likelihood-Quotienten-Test (BLRT) wurden für jede Lösung erfasst. Niedrigere AIC-, BIC- und aBIC-Werte wurden als Hinweis auf eine bessere relative Modellanpassung interpretiert, während Entropiewerte, die näher bei 1 lagen, eine deutlichere Klassentrennung anzeigten.
Jede k-Klassen-Lösung wurde mit der entsprechenden k − 1-Lösung unter Verwendung des LMR-LRT und des BLRT verglichen. Das endgültige Modell wurde nicht allein aufgrund abnehmender Informationskriterien ausgewählt; es wurden ebenfalls die Konvergenzstabilität, die Klassengröße, die a-posteriori-Zugehörigkeitswahrscheinlichkeiten, die Sparsamkeit und die klinische Interpretierbarkeit berücksichtigt. Jeder Teilnehmer wurde der Klasse mit der höchsten a-posteriori-Zugehörigkeitswahrscheinlichkeit zugeordnet, und es wurden klassenspezifische durchschnittliche a-posteriori-Wahrscheinlichkeiten als zusätzliche Maßzahl für die Klassifikationsgüte berechnet.
Analyse wiederholter CDS-Messungen
Um innerhalb der Teilnehmer bestehende Veränderungen der CDS-Scores über T1, T2, T3 und T4 in der Gesamtgruppe zu bewerten, wurde eine einfaktorielle Varianzanalyse mit Messwiederholung (RM-ANOVA) durchgeführt, wobei der Zeitpunkt der Messung als within-subjects-Faktor diente. Die Annahmen der annähernden Normalverteilung und der Sphärizität wurden überprüft. Die Sphärizität wurde mittels Mauchly-Test evaluiert, und bei Verletzung der Sphärizitätsannahme wurden die Ergebnisse mit Greenhouse–Geisser-Korrektur verwendet. Alle Tests waren zweiseitig, und ein P < 0,05 galt als statistisch signifikant.
Univariate Vergleiche über Trajektorienklassen hinweg
Analysen außer GMM wurden mit IBM SPSS Statistics Version 26.0 durchgeführt. Alter, BMI, HAMD-17-, SSRS- und GAD-7-Scores wurden als stetige Variablen ohne Kategorisierung analysiert.
Stetige Variablen, die annähernd normalverteilt waren, wurden als Mittelwert ± Standardabweichung angegeben und mittels einfaktorieller Varianzanalyse über die vier Trajektorieklassen hinweg verglichen. Kategoriale Variablen wurden als Teilnehmeranzahlen angegeben und mit dem Pearson-Chi-Quadrat-Test verglichen. Alle P-Werte waren zweiseitig, und ein P < 0,05 diente als Schwellenwert, um Variablen für die Aufnahme in das initiale multivariable Modell zu identifizieren.
In der univariaten Analyse erfüllten Alter, Familienstand, kardiale Funktionsklasse, Typ des Myokardinfarkts, PCI, thrombolytische Therapie, HAMD-17-Score, SSRS-Score, GAD-7-Score sowie Anamnese vorbestehender Erkrankungen das Kriterium von P < 0,05 und wurden daher in das initiale multivariable Modell aufgenommen. Geschlecht und BMI erfüllten dieses Kriterium nicht.
Logistische Regression mit multinomialen Daten und Modell-Diagnose
Die vier Trajektorieklassen wurden als nominale Zielgröße betrachtet, und es wurde eine multinomiale logistische Regression statt einer binären logistischen Regression durchgeführt. C1 (Hohe Unabhängigkeit-Schleppende Besserung) wurde als Referenzkategorie der Zielgröße festgelegt.
Alle Variablen mit P < 0,05 in den univariaten Analysen wurden im anfänglichen Modell berücksichtigt. Anschließend wurde eine schrittweise Likelihood-Quotienten-Selektion rückwärts durchgeführt, wobei Variablen mit P > 0,10 nacheinander entfernt wurden. Statistisch bedeutsame Haupteffekte blieben im endgültigen Modell enthalten.
Multikollinearität wurde anhand von Toleranz- und Varianzinflationsfaktor (VIF)-Werten bewertet. In der abschließenden Analyse lagen die Toleranzwerte zwischen etwa 0,81 und 0,97 und die VIF-Werte zwischen 1,03 und 1,24, was auf keine erhebliche Multikollinearität hinweist.
Die Interaktionstests beschränkten sich auf vorab festgelegte, klinisch plausible Terme, um das Risiko einer Überanpassung zu verringern. Drei vorab festgelegte Interaktionen – Alter × Vorerkrankungen, Familienstand × SSRS-Score und HAMD-17-Score × GAD-7-Score – wurden einzeln mittels Likelihood-Quotienten-Tests evaluiert. Die entsprechenden P-Werte betrugen 0,655, 0,301 bzw. 0,908; daher wurde keiner der Interaktionsterme beibehalten.
Die Gesamtleistung des Modells wurde anhand des Likelihood-Quotienten-Tests gegenüber dem reinen Intercept-Modell, der Pearson- und Devianz-Güte der Anpassung-Tests, der Pseudo-R2-Statistiken nach Cox-Snell, Nagelkerke und McFadden, der Klassifikationsgenauigkeit, der Konvergenz sowie der Beurteilung vollständiger oder quasi-vollständiger Trennung evaluiert.
Für alle endgültigen Prädiktoren wurden adjustierte Odds Ratios (ORs) mit 95 % Konfidenzintervallen (CIs) für die Vergleiche C2 gegenüber C1, C3 gegenüber C1 und C4 gegenüber C1 angegeben. Breite CIs wurden als Hinweis auf begrenzte Präzision interpretiert und nicht als eindeutiger Beleg für große Effektgrößen.
Überlegungen zur Stichprobengröße und Berichterstattung
Für die GMM wurde keine universelle, einheitliche Stichprobengröße festgelegt. Die Angemessenheit der Stichprobengröße wurde im Hinblick auf die Modellkomplexität, Klassenanteile, Klassentrennung, Muster fehlender Daten, Entropie, a-posteriori-Wahrscheinlichkeiten und Konvergenz berücksichtigt9.
Es wurde keine formale a priori Simulationsbasierte Power-Analyse durchgeführt, da die Studie eine explorative Längsschnittuntersuchung anhand der während des vorgegebenen Rekrutierungszeitraums verfügbaren Population darstellte. Die endgültige Vier-Klassen-Lösung umfasste 66, 54, 90 und 50 Teilnehmer und ergab einen Entropiewert von 0,879, wobei die durchschnittlichen posteriori-Wahrscheinlichkeiten zwischen 0,871 und 0,927 lagen.
Bei der multinomialen logistischen Regression wurde die Stichprobengröße hinsichtlich der Anzahl der Teilnehmer in jeder Ergebniskategorie und der Anzahl der in Frage kommenden Prädiktorparameter bewertet10. Da einige Trajektorienklassen relativ klein waren, wurde die Regressionsanalyse als explorative Assoziationsanalyse und nicht als Entwicklung eines endgültigen Vorhersagemodells interpretiert.
Die Beobachtungsstudie wurde gemäß dem Strengthening the Reporting of Observational Studies in Epidemiology (STROBE)-Rahmen berichtet, einschließlich des Studiendesigns, der Rahmenbedingungen, des Teilnehmerflusses, der Datenquellen, möglicher Verzerrungsquellen, der Studiengröße, der statistischen Methoden, des Umgangs mit fehlenden Daten, der Hauptergebnisse, der Einschränkungen und der Übertragbarkeit.
Ergebnisse
Teilnehmerfluss und Vollständigkeit
Während der Rekrutierungsphase wurden 287 Patienten mit akutem Myokardinfarkt (AMI) auf Eignung geprüft. Bei 27 Patienten erfolgte keine Einschreibung: Acht hatten bereits einen vorherigen Myokardinfarkt erlitten, sechs konnten die Studienuntersuchungen aufgrund eingeschränkter Bewusstseinslage oder kognitiver Dysfunktion nicht abschließen, fünf wiesen andere organische Herzerkrankungen auf, vier hatten maligne Tumoren, ein Multiorganversagen oder andere schwere systemische Erkrankungen, und vier lehnten die Teilnahme ab. Die verbleibenden 260 Teilnehmer nahmen an der Studie teil, absolvierten alle vier CDS-Beurteilungen bis zu einem Monat nach der Entlassung und wurden in die endgültige GMM sowie die nachfolgenden Analysen eingeschlossen. Es gab keine fehlenden longitudinalen CDS-Werte, keine Verluste beim Follow-up und keine fehlenden demografischen, klinischen oder psychosozialen Daten, die eine Imputation in den berichteten Analysen erforderten.
Auswahl des vierklassigen GMM
Die Anpassungsindizes verbesserten sich schrittweise von der Ein-Klassen- zur Vier-Klassen-Lösung (Tabelle 1). Die Vier-Klassen-Lösung ergab AIC = 6978,826, BIC = 7047,822, aBIC = 6978,741, Entropie = 0,879, LMR-LRT P = 0,027 und BLRT P < 0,001. Die modellgeschätzten Klassenanteile betrugen 25,8 %, 21,0 %, 34,1 % und 19,1 %. Bei Hinzufügung einer fünften Klasse sanken AIC, BIC und aBIC moderat auf 6963,213, 7038,208 bzw. 6962,613, und die Entropie stieg auf 0,912. Allerdings zeigten weder der LMR-LRT (P = 0,128) noch der BLRT (P = 0,063) eine statistisch signifikante Verbesserung an. Zudem umfasste die fünfte Klasse lediglich 6,4 % der Stichprobe. Daher wurde das Vier-Klassen-Modell beibehalten, da es das bevorzugte Gleichgewicht zwischen Modellanpassung, Stabilität, Sparsamkeit, Klassengröße und klinischer Interpretierbarkeit bot.
Konvergenz und Klassifikationsqualität
Die Vier-Klassen-Lösung wurde normal abgeschlossen, und der optimale Log-Likelihood-Wert wurde bei 18 zufälligen Startdurchläufen repliziert. Es wurden keine inadmissiblen Parameterschätzungen beobachtet. Die durchschnittlichen posteriori-Wahrscheinlichkeiten für die wahrscheinlichste Klassenzugehörigkeit betrugen 0,914 für C1, 0,889 für C2, 0,927 für C3 und 0,871 für C4, was auf eine akzeptable Klassentrennung hinweist.
Gesamtpflegeabhängigkeit im Zeitverlauf
Die durchschnittlichen CDS-Werte betrugen zum Zeitpunkt T1 48,28 ± 10,25, zu T2 54,16 ± 14,33, zu T3 52,82 ± 12,17 und zu T4 56,58 ± 15,15. Eine einfaktorielle Varianzanalyse mit wiederholten Messungen zeigte einen signifikanten Gesamtunterschied in den CDS-Werten über die vier Erhebungszeitpunkte hinweg (F = 13,692, P < 0,001). Auf Gruppenebene stiegen die CDS-Werte bis zum dritten Tag an, gingen bei Entlassung leicht zurück und erhöhten sich erneut einen Monat nach der Entlassung. Die stärkere Variabilität zu den späteren Zeitpunkten deutete darauf hin, dass das durchschnittliche Gesamtmuster eine erhebliche Heterogenität zwischen den Teilnehmern verbarg.
Verlaufsformen
Höchstwahrscheinlich identifizierte die Klassenzuordnung vier Trajektorien: C1, Hohe Unabhängigkeit-Schlechte Besserung (n = 66, 25,4 %); C2, Mäßige Abhängigkeit-Schnelle Verschlechterung (n = 54, 20,8 %); C3, Hohe Abhängigkeit-Deutliche Verbesserung (n = 90, 34,6 %); und C4, Hohe Abhängigkeit-Schlechte Verschlimmerung (n = 50, 19,2 %; Abbildung 1). Die mittleren CDS-Werte für C1 betrugen zu den Zeitpunkten T1–T4 jeweils 55,50, 59,00, 60,00 und 64,00; für C2 betrugen sie 50,00, 49,00, 39,00 und 39,00; für C3 43,22, 59,35, 61,86 und 70,90; und für C4 46,00, 44,00, 42,00 und 40,00.
Vergleiche univariater Klassen
Das Alter unterschied sich signifikant zwischen C1–C4 (58,20 ± 7,80, 61,50 ± 7,40, 55,80 ± 7,60 bzw. 63,10 ± 7,20 Jahre; F = 12,572, P < 0,001; Tabelle 2). Der BMI unterschied sich nicht signifikant zwischen den Klassen (23,60 ± 2,70, 23,40 ± 2,80, 23,80 ± 2,90 bzw. 23,50 ± 2,60 kg/m2; F = 0,270, P = 0,847), und auch die Geschlechterverteilung war ähnlich (χ2 = 0,142, P = 0,986). Signifikante Unterschiede zeigten sich hinsichtlich des Familienstands (χ2 = 14,749, P = 0,002), der Herzfunktionseinstufung (χ2 = 15,283, P = 0,002), des Myokardinfarkt-Typs (χ2 = 15,035, P = 0,002), der PCI (χ2 = 12,863, P = 0,005), der thrombolytischen Therapie (χ2 = 15,622, P = 0,001) sowie der Vorerkrankungen (χ2 = 27,903, P < 0,001).
Die mittleren HAMD-17-Werte betrugen 10,80 ± 2,70, 13,10 ± 2,90, 11,20 ± 2,60 bzw. 14,10 ± 3,00 in C1–C4 (F = 19,040, P < 0,001). Die mittleren SSRS-Werte betrugen 43,00 ± 4,80, 38,50 ± 5,00, 42,00 ± 4,90 bzw. 36,80 ± 5,10 (F = 20,742, P < 0,001), und die mittleren GAD-7-Werte betrugen 9,50 ± 2,50, 12,10 ± 2,80, 10,00 ± 2,60 bzw. 13,70 ± 3,00 (F = 30,585, P < 0,001).
Endgültige multinomiale Regression
Kandidatenprädiktoren wurden wie in Tabelle 3 gezeigt kodiert. Bei der rückwärts gerichteten Likelihood-Quotienten-Selektion verblieben Alter, Familienstand, HAMD-17, SSRS, GAD-7 und Vorerkrankungen im endgültigen multinomialen logistischen Regressionsmodell (Tabelle 4). Bei C2 im Vergleich zu C1 war der verheiratete Status mit geringeren Chancen für eine Zugehörigkeit zu C2 assoziiert (adjustiertes OR = 0,241, 95 % KI = 0,095–0,612, P = 0,003), während höhere HAMD-17-Werte (OR = 1,324, 95 % KI = 1,121–1,564), höhere GAD-7-Werte (OR = 1,374, 95 % KI = 1,160–1,626), niedrigere SSRS-Werte (OR = 0,787, 95 % KI = 0,711–0,871) und eine Vorerkrankung (OR = 3,107, 95 % KI = 1,212–7,968) mit der Zugehörigkeit zu C2 assoziiert waren. Das Alter war bei diesem Vergleich statistisch nicht signifikant (P = 0,089). Bei C3 im Vergleich zu C1 war das Alter der einzige statistisch signifikante beibehaltene Prädiktor (OR = 0,954, 95 % KI = 0,912–0,997, P = 0,036).
Älteres Alter (OR = 1,077, 95 % KI = 1,005–1,154), lediger Familienstand (verheiratet: OR = 0,248, 95 % KI = 0,085–0,720), höhere HAMD-17-Werte (OR = 1,466, 95 % KI = 1,214–1,772), niedrigere SSRS-Werte (OR = 0,727, 95 % KI = 0,646–0,819), höhere GAD-7-Werte (OR = 1,605, 95 % KI = 1,318–1,955) sowie eine Vorgeschichte von Grunderkrankungen (OR = 4,454, 95 % KI = 1,511–13,134) waren mit der Zugehörigkeit zur Gruppe C4 im Vergleich zu C1 assoziiert.
Modelldiagnose
Das endgültige Multinomialmodell zeigte eine signifikante Verbesserung gegenüber dem reinen Achsenabschnittsmodell (Likelihood-Quotienten-χ2 = 190,966, df = 18, P < 0,001). Die Anpassungsgüte-Tests nach Pearson (χ2 = 745,020, df = 759, P = 0,635) und der Devianztest (χ2 = 515,576, df = 759, P > 0,999) deuteten nicht auf eine schlechte Modellanpassung hin. Die Werte für die Pseudo-R2-Kriterien nach Cox-Snell, Nagelkerke und McFadden betrugen jeweils 0,520, 0,557 und 0,270, und die Klassifikationsgenauigkeit lag bei 53,1 %. Das Modell konvergierte nach sieben Iterationen, ohne Hinweise auf vollständige oder quasivollständige Trennbarkeit. Einige Schätzungen für die Vorgeschichte zugrundeliegender Erkrankungen wiesen relativ breite 95 %-Konfidenzintervalle auf, was auf begrenzte Präzision hindeutet und eine vorsichtige Interpretation dieser Assoziationen unterstützt.
VERFÜGBARKEIT VON DATEN:
Die Rohdaten, die die Ergebnisse dieser Studie unterstützen, werden zusammen mit dem Artikel als Zusätzliche Datei 1 bereitgestellt.
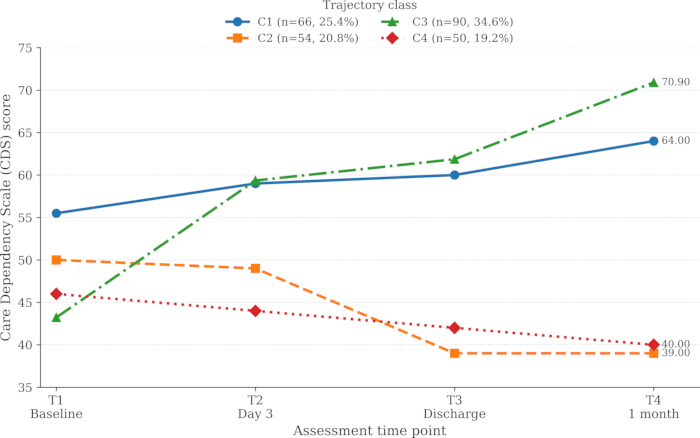
Abbildung 1: Längsschnittliche Verläufe der Pflegeabhängigkeit bei Patienten mit akutem Myokardinfarkt. Die vier durch das Growth-Mixture-Modell (GMM) identifizierten latenten Trajektorienklassen waren: Hohe Selbstständigkeit – langsamer Verbesserung (C1, n = 66, 25,4 %), moderate Abhängigkeit – schnelle Verschlechterung (C2, n = 54, 20,8 %), hohe Abhängigkeit – deutliche Verbesserung (C3, n = 90, 34,6 %) und hohe Abhängigkeit – langsame Verschlechterung (C4, n = 50, 19,2 %). T1 steht für den Ausgangswert nach erfolgreicher Notfallbehandlung und Wiedererlangung der Bewusstseinslage; T2 für Tag 3 nach Aufnahme; T3 für den Zeitpunkt der Entlassung; und T4 für 1 Monat nach Entlassung. Die y-Achse zeigt den klassenspezifischen mittleren CDS-Score an, wobei höhere Werte für größere Selbstständigkeit und geringere Pflegeabhängigkeit stehen. Abkürzungen: AMI = akuter Myokardinfarkt; CDS = Care Dependency Scale; GMM = Growth Mixture Modeling. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Modell | AIC | BIC | aBIC | Entropie | LMR-LRT-P-Wert | BLRT-P-Wert | Klassenanteil (%) |
| 1 | 7353,11 | 7384,108 | 7355,567 | — | — | — | — |
| 2 | 7141,412 | 7184,409 | 7156,355 | 0,726 | 0,002 | <0,001 | 48,2/51,8 |
| 3 | 7032,275 | 7086,271 | 7049,704 | 0,813 | 0,015 | <0,001 | 35,1/42,7/22,2 |
| 4 | 6978,826 | 7047,822 | 6978,741 | 0,879 | 0,027 | <0,001 | 25,8/21,0/34,1/19,1 |
| 5 | 6963,213 | 7038,208 | 6962,613 | 0,912 | 0,128 | 0,063 | 29,7/31,2/20,4/12,3/6,4 |
Tabelle 1: Anpassungsindizes für Wachstums-Mischmodelle mit ein bis fünf Klassen für Entwicklungsverläufe der Pflegeabhängigkeit. Niedrigere Werte der Informationskriterien weisen auf eine bessere relative Modellanpassung hin, während Entropiewerte nahe 1 auf eine klarere Trennung der Klassen hindeuten. Der LMR-LRT und der BLRT vergleichen ein k-Klassen-Modell mit dem entsprechenden k − 1-Modell. Die Klassenanteile entsprechen den modellgeschätzten Anteilen; endgültige Teilnehmerzahlen und -prozentsätze basieren auf der wahrscheinlichsten posterior Klassenzuordnung. Abkürzungen: AIC = Akaike-Informationskriterium; BIC = Bayessches Informationskriterium; aBIC = stichprobenumfangskorrigiertes Bayessches Informationskriterium; LMR-LRT = Lo-Mendell-Rubin-angepasster Likelihood-Quotienten-Test; BLRT = Bootstrap-Likelihood-Quotienten-Test.
| Element | Klassifizierung | Hohe Unabhängigkeit – langsamer Verbesserung (C1) (n = 66) | Mäßige Abhängigkeit – rasche Verschlechterung (C2) (n = 54) | Hohe Abhängigkeit – signifikante Verbesserung (C3) (n = 90) | Hohe Abhängigkeit – langsame Verschlimmerung (C4) (n = 50) | Statistik | P-Wert |
| Alter (Jahre) | − | 58,20 ± 7,80 | 61,50 ± 7,40 | 55,80 ± 7,60 | 63,10 ± 7,20 | 12,572 | <0,001 |
| Geschlecht | Männlich | 43 | 35 | 58 | 31 | 0,142 | 0,986 |
| Weiblich | 23 | 19 | 32 | 19 | |||
| BMI (kg/m²) | — | 23,60 ± 2,70 | 23,40 ± 2,80 | 23,80 ± 2,90 | 23,50 ± 2,60 | 0,27 | 0,847 |
| Familienstand | Verheiratet | 46 | 24 | 64 | 25 | 14,749 | 0,002 |
| Unverheiratet / Geschieden / Verwitwet | 20 | 30 | 26 | 25 | |||
| Klassifizierung der Herzfunktion | Klasse I–II | 41 | 22 | 60 | 20 | 15,283 | 0,002 |
| Klasse III–IV | 25 | 32 | 30 | 30 | |||
| Typ des Myokardinfarkts | ST-Strecken-Hebung | 50 | 35 | 44 | 37 | 15,035 | 0,002 |
| Keine ST-Strecken-Hebung | 16 | 19 | 46 | 13 | |||
| Perkutane koronare Intervention | Ja | 45 | 38 | 62 | 21 | 12,863 | 0,005 |
| Nein | 21 | 16 | 28 | 29 | |||
| Thrombolytische Therapie | Ja | 52 | 49 | 66 | 29 | 15,622 | 0,001 |
| Nein | 14 | 5 | 24 | 21 | |||
| HAMD-Score | − | 10,80 ± 2,70 | 13,10 ± 2,90 | 11,20 ± 2,60 | 14,10 ± 3,00 | 19,04 | <0,001 |
| SSRS-Score | − | 43,00 ± 4,80 | 38,50 ± 5,00 | 42,00 ± 4,90 | 36,80 ± 5,10 | 20,742 | <0,001 |
| GAD-7-Score | - | 9,50 ± 2,50 | 12,10 ± 2,80 | 10,00 ± 2,60 | 13,70 ± 3,00 | 30,585 | <0,001 |
| Anamnese von Grunderkrankungen | Ja | 20 | 32 | 28 | 34 | 27,903 | <0,001 |
| Nein | 46 | 22 | 62 | 16 |
Tabelle 2: Univariate Analyse der Merkmale über die Verlaufsgruppen der Pflegeabhängigkeit hinweg. Stetige Variablen sind als Mittelwert ± Standardabweichung angegeben und wurden mittels einfaktorieller Varianzanalyse verglichen. Kategoriale Variablen sind als Teilnehmeranzahlen angegeben und wurden mittels Chi-Quadrat-Tests nach Pearson verglichen. Alle P-Werte stellen zweiseitige Gesamtvergleiche über die vier Verlaufsgruppen hinweg dar. Abkürzungen: BMI = Body-Mass-Index; HAMD-17 = Hamilton-Depressions-Rating-Skala mit 17 Items; SSRS = Social Support Rating Scale; GAD-7 = Generalized Anxiety Disorder-7; PCI = perkutane koronare Intervention.
| Variable | Zuordnungsbeschreibung |
| Alter | Wird als ursprünglicher Wert eingegeben |
| Beziehungsstatus | Unverheiratet/Geschieden/Verwitwet = 0; Verheiratet = 1 |
| Klassifizierung der Herzfunktion | Klasse Ⅰ, Ⅱ = 0; Klasse Ⅲ, Ⅳ = 1 |
| Infarkttyp | Ohne ST-Strecken-Hebung = 0; Mit ST-Strecken-Hebung = 1 |
| Interventionelle Therapie | Nein = 0; Ja = 1 |
| Thrombolytische Therapie | Nein = 0; Ja = 1 |
| HAMD-Score | Wird als ursprünglicher Wert eingegeben |
| SSRS-Score | Wird als ursprünglicher Wert eingegeben |
| GAD-7-Score | Wird als ursprünglicher Wert eingegeben |
| Anamnese von Grundkrankheiten | Nein = 0; Ja = 1 |
Tabelle 3: Kodierung der Prädiktorvariablen für die multinomiale logistische Regression. Alter, HAMD-17, SSRS und GAD-7 wurden mit ihren ursprünglichen stetigen Werten eingegeben. Bei dichotomen Variablen diente die mit 0 kodierte Kategorie als Referenzkategorie: ledig/geschieden/verwitwet bei dem Familienstand; Herzfunktion Klasse I–II; NSTEMI; keine PCI; keine thrombolytische Therapie; und keine Vorgeschichte von Grundkrankheiten. Abkürzungen: HAMD-17 = 17-Item-Hamilton-Depressions-Rating-Skala; SSRS = Skala zur Bewertung der sozialen Unterstützung; GAD-7 = Allgemeine Angststörung-7; NSTEMI = nicht-ST-Hebungs-Myokardinfarkt; PCI = perkutane koronare Intervention.
| Gruppenvergleich | Variable | β | SE | Wald χ² | P | Adjustiertes OR (95 % CI) |
| C2 vs. C1 | Alter | 0,052 | 0,03 | 2,885 | 0,089 | 1,053 (0,992–1,118) |
| Verheiratet | −1,422 | 0,475 | 8,951 | 0,003 | 0,241 (0,095–0,612) | |
| HAMD-17 | 0,281 | 0,085 | 10,893 | <0,001 | 1,324 (1,121–1,564) | |
| SSRS | −0,240 | 0,052 | 21,236 | <0,001 | 0,787 (0,711–0,871) | |
| GAD-7 | 0,317 | 0,086 | 13,607 | <0,001 | 1,374 (1,160–1,626) | |
| Grundlegende Erkrankungen | 1,134 | 0,48 | 5,567 | 0,018 | 3,107 (1,212–7,968) | |
| C3 vs. C1 | Alter | −0,047 | 0,023 | 4,389 | 0,036 | 0,954 (0,912–0,997) |
| Verheiratet | 0,085 | 0,367 | 0,054 | 0,817 | 1,088 (0,531–2,233) | |
| HAMD-17 | 0,053 | 0,064 | 0,682 | 0,409 | 1,054 (0,930–1,195) | |
| SSRS | −0,048 | 0,034 | 1,982 | 0,159 | 0,953 (0,891–1,019) | |
| GAD-7 | 0,078 | 0,066 | 1,375 | 0,241 | 1,081 (0,949–1,231) | |
| Grundlegende Erkrankungen | 0,019 | 0,374 | 0,003 | 0,959 | 1,020 (0,490–2,123) | |
| C4 vs. C1 | Alter | 0,074 | 0,035 | 4,438 | 0,035 | 1,077 (1,005–1,154) |
| Verheiratet | −1,394 | 0,544 | 6,574 | 0,01 | 0,248 (0,085–0,720) | |
| HAMD-17 | 0,383 | 0,097 | 15,733 | <0,001 | 1,466 (1,214–1,772) | |
| SSRS | −0,318 | 0,06 | 27,91 | <0,001 | 0,727 (0,646–0,819) | |
| GAD-7 | 0,473 | 0,101 | 22,111 | <0,001 | 1,605 (1,318–1,955) | |
| Grundlegende Erkrankungen | 1,494 | 0,552 | 7,332 | 0,007 | 4,454 (1,511–13,134) |
Tabelle 4: Multinomiale logistische Regressionsanalyse von Faktoren, die mit der Zugehörigkeit zu Pflegeabhängigkeit-Trajektorien assoziiert sind. C1, Hohe Unabhängigkeit – langsamer Verbesserung, wurde als Referenzkategorie festgelegt. Angepasste ORs und 95 % KIs werden für C2 im Vergleich zu C1, C3 im Vergleich zu C1 und C4 im Vergleich zu C1 angegeben. Das endgültige Haupteffektmodell wurde mittels rückwärts gerichteter Likelihood-Quotienten-Auswahl gewonnen. Das endgültige Modell zeigte eine signifikante Verbesserung gegenüber dem reinen Intercept-Modell (Likelihood-Quotienten-χ2 = 190,966, df = 18, P < 0,001), wobei ein Nagelkerke-Pseudo-R2 von 0,557 und eine Gesamtklassifikationsgenauigkeit von 53,1 % erreicht wurden. Abkürzungen: OR = Odds Ratio; CI = Konfidenzintervall; HAMD-17 = 17-Item Hamilton-Depressionsskala; SSRS = Skala zur Bewertung sozialer Unterstützung; GAD-7 = Generalisierte Angststörung-7.
Zusatzdatei 1: Rohdaten, die die Ergebnisse dieser Studie unterstützen.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Die longitudinalen Veränderungen der Pflegeabhängigkeit sollten deskriptiv interpretiert werden. Auf Ebene der Gesamtstichprobe betrug der mittlere CDS-Wert zum Zeitpunkt T1 48,28 ± 10,25, was auf erhebliche Pflegebedürfnisse in der frühen Phase nach einem AMI11 hinweist. Der CDS-Wert stieg während der akuten Behandlung und der frühen Erholungsphase auf 54,16 ± 14,33 zum Zeitpunkt T212, nahm zum Zeitpunkt der Entlassung leicht auf 52,82 ± 12,17 ab und stieg erneut auf 56,58 ± 15,15 einen Monat nach der Entlassung an. Frühere Studien haben auf Herausforderungen im Zusammenhang mit der Teilnahme an einer kardiologischen Rehabilitation nach einem AMI hingewiesen13; die vorliegende Studie hat jedoch nicht direkt untersucht, ob die Teilnahme an der Rehabilitation oder andere spezifische Faktoren die beobachteten zeitlichen Veränderungen erklären können. Eine Latent-Class-Analyse zeigte darüber hinaus, dass das durchschnittliche Gesamtmuster vier deutlich unterschiedliche Verlaufsprofile verbarg. Diese Heterogenität stimmt weitgehend mit früheren Ergebnissen aus der kardiovaskulären Verlaufsforschung überein, einschließlich der Verläufe der gesundheitsbezogenen Lebensqualität nach einem AMI14 und der Selbstpflegeverläufe bei Patienten mit koronarer Herzkrankheit15. Unterschiede in der Anzahl und Form der identifizierten Klassen zwischen Studien könnten Unterschiede in den gemessenen Konstrukten, den Erhebungszeitpunkten, den Patientenpopulationen, der Dauer des Follow-ups sowie in den verwendeten Ansätzen zur Latent-Class-Modellierung widerspiegeln.
Mehrere Verfahrensschritte sind entscheidend für die Reproduzierbarkeit. Erstens muss T1 einheitlich definiert werden. Die Beurteilung des Ausgangszustands sollte nach erfolgter Notfallbehandlung und Wiedererlangung des Bewusstseins erfolgen, da eine frühere Beurteilung möglicherweise einen vorübergehenden klinischen Zustand erfasst, anstatt einen zuverlässigen Funktionszustand widerzuspiegeln. Zweitens sollte die Durchführung des CDS an allen vier Zeitpunkten standardisiert sein, da Änderungen in den Anweisungen oder Hilfestellungen künstliche longitudinale Unterschiede verursachen könnten. Drittens sollten psychosoziale Basisbeurteilungen klar von den wiederholten CDS-Bewertungen unterschieden werden. HAMD-17, GAD-7 und SSRS wurden einmalig zu T1 erhoben, während das CDS wiederholt an den Zeitpunkten T1–T4 angewendet wurde. Schließlich sollte das GMM mit ausreichend vielen zufälligen Startwerten angepasst und anhand der Reproduktion des optimalen Log-Likelihood-Werts, zulässiger Parameterschätzungen, a posteriori-Wahrscheinlichkeiten und klinisch sinnvoller Klassengrößen bewertet werden, anstatt allein aufgrund abnehmender AIC- oder BIC-Werte ausgewählt zu werden.
Die Auswahl der Vier-Klassen-Lösung verdeutlicht eine wichtige Überlegung beim Mischmodellansatz. Die Hinzunahme einer fünften Klasse verringerte die Informationskriterien leicht und erhöhte die Entropie; die Fünf-Klassen-Lösung zeigte jedoch keine statistisch signifikante Verbesserung gemäß dem LMR-LRT (P = 0,128) oder dem BLRT (P = 0,063) und führte eine kleine Untergruppe ein, die nur 6,4 % der Stichprobe ausmachte und nur eine begrenzte zusätzliche klinische Differenzierung aufwies. Bei vergleichbaren Anwendungen sollte daher jede zusätzliche Klasse nicht automatisch als bedeutungsvoller biologischer oder klinischer Untergruppe interpretiert werden. Eine einfachere Lösung sollte erneut geprüft werden, wenn ein Modell eine sehr kleine Klasse ergibt, eine instabile Konvergenz aufweist, einen nicht replizierten optimalen Log-Likelihood-Wert liefert, unplausible Trajektorien erzeugt oder erhebliche Veränderungen in der Klassenzusammensetzung als Reaktion auf geringfügige Änderungen der Startwerte zeigt. Umgekehrt kann ein statistisch einfacheres Modell unangemessen sein, wenn es klinisch unterschiedliche, klar separierte longitudinale Muster vermischt.
Die Analyse der assoziierten Faktoren sollte als explorativ verstanden werden, nicht als prädiktiv oder kausal. Das Alter zeigte klassenspezifische Assoziationen mit der Zugehörigkeit zu bestimmten Verlaufsgruppen. Frühere prospektive Studien bei Patienten mit einem akuten Myokardinfarkt (AMI) haben ein höheres Alter als wichtigen Korrelat für den nachfolgenden Rückgang des Gesundheitszustands und der Aktivitäten des täglichen Lebens identifiziert16,17. Auch der Familienstand war mit der Zugehörigkeit zu bestimmten Verlaufsklassen assoziiert, und eine systematische Übersichtsarbeit sowie Metaanalyse berichteten über Zusammenhänge zwischen dem Familien- oder Partnerstatus und patientenberichteten Ergebnissen nach Myokardinfarkt18. Eine geringere wahrgenommene soziale Unterstützung war mit einem schlechteren Gesundheitszustand und depressiven Symptomen nach AMI assoziiert19, während psychische Belastung nach Myokardinfarkt ebenfalls klinisch relevant ist20. Prospektive Befunde haben zudem eine geringe wahrgenommene soziale Unterstützung mit schlechteren körperlichen und psychischen Gesundheitsergebnissen nach AMI verknüpft21. Die Vorgeschichte von zugrundeliegenden Erkrankungen war in der vorliegenden Studie mit mehreren Vergleichen zwischen Verlaufsklassen assoziiert, und frühere Studien haben Multimorbidität mit funktionellen Beeinträchtigungen bei Patienten mit Vorgeschichte eines AMI in Verbindung gebracht22. Dennoch bewertete die vorliegende Analyse nicht die physiologischen, verhaltensbezogenen oder psychosozialen Mechanismen, die diesen Assoziationen zugrunde liegen. Die Ergebnisse sollten daher nicht als Beleg dafür interpretiert werden, dass die Modifikation dieser Faktoren zwangsläufig die Zugehörigkeit zu einer Verlaufsgruppe verändern würde.
Diese Methode weist mehrere Einschränkungen auf. Die Studie wurde an einem einzigen Zentrum mithilfe einer Convenience-Stichprobe durchgeführt, was zu einer Selektionsverzerrung und eingeschränkter externer Validität geführt haben könnte. Es wurden nur Patienten mit einem ersten Myokardinfarkt eingeschlossen; daher lässt sich die identifizierte Trajektorienstruktur möglicherweise nicht auf Patienten mit rezidivierenden Ereignissen übertragen. Die Nachbeobachtung endete einen Monat nach der Entlassung, wodurch eine Beurteilung ausgeschlossen ist, ob die vier Trajektorienklassen über längere Zeiträume stabil bleiben. Wichtige kardiovaskuläre Variablen, einschließlich Ejektionsfraktion des linken Ventrikels, Killip-Klasse, Merkmale des verursachenden Gefäßes, interventioneller Erfolg, intrahospitale Komplikationen, detaillierte medikamentöse Therapie, B-Typ-Natriuretisches Peptid, Belastungstoleranz und Teilnahme an strukturierten kardiologischen Rehabilitationsmaßnahmen, wurden nicht systematisch berücksichtigt. Eine verbleibende Störung durch Zusammenhänge mit der Schwere der Erkrankung, der Intensität der Behandlung und dem Rehabilitationsstatus kann daher nicht ausgeschlossen werden.
Eine weitere Einschränkung betrifft die Genauigkeit einiger klassenspezifischer Regressionsabschätzungen. Es wurde keine formale, a priori simulationsbasierte Stichprobengrößenberechnung durchgeführt. Obwohl das Vier-Klassen-GMM eine stabile Konvergenz und eine zufriedenstellende Klassifikationsqualität aufwies, waren einige Trajektoriengruppen relativ klein. Breite Konfidenzintervalle für ausgewählte Schätzungen, insbesondere für die Anamnese zugrundeliegender Erkrankungen, sollten daher vorsichtig interpretiert werden. Größere multizentrische, prospektive Kohorten mit längeren Nachbeobachtungszeiträumen, umfassenderer kardiovaskulärer Phänotypisierung und unabhängiger Reproduktion sind erforderlich, um die identifizierte Klassenstruktur und ihre assoziierten Faktoren zu bestätigen. Trotz dieser Einschränkungen bietet das kombinierte Rahmenwerk aus wiederholten CDS und GMM einen praktikablen Ansatz zur Identifizierung heterogener früher Erholungsmuster und könnte eine individualisiertere Pflegebeurteilung und Nachsorge bei Patienten mit AMI erleichtern.
Offenlegungen
Die Autoren geben keine Wettbewerbsinteressen an. Bei der Erstellung, beim Schreiben, Bearbeiten oder bei der Erstellung von Abbildungen für diese Manuskript wurden keine KI-Tools (künstliche Intelligenz) verwendet.
BEITRAG DER AUTOREN:
Alle Autoren trugen zur Konzeption und Durchführung der Studie, zur Datensammlung und -interpretation sowie zur Erstellung und Überarbeitung des Manuskripts bei. Alle Autoren haben die endgültige Fassung des Manuskripts geprüft und genehmigt und erklären sich damit einverstanden, für alle Aspekte der Arbeit verantwortlich zu machen.
Danksagungen
Die Autoren danken den Patienten, die an der Studie teilgenommen haben, sowie dem klinischen Personal, das bei der Befragung, Datenerhebung und Nachverfolgung unterstützt hat. Diese Forschung erhielt keine spezifische Förderung durch eine öffentliche, kommerzielle oder gemeinnützige Einrichtung.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Pflegeabhängigkeitsskala (CDS) | Dijkstra A, Buist G, Dassen T | N/V | Ursprüngliche 15-Item-Skala zur Bewertung des Pflegebedarfs; höhere Werte zeigen eine größere Selbstständigkeit an. |
| Pflegeabhängigkeitsskala, chinesische Version | Zhang SQ, Zhu YM, Li L, et al. | N/V | Chinesische Version/Validierungsquelle, die in der Publikation zitiert ist und die Anwendung der CDS in dieser Studie unterstützt. |
| Allgemeiner Fragebogen zur persönlichen Information | Studiengruppe, Linquan County People’s Hospital | Von der Studie entwickelt; keine Artikelnummer | Studienbezogenes Formular zur Erfassung von Alter, Geschlecht, BMI, Familienstand, kardialer Funktionsklasse, Myokardinfarkt-Typ, Reperfusionsstrategie und Vorerkrankungen. |
| Allgemeine Angststörung-7 (GAD-7) | Spitzer RL, Kroenke K, Williams JBW, Löwe B | N/V | Publizierte 7-Item-Skala zur Erfassung von Angstsymptomen, einmalig zum Basiszeitpunkt (T1) erhoben. |
| Hamilton-Depressionsrating-Skala, 17-Item (HAMD-17) | Hamilton M | N/V | Publizierte, ärztlich erhobene Depressions-Skala; die 17-Item-Bewertungsmethode wurde zum Basiszeitpunkt (T1) verwendet. |
| IBM SPSS Statistics | IBM Corp. | Version 26.0 | Statistische Software zur Durchführung deskriptiver Statistiken, einfaktorieller ANOVA, Chi-Quadrat-Tests und multinomialer logistischer Regression. |
| Dokumentation zu IBM SPSS Statistics 26 | IBM Corp. | Dokumentation Version 26 | Offizielle Dokumentationsressource für IBM SPSS Statistics 26. |
| Mplus | Muthén & Muthén | Version 8.3 | Statistische Software zur Berechnung von ein- bis fünfklassigen Growth-Mixture-Modellen; Version 8.3 wurde am 30. April 2019 veröffentlicht. |
| Mplus-Benutzerhandbuch | Muthén & Muthén | Achte Auflage / Version 8 | Offizielles Benutzerhandbuch für Mplus Version 8, verwendet als methodische Software-Ressource. |
| Skala zur Bewertung der sozialen Unterstützung (SSRS) | Xiao SY | N/V | Publizierte 10-Item-chinesische Skala zur sozialen Unterstützung, einmalig zum Basiszeitpunkt (T1) erhoben. |
| STROBE-Kohortenstudien-Checkliste | STROBE-Initiative | Checkliste für Kohortenstudien | Reporting-Checkliste zur Überprüfung der Vollständigkeit des Berichts zur longitudinalen Beobachtungsstudie. |
| STROBE-Erklärung | STROBE-Initiative | Leitlinie von 2007 | Reporting-Leitlinie für Beobachtungsstudien; dient als Ressource für Studiendesign, Teilnehmer, Bias, statistische Methoden, Ergebnisse und Limitationen. |
Referenzen
- Cai D, et al. Sex differences in outcomes in patients with acute myocardial infarction. BMC Cardiovasc Disord. 2025;25(1):272.
- Liu M, et al. A patient with acute myocardial infarction with electrocardiogram Aslanger's pattern. BMC Cardiovasc Disord. 2024;24(1):3.
- Yu F, Yuan X, Fu S. Optimizing emergency nursing protocols to enhance outcomes in patients with acute myocardial infarction: a retrospective study. Medicine (Baltimore). 2025;104(23):e41412.
- Guo J, Chen Y, Dai Y, Chen Q, Wang X. Influencing factors of care dependence in patients with coronary heart disease after percutaneous coronary intervention: a cross-sectional study. Nurs Open. 2023;10(1):241-251.
- Zhang SQ, Zhu YS, Li L, Ye WQ. Reliability and validity analysis of the Chinese version of the Care Dependency Scale for elderly patients. J Nurs Sci. 2014;29(3):7-9. [in Chinese].
- Li CQ, Zhong GK. Application of several commonly used mental health rating scales in psychiatry. Chin J Clin Rehabil. 2005;(12):34. [in Chinese].
- Spitzer RL, Kroenke K, Williams JBW, Löwe B. A brief measure for assessing generalized anxiety disorder: the GAD-7. Arch Intern Med. 2006;166(10):1092-1097.
- Xiao SY. The theoretical basis and research application of the Social Support Rating Scale. J Clin Psychiatry. 1994;4(2):98-100. [in Chinese].
- Muthén LK, Muthén BO. How to use a Monte Carlo study to decide on sample size and determine power. Struct Equ Modeling. 2002;9(4):599-620.
- Pate A, et al. Minimum sample size for developing a multivariable prediction model using multinomial logistic regression. Stat Methods Med Res. 2023;32(3):555-571.
- Shen Y, et al. Observation on the application effect of stressor perception and response meticulous nursing in the perioperative period of acute myocardial infarction. Altern Ther Health Med. 2024;30(1):63-67.
- Nakamura K, Ohbe H, Uda K, Fushimi K, Yasunaga H. Early rehabilitation after acute myocardial infarction: a nationwide inpatient database study. J Cardiol. 2021;78(5):456-462.
- Wang L, Liu J, Fang H, Wang X. Factors associated with participation in cardiac rehabilitation in patients with acute myocardial infarction: a systematic review and meta-analysis. Clin Cardiol. 2023;46(11):1450-1457.
- Munyombwe T, et al. Quality of life trajectories in survivors of acute myocardial infarction: a national longitudinal study. Heart. 2020;106(1):33-39.
- Ingadóttir B, Svavarsdóttir MH, Jurgens CY, Lee CS. Self-care trajectories of patients with coronary heart disease: a longitudinal, observational study. Eur J Cardiovasc Nurs. 2024;23(7):780-788.
- Hajduk AM, Dodson JA, Murphy TE, Chaudhry SI. A risk model for decline in health status after acute myocardial infarction among older adults. J Am Geriatr Soc. 2023;71(4):1228-1235.
- Hajduk AM, et al. Risk model for decline in activities of daily living among older adults hospitalized with acute myocardial infarction: the SILVER-AMI study. J Am Heart Assoc. 2020;9(19):e015555.
- Zhu C, Tran PM, Leifheit EC. Association of marital/partner status and patient-reported outcomes following myocardial infarction: a systematic review and meta-analysis. Eur Heart J Open. 2023;3(2):oead018.
- Leifheit-Limson EC, et al. The role of social support in health status and depressive symptoms after acute myocardial infarction: evidence for a stronger relationship among women. Circ Cardiovasc Qual Outcomes. 2010;3(2):143-150.
- Levine GN, et al. Post-myocardial infarction psychological distress: a scientific statement from the American Heart Association. Circulation. 2025;152(16):e298-e310.
- Bucholz EM, et al. Effect of low perceived social support on health outcomes in young patients with acute myocardial infarction: results from the VIRGO (Variation in Recovery: Role of Gender on Outcomes of Young AMI Patients) study. J Am Heart Assoc. 2014;3(5):e001252.
- Bagai A, et al. Multimorbidity, functional impairment, and mortality in older patients stable after prior acute myocardial infarction: insights from the TIGRIS registry. Clin Cardiol. 2022;45(12):1277-1286.