Diese computergestützte Studie stellt einen kompartimentbezogenen Workflow zur Bewertung öffentlicher Transkriptomdaten von Atemwegsviren vor und zeigt, dass nasale und systemische Wirtsantworten eine begrenzte Übereinstimmung auf Genebene aufweisen, jedoch reproduzierbare, biologisch interpretierbare, kompartiment-spezifische Module über unabhängige Datensätze, klinische Vergleiche, longitudinales Erholungsverhalten und Robustheitsanalysen hinweg liefern.
Forschungsartikel
Kompartiment-bewusstes Benchmarking von Transkriptomen respiratorischer Viren für nasale und blutbasierte Wirtsantwort-Module: Eine computergestützte Studie
In diesem Artikel
Zusammenfassung
Zusammenfassung
Öffentliche Transkriptomdaten von Atemwegsviren sind wertvoll für die Untersuchung der Wirtsantworten, jedoch können Unterschiede in der Gewebeprobe, der Definition der Kontrollen und dem Studiendesign zusammengefasste Analysen erschweren. Wir haben einen kompartimentbezogenen computergestützten Arbeitsablauf entwickelt, um zu ermitteln, ob reproduzierbare Aktivitäten der Wirtsantwort identifiziert werden können, während gleichzeitig der biologische Kontext von Nasen- und Blutproben erhalten bleibt. Der gepaarte pädiatrische Kohortendatensatz GSE117827 diente als Ankerdatensatz und umfasste Transkriptomdaten von Nasenabstrichen und Ganzblut von symptomatischen Infektionen mit Picornaviren und respiratorischem Synzytialvirus, asymptomatischen Nachweisen von Picornaviren sowie virusnegativen Kontrollen. Nach der Filterung gemäß dem HUGO Gene Nomenclature Committee (HGNC) wurden 27.685 Gene analysiert. Getrennte Nasen- und Blutmodule aus jeweils 50 protein-kodierenden Genen wurden basierend auf den stärksten positiven Reaktionen definiert und vor der externen Bewertung festgelegt. Die genweisen Effekte in Nase und Blut waren nahezu unabhängig voneinander (Pearson r = 0,015), und die Module teilten sich sechs überlappende Gene im explorativen Rangvergleich (Jaccard-Index = 0,064). Dennoch konnte das Nasenmodul in unabhängigen oberen Atemwegskohorten Infektionen von Kontrollen unterscheiden, mit Flächen unter der Receiver-Operating-Characteristic-Kurve (AUROC) von 0,749, 0,693 und 0,609, während das Blutmodul in externen Blutkohorten AUROC-Werte von 0,832, 0,924 und 0,870 erreichte. In longitudinalen Daten natürlicher Infektionen nahmen die gepaarten Scores von der akuten Erkrankung bis zur Entlassung ab, mit gepaarten Deltas von 0,436 für Nasenproben und 0,330 für Blutproben. Drei zusätzliche Benchmark-Datensätze mit insgesamt 666 externen Proben sowie Analysen mit zufällig ausgewählten Genen als Nullmodell, Variationen der Modulgröße, Bootstrap-Stabilität, Korrelationen mit Markergenprogrammen und Varianzpartitionierung definierten die Robustheit und Grenzen des Arbeitsablaufs. Die Pandya-33-Messenger-Ribonukleinsäure-(mRNA-)Signatur erwies sich weiterhin als stärker für die Unterscheidung von viralen und bakteriellen Infektionen, während das Blutmodul ebenfalls bei bakterieller Pneumonie anstieg. Diese Ergebnisse stützen kompartiment-spezifische Module als wiederverwendbare Scores für die Aktivität der Wirtsantwort zur Kohortenvergleichung und Verlaufskontrolle, anstelle universeller pan-geweblicher Biomarker oder eigenständiger Pathogen-Klassifikatoren.
Einleitung
Wirtstranskriptomische Signaturen werden häufig verwendet, um infektiöse Syndrome zu klassifizieren und Immunantworten zwischen verschiedenen Krankheitserregern zu vergleichen1,2,3,4,5. Atemwegsviren aktivieren oft überlappende interferonstimulierte Gene (ISGs), inflammatorische Mediatoren und Antigenpräsentationswege6,7,8,9,10. Neuere paired und longitudinale Studien zeigen außerdem, dass lokale Atemwegs- und systemische Antworten hinsichtlich ihres zeitlichen Verlaufs, ihrer zellulären Zusammensetzung und ihrer Stärke variieren können11. Dieses Phänomen betrifft nicht nur Influenza, das humane respiratorische Synzytialvirus (RSV), Rhinovirus und SARS-CoV-2. Das humane Metapneumovirus bleibt eine wichtige Ursache für Atemwegserkrankungen, doch die Literatur zu den Wirtsantworten und therapeutischen Interventionen ist noch im Aufbau12,13. Diese Beobachtungen bei verschiedenen Atemwegsvirusinfektionen verdeutlichen weiterhin Unterschiede zwischen lokalen Atemwegs- und systemischen Wirtsantworten14. Für rechnergestützte Wirt-Virus-Studien lautet die praktische Frage daher nicht nur, ob eine Antwort vorhanden ist. Vielmehr geht es darum, ob öffentlich verfügbare Daten mithilfe eines transparenten Workflows wiederverwendet werden können, der den Gewebekontext bewahrt und reproduzierbare Scores für die Wirtsantwort liefert.
Die meisten öffentlich zugänglichen Transkriptom-Datensätze zu Atemwegsviren wurden nicht für eine saubere Queranalyse zwischen verschiedenen Viren oder Geweben konzipiert. Gewebeprobe, Zeitpunkt, Schweregrad, Alter, Definition der Kontrollgruppe und Plattform variieren dabei oft gemeinsam. Hochdurchsatz-Expressionsdatensätze sind außerdem anfällig für unerwünschte technische und studienbezogene Variationen15,16. Eine gepoolte Analyse kann daher eine starke Interferon- oder Entzündungssignatur offenlegen, gleichzeitig aber deren Ursprung verschleiern. Nasale Proben erfassen die Biologie des Epithels und der Schleimhautimmunität, während Vollblut systemische Leukozytenantworten widerspiegelt. Die Behandlung dieser Kompartimente als austauschbar erleichtert die Berechnung eines Scores, erschwert jedoch seine Interpretation.
Wir haben die Analyse um GSE117827 herum aufgebaut, eine in derselben Studie gepaarte nasale-blutige Kohorte, anstatt um die größte verfügbare Entdeckungskollektion17. Die Kohorte ist klein, verringert jedoch zwischen-studienbedingte Störungen, wenn nasale und systemische Effektgrößen verglichen werden. Sie umfasst symptomatische Picornavirus-Infektionen, symptomatische RSV-Infektionen, asymptomatische Picornavirus-Nachweise sowie virusnegative Kontrollen. Wir verwendeten sie daher nur als Anker für separate kompartiment-spezifische Module. Die Modulzugehörigkeit wurde vor der externen Validierung festgelegt. Die Stabilität der Auswahl anhand der kleinen Kohorte wurde mittels stratifiziertem Bootstrap-Resampling, zufallsbasierten Gen-Nullmodellen und Analysen der Empfindlichkeit bezüglich der Modulgröße überprüft.
Wir fügten eine Vergleichsebene mit bakteriellen und nichtinfektiösen Vergleichsgruppen hinzu. GSE63990 enthält Ganzblutproben bei akuten Atemwegserkrankungen, die als viral, bakteriell oder nichtinfektiös gekennzeichnet sind18. GSE40012 enthält schwere ambulant erworbene Pneumonien, systemisches inflammatorisches Response-Syndrom (SIRS) sowie gesunde Kontrollen19. Diese Kohorten prüfen, ob ein Modul eine allgemeine Wirtsantwortaktivität oder eine Spezifität für eine Pathogengruppe widerspiegelt. GSE53543 wurde separat als ex vivo-Benchmark für eine Rhinovirus-Störung in peripheren mononukleären Blutzellen (PBMC) analysiert. Es misst die Leukozytenreaktivität unter kontrollierter Stimulation, entspricht jedoch nicht einer natürlichen Infektion.
Unsere Annahme ist bewusst konservativ. Wir versuchen nicht, eine universelle antivirale Signatur aus heterogenen öffentlichen Daten zu beweisen. Stattdessen fragen wir, ob ein kompartimentbewusster Workflow Modul-Scores erzeugen kann, die nach externer Validierung weiterhin nützlich sind. Der vorgesehene Einsatz ergänzt diagnostische Klassifikatoren wie den Pandya-33-mRNA-Test. Diese Module bewerten die Wirtenantwort-Aktivität in Nase und Blut über verschiedene Kohorten, Genesungsphasen und Symptomen-Gradienten hinweg. Sie sind nicht dafür konzipiert, eine Pathogenklasse zuzuweisen.
Protokoll
Diese Studie analysierte erneut anonymisierte, öffentlich verfügbare Daten und beinhaltete keine neue Rekrutierung, Intervention oder Probensammlung. Eine Genehmigung durch die institutionelle Ethikkommission und eine neue informierte Einwilligung waren daher für die vorliegende sekundäre Analyse nicht erforderlich. Die Ethikgenehmigung und die informierte Einwilligung für die ursprünglichen Studien wurden von den jeweiligen Datenherstellern berichtet.
Studienentwurf und Workflow-Logik
Wir führten eine retrospektive Bioinformatikstudie mit öffentlich zugänglichen Daten durch, die in der Gene Expression Omnibus20,21 hinterlegt sind. Es wurden keine neuen Proben von Patienten, Zellkulturversuche, Tierversuche oder nasschemische Validierungen durchgeführt. Der Workflow folgte einem „Anker-zuerst“-Ansatz. GSE117827 wurde zur Schätzung der Effektgrößen, zur Modulkonstruktion, zur Analyse der Übereinstimmung zwischen Kompartimenten und zur Analyse des Symptomengradienten verwendet. Unabhängige Datensätze wurden erst nach Festlegung der Modulzugehörigkeit hinzugezogen. Der Workflow umfasste die paarweise Verankerung von Kompartimenten, die Zuordnung zu HGNC-Namen und die Filterung auf protein-kodierende Gene, die separate Erstellung von Nasen- und Blutmodulen, die gewebespezifische und longitudinale Validierung, das klinische Benchmarking sowie Robustheitsanalysen. Bestätigende Analysen umfassten die festgelegten gewebespezifischen und longitudinalen Tests. Überlappungsanalysen der Gene, Analysen des Symptomengradienten, Markerprogrammanalysen und Varianzanalysen waren explorativer oder deskriptiver Natur.
Anker-Kohorte und primärer Vergleich
GSE117827 enthält Expressionsprofile aus Nasenabstrichen und Vollblut von 26 Kindern: 9 symptomatische Picornavirus-Fälle, 5 asymptomatische Picornavirus-Nachweise, 6 symptomatische RSV-Fälle und 6 asymptomatische, virusnegative Kontrollen17. Bei zwei RSV-Fällen fehlten Blutproben. Das vollständige Anker-Design umfasste daher 50 Proben, und der primäre infizierte-gegenüber-Kontroll-Vergleich enthielt 40 Proben, nachdem asymptomatische Picornavirus-Nachweise von der Modulkonstruktion ausgeschlossen wurden. Für den primären Vergleich wurden symptomatische Picornavirus- und symptomatische RSV-Proben als infiziert gekennzeichnet und asymptomatische, virusnegative Proben als Kontrollen. Asymptomatische Picornavirus-Nachweise wurden nicht als Kontrollen betrachtet, da der virale Nachweis ohne Symptome biologisch von der virusnegativen Gesundheit verschieden ist. Diese Proben wurden von der Modulkonstruktion ausgeschlossen und später für eine Analyse des Symptomgradienten verwendet.
Probenzuordnung und Vorverarbeitung
GSE117827 wurde auf GPL23126 profiliert. Transkript-Cluster-Identifikatoren wurden mithilfe der über die GEO-Plattform GPL24539 bereitgestellten Clariom-D-Human-na36-hg38-Anmerkungsdatei den Gen-Symbolen zugeordnet. Es wurden nur von der HGNC genehmigte Symbole beibehalten22. Kontrollproben, ERCC-Proben, nicht zugeordnete Transkript-Cluster und nicht genehmigte Symbole wurden entfernt. Mehrfache Transkript-Cluster, die auf dasselbe genehmigte Symbol abgebildet wurden, wurden durch mediane Expression zusammengefasst. Nach Filterung und Zusammenfassung standen 27.685 Gene für die Ankeranalyse zur Verfügung. Eine log₂(x + 1)-Transformation wurde nur dann angewendet, wenn das 95. Perzentil der Expressionsmatrix 50 überschritt, was auf eine nicht logarithmierte Intensitätsskala hindeutete. Gene mit mehr als 20 % fehlenden Werten wurden entfernt; verbleibende fehlende Werte wurden durch den medianen Wert innerhalb des Gens ersetzt. Jedes Gen wurde anschließend über alle Proben des Datensatzes hinweg als z = (x − Mittelwert)/Stichprobenstandardabweichung (ddof = 1) standardisiert. Gene mit einer Varianz von null erhielten einen standardisierten Wert von 0. Die Modulkonstruktion beschränkte sich auf Einträge, die im vollständigen HGNC-Satz als protein-kodierende Gene klassifiziert waren.
Effektgrößenanalyse und Modulkonstruktion
Die Nasen- und Blutkompartimente wurden getrennt analysiert. Symptomatische Virusproben wurden mit virusnegativen Kontrollen mittels Hedges g standardisierter mittlerer Differenzen und zweiseitiger Welch-Tests23 verglichen. Hedges g wurde berechnet als die Differenz des Mittelwerts (infiziert minus Kontrolle) dividiert durch die gepoolte Standardabweichung und multipliziert mit der Korrektur für kleine Stichproben 1 − 3/(4df − 1), wobei df = ninfiziert + nKontrolle − 2. Die Welch-Tests wurden unter Annahme ungleicher Varianzen durchgeführt. Die Falsch-Entdeckungs-Raten nach Benjamini–Hochberg wurden für alle getesteten Gene innerhalb jedes Kompartiments berechnet24. Da im kleinen Anker-Kollektiv kein protein-kodierendes Gen die vorgegebene strenge Kombination aus FDR < 0,05 und Hedges g > 0,8 erfüllte, wurden Gene mit positivem Effekt zunächst nach aufsteigendem zweiseitigem Welch-P-Wert, danach nach absteigendem Hedges g geordnet, wobei das Gensymbol als deterministischer letzter Kriterium zur Bindungsauflösung diente. Die jeweils 50 am höchsten bewerteten Gene bildeten jedes Primärmodul. Eine Anzahl von 50 Genen wurde a priori als moderates Modulmaß gewählt, um eine breite biologische Aussagekraft zu erhalten, gleichzeitig aber den Verlust durch fehlende Gene auf verschiedenen Plattformen zu begrenzen. Diese Modulgröße wurde nicht an externe AUROC-Werte angepasst. Empfindlichkeitsanalysen mit 10, 25, 50, 100 und 200 Genen führten zum gleichen qualitativen Ergebnis hinsichtlich der Trennung im Anker-Kollektiv. Ziel war die Reproduzierbarkeit auf Ebene der Module, nicht die Entdeckung einzelner Gene.
Konkordanz zwischen Kompartimenten
Hedges-g-Schätzungen aus Nase und Blut wurden genweise abgeglichen und mittels Pearson- und Spearman-Korrelationen verglichen. Die Überschneidung zwischen den jeweils 50 stärksten Modulen in Nase und Blut wurde anhand der Anzahl überschneidender Gene und des Jaccard-Index zusammengefasst. Gene mit Überschneidung wurden als explorative Kandidaten für eine Rangüberschneidung zwischen Kompartimenten interpretiert, nicht jedoch als validierte konservierte Biomarker.
Externe, gewebematchende Validierung
Zur Validierung der Modul-Scores wurden unabhängige öffentliche Datensätze mit interpretierbaren Quellgruppen verwendet. Die Validierung an oberen Atemwegen umfasste RSV-Nasenspülproben aus dem Datensatz GSE41374 sowie die SARS-CoV-2-Datensätze GSE152075 und GSE156063. Die Validierung an Blutproben beinhaltete GSE171110 und zwei separat normalisierte Einheiten aus GSE38900: GPL10558 (36 Proben; 28 RSV und 8 Kontrollen) sowie GPL6884 (138 Proben; 107 RSV und 31 Kontrollen). Für jeden externen Datensatz wurden die Sonden auf HGNC-Symbole abgebildet, und doppelte Symbole wurden durch mediane Expression zusammengefasst. Dieselben Transformationen, die Filterung fehlender Werte, mediane Imputation sowie die pro-Gen-z-Standardisierung, die für den Referenzdatensatz angewendet wurden, kamen in jedem Datensatz zum Einsatz. Der Modul-Score wurde als ungewichtetes Mittel der standardisierten Expressionswerte der jeweiligen Modul-Gene berechnet. AUROC, durchschnittliche Präzision und der FDR-Wert nach dem Welch-Test wurden als Maße für die Übertragbarkeit angegeben, nicht als Schätzwerte für die klinische diagnostische Leistungsfähigkeit.
Große klinische Referenz- und ex-vivo-Störungsdatensätze
Zwei Vollblut-Datensätze wurden als klinische Referenz verwendet, anstatt als Entdeckungs-Kohorten. Bei GSE63990 wurden die Proben basierend auf den hinterlegten Infektionsstatus-Metadaten einer viralen Atemwegsinfektion (n = 117), einer bakteriellen Atemwegsinfektion (n = 73) oder einer nichtinfektiösen Erkrankung (n = 90) zugeordnet; Proben ohne eine dieser eindeutigen Kennzeichnungen wurden ausgeschlossen18. Bei GSE40012 wurden die hinterlegten Diagnosefelder Influenza-A-Pneumonie (n = 39), bakterieller Pneumonie ohne Influenza (n = 61), SIRS ohne Pneumonie (n = 40), gesunden Kontrollen (n = 36) oder einer gemischten bakteriellen/Influenza-Pneumonie (n = 14) zugeordnet19. Gemischte bakterielle/Influenza-Proben wurden beschrieben, aber von den binären Referenzvergleichen ausgeschlossen.
GSE53543 enthält 196 ex-vivo-PBMC-Profile von 98 Individuen. Jedes Individuum trug eine Probe mit nur Medium und eine Probe, die 24 Stunden lang Rhinovirus 16 ausgesetzt war, bei; die Identifikatoren der Probanden bestätigten 98 vollständige Paare. Der Hauptvergleich berichtete die AUROC-Werte über die 98 stimulierten und 98 unstimulierten Proben, da die AUROC eine Rangtrennungs-Metrik darstellt. Die Paarung der Probanden wurde in den Metadaten beibehalten und für eine gepaarte Sensitivitätsanalyse der Score-Unterschiede verwendet. Dieses Experiment wurde separat von natürlichen klinischen Infektionen analysiert und diente nicht zur Unterstützung klinischer Diagnosebehauptungen.
Rohe GEO-Serienmatrizen wurden für GSE63990, GSE40012 und GSE53543 heruntergeladen. Für GSE63990 wurde GPL571 verwendet, für GSE40012 GPL6947 und für GSE53543 GPL10558. Die Proben wurden auf HGNC-empfohlene Symbole abgebildet, und doppelte Zuordnungen wurden durch mediane Expression zusammengefasst. Abgelegte normalisierte Matrizen wurden verwendet. Die allgemeine Regel des 95. Perzentils führte nur dann zu einer log₂(x + 1)-Transformation, wenn die Matrizen auf einer nicht logarithmierten Skala vorlagen. GSE53543 war bereits log₂-transformiert, mittels rankinvarianter Normalisierung bearbeitet und von den ursprünglichen Untersuchern auf den Verarbeitungstag korrigiert worden, sodass keine zusätzliche Log-Transformation angewendet wurde. Nach dem Entfernen von Genen mit mehr als 20 % fehlenden Werten und der Imputation der verbleibenden fehlenden Werte durch den Median wurde jedes Gen innerhalb seines Datensatzes über alle Proben hinweg z-standardisiert. Die Referenzschicht enthielt 470 klinische Vollblutproben und 196 ex vivo PBMC-Proben.
Referenzsignatur-Benchmarking
Die Nasen- und Blut-Ankermodule wurden anhand von drei ungewichteten Referenzsätzen validiert. Der offizielle Pandya-33-mRNA-Satz wurde aus der ergänzenden Tabelle 1 des ursprünglichen Klassifikationsberichts übernommen.5. Der Andres-Terre-Vergleichswert bestand aus 33 Interferon-orientierten Genen, die aus der berichteten Multi-Virus-Signatur zusammengestellt wurden3Der Hallmark-Comparator umfasste eine 33-Gene umfassende Interferon-alpha-Kern-Teilmenge, die mit dem MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE-Set verknüpft ist.25,26. Vollständige Genlisten für alle drei Referenzsätze sind in Zusatzdaten 1. Diese Referenzwerte rekonstruieren die ursprünglichen gewichteten Klassifikatoren nicht. Für jeden Datensatz wurde ein Wert als ungewichteter Mittelwert der verfügbaren pro-Gen-Werte berechnet z Scores; es wurden mindestens drei repräsentierte Gene benötigt, und die Anzahl der repräsentierten Gene wurde angegeben. Als Referenzvergleiche dienten virusbedingt gegenüber bakteriell, virusbedingt gegenüber nicht-infektiös, virusbedingt gegenüber bakteriell-oder-nicht-infektiös, virusbedingt gegenüber gesund/ Kontrolle sowie bakteriell gegenüber gesund/Kontrolle, sofern die erforderlichen Gruppen verfügbar waren. AUROC und durchschnittliche Präzision wurden als Bewertungskennzahlen interpretiert. Welch-Test P Die Werte wurden mithilfe des Benjamini–Hochberg-Verfahrens für alle gültigen Kombinationen aus Datensatz, Kontrast und Modul in der Benchmark-Tabelle angepasst.
Unabhängige longitudinale Validierung
Die gepaarten Datensätze zur Akutphase im Vergleich zur Entlassungsphase, GSE97741 und GSE97742, wurden ausschließlich zur longitudinalen Validierung verwendet27. Die Proben, die in den hinterlegten Metadaten als RSV-Monoinfektion (RSVsi) oder als Rhinovirus-Infektion (hRV) gekennzeichnet waren, bildeten die Grundlage der primären Analyse; RSV-Koinfektionen (RSVco) wurden nur in den ergänzenden Ergebnissen berücksichtigt. Akut- und Entlassungsbezeichnungen wurden aus den Probennamen extrahiert. Die Proben wurden nach Datensatz, Kompartiment, Virusgruppe und Probanden-ID gepaart, wobei nur Probanden mit beiden Zeitpunkten berücksichtigt wurden. Die primäre kombinierte Gruppe umfasste 38 RSVsi- und 30 hRV-Paare (68 Paare pro Kompartiment).
Keine Genauswahl, Modulverfeinerung oder Schwellenwertanpassung wurde für GSE97741 oder GSE97742 verwendet. Diese Datensätze wurden für die externe Validierung reserviert. Sondenidentifikatoren wurden auf genehmigte HGNC-Symbole abgebildet, und doppelte Symbole wurden durch mediane Expression zusammengefasst. Dieselbe Regel zur logarithmischen Transformation am 95. Perzentil, fehlende Werte-Filterung, mediane Imputation und pro-gen interne Datensatz-Normalisierung zEs wurden Standardisierungsverfahren angewandt, bevor die festen Modul-Scores für GSE117827 berechnet wurden.
Für jedes Gewebe und jedes Modul wurden akute und Entlassungswerte paarweise nach Proband und Virusgruppe gepaart. Die Differenz zwischen akutem und Entlassungswert wurde für jedes Paar berechnet. Cohen dz wurde berechnet als der mittlere gepaarte Unterschied dividiert durch die zugehörige Stichprobenstandardabweichung. Zweiseitig gepaart t Tests und zweiseitige Wilcoxon-Test wurden zusammen mit dem AUROC für die Trennung akuter und Entlassungsscores berichtet. Benjamini–Hochberg-FDR-Werte wurden über alle 20 gültigen gepaarten t Tests in der vollständigen longitudinalen Ausgabe (zwei Datensätze, zwei Modulquellen und fünf vorgegebene Zusammenfassungen nach Virusgruppen).
Symptom-Gradient- und Post-hoc-Analyse
Nachdem die Modulzugehörigkeit festgelegt worden war, dienten die bei GSE117827 ausgeschlossenen asymptomatischen Picornavirus-Nachweise ausschließlich der Symptom-Gradient-Analyse. Der ordinale klinische Score betrug 0 für virusnegative Kontrollen, 1 für asymptomatische Picornavirus-Nachweise und 2 für symptomatische Infektionen. Die ordinale Trendentwicklung wurde mittels Spearman-Korrelation bewertet, während der Kruskal-Wallis-Test die gesamten Unterschiede zwischen den drei Gruppen prüfte. Zweiseitige post-hoc-Mann-Whitney-U-Tests verglichen die drei Gruppenpaare. Die Korrektur nach Benjamini-Hochberg wurde für jede Kompartimentgruppe separat auf ihr jeweiliges Ensemble von drei paarweisen Vergleichen angewandt.
Funktionelle Anreicherung
Gene aus nasalen und Blutmodulen wurden mittels Enrichr über gseapy mit den Bibliotheken MSigDB Hallmark 2020, Reactome 2022 und GO Biologischer Prozess 2023 analysiert25,26,28,29,30,31. Enrichr verwendete sein standardmäßiges Überrepräsentationsverfahren basierend auf dem exakten Fisher-Test. Als signifikant galten die von der Bibliothek gemeldeten, nach Benjamini–Hochberg adjustierten P-Werte < 0,05. Die acht signifikantesten Terme pro Modul über alle drei abgefragten Bibliotheken hinweg wurden nach dem adjustierten P-Wert sortiert. Die Anreicherungsergebnisse dienten ausschließlich der Interpretation.
Robustheits-, Markerprogramm- und Varianzanalysen
Die Robustheitsanalysen prüften, ob die Ergebnisse von der Modulgröße oder der zufälligen Auswahl abhingen. Es wurden Modulgrößen von 10, 25, 50, 100 und 200 Genen bewertet. Bei der Nullmodellanalyse mit zufällig ausgewählten Genen umfasste das zugrundeliegende Genom die in der verarbeiteten GSE117827-Matrix enthaltenen protein-kodierenden HGNC-Gene. Fünfhundert 50-Gen-Sets wurden ohne Zurücklegen unter Verwendung eines NumPy-Zufallsseeds von 20260622 gezogen. Die Bootstrap-Neuauswahl beschränkte sich auf die 1.000 protein-kodierenden Gene mit positivem Effekt, die in der ursprünglichen Ankeranalyse für jeden Kompartiment am höchsten eingestuft waren. Bei jeder erneuten Stichprobe wurden die positiven protein-kodierenden Gene nach aufsteigendem zweiseitigem Welch-P-Wert und anschließend nach absteigender mittlerer Differenz geordnet. Die jeweils 50 am höchsten eingestuften Gene wurden ausgewählt. Die Genstabilität wurde als Anzahl der Auswahlen dividiert durch 100 berechnet. Die 20 Gene mit der höchsten Selektionshäufigkeit in jedem Kompartiment wurden dargestellt.
Die Marker-Programm-Scores wurden als beschreibende Hilfsmittel verwendet, nicht als Schätzungen des Zellanteils. Sechs kuratierte Programme wurden evaluiert: epithelial (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), Monozyt/Makrophage (LYZ, LST1, S100A8, S100A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), Neutrophil (S100A8, S100A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/Plasma (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1) sowie myeloide Interferonantwort (SIGLEC1, IFI27, IFI44L, ISG15, MX1, OAS1, RSAD2, IFIT3). Jeder Programmscore wurde als Mittelwert der verfügbaren z-Scores pro Gen berechnet, wobei mindestens drei repräsentierte Gene erforderlich waren. Die Spearman-P-Werte wurden mittels der Benjamini-Hochberg-Prozedur über die gesamte Familie der Korrelationen zwischen Datensatz, Modul und Programm angepasst. Eta-Quadrat nach Einfaktorieller Varianzanalyse wurde berechnet als die Quadratsumme zwischen den Gruppen dividiert durch die gesamte Quadratsumme für jedes Paar aus Modul und Faktor. Zeilen, die den relevanten Faktor nicht enthielten, wurden von dieser Berechnung ausgeschlossen. Diese Analyse war deskriptiv und berücksichtigte keine miteinander korrelierten Faktoren.
Reproduzierbarkeit
Alle Analysen wurden mithilfe skriptbasierter Workflows in Python 3.12.13 durchgeführt, wobei die verwendeten Softwarepakete und Versionen in der Tabelle der Materialien angegeben sind. Für randomisierte Verfahren wurde ein fester Zufallsstartwert (Seed) von 20260622 verwendet. Öffentliche GEO-Expressionsmatrizen wurden mit einer einheitlichen Projektstruktur verarbeitet, die rohe Eingabedaten, verarbeitete Daten, statistische Ergebnisse, Tabellen und Abbildungen voneinander trennte. Moduldefinitionen, Aufzeichnungen zur Probenkuratierung, Effektgrößenschätzungen, Validierungsstatistiken, Anreicherungsergebnisse, Robustheitsanalysen und Datenquellen für Abbildungen wurden gespeichert, um eine unabhängige Überprüfung zu ermöglichen. Der Analysecode, Angaben zu den Abhängigkeiten und unterstützende abgeleitete Daten sind wie im Abschnitt „Data Availability“ beschrieben verfügbar.
Ergebnisse
Benchmarking der Anker-Schritte trennte gewebespezifische von pan-geweblichen Gen-Effekten
Die kuratierte GSE117827-Anker-Matrix enthielt 27.685 von der HGNC genehmigte Gene. Der primäre nasale Vergleich umfasste 15 symptomatische infizierte und 6 virusnegative Kontrollproben; der Blutvergleich enthielt 13 symptomatische infizierte und 6 Kontrollen (Tabelle 1). Da diese kleine Kohorte keine stabile Einzelgen-Entdeckung ermöglicht, wurde sie als gepaarter Kompartments-Anker verwendet. Die Stabilität wurde auf Modul-Ebene durch Bootstrap-Resampling, zufallsbasierte Gen-Null-Tests, externe Validierung sowie Analysen der Empfindlichkeit gegenüber der Modulgröße bewertet.
| Quelle | Gruppe | Zustand | Primärer Vergleich | n |
| Blut | RSV | Infiziert | Ja | 4 |
| Blut | Asymptomatisches Picornavirus | Sekundär | Nein | 5 |
| Blut | Symptomatisches Picornavirus | Infiziert | Ja | 9 |
| Blut | Virusnegativer Kontrollwert | Kontrolle | Ja | 6 |
| Nasal | RSV | Infiziert | Ja | 6 |
| Nasal | Asymptomatisches Picornavirus | Sekundär | Nein | 5 |
| Nasal | Symptomatisches Picornavirus | Infiziert | Ja | 9 |
| Nasal | Virusnegativer Kontrollwert | Kontrolle | Ja | 6 |
Tabelle 1: GSE117827 Anker-Design nach der Kuration des primären Kontrasts. Probenverteilung über Blut- und Nasenkompartimente in dem gepaarten Anker-Datensatz nach der Kuration des primären Kontrasts. Symptomatische Proben von Respiratorischem Synzytialvirus (RSV) und symptomatische Picornavirus-Proben wurden als infiziert klassifiziert und in den primären Kontrast eingeschlossen, während virusnegative Kontrollen als Kontrollen klassifiziert und ebenfalls in den primären Kontrast eingeschlossen wurden. Asymptomatische Picornavirus-Proben wurden als sekundär eingestuft und von der Modulkonstruktion ausgeschlossen; sie wurden nur in der explorativen Analyse des Symptomgradienten verwendet. Bei zwei RSV-Fällen fehlten Blutproben, sodass insgesamt vier Blut- und sechs Nasenproben für RSV vorlagen.
Bei den 27.685 gemeinsamen Genen waren die Hedges-g-Schätzungen für Nasen- und Blutproben nahezu unkorreliert (Pearson-r = 0,015; Abbildung 1). Dieses Ergebnis stammt aus einer einzelnen Studie und ist weniger von Unterschieden zwischen Studien betroffen als ein gepoolter vergleichender Querschnittsvergleich. Die dichte zentrale Wolke zeigt, dass die meisten Gene in beiden Kompartimenten nicht gleichartig reguliert wurden. Die hervorgehobenen überlappenden Gene stellen Ausnahmen dar, die jeweils an der Spitze beider Ranglisten liegen. Dieses Muster spricht für die getrennte Konstruktion von Nasen- und Blutmodulen.
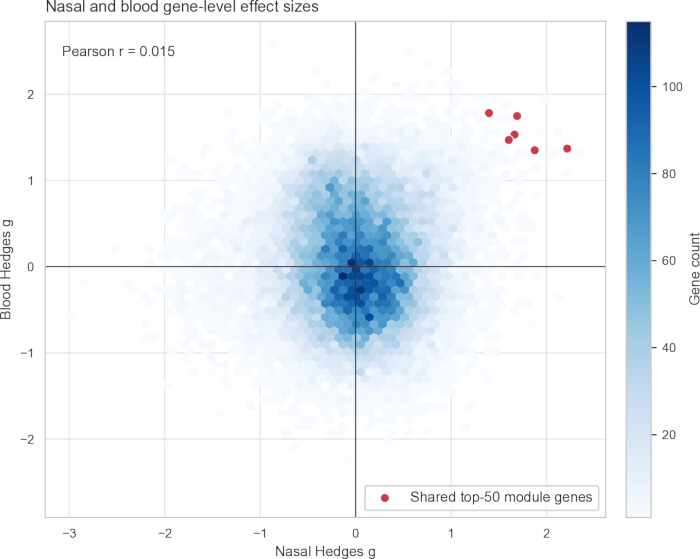
Abbildung 1. Nasale und blutbasierte Gen-Effektgrößen in der gepaarten Anker-Kohorte GSE117827. Hedges g-Werte vergleichen symptomatische Infektionen mit virusnegativen Kontrollen für 27.685 Gene. Nasale Schätzungen (15 infiziert, 6 Kontrollen) sind auf der x-Achse dargestellt, blutbasierte Schätzungen (13 infiziert, 6 Kontrollen) auf der y-Achse. Die Schattierung der hexagonalen Bin-Flächen zeigt die Anzahl der Gene pro Bin an. Rote Punkte kennzeichnen die sechs Gene, die sowohl in den Top-50-Modulen der Nasen- als auch der Blutproben vorkommen. Pearson r = 0,015. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Die Modulkonstruktion ergab eine kleine, um Interferone zentrierte Überlappung
Die jeweils 50 stärksten Nasen- und Blutmodule teilten sich sechs Gene: ISG15, ACRBP, IFIT1, RSAD2, CCRL2 und XAF1 (Jaccard-Index = 0,064; Tabelle 2; Abbildung 2). ISG15, IFIT1, RSAD2 und XAF1 passen zu einer interferonvermittelten antiviralen Biologie32,33,34. CCRL2 lässt sich besser im Kontext der entzündlichen Leukozytenwanderung interpretieren35. ACRBP hat keine etablierte antivirale Funktion. Alle sechs Gene werden zur Transparenz genannt, aber keines wird als validierter Biomarker für beide Gewebe beansprucht. Ihre Einzelgen-FDR-Werte waren in der kleinen Ankerkohorte nicht signifikant. Die wesentliche Schlussfolgerung beruht daher auf der gesicherten Modul-Ebene-Validierung und nicht auf der Überlappungsliste.
| Gen | Nasale Hedges g | Nasale FDR | Blood Hedges g | Blood FDR | Interpretation |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.442 | Interferonstimuliertes antivirales Gen; explorativer Überlapp |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | Keine etablierte antivirale Funktion; beibehalten aus Transparenzgründen |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.442 | Interferonstimuliertes antivirales Gen; explorativer Überlapp |
| RSAD2 | 1.663 | 0.213 | 1.532 | 0.442 | Interferonstimuliertes antivirales Gen; explorativer Überlapp |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.442 | Immunologischer Kontext der Leukozytenmigration; nicht virus-spezifisch |
| XAF1 | 1.603 | 0.226 | 1.47 | 0.442 | Mit Interferon assoziiertes Apoptosefaktor; explorativer Überlapp |
Tabelle 2: Vollständige explorative Überschneidung zwischen den am höchsten bewerteten nasalen und blutbasierten Modulen. Alle sechs gemeinsamen Gene werden mit nasalen und blutbasierten Hedges g sowie genweisen FDR-Werten angegeben. Alle sechs Gene gelten als explorative Kandidaten für eine Rangüberschneidung, da die genweisen FDR-Werte in der kleinen Ankerkohorte nicht signifikant waren. ACRBP wird der Transparenz halber beibehalten, obwohl ihm keine etablierte antivirale Funktion zugeschrieben wird. Keines der sechs Gene wird als validierter universeller Biomarker präsentiert; der primäre Nachweis basiert auf einer externen Validierung auf Modulebene.
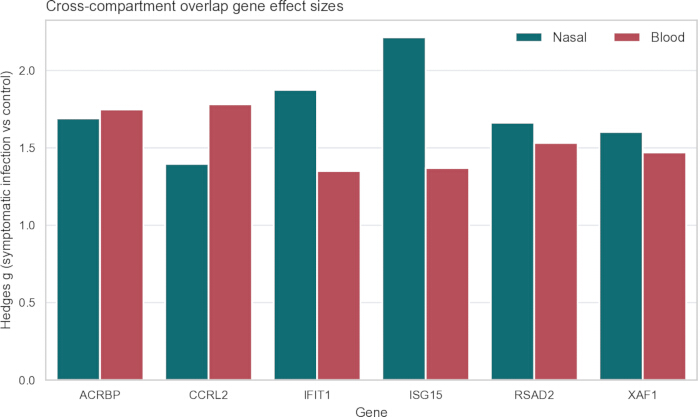
Abbildung 2. Effektgrößen der sechs explorativen Gene mit Überschneidung zwischen Nasen- und Blutproben. Dargestellt sind die Schätzungen der Hedges-g-Effektgrößen für ACRBP, CCRL2, IFIT1, ISG15, RSAD2 und XAF1 aus GSE117827 in Nasen- und Blutproben. Positive Werte zeigen eine höhere Expression bei symptomatischer Infektion im Vergleich zu virusnegativen Kontrollen an. Die vollständige Überschneidung ist der Transparenz halber dargestellt; die FDR-Werte für Einzelgene waren jedoch nicht signifikant, und diese Gene werden daher nicht als validierte universelle Biomarker präsentiert. Bitte klicken Sie hier, um eine vergrößerte Ansicht dieser Abbildung einzusehen.
Die funktionelle Anreicherung bot eine biologische Überprüfung des Modulinhalts
Beide Module zeigten eine Anreicherung für Interferon- und antivirale Signalwege, wobei sich jedoch die Genzusammensetzung und die Stärke der Anreicherung unterschieden (Abbildung 3). Die acht signifikantesten Terme pro Modul sind dargestellt. Für das nasale Modul gehörten die Hallmark-Interferon-gamma-Antwort (adjustierter P = 2,23 × 10⁻24), die Hallmark-Interferon-alpha-Antwort (adjustierter P = 1,40 × 10⁻22), die Reactome-Interferon-alpha/beta-Signalübertragung (adjustierter P = 3,64 × 10⁻19) und die GO-Abwehrantwort gegen Viren (adjustierter P = 5,47 × 10⁻15) zu den führenden Begriffen. Das Blutmodul zeigte dieselbe übergeordnete Biologie bei geringerer Anreicherungsstärke: Interferon-alpha-Antwort (adjustierter P = 3,87 × 10⁻6), Reactome-Interferon-alpha/beta-Signalübertragung (adjustierter P = 5,70 × 10⁻6), Interferon-gamma-Antwort (adjustierter P = 8,89 × 10⁻6) und Abwehrantwort gegen Viren (adjustierter P = 1,07 × 10⁻4). Diese Ergebnisse stützen die biologische Kohärenz, ohne identische genetische Rangfolgen in den Kompartimenten zu implizieren.
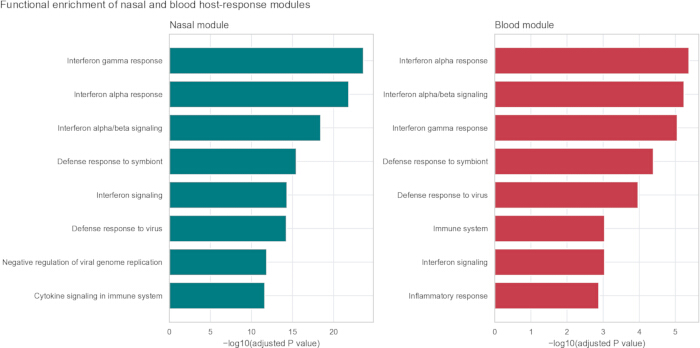
Abbildung 3. Ausgewählte Anreicherungsbegriffe für die nasalen und blutbasierten Module. Eine Überrepräsentanzanalyse wurde mittels Enrichr unter Verwendung von Hallmark 2020, Reactome 2022 und GO Biological Process 2023 durchgeführt. Die acht Begriffe mit den jeweils niedrigsten, nach Benjamini–Hochberg adjustierten P-Werten für jedes Modul sind dargestellt. Die Balkenlänge entspricht −log10(adjustierter P-Wert). Die linken und rechten Diagramme zeigen die nasalen bzw. die blutbasierten Module. Die Begriffe sind in Satzschreibweise angegeben. Die Anreicherungsanalyse führte nicht zu einer Änderung der Modulzugehörigkeit. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Gesperrte Module wurden in einer gewebematchenden externen Validierung getestet
Das gesperrte nasale Modul erreichte AUC-Werte (AUROC) von 0,749 in GSE41374, 0,693 in GSE152075 und 0,609 in GSE156063 (Tabelle 3; Abbildung 4). Das gesperrte Blutmodul erreichte AUC-Werte (AUROC) von 0,832 in GSE171110, 0,924 in der GSE38900 GPL10558-Einheit und 0,870 in der GPL6884-Einheit. Die Leistung der internen Anker wird weggelassen, da sie aufgrund der Konstruktion optimistisch verzerrt ist. Externe AUC-Werte (AUROC) werden als Zusammenfassung der Übertragbarkeit betrachtet. Sie belegen weder klinische Sensitivität noch Spezifität oder die Eignung für die Diagnose.
| Kohorte | Probe/Virus | Modul | n positiv | n negativ | Vertretene Gene | AUROC | Durchschnittliche Präzision | Welch-Test FDR |
| GSE152075 | SARS-CoV-2 oberer Atemweg | Nasal | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 oberer Atemweg | Nasal | 93 | 100 | 49 | 0.609 | 0.551 | 1.38 × 10⁻² |
| GSE171110 | SARS-CoV-2 Vollblut | Blut | 44 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE38900-GPL10558 | RSV Vollblut | Blut | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE38900-GPL6884 | RSV Vollblut | Blut | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | RSV Nasalspülung | Nasal | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
Tabelle 3: Externe, gewebematchende Modul-Score-Validierung. Das fixierte nasale Modul wurde in GSE41374, GSE152075 und GSE156063 getestet, und das fixierte Blutmodul wurde in GSE171110 sowie in den GSE38900-Plattformeinheiten GPL10558 und GPL6884 überprüft. In der Tabelle sind die Anzahlen positiver und negativer Proben, die repräsentierten Modulgene, AUROC, durchschnittliche Präzision und Welch-Test-FDR aufgeführt. Die Leistung des internen Ankers wird nicht angegeben. AUROC und durchschnittliche Präzision werden als Portabilitätszusammenfassungen angegeben und nicht als Schätzwerte der klinischen diagnostischen Leistungsfähigkeit.
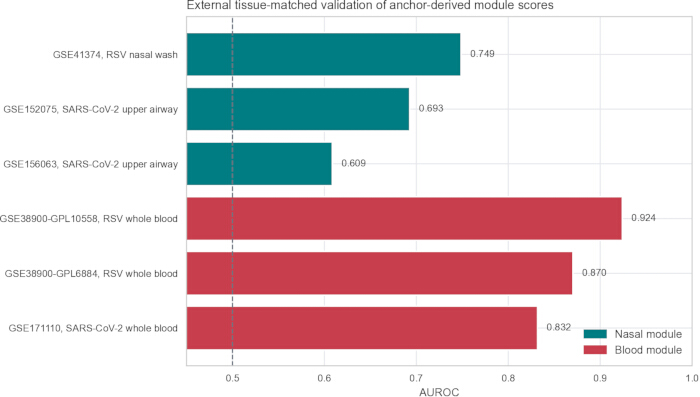
Abbildung 4. Externe, gewebematchende Übertragbarkeit von Modulscores. Dargestellt sind die AUROCs für das Nasenmodul in GSE41374 (76 RSV, 10 Kontrollen), GSE152075 (430 SARS-CoV-2, 54 Kontrollen) und GSE156063 (93 SARS-CoV-2, 100 Kontrollen) sowie für das Blutmodul in GSE171110 (44 SARS-CoV-2, 10 Kontrollen), GSE38900-GPL10558 (28 RSV, 8 Kontrollen) und GSE38900-GPL6884 (107 RSV, 31 Kontrollen). Die Scores entsprechen ungewichteten Mittelwerten der repräsentativen z-Werte pro Gen. Die gestrichelte Linie zeigt AUROC = 0,5 an. Die Werte stellen Zusammenfassungen zur Übertragbarkeit dar, keine klinischen diagnostischen Schätzungen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Die longitudinale Validierung prüfte, ob die Werte während der Genesung abnehmen
Die begleitenden Datensätze GSE97741/GSE97742 boten eine unabhängige Validierung unter natürlicher Infektion mit Proben aus der akuten Phase und beim Krankenhausaufenthalt von hospitalisierten Kindern27. Diese Proben wurden nicht als Entdeckungsdaten von gesunden Kontrollen verwendet. Stattdessen dienten sie dazu zu bewerten, ob sich die anhand der Anker abgeleiteten Modulwerte von der akuten Erkrankung bis zur Entlassung verringerten.
Für die vorgegebene kombinierte Gruppe mit alleinigem RSV-Infekt und Rhinovirus-Infektion wurden jeweils 68 gepaarte Probanden in jedem Gewebe analysiert (Tabelle 4; Abbildung 5). Das Blutmodul nahm von der akuten Erkrankung bis zur Entlassung im Blut ab (mittlere Differenz = 0,330; Cohen dz = 0,740; gepaarter Test, FDR = 1,98 × 10⁻7; AUROC = 0,765). Das nasale Modul nahm ebenfalls in nasopharyngealen Proben ab (mittlere Differenz = 0,436; Cohen dz = 0,477; gepaarter Test, FDR = 3,06 × 10⁻4; AUROC = 0,679). Gepaarte Verläufe und ihre Standardfehler zeigen, dass der gruppenbezogene Rückgang nicht durch wenige ungepaarte Extremwerte verursacht wurde.
| Datensatz | Probenquelle | Modul | Gewebe abgeglichen | n Paare | Mittlere akute-Entlassungs-Differenz | Cohen dz | AUROC | FDR des gepaarten Tests |
| GSE97741 | Blut | Blut | Ja | 68 | 0,330 | 0,740 | 0,765 | 1,98 × 10⁻⁷ |
| GSE97741 | Blut | Nasal | Nein | 68 | 0,479 | 0,721 | 0,755 | 3,19 × 10⁻⁷ |
| GSE97742 | Nasopharyngeal | Blut | Nein | 68 | 0,361 | 0,914 | 0,845 | 9,42 × 10⁻¹⁰ |
| GSE97742 | Nasopharyngeal | Nasal | Ja | 68 | 0,436 | 0,477 | 0,679 | 3,06 × 10⁻⁴ |
Tabelle 4: Unabhängige longitudinale Akut- versus Entlassungs-Validierung. In der Tabelle sind die Anzahl der vollständigen Paare, die durchschnittliche Differenz zwischen Akut- und Entlassungswert, Cohens dz, die AUROC sowie der FDR-Wert des gepaarten Tests für die festen Module in GSE97741 und GSE97742 angegeben. Ein positiver Delta-Wert zeigt einen höheren Modulwert während der akuten Erkrankung an. Die FDR-Werte des gepaarten Tests entsprechen den mit der Methode von Benjamini–Hochberg angepassten zweiseitigen P-Werten des gepaarten t-Tests, berechnet über alle 20 gültigen gepaarten t-Tests in der vollständigen longitudinalen Ausgabe.
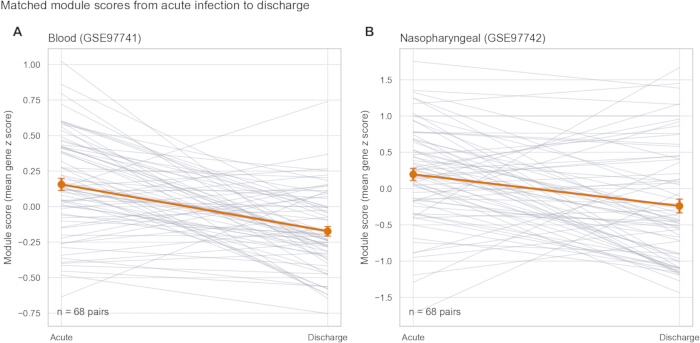
Abbildung 5. GePaarte Änderungen der Modul-Scores von der akuten Erkrankung bis zur Entlassung. (A) Modul-Scores im Vollblut (GSE97741). (B) Nasale Modul-Scores in nasopharyngealen Proben (GSE97742). Jedes Diagramm enthält 68 vollständige Probenpaare: 38 RSV-Einzelinfektionen und 30 Rhinovirus-Infektionen. Dünne Linien verbinden die den Probanden zugeordneten Messungen. Orangefarbene Punkte zeigen die Gruppenmittelwerte, orangefarbene Fehlerbalken die Standardfehler des Mittelwerts. Zweiseitige gepaarte t-Tests und Wilcoxon-gepaarte Rangtests wurden durchgeführt; die FDR-Korrektur nach Benjamini–Hochberg wurde auf die 20 gültigen longitudinalen gepaarten t-Tests angewandt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Die Kreuzkompartimenttests zeigten eine nützliche Feinheit. Das Blutmodul, angewendet auf nasopharyngeale Proben, ergab eine AUROC von 0,845, obwohl die individuellen Effektstärken von Nase und Blut im Anker nur schwach übereinstimmten. Die Untersuchung gepaarter Verläufe zeigte einen durchgängigen Abfall der Werte, anstatt einer umgekehrten Verteilung der Beschriftungen. Das Ergebnis ist daher kein Hinweis darauf, dass dieselben Einzelgene in beiden Geweben dominieren. Es zeigt vielmehr, dass ein koordiniertes Interferon-/Entzündungsprogramm durch unterschiedliche, aber teilweise redundante Gen-Sets zusammengefasst werden kann. Die Kompartiment-Spezifität ist auf der Ebene der Gen-Rangfolge am stärksten ausgeprägt, jedoch nicht absolut auf der Ebene von Pfadwegen oder Scores.
Ausgeschlossene asymptomatische Nachweise zur Überprüfung des Symptomengradientenverhaltens getestet
Asymptomatische Picornavirus-Nachweise in GSE117827 wurden von der Modulkonstruktion ausgeschlossen, um sie nicht in die primäre Kontrollgruppe einzubeziehen. Diese ausgeschlossene Gruppe diente anschließend als biologische Überprüfung. In beiden Kompartimenten stiegen die Modulwerte über die geordneten Gruppen hinweg an: virusnegative Kontrollen, asymptomatischer Picornavirus-Nachweis und symptomatische Infektion (Abbildung 6A,B).
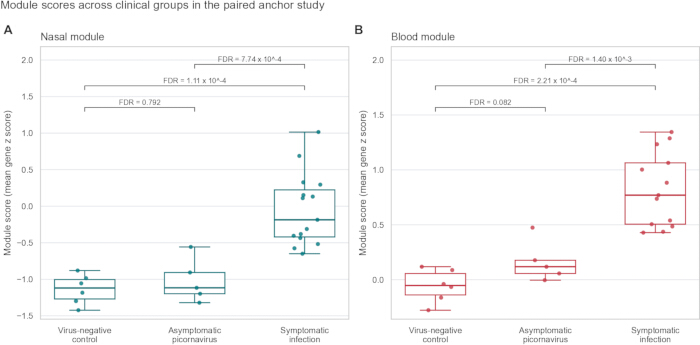
Abbildung 6. Modulscores entlang des ausgelassenen Symptomgradienten. (A) Nasenmodul: 6 virusnegative Kontrollen, 5 asymptomatische Picornavirus-Nachweise und 15 symptomatische Infektionen. (B) Blutmodul: 6 virusnegative Kontrollen, 5 asymptomatische Picornavirus-Nachweise und 13 symptomatische Infektionen. Die Punkte repräsentieren einzelne Proben. Die mittleren Linien zeigen die Mediane an; die Boxen erstrecken sich vom 25. bis zum 75. Perzentil; die Whisker reichen bis zu den extremsten Werten innerhalb des 1,5-fachen des Interquartilsabstands. Die Beschriftungen geben zweiseitige post-hoc-Vergleiche nach Mann–Whitney U mit Benjamini–Hochberg-Korrektur für jeweils drei Vergleiche pro Kompartiment an. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Das nasale Modul korrelierte mit dem ordinalen Symptom-Score (Spearman-Rho = 0,818, P = 3,28 × 10⁻7; Kruskal-Wallis P = 1,57 × 10⁻4). Das Blutmodul zeigte einen ähnlichen Gradienten (Rho = 0,861, P = 6,89 × 10⁻8; Kruskal-Wallis P = 1,92 × 10⁻4). Nach Korrektur innerhalb jeder Dreivergleichsgruppe unterschied sich die symptomatische Infektion sowohl im nasalen als auch im Blutkompartiment von den Kontrollen und den asymptomatischen Nachweisen. Asymptomatische Nachweise unterschieden sich nicht von virusnegativen Kontrollen (nasales FDR = 0,792; Blut-FDR = 0,082). Die Module verfolgten somit die symptomatische Wirtsantwortaktivität deutlicher als der alleinige virale Nachweis.
Klinische Referenzwerte definierten die Grenze zwischen Wirtsantwort und Pathogenspezifität
Klinische Referenzwerte definierten den Unterschied zwischen Aktivität der Wirtsantwort und Pathogenklassifizierung (Tabelle 5; Abbildung 7). In GSE63990 erzielte das nasale Modul AUROCs von 0,782 für virale versus bakterielle Erkrankungen und 0,791 für virale versus nichtinfektiöse Erkrankungen. Das Blutmodul ergab entsprechend AUROCs von 0,678 und 0,753. Der Pandya-33-mRNA-Vergleichsansatz zeigte bessere Werte mit AUROCs von 0,867 bzw. 0,852. Dieses Ergebnis ist bei einem für die Unterscheidung von viral und nicht-viral konzipierten Satz zu erwarten und zeigt, dass die Ankermodule nicht als Ersatz-Diagnoseklassifikatoren dargestellt werden sollten.
| Datensatz | Kontrast | Nasal-Anker | Blut-Anker | Pandya 33 mRNA | Andres-Terre ISG | Hallmark Interferon-alpha |
| GSE63990 | Viral vs. bakteriell | 0,782 | 0,678 | 0,867 | 0,833 | 0,831 |
| GSE63990 | Viral vs. nicht-infektiös | 0,791 | 0,753 | 0,852 | 0,851 | 0,848 |
| GSE40012 | Virale Pneumonie vs. bakterielle Pneumonie | 0,755 | 0,789 | 0,893 | 0,867 | 0,872 |
| GSE40012 | Virale Pneumonie vs. SIRS | 0,897 | 0,907 | 0,985 | 0,965 | 0,956 |
| GSE40012 | Virale Pneumonie vs. gesund | 0,804 | 0,986 | 0,923 | 0,906 | 0,891 |
| GSE40012 | Bakterielle Pneumonie vs. gesund | 0,476 | 0,917 | 0,465 | 0,391 | 0,378 |
| GSE53543 | Ex vivo Rhinovirus-stimulierte vs. unstimulierte PBMCs | 1 | 0,957 | 1 | 1 | 1 |
Tabelle 5: AUROC-Benchmark für Ankermodule und Referenz-Sets zur Wirtsantwort. GSE63990 und GSE40012 sind klinische Ganzblut-Kohorten. GSE53543 ist ein ex vivo PBMC-Störungsexperiment mit 98 gepaarten Probanden und wird separat von den natürlichen klinischen Kohorten berichtet. Die Referenz-Sets wurden als ungewichtete Genmittelwerte bewertet, anstelle ihrer ursprünglichen gewichteten Klassifikatoren. AUROC-Werte werden als Benchmarking-Maßzahlen angegeben und nicht als Schätzwerte der klinischen diagnostischen Leistung.
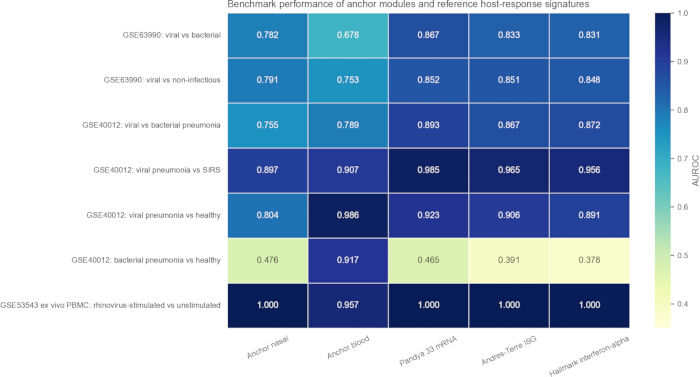
Abbildung 7. AUROC-Benchmarking von Ankermodulen und Referenz-Host-Response-Sets. Die Zeilen repräsentieren vorab festgelegte Vergleiche in GSE63990, GSE40012 und GSE53543; die Spalten repräsentieren die beiden Ankermodule und drei ungewichtete Referenzsets. GSE53543 ist als ex vivo Rhinovirus-stimulierte im Vergleich zu unstimulierten PBMCs gekennzeichnet und separat von den natürlichen klinischen Kohorten dargestellt. Der Hallmark-Vergleichsset ist als Hallmark-Interferon-alpha gekennzeichnet. Die Zellenwerte geben die zur Methodenbewertung verwendeten AUROC-Werte an und sollten nicht als Schätzwerte der klinischen diagnostischen Leistung interpretiert werden. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
GSE40012 präzisierte diese Grenze. Der Pandya-Vergleichsalgorithmus erreichte AUC-Werte (AUROC) von 0,893 für virale versus bakterielle Pneumonie und von 0,985 für virale Pneumonie versus SIRS. Das Blutmodul unterschied Influenza-A-Pneumonie von gesunden Kontrollen (AUROC = 0,986) sowie von SIRS (AUROC = 0,907), trennte aber auch bakterielle Pneumonie von gesunden Kontrollen (AUROC = 0,917). Das Blutmodul misst somit eine breite, systemische entzündliche und interferonassoziierte Aktivität. Es ist nicht virus-spezifisch, und ein hoher Wert kann keine Zuweisung zur Erregerklasse ermöglichen.
In dem separaten ex vivo PBMC-Benchmark GSE53543 erreichten das nasale Modul und die Interferon-Vergleichsparameter für Rhinovirus-stimulierte gegenüber nur mit Medium behandelten PBMCs einen AUROC von 1,000; das Blutmodul erreichte einen AUROC von 0,957. Alle 98 Probanden trugen gepaarte Bedingungen bei. Dieses kontrollierte Ergebnis untermauert die Ansprechbarkeit der bewerteten Programme auf Rhinovirus-Stimulation. Es schätzt jedoch nicht die klinische diagnostische Leistungsfähigkeit ab.
Robustheitsprüfungen testeten Modulgröße, zufällige Alternativen und Stabilität der Auswahl
Die Ankerseparation blieb unverändert bei den jeweils 10, 25, 50, 100 und 200 am höchsten bewerteten Genen (Abbildung 8A). Diese internen AUROC-Werte stellen keine externe Validierung dar, zeigen aber, dass das qualitative Ergebnis nicht davon abhängt, exakt 50 Gene auszuwählen. Bei 500 zufälligen 50-Gen-Sätzen lagen die medianen Null-AUROC-Werte bei 0,489 für nasales Gewebe und 0,705 für Blut; die entsprechenden 99. Perzentile betrugen 0,722 bzw. 0,872 (Abbildung 8B). Die beobachteten Module lagen über diesen Nullverteilungen. Die Häufigkeiten der Bootstrap-Auswahl waren breit verteilt und nicht auf eine einzige invariable Liste konzentriert (Abbildung 8C). Dieses Ergebnis spiegelt direkt die geringe Größe der Ankerstichprobe wider. Es untermauert ein stabiles Gesamtsignal, warnt jedoch davor, jedes ausgewählte Gen als feststehend zu betrachten.
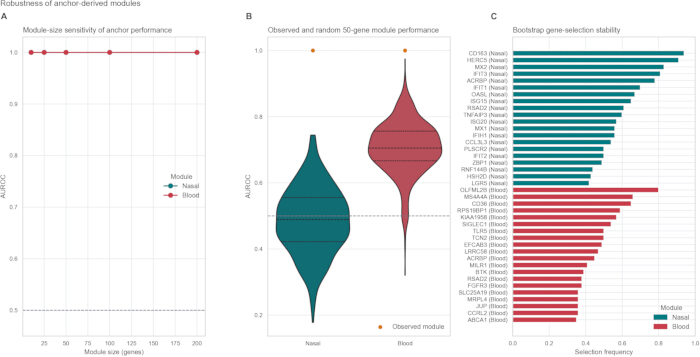
Abbildung 8. Analysen zur Modulgröße, Zufalls-Gen- und Bootstrap-Robustheit. (A) Anchor-AUROC über Modulgrößen von 10, 25, 50, 100 und 200 Genen; diese Werte stellen interne Sensitivitätsprüfungen dar. (B) AUROC-Verteilungen aus 500 zufälligen, protein-kodierenden 50-Gen-Sätzen, die ohne Zurücklegen aus den in GSE117827 vertretenen Genen gezogen wurden (Zufallskeimzahl = 20260622). Die orangefarbenen Punkte zeigen die beobachteten Modul-AUROCs an. Horizontale Linien innerhalb jedes Violin-Plots kennzeichnen das 25. Perzentil, den Median und das 75. Perzentil. (C) Bei der Bootstrap-Neuauswahl wurden nur die 1.000 protein-kodierenden Gene mit positivem Effekt berücksichtigt, die in der ursprünglichen Anchor-Analyse für jeden Kompartiment am höchsten eingestuft wurden. Die Balken zeigen die 20 Gene mit der höchsten Selektionshäufigkeit pro Kompartiment an; die Selektionshäufigkeit wurde als Anzahl der Auswahlen dividiert durch 100 berechnet. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Marker-Programm- und Varianzanalysen verdeutlichten, was die Werte messen
In den Datensätzen GSE40012, GSE53543 und GSE63990 korrelierten beide Module am stärksten und konsistentest mit dem myeloischen Interferon-Programm (Abbildung 9A). Die Korrelationen des Nasal-Moduls betrugen 0,812, 0,878 und 0,882; die des Blut-Moduls 0,517, 0,843 und 0,774. Die Varianzaufteilung war beschreibend (Tabelle 6; Abbildung 9B). Für das Blut-Modul erklärten die biologische Bedingung und die detaillierte Gruppe mehr Varianz (Eta² = 0,282 bzw. 0,250) als der Datensatz (0,066), der Proben-Typ (0,026) oder die Quellgruppe (0,025). Für das Nasal-Modul erklärten ebenfalls die detaillierte Gruppe und die biologische Bedingung mehr Varianz als der Datensatz, der Proben-Typ oder die Quellgruppe. Biologische Bedingung und detaillierte Gruppe trugen somit zu einem größeren Anteil an der Varianz der Modulwerte bei als der Datensatz oder der Proben-Typ, obwohl nicht vernachlässigbare Effekte des Datensatzes und der Probengruppenzusammensetzung eine Limitation der erneuten Nutzung öffentlicher Bulk-Daten darstellen.
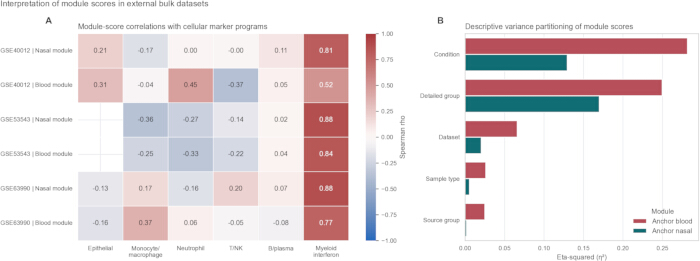
Abbildung 9. Korrelationen zwischen Markern und Programmen sowie deskriptive Varianzzerlegung. (A) Spearman-Korrelationen zwischen Modul-Scores und sechs Marker-Programm-Scores in GSE40012, GSE53543 und GSE63990. Für die Programme wurden mindestens drei vertretene Gene benötigt. P-Werte wurden über alle Dataset-Modul-Programm-Korrelationen hinweg adjustiert. Leere Zellen zeigen nicht verfügbare oder nicht schätzbare Kombinationen nach Gen- und Stichprobenanforderungen an. (B) Einfaktorielles Eta-Quadrat (η2; Anteil der Quadratsumme zwischen den Gruppen an der gesamten Quadratsumme) für Bedingung, detaillierte Gruppe, Datensatz, Probenart und Quellgruppe. Die Analyse umfasste 934 Blut-Modul- und 1.469 Nasen-Modul-Scores und ist deskriptiv, nicht kausal. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Modul | Faktor | Eta-Quadrat | n Stichproben |
| Ankerblut | Bedingung | 0.282 | 934 |
| Ankerblut | Detaillierte Gruppe | 0.25 | 934 |
| Ankerblut | Datensatz | 0.066 | 934 |
| Ankerblut | Probenart | 0.026 | 934 |
| Ankerblut | Quellgruppe | 0.025 | 934 |
| Ankernasal | Detaillierte Gruppe | 0.17 | 1469 |
| Ankernasal | Bedingung | 0.13 | 1469 |
| Ankernasal | Datensatz | 0.021 | 1469 |
| Ankernasal | Probenart | 0.006 | 1469 |
| Ankernasal | Quellgruppe | 0.002 | 1469 |
Tabelle 6: Deskriptive Varianzaufteilung der Modulwerte. Für jedes Modul-Faktor-Paar ist eine Zeile mit dem entsprechenden Eta-Quadrat und der Stichprobengröße angegeben. Eta-Quadrat wurde berechnet als die Quadratsumme zwischen den Gruppen dividiert durch die gesamte Quadratsumme, nachdem Zeilen mit fehlenden Werten für den jeweiligen Modulwert oder Faktor ausgeschlossen wurden. Die Faktoren wurden einzeln bewertet; daher ist die Analyse deskriptiv, berücksichtigt keine gegenseitig korrelierten Faktoren und darf nicht kausal interpretiert werden.
Datenverfügbarkeit:
Alle in dieser Studie analysierten transkriptomischen Datensätze sind öffentlich über die Gene Expression Omnibus unter den Zugangsnummern GSE117827, GSE41374, GSE152075, GSE156063, GSE171110, GSE38900, GSE97741, GSE97742, GSE63990, GSE40012 und GSE53543 verfügbar. Die aus der Analyse gewonnenen Daten, die den Hauptabbildungen und -tabellen zugrunde liegen, sowie der Analysecode sind auf begründete Anfrage beim entsprechenden Autor erhältlich. In dieser Studie wurden keine eingeschränkten oder neu generierten daten auf Ebene der Teilnehmer verwendet.
Diskussion
Die Haupterkenntnis betrifft die praktische Durchführung: Beginnen Sie mit dem untersuchten Kompartiment, nicht mit der größten gepoolten Matrix. GSE117827 ist klein, aber das gepaarte Design ermöglicht einen direkten Vergleich von Nasen- und Blutproben innerhalb einer einzigen Studie. Die nahezu null liegende Gen-ebenen-Effektkorrelation zeigt, dass eine gepoolte, pan-gewebliche Rangliste erhebliche kompartimentäre Strukturen verbergen würde. Separate Module waren daher das vertretbarere Design. Ihre externe und longitudinale Leistungsfähigkeit untermauert reproduzierbare Aktivität der Wirtsantwort auf Modulebene, nicht eine universelle Genliste.
Gen- und Modul-Ebene sind unterschiedlich übertragbar. Das Blutmodul zeigte eine gute Leistung in nasopharyngealen longitudinalen Proben (AUROC 0,845), obwohl die Übereinstimmung zwischen individuellen nasalen und blutbasierten Effektgrößen gering war. Bei den gepaarten Trajektorien trat kein Label-Umschlag auf. Eine wahrscheinlichere Erklärung ist die Redundanz von Wegen: koordinierte Interferon- und entzündliche Aktivität kann in verschiedenen Kompartimenten durch unterschiedliche Teilmengen von Genen zusammengefasst werden6,7,8,9,10,11,32,33,34. Aus diesem Grund beschreiben wir die Module als kompartimentbezogen statt kompartimentexklusiv. Die genauen Rangfolgen unterscheiden sich, aber eine gemeinsame komponentenbasierte Wegaktivität bleibt nachweisbar. Bulk-Profile vermischen außerdem Expressionsänderungen mit Veränderungen in der Zellzusammensetzung. Korrelationen zwischen Markerprogrammen können dieses Problem aufzeigen, liefern jedoch keine zellauflösenden Mechanismen36,37.
Die klinischen Referenzwerte definieren eine zweite Grenze. Die Pandya-33-mRNA- und Interferon-Vergleichsverfahren zeigten eine stärkere Trennschärfe bei der Unterscheidung von viralen und bakteriellen Infektionen. Die Ankermodule beantworten eine andere Frage: Wie stark exprimiert eine Probe ein Programm der akuten Wirtsantwort? Das Blutmodul stieg ebenfalls bei bakterieller Pneumonie an. Es sollte daher als Score für eine breite systemische entzündliche/Interferon-Aktivität verstanden werden, nicht als virus-spezifischer Klassifikator. Ein hoher Wert kann den Vergleich von Kohorten, die Verfolgung der Antwort oder die Beschreibung eines entzündlichen Zustands unterstützen, erlaubt aber keine Identifizierung des Erregers. Die zunehmende klinische Bedeutung von Viren wie dem humanen Metapneumovirus spricht zudem für eine validierte, erregervielfältige und gewebegerechte Untersuchung statt einer Extrapolation von einer engen Virusgruppe12,13.
Die sechs Überlappungsgene sind explorativ. ISG15, IFIT1, RSAD2 und XAF1 haben plausible, mit Interferonen verknüpfte Funktionen32,33,34; CCRL2 ist mit der Wanderung entzündlicher Leukozyten assoziiert35; ACRBP hat keine etablierte antivirale Interpretation. Die kleine Kohorte und die nicht signifikanten, geneweisen FDR-Werte verbieten stärkere Aussagen. Die methodische Innovation liegt anderswo: bei einem innerhalb derselben Studie gepaarten Anker, festgelegten kompartmentspezifischen Modulen, gewebegleichen externen Tests, gepaarter Wiederfindungsanalyse, Benchmarking mit klinischen Vergleichsparametern sowie expliziten Zufalls-, Größen-, Bootstrap-, Marker- und Varianzprüfungen. Diese Evidenzhierarchie bietet einen konservativen Rahmen zur Interpretation der Ergebnisse.
Mehrere Einschränkungen bleiben bestehen. Die Anker-Kohorte umfasst nur 15 infizierte und 6 Kontroll-Nasalproben sowie 13 infizierte und 6 Kontroll-Blutproben. Bootstrap-Analysen bestätigen, dass die Zugehörigkeit einzelner Gene nicht vollständig stabil ist. Symptomatische RSV- und Picornavirus-Infektionen wurden zusammengefasst, sodass die Anker-Effekte nicht virus-spezifisch sind. Externe Kohorten unterscheiden sich hinsichtlich Alter, Plattform, Schweregrad, Zeitpunkt und Definition der Kontrollen. GSE53543 ist eine ex-vivo gepaarte Störungsstudie. GSE63990 und GSE40012 liefern nützliche klinische Vergleichsgruppen, jedoch keine gepaarte Nasal-Blut-Probenahme. Virenlast, Symptomdauer, Sauerstoffbedarf und Schweregrad lagen nicht durchgängig vor. Ein stärkeres prospektives Design würde Nasalabstriche und Blutproben von denselben Teilnehmern zu zeitlich abgestimmten Zeitpunkten erheben, ergänzt durch Messungen der Virenlast und der Symptome, vergleichende Gruppen mit bakteriellen und symptomatischen virus-negativen Proben sowie eine zellulär aufgelöste Validierung11,14,36,37.
Zusammenfassend unterstützen aktuelle öffentliche Transkriptomdaten reproduzierbare Module der Wirt-Antwort-Aktivität in Nase und Blut, sofern der Gewebekontext erhalten bleibt. Sie unterstützen jedoch keine austauschbare pan-gewebespezifische Gen-Signatur. Die paarweise verankerte Analyse zeigte eine geringe Übereinstimmung auf Genebene, während feste Modulwerte innerhalb übereinstimmender Gewebe übertragbar waren und während der Genesung abnahmen. Die Antwort des Blutmoduls bei bakterieller Pneumonie sowie die überlegene Leistung eines etablierten Klassifizierers bei der Unterscheidung von viralen und bakteriellen Erregern definieren den vorgesehenen Einsatz: Diese Module beschreiben die Aktivität der Wirt-Antwort und ermöglichen eine transparente Vergleichbarkeit von Kohorten; sie sind keine eigenständigen Klassifizierer für Krankheitserreger. Der Analysecode und die abgeleiteten Daten sind gemäß der Aussage zur Datenverfügbarkeit zugänglich, um eine unabhängige Überprüfung und Wiederverwendung des Workflows zu unterstützen.
Offenlegungen
Die Autoren erklären, dass keine finanziellen oder nichtfinanziellen Interessenkonflikte im Zusammenhang mit dieser Arbeit bestehen.
Danksagungen
Die Autoren danken den beteiligten Forschern und Teilnehmern der öffentlichen GEO-Studien, die in dieser Arbeit erneut analysiert wurden. Weitere Personen erfüllten nicht die Kriterien für eine Autorenschaft. Diese Forschung erhielt keine spezifische Förderung durch öffentliche, kommerzielle oder gemeinnützige Institutionen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Andres-Terre Multi-Virus-Interferon-angeregte Gen-Sammlung | Andres-Terre et al. | 33-Gen-Vergleichssatz; Zusatzdaten 1 | Unbewichteter, interferonorientierter Vergleichssatz, zusammengestellt aus der berichteten Multi-Virus-Signatur; die vollständige Genliste ist in den Zusatzdaten 1 angegeben. |
| Enrichr | Ma'ayan Laboratory | Zugegriffen am 18. August 2026; RRID:SCR_001575 | Ressource zur Analyse der Überrepräsentation von Gen-Sätzen, zugegriffen über gseapy. |
| Gene Expression Omnibus | Nationales Zentrum für Biotechnologieinformationen (National Center for Biotechnology Information) | GEO; RRID:SCR_005012 | Öffentliches Transkriptom-Repository, das zur Nutzung der analysierten Datensätze verwendet wurde. |
| Genontologie | Genontologie-Konsortium (Gene Ontology Consortium) | GO Biologischer Prozess 2023; RRID:SCR_002811 | Funktionelle Anmerkungsbibliothek, verwendet über Enrichr. |
| GPL10558 | NCBI GEO | GPL10558 | Plattform für GSE53543 und die 36-Proben-GSE38900-Validierungseinheit. |
| GPL23126 | NCBI GEO | GPL23126 | Expressionsplattform für GSE117827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Clariom D Human na36, hg38-Anmerkung zur Transkript-Cluster-Zuordnung für GSE117827 verwendet. |
| GPL571 | NCBI GEO | GPL571 | Plattformanmerkung, angewendet auf GSE63990. |
| GPL6884 | NCBI GEO | GPL6884 | Plattform für die 138-Proben-GSE38900 RSV-Ganzblut-Validierungseinheit. |
| GPL6947 | NCBI GEO | GPL6947 | Plattformanmerkung, angewendet auf GSE40012. |
| GSE117827 | NCBI GEO | GSE117827 | Primärer gepaarter Nasenabstrich- und Ganzblut-Ankerdatensatz. |
| GSE152075 | NCBI GEO | GSE152075 | Externer SARS-CoV-2 Oberluftweg-Validierungsdatensatz. |
| GSE156063 | NCBI GEO | GSE156063 | Externer SARS-CoV-2 Oberluftweg-Validierungsdatensatz. |
| GSE171110 | NCBI GEO | GSE171110 | Externer SARS-CoV-2 Ganzblut-Validierungsdatensatz. |
| GSE38900 | NCBI GEO | GSE38900; GPL10558 und GPL6884 | Externer RSV Ganzblut-Validierungsdatensatz, analysiert als separat normalisierte Plattform-Einheiten mit 36 und 138 Proben. |
| GSE40012 | NCBI GEO | GSE40012 | Klinischer Vergleichsdatensatz für Influenza-A-Pneumonie, bakterielle Pneumonie, SIRS und gesunde Kontrollen. |
| GSE41374 | NCBI GEO | GSE41374 | Externer RSV Nasenspül-Validierungsdatensatz. |
| GSE53543 | NCBI GEO | GSE53543 | Gepaarter ex-vivo PBMC Rhinovirus-Störungsvergleich mit 98 Probanden und 196 Proben. |
| GSE63990 | NCBI GEO | GSE63990 | Klinischer Vergleichsdatensatz für virale, bakterielle und nichtinfektiöse Ganzblutproben. |
| GSE97741 | NCBI GEO | GSE97741 | Longitudinaler Ganzblut-Akut-gegen-Entlassung-Validierungsdatensatz. |
| GSE97742 | NCBI GEO | GSE97742 | Longitudinaler nasopharyngealer Akut-gegen-Entlassung-Validierungsdatensatz. |
| gseapy | gseapy-Entwickler | Version 1.3.1 | Python-Schnittstelle zur Abfrage von Enrichr. |
| HGNC Gen-Symbol-Ressource | HUGO Gen-Nomenklatur-Komitee (HUGO Gene Nomenclature Committee) | Zugegriffen am 18. August 2026; RRID:SCR_002827 | Ressource zur Genehmigung der Gen-Symbol-Normalisierung und zur Klassifizierung protein-kodierender Gene. |
| Matplotlib | Matplotlib-Entwicklungsteam | Version 3.11.1 | Erstellung von Abbildungen. |
| MSigDB Hallmark-Gen-Sets | Broad Institute | Hallmark 2020; RRID:SCR_016863 | Enrichment-Bibliothek der Hallmark-Gen-Sets, zugegriffen über Enrichr. |
| MSigDB Hallmark Interferon-alpha-Antwort-Gen-Satz | Broad Institute | HALLMARK_INTERFERON_ALPHA_ RESPONSE; 33-Gen-Kernsubset in Zusatzdaten 1 | Unbewichteter Interferon-alpha-Vergleichssatz; das genaue Subset ist in den Zusatzdaten 1 angegeben. |
| NumPy | NumPy-Entwickler | Version 2.5.2 | Numerische Berechnungen und zufällige Stichproben mit festgelegtem Startwert. |
| pandas | pandas-Entwicklungsteam | Version 3.0.5 | Verarbeitung tabellarischer Daten. |
| Pandya 33-mRNA Wirtsantwort-Gen-Satz | Pandya et al. | Zusatz-Tabelle 1; Zusatzdaten 1 | Offizieller 33-Gen-Satz, bewertet als unbewichteter Vergleichssatz. |
| Python | Python Software Foundation | Version 3.12.13 | Umgebung für die rechnergestützte Analyse. |
| Reactome | Reactome | Reactome 2022; RRID:SCR_003485 | Pfad-Enrichment-Bibliothek, zugegriffen über Enrichr. |
| scikit-learn | scikit-learn-Entwickler | Version 1.9.0 | Berechnung von AUROC und durchschnittlicher Präzision. |
| SciPy | SciPy-Entwickler | Version 1.18.0 | Welch-, gepaarter t-, Wilcoxon-, Mann–Whitney- und Korrelationstests. |
| Seaborn | Seaborn-Entwicklungsteam | Version 0.13.2 | Statistische Grafiken. |
| statsmodels | statsmodels-Entwickler | Version 0.14.6 | Statistische Hilfsprogramme. |
Referenzen
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.