Diese Forschungsarbeit stellte einen Ansatz, FusionNetX, vor, bei dem die Fähigkeit zur Merkmalsfusion von DenseNet121 und EfficientNetB7 durch Datenaugmentierung, Vorverarbeitung und Anpassung des hybriden Modells (intermediate Fusion) verbessert wurde, um Gehirntumore in fünf öffentlich verfügbaren Datensätzen zu klassifizieren, wobei Ergebnisse zwischen 98,77 % und 99,89 % erzielt wurden und der Ansatz in mehreren Evaluierungsparametern überlegen war.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
FusionNetX: Ein Deep-Feature-Fusionsmodell unter Nutzung von MRT und Deep Learning zur verbesserten Detektion von Hirntumoren
In diesem Artikel
Zusammenfassung
Zusammenfassung
Hirntumore gelten als eine der tödlichsten Erkrankungen weltweit, und eine Fehldiagnose gefährdet das Leben der Patienten sowie verringert die Überlebensrate. Die Magnetresonanztomographie (MRT) in Kombination mit auf Deep Learning basierenden Verfahren, insbesondere faltenden neuronalen Netzen, ist entscheidend, um diese Hürde zu überwinden, da sie eine detailliertere Untersuchung der inneren Struktur des Gehirns ermöglicht und hervorragende Lern- und Vorhersagefähigkeiten bietet. Die Notwendigkeit einer genauen Diagnose von Hirntumoren bleibt weiterhin hoch. Daher wird ein erweitertes, auf Merkmalsfusion basierendes Deep-Learning-Modell (FusionNetX) vorgeschlagen, das die Stärken zweier vortrainierter Modelle, DenseNet121 und EfficientNetB7, nutzt und dabei angepasste Hyperparameter für die Feinabstimmung verwendet, einschließlich trainierbarer und nicht-trainierbarer Schichten. Das vorgeschlagene FusionNetX-Modell wurde auf fünf öffentlich verfügbare Datensätze zu Hirntumoren angewandt: Br35H, Figshare, Sartaj, Masoud und Balanced Brain Tumor. Zur Verbesserung der Bildqualität und zur Vermeidung von Überanpassung wurden einige Vorverarbeitungsschritte wie Größenänderung und Datenaugmentierung durchgeführt. Mithilfe verschiedener Leistungsbewertungsmetriken – wie Genauigkeit, Verlust, positiver Vorhersagewert, negativer Vorhersagewert, True-Positive-Rate, True-Negative-Rate, F1-Score, False-Negative-Rate und False-Positive-Rate – zeigte sich, dass das vorgeschlagene Modell FusionNetX eine Genauigkeit von 99,33 % für Br35H, 99,13 % für Figshare, 99,89 % für Masoud, 99,19 % für BBT-Dataset und 98,77 % für Sartaj erreichte. Zusätzlich wurden die fünf Datensätze zu Hirntumoren mittels spätem und auf Aufmerksamkeitsmechanismen basierendem Fusionsverfahren ausgewertet, um die Bedeutung des vorgeschlagenen FusionNetX-Modells zu verdeutlichen; die Ergebnisse waren deutlich besser mit Gewinnen zwischen 0,3 % und 1,9 % über alle Datensätze hinweg. Darüber hinaus wurde die Receiver-Operating-Characteristic-Kurve berechnet, und die Ergebnisse verschiedener Leistungsbewertungsmetriken zeigen, dass das vorgeschlagene FusionNetX-Modell Hirntumore präzise erkennen und vorhersagen kann und somit medizinischem Fachpersonal bei der zeitnahen Entscheidungsfindung hilft.
Einleitung
Krebs ist heutzutage die tödlichste Erkrankung im menschlichen Körper aufgrund seiner Schwere und steigenden Häufigkeit, während mehrere Krebserkrankungen wie Gehirntumore, Brustkrebs, Lungenknoten, Nierenkrebs und andere im menschlichen Körper auftreten und somit die Sterblichkeitsrate erhöhen. Krebs entsteht, wenn sich Zellen oder Gewebe im Körper eines Menschen abnormal vermehren. Wenn sich der Krebs metastasiert, kann er andere Organe schädigen und dadurch noch gefährlicher werden1. Da das Gehirn alle Körperfunktionen steuert, kann jede Schädigung weitreichende Folgen für den gesamten Körper haben. Deshalb sind Gehirntumore oder -krebs für den Menschen so lebensbedrohlich2. Zudem werden Gehirntumore in zwei Hauptkategorien unterteilt: gutartig und bösartig. „Gutartig“ bedeutet im Wesentlichen nicht krebsartig; es handelt sich lediglich um ein Problem im Gehirn, das durch eine Veränderung der Umgebung behoben werden kann. Bei bösartigen Tumoren hingegen wird von einer Gefährdung ausgegangen, da sie aufgrund ihres metastasierenden Verhaltens abnormale Zellen oder Gewebe in andere Körperteile befördern oder von dort aufnehmen können, wodurch auch andere Organe gestört werden und die Wahrscheinlichkeit für die Ausbreitung des Krebses im Körper steigt3.
Außerdem sind laut der American Brain Tumor Association und der Weltgesundheitsorganisation (WHO) Hypophysentumore, Meningiome und Gliome die drei Hauptkategorien von Hirntumoren4. Gliome entstehen aus Gliazellen, die die Neuronen im Gehirn ernähren. Hypophysentumore entstehen in der Hypophyse, die sich am Hirnbasis befindet und für verschiedene Körperfunktionen verantwortlich ist; Meningeome hingegen entstehen in den Hirnhäuten, die die Membranen um Gehirn und Rückenmark schützen. Darüber hinaus werden zur Untersuchung innerer Körperstrukturen zu diagnostischen Zwecken mehrere bildgebende Verfahren eingesetzt, darunter Röntgenaufnahmen, Computertomographien (CT) und die Magnetresonanztomographie (MRT)5,6. Jedes bildgebende Verfahren hat eigene Vor- und Nachteile. Die MRT ist ein bildgebendes Verfahren, das detaillierte Bilder von Weichgewebe und Zellen im Körper liefert, insbesondere im Gehirn. Krebs beinhaltet abnormales Gewebe oder Zellen im Körper, und die MRT ermöglicht detaillierte Darstellungen dieser Anomalien, wodurch sie für die Diagnose von Hirntumoren oder Krebserkrankungen besonders geeignet ist. Zudem ist die MRT sicherer als andere bildgebende Verfahren, da sie während der Untersuchung der inneren Körperanatomie keine schädliche Strahlung erzeugt.
Darüber hinaus werden zahlreiche computergestützte Methoden eingesetzt, um die diagnostischen Herausforderungen bei Gehirntumoren zu bewältigen, darunter maschinelles Lernen (ML), Bildverarbeitung (IP) und Deep Learning (DL). Jeder dieser Ansätze wird auf Bilder angewendet, die mit bildgebenden Verfahren aufgenommen wurden, um die Krebserkrankung zu diagnostizieren7. Diese Verfahren lernen verborgene Muster und Strukturen verschiedener Objekte in den Bildern, um Krebs durch die Identifizierung charakteristischer Muster im betroffenen Bereich zu erkennen. Jeder rechnergestützte Ansatz weist eigene Vor- und Nachteile im Diagnoseprozess auf. ML- und IP-basierte Ansätze extrahieren manuell konstruierte Merkmale, was häufig zu ungenauen Vorhersagen und Fehldiagnosen führt, insbesondere bei größeren Datensätzen8. Um die Probleme der manuellen Merkmalsextraktion zu überwinden, greift man zunehmend auf Deep-Learning-Modelle zurück, sogenannte auf konvolutionalen neuronalen Netzen (CNN) basierende Modelle, die die besten Merkmale automatisch aus den Bildern lernen und extrahieren, um Tumore präzise zu diagnostizieren. DL-basierte Ansätze werden heute häufig in der medizinischen Bildgebung zur Diagnose von Erkrankungen im menschlichen Körper eingesetzt, insbesondere zur frühzeitigen und genauen Erkennung von Gehirntumoren, Brustkrebs, Lungenkrebs und anderen Krankheiten, da sie komplexe Muster in großskaligen Datensätzen erkennen und extrahieren können und dadurch genauere Ergebnisse liefern9. Das Hauptproblem bei DL-Modellen ist der hohe Ressourcenverbrauch und der Bedarf an umfangreicher Datensammlung, was durch einen weiteren Deep-Learning-Ansatz namens Transferlernen10 (TL) überwunden wird. Dabei werden vortrainierte Modelle zur Diagnose der Erkrankung verwendet, wodurch Zeit und Ressourcen gespart werden. Die frühzeitige und genaue Diagnose von Gesundheitsproblemen wird durch vortrainierte Modelle ermöglicht, die bereits grundlegende Merkmale im Hinblick auf Textur, Farbe, Kanten und weitere Aspekte aus einem großen Datensatz gelernt haben. Diese Modelle können anschließend auf einen neuen, zuvor unbekannten Datensatz übertragen werden, indem das Modell genutzt und Hyperparameter sowie trainierbare und nicht trainierbare Schichten hinzugefügt werden11. Es wurde bereits umfangreiche Forschung zur Klassifizierung von Gehirntumoren betrieben, und Tabelle 112,13,14,15,16,17,18,19,20,21,22,23 fasst die Details dieser Forschungsarbeiten zusammen, einschließlich der verwendeten Ansätze, Datensätze und Ergebnisse. Dennoch wurde bisher keine Studie durchgeführt, die eine Methodik anwendet, welche zwei Transferlern-Modelle zur robusten Merkmalsextraktion kombiniert und Regularisierungstechniken anpasst, um ein stabiles Training und Testen sicherzustellen. Eine umfassende Evaluierung der vorgeschlagenen Methodik liefert Einblicke in die Modellleistung über verschiedene Merkmale von Gehirntumoren hinweg.
| Ref | Ansatz | Datenproben | Ergebnisse | Einschränkungen |
| 12 | Angepasstes CNN | Br35H | Genauigkeit = 97,45 %, | Es besteht weiterhin Bedarf an Verbesserungen der Ergebnisse; anstelle eines selbstentwickelten CNN ist es besser, ein bereits vorhandenes CNN-Modell mit Modifikation zu verwenden. |
| Verlust = 0,1141 %, | ||||
| Erkennungsrate = 98,09 %, | ||||
| F1-Score = 97,69 %, | ||||
| Präzision = 97,29 %, | ||||
| Augmentiertes Br35H | Genauigkeit = 98,99 %, | |||
| Präzision = 98,90 %, | ||||
| Verlust = 0,0570 %, | ||||
| Erkennungsrate = 98,91 %, | ||||
| F1-Score = 99,04 % | ||||
| 13 | Feature-Fusion-DNN-Modell | Br35H | Genauigkeit = 98,22 %, | Es besteht weiterhin Bedarf an Verbesserungen der Ergebnisse, und anstelle eines angepassten Modells besteht weiterhin Bedarf an der Verwendung eines bereits vorhandenen Modells zur Merkmalsfusion. |
| FNR = 1,77 %, | ||||
| Sensitivität = 98,2 %, | ||||
| F1-Score = 98 %, | ||||
| Spezifität = 98 %, | ||||
| Figshare | Genauigkeit = 98,01 %, | |||
| Sensitivität = 96,03 %, | ||||
| F1-Score = 96 %, | ||||
| Spezifität = 98,67 %, | ||||
| FNR = 3,96 % | ||||
| 14 | AlexNet mit SGD | Br35H | Genauigkeit = 98,79 %, | Trotzdem besteht Bedarf an weiteren Verbesserungen der Ergebnisse, und wir müssen auch fortgeschrittenere, auf CNN basierende Modelle an verschiedenen Datensätzen testen. |
| MCR = 1,20 %, | ||||
| Sensitivität = 98,98 %, | ||||
| Spezifität = 98,58 %, | ||||
| F1-Score = 98,82 % | ||||
| 15 | InceptionV3 | Figshare | Genauigkeit = 98,89 %, | Die Autoren verwendeten den Figshare-Datensatz, der drei Tumorklassen enthält; anstelle einer Klassifizierung dieser Klassen erfolgt lediglich die Unterscheidung, ob ein Tumor vorliegt oder nicht, und es besteht weiterhin Bedarf an Verbesserungen der Ergebnisse sowie an einer Klassifizierung der Tumorklassen. |
| SensitivitätB = 95,28 %, | ||||
| SensitivitätM = 94,47 % | ||||
| 16 | Optimiertes ResNet50 | Figshare | Genauigkeit = 99,03 %, | Weitere Leistungsparameter müssen berechnet werden, und die Ergebnisse könnten weiter verbessert werden. |
| Erkennungsrate = 99 %, | ||||
| F1-Score = 99 % | ||||
| 17 | Res-BRNet | Br35H | Genauigkeit = 98,22 %, | Es besteht weiterhin Bedarf an Verbesserungen der Ergebnisse. |
| Sensitivität = 98,11 %, | ||||
| Präzision = 98,22 %, | ||||
| Figshare | F1-Score = 98,41 % | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Genauigkeit = 99,18 %, | Die Ergebnisse zeigen eine geringfügige Verbesserung, und es besteht Bedarf, weitere datensätze im Zusammenhang mit Gehirntumoren zu prüfen. |
| Erkennungsrate = 99,11 %, | ||||
| F1-Score = 99,08, | ||||
| Präzision = 99,07 %, | ||||
| Sartaj | Genauigkeit = 97,24 %, | |||
| Erkennungsrate = 97,58 %, | ||||
| F1-Score = 97,28 %, | ||||
| Präzision = 97,06 %, | ||||
| 19 | CNN-SVM | Brats | Genauigkeit = 98,02 %, | Es besteht Bedarf, bereits vorhandene Modelle mit SVM anzuwenden, und es besteht weiterhin Bedarf an Verbesserungen der Ergebnisse. |
| F1-Score = 98,31 %, | ||||
| Präzision = 98,09 %, | ||||
| Sensitivität = 98,53 %, | ||||
| Spezifität = 97,30 %, | ||||
| Sartaj | Genauigkeit = 96,83 %, | |||
| Präzision = 95,36 %, | ||||
| Sensitivität = 94,73 %, | ||||
| Spezifität = 97,56 %, | ||||
| F1-Score = 95 % | ||||
| 20 | Feinabgestimmtes EfficientNetB3 | Figshare | Genauigkeit = 98,70 % | Es besteht Bedarf an den oben genannten Varianten von EfficientNetB3, um die Ergebnisse zu verbessern. |
| Sartaj | Genauigkeit = 97,50 % | |||
| 21 | InceptionV4 | Masoud | Genauigkeit = 98,7 %, | Erforderlich sind einige Verbesserungen der Ergebnisse durch die Nutzung weiterer Datensätze. |
| Präzision = 99 %, | ||||
| Sensitivität = 98 %, | ||||
| Spezifität = 99 %, | ||||
| F1-Score = 99,1 % | ||||
| 22 | VGG16 | Masoud | Genauigkeit = 98 % | Es besteht Bedarf an Verbesserungen der Ergebnisse durch die Prüfung weiterer tiefer neuronaler Netzwerke. |
| 23 | MFR-CNN | Masoud | Genauigkeit = 94 %, | Es handelt sich um eine komplexe Architektur, die in dieser vorgeschlagenen Lösung verwendet wird. |
| Erkennungsrate = 96 %, | ||||
| F1-Score = 96 %, | ||||
| Präzision = 96 %, |
Tabelle 1: Ein vergleichender Überblick über die aktuellsten Forschungsarbeiten. Die Tabelle fasst bestehende Studien zusammen, einschließlich ihrer Ansätze, Datensätze, Ergebnisse und Grenzen. Klicken Sie bitte hier, um diese Tabelle herunterzuladen.
Tabelle 1 fasst bestehende Ansätze zusammen und hebt deren Einschränkungen bei der Verbesserung der Ergebnisse hervor sowie die Notwendigkeit, vorgefertigte DL-Modelle zu verwenden, während ihre Leistung anhand verschiedener statistischer Parameter bewertet wird, alles innerhalb eines effizienten Rahmens, der bei unterschiedlichen Datensätzen von Hirntumoren bessere Ergebnisse erzielt.
Zielsetzung der Studie und Problemstellung
Die manuelle Interpretation ist zeitaufwendig und weist eine Variabilität zwischen Beobachtern auf; daher ist eine schnelle und genaue Kategorisierung von Hirntumortypen mittels MRT für die klinische Entscheidungsfindung entscheidend. Die meisten Deep-Learning-Ansätze zur automatisierten Klassifizierung von Hirntumoren basieren derzeit auf einem einzelnen Backbonenetzwerk oder einer einfachen fusionierten Entscheidungsebene, wodurch die komplementären Merkmalsdarstellungen mehrerer vortrainierter Architekturen nicht vollständig genutzt werden. Zudem werden sie häufig nur an einem einzigen Datensatz validiert, was das Vertrauen in ihre Generalisierbarkeit einschränkt.
Dieses Forschungsprojekt zielt darauf ab, eine vollständige und präzise Methode zur Diagnose von Gehirntumoren im menschlichen Gehirn zu entwickeln und bereitzustellen, die auf einem Deep-Learning-Framework mit doppeltem Backbone (EfficientNetB7 und DenseNet121) basiert und komplementäre Merkmalsdarstellungen nutzt, um eine robuste Klassifizierung von Gehirntumoren aus MRT-Bildern zu ermöglichen. Außerdem wird die Robustheit des Frameworks an mehreren unabhängigen öffentlichen Datensätzen evaluiert. Dieser Ansatz kann Radiologen und medizinischem Fachpersonal helfen, Gehirntumore schnell und effektiv zu diagnostizieren, wodurch das Erkennen und Klassifizieren lebensrettend erfolgen kann.
Um ein bestimmtes Forschungsproblem zu lösen und die Ziele oder Zielsetzungen dieses Forschungsprojekts zu erreichen, lauten die Forschungsfragen und der Beitrag zur Beantwortung dieser Fragen wie folgt: 1) Ist die fusionsbasierte Verknüpfung auf Merkmalsebene (intermediär) zweier vortrainierter Backbonenetzwerke besser als die Entscheidungsstufenfusion (spät) und aufmerksamkeitsbasierte Fusionsverfahren für die Klassifizierung von Hirntumoren? 2) Wird das vorgeschlagene System eine konsistente Klassifizierungsleistung in vielen unabhängig erhobenen MRT-Datensätzen von Hirntumoren liefern?
Der Umfang dieser Studie beschränkt sich auf die Klassifizierung auf Bildebene (2D-MRT-Schnitt) unter Verwendung von fünf öffentlich verfügbaren MRT-Datensätzen von Hirntumoren (Br35H, Figshare, Sartaj, Masoud und BBT-Dataset); die Bewertung erfolgte separat, nicht zwischen den Datensätzen, und unter Anwendung der spezifischen Architektur, der Vorverarbeitungspipeline sowie der experimentellen Konfiguration, die im Methodenteil beschrieben sind. Die Studie beinhaltet keine patientenbasierte Validierung oder klinische Testung unter Einsatzbedingungen.
Die wesentlichen Beiträge dieser Forschungsarbeit sind wie folgt: 1) Der primäre Beitrag dieser Arbeit besteht darin, duale vortrainierte Modelle zur Verbesserung der Merkmalsextraktion einzusetzen, darunter DenseNet121 und EfficientNetb7 mit optimierten Hyperparametern. 2) Eine innovative Modellarchitektur mit einer fortschrittlichen Regularisierungstechnik, die mit konkatenierten Merkmalen eines dual vortrainierten Modells verbunden ist, um eine robuste Leistung zu erzielen. 3) Es wurde eine effektive Strategie zur Datenaugmentierung angewandt, um die Vielfalt der Trainingsstichproben zu erhöhen und allgemeinere sowie spezifischere Merkmale zu erlernen, wodurch Überanpassungsprobleme vermieden werden. 4) Die Leistung des vorgeschlagenen Modells wurde an fünf verschiedenen öffentlich verfügbaren Datensätzen von Hirntumoren bewertet, wobei verschiedene statistische Evaluierungsparameter berücksichtigt wurden, darunter Genauigkeit, Fehlklassifizierungsrate, Präzision, negativer Vorhersagewert, Sensitivität, Spezifität, F1-Score, Falsch-negativ-Rate und Falsch-positiv-Rate.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Die bedrohlichste Krankheit der Welt ist ein Hirntumor. Eine genaue Diagnose kann das Überleben der Patienten verbessern. Dennoch besteht weiterhin Bedarf an einem präzisen Diagnosesystem, das Hirntumore in einem frühen Stadium erkennen kann. Um dieses Problem zu lösen, wurde eine zuverlässigere Technik zur genauen Früherkennung von Hirntumoren vorgeschlagen, die auf einem hybriden, dualen Deep-Learning-Verfahren mit optimierten Hyperparametern und feinabgestimmten Schichten basiert, die auf den Modellen DenseNet121 und EfficientNetB7 beruhen. Der vorgeschlagene Ansatz verwendet 2D-MRT-Bilder als Eingabe und liefert eine Vorhersage über das Vorhandensein oder Nichtvorhandensein eines Tumors für den binären Klassifizierungsdatensatz Br35H sowie die Kategorisierung von Tumoren für vier weitere Multiklassen-Klassifizierungsdatensätze. Dieser Abschnitt beschreibt daher die wesentlichen Schritte des vorgeschlagenen Ansatzes – von der Datensammlung bis zur endgültigen Ausgabe – einschließlich Datenerfassung, Daten-Vorverarbeitung, Datenaufteilung, Modellauswahl, Merkmalsextraktion, Tumordiagnose und Bewertung des vorgeschlagenen Modells, wie in Abbildung 1 dargestellt.
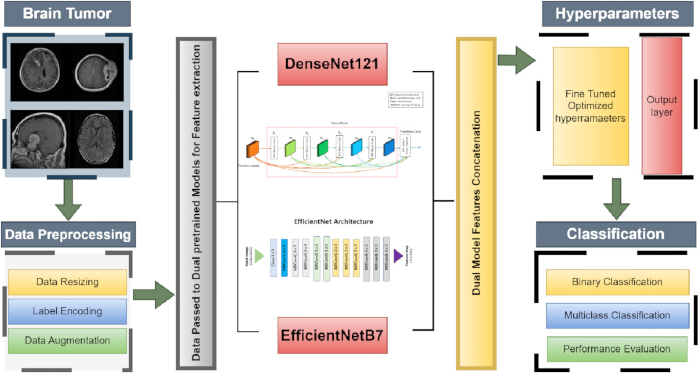
Abbildung 1: Ablaufschema der vorgeschlagenen Methodik. Dieses Diagramm zeigt die Gesamtarchitektur des vorgeschlagenen Modells, einschließlich Datenerfassung und -vorverarbeitung; zwei vortrainierte Modelle zur Merkmalsextraktion; die Konkatenation ihrer Merkmale; sowie die Feinabstimmung der Hyperparameter zur Tumorklassifizierung und -typisierung. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Datenerfassung
In jeder experimentellen Forschung ist der erste Schritt die Datenerfassung. Dafür wurden fünf verschiedene öffentlich verfügbare Datensätze ausgewählt, darunter Br35H24, Figshare25, Sartaj26, Masoud27 und der auf MRT-Bildern basierende Datensatz für Gehirntumore aus der Open-Source-Bibliothek Kaggle28, die bereits von zahlreichen Wissenschaftlern zur Diagnose der Gehirntumorerkennung verwendet wurden. Der Br35H-Datensatz umfasst 3.000 Bilder, die in zwei Klassen unterteilt sind: gesunde und kranke (Tumor-)Gehirnbilder, jeweils mit 1.500 Bildern pro Klasse. Der Figshare-Datensatz besteht aus 3.064 Bildern, die in drei Gruppen nach Tumorart aufgeteilt sind: 1.426 Gliom-Bilder, 708 Meningiom-Bilder und 930 Hypophysentumor-Bilder. Der Sartaj-Datensatz enthält 3.264 Bilder, die in vier Tumorklassen kategorisiert sind: Gliome (926 Bilder), Meningiome (937 Bilder), Hypophysentumore (901 Bilder) und gesund oder kein Tumor (500 Bilder). Der Masoud-Datensatz umfasst ebenfalls vier verschiedene Tumorklassen, wobei die Bilder aus den zuvor genannten drei Datensätzen stammen und insgesamt 7.023 Bilder enthalten, die weiter unterteilt sind in Gliom (1.621 Bilder), Meningiom (1.645 Bilder), Hypophyse (1.757 Bilder) und gesund oder kein Tumor (2.000 Bilder). Der letzte Datensatz ist ein auf MRT-Bildern basierender Datensatz, der ebenfalls vier Klassen mit insgesamt 5.248 Bildern umfasst, die wiederum in Tumorarten unterteilt sind, darunter jeweils 1.312 Gliom-, 1.312 Meningiom-, 1.312 Hypophysentumor- und 1.312 gesunde oder tumorfreie Bilder, die bereits gleichmäßig nach Tumorarten aufgeteilt sind und somit einen ausgewogenen Datensatz darstellen.
Datenvorverarbeitung
Nach der Datenerfassung folgt der nächste Schritt, die Vorverarbeitung, die für bessere Ergebnisse unerlässlich ist und computergestützte Ansätze dabei unterstützt, die besten Merkmale aus den Daten zu extrahieren und zu lernen, wodurch genauere Ergebnisse erzielt werden. Der erste angewendete Schritt war die Änderung der Bildgröße. Fünf öffentlich verfügbare Datensätze mit unterschiedlichen Klassen und Bildgrößen, auch innerhalb desselben Datensatzes für verschiedene Tumorklassen, wurden ausgewählt und einheitlich auf 224 × 224 verkleinert, um eine bessere Modellinterpretation und ein effizienteres Lernen zu ermöglichen. Außerdem wurde eine Datenaugmentierung auf alle Datensätze angewendet, indem zusätzliche Stichproben aus verschiedenen Blickwinkeln erzeugt wurden, wodurch die Merkmalsextraktion und das Lernen durch DL-Modelle verbessert wurden. Dazu wurde ein Rotationsbereich von 7 % auf alle Bilder angewendet, wobei sie bis zu 7 Grad gedreht wurden. Weiterhin wurde eine zufällige Verschiebung um 5 % horizontal und vertikal auf alle Bilder angewendet, mit einer Verschiebung von 5 % in Höhe und Breite bezogen auf die ursprünglichen Bilder. Danach wurden die Bilder um 10 % im Vergleich zu den ursprünglichen Bildern herangezoomt, und schließlich wurden alle Bilder horizontal und vertikal gespiegelt. Der Hauptgrund für die Durchführung der Datenaugmentierung29 besteht darin, Überanpassung zu vermeiden und die Generalisierungsfähigkeit der Modelle zu verbessern, indem mit verschiedenen transformierten Versionen der ursprünglichen Datensätze trainiert wird. Vor der Aufteilung der Datensätze in Trainings- und Validierungsdaten wurde eine Label-Codierung angewendet, die hilfreich ist, um den Verlust während des Trainings und der Validierung besser berechnen zu können und die Datenstichproben für die Modelle aussagekräftiger zu machen, sodass die Labels korrekt verarbeitet werden können. Zusätzlich wurde der Datensatz in Trainings- und Validierungssets mit einem Verhältnis von 80 % zu 20 %30 aufgeteilt, und Tabelle 2 zeigt die gesamte Verteilung der Datenstichproben sowie ihre Trainings- und Validierungsanteile.
| Datensatz | Tumorklassen | Gesamtanzahl der Bilder | Trainingsbilder | Validierungsbilder |
| Br35H | Gesund | 1500 | 1200 | 300 |
| Tumor | 1500 | 1200 | 300 | |
| Gesamtanzahl der Bilder | 3000 | 2400 | 600 | |
| Figshare | Gliom | 1426 | 1141 | 285 |
| Meningeom | 708 | 566 | 142 | |
| Hypophysentumor | 930 | 744 | 186 | |
| Gesamtanzahl der Bilder | 3064 | 2451 | 613 | |
| Sartaj | Gliom | 926 | 741 | 185 |
| Meningeom | 937 | 749 | 188 | |
| Kein Tumor | 500 | 400 | 100 | |
| Hypophysentumor | 901 | 721 | 180 | |
| Gesamtanzahl der Bilder | 3264 | 2611 | 653 | |
| Masoud | Gliom | 1621 | 1297 | 324 |
| Meningeom | 1645 | 1316 | 329 | |
| Kein Tumor | 2000 | 1600 | 400 | |
| Hypophysentumor | 1757 | 1405 | 352 | |
| Gesamtanzahl der Bilder | 7023 | 5618 | 1405 | |
| Ausgewogener Gehirntumordatensatz (BBT-Datensatz) | Gliom | 1312 | 1050 | 262 |
| Meningeom | 1312 | 1050 | 262 | |
| Kein Tumor | 1312 | 1050 | 262 | |
| Hypophysentumor | 1312 | 1050 | 262 | |
| Gesamtanzahl der Bilder | 5248 | 4200 | 1048 |
Tabelle 2: Verteilung des Datensatzes. Die Tabelle zeigt klassenweise Statistiken zur Gesamtanzahl sowie zu den Anzahlen der Trainings- und Validierungsbilder in Datensätzen von Hirntumoren.
Der Br35H-Datensatz besteht aus 3000 Bildern, wobei 2400 zur Schulung und 600 zur Validierung ausgewählt wurden. Der Figshare-Datensatz umfasst 3064 Bilder. Von allen Bildern wurden 2451 zur Schulung ausgewählt und die verbleibenden 613 zur Validierung. Der Sartaj-Datensatz weist insgesamt 3264 Bilder auf, wobei 2611 für das Training verwendet wurden und die restlichen 653 zur Validierung dienten. Der Masoud-Datensatz umfasst insgesamt 7023 Bilder; davon wurden 5618 für das Training genutzt und die verbleibenden 1405 zur Validierung. Der BBT-Datensatz besteht aus insgesamt 5248 Bildern. Von diesen wurden 4200 für Schulungszwecke herangezogen, während die verbleibenden 1048 Bilder für die Validierung verwendet wurden. Zusätzlich Abbildung 2 unten zeigt die verschiedenen Bilder von Gehirntumoren.
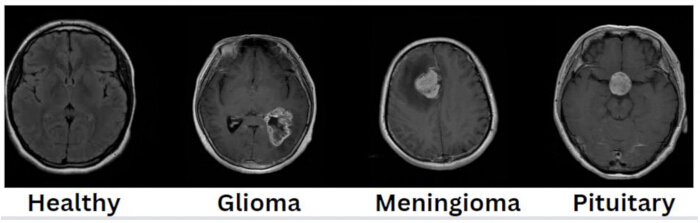
Abbildung 2: Bilder von Hirntumoren, einschließlich der Tumorarten. Der Datensatz enthält vier Bilder gesunden Hirngewebes und drei Bilder mit Tumoren: Gliom, Meningeom und Hypophysentumor. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Vorgeschlagenes Modell
Nach der Vorverarbeitung folgt der nächste Schritt, ein Trainingsmodell vorzuschlagen, das ausschließlich für die Klassifizierung von Hirntumoren geeignet ist. Dazu wurde ein effizientes Modell zum Training speziell für die Klassifizierung von Hirntumoren vorgeschlagen. Im Einzelnen handelt es sich um ein neuartiges und effizientes, auf hybrider Merkmalsfusion basierendes vortrainiertes Modell, das DenseNet12131,32 und EfficientNetB733 umfasst, welche zur Extraktion der Merkmale aus den Bildern verwendet wurden. Die so extrahierten Merkmale wurden anschließend konkateniert und an verschiedene feinabgestimmte Hyperparameter weitergeleitet, darunter trainierbare und nicht trainierbare Schichten, um Hirntumore präzise zu diagnostizieren. Das Modell wurde auf fünf verschiedenen öffentlich verfügbaren Datensätzen implementiert, die in den oben genannten verwandten Abschnitten diskutiert wurden. Darüber hinaus wurde das DenseNet121-Modell 2017 von Gao Huang und seinen Mitarbeitern entwickelt und besteht aus 121 Schichten. Das Hauptziel dieses Modells bestand darin, die Wiederverwendung von Merkmalen zu maximieren und das Problem des verschwindenden Gradienten zu vermeiden34. Die Schichten dieses Modells sind in dichten Blöcken organisiert, wobei jeder Block mehrere Faltungsschichten enthält, die Merkmale extrahieren und lernen. Jede Schicht nimmt die Merkmalskarte aller vorhergehenden Schichten als Eingabe, und ihre Ausgabe wird mit den Ausgaben dieser Schichten verbunden und als Eingabe an nachfolgende Schichten innerhalb desselben Blocks in vorwärtsgerichteter Weise weitergeleitet. Zwischen den dichten Blöcken werden Übergangsschichten hinzugefügt, die jeweils aus einer 1 × 1-Faltungsschicht, einer Batch-Normalisierungsschicht und 2 × 2-Durchschnittspooling-Schichten bestehen und die Merkmalskarte reduzieren, um die Komplexität des Modells zu steuern. Zusätzlich wird eine letzte Schicht mit einer SoftMax-Aktivierungsfunktion (AF) vor einer globalen Durchschnittspooling-Schicht für die Klassifizierung hinzugefügt. Der grundlegende Aufbau des DenseNet121-Modells ist in Abbildung 334 unten dargestellt.
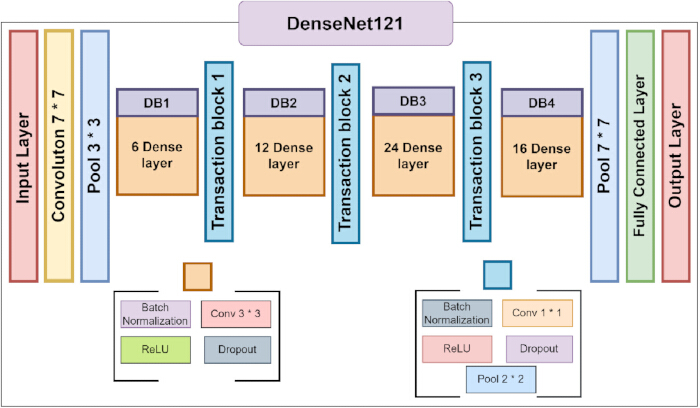
Abbildung 3: Detaillierte Architektur von DenseNet12134. Diese Abbildung zeigt die architektonischen Details des DenseNet121-Modells, einschließlich aller dichten Blöcke und Übergangsblöcke. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Weiterhin wurde das EfficientNetB7-Modell 2019 von Tan und Lee entwickelt. Es gehört zur EfficientNet-Familie mit Varianten von B0 bis B7, wobei das Hauptziel darin besteht, andere Modelle zu übertreffen, während gleichzeitig weniger Parameter und geringere Rechenleistung benötigt werden. Die Modellbreite (Anzahl der Kanäle pro Schicht), -tiefe (Anzahl der Schichten) und -auflösung können alle über eine kombinierte Skalierung feinabgestimmt werden, die das zentrale Merkmal des Modells darstellt. Zudem besteht dieses Modell aus MBConv-Blöcken (mobile inverted bottleneck convolutional), die eine 1 × 1-Faltungserweitungsschicht enthalten, die für die Erweiterung der Kanäle zuständig ist, eine tiefenweise separable Faltung, die jeweils auf jeden Kanal separat angewendet wird, sowie eine 1 × 1-Faltungsprojektionsschicht, die die Anzahl der Kanäle wieder auf den ursprünglichen Wert reduziert. Jeder MBConv-Block enthält außerdem Squeeze-and-Excitation-(SE)-Blöcke35, die kanalweise Merkmale neu kalibrieren und dem Netzwerk helfen, sich auf die wichtigsten zu konzentrieren. Anstelle der Sigmoid-Funktion oder einer anderen Aktivierungsfunktion (AF) kommt die Swish-Funktion zum Einsatz, die im Vergleich zu ReLU bessere Leistung erbringt, da sie negative Werte zulässt und dadurch den Gradientenfluss verbessert. Außerdem wird eine finale Ausgabeschicht mit einer SoftMax-Aktivierungsfunktion vor einer globalen Durchschnittspooling-Schicht für Klassifizierungszwecke hinzugefügt. Abbildung 435 zeigt den grundlegenden Aufbau des EfficientNetB7-Modells, während Abbildung 5 die empfohlene Modellarchitektur darstellt.
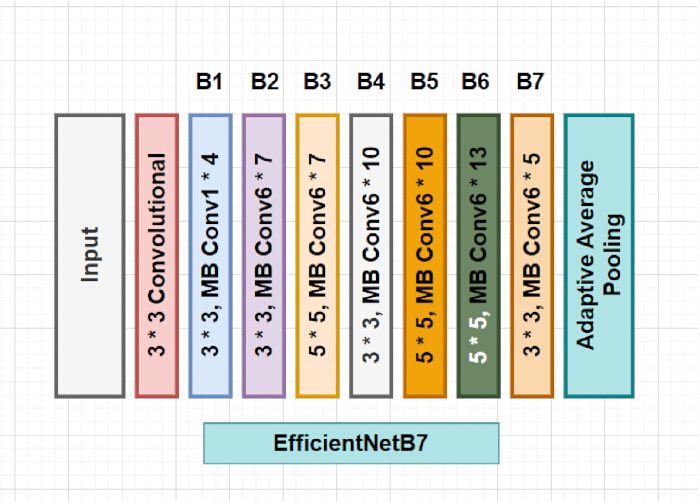
Abbildung 4: Detaillierte Architektur von EfficientNetB735. Diese Abbildung zeigt die detaillierte Architektur des EfficientNetB7-Modells, einschließlich aller mobilen invertierten Bottleneck-Konvolutionseinheiten. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
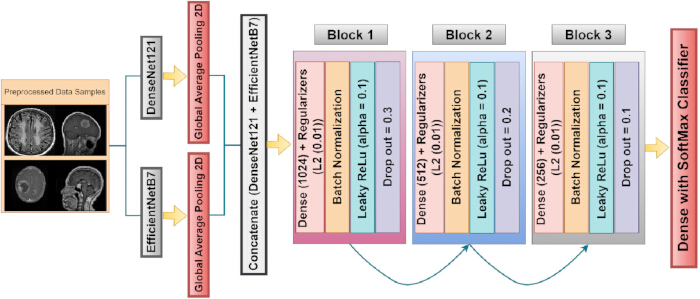
Abbildung 5: Vorgeschlagene hybride, fusionierte Modellarchitektur. Die vorgeschlagene Architektur veranschaulicht, wie vorverarbeitete Bilder an den Merkmalsextraktor übergeben werden, der aus drei angepassten Blöcken mit unterschiedlichen Hyperparametern besteht, gefolgt von einer Ausgabeschicht. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zusätzlich wurden zunächst Merkmale aus den vortrainierten Modellen DenseNet121 und EfficientNetB7 extrahiert. Die aktualisierten Gewichte der vortrainierten Modelle wurden in die trainierten Modelle geladen, und die nicht trainierbaren Basisschichten der Modelle wurden eingefroren, um ein erneutes Training des Modells zu verhindern. Dies sollte dem Modell helfen, sein bisher bestes Wissen beizubehalten, es angesichts neuer Datensätze anzupassen, um die Konvergenz zu verbessern, und sich auf zusätzliche Schichten zu konzentrieren, um fortgeschrittene Merkmale zu trainieren und zu extrahieren. Die folgenden Gleichungen 1 und 2 zeigen die Funktionsweise der Modelle DenseNet121 und EfficientNetB7.
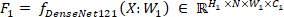 (1)
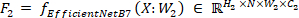 (2)
Die obigen Gleichungen 1 und 2 zeigen die Funktionsweise des vortrainierten Modells hinsichtlich der Merkmalsextraktion; F1 bezeichnet die Ausgabe von Merkmalskarten, die vom vortrainierten DenseNet121-Modell erzeugt werden, und F2 bezeichnet die Ausgabe von Merkmalskarten, die vom vortrainierten EfficientNetB7-Modell durch Verarbeitung der Eingabebilder erzeugt werden, die durch X repräsentiert sind. Weiterhin sind W1 und W2 die lernbaren Parameter beziehungsweise Gewichte, die den ersten Blöcken und Schichten der Modelle DenseNet121 und EfficientNetB7 zugeordnet sind. Außerdem repräsentieren ∈ RN ×H1×W1×C1 und ∈ RN ×H2×W2×C2 die Dimensionalität der Ausgabe-Merkmalskarten der Modelle DenseNet121 und EfficientNetB7, jeweils mit den Dimensionen H1 ×N×W1×C1 und H2 ×N×W2×C2, wobei N die Batch-Größe der Bilder repräsentiert, die als 16 festgelegt wurde. Weiterhin steht H1×W1 für Höhe und Breite der Bilder im DenseNet121-Modell, und H2×W2 steht für Höhe und Breite der Bilder im EfficientNetB7-Modell, wobei die Größe 224 × 224 gewählt wurde. C1 und C2 repräsentieren die Farbkanäle der Modelle DenseNet121 und EfficientNetB7, jeweils. Nachdem die Ausgabe-Merkmalskarten des Modells erhalten wurden – 2560 Kanäle von EfficientNetB7 und 1024 von DenseNet121 –, wird die globale durchschnittliche 2D-Pooling-Schicht36 auf die Ausgabe-Merkmalskarten angewendet, um die räumliche Dimension zu reduzieren, indem der Durchschnitt aller räumlichen Dimensionen zu einem einzelnen Vektor gebildet wird, was die Weitergabe an die nächste Schicht erleichtert und eine bessere Merkmalsextraktion sowie Mustererkennung in Bezug auf interpretierbare Merkmale ermöglicht.
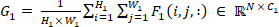 (3)
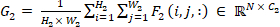 (4)
Die obigen Gleichungen 3 und 4 zeigen die Funktionsweise der zweidimensionalen Global Average Pooling-Schicht, die auf die Modelle DenseNet121 bzw. EfficientNetB7 angewendet wird, wobei  und
 das Verfahren der Normalisierung der Summe veranschaulichen, indem die Summe durch die Gesamtanzahl der räumlichen Positionen beider Modelle geteilt wird, um sicherzustellen, dass die gepoolte Ausgabe ein Durchschnittswert und keine einfache Summe ist.
 und
 stellen die Summation über die räumlichen Dimensionen der Merkmalskarten dar, während i und j lediglich zur Iteration über Höhe bzw. Breite dienen, um die Merkmalskarten beider Modelle zu summieren. Außerdem stellen F1(i, j, :) und F2(i, j, :) die Werte der Merkmalskarten an bestimmten räumlichen Positionen (i, j) über alle Kanäle hinweg für die Modelle DenseNet121 bzw. EfficientNetB7 dar. Diese Pooling-Operation fasst räumliche Informationen zu einer kompakteren und präziseren Darstellung zusammen, wobei die wichtigsten Merkmale jedes Bildes erhalten bleiben. Darüber hinaus werden die Ausgaben der Global Average Pooling-Schichten verkettet, um für jede Probe einen einzelnen Merkmalsvektor zu erzeugen, der häufig verwendet wird, um Merkmale aus verschiedenen Modellen zu fusionieren und die Leistung zu verbessern, indem die Stärken beider Modelle genutzt werden; Gleichung 5 zeigt, wie dies funktioniert.
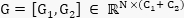 (5)
Die obige Gleichung 5 zeigt das Verfahren der Verkettung zweier verschiedener Merkmalsvektoren [G1, G2], wobei G1 den Merkmalsvektor des DenseNet121-Modells und G2 den Merkmalsvektor des EfficientNetB7-Modells darstellt. Die Form des verketteten Merkmalsvektors wird durch RN ×(C1+ C2) ausgedrückt, wobei N die Batch-Größe bezeichnet, also die Anzahl der parallel verarbeiteten Stichproben, und (C1+ C2) die Gesamtanzahl der aus Modell 1 und 2 gewonnenen Merkmale repräsentiert, die zusammen etwa 3584 betragen und parallel verarbeitet werden. Der resultierende verkettete Ausgabe-Merkmalsvektor wird durch G dargestellt. Zusätzlich wurden drei verschiedene Blöcke hinzugefügt, um das fusionierte Modell zu modifizieren, komplexere Merkmale zu extrahieren, die Generalisierungsfähigkeit zu verbessern und Überanpassung zu verhindern, um genauere und effizientere Ergebnisse zu erzielen. Jeder Block besteht aus einer dichten Schicht mit einer unterschiedlichen Anzahl an Neuronen. Der erste Block verfügt über 1024 Neuronen in seinen dichten Schichten und konzentriert sich darauf, eine breite Palette an Merkmalen und allgemeinere Muster in den Daten zu erfassen. Der zweite Block besitzt 512 Neuronen in seiner dichten Schicht und verfeinert die Merkmale gezielt, indem er die Dimensionalität reduziert und sich auf spezifischere Muster konzentriert. Der dritte Block enthält 256 Neuronen in seiner dichten Schicht, die die Merkmale noch stärker verdichten, sodass nur die relevantesten Merkmale und Muster an die Ausgabeschicht weitergeleitet werden, um eine präzisere Aufgabe auszuführen. Außerdem wurden L2-Regularisierungsansätze37 in jeder dichten Schicht jedes Blocks hinzugefügt, um Überanpassung zu verhindern, indem größere Gewichtungen bestraft werden, was gleichzeitig die Komplexität des Modells erhöht. Eine Dropout-Schicht38 wurde nach jedem Block eingefügt, um zufällig 30 %, 20 % bzw. 10 % der Neuronen in den Blöcken 1, 2 und 3 zu ignorieren, wodurch das Netzwerk gezwungen wird, robustere Merkmale zu entwickeln, die nicht von einzelnen Neuronen abhängig sind. Um den Trainingsprozess zu stabilisieren, wurde nach jeder dichten Schicht eine Batch-Normalisierungsschicht39 angewendet, die sicherstellt, dass die Aktivierungen in einem stabilen Bereich bleiben, und das Modell dabei unterstützt, Probleme wie verschwindende oder explodierende Gradienten während der Trainingsphase zu vermeiden. Zusätzlich beschleunigt diese Batch-Normalisierungsschicht den Trainingsprozess, indem sie das Verlust-Landschaft glättet, wodurch das Modell schneller konvergiert und Optimierer leichter globale Minima finden können. In jedem Block wird zur Erzeugung von Nichtlinearität die Leaky-ReLU-Aktivierungsfunktion40 verwendet, die es dem Modell ermöglicht, komplexe Muster zu lernen. Leaky ReLU bietet Vorteile gegenüber anderen Aktivierungsfunktionen, da sichergestellt wird, dass das Neuron nicht inaktiv wird, indem für negative Eingaben ein kleiner, nicht-null Gradient zugelassen wird. Die unten stehende Gleichung 6 zeigt die Funktionsweise der verschiedenen Blöcke, die in das hybride fusionierte Modell integriert wurden.
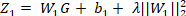 (6)
Nachdem der verkettete Vektor erhalten wurde, durchläuft G die dichte Schicht (voll verbunden) des Blocks 1 mit 1024 Neuronen, wobei die Gewichtsmatrix W1 den Eingabevektor G in einen 1024-dimensionalen Ausgabevektor transformiert und jedes Element im Ausgabevektor eine Linearkombination der Eingabemerkmale ist. Anschließend wird der Bias-Vektor b1 zu jedem der 1024 Elemente im Ausgabevektor addiert, wodurch das Modell die Ausgabe der Eingabemerkmale unabhängig verschieben kann. Des Weiteren bestraft der L2-Regularisierungsterm: λ||W1||22 große Gewichtswerte, wodurch verhindert wird, dass das Modell übermäßig von einem einzelnen Neuron abhängt, was zur Vermeidung von Überanpassung beiträgt. Dabei bezeichnet W1 die Gewichtsmatrix einer bestimmten Schicht im neuronalen Netzwerk, ||W1||22 die quadrierte L2-Norm der Gewichtsmatrix W1 und λ den Regularisierungsparameter, der das Ausmaß der angewendeten Regularisierung steuert und in allen Blöcken auf 0,1 festgelegt wurde. Z1 wird zur neuen Merkmalsdarstellung, nachdem die dichte Schicht sowie die L2-Regularisierung auf den vom verketteten Vektor G übergebenen Eingabevektor angewendet wurden, wie in Gleichung 6 dargestellt.
Nachdem die Ausgabe der dichten Schicht des Blocks 1 als Z1 erhalten wurde, wurde die Batch-Normalisierungsschicht angewendet, die dazu dient, den Trainingsprozess zu beschleunigen. Die unten stehende Gleichung 7 zeigt, wie sie funktioniert.
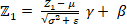 (7)
σ2 stellt die Varianz der Ausgabe der letzten Schicht Z1 über den Batch hinweg dar, während μ der Mittelwert der Ausgabe Z1 ist, der separat für jedes Neuron berechnet wird, wobei die Anzahl in der ersten dichten Schicht 1024 betrug. Hingegen ist ε eine kleine Konstante, die zur Gewährleistung der numerischen Stabilität und zur Vermeidung einer Division durch null hinzugefügt wird. Die normalisierte Ausgabe kann vom Modell durch Anpassung des lernbaren Skalierungsparameters γ skaliert und durch den lernbaren Verschiebungsparameter β verschoben werden. Schließlich sorgt die Anwendung der Batch-Normalisierungsschicht auf die Ausgabe der dichten Schicht dafür, dass die normalisierte Ausgabe Z1 Aktivierungen mit einer konsistenten Verteilung über die verschiedenen Schichten aufweist, was zur Stabilisierung und Beschleunigung des Trainings beiträgt. Nach der Batch-Normalisierung durchläuft die normalisierte Ausgabe Z1 die Leaky-ReLU-Aktivierungsfunktion, die Nichtlinearität im Netzwerk erzeugt und somit das Lernen komplexer Muster in den Daten unterstützt. Anstelle von ReLU oder einer anderen Aktivierungsfunktion wurde Leaky ReLU gewählt, eine modifizierte Version der ReLU-Funktion, die auch kleine negative Werte berücksichtigt, anstatt sie wie die herkömmliche ReLU-Aktivierungsfunktion auf 0 zu setzen, wodurch das Problem der „absterbenden ReLU“ umgangen wird. Gleichung 8 unten zeigt, wie diese Funktion arbeitet.
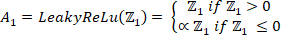 (8)
Dabei gehört Z1 zur Ausgabe der Batch-Normalisierungsschicht, die als Eingabe an die Leaky-ReLU-Funktion übergeben wird, um die Nichtlinearität durchzuführen, während ∝ eine kleine Konstante ist, die zur Bestimmung der Steigung des negativen Teils der Funktion verwendet wird. Außerdem zeigt A1 die Ausgabe an, die nach Anwendung der Nichtlinearität erhalten wird. Schließlich wird eine Dropout-Schicht auf die Ausgabe A1 angewendet, die als Eingabe von der Leaky-ReLU-Aktivierungsfunktion empfangen wird, wie in Gleichung 9 dargestellt.
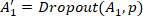 (9)
Dabei ist A1 die ursprüngliche Ausgabe der Aktivierungsfunktion, die von der letzten ReLU-Aktivierungsfunktion empfangen wurde, und p die Dropout-Rate, die zwischen 0 und 1 variiert und für drei Blockschichten jeweils als 0,3, 0,2 und 0,1 festgelegt wurde, um lediglich einen Bruchteil der Neuronen zu deaktivieren. Weiterhin bezeichnet A1′ die modifizierte Ausgabe nach Anwendung der Dropout-Schicht, bei der einige Neuronen auf 0 gesetzt wurden. Der Hauptvorteil ihrer Verwendung liegt darin, Überanpassung zu vermeiden und die kooperative Anpassung (Co-Adaptation) zu reduzieren. Zudem wird die Ausgabe aus Block1, A1′, erneut an den nächsten Block weitergeleitet, um erneut abstraktere Merkmale zu extrahieren, wobei dieselben Parameter wie in Block 1 angewendet werden, mit der Unterscheidung, dass die dichte Schicht 512 Neuronen anstelle von 1024 aufweist und eine Dropout-Rate von 0,2 anstelle von 0,3 verwendet wird; alle weiteren operationellen Abläufe bleiben unverändert, wie in den nachstehenden Gleichungen 10 bis 13 beschrieben.
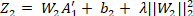 (10)
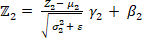 (11)
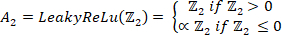 (12)
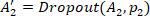 (13)
Nachdem die Ausgabe aus Block 1 als A1′ erhalten wurde, durchläuft diese die dichte Schicht (vollständig verbunden) von Block 2 mit 512 Neuronen, wobei die Gewichtsmatrix W2 den Eingabevektor A1′ in einen 512-dimensionalen Ausgabevektor transformiert, und jedes Element im Ausgabevektor eine lineare Kombination der Eingabemerkmale ist. Anschließend wird der Bias-Vektor b2 zu jedem der 512 Elemente im Ausgabevektor addiert, wodurch das Modell in der Lage ist, die Ausgabe der Eingabemerkmale unabhängig zu verschieben. Außerdem wird L2-Regularisierung angewendet, bei der: λ||W2||22 große Gewichtswerte bestraft, um Überanpassung zu verringern, indem verhindert wird, dass das Modell in diesem spezifischen Block übermäßig stark auf ein bestimmtes Neuron vertraut. Dabei ist W2 die Gewichtsmatrix einer bestimmten Schicht im neuronalen Netzwerk, während λ der Regularisierungsparameter ist, der das Ausmaß der angewendeten Regularisierung steuert und hier mit 0,1 festgelegt wurde. Z2 wird zur neuen Merkmalsdarstellung, nachdem die dichte Schicht sowie die L2-Regularisierung auf die von Block 1 übergebene Eingabe angewendet wurden, wie in Gleichung 10 dargestellt.
Weiterhin wurde die Batch-Normalisierungsschicht auf die neue Merkmalsgröße Z2 angewendet, um den Trainingsprozess zu beschleunigen. Dabei steht σ22 für die Varianz über den Batch, während μ2 den Mittelwert der Ausgabe Z2 darstellt. Obwohl ε eine kleine Konstante ist, die zur Gewährleistung der numerischen Stabilität hinzugefügt wird, ist γ ein lernbarer Skalierungsparameter, der es dem Modell ermöglicht, die normalisierte Ausgabe anzupassen, und β ein lernbarer Verschiebungsparameter, der das Modell in die Lage versetzt, die normalisierte Ausgabe zu verschieben. Schließlich wurde nach Anwendung der Batch-Normalisierungsschicht, wie sie in Gleichung 11 dargestellt ist, die normalisierte Ausgabe Z2 über die Leaky-ReLU-Aktivierungsfunktion (AF) geleitet, wodurch Nichtlinearität im Netzwerk erzeugt wurde, wie in Gleichung 12 gezeigt. Dabei gehört Z2 zur Ausgabe der Batch-Normalisierungsschicht, die als Eingabe an Leaky ReLU übergeben wird, um die Nichtlinearität zu berechnen. A2 zeigt hingegen die Ausgabe an, die nach Anwendung der Nichtlinearität erhalten wird.
Abschließend wird eine Dropout-Schicht auf den Ausgang A2 angewendet, der als Eingabe von der Leaky-ReLU-Aktivierung empfangen wird, wie in Gleichung 13 dargestellt. Dabei ist A2 der Ausgang, der von der letzten ReLU-Aktivierungsfunktion empfangen wird, und p2 die Dropout-Rate, die für diesen Block mit 0,2 festgelegt wurde, um lediglich einen Bruchteil der Neuronen auszuschalten. Weiterhin bezeichnet A2′ den modifizierten Ausgang nach Anwendung der Dropout-Schicht, bei dem einige Neuronen auf 0 gesetzt wurden. Anschließend wird der Ausgang des Blocks 2, A2′, an den dritten Block weitergegeben, um erneut abstraktere Merkmale zu extrahieren, wobei dieselben Parameter wie im Block 2 verwendet werden, mit der Unterscheidung, dass die dichte Schicht 256 Neuronen anstelle von 512 aufweist und eine Dropout-Rate von 0,1 anstelle von 0,2 verwendet wird; die übrigen operationellen Abläufe sind identisch und werden in den folgenden Gleichungen 14 bis 17 beschrieben.
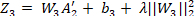 (14)
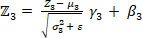 (15)
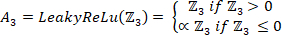 (16)
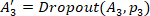 (17)
Nachdem die Ausgabe aus Block 2 als A2′ erhalten wurde, durchläuft diese die dichte Schicht (voll verbunden) von Block 3 mit 256 Neuronen, wobei die Gewichtsmatrix W3 den Eingabevektor A2′ in einen 256-dimensionalen Ausgabevektor transformiert, und jedes Element im Ausgabevektor eine lineare Kombination der Eingabemerkmale ist. Anschließend wird der Bias-Vektor b3 zu jedem der 256 Elemente im Ausgabevektor addiert, wodurch das Modell in der Lage ist, die Ausgabe der Eingabemerkmale unabhängig zu verschieben. Außerdem wird L2-Regularisierung angewendet, bei der: λ||W3||22 große Gewichtswerte bestraft, wodurch verhindert wird, dass das Modell übermäßig von einem einzelnen Neuron abhängt, was zur Vermeidung von Überanpassung beiträgt. Dabei ist W3 die Gewichtsmatrix einer bestimmten Schicht im neuronalen Netzwerk, während der Grad der angewendeten Regularisierung durch den Regularisierungsparameter λ gesteuert wird, der auf 0,01 festgelegt wurde. Z3 wird zur neuen Merkmalsdarstellung, nachdem die dichte Schicht sowie die L2-Regularisierung auf die von Block 3 übergebene Eingabe angewendet wurden, wie in Gleichung 14 dargestellt.
Weiterhin wurde die Batch-Normalisierungsschicht auf die neue Merkmalsgröße Z3 angewendet, um den Trainingsprozess zu beschleunigen. Dabei steht σ32 für die Varianz über den Batch, während μ3 den Mittelwert der Ausgabe Z3 darstellt. Die Konstante ε ist ein kleiner Wert, der aus Gründen der numerischen Stabilität hinzuaddiert wird. Die normalisierte Ausgabe kann vom Modell mithilfe des lernbaren Skalierungsparameters γ3 angepasst und durch den lernbaren Verschiebungsparameter β3 verschoben werden. Schließlich durchläuft die normalisierte Ausgabe Z3 nach Anwendung der Batch-Normalisierungsschicht, wie in Gleichung 15 dargestellt, die Leaky-ReLU-Aktivierungsfunktion, wodurch Nichtlinearität im Netzwerk erzeugt wird, wie in Gleichung 16 gezeigt. Dabei entspricht Z3 der Ausgabe der Batch-Normalisierungsschicht, die als Eingabe an Leaky ReLU übergeben wird, um Nichtlinearität zu erzeugen. Die Größe A3 zeigt die Ausgabe an, die nach Anwendung der Nichtlinearität erhalten wird.
Abschließend wird eine Dropout-Schicht auf den Ausgang A3 angewendet, der als Eingabe von der Leaky-ReLU-Aktivierung empfangen wird, wie in Gleichung 17 dargestellt. Dabei ist A3 der Ausgang der letzten ReLU-Aktivierungsfunktion und p3 die Dropout-Rate, die für diesen Block mit 0,1 festgelegt wurde, um lediglich einen Bruchteil der Neuronen auszuschalten. Weiterhin bezeichnet A3′ den modifizierten Ausgang nach Anwendung der Dropout-Schicht, bei dem einige Neuronen auf 0 gesetzt wurden.
Außerdem wird die Ausgabe des Blocks 3 A3′ zur Klassifizierung durch die letzte dichte Schicht geleitet, die über eine Anzahl K von Neuronen verfügt, welche der tatsächlichen Anzahl an Klassen im Datensatz entspricht, wie in Gleichung 18 unten beschrieben.
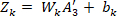 (18)
Die mit der dicken Schicht verknüpfte Gewichtsmatrix ist Wk, die dafür verantwortlich ist, den 256-dimensionalen Vektor A3′ in einen k-dimensionalen Vektor umzuwandeln, der die aus dem vorherigen Block gelernten Merkmale darstellt und als Ausgabe vorliegt. Weiterhin repräsentiert bk den Bias-Vektor, der die Vorhersage anpasst, um sicherzustellen, dass die Aktivierungsfunktion einen von null verschiedenen Ausgabewert liefert, wenn die Eingabe null ist, und Zk ist die Ausgabe der letzten Schicht vor der Anwendung der Aktivierungsfunktion; sie erzeugt die Logits für jede Klasse. Abschließend wurde ein SoftMax41-Klassifikator angewendet, der den Logit Zk in die Wahrscheinlichkeit jeder Klasse umwandelt, wie in den Gleichungen 19 und 20 dargestellt.
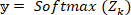 (19)
 (20)
Die vorhergesagte Wahrscheinlichkeit der iten Klasse wird durch yi dargestellt, K ist die Anzahl der Klassen, während Zk, i das Logit für die ite Klasse und eZk, i die Exponentialfunktion des Logits der iten Klasse ist. y zeigt die Wahrscheinlichkeitsverteilung aller möglichen Klassen an und stellt sicher, dass die Summe der Wahrscheinlichkeiten 1 beträgt. Tabelle 3 unten enthält die Details zu den Hyperparametern, die zum Trainieren des vorgeschlagenen hybriden Modells verwendet wurden, einschließlich der architektonischen Details, die zur Verbesserung der Reproduzierbarkeit und Leistung übernommen wurden.
| Hyperparameter | Vorgeschlagenes Modell (FusionNetX) |
| Bildgröße | 224 × 224 |
| Backbone-Architektur | Vortrainiertes EfficientNetB7 und DenseNet121 als BBA1 und BBA2 |
| Datenaugmentierung | Rotationsbereich = 7, |
| Breiten-/Höhenverschiebungsbereich bis zu 0,05, | |
| Zoombereich bis zu 0,01, | |
| Horizontale/vertikale Spiegelung | |
| Verhältnis der Datenaufteilung | 80 % für das Training und 20 % für die Validierung bei stratifizierter Stichprobe mit festem random_state = 42 |
| Merkmalsextraktion und -fusion | Globaler Durchschnittspooling wird auf den Ausgang jedes Backbones angewendet: 2560 für BBA1 und 1024 für BBA2, gefolgt von Fusion zu 3584 gemeinsamen Merkmalsvektoren. |
| Aufbau des vollverbundenen Blocks | 3 vollverbundene Blöcke mit 1 Ausgabeschicht. Jeder Block enthält L2-Regularisierung (λ = 0,01), Batch-Normalisierung, LeakyReLU (α = 0,01), Dropout (0,3, 0,2 und 0,1) und verdeckte Dimensionen (1024, 512, 256) jeweils. Es wurde keine zusätzliche Skip-Verbindung im Fusion-Head eingeführt. |
| Aktivierungsfunktion | Leaky ReLU & SoftMax |
| Optimierer und Lernrate | Adam mit fester Lernrate von 0,00001, ohne Lernraten-Scheduler. |
| Verlustfunktion | sparse_categorical_crossentropy |
| Batch-Größe | 16 |
| Epochen | 100 feste Epochen für jeden Datensatz |
| Verwendete Plattform | Kaggle Notebook mit einer P100-GPU und 16 GB VRAM sowie den Plattformen TensorFlow und Keras. |
Tabelle 3: Hyperparameter, die zum Training des vorgeschlagenen Modells und der vorgeschlagenen Architekturdetails verwendet wurden. Diese Tabelle enthält die strukturellen und architektonischen Details des vorgeschlagenen Modells sowie feinabgestimmte Parameter und die Implementierungsumgebung.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Dieser Teil beschreibt die Ergebnisse der Überprüfung des vorgeschlagenen Dual-Feature-Fusion-Modells anhand von fünf Open-Source-Datensätzen zu Gehirntumoren, einschließlich der Datensätze Br35H, Figshare, Sartaj, Masoud und Balanced Brain Tumor. Die Leistung wird anhand verschiedener statistischer Parameter zur Leistungsbewertung bewertet, darunter Genauigkeit42,43,44, Fehlklassifizierungsrate (MCR)45, ...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Zusammenfassend funktionierte das vorgeschlagene Modell wie folgt: Zunächst wurde die Bildgröße auf 224 × 224 festgelegt, was eine moderate Größe darstellt, die es jedem Deep-Learning-Modell ermöglicht, geeignete Merkmale aus den Datensätzen zu extrahieren und zu lernen, ohne dabei wichtige Informationen zu verlieren. Anschließend wurde eine Datenaugmentierung durchgeführt, was vorteilhaft ist, um die Datensätze in vielfältigere Richtungen zu erweitern und somit eine wichtige Rolle dabei spielt, dass Modelle Merkmale aus...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren haben nichts zu offenbaren und weisen keinerlei Interessenkonflikte auf. Darüber hinaus wurden keine KI-Tools zur Erstellung des Manuskripts sowie der Abbildungen verwendet.
Danksagungen
Die Autoren danken für die Unterstützung durch das Princess Nourah bint Abdulrahman University Researchers Supporting Project (PNURSP2026R192), Princess Nourah bint Abdulrahman University, Riad, Saudi-Arabien. Die Autoren danken außerdem den Forschungsteilnehmern und Institutionen, die zu dieser Studie beigetragen haben.
Finanzierung:
Diese Arbeit wurde durch eine Förderung der National Research Foundation of Korea (NRF), finanziert durch das koreanische Ministerium für Wissenschaft und Informationstechnologie (MSIT) (Nr. RS-2023-00218176), sowie durch das Forschungsstipendium der Soonchunhyang University unterstützt. Projekt zur Unterstützung von Forscherinnen der Princess Nourah bint Abdulrahman University (PNURSP2026R192), Princess Nourah bint Abdulrahman University, Riad, Saudi-Arabien.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Br35H-Hirntumordatensatz | Kaggle (Datensatz-Ersteller) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Öffentlicher Datensatz; binäre Klassifizierung (Tumor / kein Tumor), 300 MRT-Bilder |
| Figshare-Hirntumordatensatz | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Öffentlicher Datensatz; Multiklasse (Gliom, Meningeom, Hypophysentumor), 3064 MRT-Bilder |
| Sartaj-Datensatz zur MRT-Klassifizierung von Hirntumoren | Kaggle (Datensatz von Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | Öffentlicher Datensatz; Multiklasse (Gliom, Meningeom, kein Tumor, Hypophysentumor), 3264 MRT-Bilder |
| Masoud-Hirntumor-MRT-Datensatz | Kaggle (Datensatz von Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | Öffentlicher Datensatz; Multiklasse (Gliom, Meningeom, kein Tumor, Hypophysentumor), 7023 MRT-Bilder |
| BBT-Datensatz (Hirntumordatensatz) | Kaggle (Datensatz-Ersteller) | https://doi.org/10.34740/kaggle/dsv/6758053 | Öffentlicher Datensatz; ausgewogener Multiklasse-Hirntumordatensatz, 5248 MRT-Bilder |
| Python | Python Software Foundation | https://www.python.org | Programmiersprache, Version 3.10.13 |
| TensorFlow / Keras | Google / TensorFlow-Entwickler | https://www.tensorflow.org | Tiefes Lern-Framework; Modellkonstruktion, -training und -bewertung, Version 2.15.0 |
| EfficientNetB7 (vortrainiert) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | ImageNet-vortrainiertes Backbone; Merkmalsextraktion |
| DenseNet121 (vortrainiert) | Keras Applications | https://keras.io/api/applications/densenet/ | ImageNet-vortrainiertes Backbone; Merkmalsextraktion |
| scikit-learn | scikit-learn-Entwickler (NumFOCUS) | https://scikit-learn.org | Label-Codierung, Aufteilung in Trainings- und Testdaten, Evaluationsmetriken (Klassifizierungsbericht, Konfusionsmatrix, ROC/AUC) |
| OpenCV (cv2) | OpenCV-Team | https://opencv.org | Bildladen und -skalierung |
| NumPy | NumPy-Entwickler (NumFOCUS) | https://numpy.org | Numerische Berechnungen und Array-Operationen |
| pandas | pandas-Entwicklungsteam (NumFOCUS) | https://pandas.pydata.org | Datenorganisation und Zusammenstellung von Metriken in Tabellen |
Referenzen
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.