Dieser Artikel stellt einen menschlich überwachten computerbasierten Arbeitsablauf zur Untersuchung wiederkehrender Darstellungen von Frauen in 433 chinesischen Exportgemälden aus der Qing-Dynastie vor. Sieben menschlich definierte Kategorien und wiederkehrende visuelle Hinweise charakterisieren Muster innerhalb des Korpus, wobei die Ergebnisse auf die Stichprobe der Bilder begrenzt bleiben und keine Aussagen über die soziale Realität oder historische Rezeption in der Qing-Zeit treffen.
Forschungsartikel
Weibliche Identität und Klassenvorstellungen in chinesischen Exportgemälden der Qing-Dynastie: Eine KI-gestützte Studie zur interkulturellen Interpretation
In diesem Artikel
Zusammenfassung
Zusammenfassung
Diese Studie untersuchte wiederkehrende Darstellungen weiblicher Identität und sozialklassenspezifischer visueller Hinweise in einem Korpus von 433 chinesischen Exportgemälden aus der Qing-Dynastie, datiert zwischen 1757 und 1911. Der Arbeitsablauf kombinierte CLIP ViT-B/32 zur vorläufigen Kennzeichnung, die Segmentierung beliebiger Objekte (Segment Anything Model, SAM) zur Unterstützung der Lokalisierung, Dimensionsreduktion und Clustern sowie manuelle ikonographische Kodierung durch zwei unabhängige Kodierer. CLIP-Kennzeichnungen dienten der vorläufigen Organisation, SAM fungierte als Hilfsmittel zur Lokalisierung, und die konsensbasierte manuelle Kodierung lieferte die Referenzkategorien. Die aggregierten Ergebnisse identifizierten sieben menschliche Referenzkategorien: Adelige/Schönheit (n = 112), Arbeitende (n = 72), Häusliche (n = 64), Dienstmädchen (n = 58), Ritual/Hochzeit (n = 45), Markt (n = 43) und Darbietende (n = 39). Die vorläufigen computergestützten Kennzeichnungen stimmten bei 356 von 433 Gemälden (82,2 %) mit den menschlichen Referenzkennzeichnungen überein, wobei die Kategorie-spezifische Rückstellrate zwischen 73,3 % und 88,4 % lag. Wiederkehrende Kombinationen aus Kleidung, räumlichem Setting, Objekten, Körperhaltung und dargestellten sozialen Beziehungen wurden verwendet, um die visuellen Profile dieser Kategorien zu charakterisieren. Die Bewertung der 433 fallbezogenen KI–Mensch-Kennzeichnungspaare ergab umfassende präzise Werte, Rückstellraten und F1-Scores auf Kategorieebene sowie eine Konfusionsmatrix zur Darstellung der Klassifizierungsmuster. Die Cluster-Validierung unterstützte die gewählte Clustering-Lösung und zeigte eine Übereinstimmung zwischen den abgeleiteten Clustern und den menschlich definierten Referenzkategorien. Insgesamt deuten wiederkehrende Kombinationen aus Kleidung, räumlichem Setting, Objekten, Körperhaltung und sozialen Beziehungen auf strukturierte bildliche Typologien innerhalb des untersuchten Korpus hin. Diese Ergebnisse charakterisieren die visuelle Repräsentation in chinesischen Exportgemälden der Qing-Dynastie, sollten jedoch nicht als direkte Maße für rechtlichen Status, gelebte Erfahrung, Marktnachfrage oder historische Wahrnehmung im Ausland interpretiert werden.
Einleitung
Chinesische Exportgemälde aus der Qing-Dynastie waren Teil der kommerziellen und kulturellen Netzwerke, die ab dem späten achtzehnten Jahrhundert Kanton und andere Sammelmärkte mit europäisch-amerikanischen Käufern verbanden1,2,3,4,5. Kaufleute, Reisende, Diplomaten, Missionare und Sammler erwarben diese Gemälde als transportable Waren, Andenken, Quellen visueller Informationen sowie als Darstellungen von Orten, Berufen, Produktionsweisen, Bräuchen und gesellschaftlichen Typen. Ihre Verbreitung spiegelte somit sowohl chinesische Werkstattpraktiken als auch die Erwartungen ausländischer Märkte wider.
Die ausländische Nachfrage bevorzugte bekannte Motive, Serienformate, wiederkehrende Themen und Szenen, die gesammelt und verglichen werden konnten. Werkstätten passten Medien, Formatgrößen, Komposition und Inhalte für den Verkauf an, während Käufer oft leicht verständliche Darstellungen von Berufen, Zeremonien, Innenräumen, Gärten, Straßen und malerischen gesellschaftlichen Typen bevorzugten. Wiederholte Versionen von Szenen aus Kantoner Werkstätten verdeutlichen weiter, wie Künstler und ihre Assistenten Ikonographie und westliche bildnerische Mittel für ausländische Auftraggeber anpassten1,2,3,4,5. Obwohl die Marktnachfrage beeinflusst haben mag, was produziert und bewahrt wurde, erlaubt der vorliegende Korpus keine direkte Messung individueller Käuferpräferenzen oder -reaktionen.
Diese Gemälde sollten daher als selektive und vermittelte Quellen betrachtet werden, nicht als vollständige Aufzeichnungen des Alltagslebens. Ihre Darstellungen können soziale Praktiken idealisieren, vereinfachen, standardisieren oder anpassen – und zwar durch Werkstattkonventionen, Marktauswahl, Museumsakquise, Katalogisierung und Digitalisierung1,2,3,4,5. Bei der historischen Interpretation muss zwischen Merkmalen, die direkt in den Gemälden beobachtbar sind, und Schlussfolgerungen über die dargestellten Personen, die Produktionsbedingungen sowie über die Bedeutungen unterschieden werden, die spätere Betrachter den Werken zuschrieben.
Weibliche Figuren bieten eine gezielte Möglichkeit, diesen Unterschied zu untersuchen. Kleidung, Frisur, Körperhaltung, räumliche Umgebung, Gegenstände, Tätigkeiten und Beziehungen zu anderen Figuren können Frauen in visuell wiederkehrende Rollen einordnen, darunter Kategorien wie Adelige/Schönheit, häuslich, Dienstmagd, arbeitend, Marktszene, darstellende Kunst sowie rituelle/hochzeitliche Darstellungen. Diese Kategorien sind analytische Beschreibungen bildlicher Muster und legen für sich genommen weder rechtlichen Rang, Reichtum, Beruf, ethnische Zugehörigkeit, Zugehörigkeit zu Banner oder Han, moralischen Charakter noch gelebte Identität fest.
Die digitale Kunstgeschichte und die maschinelle Bildverarbeitung können großangelegte Vergleiche digitalisierter visueller Sammlungen erleichtern und gleichzeitig eine kritische Prüfung der in rechnergestützten Modellen enthaltenen Annahmen ermöglichen6,7. Modelle zur Verknüpfung von Sehen und Sprache können bei der Identifizierung und Ordnung wiederkehrender visueller Motive helfen, obwohl kulturelle Voreingenommenheit eine wichtige Einschränkung bleibt, wenn moderne Modellwortschätze auf historische, nicht-westliche Bilder angewendet werden8. Ähnliche rechnergestützte Untersuchungen zur traditionellen chinesischen Malerei verdeutlichen ebenfalls den Wert, quantitative Mustererkennung mit historisch fundierter Interpretation zu verbinden9.
Diese Studie befasst sich mit drei Fragen: (1) Welche durch Menschen kodierten, geschlechtsspezifischen Identitätskategorien für Frauen sind im Korpus vertreten? (2) Welche Kombinationen aus Kleidung, räumlichem Setting, Objekten, Körperhaltung und sozialen Beziehungen charakterisieren diese Kategorien? (3) Wie unterscheiden sich die Gesamtgenauigkeit bezüglich exakter Übereinstimmung und die Kategorie-spezifische Rückstellrate zwischen den sieben Kategorien? Der Arbeitsablauf stützt sich auf computergestützte Ansätze zur Analyse traditioneller chinesischer Malerei9, beschränkt seine historischen Aussagen jedoch auf die Stichprobenbilder und die dokumentierten Analysen.
Der angestrebte Beitrag ist sowohl historiographisch als auch technisch. Der Vergleich auf Korpus-Ebene kann wiederkehrende bildliche Formeln identifizieren, die anschließend durch engmaschige historische Analysen kontextualisiert werden können. Dieser Ansatz kann Forschung zu Geschlecht, Hierarchie, Darstellungen des Alltagslebens und interkulturellen Begegnungen unterstützen, ohne die Häufigkeit von Bildern als Beleg für soziale Verbreitung oder visuelle Ähnlichkeit als Beweis für historische Identität zu betrachten.
Protokoll
Studienaufbau und Analyseeinheit
Jedes Gemälde oder Katalogeintrag wurde als eine Analyseeinheit behandelt. Es wurde ein korpusbasierter Beobachtungsaufbau verwendet, der die Überprüfung von Metadaten, eine vorläufige computergestützte Organisation, eine unabhängige manuelle Kodierung und kunsthistorische Interpretation kombinierte. Der Untersuchungszeitraum wurde als 1757–1911 festgelegt, und innerhalb dieses Zeitraums wurden Ein- und Ausschlusskriterien angewandt. Historische Kunstwerke und die damit verbundenen Katalogmetadaten wurden analysiert. Bei Vergleichen von Verteilungen über Zeitintervalle ungleicher Dauer wurden die Häufigkeiten anhand der Intervalllänge normalisiert, während potenzielle Überlebens- und Erwerbsverzerrungen bei der Interpretation berücksichtigt wurden.
Erstellung und Auswahl des Korpus
Kandidatenaufzeichnungen wurden aus den zitierten Museums- und digitalen Archiven sowie aus veröffentlichten Katalogen gewonnen. Für jede Kandidatenaufzeichnung wurden Institution, Titel, Datum oder Datumsbereich, Medium, Inventar- oder Katalognummer, stabile Quell-URL, Abrufdatum und Rechtehinweis erfasst. Quelllinks wurden beibehalten, auch wenn die entsprechende Bilddatei aus rechtlichen Gründen nicht weiterverbreitet werden durfte. Das beschriebene Screening-Verfahren begann mit 612 Kandidatenbildern. Davon wurden 85 Aufzeichnungen ausgeschlossen, da sie außerhalb des Zeitraums 1757–1911 lagen oder nicht der Exportmalerei-Tradition angehörten; 58 weitere wurden ausgeschlossen, weil es sich um moderne Reproduktionen, unscharfe Aufzeichnungen oder falsch dargestellte Motive handelte; 29 wurden ausgeschlossen, da sie keine identifizierbare weibliche Figur enthielten oder eine unzureichende Bildauflösung aufwiesen; und 7 wurden aufgrund ungenügender Metadaten entfernt. Das endgültige analytische Korpus umfasste 433 Aufzeichnungen.
Standardisierung von Metadaten und Bildvorverarbeitung
Jedem Gemälde im endgültigen analytischen Korpus wurde ein stabiler QEP-Identifikator von QEP_001 bis QEP_433 zugewiesen. Die zugehörigen Museums-Metadaten wurden beibehalten, darunter Institution, Inventarnummer, Titel, Datierung, Technik oder Materialien, Herkunftsort, Quelllink und verfügbare Katalogbeschreibung. Für die visuelle Analyse wurden die vorläufige KI-Beschriftung, die überprüfte menschliche Kategorie, die Anzahl weiblicher Figuren, Altersgruppe, Körperhaltung, Kleidung, räumliche Umgebung, zugeordnete Objekte und soziale Beziehungen erfasst. Jedes Gemälde wurde einer von sieben Hauptkategorien zugeordnet: Elite/Schönheit, häuslich, Dienstmagd, arbeitend, Markt, darstellende Kunst oder Ritual/Hochzeit. Bei Szenen mit mehreren weiblichen Figuren wurde die zentrale Figur anhand ihrer visuellen Dominanz und narrativen Bedeutung identifiziert. Wenn keine einzelne weibliche Figur überwiegend war, erfolgte die Zuordnung der Hauptkategorie anhand der hauptsächlich dargestellten Tätigkeit und des Gesamtkontexts der Szene. Überlappende Kategorien wurden gelöst, indem die dargestellte Tätigkeit und der Szenenkontext gegenüber Kleidung oder Erscheinungsbild allein Vorrang hatten. Unklare Fälle wurden unabhängig von beiden Kodierenden überprüft und im Konsens entschieden. Quellbilder wurden im JPEG- oder PNG-Format gespeichert. Lediglich Webseitenränder, Katalograhmen oder nicht-bildliche Ränder wurden zugeschnitten. Der gemalte Inhalt wurde nicht rekonstruiert, umgefärbt, verbessert oder restauriert.
Vorläufige Markierung basierend auf CLIP
Der CLIP ViT-B/32-Bildencoder wurde für die vorläufige Bild-Text-Ähnlichkeitsanalyse verwendet⁹. Zu den Kandidaten-Identitätsbegriffen gehörten elite Frau, häusliche Frau, weibliche Dienstbotin, arbeitende Frau, Marktfrau, weibliche Darstellerin, Braut und rituelle Frau. Szenebegriffe umfassten chinesische Innenräume, Garten, Straßenmarkt, Werkstatt, Teeproduktion, textilgewerbliche Tätigkeit und zeremonielle Szene. Der vollständige Satz an Fragenvorlagen, deren Reihenfolge, jegliche Zusammenstellung von Abfragevorlagen (Prompt Ensembling), Textnormalisierungsverfahren, Entscheidungsregeln, Konfidenzwerte und Gleichstände wurde für jedes Bild beibehalten.
Die vollständige Liste der Textvorgaben wurde einheitlich auf alle Bilder angewandt, wobei das OpenAI CLIP ViT-B/32-Modell in Python 3.10 mit PyTorch 2.0.1 und dem OpenAI CLIP-Paket verwendet wurde. Die Inferenz erfolgte auf einer CUDA-fähigen GPU mit einer Batchgröße von 32 und FP32-Genauigkeit. Jedes Bild wurde auf 224 × 224 Pixel verkleinert und zentriert zugeschnitten, und die RGB-Kanäle wurden mithilfe der mit dem ViT-B/32-Modell verknüpften Vorverarbeitungstransformation normalisiert. Die Textvorgaben wurden unter Verwendung der oben definierten Identitäts- und Szenenbeschreibungen erstellt und mit dem CLIP-Textencoder kodiert. Die Kosinus-Ähnlichkeit zwischen den normalisierten Bild- und Text-Embeddings wurde berechnet, und die Vorgabe mit der höchsten Ähnlichkeitsscore wurde als vorläufiges KI-Etikett zugewiesen. Die Ähnlichkeitsscores für alle in Frage kommenden Etiketten wurden für eine anschließende manuelle Überprüfung gespeichert. Ein fester Zufallsstartwert (Seed) von 42 wurde verwendet, und identische Vorverarbeitungsverfahren, Vorgabenvorlagen und Entscheidungsregeln wurden auf alle 433 Gemälde angewandt.
Lokalisierung mithilfe von SAM
Das Segment Anything Model (SAM) wurde ausschließlich zur Lokalisierung von Figuren, Kleidungsstücken, Möbeln, Werkzeugen, rituellen Objekten und architektonischen Bereichen für die visuelle Überprüfung durch Menschen eingesetzt. Es muss betont werden, dass SAM nicht in der Klassifizierungspipeline verwendet wurde; seine Masken, Ausschnitte und abgeleiteten Merkmale waren von den CLIP-Beschriftungs- und Clustervorgängen getrennt, sodass der Einsatz von SAM lediglich Lokalisierungshilfen bot, ohne die Klassifizierungsleistung zu beeinflussen oder zu verfälschen.
Manuelle Punktanweisungen oder Begrenzungsrahmen wurden bei Bedarf angewendet, um die Lokalisierung visueller Elemente zu verfeinern. SAM-Masken wurden für weibliche Figuren, Kleidungsstücke, Möbel, Werkzeuge, rituelle Objekte und architektonische Elemente erzeugt, und jedes Segmentierungsergebnis wurde visuell auf angemessene regionale Abdeckung überprüft. Die resultierenden Masken unterstützten die Identifizierung und Überprüfung relevanter ikonografischer Merkmale, wurden jedoch nicht für CLIP-Kennzeichnung oder Kategorienzuweisung verwendet.
Dimensionsreduktion und Clustering
CLIP-Bild-Embeddings wurden berechnet, und UMAP mit kosinischem Abstand wurde zur zweidimensionalen Visualisierung verwendet10. Die für das Clustering verwendete Darstellung zusammen mit ihrem Vorverarbeitungsverfahren, der Dimensionalität und der Abstandsdefinition wurde dokumentiert.
K-Means- und hierarchische Clusterung wurden auf die Bildmerkmalsdarstellungen angewendet, um wiederkehrende visuelle Gruppierungen innerhalb des Korpus zu identifizieren11. Kandidatenlösungen für die K-Means-Clusterung mit k = 5–9 wurden mithilfe des Silhouettenkoeffizienten und des Davies-Bouldin-Index bewertet. Zur Initialisierung wurde K-Means++ mit n_init = 10, max_iter = 300, tol = 1 × 10⁻4 und random_state = 42 verwendet. Die hierarchische Clusterung erfolgte mittels agglomerativer Clusterung mit durchschnittlicher Verknüpfung (average linkage) und Kosinusdistanz. Die Kandidatenlösungen wurden anhand quantitativer Validierungsindizes, der Clusterstabilität und der kunsthistorischen Interpretierbarkeit verglichen, und die endgültige Clustering-Lösung wurde aufgrund ihrer kohärentesten Darstellung wiederkehrender visueller Muster ausgewählt. Die resultierende Clusterzuordnung für jedes der 433 Gemälde wurde für den anschließenden Vergleich mit den menschlich kodierten Kategorien beibehalten.
Manuelle Kodierung, Schulung und Schlichtung
Zwei Kodiererinnen bewerteten unabhängig voneinander alle 433 Bilder anhand eines versionierten Kodierhandbuchs, das die Hauptkategorie, die Anzahl der Figuren, Altersgruppe, Körperhaltung, Kleidung, räumliche Umgebung, Objekte und soziale Beziehungen abdeckte. Vor der Schlichtung wurden kodiererspezifische Aufzeichnungen gespeichert. Die Kodiererinnen verfügten über einschlägige Kenntnisse in Kunstgeschichte und visueller Analyse und wurden mithilfe des standardisierten Kodierhandbuchs sowie repräsentativer Beispiele aus dem Gemäldeschatz geschult. Vor der eigentlichen Kodierung absolvierten sie eine Kalibrierungsübung mit 30 Gemälden, um eine konsistente Interpretation der sieben Identitätskategorien und fünf Dimensionen visueller Hinweise zu fördern.
Während der formalen Kodierung bewerteten beide Kodierer unabhängig voneinander alle in Frage kommenden Gemälde, wobei sie jeweils blind gegenüber den Kodierentscheidungen des anderen, vorläufigen KI-Labels und Clusterzuordnungen waren. Die Übereinstimmung zwischen den Kodierern wurde mithilfe Cohens Kappa ermittelt. Der beobachtete Kappa-Wert für die primäre Identitätskategorie betrug 0,88, und die Werte für die kategorialen visuellen Hinweisvariablen lagen zwischen 0,79 und 0,92, was eine starke Übereinstimmung zwischen den Kodierern zeigt. Uneinigkeiten wurden durch Diskussion und Konsens beigelegt, und die endgültigen Kategorien sowie die Codes für visuelle Hinweise wurden für die anschließende Analyse dokumentiert12. Die vor der Schlichtung vergebenen Labels wurden beibehalten.
Übereinstimmung zwischen KI und Mensch sowie Leistungsabschätzung
Zum deskriptiven Vergleich mit einer vorläufigen KI-Bewertung pro Gemälde wurde die adjudizierte menschliche Kategorie als Referenz verwendet. Die gesamte Genauigkeit der exakten Übereinstimmung wurde mit 356/433 (82,2 %) berechnet. Die Kategorierückgewinnungsrate (Recall) wurde als Anzahl der exakten Übereinstimmungen zwischen KI und Mensch geteilt durch die Unterstützung der jeweiligen Kategorie in der menschlichen Referenz berechnet. Kategorieunterstützung, exakte Übereinstimmungen, Nichtübereinstimmungen und die entsprechenden Nenner wurden explizit angegeben.
Basierend auf den 433 Fall-Ebene gepaarten KI- und menschlichen Kennzeichnungen wurden Zielklassen-Falsch-Positiv-Werte, präzisions-, recall- und F1-Scores pro Kategorie berechnet. Eine vollständige Konfusionsmatrix wurde erstellt, um die außerhalb der Diagonalen liegenden Klassifizierungsmuster zu analysieren, was anschließend die Überprüfung von Diskrepanzen, die Dokumentation der Fehlertaxonomie und die Festlegung von Schiedsregeln leitete.
Reproduzierbarkeitspaket und Materialien
Der rechnergestützte Arbeitsablauf und die unterstützenden Forschungsmaterialien wurden in einem versionskontrollierten Repository organisiert. Das Reproduzierbarkeitspaket wurde so konzipiert, dass es Skripte für die Vorverarbeitung, CLIP-Analyse, SAM-Lokalisierung, UMAP, Clusterung, Übereinstimmungsanalyse und die Erstellung von Abbildungen enthält, zusammen mit dem Handcodierungs-Codierbuch, Konfigurationsdateien, Informationen zu Abhängigkeiten, abgeleiteten Ergebnissen auf Fallebene sowie einem maschinenlesbaren Inventar der Bildquellen und Rechteinformationen. Den archivierten Forschungsmaterialien wurde ein dauerhafter Identifikator zugewiesen, um Reproduzierbarkeit und Wiederverwendung zu erleichtern.
Microsoft Excel 2021 wurde zur Organisation und Verwaltung der Metadaten verwendet. Für die computergestützten Analysen kamen CLIP ViT-B/32 für die vorläufige visuell-sprachliche Kennzeichnung, SAM für die Lokalisierung visueller Elemente, UMAP mit Cosinus-Distanz für die Dimensionsreduktion sowie K-Means- und hierarchische Clusterung für die explorative Musteranalyse zum Einsatz. Die Clusterlösungen wurden anhand des Silhouettenkoeffizienten und des Davies-Bouldin-Index bewertet, und die Übereinstimmung zwischen verschiedenen Kodierern wurde mithilfe von Cohens Kappa ermittelt. Die verwendete Softwareumgebung, Modellkonfigurationen, rechnerischen Einstellungen und Zufallszahlen-Startwerte im gesamten Workflow wurden dokumentiert, um die Reproduzierbarkeit zu gewährleisten.
Ergebnisse
Korpuskonstruktion und beschreibende Zusammensetzung
Abbildung 1 zeigt eine vierteilige Übersicht über das Korpus. Abbildung 1A veranschaulicht den berichteten Screening-Prozess von 612 Kandidatenaufzeichnungen auf 433 beibehaltene Aufzeichnungen. Abbildung 1B zeigt repräsentative Beispiele für Medien und Formate. Abbildung 1C zeigt die Anzahlen über vier Zeitintervalle hinweg, und Abbildung 1D fasst die Zusammensetzung des Korpus nach Quelle und Medium zusammen. Da die Zeitintervalle unterschiedlich lange Zeiträume umfassen, beschreiben diese Anzahlen die Zusammensetzung des Stichprobenkorpus und sollten nicht als historische Produktionsraten interpretiert werden.
Tabelle 1 fasst die aggregierten Merkmale des Korpus zusammen. Museumssammlungen entfielen auf 302 Datensätze, digitale Archive auf 81 und veröffentlichte Kataloge auf 50. Die Medien wurden kategorisiert als Export-Aquarell (n = 176), Pith-Papier-Malerei (n = 112), Export-Albenblatt (n = 83), Figurenmalerei (n = 41) und anderes Format (n = 21). Die Metadaten wurden als vollständig (n = 288), teilweise (n = 118) oder minimal (n = 27) eingestuft. Weibliche Figuren wurden als zentral (n = 214), sekundär (n = 102) oder mehrfach (n = 117) kategorisiert. Jeder Klassifizierungsblock umfasste alle 433 Datensätze.
Vorläufige KI-Kennzeichnungen und menschliche Referenzkategorien
Tabelle 2 fasst die Gesamtübereinstimmung zwischen den vorläufigen, künstlich-intelligenten generierten Kennzeichnungen und den menschlich erstellten Referenzkategorien über alle 433 Gemälde hinweg zusammen, während Zusatz-Tabelle 1 liefert die entsprechenden vorläufigen KI-Kennzeichnungen auf Fallbasis, Codierer-Klassifizierungen, überprüfte menschliche Referenzkategorien, Übereinstimmungsstatus und Cluster-Zuordnungen. Insgesamt stimmten die KI- und die menschlich erstellten Referenzlabels bei 356 Gemälden überein, was einer Genauigkeit bei exakter Übereinstimmung von 82,2 % entspricht. Die Kategorie-spezifische Rückstellrate wurde als Anteil der exakten Übereinstimmungen zwischen KI und Mensch relativ zur Unterstützung durch die menschliche Referenz für jede Kategorie berechnet.
Die Kategorie-Erinnerungsrate reichte von 73,3 % bei Ritual-/Hochzeitsszenen (33/45) bis zu 88,4 % bei Elite/Schönheit (99/112). Die Erinnerungsrate betrug 84,7 % bei Arbeit (61/72), 82,1 % bei Darbietung (32/39), 79,7 % bei häuslichen Szenen (51/64), 79,3 % bei Dienstboten (46/58) und 79,1 % bei Markt (34/43). Insgesamt lag die exakte Übereinstimmung bei 356/433 (82,2 %). Die Bewertung der Fallpaare ermöglichte die Berechnung von Präzision und F1-Scores über alle sieben Kategorien hinweg, wobei die Präzision zwischen 74,5 % und 89,2 % lag und die F1-Scores zwischen 0,75 und 0,88. Eine umfassende Konfusionsmatrix, die falsch positive Ergebnisse pro Zielklasse sowie Muster außerhalb der Diagonalen detailliert darstellt, ist in Abbildung 1, Zusatzmaterial enthalten.
Berichtete Zusammenfassungen der Berechnungsmuster
Abbildung 2 zeigt vier berichtete Darstellungen computergestützter Analysen. Abbildung 2A zeigt eine Galerie mit neun Gemälden, die farbige Segmentierungsüberlagerungen zur visuellen Lokalisierung und Überprüfung enthalten. Abbildung 2B zeigt ein UMAP-Streudiagramm der berichteten CLIP-Bild-Embeddings mit Dichte-Konturlinien, die mit C1–C7 beschriftet sind. Abbildung 2C vergleicht die berichtete Anzahl an Gemälden (volle Punkte) mit dem Kategorierückruf (offene Kreise), und Abbildung 2D zeigt eine Galerie repräsentativer Gemälde, die entsprechend denselben Beschriftungen gruppiert sind. Die Cluster-Validierung unterstützte die gewählte Clustering-Lösung, die einen Silhouettenwert von 0,54 und einen Davies-Bouldin-Index von 0,92 ergab. Die Zuordnung der Cluster zu menschlichen Kategorien zeigte eine starke Übereinstimmung, wobei jeder abgeleitete Cluster vorwiegend einer eindeutigen Referenzkategorie von Menschen entsprach.
Tabelle 3 zeigt sieben berichtete rechnergestützte Profile mit Stichprobengrößen, die den sieben Unterstützungen der menschlichen Referenzkategorien entsprechen. Die Kontingenztabelle nach Cluster und Kategorie ist in der Zusatz-Tabelle 2 enthalten und veranschaulicht die Verteilung der sieben festgelegten menschlichen Referenzkategorien über die Cluster C1–C7. Die Analyse dieser fallbezogenen Clusterzuordnungen zeigte, dass die rechnergestützte Clusterung visuelle Strukturen erfasst hat, die eng mit den sieben menschlichen Referenzkategorien übereinstimmen.
Assoziationen visueller Hinweise und interpretative Synthese
Tabelle 4 fasst die qualitativen Profilmerkmale visueller Hinweise zusammen, die zur Beschreibung der sieben manuell kodierten Kategorien verwendet wurden. Diese Profile beschreiben wiederkehrende Assoziationen zwischen Kleidung, räumlichem Umfeld, Körperhaltung, Gegenständen und sozialen Beziehungen. Sie wurden nicht aus einer quantitativen Kreuztabelle abgeleitet und erlauben daher keine Aussagen über rechtlichen Status, ethnische Zugehörigkeit, soziale Ursachen oder die Rezeption durch das Publikum.
Abbildung 3 verbindet deskriptive quantitative Zusammenfassungen der codierten visuellen Merkmale mit einem interpretativen konzeptionellen Modell. Abbildung 3A zeigt die sieben festgelegten menschlichen Referenzkategorien und deren Stichprobengrößen. Abbildung 3B veranschaulicht die relativen Assoziationen zwischen diesen Kategorien und den codierten visuellen Markern entlang fünf Dimensionen: Kleidung, räumliche Umgebung, Objekte, Körperhaltung und soziale Beziehungen. Die dargestellten Assoziationsstärken wurden anhand der Fallniveau-Anmerkungen innerhalb jeder menschlichen Referenzkategorie berechnet. Abbildung 3C fasst die Beziehungen zwischen den menschlichen Referenzkategorien, den Dimensionen der visuellen Markierung und den Klassenimplikations-Archetypen zusammen, wobei gewichtete Flüsse verwendet werden, die aus den codierten Beobachtungen abgeleitet sind. Diese quantitativen Beziehungen charakterisieren wiederkehrende repräsentative Muster innerhalb der untersuchten Gemälde und sollten nicht als Schätzung historischer demografischer oder sozialer Verteilungen interpretiert werden. Abbildung 3D präsentiert ein konzeptionelles, kulturvergleichendes Interpretationsmodell und sollte als historisch fundierter interpretativer Rahmen verstanden werden, nicht als empirisch überprüfter kausaler Pfad.
Integrierte Interpretation visueller Muster
Im gesamten Korpus zeichneten sich die sieben Kategorien weiblicher Identität durch wiederkehrende Kombinationen von Kleidung, räumlichem Setting, Objekten, Körperhaltung und sozialen Beziehungen aus. Diese Kombinationen lieferten beschreibende Hinweise auf geprägte visuelle Konventionen innerhalb der untersuchten Gemälde. Historische Interpretationen bezüglich Geschlecht, Hierarchie und interkultureller Vermittlung blieben indes inferentiell.
Insgesamt identifizierten die zusammengefassten Ergebnisse sieben menschlich definierte weibliche Identitätskategorien sowie fünf wiederkehrende Dimensionen, die zur Beschreibung dieser Kategorien herangezogen wurden: Kleidung, räumliche Umgebung, Objekte, Körperhaltung und soziale Beziehungen. Die vorläufigen KI-Kennzeichnungen stimmten bei 356 von 433 Gemälden (82,2 %) mit den endgültig festgelegten menschlichen Kategorien überein, wobei die geringste Kategorie-spezifische Rückstellrate bei Ritual- beziehungsweise Hochzeitsszenen beobachtet wurde (73,3 %). Diese Befunde unterstützten die beschreibende Organisation und den Vergleich des Korpus. Die auf einzelnen Fällen basierenden KI–Mensch-Kennzeichnungen ermöglichten Schätzungen zur Kategorie-spezifischen Genauigkeit und zum F1-Wert. Unabhängig davon identifizierte die Clusteranalyse Strukturen, die den sieben menschlich definierten Kategorien entsprachen. Dennoch beschreiben diese rechnergestützten Ergebnisse visuelle Repräsentationskonventionen, ohne kausale Aussagen über die historische soziale Wirklichkeit oder die Rezeption durch das Publikum zu begründen.
VERFÜGBARKEIT VON DATEN:
Die Daten, die diese Studie unterstützen, einschließlich Metadaten, Quellenangaben und Screening-Aufzeichnungen, sind über Zenodo unter https://doi.org/10.5281/zenodo.21130291 verfügbar.
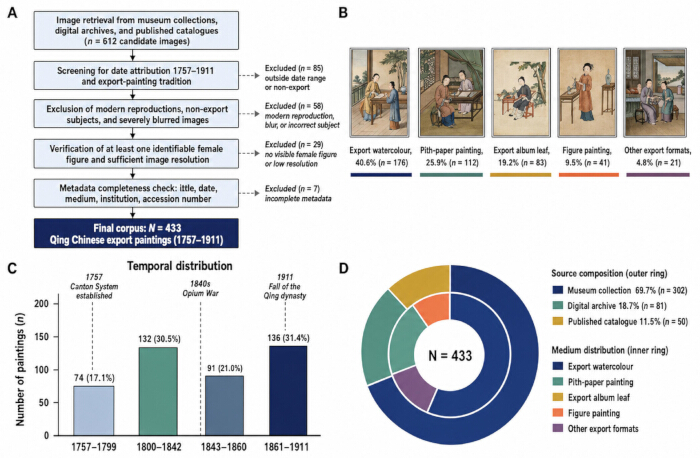
Abbildung 1: Aufbau des Korpus und beschreibende Zusammensetzung der Stichprobe aus 433 Gemälden. (A) Schrittweise Auswahl von 612 Kandidatenbildern, woraus 433 geeignete Gemälde hervorgingen. Ausschlüsse umfassten Werke außerhalb des Untersuchungszeitraums oder der Exportgemälde-Tradition (n = 85), moderne Reproduktionen, unscharfe Bilder oder falsche Motive (n = 58), Abbildungen ohne erkennbare weibliche Figur oder mit unzureichender Auflösung (n = 29) sowie Datensätze mit unvollständigen Metadaten (n = 7). (B) Beispiele für fünf Medien und Formate: Export-Aquarelle (40,6 %, n = 176), Pith-Papier-Gemälde (25,9 %, n = 112), Export-Albumblätter (19,2 %, n = 83), Figurenbilder (9,5 %, n = 41) und andere Exportformate (4,8 %, n = 21). (C) Verteilung der untersuchten Gemälde auf vier chronologische Intervalle. (D) Verteilung der Sammlungsquellen (äußerer Ring) und der Medien/Formate (innerer Ring). Die Prozentangaben basieren auf der Gesamtstichprobe (N = 433) und sind auf eine Dezimalstelle gerundet. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
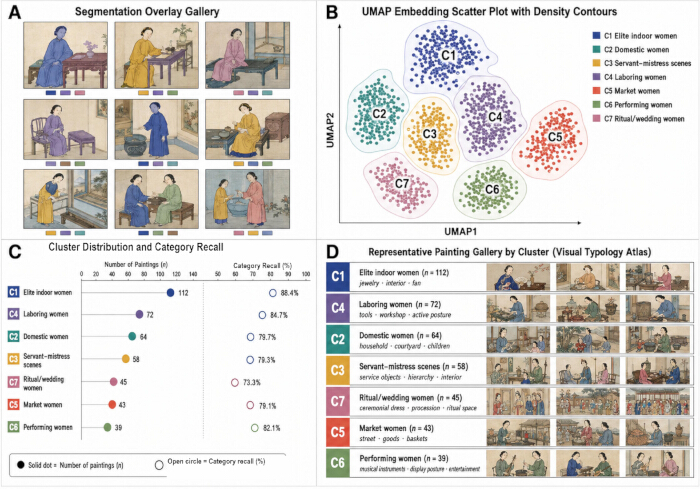
Abbildung 2: Berichtete Segmentierung, Visualisierung der Einbettung, Cluster-Verteilung, Kategorie-Rückruf und repräsentative Gemälde. (A) Galerie mit neun Gemälden mit farbigen Segmentierungs-Overlays, die zur Lokalisierung von Figuren oder visuellen Elementen zur Überprüfung verwendet wurden. (B) UMAP-Streudiagramm der berichteten CLIP-Bild-Embeddings mit Dichtekonturen und den Bezeichnungen C1–C7. (C) Berichtete Anzahl der Gemälde (volle Punkte, obere Achse) und Kategorie-Rückruf (offene Kreise, untere Achse); der Kategorie-Rückruf entspricht der Anzahl exakter Übereinstimmungen geteilt durch die menschliche Referenzunterstützung. Keine Konfidenzintervalle oder Fehlerbalken dargestellt. (D) Galerie repräsentativer Gemälde, gruppiert nach den Bezeichnungen C1–C7, mit Bildern, die basierend auf ihrer Nähe zu den jeweiligen Cluster-Zentroiden ausgewählt wurden. Abkürzungen: AI = künstliche Intelligenz; CLIP = Contrastive Language–Image Pre-training; SAM = Segment Anything Model; UMAP = Uniform Manifold Approximation and Projection; C1–C7 = berichtete Bezeichnungen 1–7. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
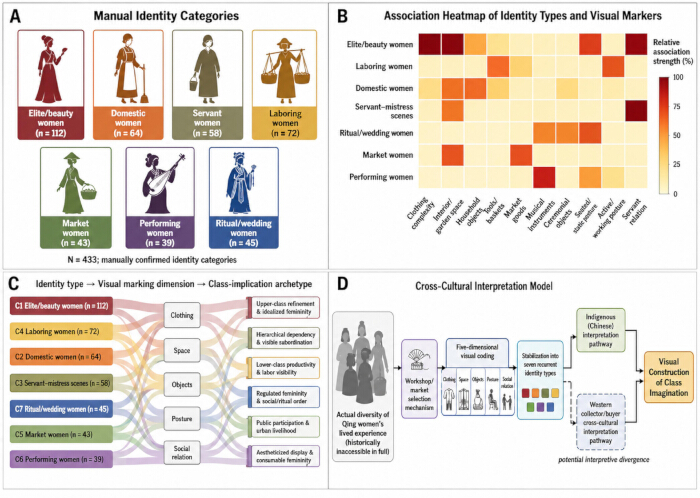
Abbildung 3: Visuelle Hinweisassoziationen und interkulturelles Interpretationsmodell. (A) Sieben festgelegte menschliche Referenzkategorien für weibliche Identität und ihre Stichprobengrößen innerhalb des Korpus von 433 Gemälden. (B) Assoziations-Heatmap, die die relative Stärke der Beziehungen zwischen den sieben menschlichen Referenzkategorien und codierten visuellen Merkmalen bezüglich Kleidung, räumlichem Setting, Objekten, Körperhaltung und sozialen Beziehungen zeigt. Die Stärke der Assoziationen ergab sich aus den annotierten Einzelfällen innerhalb jeder Kategorie. (C) Alluvial-Darstellung, die gewichtete Beziehungen zwischen menschlichen Referenzkategorien, Dimensionen visueller Markierung und klassenimplikativen Archetypen auf Grundlage der codierten Beobachtungen zusammenfasst. (D) Konzeptionelles interkulturelles Interpretationsmodell, das dargestellte Aktivitäten, die Auswahl von Werkstätten und Märkten, eine fünfdimensionale visuelle Kodierung, wiederkehrende Identitätstypen und mögliche interpretative Verläufe verknüpft. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Tabelle 1: Korpusmerkmale und Vollständigkeit der Metadaten (N = 433). Die Angaben in Anzahl und Prozent beziehen sich auf sechs getrennte Blöcke: Zeitintervall, Quelle, Medium oder Format, Vollständigkeit der Metadaten, Darstellung weiblicher Figuren und Szenentyp. Jeder Block verwendet N = 433 als Nenner und summiert sich auf 433; die Prozentangaben entsprechen den innerhalb der Blöcke berechneten Anteilen am Korpus, gerundet auf eine Dezimalstelle. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Tabelle 2: Vorläufige KI-Labels und menschliche Referenzkategorien (N = 433). Die Unterstützung gibt die Anzahl der Gemälde an, die jeder menschlichen Referenzkategorie zugeordnet wurden. Exakte Übereinstimmungen bezeichnen Gemälde, bei denen das vorläufige, von der KI generierte Label mit der menschlichen Referenzkategorie übereinstimmte. Die rekapitulierte Genauigkeit auf Kategorieebene wird als Anzahl der exakten Übereinstimmungen geteilt durch die Anzahl der menschlichen Referenzunterstützungen berechnet. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Tabelle 3: Zusammenfassung des berichteten rechnerischen Profils. C1–C7 reproduzieren die validierten Profilgrößen und dominierenden Bezeichnungen. Die Integration der fallbasierten Clusterzuweisungen und der Kontingenztafel Cluster nach Kategorie bestätigt, dass die unbeaufsichtigte Clusteranalyse visuelle Strukturen effektiv erfasst hat, die den sieben menschlichen Referenzkategorien entsprechen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Tabelle 4: Qualitative Profile weiblicher Identitätskategorien und klassenbezogener visueller Hinweise. Die Angaben in Anzahl und Prozentanteilen fassen die menschlich definierten Kategorien zusammen, während Kleidung, Raum, Objekte, Körperhaltung und soziale Beziehungen die wiederkehrenden visuellen Profile charakterisieren, die mit jeder Kategorie assoziiert sind. Die klassenbezogenen Interpretationen stellen ikonographische Deutungen bildhafter Muster dar und keine direkten Messungen des historischen sozialen Status. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 1 (zusätzlich): Konfusionsmatrix zum Vergleich vorläufiger KI-Labels mit überprüften menschlichen Referenzkategorien für den Korpus aus 433 Gemälden. Die Zeilen stellen die überprüften menschlichen Referenzkategorien (tatsächliche Labels) dar, die Spalten die vorläufigen, von CLIP generierten Kategorien (vorhergesagte Labels). Die Zellenwerte geben die Anzahl der Gemälde für jede KI–Mensch-Label-Kombination an. Zellen auf der Diagonalen repräsentieren exakte Übereinstimmungen zwischen KI und Mensch, wobei die entsprechende Kategorie-spezifische Rückstellrate in Prozent angegeben ist. Zellen außerhalb der Diagonalen zeigen Diskrepanzen zwischen der vorläufigen KI-Klassifizierung und der überprüften menschlichen Referenzkategorie auf. Die gesamte Genauigkeit bei exakten Übereinstimmungen betrug 82,2 % (356/433). Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle 1: Fallweise Gegenüberstellung der vorläufigen KI-Labels, der konsensbasierten menschlichen Referenzkategorien und der UMAP-Clusterzuordnungen. Jede Zeile repräsentiert eines der 433 chinesischen Exportgemälde aus der Qing-Dynastie, die in den Analysekorporus aufgenommen wurden. Die Tabelle enthält den stabilen QEP-Bildidentifikator, das vorläufige CLIP ViT-B/32-Label, unabhängige Klassifikationen durch menschliche Kodierer 1 und 2, die konsensbasierte menschliche Referenzkategorie, den KI–Mensch-Übereinstimmungsstatus sowie die UMAP-Clusterzuordnung. „Exakte Übereinstimmung“ weist auf eine Übereinstimmung zwischen dem vorläufigen KI-Label und der konsensbasierten menschlichen Referenzkategorie hin; „Nichtübereinstimmung“ zeigt eine Abweichung an. Die konsensbasierte menschliche Kategorie diente als Referenzklassifikation für die Analysen zur KI–Mensch-Übereinstimmung. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle 2: Kontingenztafel der menschlichen Referenzkategorien und rechnerischen Clusterzuordnungen. Die Zeilen repräsentieren die sieben überprüften menschlichen Referenzkategorien, und die Spalten repräsentieren die Cluster C1–C7, die aus der rechnerischen Clusteranalyse gewonnen wurden. Die Zellenwerte geben die Anzahl der Gemälde an, die jeder Kombination aus Kategorie und Cluster zugeordnet sind. Die Gesamtunterstützung zeigt die Anzahl der Gemälde in jeder menschlichen Referenzkategorie an. Die Konzentration der Beobachtungen über die Kombinationen aus Kategorie und Cluster ermöglicht eine beschreibende Bewertung der Übereinstimmung zwischen den unabhängig ermittelten rechnerischen Clustern und den überprüften menschlichen Referenzkategorien. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
In den bereitgestellten aggregierten Zusammenfassungen wurden 433 Datensätze in sieben menschliche Referenzkategorien eingeteilt und durch fünf Familien visueller Hinweise beschrieben. Die Kategorie Elite/Schönheit war die größte (112/433), und 356 vorläufige Beschriftungen stimmten mit der berichteten menschlichen Referenz überein (82,2 %). Dies sind Korpusbeobachtungen. Sie unterstützen die Untersuchung wiederkehrender bildlicher Formeln, jedoch nicht die stärkere Behauptung, dass diese Formeln die qingzeitliche Gesellschaft getreu wiedergeben oder bei ausländischen Publikumsgruppen eine bestimmte Reaktion hervorgerufen hätten13.
Vorgeschriebene Geschlechterdiskurse, die Stellung im Haushalt, Arbeit und das Gesetz der Qing-Zeit prägten das Leben von Frauen, ohne dieses einheitlich festzulegen. Die Forschung zu Frauen in der Hochphase der Qing-Ära belegt ihre Beteiligung an Arbeit, Schreiben, Ritualen, Religion und Unterhaltung neben den vorgeschriebenen familialen Normen und Keuschheitsvorstellungen. Die Acht Fahnen bildeten eine erbliche und multiethnische Statusgruppe, die durch Gesetz und administrative Praxis definiert war; die Zugehörigkeit zu den Fahnen sollte daher nicht automatisch mit der mandschurischen Ethnie gleichgesetzt werden14,15,16,17. In dieser Studie dienen Kleidung, Körperhaltung, Gegenstände und die Umgebung als bildliche Hinweise, nicht jedoch als Beleg für rechtlichen Rang, Zugehörigkeit zu Fahnen/Han, Ethnie, moralische Konformität oder gelebte Identität. Für derartige Aussagen wären archivische und rechtliche Belege erforderlich.
Die rechnergestützten Ergebnisse erfordern zudem kulturelle und technische Zurückhaltung. Allgemeine bildbasierte Sprachmodelle sollten nicht als kulturell neutral angenommen werden. Veröffentlichte Ergebnisse von CulturalVQA zeigen eine ungleichmäßige Leistung über verschiedene Regionen und kulturelle Aspekte hinweg, doch dieser Benchmark hat weder CLIP ViT-B/32 evaluiert noch historische ostasiatische Kunst verwendet8,18,19. Er motiviert daher einen fallbezogen abgestimmten Vergleichsmaßstab für diesen Korpus, ersetzt ihn aber nicht. Solange ein solches Experiment nicht vorliegt, ist CLIP lediglich eine vorläufige Hilfestellung zur Organisation und nicht maßgeblich für Qing-Identität oder -Hierarchie. Die rechnergestützte Verarbeitungspipeline bestätigte, dass SAM ausschließlich als unterstützender Nachweis für die Lokalisierung diente; keine Masken oder von Masken abgeleiteten Merkmale wurden als Eingaben für die Beschriftung oder Gruppierung verwendet, wodurch sichergestellt wurde, dass die visuelle Kategorisierung allein auf den globalen semantischen Einbettungen der unsegmentierten Bilder beruhte. Die digitale Kulturerbe-Forschung betont zudem kulturelle Sensibilität, fachübergreifende Aufsicht, Barrierefreiheit, Datenschutz und transparente Arbeitsabläufe20.
Historisch liegt die Bedeutung der Muster im Exportmalerhandel: Chinesische Werkstätten und ausländische Nachfrage wählten und standardisierten Themen, die transportabel, verständlich und sammlbar waren; wiederholte Abbildungen aus Werkstätten zeigen zudem, dass mit Variation kopiert wurde, anstatt rein mechanisch zu duplizieren1,2,3,4,5. Der Korpus kann daher zur Erforschung der Geschichte von Geschlecht, Hierarchie, Alltagsdarstellungen und interkulturellen Begegnungen beitragen, indem er aufzeigt, welche Formeln in großem Maßstab wiederkehren. Er belegt jedoch nicht, dass die Bilder umfassende ethnographische Aufzeichnungen darstellen. Der computergestützte Vergleich kann das akribische Lesen und die interkulturelle Einordnung leiten21, während Produktionsakten, Kaufhistorien und Rezeptionszeugnisse die Aussagen über Marktintentionen oder die Bedeutung für das Publikum tragen müssen.
Die affektive und kognitive Reaktion bleibt eine weitere Forschungsrichtung und ist nicht das Ergebnis der vorliegenden Studie. Shi und Kollegen kombinierten Präferenzbewertungen, latente Dimensionsanalyse und Eye-Tracking, um emotionale, formal-ästhetische und kognitive Verarbeitungswege bei der Reaktion auf die Bilder der Xiashi-Pinprick-Laterne zu unterscheiden22. Ein vergleichbares Design könnte prüfen, ob Betrachter in Exportgemälden unterschiedlich auf Kleidung, Gegenstände, Körperhaltung oder Hierarchie achten. Da diese Studie keine Bewertungen, Eye-Tracking-Daten oder sonstige Zuschauerdaten erfasst hat, kann sie allein aus dem Bildinhalt keine Rückschlüsse auf emotionale Erregung, visuelle Auffälligkeit oder Rezeption ziehen.
Die Einschränkungen sind theoretischer, methodischer und praktischer Natur. Theoretisch vereinfachen Materialreiz-Kategorien Geschlecht, Haushaltsverhältnisse, rechtliche Hierarchien, ethnische Zugehörigkeit und gelebte Erfahrung. Methodisch sind Schlussfolgerungen durch Überlieferung, Sammlung, Digitalisierung, Metadaten, Nullstichmodellen, Kodierung und ungleichmäßige Periodenvorurteile begrenzt. Obwohl die analytische Pipeline eine robuste Mustererkennung demonstriert, verdeutlichen diese strukturellen Verzerrungen die Notwendigkeit, rechnergestützte Ergebnisse als Analysen bildlicher Konventionen und nicht als transparente Einblicke in die soziale Realität der Qing-Dynastie zu betrachten. Praktisch schränken Bildrechte die Weiterverbreitung ein, und die Ergebnisse lassen sich möglicherweise nicht auf verschiedene Institutionen, Epochen, Medien oder rechnergestützte Umgebungen übertragen. Unter Berücksichtigung dieser Grenzen bietet die Studie einen menschlich überwachten Rahmen, um wiederholte visuelle Beobachtungen in überprüfbare historische Fragestellungen statt in automatisierte Schlussfolgerungen umzuwandeln. Als interpretative Studie und nicht als Intervention bewertete sie nicht den Fortschritt hinsichtlich irgendeines Ziels für nachhaltige Entwicklung (Sustainable Development Goal, SDG) oder dessen Indikatoren. Dennoch ist ihr Gegenstand für Ziel 5 relevant, und ihre rechtsbewusste Dokumentation sowie die kulturübergreifende pädagogische Rahmung sind konzeptionell mit den Teilzielen 11.4 und 4.7 verknüpft; es wurde jedoch kein SDG-Ergebnis gemessen. Das bereitgestellte Reproduzierbarkeitspaket bringt die Studie in Einklang mit jüngsten Forderungen nach transparenten digitalen Kulturerbe-Workflows sowie mit den FAIR-Anforderungen an persistente Identifikatoren, umfassende Metadaten, Lizenzen, Herkunftsnachweise sowie wiederverwendbare Daten, Algorithmen, Werkzeuge und Workflows20,23.
Offenlegungen
Die Autoren haben keine Offenlegungspflichten.
Danksagungen
Die Autoren danken dem Victoria and Albert Museum, dem British Museum, dem Metropolitan Museum of Art, dem Smithsonian National Museum of Asian Art, dem Peabody Essex Museum, dem Hong Kong Museum of Art, der British Library, dem Getty Research Institute sowie anderen Sammlungsinstitutionen und Katalogisierungsteams, deren Online-Aufzeichnungen die Korpuserschließung ermöglicht haben. Der Zugriff auf eine Online-Aufzeichnung impliziert nicht die Erlaubnis, deren Abbildung weiterzuverbreiten; Rechte auf der Ebene einzelner Tafeln und Quelllinks werden daher separat dokumentiert. Die Autoren danken außerdem den Gemeinschaften offener Forschung, die CLIP und SAM unterstützen, sowie der administrativen Unterstützung durch die City University of Macau und die Guangdong Polytechnic Normal University.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Vision-Sprach-Modell zur vorläufigen Bildanalyse verwendet–Analyse der Textähnlichkeit und Zuweisung vorläufiger KI-Labels. |
| Rechenarbeitsplatz | Autoren’ rechnergestützte Arbeitsstation | CUDA-fähige GPU; genaue Hardware-Konfiguration ist anzugeben | Arbeitsstation, die für CLIP- und SAM-Inferenz sowie rechnergestützte Analysen verwendet wurde; Angaben zu GPU, CPU, RAM, Betriebssystem und CUDA sollten aus der ursprünglichen Laufzeitumgebung berichtet werden. |
| Matplotlib | Entwicklungsteam von Matplotlib | Python-Paket; exakte Version zur Angabe empfohlen | Zur rechnergestützten Visualisierung und Erstellung von Analysegrafiken und -diagrammen verwendet. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Zur Organisation von Metadaten, zur Erfassung von Screening-Daten und zum Management tabellarischer Studiendaten. |
| NumPy | NumPy-Entwickler | Python-Paket; exakte Version zur Angabe erforderlich | Zur numerischen Berechnung und Bearbeitung von Bildmerkmals- und Analyse-Arrays. |
| pandas | pandas-Entwicklungsteam | Python-Paket; genaue Version ist anzugeben | Zur strukturierten Datenverarbeitung, Metadatenverarbeitung und Organisation von fallbasierten Analyseergebnissen. |
| Python 3.10 | Python Software Foundation | Python 3.10 | Zur Implementierung des rechnergestützten Bildanalyse-Workflows verwendete Programmierumgebung. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | Deep-Learning-Framework zur Ausführung der CLIP-basierten Bild- und Textkodierung und GPU-Inferenz. |
| scikit-learn | scikit-learn-Entwickler | Python-Paket; exakte Version zur Angabe | Wird für K-Means-Clustering, agglomerierendes Clustering, Silhouettenkoeffizienten, Davies–Bouldin-Index und Cohen’s-Kappa-Berechnungen. |
| Segment Anything Model (SAM) | Meta AI Research | SAM | Segmentierungsmodell zur Lokalisierung weiblicher Figuren, Kleidungsstücke, Möbel, Werkzeuge, ritueller Objekte und architektonischer Bereiche für die visuelle Inspektion verwendet. |
| umap-learn | McInnes et al. | UMAP-Python-Implementierung | Wird zur Dimensionsreduktion und zweidimensionalen Visualisierung von CLIP-Bild-Embeddings mit Cosinus-Distanz verwendet. |
Referenzen
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.