Dieses Protokoll integriert multimodale Verhaltensaufzeichnungen, um beobachtbare Korrelate kognitiver Anstrengung und die funktionale Wirksamkeit von Überarbeitungen bei der schriftlichen Übersetzung und Simultandolmetschung aus dem Englischen ins Chinesische zu bewerten. Es kombiniert Tastaturprotokollierung, Bildschirmaufnahme, Audioanalyse, transkriptbasierte Kodierung und standardisierte Qualitätsbewertung.
Methodenartikel
Ein Verhaltensprotokoll zur Bewertung des kognitiven Aufwands und der strategischen Revision bei englisch-chinesischen Übersetzungs- und Sichtübersetzungsaufgaben
In diesem Artikel
Zusammenfassung
Zusammenfassung
Dieser Artikel stellt ein multimodales Verhaltensprotokoll zur Untersuchung beobachtbarer Korrelate kognitiver Anstrengung und strategischer Revision während des schriftlichen Übersetzens aus dem Englischen ins Chinesische sowie des Simultandolmetschens vor. Für die schriftliche Übersetzung werden Tastaturprotokolle und Bildschirmaufnahmen synchronisiert, während für das Simultandolmetschen Audioaufnahmen und wörtliche Transkripte verwendet werden. Revisions- und Selbstkorrekturepisoden werden nach Typ und funktionalem Ergebnis (wirksam, neutral oder nachteilig) unabhängig von globalen Bewertungen der Ausgabegüte kategorisiert. In einer Demonstration mit 62 Teilnehmern, die in Anfänger- und geschulte Gruppen eingeteilt wurden, absolvierten beide Gruppen die beiden Aufgabenbedingungen in zufälliger Reihenfolge. Geschulte Teilnehmer erzielten höhere mittlere Ausgabegütescores bei der schriftlichen Übersetzung (20,1 ± 2,1 vs. 16,8 ± 2,3) und beim Simultandolmetschen (18,9 ± 2,4 vs. 15,4 ± 2,6) sowie einen größeren Anteil wirksamer Revisionen oder Selbstkorrekturen. Da Pausen, Löschungen, Reaktionslatenzen und Revisionsdichte indirekt und aufgabenabhängig sind, werden sie als Verhaltenskorrelate interpretiert, die einer Triangulation bedürfen, anstatt als direkte Maße eines einheitlichen Konstrukts. Das Protokoll ist für kontrollierte erläuternde Texte konzipiert und kann nach Neukalibrierung der Eingabemethoden, Pausenschwellen, Textvergleichbarkeit und Bewertungsverfahren auf andere Sprachpaare übertragen werden.
Einleitung
Schriftliche Übersetzung und Simultandolmetschen vom Lesen erfordern Textverständnis, sprachübergreifende Transferleistungen und die Formulierung in der Zielsprache, stellen jedoch unterschiedliche Aufgabenbedingungen. Die schriftliche Übersetzung erlaubt rekursives Lesen und verzögerte Korrekturen, während das Simultandolmetschen vom Lesen mündliche Äußerungen unter strikteren zeitlichen Zwängen verlangt. Kognitive Belastung, Verarbeitungsschwierigkeiten und kognitiver Aufwand sind verwandte, jedoch nicht austauschbare Konstrukte: Die Belastung bezieht sich auf die Anforderungen der Aufgabe, der Aufwand hingegen auf die Ressourcen, die eine Person unter diesen Anforderungen einsetzt. Kognitiver Aufwand ist latenter Natur und mehrdimensional; daher werden Reaktionszeiten, Pausen, Streichungen und die Dichte von Überarbeitungen hier als verhaltensbezogene Korrelate betrachtet, die Planungs-, Überwachungs- oder motorische Prozesse widerspiegeln oder Schwierigkeiten anzeigen können und gemeinsam interpretiert werden müssen, anstatt als direkte Messgrößen für den Aufwand1,2,3,4,5,6,7,8.
Die prozessorientierte Forschung kombiniert Produktbewertungen mit zeitlich abgestimmten Verhaltensaufzeichnungen, um zu ermitteln, wann und wie Übersetzungsentscheidungen erfolgen. Die Aufzeichnung von Tastatureingaben liefert Informationen über Produktions- und Überarbeitungssequenzen, doch bei der chinesischen Eingabemethode kann die Zusammensetzung die physischen Tastenereignisse von den tatsächlich eingegebenen Zeichen trennen; daher ist eine synchronisierte Bildschirmaufnahme erforderlich, um den sichtbaren Textzustand rekonstruieren zu können9,10,11. Pausenschwellen sind analytische Entscheidungen und keine universellen kognitiven Grenzen, und kürzere Schwellenwerte können pausebasierte Schlussfolgerungen erheblich verändern8,12. Das Protokoll erfordert daher explizite Synchronisationsprüfungen, Sensitivitätsanalysen der Schwellenwerte sowie die Unterscheidung zwischen aufgabenspezifischen und gemeinsamen Messgrößen.
Die Häufigkeit von Überarbeitungen allein gibt nicht an, ob die Überwachung eine Leistungsverbesserung bewirkt. Schriftliche Überarbeitungen und mündliche Selbstkorrekturen können sich auf lexikalische Auswahl, Syntax, Bedeutung oder Stil beziehen, ihr funktionales Ergebnis muss jedoch anhand der Quellbedeutung und des unmittelbar vorhergehenden Zielsegments beurteilt werden. Untersuchungen zur Simultandolmetschen aus dem Englischen ins Chinesische und aus dem Chinesischen ins Englische zeigen, dass Schulung, Dolmetschrichtung, Augen-Stimme-Koordination und sprachspezifische Problemauslöser die Leistungsmuster beeinflussen können13,14,15,16. Aus diesem Grund werden Episodentyp, Episodenergebnis, Qualität des Endprodukts und lieferungsbezogenes Verhalten als separate Variablen kodiert.
Das Protokoll ist für erwachsene Lernende oder ausgebildete Übersetzer/Interpreten konzipiert, die mit kurzen, nicht spezialisierten erläuternden Texten in kontrollierten, computerbasierten Sitzungen arbeiten. Es eignet sich am besten, wenn Tastenanschläge und Bildschirmaufzeichnungen für die schriftliche Produktion erfasst werden können und hochwertige Audioaufnahmen für die mündliche Produktion angefertigt werden können. Der Rahmen kann auf andere Sprachpaare angepasst werden, doch die Textübereinstimmung, Segmentierung in InformationsEinheiten, Tastatur- oder Eingabemethoden-Verhalten, Pausenschwellen und Bewertungsanker müssen für jedes Sprachpaar und Schriftsystem erneut validiert werden17. Die Demonstration vergleicht Aufgabenbedingungen, anstatt alle Unterschiede allein der Modalität zuzuschreiben, da sich auch Textlänge, Zeitlimits, Ausgabemodus und Überarbeitungsmöglichkeiten unterscheiden.
Protokoll
Alle Methoden, die den Einsatz von menschlichen Probanden beinhalten, wurden gemäß den institutionellen Richtlinien durchgeführt und erhielten die ausdrückliche Genehmigung des Ethik-Komitees für Humorforschung des Guilin Institute of Information Technology (Genehmigungsnummer UYHAJ2025899). Von allen Teilnehmern wurde vor ihrer Teilnahme eine schriftliche informierte Einwilligung eingeholt. Weitere Informationen zu der in dieser Studie verwendeten Ausrüstung und Software finden Sie in der Tabelle der Materialien.
1. Rekrutierung der Teilnehmer und Zuweisung zu Gruppen
- Rekrutieren Sie 62 Teilnehmer, darunter Studierende der Fächer Englisch oder Übersetzungswissenschaft sowie Auszubildende im Bereich Dolmetschen. Stellen Sie sicher, dass alle Teilnehmer Muttersprachler des Chinesischen sind und über normales oder korrigiert normales Seh- und Hörvermögen verfügen.
- Weisen Sie Teilnehmer mit weniger als 12 Monaten strukturierter Übersetzungsausbildung der Anfängergruppe zu und Teilnehmer mit mindestens 12 Monaten Ausbildung der geschulten Gruppe zu. Geben Sie die bisherige schriftliche Übersetzungspraxis und simultane Dolmetscherfahrung aller Teilnehmer getrennt an.
- Screenen Sie die Teilnehmer vor der Aufgabenvergabe, um Personen mit vorherigem Kontakt zu den Quelltexten, nicht korrigierten Sinnesbeeinträchtigungen oder der Unfähigkeit, die standardisierte chinesische Eingabemethode zu nutzen, auszuschließen.
- Schließen Sie Aufgaben erst nach der Aufnahme aus, und zwar nur aus vorab festgelegten Gründen wie der Nutzung nicht erlaubter externer Werkzeuge, unvollständiger Durchführung, beschädigter Dateien oder unbrauchbarer Audioaufnahmen.
- Führen Sie ein Ausschlussprotokoll für Aufgaben ohne personenbezogene Informationen. Geben Sie die endgültige analysierte Stichprobe einheitlich im Text und in Abbildung 1A–D an.
2. Materialauswahl und Pilotbewertung
- Wählen Sie kurze englische Sachtexte aus allgemeinen akademischen, bildungsbezogenen, gesellschaftlichen oder öffentlichen Kommunikationsbereichen aus. Verwenden Sie Texte für das schriftliche Übersetzen mit etwa 180–220 Wörtern und Texte für das Simultandolmetschen mit etwa 120–160 Wörtern.
- Passen Sie die Textlänge, lexikalische Schwierigkeit, syntaktische Komplexität, Informationsdichte und thematische Vertrautheit zwischen den Aufgabenbedingungen an oder gleichen Sie diese statistisch aus.
- Weisen Sie drei zweisprachige Experten an, lexikalische Schwierigkeit, syntaktische Komplexität, Informationsdichte, thematische Vertrautheit und Eignung für die Übertragung unabhängig voneinander auf einer Skala von 1 bis 5 zu bewerten (1 = sehr gering, 5 = sehr hoch).
- Berechnen Sie einen zweifaktoriellen Intraklassenkorrelationskoeffizienten (ICC) mit zufälligen Effekten und einem 95 %-Konfidenzintervall für die gemittelten Bewertungen. Überarbeiten Sie Texte mit schlechter Übereinstimmung (ICC < 0,75).
- Behalten Sie Textpaare nur dann bei, wenn die standardisierten Anpassungsvariablen innerhalb einer Toleranzgrenze von ±10 % liegen.
- Definieren Sie eine Informationseinheit als die kleinste Aussage im Ausgangstext, die eine eigenständig bewertbare Idee, Beziehung oder Ereignis ausdrückt. Klären Sie Uneinigkeiten bezüglich der Abgrenzung, bevor die Aufgabe durchgeführt wird.
- Testen Sie die Anweisungen, Eingabemethode, Synchronisation, Tonqualität und Zeitlimits an Probanden, die nicht in die Hauptanalyse einbezogen werden. Erfassen Sie die Verteilung der Bearbeitungszeiten und den Anteil der Teilnehmer, die jeweils das Zeitlimit erreichen.
- Überarbeiten Sie einen Text oder ein Zeitlimit, wenn in der Pilotphase Deckel- oder Bodeneffekte, anhaltende Mehrdeutigkeiten oder Aufnahmeinstabilitäten auftreten. Dokumentieren Sie alle Änderungen, bevor die Hauptstudie beginnt.
3. Durchführung der Aufgabe und Aufbau der Aufzeichnung
- Testen Sie die Teilnehmer einzeln in einem ruhigen, schallgedämpften Raum mit standardisierter Hardware und Software-Konfiguration.
- Lesen Sie einen standardisierten Instruktionstext vor und ermöglichen Sie eine nicht-experimentelle Übungsaufgabe. Verbieten Sie Wörterbücher, Suchmaschinen, generative künstliche Intelligenz, maschinelles Übersetzen und externe Korpora.
- Balancieren Sie die beiden Aufgabenreihenfolgen (schriftliche Übersetzung zuerst vs. Simultandolmetschen zuerst) innerhalb jeder Trainingsgruppe aus und halten Sie ein Ruheintervall von 5 Minuten ein.
- Erstellen Sie die Zuordnungsliste vor Abschluss der Rekrutierung und verschleiern Sie die Zuweisung, bis die Eignung bestätigt ist. Falls mehrere Ausgangstexte verwendet werden, balancieren Sie die Textidentität unabhängig von der Aufgabenreihenfolge aus und führen Sie eine Text-ID-Variable für die Analyse fort.
- Präsentieren Sie den englischen Ausgangstext kontinuierlich und weisen Sie den Teilnehmer an, im vorgesehenen Eingabefeld eine genaue, natürliche chinesische Übersetzung anzufertigen. Erlauben Sie uneingeschränktes Bearbeiten, verbieten Sie jedoch strikt das Einfügen von externen Texten.
- Wenden Sie die im Pilotversuch festgelegte Obergrenze von 20 Minuten an, ohne eine Countdown-Uhr anzuzeigen, und dokumentieren Sie, ob die Obergrenze erreicht wurde.
- Erfassen Sie den gesamten schriftlichen Übersetzungsprozess kontinuierlich mithilfe einer Tastenprotokollierungssoftware, die mit einer kontinuierlichen Bildschirmaufnahme synchronisiert ist. Bewahren Sie die endgültigen Übersetzungsergebnisse zusammen mit den zeitgestempelten Protokolldateien zur späteren Verhaltensauswertung auf.
- Zeigen Sie den Quelltext für das Simultandolmetschen am Bildschirm an und weisen Sie den Teilnehmer an, eine mündliche chinesische Wiedergabe ohne schriftliche Notizen zu beginnen.
- Wenden Sie konsequent die Obergrenze von 6 Minuten an und dokumentieren Sie, ob diese erreicht wurde. Unterscheiden Sie eine zeitlich begrenzte Beobachtung von einer regulär abgeschlossenen Beobachtung.
- Nehmen Sie die mündliche Leistung mit einer digitalen Audioaufzeichnungssoftware auf. Erstellen Sie daraus exakte wörtliche Transkripte, um die anschließende Kodierung zu ermöglichen.
4. Extraktion von Indikatoren des Verhaltensprozesses
- Extrahieren Sie die Verhaltenskorrelate der Schreibaufgabe aus den Protokolldateien, wobei die initiale Latenz als das Intervall vom Stimulusbeginn bis zum ersten eingetragenen chinesischen Schriftzeichen definiert wird.
- Extrahieren Sie die gesamte Aufgabendauer, die Anzahl und Dauer von Pausen, die Löschrate, die Überarbeitungsdichte und die Produktionsrate. Behalten Sie die rohen Zeitstempel und den exakten Nenner, der für jede normalisierte Messgröße verwendet wurde.
- Verwenden Sie 2 s als operationelle Schreibpausenschwelle. Geben Sie an, ob Pausen während der Cursorsteuerung, Textauswahl oder Auswahl von Eingabemethoden-Kandidaten eingeschlossen sind.
- Extrahieren Sie die Verhaltenskorrelate der mündlichen Aufgabe aus dem Wellenformsignal und dem verifizierten Transkript, wobei die Startlatenz als das Intervall von der Stimuluspräsentation bis zur ersten sinnvollen Äußerung in der Zielsprache definiert wird.
- Schließen Sie Einatmen, Räuspern und abgebrochene nicht-lexikale Laute von der Startlatenz aus. Extrahieren Sie die gesamte Dolmetschdauer, stille Pausen, gefüllte Pausen, Wiederholungen, Fehlstarts, Selbstkorrekturen und die Sprechgeschwindigkeit.
- Definieren Sie eine stille mündliche Pause als eine Stille innerhalb einer Äußerung von mindestens 1,0 s. Überprüfen Sie die Pausengrenzen anhand des Wellenformsignals und des verifizierten Transkripts und schließen Sie führende und abschließende Stille von der Zählung innerhalb-utteranzlicher Pausen aus.
- Erstellen Sie für jede durchgeführte Aufgabe eine Qualitätskontrollaufzeichnung. Dokumentieren Sie, ob die zugehörige Prozessdatei lesbar und vollständig ist, ob das Transkript verifiziert wurde und ob die Kodierung abgeschlossen oder überprüft wurde. Bewahren Sie die ursprüngliche Aufzeichnung auf und dokumentieren Sie alle Korrekturen in der Audit-Spur.
5. Kodierung strategischer Überarbeitung und mündlicher Selbstkorrektur
- Rekonstruieren Sie jede schriftliche Überarbeitung, indem Sie das Tastaturprotokoll, das Bildschirmvideo und den endgültigen Text abgleichen.
- Behandeln Sie eine Episode als kontinuierliche Abfolge von Bearbeitungsaktionen, die auf denselben Zielabschnitt gerichtet sind, und schließen Sie die Episode, wenn die Produktion an einer anderen Stelle mindestens 2 s lang fortgesetzt wird oder ein anderer Abschnitt bearbeitet wird.
HINWEIS: Unterscheiden Sie bei chinesischer Eingabe zwischen Änderungen während der Vorbereitung vor der Eingabe und nachträglichen Löschungen im Zieltext und kodieren Sie nur Letztere als textliche Überarbeitungen. - Weisen Sie je eine primäre Überarbeitungskategorie basierend auf semantischen, syntaktischen, lexikalischen oder stilistischen Änderungen zu. Erlauben Sie ein sekundäres Tag für überlappende Fälle, verwenden Sie jedoch das primäre Tag für sich gegenseitig ausschließende Zählungen. Wenden Sie die in Supplementary File 1 bereitgestellten Beispiele an.
- Erstellen Sie vor der Kodierung mündlicher Selbstkorrekturen eine wortgetreue, zeitstempelbasierte Transkription. Weisen Sie den ersten Transkribierenden an, lexikalische Inhalte, gefüllte Pausen, Wiederholungen, Fehlstarts, Abbrüche und nicht verständliche Passagen zu markieren.
- Lassen Sie einen zweiten geschulten Prüfer die Transkription anhand des Audiomaterials überprüfen und Unstimmigkeiten unter Beibehaltung der ursprünglichen Audiotimestamps klären.
- Definieren Sie eine mündliche Selbstkorrektur als offensichtliche Neugestaltung, die ein unmittelbar vorangegangenes Zieltextsegment ersetzt, vervollständigt oder korrigiert. Leiten Sie keine verdeckte Überwachung allein aus Stille ab. Wenden Sie dieselben Entscheidungsregeln bezüglich Lexik, Syntax, Semantik und Stil auch auf mündliche Selbstkorrekturen an.
- Kodieren Sie eine exakte Wiederholung ohne korrigierende Änderung als Dysfluenz, einen abgebrochenen Satzanfang, dem eine neue Konstruktion folgt, als Fehlstart plus Korrektur, und eine Auslassung oder Fehlübersetzung ohne offensichtliche Neugestaltung als Ausgabefehler.
- Falls die Audioqualität unklar ist oder zwei Kategorien gleich plausibel erscheinen, kennzeichnen Sie die Episode als mehrdeutig. Behalten Sie vorläufige Tags für mehrdeutige Episoden bei und klären Sie diese vor der Reliabilitätsanalyse.
- Bewerten Sie das funktionale Ergebnis, indem Sie die Zielabschnitte vor und nach der Episode mit der Quellinformationsseinheit und dem lokalen Zielkontext vergleichen. Fällen Sie diese Bewertung, bevor die endgültige globale Bewertung bekannt gegeben wird. Verwenden Sie keine Veränderung der globalen Bewertung als Definition von Effektivität.
- Doppelkodieren Sie mindestens 20 % der Ausgaben, die über beide Gruppen und Aufgabenreihenfolgen hinweg ausgewählt wurden, und berechnen Sie die Reliabilität anhand der unabhängigen Kodierungen vor der Klärung.
- Schulen Sie die Kodierenden nach und wiederholen Sie die Kodierung, wenn die Übereinstimmung zwischen den Bewertenden unter einen Cohen’s Kappa von 0,80 fällt. Dokumentieren Sie diesen genauen Schwellenwert und alle ergriffenen Korrekturmaßnahmen.
6. Qualitätsbewertung und statistische Modellierung
- Bewerten Sie jede endgültige schriftliche Übersetzung und mündliche Simultandolmetschung mit dem 25-Punkte-analytischen Bewertungsraster in Supplementary File 1.
- Bewerten Sie Genauigkeit, Vollständigkeit, lexikalische Angemessenheit, Kohärenz und Natürlichkeit der Zielsprache von 0 bis 5 anhand der festgelegten Ankerpunkte. Interpolieren Sie die Bewertungskriterien nicht, nachdem Sie die Gruppenzugehörigkeit geprüft haben.
- Weisen Sie die Bewertenden an, sowohl das Audio als auch das verifizierte Transkript für die Beurteilung der Simultandolmetschungsleistung heranzuziehen. Analysieren Sie Pausen- und Dysfluenzmaße getrennt von den Rasterbewertungen.
- Schulen Sie zwei unabhängige Bewertende mithilfe des Codebuchs und mindestens 10 Übungsleistungen; dabei bleiben die Bewertenden bezüglich der Teilnehmergruppe und der Reihenfolge der Aufgaben verblindet.
- Nach der unabhängigen Bewertung und Kodierung der Episoden berechnen Sie die Zuverlässigkeit, bevor Sie diskutieren. Lösen Sie Uneinigkeiten durch Konsens; ziehen Sie nur dann eine dritte Bewertungsperson hinzu, wenn kein Konsens erzielt werden kann.
- Berichten Sie einen Intraklassen-Korrelationskoeffizienten mit zufälligen Zweiwegeffekten und absoluter Übereinstimmung für die gemittelten kontinuierlichen Qualitätsbewertungen. Berichten Sie Cohens Kappa für den primären kategorialen Überarbeitungscode und ein separates Kappa für den Wirkungscode (wirksam/neutral/schädlich). Nennen Sie exakt Anzahl und Anteil der doppelt kodierten Episoden.
- Prüfen Sie vor der Analyse, ob jede Prozessdatei lesbar und vollständig ist, passen Sie die Aufzeichnungen der Schreibaufgabe den entsprechenden Bildschirmaufzeichnungen an und überprüfen Sie die Transkripte anhand des Audiomaterials.
- Notieren Sie Fehlausrichtungen, Verständlichkeitsprobleme und Korrekturmaßnahmen in einem Qualitätskontrollprotokoll. Normalisieren Sie Häufigkeitsmaße mit 100 Informationseinheiten des Quelltextes für die Pausenhäufigkeit und mit 100 produzierten chinesischen Schriftzeichen für die Dichte der schriftlichen Überarbeitung.
- Kodieren Sie das funktionale Ergebnis unabhängig von der endgültigen globalen Qualitätsbewertung. Kodieren Sie eine Episode als wirksam, wenn der nach der Überarbeitung entstandene Textabschnitt den Text verbessert, ohne neue Fehler einzuführen, als neutral, wenn keine wesentliche Änderung erfolgt, und als schädlich, wenn ein Fehler eingeführt wird.
- Berechnen Sie die Wirksamkeitsrate als Anzahl der wirksamen Episoden geteilt durch alle klassifizierbaren Episoden, wobei unklare Episoden im Nenner ausgeschlossen werden.
- Analysieren Sie die Untersuchung als exploratives Datenset mit wiederholten Messungen. Legen Sie das Modell mit festen Effekten fest, um die Gesamtqualitätsbewertung mittels Aufgabenbedingung, Trainingsgruppe, Pausenmaßen, Überarbeitungsdichte, Wirksamkeitsrate, Dysfluenzlast und Sprechgeschwindigkeit vorherzusagen.
- Fügen Sie einen zufälligen Intercept für Teilnehmer hinzu und berücksichtigen Sie zufällige Effekte des Quelltextes nur, wenn das Design genügend unabhängig stichprobenbasierte Texte enthält.
- Zentrieren Sie kontinuierliche Prädiktoren, prüfen Sie die Residuen und überprüfen Sie Multikollinearität. Berichten Sie die Schätzmethode, Softwareversion, β, SE, 95 % KI, exakte p-Werte, Varianzkomponenten, AIC, BIC sowie marginales/konditionales R2. Beschreiben Sie die Analyse als explorativ und vermeiden Sie kausale Schlussfolgerungen.
- Exportieren Sie ein reproduzierbares Analysepaket, das anonymisierte Daten, Wörterbuch, Codebuch, Bewertungsraster, Softwaredetails, Skripte und Ergebnisse enthält. Stellen Sie vor der Veröffentlichung sicher, dass jeder Wert in Abbildungen und Tabellen auf eine benannte Variable und einen Analyse-Schritt zurückgeführt werden kann.
Ergebnisse
Grundlegende Merkmale der Teilnehmer und Datenverfügbarkeit
Der Fragebogen enthielt 62 Teilnehmer (31 Anfänger und 31 Erfahrene), und das Aufgabenblatt enthielt 124 Datensätze, was zwei vollständige Aufzeichnungen pro Teilnehmer entspricht (Tabelle 1). Die Anfängergruppe hatte weniger als 12 Monate strukturierte Übersetzungsausbildung absolviert (beobachtetes Maximum: 8,6 Monate), während die erfahrene Gruppe mindestens 12 Monate Ausbildung hatte (beobachtetes Minimum: 13,3 Monate). Die Verteilungen bezüglich Alter, Geschlecht, Dauer des Englischlernens, Sprachkompetenz und Aufgabenreihenfolge waren zwischen den Gruppen ähnlich. Abbildung 1 zeigt die endgültige analysierte Stichprobe und unterscheidet korrekt aufgabenspezifische Daten: Tastenanschlagsprotokolle und Bildschirmaufzeichnungen beziehen sich auf schriftliche Übersetzung, Audio- und wörtliche Transkripte beziehen sich auf Simultandolmetschen, und Qualitätsbewertungen gelten für beide Aufgaben.
Verhaltensprofile über verschiedene Aufgabenbedingungen hinweg
Die Verhaltensprofile unterschieden sich zwischen den beiden Aufgabenbedingungen und den Trainingsgruppen (Tabelle 2; Abbildung 2A–E). Die schriftliche Übersetzung wies längere Bearbeitungszeiten und längere durchschnittliche Pausen auf, während das Simultandolmetschen mehr Pausen pro 100 InformationsEinheiten unterhalb der angegebenen Schwelle aufwies. Innerhalb jeder Aufgabenbedingung absolvierten die trainierte Gruppe die Aufgaben schneller und erzielte höhere durchschnittliche Leistungswerte. Diese Unterschiede sollten nicht als reine Modalitätseffekte interpretiert werden, da sich auch Textlänge, Zeitlimit, Ausgabemodus und Überarbeitungsmöglichkeit unterschieden. Pausen sind nicht durchweg störend: Eine Pause kann ungelöste Schwierigkeiten, erfolgreiche Planung, Monitoring oder Tätigkeiten im Zusammenhang mit der Eingabemethode widerspiegeln. Daher werden Pausenmaße gemeinsam mit Überarbeitungs-, Abgabegeschwindigkeits- und Qualitätsmaßen interpretiert.
Strategische Überarbeitung, Selbstkorrektur und prädiktive Modellierung
Der Kodierungsrahmen trennte Episodentyp von funktionalem Ergebnis (Tabelle 3; Abbildung 3A–D). Geschulte Teilnehmer erzeugten mehr Schreibüberarbeitungsepisoden als Anfänger (12,4 ± 3,7 vs. 8,9 ± 3,0 pro Aufgabe), während die Gesamtanzahl mündlicher Selbstkorrekturen zwischen den Gruppen nicht signifikant unterschiedlich war (4,9 ± 1,6 vs. 4,4 ± 1,5 pro Aufgabe). Die geschulte Gruppe wies dennoch in beiden Aufgaben einen höheren Anteil wirksamer Episoden auf. Die gemeldete Zusammenfassung der gemischten Effekte in Tabelle 4 zeigt Assoziationen statt kausaler Pfade; Abbildung 3E zeigt daher die gemeldeten Schätzungen der festen Effekte und Konfidenzintervalle anstelle eines Kausalmodells.
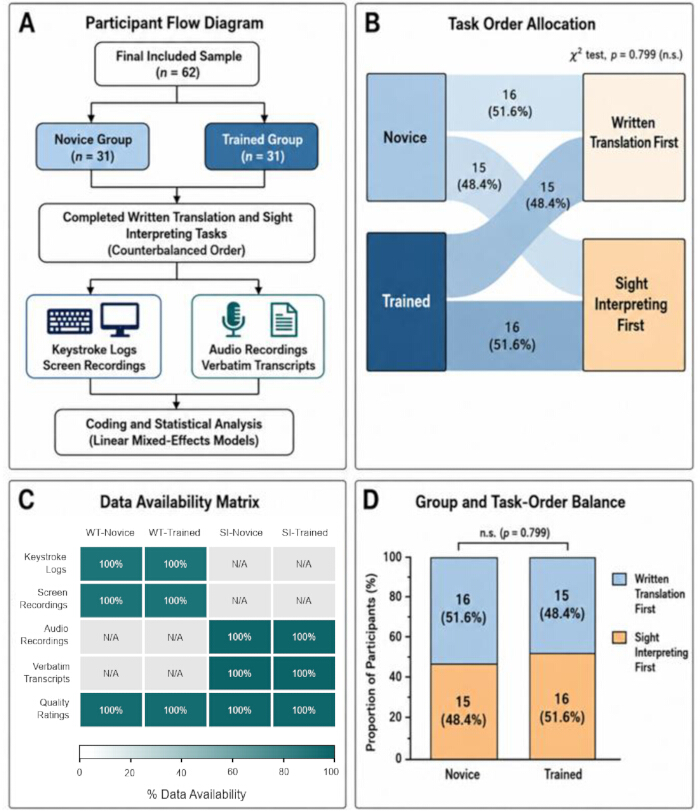
Abbildung 1: Teilnehmerfluss, Zuordnung der Aufgabenreihenfolge und verfügbare aufgabenspezifische Daten. (A) Endgültige analysierte Stichprobe von 62 Teilnehmern und 124 Aufgabendatensätzen. (B) Gegengewichtete Zuordnung der Aufgabenreihenfolge innerhalb der Anfänger- und der geschulten Gruppe. (C) Verfügbarkeitsmatrix, in der Tastenanschlags-Logs und Bildschirmaufzeichnungen nur für die schriftliche Übersetzung, Audioaufnahmen und wörtliche Transkripte nur für das Simultandolmetschen und Qualitätsbewertungen für beide Aufgaben gelten. (D) Gruppen- und Reihenfolgen-Balance (Chi-Quadrat-Test, p = 0,799). n = 62 Teilnehmer (31 pro Gruppe). Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
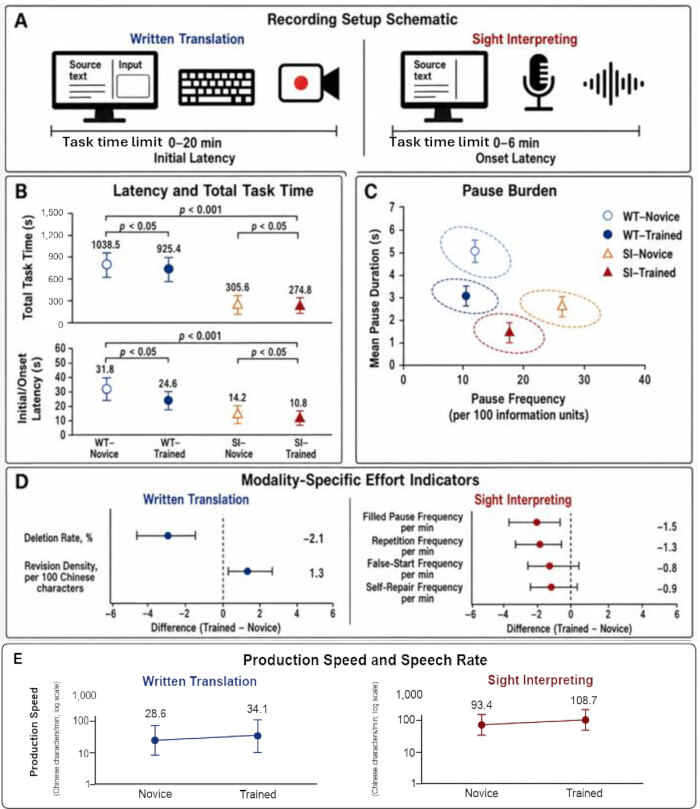
Abbildung 2: Verhaltensprofile bei schriftlicher Übersetzung und simultanem Dolmetschen. (A) Aufgabenspezifischer Aufbau der Aufnahme. (B) Anfängliche/Beginn-Latenz und gesamte Aufgabendauer. (C) Gemeinsame Verteilung der Pausenhäufigkeit und mittleren Pausendauer. (D) Aufgabenspezifische Indikatoren für Löschungen, Revisionen und mündliche Fehlflüssigkeiten. (E) Geschwindigkeit der schriftlichen Produktion und der mündlichen Sprache. In den Teilabbildungen B, C und E zeigen die Punkte und Fehlerbalken die Gruppenmittelwerte ± SD; in Teilabbildung D zeigen die Punkte die Differenzen zwischen erfahrenen und unerfahrenen Probanden (erfahren minus unerfahren) und die Fehlerbalken die 95 %-Konfidenzintervalle. n = 31 Teilnehmer pro Gruppe. In Teilabbildung E ist die y-Achse logarithmisch skaliert. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
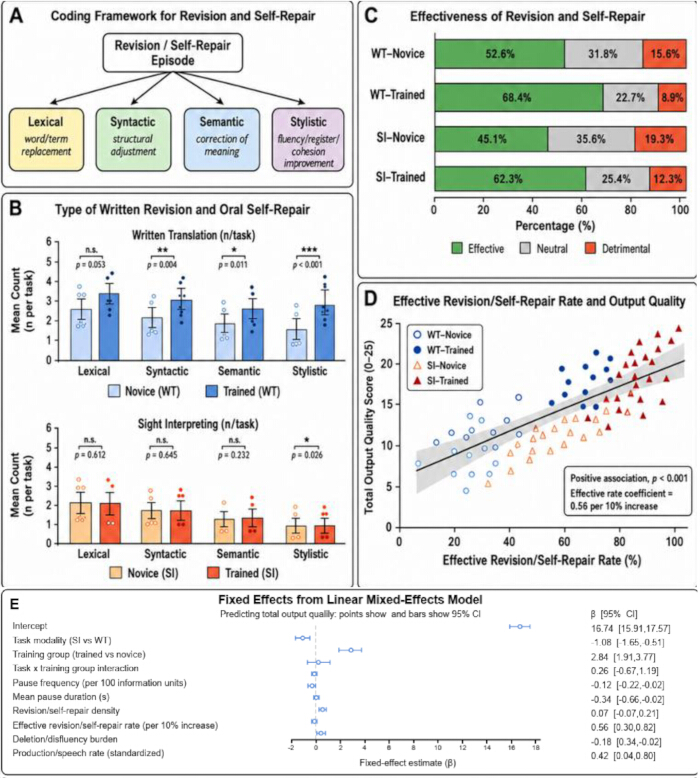
Abbildung 3: Überarbeitung/Selbstreparatur-Codierung, funktionale Ergebnisse und Zusammenhänge mit der Ausgabegüte. (A) Entscheidungsmodell zur unabhängigen Zuordnung von Episodentyp und funktionalem Ergebnis. (B) Mittlere Häufigkeiten lexikalischer, syntaktischer, semantischer und stilistischer Episoden in jeder Aufgabenbedingung. (C) Mittlere Anteile wirksamer, neutraler und nachteiliger Episoden. (D) Deskriptiver Zusammenhang zwischen der Rate wirksamer Episoden und der Gesamtpunktzahl der Ausgabegüte. (E) Forest-Plot, der feste Effekte aus einem linearen gemischten Modell mit 95 % Konfidenzintervallen anzeigt (im Detail in Tabelle 4 beschrieben); der Plot zeigt einen assoziativen Zusammenhang und stellt kein kausales Pfadmodell dar. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Variablen | Gruppe ohne Vorerfahrung (n = 31) | Trainierte Gruppe (n = 31) | p-Wert |
| Alter, Jahre | 21,9 ± 1,7 | 22,4 ± 1,9 | 0,279 |
| Weiblich, n (%) | 22 (71,0) | 21 (67,7) | 0,779 |
| Dauer des Englischlernens, Jahre | 12,4 ± 2,1 | 12,9 ± 2,2 | 0,36 |
| Englischkenntnisse-Score | 548,6 ± 41,3 | 562,4 ± 45,8 | 0,216 |
| Dauer der Übersetzungsausbildung, Monate | 5,6 ± 3,0 | 18,7 ± 5,4 | <0,001 |
| Dauer der Dolmetscherausbildung, Monate | 2,3 ± 2,1 | 13,9 ± 5,7 | <0,001 |
| Vorherige schriftliche Übersetzungspraxis ≥5 Aufgaben, n (%) | 9 (29,0) | 24 (77,4) | <0,001 |
| Vorherige Simultandolmetschpraxis ≥5 Aufgaben, n (%) | 5 (16,1) | 20 (64,5) | <0,001 |
| Schriftliche Übersetzung zuerst, n (%) | 16 (51,6) | 15 (48,4) | 0,799 |
| Simultandolmetschen zuerst, n (%) | 15 (48,4) | 16 (51,6) | 0,799 |
Tabelle 1: Teilnehmermerkmale und sprachliche Grundausbildung nach Gruppen. Variablen werden als Mittelwert ± Standardabweichung für kontinuierliche Daten und als Anzahlen (Prozentanteile) für kategoriale Daten dargestellt. Die angegebenen p-Werte spiegeln Gruppenvergleiche wider, um die basale demografische Ausgeglichenheit zu überprüfen und die beabsichtigten Unterschiede in der Trainingsdauer zu bestätigen.
| Variablen | Schriftliche Übersetzung Anfänger (n = 31) | Schriftliche Übersetzung Ausgebildete (n = 31) | Simultandolmetschen Anfänger (n = 31) | Simultandolmetschen Ausgebildete (n = 31) | Aufgabeneffekt p | Gruppeneffekt p |
| Initiale/Onset-Latenz, s | 31,8 ± 12,4 | 24,6 ± 9,7 | 14,2 ± 5,6 | 10,8 ± 4,2 | <0,001 | 0,003 |
| Gesamte Aufgabendauer, s | 1038,5 ± 168,2 | 925,4 ± 151,6 | 305,6 ± 59,3 | 274,8 ± 50,7 | <0,001 | 0,004 |
| Pausenhäufigkeit, pro 100 InformationsEinheiten | 18,6 ± 6,1 | 14,2 ± 5,0 | 24,8 ± 7,4 | 19,6 ± 6,3 | <0,001 | 0,001 |
| Mittlere Pausendauer, s | 4,1 ± 1,2 | 3,3 ± 1,0 | 2,7 ± 0,8 | 2,3 ± 0,7 | 0,012 | 0,002 |
| Produktions-/Sprechgeschwindigkeit, chinesische Schriftzeichen/min | 28,6 ± 6,7 | 34,1 ± 7,5 | 93,4 ± 18,9 | 108,7 ± 20,4 | 0,001 | |
| Löschungsrate, % | 8,9 ± 3,4 | 6,8 ± 2,7 | 0,009 | |||
| Revisionsdichte, pro 100 chinesische Schriftzeichen | 7,6 ± 2,8 | 8,9 ± 3,1 | 0,087 | |||
| Häufigkeit gefüllter Pausen, pro min | 5,7 ± 1,9 | 4,2 ± 1,6 | 0,002 | |||
| Wiederholungshäufigkeit, pro min | 4,9 ± 1,8 | 3,6 ± 1,4 | 0,004 | |||
| Häufigkeit von Fehlstarts, pro min | 2,8 ± 1,1 | 2,0 ± 0,9 | 0,006 | |||
| Häufigkeit von Selbstkorrekturen, pro min | 4,8 ± 1,7 | 3,9 ± 1,4 | 0,031 | |||
| Gesamtbewertungsscore, 0–25 | 16,8 ± 2,3 | 20,1 ± 2,1 | 15,4 ± 2,6 | 18,9 ± 2,4 | 0,002 | <0,001 |
| Richtigkeit, 0–5 | 3,4 ± 0,7 | 4,1 ± 0,6 | 3,1 ± 0,8 | 3,8 ± 0,7 | 0,004 | <0,001 |
| Vollständigkeit, 0–5 | 3,3 ± 0,8 | 4,0 ± 0,6 | 3,0 ± 0,8 | 3,7 ± 0,7 | 0,006 | <0,001 |
| Lexikalische Angemessenheit, 0–5 | 3,2 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,041 | <0,001 |
| Kohärenz, 0–5 | 3,5 ± 0,6 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,003 | <0,001 |
| Natürlichkeit in der Zielsprache, 0–5 | 3,4 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,7 | 0,007 | <0,001 |
Tabelle 2: Verhaltensbezogene Prozessindikatoren und Ergebnisqualität über verschiedene Aufgabenbedingungen und Gruppen hinweg. Die Werte sind als Mittelwert ± Standardabweichung angegeben. Die angegebenen p-Werte zeigen die Haupteffekte der Aufgabenmodalität (schriftliche Übersetzung vs. Simultandolmetschen) und des Ausbildungsstandes (Anfänger vs. Ausgebildete) auf jede Prozess- und Qualitätsvariable an.
| Variablen | Schriftliche Übersetzung Anfänger | Schriftliche Übersetzung Erfahrene | p-Wert | Simultandolmetschen Anfänger | Simultandolmetschen Erfahrene | p-Wert |
| Lexikalische Revision/Selbstkorrektur, n/Aufgabe | 3,4 ± 1,5 | 4,2 ± 1,7 | 0,053 | 1,8 ± 0,8 | 1,7 ± 0,7 | 0,612 |
| Syntaktische Revision/Selbstkorrektur, n/Aufgabe | 2,1 ± 1,1 | 3,0 ± 1,2 | 0,004 | 1,1 ± 0,7 | 1,2 ± 0,8 | 0,645 |
| Semantische Revision/Selbstkorrektur, n/Aufgabe | 1,8 ± 1,0 | 2,5 ± 1,1 | 0,011 | 0,9 ± 0,6 | 1,1 ± 0,7 | 0,232 |
| Stilistische Revision/Selbstkorrektur, n/Aufgabe | 1,6 ± 0,9 | 2,7 ± 1,2 | <0,001 | 0,6 ± 0,4 | 0,9 ± 0,6 | 0,026 |
| Gesamtanzahl der Revisionen/Selbstkorrekturen, n/Aufgabe | 8,9 ± 3,0 | 12,4 ± 3,7 | <0,001 | 4,4 ± 1,5 | 4,9 ± 1,6 | 0,209 |
| Effektive Episoden, % | 52,6 ± 13,5 | 68,4 ± 12,1 | <0,001 | 45,1 ± 14,2 | 62,3 ± 13,0 | <0,001 |
| Neutrale Episoden, % | 31,8 ± 10,4 | 22,7 ± 8,8 | 0,001 | 35,6 ± 11,7 | 25,4 ± 9,6 | 0,001 |
| Nachteilige Episoden, % | 15,6 ± 7,1 | 8,9 ± 5,6 | <0,001 | 19,3 ± 8,6 | 12,3 ± 6,8 | 0,001 |
Tabelle 3: Art und Wirksamkeit schriftlicher Überarbeitungen und mündlicher Selbstkorrekturen über die Aufgabenbedingungen hinweg. Episodentypen werden als mittlere Anzahl pro Aufgabe (± Standardabweichung) angegeben, funktionale Ergebnisse als mittlere Prozentsätze (± Standardabweichung). Die p-Werte zeigen die Signifikanz der Unterschiede zwischen den Gruppen innerhalb jeder Aufgabenmodalität an.
| Feste Effekte | β | SE | 95 % KI | p-Wert |
| Achsenabschnitt | 16,74 | 0,42 | 15,91 bis 17,57 | <0,001 |
| Aufgabenmodus: simultanes Dolmetschen vs. schriftliche Übersetzung | -1,08 | 0,29 | -1,65 bis -0,51 | <0,001 |
| Trainingsgruppe: trainiert vs. Anfänger | 2,84 | 0,47 | 1,91 bis 3,77 | <0,001 |
| Aufgabenmodus × Trainingsgruppe | 0,26 | 0,47 | -0,67 bis 1,19 | 0,581 |
| Pausenhäufigkeit, pro 100 InformationsEinheiten | -0,12 | 0,05 | -0,22 bis -0,02 | 0,018 |
| Mittlere Pausendauer, s | -0,34 | 0,16 | -0,66 bis -0,02 | 0,041 |
| Dichte von Revisionen/Selbstkorrekturen | 0,07 | 0,07 | -0,07 bis 0,21 | 0,334 |
| Effektive Rate von Revisionen/Selbstkorrekturen, pro 10 % Zunahme | 0,56 | 0,13 | 0,30 bis 0,82 | <0,001 |
| Belastung durch Löschungen/Unflüssigkeiten | -0,18 | 0,08 | -0,34 bis -0,02 | 0,027 |
| Produktions-/Sprechgeschwindigkeit, standardisiert | 0,42 | 0,19 | 0,04 bis 0,80 | 0,032 |
Tabelle 4: Berichtete feste Effekte aus dem linearen gemischten Modell zur Vorhersage der Gesamtausgabegüte. Die Zusammenfassung enthält die nicht standardisierten Koeffizienten (β), Standardfehler (SE), 95 %-Konfidenzintervalle (KI) und exakten p-Werte für alle spezifizierten Aufgaben- und Verhaltensprädiktoren.
Diskussion
Diese Studie demonstriert ein multimodales Protokoll zur Messung beobachtbarer Prozessindikatoren und zur Kodierung strategischer Revisionen bei schriftlicher Übersetzung und Simultandolmetschen aus dem Englischen ins Chinesische. Das Protokoll misst nicht direkt eine einheitliche Variable kognitiver Anstrengung. Stattdessen werden Latenzzeiten, Pausen, Löschungen und Revisionsmuster als aufgabenabhängige Verhaltenskorrelate interpretiert, deren Bedeutung von der Triangulation mit synchronisierten Aufzeichnungen und Belegen zur Ausgabegüte abhängt1,2,3,4,5,6,7,8. Die beiden Aufgaben unterscheiden sich zudem in Material, zeitlichem Ablauf, Ausgabemodus und Überarbeitungsmöglichkeiten; die beschriebenen repräsentativen Unterschiede charakterisieren daher Unterschiede zwischen Aufgabenbedingungen und nicht isolierte Modaleffekte. Der zentrale analytische Beitrag besteht in der Trennung von Revisionshäufigkeit und funktionalem Ergebnis. In den berichteten Zusammenfassungen führten geschulte Teilnehmer mehr schriftliche Revisionen durch, nicht weniger, während die Gesamtanzahl mündlicher Selbstkorrekturen zwischen den Gruppen nicht signifikant unterschiedlich war. Ihre höheren Anteile effektiver Episoden legen nahe, dass die Überwachung der Qualität möglicherweise aussagekräftiger ist als die reine Häufigkeit, doch diese Interpretation hängt von transparenten Entscheidungsregeln, einer unabhängigen Kodierung der Ergebnisse und berichteter Zuverlässigkeit ab. Das Kodierhandbuch und die ausgearbeiteten Beispiele in Zusatzdatei 1 sollen diese Unterscheidung nachvollziehbar und nicht werblich darstellen.
Kritische Schritte sind die zeitliche Abstimmung zwischen den Aufzeichnungen, die Audioqualität, die Überprüfung der Transkripte und die Konsistenz der Kodierung. Vor der Abstimmung von Logdateien und Aufzeichnungen sollten vorhandene Zeitstempel und Hinweise auf Aufgabengrenzen überprüft werden. Das Audio muss vor der Transkription auf Übersteuerung und Verständlichkeit geprüft werden, und vorgeschlagene Pausengrenzen müssen anhand des Wellenformverlaufs und des Transkripts verifiziert werden. Bei chinesischer Eingabe sollten Tastatureingaben für die Zeichenerstellung nicht mit übernommenen Zeichenrevisionen gleichgesetzt werden. Diese Kontrollen und Korrekturmaßnahmen sollten in einem Qualitätskontroll-Protokoll dokumentiert bleiben.
Mehrere Einschränkungen beeinträchtigen die Interpretation. Die Studie basiert auf Kohorten von Studierenden und Auszubildenden, kurzen allgemeinen erläuternden Texten, unterschiedlichen Aufgabenumfängen und Zeitbegrenzungen sowie einer Stichprobe, die nach Verfügbarkeit ausgewählt wurde. Die Aufgabenbedingungen unterscheiden sich zudem hinsichtlich des Ausgabemodus und der Überarbeitungsmöglichkeiten, und der Datensatz enthält keine unabhängig erfassten Quelltext-Identifikatoren, um Variationen auf Textebene zu schätzen. Außerdem sind Pausenschwellen operational festgelegt, und längere Pausen können sowohl produktive Planung als auch ungelöste Schwierigkeiten widerspiegeln. Eine Verallgemeinerung auf Fachkräfte, spezialisierte Bereiche, andere Sprachpaare oder andere Schriftsysteme erfordert eine erneute Validierung der Materialien, der Behandlung der Eingabemethoden, der Schwellenwerte und der Bewertungsanker.
Zukünftige Arbeiten können die Verhaltensaufzeichnungen mit Eye-Tracking, Pupillometrie oder subjektiven Arbeitslastmaßen kombinieren, um zu prüfen, welche Pausen und Überarbeitungen mit Aufmerksamkeit, empfundenem Aufwand oder erfolgreichem Planen korrespondieren5,6,13,14,15,16. Shreve et al. verwendeten Eye-Tracking bei der Simultansprache und sollten nicht als Pupillometriestudie zitiert werden18; Pupillometrie wird direkt von Seeber5 diskutiert. Solche multimodalen Erweiterungen sollten die Unterscheidung zwischen Aufgabenanforderung, investiertem Aufwand, beobachtetem Verhalten und Leistung beibehalten. Das vorliegende Protokoll sollte daher am besten als transparentes Rahmenwerk zur Prozessbewertung genutzt werden, dessen Indikatoren Aussagen über latenten kognitiven Aufwand unterstützen, diese jedoch allein nicht belegen.
Offenlegungen
Die Autoren geben keine kommerziellen oder finanziellen Interessenkonflikte an. Bezüglich des Einsatzes von künstlicher Intelligenz erklären die Autoren, dass OpenAI Codex während des Überarbeitungsprozesses ausschließlich zur Unterstützung bei der Sprachbearbeitung, Konsistenzprüfungen, der Erstellung nachverfolgbarer Änderungen sowie zur Neugestaltung von Abbildungsanordnungen auf Grundlage von den Autoren bereitgestellter Daten verwendet wurde. Die Autoren haben alle von KI unterstützten Ergebnisse sorgfältig geprüft und übernehmen die volle Verantwortung für die Genauigkeit, Integrität und Originalität des endgültigen Manuskripts. Das strukturierte Arbeitsheft, das den berichteten Zusammenfassungen zugrunde liegt, ist öffentlich über Zenodo verfügbar (https://doi.org/10.5281/zenodo.21189434). Die Zusatzdatei 1 enthält das Kodierhandbuch und den angebundenen Qualitätsraster.
Danksagungen
Der Autor dankt dem Guilin Institute of Information Technology für die Unterstützung im Labor, den zweisprachigen Experten, die die Quelltexte bewertet haben, den unabhängigen Gutachtern und den Teilnehmern. Diese Forschung erhielt keine spezifische Förderung durch eine öffentliche, kommerzielle oder gemeinnützige Einrichtung.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Software zur akustischen Analyse (Praat) | Paul Boersma und David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Desktop-Computer | Dell | OptiPlex | |
| Software zur digitalen Audioaufnahme (Audacity) | Audacity-Team | https://www.audacityteam.org/ | |
| Software zur Tastaturprotokollierung (Inputlog) | Universität Antwerpen | https://www.inputlog.net/ | |
| Software zur Bildschirmaufnahme (OBS Studio) | OBS-Projekt | https://democreator.wondershare.com/ | |
| Software zur statistischen Analyse (SPSS) | IBM | Version 27 |
Referenzen
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Nachdrucke und Genehmigungen
Dieser Artikel wurde veröffentlicht
Video demnächst verfügbar