Dieser Artikel stellt einen reproduzierbaren Bioinformatik-Workflow vor, der öffentliche transkriptomische Datensätze, maschinelles Lernen, externe Validierung, quantitative reverse Transkriptions-PCR, die Screening der Connectivity Map und molekulares Docking integriert, um Biomarker für pulmonale Hypertonie und potenzielle therapeutische Substanzen zu identifizieren.
Forschungsartikel
Bioinformatische und maschinell lernende Identifizierung von Biomarkern und therapeutischen Wirkstoffkandidaten für pulmonale Hypertonie
In diesem Artikel
Zusammenfassung
Zusammenfassung
Diese Studie hatte das Ziel, molekulare Biomarker im Zusammenhang mit pulmonaler Hypertonie (PH) sowie vielversprechende kleine Moleküle mithilfe öffentlich zugänglicher transkriptomischer Daten und unabhängiger Validierungsressourcen zu identifizieren. Drei Genexpressions-Omnibus-Datensätze (GSE22356, GSE33463 und GSE48149) wurden nach Normalisierung, Probennachbeschriftung und ComBat-Korrektur für Batch-Effekte integriert. Zur Identifizierung zentraler Merkmalgene wurden Analysen zur differentiellen Expression, gewichtete Gen-Koexpressionsnetzwerkanalysen, funktionelle Anreicherungsanalysen, Protein-Protein-Interaktionsnetzwerkanalysen sowie drei maschinelle Lernalgorithmen eingesetzt. Die diagnostische Leistungsfähigkeit wurde anhand von Receiver-Operating-Characteristic-Kurven bewertet. Die externe Validierung umfasste eine unabhängige Lungen-Gewebekohorte (GSE117261), einen Einzelzell-RNA-Sequenzierungsdatensatz der Lungenarterie (GSE210248) und eine quantitative Reverse-Transkriptase-PCR-Validierung in unabhängigen Lungen-Gewebeproben. Mithilfe der Connectivity-Map-basierten Arzneimittelumpositionierung und molekularen Docking-Analysen wurden potenzielle Wirkstoffe identifiziert. Es wurden 78 differentiell exprimierte Gene gefunden, wobei CXCL10, JUN, IFIH1, MX1 und TLR7 als zentrale Merkmalgene ausgewählt wurden. In der unabhängigen Lungen-Gewebekohorte GSE117261 zeigte JUN die stärkste externe Unterstützung, während die Reproduktion der übrigen Gene variabel war. Die quantitative Reverse-Transkriptase-PCR in 20 biologisch unabhängigen Proben von pulmonaler arterieller Hypertonie und 20 Kontrollproben bestätigte die Hochregulation aller fünf Gene. Sowohl das offensichtliche Fünf-Gen-qRT-PCR-Modell als auch 100 wiederholte stratifizierte Fünf-Fold-Kreuzvalidierungsanalysen ergaben eine AUC von 1,000, obwohl aufgrund der geringen Kohortengröße vorsichtige Interpretation und eine unabhängige prospektive Validierung erforderlich sind. Die Einzelzellanalyse von GSE210248 unterstützte veränderte Kommunikation zwischen Immun- und Strukturrzellen sowie einen phänotypischen Wechsel der glatten Muskelzellen. BRD-K91900765/VX-745 erzielte im Connectivity-Map-Screening die höchste Bewertung. MAPK14/p38α, das etablierte pharmakologische Zielmolekül, wurde als positiver Referenz-Docking-Protein eingeschlossen, während das Docking an die fünf biomarkerassoziierten Proteine als explorativ betrachtet wurde. Diese Ergebnisse stützen die fünf Gene als potenzielle PH-Biomarker und VX-745 als rechnergestützte Hypothese zur Arzneimittelumpositionierung, die experimentell validiert werden muss.
Einleitung
Pulmonale Hypertonie (PH) ist ein progredienter kardiopulmonaler Syndromkomplex, der durch eine anhaltend erhöhte pulmonale arterielle Drucklage, einen erhöhten pulmonalen Gefäßwiderstand und letztlich ein rechtherzliches Versagen gekennzeichnet ist. Die aktuellen hämodynamischen Kriterien definieren die PH als mittleren pulmonal-arteriellen Druck im Ruhezustand von >20 mmHg, gemessen mittels Rechtsherzkatheterisierung1. Unter den verschiedenen klinischen Subtypen ist die pulmonal-arterielle Hypertonie (PAH) eine der schwersten Formen und zeichnet sich durch eine progrediente Remodellierung der pulmonalen Gefäße aus. Zu ihren pathologischen Merkmalen gehören endotheliale Dysfunktion, abnorme Proliferation und Migration von glatten Muskelzellen der pulmonalen Arterien, Aktivierung von adventitiellen Fibroblasten, Ablagerung der extrazellulären Matrix, Infiltration entzündlicher Zellen sowie Verengung oder Obliteration der distalen pulmonalen Arterien2. Diese Veränderungen zeigen, dass die PH/PAH nicht nur eine Erkrankung der Vasokonstriktion, sondern auch eine komplexe Gefäßremodellierungserkrankung ist, die durch koordinierte molekulare, zelluläre und immun-entzündliche Mechanismen verursacht wird.
Aktuelle PAH-Therapien zielen hauptsächlich auf die Prostazyklin-, Endothelin-, Stickoxid-lösliche Guanylatcyclase- und Phosphodiesterase-Typ-5-Signalwege ab3˒4. Obwohl diese Behandlungen die Symptome, die Belastungstoleranz und hämodynamische Parameter verbessern, beschränken sich ihre Wirkungen weitgehend auf vasodilatatorische und hämodynamische Effekte. Ihre Fähigkeit, bereits bestehende pulmonale Gefäßumbauvorgänge rückgängig zu machen, ist begrenzt, und viele Patienten zeigen trotz Kombinationstherapie einen fortschreitenden Krankheitsverlauf. Daher besteht ein wichtiger, bisher ungedeckter Bedarf an der Identifizierung neuartiger molekularer Biomarker und therapeutischer Kandidaten, die den Umbauprozess widerspiegeln. Insbesondere die immun-entzündliche Aktivierung, interferonassoziierte Signalwege, Toll-ähnliche Rezeptorwege, chemokinvermittelte Immunzellrekrutierung sowie der phänotypische Wechsel der glatten Muskelzellen haben sich als mögliche Faktoren für das Fortschreiten der PH/PAH herauskristallisiert5˒6.
Durchsatzstarke transkriptomische Datensätze stellen wertvolle Ressourcen für die Identifizierung molekularer Signaturmuster bei PH/PAH dar. Studien, die auf einem einzelnen Datensatz basieren, sind jedoch häufig durch kleine Stichprobengrößen, Batch-Effekte, Plattform-Heterogenität und unzureichende Validierung eingeschränkt. Die differentielle Expressionsanalyse kann Gene mit veränderter Expression identifizieren, erfasst jedoch möglicherweise nicht vollständig krankheitsrelevante Ko-Expressionsmodule oder Interaktionen auf Netzwerkebene. Die gewichtete Gen-Ko-Expressionsnetzwerk-Analyse (WGCNA) kann Genmodule identifizieren, die mit Krankheitseigenschaften assoziiert sind, während die Analyse von Protein-Protein-Interaktionsnetzwerken (PPI) stark vernetzte Gene innerhalb biologischer Netzwerke aufzeigen kann. Maschinelle Lernverfahren können zudem Gene priorisieren, die diagnostischen oder Klassifizierungswert besitzen. Die alleinige Nutzung eines einzelnen Algorithmus kann jedoch modellspezifische Verzerrungen verursachen. Die Integration der differentiellen Expressionsanalyse, WGCNA, PPI-Netzwerkanalyse und mehrerer maschineller Lernalgorithmen kann daher die Robustheit der Biomarker-Entdeckung verbessern.
Eine weitere große Herausforderung bei transkriptomischen Biomarker-Studien besteht in der biologischen Interpretation. Signale aus Gesamtgewebe können Veränderungen der Genexpression in residenten vaskulären Zellen, eine Infiltration von Immunzellen oder veränderte Anteile mehrerer Zellpopulationen widerspiegeln. Die Einzelzell-RNA-Sequenzierung bietet die Möglichkeit, aus Gesamtgewebe abgeleitete Kandidatengene in einen zellulären Kontext einzubetten. Bei PH/PAH umfasst die pulmonale vaskuläre Remodelung Endothelzellen, glatte Muskelzellen, Fibroblasten, Monozyten/Makrophagen, Lymphozyten sowie andere Immun- oder Strukturzellen. Der Krankheitsverlauf ist ebenfalls mit veränderter Zell-Zell-Kommunikation und einem Phänotypwechsel der glatten Muskelzellen assoziiert. Daher kann die Kombination einer transkriptomischen Screening-Methode an Gesamtgewebe mit einer Validierung auf Einzelzellebene helfen zu bestimmen, ob Kandidaten-Biomarker mit einer Immunaktivierung, einer vaskulären strukturellen Remodelung oder einem Ungleichgewicht in der multizellulären Kommunikation verknüpft sind.
Neben der Biomarker-Entdeckung können transkriptomische Signaturen für die computergestützte Neupositionierung von Arzneimitteln verwendet werden. Die Connectivity Map (CMap) verknüpft krankheitsassoziierte Genexpressionsprofile mit kleinen Molekülen, die diese Signaturen umkehren oder modulieren können7. In Kombination mit der Kuration von Verbindungen und molekularem Docking kann diese Strategie experimentell überprüfbare therapeutische Hypothesen generieren. Obwohl CMap-Vorhersagen und molekulares Docking die Wirksamkeit von Arzneimitteln nicht belegen können, lassen sie sich dazu nutzen, Kandidatenverbindungen für zukünftige Target-Bindungsassays, zellbasierte Experimente und die Validierung im Tiermodell zu priorisieren.
Es wurde ein integrierter und reproduzierbarer Arbeitsablauf zur Identifizierung von Biomarkern sowie kandidatenhaft wirksamer therapeutischer Substanzen für PH/PAH entwickelt. Drei öffentliche Transkriptom-Datensätze der Gene Expression Omnibus-Datenbank wurden nach Normalisierung und Korrektur von Batch-Effekten integriert. Mittels Analyse differentieller Expression, WGCNA, funktionaler Anreicherungsanalyse, PPI-Netzwerkanalyse und drei maschinellen Lernalgorithmen erfolgte die Identifizierung robuster Merkmal-Gene. Zur weiteren Evaluierung der ausgewählten Gene wurden die Receiver-Operating-Characteristic-Analyse, eine unabhängige Validierungs-Kohorte aus Lungen-Gewebe, Einzelzell-RNA-Sequenzierungsdaten der Lungenarterie sowie die quantitative reverse Transkriptions-PCR an unabhängigen Proben herangezogen. Schließlich wurden eine auf CMap basierende Arzneimittelumpositionierung und molekulares Docking eingesetzt, um in Frage kommende Verbindungen zu identifizieren. Die Neuheit der Studie liegt in ihrem mehrschichtigen Validierungsansatz, der die Entdeckung mittels Bulk-Transkriptomik, Priorisierung durch maschinelles Lernen, unabhängige Validierung, experimentelle Bestätigung mittels quantitativer reverser Transkriptions-PCR, interpretationsfähige Einzelzell-Mechanismusanalyse und computergestützte Substanz-Screening miteinander verknüpft. Die Hypothese der Studie besagte, dass PH/PAH durch ein koordiniertes immun-entzündliches Programm und Gefäßremodeling getrieben wird und dass robuste Gene innerhalb dieses Programms als Kandidaten-Biomarker dienen könnten sowie Ansatzpunkte für die Umpositionierung von Wirkstoffen bieten könnten.
Protokoll
Die in dieser Studie analysierten öffentlichen Datensätze der Gene Expression Omnibus (GEO) enthielten anonymisierte transkriptomische Daten aus zuvor veröffentlichten Studien und erforderten keine zusätzliche ethische Genehmigung. Der Ethikausschuss der Huaihua University genehmigte die unabhängige Validierungsstudie mittels quantitativer reverser Transkriptions-PCR (qRT-PCR) an menschlichem Lungengewebe (Genehmigungsnummer 2024(A05112)). Von allen Teilnehmern oder deren gesetzlich bevollmächtigten Vertretern wurde vor der Probennahme schriftlich informierte Einwilligung eingeholt. Die Genehmigungs- und Einwilligungsverfahren galten für alle 20 Pulmonalarterienhypertonie-(PAH)- und 20 Kontroll-Lungengewebeproben, die in die qRT-PCR-Validierung eingeschlossen wurden. Die für dieses Protokoll verwendeten Forschungswerkzeuge sind in der Tabelle der Materialien aufgeführt.
1. Sammlung und Vorverarbeitung öffentlicher transkriptomischer Datensätze
Mikroarray-Datensätze im Zusammenhang mit pulmonaler Hypertonie (PH), GSE22356, GSE33463 und GSE48149, wurden aus der GEO-Datenbank bezogen. PH/pulmonal-arterielle Hypertonie (PAH)- und Kontrollproben wurden gemäß den ursprünglichen Phänotyp-Beschriftungen extrahiert. Expressionsmatrizen und Plattform-Annotationsdateien wurden mithilfe reproduzierbarer R-Skripte und des GEOquery-Pakets heruntergeladen.
Die Probennotation und Gen-Symbol-Zuordnung wurde einheitlich über alle Datensätze hinweg durchgeführt. Wenn mehrere Proben auf dasselbe Gen abgebildet wurden, wurde der mittlere Expressionswert berechnet. Es wurde eine Quantilnormalisierung durchgeführt, und Gene mit geringer Expression oder geringer Varianz wurden entfernt. Die Datensätze wurden zusammengeführt, und Batch-Effekte wurden mithilfe des ComBat-Algorithmus im sva-Paket8 korrigiert. Die Korrektur wurde anhand von Boxplots und der Hauptkomponentenanalyse evaluiert.
2. Identifizierung differentiell exprimierter Gene
Das limma-Paket wurde verwendet, um die Expressionsniveaus zwischen PH- und Kontrollproben in der batch-korrigierten Expressionsmatrix zu vergleichen9. Ein lineares Modell wurde angepasst, und empirische Bayes-Statistiken wurden angewendet. Differenziell exprimierte Gene wurden anhand eines adjustierten P-Werts <0,05 und einer absoluten log2-Fold-Change > 0,585 definiert. Die Ergebnisse wurden mithilfe von Volcano-Plots und Heatmaps visualisiert.
3. Konstruktion eines gewichteten genen Koregulationsnetzwerks
Ein gewichtetes Gen-Koexpressionsnetzwerk wurde unter Verwendung des WGCNA-Pakets10 konstruiert. Die Proben wurden mittels Clusteranalyse auf Ausreißer überprüft. Die Soft-Thresholding-Potenz wurde anhand des Fit-Index für die skalenfreie Topologie gewählt. Genmodule wurden mithilfe des dynamischen Baum-Schneide-Algorithmus identifiziert. Die Moduleigenvektoren wurden mit dem PH-Phänotyp korreliert, und das krankheitsassoziierte Modul mit der stärksten Korrelation wurde ausgewählt. Die Gene im Schlüsselmodul wurden mit den differentiell exprimierten Genen geschnitten, um Konsensgene zu erhalten.
4. Funktionsanreicherungsanalyse
Die biologischen Prozesse, zellulären Komponenten und molekularen Funktionen der Genontologie wurden mittels clusterProfiler11 analysiert. Eine Anreicherungsanalyse der Kyoto Encyclopedia of Genes and Genomes (KEGG) wurde durchgeführt, um Signalwege zu identifizieren12. Als Anreicherungsschwellenwerte dienten ein P-Wert < 0,05 und ein q-Wert < 0,2; die angereicherten Terme wurden mithilfe von Bubble-Plots visualisiert11.
5. Konstruktion des Protein-Protein-Interaktionsnetzwerks und Identifizierung von Hub-Genen
Die konsensierte Genliste wurde in die STRING-Datenbank eingereicht, wobei Homo sapiens als Spezies und eine Interaktionsvertrauensschwelle von > 0,413 ausgewählt wurde. Die Interaktionsdatei wurde in Cytoscape importiert, und das CytoHubba-Plug-in wurde verwendet, um Gene nach Knotengrad zu sortieren. Stark vernetzte Gene wurden als Hub-Gene definiert.
6. Auswahl diagnostischer Merkmal-Gene mithilfe maschinellen Lernens
Es wurden drei unabhängige Algorithmen zur Merkmalsauswahl angewendet. Zunächst wurde eine logistische Regression mit der Methode „Least Absolute Shrinkage and Selection Operator“ unter Verwendung des glmnet-Pakets und einer 10-fachen Kreuzvalidierung durchgeführt, um Gene mit von null verschiedenen Koeffizienten zu identifizieren14. Als Zweites wurde die schrittweise Merkmalseliminierung mittels Support-Vektor-Maschinen angewendet, um redundante Merkmale zu entfernen und diejenige Teilmengen von Merkmalen auszuwählen, die die höchste Genauigkeit in der Kreuzvalidierung erreichte15. Drittens wurde ein Random-Forest-Modell erstellt, und die Merkmale wurden nach dem mittleren Rückgang der Gini-Unreinheit sortiert16. Der Durchschnitt der aus den drei Algorithmen gewonnenen Genmengen wurde verwendet, um die endgültige Menge der zentralen Merkmalsgene festzulegen. Mit dem pROC-Paket wurden Receiver-Operating-Characteristic-Kurven erstellt und die Flächen unter der Kurve berechnet17.
7. Validierung der Kerngene mithilfe unabhängiger Bulk- und Einzelzell-Datensätze
GSE117261 wurde als unabhängige externe Validierungskohorte von Lungengewebe verwendet, die 58 PAH-Proben und 25 Kontrollproben von verstorbenen Spendern umfasst18. Dieser Datensatz wurde nicht für die Entdeckungsanalyse differentieller Expression, den Aufbau des gewichteten Gen-ko-Expressionsnetzwerks oder die Merkmalsauswahl mittels maschinellem Lernen herangezogen. Die Expressionsmatrix wurde normalisiert und annotiert, und die differentielle Expression wurde mit limma v3.68.0 analysiert. Die False-Discovery-Rate-Korrektur nach Benjamini-Hochberg wurde auf das gesamte annotierte Transkriptom angewandt. Einzelne ROC-Kurven (Receiver Operating Characteristic) wurden mit pROC v1.19.0.1, DeLong-95%-Konfidenzintervallen und Youden-Index-Schwellenwerten berechnet. Ein exploratives logistisches Regressionsmodell mit fünf Genen wurde innerhalb von GSE117261 angepasst, und seine interne Leistung zusätzlich mittels wiederholter geschachtelter Kreuzvalidierung bewertet.
GSE210248 (Tabelle 1) wurde als Einzelzell-Pulmonalarterien-Validierungsdatensatz verwendet, der Proben von drei Patienten mit PAH und drei gesunden Spendern umfasst19. Die Daten wurden mit Seurat v5.5.1 zur Qualitätskontrolle, Normalisierung, Dimensionsreduktion, Clusterung und Zellannotation verarbeitet20. Wichtige Zellpopulationen, darunter Endothelzellen, glatte Muskelzellen, Fibroblasten, Monozyten/Makrophagen sowie T- und natürliche Killerzellen, wurden identifiziert. Die Zell-Zell-Kommunikation wurde mit CellChat v2.1.2 und der Ligand-Rezeptor-Datenbank CellChatDB.human analysiert21. Ein CellChat-Objekt wurde aus der normalisierten Seurat-Expressionsmatrix und den Zelltyp-Metadaten erstellt. Überexprimierte Gene und Ligand-Rezeptor-Interaktionen wurden identifiziert; Kommunikationswahrscheinlichkeiten berechnet; Interaktionen, an denen Zellgruppen mit weniger als 10 Zellen beteiligt waren, entfernt; und auf Pfadwirkungsebene basierende Kommunikationsnetzwerke wurden abgeleitet und aggregiert. Dieser Datensatz wurde ausschließlich zur externen mechanistischen Validierung und nicht zum Modelltraining verwendet.
| Element | Beschreibung |
| Datensatz | GSE210248 |
| Datentyp | 10x Genomics/Tropfen-basierte Einzelzell-RNA-Sequenzierung; hochdurchsatzfähige transkriptomische Profilierung |
| Menschliche Proben | Drei pulmonalarterielle Proben von PAH-Patienten und drei pulmonalarterielle Proben von gesunden Spendern |
| Gewebekomponente | Ex-vivo-Pulmonalarterien-Gewebe, das hauptsächlich die zelluläre Ökologie der pulmonalen Gefäßwand und den Prozess der Gefäßumbildung widerspiegelt |
| Hauptanalytischer Zweck | Zelltyp-Lokalisierung, phänotypischer Übergang von glatten Muskelzellen, Kommunikation zwischen immunen und strukturellen Zellen sowie Validierung der mechanistischen Konsistenz von Kandidatengenen |
Tabelle 1: Grundlegende Informationen zum GSE210248 Einzelzell-Validierungsdatensatz. Die Tabelle fasst die Datensatz-ID, Sequenzierplattform, Gewebeprobe, Probenzusammensetzung und analytische Zielsetzung der Einzelzell-Analyse der Lungenarterie zur Validierung zusammen.
8. Validierung der Genexpression durch qRT-PCR
Die qRT-PCR-Validierung umfasste 20 biologisch unabhängige Lungenproben von Patienten mit PH/PAH und 20 biologisch unabhängige Kontroll-Lungenproben. Die Gesamt-RNA wurde mit dem Total RNA Extraction Kit extrahiert. Die RNA-Konzentration und -Reinheit wurden mithilfe eines Spektrophotometers bestimmt, und die RNA-Integrität wurde durch Agarose-Gelelektrophorese überprüft. Nur RNA-Proben mit A260/280-Werten zwischen 1,8 und 2,1 und ohne sichtbare Degradation wurden einbezogen.
Gleiche Mengen an RNA wurden mit dem Solarbio Universal RT-PCR Kit (AMV; Artikelnummer RP1200) in komplementäre DNA umgeschrieben. Die quantitative PCR für CXCL10, JUN, IFIH1, MX1 und TLR7 wurde unter Verwendung von SYBR Green PCR Master Mix auf einem Echtzeit-PCR-System durchgeführt. Jede biologische Probe wurde in drei technischen Wiederholungen analysiert, zusammen mit Kontrollen ohne Template und ohne Reverse Transkription. Der mittlere Ct-Wert der drei technischen Wiederholungen wurde für die nachfolgende Analyse verwendet; technische Wiederholungen wurden nicht als unabhängige Beobachtungen betrachtet. Es wurden Primer verwendet, die Exon-Intron-Übergänge überspannen und Amplikone von 80–200 bp erzeugen (Tabelle 2). Die Primer-Spezifität wurde mittels NCBI Primer-BLAST und Schmelzkurvenanalyse überprüft22.
β-Aktin (ACTB) wurde als internes Referenzgen verwendet, um die Expressionsniveaus der Zielgene zu normalisieren. Die relative Expression wurde mit der 2-ΔΔCt-Methode berechnet23. Für den Vergleich zwischen Gruppen wurden zweiseitige Mann-Whitney-U-Tests in Abhängigkeit von der Datenverteilung verwendet, und eine Falsch-Entdeckungs-Rate-Korrektur nach Benjamini-Hochberg wurde für die fünf Gene angewandt. Einzelne ROC-Kurven pro Gen wurden mit 95 % Konfidenzintervallen nach DeLong erstellt, und die optimalen Cut-offs wurden anhand des Youden-Index ausgewählt. Das logistische Regressionsmodell mit fünf Genen wurde zunächst an denselben 40 biologischen Proben angepasst und bewertet; diese Schätzung wurde daher als scheinbare In-Sample-Performance definiert. Um eine mögliche Überanpassung zu beurteilen, wurden 100 Wiederholungen einer stratifizierten fünffachen Kreuzvalidierung unter Verwendung eines L2-regulären logistischen Regressionsmodells durchgeführt, und die gepoolte ROC-Performance außerhalb der Folds wurde berechnet.
| Gen | RefSeq-Zugangsnummer | Forward-Primer (5′–3′) | Reverse-Primer (5′–3′) | Produktgröße (bp) | Tm (°C) | Exon-überspannend |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Ja |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Ja |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Ja |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Ja |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Ja |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Ja |
Tabelle 2: Primersequenzen für die quantitative reverse Transkriptions-PCR. Die Tabelle enthält die Zielgene, RefSeq-Zugangsnummern, Vorwärts- und Rückwärts-Primersequenzen, Produktgrößen, Schmelztemperaturen und Angaben dazu, ob die Primer auf Exon-Übergängen liegen, die bei der qRT-PCR verwendet wurden.
9. Screening von Wirkstoffkandidaten und molekulares Docking
Die hoch- und herunterregulierten Kern-Gen-Signaturen wurden in die Connectivity-Map-Datenbank eingegeben, um kleine Moleküle zu identifizieren, von denen vorhergesagt wird, dass sie das PH-assozierte Expressionsprofil umkehren7. Die Kandidaten wurden nach Logit-Score und Vorhersagewahrscheinlichkeit geordnet.
Die dreidimensionale Struktur von BRD-K91900765/VX-745 wurde aus PubChem unter CID 303852524 bezogen. Pharmakologische Informationen zum Wirkstoff wurden aus öffentlichen Arzneimitteldatenbanken zusammengestellt, und strukturelle Deskriptoren wurden mithilfe von DrugBank und SwissADME25,26 berechnet. Proteinstrukturen wurden aus der RCSB Protein Data Bank unter Verwendung der folgenden PDB-Identifikatoren bezogen: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN; sowie MAPK14/p38α, 1OUK27. Die blinde Hohldetektion und molekulare Docking-Analysen wurden mit CB-Dock2 v2.0 unter Verwendung der AutoDock Vina v1.2.0 Scoring-Engine durchgeführt28,29. Protein- und Ligandendateien wurden auf CB-Dock2 hochgeladen, potenzielle Hohlräume automatisch detektiert, und das Docking wurde innerhalb der vom Server generierten hohlraumspezifischen Boxen durchgeführt. Für jedes Protein wurden der Hohlraum-Identifikator, der Vina-Score, das Hohlraumvolumen, der Mittelpunkt der Docking-Box, die Abmessungen der Docking-Box sowie die Datei des Protein-Ligand-Komplexes dokumentiert. Die Pose mit dem niedrigsten (negativsten) Vina-Score wurde als die am höchsten bewertete vorhergesagte Konformation ausgewählt. MAPK14/p38α wurde als etabliertes pharmakologisches Ziel und als positiver Referenz-Docking-Protein für VX-745 einbezogen. Das Docking an CXCL10, JUN, IFIH1, MX1 und TLR7 diente explorativen Zwecken und wurde nicht als Hinweis auf eine direkte pharmakologische Zielgerichtetheit, Bindung, Hemmung oder Wirksamkeit interpretiert.
10. Statistische Analyse und Reproduzierbarkeitskontrolle
Alle statistischen Analysen wurden in R durchgeführt, sofern nicht anders angegeben. Zweiseitige P-Werte < 0,05 wurden als statistisch signifikant betrachtet. Eine Korrektur für Mehrfachvergleiche wurde auf die Analysen zur differentiellen Expression, Anreicherung, externen Validierung und qRT-PCR wie oben beschrieben angewandt. Eine Kreuzvalidierung wurde verwendet, um die Stabilität der Machine-Learning- und kombinierten qRT-PCR-Modelle zu bewerten.
Ergebnisse
Vorverarbeitung öffentlicher transkriptomischer Daten und Identifizierung differentiell exprimierter Gene
Die Integration und ComBat-Korrektur von GSE22356, GSE33463 und GSE48149 verringerte systematische Unterschiede zwischen den Datensätzen. Boxplots zeigten, dass die Expressionsverteilungen der Proben nach der Korrektur konsistenter wurden. Die Hauptkomponentenanalyse zeigte, dass sich die Proben vor der Korrektur hauptsächlich entsprechend ihrer Datensatzherkunft gruppierten, danach jedoch stärker durchmischten, was auf eine effektive Reduktion von Batch-Effekten hinweist (Abbildung 1).
Unter Verwendung von Schwellenwerten für eine absolute log2-Fold-Change >0,585 und einen adjustierten P-Wert < 0,05 wurden 78 differentiell exprimierte Gene identifiziert, darunter 44 hochregulierte und 34 herunterregulierte Gene (Abbildung 2A). Die Heatmap zeigte, dass interferonassoziierte Gene, einschließlich XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 und TLR7, in Proben mit PH-Bezug im Allgemeinen hochreguliert waren. Im Gegensatz dazu waren erythroidassoziierte Gene, darunter HBG1, HBD, ALAS2, CA1 und SLC4A1, tendenziell herunterreguliert (Abbildung 2B).
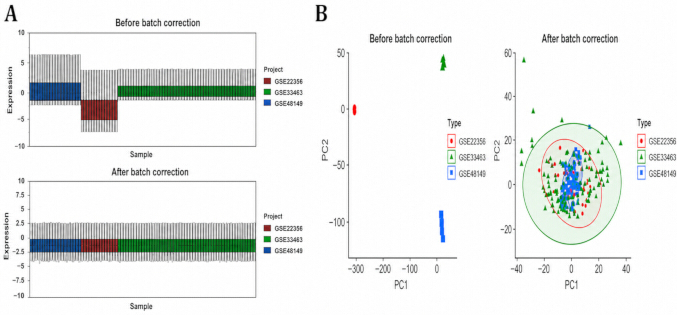
Abbildung 1: Korrektur von Batch-Effekten. (A) Boxplots der zusammengeführten Expressionsmatrix vor und nach der ComBat-Korrektur. (B) Hauptkomponentenanalyse-Diagramme (PCA), die die Verteilung der Proben vor und nach der Korrektur von Batch-Effekten zeigen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
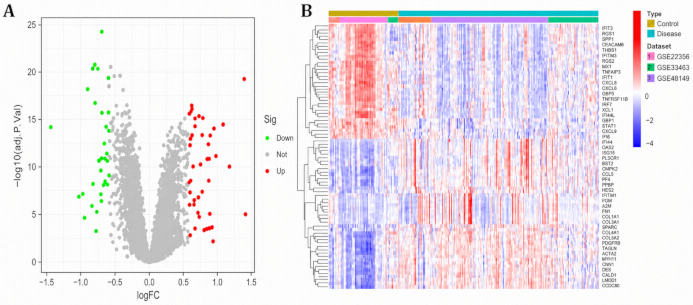
Abbildung 2: Differentiell exprimierte Gene. (A) Vulkandiagramm, das hoch- und herunterregulierte Gene in mit PH assoziierten Proben zeigt. (B) Heatmap, die die differentiell exprimierten Gene zwischen den Kontroll- und Krankheitsgruppen darstellt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Konstruktion gewichteter genetischer Ko-Expressionsnetzwerke und funktionale Anreicherung
Die Probengruppierung zeigte eine stabile Gesamtgruppierung ohne offensichtliche Ausreißer (Abbildung 3A). Der Fit-Index für die skalenfreie Topologie näherte sich bei einer Potenz von 9 dem Wert 0,8, und β = 9 wurde für die Netzwerkkonstruktion ausgewählt (Abbildung 3B). Die Gen-Clustering- und dynamische Modulidentifikation ergab mehrere Ko-Expressionsmodule (Abbildung 3C). Das blaue Modul zeigte die stärkste Assoziation mit dem PH-Status (r = 0,55, P = 1 × 10⁻¹⁹), während auch die türkis- und grau-gefärbten Module Korrelationen mit PH aufwiesen (Abbildung 3D).
Konsensgene, die durch den Durchschnitt der Schlüssel-Module der gewichteten Gen-ko-Expressionsnetzwerkanalyse mit den differentiell exprimierten Genen erhalten wurden, waren angereichert in der antiviralen Immunabwehr, der Regulation von NF-κB und JAK-STAT, Entzündungsfaktor-Antworten, Bindung an Zytokin- und Chemokinrezeptoren sowie der transkriptionellen Regulation (Abbildung 4A). Die Anreicherungsanalyse der Kyoto Encyclopedia of Genes and Genomes identifizierte Interaktionen zwischen Zytokinen und Zytokinrezeptoren, Chemokin-Signalgebung, NOD-ähnliche Rezeptor-Signalgebung, Toll-ähnliche Rezeptor-Signalgebung, Tumornekrosefaktor-Signalgebung und Interleukin-17-Signalgebung (Abbildung 4B) und unterstützt damit eine immun-entzündliche Dysregulation als molekulare Grundlage der pulmonalen Gefäßremodellierung.
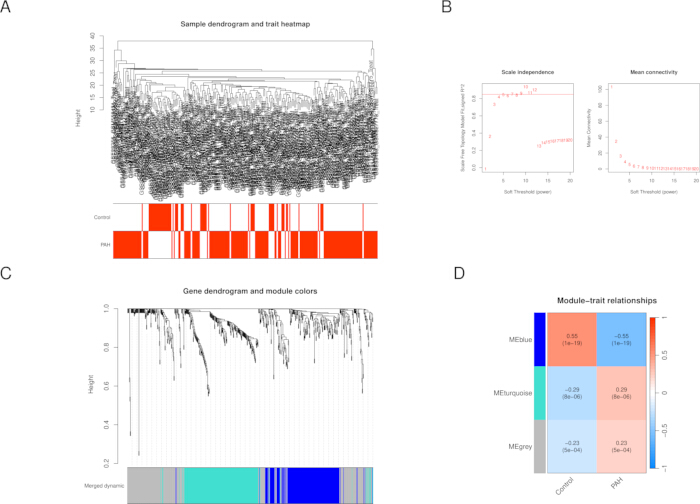
Abbildung 3: Gewichtete Analyse des ko-exprimierten Gen-Netzwerks. (A) Baum zur Probenclustering und Heatmap der Merkmale. (B) Diagramm zur Auswahl des Soft-Schwellenwerts. (C) Gen-Dendrogramm und Modulfarben. (D) Heatmap der Beziehung zwischen Modulen und Merkmalen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
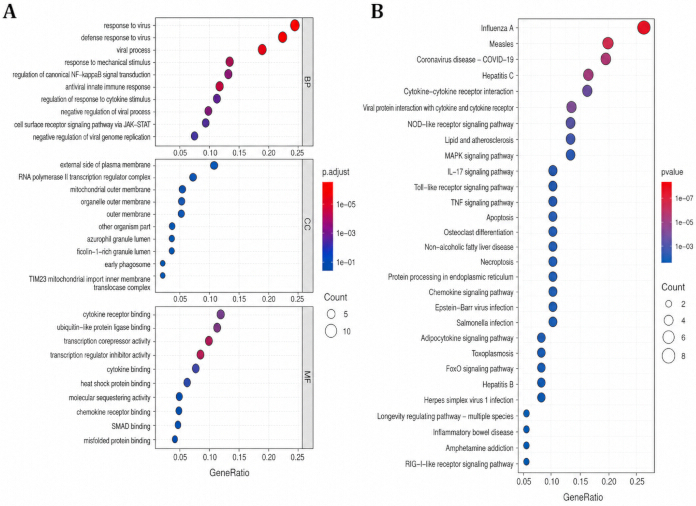
Abbildung 4: Funktionsanalyse der Genanreicherung. (A) Ergebnisse der Genontologie-Anreicherung für die Konsensusgene. (B) Ergebnisse der Pfadanreicherung aus der Kyoto-Enzyklopädie für Gene und Genome (KEGG) für die Konsensusgene. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Protein-Protein-Interaktionsnetzwerk und Screening von Hub-Genen
Das aus den Konsensgenen erstellte Protein-Protein-Interaktionsnetzwerk von STRING zeigte ein vernetztes immuninflammatorisches Netzwerk (Abbildung 5A). Die gradbasierte CytoHubba-Rangfolge ergab, dass FN1, CD44, JUN, TGFB1, CXCL8 und BCL2 eine hohe Vernetzung aufwiesen (Abbildung 5B). Diese Hub-Gene könnten an inflammatorischen Signalwegen, der Zelladhäsion, der Remodellierung der extrazellulären Matrix sowie der strukturellen Remodellierung des pulmonalen Gefäßsystems beteiligt sein.
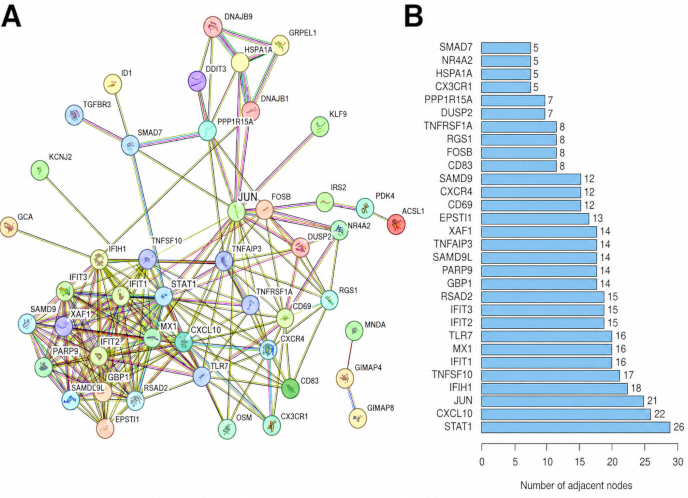
Abbildung 5: Protein-Protein-Interaktionsnetzwerk und HUB-Gene. (A) STRING-Protein-Protein-Interaktionsnetzwerk der Konsensgene. (B) Nach Grad sortierte HUB-Gene, identifiziert mittels CytoHubba. Klicken Sie bitte hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Feature-Selektion mittels maschinellem Lernen und diagnostische Leistung
Die Regression mit dem Verfahren „Least absolute shrinkage and selection operator“ identifizierte nach der Kreuzvalidierung sechs Kandidatengene mit von null verschiedenen Koeffizienten (Abbildung 6A, B). Die Methode „Support Vector Machine – Recursive Feature Elimination“ behielt acht Gene bei und erreichte eine Kreuzvalidierungsgenauigkeit von 0,883 sowie einen Fehler von 0,117 (Abbildung 7A). Beim Random-Forest-Modell stabilisierte sich der Out-of-Bag-Fehler, sobald die Anzahl der Bäume ≥100 betrug, und IFIH1, JUN und TLR7 gehörten zu den Genen mit den höchsten Rängen gemäß dem Wichtigkeitsscore (Abbildung 7B).
Der Durchschnitt der Ergebnisse des Least Absolute Shrinkage and Selection Operator, des Support Vector Machine–Recursive Feature Elimination und des Random Forest identifizierte fünf zentrale Gene: CXCL10, JUN, IFIH1, MX1 und TLR7 (Abbildung 8A). Die Einzelgen-Analyse der Receiver-Operating-Characteristic-Kurve zeigte eine moderate bis gute diagnostische Trennschärfe mit Flächen unter der Kurve von 0,842 für IFIH1, 0,833 für JUN, 0,827 für TLR7, 0,814 für CXCL10 und 0,759 für MX1 (Abbildung 8B).
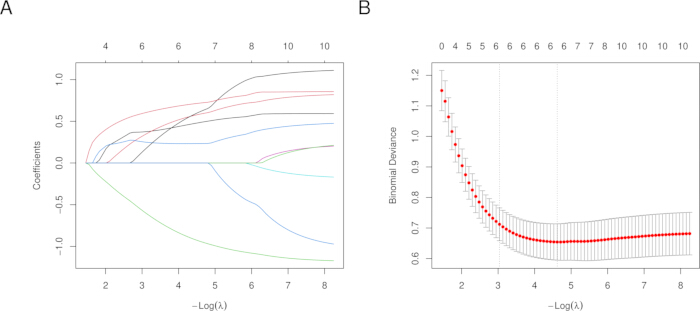
Abbildung 6: Regressionsanalyse mittels Least Absolute Shrinkage and Selection Operator (Lasso). (A) Koeffizientenpfad, erzeugt durch die Lasso-Regression. (B) Kreuzvalidierungsfehlerdiagramm. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
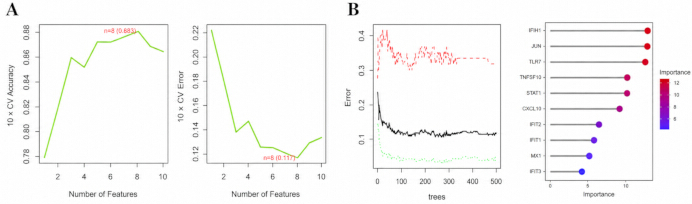
Abbildung 7: Analysen mittels Support-Vektor-Maschine mit rekursiver Merkmalseliminierung und zufälligem Waldverfahren. (A) Merkmalsauswahl-Diagramm der Support-Vektor-Maschine mit rekursiver Merkmalseliminierung. (B) Modell des zufälligen Waldverfahrens und Rangfolge der Genwichtigkeit. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
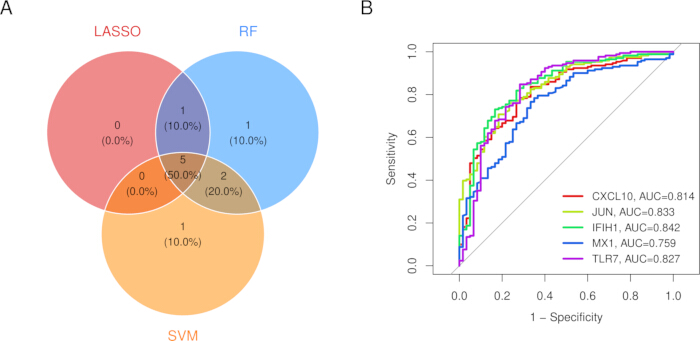
Abbildung 8: Zusammenfassung des maschinellen Lernens. (A) Venn-Diagramm, das den Durchschnitt der drei Feature-Selection-Algorithmen zeigt. (B) Receiver-Operating-Characteristic-Kurven für die fünf Kerngene. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Externe Validierung in GSE117261
GSE117261 wurde als unabhängiger Validierungs-Kohorte für Lungengewebe verwendet und war nicht in die differentielle Expressionsanalyse, den Aufbau des gewichteten Gen-ko-Expressionsnetzwerks oder die Merkmalsauswahl mittels maschinellem Lernen einbezogen (Tabelle 3). Die vollständigen Validierungsergebnisse zeigten eine heterogene Reproduktion über die fünf Gene hinweg (Tabelle 4). CXCL10 war erhöht (log₂-Fold-Change = 0,677; P = 0,0410; FDR = 0,144) und ergab eine AUC von 0,639 (95 % Konfidenzintervall, 0,491–0,786) mit einem Schwellenwert von 6,245, einer Sensitivität von 0,724 und einer Spezifität von 0,600. JUN war erhöht (log₂-Fold-Change = 0,463; P = 0,00248; FDR = 0,0194) und ergab eine AUC von 0,714 (95 % Konfidenzintervall, 0,593–0,835) mit einem Schwellenwert von 8,708, einer Sensitivität von 0,707 und einer Spezifität von 0,720.
IFIH1 (log2-Fold-Change = 0,107; P = 0,371; FDR = 0,591; AUC = 0,543, 95 % CI, 0,398–0,687), MX1 (log2-Fold-Change = 0,109; P = 0,488; FDR = 0,690; AUC = 0,475, 95 % CI, 0,337–0,614) und TLR7 (log2-Fold-Change = -0,050; P = 0,543; FDR = 0,733; AUC = 0,546, 95 % CI, 0,414–0,679) erfüllten die vorab festgelegten Kriterien für externe Unterstützung nicht. TLR7 zeigte außerdem eine entgegengesetzte Richtung im Vergleich zum qRT-PCR-Ergebnis. Das explorative Fünf-Gen-Modell, das innerhalb von GSE117261 angepasst und bewertet wurde, ergab eine scheinbare AUC von 0,740, während wiederholte geschachtelte Kreuzvalidierung eine AUC von 0,656 ergab. Somit erhielt JUN die stärkste unabhängige Unterstützung, CXCL10 zeigte begrenzte, richtungskonsistente Hinweise, und die Reproduktion von IFIH1, MX1 und TLR7 war schwach oder widersprüchlich.
| Element | Beschreibung |
| Datensatz-Zugriffsnummer | GSE117261 |
| Datenquelle | Gene Expression Omnibus (GEO) |
| Probenart | Transkriptomische Mikroarray-Daten von menschlichem Lungen-Gewebe |
| Stichprobengröße | 58 PAH-Proben und 25 Kontrollproben von nicht verwendbaren Spenderlungen |
| Plattform | GPL6244 / Affymetrix Human Gene 1.0 ST Array |
| Validierungsziel | Expressionsunterschiede, ROC-Analyse einzelner Gene und explorative kombinierte ROC-Modellierung aus fünf Genen für CXCL10, JUN, IFIH1, MX1 und TLR7 |
| Rolle in dieser Studie | Unabhängiger externer Validierungsdatensatz; wurde nicht in die ursprüngliche Trainings-, WGCNA- oder Merkmalsauswahl-Analysen einbezogen |
Tabelle 3: Grundlegende Informationen zum unabhängigen externen Validierungsdatensatz GSE117261. Die Tabelle fasst die Datenquellen, Probentypen, Stichprobengröße, Plattform, Validierungsziele und die Rolle von GSE117261 in der Studie zusammen.
| Gen/Modell | PAH n | Kontrolle n | log2-Fold-Change | P-Wert | FDR | AUC | AUC 95 % KI | Youden-Schwellenwert | Sensitivität | Spezifität |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Fünf-Gen-Modell (scheinbar/innerhalb der Stichprobe) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Fünf-Gen-Modell (wiederholte geschachtelte CV) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Tabelle 4: Tatsächliche Expressionsunterschiede und ROC-Validierungsergebnisse für GSE117261. Die Tabelle gibt die Stichprobengrößen für PAH und Kontrollen, log₂-Fold-Changes, P-Werte, auf falsche Entdeckungsrate angepasste Werte, AUCs, 95 % Konfidenzintervalle, Youden-Index-Schwellenwerte, Sensitivitäten, Spezifitäten sowie Interpretationen für die fünf Gene und die explorativen kombinierten Modelle an.
Validierung mittels quantitativer reverser Transkriptions-PCR
Die quantitative Validierung mittels reverser Transkription-PCR umfasste 20 biologisch unabhängige Lungenproben von PAH-Patienten und 20 biologisch unabhängige Kontrollproben, wobei für jede biologische Probe der Mittelwert aus drei technischen Wiederholungen gebildet wurde. CXCL10, JUN, IFIH1, MX1 und TLR7 waren in PAH signifikant hochreguliert (Tabelle 5; Abbildung 9A). Die mittleren relativen Expressionswerte betrugen ungefähr 3,470 für CXCL10, 2,560 für JUN, 2,760 für IFIH1, 2,650 für MX1 und 2,580 für TLR7. Die entsprechenden P-Werte/FDR-Werte lagen bei 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 bzw. 1,37 × 10⁻6/2,63 × 10⁻6.
Die ROC-Analyse für Einzelgene basierend auf qRT-PCR-Expression zeigte AUC-Werte von 0,988 für CXCL10 (95 % KI, 0,961–1,000), 0,880 für JUN (95 % KI, 0,758–1,000), 0,908 für IFIH1 (95 % KI, 0,820–0,995), 0,945 für MX1 (95 % KI, 0,874–1,000) und 0,948 für TLR7 (95 % KI, 0,886–1,000) (Abbildung 9B; Tabelle 5). Das Fünf-Gen-Logistische-Regressionsmodell erreichte eine scheinbare AUC von 1,000 (DeLong 95 % KI: 1,000–1,000) mit einer Sensitivität und Spezifität von jeweils 1,000 (Abbildung 9C). Die Konsistenz der Expressionsrichtung zwischen der Validierung mittels quantitativer reverser Transkription-PCR und GSE117261 wurde mithilfe einer Heatmap veranschaulicht (Abbildung 9D). Da dieselben 40 Proben sowohl zur Modellanpassung als auch zur Evaluierung verwendet wurden, spiegelt dies die scheinbare In-Sample-Performance wider. Bei 100 Wiederholungen einer stratifizierten fünffachen Kreuzvalidierung unter Verwendung eines L2-regulären logistischen Regressionsmodells betrug die gepoolte Out-of-Fold-AUC ebenfalls 1,000 (95 % KI, 1,000–1,000), und jede Wiederholung ergab eine AUC von 1,000. Trotz dieser internen Stabilität war die Kohorte klein, und eine unabhängige prospektive Validierung bleibt notwendig. Der direktionale Vergleich mit GSE117261 zeigte übereinstimmende Anstiege für CXCL10, JUN, IFIH1 und MX1, jedoch eine diskordante Richtung für TLR7 (Abbildung 9D).
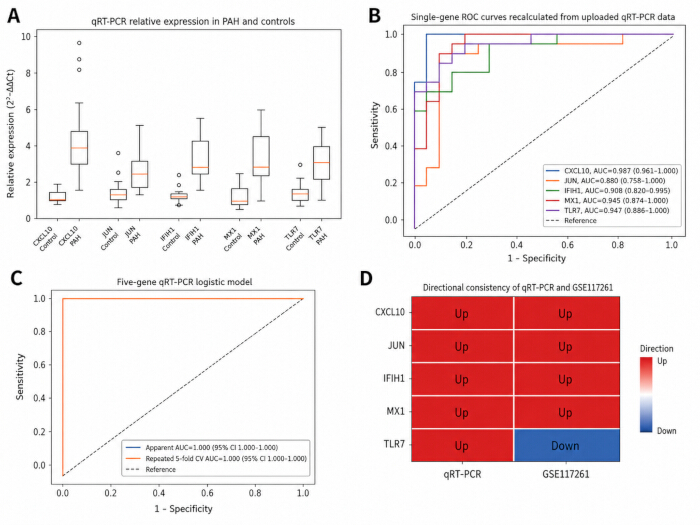
Abbildung 9: Validierung mittels quantitativer reverser Transkriptions-PCR. (A) Boxplots, die die relative Expression von CXCL10, JUN, IFIH1, MX1 und TLR7 in 20 biologisch unabhängigen Lungenproben von PAH-Patienten und 20 biologisch unabhängigen Kontrollproben zeigen. Jede biologische Probe wurde in drei technischen Replikaten gemessen, und der mittlere Ct-Wert wurde für die Analyse verwendet. Bei jedem Boxplot stellt die mittlere Linie den Median dar, der Kasten den Interquartilsabstand, die Whisker erstrecken sich bis zum 1,5-fachen des Interquartilsabstands, und einzelne Punkte außerhalb der Whisker repräsentieren Ausreißer. (B) Einzelgen-ROC-Kurven basierend auf den qRT-PCR-Expressionswerten; AUCs und DeLong-95%-Konfidenzintervalle sind angegeben. (C) ROC-Kurven für das Fünf-Gen-Logistische-Regressionsmodell, die sowohl die scheinbare Leistung innerhalb der Stichprobe als auch die gepoolte Leistung außerhalb der Folds aus 100 wiederholten stratifizierten fünffachen Kreuzvalidierungsanalysen zeigen. (D) Heatmap, die die Konsistenz der Expressionsrichtung zwischen qRT-PCR und GSE117261 darstellt; CXCL10, JUN, IFIH1 und MX1 waren übereinstimmend erhöht, während TLR7 inkonsistent war. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Gen/Modell | PAH n | Kontrolle n | Kontrolle 2^-ΔΔCt, Mittelwert ± SD | PAH 2^-ΔΔCt, Mittelwert ± SD | Richtung | P-Wert | FDR | AUC | AUC 95% KI | Youden-Schwellenwert | Sensi- bilität | Spezifi- zität | Validierungstyp | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Hochreguliert | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Einzelgen-qRT-PCR-Analyse | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Hochreguliert | 4.17E-05 | 4.17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | Einzelgen-qRT-PCR-Analyse | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Hochreguliert | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Einzelgen-qRT-PCR-Analyse | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Hochreguliert | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Einzelgen-qRT-PCR-Analyse | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Hochreguliert | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Einzelgen-qRT-PCR-Analyse | ||||
| Fünf-Gen-Modell (scheinbar/in-Stichprobe) | 20 | 20 | Nicht zutref- fend | Nicht zutref- fend | Nicht zutreffend | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Dasselbe Set aus 40 biologischen Proben zur Modellanpassung und -bewertung verwendet | ||||
| Fünf-Gen-Modell (100-fach wiederholte 5-fache CV) | 20 | 20 | Nicht zutref- fend | Nicht zutref- fend | Nicht zutreffend | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Interne Kreuzvalidierung mittels L2-regulierter logistischer Regression | ||||
Tabelle 5: Vollständige qRT-PCR-Expressions- und ROC-Ergebnisse für CXCL10, JUN, IFIH1, MX1 und TLR7, einschließlich der Analysen des kombinierten Fünf-Gen-Modells. Die Tabelle gibt die Stichprobengrößen für PAH und Kontrollen, relative Expressionswerte, Expressionsrichtungen, P-Werte, auf falsche Entdeckungsrate angepasste Werte, AUCs, 95 % Konfidenzintervalle, Youden-Index-Schwellenwerte, Sensitivitäten, Spezifitäten und Validierungstypen für die einzelnen Gene und kombinierten Modelle an.
Validierung der Einzelzell-Transkriptomik in GSE210248
GSE210248 lieferte zelluläre mechanistische Hinweise, indem gezeigt wurde, dass die pulmonal-arterielle Remodeling bei PAH von veränderten Kommunikationsvorgängen zwischen Immunzellen und vaskulären Strukturzellen begleitet war. Diese Beobachtung stand im Einklang mit der anreicherung entzündlicher Reaktionen, Chemokin-Signalgebung, Toll-ähnlicher Rezeptor-Signalgebung und Tumor-Nekrose-Faktor-Signalgebung in der Gesamttranskriptomik.
Einzelzell-Analysen deuteten darauf hin, dass das PAH-Lungenarterien-Signalnetzwerk eine Verschiebung hin zu strukturellen Zellen, einschließlich glatter Muskelzellen und Fibroblasten, aufwies. Die glatten Muskelzellen zeigten mehrere Zustände, darunter solche mit Sauerstoffsensorik/perizyt-ähnlichen, kontraktilen, synthetischen und fibroblastenähnlichen Eigenschaften. Diese Ergebnisse stützen ein Krankheitsmodell, bei dem eine gemeinsame Wirkung von immun-entzündlicher Aktivierung und Remodeling vaskulärer Strukturzellen den Fortschritt der PH/PAH antreibt.
Screening von Wirkstoffkandidaten und molekulares Docking
Die Connectivity-Map-Analyse identifizierte BRD-K91900765 als den am höchsten bewerteten Kandidaten unter den Top-10-Treffern, mit einem Logit-Score von 10,13 und einer vorhergesagten Wahrscheinlichkeit von 0,085 (Abbildung 10). Die Überprüfung der Verbindung ergab, dass BRD-K91900765 der Substanz VX-745/neflamapimod entspricht, einem selektiven p38α/MAPK14-Hemmer mit einer PubChem-Verbindungs-ID von 3038525 und einer molaren Masse von 436,27 g/mol (Tabelle 6).
Die explorative Docking-Analyse von BRD-K91900765/VX-745 mit den fünf biomarkerassoziierten Proteinen ergab beste Vina-Scores von -7,5 kcal/mol für CXCL10, -7,6 kcal/mol für JUN, -7,5 kcal/mol für IFIH1, -8,7 kcal/mol für MX1 und -8,1 kcal/mol für TLR7 (Tabellen 7–11; Abbildung 11A–E). Diese Ergebnisse deuten auf eine vorhergesagte strukturelle Verträglichkeit hin, belegen jedoch nicht, dass die fünf Proteine direkte pharmakologische Zielstrukturen darstellen. Vorläufige Vorhersagen zur Absorption, Verteilung, Metabolisierung, Ausscheidung und Toxizität deuteten darauf hin, dass die Verbindung mehrere arzneimittelähnliche Eigenschaften besitzt, obwohl das relativ hohe berechnete cLogP einer weiteren Bewertung bedarf (Tabelle 12). Als positiver Referenzbefund wurde das Docking an das etablierte VX-745-Zielprotein MAPK14/p38α (PDB-ID: 1OUK) durchgeführt. Die beste Bindungstasche an MAPK14, C1, ergab einen Vina-Score von -7,9 kcal/mol, ein Taschenvolumen von 3560 Å3, ein Docking-Box-Zentrum bei (2, 22, 34) sowie Abmessungen von (22, 31, 31) (Tabelle 13; Abbildung 11F).
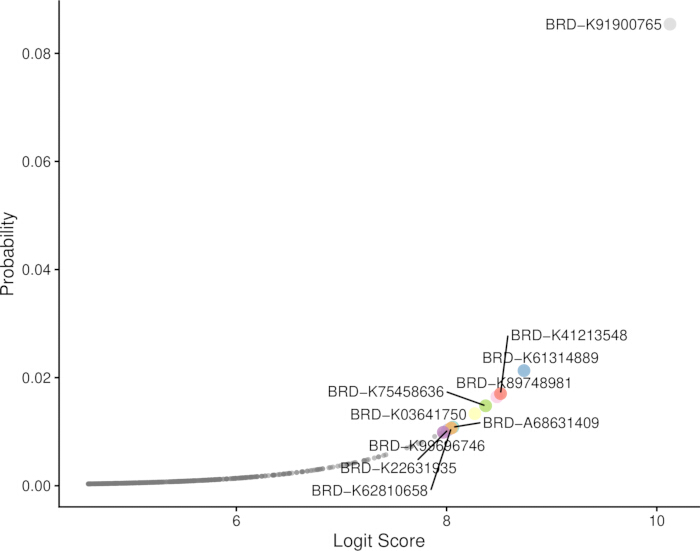
Abbildung 10: Rangfolge der Kandidatenverbindungen aus der Connectivity-Map-Analyse. Rangfolge der Kandidatenverbindungen, die durch die Connectivity-Map-Screening-Analyse identifiziert wurden. BRD-K91900765 war die am höchsten bewertete Verbindung mit einem Logit-Score von 10,13 und einer vorhergesagten Wahrscheinlichkeit von 0,085. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
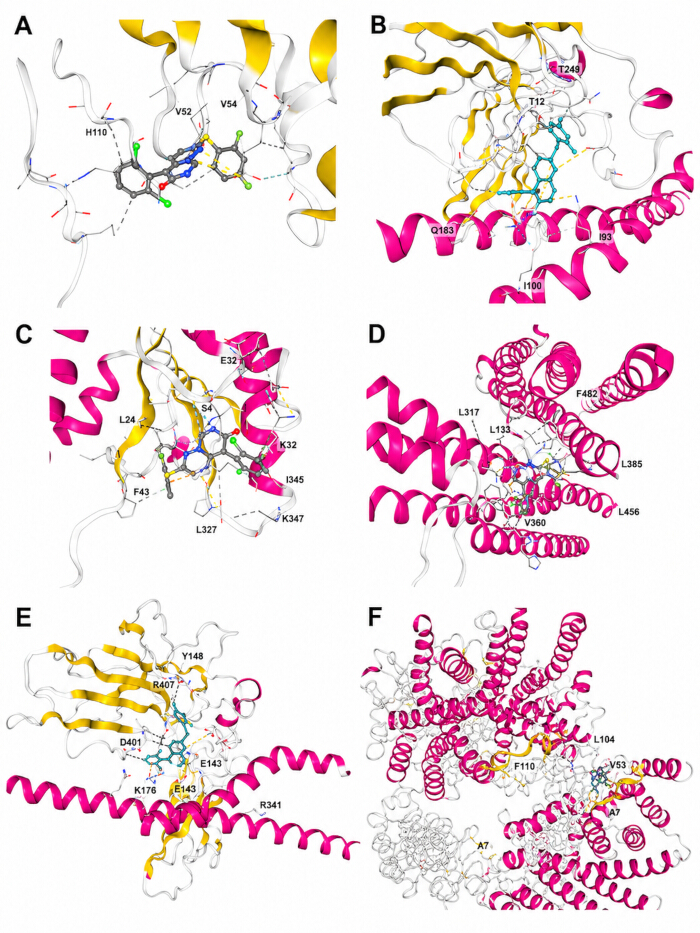
Abbildung 11: Dreidimensionale molekulare Docking-Darstellungen für BRD-K91900765/VX-745. (A) Exploratives Docking mit CXCL10. (B) Exploratives Docking mit JUN. (C) Exploratives Docking mit IFIH1. (D) Exploratives Docking mit MX1. (E) Exploratives Docking mit TLR7. (F) Positiv-Referenz-Docking mit dem etablierten pharmakologischen Zielprotein MAPK14/p38α (PDB ID: 1OUK). Die Panels A–E zeigen eine vorhergesagte strukturelle Verträglichkeit an und belegen keine direkte pharmakologische Angriffspunktbindung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Artikel | Beschreibung |
| CMap/Broad ID | BRD-K91900765 (übliches Chargenformat: BRD-K91900765-001-xx-x) |
| Allgemeine Bezeichnung/Aliase | VX-745; neflamapimod; VRT-031745; VD-31745 |
| Chemische Bezeichnung | 5-(2,6-Dichlorphenyl)-2-(2,4-difluorphenyl)sulfanylpyrimido[1,6-b]pyridazin-6-on |
| PubChem CID | 3038525 |
| CAS-Nummer | 209410-46-8 |
| Molekularformel / relative Molekularmasse | C19H9Cl2F2N3OS; 436,27 g/mol |
| Kanonische SMILES | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Bekanntes, wichtiges pharmakologisches Target | MAPK14/p38α; Hemmung von p38β wurde ebenfalls beschrieben, jedoch mit geringerer Selektivität als gegenüber p38α |
Tabelle 6: Chemische und pharmakologische Informationen zu BRD-K91900765/VX-745. Die Tabelle fasst die Verbindungsbezeichner, Synonyme, chemische Bezeichnung, Summenformel, molare Masse, strukturelle Deskriptoren und den etablierten pharmakologischen Zielort von BRD-K91900765/VX-745 zusammen.
| CurPocket ID | Vina-Score (kcal/mol) | Hohlraumvolumen (ų) | Mittelpunkt (x, y, z) | Größe des Dockings (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Tabelle 7: Vorhergesagte Docking-Taschen für BRD-K91900765/VX-745 mit CXCL10 (PDB ID: 1LV9). Die Tabelle listet die ranggeordneten Hohlraumbezeichner, Vina-Scores, Hohlraumvolumina, Docking-Box-Mittelpunkte und Docking-Box-Abmessungen auf, die von CB-Dock2 generiert wurden.
| CurPocket ID | Vina-Score (kcal/mol) | Hohlvolumen (ų) | Mittelpunkt (x, y, z) | Größe des Dockings (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Tabelle 8: Vorhergesagte Docking-Taschen für BRD-K91900765/VX-745 mit JUN (PDB-ID: 1JUN). Die Tabelle listet die ranggeordneten Hohlräume, Vina-Scores, Hohlraumvolumina, Docking-Box-Mittelpunkte und Docking-Box-Abmessungen auf, die von CB-Dock2 generiert wurden.
| CurPocket-ID | Vina-Score (kcal/mol) | Hohlvolumen (ų) | Mittelpunkt (x, y, z) | Größe des Dockings (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Tabelle 9: Vorhergesagte Docking-Taschen für BRD-K91900765/VX-745 mit IFIH1 (PDB-ID: 3B6E). Die Tabelle enthält die Rangfolge der Hohlräume, Vina-Scores, Hohlraumvolumina, Mittelpunkte der Docking-Boxen und Abmessungen der Docking-Boxen, die von CB-Dock2 generiert wurden.
| CurPocket ID | Vina-Score (kcal/mol) | Hohlvolumen (ų) | Mittelpunkt (x, y, z) | Docking-Größe (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Tabelle 10: Vorhergesagte Docking-Taschen für BRD-K91900765/VX-745 mit MX1 (PDB-ID: 5GTM). Die Tabelle enthält die nach Rang geordneten Hohlräume, Vina-Scores, Hohlraumvolumina, Docking-Box-Mittelpunkte und Docking-Box-Abmessungen, die von CB-Dock2 generiert wurden.
| CurPocket ID | Vina-Score (kcal/mol) | Hohlraumvolumen (ų) | Mittelpunkt (x, y, z) | Größe des Dockings (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Tabelle 11: Vorhergesagte Docking-Taschen für BRD-K91900765/VX-745 mit TLR7 (PDB-ID: 7CYN). Die Tabelle listet die ranggeordneten Hohlräume, Vina-Scores, Hohlvolumina, Docking-Box-Mittelpunkte und Docking-Box-Abmessungen auf, die von CB-Dock2 generiert wurden.
| Kategorie | Parameter | Ergebnis | Interpretation |
| Physikochemische Eigenschaft | Molekulargewicht | 436,27 g/mol | Unterhalb von 500 Da, erfüllt die Lipinski-Grenze für das Molekulargewicht |
| Physikochemische Eigenschaft | cLogP | Ungefähr 5,49 | Etwas höher als 5, deutet auf hohe Lipophilie hin und erfordert Berücksichtigung von Löslichkeit und unspezifischer Bindung |
| Physikochemische Eigenschaft | TPSA | Ungefähr 47,26 Ų | Niedrige polare Oberfläche, vereinbar mit potenziell günstiger Membranpermeabilität |
| Drug-ähnlichkeit | HBA/HBD | May-00 | Erfüllt die Lipinski-Schwellenwerte für Wasserstoffbrücken-Akzeptoren und -Donatoren |
| Drug-ähnlichkeit | Drehbare Bindungen | 3 | Niedrige konformationelle Flexibilität, günstig für stabile Bindungskonformationen |
| Strukturelle Warnhinweise | PAINS/Brenk-Warnhinweise | Nicht nachgewiesen | Keine gängigen pan-assay Interferenzen oder reaktiven strukturellen Warnhinweise nachgewiesen |
| Toxizitätsvorhersage | Ames-Mutagenität | Vorhergesagt als nicht Ames-toxisch | Deutet auf ein geringes vorhergesagtes mutagenes Risiko hin; experimentelle Validierung ist weiterhin erforderlich |
| Toxizitätsvorhersage | Karzinogenität | Vorhergesagt als nicht karzinogen | Deutet auf ein relativ geringes vorhergesagtes Langzeit-Karzinogenitätsrisiko hin; experimentelle Validierung ist weiterhin erforderlich |
| Pharmakokinetische Anmerkung | Orale Verfügbarkeit/Blut-Hirn-Schranke-Übertritt | Literatur und Datenbanken weisen auf ein oral verfügbares, ins Gehirn eindringendes kleines Molekül hin | Vereinbar mit der Entwicklungshintergrund als p38α-Inhibitor; Neubewertung ist für PH-Indikationen weiterhin erforderlich |
Tabelle 12: Vorläufige physikochemische, drug-like, ADMET- und Toxizitätsvorhersagen für BRD-K91900765/VX-745. Die Tabelle fasst vorhergesagte physikochemische Eigenschaften, drug-like-Kennzahlen, strukturelle Warnhinweise, Toxizitätsendpunkte und pharmakokinetische Merkmale zusammen. Diese computergestützten Vorhersagen sind vorläufig und ersetzen keine experimentelle pharmakokinetische oder toxikologische Validierung.
| CurPocket-ID | Vina-Score (kcal/mol) | Kavitätsvolumen (ų) | Mittelpunkt (x, y, z) | Größe des Dockings (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Tabelle 13: Vorhergesagte Docking-Taschen für BRD-K91900765/VX-745 mit seinem etablierten pharmakologischen Target MAPK14/p38α (PDB ID: 1OUK), enthalten als positive Referenzanalyse. Die Tabelle listet die ranggeordneten Hohlräume, Vina-Scores, Hohlraumvolumina, Docking-Box-Mittelpunkte und Docking-Box-Abmessungen auf, die mit dem gleichen Docking-Workflow generiert wurden, der auch auf die fünf biomarkerassoziierten Proteine angewandt wurde.
Insgesamt stützen die Entdeckungsanalysen und die qRT-PCR-Ergebnisse CXCL10, JUN, IFIH1, MX1 und TLR7 als kandidatenartige PH/PAH-Biomarker, die mit einer immuninflammatorischen Dysregulation und einer pulmonalen Gefäßremodellierung assoziiert sind, wobei die unabhängige Replikation in GSE117261 für JUN am stärksten ausgeprägt war und für die anderen Gene variabel war. BRD-K91900765/VX-745 ist ein rechnergestützt priorisierter Kandidat für eine Arzneimittelumwidmung mit einem plausiblen Wirkmechanismus der MAPK14/p38α-Hemmung; eine Validierung hinsichtlich Zielstrukturnbindung, zellulärer Wirkung, pharmakokinetischer Eigenschaften, Toxizität und in Tiermodellen ist erforderlich, bevor therapeutische Schlussfolgerungen gezogen werden können.
VERFÜGBARKEIT VON DATEN:
Alle in dieser Studie verwendeten öffentlichen transkriptomischen Datensätze sind über die Gene Expression Omnibus-Datenbank unter den Zugangsnummern GSE22356, GSE33463, GSE48149, GSE117261 und GSE210248 verfügbar. Alle verwendeten Programmierdateien, verarbeiteten Datensätze, anonymisierten qRT-PCR-Roh- und Analyseergebnisse, Modellausgaben sowie Eingabe- und Ausgabedateien für molekulares Docking wurden in einem strukturierten Zenodo-Repository zusammengefasst. Das Repository enthält eine README-Datei, die jede Datei beschreibt, sowie Angaben zu Software- und Paketversionen, der Reihenfolge der Skriptausführung und vollständigen Reproduktionsschritten – https://zenodo.org/records/21682282
Diskussion
Es wurde ein integrierter und reproduzierbarer Workflow entwickelt, um molekulare Biomarker und kandidatenwirksame therapeutische Verbindungen im Zusammenhang mit PH/PAH zu identifizieren, indem öffentlich zugängliche Transkriptomik, gewichtete Gen-ko-Expressionsnetzwerkanalyse, funktionelle Anreicherung, Protein-Protein-Interaktionsnetzwerkanalyse, drei maschinelle Lernalgorithmen, externe Validierung, Interpretation der Einzelzell-Transkriptomik, quantitative reverse Transkriptions-PCR-Bestätigung, Connectivity-Map-Screening und molekulares Docking kombiniert wurden. CXCL10, JUN, IFIH1, MX1 und TLR7 wurden durchgehend als zentrale Merkmalsgene priorisiert und gemeinsam auf eine immun-entzündliche und interferonbezogene molekulare Achse abgebildet. Diese Ergebnisse stützen die Vorstellung, dass PH/PAH nicht nur eine hämodynamische Erkrankung, sondern auch eine komplexe Gefäßremodelerkrankung ist, die Immunaktivierung, entzündliche Signalwege, angeborene Nukleinsäureerfassung sowie strukturelle und zelluläre phänotypische Veränderungen beinhaltet2,5,6.
Das diagnostische Potenzial der fünf Gene wurde durch eine Multi-Algorithmus-Feature-Auswahl und ROC-Analyse in der Entdeckungs-Kohorte gestützt. Die unabhängige Validierung in GSE117261 war heterogen statt einheitlich: JUN erfüllte die vorab festgelegten Kriterien für FDR und AUC, CXCL10 zeigte eine in der Richtung konsistente nominelle Zunahme, jedoch ohne genomweite FDR-Signifikanz, IFIH1 und MX1 zeigten eine begrenzte Reproduzierbarkeit, und TLR7 wies eine diskordante Richtung auf. Diese Ergebnisse stützen nicht die Behauptung, dass alle fünf Gene unabhängig validiert wurden, und deuten auf mögliche Einflüsse der Kohortenzusammensetzung, der Gewebeheterogenität, Plattformunterschiede und der Schwere der Erkrankung hin. Im Gegensatz dazu bestätigte die qRT-PCR in 20 PAH- und 20 Kontroll-Lungengewebeproben eine signifikante Hochregulation aller fünf Gene sowie eine günstige ROC-Leistung auf Ebene einzelner Gene.
Das Fünf-Gen-qRT-PCR-Logistikmodell erreichte eine scheinbare AUC von 1,000 (95 % Konfidenzintervall, 1,000–1,000), und die gepoolte AUC außerhalb der Folds blieb bei 100 wiederholten stratifizierten Fünf-Fold-Kreuzvalidierungsanalysen bei 1,000. Dennoch wurde das Modell an lediglich 40 biologischen Proben entwickelt, und eine vollständige Trennung in einer kleinen retrospektiven Kohorte kann zu übermäßig optimistischen und instabilen Leistungsschätzungen führen. Die Panelkonfiguration sollte daher als explorative molekulare Signatur und nicht als klinisch validiertes diagnostisches Instrument betrachtet werden. Größere multizentrische Kohorten, vorab festgelegte feste Modellkoeffizienten, Validierung auf Proteinebene, Immunhistochemie und prospektive Tests sind erforderlich, bevor eine klinische Anwendung möglich ist.
Unter den fünf Kerngenen könnte CXCL10 die Rekrutierung von Immunzellen und die lokale Verstärkung der Entzündungsreaktion im pulmonalen vaskulären Mikromilieu fördern. IFIH1 und TLR7 sind an der angeborenen Nukleinsäureerkennung beteiligt und könnten eine Aktivierung antiviral-ähnlicher entzündlicher Signalwege widerspiegeln. MX1 ist ein klassisches Interferon-aktiviertes Gen und könnte einen downstream-Marker der Aktivierung des Typ-I-Interferon-Signalwegs darstellen. JUN ist ein stressreaktiver Transkriptionsfaktor, der entzündliche Reize mit Zellproliferation, Apoptose und Gewebeumbildung verknüpft. Gemeinsam deuten diese Gene auf ein biologisch kohärentes Modell hin, bei dem eine Aktivierung des angeborenen Immunsystems und interferonassoziierte Signalübertragung mit Prozessen der Gefäßumbildung bei PH/PAH interagieren. Diese Interpretation steht im Einklang mit früheren Befunden, dass Entzündung, Immunität und interferonassoziierte Signalwege zur Pathobiologie der PAH beitragen2,5,6.
Die Validierung auf Einzelzellebene lieferte einen mechanistischen Kontext für die Befunde aus der Gesamtzellpopulation. GSE210248 deutete darauf hin, dass die pulmonal-arterielle Remodellierung bei PAH von veränderten Kommunikationsvorgängen zwischen Immunzellen und vaskulären Strukturzellen begleitet wird, einschließlich glatter Muskelzellen, Fibroblasten, Endothelzellen und Monozyten/Makrophagen. Das Vorhandensein mehrerer phänotypischer Zustände glatter Muskelzellen, darunter kontraktiler, synthetischer, sauerstoffsensorischer/perizytähnlicher und fibroblastenähnlicher Phänotyp, stützt ein Krankheitsmodell, bei dem Immunaktivierung und strukturelle Umbildung der Zellen gleichzeitig auftreten. Dieser zelluläre Befund ist wichtig, da Signale aus der Transkriptomik der Gesamtprobe aus veränderten Zellanteilen, Infiltration von Immunzellen oder transkriptionellen Veränderungen in residenten vaskulären Zellen resultieren können. Die Einzelzellanalyse verortet CXCL10, JUN, IFIH1, MX1 und TLR7 somit in einem multizellulären Ökosystem der pulmonal-vaskulären Remodellierung und nicht in einem Prozess, der auf einen einzelnen Zelltyp beschränkt ist18,19,20,21.
Die Arzneimittelumwidmungsanalyse identifizierte BRD-K91900765, das VX-745/neflamapimod entspricht, als den am höchsten eingestuften computergestützten Kandidaten. VX-745 ist ein selektiver p38α/MAPK14-Inhibitor, und seine Beziehung zu entzündlichen Stresswegen macht es im Hinblick auf die mit PH/PAH assoziierte Entzündung mechanistisch plausibel30. Daher wurde die Docking-Analyse an MAPK14/p38α als mechanistisch relevante positive Referenzanalyse einbezogen. Im Gegensatz dazu war die Docking-Analyse an CXCL10, JUN, IFIH1, MX1 und TLR7 explorativ und wies lediglich auf vorhergesagte strukturelle Verträglichkeit hin; sie zeigte nicht, dass diese biomarkerassoziierten Proteine direkte VX-745-Ziele sind, noch wurde eine direkte Bindung, Zielinhibition oder therapeutische Wirksamkeit nachgewiesen. Eine biologisch plausiblere Hypothese ist, dass VX-745 die identifizierte immunentzündliche und interferonassoziierte transkriptionelle Signatur möglicherweise indirekt durch Hemmung von MAPK14 moduliert. Vorhersagen der Connectivity Map, Docking-Scores und ADMET-Schätzungen stellen weiterhin computergestützte Belege dar. Weitere Arbeiten sollten biochemische Zielbindungsassays, Experimente an pulmonal-arteriellen endothelialen und glatten Muskelzellen, Modelle zur Entzündungsstimulation, pharmakokinetische und toxikologische Bewertungen sowie die Validierung in Tiermodellen umfassen.
Aktuelle experimentelle Studien zur hypoxischen pulmonalen Hypertonie haben ebenfalls die Bedeutung der Kommunikation zwischen Neutrophilen und pulmonalen Gefäßzellen hervorgehoben. HCK-vermittelte Interaktionen zwischen Neutrophilen und glatten Muskelzellen der Lungenarterien sowie SERPINB3-vermittelte Interaktionen zwischen Neutrophilen und Endothelzellen wurden als Beiträge zur pulmonalen Gefäßremodelierung beschrieben31˒32. Die SERPINB3–STAT1/3-Achse ist besonders relevant für die vorliegenden Befunde, da interferonassoziierte Signale sowie STAT1- und JAK–STAT-Signale in den transkriptomischen Analysen identifiziert wurden. Insgesamt stützen diese Beobachtungen die Interpretation, dass die Aktivierung von Immunzellen und deren Kommunikation mit vaskulären Strukturzellen zur Progression der PH/PAH beitragen könnten.
Die Studie weist mehrere Stärken auf. Es wurden mehrere öffentliche Datensätze und eine Korrektur von Batch-Effekten verwendet, um datensatzspezifische Verzerrungen zu reduzieren. Die Analyse der differentiellen Expression, die gewichtete Gen-ko-Expressions-Netzwerkanalyse, die Protein-Protein-Interaktionsanalyse sowie drei maschinelle Lernalgorithmen wurden kombiniert, um die Robustheit der Merkmale zu verbessern. Unabhängige Bulk-Validierung, qRT-PCR-Bestätigung und Einzelzellnachweise lieferten komplementäre, aber nicht identische Evidenzebenen. Die heterogenen Befunde aus GSE117261 und die kleine qRT-PCR-Kohorte verdeutlichen zudem wichtige Limitationen, darunter unvollständige externe Replikation, potenzielle gewebe- und plattformspezifische Effekte sowie die Gefahr der Überanpassung. Die Biomarker-Entdeckung wurde zudem auf die Screening-Identifizierung von Kandidatenverbindungen ausgeweitet, doch bleiben die Docking-Analysen hypothetisch. Zukünftige Studien sollten die fünf Gene in größeren, unabhängigen Kohorten mittels räumlicher Transkriptomik, Proteomik, Immunhistochemie sowie mittels Organoid- oder Gefäß-auf-Chip-Modellen validieren. Insgesamt bleiben CXCL10, JUN, IFIH1, MX1 und TLR7 Kandidaten-Biomarker für PH/PAH, die mit immun-entzündlichen und interferonbezogenen Gefäßremodeling-Prozessen assoziiert sind, während BRD-K91900765/VX-745 ein rechnergestützter Kandidat für Drug-Repurposing ist, dessen therapeutische Relevanz experimentell validiert werden muss.
Offenlegungen
Die Autoren geben keine Wettbewerbsinteressen an.
Danksagungen
Diese Studie wurde durch das Hunan Innovative Province Construction Project (Nr. 2022JJ30465) unterstützt.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | Beijing Solarbio Science & Technology Co., Ltd. | Katalog-Nr. SR1110 | Für dye-basierte quantitative Echtzeit-PCR-Amplifikation und Fluoreszenzdetektion |
| AI21.msvmRFE.R und e1071 | Individuelles R-Skript mit dem CRAN-Paket e1071 | AI21.msvmRFE.R; e1071 v1.7-17 | Support-Vektor-Maschinen-Verfahren mit rekursiver Merkmalsauswahl (SVM-RFE) |
| Agarose | Beijing Solarbio Science & Technology Co., Ltd. | Katalog-Nr. A8201; CAS 9012-36-6 | Beurteilung der Gesamt-RNA-Integrität mittels Agarose-Gelelektrophorese |
| Apparat für Agarose-Gelelektrophorese | Beijing Liuyi Biotechnologie Co., Ltd. | Modell DYCZ-24DN | Elektrophoretische Beurteilung der RNA-Integrität |
| AutoDock Vina Scoring-Engine | Zentrum für Computerbasierte Strukturbiologie, Scripps Research | v1.2.0; RRID: SCR_011958 | Scoring von Protein-Ligand-Komplexen im CB-Dock2-Workflow |
| CB-Dock2 | Cao-Laborgruppe, CB-Dock2-Webserver | v2.0; Zugriff im Juli 2026 | Blinddetektion von Bindungstaschen und molekulare Docking-Analyse von VX-745 mit ausgewählten Proteinstrukturen |
| CellChat | CellChat R-Paket | v2.1.2 | Rekonstruktion und Visualisierung von Zell-Zell-Kommunikation aus der Einzelzell-Expressionsmatrix |
| CellChatDB.human | Wird zusammen mit dem CellChat R-Paket bereitgestellt | CellChatDB.human; Secreted Signaling-Teilmenge; minimale Zellanzahl-Schwelle = 10 | Menschliche Ligand-Rezeptor-Interaktionsdatenbank für CellChat |
| clusterProfiler | Bioconductor R-Paket | v4.20.0; Bioconductor Release 3.23 | Anreicherungsanalysen für Gene Ontology und Kyoto Encyclopedia of Genes and Genomes (KEGG) |
| Connectivity Map (CMap/CLUE) | Broad Institute | L1000/CLUE-Ressource; RRID: SCR_016204; Zugriff im Juli 2026 | Computerbasierte Analyse zur Arzneimittelumwidmung (Drug Repositioning) |
| Individuell synthetisierte Oligonukleotid-Primer | Beijing Solarbio Science & Technology Co., Ltd. | Individuell synthetisiert; Primersequenzen in Tabelle 2 angegeben | Amplifikation von ACTB, CXCL10, JUN, IFIH1, MX1 und TLR7 |
| cytoHubba | Cytoscape App Store | v0.1 | Gradbasierte Rangfolge von Hub-Genen im Protein-Protein-Interaktionsnetzwerk |
| Cytoscape | Cytoscape-Konsortium | v3.10.4; RRID: SCR_003032 | Visualisierung und Analyse von Protein-Protein-Interaktionsnetzwerken |
| DrugBank | DrugBank-Wissensdatenbank | v6.0; RRID: SCR_002700 | Erfassung von Verbindungskennungen und pharmakologischen Informationen |
| Gel-Dokumentationssystem | Beijing Liuyi Biotechnologie Co., Ltd. | Modell WO-9413B | Sichtbarmachung und Aufzeichnung der Ergebnisse zur RNA-Integrität im Agarosegel |
| Gene Expression Omnibus (GEO) | Nationales Zentrum für Biotechnologieinformationen (National Center for Biotechnology Information) | GSE22356, GSE33463, GSE48149, GSE117261 und GSE210248; RRID: SCR_005012 | Bezug von Bulk- und Einzelzell-Transkriptomdatensätzen |
| GEOquery | Bioconductor R-Paket | v2.80.0; Bioconductor Release 3.23 | Programmgestützter Download und Import von GEO-Expressions- und Phänotypdaten |
| glmnet | CRAN R-Paket | v5.0 | Logistische Regression mit Least Absolute Shrinkage and Selection Operator (LASSO) und regularisierte logistische Modellierung |
| limma | Bioconductor R-Paket | v3.68.0; Bioconductor Release 3.23; RRID: SCR_010943 | Differenzielle Expressionsanalyse und empirische Bayes-Statistik |
| NanoDrop-Spektrophotometer | Thermo Fisher Scientific | NanoDrop ND-1000; Software v3.8 | Bestimmung der RNA-Konzentration sowie der Reinheitsverhältnisse A260/280 und A260/230 |
| NCBI Primer-BLAST | Nationales Zentrum für Biotechnologieinformationen (National Center for Biotechnology Information) | Web-Tool; RRID: SCR_003095; Zugriff im Juli 2026 | Überprüfung der Primer-Spezifität |
| pROC | CRAN R-Paket | v1.19.0.1; RRID: SCR_024286 | Receiver-Operating-Characteristic-Analyse (ROC), DeLong-Konfidenzintervalle und Youden-Index-basierte Cutoffs |
| Protein Data Bank (PDB) | RCSB Protein Data Bank | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | Bezug experimentell bestimmter Proteinstrukturen für molekulares Docking |
| PubChem | Nationales Zentrum für Biotechnologieinformationen (National Center for Biotechnology Information) | PubChem CID 3038525; RRID: SCR_004284 | Bezug der dreidimensionalen Struktur und chemischen Kennungen von BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1; RRID: SCR_001905 | Statistische Datenverarbeitung, maschinelles Lernen und Visualisierung |
| randomForest | CRAN R-Paket | v4.7-1.2 | Feature-Auswahl mittels Random Forest und Rangfolge der Variablenwichtigkeit |
| Echtzeit-PCR-System | Stratagene, jetzt Agilent Technologies | Mx3000P Echtzeit-PCR-System | qRT-PCR-Amplifikation, Fluoreszenzdetektion, Schmelzkurvenanalyse und Ct-Werte-Export |
| Seurat | CRAN R-Paket; Satija-Laborgruppe | v5.5.1; RRID: SCR_016341 | Qualitätskontrolle, Normalisierung, Dimensionsreduktion, Clusterung und Annotation von Einzelzell-RNA-Sequenzierungsdaten |
| STRING | STRING-Konsortium | v12.0; RRID: SCR_005223 | Erstellung von Protein-Protein-Interaktionsnetzwerken |
| sva (ComBat) | Bioconductor R-Paket | v3.60.0; Bioconductor Release 3.23 | Korrektur von Batch-Effekten zwischen Datensätzen |
| SwissADME | Schweizerisches Institut für Bioinformatik (Swiss Institute of Bioinformatics) | Webserver; Zugriff im Juli 2026 | Vorab-Screening hinsichtlich Arzneimittelähnlichkeit, physikochemischer Eigenschaften und ADME |
| Gesamt-RNA-Extraktionskit | Beijing Solarbio Science & Technology Co., Ltd. | Katalog-Nr. R1200 | Extraktion und Reinigung der Gesamt-RNA aus Lungenproben |
| Universal RT-PCR-Kit (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | Katalog-Nr. RP1200 | Reverse Transkription der Gesamt-RNA in komplementäre DNA (cDNA) |
| WGCNA | CRAN R-Paket | v1.74 | Erstellung gewichteter Gen-Coe-Expressionsnetzwerke und Analyse von Modul-Merkmal-Beziehungen |
Referenzen
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.