Diese Studie identifiziert fünf kupfer- und eisenabhängige Biomarker bei Colitis ulcerosa mittels integrierter maschineller Lernverfahren, Einzelzell-RNA-Sequenzierung und experimenteller Validierung und liefert Erkenntnisse für die klinische Diagnose und eine gezielte Immuntherapie.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Targeting von Ferroptose und Cuproptose bei Colitis ulcerosa: Erkenntnisse aus umfassender Bioinformatik und experimenteller Validierung
In diesem Artikel
Zusammenfassung
Zusammenfassung
Colitis ulcerosa (CU) ist eine chronische Darmerkrankung mit noch nicht vollständig geklärter Pathogenese und zunehmender Prävalenz sowie steigenden Krankenhausaufnahmeraten in neu industrialisierten Ländern. Bei der CU führt ein übermäßiger Zelltod der intestinalen Epithelzellen zur Störung der Schleimhautbarriere und löst entzündliche Reaktionen aus. Ferroptose und Cuproptose sind zwei kürzlich beschriebene Formen des regulierten Zelltods. Die meisten Studien zur CU haben diese Prozesse getrennt untersucht; ihre kombinierte Rolle im Fortschreiten der CU ist jedoch bisher unzureichend charakterisiert. Um ihre synergistische Bedeutung für die Pathogenese der CU zu untersuchen, verwendeten wir einen schrittweisen Ansatz, der eine groß angelegte transkriptomische Profilierung zur Identifizierung potenzieller Zielstrukturen umfasste, gefolgt von der Validierung in In-vitro-Modellen. Differenziell exprimierte Gene (DEGs) wurden mit eisenbezogenen Genen (FRGs) und kupferbezogenen Genen (CRGs) geschnitten. Die überlappenden Zielstrukturen wurden mithilfe eines Konsenss aus maschinellen Lernalgorithmen und der gewichteten Gen-koexpressionsnetzwerkanalyse (WGCNA) priorisiert. Fünf Biomarker – LCN2, IDO1, CXCL2, NOS2 und CD274 – waren bei CU signifikant hochreguliert. Eine Einzelzellanalyse charakterisierte ihre Expression in verschiedenen Zelltypen, wobei LCN2 und NOS2 vorwiegend in Epithelzellen angereichert waren. Die mechanistische Relevanz dieser Marker wurde anschließend durch In-vitro-Assays überprüft. Die Behandlung mit Ferroptose- oder Cuproptose-Inhibitoren milderte die CU-assoziierte Entzündung und modulierte die Expression der Biomarker in Caco-2-Zellmodellen. Diese Ergebnisse identifizieren fünf mit dem Fortschreiten der CU assoziierte Biomarker und liefern experimentelle Belege für ihre potenzielle Anwendung in der klinischen Diagnostik und therapeutischen Intervention.
Einleitung
Colitis ulcerosa (CU) ist eine rezidivierende entzündliche Darmerkrankung, die mit einer zunehmenden globalen Belastung und erheblichen langfristigen Behandlungskosten verbunden ist1,2. Obwohl Aminosalicylate, Kortikosteroide, Biologika und Therapien mit kleinen Molekülen die Behandlungsoptionen erweitert haben, bleibt eine dauerhafte Remission für viele Patienten schwer erreichbar3,4. Dieser ungedeckte klinische Bedarf unterstreicht die Bedeutung der Identifizierung reproduzierbarer molekularer Marker und handhabbarer Mechanismen, die eine frühere Diagnose und eine mechanismengesteuerte Therapie unterstützen könnten5.
Ferroptose ist eine eisenabhängige Form des regulierten Zelltods, die durch Lipidperoxidation, Glutathion-Depletion und beeinträchtigte GPX4-Aktivität ausgelöst wird6. Erhöhte Eisen- und Malondialdehydspiegel bei Colitis ulcerosa entsprechen einem ferroptotischen epithelialen Schaden, während die experimentelle Aktivierung der SLC7A11–GSH–GPX4-Achse oder eine direkte Hemmung der Ferroptose die intestinale Barriere schützen können7,8.
Cuproptose, erstmals 2022 beschrieben, wird ausgelöst, wenn Kupfer an lipoylierte mitochondriale Proteine bindet, was zur Proteinstapelung und proteotoxischen Belastung führt9. Da der Darm eine zentrale Rolle im Kupferstoffwechsel spielt, könnte eine Störung dieses Signalwegs die oxidative und entzündliche Schädigung des Epithels bei Colitis ulcerosa verstärken10.
Ferroptose und Cuproptose könnten sich über ein Ungleichgewicht der Metallionen, den mitochondrialen Stoffwechsel, den Glutathionabbau und oxidativen Stress vereinen11. Es ist jedoch unklar, ob diese Wechselwirkung eine reproduzierbare molekulare Signatur bei Colitis ulcerosa hervorruft und ob eine solche Signatur auf eine wegweisspezifische Hemmung anspricht.
Die Studienhypothese war, dass eine dysregulierte Ferroptose–Cuproptose-Kreuzkommunikation bei Colitis ulcerosa (CU) auf eine reproduzierbare Biomarker-Signatur zusammenspielt, die über Bulk- und Einzelzell-Transkriptomdatensätze hinweg priorisiert und in einem Modell für intestinale epitheliale Verletzung durch pathway-spezifische Inhibition abgeschwächt werden kann. Entsprechend wurden multikohortenbasierte Bioinformatik, maschinelles Lernen, Einzelzellanalysen und gezielte Caco-2-Experimente kombiniert, um Kandidaten-Biomarker zu identifizieren und funktionell zu bewerten (Abbildung 1).
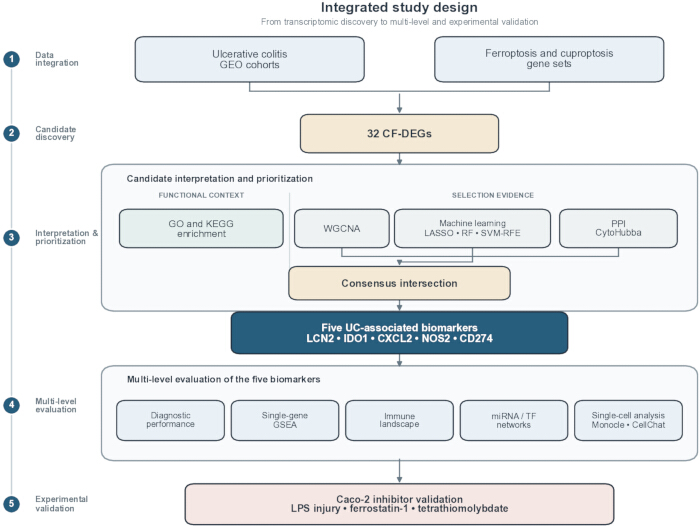
Abbildung 1: Studienarbeitsablauf. Integrierter Arbeitsablauf für die transkriptomische Multikohorten-Screeninganalyse, biomarkerbasierte Priorisierung mittels maschinellem Lernen und Netzwerkanalyse, Einzelzelllokalisation sowie inhibitorische Validierung in Caco-2-Zellen. UC: Colitis ulcerosa; GEO: Gene Expression Omnibus; WGCNA: gewichtete Gen-koexprimierungsnetzwerkanalyse; PPI: Protein-Protein-Interaktion; ROC: Empfänger-Operationscharakteristik; GSEA: Gen-Set-Verdünnungsanalyse. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie verwendete öffentlich zugängliche Datensätze und kommerziell erhältliche humane Zelllinien. Es waren keine menschlichen Probanden, neu gewonnene menschliche Gewebe oder Wirbeltiere beteiligt; daher war keine Genehmigung durch einen institutionellen Ethikausschuss erforderlich. In der Tabelle der Materialien sind die im Protokoll verwendeten Forschungswerkzeuge, Software und Online-Ressourcen aufgelistet.
1. Datenverarbeitung für die differentielle Expressionsanalyse
Um die transkriptomischen Entdeckungs- und Validierungskohorten aufzustellen, wurde die Gene Expression Omnibus (GEO)-Datenbank mit dem Begriff „ulcerative colitis“ durchsucht. Vier Datensätze – GSE87466, GSE92415, GSE107499 und GSE75214 – wurden als Trainingsset verwendet, während GSE47908 für die externe Validierung reserviert wurde. Die Trainingsdatensätze wurden mit ComBat in Sangerbox 3.0 normalisiert und auf Batch-Effekte korrigiert, während der Validierungsdatensatz unabhängig verarbeitet wurde.
Insgesamt wurden 583 eisenabhängige Zelltod-assozierte Gene (FRGs) aus FerrDB gewonnen und durch Gene ergänzt, die in der Literatur beschrieben wurden, um eine Einzelquellenverzerrung zu reduzieren12. Ein Satz von 96 kupferabhängige Zelltod-assozierten Genen (CRGs) wurde aus veröffentlichten Studien zusammengestellt12,13,14. Die differentielle Expression wurde mit limma unter Verwendung der Schwellenwerte |log₂-Fold-Change| > 1 und benjamini-hochberg-korrigiertem P < 0,05 analysiert. Diagnostische Plots zur Normalisierung, Batch-Korrektur, differentiellen Expression und Clusterung sind in Abbildung 1, Zusatzmaterial enthalten. Die Probenzusammensetzung, Plattformen und Kohortenzuordnungen sind in Tabelle 1, Zusatzmaterial aufgeführt.
2. Identifizierung von CF-DEGs bei UC
Die Pearson-Korrelationsanalyse wurde unter Verwendung von Schwellenwerten von |r| > 0,5 und P < 0,05 durchgeführt, um koexprimierte FRGs und CRGs zu identifizieren. Der resultierende Gen-Satz wurde mit den differentiell exprimierten Genen (DEGs) geschnitten, um kuproptotisch-ferroptotisch koexprimierte differentiell exprimierte Gene (CF-DEGs) zu ermitteln.
3. Anreicherungsanalyse
Genontologie (GO)- und Kyoto Encyclopedia of Genes and Genomes (KEGG)-Anreicherungsanalysen wurden mit clusterProfiler und der Bioinformatics.com.cn-Plattform durchgeführt. Ein nach Benjamini–Hochberg korrigierter P < 0,05 diente als Signifikanzschwelle. Anreicherungsdiagramme sind in Abbildung 2, Zusatzmaterial enthalten.
4. Gewichtete Gen-koexpressions-Netzwerkanalyse (WGCNA)
Die der Genexpressionsprofile zugrunde liegende modulare Struktur wurde mittels gewichteter Gen-Koexpressionsnetzwerkanalyse (WGCNA) analysiert. Anormale Proben wurden durch hierarchisches Clustering in Kombination mit der goodSamplesGenes-Funktion identifiziert und ausgeschlossen. Anschließend wurde eine geeignete Soft-Thresholding-Potenz (β) bestimmt, um das Kriterium der skalenfreien Topologie für die Netzwerkkonstruktion zu erfüllen.
Die aufbereiteten Expressionsdaten wurden verwendet, um eine topologische Überlappungsmatrix (TOM) für die Gen-Koexpressionsanalyse zu erstellen. Mithilfe des dynamischen Baumzerschneidungsansatzes wurden Gene mit stark übereinstimmenden Expressionsmustern in Genmodule gruppiert, wobei jedes Modul mindestens 100 Gene enthielt. Die Assoziationen zwischen Moduleigenengenen (MEs) und Phänotypen wurden analysiert, um Module zu identifizieren, die mit dem Krankheitsprozess assoziiert sind, und die entsprechenden Gensätze zu extrahieren. Die WGCNA-Screening-Diagnosen sind in Abbildung 3 (Zusatzmaterial) dargestellt.
5. Auswahl von Biomarkern
Um Kandidaten für die experimentelle Weiterverfolgung zu priorisieren, wurden drei maschinelle Lernalgorithmen parallel angewandt15. Für die Merkmalsauswahl wurde eine Least-Absolute-Shrinkage-and-Selection-Operator-(LASSO-)Regression verwendet, ein Random-Forest-Modell mit ntree = 500 diente zur Rangfolgebestimmung der Genwichtigkeit und ein Support-Vektor-Maschine–rekursiver Merkmalsausschluss (SVM-RFE) wurde genutzt, um die Merkmalsuntergruppe mit dem geringsten Kreuzvalidierungsfehler zu identifizieren. Die vollständigen Screening-Diagnosen sind in der ergänzenden Abbildung 5 dargestellt.
Die Genwichtigkeit wurde anhand des Beitrags einzelner Gene zur Klassifizierungsgenauigkeit bewertet, und hochrangige Gene wurden gesammelt, um einen vorläufigen Gen-Satz zu generieren¹⁶. Der SVM-RFE-Algorithmus führte eine Merkmalsauswahl und Modelloptimierung durch iterative Merkmalseliminierung durch, wodurch die optimale Teilmenge an Merkmalen für die Klassifizierung identifiziert werden konnte¹⁷. Gene, die von allen drei Algorithmen gemeinsam identifiziert wurden, galten als Kandidaten-Biomarker, die mittels maschinellem Lernen ermittelt wurden.
Die CF-DEGs wurden verwendet, um ein Protein-Protein-Interaktionsnetzwerk (PPI) zu konstruieren, und CytoHubba wurde zur Rangfolgebestimmung der zentralen Knotenpunkte genutzt. Der Durchschnitt der Schlüsselmodule der WGCNA, der drei maschinellen Lernausgaben und des PPI-Kernsets ergab fünf integrierte Kandidaten-Biomarker: LCN2, IDO1, CXCL2, NOS2 und CD274. Diese Gene wurden als UC-assoziierte diagnostische Kandidaten klassifiziert. Nachfolgende Inhibitorexperimente klassifizierten LCN2, IDO1, CXCL2 und NOS2 zusätzlich als Marker, die auf Hemmung der Ferroptose ansprechen, und CD274 als Marker, der auf Hemmung der Cuproptose anspricht. Diese Gene wurden nicht als nachgewiesene upstream-Regulatoren beider Signalwege betrachtet.
6. Entwicklung eines Vorhersagemodells und multimethodische Bewertung
Um das klinisch übertragbare Potenzial der identifizierten Gen-Signatur zu bewerten, wurde mithilfe des rms-Pakets ein Nomogramm zur Beurteilung der diagnostischen Leistung erstellt. Die Modellleistung wurde anhand einer Kalibrierungskurve, des Hosmer–Lemeshow-(HL-)Tests und des Harrellschen Konkordanzindexes (C-Index) evaluiert.
Die Modellkalibrierung wurde anhand des HL-Tests und des mittleren absoluten Fehlers (MAE) bewertet. Ein P-Wert > 0,05 und ein MAE < 0,1 wurden als Schwellenwerte für eine akzeptable Modellanpassung bzw. Genauigkeit festgelegt. Es wurden Receiver-Operating-Characteristic-(ROC)-Kurven erstellt, und die Fläche unter der Kurve (AUC) wurde berechnet, um die Vorhersageleistung des Nomogramms für UC zu bewerten. Ein unabhängiger Datensatz wurde verwendet, um die Generalisierbarkeit und Stabilität des Modells zu überprüfen.
7. Analyse der Gen-Set-Verstärkung (GSEA)
Im Trainingsset wurde eine Spearman-Korrelationsanalyse zwischen jedem Biomarker und allen anderen Genen durchgeführt. Die Korrelationsergebnisse wurden rangiert, um ein geordnetes Gen-Set zu generieren. Eine Gen-Set-Verdünnungsanalyse (GSEA) wurde unter Verwendung des c2.cp.kegg_medicus.v2025.1.Hs.symbols Gen-Sets aus der Molecular Signatures Database (MSigDB) als Referenz durchgeführt. Biologische Signalwege mit P < 0,05 galten als signifikant angereichert.
8. Analyse des Immunlandschaftsprofils
Das CIBERSORT-Tool und die LM22-Signaturmatrix wurden verwendet, um eine Dekonvolutionanalyse der Expressionsdaten durchzuführen und die Anteile von 22 Immunzellsubtypen zu schätzen. Anschließend wurde eine Spearman-Korrelationsanalyse durchgeführt, um die Assoziationen zwischen den fünf Biomarkern und den Immunzellsubtypen zu bewerten.
9. Analyse des regulatorischen Netzwerks
Informationen zur genbezogenen Regulation durch Transkriptionsfaktoren (TF) und Mikro-RNAs (miRNA) wurden über die integrierten Datenbanken ChEA3 und TarBase 9.0 über die Plattform NetworkAnalyst gewonnen. In das regulatorische Netzwerk wurden miRNAs einbezogen, die mit mindestens zwei Knoten assoziiert waren.
10. Einzelzell-RNA-Seq
Die Einzelzell-Datensätze GSE116222, bestehend aus drei gesunden und drei UC-Proben, und GSE214695, bestehend aus sechs gesunden und sechs UC-Proben, wurden integriert. Zellen wurden beibehalten, wenn sie 200–5.000 nachgewiesene Gene, >1.000 eindeutige molekulare Identifikatoren, < 30 % mitochondriale Transkripte, < 3 % Hämoglobin-Transkripte und < 50 % ribosomale Transkripte enthielten. Die NormalizeData-Funktion wurde zur Normalisierung verwendet, und Harmony wurde vor der Clusterung und Annotation für die Batch-Korrektur eingesetzt.
Nach der Filterung wurden die Daten mithilfe der NormalizeData-Funktion normalisiert. Harmony wurde verwendet, um Batch-Effekte zwischen den Proben zu minimieren. Die uniforme Mannigfaltigkeitsapproximation und Projektion (UMAP) sowie die t-verteilte stochastische Nachbarn-Einbettung (t-SNE) dienten der Dimensionsreduktion und Zellclustering, um lokale und globale Strukturen innerhalb der Zellpopulation zu charakterisieren. Insgesamt wurden 31.712 hochwertige Zellen für weitere Analysen beibehalten. Die Zelltypen wurden basierend auf kanonischen Zellmarkergenen annotiert.
Die Pseudotime-Analyse wurde mit Monocle 2 durchgeführt, um Veränderungen in den Zuständen epithelialer und myeloischer Zellen aus UC-Geweben zu untersuchen. Zelluläre Entwicklungstrajektorien und Gruppenunterschiede wurden evaluiert, und die Expressionsmuster von Biomarkern entlang der Pseudotime-Trajektorie wurden visualisiert.
CellChat wurde verwendet, um die Zell-Zell-Kommunikation zwischen epithelialen und myeloiden Zellsubpopulationen zu bewerten. Subpopulationsspezifische Expressionsmuster wurden integriert, um Interaktionswahrscheinlichkeiten und zentrale Signalwege zwischen epithelialen und myeloiden Zellen abzuleiten und ihre potenziellen zellulären Regulierungsnetzwerke zu charakterisieren.
11. Zellversuche
Humanen Caco-2-Kolonadenokarzinomzellen wurden in Dulbeccos modifiziertem Eagle-Medium, das 10 % fetalen Kälberserum, 100 U/mL Penicillin und 100 µg/mL Streptomycin enthielt, bei 37 °C in 5 % CO₂ kultiviert. Caco-2-Zellen wurden als reproduzierbares epitheliales Einschichtmodell für Darmbarrieren- und Entzündungs-Schädigungs-Assays ausgewählt; jedoch beschränkt ihr maligner Ursprung eine direkte Übertragung auf nichtmalignes kolonales Epithel. Informationen zur Passage waren in den archivierten experimentellen Aufzeichnungen nicht verfügbar.
Ein in vitro-Entzündungs-Schädigungsmodell wurde etabliert, indem Zellen 24 h lang 1 µg/mL Lipopolysaccharid (LPS) ausgesetzt wurden. Die Zellen wurden einer Dimethylsulfoxid-Fahrzeugkontrollgruppe, einer LPS-allein-Gruppe, einer LPS + 4 µM Ferrostatin-1-Gruppe oder einer LPS + 40 µM Tetrathiomolybdat-Gruppe zugeordnet, jeweils mit angepassten endgültigen Lösungsmittelkonzentrationen. Die LPS-allein-Gruppe diente als positive Schädigungs-/Modellkontrolle für die Inhibitor-Rettungsvergleiche.
- Zellviabilität
Die Zellviabilität wurde mithilfe eines Zellviabilitätsassays gemäß den Anweisungen des Herstellers bewertet. Nach einer Inkubation bei 37 °C für etwa 2 h wurde die Absorption bei 450 nm mit einem Mikroplatten-Reader gemessen. - Bestimmung der MDA- und Fe²⁺-Konzentrationen
Die intrazellulären Konzentrationen von Malondialdehyd (MDA) und Fe2⁺ wurden mit den entsprechenden Testkits gemäß den Anweisungen der Hersteller bestimmt. Die Gesamtproteinmenge wurde mittels eines Bicinchoninsäure-Assays quantifiziert, und jede Messgröße wurde auf den Proteingehalt der entsprechenden Probe normalisiert. - Fluoreszenzsonden-Assay für Kupferionen
Nach dem Entfernen des Kulturmediums wurde eine Cu2⁺-spezifische fluoreszierende Sonde in einer Endkonzentration von 1 µM hinzugefügt und 30 min bei 37 °C inkubiert. Bilder wurden unmittelbar ohne Waschschritte mit einem invertierten Fluoreszenzmikroskop bei Anregungs- und Emissionswellenlängen von jeweils 510 und 578 nm aufgenommen. Die Aufnahmeparameter blieben zwischen den Gruppen konstant, und die Maßstabsleiste im Bild wurde auf 50 µm kalibriert. - RT-qPCR
Gesamt-RNA wurde mit einem auf Phenol–Guanidinium basierenden RNA-Extraktionsreagenz isoliert. Komplementäre DNA wurde aus 1 µg RNA unter Verwendung eines Kits zur Synthese des ersten DNA-Strangs hergestellt, und SYBR-Green-basierte Reagenzien wurden für die Echtzeit-PCR verwendet. Jede Reaktion wurde technisch dreifach durchgeführt. Die Primersequenzen sind in Supplementary Table 2 angegeben, und die relative mRNA-Menge wurde nach der 2⁻ΔΔCt-Methode berechnet.
12. Statistische Analyse
Die Normalverteilung und die Varianzhomogenität wurden mithilfe des Shapiro-Wilk-Tests bzw. des medianzentrierten Levene-Tests überprüft. Daten, die beide Annahmen erfüllten, wurden mit einem ungepaarten zweiseitigen t-Test oder einer einfaktoriellen Varianzanalyse, gefolgt vom ehrlichen signifikanten Differenztest nach Tukey, analysiert. Wenn eine der Annahmen nicht erfüllt war, kamen der t-Test nach Welch oder die Varianzanalyse nach Welch, gefolgt von den Vergleichen nach Games-Howell, zum Einsatz.
Die Ergebnisse werden als Mittelwert ± Standardabweichung angegeben. Die tatsächlichen Anzahlen biologischer Wiederholungen, exakten zweiseitigen P-Werte und Annahmenprüfungen sind in ergänzender Tabelle 3 aufgeführt. Die archivierte Quelldatei zu Abbildung 13 enthält für die Bereiche A (n = 4), C (n = 4) und F (n = 2) weniger Kontrollwiederholungen, während alle anderen Kombinationen aus Bereich und Gruppe n = 6 aufweisen.
Die computergestützten Analysen wurden mit R sowie den limma-, WGCNA-, clusterProfiler-, glmnet-, randomForest-, e1071-, pROC-, rms-, Seurat-v4-, Harmony-, Monocle-2-, CellChat- und Cytoscape/CytoHubba-Workflows durchgeführt. Zu den verwendeten Online-Ressourcen gehörten FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn und Sangerbox 3.0.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Identifizierung und funktionelle Annotation von kuproptotisch-ferroptotisch koexprimierten Genen
Vier Trainingsdatensätze, bestehend aus 421 UC-Proben und 97 gesunden Kontrollen, wurden integriert. Insgesamt wurden 551 differentiell exprimierte Gene identifiziert, darunter 362 hochregulierte und 189 herunterregulierte Gene. Die Korrelationsanalyse ergab 444 Eisenoptose–Kupferoptose-korrelierte Gene, und der Durchschnitt mit den differentiell exprimierten Genen ergab 32 kupfero...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Diese Studie kombinierte Bulk-Transkriptomik, maschinelles Lernen, Einzelzellanalysen und gezielte Zellexperimente, um die Wechselwirkung zwischen Ferroptose und Cuproptose bei Colitis ulcerosa (UC) zu untersuchen. Fünf mit UC assoziierte diagnostische Kandidaten zeigten sich reproduzierbar in Entdeckungs- und Validierungskohorten, lokalisierten sich hauptsächlich in epithelialen und myeloiden Kompartimenten und wiesen in Caco-2-Zellen eine expressionsmäßige Antwort auf die Hemmung entsprechender Signalwege auf. Diese Er...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren haben keine Offenlegungen vorzunehmen.
Danksagungen
Diese Arbeit wurde durch das Projekt „Young Qihuang Scholar“ der Nationalen Verwaltung für Traditionelle Chinesische Medizin gefördert (Förderkennzeichen Nr. 2022256). Wir danken allen Mitgliedern der Forschungsteams der Liaoning-Universität für Traditionelle Chinesische Medizin und des Dritten Angegliederten Krankenhauses der Liaoning-Universität für Traditionelle Chinesische Medizin für die technische Unterstützung sowie für ihren Beitrag zur Datenaufbereitung und bioinformatischen Analyse.
OpenAI Codex (OpenAI) wurde während der Überarbeitung ausschließlich zur Unterstützung bei der englischsprachigen Bearbeitung, der Dokumentformatierung und der Überprüfung der Abbildungsqualität verwendet. Alle wissenschaftlichen Inhalte, Analysen, Zitate und die endgültige Darstellung wurden von den Autoren geprüft und verifiziert, die die volle Verantwortung für den Manuskriptinhalt übernehmen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| BCA-Protein-Assay-Kit | Beyotime Institute of Biotechnology | P0010 | Proteinquantifizierung zur Normalisierung. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Online-Plattform; Zugriff 2026 | GO/KEGG-Visualisierungs- und Analyseplattform. |
| Caco-2-Zelllinie | ATCC | HTB-37 | Menschliche kolorektale Adenokarzinom-Zelllinie, verwendet für das epitheliale Verletzungsmodell. |
| Cell Counting Kit-8 | GLPBio | GK10001 | Zellviabilitäts-Assay, gemessen bei 450 nm. |
| CIBERSORT mit LM22-Signatur | CIBERSORT-Entwickler | LM22 | Entflechtung von 22 Immunzellfraktionen. |
| ChEA3 | Ma'ayan Laboratory | Online-Plattform; Zugriff 2026 | Transkriptionsfaktor-Anreicherung und Vorhersage regulatorischer Netzwerke. |
| CO2 inkubator | Nicht dokumentiert | N/V | Befeuchteter Inkubator zur Kultur bei 37 °C und 5 % CO2. |
| Cu2+ fluoreszenzsonde | BIOFOUNT | CAS 98907-26-7 | Intrazelluläre Fluoreszenzdetektion von Cu2+ . |
| Cytoscape mit CytoHubba | Cytoscape-Konsortium | Version nicht dokumentiert | PPI-Visualisierung und Rangfolge der Kernknoten. |
| Dulbeccos modifiziertes Eagle-Medium | Gibco | 11965092 | Kulturmedium für Caco-2-Zellen. |
| Dimethylsulfoxid | Nicht dokumentiert | N/V | Fahrzeugkontrolle. |
| Fötales Rinderserum | Nicht dokumentiert | N/V | Mediumzusatz in 10 %iger Konzentration. |
| Fe2+ -Assay-Kit | Abcam | ab83366 | Bestimmung des intrazellulären Fe2+-Spiegels. |
| FerrDB | FerrDB-Entwickler | Online-Datenbank; Zugriff 2026 | Quelle für ferroptosebezogene Gene. |
| Ferrostatin-1 | Sigma-Aldrich | SML0583 | Ferroptose-Inhibitor; Endkonzentration 4 µM. |
| Harmony | Broad Institute/Gemeinschaft | Version nicht dokumentiert | Korrektur von Batch-Effekten in Einzelzell-Daten. |
| Invertiertes Fluoreszenzmikroskop | Olympus | IX71 | Fluoreszenzbildgebung von Cu2+ bei 510/578 nm Anregung/Emission. |
| Lipopolysaccharid | Nicht dokumentiert | N/V | Entzündlicher Verletzungsreiz bei 1 µg/mL für 24 h. |
| Malondialdehyd-Assay-Kit | Beyotime Institute of Biotechnology | S0131S | Bestimmung der Lipidperoxidation. |
| Mikroplattenreader | Nicht dokumentiert | N/V | Absorptionsmessung bei 450 nm. |
| Monocle | Bioconductor/Gemeinschaft | Version 2 | Pseudotime-Analyse auf Einzelzellebene. |
| Molecular Signatures Database | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | Referenz-Gen-Satz für GSEA. |
| NetworkAnalyst | NetworkAnalyst-Entwickler | Online-Plattform; Zugriff 2026 | Integration von Transkriptionsfaktor- und miRNA-Netzwerken. |
| Penicillin–Streptomycin | Nicht dokumentiert | N/V | 100 U/mL Penicillin und 100 µg/mL Streptomycin. |
| R | R Foundation for Statistical Computing | Version nicht dokumentiert | Bioinformatik-Analyseumgebung. |
| R-Paket-Sammlung | CRAN/Bioconductor | Paketversionen nicht dokumentiert | limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC und rms Workflows. |
| Echtzeit-PCR-System | Nicht dokumentiert | N/V | SYBR-Green-RT-qPCR-Gerät. |
| RevertAid First Strand cDNA Synthesis Kit | Thermo Fisher Scientific | K1622 | Synthese der ersten cDNA-Stranges aus 1 µg RNA. |
| Sangerbox | Sangerbox-Entwickler | 3.0 | Normalisierung und ComBat-Batch-Korrektur. |
| Seurat | Satija-Labor/Gemeinschaft | Version 4 | Qualitätskontrolle, Normalisierung, Clusterung und Visualisierung von Einzelzell-Daten. |
| Statistische Analyse-Software | Nicht dokumentiert | N/V | Statistische Analyse der ursprünglichen Zellversuche. |
| STRING | STRING-Konsortium | Online-Datenbank; Zugriff 2026 | Konstruktion von Protein–Protein-Interaktionsnetzwerken. |
| SYBR-Green-Echtzeit-PCR-Reagenzien | Takara | RR820A | Quantitative Echtzeit-PCR. |
| TarBase | DIANA Tools | 9.0 | Experimentell bestätigte miRNA–Gen-Interaktionen. |
| Tetrathiomolybdat | Sigma-Aldrich | 323446 | Kupferchelator; Endkonzentration 40 µM. |
| TRIzol-Reagenz | Takara | 9108 | Extraktion der Gesamt-RNA. |
Referenzen
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.