Die Netzwerkpharmakologie und molekulare Docking-Analyse zeigten, dass Rhizoma Drynariae über entzündungshemmende, antiapoptotische und proangiogene Wirkungen auf mehrere Zielstrukturen und Signalwege einwirkt, um eine Rotatorenmanschettenverletzung zu lindern.
Forschungsartikel
Netzwerkpharmakologie und molekulares Docking zeigen den Wirkmechanismus von Rhizoma Drynariae gegen Rotatorenmanschettenverletzungen auf
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Rotatorenmanschettenverletzung (RMV) ist eine therapieresistente muskuloskelettale Erkrankung, die durch chronische Entzündung, Tenozytenapoptose, beeinträchtigte Angiogenese und Dysregulation der extrazellulären Matrix (ECM) gekennzeichnet ist und für die bisher nur begrenzte klinische Behandlungsmöglichkeiten existieren. In dieser Studie wurden mittels Netzwerkpharmakologie und molekularem Docking die wirksamen Inhaltsstoffe, zentralen Zielstrukturen und Signalwege von Rhizoma Drynariae (RD) gegen RMV systematisch untersucht. Achtzehn pharmakologisch aktive Inhaltsstoffe von RD und 213 nicht redundante Zielgene wurden aus TCMSP, ETCM und SymMap identifiziert, während 870 RMV-assoziierte Zielgene aus GeneCards und OMIM extrahiert wurden, woraus sich 71 überlappende Kandidatenziele ergaben. Die Analyse des Protein-Protein-Interaktionsnetzwerks und die Screening-Methode cytoHubba identifizierten zehn zentrale Gene, darunter TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 und HMOX1. Die Gen-Ontologie-Enrichment-Analyse betonte Entzündungsreaktion, oxidativen Stress, Angiogenese, Zellproliferation und Organisation der ECM, während die KEGG-Pfad-Analyse die TNF-, PI3K-Akt-, MAPK- und HIF-1-Signalwege einbezog. Das molekulare Docking bestätigte eine stabile, hochaffine Bindung von Eriodictyol, Luteolin, Catechin, Naringenin und Aureusidin an diese Kernproteine. Insgesamt entfaltet RD anti-RMV-Wirkungen über ein Netzwerk aus mehreren Wirkstoffen, Zielstrukturen und Signalwegen, wodurch RMV möglicherweise durch Hemmung von Entzündung und Apoptose, Förderung der Angiogenese und Verbesserung der ECM-Reparatur gelindert wird, und bietet damit eine theoretische Grundlage für die klinische Anwendung und experimentelle Validierung.
Einleitung
Die Rotatorenmanschettenverletzung (RMV) ist eine der häufigsten Schultererkrankungen in der Orthopädie und Sportmedizin und betrifft etwa 20 % der Erwachsenen über 20 Jahre sowie bis zu 54 % der über 60-Jährigen1,2. Pathologisch zeichnet sich die RMV durch Sehnendegeneration, Infiltration entzündlicher Zellen, übermäßige Tenocytenapoptose, unzureichende Neovaskularisierung und gestörte Synthese der extrazellulären Matrix aus, was zu chronischen Schulterschmerzen, eingeschränkter Beweglichkeit, Muskelatrophie und sogar Gelenkinstabilität führt3. Wenn unbehandelt, kann die RMV die Lebensqualität erheblich beeinträchtigen und eine hohe sozioökonomische Belastung verursachen4. Zu den derzeitigen therapeutischen Strategien bei RMV gehören konservative Behandlung und chirurgische Reparatur5. Nichtsteroidale Antiphlogistika (NSAR) und Kortikosteroidinjektionen lindern Schmerzen, bergen jedoch das Risiko von gastrointestinalen Verletzungen, Nierenfunktionsstörungen, Knorpeldegeneration und Osteoporose6,7. Die chirurgische Reparatur verbessert die kurzfristige Funktion, ist jedoch durch hohe Re-Riss-Raten, postoperative Adhäsionen und schlechte Langzeitheilungsqualität begrenzt8,9. Daher besteht dringender Bedarf an sicheren, wirksamen und mehrfach angreifenden therapeutischen Wirkstoffen zur Behandlung der RMV.
Die traditionelle chinesische Medizin (TCM) hat eine lange Geschichte bei der Behandlung von Erkrankungen des Bewegungsapparats mit den Vorteilen multipler Komponenten, multipler Zielstrukturen und geringer Toxizität10. Rhizoma Drynariae (RD), das getrocknete Rhizom von Drynaria fortunei (Kunze) J. Sm., ist ein repräsentatives, die Knochen stärkendes Kraut, das die Durchblutung fördert, Blutstauungen beseitigt und die Regeneration von Sehnen und Knochen beschleunigt11,12. Die moderne Pharmakologie hat bestätigt, dass Flavonoide die wichtigsten Wirkstoffe von RD sind und entzündungshemmende, antioxidative, osteogene sowie chondroprotektive Effekte entfalten13. RD wird häufig bei Osteoporose, Arthrose, Knochenkopfnekrose und Bandscheibendegeneration eingesetzt14,15,16. Bisher wurde jedoch keine systematische Studie durchgeführt, um die Wirksamkeit und Wirkmechanismen von RD bei RCI zu untersuchen. Die Netzwerkpharmakologie ist ein neuartiger interdisziplinärer Ansatz, der Bioinformatik, Systembiologie und Pharmakologie integriert und sich besonders gut eignet, um die ganzheitlichen Wirkmechanismen der TCM aufzuklären17,18. Sie ermöglicht den systematischen Aufbau eines regulatorischen Netzwerks aus „Arzneimittel–Komponente–Target–Signalweg–Erkrankung“ sowie die Hochdurchsatzvorhersage potenzieller therapeutischer Zielstrukturen19. In dieser Studie wurde die Netzwerkpharmakologie in Kombination mit molekularem Docking eingesetzt, um die wirksamen Inhaltsstoffe, zentrale Gene und zentrale Signalwege von RD bei der Behandlung von RCI zu untersuchen, um damit eine theoretische Grundlage für die klinische Anwendung und nachfolgende experimentelle Forschung zu schaffen.
Protokoll
Diese Studie verwendete ausschließlich anonymisierte öffentliche Bioinformatik-Datenbanken und beinhaltete keine Experimente an Menschen oder Tieren. Gemäß Artikel 32 der chinesischen nationalen Vorschriften zur ethischen Prüfung und der Erklärung von Helsinki wurden eine ethische Genehmigung und eine informierte Einwilligung nicht erforderlich. Alle in dieser Studie verwendeten Materialien sind in der Tabelle der Materialien aufgeführt.
Studienentwurf und Ablaufdiagramm
Der gesamte Arbeitsablauf dieser Netzwerkpharmakologie-Studie, einschließlich der Inhaltsstoff-Screening, Zielidentifikation, Netzwerkkonstruktion, Anreicherungsanalyse und molekularen Docking-Verifizierung, wurde in jedem Schritt gemäß einheitlicher bioinformatischer Standards durchgeführt, um die Reproduzierbarkeit aller vorhergesagten Daten zu gewährleisten (Abbildung 1).
Screening auf Wirkstoffe in RD
Die Datenbank und Analyseplattform für die Systempharmakologie der traditionellen chinesischen Medizin (TCMSP, https://old.tcmsp-e.com/tcmsp.php) war eine Online-Plattform, die auf der systemischen Pharmakologie von Heilpflanzen basiert20. Sie sammelte umfassend pharmakokinetische Parameter natürlicher Verbindungen, einschließlich oraler Bioverfügbarkeit (OB), Arzneimittelähnlichkeit (DL), Blut-Hirn-Schranke sowie zugehöriger Zielinformatik. Die Autoren gaben das Stichwort „Rhizoma Drynariae“ ein, um alle in der TCMSP-Datenbank gespeicherten chemischen Inhaltsstoffe von RD zu suchen, und筛ten geeignete wirksame Inhaltsstoffe anhand von Absorptions-, Verteilungs-, Metabolisierungs- und Exkretionsindizes (ADME) mit OB ≥ 30 % und DL ≥ 0,18 aus. Verbindungen, die beide oben genannten Kriterien erfüllten, wurden als potenzielle wirksame Inhaltsstoffe zur Erforschung des therapeutischen Wirkmechanismus von RD gegen RCI beibehalten. Zugriffsdatum der Datenbank: TCMSP V2.3 [2025-12-08]. Exportierte Felder umfassten Verbindungsname, OB-Wert, DL-Wert und zugehörige Zielprotein-Einträge. Doppelte Einträge von Verbindungen wurden manuell entfernt.
Sammlung potenzieller Zielstrukturen von RD
Die Forscher erhielten Wirkziele von RD aus drei unabhängigen Datenbanken: TCMSP, The Encyclopedia of Traditional Chinese Medicine (ETCM, http://www.tcmip.cn/ETCM/)21 und SymMap (http://www.symmap.org/)22. TCMSP diente als spezielle Plattform für pflanzliche Systempharmakologie, die die Wechselbeziehungen zwischen pflanzlichen Arzneimitteln, kleinen Molekülverbindungen, Proteinzielen und menschlichen Krankheiten erfasst. ETCM integrierte standardisierte Informationen zu gängigen chinesischen Heilpflanzen und Rezepturen und enthielt Daten zu pflanzlichen Inhaltsstoffen, Zielgenen, Signalwegen und Krankheiten. SymMap verknüpfte TCM-Theorien und moderne Medizin über molekulare Mechanismen und Symptommapping. Bei der Extraktion von Arzneimittelzielen wurde die Spezies einheitlich auf Homo sapiens festgelegt. Nachdem die ursprünglichen Zielproteinsequenzen erhalten wurden, wandelte die UniProt-Datenbank (https://www.uniprot.org/)23 alle Zieleinträge in einheitliche, standardisierte Gensymbole um. Doppelte Zielgene wurden entfernt, und der bereinigte Zielgen-Satz von RD wurde für die Kreuzanalyse mit Krankheitszielen beibehalten. Zugriffsdaten der Datenbanken: ETCM V2.0 [2025-12-10], SymMap V2.0 [2025-12-11], UniProt-Version [2025-12-12]. Die Autoren exportierten die ursprünglichen Ziel-Protein-Einträge aus TCMSP, ETCM und SymMap. UniProt wurde verwendet, um Proteinidentifikatoren offiziellen menschlichen HUGO-Gen-Symbolen zuzuordnen. Doppelte Ziele aus mehreren Datenbanken wurden entfernt, wobei pro Ziel jeweils ein eindeutiges Gensymbol beibehalten wurde.
Suche nach potenziellen Zielstrukturen für RCI
Zwei maßgebliche Datenbanken wurden verwendet, um menschliche Gene im Zusammenhang mit RCI unter Verwendung des Suchbegriffs „rotator cuff injury“ zu identifizieren. GeneCards (https://www.genecards.org/) bündelt Multi-Omics-Daten aus über 150 genetischen Plattformen und bietet Annotationen zur Genfunktion24. Die Online-Mendelsche Vererbung beim Menschen (OMIM, https://omim.org/) dokumentiert erbliche Erkrankungen des Menschen und zeigt Zusammenhänge zwischen Genvariationen und klinischen Phänotypen auf25. Alle Gen-Einträge, die mit RCI assoziiert waren, einschließlich Genbezeichnungen und IDs, wurden extrahiert. Die Daten beider Datenbanken wurden zusammengeführt und doppelte Einträge entfernt, um einen vollständigen Pool an pathogenen Genen für die Venn-Schnittmengenanalyse zu erhalten. Zugriffsdaten der Datenbanken: GeneCards [2025-12-15], OMIM [2025-12-21]. Suchbegriff: „rotator cuff injury“. Exportierte Felder enthielten krankheitsrelevante menschliche Genbezeichnungen und Gen-IDs. Doppelte Gen-Einträge zwischen den beiden Datenbanken wurden nach der Zusammenführung entfernt. Der Speziesfilter wurde auf Homo sapiens festgelegt.
Aufbau eines Protein-Protein-Interaktionsnetzwerks (PPI)
Der untersuchte RD-Ziel-Gen-Datensatz und der RCI-pathogene Gen-Datensatz wurden auf die Venny-Online-Plattform (https://bioinfogp.cnb.csic.es/tools/venny/) hochgeladen, um ein Venn-Diagramm zu erstellen und überlappende gemeinsame Gene zu identifizieren. Die gemeinsamen Gene wurden in STRING v11.5 (https://cn.string-db.org/) importiert, um ein PPI-Netzwerk aufzubauen26. STRING lieferte verifizierte und vorhergesagte Protein-Interaktionen und umfasst über 24 Millionen Proteine aus mehr als 5000 Arten. Die Spezies wurde auf Homo sapiens festgelegt, und die Konfidenzschwelle betrug 0,7, um Interaktionspaare mit geringer Glaubwürdigkeit auszuschließen. Die exportierten PPI-Dateien wurden in Cytoscape 3.8.0 zur Visualisierung und topologischen Analyse importiert27. Auf Venny 2.0 wurde am [2025-12-24] zugegriffen, um die Berechnung des Venn-Diagramms durchzuführen. Zugriffsdatum für STRING v11.5: [2025-12-28]. Die Autoren exportierten die vollständige Protein-Protein-Interaktionstabelle im TSV-Format, die Protein-Identifikatoren, Gen-Symbole und kombinierte Konfidenz-Scores für die Interaktionen enthielt.
Analyse von Hub-Genen
Das in Cytoscape 3.8.0 eingebettete Plugin cytoHubba analysierte die topologischen Merkmale jedes Netzwerkknotens. Die 10 wichtigsten Hub-Gene mit den höchsten Maximal Clique Centrality (MCC)-Werten wurden ausgewählt. MCC ist ein integrierter Rangalgorithmus innerhalb von cytoHubba; höhere MCC-Werte deuten auf zentralere topologische Positionen innerhalb des PPI-Netzwerks hin. Diese Gene entfalten zentrale regulatorische Effekte im gesamten Netzwerk.
Analyse der Anreicherung von Gene Ontology (GO) und Kyoto Encyclopedia of Genes and Genomes (KEGG)-Signalwegen
Alle überlappenden therapeutischen Zielstrukturen von RD gegen RCI wurden in die Software R x64 4.0.3 importiert, wobei die Spezies auf Homo sapiens festgelegt wurde. Mit dem Bioconductor-Paket clusterProfiler wurden GO- und KEGG-Anreicherungsanalysen durchgeführt. Die GO-Analyse umfasste drei Module: biologischer Prozess (BP), zelluläre Komponente (CC) und molekulare Funktion (MF), die jeweils biologische Verhaltensweisen, subzelluläre Lokalisationen und biochemische Funktionen der Zielproteine annotierten28. Die KEGG-Analyse ordnete Gene intrazellulären Signalwegen zu, um die Verteilung der Zielstrukturen in verschiedenen biologischen Pfaden zu beobachten29. Signifikant angereicherte BP-, CC- und MF-Terme sowie zentrale Signalwege im Zusammenhang mit der RD-Intervention bei RCI wurden extrahiert, und alle Anreicherungsergebnisse zur Darstellung exportiert, wobei ein p < 0,05 als Signifikanzschwelle galt.
Molekulare Docking-Simulation
Hub-Gene, die aus der PPI-Analyse herausgefiltert wurden, wurden als Proteinrezeptoren definiert, und die Wirkstoffe von RD wurden als niedermolekulare Liganden festgelegt. Eine molekulare Docking-Simulation wurde durchgeführt, um natürliche Bindungswechselwirkungen zwischen Hub-Proteinen und den entsprechenden Inhaltsstoffen zu untersuchen. Dreidimensionale Ligandstrukturen wurden von PubChem heruntergeladen (https://pubchem.ncbi.nlm.nih.gov/)30, und die Kristallstrukturen der Rezeptoren wurden aus der RCSB PDB bezogen (https://www.rcsb.org/)31. Die Rezeptorstrukturen wurden in AutoDock 432 vorbehandelt, einschließlich der Entfernung überflüssigen Wassers und der Hinzufügung polarer Wasserstoffatome. Die Batch-Docking-Berechnung wurde mittels AutoDock Vina in Kombination mit der Open-Babel-Software durchgeführt. Komplexe mit einer Bindungsenergie von ≤ −7,0 kcal/mol wurden als stabile Bindungsstrukturen definiert, die die am höchsten bewerteten Docking-Komplexe darstellen. Komplexe mit einer Bindungsenergie von ≤ −7,0 kcal/mol galten als stabile Bindungsstrukturen mit hoher intermolekularer Affinität. Diese empirische Schwelle wird häufig in computergestützten, auf AutoDock Vina basierenden Untersuchungen pflanzlicher bioaktiver Verbindungen verwendet, ersetzt jedoch nicht die experimentelle Validierung von Protein-Ligand-Wechselwirkungen33. Die 20 Docking-Komplexe mit der besten Affinität wurden in PyMOL importiert, um dreidimensionale Bindungskonformationsdiagramme zu erstellen34. Abrufdatum PubChem: [2026-02-10]; Abrufdatum RCSB-PDB: [2026-02-03]. Niedermolekulare Strukturen wurden anhand des Verbindungsnamens abgerufen; Proteinrezeptorstrukturen wurden anhand der genkorrespondierenden PDB-Zugangsnummern abgerufen.
Statistische Analyse
R x64 4.0.3, Cytoscape 3.8.0 und PyMOL wurden zur Durchführung aller bioinformatischen Statistiken und Abbildungen verwendet. p < 0,05 repräsentierte einen statistisch signifikanten Unterschied für alle Anreicherungsgegenstände.
Ergebnisse
Die Wirkstoffe von RD
Insgesamt wurden 71 rohe chemische Inhaltsstoffe aus TCMSP mit „Rhizoma Drynariae“ als Stichwort abgerufen. Eine sekundäre Selektion erfolgte gemäß ADME-Kriterien (OB ≥ 30 %, DL ≥ 0,18), wobei schließlich 18 bioaktive Inhaltsstoffe mit günstiger oraler Bioverfügbarkeit und Arzneimitteltauglichkeit erhalten wurden. Tabelle 1 fasst detaillierte Grundinformationen zu diesen 18 Wirkstoffen zusammen. Diese 18 Verbindungen bilden die mehrkomponentige stoffliche Grundlage von RD gegen RCI.
Relevante Genziele von RD
In den Datenbanken TCMSP, ETCM und SymMap wurden nach Zielgenen gesucht, die zu den wirksamen Inhaltsstoffen von RD passen, und insgesamt 327 ursprüngliche Zielgeneinträge gesammelt. Nach Integration der Daten und Entfernung wiederholter Gensymbole wurden 213 nicht redundante potenzielle Zielgene von RD für die anschließende Schnittmengenanalyse gewonnen.
Relevante Genziele für RCI
In den Datenbanken Genecards und OMIM wurde mit dem Stichwort „rotator cuff injury“ gesucht, und es wurden 989 rohe, mit RCI assoziierte Gen-Einträge erhalten. Nach Datenintegration und Entfernung von Duplikaten wurden 870 eindeutige humane pathogene Gene identifiziert, die eng mit dem Fortschreiten einer RCI assoziiert sind.
Aufbau des PPI-Netzwerks
Die Schnittmengenanalyse zwischen 213 RD-Zielgenen und 870 RCI-pathogenen Genen ergab 71 überlappende Gene, die als potenzielle therapeutische Zielstrukturen von RD für die Behandlung von RCI definiert wurden. Ein Venn-Diagramm zur Darstellung der Schnittmengenbeziehung wurde mit der Software Venny 2.0 erstellt (Abbildung 2). Die 71 überlappenden Zielgene wurden in STRING importiert, um das PPI-Netzwerk von RD, das in RCI eingreift, aufzubauen (Abbildung 3). Die vollständigen PPI-Daten wurden in Cytoscape importiert, und cytoHubba identifizierte die 10 wichtigsten Hub-Gene mit den höchsten MCC-Scores: TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3, HMOX1. Ihre topologischen Informationen bezüglich des MCC-Werts sind in Tabelle 2 zusammengefasst und in Abbildung 4 visualisiert. Die 71 überschneidenden Gene repräsentieren die zentralen Zielstrukturen, die die therapeutische Wirkung von RD gegen RCI vermitteln.
GO- und KEGG-Anreicherungsanalyse
Um den molekularen Wirkmechanismus der RD-Kandidatenziele bei der Behandlung von RCI zu untersuchen, wurde mit dem clusterProfiler-Paket eine GO- und KEGG-Enrichment-Analyse an den überlappenden therapeutischen Zielstrukturen durchgeführt. Separate GO-Enrichment-Statistiken wurden für BP, CC und MF durchgeführt. Abbildungen 5A–B, 6A–B und 7A–B zeigen die 10 signifikant angereicherten Einträge für BP, CC und MF; in jedem Teilbild B ist die Genverteilung für jeden funktionellen Begriff dargestellt. Eine weitere KEGG-Enrichment-Analyse wurde durchgeführt, um die zentralen Signalwege aufzudecken, die an der RD-bedingten Intervention bei RCI beteiligt sind; die 30 am stärksten angereicherten Signalwege sind in Abbildung 8 visualisiert.
Molekulare Docking-Simulation
Die 10 wichtigsten Hub-Gene wurden als Proteinrezeptoren festgelegt, und alle 18 RD-Wirkstoffe wurden als Liganden für die Docking-Berechnung mittels AutoDock Vina und Open Babel verwendet. PyMOL visualisierte die Bindungskonformationen von Ligand und Rezeptor. Die Docking-Ergebnisse zeigten, dass die meisten Hub-Zielproteine stabile Bindungsstrukturen mit den RD-Wirkstoffen bildeten. Tabelle 3 und Abbildung 9 enthalten die vollständigen Docking-Parameter sowie dreidimensionale Bindungsdiagramme der 20 Komplexe mit der besten Bindungsaffinität.
In der vorliegenden Netzwerkpharmakologie-Analyse wurden 18 bioaktive Inhaltsstoffe von RD und 213 nicht redundante arzneimittelbezogene Zielstrukturen ermittelt. Nach dem Abgleich mit 870 RCI-assoziierten Genen wurden 71 gemeinsame therapeutische Kandidatenziele identifiziert. Die Konstruktion des PPI-Netzwerks und die cytoHubba-MCC-Auswertung ergaben zehn zentrale Gene: TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 und HMOX1. Die GO-Enrichment-Analyse umfasste biologische Prozesse (BP), zelluläre Komponenten (CC) und molekulare Funktionen (MF), während die KEGG-Enrichment-Analyse mehrere angereicherte Signalwege identifizierte. Die molekulare Docking-Simulation bestätigte eine günstige Bindungsaffinität zwischen den wichtigsten aktiven Inhaltsstoffen von RD und diesen zentralen Zielproteinen.
VERFÜGBARKEIT VON DATEN:
Alle in dieser Studie generierten Roh- und verarbeiteten Daten, einschließlich Ziel-Listen, PPI-Netzwerkdateien, GO- und KEGG-Anreicherungsergebnisse sowie die molekulare Docking-Matrix, sind in der Science Data Bank hinterlegt. Der Zugangslink zu den Rohdaten lautet https://www.scidb.cn/anonymous/alVOVlJu.
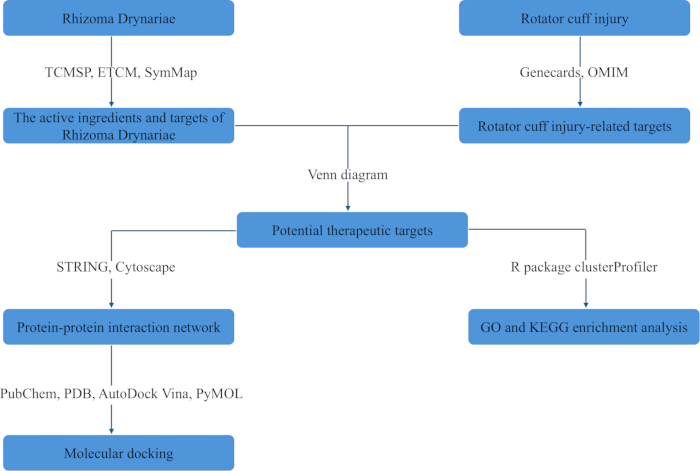
Abbildung 1: Schematischer Arbeitsablauf zur Darstellung der in dieser Studie angewendeten bioinformatischen Pipeline. Beginnend links wurden Kandidaten bioaktiver Verbindungen und ihre entsprechenden RD-Ziele aus den Datenbanken TCMSP, ETCM und SymMap abgerufen. Auf der rechten Seite wurden Gene, die mit RCI assoziiert sind, aus GeneCards und OMIM extrahiert. Die gemeinsamen Gengesichtspunkte dieser beiden Datensätze wurden mithilfe eines Venn-Diagramms identifiziert und als potenzielle therapeutische Zielstrukturen definiert. Die gemeinsamen Zielgene wurden anschließend in zwei getrennten Zweigen weiterverarbeitet: Ein Zweig erstellte ein Protein-Protein-Interaktionsnetzwerk unter Verwendung von STRING und Cytoscape; der andere Zweig führte GO- und KEGG-Enrichment-Analysen mit dem R-Paket clusterProfiler durch. Die aus dem PPI-Netzwerk extrahierten Hub-Gene wurden anschließend durch molekulares Docking validiert, wobei die strukturelle Vorbereitung und Simulation mit PubChem, PDB, AutoDock Vina und PyMOL durchgeführt wurde. Abkürzungen: RD = Rhizoma Drynariae, RCI = rotator cuff injury, TCMSP = The Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform, ETCM = The Encyclopedia of Traditional Chinese Medicine, OMIM = The Online Mendelian Inheritance in Man, GO = gene ontology, KEGG = Kyoto encyclopedia of genes and genomes. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
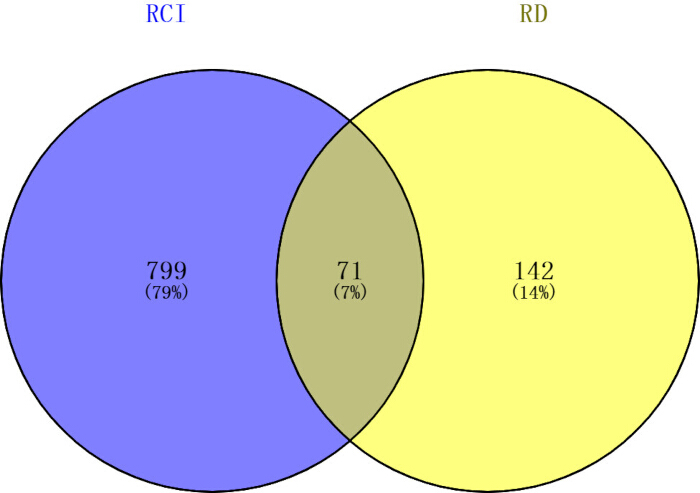
Abbildung 2: Mengendiagramm der überlappenden Zielstrukturen zwischen RD und RCI. Der blaue Kreis stellt die mit RCI assoziierten Zielstrukturen dar. Der gelbe Kreis stellt die potenziellen therapeutischen Zielstrukturen von RD dar. Der überlappende olivgrüne Bereich zeigt die gemeinsamen Zielstrukturen zwischen RD und RCI an. Die Zahlen und Prozentsätze in den einzelnen Bereichen geben die Anzahl und den Anteil eindeutiger oder gemeinsamer Zielstrukturen an. Abkürzungen: RD = Rhizoma Drynariae, RCI = Rotatorenmanschettenverletzung. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
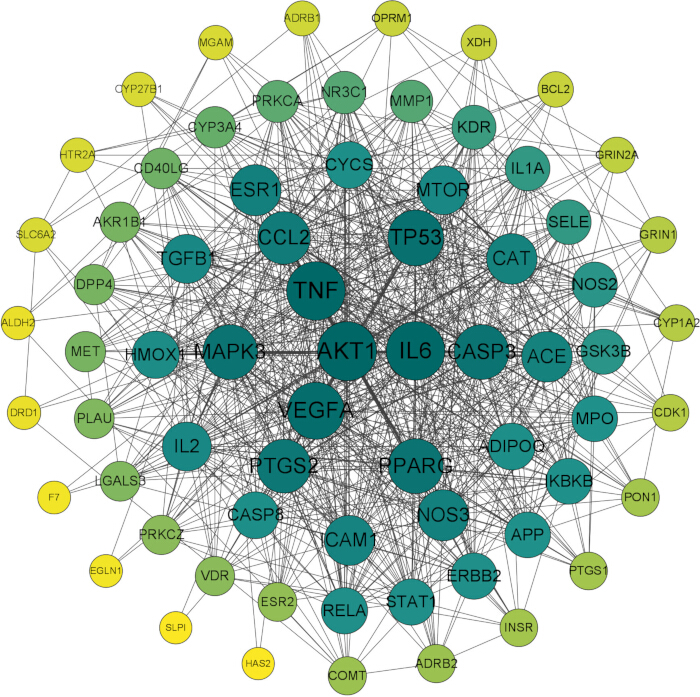
Abbildung 3:PPI-Netzwerk, erstellt aus den 71 überlappenden Genzielen, die RD und RCI verbinden. Jeder Kreis im Netzwerk repräsentiert ein Zielgen, beschriftet mit seinem offiziellen Gensymbol. Linien, die zwei Kreise verbinden, veranschaulichen Protein-Protein-Assoziationen, die aus öffentlichen bioinformatischen Datenbanken gewonnen wurden. Die Knotengröße und die Farbsättigung spiegeln die topologische Bedeutung einzelner Gene innerhalb des Netzwerks wider. Gene mit größeren Kreisen und intensiveren Grüntönen weisen höhere topologische Werte auf und nehmen zentralere Positionen ein; kleinere, blassgelbe Kreise kennzeichnen Gene mit geringerer topologischer Bedeutung. Abkürzungen: RD = Rhizoma Drynariae, RCI = Rotator-Manschette-Verletzung, PPI = Protein-Protein-Interaktion. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
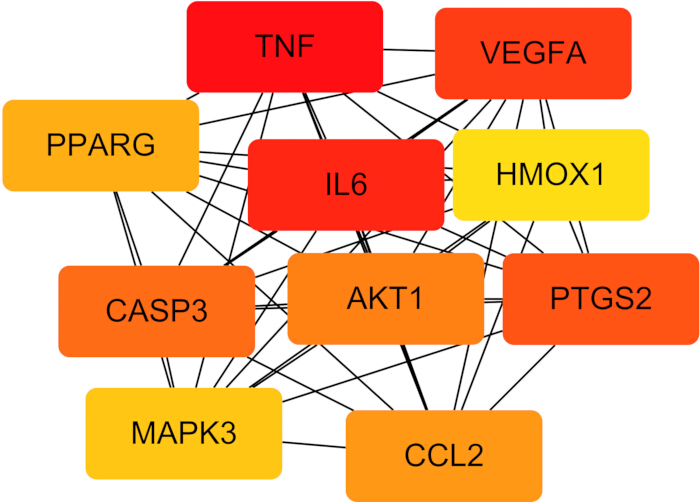
Abbildung 4: Die 10 wichtigsten Hub-Gene, identifiziert im PPI-Netzwerk mithilfe des cytoHubba-Plugins. Rechteckige Kästen stellen Hub-Gene dar, die jeweils mit ihrem offiziellen Gensymbol beschriftet sind. Schwarze Linien zwischen den Kästen zeigen Proteinwechselwirkungen zwischen diesen zentralen Zielstrukturen. Der Farbverlauf von hellrot über orange bis gelb veranschaulicht die Rangfolge der Hub-Gene entsprechend den von cytoHubba berechneten MCC-Scores; hellrote Kästen kennzeichnen Gene mit den höchsten MCC-Scores und somit der größten Netzwerkbedeutung, während gelbe Kästen Gene mit relativ niedrigeren Werten anzeigen. Abkürzungen: PPI = Protein-Protein-Interaktion, MCC = Maximal Clique Centrality.Bitte klicken Sie hier, um eine vergrößerte Ansicht dieser Abbildung einzusehen.
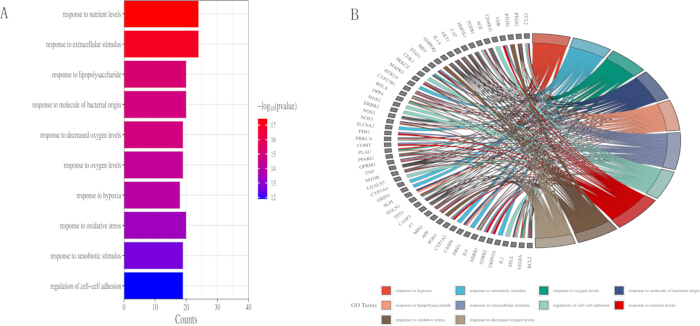
Abbildung 5: BP-Anreicherungsanalyse der 71 gemeinsamen Zielgene von RD im Vergleich zu RCI. (A) GO-Anreicherungsanalyse potenzieller therapeutischer Zielstrukturen für BP. Es handelt sich um ein horizontales Balkendiagramm, das die 10 signifikant angereicherten GO-Biologische-Prozesse-Terme zeigt. Die horizontale X-Achse stellt die Genanzahl dar, die der Anzahl der Zielgene entspricht, die jedem GO-Term zugeordnet sind. Die vertikale Y-Achse listet einzelne angereicherte GO-Terme auf. Die kontinuierliche Farbleiste rechts kodiert -log10(p-Wert); wärmere Rottöne zeigen einen höheren -log10(p-Wert) und eine stärkere statistische Signifikanz an, während kühlere Violett- und Blautöne eine geringere Signifikanz anzeigen. (B) Beziehung zwischen potenziellen therapeutischen Zielstrukturen und BP. Panel B zeigt ein Chord-Diagramm, das die paarweisen Assoziationen zwischen angereicherten GO-Termen und den entsprechenden Zielgenen veranschaulicht. Die äußeren kreisförmigen Segmente sind in zwei Kategorien unterteilt: farbige Blöcke stehen für unterschiedliche GO-Biologische-Prozesse-Terme, und graue rechteckige Markierungen kennzeichnen einzelne Zielgen-Symbole. Gebogene Bänder innerhalb des Kreises verbinden GO-Terme mit ihren zugehörigen Zielgenen, wobei jedes Band ein Gen mit dem GO-Term verknüpft, an dem es beteiligt ist. Die Farbe jedes Bandes entspricht dem Farbton des entsprechenden GO-Terms aus dem äußeren Ring. Eine Legende unten ordnet jeder Farbe den jeweiligen GO-Term zu. Abkürzungen: RD = Rhizoma Drynariae, RCI = Rotatorenmanschettenverletzung, BP = biologischer Prozess, GO = Genontologie. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
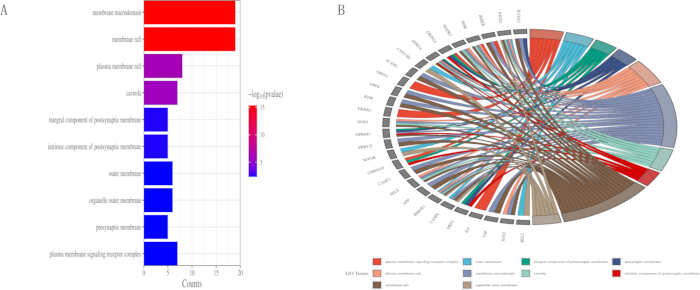
Abbildung 6: GO-CC-Terme, abgeleitet von den 71 Kandidatentargets von RD bei der Behandlung von RCI. (A) GO-Anreicherungsanalyse potenzieller therapeutischer Targetstrukturen für CC. (B) Beziehung zwischen potenziellen therapeutischen Targetstrukturen und CC. Panel A zeigt ein horizontales Balkendiagramm mit den 10 signifikant angereicherten GO-Zellkomponenteneinträgen. Die horizontale X-Achse quantifiziert die Anzahl der Zielgene, die jedem GO-Term zugeordnet sind, gekennzeichnet als „Counts“. Die Beschreibungen der angereicherten GO-Zellkomponenten sind entlang der vertikalen Y-Achse angeordnet. Die Farbleiste rechts ordnet die Farbvariation den -log10(pvalue)-Werten zu; helles Rot entspricht höheren -log10(pvalue)-Werten und stärkerer statistischer Signifikanz, während blaue Töne geringere Signifikanzniveaus darstellen. Panel B zeigt ein Chord-Diagramm, das Verbindungen zwischen angereicherten GO-Zellkomponententermen und ihren assoziierten Zielgenen veranschaulicht. Segmente am äußeren Ring sind in zwei Gruppen unterteilt: farbige Blöcke stehen für unterschiedliche GO-Zellkomponententerme, und graue Markierungen bezeichnen individuelle Gen-Symbole der Zielgene. Geschwungene Bänder innerhalb des Kreises verbinden jedes Gen mit seinem zugehörigen GO-Term, wobei jedes Band die Farbe seines entsprechenden GO-Terms aus dem äußeren Ring übernimmt. Eine Legende unten erklärt die Farbcodierung aller GO-Zellkomponentenkategorien. Abkürzungen: RD = Rhizoma Drynariae, RCI = Rotatorenmanschettenverletzung, CC = Zellkomponente, GO = Genontologie Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
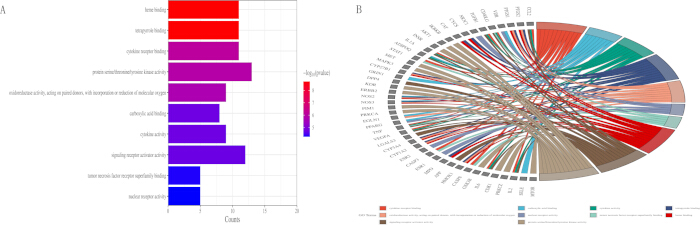
Abbildung 7: Analysen der Anreicherung molekularer Funktionen (MF) anhand der 71 überlappenden Zielgene von RD bei RCI-Behandlung. (A) GO-Anreicherungsanalyse potenzieller therapeutischer Zielstrukturen für molekulare Funktionen (MF). (B) Zusammenhang zwischen potenziellen therapeutischen Zielstrukturen und molekularen Funktionen (MF). Panel A zeigt ein horizontales Balkendiagramm, das die 10 signifikant angereicherten GO-Terme für molekulare Funktionen auflistet. Die Werte auf der horizontalen X-Achse repräsentieren die Genanzahl, die der Gesamtanzahl der Zielgene entspricht, die jeweils einem Eintrag für molekulare Funktionen zugeordnet sind. Auf der vertikalen Y-Achse sind die einzelnen Beschreibungen der GO-Terme für molekulare Funktionen aufgeführt. Die farbige Gradientenleiste rechts veranschaulicht die Farbunterschiede als -log10(p-Wert)-Maßstab; hellrot steht für höhere -log10(p-Wert)-Werte und stärkere statistische Signifikanz, während blaue Töne eine geringere Signifikanz anzeigen. Panel B zeigt ein Sehnendiagramm (Chord-Diagramm), das die Beziehungen zwischen angereicherten GO-Kategorien für molekulare Funktionen und den dazugehörigen Zielgenen darstellt. Die Segmente im äußeren Ring enthalten zwei Arten von Beschriftungen: farbige Blöcke kennzeichnen unterschiedliche GO-Terme für molekulare Funktionen, und kleine graue rechteckige Markierungen zeigen die einzelnen Symbole der Zielgene. Geschwungene Bänder, die vom äußeren Ring nach innen verlaufen, verbinden jedes Gen mit dem zugehörigen Funktionsbegriff; dabei übernimmt jedes Band die Farbe des entsprechenden GO-Terms. Eine Legende unten erklärt die Farbcodierung aller im Diagramm dargestellten GO-Kategorien für molekulare Funktionen. Abkürzungen: RD = Rhizoma Drynariae, RCI = Rotatorenmanschettenverletzung, MF = molekulare Funktion, GO = Genontologie Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
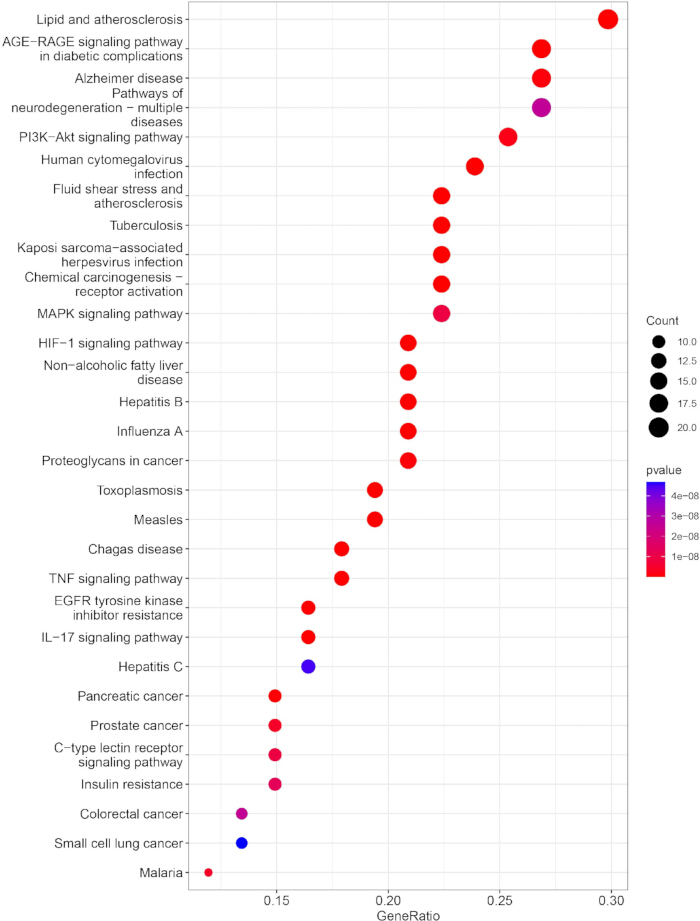
Abbildung 8: KEGG-Pfad-Anreicherungsanalyse der 71 gemeinsamen Zielgene von RD im Vergleich zu RCI. Dieses Punktdiagramm veranschaulicht die am stärksten angereicherten KEGG-Pfade. Die vertikale Y-Achse listet die Namen der einzelnen angereicherten Pfade auf. Die horizontale X-Achse stellt das Genverhältnis (GeneRatio) dar, definiert als das Verhältnis der Zielgene, die einem Pfad zugeordnet wurden, zur Gesamtanzahl der Gene in diesem Pfad. Jeder Kreispunkt steht für einen angereicherten Pfad. Die Punktgröße entspricht der Genanzahl, wobei größere Kreise auf mehr Zielgene, die dem Pfad zugeordnet sind, hinweisen. Die Punktfarbe spiegelt den p-Wert wider: Rot deutet auf niedrigere p-Werte und stärkere statistische Signifikanz hin, während tiefes Blau höhere p-Werte und schwächere statistische Signifikanz anzeigt. Zwei seitliche Legenden definieren jeweils die Skala für die Genanzahl und die Farbkodierung des p-Werts. Abkürzungen: RD = Rhizoma Drynariae, RCI = Rotatorenmanschettenverletzung, KEGG = Kyoto Encyclopedia of Genes and Genomes. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
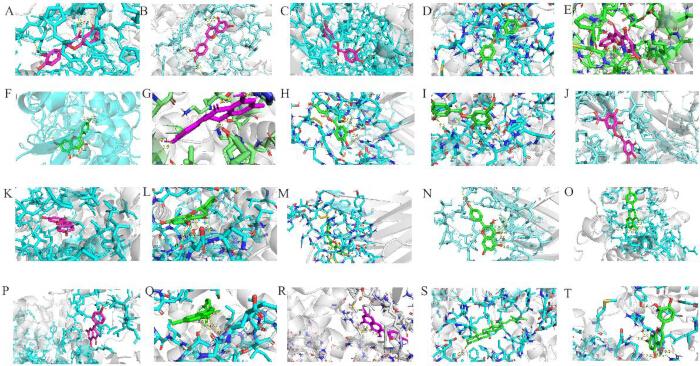
Abbildung 9: Die am höchsten bewerteten Docking-Komplexe. (A) (PTGS2, Eriodictyol, -9,7 kcal/mol). (B) (PTGS2, Luteolin, -9,6 kcal/mol). (C) (PTGS2, Catechin, -9,5 kcal/mol). (D) (PTGS2, Naringenin, -9,5 kcal/mol). (E) (PTGS2, Aureusidin, -9,4 kcal/mol). (F) (PTGS2, Kaempferol, -9,2 kcal/mol). (G) (PTGS2, Chroman, -9,1 kcal/mol). (H) (TNF, Catechin, -9,1 kcal/mol). (I) (PTGS2, Digallat, -9 kcal/mol). (J) (TNF, Digallat, -9 kcal/mol). (K) (PPARG, Chroman, -8,9 kcal/mol). (L) (PPARG, Naringenin, -8,9 kcal/mol). (M) (TNF, Aureusidin, -8,9 kcal/mol). (N) (TNF, Kaempferol, -8,8 kcal/mol). (O) (MAPK3, Chroman, -8,7 kcal/mol). (P) (MAPK3, Naringenin, -8,7 kcal/mol). (Q) (PPARG, Aureusidin, -8,7 kcal/mol). (R) (PPARG, Kaempferol, -8,7 kcal/mol). (S) (PTGS2, 22_Stigmasten_3_one, -8,7 kcal/mol). (T) (MAPK3, Luteolin, -8,6 kcal/mol). Die Panels A bis T zeigen jeweils die berechnete Bindungsgeometrie einzelner kleiner Moleküle innerhalb der Bindungstasche der entsprechenden Proteintargets. Cyanfarbene Stabmodelle stellen die Aminosäurereste dar, die die Proteinbindungstasche auskleiden. Kleine Molekül-Liganden sind als magenta- oder grüne Stäbchen dargestellt, um unterschiedliche chemische Strukturen zu unterscheiden. Gelbe gestrichelte Linien markieren intermolekulare Wasserstoffbrückenbindungen zwischen Liganden und Taschenresten, wobei numerische Anmerkungen die Abstände der Wasserstoffbrücken in Ångström (Å) angeben. Die durchscheinende weiße Oberfläche skizziert die gesamte dreidimensionale Topologie jedes Proteinrezeptors. Alle Berechnungen der Bindungspositionen wurden mittels starrem Rezeptor-Moleküldocking mit der AutoDock-Vina-Software durchgeführt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Mol-ID | Molekülname | orale Bioverfügbarkeit (OB) (%) | Arzneimittelähnlichkeit (DL) |
| MOL001040 | (2R)-5,7-Dihydroxy-2-(4-hydroxyphenyl)chroman-4-on | 42,36 | 0,21 |
| MOL001978 | Aureusidin | 53,42 | 0,24 |
| MOL002914 | Eriodyctiol (Flavanon) | 41,35 | 0,24 |
| MOL000449 | Stigmasterol | 43,83 | 0,76 |
| MOL000358 | Beta-Sitosterol | 36,91 | 0,75 |
| MOL000422 | Kaempferol | 41,88 | 0,24 |
| MOL004328 | Naringenin | 59,29 | 0,21 |
| MOL000492 | (+)-Catechin | 54,83 | 0,24 |
| MOL005190 | Eriodictyol | 71,79 | 0,24 |
| MOL000569 | Digallat | 61,85 | 0,26 |
| MOL000006 | Luteolin | 36,16 | 0,25 |
| MOL009061 | 22-Stigmasten-3-on | 39,25 | 0,76 |
| MOL009063 | Cyclolaudenolacetat | 41,66 | 0,79 |
| MOL009075 | Cycloartenon | 40,57 | 0,79 |
| MOL009076 | Cyclolaudenol | 39,05 | 0,79 |
| MOL009078 | Davalliosid A_qt | 62,65 | 0,51 |
| MOL009087 | Mariosid_qt | 70,79 | 0,19 |
| MOL009091 | Xanthogalenol | 41,08 | 0,32 |
Tabelle 1: Pharmakokinetische Profile von achtzehn Kandidaten bioaktiver Inhaltsstoffe aus RD. Verbindungen wurden aus der TCMSP-Datenbank abgerufen und anhand von zwei ADME-bezogenen Schwellenwerten gefiltert: OB ≥ 30 % und DL ≥ 0,18. Die Spalten enthalten die TCMSP-Zugangsnummer (Mol ID), den Namen der Verbindung, den berechneten OB-Wert (%) sowie den DL-Score jedes untersuchten Inhaltsstoffs. Abkürzungen: RD = Rhizoma Drynariae, RCI = Rotatorenmanschettenverletzung, ADME = Absorption, Verteilung, Metabolismus, Exkretion, TCMSP = The Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform, OB = orale Bioverfügbarkeit, DL = Arzneimittelähnlichkeit.
| Rang | Gen | Name | Punktzahl |
| 1 | TNF | Tumor-Nekrose-Faktor | 328291218366500 |
| 2 | IL6 | Interleukin 6 | 328291215913592 |
| 3 | VEGFA | Wachstumsfaktor A für vaskuläre endotheliale Zellen | 328291215896284 |
| 4 | PTGS2 | Prostaglandin-Endoperoxid-Synthase 2 | 328288656326402 |
| 5 | CASP3 | Caspase 3 | 328288180323600 |
| 6 | AKT1 | AKT-Serin/Threonin-Kinase 1 | 328287745700516 |
| 7 | CCL2 | C-C-Motiv-Chemokin-Ligand 2 | 328161521686320 |
| 8 | PPARG | Peroxisom-Proliferator-aktivierter Rezeptor Gamma | 325302724852296 |
| 9 | MAPK3 | mitogenaktivierte Proteinkinase 3 | 308779166166218 |
| 10 | HMOX1 | Häm-Oxygenase 1 | 299171945318400 |
Tabelle 2: Die 10 wichtigsten Hub-Gene, identifiziert aus dem PPI-Netzwerk. Die Gene wurden nach MCC-Scores geordnet, die mit dem cytoHubba-Plugin in Cytoscape berechnet wurden. MCC ist ein topologisches Maß von cytoHubba, bei dem höhere numerische Werte eine größere topologische Bedeutung innerhalb des Netzwerks widerspiegeln. Die Spalten zeigen die Rangfolge, das offizielle Gen-Symbol, den vollständigen Gen-Namen und den entsprechenden rohen MCC-Score für jedes Hub-Gen an. Abkürzungen: PPI = Protein-Protein-Interaktion, MCC = Maximal Clique Centrality.
| Rezeptoren | Liganden | Freie Energie (kcal/mol) | Entsprechende Seriennummern in Abbildung 9 |
| PTGS2 | eriodictyol | -9.7 | A |
| PTGS2 | luteolin | -9.6 | B |
| PTGS2 | catechin | -9.5 | C |
| PTGS2 | naringenin | -9.5 | D |
| PTGS2 | Aureusidin | -9.4 | E |
| PTGS2 | kaempferol | -9.2 | F |
| PTGS2 | chroman | -9.1 | G |
| TNF | catechin | -9.1 | H |
| PTGS2 | digallate | -9 | I |
| TNF | digallate | -9 | J |
| PPARG | chroman | -8.9 | K |
| PPARG | naringenin | -8.9 | L |
| TNF | Aureusidin | -8.9 | M |
| TNF | kaempferol | -8.8 | N |
| MAPK3 | chroman | -8.7 | O |
| MAPK3 | naringenin | -8.7 | P |
| PPARG | Aureusidin | -8.7 | Q |
| PPARG | kaempferol | -8.7 | R |
| PTGS2 | 22_Stigmasten_3_one | -8.7 | S |
| MAPK3 | luteolin | -8.6 | T |
Tabelle 3: Ergebnisse der molekularen Docking-Bindungsaffinität für die 20 ausgewählten Rezeptor-Ligand-Komplexe. Jede Zeile enthält das Rezeptorprotein, den kleinen molekularen Liganden, die berechnete Bindungsenergie (kcal/mol) sowie die entsprechende Unterdiagramm-Bezeichnung in Abbildung 9. Je negativer die Werte der freien Energie sind, desto stärker ist die Bindungsstabilität zwischen der Proteintasche und der Ligandverbindung. Abkürzungen: PTGS2 = Prostaglandin-Endoperoxid-Synthase 2, TNF = Tumornekrosefaktor, PPARG = Proliferator-aktivierter Rezeptor gamma, MAPK3 = mitogenaktivierter Proteinkinase 3.
Diskussion
RCI ist eine komplexe muskuloskelettale Erkrankung, die eine chronische Entzündung, übermäßige Tenocytenapoptose, gestörte Angiogenese und unzureichendes Remodeling der extrazellulären Matrix umfasst, deren kombinierte pathologische Veränderungen eine schlechte Heilung der Sehne am Knochen und eine suboptimale klinische Prognose zur Folge haben35. Diese Erkrankung entsteht häufig durch akute Traumata oder langfristige Überbeanspruchung der Schulter, und eine anhaltende Entzündung stört das metabolische Gleichgewicht der extrazellulären Matrix der Sehne36. Klinisch versagen aktuelle Behandlungen darin, mehrere pathologische Mechanismen gleichzeitig anzusprechen, was zu begrenzter Wirksamkeit und einer hohen Rezidivrate führt37. RD ist ein klassisches TCM-Kraut, das die Knochen stärkt, die Durchblutung aktiviert und die Gewebereparatur fördert und das seit Langem klinisch zur Behandlung von Knochen- und Sehnenschäden eingesetzt wird38. Der genaue molekulare Regulationsmechanismus von RD gegen RCI wurde in bisherigen Studien jedoch nicht systematisch analysiert.
Auf der Grundlage des oben genannten Forschungshintergrunds enthüllt diese Studie systematisch den Mechanismus von RD gegen RCI mit mehreren Komponenten, multiplen Zielstrukturen und mehrfachen Wirkwegen mittels Netzwerkpharmakologie und molekularem Docking. Frühere phytochemische und pharmakologische Untersuchungen haben umfassend bestätigt, dass aus RD stammende Flavonoide bedeutende entzündungshemmende, antioxidative, antiapoptotische und proangiogene biologische Aktivitäten aufweisen, die die zentrale materielle Grundlage für ihre Gewebereparaturfunktion darstellen39. Im Einklang mit den Ergebnissen früherer Studien wurden insgesamt 18 Wirkstoffe aus RD identifiziert, wobei Eriodictyol, Luteolin, Catechin, Naringenin und Aureusidin als zentrale Komponenten anerkannt wurden. Zahlreiche phytochemische Studien haben belegt, dass Flavonoide die wichtigsten pharmakodynamischen Substanzen von RD sind40. Solche niedermolekularen Verbindungen können Gewebebarrieren durchdringen und umfassende regulierende Effekte auf das Reparaturmikromilieu geschädigter Sehnen entfalten41. Ihre günstigen ADME-Eigenschaften gewährleisten eine gute orale Bioverfügbarkeit (OB) und drugähnliche Eigenschaften, was ihre Eignung als natürliche therapeutische Wirkstoffe für RCI unterstützt. Im Gegensatz zu Einzelziel-Richtungssynthese-Medikamenten können diese natürlichen Flavonoide gleichzeitig in Entzündungsprozesse, oxidative Schäden, Zellüberleben und Angiogenese eingreifen und weisen somit besondere Vorteile bei chronisch-degenerativen Sehnenläsionen auf42.
Eine zunehmende Zahl von Studien hat bestätigt, dass das Auftreten und die Entwicklung von RCI eng mit der abnormalen Expression mehrerer funktioneller Gene verbunden sind, und es wurde nachgewiesen, dass eine Vielzahl zentraler Gene an den pathologischen Prozessen der Sehnenentzündung, Apoptose und Gewebeumgestaltung beteiligt ist43. Auf der Grundlage des anerkannten genregulatorischen Mechanismus von RCI untersuchte diese Arbeit weiterhin therapeutische Zielstrukturen von RD. Es wurden 71 überlappende Zielstrukturen als potenzielle therapeutische Zielgene von RD gegen RCI identifiziert. Die PPI-Netzwerkanalyse identifizierte 10 zentrale Gene: TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 und HMOX1. Dabei handelt es sich bei TNF und IL6 um zentrale proinflammatorische Zytokine, die entzündliche Kaskaden auslösen, die Proliferation von Tenocyten hemmen und die Synthese der extrazellulären Matrix unterdrücken, wodurch die Sehnenverletzung verschlimmert wird44. Die massive Freisetzung dieser beiden Zytokine führt zur Rekrutierung von Immunzellen, verstärkt die Entzündungsreaktion und hemmt die Proliferation von Sehnenstammzellen45. VEGFA fördert die Neovaskularisierung an der Verletzungsstelle, verbessert die lokale Durchblutung und erhöht die mechanische Festigkeit des heilenden Gewebes46. Die Sehnen-Knochen-Grenzfläche ist von Natur aus arm an Blutgefäßen, und unzureichende Neubildung von Gefäßen ist ein wesentlicher Faktor für die unbefriedigende Heilungsqualität nach einer Verletzung47. PTGS2 vermittelt entzündliche Schmerzen und die Produktion von Prostaglandinen, während CASP3 ein zentraler Effektor der Apoptose von Tenocyten ist48,49. Eine Überexpression von PTGS2 verschlimmert entzündliche Schwellung und Schmerzen, während eine starke Aktivierung von CASP3 einen kontinuierlichen Verlust funktioneller Tenocyten induziert50,51. AKT1 und MAPK3 sind zentrale Kinasen, die Zellüberleben, Proliferation und Differenzierung regulieren und für die Sehnenregeneration unerlässlich sind52,53. Eine moderate Aktivierung dieser beiden Kinasen kann die Vitalität der Reparaturzellen aufrechterhalten und die Ablagerung der extrazellulären Matrix beschleunigen54. CCL2 rekrutiert entzündliche Zellen, während PPARG und HMOX1 entzündungshemmende und antioxidative Wirkungen entfalten55,56,57. Diese beiden Gene können oxidativen Stress lindern und eine übermäßige entzündliche Infiltration in lokalen Sehnengeweben reduzieren58. Insgesamt bilden diese zentralen Gene ein kernartiges regulatorisches Netzwerk, das Entzündung, Apoptose, Angiogenese und Gewebeumgestaltung bei RCI moduliert.
Bestehende pathologische Studien haben verdeutlicht, dass der pathologische Fortschritt der RCI hauptsächlich durch Entzündungsreaktionen, oxidativen Stress, abnormale Zellproliferation und gestörte Organisation der extrazellulären Matrix angetrieben wird, welche die zentralen pathologischen Verbindungen während des Auftretens und der Reparatur von RCI darstellen59. Auf dieser Grundlage wurde in der vorliegenden Studie eine GO-Enrichment-Analyse durchgeführt, um den potenziellen biologischen Wirkmechanismus von RD bei der Intervention in RCI zu untersuchen. Diese biologischen Prozesse entsprechen genau den zentralen pathologischen Verbindungen der RCI während Läsionsentstehung und Reparatur, was darauf hindeutet, dass RD gleichzeitig mehrere pathologische Prozesse gezielt beeinflussen kann60. Zahlreiche frühere mechanistische Studien haben bestätigt, dass der TNF-Signalweg, der PI3K-Akt-Signalweg, der MAPK-Signalweg und der HIF-1-Signalweg zentrale Signalwege sind, die die Sehnenentzündung, Zellreparatur und Gewebeumbildung regulieren61,62,63,64. Um den potenziellen Signalmechanismus von RD bei der Behandlung der RCI weiter zu erforschen, führte diese Studie eine KEGG-Pfad-Enrichment-Analyse auf der Grundlage der oben genannten Forschungsergebnisse durch. Die Ergebnisse zeigten, dass RD bei RCI vorrangig die oben genannten vier Signalwege beeinflusst. Der TNF-Signalweg fördert die Entzündungsreaktion und die Tenozytenapoptose und wirkt dabei als übergeordneter Auslöser der entzündlichen Sehnendegeneration65. Der PI3K-Akt-Signalweg verbessert das Zellüberleben und die Angiogenese, was der Sehnenheilung zugutekommt, und kann mehrere Wachstumsfaktoren koordinieren, um die Kollagenausschüttung von Fibroblasten zu fördern66,67. Der MAPK-Signalweg reguliert die Zellproliferation, Differenzierung und die Synthese der extrazellulären Matrix und ist somit in den gesamten Prozess der Sehnenrekonstruktion eingebunden68. Der HIF-1-Signalweg reagiert auf Hypoxie und fördert die Neubildung von Blutgefäßen, wodurch die hypoxische Mikroumgebung verletzter Sehnen effektiv verbessert wird69. Diese Signalwege interagieren miteinander und bilden ein komplexes regulatorisches Netzwerk, das die multizellulären Wirkmechanismen von RD bei der Behandlung der RCI deutlich widerspiegelt.
Das molekulare Docking ist zu einer routinemäßigen und unterstützenden Verifizierungsmethode in der Netzwerkpharmakologie-Forschung geworden und kann die Bindungsaktivität zwischen Wirkstoffen und zentralen Zielstrukturen direkt charakterisieren. Daher wurde in dieser Studie das molekulare Docking eingesetzt, um die Vorhersageergebnisse der Netzwerkpharmakologie zu überprüfen70. Die Ergebnisse zeigten, dass die zentralen flavonoiden Komponenten von RD stabil an die aktiven Taschen von Hub-Proteinen binden können, was die Zuverlässigkeit der netzwerkpharmakologischen Vorhersagen weiter bestätigt. Diese stabilen Bindungsmodi deuten darauf hin, dass RD möglicherweise direkt auf Schlüsselziele wirkt, um therapeutische Effekte auszuüben. Die enge Bindung zwischen flavonoiden Liganden und den aktiven Stellen der Hub-Proteine liefert anschauliche molekulare Interaktionsnachweise und bietet zudem Kandidatenverbindungen für nachfolgende zelluläre Funktionsverifikationsexperimente.
Diese Studie weist mehrere Einschränkungen auf. Erstens basieren die Vorhersagen auf bioinformatischen Analysen öffentlicher Datenbanken, die eine Annotationsverzerrung zugunsten gut erforschter Proteine aufweisen können. Die rotationsmangelspezifische Genexpression und Protein-Isoformen wurden nicht berücksichtigt, und das ungerichtete, aus STRING abgeleitete PPI-Netzwerk kann die rotationsmangelspezifische Biologie nicht vollständig nachbilden. Angereicherte Signalwege wie TNF, PI3K-Akt und MAPK repräsentieren allgemeine entzündliche Kaskaden und keine ausschließlich auf RD bezogenen Signaturen. Öffentliche Omics-Ressourcen können die dynamischen pathologischen Veränderungen in vivo und individuelle Unterschiede im menschlichen Rotatorenmanschetten-Gewebe nicht nachbilden. Zukünftige Arbeiten könnten Single-Cell-RNA-Sequenzierungsdatensätze integrieren, um die mechanistische Interpretation zu verfeinern. Zweitens kamen bei der Verbindungsscreening empirische ADME-Grenzwerte zum Einsatz (OB ≥ 30 %, DL ≥ 0,18), die bioaktive Verbindungen mit geringer oraler Bioverfügbarkeit ausschließen könnten. Das molekulare Docking verwendete eine starre Rezeptorkonfiguration, wobei Proteinflexibilität und strukturelle Wassermoleküle unberücksichtigt blieben, und es erfolgte keine biophysikalische Validierung (z. B. SPR, ITC). Positive Kontrollarzneimittel, Sensitivitätsanalysen, Toxizitätsbewertungen sowie eine vollständige pharmakokinetische Charakterisierung wurden nicht durchgeführt. Alle Ergebnisse sind computergestützte Vorhersagen; in vitro-zelluläre und in vivo-Tierexperimente sind erforderlich, um die Funktionen der Ziel-Signalwege sowie die regulatorischen Beziehungen zwischen Inhaltsstoffen und Hub-Genen zu validieren. Drittens blieben synergistische Wechselwirkungen zwischen mehreren RD-Bestandteilen und deren in vivo-pharmakokinetisches Verhalten unerforscht. Systematische experimentelle Arbeiten sind notwendig, um die Wechselwirkungen zwischen den Inhaltsstoffen und die Stoffwechselprofile dieses pflanzlichen Arzneimittels aufzuklären. Diese Studie zeigt systematisch, dass RD RCI über ein regulatorisches Netzwerk mit mehreren Komponenten, mehreren Zielstrukturen und mehreren Signalwegen behandelt. RD könnte therapeutische Wirkungen entfalten, indem es Entzündungen hemmt, die Tenozytenapoptose reduziert, die Angiogenese fördert und die Reparatur der extrazellulären Matrix über die TNF-, PI3K-Akt-, MAPK- und HIF-1-Signalwege verbessert. Diese Ergebnisse liefern eine fundierte theoretische Grundlage für die klinische Anwendung und die mechanistische Forschung zu RD bei RCI.
Offenlegungen
Die Autoren erklären, dass die Forschung ohne bestehende oder mögliche kommerzielle oder finanzielle Beziehungen durchgeführt wurde, die als potenzieller Interessenkonflikt gewertet werden könnten.
Danksagungen
Die Autoren danken den Entwicklern und Betreuern der öffentlichen bioinformatischen Ressourcen, die in dieser Arbeit verwendet wurden, einschließlich TCMSP, ETCM, SymMap, GeneCards, OMIM, STRING, UniProt, PubChem und RCSB‑PDB. Diese Open-Access-Datenbanken stellten öffentlich zugängliche Datensätze bereit, die die in dieser Studie beschriebenen computergestützten Analysen unterstützten. Diese Forschung erhielt keine externe Förderung.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| AutoDock Vina | Scripps Research Institute | V1.2.0 | Software für molekulares Docking zur Simulation der Protein-Ligand-Bindung; RRID: Nicht verfügbar. URL: https://github.com/ccsb-scripps/AutoDock-Vina |
| clusterProfiler | Bioconductor | V3.2.14 | R-Paket für GO- und KEGG-Enrichment-Analysen; kompatibel mit R 4.0.3; RRID: SCR_016884. URL: https://bioconductor.org/packages/release/bioc/html/clusterProfiler.html |
| cytoHubba | National Taiwan University (Cytoscape-Plugin) | V0.1 | Cytoscape-Plugin zur Identifizierung von Hub-Genen anhand topologischer Metriken; RRID: SCR_006556. URL: https://apps.cytoscape.org/apps/cytohubba |
| Cytoscape | Institute for Systems Biology | V3.8.0 | Software zur Visualisierung und Analyse von Netzwerken; RRID: SCR_003032. URL: https://cytoscape.org/ |
| ETCM (Enzyklopädie der Traditionellen Chinesischen Medizin) | Institut für Chinesische Arzneimittel, China Academy of Chinese Medical Sciences | V2.0 | Kuratierte Datenbank für Inhaltsstoffe, Zielstrukturen und Rezepturen der TCM; RRID: Nicht verfügbar. URL: http://www.tcmip.cn/ETCM2/front/#/ |
| GeneCards | Weizmann-Institut für Wissenschaft | — | Integrierte Datenbank menschlicher Gene mit regelmäßigen Hauptversionen und inkrementellen Aktualisierungen; Daten abgerufen am 2025-12-15; RRID: Nicht verfügbar. URL: https://www.genecards.org |
| Open Babel | Open Babel-Entwicklungsteam | — | Täglich aktualisierte Gen-Phänotyp-Datenbank ohne globale Versionsveröffentlichung; Daten abgerufen am 2026-02-16; RRID: Nicht verfügbar. URL: https://omim.org |
| OMIM (Online Mendelian Inheritance in Man) | Johns Hopkins University | — | Open-Source-Chemoinformatik-Toolkit zur Umwandlung von Molekülformaten; Daten abgerufen am 2025-12-21; RRID: Nicht verfügbar. URL: https://openbabel.org/ |
| PubChem | Nationales Zentrum für Biotechnologieinformation (NCBI) | — | Öffentliche chemische Datenbank, kontinuierlich aktualisiert ohne feste globale Version; Verbindungsdaten abgerufen am 2026-02-10; RRID: Nicht verfügbar. URL: https://pubchem.ncbi.nlm.nih.gov |
| PyMOL | Schrödinger, LLC | V2.5 | Software zur Visualisierung und Darstellung von Protein-Ligand-Strukturen; RRID: SCR_000305. URL: https://pymol.org |
| R-Software | R Foundation for Statistical Computing | V4.0.3 | Umgebung für statistische Berechnungen und Grafiken; RRID: SCR_001905. URL: https://cran.r-project.org |
| RCSB PDB | RCSB Protein Data Bank | — | Öffentliches Archiv dreidimensionaler Proteinstrukturen; jeder PDB-Eintrag hat eine eigenständige Versionsnummer; Strukturdateien abgerufen am 2026-02-03; RRID: SCR_012820. URL: https://www.rcsb.org |
| STRING | ELIXIR | V11.5 | Datenbank bekannter und vorhergesagter Protein-Protein-Interaktionen; RRID: SCR_005223. URL: https://string-db.org |
| SymMap | China Academy of Chinese Medical Sciences | V2.0 | Integrierte Datenbank, die pflanzliche Arzneimittel, Inhaltsstoffe, Zielstrukturen und Symptome verknüpft; RRID: Nicht verfügbar. URL: http://www.symmap.org |
| TCMSP | Northwest A&F University | V2.3 | TCM-Systempharmakologie-Datenbank mit Inhaltsstoffen, Zielstrukturen und ADME-Eigenschaften; RRID: Nicht verfügbar. URL: https://old.tcmsp-e.com/tcmsp.php |
| UniProt | Europäisches Bioinformatik-Institut (EMBL-EBI) | — | Umfassende Datenbank für Proteinsequenzen und Annotationen mit geplanten Veröffentlichungen und kontinuierlichen Aktualisierungen; Daten abgerufen am 2025-12-12; RRID: SCR_002380. URL: https://www.uniprot.org |
| Venny | BioinfoGP, Spanisches Nationales Zentrum für Biotechnologie | V2.0 | Webbasiertes Tool zur Erstellung von Venn-Diagrammen und zur Analyse überlappender Genmengen; RRID: SCR_016561. URL: https://bioinfogp.cnb.csic.es/tools/venny/index2.0.2.html |
Referenzen
- Desmeules F, et al. Rotator cuff tendinopathy diagnosis, nonsurgical medical care, and rehabilitation: a clinical practice guideline. J Orthop Sports Phys Ther. 2025;55(4):235-274.
- Yoshida M, et al. Post-operative rotator cuff integrity, based on Sugaya's classification, can reflect abduction muscle strength of the shoulder. Knee Surg Sports Traumatol Arthrosc. 2018;26(1):161-168.
- Aydın A, et al. The effects of N-acetylcysteine and adipose-derived stem cells on tendon healing in chronic rotator cuff tears: a rabbit model study. BMC Musculoskelet Disord. 2025;26(1):1014.
- Bolam SM, et al. Ethnicity, sex, and socioeconomic disparities in the treatment of traumatic rotator cuff injuries in Aotearoa/New Zealand. J Shoulder Elbow Surg. 2023;32(1):121-132.
- Patel HP, Patel S, Zalin M, Agrawal DK. Calcified vs. non-calcified tendinopathy of the rotator cuff: clinical presentations, prognostic implications, and emerging therapeutic strategies. J Orthop Sports Med. 2025;7(3):379-391.
- Sewpaul Y, et al. Non-steroidal anti-inflammatory drugs and cyclooxygenase-2 inhibitors do not affect healing after rotator cuff repair: a systematic review and meta-analysis. Arthroscopy. 2024;40(3):930-940.e1.
- Hopewell S, et al. Progressive exercise compared with best practice advice, with or without corticosteroid injection, for the treatment of patients with rotator cuff disorders (GRASP): a multicentre, pragmatic, 2 × 2 factorial, randomised controlled trial. Lancet. 2021;398(10298):416-428.
- Kandikattu S, Aavula M, Pisarski T, Parvizi D, Agrawal DK. Effect of metabolic syndrome in the incidence of rotator cuff injury and recovery following surgical repair. J Surg Res (Houst). 2025;8(1):202-210.
- Longo UG, et al. Retear rates after rotator cuff surgery: a systematic review and meta-analysis. BMC Musculoskelet Disord. 2021;22(1):749.
- Siu WS, Ma H, Cheng W, Shum WT, Leung PC. Traditional Chinese medicine for topical treatment of skeletal muscle injury. Pharmaceuticals (Basel). 2023;16(8):1144.
- Jingying G, et al. A comprehensive review of Drynariae rhizoma: botany, traditional applications, and active flavonoid components. J Pharm Pharmacol. 2025;77(10):1319-1337.
- Chen GY, et al. Prediction of Rhizoma Drynariae targets in the treatment of osteoarthritis based on network pharmacology and experimental verification. Evid Based Complement Alternat Med. 2021;2021:5233462.
- Yang G, et al. Total flavonoids of Rhizoma Drynariae enhance bone marrow mesenchymal stem cell-mediated tendon-bone healing by promoting tissue regeneration, angiogenesis, and modulation of cytokine expression. Biology (Basel). 2025;14(11):1593.
- Shen J, et al. Rhizoma Drynariae-derived EV-like particles alleviate osteoporosis by promoting osteogenic differentiation in BMSCs through the activation of the hsa_circ_0001275/miR-422a pathway. Bone. 2025;196:117489.
- Cai L, et al. Hydrogel microspheres loaded with sinomenine and Drynaria rhizome enhance the treatment of rheumatoid arthritis via immune regulation and promoting bone repair. J Nanobiotechnology. 2026;24(1):174.
- Chen GY, et al. Network pharmacology analysis and experimental validation to investigate the mechanism of total flavonoids of Rhizoma Drynariae in treating rheumatoid arthritis. Drug Des Devel Ther. 2022;16:1743-1766.
- Chen GY, et al. Mechanisms of total glucosides of paeony in alleviating methotrexate-induced liver injury. Drug Des Devel Ther. 2025;19:3407-3423.
- Zhang P, et al. Network pharmacology: towards the artificial intelligence-based precision traditional Chinese medicine. Brief Bioinform. 2024;25(1):bbad518.
- Zhao L, et al. Network pharmacology, a promising approach to reveal the pharmacology mechanism of Chinese medicine formula. J Ethnopharmacol. 2023;309:116306.
- Ru J, et al. TCMSP: a database of systems pharmacology for drug discovery from herbal medicines. J Cheminform. 2014;6:13.
- Xu HY, et al. ETCM: an encyclopaedia of traditional Chinese medicine. Nucleic Acids Res. 2019;47(D1):D976-D982.
- Wu Y, et al. SymMap: an integrative database of traditional Chinese medicine enhanced by symptom mapping. Nucleic Acids Res. 2019;47(D1):D1110-D1117.
- UniProt Consortium. UniProt: the universal protein knowledgebase. Nucleic Acids Res. 2018;46(5):2699.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Amberger JS, Hamosh A. Searching Online Mendelian Inheritance in Man (OMIM): a knowledgebase of human genes and genetic phenotypes. Curr Protoc Bioinformatics. 2017;58:1.2.1-1.2.12.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-D646.
- Otasek D, Morris JH, Bouças J, Pico AR, Demchak B. Cytoscape Automation: empowering workflow-based network analysis. Genome Biol. 2019;20(1):185.
- Pitarch B, Chagoyen M, Ranea JAG, Pazos F. A review on Gene Ontology evaluations. Database (Oxford). 2025;2025:baaf058.
- Kanehisa M, Furumichi M, Sato Y, Kawashima M, Ishiguro-Watanabe M. KEGG for taxonomy-based analysis of pathways and genomes. Nucleic Acids Res. 2023;51(D1):D587-D592.
- Kim S, et al. PubChem in 2021: new data content and improved web interfaces. Nucleic Acids Res. 2021;49(D1):D1388-D1395.
- Burley SK, et al. RCSB Protein Data Bank: celebrating 50 years of the PDB with new tools for understanding and visualizing biological macromolecules in 3D. Protein Sci. 2022;31(1):187-208.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891-3898.
- Li QR, Han YX, Bian YT, Lan MQ, Chen GY. Unveiling the mechanism of Cibotium barometz in the treatment of rheumatoid arthritis: a study based on network pharmacology and experimental validation. Curr Med Chem. 2026. Online ahead of print.
- Seeliger D, de Groot BL. Ligand docking and binding site analysis with PyMOL and Autodock/Vina. J Comput Aided Mol Des. 2010;24(5):417-422.
- Wang Y, Xu B, Ma C, Huang D, Zhou L. Association between inflammatory proteins and rotator cuff tears: a bidirectional Mendelian randomization study. Sci Rep. 2025;15(1):26987.
- Wang KC, et al. The influence of age on cellular senescence in injured versus healthy muscle and its implications on rotator cuff injuries. J Shoulder Elbow Surg. 2025;34(6 Suppl):S117-S126.
- Wellington IJ, et al. Management of failed rotator cuff repairs: a review. Orthop Clin North Am. 2022;53(4):473-482.
- Han L, Wang C, Wang T, Hu Y, Wang H. Total flavonoids of Rhizoma Drynariae improves tendon-bone healing for anterior cruciate ligament reconstruction in mice and promotes the osteogenic differentiation of bone mesenchymal stem cells by the ERR1/2-Gga1-TGF-β/MAPK pathway. Environ Toxicol. 2024;39(1):106-119.
- Chai S, et al. Luteolin rescues postmenopausal osteoporosis elicited by OVX through alleviating osteoblast pyroptosis via activating PI3K-AKT signaling. Phytomedicine. 2024;128:155516.
- Li W, et al. Effects of total flavonoids of Rhizoma Drynariae on biochemical indicators of bone metabolism: a systematic review and meta-analysis. Front Pharmacol. 2024;15:1443235.
- Wang Z, Cao L, Wang X. Total flavonoids of Rhizoma Drynariae ameliorate tendon-bone healing following anterior cruciate ligament reconstruction in rats by activating the FSP1/CoQ10 pathway to inhibit osteoblast mitochondrial dysfunction and ferroptosis. Appl Biochem Biotechnol. 2026;198(8):5916-5938.
- Kim JG, et al. Therapeutic potential of quercetin as an antioxidant for bone-muscle-tendon regeneration and aging. Aging Dis. 2024;16(3):1414-1437.
- Worsfold SI, et al. Rotator cuff tendinopathy: pathways of apoptosis. Sports Med Arthrosc Rev. 2024;32(1):12-16.
- Chen L, et al. AMPK signaling in osteoarthritis: from mechanisms to targeted therapeutics. Front Pharmacol. 2025;16:1681610.
- Li Y, et al. Leptin enhances M1 macrophage polarization and impairs tendon-bone healing in rotator cuff repair: a rat model. Clin Orthop Relat Res. 2025;483(5):939-951.
- Yang Y, et al. Celastrol suppresses neovascularization in rat aortic vascular endothelial cells stimulated by inflammatory tenocytes via modulating the NLRP3 pathway. Open Med (Wars). 2025;20(1):20241121.
- Li Y, et al. Prevascularized bone marrow-derived mesenchymal stem cell sheets promote tendon-bone integration in rotator cuff repair. J Bone Joint Surg Am. 2026;108(17):1389-1398.
- Zhao MJ, et al. Eupatorin as a promising natural compound against knee osteoarthritis: from network pharmacology to experimental validation. Front Biosci (Landmark Ed). 2025;30(12):46747.
- Cho W, et al. Valdecoxib ameliorates apoptosis and ferroptosis in tenocytes via the SIRT6/NRF2-mediated suppression of oxidative stress. Arch Med Res. 2025;56(6):103231.
- Cheng Y, et al. Amentoflavone alleviated cartilage injury and inflammatory response of knee osteoarthritis through PTGS2. Naunyn Schmiedebergs Arch Pharmacol. 2024;397(11):8903-8916.
- Cho W, et al. Therapeutic potential of ginsenoside compound K in managing tenocyte apoptosis and extracellular matrix damage in diabetic tendinopathy. Tissue Cell. 2024;86:102275.
- Cheng P, et al. High-purity magnesium screws modulate macrophage polarization during the tendon-bone healing process in the anterior cruciate ligament reconstruction rabbit model. Regen Biomater. 2022;9:rbac067.
- Zhou L, et al. Regorafenib attenuates osteoclasts differentiation by inhibiting the NF-κB, NFAT, ERK, and p38 signaling pathways. ACS Omega. 2024;9(31):33574-33593.
- Cho MH, Jin H, Ha J, Chu S, An S. An integrated systems pharmacology approach combining bioinformatics, untargeted metabolomics and molecular dynamics to unveil the anti-aging mechanisms of Tephroseris flammea. Biomolecules. 2025;15(12):1740.
- Wang L, et al. IL-33/ST2 drives inflammatory pain via CCL2 signaling and activation of TRPV1 and TRPM8. Commun Biol. 2025;8(1):724.
- Zhang P, Xu X, Wang H, Zhang Y. Anti-inflammatory activity and potential anti-inflammatory mechanisms of Artemisia scoparia essential oil. J Pharm Pharmacol. 2026;78(2):rgag004.
- Wang Z, et al. Engineered mesenchymal stem cells with endogenous trehalose expression activate the NRF2-HMOX1 pathway to enhance antioxidant stress and wound healing capacity. Adv Wound Care (New Rochelle). 2026. Online ahead of print.
- Lu Y, et al. Dual-PPARα/δ agonist H11 alleviates tendinopathy via modulating the Nrf2/HO-1/GPX4 pathway. Free Radic Biol Med. 2026;242:333-344.
- Chung SW, Yoon JP, Park SJ. Inhibiting muscle degeneration in rotator cuff tears: integrative biologic approaches targeting regeneration, fibrosis, and metabolism. Stem Cells Transl Med. 2026;15(6):szag023.
- Feuerriegel GC, et al. Assessment of the rotator cuff muscles: state-of-the-art MRI and clinical implications. Radiology. 2025;315(2):e242131.
- He Y, et al. SHED-derived exosome-mimetics promotes rotator cuff tendon-bone healing via macrophage immunomodulation through NF-κB suppression and autophagy activation. Mater Today Bio. 2025;34:102146.
- Zhang Z, et al. Curcumin improves functional recovery of ruptured tendon by promoting tenogenesis via PI3K/Akt signaling. Stem Cells Transl Med. 2024;13(5):477-489.
- Chen C, et al. CTHRC1 attenuates tendinopathy via enhancing EGFR/MAPK signaling pathway. Adv Sci (Weinh). 2024;11(47):e2406611.
- Zulkifli A, et al. The potential mechanism of hypoxia-induced tenogenic differentiation of mesenchymal stem cell for tendon regeneration. Tissue Cell. 2023;82:102075.
- Xiang L, Deng H, Zhou S. Effects of TNF-α on behaviour and inflammation in rats with rotator cuff injury through NGF. Discov Med. 2024;36(185):1241-1249.
- Liu H, et al. RNA-sequencing-based elucidation of the mechanism underlying aFGF mediated regulation of BMSCs via the PI3K-AKT pathway and its implications for rotator cuff injury repair. J Orthop Surg Res. 2025;20(1):997.
- Chen GY, et al. Total flavonoids of Rhizoma Drynariae restore the MMP/TIMP balance in models of osteoarthritis by inhibiting the activation of the NF-κB and PI3K/AKT pathways. Evid Based Complement Alternat Med. 2021;2021:6634837.
- Wang Y, Gu X, Tu J, Xu B. MCP-1 exacerbates diabetic rotator cuff tear by driving synovial inflammation via MAPK/ERK-mediated macrophage polarization. J Shoulder Elbow Surg. 2026. Online ahead of print.
- Lin J, et al. Hypobaric hypoxia ameliorates impaired regeneration after diabetic skeletal muscle injury by promoting HIF-1α signaling. Int J Mol Sci. 2026;27(2):648.
- Tian M, Wang K, Chen D. Efficacy and mechanisms of Xiangsha Liujunzi Decoction for gastroesophageal reflux disease: a study integrating meta-analysis, network pharmacology and molecular docking. Phytomedicine. 2026;151:157766.