Dieses Protokoll integriert Anonymisierung, Terminologienormalisierung, Quellenverifikation und reproduzierbare Visualisierung, um nachvollziehbare, aggregierte Ergebnisse aus realen ambulanten Behandlungsakten der traditionellen Chinesischen Medizin zu generieren.
Methodenartikel
Quellgeprüftes Mining und Visualisierung von realen Fallberichten der Traditionellen Chinesischen Medizin unter Verwendung der Hegan-Jianpi-Formel
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Reale, traditionelle chinesische Medizin (TCM) ambulante Aufzeichnungen enthalten Längsschnittdaten zu Diagnosen, Syndrombestandteilen, symptomatischen Beschreibungen und individuellen Rezepturen, doch ihr halbstrukturierter Aufbau erschwert eine reproduzierbare Analyse. Dieser Artikel stellt ein quellengeprüftes Protokoll zur Umwandlung anonymisierter Fallakten in nachvollziehbare aggregierte Tabellen und publikationsfähige Visualisierungen vor. Der Arbeitsablauf definiert Eingabekriterien und Analyseeinheiten, bewahrt Zuordnungen zwischen Original- und normalisierter Terminologie auf, überprüft sämtliche angegebenen Zähler und Nenner und generiert Abbildungen erneut aus versionierten Quelltabellen. Angewandt auf Aufzeichnungen vom Januar 2015 bis Juni 2024 identifizierte das Protokoll 555 qualifizierte Rezepturbesuche von 396 Patienten. Der endgültige Datensatz enthielt 324 normalisierte Kräuterbezeichnungen und 9.339 Kräuterverwendungen. Der Workflow erzeugte parallele Krankheitsspektren nach westlicher Medizin und TCM, ein explizites Syndrombestandteil-Spektrum und eine Ko-Verwendungs-Matrix, Häufigkeitsprofile für Kräuter und Arzneistoffe, ein aus der Anamnese abgeleitetes Symptomspektrum mit 37 Begriffen, 15 gerichtete Assoziationsregeln, hierarchische Clusterung sowie diagnosespezifische Heatmaps zur Kräuteranwendung. Mindestens ein vorgegebenes Anamnese-Schlüsselwort wurde in 474 Besuchen (85,41 %) erfasst. Sofern es die institutionelle Richtlinie erlaubt, kann eine menschlich überwachte künstliche Intelligenz (KI) bei der Terminüberprüfung, der konsistenzprüfung über mehrere Dateien hinweg und der Zuordnung von Abbildungsunterschriften zu Grafiken unterstützen. Jede KI-Nutzung muss in einer separaten Audit-Akte dokumentiert werden und darf die Überprüfung der Quelldaten nicht ersetzen. Indem das Verfahren Governance, Normalisierung, Berechnung, klinische Interpretation und visuelle Ausgabe in einem einzigen reproduzierbaren Workflow integriert, verwandelt es verstreute klinische Dokumentationen in eine überprüfbare Forschungsressource. Das Protokoll kann an andere Expertendatensätze, multizentrische Terminologieprojekte sowie prospektive klinische Datenplattformen angepasst werden.
Einleitung
Ambulante Patientenakten der traditionellen chinesischen Medizin (TCM) aus der Praxis bewahren langfristige klinische Schlussfolgerungen in Form narrativer Symptombeschreibungen, paralleler Diagnosesysteme, Syndromdarstellungen und individueller Rezepturen. Frühe Arbeiten zur Wissensentdeckung erkannten an, dass Fallakten komplexe erfahrungsbezogene Daten darstellen, die spezialisierte informatische Methoden erfordern, bevor ihre Muster zuverlässig untersucht werden können1. Spätere Forschung zeigte, dass synonyme Symptomausdrücke, feingliedrige Entitäten und lokal dokumentierte diagnostische Begriffe normalisiert werden müssen, ohne die ursprüngliche Formulierung zu löschen2,3,4,5,6. Daten aus elektronischen Gesundheitsakten (EHR) können zudem die computergestützte Rezepturforschung und die Nutzung wiederverwendbarer Analysewerkzeuge unterstützen, sofern klinischer Kontext und Datenherkunft nachvollziehbar bleiben7,8. Deshalb werden autoritative Referenzen zur Arzneimittellehre benötigt, um Namen von Heilpflanzen, Verarbeitungsformen, Eigenschaften, Geschmacksrichtungen und Meridianzuordnungen zu standardisieren9,10. Auf Ebene der Berichterstattung fordern die RECORD- und STROBE-Empfehlungen transparente Beschreibungen von Datenquellen, Einschlusskriterien, Variablen und analytischen Entscheidungen, während die FAIR-Prinzipien nachvollziehbare und wiederverwendbare Forschungsobjekte betonen11,12,13. Diese Aspekte sind besonders wichtig, wenn die Akten wiederholte Besuche, fehlende Felder, überlappende Terminologie und Freitext enthalten. Die Bewertung der Eignung für den jeweiligen Zweck muss Vollständigkeit, Konformität, Plausibilität und Übereinstimmung der Quellen berücksichtigen14,15. Die Entfernung personenbezogener Daten aus Freitext erfordert ebenfalls explizite Verfahren und menschliche Überprüfung, da automatisierte Methoden zwar klinisch nützliche Inhalte bewahren können, jedoch verbleibende Datenschutzrisiken bestehen lassen16,17,18.
Sobald Governance und Terminologie festgelegt sind, können Frequenzprofilanalysen, Assoziationsregel-Mining und hierarchisches Clustering komplementäre Einblicke in die Struktur von Verschreibungen liefern19,20,21. Netzwerk- und Wissenschaftsmapping-Methoden verdeutlichen zudem, wie koordinierte visuelle Darstellungen Beziehungen offenbaren können, die eine einzelne Rangliste nicht erfassen kann22,23,24,25. Aktuelle Studien zu rheumatoider Arthritis mit Depression, Janus-Kinase-Hemmern bei Colitis ulcerosa und rheumatoider Arthritis mit Fibromyalgie veranschaulichen den Wert von versionsfixierten Abrufkriterien, Ko-Okurrenznetzwerken, Clustering, zeitlicher Interpretation und expliziten Aussagen zu analytischen Einschränkungen26,27,28. Die vorliegende Studie überträgt diese übertragbaren Gestaltungsprinzipien auf das Mining klinischer Datensätze statt auf literaturbasierte Bibliometrie. In den Quelldatensätzen bezeichnet Hegan Jianpi Formula eine auf Erfahrung basierende Rezeptur, die mit der klinischen Praxis von Professor Nai-li Yao verbunden ist29,30. Verwandte Publikationen beschreiben seinen umfassenderen Ansatz zur Harmonisierung von Leber und Milz sowie von Milz und Magen29,30. In diesem Methodenartikel identifiziert der Formelname lediglich den Kontext der Quelldatensätze und begründet weder eine feste Zusammensetzung, Dosierung, Behandlungsindikation noch Wirksamkeitsaussagen. Der rechnergestützte Workflow nutzt deterministische Regeln und allgemeine statistische Verfahren. Reproduzierbare rechnergestützte Praxis erfordert darüber hinaus die Sicherung der Eingabedaten, Dokumentation der Parameter, skriptbasierte Transformationen und überprüfbare Ergebnisse31,32. Eine menschlich überwachte Künstliche Intelligenz (KI) kann bei der Überprüfung der Terminologie, der Sicherstellung der Konsistenz über mehrere Dateien hinweg sowie bei der visuellen Qualitätskontrolle unterstützen, sofern ihr Einsatz dokumentiert ist. Klinische Fachkenntnis, Datenschutzmaßnahmen und verantwortliche menschliche Entscheidungsfindung müssen weiterhin im Vordergrund stehen (Zusätzliche Tabelle 1)33,34. Das übergeordnete Ziel dieser Methode besteht darin, anonymisierte TCM-Falldatensätze in eine von der Quelle geprüfte Kette von Ergebnissen zu überführen, die nach Erkrankung, Syndrom, Symptomen, Kräuterverwendung, Assoziationen, Clustering und Diagnosen gestaffelt sind. Das ausgearbeitete Beispiel nutzt 555 berechtigte Verschreibungsbesuche von 396 Patienten, um zu demonstrieren, wie Governance, Normalisierung, Berechnung, klinische Interpretation und visuelle Aufbereitung integriert werden können, ohne patientenbezogene Datensätze, exakte Formulierungsdetails, Dosisverhältnisse oder Verschreibungsinstruktionen offenzulegen.
Protokoll
Diese retrospektive Analyse von anonymisierten klinischen Unterlagen wurde vom Medizinischen Ethikkomitee des Guang'anmen-Krankenhauses, Chinesische Akademie für Medizinische Wissenschaften der Traditionellen Chinesischen Medizin (Genehmigungsnummer 2026-108-KY; 13. Juli 2026), geprüft und genehmigt. Die Anforderung zur Einholung einer informierten Einwilligung wurde vom Komitee aufgehoben.
1. Festlegung von Ethik, Governance und Datensicherheit
- Benennen Sie einen Datenverwalter, Quelldatenanalysten, klinischen Terminologiereviewer, quantitativen Reviewer und einen berechtigten Ermittler zur Genehmigung der Freigabe aggregierter Daten. Dokumentieren Sie jede Rolle im Projektlogbuch.
- Erstellen Sie einen Datenmanagementplan, der das zulässige Quellsystem, den Studienzeitraum, die Felder, den Speicherort, Zugriffsberechtigungen, das Sicherungsverfahren, die Aufbewahrungsfrist und Einschränkungen bezüglich Verknüpfungsschlüsseln festlegt.
- Exportieren Sie nur die minimal erforderlichen Variablen für die vorab festgelegte Analyse. Fügen Sie einen lokalen Patientenidentifikator, Besuchsdatum, Alter oder Geburtsdatum (sofern erlaubt), Geschlecht, westliche Diagnose, TCM-Krankheitsbezeichnung, anonymisierten Anamnesetext, Zungentext, Pulstext, Syndromtext sowie Felder zur Rezeptur mit Kräutern ein.
- Entfernen Sie Namen, nationale Identifikationsnummern, Telefonnummern, detaillierte Adressen, Versicherungskennungen, Kontaktdaten und andere direkte Identifikatoren innerhalb der kontrollierten institutionellen Umgebung. Ersetzen Sie jede Krankenaktennummer durch einen projektspezifischen Patientenidentifikator.
- Durchsuchen Sie Freitextfelder nach verbliebenen Identifikatoren und maskieren Sie jedes erkannte Element. Speichern Sie sämtliche Verknüpfungsschlüssel getrennt vom Analyse-Datensatz und schließen Sie sie von Arbeits-, Kooperations- und Einreichungsordnern aus.
- Bewahren Sie den ursprünglichen anonymisierten Export als schreibgeschützte Quellkopie auf. Notieren Sie Dateinamen, Erstellungsdatum, Anzahl der Zeilen, Anzahl der Spalten, Dateigröße und Prüfsumme in einem Quellverzeichnis.
- Erstellen Sie separate Verzeichnisse für Quelldateien, Arbeitsdateien, Wörterbücher, aggregierte Tabellen, Abbildungen, Skripte und Auditunterlagen.
- Stellen Sie ausschließlich aggregierte Tabellen, genehmigte anonymisierte Wörterbücher, Skripte und Publikationsabbildungen zur Verfügung oder teilen Sie diese. Laden Sie keine identifizierbaren oder potenziell reidentifizierbaren Datensätze auf öffentliche generative-KI-Systeme, nicht genehmigte Cloud-Dienste oder öffentliche Repositories hoch.
HINWEIS: Wenn die institutionelle Richtlinie menschlich überwachte KI-Unterstützung erlaubt, stellen Sie ausschließlich anonymisierte Textauszüge oder aggregierte Tabellen bereit. Dokumentieren Sie Zweck, überprüfte Ergebnisse, akzeptierte Korrekturen, Reviewer und Datum im Audit-Logbuch.
2. Definieren Sie die Regel zur Datensatzidentifizierung und die Analyseeinheiten
- Legen Sie die Institution, den ambulanten Behandlungsort, das verantwortliche klinische Team, das elektronische Patientenakten-System und den Quellzeitraum vor der Screening-Phase fest. Verwenden Sie für das durchgerechnete Beispiel Akten mit Datierung von Januar 2015 bis Juni 2024.
- Speichern Sie die Regel zur Kohortenidentifizierung vor der Auswertung der Analyseergebnisse in einer geschützten, versionskontrollierten Datei. Dokumentieren Sie akzeptierte terminologische Varianten sowie alle Ein- und Ausschlusskriterien, ohne vertrauliche Details zur Formulierung im Manuskript offenzulegen.
- Wenden Sie die versionsfixierte Regel zur Datensatzidentifizierung auf Ebene des Rezeptbesuchs nach der Normalisierung der Kräuternamen an. Schließen Sie die Quelldateien, Wörterbücher, die Kohortenregel und Analyseparameter zu einem einzigen Freigabesatz ab.
- Erstellen Sie eine neue Version und generieren Sie alle abhängigen Ausgaben neu, sobald sich eine versionsfixierte Komponente ändert. Ändern Sie die Regel zur Kohortenidentifizierung nicht nach der Betrachtung von Krankheitsverteilungen, Kräuterhäufigkeiten, Assoziationsregeln oder Clustern.
- Einbeziehen eines ambulanten Besuchs, wenn dieser innerhalb des versionsfixierten Studienzeitraums liegt, einer gültigen Projektpatienten-ID zugeordnet werden kann, einen interpretierbaren Rezeptdatensatz enthält und die eingeschränkte Regel zur Datensatzidentifizierung erfüllt.
- Ausschluss exakter doppelter Exporte, Datensätze außerhalb des Studienzeitraums, Datensätze ohne interpretierbares Rezept und Zeilen, die die versionsfixierte Identifizierungsregel nicht erfüllen. Weisen Sie jeder ausgeschlossenen Zeile einen primären Ausschlussgrund zu.
- Unterscheiden Sie wiederholte Exporte von echten Folgebesuchen. Entfernen Sie nur exakte System- oder Exportdoppelungen und behalten Sie echte wiederholte Besuche bei.
- Weisen Sie stabile Patienten- und Rezeptbesuchs-Identifikatoren zu. Erstellen Sie ein Kohorten-Protokoll, das die Quellversion, Regelausführungsversion, Screening-Status, Ein- oder Ausschlussgrund, Patienten-ID, Besuchs-ID und den Prüfstatus enthält.
- Verwenden Sie einen Datensatz pro eindeutigem Patienten für feste demografische Zusammenfassungen, einschließlich Alter und Geschlecht. Verwenden Sie den Rezeptbesuch als Analyseeinheit für Analysen zu Krankheiten, Syndromen, anamnestischen Stichworten, Zunge, Puls, Kräutern, Assoziationsregeln und Clustern.
- Trennen Sie die Kohortenzugehörigkeit von der Variablenverfügbarkeit. Behalten Sie einen ansonsten berechtigten Besuch bei, wenn ein variablenspezifisches Feld fehlt, und geben Sie den auswertbaren Nenner für jede Analyse an.
- Speichern Sie das Kohorten-Protokoll vor der deskriptiven Analyse endgültig ab. Notieren Sie die Anzahl der berechtigten Rezeptbesuche und eindeutigen Patienten und generieren Sie alle abhängigen Ausgaben erneut, falls sich eine Zulassungsentscheidung ändert.
3. Terminologie standardisieren und die Nachvollziehbarkeit sicherstellen
- Erstellen Sie separate, versionskontrollierte Wörterbücher für Kräuter, westliche Diagnosen, TCM-Krankheitsnamen, Syndrom-Elemente, Anamnese-Schlüsselwörter, Zungenbegriffe, Pulsbegriffe und Materia-Medica-Attribute.
- Fügen Sie in jedes Wörterbuch den Originalbegriff, normalisierten Begriff, Begriffskategorie, Quellfeld, Regel, Referenzquelle, Wörterbuchversion, Prüfer und Prüfdatum sowie Kommentare ein. Behalten Sie jeden Originalbegriff nach der Normalisierung bei.
- Normalisieren Sie die Namen chinesischer Arzneimittel (CMM) mithilfe autoritativer Nomenklaturquellen9,10. Korrigieren Sie typographische Varianten und systembedingte Abkürzungen, wobei klinisch relevante Verarbeitungsformen erhalten bleiben.
- Behandeln Sie Verarbeitungsqualifikatoren wie gebraten, mit Essig verarbeitet, mit Honig gebraten, mit Ingwer verarbeitet, mit Wein verarbeitet, verkohlt und roh als separate Kennzeichnungen.
- Halten Sie orthographisch oder klinisch unterschiedliche Kräuter getrennt. Führen Sie Bai Shao nicht mit Bai Zhu zusammen und leiten Sie ein Kraut nicht aus einer mehrdeutigen Abkürzung ab, ohne die Quelle zu prüfen.
- Behalten Sie Dosis und Einheit in separaten Feldern bei, sofern verfügbar. Entfernen Sie den Dosistext nur beim Erstellen von variablen Besuchsebenen zur Erfassung des Vorhandenseins von Kräutern.
- Interpretieren Sie die Häufigkeit des Auftretens nicht als kumulative Dosis oder Behandlungsintensität.
- Normalisieren Sie westliche und TCM-Krankheitsnamen unabhängig voneinander. Bewahren Sie das Diagnosesystem und den Status der Hauptdiagnose auf, und übersetzen Sie eine TCM-Krankheitsbezeichnung nicht in eine westliche Diagnose, es sei denn, beide sind ausdrücklich dokumentiert.
- Definieren Sie eine transkribierte TCM-Krankheitsbezeichnung bei erstmaligem Gebrauch, falls erforderlich, um den Leser zu orientieren. Behalten Sie die ursprüngliche Quellbezeichnung bei.
- Trennen Sie mehrwertige, explizite Syndromtexte mithilfe versionsgesperrter Trennzeichen und ordnen Sie Quellformulierungen normalisierten Syndrom-Elementen zu. Beseitigen Sie doppelte normalisierte Elemente innerhalb eines Besuchs.
- Halten Sie explizite Syndromtexte getrennt von vererbten oder auf Basis von Scores abgeleiteten Indikatorspalten.
- Behalten Sie die ursprünglichen Felder für Zunge, Puls, strukturierte Symptome und anonymisierte Anamnese als separate Datenprodukte bei. Gleichsetzen Sie einen Treffer eines Anamnese-Schlüsselworts nicht mit einem vom Arzt eingegebenen strukturierten Symptom.
- Weisen Sie einem Prüfer die Vorschlagserstellung für jede mehrdeutige oder viele-zu-eins-Zuordnung zu und lassen Sie einen zweiten klinischen Prüfer diese bestätigen. Schließen Sie unsichere Zuordnungen aus veröffentlichten Analysen aus, bis eine Quellenprüfung sie klärt.
- Prüfen Sie auf leere normalisierte Bezeichnungen, eins-zu-viele-Zuordnungen, viele-zu-eins-Zuordnungen, doppelte Wörterbucheinträge, ungeprüfte Begriffe und versehentliches Verlieren von Verarbeitungskennzeichnungen. Sperren Sie die Wörterbuchversionen, bevor Sie aggregierte Tabellen erstellen.
4. Quellfelder überprüfen und berichtsfähige Ausgaben sperren
- Erstellen Sie ein Nachweis-Protokoll mit einer Zeile für jede Behauptung im Manuskript, jede Tabelle und jede Abbildung. Tragen Sie die Analyseeinheit, Quellfeld, Quellversion, Wörterbuchversion, Skriptversion, Zähler, Nenner, Ausgabedatei, Prüfer und genehmigte Formulierung ein.
- Berechnen Sie die Anzahl der berechtigten Besuche und eindeutigen Patienten, demografischen Zusammenfassungen, Erkrankungszahlen, expliziten Syndromzahlen, Anzahl der Schlüsselwörter in der Anamnese, Häufigkeiten zusammengeführter Kräuter sowie Gesamtnutzung von Kräutern direkt aus den versionsgesperrten Dateien neu.
- Vergleichen Sie jeden neu berechneten Wert mit dem entsprechenden Wert im Manuskript, in der Tabellenkalkulation oder in der Abbildung. Korrigieren Sie das Manuskript und erzeugen Sie abhängige Ausgaben neu, sobald eine Abweichung bestätigt ist.
- Lösen Sie jede Abweichung auf der Ebene des Quellfeldes. Tragen Sie den Grund, die Korrektur, den Prüfer und das Datum in das Nachweis-Protokoll ein, bevor das betroffene Ergebnis freigegeben wird.
- Stellen Sie sicher, dass jede Aggregattabelle die normalisierte Bezeichnung, den Zähler, den Nenner, die Prozentdefinition, die Analyseeinheit und die Quellkennung enthält, die zur Reproduktion der entsprechenden Aussage erforderlich sind.
- Überprüfen Sie den für jede Prozentangabe verwendeten Nenner. Verwenden Sie eindeutige Patienten für feste demografische Merkmale und Verschreibungsbesuche für dynamische klinische und Verschreibungsvariablen.
- Vergleichen Sie die Beschriftungen, Werte, Reihenfolge und Panel-Definitionen der Abbildungen mit den entsprechenden versionsgesperrten Aggregattabellen. Erzeugen Sie jede Abbildung nach einer Tabellenkorrektur neu, anstatt die dargestellten Werte manuell zu bearbeiten.
- Fordern Sie einen klinischen Prüfer zur Überprüfung der Terminologiemappings an. Fordern Sie einen quantitativen Prüfer zur Überprüfung von Zählungen, Raten, Regelmetriken und Nennern in Heatmaps an.
- Sperren Sie das Nachweis-Protokoll, die Aggregattabellen und die Abbildungsquellen unter einer gemeinsamen Versionskennung, bevor das Manuskript zusammengestellt wird.
5. Erzeugen von beschreibenden Spektren und Ko-Okkurrenz-Ausgaben
- Erstellen Sie patientenbezogene Zusammenfassungen nach Alter und Geschlecht aus einer Zeile pro eindeutigem Patienten. Behalten Sie unbekannte Kategorien bei und berichten Sie diese ausdrücklich.
- Erstellen Sie westliche und TCM-Krankheitsspektren getrennt auf der Ebene von Rezeptur-Besuch. Bewahren Sie das ursprüngliche Diagnosesystem bei und berechnen Sie führende normalisierte Bezeichnungen unter Verwendung eines gemeinsamen Besuchs-Nenners.
- Erstellen Sie den Syndrom-Element-Spektrum aus dem explizit normalisierten Syndrom-Textfeld. Teilen Sie Begriffe mithilfe versionsgesperrter Trennzeichen auf, entfernen Sie Duplikate jedes Begriffs innerhalb eines Besuchs und berechnen Sie Besuchshäufigkeiten.
- Erstellen Sie die Syndrom-Ko-Okurrenzmatrix aus denselben innerhalb eines Besuchs stehenden Token-Sets. Kodieren Sie die Knotengröße anhand der Besuchshäufigkeit und die Kantenbreite oder die Intensität der Heatmap anhand der paarweisen Ko-Okurrenzanzahl.
- Legen Sie ein exaktes Wörterbuch für Anamnese-Schlüsselwörter vorab fest, wenn die Symptombeschreibung hauptsächlich narrativ ist. Durchsuchen Sie ausschließlich das anonymisierte Anamnese-Feld und zählen Sie jedes Konzept innerhalb eines Besuchs maximal einmal.
- Berechnen Sie den Anteil der berechtigten Besuche, die mindestens ein Anamnese-Schlüsselwort enthalten, und sortieren Sie alle Schlüsselwortanzahlen. Exportieren Sie die vollständige Tabelle sowie die dargestellte Teilmenge.
- Erstellen Sie Häufigkeiten für zusammengeführte Kräuter aus normalisierten Rezepturdaten. Zählen Sie jede normalisierte Kräuterbezeichnung pro Besuch maximal einmal und behalten Sie klinisch relevante Verarbeitungsformen als separate Bezeichnungen bei.
- Erstellen Sie Vier-Qi-, Fünf-Geschmack- und Meridian-Tropismus-Profile aus dem versionsgesperrten Materia-Medica-Wörterbuch. Behandeln Sie Vier-Qi als eindimensionale Kategorie für jeden eigenschaftscodierten Kräutereintrag.
- Behandeln Sie Fünf-Geschmack und Meridian-Tropismus als mehrfach belegbare Attribute. Geben Sie den eigenschaftscodierten Nenner an und bewahren Sie die getrennte Analyseeinheit auf.
- Exportieren Sie vor der Erstellung der endgültigen Abbildungen jeweils eine maschinenlesbare aggregierte Tabelle für jeden beschreibenden Bereich.
6. Durchführung von Assoziationsregel- und hierarchischen Clusteranalysen
- Konstruieren Sie eine binäre Rezeptur-Besuch-nach-Kraut-Matrix aus der versionsgesperrten, normalisierten Rezepturtabelle. Verwenden Sie eine Zeile pro berechtigtem Besuch und eine Spalte pro normalisierter Krautbezeichnung.
- Berechnen Sie Support, Konfidenz und Lift für gerichtete Einzelkraut-Assoziationsregeln19. Behalten Sie die Richtung jeder Regel bei, da die Konfidenz vom Antezedens abhängt.
- Wenden Sie die vorab festgelegten Schwellenwerte von Support ≥ 0,30, Konfidenz ≥ 0,70 und Lift > 1,0 an. Exportieren Sie jede beibehaltene Regel mit ihrer Ko-Okkurrenzanzahl und allen drei Metriken.
- Stellen Sie die vollständige Menge der beibehaltenen Regeln als gerichtetes bipartites Regeln-Netzwerk und als geordnetes Regeln-Stärke-Profil dar. Kodieren Sie die Breite der Netzwerkkanten durch den Support und die Farbe der Kanten durch den Lift.
- Kodieren Sie die Punktgröße durch den Support und kennzeichnen Sie die Konfidenz im geordneten Profil.
- Überprüfen Sie, dass beide Regel-Darstellungen dieselbe Menge an beibehaltenen Regeln enthalten und die Regelnrichtung beibehalten wird. Klären Sie jede Abweichung anhand der exportierten Regel-Tabelle, bevor Sie diese freigeben.
- Wählen Sie die 20 häufigsten Krautpräsenz-Variablen für eine hierarchische Clusterung aus. Berechnen Sie paarweise Jaccard-Distanzen und wenden Sie die durchschnittliche Verknüpfung (average linkage) an.
- Beschriften Sie das Dendrogramm mit den normalisierten Krautnamen. Interpretieren Sie die Nähe der Äste ausschließlich als Ähnlichkeit in den Mustern des Auftretens auf Ebene der Besuche.
- Exportieren Sie vor der Erstellung der Abbildungen die Spezifikation der binären Matrix, die Regel-Tabelle, die Liste der Netzwerkkanten, die Reihenfolge der Cluster-Eingabedaten, die Distanzmatrix und die Verknüpfungsmatrix.
- Fordern Sie einen quantitativen Prüfer auf, eine Regel-Metrik manuell nachzurechnen. Vergleichen Sie jede Netzwerkkante mit der Regel-Tabelle.
- Führen Sie den gesamten Workflow für Regeln und Clusterung erneut durch, sobald sich Kohorte, Terminologiewörterbuch oder Krautpräsenz-Matrix ändern.
- Führen Sie für das durchgerechnete Beispiel eine deterministische Sensitivitätsanalyse mit einem Besuch pro Patienten durch, indem Sie für jeden Patienten den frühesten Eintrag in der Quellreihenfolge beibehalten. Vergleichen Sie die resultierenden 12 Regeln mit den 15 Regeln aus der Analyse auf Besuchsebene.
- Berichten Sie die Veränderung als beschreibungsergebnis zur Robustheitsprüfung, nicht als patientenebene Validierung. Verwenden Sie die deterministische Neuberechnung, die in Supplementary File 1 bereitgestellt ist.
7. Erzeugen von diagnosestratifizierten Mustern und des Rahmens für die klinische Interpretation
- Wählen Sie klinisch relevante Hauptdiagnose-Strata nach westlicher Diagnose, bevor Sie die diagnose-spezifischen Kräuterverteilungen untersuchen.
- Zählen Sie jedes normalisierte Kräuteretikett innerhalb jedes Diagnose-Stratums pro Besuch maximal einmal. Berechnen Sie die Prävalenz als Anzahl der Besuche, die das Etikett enthalten, geteilt durch die Gesamtanzahl der in diesem Stratum berechtigten Besuche.
- Verwenden Sie dieselbe angezeigte Kräutersammlung und eine feste Farbskala von 0 % bis 100 % über alle Diagnose-Strata hinweg. Zeigen Sie Zellenwerte so an, dass eine exakte Interpretation gewährleistet ist.
- Berichten Sie Zähler und Nenner für jede dargestellte Zelle in einer separaten aggregierten Tabelle.
- Erstellen Sie nach Fertigstellung der beschreibenden Heatmap ein eigenes Panel für die klinische Interpretation. Halten Sie berechnete Ergebnisse und fachkundige Interpretation visuell getrennt.
- Füllen Sie die Hinweis-Schicht ausschließlich mit Begriffen, die auf die versionsgesperrte Tabelle der Stichwort-Historie oder expliziten normalisierten Syndromtext zurückgeführt werden können.
- Lassen Sie zwei klinische Prüfer die prägnanten, kontextbezogenen Interpretationen der ausgewählten Hinweise gemeinsam festlegen. Dokumentieren Sie die Prüfer und die endgültige Formulierung im Nachweis-Protokoll.
- Verknüpfen Sie jede kontextuelle Interpretation mit einem Forschungszweck, beispielsweise Variablenauswahl, prospektive Validierung oder Hypothesenbildung.
- Verwenden Sie gestrichelte, nicht-gerichtete Verbindungen für die Interpretationsschicht. Omission von Dosierungsangaben, festen Zusammensetzungen und Therapieempfehlungen.
- Überprüfen Sie Heatmap und Interpretations-Panel gemeinsam. Stellen Sie sicher, dass berechnete Prävalenz, fachkundiger Kontext und zukünftige Forschungszwecke klar voneinander getrennt bleiben.
8. Paket zur Reproduzierbarkeit zusammenstellen und überprüfen
- Exportieren Sie das Quell-Manifest, das Kohorten-Manifest, die Wörterbuchversionen, das Nachweis-Protokoll, die Analyse-Skripte, die aggregierten Tabellen, die Abbildungsquellen und die endgültigen Abbildungen in separate Verzeichnisse.
- Benennen Sie jede Datei mit einer stabilen Abbildungs- oder Tabellennummer sowie einem Versionsdatum. Bewahren Sie jeweils eine autoritative aktuelle Version auf und archivieren Sie überholte Ausgaben separat.
- Erstellen Sie jede Abbildung als eine mehrteilige Bilddatei. Exportieren Sie ein hochauflösendes PDF und ein PNG mit 300 dpi zur Überprüfung.
- Platzieren Sie die Abbildungserläuterungen im Manuskript und führen Sie sie nicht in den Bilddateien selbst auf. Beschreiben Sie jeden Teilbereich, Analyse-Einheit, Nenner und visuelle Kodierung.
- Bereiten Sie für jede Tabelle eine eigenständige XLSX-Datei vor.
- Bitten Sie einen unabhängigen Prüfer, die im Manuskript angegebenen Zahlen mit den aggregierten Tabellen sowie die Prozentangaben mit ihren Zählern und Nennern zu vergleichen.
- Vergleichen Sie die Kanten der Regeln mit der Regeltabelle und die Zellen der Heatmap mit der Quellmatrix.
- Führen Sie automatisierte Prüfungen auf Konsistenz der Dateinamen, erforderliche Abschnitte, Abbildungsabmessungen, Tabellenanzahl, Anzahl der Referenzen, Vorlagenreste und eingeschränkte Formulierungen durch.
- Bitten Sie das klinische Autorenteam, die Terminologie, Interpretation, Grenzen des geistigen Eigentums, Autorendaten, Reihenfolge der Förderangaben, Formulierungen zu ethischen Aspekten sowie den endgültigen Satz an Abbildungen zu überprüfen.
- Entfernen Sie patientenebenebezogene Dateien, Verknüpfungsschlüssel, uneingeschränkten Freitext, interne Korrespondenz und temporäre Überarbeitungsartefakte aus dem Einreichungspaket.
- Blockieren Sie das veröffentlichte Paket und dokumentieren Sie dessen Version, Datum, Prüfsumme, Manuskriptversion und Genehmigungsstatus durch die Autoren. Erstellen Sie für jede nachfolgende Korrektur eine neue Version und ein Änderungsprotokoll.
Ergebnisse
Die erfolgreiche Anwendung des Protokolls führte zu einer nachvollziehbaren Kette, die den anonymisierten Quell-Datensatz, den Kohorten-Manifest, die Terminologiewörterbücher, die aggregierten Tabellen, die Skripte und die endgültigen Abbildungen miteinander verbindet. Das versionsgesperrte Screening-Verfahren identifizierte 555 berechtigte Verschreibungsbesuche von 396 eindeutigen Patienten. Abbildung 1 fasst die drei koordinierten Phasen der Methode zusammen: Governance, Normalisierung der Terminologie und Analyse mit klinischer Überprüfung. Die entsprechende Transparenz- und Audit-Dokumentation, einschließlich der ausschließlich auf Aggregate beschränkten Grenze für die KI-unterstützte Überprüfung, ist in Supplementär-Tabelle 1 enthalten.
Die endgültige Kohorte umfasste 555 berechtigte Verschreibungsbesuche, die von 396 einzigartigen Patienten stammten (Abbildung 2 und Tabelle 1). Tatsächlich wiederholte Besuche wurden für dynamische klinische und Verschreibungsvariablen beibehalten, während Alter und Geschlecht nach der Entfernung von Patientenduplikaten zusammengefasst wurden. Das Alter der Patienten reichte von 13 bis 94 Jahren, mit einem Mittelwert von 47,11 Jahren und einer Standardabweichung von 14,88 Jahren. Die Kohorte umfasste 228 weibliche Patienten (57,58 %), 167 männliche Patienten (42,17 %) und einen Patienten mit unbekanntem Geschlecht (0,25 %). Diese Trennung der Analyseeinheiten bewahrte longitudinale Begegnungen, ohne den demografischen Nenner aufzublähen.
Die Krankheitsspektren der westlichen Medizin und der Traditionellen Chinesischen Medizin (TCM) sind in Abbildung 3 zusammengefasst. Die Diagnosen der westlichen Medizin konzentrierten sich auf Erkrankungen des Magen-Darm-Trakts sowie der hepatobiliären und pankreatischen Systeme. Die hierarchische Gruppierung ordnete 271 Behandlungen Magen-Darm-Erkrankungen, 222 hepatobiliären oder pankreatischen Erkrankungen und 62 anderen Systemen zu (Abbildung 3A). Die häufigsten einzelnen Diagnosen waren chronische Gastritis mit 133 Behandlungen (23,96 %), Fettleber mit 77 Behandlungen (13,87 %) und Leberzirrhose mit 46 Behandlungen (8,29 %), gefolgt von chronischer atrophischer Gastritis, Bauchschmerzen, chronischer Hepatitis B, Dyspepsie, Refluxösophagitis, chronischer oberflächlicher Gastritis und chronischer Pankreatitis (Abbildung 3C und Tabelle 2).
Das entsprechende Spektrum der TCM-Krankheitsnamen ordnete dieselben Besuche gemäß einem parallelen Diagnosesystem ein. Krankheitsbezeichnungen des Milz-Magen- oder Darmbereichs umfassten 280 Besuche, solche der Leber und der Gallenblase 223, Störungen von Qi, Blut und Körperflüssigkeiten 26, Störungen von Geist, Brust und Kopf 12, Erkrankungen der Meridiane oder Gliedmaßen 5, gynäkologische Störungen 4 sowie andere Kategorien 5 Besuche (Abbildung 3B). Wei pi, eine beibehaltene TCM-Krankheitsbezeichnung für epigastrische Völlegefühl oder Unbehagen, wurde bei 163 Besuchen (29,37 %) dokumentiert. Ji-Krankheit (eine TCM-Bezeichnung für eine Ansammlungserkrankung), Gan zhuo (wörtlich „Leberfixierung“; eine klassische, beibehaltene TCM-Krankheitsbezeichnung), Bi-Krankheit (Hinderniskrankheit) und Xiao ke (Abmagerung mit Durst) wurden als ursprüngliche TCM-Bezeichnungen belassen und nicht in moderne biomedizinische Diagnosen umgewandelt. Gan pi, eine in den aktuellen chinesischen Leitlinien für Fettlebererkrankungen verwendete TCM-Krankheitsbezeichnung, wurde bei 77 Besuchen (13,87 %) erfasst35. Die Felder für westliche und TCM-Diagnosen blieben unabhängig voneinander und wurden nicht gegenseitig ersetzt (Abbildung 3D und Tabelle 3). Xie xie (lockere oder wässrige Stühle) und Fu xie (Durchfall) waren zwei getrennte ursprüngliche TCM-Krankheitsbezeichnungen, die jeweils 6- und 2-mal dokumentiert wurden und keiner modernen biomedizinischen Diagnose zugeordnet wurden. Die nebeneinander dargestellten Spektren bewahrten die Logik jedes Diagnosesystems und verdeutlichten gleichzeitig die klinische Breite der Quelldaten.
Das explizite normalisierte Syndrom-Text-Feld enthielt 555 geeignete Besuchszeilen. Nach der innerhalb eines Besuchs erfolgenden Entfernung von Duplikaten standen Milz in 362 Besuchen (65,23 %), Leber in 304 (54,77 %), Qi-Mangel in 295 (53,15 %), Magen in 171 (30,81 %), Feuchtigkeit in 151 (27,21 %) und Qi-Stagnation in 109 (19,64 %; Abbildung 4A und Tabelle 4) an erster Stelle. Hitze, Wasserretention, Blut, Blutstase, Meridiane, Niere, Herz und Yin-Mangel machten den Rest des dargestellten Spektrums aus. Die Prozentangaben waren nicht ausschließlich, da während eines einzelnen Besuchs mehrere Syndrom-Elemente auftreten konnten.
Das Netzwerk und die Zählmatrix wurden aus denselben Token-Sets auf Besuchsebene generiert (Abbildung 4B,C). Häufige gemeinsame Nennungen konzentrierten sich auf Milz, Leber und Qi-Mangel, mit zusätzlichen Verbindungen zu Magen, Feuchtigkeit, Qi-Stagnation, Hitze und Wasserrückhaltung. Die Verwendung einer versionsfixierten Matrix für Häufigkeitsplot, Netzwerk und Heatmap stellte sicher, dass alle drei Darstellungen dieselbe zugrundeliegende Evidenz auf unterschiedlichen Detaillierungsgraden abbildeten. Die durchgeführte Überprüfung ergab 0 exakte Übereinstimmungen zwischen Syndromtexten und Indikatoren unter 555 Zeilen sowie eine durchschnittliche Jaccard-Ähnlichkeit von 0,1806 zwischen Text und Indikatoren. Die Indikatorspalten wurden daher von der inhaltlichen Berichterstattung ausgeschlossen. Die verbliebenen Materialien enthielten keine rekonstruierbaren Verteilungsvektoren vor der Bereinigung; infolgedessen konnte die verteilungsbezogene Stabilität über Versionen hinweg nicht geschätzt werden. Die Sensitivitätsanalyse mit je einem Besuch pro Patient untersuchte stattdessen den Einfluss wiederholter Besuche. Die Ergebnisse der Quellenüberprüfung und der Datenqualität sind in Zusatz-Tabelle 2 zusammengefasst.
Nach der Terminologienormalisierung und Beibehaltung klinisch bedeutsamer Verarbeitungsformen enthielten die 555 Besuche 324 unterschiedliche zusammengeführte Kräuterbezeichnungen und 9.339 Kräuteranwendungen. Bai Shao wurde in 531 Besuchen (95,68 %) dokumentiert, gefolgt von Fu Ling in 520 (93,69 %), Dang Gui in 510 (91,89 %), Chi Shao in 467 (84,14 %) und geröstetem Bai Zhu in 361 (65,05 %; Abbildung 5A und Tabelle 5). Die Rang-Häufigkeits-Kurve der 36 führenden Bezeichnungen zeigte einen steilen, hochfrequenten Abschnitt, dem eine zunehmend breitere Abnahme folgte (Abbildung 5B), was eine kompakte Darstellung der gemeinsamen Grundlage und der individuell zusammengestellten Rezepturkomponenten ermöglicht. Die Zuordnungen von Quelle zu normalisierter Bezeichnung, die Verarbeitungsqualifikatoren, die standardisierten CMM-Namen, die Quellarten sowie die Beweisgrenzen, die der Kräuternomenklatur zugrunde liegen, sind in Ergänzungstabelle 3 dokumentiert.
Das Hilfs-Werksstoff-Lexikon enthielt 9.115 eigenschaftscodierte Anwendungen von Kräutern. Die führenden Vier-Qi-Kategorien waren warm (2.588, 28,39 %), leicht kalt (2.339, 25,66 %), neutral (2.330, 25,56 %) und kalt (1.221, 13,40 %; Abbildung 5C). Nach der Normalisierung der geschmacklichen Begrifflichkeiten der Verbindungsquellen ergaben sich als führende Fünf-Geschmack-Kategorien: bitter (4.488, 49,24 %), süß (4.377, 48,02 %) und scharf (2.893, 31,74 %; Abbildung 5D). Bei der Meridian-Tropismus-Codierung standen Milz (5.541, 60,79 %), Leber (4.801, 52,67 %), Lunge (3.358, 36,84 %), Magen (2.988, 32,78 %) und Herz (2.702, 29,64 %; Abbildung 5E) an der Spitze. Abbildung 5F dokumentiert die unterschiedlichen analysierten Einheiten auf Besuchsebene und auf Basis der Eigenschaftscodierung sowie deren Reproduzierbarkeitsbezug. Zusammen zeigen diese Darstellungen, wie Häufigkeiten von Verschreibungen und standardisierte Beschreibungen der Arzneistoffe zusammengefasst werden können, ohne terminologische Unterscheidungen bezüglich der Verarbeitung zu verwischen.
Das vorgegebene Historienwörterbuch enthielt 37 exakte Symptombegriffe. In 474 von 555 berechtigten Besuchen (85,41 %) wurde mindestens ein Begriff erkannt. Die häufigsten Begriffe waren trockener Hals in 178 Besuchen (32,07 %), Müdigkeit in 151 (27,21 %), schlechter Schlaf in 139 (25,05 %), Bauchdehnung in 115 (20,72 %), saurer Reflux in 100 (18,02 %), bitterer Geschmack in 99 (17,84 %), Sodbrennen in 90 (16,22 %), Schluckauf in 87 (15,68 %), Aufstoßen in 87 (15,68 %) und weicher Stuhl in 77 (13,87 %; Abbildung 6A,B und Tabelle 6).
Die vollständige Rang-Frequenz-Kurve zeigte die volle Verteilung von 37 Begriffen, während die kumulative Linie die Konzentration aller Schlagwortnachweise über alle Ränge hinweg zusammenfasste (Abbildung 6C). Abbildung 6D dokumentiert die reproduzierbare Abfolge zur Erzeugung des Spektrums: Wörterbuch sperren, anonymisierten Verlaufs-Text durchsuchen, Konzepte innerhalb jedes Besuchs entdoppeln und aggregierte Anzahlen sowie Raten exportieren.
Das Assoziationsregel-Mining verwendete die versionsgesperrte Präsenzmatrix für 555 Verschreibungsbesuche nach Kräutern. Fünfzehn gerichtete Einzelkraut-Regeln erfüllten die Kriterien von Support ≥ 0,30, Konfidenz ≥ 0,70 und Lift > 1,0 (Abbildung 7A,B und Tabelle 7). Die beibehaltenen Support-Werte lagen zwischen 0,3009 und 0,7892, die Konfidenz-Werte zwischen 0,7302 und 0,9748 sowie die Lift-Werte zwischen 1,0010 und 1,1226.
Das am häufigsten gemeinsam aufgezeichnete gerichtete Paar war Chi Shao > Fu Ling, basierend auf 438 Besuchen, mit einer Unterstützung von 0,7892, einer Konfidenz von 0,9379 und einem Lift von 1,0010. Die umgekehrte Regel wies dieselbe Unterstützung und eine Konfidenz von 0,8423 auf, was verdeutlicht, warum die Richtung der Regel beibehalten werden muss. Die Schwellenwert-Sensitivität behielt 18, 11, 21, 14, 7 bzw. 4 Regeln unter den Bedingungen Unterstützung ≥ 0,25 oder ≥ 0,35, Konfidenz ≥ 0,65 oder ≥ 0,75 bzw. Lift > 1,02 oder > 1,05 bei. Bei der Analyse mit einem Besuch pro Patient trat dasselbe Paar in 316 Besuchen auf, mit einer Unterstützung von 0,7980, einer Konfidenz von 0,9489 und einem Lift von 0,9994; daher wurde es nicht unter dem Kriterium Lift > 1,0 beibehalten. Die Ergebnisse zu Schwellenwert-Störungen und der Empfindlichkeit gegenüber Wiederholungsbesuchen sind in Supplementary Table 4 enthalten, und die deterministische Neuberechnung ist in Supplementary File 1 angegeben. Folglich sollte eine hohe Unterstützung auf Ebene der Besuche nicht als Validierung auf Ebene der Patienten interpretiert werden.
Die höchsten Lift-Werte wurden für Gan Cao > gebratenes Bai Zhu (1,1226) und Gan Cao > Chi Shao (1,1200) beobachtet. Abbildung 7A integriert alle 15 beibehaltenen Regeln in einem gerichteten bipartiten Netzwerk, wobei die Breite der Kanten die Unterstützung und die Farbe der Kanten den Lift darstellt. Abbildung 7B ordnet dieselben Regeln nach Lift, skaliert jeden Punkt nach Unterstützung und kennzeichnet das Konfidenzniveau. Die beiden Darstellungen unterscheiden somit Netzwerktopologie von quantitativer Regelstärke, anstatt dieselbe visuelle Repräsentation zu duplizieren.
Die hierarchische Clusterung der 20 am häufigsten vorkommenden Kraut-Variablen verwendete den Jaccard-Abstand und die durchschnittliche Verknüpfung (Abbildung 7C). Das Dendrogramm liefert eine globale Darstellung der Ähnlichkeit in den Präsenzmustern auf Besuchsebene, die die lokalen, richtungsbezogenen Informationen der Assoziationsregeln ergänzt. Zusammen zeigen die Darstellungen, wie sich komplementäre analytische Ansichten auf eine einzige, versionsgesperrte binäre Matrix abstimmen lassen.
Die prävalenzbasierte Aufschlüsselung nach Diagnosen wurde für Fettleber (77 Besuche), Leberzirrhose (46 Besuche) und chronische Gastritis (133 Besuche; Abbildung 8A und Tabelle 8) berechnet. Bai Shao, Fu Ling und Dang Gui wiesen in allen drei Gruppen eine hohe Prävalenz auf. Bei den Fällen mit Leberzirrhose wurde häufig Dan Shen (95,65 %), Essig-verarbeitetes E Zhu (86,96 %), Essig-verarbeitetes Bie Jia (84,78 %) und Sheng Huang Qi (60,87 %) dokumentiert. Bei den Fällen mit Fettleber trat Yin Chen (41,56 %) und Ze Xie (31,17 %) häufiger auf als in den anderen Gruppen, während bei chronischer Gastritis wiederholt Huang Lian (44,36 %), Mu Xiang (34,59 %) und Chai Hu (36,09 %) verzeichnet wurden. Die Heatmap bietet daher einen kompakten, beschreibenden Vergleich der aggregierten Verschreibungsmuster über wesentliche klinische Kontexte hinweg.
Abbildung 8B trennt Berechnung von Interpretation. Verifizierte historische Hinweise werden mit präzisen fachkundigen Kontexten verknüpft und anschließend mit Forschungsanwendungen, einschließlich der Einordnung von Syndrom-Elementen, des Vergleichs diagnosestratifizierter Muster, der Auswahl von Variablen zur prospektiven Validierung sowie der Erstellung von Folgefragen. Dieses letzte Panel zeigt, wie klinische Expertise die analytischen Ergebnisse bereichern kann, während sie sichtbar getrennt von der berechneten Prävalenz bleibt.
Abbildung 8C fasst die Reproduzierbarkeit und Freigabegrenze zusammen, indem sie quellenverifizierte oder erneut analysierte Komponenten von Elementen abgrenzt, die Vorsicht oder weitere Bestätigung erfordern. Diese letzte Prüfebene verhindert, dass ungeklärte oder nicht rekonstruierbare analytische Produkte als validierte Ergebnisse präsentiert werden.
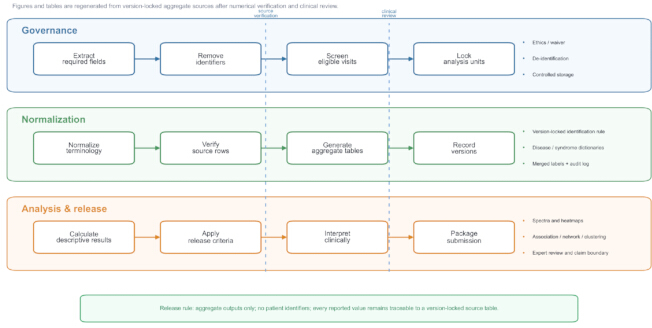
Abbildung 1: Workflow für die quellengeprüfte Datensatzanalyse aus Patientenakten. Governance, Terminologienormalisierung, aggregierte Analyse, klinische Überprüfung und Freigabeprozess sind als aufeinanderfolgende Phasen des Workflows dargestellt. Blaue, grüne und orange Bänder unterscheiden die Workflow-Bereiche, und gestrichelte vertikale Linien zeigen Prüfschwellen an. Pfeile verdeutlichen die Reihenfolge im Workflow und implizieren keine biologische Kausalität. Die Freigaberegel besagt, dass ausschließlich aggregierte Ergebnisse freigegeben werden, dass Patientenidentifikatoren ausgeschlossen sind und dass jeder berichtete Wert nachvollziehbar bleibt zu einer versionsgesperrten Quelltabelle. Es sind keine Fehlerbalken anwendbar. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
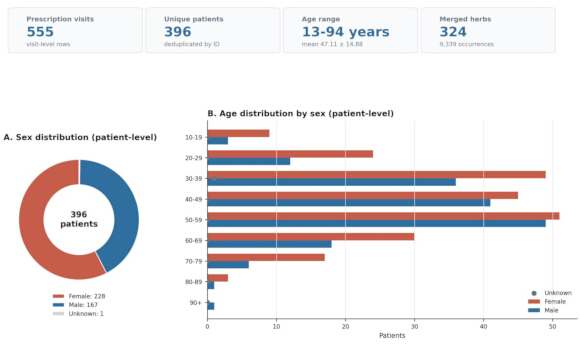
Abbildung 2: Datensatzprofil und demografische Angaben auf Patientenebene. Die Zusammenfassungsfelder zeigen 555 Verschreibungsbesuche, 396 eindeutige Patienten, einen Altersbereich auf Patientenebene von 13–94 Jahren mit einem mittleren Alter von 47,11 ± 14,88 Jahren und 324 zusammengeführte Kräuterbezeichnungen, die 9.339 Vorkommnisse von Kräuteranwendungen repräsentieren. (A) Geschlechtsverteilung auf Patientenebene unter den 396 eindeutigen Patienten, einschließlich der Kategorien weiblich, männlich und unbekannt. (B) Altersverteilung auf Patientenebene nach Geschlecht bei denselben 396 Patienten. Die Zusammenfassungsfelder verwenden je nach Anwendbarkeit die angezeigten Nenner auf Besuchsebene oder auf Patientenebene. Farben unterscheiden Geschlechtskategorien und Zusammenfassungselemente und haben keine inferenzielle Bedeutung. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
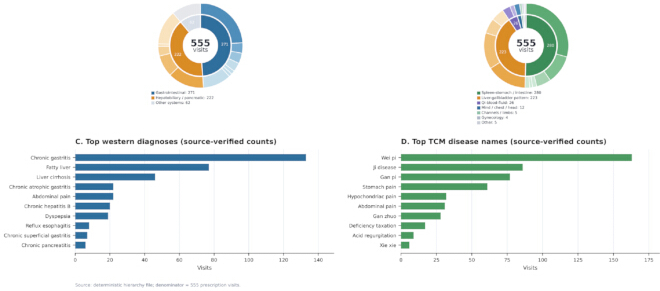
Abbildung 3: Krankheitsspektren, ermittelt aus Verschreibungsbesuchen. (A) Hierarchische westliche Krankheitsgruppen und (B) hierarchische TCM-Krankheitsgruppen, abgeleitet aus 555 qualifizierten Verschreibungsbesuchen. (C) Häufigste normalisierte westliche Diagnosen und (D) häufigste normalisierte TCM-Krankheitsnamen aus derselben Besuchsebene. Ringsegmente und Balken stellen Besuchsanzahlen dar; Farben unterscheiden Diagnosesysteme oder Kategorien und repräsentieren keine Behandlungseffekte. Beibehaltene TCM-Quellbezeichnungen sind in Tabelle 3 definiert: Wei pi (epigastrische Völlegefühl oder Beschwerden), Ji disease (akkumulationsartige TCM-Quellbezeichnung), Gan pi (eine TCM-Krankheitsbezeichnung für fettleberbedingte Störungen), Gan zhuo (wörtlich: Leberfixierung; eine beibehaltene klassische TCM-Krankheitsbezeichnung), Bi disease (Hemmkrankheit), Xiao ke (Abmagerung mit Durst), Xie xie (lockere oder wässrige Stühle) und Fu xie (Durchfall). Diese Erläuterungen wandeln die Quellbezeichnungen nicht in moderne biomedizinische Diagnosen um. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
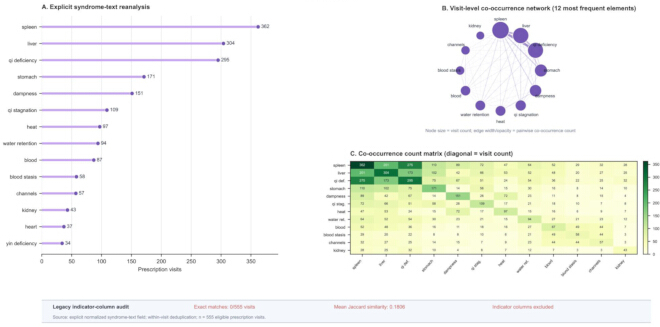
Abbildung 4: Explizites Syndrom-Text-Spektrum und Co-Occurrence-Struktur. (A) Besuchsebene-Häufigkeiten von 14 normalisierten Syndrom-Elementen nach Deduplizierung innerhalb eines Besuchs, basierend auf 555 qualifizierten Verschreibungsbesuchen als Nenner. (B) Ko-Occurrence-Netzwerk der 12 häufigsten Syndrom-Elemente; die Knotengröße repräsentiert die Besuchshäufigkeit, und die Breite sowie Deckkraft der Kanten repräsentieren paarweise Co-Occurrence-Zahlen. (C) Entsprechende symmetrische Co-Occurrence-Zählmatrix; die diagonalen Zellen repräsentieren individuelle Besuchshäufigkeiten, und die nicht-diagonalen Zellen repräsentieren paarweise Co-Occurrence-Zahlen. Die Audit-Leiste meldet 0 exakte Übereinstimmungen zwischen Syndrom-Text und Indikator über 555 Zeilen sowie eine durchschnittliche Jaccard-Ähnlichkeit zwischen Text und Indikator von 0,1806; daher wurden die alten Indikatorspalten von der inhaltlichen Berichterstattung ausgeschlossen. In der Matrix steht Qi def. für Qi-Mangel, Qi stag. für Qi-Stagnation und Water ret. für Wasserretention. Die Farbpalette ist beschreibend. Keine Fehlerbalken anwendbar. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
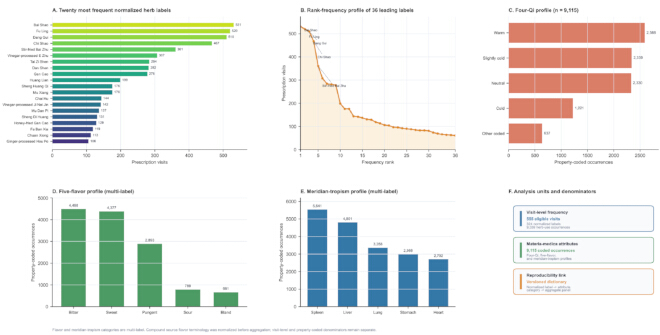
Abbildung 5: Häufig verwendete Kräuter und normalisierte Arzneimittelprofilattribute. (A) Die zwanzig häufigsten normalisierten Krautbezeichnungen unter 555 geeigneten Verschreibungsbesuchen. (B) Rang-Frequenz-Profil der 36 führenden normalisierten Krautbezeichnungen. (C) Vier-Qi-Verteilung basierend auf 9.115 arzneilich codierten Anwendungen; Vier-Qi ist für jede codierte Anwendung eindeutig. (D) Fünf-Geschmack- und (E) Meridianaffinitätsverteilungen basierend auf demselben codierten Nenner; beide sind Mehrfachlabel-Attribute, weshalb die Kategorieanzahlen nicht ausschließlich sind. (F) Analyseeinheiten auf Besuchsebene und arzneilich codierte Einheiten sowie deren Reproduzierbarkeitsbezug. Die Balkenlängen repräsentieren die Anzahlen, und die Farben unterscheiden die Felder. Es sind keine Fehlerbalken angegeben. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
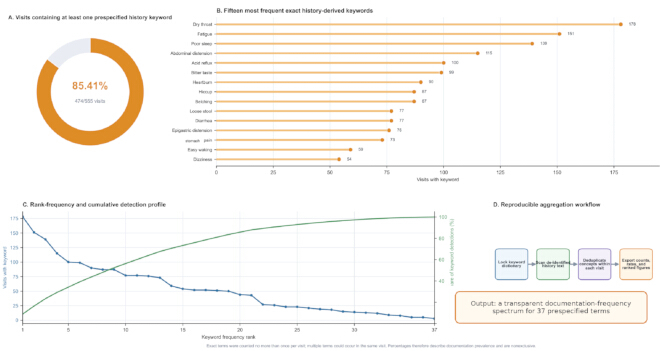
Abbildung 6: Symptombezogenes Schlüsselwort-Spektrum aus der Anamnese und reproduzierbarer Aggregationsarbeitsablauf. (A) Anteil der 555 berechtigten Verschreibungsbesuche, die mindestens ein vorgegebenes anamnestisches Schlüsselwort enthielten; 474 Besuche (85,41 %) enthielten mindestens ein Schlüsselwort. (B) Die 15 häufigsten exakten symptombezogenen Begriffe aus der Anamnese. (C) Vollständige Rang-Frequenz-Verteilung mit 37 Begriffen und kumulative Anteile der Schlüsselwortnachweise. (D) Versionsfixierter Arbeitsablauf vom vorgegebenen Wörterbuch zu den aggregierten Ergebnissen. Jeder Begriff wurde pro Besuch maximal einmal gezählt, wobei mehrere Begriffe innerhalb desselben Besuchs auftreten konnten. Orangefarbene Balken stellen die Schlüsselwortanzahlen dar, und die Farben im Arbeitsablauf unterscheiden die Verarbeitungsstufen. Es sind keine Fehlerbalken anwendbar. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
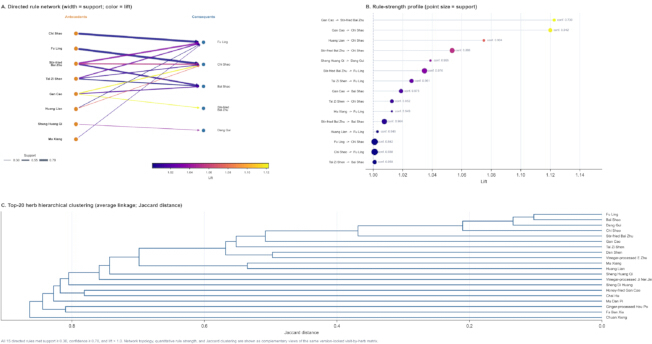
Abbildung 7: Gerichtete Kräuter-Assoziationsregeln und hierarchische Clusterung. (A) Gerichtetes bipartites Netzwerk aller 15 einzelnen Kräuter-Assoziationsregeln, die die vorgegebenen Schwellenwerte von Support ≥ 0,30, Konfidenz ≥ 0,70 und Lift > 1,0 erfüllen. Die Kantenbreite repräsentiert den Support, die Kantenfarbe den Lift. (B) Profil der Regelstärke derselben 15 Regeln, geordnet nach Lift; die Punktgröße repräsentiert den Support, benachbarte Beschriftungen geben die Konfidenz (conf.) an. (C) Hierarchische Clusterung mit Durchschnittsverknüpfung der 20 häufigsten Variablen für das Vorhandensein von Kräutern, basierend auf der Jaccard-Distanz. Alle Darstellungen verwenden Verschreibungsbesuche als Analyseeinheit und beschreiben Muster der gemeinsamen Erfassung, nicht jedoch Wirksamkeit, Synergie oder eine empfohlene feste Kombination. Es sind keine Fehlerbalken anwendbar. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
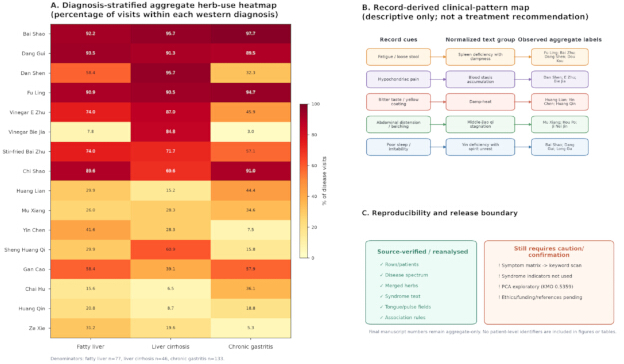
Abbildung 8: Diagnosestratifizierte aggregierte Kräutermuster, klinische Musterkarte und Freigabegrenze. (A) Diagnosestratifizierte Heatmap, die die praxisbezogene Prävalenz von 16 normalisierten Kräuterbezeichnungen bei Fettleber (n = 77), Leberzirrhose (n = 46) und chronischer Gastritis (n = 133) zeigt. Jede Zelle repräsentiert den Prozentsatz der berechtigten Besuche innerhalb des entsprechenden westlichen Diagnosestratums, wobei eine feste Farbskala von 0 % bis 100 % verwendet wird. (B) Aus den Aufzeichnungen abgeleitete klinische Musterkarte, die verifizierte Hinweise aus den Aufzeichnungen mit normalisierten Textgruppen und beobachteten aggregierten Kräuterbezeichnungen verknüpft. Gestrichelte, nicht-gerichtete Verbindungen unterscheiden diese deskriptive Interpretationsebene von der berechneten Prävalenz; das Panel stellt keine Therapieempfehlung dar. (C) Reproduzierbarkeit und Freigabegrenze, die verifizierte oder erneut analysierte Komponenten von Elementen abgrenzt, die Vorsicht oder Bestätigung erfordern. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
| Metrik | Wert | Einheit/Nenner | Status |
| Verordnungsbesuche | 555 | 555 Verordnungsbesuche | überprüft anhand der wiederhergestellten XLSX-Datei |
| Eindeutige Patienten | 396 | 396 eindeutige Patienten | überprüft anhand der wiederhergestellten XLSX-Datei |
| Altersbereich auf Patientenebene | 13–94 | Jahre | überprüft |
| Mittleres Alter auf Patientenebene +/- SD | 47,11 +/- 14,88 | Jahre | überprüft |
| Mittleres Alter auf Besuchsebene +/- SD | 48,22 +/- 15,82 | Jahre | überprüft |
| Geschlecht auf Patientenebene | Weiblich 228; männlich 167; unbekannt 1 | 396 Patienten | überprüft |
| Geschlecht auf Besuchsebene | Weiblich 327; männlich 227; unbekannt 1 | 555 Besuche | überprüft |
| Zusammengeführte Kräuter | 324 | unterschiedliche zusammengeführte Namen | überprüft |
| Vorkommen zusammengeführter Kräuteranwendungen | 9339 | 555 Verordnungsbesuche | überprüft |
Tabelle 1: Datensatzprofil. Demografische Merkmale auf Patientenebene und Variablen auf Ebene von Verschreibungsbesuchen werden jeweils bezogen auf ihre Nenner angegeben. Außerdem werden normalisierte Kräutermengen bereitgestellt.
| Krankheitsname | Anzahl | Anteil der Besuche |
| Chronische Gastritis | 133 | 24 |
| Fettleber | 77 | 13,9 |
| Leberzirrhose | 46 | 8,3 |
| Chronische atrophische Gastritis | 22 | 4 |
| Abdominalschmerz | 22 | 4 |
| Chronische Hepatitis B | 20 | 3,6 |
| Dyspepsie | 19 | 3,4 |
| Refluxösophagitis | 8 | 1,4 |
| Chronische oberflächliche Gastritis | 7 | 1,3 |
| Chronische Pankreatitis | 6 | 1,1 |
| Colitis ulcerosa | 6 | 1,1 |
| Gallengangpolyp | 6 | 1,1 |
| Postcholezystektomiesyndrom | 6 | 1,1 |
| Darmfunktionsstörung | 6 | 1,1 |
| Gallensteine | 6 | 1,1 |
| Chronische Hepatitis | 5 | 0,9 |
| Müdigkeit | 5 | 0,9 |
| Gastrointestinale Funktionsstörung (unsichere ursprüngliche Bezeichnung) | 5 | 0,9 |
| Chronische Gastritis (unsichere ursprüngliche Bezeichnung) | 5 | 0,9 |
| Autoimmunbedingte Leberzirrhose | 4 | 0,7 |
Tabelle 2: Wichtigste normalisierte westliche Diagnosen. Anzahlen und Prozentsätze der wichtigsten normalisierten westlichen Diagnosen, die bei 555 berechtigten Verschreibungsbesuchen erfasst wurden. Die Prozentsätze beziehen sich auf die Anzahl der berechtigten Verschreibungsbesuche als Bezugsgröße.
| TCM-Krankheitsname | Anzahl | Anteil der Besuche |
| Wei pi (epigastrische Völlegefühl oder Beschwerden) | 163 | 29,4 |
| Ji-Krankheit (akumulationsartige TCM-Kennzeichnung) | 86 | 15,5 |
| Gan pi (TCM-Krankheitsbezeichnung für fettleberbedingte Störungen) | 77 | 13,9 |
| Magenbeschwerden | 61 | 11 |
| Hypochondriale Schmerzen | 32 | 5,8 |
| Abdominelle Schmerzen | 31 | 5,6 |
| Gan zhuo (wörtlich: Leberfixierung; eine überlieferte klassische TCM-Krankheitsbezeichnung) | 28 | 5 |
| Mangelerschöpfung | 17 | 3,1 |
| Säurereflux | 9 | 1,6 |
| Xie xie (lockere oder wässrige Stühle) | 6 | 1,1 |
| Schlaflosigkeit | 4 | 0,7 |
| Dysenterie | 4 | 0,7 |
| Kopfschmerzen | 4 | 0,7 |
| Bi-Krankheit (Hemmungskrankheit) | 4 | 0,7 |
| Menstruationsstörung | 3 | 0,5 |
| Brustenge | 3 | 0,5 |
| Schweißstörung | 3 | 0,5 |
| Verstopfung | 3 | 0,5 |
| Fu xie (Durchfall) | 2 | 0,4 |
| Xiao ke (Abmagerung mit Durst) | 2 | 0,4 |
Tabelle 3: Wichtigste normalisierte TCM-Krankheitsnamen. Anzahlen und Prozentanteile der wichtigsten normalisierten TCM-Krankheitsnamen, die über 555 berechtigte Verschreibungsbesuche erfasst wurden. Die Prozentangaben beziehen sich auf die Anzahl der berechtigten Verschreibungsbesuche als Bezugsgröße. Beibehaltene Quellenbezeichnungen und erläuternde Erläuterungen implizieren keine Gleichwertigkeit mit modernen biomedizinischen Diagnosen.
| Rang | Syndromelement | Verschreibungsbesuche | Berechtigte Besuche | Besuchsanteil |
| 1 | Milz | 362 | 555 | 65,23 % |
| 2 | Leber | 304 | 555 | 54,77 % |
| 3 | Qi-Mangel | 295 | 555 | 53,15 % |
| 4 | Magen | 171 | 555 | 30,81 % |
| 5 | Feuchtigkeit | 151 | 555 | 27,21 % |
| 6 | Qi-Stagnation | 109 | 555 | 19,64 % |
| 7 | Hitze | 97 | 555 | 17,48 % |
| 8 | Wasserretention | 94 | 555 | 16,94 % |
| 9 | Blut | 87 | 555 | 15,68 % |
| 10 | Blutstase | 58 | 555 | 10,45 % |
| 11 | Meridiane | 57 | 555 | 10,27 % |
| 12 | Niere | 43 | 555 | 7,75 % |
| 13 | Herz | 37 | 555 | 6,67 % |
| 14 | Yin-Mangel | 34 | 555 | 6,13 % |
Tabelle 4: Wichtigste normalisierten Syndrom-Elemente. Syndrom-Elemente wurden aus explizitem, normalisiertem Syndrom-Text extrahiert und innerhalb jedes Verschreibungsbesuchs entdoppelt. Bei den Zählungen wird eine Gesamtzahl von 555 berechtigten Verschreibungsbesuchen als Bezugsgröße verwendet; die Prozentangaben sind nicht ausschließlich, da mehrere Syndrom-Elemente innerhalb eines Besuchs auftreten können.
| Zusammengefasstes Kräuteretikett | Anzahl | Anteil der Besuche |
| Bai Shao | 531 | 95,7 |
| Fu Ling | 520 | 93,7 |
| Dang Gui | 510 | 91,9 |
| Chi Shao | 467 | 84,1 |
| Stir-fried Bai Zhu | 361 | 65 |
| Vinegar-processed E Zhu | 307 | 55,3 |
| Tai Zi Shen | 284 | 51,2 |
| Dan Shen | 282 | 50,8 |
| Gan Cao | 278 | 50,1 |
| Huang Lian | 199 | 35,9 |
| Sheng Huang Qi | 176 | 31,7 |
| Mu Xiang | 176 | 31,7 |
| Chai Hu | 144 | 25,9 |
| Vinegar-processed Ji Nei Jin | 142 | 25,6 |
| Mu Dan Pi | 137 | 24,7 |
| Sheng Di Huang | 131 | 23,6 |
| Honey-fried Gan Cao | 129 | 23,2 |
| Fa Ban Xia | 119 | 21,4 |
| Chuan Xiong | 113 | 20,4 |
| Ginger-processed Hou Po | 106 | 19,1 |
| Yin Chen | 104 | 18,7 |
| Sheng Bai Zhu | 97 | 17,5 |
| Dou Kou | 96 | 17,3 |
| Sheng Long Gu | 92 | 16,6 |
| Zhe Bei Mu | 90 | 16,2 |
| Huang Qin | 88 | 15,9 |
| Dang Shen | 85 | 15,3 |
| Vinegar-processed Bie Jia | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14,6 |
| Jiao Zhi Zi | 74 | 13,3 |
| He Huan Hua | 69 | 12,4 |
| Wine-processed Huang Jing | 66 | 11,9 |
| Chen Pi | 64 | 11,5 |
| Ze Xie | 63 | 11,4 |
| Jin Qian Cao | 61 | 11 |
Tabelle 5: Wichtigste normalisierte Kräuterbezeichnungen nach Verschreibungsbesuchshäufigkeit. Jede normalisierte Kräuterbezeichnung wurde pro Verschreibungsbesuch maximal einmal gezählt. Bei den Zählungen und Prozentangaben wird die Anzahl von 555 berechtigten Verschreibungsbesuchen als Bezugsgröße verwendet, und klinisch relevante Verarbeitungsformen werden als separate Bezeichnungen beibehalten.
| Rang | Aus der Anamnese abgeleitetes Stichwort | Rezeptur-Besuche | Berechtigte Besuche | Besuchsanteil |
| 1 | Trockener Hals | 178 | 555 | 32,07% |
| 2 | Müdigkeit | 151 | 555 | 27,21% |
| 3 | Schlafstörungen | 139 | 555 | 25,05% |
| 4 | Abdominale Blähung | 115 | 555 | 20,72% |
| 5 | Säurereflux | 100 | 555 | 18,02% |
| 6 | Bitterer Geschmack | 99 | 555 | 17,84% |
| 7 | Sodbrennen | 90 | 555 | 16,22% |
| 8 | Schluckauf | 87 | 555 | 15,68% |
| 9 | Rülpsen | 87 | 555 | 15,68% |
| 10 | Lockerer Stuhl | 77 | 555 | 13,87% |
| 11 | Durchfall | 77 | 555 | 13,87% |
| 12 | Epigastrische Blähung | 76 | 555 | 13,69% |
| 13 | Magenbeschwerden | 73 | 555 | 13,15% |
| 14 | Leichtes Erwachen | 59 | 555 | 10,63% |
| 15 | Schwindel | 54 | 555 | 9,73% |
| 16 | Erbrechen | 52 | 555 | 9,37% |
| 17 | Übelkeit | 52 | 555 | 9,37% |
| 18 | Stumpfer Schmerz | 51 | 555 | 9,19% |
| 19 | Drückender Schmerz | 50 | 555 | 9,01% |
| 20 | Appetitlosigkeit | 44 | 555 | 7,93% |
| 21 | Abdominale Schmerzen | 43 | 555 | 7,75% |
| 22 | Brustenge | 27 | 555 | 4,86% |
| 23 | Reizbarkeit | 26 | 555 | 4,68% |
| 24 | Kopfschmerzen | 23 | 555 | 4,14% |
| 25 | Darmknurren | 23 | 555 | 4,14% |
| 26 | Epigastrisches Unbehagen | 21 | 555 | 3,78% |
| 27 | Herzklopfen | 19 | 555 | 3,42% |
| 28 | Gelber Urin | 18 | 555 | 3,24% |
| 29 | Fremdkörpergefühl | 15 | 555 | 2,70% |
| 30 | Stechender Schmerz | 14 | 555 | 2,52% |
| 31 | Verstopfung | 13 | 555 | 2,34% |
| 32 | Schläfrigkeit | 12 | 555 | 2,16% |
| 33 | Pharyngeales Fremdkörpergefühl | 9 | 555 | 1,62% |
| 34 | Übermäßiges Schwitzen | 8 | 555 | 1,44% |
| 35 | Hypochondriale Schmerzen | 5 | 555 | 0,90% |
| 36 | Tenesmus | 5 | 555 | 0,90% |
| 37 | Trockener Stuhl | 3 | 555 | 0,54% |
Tabelle 6: Wichtigste aus der Anamnese abgeleitete Symptom-Schlüsselwörter. Exakte Symptombegriffe, die im anonymisierten Anamnesetext erkannt wurden. Jeder Begriff wurde pro Verschreibungsbesuch höchstens einmal gezählt, wobei mehrere Begriffe innerhalb desselben Besuchs auftreten konnten. Die Angaben zu Häufigkeiten und Prozentanteilen beziehen sich auf 555 berechtigte Verschreibungsbesuche als Nenner.
| Antezedens | Konsequenz | Gemeinsam auftretende Besuche | Support | Confidence | Lift |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Stir-fried Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Stir-fried Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Stir-fried Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Stir-fried Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
Tabelle 7: Gerichtete Assoziationsregeln für Kräuter, die die vorgegebenen Schwellenwerte erfüllen. Die Regeln wurden aus 555 binären Rezepturbesuchszeilen mit einer Unterstützung von ≥ 0,30, einer Konfidenz von ≥ 0,70 und einem Lift > 1,0 generiert. Bei der Berechnung der Unterstützung wird die Gesamtanzahl von 555 Rezepturbesuchen als Nenner verwendet, und die Richtung der Regel bleibt erhalten, da die Konfidenz eine gerichtete Größe ist.
| Heilpflanzenbezeichnung | Fettleber (n) | Fettleber (N) | Fettleber (%) | Leberzirrhose (n) | Leberzirrhose (N) | Leberzirrhose (%) | Chronische Gastritis (n) | Chronische Gastritis (N) | Chronische Gastritis (%) |
| Bai Shao | 71 | 77 | 92,21% | 44 | 46 | 95,65% | 130 | 133 | 97,74% |
| Dang Gui | 72 | 77 | 93,51% | 42 | 46 | 91,30% | 119 | 133 | 89,47% |
| Dan Shen | 45 | 77 | 58,44% | 44 | 46 | 95,65% | 43 | 133 | 32,33% |
| Fu Ling | 70 | 77 | 90,91% | 43 | 46 | 93,48% | 126 | 133 | 94,74% |
| Vinegar-processed E Zhu | 57 | 77 | 74,03% | 40 | 46 | 86,96% | 61 | 133 | 45,86% |
| Vinegar-processed Bie Jia | 6 | 77 | 7,79% | 39 | 46 | 84,78% | 4 | 133 | 3,01% |
| Stir-fried Bai Zhu | 57 | 77 | 74,03% | 33 | 46 | 71,74% | 76 | 133 | 57,14% |
| Chi Shao | 69 | 77 | 89,61% | 32 | 46 | 69,57% | 121 | 133 | 90,98% |
| Huang Lian | 23 | 77 | 29,87% | 7 | 46 | 15,22% | 59 | 133 | 44,36% |
| Mu Xiang | 20 | 77 | 25,97% | 13 | 46 | 28,26% | 46 | 133 | 34,59% |
| Yin Chen | 32 | 77 | 41,56% | 13 | 46 | 28,26% | 10 | 133 | 7,52% |
| Sheng Huang Qi | 23 | 77 | 29,87% | 28 | 46 | 60,87% | 21 | 133 | 15,79% |
| Gan Cao | 45 | 77 | 58,44% | 18 | 46 | 39,13% | 77 | 133 | 57,89% |
| Chai Hu | 12 | 77 | 15,58% | 3 | 46 | 6,52% | 48 | 133 | 36,09% |
| Huang Qin | 16 | 77 | 20,78% | 4 | 46 | 8,70% | 25 | 133 | 18,80% |
| Ze Xie | 24 | 77 | 31,17% | 9 | 46 | 19,57% | 7 | 133 | 5,26% |
Tabelle 8: Diagnosegestützte Prävalenz der Kräuterverwendung. Zähler, Nenner und die auf Besuche bezogene Prävalenz von 16 normalisierten Kräuterbezeichnungen bei Fettleber (n = 77), Leberzirrhose (n = 46) und chronischer Gastritis (n = 133). Jede Kräuterbezeichnung wurde pro berechtigtem Verschreibungsbesuch maximal einmal gezählt.
Ergänzende Tabelle 1: KI-gestützte Transparenz- und Prüfaufzeichnung. Dokumentation zur Unterscheidung des ursprünglichen Analyseprotokolls von der in der Überarbeitungsphase am 21. August 2026 durchgeführten Konsistenzprüfung. Die Tabelle enthält Angaben zum verwendeten Tool/Modell/Version, zum Umfang der Eingaben, zum Zweck, zum identifizierten Four-Qi-Kardinalitätsmismatch, zur manuellen Korrektur, zu Nutzungseinschränkungen, zu den Prüferinformationen, zur Entscheidung und zur verwendeten Prompt-Vorlage. Dem KI-System wurden keine rohen, patientenindividuellen Datensätze bereitgestellt. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle 2: Ergebnisse der Datenqualität bei der Quellenprüfung. Es werden Angaben zur Vollständigkeit der erfassten Felder, zu Prüfergebnissen, analytischen Maßnahmen und Freigabestatus für klinische Quellenfelder und übertragene analytische Strukturen gemacht. Die Tabelle dokumentiert den Ausschluss nicht vereinbarter, überlieferter Syndromindikatoren, die Korrektur früherer Gesamtwerte für Kräuter, das Fehlen rekonstruierbarer Verteilungsvektoren vor der Datenaufbereitung zur Schätzung der Stabilität über verschiedene Versionen hinweg sowie Mengen, die nicht rekonstruiert werden konnten. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle 3: Zuordnung der Kräuternomenklatur. Standardisierte Anzeigelabel für Kräuter sind verknüpft mit Verarbeitungsqualifikatoren, standardisierten Namen chinesischer Arzneimittel (CMM), Quellbezeichnungen, botanischen, zoologischen oder mineralischen Herkünften, Referenzversionen, Beleglokatoren und Beleggrenzen. Verarbeitungsspezifische Label werden dort beibehalten, wo sie klinisch bedeutsam sind. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatz-Tabelle 4: Schwellenwert- und Sensitivitätsanalysen bei Wiederholungsbesuchen. Es werden Störungen der Assoziationsregel-Schwellenwerte, Vergleiche von Regelwerken mit einem Besuch pro Patient, Sensitivitätsmaße für Chi Shao > Fu Ling sowie der Vergleich der Distanzen bei der Eingabe von 190 Paaren für die Clusterung berichtet. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Zusatzdatei 1: Deterministisches Skript für Schwellenwert und Nachweisempfindlichkeit bei wiederholtem Besuch. Deterministisches Skript zur Reproduktion der aggregierten Metriken für den Schwellenwert und die Nachweisempfindlichkeit bei wiederholtem Besuch anhand des versionsgesperrten Quelldatensatzes. Die Datei enthält keine individuellen Patientendaten. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Der zentrale Beitrag dieses Protokolls besteht in einem vollständigen und überprüfbaren Weg von anonymisierten TCM-Fallakten zu aggregierten Forschungsdaten. Die wichtigsten Schritte sind, die Regel zur Kohortenidentifikation vor der Prüfung der Analyseergebnisse festzulegen, einzelne Patienten von Verschreibungsbesuchen zu unterscheiden, jede Zuordnung von Original- zu normalisierten Begriffen beizubehalten und jeden Zähler sowie Nenner vor der Visualisierung zu überprüfen. Diese Kontrollen verwandeln die Datenaufbereitung von einer unsichtbaren Vorarbeit in einen dokumentierten Bestandteil der Methode. Außerdem bringt dies den Arbeitsablauf in Einklang mit RECORD, STROBE, FAIR und etablierten EHR-Datenqualitätsrahmenwerken11,12,13,14,15. Ein Ergebnis gilt erst dann als freigabereif, wenn dessen Quellfeld, Analyseeinheit, Wörterbuchversion, Berechnungsregel, Nenner, Tabelle, Abbildung und Entscheidung des Prüfers im Nachweisdokument nachvollziehbar sind.
Die Methode ist innovativ, weil Governance, Terminologie-Engineering, Berechnung, Visualisierung und klinische Überprüfung integriert statt als separate Aufgaben behandelt werden. Eine einzige explizite Syndrom-Matrix erzeugt das Frequenzspektrum, das Ko-Okurrenz-Netzwerk und die Heatmap. Eine einzige Rezeptur-Besuch-nach-Kraut-Matrix unterstützt Frequenzzusammenfassungen, gerichtete Assoziationsregeln und hierarchisches Clustering19,20,21. Eine einzige diagnosestratifizierte Tabelle unterstützt sowohl exakte Prozentangaben als auch die endgültige Heatmap. Der analytische Workflow verwendet skriptbasierte, reproduzierbare Open-Source-Werkzeuge36,37,38,39,40, wodurch eine Korrektur eines upstream liegenden Wörterbuchs oder einer Kohortenentscheidung alle abhängigen Ergebnisse durchläuft. Frühere Arbeiten zum klinischen Daten-Repository zeigen ebenfalls die Bedeutung einer quellenverknüpften Vorverarbeitung und der strukturierten Datenwiederverwendung auf41,42. Diese Architektur reduziert manuelle Transkription, gewährleistet die Übereinstimmung zwischen grafischen Darstellungen und Quelltabelle und erleichtert Auditierung, Lehre sowie die Weitergabe an andere Forschungsteams.
Drei kürzlich erschienene Studien zur Datenbankanalyse liefern nützliche Gestaltungsprinzipien, obwohl ihre Analyseeinheit eine Publikation und nicht ein klinischer Besuch ist. Die Studie zu rheumatoider Arthritis und Depression kombiniert eine vordefinierte Suchstrategie mit Analysen nach Land, Institution, Autor, Fachzeitschrift, Schlüsselwörtern und zeitlichem Verlauf26. Die Studie zu Colitis ulcerosa und Janus-Kinase-Inhibitoren verwendet koordinierte Zusammenarbeit, Ko-Zitierungs-, Cluster- und Burst-Analysen, um anhaltende Themen von aufkommenden Forschungsschwerpunkten zu unterscheiden27. Die Studie zu rheumatoider Arthritis und Fibromyalgie erweitert die bibliometrische Kartierung um bioinformatische Methoden, behält dabei jedoch die Unterscheidung zwischen den beiden Evidenzebenen bei28. Das vorliegende Protokoll wendet dasselbe Prinzip koordinierter, aber nicht austauschbarer analytischer Perspektiven an. Eine Übertragung auf die Geburtshilfe, Pneumologie, Rheumatologie oder ein anderes Fachgebiet erfordert vor der Wiederverwendung des Regelwerks die Neukonstruktion fachgebietspezifischer Felder, Terminologiewörterbücher, Ein- und Ausschlusskriterien, Ergebnisse sowie klinischer Überprüfungsverfahren. Krankheitsspektren, Syndromnetzwerke, Symptom-Schlüsselwörter, Assoziationsregeln, Clusterbildung und diagnosespezifische Muster ergeben sich alle aus versionsgesperrten Quellen, beantworten jedoch jeweils eine eigene Fragestellung und behalten ihre jeweiligen Bezugsgrößen und Interpretationsgrenzen bei.
Unter menschlicher Aufsicht kann KI eine zusätzliche Qualitätssicherungsebene bieten, wenn sie auf genehmigte, anonymisierte Auszüge oder aggregierte Materialien beschränkt wird. Innerhalb dieses Arbeitsablaufs kann die KI die Terminologie zwischen Dateien vergleichen, Inkonsistenzen zwischen Beschriftungen und Tabellen kennzeichnen, Beschriftungen identifizieren, die über die Grenzen einer Abbildung hinausreichen, überprüfen, ob jeder angezeigte Netzwerkknoten eine gültige Verbindung aufweist, und klarere Formulierungen vorschlagen. Die KI entscheidet nicht über die Eignung einer Kohorte, erfindet keine Terminologiemappings, leitet keine Behandlungseffekte ab oder ersetzt die Überprüfung der Quelldaten. Diese Aufteilung der Verantwortlichkeiten entspricht der allgemeineren Auffassung, dass medizinische KI das menschliche Urteilsvermögen ergänzen und nicht die Verantwortlichkeit verschleiern sollte33. Sie spiegelt auch den Fokus von DECIDE-AI auf transparente menschliche Faktoren, Fehlerbehandlung und nachvollziehbare Bewertung wider34. Der Zweck jedes Prompts, die überprüfte Ausgabe, die akzeptierte Korrektur, der Prüfer und das Datum sollten daher stets im Audit-Log dokumentiert werden, wenn KI-Unterstützung genutzt wird.
Die Fehlersuche ist besonders wichtig, wenn ein Ergebnis klinisch plausibel erscheint, aber bei der Quellenabstimmung fehlschlägt. In solchen Fällen sollte die nachgelagerte Interpretation ausgesetzt werden, bis die Diskrepanz auf die Feststellung der Zulässigkeit, die Beseitigung von Duplikaten, die Zuordnung von Terminologie, die Auswahl von Feldern, die Wahl des Nenners oder die Zusammenstellung der Abbildung zurückgeführt wurde. Alle abhängigen Ergebnisse sollten anschließend nach der Korrektur neu generiert werden. Das durchgerechnete Beispiel bleibt ein Einzelzentrum-Datensatz aus der retrospektiven Expertenambulanz, bei dem wiederholte Besuche nicht voneinander unabhängig sind. Die Sensitivitätsanalyse mit je einem Besuch pro Patient reduzierte den behaltenen Regelsatz von 15 auf 12, wobei die Zugehörigkeit aller 20 häufigsten Heilpflanzen erhalten blieb. Unter allen 190 ungeordneten Paaren dieser 20 gemeinsamen Variablen betrug die Pearson-Korrelation 0,9944, der Spearman-Rho-Wert 0,9836, die durchschnittliche absolute Änderung der Jaccard-Distanz betrug 0,0146 und die maximale Änderung 0,0528 (Supplementary Table 4). Daher sollte eine hohe Unterstützung auf Ebene der Besuche nicht als Validierung auf Ebene der Patienten interpretiert werden. Das Spektrum der Anamnese-Schlüsselwörter spiegelt eine wörtliche Dokumentation wider, nicht jedoch eine validierte Symptomskala. Die Zusammenfassungen der Arzneimittellehre basieren auf Häufigkeit der Nennung, nicht auf Dosierung. Assoziationsregeln beschreiben das gemeinsame Auftreten in der Dokumentation, nicht jedoch Kausalität. Die diagnosestratifizierten Heatmaps sind deskriptiv und belegen weder vergleichende Wirksamkeit, Erkrankungsspezifität noch Notwendigkeit der Behandlung.
Das Protokoll kann auf die Erforschung der Weitergabe von Expertenwissen in der klinischen Praxis, die Beschreibung spezialisierter ambulanter Kohorten, die Harmonisierung von Begrifflichkeiten in multizentrischen Studien, die Überprüfung der Dokumentationsqualität, die Auswahl von Variablen für prospektive Registrierungen sowie die datenschutzkonforme Aufbereitung aggregierter Kollaborationsdatensätze angewendet werden. Zukünftige Arbeiten könnten die prospektive, strukturierte Erhebung von Symptomen, patientengestützte Modelle, explizite Dosierungsvariablen, vorab festgelegte vergleichende Hypothesen, externe Validierung, versionierte Terminologiedienste, datenschonende Berechnungsverfahren und interaktive Evidenznachweise einbeziehen. Die Verarbeitung natürlicher Sprache und die KI-gestützte Auswertung könnten die wiederholte Datenaufbereitung weiter reduzieren, sofern sie durch versionsgesperrte Regeln und menschliche Überprüfung gesteuert werden. Allgemeiner ermöglicht das Protokoll, dass räumlich verteilte klinische Erfahrungen in ein transparentes Forschungsobjekt umgewandelt werden, das untersucht, reproduziert, hinterfragt und erweitert werden kann. Die Methode wandelt Häufigkeit nicht in Wirksamkeit um; vielmehr werden unstrukturierte analytische Entscheidungen in sichtbare Evidenz umgesetzt und damit eine Grundlage für strengere klinische Fragestellungen sowie nachhaltigere, realitätsnahe TCM-Forschung geschaffen.
Offenlegungen
Die Autoren geben keine Wettbewerbsinteressen an.
Danksagungen
OpenAI Codex (gpt-5.6-luna und gpt-5.6-sol) wurde ausschließlich während der Manuskriptüberarbeitung für konsistenzprüfungen auf aggregierter Ebene über mehrere Dateien hinweg sowie zur Vorschlagserstellung von Formulierungen verwendet. Dem KI-System wurden keine patientenbezogenen Datensätze zur Verfügung gestellt. Alle von der KI unterstützten Ergebnisse wurden unabhängig durch Tian Xia am 21. August 2026 anhand der Quellenmaterialien überprüft. Die Autoren haben den endgültigen Inhalt geprüft und genehmigt und übernehmen die vollständige Verantwortung für das Manuskript. Dieses Projekt wurde unterstützt durch das Nationale Schlüssel-Forschungs- und Entwicklungsprogramm Chinas, Schwerpunktsprojekt zur Modernisierung der Traditionellen Chinesischen Medizin (Nr. 2025YFC3512800); das Nationale Wissenschafts- und Technologiemajorprojekt Chinas (Projektnummer 2026ZD0554100; Teilprojektnummer 2026ZD0554101); das Projekt zur Verbesserung der klinischen Forschungs- und Ergebnistransferkapazität zentraler hochrangiger Krankenhäuser für Traditionelle Chinesische Medizin, Sonderprojekt zur Überlieferung der akademischen Erfahrung namhafter erfahrener Experten der Traditionellen Chinesischen Medizin (Nr. HLCMHPP2023016); sowie durch die Naturwissenschaftliche Stiftung der Autonomen Region Xinjiang der Uigurischen Nationalität (Nr. 2025D01C213).
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Aggregierte Reanalysedatenblätter | Lokale, vom Autor erstellte Dateien | Nicht zutreffend | Verwendet für aggregierte Zählungen, Tabellen und die Erstellung von Abbildungen. |
| Deidentifizierter ambulanter Fallaufzeichnungs-Export | Institutionelles elektronisches Patientenakten-System | Nicht zutreffend | Wird ausschließlich in der kontrollierten institutionellen Umgebung verwendet; patientenebenebezogene Aufzeichnungen sind keine Einreichungsunterlagen. |
| lxml | lxml-Projekt | 6.1.1 | Softwareversion, die für die namensraumtreue Serialisierung während der Überarbeitungsphase verwendet wurde; keine historische Originalanalyseversion. |
| Matplotlib | Matplotlib-Projekt (matplotlib.org) | 3.11.1 | In der Umgebung der Überarbeitungsphase beobachtete Version und in den SVG-Metadaten von Abbildung 3 enthalten; keine historische Originalanalyseversion. |
| NetworkX | NetworkX-Projekt | PyPI-Paket: networkx | Aufgezeichnete Paketkennung; die genaue Version in der Überarbeitungsphase wurde in der übernommenen Umgebung nicht verifiziert. |
| NumPy | NumPy-Projekt | 2.3.5 | Softwareversion, die zur Neugenerierung der überarbeiteten aggregierten Ausgaben verwendet wurde; keine historische Originalanalyseversion. |
| openpyxl | openpyxl-Projekt | 3.1.5 | Softwareversion, die zum Schreiben der überarbeiteten aggregierten XLSX-Ausgaben verwendet wurde; keine historische Originalanalyseversion. |
| pandas | pandas-Projekt | 3.0.1 | Softwareversion, die zur Neugenerierung der überarbeiteten aggregierten Ausgaben verwendet wurde; keine historische Originalanalyseversion. |
| PyMuPDF | PyMuPDF-Projekt | 1.28.2 | Softwareversion, die zur Neugenerierung der überarbeiteten Abbildungsausgaben in der Überarbeitungsphase verwendet wurde; keine historische Originalanalyseversion. |
| Python | Python Software Foundation | 3.13.15 | Softwareversion, die zur Neugenerierung der überarbeiteten aggregierten Ausgaben verwendet wurde; keine historische Originalanalyseversion. |
| SciPy | SciPy-Projekt | PyPI-Paket: scipy | Aufgezeichnete Paketkennung; die genaue Version in der Überarbeitungsphase wurde in der übernommenen Umgebung nicht verifiziert. |
Referenzen
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.