Dieses Protokoll stellt einen reproduzierbaren Arbeitsablauf zur Entwicklung, Bewertung und Interpretation erklärbarer KI-Modelle im Gesundheitswesen vor. Es integriert standardisierte Datenaufbereitung, Modellentwicklung, Erklärbarkeitstechniken, quantitative Evaluierung und Praktiken zur Reproduzierbarkeit, um Transparenz, Zuverlässigkeit und klinische Anwendbarkeit zu verbessern.
Methodenartikel
Ein reproduzierbares experimentelles Protokoll zur Entwicklung und Evaluierung erklärbarer Modelle der Künstlichen Intelligenz in Gesundheitssystemen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Künstliche Intelligenz (KI) wird zunehmend als wertvolles Werkzeug für klinische Entscheidungsfindung, Krankheitsvorhersage, medizinische Diagnose und personalisierte Gesundheitsversorgung eingesetzt. Mangelnde Transparenz, inkonsistente Implementierung erklärbarer KI-Methoden (XAI) und begrenzte Reproduzierbarkeit stellen jedoch nach wie vor wesentliche Hindernisse für den vertrauenswürdigen Einsatz von KI-Modellen in klinischen Umgebungen dar. Dieser Artikel schlägt einen systematischen, reproduzierbaren und transparenten Protokollansatz zur Entwicklung, Bewertung und Interpretation erklärbarer KI-Modelle für Anwendungen im Gesundheitswesen vor. Der Workflow beginnt mit der Einrichtung der Rechenumgebung, gefolgt von Datenerfassung und -charakterisierung, Vorverarbeitung, Merkmalsentwicklung, Modellerstellung, Hyperparameter-Optimierung, Bewertung der Vorhersageleistung, Erklärbarkeitsanalyse, statistischer Validierung und Reproduzierbarkeitsbewertung. Das Protokoll integriert XAI-Methoden wie SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), Integrierte Gradienten, Visualisierung von Aufmerksamkeitsmechanismen (Attention) und kontrafaktische Erklärungen, um sowohl globale als auch lokale Modellinterpretationen zu erzeugen. Besonderes Augenmerk liegt auf mehreren zentralen Komponenten, darunter die Aufbereitung standardisierter Gesundheitsdatensätze, die Entwicklung stabiler maschineller Lernmodelle, die Bewertung der Vorhersageleistung, die Generierung klinisch relevanter Erklärungen sowie die statistische Beurteilung der Reproduzierbarkeit über wiederholte Experimente hinweg. Durch die Integration von Modellentwicklung, Erklärbarkeit, quantitativer und qualitativer Bewertung, statistischer Validierung und Reproduzierbarkeitsanalyse in einen einheitlichen Workflow bietet dieses Protokoll einen umfassenden Rahmen zur Entwicklung transparenter und reproduzierbarer KI-Modelle für Anwendungen im Gesundheitswesen.
Einleitung
KI ist zu einem integralen Bestandteil der modernen Gesundheitsversorgung geworden, da sie die intelligente Analyse komplexer klinischer Daten ermöglicht und die evidenzbasierte medizinische Entscheidungsfindung unterstützt1. Die rasche Digitalisierung des Gesundheitswesens durch elektronische Patientenakten, medizinische Bildgebungssysteme, tragbare Geräte und genomische Technologien hat große Mengen heterogener Daten generiert, die fortschrittliche computergestützte Ansätze zur effektiven Interpretation erfordern2.
Algorithmen des maschinellen Lernens (ML) und des tiefen Lernens (DL) haben bemerkenswerte Fähigkeiten bei der Extraktion aussagekräftiger Muster aus mehrdimensionalen Gesundheitsdatensätzen gezeigt und tragen so zur Verbesserung der diagnostischen Genauigkeit, der Vorhersage von Erkrankungen und der Bewertung von Patientenergebnissen bei3. KI-basierte Modelle wurden erfolgreich in der Radiologie, Pathologie, Kardiologie, Onkologie, Augenheilkunde und anderen medizinischen Fachgebieten eingesetzt, um Ärzte bei der frühzeitigen Erkennung von Krankheiten und der Empfehlung personalisierter Behandlungsstrategien zu unterstützen4. Diese Technologien haben zudem zur Optimierung von Arbeitsabläufen, zur Verringerung der diagnostischen Variabilität und zur Verbesserung der Nutzung von Gesundheitsressourcen beigetragen5.
Neuere Entwicklungen in der Rechentechnik, im Bereich Cloud-Computing und bei Open-Source-KI-Frameworks haben die Entwicklung und Bereitstellung intelligenter Gesundheitsanwendungen beschleunigt6. Folglich ist KI zu einer zentralen Schlüsseltechnologie für die präzise Medizin und klinische Entscheidungsunterstützungssysteme geworden7. Trotz dieser Fortschritte bleibt die breite Anwendung von KI in der routinemäßigen klinischen Praxis begrenzt, da viele leistungsstarke Modelle kaum Aufschluss darüber geben, wie ihre Vorhersagen zustande kommen8.
Die meisten Deep-Learning-Algorithmen funktionieren als komplexe Black-Box-Modelle, bei denen der interne Entscheidungsprozess für Ärzte und Forscher schwer nachvollziehbar ist9. Obwohl diese Modelle häufig eine hervorragende Vorhersageleistung erzielen, untergräbt ihre mangelnde Transparenz das Vertrauen der Anwender und stellt Herausforderungen für die klinische Validierung, die regulatorische Zulassung und die Patientensicherheit dar10. Gesundheitsfachkräfte müssen in der Lage sein, KI-gestützte Entscheidungen zu begründen, bevor sie diese in die routinemäßige klinische Praxis integrieren, insbesondere in medizinischen Umgebungen mit hohem Risiko11.
XAI hat sich als effektiver Ansatz zur Verbesserung der Transparenz und Interpretierbarkeit von Machine-Learning-Modellen etabliert12. Anstatt Vorhersagemodelle als undurchsichtige Systeme zu betrachten, liefern XAI-Methoden Informationen über die Merkmale, Bildbereiche oder klinischen Variablen, die zu einzelnen Vorhersagen beitragen13. Solche Erklärungen ermöglichen es Ärzten, das Modellverhalten besser zu verstehen, potenzielle Verzerrungen zu identifizieren und zu beurteilen, ob von KI generierte Entscheidungen mit etabliertem medizinischem Wissen übereinstimmen14.
Für Anwendungen im Gesundheitswesen wurden mehrere Erklärbarkeitstechniken eingeführt. SHapley Additive Explanations (SHAP) messen den Beitrag jeder Merkmalsgröße zur Modellvorhersage auf der Grundlage der kooperativen Spieltheorie15. Local Interpretable Model-agnostic Explanations (LIME) erstellen ein vereinfachtes Modell und erklären die Vorhersagen eines Blackbox-Modells16. Für medizinische Bildaufgaben, die auf Deep-Learning-Modellen basieren, erzeugen gradientengewichtete Aktivierungskarten (Grad-CAM) Heatmaps, die visuell die Bildbereiche hervorheben, die zu Klassifizierungsentscheidungen beitragen17. Die Kombination dieser Methoden hat die Transparenz von KI-Systemen in verschiedenen Bereichen des Gesundheitswesens erheblich verbessert18.
Trotz der zunehmenden Aufmerksamkeit für Erklärbarkeitsmethoden im Gesundheitswesen bleibt ihre Anwendung in der Literatur unterschiedlich. Die Forscher unterscheiden sich nicht nur in der Wahl der Vorverarbeitungsstrategien, sondern auch in der Gestaltung der Modellarchitektur, der Evaluierungsmetriken und sogar in den verwendeten Erklärungstechniken19. Zudem berichten viele Publikationen von hoher Vorhersagegenauigkeit, liefern jedoch keine gründliche Bewertung der Qualität der Erklärungen oder deren Reproduzierbarkeit20.
Die Reproduzierbarkeit ist eine der Hauptengpässe in der modernen KI-Forschung. In wissenschaftlichen Arbeiten werden oft nicht die Softwareversion, die Rechenumgebung, die Vorverarbeitungspipeline, die Hyperparameter-Einstellungen, die Initialisierung des Zufallszahlengenerators und die Hardwarekonfigurationen offengelegt21. Aus diesem Grund gelingt es unabhängigen Forschern häufig nicht, veröffentlichte Ergebnisse nachzuvollziehen oder die publizierten Methoden mit anderen Datensätzen oder Softwareplattformen zu überprüfen22. Der Mangel an detaillierter Dokumentation ist einer der Faktoren, die Benchmark-Studien, die Zusammenarbeit in der Forschung und die klinische Übertragung von KI-Systemen behindern23.
Angesichts dieser Herausforderungen haben mehrere Organisationen und Aufsichtsbehörden die Bedeutung transparenter, vertrauenswürdiger und reproduzierbarer KI für Anwendungen im Gesundheitswesen hervorgehoben24. Bestehende Berichtsleitlinien haben die methodische Dokumentation verbessert, beschreiben jedoch hauptsächlich, was berichtet werden sollte, anstatt standardisierte experimentelle Verfahren bereitzustellen, die Forschende direkt umsetzen können25. Daher besteht weiterhin Bedarf an einem umfassenden Protokoll, das Datensatzvorbereitung, Modellentwicklung, Erklärbarkeitsanalyse, statistische Bewertung und Praktiken zur Reproduzierbarkeit in einen einzigen experimentellen Workflow integriert26.
Ein standardisiertes experimentelles Protokoll bietet der Gemeinschaft der KI im Gesundheitswesen mehrere Vorteile. Darüber hinaus fördert es die methodische Konsistenz, erleichtert den Vergleich unabhängiger Studien, erhöht die Transparenz computergestützter Experimente und ermöglicht eine zuverlässige Überprüfung veröffentlichter Ergebnisse27. Standardisierte Arbeitsabläufe unterstützen außerdem die Aus- und Weiterbildung, die kollaborative Forschung und die regulatorische Bewertung durch klar dokumentierte Verfahren, die in verschiedenen Laboren und Gesundheitseinrichtungen reproduzierbar sind28.
Ein reproduzierbares experimentelles Protokoll zur Schulung und Bewertung von KI-Modellen in Gesundheitssystemen wurde entwickelt und getestet. Das Protokoll legt Standards für die Konfiguration der Rechenumgebung, die Vorverarbeitung von Gesundheitsdatensätzen, die Entwicklung von maschinellen Lernmodellen, die Anwendung von XAI-Methoden, die Bewertung der Vorhersageleistung, die Durchführung statistischer Validierungen und die Beurteilung der Reproduzierbarkeit29 fest. Die Integration solcher Komponenten in einen kohärenten Workflow wird voraussichtlich die Transparenz, Zuverlässigkeit und Reproduzierbarkeit der KI-Forschung im Gesundheitswesen erhöhen und zudem zur Entwicklung vertrauenswürdiger intelligenter Gesundheitssysteme beitragen30.
Protokoll
Das durchgeführte Validierungsexperiment verwendete den öffentlich verfügbaren, deidentifizierten Pima-Indianer-Diabetes-Datensatz und beinhaltete keine identifizierbaren Patientenakten oder neue Patientenrekrutierung. Daher waren informierte Einwilligung und die Genehmigung durch die institutionelle Ethikkommission/IRB nicht erforderlich, und alle Analysen wurden gemäß den geltenden Bedingungen des Datensatzes und den institutionellen Forschungsrichtlinien durchgeführt.
Das durchgeführte Validierungsbeispiel verwendet den öffentlich verfügbaren Pima-Indianer-Diabetes-Datensatz, der 768 Datensätze für die binäre Diabetesvorhersage enthält. Der vollständige neunstufige Kernarbeitsablauf wurde auf diesen Datensatz angewendet. Die neun Kernstufen umfassten die Datensatzauswahl und -validierung, die Konfiguration der Rechenumgebung, die Datenvorverarbeitung, die Datensatzpartitionierung, die Modellentwicklung und -schulung, die Bewertung der Vorhersage- und Rechenleistung, die Erklärbarkeitsanalyse, die statistische Validierung sowie die Beurteilung der Reproduzierbarkeit. Externe Validierung und klinische Expertenbewertung wurden als optionale Validierungsbausteine beibehalten und im vorliegenden durchgerechneten Beispiel nicht durchgeführt. Abbildung 1 veranschaulicht den Kernprotokoll-Arbeitsablauf, und Tabelle 1 fasst ausschließlich die neun im vorliegenden Validierungsbeispiel implementierten Kernstufen zusammen; optionale externe Validierung und klinische Expertenbewertung werden separat im Protokoll beschrieben und sind nicht Teil der neun experimentellen Stufen.
1. Auswahl und Validierung des Gesundheitsdatensatzes
- Wählen Sie den Pima-Indianer-Diabetes-Datensatz als primären Datensatz für das durchgeführte Validierungsbeispiel aus. Überprüfen Sie die Datensatzquelle, Stichprobengröße, Vorhersageziel, Klassenverteilung und Datenstruktur.
- Wenden Sie die vorab festgelegten Ein- und Ausschlusskriterien sowie Qualitätskriterien für die Daten an. Entfernen Sie doppelte und ungültige Datensätze vor der Modellerstellung.
- Notieren Sie die Datensatzquelle, Merkmale, Vorhersageaufgabe, Klassenverteilung, Ein- und Ausschlusskriterien sowie die Aufteilungsstrategie in Tabelle 2.
- Wenden Sie Entscheidungskriterien für die Auswahl von Datensatz und Modell an
- Definieren Sie das Vorhersageziel, bevor Sie den Datensatz, die Modellarchitektur, die Vorverarbeitungsstrategie oder die Erklärbarkeitsmethode auswählen.
- Passen Sie die Datensatzmodusart dem Vorhersageziel an. Wählen Sie tabellarische Daten für strukturierte klinische Variablen, Bilddaten für medizinische Bilder, Zeitreihendaten für physiologische Signale, Textdaten für klinische Berichte oder multimodale Daten, wenn komplementäre Modalitäten für denselben Patienten oder Untersuchungseinheit verfügbar sind.
- Bewerten Sie potenzielle Datensätze hinsichtlich Stichprobengröße, Verfügbarkeit des Endpunkts, Klassenverteilung, fehlender Werte, Qualität der Annotationen, klinischer Relevanz, Datenvervollständigung und Zugänglichkeit. Wählen Sie den Datensatz aus, der die vorab festgelegten Anforderungen erfüllt.
- Wählen Sie herkömmliche maschinelle Lernmodelle für strukturierte tabellarische Daten, wenn die Stichprobengröße, die verfügbaren Rechenressourcen oder die Anforderungen an die Interpretierbarkeit den Einsatz komplexer Architekturen einschränken. Wählen Sie Deep-Learning-Architekturen, wenn ausreichend Trainingsdaten und hochdimensionale Eingaben wie medizinische Bilder, physiologische Signale oder klinischer Text verfügbar sind.
- Wählen Sie multimodale Architekturen nur dann, wenn mehrere Modalitäten für denselben Patienten oder dieselbe Untersuchungseinheit verfügbar sind und zuverlässig zugeordnet werden können, ohne Informationslecks zu verursachen. Wählen Sie Vorverarbeitungsschritte entsprechend den Eigenschaften der ausgewählten Datenmodusart aus.
- Wählen Sie Erklärbarkeitsmethoden entsprechend dem Modell und der Datenmodusart aus. Verwenden Sie modellagnostische Methoden wie SHAP oder LIME für geeignete tabellarische Modelle und modusartspezifische Methoden wie Grad-CAM für bildbasierte Modelle, sofern anwendbar.
- Dokumentieren Sie die Begründung für die Auswahl von Datensatz, Vorverarbeitungsstrategie, Modell und Erklärbarkeitsmethoden. Bewahren Sie diese Entscheidungen als Teil des Reproduzierbarkeitsnachweises auf.
2. Konfigurieren Sie die Rechenumgebung für die Entwicklung von XAI-Modellen
- Konfigurieren Sie das Betriebssystem, die CPU, den Arbeitsspeicher, den Speicherplatz und die GPU gemäß den Anforderungen des ausgewählten Modells. Erstellen Sie eine isolierte Python-Umgebung und installieren Sie die erforderlichen Bibliotheken für maschinelles Lernen, Deep Learning, Statistik, Visualisierung und XAI.
- Notieren Sie die tatsächlich verwendete Rechenumgebung, die Modellarchitektur und die Hyperparameter, die bei der durchgeführten Validierung verwendet wurden, in Tabelle 3. Geben Sie den Optimierer, die Lernrate, die Batch-Größe, die maximale Anzahl an Epochen, die Verlustfunktion, Regularisierungsparameter, die Validierungsstrategie, die Early-Stopping-Konfiguration, die Zufallszahlen-Startwerte, die Erklärbarkeitsmethoden, die Hardware, das Betriebssystem, die Python-Version sowie die Versionen relevanter Softwarebibliotheken an. Unterscheiden Sie diese experimentell verwendeten Einstellungen von allgemeinen oder empfohlenen Protokolleinstellungen.
- Verwenden Sie die in Tabelle 3 angegebene Konfiguration, um die Validierung des Pima-Indians-Diabetes-Datensatzes sowie die entsprechenden Ergebnisse zur Vorhersage, Erklärbarkeit, Statistik und Reproduzierbarkeit zu reproduzieren.
- Führen Sie ein Validierungsskript aus, um den erfolgreichen Import der Pakete, das Laden des Datensatzes, die Ausführung des Modells und die Erzeugung der Ausgaben zu überprüfen. Bewahren Sie die endgültige Konfiguration der Umgebung zur Sicherstellung der Reproduzierbarkeit auf.
3. Bereiten Sie Gesundheitsdatensätze für die Entwicklung von XAI-Modellen vor und charakterisieren Sie diese
- Auswahl und Beschaffung des Gesundheitsdatensatzes
- Wählen Sie einen Gesundheitsdatensatz aus, der für die definierte klinische Vorhersageaufgabe geeignet ist. Bewerten Sie mögliche Datensätze anhand des Forschungsziels, Datentyps, Stichprobengröße, Annotationqualität, Klassenbalance und klinischen Relevanz.
- Bevorzugen Sie öffentlich zugängliche Benchmark-Datensätze, wenn sie die Vorhersageaufgabe ausreichend abdecken und eine unabhängige Validierung ermöglichen.
- Erhalten Sie vor der Beschaffung institutioneller oder intern verwalteter Datensätze die erforderlichen ethischen Genehmigungen, institutionellen Freigaben und Datenzugriffsberechtigungen. Beziehen Sie den ausgewählten Datensatz aus einem verifizierten Repository oder einer autorisierten institutionellen Datenbank.
- Bewahren Sie die ursprünglichen Datensatzdateien unverändert auf und dokumentieren Sie Anbieter, Version, Erwerbsinformationen, Lizenzbedingungen, Einschluss- und Ausschlusskriterien sowie begleitende Metadaten. Ordnen Sie den Datensatz in separate Verzeichnisse für Rohdaten, Annotationen, Metadaten und ergänzende Informationen.
- Charakterisierung des Gesundheitsdatensatzes
- Identifizieren Sie die Prädiktorvariablen, Outcome-Labels, Merkmalstypen, Datenausprägungen und Klassenverteilungen. Ermitteln Sie die Anzahl der Probanden, Stichproben, Merkmalsdimensionen und verfügbaren Annotationen.
- Stellen Sie sicher, dass die Datensatzmerkmale mit der ausgewählten KI-Methode kompatibel sind.
- Verwenden Sie den Pima-Indians-Diabetes-Datensatz als einzigen experimentellen Datensatz zur Validierung des neunstufigen Kernprotokolls. Die in Tabelle 2 aufgeführten zusätzlichen Datensätze dienen lediglich dazu, die Anwendbarkeit des allgemeinen Protokolls auf klinische Tabellendaten, elektronische Gesundheitsakten, dermatoskopische Bilder, physiologische Zeitreihendaten und medizinische Bildgebung zu demonstrieren. Verwenden Sie diese zusätzlichen Datensätze nicht für Modelltraining, -testung, statistische Validierung oder zur Erzeugung der berichteten experimentellen Ergebnisse.
- Bewertung der Datensatzqualität
- Prüfen Sie den Datensatz auf doppelte Einträge, beschädigte Dateien, fehlende Werte, Fehler in den Annotationen und unregelmäßige Dateneingaben. Entfernen Sie bestätigte doppelte Einträge und korrigieren Sie nachgewiesene Formatierungsfehler. Dokumentieren Sie alle Verfahren zur Qualitätskontrolle des Datensatzes.
- Überprüfen Sie bei multimodalen Datensätzen mithilfe von Probandenidentifikatoren die Übereinstimmung von bildgebenden, klinischen, laborchemischen und physiologischen Daten.
- Entfernen Sie doppelte oder inkonsistente Einträge, behandeln Sie fehlende Werte, standardisieren Sie numerische Merkmale, kodieren Sie kategoriale Variablen und wenden Sie modalitysspezifische Vorverarbeitungsschritte an. Teilen Sie den Datensatz in unabhängige Trainings-, Validierungs- und Testmengen auf. Siehe Abbildung 2 für den Workflow zur Vorbereitung, Vorverarbeitung, Aufteilung und Qualitätsbewertung von Gesundheitsdatensätzen.
- Gewährleistung von Datenschutz und ethischer Konformität
- Entfernen Sie direkte Identifikatoren aus Gesundheitsdaten. Wenden Sie bei Bedarf Anonymisierungs- oder Pseudonymisierungsverfahren an. Verarbeiten Sie Patientendaten gemäß den geltenden ethischen, Datenschutz-, Einwilligungs- und institutionellen Anforderungen.
- Dokumentieren Sie die geltende ethische Genehmigung, Befreiungen, Datenverwaltungsverfahren, Anonymisierungsmethoden und den Workflow zur Datensatzvorbereitung.
- Bewerten Sie potenzielle algorithmische Verzerrungen, indem Sie die Modellleistung bei verfügbaren und ethisch zulässigen Informationen über relevante demografische oder klinische Untergruppen vergleichen.
- Dokumentieren Sie den vorgesehenen Einsatz, die Zielgruppe, Modelllimitationen, mögliche Fehlermodi, Anforderungen an menschliche Überwachung sowie geltende ethische, datenschutzrechtliche und gesundheitsrechtliche Vorschriften.
- Dokumentieren Sie identifizierte Fairness-Einschränkungen und Aspekte verantwortungsvoller KI als Teil der endgültigen Modell-Dokumentation.
HINWEIS: Beschaffen Sie einen standardisierten und dokumentierten Gesundheitsdatensatz, der für die Entwicklung von KI-Modellen geeignet ist, ethisch konform ist und keine gravierenden, bekannten Inkonsistenzen aufweist.
4. Vorbereiten und Aufteilen von Gesundheitsdaten für das Training von KI-Modellen
- Qualitätskontrolle durchführen
- Den Datensatz auf doppelte Einträge, fehlende Werte, ungültige Werte, inkonsistente Beschriftungen, Ausreißer und beschädigte Dateien überprüfen.
- Ungültige Beobachtungen gemäß vorab festgelegter Kriterien entfernen oder korrigieren und alle Ausschlüsse dokumentieren. Die Konsistenz der Prädiktorvariablen und der Zielvariablenbezeichnungen überprüfen.
- Umgang mit fehlenden Daten
- Den Umfang der fehlenden Werte für jede Variable quantifizieren. Die vorab festgelegte Strategie zur Imputation oder zum Ausschluss anwenden.
- Imputationsparameter ausschließlich anhand der Trainingsdaten schätzen und die angepasste Transformation auf Validierungs- und Testdaten anwenden.
- Daten normalisieren und transformieren
- Skalierung, Normalisierung, Kodierung, Dimensionsreduktion oder andere Transformationen durchführen, die vom gewählten Modell verlangt werden. Alle datenabhängigen Transformationen ausschließlich anhand der Trainingsdaten anpassen.
- Die angepassten Transformationen unverändert auf Validierungs- und Testdaten anwenden.
- Die Klassenungleichverteilung in den Trainingsdaten quantifizieren. Klassengewichtung, SMOTE, Oversampling oder Datenaugmentierung ausschließlich auf den Trainingsdatensatz anwenden. Die ursprüngliche Verteilung der Validierungs- und Testdatensätze beibehalten.
- Sicherstellen, dass kein Proband, doppelte Beobachtung, augmentierte Stichprobe, Preprocessing-Statistik, Merkmalsselektionskriterium oder synthetische Stichprobe zwischen Trainings- und Evaluierungs-Teildatensätzen geteilt wird.
5. Entwickeln und konfigurieren Sie das XAI-Modell
- Definieren Sie die Modellarchitektur, indem Sie die Eingabedatenmodalitäten, Vorverarbeitungsschritte, modalitätsspezifische Merkmalsencoder, den Mechanismus zur Merkmalsfusion, die Vorhersageschicht und das Erklärbarkeitsmodul festlegen.
- Wählen Sie die Machine-Learning- oder Deep-Learning-Architektur entsprechend der Vorhersageaufgabe und der Eingabemodalität aus. Konfigurieren Sie die Eingabeschicht, die Merkmalsextraktionskomponenten, die versteckten Schichten, die Ausgabeschicht und die Aktivierungsfunktionen. Legen Sie den Optimierer, die Lernrate, die Batch-Größe, die Verlustfunktion, die Epochen, die Regularisierung, den Dropout, die vorzeitige Beendigung und den Lernraten-Plan fest.
- Optimieren Sie die Hyperparameter ausschließlich anhand der Trainings- und Validierungsdaten.
- Dokumentieren Sie die endgültige Architektur und die festgelegte Hyperparameterkonfiguration in Tabelle 3.
- Überprüfen Sie die Kompatibilität der Eingabe- und Ausgabedimensionen vor dem Training.
HINWEIS: Erstellen Sie ein vollständig konfiguriertes XAI-Modell, das eine geeignete Architektur, definierte Hyperparameter und integrierte Erklärbarkeitstechniken umfasst.
6. Trainieren, optimieren und speichern Sie das XAI-Modell
- Laden Sie die vordefinierten Trainings- und Validierungsdatensätze sowie die finale Modellkonfiguration. Initialisieren Sie das Modell mit dem vordefinierten Zufallsstartwert und den Trainingsparametern.
- Trainieren Sie das Modell unter Verwendung des vorgegebenen Optimierers, der Verlustfunktion, der Batch-Größe und der Abbruchkriterien.
- Überwachen Sie die Validierungsleistung und behalten Sie den Kontrollpunkt bei, der dem vordefinierten Modellselektionskriterium entspricht. Bewerten Sie den ausgewählten Kontrollpunkt anhand des unabhängigen Testdatensatzes ohne weitere Optimierung.
- Speichern Sie das trainierte Modell, die Vorverarbeitungskonfiguration, Hyperparameter, Zufallsstartwerte und das Trainingsprotokoll.
HINWEIS: Erhalten Sie ein optimiertes XAI-Modell, das mit dem vorbereiteten Gesundheitsdatensatz trainiert und validiert wurde. Bewahren Sie das leistungsstärkste Modell, die Hyperparameter, Trainingsprotokolle, Vorverarbeitungskonfiguration und die Rechenumgebung zur Reproduzierbarkeit auf.
7. Bewertung der Vorhersage- und Rechenleistung
- Beurteilen der Vorhersageleistung
- Laden Sie das optimierte Modell und den unabhängigen Testdatensatz, nachdem das Modelltraining und die Hyperparameter-Optimierung abgeschlossen sind. Bewahren Sie die trainierten Modellparameter und die Vorverarbeitungspipeline während des Testens unverändert auf.
- Erzeugen Sie Vorhersagen für alle Proben im Testdatensatz. Vergleichen Sie die vorhergesagten Ergebnisse mit den entsprechenden Referenzlabels.
- Berechnung von Leistungsmetriken
- Wählen Sie Evaluationsmetriken entsprechend der Art der Vorhersageaufgabe aus.
- Berechnen Sie bei Klassifizierungsaufgaben, soweit anwendbar, Genauigkeit (Accuracy), Präzision, Sensitivität (Recall), Spezifität, F1-Score, balancierte Genauigkeit, Matthews-Korrelationskoeffizient (MCC) und die Fläche unter der ROC-Kurve (AUC-ROC). Berechnen Sie bei Regressionsaufgaben, soweit anwendbar, mittleren absoluten Fehler (MAE), Wurzel des mittleren quadratischen Fehlers (RMSE), Bestimmtheitsmaß (R2) und andere relevante Maße.
- Beurteilung der Generalisierbarkeit und Robustheit des Modells
- Werten Sie das Modell anhand eines externen Datensatzes aus, der unabhängig vom Entwicklungssatz erhoben wurde, sofern solche Daten verfügbar sind.
- Bevorzugen Sie externe Datensätze aus einer anderen medizinischen Einrichtung, geografischen Region oder Patientenpopulation, um die Übertragbarkeit zu bewerten.
- Führen Sie eine zeitliche Validierung anhand von Daten durch, die in einem späteren Zeitraum erhoben wurden, sofern Längsschnittdatensätze verfügbar sind.
- Führen Sie eine multizentrische Validierung durch, indem Sie das finale Modell getrennt an den teilnehmenden Institutionen evaluieren, sofern multizentrische Daten verfügbar sind.
- Führen Sie eine geografische Validierung anhand einer unabhängigen Population aus einer anderen geografischen Region durch, sofern dies machbar ist.
- Berichten Sie über Leistungsunterschiede und Konfidenzintervalle zwischen dem Entwicklungssatz und den externen Datensätzen.
- Beurteilung der rechnerischen Leistung
- Messen Sie die Modelltrainingszeit in der vordefinierten Rechenumgebung sowie die Inferenz- und Testzeit unter identischen Rechenbedingungen, sowie den Speicherverbrauch, die Modellgröße und die Hardwareauslastung.
- Wiederholen Sie die rechnerischen Messungen in unabhängigen Durchläufen.
- Berechnen Sie die durchschnittliche Ausführungszeit, um den Einfluss experimenteller Variabilität zu verringern.
- Vergleich der Modellleistung
- Wählen Sie geeignete konventionelle maschinelle Lern- oder Deep-Learning-Verfahren für den Vergleich aus.
- Werten Sie das vorgeschlagene XAI-Modell und die Vergleichsmodelle anhand desselben Datensatzes aus. Wenden Sie identische Vorverarbeitungsschritte und Evaluationsmetriken auf alle verglichenen Modelle an.
- Führen Sie alle vergleichenden Experimente in derselben Rechenumgebung durch.
HINWEIS: Gewinnen Sie experimentelle Belege für die Vorhersagesicherheit und Reproduzierbarkeit unter den getesteten Rechenbedingungen und dem Datensatz.
8. XAI-Ergebnisse erzeugen und bewerten
- Erzeugung von Modellerklärungen
- Laden Sie das optimierte XAI-Modell. Wählen Sie Evaluierungsstichproben, die nicht für das Modelltraining verwendet wurden. Wenden Sie die vordefinierten Erklärbarkeitsmethoden an, ohne das trainierte Modell oder die Vorverarbeitungspipeline zu verändern.
- Erzeugung globaler und lokaler Modellerklärungen
- Erzeugen Sie globale Erklärungen, um das Gesamtverhalten des Vorhersagemodells zu charakterisieren.
- Erzeugen Sie lokale Erklärungen, um individuelle Modellvorhersagen zu charakterisieren.
- Wenden Sie SHAP auf den Pima-Indians-Diabetes-Datensatz an, um globale und lokale Erklärungen der tabellarischen Modellvorhersagen zu generieren.
- Erzeugen Sie ein SHAP-Zusammenfassungsdiagramm, um Richtung und Stärke der Merkmalsbeiträge zu visualisieren.
- Erzeugen Sie ein SHAP-Merkmalswichtigkeitsdiagramm mithilfe der mittleren absoluten SHAP-Werte, um Merkmale nach ihrem Gesamtbeitrag zu den Modellvorhersagen zu rangieren.
- Erzeugen Sie ein SHAP-Wasserfall-Diagramm für eine repräsentative Vorhersage aus dem Testdatensatz, um patientenspezifische Merkmalsbeiträge zu veranschaulichen.
- Erzeugen Sie ein SHAP-Abhängigkeitsdiagramm für ein ausgewähltes Merkmal, um den Zusammenhang zwischen diesem Merkmal und seinem Beitrag zur Modellausgabe zu untersuchen.
- Wenden Sie LIME auf repräsentative Vorhersagen aus dem Testdatensatz an, um lokale Erklärungen individueller Modellvorhersagen zu erzeugen.
- Erzeugen Sie eine patientenspezifische kontrastive Erklärung, um die mit einer Änderung des vorhergesagten Ergebnisses verbundenen Merkmalsänderungen zu veranschaulichen.
- Wählen Sie zusätzliche Erklärbarkeitstechniken entsprechend der Datenmodus und der Modellarchitektur aus.
- Verwenden Sie Grad-CAM oder Saliency-Maps für kompatible bildbasierte Modelle, Visualisierungen der Aufmerksamkeit (Attention) für Transformer-basierte Architekturen und Integrierte Gradienten für differenzierbare Modelle, wenn anwendbar.
- Behandeln Sie Grad-CAM, Saliency-Mapping, Attention-Visualisierung und Integrierte Gradienten als allgemeine, modusabhängige Protokolloptionen und interpretieren oder berichten Sie sie nicht als experimentelle Ergebnisse aus der Validierung des Pima-Indians-Diabetes-Datensatzes, es sei denn, die entsprechenden Analysen wurden tatsächlich durchgeführt.
- Anwendung der Erklärbarkeitsmethoden auf die durchgeführte Pima-Validierung
- Wenden Sie SHAP und LIME auf den Pima-Indians-Diabetes-Datensatz an, um globale und lokale Erklärungen der tabellarischen Modellvorhersagen zu erzeugen.
- Erzeugen Sie SHAP-Zusammenfassungs-, Merkmalswichtigkeits-, Wasserfall- und Merkmalsabhängigkeit-Diagramme aus den Ergebnissen der Pima-Validierung.
- Erzeugen Sie eine LIME-Lokalerklärung für repräsentative Vorhersagen aus dem Testdatensatz.
- Erzeugen Sie eine patientenspezifische kontrastive Erklärung, um die mit einer Änderung der Modellvorhersage verbundenen Merkmalsänderungen zu veranschaulichen.
- Behandeln Sie Grad-CAM, Attention-Visualisierung, Saliency-Mapping und Integrierte Gradienten als modusabhängige Optionen zur Erklärbarkeit für andere Gesundheitsdatentypen und Modellarchitekturen.
- Berichten Sie Grad-CAM, Attention-Visualisierung, Saliency-Mapping oder Integrierte Gradienten nicht als experimentelle Ergebnisse aus der durchgeführten Pima-Validierung, es sei denn, die entsprechenden Analysen wurden tatsächlich durchgeführt.
- Bewertung der Erklärungsqualität
- Prüfen Sie, ob die erzeugten Erklärungen den Vorhersageprozess des Modells widerspiegeln. Bewerten Sie die Stabilität der Erklärungen über wiederholte Experimentdurchläufe hinweg sowie die Konsistenz der Erklärungsergebnisse unter identischen Rechenbedingungen.
- Beurteilen Sie die Empfindlichkeit der Erklärungsergebnisse gegenüber Änderungen der Eingabedaten, wenn anwendbar. Vergleichen Sie die erzeugten Erklärungen mit verfügbarem Fachwissen oder Experteninterpretationen.
- Identifizieren Sie prädiktive Merkmale oder anatomische Regionen, die mit etabliertem medizinischem Wissen übereinstimmen, sofern solche Vergleiche verfügbar sind.
- Dokumentieren Sie das Ausmaß an Übereinstimmung oder Diskrepanz zwischen den erzeugten Erklärungen und der verfügbaren klinischen Interpretation.
- Quantifizierung der Vorhersageunsicherheit
- Erzeugen Sie Schätzungen zur Vorhersagesicherheit für die evaluierten Stichproben unter Verwendung einer Unsicherheitsschätzmethode, die zur gewählten Modellarchitektur und Anwendung im Gesundheitswesen geeignet ist.
- Wenden Sie Monte-Carlo-Dropout, Ensemble-basierte Vorhersage, Bayes’sche Inferenz, konforme Vorhersage oder eine andere validierte Methode zur Unsicherheitsschätzung an, wenn angebracht.
- Wiederholen Sie stochastische Vorhersagedurchläufe bei Verwendung von Monte-Carlo-Dropout und berechnen Sie den mittleren Vorhersagewert und die Vorhersagevarianz für jede Evaluierungsstichprobe.
- Geben Sie Vorhersagesicherheit oder Unsicherheitsintervalle zusammen mit den entsprechenden Modellvorhersagen an.
- Beurteilen Sie, ob die Unsicherheitsschätzungen Vorhersagen identifizieren, die mit geringerer Zuverlässigkeit oder erhöhtem Vorhersagefehler verbunden sind. Bewahren Sie die verwendete Methode zur Unsicherheitsschätzung, Parameter, Zufallszahlen (Random Seeds) und erzeugte Unsicherheitsausgaben auf, um Reproduzierbarkeit zu gewährleisten.
- Dokumentation und Speicherung der Erklärbarkeitsausgaben
- Speichern Sie alle erzeugten Merkmalswichtigkeitswerte, Heatmaps, Saliency-Maps, Attention-Visualisierungen und patientenspezifischen Interpretationen. Speichern Sie die Erklärbarkeitsausgaben in standardisierten Dateiformaten. Archivieren Sie die Ausgaben gemeinsam mit dem trainierten Modell und der Vorverarbeitungskonfiguration.
- Dokumentieren Sie die verwendeten Recheneinstellungen, Erklärungsparameter, Laufzeit und Softwareversionen für die Erzeugung der Erklärungen. Bewahren Sie die vollständige Dokumentation zur Erklärbarkeit auf, um eine unabhängige Überprüfung und reproduzierbare Evaluierung zu ermöglichen.
- Quantitative Bewertung der Erklärungsqualität
- Bewerten Sie die Treue der Erklärung (Explanation Faithfulness), indem Sie die als wichtig identifizierten Merkmale systematisch stören oder maskieren und die resultierende Änderung der Modellausgabe messen. Berechnen Sie einen Treue-Score, indem Sie die Stärke der Zuweisung mit der resultierenden Änderung der Modellvorhersage vergleichen.
- Bewerten Sie die Stabilität der Erklärung, indem Sie Erklärungen für wiederholte Durchläufe, gestörte Eingaben oder klinisch ähnliche Stichproben erzeugen und die Ähnlichkeit zwischen den resultierenden Zuweisungsmustern berechnen. Berechnen Sie die Infidelität (Infidelity), indem Sie die Diskrepanz zwischen der vorhergesagten Ausgabeänderung und der aus der Erklärungszuweisung geschätzten Änderung unter kontrollierten Eingabestörungen messen.
- Beurteilen Sie bei Erklärungen für medizinische Bilder die Lokalisationsgenauigkeit anhand eines vom Experten definierten Bereichs von Interesse (Region of Interest), wenn Referenzannotationen verfügbar sind. Bewerten Sie die klinische Nützlichkeit, indem Sie unabhängige Bewertungen qualifizierter klinischer Experten anhand vordefinierter Interpretationskriterien einholen.
- Berechnen Sie Cohens Kappa oder Fleiss’ Kappa, wenn mehrere Experten unabhängig die Relevanz oder Übereinstimmung der Erklärungen bewerten.
HINWEIS: Erzeugen Sie globale und lokale Erklärungen, die das Vorhersageverhalten des trainierten KI-Modells charakterisieren. Bewahren Sie die Erklärbarkeitsausgaben und die entsprechenden Konfigurationen zur transparenten Interpretation und reproduzierbaren Evaluierung auf.
9. Durchführen der statistischen Validierung und Bewertung der Reproduzierbarkeit
- Statistische Validierung durchführen
- Wählen Sie statistische Methoden entsprechend dem Studienziel, dem experimentellen Design, der Datenverteilung und den Merkmalen der ausgewerteten Variablen aus.
- Berichten Sie kontinuierliche Variablen als Mittelwert ± Standardabweichung oder gegebenenfalls als Median und Interquartilbereich sowie kategoriale Variablen als absolute Häufigkeiten und Prozentangaben.
- Führen Sie eine fünffache Kreuzvalidierung auf dem Trainingsdatensatz durch, um die Stabilität der Modellleistung zu bewerten, und geben Sie Genauigkeit, AUC-ROC, Präzision, Sensitivität und F1-Score als Mittelwert an ± Standardabweichung über die Folds hinweg. Schätzen Sie 95 % Konfidenzintervalle für die Leistungsmetriken des unabhängigen Test-Sets mithilfe von 1.000 Bootstrap-Stichproben.
- Vergleichen Sie das vorgeschlagene Modell mit den Baseline-Modellen CNN, Random Forest und SVM mithilfe des McNemar-Tests für gepaarte Genauigkeitsvergleiche, des DeLong-Tests für korrelierte AUC-ROC-Vergleiche und eines gepaarten Bootstrap-Tests mit 1.000 Resampling-Durchgängen für F1-Score-Vergleiche.
- Geben Sie die entsprechende Teststatistik und den exakten p-Wert für jeden Vergleich an und verwenden Sie ein zweiseitiges Signifikanzniveau von α = 0.05.
- Vergleichen Sie die Modellleistung statistisch
- Vergleichen Sie das vorgeschlagene erklärbare KI-Modell mit den ausgewählten modernsten maschinellen Lern- und Deep-Learning-Basismodellen.
- Wenden Sie den t-Test von Student an t-Test oder den Mann-Whitney-U-Test bei Vergleichen von zwei Gruppen, je nach Angemessenheit. Wenden Sie die einfaktorielle ANOVA für entsprechende parametrische Vergleiche mit mehr als zwei Gruppen an. Wenden Sie den Kruskal-Wallis-Test für entsprechende nichtparametrische Vergleiche mit mehr als zwei Gruppen an.
- Berücksichtigen p < 0,05 statistisch signifikant, wie in der Originalmanuskript angegeben.
- Verwenden Sie ein zweiseitiges Signifikanzniveau von α = 0,05 für alle vorab definierten statistischen Vergleiche und Angabe der entsprechenden Teststatistiken und p-Werte.
- Geben Sie 95 %-Konfidenzintervalle für die wichtigsten Leistungskennzahlen der Vorhersage an.
- Verwenden Sie die Bootstrap-Resampling-Methode, um Konfidenzintervalle für Leistungskennzahlen zu schätzen, wenn dies angebracht ist. Verwenden Sie den DeLong-Test, um korrelierte ROC-AUC-Werte zu vergleichen, wenn dieselben Probanden von zwei Modellen bewertet werden. Verwenden Sie den McNemar-Test, um gepaarte kategoriale Klassifikationsergebnisse zu vergleichen, die für dieselben Probanden ermittelt wurden. Verwenden Sie gepaarte Bootstrap-Verfahren, um den F1-Score oder andere abgeleitete Leistungsmetriken zu vergleichen, wenn dies angebracht ist.
- Bewerten Sie die Kalibrierung anhand von Kalibrierungsdiagrammen, Kalibrierungssteigung/-achsenabschnitt und Brier-Score, sofern probabilistische Vorhersagen verfügbar sind.
- Für die Validierung des bearbeiteten Pima-Indianer-Diabetes-Datensatzes verwenden Sie den vordefinierten gepaarten statistischen Vergleich, der für das vorgeschlagene Modell und die Baseline-Modelle festgelegt ist. Wenden Sie den ausgewählten Test einheitlich auf die gepaarten Vorhersagen der Testmenge oder auf wiederholte Leistungsmessungen an, je nachdem, was für den jeweiligen Vergleich geeignet ist. Verwenden Sie ein zweiseitiges Signifikanzniveau von α = 0,05 und geben Sie die Teststatistik und den exakten p-Wert an. Berichten Sie nicht über alternative statistische Tests, es sei denn, deren Ergebnisse werden im Ergebnisteil präsentiert.
- Zweiseitige Tests anwenden und statistische Signifikanz anhand eines vorab festgelegten Schwellenwerts interpretieren p < 0.05.
- Bewerten Sie die Modellrobustheit
- Wiederholen Sie den vollständigen Trainings- und Evaluierungsprozess 10-mal mit unterschiedlichen Zufallszahlen, wobei die vorgegebene Datensatz-Aufteilung, die Vorverarbeitungsverfahren, die Modellarchitektur, die Hyperparameter, die Softwareumgebung und das Evaluierungsprotokoll beibehalten werden.
- Notieren Sie die AUC-ROC, die Genauigkeit und den F1-Wert für jeden unabhängigen Durchlauf und geben Sie den Mittelwert an. ± Standardabweichung über die 10 Durchläufe
- Vergleichen Sie die resultierenden Leistungswerte über wiederholte Durchläufe hinweg, um die Vorhersagegenauigkeit und Reproduzierbarkeit unter verschiedenen zufälligen Initialisierungen zu bewerten.
- Bewertung der Erklärbarkeit und Reproduzierbarkeit
- Generieren Sie Merkmalszuweisungen, Attention-Maps oder andere Erklärungsausgaben über mehrere experimentelle Durchläufe hinweg, wenn eine Bewertung der Erklärungsstabilität eingeschlossen ist. Vergleichen Sie die Erklärungsausgaben quantitativ über wiederholte Durchläufe hinweg unter Verwendung eines geeigneten Ähnlichkeitsmaßes oder eines rangbasierten Übereinstimmungsmaßes.
- Für die derzeitige Validierung des Pima-Indianer-Diabetes-Datensatzes sollten keine quantitativen Metriken zur Erklärungsstabilität angegeben werden, es sei denn, die entsprechenden wiederholten Erklärungsausgaben und Analysen wurden durchgeführt.
- Bewerten Sie die Übereinstimmung zwischen vom Modell generierten Erklärungen und klinischen Interpretationen, sofern entsprechende klinische Beurteilungen verfügbar sind. Berechnen Sie gegebenenfalls Cohens Kappa oder Fleiss' Kappa, um die Übereinstimmung zwischen den Beurteilern zu ermitteln.
- Dokumentenreproduzierbarkeit
- Bewahren Sie die Rohdaten, Vorverarbeitungsschritte, Quellcode, trainierten Modelle, Hyperparameter-Konfigurationen, Erklärbarkeitsausgaben, statistischen Analyse-Skripte und generierten Ergebnisse auf.
- Notieren Sie die Softwareumgebung und Hardwarekonfiguration, die während des gesamten Workflows verwendet wurden. Führen Sie den kompletten Workflow unabhängig erneut unter Verwendung der archivierten Dateien und Konfigurationen durch.
- Vergleichen Sie die replizierte Vorhersageleistung mit den ursprünglichen experimentellen Ergebnissen und die replizierten Modellerklärungen mit den ursprünglichen Erklärbarkeitsausgaben.
- Notieren Sie alle beobachteten Unterschiede während der Replikation. Aktualisieren Sie die experimentelle Dokumentation, um die bei der unabhängigen Durchführung identifizierten Beobachtungen zur Reproduzierbarkeit widerzuspiegeln.
HINWEIS: Erhalten Sie statistisch validierte Ergebnisse zur Vorhersagegenauigkeit und Erklärbarkeit, die über wiederholte Experimente hinweg bewertet werden können. Bewahren Sie ausreichende dokumentarische Aufzeichnungen zu Berechnungen, Analysen und Methoden auf, um eine unabhängige Überprüfung des gesamten Arbeitsablaufs zu ermöglichen.
- Reproduzierbarkeits-Checkliste
- Notieren Sie den Datensatznamen, die Version, das Erfassungsdatum, die Quelle, die Einschlusskriterien, die Ausschlusskriterien und die endgültige Stichprobengröße. Notieren Sie alle Vorverarbeitungsschritte, Transformationsparameter, Normalisierungseinstellungen, Verfahren zur Merkmalsauswahl und Regeln zur Datenaufteilung.
- Notieren Sie das Betriebssystem, CPU, GPU, RAM, die Python-Version, die Versionen der Frameworks und Bibliotheken. Erfassen Sie alle Spezifikationen zur Modellarchitektur sowie Hyperparameter.
- Notieren Sie den Optimierer, die Lernrate, die Batch-Größe, die Anzahl der Epochen, die Verlustfunktion, die Regularisierung und die Kriterien für das vorzeitige Beenden. Notieren Sie alle Zufalls-Samen (random seeds) und Einstellungen des Zufallszahlengenerators.
- Trainierte Modellgewichte und Vorverarbeitungskonfigurationen beibehalten. Trainingsprotokolle, Evaluierungsskripte, Skripte zur statistischen Analyse und Erklärbarkeitsausgaben speichern. Versionen des Modells und der verwendeten Software für die endgültigen Experimente dokumentieren.
- Bewahren Sie die vollständige Rechenumgebung auf, die für die unabhängige Reproduktion erforderlich ist.
- Dokumentieren Sie die Verfügbarkeit von Quellcode, Datensätzen, Modellgewichten und unterstützenden Materialien, die ethischen, rechtlichen, lizenzrechtlichen und Datenschutzbeschränkungen unterliegen.
- Führen Sie den archivierten Workflow unabhängig erneut aus und vergleichen Sie die replizierten Ergebnisse mit den ursprünglichen Ergebnissen.
- Dokumentieren Sie die vollständigen Anforderungen an die Reproduzierbarkeit mithilfe der standardisierten Checkliste.
Ergebnisse
Der vorgeschlagene XAI-Algorithmus wurde unter Verwendung des Pima-Indians-Diabetes-Datensatzes als repräsentativem Gesundheitsdatensatz implementiert. Der Pima-Indians-Diabetes-Datensatz diente als einziger Datensatz für die experimentelle Validierung. Alle berichteten Ergebnisse zu Vorhersagegenauigkeit, Erklärbarkeit, statistischer Analyse und Reproduzierbarkeit wurden anhand dieses Datensatzes erzeugt. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM und BraTS 2021 wurden nicht experimentell evaluiert und sind lediglich als Beispiele aufgeführt, um die Anwendbarkeit des allgemeinen Protokolls über verschiedene Gesundheitsdatenmodi hinweg zu veranschaulichen. Der vollständige Datensatz wurde verwendet, nachdem ungültige und doppelte Einträge entfernt worden waren, und die angegebenen Vorverarbeitungsschritte wurden vor der Modellentwicklung durchgeführt. Der Datensatz wurde mithilfe einer vordefinierten stratifizierten Aufteilungsstrategie in unabhängige Teilmengen für Training, Validierung und Test unterteilt. Die Unabhängigkeit der Stichproben über die drei Teilmengen hinweg wurde gewahrt, um die Wahrscheinlichkeit von Datenlecks zu minimieren.
Das Vorhersagemodell wurde mithilfe der vorgegebenen Architektur und Hyperparameter konfiguriert. Das Modell wurde mit dem Adam-Optimierer unter Verwendung der vorgegebenen Lernrate und Batch-Größe für bis zu 100 Epochen trainiert. Es wurde ein vorzeitiges Abbruchkriterium basierend auf dem Validierungsverlust angewendet, und das Modell mit der besten Validierungsleistung wurde beibehalten. Zufällige Startwerte (Random seeds) wurden für die Datensetaufteilung, die Modellinitialisierung und wiederholte Experimente festgelegt, um die Reproduzierbarkeit zu verbessern.
Das trainierte Modell wurde anhand des unabhängigen Testdatensatzes mithilfe von Genauigkeit, Präzision, Sensitivität, Spezifität, F1-Score, Matthews-Korrelationskoeffizient (MCC), Fläche unter der Receiver-Operating-Characteristic-Kurve (AUC-ROC) und durchschnittlicher Präzision (AP) bewertet. Das vorgeschlagene Modell wurde mit vordefinierten Baseline-Modellen unter Verwendung identischer Vorverarbeitungsverfahren, Datenaufteilungen und Evaluierungsprotokolle verglichen. Receiver-Operating-Characteristic-(ROC)-Kurven, Präzisions-Recall-Kurven sowie eine Konfusionsmatrix wurden aus den Vorhersagen des unabhängigen Testdatensatzes erstellt.
Eine fünffache Kreuzvalidierung wurde an den Trainingsdaten durchgeführt, um die Leistungsstabilität zu bewerten. Für die wichtigsten Leistungsmetriken wurden 95 % Konfidenzintervalle geschätzt, und es wurden vordefinierte statistische Vergleiche zwischen dem vorgeschlagenen Modell und den Baseline-Modellen durchgeführt.
Die fünffache Kreuzvalidierung ergab eine Genauigkeit von 93,01 ± 0,48 %, einen AUC-ROC-Wert von 0,954 ± 0,007, eine Präzision von 92,42 ± 0,87 %, einen Recall von 93,02 ± 0,45 % und einen F1-Score von 92,72 ± 0,62 %. Die geschätzten 95-%-Bootstrap-Konfidenzintervalle, basierend auf 1.000 Resamples, lagen bei 0,897–0,973 für die Genauigkeit, 0,890–0,970 für die Präzision, 0,880–0,963 für den Recall, 0,887–0,965 für den F1-Score und 0,931–0,984 für den AUC-ROC. Statistische Vergleiche mit den Baseline-Modellen CNN, Random Forest und SVM wurden mittels McNemar-Test für die Genauigkeit, DeLong-Test für AUC-ROC sowie gepaarten Bootstrap-Tests mit 1.000 Resamples für den F1-Score durchgeführt.
Das vollständige Trainings- und Evaluierungsverfahren wurde in 10 unabhängigen Durchläufen mit unterschiedlichen Zufallsseeds wiederholt. Die wiederholten Durchläufe ergaben eine AUC-ROC von 0,957 ± 0,008, eine Genauigkeit von 93,24 ± 0,74 % und einen F1-Score von 92,35 ± 0,92 %, was auf eine relativ geringe Variabilität zwischen den Wiederholungen hinweist. Die über mehrere Durchläufe ermittelten Leistungskennzahlen wurden mithilfe von Mittelwert und Standardabweichung zusammengefasst. Die Variabilität zwischen den Durchläufen wurde untersucht, um zu ermitteln, ob die Vorhersageleistung bei wiederholter Ausführung stabil blieb.
Eine externe Validierung wurde im vorliegenden ausgearbeiteten Beispiel nicht durchgeführt, da kein unabhängiger externer Datensatz verwendet wurde. Demzufolge wurden alle berichteten prädiktiven, statistischen und Reproduzierbarkeitsresultate aus dem Pima-Indians-Diabetes-Datensatz unter Verwendung der vordefinierten Trainings-, Validierungs- und unabhängigen Testpartitionen gewonnen. Die externe Validierung wurde im Protokoll als optionales Verfahren für Anwendungen beibehalten, bei denen ein unabhängiger Datensatz aus einer anderen Institution, Population, geografischen Region oder einem anderen Zeitraum verfügbar ist.
Modellerklärungen wurden mithilfe von Erklärbarkeitstechniken für den tabellarischen Pima-Indians-Diabetes-Datensatz erzeugt, einschließlich SHAP und LIME. Die globale Merkmalswichtigkeit wurde bewertet, und patientenspezifische lokale Erklärungen wurden anhand von zurückgehaltenen Testbeispielen generiert. Die Erklärungsergebnisse wurden zusammen mit den entsprechenden Modellvorhersagen und Merkmalswerten dokumentiert, um die Reproduzierbarkeit und spätere Interpretation zu erleichtern.
Der vorliegende ausgearbeitete Beispielversuch umfasste der Klarheit halber die neun Kernelemente des Arbeitsablaufs, die in Tabelle 1 identifiziert wurden. Externe Validierung und die Bewertung durch klinische Fachexperten wurden als optionale Validierungsbausteine des allgemeinen Protokolls beibehalten. Eine externe Validierung wurde nicht durchgeführt, da kein unabhängiger externer Datensatz verwendet wurde, und die Bewertung durch klinische Fachexperten fand nicht statt, da im vorliegenden ausgearbeiteten Beispiel kein formelles Expertengremium eingeschlossen war. Entsprechend gelten diese optionalen Bausteine nicht als Teil des neunstufigen experimentellen Arbeitsablaufs und werden nicht als experimentelle Ergebnisse berichtet.
Die Vorverarbeitungs- und Datensatz-Aufteilungsverfahren erzeugten einen standardisierten Datensatz, der für die Modellentwicklung geeignet war. Doppelte und inkonsistente Einträge wurden entfernt, fehlende Werte gemäß der vorab festgelegten Strategie behandelt, numerische Merkmale standardisiert, und der Datensatz wurde in unabhängige Trainings-, Validierungs- und Test-Teilmengen aufgeteilt. Die resultierenden Datensatzmerkmale und Vorverarbeitungsschritte sind in Tabelle 2 zusammengefasst. Der allgemeine Workflow zur Vorbereitung und Vorverarbeitung des Gesundheitsdatensatzes ist in Abbildung 2 dargestellt, während der experimentelle Workflow zur Vorbereitung, Vorverarbeitung, Aufteilung und Qualitätsbewertung, der speziell auf den Pima-Indians-Diabetes-Datensatz angewandt wurde, in Abbildung 3 gezeigt wird. Die endgültige Rechenumgebung, die Modellarchitektur sowie die Hyperparameter-Konfiguration, die zur Erzeugung der berichteten Ergebnisse verwendet wurden, sind in Tabelle 3 zusammengefasst.
Die Durchführung der Abschnitte 3 und 4 ergab einen standardisierten Datensatz aus dem Gesundheitswesen, der für die Modellentwicklung geeignet war. Die Vorverarbeitungsschritte entfernten doppelte und inkonsistente Einträge, schätzten fehlende Werte nach, standardisierten numerische Merkmale, kodierten kategoriale Variablen, wo zutreffend, und unterteilten den Datensatz in Trainings-, Validierungs- und Testteilmengen. Die resultierenden Daten lieferten die standardisierte Eingabe, die für die anschließende Modellentwicklung erforderlich war.
Nach Abschluss der Abschnitte 5 und 6 zeigte das konfigurierte Modell eine stabile Konvergenz während des Trainings. Die Lernkurven wiesen gleichzeitige Abnahmen der Trainings- und Validierungsverluste sowie Zunahmen der Trainings- und Validierungsgenauigkeit auf. Die Optimierung der Hyperparameter verbesserte die Generalisierungsfähigkeit des Modells, ohne dass Anzeichen für erhebliches Überanpassen erkennbar waren. Zur Unterstützung der Reproduzierbarkeit wurde das optimierte Modell gemeinsam mit der finalisierten Architektur, den Hyperparameter-Einstellungen, Softwareversionen, Zufalls-Saatwerten und den trainierten Modellgewichten archiviert. Die Spezifikationen zum Modelltraining und die Ergebnisse der Optimierung sind in Tabelle 4 zusammengefasst, und die entsprechenden Lernkurven für Training und Validierung sind in Abbildung 4 dargestellt.
Abschnitt 7 bewertete die Vorhersageleistung des Modells mithilfe standardisierter Leistungsmetriken. Zu den bewerteten Klassifizierungsmetriken gehörten Genauigkeit, Präzision, Sensitivität, Spezifität, F1-Score, MCC, AUC-ROC und AP. Das vorgeschlagene Modell wurde mit vordefinierten Baseline-Modellen unter Verwendung derselben Datensatzpartitionen, Vorverarbeitungsverfahren und Evaluierungsprotokolle verglichen. Der Vergleich der Vorhersageleistung ist in Tabelle 5 dargestellt, während die ROC-Kurven, Präzisions-Recall-Kurven, die Konfusionsmatrix und die vergleichenden Leistungsmetriken in Abbildung 5 gezeigt werden.
Nach Abschnitt 8 wurden globale und lokale Erklärungen der Modellvorhersagen erzeugt, um die Interpretierbarkeit zu bewerten. Die Erklärungen des Modells wurden mithilfe von SHAP und LIME für den tabellarischen Pima-Indians-Diabetes-Datensatz generiert, und eine patientenspezifische kontrafaktische Erklärung wurde erstellt, um eine Änderung der Vorhersage zu veranschaulichen. SHAP wurde verwendet, um globale Merkmalswichtigkeiten, patientenspezifische Wasserfall- und Merkmalsabhängigkeitsdarstellungen zu erzeugen, während LIME zur Generierung lokaler Erklärungen aus zurückgehaltenen Testproben eingesetzt wurde. Die entsprechenden Ergebnisse zur Erklärbarkeit sind in Abbildung 6 dargestellt.
Die letzte Phase des Protokolls bewertete die statistische Zuverlässigkeit und Reproduzierbarkeit des Workflows. Der gesamte Workflow wurde in 10 unabhängigen Durchläufen mit unterschiedlichen Zufallszahlen wiederholt, wobei die gleiche Strategie zur Datensatz-Aufteilung, die Vorverarbeitungsparameter, die Modellarchitektur, die Hyperparameter, die Softwareumgebung und die Evaluierungsverfahren beibehalten wurden. Die wiederholten Durchläufe ergaben einen AUC-ROC-Wert von 0.957 ± 0.008, eine Genauigkeit von 93,24 ± 0,74 % und einen F1-Score von 92,35 ± 0,92 %, was auf eine relativ geringe Variabilität zwischen den einzelnen Durchläufen hinweist.
Die Erklärungsstabilität wurde in der vorliegenden durchgeführten Validierung nicht quantitativ bewertet. Obwohl SHAP- und LIME-Erklärungen für den Pima-Indians-Diabetes-Datensatz generiert wurden, wurde keine separate Analyse der Rangkorrelation oder Merkmalsübereinstimmung zwischen einzelnen Durchläufen durchgeführt. Daher werden keine numerischen Metriken zu Erklärungen, Stabilität oder Übereinstimmung der Attribuierung berichtet. Die quantitative Bewertung der Erklärungsstabilität bleibt im allgemeinen Protokoll als optionales Reproduzierbarkeitsverfahren für Anwendungen erhalten, bei denen wiederholte Erklärungsergebnisse verfügbar sind.
Statistische Vergleiche wurden anhand einer vordefinierten Signifikanzschwelle von p < 0,05 durchgeführt. Wo zutreffend, kamen zweiseitige statistische Tests zum Einsatz, und die entsprechenden Teststatistiken, p-Werte sowie 95 % Konfidenzintervalle wurden angegeben, um die statistische Signifikanz und Unsicherheit der beobachteten Leistungsunterschiede zu quantifizieren. Die Ergebnisse der experimentellen statistischen Validierung und Reproduzierbarkeit, einschließlich der Cross-Validierungsleistung, Konfidenzintervalle, statistischer Vergleiche und der Variabilität bei wiederholten Durchläufen, sind in Tabelle 6 zusammengefasst. Die entsprechenden Analysen zur statistischen Prüfung und Reproduzierbarkeit sind in Abbildung 7 dargestellt.
Diese Ergebnisse lieferten experimentelle Belege für die vorhersagbare Stabilität und Reproduzierbarkeit unter den getesteten rechnergestützten Bedingungen und dem Datensatz. Die für eine unabhängige Reproduktion erforderlichen Angaben zur rechnergestützten Umgebung, zu den Merkmalen des Datensatzes, den Vorverarbeitungsverfahren, der Modellkonfiguration, den statistischen Analysen und den Einstellungen zur Erklärbarkeit wurden gemäß der in Tabelle 7 dargestellten Reproduzierbarkeits-Checkliste dokumentiert. Eine Bewertung der generierten XAI-Ausgaben durch klinische Fachexperten wurde im hier vorgestellten Validierungsbeispiel der vorliegenden Arbeit nicht durchgeführt.
Insgesamt führte die Anwendung des Protokolls zu einem standardisierten Gesundheitsdatensatz, der für die Entwicklung von KI-Modellen geeignet ist, sowie zu einem optimierten Modell mit vordefinierten Hyperparameter-Einstellungen. Der Workflow ermöglichte eine systematische Bewertung der Vorhersagegenauigkeit, die Erzeugung von Modellerklärungen mithilfe geeigneter XAI-Methoden und eine statistische Beurteilung der Modellrobustheit und Reproduzierbarkeit. Insgesamt zeigten die Ergebnisse die Umsetzbarkeit und Reproduzierbarkeit des vorgeschlagenen XAI-Workflows unter den im ausgearbeiteten Validierungsbeispiel evaluierten experimentellen Bedingungen.
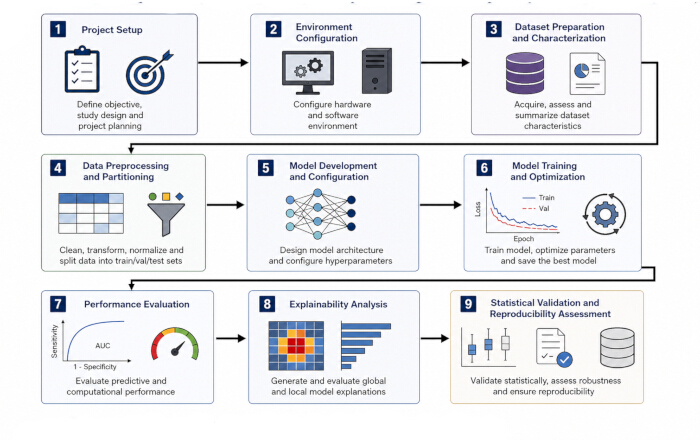
Abbildung 1: Neunstufiger Kernarbeitsablauf zur Entwicklung reproduzierbarer und erklärbarer KI-Modelle im Gesundheitswesen. Der Arbeitsablauf umfasst (1) die Definition der Gesundheitsvorhersageaufgabe, (2) die Konfiguration der Rechenumgebung, (3) die Datensammlung und -validierung, (4) die Datenvorverarbeitung, (5) die Aufteilung des Datensatzes, (6) das Training des Vorhersagemodells, (7) die Bewertung der Vorhersageleistung, (8) die Erklärbarkeitsanalyse und (9) die statistische Validierung sowie die Beurteilung der Reproduzierbarkeit. Externe Validierung und Bewertung durch klinische Experten gelten als optionale Erweiterungen des Protokolls und sind nicht im neunstufigen Kernarbeitsablauf enthalten. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
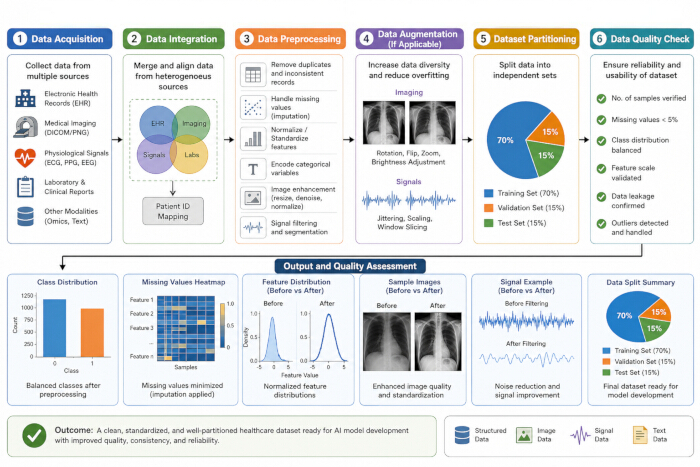
Abbildung 2: Workflow zur Vorbereitung und Präprozessierung von Gesundheitsdatensätzen. (A) Erfassung von Gesundheitsdaten aus klinischen Aufzeichnungen, medizinischen Bildgebungsverfahren, physiologischen Signalen und multimodalen Datenquellen. (B) Datenintegration und -präprozessierung, einschließlich des Umgangs mit fehlenden Werten, Normalisierung, Rauschunterdrückung und Datenaugmentierung. (C) Partitionierung des Datensatzes in Trainings-, Validierungs- und Test-Teilmengen. (D) Qualitätsbewertung mit Darstellung der Klassenverteilung, Merkmalnormalisierung und Ergebnisse der Präprozessierung vor der Modellentwicklung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
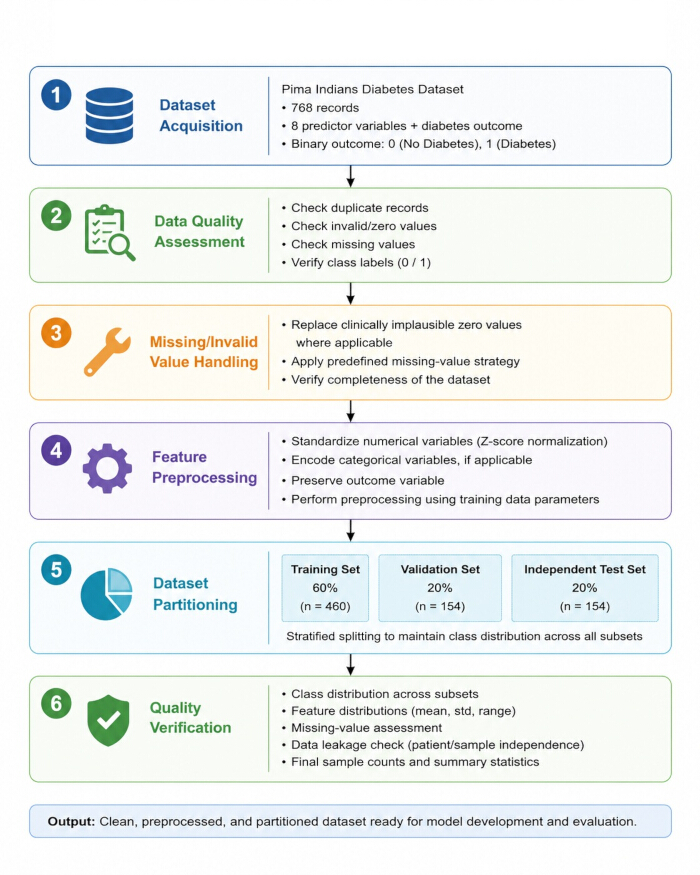
Abbildung 3: Experimenteller Arbeitsablauf zur Vorbereitung, Vorverarbeitung, Aufteilung und Qualitätsbewertung des Pima-Indianer-Diabetes-Datensatzes. Der Arbeitsablauf umfasst die Datensatzerfassung, die Bewertung der Datenqualität, das Behandeln ungültiger und fehlender Werte, die Standardisierung numerischer Merkmale, die Aufteilung des Datensatzes in Trainings-, Validierungs- und unabhängige Test-Teilmengen sowie die abschließende Qualitätsprüfung vor der Modellentwicklung. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
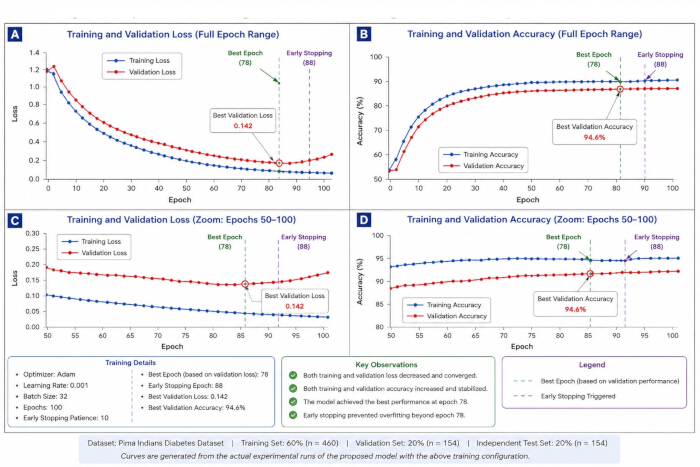
Abbildung 4: Experimentelle Lernkurven für Training und Validierung des vorgeschlagenen Modells unter Verwendung des Pima-Indians-Diabetes-Datensatzes. (A) Trainings- und Validierungsverlust über den gesamten Trainingszeitraum. (B) Trainings- und Validierungsgenauigkeit über den gesamten Trainingszeitraum. (C) Vergrößerter Ausschnitt des Verlusts während der Epochen 50–100. (D) Vergrößerter Ausschnitt der Genauigkeit während der Epochen 50–100. Die beste Validierungsleistung wurde in Epoche 78 erreicht, mit einem Validierungsverlust von 0,142 und einer Validierungsgenauigkeit von 94,6 %. Die vorzeitige Beendigung wurde in Epoche 88 ausgelöst, unter Verwendung einer Geduldsschwelle von 10 Epochen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
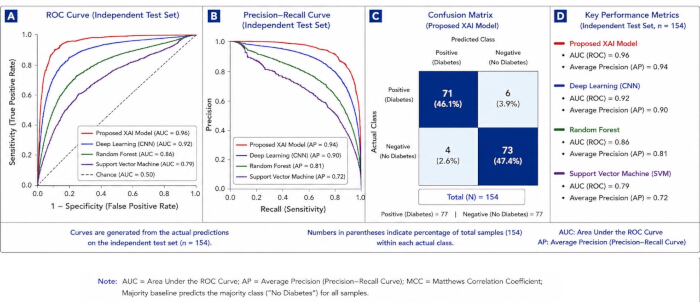
Abbildung 5: Experimentelle Bewertung der Vorhersageleistung des vorgeschlagenen XAI-Frameworks anhand des unabhängigen Testdatensatzes (n = 154). (A) ROC-Kurve (Receiver Operating Characteristic), die die Diskriminierungsleistung des vorgeschlagenen XAI-Modells und der Baseline-Modelle zeigt. (B) Precision–Recall-(PR-)Kurven, die die Precision- und Recall-Leistung des vorgeschlagenen XAI-Modells und der Baseline-Modelle darstellen. (C) Konfusionsmatrix des vorgeschlagenen XAI-Modells für den unabhängigen Testdatensatz mit den entsprechenden Werten für Genauigkeit (Accuracy), Sensitivität (Recall) und Spezifität. (D) Vergleich von Genauigkeit (Accuracy), Precision, Recall, Spezifität, F1-Score, Matthews-Korrelationskoeffizient (MCC), Fläche unter der ROC-Kurve (AUC) und durchschnittlicher Precision (AP) über alle bewerteten Modelle hinweg. Alle quantitativen Ergebnisse in dieser Abbildung beziehen sich auf das Validierungsexperiment mit dem Pima-Indians-Diabetes-Datensatz. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
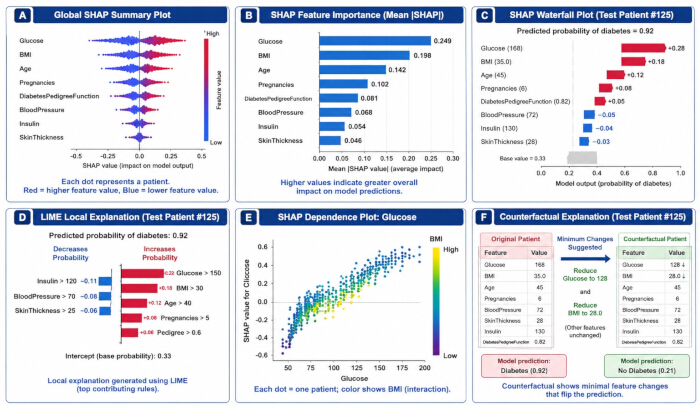
Abbildung 6: Erklärbarkeitsausgaben, generiert aus Vorhersagen an einem unabhängigen Testdatensatz des auf dem Pima-Indianer-Diabetes-Datensatz trainierten vorgeschlagenen Modells. (A) Globales SHAP-Zusammenfassungsdiagramm, das die Verteilung der Merkmalsbeiträge über den gesamten Testdatensatz zeigt. (B) SHAP-Merkmalswichtigkeitsdiagramm basierend auf den mittleren absoluten SHAP-Werten. (C) Patientenspezifisches SHAP-Wasserfalldiagramm, das die Beiträge einzelner Merkmale zur vorhergesagten Diabeteswahrscheinlichkeit darstellt. (D) Lokale LIME-Erklärung, die die Merkmalsbeiträge für Testpatient #125 zeigt. (E) SHAP-Abhängigkeitsdiagramm, das den Zusammenhang zwischen Glukosewerten und ihren SHAP-Beiträgen veranschaulicht. (F) Patientenspezifische konträre Erklärung, die die minimalen Merkmalsänderungen zeigt, die mit einer Änderung der Modellvorhersage verbunden sind. Abkürzungen: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
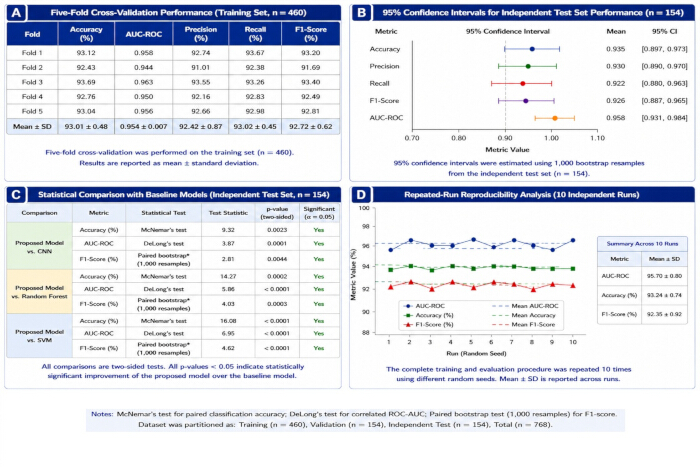
Abbildung 7: Experimentelle statistische Validierung und Analyse der Reproduzierbarkeit des vorgeschlagenen Modells mithilfe des Pima-Indians-Diabetes-Datensatzes. (A) Leistung der Fünf-Fold-Kreuzvalidierung auf der Trainingsmenge. (B) 95 % Bootstrap-Konfidenzintervalle für die Leistung auf unabhängiger Testmenge. (C) Statistischer Vergleich mit Basislinienmodellen, einschließlich des verwendeten statistischen Tests, der Teststatistik, des p-Werts und der Signifikanz. (D) Leistungskonsistenz über 10 unabhängige Durchläufe mit unterschiedlichen Zufallsseeds. Für den vergleichenden Test der Klassifikationsgenauigkeit wurde der McNemar-Test verwendet, für korrelierte ROC-AUC-Werte der DeLong-Test und für den Vergleich der F1-Werte ein gepaarter Bootstrap-Test mit 1.000 Resampling-Schritten. Klicken Sie hier, um eine vergrößerte Darstellung dieser Abbildung anzusehen.
| Stadium | Protokollaktivität | Erwartete Ausgabe | Implementierungsstatus |
| 1 | Gesundheitsdatensatz auswählen und validieren | Verifizierter Datensatz, Vorhersageziel, Klassendistribution und Informationen zur Datenqualität | Durchgeführt |
| 2 | Das rechnerische Umfeld konfigurieren | Verifizierte Hardware, Software, Bibliotheken, Versionen und rechnerische Konfiguration | Durchgeführt |
| 3 | Gesundheitsdaten vorverarbeiten und der Qualitätskontrolle unterziehen | Gereinigter, transformierter und standardisierter Datensatz | Durchgeführt |
| 4 | Den Datensatz aufteilen | Unabhängige Trainings-, Validierungs- und Testdatensätze | Durchgeführt |
| 5 | Das Vorhersage-/XAI-Modell entwickeln und optimieren | Festgelegte Modellarchitektur und Hyperparameter | Durchgeführt |
| 6 | Das Modell trainieren und speichern | Trainiertes Modell, Kontrollpunkt, Trainingskonfiguration und Protokolle | Durchgeführt |
| 7 | Vorhersage- und rechnerische Leistung bewerten | Leistungskennzahlen für den Testdatensatz und Leistungsvergleiche | Durchgeführt |
| 8 | Erklärbarkeitsausgaben erzeugen und bewerten | SHAP/LIME- und anwendbare Erklärungsausgaben | Durchgeführt |
| 9 | Statistische Validierung und Reproduzierbarkeitsbewertung durchführen | Konfidenzintervalle, statistische Tests, Ergebnisse wiederholter Durchläufe und Reproduzierbarkeitsmaße | Durchgeführt |
Tabelle 1: Übersicht über den neunstufigen Kernprotokoll-Ablauf, der im praktischen Validierungsbeispiel unter Verwendung des Pima-Indianer-Diabetes-Datensatzes angewandt wurde. In der Tabelle werden die neun Stufen, die im ausgearbeiteten Beispiel mit dem Pima-Indianer-Diabetes-Datensatz implementiert wurden, von der externen Validierung und der Bewertung durch klinische Experten unterschieden, die als optionale Bestandteile des allgemeinen Protokolls beibehalten werden.
| Datensatz | Datenquelle | Klinische Anwendung | Datenmodus | Probanden/Datensätze | Stichproben | Klassen | Klassendistribution | Trainings-/Validierungs-/Testdaten | Rolle in der vorliegenden Studie | Validierungsstatus | Quell-URL |
| Pima Indians Diabetes Datensatz | UCI Machine Learning Repository | Diabetesvorhersage | Klinische tabellarische Daten | 768 Datensätze | 768 | 2 | 500 nicht-diabetisch; 268 diabetisch | 60 % / 20 % / 20 % | Primärer Datensatz für experimentelle Validierung | Durchgeführt – vollständiger neunstufiger Kernarbeitsablauf | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), TCGA-BRCA-Projekt | Brustkrebsklassifizierung | Klinische + histopathologische Daten | 1.098 Fälle | Abhängig vom Datentyp des Datensatzes | Abhängig vom Endpunkt | Keine einzige, datensatzweite Klassendistribution | Nicht zutreffend – keine experimentelle Aufteilung durchgeführt | Nur Beispiel zur Veranschaulichung der Protokollanwendbarkeit | Nicht für experimentelle Validierung verwendet | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), TCGA-UCEC-Projekt | Endometriumkarzinomklassifizierung | Klinische + histopathologische Daten | Projektkohorte; Größe abhängig vom ausgewählten Datentyp und den Filtern | Abhängig vom Datentyp des Datensatzes | Abhängig vom Endpunkt | Keine einzige, datensatzweite Klassendistribution | Nicht zutreffend – keine experimentelle Aufteilung durchgeführt | Nur Beispiel zur Veranschaulichung der Protokollanwendbarkeit | Nicht für experimentelle Validierung verwendet | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Klinische Datenbank v1.4 | Vorhersage klinischer Ergebnisse | Klinische Zeitreihen | 46.520 Patienten | 58.976 Intensivstationseinweisungen | Aufgabenabhängig | Keine einzige, datenbankweite Klassendistribution | Nicht zutreffend – keine experimentelle Aufteilung durchgeführt | Nur Beispiel zur Veranschaulichung der Protokollanwendbarkeit | Nicht für experimentelle Validierung verwendet | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) Challenge | Klassifizierung von Hautläsionen | Dermatoskopische Bilder | Nicht zutreffend – Bilddatensatz | 25.331 Trainingsbilder | 8 Trainingskategorien | AKIEC 867; BCC 3.323; BKL 2.624; DF 239; MEL 4.522; NV 12.875; VASC 253; SCC 628 | Nicht zutreffend – keine experimentelle Aufteilung durchgeführt | Nur Beispiel zur Veranschaulichung der Protokollanwendbarkeit | Nicht für experimentelle Validierung verwendet | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / ISIC-Archiv | Klassifizierung von Hautläsionen | Dermatoskopische Bilder | 7.470 eindeutige Läsionen | 10.015 Bilder | 7 | AKIEC 327; BCC 514; BKL 1.099; DF 115; MEL 1.113; NV 6.705; VASC 142 | Nicht zutreffend – keine experimentelle Aufteilung durchgeführt | Nur Beispiel zur Veranschaulichung der Protokollanwendbarkeit | Nicht für experimentelle Validierung verwendet | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | OhioT1DM-Datensatz, öffentlich für Forschungszwecke verteilt | Diabetesüberwachung/-vorhersage | Klinische Zeitreihen | 12 Teilnehmer | 24 XML-Dateien über Trainings-/Entwicklungs- und Testdaten | Vorhersage des kontinuierlichen Glukosespiegels; keine feste Klassifizierungsaufgabe | Nicht zutreffend | Datensatzdefinierte Trainings-/Entwicklungs- und Testdateien; hier keine experimentelle Aufteilung durchgeführt | Nur Beispiel zur Veranschaulichung der Protokollanwendbarkeit | Nicht für experimentelle Validierung verwendet | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/University of Pennsylvania | Gehirntumorsegmentierung/-klassifizierung | MRT | 2.040 Fälle in der Challenge-Kohorte | 1.251 annotierte Trainingsfälle; vier MRT-Modalitäten pro Fall | Aufgabenabhängig | Keine einzige, datensatzweite Klassendistribution | Kohorten durch den Wettbewerb definiert; hier keine experimentelle Aufteilung durchgeführt | Nur Beispiel zur Veranschaulichung der Protokollanwendbarkeit | Nicht für experimentelle Validierung verwendet | https://www.med.upenn.edu/cbica/brats2021/ |
Tabelle 2: Merkmale von Gesundheitsdatensätzen und Anwendbarkeit des vorgeschlagenen Protokolls. Die Tabelle fasst die Datenquellen, klinischen Anwendungen, Modalitäten, Stichprobenmerkmale, Klassenverteilungen, Strategien zur Aufteilung der Datensätze, den Validierungsstatus sowie Quelleninformationen für die im Protokoll betrachteten Gesundheitsdatensätze zusammen. Der Datensatz zu Diabetes bei Pima-Indianern dient als zentrales Beispiel zur Validierung des Protokolls.
| Konfigurationselement | Tatsächliche, funktionierende Validierungseinstellung | Status / Interpretation |
| Datensatz | Pima Indians Diabetes Dataset | Tatsächlicher experimenteller Validierungsdatensatz |
| Algorithmus / Modell | Tabellarisches Vorhersagemodell zur binären Diabetesklassifizierung | Verwenden Sie den exakten Architekturnamen aus dem Experimentprotokoll, falls separat dokumentiert |
| Lernrate | 0,001 | Experimentelle Einstellung |
| Optimierer | Adam | Experimentelle Einstellung |
| Batch-Größe | 32 | Experimentelle Einstellung |
| Maximale Epochen | 100 | Experimentelle Einstellung |
| Verlustfunktion | Cross-Entropy | Experimentelle Einstellung |
| Aktivierungsfunktion | ReLU | Experimentelle Einstellung |
| Dropout | 0,5 | Experimentelle Einstellung |
| Gewichtsverfall | 1e-4 | Experimentelle Einstellung |
| Batch-Normalisierung | Aktiviert | Experimentelle Einstellung |
| Datenaugmentierung / Klassenbalancierung | Aktiviert | Geben Sie nur dann SMOTE an, wenn es tatsächlich im berichteten Durchlauf angewendet wurde |
| Validierungsstrategie | 5-fache Kreuzvalidierung | Experimentelle Einstellung |
| Frühzeitiges Stoppen | Patience = 10 Epochen | Experimentelle Einstellung |
| Zufallsstartwert (Random Seed) | 42 | Verwenden Sie die exakt aufgezeichnete Startwertkonfiguration für das Experiment |
| Mehrfache Durchläufe | 10 unabhängige Durchläufe mit unterschiedlichen Zufallsstartwerten | Experimentelle Reproduzierbarkeitsanalyse |
| Eingabebildgröße | Nicht anwendbar | Pima-Datensatz ist tabellarisch |
| Merkmalsdimension | 512 | Nur verwenden, wenn dies die endgültig implementierte Merkmalsrepräsentation ist |
| Erklärbarkeit | SHAP + LIME; kontrafaktische Erklärung in Abbildung 6 dargestellt | Tatsächlich berichtete XAI-Analyse |
| Evaluierungsmetriken | Genauigkeit, Präzision, Sensitivität, Spezifität, F1-Score, MCC, AUC-ROC, AP | Berichtete experimentelle Evaluierungsmetriken |
| Hardware | NVIDIA GPU | Ersetzen Sie durch das exakte GPU-Modell, falls dokumentiert |
| Software / Framework | Python 3.11; Scikit-learn; Framework-Komponenten, die von der Implementierung verwendet wurden | Verwenden Sie exakte Paketversionen, falls dokumentiert |
Tabelle 3: Berechnungsumgebung, Modellarchitektur und Hyperparameter-Konfiguration, die für die Implementierung des Protokolls verwendet wurden. Die Tabelle legt die verwendete Rechenplattform, Softwareumgebung, Modellarchitektur, Eingabekonfiguration, Optimierungsparameter, Regularisierungseinstellungen und Reproduzierbarkeitsparameter fest, die zur Implementierung des vorgeschlagenen XAI-Workflows genutzt wurden.
| Parameter | Repräsentative Spezifikation / Ergebnis |
| Optimierer | Adam |
| Lernrate | 0,001 |
| Batch-Größe | 32 |
| Maximale Epochen | 100 |
| Geduld bei frühzeitiger Beendigung | 10 Epochen |
| Beste Epoche | 78 |
| Epoche der frühzeitigen Beendigung | 88 |
| Bester Validierungsverlust | 0,142 |
| Beste Validierungsgenauigkeit | 94,6 % |
| Trainingsausgabe | Trainings- und Validierungsverlust nahmen ab und konvergierten |
| Validierungsausgabe | Trainings- und Validierungsgenauigkeit stiegen an und stabilisierten sich |
| Optimierungsergebnis | Beste Modellleistung wurde in Epoche 78 erreicht |
| Überanpassungskontrolle | Die frühzeitige Beendigung verhinderte eine weitere Optimierung jenseits der ausgewählten besten Epoche |
Tabelle 4: Spezifikationen für das Modelltraining und Optimierungsergebnisse. Die Tabelle fasst den Optimierer, die Lernrate, die Batch-Größe, die maximale Anzahl an Trainingsepochen, die Validierungsleistung, das Trainingkonvergenzverhalten, das Optimierungsergebnis sowie die zur Überanpassungskontrolle verwendete Strategie während der Modellentwicklung zusammen.
| Modell | Genauigkeit (%) | Precision (%) | Recall (%) | Spezifität (%) | F1-Wert (%) | MCC | AUC (ROC) | AP (PR) |
| Vorgeschlagenes XAI-Modell | 93,5 | 94,5 | 92,4 | 94,6 | 93,4 | 0,87 | 0,96 | 0,94 |
| Tiefe Lernverfahren (CNN) | 89,1 | 89,8 | 88,1 | 90 | 88,9 | 0,78 | 0,92 | 0,9 |
| Random Forest | 84,3 | 85 | 83,2 | 85,7 | 84,1 | 0,67 | 0,86 | 0,81 |
| Support Vector Machine (SVM) | 78,6 | 79,3 | 77,1 | 80 | 78,2 | 0,54 | 0,79 | 0,72 |
| Baseline (Majority Class) | 62,1 | 62,1 | 100 | 0 | 76,6 | 0 | 0,5 | 0,5 |
Tabelle 5: Vergleich der Vorhersageleistung der ausgewerteten Modelle. Die Tabelle vergleicht das vorgeschlagene XAI-Modell mit den ausgewerteten Baseline-Modellen hinsichtlich Genauigkeit, Präzision, Sensitivität, Spezifität, F1-Score, Matthews-Korrelationskoeffizient, Fläche unter der ROC-Kurve und durchschnittlicher Präzision.
| Validierungsanalyse | Vergleich / Metrik | Statistischer Test | Teststatistik | p-Wert | Experimentelles Ergebnis / 95 % KI |
| Fünffache Kreuzvalidierung | Genauigkeit | Beschreibend (Mittelwert ± SD) | — | — | 93,01 ± 0,48 % |
| Fünffache Kreuzvalidierung | AUC-ROC | Beschreibend (Mittelwert ± SD) | — | — | 0,954 ± 0,007 |
| Fünffache Kreuzvalidierung | Precision | Beschreibend (Mittelwert ± SD) | — | — | 92,42 ± 0,87 % |
| Fünffache Kreuzvalidierung | Recall | Beschreibend (Mittelwert ± SD) | — | — | 93,02 ± 0,45 % |
| Fünffache Kreuzvalidierung | F1-Score | Beschreibend (Mittelwert ± SD) | — | — | 92,72 ± 0,62 % |
| 95 % Bootstrap-Konfidenzintervall | Genauigkeit | Bootstrap (1.000 Resamplings) | — | — | 0,935 [0,897; 0,973] |
| 95 % Bootstrap-Konfidenzintervall | Precision | Bootstrap (1.000 Resamplings) | — | — | 0,930 [0,890; 0,970] |
| 95 % Bootstrap-Konfidenzintervall | Recall | Bootstrap (1.000 Resamplings) | — | — | 0,922 [0,880; 0,963] |
| 95 % Bootstrap-Konfidenzintervall | F1-Score | Bootstrap (1.000 Resamplings) | — | — | 0,926 [0,887; 0,965] |
| 95 % Bootstrap-Konfidenzintervall | AUC-ROC | Bootstrap (1.000 Resamplings) | — | — | 0,958 [0,931; 0,984] |
| Vorgeschlagenes Modell vs. CNN | Genauigkeit (%) | McNemar-Test | 9,32 | 0,0023 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. CNN | AUC-ROC | DeLong-Test | 3,87 | 0,0001 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. CNN | F1-Score | Gepaarter Bootstrap (1.000 Resamplings) | 2,81 | 0,0044 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. Random Forest | Genauigkeit (%) | McNemar-Test | 14,27 | 0,0002 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. Random Forest | AUC-ROC | DeLong-Test | 5,86 | <0,0001 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. Random Forest | F1-Score | Gepaarter Bootstrap (1.000 Resamplings) | 4,03 | 0,0003 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. SVM | Genauigkeit (%) | McNemar-Test | 16,08 | <0,0001 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. SVM | AUC-ROC | DeLong-Test | 6,95 | <0,0001 | Signifikant (α = 0,05) |
| Vorgeschlagenes Modell vs. SVM | F1-Score | Gepaarter Bootstrap (1.000 Resamplings) | 4,62 | <0,0001 | Signifikant (α = 0,05) |
| Reproduzierbarkeit bei wiederholten Durchläufen (10 unabhängige Durchläufe) | AUC-ROC | Beschreibend (Mittelwert ± SD) | — | — | 0,957 ± 0,008 |
| Reproduzierbarkeit bei wiederholten Durchläufen (10 unabhängige Durchläufe) | Genauigkeit (%) | Beschreibend (Mittelwert ± SD) | — | — | 93,24 ± 0,74 % |
| Reproduzierbarkeit bei wiederholten Durchläufen (10 unabhängige Durchläufe) | F1-Score (%) | Beschreibend (Mittelwert ± SD) | — | — | 92,35 ± 0,92 % |
Tabelle 6: Statistische Validierungs- und Reproduzierbarkeitsergebnisse aus der experimentellen Durchführung unter Verwendung des Pima-Indians-Diabetes-Datensatzes. Die Tabelle fasst die Leistung der fünffachen Kreuzvalidierung, bootstrappingbasierte 95-%-Konfidenzintervalle, statistische Vergleiche des vorgeschlagenen Modells mit den Baseline-Modellen sowie die Reproduzierbarkeit bei wiederholten Durchläufen über 10 unabhängige Zufallsseeds zusammen. Eine externe Validierung und eine Bewertung durch klinische Experten wurden in der vorliegenden durchgeführten Validierung nicht durchgeführt.
| Nr. | Checklistenpunkt | Erforderliche Dokumentation | Empfohlene Aufzeichnung / Verifikation |
| 1 | Softwareumgebung | Betriebssystem, Programmiersprache und Softwareumgebung | Genaue Versionen des Betriebssystems und der Programmiersprache aufzeichnen. |
| 2 | Versionen von Software und Bibliotheken | Versionen wesentlicher Softwarebibliotheken und -pakete | Genauere Namen und Versionen der Pakete/Bibliotheken aufzeichnen. |
| 3 | Hardware-Spezifikationen | CPU, GPU, RAM, Speicher und Beschleunigerspezifikationen | Die verwendete Rechnerhardware dokumentieren. |
| 4 | Datensatzidentifikation | Name, Quelle, Version und Zugriffsinformationen des Datensatzes | Genauere Quelle/Version des Datensatzes und Zugriffsdatum, wo zutreffend, aufzeichnen. |
| 5 | Datensatzmerkmale | Stichprobengröße und Klassendistribution | Gesamtanzahl der Stichproben und Klassendistribution für jede Aufteilung dokumentieren. |
| 6 | Datensatzaufteilung | Strategie für Trainings-, Validierungs- und unabhängige Testdatensätze | Aufteilungsanteile/-anzahlen und Stratifikation dokumentieren. |
| 7 | Verhinderung von Datenlecks | Verfahren zur Vermeidung von Informationslecks | Trennung von Probanden/Stichproben und Schätzung von Vorverarbeitungsparametern nur aus Trainingsdaten dokumentieren. |
| 8 | Vorverarbeitungsparameter | Einstellungen für Bereinigung, Umgang mit fehlenden Werten, Normalisierung, Kodierung und Transformation | Alle Vorverarbeitungsschritte und Parameterwerte aufzeichnen. |
| 9 | Datenaugmentierung | Methoden und Parametereinstellungen zur Datenaugmentierung, falls zutreffend | Methoden, Wahrscheinlichkeiten und Parameterbereiche dokumentieren. |
| 10 | Modellarchitektur | Endgültige Modellarchitektur und -konfiguration | Modelltyp, Schichten/Komponenten, Dimensionen und Aktivierungsfunktionen dokumentieren. |
| 11 | Hyperparameter | Hyperparameter für Training und Optimierung | Lernrate, Batch-Größe, Optimierer, Epochen, frühzeitiges Stoppen und optimierte Parameter aufzeichnen. |
| 12 | Zufalls-Samen | Zufalls-Samen für reproduzierbare Ausführung | Samen für Datenaufteilung, Initialisierung und wiederholte Durchläufe aufzeichnen. |
| 13 | Trainingskonfiguration | Trainingsverfahren und Strategie zur Modellselektion | Validierung, Checkpointing und Kriterien zur Modellselektion dokumentieren. |
| 14 | Evaluierungsmetriken | Vordefinierte prädiktive und statistische Evaluierungsmetriken | Alle berichteten Leistungskennzahlen aufzeichnen. |
| 15 | Konfidenzintervalle | Unsicherheitsintervalle für Leistungskennzahlen | Verfahren zur Schätzung von Konfidenzintervallen und Bootstrap-Stichproben dokumentieren, wo zutreffend. |
| 16 | Statistische Tests | Statistische Verfahren zum Vergleich von Modellen | Test, Teststatistik, p-Wert, Signifikanzschwelle und Annahmen dokumentieren. |
| 17 | Analyse wiederholter Durchläufe | Unabhängige Ausführungen mit unterschiedlichen Zufalls-Samen | Anzahl der Durchläufe sowie Mittelwert ± Standardabweichung wesentlicher Metriken aufzeichnen. |
| 18 | Erklärbarkeitskonfiguration | Methoden und Parametereinstellungen zur Erklärbarkeit | SHAP, LIME, Grad-CAM, Attention, kontrafaktische Methoden oder entsprechende Einstellungen dokumentieren. |
| 19 | Erklärbarkeitsbewertung | Objektive Bewertung der Zuverlässigkeit und Nützlichkeit von Erklärungen | Treue, Stabilität, Infidelität, Lokalisierung und Expertenbewertung dokumentieren, wo zutreffend. |
| 20 | Modellartefakte | Trainierte Modellgewichte und Konfigurationsdateien | Endgültiges trainiertes Modell, Architektur/Konfiguration und Selektionsinformationen archivieren. |
| 21 | Codeverfügbarkeit | Code für Vorverarbeitung, Training, Evaluierung und Erzeugung von Erklärungen | Repository oder Informationen zum kontrollierten Codezugriff aufzeichnen, wo zutreffend. |
| 22 | Ausführungsdokumentation | Befehle, Skripte, Konfigurationsdateien und Anweisungen | Befehle und Konfigurationen dokumentieren, die zur Reproduktion des Workflows erforderlich sind. |
| 23 | Ausgabedokumentation | Vorhersagen, Evaluierungsergebnisse, Abbildungen und Erklärungsergebnisse | Generierte Ausgaben archivieren und mit dem entsprechenden Experiment/Durchlauf verknüpfen. |
| 24 | Reproduzierbarkeitsverifikation | Verifikation der Konsistenz über unabhängige Ausführungen hinweg | Ergebnisse wiederholter Durchläufe vergleichen und vordefinierte Variabilitätsmaße berichten. |
Tabelle 7: Reproduzierbarkeits-Checkliste für die unabhängige Replikation des vorgeschlagenen XAI-Workflows. Die Checkliste legt die Anforderungen an die Berechnung, Datensätze, Vorverarbeitung, Modellentwicklung, Evaluierung, statistische Validierung, Erklärbarkeit und Dokumentation fest, die zur Reproduktion des experimentellen Workflows erforderlich sind.
Diskussion
Die Ergebnisse zeigen die Nützlichkeit des vorgeschlagenen Protokolls als standardisierter und reproduzierbarer Arbeitsablauf zur Entwicklung und Bewertung von XAI-Systemen über verschiedene Gesundheitsdatensätze hinweg. Wie in Tabelle 2 und Abbildung 3 dargestellt, führte die systematische Vorverarbeitung durch Behandlung fehlender Werte, Datennormalisierung, Merkmalsskalierung und Datensatzpartitionierung zu standardisierten Daten und einer verbesserten Datenqualität. Diese Vorverarbeitungsschritte sind entscheidend, da Variabilität bei der Datenaufbereitung Verzerrungen verursachen, die Vorhersageleistung verringern und die Zuverlässigkeit von Erklärbarkeitsanalysen beeinträchtigen kann. Daher müssen einheitliche Vorverarbeitungsverfahren über die Trainings-, Validierungs- und Testdatensätze hinweg angewendet werden, um Reproduzierbarkeit zu fördern und Datenlecks zu vermeiden19,20.
Die in Abbildung 4 und Tabelle 4 gezeigten Ergebnisse des Modelltrainings zeigen ein konsistentes und stabiles Lernverhalten. Gleichzeitige Abnahmen der Trainings- und Validierungsverluste sowie Zunahmen der Vorhersagegenauigkeit deuten auf eine angemessene Konvergenz des Modells ohne erhebliche Überanpassung hin. Die Optimierung von Hyperparametern, die vorzeitige Unterbrechung, Dropout und Regularisierung tragen weiter zur Stabilität und Reproduzierbarkeit des Modelltrainings bei. Instabilitäten in den Lernkurven können auf eine ungeeignete Lernrate, unzureichende Trainingsdaten oder übermäßige Modellkomplexität hindeuten. Daher muss die Konvergenz des Modells während des gesamten Trainings überwacht werden, um diese potenziellen Probleme zu erkennen und zu beheben.
Tabelle 5 und Abbildung 5 zeigen die Vorhersageleistung anhand mehrerer Evaluierungsmetriken, einschließlich Genauigkeit, Präzision, Sensitivität, Spezifität, F1-Score, Matthews-Korrelationskoeffizient und Fläche unter der Receiver-Operating-Characteristic-(ROC-)Kurve. Die ROC- und Präzisions-Recall-Kurven liefern Maße für die Diskriminationsleistung, während die Konfusionsmatrix die Verteilung korrekter und inkorrekter Klassifizierungen über die Klassen hinweg veranschaulicht. Die Evaluierung anhand mehrerer Leistungsmetriken ist besonders wichtig für unausgeglichene medizinische Datensätze, da die Gesamtgenauigkeit allein möglicherweise die Modellleistung nicht ausreichend beschreibt.
Abbildung 6 veranschaulicht die Erklärbarkeitsresultate, die aus dem Pima-Indianer-Diabetes-Datensatz generiert wurden, und demonstriert die komplementären Rollen der in der durchgeführten Validierung angewendeten Erklärbarkeitsmethoden. Die globale SHAP-Analyse charakterisiert den Gesamtbeitrag und die relative Bedeutung der Eingangsmerkmale für die Modellvorhersagen, während die SHAP-Wasserfall- und Abhängigkeitsdiagramme patientenspezifische und merkmalsbezogene Interpretationen des Modellverhaltens liefern. LIME bietet eine zusätzliche lokale Erklärung, indem es die Merkmale identifiziert, die zu einer individuellen Vorhersage auf dem Testdatensatz beitragen. Die patientenspezifische kontrastive Erklärung verdeutlicht darüber hinaus die minimalen Merkmalsänderungen, die mit einer Änderung des vorhergesagten Ergebnisses verbunden sind. Zusammen liefern diese Ansätze komplementäre globale und lokale Perspektiven auf das Modellverhalten und erhöhen die Transparenz und Interpretierbarkeit des tabellarischen Vorhersagemodells. Grad-CAM, Visualisierung der Aufmerksamkeit, Saliency-Mapping und Integrierte Gradienten wurden in der Pima-Validierungsstudie nicht angewendet und bleiben lediglich als modalitätsabhängige Optionen innerhalb des allgemeinen Protokolls erhalten.
Die statistische Validierung (Tabelle 6 und Abbildung 7) sowie Reproduzierbarkeitsbewertungen zeigen die Stabilität der Vorhersageleistung über verschiedene experimentelle Durchläufe hinweg. Die Kombination aus Kreuzvalidierung, Schätzung von Konfidenzintervallen, Hypothesentests und der Bewertung der Reproduzierbarkeit bei wiederholten Durchläufen bietet einen systematischen Rahmen zur Beurteilung der Robustheit von Modellen. Eine solche Validierung ist besonders wichtig in Anwendungen im Gesundheitswesen, da die Reproduzierbarkeit über unabhängige Experimente hinweg Belege für die Zuverlässigkeit und Generalisierbarkeit von KI-Modellen liefert, bevor diese in klinischen Umgebungen eingesetzt werden21,23.
Mehrere Schritte sind entscheidend für die erfolgreiche Durchführung dieses Protokolls. Führen Sie eine Datenaufbereitung vor der Merkmalsextraktion und dem Modelltraining durch, um potenzielle Verzerrungen aufgrund unvollständiger, inkonsistenter oder fehlerhafter Daten zu minimieren. Führen Sie die Hyperparameter-Optimierung ausschließlich mit Trainings- und Validierungsdaten durch und halten Sie den Testdatensatz während der gesamten Modellentwicklung und -optimierung unabhängig. Dokumentieren Sie den Zustand der Zufallszahlengeneratoren, Softwareversionen, Hardwarekonfigurationen und Vorverarbeitungseinstellungen klar, um die Reproduzierbarkeit über verschiedene Rechenplattformen hinweg zu erleichtern. Wählen Sie außerdem Erklärbarkeitsmethoden basierend auf dem Vorhersagemodell und der Art der Gesundheitsdaten, um interpretierbare und klinisch relevante Erklärungen zu erhalten20,29,30.
Das Protokoll weist mehrere Einschränkungen auf. Die Genauigkeit und Zuverlässigkeit von Modellvorhersagen und -erklärungen hängt weitgehend von der Verfügbarkeit ausreichend großer, repräsentativer und hochwertiger Gesundheitsdatensätze ab. Eine Unterrepräsentation bestimmter Patientengruppen, Messfehler, fehlende Variablen sowie Heterogenität zwischen den Datenquellen können sich negativ auf die Vorhersageleistung und die Stabilität der Modellerklärungen auswirken. Darüber hinaus können aktuelle Erklärbarkeitsansätze das Modellverhalten charakterisieren, stellen jedoch nicht notwendigerweise kausale Mechanismen sicher. Daher sollten XAI-Ergebnisse in Verbindung mit der entsprechenden klinischen Fachkenntnis interpretiert werden.
Insgesamt bietet dieses Protokoll einen standardisierten Ansatz für die reproduzierbare Entwicklung, Bewertung und Erklärbarkeitsanalyse von Modellen in verschiedenen Bereichen der Gesundheitsversorgung. Durch die Integration standardisierter Vorverarbeitung, Hyperparameter-Optimierung, Bewertung anhand mehrerer Leistungsmetriken, komplementärer Ansätze zur Erklärbarkeit und statistischer Validierung stellt der Workflow einen transparenten und nachvollziehbaren Rahmen für die KI-Forschung im Gesundheitswesen bereit.
Die Ergebnisse deuten weiterhin darauf hin, dass die transparente und konsistente Entwicklung von KI-Modellen durch die Kombination systematischer Datenpräprozessierung, standardisierter Verfahren zur Modellentwicklung, umfassender Leistungsbewertung, mehrerer Erklärbarkeitsmethoden und strenger statistischer Validierung unterstützt werden kann. Das Protokoll kann an klinische Datenbanken, medizinische Bilder, physiologische Signale und multimodale Gesundheitsdaten angepasst werden, wobei ein Rahmenwerk für reproduzierbare Experimente in verschiedenen rechnerischen Umgebungen beibehalten wird. Durch standardisierte Implementierung, komplementäre Erklärbarkeitstechniken und die Bewertung der Reproduzierbarkeit bietet das Protokoll einen Rahmen für die Entwicklung erklärbarer und vertrauenswürdiger KI-Modelle und kann als methodische Grundlage für zukünftige biomedizinische Forschung sowie für nachfolgende externe und klinische Validierungen dienen.
Offenlegungen
Die Autoren erklären, dass sie keine konkurrierenden finanziellen Interessen, geschäftlichen Beziehungen oder persönlichen Beziehungen haben, die die in dieser Studie beschriebene Arbeit beeinflusst haben könnten. Die Autoren haben keine Interessenkonflikte offenzulegen.
Danksagungen
Die Autoren danken ihren jeweiligen zugehörigen Institutionen für die institutionelle Unterstützung während der Entwicklung und experimentellen Validierung dieses XAI-Protokolls im Gesundheitswesen. Die Autoren danken außerdem den genutzten Rechenanlagen und Software-Ressourcen, die für die Durchführung der experimentellen Analysen verwendet wurden. Diese Forschung erhielt keine externe Förderung. Die Autoren bestätigen die Verwendung von Python 3.11, Matplotlib 3.9 und SciPy 1.13 für die computergestützte Analyse, die Visualisierung der Daten sowie die Erstellung der in dieser Studie präsentierten Abbildungen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Captum | Meta AI | Neueste stabile Version | PyTorch-Erklärbarkeit |
| CUDA Toolkit | NVIDIA | 12.2 | GPU-Beschleunigung |
| cuDNN | NVIDIA | 9.x | Deep-Learning-Backend |
| Git | Git SCM | Neueste stabile Version | Versionskontrolle |
| GitHub | GitHub Inc. | Webplattform | Quellcode-Repository |
| Grad-CAM | jacobgil | Neueste Version | CNN-Visualisierung |
| Jupyter Notebook | Project Jupyter | Neueste stabile Version | Interaktive Entwicklung |
| LightGBM | Microsoft | 4.x | Gradient-Boosting |
| LIME | LIME Community | 0.2.0 | Lokale Erklärbarkeit |
| Matplotlib | Matplotlib-Entwickler | 3.9 | Visualisierung |
| Microsoft Excel | Microsoft | Microsoft 365 | Datenorganisation |
| NumPy | NumPy-Entwickler | 1.26 | Numerische Berechnung |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | Modelltraining |
| OpenCV | OpenCV Organization | 4.10 | Bildvorverarbeitung |
| Pandas | Pandas-Entwicklungsteam | 2.2 | Datenvorverarbeitung |
| Pillow (PIL) | Python Imaging Library | 10.x | Bildverarbeitung |
| Plotly | Plotly Technologies | 5.x | Interaktive Visualisierung |
| Python | Python Software Foundation | 3.11 | Programmierumgebung |
| PyTorch | PyTorch Foundation | 2.3 | Deep Learning |
| Scikit-learn | Scikit-learn-Entwickler | 1.5 | maschinelles Lernen |
| SciPy | SciPy-Entwickler | 1.13 | Wissenschaftliche Berechnung |
| Seaborn | Seaborn-Entwickler | 0.13 | Statistische Diagramme |
| SHAP | SHAP Community | 0.46 | Globale Erklärbarkeit |
| SimpleITK | Insight Software Consortium | 2.x | Medizinische Bildverarbeitung |
| Statsmodels | Statsmodels-Entwickler | 0.14 | Statistische Analyse |
| System RAM | Beliebiger Hersteller | 32 GB oder höher | Arbeitsspeicher |
| TensorBoard | 2.15 | Trainingsüberwachung | |
| TensorFlow | 2.15 | Deep Learning | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | Betriebssystem |
| Visual Studio Code | Microsoft | Neueste stabile Version | Code-Entwicklung |
| XGBoost | XGBoost-Entwickler | 2.1 | Gradient-Boosting |
Referenzen
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.