Integrierte Bulk- und Einzelzell-Transkriptom-Analysen identifizierten sechs hämstoffwechselbezogene diagnostische Biomarker für Keloide. Die experimentelle Validierung bestätigte eine Regulationsstörung des feline Leukämievirus-Subgruppe-C-Rezeptors 1 (FLVCR1) in keloiden Fibroblasten, während molekulares Docking (+)-Gallocatechin als potenzielle FLVCR1-Interaktionsverbindung identifizierte, die weiterer funktioneller Untersuchung bedarf.
Forschungsartikel
Identifizierung von Biomarkern des Häm-Stoffwechsels in Keloiden mittels transkriptomischer Analyse und kultivierter menschlicher Fibroblasten
In diesem Artikel
Zusammenfassung
Zusammenfassung
Keloid ist eine fibroproliferative Erkrankung mit hoher Rezidivrate und unklarer Pathogenese, bei der effektive therapeutische Zielstrukturen fehlen. Neuere Erkenntnisse legen nahe, dass eine metabolische Umprogrammierung, insbesondere im Hämstoffwechsel, zur Fibrose beitragen könnte. Diese Studie untersucht die Rolle des Hämstoffwechsels, mit Fokus auf den feline Leukämievirus-Subgruppe-C-Rezeptor 1 (FLVCR1), bei der Pathogenese von Keloide und erforscht dessen diagnostisches und therapeutisches Potenzial. Wir analysierten Bulk-RNA-Seq-Datensätze sowie Einzelzell-RNA-Seq-Daten (scRNA-Seq). Mithilfe von Differenzialgenexpression, dem Least-Absolute-Shrinkage-and-Selection-Operator-Modell (LASSO) und Random-Forest-Modellen (RF) wurden hämstoffwechselbezogene diagnostische Biomarker identifiziert. Es wurden Analysen zur Immunzellinfiltration, Einzelzellzuordnung, Konstruktion von Mikro-RNA-(miRNA-)Netzwerken sowie molekulares Docking mit Verbindungen aus der traditionellen chinesischen Medizin durchgeführt. Sechs hämstoffwechselbezogene Biomarker wurden identifiziert und bilden ein diagnostisches Nomogramm mit hoher Genauigkeit. FLVCR1, angereichert in endothelialen Zellen und Melanozyten, korrelierte negativ mit T-follikulären Helferzellen, was auf einen immunmetabolischen Austausch hindeutet. Die Analyse des miRNA-Regulationsnetzwerks ergab fünf miRNAs, die alle sechs Biomarker gemeinsam regulieren. Molekulares Docking identifizierte (+)-Gallocatechin als hochaffinen FLVCR1-Liganden. Diese Ergebnisse deuten auf einen Zusammenhang zwischen FLVCR1-vermitteltem Hämstoffwechsel und immunologischen Veränderungen in der Pathogenese von Keloide hin. Das Biomarkerpanel zeigte ein exploratives diagnostisches Potenzial, und (+)-Gallocatechin wurde als Kandidatenverbindung für die Interaktion mit FLVCR1 identifiziert, die einer weiteren Validierung bedarf. Diese Studie stellt den Keloid neu im Kontext des metabo-fibrotischen Spektrums dar und schlägt eine metabolisch-immunologische Intervention als neuartige therapeutische Strategie vor.
Einleitung
Keloid, eine fibroproliferative Erkrankung, die sich durch eine übermäßige Ablagerung der extrazellulären Matrix auszeichnet, die über die Grenzen der ursprünglichen Hautverletzung hinausgeht, betrifft 4–16 % der Weltbevölkerung, wobei die Prävalenz bei Personen afrikanischer, asiatischer und hispanischer Abstammung deutlich höher ist1,2. Trotz ihres histologisch gutartigen Charakters verursacht die Keloidbildung erhebliche körperliche und psychosoziale Belastungen durch anhaltenden Juckreiz, Schmerzen, funktionelle Kontrakturen und kosmetische Entstellungen. Die derzeit verfügbaren therapeutischen Ansätze, darunter intralesionale Kortikosteroide, chirurgische Exzision, Strahlentherapie und Lasertherapie, sind suboptimal, wobei die Rezidivraten nach Monotherapie über 50 % liegen3,4,5. Dieser therapeutische Stillstand verdeutlicht eine grundlegende Lücke im Verständnis der Keloidpathogenese, insbesondere der upstream liegenden Faktoren, die die fibrotische Kaskade auslösen und aufrechterhalten, jenseits der kanonischen profibrotischen Signalwege.
Die aktuelle Forschung hat sich vorwiegend auf kanonische Signalwege wie die TGF-β/Smad-Signalübertragung und eine fehlerhafte Fibroblastenaktivierung konzentriert6,7,8. Obwohl eine Immunzellinfiltration – insbesondere M2-polarisierter Makrophagen, regulatorischer T-Zellen und dysregulierter dendritischer Zellen – in keloidem Gewebe nachgewiesen wurde9,10, betrachten diese Untersuchungen immunologische Veränderungen überwiegend als downstream Folge einer Fibroblastendysfunktion statt als upstream steuernde Faktoren. Kritisch ist, dass die Stoffwechselprogramme, die diesen immunfibrotischen Dialog aktiv prägen könnten, in der Keloid-Pathogenese bislang völlig unerforscht sind11,12,13. Diese Wissenslücke ist auffällig angesichts neu entstehender Konzepte bei fibrotischen Erkrankungen, bei denen eine Umprogrammierung des Stoffwechsels als zentraler Regulator der Gewebeumbildung fungiert.
Die metabolische Umprogrammierung hat sich kürzlich als zentraler Knotenpunkt der Fibrogenese in mehreren Organsystemen herauskristallisiert. Bei pulmonaler und hepatischer Fibrose löst eine dysregulierte Häm-Homöostase – vermittelt durch veränderte Expression von Transportern, Scavengern oder biosynthetischen Enzymen – oxidativen Stress, Ferroptose und sterile Entzündungen aus, die direkt die Kollagenablagerung fördern14. Die Anreicherung von Häm aktiviert das NLRP3-Inflammasom und treibt dadurch die Aktivierung von Fibroblasten voran, während ein Mangel am Rezeptor für die feline Leukämievirus-Subgruppe C Typ 1 (FLVCR1) die Gewebefibrose durch unaufgelöste Häm-Toxizität verschärft. Diese Befunde stellen den Häm-Stoffwechsel nicht nur als Hausmeisterprozess dar, sondern als dynamisches Signalnetzwerk, das faserbildende Kaskaden auslösen kann – ein Paradigma, der bisher noch nicht bei kutanen fibroproliferativen Erkrankungen überprüft wurde.
Die Plausibilität einer hämvermittelten Immunmodulation wird weiter durch mechanistische Belege aus Modellen von Krebs und chronischer Entzündung gestützt. Häm fungiert als Signalmolekül, das das Schicksal von Immunzellen direkt moduliert: Es fördert die Polarisation von M1- zu M2-Makrophagen über die TLR4/NF-κB-Signalübertragung15, beeinflusst die Differenzierung von T-Zellen durch Bach2-vermittelte transkriptionelle Repression16 und reguliert entscheidend die Reifung dendritischer Zellen über FLVCR1-abhängigen Hämexport17,18. Bemerkenswerterweise wurde FLVCR1, ein Hämexporter in der Plasmamembran, der für die zelluläre Häm-Homöostase essentiell ist, kürzlich mit der Entwicklung von Immunzellen und endothelialer Dysfunktion in Verbindung gebracht19. Diese zusammenlaufenden Belege stellen FLVCR1 als plausiblen molekularen Knotenpunkt dar, der eine Dysregulation des Hämstoffwechsels mit pathologischer Immunremodellierung verbindet – eine Hypothese mit tiefgreifenden Implikationen für die Pathogenese von Keloïden angesichts ihres charakteristischen, immunzellreichen Mikromilieus.
Trotz erheblicher Fortschritte beim Verständnis der Wechselwirkungen zwischen Häm und dem Immunsystem in anderen Krankheitszusammenhängen bleibt unerforscht, ob eine dysregulierte Häm-Metabolisierung als übergeordneter Auslöser die pathologische Immunlandschaft bei Keloiden initiiert oder verstärkt. Diese entscheidende Wissenslücke erfordert aus mehreren miteinander verbundenen Gründen dringende Untersuchungen: Keloider weisen charakteristische pathologische Merkmale – wie anhaltende Entzündung und oxidativen Stress – gemeinsam mit metabolisch bedingten fibrotischen Erkrankungen wie Lungen- und Leberfibrose auf, was auf Gemeinsamkeiten in den zugrundeliegenden Regulationsmechanismen hindeutet. Die auf FLVCR1 basierende Häm-Ausschleusungsmechanismen wurde in nicht-kutanen Geweben mechanistisch validiert und steuert direkt zentrale Immunfunktionen wie die Polarisierung von Makrophagen und die Reifung dendritischer Zellen, was eine solide theoretische Grundlage für deren Übertragung auf die Immunpathologie von Keloiden bietet20. Am wichtigsten ist, dass die gezielte Beeinflussung dieser metabolisch-immunologischen Achse eine paradigmatische Neuausrichtung ermöglicht, indem sie über die derzeitigen symptomatischen Therapien hinausgeht, die lediglich die nachgeschalteten fibrotischen Effekte unterdrücken, und potenziell eine frühe Intervention am metabolischen Ursprung des Krankheitsverlaufs erlaubt21.
Aufbauend auf dieser Überlegung vermuteten wir, dass eine FLVCR1-vermittelte Dysregulation des Hämstoffwechsels das immunologische Mikromilieu aktiv umgestaltet und so zur Entstehung von Keloide beiträgt. Um diese Hypothese systematisch zu überprüfen, kombinierten wir Bulk- und Einzelzell-Transkriptomanalysen in einem mehrstufigen Ansatz: Zunächst identifizierten und validierten wir mittels maschineller Lernalgorithmen und Verifizierung in einer unabhängigen Kohorte biomarkerassoziierte Störungen des Hämstoffwechsels in Keloide-Gewebe; anschließend bestimmten wir mittels Kartierung mit Einzelzellauflösung die räumlichen Expressionsmuster dieser Biomarker in verschiedenen zellulären Kompartimenten – einschließlich Endothelzellen, Fibroblasten, Melanozyten und Immunzellsubpopulationen; danach analysierten wir deren quantitative Korrelationen mit spezifischen Immunzellpopulationen, um funktionelle immun-metabolische Verbindungen aufzuzeigen; abschließend erstellten wir ein FLVCR1-zentriertes mikro-RNA-(miRNA-)Regulationsnetzwerk und führten molekulares Docking mit Verbindungen aus der traditionellen chinesischen Medizin durch, um angreifbare therapeutische Ansatzpunkte zu identifizieren. Diese umfassende Untersuchung deckt nicht nur eine bisher unbekannte Verbindung zwischen Hämstoffwechsel und Immunsystem bei der Keloide-Pathogenese auf, sondern liefert auch ein translationsrelevantes Biomarkerpanel mit doppelter diagnostischer und therapeutischer Anwendungsperspektive für diese schwer behandelbare fibroproliferative Erkrankung.
Protokoll
Eine ethische Genehmigung und informierte Einwilligung waren für diese Studie nicht erforderlich, da alle Daten aus öffentlich zugänglichen Datenbanken stammten, einschließlich des Gene Expression Omnibus (GEO), und keine identifizierbaren menschlichen Teilnehmer oder Tierprobanden direkt beteiligt waren.
Datenerfassung und Vorverarbeitung
Die mit dem Hämstoffwechsel assoziierten Gene wurden aus der Molecular Signatures Database (MSigDB; siehe die Tabelle der Materialien und Ergänzungstabelle S1) bezogen, einschließlich Gen-Sets aus REACTOME_Heme_Biosynthesis, REACTOME_Heme_Degradation, Wikipathway_Heme_Biosynthesis, REACTOME_Scavenging_Heme_from_Plasma und HALLMARK_Heme_Metabolism. Alle in dieser Studie analysierten Datensätze stammten aus öffentlich zugänglichen Quellen. Zwei umfassende Genexpressions-Microarray-Datensätze wurden aus der Gene Expression Omnibus (GEO)-Datenbank abgerufen: GSE44270, bestehend aus 18 Keloid- und 14 normalen Hautproben, sowie GSE7890, bestehend aus 10 Keloid- und 9 normalen Hautproben. GSE44270 und GSE7890 wurden jeweils auf den Plattformen GPL6244 und GPL570 generiert. Die Serie-Matrix-Dateien und die entsprechenden Probendaten wurden heruntergeladen und in die R-Umgebung importiert. Da die Expressionswerte in den Serie-Matrix-Dateien bereits von den ursprünglichen Dateneinreichern vorverarbeitet und normalisiert worden waren, wurde keine zusätzliche log2-Transformation oder Zwischenproben-Normalisierung durchgeführt. Die beiden Datensätze wurden unabhängig voneinander verarbeitet und nicht zusammengeführt, da sie auf unterschiedlichen Microarray-Plattformen generiert wurden. Die Datensätze wurden wie unten beschrieben vorverarbeitet (siehe die Tabelle der Materialien). Genproben wurden den entsprechenden Gensymbolen zugeordnet, und Proben ohne Genanmerkungen oder solche, die mehreren Genen zugeordnet waren, wurden ausgeschlossen. Bei Genen mit mehreren Probensätzen wurde der Expressionswert auf Grundlage des höchsten nachgewiesenen Expressionsniveaus festgelegt. Zusätzlich wurden Single-Cell-RNA-Sequenzierungsdaten (scRNA-seq) aus GSE163973, die drei Keloid-Proben enthielten, heruntergeladen und gemäß den Qualitätskontrollstandards der ursprünglichen Studie verarbeitet.
Screening und Validierung hämabbauassoziierter diagnostischer Marker in Keloiden
Um differentiell exprimierte, mit Hämstoffwechsel assoziierte Gene in Keloide zu identifizieren, wurde der Wilcoxon-Rangsummentest mit der R-Funktion wilcox.test auf GSE44270 angewandt, wobei eine Signifikanzschwelle von P < 0,05 verwendet wurde. Um potenzielle diagnostische Marker für Keloide zu finden, kamen zwei maschinelle Lernmodelle zum Einsatz: zufälliger Wald (Random Forest, RF) und logistische Regression mit der Methode „Least Absolute Shrinkage and Selection Operator“ (LASSO). Die Random-Forest-Analyse wurde mit einem Zufallsstartwert von 1 durchgeführt, um Reproduzierbarkeit zu gewährleisten (siehe Tabelle der Materialien). Das Modell wurde mit 500 Bäumen (ntree = 500) erstellt, und die Genwichtigkeit wurde basierend auf der mittleren Abnahme der Knotenreinheit (IncNodePurity) bewertet. Gene mit Wichtigkeitswerten größer als 0,3 wurden als Kandidaten-Biomarker aus der Random-Forest-Analyse ausgewählt. Die LASSO-logistische Regression wurde mit α = 1 durchgeführt, wobei 50 Lambda-Werte während des Modelltrainings evaluiert wurden (siehe Tabelle der Materialien). Der optimale Strafparameter wurde mittels 5-facher Kreuzvalidierung mit der Funktion cv.glmnet und binomialer Antwort bestimmt. Gene mit nicht-null Regressionskoeffizienten wurden als LASSO-ausgewählte Kandidaten beibehalten. Schließlich wurde der Durchschnitt der durch Random Forest und LASSO-Regression identifizierten Gene als endgültige diagnostische Gen-Signatur betrachtet. Die endgültige diagnostische Gen-Signatur wurde mithilfe eines auf einem Nomogramm basierenden Modells bewertet. Die gesamte Merkmalsauswahl und Parameterschätzung des Modells erfolgte ausschließlich im Entdeckungs-Kollektiv (GSE44270), und die etablierte Sechs-Gen-Signatur wurde anschließend im unabhängigen Validierungs-Kollektiv (GSE7890) überprüft. Die diagnostische Leistung des Nomogramms wurde durch Berechnung der Fläche unter der Receiver-Operating-Characteristic-Kurve (AUC) bewertet. Zur Untersuchung der Modellstabilität umfasste die Analyse eine 5-fache Kreuzvalidierung sowie 1.000 Bootstrap-Resampling-Durchläufe, aus denen eine optimistisch-korrigierte AUC abgeleitet wurde. Die Entscheidungskurvenanalyse (Decision Curve Analysis, DCA) wurde anschließend verwendet, um den potenziellen Nettovorteil des Nomogramms abzuschätzen; dieses Ergebnis wurde jedoch aufgrund der geringen Stichprobengröße mit Vorsicht interpretiert.
Infiltration von Immunzellen und Korrelationsanalyse
Die Anreicherung von Immunzellen wurde mittels single-sample Gen-Set-Anreicherungsanalyse (ssGSEA) bewertet (siehe Tabelle der Materialien). Die Signaturmatrix für Immunzellen stammte aus einer zuvor veröffentlichten Studie von Charoentong et al.22 und enthielt 782 Markergene, die 28 Populationen adaptiver und angeborener Immunzellen repräsentierten. Die Analyse wurde unter Verwendung eines Gaußschen Kerns auf den kontinuierlichen, normalisierten Microarray-Expressionswerten durchgeführt. Nach dem Zuordnen der Markergene zur Expressionsmatrix war eine minimale Gen-Set-Größe von 10 erforderlich, und die resultierenden ssGSEA-Scores wurden normalisiert. Alle übrigen Einstellungen blieben auf ihren Standardwerten. Anschließend wurden Pearson-Korrelationskoeffizienten berechnet, um die Beziehungen zwischen den Anreicherungsscores der Immunzellen und der diagnostischen Genexpression zu bewerten. Die resultierende Korrelationsmatrix wurde als Korrelationsplot dargestellt, und ausgewählte Assoziationen wurden zusätzlich als Lollipop-Plots visualisiert (siehe Tabelle der Materialien).
Verarbeitung und Analyse von Einzelzell-RNA-Sequenzierungsdaten
Einzelzell-RNA-Sequenzierungsdaten wurden aus GSE163973 bezogen, wobei für die vorliegende Analyse nur die drei Keloid-Proben KF1, KF2 und KF3 berücksichtigt wurden. Die Expressionsdaten wurden importiert und wie unten beschrieben verarbeitet (siehe Tabelle der Materialien). Zellen mit weniger als 200 oder mehr als 6.000 insgesamt eindeutigen molekularen Identifikatoren (UMI) wurden ausgeschlossen, und vorhergesagte Doppelzellen entfernt. Die Genexpressionszähldaten jeder Zelle wurden anhand der gesamten zellulären Expression normalisiert, mit einem Skalierungsfaktor von 10.000 multipliziert und anschließend log-transformiert. Batch-assoziierte Variationen wurden während der Datenskalierung herausregressiert, und die resultierenden skalierten Residuen für die nachfolgende Analyse verwendet. Die 2.000 stärksten variablen Gene wurden basierend auf ihrem durchschnittlichen Expressionsniveau und ihrer Streuung ausgewählt, und eine Hauptkomponentenanalyse wurde anhand dieser Gene durchgeführt. Die ersten 15 Hauptkomponenten dienten zur Erstellung eines k-nächsten-Nachbarn-Graphen basierend auf euklidischen Distanzen, der anschließend in einen gemeinsamen nächstgelegenen Nachbarn-Graphen umgewandelt wurde. Die Zellen wurden mit dem Louvain-Algorithmus bei einer Auflösung von 0,8 gruppiert, und die uniforme Mannigfaltigkeitsapproximation und Projektion (UMAP) wurde unter Verwendung derselben 15 Hauptkomponenten durchgeführt. Die Zelltypen wurden gemäß den in der ursprünglichen Studie angegebenen Zelltypdefinitionen annotiert, und die resultierenden Annotationen wurden im Metadatenfeld erfasst. Zelltypannotationen und Clusterzuordnungen wurden in den Koordinaten der uniformen Mannigfaltigkeitsapproximation und Projektion visualisiert, und die diagnostische Genexpression wurde über die annotierten Zellpopulationen dargestellt.
Aufbau des miRNA–mRNA-Regulationsnetzwerks
Das miRNA–mRNA-Regulationsnetzwerk wurde wie unten beschrieben konstruiert (siehe Tabelle der Materialien). Als Organismus wurde Homo sapiens ausgewählt und die Genidentifikatoren wurden als offizielle Gen-Symbole angegeben. Die Kandidatengene wurden dem Modul für Gen–miRNA-Interaktionen übermittelt, und TarBase v9.0 wurde als Interaktionsdatenbank ausgewählt. TarBase enthält experimentell validierte miRNA–Gen-Regulationsinteraktionen. Für die Netzwerkkonstruktion wurden ausschließlich experimentell unterstützte miRNA–mRNA-Interaktionen berücksichtigt, die die eingegebenen Kandidatengene betreffen, während vorhergesagte Interaktionen ohne experimentelle Belege ausgeschlossen wurden. Es wurde keine zusätzliche Schwelle für den Vertrauenswert (confidence score) festgelegt.
Virtuelle, strukturbasierte Bildschirmprüfung und molekulare Docking-Analyse
Mithilfe eines strukturbasierten virtuellen Screenings (SBVS) wurde ein virtuelles Screening durchgeführt, um Kandidaten-Liganden aus der Verbindungsbibliothek gegen den menschlichen FLVCR1 (feline Leukämievirus-Subgruppe-C-Rezeptor-verwandtes Protein 1; siehe Tabelle der Materialien) zu priorisieren. Die dreidimensionale Struktur des menschlichen FLVCR1 wurde aus der Protein Data Bank abgerufen (PDB-ID: 8UBZ). Diese Struktur stellt den cholin-gebundenen menschlichen FLVCR1 dar, der mittels Einzelpartikel-Kryoelektronenmikroskopie bei einer globalen Auflösung von 3,02 Å bestimmt wurde (EMDB-Zugriffsnummer: EMD-42110). Die experimentell bestimmte Struktur wurde ausgewählt, da sie die substratgebundene Konformation von FLVCR1 enthält und somit strukturelle Informationen zur Definition der physiologisch relevanten Ligandenbindungsstelle liefert. Während der Rezeptorpräparation wurden die ko-kristallisierten Moleküle Cholin (CHT) und Cholesterinhemisuccinat (Y01) beibehalten, um das strukturelle Umfeld der Substrat-Eintritts- und Ligandenbindungsregion zu erhalten. Der Docking-Suchraum wurde um die Substrat-/Ligandenbindungsstelle des FLVCR1 herum definiert, einschließlich der Region, in der Cholin gebunden vorliegt. Die Gitterbox war zentriert bei x = 160,587 Å, y = 160,613 Å und z = 160,484 Å. Die Abmessungen der Docking-Box wurden auf [X × Y × Z Å] festgelegt, um eine ausreichende Abdeckung der Substratbindungsstelle und der umliegenden Reste sicherzustellen. Anschließend wurden Kandidatenverbindungen in diese vordefinierte Bindungsregion eingedockt. Die Docking-Posen wurden nach ihren vorhergesagten Bindungsaffinitäten bewertet, wobei negativere Docking-Scores günstigere vorhergesagte Wechselwirkungen zwischen Ligand und FLVCR1 anzeigen. Die am höchsten bewerteten Verbindungen wurden für anschließende Analysen des Bindungsmodus sowie der Protein-Ligand-Wechselwirkungen ausgewählt.
Molekulardynamik-Simulation und Berechnung der MM/GBSA-Bindungsbindungsenergie
Die Molekulardynamik-(MD-)Simulation wurde verwendet, um den vorhergesagten Protein-Ligand-Komplex weiter zu untersuchen (siehe Tabelle der Materialien). Die Ligand-Topologie wurde erstellt, indem General-Amber-Force-Field-(GAFF-)Parameter zugewiesen und auf eingeschränktes elektrostatisches Potential (RESP) basierende Ladungen eingefügt wurden. Der Komplex wurde anschließend mit der Amber99SB-ILDN-Kraftfeldbeschreibung modelliert, in ein übertragbares intermolekulares Potential mit 3-Punkte-Wassermodell platziert und mit drei Na⁺-Ionen neutralisiert. Nach einer Energie-Minimierung mittels des steilsten Abstiegs wurde das System 100 ps lang bei konstanter Teilchenzahl, Volumen und Temperatur sowie weitere 100 ps bei konstanter Teilchenzahl, Druck und Temperatur equilibriert, jeweils mit 100.000 Schritten. Anschließend erfolgte eine Produktionsphase von 100 ns bei 300 K und 1 bar mit einem Zeitschritt von 2 fs. Die resultierende Trajektorie wurde hinsichtlich des mittleren quadratischen Abweichungsmaßes (RMSD), der mittleren quadratischen Fluktuation (RMSF), des Trägheitsradius (Rg), der lösungsmittelzugänglichen Oberfläche (SASA), der Persistenz von Wasserstoffbrückenbindungen sowie der bindenden Freien Energie nach der Molekulare-Mechanik/verallgemeinerte-Born-Oberflächenbereich-Methode (MM/GBSA) analysiert.
Zellkultur
Die NHDF-Normalzellenlinie humaner dermaler Fibroblasten und die primäre PKF-Zellenlinie keloider Fibroblasten wurden in einem Fibroblasten-Wachstumsmedium kultiviert, das mit 2 % Fötalem Kälberserum, rekombinantem humanem basischem Fibroblastenwachstumsfaktor (1 ng/mL) und Insulin (5 µg/mL) ergänzt war. Beide Zelllinien wurden in einem befeuchteten Inkubator bei 37 °C mit 5 % CO₂ gehalten und bei Erreichen einer Konfluenz von 80–90 % weitergepasst.
Western-Blot-Analyse
Gesamtprotein wurde aus NHDF- und PKF-Zellen mit einem Lysepuffer, der aus Radioimmunpräzipitationsassay, Phenylmethylsulfonylfluorid, einer Proteaseinhibitorcocktail- und Phosphataseinhibitoren bestand, isoliert. Die Proteinmenge wurde mittels Bicinchoninsäure-Assay bestimmt, woraufhin gleiche Proteinmengen durch Natrium-Dodecylsulfat-Polyacrylamid-Gelelektrophorese getrennt und auf eine Polyvinylidenfluorid-Membran übertragen wurden. Die Membran wurde 90 Minuten bei Raumtemperatur mit 5 % fettfreier Milchpulverlösung in Tween/Tris-gepufferter Salzlösung blockiert und anschließend über Nacht bei 4 °C mit primären Antikörpern gegen FLVCR1 (Kaninchen-Polyklonal, 1:1.000) und GAPDH (Maus-Monoklonal, 1:20.000) inkubiert. Am folgenden Tag erfolgte die Inkubation mit dem sekundären Antikörper für 90 Minuten bei Raumtemperatur. Die Bandenintensitäten wurden mit ImageJ gemessen und die relativen Proteinmengen auf die GAPDH-Innenkontrolle normalisiert. Für jeden Western-Blot-Assay wurden mindestens drei unabhängige biologische Wiederholungen verwendet.
Echtzeit-fluoreszenzbasierte quantitative Reverse-Transkriptase-PCR (qRT-PCR)-Analyse
Gesamt-RNA wurde aus NHDF- und PKF-Zellen mit dem referenzierten Kit gewonnen. Die cDNA wurde anschließend mit dem referenzierten cDNA-Synthese-Mix für die qPCR (mit dsDNase) erzeugt. Die qRT-PCR wurde an einem Echtzeit-PCR-System durchgeführt, und die Expression von FLVCR1 wurde mit dem referenzierten SYBR Green Fast Mix gemessen. GAPDH-mRNA diente als interne Referenz zur Normalisierung. Jede qRT-PCR-Reaktion wurde in technischen Triplikaten durchgeführt, und die relativen mRNA-Spiegel wurden nach der 2−ΔΔCt-Methode berechnet. Jedes Experiment wurde unabhängig mindestens dreimal durchgeführt, und die Primersequenzen sind in Ergänzungstabelle S2 angegeben.
Statistische Analyse
Gruppenunterschiede wurden mit dem Wilcoxon-Rangsummentest geprüft, und die Werte werden als Mittelwert ± Standardabweichung (SD) angegeben. Zusammenhänge zwischen stetigen Variablen wurden mithilfe des Pearson-Korrelationskoeffizienten untersucht. Ergebnisse mit einem P < 0,05 wurden als statistisch signifikant betrachtet. Die Signifikanzniveaus wurden wie folgt angegeben: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; und ****, P < 0,0001.
Ergebnisse
Identifizierung von potenziellen diagnostischen Biomarkern für Keloid unter Verwendung eines maschinellen Lernalgorithmus
Insgesamt wurden 283 Gene im Zusammenhang mit dem Hämstoffwechsel in diese Studie einbezogen. Die differentielle Expressionsanalyse des GSE44270-Datensatzes, die keloide mit normalem Hautgewebe verglich, identifizierte 25 signifikant anders exprimierte Gene (Abbildung 1A und Ergänzende Tabelle S3). Zur weiteren Selektion krankheitsassoziierter Biomarker identifizierte die LASSO-Regression neun Kandidatengene (Abbildung 1B,C und Ergänzende Tabelle S3), während der Random-Forest-Algorithmus (RF) 11 Gene mit hoher Vorhersagebedeutung auswählte (Abbildung 1D und Ergänzende Tabelle S3). Der Überlapp zwischen den Ergebnissen von LASSO und RF wurde mittels eines Venndiagramms dargestellt und ergab sechs zentrale Biomarker, nämlich FLVCR1, TMCC2, EIF2AK1, XK, HPX und KEL (Abbildung 1E und Ergänzende Tabelle S3). Die Analyse der Receiver-Operating-Characteristic (ROC) in der GSE44270-Kohorte zeigte eine günstige diagnostische Leistung für alle sechs Biomarker, mit AUC-Werten von 0,8016 für FLVCR1, 0,7063 für TMCC2, 0,7817 für EIF2AK1, 0,7460 für XK, 0,7500 für HPX und 0,7857 für KEL (Abbildung 1F). Basierend auf diesen sechs Biomarkern wurde anschließend ein diagnostisches Nomogramm für Keloide unter Verwendung des rms-Pakets in R erstellt (Abbildung 1G).
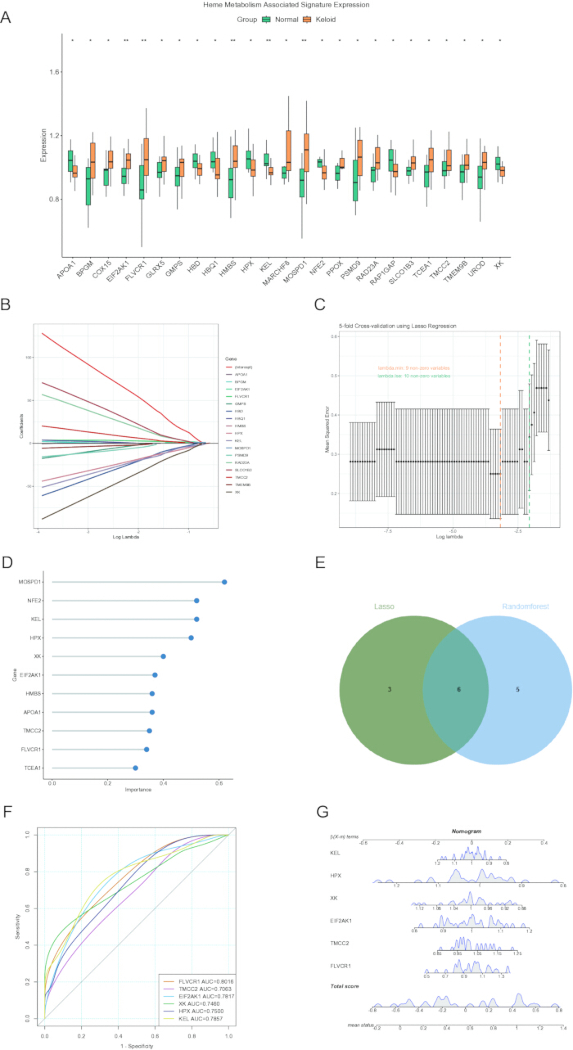
Abbildung 1: Identifizierung von kandidaten Häm-Stoffwechsel-assoziierten Genen, die mit Keloiden mittels maschineller Lernalgorithmen verknüpft sind. (A) Boxplot, der die differentielle Expression von Häm-Stoffwechsel-assoziierten Genen zwischen Keloid- und Normalgewebe veranschaulicht. (B,C) LASSO-logistische Regressionsanalyse zur Auswahl kandidater diagnostischer Marker. (D) Durch den RF-Algorithmus ausgewählte kandidaten Biomarker. (E) Venn-Diagramm, das die überlappenden Gene zeigt, die durch die beiden maschinellen Lernalgorithmen identifiziert wurden. (F) ROC-Kurvenanalyse zur Bewertung der diagnostischen Leistung der kandidaten Biomarker. (G) Nomogramm zur Vorhersage von Keloide basierend auf der Sechs-Gen-Signatur. Abkürzungen: LASSO, Least Absolute Shrinkage and Selection Operator; RF, Random Forest; ROC, Receiver Operating Characteristic. Statistische Signifikanz: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; und ****, P < 0,0001. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Die Vorhersageleistung des diagnostischen Nomogramms wurde sowohl in der Trainingskohorte (GSE44270) als auch in der Validierungskohorte (GSE7890) bewertet. Das Modell zeigte eine ausgezeichnete diagnostische Genauigkeit mit AUC-Werten von 0,984 (95 % KI: 0,950–1,000) bzw. 0,922 (95 % KI: 0,806–1,000) (Abbildung 2A,D). Um die Robustheit und das potenzielle Überanpassungsrisiko der sechsgenigen diagnostischen Signatur weiter zu bewerten, wurden zusätzliche interne Validierungsanalysen in der Entdeckungskohorte (GSE44270) durchgeführt. Die fünffache Kreuzvalidierung zeigte eine konsistente Unterscheidungsleistung über alle Teilmengen hinweg mit einer mittleren AUC von 0,925, was darauf hindeutet, dass das Modell eine stabile Klassifizierungsleistung trotz Variationen in den Trainingsproben beibehielt. Außerdem ergab die Bootstrap-Validierung mit 1.000 Resampling-Durchgängen eine mittlere AUC von 0,930 (95 % KI: 0,794–1,000). Nach Korrektur für mögliche Überoptimismus aufgrund der begrenzten Stichprobengröße blieb die optimistischkeitskorrigierte AUC bei 0,930, was darauf hindeutet, dass die diagnostische Leistung der sechsgenigen Signatur nach interner Validierung relativ stabil war. Darüber hinaus zeigte die Entscheidungskurvenanalyse (DCA), dass das Nomogramm über einen Bereich von Schwellenwahrscheinlichkeiten hinweg einen höheren potenziellen Nettovorteil aufwies als alternative diagnostische Strategien, obwohl diese Ergebnisse angesichts der begrenzten Stichprobengröße mit Vorsicht zu interpretieren sind (Abbildung 2B,E). Zusätzlich wiesen Keloid-Proben in beiden Kohorten, der Trainings- und der Validierungskohorte, signifikant höhere Risikoscores als gesunde Kontrollen auf (Abbildung 2C,F), was die Stabilität und Zuverlässigkeit des diagnostischen Modells weiter unterstreicht.
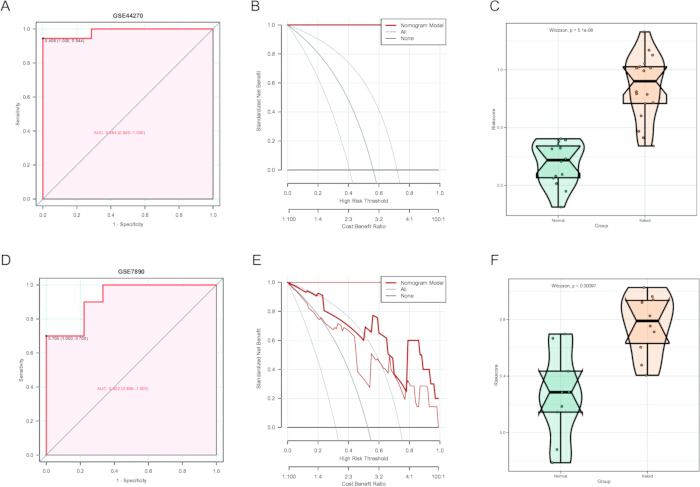
Abbildung 2: Validierung des Nomogramms zur Vorhersage von Keloide. (A) ROC-Kurve zur Bewertung der Vorhersageleistung des Nomogramms im GSE44270-Datensatz. (B) DCA zur Bewertung der klinischen Nützlichkeit des Nomogramms im GSE44270. (C) Verteilung der Risikoscores im Vergleich von Keloide- und gesunden Proben im GSE44270. (D) ROC-Kurve zur Bewertung der Vorhersageleistung des Nomogramms im unabhängigen GSE7890-Datensatz. (E) DCA zur Bewertung der klinischen Nützlichkeit des Nomogramms im GSE7890. (F) Verteilung der Risikoscores im Vergleich von Keloide- und gesunden Proben im GSE7890. Abkürzungen: ROC = receiver operating characteristic; DCA = decision curve analysis. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Diagnostische Biomarker sind mit den immunologischen Merkmalen von Keloiden assoziiert
Um die Beziehung zwischen den sechs diagnostischen Biomarkern und der immunologischen Mikroumgebung zu untersuchen, wurde eine Korrelationsanalyse durchgeführt, um die Zusammenhänge zwischen der Expression der Biomarker und der Infiltration von Immunzellen zu bewerten. Die Ergebnisse zeigten, dass alle sechs Biomarker signifikant mit mehreren infiltrierenden Immunzellpopulationen assoziiert waren (Abbildung 3A). Insbesondere war die Expression von FLVCR1 negativ mit T-follikulären Helferzellen assoziiert (Abbildung 3B). TMCC2 wies positive Korrelationen mit natürlichen Killerzellen und aktivierten dendritischen Zellen auf, während eine negative Korrelation mit unreifen dendritischen Zellen und unreifen B-Zellen bestand (Abbildung 3C–F). Außerdem war die Expression von EIF2AK1 negativ mit CD56dim natürlichen Killerzellen assoziiert (Abbildung 3G), während XK negativ mit Eosinophilen assoziiert war (Abbildung 3H).
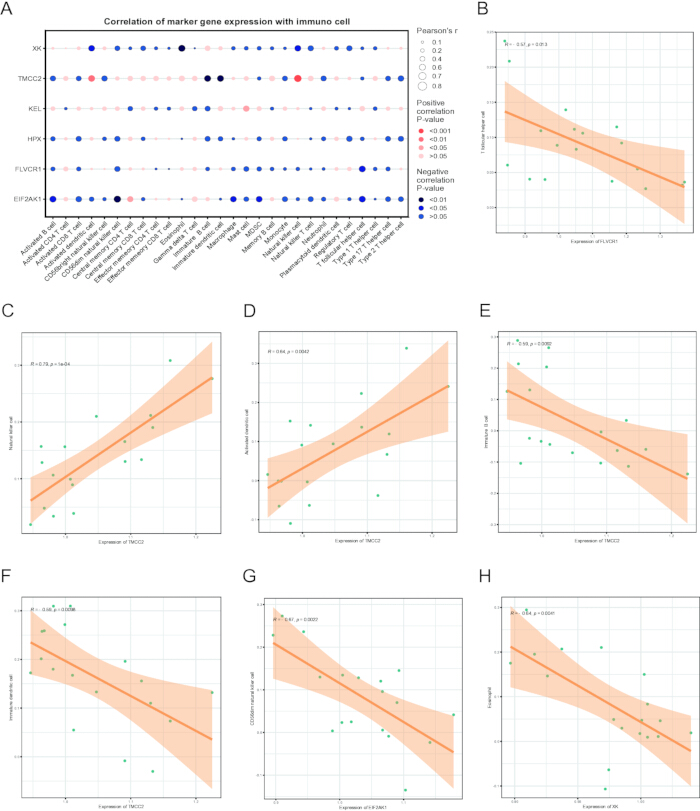
Abbildung 3: Korrelation zwischen kandidaten Hämstoffwechsel-assoziierten Genen und der Infiltration von Immunzellen. (AHeatmap mit den Korrelationen zwischen Kandidatengenen und Immunzellpopulationen. Rot zeigt positive Korrelationen an, während Blau negative Korrelationen anzeigt.B). Korrelation zwischen FLVCR1 Expression und T-follikuläre Helferzellen.C-F) Korrelationen zwischen TMCC2 Expression und natürliche Killerzellen, aktivierte dendritische Zellen, immature dendritische Zellen und immature B-Zellen, jeweils.GKorrelation zwischen EIF2AK1 Expression und CD56dim natürliche Killerzellen.H). Korrelation zwischen XK Expression und Eosinophile. Abkürzungen: FLVCR1 = feline Leukämie-Virus-Subgruppe-C-Rezeptor 1; TMCC2 = Transmembran- und Coiled-Coil-Domänen 2; EIF2AK1 = eukaryotischer Translationsinitiationsfaktor-2-alpha-Kinase 1; CD56gedimmt = Cluster der Differenzierung 56 schwach Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzuzeigen.
Analyse von Einzelzell-Transkriptomdaten
Um die Expressionsmuster der identifizierten diagnostischen Biomarker im Keloide-Mikromilieu zu charakterisieren, analysierten wir den Single-Cell-RNA-Sequenzierungsdatensatz GSE163973. Nach Qualitätskontrolle und Datenintegration wurden 21.488 hochwertige Zellen für nachfolgende Analysen beibehalten. Zellen mit weniger als 200 oder mehr als 6.000 insgesamt eindeutigen molekularen Identifikatoren (UMI) wurden ausgeschlossen, und potenzielle Doubletts wurden mithilfe des DoubletDetection-Pakets identifiziert und entfernt. Die 2.000 Gene mit der größten Expressionsvariabilität wurden ausgewählt, gefolgt von einer Dimensionsreduktion und Visualisierung mittels Uniformer Manifold-Approximation und -Projection (UMAP). Insgesamt wurden 10 größere Zellpopulationen identifiziert, darunter Endothelzellen, Fibroblasten, Muskelzellen, Keratinozyten, Immunzellen, lymphatische Endothelzellen, Drüsenzellen, Nervenzellen, Melanozyten und eine nicht klassifizierte Zellpopulation (Abbildung 4A,B). Die Expressionsprofilierung zeigte unterschiedliche, zelltypspezifische Verteilungsmuster der diagnostischen Biomarker. FLVCR1 wurde vorwiegend in Endothelzellen und Melanozyten exprimiert, während EIF2AK1 eine relativ hohe Expression in Nervenzellen, Drüsenzellen und Fibroblasten aufwies. HPX war hauptsächlich in Melanozyten angereichert, während KEL eine vorherrschende Expression in Drüsenzellen zeigte (Abbildung 4C,D).
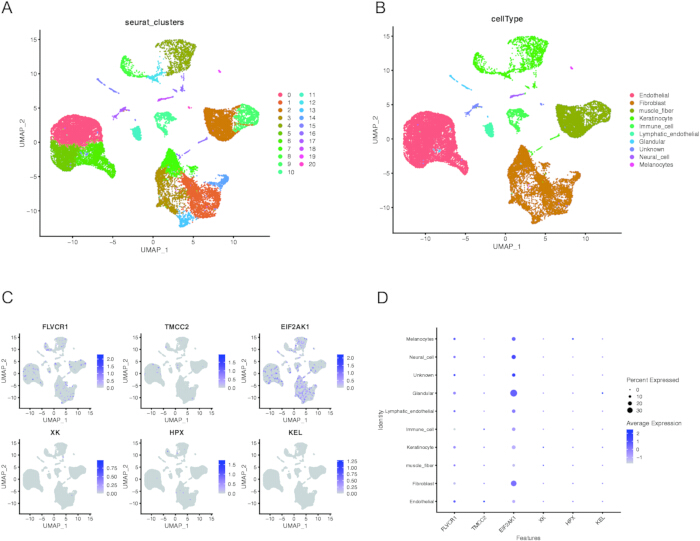
Abbildung 4: Verteilung von hämstoffwechselbezogenen diagnostischen Biomarkern im Einzelzell-Transkriptom des Keloids. (A) UMAP-Diagramm, das 21 Zellcluster mit insgesamt 21.488 Zellen aus Keloidproben zeigt. (B) Zelltyp-Annotationen basierend auf den im Originalartikel berichteten Annotationen. (C) Merkmalsdarstellungen (Feature plots), die die Expression von hämstoffwechselbezogenen diagnostischen Biomarkern in verschiedenen Zelltypen zeigen. (D) Blasendiagramm, das die durchschnittlichen Expressionsniveaus und den Anteil exprimierender Zellen für hämstoffwechselbezogene diagnostische Biomarker in verschiedenen Zelltypen darstellt. Abkürzung: UMAP = uniform manifold approximation and projection. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Identifizierung und Interaktionsnetzwerkanalyse von potenziellen diagnostischen Biomarkern
Um die regulatorischen Mechanismen der in Betracht gezogenen diagnostischen Biomarker zu untersuchen, wurde ein miRNA–mRNA-Regulationsnetzwerk konstruiert. Um die Zuverlässigkeit der vorhergesagten Interaktionen zu erhöhen, wurden überlappende miRNAs identifiziert, die die in Betracht gezogenen Biomarker gezielt ansteuern. Insgesamt wurden 282 miRNAs ermittelt, die mit den sechs diagnostischen Biomarkern interagieren, und das resultierende Regulierungsnetzwerk ist in Abbildung 5 dargestellt. Bemerkenswerterweise wurde vorhergesagt, dass hsa-miR-34a-5p, hsa-let-7a-5p, hsa-let-7d-5p, hsa-let-7e-5p und hsa-miR-26b-5p alle sechs in Betracht gezogenen Biomarker gleichzeitig regulieren.
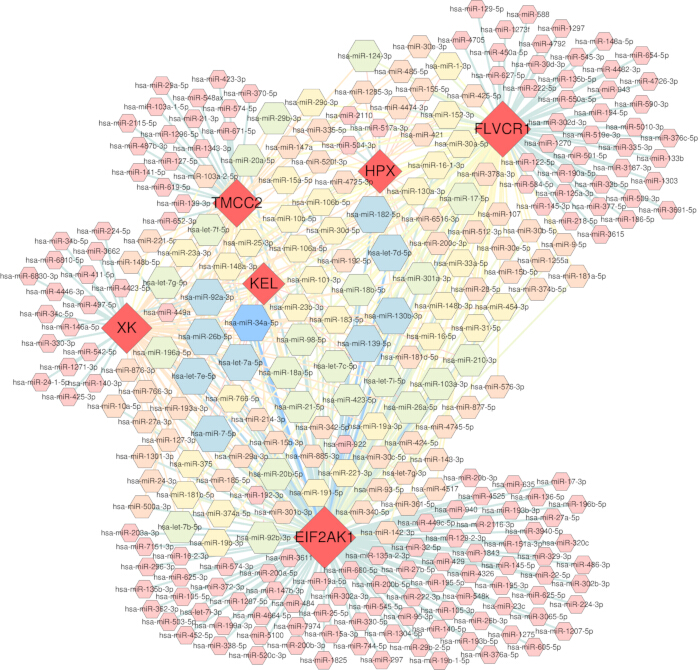
Abbildung 5: miRNA-Regulationsnetzwerk von heme-Stoffwechsel-bezogenen diagnostischen Biomarkern. Das Netzwerk veranschaulicht die regulatorischen Beziehungen zwischen den sechs diagnostischen Biomarker-Genen (FLVCR1, HPX, TMCC2, KEL, XK und EIF2AK1) und ihren assoziierten miRNAs. Genknoten repräsentieren die diagnostischen Biomarker, während die umgebenden Knoten miRNAs darstellen. Kanten zeigen experimentell bestätigte miRNA–mRNA-Interaktionen an. Abkürzungen: FLVCR1 = feline Leukämievirus-Subgruppe-C-Rezeptor 1; HPX = Hemopexin; TMCC2 = Transmembran- und Coiled-Coil-Domänen 2; KEL = Kell-Metallo-Endopeptidase; XK = X-chromosomale Kx-Blutgruppe; EIF2AK1 = eukaryotischer Initiationsfaktor 2 alpha-Kinase 1; miRNA = microRNA; mRNA = messenger RNA. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Experimentelle Validierung der FLVCR1-Expression und molekulare Docking-Analyse potenzieller therapeutischer Verbindungen
Um die bioinformatischen Ergebnisse zu validieren und die funktionelle Relevanz des identifizierten Hub-Gens zu bestätigen, untersuchten wir experimentell die Expression von FLVCR1 in PKF und NHDF. Sowohl qRT-PCR- als auch Western-Blot-Analysen zeigten durchgängig, dass FLVCR1 in keloide Fibroblasten im Vergleich zu normalen Kontrollen signifikant hochreguliert war (Abbildung 6A–C, Ergänzende Abbildung S1 und Ergänzende Tabelle S4). Diese erhöhte zelluläre Expression stützt die mögliche Beteiligung einer FLVCR1-assoziierten Dysregulation des Häm-Stoffwechsels an der Pathogenese von Keloide.
Angesichts der möglichen Beteiligung von FLVCR1 an hemo-metabolischen Immunveränderungen suchten wir als Nächstes nach potenziellen therapeutischen Verbindungen, die FLVCR1 direkt gezielt beeinflussen könnten, um diese pathogene Achse zu unterbrechen. Mithilfe einer Bibliothek mit Verbindungen aus der traditionellen chinesischen Medizin (TCM) und der vorbereiteten Proteinstruktur wurde ein Hochdurchsatz-Virtual-Screening durchgeführt. Die 20 Verbindungen mit den günstigsten Docking-Scores wurden für eine weitere Bewertung ausgewählt (ergänzende Tabelle S5). Im Allgemeinen deutet eine niedrigere Bindungsenergie auf eine stärkere Bindungsaffinität hin, und Docking-Energien unter −5 kcal/mol gelten als Hinweis auf stabile Ligand-Protein-Wechselwirkungen. Unter den untersuchten Verbindungen wiesen (+)-Gallocatechin, (−)-Epicatechin, (−)-Gallocatechin und Cyanidin (Chlorid) günstige Bindungsaffinitäten gegenüber FLVCR1 auf. Bemerkenswerterweise zeigte (+)-Gallocatechin die stärkste Wechselwirkung mit FLVCR1, indem es vier Wasserstoffbrücken mit GLU214, ASN245, GLN246 und GLN471 bildete, was auf einen stabilen Bindungsmodus zwischen Ligand und Protein hindeutet (Abbildung 6D–G). Diese Ergebnisse unterstreichen (+)-Gallocatechin als vielversprechenden Kandidaten für eine mechanismenbasierte therapeutische Intervention, die auf FLVCR1 abzielt.
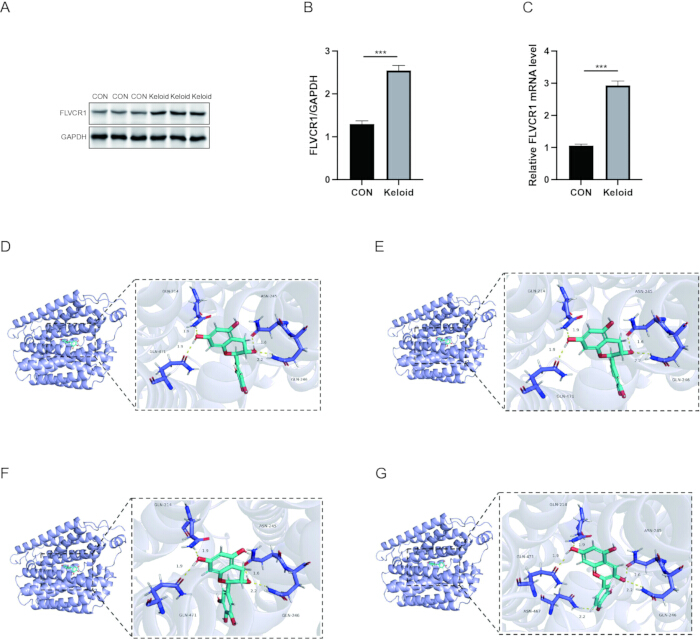
Abbildung 6: Experimentelle Validierung der FLVCR1-Expression und molekulares Docking potenzieller Verbindungen, die FLVCR1 gezielt ansprechen. (A) Repräsentative Western-Blot-Bilder, die die FLVCR1-Proteinexpression in CON und Keloid zeigen. GAPDH diente als Ladekontrolle. (B) Quantifizierung der auf GAPDH normalisierten FLVCR1-Proteinmengen. (C) Relative mRNA-Expressionsmengen von FLVCR1 in CON- und Keloid-Fibroblasten wurden mittels qRT-PCR bestimmt. GAPDH wurde als interne Referenz verwendet. (D–G) Dreidimensionale Darstellungen der vorhergesagten Bindungsmodi zwischen FLVCR1 und ausgewählten niedermolekularen Verbindungen: (D) (+)-Gallocatechin. (E) (-)-Epicatechin. (F) (-)-Gallocatechin. (G) Cyanidin (Chlorid). Abkürzungen: FLVCR1 = feline leukemia virus subgroup C receptor 1; CON, Kontrolle; GAPDH, Glyceraldehyd-3-phosphat-Dehydrogenase; qRT-PCR, quantitative reverse Transkriptase-Polymerase-Kettenreaktion; SD, Standardabweichung. Die Daten werden als Mittelwert ± SD angegeben. Statistische Signifikanz: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; und ****, P < 0,0001. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Bestätigung der Stabilität des FLVCR1–(+)-Gallocatechin-Komplexes mittels Molekulardynamik-Simulation
Um die Zuverlässigkeit der vorhergesagten Ligand–Protein-Bindungsweise zu überprüfen, wurde eine Molekulardynamik-(MD-)Simulation für den FLVCR1–(+)-Gallocatechin-Komplex durchgeführt. Die Analyse konzentrierte sich darauf, ob der Komplex über die Zeit strukturell stabil blieb und ob die Ligandenbindung das konformationelle Verhalten des Proteins mittels RMSD-, RMSF-, Trägheitsradius-(Rg-), SASA-, Wasserstoffbrückenanalyse sowie MM/GBSA-Berechnungen veränderte. Die RMSD-Analyse (Abbildung 7A) zeigte, dass sowohl das Apo-Protein als auch der ligandengebundene Komplex anfängliche Schwankungen innerhalb der ersten 20 ns aufwiesen, gefolgt von einer schrittweisen Stabilisierung, was darauf hindeutet, dass die Systeme während der Simulation ein Gleichgewicht erreichten. Nach der Equilibrierung blieb der RMSD-Wert des FLVCR1–(+)-Gallocatechin-Komplexes unterhalb von 0,2 nm, was darauf hindeutet, dass die Ligandenbindung zur Aufrechterhaltung der strukturellen Stabilität von FLVCR1 beitrug. Die RMSF-Analyse (Abbildung 7B) zeigte, dass die meisten Reste während der gesamten Simulation nur geringe Schwankungen aufwiesen, was auf die Erhaltung der Gesamtintegrität des Proteins hinweist, während mehrere flexible Regionen Schleifenbereiche darstellen könnten, die an der Ligandenaufnahme beteiligt sind. Zudem deuten stabile Rg- und SASA-Profile (Abbildung 7C,D) darauf hin, dass der Komplex eine kompakte Konformation beibehielt, ohne offensichtliche strukturelle Expansion oder Änderungen in der Lösungsmittelzugänglichkeit. Die Wasserstoffbrückenanalyse (Abbildung 7E) ergab, dass der FLVCR1–(+)-Gallocatechin-Komplex persistente intermolekulare Wechselwirkungen aufrechterhielt, wobei während der Simulation etwa 3–4 Wasserstoffbrücken gebildet wurden, was die Stabilität der Ligand–Protein-Assoziation unterstützt. Die MM/GBSA-Analyse zeigte weiterhin, dass der FLVCR1–(+)-Gallocatechin-Komplex eine günstige Bindungsenergie aufwies (ΔGtotal = −34,87 ± 4,13 kcal/mol) (Ergänzende Tabelle S6). Die Energiezerlegungsanalyse ergab, dass van-der-Waals-Wechselwirkungen (ΔVDWAALS = −46,34 ± 2,16 kcal/mol) und elektrostatische Wechselwirkungen (ΔEelec = −14,09 ± 3,45 kcal/mol) die wesentlichen günstigen Beiträge zur Bindung darstellten, trotz des ungünstigen Beitrags der polaren Solvatisierungsenergie (ΔGsolvation = 25,55 ± 0,74 kcal/mol) (Ergänzende Tabelle S6). Insgesamt zeigten diese MD-Simulationsresultate, dass (+)-Gallocatechin einen stabilen Komplex mit FLVCR1 bildete und weiterhin die Zuverlässigkeit der dockingvorhergesagten Bindungsweise untermauerten.
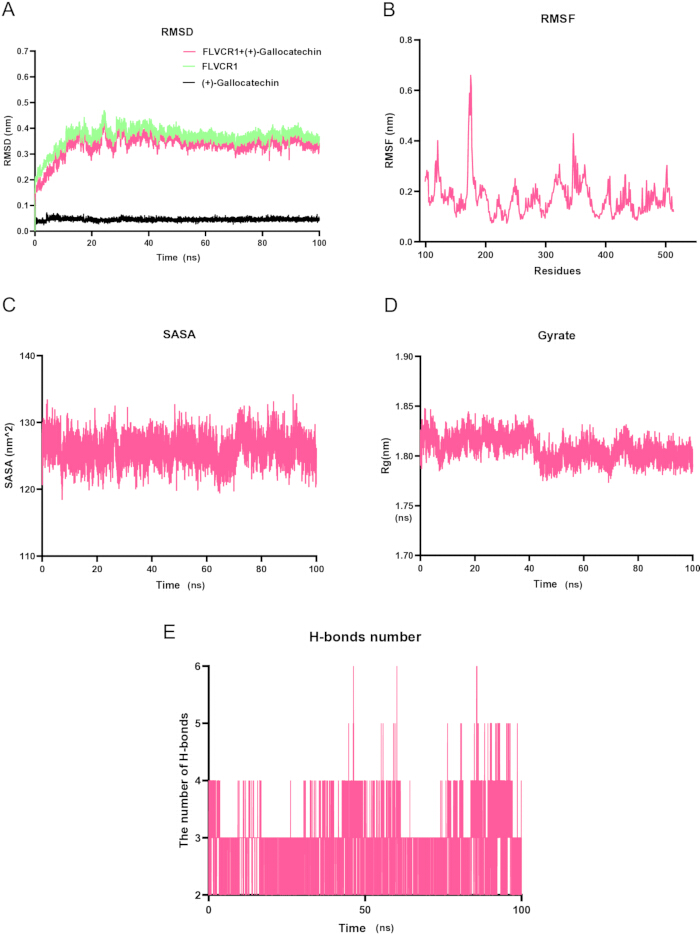
Abbildung 7: Analyse der Molekulardynamik-Simulation des FLVCR1–(+)-Gallocatechin-Komplexes. (A) RMSD-Profile von apo-FLVCR1 und dem FLVCR1–(+)-Gallocatechin-Komplex während der 100 ns langen Molekulardynamik-Simulation. (B) RMSF-Profil, das schwankungen auf Ebene der Aminosäurereste von FLVCR1 während der Simulation zeigt. (C) SASA-Profil, das Änderungen der lösungsmittelzugänglichen Oberfläche des FLVCR1–(+)-Gallocatechin-Komplexes darstellt. (D) Rg-Profil zur Bewertung der Kompressibilität des FLVCR1–(+)-Gallocatechin-Komplexes während der Simulation. (E) Wasserstoffbrückenanalyse, die dynamische intermolekulare Wechselwirkungen zwischen FLVCR1 und (+)-Gallocatechin über den gesamten Simulationszeitraum hinweg zeigt. Abkürzungen: FLVCR1 = feline Leukämievirus-Subgruppe-C-Rezeptor 1; RMSD = Root-Mean-Square-Abweichung; RMSF = Root-Mean-Square-Fluktuation; SASA = lösungsmittelzugängliche Oberfläche; Rg = Trägheitsradius. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Datenverfügbarkeit:
Die in dieser Studie analysierten öffentlich zugänglichen transkriptomischen Datensätze können über die Gene Expression Omnibus (GEO) unter den Zugangsnummern GSE44270, GSE7890 und GSE163973 abgerufen werden. Die in dieser Studie generierten Rohdaten sowie die den experimentellen Validierungen zugrundeliegenden Daten, einschließlich qRT-PCR-Messungen, Original-Western-Blot-Bilder und Western-Blot-Quantifizierungsdaten, sind als ergänzende Abbildung S1, ergänzende Tabelle S1, ergänzende Tabelle S2, ergänzende Tabelle S3 und ergänzende Tabelle S4 bereitgestellt. Die Ergebnisse der molekularen Docking-Analysen sowie die MM/GBSA-Bindungsenergiedaten sind ebenfalls in ergänzender Tabelle S5 und ergänzender Tabelle S6 enthalten.
Ergänzende Abbildung S1: Ursprüngliche Daten der Westernblot-Analyse.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle S1: Gene im Zusammenhang mit dem Hämstoffwechsel.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle S2: Primersequenzen ausgewählter Gene. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Tabelle S3: Maschinelle Lernverfahren zur Identifizierung potenzieller diagnostischer Biomarker bei Keloid. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle S4: Rohdaten zur Unterstützung der experimentellen Validierung von FLVCR1 Expression Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle S5: Die 20 besten Kandidatenverbindungen, identifiziert durch molekulares Docking mit FLVCR1.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle S6: MM/GBSA-Bindungsenergieanalyse des FLVCR1–(+)-Gallocatechin-Komplexes.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Diese Studie identifiziert eine mögliche Assoziation zwischen einer dysregulierten Häm-Metabolisierung, der FLVCR1-Expression und Veränderungen des immunologischen Mikromilieus bei der Keloidebildung. Durch die Integration von Bulk- und Einzelzell-Transkriptomik haben wir FLVCR1 als molekularen Knotenpunkt etabliert, der einen Mangel an Häm-Export mit einer pathologischen immunologischen Neuordnung verbindet und Keloide in das sich abzeichnende Spektrum der „metabo-fibrotischen“ Erkrankungen einordnet23,24,25. Die mögliche Bedeutung von FLVCR1 wird durch konvergierende Belege auf mehreren analytischen Ebenen gestützt. Bulk-Transkriptomik zeigte eine signifikante Hochregulation in Keloidegeweben mit robuster diagnostischer Aussagekraft, während die Kartierung auf Einzelzellebene die Expression vorwiegend in endothelialen Zellen und Melanozyten lokalisierte – zwei Zelltypen, die jeweils durch fehlgeleitete Angiogenese und Hyperpigmentierung eine entscheidende Rolle in der Keloidepathogenese spielen26,27. Am überzeugendsten zeigte die Expression von FLVCR1 eine starke negative Korrelation mit T-follikulären Helferzellen (Tfh-Zellen), einer Lymphozytenpopulation, die zunehmend für die Förderung einer Th2-geprägten Immunität und Kollagenablagerung in fibrotischen Mikromilieus bekannt ist28. Frühere Studien haben gezeigt, dass der FLVCR1-vermittelte Häm-Export in die Reifung dendritischer Zellen und die Antigenpräsentation involviert ist29, was auf einen möglichen Zusammenhang zwischen FLVCR1-assoziiertem Häm-Haushalt und immunologischer Regulation hindeutet. Die beobachtete Hochregulation von FLVCR1 und ihre negative Korrelation mit dem Einwandern von Tfh-Zellen könnten daher Veränderungen im immunologischen Gleichgewicht widerspiegeln, möglicherweise unter Beteiligung Tfh-assoziiierter profibrotischer Zytokine wie IL-4 und IL-1329,30,31.
Darüber hinaus führt die intrazelluläre Hämakkumulation infolge einer FLVCR1-Funktionsstörung vermutlich zur Aktivierung des NLRP3-Inflammasoms – ein Mechanismus, der bei hepatischer Fibrose gut dokumentiert ist, bei dem Häm als schädigungsassoziiertes molekulares Muster (DAMP) eine sterile Entzündungsreaktion auslöst32,33,34. Eine solche Inflammasomaktivierung würde die Freisetzung von IL-1β/IL-18 fördern und über die TLR4/NF-κB-Signalübertragung eine Polarisierung hin zu M2-Makrophagen bewirken, wodurch eine sich selbst verstärkende Schleife aus oxidativem Stress und Fibroblastenaktivierung entsteht35,36. Insgesamt stützen diese Daten die Rolle von FLVCR1 als potenzieller Biomarker und möglicher Faktor bei der Interaktion zwischen Hämstoffwechsel und Immunsystem bei Keloiden; der vorgeschlagene mechanistische Ablauf bedarf jedoch einer direkten funktionellen Validierung. Die intrazelluläre Hämretention induziert zunächst oxidativen Schaden und aktiviert das Inflammasom, was anschließend zu einer Dysfunktion dendritischer Zellen führt und somit eine Verschiebung hin zu follikulären Helfer-T-Zellen und Th2-Typ-Immunantworten begünstigt; diese Immunveränderung treibt schließlich die Polarisierung von Makrophagen in Richtung des M2-Phänotyps weiter voran und resultiert letztendlich in der Aktivierung von Fibroblasten sowie der Progression der Fibrogenese.
Über die alleinige Funktion von FLVCR1 hinaus offenbart die synergistische Dysregulation aller sechs Biomarker einen koordinierten Zusammenbruch der Häm-Homöostase über mehrere regulatorische Knotenpunkte hinweg. TMCC2, das positiv mit aktivierten dendritischen Zellen korreliert, jedoch negativ mit unreifen Subpopulationen assoziiert ist, könnte einen kompensatorischen Mechanismus darstellen, der versucht, die Immuncompetenz unter Häm-Stress wiederherzustellen37,38. EIF2AK1, das in keloide Fibroblasten und Drüsenzellen stark exprimiert wird, fungiert als direkter molekularer Sensor für Häm-Überschuss, der eIF2α phosphoryliert, um die Proteinsynthese global zu unterdrücken, während gleichzeitig Stressantwort-Gene selektiv hochreguliert werden39,40,41. Dadurch nimmt EIF2AK1 eine zentrale Brückenfunktion ein, indem es Häm-Akkumulation in einen phänotypischen Wandel der Fibroblasten übersetzt – was möglicherweise erklärt, warum keloide Fibroblasten eine erhöhte Resistenz gegenüber Apoptose und eine übermäßige Kollagenproduktion aufweisen42,43,44. HPX, der primäre Häm-Scavenger im Plasma, zeigte eine eingeschränkte Expression in Melanozyten, was auf einen zellautonomen Versuch hindeutet, die Häm-Toxizität innerhalb pigmentreicher Kompartimente abzupuffern45,46,47. Die gleichzeitige Dysregulation von XK und KEL verweist zudem auf eine Beteiligung der Häm-Verarbeitungsmaschinerie der erythroiden Linie an der Pathogenese von Keloide – ein Befund mit faszinierenden Implikationen für das Verständnis, warum Keloide häufig an Traumastellen mit Mikrohämorrhagien entstehen. Anstatt diese sechs Gene als unabhängige Marker zu betrachten, interpretieren wir ihre kollektive Dysregulation als Hinweis auf einen systemweiten Versagen der Häm-Kompartimentalisierung, bei dem beeinträchtigter Export (FLVCR1), Sensorik (EIF2AK1), Scavenging (HPX) und Membrantransport (XK, KEL) zusammenwirken, um ein profibrotisches, hämreiches Mikromilieu zu erzeugen.
Dieses Stoffwechsel-Immun-Modell wird durch eine überzeugende epigenetische Ebene weiter gestützt: Wir identifizierten ein ceRNA-Netzwerk, in dem die Herunterregulation spezifischer miRNAs (z. B. der let-7-Familie und miR-34a-5p) möglicherweise gleichzeitig hämstoffwechselbezogene und fibrotische Signalwege enthemmt, obwohl dieses regulatorische Modell weiterer Validierung bedarf23. Die räumliche Auflösung, die durch die Einzelzellanalyse ermöglicht wird, macht die zelluläre Choreografie dieses Prozesses sichtbar und zeigt, wie Stoffwechselstörungen in Strukturrzellen durch parakrine Häm-Signalgebung aktiv die immunreiche Mikroumgebung anlegen, wodurch sich unser Verständnis von einer „Gesamtgewebe“-Perspektive hin zu einem dynamischen zellulären Ökosystemmodell wandelt48,49,50. Eine Anreicherung von Häm in Endothelzellen könnte über die Induktion von Häm-Oxygenase-1 und die Hochregulation von Adhäsionsmolekülen vaskuläre Leckage und Leukozytenextravasation fördern und so die beobachtete immunreiche Mikroumgebung in Keloide anlegen51,52,53. Gleichzeitig stimmt die FLVCR1-Expression in Melanozyten mit klinischen Beobachtungen der Hyperpigmentierung bei Keloide überein und deutet auf gemeinsame metabolische Anfälligkeiten zwischen pigmentären und fibrotischen Signalwegen hin – möglicherweise vermittelt durch oxidativen Stress54,55. Diese räumliche Kartierung verändert unser Verständnis von einer „Gesamtgewebe“-Perspektive hin zu einem zellulären Ökosystemmodell, in dem Stoffwechselstörungen in Strukturrzellen (Endothel, Melanozyten) über parakrine Häm-Signalgebung aktiv das Verhalten von Immunzellen beeinflussen.
Aus translativer Sicht erreichte unser Nomogramm, das alle sechs Biomarker integriert, eine nahezu perfekte diagnostische Genauigkeit, übertraf deutlich jeden einzelnen Marker und zeigte mittels Entscheidungskurvenanalyse einen klaren klinischen Gesamtnutzen. Provokanterweise identifizierte molekulares Docking (+)-Gallocatechin – ein bioaktives Polyphenol, das reichlich in grünem Tee und traditionellen chinesischen Heilpflanzen vorkommt – als hochaffinen FLVCR1-Liganden, der stabile Wasserstoffbrückenbindungen mit GLU-214, ASN-245, GLN-246 und GLN-471 eingeht. Dieser Befund ist umso überzeugender angesichts früherer Hinweise darauf, dass Catechine die Kollagensynthese hemmen, die Sekretion von Transforming Growth Factor-beta 1 inhibieren und oxidativen Stress in Keloide-Fibroblasten abschwächen56,57,58. Wir vermuten, dass (+)-Gallocatechin die FLVCR1-Konformation stabilisieren könnte, um die Häm-Ausfuhrkapazität zu erhöhen, wodurch der metabolische Auslöser der Fibrose an seiner Quelle unterbrochen wird – ein Ansatz, der sich grundlegend von aktuellen Therapien unterscheidet, die lediglich die nachgeschaltete Kollagenproduktion unterdrücken. Ob diese Art der metabolischen Intervention das Wiederauftreten von Keloide beeinflussen könnte, bedarf weiterer experimenteller und klinischer Validierung.
Natürlich weist diese Studie auch Grenzen auf. Erstens bleiben unsere Analysen weitgehend rechnergestützt, und die beobachtete Assoziation zwischen der Expression von FLVCR1 und der Infiltration von T-follikulären Helferzellen (Tfh) belegt keinen direkten kausalen Zusammenhang. Eine Validierung der Tfh-Zellen mittels Durchflusszytometrie sowie funktionelle Untersuchungen mit Knockdown oder Überexpression von FLVCR1 in Keloide-Fibroblasten, ergänzt durch Assays zur Fibroblasten–Immunzellen-Interaktion oder basierend auf konditioniertem Medium, sind erforderlich, um die mögliche Rolle von FLVCR1 in der Immunregulation zu klären. Zweitens könnte die relativ geringe Stichprobengröße Unsicherheiten und übermäßige Optimismus bezüglich der geschätzten Leistung der Sechs-Gen-Signatur verursachen. Obwohl eine interne Validierung durchgeführt wurde, bleibt die zuverlässige Beurteilung der diagnostischen Leistung und Kalibrierung begrenzt. Daher sollte das Sechs-Gen-Panel als explorative molekulare Signatur betrachtet werden, die weitere Validierung in größeren, unabhängigen Kohorten erfordert. Drittens muss der Einzelzell-Datensatz erweitert werden, um die interindividuelle Heterogenität und seltene Zellpopulationen besser abzubilden. Viertens würde eine Validierung der Biomarker-Expression auf Proteinebene sowie deren räumliche Lokalisation mittels Immunhistochemie die klinische Relevanz unserer Ergebnisse stärken. Schließlich sind, obwohl molekulares Docking auf eine mögliche Bindung zwischen (+)-Gallocatechin und FLVCR1 hindeutet, in vitro-Bindungsassays und in vivo-Wirksamkeitsstudien notwendig, bevor eine klinische Anwendung in Betracht gezogen werden kann. Trotz dieser Einschränkungen liefern unsere Ergebnisse einen mehrdimensionalen Rahmen, der die mit FLVCR1 assoziierte Hämstoffwechselaktivität mit immunologischen Veränderungen im Keloide verknüpft, und identifizieren potenzielle molekulare Biomarker sowie therapeutische Kandidaten für zukünftige Untersuchungen.
Offenlegungen
Die Autoren haben keine Interessenkonflikte anzugeben.
Beiträge der Autoren
Qiuyan Yang trug zur Studiendurchführung bei. Jianping Zhang trug zur Datensammlung bei. Qiuyan Yang und Xiaofang Sun trugen zur statistischen Analyse bei. Qiuyan Yang und Jing Wang trugen zur Erstellung der Abbildungen und zur Fertigstellung des Manuskripts bei. Alle Autoren lasen und genehmigten die endgültige Fassung des Manuskripts.
Danksagungen
Wir danken den Forschern, die die Datensätze GSE44270, GSE7890 und GSE163973 generiert und öffentlich über die Gene Expression Omnibus (GEO)-Datenbank bereitgestellt haben, sehr herzlich.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| AmberTools | Amber Project | https://ambermd.org/AmberTools.php | Version 22; Erzeugung von Ligandenparametern unter Verwendung des GAFF-Kraftfelds |
| Anti-FLVCR1 | Proteintech | 26841-1-AP | |
| Anti-GAPDH | Proteintech | 60004-1-Ig | |
| AutoDock Vina | The Scripps Research Institute | https://vina.scripps.edu/ | Version 1.2.3; Molekulares Docking und Vorhersage der Liganden-Bindungsaffinität |
| AutoDockTools | The Scripps Research Institute | https://ccsb.scripps.edu/autodocksuite/adt/ | Version 1.5.6; Vorbereitung von Liganden und Rezeptoren für molekulares Docking |
| BCA-Protein-Assay-Kit | Servicebio | G2026 | |
| cDNA-Synthesemix für qPCR mit dsDNase | UnionScript | Reverse Transkription für qRT-PCR | |
| ChemBio3D | PerkinElmer | https://revvitysignals.com/products/research/chemdraw | Version 14.0; 3D-Konformationsoptimierung und Energieminimierung von Liganden |
| Chemilumineszenz-Imaging-System | Sichtbarmachung von Western-Blot-Banden | ||
| DoubletDetection-Paket | GitHub / JonathanShor | https://github.com/JonathanShor/DoubletDetection | Erkennung und Entfernung vorhergesagter Doubletts in der scRNA-seq-Analyse |
| ECL-Chemilumineszenz-Substrat | Signalnachweis für Western Blot | ||
| Fötales Kälberserum | Endkonzentration 2 %; Zusatz für das Kulturmedium von Fibroblasten | ||
| Fibroblast Growth Medium 2 | PromoCell | C-23020 | |
| FLVCR1- und GAPDH-Primer | Ergänzungstabelle S2 | qRT-PCR-Amplifikation von Ziel- und Referenzgenen | |
| Gaussian | Gaussian, Inc. | https://gaussian.com/ | Gaussian 16W; Berechnung von RESP-Atomladungen für die Ligandenparametrisierung |
| Gelelektrophoresegerät | Proteintrennung mittels SDS-PAGE | ||
| GEOquery-Paket | Bioconductor | https://bioconductor.org/packages/GEOquery/ | Version 2.68.0; Abruf von Genexpressions- und Metadaten aus der GEO-Datenbank |
| ggplot2-Paket | CRAN | https://cran.r-project.org/package=ggplot2 | Version 4.0.2; Datenvisualisierung |
| glmnet-Paket | CRAN | https://cran.r-project.org/package=glmnet | Version 4.1.10; LASSO-Feature-Selektion |
| GROMACS | GROMACS-Entwicklungsteam | https://www.gromacs.org/ | Version 2022.3; Molekulardynamik-Simulationen und Trajektorienanalyse |
| GS AntiQ qPCR SYBR Green Fast Mix (Universal) | Genesand | SQ410 | |
| GSE163973 | GEO-Datenbank | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE163973 | 3 Keloide-Proben; Einzelzell-Expressionsanalyse |
| GSE44270 | GEO-Datenbank | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE44270 | 18 Keloide- und 14 normale Proben; Differenzielle Expression und Biomarker-Screening |
| GSE7890 | GEO-Datenbank | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE7890 | 10 Keloide- und 9 normale Proben; Unabhängige Validierung diagnostischer Biomarker |
| GSVA-Paket | Bioconductor | https://bioconductor.org/packages/GSVA/ | Version 1.48.3; ssGSEA-basierte Analyse der Immunzellinfiltration |
| HRP-konjugiertes Ziegen-Anti-Maus-IgG | Abcam | ab97040 | |
| HRP-konjugiertes Ziegen-Anti-Kaninchen-IgG | Abcam | ab97051 | |
| Befeuchteter CO2-Inkubator | 37 °C, 5 % CO2; Kultivierung von NHDF- und PKF-Zellen | ||
| ImageJ | National Institutes of Health | https://imagej.nih.gov/ij/ | Quantifizierung der Bandenintensität im Western Blot |
| Insulin | Endkonzentration 5 μg/mL; Zusatz für das Kulturmedium von Fibroblasten | ||
| Molecular Signatures Database (MSigDB) | Broad Institute | https://www.gsea-msigdb.org/gsea/msigdb | Version 2024.1.Hs; Quelle für Gen-Sets im Zusammenhang mit Hämstoffwechsel |
| NetworkAnalyst | NetworkAnalyst | https://www.networkanalyst.ca/ | Version 3.0; Erstellung des miRNA-mRNA-Interaktionsnetzwerks |
| NHDF | Procell | CP-H106 | |
| Magermilchpulver | 5 %ige Lösung; Membranblockierung für die Western-Blot-Analyse | ||
| Optische Versiegelungsfolie oder -kappen | Versiegelung von qRT-PCR-Reaktionen | ||
| PBS | Procell | PB180327 | |
| PDB ID: 8UBZ | RCSB PDB | https://www.rcsb.org/structure/8UBZ | Struktur des menschlichen FLVCR1; Quelle der FLVCR1-Proteinstruktur für strukturbasiertes virtuelles Screening |
| Phosphataseinhibitoren | Zusatz für den Proteinlysepuffer | ||
| PKF | Procell | GCP-H235 | |
| PMSF | Servicebio | G2008-1ML | |
| pROC-Paket | CRAN | https://cran.r-project.org/package=pROC | Version 1.19.0.1; ROC-Kurven- und AUC-Analyse |
| Proteaseinhibitorcocktail | Roche | 4693124001 | |
| Proteintrennapparatur | Übertragung von Proteinen auf PVDF-Membran | ||
| PVDF-Membran | Millipore | IPVH08100 | |
| PyMOL | Schrödinger, LLC | https://pymol.org/ | Version 2.6.1; Visualisierung und Analyse von Protein-Ligand-Docking-Konformationen und molekularen Wechselwirkungen |
| qRT-PCR-Platten oder -Röhrchen | Einrichtung von qRT-PCR-Reaktionen | ||
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Version 4.3.1; Statistische und bioinformatische Analysen |
| randomForest-Paket | CRAN | https://cran.r-project.org/package=randomForest | Version 4.7.1.2; Feature-Selektion mittels Random Forest |
| REACTOME_HEME_BIOSYNTHESIS; REACTOME_HEME_DEGRADATION; WIKIPATHWAYS_HEME_BIOSYNTHESIS; REACTOME_SCAVENGING_HEME_FROM_PLASMA; HALLMARK_HEME_METABOLISM | Molecular Signatures Database (MSigDB) | https://www.gsea-msigdb.org/gsea/msigdb | Version 2024.1.Hs; 283 eindeutige Gene nach Zusammenführung; Definition von Genen im Zusammenhang mit Hämstoffwechsel |
| Echtzeit-PCR-System | qRT-PCR-Amplifikation und -detektion | ||
| Rekombinanter humaner basischer Fibroblastenwachstumsfaktor | Endkonzentration 1 ng/mL; Zusatz für das Kulturmedium von Fibroblasten | ||
| RIPA-Puffer | Servicebio | G2002 | |
| rms-Paket | CRAN | https://cran.r-project.org/package=rms | Version 6.7.1; Erstellung von Nomogrammen |
| SDS-PAGE-Reagenzien oder vorgefertigte Gele | Proteintrennung mittels SDS-PAGE | ||
| Seurat-Paket | CRAN | https://satijalab.org/seurat/ | Version 5.4.0; scRNA-seq-Vorverarbeitung, Clusterung und Visualisierung |
| TarBase | DIANA Tools | https://carolina.imis.athena-innovation.gr/diana_tools/ | Version 9.0; Quelle experimentell bestätigter miRNA-mRNA-Interaktionen |
| Total RNA Kit II | Omega | R6934-01 | |
| Bibliothek aktiver Verbindungen aus traditioneller chinesischer Medizin | Quelle für Kandidatenverbindungen für virtuelles Screening | ||
| Tween/Tris-gepufferte Salzlösung | Herstellung des Blockierpuffers und der Membranwäsche | ||
| UnionScript First-strand cDNA Synthesis Mix for qPCR (with dsDNase) | Genesand | SR511 |
Referenzen
- Dirand Z, et al. Macrophage phenotype is determinant for fibrosis development in keloid disease. Matrix Biol. 2024;128:79-92.
- Fang X, et al. Hypertrophic scarring and keloids: epidemiology, molecular pathogenesis, and therapeutic interventions. MedComm (2020). 2025;6(10):e70381.
- Adler R, et al. Pentoxifylline and long-term risk of keloid formation: a real-world 10-year outcomes study using TriNetX. J Am Acad Dermatol. 2026;94(5):1561-3.
- Banerjee P, et al. Anti-fibrotic properties of a decellularized extracellular matrix scaffold from porcine small intestinal submucosa in normal human and keloid fibroblasts. Int J Mol Sci. 2025;26(24):11764.
- Chang YH, McGrath JA, Hsu CK. Regression of extensive keloids during imatinib therapy for gastrointestinal stromal tumor. JAMA Dermatol. 2025;161(12):1293-4.
- Wang QR, et al. CCL17 drives fibroblast activation in the progression of pulmonary fibrosis by enhancing the TGF-β/Smad signaling. Biochem Pharmacol. 2023;210:115475.
- Higuchi Y, et al. Cavin-2 promotes fibroblast-to-myofibroblast trans-differentiation and aggravates cardiac fibrosis. ESC Heart Fail. 2024;11(1):167-78.
- Zhang H, et al. Plasma apolipoprotein E protein attenuates pulmonary fibrosis through LRP1 and PLAU dual receptor-mediated TGF-β/Smad inhibition. J Adv Res. 2025. doi:10.1016/j.jare.2025.12.045.
- Chen Q, et al. Immune imbalance drives keloid pathogenesis: emerging targets for precision immunotherapy. Adv Wound Care (New Rochelle). 2026:21621918261417702.
- Deng CC, et al. Single-cell RNA-seq reveals immune cell heterogeneity and increased Th17 cells in human fibrotic skin diseases. Front Immunol. 2024;15:1522076.
- Wang Q, et al. Weighted gene co-expression network analysis and machine learning identified the lipid metabolism-related gene LGMN as a novel biomarker for keloid. Exp Dermatol. 2024;33(1):e14974.
- Zhang W, et al. New insights into keloid pathogenesis: biomarker potential for CDK7 and DDB2. Front Cell Dev Biol. 2025;13:1718189.
- Li W, et al. Altered arginine metabolism affects proliferation and radiosensitivity of keloids. Exp Dermatol. 2025;34(3):e70077.
- Jiang J, et al. Ambient fine particulate matter induces cardiac fibrosis through triggering ferroptosis by heme degradation induced-iron overload. Ecotoxicol Environ Saf. 2025;297:118227.
- Lin W, et al. Heme oxygenase-1 overexpression activates the IRF1/DRP1 signaling pathway to promote M2-type polarization of spinal cord microglia. Drug Dev Res. 2024;85(8):e70033.
- Knez J, Kovačič B, Goropevšek A. The role of regulatory T-cells in the development of endometriosis. Hum Reprod. 2024;39(7):1367-80.
- Voltarelli VA, et al. Heme: the lord of the iron ring. Antioxidants (Basel). 2023;12(5):1074.
- Wilks A, Egoshi R. Heme trafficking and the importance of handling nature's most versatile cofactor. Chem Rev. 2025;125(23):11358-78.
- Bertino F, et al. Dysregulation of FLVCR1a-dependent mitochondrial calcium handling in neural progenitors causes congenital hydrocephalus. Cell Rep Med. 2024;5(7):101647.
- Kumar A, et al. Iron regulates the quiescence of naive CD4 T cells by controlling mitochondria and cellular metabolism. Proc Natl Acad Sci U S A. 2024;121(17):e2318420121.
- Jiang H, et al. Gut microbiota dysbiosis in diabetic nephropathy: mechanisms and therapeutic targeting via the gut-kidney axis. Front Endocrinol (Lausanne). 2025;16:1661037.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-62.
- Chen Y, et al. 5-ALA photodynamic metabolite-powered zero-waste ferroptosis amplifier for enhanced hypertrophic scar therapy. Nat Commun. 2025;16(1):8321.
- Li X, et al. Hypericin-mediated photodynamic therapy promotes apoptosis and inhibits fibrosis by inducing HMOX1-mediated ferroptosis in hypertrophic scar fibroblasts. J Photochem Photobiol B. 2025;273:113303.
- Chen Y, et al. Functional transdermal nanoethosomes enhance photodynamic therapy of hypertrophic scars via self-generating oxygen. ACS Appl Mater Interfaces. 2021;13(7):7955-65.
- Oh S, et al. Revealing the pathogenesis of keloids based on the status: active vs inactive. Exp Dermatol. 2024;33(5):e15088.
- Zhao S, et al. New anti-fibrotic strategies for keloids: insights from single-cell multi-omics. Cell Prolif. 2025;58(6):e13818.
- Yasujima T, et al. The role of FLVCR1 and FLVCR2 in choline transport in the Caco-2 intestinal epithelial cell model and rat small intestine. Biochim Biophys Acta Mol Basis Dis. 2025;1871(6):167883.
- Zhang M, Chen H, Qian H, Wang C. Characterization of the skin keloid microenvironment. Cell Commun Signal. 2023;21(1):207.
- Wang Y, et al. FoxC1 activates Notch3 signaling to promote the inflammatory phenotype of keloid fibroblasts and aggravates keloid. Exp Cell Res. 2025;444(2):114402.
- Zhang J, et al. ERG transcriptionally activates SFRP1 to promote apoptosis of keloid fibroblasts and inhibit epithelial-mesenchymal transition and fibrosis through the Wnt3a/β-catenin pathway. Arch Dermatol Res. 2025;317(1):467.
- Ramos-Tovar E, Muriel P. NLRP3 inflammasome in hepatic diseases: a pharmacological target. Biochem Pharmacol. 2023;217:115861.
- Brahadeeswaran S, et al. NLRP3: a new therapeutic target in alcoholic liver disease. Front Immunol. 2023;14:1215333.
- Xiao Y, et al. STING mediates hepatocyte pyroptosis in liver fibrosis by epigenetically activating the NLRP3 inflammasome. Redox Biol. 2023;62:102691.
- Paolucci T, et al. Quantum molecular resonance inhibits NLRP3 inflammasome/nitrosative stress and promotes M1 to M2 macrophage polarization: potential therapeutic effect in osteoarthritis model in vitro. Antioxidants (Basel). 2023;12(7):1358.
- Wei J, et al. FERM domain containing kindlin 1 knockdown attenuates inflammation induced by intracerebral hemorrhage in rats via NLR family pyrin domain containing 3/nuclear factor kappa B pathway. Exp Anim. 2023;72(3):324-35.
- Tao L, Zhou Y, Wu L, Liu J. Comprehensive analysis of sialylation-related genes and construct the prognostic model in sepsis. Sci Rep. 2024;14(1):18110.
- Sun Q, et al. Identification of hub genes and key pathways associated with sepsis progression using weighted gene co-expression network analysis and machine learning. Int J Mol Sci. 2025;26(9):4433.
- Chen JJ. HRI protein kinase in cytoplasmic heme sensing and mitochondrial stress response: relevance to hematological and mitochondrial diseases. J Biol Chem. 2025;301(5):108494.
- Chakrabarty Y, Yang Z, Chen H, Chan DC. The HRI branch of the integrated stress response selectively triggers mitophagy. Mol Cell. 2024;84(6):1090-100.e6.
- Bora P, et al. Drug repurposing screen identifies an HRI activating compound that promotes adaptive mitochondrial remodeling in MFN2-deficient cells. Proc Natl Acad Sci U S A. 2025;122(48):e2517552122.
- Zhang C, et al. CaMKII suppresses proteotoxicity by phosphorylating BAG3 in response to proteasomal dysfunction. EMBO Rep. 2024;25(10):4488-514.
- Chaabani H, et al. Trifloxystrobin induces oxidative stress-dependent activation of the OMA1-DELE1-HRI integrated stress response leading to apoptosis in human neuroblastoma cells. Environ Pollut. 2026;390:127562.
- Das R, et al. CMT2A-linked MFN2 mutation, T206I promotes mitochondrial hyperfusion and predisposes cells towards mitophagy. Mitochondrion. 2024;74:101825.
- De Simone G, et al. Heme scavenging and delivery: the role of human serum albumin. Biomolecules. 2023;13(3):575.
- Turilli-Ghisolfi ES, Lualdi M, Fasano M. Ligand-based regulation of dynamics and reactivity of hemoproteins. Biomolecules. 2023;13(4):683.
- Zhang P, et al. Risk factors and prediction models for cardiotoxicity induced by anthracyclines in malignant chemotherapy. Cancer Chemother Pharmacol. 2025;95(1):73.
- Petrillo S, et al. Endothelial cells require functional FLVCR1a during developmental and adult angiogenesis. Angiogenesis. 2023;26(3):365-84.
- Fiorito V, Tolosano E. Unearthing FLVCR1a: tracing the path to a vital cellular transporter. Cell Mol Life Sci. 2024;81(1):166.
- Manco M, et al. FLVCR1a controls cellular cholesterol levels through the regulation of heme biosynthesis and tricarboxylic acid cycle flux in endothelial cells. Biomolecules. 2024;14(2):149.
- Shi X, et al. Increased melanin induces aberrant keratinocyte-melanocyte-basal-fibroblast cell communication and fibrogenesis by inducing iron overload and ferroptosis resistance in keloids. Cell Commun Signal. 2025;23(1):141.
- Khunger N, Dash A. Impact of air pollution on skin pigmentation: mechanisms and protective strategies. Int J Dermatol. 2025;64(10):1788-801.
- Ahuja K, Raju S, Dahiya S, Motiani RK. ROS and calcium signaling are critical determinant of skin pigmentation. Cell Calcium. 2025;125:102987.
- Dutta A, Chakraborty S, Roy A, Mittal A, et al. Tissue fibrosis in cardiorenal syndrome: crosstalk between heart and kidneys. Nephrol Dial Transplant. 2025;40(7):1273-83.
- Noah AA, et al. Reversal of fibrosis and portal hypertension by empagliflozin treatment of CCl4-induced liver fibrosis: emphasis on gal-1/NRP-1/TGF-β and gal-1/NRP-1/VEGFR2 pathways. Eur J Pharmacol. 2023;959:176066.
- Murakami T, Shigeki S. Pharmacotherapy for keloids and hypertrophic scars. Int J Mol Sci. 2024;25(9):4674.
- Jin J, Zheng Z. Gut microbiota-derived metabolites in keloid and hypertrophic scarring. Front Microbiol. 2025;16:1644758.
- Aubert A, et al. Potential implications of granzyme B in keloids and hypertrophic scars through extracellular matrix remodeling and latent TGF-β activation. Front Immunol. 2024;15:1484462.