Dieser Arbeitsablauf kombiniert Bulk- und Einzelzell-Transkriptomik mit vorläufigen Gewebetests an Patienten, um MMP1 bei diabetischem Fußgeschwür zu priorisieren. MMP1 zeigte ein auf Fibroblasten fokussiertes Expressionsmuster und eine höhere Gewebeakkumulation, was auf eine Assoziation mit der Matrixumgestaltung hinweist, während Kausalität und klinische Anwendbarkeit ungeklärt bleiben.
Forschungsartikel
Integrative Analyse von Bulk- und Einzelzell-Transkriptomik mit Gewebevalidierung identifiziert MMP1 als Schlüsselgen bei diabetischem Fußulkus
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
Zelluläre Quellen reproduzierbarer transkriptomischer Veränderungen bei diabetischem Fußgeschwür (DFU) sind bislang unvollständig definiert. Diese Studie kombinierte die Analyse differentieller Genexpression, gewichtete Gen-ko-Expressionsnetzwerkanalyse (WGCNA), Screening von Genen zur diabetischen peripheren Neuropathie (DPN), explorative Merkmalsauswahl mittels maschinellen Lernens, zwei externe bulk-transkriptomische Datensätze, Einzelzell-Analyse, Netzwerkanalyse der traditionellen chinesischen Medizin (TCM) sowie quantitative Polymerase-Kettenreaktion (qPCR) und Western Blotting an Patientengewebe. In GSE199939 (10 DFU- und 11 Kontrollproben) wurden 3.691 differentiell exprimierte Gene identifiziert, wobei das blaue Modul der WGCNA stark mit DFU assoziiert war (r = 0,97, p = 5 × 10-13). Der Durchschnitt aus den differentiell exprimierten Genen, den Hub-Genen des blauen Moduls und 1.062 DPN-assoziierten Genen ergab 77 Kandidatengene. CCL7, CHEK1, MKI67, MMP1, MMP13 und TRPV2 wurden von mindestens zwei Verfahren zur Merkmalsauswahl unterstützt; die vollständige Trennung im support vector machine-Verfahren zur rekursiven Merkmalsauswahl (recursive feature elimination) warf Bedenken hinsichtlich einer Überanpassung im Entdeckungs-Kohortenansatz auf. MMP1 zeigte die stärkste expressionelle Veränderung in der Entdeckungskohorte (log2-Faltungsänderung = 9,854; adjustiertes p = 1,24 × 10⁻²⁹). In der kombinierten Matrix GSE68183/GSE80178 wies MMP1 ein adjustiertes p von 0,0159 und eine Fläche unter der ROC-Kurve (AUC) von 0,981 auf. In GSE134431 war die Expression von MMP1 nominal höher bei DFU im Vergleich zu nicht ulzerierter diabetischer Fußhaut (p = 0,0225; adjustiertes p = 0,135; AUC = 0,808). Die Analyse von 69.944 Zellen aus 24 Proben zeigte die höchste mittlere MMP1-Expression in Fibroblasten, mit höherer Expression auf Proben-Ebene in DFU-Fibroblasten, Keratinozyten und endothelialen Zellen. Untersuchungen am Patientengewebe ergaben eine höhere MMP1-mRNA-Menge in vier gepaarten Proben (gepaarter Test für ΔCq, p = 3,04 × 10⁻⁵) und eine höhere Proteinmenge in drei gepaarten Proben (gepaarter p-Wert = 0,0107). Die statistische Reproduktion war unvollständig. Die Ergebnisse deuten auf einen fibroblastenzentrierten Zusammenhang mit Matrixremodellierung hin, wobei Einschränkungen durch die Eingabe von Transkripten pro Million (TPM) in der zählbasierten Entdeckungsanalyse, unvollständige Vorverarbeitungsdaten der Einzelzellanalyse und kleine Kohorten in den Gewebeuntersuchungen bestehen. Kausalität und klinische Relevanz sind weiterhin nicht belegt.
Einleitung
Ein diabetischer Fußgeschwür ist eine schwere und rezidivierende Komplikation des Diabetes, die durch das Zusammentreffen von Neuropathie, wiederholter mechanischer Belastung, peripherer arterieller Verschlusskrankheit, Infektanfälligkeit und gestörter Gewebereparatur entsteht. Aktuelle Schätzungen zufolge sind weltweit jedes Jahr Millionen von Menschen betroffen, wobei die Wundheilung oft verlängert ist und erhebliche Risiken von Rezidiven, Krankenhausaufenthalten, Amputationen der unteren Extremitäten und Tod bestehen1. Die Prävention und Behandlung hängen daher nicht nur von der lokalen Wundversorgung ab, sondern auch von der Identifizierung eines Verlusts der schützenden Sensibilität, der Reduktion des plantaren Drucks, der Behandlung von Infektionen und Ischämie sowie der Berücksichtigung systemischer Risikofaktoren1,2. Die diabetische periphere Neuropathie ist besonders relevant, da ein fortschreitender sensorischer Funktionsverlust das Bewusstsein für Druck, Trauma und Gewebezerfall verringern kann, während motorische und autonome Störungen zusätzlich die Biomechanik des Fußes und die Hautintegrität beeinträchtigen können2,3. Auf Gewebeebene können neuropathische Schädigungen mit Neuroinflammation, mikrovaskulärer Dysfunktion, metabolischem Stress und fehlerhafter Reparatur koexistieren und so ein Wundmilieu schaffen, in dem Verletzungen trotz Standardtherapie anhalten1,3.
Eine erfolgreiche kutane Heilung erfordert eine koordinierte Abfolge von Entzündung, Reepithelialisierung, Angiogenese, Fibroblastenaktivierung, Ablagerung der extrazellulären Matrix (ECM) und anschließender Matrixremodellierung. Bei Diabetes können diese Prozesse zeitlich entkoppelt sein: Entzündungssignale können weiterhin aktiv bleiben, die Migration von Keratinozyten kann beeinträchtigt sein, endotheliale Reaktionen unzureichend ausfallen und Fibroblasten eine abnormale Matrix produzieren oder organisieren. Fibroblasten sind zentral für die stromale Phase der Reparatur, da sie Matrixproteine synthetisieren, die Kollagenarchitektur regulieren, mit Immun- und Epithelzellen kommunizieren und zur Wundkontraktion beitragen. Studien an patientenabgeleiteten DFU-Fibroblasten haben persistierende Abweichungen in der Transkription bezogen auf die ECM sowie in der Matrixbildung gezeigt, was die Ansicht stützt, dass der Zustand der Fibroblasten eine wichtige Komponente der Biologie chronischer Wunden darstellt4. Matrix-Metalloproteinasen (MMPs) sind an diesem Prozess beteiligt, indem sie ECM-Substrate spalten und so die Zellmigration, den Gewebeumsatz und die Remodellierung ermöglichen; ihre Wirkung hängt jedoch von Ort, Zeitpunkt, Substratverfügbarkeit und der Regulation durch Gewebeinhibitoren von Metalloproteinasen (TIMPs) ab5. Ein Ungleichgewicht zwischen Proteolyse und Matrixersatz kann daher mit einer beeinträchtigten Reparatur vereinbar sein, doch eine erhöhte Expression einer einzelnen MMP allein beweist noch nicht, ob diese schädlich oder förderlich wirkt. Die Matrix-Metalloproteinase 1 (MMP1), eine interstitielle Kollagenase, die am Umsatz fibrillärer Kollagene beteiligt sein kann, wurde in DFU-Gewebe als verändert berichtet, und frühere klinische Studien haben MMP/TIMP-Profile mit dem Wundstatus oder Heilungsdynamiken in Verbindung gebracht6,7. Diese Beobachtungen sprechen für eine weitergehende Untersuchung von MMP1 bei DFU.
Die transkriptomische Profilierung bietet einen systematischen Ansatz zur Identifizierung molekularer Programme, die mit DFU assoziiert sind, doch mehrere methodische Einschränkungen erschweren die Interpretation. Datensätze aus Gesamtgewebe mitteln Signale über Keratinozyten, Fibroblasten, endotheliale Zellen, Immunzellen und andere Kompartimente hinweg, wodurch es schwierig wird zu entscheiden, ob ein Kandidat eine veränderte Expression innerhalb eines Zelltyps, Verschiebungen in der zellulären Zusammensetzung oder beides widerspiegelt. Die Vergleichbarkeit zwischen Datensätzen kann außerdem durch Unterschiede in Plattformen, Normalisierungsstrategien, Gewebeprobenorten, Ulkus-Schweregrad, Infektionsstatus, Krankheitsstadium und Referenzgewebe vermindert werden. Bedeutsam ist, dass nicht ulzerierte diabetische Fußhaut einen klinisch relevanten diabetischen Gewebevergleich darstellt, jedoch nicht austauschbar mit gesunder Haut ist. Die Einzelzell-RNA-Sequenzierung kann das Problem der zellulären Herkunft teilweise lösen, indem sie heterogene Zellpopulationen und ihre transkriptionellen Zustände auflöst. Eine frühere Einzelzell- und räumliche transkriptomische Studie an DFU identifizierte unterschiedliche Fibroblastenpopulationen und zeigte, dass Fibroblastenprogramme je nach Wundkontext und Heilungsstatus variieren8. Diese Befunde stützen den Einsatz zellauflösender Analysen zur Ergänzung von Gesamttranskriptom-Daten.
Methoden zur Merkmalsauswahl können dabei helfen, Kandidaten aus hochdimensionalen Expressionsdaten zu priorisieren, doch sind kleine biomedizinische Studien besonders anfällig für optimistische Schätzungen und instabile Gen-Auswahl. Wenn die Anzahl gemessener Variablen die Anzahl biologischer Proben deutlich übersteigt, kann scheinbar eine perfekte Trennung auftreten, selbst wenn generalisierbare Vorhersageinformationen begrenzt sind. Die Wiederverwendung derselben Beobachtungen für Merkmalsauswahl, Optimierung und Leistungsbeurteilung überschätzt die AUC zusätzlich, weshalb verschachtelte Kreuzvalidierung, gesperrte Modelle und tatsächlich unabhängige Testkohorten unerlässlich sind, um die Vorhersageleistung zu bewerten9,10. Diese Aspekte sind für DFU-Studien relevant, da öffentlich zugängliche Kohorten oft klein und heterogen sind. Datenbanken zu Inhaltsstoffen, Zielstrukturen und Kräutern der traditionellen chinesischen Medizin wurden zusätzlich nur zur Hypothesengenerierung herangezogen.
Diese Studie kombinierte Bulk-Transkriptomik, WGCNA, die Screening von DPN-assoziierten Genen, die Merkmalsauswahl mittels maschinellem Lernen, die Bewertung anhand externer Datensätze, Einzelzellanalysen, Netzwerkanalysen der traditionellen chinesischen Medizin (TCM) und die Validierung an Patientengewebe. Die in der Entdeckungs-Kohorte identifizierten Kandidatengene wurden anhand zusätzlicher transkriptomischer Datensätze überprüft, und der führende Kandidat wurde mithilfe von Einzelzell-Daten bestimmten Zelltypen zugeordnet. MMP1 wurde anschließend auf mRNA- und Proteinebene im Patientengewebe mittels qPCR und Western Blot untersucht. Dieses Vorgehen wurde entwickelt, um einen reproduzierbaren, mit DFU assoziierten Kandidaten zu identifizieren und dessen zellulären und biologischen Kontext zu charakterisieren.
Protokoll
Studienentwurf und Datenquellen
Die Studie, einschließlich der Sammlung und Nutzung von Patientengewebeproben zur qPCR- und Western-Blot-Validierung, wurde vom Ethikkomitee des Wuhan Fourth Hospital geprüft und genehmigt (Genehmigungsnummer KY2024-161-01). Alle Verfahren mit menschlichem Gewebe wurden gemäß dem genehmigten Protokoll und den anwendbaren ethischen Grundsätzen durchgeführt. Der transkriptomische Teil der Studie nutzte öffentlich verfügbare, anonymisierte Datensätze. Von allen Teilnehmern, deren Gewebeproben für die experimentelle Validierung verwendet wurden, wurde schriftlich informierte Einwilligung eingeholt. Die öffentlich zugänglichen transkriptomischen Datensätze wurden in anonymisierter Form analysiert, und die Einwilligungsverfahren für die ursprünglichen datengenerierenden Studien wurden von den jeweiligen Institutionen durchgeführt.
Diese Studie kombinierte Bulk-Transkriptomik, Netzwerkanalyse, Merkmalsauswahl, Einzelzellanalyse, TCM-Netzwerkvorhersage und die Validierung an Patientengewebe. Der Entdeckungs-Kohorten-Datensatz war der Gene Expression Omnibus (GEO)-Datensatz GSE199939 (10 DFU- und 11 Kontrollproben). Zur externen Bulk-Transkriptomik-Bewertung gehörten eine fusionierte Matrix aus GSE68183/GSE80178 (9 DFU- und 6 Kontrollproben) sowie GSE134431 (13 DFU- und 8 Proben von nicht ulzeriertem diabetischem Fußhautgewebe [DFS]). Für die Einzelzellanalyse wurde ein vorverarbeitetes, mittels SingleR annotiertes Seurat-Objekt verwendet, das aus GSE165816 stammt und 69.944 Zellen aus 24 Proben (14 DFU und 10 Kontrollen) umfasst. Die Gewebeanalyse beinhaltete vier paarierte DFU–Periwund-Patientenpaare für qPCR sowie drei paarierte Paare für die Western-Blot-Analyse, basierend auf verfügbaren Assayaufzeichnungen und von den Autoren bestätigten Paarungen. Alle in dieser Studie verwendeten Materialien und Geräte sind in der Tabelle der Materialien aufgeführt.
Konstruktion des DPN-bezogenen Gen-Sets
Mit Hilfe von rentrez wurden DPN-bezogene Gene aus der Gen-Datenbank des National Center for Biotechnology Information (NCBI) abgerufen. Die Suchbegriffe umfassten „diabetische periphere Neuropathie“, „diabetische Neuropathie“, „diabetische Polyneuropathie“, „schmerzhafte diabetische Neuropathie“ und „diabetische sensomotorische Polyneuropathie“ und waren auf Homo sapiens beschränkt. Die zurückgegebenen Identifikatoren wurden auf offizielle Gensymbole abgebildet, in Großbuchstaben umgewandelt, bereinigt und doppelte Einträge entfernt. Die aus der Datenbank stammenden Gene wurden mit einer aus der Literatur zusammengestellten DPN-Genliste kombiniert und erneut auf Dubletten geprüft, wodurch insgesamt 1.062 DPN-bezogene Gene identifiziert wurden. Die vollständigen Suchabfragen und der Code zur Bereinigung der Identifikatoren sind in den beigefügten Skripten enthalten; dort werden auch diabetische Neuropathien, Diabetes in Kombination mit distal symmetrischer Polyneuropathie oder peripherer Neuropathie sowie der MeSH-Begriff „Diabetic Neuropathies“ berücksichtigt. Für den literaturbasierten Anteil ist noch eine Quellenangabe auf Ebene einzelner Zitate erforderlich.
Vorverarbeitung der Entdeckungs-Kohorte und Analyse differentieller Expression
Die GSE199939-Expressionsmatrix wurde anhand der Probenkennung mit der Phänotyp-Tabelle abgeglichen. Doppelte Genkennungen wurden eindeutig gemacht. Bei der archivierten Entdeckungsanalyse wurden die Expressionswerte gerundet und ein negativ-binomiales Modell mittels DESeq2 (Version 1.48.2) angepasst, wobei die Gruppe als Designfaktor und DFU im Vergleich zur Kontrolle als Kontrast diente. Gene mit fehlenden adjustierten p-Werten wurden ausgeschlossen. Die Kontrolle von Mehrfachvergleichen erfolgte mittels des Benjamini–Hochberg-Verfahrens (BH). Für die archivierte Liste der differentiell exprimierten Gene (DEG) wurde ein absoluter log2-Faltungsunterschied größer als 1 und ein BH-adjustierter p-Wert < 0,05 verwendet. Der Vergleich mit der öffentlichen GEO-Quelle bestätigte, dass die Eingabedaten TPM und nicht rohe Read-Zahlen waren. Das Runden von TPM erfüllt nicht die Voraussetzung roher Zählwerte für DESeq2. Die ursprünglichen Schätzungen wurden beibehalten, aber die Gültigkeit der Entdeckungsstatistiken sowie der darauf basierenden WGCNA- und Merkmalsauswahl-Ergebnisse bleibt bis zu einer angemessenen Neuanalyse ungeklärt. Der Quellvergleich ist im ergänzenden Archiv dokumentiert.
Zur Visualisierung wurde die varianzstabilisierende Transformation (VST) von DESeq2 mit blind = FALSE angewendet. Die Hauptkomponentenanalyse (PCA) wurde anhand der VST-Expressionsmatrix durchgeführt. Die Heatmap verwendete zeilenweise z-Werte für die 50 Gene mit den kleinsten angepassten p-Werten. Die PCA-Implementierung zentrierte und skalierte genweise transformierte Werte mithilfe von prcomp mit scale = TRUE.
Analysen gewichteter Gen-Ko-Expressionsnetzwerke
Für die WGCNA wurden Gene mit einem Zählergebnis größer als 5 in mindestens drei GSE199939-Proben beibehalten. Die Größenfaktoren wurden mit DESeq2 geschätzt, die VST mit blind = TRUE angewendet, und die 5.000 Gene mit der größten Varianz über alle Proben hinweg wurden ausgewählt. Die Probengüte und Gengüte wurde mithilfe von goodSamplesGenes überprüft, und zur qualitativen Bewertung auf Proben-Ebene wurde eine durchschnittliche hierarchische Clusterung (average-linkage) verwendet.
Ein signiertes Netzwerk wurde mit WGCNA (Version 1.74) erstellt. Kandidatenpotenzen von 1–10 und 12–30 in Zweierschritten wurden mittels pickSoftThreshold evaluiert; dabei wurde ein Zielwert für die skalenfreie Topologie-Anpassung von 0,85 verwendet, und die ausgewählte Soft-Threshold-Potenz betrug 18. Module wurden mit blockwiseModules unter Verwendung einer signierten Adjazenz und einer signierten topologischen Überlappungsmatrix, der Pearson-Korrelation, einer minimalen Modulgröße von 30, einer Merge-Schwellenhöhe von 0,25, einer Neuzuordnungs-Schwelle von 1 × 10⁻⁶, pamRespectsDendro = FALSE und einer maximalen Blockgröße von 10.000 identifiziert.
Modul-eigengene wurden mit einem binären DFU-Merkmal korreliert. Nicht-graue Module mit |r| > 0,5 und p < 0,05 galten als mit DFU assoziiert. Für jedes assoziierte Modul wurde die Gen-Signifikanz (GS) als die Pearson-Korrelation zwischen Genexpression und DFU-Status definiert und die Modul-Zugehörigkeit (MM) als die Pearson-Korrelation zwischen Genexpression und der entsprechenden Modul-eigengen. Hub-Gene wurden durch |MM| > 0,8 und |GS| > 0,5 definiert. Das blaue Modul, das die stärkste positive Assoziation mit DFU aufwies, wurde weiterverwendet. Seine Hub-Gene wurden mit den DEGs und dem DPN-assoziierten Gen-Satz geschnitten. Die angegebene Hub-Schwelle verwendet daher die absoluten Werte sowohl von MM als auch von GS, unabhängig vom Vorzeichen der Korrelation.
Merkmalspriorisierung basierend auf maschinellem Lernen
Die 77 Gene, die gemeinsam von den DEG-, blau-Modul-Hub-Gen- und DPN-bezogenen Gen-Sets geteilt werden, wurden in GSE199939 evaluiert. Doppelte Gensymbole wurden nach ihrem mittleren Expressionswert zusammengefasst. Die Matrix der Kandidatengene wurde log2-transformiert, wobei, falls der Maximalwert 50 überstieg, Merkmale mit Null-Varianz entfernt wurden und die verbliebenen Merkmale standardisiert wurden. Ein Zufsammenseed von 123 wurde verwendet. Die implementierte Abfolge umfasste eine kohortenweite Kandidatenscreening, das Zusammenfassen von doppelten Symbolen, eine bedingte log-Transformation, die Filterung von Merkmalen mit Null-Varianz, Zentrierung und Skalierung für die gesamte Kohorte sowie eine algorithmusspezifische Merkmalsauswahl. Bei der Screening von DEG und WGCNA wurde die gesamte Entdeckungskohorte vor der kreuzvalidierten Analyse auf Algorithmusebene herangezogen. Der berichtete Workflow stellt daher keine leakagefreie geschachtelte Validierung sicher, und die internen AUCs können nicht als unverzerrte Schätzwerte der Vorhersageleistung verwendet werden.
Es wurden drei Verfahren zur Merkmalsauswahl angewendet. Zuerst wurde eine logistische Regression mit Least Absolute Shrinkage and Selection Operator (LASSO) unter Verwendung von glmnet (Version 5.0), Familie binomial, Alpha = 1, mit dem Klassifikationsfehler als Maß für die Kreuzvalidierung, ohne zusätzliche Standardisierung und mit einer fünffachen Kreuzvalidierung, die durch die Größe der kleineren Klasse eingeschränkt war, durchgeführt. Die Merkmale bei lambda.1se wurden ausgewählt; lambda.min wurde nur verwendet, wenn lambda.1se kein Gen auswählte. Zweitens wurde ein Random Forest mit 1.000 Bäumen mithilfe von randomForest (Version 4.7-1.2) erstellt; dabei wurden Gene beibehalten, deren mittlere Abnahme des Gini-Koeffizienten mindestens so groß war wie die mittlere Wichtigkeit über alle in Frage kommenden Gene. Drittens wurde die rekursive Merkmalseliminierung mittels linearem Support-Vektor-Maschinen-Verfahren (SVM-RFE) mit e1071 (Version 1.7-17) implementiert, wobei die Merkmale anhand des quadrierten linearen Gewichts in der gesamten Kohorte sortiert wurden, bevor schrittweise kleinere Merkmalsmengen mittels Leave-One-Out-Kreuzvalidierung (LOOCV-AUC) bewertet wurden. Die Rangfolge wurde innerhalb der einzelnen Trainingsfalten nicht neu berechnet. Für die Anpassung des linearen SVM-Modells wurden die Parameter scale = FALSE und probability = TRUE verwendet, ohne ein explizites Gitter zur Kostenoptimierung. Die Auswahl der LASSO-Strafe basierte auf der internen Kreuzvalidierung, ohne eine separate äußere Evaluierungsschleife, und die Wichtigkeit im Random Forest wurde aus der gesamten Kohorte berechnet.
Es wurde kein Gen von allen drei Methoden ausgewählt; daher wurden Gene beibehalten, die von mindestens zwei Methoden unterstützt wurden. SVM-RFE erzielte über alle bewerteten Teilmengengrößen hinweg eine AUC von 1,00, und die kleinste gleichwertige Teilmenge wurde ausgewählt. Da diese vollständige Trennung Bedenken hinsichtlich einer Überanpassung und einer zu optimistischen Bewertung in der kleinen Entdeckungs-Kohorte aufwarf, wurde die SVM-RFE-AUC nicht als Schätzung der klinischen Leistung interpretiert. Kein festgelegtes multigenes Modell wurde in einer externen Kohorte getestet; externe Receiver-Operating-Characteristic-(ROC)-Analysen bewerteten den Expressionsstatus einzelner Kandidatengene. Die Überprüfung des Analyse-Skripts bestätigte, dass die Vorverarbeitung und die SVM-Merkmalbewertung nicht auf die Trainings-Folds beschränkt waren. Dieselben LOOCV-Ergebnisse wurden verwendet, um die Größe der Teilmenge auszuwählen, und zwar ohne eine äußere Evaluierungsschleife. Folglich weist dieser Arbeitsablauf eine Informationslecks auf und dient allein der explorativen Merkmalspriorisierung.
Funktionale Anreicherungsanalyse
Analysen zur Überrepräsentation von Gene Ontology (GO) und Kyoto Encyclopedia of Genes and Genomes (KEGG) wurden an dem Sechs-Gen-Panel durchgeführt. Gen-Symbole wurden mithilfe von org.Hs.eg.db (Version 3.21.0) auf Entrez-Identifikatoren abgebildet. Die GO-Analyse wurde mit clusterProfiler (Version 4.16.0) für die Ontologien biologischer Prozess, zelluläre Komponente und molekulare Funktion durchgeführt. Für die KEGG-Anreicherung wurde der Organismus-Code für den Menschen (hsa) verwendet. Signifikante Terme wurden als nominelles p < 0,05 und BH-angepasstes p < 0,05 definiert. Da nur sechs Gene berücksichtigt wurden, diente die Anreicherungsanalyse hauptsächlich der funktionellen Annotation. Für das KEGG-Skript wurden lokale KEGG.db-Anmerkungen mit enrichKEGG(use_internal_data = TRUE) verwendet; der Anmerkungs-Stand muss dokumentiert sein. Die GO- und KEGG-Skripte verwendeten kein benutzerdefiniertes Universum, sodass die Anmerkungsdatenbanken die Standard-Hintergrundmengen festlegten.
Externe Bulk-Transkriptom-Analyse
Für die zusammengeführte Matrix GSE68183/GSE80178 wurden Gen-Symbole standardisiert und doppelte Symbole durch Mittelung der Expression über übereinstimmende Zeilen zusammengefasst. Die sechs Kandidatengene wurden mit der Phänotyp-Datei abgeglichen. Da die verfügbaren Dateien das vorherige Zusammenführen und die Batch-Korrektur nicht vollständig dokumentierten, wurde dieser Datensatz so analysiert, wie bereitgestellt, und vorsichtig interpretiert. Daher können weder die Beseitigung von Batch-Effekten noch die Unabhängigkeit des Gruppensignals von Studien-Effekten anhand der vorliegenden Verarbeitungsdokumentation belegt werden. Diese Matrix liefert einen explorativen, datensatzübergreifenden Hinweis, jedoch keine definitive Reproduktion.
Für GSE134431 wurden die sechs Kandidatengene aus der Matrix der Reads pro Kilobase pro Million alignierter Reads (RPKM) extrahiert und als log2(RPKM + 1) transformiert. DFS wurde als Referenzgruppe und DFU als Vergleichsgruppe verwendet. DFS steht für nicht ulzerierte diabetische Fußhaut. Der ursprünglich eingereichte Abbildung 4C zeigte die rohen RPKM-Werte; die überarbeitete Darstellung verwendet die angegebene log2(RPKM + 1)-Skala. Zweiseitige Wilcoxon-Tests mit der Normalapproximation und Stetigkeitskorrektur sowie automatisch orientierte ROC-Analysen wurden auf beiden Skalen überprüft und ergaben identische p-Werte und AUCs, da die Transformation streng monoton ist.
In jedem Bulk-Validierungsdatensatz wurden die expressionsmäßigen Unterschiede zwischen den Gruppen mittels zweiseitiger Wilcoxon-Rangsummentests geprüft, und die BH-Korrektur wurde über die sechs Gene hinweg angewendet. ROC-Kurven wurden mit pROC (Version 1.19.0.1) berechnet, wobei die Richtung automatisch vom Paket ausgewählt wurde. AUCs und entsprechende 95 % Konfidenzintervalle (CIs) wurden berechnet, um die Diskriminierungsmuster zwischen den Datensätzen zu vergleichen. Die automatische Auswahl der ROC-Richtung aus jedem Bewertungsdatensatz kann zu überschätzten Diskriminierungsleistungen führen; diese Einzelgen-AUCs sind deskriptiv und validieren kein vorgegebenes klinisches Vorhersagemodell.
Lokalisierung auf Einzelzellebene und Analysen auf Proben-Ebene
Die Einzelzellanalyse verwendete das gespeicherte Seurat-Objekt biofsci_SingleR_annotated_MMP1_analyzed_MMP1_analyzed.rds aus GSE165816, das 22.889 Gene und 69.944 Zellen im RNA-Assay enthält. Der RNA-Assay enthielt eine Schicht mit nicht-negativen ganzzahligen Zählwerten sowie eine Datenebene, die durch LogNormalize mit einem Skalierungsfaktor von 10.000 und anschließender log1p-Transformation generiert wurde; letztere entsprach nicht TPM. Das Objekt enthielt 2.000 variable Gene, die mit der VST-Methode ausgewählt wurden (loess.span = 0,3; 20 gleichbreite Bins), skalierte Expression für alle beibehaltenen Gene (Zentrierung und Skalierung aktiviert; scale.max = 10) sowie 50 Hauptkomponenten, die aus den variablen Merkmalen mit Seed 42 berechnet wurden. Der gespeicherte Befehlsverlauf verwendete Harmony-Dimensionen 1–20 für die Konstruktion der nächsten Nachbarn sowie die uniforme Mannigfaltigkeitsapproximation und Projektion (UMAP). Die Nachbar-Einstellungen umfassten k = 20, Annoy mit 50 Bäumen und euklidischem Abstand sowie eine Schwelle zur Pruning von gemeinsamen nächsten Nachbarn (SNN) von 1/15. Die Clusterung erfolgte mit einer Auflösung von 0,8, Algorithmus 1, n.start = 10, n.iter = 10 und random.seed = 0. UMAP verwendete die uwot-Implementierung, 30 Nachbarn, zwei Ausgabedimensionen, ein Kosinus-Distanzmaß, min.dist = 0,3, spread = 1, learning.rate = 1 und Seed 42. Das Objekt enthielt eine Harmony-Reduktion, jedoch konnten die ursprünglichen Qualitätskontroll-Schwellenwerte, der vollständige RunHarmony-Aufruf einschließlich der Batch-Kovariaten sowie die SingleR-Referenz- und Annotationseinstellungen für dieses analysierte Objekt nicht rekonstruiert werden. Zelltyp-Bezeichnungen, Gruppenbezeichnungen und Probenidentifikatoren wurden in SingleR_label, Group bzw. orig.ident gespeichert. Zehn annotierte Zelltypen wurden beibehalten: B-Zellen, CD8+ T-Zellen, endotheliale Zellen, epitheliale Zellen, Fibroblasten, hämatopoetische Stammzellen, Keratinozyten, Makrophagen, Monozyten und Neuronen.
MMP1-Expressionen wurden nach Zelltyp zusammengefasst. Zellen mit einer normalisierten MMP1-Expression über null wurden als MMP1-positiv klassifiziert. Für die Analysen auf Proben-Ebene wurde der mittlere normalisierte Expressionswert für jede Kombination aus Probe und Zelltyp berechnet. DFU- und Kontrollproben wurden innerhalb jedes Zelltyps mittels zweiseitiger Wilcoxon-Rangsummentests verglichen, gefolgt von einer BH-Korrektur über alle getesteten Zelltypen. Als statistische Einheit für diese Vergleiche diente der GEO-Probenzugriffscode, nicht die einzelne Zelle. Die 24 Zugriffscodes wurden nicht als Nachweis von 24 unabhängigen Spendern behandelt. Das gespeicherte Objekt enthielt keinen verifizierten Spenderkennzeichner, und wiederholte Gewebeprobenahmen innerhalb desselben Spenders wurden nicht modelliert; die Testungen auf Proben-Ebene sind daher als explorativ zu interpretieren. Diese Zusammenfassungen bilden den Durchschnitt der normalisierten Expression innerhalb von Probe und Zelltyp ab; es handelt sich dabei nicht um auf Summierung von Counts basierende Pseudobulk-Modelle zur differenziellen Expression.
Zehn funktionelle Gen-Gruppen wurden mit Seurat AddModuleScore bewertet. Spearman-Korrelationen zwischen der expressionsmäßigen Verteilung von MMP1 pro Zelle und den Modul-Scores wurden berechnet und mittels BH-Korrektur angepasst. Für die explorative Analyse der MMP1-hoch-Gruppe wurden die drei Zelltypen ausgewählt, die den höchsten mittleren MMP1-Expressionswert unter den Zelltypen mit mindestens 50 Zellen aufwiesen. Eine globale Schwelle wurde als Median der Expression unter den MMP1-positiven Zellen definiert, sofern mehr als 10 positive Zellen verfügbar waren; andernfalls wurde das gesamte 75. Perzentil verwendet. Zellen oberhalb dieser Schwelle wurden der MMP1-hoch-Gruppe zugeordnet, die verbleibenden Zellen der MMP1-niedrig-Gruppe. FindMarkers verwendete einen Wilcoxon-Test mit logfc.threshold = 0,25 und min.pct = 0,1. Hochregulierte Gene mit adjustiertem p < 0,05 wurden einer GO-Biologische-Prozesse-Anreicherungsanalyse unterzogen. Da die Gruppen durch die MMP1-Expression definiert wurden, diente diese Analyse der Beschreibung von Wegen, die mit dem MMP1-hoch-Zustand assoziiert sind. Die Korrelationen pro Zelle, ihre adjustierten p-Werte sowie die Anreicherung von MMP1-hoch im Vergleich zu MMP1-niedrig sind deskriptiv, da die Abhängigkeit innerhalb von Proben nicht modelliert wurde. Einzelne Zellen wurden nicht als unabhängige biologische Wiederholungen interpretiert.
Vorhersage von Inhaltsstoffen, Zielstrukturen und Heilpflanzen der TCM
Die sechs priorisierten Gene wurden der vierten Spalte der lokalen Tabelle der chemisch-genetischen Interaktionen aus der Comparative Toxicogenomics Database (CTD) zugeordnet. Die Datensätze wurden eingeschränkt auf Homo sapiens in Spalte 7. Die Inhaltsstoffnamen wurden bereinigt und zur Übereinstimmung in Kleinbuchstaben umgewandelt, und doppelte Zuordnungen von Inhaltsstoff-Zielstrukturen sowie Kräuter-Inhaltsstoff-Zuordnungen wurden entfernt. Die Verknüpfung von Inhaltsstoffen mit Kräutern erfolgte mithilfe der Referenztabelle Kräuter-Inhaltsstoff. Die Datenbankanreicherung nutzte nominelle p < 0,05 und angepasst p < 0,05. Doppelte Einträge für Kräuter-Wirkstoff-Zielbeziehungen wurden vor der zusammenfassenden Analyse basierend auf der Abdeckung entfernt. Für die Anreicherungsanalyse von Kräutern wurde clusterProfiler::enricher unter Verwendung der Zuordnung Kräuter-Wirkstoffe als TERM2GENE, mit minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 und qvalueCutoff = 1 verwendet, bevor die nominalen und BH-adjustierten Signifikanzschwellen angewendet wurden. Diese Datenbankverknüpfungen können Veränderungen der Expression oder Aktivität beschreiben, belegen jedoch keine direkte Bindung oder eine einheitliche Wirkrichtung.
Die Kräuter wurden anhand der folgenden Bedeckungsgrad-Bewertung eingestuft:
S = 3R + 5L +2T + 3C + 2I + N (1)
Hier ist R die Anzahl der MMP1-Einträge, L die Anzahl der mit MMP1 verknüpften Inhaltsstoffe, T die Anzahl der abgedeckten Zielstrukturen, C die Anzahl der Kerninhaltsstoffe, I der Indikator für die Matrixachse und N die Gesamtanzahl der Inhaltsstoffe.
Die Hauptinhaltsstoffe waren Quercetin, Luteolin und Berberin. Der Matrix-Achsen-Indikator wurde auf 1 gesetzt, wenn eine Pflanze sowohl MMP1 als auch MMP13 abdeckte, andernfalls auf 0. Bei den in Frage kommenden Pflanzen war vorgeschrieben, dass sie mindestens einen mit MMP1 verknüpften Eintrag sowie entweder mindestens zwei mit MMP1 verknüpfte Inhaltsstoffe oder mindestens vier Zielstrukturen plus einen Hauptinhaltsstoff enthalten mussten. Die Bewertung diente der Zusammenfassung der Datenbankabdeckung und wurde nicht als Maß für pharmakologische Wirksamkeit betrachtet. Die Koeffizienten definieren eine individuelle, heuristische Abdeckungsregel, die den Schwerpunkt auf mit MMP1 verknüpfte Einträge und Inhaltsstoffe, eine umfassendere Zielstrukturabdeckung, die drei festgelegten Inhaltsstoffe sowie die gemeinsame Abdeckung von MMP1 und MMP13 legt. Sie wurden nicht an klinische Ergebnisse angepasst und nicht experimentell validiert; alternative Gewichtungen könnten die Rangfolge der Pflanzen verändern.
Probensammlung von Patientengewebe und vorläufige qPCR- und Western-Blot-Analyse
Patienten mit klinisch diagnostizierten diabetischen Fußulzera, bei denen am Wuhan Fourth Hospital eine klinisch indizierte Débridement- oder chirurgische Behandlung durchgeführt wurde, kamen für die Studie in Betracht, sofern Fußgewebe zur Verfügung stand und eine schriftliche, informierte Einwilligung vorlag. Ausschlusskriterien waren eine maligne Erkrankung am Probenentnahmeort, eine nicht-diabetische Ursache des Ulkus oder eine unzureichende Menge bzw. Qualität des Gewebes für die geplanten Analysen. DFU-Gewebe und nicht ulzeriertes, umgebendes Wundgewebe wurden vom selben Patienten gemäß dem genehmigten Studienprotokoll gewonnen. Letzteres diente als passender, periwund-assoziierter Vergleichswert; es handelte sich dabei jedoch nicht um gesunde, nicht-diabetische Haut. Die qPCR-Analyse umfasste vier gepaarte Proben (vier DFU-Proben und vier entsprechende Periwund-Proben), die Western Blot-Analyse drei gepaarte Proben. Die Paarung wurde von den Autoren für jeden Assay einzeln bestätigt; bei den statistischen Vergleichen wurde keine identitätsübergreifende Zuordnung zwischen den Assays verwendet. Jeder Patient stellte die biologische Versuchseinheit dar, wobei technische PCR-Ansätze als wiederholte Messungen innerhalb einer Probe galten. Diese vorläufigen Analysen dienten der Beurteilung der expressionsmäßigen Gewebeebene von MMP1 und waren nicht darauf ausgelegt, diagnostische Aussagekraft, Kausalität oder Übertragbarkeit über verschiedene DFU-Phänotypen hinweg zu belegen.
Zur qPCR-Validierung wurde Gesamt-RNA aus patientenstämmigen Gewebeproben unter Verwendung eines Reagenz zur Gesamt-RNA-Extraktion gemäß den Herstelleranweisungen isoliert. Die RNA-Konzentration und -Reinheit wurden spektrophotometrisch bestimmt, und Proben mit einem A260/A280-Verhältnis von 1,8–2,1 wurden für nachfolgende Analysen verwendet. Aus 1 µg Gesamt-RNA wurde mittels eines Moloney-Maus-Leukämie-Virus-(M-MLV)-Reverse-Transkriptionskits in einem Endvolumen von 20 µL cDNA synthetisiert. Das verfügbare Instrumentenprojekt identifiziert ein Echtzeit-PCR-System. Die quantitative PCR wurde unter Verwendung von 2x SYBR Green PCR-Mastermix in einem 20 µL-Reaktionsansatz durchgeführt, der 10 µL 2x SYBR Green-Mastermix, jeweils 0,4 µL Vorwärts- und Rückwärtsprimer, 2 µL komplementäre DNA (cDNA) und 7,2 µL nukleasefreies Wasser enthielt. Das Amplifikationsprogramm umfasste eine initiale Denaturierung bei 95 °C für 30 s, gefolgt von 40 Zyklen mit 95 °C für 5 s und 60 °C für 30 s. Eine Schmelzkurvenanalyse wurde durchgeführt, um die Spezifität der Amplifikation zu überprüfen. Die Transkriptmenge von MMP1 wurde unter Verwendung von β-Aktin (ACTB) als Referenzgen bestimmt. Die Primersequenzen sind in Tabelle 1 aufgelistet. Für die überarbeitete gepaarte Analyse wurden die fünf technischen Ansätze pro Ziel in jeder Probe vor der ΔCq-Berechnung gemittelt, und der relative MMP1-Expressionsgrad wurde mittels der 2-ΔΔCq -Methode berechnet, wobei die Gruppe des nicht ulzerierten Wundrandgewebes als Kalibrator diente. Die berücksichtigten Probenpaare waren NC–DFU, NC1–DFU1, NC2–DFU2 und NC3–DFU3, die von den Autoren als vier patientenangepasste Paare bestätigt wurden. Das ursprüngliche qPCR-Diagramm verwendete fünf technische Ansätze ausschließlich aus NC und DFU; das überarbeitete Diagramm zeigt jeweils einen probenspezifischen Wert nach Mittelung der technischen Ansätze für jedes der vier Paare. Für die gepaarte statistische Auswertung wurde ΔCq = mittlerer Cq(MMP1) − mittlerer Cq(ACTB) verwendet, anstelle von fold-change-Werten auf Ebene einzelner Ansätze. Das archivierte Instrumentenprojekt weicht außerdem vom angegebenen Reaktionsvolumen und Zyklenprogramm ab, sodass seine Übereinstimmung mit dem dargestellten Experiment unklar bleibt.
Zur Validierung mittels Western Blot (WB) wurden Gewebeproben in kaltem Radioimmunpräzipitationspuffer, angereichert mit Proteaseinhibitoren, homogenisiert. Die Lysate wurden 30 min auf Eis inkubiert und bei 4 °C 15 min lang bei 12.000 × g zentrifugiert. Die Überstände wurden gesammelt, und die Proteinkonzentrationen wurden mittels eines Bicinchoninsäure-Assays bestimmt. Gleichmäßige Proteinmengen (20 µg pro Lane) wurden anhand von 4–20 %igen gradienten Natriumdodecylsulfat-Polyacrylamid-Gelen getrennt und auf 0,22 µm dicke Polyvinylidenfluorid-Membranen übertragen. Die Membranen wurden eine Stunde lang bei Raumtemperatur mit 5 % Magermilch in Tris-gepuffertem Salzlösung, der 0,1 % Tween-20 enthielt, blockiert und anschließend über Nacht bei 4 °C mit einem MMP1-Polyklonalen Antikörper (1:1.000) und einem Cofilin-Polyklonalen Antikörper (1:6.000) inkubiert. Nach dreimaligem Waschen mit Tris-gepufferter Salzlösung, die 0,1 % Tween-20 enthielt, wurden die Membranen eine Stunde lang bei Raumtemperatur mit einem mit Horseradish-Peroxidase konjugierten Ziegen-Anti-Hasen-IgG (Immunglobulin G) (1:5.000) inkubiert. Die Proteinbanden wurden mithilfe eines verbesserten chemilumineszenten Substrats sichtbar gemacht und mit einem Chemilumineszenz-Bildgebungssystem unter Verwendung der zugehörigen Betriebssoftware (Version 1.2.0) aufgezeichnet, wie in den Bilddatenmetadaten festgehalten. Die Banden wurden mit der ImageJ-Software quantifiziert. Cofilin diente als Beladungskontrolle, und die MMP1-Proteinmenge wurde relativ zu Cofilin für den Vergleich zwischen den Gruppen normalisiert.
Statistische Analyse und Software
Alle Tests waren zweiseitig, sofern nicht anders angegeben. Als primäre Schwelle für Mehrfachvergleiche wurde der BH-adjustierte p < 0,05 verwendet. Die exakten Stichprobengrößen variierten je nach Datensatz und bei der Einzelzell-Analyse auf Proben-Ebene je nach Vorhandensein eines bestimmten Zelltyps in jeder Probe. Stetige Expressionszusammenfassungen werden als individuelle Beobachtungen dargestellt, wobei Boxplots den Median und den Interquartilsabstand anzeigen; die Whisker reichen bis zum 1,5-fachen des Interquartilsabstands. Bei der Western-Blot-Analyse wurden die sechs gewonnenen Verhältnisse von MMP1 zu Cofilin mittels eines zweiseitigen gepaarten t-Tests für drei vom Autor bestätigte Patientenpaare analysiert (df = 2; p = 0,0107). Bei der qPCR wurden fünf ACTB- und fünf MMP1-Cq-Werte innerhalb jeder Probe getrennt gemittelt, bevor die ΔCq-Berechnung erfolgte. Ein zweiseitiger gepaarter t-Test verglich die ΔCq-Werte von DFU und zugehörigen periwunden Geweben über vier vom Autor bestätigte Patientenpaare (df = 3; p = 3,04 × 10⁻⁵). Der mittlere periwunde ΔCq-Wert diente als gemeinsamer Kalibrator für die Darstellung der relativen Expression. Die geometrische mittlere intra-patienten Fold-Change und ihr 95 %-Konfidenzintervall (KI) wurden durch Rücktransformation der mittleren gepaarten ΔCq-Differenz und ihres auf t-Verteilung basierenden KI ermittelt. Individuelle biologische Beobachtungen werden mit Linien dargestellt, die jeweils die zugeordneten Gewebe verbinden; technische Ansätze erhöhen die biologische Stichprobengröße nicht. Die p-Werte der Gewebeanalysen sind nominal und explorativ. Bei drei oder vier Patienten kann die Normalverteilung der gepaarten Differenzen nicht zuverlässig beurteilt werden, und die Analysen bleiben vorläufig. Die bioinformatischen Analysen und die Erstellung der Abbildungen erfolgten in R 4.5.2 unter Windows 11. Zu den verwendeten Kernpaketen gehörten DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 und ggplot2 4.0.3. Eine zusammengefasste Übersicht über verwendete Software, Datenbanken und Parameter ist in Zusatz-Tabelle 1 enthalten.
Ergebnisse
Die entdeckungsorientierte Transkriptomik identifiziert ein breites DFU-assoziiertes Expressionsprogramm
GSE199939 diente als Entdeckungs-Kohorte und umfasste 10 DFU- und 11 Kontrollproben (Abbildung 1A). Die Hauptkomponentenanalyse der VST-normalisierten Expression zeigte eine klare Trennung der Gruppen; die Hauptkomponenten 1 und 2 erklärten jeweils 34,8 % und 15,1 % der gesamten Varianz (Abbildung 1B).
Mithilfe eines |log2 fold change| > 1 und einem BH-angepassten p < 0,05 identifizierte die Analyse der differentiellen Expression 3.691 DEGs, darunter 1.247 Gene, die in DFU hochreguliert waren, und 2.444 Gene, die in DFU herunterreguliert waren (Abbildung 1C). Die 50 am stärksten veränderten DEGs bildeten ein deutlich gruppenstrukturiertes Expressionsmuster (Abbildung 1D). Unter den sechs anschließend ausgewählten Genen wies MMP1 die stärkste Veränderung in der Entdeckungs-Kohorte auf (log2 fold change = 9,854; angepasstes p = 1,24 × 10⁻²⁹).
Ein mit DFU assoziiertes Ko-Expressionsmodul konvergiert mit DEGs und DPN-assoziierten Genen
Die WGCNA wurde an den 5.000 am stärksten variablen, VST-transformierten Genen durchgeführt. Für das signierte Netzwerk wurde eine Soft-Thresholding-Potenz von 18 gewählt, um eine Balance zwischen der Anpassung an die skalenfreie Topologie und der Verknüpfungsdichte zu erreichen (Abbildung 2A). Durch hierarchische Clusterung und dynamische Modulerkennung wurden mehrere Ko-Expressionsmodule identifiziert (Abbildung 2B). Das blaue Modul zeigte die stärkste positive Assoziation mit DFU (Pearson r = 0,97, p = 5 × 10-13; Abbildung 2C). Entsprechende Zusammenfassungen zur Stichproben-Clusterung und zur Qualitätskontrolle der Modulgrößen sind in Abbildung S1A,B dargestellt.
Innerhalb des blauen Moduls erfüllten 689 Gene die Kriterien für Hub-Gene: |MM| > 0,8 und |GS| > 0,5 (Abbildung 2D). Der Durchschnitt von 3.691 differentiell exprimierten Genen (DEGs), 689 Hub-Genen des blauen Moduls und 1.062 DPN-assoziierten Genen ergab 77 gemeinsame Kandidatengene (Abbildung 2E). Eine vereinfachte Darstellung des Hub-Netzwerks des blauen Moduls sowie die am höchsten eingestuften Hub-Statistiken sind in Ergänzende Abbildung 2A,B dargestellt.
Mehrfache Methoden der Merkmalsauswahl priorisieren sechs Gene, zeigen jedoch eine Überanpassung an die Entdeckungs-Kohorte
Die 77 überschneidenden Gene wurden mittels LASSO, Random Forest und SVM-RFE analysiert. LASSO behielt sieben Gene bei der ausgewählten Strafe bei: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 und CHEK1 (Abbildung 3A). Die Filterung mittels Random Forest behielt 41 Gene mit einer Wichtigkeit auf oder über dem Mittelwert bei, darunter fünf Gene der endgültigen Panelzusammenstellung, die zu den am höchsten eingestuften Merkmalen gehörten (Abbildung 3B). SVM-RFE erzielte für jede evaluierte geschachtelte Teilmenge eine AUC von 1,00; gemäß der Regel für die kleinste Teilmenge bei einem Gleichstand wurde CHEK1 als eineinzelnes Gen ausgewählt (Abbildung 3C), was Bedenken hinsichtlich einer Überanpassung und einer zu optimistischen Bewertung in der Entdeckungs-Kohorte aufwarf. Entsprechende Darstellungen der Expression, des Heatmaps und der ROC-Kurven für die Entdeckungs-Kohorte sind in Ergänzende Abbildung 3A–C zu sehen.
Es wurde kein Gen von allen drei Methoden ausgewählt. Die Beibehaltung von Genen, die von mindestens zwei Methoden unterstützt wurden, ergab CCL7, CHEK1, MKI67, MMP1, MMP13 und TRPV2 (Abbildung 3D). Die GO-Anmerkung dieser sechs Gene betonte den Abbau der extrazellulären Matrix, katabole und metabolische Prozesse von Kollagen, kondensierte Chromosomen sowie funktionelle Aspekte im Zusammenhang mit Metalloendopeptidasen (alle BH-korrigierten p < 0,05; Abbildung 3E). Die KEGG-Analyse identifizierte die Interleukin-17 (IL-17)-Signalübertragung (CCL7/MMP1/MMP13; korrigiertes p = 1,81 × 10⁻⁴) und die Relaxin-Signalübertragung (MMP1/MMP13; korrigiertes p = 0,0175; Abbildung 3F). Diese Anreicherungsergebnisse wurden verwendet, um die biologischen Funktionen zu charakterisieren, die durch das Sechs-Gen-Panel repräsentiert werden.
Die Bewertung über Datensätze hinweg zeigt eine heterogene Unterstützung für MMP1
In der zusammengeführten Matrix GSE68183/GSE80178 (9 DFU und 6 Kontrollen) unterschieden sich CCL7, MMP1 und MMP13 zwischen den Gruppen nach BH-Korrektur über die sechs Gene hinweg (adjustierter p-Wert = 0,0168, 0,0159 bzw. 0,0431; Abbildung 4A). CHEK1, MKI67 und TRPV2 erreichten die adjustierte Signifikanzschwelle nicht (adjustierter p-Wert = 0,259, 0,680 bzw. 0,259). Die ROC-Analyse für Einzelgene ergab AUC-Werte von 0,944 für CCL7 (95 % Konfidenzintervall [CI], 0,825–1,000), 0,704 für CHEK1 (0,403–1,000), 0,574 für MKI67 (0,243–0,905), 0,981 für MMP1 (0,930–1,000), 0,870 für MMP13 (0,686–1,000) und 0,722 für TRPV2 (0,447–0,997; Abbildung 4B). Diese ROC-Werte wurden als exploratorisch betrachtet, da das zugrundeliegende Verfahren zur Zusammenführung und Batch-Korrektur nicht vollständig dokumentiert war.
In GSE134431 (13 DFU- und 8 nicht-ulzerierte DFS-Proben) war die Expression von MMP1 bei DFU im Vergleich zu DFS auf dem nominalen Signifikanzniveau im Wilcoxon-Test höher (p = 0,0225), obwohl dieser Zusammenhang nach BH-Korrektur nicht signifikant blieb (adjustiertes p = 0,135; Abbildung 4C). Die anderen fünf Gene zeigten keine signifikanten Unterschiede zwischen den Gruppen. MMP1 wies außerdem die höchste deskriptive AUC auf, mit einem AUC-Wert von 0,808 (95% KI, 0,589–1,000), während die AUCs der anderen Kandidaten zwischen 0,529 und 0,635 lagen (Abbildung 4D). Insgesamt zeigte MMP1 das konsistenteste deskriptive Muster unter den sechs Kandidaten, jedoch blieb die statistische Reproduktion unvollständig.
Die Einzelzellanalyse lokalisiert MMP1 vorwiegend in Fibroblasten
Der Einzelzell-Datensatz enthielt 69.944 Zellen aus 24 Proben (14 DFU und 10 Kontrollen) und umfasste 10 annotierte Zelltypen (Abbildung 5A). Die UMAP-Feature-Visualisierung lokalisierte die Expression von MMP1 auf begrenzte zelluläre Bereiche, anstatt eine gleichmäßige Expression über den gesamten Atlas hinweg anzuzeigen (Abbildung 5B). Insgesamt wiesen 3.799 Zellen (5,43 %) eine normalisierte MMP1-Expression größer als null auf. Fibroblasten wiesen die höchste mittlere normalisierte Expression (0,181) und den größten Anteil an MMP1-positiven Zellen auf (7,88 %; Abbildung 5C).
Auf der Probeebene war die mittlere Expression von MMP1 in DFU-Proben im Vergleich zu Kontrollproben in Keratinozyten, Fibroblasten und endothelialen Zellen höher. Nach der BH-Korrektur über alle getesteten Zelltypen hinweg wies jeder dieser Vergleiche einen adjustierten p-Wert von 0,0214 auf (Keratinozyten: 9 Kontroll- und 14 DFU-Proben; Fibroblasten: 10 und 14; endotheliale Zellen: 10 und 14; Abbildung 5D). Der Anteil der MMP1-positiven Zellen stieg in Fibroblasten von 5,86 % auf 9,29 %, in Keratinozyten von 0,026 % auf 6,68 % und in endothelialen Zellen von 0,29 % auf 2,67 % an (Abbildung 5E).
Die Korrelationen der Modul-Scores pro Zelle waren geringfügig. Die stärkste positive Korrelation wurde für den Seneszenz/Senescence-associated-secretory-Phänotyp (SASP)-Modul-Score beobachtet (Spearman-Rho = 0,274), gefolgt von der Umstrukturierung der extrazellulären Matrix (Rho = 0,240), Ferroptose (Rho = 0,197) und Fibroblasten-Aktivierung (Rho = 0,170; Abbildung 5F). Der Vergleich von MMP1-hohen und MMP1-niedrigen Fibroblasten zeigte eine Anreicherung an Begriffen wie Organisation der extrazellulären Matrix, Organisation extrazellulärer Strukturen, Organisation von Kollagen-Fibrillen, Glykoprotein-Verarbeitung und Protein-Faltung (Abbildung 5G). Diese beschreibenden Ergebnisse verknüpften den MMP1-hohen Fibroblasten-Zustand mit matrixumgestaltungsbezogenen Prozessen. Zusätzliche UMAPs auf Gruppenebene, Zusammenfassungen aller Zelltypen und der funktionelle Score-Kontext sind in Ergänzende Abbildung 4A–C dargestellt. Einzelzell-Assoziationen wurden nicht als unabhängiger Nachweis auf Spender-Ebene betrachtet.
Die Netzwerkabdeckung priorisiert MMP1-verknüpfte Inhaltsstoffe und in Frage kommende Kräuter
Die gefilterte Tabelle zur Beziehung zwischen Kräutern, Inhaltsstoffen und Zielstrukturen enthielt 561 eindeutige Einträge, die 99 Kräuter, 14 Inhaltsstoffe und fünf der sechs in Frage kommenden Zielstrukturen verknüpften. MMP1 war die am häufigsten vorkommende Zielstruktur mit 156 Einträgen, gefolgt von CHEK1 (120), MMP13 (102), MKI67 (100) und TRPV2 (83; Abbildung 6A). Unter den Inhaltsstoffen hatten Quercetin und Luteolin die breiteste Abdeckung an Kräutern und waren jeweils mit 83 und 62 Kräutern verknüpft. Berberin war mit 10 Kräutern verknüpft; diese drei Inhaltsstoffe wurden als zentrale Inhaltsstoffe in der Priorisierungsregel verwendet (Abbildung 6B).
Die Abdeckungsbewertung platzierte Guanhuangbo, Mahuang und Niuxi gemeinsam an der Spitze (Bewertung = 38 jeweils; Abbildung 6C). Jede dieser Pflanzen deckte alle fünf verfügbaren Zielstrukturen ab und enthielt zwei mit MMP1 assoziierte Inhaltsstoffe. Die Matrix der Inhaltsstoff-Zielstruktur-Beziehungen zeigte, dass Quercetin die breiteste Abdeckung über das gesamte Zielpanelspektrum bot, während Luteolin und Berberin zusätzliche, auf MMP1 ausgerichtete Verbindungen bereitstellten (Abbildung 6D). Ein fokussiertes Netzwerk verband die führenden Kräuter mit repräsentativen Inhaltsstoffen und den fünf verfügbaren Zielstrukturen (Abbildung 6E). Diese Ergebnisse identifizierten Kombinationen aus Kräutern, Inhaltsstoffen und Zielstrukturen mit hoher Datenbankabdeckung für eine weitere Bewertung. Unterstützende Matrizen zur Kräuter-Zielstruktur- und zur Hauptinhaltsstoff-Abdeckung sind in Ergänzende Abbildung 5A,B dargestellt.
Erste gepaarte Gewebeanalysen zeigen eine höhere MMP1-mRNA- und Proteinmenge
Die Western-Blot-Analyse zeigte eine höhere MMP1-Aktivität in DFU-Proben im Vergleich zu den entsprechenden nicht ulzerierten Periwund-Proben (Abbildung 7A,B). Die drei gepaarten Probenpaare wiesen eine durchschnittliche Differenz im MMP1/Cofilin-Verhältnis (DFU minus Periwund) von 0,3553 auf (95 % KI: 0,1959–0,5147; zweiseitiger gepaarter t-Test, t(2) = 9,592, p = 0,0107). Die gepaarten Messungen jedes Patienten sind in Abbildung 7B dargestellt. Nach Mittelung von fünf technischen Ansätzen pro Gen und Probe zeigte die qPCR eine jeweils höhere normalisierte MMP1-mRNA-Aktivität in den vier DFU-Proben im Vergleich zu den jeweils gepaarten Periwund-Proben (Abbildung 7C). Die mittlere innerhalb der Patienten liegende Differenz im ΔCq-Wert (DFU minus Periwund) betrug −2,6035 (95 % KI: −2,8024 bis −2,4046; zweiseitiger gepaarter t-Test, t(3) = −41,663, p = 3,04 × 10⁻⁵), was einer geometrischen Mittelsteigerung um den Faktor 6,08 entspricht (95 % KI: 5,30–6,98). Diese Beobachtungen an kleinen Stichproben sind vorläufig und belegen noch keinen funktionellen Effekt.
In den Entdeckungs- und externen Gesamt-Datensätzen wies MMP1 unter den sechs priorisierten Genen das konsistenteste beschreibende Muster auf, obwohl die statistische Reproduktion unvollständig war. Einzelzell-Zusammenfassungen zeigten die höchste mittlere Expression in Fibroblasten, und gepaarte WB-Messungen von drei Patienten sowie gepaarte qPCR-Messungen von vier Patienten zeigten eine höhere MMP1-Menge. Diese Beobachtungen stützen MMP1 als mit DFU assoziierten Kandidaten für weitere Untersuchungen. Der gesamte rechnergestützte bis gewebebasierte Bewertungsworkflow ist in Abbildung 6 des Zusatzmaterials zusammengefasst.
VERFÜGBARKEIT VON DATEN:
Die öffentlich zugänglichen transkriptomischen Datensätze sind im NCBI Gene Expression Omnibus unter den Zugangsnummern GSE199939, GSE68183, GSE80178, GSE134431 und GSE165816 verfügbar. Verfügbare Analyse- und Abbildungserzeugungsskripte, verarbeitete Expressions- und Ergebnistabellen, quantitative Quelltabellen für Abbildungen, statistische Ausgabetabellen, das ursprüngliche qPCR-Arbeitsbuch und das zugehörige Instrumentenprojekt sowie bereitgestellte ungekürzte Western-Blot-Bilder sind in Zusatzdatei 1 enthalten. Das Archiv enthält außerdem extrahierte Zell-Metadaten und den Befehlsverlauf aus dem rekonstruierten Einzelzell-Objekt, Matrix-Typ-Verifizierungsberichte sowie eine Dateiübersicht. Zusatzdatei 1 bewahrt historische Quelldateien auf und beinhaltet einen Ordner R2_Updates mit den überarbeiteten Quelltabellen für die gepaarten Assays, statistischen Ausgaben, dem Code zur Abbildungserstellung und der korrigierten Parameterliste. Der vollständig analysierte Seurat-RDS wird in der Archivdokumentation angegeben, ist jedoch nicht in dieser ergänzenden ZIP-Datei enthalten. Die vollständige Historie der Bulk-Datenzusammenführung, die ursprünglichen Einstellungen zur Filterung und Annotation von Einzelzellen sowie die detaillierten Angaben zur Hintergrundsubtraktion und zur Spur-zu-Quantifizierung bei den Blots sind nicht vollständig verfügbar; diese Einschränkungen werden im Protokoll und in der Diskussion beschrieben. Der lokal rekonstruierte RDS wurde nicht in einem öffentlichen Repository hinterlegt.
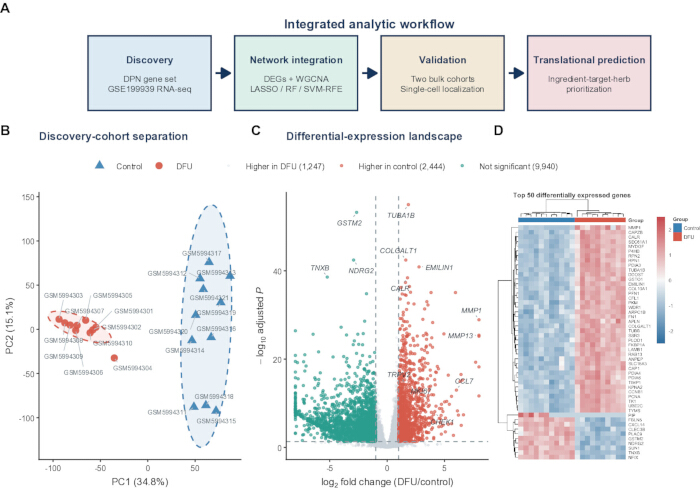
Abbildung 1: Die Entdeckungs-Transkriptomik identifiziert ein mit DFU assoziiertes Expressionsprogramm. (A) Übersicht über den rechnergestützten Arbeitsablauf, bestehend aus der Konstruktion von DPN-Gen-Sets und der Entdeckungsanalyse von GSE199939, Integration von Netzwerken und maschinellem Lernen, Bewertung von Bulk- und Einzelzell-Daten sowie Vorhersage von Wirkstoff-Ziel-Pflanze-Beziehungen in der TCM. (B) Hauptkomponentenanalyse der varianzstabilisierten Expressionsprofile von GSE199939 aus 10 DFU- und 11 Kontrollproben. Ellipsen zeigen 90-%-Gruppenbereiche an; die Prozentangaben geben die durch jede Komponente erklärte Varianz an. (C) Vulkan-Diagramm der Ergebnisse der DESeq2-Differenzialanalyse für DFU im Vergleich zur Kontrolle. Rote und türkisfarbene Punkte kennzeichnen Gene, die in DFU bzw. in der Kontrolle hochreguliert sind, unter Verwendung von |log2 Fold Change| > 1 und BH-angepasstem p < 0,05; graue Punkte erfüllten beide Schwellenwerte nicht. (D) Wärmebildkarte der zeilenweisen z-Score für die 50 Gene mit den kleinsten angepassten p-Werten. Die Spalten stellen biologische Proben dar, und die Anmerkungsleiste gibt die Gruppe an. DEGs, differentiell exprimierte Gene; DFU, diabetischer Fußulkus; DPN, diabetische periphere Neuropathie; VST, varianzstabilisierende Transformation. Die abschließende experimentelle Bewertung wird im Protokoll und in Abbildung 7 beschrieben. qPCR, quantitative Polymerase-Kettenreaktion; TCM, traditionelle chinesische Medizin; RF, Random Forest; LASSO, Least Absolute Shrinkage and Selection Operator; SVM-RFE, rekursive Merkmalseliminierung mittels Support-Vektor-Maschine. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
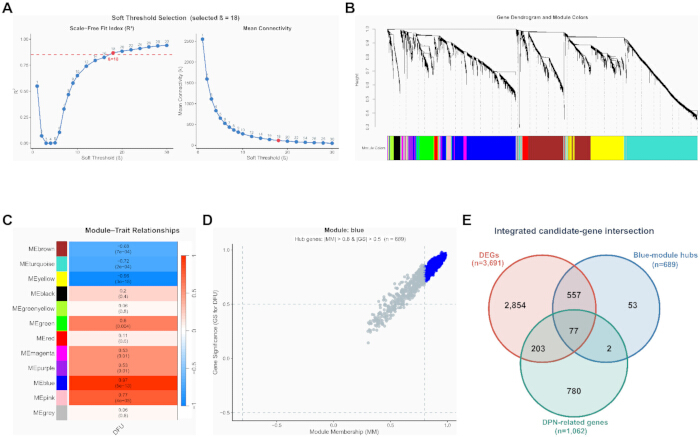
Abbildung 2: WGCNA und vorherige DPN-Kenntnisse weisen auf 77 Kandidatengene hin. (A) Bewertung des Soft-Schwellenwerts für das signierte Netzwerk der 5.000 am stärksten variablen, VST-transformierten Gene. Die ausgewählte Potenz betrug Beta = 18; die gestrichelte Linie markiert die Zielanpassung an die skalenfreie Topologie von 0,85. (B) Durchschnittsverknüpfungs-Gen-Dendrogramm mit dynamischen Modulfärbungen. (C) Pearson-Korrelationen zwischen den Modul-Eigengenen und dem binären DFU-Merkmal. Jede Zelle zeigt den Korrelationskoeffizienten und den entsprechenden zweiseitigen p-Wert; die Farbe gibt Richtung und Stärke an. (D) Gen-Signifikanz für DFU im Vergleich zur Modulzugehörigkeit im blauen Modul. Die blauen Punkte erfüllen die Bedingungen |Modulzugehörigkeit| > 0,8 und |Gen-Signifikanz| > 0,5; n = 689 Hub-Gene. (E) Dreifach-Überschneidung von 3.691 DEGs, 689 Hub-Genen des blauen Moduls und 1.062 DPN-bezogenen Genen, was 77 gemeinsame Kandidaten ergibt. DFU, diabetisches Fußgeschwür; DPN, diabetische periphere Neuropathie; GS, Gen-Signifikanz; MM, Modulzugehörigkeit; WGCNA, gewichtete Gen-Co-Expressionsnetzwerkanalyse. Die Entdeckungs-Kohorte umfasste 21 Proben (10 DFU und 11 Kontrollen). Die Annotation in Abbildung 2D verwendet |MM| > 0,8 und |GS| > 0,5, was dem im ursprünglichen Auswahlcode verifizierten Kriterium des Absolutbetrags entspricht. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
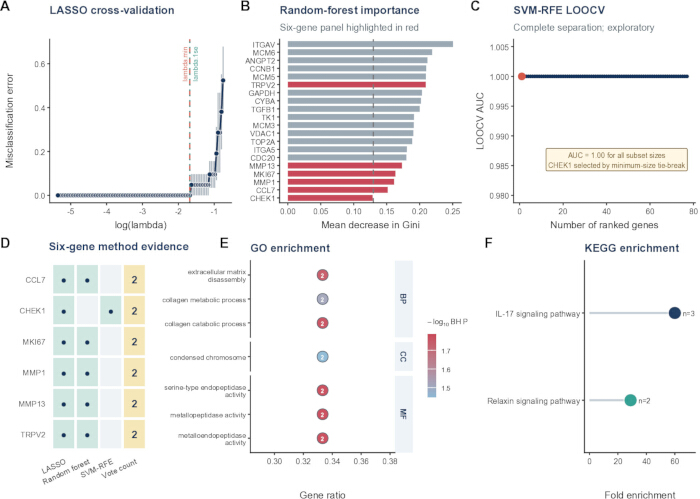
Abbildung 3: Die Kombination mehrerer Methoden zur Merkmalspriorisierung ergibt ein Sechs-Gen-Panel. (A) Fünffache Kreuzvalidierungskurve für die binomiale LASSO-Regression. Die vertikalen gestrichelten Linien markieren lambda.min und lambda.1se; die ausgewählten Merkmale ungleich null wurden bei lambda.1se abgelesen, es sei denn, diese Strafe ergab kein Merkmal. (B) Mittlere Verringerung der Gini-Importanz im Random-Forest-Modell für die 20 am höchsten eingestuften Gene aus einem Modell mit 1.000 Bäumen. Rote Balken kennzeichnen Mitglieder des endgültigen Sechs-Gen-Panels; die gestrichelte Linie markiert die mittlere Wichtigkeit, die als Aufnahmeschwelle für die gesamte Kandidatenliste diente. (C) LOOCV-AUC (Leave-One-Out-Cross-Validation) der linearen SVM-RFE über geschachtelte Merkmalsuntergruppen. Alle Untergruppengrößen ergaben eine AUC = 1,00; CHEK1 wurde gemäß der Regel für die kleinste Größe ausgewählt, was auf Überanpassung in der Entdeckungs-Kohorte hinweist. (D) Matrix der methodenübergreifenden Unterstützung für CCL7, CHEK1, MKI67, MMP1, MMP13 und TRPV2. Punkte zeigen die Auswahl durch LASSO, Random Forest oder SVM-RFE an; die letzte Spalte gibt die Anzahl unterstützender Methoden an. (E) Ausgewählte Gene Ontology-Terme, die unter den sechs Genen angereichert sind. Die Position der Punkte zeigt das Gen-Verhältnis, die Punktbeschriftungen die Anzahl der zugeordneten Gene, die Farbe zeigt -log10 BH-adjustierte p-Werte und der seitliche Streifen kennzeichnet die Ontologie. (F) KEGG-Pfade, die unter den zugeordneten Genen angereichert sind. Die Position der Punkte zeigt die Faltungsanreicherung, die Punktgrößenbeschriftungen die Anzahl der zugeordneten Gene, und die Farbe unterscheidet die Pfade. Für die Anreicherung war ein nomineller p < 0,05 und ein BH-adjustierter p < 0,05 erforderlich. AUC, Fläche unter der ROC-Kurve; BH, Benjamini-Hochberg; BP, biologischer Prozess; CC, zelluläre Komponente; KEGG, Kyoto Encyclopedia of Genes and Genomes; LOOCV, Leave-One-Out-Kreuzvalidierung; MF, molekulare Funktion; SVM-RFE, rekursive Merkmalsauswahl mittels Support-Vektor-Maschine. LASSO, Least Absolute Shrinkage and Selection Operator. Die Panels A–D verwenden die 21 Entdeckungsproben (10 DFU und 11 Kontrollen). In Panel A zeigen die Fehlerbalken den Standardfehler des Kreuzvalidierungsfehlers. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
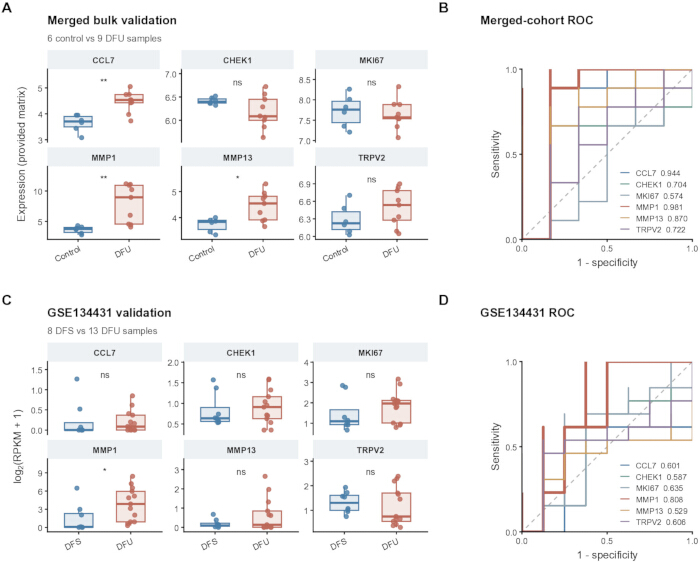
Abbildung 4: Querschnittsanalyse der Bulk-Transkriptomik über Datensätze hinweg für das Sechs-Gen-Panel. (A) Expression der sechs Gene in der zusammengeführten Matrix GSE68183/GSE80178 (6 Kontrollen und 9 DFU-Proben). (B) Entsprechende Einzel-Gen-ROC-Kurven mit AUC-Werten; 95 % Konfidenzintervalle sind in der Quelldatentabelle angegeben. Da die vorhergehende Zusammenführung und Batch-Korrektur nicht vollständig dokumentiert waren, wurden diese Ergebnisse als explorativ interpretiert. (C) log2(RPKM + 1)-Expression in GSE134431 (8 nicht ulzerierte DFS- und 13 DFU-Proben). (D) Entsprechende Einzel-Gen-ROC-Kurven und AUC-Werte. In (A) und (C) zeigen die Kästen Median und Interquartilsabstand, die Whisker erstrecken sich bis zum 1,5-fachen des Interquartilsabstands, und die Punkte repräsentieren biologische Proben. Sterne kennzeichnen nominelle Signifikanz aus zweiseitigen Wilcoxon-Rangsummentests (*p < 0,05, **p < 0,01); BH-korrigierte p-Werte über die sechs Gene hinweg sind im Text und in der Quelldatentabelle angegeben. Die ROC-Richtung wurde automatisch von pROC ausgewählt. AUC, Fläche unter der Receiver-Operating-Characteristic-Kurve; DFS, diabetische Fußhaut ohne Ulzeration; DFU, diabetisches Fußulkus; RPKM, Reads pro Kilobase pro Million zugeordneter Reads; ROC, Receiver Operating Characteristic. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
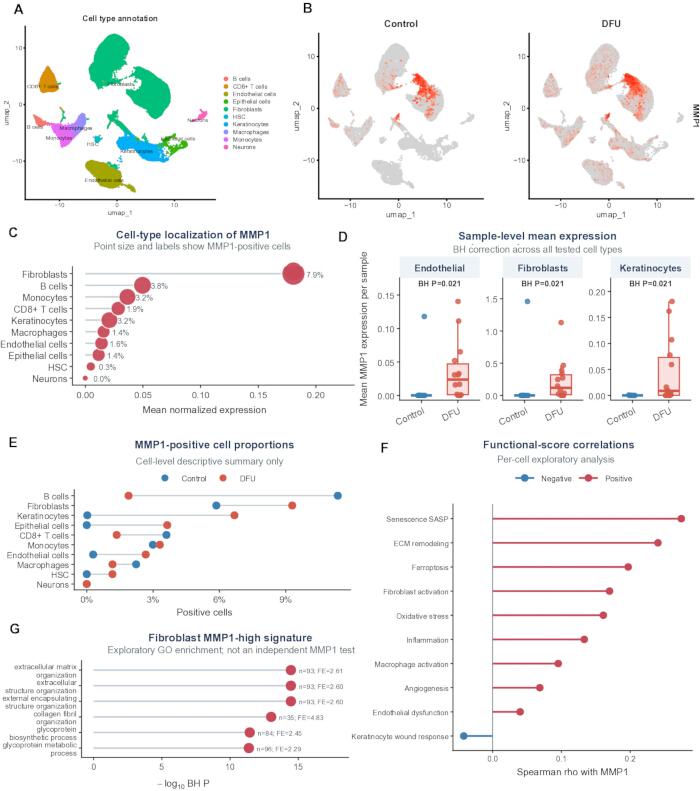
Abbildung 5: Die Einzelzell-Lokalisation verknüpft MMP1 mit Signalen der Fibroblasten- und Matrix-Remodellierung. (A) UMAP von 69.944 Zellen aus 24 Proben (10 Kontrollen und 14 DFU-Proben), eingefärbt nach den 10 durch SingleR bestimmten Zelltyp-Annotierungen. (B) UMAP-Funktionsdarstellungen, die die normalisierte MMP1-Expression in Kontroll- und DFU-Zellen zeigen. (C) Zusammenfassung nach Zelltyp der mittleren normalisierten MMP1-Expression; die Punktgröße und Beschriftungen geben den gesamten MMP1-positiven Anteil an, definiert als normalisierte Expression > 0. (D) Mittlere MMP1-Expression auf Proben-Ebene in endothelialen Zellen, Fibroblasten und Keratinozyten. Die Kästen zeigen Median und Interquartilbereich; die Punkte repräsentieren biologische Proben. Zweiseitige Wilcoxon-Rangsummentests wurden durch BH-Korrektur über alle getesteten Zelltypen hindurch ergänzt. Die verfügbaren Probenanzahlen betrugen 10 Kontrollen und 14 DFU für endotheliale Zellen und Fibroblasten sowie 9 Kontrollen und 14 DFU für Keratinozyten. (E) Anteile MMP1-positiver Zellen nach Gruppe und Zelltyp. (F) Spearman-Korrelationen pro Zelle zwischen MMP1-Expression und funktionellen Modul-Scores. (G) GO-Biologische-Prozess-Anreicherung unter Genen, die in MMP1-hohen im Vergleich zu MMP1-niedrigen Fibroblasten hochreguliert sind. BH, Benjamini-Hochberg; DFU, diabetischer Fußgeschwür; ECM, extrazelluläre Matrix; GO, Genontologie; HSC, hämatopoetische Stammzellen; UMAP, uniforme Mannigfaltigkeitsapproximation und -projektion. Die Korrelationen pro Zelle und die expressionsbedingte Anreicherung in den Panels F und G stellen explorative Beschreibungen dar, ohne bestätigende, spenderkorrelierte Schlussfolgerungen. Die Unabhängigkeit auf Proben-Ebene erfordert die Überprüfung der Spenderkennungen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
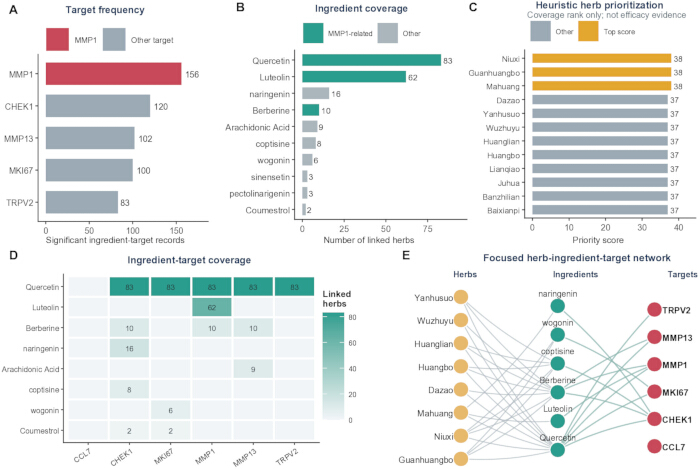
Abbildung 6: Vorhersage der TCM-Zutaten-Wirkstoff-Pflanze-Beziehungen basierend auf der Abdeckung, zentriert auf MMP1. (A) Anzahl der gefilterten Datenbankeinträge für Pflanze-Zutat-Wirkstoff-Beziehungen für jedes verfügbare Kandidatenziel. (B) Anzahl der verknüpften Pflanzen für die am häufigsten vorkommenden Zutaten; türkisfarbene Zutaten sind mit MMP1 verknüpft. (C) Rangfolge der führenden Pflanzen nach Abdeckungswert; goldfarbene Balken markieren die drei höchsten Werte. (D) Matrix der Zutaten-Wirkstoff-Beziehungen für repräsentative Zutaten mit hoher Abdeckung. Die Zellen zeigen die Anzahl der verknüpften Pflanzen; leere Zellen bedeuten keinen Eintrag in der gefilterten Beziehungstabelle. (E) Fokussiertes Netzwerk, das repräsentative hochrangige Pflanzen, Zutaten und Kandidatenziele verbindet. Die Knotenfarbe kennzeichnet den Entitätstyp; graue Kanten zwischen Pflanzen und Zutaten zeigen Inhaltsbeziehungen an, türkisfarbene Kanten zwischen Zutaten und Wirkstoffen zeigen Datenbankverknüpfungen. Die gefilterte Beziehungstabelle enthielt 561 eindeutige Einträge, 99 Pflanzen, 14 Zutaten und fünf Ziele mit qualifizierenden Verbindungen; CCL7 ist als isolierter sechster Kandidatenknoten dargestellt. TCM, traditionelle chinesische Medizin. Bitte klicken Sie hier, um eine vergrößerte Ansicht dieser Abbildung einzusehen.
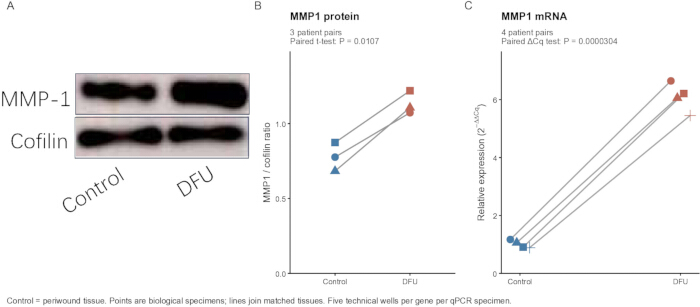
Abbildung 7: Vorläufige Analyse der MMP1-Expression in Patientengewebe mittels qPCR und Western Blot bei DFU. (A) Zuvor bereitgestellter repräsentativer Western Blot, der die MMP1-Proteinmenge in nicht ulzeriertem Periwundgewebe und DFU-Gewebe zeigt, wobei Cofilin als Ladekontrolle diente. (B) Aus dem ursprünglichen Auswertungsprojekt erhaltene MMP1-zu-Cofilin-Verhältnisse. Symbole zeigen individuelle biologische Messungen aus drei Patientenpaaren; Linien verbinden jeweils das zugehörige Periwund- und DFU-Probenpaar. Der zweiseitige gepaarte t-Test ergab t(2) = 9,592 und p = 0,0107. (C) Relative MMP1-mRNA-Menge in vier von den Autoren bestätigten, gepaarten Patientenpaaren: NC–DFU, NC1–DFU1, NC2–DFU2 und NC3–DFU3. Fünf technische ACTB-Ansätze und fünf technische MMP1-Ansätze wurden innerhalb jeder Probe separat gemittelt, bevor die ΔCq-Berechnung erfolgte. Die relative Expression wurde nach der 2−ΔΔCq-Methode berechnet, wobei der mittlere Periwund-ΔCq als gemeinsamer Kalibrator verwendet wurde. Jedes Symbol repräsentiert eine biologische Probe; Linien verbinden die jeweils zugehörigen Gewebeproben. Der zweiseitige gepaarte t-Test verwendete wertebasierte ΔCq-Werte auf Proben-Ebene (t(3) = −41,663; p = 3,04 × 10⁻⁵), nicht die technischen Ansätze mit Fold-changes. Es wurden keine Signifikanzsterne verwendet. Technische Ansätze sind keine biologischen Replikate. „Control“ bezeichnet nicht ulzeriertes Periwundgewebe. Cq, Quantifizierungszyklus. Die p-Werte für Gewebe-Assays sind nominal und exploratorisch. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Gen | RefSeq-Zugangsnummer | Forward-Primer von 5' nach 3' | Reverse-Primer von 5' nach 3' |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tabelle 1: Primersequenzen zur quantitativen PCR-Validierung von MMP1. Vorwärts- und Rückwärts-Oligonukleotidsequenzen (5′–3′) sowie NCBI RefSeq-Transkriptzugriffsnummern sind für humanes MMP1 (NM_002421) und ACTB (NM_001101.5) angegeben. ACTB (β-Aktin) wurde als Referenzgen für die relative MMP1-Expression verwendet.
Abbildung S1: Zusammenfassungen der WGCNA-Qualitätskontrolle. (A) Hierarchische Clusterung nach der Durchschnittsverbindungsmethode der GSE199939-Proben basierend auf den 5.000 variabelsten varianzstabilisierten Genen. Die Probenbezeichnungen sind nach Gruppen eingefärbt; die gestrichelte horizontale Linie stellt die Höhe des Dendrogramms auf dem 95. Perzentil dar, die als visueller Leitfaden zur Ausreiterbeurteilung dient. (B) Anzahl der Gene, die jedem WGCNA-Modul zugeordnet wurden. Türkisfarbene Balken kennzeichnen die acht nicht-grauen Module, die das DFU-Assoziationskriterium erfüllen; graue Balken kennzeichnen die übrigen Module. DFU, diabetischer Fußulcus; VST, varianzstabilisierende Transformation; WGCNA, gewichtete Genko-Expressionsnetzwerkanalyse. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung S2: Unterstützung der Ko-Expressionsanalyse des blauen Moduls. (A) Vereinfachtes Ko-Expressionsnetzwerk der 25 am höchsten bewerteten Hub-Gene des blauen Moduls. Unter allen paarweisen Korrelationen mit |r| > 0,70 enthält das dargestellte Netzwerk die Vereinigung der jeweils zwei stärksten Verbindungen jedes Gens. Die Knotengröße kennzeichnet den Grad innerhalb dieses dargestellten, verdünnten Netzwerks, und die Füllung der Knoten kennzeichnet die Gen-Signifikanz für diabetische Fußulzer (DFU). (B) Gen-Signifikanz und Zugehörigkeit zum blauen Modul für die 15 am höchsten bewerteten Hub-Gene. Die Kantenmenge wurde aus Gründen der Lesbarkeit ausgewählt und stellt nicht alle qualifizierenden Korrelationen dar. DFU, diabetischer Fußulzer; GS, Gen-Signifikanz; MM, Modulzugehörigkeit. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 3, Zusatzmaterial: Darstellungen des maschinellen Lernens in der internen Entdeckungs-Kohorte. (A) Skalierte Expression von CCL7, CHEK1, MKI67, MMP1, MMP13 und TRPV2 in der Entdeckungs-Kohorte GSE199939. Die Kästen zeigen Median und Interquartilsabstand, die Punkte repräsentieren biologische Proben. (B) Heatmap der zeilenweisen z-Score auf Proben-Ebene für dieselben sechs Gene. Kurze Probenbezeichnungen sind in der Quelldaten-Tabelle den GEO-Identifikatoren zugeordnet. (C) ROC-Kurve des angepassten multigenen Modells der Entdeckungs-Kohorte. Eine AUC von 1,00 ergab sich durch Anpassung und Bewertung des Modells an denselben 21 Proben, was auf eine Überanpassung in der Entdeckungs-Kohorte hinweist. AUC, Fläche unter der ROC-Kurve; ROC, receiver operating characteristic (Empfänger-Charakteristik). Die Entdeckungs-Kohorte umfasste 21 Proben (10 DFU und 11 Kontrollen). Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 4, Zusatzmaterial: Einzelzell-Expressionskontext. (A) UMAP von 69.944 Zellen, eingefärbt nach Kontroll- und DFU-Gruppe. (B) Mittlere biologische Proben-Ebene MMP1-Expression über alle 10 Zelltyp-Annotierungen hinweg; die Punkte repräsentieren Proben, und die x-Achse verwendet eine Quadratwurzel-Transformation zur Anzeige. (C) Heatmap der funktionellen Modul-Scores, zusammengefasst über die Zellen innerhalb jedes annotierten Zelltyps und innerhalb jedes Moduls standardisiert. DFU, diabetischer Fußgeschwür; UMAP, uniforme Mannigfaltigkeitsapproximation und -projektion. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung S5: Unterstützende TCM-Abdeckungsmatrizen. (A) Anzahl der Datenbankeinträge zu Kräuter-Wirkstoff-Beziehungen für die 18 am höchsten eingestuften Kräuter mit MMP1-verknüpfter Abdeckung und die fünf Kandidaten-Zielstrukturen in der gefilterten Relations-Tabelle. (B) Anzahl der Datenbankeinträge, die dieselben Kräuter mit den Hauptinhaltsstoffen Quercetin, Luteolin und Berberin verknüpfen. Die Zellen zeigen die Anzahl eindeutiger Datenbankeinträge nach Entfernung von Duplikaten an. TCM, traditionelle chinesische Medizin. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 6, Zusatzinformationen: Rechnerischer und geweblicher Bewertungsworkflow. Das Schema fasst die Eingabedaten für die Entdeckung, den Schnittbereich von DEG/WGCNA, die explorative Merkmalsauswahl, die externe Bulk-Bewertung, den Einzelzellkontext, die TCM-Erweiterung und die Bewertung der korrespondierenden Gewebeexpression zusammen. Für die qPCR kamen vier Paare von Patienten mit passenden Proben zum Einsatz, für die Western Blot-Analyse drei solcher Paare. Die Anzahl der Kandidaten und die angegebenen rechnerischen Ergebnisse stammen aus der ursprünglichen Analyse. Einschränkungen bestehen weiterhin hinsichtlich des TPM-Eingangs im entdeckungsorientierten, zählbasierten Workflow, unvollständiger Aufzeichnungen zur ursprünglichen Einzelzell-Vorverarbeitung und kleiner Kohorten in den Gewebeassays. Das Schema besagt nicht, dass die Entdeckungsanalysen erneut validiert wurden. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzungstabelle 1: Bestand an Analyse-Software, Datenbanken, Parametern und Einschränkungen. Dieses Arbeitsblatt dokumentiert 26 Analyse-Schritte, einschließlich des Analyse-Schritts, des verwendeten Tools oder der Datenbank, der angegebenen Version, der Eingaben, der wichtigsten Parameter, der Ausgaben sowie fehlender Informationen oder Einschränkungen. Es umfasst die entdeckungsorientierte Transkriptomik, WGCNA, Gen-Screening und Merkmalsauswahl, Anreicherungsanalysen, externe Bulk- und Einzelzell-Analysen, TCM-Netzwerkanalysen sowie die Berichterstattung zu Gewebe-Assays. Die Tabelle erfasst die verfügbaren methodischen Informationen, stellt jedoch keine eigenständige Reproduzierbarkeit sicher. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Ergänzende Datei 1: Daten, Analysecode, Abbildungsquellen und Assay-Quellenarchiv. Dieses Archiv enthält verfügbare Skripte zur Analyse und Erstellung von Abbildungen, verarbeitete Ausdrucks- und Ergebnistabellen, quantitative Abbildungen und statistische Quelldaten, das ursprüngliche qPCR-Arbeitsheft und das Instrumentenprojekt, bereitgestellte ungekürzte Western Blot-Bilder, extrahierte Einzelzell-Metadaten und Befehlshistorie, Matrix-artige Verifizierungsberichte sowie eine Dateiübersicht. Historische Dateien sind erhalten geblieben; der Ordner R2_Updates enthält die korrigierte Analyse gepaarter Assays, aktualisierte Abbildungsquellen und eine überarbeitete Parameterliste. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Dieser integrative Arbeitsablauf priorisierte MMP1 basierend auf Bulk-Transkriptomik, WGCNA, DPN-bezogener Gen-Screening und explorativer Merkmalsauswahl und untersuchte anschließend dessen zellulären Kontext und Gewebeexpression. Sechs Gene wurden durch mindestens zwei Selektionsmethoden gestützt, wobei MMP1 die stärkste Expressionsänderung in der Entdeckungs-Kohorte aufwies. Externe Belege waren heterogen: MMP1 blieb in der zusammengeführten Matrix GSE68183/GSE80178 signifikant, während der Zusammenhang in GSE134431 nur nominal war (p = 0,0225) und keine BH-Korrektur überlebte (adjustiertes p = 0,135). Die AUC von 0,808 in GSE134431 ist deskriptiv, insbesondere weil die ROC-Richtung innerhalb des Bewertungsdatensatzes festgelegt wurde. Demnach beschreibt „am stärksten konsistent“ das beobachtete Muster unter den sechs Kandidaten und impliziert nicht eine vollständige statistische Replikation oder einen validierten diagnostischen Biomarker.
Das Kandidatenpanel wurde funktionell zugeordnet der Kollagen-Umstellung, der ECM-Abbauaktivität, der Metalloendopeptidase-Aktivität sowie der IL-17- und Relaxin-Signalübertragung. Diese Zuordnungen entsprechen der Biologie chronischer Wunden, beinhalten jedoch nur wenige Gene. Frühere humanmedizinische Studien berichteten über veränderte Profile von MMPs und deren Inhibitoren bei diabetischen Wunden6, während eine prospektive Studie an Diabetischen Fußulzera (DFU) ein höheres Verhältnis von MMP1 zu Gewebe-Inhibitor der Metalloproteinasen 1 (TIMP1) mit einer besseren Wundheilung assoziierte7. Daher muss eine erhöhte MMP1-Expression keinen einheitlich schädlichen Effekt bedeuten; ihre Relevanz könnte von der Reparaturphase, der Substratverfügbarkeit und dem Inhibitorengleichgewicht abhängen. Experimentelle Beobachtungen zu MMP13, CCL7 und IL-17 liefern zusätzlichen Kontext11,12,13,14, jedoch dürfen deren Funktionen nicht als gleichwertig im menschlichen DFU angesehen werden.
Einzelzell-Zusammenfassungen lokalisierten die höchste mittlere MMP1-Expression in Fibroblasten, wobei auf Proben-Ebene eine höhere Expression in DFU-Fibroblasten, Keratinozyten und endothelialen Zellen beobachtet wurde. Dieses Muster stimmt überein mit Berichten über veränderte ECM-Organisation in aus DFU stammenden Fibroblasten4, heterogenen Fibroblastenzuständen in Einzelzell- und räumlichen Studien8 sowie makrophagenassoziierten heilungsfördernden Fibroblastenprogrammen15. Allerdings erfordern die Probenidentifikatoren eine Verifizierung auf Spender-Ebene, und die korrelationsbasierten Modulbewertungen auf Zell-Ebene sowie die expressionsbedingte Anreicherung bleiben beschreibend, da die Abhängigkeit innerhalb desselben Spenders nicht modelliert wurde. Beiträge von epithelialen und endothelialen Populationen sprechen zudem gegen einen ausschließlich fibroblastenautonomen Mechanismus. Die räumliche Transkriptomik, die RNA-in situ-Hybridisierung oder eine Immunfärbung könnten eine ergänzende Lokalisierung ermöglichen16.
Der methodologische Wert liegt in der Kombination differenzieller Expression, Koregulation, vorherigen Genkenntnissen, zellauflösenden Zusammenfassungen und unabhängigen Assay-Modalitäten zur Priorisierung von Kandidaten. Er liegt nicht in der Vorhersagegenauigkeit an einem Entdeckungs-Kohorte. Ein kohortenweiter Screening ging der übergeordneten Kreuzvalidierung auf Algorithmusebene voraus, und die einheitliche SVM-RFE-AUC von 1,00 wirft Bedenken hinsichtlich Datenleakage, Überanpassung und optimistischer Bewertung auf. Die Panel-Zusammenstellung sollte daher als Ergebnis der Merkmalspriorisierung verbleiben. Für eine prädiktive Evaluation wären vollständig geschachtelte Vorverarbeitung, Merkmalsauswahl und Parametertuning sowie anschließend ein gesperrter, unabhängiger Test erforderlich.9,10Die Eingabe für die Entdeckungsanalyse wurde als TPM verifiziert, obwohl sie in einem auf Zählungen basierenden Modell verwendet wurde; die resultierenden Entdeckungsstatistiken und die nachfolgende Selektion sind daher bis zur Durchführung einer angemessenen Neuanalyse nicht verifiziert. Die zusammengeführte Bulk-Matrix verfügt nicht über die vollständige Historie ihrer Vorverarbeitung. Das rekonstruierte Seurat-Objekt enthält Angaben zu Normalisierung, Auswahl variabler Merkmale, PCA, Nachbarschaftsberechnung, Clusterung und UMAP-Einstellungen, doch die ursprüngliche Filterung, der vollständige Harmony-Aufruf und die Referenz für die Annotation sind unvollständig dokumentiert. Alternativ können eine harmonisierte Neubearbeitung anhand der Quelldaten, eine dokumentierte Beurteilung von Batch-Effekten sowie Spender-berücksichtigende Pseudobulk- oder gemischte Modelle zur weiteren Evaluierung herangezogen werden.
Patienten-Gewebeproben liefern vorläufige, unabhängige Hinweise auf ein höheres Vorkommen von MMP1. Als Vergleich diente nicht ulzeriertes Wundrandgewebe derselben Patienten, sodass der Unterschied lokale, ulzerationsassoziierte Unterschiede innerhalb des diabetischen Gewebes widerspiegelt und keinen Vergleich mit gesunder Haut darstellt. Die gewonnenen WB-Messungen aus drei gepaarten Patientenpaaren sowie qPCR-Messungen aus vier vom Autor bestätigten, gepaarten Paaren wurden mittels gepaarter Tests analysiert, wobei die einzelnen biologischen Beobachtungen dargestellt wurden. Bei der qPCR wurden technische Ansätze innerhalb jeder Probe gemittelt, und die Schlussfolgerungen basierten auf ΔCq; technische Ansätze vergrößerten die biologische Stichprobengröße nicht. Die einheitliche Richtung der gepaarten Beobachtungen stützt einen vorläufigen Expressionsvergleich, doch die kleinen Kohorten erlauben keine Aussage zur Verallgemeinerbarkeit oder zuverlässigen Prüfung von Verteilungsannahmen. Die Mengenbestimmung im Gesamtgewebe belegt weder die zelluläre Proteinlokalisation, noch die enzymatische Aktivität oder einen kausalen Einfluss auf die Wundheilung. Größere, klinisch gut charakterisierte Kohorten sind erforderlich. Weitere Limitationen umfassen unvollständige klinische Kovariaten, unterschiedliche Vergleichsgewebeproben, einen unvollständig dokumentierten, aus der Literatur abgeleiteten Gen-Satz für diabetische Polyneuropathie (DPN) sowie unvollständige Aufzeichnungen zur Hintergrundsubtraktion der ursprünglichen Blots. Gesundes Gewebe, die als Kontrolle definierte Studiengruppe und nicht ulzerierte diabetische Fußhaut sollten nicht als austauschbar betrachtet werden.
Das TCM-Netzwerk ist eine hypothetisch generierende Erweiterung. Die individuellen Gewichtungen fassen den Umfang der Datenbankabdeckung zusammen, nicht die Zielinteraktion oder Wirksamkeit, und die Rangfolgen können sich mit dem Inhalt der Datenbank und der Wahl der Gewichtungen ändern. Quercetin und Berberin weisen außerdem eine variable oder begrenzte systemische Exposition auf17,18. Kandidateninhaltsstoffe und -pflanzen erfordern daher direkte Untersuchungen hinsichtlich Zielinteraktion, Dosis-Wirkungs-Beziehung, Pharmakokinetik, Toxizität und funktioneller Wirkung. Zukünftige Arbeiten sollten gut dokumentierte, unabhängige Kohorten mit räumlicher Lokalisation und MMP1-Störung in primären Fibroblasten oder multizellulären Wundmodellen kombinieren. Die vorliegenden Ergebnisse stützen MMP1 als mit DFU assoziierten Kandidaten in einem fibroblastenzentrierten Kontext der Matrixumgestaltung, ohne jedoch einen kausalen Zusammenhang oder klinische Anwendbarkeit nachzuweisen.
Offenlegungen
Die Autoren erklären, dass kein Interessenkonflikt besteht.
Danksagungen
Diese Forschung wurde durch das Wuhaner kommunales medizinisches Forschungsprojekt (Leitprojekt, Förderkennzeichen WX23Z77) unterstützt, das von der Wuhaner kommunalen Gesundheitskommission verwaltet wird.
Die Autoren danken den Teilnehmern, die Gewebeproben für diese Studie bereitgestellt haben, sowie den Wissenschaftlern, die die öffentlich zugänglichen Datensätze im NCBI Gene Expression Omnibus erzeugt und hinterlegt haben.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| 0,2-mL PCR-Röhrchenstreifen mit dünner Wand und klarem Material | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| 1.000-μL sterile Filterpipettenspitzen | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| 1,5-mL sterile Mikrozentrifugenröhrchen, DNase/RNase-frei | Solarbio Life Sciences | YA0430 | URL: https://www.solarbio.com/goodsInfo?id=305429 |
| 10-μL sterile Filterpipettenspitzen | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× SYBR Green PCR-Mastermix | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 |
| 20× Tris-gepufferte Salzlösung | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| 200-μL sterile Filterpipettenspitzen | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| ACTB qPCR-Primer-Paar | Solarbio Life Sciences (kundenspezifische Oligonukleotidsynthese) | Custom | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Schweden | Amersham Imager 600 | Modell in allen 22 gelieferten TIFF-Dateien erfasst; Bedienungssoftware Version 1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Bicinchoninsäure-Proteinassay-Kit | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Version 4.16.0 |
| Polyklonaler Cofilin-Antikörper (Kaninchen anti-Cofilin) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10960-1-AP | Verwendete WB-Verdünnung in dieser Studie: 1:6.000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | Ressource für Wirkstoff-Zielinteraktionen |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Version 1.48.2 |
| DNase/RNase-freies Wasser | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / e1071-Autoren | https://cran.r-project.org/package=e1071 | Version 1.7-17 |
| Chemilumineszenter Substrat ECL Plus | Solarbio Life Sciences | PE0010 | URL: https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus: GSE134431 | National Center for Biotechnology Information | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | National Center for Biotechnology Information | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | National Center for Biotechnology Information | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | National Center for Biotechnology Information | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | National Center for Biotechnology Information | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Gene Ontology Consortium | https://geneontology.org/ | GO |
| ggplot2 | ggplot2-Entwickler | https://ggplot2.tidyverse.org/ | Version 4.0.3 |
| glmnet | CRAN / glmnet-Autoren | https://cran.r-project.org/package=glmnet | Version 5.0 |
| Referenztabelle für Kräuter und Inhaltsstoffe | Quelle im Manuskript nicht angegeben | Nicht angegeben | Nicht dokumentiert: genauer Datenbank-/Dateiname, Version/Datum und öffentliche Zugriffs-URL |
| HRP-konjugiertes Ziegen-Anti-Kaninchen-IgG (H+L) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | SA00001-2 | Verwendete WB-Verdünnung in dieser Studie: 1:5.000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| Gewebeproben menschlicher diabetischer Fußulzeren | Wuhan Fourth Hospital, Wuhan, China | N/V | Patientenangepasste DFU-Proben; qPCR n=4 Proben; WB n=3 Proben; genehmigtes Protokoll KY2024-161-01 |
| Gewebeproben menschlicher nicht-ulzerierter peripherer Wundgebiete | Wuhan Fourth Hospital, Wuhan, China | N/V | Patientenangepasste Vergleichsproben aus dem Wundrand; qPCR n=4 Proben; WB n=3 Proben; genehmigtes Protokoll KY2024-161-01 |
| ImageJ | National Institutes of Health | https://imagej.net/ij/ | Version nicht dokumentiert |
| Kyoto-Enzyklopädie der Gene und Genome | KEGG | https://www.genome.jp/kegg/ | Menschlicher Organismuscode hsa |
| Literaturbasierte DPN-Genliste | Literaturbasierte Komponente; genaue Quelltabelle auf Genebene nicht vollständig dokumentiert | Nicht angegeben | Genetische Herkunft auf Genebene nicht vollständig dokumentiert |
| Mikrovolumen-UV-sichtbares Spektrophotometer | Hersteller/Modell im Manuskript nicht angegeben | Nicht angegeben | Nicht dokumentiert: genauer Hersteller, Modell und Produkt-URL; angegebener Einsatz: RNA-Konzentration und A260/A280-Bestimmung |
| Polyklonaler MMP1-Antikörper (Kaninchen anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10371-2-AP | Verwendete WB-Verdünnung in dieser Studie: 1:1.000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| MMP1 qPCR-Primer-Paar | Solarbio Life Sciences (kundenspezifische Oligonukleotidsynthese) | Custom | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/gene/ | Menschliche Gen-Datenbank |
| Magermilchpulver, Blockierreagenz | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Version 3.21.0 |
| Vorgefertigtes SDS-PAGE-Gel, 4%–20%-Gradient | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / pROC-Autoren | https://cran.r-project.org/package=pROC | Version 1.19.0.1 |
| Proteaseinhibitoren-Mixtur, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| Proteintrennsystem | Hersteller/Modell im Manuskript nicht angegeben | Nicht angegeben | Nicht dokumentiert: genauer Hersteller, Modell und Produkt-URL; angegebener Einsatz: Übertragung auf 0,22-μm-PVDF-Membran |
| PVDF-Membran, 0,22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Version 4.5.2 |
| randomForest | CRAN / randomForest-Autoren | https://cran.r-project.org/package=randomForest | Version 4.7-1.2 |
| Echtzeit-PCR-Gerät | Roche Diagnostics | LightCycler 96 | Softwareversion nicht bestätigt. Projektvolumen/Zyklen weicht vom angegebenen Protokoll ab; exakte Experimentzuordnung muss noch überprüft werden. |
| Kühlmikrozentrifuge | Hersteller/Modell im Manuskript nicht angegeben | Nicht angegeben | Nicht dokumentiert: genauer Hersteller, Modell und Produkt-URL; angegebener Einsatz: 12.000 × g für 15 min bei 4 °C |
| rentrez | CRAN / rentrez-Autoren | https://cran.r-project.org/package=rentrez | Version 1.2.4 |
| RIPA-Lysepuffer, hohe Konzentration | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| SDS-PAGE-Elektrophorese-System | Hersteller/Modell im Manuskript nicht angegeben | Nicht angegeben | Nicht dokumentiert: genauer Hersteller, Modell und Produkt-URL; angegebener Einsatz: Proteintrennung auf 4%–20%-Gradient-Gelen |
| Seurat | Satija Lab / Seurat-Entwickler | https://satijalab.org/seurat/ | Version 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Version 2.10.0 |
| Gewebepuffer | Hersteller/Modell im Manuskript nicht angegeben | Nicht angegeben | Nicht dokumentiert: genauer Hersteller, Modell und Produkt-URL; angegebener Einsatz: Homogenisierung von Gewebe in eiskaltem Lysepuffer |
| TriQuick Reagenz zur Gesamt-RNA-Extraktion | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| Klare flache Verschlüsse für 0,2-mL PCR-Röhrchenstreifen | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Universal-RT-PCR-Kit (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / WGCNA-Autoren | https://cran.r-project.org/package=WGCNA | Version 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Referenzen
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.