Aquí se establece y se describe un protocolo de minería del genoma guiado por espectrometría de masas. Se basa en la información de la secuencia del genoma y el análisis LC-MS/MS y tiene como objetivo facilitar la identificación de moléculas a partir de extractos microbianos y vegetales complejos.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
La minería del genoma guiada por espectrometría de masas como herramienta para descubrir nuevos productos naturales
En este artículo
Resumen
Resumen
El espacio químico cubierto por productos naturales es inmenso y ampliamente no reconocido. Por lo tanto, se desean metodologías convenientes para realizar una evaluación amplia de sus funciones en la naturaleza y beneficios humanos potenciales (por ejemplo, para aplicaciones de descubrimiento de fármacos). Este protocolo describe la combinación de la minería del genoma (GM) y la red molecular (MN), dos enfoques contemporáneos que coinciden con las anotaciones codificadas por grupos genéticos en la secuenciación del genoma completo con las firmas de la estructura química de extractos metabólicos crudos. Este es el primer paso hacia el descubrimiento de nuevas entidades naturales. Estos conceptos, cuando se aplican juntos, se definen aquí como minería del genoma guiada por MS. En este método, los componentes principales se designan previamente (utilizando MN), y los nuevos candidatos relacionados estructuralmente se asocian con anotaciones de secuencia del genoma (mediante GM). La combinación de GM y MN es una estrategia rentable para apuntar a nuevas redes troncales de moléculas o cosechar perfiles metabólicos con el fin de identificar análogos de compuestos ya conocidos.
Introducción
Las investigaciones del metabolismo secundario a menudo consisten en el cribado de extractos crudos para actividades biológicas específicas seguidos de purificación, identificación y caracterización de los componentes pertenecientes a fracciones activas. Este proceso ha demostrado ser eficiente, promoviendo el aislamiento de varias entidades químicas. Sin embargo, hoy en día esto es visto como inviable, principalmente debido a las altas tasas de redescubrimiento. A medida que la industria farmacéutica revolucionó sin conocer las funciones y funciones de los metabolitos especializados, su identificación se llevó a cabo en condiciones de laboratorio que no representaban con precisión la naturaleza1. Hoy en día, hay una mejor comprensión de las influencias de señalización natural, secreción, y la presencia de la mayoría de los objetivos en concentraciones indetectablemente bajas. Además, la regulación del proceso ayudará a la comunidad académica y a la industria farmacéutica a aprovechar este conocimiento. También beneficiará la investigación que implica el aislamiento directo de metabolitos relacionados con los grupos de genes biosintéticos silenciosos (BGC)2.
En este contexto, los avances en la secuenciación genómica han renovado el interés por el cribado de metabolitos de microorganismos. Esto se debe a que el análisis de la información genómica de los cúmulos biosintéticos descubiertos puede revelar genes que codifican nuevos compuestos no observados o producidos en condiciones de laboratorio. Muchos proyectos o borradores de genoma completo microbiano están disponibles hoy en día, y el número está creciendo cada año, proporcionando perspectivas masivas para descubrir nuevas moléculas bioactivas a través de la minería del genoma3,4.
El Atlas of Biosynthetic Gene Clusters es la mayor colección actual de cúmulos de genes extraídos automáticamente como componente de la Plataforma Integrada de Genomas Microbianos del Instituto Conjunto del Genoma (JGI IMG-ABC)2. Más recientemente, la Iniciativa de Normalización de la Información Mínima para Clústeres de Gen Biosintéticos (MIBiG) ha promovido la reanotación manual de los BGC, proporcionando un conjunto de datos de referencia altamente seleccionado5. Hoy en día, hay muchas herramientas disponibles para permitir la minería computacional de datos genéticos y su conexión con metabolitos secundarios conocidos. También se han desarrollado diferentes estrategias para acceder a nuevos productos naturales bioactivos (es decir, expresión heteróloga, eliminación de genes diana, reconstitución in vitro, secuencia genómica, cribado guiado por isótopos [enfoque genomisotópico], manipulación de reguladores locales y globales, minería basada en objetivos de resistencia, minería independiente del cultivo y, más recientemente, enfoques guiados por MS/código2,6,7,8,9, 10,11,12,13,14,15).
La minería del genoma como estrategia singular requiere esfuerzos para anotar un grupo único o pequeño de moléculas; por lo tanto, siguen existiendo lagunas en el proceso en el que se priorizan nuevos compuestos para el aislamiento y el esclarecimiento de la estructura. En principio, estos enfoques se dirigen a una sola vía biosintética por experimento, lo que resulta en una tasa de descubrimiento lenta. En este sentido, el uso de GM junto con un enfoque de redes moleculares representa un avance importante para la investigación de productos naturales14,,15.
La versatilidad, precisión y alta sensibilidad de la cromatografía líquida-espectrometría de masas (LC-MS) lo convierten en un buen método para la identificación de compuestos. Actualmente, varias plataformas han invertido algoritmos y conjuntos de software para metabolómicas no dirigidas16,,17,18,19,20. El núcleo de estos programas incluye la detección de características (selección de picos)21 y la alineación de picos, lo que permite la coincidencia de entidades idénticas en un lote de muestras y la búsqueda de patrones. Los algoritmos basados en patrones de MS22,23 comparan patrones de fragmentación característicos y coinciden con las similitudes de MS2 que generan familias moleculares que comparten características estructurales. Estas características pueden ser resaltadas y agrupadas, confiriendo la capacidad de descubrir rápidamente moléculas conocidas y desconocidas de un extracto biológico complejo por tándem MS2,24,25. Por lo tanto, la MUS en tándem es un método versátil para obtener información estructural de varios quimiotipos contenidos en una gran cantidad de datos simultáneamente.
El algoritmo Global Natural Products Social Molecular Networking (GNPS)26 utiliza la intensidad de los iones de fragmentos normalizados para construir vectores multidimensionales, en los que las similitudes se comparan utilizando una función de coseno. La relación entre los diferentes iones primarios se traza en una representación de diagrama, en la que cada fragmentación se visualiza como un nodo (círculos) y la relación de cada nodo se define mediante una arista (líneas). La visualización global de moléculas de una sola fuente se define como una red molecular. Las moléculas estructuralmente divergentes que se fragmentan de forma única formarán su propio cúmulo o constelación específico, mientras que las moléculas relacionadas se agrupan. La agrupación de quimiotipos permite la conexión hipotética de características estructurales similares a sus orígenes biosintéticos.
La combinación de enfoques quimiotipo a genotipo y genotipo a quimiotipo es poderosa cuando se crean vínculos bioinformáticos entre los BGC y sus pequeños productos de moléculas27. Por lo tanto, la minería del genoma guiada por MS es un método rápido y una estrategia de bajo consumo de materiales, y ayuda a salvar los iones padres y las vías biosintéticas reveladas por WGS de una o más cepas bajo diversas condiciones metabólicas y ambientales.
El flujo de trabajo de este protocolo(Figura 1) consiste en alimentar los datos wgS en una plataforma de anotación de clúster de genes biosintéticos como antiSMASH28,,29,30. Ayuda a estimar la variedad de compuestos y la clase de compuestos codificados por el genoma. Se debe adoptar una estrategia para atacar un grupo genético biosintético que codifica una entidad química de interés, y se pueden analizar extractos de cultivo de una cepa de tipo silvestre y/o cepa heteróloga que contenga el BGC para generar iones agrupados basados en similitudes utilizando GNPS26,,31. Por lo tanto, es posible identificar nuevas moléculas que se asocian con el BGC objetivo y no están disponibles en la base de datos (principalmente análogos desconocidos, a veces producidos en títulos bajos). Es relevante tener en cuenta que los usuarios pueden contribuir a estas plataformas y que la disponibilidad de datos bioinformáticos y MS/MS está aumentando rápidamente, impulsando a un desarrollo constante y actualización de herramientas y algoritmos computacionales eficaces para guiar conexiones eficientes de extractos complejos con moléculas.
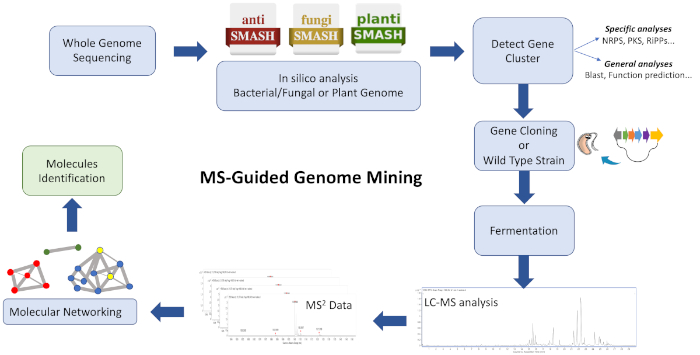
Figura 1: Información general de todo el flujo de trabajo. Se muestra una ilustración de los pasos bioinformáticos, de clonación y redes moleculares implicados en el enfoque de minería del genoma guiado por la EM para identificar nuevos metabolitos. Haga clic aquí para ver una versión más grande de esta figura.
Este protocolo describe un flujo de trabajo rápido y eficiente para combinar la minería del genoma y las redes moleculares como punto de partida para la canalización de descubrimiento de productos naturales. Aunque muchas aplicaciones son capaces de visualizar la composición y relación de moléculas detectables por MS en una red, aquí se adoptan varias para visualizar moléculas agrupadas estructuralmente similares. Usando esta estrategia, nuevos productos de ciclodepsipéptidos observados en extractos metabólicos de Streptomyces sp. CBMAI 2042 se identifican con éxito. Guiado por la minería del genoma, todo el cúmulo de genes biosintéticos que codifican valinomicinas es reconocido y clonado en la cepa productora Streptomyces coelicolor M1146. Por último, tras una red molecular basada en patrones de EP, las moléculas detectadas por la EM están correlacionadas con los BGC responsables de su biogénesis32.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
1. Minería del genoma para grupos genéticos biosintéticos
- Realizar la secuenciación del genoma completo (WGS) como el primer paso para elegir un cúmulo de genes biosintéticos (BCG) para la minería del genoma guiado por EM. Todo el borrador del genoma de la cepa de interés (bacterias) se puede obtener mediante la tecnología Illumina MiSeq utilizando lo siguiente con ADN genómico de alta calidad: escopeta TruSeq PCR-Free library prep y Nextera Mate Pair Library Preparation Kit33.
NOTA: Después de la secuenciación, la biblioteca de escopetas Illumina y la biblioteca de pares de relaciones de posición De Illumina se pueden montar con el Newbler v3.0 (Roche, 454) programa ensamblador (que se encuentra en ) y anotado mediante una canalización basada en FgeneSB (que se encuentra en ), como se describió anteriormente33. Microbiology Resource Announcements (MRA) es una revista de acceso totalmente abierto con artículos que publican la disponibilidad de cualquier recurso microbiológico depositado en un repositorio disponible (que se encuentra en ). Los genes de codificación de proteínas candidatos se identifican mediante la anotación34del servidor RAST y el proyecto De sesión de escopeta genómico completo (WGS) se deposita en las bases de datos de secuencia SDBJ/ENA/GenBank (que se encuentra en ) y Gold (que se encuentra en las bases de datos de secuencia ). - Para obtener en silico información sobre las anotaciones de los clústeres de genes del metabolismo secundario de un genoma secuenciado completo, envíe el archivo de secuencia (formato GenBank/EMBL o FASTA) a una plataforma antiSMASH (que se encuentra en ).
- Seleccione el grupo genético de interés de los datos de salida(Figura 2) en función del clúster conocido más similar.
NOTA: En primer lugar, es rutinario explorar gene-by-gene y realizar búsquedas individuales (blastp) para evaluar qué funciones están asociadas con los grupos de genes biosintéticos deseados. Este procedimiento también puede ayudar a determinar qué BGC está probablemente asociado con la producción de un compuesto deseado, incluso si es un porcentaje bajo. Una predicción antiSMASH considera todos los genes dentro de un clúster para hacer cobertura porcentual, que puede representar un bajo porcentaje global de similitud para el BGC objetivo. Sin embargo, al analizar gene-by-gene, es posible obtener información más precisa utilizando el grupo conocido más similar. En segundo lugar, antiSMASH tiene dos opciones para refinar una búsqueda: 1) la rigurosidad de detección: el grado de rigurosidad al que debe considerarse un golpe en el grupo genético biosintético. Para esta opción, el usuario debe utilizar los siguientes parámetros: a) estricto: detecta clústeres exclusivamente bien definidos que contienen todas las regiones requeridas, insensibles a errores sobre información genética; b) relajado: detecta los clústeres parciales que faltan una o más regiones funcionales, que también funciona para detectar la característica estricta; o c) sueltos: detecta racimos y clústeres mal definidos que probablemente coincidan con metabolitos primarios, lo que puede dar lugar a la aparición de falsos positivos o BGC mal definidos. La otra opción es 2) características adicionales: el tipo de información que la plataforma debe buscar y mostrar en la salida. En general, estas dos opciones pueden ahorrar tiempo después de la predicción. Sin embargo, el trabajo antiSMASH requiere un período de tiempo más largo.
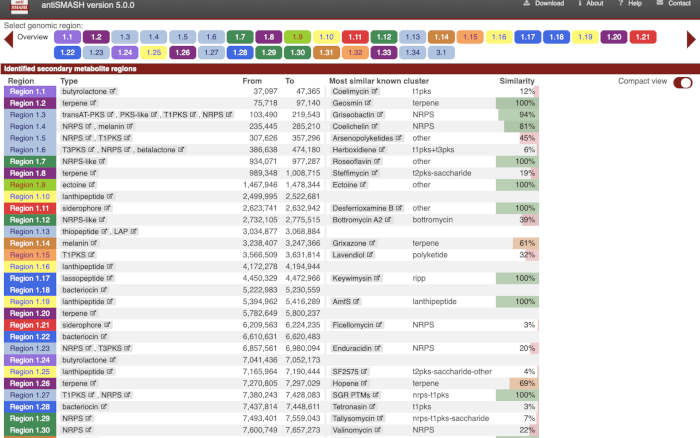
Figura 2: Salida desde la plataforma antiSMASH. Metabolismo secundario en análisis de silico a partir de la anotación de la secuencia del genoma completo. Haga clic aquí para ver una versión más grande de esta figura.
- Sobre la base de la información de secuencia de ADN del BGC, imprimaciones de diseño (20-25 nt) que flanquean el grupo genético para el cribado de la biblioteca ESAC (E. coli/Streptomyces Artificial Chromosome).
NOTA: Se pueden utilizar diferentes métodos35,,36 para capturar todo el grupo genético biosintético del ADN. Aquí, el método utilizado es la construcción de una biblioteca esca la esca representativa37,38 de Streptomyces sp. CBMAI 2042 que contiene clones con fragmentos de tamaño medio de 95 kb.
2. Expresión hetróloga de un cúmulo de genes biosintéticos completos de la biblioteca ESAC
- Mueva el vector ESAC de E. coli DH10B a E. coli ET12567 por conjugación triparental32.
- Inoculación E. coli ET12567 (CamR), TOPO10/pR9604 (CarbR), DH10B/ESAC4H (AprR) en 5 mL de Luria-Bertani (LB) medio que contiene cloranfenicol (25 g/ml), carbenicilina (100 g/ml) y apramicina (50 g/mL).
- Incubar el cultivo durante la noche a 37oC y 250 rpm.
- Inocular 500 ml del cultivo nocturno en 10 ml de medio LB que contiene una media concentración de antibióticos.
- Incubar el cultivo a 37oC y 250 rpm hasta alcanzar una A600 de 0,4–0,6.
- Cosecha las células por centrifugación a 2.200 x g durante 5 min.
- Lave las células dos veces con 20 ml de medio LB.
- Resuspenda las células en 500 s de medio LB.
- Mezclar 20 ml de cada cepa en un tubo de microcentrífuga y gotear en una placa de agar con un medio LB carente de antibióticos.
- Incubar las placas a 37oC durante la noche.
- Raya las células cultivadas en una placa de agar LB fresca que contiene antibióticos e incuba a 37 oC durante la noche.
3. Estreptomiación/ Conjugación deE. coli
- Para obtener el organismo hetrólogo recombinante, realice la conjugación32 entre E. coli ET12567 que contenga el vector ESAC, plásmido auxiliar pR9604 y Streptomyces coelicolor M1146 u otra cepa huésped seleccionada39.
- Día 1: Inocular colonias aisladas de S. coelicolor M1146 en 25 mL de medio TSBY en un matraz Erlenmeyer de 250 ml equipado con un inox-primavera a 30oC y 200 rpm durante 48 h.
- Día 2/3: Inocular ET12567/ESAC/pR9604 en 5 ml de medio DE LB que contenga cloramphenicol (25 g/ml), carbenicilina (100 g/ml) y apramycina (50 g/ml) durante la noche a 37 oC y 250 rpm.
- Día 3/4: Inocular 500 ml del cultivo nocturno en 10 ml de 2TY (en un tubo cónico de 50 ml) que contiene concentraciones a medio funcionamiento de antibióticos. Incubar a 37oC y 250 rpm hasta alcanzar una A600 de 0,4–0,6.
- Centrifugar los cultivos (ET12567/ESAC/pR9604 y M1146) a 2200 x g durante 10 min.
- Lavar los gránulos 2veces en 20 ml de medio 2TY y resuspender en 500 oL de 2TY.
- Alícuota 200 l de la suspensión S. coelicolor M1146 y diluir en 500 éL de 2TY (suspensión A).
- Aliquot 200 l de suspensión A y diluir en 500 éL de 2TY (suspensión B).
- Aliquot 200 l de suspensión B y diluir en 500 éL de 2TY (suspensión C).
- Alícuota 200 l de la suspensión ET12567/ESAC/pR9604 y mezcle con 200 l de suspensión C.
- Placa 150 l de la mezcla de conjugación en una placa de agar SFM que carece de antibióticos.
- Incubar a 30oC durante 16 h.
- Cubra las placas con 1 ml de solución antibiótica (según resistencia al plásmido). Después del secado, incubar a 30oC durante 4-7 días.
NOTA: Aquí se preparó una solución que contiene 1,0 mg/ml de tallotrepton y 0,5 mg/ml de ácido nalidixico. - Exconjugantes putativos de rayas en placas de agar SFM que contienen thiostrepton (50 mg/ml) y ácido nalidixic (25 mg/ml). Incubar a 30oC.
- Exconjugantes de rayas en un agar SFM que contiene sólo ácido nalidixic.
- Realizar análisis de PCR con colonias aisladas para confirmar que todo el cúmulo genético ha sido transferido al huésped S. coelicolor M1146.
4. Cultivo de cepas
- Para obtener el perfil metabólico, inocular 1/100 del precultivo de la cepa en medios de fermentación adecuados y en las condiciones de cultivo adecuadas.
- Cultivos de centrífuga a 2200 x g durante 10 min.
- Realizar la extracción según la clase del compuesto de interés40.
5. Adquisición de espectros de masas y preparación para el análisis de GNPS
- Para adquirir datos MS/MS, programe métodos HPLC y espectrometría de masas adecuados utilizando el software de control. Se puede analizar el análisis de espectrometría de masas (DDA) dependiente de datos de alta y baja resolución.
NOTA: Generalmente, una solución de 1 mg/ml de muestras complejas de extracto bruto es ideal. Las diluciones son necesarias para extractos menos complejos. Cabe señalar que las redes MS/MS son la red molecular detectable bajo las condiciones espectrométricas de masadadas. - Convierta los espectros de masas al formato .mzXML mediante MSConvert de Proteowizard (que se encuentra en ). Los parámetros de entrada para la conversión se ilustran en la Figura 3. Los datos de software de casi todas las empresas son compatibles.
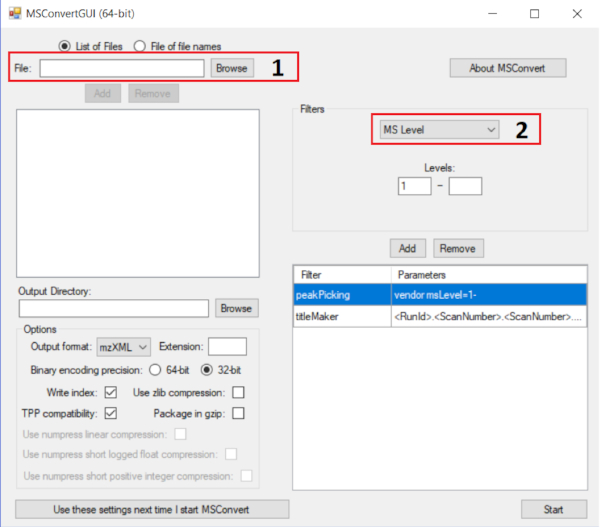
Figura 3: Uso de MsConvert para convertir archivos MS a extensión mzXML. Se muestra el parámetro correcto para el análisis GNPS. Las instrucciones son las siguientes: agregue todos los archivos MS en la caja 1 y agregue el filtro Peak Picking en la caja 2; para este filtro, utilice el proveedor del algoritmo; pulse start y seguirán los procesos de conversión. Haga clic aquí para ver una versión más grande de esta figura.
- Cargue los archivos LC-MS/MS convertidos en la base de datos GNPS. Hay dos opciones disponibles: el uso de un protocolo de transferencia de archivos (FTP) o directamente en un navegador a través de la plataforma en línea.
NOTA: La información detallada sobre cómo instalar y transferir datos a GNPS está disponible en .
6. Análisis GNPS
- Después de crear una cuenta en GNPS (que se encuentra en ), inicie sesión en la cuenta creada, seleccione Crear red molecular. Agregue un puesto de trabajo.
- Opciones básicas: seleccione los archivos mzXML para realizar la red molecular. Se pueden organizar en un máximo de seis grupos. Seleccione las bibliotecas para la rutina de desreplicación(figura 4).
NOTA: Estos grupos no interfieren con la construcción de la red molecular. Esta información se utilizará únicamente para la representación gráfica.
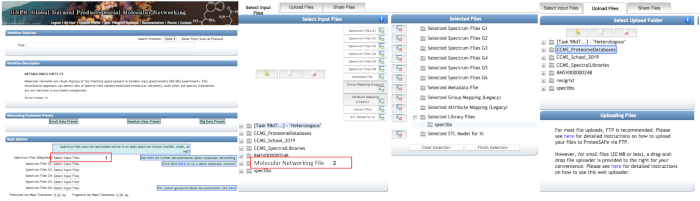
Figura 4: Uso de la plataforma GNPS en línea para realizar análisis de redes moleculares. La selección de archivos mzXML se realiza haciendo clic en el cuadro 1. En el cuadro de diálogo Abrir, los archivos se pueden seleccionar de la carpeta personal (cuadro 2) o cargarse en la segunda pestaña mediante el cargador de archivos de arrastrar y soltar (menos de 20 MB). Los archivos se pueden agrupar en hasta seis grupos. Haga clic aquí para ver una versión más grande de esta figura.
- Seleccione la tolerancia de masa de iones precursor y la tolerancia de masa de iones de fragmento de 0,02 Da y 0,05 Da, respectivamente.
NOTA: GNPS tiene diferentes tipos de rigurosidad disponibles en función de 1) cuán precisos son los datos de MS/MS y 2) cuán precisa debe ser la asociación. Opciones básicas: en esta carpeta, es posible establecer Tolerancia de masa de iones de precursor y Tolerancia de masa de ionesde fragmento . Estos parámetros se utilizan como guía para determinar la precisión del ion precursor y el ion de fragmentos. Las tolerancias de masa seleccionadas dependen de la resolución y precisión del espectrómetro de masas que se utiliza. - Opciones avanzadas de red: seleccione los parámetros según la Figura 5. Estos parámetros influyen directamente en el tamaño y la forma del clúster de red. Otro parámetro en la sección de pestañas restantes son para usuarios avanzados; por lo tanto, deje los valores predeterminados.
NOTA: Los parámetros avanzados se pueden leer en la documentación de GNPS (que se encuentra en ).
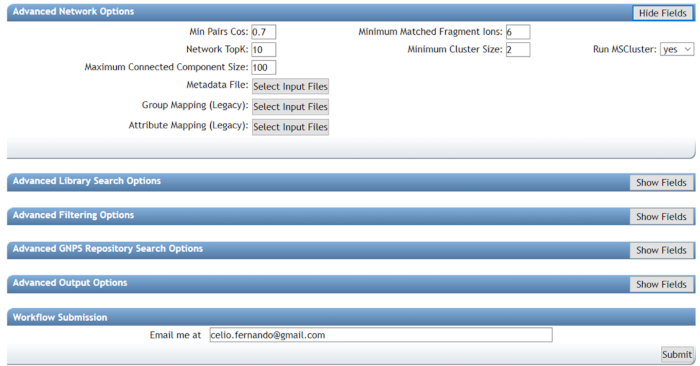
Figura 5: Uso de GNPS para realizar análisis de red molecular (opciones avanzadas). Min Pair Cos influirá directamente en el tamaño de los clústeres, ya que los valores altos darán como resultado la combinación de compuestos estrechamente relacionados y valores bajos en la combinación de compuestos relacionados distantemente. Se debe evitar el uso de valores demasiado bajos. Los iones de fragmentos coincidentes mínimos representan el número de fragmentos compartidos entre dos espectros de fragmentación que se vincularán en la red. Juntos, ambos parámetros guían el formato de red; valores más bajos se agruparán compuestos más distantes y viceversa. El uso de los valores adecuados ayudará en gran medida a la aclaración compuesta. Haga clic aquí para ver una versión más grande de esta figura.
- Elija una dirección de correo electrónico para recibir una alerta cuando el trabajo haya terminado y envíe el trabajo.
7. Análisis de los resultados de GNPS
- Inicie sesión en GNPS. Seleccione Trabajos > Trabajo publicado > Listo para abrir el trabajo. Se abrirá una página web como se muestra en la figura 6. Se mostrarán todos los resultados obtenidos de las redes moleculares.
- Seleccione Ver familias espectrales (en el visualizador de red del explorador) para ver todos los clústeres de red (cuadro rojo, figura 6).
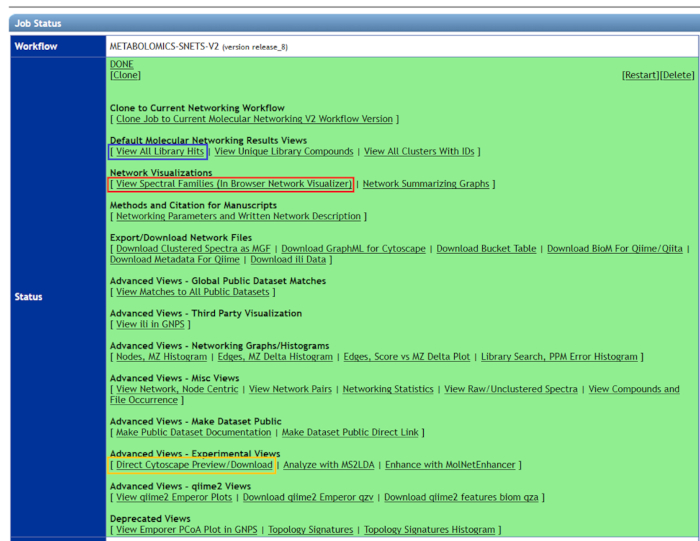
Figura 6: Uso de GNPS para visualizar los resultados de la red molecular. Todos los clústeres compuestos relacionados se pueden ver en familias espectrales de vista (caja roja). Para visualizar solo los hits de la biblioteca, se debe seleccionar "ver todos los hits de biblioteca" (cuadro azul). Para una mejor representación gráfica de los resultados de la red molecular, se debe descargar "Direct Cytoscape Preview" (caja amarilla) y se debe utilizar la última versión de Cytoscape. Haga clic aquí para ver una versión más grande de esta figura.
- Se mostrará una lista con todos los clústeres de redes moleculares generados. Si se seleccionó una búsqueda de biblioteca para generar los hallazgos, la identificación de moléculas provisionales se mostrará en AllIDs. Seleccione Mostrar para visualizarlos.
NOTA: Los análisis de datos pueden ser impulsados para otros resultados (es decir, minería del genoma, ensayos biológicos, moléculas de desreplicación de bibliotecas, etc.). - Para analizar el clúster de red molecular, seleccione Visualizar red.
NOTA: Cada grupo se compone de nodos (círculos) y bordes, que representa moléculas y similitud molecular, respectivamente. Las moléculas desreplicadas se resaltarán como un nodo azul en el visualizador de red del navegador en línea. - En el cuadro etiquetas de nodo, seleccione masa primaria (cuadro rojo, figura 7).
- En el cuadro etiquetas de borde, seleccione Coseno o DeltaMZ para observar la similitud de nodos o la diferencia de masa entre nodos, respectivamente (cuadro amarillo, Figura 7).
- En el caso de los análisis multigrupo, haga clic en Dibujar pasteles en el cuadro de color de nodo para observar la frecuencia con la que aparece cada nodo en cada grupo (cuadro azul, Figura 7).
NOTA: Otras opciones son posibles, pero las sugeridas anteriormente son óptimas para anotar nodos de clúster y desentrañar sus estructuras.
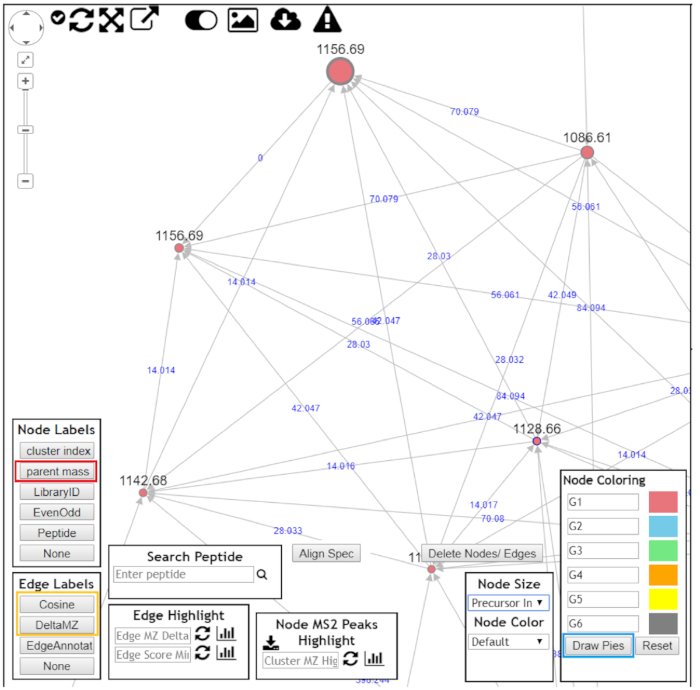
Figura 7: Uso de GNPS para visualizar los resultados del clúster molecular. Después de abrir los clústeres moleculares para una mejor visualización de datos, se debe elegir lo siguiente: "Masa principal" como etiquetas de nodo (caja roja); "DeltaMZ" como etiquetas de borde (caja amarilla); y "Dibujar pasteles" como color de nodo (caja azul). Navegue a través del clúster molecular e intente anotar todos los nodos. Haga clic aquí para ver una versión más grande de esta figura.
- Para ver todos los hits de biblioteca, seleccione Ver todos los hits de biblioteca (cuadro azul, Figura 7).
NOTA: Además, el MNW se puede descargar en "Direct Cytoscape Preview/Download" (cuadro amarillo, Figura 7), y el archivo se puede abrir en la plataforma Cytoscape (que se encuentra en ) para obtener más opciones en estructura gráfica. - Se necesita confirmación manual de compuestos desreplicados y aclaración de la estructura de los compuestos relacionados. Abra los espectros de fragmentaciones directamente en la plataforma GNPS o en archivos sin procesar originales.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
El protocolo se ejemplificó con éxito utilizando una combinación de minería del genoma, expresión hetróloga y enfoques guiados por MS/código para acceder a nuevas moléculas análogas especializadas en valinomicina. El flujo de trabajo genoma-molécula para el objetivo, valinomicina (VLM), se representa en la Figura 8. El genoma del borrador CBMAI 2042 se analizó en silico, y el grupo genético VLM fue identificado y transferido a un huésped hetrólogo. Las cepas de tipo heterologous y s...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
La mayor ventaja de este protocolo es su capacidad para desreplicar rápidamente los perfiles metabólicos y salvar la información genómica con datos de MS con el fin de dilucidar las estructuras de las nuevas moléculas, especialmente los análogos estructurales2. Sobre la base de información genómica, se pueden investigar diferentes productos naturales quimiotipos, tales como poliketidas (PK), péptidos nonribosomales (NRP) y productos naturales glucosilados (GNP), así como BGCcrígos crípticos. Por l...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen nada que revelar.
Agradecimientos
El apoyo financiero para este estudio fue proporcionado por la Fundación de Investigación de Sao Paulo - FAPESP (2019/10564-5, 2014/12727-5 y 2014/50249-8 a L.G.O; 2013/12598-8 y 2015/01013-4 a R.S.; y 2019/08853-9 a C.F.F.A). B.S.P, C.F.F.A. y L.G.O. recibieron becas del Consejo Nacional de Desarrollo Científico y Tecnológico - CNPq (205729/2018-5, 162191/2015-4 y 313492/2017-4). L.G.O. también agradece el apoyo de la subvención proporcionado por el programa Para mujeres en la ciencia (2008, Edición Brasileña). Todos los autores reconocen capeS (Coordinación para la mejora del personal de educación superior) por apoyar los programas de post-graduación en Brasil.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Acetonitrilo | Tedia | AA1120-048 | |
| Agar | Oxoide | LP0011 | NA |
| Apramicina | Sigma Aldrich | A2024 | NA |
| Carbenicillina | Sigma Aldrich | C9231 | NA |
| Centrífuga | Eppendorf | NA | 5804 |
| Cloranfenicol | Sigma Aldrich | C3175 | NA |
| Columna C18 | Agilent Technologies | NA | ZORBAX RRHD Extend-C18, 80Å, 2,1 x 50 mm, 1,8 µ m, límite de presión de 1200 bar N/P 757700-902 |
| Kanamicina | Sigma Aldrich | K1377 | NA |
| Manitol P.A.- A.C.S. | Synth | NA | NA |
| Microcentrífuga | Eppendorf | NA | 5418 |
| Ácido nalidíxico | Sigma Aldrich | N4382 | NA |
| Phusion Flash PCR de alta fidelidad Master Mix | ThermoFisher Scientific | F548S | NA |
| Q-TOF espectrómetro de masas | Agilent technologies | NA | 6550 iFunnel Q-TOF LC/MS |
| Sacarose P.A.- A.C.S. | Synth | NA | NA |
| Shaker/Incubadora | Marconi | MA420 | NA |
| Cloruro de Sodio | Synth NA | P. A. - ACS | |
| Extracto de soja | NA | NA | NA |
| Sintetizador de sacarosa | NA | P. A. - ACS | |
| Ciclos Térmicos | Eppendorf | NA | Mastercycler Nexus Gradient |
| Thiostrepton | Sigma Aldrich | T8902 | NA |
| Triptona | Oxoid | LP0042 | NA |
| Triptona Caldo de Soja | Oxoid CM0129 | ||
| NA UPLC Agilent | Technologies | NA | 1290 Infinity LC System |
| Extracto de levadura | Oxoid | LP0021 | NA |
Referencias
- Davies, J. Specialized microbial metabolites: functions and origins. The Journal of Antibiotics. 66 (7), Tokyo. 361-364 (2013).
- Ziemert, N., Alanjary, M., Weber, T. The evolution of genome mining in microbes - a review. Natural Product Reports. 33 (8), 988-1005 (2016).
- Zerikly, M., Challis, G. L. Strategies for the Discovery of New Natural Products by Genome Mining. ChemBioChem. 10 (4), 625-633 (2009).
- Gomez-Escribano, J. P., Bibb, M. J. Heterologous expression of natural product biosynthetic gene clusters in Streptomyces coelicolor: from genome mining to manipulation of biosynthetic pathways. Journal of Industrial Microbiology & Biotechnology. 41 (2), 425-431 (2014).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nature Chemical Biology. 11 (9), 625-631 (2015).
- Lautru, S., Deeth, R. J., Bailey, L. M., Challis, G. L. Discovery of a new peptide natural product by Streptomyces coelicolor genome mining. Nature Chemical Biology. 1 (5), 265-269 (2005).
- Chiang, Y. -M., et al. Molecular Genetic Mining of the Aspergillus Secondary Metabolome: Discovery of the Emericellamide Biosynthetic Pathway. Chemistry & Biology. 15 (6), 527-532 (2008).
- Huang, T., et al. Identification and Characterization of the Pyridomycin Biosynthetic Gene Cluster of Streptomyces pyridomyceticus NRRL B-2517. Journal of Biological Chemistry. 286 (23), 20648-20657 (2011).
- Udwary, D. W., et al. Genome sequencing reveals complex secondary metabolome in the marine actinomycete Salinispora tropica. Proceedings of the National Academy of Sciences. 104 (25), 10376-10381 (2007).
- Gross, H., et al. The Genomisotopic Approach: A Systematic Method to Isolate Products of Orphan Biosynthetic Gene Clusters. Chemistry & Biology. 14 (1), 53-63 (2007).
- Spohn, M., Wohlleben, W., Stegmann, E. Elucidation of the zinc-dependent regulation in Amycolatopsis japonicum enabled the identification of the ethylenediamine-disuccinate ([S,S ]-EDDS) genes. Environmental Microbiology. 18 (4), 1249-1263 (2016).
- Thaker, M. N., Waglechner, N., Wright, G. D. Antibiotic resistance-mediated isolation of scaffold-specific natural product producers. Nature Protocols. 9 (6), 1469-1479 (2014).
- Katz, M., Hover, B. M., Brady, S. F. Culture-independent discovery of natural products from soil metagenomes. Journal of Industrial Microbiology & Biotechnology. 43, 129-141 (2016).
- Quinn, R. A., et al. Molecular Networking as a Drug Discovery, Drug Metabolism, and Precision Medicine Strategy. Trends in Pharmacological Sciences. 38 (2), 143-154 (2017).
- Yang, J. Y., et al. Molecular Networking as a Dereplication Strategy. Journal of Natural Products. 76 (9), 1686-1699 (2013).
- Lommen, A. MetAlign: Interface-Driven, Versatile Metabolomics Tool for Hyphenated Full-Scan Mass Spectrometry Data Preprocessing. Analytical Chemistry. 81 (8), 3079-3086 (2009).
- Katajamaa, M., Miettinen, J., Oresic, M. MZmine: toolbox for processing and visualization of mass spectrometry based molecular profile data. Bioinformatics. 22 (5), 634-636 (2006).
- Pluskal, T., Castillo, S., Villar-Briones, A., Orešič, M. MZmine 2: Modular framework for processing, visualizing, and analyzing mass spectrometry-based molecular profile data. BMC Bioinformatics. 11 (1), 395(2010).
- Tautenhahn, R., Patti, G. J., Rinehart, D., Siuzdak, G. XCMS Online: A Web-Based Platform to Process Untargeted Metabolomic Data. Analytical Chemistry. 84 (11), 5035-5039 (2012).
- Kuhl, C., Tautenhahn, R., Böttcher, C., Larson, T. R., Neumann, S. CAMERA: An Integrated Strategy for Compound Spectra Extraction and Annotation of Liquid Chromatography/Mass Spectrometry Data Sets. Analytical Chemistry. 84 (1), 283-289 (2012).
- Katajamaa, M., Orešič, M. Data processing for mass spectrometry-based metabolomics. Journal of Chromatography A. 1158, 318-328 (2007).
- Liu, W. -T., et al. Interpretation of Tandem Mass Spectra Obtained from Cyclic Nonribosomal Peptides. Analytical Chemistry. 81 (11), 4200-4209 (2009).
- Ng, J., et al. Dereplication and de novo sequencing of nonribosomal peptides. Nature Methods. 6 (8), 596-599 (2009).
- Liaw, C., et al. Vitroprocines, new antibiotics against Acinetobacter baumannii, discovered from marine Vibrio sp. QWI-06 using mass-spectrometry-based metabolomics approach. Scientific Reports. 5 (1), 1-11 (2015).
- Kang, K. B., et al. Targeted Isolation of Neuroprotective Dicoumaroyl Neolignans and Lignans from Sageretia theezans Using in Silico Molecular Network Annotation Propagation-Based Dereplication. Journal of Natural Products. 81 (8), 1819-1828 (2018).
- Wang, M., et al. Sharing and community curation of mass spectrometry data with Global Natural Products Social Molecular Networking. Nature Biotechnology. 34 (8), 828-837 (2016).
- Doroghazi, J. R., et al. A roadmap for natural product discovery based on large-scale genomics and metabolomics. Nature Chemical Biology. 10 (11), 963-968 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Research. 39, 339-346 (2011).
- Weber, T., et al. antiSMASH 3.0-a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Research. 43, 237-243 (2015).
- Blin, K., et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Research. 47, 81-87 (2019).
- Watrous, J., et al. Mass spectral molecular networking of living microbial colonies. Proceedings of the National Academy of Sciences. 109 (26), 1743-1752 (2012).
- Paulo, B. S., Sigrist, R., Angolini, C. F. F., De Oliveira, L. G. New Cyclodepsipeptide Derivatives Revealed by Genome Mining and Molecular Networking. ChemistrySelect. 4 (27), 7785-7790 (2019).
- Gonzaga de Oliveira, L., Sigrist, R., Sachetto Paulo, B., Samborskyy, M. Whole-Genome Sequence of the Endophytic Streptomyces sp. Strain CBMAI 2042, Isolated from Citrus sinensis. Microbiology Resource Announcements. 8 (2), 1-2 (2019).
- Aziz, R. K., et al. The RAST Server: Rapid Annotations using Subsystems Technology. BMC Genomics. 9 (1), 75(2008).
- Nah, H. -J., Pyeon, H. -R., Kang, S. -H., Choi, S. -S., Kim, E. -S. Cloning and Heterologous Expression of a Large-sized Natural Product Biosynthetic Gene Cluster in Streptomyces Species. Frontiers in Microbiology. 8, 1-10 (2017).
- Zhang, J. J., Tang, X., Moore, B. S. Genetic platforms for heterologous expression of microbial natural products. Natural Product Reports. 36 (9), 1313-1332 (2019).
- Alduina, R., et al. Artificial chromosome libraries of Streptomyces coelicolor A3(2) and Planobispora rosea. FEMS Microbiology Letters. 218 (1), 181-186 (2003).
- Jones, A. C., et al. Phage P1-Derived Artificial Chromosomes Facilitate Heterologous Expression of the FK506 Gene Cluster. PLoS One. 8 (7), 69319(2013).
- Gomez-Escribano, J. P., Bibb, M. J. Engineering Streptomyces coelicolor for heterologous expression of secondary metabolite gene clusters. Microbial Biotechnology. 4 (2), 207-215 (2011).
- Cannell, R. J. P. Natural Products Isolation. , Humana Press. Totowa, NJ. (1998).
- Kersten, R. D., et al. A mass spectrometry-guided genome mining approach for natural product peptidogenomics. Nature Chemical Biology. 7 (11), 794-802 (2011).
- Kersten, R. D., et al. Glycogenomics as a mass spectrometry-guided genome-mining method for microbial glycosylated molecules. Proceedings of the National Academy of Sciences. 110 (47), 4407-4416 (2013).
- Liu, W., et al. MS/MS-based networking and peptidogenomics guided genome mining revealed the stenothricin gene cluster in Streptomyces roseosporus. The Journal of Antibiotics. 67 (1), Tokyo. 99-104 (2014).
- Duncan, K. R., et al. Molecular Networking and Pattern-Based Genome Mining Improves Discovery of Biosynthetic Gene Clusters and their Products from Salinispora Species. Chemistry & Biology. 22 (4), 460-471 (2015).
- Cao, L., et al. MetaMiner: A Scalable Peptidogenomics Approach for Discovery of Ribosomal Peptide Natural Products with Blind Modifications from Microbial Communities. Cell Systems. , (2019).
- Chen, L. -Y., Cui, H. -T., Su, C., Bai, F. -W., Zhao, X. -Q. Analysis of the complete genome sequence of a marine-derived strain Streptomyces sp. S063 CGMCC 14582 reveals its biosynthetic potential to produce novel anti-complement agents and peptides. PeerJ. 7 (1), 6122(2019).
- Kim Tiam, S., et al. Insights into the Diversity of Secondary Metabolites of Planktothrix Using a Biphasic Approach Combining Global Genomics and Metabolomics. Toxins. 11 (9), 498(2019).
- Özakin, S., Ince, E. Genome and metabolome mining of marine obligate Salinispora strains to discover new natural products. Turkish Journal of Biology. 43 (1), 28-36 (2019).
- Trivella, D. B. B., de Felicio, R. The Tripod for Bacterial Natural Product Discovery: Genome Mining, Silent Pathway Induction, and Mass Spectrometry-Based Molecular Networking. mSystems. 3 (2), 00160(2018).
- Maansson, M., et al. An Integrated Metabolomic and Genomic Mining Workflow To Uncover the Biosynthetic Potential of Bacteria. mSystems. 1 (3), 1-14 (2016).
- Blin, K., Kim, H. U., Medema, M. H., Weber, T. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Briefings in Bioinformatics. 20 (4), 1103-1113 (2019).
- Fisch, K. M. Biosynthesis of natural products by microbial iterative hybrid PKS-NRPS. RSC Advances. 3 (40), 18228-18247 (2013).
- Tatsuno, S., Arakawa, K., Kinashi, H. Analysis of Modular-iterative Mixed Biosynthesis of Lankacidin by Heterologous Expression and Gene Fusion. The Journal of Antibiotics. 60 (11), Tokyo. 700-708 (2007).
- Helfrich, E. J. N., Piel, J. Biosynthesis of polyketides by trans-AT polyketide synthases. Natural Product Reports. 33 (2), 231-316 (2016).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Reimpresiones y permisos
