Este estudio examina si los factores de marketing de relaciones mejoran los sistemas de recomendación deportiva para los aficionados de la Superliga China. Incorporar satisfacción, confianza, compromiso y reciprocidad mejora significativamente la precisión de las recomendaciones de Top-N, especialmente en condiciones de poca y larga cola. Los resultados muestran que el compromiso y la reciprocidad impulsan comportamientos repetidos de alta implicación, mientras que la satisfacción y la confianza apoyan principalmente el compromiso temprano.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Sistemas inteligentes de recomendación para la predicción del comportamiento de consumo de los aficionados de la Super League China
En este artículo
Resumen
Resumen
Comprender y predecir el comportamiento de consumo de los aficionados es un desafío central en el deporte profesional, pero la mayoría de los sistemas de recomendación se basan principalmente en interacciones históricas y prestan poca atención a los factores de marketing de relaciones que influyen en la implicación de los aficionados. Para abordar esta brecha, este estudio desarrolla MLP-PA (Perceptrón Multicapa con Atención en Pirámide) y examina si incorporar estados relacionales de los aficionados —como satisfacción, confianza, compromiso y reciprocidad— puede mejorar la efectividad de las recomendaciones en múltiples escenarios de consumo entre los aficionados de la Superliga China (CSL). Utilizando un conjunto de datos multiescenario que abarca ticketing, merchandising, membresía y contenido digital, los resultados empíricos muestran que las recomendaciones generadas por MLP-PA alcanzan una precisión significativamente mayor en el ranking Top-N que los enfoques convencionales de filtrado colaborativo, con mejoras especialmente pronunciadas en entornos de escasez y de cola larga. El análisis revela además que diferentes factores de relación están asociados a patrones de consumo distintos: el compromiso y la reciprocidad están más fuertemente vinculados a comportamientos repetidos y de alta implicación, mientras que la satisfacción y la confianza influyen principalmente en las respuestas iniciales y a corto plazo. Estos hallazgos demuestran que los factores de marketing de relaciones juegan un papel sustantivo y diferenciado en el comportamiento de consumo de los aficionados, ofreciendo información útil para estrategias de interacción personalizadas y operaciones digitales en el fútbol profesional.
Introducción
En los últimos años, los sistemas de recomendación se han convertido en un componente central de las plataformas digitales, permitiendo la alineación de usuarios, productos y contextos de consumo mediante la personalización basada en datos. Aunque las tecnologías de recomendación están bien establecidas en ámbitos como el comercio electrónico y los medios online, su aplicación en el deporte profesional sigue siendo relativamente pocodesarrollada. En ligas como la Superliga China (CSL), el comportamiento de consumo de aficionados es muy sensible al contexto y evoluciona a lo largo de las fases previas, días de encuentro y post-partido, con las decisiones de compra estrechamente entrelazadas con la asistencia presencial, el apego emocional y la identidad social. Sin embargo, la mayoría de los estudios existentes sobre recomendadores deportivos adaptan principalmente técnicas de filtrado colaborativo o basadas en contenido de otros ámbitos y se centran en señales de interacción a corto plazo, como clics o compras. Estos enfoques pasan en gran medida por alto las dinámicas relacionales entre aficionados y clubes —como la confianza, el compromiso o la reciprocidad— que en la investigación de marketing deportivo se sabe que moldean el compromiso a largo plazo y el consumorepetido 2. Como resultado, los modelos actuales tienen dificultades para explicar por qué historias conductuales similares pueden conducir a resultados divergentes de consumo bajo diferentes estados relacionales. Esta carencia pone de manifiesto la necesidad de marcos de recomendación que vayan más allá de la frecuencia de interacción y tengan en cuenta explícitamente los mecanismos impulsados por las relaciones en la toma de decisiones de los fans3.
Desde una perspectiva de marketing relacional, la satisfacción, la confianza, el compromiso y la reciprocidad constituyen conjuntamente la calidad de la relación y están bien establecidos como motores clave de los resultados clave para los fans, incluyendo la asistencia a partidos, la compra de merchandising, la renovación de membresía y la defensa del boca aboca 4,5,6. En cambio, la mayoría de los sistemas de recomendación deportiva existentes continúan modelando las interacciones fan-item como señales conductuales en gran medida homogéneas, prestando poca atención al contexto relacional subyacente a esas interacciones. Esta simplificación limita su capacidad para captar cómo diferentes factores de relación ejercen influencias distintas a través de las etapas de consumo y las intensidades de la interacción, y ayuda a explicar por qué los modelos basados únicamente en historias de interacción a menudo no diferencian las respuestas a corto plazo del comportamiento sostenido y de alta implicación de los fans.
Desde el punto de vista de la ingeniería, los sistemas de recomendación deportiva se enfrentan a desafíos adicionales, incluyendo retroalimentación implícita asimétrica, esparsidad severa de cola larga y contextos de interacción multitáctilesheterogéneos 7. Los enfoques tradicionales de filtrado colaborativo y los modelos profundos de un solo camino suelen mostrar una generalización limitada entre contextos en estos entornos y ofrecen poca interpretabilidad para el apoyo a la decisión en operaciones de marketing.
Metodológicamente, investigaciones previas sobre sistemas recomendadores han propuesto una variedad de soluciones para abordar la escasidez, heterogeneidad y optimización a largo plazo. Los modelos basados en grafos y orientados a la atención han mejorado el aprendizaje de representación y el rendimiento de clasificación al reponderar la importancia de los vecinos y capturar interacciones de ordensuperior 8,9. Las arquitecturas híbridas que combinan señales colaborativas con aprendizaje profundo han demostrado avances en tareas de recomendación a granescala 10. Los enfoques basados en aprendizaje por refuerzo amplían aún más la optimización hacia objetivos a largo plazo en lugar de la precisiónmiope 11. Estos avances proporcionan fundamentos metodológicos valiosos para modelar interacciones complejas bajo retroalimentación escasa.
No obstante, la mayoría de estos enfoques siguen siendo agnósticos respecto a los conceptos de marketing de relaciones y no incorporan explícitamente variables como la satisfacción, la confianza, el compromiso o la reciprocidad en el proceso de recomendación. Esta limitación es especialmente evidente en contextos de fútbol profesional, donde evolucionan las relaciones entre aficionados y clubes y donde se sabe que diferentes dimensiones relacionales dominan resultados conductuales distintos (por ejemplo, compra a primera vez frente a asistencia repetida)12,13,14,15.
Para cubrir esta brecha, proponemos MLP-PA (Multi-Layer Perceptron with Pyramid Attention), un marco de recomendación consciente de la relación adaptado al escenario de la Superliga China (CSL). Basándose en una arquitectura de Filtrado Colaborativo Neural (NCF) con una columna vertebral Multi-Layer Perceptron (MLP), el modelo propuesto trata la satisfacción, la confianza, el compromiso y la reciprocidad como características relacionales de primera clase e inyecta estos en un canal previo basado en la atención. A continuación, se emplea un módulo de atención de características piramidal para la fusión tardía para amplificar selectivamente patrones de interacción salientes a través de múltiples escalas, integrando representaciones de abanico, objeto y contextuales. Al modelar explícitamente variables de relación junto con características de interacción no lineales, MLP-PA pretende mejorar tanto la precisión predictiva como la interpretabilidad en la recomendación deportiva.
Una evaluación empírica de un conjunto de datos CSL autoconstruido muestra que el enfoque propuesto supera consistentemente las líneas base clásicas, incluyendo UserCF, ItemCF y MF-BPR, en las métricas de ranking Top-N. Un análisis más profundo de las variantes del modelo indica que incorporar la atención consciente de las relaciones ayuda a aliviar la escasez de cola larga y la heterogeneidad contextual. Los resultados también revelan roles diferenciados de los factores relacionales. El compromiso y la reciprocidad están más fuertemente asociados con conductas repetidas y de alta implicación, mientras que la satisfacción y la confianza apoyan principalmente las respuestas a corto y la primera vez.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utiliza registros de interacción fan–item desidentificados y datos anonimizados de cuestionarios recogidos únicamente con fines de investigación. No se accedió, almacenó ni procesó información personal identificable. Según las directrices institucionales y nacionales, este estudio no requería la aprobación formal del comité de ética ni el consentimiento informado individual.
Preparación del conjunto de datos y procedimiento experimental
Paso 1. Preparación y preprocesamiento de datos
La preparación de conjuntos de datos y los procedimientos experimentales fueron diseñados para transformar los registros conductuales en bruto y las respuestas de encuestas en un conjunto de datos experimental unificado y reproducible adecuado para el entrenamiento y evaluación del modelo. El proceso se centra en la limpieza de datos, anonimización, construcción de características, normalización y alineación de registros de interacción con variables relacionadas con la relación. Los registros de interacción en bruto se revisaron primero para eliminar entradas incompletas y eventos duplicados y asegurar la consistencia de los datos. Los identificadores de fans y de elementos se anonimizaron mediante hashing para proteger la privacidad de los usuarios. Múltiples formas de interacción, incluyendo navegación, clic, compra y validación de asistencia, se asignaron a señales de retroalimentación implícitas, tratando cada interacción observada como una instancia positiva. Se recogieron variables relacionadas con la relación —satisfacción, confianza, compromiso y reciprocidad— de las respuestas al cuestionario y se vincularon a los identificadores de fans correspondientes. Los valores faltantes del cuestionario se abordaron mediante imputación media dentro del mismo nivel de membresía para preservar las características a nivel de grupo. Las características continuas se normalizaron usando escalado min–max al rango [0, 1] para asegurar la comparabilidad entre variables. Tras el preprocesamiento, el conjunto de datos finalizado se almacenó en archivos estructurados que comprendían identificadores de fans anonimizados, IDs de elementos, marcas de tiempo, etiquetas contextuales y variables de relación normalizadas, que luego se usaron de forma consistente en todos los entornos experimentales.
Producción esperada:
Como resultado de este proceso, los resultados incluyen una tabla de interacción limpia, una tabla normalizada de variables de relación alineadas con identificadores de ventilador y un resumen estadístico detallando el número de ventiladores, elementos e interacciones en el conjunto de datos final.
Paso 2. División de entrenamiento/validación/prueba y muestreo negativo
Los datos se distribuyen cronológicamente a nivel de usuario para evitar fugas de información. Para cada ventilador, la interacción más reciente se reserva para pruebas, la segunda más reciente para validación y las interacciones restantes para entrenamiento. Las muestras negativas se generan al muestrear uniformemente los elementos no interactuados del conjunto de ítems. Por cada interacción positiva, se extrae un número fijo de muestras negativas (razón de muestreo negativa = 1:5) durante el entrenamiento. La misma construcción de conjuntos candidatos se aplica de forma consistente en todos los modelos.
Producción esperada:
Como resultado de este paso, los resultados incluyen conjuntos de datos de entrenamiento, validación y prueba divididos cronológicamente, junto con listas de muestras negativas pregeneradas construidas según la proporción de muestreo especificada.
Paso 3. Entorno de software e implementación
Todos los experimentos están implementados en Python. El entrenamiento y la evaluación de modelos se realizan utilizando PyTorch (versión ≥ 1.12). La optimización bayesiana de hiperparámetros se realiza usando Optuna (versión ≥ 3.0). Los scripts de entrenamiento se ejecutan en una estación de trabajo equipada con una única GPU NVIDIA (≥ 8 GB de memoria). Los archivos de configuración especifican rutas de conjuntos de datos, parámetros del modelo y ajustes de optimización para garantizar la reproducibilidad.
Paso 4. Construcción del modelo y especificación de parámetros
El modelo MLP-PA consta de una capa de incrustación, una columna vertebral de perceptrón multicapa, un canal de relación y atención y un módulo de fusión de atención piramidal. Los parámetros clave se establecen de la siguiente manera: dimensión de incrustación = 32; Capas ocultas MLP = [64, 32]; función de activación = ReLU; optimizador = Adam con tasa de aprendizaje 0,001 y decaimiento de peso 1e-5. El módulo de atención piramidal utiliza tres escalas de agrupación con tamaños de núcleo {1, 2, 4} y paso igual al tamaño del grano. La relación de reducción de atención se establece en 4. Se aplica un dropout con tasa 0,3 para evitar sobreajustes. Se activa la detención temprana si la validación NDCG@10 no mejora durante 10 épocas consecutivas.
Paso 5. Entrenamiento y optimización de hiperparámetros
El modelo se entrena utilizando una pérdida de Clasificación Bayesiano Personalizada (BPR) por pares. Durante la formación, el rendimiento de validación se monitoriza al final de cada época. Búsquedas bayesianas de optimización de hiperparámetros sobre la tasa de aprendizaje, el tamaño de incrustación, la tasa de abandono, la razón de muestreo negativa y los parámetros relacionados con la atención. El objetivo de optimización es validar NDCG@10. Cada configuración candidata se entrena con parada temprana para reducir el coste computacional.
Producción esperada:
Como resultado de este proceso, los resultados incluyen puntos de control entrenados del modelo, registros de rendimiento de validación y la configuración óptima de hiperparámetros identificada mediante la optimización bayesiana.
Paso 6. Evaluación y generación de resultados
Tras el entrenamiento, el modelo con mejor rendimiento (basado en el NDCG@10 de validación) se evalúa en el conjunto de pruebas. Se generan listas de recomendaciones Top N para cada ventilador y el rendimiento se mide usando HR@K y NDCG@K. Se realizan análisis adicionales, incluidos estudios de ablación y perfilado de atención condicionado por fase, utilizando el mismo protocolo de evaluación para garantizar la comparabilidad.
Criterios de finalización
El protocolo se considera completo cuando se obtienen las siguientes salidas: 1) Un modelo MLP-PA completamente entrenado con hiperparámetros optimizados; 2) Resultados de HR@K y NDCG@K de conjunto de pruebas para todos los modelos de referencia y ablación; 3) Puntos de control de modelos guardados, métricas de evaluación y archivos de configuración reproducibles. Estos resultados permiten colectivamente la replicación independiente del protocolo propuesto del sistema de recomendación.
Teoría del marketing entre compromiso y confianza
La teoría del compromiso y la confianza identifica el compromiso y la confianza como los determinantes fundamentales de la calidad de la relación. Al reducir la incertidumbre transaccional y fomentar la orientación a largo plazo y la intención cooperativa, estos factores promueven la continuidad relacional y la creaciónde valor 16. La confianza refleja la creencia de los aficionados en la competencia, integridad y benevolencia de un club, lo que reduce el riesgo percibido y la asimetría de información. Como resultado, una mayor confianza facilita un compromiso de baja fricción con recomendaciones personalizadas, autorización de datos y procesos de pago, apoyando así comportamientos en etapas tempranas y de bajo compromiso a lo largo del embudo de compra por clic. El compromiso, en cambio, captura la disposición de los fans a invertir tiempo, recursos financieros y apego emocional para mantener la relación a pesar de alternativas en competencia o insatisfaccióntemporal 17. Debido a que el compromiso está estrechamente asociado con la alineación de identidad, los costes hundidos y las inversiones dedicadas, proporciona un poder explicativo más estable para comportamientos de alto coste y alta implicación, como compras repetidas, renovación de membresía, asistencia en estadios y defensa del boca aboca 18.
Basándonos en estas distinciones, derivamos las siguientes hipótesis.
H1 (Confianza → Comportamiento de Apoyo): Una mayor confianza reduce la fricción de decisión y el riesgo percibido, aumentando así la probabilidad de comportamientos superficiales como clics, acciones de añadir al carrito y compras primerizas.
H2 (Ventaja Relativa del Compromiso): Entre las cuatro dimensiones relacionales, el compromiso muestra el mayor poder explicativo marginal para comportamientos de alto coste y a largo plazo, incluyendo compras repetidas, renovaciones y asistencia offline, y su contribución al rendimiento predictivo supera la de la satisfacción y la confianza.
Teoría del intercambio social
La teoría del intercambio social enfatiza que los individuos siguen las normas de reciprocidad y equidad en interaccionesrepetidas 19. La percepción de reciprocidad hace que los aficionados sientan que el club tiene un intercambio en concesiones de valores, respuestas emocionales y asignación de recursos. Cuando la reciprocidad se percibe como genuina y sostenible, los aficionados son más propensos a corresponder mediante el consumo y la asistencia, formando un ciclo de retroalimentación positiva20. La satisfacción es una función de las experiencias acumuladas en relación con las expectativas. A través de un mecanismo de expectativas y confirmación, promueve el cumplimiento a corto plazo y el boca a boca positivo, y proporciona un terreno fértil para el desarrollo de la confianza y el compromiso21.
En consecuencia, derivamos:
H3 (Satisfacción → Comportamiento de Apoyo): Una mayor satisfacción reduce el arrepentimiento y aumenta la inmediatez de la respuesta, aumentando la compra y la participación a corto plazo.
H4 (Reciprocidad → Conversión y Recompra): Dentro de un marco de juego repetido, las señales de reciprocidad amplifican la intensidad del intercambio "Beneficio → devuelvo", mejorando significativamente las tasas de conversión y recompra, especialmente en contextos sensibles al precio o escasez.
Sintetizando ambas teorías, las cuatro dimensiones muestran una clara heterogeneidad contextual en sus vías de influencia:
En contextos de incertidumbre o alto riesgo percibido—nuevos productos, precios dinámicos, autorización/pago de alto riesgo—la confianza ejerce efectos marginales más fuertes (soporta H1).
En contextos a largo plazo o con complicaciones de identidad—pases de temporada, partidos consecutivos en casa, renovación de membresía—el compromiso predomina (apoya H2).
En nodos de coincidencia principales o por debajo de incentivos/escasez—beneficios limitados, promociones—la reciprocidad impulsa más la conversión y la recompra (soporta H4).
La satisfacción actúa como el "suelo base", impulsando positivamente comportamientos a corto plazo en casi todos los contextos (apoya la H3) e indirectamente consolidando la confianza y el compromiso al mejorar la calidad de la experiencia. En lugar de probar estas hipótesis mediante modelado de ecuaciones estructurales, inyectamos las cuatro dimensiones en una capa de atención, permitiendo que el modelo aprenda pesos contextualizados y corrobore los mecanismos mediante experimentos de ablación.
MLP
El perceptrón multicapa (MLP) actúa como aprendiz de representación principal en nuestro marco.
(1) Capa de mapeo de entrada.
El vector de características original se expande linealmente una vez mediante una matriz 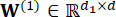 de pesos y sesgo b(1), dando lugar
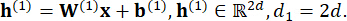 (1)
(2) Capa profunda de no linealidad.
Apilamos capas lineales, de activación y de normalización. La aplicación lineal utiliza una transformada afín totalmente conexa:
z = Wx + b, (2)
Donde 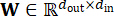 es la matriz de pesos,
 es el vector de sesgo, x es la salida de la capa anterior y z es la salida lineal. Para coincidir con las características de activación de ReLU y mantener los gradientes estables durante el entrenamiento, adoptamos la inicialización de He para W:
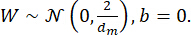 (3)
La función de activación es ReLU, que es especialmente adecuada para arquitecturasprofundas 22. Cuando x>0, la derivada de ReLU es constante, lo que alivia efectivamente el problema del gradiente nulo asociado a las activaciones sigmoides y, por tanto, acelera la retropropagación y convergencia23. ReLU también es computacionalmente simple (sin exponenciales) y naturalmente escasa (produce cero para x<0), lo que reduce las respuestas redundantes de neuronas y mejora la generalización. Su definición es24
σ(x) = max(0,x), (4)
Aplicado elemento por elemento a la salida lineal, obtenemos:
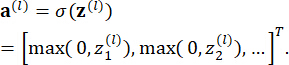 (5)
Tras cada operación de "activación de → lineal", introducimos la Normalización por Lotes (BN) para estabilizar gradientes y acelerar la convergencia. BN estandariza dinámicamente las características dentro de cada mini-lote, mitigando el desplazamiento interno de covariables, mejorando la estabilidad del entrenamiento y reduciendo la sensibilidad a la tasa de aprendizaje. BN también tiene un efecto de regularización leve similar a la inyección de ruido, que ayuda a evitar el sobreajuste sin afectar la capacidad del modelo.
Sea la salida 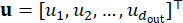 actual del mini-lote , la transformada BN para la característica j-ésima es
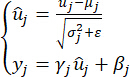 (6)
Donde μj y σj2 son la media y varianza por lotes de la característica j-ésima, ε es una pequeña constante para la estabilidad numérica, y γj, βj son parámetros de escala y desplazamiento aprendibles que restauran la expresividad no lineal de la red.
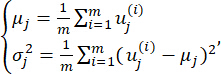 (7)
Aquí m es el tamaño del mini-lote, ε es una pequeña constante para la estabilidad numérica, y γj, βj son parámetros de escala/desplazamiento aprendibles usados para recuperar la expresividad no lineal de la red tras la normalización.
(3) Capa de compresión de características
Tras la extracción profunda de características, añadimos una capa de compresión de características al final del bloque MLP para conservar la información relevante mientras suprimimos la redundancia, reducir la carga computacional de los módulos posteriores y proporcionar una regularización moderada. Sea el vector  de entrada . La salida comprimida es
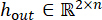 , con parámetros
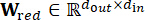 ,
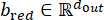 . La operación es:
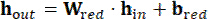 (8)
Mecanismo de atención piramidal (PA)
Sea la última salida  de la capa MLP . Para permitir la selección explícita sobre interacciones no lineales de orden superior, primero reorganizamos
 por campo/canal en una matriz25:

 (9)
Donde C es el número de canales y L es la longitud por canal.
(1) Construcción de características a múltiples escalas.
A lo largo del eje de la característica L, aplica agrupación unidimensional con múltiples escalas para obtener26
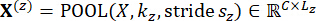 (10)
donde ks y stride definen la escala s-ésima.
(2) Canalizar la atención por escala.
Para cada escala, construye un descriptor de canal y un pesode atención 27:
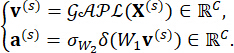 (11)
Donde δ(⋅) es ReLU, σ(⋅) es Sigmoide,
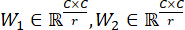 , r es la razón de reducción.
Aplica los pesos por canal:
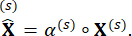 (12)
(3) Fusión y escritura de regreso.
Proyecta cada escala con GAPL a un espacio unidimensional unificado y fusionalas:
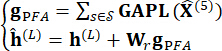 (13)
donde Ps son pesos de fusión y Wr es una proyección aprendible usada en la escritura residual.
Marcador final:
 (14)
Donde ⊙ denota el producto de Hadamard (elemento por elemento) y  denota la concatenación vectorial.
Formalización de tareas top-N y objetivo de aprendizaje
(1) Configuración de problemas.
Que el set de fans sea F y el set de objetos I (entradas, merchandising, beneficios de membresía y contenido). La retroalimentación  impleta indica si el fan
 ha interactuado con el artículo
 (clic, compra, asistencia/validación, etc.). Las muestras positivas en el conjunto de entrenamiento son
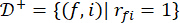 ,
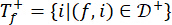 .
Inyectamos las cuatro variables de marketing relacional —satisfacción, confianza, compromiso, reciprocidad— como un vector: 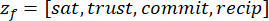 en la capa de atención para obtener una representación
 de relación consciente del contexto , que se fusiona con incrustaciones
 fan/item para producir la puntuación
 . Para cada par
 positivo , extraemos varios negativos en una razón fija de
 para formar
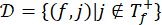 .
(2) Objetivo por parejas.
Para optimizar directamente el ranking relativo, usamos el BPR (Ranking Personalizado Bayesiano) de pérdida28:
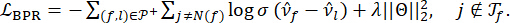 (15)
Aquí 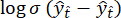 expresa la probabilidad de que "la puntuación positiva supere la negativa";
 es un regularizador L-2para controlar el sobreajuste;
 denota todos los parámetros aprendibles.
(3) Inferencia y clasificación.
En el momento de la prueba, el conjunto candidato es 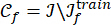 . Calculamos las puntuaciones , y devolvemos la listaTop-N 29:
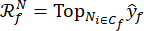 (16)
Diseño del algoritmo de recomendación
Esta sección describe el flujo de trabajo completo de recomendaciones utilizado en este estudio, cubriendo la cadena de principio a fin desde el preprocesamiento de datos hasta el entrenamiento de modelos y la inferencia en línea. El flujo de trabajo explica cómo los datos brutos de interacción fan–item y las variables de relación se transforman en puntuaciones personalizadas de clasificación mediante aprendizaje de representación y modelado basado en la atención. El procedimiento detallado se detalla de la siguiente manera.
Paso 1: Preparación y normalización de datos.
Los registros de interacción fan–ítem de CSL se transforman en señales de retroalimentación implícitas. Se gestionan los valores ausentes y se normalizan las cuatro variables de la relación —satisfacción, confianza, compromiso y reciprocidad. Los datos se dividen cronológicamente en conjuntos de entrenamiento, validación y prueba, y se generan múltiples muestras negativas para cada interacción positiva.
Paso 2: Codificación de atención en la relación.
Las cuatro variables de relación se introducen en un módulo de atención para aprender pesos de importancia conscientes del contexto, produciendo una representación compacta de relaciones con los ventiladores para el modelado posterior.
Paso 3: Construcción de la entrada de interacción.
Las incrustaciones de abanico e ítem se aprenden y se concatenan con la representación de relaciones para formar el vector completo de características para cada interacción fan–ítem.
Paso 4: Aprendizaje de representación.
Las características de interacción se pasan por una rama MLP para capturar patrones no lineales de alto orden y generar una representación latente fusionada.
Paso 5: Atención a la característica pirámide.
Se construye una pirámide de características multiescala sobre la salida MLP. Se aplica atención canal por canal y fusión a escala cruzada, y se integran características mejoradas mediante conexiones residuales para amplificar canales salientes mientras suprimen los redundantes.
Paso 6: Puntuación y salida.
La rama lineal se concatena con la representación no lineal mejorada y se introduce en la capa de salida para calcular una puntuación de preferencia para cada par fan–elemento.
Paso 7: Formación y optimización.
El modelo se optimiza utilizando un objetivo de clasificación por pares. Se emplea un optimizador adaptativo junto con decaimiento de peso, caída y parada temprana para mejorar la generalización y mitigar el sobreajuste.
Paso 8: Optimización bayesiana de hiperparámetros.
Las métricas de clasificación de validación se utilizan como objetivo para buscar automáticamente los hiperparámetros clave, incluyendo dimensiones de incrustación, profundidad y ancho de red, tasa de aprendizaje, tasa de muestreo negativa, tasa de abandono y parámetros relacionados con la pirámide y la atención.
Paso 9: Inferencia y clasificación.
Durante la inferencia online, se calculan puntuaciones de preferencia para cada fan sobre el conjunto de elementos candidatos para generar recomendaciones Top-N, aplicándose estrategias opcionales tras el ranking para tener en cuenta la frescura, la diversidad y las limitaciones de negocio.
Validación experimental
Esquema de conjuntos de datos y características
Evaluamos sobre un conjunto de datos autoconstruido que une (mediante identificaciones hasheadas de IDs de fans) los registros del sistema de información del club CSL de interacciones implícitas fan–ítem con una encuesta de relaciones contemporánea. Los datos cubren cuatro dominios empresariales: entradas, merchandising, membresía y contenido, e incluyen eventos de exploración, clic, añadir al carrito/favoritos, compra/venta de entradas y validación dentro del estadio, con marcas de tiempo, canal de contacto, etiquetas contextuales y banderas promocionales. El tramo es ≥ una temporada completa; La escala es del orden de los ventiladores, objetos y eventos suficientes para un modelado profundo.
Esquema de características y codificaciones: Items-ArticleID, TypeItem, TeamTag, PriceBand (incrustaciones de ID/categoría); Fans—FanID, Región, Nivel de Membresía, Titularidad (FanID aprendido como incrustación; otros campos categóricos/numéricos estandarizados); Características RQ—Satisfacción, Confianza, Compromiso, Reciprocidad escaladas a [0,1] y alimentadas al canal de Atención, luego fusionadas con representaciones MLP vía PA; Contexto—PhaseTag, Channel, PromoFlag, Hour, Día laborable (categorías como embeddings; características temporales con codificación sinusoidal sin/cos).
Optimización de hiperparámetros
Los hiperparámetros clave de MLP-PA se ajustan mediante optimización bayesiana dentro de un espacio de búsqueda preestablecido, usando NDCG@10 en el conjunto de validación como objetivo principal (con HR@10 como referencia) y deteniéndose temprano para mitigar el sobreajuste. Cada configuración candidata se ejecuta bajo múltiples semillas aleatorias y se promedia. Los ajustes finales desplegados se informan en la Tabla 1.
| Hiperparámetro | Descripción | Rango de búsqueda | Valor seleccionado |
| Dimensión de incrustación | Tamaño de incrustación de abanico/objeto | {32, 64, 128} | 64 |
| Capas ocultas MLP | Número de capas MLP | {2, 3, 4} | 3 |
| Unidades ocultas MLP | Unidades por capa oculta | {64, 128, 256} | 128 |
| Tasa de abandono | Probabilidad de abandono | [0.1, 0.5] | 0.3 |
| Tasa de aprendizaje | Tasa inicial de aprendizaje | [1e-4, 1e-2] | 1.00E-03 |
| Índice de muestreo negativo | Negativos por muestra positiva | {1, 3, 5, 10} | 5 |
Tabla 1: Ajustes finales de hiperparámetros del modelo MLP-PA
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Convergencia y estabilidad
Para evaluar el comportamiento de convergencia y la estabilidad en el entrenamiento del modelo propuesto, comparamos su rendimiento de validación con un recomendador estándar basado en MLP sin atención piramidal ni atención consciente de relaciones, que actúa como modelo de control. Todos los modelos se entrenan bajo divisiones de datos, ajustes de optimización y criterios de parada idénticos para garantizar una compar...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Contribuciones conceptuales y metodológicas
Este estudio contribuye conceptualmente al replantear las dimensiones de la relación —satisfacción, confianza, compromiso y reciprocidad— no como características auxiliares estáticas, sino como señales relacionales sensibles al contexto cuya influencia varía según las etapas de compromiso. El marco propuesto operacionaliza esta idea mediante un mecanismo basado en la atención que repondera dinámicame...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
El autor no tiene conflictos de interés que declarar.
Agradecimientos
El autor desea agradecer a los revisores anónimos por sus comentarios constructivos y sugerencias, que ayudaron a mejorar la claridad y calidad de este manuscrito. También reconoce el apoyo de la organización colaboradora por proporcionar acceso a los datos utilizados en este estudio. Cualquier opinión, hallazgo o conclusión expresada en este artículo es responsabilidad del autor y no refleja necesariamente las opiniones de las instituciones afiliadas.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Python | https://www.python.org | 3.9.10 | |
| Deep learning framework | PyTorch | https://pytorch.org | >= 1.12 |
| Hyperparameter optimization library | Optuna | https://optuna.org | >= 3.0 |
| Hardware | NVIDIA GPU | https://www.nvidia.com | Single GPU, >= 8 GB memory |
| Dataset | Self-built CSL fan dataset | N/A | One full season or longer; scale sufficient for deep modeling |
| Interaction data | Fan–item implicit interaction logs | N/A | Not separately versioned |
| Survey data | Relationship questionnaire data | N/A | Not separately versioned |
| Data preprocessing method | Hash-based anonymization | N/A | Applied to fan and item identifiers |
| Data preprocessing method | Mean imputation within membership tier | N/A | Applied to missing questionnaire responses |
| Data preprocessing method | Min–max normalization | N/A | Range [0, 1] |
| Data splitting strategy | Chronological user-level split | N/A | Most recent = test; second most recent = validation; remainder = training |
| Negative sampling | Uniform negative sampling | N/A | Positive:negative ratio = 1:5 |
| Model backbone | MLP (Multi-Layer Perceptron) | https://pytorch.org/docs/stable/nn.html | Hidden layers [128, 64, 32] (optimized) |
| Attention module | Relationship-attention channel | N/A | Custom module |
| Fusion module | Pyramid Attention (PA) | N/A | Pooling scales {1, 2, 4}, stride = kernel size, reduction ratio = 4 |
| Optimizer | Adam | https://pytorch.org/docs/stable/generated/torch.optim.Adam.html | Learning rate 0.001, weight decay 1e-5 |
| Regularization | Dropout | https://pytorch.org/docs/stable/generated/torch.nn.Dropout.html | Rate 0.3 |
Referencias
- Wang, L., et al. Drug combination recommendation model for systemic lupus erythematosus and antiphospholipid syndrome. Pharmaceutics. 18 (8), 1224(2025).
- Hu, X., Yuan, Z., Ma, Z. A robot control knowledge recommendation model PKGAT based on multimodal knowledge graph. Int J Softw Eng Knowl Eng. 35 (8), (2025).
- Ji, S. An intelligent recommendation model for disclosure of electricity market entities based on association rule mining algorithm. Electr Eng. , In press (2025).
- Xie, F., et al. Differential weighting and flexible residual GCN-based contrastive learning for recommendation. Symmetry. 17 (8), 1320(2025).
- Duan, J., et al. A deep recommendation model based on semantic information and correlation between items. J Intell Inf Syst. , In press (2025).
- Malakhatka, E., et al. Optimal time recommendation model for home appliances: HSB Living Lab dishwasher study. Energy Effic. 18 (1), 3(2024).
- Yuan, Q., Cong, G., Ma, Z., Sun, A., Magnenat-Thalmann, N. Time-aware point-of-interest recommendation. Proc Int ACM SIGIR Conf Res Dev Inf Retr, 36, 363-372 (2013).
- Alaoui, E. D., et al. Comparative study of filtering methods for scientific research article recommendations. Big Data Cogn Comput. 8 (12), 190(2024).
- Li, X., Hu, G. Design and implementation of an electronic journal resource recommendation system integrating user profile and knowledge graph. Front Comput Intell Syst. 10 (2), 74-78 (2024).
- Sami, A., et al. A deep learning-based hybrid recommendation model for internet users. Sci Rep. 14 (1), 29390(2024).
- Zhonghua, W. Intelligent recommendation model of tourist places based on collaborative filtering and user preferences. Appl Artif Intell. 37 (1), (2023).
- Wang, Q., Esquivel, A. J. Personalized movie recommendation system based on DDPG: Application and analysis of reinforcement learning in user preferences. Front Soc Sci Technol. 5 (18), (2023).
- Miao, L., et al. Study on two-tier EV charging station recommendation strategy under multi-factor influence. J Artif Intell. 5, 181-193 (2023).
- Yunni, X., et al. A quasi-Newton matrix factorization-based model for recommendation. Int J Web Serv Res. 20 (1), 1-15 (2023).
- Mourad, J., et al. Personalized PV system recommendation for enhanced solar energy harvesting using deep learning and collaborative filtering. Sustain Energy Technol Assess. 60, 103456(2023).
- Pfajfar, G., et al. Value of corporate social responsibility for multiple stakeholders and social impact: A relationship marketing perspective. J Bus Res. 143, 46-61 (2022).
- Khan, R. U., et al. The impact of customer relationship management and company reputation on customer loyalty: The mediating role of customer satisfaction. J Relatsh Mark. 21 (1), 1-26 (2022).
- Sheth, J. New areas of research in marketing strategy, consumer behavior, and marketing analytics: The future is bright. J Mark Theory Pract. 29 (1), 3-12 (2021).
- Mishra, M., Mund, P. Fifty-two years of consumer research based on social exchange theory: A review and research agenda using topic modeling. Int J Consum Stud. 48 (4), e13074(2024).
- Cook, K. S., Hahn, M. Social exchange theory: Current status and future directions. Theor Sociol. 50, 179-205 (2021).
- Naseer, A., Jalal, A. Multimodal objects categorization by fusing GMM and multilayer perceptron. Proc 5th Int Conf Adv Comput Sci (ICACS), , 1-7 (2024).
- Hussain, K., et al. Analyzing LULC transformations using remote sensing data: Insights from a multilayer perceptron neural network approach. Ann GIS. 30, 1-28 (2024).
- Mfetoum, I. M., et al. A multilayer perceptron neural network approach for optimizing solar irradiance forecasting in Central Africa with meteorological insights. Sci Rep. 14 (1), 3572(2024).
- Yu, Y., et al. Multi-scale spatial pyramid attention mechanism for image recognition: An effective approach. Eng Appl Artif Intell. 133, 108261(2024).
- Liu, H., et al. A deep convolutional neural network for the automatic segmentation of glioblastoma brain tumor: Joint spatial pyramid module and attention mechanism network. Artif Intell Med. 148, 102776(2024).
- Liu, M., et al. Vehicle object counting network based on feature pyramid split attention mechanism. Vis Comput. 40 (2), 663-680 (2024).
- Alvarado, O., et al. A systematic review of interaction design strategies for group recommendation systems. Proc ACM Hum-Comput Interact, 6 (CSCW2), 1-51 (2022).
- Zhao, Y. Design of garment style recommendation system based on interactive genetic algorithm. Comput Intell Neurosci. 2022, 9132165(2022).
- Nazer, L. H., et al. Bias in artificial intelligence algorithms and recommendations for mitigation. PLOS Digit Health. 2 (6), e0000278(2023).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.