El estudio actual describe un flujo de trabajo para la secuenciación nanoporosa de plásmidos cuando la secuencia cromosómica ya se conoce o no tiene interés. Un paso inicial de enriquecimiento de ADN plasmidal asegura una profundidad óptima de secuencia plasmidal y maximiza el número de muestras que pueden secuenciarse por celda de flujo.
Artículo de método
Secuenciación y ensamblaje de plásmidos de lectura larga utilizando flujos de trabajo basados en secuenciación nanopore
* These authors contributed equally
En este artículo
Resumen
Resumen
El presente estudio describe un flujo de trabajo para la secuenciación de nanoporos diseñado para maximizar el rendimiento del ADN plasmidal y la precisión de la secuenciación. Los investigadores cubren cada paso del proceso, que incluye la extracción de ADN plasmídico, la preparación de la biblioteca con codificación rápida de barras y ligación de adaptadores, la carga de la biblioteca en una celda de flujo para secuenciación, la llamada de bases (en tiempo real o post-hoc) y el ensamblaje de secuencias usando Autocycler. Los autores también especifican los requisitos del ordenador, que dependen en gran medida de si la basecalling se realiza en tiempo real. Los autores secuenciaron plásmidos purificados de diez cepas clínicas utilizando este flujo de trabajo. Para eliminar las diferencias entre cepas hospedadoras y células como variable, los autores también conjugaron estas cepas clínicas con una cepa receptora común y secuenciaron los transconjugantes. Estos experimentos produjeron conjuntos de plásmidos que coinciden con tamaños de plásmidos inferidos de la movilidad del gel y que, en dos tercios de los casos, también coinciden con ensamblajes pulidos de lectura corta o están dentro del 0,05% de identidad de secuencia por pares. El enriquecimiento de secuencias de ADN plasmidal también maximiza la eficiencia de la secuenciación de plásmidos, permitiendo la secuenciación paralela de hasta 24 muestras con cobertura óptima. Este protocolo es adecuado para plásmidos que van de 4 a 174 kb y tolera hasta un 72% de contaminación cromosómica sin afectar la precisión. Este protocolo es ideal para situaciones en las que la secuencia cromosómica ya se conoce o no tiene interés, como para la verificación de secuencias de plásmidos, mejorar la precisión de secuencias de plásmidos ya obtenidas por WGS, o secuenciar plásmidos capturados por conjugación. El organismo utilizado para ilustrar este trabajo es Escherichia coli, que representa a los hospedadores utilizados para la expresión génica recombinante y para la captura de plásmidos mediante conjugación.
Introducción
Los plásmidos son fragmentos autorreplicantes de ADN que se encuentran de forma ubicua en las bacterias. Son muy variables en tamaño, oscilando entre <800 pb y 2,5 Mbp, y suelen seguir una distribución bimodal, con un pico menor correspondiente a plásmidos multicopiados no conjugativos y un pico mayor correspondiente a plásmidos de baja copia, a menudo conyugativos, 1,2. Los plásmidos desempeñan un papel clave en la ecología microbiana, portando genes que ayudan a sus hospedadores a adaptarse a los desafíos medioambientales o a acceder a nuevos nichos ecológicos. Los plásmidos también sirven como plataformas para una evolución acelerada, proporcionando una mayor plasticidad genética y mediando la transferencia horizontal de genes entre cepas, especies, géneros e incluso familias 3,4. Los análisis genómicos en red y comparativos han confirmado el papel del resistoma ambiental como un reservorio persistente para genes clínicamente relevantes de resistencia a antibióticos (ARG), facilitando así su mantenimiento y difusión en entornosecológicos 5. Rastrear plásmidos y su carga de genes de resistencia a antibióticos y virulencia ayuda a identificar las rutasde transmisión 6. Por ello, la identificación y caracterización de plásmidos es de gran interés para una variedad de aplicaciones de salud pública, microbiología clínica y biotecnología.
La introducción de tecnologías de secuenciación de nueva generación (NGS), que permiten la secuenciación de alto rendimiento de plantillas de ADN desconocidas, ha abierto la puerta a la caracterización genómica de aislados microbianos. La secuenciación del genoma completo (WGS) permite rastrear la emergencia, propagación y transmisión de nuevos patógenos, cepas resistentes a medicamentos y variantes que evaden vacunas. También se está utilizando cada vez más para ayudar a identificar las rutas de transmisión durante brotes clínicos, lo que podría informar las intervenciones para futuros brotesde prevención 7. Finalmente, el WGS permite el perfilado de los ARG, que puede informar decisiones terapéuticas8, aunque vincular los ARGs con fenotipos cualitativos y cuantitativos de resistencia a antibióticos sigue siendo un trabajo enprogreso 9.
Sin embargo, los datos de secuenciación de lectura corta (SR) que normalmente produce WGS a gran escala suelen estar en el rango de 400–500 pb. Este tamaño es menor que el tamaño de la mayoría de los Elementos Genéticos Móviles (MGE) y, por tanto, no puede resolverlos10. La identificación in silico de secuencias de plásmidos en datos de WGS se complica aún más por la cobertura incompleta y debido a la compartición de secuencias entre plásmidos y entre cromosomas bacterianos y otrosplásmidos 10. Como consecuencia, los ensamblajes suelen estar muy fragmentados e incompletos, lo que hace imposible atribuir su ubicación subgenómica (cromosómica o plásmida)10.
La tecnología de secuenciación de lectura larga (LR) genera ensamblajes altamente contiguos que abarcan más repeticiones, facilitando enormemente la producción de conjuntos completos de plásmidos. Existen esencialmente dos tipos de tecnologías de larga lectura y molécula únicadisponibles: 11,12. Uno de estos enfoques, la secuenciación por nanoporos, se está popularizando en genómica microbiana debido a su bajo coste, tiempos de respuesta rápidos y idoneidad para entornos con recursoslimitados 13,14.
Los dispositivos de secuenciación de nanoporos utilizan celdas de flujo que contienen matrices de miles de nanoporos. El ADN se carga en la celda de flujo, se abre mediante una proteína motora con actividad helicasa, y atraviesa el nanoporo impulsado por un diferencial de corriente. A medida que los nucleótidos de una cadena única pasan a través de nanoporos individuales, la corriente se interrumpe para producir una señal característica que se mide mediante un sensor electrónico conectado a cada poro. Esta señal se decodifica mediante algoritmos de basecalling, y los datos resultantes se ensamblan y analizan más adelante utilizando diversas herramientas de bioinformática.
En comparación con los enfoques de secuenciación SR, la secuenciación nanopore tiende a producir menor calidad de lectura (puntuaciones Q más bajas) y a generar inserciones/deleciones en secuencias homopoliméricas durante el análisis de datos de señales eléctricas (basecalling)15. También se ha observado que la metilación cercana en el ADN nativo puede causar errores sistemáticos de llamadade bases 16. Una solución comúnmente adoptada ha sido incluir datos de lectura corta para la corrección de errores post-ensamblaje. Sin embargo, este proceso (conocido como "pulido") incrementa el coste y la complejidadde la carga 17. Aumentar la cobertura de secuenciación también puede mejorar la precisión, aunque no siempre es técnicamente alcanzable.
En 2024, se demostró que las células de flujo Oxford Nanopore Sequencing (ONT) R10.4.1 y la química V14 producen ensamblajes de alta calidad y contiguos para bacterias G-, mientras que los análisis a mayor escala en niveles de nucleótido único aún se benefician de los datos de secuenciación SR18. Sin embargo, la brecha entre la precisión de secuenciación LR y SR se está reduciendo gradualmente. Diversas mejoras recientes incluyen un proceso de muestreo de datos más preciso a mayor velocidad de secuenciación, la introducción de un novedoso basecaller adaptado al ADN bacteriano nativo y la metilación, lo que ha incrementado la precisión de la llamadabase 19, y herramientas de análisis actualizadas como nuevos algoritmos para la fase, la llamada de variantes y la llamada estrella-alelo. Cabe señalar también que el último algoritmo de Dorado, V.0.9.0 ONT (2025), puede usarse para la llamada de rebase de datos de garabatos en bruto. De hecho, algunos estudios de WGS ya están informando de la generación de genomas microbianos mediante secuenciación nanoporosa de una cualidad para la cual el pulido de lectura corta no se espera que mejore significativamente la secuenciaconsensuada 20,21.
Los plásmidos suelen contener la mayor parte de los genes de resistencia adquiridos, especialmente en los aislados22 de Enterobacteriaceae. Por lo tanto, resolver secuencias de plásmidos permite contextualizar los genes AR, que es clave para el seguimiento de la transmisión de la RAM23,24. La secuenciación por nanoporos ya se ha utilizado para examinar la microevolución de blaKPC que alberga plásmidos25. Los dispositivos MinION también se han utilizado para la secuenciación en tiempo real de plásmidos en el laboratorio y la detección de genes de resistencia en aislamientos clínicos en entornoshospitalarios 26. Dicho esto, la interrogación de plásmidos aún no forma parte de la práctica rutinaria de control de infecciones.
A pesar de la mejora sustancial de la secuenciación LR respecto a la SR en la capacidad de rescatar plásmidos de la secuenciagenómica 27, persisten algunos problemas. Los ensambladores de lectura larga como Flye28, Canu29 y Raven30 producen ensamblajes cromosómicos de alta calidad pero tienen dificultades para ensamblar secuencias de plásmidos. Esto se debe en parte a la insuficiente profundidad de cobertura porque el ADN plasmídico está subrepresentado en los datos de secuenciaciónWGS 31. Cabe señalar que, debido a su estructura modular, abundancia de estructuras secundarias y presencia frecuente de repeticiones, el ensamblaje de alta calidad para la secuencia de ADN plasmidico requiere una mayor cobertura que el ADN cromosómico (50x profundidadde lectura 32).
Enriquecer las muestras de ADN con secuencias de plásmidos es un enfoque eficaz para aumentar la profundidad de cobertura, pero el aislamiento o enriquecimiento del ADN plasmidal antes de la secuenciación del ADN es demasiado costoso o laborioso para aplicaciones diagnósticas clínicas y podría introducir sesgos al enriquecer secuencias seleccionadas de ADN. En 2017, se utilizó ADN enriquecido con plásmidos para intentar el ensamblaje completo de ADN plasmídico en muestras clínicas para la detección deARGs 24. Se secuenciaron ocho aislados de seis especies diferentes de Enterobacteriaceae para maximizar la diversidad estructural poblacional y de plásmidos. Tras probar varios ensambladores, se demostró que Canu/Canu+Pilon claramente superaba a otros; Este grupo de investigación también probó un enfoque de meta-ensamblaje que logró la resolución de estructuras plásmidicas adicionales, resultando en el ensamblaje completo del 78% de todos los plásmidos conocidos en las muestras secuenciadas. Sin embargo, la presencia de estructuras de gran repetición y (en menor medida) problemas con la extracción de ADN seguían planteando problemas significativos para la detección de todos los conjuntos de plásmidos de un solocontig 24.
Más recientemente, el muestreo adaptativo como enfoque complementario para el enriquecimiento de secuencias de plásmidos de baja abundancia se ha examinado rechazando secuencias cromosómicas en muestras de aislamiento bacteriano, aunque este método requiere secuencias de referencia conocidas33.
Aquí, los autores describen protocolos para la secuenciación de ONT que se personalizan para muestras enriquecidas con ADN plásmidico. Combinando una mayor representación del ADN plasmídico con protocolos actualizados de preparación de bibliotecas, tecnología de células de flujo y herramientas de ensamblaje de secuencias, el flujo de trabajo produjo ensamblajes que coincidían con tamaños inferidos por la movilidad del gel y, en dos tercios de los casos, coincidían con el pulido por secuenciación SR o estaban dentro del 0,05% de identidad de secuenciación por pares. El enriquecimiento de secuencias de ADN plasmidal también maximiza la eficiencia de la secuenciación de plásmidos, permitiendo la secuenciación paralela de hasta 24 muestras con cobertura óptima. Los protocolos no están destinados a sustituir los enfoques estándar de WGS por nanoporos, sino a maximizar la precisión y eficiencia de la secuenciación de plásmidos en situaciones donde la secuencia cromosómica ya es conocida o no es de interés.
El flujo de trabajo incluye la extracción de ADN plasmídico, preparación de la biblioteca con código de barras, ligación de adaptador a una proteína motora, comprobación de la celda de flujo, carga de la biblioteca en una celda de flujo para secuenciación, análisis de datos de las señales eléctricas (en tiempo real o post hoc), ensamblaje de secuencias usando Autocycler34 y varios análisis posteriores (Figura 1).
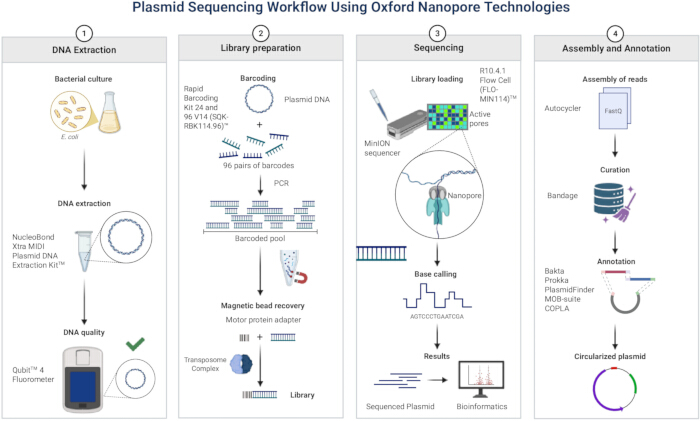
Figura 1: Flujo de trabajo de secuenciación de plásmidos usando Oxford Nanopore Technologies. Paso 1: Extracción de ADN; Paso 2: Preparación para la biblioteca; Paso 3: Secuenciación; Paso 4: Ensamblaje y anotación. Creado en BioRender. Cortés, G. (2026) https://BioRender.com/u3b15st. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
Protocolo
1. Extracción de ADN plasmide
NOTA: Este protocolo se utilizó para extraer ADN plasmídico de una cepa clínica de Escherichia coli y sus transconjugantes correspondientes utilizando un Kit de Extracción de ADNPlasmid comercial 35. Los protocolos detallados para la conjugación se pueden encontrar enel 36. El protocolo es adecuado tanto para plásmidos de alta copia como de baja copia, que van desde ~3 kb hasta ~200 kb. Los plásmidos grandes requieren atención especial porque tienden a tener un número bajo de copias (tan solo 1–2 copias por célula), lo que limita el rendimiento de ADN. Para compensar, el protocolo recomienda aumentar la masa celular y los volúmenes de tampones de lisis y neutralización para asegurar suficiente ADN plasmídico para la unión a columnas. Aún se pueden recuperar plásmidos de hasta 200 kb usando este protocolo; sin embargo, su aplicabilidad a mega plásmidos (>200 kb) es limitada.
- Extracción de plásmidos
- Día 1: Muestras de rayas en placas de agar de Luria–Bertani (LB) suplementadas con el antibiótico adecuado para seleccionar el marcador de resistencia plasmídico respectivo e incubar a 37 °C durante 24 horas.
NOTA: Añadir carbbenicilina (o antibiótico adecuado) a LB a una concentración final de 100 μg/mL añadiendo 1 μL de una solución de 100 mg/mL por mL de medio. - Día 2: Inocular 3–5 mL de LB con el medio antibiótico adecuado y una sola colonia aislada desde el primer día. Incubar con agitación a 37 °C durante ~8 horas, o hasta que el cultivo alcance un OD₆₀₀ de 1–2.
NOTA: Medición del OD600: Vaciar el espectrofotómetro con un medio LB fresco que contenga el antibiótico adecuado, luego transfiera 1 mL de cultivo a una cuveta limpia y mide el diámetro exterior a 600 nm. Si la lectura supera el rango lineal, diluir la muestra y volver a medir. - Inocular 400 mL de LB suplementados con el medio antibiótico adecuado y 400 μL de cultivo inicial del día 2. Incubar con agitación a 37 °C durante 8–12 horas, o hasta que el OD600 alcance 1–2 (como se describió anteriormente).
NOTA: Aumentar el volumen de cultivo más allá de 400 mL si el OD600 no alcanza 1–2 en 12 horas. Para reducir el riesgo de pérdida o reorganización de plásmidos, limita el paso en cultivo tanto como sea posible y mantén la selección de antibióticos durante todas las etapas de crecimiento. Aumentar el volumen de cultivo solo cuando se desee un mayor rendimiento de ADN. - Día 3: Transfiere el cultivo a botellas centrífugas adecuadas al volumen de cultivo. Centrifugar a 4200 x g durante 10 minutos, luego resuspender el pellet usando los volúmenes de reactivos recomendados por el fabricante según la siguiente fórmula:
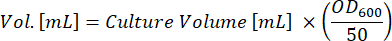
NOTA: Ejemplo: Para que se lisen 400 mL de un cultivo bacteriano de baja copia (DO 600 = 2), los volúmenes apropiados de tampones de lisis RES, LYS y NEU son de 16 mL cada uno.
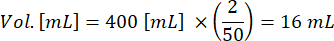
NOTA: si los volúmenes de reactivos para resuspensión, lisis o neutralización no se escalan adecuadamente a la biomasa total de cultivo (OD600 × Volumen, o ODV), la lisis puede ser incompleta, la neutralización ineficiente y la formación de precipitados excesiva. Esto puede provocar un menor rendimiento plasmidal, una menor pureza y un posible atasco de las columnas de purificación. Escalar proporcionalmente los volúmenes de búfer, utilizando la fórmula del fabricante (paso 1.1.4), garantiza una lisis eficiente, neutralización completa y recuperación constante de ADN plasmidal de alta calidad. - Realiza la lisis celular, filtra la humectación usando el tampón adecuado y neutraliza según las instrucciones del kit.
NOTA: Apila dos filtros si el volumen de precipitado es grande, ajustando el buffer proporcionalmente. Realiza pasos adicionales de centrifugación si el sobrenadante permanece opaco. Tras la neutralización, el alto volumen de precipitado puede requerir pasos adicionales de centrifugación. Esto ocurre en la mayoría de las muestras clínicas de E. coli, posiblemente porque tienden a formar biofilm en elcultivo 37, que implica la secreción de una matrizgruesa 38. Un precipitado excesivo en el lisato puede obstruir la columna, prolongar el tiempo de drenaje y potencialmente contaminar la muestra con proteínas. Si el sobrenadante es transparente, estos pasos adicionales pueden no ser necesarios. - Centrifuga el lisado a 4200 x g durante 30 minutos. Transfiere el sobrenadante a un tubo nuevo y centrifuga de nuevo durante 30 minutos. Si el sobrenadante permanece opaco tras estos espines (Figura 2), realizar una centrifugación adicional a 4200 x g.
NOTA: Transferir el lisato a un tubo de cultivo de 50 mL durante la centrifugación puede facilitar la eliminación del sobrenadante, ya que el precipitado a veces puede no formar correctamente los pellets y quedar atrapado cerca de la parte superior del tubo. Debido a los grandes volúmenes procesados, una sola columna puede saturarse e incapaz de contener muestras adicionales. Para aumentar la velocidad de filtración o maximizar el rendimiento de ADN, el lisato puede dividirse entre dos columnas. - Realiza los pasos EQU, WASH y ELU según las instrucciones del kit.
- Precipitar ADN usando isopropanol.
NOTA: Incubar a -20 °C durante ~10 minutos si el pellet no es visible. Sin embargo, generalmente es mejor retirar cuidadosamente el sobrenadante, confiando en que el pellet permanezca adherido a las paredes del tubo, incluso si no es visible. - Lava el ADN con etanol según las instrucciones. Realiza un lavado adicional si persiste el precipitado proteico.
- ADN seco a temperatura ambiente (~20 °C) durante 15–30 minutos.
- Resuspender ADN en 100 μL de agua libre de nucleasa; este pequeño volumen ayuda a maximizar la concentración para la preparación de la biblioteca Nanopore.
NOTA: Este es un punto de parada conveniente. El ADN plasmídico puede almacenarse durante varios meses a –20 °C. El kit de extracción utilizado en este protocolo está diseñado para minimizar la contaminación del ADN cromosómico (genómico) mediante una química tampón optimizada, lisis suave y pasos de clarificación del lisado, aunque no se puede excluir una contaminación sustancial por ADN cromosómico, y los autores la encontraron en los preparativos (ver resultados).
- Día 1: Muestras de rayas en placas de agar de Luria–Bertani (LB) suplementadas con el antibiótico adecuado para seleccionar el marcador de resistencia plasmídico respectivo e incubar a 37 °C durante 24 horas.
- Rendimiento de ADN y control de calidad
Cuantifiquen el ADN y evalúen su calidad utilizando tintes fluorescentes, que ofrecen mayor especificidad y sensibilidad para bajas concentraciones de ADN en comparación con los métodos de absorción UV. En este protocolo, utiliza un dispositivo fluorómetro para cuantificar de forma precisa y cómoda muestras de ADN, ARN oproteínas 39.- Flujo de trabajo del fluorómetro
- Lleva muestras de ADN a temperatura ambiente. Prepara tubos para estándares y muestras.
NOTA: Calcular los volúmenes apropiados de tinte y tampón a incluir en la solución de trabajo en función del número de muestras. Para cada estándar y muestra, se deben preparar 200 μL de solución de trabajo diluyendo el tinte en el tampón en una proporción 1:200. El dispositivo cuenta con una calculadora de reactivos incorporada que también puede utilizarse para estos cálculos. - Prepare los tubos de ensayo según la Tabla 1.
- Esteriliza cada tubo durante unos segundos antes de incubarlo durante 2 minutos a temperatura ambiente.
- Calibra el fluorómetro usando los estándares. Inserta tubos de muestra y registra las lecturas. Para instrucciones detalladas, consulte el manual deFluorómetro 39.
NOTA: Para preparaciones típicas de plásmidos Midi, se espera que los rendimientos de ADN oscilen entre ~50 y 150 μg por cultivo de 100–400 mL, dependiendo del tamaño del plásmido, el número de copias y las condiciones de crecimiento. Las longitudes típicas de lectura de nanoporos varían entre ~2 kb y 20 kb, con lecturas medianas que suelen estar alrededor de 5–10 kb para plásmidos estándar. Los kits basados en ligaduras pueden producir lecturas más largas (mediana de >20 kb) para plásmidos más grandes, pero el kit rápido proporciona una preparación más rápida a costa de lecturas ligeramente más cortas.
- Lleva muestras de ADN a temperatura ambiente. Prepara tubos para estándares y muestras.
- Flujo de trabajo del fluorómetro
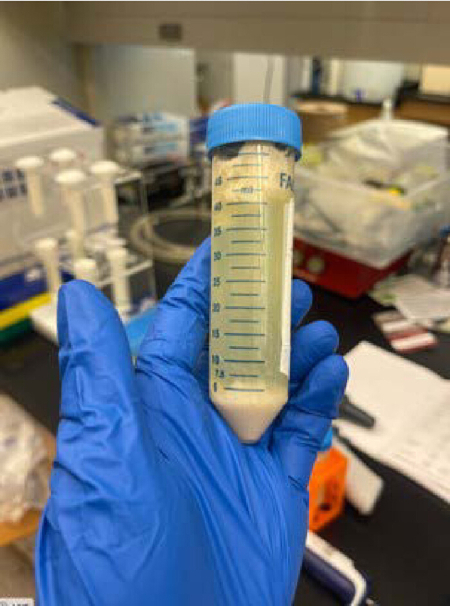
Figura 2: Sobrenadante de lisato turbio tras un paso de centrifugación. Se necesita centrifugación en serie hasta que el sobrenadante esté despejado para evitar obstrucciones de la columna de filtración. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
| Tubos de ensayo estándar | Tubos de ensayo de muestra de usuario | |
| Solución de trabajo (tinte y tampón, 1:200) | 190 μL | 180–199 μL |
| Estándar (a partir del kit) | 10 μL | – |
| Ejemplo de usuario | – | 1–20 μL |
| Volumen total en cada tubo de ensayo | 200 μL | 200 μL |
Tabla 1: Volúmenes y cantidades de reactivos para fluorómetro. Se muestran cantidades para una sola muestra; Se puede preparar un pool en función del número de muestras a analizar.
2. Método 2: Preparación de la biblioteca
NOTA: Consideraciones. La preparación de la biblioteca para secuenciar los plásmidos extraídos se realizó según las instrucciones proporcionadas con el Kit de Codificaciónde Barras 40. Este protocolo utiliza un kit que emplea un enfoque basado en transposasas para fragmentar y codificar ADN simultáneamente, proporcionando un flujo de trabajo rápido y ágil que reduce el tiempo de trabajo manual y simplifica la preparación de la biblioteca.
- Preparación del ADN
- Día 1: Programa un ciclador térmico: 30 °C durante 2 minutos, luego 80 °C durante 2 minutos.
- Descongela los componentes del kit a temperatura ambiente, centrifuga y mezcla según la Tabla 2.
NOTA: Si usas una centrífuga, centrifuga a una velocidad baja que no supere los 330 x g. - Preparación del ADN en agua libre de nucleasa: Transfiere 200 ng de ADN a tubos PCR de 0,2 mL y añade un volumen adecuado de agua libre de nucleasas a cada muestra para llevar el volumen final a 10 μL. Mezclar pipeteando suavemente entre 10 y 15 veces. Centrifuga brevemente en una microfuga o centrífuga a 330 x g para facilitar el pipeteado en los siguientes pasos.
- Preparar las mezclas en tubos de PCR según se indica en la Tabla 3.
- Mezcla pipeteando y luego centrifuga brevemente.
- Incubar tubos de PCR usando el programa de ciclo térmico del Paso 1. Coloca tubos sobre hielo para que se enfríen.
- Gira brevemente.
- Ligadura de códigos de barras nativa
- Muestras con código de barras en piscina en un tubo limpio de Eppendorf de 1,5 mL. Asegúrese de que el volumen total no supere los 1000 μL.
- Resuspende las cuentas mediante vórtice. Añade un volumen igual de Cuentas a las muestras agrupadas con código de barras y mezcla haciendo un clic rápido.
- Incuba los tubos durante 10 minutos a temperatura ambiente en una batidora Hula.
- Prepare 2 mL de etanol al 80% en agua libre de nucleasa.
- Centrifuga la muestra y la pastilla sujetando el tubo contra un imán. Manteniendo el tubo en el imán, la pipeta fuera del sobrenadante como residuo.
NOTA: Cualquier imán de fuerza y tamaño adecuados, incluidos los imanes de neodimio, puede servir como una alternativa eficaz al uso de un costoso estante para imanes. Los imanes con una fuerza de sujeción de aproximadamente 5–12 lb y un diámetro de 0,3–1 pulgada suelen ser adecuados para tubos estándar de 0,2–1,5 mL, permitiendo la eliminación limpia del sobrenadante durante los pasos de limpieza basados en perlas. - Lava las perlas con 1 mL de etanol al 80% mientras estás sobre el imán. Quita etanol. Repetir el lavado.
NOTA: Cambiar la posición del tubo respecto al imán puede mejorar la facilidad para eliminar etanol. Utiliza un giro adicional a baja velocidad para asegurar un pelletado completo de la perla si el pellet se mueve accidentalmente. - Gira brevemente hacia abajo y coloca el tubo de nuevo en el imán. Quita cualquier etanol residual por pipeta. Seca durante 30 segundos, pero no seques el pellet hasta que se agriete.
- Retira el imán y vuelve a suspender las cuentas en el buffer de elución. Consulte la Tabla 4 para conocer los volúmenes apropiados de EB a utilizar según el número de códigos de barras utilizados.
- Incuba el tubo durante 10 minutos a temperatura ambiente.
- Devuelve el tubo al imán hasta que el eluado esté despejado.
- Cuantifique la concentración de ADN utilizando 1 μL de la muestra eluída en el fluorómetro para asegurar que la preparación de la biblioteca se ha ejecutado correctamente y evitar desperdiciar una celda de flujo en una biblioteca fallida.
- Ligación de adaptadores
- Transfiere 11 μL de la biblioteca de ADN a un nuevo tubo y marca.
NOTA: Almacenar ADN extra a -20 °C para futuras secuenciaciones si es necesario. - Diluye el adaptador rápido descongelado en un tubo nuevo según la Tabla 5 y pipetea arriba y abajo para mezclar.
- Añade 1 μL de AR diluida a la biblioteca de ADN de 11 μL.
- Gira el tubo para mezclar, gira un poco hacia abajo para asegurarte de que el volumen completo se acumule en el fondo del tubo.
- Incuba durante 5 minutos en el banco.
- Transfiere 11 μL de la biblioteca de ADN a un nuevo tubo y marca.
| Reactivo | Deshielo a temperatura ambiente | Gira hacia abajo | Mezcla pipeteando |
| Códigos de barras rápidos | No congelado | ✓ | ✓ |
| Adaptador rápido | No congelado | ✓ | ✓ |
| Cuentas AMPure XP | ✓ | ✓ | Mezcla pipeteando o haciendo vórtices inmediatamente antes de usarlo |
| Amortiguador de elución | ✓ | ✓ | ✓ |
| Búfer adaptador | ✓ | ✓ | Mezcla por vórtice |
Tabla 2: Volúmenes y cantidades de reactivos para la preparación de la biblioteca de nanoporos. Las acciones a realizar con cada reactivo se marcan (✓).
| Reactivo | Volumen/sample |
| ADN plantilla de 10 μL (200 ng respecto al paso anterior) | 10 μL |
| Códigos de barras rápidos de 1,5 μL, uno para cada muestra | 1,5 μL |
| Volumen total | 11,5 μL |
Tabla 3: Reactivos y volúmenes para codificación rápida de barras. Se muestran los volúmenes por muestra de ADN; se puede preparar una mezcla agrupada y añadir el ADN por separado.
| Códigos de barras 1-24 | 48 códigos de barras | 72 códigos de barras | 96 códigos de barras | |
| Volumen del Buffer de Elución | 15 μL | 30 μL | 45 μL | 60 μL |
Tabla 4: Volúmenes de búfer de elución usados por cada 24 códigos de barras. Los volúmenes se indican según el número de códigos de barras.
| Reactivo | Volumen |
| Adaptador Rápido (RA) | 1,5 μL |
| Búfer adaptador (ADB) | 3,5 μL |
| Volumen total | 5μL |
Tabla 5: Reactivos y cantidades para el adaptador. Los volúmenes pueden ajustarse según el número de muestras.
3. Funcionamiento de la celda de flujo
NOTA: Elige una celda de flujo de salida estándar al secuenciar un pequeño número de plásmidos con necesidades moderadas de cobertura. Nanopore recomienda realizar una comprobación de celda de flujo para determinar el recuento activo de poros; Las celdas de flujo de los dispositivos Nanopore deben tener al menos 800 poros activos según lo definido por los criterios de garantía. Una sola celda de flujo MinION proporciona una salida suficiente para la secuenciación de múltiples muestras de ADN enriquecidas con ADN plasmídico (véase más detalles sobre multiplexación en la sección de discusión), ofreciendo a la vez menor coste y mayor flexibilidad que una celda de flujo GRIDion o Promethean.
- Cebado y carga de la celda de flujo
NOTA: Se utilizaron celdas de flujo R10.4.1 (lanzadas en 2022) para desarrollar este protocolo. Estas celdas de flujo tienen poros más largos con una cabeza lectora doble, lo que mejora la secuenciación de homopolímeros20,21. Este protocolo de secuenciación y el Kit de Codificación de Barras no son compatibles con otras celdas de flujo. Opta por una celda de flujo de alta salida al realizar multiplexación a gran escala, buscando una alta cobertura o trabajando con plásmidos o genomas más grandes. Considera el número de muestras y la profundidad objetivo para equilibrar coste, rendimiento y calidad de secuenciación.- Retirar los reactivos del almacenamiento en frío, incluyendo el buffer de secuenciación (SB), las perlas biblioteca (LIB) o la solución de biblioteca (LIS), la albúmina sérica bovina (BSA), el ancla de celda de flujo (FCT) y el lavado de celda de flujo (FCF). Deshielo sobre hielo a temperatura ambiente. Una vez que los reactivos se han descongelado, se mezcla en vórtice, centrifuga rápido y se almacena en hielo.
- Prepara el cebado de celda de flujo mezclando un tubo de ADN fresco usando los reactivos listados en la Tabla 6. Mezcla por inversión y pipeteo.
- Levanta la tapa del dispositivo e inserta la celda de flujo. Aplica una presión suave para asegurar la colocación correcta.
- Expone el puerto de cebado empujando la tapa hacia un lado.
- Comprueba si hay burbujas de aire dentro o adyacentes al puerto de cebado. Retira 20–30 μL de líquido para eliminar las burbujas.
NOTA: No elimines más de 20–30 μL de buffer. Los poros deben permanecer sumergidos en el amortiguador en todo momento. Los poros expuestos al aire pueden quedar inutilizables. Asegúrate de que el buffer sea continuo a lo largo del canal visible. - Extrae 800 μL de mezcla de cebado y dispensa en el puerto de cebado. Evita introducir burbujas de aire. Deja reposar el dispositivo durante 5 minutos.
- Suspende el liberal pipeteando arriba y abajo.
NOTA: Suspende inmediatamente antes de usar, ya que la liberación se asienta rápidamente. - Mezcle la biblioteca de ADN con el volumen adecuado de cuentas bibliotecas en un tubo nuevo, como se indica en la Tabla 7.
NOTA: El kit de codificación rápida de barras que utilizan los autores emplea un enfoque basado en transposasas para fragmentar ADN y unir códigos de barras sin selección intencionada de tamaño, por lo que las longitudes de lectura reflejan principalmente el ADN de entrada original. A diferencia de kits basados en ligadura como los Native Barcoding Kits, el kit Rapid Barcoding no incluye búferes separados de fragmentos cortos o largos. Aunque el ADN más largo puede seguir generando lecturas largas, la distribución es más variable y generalmente más corta que en las bibliotecas basadas en ligación, que utilizan Long Fragment Buffer para enriquecer fragmentos largos. La ausencia de búferes simplifica el flujo de trabajo y reduce el tiempo de trabajo manual, pero ofrece menos control sobre la distribución del tamaño de la biblioteca, lo que puede afectar a la calidad del ensamblador. Los kits basados en ligadura, al enriquecer selectivamente fragmentos grandes y eliminar los cortos, suelen ofrecer longitudes medianas de lectura más altas y una mejor continuidad del ensamblaje, especialmente para ensamblajes de novo y genomas complejos. - Ajusta la tapa del puerto de muestra para revelar el puerto. Carga 200 μL de mezcla de cebado en el puerto de cebado de la celda de flujo.
- Mezcla suavemente la biblioteca de ADN preparada antes de cargarla.
- Dispensar 75 μL de la biblioteca de ADN con perlas en el puerto de muestra, una gota a la vez, permitiendo que cada gota se absorba antes de añadir la siguiente.
- Vuelve a aplicar la tapa del puerto de muestra y cierra el puerto de cebado.
- Añade el protector de luz a la celda de flujo alineando el borde delantero del protector con el clip y luego bajando el resto para cubrir la celda de flujo. No intentes colocar el protector de luz debajo del clip. El protector de luz debe situarse alrededor de la tapa, protegiendo toda la sección superior de la celda de flujo de la exposición a la luz.
NOTA: Instala el protector de luz en la celda de flujo tan pronto como la biblioteca se haya cargado para obtener una salida óptima de secuenciación. Déjalo encendido durante cualquier paso posterior hasta que la biblioteca haya sido retirada de la celda de flujo. El protector de luz no está fijado de forma segura al dispositivo; Trátalo con cuidado para no desplazarlo. - Cierra la tapa del dispositivo y comienza la secuenciación.
- Comenzar los requisitos de secuenciación y cálculo de ejecución:
Mínimo: CPU de 8 hilos, 16 GB de RAM, GPU NVIDIA 1070, SSD de 500 GB
Recomendado: CPU de 16 hilos, 32 GB de RAM, GPU NVIDIA 2070, SSD de 1 TB
NOTA: Asegúrate de que tanto el software como el ordenador estén actualizados y tengan al menos 500 GB de almacenamiento libre para acomodar nuevos archivos. Las actualizaciones de software y otros programas pueden interferir con la secuenciación. Asegúrate de ejecutar el software en un sistema operativo Windows o Ubuntu.- Establece el límite de tiempo de ejecución: dependiendo de cuántos plásmidos se multiplexen, fija el límite de ejecución. El valor por defecto es 48 horas, con un tiempo máximo de 72 horas. Para instrucciones detalladas, consulte el manual.
NOTA: el tiempo de ejecución depende de la multiplexación y del tamaño del plásmido más que del número de plásmidos. El número de muestras o plásmidos que pueden multiplexarse depende de la profundidad de secuenciación deseada y de la salida de la celda de flujo. Para la secuenciación típica de plásmidos, multiplexar 20–24 muestras por celda de flujo nanoporo estándar suele proporcionar una cobertura suficiente para un ensamblaje preciso y detección de variantes, asumiendo tamaños de plásmidos inferiores a ~200 kb. Plásmidos más grandes o mayores requisitos de cobertura pueden requerir menos muestras por celda de flujo. Las celdas de flujo de mayor salida pueden soportar muchas más muestras (hasta 96 o más) por tirada, lo que las hace adecuadas para secuenciación de plásmidos de alto rendimiento o proyectos que requieren una cobertura muy profunda. Los usuarios deben equilibrar el número de códigos de barras, el tamaño del plásmido y la profundidad del objetivo para asegurar que cada plásmido reciba lecturas adecuadas para el ensamblaje completo. - Activa el recorte de códigos de barras si realizas la demultiplexación durante la secuenciación.
NOTA: Monitorizar las lecturas por código de barras y detener la ejecución cuando se alcance suficiente cobertura para preservar la vida útil de la celda de flujo. - Selecciona el modo de llamada base súper preciso.
NOTA: No selecciones muestreo adaptativo o balanceo de códigos de barras. Esta opción reduce considerablemente la salida de lectura y degrada los poros a un ritmo más rápido. Si no tienes GPU, es mejor esperar a hacer la llamada a base después de que termine la partida. - Selecciona el kit de código de barras rápido adecuado (24 o 96).
- Asegúrate de que el dispositivo esté nivelado y comienza la secuenciación con la configuración predeterminada (puntuación mínima Q: 10)
NOTA: Este es un punto de parada conveniente. El dispositivo puede funcionar durante la noche. - Basecalling post-hoc (en caso de que el ordenador no tenga suficiente capacidad para basecalling en vivo o para mejorar la precisión de la basecalling, reanalizando los datos en bruto con herramientas analíticas mejoradas): abre la secuenciación completada en el software
NOTA: Los siguientes pasos solo se aplican si no seleccionaste la llamada en directo en la base. - Selecciona Basecalling y elige el modelo de superprecisión (SUP).
- Selecciona los datos en bruto de FAST5/POD5 y establece un directorio de salida.
- Empieza a llamar base.
- Establece el límite de tiempo de ejecución: dependiendo de cuántos plásmidos se multiplexen, fija el límite de ejecución. El valor por defecto es 48 horas, con un tiempo máximo de 72 horas. Para instrucciones detalladas, consulte el manual.
| Reactivos | Volumen por celda de flujo |
| Lavado de celda de flujo (FCF) | 1.170 μL |
| Albúmina sérica bovina (BSA) a 50 mg/mL | 5 μL |
| Ancla de celda de flujo (FCT) | 30 μL |
| Volumen total final en tubo | 1.205 μL |
Tabla 6: Reactivos y volúmenes para cebar y cargar la celda de flujo. Se indican los volúmenes de reactivos por celda de flujo.
| Reactivos | Volumen por celda de flujo |
| Búfer de secuenciación (SB) | 37,5 μL |
| Cuentas de biblioteca (LIB) o solución de biblioteca (LIS), si se utiliza | 25,5 μL |
| Biblioteca de ADN | 12 μL |
| Total | 75 μL |
Tabla 7: Reactivos y volúmenes para cargar la biblioteca. Se muestran volúmenes para la biblioteca de ADN; Las cuentas de biblioteca (BID) deben mezclarse inmediatamente antes de usarlas.
4. Método 4: montaje usando un autociclador
NOTA: Hay muchas opciones para ensamblar lecturas en contigs. Cada ensamblador tiene sus aspectos positivos y sus sesgos. Este protocolo recomienda usar Autocycler, que utiliza muchos conjuntos diferentes y los combina en un solo conjunto. Esto requiere más mano de obra y puedes usar un solo ensamblador para ahorrar tiempo. Por favor, instala Conda en el terminal para descargar el software adecuado. El documento de comandos suplementarios contiene un enlace a un archivo ambiental para configurar el sistema.
- Evaluar la calidad de la ejecución: Comprueba la calidad de la ejecución desde el software Minknow o desde el informe .html archivo para anotar métricas de calidad (rendimiento, Q-scores, longitud, distribución). Opcionalmente, evalúa los archivos FASTQ usando NanoPlot para confirmar la distribución de la longitud de lectura, el N50 y los perfiles de puntuación de calidad para cada código de barras. Proceder solo si las distribuciones de rendimiento y longitud de lectura de secuenciación son consistentes con los tamaños esperados de plásmido.
- Eliminar códigos de barras: Determinar si el recorte de códigos de barras estaba activado durante la secuenciación. Si no se eliminaron los códigos de barras, recortar archivos FASTQ usando Porechop (v0.2.4) y verificar la eliminación correcta de secuencias de adaptadores de códigos de barras antes del análisis posterior.
- Recortar lecturas: Recortar lecturas largas usando Filtlong (v0.3.1), eliminando aproximadamente entre el 5 y el 10% de las lecturas de menor calidad mientras se conserva el ~90% del rendimiento total. Genera un archivo FASTQ filtrado para ensamblaje. Si los conjuntos posteriores producen contigs quiméricos, aumenta la stringencia de filtrado imponiendo un umbral de longitud mínima de lectura de ≥3.000 bp y regenera las lecturas filtradas.
- Subsubsubconjuntos de lectura y ensamblaje: Las lecturas de submuestra usando Autocycler según los ajustes recomendados y ensamblan cada subconjunto de lectura usando Raven (v1.8.3), Flye (v2.9.6), Canu (v2.3.0), miniasm (v0.3.0), Myloasm (v0.2.0), NECAT (v0.0.1), Plassembler (v1.8.1) y cualquier otro ensamblaje que prefieras. Observa las longitudes contig y el estado de circularización de cada conjunto. Los ensambladores que reportan circularización (Raven, Flye, miniasm, Myloasm y Plassembler) deben ser priorizados para la reconstrucción de plásmidos. Para ensamblajes Canu y NECAT, identifica contigs plásmidos candidatos basándose en el tamaño esperado del plásmido a partir de contigs circulares en ensamblajes anteriores.
- Inspeccionar y seleccionar ensamblajes: visualizar cada archivo de grafo de ensamblaje (.gfa) usando Bandage (v0.9.0) y evaluar los contigs para circularidad, consistencia de tamaño entre ensambladores y evidencia de uniones quiméricas. Elimina contigs lineales que carecen de soporte entre varios ensambladores y conserva contigs circulares con estimaciones de tamaño consistentes. Si muchos conjuntos contienen uniones quiméricas, se vuelve al paso 4.3 y se aumenta el umbral de longitud mínima de lectura (recomendado ≥3.000 bp). En los casos en que los plásmidos principales están circularizados pero permanecen contigs más pequeños sin soporte, se eliminan contigs menores antes de la generación por consenso. Se pueden ejecutar los pasos de generación de consenso y pulido en lote, tras la curación manual.
- Generar consenso y ensamblaje final: Tras la curación manual, procede a la generación de consenso de Autocycler usando los ensamblajes seleccionados. Ejecuta los comandos restantes del Autocycler para producir la secuencia final de plásmidos consensuados. Las instrucciones detalladas de línea de comandos y la configuración de parámetros se proporcionan en el Material Suplementario.
- Pulido: Una vez que se haya generado un ensamblaje completo, pule el ensamblaje usando las lecturas largas recortadas con Medaka (v2.1.1) para mejorar significativamente la precisión del consenso.
NOTA: Aunque los cartuchos de pulido extra pueden ayudar a la precisión del consenso, también pueden introducir errores. Es buena práctica usar un programa como DNAapler para rotar el nuevo contig antes de pulir; Los comandos se pueden encontrar en la sección de comandos suplementarios.
5. Método 5: Anotación
NOTA: Existen muchas herramientas de anotación efectivas para bacterias. Se recomiendan los siguientes programas para una anotación exhaustiva.
- Bakta es excelente para análisis proteómicos porque actualmente se mantiene activamente y sirve como sucesor espiritual deProkka 41,42.
- Para tipado de replicones, movilidad de plásmidos y tipado por conjugación, MOB-suite es fiable6. MOB-suite puede inferir la filogenia plasmidiana usando distanciamiento por macerado y puede identificar elementos43 de la secuencia de inserción (IS).
- COPLA también es una herramienta útil para la taxonomía de plásmidos. El enfoque único de Copla, que clasifica los plásmidos en unidades taxonómicas de plásmidos, se recomienda en el campo44.
NOTA: La filogenia de plásmidos ha supuesto históricamente desafíos significativos porque la estructura modular de los plásmidos y la alta frecuencia de recombinación dificultan los alineamientos de secuencias. COPLA aborda estos desafíos calculando las identidades medias de nucleótidos (ANI).
Resultados
Cepas clínicas de E. coli
Para ilustrar el uso de ONT para la secuenciación de plásmidos de cepas clínicas, los autores secuenciaron 10 cepas, que fueron un generoso regalo del Dr. Stephen Salipante en la Universidad de Washington. Estas cepas formaban parte de una colección de 312 aislados de E. coli patogénico extraintestinal (ExPEC), obtenidos durante el curso de cuidados clínicos rutinarios en el Centro Médico de la Universidad deWashington 45.
Conjugación y caracterización de plásmidos mediante ensayo de movilidad en gel
Los investigadores también realizaron un ensayo de conjugación utilizando la cepa de E. coli LMB100 como receptor. La conjugación es un proceso que conduce a la transferencia de un plásmido presente en una célula (el donante) a otra célula (llamada receptor)46. La transferencia requiere contacto físico entre ambas células y normalmente se detecta mediante marcadores que indican la presencia del plásmido conjugativo en las células receptoras. Esto permitió a los autores eliminar diferencias en la cepa del hospedador como variable e ilustrar el uso del protocolo para la secuenciación de plásmidos obtenidos mediante captura de plásmidos (un método utilizado para perfilar plásmidos de un nicho ecológico dado). Todos los ensayos de conjugación produjeron transconjugantes, confirmando la presencia de un plásmido conjugativo en los donantes. El protocolo que siguieron los autores se describe enel 36. El grupo identificó los plásmidos presentes en las cepas donantes y receptoras y estimó su movilidad mediante electroforesis en gel de campo pulsado (PFGE). En la Tabla 8 se muestra una lista de diez cepas representativas de donantes, y los tamaños estimados de los plásmidos presentes en ellas se muestran en la tercera columna. Los plásmidos fuera del rango de resolución del gel de PFGE se excluyen de esta tabla, pero los investigadores pudieron ensamblar varios plásmidos más pequeños alrededor de ~4kb (no mostrado).
| Cepa donante | Plásmido | Tamaño estimado del PFGE | Longitud de ensamblaje | Profundidad media | pb Profundidad cero | Porcentaje de cobertura | Cambios de postura | Porcentaje de precisión antes de la SR |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
Tabla 8: Estimaciones del tamaño del plásmido y métricas de precisión de secuenciación para un panel de 10 cepas donantes. Se listan estimaciones del tamaño del plásmido basadas en PFGE o secuencias ensambladas de plásmidos donantes de ONT. Las comparaciones por pares de los conjuntos de plásmidos pulidos solo por ONT y de secuencia SR también se muestran como indicador de precisión. Las métricas incluyen: longitud de ensamblaje, profundidad media, regiones de profundidad cero, porcentaje de cobertura, posiciones cambiadas y porcentaje de precisión previa a la SR.
Métricas de salida de secuenciación de plásmidos basadas en ONT
La secuencia de secuencias se estableció para 24 horas. Se multiplexaron un total de 24 muestras. Los datos técnicos de cada muestra, incluyendo puntuación de calidad (Q), duración y cobertura, se enumeran en la Tabla 9. La secuenciación nanopore produjo una salida de lectura y calidad suficientes para todas las muestras analizadas. En todas las bibliotecas, la secuenciación generó una media de 134.115 lecturas por muestra, lo que corresponde a un rendimiento medio de 576,2 Mb. Las lecturas tenían una longitud media de 8.797 pb con un N50 medio de 3.693 pb, proporcionando suficiente continuidad de lectura para el ensamblaje de plásmidos. La puntuación media de calidad de lectura fue Q16,0 con una mediana de Q16,6, y las carreras individuales oscilaron entre Q13,7 y Q18,0.
| Deformación secuenciada | Lecturas (kb) | Bases (Mb) | Longitud media | Longitud máxima | Longitud mínima | N50 | Longitud mediana | Q media | Mediana Q | |
| Blood_08_0081 donante | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 donante | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 donante | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 donante | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 donante | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 donante | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 donante | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 donante | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 donante | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 donante | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 transconjugante LMB100 | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 transconjugante LMB100 | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 transconjugante LMB100 | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 transconjugante LMB100 | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 transconjugante LMB100 | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 transconyugante LMB100 | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 transconjugante LMB100 | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 transconjugante LMB100 | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 transconjugante LMB100 | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 transconyugante LMB100 | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
Tabla 9: Informe NanoQ de métricas de salida de secuenciación para un panel de 10 cepas donantes. Se listan las métricas de salida de secuenciación. Estos incluyen lecturas, bases, longitud (media, mediana, máximo y mínimo), longitudes, valores N50 y Q (media y mediana) de donantes y transconjugantes.
Ensamblaje de plásmidos y precisión
Las secuencias de plásmidos se ensamblaron usando Autocycler34. Los tamaños de las secuencias de plásmidos ensamblados para 10 de las muestras se listan en la Tabla 8, cuarta columna, y en todos los casos coincidían con estimaciones basadas en la movilidad de la PFGE (listadas en la tercera columna). La precisión se evaluó comparando ensamblajes de lectura larga pulidos con Medaka (v2.2.0) más ensamblajes de polipolaco (v0.6.1). La identidad de la secuencia se calculó usando dnadiff de MUMmer (v3.2.4) (Tabla 8). En todos los plásmidos analizados (n = 12), los ensamblajes tenían una longitud media de 120,4 kb y estaban soportados por una profundidad media de secuenciación de 109x, con una cobertura media del 97,9% en las secuencias de plásmidos. Antes del pulido, los conjuntos mostraban una identidad media de secuencia del 99,74% en relación con el conjunto pulido por la secuencia SR.
Estimación de la contaminación cromosómica
Para estimar la cobertura de plásmidos y la contaminación cromosómica, se mapearon las lecturas a secuencias de plásmidos ensambladas y a la secuencia cromosómica LMB100 de E. coli. Las lecturas basellamadas Nanopore se alineaban usando minimap2 (v2.2.6). Las alineaciones resultantes se procesaban usando SAMtools (v1.1.7) para generar archivos BAM ordenados y calcular estadísticas de mapeo. La cobertura de plásmidos y la profundidad media se estimaron utilizando la cobertura de herramientas SAMtools. La profundidad de secuenciación de plásmidos varió entre muestras, pero se mantuvo muy por encima de la cobertura mínima requerida para un ensamblaje preciso (50–70 x). Una fracción de lecturas se mapeó al cromosoma, indicando la retención de ADN del huésped durante la extracción del plásmido (Tabla 10).
| Plásmidos | Total de lecturas | Lecturas cromosómicas | % de lecturas cromosómicas | Cobertura cromosómica media | Cobertura media de plásmidos | Relación P:C |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
Tabla 10: Estimaciones de la contaminación por ADN cromosómico. La contaminación cromosómica en plásmidos purificados de cepas receptoras se cuantificó como la proporción de lecturas que corresponden a la secuencia cromosómica LMB100 en relación con las lecturas plasmóticas. Para cada plásmido se listan las lecturas de plásmidos, lecturas totales, cromosómicas, cobertura cromosómica media, cobertura media de plásmidos y la relación P:C. Cabe señalar que pBlood_08_0081_1 está ausente porque no pudo recuperarse en el receptor, y estas estimaciones se realizaron en los receptores debido a su uniforme fondo cromosómico.
La contaminación cromosómica se cuantificó como la proporción de lecturas que se corresponden a la secuencia cromosómica ensamblada de LMB100 en relación con las lecturas plasmódicas. Las tasas de contaminación cromosómica oscilaron entre el 72,1% y el 28,0%, con una media del 46,9% (Tabla 10). El método probablemente sobreestimará la contaminación cromosómica porque las lecturas que mapean tanto al plásmido como al cromosoma se cuentan como solo cromosómicas, pero aún así indica una transferencia cromosómica sustancial. A pesar de esta transferencia cromosómica, el flujo de trabajo de ensamblaje reconstruyó con éxito secuencias completas de plásmidos, que seguían siendo consistentes con el tamaño predicho por movilidad del PFGE en todas las muestras (Tabla 8, tercera y cuarta columnas).
Pares representativos donante-receptor de plásmidos conjugativos
La cepa upec271 fue aislada de una muestra urinaria entre 2011 y 2013 y asignada al filogrupo B2 y al tipo de secuencia ST131. El análisis de PFGE reveló la presencia de una banda correspondiente a un plásmido de aproximadamente 145 kb [Figura 3A, (Donador)]. El análisis de secuencias de lectura corta identificó la presencia de un réplica IncF.
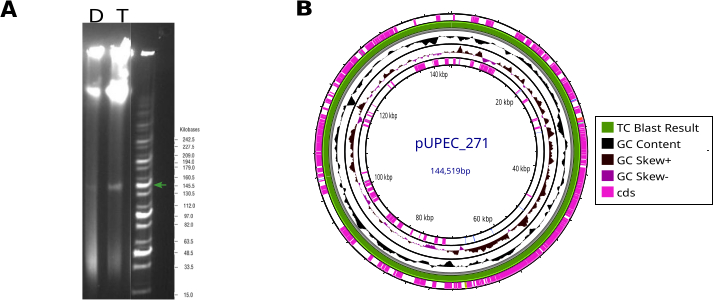
Figura 3: Caracterización de pUPEC271. (A) PFGE de donante y transconyugante. Se muestran las bandas PFGE para el donante (D) y el transconjugante (T); las flechas verdes indican la banda de plásmidos correspondiente a pUPEC271. El protocolo utilizado para la PFGE se describe en un estudio36. (B) Mapa de pUPEC271. El transconjugante fue lanzado contra el donante, y el consenso (que es 100% idéntico) se muestra como el anillo verde. Esta representación se generó usando Proksee48. El anillo más externo muestra la ubicación de CDS, dos anillos internos muestran el contenido y la sesgo de GC, y el anillo más interno muestra la ubicación de genes de ARNt. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
La transferencia de este plásmido, que los autores denominaron pUPEC271, fue confirmada posteriormente mediante análisis de PFGE utilizando el protocolo descrito previamente en36 [Figura 3A, T(transconjugante)]. El ADN plasmidal purificado de la cepa donante upec271 (pUPEC271_donor) fue secuenciado usando nanopore. Consistente con el tamaño de su banda en el gel PFGE, la secuencia pUPEC271_donor reveló un plásmido de 144.519 pb (Figura 3B). Este plásmido tenía un réplicón tipo IncF y albergaba genes de resistencia a seis clases distintas de antibióticos (véase la Tabla Suplementaria 1). Los autores también purificaron el ADN de uno de los transconjugantes (pUPEC271_TC) y obtuvieron una secuencia idéntica a la del donante. El ensamblaje final, comparado con pUPEC271_donor, se representa en la Figura 3B. Esto confirmó que el plásmido conjugativo presente en el donante se transfirió a la cepa transconjugante. Los datos técnicos se muestran en la Tabla 9.
La Blood_10_0913 de deformación es un ejemplo de cepa con más de un plásmido. Esta muestra se recogió de sangre entre 2008 y 2013, y la secuenciación de lecturas cortas indicó la presencia de dos réplicones, uno IncF y otro IncY. El análisis de esta cepa por la PFGE identificó dos plásmidos de aproximadamente 70 y 110 kb, respectivamente (Figura 4A). Esto se confirmó mediante la secuenciación por nanoporos, que produjo dos conjuntos, de 71.182 pb y 111.226 pb, respectivamente. Los autores nombraron estos dos plásmidos pBlood_10_0913_1 y pBlood_10_0913_2 (Figura 4B). Sin embargo, los ensamblajes inicialmente no circularizaron debido a la extensa homología de secuencias en la sección de los plásmidos que alberga la maquinaria de conjugación (la sección de homología extensiva se destaca en la Figura 4B). El diagrama de ensamblaje fallido, generado usando la Venda47 , se muestra en la Figura 4C. El ensamblaje completo de los dos plásmidos solo fue posible tras un eliminado agresivo de lecturas de secuencias de lectura más corta (< 3000 pb).
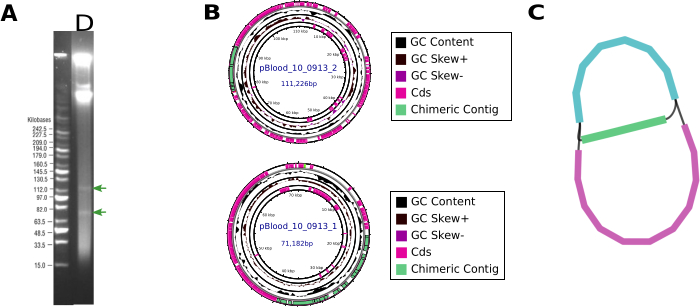
Figura 4: Identificación y ensamblaje de los plásmidos de Blood_10_0913 cepa. (A) PFGE. Las flechas verdes indican bandas plásmidicas. El protocolo utilizado para la PFGE se describe enel ensamblaje de secuencias 36 (B). Ensamblaje de los dos plásmidos más pequeños presentes en la muestra pBlood_10_0913, pBlood_10_0913_2 y pBlood_10_0913_2. (C) Montaje fallido. Representación de fallo de ensamblaje debido a la presencia de una secuencia compartida entre dos ensamblajes distintos. Esta representación se generó usando elVendaje 47. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
Tabla suplementaria 1: Genes de resistencia portados por pUPEC271. Se muestran el tamaño del plásmido, los réplicones y los genes de resistencia asociados con pUPEC271. Por favor, haga clic aquí para descargar este archivo.
Comandos Suplementarios. Por favor, haga clic aquí para descargar este archivo.
Discusión
La identificación y caracterización de plásmidos es de gran interés para la salud pública, la microbiología clínica y la ecología microbiana, ya que facilitan el mantenimiento y la difusión de genes adaptativos en entornos ecológicos 1,5 y sirven como plataformas para una evoluciónacelerada 4. La introducción de tecnologías NGS permitió la secuenciación de alto rendimiento de genomas de aislados microbianos y poblaciones, aunque la identificación post-ensamblaje de plásmidos completos o de contigs derivados de plásmidos generalmente requiere secuencias de lectura larga porque los datos de secuenciación de lectura corta no pueden resolver regiones repetidas mayores que el tamaño de las lecturas. ONT se ha convertido en un enfoque muy popular de secuenciación de lectura larga, con aplicaciones que van más allá de la secuenciación del genoma completo y la metagenómica, que incluyen la verificación de secuencias de plásmidos, la detección y caracterización de modificaciones epigenéticas, la secuenciación de ARN y la evaluación de la inestabilidad intrínseca de los arreglos génicos en tándem (revisado en12,49).
Aquí, los investigadores presentan un flujo de trabajo para la secuenciación ONT de plásmidos diseñado para situaciones donde la secuencia cromosómica ya se conoce o no tiene interés. La razón es que la extracción de plásmidos es laboriosa, costosa y lleva mucho tiempo (ya que la población huésped necesita cultivarse y procesarse), y secuenciar todo el genoma usando tecnología de nanoporos suele ser suficiente para obtener ensamblajes completos de plásmidos proporcionando su contexto genómico. Ejemplos en los que el protocolo resulta útil incluyen la verificación de una secuencia de plásmidos en el contexto de la ingeniería genéticade plásmidos 50,51, la mejora de la precisión de secuencias de plásmidos ya obtenidas por WGS24, o la caracterización de plásmidos capturados de muestras clínicas o ambientales mediante conjugación.
La extracción de ADN de muestras clínicas y ambientales puede requerir cierta personalización. Aquí, los autores informan que algunas de las cepas clínicas que utilizaron produjeron una matriz de biofilm que obstruyó los filtros, requiriendo múltiples pasos de pelletado y, a veces, la adición de dos filtros. Además, para secuenciar plásmidos conjugativos, se necesita un mayor volumen de cultivo en relación con la secuenciación de plásmidos multicopia, ya que los plásmidos de tamaño medio y grande de origen natural tienden a tener un número bajo de copiade plásmidos 2.
El protocolo ha permitido la secuenciación de plásmidos entre 4 kb y 173 kb de tamaño. Este rango se ajusta perfectamente a las especificaciones del fabricante (entre 2 y 200 kb). Recientemente, un estudio analizó 23.000 secuencias de plásmidos depositadas en NCBI y encontró diferencias significativas de tamaño según la fuente, siendo los plásmidos de origen humano el tamaño medio más pequeño (76 kb), y los plásmidos de suelo y planta los mayores (215 y 427 kb); Los plásmidos de todas las demás fuentes tenían un tamaño medio entre 79 y 147 kB, por lo que este protocolo debería cubrir la mayoría de los plásmidos, siendo la posible excepción de los megaplásmidos52 y los plásmidos de origen de sueloo planta 3.
Los autores incluyen un paso de enriquecimiento de ADN plasmidico para mejorar la precisión de los ensamblajes de ADN plasmid. La presencia de grandes cantidades de ADN cromosómico inunda los poros celulares de la célula de flujo secuenciador con lecturas no objetivo, reduciendo sustancialmente la profundidad del ADN plasmídico. Ya se había implementado un paso de enriquecimiento de ADN plasmidico para intentar el ensamblaje completo del ADN plasmídico en muestras clínicas para la detección deARGs 24. Esto mostró mejoras sustanciales en la efectividad de completar el ensamblaje de plásmidos con secuencias solo de nanoporos (78% de ensamblajes completos respecto al punto de referencia). Otros ejemplossiguieron en 50, 53, 54.
Para mejorar la precisión de la lectura, dos de estos estudios utilizaron una técnica desarrollada por nanopore llamada "llamada de base pareada en lecturas pseudopareadas"50,53. Este enfoque implica alinear las señales eléctricas en bruto de las cadenas sensoriales y antisentido de la misma molécula de ADN, lo que resulta en una mejora de precisión de aproximadamente un orden de magnitud. La llamada de bases emparejada en lecturas pseudopareadas es compatible con la multiplexación, siempre que la estrategia permita identificar las cadenas directa y inversa de la misma molécula. Por tanto, no puede utilizarse en plásmidos purificados de muestras de complemento plásmico desconocido o que contienen una mezcla de plásmidos. Cabe señalar que el número de plásmidos en un genoma suele oscilar entre 0 y 7 plásmidos (especialmente en aislados clínicos)2,55.
Los investigadores observaron un alto nivel de contaminación cromosómica en las muestras (Tabla 10). El nivel de contaminación de 10 muestras analizadas osciló entre el 28 y el 72% según el mapeo de lecturas. Sin embargo, cuando los investigadores normalizaron esta secuencia al tamaño del cromosoma en relación con el del plásmido o plásmidos presentes, se descubrió que las secuencias de plásmidos eran de media 144 veces más abundantes que las cromosómicas. Traducir este número al nivel de enriquecimiento del ADN plasmidal requeriría conocer el número de copias plasmidicas de los plásmidos en cada muestra.
Las celdas de flujo MinION suelen producir una salida de secuenciación de ~30 GB, lo que teóricamente permite la secuenciación de más de 96 plásmidos por secuencia. En la práctica, la multiplexación también está limitada por el límite de 96 códigos de barras, lo que convierte 96 plásmidos en el límite superior práctico por celda de flujo. Sin embargo, la contaminación por ADN cromosómico y el desequilibrio natural de códigos de barras reducen la profundidad efectiva de lectura por muestra. Para asegurar una profundidad de lectura suficiente para cada muestra, un enfoque más conservador es multiplexar aproximadamente 24 plásmidos por celda de flujo. La profundidad recomendada para el ensamblaje preciso de la secuencia de plásmidos está entre 50 y70x32,56. En los ejemplos ilustrativos presentados en este artículo, los autores analizaron 21 muestras multiplexadas en una celda de flujo y obtuvieron una profundidad media (109x), que se alinea bien con el óptimo recomendado para cada celda de flujo.
Ten en cuenta que, con un exceso de profundidad de lectura, las particiones de aprobado/fallo son menos informativas para evaluar la calidad general de lectura. En cambio, las métricas derivadas de la distribución de longitud proporcionan una representación más clara de la calidad del conjunto de datos. Una de estas métricas es el N50, definido como la longitud de lectura a la que las lecturas de esa longitud o más representan el 50% del total de bases. Este valor es muy sensible a los pasos de control de calidad. Por ejemplo, filtrar lecturas de baja calidad o cortas con herramientas como Filtlong elimina una fracción sustancial de la cola más corta de la distribución, inflando así el N50. Este efecto es evidente en la Tabla 9.
Los autores utilizaron el kit Rapid Barcode de ONT, que utiliza un transposoma para fragmentar ADN de plásmido, por lo que no requiere conocimiento previo del patrón de restricción del plásmido. Un estudio anterior encontró que para plásmidos pequeños (<20 kb), la fragmentación enzimática es necesaria porque los plásmidos pequeños permanecen circularizados durante la mayoría de las extracciones de ADN y, por tanto, no contienen extremos libres para la ligaciónadaptadora 54. Ese estudio no utilizó códigos de barras, que generan extremos libres adicionales mediante amplificación por PCR, así que en este caso esto probablemente no tiene sentido. OnRamp, uno de los procedimientos avanzados para la validación rutinaria de plásmidos, evita el uso de códigos de barras aprovechando lecturas de plásmidos de longitud completa para el ensamblaje, simplificando así la preparaciónde la muestra 54. En este caso, los autores preferían los códigos de barras por tres razones. La primera es construir un conjunto independientemente de la longitud del plásmido. La segunda es tolerar la contaminación por ADN cromosómico. La tercera es que esto abre la posibilidad de multiplexar varias muestras, como se ha mencionado antes.
Un estudio anterior señaló que la agregación de diferentes ensambladores mejoró el resultado final al cancelar los sesgos incorporados en las plataformas de ensamblajeindividuales 24. Este metaanálisis es una función que se ha incorporado al programa de ensamblaje que utilizan los autores, Autocycler34. En comparación con su versión anterior, llamada Trycycler57, Autocycler es algo más automatizado; Utiliza varios subconjuntos de las lecturas y (como se mencionó antes) realiza ensamblajes con múltiples ensambladores para crear un ensamblaje de consenso más preciso. Sin embargo, la mayoría de los ensambladores, incluso los mejores, como Flye28, Canu29 y Raven30, tienen dificultades con la presencia de plásmidos con homología de secuencias extensa, fusionando erróneamente secuencias de plásmidos o generando múltiples copias de un solo plásmido, y son propensos a perder plásmidos pequeños58,59 (véase también la Figura 4C). Cuando esto ocurre, eliminar lecturas de menor calidad y eliminar lecturas cortas puede dar lugar a resolver contigs quiméricos.
Para establecer la precisión general de los protocolos de secuenciación, los autores compararon los ensamblajes solo ONT con ensamblajes pulidos combinando lecturas largas y cortas, que (sin los datos de PacBio) es el estándar de oro actual. Los autores también disponían de datos en gel que mostraban el número de plásmidos presentes y sus tamaños estimados (Tabla 8, tercera columna). Los investigadores ensamblaron con éxito los 13 plásmidos encontrados en las 10 muestras y obtuvieron tamaños consistentes con las secuencias ensambladas. Esto es todo un éxito, ya que los ensambladores de secuencias LR a menudo no logran ensamblar plásmidos con secuencias estructuralmente complejas. A un nivel más detallado, las comparaciones por pares entre los dos conjuntos de secuencias indicaron un nivel variable de precisión (Tabla 8). Cinco de los conjuntos de plásmidos tenían áreas sin cobertura en los ensamblajes ONT, presumiblemente como resultado de la secuencia añadida artificialmente durante el ensamblaje de secuencias solo con ONT. De los otros siete, tres mostraron polimorfismos de un solo nucleótido, con diferencias por pares que oscilaban entre 0,0023 y 0,05%, y cuatro mostraron concordancia perfecta. El nivel de precisión no parece correlacionarse con el nivel de enriquecimiento del ADN o la profundidad de secuenciación del ADN plasmid, pero sí la presencia de más de un plásmido en una muestra dada, posiblemente porque tener más de un plásmido tiende a amplificar el nivel de complejidad de la secuencia (Tabla 8). En resumen, el flujo de trabajo está diseñado para optimizar el rendimiento y la precisión de las secuencias de plásmidos. Aunque es capaz de ensamblar secuencias de plásmidos, produce un nivel variable de precisión a nivel de nucleótidos. El protocolo puede usarse para secuenciar plásmidos de un amplio rango de tamaños, tolera al menos un 72% de contaminación cromosómica por ADN y puede acomodar (dependiendo del tamaño del plásmido y el estado de la celda de flujo) al menos 24 plásmidos en una sola celda de flujo.
Divulgaciones
Los autores no tienen nada que revelar.
Agradecimientos
Estamos muy agradecidos a Steve Salipante (Universidad de Washington) por compartir generosamente un conjunto de cepas clínicas de E. coli publicadas en45. Este trabajo fue parcialmente apoyado por fondos de apoyo a la investigación para un nombramiento de Dirección en Innovación y Desarrollo Emprendedor de UCSC a MC y por la subvención Alianza MX de la Universidad de California "Perfilado genómico de aislados de tuberculosis entre poblaciones de alta carga y vulnerables en México: conocimientos sobre transmisión y resistencia a fármacos" a MC.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Se puede reemplazar por otra marca |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Se puede reemplazar por otra marca |
| 15 mL conical tubes | FALCON | 352096 | Se puede reemplazar por otra marca |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Se puede reemplazar por otra marca |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Se puede reemplazar por otra marca |
| 250 mL sterile flasks | PYREX | 5320 | Se puede reemplazar por otra marca |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Se puede reemplazar por otra marca |
| Centrifuge | Eppendorf | 5424R-PR-R | Se puede reemplazar por otra marca |
| Centrifuge | Eppendorf | 5810R-P-R | Se puede reemplazar por otra marca |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Se puede reemplazar por otra marca |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Se puede reemplazar por otra marca |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Se puede reemplazar por otra marca |
| Ethanol | Fisher Scientific | 04-355-720 | Se puede reemplazar por otra marca |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Se puede reemplazar por otra marca |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Cualquier marca de guantes de nitrilo funciona |
| Ice bucket | Thermo Fisher Scientific | 432128 | Se puede reemplazar por otra marca |
| Isopropanol | Fisher Scientific | BP26184 | Se puede reemplazar por otra marca |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Se puede reemplazar por otra marca |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Se puede reemplazar por otra marca |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit™ 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit™ Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Las micropipetas deben estar calibradas |
| Spectrophotometer | Thermo Scientific | 335905P | Se puede reemplazar por otra marca |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Se puede reemplazar por otra marca |
| Water bath | Thermo Scientific | 51221052 | Se puede reemplazar por otra marca |
Referencias
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Reimpresiones y permisos
