Este artículo presenta un protocolo paso a paso para la recopilación de datos de seguimiento ocular con alta precisión en experimentos de lectura humana, que abarca la selección de hardware y pantallas, configuración del laboratorio, manejo de participantes, calibración y validación, control de calidad en línea y preprocesamiento (detección de eventos y corrección de deriva) para obtener datos con alta exactitud y precisión, así como resultados reproducibles.
Artículo de método
Protocolo metodológico para la recolección de datos de alta calidad durante el seguimiento ocular en la lectura humana
En este artículo
Resumen
Resumen
El seguimiento ocular es un enfoque metodológico central para estudiar la atención y el procesamiento del lenguaje durante la lectura. La validez y la reproducibilidad de los resultados dependen de la calidad de los datos, una metodología clara y un preprocesamiento consistente. Este artículo presenta un protocolo integral y paso a paso para recopilar datos de seguimiento ocular de alta calidad en estudios de lectura. El protocolo comienza con la preparación del entorno del laboratorio y la configuración del equipo, seguido de la selección y configuración del hardware y software de seguimiento ocular, así como de la preparación de los estímulos y del diseño experimental. Se lleva a cabo la gestión de los participantes, el consentimiento informado y la documentación de las características lingüísticas y psicométricas. Luego se realizan procedimientos de calibración y validación, monitoreando cuidadosamente la comodidad del participante y la calidad de los datos en tiempo real durante la recopilación. La canalización de preprocesamiento incluye la exportación de datos brutos en formatos estándar, la limpieza de datos, la detección de fijaciones y sacadas (empleando algoritmos basados en velocidad y en dispersión) con parámetros claramente definidos, la inspección visual para detectar pérdida de señal y control de ruido, la corrección de deriva vertical en texto de varias líneas y la extracción de medidas estándar de lectura (duración de la fijación, métricas de sacadas, omisión de palabras y tasas de regresión). A lo largo del protocolo, se enfatiza especialmente la alineación entre las preguntas de investigación y las especificaciones del hardware, la gestión de la deriva mediante revisiones regulares y la descripción detallada de todos los parámetros y decisiones críticos. Una recopilación exitosa de datos suele resultar en una precisión de validación estable dentro de los límites establecidos, tasas bajas de pérdida de datos y distribuciones interpretables de duraciones de fijación y comportamiento sacádico que reproducen efectos bien conocidos relacionados con la longitud, frecuencia y predictibilidad de las palabras. El protocolo es compatible con dispositivos de seguimiento ocular de escritorio, entornos de software comunes y configuraciones tanto con la cabeza estabilizada como sin estabilizar, abordando cuestiones prácticas como las condiciones de iluminación, los reflejos de las gafas y los cambios en la postura del participante. Este estudio presenta un protocolo claro y práctico que consolida la orientación metodológica en un flujo de trabajo unificado. Tiene como objetivo apoyar la recopilación confiable de datos de seguimiento ocular en la investigación de la lectura, promover la replicabilidad y los análisis por metasíntesis, mejorar la consistencia entre laboratorios y grupos, y fortalecer, en última instancia, la credibilidad científica de la investigación sobre la lectura.
Introducción
El seguimiento ocular es un método central para estudiar la atención y el procesamiento del lenguaje durante la lectura, ya que las fijaciones y los sacádicos indican la asignación momento a momento de los recursos visuales y cognitivos a los estímulos. Revisiones clásicas y contemporáneas documentan vínculos sólidos entre los movimientos oculares y constructos teóricos como el campo perceptivo, el beneficio de previsualización y los modelos de control de los movimientos oculares1,2. Para realizar estudios confiables que examinen estos vínculos, es esencial el rigor metodológico en la selección del equipo, el diseño experimental, la calibración y validación, y el preprocesamiento; de lo contrario, la degradación de la calidad de los datos sesga las estimaciones y compromete la replicabilidad3.
Durante la última década, varios artículos introductorios y de buenas prácticas han consolidado el conocimiento metodológico del campo. Una serie reciente de fundamentos conecta la teoría con las mediciones, analiza la operacionalización y la variabilidad algorítmica, y ofrece orientación para elegir rastreadores oculares según preguntas de investigación específicas4,5,6,7,8. Guías complementarias presentan buenas prácticas para seleccionar hardware, garantizar precisión y exactitud, definir mediciones y reportar resultados, con recomendaciones para reducir amenazas a la validez9. Recursos introductorios para la investigación en lectura también ofrecen panoramas accesibles del diseño experimental, las mediciones comunes y las canalizaciones de análisis10,11. En lingüística aplicada y lectura, revisiones específicas del dominio resumen la selección de mediciones y rastreadores y destacan las limitaciones dependientes de la tarea12,13,14,15,16,17.
Este artículo traduce esas recomendaciones en un protocolo paso a paso para la recopilación de datos de seguimiento ocular con alta precisión en estudios de lectura. A diferencia de los recursos existentes que ofrecen principalmente pautas teóricas generales sobre buenas prácticas o se centran exclusivamente en técnicas analíticas específicas, este protocolo convierte estos conceptos en un flujo de trabajo completo y aplicable. Su objetivo es facilitar la práctica diaria en el laboratorio proporcionando instrucciones concretas y secuenciales. En cuanto a su aplicabilidad, este protocolo está optimizado específicamente para experimentos de lectura en laboratorio altamente controlados, que utilizan dispositivos de seguimiento ocular de escritorio con alta frecuencia (por ejemplo, 500-2000 Hz) y configuraciones con estabilización de la cabeza (reposacabezas o reposa mentón). Es más adecuado para investigaciones que requieren restricciones estrictas de calidad de datos, alta precisión espacial y exactitud, como estudios que analizan fijaciones precisas a nivel de palabra o métricas detalladas de sacadas.
El uso de configuraciones sin restricciones o naturalistas también ha ido ganando popularidad, incluso en la investigación sobre lectura, aunque limitamos el alcance del artículo a estudios de laboratorio. Abordamos la selección de hardware y software, la configuración del laboratorio, la preparación de estímulos, la gestión de participantes, la calibración y validación, el control de calidad en línea y el preprocesamiento (incluyendo la detección de eventos y la corrección de deriva). Al seguir el protocolo, los investigadores pueden documentar y lograr una calidad de datos coherente con los estándares actuales, mejorando así la transparencia, credibilidad y reproductibilidad de los hallazgos relacionados con la lectura.
Protocolo
Se obtuvo permiso ético para la recopilación de datos de COST CA21131 por parte del Comité de Ética de Investigación de la Facultad de Filosofía de la Universidad Jaguelona, Polonia, con el número de protocolo 221.0042.18_2024. Se obtuvo el consentimiento informado de todos los participantes.
1. Preparación del entorno de laboratorio y configuración del equipo
- Preparación del entorno del laboratorio
- Verifique las condiciones de luz y ruido ambiental. Las ventanas en el entorno del laboratorio pueden provocar cambios repentinos en la dilatación de la pupila y reflejos de luz en la cámara del rastreador ocular y en el monitor. Si es posible, recoja los datos en una habitación sin ventanas o use cortinas opacas para bloquear la luz solar. Utilice iluminación artificial y elimine fuentes de luz reflectante. Asegúrese de que no haya reflejos en el monitor; ajuste las persianas o los ángulos hasta que desaparezcan por completo. Asegúrese de que la habitación esté en silencio y evite interrupciones (por ejemplo, colocando señales o cerrando la puerta con llave). Utilice señales externas para evitar interrupciones (por ejemplo, coloque un cartel en el exterior que diga: “Experimento en curso. Por favor, no golpee la puerta ni ingrese a la habitación.”)
- Verifique la ergonomía física. Utilice una silla estable y sin giro; ajuste la altura de la mesa (si es posible) para mantener una postura adecuada y evitar la pérdida de calibración por rotación de la silla.
- Evite la presencia social. La presencia de un experimentador en la misma habitación podría distraer al participante. Separe la sala de control de la sala del participante, o manténgase fuera de su campo visual, para minimizar los efectos de la presencia social.
- Verifique la ventilación del aire. Ventile la habitación antes y después de las sesiones experimentales. Compruebe la temperatura ambiente, ya que los participantes deberán permanecer inmóviles durante cierto tiempo.
- Selección del equipo de rastreo ocular
- Verifique la compatibilidad entre los objetivos de investigación y las medidas. Se espera que los objetivos de un estudio específico, y por tanto las medidas objetivo (variables dependientes), coincidan con las capacidades del equipo de rastreo ocular. La disponibilidad institucional del equipo podría introducir limitaciones al alcance del estudio previsto. Revise las tres características principales del sistema de rastreo ocular (frecuencia de muestreo, precisión y exactitud) y su potencial para satisfacer las necesidades de la investigación. El punto principal es asegurar que las capacidades del equipo de rastreo ocular sean compatibles con los objetivos del estudio.
NOTA: Frecuencia de muestreo = La frecuencia de muestreo se expresa en Hz y refleja el tamaño de las muestras recopiladas por el rastreador ocular durante un período: un rastreador ocular de 60 Hz recopila muestras cada 16 ms, mientras que un rastreador de 500 Hz recopila muestras cada 1 ms. Esto afecta los diferentes tipos de medidas, ya que los rastreadores oculares de baja frecuencia podrían incluir sacadas que comenzaron durante un período de 16 ms como fijaciones, o viceversa. A veces se confunde el muestreo con la exactitud de los datos, pero estas son propiedades distintas.
Precisión = La consistencia con la que el rastreador ocular puede recopilar datos a lo largo del tiempo.
Exactitud = La cantidad de error entre el punto de mirada detectado por el rastreador ocular y el punto de mirada real.
Por ejemplo, al estudiar los puntos de aterrizaje de las fijaciones en palabras, que se describen en términos de la posición de la mirada sobre las letras de una palabra, se requiere una frecuencia de muestreo (≥500-2000 Hz), precisión y exactitud mucho más altas que en un estudio que se centre únicamente en el porcentaje de sacadas regresivas (en comparación con las sacadas progresivas) durante la lectura. - Determine la metodología de registro del movimiento ocular. Utilice un rastreador ocular de escritorio con alta frecuencia de muestreo, precisión y exactitud. Use estabilización de la cabeza con un reposacabezas o un soporte para la frente. En caso de utilizar rastreo ocular sin soporte de cabeza (rastreo ocular remoto), use adhesivos, si están disponibles, en la frente del participante para mejorar el seguimiento facial; además, evite adhesivos reflectantes a menos que lo recomiende el fabricante del rastreador.
NOTA: El uso de equipos portátiles de rastreo ocular ha sido poco común en estudios de lectura debido a su frecuencia de muestreo, precisión y exactitud relativamente bajas en comparación con los rastreadores oculares de escritorio, así como a las dificultades para analizar los datos de movimiento ocular. Sin embargo, en la última década han ganado popularidad los montajes sin soporte de cabeza o en entornos naturalistas, acompañados de una mejora en la calidad de los datos y en las canalizaciones automatizadas de análisis, ampliando así el alcance de los estudios sobre movimientos oculares durante la lectura hacia entornos más naturalistas y la lectura en entornos de realidad virtual (VR).
- Verifique la compatibilidad entre los objetivos de investigación y las medidas. Se espera que los objetivos de un estudio específico, y por tanto las medidas objetivo (variables dependientes), coincidan con las capacidades del equipo de rastreo ocular. La disponibilidad institucional del equipo podría introducir limitaciones al alcance del estudio previsto. Revise las tres características principales del sistema de rastreo ocular (frecuencia de muestreo, precisión y exactitud) y su potencial para satisfacer las necesidades de la investigación. El punto principal es asegurar que las capacidades del equipo de rastreo ocular sean compatibles con los objetivos del estudio.
- Configuración del hardware y software
- Configuración del hardware. Mida las distancias entre el rostro del participante, el monitor y el rastreador ocular. Establezca la distancia de visualización según el fabricante (por ejemplo, ~60–70 cm) y la geometría de configuración requerida, preferiblemente utilizando un monitor LCD plano de 21–27 pulgadas (por ejemplo, 24 pulgadas a 60 cm, campo visual de ~48° x 28°) de modo que todo el texto permanezca dentro del campo visual central y del rango efectivo del rastreador. Verifique la inclinación y rotación del monitor, y la alineación entre el vector de mirada y su ubicación correspondiente en la pantalla. Establezca el tamaño del monitor y la frecuencia de actualización en los valores deseados. Configure la resolución de pantalla al valor especificado. Mida la luminancia del monitor sobre un fondo blanco a la distancia especificada. Registre el valor de luminancia en el informe de la sesión.
- Si es necesario, prefiera monitores LCD con altas tasas de actualización (120 Hz o más, por ejemplo, 144–240 Hz), especialmente para tareas dependientes de la mirada y para verificar la sincronización temporal. Desactive las tecnologías de actualización variable (G-Sync/FreeSync). Si diferentes investigadores utilizan el rastreador ocular para distintos experimentos, es importante llevar un registro de cualquier cambio realizado durante cada sesión de recopilación de datos. Al final de cada sesión de recopilación, la configuración debe devolverse al estado original con el que comenzó la sesión, o según lo definido por el protocolo del laboratorio.
- Configuración del software. La mayoría de los fabricantes de rastreadores oculares proporcionan software relevante, kits de desarrollo de software (SDK) y/o bibliotecas para compatibilidad e integración con software de código abierto.
NOTA: Recientemente, ciertos montajes específicos han seguido siendo un desafío técnico que requiere soluciones personalizadas. Por ejemplo, la sincronización temporal de un rastreador ocular con métodos complementarios de medición, como EEG y fNIRS, requiere soluciones especiales de hardware y/o software para garantizar un nivel adecuado de sincronización entre el reloj del rastreador ocular y el reloj de presentación de estímulos, y/o la desincronización con la actualización de la pantalla. Por lo tanto, la mayoría de las herramientas de los fabricantes proporcionan un entorno para diseñar experimentos que satisfaga las necesidades básicas de los investigadores, como presentar estímulos y registrar movimientos oculares. A continuación se presenta una lista de los paquetes de software actualmente disponibles en la Tabla de Materiales.
- Configuración del hardware. Mida las distancias entre el rostro del participante, el monitor y el rastreador ocular. Establezca la distancia de visualización según el fabricante (por ejemplo, ~60–70 cm) y la geometría de configuración requerida, preferiblemente utilizando un monitor LCD plano de 21–27 pulgadas (por ejemplo, 24 pulgadas a 60 cm, campo visual de ~48° x 28°) de modo que todo el texto permanezca dentro del campo visual central y del rango efectivo del rastreador. Verifique la inclinación y rotación del monitor, y la alineación entre el vector de mirada y su ubicación correspondiente en la pantalla. Establezca el tamaño del monitor y la frecuencia de actualización en los valores deseados. Configure la resolución de pantalla al valor especificado. Mida la luminancia del monitor sobre un fondo blanco a la distancia especificada. Registre el valor de luminancia en el informe de la sesión.
2. Diseño y prueba piloto del experimento
- Preparación de los estímulos
- Preparar los materiales de lectura. Los materiales de lectura generalmente se presentan en forma de oraciones o párrafos, dependiendo de los objetivos del estudio. Considere extraer los materiales de lectura de fuentes disponibles en lugar de crear manualmente el texto, siempre que este método sea coherente con el objetivo del estudio.
- Verifique las condiciones de licencia para la reutilización del texto. Revise las condiciones de licencia de todos los textos. Si los materiales de experimentos publicados son de código abierto y, por lo tanto, están disponibles públicamente para cualquier persona que desee utilizarlos, entonces no se requiere permiso. En caso contrario, obtenga los permisos necesarios antes del uso. Es importante verificar si los estímulos pueden utilizarse en el experimento y si pueden compartirse como materiales suplementarios.
- Preparar estímulos formateados. El formateo de estímulos de texto requiere el uso de propiedades adecuadas de fuente (tipo, tamaño, espaciado entre letras, palabras y líneas). Utilice una fuente de ancho fijo con un tamaño y espaciado de fuente apropiados, considerando los parámetros utilizados en la literatura.
NOTA: Se recomiendan fuentes de ancho fijo, como Courier New, en experimentos de lectura que utilizan Áreas de Interés (AOI) basadas en palabras, ya que estas fuentes proporcionan el mismo tamaño en píxeles para diferentes caracteres y símbolos alfanuméricos dentro del alfabeto latino. El investigador debe verificar la compatibilidad entre la fuente, la interfaz y las propiedades específicas de los estímulos, como la presentación de estímulos en caracteres no latinos o direcciones de lectura de derecha a izquierda, y si las herramientas de software para el experimento ofrecen una metodología para realizar la especificación automática de IA (Área de Interés) u AOI (Área de Interés).
- Diseñar el procedimiento del experimento
- Preparación de instrucciones
NOTA: Las instrucciones son importantes porque tienen un impacto significativo en los movimientos oculares durante la lectura. El uso de instrucciones de la tarea, incluso en forma mínima, es fundamental. La falta de instrucciones explícitas puede provocar consecuencias no deseadas que afectan el comportamiento visual de los participantes. Por ejemplo, un participante podría tener una suposición latente sobre la lectura cuidadosa, mientras que otro podría realizar una lectura rápida en lugar de una lectura natural con comprensión.- Presente instrucciones estandarizadas en pantalla y registre el momento de inicio y la duración de las instrucciones; evite las indicaciones verbales durante la grabación. Una práctica común consiste en pedir al participante que lea para comprender. Si se espera que los participantes lean como lo hacen en situaciones cotidianas, infórmeles de que deben leer de forma natural; es decir, que no necesitan evitar parpadear ni releer. Asimismo, informe a los participantes si existe alguna tarea adicional, como preguntas de comprensión (que son importantes para garantizar que los participantes lean comprendiendo). Las instrucciones pueden variar no solo según la tarea, sino también según la fase del experimento (por ejemplo, entrenamiento frente a tarea principal). Para ilustrar esto, a continuación se proporciona un ejemplo de las instrucciones utilizadas durante una fase de entrenamiento18.
Ahora comenzaremos con una sesión de entrenamiento. Para ello, necesitará las cuatro teclas marcadas (A, B, C, D). En breve se le mostrarán instrucciones adicionales. Después del entrenamiento, se evaluará su desempeño, lo cual tomará de uno a dos minutos. Si su desempeño durante el entrenamiento no es suficiente, se repetirá la última parte del mismo. Si es suficiente, regresaré a la habitación. Cuando esté listo, simplemente presione la barra espaciadora. - Depende del investigador utilizar tales instrucciones en las sesiones de entrenamiento de experimentos diseñados para estudiar la lectura. Sin embargo, utilice las instrucciones para la sesión del experimento. Un ejemplo de instrucciones de la fase experimental utilizadas en una condición de instrucción de relevancia general (tanto con como sin una pregunta en el texto) podría ser como la que se muestra a continuación19.
Leerá un conjunto de textos expositivos breves. Deseamos que lea el texto con atención, comprendiendo la mayor parte posible del contenido. Posteriormente, después de la lectura, se le pedirá que dé un resumen oral sobre las ideas principales del texto, con el fin de evaluar qué tan bien comprendió lo que ha leído.
Otro ejemplo de instrucción se proporciona a continuación para un experimento que emplea tareas de lectura de oraciones20.
Bienvenido a nuestro estudio de lectura. En este estudio, se le presentarán aproximadamente cien oraciones seleccionadas al azar de diversas fuentes. Las oraciones se mostrarán en orden aleatorio. Léalas en silencio, procurando comprender su significado, a su ritmo natural de lectura, de forma similar a como leería oraciones en un libro. Después de algunas oraciones, es posible que se le formulen preguntas de comprensión. Por favor, responda las preguntas de comprensión. Si no conoce la respuesta, omita la pregunta. Habrá una pausa en la mitad de la sesión. Puede solicitar una pausa o abandonar la sesión en cualquier momento si se siente incómodo. Si tiene alguna pregunta, infórmelo al experimentador. De lo contrario, presione un botón para comenzar el procedimiento.
- Presente instrucciones estandarizadas en pantalla y registre el momento de inicio y la duración de las instrucciones; evite las indicaciones verbales durante la grabación. Una práctica común consiste en pedir al participante que lea para comprender. Si se espera que los participantes lean como lo hacen en situaciones cotidianas, infórmeles de que deben leer de forma natural; es decir, que no necesitan evitar parpadear ni releer. Asimismo, informe a los participantes si existe alguna tarea adicional, como preguntas de comprensión (que son importantes para garantizar que los participantes lean comprendiendo). Las instrucciones pueden variar no solo según la tarea, sino también según la fase del experimento (por ejemplo, entrenamiento frente a tarea principal). Para ilustrar esto, a continuación se proporciona un ejemplo de las instrucciones utilizadas durante una fase de entrenamiento18.
- Diseñe los ensayos y bloques. Diseñe el flujo del experimento considerando la presentación de los ensayos en bloques y la aleatorización del orden de los ensayos dentro y entre los bloques. Utilice una cruz de fijación antes de cada ensayo (500-800 ms) para asegurar que las fijaciones iniciales de los participantes se ubiquen en la misma posición de la pantalla y lejos de cualquier parte del texto.
El diseño de un experimento de seguimiento ocular en el que el tamaño de la pupila es una variable dependiente requiere ajustar el flujo del experimento de manera correspondiente, ya que el tamaño de la pupila no es una respuesta momentánea como una secuencia de fijación-sacádica. Específicamente, en el caso de utilizar el tamaño de la pupila como variable dependiente, es necesario introducir una ventana de línea base previa al inicio y periodos de pantalla negra con duraciones adecuadas para garantizar la estabilización del tamaño de la pupila antes de la presentación de los estímulos y del siguiente ensayo. El investigador debe consultar estudios recientes sobre orientaciones en pupilometría para asegurarse de que los datos registrados del tamaño pupilar puedan interpretarse adecuadamente como una variable dependiente21,22. - Diseñar pausas entre bloques. Introducir pantallas de corrección de deriva y pausas breves opcionales entre los bloques del experimento para garantizar la calidad de los datos y reducir la fatiga. Insertar controles de deriva tras un número predeterminado de ensayos, o cuando la precisión disminuya visiblemente (verificar si existen teclas cortas para forzar la calibración/validación durante el experimento); volver a validar si hay deriva >1° del ángulo visual (media de las coordenadas x e y).
- Identifique las variables independientes objetivo. En estudios de lectura, propiedades específicas del texto, como la frecuencia de las palabras y la predecibilidad oracional de las palabras, constituyen las principales variables independientes objetivo. Liste las variables independientes del experimento según los objetivos del estudio. En los análisis estadísticos, puede ser necesario normalizar los valores de las métricas de las variables independientes. Evalúe la relevancia de cada variable en función de las propiedades de los estímulos.
- Excluya las palabras al principio de la línea de texto del análisis, ya que las fijaciones en esas palabras generalmente no son precisas: pueden reflejar la primera fijación tentativa en el texto/oración o la primera fijación tras un salto de línea (lo que se denomina «barrido de retorno»), que en cualquier caso no son precisas y suelen ir seguidas de fijaciones correctoras. Excluya la última palabra de cada línea porque esas palabras están sujetas a menor aglomeramiento visual (por palabras subsiguientes) y porque las fijaciones en las palabras al final de la línea a menudo reflejan la finalización de un ensayo o la programación de un barrido de retorno a la siguiente línea del texto.
NOTA: La duración de la primera fijación podría ser menos significativa en idiomas con muchas palabras funcionales, como los artículos antes de los sustantivos (la región de análisis debe incluir el artículo y el sustantivo, pero la primera fijación será menos importante, ya que podría reflejar únicamente el procesamiento del artículo).
- Excluya las palabras al principio de la línea de texto del análisis, ya que las fijaciones en esas palabras generalmente no son precisas: pueden reflejar la primera fijación tentativa en el texto/oración o la primera fijación tras un salto de línea (lo que se denomina «barrido de retorno»), que en cualquier caso no son precisas y suelen ir seguidas de fijaciones correctoras. Excluya la última palabra de cada línea porque esas palabras están sujetas a menor aglomeramiento visual (por palabras subsiguientes) y porque las fijaciones en las palabras al final de la línea a menudo reflejan la finalización de un ensayo o la programación de un barrido de retorno a la siguiente línea del texto.
- Identifique las variables dependientes objetivo. En estudios de lectura, un conjunto de métricas de movimiento ocular, como la duración de la primera fijación, la duración de fijación única, la duración de la mirada, el porcentaje de regresiones y la probabilidad de omisión de palabras, constituye las principales variables dependientes objetivo en relación con los objetivos del estudio. Especifique las métricas de movimiento ocular que se analizarán. Utilice estas métricas como base del análisis estadístico.
NOTA: Evite utilizar cualquier tarea que requiera que el participante escriba en el teclado, ya que podría necesitar abandonar el reposacabezas, lo que provocaría la pérdida de la calibración. En su lugar, los participantes pueden usar el ratón para seleccionar su respuesta. En los casos en que sea necesaria una retroalimentación oral del participante durante la grabación de los movimientos oculares, utilice un reposafrente en lugar de un reposacabezas, y pida al participante que responda verbalmente o permita respuestas de una sola tecla mientras permanece en el reposafrente.
- Preparación de instrucciones
- Implementación del procedimiento experimental
- Seleccione un software para la presentación de estímulos. Configure el experimento utilizando un software adecuado para la presentación de estímulos. Pueden emplearse tanto herramientas proporcionadas por el fabricante como herramientas generales para el diseño de experimentos con el fin de presentar texto y registrar los movimientos oculares. Al elegir el software, considere las integraciones de hardware disponibles (por ejemplo, compatibilidad nativa con su dispositivo de seguimiento ocular), el grado de precisión temporal requerido y su preferencia entre diseño basado en secuencias de comandos o mediante interfaz gráfica de usuario. Independientemente de la plataforma, el software debe permitir una sincronización fiable entre los eventos del estímulo (por ejemplo, inicio de palabra, inicio de oración) y el flujo de datos del seguimiento ocular, de modo que las fijaciones y sacadas puedan alinearse con los elementos textuales correspondientes durante el análisis. Si se utiliza software externo, verifique la compatibilidad entre el software del dispositivo de seguimiento ocular y el software externo, especialmente en lo que respecta a la visualización y exportación de datos.
NOTA: Ejemplos de software: Experiment Builder (SR Research, para sistemas EyeLink) ofrece una interfaz gráfica con soporte integrado para verificaciones de deriva, rutinas de calibración y envío de mensajes de eventos al ordenador de grabación. Plataformas de código abierto como PsychoPy y OpenSesame ofrecen funcionalidades similares y son independientes del hardware, ya que permiten diseñar ensayos mediante una interfaz gráfica o mediante secuencias de comandos (por ejemplo, Python en el caso de PsychoPy), controlar la temporización de los estímulos y definir regiones de interés, también conocidas como áreas de interés (AOI, por sus siglas en inglés) o IAs, alrededor de palabras o líneas de texto. A veces, la vinculación entre visualización de datos y exportación de datos no resulta sencilla para investigadores principiantes, por lo que puede ser más fácil utilizar el software del fabricante. En consecuencia, un aspecto importante a considerar al elegir rastreadores oculares es el nivel de soporte ofrecido por los distintos fabricantes o por la comunidad de desarrolladores. - Realice un estudio piloto. Pruebe el procedimiento del experimento implementado y revise los datos registrados para asegurarse de que el experimento funcione según lo previsto. Lleve a cabo estudios piloto en el entorno de laboratorio para garantizar que el experimento se desarrolle como se espera, monitoreando criterios predefinidos de éxito. Revise los datos registrados para confirmar que se esté registrando toda la información necesaria para el estudio.
- Seleccione un software para la presentación de estímulos. Configure el experimento utilizando un software adecuado para la presentación de estímulos. Pueden emplearse tanto herramientas proporcionadas por el fabricante como herramientas generales para el diseño de experimentos con el fin de presentar texto y registrar los movimientos oculares. Al elegir el software, considere las integraciones de hardware disponibles (por ejemplo, compatibilidad nativa con su dispositivo de seguimiento ocular), el grado de precisión temporal requerido y su preferencia entre diseño basado en secuencias de comandos o mediante interfaz gráfica de usuario. Independientemente de la plataforma, el software debe permitir una sincronización fiable entre los eventos del estímulo (por ejemplo, inicio de palabra, inicio de oración) y el flujo de datos del seguimiento ocular, de modo que las fijaciones y sacadas puedan alinearse con los elementos textuales correspondientes durante el análisis. Si se utiliza software externo, verifique la compatibilidad entre el software del dispositivo de seguimiento ocular y el software externo, especialmente en lo que respecta a la visualización y exportación de datos.
3. Reclutamiento e información a los participantes
- Selección de participantes
- Determine los requisitos relacionados con la condición visual. Reclute participantes con visión normal o corregida a la normalidad. Es posible acomodar gafas y lentes de contacto, que tengan reflejos mínimos (antirreflejo, ángulo del monitor) según las indicaciones del fabricante. Documente el tipo de corrección (gafas, lentes de contacto) para verificaciones como covariable.
NOTA: Por lo general, los lentes de contacto rígidos (que ya no son muy comunes) son muy difíciles de rastrear. Aunque los lentes de contacto no representan un problema, a veces puede formarse una burbuja de aire entre el lente y la córnea, causando reflejos que interrumpen el seguimiento. Las gafas con monturas brillantes también pueden interferir con el rastreo. Para monturas de vidrio brillantes, reduzca la detección del campo de visión en el software del rastreador ocular. - Seleccione a los participantes según rasgos individuales específicos, como edad, nivel de lectura, antecedentes lingüísticos, lateralidad y criterios comunes de inclusión y exclusión. Por ejemplo, la dislexia, el bilingüismo o los trastornos de lectura pueden influir en los datos de movimiento ocular. Por lo tanto, dependiendo de los objetivos de la investigación, especifique las condiciones bajo las cuales un lector es un participante adecuado para el experimento, es decir, los criterios de inclusión y exclusión (véase la Discusión).
- Verifique las condiciones de discapacidad visual. Asegúrese de que el participante no tenga ninguna discapacidad visual no corregible, como cataratas (incluso después de cirugía), glaucoma o degeneración macular.
- Verifique las condiciones neurológicas. Asegúrese de que el participante no tenga ninguna condición que le cause incomodidad con las grabaciones de movimiento ocular. La mayoría de los rastreadores oculares utilizan LED/láseres de infrarrojo cercano o iluminación NIR certificada LED/VCSEL, que se consideran seguros para los ojos. Confirme la certificación de seguridad ocular del dispositivo (por ejemplo, Clase 1 IEC 60825-1, IEC/EN 62471 o similar). Informe al participante sobre las normas de seguridad del equipo (como la disponibilidad de un certificado CE del fabricante, comúnmente conocido como Declaración UE de Conformidad, que es un documento emitido por el fabricante para certificar que un producto cumple con todas las regulaciones europeas necesarias de salud, seguridad y medio ambiente).
- Determine los requisitos relacionados con la condición visual. Reclute participantes con visión normal o corregida a la normalidad. Es posible acomodar gafas y lentes de contacto, que tengan reflejos mínimos (antirreflejo, ángulo del monitor) según las indicaciones del fabricante. Documente el tipo de corrección (gafas, lentes de contacto) para verificaciones como covariable.
- Establecimiento de la higiene
- Adopte precauciones relacionadas con la distancia personal. Si es necesario, use guantes desechables y mascarilla, ya que la ejecución de los protocolos del experimento puede requerir una distancia personal reducida.
- Desinfecte el equipo. Desinfecte el reposacabezas y otros accesorios utilizando toallitas con alcohol, según las indicaciones institucionales vigentes. Tenga cuidado de no usar productos químicos que puedan dañar el equipo. Consulte las especificaciones del fabricante. Los participantes pueden sentirse más cómodos si la limpieza se realiza en su presencia, especialmente en el reposacabezas, el soporte para la cabeza, el ratón o cualquier otra parte del equipo con la que entrarán en contacto.
- Información al participante
- Informar al participante sobre el entorno del laboratorio. Diseñe una sesión de instrucciones verbales en la que el experimentador presente al participante el entorno del laboratorio y el equipo de rastreo ocular.
- Informar al participante sobre el experimento. Proporcione una explicación clara del contexto del experimento (el objetivo y la duración aproximada del estudio; esto debe verificarse durante los ensayos piloto), el procedimiento de incentivo o pago, la contribución del participante al experimento y sus derechos para hacer seguimiento de los resultados del estudio a largo plazo. Informe al participante sobre lo que debe y no debe hacer durante una sesión de grabación. Pida al participante que intente no mover demasiado la cabeza durante la grabación (en caso de no usar estabilizador de cabeza) ni abandonar el reposacabezas, indicando que estas precauciones son necesarias para obtener una grabación de alta calidad de los datos (de lo contrario, los participantes siempre pueden detener el experimento y abandonar la sesión sin dar una razón).
- Obtenga el consentimiento informado. Proporcione a los participantes los documentos de aprobación ética y de consentimiento y explíqueles su contenido antes de comenzar la sesión. Para adultos, obtenga el consentimiento informado por escrito tras asegurarse de que comprenden el propósito del estudio, lo que ocurrirá y sus derechos, incluyendo la opción de participar voluntariamente, la privacidad de los datos y el derecho a retirarse. Para menores que participen, obtenga el consentimiento por escrito de un padre o tutor y el acuerdo del menor. Continúe con la calibración y la grabación solo después de que se hayan completado todos los formularios de consentimiento y asentimiento requeridos. Los procedimientos de consentimiento informado varían considerablemente entre participantes adultos y menores. Por lo tanto, el investigador debe seguir las directrices institucionales locales.
NOTA: Si se produce una pausa o interrupción durante el experimento, se requiere una nueva validación de la calibración; si la revalidación falla, será necesario volver a calibrar.
4. Realización de la calibración y validación
- Colocación del participante y ajuste del equipo
- Coloque al participante. Pida al participante que se siente cómodamente. Ajuste la silla, la mesa y/o el reposacabezas para mantener una posición estable de la cabeza. Informe al participante de que esta es la posición esperada de la cabeza durante las fases de calibración, validación y registro.
- Ajuste el equipo. Ajuste el equipo de seguimiento ocular alineando la cámara del rastreador de ojos de manera que las pupilas del participante sean claramente visibles y detectables. Algunos sistemas de seguimiento ocular realizan esta alineación automáticamente, mientras que otros pueden requerir ajustar manualmente el enfoque de la cámara.
NOTA: El experimentador debe practicar el ajuste del equipo y la calibración antes de comenzar la recopilación real de datos para evitar sobrecargar al participante con estos pasos.
- Realización de la calibración
- Informar al participante. Informe al participante sobre el procedimiento de calibración (por ejemplo, indicando que se mostrará una serie de marcadores objetivo y que el participante deberá seguirlos durante aproximadamente un minuto).
NOTA: Se recomienda tener cuidado con el lenguaje utilizado durante los ajustes. Por ejemplo, el experimentador debe enfatizar que el procedimiento sirve para calibrar el rastreador de ojos para el participante, y no para calibrar al participante para el rastreador de ojos. Además, es importante asegurarse de que no se grabe ningún video o imagen con el equipo de seguimiento ocular. Aunque el ojo del participante sea visible, solo se registrará la posición del ojo, convertida en coordenadas. - Realice el procedimiento de calibración. Instruya al participante a seguir los marcadores objetivo y a mantener constante la posición de su cabeza; por ejemplo, a no inclinarse hacia atrás al finalizar el procedimiento de calibración. Indique a los participantes que fijen la mirada en el centro del símbolo de calibración y que no muevan los ojos hasta que el símbolo cambie de posición. Los participantes tienden a anticipar el movimiento del símbolo, especialmente durante la validación, lo cual puede aumentar los errores y provocar pasos innecesarios de calibración. Incluya esta explicación en las instrucciones o en la descripción del proceso de calibración/validación.
NOTA: Los fabricantes ofrecen diferentes tipos de símbolos para el proceso de calibración (puntos, símbolos amigables para niños, símbolos estáticos o que se reducen, etc.) y diferentes configuraciones de calibración (es decir, el número de puntos de calibración). Es importante verificar las diferencias de calibración con estas distintas configuraciones y elegir la que mejor se adapte a las necesidades de un estudio específico. Por ejemplo, si los estímulos utilizan toda la pantalla (por ejemplo, un texto con muchos párrafos), es importante contar con una configuración de calibración que garantice una buena calibración de arriba a abajo, incluyendo las esquinas. Sin embargo, si los estímulos son oraciones presentadas en el centro de la pantalla, una configuración con menos puntos puede ser suficiente. Además, la precisión de la calibración en la coordenada horizontal, o coordenada x, es más importante en el segundo caso que en el primero, que requiere buena precisión tanto en las coordenadas vertical como horizontal. - Finalice el procedimiento de calibración. Informe al participante sobre el procedimiento de validación tras completar el procedimiento de calibración.
NOTA: En caso de fallos persistentes en la calibración, revise la alineación de la cámara del rastreador de ojos, las condiciones de iluminación y la posición del participante. En participantes adultos, el maquillaje reflectante, las gafas o las lentes de contacto pueden interferir con el seguimiento. Tranquilice al participante, permita pausas breves o repita la calibración según sea necesario. Si los problemas continúan, considere reiniciar el sistema de seguimiento ocular. Si los problemas persisten tras reiniciar el sistema y no se encuentra ninguna causa para el fallo de calibración tras verificar los parámetros de configuración, informe al participante de que la tecnología de seguimiento ocular aún no se ha desarrollado lo suficiente, y que se trata de un problema relacionado con el estado actual de la tecnología, no con el participante.
- Informar al participante. Informe al participante sobre el procedimiento de calibración (por ejemplo, indicando que se mostrará una serie de marcadores objetivo y que el participante deberá seguirlos durante aproximadamente un minuto).
- Realización de la validación
- Realice el procedimiento de validación. Ejecute el procedimiento de validación inmediatamente después de la calibración.
- Revise los errores. Verifique el error promedio de la posición de la mirada y asegúrese de que esté dentro de límites aceptables. Por lo general, se desea un ángulo visual inferior a 1 grado (<1°), lo que equivale aproximadamente a 4 caracteres (es decir, 0.5 corresponde a ~2 caracteres). Vuelva a calibrar si los errores están fuera de estos límites. Por ejemplo, acepte la calibración si el error medio es ≤0.5–1.0° y el error máximo o por punto es ≤1.5–2.0°; de lo contrario, vuelva a calibrar. Especifique la frecuencia de revalidación (por ejemplo, tras cada bloque o interrupción). Como ejemplo de criterios del fabricante para evaluar la calidad de una calibración, SR Research considera que los errores son aceptables para la mayoría de las tareas si el error promedio es <1° y el error máximo es <1.5°; razonables si el error promedio es <1°-1.5° y el error máximo es <1.5°-2°; y deficientes si superan estos valores.
- Informar al participante. Instruya al participante a mantener su posición lo más parecida posible y avíselo del inicio de la sesión de grabación.
5. Recopilación de datos
- Procedimiento de recopilación de datos
- Iniciar sesión de grabación. Comience la sesión de grabación y evite interrumpir al participante mientras realiza la tarea, como dar instrucciones verbales.
- Supervisar al participante. Monitoree la comodidad del participante durante la grabación de datos. Asegúrese de que el participante mantenga una postura estable sin esfuerzo ni fatiga. Observe signos de distracción, sequedad ocular o molestias causadas por el reposacabezas o el soporte de barbilla.
- Supervisar la grabación de datos. Monitoree la calidad de los datos durante la grabación. Vuelva a calibrar si el error medio de validación o la precisión en línea supera 1° (o un umbral de precisión predeterminado), o si el participante cambia de postura.
- Llevar un registro. Lleve un registro de la sesión de grabación anotando cualquier anomalía observada durante el experimento (por ejemplo, un procedimiento de calibración inusualmente largo o una interrupción no intencionada durante la grabación) para su inspección posterior al experimento, utilizando un esquema de registro de sesión para monitorear el momento de los eventos, interrupciones, número de recalibraciones realizadas y sus errores, verificaciones de deriva y cambios en la iluminación.
- Finalización de la sesión
- Guardar datos. Guarde los datos brutos de la mirada al final de la sesión del experimento, preferiblemente utilizando un método sistemático para etiquetar la sesión (por ejemplo, la fecha del experimento y el número del participante, como 25071801 o 250718-P01 para el participante 01 del 18 de julio de 2025; evite usar información personal identificable del participante).
- Despedida. Agradezca al participante y responda cualquier pregunta que pueda tener sobre el experimento; sane los equipos (véase el paso 3.2.2).
- Verificar datos. Revise los datos y los registros para asegurarse de que la sesión se completó correctamente.
6. Preprocesamiento de datos y control de calidad
- Exportación, organización y limpieza de los datos brutos
- Exportar datos. Exporte los datos brutos de mirada en un formato estándar (por ejemplo, .csv, .tsv, .edf) y estandarice el identificador de sesión (por ejemplo, 25071801 o 250718-P01, véase 5.2.1).
- Limpiar datos. Limpie los datos brutos aplicando algoritmos para la detección de parpadeos y de datos faltantes, utilizando herramientas integradas proporcionadas por el software del fabricante o mediante scripts personalizados, ajustados al dispositivo o a la frecuencia de muestreo.
NOTA: Cree copias de seguridad de los datos brutos mientras ejecuta las rutinas de limpieza.
- Detección de eventos de movimiento ocular
- Seleccionar algoritmo de detección de movimientos oculares. Seleccione y ejecute los procedimientos para la detección de fijaciones, ajustando los parámetros del algoritmo según sea necesario. Los algoritmos representativos para la identificación de fijaciones incluyen principalmente algoritmos basados en velocidad (por ejemplo, identificación por umbral de velocidad I-VT) y algoritmos basados en dispersión (por ejemplo, identificación por umbral de dispersión I-DT), entre otros23. Cada algoritmo tiene sus propios parámetros.
NOTA: Por lo general, el software del fabricante asume por defecto un algoritmo específico y un conjunto específico de parámetros comúnmente utilizados. Es responsabilidad del investigador seleccionar un algoritmo adecuado y sus parámetros, y reportarlos en la descripción de la metodología del estudio, como umbrales de dispersión/velocidad, un umbral mínimo de duración de fijación (por ejemplo, 60 ms o 100 ms) para eliminar fijaciones más cortas que este valor, un umbral máximo de duración de fijación (por ejemplo, 1000 ms) para eliminar fijaciones más largas que este valor, la ventana de suavizado utilizada y las reglas de combinación para fijaciones adyacentes23. - Identificar fijaciones ilegítimas. Elimine o etiquete las fijaciones fuera de la región de visualización. Elimine o etiquete fijaciones más cortas que un umbral mínimo predefinido y más largas que un umbral máximo predefinido.
- Inspeccionar visualmente los datos. Inspeccione visualmente los datos utilizando herramientas de visualización disponibles para asegurar la validez de los mismos. Verifique la pérdida de señal, ruido excesivo, muestras faltantes o fijaciones mal alineadas. Después de cada sesión de grabación, inspeccione visualmente los datos utilizando las herramientas de visualización proporcionadas con el software de seguimiento ocular (por ejemplo, gráficos de mirada, rutas de exploración, trazas de series temporales). Este paso ayuda a garantizar que los datos sean de calidad suficiente antes de proceder al preprocesamiento y al análisis.
- En particular, verifique la pérdida de señal y problemas de seguimiento buscando largas interrupciones en los patrones de mirada o regiones en los estímulos donde no se registran muestras de mirada. Una pérdida frecuente o prolongada del seguimiento puede indicar que la sesión debe excluirse o repetirse.
- Para verificar ruido excesivo, examine las trazas brutas de posición x/y en busca de saltos repentinos o muestras erróneas que no correspondan al diseño del estímulo. El ruido excesivo puede indicar una calibración deficiente, una posición inestable de la cabeza o problemas de hardware.
- Para detectar muestras faltantes o irregulares, verifique si la frecuencia de muestreo es aproximadamente la esperada (por ejemplo, 500 Hz) y si existen agrupaciones inesperadas de muestras faltantes más allá de los parpadeos normales.
- Para detectar fijaciones mal alineadas, superponga las fijaciones sobre los estímulos presentados y verifique que caigan sobre las líneas y palabras deseadas. Desviaciones sistemáticas (por ejemplo, fijaciones consistentemente fuera del texto) pueden indicar una deriva en la calibración o una asignación incorrecta entre las coordenadas de la mirada y las coordenadas de la pantalla. Los patrones registrados de mirada deben seguir aproximadamente la estructura del texto (por ejemplo, progresiones de izquierda a derecha, línea por línea), con fijaciones agrupadas sobre las palabras y sacadas relativamente suaves entre ellas. Una desviación sistemática de este patrón, o una pérdida frecuente de datos utilizables, puede requerir la exclusión de los datos afectados del análisis posterior.
- Realizar corrección de deriva. Realice corrección del error de deriva vertical cuando sea necesario. Aplique corrección de deriva vertical por líneas para textos de múltiples filas. Verifique la aplicabilidad de métodos validados21.
NOTA: Figura 1 presenta una representación de los pasos involucrados en el diseño de un montaje experimental de seguimiento ocular y del flujo de análisis de datos, tal como se describe en la sección del protocolo. La siguiente sección presenta resultados representativos de sesiones grabadas.
- Seleccionar algoritmo de detección de movimientos oculares. Seleccione y ejecute los procedimientos para la detección de fijaciones, ajustando los parámetros del algoritmo según sea necesario. Los algoritmos representativos para la identificación de fijaciones incluyen principalmente algoritmos basados en velocidad (por ejemplo, identificación por umbral de velocidad I-VT) y algoritmos basados en dispersión (por ejemplo, identificación por umbral de dispersión I-DT), entre otros23. Cada algoritmo tiene sus propios parámetros.
Resultados
Calidad y validación de los datos
Las sesiones exitosas suelen producir una precisión de validación con un error medio ≤0,5–1,0° y un error máximo o por punto <1,0–1,5° en todos los objetivos; se deben informar tanto los valores medios como los valores por punto. Proporcione un histograma del error por punto y una tabla que resuma el error medio ± DE y el error máximo por sesión. Estos criterios coinciden con las prácticas comunes y las recomendaciones del fabricante; las sesiones que superen estos umbrales deben excluirse parcial o totalmente, según las reglas del estudio. Figura 2 muestra un ejemplo de histograma de error por punto para la precisión de calibración en una calibración de 9 puntos, que incluye tres intentos de calibración.
Precisión y pérdida de datos
Informe la precisión (por ejemplo, dispersión muestra a muestra RMS –Root Mean Square– durante la fijación) y la pérdida de datos (% de muestras perdidas por ensayo/sesión). Las buenas series de ensayos suelen mostrar una baja dispersión durante la fijación y una baja pérdida de datos (por ejemplo, <5–10%, dependiendo del equipo y configuración de seguimiento ocular). Proporcione distribuciones de porcentajes de pérdida de datos y un diagrama de dispersión por ensayo de precisión frente a pérdida para identificar valores atípicos. Consulte la literatura actual sobre definiciones e ítems mínimos de reporte3,4,5,6,7,8,9,10,11.
Comportamiento de la deriva (antes y después de la corrección)
Las series de prueba adecuadas presentan desplazamientos verticales pequeños y casi constantes que se reducen considerablemente mediante la corrección por línea, ya sea por algoritmos automatizados de corrección de deriva21 o de forma manual. Por otro lado, las series problemáticas muestran deriva residual no monótona o de gran magnitud. Incluir el error vertical absoluto mediano antes y después de la corrección. Verificar la aplicabilidad de los métodos automatizados de corrección de deriva.
Distribuciones de medidas comunes de lectura
Proporcione distribuciones resumidas para la duración de la primera fijación (FFD), la duración de la fijación única (SFD), la duración del primer paso (FP) y la duración total o de mirada (GD), el tiempo de avance, la probabilidad de omisión y la probabilidad de regresión. Para lectores adultos hábiles leyendo texto alfabético, las duraciones de fijación suelen centrarse alrededor de ~200–250 ms (con asimetría sustancial), y los sacádicos abarcan en promedio ~7–9 caracteres. Los valores muy alejados de estos rangos o distribuciones de sacádicos altamente bimodales deben verificarse para determinar si indican sacádicos progresivos y regresivos esperados debido a restricciones de la tarea o dificultades de procesamiento, más que errores de temporización. La elección y el rango de medidas pueden variar en consecuencia según la población, el idioma específico y la ortografía. Figura 3 muestra un protocolo de distribución de duración de fijación de ejemplo de una sesión representativa.
Comprobaciones de validez
Un aumento en la longitud de las palabras (palabras largas) generalmente conduce a una reducción en la tasa de omisión y a duraciones de fijación visual más largas en esas palabras. Por otro lado, las palabras funcionales (por ejemplo, artículos o preposiciones) suelen omitirse. Las palabras de alta frecuencia y las palabras altamente predecibles según el contexto lingüístico (dentro del texto o la oración) suelen dar como resultado fijaciones iniciales y duraciones de fijación visual más cortas, así como tasas de omisión más altas (se espera lo opuesto para palabras de baja frecuencia y baja previsibilidad). Verifique si los datos replican algunos de estos patrones, al menos en un sentido. Grandes inversiones podrían indicar errores de deriva, desalineación entre palabras y fijaciones, o errores en el procesamiento de los datos.
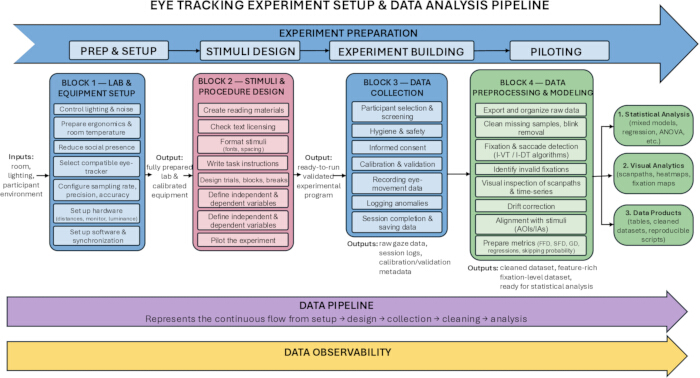
Figura 1. Representación de los pasos involucrados en el diseño de una configuración experimental de seguimiento ocular y el flujo de análisis de datos. Haga clic aquí para ver una versión más grande de esta figura.
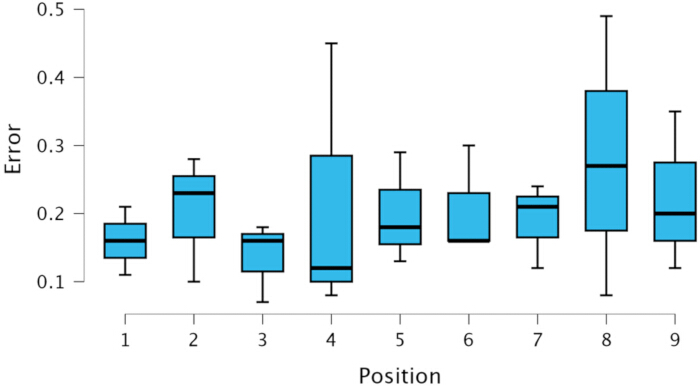
Figura 2. Histograma del error por punto para la precisión de calibración en una calibración de 9 puntos, que incluye tres intentos de calibración. Haga clic aquí para ver una versión más grande de esta figura.
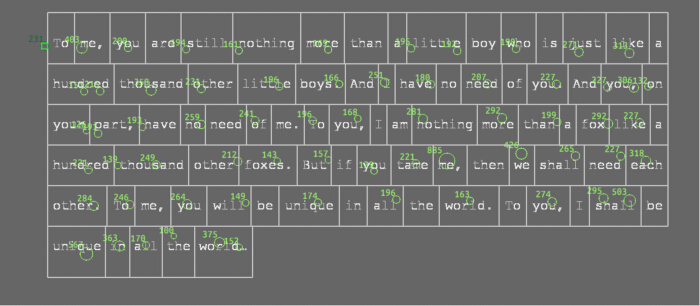
Figura 3. Protocolo de distribución de la duración de las fijaciones en una sesión representativa; un participante leyendo un extracto de la novela El Principito. La posición y el tamaño de los círculos indican las ubicaciones y duraciones de las fijaciones, respectivamente. Los números junto a los círculos muestran las duraciones de las fijaciones en ms. Haga clic aquí para ver una versión más grande de esta figura.
Discusión
El protocolo presentado aquí resume los pasos principales necesarios para obtener datos confiables de seguimiento ocular en investigaciones sobre lectura. Aunque muchos de estos pasos pueden ser bien conocidos por investigadores experimentados, con frecuencia están dispersos en distintos artículos metodológicos, documentación de proveedores y prácticas informales de laboratorio. Al organizarlos en un único flujo de trabajo, desde la preparación del laboratorio hasta el preprocesamiento, nuestro objetivo es ofrecer una guía práctica para investigadores que se inician en estudios de seguimiento ocular aplicados a la lectura. En comparación con pautas generales de seguimiento ocular o recursos centrados principalmente en algoritmos de detección de movimientos oculares, este protocolo proporciona un marco integral como respuesta a las exigencias de la investigación en lectura, que requiere la grabación de datos con alta resolución espacial y frecuencia de muestreo.
Un tema central en todas las etapas del flujo de trabajo es la importancia de una gestión proactiva de la calidad de los datos, que comienza con el control ambiental y la configuración del equipo. Pequeños problemas, como reflejos en la pantalla, inestabilidad de la silla o distancias de visualización inconsistentes, pueden generar sesgos sistemáticos en la ubicación o precisión de la fijación. Abordar estos factores desde el principio minimiza la necesidad de correcciones posteriores extensas y favorece una mayor precisión constante en la validación (error medio ≤ 0,5–1°).
El protocolo también destaca la importancia de la alineación entre las preguntas de investigación y las características del equipo. Muchos estudios sobre lectura dependen de mediciones precisas en el espacio y el tiempo de las fijaciones, las posiciones de aterrizaje de los sacádicos y las regresiones1,2. Por lo tanto, elegir un rastreador ocular con una frecuencia de muestreo, precisión y exactitud adecuadas es esencial, especialmente para medidas como la posición de aterrizaje o la vista previa paracentral, que son sensibles a pequeños errores espaciales. Dependiendo de las limitaciones específicas del estudio, estos métodos pueden modificarse. Por ejemplo, al trabajar con poblaciones neurodivergentes que no toleran el reposacabezas, los investigadores podrían optar por rastreadores remotos sin soporte de cabeza y compensar la pérdida de precisión espacial utilizando fuentes más grandes, un interlineado más amplio y Áreas de Interés más amplias. Cuando se utilizan sistemas sin soporte de cabeza, los investigadores deben tener en cuenta el mayor movimiento y la posible pérdida de datos. Aunque los rastreadores remotos permiten configuraciones más naturalistas, la estabilización de la cabeza sigue siendo preferible para la mayoría de las tareas de lectura en la actualidad.
El diseño del experimento es otro factor clave que afecta tanto la calidad como la interpretabilidad de los datos. Las instrucciones estandarizadas en pantalla, la aleatorización de los ensayos y una estructura de bloques adecuada ayudan a mantener un comportamiento estable del participante durante toda la sesión. Incluir verificaciones de deriva a intervalos regulares es especialmente importante en experimentos de lectura, ya que incluso pequeños desplazamientos graduales pueden acumularse a lo largo de las líneas de texto. El protocolo también permite el uso de normas léxicas dependientes del idioma y la presentación transparente de las variables independientes y dependientes, lo que facilita la replicación y la comparación entre estudios.
Durante la recopilación de datos, el monitoreo continuo de la precisión, la postura y la comodidad del participante ayuda a prevenir pérdidas masivas de datos. A menudo es necesario realizar un diagnóstico activo para resolver problemas comunes. Por ejemplo, la calibración puede fallar en las esquinas de la pantalla; en ese caso, ajustar la altura del monitor o de la silla puede solucionar la pérdida de seguimiento periférico. Los problemas causados por gafas reflectantes o lentes de contacto a veces se pueden resolver ajustando la iluminación ambiental o cambiando los ángulos del monitor. Llevar un registro detallado de la sesión facilita la resolución de problemas posteriores y refuerza la transparencia al documentar interrupciones, recalibraciones y eventos inesperados. Esto es cada vez más importante porque muchos estudios publicados actualmente exigen la presentación explícita de métricas de calidad, incluyendo la precisión y el porcentaje de pérdida de datos.
La sección de preprocesamiento destaca la importancia de realizar elecciones consistentes y bien documentadas en la detección de eventos, la corrección de deriva y las rutinas de limpieza. Dado que los algoritmos y umbrales de clasificación de fijaciones pueden influir notablemente en las medidas resultantes, los investigadores deben especificar todos los parámetros utilizados y justificarlos cuando difieran de los valores predeterminados comunes. La inspección visual sigue siendo un paso fundamental, incluso cuando se aplican herramientas automatizadas. El protocolo también recomienda informar indicadores estándar de calidad, como la exactitud de validación, la precisión, la pérdida de datos y el comportamiento de la deriva, para que los estudios puedan compararse de manera más confiable.
Además, el protocolo recomienda pruebas sencillas de verificación del comportamiento de lectura, como los efectos de la longitud de la palabra, la frecuencia o la predecibilidad. Reproducir estos patrones canónicos proporciona una salvaguarda adicional contra problemas de alineación no detectados, deriva problemática o errores en el preprocesamiento. Estas verificaciones no sustituyen un análisis estadístico completo, pero ofrecen una retroalimentación rápida sobre si los datos se comportan como se espera en una lectura hábil.
Además de los detalles del protocolo experimental ya mencionados, es importante describir las características lingüísticas y psicométricas de los participantes. La principal justificación para esto es el desafío al que se enfrentan los investigadores experimentales respecto a la comparabilidad entre diferentes estudios. Esto es particularmente importante en la era de la ciencia abierta, donde conjuntos de datos disponibles públicamente pueden ser utilizados por investigadores que no los recopilaron originalmente y que por tanto podrían no ser conscientes de posibles particularidades derivadas de variaciones en los antecedentes (socio)lingüísticos de los participantes.
Con respecto al contexto lingüístico, debe señalarse la lengua materna de los participantes y recopilarse información sobre los dialectos que utilizan, con el fin de tener en cuenta cualquier diferencia dialectal que pueda afectar los resultados. Si los participantes hablan más de un idioma, una situación común en el mundo actual, debe registrarse su dominio del segundo idioma. En estudios sobre bilingüismo o procesamiento de una segunda lengua, el dominio del segundo idioma debe evaluarse mediante pruebas validadas de ubicación en un segundo idioma. Además, pueden registrarse aspectos relevantes del estatus socioeconómico (por ejemplo, los hábitos de lectura de los participantes).
Se deben realizar pruebas para evaluar las características psicométricas de los participantes, como la amplitud de la memoria de trabajo y la flexibilidad cognitiva (especialmente en estudios bilingües). Desde una perspectiva metodológica, se debe considerar qué pruebas seleccionar, sus demandas cognitivas y temporales, y cuándo aplicar estas mediciones dentro del protocolo experimental: antes, después de la sesión de seguimiento ocular, o en una sesión separada.
Es fundamental recordar que, en los estudios de lectura, el comportamiento lingüístico se mide y explica utilizando tanto las características lingüísticas del estímulo como las características psicométricas de los lectores (o cualquier otra característica relevante para el comportamiento lingüístico de los participantes)11,12,17,20. Para permitir la comparación entre estudios, deben incluirse todos los factores que puedan ser relevantes para la interpretación de los datos. La elección de qué características incluir dependerá del objetivo del estudio. Los datos deben ser comparables. En resumen, los datos deben recopilarse y describirse con suficiente detalle para otorgar a cualquier usuario potencial la mayor flexibilidad posible en su uso. Estas consideraciones pueden no formar parte del protocolo en sí, pero son relevantes para cada estudio individual. En el entorno científico global actual, tales detalles aumentan el potencial futuro de uso de los datos recopilados.
Este protocolo tiene limitaciones, principalmente el compromiso entre la calidad de los datos y la validez ecológica, ya que la lectura en una pantalla estática con la cabeza restringida no captura completamente el comportamiento lector naturalista, y criterios visuales de inclusión estrictos pueden limitar la representatividad de la muestra. Además, los rastreadores oculares difieren considerablemente en la escala de coordenadas, la precisión de las marcas de tiempo y la clasificación de eventos. Una limitación del protocolo actual es que no aclara cómo esta variabilidad afecta la reproducibilidad entre laboratorios o marcas de hardware. Establecer directrices para la validación entre dispositivos y para aplicaciones futuras realistas, como adaptar paradigmas de laboratorio a entornos de lectura inmersivos de Realidad Virtual o Realidad Aumentada, y desarrollar biomarcadores digitales para trastornos cognitivos o de atención, llenaría un vacío importante.
En general, el protocolo consolida la orientación metodológica existente en un flujo de trabajo claro y transparente para recopilar datos de seguimiento ocular de alta calidad en la lectura. Al seguir los pasos y reportar las métricas de calidad asociadas, los investigadores pueden mejorar la reproducibilidad y la credibilidad de los estudios de lectura y ayudar a establecer una mayor consistencia metodológica en todo el campo.
Agradecimientos
Financiamiento: Este proyecto ha sido apoyado por COST–Cooperación Europea en Ciencia y Tecnología (CA21131–Habilitación de la recopilación de datos de seguimiento ocular multilingüe para la investigación en procesamiento del lenguaje humano y de máquinas (MultiplEYE), https://www.cost.eu/actions/CA21131)24, La Fundación para la Ciencia y la Tecnología, Portugal (becas: UID/214/2025, UI/BD/154500/2022), y el Programa Estratégico de la Universidad Jagellónica, Iniciativa de Excelencia, Área Prioritaria de Investigación DigiWorld (ID.UJ), proyecto «Aspectos cognitivos de la interacción y la comunicación en agentes naturales y artificiales». Agradecemos a Anna Maria Wilkosz su amable apoyo técnico.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Toallitas con alcohol (70% isopropílico) | Material de limpieza | Suministro local de laboratorio | |
| Reposabarbilla con altura ajustable | Dispositivo de estabilización de la cabeza | Varios proveedores de laboratorio | |
| Formulario de consentimiento e instrumentos de explicación posterior | Documentación | Plantillas aprobadas institucionalmente | |
| Seguimiento ocular (por ejemplo, SR Research EyeLink 1000 Plus, Tobii Pro Fusion) | Hardware para seguimiento ocular | SR Research Ltd., Tobii AB | |
| Software para análisis de datos de seguimiento ocular (Data Viewer, Tobii Pro Lab) | Software para análisis de datos de movimiento ocular | SR Research Ltd., Tobii AB | |
| Software de seguimiento ocular (por ejemplo, Experiment Builder, Tobii Pro Lab, PsychoPy) y sus SDK | Software de presentación de estímulos y kits de desarrollo de software | SR Research Ltd., Tobii AB, código abierto | |
| Software genérico para análisis de datos (R con lme4, ggplot2, JASP, Python con Pandas, NumPy, Matplotlib) | Preprocesamiento y análisis de datos | Código abierto, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| Software genérico para diseño de experimentos (PsychoPy) | Software de presentación de estímulos | Código abierto, https://www.psychopy.org | |
| Otro software de terceros (por ejemplo, E-Prime) | Software de presentación de estímulos | Psychology Software Tools, Inc. | |
| Habitación insonorizada | Control ambiental | Instalación institucional | |
| Monitor LCD estándar de 24 pulgadas (o más pequeño) | Dispositivo de visualización | Cualquier fabricante conforme a normas ISO |
Referencias
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).