Este artículo propone un método de monitoreo de seguridad en líneas de producción que integra You Only Look Once versión 11 (YOLOv11) con redes neuronales convolucionales. El método alcanzó una precisión media promedio a un umbral de intersección sobre unión de 0,5 (mAP@0,5) de 0,91, un mAP@0,5:0,95 de 0,82 y 120 cuadros por segundo en una unidad de procesamiento gráfico, superando a los modelos de referencia evaluados.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
Monitoreo de seguridad de líneas de producción en tiempo real mediante detección de objetos basada en aprendizaje profundo y mejora de características
En este artículo
Resumen
Resumen
Con la profundización de la Industria 4.0, los niveles de automatización e inteligencia de las líneas de producción han mejorado significativamente, lo que plantea mayores exigencias sobre el rendimiento en tiempo real, la precisión y la seguridad del monitoreo. Los sistemas tradicionales de monitoreo, que dependen de inspecciones manuales o decisiones basadas en umbrales simples, generalmente presentan tiempos de respuesta lentos, altas tasas de falsas alarmas y una inteligencia limitada. Por lo tanto, este artículo propone un sistema de monitoreo de seguridad para líneas de producción que integra You Only Look Once versión 11 (YOLOv11) con una red neuronal convolucional (CNN). Primero, las imágenes adquiridas fueron preprocesadas. Luego, se utilizó YOLOv11 para identificar trabajadores, equipos y posibles peligros en tiempo real. A continuación, se introdujo una red CNN mejorada con fusión de características multiescala y mecanismos de atención para potenciar las capacidades de extracción de características de objetivos pequeños y parcialmente ocultos. Finalmente, los resultados de detección se fusionaron con las características mejoradas por la CNN para evaluar el estado de seguridad. Se realizaron experimentos utilizando un conjunto de datos de seguridad en líneas de producción construido por nosotros, empleando el optimizador de descenso de gradiente estocástico (SGD) con momento 0.9, una tasa de aprendizaje inicial de 0.01, decaimiento del peso de 0.0005, ajuste de tasa de aprendizaje con enfriamiento cosenoidal, un tamaño de lote de 32 y entrenamiento durante 200 épocas. Se utilizaron mAP@0.5 y la velocidad de detección en cuadros por segundo (FPS) como métricas de evaluación para comparar con los algoritmos de referencia evaluados. Los resultados muestran que el sistema propuesto alcanzó un mAP@0.5 de 0.91 y una velocidad de detección de 120 FPS. Además, demostró un rendimiento robusto bajo condiciones complejas, como sombreado e iluminación variable, lo que respalda su eficacia y potencial de aplicación práctica en el monitoreo de seguridad de líneas de producción.
Introducción
En la producción industrial moderna, la seguridad es el pilar fundamental para garantizar la eficiencia productiva y el bienestar del personal. El entorno de la línea de producción suele incluir equipos mecánicos de alta velocidad, procesos tecnológicos complejos y operaciones colaborativas que implican múltiples tareas. Cualquier pequeño riesgo potencial de seguridad puede provocar accidentes graves en la producción, lo que resulta en pérdidas económicas significativas e incluso en fatalidades. Por lo tanto, es crucial establecer un sistema inteligente, eficiente y en tiempo real para la supervisión de la seguridad, con el fin de mejorar la seguridad en la producción industrial1,2.
Los métodos tradicionales de monitoreo de seguridad dependen principalmente de la vigilancia manual por video y diversos sensores (como sensores infrarrojos, de humo y de vibración)3. La supervisión manual no solo es ineficiente, sino que también está propensa a detecciones omitidas debido al cansancio del personal de vigilancia, y no puede ofrecer una cobertura continua e integral. Aunque los sensores pueden proporcionar cierta función de alerta temprana, su rango de detección es limitado y son sensibles a las interferencias ambientales, lo que provoca problemas destacados de falsas alarmas4. Los sistemas de monitoreo inteligentes se han convertido en un enfoque creciente de investigación. El análisis en tiempo real de una secuencia de video mediante un algoritmo de aprendizaje profundo puede identificar automáticamente eventos anómalos, comportamientos inseguros y peligros potenciales, mejorando así considerablemente la inteligencia del sistema de monitoreo4,5.
La detección de objetos es una tecnología fundamental en la vigilancia inteligente. Como representantes de detectores de objetos de una sola etapa, los algoritmos de la serie You Only Look Once (YOLO) muestran ventajas significativas. Desde YOLOv1 hasta YOLOv8, esta colección de algoritmos ha experimentado un desarrollo continuo, con mejoras en la arquitectura de red, la función de pérdida y la metodología de entrenamiento, entre otros aspectos6,7. YOLOv11, en particular, ha logrado una mayor precisión en la detección manteniendo un alto número de fotogramas por segundo, especialmente cuando se enfrenta a fondos complejos y objetivos densamente empaquetados8.
Sin embargo, a pesar de su excelente desempeño en tareas generales de detección de objetos, YOLOv11 aún enfrenta desafíos en escenarios específicos de monitoreo de seguridad en líneas de producción9. Por ejemplo, la precisión de detección de YOLOv11 puede disminuir cuando los trabajadores están parcialmente ocultos por equipos o cuando las señales de seguridad son pequeñas y se asemejan mucho al color del fondo. Esto exige que el modelo tenga capacidades más fuertes de extracción de características y comprensión semántica10.
Las redes neuronales convolucionales (CNN) tienen capacidades potentes en la extracción de características de imágenes11. Al diseñar arquitecturas de redes más profundas y complejas, las CNN pueden aprender características de imagen más ricas y abstractas. Combinar una CNN con YOLOv11 aprovecha las capacidades de detección rápida de YOLOv11 y la extracción profunda de características de la CNN, construyendo así un sistema de monitoreo de seguridad más robusto e inteligente.
Con base en esto, en este artículo se propone un sistema de monitoreo de seguridad en líneas de producción que utiliza YOLOv11 y una CNN. Los aspectos innovadores de este estudio incluyen: (1) proponer una arquitectura de fusión profunda de YOLOv11 y una CNN mejorada; (2) introducir la fusión de características multi-escala y un mecanismo de atención compuesto para mejorar el reconocimiento de características clave de seguridad; y (3) verificar las ventajas de desempeño del modelo en un conjunto de datos de escenas complejas construido por nosotros mismos.
Desarrollo de los algoritmos de la serie YOLO
Desde su primera presentación por Redmon et al. en 201512, el algoritmo You Only Look Once (YOLO) ha suscitado un gran interés. A diferencia de los detectores de dos etapas que dependen de propuestas de regiones, YOLO trata la detección de objetos como una tarea de regresión. Al predecir directamente las clases y posiciones de los objetos en una imagen, YOLO aumenta notablemente la velocidad de detección, lo que la hace adecuada para uso en tiempo real13.
Como trabajo pionero en esta serie, YOLOv1 logra por primera vez la detección de objetivos de extremo a extremo14. YOLOv1 implica dividir la imagen de entrada en una estructura de cuadrícula, donde cada celda de la cuadrícula, dispuesta típicamente en un formato S × S, tiene la tarea de detectar objetos que se encuentran dentro de sus límites.
Específicamente, la salida de YOLOv1 es un tensor. Dentro del S × S × (B × 5 + C), la predicción de cada cuadro delimitador contiene 5 elementos: coordenada del punto central (x,y), ancho w, alto h y confianza c. El proceso de cálculo se ilustra en la Ecuación (1):
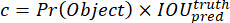 (1)
Entre ellos, Pr(Object) representa la probabilidad de que haya un objetivo en la cuadrícula, e IOU representa la razón de la intersección sobre la unión entre el cuadro delimitador predicho y el cuadro real. Cada cuadrícula también predice un conjunto de probabilidades de clase, donde Pr representa la probabilidad de que el objetivo pertenezca a la clase i-ésima cuando existe un objetivo. La función de pérdida de YOLOv1 se compone de tres componentes principales: la pérdida para la predicción de coordenadas, la pérdida para la estimación de confianza y la pérdida para la predicción de categorías15.
YOLOv2 introduce la normalización por lotes, un clasificador de alta resolución y una estrategia de entrenamiento multi-escala, lo que mejora la estabilidad y la precisión16. YOLOv3 utiliza Darknet-53 como red troncal y se inspira en el concepto de la Red de Pirámide de Características (FPN) para mejorar la detección de objetivos17.
YOLOv4 ha realizado numerosas optimizaciones basadas en YOLOv3, introduciendo tecnologías como la Cross Stage Partial Network (CSPNet)18, la Path Aggregation Network (PANet)19 y el aumento de datos Mosaic para mejorar aún más el rendimiento del modelo. YOLOv5 ha realizado contribuciones significativas en ingeniería, ofreciendo una implementación más fácil de usar y más eficiente20.
En los últimos años, la serie YOLO ha seguido evolucionando, con el lanzamiento sucesivo de versiones como YOLOv6, YOLOv7 y YOLOv8. Al introducir la estructura Extended Efficient Layer Aggregation Network (E-ELAN) y técnicas de reparametrización del modelo, YOLOv7 logra nuevos avances tanto en velocidad como en precisión. Estas mejoras no solo aumentan la eficiencia del aprendizaje de características, sino que también optimizan el rendimiento de inferencia de la red, permitiendo que YOLOv7 supere a versiones anteriores y a muchos detectores convencionales en diversas tareas de detección en tiempo real. YOLOv8 continúa optimizando la estructura de la red, adopta un diseño libre de anclas, simplifica el modelo y mejora su capacidad de generalización21.
Aprovechando las ventajas de versiones anteriores, YOLOv11, utilizado en este estudio, ha sido optimizado para escenarios industriales complejos. Sus mejoras principales incluyen una red de extracción de características, un módulo de fusión de características más eficiente y un diseño de función de pérdida más robusto. Estas mejoras permiten a YOLOv11 desempeñarse mejor al manejar oclusiones, objetivos pequeños y fondos complejos en entornos de producción. YOLOv11 es una versión de la serie YOLO lanzada por Ultralytics. En comparación con YOLOv8, mejora el módulo C3K2 y la ruta de fusión de características, e introduce una estrategia adaptativa de cajas ancla, proporcionando así una mayor robustez en la detección en escenarios industriales.
Base y progreso de la red neuronal convolucional (CNN)
La red neuronal convolucional (CNN) es un modelo fundamental que ha influido profundamente en el éxito del aprendizaje profundo dentro de la visión por computadora. Funciona extrayendo características locales de la imagen mediante operaciones de convolución y posteriormente reduciendo la dimensionalidad de las características mediante operaciones de agrupación, logrando así una abstracción jerárquica de la imagen22.
Una CNN típica se compone de múltiples capas convolucionales, de agrupación y completamente conectadas. La capa convolucional escanea la imagen de entrada con un kernel de convolución, calcula productos escalares sobre regiones locales y produce un mapa de características. El proceso de cálculo se muestra en la Ecuación (2):
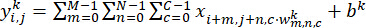 (2)
Donde x es la imagen de entrada, wk y bk son los pesos y el sesgo del núcleo de convolución, respectivamente, y  son los valores del mapa de características de salida en la posición (i,j). La capa de agrupamiento comúnmente utiliza Max Pooling o Average Pooling. La capa completamente conectada se encarga de extraer características y predecir probabilidades de clasificación.
Con base en esto, en este artículo se diseña un módulo de realce de características CNN para YOLOv11, que consta de dos ramas paralelas: una rama de convolución multiescala que utiliza núcleos de convolución de 3 × 3 y 5 × 5 para extraer características multiescala; y una rama de atención que conecta secuencialmente los módulos de atención de canal (Squeeze-and-Excitation) y de atención espacial para potenciar las características discriminativas de los objetivos clave. Las salidas de las dos ramas se fusionan mediante suma elemento a elemento, y la función de pérdida correspondiente para el realce de características se muestra en la fórmula (3):
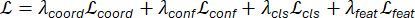 (3)
Lcoord es la pérdida por regresión de coordenadas del cuadro delimitador; Lconf es la pérdida de confianza del objetivo; Lcls es la pérdida de clasificación por categoría; Lfeat es la pérdida de mejora de características, utilizada para restringir las características discriminativas de objetivos pequeños y objetivos ocluidos extraídas por el módulo de mejora de la CNN; λcoord, λconf, λcls, λfeat son los coeficientes de peso de los términos de pérdida correspondientes. Para esta tarea, se establece λfeat = 0.05, y los pesos restantes se equilibran de acuerdo con los requisitos de la tarea de detección.
Las estructuras clásicas de CNN, como VGGNet23 y ResNet24, han logrado un gran éxito en tareas de clasificación de imágenes. Entre estas arquitecturas, ResNet mitiga eficazmente el problema del gradiente que desaparece durante el entrenamiento de redes profundas, facilitando así la construcción de estructuras de redes más profundas y complejas.
En tareas de detección de objetos, la CNN suele utilizarse como extractor de características (estructura básica). Por ejemplo, Darknet, Darknet parcial por etapas cruzadas (CSPDarknet), etc., en la serie de algoritmos YOLO, están todos basados en CNN25. Para mejorar las capacidades de extracción de características, los investigadores han propuesto numerosas estructuras mejoradas de CNN. Por ejemplo, el módulo Inception extrae características en paralelo mediante núcleos de convolución de múltiples escalas. DenseNet potencia el reutilización de características mediante conexiones densas. La red Squeeze-and-Excitation ajusta adaptativamente la importancia de los canales de características mediante mecanismos de atención26.
En este estudio, diseñamos un módulo CNN mejorado para potenciar las capacidades de extracción de características de YOLOv11. Este módulo combina la fusión de características multiescala con un mecanismo de atención para capturar de manera más eficaz la información clave de seguridad en escenarios de línea de producción.
Estado de aplicación del aprendizaje profundo en la vigilancia de la seguridad industrial
El aprendizaje profundo ha ganado una gran relevancia en la vigilancia de la seguridad industrial. Los algoritmos basados en CNN se emplean para determinar si los trabajadores llevan correctamente puestos los cascos de seguridad, detectar intrusiones no autorizadas en zonas peligrosas y monitorear el estado de equipos con fallos.27
En cuanto al reconocimiento de comportamiento, se utilizan redes neuronales convolucionales 3D y redes neuronales recurrentes para analizar el comportamiento operativo de los trabajadores e identificar acciones potencialmente inseguras. Por ejemplo, al analizar las secuencias de postura de los trabajadores, se puede determinar si están violando los procedimientos operativos de seguridad28.
YOLO y Faster R-CNN se utilizan ampliamente para la detección de personal y equipos en videos de vigilancia en tiempo real. Por ejemplo, se ha propuesto en la literatura un sistema de detección de cascos en tiempo real basado en YOLOv5, que mejora eficazmente la inteligencia en la gestión de la seguridad en sitios de construcción29.
Aunque se ha avanzado algo en la investigación existente, aún persisten varios desafíos. En primer lugar, las escenas industriales suelen presentar iluminación compleja, oclusión e interferencia de fondo, lo que impone requisitos rigurosos sobre la robustez del algoritmo. En segundo lugar, el rendimiento en tiempo real es un requisito clave, y el algoritmo debe lograr una inferencia de alta velocidad manteniendo la precisión. Por último, la investigación existente se centra principalmente en la detección de una sola tarea y carece de exploración sobre la fusión de información multisensorial y el análisis integral30.
En este estudio, el modelo de fusión propuesto YOLOv11 y CNN tiene como objetivo abordar los desafíos mencionados y lograr un monitoreo integral y en tiempo real de los riesgos de seguridad en la línea de producción, mejorando las capacidades de extracción y fusión de características.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Algoritmo YOLOv11 y CNN
Arquitectura general del sistema
El sistema de monitoreo de seguridad para líneas de producción propuesto en este artículo adopta una arquitectura híbrida que combina YOLOv11 con una CNN mejorada para lograr un monitoreo de seguridad en tiempo real con alta precisión y velocidad. Como se muestra en Figura 1, el sistema consta principalmente de un módulo de preprocesamiento de entrada, un módulo de detección de objetos YOLOv11, un módulo de mejora de características CNN y un módulo de decisión por fusión. La imagen de entrada se normaliza primero y se aumenta mediante el módulo de preprocesamiento para mejorar la capacidad de generalización del modelo. Posteriormente, las características se extraen mediante el armazón CSPDarknet, y el campo receptivo se amplía mediante el módulo de agrupación piramidal espacial rápida (SPPF). Las características multiescala se fusionan tras el muestreo ascendente, y se aplican secuencialmente la atención de canal y la atención espacial a las características fusionadas para mejorar aún más la representación discriminativa de los objetivos clave. El módulo de mejora de características CNN se inserta tras las salidas de las capas C3, C4 y C5 de la red troncal YOLOv11, recibiendo mapas de características multiescala de tamaños 80 × 80 × 256, 40 × 40 × 512 y 20 × 20 × 1,024, respectivamente. El módulo de mejora de características CNN potencia aún más la extracción de características para objetivos pequeños y ocluidos. Finalmente, el módulo de decisión por fusión combina los resultados de detección de YOLOv11 con las características mejoradas por CNN y los optimiza conjuntamente mediante una función de pérdida diseñada para generar la ubicación precisa, la categoría y la puntuación de confianza del objetivo.
Marco de detección YOLOv11
YOLOv11 ha introducido varias mejoras fundamentales que aprovechan las fortalezas del marco de detección de una sola etapa de la serie YOLO. Su arquitectura se divide en tres componentes principales: una red troncal, una red de fusión de características y una cabecera de detección. La red troncal utiliza una estructura CSPDarknet mejorada. La red de fusión de características incorpora conexiones locales entre etapas y convoluciones separables por profundidad, inspirándose en redes piramidales de características y redes de agregación de rutas para fusionar eficazmente características de múltiples escalas.
Módulo de mejora de características
El módulo de mejora de características tiene como objetivo aumentar la sensibilidad del modelo ante características clave de seguridad. Procesa los mapas de características generados por cada capa de la red troncal YOLOv11, fusionando información a diferentes escalas mediante operaciones de sobremuestreo y submuestreo. Específicamente, la rama multiescala captura la diversidad espacial de escala, mientras que la rama de atención mejora dinámicamente los canales clave y las respuestas posicionales. Estas dos ramas no actúan de forma independiente, sino que son complementarias y se fusionan mediante conexiones residuales y recalibración de características. El mapa de características procesado por el módulo de mejora en cada escala se ajusta para que coincida con el número de canales del mapa de características original mediante una convolución 1 × 1, y luego se fusiona con el mapa de características original de YOLOv11 mediante suma elemento a elemento. El mapa de características fusionado se introduce posteriormente en la Red de Pirámide de Características (FPN) para la fusión multiescala, formando así una representación jerárquica de características de seguridad. Para garantizar una integración perfecta entre los módulos, se adopta una estrategia de entrenamiento conjunto de extremo a extremo, cuya función de pérdida combina la pérdida de detección de YOLOv11 y la pérdida de mejora de características del módulo CNN.
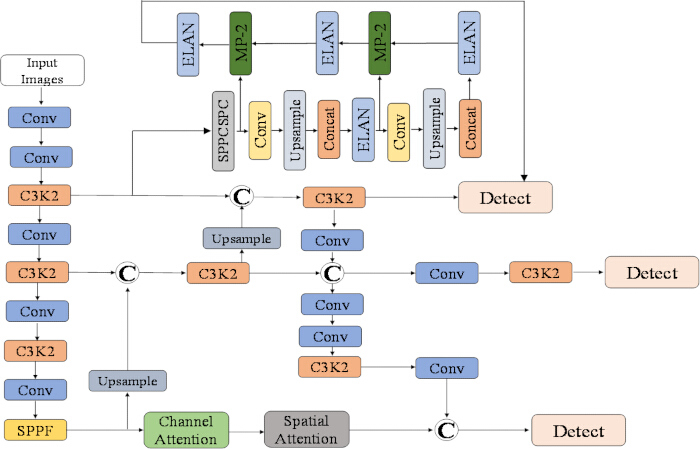
Figura 1. Algoritmo YOLOv11-CNN. El módulo de mejora de características tiene como objetivo amplificar la sensibilidad del modelo ante características críticas de seguridad. Procesa mapas de características provenientes de distintas capas del armazón de YOLOv11, fusionando características de diferentes escalas mediante operaciones de sobre-muestreo y sub-muestreo. Además, incorpora mecanismos de atención espacial y por canales. Para garantizar una integración perfecta entre los módulos YOLOv11 y CNN, se emplea una estrategia de entrenamiento conjunto. Durante el entrenamiento, los parámetros de ambos módulos se optimizan de extremo a extremo. La función de pérdida combina la pérdida de detección de YOLOv11 con la pérdida de mejora de características del módulo CNN. Haga clic aquí para ver una versión más grande de esta figura.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Para verificar la eficacia del modelo propuesto de fusión YOLOv11 y CNN en la supervisión de seguridad en líneas de producción, se construyó un conjunto de datos que abarca diversos escenarios de riesgos de seguridad. Este conjunto contiene 12 000 imágenes de escenas de líneas de producción, divididas en conjuntos de entrenamiento, validación y prueba en una proporción de 7:1,5:1,5, con una semilla aleatoria fija de 42. Cubre diversas condiciones de trabajo, incluyendo iluminación estándar, baja iluminación, oclusión par...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Los resultados experimentales muestran que el modelo de fusión propuesto YOLOv11–CNN mejora la precisión de detección y el rendimiento en tiempo real para la supervisión de seguridad en líneas de producción. Aprovechando la detección eficiente en una sola etapa de YOLOv11 y la mejora de características del módulo CNN, el sistema identificó trabajadores, equipos y zonas peligrosas bajo condiciones complejas de iluminación y oclusión. La fusión de características multi-escala y los mecanismos de atención mejoraron la capac...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Agradecimientos
Este trabajo fue patrocinado en parte por la Fundación Científica de la Universidad de Taizhou para Talentos Avanzados «Investigación sobre tecnologías clave de detección de precisión para la fabricación inteligente» (TZXY2020QDJJ006).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| COCO API | N/A | Herramienta de evaluación utilizada para la evaluación de la precisión en la detección de objetivos y análisis estadístico. | |
| CUDA 11.4 | NVIDIA | N/A | Plataforma de computación paralela utilizada junto con el entorno PyTorch 1.12. |
| Edge TPU | N/A | Plataforma de implementación utilizada para pruebas de latencia y consumo de energía; la latencia reportada fue de 18 ms y el consumo de energía fue de 15 W. | |
| Dispositivo de computación en el borde Jetson Xavier | NVIDIA | Dispositivo de computación en el borde utilizado para pruebas de rendimiento; la velocidad de procesamiento reportada fue de 70 FPS con latencia del percentil 99 dentro de los 50 ms. | |
| GPU NVIDIA Tesla V100 | NVIDIA | GPU utilizada en el servidor de entrenamiento/evaluación. | |
| PyTorch 1.12 | N/A | Entorno de aprendizaje profundo utilizado para el entrenamiento y evaluación del modelo. | |
| scikit-learn | N/A | Herramienta de evaluación y análisis estadístico utilizada para la evaluación del modelo. | |
| Conjunto de datos de seguridad en línea de producción construido internamente | N/A | N/A | Conjunto de datos de 12 000 imágenes de escenas de líneas de producción en formato VOC, que incluye condiciones de iluminación estándar, baja iluminación, oclusión parcial, oclusión severa, desenfoque por movimiento y fondos complejos; seis categorías de anotación: trabajadores, cascos de seguridad, brazos robóticos, zonas peligrosas, herramientas y vehículos. |
| Servidor de entrenamiento | Servidor equipado con una GPU NVIDIA Tesla V100 y sistema operativo Ubuntu 20.04. | ||
| Sistema operativo Ubuntu 20.04 | N/A | Sistema operativo utilizado en el servidor de entrenamiento/evaluación. | |
| Formato de anotación VOC | N/A | N/A | Formato de anotación utilizado para el conjunto de datos de seguridad en línea de producción construido internamente. |
| Modelo de detección de objetos YOLOv11 | Ultralytics | N/A | Modelo de detección de objetos utilizado para detectar trabajadores, equipos y posibles peligros en tiempo real. |
Referencias
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.