Este estudio presenta un marco automatizado para la prototipación de interfaces de usuario que integra principios de diseño cognitivo, modelado perceptual del color y aprendizaje profundo. El sistema mejora la accesibilidad, la claridad del diseño, la armonía del color y la coherencia entre pantallas, lo que resulta en diseños de interfaz coherentes y centrados en el usuario.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Marco de prototipado automatizado de interfaces de usuario que integra principios de diseño cognitivo y visual para mejorar la usabilidad y la claridad del diseño
En este artículo
Resumen
Resumen
El diseño eficaz de interfaces de usuario (UI) requiere un equilibrio armonioso entre atractivo visual, usabilidad cognitiva y consistencia de diseño. Sin embargo, los enfoques actuales de generación automática de interfaces se centran principalmente en la apariencia visual o en la detección de componentes, y carecen de un marco unificado que integre principios cognitivos, inteligencia del color y razonamiento estructural. Además, los métodos existentes presentan limitaciones en la generalización del diseño, baja interpretabilidad, selección estática de colores e inconsistencia de comportamiento entre pantallas. En este contexto, este trabajo propone un marco automatizado para la creación de prototipos de interfaces que integra la detección de componentes basada en la red neuronal convolucional con regiones más rápidas (Faster R-CNN) y un modelado del color perceptual guiado por el espacio de color uniforme CIECAM02 (CAM02-UCS), enriquecido con principios cognitivos y de diseño visual. Se utiliza Faster R-CNN para identificar componentes de la interfaz e inferir estructuras jerárquicas a partir de conjuntos de datos de interfaces a gran escala. Un módulo mejorado de generación de color analiza imágenes de marca o de referencia para garantizar paletas cromáticas perceptualmente uniformes, armónicas y compatibles con la usabilidad, empleando CAM02-UCS. Estas salidas se optimizan además mediante reglas de diseño cognitivo, incluyendo agrupación gestáltica, leyes de Fitts y Hick, espaciado basado en la atención y modelado de jerarquía visual, con el fin de generar automáticamente diseños de interfaz refinados y orientados a tareas. Los experimentos realizados en los conjuntos de datos RICO, ENRICO y Guo sobre colores en interfaces muestran que el sistema propuesto alcanza una precisión del 92,4 % en la detección de componentes, mejora la claridad del diseño y la precisión del orden de lectura en un 18,7 %, y genera paletas de color valoradas como un 24,5 % más armónicas por diseñadores, en comparación con los métodos de referencia. Las evaluaciones de usuarios también indican una reducción del 31 % en la carga cognitiva percibida y un aumento del 28 % en la consistencia del diseño entre pantallas. Estos resultados demuestran que combinar la comprensión estructural basada en aprendizaje profundo con modelado del color fundamentado en la percepción y principios de diseño cognitivo produce prototipos de interfaz altamente eficientes, estéticamente coherentes y fáciles de usar. Este marco establece un enfoque novedoso, integral y centrado en el ser humano para la creación automatizada de prototipos de interfaces inteligentes.
Introducción
Las interfaces gráficas de usuario (GUI) sirven como un medio fundamental de comunicación entre los seres humanos y los sistemas informáticos, influyendo significativamente en la usabilidad, accesibilidad y experiencia general del usuario (UX)1,2. Los sistemas de software modernos dependen de interfaces intuitivas y visualmente atractivas para atraer y retener usuarios. Tradicionalmente, el diseño de interfaces implica crear diseños gráficos que posteriormente son traducidos en código de front-end por ingenieros. Sin embargo, las diferencias en los protocolos específicos de cada plataforma entre sistemas operativos requieren adaptaciones repetidas, lo que aumenta la complejidad y el esfuerzo de desarrollo. Por ello, la generación automática de código de interfaz de usuario ha surgido como una dirección de investigación importante, reduciendo el esfuerzo manual y mejorando la eficiencia del desarrollo.
Los primeros enfoques para la generación automatizada de interfaces de usuario combinaban técnicas tradicionales de procesamiento de imágenes con modelos de aprendizaje profundo para la detección y clasificación de regiones3,4. Actualmente, las estrategias predominantes para la generación de código de interfaces gráficas de usuario aplican técnicas de visión por computadora para analizar imágenes de interfaces y convertirlas en representaciones estructuradas del front-end5,6,7. Mientras que los métodos de procesamiento de imágenes dependen de características diseñadas manualmente, los enfoques de aprendizaje profundo extraen representaciones jerárquicas a partir de conjuntos de datos a gran escala. Como resultado, los investigadores han explorado enfoques híbridos que combinan el aprendizaje profundo con técnicas específicas del dominio de procesamiento de imágenes para mejorar la robustez y precisión.
El color es otro factor crítico en el diseño de interfaces de usuario, ya que influye en la percepción del usuario, la usabilidad y el atractivo estético1. Mantener la coherencia entre el contenido de la imagen y las combinaciones de colores de la interfaz resulta complicado cuando las entradas visuales varían en matiz y contexto8,9,10. Por consiguiente, una cantidad significativa de investigación se ha centrado en la generación automatizada de paletas de colores y en la modelización perceptual del color. Los métodos existentes para la generación de colores incluyen técnicas basadas en el espacio de color CIELAB11. Otros enfoques utilizan algoritmos de agrupamiento, como k-medias, para extraer los colores dominantes de las imágenes12. Como resultado, trabajos recientes han adoptado cada vez más enfoques basados en datos y en aprendizaje automático para la modelización del color.
Paralelamente, los enfoques de aprendizaje profundo han mejorado significativamente la detección de componentes de interfaz de usuario y la comprensión del diseño. Las redes neuronales han permitido un análisis estructural más preciso de las interfaces móviles13. Sin embargo, estos métodos se centran principalmente en la precisión de la detección y a menudo pasan por alto aspectos de nivel superior, como la usabilidad cognitiva, la jerarquía del diseño y la eficiencia de la interacción. También se han propuesto modelos generativos para la síntesis de diseños de interfaz de usuario14,15, pero enfrentan dificultades para mantener la coherencia entre pantallas y ofrecer decisiones de diseño interpretables16. Otros enfoques se centran en la similitud visual o en la calidad de representación, pero carecen de un marco unificado que combine la semántica de los componentes, la armonía cromática y las restricciones de usabilidad17. El reconocimiento de texto también es importante para comprender el contenido de la interfaz de usuario. Técnicas como las redes neuronales recurrentes convolucionales (CRNN) permiten reconocer con precisión patrones de texto complejos en las pantallas de interfaz18,19,20.
Se han propuesto varios sistemas para generar código de interfaz de usuario (UI) a partir de bocetos o imágenes. Sketch2Code utiliza detección de objetos para convertir bocetos en representaciones de código21,22, pero es sensible a la calidad de la imagen. REDRAW proporciona una canalización automatizada para la recolección de datos y el entrenamiento de modelos, combinando redes neuronales convolucionales y recurrentes para generar representaciones estructuradas de interfaces de usuario23,24. Trabajos posteriores han introducido métricas de evaluación mejoradas para evaluar la calidad de las interfaces generadas25. Enfoques más recientes incluyen modelos basados en difusión y en transformadores para la generación de diseños, como transformadores de diseño por difusión sin métodos de autoencoder, generación de diseños de interfaces gráficas de usuario (GUI) mediante grafos de disposición basados en transformadores, y generación de diseños de interfaces guiada por modelos de lenguaje grandes26,27,28. En el Table 1 se ofrece una visión comparativa de estos enfoques.
| Referencias y Método(s) Clave | Objetivo | Ventajas | Desventajas |
| Generación Automatizada de Temas de Color de Interfaz de Usuario Basada en Imágenes: extracción de colores prominentes + modelado perceptual de color CAM02-UCS¹ | Generar automáticamente temas de color para interfaces de usuario a partir de imágenes de referencia, optimizando armonía y usabilidad. | Sólida base perceptual (CAM02-UCS); equilibra explícitamente armonía y usabilidad (contraste y diversidad); incluye implementación web y evaluación por diseñadores. | Enfocado únicamente en color/tema (no en diseño ni estructura de componentes); basado en reglas o heurísticas en lugar de síntesis de interfaz de usuario aprendida de extremo a extremo. |
| Unificación de la Generación de Diseños con un Modelo de Difusión Desacoplado (LDGM)²⁵ | Generación unificada y flexible de diseños para escenas gráficas e interfaces de usuario. | Diversidad y controlabilidad de vanguardia en la generación de diseños; admite generación condicional y múltiples tipos de atributos. | Las salidas basadas en difusión pueden presentar problemas de alineación o detalles finos del diseño a menos que estén restringidas; mayor complejidad del modelo y costo de inferencia. |
| Transformadores de Diseño por Difusión sin Métodos de Autoencoder: transformador + difusión para generación de diseño (sin autoencoder)²⁶ | Mejorar la fidelidad y alineación en pruebas de generación de diseño (métricas FID, alineación y superposición). | Mejor captura de correlaciones semánticas entre objetos vecinos; alto desempeño en métricas FID y de alineación. | Se centra principalmente en la geometría del diseño (posiciones, tamaños, categorías) más que en la semántica de la interfaz de usuario. |
| Generación de Diseños de GUI con Modelos Basados en Transformadores a partir de Grafos de Disposición de GUI (GUI-AGs)²⁷ | Crear diseños de GUI a partir de restricciones posicionales o de grafo para asistir a diseñadores. | Las representaciones en grafo capturan restricciones relacionales; el transformador permite una generación flexible condicionada a restricciones. | Puede requerir grafos de restricción explícitos por parte de los diseñadores; énfasis limitado en métricas de color y usabilidad. |
| Generación de Diseños de Interfaz de Usuario con Modelos de Lenguaje Grande Guiados por Gramática de Interfaz de Usuario: Modelos de Lenguaje Grande (LLMs) + gramática jerárquica de interfaz de usuario²⁸ | Explorar el uso de LLMs en la generación de diseños y mejorar la explicabilidad y el control mediante representaciones gramaticales. | Alto nivel de controlabilidad y explicabilidad; puede aprovechar el aprendizaje en contexto de LLMs (tipo GPT). | Trabajo en etapas iniciales con validación empírica limitada; diseño de gramática y robustez a través de diferentes interfaces de usuario |
Tabla 1: Comparación de los métodos existentes de modelado de colores de interfaz de usuario y generación de diseños. La tabla resume enfoques representativos para el diseño de interfaces de usuario, incluyendo la generación de temas de color, la generación de diseños basada en difusión, métodos basados en transformadores y la generación de diseños guiada por modelos de lenguaje grandes. Para cada método, se presentan la técnica subyacente, el objetivo, las ventajas y las limitaciones, destacando las diferencias en el modelado perceptual, la capacidad de generación de diseños, la controlabilidad y las consideraciones de usabilidad.
A pesar de estos avances, persiste una limitación clave: ningún sistema existente integra conjuntamente la detección de componentes, el modelado perceptual del color, los principios cognitivos de diseño y la coherencia de diseño en múltiples pantallas dentro de un único marco integral1. Los enfoques actuales suelen optimizar solo uno o dos aspectos, como la detección, el diseño o el color, sin considerar sus interdependencias. Esta fragmentación pone de manifiesto una brecha crítica en la investigación para desarrollar sistemas unificados de prototipado automatizado de interfaces de usuario centrados en el ser humano. En particular, los principios de diseño cognitivo, como las leyes de la Gestalt, la ley de Fitts y la ley de Hick, a menudo se tratan de forma conceptual en lugar de integrarse formalmente en modelos computacionales.
Para abordar estas limitaciones, este estudio propone un marco automatizado de prototipado de interfaz de usuario (UI) de extremo a extremo que integra la detección de componentes, el modelado perceptual del color y principios de diseño cognitivo dentro de un sistema unificado. El marco está diseñado para mejorar la calidad del diseño, reducir la carga cognitiva, potenciar la armonía cromática y aumentar la usabilidad general. Estas mejoras se validan mediante experimentos con los conjuntos de datos RICO, ENRICO y Guo’s UI Color Datasets, demostrando la eficacia de combinar aspectos estructurales, perceptuales y cognitivos dentro de una única canalización automatizada de prototipado de interfaz de usuario. Se plantea la hipótesis de que integrar la detección de componentes basada en aprendizaje profundo, el modelado perceptual del color y principios de diseño cognitivo dentro de un marco unificado mejorará significativamente la calidad del prototipo de interfaz de usuario en comparación con los enfoques existentes. Específicamente, H1 propone que el marco mejora la calidad del diseño, incluyendo alineación, agrupación y orden de lectura. H2 postula que el marco reduce la carga cognitiva del usuario. H3 sugiere que el modelado perceptual del color mejora la coordinación cromática y la armonía visual. H4 afirma que mejoran la usabilidad general y la calidad estética de los prototipos de interfaz de usuario.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utiliza conjuntos de datos de acceso público y no involucra sujetos humanos ni animales.
El marco propuesto de prototipado automatizado de interfaces de usuario integra la comprensión estructural basada en aprendizaje profundo, la modelización de color perceptualmente uniforme y principios de diseño cognitivo para generar prototipos de interfaz coherentes y centrados en el usuario. La metodología comienza con una arquitectura Faster R-CNN entrenada en los conjuntos de datos RICO y ENRICO para detectar componentes de interfaz de usuario y extraer sus relaciones jerárquicas, lo que permite una interpretación precisa de diversas disposiciones de pantalla. Los componentes detectados son procesados luego por un módulo de inteligencia del color, que extrae pistas cromáticas basadas en marcas o imágenes, modela la similitud perceptual mediante CAM02-UCS y genera paletas de colores armoniosas, conscientes del contraste y compatibles con los requisitos de accesibilidad. Posteriormente, se aplican principios de diseño cognitivo —incluyendo las leyes de agrupamiento de la Gestalt, la ley de Fitts, la ley de Hick, el espaciado basado en la atención y las restricciones de jerarquía visual— mediante un motor de optimización cognitiva para perfeccionar la organización espacial y el alineamiento de los componentes. Finalmente, una capa de razonamiento de diseño integra restricciones estructurales, perceptuales y cognitivas para generar prototipos de interfaz de usuario coherentes entre múltiples pantallas, que equilibran usabilidad, estética y claridad funcional. Esta tubería integrada garantiza coherencia perceptual, reduce la carga cognitiva y se ajusta a principios de diseño centrados en el ser humano. El flujo de trabajo completo del método propuesto se ilustra en Figura 1.
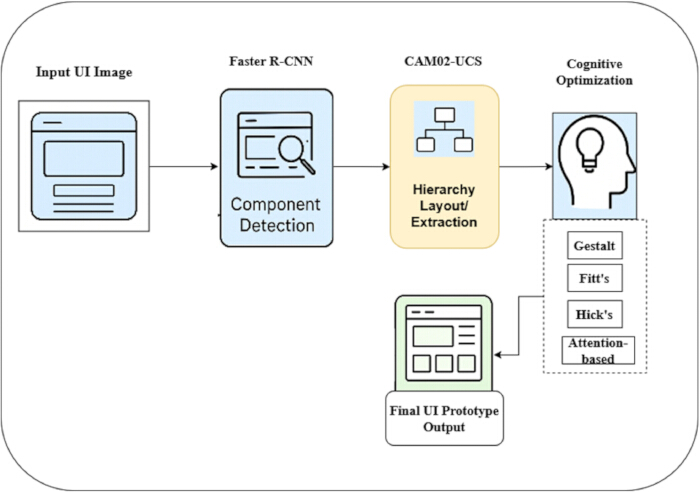
Figura 1. Arquitectura general del marco propuesto para la prototipación automatizada de interfaces de usuario. El diagrama ilustra la tubería completa, que comienza con una imagen de interfaz de usuario de entrada. La detección de componentes se realiza mediante Faster R-CNN para identificar los elementos de la interfaz. Los componentes detectados se procesan luego utilizando un modelado perceptual basado en CAM02-UCS para la extracción de jerarquía y disposición. Posteriormente, se aplica una optimización cognitiva utilizando principios de la Gestalt, la ley de Fitts, la ley de Hick y ajustes basados en la atención. Las flechas indican el flujo de datos entre los módulos, lo que resulta en la salida del prototipo final de interfaz de usuario. Haga clic aquí para ver una versión más grande de esta figura.
Resumen del marco
Figura 1 ilustra el flujo de trabajo completo del marco propuesto para prototipado automatizado de interfaces de usuario (UI), que transforma una captura de pantalla de UI en bruto en un prototipo refinado cognitivamente. El proceso comienza con la imagen de entrada de la interfaz, que se envía al módulo de detección de componentes basado en Faster R-CNN. Este módulo identifica elementos de la interfaz, como botones, iconos, campos de texto y contenedores, y genera sus respectivas cajas delimitadoras y etiquetas de clase. Los componentes detectados se procesan luego en la etapa de extracción de jerarquía y disposición. Basándose en las relaciones espaciales y los patrones estructurales, el sistema construye un árbol jerárquico de disposición que refleja la forma en que los usuarios perciben naturalmente la organización de la pantalla. Esta representación captura la agrupación visual y las dependencias estructurales entre los elementos de la interfaz. La disposición extraída se perfecciona posteriormente mediante una optimización cognitiva que aplica principios de diseño centrados en el ser humano. Estos incluyen el agrupamiento de la Gestalt para la agrupación visual, la ley de Fitts para optimizar el tamaño y accesibilidad de los objetivos táctiles, la ley de Hick para reducir la complejidad de las decisiones y el espaciado basado en la atención para mejorar la jerarquía visual. Como resultado, la disposición se vuelve más intuitiva, legible y eficiente para la interacción del usuario. Finalmente, la disposición optimizada se combina con un modelo de color perceptual para generar un prototipo de interfaz coherente. La interfaz resultante es estructuralmente precisa, visualmente armoniosa y coherente con las expectativas humanas de usabilidad.
El marco se implementó utilizando PyTorch 2.0 en Ubuntu 22.04. Los experimentos se realizaron en un sistema equipado con una GPU NVIDIA RTX 4090 (24 GB de VRAM). El modelo Faster R-CNN empleó una estructura ResNet-50 previamente entrenada en el conjunto de datos ImageNet. El entrenamiento se realizó utilizando el optimizador de descenso de gradiente estocástico (SGD) con una tasa de aprendizaje de 0,001, un tamaño de lote de 16 y hasta 60 épocas. Se aplicó la detención anticipada para prevenir el sobreajuste, utilizando un conjunto de validación que comprendía el 20 % de los datos. Aunque el entrenamiento se realizó durante hasta 60 épocas, la convergencia generalmente se alcanzó antes mediante la detención anticipada basada en la pérdida de validación. El momento y la reducción de peso se establecieron en 0,9 y 0,0005, respectivamente. La ampliación de datos incluyó normalización, volteo horizontal aleatorio, y recorte y redimensionamiento aleatorios.
Preparación del conjunto de datos
Para respaldar el marco propuesto de prototipado automatizado de interfaces de usuario (UI), se utilizaron tres conjuntos de datos complementarios: ENRICO29, RICO30 y el Conjunto de Datos de Colores de UI de Guo1. El conjunto de datos RICO contiene 66 261 pantallas de interfaces de usuario de Android recopiladas de 9 700 aplicaciones, lo que proporciona una diversidad a gran escala para la detección de componentes y la extracción de diseños jerárquicos. ENRICO incluye 1 464 capturas de pantalla de alta calidad clasificadas manualmente en 20 patrones de diseño, lo que permite una mejor generalización en el razonamiento estructural y la modelización de la coherencia del diseño. El Conjunto de Datos de Colores de UI de Guo consta de 128 imágenes de interfaces seleccionadas con temas de color anotados, que se utilizan para la modelización del color perceptual y la evaluación de paletas. Sin embargo, debido a su tamaño relativamente pequeño, este conjunto de datos puede introducir cierta variabilidad en las características del diseño. Para este estudio, se preparó un conjunto combinado de 5 128 pantallas para entrenamiento y evaluación. Específicamente, aproximadamente 4 000 imágenes de RICO se utilizaron para entrenar el modelo Faster R-CNN en la detección de componentes, 1 000 imágenes de ENRICO se emplearon para el aprendizaje de patrones de diseño y la modelización de la coherencia estructural, y 128 imágenes del conjunto de datos de Guo se usaron para tareas de evaluación del color. Todas las imágenes se normalizaron a una resolución de 480 × 800 píxeles, se convirtieron a un espacio de color sRGB uniforme y se volvieron a anotar con cuadros delimitadores estandarizados y metadatos jerárquicos para garantizar la compatibilidad entre los conjuntos de datos. En Tabla 2 se proporciona una visión general de los conjuntos de datos utilizados en este estudio. El conjunto de datos RICO permite la detección a gran escala de componentes de interfaz de usuario y el análisis estructural, mientras que ENRICO mejora la capacidad del modelo para reconocer patrones de diseño y aplicar coherencia entre pantallas. El Conjunto de Datos de Colores de UI de Guo, aunque más pequeño en tamaño, desempeña un papel fundamental en la evaluación de la armonía perceptual del color y la modelización del contraste. En conjunto, estos conjuntos de datos ofrecen una base completa y bien equilibrada para el entrenamiento, validación y evaluación del marco propuesto de prototipado automatizado de interfaces de usuario.
| Conjunto de datos | Total de imágenes disponibles | Imágenes utilizadas en el estudio | Objetivo en el marco propuesto |
| RICO Dataset30 | 66,261 | 4,000 | Detección de componentes de interfaz de usuario, extracción de distribución estructural |
| ENRICO Dataset29 | 1,464 | 1,000 | Aprendizaje de patrones de diseño, modelado de consistencia de distribución |
| Guo’s UI Color Dataset1 | 128 | 128 | Extracción de tema de color, evaluación perceptual del color |
| Total combinado | 67,853 | 5,128 | Conjunto de datos integral para detección, distribución y modelado del color |
Tabla 2: Resumen de los conjuntos de datos utilizados en el marco propuesto. La tabla presenta los conjuntos de datos empleados para el entrenamiento y la evaluación, incluyendo los conjuntos de datos RICO, ENRICO y Guo’s UI Color. Se indica el número total de imágenes disponibles, el subconjunto utilizado en este estudio y el papel específico de cada conjunto de datos en la detección de componentes, modelado de diseño y análisis perceptual del color dentro del marco propuesto.
Se empleó una estrategia de muestreo estratificado para preservar la diversidad en los componentes de interfaz de usuario, las estructuras de diseño y las distribuciones de color en los conjuntos de datos RICO, ENRICO y Guo. El conjunto de datos se dividió en subconjuntos de entrenamiento (70 %), validación (15 %) y prueba (15 %) utilizando muestreo estratificado. Las imágenes se normalizaron utilizando la media (0.485, 0.456 y 0.406) y la desviación estándar (0.229, 0.224 y 0.225). La ampliación de datos incluyó volteo horizontal aleatorio (probabilidad = 0,5) y recorte aleatorio (rango de escala: 0,8–1,0), seguido de un cambio de tamaño a 224 × 224 píxeles aplicado durante el entrenamiento.
Anotación de componentes y preprocesamiento
Los conjuntos de datos RICO, ENRICO y Guo’s UI Color respaldan conjuntamente los tres componentes funcionales principales del marco propuesto para prototipado automatizado de interfaces de usuario (UI): detección de componentes, modelado de diseño y optimización perceptual del color. El conjunto de datos RICO contiene una colección a gran escala de más de 66 000 pantallas de interfaces de usuario móviles y se utiliza principalmente para entrenar el módulo de detección de componentes. Su diversidad permite que el modelo Faster R-CNN aprenda representaciones robustas de elementos comunes de interfaces de usuario, como botones, imágenes y campos de texto, en una amplia variedad de aplicaciones. Esto garantiza la detección y localización precisas de los componentes de la interfaz de usuario bajo distintas condiciones de diseño. El conjunto de datos ENRICO proporciona pantallas de interfaces de usuario de alta calidad etiquetadas por patrones, para aprender relaciones estructurales y patrones de diseño. Permite al sistema comprender las relaciones entre componentes, la organización jerárquica y las plantillas de diseño comunes. Este conjunto de datos desempeña un papel fundamental en el modelado de estructuras de diseño y en el cumplimiento de la coherencia entre múltiples pantallas, lo que permite al marco generar diseños que se ajusten a las convenciones de diseño establecidas. En contraste, el conjunto de datos Guo’s UI Color se utiliza específicamente para el modelado del color desde una perspectiva perceptual y cognitiva. A diferencia de RICO y ENRICO, que se centran en aspectos estructurales, este conjunto contiene imágenes de interfaces de usuario curadas con temas de color anotados. Estas anotaciones se emplean para entrenar módulos de extracción de color y evaluación de armonía cromática. Al mapear las relaciones de color en espacios cromáticos perceptuales como CAM02-UCS, el marco aprende a generar paletas de colores que equilibren contraste, accesibilidad y coherencia estética. En conjunto, estos conjuntos de datos forman una tubería integrada: RICO respalda la detección de componentes, ENRICO permite comprender los patrones de diseño y mantener la coherencia estructural, y el conjunto de datos de Guo facilita la optimización perceptual del color. Esta integración asegura que los prototipos de interfaz de usuario generados sean estructuralmente precisos, visualmente armónicos y cognitivamente optimizados.
La normalización se realizó utilizando una media de [0.485, 0.456, 0.406] y una desviación estándar de [0.229, 0.224, 0.225]. Se aplicaron técnicas de aumento de datos, incluyendo recorte aleatorio, volteo horizontal y rotación, para mejorar la generalización del modelo. Además, los valores de los píxeles se escalaron al rango [0, 1], y todas las imágenes se redimensionaron a una resolución de 480 × 800 píxeles para garantizar la consistencia entre los conjuntos de datos. Las imágenes redimensionadas a 224 × 224 píxeles se utilizan para el aumento durante el entrenamiento, mientras que se conserva la resolución original de 480 × 800 píxeles para el análisis de diseño. Se ajustaron los cuadros delimitadores para filtrar anotaciones irrelevantes utilizando umbrales predefinidos. Para lograr uniformidad entre los conjuntos de datos, todos los elementos de interfaz de usuario fueron anotados manualmente utilizando la herramienta de anotación LabelImg. Se estableció un esquema predefinido antes de la anotación para clasificar los elementos de interfaz de usuario en categorías como botón, texto, imagen, icono y contenedor. Para la representación de los cuadros delimitadores, se aplicó un sistema de coordenadas uniforme, y se construyó información jerárquica basada en las relaciones espaciales entre los elementos y sus asociaciones padre-hijo dentro del árbol de diseño. Además, se establecieron directrices para asegurar una anotación consistente de los elementos, un manejo adecuado de los componentes superpuestos y el cumplimiento de umbrales mínimos de tamaño en los conjuntos de datos RICO, ENRICO y Guo.
Se proporcionan formulaciones matemáticas detalladas para el entrenamiento de detección de componentes y la extracción de patrones de diseño en el Archivo Suplementario 1.
El modelo Faster R-CNN se entrenó utilizando SGD con un momento de 0,9 y una reducción de peso de 0,0005. La tasa de aprendizaje inicial se estableció en 0,001 y se ajustó utilizando una política de decaimiento escalonado basada en el rendimiento de validación. El entrenamiento se realizó durante un máximo de 60 épocas con un tamaño de lote de 16. Se aplicó detención temprana para prevenir el sobreajuste, utilizando un conjunto de validación que comprendía el 20 % de los datos de entrenamiento.
La función de mapeo f(.) toma como entrada los elementos de interfaz de usuario detectados y produce como salida una representación jerárquica del diseño. Calcula las relaciones de adyacencia entre los elementos de la interfaz de usuario basándose en criterios de distancia espacial y alineación, y construye una matriz de adyacencia para representar dichas relaciones. Luego, se aplica un algoritmo de agrupamiento, como DBSCAN, para agrupar los componentes relacionados. Finalmente, los elementos agrupados se organizan en estructuras jerárquicas según las relaciones de padre-hijo, formando una representación estructurada del diseño.
Se proporcionan formulaciones detalladas para la modelización de la armonía de color y el objetivo de optimización unificado en el Archivo Suplementario 1.
Esta función objetivo formaliza matemáticamente la integración de la detección estructural, el razonamiento de diseño y la modelización perceptual del color, asegurando que todos los componentes del marco contribuyan conjuntamente a generar prototipos de interfaz de usuario coherentes y centrados en el usuario. La optimización se realiza de manera modular para cada componente del marco. Se utiliza SGD para entrenar el módulo de detección de componentes, mientras que el optimizador Adam se emplea durante la optimización conjunta del objetivo unificado. La función objetivo combinada se utiliza para guiar el rendimiento general del sistema. En las etapas de optimización conjunta, la función objetivo se minimiza utilizando el optimizador Adam con una tasa de aprendizaje de 0,001 y un tamaño de lote de 16. El entrenamiento se realiza durante un máximo de 60 épocas, aplicando detención temprana cuando el cambio en la pérdida de validación es menor que 10−4 durante cinco épocas consecutivas.
Detección de componentes mediante Faster R-CNN
El marco propuesto emplea Faster R-CNN para la detección automática de componentes de interfaz de usuario (UI), incluyendo botones, iconos, campos de texto, imágenes y contenedores. Faster R-CNN es especialmente adecuado para esta tarea porque combina una alta precisión en la detección de objetos con una generación eficiente de propuestas de regiones, lo cual es esencial para manejar diseños de interfaz complejos que contienen elementos densamente empaquetados. El modelo utiliza una estructura ResNet-50 preentrenada en el conjunto de datos ImageNet para extraer mapas de características convolucionales de cada pantalla de interfaz. Durante el entrenamiento, las capas iniciales se mantuvieron fijas para conservar características visuales generales, mientras que las capas superiores (conv4_x y conv5_x) se ajustaron finamente para la detección específica de componentes de interfaz. Estos mapas de características capturan estructuras visuales, bordes, texturas y límites de los componentes. Durante la detección, la red de propuesta de regiones (RPN) identifica regiones candidatas (anclas) que probablemente contengan componentes de interfaz. Las anclas se definen utilizando múltiples escalas (128, 256 y 512) y relaciones de aspecto (1:1, 1:2 y 2:1) para adaptarse a elementos de interfaz de diferentes tamaños. Durante el entrenamiento, las anclas con una intersección sobre unión (IoU) mayor que 0,7 respecto a las cajas reales se etiquetan como positivas, mientras que aquellas con IoU menor que 0,3 se etiquetan como negativas; las anclas con valores intermedios de IoU se ignoran. A cada ancla se le asigna una probabilidad que indica la presencia de un componente. Luego se aplica supresión no máxima (NMS) para eliminar propuestas redundantes y solapadas, asegurando una localización eficiente de elementos de interfaz significativos incluso en interfaces con mucho contenido. Una vez generadas las regiones candidatas, cada propuesta se clasifica en categorías predefinidas de componentes y se refina su coordenada de cuadro delimitador. Una operación de alineación de región de interés (ROI) extrae representaciones de características de tamaño fijo para cada propuesta, que luego son procesadas por capas completamente conectadas para clasificación y regresión. La rama de clasificación produce probabilidades de clase, mientras que la rama de regresión predice coordenadas precisas del cuadro delimitador. Todo el modelo Faster R-CNN se entrena de extremo a extremo mediante la optimización de una función de pérdida conjunta que combina la pérdida de la RPN con la pérdida final de detección. Esto permite al sistema no solo reconocer con precisión los componentes de interfaz, sino también localizarlos con exactitud a través de diversas estructuras de interfaz. Se proporciona una descripción detallada de la detección de componentes mediante Faster R-CNN, incluyendo la etapa RPN, clasificación de ROI, refinamiento del cuadro delimitador y el objetivo final de optimización, en Supplementary File 1.
Algoritmo S1 proporciona el flujo de trabajo detallado de detección de componentes y extracción estructural (Archivo Suplementario 1). Describe el proceso completo de detección automática de componentes de interfaz de usuario (UI) y extracción estructural a partir de una imagen de pantalla en bruto. Primero, la imagen de entrada se preprocesa y se introduce en una red neuronal convolucional (CNN) para extraer características visuales profundas. Estas características son utilizadas por la red de propuestas regionales (RPN) para generar cajas delimitadoras candidatas, que luego se refinan mediante clasificación y regresión. La supresión no máxima (NMS) elimina las detecciones redundantes para garantizar una localización precisa. Tras la detección, los componentes se agrupan según su proximidad espacial mediante agrupamiento espacial basado en densidad de aplicaciones con ruido (DBSCAN). Este paso de agrupamiento permite construir un árbol jerárquico de interfaz de usuario que captura las relaciones padre-hijo y agrupaciones lógicas entre los componentes. Esta representación jerárquica constituye la base para el análisis de diseño y la comprensión de la interfaz de usuario en etapas posteriores. Figura 2 ilustra el proceso de detección de componentes mediante Faster R-CNN en una pantalla de interfaz de usuario móvil. La interfaz de entrada (izquierda) contiene elementos de interfaz de usuario como botones y bloques de texto, que quedan automáticamente encerrados dentro de cajas delimitadoras. Estas regiones detectadas se clasifican luego en categorías de componentes (por ejemplo, Botón y Texto), tal como indican las conexiones etiquetadas. El módulo de detección Faster R-CNN (derecha) refina las coordenadas de las cajas delimitadoras, asigna etiquetas semánticas y genera información estructurada a nivel de componente. Este paso sirve como fundamento crítico para procesos posteriores, incluyendo la extracción de diseño, la optimización cognitiva y la generación de prototipos de interfaz de usuario, al proporcionar representaciones precisas y semánticamente significativas de los componentes de la interfaz.
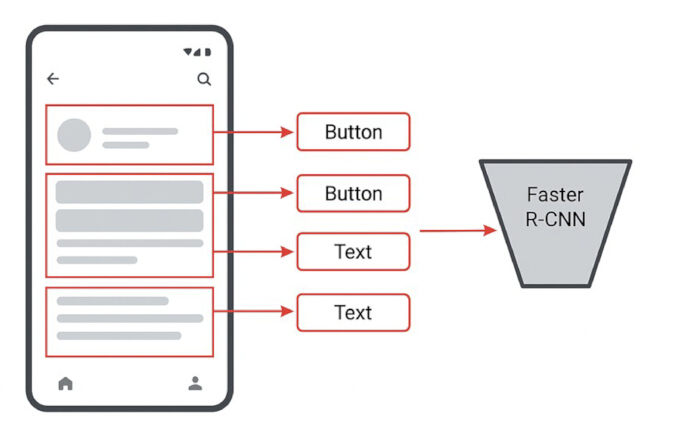
Figura 2. Detección de componentes de elementos de interfaz de usuario mediante Faster R-CNN. La figura ilustra la detección de componentes de interfaz a partir de una captura de pantalla de una interfaz de entrada. Las regiones de interés se identifican mediante cuadros delimitadores, y elementos como botones y campos de texto se clasifican utilizando Faster R-CNN. Las flechas indican la asignación de los componentes detectados a sus etiquetas semánticas correspondientes. Haga clic aquí para ver una versión más grande de esta figura.
Extracción del patrón de diseño y modelado jerárquico
Tras la detección de componentes mediante Faster R-CNN, cada elemento de la interfaz de usuario (UI) se representa mediante un cuadro delimitador. Sin embargo, estos cuadros delimitadores por sí solos no indican cómo están organizados estructuralmente los elementos dentro de la interfaz, por ejemplo, qué elementos pertenecen a encabezados, barras de navegación o regiones de contenido agrupado. Para abordar esta limitación, los componentes detectados se transforman en un árbol lógico de interfaz de usuario, en el que cada componente se trata como un nodo y los componentes relacionados funcional o visualmente se agrupan bajo nodos padres comunes. Para identificar grupos de diseño significativos, se aplican técnicas de agrupamiento como DBSCAN o agrupamiento jerárquico aglomerativo. Estos métodos analizan la proximidad espacial y los patrones de alineación entre los componentes para detectar relaciones entre los elementos de la interfaz de usuario. De manera análoga a las prácticas humanas de diseño, el sistema aprende a reconocer patrones estructurales comunes, como encabezados, pies de página, cuadrículas y bloques de contenido. Una vez establecido el agrupamiento, se analizan propiedades estructurales adicionales, incluyendo alineación, organización en cuadrícula y orden de lectura, para construir una representación completa del diseño. Por ejemplo, los componentes alineados en columnas de igual ancho pueden indicar un diseño basado en tarjetas, mientras que los elementos apilados verticalmente pueden indicar una interfaz basada en formularios o en un flujo continuo. Al integrar el agrupamiento, el razonamiento espacial y las reglas de alineación, el marco de trabajo construye un árbol jerárquico de interfaz de usuario que captura tanto el agrupamiento visual como las relaciones funcionales. Esta representación jerárquica sirve como base para el refinamiento posterior del diseño y la modelización de la coherencia entre múltiples pantallas, permitiendo al sistema generar diseños de interfaz estructurados, coherentes y centrados en el usuario.
Se proporcionan formulaciones detalladas para la distancia espacial y la similitud de alineación en el Archivo Suplementario 1.
Agrupamiento por agrupación espacial (DBSCAN)
Para identificar los grupos de diseño, se aplica DBSCAN. DBSCAN utiliza dos parámetros: (1) ε = distancia máxima entre componentes vecinos y (2) = número mínimo de componentes necesarios para formar un grupo. Para este análisis, los parámetros de DBSCAN se seleccionaron empíricamente en función de la resolución normalizada de la interfaz de usuario (480 × 800 píxeles). El parámetro de distancia de vecindad se estableció en ε = 50 píxeles para capturar la proximidad espacial entre componentes adyacentes de la interfaz de usuario. El número mínimo de puntos requeridos para formar un grupo se estableció en MinPts = 3 para evitar la formación de grupos insignificantes o espurios de componentes de la interfaz de usuario.
Se proporciona la formulación detallada de la construcción del árbol lógico de interfaz de usuario en el Archivo Suplementario 1.
Modelado del color perceptual con CAM02-UCS
La modelización perceptual de color garantiza que los colores utilizados en la interfaz generada sean armónicos, legibles y cognitivamente eficientes. Los colores dominantes se extraen de fuentes de entrada, como imágenes de interfaces, mediante técnicas de agrupamiento. En concreto, se aplica el agrupamiento K-medias con inicialización K-means++ durante 300 iteraciones para obtener paletas de colores representativas. Sin embargo, el espacio de color RGB no refleja con precisión la percepción visual humana, lo que significa que colores numéricamente similares pueden parecer perceptualmente diferentes. Para abordar esta limitación, todos los colores extraídos se transforman al espacio CAM02-UCS, que es perceptualmente uniforme. En este espacio, distancias iguales corresponden a diferencias de color percibidas iguales, lo que lo hace adecuado para modelar armonía y contraste de color. Una vez mapeados al espacio CAM02-UCS, las diferencias perceptuales de color se calculan mediante la distancia euclidiana, permitiendo al sistema cuantificar el contraste, la armonía y la variación entre colores. Los colores demasiado similares se separan para mejorar la legibilidad, mientras que los colores con contraste excesivo se moderan para evitar incomodidad visual. La paleta generada también cumple con estándares de accesibilidad como WCAG AA y AAA, asegurando un contraste suficiente entre elementos de primer plano y de fondo. Además, se refuerza la armonía del color restringiendo las relaciones de la paleta a esquemas complementarios, análogos o triádicos, según el tema de interfaz previsto. Esto garantiza que la paleta de colores resultante no solo sea visualmente atractiva, sino también funcionalmente accesible y cognitivamente optimizada. Para refinar aún más la paleta, se aplica un proceso de optimización bajo restricciones de similitud perceptual, contraste, armonía y coherencia de marca. Se selecciona un color principal (por ejemplo, a partir de la identidad de marca), y los colores secundarios se ajustan en cuanto a luminancia y croma para preservar la jerarquía visual. Un mecanismo de evaluación basado en reglas analiza las paletas candidatas según distancias perceptuales y métricas de accesibilidad, minimizando la carga cognitiva mientras se mantiene el equilibrio estético. Como resultado, el marco produce esquemas de color para interfaces que presentan coherencia, legibilidad y consistencia perceptual a nivel profesional.
Se proporcionan expresiones matemáticas detalladas para el modelado del color perceptual basado en CAM02-UCS en el Archivo Suplementario 1.
Algoritmo S2 (Archivo Suplementario 1) describe el flujo de trabajo de extracción y optimización de colores perceptuales basado en CAM02-UCS, sujeto a restricciones de armonía y accesibilidad. En primer lugar, se extraen los colores dominantes de la imagen de entrada y se transforman al espacio CAM02-UCS para garantizar que las diferencias cromáticas correspondan a la percepción humana. Luego, se calculan las distancias perceptuales entre los colores y se limitan dentro de rangos predefinidos para mantener la claridad y la armonía. A continuación, se aplica accesibilidad evaluando las relaciones de contraste de luminancia según las directrices WCAG. La paleta final se obtiene optimizando una función objetivo combinada que equilibra el espaciado perceptual, los requisitos de contraste y las restricciones de armonía cromática. Esto asegura que los esquemas de color de interfaz generados sean no solo visualmente atractivos, sino también legibles, accesibles y perceptualmente consistentes.
Optimización del diseño cognitivo
La optimización del diseño cognitivo garantiza que los prototipos de interfaz de usuario generados automáticamente no solo sean visualmente consistentes, sino también fáciles de comprender y de utilizar. Este módulo integra principios clave del diseño cognitivo, incluyendo los principios de la Gestalt, la ley de Fitts y la ley de Hick, para guiar la disposición, agrupación y espaciado de los componentes de la interfaz de usuario. En el Archivo Suplementario 1 se proporcionan formulaciones matemáticas detalladas para la optimización del diseño cognitivo.
Objetivo integrado de optimización cognitiva
La expresión matemática para el objetivo integrado de optimización cognitiva se proporciona en el Archivo Suplementario 1. Los coeficientes que representan la importancia del agrupamiento visual, la eficiencia de la interacción y la complejidad de la decisión se denotan con alfa, beta y gamma, respectivamente. En este estudio, los valores de alfa, beta y gamma se determinaron empíricamente utilizando el conjunto de datos de validación. Para el presente experimento, los coeficientes se establecieron de la siguiente manera: α = 0.5, β = 0.3 y γ = 0.2. Esta configuración proporciona un equilibrio efectivo entre el agrupamiento visual, la eficiencia de la interacción y la simplicidad de la decisión.
Consistencia entre múltiples pantallas y generación de interfaz de usuario
El modelado de consistencia multipantalla garantiza que diferentes pantallas dentro de una aplicación compartan una identidad visual coherente, una disposición estructural y un patrón de interacción. A medida que los usuarios navegan entre pantallas, desarrollan expectativas respecto a la colocación de elementos, la tipografía, el espaciado y la jerarquía visual. Para satisfacer estas expectativas, el sistema analiza patrones entre pantallas mediante plantillas derivadas de los conjuntos de datos RICO y ENRICO. Estas plantillas capturan estructuras comunes de interfaces de usuario, como diseños de inicio–detalle, patrones de lista–detalle, formularios de múltiples pasos y flujos de panel de control. Al comparar la colocación de componentes y el comportamiento de agrupamiento, el sistema construye un perfil estructural entre pantallas que identifica qué elementos deben mantenerse consistentes y cuáles pueden variar. Una vez identificados los patrones estructurales, el marco de trabajo aplica consistencia en escalas tipográficas, proporciones de espaciado, diseños de cuadrícula y puntos de navegación. Por ejemplo, las barras de encabezado mantienen una altura constante, los botones principales conservan un tamaño y alineación uniformes, y los bloques de contenido siguen un orden visual predecible. Esto se logra mediante un proceso de regularización de diseño que evalúa cada pantalla frente a restricciones estructurales globales. Si una pantalla se desvía de las plantillas aprendidas—por ejemplo, por relleno inconsistente o títulos mal alineados—el sistema ajusta automáticamente el diseño para restaurar la coherencia. Estas correcciones ayudan a garantizar una experiencia de usuario (UX) fluida y reducen los costos cognitivos asociados al cambio entre pantallas. Además, el marco analiza el grafo de navegación entre pantallas para mantener la consistencia en el flujo de interacción. Se identifican y aplican patrones comunes de navegación, incluyendo transiciones hacia adelante/atrás, navegación con pestañas y flujos de trabajo de múltiples pasos. Cada transición se valida para asegurar su alineación con el modelo mental del usuario, mejorando así la usabilidad y reduciendo la confusión. Como resultado, el modelo de consistencia multipantalla minimiza el ruido visual, aumenta la familiaridad y promueve una experiencia de interacción unificada.
Se proporcionan formulaciones matemáticas detalladas para la consistencia de múltiples pantallas y la generación de interfaces de usuario en el Archivo Suplementario 1.
Finalmente, el motor de renderizado genera salidas visuales en formatos como estructuras SVG, prototipos HTML/CSS o maquetas de interfaz de usuario basadas en píxeles. Las pantallas de interfaz resultantes presentan un orden de lectura correcto, relaciones armónicas de color, alineación precisa de la cuadrícula y una jerarquía visual consistente entre múltiples pantallas.
Algoritmo S3 proporciona la optimización del diseño cognitivo-visual y el flujo de trabajo de coherencia en múltiples pantallas (Archivo Suplementario 1). El Algoritmo S3 describe el proceso integrado de optimización cognitiva y estructural utilizado para generar diseños de interfaz de usuario fáciles de usar. Combina la agrupación perceptual (principios de la Gestalt), la eficiencia de la interacción (ley de Fitts) y la simplicidad en la toma de decisiones (ley de Hick) dentro de un marco unificado de optimización. En primer lugar, se evalúan las relaciones espaciales entre los componentes para establecer agrupaciones perceptuales. Luego, se optimiza la eficiencia de la interacción ajustando el tamaño y la colocación de los componentes, mientras que la complejidad de las decisiones se controla limitando el número de opciones presentadas al usuario. Además, el algoritmo garantiza la coherencia entre múltiples pantallas alineando cada pantalla con plantillas de diseño aprendidas, asegurando uniformidad en la tipografía, el espaciado y la organización estructural. Una función de optimización multiobjetivo perfecciona entonces el diseño equilibrando alineación, espaciado y costo cognitivo, resultando en una interfaz que es visualmente coherente y cognitivamente eficiente. En conjunto, este algoritmo asegura que los diseños generados en múltiples pantallas mantengan altos niveles de coherencia visual, usabilidad y claridad perceptual.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
El marco propuesto para prototipado automático de interfaces de usuario (UI) fue evaluado utilizando un conjunto de datos integrado de 5.128 pantallas de UI provenientes de tres fuentes: 4.000 imágenes de RICO, 1.000 pantallas de ENRICO y 128 muestras de UI con anotaciones de color del Conjunto de Datos UI Color de Guo. Este conjunto de datos combinado proporciona un punto de referencia bien equilibrado para evaluar la precisión en la detección de componentes, la claridad estructural del diseño, la consistencia entre múl...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Los hallazgos demuestran mejoras estadísticamente significativas en usabilidad, organización estructural y calidad perceptual (p < 0,05), confirmando la eficacia de incorporar principios de diseño cognitivo en la prototipación automatizada de interfaces de usuario. A diferencia de los sistemas tradicionales de generación de interfaces que dependen principalmente de la detección visual o de heurísticas basadas en reglas, el marco propuesto integra agrupamiento gestáltico, modelado de jerarquías, restricciones de espac...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen conflictos de intereses.
Agradecimientos
Los autores agradecen el apoyo académico e institucional brindado por Wuhan College of Foreign Languages & Asuntos Exteriores, Universidad Keimyung y Instituto de Comercio e Idiomas Extranjeros de Shanghái durante la realización de esta investigación.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| CPU (Procesador) | AMD Ryzen 9 7950X (16 núcleos, 32 hilos, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), EE. UU. | Ryzen 9 7950X |
| CUDA Toolkit | Versión 11.8 | NVIDIA Corporation, EE. UU. | CUDA Toolkit 11.8 |
| cuDNN | Versión 8.9 | NVIDIA Corporation, EE. UU. | cuDNN v8.9 |
| Faster R-CNN | Modelo de detección de objetos (con red de propuesta de regiones) | Meta AI Research / Detectron2 | Entorno Detectron2 |
| Matplotlib | Versión 3.7 | Equipo de desarrollo de Matplotlib | v3.7.0 |
| GPU NVIDIA RTX 4090 | Tarjeta gráfica de 24 GB GDDR6X | NVIDIA Corporation, Santa Clara, CA, EE. UU. | RTX 4090 |
| NumPy | Versión 1.24 | Desarrolladores de NumPy | v1.24.0 |
| OpenCV | Versión 4.8 | Fundación OpenCV | v4.8.0 |
| PyTorch | Versión 2.0 | Fundación PyTorch (Meta AI) | v2.0.0 |
| ResNet-50 con FPN | CNN base con red de pirámide de características | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Versión 1.3 | Desarrolladores de Scikit-learn | v1.3.0 |
| SciPy | Versión 1.10 | Comunidad SciPy | v1.10.0 |
| Memoria del sistema (RAM) | 64 GB DDR5 | Corsair / Kingston (o equivalente) | Kit DDR5 de 64 GB |
| Sistema operativo Ubuntu | Versión 22.04 LTS | Canonical Ltd., Reino Unido | Ubuntu 22.04 LTS |
Referencias
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.