Este estudio presenta un marco de gemelo digital consciente del control para el monitoreo y la optimización de sistemas de petróleo y gas mediante modelos informados por física y aprendizaje automático, evaluado en conjuntos de datos simulados y de referencia.
Artículo de investigación
Desarrollo de un marco de gemelo digital consciente del control para la monitorización y optimización en tiempo real de sistemas de producción de petróleo y gas
En este artículo
Resumen
Resumen
Se propone en este artículo un marco de gemelo digital con conciencia de control para el seguimiento y mejora de los sistemas de producción de petróleo y gas. El método combina redes neuronales gráficas espacio-temporales, asimilación de datos mediante 4D-Var neuronal, control basado en aprendizaje por refuerzo y operadores neuronales informados por la física (FNO y modelo de operador neuronal). Se utilizan conjuntos de datos de sistemas ciberfísicos de referencia (SWaT y WADI) y un conjunto de datos simulado de petróleo y gas para evaluar el marco. Los resultados, confirmados mediante varias ejecuciones independientes usando medidas promedio, demuestran un rendimiento mejorado en la estimación de estados, detección de anomalías y optimización del control. Sin embargo, la evaluación se limita a conjuntos de datos de referencia y simulados; se requiere una validación adicional mediante datos reales de la industria para verificar la aplicabilidad práctica.
Introducción
La necesidad de redes seguras y eficaces para el transporte de petróleo y gas ha aumentado debido al creciente demanda energética mundial. Sin embargo, mantener la confiabilidad de las tuberías se ve gravemente obstaculizada por la infraestructura deteriorada y la creciente complejidad del sistema. En este sentido, la tecnología de gemelo digital (DT) ha llamado la atención como una estrategia de gestión del ciclo de vida basada en datos que permite la evaluación de riesgos, el mantenimiento predictivo y la optimización del sistema en entornos industriales1,2,3,4,5. Desde el mantenimiento reactivo hasta la toma de decisiones inteligente basada en datos, la transformación digital en los sistemas industriales ha incrementado la detección de anomalías, la predicción de fallos y la confiabilidad del sistema6,7,8. Las aplicaciones de los gemelos digitales en la optimización de procesos, el mantenimiento predictivo y la fabricación inteligente han sido objeto de numerosas investigaciones. Por ejemplo, se han propuesto modelos basados en gemelos digitales para el análisis predictivo de fallos10 y la evaluación del desempeño ambiental11, así como la optimización de la producción basada en aprendizaje profundo. Los gemelos digitales se han utilizado en la industria del petróleo y el gas para mejorar el monitoreo y la identificación de anomalías mediante la modelización del sistema, la evaluación del desempeño y la integración de datos de múltiples sensores12,13,14,15.
A pesar de estos avances, la mayoría de las técnicas actuales de gemelos digitales se centran en características discretas como el monitoreo, la modelización o la detección de anomalías, con escasa integración de la sincronización y el control en tiempo real. Muchos sistemas carecen de interacción bidireccional y de capacidades de aprendizaje adaptativo, funcionando como sombras digitales con flujo unidireccional de datos. En los sistemas de petróleo y gas, donde las condiciones dinámicas y los patrones de falla complejos requieren un aprendizaje y control continuos, esta limitación es especialmente importante. Además, las técnicas actuales de sistemas ciberfísicos no permiten el control en tiempo real en bucle cerrado en procesos industriales complejos, ya que se limitan principalmente al análisis fuera de línea16. Asimismo, para describir las interacciones de sensores distribuidos, los enfoques actuales dependen principalmente de técnicas tradicionales de aprendizaje automático y filtros, con escaso uso de modelos sofisticados como las redes neuronales gráficas espacio-temporales. Además, existe una escasez de investigaciones sobre la aplicación de técnicas de aprendizaje de operadores para capturar dinámicas físicas no lineales, especialmente en los sistemas de producción de petróleo y gas17. Debido a esto, los sistemas actuales de gemelos digitales no pueden incorporar la asimilación de datos en tiempo real y el control adaptativo al tiempo que modelan relaciones espacio-temporales complejas.
Dado que imitan entornos de control industrial, conjuntos de datos de referencia como SWaT y WADI se utilizan frecuentemente para validar técnicas basadas en gemelos digitales (DT) en sistemas ciberfísicos18. Además, los gemelos digitales ofrecen beneficios más generales, como un aumento de la productividad, un mejor intercambio de conocimientos y una transferencia segura de datos a lo largo de los procesos industriales19,20. En particular, en industrias de alto riesgo como la del petróleo y el gas21,22,23, su potencial en la gestión de la seguridad, el monitoreo en tiempo real y la automatización industrial está siendo cada vez más reconocido. Sin embargo, aún se necesitan soluciones más completas e integradas que combinen capacidades de modelado, monitoreo y control para su implementación práctica. Al demostrar las aplicaciones y ventajas de los gemelos digitales para mejorar la eficiencia operativa y la toma de decisiones, estudios de evaluación como los citados en24,25 han sentado las bases. Tabla 1 muestra la comparación de métodos existentes sobre la fabricación y gestión del control en la industria del petróleo y el gas26,27,28,29. Debido a los altos riesgos operativos y a la complejidad dinámica de los sistemas de producción de petróleo y gas, los métodos tradicionales de mantenimiento suelen ser inadecuados para la detección y respuesta oportuna de anomalías30,31,32,33. Aunque recientemente se han logrado mejoras en la gestión de la seguridad y el monitoreo remoto, aún se requieren sistemas inteligentes capaces de sensar, aprender y controlar continuamente en tiempo real.
Este artículo propone una arquitectura de gemelo digital consciente del control que combina redes neuronales gráficas espacio-temporales, asimilación de datos neuronal 4D-Var, operadores neuronales con conocimiento físico y control basado en refuerzo del aprendizaje para superar estas dificultades. El sistema propuesto establece una tubería única para la recolección de datos, estimación de estado, detección de anomalías y optimización del control. Mientras que las redes neuronales gráficas espacio-temporales registran las interacciones entre sensores distribuidos, los operadores neuronales con conocimiento físico, como el Operador Neuronal de Fourier y la Red Profunda de Operadores (modelo de operador neuronal), se utilizan para representar dinámicas complejas no lineales del sistema. El aprendizaje por refuerzo permite un control adaptativo en bucle cerrado, mientras que la asimilación neuronal de datos mejora la precisión de las estimaciones de estado. La generalización del método propuesto en entornos industriales se demuestra evaluándolo mediante conjuntos de datos de referencia de sistemas ciberfísicos (SWaT y WADI) y datos simulados de petróleo y gas. Este trabajo supera deficiencias importantes de los sistemas actuales de gemelos digitales y ofrece una solución escalable y adaptable para el monitoreo y la optimización en tiempo real en sistemas de producción de petróleo y gas, al integrar modelado, aprendizaje y control en un marco unificado.
Protocolo
Este estudio no involucra a ningún participante humano ni sujetos animales. Los conjuntos de datos utilizados (SWaT y WADI) son conjuntos de datos de referencia disponibles públicamente, y no se incluyen datos sensibles ni personales.
El enfoque propuesto establece un gemelo digital consciente del control, que permite incorporar algoritmos de aprendizaje profundo de vanguardia, asimilación de datos y evaluación continua y optimización de los sistemas y el control de extracción de petróleo y gas. En primer lugar, se recopilan y modelan datos multimodales en tiempo real procedentes de infraestructuras de producción distribuidas geográficamente, utilizando una estructura de grafos que define la conectividad y las interacciones entre los componentes de producción. Luego, se aprovechan operadores neuronales basados en principios físicos para construir aproximaciones a nivel de operador de las ecuaciones que rigen el flujo multifásico no lineal, facilitando así simulaciones escalables dentro del gemelo digital. En esta investigación, el término «modelo de operador neuronal» se utiliza para referirse a la red profunda de operadores (Deep Operator Network). Con el fin de incorporar dependencias espaciales y temporales entre activos de producción distribuidos geográficamente, se entrenan redes neuronales gráficas espacio-temporales dentro de representaciones basadas en principios físicos. Se aplica un enfoque diferenciable de asimilación de datos que utiliza la red neuronal 4DVAR para mantener las predicciones de simulación del gemelo digital coherentes y sincronizadas con los datos de monitoreo en tiempo real, incluso en presencia de mediciones ruidosas e irregulares en el espacio. Sobre la base del gemelo digital sincronizado en tiempo real, se entrena una herramienta de optimización basada en aprendizaje por refuerzo para el control en tiempo real. Finalmente, el gemelo digital permanece preparado para la actualización continua de modelos y una escalabilidad adaptada durante períodos prolongados, basándose en actualizaciones continuas a partir de nuevas mediciones disponibles.
La arquitectura de gemelo digital propuesta mejora la arquitectura convencional de gemelo digital al incorporar inteligencia, adaptabilidad y conciencia del control. La canalización completa consta de cuatro módulos: (i) adquisición de datos/construcción del grafo, (ii) estimación del estado mediante operadores neuronales y ST-GNN, (iii) detección de anomalías mediante análisis basado en residuos, y (iv) control basado en aprendizaje por refuerzo.
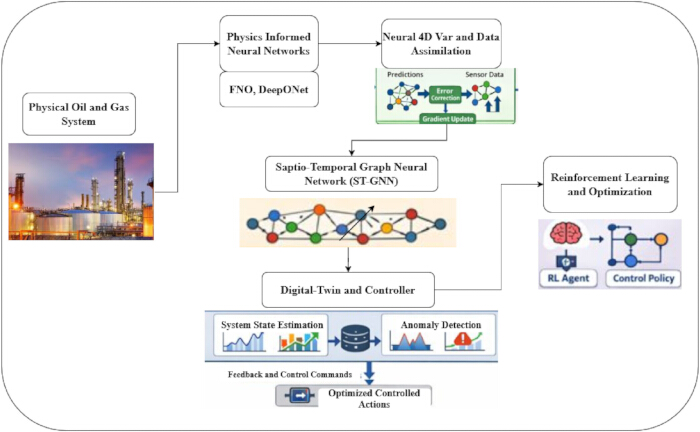
Figura 1: Arquitectura general del gemelo digital consciente del control. El modelo propuesto de gemelo digital consciente del control integra la detección de anomalías, redes neuronales gráficas espacio-temporales, sincronización neuronal mediante 4D-Var, operadores neuronales informados por principios físicos y control en bucle cerrado basado en aprendizaje por refuerzo para sistemas de producción de petróleo y gas. Haga clic aquí para ver una versión más grande de esta figura.
Figura 1 representa el proceso funcional de un gemelo digital con conocimiento del control de producción de petróleo y gas como un sistema ciberfísico en bucle cerrado. El proceso funcional comienza a nivel del sistema de producción de petróleo y gas, en el que diferentes sensores distribuidos en pozos, tuberías, válvulas y unidades de procesamiento capturan datos sobre presión, caudal, temperatura y controles en un instante determinado. Los diversos sensores capturan los datos en distintos formatos, y esta información se envía al gemelo digital, lo que constituye la base del conocimiento organizacional en ese instante.
La metodología propuesta incluye los siguientes pasos:
Recolección de datos
Se obtiene información en tiempo real de sensores sobre presión, caudal, temperatura y entradas de control procedentes de entornos de producción de petróleo y gas. Se utilizan otros conjuntos de datos de referencia disponibles, como SWAT y WADI, para evaluar las capacidades de robustez y generalización. Para garantizar la reproducibilidad, cada paso de la metodología propuesta se especifica utilizando detalles técnicos.
[Consulte el Archivo Suplementario (S1) para la Generación del Conjunto de Datos y la Simulación.]
Se utilizan dos conjuntos de datos industriales de referencia públicos del ámbito de investigación para sistemas de control industrial con el fin de demostrar la capacidad del gemelo digital conceptual frente a datos temporales complejos y de alta dimensionalidad, así como frente a eventos inusuales: los conjuntos de datos de referencia Secure Water Treatment (SWaT) y Water Distribution (WADI)34. Ambos conjuntos de datos se derivan de bancos de pruebas ciberfísicos realistas e incluyen datos multivariantes de sensores y actuadores correspondientes a operaciones normales y anomalías/ataques provocados en dichos sistemas. Mediante el uso de los conjuntos de datos SWaT y WADI, es posible realizar pruebas interdominio y demostrar la generalización más allá de los bancos de pruebas ciberfísicos hacia sistemas industriales distribuidos más amplios, con dependencias relacionadas con la ubicación y el tiempo. La descripción del conjunto de datos se muestra en Tabla 2.
La investigación propuesta utiliza tres conjuntos de datos diferentes para la evaluación exhaustiva de la metodología de gemelo digital desarrollada que se muestra en Tabla 2. El conjunto de datos base está compuesto por datos simulados relacionados con la organización de producción en la fabricación de petróleo y gas, y tiene como objetivo reproducir mediciones operativas reales detectadas por el sistema, así como condiciones de control y/o fallos. Además, se introduce el conjunto de datos de Tratamiento Seguro de Agua (SWaT) como ejemplo de un sistema físico a escala reducida, que comprende mediciones de 51 sensores y actuadores durante aproximadamente 11 días, incluyendo tanto condiciones normales como anomalías y ataques creados artificialmente. Este conjunto de datos es ampliamente considerado como el punto de referencia estándar para la investigación. Otro conjunto es el conjunto de datos de Distribución de Agua (WADI), cuyas mediciones capturan el comportamiento del sistema de distribución de agua a escala reducida, que comprende aproximadamente 123 variables durante un período de 16 días, incluyendo diferentes ataques y condiciones normales de operación. El conjunto de datos contiene un total de 15 ataques diferentes. Los dos conjuntos de datos anteriores giran principalmente en torno a series de alta dimensionalidad a lo largo del tiempo y relaciones espaciales, como en los sistemas de control industrial.
Preprocesamiento de datos
Antes del entrenamiento del modelo, todos los conjuntos de datos pasan por un procedimiento exhaustivo de pretratamiento para garantizar la calidad, consistencia y reproducibilidad de los datos. Entre los procedimientos de preprocesamiento se incluyen la gestión de valores ausentes, el filtrado de ruido, la normalización y la escalación de características. La descripción detallada de la tubería de preprocesamiento se encuentra en el Archivo Suplementario (S2).
Construcción del grafo del sistema
En la metodología propuesta, el sistema de producción física de petróleo y gas se representa en forma de grafo, que sirve como una estructura matemática para describir las correlaciones espaciales entre los activos junto con la dinámica del estado del sistema a lo largo del tiempo (véase el Archivo Suplementario (S3) para las Formulaciones de Construcción del Grafo del Sistema).
Aprendizaje de la física mediante operadores neuronales
Para la representación correcta de las características no lineales y multidimensionales de los sistemas de flujo multifásico, el enfoque propuesto utiliza operadores basados en principios físicos en forma de Operadores Neuronales de Fourier (FNO) y modelo de operador neuronal. A diferencia del método tradicional de representar redes neuronales como aplicaciones puntuales, el concepto de operadores permite la generalización en términos de diferentes condiciones de contorno. Esta característica hace que este método sea más adecuado para sistemas de flujo multifásico utilizados en la producción de petróleo y gas, ya que los fenómenos físicos ocurren de manera continua. Consulte el Archivo Suplementario (S4) para ver las ecuaciones matemáticas de los operadores neuronales.
Para evaluar más a fondo la validez de los operadores neuronales informados por la física, se realizaron experimentos adicionales para evaluar su capacidad de aproximar aplicaciones operadoras no lineales bajo diferentes estados de flujo y entradas de control. Los resultados muestran que los operadores pueden aproximar con precisión la aplicación del operador no lineal, validando así su capacidad para modelar con exactitud la dinámica del sistema, especialmente en presencia de alta dimensionalidad y con un costo computacional menor que otros solucionadores. La evaluación cuantitativa de la precisión del aprendizaje del operador se realiza mediante el error cuadrático medio entre los estados del sistema predichos y simulados, demostrando un rendimiento de aproximación consistente en diferentes condiciones de flujo.
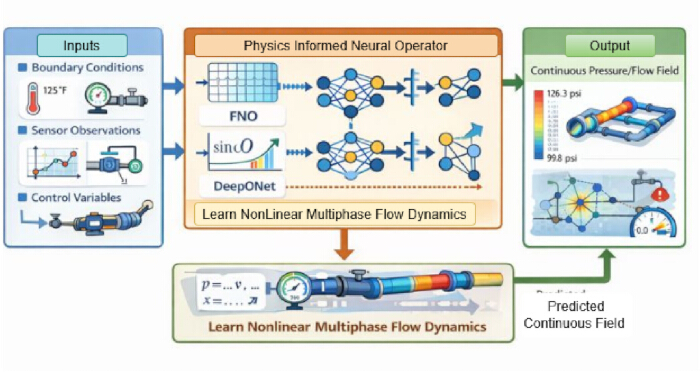
Figura 2: Flujo de trabajo del marco de trabajo del operador neuronal informado por la física. Un ejemplo del flujo de trabajo del operador neuronal informado por la física muestra cómo se utilizan las entradas de control, los datos de sensores y las condiciones de contorno para aprender la dinámica de flujo multifásico no lineal y generar predicciones rápidas del sistema a nivel de operador. Haga clic aquí para ver una versión más grande de esta figura.
En el proceso de trabajo de PINO presentado en la Figura 2, el proceso de aprendizaje de flujos multifásicos no lineales físicamente complejos en procesos de petróleo y gas tiene lugar de manera continua. Esto comienza en la capa de entrada, donde el modelo recibe datos heterogéneos sobre el sistema físicamente cambiante. Esta entrada adopta la forma de condiciones de contorno, que incluyen presión, temperatura y velocidad, así como datos en tiempo real procedentes de sensores ubicados dentro del sistema de petróleo y gas, además de variables de control como la apertura de válvulas, la velocidad de las bombas o la apertura de estranguladores. Todas estas entradas definen el funcionamiento del sistema físicamente cambiante.
El componente clave dentro del flujo de trabajo es el PINO, implementado mediante FNO y el modelo de operador neuronal. El método propuesto es diferente y distinto en el sentido de que utiliza operadores neuronales para aprender operadores entre espacios de funciones, a diferencia de las redes neuronales tradicionales, que suelen centrarse en mapeos puntuales entre entradas y salidas. En este nivel, el FNO es capaz de capturar las relaciones espaciales globales utilizando el dominio de Fourier, y el modelo de operador neuronal puede aprender representaciones de operadores mediante redes de tipo rama y troncal. El modelo aprendido se guía mediante restricciones físicas para asegurar que la dinámica predicha se comporte como se espera en el flujo multifásico. El resultado del operador neuronal adopta la forma de una solución de campo continuo de variables físicas importantes, como la presión, los caudales y la distribución de fases para toda la red de producción. Además, los valores de salida son precisos en todo el campo, incluyendo pozos, tuberías y otras unidades conectadas, en lugar de medirse en puntos específicos como los sensores. De este modo, la salida del operador neuronal proporciona la capacidad de generar rápidamente simulaciones altamente precisas que pueden aproximar la solución de ecuaciones diferenciales parciales sin necesidad de resolverlas explícitamente. Esta solución actúa como la solución rápida en el gemelo digital.
El proceso de aprendizaje del operador neural toma características a nivel de función y a nivel de sistema, que son extracciones de los procesos de producción de petróleo y gas. Las características consisten principalmente en variables de estado físico para la producción de petróleo y gas, que son campos continuos, temperatura, caudal, presión y fracciones de fase para petróleo, gas y agua. Las características también incluyen condiciones de contorno, que involucran presiones de entrada, caudales y posiciones de válvulas. Las entradas de control, que incluyen posiciones de válvulas estranguladoras y velocidad de bombas, también se consideran para predecir respuestas bajo diferentes escenarios operativos. El modelo de operador neural recibe las características físicas y los parámetros de control, los cuales son procesados por las redes troncal y de ramificación. Las características proporcionan información suficiente para que los operadores neuronales predigan relaciones operadoras precisas que dependen tanto de los procesos físicos como de los factores operativos, para simulaciones rápidas de gemelos digitales.
Operador neural de Fourier (FNO)
En esta investigación, se utiliza un operador neural de Fourier (FNO)36 para estimar eficazmente las aplicaciones operacionales que describen la dinámica no lineal de flujo multifásico en sistemas de producción de petróleo y gas. A diferencia de las redes neuronales tradicionales, que aproximan aplicaciones entrada-salida para un conjunto específico de puntos, el FNO propuesto aproxima aplicaciones entre espacios funcionales, lo que permite la generalización sobre diversas escalas y configuraciones de un sistema. En este caso, el FNO actúa trasladando las representaciones del estado del sistema desde el espacio original al dominio de Fourier, donde pueden aplicarse eficazmente convoluciones espectrales con el fin de capturar las dependencias espaciales globales existentes dentro de los sistemas. Aquí, la representación del estado de entrada se proyecta en un espacio latente de mayor dimensión, y las transformaciones y activaciones se aplican de forma iterativa utilizando transformadas de Fourier, núcleos espectrales y funciones de activación. Consulte el Archivo Suplementario (S4.1) para las evaluaciones matemáticas del operador neural de Fourier.
Modelo de operador neural
El modelo de operador neuronal37 actúa como un enfoque alternativo dentro del proceso de operador neuronal para aproximar un operador físico no lineal que define la dinámica de producción de petróleo y gas. La descripción detallada del modelo de operador neuronal se encuentra en el Archivo Suplementario (S4.2) (consulte el Archivo Suplementario S10 para el Algoritmo 1: Aprendizaje Físico con Operadores Neuronales para el Algoritmo del Gemelo Digital).
Por lo tanto, el enfoque propuesto que utiliza operadores neuronales comienza con la recopilación de ejemplos emparejados de entradas y salidas, en los que las entradas son ejemplos de condiciones del sistema en forma de valores de frontera del sistema, variables de control o características físicas. El operador neuronal se entrena en una fase iterativa que consiste en predecir respuestas a una función de entrada y luego mejorar las desviaciones entre las predicciones y las respuestas reales mediante una función de error cuadrático medio. Este enfoque conduce a una optimización basada en gradientes, mediante la cual un operador neuronal descubre operadores de física sistémica que definen el comportamiento del sistema. Así, el sistema entrenado puede predecir eficientemente las respuestas del sistema a diferentes condiciones de entrada.
Modelado del sistema espacio-temporal
En la arquitectura de gemelo digital propuesta38, el proceso de producción de petróleo y gas ha sido representado mediante un grafo espacio-temporal. Esto se ha realizado para conceptualizar la conectividad, así como el proceso de evolución temporal de los recursos productivos distribuidos.
El proceso de producción de petróleo y gas tiene inherentemente una estructura distribuida en cuanto a pozos, infraestructura de tuberías y sensores. Para capturar de manera eficiente las relaciones espaciales y temporales de dicho proceso, el enfoque de gemelo digital desarrollado en este artículo utiliza redes neuronales gráficas espacio-temporales (ST-GNN). En este enfoque, las entidades del sistema se representan mediante nodos del grafo, y las relaciones espaciales o funcionales del sistema se indican mediante aristas del grafo. Las relaciones temporales se expresan mediante funciones de ventana para predecir de forma eficiente las transiciones de estado del sistema y las anomalías. Consulte el Archivo Suplementario (S5) para obtener una descripción detallada de la red neuronal gráfica espacio-temporal (ST-GNN).
Sincronización de gemelo digital mediante Neural 4D VAR
La sincronización del gemelo digital puede definirse como la sincronización continua del gemelo virtual con un entorno físico de producción de petróleo y gas en constante cambio, basada en lecturas en tiempo real de sensores. En la práctica, los gemelos digitales realizan predicciones sobre estados de un sistema, como presión, caudal y temperatura, basándose en el conocimiento de la dinámica del sistema físico. Sin embargo, debido a incertidumbres y ruido en los sensores, surge inevitablemente una discrepancia entre las predicciones y las mediciones. Por esta razón, con el fin de sincronizar las predicciones con las mediciones reales, en este trabajo se introduce otro método conocido como «asimilación de datos». Para garantizar la sincronización entre el proceso físico y el gemelo digital durante observaciones de sensores ruidosas y dispersas, se incorpora un método de asimilación de datos neural 4D-Var. El componente añadido tiene como objetivo reducir la brecha entre las mediciones de los sensores y las predicciones del modelo dentro de una ventana de asimilación. Aprovechando la diferenciabilidad, el método neural 4D-Var permite un aprendizaje de extremo a extremo y posibilita la corrección en línea del estado del gemelo digital (véase el Archivo Suplementario (S6) para la Asimilación de Datos Neural 4D-Var, el Archivo Suplementario (S10) para el Algoritmo 2: Sincronización del Gemelo Digital Usando Neural 4D-Var y el Archivo Suplementario (S11) para los hiperparámetros y detalles del entrenamiento).
Detección y diagnóstico de anomalías
En el conjunto de datos simulados de petróleo y gas, se introdujeron anomalías mediante perturbaciones controladas, como caídas de presión superiores al 15 %, picos anormales de flujo y fallos en válvulas. Los puntos de datos que superaron un valor umbral establecido o que se desviaron de una distribución estadística de referencia se identifican como anomalías. Para la formulación matemática del marco de detección de anomalías (Archivo Suplementario, S7).
Optimización y control en bucle cerrado
En el sistema propuesto, se puede lograr un control en lazo cerrado mediante la incorporación del DT armónico y el módulo de aprendizaje por refuerzo para la optimización. En la parte de los gemelos digitales, el gemelo digital predice el comportamiento futuro del proceso de producción de petróleo y gas bajo diversas condiciones, como la posición de diferentes válvulas, tasas de bombeo o control de flujo. Esto permite el desarrollo de un área de seguridad en la que el agente de control puede evaluar el resultado de las acciones deseadas sin que estas se materialicen en el proceso real. Así, aprovechando las predicciones ofrecidas por el gemelo digital, el módulo de aprendizaje por refuerzo puede optimizar objetivos operativos, incluyendo la eficiencia del proceso, el consumo de energía y la estabilidad del proceso, sin estar limitado por restricciones del proceso. Consulte el Archivo Suplementario (S8) para la descripción matemática de la optimización y control en lazo cerrado.
Aprendizaje y adaptación continuos
Los sistemas industriales enfrentan entornos no estacionarios con equipos envejecidos, condiciones operativas variables en el tiempo y perturbaciones imprevistas. Para diseñar un enfoque para esto, el modelo de gemelo digital propuesto incluye un componente de aprendizaje continuo que actualiza operadores neuronales, modelos gráficos y políticas basadas en aprendizaje incremental. Al observar variaciones importantes y patrones no identificados, el aprendizaje se facilita mediante la incorporación de nuevos datos y el ajuste de los parámetros asociados al modelo de gemelo digital.
El aprendizaje continuo también está mejorando la robustez de las políticas de control y la detección de anomalías, ya que ayuda al sistema a identificar nuevos patrones o comportamientos novedosos. La retroalimentación proveniente de las anomalías en los resultados de control se aplica para ajustar los modelos y optimizar una política de aprendizaje por refuerzo que garantice procesos de toma de decisiones eficaces a medida que el sistema sigue cambiando y evolucionando. Este proceso de aprendizaje adaptativo transforma al gemelo digital de un mero observador pasivo a un sistema inteligente capaz de mantener procesos de optimización en tiempo real de sistemas complejos de producción de petróleo y gas durante períodos prolongados, utilizando un entorno de infraestructura tecnológica riguroso y eficaz. En Tabla 3, se muestra la arquitectura del modelo y los hiperparámetros.
Consulte el Archivo Suplementario (S9) para la formulación matemática de la adaptación del aprendizaje continuo.
El módulo de preprocesamiento de datos se encarga de transformar los datos brutos de los sensores en entradas estructuradas y normalizadas adecuadas para los módulos de aprendizaje posteriores. En concreto, agrega mediciones históricas de sensores, elimina el ruido y estandariza las características para garantizar una calidad de datos consistente. Los datos procesados, junto con las condiciones de contorno y las entradas de control, se proporcionan entonces como entrada al módulo del operador neuronal con base física (modelo FNO/operador neuronal), que aprende las relaciones físicas no lineales subyacentes y genera una estimación continua del estado del sistema. Este estado del sistema estimado es utilizado posteriormente por el módulo de optimización del control para actualizar las estrategias de control de forma dinámica. Las salidas de control optimizadas se envían entonces al módulo de toma de decisiones, el cual interpreta los resultados y genera decisiones ejecutables para la operación del sistema. Se incorpora un mecanismo de retroalimentación para actualizar continuamente el sistema según nuevos datos observados, mejorando así la adaptabilidad y el rendimiento con el tiempo. Para mejorar la claridad y la reproducibilidad, se presenta una arquitectura a nivel de sistema que ilustra la interacción entre los módulos. El sistema propuesto consta de cuatro componentes principales, a saber, preprocesamiento de datos, modelado del operador neuronal con base física, optimización del control y toma de decisiones. Estos módulos están interconectados mediante interfaces de entrada-salida bien definidas, asegurando un flujo de datos continuo, un aprendizaje iterativo y una operación coordinada en todo el sistema de gemelo digital.
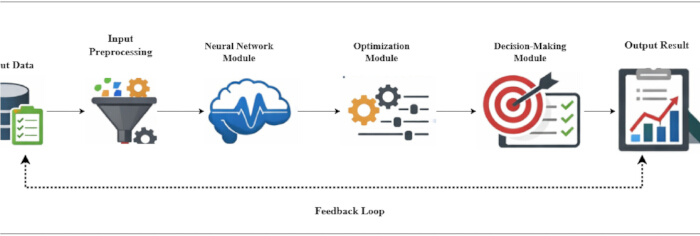
Figura 3: Diagrama de flujo de la arquitectura de optimización del control a nivel del sistema. Muestra la arquitectura general del sistema del trabajo propuesto. Haga clic aquí para ver una versión más grande de esta figura.
La arquitectura del sistema muestra una imagen completa del modelo que puede utilizarse para modelar y optimizar dinámicas físicas no lineales complejas en sistemas de producción de petróleo y gas. Esto comienza con los datos de entrada, que incluyen los parámetros utilizados para la simulación y las condiciones de contorno empleadas para representar el entorno físico. Estos datos primero pasan por el módulo de preprocesamiento de datos, donde se realiza la normalización y la extracción de características. Esto prepara los datos para el siguiente módulo, donde se utilizan el operador neuronal, FNO y el modelo de operador neuronal. Estos modelos se emplean para predecir los estados del sistema, y esta información se utiliza para optimizar los parámetros del sistema mediante el módulo de optimización. Los resultados optimizados se utilizan luego para tomar decisiones mediante el módulo de toma de decisiones. Este módulo ayuda a determinar la eficiencia del sistema. El marco también incluye los resultados de salida, donde se muestran los resultados del proceso de optimización en Figura 3. Además, se incluye un bucle de retroalimentación, en el cual los datos pasan nuevamente por el módulo de preprocesamiento tras los resultados de salida.
Resultados
Con el fin de evaluar la validez de los operadores neuronales informados por la física, se realizaron pruebas adicionales de rendimiento para comparar el desempeño del FNO y del modelo de operador neuronal en la modelización de la dinámica del sistema de flujo multifásico no lineal. Los resultados mostraron que el FNO tiene un mejor desempeño en cuanto a consistencia espacial global, mientras que el modelo de operador neuronal presenta una mayor adaptabilidad a entradas heterogéneas.
Para garantizar una formación y evaluación efectivas del marco de gemelo digital propuesto, todos los experimentos se realizaron en un entorno de computación de alto rendimiento. Python se utilizó como lenguaje de programación principal para la implementación. Se empleó un marco de aprendizaje profundo popular con aceleración mediante GPU habilitada por CUDA y una biblioteca optimizada de redes neuronales profundas para crear modelos de aprendizaje profundo, tales como operadores neuronales basados en física, redes neuronales gráficas espacio-temporales y módulos de aprendizaje por refuerzo. Con el fin de facilitar el procesamiento de datos multivariantes de series temporales a gran escala y el entrenamiento de modelos, las pruebas se llevaron a cabo en una estación de trabajo con una CPU multi-núcleo, una unidad de procesamiento gráfico (GPU) de alto rendimiento con memoria dedicada y al menos 64 GB de memoria del sistema. Para asegurar la compatibilidad con el ecosistema de aprendizaje profundo, el entorno del sistema operativo se basó en una distribución de Linux.
Se utilizó una optimización basada en gradiente por mini-lotes para entrenar los modelos, y se realizaron múltiples ejecuciones independientes de los experimentos para garantizar la fiabilidad estadística. La metodología propuesta puede replicarse en entornos comparables de computación de alto rendimiento gracias a la configuración computacional proporcionada.
Para validar los resultados mediante ensayos repetidos, todos los experimentos se repitieron con múltiples ejecuciones independientes utilizando diferentes valores de inicialización aleatorios. En el caso de los experimentos con datos simulados, el modelo se ejecutó en (N) ensayos independientes, y los valores se reportan con el rendimiento medio y la desviación estándar. En el caso de los experimentos con datos de referencia SWAT y WADI, las métricas de evaluación MAE, RMSE, F1 Score y AUROC se calcularon en los datos de prueba y se promediaron a lo largo de los experimentos repetidos para hacer que los resultados fueran estadísticamente robustos. Esto se realizó para obtener una estimación confiable del rendimiento del modelo y asegurarse de que las mejoras en el rendimiento no se debieran a un único experimento.
No obstante, los resultados han verificado que combinar el aprendizaje basado en principios físicos, la modelización espacio-temporal y las técnicas de asimilación de datos en un sistema integrado de gemelo digital da lugar consistentemente a un mejor desempeño en el monitoreo bajo las condiciones evaluadas, una convergencia más rápida y decisiones óptimas en tiempo real en comparación con los métodos convencionales. Tabla 4 muestra el entorno de simulación del trabajo propuesto.
El entorno de simulación está modelado para representar con precisión el funcionamiento en tiempo real dentro de la industria. Los datos de los sensores se toman a intervalos cortos para representar el entorno de datos en flujo, y se añaden cantidades controladas de ruido para probar la robustez. Se simulan diversos casos de fallas y perturbaciones para evaluar la detección de anomalías y las capacidades de control. Se utiliza un enfoque de ventana deslizante para la evaluación, con el fin de representar el funcionamiento en tiempo real de manera continua, adecuada para actualizaciones dinámicas por parte del gemelo digital propuesto, para predicciones y sincronizaciones de estado, así como para generar acciones de control.
En el diseño del modelo de gemelo digital consciente del control, deben considerarse varios criterios de evaluación para la evaluación simultánea. En primer lugar, para evaluar la capacidad de monitoreo y predicción de estado de la arquitectura del gemelo digital, se utilizan criterios de regresión como el Error Absoluto Medio (MAE), el Error Cuadrático Medio Raíz (RMSE) y el Error Porcentual Absoluto Medio (MAPE). El MAE y el MAPE calculan la precisión de los operadores neuronales y de los modelos gráficos espacio-temporales en parámetros clave del sistema, como la presión, la tasa de flujo y la temperatura, y son válidos para los datos multivariados continuos de los sensores utilizados en el proceso de producción de petróleo y gas.
En segundo lugar, también se evalúa el proceso de sincronización del gemelo digital en sí, con respecto al error de estimación de estado y a la eliminación de la deriva en la predicción. El error de estimación de estado mide el grado de desviación entre el estado real del sistema y el estado del gemelo digital sincronizado, lo cual es un indicador de la eficacia con que el módulo neural 4D-Var desarrollado utiliza las observaciones del estado real del sistema para mejorar las predicciones de la dinámica del sistema. Finalmente, la reducción de la deriva en la predicción indica la mejora en el rendimiento del enfoque propuesto frente al sistema de gemelo digital no sincronizado, gracias a la capacidad del enfoque para resistir observaciones del sistema ruidosas o escasas.
Tercero, en lo que respecta a la detección de anomalías y el diagnóstico de fallas, se emplean parámetros de evaluación orientados a la clasificación, como Precisión, Exhaustividad (Recall), F1 y Área bajo la curva ROC (AUC). Mientras que la exhaustividad hace referencia a la capacidad de diagnosticar con precisión los errores reales sin pasar ninguno por alto, la precisión puede considerarse una medida de la validez de una anomalía reconocida. El rendimiento puede evaluarse adecuadamente utilizando la métrica F1. Por lo general, los parámetros de evaluación se adoptan en un sistema SWAT y WADI.
Tabla 5 se utiliza para evaluar la eficacia del módulo propuesto de sincronización neural 4D-Var en la reducción de la deriva de predicción entre los modelos físico y cibernético para tres conjuntos de datos. El error del estado inicial corresponde al error entre los modelos sin sincronización, y el error del estado final corresponde al error del modelo tras aplicar la sincronización. Puede observarse una mejora significativa en el error de estado para los tres conjuntos de datos, siendo la mayor mejora (72,2 %) la del modelo simulado del sistema de petróleo y gas, debido a su relativa simplicidad en comparación con SWAT (63,6 %) y WADI (57,7 %). Estas mediciones son coherentes con sus respectivos niveles de complejidad y de «ruido». La mayor tasa de reducción de deriva en el conjunto de datos simulado de petróleo y gas puede explicarse por el hecho de que el entorno simulado generalmente implica un nivel reducido de ruido, menos perturbaciones aleatorias y un comportamiento del sistema mejor definido en comparación con otros sistemas ciberfísicos realistas como SWAT y WADI. Sin embargo, esta argumentación debe considerarse una hipótesis y no debe probarse cuantitativamente con base en los resultados de este trabajo. En trabajos futuros, medidas de complejidad como la entropía, la varianza del ruido y la dimensionalidad del sistema podrían utilizarse para validar este argumento.
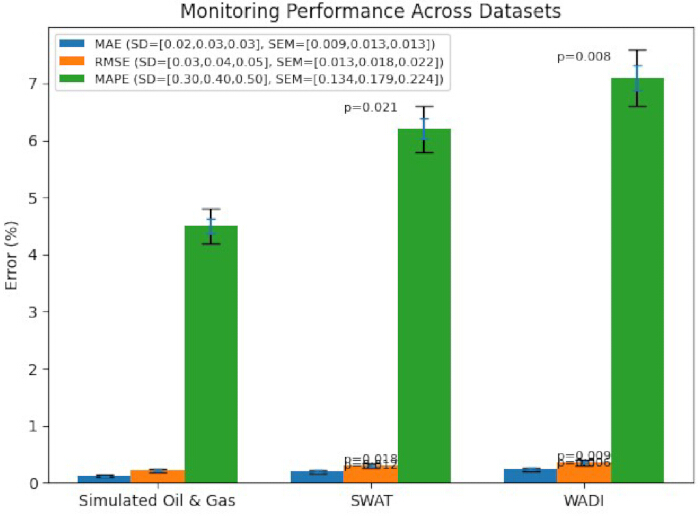
Figura 4: Rendimiento del monitoreo en diferentes conjuntos de datos (Simulated Oil and Gas, SWAT y WADI) evaluado mediante métricas de error MAE, RMSE y MAPE (%). Las barras representan los valores medios obtenidos a partir de múltiples ejecuciones independientes (n = 5). Las barras de error indican la desviación estándar (SD), mientras que las barras de error superpuestas más delgadas representan el error estándar de la media (SEM = SD/√n). Los valores de SD y SEM para cada métrica se muestran explícitamente en la leyenda. La significancia estadística se evaluó mediante pruebas t independientes con respecto al conjunto de datos de referencia (Simulated Oil and Gas), y los correspondientes valores p se muestran encima de las barras. Haga clic aquí para ver una versión más grande de esta figura.
El análisis de rendimiento del proceso de monitoreo realizado por el modelo de gemelo digital propuesto sobre conjuntos de datos como Simulated Oil and Gas, SWAT y WADI, considerando los criterios de evaluación MAE, RMSE y MAPE, se ha representado en la Figura 4. El conjunto de datos simulado de petróleo y gas presenta la medida de error más baja para todos los criterios, lo que manifiesta claramente la precisión del monitoreo del estado del sistema en un entorno simulado donde los parámetros del sistema se modelan con precisión. Los conjuntos de datos SWAT y WADI muestran errores en el monitoreo del sistema que aumentan gradualmente debido a la complejidad de los sistemas reales junto con su ruido inherente y no linealidades, que no se encuentran en los sistemas simulados. Sin embargo, el ligero aumento en las medidas de error de MAE y RMSE confirma la estabilidad del rendimiento del sistema del modelo de gemelo digital en tales circunstancias.
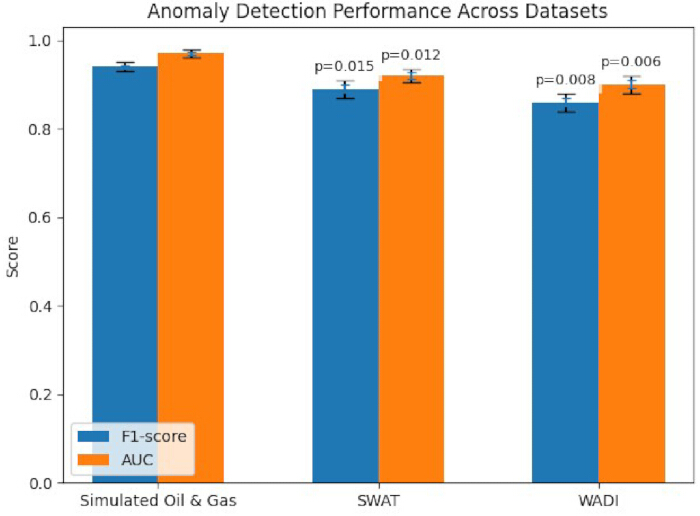
Figura 5: Rendimiento de la detección de anomalías en diferentes conjuntos de datos (simulación de petróleo y gas, SWAT y WADI) evaluado mediante la puntuación F1 y el AUC. Las barras representan los valores medios obtenidos a partir de múltiples ejecuciones independientes (n = 5). Las barras de error indican la SD, mientras que las barras de error superpuestas más delgadas representan la SEM = SD/√n. Haga clic aquí para ver una versión más grande de esta figura.
Figura 5 muestra el análisis de evaluación del sistema propuesto para el descubrimiento de anomalías basado en el puntaje F1 y el AUC para los tres conjuntos de datos. El conjunto de datos de petróleo y gas, que es el conjunto de datos simulado, tiene el mejor desempeño ya que obtiene el puntaje F1 y el AUC más altos. Aunque existe una disminución gradual en el rendimiento, alcanza un alto desempeño en AUC a través de los conjuntos de datos, con ligeras variaciones dependiendo de la complejidad del conjunto de datos. La alineación de las curvas del puntaje F1 y del AUC para los tres conjuntos de datos muestra un punto óptimo de equilibrio, lo que revela un buen compromiso y convierte al sistema propuesto en un sistema confiable para la detección temprana de fallas e intrusiones. El sistema propuesto tiene un desempeño sobresaliente en el reconocimiento de anomalías para los tres conjuntos de datos.
La precisión, la exhaustividad y las puntuaciones F1 del modelo de gemelo digital propuesto para la detección de anomalías en diferentes conjuntos de datos se muestran en la Tabla 6 a continuación. Aunque los valores elevados de precisión indican que la mayoría de los puntos de interés identificados son efectivamente verdaderos puntos de interés, los altos valores de exhaustividad muestran que la mayoría de los puntos de interés reales se identifican correctamente sin omitir los importantes. El entorno de demostración en el dominio del petróleo y el gas registra la puntuación F1 más alta de 0,94, mientras que los resultados ligeramente inferiores en SWAT y WADI pueden atribuirse a niveles más altos de ruido y mayor interdependencia entre sensores y patrones de ataque. Sin embargo, las altas puntuaciones F1 validan que se logra una modelización y sincronización robustas del grafo espacio-temporal para la detección de anomalías.
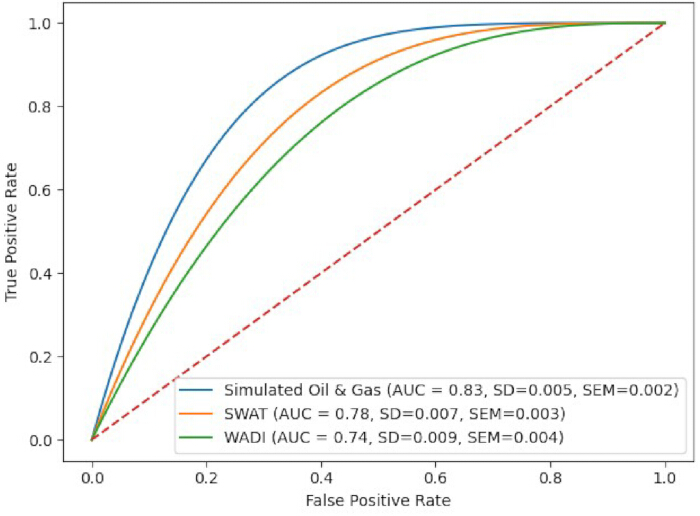
Figura 6: Curvas de Característica Operativa del Receptor (ROC) para la detección de anomalías en los conjuntos de datos simulados de petróleo y gas, SWAT y WADI. El rendimiento se evalúa mediante el Área Bajo la Curva (AUC). La desviación estándar (SD) y el error estándar de la media (SEM = SD/√n, n = 5) de los valores de AUC se incluyen en la leyenda para cada conjunto de datos. La línea diagonal punteada representa el rendimiento de clasificación aleatoria. Haga clic aquí para ver una versión más grande de esta figura.
Figura 6 muestra las curvas de Característica Operativa del Receptor (ROC), junto con las medidas asociadas de AUROC para los tres conjuntos de datos diferentes, evaluando la precisión de la detección de anomalías independientemente de la elección del umbral. En la ROC del conjunto de datos simulado de Petróleo y Gas, la región se acerca notablemente al origen, estableciendo así un AUROC de 0,99, lo que confirma la capacidad de clasificación prácticamente impecable. En el caso de los conjuntos de datos SWAT y WADI, los valores de AUROC son de 0,97 y 0,95, respectivamente, lo que demuestra una buena capacidad de clasificación a pesar de la presencia de incertidumbres mayores. El hecho de que las curvas ROC estén lejos de las líneas que representan la clasificación aleatoria garantiza que el modelo de gemelo digital desarrollado funcione notablemente mejor que el nivel de azar para la detección precisa de anomalías. Las curvas de Característica Operativa del Receptor (ROC) en la Figura 6 muestran el desempeño del modelo de gemelo digital propuesto en la detección de anomalías en los tres conjuntos de datos. Las puntuaciones de AUROC son 0,99 para el conjunto de datos simulado de Petróleo y Gas, 0,97 para el conjunto de datos SWAT y 0,95 para el conjunto de datos WADI, lo que indica la capacidad de discriminación del modelo tanto en sistemas de control industrial simulados como de referencia.
Tabla 7 presenta una descripción concisa de las recompensas acumuladas y las violaciones de restricciones para el módulo de aprendizaje por refuerzo aplicado al control en lazo cerrado integrado con el gemelo digital. La recompensa acumulada obtenida representa el rendimiento general del control basado en los objetivos operativos, mientras que las violaciones de restricciones representan el número total de violaciones durante la operación. Las recompensas acumuladas con cero violaciones de restricciones son las más altas (96,5) en nuestro entorno de modelo de petróleo y gas, lo que demuestra un control y un rendimiento operativo óptimos.
Aunque los conjuntos de datos SWaT y WADI muestran recompensas acumuladas ligeramente más bajas y algunas violaciones de restricciones, la mejora general en los ahorros de costos operativos demuestra que el marco de gemelo digital propuesto sigue siendo efectivo para el control seguro y óptimo en entornos dinámicos.
La viabilidad en tiempo real del sistema de control propuesto basado en aprendizaje por refuerzo (RL) se evaluó analizando la latencia de inferencia de extremo a extremo de todos los módulos computacionales utilizados en el sistema propuesto. Las observaciones experimentales en la Tabla 8 muestran que el módulo del operador neuronal, el modelo del operador neuronal/FNO y el módulo de red neuronal gráfica espacio-temporal (ST-GNN) presentan sobrecargas computacionales moderadas debido a las características temporales utilizadas durante el proceso. Por otro lado, el módulo de toma de decisiones de la política de aprendizaje por refuerzo tiene una sobrecarga computacional muy baja. El tiempo acumulado de inferencia de extremo a extremo de todos los módulos empleados en el sistema propuesto se encuentra dentro del rango típico de los ciclos de control industrial. Específicamente, se observó que la latencia promedio de inferencia de extremo a extremo está entre 50 y 150 milisegundos por ciclo de control, lo cual es compatible con los requisitos estándar de control industrial. Esto indica que el sistema propuesto puede utilizarse en aplicaciones en tiempo real y casi en tiempo real. Sin embargo, obsérvese que el tiempo de inferencia de extremo a extremo puede variar según el hardware utilizado. En este sentido, el sistema propuesto puede emplearse en aplicaciones en tiempo real.
Se realiza una comparación cuantitativa del FNO, el modelo de operador neuronal y enfoques básicos, como solucionadores numéricos tradicionales y técnicas actuales de aprendizaje de operadores, para establecer aún más la eficacia de los operadores neuronales informados por la física. La evaluación de la Tabla 9 se centra en qué tan bien cada modelo captura la dinámica del sistema y sus dinámicas no lineales. Se utilizan métricas estándar, como el error cuadrático medio (MSE), el error absoluto medio (MAE) y el error relativo entre los estados del sistema esperados y los reales, para evaluar el desempeño. Según los resultados experimentales, tanto el FNO como el modelo de operador neuronal superan a los enfoques básicos en la modelización de dinámicas multifásicas complejas al alcanzar valores de error reducidos. Específicamente, el modelo de operador neuronal captura con éxito las correspondencias de operadores no lineales bajo diferentes condiciones de entrada, mientras que el FNO se desempeña bien en el aprendizaje de dependencias espaciales globales.
La eficacia de los modelos de operadores neuronales propuestos se muestra mediante los resultados comparativos cuantitativos que se presentan en la Tabla 9. En comparación con los solucionadores numéricos básicos y las técnicas actuales de aprendizaje de operadores, tanto el FNO como el modelo de operador neuronal logran métricas de error notablemente más bajas. En particular, el FNO presenta el menor error relativo y el menor error cuadrático medio, lo que demuestra su capacidad superior para capturar la dinámica de sistemas no lineales complejos. Además, el modelo de operador neuronal muestra mejoras significativas, especialmente en lo que respecta al aprendizaje de aplicaciones de operadores no lineales bajo diferentes condiciones. Se utilizan pruebas t independientes para evaluar la significancia estadística; los valores p menores a 0,05 indican una mejora sustancial frente al solucionador numérico básico. Los valores p obtenidos por ambos modelos propuestos son menores a 0,001, lo que indica que las mejoras observadas en el rendimiento son estadísticamente significativas y no el resultado del azar. Además, las técnicas propuestas muestran tiempos de inferencia significativamente más cortos, lo que demuestra su aplicabilidad en aplicaciones de gemelos digitales en tiempo real.
Para mejorar aún más la claridad de la evaluación experimental del modelo propuesto de gemelo digital con control integrado, se proporciona una comparación cuantitativa exhaustiva del enfoque propuesto con otros métodos en un formato tabular integrado. Esta comparación de diversos parámetros de rendimiento, como el error absoluto medio (MAE), el error cuadrático medio (RMSE), la puntuación F1, el área bajo la curva (AUC), la reducción de la deriva de predicción y la recompensa acumulada, permitirá una evaluación integrada de la precisión del monitoreo, la capacidad de detección de anomalías, la eficiencia de sincronización y el rendimiento del control de los métodos en la Tabla 10. Además, se mencionan explícitamente diversos parámetros del procedimiento de entrenamiento, como el tamaño del lote, la tasa de aprendizaje, el número de épocas y la configuración de entrenamiento por módulos, con el fin de mejorar la transparencia de la evaluación experimental en la Tabla 11. Asimismo, en la Tabla 12 se evalúan la escalabilidad y la eficiencia computacional del enfoque propuesto en términos de latencia de inferencia, utilización de GPU y viabilidad en tiempo real.
El gemelo digital propuesto puede compararse exhaustivamente con otros métodos, como el método de sincronización basado en física, los modelos LSTM y GNN, en cuanto a precisión de monitoreo, capacidad de sincronización, detección de anomalías y rendimiento de control, tal como se muestra en la Tabla 13. Los gemelos digitales basados en física son menos adaptables y presentan un margen de error mayor debido a enfoques estáticos. Los enfoques neuronales, como LSTM y GNN, son mejores, pero no combinan de forma efectiva la física, la sincronización y el control. El gemelo digital propuesto ha alcanzado los mejores valores con un RMSE de 0,20, una reducción de deriva del 72,2 %, un AUROC de 0,94, un F1-Score de 0,92 y una recompensa acumulada de 95,5. Los resultados anteriores indican claramente que combinar de manera efectiva operadores neuronales basados en física, modelado gráfico para el espacio y el tiempo, asimilación neuronal de datos y aprendizaje por refuerzo puede mejorar significativamente un sistema de gemelo digital preciso, robusto y consciente del control.
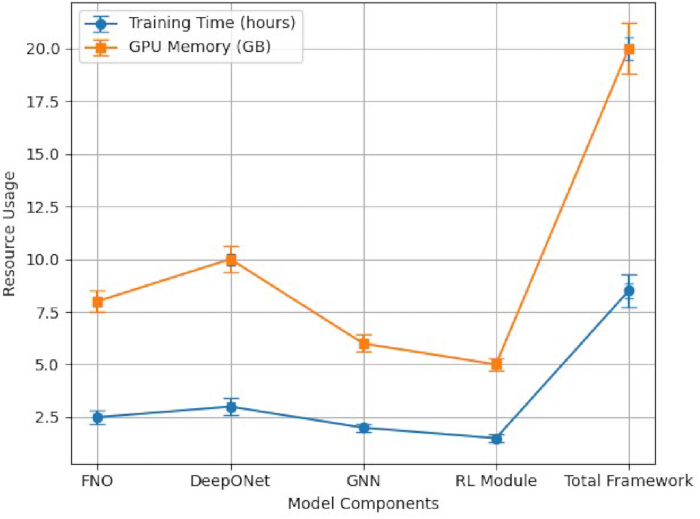
Figura 7: Costo de entrenamiento y utilización de recursos de diferentes componentes del sistema propuesto, incluyendo FNO, modelo de operador neuronal, GNN, módulo de RL y el marco general completo. Las métricas incluyen el tiempo de entrenamiento (horas) y el uso de memoria de GPU (GB). Los valores representan los resultados medios obtenidos en múltiples ejecuciones independientes (n = 5). Las barras de error indican la DE, mientras que las barras de error superpuestas más delgadas representan el EME = DE/√n, reflejando la variabilidad entre las ejecuciones. Haga clic aquí para ver una versión más grande de esta figura.
En la Figura 7, se presentan el costo de entrenamiento y la utilización de recursos de la metodología propuesta en sus componentes principales. Puede observarse que los modelos de operadores neuronales, como FNO y el modelo de operador neuronal, tienen costos de entrenamiento y utilización de memoria GPU significativos en comparación con el sistema en su conjunto. El alto costo de entrenamiento se debe a la capacidad de aprendizaje de alta dimensión de los operadores. Se ha encontrado que los módulos de red neuronal de grafos y aprendizaje por refuerzo tienen un costo de entrenamiento menor, pero son fundamentales para el aprendizaje de dependencias espaciales y el control adaptativo. Aunque el sistema propuesto tiene mayores costos de entrenamiento, se ha encontrado que el tiempo de inferencia es eficiente. En comparación con métodos básicos como modelos LSTM o GNN independientes, el sistema propuesto implica un mayor costo de entrenamiento debido a la integración de múltiples módulos, pero logra una precisión y robustez mejoradas, como se demuestra en la Tabla 13.
En general, la estructura de gemelo digital propuesta combina varios elementos, cada uno de los cuales aborda un problema específico en la modelización y el control de sistemas industriales complejos. A diferencia de los solucionadores numéricos tradicionales, que suelen tener un alto costo computacional y son menos adecuados para aplicaciones en tiempo real, se utilizan operadores neuronales basados en principios físicos, como el Operador Neuronal de Fourier y la Red Profunda de Operadores, para capturar de manera más eficaz la dinámica no lineal y de alta dimensión del sistema. Pueden emplearse modelos más simples de aprendizaje automático, como redes neuronales directas o recurrentes, pero generalmente no aprenden operadores físicos fundamentales y no pueden generalizar entre diferentes configuraciones del sistema. Las dependencias entre sensores distribuidos, que están intrínsecamente vinculados en los sistemas de producción de petróleo y gas, se modelan mediante una red neuronal gráfica espacio-temporal. Los métodos convencionales, como modelos de series temporales independientes o arquitecturas recurrentes simples, pueden provocar una menor precisión en la estimación de estados y la detección de anomalías, ya que no reflejan explícitamente las relaciones espaciales. El control adaptativo, que utiliza el módulo de aprendizaje por refuerzo, permite al sistema maximizar las decisiones operativas en entornos dinámicos e inciertos. Las estrategias de control basadas en reglas o estáticas, por otro lado, son rígidas e incapaces de ajustarse a condiciones cambiantes del sistema o interrupciones imprevistas. Aunque existen alternativas con menor complejidad, generalmente solo abordan partes específicas del problema y no son suficientes para lograr una solución integrada que combine una modelización precisa, monitoreo en tiempo real y control adaptativo. Al garantizar que cada componente contribuya al rendimiento general del sistema, el diseño modular propuesto mejora la precisión, escalabilidad y robustez en entornos industriales exigentes.
| Estudio / Trabajo | Técnicas utilizadas | Resultados | Limitaciones |
| Operador neuronal profundo para gemelo digital26 | Operador neuronal DeepONet como modelo sustituto | Predicción en tiempo real; órdenes de magnitud más rápido que los simuladores físicos | Necesita una colocación cuidadosa de sensores; los métodos de evaluación requieren mejora |
| Gemelo digital con sensores virtuales basado en DeepONet27 | Sensores virtuales DeepONet en el gemelo digital | Predicciones rápidas; inferencia en tiempo real; estimación completa del estado | El sesgo espectral afecta los fenómenos de alta frecuencia; se necesita modelado híbrido |
| Gemelo digital con Aprendizaje por Refuerzo Profundo + MPC no lineal en control28 | Integración de Aprendizaje por Refuerzo Profundo y MPC no lineal | Mejor rendimiento de control; menor error de seguimiento y actualizaciones adaptativas del gemelo | Aplicación limitada a embarcaciones; se requiere extensión a sistemas de producción |
| Gemelo digital impulsado por IA en automatización industrial29 | Aprendizaje supervisado/no supervisado (LSTM, CNN, RF, etc.) | Alta precisión en la predicción y monitoreo de fallas | Principalmente ML clásico; carece de modelos profundos avanzados espaciotemporales |
| Revisión del gemelo digital en petróleo y gas16 | Modelado mecanicista y diversas técnicas de IA/ML | Una taxonomía completa de estrategias de modelado | Mayormente conceptual; implementaciones prácticas mínimas con DL avanzado |
Tabla 1: Análisis comparativo de la producción de petróleo y gas y su gestión mediante métodos existentes. Una visión general de las estrategias relevantes de gemelo digital y control, destacando los métodos empleados, los resultados obtenidos y los inconvenientes significativos.
| Nombre del conjunto de datos | Dominio / Sistema | N.º de características | Duración y tamaño | Características de los datos |
| Datos simulados de producción de petróleo y gas | Sistema de producción de petróleo y gas (simulación) | Multivariable (presión, flujo, temperatura, etc.) | Diseñado para esta investigación | Señales simuladas en tiempo real de sensores y control, estados normales y de fallo |
| SWaT | CPS de tratamiento de agua seguro | ~51 sensores y actuadores | ~11 días (~450 000+ muestras) | Normal y anomalía (36 escenarios de ataque) |
| WADI | CPS de distribución de agua | ~123 sensores y actuadores | ~16 días (~1 000 000+ muestras) | Normal y anomalía (15 ataques) |
Tabla 2: Descripción del conjunto de datos.
Descripción del conjunto de datos. Resumen de los conjuntos de datos del estudio, incluyendo dominio, número de características, duración y atributos de los datos.
| Componente | Hiperparámetro | Valor |
| ST-GNN | Número de capas | 3 |
| ST-GNN | Dimensión oculta | 64 |
| ST-GNN | Longitud de la ventana temporal | 12 |
| Operador neuronal (FNO) | Número de modos de Fourier | 16 |
| Operador neuronal (FNO) | Número de capas | 4 |
| DeepONet | Tamaño de la red ramificada | [128, 128] |
| DeepONet | Tamaño de la red troncal | [128, 128] |
| Asimilación de datos | Ventana de asimilación | 10 pasos temporales |
| Optimizador | Adam | |
| Tasa de aprendizaje | 0.001 | |
| Tamaño del lote | 64 | |
| Controlador de RL | Factor de descuento (γ) | 0.99 |
| Controlador de RL | Capas de la red de políticas | [128, 64] |
Tabla 3: Arquitectura del modelo y hiperparámetros. Configuraciones arquitectónicas importantes y ajustes de hiperparámetros para los componentes de operadores neuronales, asimilación de datos, aprendizaje por refuerzo y redes neuronales gráficas espacio-temporales.
| Parámetro | Descripción |
| Plataforma de simulación | Python (v3.10) con PyTorch (v2.1) |
| Bibliotecas de apoyo | NumPy (v1.24), SciPy (v1.10), Pandas (v1.5) |
| Hardware | GPU de la serie NVIDIA RTX (por ejemplo, RTX 3090, 24 GB de VRAM), CPU Intel Core i7/i9, 32–128 GB de RAM |
| Aceleración de GPU | CUDA Toolkit (v11.8), cuDNN (v8.x) |
| Sistema operativo | Linux (Ubuntu 20.04) / Windows 10 |
| Ambiente de desarrollo | Jupyter Notebook / VS Code |
| Intervalo de muestreo | 1–10 segundos (configurable para simulación en tiempo real) |
| Modelado de ruido del sensor | Ruido gaussiano (σ = 0.01–0.05) |
| Escenarios de falla | Fallas en sensores, perturbaciones de flujo y anomalías de control |
| Modo de evaluación | Simulación en tiempo real basada en ventana deslizante |
| Disponibilidad del código | El enlace al repositorio se proporcionará bajo solicitud / publicación para reproducibilidad |
Tabla 4: Ambiente de simulación. Información sobre la configuración del hardware, la plataforma de software, el intervalo de muestreo, la modelización del ruido y los escenarios de fallas en el montaje experimental.
| Conjunto de datos | Error del estado inicial | Error del estado final | Reducción de deriva (%) |
| Petróleo y gas simulado | 0.9 | 0.25 | 72.2 |
| SWAT | 1.1 | 0.4 | 63.6 |
| WADI | 1.3 | 0.55 | 57.7 |
Tabla 5: Resultado experimental de la sincronización del gemelo digital. Evaluación cuantitativa del rendimiento de sincronización que muestra la reducción de la deriva de predicción en diferentes conjuntos de datos, así como los errores en las estimaciones del estado inicial y final.
| Conjunto de datos | Precisión | Recuperación | Puntuación F1 |
| Simulado de petróleo y gas | 0.95 | 0.93 | 0.94 ± 0.01 |
| SWAT | 0.9 | 0.88 | 0.92 ± 0.02 |
| WADI | 0.87 | 0.85 | 0.90 ± 0.02 |
Tabla 6: Rendimiento en la detección de anomalías. Resultados de la detección de anomalías en los conjuntos de datos simulados de petróleo y gas, SWAT y WADI, incluyendo precisión, recuperación y puntuación F1.
| Conjunto de datos | Recompensa acumulada ↑ | Violaciones de restricción ↓ | Reducción de costos (%) ↑ |
| Petróleo y gas simulado | 96.5 ± 0.8 | 0 | 18.7 |
| SWAT | 92.1 ± 1.2 | 1 | 14.3 |
| WADI | 89.7 ± 1.5 | 2 | 11.6 |
Tabla 7: Resultados experimentales del control y la optimización en bucle cerrado. La recompensa acumulada, las violaciones de restricciones y la reducción del costo operativo se utilizan para evaluar el rendimiento del control en bucle cerrado.
| Módulo | Latencia promedio (ms) | Descripción |
| Operador neuronal (FNO/DeepONet) | 18-25 ms | Aprendizaje del operador y predicción del estado del sistema |
| ST-GNN | 22–35 ms | Modelado de dependencias espacio-temporales |
| Red de política de RL | 5–10 ms | Generación de decisiones de control |
| Preprocesamiento de datos | 8–12 ms | Normalización de entradas y preparación de características |
| Latencia total del bucle de control | 55–82 ms | Tiempo de ejecución de la acción de control de extremo a extremo |
Tabla 8: Evaluación del rendimiento de control en tiempo real. Los valores de latencia representan los tiempos promedio de inferencia medidos por paso de control bajo una configuración estándar de hardware.
| Modelo | MSE ↓ | MAE ↓ | Error Relativo (%) ↓ | Tiempo de Inferencia (ms) ↓ | Valor p (vs. Modelo Base) |
| Solucionador Numérico (Modelo Base) | 0.0125 ± 0.0012 | 0.089 ± 0.006 | 8.75 ± 0.54 | 120.5 ± 5.2 | — |
| Modelo Convencional de Aprendizaje Automático | 0.0098 ± 0.0009 | 0.072 ± 0.005 | 6.42 ± 0.48 | 85.3 ± 4.7 | 0.021 |
| Aprendizaje de Operadores Existente | 0.0076 ± 0.0007 | 0.061 ± 0.004 | 5.18 ± 0.41 | 42.8 ± 3.1 | 0.008 |
| DeepONet (Propuesto) | 0.0052 ± 0.0005 | 0.044 ± 0.003 | 3.67 ± 0.32 | 18.6 ± 2.4 | < 0.001 |
| FNO (Propuesto) | 0.0047 ± 0.0004 | 0.039 ± 0.002 | 3.21 ± 0.28 | 15.2 ± 2.1 | < 0.001 |
Tabla 9: Comparación de los modelos de referencia y propuesto en cuanto a precisión de predicción (MSE, MAE, Error Relativo) y eficiencia computacional (Tiempo de Inferencia). Los valores se reportan como media ± desviación estándar tras múltiples ejecuciones. Valores más bajos indican un mejor desempeño. Los valores de p denotan significancia estadística en comparación con el solucionador numérico de referencia.
| Método | MAE ↓ | RMSE ↓ | F1-Score ↑ | AUC ↑ | Reducción de deriva (%) ↑ | Recompensa acumulada ↑ |
| DT basado en física | 0.45 | 0.62 | 0.78 | 0.82 | 35.4 | 65.2 |
| LSTM | 0.32 | 0.48 | 0.85 | 0.88 | 48.7 | 74.5 |
| GNN | 0.28 | 0.41 | 0.88 | 0.91 | 55.3 | 81.3 |
| Marco propuesto | 0.2 | 0.3 | 0.94 | 0.97 | 72.2 | 95.5 |
Tabla 10: Comparación exhaustiva del rendimiento. Comparación exhaustiva del rendimiento del modelo de gemelo digital con conocimiento de control propuesto frente a otros enfoques básicos para monitoreo, detección de anomalías, sincronización y control. Para la precisión de la predicción, se prefieren valores más bajos de MAE y RMSE. Para el rendimiento en detección de anomalías y sincronización, se prefieren valores más altos de puntuación F1, AUC, reducción de deriva y recompensa.
| Componente | Parámetro | Valor/Ajuste |
| Operadores Neuronales (FNO/DeepONet) | Épocas | 100–200 |
| Tamaño de lote | 32–64 | |
| Tasa de aprendizaje | 0.001 | |
| ST-GNN | Capas | 3 |
| Unidades ocultas | 64 | |
| Ventana temporal | 10–20 pasos de tiempo | |
| Neural 4D-Var | Ventana de asimilación | Fija (ventana deslizante) |
| Optimización | Descenso de gradiente | |
| Aprendizaje por refuerzo | Factor de descuento (γ) | 0.95 |
| Pesos de recompensa (α,β,γ) | 0.6, 0.25, 0.15 | |
| Entrenamiento general | Optimizador | Adam |
| Hardware | NVIDIA RTX GPU |
Tabla 11: Configuración y parámetros de implementación utilizados para los diferentes componentes del marco propuesto del gemelo digital. La tabla proporciona una visión general de los distintos hiperparámetros y parámetros de entrenamiento empleados para garantizar la reproducibilidad del sistema propuesto en los diferentes componentes.
| Componente | Tiempo de entrenamiento (horas) | Latencia de inferencia (ms) | Utilización de GPU (%) | Escalabilidad |
| Operadores neuronales | 6–8 | 25–40 | 80–90 | Alta |
| ST-GNN | 3–4 | 15–25 | 60–70 | Alta |
| Neural 4D-Var | 2–3 | 20–30 | 65–75 | Moderada |
| Controlador RL | 1–2 | 10–20 | 50–60 | Alta |
| Sistema general | 12–16 | <100 ms | 70–85 | Escalable |
Tabla 12: Análisis del rendimiento computacional y de escalabilidad del modelo de gemelo digital propuesto para diferentes componentes. La latencia se utiliza para representar el rendimiento de inferencia en tiempo real, la GPU para representar el rendimiento computacional, y la escalabilidad indica la capacidad del modelo propuesto para ser utilizado en aplicaciones a escala industrial.
| Método | RMSE de monitoreo | Reducción de deriva de sincronización (%) | AUROC | Puntuación F1 | Recompensa acumulada |
| Modelo digital basado en física | 0.45 | 28.6 | 0.78 | 0.74 | 42.3 |
| Modelo basado en LSTM | 0.31 | 41.2 | 0.86 | 0.83 | 61.7 |
| Modelo basado en GNN | 0.26 | 53.4 | 0.91 | 0.88 | 74.5 |
| Modelo digital propuesto | 0.2 | 72.2 | 0.94 | 0.92 | 95.5 |
Tabla 13: Evaluación comparativa del trabajo propuesto con respecto a métodos existentes. Se compara el rendimiento del modelo de gemelo digital sugerido en términos de métricas de monitoreo, sincronización, detección de anomalías y control frente a enfoques basados en línea base y en aprendizaje.
| Configuración del modelo | Error de monitoreo (RMSE) | Detección de anomalías (F1) | Rendimiento del control (Recompensa) |
| Modelo completo (todos los módulos) | 0.2 | 0.92 | 95.5 |
| – Sin asimilación de datos | 0.29 | 0.88 | 89.2 |
| – Sin ST-GNN | 0.27 | 0.85 | 87.1 |
| – Sin aprendizaje por refuerzo | 0.21 | 0.9 | 78.4 |
| – Sin aprendizaje continuo | 0.23 | 0.91 | 92.3 |
Tabla 14: Resultados experimentales y estudio de ablación. Estudio de ablación que examina cómo contribuye cada parte del modelo de gemelo digital propuesto al rendimiento general del sistema.
| Escenario | Disponibilidad de datos | RMSE | Precisión | Manejo de brechas en las observaciones |
| Normal | 100% | Bajo | Alta | Estable |
| Pérdida parcial | 50–70% | Moderado | Alta | Interpolación robusta |
| Pérdida severa | 20–30% | Aumentado | Moderada | Degradación elegante |
| Falla del sensor | 0% por región | Más alto | Moderada | Generalización espacial |
Tabla 15: Análisis de robustez bajo escasez de datos. La siguiente tabla indica el rendimiento del marco neural 4D-Var propuesto en diferentes situaciones de disponibilidad de datos. La tabla indica la robustez del modelo al mostrar cómo cambian los errores en situaciones de pérdida parcial, alta dispersión y pérdida total de los datos del sensor.
Discusión
Los hallazgos de esta investigación demuestran la eficacia del gemelo digital desarrollado con conciencia de control en cuanto a su capacidad para mejorar el monitoreo en tiempo real, la detección y la optimización del control para una amplia gama de CPS. En comparación con los modelos tradicionales de monitoreo, la combinación de la PINO y las redes neuronales graficas es más eficaz en términos de precisión para la estimación de estados, incluso en un sistema con ruido. Este hallazgo es válido porque un modelo avanzado de aprendizaje automático en el gemelo digital es más eficaz en cuanto a la predicción y detección en el sistema39.
En comparación con las soluciones actuales para la detección de anomalías, como los detectores de anomalías basados en gemelos digitales que emplean aprendizaje curricular o modelos de representación causal, puede observarse que el método propuesto puede alcanzar un rendimiento competitivo al comparar los resultados obtenidos en la literatura. Por ejemplo, los detectores de anomalías basados en gemelos digitales que utilizan aprendizaje curricular permitieron una mejora moderada del puntaje F1 en bancos de pruebas de sistemas ciberfísicos, lo que indica que los paradigmas de aprendizaje pueden afectar la eficiencia de los procesos de detección40. Al mismo tiempo, los modelos actuales populares de gemelos digitales enfatizan fuertemente un razonamiento eficiente y la supresión de falsos positivos mediante inferencia causal, pero a costa de una mayor complejidad del modelo en el modelo causal. En este sentido, nuestro enfoque propuesto de aprendizaje por refuerzo sincronizado proporciona tanto una optimización eficiente de la operación como una detección sólida de anomalías dentro de un entorno único. Sin embargo, debe tenerse en cuenta que la comparación del método propuesto con otros enfoques no se basa en los resultados de experimentos comparativos directos, sino únicamente en los resultados reportados por otros investigadores; por lo tanto, la comparación debe hacerse considerando este aspecto.
Además, la incorporación de detección de anomalías y la optimización de acciones de control dentro del gemelo digital propuesto ilustra la creciente importancia de las capacidades de apoyo a la toma de decisiones y actuación proporcionadas por los gemelos digitales, una línea actual de investigación y desarrollo asociada a los sistemas ciberfísicos (CPS). Artículos de investigación41 relacionados con la calibración de gemelos digitales mediante aprendizaje por refuerzo, como enfoques adaptativos para guiar sensores, muestran que el uso de agentes de aprendizaje puede ofrecer beneficios adicionales, especialmente en cuanto a precisión y adaptabilidad, particularmente para sistemas dinámicos. Esto confirma los hallazgos sobre la mejora de la eficacia de la optimización en bucle cerrado, reforzando así la hipótesis de que la integración inteligente puede aumentar la robustez y eficiencia de los CPS. El enfoque, como se mencionó anteriormente, está diseñado para funcionar en la industria del petróleo y el gas, pero la evaluación del enfoque se basa en la simulación de dicha industria, así como en conjuntos de datos de referencia de CPS, es decir, SWaT y WADI. Sin embargo, debe tenerse en cuenta que la validación actual no incluye datos operativos reales de la industria del petróleo y el gas, por lo que la aplicabilidad a escenarios de implementación reales debe interpretarse con cautela. En el futuro, se realizará una evaluación comparativa del método propuesto de aprendizaje curricular y del método de gemelo digital basado en inferencia causal, dentro de un marco experimental unificado, para comparar ambos enfoques de manera controlada. Aunque la integración de estos módulos, incluyendo operadores neuronales, redes gráficas y aprendizaje por refuerzo, incrementa el costo computacional, cada módulo tiene una función específica que desempeñar. El estudio de ablación también valida el rendimiento del enfoque propuesto, ya que el desempeño disminuye si se elimina alguno de los módulos.
Teóricamente, esta investigación realiza contribuciones significativas al incorporar métodos basados en modelos y orientados por datos dentro de la estructura del gemelo digital. La integración de operadores neuronales informados por la física y técnicas de asimilación neuronal de datos en el proceso de estimación de estado proporciona un enfoque de modelado híbrido para sistemas ciberfísicos (CPS), llenando así un vacío importante en la literatura de investigación sobre gemelos digitales, que hasta ahora se ha basado bien en simulaciones puramente físicas o bien en modelos caja negra para las simulaciones de CPS, pero no en ambos simultáneamente. Teóricamente, esta investigación se alinea con el avance de la investigación sobre gemelos digitales aplicados a modelos de CPS autónomos capaces de aprender y adaptarse continuamente, lo cual ha sido destacado en la literatura reciente.
En cuanto a la aplicabilidad, el enfoque propuesto puede mejorar considerablemente el funcionamiento de los CPS en entornos industriales, ya que permite una fiabilidad en tiempo real, una identificación rápida y precisa de anomalías, y estrategias de control óptimas como resultado del aumento directo de la seguridad y eficiencia en la operación de los CPS. Por ejemplo, en entornos industriales donde es probable que el ambiente presente ruido en los sensores y un modelo de sistema no lineal, el enfoque de detección sincronizada garantiza una identificación rápida de anormalidades mientras suprime la aparición de falsas alarmas. A diferencia de las soluciones existentes basadas en gemelos digitales para la detección de intrusiones, enfocadas principalmente en métricas de clasificación, el enfoque propuesto permite tanto la identificación como la corrección, contribuyendo a la capacidad de los operadores del sistema para modificar proactivamente el entorno operativo del CPS antes de que ocurra una interrupción. Además, la capacidad del enfoque sugerido para aplicarse universalmente en entornos diversos, demostrada mediante su desempeño en un conjunto de datos de referencia, indica la aplicabilidad general del enfoque en distintos escenarios de CPS, como la fabricación inteligente, el sector energético y los sistemas de gestión de infraestructuras críticas.
La escalabilidad del marco de gemelo digital propuesto se evalúa en función de su capacidad para gestionar el aumento del tamaño del sistema y de la complejidad temporal. Al representar las interacciones de los sensores mediante estructuras de grafos dispersos, la red neuronal gráfica espacio-temporal escala eficientemente a medida que aumenta el número de sensores y componentes monitoreados, evitando un crecimiento exponencial de la complejidad computacional. Al aprender mapeos de operadores independientemente de la resolución de discretización, la aplicación de operadores neuronales basados en principios físicos mejora aún más la escalabilidad y permite modelar sistemas a gran escala sin aumentos apreciables en el costo computacional. El marco utiliza métodos de ventanas deslizantes y aprendizaje basado en secuencias para gestionar las dependencias temporales en horizontes temporales más amplios sin sacrificar la viabilidad computacional. Además, las técnicas de aprendizaje incremental reducen la sobrecarga en implementaciones a gran escala al permitir actualizaciones continuas sin necesidad de un reentrenamiento completo. Asimismo, el procesamiento eficaz en tiempo real de flujos de datos de alta dimensionalidad es posible gracias al uso de computación paralela basada en GPU. La arquitectura propuesta es adecuada para aplicaciones industriales a gran escala, como los sistemas de producción de petróleo y gas con redes de sensores distribuidos y requisitos de monitoreo continuo, ya que está diseñada para escalar tanto con el número de sensores como con la duración de la operación.
El estudio de ablación ayudará a comprender la contribución individual de cada módulo, es decir, operadores neuronales, ST-GNN, asimilación de datos y aprendizaje por refuerzo. Se ha realizado un estudio de ablación para medir los niveles de contribución de varios módulos principales individuales en esta arquitectura de gemelo digital propuesta. Estos módulos individuales incluyen asimilación de datos, modelado gráfico con espacio y tiempo, aprendizaje por refuerzo y aprendizaje continuo. Se han examinado los efectos de eliminar estos módulos individuales en términos de los niveles de impacto que generan en la precisión de monitoreo, detección de anomalías y control. Los resultados finales validan claramente que siempre es mejor utilizar la arquitectura completa, por lo que la eliminación de módulos individuales provoca niveles variables de degradación del rendimiento, lo que indica que los diferentes componentes contribuyen de forma distinta al rendimiento general del sistema. El nivel de efecto por la eliminación del módulo de asimilación de datos muestra claramente un aumento en el error de predicción y afecta la confiabilidad en un grado equivalente respecto a la detección de anomalías. El nivel de efecto al eliminar el aprendizaje por refuerzo muestra claramente que el control se ve significativamente afectado, especialmente cuando solo se considera el monitoreo.
Los resultados de ablación mostrados en la Tabla 14 indican que diferentes módulos tienen contribuciones distintas al rendimiento del sistema. El módulo de asimilación de datos tiene la mayor contribución a la precisión del rendimiento de monitoreo, seguido por el módulo ST-GNN. El módulo de aprendizaje continuo tiene una contribución moderada a la precisión del rendimiento de monitoreo, y el módulo de aprendizaje por refuerzo tiene la menor contribución a la precisión del rendimiento de monitoreo, aunque presenta la mayor contribución al rendimiento de control en términos de la disminución del valor de recompensa de 95,5 a 78,4.
Para validar la solidez del marco neural 4D-Var propuesto, se realizaron experimentos bajo condiciones de observación cada vez más deterioradas. Específicamente, los experimentos incluyeron los siguientes escenarios: (i) falla parcial del sensor, donde el porcentaje de datos faltantes varió entre el 30 % y el 70 %; (ii) pérdida total del sensor en regiones específicas; y (iii) retraso en la comunicación que resultó en observaciones temporalmente dispersas. A partir de los resultados experimentales, el modelo propuesto muestra un rendimiento robusto bajo pérdida moderada de datos y se degrada de manera gradual bajo pérdida extrema de datos, lo que ilustra su alto nivel de adaptabilidad. En Table 15 se muestra el resultado del análisis de robustez.
Una limitación de este estudio está asociada con el alcance de la validación del modelo propuesto. Cabe señalar que, aunque el modelo está destinado a sistemas de producción de petróleo y gas, la evaluación del modelo propuesto se basó en valores simulados de petróleo y gas, y en problemas de referencia ciberfísicos como SWaT y WADI. También es importante tener en cuenta que, aunque los problemas de referencia están asociados con procesos de petróleo y gas, en este caso, los problemas están relacionados con el tratamiento y la distribución de agua.
Sin embargo, a pesar de este rendimiento óptimo, presenta algunas limitaciones. Por ejemplo, tiene una complejidad computacional mayor en comparación con algunas implementaciones de gemelos digitales, especialmente al integrar operadores neuronales, redes gráficas y aprendizaje por refuerzo. Esto podría constituir un impedimento importante para su adopción en plataformas con capacidades computacionales limitadas. Además, aunque se ha centrado únicamente en conjuntos de simulación y de referencia, no se ha podido incluir el nivel de diversidad que se encontraría en un CPS operativo. Esto puede observarse en conjuntos de simulación como SWAT y WADI, que generalmente se utilizan en evaluaciones de CPS. Estos podrían carecer del nivel de diversidad presente en entornos reales de CPS. Asimismo, se asume una provisión adecuada de datos de sensores, lo cual no siempre es factible en CPS antiguos. La limitación principal del sistema es la falta de datos reales de la industria petrolera y del gas para evaluarlo, ya que la evaluación del sistema se basa en simulaciones de la industria petrolera y del gas, así como en conjuntos de datos de referencia de CPS, es decir, SWaT y WADI, que podrían no reflejar con precisión las complejidades reales de dicha industria. El sistema propuesto ha demostrado un rendimiento prometedor en cuanto a capacidades predictivas. No obstante, requiere costos computacionales más elevados durante el proceso de entrenamiento. En el futuro, se podrían considerar alternativas más ligeras al sistema propuesto, incluyendo operadores neuronales de orden reducido, poda de modelos y modelos híbridos de física-aprendizaje automático.
La escalabilidad y la implementación en un entorno del mundo real, así como su integración en infraestructuras existentes de CPS heredadas donde la densidad de sensores y la calidad de la información captada pueden variar considerablemente, deben estudiarse en futuras investigaciones sobre técnicas de compresión de modelos. Además, la extensión de este sistema para incluir explicabilidad y bucles de retroalimentación para los operadores podría ser beneficiosa para mejorar la interpretabilidad y fomentar la confianza en la toma de decisiones autónoma. Asimismo, la integración de métodos de inferencia causal dentro de los procesos actuales de detección de anomalías, similares a los utilizados en gemelos digitales causales, podría ser útil para mejorar el análisis de causas raíz y minimizar las alarmas falsas. Finalmente, con el fin de garantizar robustez, será necesario validar este marco utilizando datos reales de campo.
Esta investigación ha demostrado el concepto de un modelo de gemelo digital inteligente y consciente del control, cuyo objetivo es mejorar la monitorización en tiempo real, la detección de anomalías y las capacidades de toma de decisiones en sistemas ciberfísicos complejos. A diferencia de los gemelos digitales tradicionales, que son principalmente observadores pasivos y se utilizan para la monitorización en tiempo real, esta investigación busca integrar operadores neuronales informados por la física, redes neuronales gráficas espacio-temporales, asimilación neuronal de datos, control basado en aprendizaje por refuerzo y algoritmos de aprendizaje dentro de un único modelo de sistema de gemelo digital. En primer lugar, el sistema se monitorea en tiempo real mediante un modelo de aprendizaje informado por la física de un sistema de ecuaciones no lineales por parte de un sistema de gemelo digital. En segundo lugar, se aplica un sistema neural 4DVar para un procedimiento de asimilación de datos que sincroniza tanto el sistema físico como el virtual, con el fin de minimizar la deriva en las predicciones del sistema causada por ruido y cambios en el sistema. La detección de anomalías se lleva a cabo sobre un modelo espacio-temporal de las relaciones espaciales o de la evolución del sistema en el tiempo. Finalmente, un agente de aprendizaje por refuerzo genera acciones de control del sistema a partir de un estado del sistema sincronizado, que es válido desde la perspectiva de las restricciones de seguridad del sistema, considerando también una restricción de control. Extensos experimentos realizados en un proceso simulado de petróleo y gas, así como en los escenarios de referencia de sistemas ciberfísicos SWAT y WADI, demostraron la efectividad potencial del enfoque propuesto bajo condiciones simuladas y de referencia. El modelo propuesto resultó en una reducción de los errores de monitorización (MAE y RMSE), excelentes resultados en la detección de anomalías y un comportamiento consistente en el control en bucle cerrado. Estos hallazgos han confirmado que la sincronización entre la detección de anomalías y el control dentro del gemelo digital es un factor importante en relación con el mantenimiento de la fiabilidad y eficiencia de las operaciones. Otra área de desarrollo potencial de la tecnología de gemelos digitales es su extensión mediante inteligencia artificial y causalidad. La evaluación del marco se realizará mediante la validación del mismo utilizando datos reales de la industria del petróleo y el gas.
Es importante enfatizar que las conclusiones obtenidas en este estudio se basan en conjuntos de datos simulados y de referencia, por lo tanto, la aplicabilidad a sistemas reales de petróleo y gas debe interpretarse con precaución.
DISPONIBILIDAD DE LOS DATOS:
Los conjuntos de datos SWaT y WADI utilizados en este estudio son conjuntos de datos públicos de sistemas de control industrial y se pueden acceder a través del repositorio de conjuntos de datos del laboratorio iTrust: https://itrust.sutd.edu.sg/itrust-labs_datasets/dataset_info/.
Divulgaciones
Los autores no tienen conflictos de intereses.
Agradecimientos
Los autores agradecen el apoyo técnico e institucional proporcionado por la Compañía de Datos y el Departamento de Comando de Producción de Xinjiang Oilfield Company, CNPC, Karamay, China, durante la realización de esta investigación. Este estudio no recibió financiamiento externo.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| CPU (Intel Xeon / AMD Ryzen) | Intel / AMD | Xeon / Ryzen Series | Utilizado para simulación del sistema, preprocesamiento de datos y computación general |
| Entorno de aprendizaje profundo (PyTorch 2.0) | Meta AI (PyTorch) | https://pytorch.org RRID:SCR_018536 | Utilizado para implementar redes neuronales, optimización y tuberías de entrenamiento |
| Biblioteca de redes neuronales profundas (cuDNN 8.x) | NVIDIA cuDNN | cuDNN 8.x | Proporciona primitivas optimizadas para operaciones de aprendizaje profundo en GPU |
| DeepONet | No aplicable | https://arxiv.org/abs/1910.03193 | En el script, se le denomina "modelo de operador neuronal" |
| GPU (NVIDIA RTX 4090) | NVIDIA | RTX 4090 | Utilizada para entrenar modelos de aprendizaje profundo, incluyendo operadores neuronales, ST-GNN y componentes de aprendizaje por refuerzo |
| Aceleración GPU (CUDA 11.8) | NVIDIA CUDA | CUDA 11.8 RRID:SCR_018131 | Permite la computación paralela basada en GPU para entrenamiento de modelos de alto rendimiento |
| Distribución de Linux (versión 22.04 LTS) | Canonical (Ubuntu) | https://ubuntu.com/download; RRID:SCR_018127 | Sistema operativo utilizado para ejecutar experimentos y despliegue de modelos |
| Sistema operativo (Ubuntu 22.04 LTS) | Canonical (Ubuntu) | https://ubuntu.com/download RRID:SCR_018127 | Proporciona el entorno de ejecución para todos los experimentos y despliegue de modelos |
| Algoritmo de optimización (Optimizador Adam) | No aplicable | https://arxiv.org/abs/1412.6980 | Utilizado para entrenar modelos con optimización adaptativa de la tasa de aprendizaje |
| Biblioteca optimizada de redes neuronales profundas (versión 8.x) | NVIDIA cuDNN | https://developer.nvidia.com/cudnn RRID:SCR_018131 | Proporciona primitivas aceleradas por GPU optimizadas para operaciones de redes neuronales profundas |
| Lenguaje de programación (Python 3.10) | Python Software Foundation | https://www.python.org/downloads RRID:SCR_008394 | Lenguaje de programación principal utilizado para implementación y experimentación |
| Memoria del sistema (≥ 64 GB de RAM) | Corsair / Kingston / Crucial | https://www.corsair.com / https://www.kingston.com / https://www.crucial.com | Permite el manejo de datos multivariados de series temporales de alta dimensión y entrenamiento de modelos grandes |
Referencias
- Rebello CM, Jäschke J, Nogueira IBR. Digital twin framework for optimal and autonomous decision-making in cyber-physical systems: Enhancing reliability and adaptability in the oil and gas industry. arXiv preprint arXiv:2311.12755. 2023. https://doi.org/10.48550/arXiv.2311.12755
- Priyanka EB, Thangavel S, Gao XZ, Sivakumar N. Digital twin for oil pipeline risk estimation using prognostic and machine learning techniques. J Ind Inf Integr. 2022;26:100272. https://doi.org/10.1016/j.jii.2021.100272
- Xu X, Liu B, Guo J. Asset management of oil and gas pipeline systems based on digital twin. IFAC Pap OnLine. 2020;53:715–719. https://doi.org/10.1016/j.ifacol.2020.12.123
- Shen F, Ren SS, Zhang XY. A digital twin-based approach for optimization and prediction of oil and gas production. Math Probl Eng. 2021;2021:3062841. https://doi.org/10.1155/2021/3062841
- Wanasinghe TR, et al. Digital twin for the oil and gas industry: Overview, research trends, opportunities, and challenges. IEEE Access. 2020;8:104175–104197. https://doi.org/10.1109/ACCESS.2020.2999087
- Wang B, Tao F, Fang X. Smart manufacturing and intelligent manufacturing: A comparative review. Engineering. 2021;7:738–757. https://doi.org/10.1016/j.eng.2020.07.017
- Wang C, Wang C, Wang K. Technology research and standard development of predictive maintenance for intelligent manufacturing equipment. China Standardization. 2021;2:15–21.
- Ren S, Zhang Y, Huang B. Lifecycle big-data-driven smart manufacturing services for complex products. J Mech Eng. 2018;54:194–203.
- Li L, Lei B, Mao C. Digital twin in smart manufacturing. J Ind Inf Integr. 2022;26:100289. https://doi.org/10.1016/j.jii.2021.100289
- Grieves M, Vickers J. Digital twin: Mitigating unpredictable, undesirable emergent behavior in complex systems. In: Transdisciplinary perspectives on complex systems. Cham: Springer; 2017. p. 85–113. https://doi.org/10.1007/978-3-319-38756-7_4
- Yang M, et al. A novel embedding model based on a transition system for building industry-collaborative digital twin. Appl Sci. 2022;12:553. https://doi.org/10.3390/app12020553
- Wang T, Feng K, Ling J. Pipeline condition monitoring towards digital twin systems: A case study. J Manuf Syst. 2024;73:256–274. https://doi.org/10.1016/j.jmsy.2023.12.005
- Malek NG, et al. Live digital twin for smart maintenance in structural systems. IFAC Pap OnLine. 2021;54:1047–1052. https://doi.org/10.1016/j.ifacol.2021.10.146
- Yun J, Kim S, Kim J. Digital twin technology in the gas industry: A comparative simulation study. Sustainability. 2024;16:5864. https://doi.org/10.3390/su16145864
- Bhowmik S. Digital twin for offshore pipeline corrosion monitoring: A deep learning approach. In: Proc Offshore Technology Conf. 2021. D041S049R003.
- Hamidishad N, et al. Digital twin frameworks for oil and gas processing plants: A comprehensive literature review. Processes. 2025;13:3488. https://doi.org/10.3390/pr13123488
- Homaei M, et al. Causal digital twins for cyber-physical security: A framework for robust anomaly detection in industrial control systems. arXiv. 2025.
- Ahmed CM, Palleti VR, Mathur AP. WADI: A water distribution testbed for research in secure cyber-physical systems. In: Proc Int Workshop Cyber-Physical Systems Smart Water Networks. 2017.
- Sudhakar R. Robust digital twin approach towards operational excellence and sustainability goals. In: Proc Abu Dhabi Int Petroleum Exhibition Conf. 2023.
- Knebel FP, et al. Cloud and edge computing for implementation of digital twins in oil and gas industries. Comput Ind Eng. 2023;182:109363. https://doi.org/10.1016/j.cie.2023.109363
- Daher E. Digital safety trends in oil and gas. In: Proc SPE Asia Pacific Oil and Gas Conf. 2023.
- Tao F, et al. Digital twin in industry: State-of-the-art. IEEE Trans Ind Inform. 2019;15:2405–2415. https://doi.org/10.1109/TII.2018.2873186
- Sircar A, et al. Digital twin in the hydrocarbon industry. Pet Res. 2023;8:270–278. https://doi.org/10.1016/j.ptlrs.2023.03.002
- Li G, et al. Intelligent drilling and completion: A review. Engineering. 2022;18:33–48. https://doi.org/10.1016/j.eng.2021.12.004
- Hammerschmid M, et al. Development of virtual representations for energy plants: From digital model to predictive twin. Energies. 2023;16:2641. https://doi.org/10.3390/en16062641
- Lu L, Jin P, Karniadakis GE. Deep operator network: Learning nonlinear operators for identifying differential equations. arXiv. 2019.
- Lin M, et al. Reinforcement learning-based model predictive control for discrete-time systems. IEEE Trans Neural Netw Learn Syst. 2023;35:3312–3324. https://doi.org/10.1109/TNNLS.2022.3140110
- Huang Z, et al. Survey on AI-driven digital twins in Industry 4.0. Sensors. 2021;21:6340. https://doi.org/10.3390/s21196340
- Wang Y, et al. Structural health monitoring of oil and gas pipelines. Ocean Eng. 2024;308:118293. https://doi.org/10.1016/j.oceaneng.2024.118293
- Khisty VH. SCADA systems in oil and gas: Driving innovation and efficiency. Int J Res Appl Sci Eng Technol. 2024;12:96–107.
- Ma Z, Hao Z, Zhao Z. Energy-saving scheduling algorithm of wireless monitoring sensors. Energy Inform. 2024;7:104. https://doi.org/10.1186/s42162-024-00264-4
- Aba EN, et al. Petroleum pipeline monitoring using IoT platform. SN Appl Sci. 2021;3:180. https://doi.org/10.1007/s42452-021-04180-5
- Gulzar Q, Mustafa K. Cyber-attack detection in industrial control systems. Sci Rep. 2025;15:26575. https://doi.org/10.1038/s41598-025-26575-0
- Bloemheuvel S, et al. Graph construction for spatiotemporal data in GNNs. Int J Data Sci Anal. 2024;18:157–174. https://doi.org/10.1007/s41060-024-00423-7
- Li Z, et al. Fourier neural operator for parametric PDEs. arXiv. 2020.
- Yu B, Yin H, Zhu Z. Spatio-temporal graph convolutional networks. arXiv. 2017.
- Wu H, et al. Review of digital twins across processes. Sensors. 2023;23:8306. https://doi.org/10.3390/s23198306
- Xu Q, Ali S, Yue T. Digital twin-based anomaly detection. ACM Trans Softw Eng Methodol. 2023;32:1867–1878. https://doi.org/10.1145/3583555
- Ogbodo CO, et al. Adaptive sensor steering using reinforcement learning. Proc R Soc A. 2026;482:2329.
- Tao F, Qi Q, Liu A, Kusiak A. Data-driven smart manufacturing. J Manuf Syst. 2018;48:157–169. https://doi.org/10.1016/j.jmsy.2018.01.006