Este estudio evaluó si las intervenciones de estilo de vida y enfermería en oncología ginecológica mejoran la calidad de vida en mujeres con cánceres ginecológicos. Solo se observó una mejora significativa en el subgrupo de cáncer de ovario a los 6 meses, mientras que la evidencia general permaneció muy incierta debido a la heterogeneidad sustancial, tamaños pequeños de los subgrupos y limitaciones metodológicas.
Artículo de investigación
Un metaanálisis sobre el impacto de las intervenciones de enfermería en oncología ginecológica y del estilo de vida en la mejora de la calidad de vida
* These authors contributed equally
En este artículo
Resumen
Resumen
Este metaanálisis evaluó el impacto de las intervenciones de enfermería en oncología ginecológica y del estilo de vida sobre la calidad de vida (CV). Una búsqueda sistemática realizada hasta junio de 2026 identificó 1.123 registros. Se incluyeron trece ensayos controlados aleatorizados que involucraron a 915 mujeres con cáncer ginecológico. El impacto de las intervenciones de enfermería en oncología ginecológica y del estilo de vida sobre la CV se evaluó mediante diferencias medias agrupadas (DM) con intervalos de confianza del 95 %, utilizando modelos de efectos aleatorios para los análisis generales y modelos de efectos fijos para los análisis de subgrupos específicos del cáncer. En comparación con los controles, las intervenciones mejoraron significativamente la CV en mujeres con cáncer de ovario (DM 4,28, IC del 95 %: 0,45–8,10, p = 0,03; I2 = 0 %). No se observaron diferencias significativas en la CV a los 6 meses en cánceres mixtos (DM 2,11, IC del 95 %: -0,90–5,12, p = 0,17; I2 = 71 %), cáncer de endometrio a los 6 meses (DM 2,00, IC del 95 %: –1,49–5,49, p = 0,26; I2 = 0 %) ni en cánceres mixtos a los 3 meses (DM 6,43, IC del 95 %: –0,16–13,01, p = 0,06; I2 = 74 %). Sin embargo, la marcada heterogeneidad, los diseños y las intervenciones variadas, los tamaños muestrales pequeños y el riesgo variable de sesgo limitan la certeza de los hallazgos, lo que exige una interpretación cautelosa y la confirmación mediante ensayos rigurosos y estandarizados. Las intervenciones de enfermería en oncología ginecológica y del estilo de vida mejoraron significativamente la CV solo en mujeres con cáncer de ovario a los 6 meses. No obstante, la heterogeneidad sustancial, las limitaciones metodológicas y la evidencia de certeza muy baja exigen una interpretación cautelosa, y se necesitan ensayos más grandes y estandarizados.
Introducción
El cáncer que se origina en los órganos reproductivos femeninos se denomina cáncer ginecológico. Los cánceres ginecológicos, que incluyen las malignidades cervicales, ováricas, uterinas, vaginales y vulvares, siguen siendo una preocupación importante de salud pública, afectando a millones de mujeres en todo el mundo1. Estos tumores no solo son devastadores físicamente, sino que también causan un malestar emocional y psicológico significativo. A pesar de los avances en el tratamiento, la frecuencia global de estos tumores está aumentando, y el pronóstico general sigue siendo desfavorable en varias regiones, particularmente donde el acceso a la atención médica es limitado. Los estudios sobre la atención de enfermería en oncología ginecológica subrayan la necesidad de estrategias integrales e interdisciplinarias en la gestión del paciente, dada la importante repercusión de estas malignidades en la calidad de vida de las mujeres2. Por el contrario, las intervenciones exitosas de enfermería van más allá del manejo de síntomas físicos como el dolor y las náuseas; también incluyen apoyo emocional, asesoramiento psicológico, educación al paciente y manejo integral de los síntomas. Estas intervenciones son cruciales para mejorar los resultados en los pacientes, ayudar a las mujeres a enfrentar las complejidades de los protocolos de tratamiento y garantizar una atención integral.
El papel de las intervenciones de enfermería en la calidad de vida requiere una mayor investigación, particularmente en lo que respecta a cómo diferentes aspectos de la atención de enfermería afectan el bienestar físico, emocional y psicológico en diversas demografías de pacientes3. La atención de enfermería eficaz para pacientes con cáncer puede mejorar su bienestar general. La atención de enfermería en oncología ginecológica es una disciplina especializada de enfermería centrada en brindar apoyo integral a mujeres diagnosticadas con cáncer ginecológico. El cáncer ginecológico incluye tumores de células granulosas, melanoma del tracto genital, cáncer cervical susceptible de cirugía conservadora de la fertilidad y cáncer de endometrio4. La prevalencia del cáncer cervical ha disminuido en toda Europa; sin embargo, continúa representando un desafío considerable para la salud pública. Esto se destaca por las estadísticas de 2018, que indican 61 000 casos nuevos y 25 800 fallecimientos. Los resultados de supervivencia muestran desigualdades regionales, con una tasa de supervivencia relativa a cinco años del 62 % entre 2000 y 2007, que varía desde el 57 % en Europa del Este hasta el 67 % en Europa del Norte.
El cáncer cervical sigue siendo un problema importante de salud mundial a pesar de los avances en prevención y tratamiento. Estas desigualdades destacan la necesidad de intervenciones de enfermería dirigidas para mejorar los resultados en pacientes y abordar las inequidades en la atención en diferentes entornos. Otras neoplasias ginecológicas, como los tumores ováricos, uterinos y de vulva, representan dificultades sanitarias considerables. El cáncer de ovario es la causa principal de muerte relacionada con cánceres ginecológicos a nivel mundial, con más de 300.000 casos nuevos y 185.000 fallecimientos anuales. Las tasas de supervivencia para las neoplasias ováricas y uterinas generalmente superan a las del cáncer cervical; no obstante, persisten discrepancias notables entre países y regiones. Como en el cáncer cervical, estas disparidades están influenciadas por el acceso a la atención sanitaria, los métodos de detección temprana y las opciones de tratamiento. Las intervenciones de enfermería específicas son esenciales para estos cánceres con el fin de mejorar los resultados y potenciar la calidad de vida de las mujeres en todo el mundo5.
Las enfermeras en oncología ginecológica brindan una atención integral centrada en la paciente que va más allá del apoyo emocional. Además de ofrecer apoyo emocional, facilitan la planificación del tratamiento, defienden las necesidades de las pacientes y las guían a través del proceso terapéutico. Las terapias efectivas incluyen el manejo de síntomas, como el alivio del dolor, la reducción de la fatiga y el control de las náuseas, así como terapia psicológica y programas educativos para las pacientes que mejoran tanto los resultados emocionales como físicos6. Las estrategias de tratamiento multidisciplinarias que incluyen apoyo psicológico junto con fisioterapia han sido particularmente beneficiosas para mejorar la calidad de vida. Por consiguiente, las enfermeras en oncología ginecológica desempeñan un papel fundamental en el manejo de síntomas, la educación de las pacientes y el tratamiento integral, mejorando así los resultados para las pacientes6. Esta atención de enfermería especializada incluye la administración de quimioterapia, el monitoreo e interpretación de signos vitales, el análisis de las respuestas al tratamiento y la provisión de apoyo integral, todo lo cual requiere una formación y habilidades específicas en enfermería oncológica7.
La atención de enfermería mejora significativamente el bienestar de las personas en diversos entornos de atención sanitaria. Los hospitales proporcionan tratamiento, vigilan el estado de los pacientes y colaboran con el equipo médico. Las enfermeras en centros de atención domiciliaria ofrecen apoyo continuo, supervisan enfermedades crónicas y ayudan a los pacientes a mantener su independencia8. La calidad de vida incluye el bienestar físico, mental, emocional y social. La atención de enfermería es esencial para mejorar estos aspectos mediante intervenciones específicas. La atención continua a pacientes con enfermedades crónicas comprende el monitoreo de signos vitales, la administración de medicamentos y la instrucción en técnicas de autorregulación8. Estas intervenciones de enfermería permiten controlar eficazmente las enfermedades crónicas, reduciendo los síntomas y mejorando la salud física, lo que aumenta la calidad de vida en general.
Los cánceres ginecológicos constituyen un problema importante de salud pública para las mujeres en todo el mundo, con más de un millón de diagnósticos por año, lo que provoca importantes discapacidades físicas y trastornos psicosociales, disminuyendo así la calidad de vida9. La investigación indica que hasta el 40 % de las mujeres diagnosticadas con cánceres ginecológicos sufren angustia mental considerable, mientras que el 60 % refiere una deterioración en la calidad de vida relacionada con la salud durante el tratamiento (Estadísticas y Informes Mundiales sobre el Cáncer)10. Smits et al. no encontraron efectos significativos derivados de tratamientos similares, lo que resalta la importancia de la participación activa de los sujetos y la calidad de la implementación para determinar los resultados11. El estudio subraya el papel fundamental de las enfermeras en la prevención de enfermedades, la promoción de estilos de vida saludables y la atención a las necesidades físicas y emocionales de los pacientes.
El presente estudio busca evaluar los efectos de las intervenciones en el estilo de vida y la atención de enfermería en oncología ginecológica sobre la mejora de la calidad de vida de mujeres diagnosticadas con malignidades ginecológicas, mediante una revisión sistemática y un metaanálisis. El estudio tiene como objetivo evaluar el impacto de intervenciones específicas en el estilo de vida y la atención de enfermería en oncología ginecológica en aspectos esenciales de la calidad de vida, incluyendo el bienestar físico, emocional y social. Centrarse en mediciones estandarizadas de la calidad de vida y en estrategias de intervención explícitamente definidas proporciona datos prácticos sobre la eficacia de estos métodos. Este estudio examina específicamente los efectos a corto plazo (dentro de los seis meses) de la atención de enfermería psicológica intensiva en el bienestar emocional y social. Esta metodología específica ofrece un análisis exhaustivo del impacto de intervenciones concretas en los resultados de calidad de vida y proporciona evidencia para orientar estrategias de atención personalizadas.
Las revisiones sistemáticas previas, incluida la de Smits et al.11, evaluaron principalmente intervenciones de estilo de vida en mujeres con cáncer de endometrio y de ovario, e incluyeron relativamente pocos estudios. Desde entonces, se ha acumulado nueva evidencia, y ninguna revisión sistemática ha evaluado de manera integral tanto las intervenciones de estilo de vida como la atención de enfermería en oncología ginecológica en un espectro más amplio de malignidades ginecológicas. Por lo tanto, esta revisión sistemática y metaanálisis tuvieron como objetivo sintetizar la evidencia actual sobre los efectos de estas intervenciones en la calidad de vida.
Protocolo
Criterios de elegibilidad
Los estudios eran elegibles si cumplían todos los siguientes criterios: (1) incluían mujeres con cualquier tipo de malignidad ginecológica; (2) evaluaban una intervención definida sobre el estilo de vida o una intervención dirigida por enfermería; (3) informaban datos cuantitativos sobre la calidad de vida; y (4) eran estudios comparativos (intervención frente a control) o estudios observacionales de trayectoria que proporcionaran datos descriptivos relevantes sobre la calidad de vida; (5) estaban publicados en inglés. . Para el metaanálisis cuantitativo de intervención frente a control, se requería un grupo comparador concurrente12. Dos estudios sin grupo comparador se conservaron únicamente para la síntesis narrativa13. No se aplicaron restricciones geográficas.
Fuentes de información
El proceso completo de selección de estudios se muestra en la Figura 1 como un diagrama de flujo PRISMA. Se realizó una búsqueda en The Cochrane Library, Embase, Google Scholar, OVID y PubMed desde la creación de cada base de datos hasta junio de 2026. Los registros recuperados se importaron a EndNote 20 y se eliminaron los duplicados. Dos revisores evaluaron de forma independiente los títulos y resúmenes, seguido de la evaluación del texto completo de los estudios potencialmente elegibles. Las discrepancias se resolvieron mediante discusión. Solo se consideraron publicaciones en inglés para inclusión, de acuerdo con los criterios de elegibilidad preestablecidos.
Estrategia de búsqueda
La estrategia de búsqueda se desarrolló utilizando el marco PICOS: Población—mujeres con oncología ginecológica; Intervención—intervenciones de estilo de vida o de enfermería; Comparación—atención habitual u otras intervenciones; Resultado—calidad de vida; Diseño del estudio—sin restricciones14. Se utilizó un conjunto exhaustivo de palabras clave y términos de vocabulario controlado en todas las bases de datos; las cadenas detalladas de búsqueda para cada base de datos se proporcionan en Tabla 113.
Proceso de selección
Tras la recuperación del texto completo, dos revisores verificaron de forma independiente que cada informe cumpliera todos los criterios de elegibilidad. Además, revisaron cruzadamente las listas de autores, los nombres de los ensayos (por ejemplo, SUCCEED, WALC, BENITA, TOPCAT‑G), los períodos de reclutamiento y los centros del estudio para identificar cohortes de pacientes superpuestas. Se identificaron y documentaron las cohortes de pacientes potencialmente superpuestas. Cuando los informes superpuestos contribuían al análisis primario, su influencia se evaluó en un análisis de sensibilidad prespecificado que excluía el conjunto de datos superpuesto.
Extracción de datos y medidas de los resultados
Dos revisores extrajeron de forma independiente los datos de los 15 informes incluidos utilizando un formulario estandarizado y previamente probado para la extracción de datos. Las discrepancias se resolvieron por consenso con el autor correspondiente. Para cada estudio, se registró la siguiente información: primer autor, año de publicación, país, diseño del estudio, tipo de cáncer, descripción de la intervención, descripción del comparador, tamaño de la muestra por grupo, edad de los participantes y estadio de la enfermedad, instrumento de calidad de vida (CV), puntos temporales evaluados, y todos los datos numéricos de calidad de vida (medias, medidas de dispersión y tamaños de muestra por brazo)15.
Acumulación cuantitativa (13 estudios comparativos)
Para la metaanalítica de intervención frente al grupo control, se extrajeron las puntuaciones finales posteriores a la intervención (medias y desviaciones estándar) en los puntos temporales preespecificados (3 y 6 meses) para ambos grupos. Cuando un estudio informaba tanto las puntuaciones finales como las de cambio, únicamente se extrajeron las puntuaciones finales16. El enfoque metodológico para la metaanalítica y la evaluación de la calidad de los estudios siguió las directrices establecidas por Cochrane17. La elección del modelo metaanalítico consideró la heterogeneidad clínica y metodológica esperada entre los estudios18, y la heterogeneidad estadística se cuantificó utilizando el estadístico I2, según lo descrito por Higgins et al.19. Los 13 estudios comparativos incluidos en la síntesis cuantitativa se resumen en la Tabla 220,21,22,23,24,25,26,27,28,29,30,31,32.
Medidas de resultados sobre la calidad de vida, alineación y métrica del efecto
Se registró el instrumento específico de calidad de vida utilizado en cada estudio. Las escalas identificadas incluyeron la Evaluación Funcional de la Terapia contra el Cáncer – General (FACT‑G), FACT‑Ovario (FACT‑O), FACT‑Endometrio (FACT‑En), el Cuestionario de Calidad de Vida del Organismo Europeo para la Investigación y el Tratamiento del Cáncer, Módulo Central 30 (EORTC QLQ‑C30), la Forma Breve‑36 (SF‑36) y escalas específicas de la condición. Para todos los instrumentos, puntuaciones más altas indicaron una mejor calidad de vida, y no se incluyeron instrumentos con puntuación invertida. Por lo tanto, todos los datos de calidad de vida extraídos se alinearon a la misma métrica, con una diferencia media (MD) positiva que favoreció consistentemente al grupo de intervención.
Para el metaanálisis principal, se extrajeron las puntuaciones finales posteriores a la intervención en lugar de las puntuaciones de cambio respecto a la línea base. Esta decisión se basó en: (i) no todos los estudios informaron las puntuaciones de cambio ni sus desviaciones estándar; (ii) las puntuaciones finales reflejan el estado absoluto de la calidad de vida (QoL) tras el tratamiento, lo cual es clínicamente significativo; y (iii) el uso de puntuaciones finales maximizó el número de estudios que podían agruparse. Cuando un estudio informaba múltiples subescalas de QoL, se priorizaba como resultado principal la puntuación global de QoL o la puntuación total FACT-G; si no estaba disponible, se utilizaba la subescala de función física, indicando explícitamente esta desviación en una nota al pie de Tabla 2.
La MD cruda se utilizó como medida del efecto en lugar de la diferencia media estandarizada (DME), ya que todos los instrumentos incluidos están validados para medir el mismo constructo subyacente—calidad de vida relacionada con la salud—en escalas conceptualmente similares (los puntajes totales oscilan entre 0–100 o 0–148). La DM es directamente interpretable en las unidades originales de estas escalas y tiene una mayor relevancia clínica que una DMC expresada en unidades de desviación estándar. No se utilizaron estimaciones ajustadas (por ejemplo, medias ajustadas por ANCOVA) porque las covariables de ajuste variaban ampliamente entre los estudios, lo que comprometía la comparabilidad.
Conversiones de desviación estándar
Cuando los estudios informaron errores estándar (EE) o intervalos de confianza del 95 % en lugar de desviaciones estándar, se convirtieron a DE utilizando fórmulas estándar: DE = EE × √n para EE, y DE = √n × (IC superior – IC inferior) / (2 × 1.96) para IC del 95 %. Para los estudios que presentaron medianas con rangos intercuartílicos (RIC), no se imputaron medias ni DE; dichos datos se extrajeron de forma narrativa y no se incluyeron en los cálculos del DM agrupado. No se requirió ninguna imputación de este tipo para los 13 estudios que contribuyeron a la síntesis cuantitativa.
Manejo de datos faltantes
Se extrajeron preferentemente las estimaciones de intención de tratar (ITT) cuando se informaron explícitamente, ya que proporcionan la estimación más conservadora e imparcial del efecto del tratamiento. Cuando no había disponibles datos ITT, se extrajeron los datos por protocolo o de casos completos tal como los reportaron los autores originales. No se imputaron medias, desviaciones estándar (SD) ni valores de resultados faltantes; la ausencia de datos se registró para cada estudio y se tuvo en cuenta en el análisis de sensibilidad. Se anotaron los estudios con desviaciones estándar no reportadas para puntos temporales clave, y se contactó por correo electrónico a los autores correspondientes para solicitar las estadísticas faltantes. Si no se recibió respuesta dentro de las dos semanas, se utilizaron los datos disponibles más conservadores (por ejemplo, la desviación estándar agrupada de la línea base si faltaba la desviación estándar postintervención) o se excluyó el punto temporal específico del agrupamiento.
Brazos de intervención múltiples y controles compartidos
Ningún estudio incluido presentó más de un brazo activo de intervención sobre estilo de vida o cuidados de enfermería comparado con un único grupo control compartido, lo cual habría requerido dividir la muestra control para el análisis. En el único estudio con diseño factorial (McCloy et al.30), los datos se extrajeron del brazo combinado de ejercicio y atención plena, y del brazo control de atención habitual, con el fin de simplificar la agrupación y evitar el recuento duplicado. Para las cohortes solapadas del ensayo SUCCEED (Von Gruenigen et al.21 y McCarroll et al.23), ambos informes se mantuvieron en la tabla de extracción. Para el metaanálisis principal, se incluyeron ambos conjuntos de datos (ya que informaron sobre la calidad de vida en el mismo punto temporal). En un análisis de sensibilidad preespecificado, se excluyó el último informe para evaluar el impacto de la duplicación de cohortes en la estimación agrupada; los resultados se presentan en el texto.
Estudios observacionales no comparativos
Para dos informes (Budisan et al.33 y Betea et al.34), que carecía de un grupo control concurrente, no se extrajeron datos comparativos de intervención frente a control (es decir, no pudo calcularse una DM). En su lugar, se extrajeron datos descriptivos sobre la trayectoria de la calidad de vida (cambios intra-grupo a lo largo del tiempo) y presentados de forma narrativa en el texto y en Tabla 2No se incluyeron en ningún gráfico de bosque ni en ninguna síntesis cuantitativa agrupada.
Evaluación del riesgo de sesgo
Se evaluó el posible sesgo de publicación y otros efectos de estudios pequeños mediante la inspección visual de gráficos en embudo y la prueba de regresión lineal de Egger (que realiza una regresión del efecto estandarizado de la intervención sobre su precisión). Dado que la prueba de Egger tiene un poder estadístico limitado cuando el número de estudios es pequeño (generalmente <10), se estableció previamente que los gráficos en embudo y las pruebas de Egger se realizarían únicamente para metaanálisis que incluyeran 10 o más estudios. Para los resultados con menos de 10 estudios incluidos, no se presentan los gráficos en embudo ni los valores p de Egger, ya que dichas pruebas tienen poca potencia y podrían arrojar resultados engañosos17.
Dos revisores evaluaron de forma independiente la calidad metodológica de los 15 informes incluidos, y las discrepancias se resolvieron mediante discusión con los autores correspondientes. Dado que los estudios incluidos comprendían tanto ensayos controlados aleatorizados (RCTs; n = 13) como estudios de cohorte observacionales no aleatorizados (n = 2; Budisan et al.33; Betea et al.34), se aplicaron herramientas específicas según el diseño.
Para los ECA (13 estudios), se utilizó la herramienta Cochrane RoB 2.0 (versión revisada), evaluando cada estudio en cinco dominios17: (1) Proceso de aleatorización: generación de la secuencia y ocultación de la asignación; (2) Desviaciones respecto a las intervenciones previstas: enmascaramiento de participantes y personal, y si el análisis fue por intención de tratar; (3) Datos ausentes sobre el resultado: completitud del seguimiento y manejo de las pérdidas; (4) Medición del resultado: enmascaramiento de los evaluadores de los resultados (particularmente relevante para la calidad de vida autoinformada, donde el enmascaramiento es menos factible pero aún así considerado); (5) Selección del resultado informado: riesgo de informe selectivo de resultados (verificado frente a registros de ensayos o protocolos publicados cuando estuvieron disponibles).
Cada dominio se calificó como riesgo bajo, algunas preocupaciones o riesgo alto. Luego se asignó un juicio general sobre el riesgo de sesgo para cada estudio: bajo (todos los dominios con riesgo bajo), algunas preocupaciones (uno o más dominios con algunas preocupaciones) o alto (cualquier dominio con riesgo alto o múltiples dominios con algunas preocupaciones). Para resultados autoinformados, como la calidad de vida, a menudo no es factible el enmascaramiento de los participantes; por lo tanto, no se asignó automáticamente un juicio de riesgo alto por falta de enmascaramiento de los participantes. En cambio, la falta de enmascaramiento se indicó explícitamente como una fuente potencial de sesgo de desempeño en la evaluación del dominio 2.
Para estudios de cohorte observacionales no aleatorizados (2 estudios), Budisan et al.33 y Betea et al.34 no incluyeron un grupo comparador concurrente y no se incluyeron en el metaanálisis cuantitativo. Para estos, se utilizó la Escala Newcastle-Ottawa (NOS), adaptada para estudios de cohorte, para evaluar la selección, la comparabilidad (no aplicable debido a la ausencia de un grupo comparador) y la verificación del resultado. Sin embargo, debido a que carecían de un grupo control, se consideró que tenían un alto riesgo de confusión y sesgo de selección en cualquier inferencia causal. Se mantuvieron únicamente con fines descriptivos; sus perfiles de riesgo de sesgo no afectan las estimaciones del efecto agrupado, pero se documentan en Tabla 2.
Resumen del riesgo de sesgo
Se creó una figura resumen del riesgo de sesgo (gráfico de semáforo) que muestra las evaluaciones a nivel de dominio para cada ECA. En resumen, las principales preocupaciones en los ECA fueron: (i) la falta de enmascaramiento de los participantes y del personal respecto a las intervenciones de estilo de vida (dominio 2 – algunas preocupaciones/alto riesgo en 9 de 13 estudios) y (ii) datos de resultado incompletos debido a la deserción (dominio 3 – algunas preocupaciones en 4 estudios). Ningún estudio fue clasificado como de bajo riesgo en todos los dominios; la mayoría (8/13) tuvo algunas preocupaciones, y 5/13 fueron clasificados de alto riesgo en general, principalmente debido a la falta de enmascaramiento y tamaños muestrales pequeños que provocan imprecisión.
Certidumbre de la evidencia (GRADE)
La certeza general del conjunto de evidencia se evaluó para cada resultado agrupado utilizando el marco de Grado de Evaluación de Recomendaciones, Desarrollo y Evaluación (GRADE), siguiendo la Guía GRADE y utilizando el software GRADEpro GDT. La certeza se calificó como alta, moderada, baja o muy baja en cinco dominios: riesgo de sesgo, inconsistencia, indirectividad, imprecisión y sesgo de publicación. Los resultados evaluados incluyen: (1) calidad de vida (QoL) a los 6 meses – oncología ginecológica general (diferencia media agrupada [MD] de 9 estudios comparativos); (2) QoL a los 6 meses – cáncer de ovario (MD agrupada de 2 estudios comparativos); (3) QoL a los 6 meses – cáncer de endometrio (MD agrupada de 4 estudios comparativos, incluyendo cohortes SUCCEED superpuestas); (4) QoL a los 3 meses – oncología ginecológica general (MD agrupada de 6 estudios comparativos).
Medida del efecto y modelo de metanálisis
Se utilizaron modelos de efectos aleatorios por varianza inversa para los análisis generales a los 6 meses y a los 3 meses, ya que se anticipó una heterogeneidad clínica y metodológica sustancial entre los estudios, incluyendo diferencias en los tipos de cáncer, componentes de la intervención, intensidad, duración y condiciones de control18. Se emplearon modelos de efectos fijos por varianza inversa para los análisis de subgrupos de cáncer ovárico y de endometrio, en los cuales no se observó heterogeneidad estadística (I2 = 0%). La heterogeneidad se evaluó utilizando el estadístico I219.
La heterogeneidad se cuantificó utilizando el estadístico I2, con umbrales del 25%, 50% y 75% que representan heterogeneidad baja, moderada y alta, respectivamente. Además del I2, se informó τ2 para los análisis de efectos aleatorios con el fin de cuantificar la magnitud absoluta de la varianza entre estudios. Todos los análisis se realizaron utilizando los paquetes meta y metafor en R (versión 4.3.1).
Justificación para la combinación de datos a pesar de la heterogeneidad sustancial y manejo de la heterogeneidad
Para el análisis primario a los 6 meses, I2 = 71 % indicó una heterogeneidad sustancial. Se consideró apropiado realizar la agrupación bajo el modelo de efectos aleatorios por las siguientes razones: (i) la estimación agrupada representa el efecto promedio en una variedad de intervenciones y poblaciones, lo cual constituye una pregunta de resumen legítima; (ii) el modelo de efectos aleatorios incorpora explícitamente la varianza entre estudios (τ2) en el error estándar, reduciendo el riesgo de intervalos de confianza falsamente estrechos; (iii) se realizaron análisis de subgrupos preespecificados según el tipo de cáncer (ovárico, endometrial) para explicar las fuentes clínicas de heterogeneidad; (iv) se llevaron a cabo análisis de influencia y sensibilidad para evaluar la solidez de la estimación agrupada.
La decisión de agrupar estudios a pesar de la heterogeneidad estadística sustancial se basó en los siguientes principios: interpretación de I2 — se establecieron previamente valores de I2 del 25%, 50% y 75% para representar heterogeneidad baja, moderada y alta, respectivamente. Un valor de I2 superior al 75% indica una heterogeneidad considerable, lo cual podría hacer inapropiada la agrupación si la heterogeneidad no puede explicarse de manera significativa por factores clínicos o metodológicos. Para el análisis general primario a los 6 meses (I2 = 71%), se planificaron previamente análisis por subgrupos según tipo de cáncer (ovárico, endometrial) para explorar fuentes clínicas de heterogeneidad. La división en subgrupos redujo considerablemente la I2 a 0% tanto en los subgrupos de cáncer ovárico como endometrial, lo que sugiere que una parte importante de la heterogeneidad general se debe a diferencias en el tipo de cáncer y a los objetivos terapéuticos asociados. Sin embargo, dado que estos subgrupos incluyen muy pocos estudios, no puede concluirse con fiabilidad que la heterogeneidad esté completamente explicada.
Se consideró justificado proceder con la agrupación de datos para el análisis general a los 6 meses porque: (i) proporciona un efecto promedio resumido a través de una amplia gama de intervenciones, lo cual constituye una pregunta metaanalítica legítima; (ii) se informa explícitamente τ2 para cuantificar la varianza entre estudios; (iii) se realizaron análisis de influencia para verificar resultados impulsados por valores atípicos; y (iv) la estimación agrupada no se considera definitiva ni aplicable clínicamente — se interpreta como generadora de hipótesis y se acompaña de numerosas advertencias en la discusión.
De acuerdo con el Manual Cochrane, cuando la I2 supera el 75 % y los análisis de subgrupos no explican de manera convincente la heterogeneidad, las estimaciones agrupadas deben interpretarse con extrema precaución. Dado el reducido número de estudios en los subgrupos, no puede afirmarse con certeza que la heterogeneidad esté completamente explicada. Por lo tanto, la estimación agrupada principal se presenta principalmente con fines descriptivos y exploratorios, y no constituye la base para recomendaciones clínicas. Todas las estadísticas de heterogeneidad (I2, τ2) y los análisis de sensibilidad se informan de forma transparente, permitiendo a los lectores evaluar por sí mismos la estabilidad de las estimaciones.
Análisis de subgrupos, sensibilidad e influencia
Para explorar las fuentes de heterogeneidad, se realizaron los siguientes análisis preespecificados, sin llevar a cabo una meta-regresión: 1) Para los análisis por subgrupos, el resultado general a los 6 meses se estratificó según el tipo de cáncer (ovárico, endometrial) para examinar si el efecto difería según el sitio tumoral; 2) Análisis de sensibilidad (cohortes superpuestas): para evaluar el impacto de las cohortes superpuestas del ensayo SUCCEED (Von Gruenigen et al.21 y McCarroll et al.23), se repitió el análisis por subgrupos de endometrial excluyendo a McCarroll et al.23. 3) Análisis de influencia eliminando un estudio cada vez: cada estudio se eliminó secuencialmente y se recalculó la DM agrupada y la I2 para el resultado general a los 6 meses, con el fin de identificar si algún estudio individual influía desproporcionadamente en los resultados o en la heterogeneidad; 4) Comparación con el modelo de efectos fijos: por completitud, las estimaciones agrupadas también se calcularon bajo un modelo de efectos fijos (ponderación por varianza inversa) para compararlas con los resultados de efectos aleatorios; cualquier discrepancia sustancial indicaría que la heterogeneidad entre estudios influye significativamente en la estimación.
La meta-regresión no se realizó para explorar covariables continuas (por ejemplo, edad, calidad de vida basal, duración de la intervención) debido al número de estudios por subgrupo (≤9 para el resultado general a los 6 meses) es insuficiente para obtener coeficientes de regresión confiables. Con <10 estudios por covariable, la meta-regresión tiene un poder estadístico muy bajo y es propensa a errores de tipo I, y los datos disponibles de las covariables se informaron de manera inconsistente entre los estudios.
Sesgo de publicación
Ninguno de los resultados combinados incluyó 10 o más estudios. Por lo tanto, no se realizaron gráficos en embudo ni pruebas de regresión de Egger, ya que estas evaluaciones tendrían poca potencia estadística y podrían ser engañosas dada la cantidad de estudios disponibles.
Resultados
Selección del estudio
Una búsqueda sistemática de la literatura en PubMed, Embase, Cochrane Library, Ovid y Google Scholar hasta junio de 2026 identificó 1.123 registros. Tras eliminar 897 duplicados, se evaluaron el título y el resumen de 226 registros. De estos, se excluyeron 124 registros según los criterios de elegibilidad. Se realizó una evaluación del texto completo de 102 informes, de los cuales se excluyeron 89 con las razones documentadas en el diagrama de flujo PRISMA (Figura 1; Archivo Suplementario 1). En última instancia, 15 informes cumplieron los criterios de inclusión y se incluyeron en la revisión sistemática, compuestos por 13 ensayos controlados aleatorizados comparativos y 2 estudios observacionales no comparativos. Trece ensayos controlados aleatorizados proporcionaron datos extraíbles de intervención frente a control para el metaanálisis cuantitativo, mientras que los dos estudios observacionales se conservaron únicamente para la síntesis narrativa20,21,22,23,24,25,26,27,28,29,30,31,32.
Figura 1 presenta el diagrama de flujo PRISMA 2020 que detalla el proceso de cribado y selección. Los 13 ensayos controlados aleatorizados proporcionaron datos extraíbles de intervención frente a control para el metaanálisis cuantitativo20,21,22,23,24,25,26,27,28,29,30,31,32.
Características del estudio
Las características de los 15 informes incluidos se resumen en la Tabla 2. Trece ECA comparativos aportaron datos a la síntesis cuantitativa, mientras que dos estudios observacionales se conservaron únicamente para la síntesis narrativa. En conjunto, los 13 ECA comparativos incluyeron a 915 mujeres, con 468 participantes asignadas a grupos de intervención de estilo de vida o de enfermería y 447 a grupos control, según se informó originalmente.
Para los metaanálisis cuantitativos, los 13 ECA comparativos incluyeron 915 participantes (468 en intervención, 447 en control). Los ECA incluidos fueron publicados entre 2009 y 2025 y se realizaron en varios países, incluidos Estados Unidos, Dinamarca, el Reino Unido, China, Egipto y Rumania. Los tipos de cáncer incluidos fueron cáncer de ovario (2 estudios), cáncer de endometrio (4 estudios) y cánceres ginecológicos mixtos (7 estudios). Las intervenciones variaron ampliamente e incluyeron: programas estructurados de ejercicio, modificación de la dieta, asesoramiento para la pérdida de peso, sesiones psicoeducativas, seguimiento dirigido por enfermeras, atención iniciada por el paciente, atención plena basada en aplicaciones y intervenciones combinadas de estilo de vida. Las duraciones del seguimiento oscilaron entre 3 y 6 meses.
Los instrumentos de evaluación de la calidad de vida incluyeron: Evaluación Funcional de la Terapia contra el Cáncer–General (FACT-G), FACT-Ovario (FACT-O), FACT-Endometrio (FACT-En), Cuestionario de Calidad de Vida de la Organización Europea para la Investigación y el Tratamiento del Cáncer, módulo básico 30 (EORTC QLQ-C30), Forma Breve-36 (SF-36) y escalas específicas para la condición. Todos los instrumentos se puntuaron de manera que valores más altos indicaran una mejor calidad de vida.
Evaluación del riesgo de sesgo
Se evaluó el riesgo de sesgo utilizando la herramienta Cochrane RoB 2.0 para los 13 ECA y la Escala Newcastle-Ottawa para los 2 estudios de cohorte observacionales. Se presenta un resumen de los juicios por dominios en el gráfico de semáforo de riesgo de sesgo. Para los ECA, las preocupaciones metodológicas más comunes fueron: (1) Dominio 2 (Desviaciones respecto a las intervenciones previstas): no fue factible enmascarar a los participantes ni al personal respecto a las intervenciones de estilo de vida en ningún estudio; 9 de los 13 estudios (69 %) se calificaron como "algunas preocupaciones" o "alto riesgo" en este dominio; (2) Dominio 3 (Datos ausentes sobre el resultado): cuatro estudios (31 %) presentaron datos de resultados incompletos debido a tasas de abandono superiores al 20 %, calificados como "algunas preocupaciones"; (3) Dominio 1 (Proceso de aleatorización): siete estudios (54 %) describieron adecuadamente la generación de la secuencia y el ocultamiento de la asignación; el resto presentó informes poco claros o inadecuados; (4) Dominio 4 (Medición del resultado): todos los estudios utilizaron instrumentos validados de calidad de vida (QoL) autorreportados; sin embargo, no se informó de forma consistente sobre el enmascaramiento de los evaluadores del resultado; (5) Dominio 5 (Selección del resultado informado): seis estudios (46 %) tenían protocolos registrados de forma prospectiva; los estudios restantes carecían de protocolos disponibles, lo que generó preocupaciones sobre la posible selección sesgada en la presentación de resultados.
Juicios generales sobre el riesgo de sesgo: Ningún estudio fue calificado como de bajo riesgo en todos los dominios. Ocho estudios (62 %) fueron considerados como tener "algunas preocupaciones" en general, y cinco estudios (38 %) fueron calificados como "alto riesgo" en general, principalmente debido a la falta de enmascaramiento y a tamaños muestrales pequeños, lo que condujo a imprecisión.
En los dos estudios de cohortes observacionales (Budisan et al.33; Betea et al.34), la ausencia de un grupo comparador concurrente dio como resultado un alto riesgo de confusión y sesgo de selección para cualquier inferencia causal. Estos estudios se mantuvieron únicamente para la síntesis narrativa y no contribuyeron a las estimaciones del efecto agrupado.
Resultados primarios
Calidad de vida a los 6 meses – oncología ginecológica general
Nueve ECA comparativos aportaron datos en el punto temporal de 6 meses, compuestos por 693 participantes (358 en el grupo de intervención y 335 en el grupo control). La diferencia media agrupada (DM) utilizando un modelo de efectos aleatorios no mostró una mejora estadísticamente significativa en la calidad de vida a los 6 meses en comparación con el grupo control (DM = 2,11; IC del 95 %: –0,90 a 5,12; p = 0,17).
Figura 2 presenta el gráfico de bosque para este análisis. La heterogeneidad fue considerable: I2 = 71%, τ2 = 10,60.
Calidad de vida a los 6 meses – subgrupo de cáncer de ovario
Dos estudios (Zhou et al.25; Maurer et al.29) proporcionaron datos específicamente para el cáncer de ovario, con un total de 124 participantes (66 en intervención, 58 en control). La diferencia media agrupada indicó una mejora estadísticamente significativa en la calidad de vida a favor del grupo de intervención (MD 4,28; IC 95% 0,45–8,10; p = 0,03). Figura 3 presenta el gráfico de bosque para este análisis. La heterogeneidad fue baja: I2 = 0%, τ2 = 0.
Calidad de vida a los 6 meses – subgrupo de cáncer de endometrio
Cuatro estudios (Von Gruenigen et al.21; McCarroll et al.23; Rossi et al.24; Jeppesen et al.26) aportaron datos sobre cáncer de endometrio, que comprendieron a 172 participantes (92 en intervención, 80 en control). Para evaluar el impacto de las cohortes superpuestas del ensayo SUCCEED, se repitió el análisis del subgrupo de endometrio, excluyendo a McCarroll et al.23. La DMedia agrupada cambió ligeramente de 2,00 (IC del 95 %: –1,49–5,49) a 1,87 (IC del 95 %: –1,62–5,36), y la I2 permaneció en 0 %. Excluir a McCarroll et al. no alteró sustancialmente la estimación agrupada; el efecto continuó siendo estadísticamente no significativo y la heterogeneidad siguió ausente (I2 = 0 %). Figura 4 presenta el gráfico de bosque para este análisis. La heterogeneidad fue baja: I2 = 0 %, τ2 = 0.
Calidad de vida a los 3 meses – oncología ginecológica general
Seis estudios comparativos (Von Gruenigen et al.21; Donnelly et al.22; McCarroll et al.23; Maurer et al.29; Elzeblawy Hassan et al.32; McCloy et al.30) informaron resultados a los 3 meses, con un total de 275 participantes (140 en el grupo de intervención y 135 en el grupo control). La diferencia media agrupada no mostró una diferencia estadísticamente significativa entre los grupos de intervención y control (DM 6,43; IC del 95 %: −0,16 a 13,01; p = 0,06). Figura 5 presenta el gráfico de bosque para este análisis. La heterogeneidad fue considerable (I2 = 74 %; τ2 = 42,53).
Análisis por subgrupos
Se realizaron análisis prespecificados de subgrupos por tipo de cáncer para explorar las fuentes de heterogeneidad. Para el resultado general de Oncología Ginecológica a los 6 meses: (1) subgrupo de cáncer de ovario (2 estudios): I2 = 0%, τ2 = 0; DM 4,28 (IC 95% 0,45–8,10); (2) subgrupo de cáncer de endometrio (4 estudios): I2 = 0%, τ2 = 0; DM 2,00 (IC 95%: –1,49–5,49)
La subagrupación por tipo de cáncer redujo sustancialmente la heterogeneidad de I2 = 71% en el análisis general a 0% dentro de cada subgrupo. Sin embargo, el reducido número de estudios dentro de cada subgrupo (2 y 4, respectivamente) limita la precisión de estas estimaciones por subgrupo.
No se realizó una prueba formal de interacción entre subgrupos porque el número de estudios por subgrupo (<10) fue insuficiente para obtener estimaciones de interacción confiables. Las diferencias aparentes en significancia estadística entre los subgrupos de ovario y endometrio no deben interpretarse como evidencia de efectos de tratamiento diferenciales según el tipo de cáncer.
De manera similar, no se realizó una prueba formal de interacción entre el tiempo y los resultados a los 3 y 6 meses.
Análisis de sensibilidad
Exclusión de cohortes superpuestas
Para evaluar el impacto de las cohortes superpuestas del ensayo SUCCEED (Von Gruenigen et al.21 y McCarroll et al.23), se repitió el análisis del subgrupo de endometrio, excluyendo a McCarroll et al.23.
La MD agrupada cambió ligeramente de 2,00 (IC del 95 %: –1,49–5,49) a 1,87 (IC del 95 %: –1,62–5,36), e I2 se mantuvo en 0 %. Esto indica que la cohorte duplicada no afectó materialmente la estimación puntual ni la conclusión de que no existe un efecto significativo.
Para el resultado general a los 6 meses, al excluir McCarroll et al. el DM agrupado cambió de 2,11 (IC del 95 %: −0,90–5,12) a 2,33 (IC del 95 %: −1,16–5,82), con un cambio en I2 del 71 % a aproximadamente el 72 %. El efecto se mantuvo estadísticamente no significativo, lo que indica que la exclusión de la cohorte solapada no alteró sustancialmente la conclusión general.
Análisis de influencia dejando uno fuera
La eliminación secuencial de estudios individuales produjo diferencias medias agrupadas que oscilaron aproximadamente entre 1,29 y 4,33. La heterogeneidad generalmente permaneció considerable tras la exclusión de la mayoría de los estudios; sin embargo, la exclusión de McCorkle et al.20 redujo el valor de I2 a 0 %, lo que indica que este estudio contribuyó sustancialmente a la heterogeneidad observada entre los estudios. Por lo tanto, los hallazgos generales deben interpretarse con cautela.
Comparación de modelos de efectos fijos
Bajo un modelo de efectos fijos, la DM agrupada para el resultado general a los 6 meses fue de 3,80 (IC del 95 %: 2,97–4,62), mientras que el modelo de efectos aleatorios arrojó una DM de 2,11 (IC del 95 %: −0,90–5,12). La diferencia en significación estadística entre los dos modelos indica que la heterogeneidad entre estudios afecta sustancialmente la inferencia agrupada. Dada la heterogeneidad considerable (I2 = 71 %), se consideró que la estimación de efectos aleatorios era más apropiada para la interpretación.
Sesgo de publicación
Ninguno de los resultados agrupados incluyó 10 o más estudios. Por lo tanto, no se realizaron gráficos en embudo ni pruebas de regresión de Egger, ya que estas evaluaciones tendrían poca potencia estadística y podrían ser engañosas dada la cantidad de estudios disponibles.
Aunque no se realizó una evaluación formal debido al reducido número de estudios, no puede descartarse un sesgo de publicación ni la divulgación selectiva. Por lo tanto, al interpretar las evidencias, debe considerarse la posibilidad de que hallazgos negativos o nulos permanezcan sin publicar.
Disponibilidad de datos
El conjunto de datos analizado durante el presente estudio está disponible en 10.5281/zenodo.21777130 (https://doi.org/10.5281/zenodo.21777130).
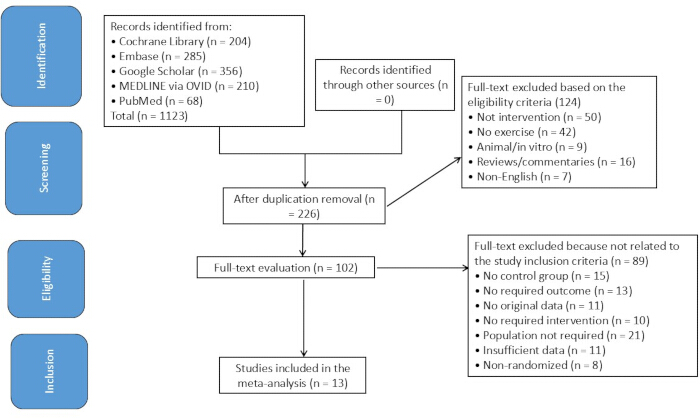
Figura 1: Diagrama de flujo PRISMA 2020 de selección de estudios. Diagrama de flujo que ilustra la identificación, cribado, evaluación de elegibilidad e inclusión de estudios que evalúan intervenciones de estilo de vida y enfermería en oncología ginecológica sobre la calidad de vida en mujeres con cánceres ginecológicos. Haga clic aquí para ver una versión más grande de esta figura.
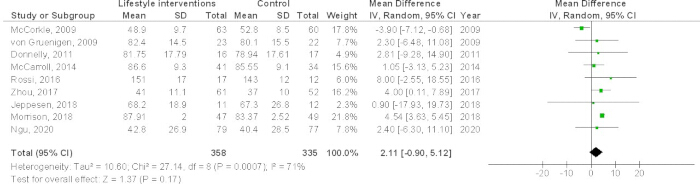
Figura 2: Gráfico de bosque de la calidad de vida a los 6 meses en mujeres con cánceres ginecológicos. Gráfico de bosque que compara intervenciones de estilo de vida y de enfermería en oncología ginecológica con grupos control respecto a la calidad de vida en el seguimiento a los 6 meses. Los resultados se presentan como diferencias medias (DM) con intervalos de confianza del 95 % (IC) utilizando un modelo de efectos aleatorios. Valores positivos de DM favorecen al grupo de intervención. La heterogeneidad se informa mediante el estadístico I2. Haga clic aquí para ver una versión más grande de esta figura.
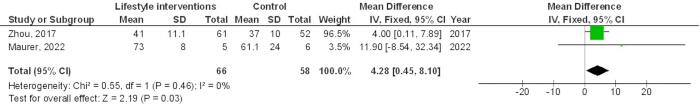
Figura 3: Gráfico de bosque de la calidad de vida a los 6 meses en mujeres con cáncer de ovario. Gráfico de bosque que muestra el efecto de las intervenciones en el estilo de vida y en enfermería de oncología ginecológica sobre la calidad de vida en el seguimiento a los 6 meses en mujeres con cáncer de ovario. Los resultados se presentan como diferencias medias (DM) con intervalos de confianza del 95% (IC). Valores positivos de DM favorecen al grupo de intervención, y la heterogeneidad se resume utilizando el estadístico I2. Haga clic aquí para ver una versión más grande de esta figura.
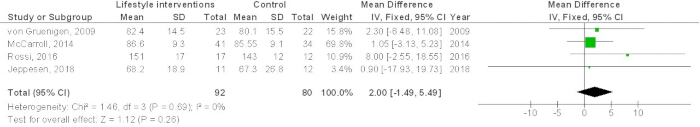
Figura 4: Gráfico de bosque de la calidad de vida a los 6 meses en mujeres con cáncer de endometrio. Gráfico de bosque que compara intervenciones de estilo de vida y de enfermería en oncología ginecológica con grupos control respecto a la calidad de vida en el seguimiento a los 6 meses en mujeres con cáncer de endometrio. Los resultados se expresan como diferencias medias (DM) con intervalos de confianza del 95% (IC). Valores positivos de la DM favorecen al grupo de intervención, y la heterogeneidad se informa utilizando el estadístico I2. Haga clic aquí para ver una versión más grande de esta figura.
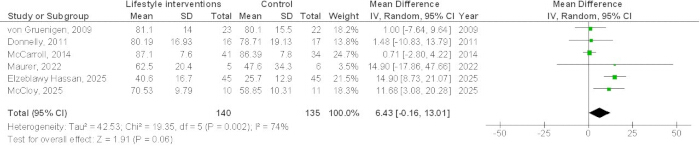
Figura 5: Gráfico de bosque de la calidad de vida a los 3 meses en mujeres con cánceres ginecológicos. Haga clic aquí para ver una versión más grande de esta figura.
Gráfico de bosque que compara las intervenciones de estilo de vida y de enfermería en Oncología Ginecológica con los grupos de control respecto a la calidad de vida en el seguimiento a los 3 meses. Los resultados se presentan como diferencias medias (DM) con intervalos de confianza del 95 % (IC) utilizando un modelo de efectos aleatorios. Valores positivos de DM favorecen al grupo de intervención. La heterogeneidad se informa utilizando el estadístico I2.
Tabla 1: Estrategias de búsqueda en bases de datos utilizadas para la revisión bibliográfica. Se emplearon estrategias de búsqueda exhaustivas para identificar estudios elegibles en PubMed, Embase, Cochrane Library, Ovid y Google Scholar. Los términos de búsqueda combinaron vocabulario controlado y palabras clave en texto libre relacionadas con cánceres ginecológicos, intervenciones de estilo de vida, enfermería oncológica y calidad de vida. Haga clic aquí para descargar esta tabla.
Tabla 2: Características de los ECA incluidos. Resumen de las características de los estudios incluidos, incluyendo el diseño del estudio, tipo de cáncer, intervención y grupo comparador, tamaño de la muestra, instrumento de evaluación de la calidad de vida, duración del seguimiento y elegibilidad para inclusión en el metaanálisis cuantitativo. Los estudios sin un grupo comparador adecuado se incluyeron únicamente en la síntesis cualitativa. Haga clic aquí para descargar esta tabla.
Archivo complementario 1: Lista de verificación PRISMA 2020. Lista de verificación PRISMA 2020 completada que indica los números de página del manuscrito correspondientes a cada ítem de informe, de acuerdo con la Declaración PRISMA 2020 para la presentación de revisiones sistemáticas y metaanálisis.Haga clic aquí para descargar este archivo.
Discusión
El análisis primario a los 6 meses no mostró una mejora estadísticamente significativa en la calidad de vida para los cánceres ginecológicos mixtos (DM 2,11, IC del 95 %: −0,90 a 5,12, p = 0,17), mientras que se observó una mejora significativa en el subgrupo de cáncer de ovario (DM 4,28, IC del 95 %: 0,45–8,10, p = 0,03). No se observó un efecto significativo para el cáncer de endometrio a los 6 meses (DM 2,00, IC del 95 %: −1,49 a 5,49, p = 0,26) ni para los cánceres mixtos a los 3 meses (DM 6,43, IC del 95 %: −0,16 a 13,01, p = 0,06).
Estos hallazgos no demuestran un beneficio significativo general en la calidad de vida (QoL) a los 6 meses, aunque se observó una mejora significativa en el subgrupo de cáncer de ovario. El análisis primario a los 6 meses mostró una heterogeneidad sustancial (I2 = 71%), y la certeza de la evidencia según GRADE para todos los resultados agrupados se calificó como muy baja. Por consiguiente, estos resultados deben considerarse generadores de hipótesis más que cambiadores de la práctica clínica.
Es fundamental señalar que las diferencias aparentes en significancia entre tipos de cáncer y puntos temporales no se probaron formalmente mediante análisis de interacción y no deben interpretarse como evidencia de una eficacia diferencial. Los patrones observados podrían reflejar diferencias en las poblaciones estudiadas, los componentes de la intervención, los tamaños muestrales o la variabilidad aleatoria, más que diferencias biológicas o temporales reales. Cualquier conclusión sobre efectos relacionados con el momento de la intervención o específicos del tumor es especulativa y requiere confirmación en futuros ensayos directos comparativos.
Comparación con estudios previos
Los hallazgos actuales coinciden parcialmente con la revisión sistemática previa de Smits et al.10, que evaluó intervenciones de estilo de vida en mujeres con cáncer de endometrio y de ovario y encontró evidencia limitada de mejoras significativas en la calidad de vida (QoL). Sin embargo, la inclusión más amplia de intervenciones de enfermería y estudios adicionales publicados desde 2015 ofrecen una imagen más actual, aunque aún incierta. La certeza muy baja según GRADE en esta revisión es considerablemente más cautelosa que las conclusiones de algunos estudios primarios, lo que refleja la evaluación metodológica más rigurosa aplicada en la presente revisión y el reconocimiento explícito de las limitaciones inherentes a la base de evidencia11.
El beneficio observado en el subgrupo de cáncer de ovario es consistente con investigaciones previas de Zhou et al.25 y Maurer et al.29, quienes informaron que intervenciones estructuradas de ejercicio mejoraron el funcionamiento físico y el bienestar general en sobrevivientes de cáncer de ovario. Esto podría explicarse por el importante deterioro físico, la neuropatía inducida por la quimioterapia y las complicaciones abdominales que afectan la movilidad en esta población, lo que hace que las intervenciones de ejercicio sean particularmente beneficiosas. Sin embargo, el reducido número de estudios (n = 2) impide obtener conclusiones sólidas.
En contraste, el resultado nulo para el cáncer de endometrio a los 6 meses contradice algunos informes previos positivos de ensayos individuales (por ejemplo, Von Gruenigen et al.21; Rossi et al.24). La agrupación de estos estudios, incluyendo cohortes superpuestas del ensayo SUCCEED, reveló que no hubo un efecto significativo, lo que sugiere que los hallazgos positivos anteriores podrían haber sido sobreestimados debido a tamaños muestrales pequeños o sesgo de publicación. La ausencia de un efecto significativo también podría reflejar la naturaleza heterogénea de las sobrevivientes de cáncer de endometrio, quienes a menudo presentan obesidad y síndrome metabólico, lo que requiere intervenciones más intensivas o personalizadas para lograr mejoras medibles en la calidad de vida (QoL).
Los hallazgos actuales también coinciden con Mokhtari-Hessari y Montazeri35, quienes informaron mejoras sustanciales en la calidad de vida (QoL) derivadas de intervenciones de enfermería en pacientes con cáncer de mama. De manera similar, Aktas y Terzioglu36 encontraron que la atención de enfermería domiciliaria mejoró notablemente la calidad de vida en mujeres que recibían tratamiento por oncología ginecológica, y Ma et al.37 demostraron que la atención de enfermería psicológica intensiva alivió los estados de ánimo negativos y mejoró la calidad de vida en pacientes con cáncer de cuello uterino. Estas señales consistentes en diferentes tipos de cáncer y contextos subrayan el valor potencial de una atención de enfermería integral, aunque la calidad metodológica de las evidencias que la respaldan sigue siendo una preocupación.
Mecanismos probables
Aunque las estimaciones agrupadas no pueden establecer causalidad, varias vías pueden explicar las señales observadas en la calidad de vida. El ejercicio estructurado y la modificación de la dieta reducen los pro‑citoquinas inflamatorias (por ejemplo, IL‑6, TNF‑α) y C‑proteína reactiva, que está vinculada al cáncer‑fatiga, dolor y depresión relacionados. En sobrevivientes de cáncer de endometrio y de mama, la pérdida de peso y el ejercicio también reducen los niveles de estrógeno y de IGF‑1 niveles, afectando potencialmente el metabolismo tumoral y el equilibrio energético sistémico. Desde el punto de vista psicosocial, enfermera‑psicoeducación dirigida, asesoramiento y seguimiento regular‑puede mejorar el auto‑eficacia, reducir el miedo a la recurrencia y mejorar la adherencia al tratamiento. El más constante 6‑mes (frente a 3‑efectos mensuales (aunque no se probaron formalmente) podrían reflejar el tiempo necesario para que los cambios conductuales se vuelvan habituales y para que se acumulen adaptaciones biológicas. Sin embargo, ninguno de estos mecanismos se midió directamente en los estudios incluidos; esta discusión es especulativa y tiene como finalidad orientar futuras investigaciones mecanicistas.
Limitaciones metodológicas
Falta de registro prospectivo del protocolo: Una limitación principal es la ausencia de registro en un registro prospectivo (por ejemplo, PROSPERO, INPLASY o OSF Registries). Sin un protocolo registrado por adelantado y de acceso público, existe un riesgo de sesgo en la presentación o de selección de resultados, ya que no se pueden verificar de forma independiente las decisiones sobre la selección de estudios, la extracción de datos y los análisis frente a un plan preespecificado. Los lectores deben interpretar las estimaciones agrupadas teniendo esto en cuenta.
Alta heterogeneidad: El análisis primario a los 6 meses mostró una I2 = 71 %, lo cual, según las directrices de Cochrane, se considera "considerable" y a menudo un criterio para no combinar los datos. Aunque la subdivisión por tipo de cáncer redujo la I2 a 0 % tanto para los subgrupos de ovario como de endometrio, cada subgrupo incluyó solo unos pocos estudios (2 y 4, respectivamente), lo que hace que estas estimaciones sean imprecisas. La heterogeneidad no puede atribuirse con certeza únicamente al tipo de cáncer. Otras fuentes plausibles—diferencias en la intensidad de la intervención, duración, modalidad de aplicación, condiciones de control, características basales de los participantes y medición de los resultados—no se investigaron formalmente debido a datos covariables insuficientes. Dadas estas consideraciones, la diferencia media agrupada (MD) para el análisis primario debe considerarse como un resumen generado matemáticamente más que como una estimación clínicamente significativa.
Riesgo de sesgo: Ningún ECA fue calificado como de bajo riesgo en todos los dominios de la Cochrane RoB 2.0. La mayoría fueron calificados como tener "algunas preocupaciones" o "alto riesgo," principalmente debido a la falta de enmascaramiento de los participantes (inevitable en intervenciones sobre el estilo de vida) y a datos de resultado incompletos. La inclusión de cohortes solapadas del ensayo SUCCEED infla artificialmente el peso de esa intervención específica en el subgrupo de endometrio; el análisis de sensibilidad que excluyó el duplicado no alteró sustancialmente la estimación puntual, pero sigue siendo una limitación estructural.
Inclusión de estudios observacionales: Dos de los 15 informes incluidos carecían por completo de un grupo comparador (Budisan et al.33; Betea et al.34). Aunque estos estudios se mantuvieron para la síntesis narrativa con el fin de evitar el sesgo de selección, no pudieron incluirse en los efectos de intervención agrupados y se consideró que tenían un alto riesgo de confusión y sesgo de selección.
Diversidad de intervenciones y resultados: Los estudios comparativos incluyeron una amplia gama de intervenciones—programas de ejercicio estructurados, modificación de la dieta, asesoramiento para la pérdida de peso, sesiones psicoeducativas, seguimiento dirigido por enfermería, atención iniciada por el paciente y atención plena basada en aplicaciones. Agrupar intervenciones tan diversas bajo el término genérico "intervención de estilo de vida/enfermería" proporciona una estimación del efecto promedio, pero este promedio podría no aplicarse a ningún tipo específico de intervención. De manera similar, aunque todos los estudios midieron la calidad de vida relacionada con la salud, utilizaron instrumentos diferentes (FACT-G, FACT-O, FACT-En, EORTC QLQ-C30, SF-36), lo que podría introducir una heterogeneidad indirecta.
No se pudo evaluar de forma confiable el sesgo de publicación porque ninguno de los resultados agrupados incluyó 10 o más estudios. Por lo tanto, no se realizaron gráficos en embudo ni pruebas de regresión de Egger. El tamaño reducido de las muestras y la predominancia de estudios positivos en la literatura sugieren la posibilidad de que los hallazgos negativos o nulos permanezcan sin publicar.
Seguimiento breve y falta de análisis por subgrupos: La mayoría de los estudios incluyeron períodos de seguimiento cortos (3–6 meses), lo que limita la comprensión sobre la sostenibilidad a largo plazo de las mejoras en la calidad de vida. La ausencia de análisis exhaustivos por subgrupos (por ejemplo, por edad, estadio de la enfermedad, nivel socioeconómico) dificultó la identificación de categorías específicas de pacientes que podrían obtener el mayor beneficio.
Grado de certeza
La evaluación formal GRADE calificó como MUY BAJA la certeza general de la evidencia para los cuatro resultados agrupados. Este juicio refleja: (i) un riesgo de sesgo serio a muy serio en los ECA incluidos; (ii) una inconsistencia muy seria para el resultado principal a los 6 meses (I2 = 71%); (iii) una falta de aplicabilidad directa en el subgrupo de endometrio, que incluyó predominantemente sobrevivientes con sobrepeso u obesidad, lo que limita la generalización; y (iv) una imprecisión seria a muy seria debido a tamaños muestrales totales pequeños por subgrupo e intervalos de confianza amplios que a menudo cruzan el valor nulo. En consecuencia, la confianza en las estimaciones del efecto es muy limitada; es probable que los efectos reales sean sustancialmente diferentes de las estimaciones puntuales informadas.
Implicaciones clínicas
Dada la certeza muy baja de la evidencia y la heterogeneidad sustancial, estos hallazgos son hipotéticos‑generación en lugar de práctica‑cambiando. Los clínicos no deberían modificar la atención de apoyo habitual basándose en estas estimaciones agrupadas. Sin embargo, algunas observaciones cautelosas pueden orientar las conversaciones con los pacientes: (i) las decisiones sobre la atención de apoyo deben individualizarse según las preferencias del paciente y el contexto clínico; (ii) el subgrupo de cáncer de ovario mostró la única señal estadísticamente coherente (DM 4,28, IC del 95 %: 0,45–8.10), lo que sugiere que esta población podría beneficiarse particularmente de intervenciones basadas en el ejercicio, aunque esto se basa únicamente en dos estudios pequeños. Las señales positivas consistentes observadas en los estudios subrayan la importancia de una atención de enfermería integral, que incluya el manejo del dolor, el apoyo emocional, la educación del paciente y la coordinación de la atención, como componente fundamental de la atención oncológica multidisciplinaria. Es crucial señalar que las diferencias aparentes entre los tipos de cáncer y los puntos temporales no se probaron formalmente mediante análisis de interacción y no deben sobreinterpretarse.
Investigaciones futuras
Esta revisión expone brechas críticas de evidencia que futuras investigaciones deben abordar. Alto‑se necesitan urgentemente ECA multicéntricos de alta calidad, con intervenciones estandarizadas y manuales protocolos publicados, intención‑a‑análisis de tratamiento, seguimiento más largo‑arriba≥12 meses) y análisis de subgrupos preespecificados con pruebas formales de interacción. Los estudios mecanicistas deben incorporar evaluaciones de biomarcadores (citoquinas inflamatorias, perfiles hormonales) y mediadores psicosociales validados (autoeficacia‑eficacia, apoyo social) para identificar qué componentes de la intervención son más eficaces y en qué subgrupos de pacientes se observan mayores beneficios. Asimismo, se necesitan evaluaciones económicas para analizar el costo‑eficacia e informar la asignación de recursos. Las revisiones sistemáticas futuras con una base de evidencia más amplia deberían considerar si la metanálisis‑análisis sigue siendo apropiado para intervenciones tan diversas, o si una síntesis narrativa sería más informativa. Finalmente, paciente‑resultados centrados—incluyendo dominio‑medidas específicas de CV y paciente‑medidas de experiencia comunicadas—debe tener prioridad, con la participación de pacientes y del público en el diseño del estudio para garantizar que la investigación aborde lo que más importa a las mujeres con malignidades ginecológicas.
Este metaanálisis no encontró una mejora estadísticamente significativa en la calidad de vida general a los 3 o 6 meses entre mujeres con cánceres ginecológicos. Se observó una mejora significativa en el subgrupo de cáncer de ovario a los 6 meses, mientras que no se observó un efecto significativo en el subgrupo de cáncer de endometrio. Sin embargo, la heterogeneidad sustancial, las limitaciones metodológicas, el tamaño pequeño de los subgrupos y la evidencia de certeza muy baja justifican una interpretación cautelosa. Se necesitan ensayos más grandes y bien diseñados, con intervenciones estandarizadas y un seguimiento más prolongado, para aclarar los efectos de las intervenciones relacionadas con el estilo de vida y las intervenciones de enfermería en la calidad de vida de las mujeres con malignidades ginecológicas.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| EndNote | Clarivate Analytics | https://endnote.com | Gestión de referencias, eliminación de duplicados, formato de citas |
| GRADEpro GDT | Universidad McMaster y Evidence Prime | Universidad McMaster / Evidence Prime; https://gradepro.org | Evaluación de la certeza según GRADE (versión en línea) |
| Lista de verificación PRISMA 2020 | Declaración PRISMA | Declaración PRISMA; https://www.prisma-statement.org | Cumplimiento en la presentación de informes |
| R | Foundation for Statistical Computing | Foundation; https://cran.r-project.org | Análisis estadístico, análisis de sensibilidad, análisis de influencia, figuras (versión 4.3.1 o superior) |
| Paquete R: meta | CRAN | CRAN; https://cran.r-project.org/package=meta | Funciones para metaanálisis (agrupación, heterogeneidad, gráficos de bosque, gráficos en embudo), versión 6.0.0 o superior |
| Paquete R: metafor | CRAN | CRAN; https://cran.r-project.org/package=metafor | Estimación REML, diagnósticos de influencia, funciones adicionales para metaanálisis (versión 4.0.0 o superior) |
| Review Manager | RevMan | Colaboración Cochrane; https://training.cochrane.org/online-learning/core-software-cochrane-reviews/revman[reference:14] | Metaanálisis (agrupación, gráficos de bosque, heterogeneidad, evaluación del riesgo de sesgo), versión 5.4 |
Referencias
- Ackroyd SA, Shih YCT, Kim B, Lee NK, Halpern MT. A look at the gynecologic oncologist workforce – are we meeting patient demand Gynecol Oncol. 2021;163(2):229-36.
- Williams N, et al. The supportive care needs of women experiencing gynaecological cancer: a Western Australian cross-sectional study. BMC Cancer. 2018;18(1):912.
- Bizzarri N, et al. Building a personalized medicine infrastructure for gynecological oncology patients in a high-volume hospital. J Pers Med. 2022;12(1):3.
- Buckley L, Robertson S, Wilson T, Sharpless J, Bolton S. The role of the specialist nurse in gynaecological cancer. Curr Oncol Rep. 2018;20(10):83.
- Parkinson N, Pratt H. Clinical nurse specialists and the psychosexual needs of patients with gynaecological cancer. Br Menopause Soc J. 2005;11(1):33-5.
- Kobleder A, Mayer H, Gehrig L, Senn B. “Promoting continuity of care”—specialist nurses’ role experiences in gynaecological oncology: a qualitative study. J Clin Nurs. 2017;26(23-24):4890-8.
- Cook O, McIntyre M, Recoche K, Lee S. “Our nurse is the glue for our team”—multidisciplinary team members' experiences and perceptions of the gynaecological oncology specialist nurse role. Eur J Oncol Nurs. 2019;41:7-15.
- Lavdaniti M, et al. Factors influencing quality of life in breast cancer patients six months after the completion of chemotherapy. Diseases. 2019;7(1):26.
- Perry S, Kowalski TL, Chang CH. Quality of life assessment in women with breast cancer: benefits, acceptability and utilization. Health Qual Life Outcomes. 2007;5(1):24.
- Chhikara BS, Parang K. Global cancer statistics 2022: the trends projection analysis. Chem Biol Lett. 2023;10(1):451.
- Smits A, et al. The effect of lifestyle interventions on the quality of life of gynaecological cancer survivors: a systematic review and meta-analysis. Gynecol Oncol. 2015;139(3):546-52.
- Stroup DF, et al. Meta-analysis of observational studies in epidemiology: a proposal for reporting. JAMA. 2000;283(15):2008-12.
- Page MJ, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71.
- Liberati A, et al. The PRISMA statement for reporting systematic reviews and meta-analyses of studies that evaluate health care interventions: explanation and elaboration. J Clin Epidemiol. 2009;62(10):e1-34.
- Gupta S, et al. Efficacy of generic oral directly acting agents in patients with hepatitis C virus infection. J Viral Hepat. 2018;25(7):771-8.
- Adeiza SS, Aminul I. Meta-meta-analysis of the mortality risk associated with MRSA compared to MSSA bacteraemia. Infez Med. 2024;32(2):131-7.
- Higgins J, et al., editors. Cochrane handbook for systematic reviews of interventions. 2nd ed. Wiley & Sons; Chichester, UK; 2019.
- Sheikhbahaei S, et al. FDG-PET/CT and MRI for evaluation of pathologic response to neoadjuvant chemotherapy in patients with breast cancer: a meta-analysis of diagnostic accuracy studies. Oncologist. 2016;21(8):931-9.
- Higgins JP, Thompson SG, Deeks JJ, Altman DG. Measuring inconsistency in meta-analyses. BMJ. 2003;327(7414):557-60.
- McCorkle R, et al. Effects of a nursing intervention on quality of life outcomes in post-surgical women with gynecological cancers. Psychooncology. 2009;18(1):62-70.
- Von Gruenigen VE, et al. A randomized trial of a lifestyle intervention in obese endometrial cancer survivors: quality of life outcomes and mediators of behavior change. Health Qual Life Outcomes. 2009;7(1):17.
- Donnelly CM, et al. A randomised controlled trial testing the feasibility and efficacy of a physical activity behavioural change intervention in managing fatigue with gynaecological cancer survivors. Gynecol Oncol. 2011;122(3):618-24.
- McCarroll ML, et al. Self-efficacy, quality of life, and weight loss in overweight/obese endometrial cancer survivors (SUCCEED): a randomized controlled trial. Gynecol Oncol. 2014;132(2):397-402.
- Rossi A, et al. Feasibility of a physical activity intervention for obese, socioculturally diverse endometrial cancer survivors. Gynecol Oncol. 2016;142(2):304-10.
- Zhou Y, et al. Randomized trial of exercise on quality of life in women with ovarian cancer: Women’s Activity and Lifestyle Study in Connecticut (WALC). J Natl Cancer Inst. 2017;109(12).
- Jeppesen M, Jensen P, Hansen D, Christensen R, Mogensen O. Patient-initiated follow up affects fear of recurrence and healthcare use: a randomised trial in early-stage endometrial cancer. BJOG. 2018;125(13):1705-14.
- Morrison V, et al. Trial of optimal personalised care after treatment—gynaecological cancer (TOPCAT-G): a randomized feasibility trial. Int J Gynecol Cancer. 2018;28(2):401-11.
- Ngu SF, et al. Nurse-led follow-up in survivorship care of gynaecological malignancies—a randomised controlled trial. Eur J Cancer Care (Engl). 2020;29(6):e13325.
- Maurer T, et al. Randomised controlled trial testing the feasibility of an exercise and nutrition intervention for patients with ovarian cancer during and after first-line chemotherapy (BENITA-study). BMJ Open. 2022;12(2):e054091.
- McCloy K, et al. Management of fatigue in gynaecological cancer: a feasibility study of an app-based exercise and mindfulness intervention. Gynecol Oncol Rep. 2025;60:101807.
- Darwish EAF, Tayel SEA, Meleis MEH, Abou Elwafa HE, Shaaban Marouf FSA. A randomized controlled trial of the effect of a psychoeducational intervention program on quality of life of patients with gynecological cancers. Alex J Med. 2025;61(1):6-14.
- Elzeblawy Hassan H, Khalaf Gooda W, Ragabahmed T, Shehta Said Farag D. Marital, sexual satisfaction and quality of life among post-hysterectomy women: impact of nursing counseling guided by BETTER model. Egypt J Health Care. 2025;16(1):99-116.
- Budisan C, et al. Physical, emotional, and stress-related dynamics over six months in newly diagnosed epithelial ovarian cancer survivors. J Clin Med. 2025;14(14):5087.
- Betea R, et al. Quality-of-life trajectories and perceived stress in women treated for uterine cancer: a six-month prospective study. Healthcare (Basel). 2025;13(15):1787.
- Mokhtari-Hessari P, Montazeri A. Health-related quality of life in breast cancer patients: review of reviews from 2008 to 2018. Health Qual Life Outcomes. 2020;18(1):338.
- Aktas D, Terzioglu F. Effect of home care service on the quality of life in patients with gynecological cancer. Asian Pac J Cancer Prev. 2015;16(9):4089-94.
- Ma Y, Kamalibaike M, Xin C, Li L. Effect of the intensive psychological nursing on adverse mood and quality of life in patients with cervical cancer. Am J Transl Res. 2021;13(8):9633-8.