El trabajo propone un marco de análisis de emociones multimodal de extremo a extremo que aprovecha codificadores transformadores, representaciones de emociones desacopladas y atención multimodal basada en grafos con mapeo visual para mejorar la precisión del reconocimiento de emociones en dos conjuntos de datos.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Mapeo visual de características emocionales multimodales para el diseño de interacción inteligente
En este artículo
Resumen
Resumen
Al permitir que las máquinas comprendan, interpreten y reaccionen a estados afectivos humanos, la representación visual de rasgos emocionales multimodales es fundamental para el diseño de interfaces inteligentes. Sin embargo, los algoritmos actuales de detección emocional multimodal se centran principalmente en el rendimiento predictivo, aportando escasa comprensión sobre la interpretabilidad, la conciencia de la interacción o las interacciones entre modalidades a nivel de características. Este trabajo presenta un marco para la representación visual de aspectos emocionales multimodales que combina visualización orientada a la interacción, aprendizaje de representaciones interpretables y predicción emocional. Sin utilizar características creadas manualmente, se emplearon codificadores basados en transformadores para extraer representaciones emocionales de alto nivel a partir de modalidades textual, de audio y visual. Para mejorar la robustez, se separó la información específica de cada emoción y de cada modalidad mediante una técnica de aprendizaje de representaciones desentrañadas. Además, se diseñó una red de atención multimodal basada en grafos que utiliza ponderación adaptativa de la atención para simular relaciones emocionales sutiles entre modalidades. Se desarrolló un módulo de representación visual multivista para mostrar trayectorias emocionales temporales, distribuciones de atención cruzada entre modalidades e incrustaciones emocionales latentes, con el fin de aumentar la transparencia. El marco propuesto fue evaluado utilizando el conjunto de datos Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) y el conjunto de datos chino de Análisis de Sentimientos Multimodal (CH-SIMS). Los resultados experimentales indican que el marco sugerido ofrece una mejor interpretabilidad a nivel de características y una visualización consciente de la interacción, superando consistentemente a técnicas básicas representativas en términos de precisión, puntuación F1, correlación y error absoluto medio. Además, el módulo de representación visual facilitó la interpretación cualitativa de las representaciones emocionales multimodales, las interacciones entre modalidades y la dinámica emocional temporal, apoyando así la visualización y el análisis con conciencia de la interacción.
Introducción
La capacidad de identificar y comprender correctamente el sentimiento humano se ha vuelto crucial para mejorar la interacción entre humanos y máquinas. Además de ser esencial para mejorar la interacción humano-ordenador, el análisis de emociones tiene el potencial de revolucionar varios campos, incluyendo el diagnóstico médico pre-diagnóstico1, el análisis del comportamiento en el aula2, el seguimiento psicológico de pacientes3, la identificación de fatiga en vehículos4, y la gestión inteligente en entornos de hogares inteligentes5. Los recientes avances en computación afectiva y aprendizaje profundo6 han aumentado el interés en crear sistemas en tiempo real que puedan capturar la complejidad de la emoción humana.
Muchos métodos actuales dependen principalmente de datos unimodales, como signos textuales, gráficos o auditivos7,8,9. Estos enfoques fracasan repetidamente en detectar señales refinadas, como el sarcasmo o matices específicos del contexto. La investigación ha avanzado hacia la evaluación multimodal de emociones, que incorpora datos complementarios de múltiples fuentes para superar estas limitaciones.10,11,12. Las ventajas de combinar múltiples modalidades han sido demostradas por modelos de referencia como la fusión temprana-red neuronal de memoria a corto plazo (EF-LSTM)13 y las redes neuronales profundas ligeras y FM (LF-DNN)14, redes de fusión tensorial (TFN) y enfoques de fusión multimodal de rango bajo. Sin embargo, la mayoría de estos enfoques dependen de la generación previa de características y no son adecuados para situaciones dinámicas del mundo real.
Con el fin de dar cabida a los estados emocionales, en los últimos diez años ha crecido la investigación y las aplicaciones en identificación multimodal de emociones15. Una de las áreas de investigación más desafiantes y significativas en la actualidad es el monitoreo continuo de los estados emocionales mediante diversas fuentes de datos16. La idea de multimodalidad surgió de forma bastante natural con el surgimiento de un sistema tan diverso de conocimientos, lo que ha llevado a numerosos avances en la aplicación de emociones en áreas como la computación emocional, la interacción humano-computadora (HCI), el aprendizaje, los videojuegos, el servicio al consumidor, la atención médica, la evaluación de la experiencia del usuario (UX), etc. Sin embargo, no siempre ha sido sencillo aplicar técnicas de reconocimiento emocional en la evaluación de la experiencia del usuario.
Una de las principales razones para centrarse en el reconocimiento multimodal en lugar de métodos unimodales radica en las desventajas inherentes de depender de una única fuente de información. Los sistemas de detección de emociones unimodales pueden presentar menor precisión debido a datos ausentes o poco claros, mientras que los esquemas de MER son más confiables y ofrecen una comprensión más completa y reflexiva de los estados expresivos al integrar múltiples fuentes de datos17. Por ejemplo, el lenguaje facial por sí solo podría no ser suficiente para clasificar con precisión los sentimientos, especialmente cuando los gestos son complejos o ambiguos. Sin embargo, combinar expresiones faciales con otras formas de comunicación, como el lenguaje o las señales físicas, podría aumentar la precisión en el reconocimiento de emociones.
Se ha realizado una amplia investigación sobre el reconocimiento de emociones en varias modalidades. Los estudios iniciales se centraron en identificar características distintivas de diferentes modalidades, como entradas gráficas, acústicas o basadas en texto. Aunque cada vez es más evidente que la integración de diversas modalidades puede proporcionar información emocional equilibrada, lo que conduce a una detección de sentimientos más confiable y precisa. Este segmento revisa los avances clave en el análisis de emociones unimodal y multimodal, centrándose en los enfoques básicos, sus limitaciones y la justificación de nuestro método.
El estudio inicial sobre el reconocimiento de emociones se centró principalmente en una única modalidad. En el ámbito visual, investigaciones pioneras condujeron a la categorización de movimientos faciales prototípicos20. Avances posteriores incluyeron técnicas para capturar dinámicas temporales, como el movimiento visual21 y los modelos ocultos de Markov22, mientras que las respuestas faciales se dividieron en unidades de acción mediante el Sistema de Codificación de Acciones Faciales (FACS)23. Las redes neuronales de memoria a corto y largo plazo (LSTM) y las redes neuronales convolucionales (CNN) se han utilizado con éxito para extraer características significativas directamente de señales de audio en bruto; las metodologías para la identificación de emociones basadas en audio han evolucionado desde el procesamiento convencional de señales hasta el aprendizaje profundo24. La extracción de señales de sentimiento contextual en el análisis de emociones basado en texto se ha mejorado considerablemente mediante redes neuronales recurrentes (RNN) que incorporan mecanismos de atención y, más recientemente, mediante modelos basados en transformadores. A pesar de sus logros, las técnicas unimodales son intrínsecamente incapaces de representar con precisión las complejidades que experimentan las personas, ya que carecen de la información complementaria presente en otras modalidades.
Algunos modelos basados en mecanismos de atención, como el modelo DialogXL25, fueron propuestos en 2021 para recopilar datos ambientales de mayor duración en el área de identificación del sentimiento en conversaciones. Kim et al.26 presentó el modelo EmoBERTa en 2021 para aumentar la precisión del ERC. Este modelo utiliza datos de los hablantes para mejorar las características de los interlocutores en las conversaciones y sus interacciones mutuas. En 2022, Li et al.27 presentó el método CoG-BART. La organización utiliza aprendizaje contrastivo supervisado para mejorar la capacidad del modelo de interpretar datos relevantes. Cabe destacar que el aprendizaje supervisado requiere una cantidad considerable de datos etiquetados.
Un ejemplo típico de este tipo de trabajo es el marco de Representación con Conciencia de Interacción Multimodal (MIAR, por sus siglas en inglés)28, que utiliza tokens de interacción de características y alineación contrastiva para mejorar la generalización entre modalidades. MIAR mejora el alineamiento de modalidades y logra un rendimiento sólido en múltiples conjuntos de datos; sin embargo, se centra principalmente en la precisión predictiva sin abordar el mapeo visual. De manera similar, el modelo de Fusión Audiovisual con Atención Cruzada29 captura eficazmente interacciones audiovisuales finamente detalladas para la predicción de valencia y activación, pero se limita a dos modalidades y carece de capacidades de visualización. Los enfoques de modelado temporal basados en redes LSTM y fusión mediante autoencoders capturan con éxito la dinámica temporal de las emociones, pero ofrecen una visión limitada sobre las interacciones entre modalidades y las representaciones emocionales aprendidas. Más recientemente, métodos basados en transformadores, como la Red Neuronal de Fusión Multimodal Basada en Transformadores (TMFN, por sus siglas en inglés)30, han demostrado un buen desempeño en CMU-MOSI y CMU-MOSEI mediante una fusión multimodal mejorada y aprendizaje contrastivo. No obstante, estos enfoques siguen siendo principalmente impulsados por el rendimiento y ofrecen un soporte limitado para la explicabilidad, la interpretación a nivel de características y la visualización orientada a interacciones.
Para mejorar la integración de datos textuales, acústicos y visuales, se han propuesto varias técnicas de reconocimiento multimodal de emociones. Aunque las técnicas de fusión temprana como EF-LSTM y LF-DNN demostraron las ventajas de utilizar información multimodal para el análisis de sentimientos y emociones, no lograron capturar interacciones complejas entre modalidades. Aunque TFN mejoró el rendimiento en conjuntos de datos de referencia como CMU-MOSI y CMU-MOSEI e introdujo un modelado explícito de las interacciones intermodales, su baja interpretabilidad y alta complejidad computacional limitaron su utilidad. Para mejorar la alineación de modalidades y la fusión dinámica de características, técnicas más modernas como MIAR, modelos de fusión con atención cruzada, TMFN y transformadores multimodales adaptativos han empleado topologías de transformadores y mecanismos de atención. Estos métodos se centraron principalmente en el rendimiento predictivo, ofreciendo poca información sobre las representaciones emocionales a nivel de características y las dependencias intermodales, a pesar de obtener resultados competitivos en métricas de evaluación comunes como precisión, puntuación F1 y error absoluto medio. Además, pocos estudios han establecido técnicas de visualización que puedan revelar incrustaciones latentes de emociones, distribuciones de atención y dinámicas temporales de las emociones, o han integrado modelado basado en grafos de las interacciones intermodales. El enfoque propuesto incorpora mapeo visual multi-vista, fusión de atención intermodal basada en grafos y aprendizaje de representaciones desacopladas para superar estas limitaciones y mejorar el rendimiento del reconocimiento multimodal de emociones.
De manera similar, el Transformador Multimodal Adaptativo32 propone una fusión basada en intercambio para mitigar de forma adaptativa información modal ruidosa o faltante, mejorando así el rendimiento en la clasificación de sentimientos. Aunque este enfoque puede abordar eficazmente las discrepancias en la distribución de la información modal, su diseño es específico para el análisis de sentimientos y ofrece una visión limitada sobre las representaciones emocionales aprendidas. Otra contribución importante es el Modelo de Fusión Multimodal33, que integra CNN, LSTMs multiplicativos y atención basada en transformadores para el reconocimiento multimodal de emociones en tiempo real. El modelo realiza una fusión completa de las modalidades de video, audio y texto, y muestra un rendimiento robusto en el reconocimiento. Sin embargo, al igual que otros modelos existentes, se centra principalmente en la precisión predictiva y carece de características explícitas para la visualización y la interpretabilidad orientada a la interacción.
En conclusión, aunque los actuales enfoques multimodales de última generación para el reconocimiento de emociones han logrado un éxito considerable en la captura de interacciones entre modalidades y en la mejora de la precisión de las predicciones, la mayoría de ellos se centran en tareas orientadas al reconocimiento. Se ha prestado poca atención a aspectos como la interpretabilidad a nivel de características, la visualización de representaciones emocionales en el espacio de la imagen y la incorporación del marco propuesto para el diseño de interacciones inteligentes. Es con estos desafíos en mente que se presenta el marco propuesto.
La mayoría de los métodos actuales se centran principalmente en mejorar el rendimiento predictivo, ofreciendo escasa interpretabilidad de las representaciones emocionales aprendidas y de las interacciones multimodales, a pesar de los notables avances en el reconocimiento multimodal de emociones28,29. Las interacciones complejas entre las modalidades textual, acústica y visual suelen ser difíciles de modelar para las estrategias de fusión actuales, especialmente cuando ocurren discrepancias entre modalidades y escasez de información 28,31. Aunque los diseños basados en transformadores y los mecanismos de atención han mejorado el aprendizaje de representaciones, su transparencia e interpretabilidad a menudo se ven reducidas por la falta de separación explícita de la información específica de la emoción y de la información específica de la modalidad31,32,33. Además, solo un pequeño número de estudios ha investigado la modelización basada en grafos de las interacciones intermodales o ha creado marcos de visualización capaces de revelar dinámicas temporales de la emoción, distribuciones de atención e incrustaciones de emociones. Estas limitaciones demuestran la necesidad de un marco multimodal interpretable para la interacción inteligente entre humanos y máquinas que combine una representación visual orientada a la interacción con un aprendizaje cruzado modal robusto.
Este trabajo presenta un marco interpretable para la representación visual de aspectos emocionales multimodales en el diseño de interfaces inteligentes. Sin necesidad de características creadas manualmente, el sistema utiliza aprendizaje profundo de extremo a extremo para extraer representaciones emocionales de alto nivel a partir de modalidades textual, de audio y visual. Las interacciones emocionales cruzadas se modelan mediante un mecanismo de fusión con atención basado en grafos que separa la información específica de la emoción y la específica de la modalidad, lo que permite un aprendizaje de representación desacoplado y mejora la interpretabilidad y la robustez. Además, se crea un módulo de visualización multivista para mostrar la dinámica emocional temporal, los patrones de atención cruzada entre modalidades y los embeddings emocionales. La eficacia y adecuación del marco propuesto en sistemas inteligentes de interacción humano-máquina se evalúan mediante validación en conjuntos de datos de referencia para el reconocimiento emocional multimodal.
Este trabajo ofrece un marco único para la representación visual de aspectos emocionales multimodales que va más allá de los enfoques tradicionales orientados a la predicción, con el fin de superar la deficiente modelización de las interacciones entre modalidades y la limitada interpretabilidad en los actuales sistemas de identificación emocional multimodal. Dentro de una única arquitectura, el enfoque propuesto combina aprendizaje de representaciones multimodales basado en transformadores, modelado de características desacopladas con conciencia emocional, fusión de atención entre modalidades basada en grafos y visualización orientada a las interacciones. El marco separa claramente las representaciones específicas de la emoción y las específicas de la modalidad para mejorar la interpretabilidad, la robustez y la coherencia entre modalidades, en contraste con los enfoques actuales que se centran principalmente en el rendimiento de clasificación. Además, se presenta un mecanismo de atención basado en grafos para permitir la modelización adaptativa de las interacciones intermodales, capturando la interdependencia emocional fina entre las modalidades textual, de audio y visual. Se desarrolla un módulo de representación visual multivista para aumentar la transparencia, revelando trayectorias temporales de las emociones, patrones de atención entre modalidades y representaciones latentes de las emociones, lo que proporciona una comprensión intuitiva del proceso de toma de decisiones del modelo. Además de ofrecer una visualización y interpretabilidad mejoradas de la dinámica emocional multimodal, la evaluación experimental en los conjuntos de datos de referencia CH-SIMS y CMU-MOSEI mostró un rendimiento competitivo en cuanto a precisión, puntuación F1, error absoluto medio y correlación.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
El trabajo propuesto tiene como objetivo mejorar el diseño de interacción inteligente al ofrecer un marco interpretable para la representación visual de características emocionales multimodales. En este trabajo se utilizaron las bases de datos CH-SIMS y CMU-MOSEI, que son de acceso público. Ambos conjuntos de datos se obtuvieron de sus fuentes oficiales y se emplearon cumpliendo con las directrices de uso, estándares de investigación y términos de licencia establecidos por sus respectivos creadores. El contenido multimodal de los conjuntos de datos, que incluye texto, audio y datos de video, fue recopilado y anotado inicialmente por los proveedores de los conjuntos de datos, de acuerdo con los permisos autorizados de los participantes y sus protocolos de recolección de datos. En este estudio no hubo interacción directa con seres humanos, ni reclutamiento de nuevos participantes, ni recopilación de información identificable personalmente. Todos los análisis se realizaron utilizando conjuntos de datos de investigación de acceso público. Por consiguiente, nuestro análisis secundario de datos no requirió ninguna aprobación ética adicional ni revisión por parte de una Junta de Revisión Institucional (IRB). El estudio se llevó a cabo cumpliendo con las normas institucionales adecuadas que regulan el uso de conjuntos de datos de acceso público, los procedimientos éticos de investigación y las políticas aplicables de uso de datos.
Se empleó un mecanismo de atención cruzada basado en grafos para aprender caracterizaciones emocionales entre modalidades, utilizando características específicas de la emoción o de la modalidad con el fin de mejorar la comprensión. Se utiliza un componente de mapeo visual multivista para potenciar el diseño interactivo consciente de las emociones en tiempo real, y se estima su eficiencia en el reconocimiento emocional. Los resultados muestran que el método propuesto mejora tanto la interpretabilidad como la eficiencia de las interfaces de usuario inteligentes sensibles a las emociones en entornos reales. Figura 1 muestra el flujo arquitectónico del trabajo propuesto. Figura 1 muestra el flujo completo del marco de mapeo visual sugerido para el aprendizaje de características emocionales multimodales en el contexto de sistemas de interacción inteligentes. El flujo comienza con tres modalidades de entrada sincronizadas, a saber, texto, audio y video, que capturan información emocional complementaria proveniente de las modalidades lingüística, prosódica y de expresión facial, respectivamente. Un codificador transformador específico de modalidad procesa cada modalidad para obtener representaciones de alto nivel de los datos de entrada brutos. Luego, las representaciones se introducen en un módulo de aprendizaje de representaciones desacopladas, donde los incrustados específicos de la emoción se separan de las características específicas de la modalidad, asegurando así la coherencia en las emociones aprendidas a través de fuentes de datos heterogéneas. Los incrustados específicos de la emoción de cada modalidad se agrupan entonces mediante una red de atención cruzada basada en grafos, que modela las dependencias emocionales intermodales y asigna pesos dinámicos de importancia a cada modalidad según el contexto de interacción. Finalmente, el marco proporciona tanto salidas de clasificación emocional como información sobre la interacción, lo que facilita la toma de decisiones transparente basada en emociones y el diseño adaptativo de interacciones inteligentes.
Adquisición de datos multimodal
Los conjuntos de datos CH-SIMS y CMU-MOSEI son dos conjuntos de datos multimodales de dominio público existentes que han recopilado información multimodal, como video, audio y texto sincronizados. El conjunto de datos CH-SIMS comprende exámenes multimodales de personas chinas, incluyendo 2.281 segmentos de video, derivados de múltiples segmentos de películas, dramas televisivos y programas de variedades. La adición de audio y texto correspondientes a estos segmentos de video hace que los estudios sobre análisis multimodal de emociones utilizando datos multimodales sean más atractivos y viables. Sin embargo, uno de los conjuntos de datos multimodales más grandes para el examen de opiniones, sentimientos y emociones es el conjunto de datos CMU-MOSEI, que fue recopilado a partir de más de 23.000 clips de video de frases pronunciadas por más de 1.000 hablantes sobre una variedad de temas. El conjunto de datos se dividió aleatoriamente en subconjuntos de entrenamiento (70 %), validación (15 %) y prueba (15 %), manteniendo la distribución de clases.
Se obtienen transcripciones textuales, señales de audio y cuadros de video, y se alinean mediante marcas de tiempo para coincidir a un nivel temporal finamente detallado. La integración a nivel de cuadro garantiza que los mecanismos propuestos de aprendizaje de representación y fusión basada en grafos puedan modelar y aprovechar conjuntamente el contenido emocional derivado de expresiones visuales, tonos vocales y contenido lingüístico. La extracción eficaz de las dinámicas emocionales intermodales se posibilita mediante este tipo de técnica de adquisición multimodal, que es esencial para el diseño de interacciones inteligentes y la creación de mapas visuales comprensibles.
Tabla 1 presenta las estructuras clave de los conjuntos de datos multimodales de emociones utilizados en el método propuesto. Para obtener un rango más amplio de sentimientos relacionados, como palabras habladas, entonaciones de voz y expresiones faciales, CH-SIMS y CMU-MOSEI integran modalidades de video, audio y texto provenientes de estos conjuntos de datos. Además, el número de muestras de datos disponibles en CH-SIMS es limitado, lo que permite un examen exhaustivo de las interacciones entre modalidades y la variación emocional en China. Por otro lado, el conjunto de datos CMU-MOSEI es más importante para evaluar la robustez del aprendizaje de representaciones y los algoritmos relacionados de visualización tratados en este trabajo, ya que contiene una gran cantidad de datos en diversos idiomas, sujetos y niveles de emoción anotados. Asimismo, en comparación con investigaciones anteriores, reduce las dificultades en la selección de información al probar modelos.
Preprocesamiento y sincronización multimodal
Las anotaciones de marca de tiempo de los conjuntos de datos CH-SIMS y CMU-MOSEI se utilizaron para sincronizar las modalidades textual, auditiva y visual, asegurando un aprendizaje consistente de representación multimodal. Cada emisión funcionó como la unidad fundamental de análisis y se vinculó con segmentos de audio y video correspondientes dentro del mismo intervalo temporal. La alineación se realizó a nivel de emisión. La transcripción se dividió en segmentos según las marcas de tiempo de inicio y finalización de cada emisión. Se estableció la correspondencia entre transcripción, audio y video extrayendo los fotogramas de video y las señales de audio que caían dentro del mismo intervalo de tiempo. Mientras que los segmentos de audio se procesaron utilizando Wav2Vec 2.0 para producir representaciones acústicas, los fotogramas visuales del segmento de video se muestrearon a una tasa predeterminada y se codificaron usando el Transformador de Visión (ViT). El codificador RoBERTa se utilizó para crear incrustaciones textuales a partir de las transcripciones de las emisiones. La sincronización temporal se logró alineando todas las características de modalidad con un único límite de emisión, ya que las tres modalidades producían secuencias de características de longitudes variables. Se utilizó un formato de longitud fija para normalizar secuencias de longitudes variables. Las secuencias más largas se acortaron hasta la longitud máxima permitida, mientras que las secuencias más cortas se rellenaron con ceros. Durante el entrenamiento, se utilizaron máscaras de atención para separar los elementos rellenados de las posiciones legítimas de características. Las incrustaciones específicas de cada modalidad se proyectaron en un espacio latente común antes de la fusión, con el fin de superar las diferentes longitudes de secuencia entre modalidades. Esto garantizó consistencia dimensional y permitió que el mecanismo de atención basado en grafos facilitara un aprendizaje efectivo de interacción cruzada entre modalidades. Para preservar la calidad de los datos y la integridad de la sincronización, se excluyeron de los estudios las muestras con archivos dañados, anotaciones faltantes o información incompleta de modalidad.
Extracción de características basada en transformadores
Se utiliza un método de aprendizaje profundo para aprender representaciones de características de alto nivel con reconocimiento emocional a partir de información de múltiples modalidades, como visión, audio y texto, de manera integral, tras alinear los datos multimodales y realizar cualquier preprocesamiento necesario. Al emplear un codificador transformador para aprender representaciones de características intrínsecamente discriminativas a partir de datos multimodales crudos, el método propuesto elimina la necesidad de ingeniería de características. Para facilitar la coherencia entre los conjuntos de datos utilizados en el enfoque propuesto, se aprende un embedding de tamaño fijo para cada modalidad. Por ejemplo, se aprenden embeddings de características de 768 dimensiones en cada una de las modalidades individuales, incluyendo imágenes, audio y texto, formando colectivamente un espacio de características unificado que se utiliza en todo el enfoque, particularmente en un método de extracción de características aplicado al conjunto de datos CH-SIMS propuesto y al conjunto de datos CMU-MOSEI, con el fin de aprender características de alto nivel a partir de datos de diversos tamaños.
Modalidad visual: Transformador de visión para incorporaciones de fotogramas con reconocimiento de emociones
Se utilizó un modelo de Transformador de Visión (ViT-Base) para extraer información visual de los fotogramas de video con el fin de obtener representaciones espaciales relevantes para las emociones. Antes de extraer las características, los fotogramas de cada segmento de video se redimensionaron a (224 × 224) píxeles y se muestrearon a intervalos temporales regulares. Mediante un tamaño de fragmento de 16 × 16 píxeles, la arquitectura ViT-Base produce una serie de tokens visuales que son procesados por 12 capas codificadoras tipo transformador. Las representaciones de nivel de fotograma recuperadas se proyectaron en un espacio de incrustación de 768 dimensiones utilizando un modelo ViT previamente entrenado como base visual. Las incrustaciones a nivel de fotograma se agregaron mediante agrupamiento promedio (mean pooling) para crear la representación visual final de cada segmento. Durante el entrenamiento, se utilizaron normalización de imágenes y métodos comunes de aumento de datos, como recorte aleatorio y volteo horizontal, para mejorar la generalización. Luego, se empleó el marco sugerido de fusión multimodal para combinar estas incrustaciones visuales con representaciones textuales y auditivas.
Para mantener la dinámica temporal en la emoción, se tomarán muestras uniformemente de los videos de los conjuntos de datos CH-SIMS y CMU-MOSEI para la modalidad visual. Los fotogramas de cada video, 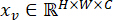 , pueden dividirse en N secciones de tamaño fijo, que luego se aplanan y se transforman inversamente a un espacio de incrustación latente con dimensión
 . Se crea una serie mediante la adición de incrustaciones posicionales y un token de agrupación aprendible:
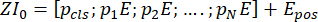 (1)
donde  representa la codificación posicional y
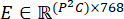 es la matriz de incrustación de fragmentos.
Se utilizan capas de codificador transformador apiladas, compuestas por redes de alimentación directa y autoatención multi-cabeza, para procesar la secuencia de fragmentos incrustados. La transformación en la capa l se describe como:
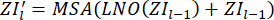 (2)
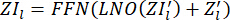 (3)
Para obtener el vector de características visuales consciente de emociones, se extrae la salida equivalente al token de clase como vector de características  . Para abordar representaciones visuales de emociones consistentes a pesar de las diferencias lingüísticas y de contenido entre conjuntos de datos, los incrustados a nivel de cuadro de cada segmento de video se combinan para capturar expresiones faciales y la evolución de las emociones.
Modalidad de audio utilizando Wav2Vec 2.0 para prosodia e incrustaciones acústicas semánticas Se generaron incrustaciones de habla contextualizadas utilizando un codificador Wav2Vec 2.0 previamente entrenado como base acústica. Se obtuvo un vector de características acústicas de longitud fija para cada frase mediante la agregación de las representaciones ocultas de salida usando promediado. El modelo Wav2Vec 2.0 se utilizó para extraer representaciones acústicas de señales de audio con el fin de capturar características del habla contextualmente relevantes para la emoción. Antes de la extracción de características, las grabaciones de audio se normalizaron y remuestrearon a 16 kHz. Para garantizar la sincronización entre las modalidades textual y visual, cada segmento de audio a nivel de enunciado se aisló utilizando los límites de marca de tiempo proporcionados por las anotaciones del conjunto de datos. El codificador acústico previamente entrenado se ajustó durante el entrenamiento del modelo para mejorar la adaptación específica a la tarea, permitiendo que las representaciones derivadas representen con mayor precisión los aspectos emocionales de las señales de habla. Luego, se realizó una fusión de atención multimodal basada en grafos y un aprendizaje de representaciones desentrelazadas utilizando las incrustaciones de audio finales.
En la modalidad de audio, se utiliza Wav2Vec-2.0 para modelar las señales de voz derivadas de la información inicial de habla en los conjuntos de datos CH-SIMS y CMU-MOSEI, extrayendo directamente características de audio relacionadas con la emoción. Existe una codificación de características convolucional para cada señal de voz de entrada  :
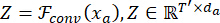 (4)
donde Z representa rasgos prosódicos de bajo nivel como melodía, tono y energía. Una red contextual basada en transformadores es útil para las estructuras mencionadas anteriormente, ya que representa dependencias temporales de largo alcance:
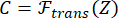 (5)
Los datos acústicos prosódicos y semánticos, que son esenciales para expresar emociones, se incluyen en estas representaciones acústicas contextuales. Un vector de audio de longitud específica se crea realizando un procedimiento de agrupación temporal:
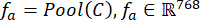 (6)
El diseño evita el uso de características acústicas como los MFCC y logra durabilidad utilizando datos de habla en inglés del CMU-MOSEI y datos de habla en chino del CH-SIMS, extrayendo simplemente representaciones de las formas de onda.
Modalidad de texto utilizando RoBERTa para incorporaciones contextuales de emociones
Para la modalidad textual, se aplicó el transformador bidireccional profundo RoBERTa a las transcripciones de habla de los dos conjuntos de datos para generar semántica contextual y significado afectivo. Se utilizaron codificadores transformadores basados en RoBERTa para extraer representaciones textuales de los datos de transcripción y capturar información semántica y emocional contextual. Se empleó un modelo RoBERTa preentrenado para el conjunto de datos CMU-MOSEI en inglés, mientras que se utilizó una variante de RoBERTa en chino para el conjunto de datos CH-SIMS en chino, con el fin de considerar mejor las características lingüísticas específicas del idioma. El preprocesamiento del texto incluyó la tokenización mediante el tokenizador RoBERTa adecuado para cada idioma y la normalización del texto. Para garantizar un procesamiento por lotes coherente, las secuencias de entrada se convirtieron en incrustaciones de tokens y se rellenaron o recortaron hasta una longitud máxima de secuencia predeterminada. De acuerdo con el formato de entrada de RoBERTa, se introdujeron tokens especiales de clasificación y separadores. Se obtuvo una incrustación textual de longitud fija mediante la agregación de las representaciones de tokens contextualizados producidas por el codificador transformador, utilizando la representación final de oración equivalente a [CLS]. Para adaptar las representaciones aprendidas a la tarea de reconocimiento de emociones, los codificadores RoBERTa preentrenados se afinaron mediante entrenamiento multimodal. Luego, se utilizó el marco sugerido de fusión multimodal para combinar las incrustaciones textuales con las características auditivas y visuales.
Las incorporaciones de tokens y las codificaciones posicionales se pueden combinar para cada entrada tokenizada, 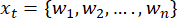 , para crear la representación de entrada en la técnica de transformación bidireccional profunda conocida como
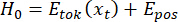 (7)
Esta forma se representa mediante las capas del transformador L, que utiliza la autoatención para descubrir las dependencias de contexto entre las palabras:
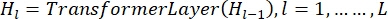 (8)
La incorporación del contexto emocional se obtiene utilizando el estado oculto final del token de clasificación:
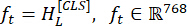 (9)
La polaridad del sentimiento, las emociones intensas y las implicaciones asociadas son ejemplos de características lingüísticas relacionadas con las emociones que estarán representadas por esta incrustación. RoBERTa facilita la modelización independiente del lenguaje. Esto permite al sistema utilizar el mismo tamaño de incrustación tanto para textos en inglés del conjunto de datos CMU-MOSEI como para textos en chino del conjunto de datos CH-SIMS.
Tres vectores de características específicas de modalidad de 768 dimensiones, cada uno correspondiente a las modalidades visual fv, auditiva fa y textual ft , se extraen mediante el paso propuesto de aprendizaje de representación de características profundas. En el diseño de interacción inteligente, estas representaciones aprendidas crean un espacio unificado de características multimodal que sirve como base para la asignación visual a nivel de características, la fusión cruzada de modalidades basada en grafos y el aprendizaje de representaciones desacopladas.
Aprendizaje de representación desenredada
Después de aprender una representación de características profundas, un procesamiento adicional de los vectores de características multimodales provenientes de las modalidades visual, auditiva y textual puede generar una descripción emocional disociada. Si las incrustaciones de características específicas de cada modalidad —auditiva, visual y textual— utilizadas en el paso anterior se representan mediante fv, fa y ft, respectivamente, de tal manera que  y
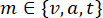 , el objetivo de este paso consiste en factorizar todas las características modales en dos representaciones latentes distintas, que incluyen las representaciones emocionales tras considerar la semántica previa de cada una de las diferentes modalidades.
Esto se logra alimentando cada característica de modalidad, fm, en dos redes de proyección paralelas: un codificador de emoción  y un codificador de modalidad
 , donde se generan las dos codificaciones.
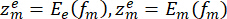 (10)
Donde  representa la característica latente asociada a la emoción y
 representa una característica latente específica de una modalidad. Esto permite que los incrustados específicos de la emoción se comuniquen con un espacio de manera repetida a través de múltiples entradas, incluyendo audio, visual y texto, al tiempo que conservan los datos estructurales únicos asociados a cada modalidad.
Se logra una separación efectiva mediante la reconstrucción con restricciones de independencia. La reconstrucción de la característica de la modalidad original viene dada por:
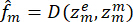 (11)
donde  es una red decodificadora. La pérdida de reconstrucción conserva los siguientes datos:
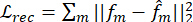 (12)
Además, la ortogonalidad, o decorrelación, entre la emoción y las representaciones específicas de la modalidad suele limitar la superposición de información:
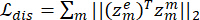 (13)
Al alcanzar estos objetivos, el modelo podría aprender representaciones de emociones que sean confiables, comprensibles y resistentes a la variabilidad de la modalidad. Las fusiones posteriores basadas en grafos entre modalidades y las características de mapeo visual, especialmente para el diseño de interacción inteligente, dependen en gran medida de representaciones emocionales interpretables y estructuradas.
Coincidencia emocional entre modalidades
La incorporación de la consistencia emocional mejora claramente la eficacia de la fusión entre las modalidades. Esto se debe a que las estrategias de fusión no necesitan compensar grandes diferencias entre las dos representaciones, ya que los embeddings emocionales específicos de cada modalidad comparten un espacio latente. La ilustración combinada de las dos emociones se describe a continuación  . La fusión ponderada será más estable cuando las representaciones específicas de la emoción sean coherentes, porque las variaciones entre las señales provenientes de distintas modalidades ya no afectarán al resultado.
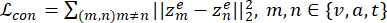 (14)
Al exigir el alineamiento semántico de la información emocional, este objetivo minimiza las discrepancias entre modalidades y garantiza que la percepción emocional permanezca consistente independientemente de la modalidad utilizada para expresarla. En consecuencia, se crea un espacio de representación coherente y afectivo mediante la proyección de las señales emocionales obtenidas de las señales de habla, expresiones faciales y contenido lingüístico.
Impacto en la fusión cruzada de modalidades
La fusión multimodal se vuelve más efectiva cuando se introduce consistencia emocional entre las modalidades. Los mecanismos de fusión ya no tienen que compensar grandes brechas en las representaciones intermodales, ya que los embeddings específicos de la emoción están alineados en un espacio latente común. La representación emocional fusionada se define de la siguiente manera:
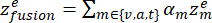 (15)
Donde αm representa el peso de la atención asignado a la modalidad m. La fusión ponderada se vuelve más estable y comprensible cuando las representaciones específicas de la emoción son coherentes, ya que el resultado de la fusión muestra evidencia emocional complementaria en lugar de señales de modalidad contradictorias.
Matemáticamente, reducir  varianza entre diversos tipos de representaciones específicas de emociones en relación con es equivalente a:
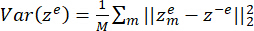 (16)
donde  representa la expresión media de la emoción. La varianza reducida hace que las modalidades de entrada se ponderen según su significado emocional preciso en lugar del ruido de la modalidad, lo que garantiza una mejor convergencia de la red y una evaluación de la atención más precisa.
El objetivo final de aprendizaje de las visualizaciones de emociones desacopladas es combinar la fragmentación, la reconstrucción y la uniformidad emocional:
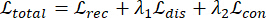 (17)
que dos hiperparámetros, λ1 y λ2, controlan la relación entre la fiabilidad emocional cruzada y la disociación. El modelo propuesto obtiene representaciones emocionales modales-invariantes, interpretables y fusibles para lograr esto, haciendo hincapié en proporcionar una base sólida para la fusión basada en grafos y la representación a nivel de características en el diseño de interfaces inteligentes.
Fusión de atención multimodal basada en grafos
Se utilizó una red de atención multimodal basada en grafos para simular relaciones emocionales finamente detalladas entre modalidades. Para facilitar el flujo de información entre modalidades, se construyó un grafo multimodal completamente conectado, en el que cada embedding específico de una modalidad (texto, audio y visual) se representaba como un nodo del grafo. Las relaciones entre modalidades se emplearon para establecer la matriz de adyacencia del grafo, la cual luego se mejoró mediante un método de atención aprendible. Se creó un espacio latente compartido concatenando y proyectando las salidas de varias cabezas de atención. Una representación unificada de la emoción multimodal se generó entonces al agregar las representaciones de los nodos usando una agrupación ponderada por atención. Este vector fusionado fue enviado posteriormente a los módulos de predicción y visualización para el análisis sensible a interacciones y el reconocimiento emocional. El módulo de fusión basado en grafos tenía una dimensión de representación oculta de 256 y dos capas de atención en grafos, cada una con ocho cabezas de atención. Para determinar la importancia relativa de las modalidades cercanas, se calcularon y estandarizaron los coeficientes de atención entre nodos conectados utilizando la función softmax. Cada capa de atención en grafos fue seguida por una normalización por capas, conexiones residuales y una tasa de abandono (dropout) de 0,2 para aumentar la estabilidad durante el entrenamiento y reducir el sobreajuste. Tras concatenar y proyectar las salidas de varias cabezas de atención hacia un espacio latente común, las representaciones de los nodos se combinaron en un único embedding multimodal de emoción mediante una agrupación ponderada por atención. Posteriormente, esta representación fusionada se utilizó para la predicción emocional y la proyección visual multi-vista.
Se capturaron diversas interacciones multimodales utilizando una atención gráfica multi-cabeza. Se utilizó la función softmax para normalizar los coeficientes de atención entre nodos conectados para cada nodo. Para aumentar la estabilidad durante el entrenamiento y evitar el sobreajuste, a las capas apiladas de atención gráfica del módulo de fusión gráfica se les añadieron conexiones residuales, normalización por capas y regularización por eliminación aleatoria.
Consideremos que los términos representan individualmente las representaciones correspondientes a las emociones particulares captadas por las modalidades visual, auditiva y textual; cada componente se encuentra dentro del espacio latente compartido  . Los modelos para los nodos de modalidad utilizan una notación para el grafo
 , con los nodos de la colección
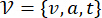 correspondientes a los tres nodos de modalidad mismos, con el fin de reforzar explícitamente las dependencias emocionales compartidas entre las distintas representaciones de modalidad.
Después de asignar un vector de características específico a cada emoción a cada nodo en el grafo, tenemos:
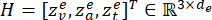 (18)
A diferencia de los métodos tradicionales de fusión, que utilizan pesos de fusión predeterminados o fijos, el método propuesto aprende pesos de borde adaptativos según su importancia y dependencias, tanto entre canales como entre situaciones emocionales.
Se utiliza una red de atención gráfica (GAT) para la fusión multimodal. Se calcula un coeficiente de atención para cada nodo i y sus nodos vecinos, es decir, el nodo j:
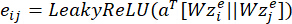 (19)
El efecto emocional de cambiar del modo j a la modalidad i se mide mediante los pesos normalizados αij.
A continuación, se calcula la apariencia fusionada de cada nodo de modalidad como un agrupamiento ponderado de sus vecinos:
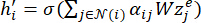 (20)
donde la función de activación  es no lineal. Finalmente, las características actualizadas de cada nodo se combinan para obtener una representación global fusionada de la emoción:
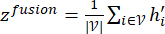 (21)
Es una técnica útil para la modelización de emociones interpretable y la posterior representación visual porque captura información complementaria de diversas modalidades, al tiempo que conserva las complejas relaciones intermodales.
El algoritmo 1 (Archivo Suplementario 1) proporciona el esquema general para llevar a cabo la fusión multimodal basada en grafos. Inicialmente, se crea un grafo con las características específicas de cada emoción vinculadas a las modalidades visual, auditiva y textual. Luego, se calculan las puntuaciones de atención para cada par de nodos del grafo, que representan la combinación de dependencia emocional. Estas puntuaciones se normalizan a continuación para indicar la contribución relativa de cada modalidad al contexto emocional especificado, lo que permite el aprendizaje de los pesos de atención. La representación general de la emoción se genera en la última etapa mediante la agregación de las características asociadas a los nodos del grafo. En este sentido, la fusión general del algoritmo de las características multimodales vinculadas a las emociones especificadas muestra potencial en cuanto a adaptabilidad, interpretabilidad e inteligencia contextual.
Figura 2 muestra la estructura y el funcionamiento de la red propuesta de atención cruzada modal para la fusión de sentimientos multimodal. Las representaciones específicas de la emoción, derivadas de forma independiente para las modalidades de texto, auditiva y de video, pasan inicialmente a través de mecanismos de atención a nivel modal que aprenden la importancia relativa de la información lingüística, vocal y facial en un contexto emocional determinado. Las representaciones ponderadas por la atención de las modalidades se combinan luego para formar una representación unificada de la emoción, en la cual la matriz de atención captura las dependencias intermodales y las intensidades de interacción. La matriz de atención aprendida por la red modula dinámicamente las contribuciones de las modalidades, permitiéndole enfocarse en la modalidad instruccional más fuerte mientras ignora aquellas que son ruidosas o menos informativas. La representación emocional fusionada permite un reconocimiento preciso de la emoción y un análisis detallado de estados emocionales como neutral, abrazo y preocupación.
Módulo de mapeo visual
Con la ayuda de la sección de mapeo visual, creada específicamente para este fin, un diseñador de interacciones inteligente puede convertir la representación unificada del estado emocional en una forma visual comprensible y fácilmente asimilable tras el proceso de fusión multimodal, basándose en el grafo.
Para facilitar la comprensión de las representaciones emocionales latentes, se utilizaron técnicas de reducción de dimensionalidad para visualizar los embeddings multimodales de emociones aprendidos. Después de reducir la dimensionalidad de las características manteniendo la mayor parte de la varianza mediante el Análisis de Componentes Principales (PCA), los embeddings se proyectaron en un espacio bidimensional para su visualización usando el Método t-SNE (t-distributed Stochastic Neighbor Embedding). Para t-SNE se utilizó un valor de perplejidad de 30, una tasa de aprendizaje de 200 y 1.000 iteraciones de optimización. Las agrupaciones específicas de emociones y las relaciones entre modalidades se visualizaron empleando las proyecciones obtenidas. Los pesos normalizados de atención cruzada obtenidos mediante la red de atención basada en grafos se utilizaron para crear mapas térmicos de atención. En estos mapas térmicos se muestra la contribución relativa de las modalidades textual, de audio y visual durante la predicción de emociones. Los coeficientes de atención aprendidos se usaron como pesos de las aristas para crear grafos de interacción cruzada, lo que permitió examinar visualmente las relaciones intermodales y el flujo de información dentro del marco de fusión. Se generaron gráficos de trayectoria emocional mediante el seguimiento del desarrollo de los embeddings emocionales latentes a lo largo de enunciados sucesivos, con el fin de examinar la dinámica emocional temporal. Estas trayectorias proporcionan información sobre cómo evolucionan los estados emocionales y las contribuciones de las modalidades a lo largo del tiempo. Todos los gráficos se crearon utilizando paquetes de Python como Matplotlib y Scikit-learn. Para evaluar la interpretabilidad, la formación de agrupaciones, las contribuciones de las modalidades y la dinámica emocional temporal, se realizaron análisis cualitativos de las visualizaciones de embeddings, los grafos de interacción y los mapas térmicos de atención.
Sea la variable 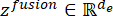 que represente la representación fusionada del estado emocional mediante la función de red de atención gráfica. En contraste con la visualización a nivel de salida de las gráficas de estado emocional, el objetivo principal del módulo consiste en convertir las representaciones del estado emocional y los pesos correspondientes del mecanismo de atención en una forma visual comprensible.
Utilizando el αji aprendido, se crea un mapa de calor de atención para examinar visualmente la contribución de cada modalidad. Luego, los pesos de atención entrantes se suman para determinar una puntuación de importancia compuesta para cada modalidad:
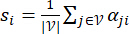 (22)
donde si representa la contribución emocional relativa de la modalidad I. Para ayudar a crear un mapa de calor de atención, los valores obtenidos se normalizan y se asignan a un mapa de colores que facilita al usuario identificar la modalidad predominante en diferentes pasos temporales o estados interactivos. Mediante diversas modalidades de entrada visual, auditiva o textual, dicha interfaz ayuda al usuario a comprender cómo funciona el mecanismo de atención del sistema.
El grafo aprendido se modela específicamente como un «grafo de interacción ponderado» para representar la dependencia cruzada de modalidades en las emociones humanas. Cada modalidad se representa mediante un nodo en el grafo, y la intensidad de las interacciones relacionadas con las emociones humanas se representa mediante pesos en forma de αji en las aristas que las conectan. El grafo ponderado anterior ilustra la intensidad de las interacciones emocionales humanas. La definición de i y j es:
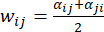 (23)
El grosor o la transparencia de las líneas en la visualización del grafo se muestran adecuadamente gracias a estos pesos. Esto facilita la comprensión de cómo interactúan las modalidades. El diseñador puede comprender mejor cómo interactúan los indicadores emocionales durante el proceso de fusión con la ayuda de los gráficos de interacción cruzada.
Las incrustaciones de emoción fusionadas  en diferentes pasos de tiempo se reducen a un espacio de menor dimensionalidad mediante un algoritmo de reducción de dimensionalidad, como PCA o t-SNE, con el fin de mostrar la evolución de las emociones temporales:
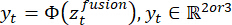 (24)
donde la función de proyección está representada por  . La aparición de trayectorias emocionales 2D/3D, que muestran transiciones emocionales, intensidades y estabilidad en las interacciones, puede interpretarse como una representación intuitiva de la evolución de los estados emocionales a lo largo del tiempo. Estos aspectos pueden utilizarse para la interacción inteligente, la toma de decisiones y la monitorización en tiempo real.
A diferencia de los sistemas convencionales de emociones que simplemente proporcionan asignaciones a clases o puntuaciones específicas, este sistema se centra en demostrar cómo se forman las emociones humanas dentro de él. Revela su proceso de toma de decisiones mediante visualizaciones de características intermedias, incluyendo factores de ponderación, interacciones entre modelos y sus trayectorias correspondientes. Esto permite al usuario comprender cómo cada factor—visual, vocal o lingüístico—influye en la generación de sus respuestas ante la emoción humana.
Asignar emociones a formas comprensibles mediante representaciones visuales puede, por tanto, cerrar la brecha entre el análisis de emociones utilizando métodos de aprendizaje profundo y su integración en el diseño de interfaces inteligentes. Los datos recopilados a partir de ambos enfoques pueden utilizarse entonces para crear interfaces de usuario más precisas. Así, el enfoque propuesto puede proporcionar a los diseñadores de interacción información esencial para desarrollar interfaces de usuario más precisas. Dicho de otro modo, la comprensión de las emociones se convierte en una parte muy activa del diseño de interacción. La precisión solo puede aumentar cuando la comprensión de las emociones se incorpora activamente al diseño de interacción.
El módulo de mapeo visual posibilita la explicabilidad de varias formas interconectadas pero diferentes: la explicabilidad a nivel de características revela las representaciones subyacentes de la emoción creadas por la red neuronal profunda (DNN), permitiéndonos comprender la semántica utilizada para describir cada característica relacionada con la emoción; la explicabilidad a nivel de modalidad utiliza datos provenientes de los gráficos de interacción y los mapas de calor de atención visual para describir cómo cada modalidad —visual, auditiva o textual— contribuye a las decisiones tomadas para expresar emociones; y finalmente, las trayectorias resultantes del incrustado de emociones nos permiten entender cómo cambia cada modalidad visual y textual a lo largo del tiempo desde una perspectiva dinámica de interacción. Consulte el Algoritmo 2 (Supplementary File 1).
Las características emocionales multimodales fusionadas se asignan a representaciones visualmente significativas para el diseño de interacción inteligente mediante el algoritmo de asignación visual propuesto, Algoritmo 2. Los pesos de atención multimodal basados en grafos se utilizan para cuantificar las diferencias entre los elementos visuales, auditivos y textuales de entrada en cada paso temporal. Estas diferencias se asignan luego a representaciones visuales para resaltar las principales fuentes que influyen en las emociones, utilizando elementos visuales de mapa de calor. Para ofrecer una visión informativa de la interacción entre los elementos de entrada y transmitir la evolución emocional generada por los elementos de entrada multimodales, se calculan entonces las intensidades de interacción por pares para crear los pesos de interacción multimodal. Al mismo tiempo, se genera una vista de la evolución emocional mediante la proyección de los elementos emocionales fusionados acumulados a lo largo del tiempo en un espacio de baja dimensionalidad, produciendo así una evolución continua del elemento emocional.
Predicción de emociones y retroalimentación de la interacción
El resultado de la representación de emociones fusionadas, representado como , se utiliza entonces como función tanto para la retroalimentación de la interacción como para la predicción de emociones. Además, la predicción de emociones se describe como un modelo multitarea que comprende una tarea de regresión para el reconocimiento de la intensidad emocional continua y una tarea de clasificación para el reconocimiento de emociones discretas. Se utiliza el siguiente modelo de clasificación basado en softmax para el reconocimiento de emociones discretas:
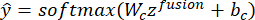 (25)
donde  representa las probabilidades esperadas de las clases de emociones y Wc y bc son restricciones aprendibles. Se utiliza la pérdida de entropía cruzada para mejorar el objetivo de clasificación:
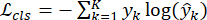 (26)
donde yk es la etiqueta real, y K es el número de clases de emociones. Se utiliza una rama de regresión para estimar la intensidad emocional en paralelo, generando una predicción de diversos atributos afectivos continuos, incluyendo valencia y activación. Asígnale la siguiente definición:
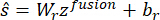 (27)
donde el puntaje esperado de intensidad emocional está indicado por  . Se utiliza la pérdida del error cuadrático medio para mejorar la tarea de regresión:
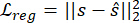 (28)
En general, las dos tareas se combinan en el objetivo de predicción:
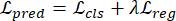 (29)
donde los objetivos de regresión y clasificación están equilibrados por λ. Se sugiere una modificación dinámica del módulo de visualización basada en el estado emocional identificado para permitir este tipo de retroalimentación sensible a la interacción. El contexto de interacción en un momento dado t está representado por ct. La respuesta del módulo de visualización se proporciona mediante:
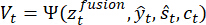 (30)
donde la función de adaptación de visualización está representada por  . Esto permite ajustar en tiempo real los mapas de calor de modalidad, los gráficos de interacción y las trayectorias emocionales según los cambios y emociones anticipados. Esto indica que el sistema proporciona un apoyo considerable para la retroalimentación, además de desempeñarse adecuadamente en la predicción de estados emocionales.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Este trabajo valida el marco propuesto de mapeo visual para características multimodales de emociones en términos tanto de interpretabilidad sensible a la interacción como de rendimiento predictivo, utilizando dos conjuntos de datos de referencia, CH-SIMS y CMU-MOSEI. De acuerdo con los resultados experimentales, el enfoque sugerido supera consistentemente a las técnicas actuales de reconocimiento multimodal de emociones en una variedad de métricas, incluyendo correlación, exactitud, puntuación F1 y error absoluto medio ...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Los hallazgos experimentales demuestran que, en los conjuntos de datos CH-SIMS y CMU-MOSEI, el marco propuesto de mapeo visual para características emocionales multimodales supera a las técnicas actuales de reconocimiento emocional multimodal. En comparación con los modelos de fusión temprana y tardía, como EF-LSTM y TFN, la técnica propuesta alcanza una mayor precisión y puntuaciones F1, lo que demuestra su robustez para manejar información emocional diversa. La mejora del método puede atribuirse a la representación emo...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen conflictos de intereses.
Agradecimientos
Los autores desean agradecer el apoyo brindado por la Escuela de Vivienda, Construcción y Planeación, Universiti Sains Malaysia, Penang, Malasia, y la Escuela de Diseño y Arte, Universidad de Ciencia y Tecnología de Changsha & Technology, Changsha, China. Los autores también expresan su agradecimiento a la Academia de Arte y Diseño de Xiamen, Universidad de Fuzhou, Xiamen, China, por su apoyo académico e investigador a lo largo de este trabajo.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Adam | Biblioteca de Optimizadores de PyTorch | https://pytorch-optimizers.readthedocs.io/en/latest/ (Tasa de Aprendizaje = 1 × 10⁻⁴) | Optimización de parámetros durante el entrenamiento del modelo |
| CH-SIMS | Repositorio del Conjunto de Datos Original | Última Versión Pública | Conjunto de datos de referencia para el análisis multimodal de sentimientos/emociones en chino |
| CMU-MOSEI | Repositorio del SDK Multimodal de CMU | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (Última Versión Pública) | Conjunto de datos de referencia para el reconocimiento multimodal de sentimientos y emociones |
| Codificador de Emociones Desacoplado | Implementación Personalizada | https://pytorch-geometric.readthedocs.io/en/latest/(Arquitectura de Doble Codificador) | Separación de representaciones latentes específicas de emociones y específicas de modalidad |
| Red de Atención Basada en Grafos (GAT) | PyTorch Geometric | GAT de múltiples cabezas (https://pytorch-geometric.readthedocs.io/en/latest/) | Modelado de relaciones emocionales cruzadas entre modalidades y fusión adaptativa de características |
| Capa de Atención Cruzada Basada en Grafos | Implementación Personalizada | Fusión de Atención de Múltiples Cabezas | Aprendizaje de dependencias emocionales finas entre modalidades |
| Matplotlib | Proyecto Matplotlib | 3.7+ | Generación de gráficos y análisis visuales |
| NetworkX | Proyecto NetworkX | 3.0+ | Construcción y visualización de grafos de interacción cruzada entre modalidades |
| GPU de NVIDIA | Corporación NVIDIA | GPU con CUDA habilitado | Aceleración del entrenamiento de transformadores y redes neuronales gráficas |
| Análisis de Componentes Principales (PCA) | Scikit-learn | sklearn.decomposition.PCA | Reducción inicial de embeddings emocionales de alta dimensión |
| Python | Python Software Foundation | 3.8+ | Lenguaje de programación principal para implementar el marco de análisis multimodal de emociones |
| PyTorch | PyTorch Foundation | 2.0+ | Desarrollo, entrenamiento y optimización de redes neuronales profundas |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, embeddings de 768 dimensiones) | Extracción de representaciones lingüísticas y semánticas contextuales de emociones |
| Seaborn | Proyecto Seaborn | 0.12+ | Generación de mapas de calor de atención y visualizaciones estadísticas |
| t-SNE (t-distributed Stochastic Neighbor Embedding) | Scikit-learn | scikit-learn.org (Perplejidad = 30, Iteraciones = 1000) | Visualización de clústeres y trayectorias latentes de emociones |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS o posterior | Entorno de ejecución experimental |
| Transformador de Visión (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, embeddings de 768 dimensiones | Extracción de representaciones visuales conscientes de emociones a partir de fotogramas de video |
| Wav2Vec 2.0 | Meta AI Research | Modelo Base, embeddings de 768 dimensiones | Extracción de características contextuales acústicas y de habla relacionadas con las emociones |
Referencias
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.