Este protocolo describe un flujo de trabajo de seguimiento múltiple de objetos guiado por la confianza para videos deportivos que integra la información del color del uniforme y el número del jugador para mejorar la asociación de trayectorias y la consistencia de identidad ante fluctuaciones de confianza, oclusiones y apariencias visuales similares entre atletas.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
Un método de seguimiento de múltiples objetos guiado por confianza para vídeos deportivos mediante la fusión semántica de camisetas
En este artículo
Resumen
Resumen
El seguimiento de múltiples objetos (MOT) en videos deportivos proporciona información de trayectoria para el análisis táctico, la interpretación del comportamiento de los jugadores y el análisis estadístico automatizado. Sin embargo, los escenarios deportivos frecuentemente implican cambios rápidos de dirección, paradas bruscas, oclusiones frecuentes y compañeros de equipo visualmente similares, lo que provoca fluctuaciones en la confianza de detección y confusión de identidad durante la asociación entre cuadros. Para abordar estos desafíos, este estudio presenta JerseyTrack, un método de MOT deportivo guiado por confianza basado en la fusión semántica de camisetas. El flujo de trabajo divide adaptativamente las cajas de detección en intervalos de alta, media y baja confianza según la distribución de confianza de cada cuadro. Las detecciones de alta confianza se asocian principalmente mediante similitud de movimiento, mientras que las detecciones de confianza media y baja incorporan además características del color de la camiseta y del número del jugador, extraídas mediante agrupamiento de colores y un modelo ligero de Reconocimiento Óptico de Caracteres (OCR). Estas características semánticas se fusionan con la información de movimiento durante la coincidencia complementaria para mejorar la continuidad de la trayectoria y la consistencia de la identidad. El método se evaluó en el conjunto de datos SportsMOT. JerseyTrack alcanzó una precisión del 88,9 % en el seguimiento de múltiples objetos (MOTA), un 74,3 % en la puntuación F1 de identidad (IDF1) y un 69,9 % en la precisión de seguimiento de orden superior (HOTA), lo que demuestra un mejor desempeño de seguimiento en el entorno deportivo evaluado. Este protocolo proporciona un flujo de trabajo reproducible para integrar la asociación guiada por confianza con información semántica de camisetas con el fin de mejorar el seguimiento de múltiples objetos en videos deportivos.
Introducción
El seguimiento de múltiples objetos (MOT) proporciona una localización continua de los objetos y el mantenimiento de sus identidades en secuencias de video, y permite la extracción de trayectorias de atletas, el análisis táctico y el análisis estadístico automatizado en aplicaciones de video deportivo1,2,3. La información visual confiable también está relacionada con la toma de decisiones específica del deporte y la evaluación del rendimiento en la ciencia del deporte, lo que resalta aún más el valor de los datos estables de movimiento derivados de video para análisis deportivos posteriores4. En escenarios deportivos, la fiabilidad de los datos tácticos depende de la continuidad de las trayectorias de seguimiento y de la consistencia de las identidades de los objetivos.
En comparación con los escenarios generales de seguimiento de múltiples objetos (MOT), los videos deportivos contienen cambios rápidos de dirección, paradas bruscas, saltos, interacciones densas y oclusiones frecuentes. Estos factores provocan fluctuaciones sustanciales en la confianza de las cajas de detección y aumentan la frecuencia de detecciones con baja confianza, lo que puede interrumpir la asociación de trayectorias5,6. Los uniformes de equipo similares reducen aún más la capacidad discriminativa de las características generales de apariencia y aumentan la confusión de identidad entre compañeros de equipo visualmente parecidos7,8. Cuando la oclusión y la similitud en la apariencia ocurren en la misma secuencia, la confianza en la detección disminuye y la información sobre la apariencia del objetivo se vuelve incompleta, lo que incrementa la dificultad para asociar trayectorias y mantener la identidad9,10. En el seguimiento de múltiples objetos, la re-identificación (Re-ID) se refiere al proceso de asociar la misma identidad de un objetivo a través de cuadros, períodos de oclusión o casos de reingreso, utilizando evidencia visual relacionada con la identidad. En videos de deportes de equipo, las señales generales de Re-ID pueden debilitarse porque los atletas del mismo equipo suelen compartir uniformes y apariencias corporales similares. La revisión de la literatura técnica indica que la fragmentación de trayectorias y la confusión de identidad en el MOT deportivo se abordan comúnmente mediante dos enfoques complementarios: la utilización de la confianza en la detección y el realce de las señales de identidad. JerseyTrack se sitúa en la intersección de estos enfoques al regular el uso de señales semánticas del uniforme según la calidad de la detección, en lugar de aplicar la información de color y número del jugador de forma uniforme a todas las detecciones.
Este estudio presenta JerseyTrack, un método de seguimiento múltiple de objetos deportivos guiado por la confianza y basado en la fusión semántica de camisetas. El método está diseñado para vídeos de deportes de equipo en los que los atletas llevan camisetas visibles y los resultados de detección proporcionan cajas delimitadoras con puntuaciones de confianza. JerseyTrack combina cuatro componentes principales: detección de atletas, partición por niveles de confianza, extracción de características semánticas de la camiseta y asociación interfotograma en cascada. La confianza en la detección se utiliza para particionar de forma adaptativa las detecciones en grupos de alta, media y baja confianza, que se procesan mediante estrategias de asociación diferentes. Las detecciones de alta confianza se asocian principalmente mediante información de movimiento, mientras que las detecciones de confianza media y baja incorporan además información sobre el color de la camiseta y el número del jugador para mejorar el mantenimiento de la identidad cuando la evidencia visual es débil. El método está destinado a tareas de análisis de vídeos deportivos que requieren trayectorias estables de los atletas, como el análisis táctico y la interpretación del comportamiento de los jugadores.
El enfoque propuesto también presenta limitaciones operativas. La extracción semántica de la camiseta puede verse afectada por oclusión severa, desenfoque por movimiento, baja resolución de la imagen, poses anormales de la camiseta o números de jugador invisibles. En estos casos, las pistas semánticas basadas en la camiseta pueden volverse incompletas, y el proceso de asociación depende más fuertemente de la coherencia del movimiento y de la verificación mediante múltiples fotogramas. Por lo tanto, las afirmaciones sobre el rendimiento en este estudio se limitan a los conjuntos de datos evaluados y a las condiciones experimentales. Los experimentos en el conjunto de datos SportsMOT muestran que JerseyTrack mejora las métricas de seguimiento evaluadas y reduce los eventos de cambio de identidad bajo las condiciones de seguimiento deportivo evaluadas. La principal dificultad del MOT en videos deportivos radica en mantener la continuidad de la trayectoria y la coherencia de la identidad ante movimientos rápidos, oclusión y similitud en la apariencia. Los estudios existentes relacionados con JerseyTrack pueden clasificarse ampliamente en dos direcciones de investigación: el uso de la confianza en la detección para la asociación de trayectorias y la mejora de las pistas de identidad mediante características semánticas específicas de los deportes.
La confianza de detección se ha utilizado ampliamente para estimar la fiabilidad de los cuadros de detección y para guiar la asociación de trayectorias en el seguimiento de múltiples objetos (MOT). Los métodos iniciales de seguimiento solían tratar la confianza como un criterio binario de filtrado, en el que se eliminaban las detecciones por debajo de un umbral fijo para reducir los falsos positivos11,12. Esta estrategia reduce las detecciones ruidosas, pero también puede descartar objetivos reales en condiciones de oclusión, movimiento rápido o baja calidad de imagen, lo que provoca fragmentación de trayectorias13,14,15. Estrategias de filtrado similares han demostrado también que los umbrales fijos de confianza son sensibles a las variaciones de la escena y a la calidad de la detección16,17. Para mejorar el uso de detecciones con baja confianza, ByteTrack introdujo una estrategia de asociación que conserva los cuadros de baja confianza como objetivos candidatos para una coincidencia secundaria y los vincula con trayectorias existentes mediante la similitud de movimiento y el historial de trayectorias18. McByte amplía aún más la asociación en el MOT deportivo incorporando máscaras de segmentación propagadas temporalmente como una pista de asociación, mejorando la robustez en condiciones de movimiento rápido, oclusión y desplazamiento de cámara sin necesidad de entrenamiento adicional por video19. Estudios relacionados también han ajustado el uso de detecciones con baja confianza para conservar objetivos débiles pero potencialmente válidos durante la asociación20,21,22. Las estrategias de asociación adaptativas según la confianza refinaron posteriormente los criterios de coincidencia según la consistencia del movimiento y la fiabilidad de la detección23,24,25. También se han utilizado métodos de refinamiento de trayectorias basados en regresión de cuadros de detección y optimización de suavidad de trayectorias para reducir la fragmentación de trayectorias26,27,28. Estrategias adicionales de refinamiento proporcionan apoyo complementario para mantener la continuidad de las trayectorias en condiciones de movimiento complejas29. El flujo temporal coherente de objetos modela aún más la consistencia temporal a nivel de objeto entre cuadros, proporcionando otro enfoque orientado a la asociación para reducir la interrupción de trayectorias en escenarios complejos de MOT30. Los métodos de fusión de rastreadores también aprenden de las salidas de múltiples rastreadores y utilizan estrategias de selección o fusión basadas en aprendizaje para mejorar la robustez del seguimiento en diferentes referencias de MOT31. En conjunto, estos estudios indican que la asociación sensible a la confianza ayuda a recuperar trayectorias interrumpidas; sin embargo, la confianza y las pistas de movimiento proporcionan información limitada sobre la identidad cuando los jugadores del mismo equipo tienen apariencias visuales similares. Aunque estos métodos alivian eficazmente la fragmentación de trayectorias en escenarios generales, enfrentan limitaciones inherentes en contextos deportivos porque los jugadores del mismo equipo a menudo tienen apariencias visuales muy similares, y depender únicamente de la confianza y la información de movimiento no proporciona una base suficiente para diferenciar identidades32,33,34. Incluso cuando se recuperan eficazmente cuadros con baja confianza, la similitud de características aún puede provocar intercambios de identidad, dificultando el cumplimiento de los estrictos requisitos de consistencia de identidad en el análisis deportivo.
Las señales específicas de identidad deportiva también se han utilizado para mejorar la discriminación de identidad en el seguimiento de atletas. La información semántica de las camisetas, como el color del equipo y el número del jugador, proporciona señales de identidad más directamente relacionadas con escenarios deportivos que los embeddings generales de apariencia35,36,37. El color de la camiseta se ha empleado para facilitar la discriminación a nivel de equipo y reducir la confusión entre equipos, mientras que el reconocimiento del número del jugador ofrece una señal de identidad más precisa cuando la zona del número es visible y legible38,39. Estudios previos sobre seguimiento deportivo han incorporado características visuales específicas del dominio y el reconocimiento del color de la camiseta para mejorar la asociación de jugadores en condiciones deportivas concurridas40,41. Trabajos relacionados sobre el reconocimiento del número de la camiseta y datos sintéticos de números respaldan adicionalmente la modelización de identidad en condiciones de baja resolución o con oclusión parcial42,43. Estos estudios indican que la semántica de las camisetas puede fortalecer la representación de identidad en el seguimiento de múltiples objetos en deportes (sports MOT). Sin embargo, la mayoría de los métodos de seguimiento mejorados con semántica no modelan adecuadamente la relación entre la confianza en la detección y la calidad de la característica semántica. Las detecciones con alta confianza ya pueden contener información espacial y de apariencia confiable, lo que hace que la extracción semántica repetida sea menos eficiente. Las detecciones con baja confianza suelen verse afectadas por oclusión, desenfoque, recorte o baja resolución, lo que reduce la fiabilidad de las señales de color y del número del jugador. Esta limitación motiva un diseño de asociación guiado por la confianza, en el cual la semántica de la camiseta se introduce según la calidad de la detección, en lugar de aplicarse uniformemente a todas las detecciones. Los estudios revisados muestran que la asociación sensible a la confianza y la modelización semántica de la camiseta abordan aspectos diferentes del seguimiento de múltiples objetos en deportes. Las estrategias basadas en la confianza determinan principalmente si una detección debe participar en la asociación y cómo debe emparejarse con trayectorias existentes, mientras que las estrategias semánticas de la camiseta mejoran principalmente la representación de identidad mediante señales específicas del deporte. No obstante, estos dos mecanismos suelen diseñarse como componentes separados. Como resultado, las señales semánticas no siempre se ajustan según la calidad de la detección, y los niveles de confianza no regulan directamente el uso de la información de color y del número del jugador durante la asociación. Esta separación limita el manejo conjunto de la fragmentación de trayectorias y la confusión de identidad en vídeos de deportes de equipo. El vacío investigador restante consiste en vincular la evaluación de la calidad de la confianza en la detección con la asociación semántica de la camiseta dentro del mismo flujo de trabajo de seguimiento.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio implicó un análisis secundario de conjuntos de datos de video de referencia disponibles públicamente, específicamente SportsMOT, TeamTrack, SoccerNet Tracking, MOT17 y MOT20. No se reclutaron participantes, no se realizó ninguna intervención y no se recopilaron nuevos datos de sujetos humanos. No se requirió la aprobación del comité de ética para este estudio según los requisitos institucionales aplicables de la Universidad Bangkok Thonburi.
El siguiente protocolo describe el flujo de trabajo utilizado para reproducir JerseyTrack, desde la preparación de los datos hasta la evaluación del seguimiento. El flujo de trabajo incluye la preparación del conjunto de datos, la preparación del detector, la extracción semántica de las camisetas, la partición por niveles de confianza, la asociación guiada por la confianza, la inferencia de seguimiento y la evaluación del rendimiento, como se resume en la Figura 1. El software, los conjuntos de datos y los recursos de hardware necesarios se enumeran en la Tabla de materiales.
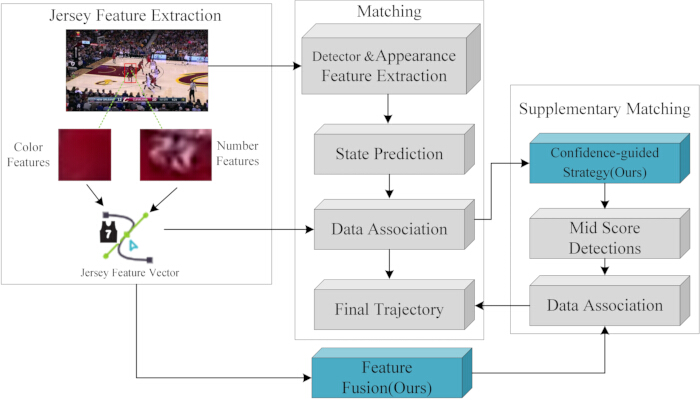
Figura 1. Flujo general del método JerseyTrack. El flujo de trabajo consta de la extracción de características semánticas del jersey, la coincidencia inicial de objetos, la coincidencia suplementaria guiada por confianza y la fusión de características. Las características del color del equipo y del número del jugador se extraen de las regiones de los atletas detectados y se incorporan al proceso de asociación para mejorar el emparejamiento de trayectorias bajo condiciones de detección inciertas. Haga clic aquí para ver una versión más grande de esta figura.
1. Preparar los conjuntos de datos y la estructura de directorios
- Descargue los conjuntos de datos de referencia públicos enumerados en la Tabla de materiales. Utilice SportsMOT como conjunto de datos principal para la preparación del detector y la evaluación del seguimiento. Mantenga TeamTrack, SoccerNet Tracking, MOT17 y MOT20 para la evaluación entre conjuntos de datos.
- Almacene todos los conjuntos de datos en un directorio de proyecto unificado. Asegúrese de que el detector, el módulo de extracción semántica, el módulo de seguimiento y el kit de evaluación utilicen los mismos identificadores de secuencia.
- Convierta las anotaciones oficiales de SportsMOT al formato de entrenamiento del detector utilizando el script de preparación de datos empleado en este estudio. Ejecute el siguiente comando:
..\venv\Scripts\python.exe scripts\prepare_data.py --config configs\datasets.local.json --dataset SportsMOT --out data\processed\SportsMOT_yolo --splits train val. - El script de preparación de datos (scripts/prepare_data.py) está disponible en el repositorio de código fuente de JerseyTrack (https://doi.org/10.5281/zenodo.21274352). Las dependencias de software requeridas se especifican en environment.yml, incluyendo Python 3.12, PyTorch 2.11.0 y OpenCV 4.10 o posterior. Configure el entorno de software utilizando el siguiente comando: conda env create -f environment.yml. Ejecute el script de preparación de datos utilizando el siguiente comando: python scripts/prepare_data.py --config configs/datasets.local.json --dataset SportsMOT --out data/processed/SportsMOT_yolo --splits train val.
- Verifique que la conversión genere el archivo de configuración para el entrenamiento del detector: data\processed\SportsMOT_yolo\data.yaml y el manifiesto de conversión: data\processed\SportsMOT_yolo\conversion_manifest.csv.
NOTA: En este estudio, el conjunto de datos de entrenamiento y validación de SportsMOT convertido contenía 90 secuencias, 55.544 fotogramas y 608.152 objetos anotados. - Inspeccione secuencias representativas para verificar que el orden de los fotogramas, las coordenadas de los cuadros delimitadores y las etiquetas de identidad sean coherentes con las anotaciones originales del conjunto de referencia.
- Mantenga los archivos de anotación convertidos sin modificaciones durante toda la preparación del detector, la inferencia de seguimiento y la evaluación, de modo que todos los métodos utilicen la misma partición del conjunto de datos y el mismo protocolo de evaluación.
NOTA: El resultado esperado de esta sección es un directorio estandarizado de entrenamiento del detector SportsMOT que contenga las anotaciones convertidas, el manifiesto de conversión y los archivos de división del conjunto de datos necesarios para la preparación del detector y la evaluación del seguimiento.
2. Preparar las salidas del detector
- Ajuste finamente el detector de objetos utilizando la división de entrenamiento SportsMOT preparada. Optimice el detector utilizando la pérdida de clasificación y la pérdida de regresión del cuadro delimitador definidas en la Ecuación 1. Utilice la resolución de entrada del detector, tamaño del lote, tasa de aprendizaje, número de épocas de entrenamiento y otros parámetros de entrenamiento indicados en la configuración de implementación y en la Tabla de Materiales
Ldet = Lcls + Lbox (1)
Aquí, Ldet denota la pérdida total del detector, Lcls denota la pérdida de clasificación, y Lbox denota la pérdida de regresión del cuadro delimitador.
NOTA: El punto de control del detector utilizado en los experimentos principales (identificador interno del experimento e3) se entrenó utilizando el marco Ultralytics YOLO con la configuración del conjunto de datos SportsMOT en formato YOLO (data/processed/SportsMOT_yolo/data.yaml). Ejecute el entrenamiento del detector utilizando el siguiente comando: yolo detect train data=data/processed/SportsMOT_yolo/data.yaml model=yolo11x.pt epochs=80 imgsz=960 batch=16 lr0=0.01 project=outputs/formal name=checkpoints/detector device=0. Después del entrenamiento, utilice el punto de control con mejor rendimiento resultante para generar las salidas del detector para las secuencias de validación utilizando el siguiente comando: python scripts/formal_detect_yolo.py --dataset-root datasets/SportsMOT/dataset --split val --model outputs/formal/checkpoints/detector/weights/best.pt --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --imgsz 960 --conf 0.05 --device 0 --batch 16. - Guarde el punto de control del detector entrenado, el archivo de metadatos correspondiente y el registro de entrenamiento tras finalizar el entrenamiento.
NOTA: En este estudio, el punto de control del detector utilizado para los experimentos formales se guardó como:
outputs\formal\checkpoints\detector\sportsmot_yolo11x_i960_e3_best.pt. El archivo de metadatos correspondiente se guardó como: outputs\formal\checkpoints\detector\sportsmot_yolo11x_i960_e3_best.json. El directorio de salida del detector utilizado en los experimentos principales de validación de SportsMOT fue: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_threshold_sweep\t005\detections. - Ejecute el detector entrenado en cada secuencia de validación para generar cuadros delimitadores de atletas y puntuaciones de confianza. Exporte un archivo de detección por cada secuencia que contenga el índice del fotograma, las coordenadas del cuadro delimitador, la confianza de la detección y la etiqueta de clase.
NOTA: En la ejecución de validación de SportsMOT utilizada para los experimentos principales, un umbral de confianza de 0,05 generó 343.990 detecciones de atletas. - Revise el directorio de salida del detector antes de realizar la inferencia de seguimiento. Confirme que cada secuencia tenga un archivo de detección correspondiente, que los índices de los fotogramas coincidan con la secuencia de imágenes preparada y que cada registro de detección contenga una puntuación de confianza.
NOTA: El resultado esperado de esta sección es un directorio de salida del detector completo que sirva como entrada para la extracción semántica de camisetas, la partición por niveles de confianza y la asociación de seguimiento.
3. Extraer características semánticas del jersey
- Utilice los archivos de salida del detector para recortar las regiones de los atletas de cada fotograma del video. Guarde cada imagen recortada del atleta con su identificador de secuencia, índice de fotograma e índice de detección. Excluya los recortes no válidos que tengan contenido de imagen faltante o cajas delimitadoras que se extiendan fuera del límite de la imagen. Mantenga el vínculo entre cada nombre de archivo del recorte y su registro de detección original para que las características semánticas extraídas puedan asociarse con la detección correspondiente durante la asociación de seguimiento.
- Extraiga características del color del uniforme a partir de las imágenes recortadas de los atletas utilizando el script de extracción semántica empleado en este estudio.
NOTA: Los scripts de extracción de características semánticas (scripts/extract_fast_color_semantics.py y scripts/formal_extract_semantics.py) están disponibles en el repositorio de código fuente de JerseyTrack (https://doi.org/10.5281/zenodo.21274352). No se requiere un archivo de configuración independiente; todos los parámetros de ejecución se proporcionan a través de argumentos de línea de comandos.
Generar descriptores del color del uniforme utilizando el siguiente comando: python scripts/extract_fast_color_semantics.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --frames-root datasets/SportsMOT/dataset/val --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_t005_color. Genere características semánticas del número del jugador utilizando el modelo OCR con el siguiente comando: python scripts/formal_extract_semantics.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --frames-root datasets/SportsMOT/dataset/val --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_t005_ocr. Los descriptores generados del color del uniforme y las salidas de probabilidad del número del jugador se vinculan por identificador de secuencia y se combinan en los archivos de características semánticas utilizados durante la asociación de seguimiento. - Convierta cada imagen recortada del atleta al espacio de color Matiz, Saturación, Valor (HSV). Extraiga los píxeles del primer plano de la región del uniforme y resuma el color dominante del uniforme utilizando agrupamiento K-means con K = 3. Normalice el descriptor de color resultante utilizando normalización L2 antes de la comparación de características.
- Entrene la rama de reconocimiento del número del jugador utilizando imágenes recortadas de atletas con un tamaño de entrada de 128 × 64 píxeles. Genere pseudomarcas del número del jugador utilizando el procedimiento de etiquetado débilmente supervisado empleado en este estudio. Excluya los recortes con regiones del número del jugador invisibles, ilegibles, severamente ocluidas o con baja confianza del cálculo de la pérdida OCR.
- Optimice la rama OCR utilizando la pérdida de entropía cruzada definida en Ecuación 2.
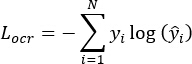 (2)
Aquí, Locr denota la pérdida OCR, yi denota la marca supervisada del número del jugador, y denota la categoría predicha del número del jugador.
- Optimice el módulo de extracción de características semánticas utilizando el optimizador adaptativo, la tasa de aprendizaje, el tamaño del lote, la disminución del peso y la duración del entrenamiento indicados en la Tabla de Materiales. Combine la pérdida del detector y la pérdida OCR utilizando el objetivo total de entrenamiento definido en Ecuación 3.
Ltotal = Ldet + γLocr (3)
Aquí, Ltotal denota la pérdida total de entrenamiento, Ldet denota la pérdida del detector definida en Ecuación 1, Locr denota la pérdida OCR definida en Ecuación 2, y denota el coeficiente de ponderación definido por el usuario para la pérdida OCR. - Aplique la rama OCR entrenada a cada imagen recortada del atleta. Guarde la categoría predicha del número del jugador o el vector de probabilidad para cada recorte. Si el número del jugador no es visible o la confianza OCR está por debajo del umbral definido en la implementación, registre la característica del número del jugador como no disponible en lugar de forzar una predicción.
- Combine el descriptor del color del uniforme y la salida del número del jugador en el archivo de características semánticas utilizado por el módulo de seguimiento.
NOTA: En la ejecución principal de validación de SportsMOT, el script de extracción semántica procesó 343.990 detecciones sin fotogramas faltantes ni recortes inválidos. En el paquete de revisión actual, el resumen de extracción semántica reportó una precisión general de extracción semántica de color y OCR del 86,7 % en la configuración evaluada de SportsMOT. El resultado esperado de esta sección es un archivo de características semánticas en el que cada registro de detección válido esté vinculado a un descriptor de color del uniforme, una salida del número del jugador cuando esté disponible, y una marca que indique si la información semántica está disponible para la asociación de seguimiento.
4. Niveles de confianza en la detección de particiones
- Cargue el archivo de salida del detector para cada secuencia de video. Recolecte las puntuaciones de confianza de todas las detecciones de atletas en cada fotograma.
- Particione las puntuaciones de confianza a nivel de fotograma en intervalos de alta, media y baja confianza utilizando agrupamiento K-means con K = 3, siguiendo el flujo de trabajo de asociación guiada por la confianza mostrado en la Figura 2. Determine los umbrales de confianza adaptativos minimizando la varianza dentro del grupo según la Ecuación 4.
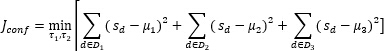 (4)
Aquí, sd denota la puntuación de confianza de la detección d; D1, D2 y D3 denotan los intervalos de alta, media y baja confianza, respectivamente; μ1, μ2 y μ3 denotan las puntuaciones medias de confianza de los tres intervalos; y τ1 y τ2 denotan los umbrales de confianza adaptativos obtenidos a partir de los resultados del agrupamiento K-means.
NOTA: El script de partición por confianza (scripts/formal_partition_confidence.py) está disponible en el repositorio de código fuente de JerseyTrack (https://doi.org/10.5281/zenodo.21274352). El módulo de partición por confianza utiliza un procedimiento de agrupamiento K-means unidimensional basado en NumPy con K = 3. No se requiere un archivo de configuración independiente; el directorio de entrada, el directorio de salida y el parámetro de agrupamiento se especifican mediante argumentos de línea de comandos. Ejecute el procedimiento de partición por confianza utilizando el siguiente comando: python scripts/formal_partition_confidence.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/confidence --k 3. Las dependencias de software requeridas, incluida la versión de NumPy, se especifican en environment.yml. - Ejecute el procedimiento de partición por confianza utilizando el directorio de salida del detector como entrada.
NOTA: En este estudio, el directorio de salida del detector fue: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_threshold_sweep\t005\detections. El directorio de salida de la partición por confianza fue: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_threshold_sweep\t005\confidence. Los archivos de salida generados incluyeron los archivos CSV de confianza por secuencia, _confidence_frame_summary.csv y _confidence_runtime.csv. - Asigne una etiqueta de nivel de confianza a cada detección. Etiquete las detecciones de alta confianza para asociación basada en movimiento, las detecciones de confianza media para asociación semántica-movimiento y las detecciones de baja confianza únicamente para recuperación de trayectoria. Mantenga la puntuación original de confianza junto con la etiqueta de nivel de confianza asignada.
- Revise las distribuciones de las puntuaciones de confianza y los fotogramas representativos, como se ilustra en la Figura 3. Verifique que las detecciones de alta confianza correspondan predominantemente a cajas delimitadoras completas y confiables de atletas, mientras que las detecciones de confianza media y baja contengan principalmente detecciones parciales, ocluidas, borrosas o débiles.
NOTA: El resultado esperado de esta sección es un archivo de partición por confianza que contenga el índice de detección, la puntuación de confianza original, el nivel de confianza asignado y los umbrales de confianza adaptativos a nivel de fotograma para cada detección.
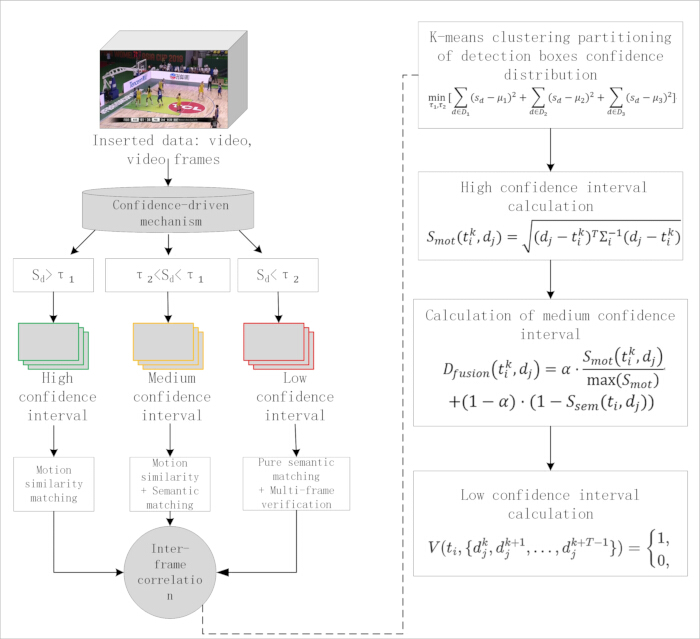
Figura 2. Estrategia de asociación guiada por confianza. El flujo de trabajo divide la confianza de detección en intervalos de alta, media y baja confianza mediante agrupamiento adaptativo de confianza. Las detecciones de alta confianza se asocian utilizando similitud de movimiento, las detecciones de confianza media se asocian utilizando similitud combinada de movimiento y semántica del uniforme, y las detecciones de baja confianza se utilizan para la recuperación de trayectorias asistida por información semántica con verificación de múltiples fotogramas. El panel derecho resume la formulación matemática utilizada para la partición por confianza y la asociación. Haga clic aquí para ver una versión más grande de esta figura.
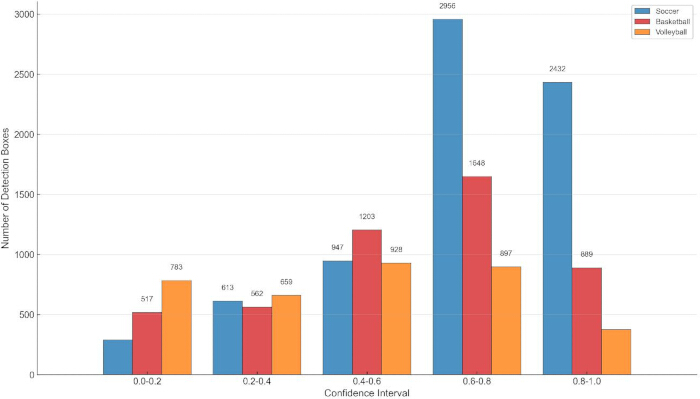
Figura 3. Distribución de las puntuaciones de confianza en la detección. El histograma muestra el número de cajas de detección de atletas dentro de cinco intervalos de confianza para las secuencias de fútbol, baloncesto y voleibol en el conjunto de datos SportsMOT. La distribución ilustra diferencias en la confianza del detector entre las categorías de deportes evaluadas. Haga clic aquí para ver una versión más grande de esta figura.
5. Realizar la asociación guiada por confianza
- Cargue el archivo de salida del detector, el archivo de características semánticas y el archivo de partición de confianza para cada secuencia de video. Inicialice el rastreador utilizando las primeras detecciones válidas y mantenga un estado de trayectoria para cada atleta rastreado. Para cada cuadro subsiguiente, prediga la posición de cada trayectoria existente utilizando el modelo de movimiento del filtro de Kalman.
- Calcule la similitud de movimiento entre cada trayectoria predicha y la detección candidata utilizando la distancia de Mahalanobis definida en Ecuación 5.
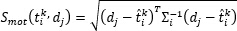 (5)
Aquí, denota la trayectoria I-ésima en el cuadro k,
 denota el estado predicho por Kalman de la trayectoria, dj denota la detección candidata,
 denota la matriz de covarianza inversa del estado predicho de la trayectoria, y Smot denota la distancia de movimiento entre la trayectoria predicha y la detección.
NOTA: El flujo de trabajo principal de asociación está implementado en jerseytrack/formal_tracker.py y se ejecuta a través de scripts/formal_track.py, ambos disponibles en el repositorio de código fuente de JerseyTrack (https://doi.org/10.5281/zenodo.21274352). No se requiere un archivo de configuración independiente. Todos los parámetros en tiempo de ejecución, incluidos los umbrales de confianza, la edad máxima de la trayectoria, los coeficientes de peso del movimiento y el peso de la distancia central, se proporcionan mediante argumentos de línea de comandos. El comando completo de ejecución y la configuración de parámetros se proporcionan en el paso 6.2. La implementación utiliza el algoritmo de asignación de suma lineal de SciPy para la coincidencia húngara y NumPy para la asociación basada en costos. - Ejecute el flujo de trabajo de rastreo utilizando como entradas el archivo de salida del detector, el archivo de características semánticas y el archivo de partición de confianza.
NOTA: En este estudio, el rastreador principal se implementó en jerseytrack\formal_tracker.py, y el flujo de trabajo de rastreo se ejecutó utilizando scripts\formal_track.py. - Asocie detecciones de alta confianza con trayectorias existentes utilizando la consistencia de movimiento. Actualice las trayectorias emparejadas e inicialice nuevas trayectorias solo cuando las detecciones de alta confianza sin emparejar cumplan con los criterios de inicialización de trayectoria.
- Revise las salidas de extracción semántica de camiseta ilustradas en Figura 4, y construya el vector de características semánticas de la camiseta para cada detección combinando el descriptor de color del equipo y la característica del número del jugador según la Ecuación 6.
fsem = [fcol;fid] (6)
Aquí, fsem denota el vector de características semánticas fusionado, fcol denota el descriptor de color del equipo, y fid denota la característica del número del jugador generada por la rama OCR. - Asocie detecciones de confianza media combinando la similitud de movimiento con la similitud semántica de la camiseta. Calcule la puntuación combinada de coincidencia según la Ecuación 7.
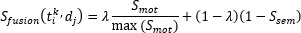 (7)
Aquí, Ssem denota la similitud coseno entre los vectores de características semánticas de la trayectoria y la detección candidata, Smot denota la distancia de movimiento definida en la Ecuación 5, y λ denota el coeficiente de fusión adaptativo que equilibra los términos de similitud de movimiento y semántica. - Calcule el coeficiente de fusión adaptativo según la Ecuación 8.
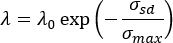 (8)
Aquí, λ0 denota el coeficiente inicial de peso del movimiento, σsd denota la desviación estándar de las puntuaciones de confianza de detección en el cuadro actual, y σmax denota la desviación estándar máxima de puntuación de confianza utilizada para la normalización. - Utilice detecciones de baja confianza únicamente para la recuperación de trayectorias. Empareje detecciones de baja confianza con trayectorias interrumpidas solo cuando haya información semántica disponible y se cumplan los criterios de recuperación. Aplique verificación de múltiples cuadros antes de restaurar la identidad de una trayectoria, y descarte las detecciones que no pasen la verificación.
NOTA: Cuando no esté disponible la característica del número del jugador, realice la asociación utilizando la información semántica disponible y la consistencia de movimiento, en lugar de forzar una coincidencia del número del jugador. El resultado esperado de esta sección es un registro de seguimiento cuadro por cuadro que contiene identidades de trayectoria, cuadros delimitadores, etiquetas de nivel de confianza, costos de movimiento, información semántica y decisiones finales de asociación. En el paquete de evidencia de revisión, los resultados de seguimiento se almacenaron en: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_sweep_round2\age45_h0p95_m0p94_l0p58_mw0p65_lw0p5_va0p25_hsp0p0_cdw0p1\tracking.
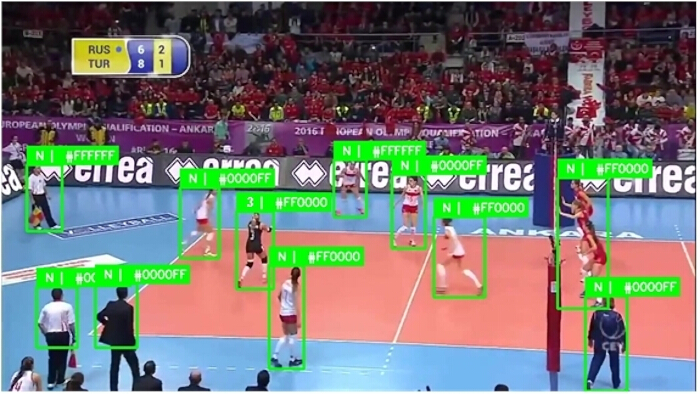
Figura 4. Extracción de características semánticas de las camisetas. Las detecciones representativas de atletas están anotadas con los descriptores de color del equipo y la información del número del jugador generados por el módulo de extracción semántica de camisetas. Las características semánticas extraídas se incorporan posteriormente a la asociación de datos guiada por la confianza. Haga clic aquí para ver una versión más grande de esta figura.
6. Ejecutar la inferencia de seguimiento y exportar los resultados
- Realice la inferencia de seguimiento para cada secuencia de video utilizando los archivos preparados de salida del detector, archivos de características semánticas y archivos de partición de confianza. Procese los fotogramas de video en orden cronológico para que los estados de trayectoria, el historial semántico y las decisiones de recuperación de trayectoria se actualicen de manera consistente a lo largo de la secuencia. Utilice la misma configuración de inferencia para todas las secuencias evaluadas, a menos que se indique explícitamente una configuración específica del conjunto de datos.
NOTA: La inferencia de seguimiento se ejecutó utilizando scripts/formal_track.py, disponible en el repositorio de código fuente de JerseyTrack (https://doi.org/10.5281/zenodo.21274352). No se requiere un archivo de configuración independiente. Ejecute la inferencia de seguimiento con el siguiente comando: python scripts/formal_track.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --semantic-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_t005_color --confidence-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/confidence --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_center_motion_sweep_round2/age45_h0p95_m0p94_l0p58_mw0p65_lw0p5_va0p25_hsp0p0_cdw0p1/tracking --max-age 45 --high-threshold 0.95 --medium-threshold 0.94 --low-threshold 0.58 --medium-motion-weight 0.65 --low-motion-weight 0.5 --velocity-alpha 0.25 --center-distance-weight 0.1. Todos los parámetros no especificados conservaron los valores predeterminados registrados en el código fuente archivado. - Tras la inferencia, aplique la secuencia principal de postprocesamiento utilizando los siguientes comandos: python scripts/merge_tracklets.py y python scripts/sweep_track_filter.py --min-len 95.
- Exporte los resultados de seguimiento en el formato requerido por la herramienta de evaluación. Incluya el índice de fotograma, la identidad de la trayectoria, las coordenadas del cuadro delimitador y todos los campos exigidos por el formato de evaluación del conjunto de referencia. Guarde un archivo de resultados de seguimiento por cada secuencia utilizando una convención de nomenclatura coherente, de modo que cada archivo de resultados pueda asociarse con su archivo de anotaciones de referencia correspondiente.
- Aplicar únicamente las operaciones de postprocesamiento utilizadas en este estudio. Realice la fusión de trazas y el filtrado de trazas utilizando los scripts de postprocesamiento descritos en el paquete de revisión.
NOTA: En este estudio, el flujo de trabajo de postprocesamiento utilizó los siguientes scripts:
⋅ scripts\merge_tracklets.py
⋅ scripts\sweep_track_filter.py
⋅ scripts\correct_identity_swaps.py
⋅ scripts\sweep_identity_swap_correction.py
⋅ scripts\interpolate_tracks.py
⋅ scripts\sweep_track_interpolation.py - Revise los resultados de seguimiento exportados antes de la evaluación cuantitativa. Confirme que las identidades de trayectoria permanezcan numéricas y consistentes dentro de cada secuencia, que no falte ningún índice de fotograma y que todos los cuadros delimitadores permanezcan dentro de los límites de la imagen.
NOTA: El resultado esperado de esta sección es un conjunto completo de archivos de resultados de seguimiento a nivel de secuencia, listos para la evaluación cuantitativa.
7. Evaluar el rendimiento del seguimiento
- Evalúe los archivos de resultados de seguimiento exportados utilizando el kit de evaluación enumerado en la Tabla de materiales. Asocie cada archivo de resultados de seguimiento con el archivo de anotación de referencia y la división del conjunto de datos correspondientes. Utilice la misma configuración de evaluación para todos los métodos comparados para asegurar que las diferencias de rendimiento se deban a los resultados de seguimiento y no a las configuraciones de evaluación.
- Ejecute la evaluación utilizando el siguiente comando
\.venv\Scripts\python.exe evaluation\trackeval\scripts\nun_mot_challenge.py --GT_FOLDER datasets\SportsMOT\dataset\val --RESULTS_DIR outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_filter_fine
_round1\minlen95 --OUTPUT_FOLDER outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_filter_fine_
round1\minlen95\trackeval --TRACKERS_TO_EVAL JerseyTrack_i960_e3_center_motion_minlen95 --BENCHMARK SportsMOT --SPLIT_TO_EVAL val
NOTA: La evaluación se realizó utilizando la implementación estándar de métricas de TrackEval (versión 1.3.0) archivada dentro del paquete de reproducibilidad de JerseyTrack. No se realizaron modificaciones en las implementaciones de las métricas de Precisión de Seguimiento de Orden Superior (HOTA), CLEAR ni de Identidad. El repositorio incluye el contenedor de ejecución en estilo MOTChallenge ubicado en evaluation/trackeval/scripts/run_mot_challenge.py, que configura las rutas del conjunto de datos y de los resultados e invoca las métricas de evaluación estándar de TrackEval. - Registre las métricas de evaluación reportadas en el manuscrito, incluyendo la Precisión en el Seguimiento de Múltiples Objetos (MOTA), la puntuación F1 de Identidad (IDF1), la Precisión de Seguimiento de Orden Superior (HOTA), la Precisión de Detección (DetA), la Precisión de Asociación (AssA), los falsos positivos (FPs), los falsos negativos (FNs) y los eventos de cambio de identidad. Exporte el resumen de evaluación como una tabla y conserve los archivos de evaluación por secuencia para su verificación.
- Al comparar JerseyTrack con los métodos básicos, utilice la misma división del conjunto de datos, las salidas del detector y la configuración de evaluación para todos los métodos. Registre el conjunto de datos, la fuente de las salidas del detector, la configuración del kit de evaluación y los valores métricos para cada comparación.
- Revise los registros de evaluación para verificar que todas las secuencias se hayan evaluado correctamente y que no falte ningún archivo de resultados de seguimiento.
NOTA: En este estudio, el archivo de resumen principal de TrackEval se almacenó en: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_filter_fine_
round1\minlen95\trackeval\JerseyTrack_i960_
e3_center_motion_minlen95\pedestrian_summary.txt. El resultado esperado de esta sección es una tabla completa de resumen de evaluación junto con los archivos métricos por secuencia que respaldan los Resultados reportados y la verificación posterior.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Esta sección presenta los resultados cuantitativos y cualitativos obtenidos a partir de los experimentos evaluados de seguimiento múltiple en deportes. Los resultados se centran en la precisión del seguimiento, la preservación de la identidad, la calidad de la asociación y la robustez bajo las configuraciones del conjunto de datos probadas. Las afirmaciones sobre el rendimiento se limitan a los métodos evaluados, conjuntos de datos, salidas del detector y configuración del kit de evaluación descritos en el Protocolo y la...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Este estudio evaluó un flujo de trabajo de seguimiento múltiple de objetos en deportes guiado por confianza que combina la partición basada en la confianza de detección con pistas semánticas de las camisetas. Se ha investigado la asociación guiada por confianza y la fusión de características semánticas como estrategias complementarias para mejorar la asociación de datos en el seguimiento múltiple de objetos12,20,23,
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no tienen conflictos financieros de interés.
Agradecimientos
Los autores no tienen reconocimientos que declarar.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Tiempo de ejecución CUDA | NVIDIA | Versión 12.8 | Tiempo de ejecución de computación GPU utilizado para el entrenamiento del detector, extracción de características semánticas e inferencia de seguimiento. |
| EasyOCR | Jaided AI | Versión 1.7.2 | Kit de herramientas de reconocimiento óptico de caracteres utilizado para el reconocimiento del número de los jugadores. |
| Código fuente de JerseyTrack | Autores | N/A | Implementación personalizada que contiene los scripts de preparación de datos, extracción de características semánticas, partición de confianza, seguimiento, postprocesamiento y evaluación. Disponible en: https://doi.org/10.5281/zenodo.21274352 |
| Modelo OCR CRNN ligero | Autores | N/A | Red neuronal recurrente convolucional personalizada (CRNN) utilizada para el reconocimiento del número de los jugadores. |
| Conjunto de datos MOT17 | MOTChallenge | N/A | Conjunto de datos de referencia público utilizado para evaluación entre conjuntos de datos. Disponible en: https://motchallenge.net/data/MOT17/ |
| Conjunto de datos MOT20 | MOTChallenge | N/A | Conjunto de datos de referencia público utilizado para evaluación entre conjuntos de datos. Disponible en: https://motchallenge.net/data/MOT20/ |
| motmetrics | Desarrolladores de motmetrics | Versión 1.4.0 | Biblioteca utilizada para el cálculo de métricas diagnósticas de seguimiento de múltiples objetos. |
| GPU NVIDIA | NVIDIA | GeForce RTX 5090 D V2 | Unidad de procesamiento gráfico utilizada para el entrenamiento del detector y la inferencia de seguimiento. |
| Controlador de GPU NVIDIA | NVIDIA | Versión 610.62 | Controlador de GPU utilizado en el entorno experimental. |
| NumPy | Desarrolladores de NumPy | Versión 2.4.4 | Biblioteca de computación numérica utilizada para el procesamiento de características y manejo de datos. |
| OpenCV | OpenCV | Versión 4.10.0 | Biblioteca de visión por computadora utilizada para carga, recorte, preprocesamiento y visualización de imágenes. |
| Python | Python Software Foundation | Versión 3.12.2 | Lenguaje de programación utilizado en todo el flujo de trabajo. |
| PyTorch | PyTorch Foundation | Versión 2.11.0+cu128 | Marco de aprendizaje profundo utilizado para la implementación del detector y del modelo semántico. |
| scikit-learn | Desarrolladores de scikit-learn | Versión 1.9.0 | Biblioteca de aprendizaje automático utilizada para agrupamiento K-medias durante la extracción del color del uniforme y la partición de confianza. |
| Conjunto de datos SoccerNet Tracking | SoccerNet | N/A | Conjunto de datos de referencia público para seguimiento de fútbol utilizado para evaluación entre conjuntos de datos. Disponible en: https://www.soccer-net.org/tasks/tracking |
| Conjunto de datos SportsMOT | Benchmark SportsMOT | N/A | Conjunto de datos de referencia principal utilizado para la preparación del detector y la evaluación del seguimiento. Disponible en: https://deeperaction.github.io/datasets/sportsmot.html |
| Conjunto de datos TeamTrack | Benchmark TeamTrack | N/A | Conjunto de datos de referencia público para seguimiento deportivo utilizado para evaluación entre conjuntos de datos. Disponible en: https://atomscott.github.io/TeamTrack/ |
| Torchvision | PyTorch Foundation | Versión 0.26.0+cu128 | Biblioteca de visión por computadora utilizada junto con PyTorch para transformación de imágenes y soporte de modelos. |
| TrackEval | Desarrolladores de TrackEval | Versión 1.3.0 | Kit de herramientas de evaluación utilizado para calcular la Precisión en el Seguimiento de Múltiples Objetos (MOTA), Puntuación F1 de Identidad (IDF1), Precisión de Seguimiento de Orden Superior (HOTA), Precisión de Detección (DetA), Precisión de Asociación (AssA), falsos positivos (FP), falsos negativos (FN) y cambios de identidad (IDs). |
| Ultralytics | Ultralytics | Versión 8.4.90 | Marco de detección de objetos utilizado para entrenar el detector y generar detecciones de atletas. |
Referencias
- Naik BT, Hashmi MF, Bokde ND. A comprehensive review of computer vision in sports: open issues, future trends and research directions. Applied Sciences. 2022;12(9):4429-46.
- Cao W, Wang X, Liu X, Xu Y. A deep learning framework for multi-object tracking in team-sports videos. IET Computer Vision. 2024;18(5):574-90.
- Fu X, et al. A novel dataset for multi-view multi-player tracking in soccer scenarios. Applied Sciences. 2023;13(9):5361-77.
- Guo Y, et al. Does visual training enhance athletes' decision-making skills and sport-specific performance? A systematic review and meta-analysis. Scand J Med Sci Sports. 2025;35(10):e70140.
- Chen X, et al. Multi-object detection and tracking based on CRF network and spatio-temporal attention for sports videos. Scientific Reports. 2025;15(1):6808-21.
- Cheng X, Zhao H, Deng Y, Shen S. Multi-object tracking with predictive information fusion and adaptive measurement noise. Applied Sciences. 2025;15(2):736-48.
- Hu Q, Scott A, Yeung C, Fujii K. Basketball-SORT: an association method for complex multi-object occlusion problems in basketball multi-object tracking. Multimedia Tools Appl. 2024;83(38):86281-97.
- Meng W, Duan S, Ma S, Hu B. Motion-Perception Multi-Object Tracking (MPMOT): enhancing multi-object tracking performance via motion-aware data association and trajectory connection. Journal of Imaging. 2025;11(5):144.
- Nie G, Wang X, Zhang D, Wang H. SCT-Diff: seamless contextual tracking via diffusion trajectory. Journal of Imaging. 2026;12(1):38.
- Yue Y, et al. Improving multi-object tracking by full occlusion handle and adaptive feature fusion. IET Image Processing. 2023;17(12):3423-40.
- Li H, et al. Synergistic-aware cascaded association and trajectory refinement for multi-object tracking. Image Vis Comput. 2025;154:105695.
- Wang C, Xie H. FCD-Net: feature decorrelation and confidence-driven dynamic fusion for robust pedestrian recognition in autonomous driving. IEEE Trans Intell Transp Syst. 2025;26(1):1-13.
- Wan S, Chen W. Improved multi-target athlete tracking in sports videos using IYOLOv8-MTD and enhanced DeepSORT with hybrid attention and IMM. Informatica. 2025;49(35):101-16.
- Sun Z, et al. Multiple pedestrian tracking under occlusion: a survey and outlook. IEEE Trans Circuits Syst Video Technol. 2025;35(2):1009-27.
- Qian H, et al. Low-altitude multi-object tracking via graph neural networks with cross-attention and reliable neighbor guidance. Remote Sensing. 2025;17(20):3502.
- Liu C, Li H, Wang Z. FastTrack: a highly efficient and generic GPU-based multi-object tracking method with parallel Kalman filter. Int J Comput Vis. 2024;132(5):1463-83.
- Urdiales J, Martín D, Armingol JM. An improved deep learning architecture for multi-object tracking systems. Integr Comput Aided Eng. 2023;30(2):121-34.
- You L, et al. Multi-object vehicle detection and tracking algorithm based on improved YOLOv8 and ByteTrack. Electronics. 2024;13(15):3033.
- Stanczyk T, Yoon S, Bremond F. No train yet gain: towards generic multi-object tracking in sports and beyond [conference paper]. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops; 2025. p. 6085-94. https://doi.org/10.48550/arXiv.2506.01373
- Mandel T, et al. Detection confidence driven multi-object tracking to recover reliable tracks from unreliable detections. Pattern Recognit. 2023;135:109107.
- Hou M, Wu Y, Shi H, Mu X. A two-stage multi-object tracking algorithm with transformer and attention mechanism. Scientific Reports. 2025;15(1):31414.
- Wenkel S, et al. Confidence score: the forgotten dimension of object detection performance evaluation. Sensors. 2021;21(13):4350.
- Zhang F, Hu Y, Li Z, Luo D. Two-stage multi-object tracking via low confidence dynamic adaptive matching enhancement for autonomous driving. Applied Soft Computing. 2025;168:112101.
- Stanojevic VD, Todorovic BT. BoostTrack: boosting the similarity measure and detection confidence for improved multiple object tracking. Mach Vis Appl. 2024;35(3):53.
- Tan S, Kuang Z, Jin B. AppleYOLO: apple yield estimation method using improved YOLOv8 based on Deep OC-SORT. Expert Syst Appl. 2025;272:126764.
- Li YF, et al. Multi-object tracking with robust object regression and association. Comput Vis Image Underst. 2023;227:103586.
- Mao H, Chen Y, Li Z, Chen F, Chen P. SCTracker: multi-object tracking with shape and confidence constraints. IEEE Sensors Journal. 2023;24(3):3123-30.
- Ma J, Yang J, Zhang J, Fu F. Online multiple object tracker with enhanced features. Journal of Electronic Imaging. 2023;32(1):013030.
- Liu Y, et al. A full-detection association tracker with confidence optimization for real-time multi-object tracking. J Real-Time Image Process. 2024;21(4):1-15.
- Song Z, et al. Temporal coherent object flow for multi-object tracking [conference paper]. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2025;39(7):6978-86. https://doi.org/10.1609/aaai.v39i7.32749.
- Scarrica VM, Staiano A. Learning from outputs: improving multi-object tracking performance by tracker fusion. Technologies. 2024;12(12):239.
- Miah M, Bilodeau GA, Saunier N. Learning data association for multi-object tracking using only coordinates. Pattern Recognit. 2025;160:111169.
- Yang C, Yang M, Li H. A survey on soccer player detection and tracking with videos. Visual Computer. 2025;41(2):815-29.
- Pham DT, Thuy NTT, Tran LQ. SportsORT: overcoming challenges of multi-object tracking in sports through domain-specific features and out-of-view re-association. Mach Vis Appl. 2025;36(6):1-17.
- Naik BT, Hashmi MF, Geem ZW, Bokde ND. DeepPlayer-Track: player and referee tracking with jersey color recognition in soccer. IEEE Access. 2022;10:32494-509.
- Scott A, et al. TeamTrack: a dataset for multi-sport multi-object tracking in full-pitch videos. Sports Engineering. 2024;27(2):24.
- Vats K, et al. Player tracking and identification in ice hockey. Expert Syst Appl. 2023;213:119250.
- Liu W, Yao J, Jiang F, Wang M. An improved multi-object tracking algorithm designed for complex environments. Sensors. 2025;25(17):5325.
- Kausalya K, Kanaga Suba Raja S. OTRN-DCN: an optimized transformer-based residual network with deep convolutional network for action recognition and multi-object tracking of adaptive segmentation using soccer sports video. Int J Wavelets Multiresolut Inf Process. 2024;22(1):2350034.
- Lopes JM, et al. Object and event detection pipeline for rink hockey games. Future Internet. 2024;16(6):179.
- Thulasya Naik B, Hashmi MF, Gupta A. EIoU-distance loss: an automated team-wise player detection and tracking with jersey colour recognition in soccer. Connection Science. 2024;36(1):2291991.
- Liu H, et al. Automated player identification and indexing using two-stage deep learning network. Scientific Reports. 2023;13(1):10036.
- Bhargavi D, Gholami S, Pelaez Coyotl E. Jersey number detection using synthetic data in a low-data regime. Front Artif Intell. 2022;5:988113.
- Dendorfer P, et al. MOTChallenge: a benchmark for single-camera multiple target tracking. Int J Comput Vis. 2021;129(4):845-81.
- Luiten J, et al. HOTA: a higher order metric for evaluating multi-object tracking. Int J Comput Vis. 2021;129(2):548-78.
- Pal SK, Pramanik A, Maiti J, Mitra P. Deep learning in multi-object video tracking: a review. Mach Vis Appl. 2021;51(9):6400-29.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.