Este protocolo describe un flujo de trabajo de aprendizaje profundo para la segmentación semántica, reconstrucción y síntesis de estilos artísticos de patrones del patrimonio cultural inmaterial, utilizando extracción de características basada en transformadores, reconstrucción adversaria y generación espacialmente adaptativa de imágenes para apoyar la preservación digital y aplicaciones creativas del patrimonio.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Reconstrucción guiada por segmentación semántica y síntesis de estilo artístico de patrones del patrimonio cultural inmaterial mediante un marco de aprendizaje profundo
En este artículo
Resumen
Resumen
La preservación digital y la reconstrucción de patrones del patrimonio cultural inmaterial (ICH) han atraído una atención creciente con el avance de las técnicas de síntesis de imágenes basadas en aprendizaje profundo. Los enfoques existentes basados en SegCycle-SPADE han demostrado potencial para la segmentación estructural y la reconstrucción artística de patrones artesanales tradicionales; sin embargo, persisten limitaciones, como la diversidad limitada de los conjuntos de datos, la incorporación insuficiente de semántica cultural y la preservación inadecuada de las características estructurales de los patrones durante la reconstrucción. Para abordar estos desafíos, este estudio propone un marco SegCycle-SPADE mejorado para la segmentación semántica y la reconstrucción artística de tipos de patrones de ICH. Se emplea un modelo de segmentación basado en Transformador, SegFormer, para identificar con precisión los límites de los motivos y las regiones del patrón. Además, se introduce un Módulo de Fusión de Características Culturales con Atención Cruzada para realzar los motivos culturalmente significativos y mejorar la representación de características. La traducción y reconstrucción del patrón se realizan utilizando CycleGAN, mientras que la Denormalización Espacialmente Adaptativa (SPADE) se utiliza para la síntesis de estilo artístico con el fin de mantener la coherencia semántica entre los mapas de segmentación y las imágenes generadas. Para mejorar la generalización del modelo y la diversidad artística, el marco se entrena utilizando tanto el conjunto de datos de motivos culturales Miao Batik como el conjunto de datos WikiArt. Los resultados experimentales demuestran que el marco SegCycle-SPADE guiado por atención propuesto mejora la precisión de segmentación y el rendimiento en la reconstrucción de patrones del patrimonio en comparación con los métodos existentes de reconstrucción basados en redes generativas antagónicas (GAN). El marco propuesto ofrece una solución escalable para la documentación asistida por inteligencia artificial, la reconstrucción y la revitalización artística de diseños de patrones tradicionales.
Introducción
El patrimonio cultural, que incluye elementos intangibles como costumbres, lenguas y creencias, así como elementos tangibles como obras de arte, edificios y registros escritos, es una manifestación fundamental de la historia, la creatividad y la identidad humanas1. La conservación del patrimonio busca permitir que las comunidades se reconecten con sus orígenes y posibilita que las generaciones futuras se beneficien de su memoria cultural colectiva. Asimismo, promueve el entendimiento intercultural, la apreciación de tradiciones y costumbres diversas, y el reconocimiento de diferentes narrativas históricas. Estos bienes culturales nos ayudan a comprender los valores, perspectivas y experiencias de generaciones pasadas y contribuyen a la formación de identidades sociales contemporáneas y a la continuidad cultural. Los principios básicos de la preservación del patrimonio cultural se ilustran en Figura 1.
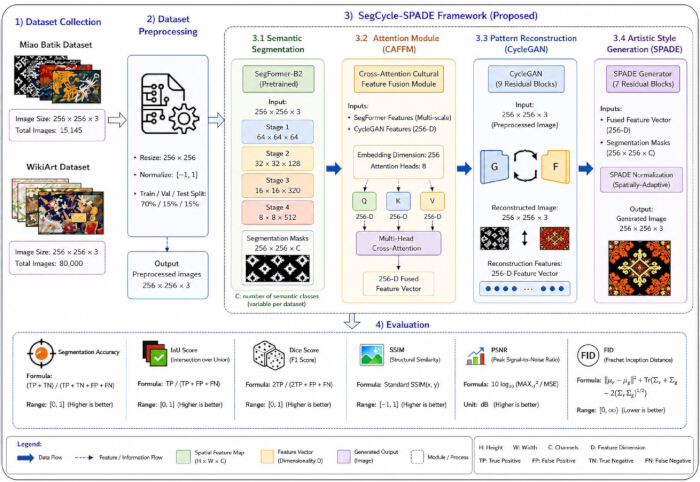
Figura 1. Visión conceptual de la reconstrucción de patrones del patrimonio cultural mediante el marco SegCycle-SPADE. Ilustración esquemática del enfoque propuesto para reconstruir y realzar patrones del patrimonio cultural inmaterial. El flujo de trabajo incluye la recolección de conjuntos de datos a partir de las bases de datos Miao Batik y WikiArt, preprocesamiento de imágenes, segmentación semántica mediante SegFormer-B2, fusión de características mediante el Módulo de Fusión de Características Culturales con Atención Cruzada (CAFFM), reconstrucción de patrones mediante CycleGAN, síntesis de estilo artístico mediante SPADE y evaluación final mediante métricas de segmentación y reconstrucción. Las flechas indican el flujo de datos y representaciones de características a través del marco. Haga clic aquí para ver una versión ampliada de esta figura.
La memoria colectiva y el legado cultural de la sociedad humana se encarnan en el patrimonio cultural inmaterial (PCI), que sirve como un medio importante para la expresión artística y la identidad cultural. Sin embargo, el PCI enfrenta desafíos significativos debido a los efectos de la globalización y la digitalización2,3,4. Muchas prácticas de PCI en peligro requieren nuevos enfoques para su preservación y desarrollo debido a la disminución del número de artesanos calificados y a la limitada capacidad de adaptación a los mercados modernos5,6. Como un área importante de la investigación sobre PCI, el diseño sostenible enfatiza el desarrollo integrado de la cultura, la sociedad y el medio ambiente, y proporciona una vía práctica para la preservación continua del PCI. A través de enfoques de diseño sostenible, el PCI puede revitalizarse adaptándose a las necesidades de la sociedad contemporánea7,8.
En este estudio, el término «patrones del patrimonio cultural inmaterial» se refiere a representaciones de motivos visuales que comunican y preservan valores culturales inmateriales subyacentes. En consecuencia, el marco propuesto tiene como objetivo preservar y documentar la información cultural asociada a estos motivos mientras se reconstruyen sus formas visuales.
El bordado miao y el batik son formas significativas del PCI chino, que reflejan la historia, creencias y tradiciones de la comunidad miao mediante motivos simbólicos como aves, mariposas y tótems ancestrales9. Estos motivos están profundamente arraigados en la vestimenta ritual y las prácticas festivas, y contribuyen al desarrollo cultural y económico local10,11. Los avances en tecnologías digitales, particularmente la inteligencia artificial (AI) y el aprendizaje profundo (DL), han creado nuevas oportunidades para la preservación, análisis, reconstrucción y documentación del patrimonio cultural. El batik miao de Guizhou, una de las tradiciones de batik mejor conservadas en China, sirve como un medio importante para transmitir el conocimiento cultural, creencias, costumbres y rituales del pueblo miao12,13,14,15,16.
Estudios recientes han demostrado el potencial del aprendizaje profundo (DL) para la preservación del patrimonio cultural y la reconstrucción de patrones, logrando una mayor precisión en la segmentación (precisión por píxel = 88,6 %, media de intersección sobre unión [IoU] = 78,1 %) y un mejor desempeño en la reconstrucción en comparación con U-Net y DeepLabV3+. Sin embargo, aún persisten varios desafíos. Los enfoques existentes basados en redes generativas antagónicas (GAN) suelen tener dificultades para preservar detalles estructurales finos en patrones complejos.17, mientras que la diversidad limitada de los conjuntos de datos restringe la generalización del modelo a través de dominios culturales18Además, los modelos de traducción de imagen a imagen, como CycleGAN, pueden no mantener la coherencia semántica entre los mapas de segmentación y las imágenes generadas.19, y la ausencia de mecanismos de atención puede provocar la pérdida de detalles de motivos culturalmente significativos durante la reconstrucción20Por lo tanto, se necesita un marco mejorado que integre la segmentación basada en transformadores, el aprendizaje de características guiado por la atención y el entrenamiento con múltiples conjuntos de datos para una reconstrucción efectiva de los patrones de HIC.
Han surgido nuevas oportunidades para la preservación del patrimonio cultural mediante la digitalización del bordado Miao y el rápido avance de la inteligencia artificial generativa. Los modelos de difusión, una clase emergente de modelos generativos profundos, han demostrado un rendimiento notable en tareas de visión por computadora debido a sus potentes capacidades de generación de contenido21,22,23,24,25. Durante el proceso de difusión inversa, el modelo aprende gradualmente a reconstruir los datos originales a partir de representaciones ruidosas26,27,28. Estudios previos también han explorado la aplicación de tecnologías de reconstrucción tridimensional y diseño asistido por computadora (CAD) para la preservación y difusión del patrimonio cultural.
Aunque las redes neuronales convolucionales (CNN) y las GAN funcionan bien en la generación de imágenes y la preservación de características, aún enfrentan desafíos relacionados con campos receptivos limitados, colapso de modos e inestabilidad durante el entrenamiento29. Las arquitecturas basadas en transformadores, como SegFormer y Segmenter, sobresalen en captar el contexto global y las relaciones semánticas; sin embargo, son computacionalmente intensivas y pueden tener dificultades con detalles finos. Aunque los modelos de difusión como Stable Diffusion demuestran fuertes capacidades de generación de imágenes, a menudo carecen de control preciso sobre las características estructurales y artísticas de los diseños generados. Además, la mayoría de los enfoques existentes emplean estrategias de entrenamiento independientes que limitan el intercambio efectivo de información y la optimización colaborativa entre los componentes de segmentación y generación, lo que resulta en un equilibrio entre precisión estructural y autenticidad artística30.
Modelos recientes basados en difusión, como la difusión latente y la difusión estable, logran una síntesis de imágenes de alta calidad, pero requieren un denoising iterativo, lo que incrementa el costo computacional y el tiempo de inferencia. Además, mantener motivos culturales finos y la coherencia estructural sigue siendo un desafío sin mecanismos especializados de acondicionamiento. Los modelos generativos basados en transformadores capturan eficazmente las relaciones contextuales globales, pero a menudo necesitan conjuntos de datos a gran escala y recursos computacionales sustanciales. En contraste, el marco propuesto SegCycle-Normalización Adaptativa Espacial (SegCycle-SPADE) combina la segmentación basada en SegFormer, la fusión de características mediante atención cruzada, la reconstrucción mediante CycleGAN y la síntesis guiada por SPADE para proporcionar una guía estructural explícita, mejorando así la preservación de motivos, la coherencia semántica y la reconstrucción controlable de patrones del patrimonio cultural.
La mayoría de las técnicas modernas de segmentación semántica se basan en CNN completas (FCNN) con arquitecturas en forma de U31. Durante la etapa de codificación, se extraen características profundas con campos receptivos grandes mediante una serie de operaciones de convolución y submuestreo. La etapa de decodificación restaura progresivamente la resolución espacial mediante sobremuestreo, permitiendo finalmente la predicción semántica a nivel de píxel. Al compensar la pérdida de información espacial durante el submuestreo y mejorar el rendimiento de la segmentación en una amplia gama de aplicaciones, las conexiones residuales permiten integrar directamente información de alta resolución de diferentes niveles del codificador en el decodificador32.
Si bien los métodos recientes basados en GAN, CNN y difusión han mostrado resultados prometedores en la generación de imágenes y la restauración del patrimonio cultural, a menudo tienen dificultades para mantener la coherencia semántica, preservar los motivos estructurales finos y garantizar una reconstrucción reproducible en diversos patrones culturales. La mayoría de los enfoques existentes tratan la segmentación, la reconstrucción y la síntesis de estilo como procesos separados, lo que puede provocar la pérdida de elementos culturalmente significativos y resultados inconsistentes. Para abordar esta brecha metodológica, este estudio propone un marco unificado SegCycle-SPADE que integra la segmentación semántica basada en SegFormer, un nuevo Módulo de Fusión de Características Culturales con Atención Cruzada (CAFFM), la reconstrucción basada en CycleGAN y la síntesis de estilo guiada por SPADE. Al integrar explícitamente la información de segmentación estructural con el aprendizaje generativo de características, el marco propuesto permite una reconstrucción más confiable, semánticamente coherente y reproducible de los motivos del patrimonio cultural inmaterial (ICH), al tiempo que preserva tanto la autenticidad cultural como la calidad artística.
En este estudio se identifican tres limitaciones principales de los enfoques actuales de reconstrucción del patrimonio cultural: (i) la preservación insuficiente de motivos estructurales finos en los métodos de reconstrucción basados en GAN; (ii) la generalización limitada derivada del entrenamiento con conjuntos de datos pequeños o específicos del dominio; y (iii) la consistencia semántica inadecuada entre las salidas de segmentación y las imágenes generadas en los marcos de traducción de imagen a imagen. Además, la segmentación, la reconstrucción y la síntesis de estilo suelen tratarse como procesos separados, lo que provoca la pérdida de elementos culturalmente importantes durante la reconstrucción. Al combinar la segmentación semántica basada en transformadores, la fusión de características con atención cruzada, la reconstrucción mediante CycleGAN y la síntesis artística guiada por SPADE dentro de una arquitectura unificada, el marco propuesto SegCycle-SPADE aborda estas limitaciones y mejora la preservación de motivos, la consistencia semántica y la autenticidad artística en la reconstrucción de patrones del patrimonio cultural inmaterial (ICH).
El objetivo principal de este estudio es desarrollar un marco SegCycle-SPADE mejorado para la reconstrucción artística guiada por segmentación semántica de patrones de ICH. El marco integra SegFormer para la segmentación precisa de motivos culturales, CycleGAN para la reconstrucción de patrones y SPADE para la síntesis artística con consistencia de estilo. Para mejorar la representación de características y preservar detalles estructurales finos, se introduce un CAFFM para facilitar una interacción eficaz entre las características de segmentación y las generativas. Entrenado con los conjuntos de datos Miao Batik y WikiArt, el marco propuesto mejora la autenticidad de la reconstrucción, la consistencia de estilo y la preservación de motivos culturalmente significativos.
Al combinar la segmentación semántica, la fusión de características guiada por atención, la reconstrucción de patrones y la síntesis de estilo dentro de una arquitectura unificada, este estudio presenta un nuevo marco SegCycle-SPADE para la reconstrucción artística de patrones de patrimonio cultural. Las principales contribuciones de este trabajo son las siguientes. Primero, se desarrolla un nuevo marco de reconstrucción guiado por segmentación semántica mediante la integración de SegFormer, lo que permite la extracción y preservación precisa de motivos culturales intrincados y elementos estructurales. Segundo, se introduce un nuevo módulo CAFFM para fusionar eficazmente las características de segmentación con representaciones generativas, permitiendo al modelo capturar relaciones de largo alcance entre los motivos culturales y los patrones de estilo artístico. Tercero, el CAFFM propuesto mejora la preservación de elementos culturalmente significativos al tiempo que aumenta el realismo visual y la coherencia estructural de los patrones de patrimonio reconstruidos. Cuarto, mediante la integración de CycleGAN para la reconstrucción de patrones culturales y SPADE para la síntesis artística guiada por segmentación, el marco garantiza tanto la precisión semántica como la autenticidad estilística en las salidas generadas. Quinto, para mejorar la generalización y la diversidad artística, el modelo se entrena utilizando el conjunto de datos de motivos culturales Miao Batik para el aprendizaje de patrones culturales y el conjunto de datos WikiArt para la representación de estilos artísticos. WikiArt sirve como un conjunto de datos auxiliar para evaluar la capacidad de generalización del marco, la solidez del aprendizaje de características y la eficacia del control de estilo en diversos contextos visuales, más que como un estilo objetivo para su aplicación directa en productos del patrimonio cultural Miao. Finalmente, en comparación con los métodos existentes basados en GAN para la reconstrucción de patrimonio cultural, los resultados experimentales demuestran que el marco propuesto SegCycle-SPADE logra una mayor precisión de segmentación, calidad de reconstrucción y consistencia estilística.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
El marco propuesto de SegCycle-SPADE está diseñado para reconstruir y mejorar patrones tradicionales del patrimonio cultural mediante segmentación semántica, realce de características usando atención, reconstrucción generativa y síntesis de estilo artístico. Este estudio utilizó conjuntos de datos públicos de imágenes artísticas y del patrimonio cultural, incluyendo el conjunto de datos Miao Batik y el conjunto de datos WikiArt. No se involucraron participantes humanos, datos de pacientes, información personal, sujetos animales ni registros clínicos en la investigación; por lo tanto, no se requirió la aprobación del comité de ética institucional ni el consentimiento informado. En primer lugar, se utilizan el conjunto de datos de motivos culturales Miao Batik y el conjunto de datos WikiArt para la evaluación. El conjunto de datos Miao Batik fue descrito en Quan et al. (2024)32 y contiene 15.148 imágenes anotadas de motivos tradicionales de batik Miao. Las anotaciones existentes proporcionadas por los creadores del conjunto de datos se utilizaron directamente, y no se generaron anotaciones manuales adicionales en este estudio. A continuación, se realiza el preprocesamiento de las imágenes mediante redimensionado, normalización, eliminación de ruido y creación de una máscara de segmentación. Los parámetros exactos de preprocesamiento se describen en la sección de Preprocesamiento de Datos. El marco propuesto utiliza un modelo basado en transformadores denominado SegFormer-B2 para la segmentación semántica de los datos. El método está diseñado para detectar regiones clave de los motivos culturales y aprender sus estructuras. Las características segmentadas se realzan posteriormente mediante un mecanismo de atención, en el cual se resalta la información importante relacionada con los motivos culturales y se descarta la información irrelevante. La configuración del mecanismo de atención se describe en la sección CAFFM. Las características realzadas se procesan luego mediante CycleGAN, donde se reconstruyen estructuras dañadas mediante aprendizaje cíclico. Durante el entrenamiento, se crearon artificialmente muestras de motivos incompletos aplicando operaciones de enmascaramiento aleatorio y oclusión parcial a las imágenes originales de Miao Batik. Estos procedimientos de degradación simularon regiones faltantes de los motivos y daños estructurales comúnmente observados en artefactos del patrimonio cultural deteriorados. Las imágenes incompletas resultantes se utilizaron como entradas para el módulo de reconstrucción de CycleGAN, mientras que las imágenes originales correspondientes sirvieron como objetivos de reconstrucción. Los patrones del patrimonio cultural reconstruidos se realzan posteriormente mediante SPADE, donde se lleva a cabo el realce artístico basado en los mapas de segmentación generados. El rendimiento del marco propuesto se evalúa mediante métricas cuantitativas de segmentación y calidad de imagen, mientras que la autenticidad visual de los motivos culturales reconstruidos se evalúa cualitativamente. La autenticidad visual se evaluó mediante inspección visual de los patrones culturales generados y no se utilizó como métrica cuantitativa independiente. La evaluación se centró en la preservación del motivo, la coherencia semántica, las características culturales, la coherencia estructural y la apariencia artística en relación con los motivos culturales de referencia correspondientes. La evaluación cuantitativa del rendimiento del modelo se realizó utilizando precisión de segmentación, coeficiente IoU, coeficiente de Dice, índice de similitud estructural (SSIM), relación pico de señal a ruido (PSNR) y distancia de Inception de Fréchet (FID). Figura 2 ilustra el flujo de trabajo general del marco propuesto SegCycle-SPADE y resume las métricas de evaluación utilizadas en este estudio.
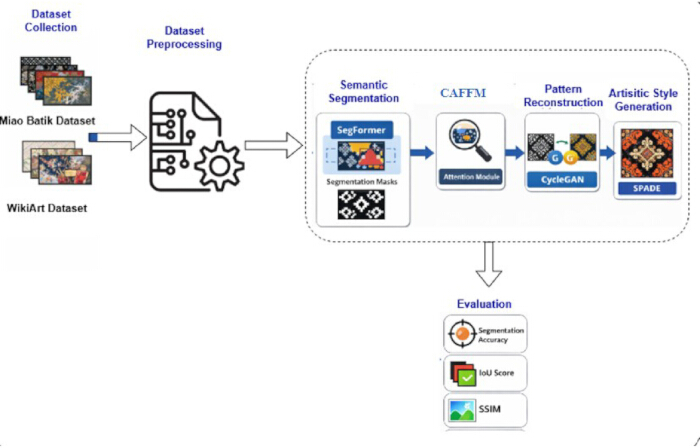
Figura 2. Flujo de la Arquitectura General del Marco Propuesto SegCycle-SPADE. Resumen del flujo de trabajo completo del marco SegCycle-SPADE. Las imágenes de los conjuntos de datos Miao Batik y WikiArt pasan por un preprocesamiento antes de ser procesadas mediante segmentación semántica utilizando SegFormer-B2, mejora de características mediante CAFFM, reconstrucción de patrones mediante CycleGAN y generación de estilo artístico mediante SPADE. El rendimiento del modelo se evalúa utilizando precisión de segmentación, intersección sobre unión (IoU), coeficiente de Dice, medida del índice de similitud estructural (SSIM), PSNR y distancia de Inception de Fréchet (FID), mientras que la autenticidad visual se evalúa de forma cualitativa. Haga clic aquí para ver una versión ampliada de esta figura.
El marco SegCycle-SPADE para la reconstrucción de patrones del patrimonio cultural está diseñado para integrar múltiples componentes de aprendizaje profundo (DL) con el fin de lograr una segmentación precisa de motivos, su reconstrucción y mejora artística, como se ilustra en la Figura 2. Se utilizan imágenes del conjunto de datos de motivos culturales del Batik Miao y del conjunto de datos WikiArt para proporcionar patrones culturales y estilos artísticos diversos. Inicialmente, las imágenes se procesan mediante un módulo de segmentación semántica basado en SegFormer para identificar y delimitar los motivos culturales respecto al fondo. La arquitectura general consta de cuatro etapas principales. Primero, el modelo SegFormer extrae mapas de segmentación semántica a partir de las imágenes de patrones culturales. Segundo, el CAFFM integra características de segmentación con representaciones generativas para mejorar el aprendizaje de características. Tercero, el módulo CycleGAN reconstruye los patrones culturales utilizando las representaciones de características fusionadas. Finalmente, el módulo SPADE genera salidas mejoradas estilísticamente mientras preserva la coherencia estructural mediante una síntesis guiada por segmentación. Los mapas de características refinados son posteriormente procesados por el módulo de reconstrucción CycleGAN, que aprende a restaurar motivos culturales incompletos mediante la transformación de patrones degradados en sus formas completas correspondientes. Las muestras de motivos incompletos se generaron aplicando operaciones aleatorias de enmascaramiento y oclusión parcial a las imágenes originales de Batik Miao, simulando así regiones de patrón faltantes y degradación estructural comúnmente observadas en artefactos culturales dañados. Cada imagen degradada se emparejó con su imagen original correspondiente, que sirvió como objetivo de reconstrucción durante el entrenamiento. Esta estrategia permitió que el módulo CycleGAN aprendiera a restaurar las estructuras de motivos faltantes, preservando al mismo tiempo la coherencia semántica y las características culturalmente significativas. Finalmente, el generador SPADE produce salidas artísticas visualmente mejoradas al condicionar la síntesis de imágenes a los mapas de segmentación generados, manteniendo así la integridad estructural de los motivos culturales durante todo el proceso de mejora artística.
Los siguientes pasos están involucrados en el marco propuesto SegCycle-SPADE.
Paso 1: Recopilación del conjunto de datos
Se utilizaron dos conjuntos de datos para alcanzar los objetivos de aprendizaje de patrones culturales y generación de estilos artísticos. El conjunto de datos de motivos culturales del arte textil Miao Batik se empleó para proporcionar información sobre patrones culturales tradicionales. Este conjunto de datos está disponible públicamente a través de Zenodo (https://doi.org/10.5281/zenodo.20807658) y contiene 15 148 imágenes anotadas de motivos tradicionales de batik Miao. Las anotaciones existentes proporcionadas por los creadores del conjunto de datos se utilizaron directamente, y en este estudio no se generaron anotaciones manuales adicionales. El conjunto de datos WikiArt se utilizó para aportar información diversa sobre estilos artísticos destinada a la generación de estilos artísticos, y fue obtenido del repositorio públicamente accesible WikiArt (https://www.wikiart.org/).
Paso 2: Preprocesamiento de datos
Todas las imágenes se preprocesaron mediante redimensionado, normalización y reducción de ruido. Se utilizaron las anotaciones existentes de motivos culturales obtenidas de las fuentes originales del conjunto de datos para apoyar la etapa de segmentación semántica. No se realizaron procedimientos adicionales de anotación ni de reclasificación como parte de este estudio.
Paso 3: Segmentación de patrones semánticos mediante SegFormer
Se utilizó el modelo SegFormer para la segmentación de motivos culturales. La arquitectura exacta de SegFormer y la estrategia de inicialización se describen en el apartado Semantic Pattern Segmentation Using SegFormer. Específicamente, se empleó la arquitectura SegFormer-B2 con una base MIT-B2 preentrenada en ImageNet para la segmentación semántica de motivos. Este modelo captura eficazmente la información contextual global al tiempo que conserva los detalles estructurales complejos de los patrones culturales tradicionales.
Paso 4: CAFFM
El CAFFM combina características de segmentación semántica con representaciones generativas, lo que permite al marco aprender tanto las características de los motivos estructurales como la información del estilo artístico. Los detalles de integración del CAFFM se proporcionan en la subsección CAFFM. El módulo se sitúa entre la etapa de segmentación semántica basada en SegFormer y la etapa de reconstrucción generativa, donde fusiona características estructurales derivadas de la segmentación con características de reconstrucción mediante una atención cruzada multinúcleo. Este proceso mejora la preservación de los motivos culturales y aumenta el realismo de las salidas reconstruidas.
Paso 5: Reconstrucción del patrón (CycleGAN)
Las características fusionadas se procesan posteriormente mediante el módulo CycleGAN para reconstruir estructuras de patrones culturales. La arquitectura CycleGAN y la configuración de entrenamiento se describen en el apartado Reconstrucción del patrón mediante CycleGAN. El módulo de reconstrucción consta de dos generadores y dos discriminadores, utiliza una arquitectura de generador basada en redes residuales con nueve bloques residuales, emplea un discriminador PatchGAN y se entrena utilizando pérdidas adversariales y de consistencia cíclica. Esta configuración permite la asignación bidireccional entre dominios y facilita la reconstrucción de estructuras de patrones culturales incompletas.
Paso 6: Generación de estilo artístico (SPADE)
Los patrones reconstruidos se procesan luego a través del módulo SPADE para realizar una síntesis de estilo artístico guiada por segmentación. La configuración del generador SPADE se describe en el apartado Generación de estilo artístico mediante SPADE. El módulo emplea bloques residuales SPADE, capas de normalización adaptativa espacial y condiciones semánticas derivadas de mapas de segmentación de SegFormer y representaciones de características CAFFM. Al condicionar la generación de imágenes a los mapas de segmentación, las salidas sintetizadas mantienen una alineación estructural con los motivos culturales originales, a la vez que incorporan características de estilo artístico.
Paso 7: Estimación del rendimiento
El marco propuesto se evaluó utilizando múltiples métricas de segmentación y evaluación de la calidad de imagen, incluyendo la precisión de segmentación, la intersección sobre unión (IoU), el coeficiente de similitud de Dice (Dice), SSIM, PSNR y FID. Para evaluar la consistencia experimental, todos los experimentos se repitieron cinco veces utilizando diferentes semillas aleatorias, y los resultados se presentan como media ± desviación estándar. La significancia estadística se evaluó mediante pruebas t pareadas, con un umbral de significancia de p < 0,05.
Recolección de conjuntos de datos
En el marco propuesto de SegCycle-SPADE, se utilizan dos conjuntos de datos para la comprensión de patrones culturales y el aprendizaje de estilos. El primer conjunto de datos empleado en el marco propuesto es el conjunto de datos de motivos culturales de bordado Miao Batik. Este conjunto contiene motivos culturales del bordado Miao Batik, que generalmente son imágenes tradicionales de Miao Batik que incluyen motivos como animales, plantas y formas geométricas, utilizados en el arte de la etnia Miao. Este conjunto de datos contiene imágenes con información rica en texturas, que generalmente son importantes para preservar el patrimonio cultural. El segundo conjunto de datos empleado en el marco propuesto de SegCycle-SPADE es el conjunto de datos WikiArt. Este conjunto contiene una gran cantidad de obras artísticas, que generalmente pertenecen a diferentes estilos. Este conjunto de datos se utiliza para el aprendizaje de estilos complejos, lo cual es generalmente útil para mejorar obras artísticas. Este conjunto incluye 80 000 obras artísticas en alta definición, con 27 diseños diferentes, lo que lo hace más útil para tareas de generación o transformación de estilos basadas en aprendizaje profundo (DL).
Conjunto de datos de Batik Miao:
El conjunto de datos de Batik Miao (https://doi.org/10.5281/zenodo.20807658) comprende 15.148 imágenes de patrones de batik que representan motivos de significado cultural. Las imágenes incluyen una variedad de diseños tradicionales, como motivos animales (por ejemplo, mariposas y peces), patrones basados en plantas y motivos geométricos que poseen simbolismo cultural. Este conjunto de datos es un componente importante del marco propuesto porque proporciona estructuras culturales auténticas que permiten al módulo de segmentación identificar y preservar con precisión los límites de los motivos durante la reconstrucción del patrón (Tabla 1). En este estudio, los motivos culturalmente importantes hacen referencia a elementos visuales simbólicos comúnmente documentados en la literatura sobre el patrimonio cultural Miao y representados en las anotaciones del conjunto de datos, incluyendo aves, mariposas, patrones florales y tótems ancestrales. Estos motivos fueron seleccionados según su significado cultural documentado y su presencia recurrente en diseños tradicionales de batik y bordado Miao, más que únicamente por su frecuencia de aparición o composición espacial. Las anotaciones de motivos guiadas por expertos y las etiquetas de segmentación se obtuvieron de la fuente original del conjunto de datos de Batik Miao y se utilizaron directamente en este estudio. Los autores no realizaron ninguna anotación manual adicional, reetiquetado ni procedimientos de anotación guiados por expertos. Las anotaciones existentes proporcionadas por los creadores del conjunto de datos se utilizaron para el entrenamiento y la evaluación en la segmentación semántica.
| Parámetro | Descripción |
| Nombre del conjunto de datos | Miao Batik Cultural Pattern Dataset |
| Origen del conjunto de datos | Repositorio Zenodo (DOI: 10.5281/zenodo.20807658) |
| Dominio | Patrimonio Cultural Inmaterial (PCI) / Análisis de patrones textiles |
| Número total de imágenes | 15.148 imágenes |
| Tipo de imagen | Imágenes digitales de patrones textiles tradicionales de batik Miao |
| Categorías de patrón | Motivos animales, motivos vegetales y motivos geométricos |
| Origen cultural | Cultura étnica Miao, provincia de Guizhou, China |
| Resolución original de las imágenes | Imágenes de alta resolución (típicamente ≥ 1.000 píxeles en el lado más corto) capturadas como escaneos o fotografías en bruto antes del preprocesamiento |
| Resolución para entrenamiento | Imágenes redimensionadas a 256 × 256 píxeles durante el preprocesamiento |
| Disponibilidad de anotaciones | Se utilizaron las anotaciones de segmentación existentes proporcionadas por los creadores del conjunto de datos sin modificaciones para el entrenamiento y la evaluación. En este estudio no se realizaron anotaciones manuales adicionales, reclasificaciones ni procedimientos de confirmación por expertos. |
| Aplicación en este estudio | Segmentación de motivos culturales, extracción de características, preservación de motivos y reconstrucción de patrones |
Tabla 1: Características del conjunto de datos de patrones culturales de la técnica batik de los Miao. Resumen del conjunto de datos de motivos culturales de la técnica batik de los Miao utilizado para la segmentación semántica, el análisis de patrones culturales y la reconstrucción de motivos. La tabla describe la fuente del conjunto de datos, las características de las imágenes, las categorías de motivos, el origen cultural, la resolución de las imágenes y su función dentro del marco propuesto SegCycle-SPADE.
Conjunto de datos de WikiArt:
El conjunto de datos de WikiArt [https://www.wikiart.org/] es un repositorio digital de arte a gran escala muy utilizado que comprende más de 80 000 imágenes de 27 estilos artísticos diferentes en la Tabla 2. Los estilos incluyen arte renacentista, impresionismo, cubismo y surrealismo. El conjunto de datos es muy importante en el marco propuesto, ya que ofrece conocimientos que permiten al módulo SPADE crear patrones enriquecidos culturalmente, manteniendo al mismo tiempo la información estructural obtenida del proceso de segmentación. El conjunto de datos consta de 56 000 imágenes para el aprendizaje y 12 000 imágenes para validación y pruebas. Las imágenes del conjunto de datos contribuyen a entrenar eficazmente el modelo de aprendizaje profundo.
| Parámetro | Descripción |
| Nombre del conjunto de datos | Conjunto de datos WikiArt |
| Fuente del conjunto de datos | Repositorio WikiArt (https://www.wikiart.org/) |
| Dominio | Arte digital y pinturas |
| Número total de imágenes | Aproximadamente 80 000 obras de arte |
| Imágenes de entrenamiento | 56 000 |
| Imágenes de validación | 12 000 |
| Imágenes de prueba | 12 000 |
| Estilos artísticos | 27 estilos artísticos, incluyendo Renacimiento, Impresionismo, Cubismo, Surrealismo, Expresionismo, Realismo y Arte abstracto |
| Resolución original de las imágenes | Las resoluciones originales de las imágenes varían según las obras y las fuentes. Las imágenes se redimensionaron a una resolución uniforme de 256 × 256 píxeles durante el preprocesamiento. |
| Resolución de entrenamiento | Las imágenes se redimensionaron a 256 × 256 píxeles durante el preprocesamiento, antes del aprendizaje de estilos artísticos y de la síntesis de imágenes guiada por segmentación. |
| Particionado del conjunto de datos | Particionado aleatorio estratificado (70 % entrenamiento, 15 % validación y 15 % prueba) utilizando una semilla aleatoria fija de 42 |
| Estrategia de muestreo de estilos | Se empleó un muestreo proporcional estratificado para preservar la distribución de los 27 estilos artísticos en los subconjuntos de entrenamiento, validación y prueba |
| Aplicación en este estudio | Aprendizaje de estilos artísticos, representación de estilos y síntesis artística guiada por segmentación |
Tabla 2: Características del conjunto de datos WikiArt. Resumen del conjunto de datos WikiArt utilizado para el aprendizaje de estilos artísticos y la síntesis de imágenes guiada por estilo. La tabla describe la fuente del conjunto de datos, la distribución de imágenes, la cobertura de estilos artísticos, la partición del conjunto de datos, la resolución de las imágenes y su aplicación dentro del marco propuesto SegCycle-SPADE.
El conjunto de datos Miao Batik contiene 15.148 imágenes que representan motivos culturales tradicionales de los Miao.32 Este conjunto de datos está disponible públicamente a través de Zenodo (https://doi.org/10.5281/zenodo.20807658). Antes del entrenamiento del modelo, todas las imágenes fueron inspeccionadas visualmente, redimensionadas a 256 × 256 píxeles, normalizadas y revisadas para detectar muestras corruptas o duplicadas. La evaluación de control de calidad no condujo a la exclusión de ninguna imagen; por lo tanto, se conservaron las 15.148 imágenes para el análisis posterior. El conjunto de datos se dividió aleatoriamente en subconjuntos de entrenamiento (70 %), validación (15 %) y prueba (15 %) utilizando una semilla aleatoria fija de 42 para garantizar la reproducibilidad de las particiones. El conjunto de datos WikiArt fue obtenido a través del repositorio oficial de WikiArt (https://www.wikiart.org/) y contiene más de 80.000 obras de arte que abarcan 27 estilos artísticos. Para los experimentos de aprendizaje de estilo, se utilizaron 56.000 imágenes para entrenamiento, 12.000 para validación y 12.000 para pruebas.
Preprocesamiento de datos
Antes de entrenar el marco propuesto SegCycle-SPADE, el conjunto de datos de motivos culturales de la indumentaria Miao Batik y el conjunto de datos WikiArt se sometieron a varios pasos de preprocesamiento para garantizar una calidad de imagen consistente y una representación precisa de las características. La misma canalización básica de preprocesamiento, que incluye eliminación de ruido gaussiano, normalización, redimensionamiento a una resolución de entrada uniforme y verificación de la calidad de la imagen, se aplicó a ambos conjuntos de datos. Sin embargo, los conjuntos de datos desempeñaron funciones distintas dentro del marco. El conjunto de datos WikiArt se utilizó para el aprendizaje y la síntesis de estilos artísticos, mientras que el conjunto de datos Miao Batik se utilizó principalmente para la segmentación y reconstrucción de motivos culturales. No se realizaron cambios específicos en el preprocesamiento más allá de estos roles específicos de cada tarea. Para asegurar un procesamiento consistente por parte del modelo de aprendizaje profundo (DL), las imágenes se redimensionaron primero a una resolución fija. Este paso fue necesario porque las imágenes en ambos conjuntos de datos variaban en resolución según su origen. El redimensionamiento mejoró la eficiencia computacional y evitó que las inconsistencias dimensionales afectaran el entrenamiento. El segundo paso de preprocesamiento fue la normalización, en la cual los valores de los píxeles se escalonaron a un rango estandarizado para estabilizar las actualizaciones del gradiente durante el entrenamiento. Luego, las imágenes se procesaron utilizando un filtro gaussiano para reducir el ruido que pudiera interferir con las estructuras de los motivos culturales. Para el conjunto de datos Miao Batik, se utilizaron directamente las máscaras existentes de segmentación de motivos culturales obtenidas de la fuente original del conjunto de datos, sin modificaciones, para el entrenamiento y evaluación de segmentación semántica. No se generaron nuevas máscaras de segmentación específicamente para este estudio.
A menos que se indique lo contrario, las ecuaciones que describen métodos establecidos fueron adaptadas de estudios previos y se citan en consecuencia. Las ecuaciones que describen el CAFFM propuesto y el marco de optimización compuesto SegCycle-SPADE fueron desarrolladas por los autores para este estudio.
Sea una imagen de entrada del conjunto de datos representada como Ec. 1:
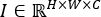 (1)
Aquí, H, W y C se refieren a la altura, anchura y número de canales de color de la imagen, respectivamente. Todas las imágenes se redimensionan a una dimensión fija H′ × W′, como se muestra en la Ecuación 2:
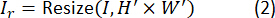
Aquí, Ir es la imagen redimensionada. Los valores normalizados de los píxeles se calculan según la Ecuación 3:
 (3)
Esto ayuda a estabilizar el procedimiento de entrenamiento. El filtrado de ruido se realiza utilizando un filtro gaussiano como se muestra en la Ecuación 4:
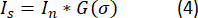
Aquí, G(σ) es un filtro gaussiano y * representa la convolución. Se utilizó un filtro gaussiano con un kernel de 5 × 5 y una desviación estándar de σ = 1.0. Se aplicó un relleno reflectante a los píxeles del borde para reducir los artefactos de borde. Antes de la escala y la normalización, el proceso de eliminación de ruido se realizó inmediatamente después de la carga de la imagen. Para garantizar un preprocesamiento uniforme durante todo el estudio, se aplicó la misma configuración de filtro a cada imagen de los conjuntos de datos Miao Batik y WikiArt. Para el conjunto de datos Miao Batik, las máscaras de segmentación se crean según la Ecuación 5:

Aquí, M es una máscara de segmentación utilizada para guiar el modelo SegFormer.
La canalización de preprocesamiento comienza con la adquisición de imágenes del conjunto de datos Miao Batik y del conjunto de datos WikiArt, como se muestra en la Figura 3. No se emplearon técnicas de aumento de datos durante el entrenamiento. Después del preprocesamiento, que incluyó el redimensionamiento, la normalización, la eliminación de ruido gaussiano y la preparación de máscaras de segmentación, las imágenes se utilizaron directamente para el entrenamiento, validación y prueba del marco propuesto SegCycle-SPADE. El primer paso de la canalización de preprocesamiento consiste en redimensionar las imágenes a un tamaño fijo, lo que permite que el modelo de aprendizaje profundo procese las imágenes de manera más eficiente. El segundo paso implica la normalización, que convierte los valores de los píxeles a un rango numérico estandarizado y facilita la convergencia del modelo. El tercer paso consiste en la eliminación de ruido, mediante el cual se eliminan los ruidos no deseados de las imágenes para mejorar el reconocimiento de patrones. Además, para el conjunto de datos Miao Batik, se anotan las regiones de motivos culturales, lo que permite generar máscaras utilizadas en el módulo de segmentación del modelo propuesto, asegurando que los motivos culturales se conserven durante la generación. La salida final de esta etapa es un conjunto de datos limpio que está listo para entrenar los módulos de segmentación y generación del modelo propuesto.
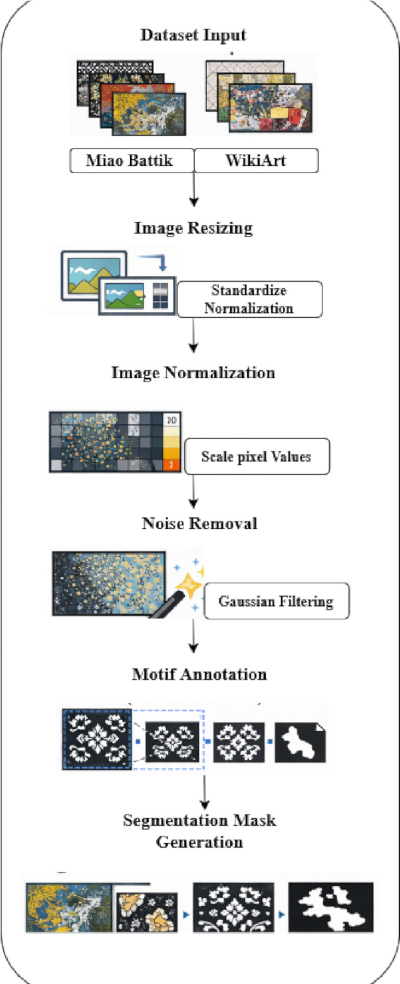
Figura 3. Tubo de preprocesamiento de datos para imágenes del patrimonio cultural. Flujo de trabajo que ilustra los procedimientos de preprocesamiento de imágenes aplicados antes del entrenamiento del modelo. La tubería incluye la adquisición del conjunto de datos, el redimensionamiento de imágenes, la normalización, la eliminación de ruido gaussiano, las anotaciones existentes de motivos culturales y la preparación de máscaras de segmentación. Las imágenes y máscaras procesadas resultantes se utilizan como entradas para la segmentación semántica y la reconstrucción de patrones. Haga clic aquí para ver una versión más grande de esta figura.
Cada imagen fue sometida a un proceso de control de calidad antes del entrenamiento del modelo. El conjunto de datos de Miao Batik contenía 15.148 imágenes. Las muestras corruptas, duplicadas y de baja calidad ya habían sido corregidas por los creadores originales del conjunto de datos; por lo tanto, no se excluyeron imágenes adicionales durante la evaluación de control de calidad en este estudio. En consecuencia, se conservaron las 15.148 imágenes para el análisis. Las imágenes se cargaron en formato RGB durante el preprocesamiento y se redimensionaron a 256 × 256 píxeles utilizando interpolación bilineal. Los valores de los píxeles se escalonaron desde el rango [0, 255] al [0, 1] dividiendo por 255. Luego se aplicó una normalización por canal utilizando valores medios de [0,485, 0,456, 0,406] y valores de desviación estándar de [0,229, 0,224, 0,225] para los canales rojo, verde y azul, respectivamente. La tubería de preprocesamiento incluyó la carga de imágenes, conversión a RGB, redimensionamiento, escalonamiento de valores de píxeles, normalización y conversión a tensor. Cuando fue necesario, las imágenes en escala de grises se convirtieron al formato RGB de tres canales para mantener la compatibilidad con los modelos de aprendizaje profundo. Tras el preprocesamiento, las imágenes se dividieron en subconjuntos de entrenamiento, validación y prueba. Todas las etapas del marco SegCycle-SPADE —incluyendo segmentación semántica, fusión de características, reconstrucción de motivos y síntesis artística basada en SPADE— utilizaron una resolución de entrada consistente de 256 × 256 píxeles.
Segmentación por Patrones Semánticos usando SegFormer
Después de esta etapa de preprocesamiento, las imágenes limpias y normalizadas del conjunto de datos de motivos culturales del batik miao y del conjunto de datos de WikiArt se introducen en el módulo de segmentación semántica basado en el marco propuesto de SegFormer-B2. El objetivo de este paso es identificar y separar correctamente los motivos culturales presentes en los patrones patrimoniales. El marco propuesto de SegFormer se basa en una arquitectura de transformador que incorpora un codificador Transformer jerárquico y un decodificador MLP ligero para capturar con precisión la información contextual global, así como la información estructural detallada de patrones patrimoniales complejos. El modelo primero extrae representaciones de características a múltiples escalas a partir de la imagen de entrada, seguido de la fusión de estas representaciones mediante el decodificador para generar patrones segmentados precisos. Esto garantiza que los patrones en la imagen patrimonial se segmenten correctamente en motivos como patrones geométricos, patrones florales y patrones simbólicos, separándolos así del fondo mientras se mantiene su integridad estructural. Esta información estructural se utiliza posteriormente en las etapas posteriores de generación de patrones dentro del marco SegCycle-SPADE.
Sea la imagen de entrada preprocesada representada como Ec. 6:
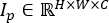 (6)
El codificador SegFormer divide la imagen en fragmentos y extrae características jerárquicas utilizando capas transformadoras, como se muestra en Ecuación 71:
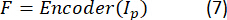
Aquí, F denota los mapas de características multiescala obtenidos del codificador transformador. Estas características codifican tanto los patrones de textura locales como las relaciones contextuales globales entre las regiones del motivo. El modelo SegFormer extrae mapas de características a diferentes escalas según se define en la Ecuación 8:
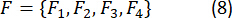
El uso de representaciones multiescala facilita la detección de patrones de diferentes tamaños dentro de los motivos culturales. Finalmente, las características se combinan utilizando el decodificador MLP como se muestra en Ecuación 91:
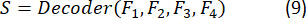
Aquí, S denota el mapa final de segmentación predicho.
El modelo base SegFormer-B2 se inicializó utilizando pesos preentrenados en ImageNet y posteriormente se ajustó finamente en el conjunto de datos Miao Batik para la segmentación de motivos culturales. El punto de control preentrenado se obtuvo de la implementación oficial de SegFormer. Específicamente, se utilizó el punto de control MIT-B2 preentrenado en ImageNet-1K (mit_b2.pth) proporcionado por el repositorio oficial de SegFormer para inicializar el modelo base SegFormer-B2 antes del ajuste fino. Los pesos preentrenados corresponden al modelo base MIT-B2 publicado por los autores de SegFormer y sirvieron como modelo de inicialización para el entrenamiento de segmentación semántica. Las capas restantes específicas de la tarea se inicializaron utilizando los procedimientos predeterminados de inicialización de pesos de PyTorch antes del entrenamiento.
Se utiliza un codificador Transformer jerárquico de cuatro etapas con incrustaciones de fragmentos superpuestos en la arquitectura. En la etapa inicial, el tamaño del fragmento se estableció en 7 × 7 con un paso de 4. Para cada una de las cuatro etapas del codificador, las dimensiones de incrustación fueron 64, 128, 320 y 512. A lo largo de las cuatro etapas, hubo 1, 2, 5 y 8 cabezales de autoatención multinivel, y las profundidades correspondientes del codificador fueron 3, 4, 6 y 3 capas. Las características multiescala recuperadas del codificador se agruparon utilizando un decodificador ligero completamente basado en MLP. Antes de crear el mapa final de segmentación, el decodificador proyectó las características de cada etapa del codificador en un único espacio de incrustación. Todos los bloques Transformer utilizaron la función de activación Unidad Lineal de Error Gaussiana (GELU). Durante el entrenamiento se utilizó una tasa de abandono (dropout) de 0,1 para mejorar la generalización y reducir el sobreajuste.
Durante la fase de entrenamiento, el marco SegFormer recibe las imágenes preprocesadas de ambos conjuntos de datos. Las imágenes del conjunto de datos de Miao Batik contienen regiones de motivos que sirven como etiquetas para el aprendizaje supervisado del modelo de segmentación. El codificador Transformer procesa la imagen completa y captura relaciones de largo alcance entre los componentes de la imagen, lo cual es particularmente importante para los patrones tradicionales de batik que contienen motivos distribuidos espacialmente. El mecanismo jerárquico de extracción de características captura simultáneamente estructuras locales, como texturas geométricas repetidas. El decodificador MLP procesa estas características extraídas y produce una máscara de segmentación que resalta las regiones de los motivos. Los mapas de segmentación generados en esta etapa se utilizan posteriormente como entradas estructurales para el módulo de atención y la etapa de reconstrucción del patrón, ayudando así a preservar la autenticidad de los patrones generados.
Los motivos culturales se dividieron en diferentes clases para la segmentación semántica según sus características visuales y culturales. La taxonomía de segmentación comprendía motivos de animales (por ejemplo, mariposas, peces, aves y otra fauna simbólica), motivos de plantas (por ejemplo, flores, hojas, enredaderas y patrones botánicos), motivos geométricos (por ejemplo, formas repetitivas, bordes y estructuras geométricas abstractas) y regiones de fondo que representan áreas sin motivos. Se utilizaron máscaras de segmentación a nivel de píxel para asignar cada píxel a una de las clases predefinidas. Las etiquetas enteras se codificaron de la siguiente manera: Etiqueta 0 = fondo, Etiqueta 1 = motivos de animales, Etiqueta 2 = motivos de plantas y Etiqueta 3 = motivos geométricos. Las anotaciones de segmentación y las etiquetas de los motivos se obtuvieron directamente de la fuente original del conjunto de datos Miao Batik. En este estudio no se realizaron anotaciones manuales adicionales, reetiquetado, verificación de límites ni procedimientos de confirmación por expertos. Las anotaciones existentes proporcionadas por los creadores del conjunto de datos se utilizaron sin modificaciones para el entrenamiento y la evaluación.
El modelo SegFormer para la segmentación de motivos culturales procesa las imágenes preprocesadas del conjunto de datos Miao Batik y del conjunto de datos WikiArt utilizando un mecanismo basado en transformadores para la detección precisa de regiones con patrones culturales, como se muestra en la Figura 4. Primero, se proporciona al modelo SegFormer la imagen de entrada que contiene motivos culturales tradicionales. El codificador Transformer extrae tanto información contextual global como características estructurales locales a partir de fragmentos de la imagen. Las características multiescala resultantes se proporcionan al decodificador de segmentación, que utiliza una red de alimentación mixta (Mix Feed-Forward Network) para perfeccionar las representaciones de características y mejorar la detección de motivos. La salida del modelo SegFormer es una máscara de segmentación que resalta los píxeles correspondientes a los patrones culturales mientras suprime la información irrelevante del fondo. Los patrones culturales aislados sirven entonces como guía estructural para las etapas posteriores del marco SegCycle-SPADE.
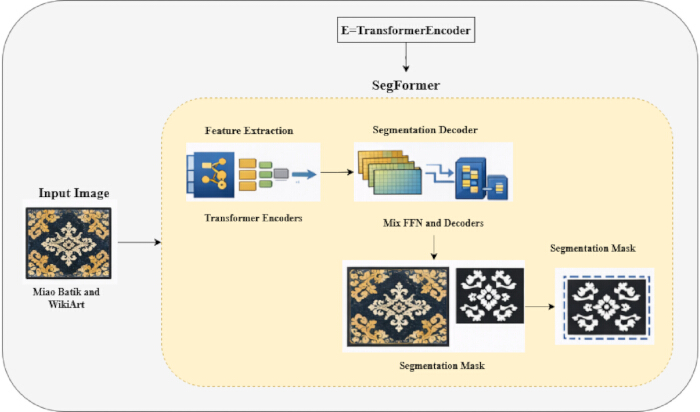
Figura 4. Segmentación semántica basada en SegFormer-B2 de motivos culturales. Arquitectura del módulo de segmentación semántica SegFormer-B2 utilizado para la extracción de motivos culturales y entrenado exclusivamente con el conjunto de datos Miao Batik. El marco consta de un codificador basado en transformadores para la extracción de características a múltiples escalas y un decodificador de segmentación ligero para generar máscaras de motivos. El modelo predice cuatro clases semánticas: animal, planta, geométrico y fondo, donde las máscaras de segmentación resultantes identifican regiones de motivos culturalmente significativas mientras suprimen información de fondo irrelevante. Estas salidas de segmentación proporcionan orientación estructural para las etapas posteriores de fusión de características, reconstrucción y síntesis artística del marco propuesto SegCycle-SPADE. Haga clic aquí para ver una versión más grande de esta figura.
No es necesario crear nuevas anotaciones de segmentación en el marco sugerido. El conjunto de datos Miao Batik se obtuvo de una fuente pública ya existente, y el modelo se entrenó utilizando la información de motivos relacionados proporcionada por los creadores del conjunto de datos. Durante el proceso de aprendizaje, el modelo SegFormer produjo mapas de segmentación semántica. Como resultado, el presente estudio no requirió ningún software adicional de anotación manual, directrices de anotación ni procedimientos de control de calidad de anotaciones.
CAFFM
Para mejorar la interacción entre las características de la segmentación semántica y las representaciones de la reconstrucción generativa, el estudio también propuso un CAFFM. El codificador SegFormer-B2 proporciona mapas de características semánticas al módulo CAFFM, mientras que el paso de reconstrucción de CycleGAN proporciona mapas de características generativas. Primero, se utilizan capas de proyección lineal para proyectar ambos flujos de características en un espacio de incrustación común. Para el cálculo de la atención cruzada, se crean representaciones de consulta (Q), clave (K) y valor (V) utilizando los tensores de características generadas. Luego, se modelan las relaciones entre la información de los motivos estructurales y los elementos del estilo artístico mediante atención cruzada multinúcleo. A continuación, se aplican normalización de capa, conexiones residuales y capas de alimentación directa con activación GELU a las representaciones de características fusionadas. La etapa de síntesis basada en SPADE recibe la salida del módulo CAFFM, lo que permite preservar temas culturalmente significativos sin sacrificar la coherencia artística.
Para garantizar la compatibilidad de características, las características de entrada se proyectan primero mediante capas de proyección lineal en un espacio compartido de incrustación con una dimensión de incrustación de 256. Las interconexiones entre la información estructural semántica y las representaciones de estilo generativo se modelan luego mediante un mecanismo de atención cruzada MultiHead con ocho cabezas de atención. El cálculo de la atención cruzada utiliza los vectores Consulta (Q), Clave (K) y Valor (V), que son producidos por capas específicas de transformación lineal. Para aumentar la estabilidad durante el entrenamiento y mantener la integridad de las características, se emplean conexiones residuales y normalización por capas para mejorar aún más las representaciones de características fusionadas. El aprendizaje de características no lineales se mejora posteriormente mediante la aplicación de una red de alimentación directa con la función de activación Unidad Lineal de Error Gaussiana (GELU). El módulo genera una representación de características de salida con dimensión 256, que se envía a otras etapas para la síntesis creativa. CAFFM combina con éxito datos de estilo artístico con estructuras de motivos culturales mediante una técnica de fusión basada en atención cruzada, lo que mejora la preservación de motivos y la coherencia visual en los patrones de patrimonio cultural reconstruidos.
En el sistema propuesto, las características estructurales se derivan del conjunto de datos Miao Batik, mientras que las características estilísticas se aprenden a partir del conjunto de datos WikiArt. Sea el mapa de características derivado de la red de segmentación SegFormer utilizando imágenes del conjunto de datos Miao Batik representado por Fs, mientras que el mapa de características derivado de la rama de extracción de características estilísticas utilizando imágenes de WikiArt se denota por Fa. El CAFFM propuesto combina los dos dominios de características mediante un mecanismo de atención cruzada para aprender tanto las dependencias estructurales como estilísticas de los patrones culturales. Tabla 3 informa todas las características arquitectónicas, incluyendo dimensiones de incrustación, capas de normalización, funciones de activación y configuración de cabezales de atención. Para un tamaño de imagen de entrada de 256 × 256 píxeles, el codificador SegFormer-B2 produjo mapas de características semánticas de tamaño 64 × 64 × 128, mientras que la rama de extracción de características estilísticas produjo mapas de características de tamaño 64 × 64 × 128. Ambos mapas de características se proyectaron mediante capas lineales entrenables a un espacio de incrustación compartido de dimensión 256 antes de la fusión por atención cruzada.
| Parámetro | Configuración |
| Marco propuesto | SegCycle-SPADE |
| Modelo de segmentación semántica | SegFormer-B2 |
| Etapa del codificador SegFormer | 4 |
| Inicialización de pesos | SegFormer-B2 preentrenado en ImageNet-1K (estructura MIT-B2) |
| Origen del punto de control | Repositorio oficial de NVIDIA SegFormer (https://github.com/NVlabs/SegFormer); punto de control: segformer.b2.512x512.ade.160k |
| Estrategia de ajuste fino | Ajuste fino de extremo a extremo en el conjunto de datos Miao Batik |
| Tamaño del parche de incrustación | 7 × 7 |
| Paso del parche | 4 |
| Dimensiones de incrustación | 64, 128, 320 y 512 |
| Profundidades del codificador | 3, 4, 6 y 3 |
| Cabezales de atención | 1, 2, 5 y 8 |
| Tipo de decodificador | Decodificador completamente MLP |
| Función de activación | GELU |
| Tasa de abandono (dropout) | 0,1 |
| Módulo de mejora de características | Módulo de fusión de características culturales con atención cruzada (CAFFM) |
| Dimensión de incrustación CAFFM | 256 |
| Cabezales de atención CAFFM | 8 |
| Escala de fusión CAFFM | 4 |
| Modelo de reconstrucción | CycleGAN |
| Modelo de generación de estilo | SPADE |
| Conjunto de datos cultural | Conjunto de datos Miao Batik |
| Conjunto de datos de estilo | Conjunto de datos WikiArt |
| Imágenes Miao Batik | 15 148 |
| Imágenes WikiArt | Aproximadamente 80 000 |
| Resolución de imagen de entrada | 256 × 256 píxeles |
| Formato de color | RGB |
| Método de interpolación | Interpolación bilineal |
| Método de eliminación de ruido | Filtrado gaussiano |
| Tamaño del kernel gaussiano | 5 × 5 |
| Sigma gaussiana (σ) | 1 |
| Rango de normalización | [0, 1] |
| Tamaño del lote | 16 |
| Número de épocas | 100 |
| Optimizador | Adam |
| Tasa de aprendizaje | 0,0002 |
| Parámetros de Adam | β₁ = 0,5, β₂ = 0,999, ε = 1 × 10⁻⁸, decaimiento de peso = 0 |
| Funciones de pérdida | Pérdida de segmentación, pérdida adversaria, pérdida de consistencia cíclica, pérdida de reconstrucción, pérdida de preservación de motivos y pérdida de consistencia de estilo |
| Estrategia de división del conjunto de datos | Entrenamiento / Validación / Prueba |
| Conjunto de entrenamiento | 70 % |
| Conjunto de validación | 15 % |
| Conjunto de prueba | 15 % |
| Semilla aleatoria | 42 |
| Métricas de evaluación | Precisión de segmentación, IoU, coeficiente Dice, SSIM, PSNR y FID |
| Lenguaje de programación | Python 3.8.10 |
| Framework de aprendizaje profundo | PyTorch 1.10.0 |
| Plataforma de hardware | GPU NVIDIA RTX 3090 (24 GB de VRAM), Intel Core i7 (11.ª generación), 32 GB de RAM |
| Entorno operativo | Ubuntu 20.04 LTS |
Tabla 3: Configuración experimental y configuración del modelo. Resumen de los componentes arquitectónicos, configuración de entrenamiento, ajustes de preprocesamiento, conjuntos de datos, parámetros de optimización, métricas de evaluación y entorno computacional utilizados para la implementación y evaluación del marco propuesto SegCycle-SPADE.
El módulo de atención primero transforma el mapa de características en representaciones de consulta, clave y valor utilizando la Ecuación 10:
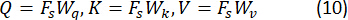
Aquí, Wq, Wk y Wv son matrices de pesos aprendibles. Los pesos de atención se calculan en función de la similitud entre el vector de consulta y el vector clave utilizando la Ecuación 1117:
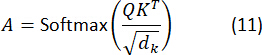
Aquí, dk es la dimensión del vector clave. La representación de características mejorada se calcula multiplicando los pesos de atención con la matriz de valores utilizando la Ecuación 12:
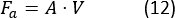
Aquí, Fa es la representación mejorada de la característica del mapa de características. La representación mejorada de la característica se calcula combinando las características originales de segmentación con las características mejoradas obtenidas mediante el mecanismo de atención utilizando la Ecuación 13:
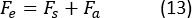
Aquí, Fe es el mapa de características mejorado utilizado para la reconstrucción del patrón. La CAFFM se amplía con un mecanismo de atención cruzada multiescala para extraer características de motivos culturales a diferentes escalas. Sea Fsi la representación de las características de segmentación a la escala i, mientras que Faj denota las características de estilo artístico a la misma escala. La representación final de las características se define mediante la Ecuación 14:
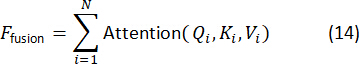
Aquí, Qi, Ki y Vi representan las matrices de consulta, clave y valor a la escala i, respectivamente, y N denota el número de escalas de características. En este estudio, N = 4, lo que corresponde a mapas de características extraídos a resoluciones espaciales de 1/4, 1/8, 1/16 y 1/32 del tamaño de la imagen de entrada. Estas representaciones de características multiescala se fusionaron utilizando pesos de atención entrenables antes de la reconstrucción y la síntesis artística. Esta extensión permite al método extraer motivos culturales globales y texturas para reconstruir patrones culturales. CAFFM se sitúa entre la etapa de segmentación basada en SegFormer y la etapa de síntesis creativa basada en SPADE en el sistema propuesto SegCycle-SPADE. En primer lugar, mientras que CycleGAN crea simultáneamente características de reconstrucción con información estilística y relacionada con patrones, SegFormer-B2 recupera mapas de características semánticas que describen las propiedades estructurales de los motivos culturales. El módulo CAFFM recibe estos dos flujos de características y utiliza una fusión basada en atención cruzada para identificar las relaciones entre las representaciones estructurales y artísticas. Con el fin de crear patrones culturalmente auténticos manteniendo la coherencia semántica y las características estructurales, los mapas de características fusionados resultantes se envían luego al módulo SPADE para la síntesis creativa guiada por segmentación.
Reconstrucción de Patrones usando CycleGAN
Una vez finalizada la etapa de mejora de características basada en la atención, los mapas de características contendrán las estructuras de motivos culturales realzadas. Sin embargo, los mapas de características aún podrían incluir regiones de patrón incompletas o dañadas. Por lo tanto, para abordar el problema de la reconstrucción de los patrones, el marco propuesto utilizará el modelo CycleGAN. En este marco, los dos dominios serán los patrones originales de motivos culturales y los patrones reconstruidos de motivos culturales. Utilizando las características mejoradas de las etapas anteriores, el modelo CycleGAN reconstruirá los patrones culturales manteniendo la coherencia estructural. Esto garantizará que los patrones culturales, como los patrones geométricos, florales y simbólicos, conserven su disposición espacial. Las imágenes originales de Batik Miao se sometieron a operaciones aleatorias de enmascaramiento y oclusión parcial para generar motivos culturales incompletos o dañados. Estos procedimientos de degradación simularon regiones de patrón faltantes y daños estructurales comúnmente observados en artefactos del patrimonio cultural deteriorados. Las imágenes degradadas se utilizaron como entradas para el módulo de reconstrucción, mientras que las imágenes originales correspondientes sirvieron como imágenes de referencia para la evaluación del rendimiento y la valoración de la calidad de la reconstrucción. Esta estrategia permitió al modelo aprender la restauración de estructuras de motivos faltantes, preservando al mismo tiempo la coherencia semántica y las características culturales.
Sea X el dominio de los patrones culturales incompletos y Y el dominio de los patrones culturales reconstruidos. Los dos generadores aprenden a realizar la asignación bidireccional utilizando la ecuación 15:
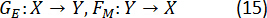
Aquí, GE se utiliza para reconstruir estructuras de motivos y FM se utiliza para mapear los patrones de vuelta al dominio original. La pérdida adversaria se utiliza para garantizar que los patrones reconstruidos sean realistas (Ecuación 16)30
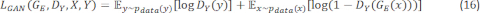
Aquí, DY es el discriminador utilizado para distinguir entre patrones reales y reconstruidos, y GE(x) denota el patrón reconstruido generado. CycleGAN también exige la consistencia cíclica para preservar la disposición estructural de los motivos culturales (Ecuación 17)30.
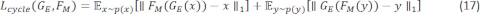
La función de pérdida final se define utilizando la Ecuación 1830:
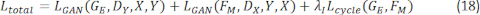
Aquí, λi denota el coeficiente de ponderación para la pérdida de consistencia cíclica y se estableció en 10 durante el entrenamiento, de acuerdo con la formulación original de CycleGAN. Este valor se seleccionó para equilibrar el aprendizaje adversarial y la consistencia de reconstrucción entre los dominios de origen y destino.
El módulo de reconstrucción CycleGAN consta de dos generadores y dos discriminadores para la traducción bidireccional de imágenes. Cada generador sigue una arquitectura de red residual que comprende una capa convolucional inicial 7 × 7, seguida de dos capas convolucionales de submuestreo, nueve bloques residuales y dos capas de sobremuestreo. Todas las operaciones convolucionales emplean un tamaño de kernel de 3 × 3, excepto la capa de entrada, que utiliza un kernel de 7 × 7 para una extracción mejorada de características. Se aplica Normalización por Instancias tras cada capa convolucional para mejorar la estabilidad del entrenamiento, mientras que se utiliza la activación ReLU en toda la red del generador. La capa de salida emplea una función de activación Tanh para generar salidas de imagen normalizadas. El discriminador sigue una arquitectura PatchGAN 70 × 70 que consiste en una serie de capas convolucionales con tamaños de kernel de 4 × 4 y canales de características progresivamente crecientes. Se emplean Normalización por Instancias y activación LeakyReLU (pendiente negativa = 0,2) en el discriminador para mejorar la discriminación de características y el aprendizaje adversarial. El módulo CycleGAN recibe como entrada imágenes preprocesadas de motivos culturales y genera representaciones de patrones reconstruidos, que posteriormente se envían al CAFFM para su integración con características de segmentación. El entrenamiento de CycleGAN se realizó utilizando el optimizador Adam (β₁ = 0,5, β₂ = 0,999) con una tasa de aprendizaje inicial de 0,0002. La tasa de aprendizaje se mantuvo constante durante las primeras 100 épocas y posteriormente se redujo linealmente a cero durante el resto del período de entrenamiento. Se utilizó un búfer de repetición que contenía 50 imágenes generadas previamente para estabilizar el entrenamiento del discriminador. Los generadores y discriminadores se actualizaron utilizando una relación de actualización 1:1, con una actualización del generador seguida de una actualización del discriminador en cada iteración de entrenamiento.
El proceso de reconstrucción del CycleGAN se basa en los mapas de características mejorados obtenidos mediante el mecanismo CAFFM en la Figura 5. Los mapas de características contienen motivos culturales realzados procedentes de las etapas previas de segmentación y CAFFM. Estos mapas de características se utilizan como entrada para el primer generador GE. El primer generador GE aprende la transformación necesaria para reconstruir los patrones culturales. Las salidas se introducen luego en el discriminador DY para distinguir entre patrones culturales reales y patrones reconstruidos. El discriminador DY ayuda al generador GE a producir salidas realistas. Para asegurar que los patrones culturales no se distorsionen durante la reconstrucción, el segundo generador FM realiza una transformación de consistencia cíclica. El segundo generador FM proyecta las salidas de vuelta al dominio original. Las salidas se evalúan entonces mediante el discriminador para garantizar su realismo. Las salidas finales se envían posteriormente al módulo SPADE para la generación de estilo artístico en la siguiente etapa del marco propuesto SegCycle-SPADE.
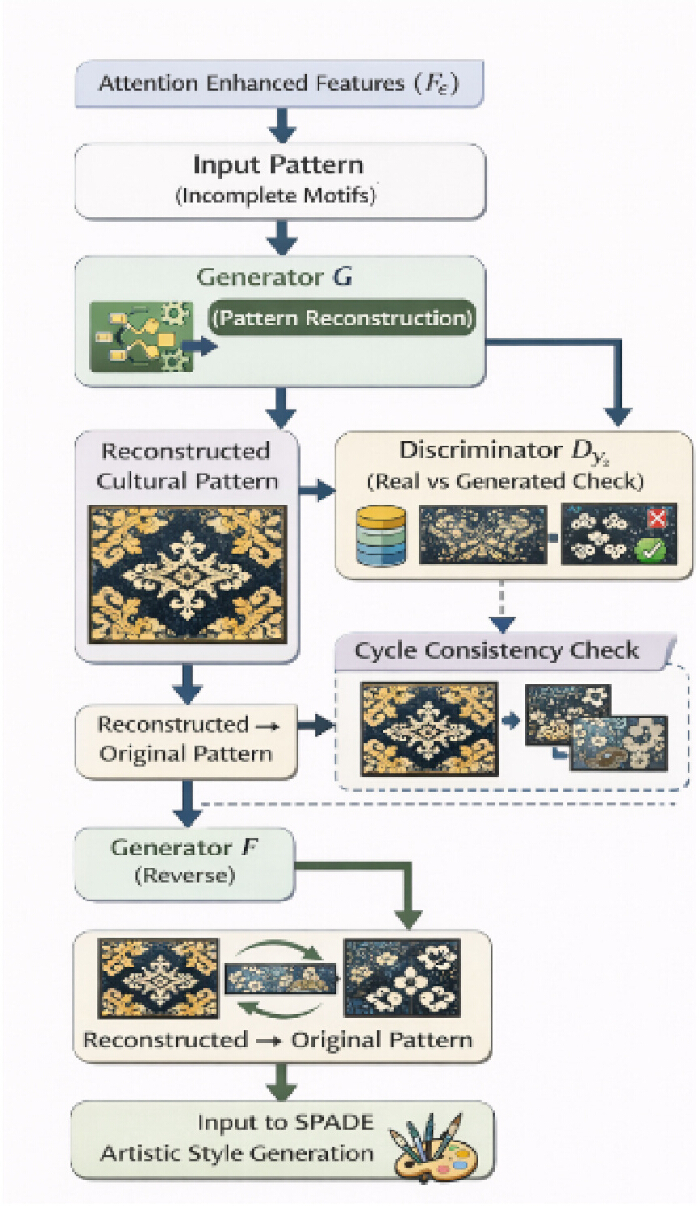
Figura 5. Flujo de trabajo de reconstrucción de patrones basado en CycleGAN. Flujo de trabajo del módulo de reconstrucción CycleGAN. Las representaciones de características mejoradas mediante atención se proporcionan como entradas a la red generadora para reconstruir motivos culturales incompletos. El discriminador evalúa las salidas reconstruidas frente a patrones de referencia, mientras que la correspondencia de consistencia cíclica preserva la integridad estructural durante la traducción bidireccional de imágenes. Los motivos reconstruidos se envían posteriormente al módulo SPADE para la síntesis de estilo artístico. Haga clic aquí para ver una versión más grande de esta figura.
Generación de estilo artístico mediante SPADE
Posteriormente, los motivos culturales reconstruidos se someten al módulo SPADE para la generación de estilo artístico. El objetivo principal del módulo SPADE consiste en añadir texturas visualmente más ricas de estilo artístico a los motivos culturales reconstruidos sin comprometer la disposición estructural de dichos motivos. El módulo SPADE es una técnica de generación condicional de imágenes que utiliza el concepto de segmentación de imágenes para la creación de imágenes. Se codificaron mapas semánticos multicanal que correspondían a las clases predeterminadas de motivos a partir de las máscaras de segmentación semántica generadas por SegFormer-B2. El generador SPADE recibió estos mapas codificados como entradas condicionantes. Los parámetros de escalado espacialmente adaptativo (γ) y de sesgo (β) se generaron procesando los mapas semánticos a través de capas convolucionales dentro de cada capa SPADE. De este modo, el generador pudo mantener los límites de los motivos, las disposiciones estructurales y la información semántica durante la síntesis artística al aplicar estos parámetros a las activaciones de características normalizadas. La guía semántica fue capaz de influir tanto en la reconstrucción estructural de alto nivel como en la síntesis de texturas de bajo nivel, ya que el proceso de condicionamiento se llevó a cabo en varias capas del generador SPADE. Como resultado, los patrones artísticos creados incorporaron rasgos estilísticos obtenidos del conjunto de datos WikiArt, al tiempo que conservaron las estructuras de motivos culturales identificadas durante la etapa de segmentación.
El conjunto de datos WikiArt, que incluye obras de 27 categorías artísticas diferentes—como Renacimiento, Impresionismo, Cubismo, Expresionismo, Surrealismo, Realismo y Arte Abstracto—se utilizó como recurso principal para comprender los estilos artísticos. Con el fin de exponer el modelo a una variedad de rasgos creativos y mejorar la generalización de estilo, se seleccionaron aleatoriamente imágenes de estilo de las distintas categorías durante el entrenamiento. El conjunto de datos se dividió en subconjuntos de entrenamiento, validación y prueba con una representación equilibrada de las categorías artísticas para reducir el sesgo de estilo. Para garantizar una representación equilibrada de las 27 categorías artísticas, se utilizó muestreo estratificado. Las muestras de cada categoría se asignaron proporcionalmente a los subconjuntos de entrenamiento, validación y prueba, manteniendo la distribución original de clases. El módulo CAFFM se utilizó para fusionar los aspectos de estilo derivados de las imágenes de WikiArt con las características de reconstrucción generadas por CycleGAN. Con el fin de permitir que la red de síntesis transfiera cualidades artísticas manteniendo al mismo tiempo la estructura semántica y los límites de los motivos culturales derivados de los mapas de segmentación, las representaciones fusionadas resultantes se proporcionaron como información de condicionamiento al generador SPADE. Gracias a esta técnica de condicionamiento de estilo, el marco propuesto fue capaz de producir patrones artísticos culturalmente auténticos con representaciones estructurales y estilísticas coherentes.
SPADE también introduce parámetros adaptativos espacialmente que dependen del mapa de segmentación. Los parámetros pueden definirse como se muestra en la Ecuación 191:
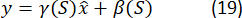
Aquí, γ(S) es el parámetro de escala que varía espacialmente y β(S) es el parámetro de sesgo que varía espacialmente. Los parámetros pueden ayudar al generador a crear diferentes texturas y estilos dependiendo de la región semántica en las imágenes. La obra de arte cultural final puede definirse como se muestra en la Ecuación 20:
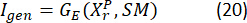
Aquí, GE es el generador SPADE, XrP es el patrón reconstruido y SM es el mapa de segmentación. La obra final mantiene la integridad estructural de los motivos culturales mientras mejora la apariencia artística. Se utilizó una función de pérdida compuesta que equilibra la precisión de la segmentación semántica, la preservación de motivos culturales, la calidad de reconstrucción del patrón y la coherencia del estilo artístico para optimizar la arquitectura propuesta SegCycle-SPADE. Se empleó una mezcla ponderada de la pérdida de segmentación (Lseg), la pérdida adversarial (Ladv), la pérdida de consistencia cíclica (Lcycle), la pérdida de reconstrucción (Lrecon), la pérdida de preservación de motivos (Lmotif) y la pérdida de consistencia de estilo (Lstyle) para establecer el objetivo general de entrenamiento. La función de pérdida total se define en la Ec. 21:
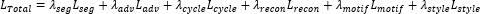 (21)
Con el fin de garantizar la coherencia estructural entre los motivos culturales de entrada y los reconstruidos, el coeficiente de la pérdida de consistencia cíclica se estableció en 10. Para mantener características finas de los motivos y mejorar la precisión visual, el coeficiente de la pérdida de reconstrucción se fijó en 5. Para resaltar la preservación de patrones estructurales culturalmente esenciales durante la síntesis artística, se utilizó un coeficiente de 2 para la pérdida de preservación del motivo. Con el fin de promover la transferencia de estilo artístico sin distorsionar excesivamente las estructuras semánticas del motivo, el coeficiente de la pérdida de consistencia de estilo se ajustó a 1. Para mantener una contribución equilibrada entre la generación realista de imágenes y la segmentación precisa de motivos, se asignaron pesos iguales a las pérdidas de segmentación y adversaria. Se utilizaron representaciones de estilo basadas en características del conjunto de datos WikiArt para calcular la pérdida de consistencia de estilo. En particular, las características de estilo artístico se capturaron mediante correlaciones de matrices de Gram extraídas de mapas de características profundas. La diferencia de la norma de Frobenius entre las matrices de Gram de la imagen de estilo objetivo y la imagen generada se utilizó para calcular la pérdida de estilo, como se muestra en la Ecuación 22:
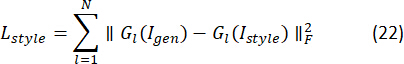
Aquí, Gl es la matriz de Gram calculada a partir de la capa de características lª, Igen denota la imagen artística generada, Istyle denota la imagen de estilo objetivo del conjunto de datos WikiArt, y F denota la norma de Frobenius. Esta formulación permite que el marco propuesto conserve las características artísticas manteniendo al mismo tiempo la integridad estructural y semántica de los motivos culturales.
Las representaciones de características fusionadas producidas por el módulo CAFFM se utilizan como entradas condicionantes para el módulo SPADE, que actúa como el componente de síntesis artística del marco propuesto. El generador SPADE consta de siete bloques residuales SPADE con una dimensión de características latentes de 256 canales y genera imágenes de salida con una resolución de 256 × 256 píxeles. Los mapas de segmentación semántica obtenidos del módulo SegFormer–CAFFM se utilizan como entradas condicionantes a lo largo de todas las capas residuales SPADE. Las capas SPADE se aplican antes de las funciones de activación dentro de cada bloque residual, permitiendo una condición semántica guiada por segmentación. Mediante operaciones sucesivas de sobremuestreo y convolucionales, la representación de características latentes se refina progresivamente para generar patrones artísticos de alta resolución, manteniendo al mismo tiempo la consistencia semántica y la estructura del motivo. Se utilizan funciones de activación LeakyReLU en todo el generador, y se aplica una función de activación Tanh en la capa de salida para producir imágenes normalizadas.
Algoritmo y flujo de trabajo
El marco SegCycle-SPADE integra segmentación semántica, fusión de características, reconstrucción de patrones y síntesis de estilo artístico dentro de una tubería de entrenamiento unificada. El flujo de trabajo comienza con la adquisición y preprocesamiento del conjunto de datos, incluyendo el redimensionamiento de imágenes, normalización, eliminación de ruido y preparación de máscaras de segmentación. Las imágenes preprocesadas se procesan posteriormente utilizando la red de segmentación SegFormer-B2 para extraer representaciones semánticas de motivos. Las características de segmentación resultantes se fusionan con las características de reconstrucción mediante el módulo CAFFM, permitiendo la interacción entre la información estructural de los motivos y las representaciones de características artísticas. Los mapas de características fusionados se proporcionan entonces al módulo de reconstrucción CycleGAN, que restaura estructuras de motivos culturales incompletas preservando la coherencia semántica. Los patrones reconstruidos se entregan posteriormente al generador SPADE para la síntesis artística guiada por segmentación, lo que permite mejorar el estilo manteniendo los límites de los motivos y la autenticidad estructural. Durante el entrenamiento, los parámetros del modelo se optimizan utilizando la función de pérdida compuesta descrita en las ecuaciones 21 y 22, que equilibra la precisión de la segmentación, la preservación de motivos, la calidad de reconstrucción y la coherencia del estilo artístico. Se proporciona un flujo de implementación detallado paso a paso, que incluye la carga del conjunto de datos, preprocesamiento, inicialización del modelo, iteraciones de entrenamiento, procedimientos de validación, selección de puntos de control y evaluación final, en el Archivo Suplementario 1 (Algoritmo 1). El flujo de trabajo algorítmico completo se implementó utilizando un tamaño de lote de 16, una tasa de aprendizaje de 0,0002 y 100 épocas de entrenamiento. Se utilizó una semilla aleatoria fija de 42 para la partición del conjunto de datos, la inicialización del modelo y todos los experimentos de entrenamiento. La semilla se aplicó de forma consistente en los generadores de números aleatorios de Python, NumPy y PyTorch para garantizar la reproducibilidad. El optimizador Adam se configuró con β₁ = 0,5, β₂ = 0,999 y sin decaimiento de peso (weight decay = 0). Los puntos de control del modelo se seleccionaron según la puntuación más alta de IoU obtenida en el conjunto de datos de validación.
Optimización de la función de pérdida
Para preservar las estructuras de los motivos culturales durante la reconstrucción y la síntesis artística, el marco propuesto emplea un objetivo de optimización compuesto que combina pérdidas de segmentación, adversariales, de consistencia cíclica, de reconstrucción, de preservación de motivos y de consistencia de estilo. La formulación matemática completa, los coeficientes de ponderación y la definición de la pérdida de estilo se proporcionan en las ecuaciones 21 y 22 dentro del apartado Generación de estilo artístico usando SPADE. El componente de preservación de motivos penaliza las desviaciones estructurales entre las regiones de motivos predichas y las máscaras de segmentación reales correspondientes, fomentando así la preservación de estructuras de patrones culturalmente significativas a lo largo del proceso de reconstrucción.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
El marco propuesto SegCycle-SPADE se evaluó utilizando dos conjuntos de datos: el conjunto de datos de motivos culturales de bordado Miao y el conjunto de datos WikiArt. El conjunto de datos de bordado Miao contiene imágenes de patrimonio cultural tradicional y se utilizó principalmente para tareas de segmentación semántica y reconstrucción estructural, mientras que el conjunto de datos WikiArt contiene estilos artísticos diversos y se empleó para el aprendizaje y la generación de estilos artísticos. Las imágenes de ambo...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
La preservación y reconstrucción digital de patrones del patrimonio cultural inmaterial (ICH) ha ganado una atención creciente en los últimos años debido a la pérdida gradual de oficios tradicionales. Estudios previos han intentado abordar la pérdida del patrimonio cultural mediante técnicas de procesamiento de imágenes basadas en el aprendizaje profundo (DL). Por ejemplo, Quan et al.32 propusieron un marco para la preservación del patrimonio cultural basado en grafos de conocimiento y DL para la ...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Conflicto de intereses:
Los autores declaran que no tienen intereses competidores.
Agradecimientos
Los autores agradecen el apoyo académico e institucional brindado por la Escuela Politécnica de Guangdong y la Universidad Normal del Sur de China durante la realización de esta investigación. Esta investigación fue financiada por el Proyecto General del Fondo Nacional de Ciencias Sociales 2023 (No. 23BH161), titulado “Museo de Regeneración Digital: Investigación sobre la Activación y Difusión de Reliquias Culturales Chinas Clásicas de Caligrafía y Pintura”.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Optimizador Adam | Biblioteca de optimizadores de PyTorch | Adam | Algoritmo de optimización utilizado durante el entrenamiento del modelo. |
| Kit de herramientas CUDA | Corporación NVIDIA | CUDA 11.3 | Aceleración mediante GPU para cálculos de aprendizaje profundo. |
| cuDNN | Corporación NVIDIA | cuDNN 8.2 | Biblioteca de aceleración de redes neuronales profundas utilizada para acelerar el entrenamiento y la inferencia. |
| CycleGAN | Universidad de California, Berkeley / Código abierto | Implementación oficial de PyTorch (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Red generativa antagonista utilizada para la reconstrucción de motivos culturales. |
| Pesos preentrenados de ImageNet | ImageNet / Código abierto | mit_b2.pth (punto de control preentrenado en ImageNet-1K) | Utilizado para inicializar la base del modelo SegFormer-B2 antes del ajuste fino en el conjunto de datos de Batik Miao. |
| Procesador Intel | Corporación Intel | Intel Core i7 (11.ª generación) | CPU utilizada para el preprocesamiento de imágenes, soporte del entrenamiento del modelo y la inferencia. |
| Matplotlib | Equipo de desarrollo de Matplotlib | Matplotlib 3.5.1 | Visualización de curvas de entrenamiento y resultados de evaluación. |
| Conjunto de datos Batik Miao | Repositorio Zenodo | DOI: 10.5281/zenodo.20807658 | Conjunto de datos de motivos culturales que contiene 15 148 imágenes, utilizado para segmentación semántica y reconstrucción de patrones. |
| NumPy | Desarrolladores de NumPy | NumPy 1.21.5 | Cálculo numérico y procesamiento del conjunto de datos. |
| GPU de NVIDIA | Corporación NVIDIA | NVIDIA RTX 3090 (24 GB de VRAM) | Plataforma de hardware utilizada para el entrenamiento del modelo y la inferencia. |
| OpenCV | Fundación OpenCV | OpenCV 4.5.5 | Preprocesamiento de imágenes, redimensionamiento, interpolación y reducción de ruido gaussiano. |
| Sistema operativo | Canonical Ltd. | Ubuntu 20.04 LTS | Entorno de ejecución experimental. |
| Pillow (PIL) | Biblioteca de imágenes de Python | Pillow 8.4.0 | Carga y manipulación de imágenes. |
| Python | Fundación del Software Python | Python 3.8.10 | Lenguaje de programación utilizado para la implementación y experimentación. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Entorno de aprendizaje profundo utilizado para el entrenamiento y la inferencia del modelo. |
| Semilla aleatoria | Configuración experimental | 42 | Semilla fija utilizada para la partición del conjunto de datos, inicialización del modelo y reproducibilidad experimental. |
| Scikit-learn | Desarrolladores de Scikit-learn | Scikit-learn 1.0.2 | Partición del conjunto de datos, análisis estadístico y métricas de evaluación. |
| Seaborn | Comunidad de código abierto | Seaborn 0.11.2 | Visualización estadística de datos. |
| SegFormer-B2 | Investigación de NVIDIA / Código abierto | SegFormer-B2 (base MIT-B2) | Modelo de segmentación semántica basado en transformadores, utilizado para la segmentación de motivos culturales. |
| Máscaras de segmentación / anotaciones | Conjunto de datos Batik Miao | Incluidas con el conjunto de datos | Etiquetas de segmentación semántica a nivel de píxel utilizadas para clasificación de motivos y entrenamiento. |
| SPADE | Investigación de NVIDIA / Código abierto | Implementación oficial de PyTorch (https://github.com/NVlabs/SPADE) | Modelo de síntesis de imágenes guiado por segmentación, utilizado para la generación artística de patrones. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Utilidades de procesamiento de imágenes y transformaciones de conjuntos de datos utilizadas con PyTorch. |
| Conjunto de datos WikiArt | WikiArt | https://www.wikiart.org/ | Conjunto de datos de estilos artísticos que contiene más de 80 000 obras de arte en 27 estilos artísticos, utilizado para el aprendizaje y la síntesis de estilos. |
Referencias
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.