Este estudio examina la toma de decisiones y los comportamientos de revisión de estudiantes de inglés al traducir narrativas centradas en China, integrando registros de pulsaciones de teclado y un corpus de danmu para revelar cómo la saliencia textual influye en el esfuerzo de procesamiento y la calidad de la traducción.
Artículo de investigación
Comportamiento de toma de decisiones y revisión en la traducción del chino al inglés: evidencia de estudiantes de especialidad en inglés que traducen narrativas centradas en China
En este artículo
Resumen
Resumen
A medida que las narrativas centradas en China ingresan cada vez más al ámbito internacional, la traducción del chino al inglés se ha convertido en un espacio de negociación de significados, más que en una transferencia lingüística directa. Para los estudiantes traductores, el desafío principal va más allá de la selección léxica; implica decidir cómo representar referencias cargadas de cultura, posturas evaluativas y posicionamientos narrativos para lectores ajenos al contexto fuente. Este estudio examina la toma de decisiones en tiempo real y los comportamientos de revisión de 72 estudiantes de inglés al traducir narrativas centradas en China. Mediante un diseño proceso-producto, la investigación integra datos de registro de pulsaciones recopilados con Translog-II, evaluaciones del producto traducido y un corpus auxiliar de danmu (comentarios sincronizados en el tiempo) tratado como una capa de relevancia para la audiencia, más que como una medida directa de la dificultad lingüística a nivel de segmento. Los procesos de traducción se analizaron según la duración de las pausas, la frecuencia de revisiones, la ubicación de las revisiones y la distribución por etapas, mientras que la calidad del producto se evaluó mediante calificaciones de expertos y codificación específica de segmentos relacionados con la cultura. Un corpus de 18.642 comentarios danmu provenientes de 24 videos de Bilibili se utilizó para identificar temas narrativos relevantes para el público y expresiones culturalmente sensibles. Los resultados muestran que los segmentos cargados de contenido cultural y densos en evaluación provocaron pausas más largas, un mayor número de revisiones recursivas y reformulaciones más frecuentes durante el proceso. Las traducciones de mayor calidad se asociaron con revisiones selectivas y estratégicamente temporizadas a nivel discursivo y de adaptación cultural, más que con un mayor número total de revisiones. La superposición entre los desencadenantes narrativos relevantes en los danmu y los segmentos de traducción de alto esfuerzo se interpreta como evidencia convergente de la saliencia para la audiencia y la presión en el procesamiento del traductor, y no como evidencia de causalidad. Este estudio impulsa la investigación sobre el proceso traductivo al vincular el comportamiento de revisión con la traducción de narrativas culturalmente enraizadas, y ofrece implicaciones para la formación de traductores en comunicación intercultural.
Introducción
En los últimos años, la traducción de discursos relacionados con China ha pasado de ser una preocupación relativamente especializada a convertirse en un tema central en la comunicación internacional1. Lo que está en juego en dicha traducción no es simplemente la transferencia de contenido proposicional, sino la rearticulación de narrativas públicas que transportan posicionamientos políticos, marcos culturales y diseño de audiencias. Los estudios sobre la traducción del discurso político chino han dejado cada vez más clara esta idea: cuando los textos se traducen para lectores fuera de China, las decisiones sobre el uso léxico, la modalidad y el énfasis textual también se convierten en decisiones sobre cómo se narra e interpreta a China en el extranjero2. Una vez que el problema se plantea de esta manera, un enfoque basado únicamente en el producto resulta insuficiente. Una traducción finalizada puede mostrar qué decisiones se tomaron, pero no puede revelar cuándo surgió la incertidumbre, dónde comenzó la reformulación, ni cómo se probaron y descartaron soluciones alternativas3.
Estas limitaciones ayudan a explicar por qué la investigación empírica sobre los procesos de traducción se ha convertido en una rama importante dentro de los estudios de traducción, utilizando herramientas de rastreo de procesos para capturar pausas, eliminaciones, inserciones y la estructura temporal de la toma de decisiones, en lugar de inferirlas indirectamente a partir del texto final4. Esto no sustituye los enfoques basados en el producto, sociológicos, culturales o en corpus; más bien, aporta evidencia sobre la formación momento a momento de las decisiones de traducción. Trabajos recientes han avanzado desde la descripción de pausas aisladas hacia la modelización de la traducción como una actividad estructurada temporalmente. La taxonomía de vacilación-orientación-fluidez, por ejemplo, considera el comportamiento traductor como una alternancia organizada entre incertidumbre, búsqueda y producción fluida, explicando por qué ciertos segmentos de una tarea se vuelven inestables y desencadenan reformulaciones5. Este enfoque resulta especialmente relevante en la traducción estudiantil, donde la competencia lingüística, el conocimiento temático y el control estratégico aún se encuentran en desarrollo simultáneo6.
La evidencia procedente de estudios combinados con seguimiento ocular y registro de pulsaciones de teclas muestra que los traductores novatos no distribuyen la atención de manera uniforme, y que la producción del texto meta a menudo se convierte en un foco importante de carga cognitiva durante la traducción del chino al inglés7. En consecuencia, lo que parece un problema local de redacción en el producto puede reflejar en realidad una reorganización más amplia de la atención y el esfuerzo durante el proceso en tiempo real8. Evidencia reciente sugiere además que los estudiantes de traducción pueden producir textos con una adecuación superficial similar, pero que difieren considerablemente en la cantidad de esfuerzo, incertidumbre y autorregulación requeridos. Una versión final satisfactoria aún puede basarse en una ruta de decisiones frágil o ineficiente, que solo puede capturarse mediante medidas sensibles al proceso9. Además, investigaciones comparativas indican que la competencia traductora implica un control metacognitivo estable sobre cuándo detenerse, buscar información, continuar redactando o regresar para revisar10.
La revisión es el punto exacto en el que este proceso cognitivo oculto se vuelve más visible. Es donde los traductores regresan a formulaciones anteriores, prueban alternativas y deciden si un problema es léxico, sintáctico, discursivo o cultural. Por consiguiente, la revisión no debe tratarse como una etapa final de pulido, sino como un indicador fundamental del desarrollo del traductor. Los mejores resultados están vinculados a cómo se consolidan las alternativas durante la producción, lo que demuestra que una revisión efectiva es selectiva, estratégicamente oportuna y sensible a las mayores exigencias del texto, más que una simple acumulación de modificaciones11,12,13.
La complejidad de la toma de decisiones y la revisión se vuelve más evidente cuando el texto fuente es una narrativa centrada en China, en lugar de un pasaje informativo neutral. Tales textos suelen basarse en supuestos cargados culturalmente, expresiones situadas históricamente y señales evaluativas cuyo significado depende de un trasfondo compartido más que de una exposición explícita14,15,16. La dificultad del texto altera la propia granularidad del procesamiento; los textos narrativos con densidad cultural o evaluativa obligan a los traductores a trabajar en unidades más pequeñas, realizar operaciones no lineales y llevar a cabo reestructuraciones locales repetidas8. Para los estudiantes traductores, el problema central consiste en decidir cuánto de ese trasfondo implícito deben desglosar o reorganizar para lectores ajenos a la comunidad discursiva original, sin eliminar la especificidad cultural.
Tres lagunas específicas motivan el presente estudio. En primer lugar, las métricas del proceso de traducción, como la duración de las pausas, la frecuencia de pausas largas, la interrupción del cursor y la consulta del diccionario, suelen examinarse por separado de las tipologías de revisión, lo que dificulta observar cómo la presión de decisión se manifiesta como reformulaciones posteriores. En segundo lugar, las categorías narrativas específicas de la cultura han recibido menos atención basada en procesos que los textos académicos o expositivos generales, a pesar de que las narrativas centradas en China a menudo exigen que los traductores gestionen simultáneamente la carga cultural, la densidad evaluativa y la implicación condensada del trasfondo14,15,16. En este estudio, la carga cultural se refiere a la densidad de referencias ligadas a la cultura y de presuposiciones compartidas; la densidad evaluativa se refiere a la adopción de posturas explícitas o implícitas, la intensidad afectiva y los marcos cargados de valor; y la compresión narrativa alude al grado en que la información de trasfondo, las relaciones causales o la posición social se condensan en tramos textuales breves. En tercer lugar, las tareas de traducción suelen diseñarse únicamente sobre la base de un análisis interno del texto, sin considerar suficientemente si los segmentos identificados como difíciles coinciden con los puntos que atraen la atención pública en la circulación digital. Los danmu (comentarios en video sincronizados en el tiempo) pueden funcionar como paratexto y discurso participativo, destacando lo que las audiencias notan, cuestionan y reinterpretan17,18; sin embargo, la saliencia de los danmu debe considerarse un indicador a nivel semántico del compromiso de la audiencia, y no como un sustituto directo de la dificultad lingüística a nivel de segmento.
Abordando estas brechas, el presente estudio examina cómo los estudiantes de inglés toman decisiones y realizan revisiones al traducir narrativas centradas en China del chino al inglés. Al integrar datos sobre el proceso de traducción y el discurso digital de la audiencia en un mismo marco analítico, el estudio pretende explicar no solo en qué aspectos tienen dificultades los estudiantes traductores, sino también por qué dichas dificultades se concentran en torno a ciertos tipos de significado narrativo.
Específicamente, este estudio aborda cuatro preguntas de investigación: (1) ¿Qué patrones de toma de decisiones caracterizan la traducción del chino al inglés de narrativas centradas en China realizada por estudiantes de inglés? (2) ¿Cómo varían los comportamientos de revisión en segmentos con distintos niveles de carga cultural y densidad narrativa? (3) ¿Qué dimensiones del comportamiento de revisión se asocian con una mayor calidad de traducción? y (4) ¿Coinciden los puntos culturalmente relevantes identificados en el discurso danmu con los segmentos que generan el mayor esfuerzo de procesamiento durante la traducción?
En correspondencia, el estudio prueba cuatro hipótesis relacionadas en una única secuencia analítica: H1 propone que los segmentos con mayor carga cultural provocarán pausas más largas, mayor incertidumbre en la toma de decisiones y revisiones más frecuentes que los segmentos con menor carga cultural; H2 distingue dos vías, prediciendo que la densidad evaluativa aumentará las revisiones diferidas, mientras que la compresión narrativa incrementará la reformulación a nivel discursivo; H3 predice que la calidad de la traducción estará explicada más fuertemente por la selectividad y el momento de las revisiones que únicamente por el número total de revisiones; y H4 predice que los segmentos destacados por danmu se solaparán con los segmentos de traducción de alto esfuerzo, como una convergencia asociativa entre la relevancia para la audiencia y la presión en el procesamiento del traductor.
Protocolo
Todos los métodos que involucraron a sujetos humanos se realizaron cumpliendo con las directrices institucionales y fueron aprobados por el comité de revisión institucional (IRB) o el comité de ética en investigación humana de la Universidad Hanshan Normal. Se obtuvo el consentimiento informado de todos los participantes antes del experimento.
Marco conceptual y diseño de la investigación
Este estudio empleó un diseño de investigación proceso-producto con una capa discursiva auxiliar para examinar cómo los comentarios danmu generados por la audiencia influyen en la traducción de subtítulos. El marco analítico integró características textuales, indicadores del proceso de traducción y resultados de calidad traductora. Específicamente, investigó si la atención de la audiencia, reflejada en la densidad de danmu, dirigía los recursos cognitivos de los traductores hacia características textuales particulares y si esta asignación de atención afectaba posteriormente la calidad de la traducción.
Para operacionalizar este marco, el estudio estableció primero características textuales a nivel de segmento basadas en cuatro dimensiones: carga cultural, densidad evaluativa, compresión narrativa y relevancia de los danmu. La carga cultural hacía referencia a la presencia de referencias específicas de una cultura que requerían adaptación o explicación. La densidad evaluativa medía la concentración de lenguaje cargado emocional o actitudinalmente dentro de un segmento. La compresión narrativa capturaba el grado en que el contenido semántico se condensaba bajo las limitaciones de los subtítulos. La relevancia de los danmu representaba el grado de atención del público dirigida hacia cada segmento de subtítulo, cuantificada por el volumen de comentarios danmu sincronizados. A diferencia de las medidas convencionales de dificultad de traducción, la relevancia de los danmu reflejaba una atención socialmente distribuida en lugar de una complejidad textual intrínseca. Un segmento que recibía una participación intensa del público no era necesariamente más difícil de traducir; más bien, representaba un punto de significación comunicativa acentuada dentro de la experiencia de visualización.
El marco analítico comprendió tres conjuntos de datos interconectados. El conjunto de datos a nivel de participante incluyó características demográficas individuales y experiencia en traducción. El conjunto de datos proceso-producto vinculó cada segmento de subtítulo con indicadores conductuales extraídos del registro de pulsaciones del teclado, junto con evaluaciones expertas de la calidad de la traducción. El conjunto de datos danmu contenía comentarios sincronizados del público alineados con el momento de los subtítulos, a partir de los cuales se calcularon los valores de relevancia (salience) de los danmu. Estos conjuntos de datos se vincularon mediante identificadores de participantes y segmentos, lo que permitió el análisis simultáneo de cada segmento de subtítulo traducido en relación con las características del traductor, el comportamiento del procesamiento cognitivo, la atención del público y los resultados de la traducción. La base de datos integrada final comprendió 216 sesiones completas de traducción y 3.168 observaciones de participante–texto–segmento, proporcionando la base empírica para los análisis proceso-producto posteriores.
Selección de participantes y caracterización de antecedentes
La muestra comprendió a 72 estudiantes de inglés reclutados de una universidad pública del sur de China, distribuidos equitativamente entre el segundo, tercer y cuarto año de estudios de pregrado (24 participantes por grupo anual). Todos los participantes eran hablantes nativos de chino que recibían instrucción formal en escritura y traducción en inglés. Para garantizar la comparabilidad dentro de la población de traductores en formación, se excluyeron aquellos individuos que hubieran residido en un país de habla inglesa durante más de 6 meses o que tuvieran certificación profesional como traductor. Los participantes no fueron estratificados en grupos experimentales separados según su experiencia en traducción, familiaridad cultural o dominio del segundo idioma. En cambio, se registraron el nivel académico, las puntuaciones recientes en pruebas de dominio del inglés, los cursos previos de traducción, la familiaridad autopercebida con temas culturales relacionados con China y la participación promedio semanal en práctica bilingüe, y se incluyeron como covariables a nivel de participante en los modelos estadísticos. Esta aclaración también resuelve la inconsistencia en el número de participantes señalada durante la revisión por pares: tanto el manuscrito como el conjunto de datos de replicación incluyen 72 participantes, 216 sesiones de tareas y 3.168 observaciones a nivel de segmento.
Selección del texto fuente y construcción de la tarea
Los materiales de traducción consistieron en tres textos narrativos contemporáneos centrados en China, desarrollados específicamente para este estudio con el fin de reflejar un discurso público auténtico y evitar la reproducción de materiales con derechos de autor. Cada texto contenía entre 205 y 225 caracteres chinos, pero difería sistemáticamente en sus características internas. El texto A presenta una narrativa sobre el regreso a casa durante la Fiesta de Primavera, con una carga cultural moderada y una sintaxis relativamente sencilla. El texto B relata un recuerdo sobre la Fiesta del Bote del Dragón y contiene una mayor densidad de expresiones específicas de la cultura y conocimientos previos implícitos. El texto C describe una narrativa sobre transmisiones en vivo y comercio electrónico en zonas rurales, caracterizada por un lenguaje evaluativo denso y una posición narrativa comprimida.
Los textos se segmentaron sistemáticamente utilizando límites de cláusulas, seguidos de límites de unidades de significado, obteniendo 44 unidades analizables en las tres tareas de traducción (Tabla 1). Antes del codificado formal, un manual de codificación definió la carga cultural, la densidad evaluativa y la compresión narrativa mediante escalas ordinales de 1 a 5. Un estudio piloto con 12 estudiantes que no participaron en el experimento principal confirmó la calibración de dificultad prevista, la claridad de las instrucciones de la tarea y la estabilidad de los límites de segmento para la alineación de pulsaciones de tecla.
Construcción del corpus auxiliar y mapeo de la saliencia
Para identificar indicadores narrativos públicamente relevantes, se compiló un corpus auxiliar de danmu a partir de 24 videos de Bilibili subidos entre enero de 2023 y diciembre de 2025. Solo se incluyeron videos que coincidieran con uno de los tres dominios semánticos representados en los textos fuente, que hubieran acumulado más de 50.000 visualizaciones, que contuvieran interacciones densas de danmu y que permitieran la exportación y la asignación temática de comentarios sincronizados en el tiempo. Tras la eliminación de duplicados y el filtrado de emojis, rellenos onomatopéyicos y fragmentos irrelevantes, el corpus final constaba de 18.642 comentarios.
Las palabras clave se estandarizaron y agruparon utilizando anclas de palabras clave relacionadas con el texto fuente. Luego, a cada segmento del texto fuente se le asignó una puntuación continua de relevancia danmu basada en una composición ponderada de la frecuencia normalizada del grupo de palabras clave, la concentración de comentarios dentro del grupo temático correspondiente y la intensidad evaluativa media. Este procedimiento permite comparaciones entre el esfuerzo de procesamiento del traductor y la relevancia del público a nivel de grupo semántico, en lugar de mediante coincidencia léxica directa. Dado que los danmu reflejan las respuestas del público a videos en línea y no a la tarea experimental de traducción en sí, la relevancia danmu se interpreta como un indicador externo del nivel de participación del público, y no como evidencia directa de la dificultad lingüística de un segmento fuente.
Procedimiento experimental y captura de datos
Las sesiones de traducción se realizaron individualmente en un laboratorio informático controlado, bajo condiciones estandarizadas de hardware, software y acceso a internet (Figura 2). Tras una orientación de cinco minutos que enfatizaba la producción de un inglés comprensible para una audiencia internacional, los participantes realizaron un calentamiento de escritura en inglés de tres minutos para minimizar los efectos de adaptación al teclado. Las tres tareas de traducción se administraron secuencialmente utilizando Translog-II, con el orden de las tareas contrabalanceado mediante un diseño cuadrado latino para distribuir de forma equitativa los posibles efectos de fatiga y de orden entre los participantes. Se asignó a cada participante un máximo de 20 minutos por texto, separados por intervalos de descanso de cinco minutos.
Aunque se permitió el uso del diccionario bilingüe integrado, se prohibieron los sistemas de traducción automática y los motores de búsqueda externos. Todos los pulsaciones de teclas, pausas y movimientos del cursor se registraron automáticamente y se complementaron con grabaciones sincrónicas de pantalla para verificar episodios de revisión no lineales. Después de completar cada tarea, los participantes realizaron una evaluación subjetiva de dificultad utilizada únicamente para ayudar a interpretar casos límite en la codificación.
Medición del proceso y codificación de variables
Los registros de pulsaciones se alinearon con la estructura de segmentos predefinida. Un episodio de alineación comenzaba con la primera pulsación en el idioma objetivo correspondiente a un segmento y finalizaba cuando el participante avanzaba definitivamente al siguiente segmento. Las revisiones superpuestas se reasignaron utilizando registros cronometrados de seguimiento del cursor.
El comportamiento de toma de decisiones se cuantificó mediante cinco indicadores: duración de la primera pausa antes de la traducción del segmento inicial, duración media de las pausas dentro de los segmentos, frecuencia de pausas superiores a dos segundos, número de consultas al diccionario y número de interrupciones basadas en el cursor que indican desviaciones del redactado lineal (Tabla 2). El comportamiento de revisión se clasificó según dos dimensiones: momento y función. El momento diferenciaba entre revisiones locales inmediatas y revisiones diferidas realizadas después de que la redacción hubiera avanzado más allá del segmento actual. La codificación funcional clasificó las revisiones como revisiones superficiales (correcciones a nivel formal sin cambio semántico), revisiones de significado (modificaciones léxicas o sintácticas), revisiones a nivel del discurso (ajustes en las relaciones entre cláusulas o en la coherencia) y revisiones de adaptación cultural (reformulaciones orientadas al público objetivo). Dos codificadores entrenados analizaron independientemente cada episodio de revisión antes de la resolución de discrepancias y asignaron una única categoría funcional principal a cada evento. La confiabilidad entre evaluadores fue sólida en todas las medidas codificadas. El coeficiente kappa de Cohen indicó un acuerdo sustancial en la codificación categórica de las funciones de revisión (ĸ = 0.84, p < 0.001). Para las variables ordinales a nivel del texto, los coeficientes de correlación intraclase (CCI, modelo mixto de dos vías, acuerdo absoluto) mostraron una alta confiabilidad para la carga cultural (CCI = 0.86), la densidad evaluativa (CCI = 0.78) y la compresión narrativa (CCI = 0.82). Cualquier discrepancia inicial en la codificación se resolvió posteriormente mediante adjudicación conjunta.
Evaluación de la calidad de la traducción
La calidad de la traducción fue evaluada independientemente de los datos del proceso por dos evaluadores con formación a nivel doctoral y amplia experiencia en la enseñanza de la traducción. Sin conocer las identidades de los participantes ni las medidas del proceso, los evaluadores aplicaron una rúbrica de 100 puntos, distribuida equitativamente en cinco dimensiones: precisión semántica, fluidez lingüística, coherencia narrativa, adecuación cultural y adecuación del registro (Tabla 3). Las discrepancias en las puntuaciones superiores a ocho puntos dieron lugar a una revisión conjunta y una nueva calificación por consenso, utilizando el promedio adjudicado como puntuación final de calidad de la traducción. Se conservaron los registros de evaluación previos a la adjudicación para facilitar la presentación transparente de la confiabilidad entre evaluadores en los materiales de replicación.
Modelado estadístico
Los análisis avanzaron en tres etapas secuenciales. Primero, se calcularon estadísticas descriptivas para resumir todas las variables a través de los grupos por año y tipos de texto. Segundo, se analizó el esfuerzo de procesamiento a nivel de segmento mediante modelos de regresión de efectos mixtos para tener en cuenta la estructura anidada de los segmentos dentro de los textos y las observaciones repetidas de participantes individuales. Las variables dependientes, incluyendo la duración de la primera pausa y la frecuencia de revisión, se modelaron como funciones de la carga cultural, la densidad evaluativa, la compresión narrativa y la saliencia del danmu, controlando al mismo tiempo la competencia del participante. Se incluyeron correlaciones entre predictores, diagnósticos de inflación de varianza, intervalos de confianza del 95 %, estimaciones del tamaño del efecto e índices de ajuste del modelo para mejorar la transparencia estadística.
Finalmente, se modeló la calidad de la traducción para evaluar las contribuciones predictivas del momento de la revisión y la función de la revisión en relación con la frecuencia total de revisiones. Se evaluó la superposición entre los segmentos destacados de danmu y los segmentos de traducción de alto esfuerzo utilizando el quintil superior de cada distribución, un índice compuesto estandarizado de esfuerzo y un análisis de superposición aleatoria. No se realizó ningún análisis factorial exploratorio ni modelado de ecuaciones estructurales. Por consiguiente, las figuras adjuntas se presentan únicamente como resúmenes conceptuales, descriptivos o basados en regresión.
Resultados
Perfil general de las sesiones de traducción
Todos los 72 participantes completaron las tres tareas de traducción bajo condiciones experimentales estandarizadas, obteniendo 216 sesiones completas de traducción. Tras el alineamiento de segmentos, el conjunto de datos analítico final comprendió 3.168 observaciones de participante-texto-segmento. El tiempo medio de finalización de la tarea en la muestra fue de 998,4 s por texto, con diferencias claras entre los grupos por año y los textos fuente (Tabla 4; Figura 3). Por lo tanto, tanto el manuscrito como los datos adjuntos respaldan consistentemente un tamaño muestral de n = 72 participantes; cualquier figura que resuma subconjuntos debe identificar explícitamente dichos subconjuntos.
Los estudiantes de cuarto año completaron las tareas de traducción más rápidamente y con menos interrupciones que los estudiantes de segundo año. Esta diferencia fue más allá de la velocidad de procesamiento. El grupo de cuarto año también presentó duraciones medias más cortas de la primera pausa, menos pausas largas y un número total menor de revisiones, al tiempo que obtuvo las puntuaciones más altas en calidad de traducción. En contraste, los estudiantes de segundo año realizaron el mayor número de revisiones, la mayoría de las cuales fueron modificaciones superficiales y correcciones locales inmediatas. Los estudiantes avanzados mostraron una proporción mayor de revisiones diferidas y revisiones de adaptación cultural, lo que indica que un desempeño superior en la traducción estuvo asociado con estrategias selectivas de revisión, en lugar de un mayor volumen de revisiones.
Las diferencias entre los tres textos fuente fueron igualmente notorias. El texto A produjo los tiempos de finalización más cortos, la menor cantidad de pausas largas y la densidad de revisiones más baja. Los textos B y C impusieron mayores demandas de procesamiento, aunque mediante mecanismos diferentes. El texto B provocó el mayor número de eventos de revisión relacionados con la cultura, mientras que el texto C generó la frecuencia más alta de revisiones a nivel del discurso y la duración media de pausas dentro de los segmentos más larga. Por lo tanto, el origen de la dificultad de procesamiento varió entre los textos. En el texto B, la dificultad se concentró en torno a referencias ligadas a la cultura y supuestos implícitos del trasfondo, mientras que en el texto C estuvo principalmente asociada a la compresión narrativa y a la posición evaluativa.
Un análisis de varianza de un factor confirmó diferencias significativas entre los grupos de estudiantes según el año académico en cuanto a la calidad total de la traducción, F (2, 69) = 31.84, p < 0,001, con un tamaño del efecto grande (η2 ≈ 0,48 basado en las puntuaciones medias por participante). Las comparaciones post hoc mostraron que los estudiantes del cuarto año obtuvieron puntuaciones significativamente más altas que los del tercer año, quienes a su vez superaron a los del segundo año. El mismo patrón se observó en la duración de la primera pausa, la frecuencia de pausas largas y la proporción de revisiones diferidas. En conjunto, estos hallazgos preliminares establecen dos puntos importantes para los análisis posteriores. Primero, los tres textos fuente diferían en dificultad de procesamiento y no simplemente en contenido temático. Segundo, una mayor calidad de traducción estuvo asociada con una reorganización de los procesos de traducción y no con una simple reducción del esfuerzo de procesamiento.
Efectos de la saliencia textual en la toma de decisiones y el comportamiento de revisión
Para determinar si las propiedades textuales a nivel de segmento predecían el esfuerzo de procesamiento, se estimaron modelos de efectos mixtos para la duración de la primera pausa, la frecuencia de pausas largas, la densidad total de revisiones y la densidad de revisiones diferidas. Se introdujeron como efectos fijos la carga cultural, la densidad evaluativa, la compresión narrativa y la saliencia de danmu, con el participante y el segmento incluidos como interceptos aleatorios (Tabla 5; Figura 4). La selección de predictores confirmó la ausencia de multicolinealidad problemática, con todos los valores del Factor de Inflación de la Varianza (VIF) muy por debajo del umbral conservador de 2,5 (VIF máximo = 1,45). Para evaluar el ajuste del modelo y la proporción de varianza explicada, se calcularon tanto los valores de R2 marginales como condicionales para todos los modelos de efectos mixtos (R2 marginal entre 0,08 y 0,19; R2 condicional entre 0,46 y 0,64). Los componentes completos de la varianza para los efectos aleatorios (interceptos de participante y segmento) y los índices correspondientes de ajuste del modelo se detallan en la Tabla 5. Las estimaciones de los coeficientes se interpretan junto con sus intervalos de confianza del 95 %, y no únicamente con base en los valores de p.
La carga cultural mostró el efecto más fuerte y más consistente en todos los modelos. En el modelo de la primera pausa, cada aumento de una unidad en la puntuación de carga cultural se asoció con un incremento de 0,91 s en la duración de la primera pausa (b = 0,91, EE = 0,12, IC del 95% [0,67, 1,15], p < 0,001). La carga cultural también aumentó significativamente la frecuencia de pausas largas (b = 0,19, EE = 0,04, IC del 95% [0,11, 0,27], p < ,001) y la densidad total de revisiones (b = 0,27, EE = 0,06, IC del 95% [0,15, 0,39], p < ,001). Por lo tanto, los segmentos con carga cultural no solo retrasaron el procesamiento inicial, sino que también aumentaron la probabilidad de reformulaciones posteriores.
La compresión narrativa demostró un patrón de efectos igualmente robusto pero distinto. Fue un predictor fuerte de la revisión a nivel del discurso (b = 0.31, SE = 0.07, IC 95% [0.17, 0.45], p < .001) y aumentó significativamente la duración media de las pausas dentro de los segmentos (b = 0.58, SE = 0.14, IC 95% [0.31, 0.85], p < .001). En términos prácticos, los segmentos que condensaban información sustancial de fondo en extensiones textuales breves tenían menos probabilidades de provocar sustitución léxica inmediata y más probabilidades de requerir una reconsideración estructural más amplia.
La densidad evaluativa también contribuyó de manera significativa, aunque su efecto principal fue sobre la revisión diferida en lugar de la latencia de la decisión inicial. En el modelo de revisión diferida, la densidad evaluativa produjo un coeficiente positivo (b = 0.23, SE = 0.05, IC del 95 % [0,13, 0,33], p < ,001). Su efecto sobre la duración de la primera pausa fue comparativamente modesto (b = 0,34, SE = 0,13, IC del 95 % [0,09, 0,59], p = 0,010). Estos hallazgos sugieren que las señales evaluativas no siempre se reconocieron como cuellos de botella en el procesamiento durante la traducción inicial. En cambio, con frecuencia solo se volvieron problemáticas después de que se había producido un borrador inicial, lo que llevó a los traductores a revisar cuestiones relacionadas con la postura, el tono o la adecuación narrativa.
La relevancia del danmu siguió siendo un predictor significativo tras controlar las variables internas del texto. Predijo significativamente tanto la duración de la primera pausa (b = 0.36, SE = 0.14, IC del 95% [0.09, 0.63], p = 0.011) como la densidad total de revisiones (b = 0.17, SE = 0.06, IC del 95% [0.05, 0.29], p = 0.006). Aunque su tamaño del efecto fue menor que el de la carga cultural y la compresión narrativa, su contribución constante sugiere que los segmentos que atraen mayor atención pública en el corpus de danmu también tienden a requerir un mayor esfuerzo de procesamiento durante la traducción. Este hallazgo se interpreta como una evidencia convergente de la relevancia semántica, más que como una evidencia de que la frecuencia del danmu cause directamente dificultades en la traducción.
Comportamiento de revisión y calidad de la traducción
Los análisis posteriores examinaron si la calidad de la traducción se explicaba mejor por la cantidad total de revisiones o por sus características temporales y funcionales. El modelo de calidad (Tabla 5) produjo un patrón claro de resultados. El número total de revisiones no predijo significativamente la calidad de la traducción (b = 0,04, IC del 95 % [-0,06, 0,14], p = 0,412), mientras que tanto el momento de las revisiones como su función resultaron ser predictores significativos. Específicamente, la proporción de revisiones diferidas (b = 1,12, IC del 95 % [0,39, 1,85], p = 0,003), las revisiones a nivel del discurso (b = 1,76, IC del 95 % [0,96, 2,56], p < 0,001) y las revisiones de adaptación cultural (b = 2,04, IC del 95 % [1,14, 2,94], p < 0,001) se asociaron positivamente con la calidad de la traducción. En contraste, las revisiones superficiales mostraron una pequeña pero estadísticamente significativa asociación negativa (b = -0,63, IC del 95 % [-1,18, -0,08], p = 0,028).
Estos hallazgos indican que la cantidad de revisiones por sí sola no puede distinguir una reformulación productiva de una redacción inestable (Figura 5). El examen cualitativo de los guiones de traducción respaldó esta interpretación. En las traducciones con puntuaciones más bajas, las revisiones solían concentrarse en sustituciones léxicas locales y correcciones gramaticales sin resolver discrepancias más profundas entre las señales narrativas chinas y el marco retórico en inglés. En las traducciones con puntuaciones más altas, las revisiones tardías frecuentemente implicaban reorganizar la estructura de la información, introducir una explicitación selectiva o ajustar el lenguaje evaluativo para mejorar la accesibilidad para una audiencia internacional. Comentarios representativos traducidos de danmu, como «esta expresión es muy china», «el contexto necesita ser explicado» y «el público extranjero podría no entender esta referencia», ilustran los tipos de preocupaciones culturales relevantes del público asociadas con los grupos de segmentos correspondientes. Estos ejemplos se presentan únicamente para facilitar la interpretación y no deben interpretarse como evidencia de las intenciones de los participantes.
Solapamiento entre la saliencia de danmu y los cuellos de botella en la traducción
El análisis final examinó si los segmentos públicamente salientes en el corpus de danmu coincidían con aquellos que generaban el mayor esfuerzo de procesamiento durante la traducción. Se calculó un índice compuesto de esfuerzo para cada segmento mediante la estandarización y suma de la duración de la primera pausa, la frecuencia de pausas largas y la densidad de revisiones. Los segmentos correspondientes al 20 % superior según este índice compuesto de esfuerzo se compararon entonces con el 20 % superior clasificado por saliencia de danmu.
La superposición fue considerable: seis de los nueve segmentos con mayor esfuerzo también aparecieron entre los nueve segmentos más salientes en danmu, lo que corresponde a una tasa de superposición del 66,7%. Dado que la comparación del quintil superior involucraba solo nueve segmentos, el intervalo de confianza de Wilson fue relativamente amplio (IC del 95% aproximadamente entre 35,4% y 87,9%). No obstante, un análisis exacto de superposición por azar indicó que una superposición de seis o más segmentos sería poco probable bajo una asignación aleatoria (p ≈ ,001). A nivel de segmento, la saliencia de danmu se correlacionó positivamente con el índice compuesto de esfuerzo (rho de Spearman = 0,41, p = 0,006). La mayoría de los segmentos superpuestos ocurrieron en los Textos B y C y se centraron en referencias culturalmente arraigadas, emprendimiento digital y posicionamiento evaluativo. Estos hallazgos sugieren que el discurso público sirve como un indicador externo de los puntos en los que el significado narrativo se vuelve particularmente saliente, aunque la relación permanece correlacional y no causal.
En conjunto, estos hallazgos demuestran que el esfuerzo de procesamiento en la traducción de narrativas centradas en China es específico de segmento y está determinado principalmente por la carga cultural, la compresión narrativa y la densidad evaluativa. La calidad de la traducción depende no del volumen total de revisiones, sino de estrategias de revisión diferidas, sensibles al discurso y orientadas culturalmente. Por último, la alineación observada entre segmentos de traducción de alto esfuerzo y puntos narrativos con alta presencia de danmu respalda una relación asociativa entre la saliencia del público y el esfuerzo de procesamiento del traductor, sin implicar que la saliencia de los danmu cause por sí misma dificultades en la traducción.
DISPONIBILIDAD DE LOS DATOS:
Todos los datos brutos, archivos de registro de pulsaciones de teclas, observaciones procesadas a nivel de segmento, observaciones a nivel de sesión, metadatos del video danmu y los primeros 5.000 comentarios danmu mostrados se proporcionan en el libro de trabajo del conjunto de datos de replicación. El archivo completo de comentarios danmu contiene 18.642 comentarios y se encuentra depositado junto con el paquete de datos. El conjunto de datos puede accederse a través del repositorio Zenodo en https://doi.org/10.5281/zenodo.19289665.
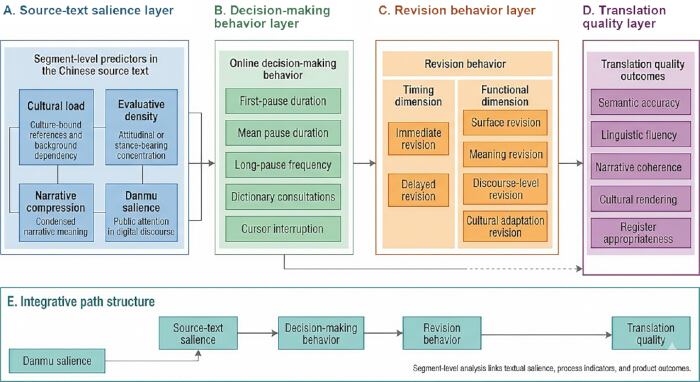
Figura 1: Marco conceptual del estudio. (A) Predictores textuales a nivel de segmento, incluyendo carga cultural, densidad evaluativa, compresión narrativa y saliencia de danmu. (B) Indicadores del proceso utilizados para operacionalizar el comportamiento de toma de decisiones en línea, incluyendo duración de la primera pausa, duración media de las pausas, frecuencia de pausas largas, consultas al diccionario e interrupciones del cursor. (C) Clasificación bidimensional del comportamiento de revisión según el momento de la revisión y su función. (D) Cinco dimensiones utilizadas para evaluar la calidad de la traducción: precisión semántica, fluidez lingüística, coherencia narrativa, representación cultural y adecuación del registro. (E) Marco analítico general que muestra las relaciones entre la saliencia del texto fuente, el comportamiento de toma de decisiones, el comportamiento de revisión y la calidad de la traducción, siendo la saliencia de danmu un indicador externo de la prominencia semántica ante la audiencia. En este estudio no se realizó ni se presenta ningún análisis factorial exploratorio (EFA) ni modelado de ecuaciones estructurales (SEM). Haga clic aquí para ver una versión más grande de esta figura.
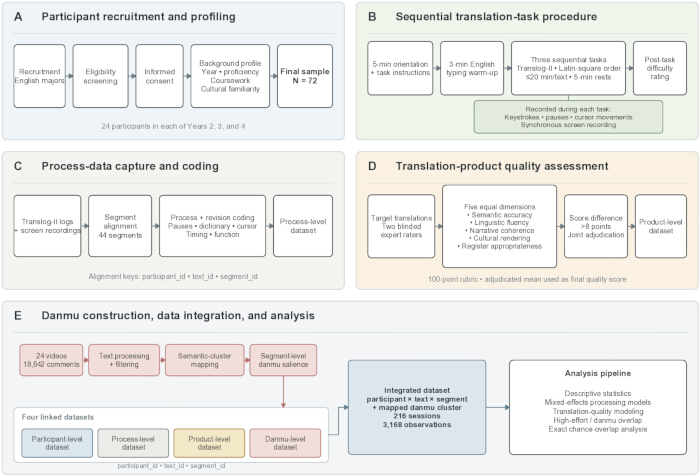
Figura 2: Flujo de trabajo de recopilación y alineación de datos. (A) Reclutamiento de participantes, evaluación de elegibilidad, consentimiento informado y recopilación de información de antecedentes. (B) Aplicación de las tres tareas de traducción en Translog-II bajo condiciones experimentales estandarizadas. (C) Recopilación de datos del proceso, incluyendo pulsaciones de teclas, pausas, movimientos del cursor, episodios de revisión y grabaciones de pantalla sincronizadas. (D) Evaluación ciega por expertos de los productos de traducción, seguida de la resolución de discrepancias en las puntuaciones. (E) Construcción del corpus auxiliar danmu y su alineación con conjuntos de datos a nivel de participante, texto, segmento, proceso y producto para generar el conjunto de datos integrado final utilizado en los análisis inferenciales. Haga clic aquí para ver una versión ampliada de esta figura.
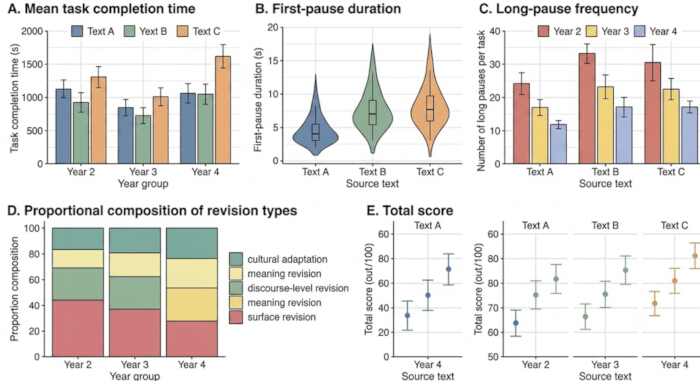
Figura 3: Distribución de las medidas de proceso y producto entre los grupos por año y textos fuente. (A) Tiempo medio de finalización de la tarea según el texto fuente y el grupo por año. (B) Distribución de la duración de la primera pausa entre los tres textos fuente. (C) Frecuencia de pausas largas según el texto fuente y el grupo por año. (D) Distribución proporcional de las categorías de revisión entre los grupos por año, incluyendo revisiones superficiales, revisiones de significado, revisiones a nivel del discurso y revisiones de adaptación cultural. (E) Puntuaciones totales de calidad de traducción por grupo de año para cada texto fuente. En conjunto, los paneles muestran que los niveles superiores están asociados con menos interrupciones en el procesamiento, estrategias de revisión más selectivas y mayor calidad en la traducción, mientras que los Textos B y C imponen mayores demandas de procesamiento que el Texto A. Haga clic aquí para ver una versión más grande de esta figura.
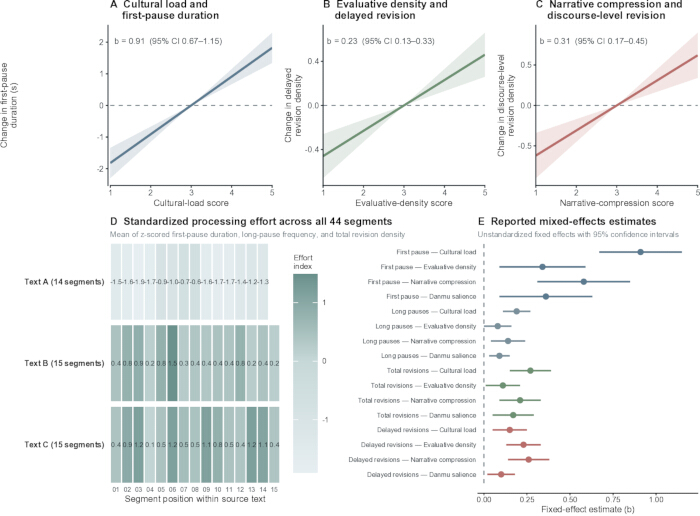
Figura 4: Efectos de la saliencia textual a nivel de segmento en el comportamiento del proceso de traducción. (A) Efecto marginal ajustado de la carga cultural sobre la duración de la primera pausa. (B) Efecto marginal ajustado de la densidad evaluativa sobre la densidad de revisiones diferidas. (C) Efecto marginal ajustado de la compresión narrativa sobre la densidad de revisiones a nivel discursivo. (D) Mapa de calor del índice estandarizado de esfuerzo de procesamiento en todos los segmentos del texto fuente, agrupados por texto fuente. (E) Coeficientes estandarizados de efectos fijos estimados a partir de los modelos de regresión de efectos mixtos. La figura demuestra que diferentes características textuales activan vías de procesamiento distintas, siendo la carga cultural, la densidad evaluativa y la compresión narrativa factores que contribuyen a la vacilación y a las revisiones mediante mecanismos parcialmente diferentes. Haga clic aquí para ver una versión más grande de esta figura.
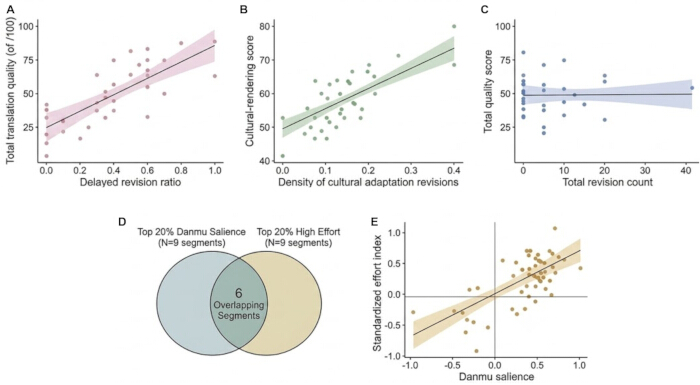
Figura 5: Relaciones entre el proceso de traducción, la calidad de la traducción y la saliencia de los danmu. (A) Asociación entre la proporción de revisiones diferidas y la puntuación total de calidad de la traducción. (B) Relación entre las revisiones destinadas al ajuste cultural y la puntuación de representación cultural. (C) Asociación entre el número total de revisiones y la calidad general de la traducción, lo que demuestra el valor predictivo limitado de la cantidad de revisiones por sí sola. (D) Solapamiento entre el 20 % superior de segmentos con alta saliencia de danmu y el 20 % superior de segmentos de traducción de alto esfuerzo. (E) Asociación a nivel de segmento entre la saliencia de los danmu y el índice estandarizado de esfuerzo de procesamiento. En conjunto, los paneles muestran que el rendimiento exitoso en la traducción está asociado con revisiones estratégicamente programadas y orientadas funcionalmente, más que únicamente con el volumen de revisiones, y que los segmentos narrativos salientes para el público tienden también a coincidir con cuellos de botella en la traducción. Haga clic aquí para ver una versión ampliada de esta figura.
| ID del texto | Tema narrativo | Caracteres chinos | Número de segmentos | Puntuación de carga cultural (1–5) | Puntuación de densidad evaluativa (1–5) | Puntuación de compresión narrativa (1–5) | Dificultad predicha | Nota de validación |
| Texto A | Narrativa del regreso para el Festival de Primavera | 212 | 14 | 3 | 2 | 3 | Moderada | Probado previamente con 12 estudiantes no participantes |
| Texto B | Narrativa de recuerdo del Festival del Bote del Dragón | 219 | 15 | 5 | 3 | 4 | Alta | Probado previamente con 12 estudiantes no participantes |
| Texto C | Narrativa sobre transmisiones en vivo rurales y desarrollo local | 223 | 15 | 4 | 5 | 4 | Alta | Probado previamente con 12 estudiantes no participantes |
Tabla 1: Perfil del texto fuente y estructura de segmentos.
| Variable | Nivel | Definición operacional | Unidad de medida |
| Duración de la primera pausa | Segmento | Tiempo desde el inicio del segmento hasta la primera pulsación relevante en el idioma de destino | Segundos |
| Duración media de las pausas dentro del segmento | Segmento | Duración media de todas las pausas dentro del segmento | Segundos |
| Frecuencia de pausas largas | Segmento | Número de pausas mayores de 2 segundos | Recuento |
| Consultas al diccionario | Segmento | Número de activaciones de la ventana del diccionario durante el procesamiento del segmento | Recuento |
| Interrupciones del cursor | Segmento | Número de desplazamientos basados en el cursor fuera del borrado lineal antes de la finalización estable | Recuento |
| Revisión inmediata | Segmento | Revisión realizada antes de que el borrado avance más allá del área de texto local actual | Recuento / densidad |
| Revisión diferida | Segmento | Revisión realizada después de que el borrado haya progresado a una zona de texto posterior | Recuento / densidad |
| Revisión superficial | Función de revisión | Corrección a nivel formal sin cambio semántico | Recuento / densidad |
| Revisión de significado | Función de revisión | Alteración léxica o sintáctica que afecta a la expresión del significado | Recuento / densidad |
| Revisión a nivel discursivo | Función de revisión | Ajuste a las relaciones entre cláusulas, coherencia u orden de la información | Recuento / densidad |
| Revisión de adaptación cultural | Función de revisión | Reformulación u explicitación orientada al público objetivo de significados ligados a la cultura | Recuento / densidad |
| Índice compuesto de esfuerzo | Segmento | Compuesto estandarizado de la duración de la primera pausa, la frecuencia de pausas largas y la densidad de revisiones | puntuación z |
| Relevancia de Danmu | Segmento / grupo semántico | Indicador ponderado del grupo semántico basado en la frecuencia normalizada de grupos de palabras clave, la concentración de comentarios y la intensidad evaluativa | Puntuación continua |
Tabla 2: Definiciones operacionales de las variables del proceso.
| Dimensión | Rango de puntuación | Enfoque de la calificación |
| Exactitud semántica | 1-20 | Fidelidad al significado original, precisión del contenido transferido y ausencia de distorsiones importantes |
| Fluidez lingüística | 1-20 | Gramaticalidad, naturalidad, uso idiomático y legibilidad a nivel de oración |
| Cohesión narrativa | 1-20 | Flujo de la información, conexión entre cláusulas, progresión y estabilidad textual |
| Adaptación cultural | 1-20 | Manejo de referencias ligadas a la cultura, explicitación, enfoque y accesibilidad interpretativa |
| Adecuación del registro | 1-20 | Adecuación al público objetivo, idoneidad estilística y control del tono |
Tabla 3: Rúbrica de calificación de la calidad de la traducción.
| Sección | Variable | Año 2 (n = 24), media ± DE | Año 3 (n = 24), media ± DE | Año 4 (n = 24), media ± DE |
| Perfil de sesión a nivel de participante | Tiempo de finalización de la tarea (seg) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| Perfil de sesión a nivel de participante | Duración media de la primera pausa (seg) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| Perfil de sesión a nivel de participante | Frecuencia de pausas largas por tarea | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| Perfil de sesión a nivel de participante | Revisiones totales por tarea | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| Configuración de la revisión | Proporción de revisiones diferidas | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| Configuración de la revisión | Proporción de revisiones a nivel discursivo | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| Configuración de la revisión | Proporción de revisiones de adaptación cultural | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| Configuración de la revisión | Proporción de revisiones superficiales | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| Calidad del producto | Puntuación total de calidad | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| Calidad del producto | Puntuación de representación cultural | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
Tabla 4: Estadísticas descriptivas para las variables del proceso y del producto.
| Variable resultado | Predictor | b | EE | IC 95% | t/z | p |
| Duración de la primera pausa | Carga cultural | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Duración de la primera pausa | Densidad evaluativa | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Duración de la primera pausa | Compresión narrativa | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Duración de la primera pausa | Saliente Danmu | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Frecuencia de pausas largas | Carga cultural | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Frecuencia de pausas largas | Densidad evaluativa | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Frecuencia de pausas largas | Compresión narrativa | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Frecuencia de pausas largas | Saliente Danmu | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Densidad total de revisiones | Carga cultural | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Densidad total de revisiones | Densidad evaluativa | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Densidad total de revisiones | Compresión narrativa | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Densidad total de revisiones | Saliente Danmu | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Densidad de revisiones diferidas | Carga cultural | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Densidad de revisiones diferidas | Densidad evaluativa | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Densidad de revisiones diferidas | Compresión narrativa | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Densidad de revisiones diferidas | Saliente Danmu | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Puntuación total de calidad | Revisiones totales | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| Puntuación total de calidad | Proporción de revisiones diferidas | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| Puntuación total de calidad | Revisiones a nivel del discurso | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| Puntuación total de calidad | Revisiones de adaptación cultural | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| Puntuación total de calidad | Revisiones superficiales | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| Puntuación total de calidad | Grupo del año | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
Tabla 5: Modelos de efectos mixtos que predicen el comportamiento del proceso a nivel de segmento y la calidad de la traducción.
Discusión
Los hallazgos actuales demuestran que la dificultad en la traducción del chino al inglés de narrativas centradas en China no se distribuye uniformemente a lo largo de un texto. Por el contrario, se concentra en segmentos donde convergen referencias culturales, posturas evaluativas y significados narrativos comprimidos. Esto respalda una concepción basada en el proceso, y no en la carencia de vocabulario, de la dificultad traductora. La investigación empírica sobre el proceso de traducción enfatiza que la traducción es una actividad organizada temporalmente en la que la vacilación, la orientación y la producción se distribuyen de forma desigual19. La concentración de esfuerzo observada en este estudio refleja cómo ciertos segmentos ejercen una mayor presión interpretativa, interrumpiendo la redacción lineal más profundamente que otros. La comprobación de hipótesis puede resumirse como sigue: se confirmó la H1 porque la carga cultural incrementó la vacilación inicial y la densidad de revisiones; se refinó la H2 porque la densidad evaluativa y la compresión narrativa actuaron a través de vías de revisión diferentes; se confirmó la H3 porque el momento y la función de las revisiones predijeron la calidad con mayor fuerza que el número total de revisiones; y se confirmó la H4 como una superposición asociativa entre la saliencia de los danmu y los segmentos de alto esfuerzo, y no como una relación causal.
En cuanto al comportamiento de revisión, los datos revelan que el recuento total de revisiones no predice la calidad de la traducción; más bien, las revisiones diferidas, a nivel del discurso y de adaptación cultural son los factores principales que impulsan un mejor desempeño. Esta distinción sugiere que la revisión es productiva solo cuando se lleva a cabo como una reevaluación estructurada, y no como una reparación local repetida. En consonancia con investigaciones basadas en el rastreo ocular y el registro de pulsaciones de teclas, que indican que los traductores novatos distribuyen su esfuerzo de manera diferente cuando las tareas se vuelven difíciles, los estudiantes con mejor desempeño en este estudio no fueron simplemente más activos7. Ellos interrumpieron selectivamente soluciones provisionales, las reevaluaron en etapas posteriores y dirigieron las revisiones hacia la coherencia narrativa o la adecuación cultural. Por consiguiente, las calificaciones del producto final por sí solas son insuficientes para explicar el desempeño del traductor, ya que puntuaciones finales comparables a menudo surgen de trayectorias de proceso muy distintas9.
Este fenómeno se entiende mejor a través de la lente de la conversión del esfuerzo. En las traducciones con puntuaciones más bajas, el esfuerzo cognitivo permaneció atrapado a nivel local: los estudiantes hacían pausas, sustituían elementos léxicos o ajustaban artículos, pero no lograban resolver discrepancias más profundas entre las implicaciones del texto fuente y la estructura del texto meta. Por el contrario, en los textos con puntuaciones más altas se observó un esfuerzo convertido en decisiones estructurales que optimizaban el texto para el lector meta. Paralelamente a la investigación sobre el desempeño de los estudiantes en la posedición, estos resultados confirman que el esfuerzo del proceso no es automáticamente beneficioso; su valor depende de su conversión en mejoras textuales interpretables20.
Además, diferentes propiedades textuales activan mecanismos de procesamiento distintos. La carga cultural aumentó de forma fiable la vacilación temprana y la densidad de revisiones, mientras que la compresión narrativa predijo con fuerza las revisiones a nivel discursivo. Esta distinción aclara por qué los segmentos difíciles se manifiestan de manera diferente durante el proceso de traducción: algunos interrumpen el acceso cognitivo en la fase inicial de formulación, mientras que otros solo se vuelven problemáticos durante el mantenimiento de la coherencia a lo largo de extensiones más amplias del discurso. En consonancia con estudios que muestran que los textos difíciles producen unidades de procesamiento más pequeñas y pausas más frecuentes, estos hallazgos subrayan cómo los significados culturales y evaluativos comprimidos obligan a los traductores a oscilar entre la expresión local y la estructuración narrativa global8.
Una contribución metodológica importante de este estudio es la integración de la saliencia de danmu como una capa de discurso del público. La considerable superposición entre los segmentos de traducción de alto esfuerzo y los segmentos con saliencia de danmu indica que los cuellos de botella que enfrentan los estudiantes suelen coincidir con puntos que atraen una atención intensificada del público en la circulación digital. Esto conecta la dificultad de la traducción con el discurso participativo sin confundir ambos constructos. Los comentarios danmu revelan aquello que las audiencias perciben o cuestionan en la circulación mediada por video, mientras que los registros de pulsaciones de teclas y revisiones revelan cómo los estudiantes traductores procesan segmentos semánticamente relacionados del texto fuente. La interpretación más plausible es por tanto una explicación basada en estímulos comunes: referencias cargadas culturalmente, supuestos implícitos comprimidos y posicionamientos evaluativos pueden simultáneamente atraer la atención del público y aumentar la presión de procesamiento para el traductor21.
Pedagógicamente, esta superposición sugiere que las narrativas centradas en China circulan en contextos donde el significado se negocia públicamente y de forma rápida, regida por prioridades en competencia, como la inmediatez, la inteligibilidad y la alineación con la audiencia22. En consecuencia, la formación de traductores debe pasar de concebir la revisión como una etapa genérica de corrección a enfatizar intervenciones funcionales y estratégicas en el tiempo. Los cuellos de botella observados rara vez fueron causados únicamente por cuestiones terminológicas; surgieron en puntos donde el significado narrativo dependía de presuposiciones culturalmente arraigadas, marcos relacionales y acceso selectivo por parte de la audiencia. De forma similar a la difusión de la literatura narrativa étnica china, la transferencia de estas narrativas requiere ir más allá de la fidelidad léxica para determinar cómo debe reestructurarse el significado cultural local con miras a una circulación global más amplia23. El método puede aplicarse en la formación de traductores utilizando registros de pulsaciones de teclado, grabaciones de pantalla y ejemplos de discurso dirigido a audiencias, con el fin de ayudar a los estudiantes a identificar cuándo un segmento requiere explicitación, reordenamiento, enmarcamiento cultural o ajuste de registro, en lugar de un simple reemplazo léxico.
Varias limitaciones restringen la interpretación de estos hallazgos. En primer lugar, la saliencia del danmu es un indicador basado en agrupaciones semánticas del compromiso del público, no una medida directa de la dificultad lingüística, y el diseño correlacional actual no permite establecer una relación causal entre la saliencia pública y el esfuerzo de traducción. Estudios futuros podrían manipular experimentalmente la carga cultural, la densidad evaluativa y la compresión narrativa para probar las vías causales. En segundo lugar, la muestra se limita a traductores en formación de una sola universidad, y la experiencia de los participantes, su familiaridad cultural y su competencia en un segundo idioma se controlaron estadísticamente en lugar de mediante un muestreo completamente estratificado. La replicación con traductores profesionales, estudiantes de múltiples instituciones y grupos con un rango más amplio de competencia reforzaría la generalización de los resultados. En tercer lugar, los textos fuente fueron elaborados por los investigadores y sometidos a pruebas piloto para calibrar la tarea, pero estudios futuros deberían incluir una validación adicional utilizando textos públicos auténticos y paneles independientes para el desarrollo de materiales. En cuarto lugar, la codificación de la carga cultural, la densidad evaluativa, la compresión narrativa y las funciones de revisión depende de definiciones operativas transparentes, registros de codificadores independientes y una confiabilidad interjueces verificable, junto con el archivo de codificación consensuado. Asimismo, investigaciones futuras podrían combinar el registro de pulsaciones de teclas con seguimiento ocular, entrevistas retrospectivas, protocolos de pensamiento en voz alta o tareas de posedición para triangular los mecanismos cognitivos subyacentes a las decisiones de revisión.
En última instancia, este estudio aclara la base procesal del rendimiento estudiantil en la traducción del chino al inglés de narrativas centradas en China. Al conectar datos de registro de pulsaciones de teclado, evaluación del producto y discurso digital de la audiencia, los hallazgos demuestran que los cuellos de botella en la traducción surgen en puntos de significado narrativo cargado públicamente. El factor decisivo en la traducción intercultural no es el mero volumen de revisiones, sino la capacidad del traductor para reconocer los segmentos que requieren una reestructuración interpretativa y para retrasar estratégicamente el cierre hasta que se formule una solución estable y adecuada para la audiencia.
Divulgaciones
Los autores han nada que declarar.
Contribuciones de los autores
Weijia Chen: Conceptualización, metodología, análisis formal, investigación, redacción del borrador original.
Chunming Wu: Diseño del estudio, orientación sobre procedimientos de análisis formal y manejo de datos, y revisión y comentarios sobre las revisiones realizadas en respuesta a las observaciones de los revisores.
Agradecimientos
Esta investigación recibió apoyo financiero de dos subvenciones de la Universidad Normal de Hanshan. Específicamente, constituye un resultado parcial de la iniciativa de 2023 del programa de Cursos de Pregrado de Primera Clase (Curso Presencial de Primera Clase) para "Teoría y Práctica de la Traducción Chino-Inglés II" (Número de Aprobación: YHS [2023] 172). Además, el estudio fue respaldado por el Proyecto de Calidad Docente y Reforma Educativa 2025, designado como Curso Modelo para la Educación Ideológica y Política Basada en el Currículo en "Traducción Chino-Inglés" (Número de Aprobación: YHSJ〔2025〕126). Los autores agradecen sinceramente el apoyo institucional brindado para la realización de esta investigación.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Corpus de danmu de Bilibili | Bilibili | 24 videos; 18.642 comentarios;https://www.bilibili.com | Construcción del corpus auxiliar de danmu y cálculo de la saliencia de los segmentos de danmu |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | Limpieza de datos, organización del código y gestión preliminar de datos |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | Modelado de efectos mixtos, análisis de correlación y generación de figuras |
| Software de grabación de pantalla | Estación de trabajo del laboratorio | Utilidad de la estación de trabajo local; sin número de catálogo | Verificación de episodios de revisión no lineales y respaldo de los datos del proceso |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | Estadística descriptiva, ANOVA y análisis estadísticos básicos |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | Registro de pulsaciones de teclas y grabación de pausas, movimientos del cursor y episodios de revisión durante las tareas de traducción |
Referencias
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.