Este método presenta un marco integral basado en inteligencia artificial explicativa (XAI) para permitir la migración segura de datos en la nube de atención médica, aprovechando un conjunto de datos sintéticos de atención médica dentro de un entorno de nube controlado. El resultado es un prototipo que combina seguridad de confianza cero, control de acceso basado en el tiempo y detección explicativa de anomalías para respaldar la transparencia y la seguridad durante la migración.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
Un protocolo experimental para la migración segura de datos en la nube impulsada por IA explicable utilizando datos sintéticos de atención sanitaria
En este artículo
Resumen
Resumen
En los sistemas de salud, se está realizando cada vez más migración de datos a la nube, pero esto también modifica los momentos en que la transferencia de datos probablemente representa el mayor riesgo en términos de seguridad. Este artículo describe un protocolo reproducible para la migración segura de datos a la nube basado en inteligencia artificial explicable (XAI, por sus siglas en inglés), utilizando un conjunto de datos sintéticos del sector salud y un entorno de nube controlado. El marco desarrollado combina la arquitectura de confianza cero, el privilegio temporal mínimo, la comunicación cifrada, la supervisión centralizada y la detección explicable de anomalías para lograr una migración más segura, transparente y susceptible de auditoría. Las pruebas utilizan un conjunto de datos de 10 GB de historias clínicas electrónicas sintéticas, que comprende aproximadamente 20 millones de registros distribuidos en 28 tablas relacionales. El proceso de migración se llevó a cabo en Amazon Web Services (AWS) utilizando bases de datos PostgreSQL y redes virtuales privadas. Para la detección de anomalías se utilizó el algoritmo Isolation Forest, y las explicaciones aditivas de Shapley (SHAP) sirvieron para la interpretación segura de eventos. El marco se evaluó en diez intentos de migración independientes, empleando métricas como la duración de la exposición de credenciales, el tiempo de detección de incidentes, la precisión en la detección de anomalías, la latencia de migración y la integridad de los datos. En la configuración evaluada, la exposición de credenciales se redujo de 24 h a 1 h (una reducción del 95,8 %), la precisión en la detección de anomalías fue del 97,4 %, el tiempo de detección de incidentes se redujo a aproximadamente 15 minutos, y se mantuvo una integridad de datos del 100 % mediante validación por suma de comprobación. Sin embargo, las medidas de seguridad más estrictas provocaron un aumento promedio del 11 % en la latencia de migración. Estos resultados demuestran el potencial de combinar la inteligencia artificial explicable con flujos de trabajo seguros de migración a la nube para gestionar datos de salud.
Introducción
La computación en la nube es ahora una parte integral de los sistemas de salud en todo el mundo, ya que ofrece almacenamiento escalable, recursos computacionales y la capacidad de intercambiar registros médicos, apoyar sistemas de toma de decisiones y permitir análisis sanitarios a través de la nube1,2,3. A medida que muchas instituciones sanitarias modernizan sus sistemas de información, la migración a la nube se ha convertido en un paso fundamental para transferir sus datos médicos sensibles almacenados en antiguos sistemas locales a la nube4. Una migración adecuada facilita la recuperación de datos, permite ejecutar operaciones de manera más eficiente y apoya análisis con mayores niveles de inteligencia; sin embargo, al mismo tiempo, no se pueden ignorar los riesgos bastante serios para la seguridad y la privacidad que conlleva trasladar datos de un lugar a otro5.
La fase de migración es un momento notoriamente vulnerable en el ciclo de vida de los datos, ya que por naturaleza del proceso los datos de atención médica se están moviendo activamente entre sistemas y redes6. Además, las organizaciones pueden verse expuestas a amenazas como el pirateo de credenciales, acceso no autorizado, interceptación de datos, manipulación de esquemas e incluso pérdida de datos durante la fase de migración6,7. Los entornos de atención médica son menos inmunes a tales riesgos, dado que la información del paciente es altamente sensible y, por tanto, requiere el más alto nivel de cumplimiento de las medidas regulatorias y de seguridad8,9. Sin ello, no es factible garantizar la confidencialidad, integridad y responsabilidad de los datos si el flujo de trabajo de migración no está protegido y no es observable10,11.
Se han desarrollado varios marcos y estándares de seguridad con el objetivo de mejorar la seguridad en la nube. Por ejemplo, la Arquitectura de Confianza Cero del Instituto Nacional de Estándares y Tecnología (NIST) se centra en verificar constantemente a los usuarios, dispositivos y servicios12, mientras que los marcos para la adopción de la nube ofrecen orientaciones sobre gobernanza, gestión de identidades, cifrado y monitoreo13. De hecho, los métodos actuales de seguridad en la nube se enfocan en la automatización, la infraestructura como código y el monitoreo continuo14,15. Aunque tales enfoques se basan en principios de seguridad valiosos, en gran medida abordan entornos generales de implementación y operación en la nube, más que el proceso de migración en sí16. En realidad, apenas proporcionan procedimientos detallados, paso a paso y reproducibles para realizar flujos de trabajo seguros de migración de datos sanitarios a la nube que combinen gestión de identidades, transferencia segura de datos, validación, monitoreo y endurecimiento tras la migración17.
La detección de anomalías mediante aprendizaje automático ha sido reconocida como una tecnología útil en la supervisión de seguridad de entornos en la nube. Detecta actividades anómalas del sistema así como posibles incidentes de seguridad18. Sin embargo, muchos métodos de detección de anomalías son sistemas cerrados que no proporcionan explicaciones sobre la lógica detrás de la identificación de un evento de seguridad19. La incapacidad para explicar las decisiones tomadas por el sistema reduce la credibilidad de los administradores, dificulta la auditoría y disminuye el valor de las decisiones automatizadas de seguridad en entornos sanitarios altamente regulados20. Los métodos de inteligencia artificial explicable (XAI) como SHapley Additive exPlanations (SHAP) y Local Interpretable Model-agnostic Explanations (LIME) no solo ofrecen explicaciones claras para las predicciones del aprendizaje automático, sino que también mejoran la comprensión, la responsabilidad y la confianza en los sistemas de supervisión de seguridad21,22.
Aunque la seguridad en la nube y la inteligencia artificial explicable han avanzado considerablemente, aún existe una escasez de protocolos experimentales reproducibles que combinen controles de migración segura con monitoreo de seguridad explicable con fines de integración23. La investigación existente aborda principalmente componentes individuales, como cifrado, control de acceso, detección de anomalías o gobernanza en la nube, y en ningún caso ofrece una metodología integrada que pueda implementarse, evaluarse y reproducirse sistemáticamente24. Además, casi ningún estudio ha intentado integrar los principios de seguridad de cero confianza, el privilegio mínimo temporal, la observabilidad centralizada y la detección explicable de anomalías en un único flujo de trabajo de migración a la nube en el sector salud25,26.
Este artículo presenta un marco basado en inteligencia artificial explicable para la migración segura de datos en la nube en sistemas de atención médica, con el fin de llenar este vacío. La arquitectura propuesta utiliza un modelo de confianza cero, acceso restringido por tiempo, comunicación segura, registro y supervisión centralizados, y detección de anomalías interpretable basada en SHAP, integrados en un proceso de migración bien estructurado27,28. El protocolo es una guía paso a paso para implementar, supervisar y evaluar la migración segura de datos sanitarios en condiciones experimentales. Al combinar controles de seguridad con monitoreo interpretable mediante inteligencia artificial, el marco propuesto busca aumentar el nivel de transparencia, auditabilidad y seguridad a lo largo de todo el ciclo de vida de la migración29,30.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utilizó un conjunto de datos sanitarios completamente sintético, generado para la evaluación experimental de la migración segura de datos a la nube. No se utilizaron datos reales de pacientes, información protegida de salud (PHI) ni registros sanitarios identificables. Por lo tanto, no se requirió la aprobación del comité de revisión institucional ni el consentimiento informado. Todos los materiales utilizados en este estudio se incluyen en la Tabla de Materiales.
1. Resumen
- Configure un entorno seguro de migración a la nube compuesto por una capa de origen, una capa de centro de migración, una capa de destino, una capa de red, una capa de gestión de identidad y acceso, una capa de observabilidad y una capa de inteligencia artificial explicable.
- Despliegue todos los componentes dentro de entornos en la nube aislados para respaldar la migración segura de datos sanitarios. Establezca canales de comunicación cifrados entre todos los componentes del sistema.
- Ejecute el protocolo mediante la preparación del conjunto de datos, la configuración del entorno, el despliegue de la arquitectura, la migración segura, el monitoreo de anomalías y la validación posterior a la migración. La arquitectura general del marco propuesto para la migración segura de datos a la nube impulsado por inteligencia artificial explicable se ilustra en Figure 1.
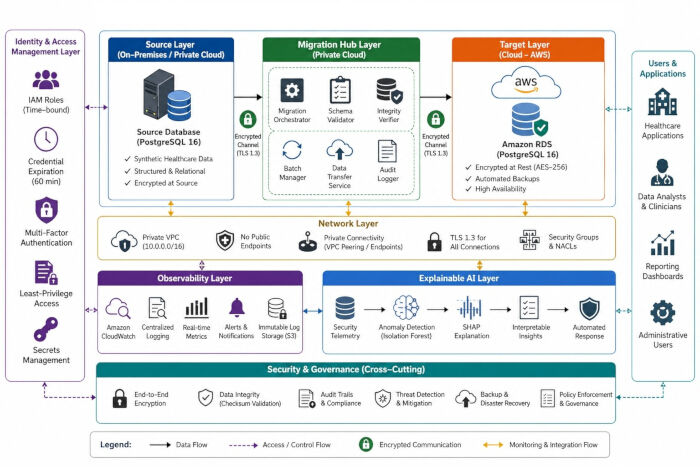
Figura 1: Arquitectura general del marco de migración segura de datos en la nube habilitado para inteligencia artificial explicable (XAI) para sistemas de atención médica. El marco consta de la capa de gestión de identidad y acceso, la capa de base de datos de origen, la capa de centro de migración, la capa de base de datos en la nube de destino, la capa de seguridad de red, la capa de observabilidad, la capa de monitoreo de inteligencia artificial explicable y los servicios transversales de seguridad y gobernanza. La arquitectura integra el control de acceso temporal con privilegio mínimo, comunicación cifrada con TLS 1.3, verificación de integridad basada en sumas de comprobación, monitoreo continuo de seguridad y explicabilidad basada en SHAP para proporcionar una migración segura, transparente y reproducible de bases de datos médicas. Esta figura fue creada por los autores utilizando Microsoft PowerPoint (Microsoft 365). Haga clic aquí para ver una versión más grande de esta figura.
2. Configuración del entorno computacional
- Configurar el entorno computacional
- Preparar los recursos computacionales necesarios para la migración segura de datos a la nube y el monitoreo basado en inteligencia artificial explicativa.
- Instalar y configurar todo el hardware, software, servicios en la nube, bases de datos, herramientas de seguridad y bibliotecas de aprendizaje automático que se indican en la Tabla de Materiales. Verificar que todos los componentes necesarios estén operativos antes de iniciar el experimento de migración.
- Configurar el entorno en la nube
- Configurar un entorno en la nube seguro para la migración de datos de atención médica. Establecer una VPC privada para permitir una comunicación fluida entre los sistemas de origen, el centro de migración y los sistemas de destino. Utilizar cifrado robusto no solo para los datos en reposo, sino también para los datos en tránsito.
- Preparar la base de datos de destino y los servicios de migración según los detalles indicados en la Tabla de Materiales.
- Configurar la gestión de identidad y acceso. Configurar servicios de monitoreo y registro.
3. Preparación y descripción del conjunto de datos
- Genere un conjunto de datos sintéticos de atención médica utilizando la biblioteca Python Faker que se enumera en la Tabla de Materiales. Configure atributos demográficos, incluyendo edad del paciente, sexo, etnia y ubicación geográfica, utilizando distribuciones de probabilidad predefinidas.
- Genere información clínica, incluyendo diagnósticos, resultados de laboratorio, medicamentos, alergias, procedimientos e ingresos hospitalarios, manteniendo relaciones clínicas realistas.
- Genere encuentros longitudinales del paciente asignando múltiples visitas a pacientes individuales de acuerdo con distribuciones predefinidas de frecuencia de visitas.
- Genere marcas de tiempo para ingresos, análisis de laboratorio, administración de medicamentos, resúmenes de alta y registros de auditoría utilizando un orden cronológico de eventos.
- Introduzca valores ausentes clínicamente realistas, registros duplicados y observaciones atípicas según distribuciones predefinidas de calidad de datos.
- Sustituya toda la información de identificación personal por valores sintéticos generados mediante la biblioteca Faker. Valide la integridad referencial y la coherencia lógica antes de exportar el conjunto de datos. Exporte el conjunto de datos validado en formato SQL compatible con PostgreSQL. Configure el conjunto de datos para que admita escenarios realistas de migración de datos de atención médica. Las características del conjunto de datos generado se resumen en Tabla 1.
- Defina las relaciones de la base de datos. Asigne Patient_ID como clave primaria para la tabla de pacientes. Establezca relaciones de clave externa entre las tablas de pacientes, visitas, laboratorio, medicamentos y registros de auditoría. Verifique la integridad referencial en todas las tablas antes de iniciar la migración.
- Simule características realistas de datos de atención médica. Genere edades de pacientes utilizando una distribución normal. Genere frecuencias de visitas utilizando una distribución de Poisson. Introduzca valores ausentes a una tasa del 5 % para simular la incompletitud real de los EHR. Sustituya todos los identificadores de pacientes por valores codificados antes de la migración. Verifique que todos los registros generados cumplan con las restricciones predefinidas del esquema.
- Valide el conjunto de datos generado verificando la coherencia del esquema, la integridad referencial, los valores ausentes, los registros duplicados y las restricciones de calidad predefinidas antes de la migración.
| Parámetro | Valor |
| Tipo de conjunto de datos | Conjunto de datos sintéticos de historias clínicas electrónicas en atención médica |
| Tamaño del conjunto de datos | 10 GB |
| Total de registros | 20 millones |
| Número de tablas | 5 tablas principales - 28 tablas relacionales |
| Registros de pacientes | 5.000.000 |
| Registros de visitas | 10.000.000 |
| Resultados de laboratorio | 4.000.000 |
| Registros de medicamentos | 3.000.000 |
| Registros de auditoría | 5.000.000 |
| Clave principal | Patient_ID |
| Tasa de valores faltantes | 5% |
| Distribución de edad | Distribución normal |
| Frecuencia de visitas | Distribución de Poisson |
| Umbral de integridad | <0,1% de violaciones |
Tabla 1: Características del conjunto de datos sanitarios sintéticos utilizado para la validación del protocolo. La tabla proporciona una descripción general del conjunto de datos, como el tamaño de la base de datos, el número de tablas relacionales, el número total de registros, los atributos de los pacientes, las variables clínicas y las características de validación necesarias para reproducir los experimentos de migración segura.
4. Despliegue de la arquitectura del sistema
- Despliegue la arquitectura segura de migración a la nube compuesta por la capa de origen, la capa de centro de migración, la capa de destino, la capa de seguridad de red, la capa de observabilidad y la capa de inteligencia artificial explicable. La arquitectura de sistema desplegada utilizada en este estudio se ilustra en Figura 2.
- El marco consta de seis capas funcionales que, durante el proceso de migración, realizan sus funciones una tras otra. La primera capa, la Capa de Origen, es la que contiene la base de datos sintética de atención médica.
- El Centro de Migración es el encargado de la extracción del esquema, la transferencia cifrada de datos, la validación de integridad y la orquestación de la migración. La capa de destino es donde se almacena la base de datos migrada en Amazon RDS PostgreSQL.
- La capa de seguridad de red es la que protege todas las comunicaciones mediante el uso de puntos finales privados de VPC, cifrado TLS 1.3, grupos de seguridad y listas de control de acceso a la red.
- La capa de observabilidad es la que constantemente recopila registros de autenticación, registros de migración, registros de actividad de la base de datos y eventos de seguridad con la ayuda de Amazon CloudWatch.
- La capa de inteligencia artificial explicable es la que obtiene la telemetría de seguridad recopilada, la procesa mediante un algoritmo de Bosque de Aislamiento y genera explicaciones basadas en SHAP para las anomalías detectadas. Todas las capas arquitectónicas se comunican entre sí a través de canales de red privados que se autentican durante todo el flujo de trabajo de migración.
- Despliegue y verifique el entorno de la base de datos de origen para garantizar el acceso seguro y la disponibilidad de los datos antes de la migración.
- Configure una base de datos PostgreSQL 16 con el conjunto de datos sintético de atención médica. Mantenga en la base de datos de origen la información de pacientes, detalles de visitas, resultados de laboratorio, registros de medicamentos y registros de auditoría.
- Restrinja el acceso a la base de datos únicamente a los servicios autorizados de migración y a usuarios administrativos. Verifique la disponibilidad y conectividad de la base de datos antes de iniciar las operaciones de migración.
- Configure el centro de migración para coordinar la extracción del esquema, la transferencia cifrada de datos y la orquestación de la migración.
- Despliegue un servidor de migración dedicado dentro de la nube privada virtual (VPC). Configure los servicios de orquestación de migración para coordinar la extracción del esquema, la transferencia de datos y las actividades de validación.
- Habilite servicios de validación de esquema para verificar la compatibilidad entre los entornos de origen y destino. Habilite servicios de verificación de integridad para validar los datos migrados durante y después de la transferencia. Verifique la comunicación entre el centro de migración y los sistemas de base de datos antes de ejecutar las tareas de migración.
- Despliegue la Capa de Destino. Implemente Amazon RDS PostgreSQL 16 como entorno de base de datos de destino. Habilite servicios automáticos de copia de seguridad y recuperación. Active el cifrado AES-256 para los datos almacenados en la base de datos de destino.
- Configure la seguridad de red. Desactive todas las direcciones IP públicas asociadas con los recursos de migración. Permita la comunicación únicamente a través de puntos finales privados dentro de la VPC. Configure listas de control de acceso a la red (NACLs) y grupos de seguridad. Habilite el cifrado TLS 1.3 para todas las comunicaciones entre los componentes del sistema. Verifique que no queden puntos finales públicamente accesibles activos.
- Configure la supervisión centralizada para recopilar continuamente eventos de seguridad, registros de migración y métricas de rendimiento del sistema.
- Habilite los servicios de registro y supervisión de Amazon CloudWatch. Recopile registros de autenticación, registros de migración, registros de actividad de la base de datos y registros de eventos de seguridad. Configure un período de retención de registros de 365 días. Habilite el almacenamiento inmutable de registros para cumplir con los requisitos de auditoría y cumplimiento. Verifique la recopilación en tiempo real de métricas y la generación de alertas.
- Configure el entorno de inteligencia artificial explicable para realizar detección de anomalías en tiempo real y generar explicaciones de seguridad interpretables.
- Despliegue servicios de detección de anomalías dentro del entorno de supervisión. Configure el marco de inteligencia artificial explicable para procesar la telemetría de seguridad generada durante la migración. Conecte flujos de telemetría de seguridad provenientes del origen, del centro de migración, de la base de datos de destino y de los servicios de supervisión.
- Habilite la detección de anomalías en tiempo real y la generación de explicaciones basadas en SHAP. Verifique la ingesta exitosa de los datos de telemetría antes de iniciar los experimentos de migración.
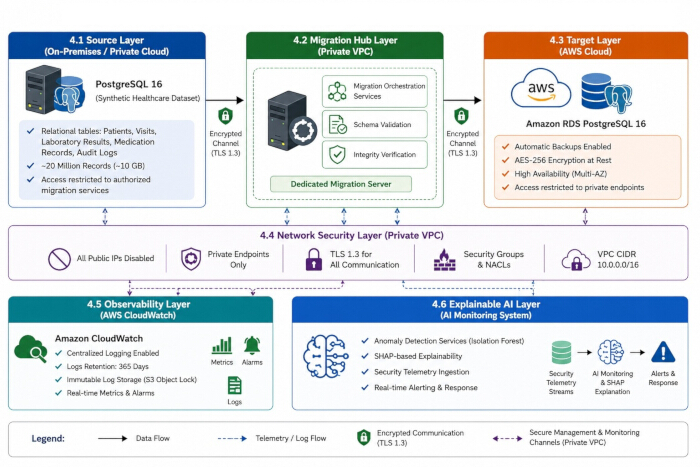
Figura 2: Arquitectura de implementación del marco de migración segura a la nube para atención médica. El entorno de implementación muestra la base de datos origen PostgreSQL que contiene el conjunto de datos sintético de atención médica, el centro de migración dedicado dentro de una nube privada virtual (VPC), la base de datos destino Amazon RDS PostgreSQL, la capa de seguridad de red, la observabilidad centralizada mediante Amazon CloudWatch y la capa de monitoreo de Inteligencia Artificial Explicable. Toda la comunicación se realiza a través de puntos finales privados protegidos por cifrado TLS 1.3. Esta figura fue creada por los autores utilizando Microsoft PowerPoint (Microsoft 365). Haga clic aquí para ver una versión más grande de esta figura.
5. Flujo de trabajo de migración seguro
NOTA: Ejecute el flujo de trabajo de migración segura realizando modelado de amenazas, transferencia de esquema, migración segura de datos, validación de la migración y endurecimiento posterior a la migración.
- Identifique las amenazas de seguridad potenciales y establezca controles de mitigación adecuados antes de iniciar el proceso de migración.
- Identifique los activos de migración, los vectores de ataque potenciales y los escenarios realistas de ciberataques.
- Evalue el robo de credenciales derivado de tokens de autenticación comprometidos, los ataques internos que implican acceso administrativo no autorizado, los ataques de repetición dirigidos a solicitudes de autenticación previamente interceptadas, los ataques de tipo man-in-the-middle (MITM) que intentan interceptar canales de comunicación cifrados, la manipulación de esquemas destinada a modificar las estructuras de la base de datos durante la migración y los ataques de escalada de privilegios orientados a obtener permisos administrativos no autorizados.
- Verifique que el uso de la gestión temporal de credenciales con privilegios mínimos sea suficiente para prevenir el robo de credenciales y los ataques de escalada de privilegios. Confirme que la comunicación cifrada con TLS 1.3 protege contra ataques de repetición y ataques man-in-the-middle.
- Verifique que las políticas de gestión de identidad y acceso (IAM) impidan el acceso administrativo no autorizado. Asegúrese de que el registro continuo de auditoría mantenga un historial de todas las actividades de migración relacionadas con la seguridad. Confirme que la verificación mediante sumas de comprobación SHA-256 puede detectar cambios no autorizados en el esquema o en los datos.
- Verifique que el marco de detección de anomalías explicable pueda localizar actividades inusuales durante la migración y que también pueda proporcionar explicaciones de seguridad interpretables. Elabore un mapa de controles de seguridad para cada amenaza identificada. Confirme que todas las amenazas identificadas estén adecuadamente mitigadas antes de comenzar la migración de la base de datos. Los autores resumieron el modelo de amenazas y los controles de seguridad en Tabla 2.
- Transfiera el esquema de la base de datos. Extraiga las definiciones del esquema desde la base de datos PostgreSQL de origen. Valide la compatibilidad del esquema con el entorno de la base de datos de destino. Verifique las estructuras de las tablas, claves primarias, claves externas, índices y restricciones. Implemente las definiciones de esquema validadas en la base de datos de destino. Confirme la implementación exitosa del esquema antes de transferir los datos.
- Migre los datos de salud mediante canales de comunicación cifrados mientras supervisa continuamente las actividades de migración.
- Configure el tamaño del lote de migración en 10 000 registros por transacción. Establezca canales de comunicación cifrados utilizando TLS 1.3. Transfiera los datos a través de puntos finales privados dentro de la nube privada virtual (VPC).
- Habilite intentos automáticos de reintento con un máximo de tres reintentos para transacciones fallidas.
Mantenga el rendimiento de transferencia de datos entre 100 MB/s y 150 MB/s. Supervise las actividades de migración continuamente durante todo el proceso de transferencia. Registre todos los eventos de migración en registros centralizados de auditoría.
- Verifique la integridad y completitud de la migración comparando las sumas de comprobación, los conteos de registros y las estructuras de la base de datos.
- Genere valores hash SHA-256 para todas las tablas de origen antes de la migración y valores hash SHA-256 para todas las tablas de destino después de la migración. Compare los valores de suma de comprobación entre origen y destino. Contraste los conteos de filas entre las bases de datos de origen y destino. Verifique la consistencia de los esquemas, las relaciones entre tablas y las restricciones de la base de datos. Considere la migración como exitosa únicamente cuando los valores de suma de comprobación, los conteos de registros y las estructuras del esquema sean idénticos.
- Elimine los privilegios temporales y finalice los controles de seguridad tras la finalización exitosa de la migración de datos.
- Revocar inmediatamente todas las credenciales temporales de migración tras completar la migración. Elimine los privilegios elevados de migración de las cuentas de servicio. Archive los registros de auditoría y los registros de monitoreo de seguridad.
- Verifique la finalización exitosa de los procedimientos de respaldo. Deseche los servidores temporales de migración y los recursos auxiliares. Realice una revisión final de seguridad del entorno migrado. Documente los resultados de la migración y los resultados de validación. El flujo de trabajo completo de migración segura utilizado en este estudio se ilustra en Figura 3.
| Escenario de amenaza | Control de seguridad | Método de detección | Medida de mitigación |
| Robo de credenciales | Privilegio temporal mínimo (TLP) | Registros de IAM | Revocación automática de credenciales |
| Ataque interno | Control de acceso basado en roles (RBAC) | Registros de auditoría + SHAP | Terminación de sesión |
| Ataque de repetición | TLS 1.3 + validación de número único (nonce) | Supervisión de red | Rechazar solicitudes duplicadas |
| Ataque de intermediario (MITM) | Cifrado TLS 1.3 | Validación de certificados | Comunicación cifrada |
| Alteración del esquema | Suma de comprobación SHA-256 + validación del esquema | Verificación de integridad | Restaurar el esquema validado |
| Escalada de privilegios | Aplicación de políticas de IAM | Registros de seguridad | Revocación de privilegios |
Tabla 2: Modelo de amenazas y medidas de seguridad respectivas adoptadas en el marco de migración propuesto. La tabla describe las principales amenazas de seguridad representativas y sus correspondientes mecanismos de mitigación basados en principios de seguridad de confianza cero, cifrado, gestión de identidad, verificación de integridad, monitoreo y detección de anomalías explicables.
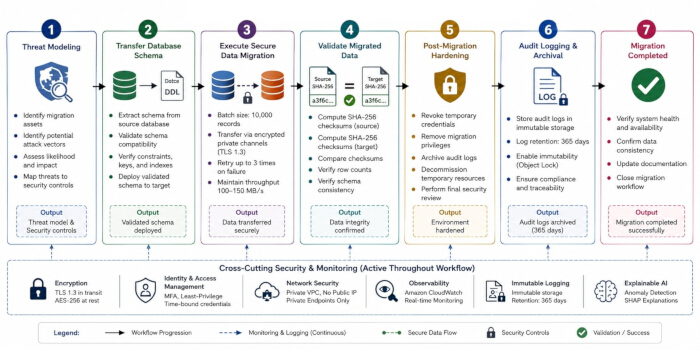
Figura 3: Flujo de trabajo del protocolo propuesto para la migración segura de bases de datos a la nube. El protocolo consta de siete etapas secuenciales: modelado de amenazas, transferencia del esquema, migración segura de la base de datos, validación de los datos migrados, endurecimiento posterior a la migración, registro y archivo de auditoría, y finalización de la migración. A lo largo de todo el flujo de trabajo de migración se mantiene el monitoreo de seguridad, la comunicación cifrada, la gestión de identidades, el registro inmutable y la detección explicativa de anomalías. Esta figura fue creada por los autores utilizando Microsoft PowerPoint (Microsoft 365). Haga clic aquí para ver una versión más grande de esta figura.
6. Configurar el monitoreo de inteligencia artificial interpretable
NOTA: La descripción general del proceso es: identificar las características de seguridad de la migración, construir un modelo para detectar irregularidades, reconocer cuándo las acciones de migración son sospechosas y producir resultados explicables mediante métodos de interpretación SHAP.
- Extraiga y preprocese las características de telemetría de seguridad necesarias para la detección de anomalías y el análisis de explicabilidad.
- Recopile registros de seguridad de servidores de bases de datos, servidores de autenticación, servidores de aplicaciones y sistemas de monitoreo de red. Agregue todos los eventos relacionados con la migración en un repositorio centralizado de registros. Elimine registros duplicados y entradas incompletas. Sincronice las marcas de tiempo en todas las fuentes de registros utilizando la hora universal coordinada (UTC).
- Calcule la frecuencia de acceso de cada usuario durante las operaciones de migración. Registre el número de intentos fallidos de inicio de sesión asociados con cada cuenta. Supervise los cambios en las direcciones IP de origen durante las sesiones de migración.
- Mida la duración de la sesión de usuario desde el inicio hasta la finalización. Calcule los volúmenes de transferencia de datos entrantes y salientes durante las actividades de migración. Normalice todas las características extraídas utilizando la normalización Min-Max.
- Tabla 3 resume las características de seguridad utilizadas para la detección de anomalías y el análisis de explicabilidad.
- Entrene y valide el modelo Isolation Forest utilizando el conjunto de datos de características de seguridad preparado.
- Divida el conjunto de datos. Divida aleatoriamente el conjunto de datos en conjunto de entrenamiento (70 %), conjunto de validación (15 %) y conjunto de prueba (15 %). Mantenga una distribución consistente de eventos normales y anómalos en todos los subconjuntos.
- Selección del modelo de inteligencia artificial explicativa. Seleccione el algoritmo Isolation Forest porque detecta eficientemente actividades anómalas de migración sin requerir datos etiquetados para el entrenamiento. Utilice el algoritmo para aislar observaciones anómalas mediante la partición aleatoria recursiva del espacio de características.
- Aplique SHAP TreeExplainer para cuantificar la contribución de cada característica de seguridad a la predicción de anomalías y mejorar la transparencia del proceso de monitoreo de seguridad.
- Configure el modelo de detección de anomalías. Inicialice un modelo Isolation Forest. Configure el modelo utilizando los parámetros enumerados en Tabla 4.
- Defina la formulación matemática utilizada para calcular las puntuaciones de anomalía y explicar las contribuciones de las características.
- Defina el vector de características de seguridad para cada evento de migración como se muestra en la Ecuación 1.
xi = [x1 , x2, x3, x4, x5 ] (1)
donde x1 denota frecuencia de acceso, x2 denota número de intentos fallidos de inicio de sesión, x3 denota frecuencia de cambio de dirección IP, x4 denota duración de la sesión, y x5 denota volumen de transferencia de datos. - Extraiga las características de seguridad de los registros de migración. Normalice todos los valores de características antes del entrenamiento del modelo. Calcule la puntuación de anomalía de Isolation Forest para cada evento de migración utilizando la Ecuación 2.
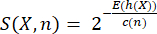 (2)
donde S(X,n) denota la puntuación de anomalía de la observación X, X denota el vector de características de seguridad, E(h(X)) es la longitud esperada del camino de la observación X, c(n) es la longitud promedio del camino de búsquedas fallidas en un árbol binario de búsqueda, y n es el número total de muestras de entrenamiento. El factor de normalización se calcula como se muestra en la Ecuación 3.
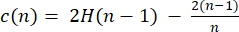 (3)
donde H(n-1) denota el número armónico (n-1)-ésimo. - Clasifique los eventos de migración con puntuaciones de anomalía mayores que el umbral de decisión predeterminado como anómalos.
- Aplique SHAP (SHapley Additive exPlanations) para explicar la contribución de cada característica de seguridad a la predicción de anomalías. Calcule el valor SHAP para la característica i utilizando la Ecuación 4.
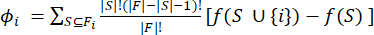 (4)
donde (F) denota el conjunto completo de características, (S) denota un subconjunto de características, y (f(.)) denota la función de predicción de Isolation Forest. - Calcule la importancia global de las características calculando el valor absoluto medio de SHAP utilizando la Ecuación 5.
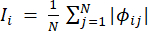 (5)
donde (N) denota el número total de eventos de migración. - Ordene las características de seguridad según sus valores absolutos medios de SHAP. Genere gráficos resumen de SHAP, gráficos de dependencia y gráficos de fuerza para visualizar la importancia global y local de las características.
- Defina el vector de características de seguridad para cada evento de migración como se muestra en la Ecuación 1.
- Entrene el modelo Isolation Forest utilizando el conjunto de datos de entrenamiento. Evalúe el rendimiento del modelo utilizando el conjunto de datos de validación. Si es necesario, ajuste los umbrales de contaminación. Almacene la configuración del modelo que presente el mejor rendimiento. Valide el rendimiento del modelo. Determine métricas como exactitud, precisión, exhaustividad, puntuación F1 y ROC-AUC. Registre las medidas de rendimiento del modelo para comparaciones posteriores.
- Aplique el modelo entrenado para identificar eventos de migración anómalos y clasificar actividades sospechosas.
- Realice la predicción de anomalías. Aplique el modelo Isolation Forest entrenado al conjunto de datos de prueba. Genere puntuaciones de anomalía para todos los eventos de migración.
- Identifique actividades sospechosas. Determine si los eventos de migración son típicos o anómalos. Marque como sospechosos aquellos eventos que superen los niveles predeterminados de anomalía. Produzca documentación de anomalías para su revisión de seguridad.
- La finalización del proceso de detección de anomalías produce puntuaciones de anomalía, etiqueta los eventos de migración como normales o anómalos, mide la eficacia de la detección mediante análisis ROC y detecta principales anomalías de seguridad. Se muestran ejemplos de resultados generados por el proceso diseñado en Figura 4.
- Categorice las anomalías detectadas. Clasifique las anomalías en anomalías de autenticación, anomalías de red, anomalías de sesión y anomalías de transferencia de datos. Mantenga las etiquetas de anomalías para el análisis de explicabilidad.
- Evalúe el rendimiento de la detección. Revise los incidentes de seguridad registrados hasta la fecha. Luego, utilícelos como referencia para evaluar las anomalías detectadas y determine cuáles de ellas fueron verdaderamente anómalas. Determine la tasa de detección de anomalías y la tasa de falsos positivos. Elabore un registro oficial de la documentación de la precisión de detección para poder reproducirla.
- Genere explicaciones basadas en SHAP para interpretar la contribución de características individuales de seguridad a las predicciones de anomalías.
- Configure el entorno SHAP. Cargue el modelo Isolation Forest entrenado. Inicialice SHAP TreeExplainer. Verifique la integración exitosa entre el modelo de detección de anomalías y el marco de explicabilidad.
- Seleccione muestras de referencia. Seleccione aleatoriamente 1.000 muestras representativas del conjunto de datos de entrenamiento. Utilice las muestras seleccionadas como conjunto de datos de referencia de SHAP. Calcule los valores SHAP. Calcule los valores SHAP para todas las anomalías detectadas. Mida las contribuciones individuales de las características a las predicciones de anomalías. Almacene los resultados de SHAP para análisis posteriores.
- Genere explicaciones globales. Cree gráficos resumen de SHAP que muestren la importancia general de las características. Genere gráficos de barras de SHAP basados en los valores absolutos medios de SHAP. Produzca gráficos de dependencia de SHAP para características altamente influyentes.
- Genere explicaciones locales. Seleccione eventos representativos de migración anómalos. Cree gráficos de fuerza y gráficos de cascada de SHAP. Visualice las contribuciones de las características responsables de cada anomalía.
- Se muestran en Figura 5 resultados representativos de explicabilidad generados durante el proceso de interpretación. Estas visualizaciones demuestran la importancia global de las características, los rankings de contribución de características, las relaciones de dependencia entre características de seguridad influyentes y explicaciones locales para anomalías individuales de migración.
- Ordene las características de seguridad. Calcule los valores absolutos medios de SHAP para todas las características. Ordene las características según su contribución a la detección de anomalías. Identifique los indicadores de seguridad más influyentes que afectan la seguridad de la migración. Tabla 5 resume los rankings de importancia de características basados en SHAP.
- Valide la consistencia de las explicaciones. Repita el análisis SHAP en cinco ejecuciones experimentales independientes. Mida la estabilidad y consistencia de las explicaciones. Verifique que los rankings de características permanezcan estables en análisis repetidos.
NOTA: Tabla 6 proporciona problemas comunes encontrados durante la detección de anomalías explicativas y las acciones correctivas recomendadas.
| Característica | Descripción | Finalidad |
| Frecuencia de acceso | Número de solicitudes de acceso de usuario durante la migración | Detectar comportamientos anómalos de acceso |
| Conteo de inicio de sesión fallido | Número de intentos de autenticación no exitosos | Identificar intentos de acceso por fuerza bruta o no autorizados |
| Cambios de dirección IP | Frecuencia de cambios en la dirección IP de origen | Detectar comportamientos sospechosos en la red |
| Duración de la sesión | Duración de las sesiones de usuario durante la migración | Identificar actividades anómalas en la sesión |
| Volumen de transferencia de datos | Cantidad de datos transferidos durante la migración | Detectar movimientos inusuales de datos o exfiltración |
Tabla 3: Características de telemetría de seguridad utilizadas para la detección explicable de anomalías. La tabla presenta las características de seguridad que se monitorearon durante la migración de la base de datos, sus significados, las formas en que se midieron y cómo ayudaron en el análisis de detección de anomalías y explicabilidad.
| Parámetro | Valor | Descripción |
| Algorithm | Isolation Forest | Modelo de detección de anomalías |
| n_estimators | 100 | Número de árboles de aislamiento |
| contamination | 0.02 | Proporción esperada de anomalías |
| max_samples | Auto | Muestras utilizadas por árbol |
| random_state | 42 | Semilla para reproducibilidad |
| bootstrap | False | Muestreo sin reemplazo |
| Training Set | 70% | Datos para entrenamiento del modelo |
| Validation Set | 15% | Validación de hiperparámetros |
| Testing Set | 15% | Evaluación final del modelo |
Tabla 4: Configuración del bosque de aislamiento utilizada para detectar anomalías durante la migración segura de bases de datos. Esta tabla detalla los ajustes de los hiperparámetros del modelo de bosque de aislamiento para el entrenamiento, como la forma en que se dividió el conjunto de datos, el nivel de contaminación, el número de estimadores, la semilla aleatoria y la configuración de evaluación.
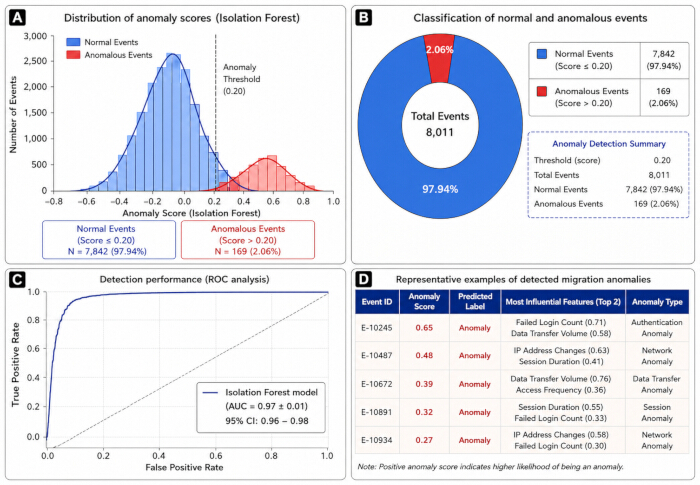
Figura 4: Resultados representativos del marco de detección de anomalías durante la migración segura de datos a la nube. (A) Distribución de las puntuaciones de anomalía del bosque de aislamiento que muestra el umbral de anomalía. (B) Clasificación de eventos de migración en categorías normales y anómalas. (C) Curva característica de operación del receptor (ROC) que demuestra el rendimiento del modelo de bosque de aislamiento (AUC = 0.97 ± 0.01). (D) Eventos de migración anómalos representativos que muestran las puntuaciones de anomalía, las etiquetas predichas, las características de seguridad influyentes y las categorías de anomalía. Esta figura fue generada por los autores utilizando Python 3.11 (Matplotlib 3.9) y formateada utilizando Microsoft PowerPoint (Microsoft 365). Haga clic aquí para ver una versión más grande de esta figura.
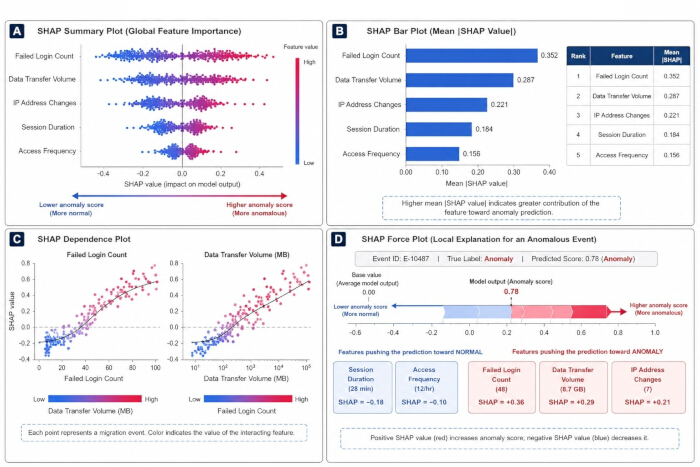
Figura 5: Ejemplos de salidas de explicabilidad basadas en SHAP generadas durante la interpretación de anomalías. (A) Gráfico de resumen SHAP que resalta las características más importantes a nivel global. (B) Clasificación de las características de seguridad según su valor absoluto medio de SHAP. (C) Gráficos de dependencia SHAP que muestran cómo el número de intentos de inicio de sesión fallidos y el volumen de transferencia de datos afectan la predicción de anomalías. (D) Gráfico de fuerza SHAP que ofrece una explicación local para un evento típico de migración anómala. Estos gráficos muestran la interpretabilidad global y local del modelo propuesto de detección de anomalías. Esta figura fue generada por los autores utilizando Python 3.11 (Matplotlib 3.9) y formateada con Microsoft PowerPoint (Microsoft 365). Haga clic aquí para ver una versión más grande de esta figura.
| Clasificación | Característica | Valor SHAP Medio Absoluto | Interpretación |
| 1 | Conteo de Inicios de Sesión Fallidos | 0.352 | Indicador más influyente de actividad anómala |
| 2 | Volumen de Transferencia de Datos | 0.287 | Contribuye significativamente a la detección de anomalías |
| 3 | Cambios de Dirección IP | 0.221 | Indica comportamiento sospechoso en la red |
| 4 | Duración de la Sesión | 0.184 | Asociada con sesiones de usuario anormales |
| 5 | Frecuencia de Acceso | 0.156 | Refleja patrones de acceso inusuales |
Tabla 5: Puntuaciones de importancia de características SHAP de los datos de telemetría de seguridad. La tabla muestra la clasificación de las características de seguridad según sus valores absolutos medios de SHAP y describe sus respectivas contribuciones a la predicción de anomalías.
| Problema | Causa posible | Solución recomendada |
| Detección de pocas anomalías | Parámetro de contaminación demasiado bajo | Aumente el umbral de contaminación y vuelva a entrenar el modelo. |
| Tasa alta de falsos positivos | Registros de migración ruidosos o inconsistentes | Limpie los datos de registro y normalice las características de seguridad antes del entrenamiento del modelo. |
| Explicaciones SHAP inestables | Insuficiencia de muestras de referencia | Aumente el número de muestras de fondo representativas utilizadas por SHAP. |
| Baja precisión en la detección de anomalías | Desbalance de características o preprocesamiento inadecuado | Aplique procedimientos de normalización, equilibrio y control de calidad de las características. |
| Convergencia lenta del modelo | Conjunto de datos grande o recursos computacionales limitados | Optimice los hiperparámetros o utilice GPU/procesamiento paralelo. |
| Fallas de comunicación | Inestabilidad de red durante la supervisión | Verifique los canales de comunicación segura y repita la sincronización. |
| Falta de características de seguridad | Recolección incompleta de registros | Valide las fuentes de registro antes de la extracción de características y regenere el conjunto de datos de características. |
Tabla 6: Guía para la resolución de problemas en la migración segura de bases de datos basada en inteligencia artificial explicable. Esta tabla proporciona un resumen de problemas típicos de implementación, razones posibles, signos diagnósticos, acciones recomendadas y resultados esperados como consecuencia de la ejecución del protocolo y su reproducibilidad.
7. Evaluación del rendimiento
NOTA: Esta sección describe el procedimiento experimental utilizado para comparar el marco de migración de referencia con el marco de migración propuesto basado en inteligencia artificial explicativa y cero confianza. La evaluación del rendimiento incluye seguridad, capacidad de detección de anomalías, eficiencia de migración y validación estadística bajo condiciones experimentales idénticas.
- Configure ambos entornos, el de referencia y el propuesto, en condiciones idénticas para permitir una comparación justa del rendimiento.
- Configure el entorno de migración convencional. Establezca credenciales estáticas a largo plazo con un período de validez mayor a 24 h. Habilite puntos de acceso en red pública para el acceso a la base de datos. Desactive los mecanismos de detección y explicabilidad de anomalías basados en IA. Supervise las actividades de migración manualmente utilizando registros de seguridad convencionales. Registre los eventos de migración para la comparación posterior del rendimiento.
- Configure el marco de migración de cero confianza (Zero-Trust). Habilite credenciales temporales de privilegio mínimo con expiración automática tras la finalización de la migración. Desactive todos los puntos de acceso en red pública. Habilite la comunicación mediante red privada utilizando canales seguros.
- Implemente el modelo entrenado de detección de anomalías mediante bosque de aislamiento (Isolation Forest). Habilite SHAP TreeExplainer para la interpretación del modelo. Configure la supervisión de seguridad automatizada durante todo el proceso de migración. Verifique la comunicación segura entre todos los componentes de migración antes de la ejecución.
- Realice experimentos de migración repetidos en condiciones controladas para evaluar la reproducibilidad del marco.
- Realice el experimento de migración. Lleve a cabo diez experimentos de migración independientes tanto para el entorno de referencia como para el entorno propuesto. Mantenga configuraciones idénticas de hardware, software y red durante todos los experimentos.
- Migre 10 GB de datos de salud en cada ejecución experimental. Repita todos los experimentos en condiciones de carga idénticas. Registre eventos de seguridad, registros de migración, resultados de detección de anomalías y tiempos de ejecución durante cada experimento.
- Valide la integridad de la migración. Calcule las sumas de verificación SHA-256 antes y después de la migración. Verifique la integridad completa de los datos tras cada experimento de migración. Documente los resultados de la validación de las sumas de verificación.
- Calcule métricas cuantitativas de seguridad, migración y detección de anomalías para la evaluación comparativa.
- Mida el rendimiento en seguridad. Mida la duración de la exposición de las credenciales. Calcule el número de credenciales expuestas durante la migración. Mida el tiempo de detección de incidentes. Registre la duración de la exposición en red pública.
- Evalúe el rendimiento de la detección de anomalías. Calcule la exactitud, precisión, exhaustividad (recall), puntuación F1 y el área bajo la curva de la característica operativa del receptor (AUC). Evalúe el rendimiento de la migración. Mida la latencia total de migración y calcule el rendimiento de migración (throughput). Registre la sobrecarga de comunicación introducida por los mecanismos de seguridad.
- Realice la validación estadística. Calcule la media y la desviación estándar para todas las métricas de rendimiento. Calcule intervalos de confianza del 95 %. Realice pruebas t de Student pareadas para comparar los marcos de referencia y propuesto. Considere significancia estadística cuando p < 0,05. En Figura 6 se muestran resultados representativos de la evaluación del rendimiento generados durante la comparación experimental.
- Tabla 7 resume la comparación cuantitativa del rendimiento entre el marco de referencia y el marco de migración propuesto.
Tabla 8 resume los problemas comunes de implementación encontrados durante la migración segura de bases de datos, sus posibles causas y las acciones correctivas recomendadas.
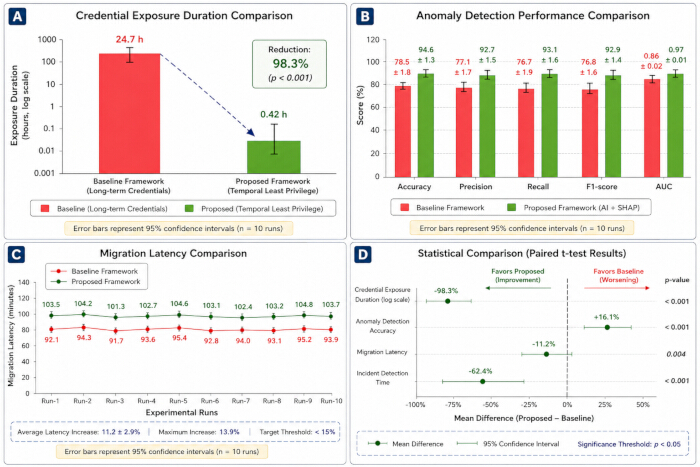
Figura 6: Comparación del rendimiento entre el marco de migración de referencia y el marco propuesto de migración segura a la nube basado en cero confianza y habilitado con inteligencia artificial explicable. (A) Comparación de la duración de la exposición de credenciales utilizando credenciales de privilegio mínimo a largo plazo y temporales. (B) Comparación de métricas de rendimiento en la detección de anomalías, incluyendo exactitud, precisión, exhaustividad, puntuación F1 y AUC. (C) Comparación de la latencia de migración en diez ejecuciones experimentales independientes, mostrando que el aumento de latencia permaneció por debajo del umbral de aceptación predefinido. (D) Comparación estadística de métricas clave de rendimiento mediante pruebas t de Student pareadas, mostrando diferencias medias e intervalos de confianza del 95 %. Las barras de error representan intervalos de confianza del 95 % obtenidos de diez ejecuciones experimentales independientes. Esta figura fue generada por los autores utilizando Python 3.11 (Matplotlib 3.9) y formateada usando Microsoft PowerPoint (Microsoft 365). Haga clic aquí para ver una versión más grande de esta figura.
| Métrica de rendimiento | Marco de referencia inicial (media ± DE) | Marco de referencia propuesto (media ± DE) | Mejora | Intervalo de confianza del 95 % | p-valor |
| Duración de exposición de credenciales (h) | 24,70 ± 1,32 | 0,42 ± 0,18 | reducción del 98,3 % | 23,6–24,9 | <0,001 |
| Precisión en la detección de anomalías (%) | 72,4 ± 2,1 | 94,6 ± 1,3 | +22,2 % | 20,8–23,5 | <0,001 |
| Precisión (%) | 68,1 ± 2,5 | 92,7 ± 1,5 | +24,6 % | 23,1–26,0 | <0,001 |
| Recuperación (%) | 70,3 ± 2,4 | 93,1 ± 1,6 | +22,8 % | 21,4–24,2 | <0,001 |
| Puntuación F1 (%) | 69,2 ± 2,2 | 92,9 ± 1,4 | +23,7 % | 22,3–25,0 | <0,001 |
| AUC | 0,78 ± 0,03 | 0,97 ± 0,01 | +0,19 | 0,17–0,21 | <0,001 |
| Latencia de migración (min) | 87,6 ± 3,2 | 97,4 ± 2,9 | sobrecarga del 11,2 % | 8,9–10,7 | 0,002 |
| Integridad de datos (%) | 99,8 | 100,0 | mejora del 0,2 % | 0,1–0,3 | 0,031 |
| Exposición a red pública | Habilitada | Eliminada | eliminada al 100 % | N/D | <0,001 |
Tabla 7: Comparación del rendimiento entre los marcos de migración de bases de datos seguras actuales y propuestos. La tabla muestra la duración de la exposición de credenciales, la eficacia en la detección de anomalías, la latencia de migración, la integridad de los datos y las mejoras de seguridad evaluadas cuantitativamente durante la validación del protocolo.
| Problema | Causa posible | Solución recomendada |
| Fallo en la autenticación de migración | Credenciales temporales expiradas o no válidas | Regenere las credenciales temporales y verifique las políticas IAM antes de reiniciar la migración. |
| Alta latencia en la migración | Congestión de red o ancho de banda insuficiente | Optimice el enrutamiento de red, programe la migración durante períodos de bajo tráfico y verifique la conectividad de los extremos. |
| Alertas de anomalías falsas positivas | Umbral de contaminación inadecuado en el bosque de aislamiento | Ajuste el parámetro de contaminación utilizando el conjunto de datos de validación y vuelva a entrenar el modelo. |
| Explicaciones SHAP inestables | Muestras de fondo insuficientes o no representativas | Aumente el tamaño de la muestra de fondo para SHAP y asegúrese de que el muestreo sea representativo. |
| Discrepancia en la integridad de los datos | Migración interrumpida o transferencia de datos dañados | Vuelva a ejecutar la migración después de validar los valores de suma de comprobación SHA-256 y la consistencia entre origen y destino. |
| Fallo en la conexión de extremo seguro | Errores en la configuración del cortafuegos o TLS | Verifique los certificados SSL/TLS, las reglas del cortafuegos y la configuración del extremo privado. |
| Baja precisión en la detección de anomalías | Extracción de características incompleta o preprocesamiento deficiente | Revise la ingeniería de características, normalice las características de seguridad y vuelva a entrenar el modelo. |
| Problemas de convergencia del modelo | Hiperparámetros inadecuados | Ajuste los parámetros de aprendizaje y valide el rendimiento del modelo antes del despliegue. |
Tabla 8: Guía de solución de problemas para la migración segura de bases de datos de atención médica. La tabla enumera errores frecuentes durante la migración, sus causas posibles, las medidas correctivas recomendadas y los resultados esperados para garantizar una ejecución confiable del protocolo de migración segura.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Resumen del experimento
El protocolo propuesto de migración segura de datos en la nube habilitado por inteligencia artificial explicable (XAI) fue evaluado utilizando un conjunto de datos sintéticos de atención médica que comprende aproximadamente 20 millones de registros electrónicos de salud (EHR) distribuidos en 28 tablas de bases de datos relacionales, con un total de 10 GB. Los experimentos se realizaron en un entorno en la nube de Amazon Web Services (AWS) utilizando Ama...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
En esta investigación, se desarrolló un protocolo reproducible y seguro para la migración de bases de datos a la nube que incorpora principios de seguridad de confianza cero, control de acceso basado en tiempo y privilegio mínimo, inteligencia artificial explicable (XAI) y monitoreo continuo de seguridad, todo ello dentro de un entorno experimental restringido. No era intención de este artículo utilizar un nuevo algoritmo de migración; por lo tanto, los autores presentan principalmente un flujo de trabajo estandarizado q...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no tienen intereses financieros competitivos, relaciones comerciales ni relaciones personales que pudieran haber influido en el trabajo presentado en este estudio. Los autores no tienen conflictos de interés que declarar. Todos los materiales necesarios para reproducir la metodología presentada en este estudio están disponibles públicamente en un repositorio de GitHub. El repositorio está disponible en: https://github.com/priyankanalawade896-tech/XAI-Secure-Cloud-Data-Migration. El repositorio contiene únicamente datos de referencia generados sintéticamente y no incluye ninguna información real de pacientes, información protegida de salud ni registros sanitarios identificables.
Agradecimientos
Los autores reconocen el apoyo institucional brindado por sus respectivas instituciones afiliadas durante el desarrollo y evaluación de este protocolo. Los autores también reconocen el uso de instalaciones computacionales institucionales y recursos de computación en la nube que respaldaron la validación experimental del marco propuesto para la migración segura de datos en la nube.
Esta investigación no recibió financiación externa. El estudio se realizó utilizando instalaciones de investigación institucionales y recursos computacionales proporcionados por las instituciones afiliadas de los autores. No se recibió financiamiento mediante subvenciones ni apoyo económico de ninguna agencia pública, comercial o sin fines de lucro.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Encriptación AES | NIST | AES-256 | Encriptación de datos en reposo |
| Amazon RDS PostgreSQL | Amazon Web Services | PostgreSQL 16 | Base de datos de destino |
| Plataforma en la nube | Amazon Web Services | AWS | Infraestructura en la nube |
| CloudWatch | Amazon Web Services | Última versión estable | Supervisión y registro |
| Docker | Docker Inc. | 27.0 | Contenerización |
| Faker | Desarrolladores de Faker | 30.0 | Generación de datos sintéticos |
| GPU | NVIDIA | RTX 4090 | 24 GB de VRAM |
| Matplotlib | Desarrolladores de Matplotlib | 3.9 | Visualización |
| NumPy | Desarrolladores de NumPy | 1.26 | Procesamiento numérico |
| Sistema operativo | Canonical | Ubuntu 22.04 LTS | Entorno del sistema |
| Pandas | PyData | 2.2 | Procesamiento de datos |
| PostgreSQL | Grupo de Desarrollo Global de PostgreSQL | 16 | Base de datos de origen |
| Python | Fundación Python Software | 3.11 | Lenguaje de programación |
| Scikit-learn | Desarrolladores de Scikit-learn | 1.5 | Aprendizaje automático |
| SHAP | Desarrolladores de SHAP | 0.46 | IA explicable |
| Terraform | HashiCorp | 1.8 | Provisionamiento de infraestructura |
| TLS | IETF | TLS 1.3 | Encriptación de datos en tránsito |
| Nube privada virtual | Amazon Web Services | VPC | Entorno de red privada |
| Estación de trabajo | Dell/HP | NA | Intel Xeon Gold 6226R, 64 GB de RAM, 1 TB de SSD |
Referencias
- Kindervag J. Build security into your network's DNA: The Zero Trust Network Architecture. Cambridge (MA): Forrester Research; 2010.
- Rose S, Borchert O, Mitchell S, Connelly S. Zero Trust Architecture. NIST Special Publication 800-207. Gaithersburg (MD): National Institute of Standards and Technology; 2020. doi:10.6028/NIST.SP.800-207.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119. doi:10.1038/s41746-020-00323-1.
- Kairouz P, McMahan HB, Avent B, Bellet A, Bennis M, Bhagoji AN, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210. doi:10.1561/2200000083.
- Nguyen DC, Ding M, Pathirana PN, Seneviratne A, Li J, Niyato D, et al. Privacy-preserving federated learning: A comprehensive survey. IEEE Commun Surv Tutor. 2021;23(3):1622-1651. doi:10.1109/COMST.2021.3075434.
- Sarker IH. AI-driven cybersecurity: An overview, security intelligence modeling, and research directions. SN Comput Sci. 2021;2:173. doi:10.1007/s42979-021-00557-0.
- Kuo AM. Opportunities and challenges of cloud computing to improve health care services. J Med Internet Res. 2011;13(3):e67. doi:10.2196/jmir.1867.
- Kota TK. Cloud migration for healthcare data: Challenges and solutions. Nanotechnol Percept. 2024;20:3048-3062.
- Rancea A, Anghel I, Cioara T. Edge computing in healthcare: Innovations, opportunities, and challenges. Future Internet. 2024;16(9):329.
- Mersha M, et al. Explainable artificial intelligence: A survey of needs, techniques, applications, and future direction. Neurocomputing. 2024;599:128111. doi:10.1016/j.neucom.2024.128111.
- Mennella C, Maniscalco U, De Pietro G, Esposito M. Ethical and regulatory challenges of AI technologies in healthcare: A narrative review. Heliyon. 2024;10(4):e26297. doi:10.1016/j.heliyon.2024.e26297.
- Roppelt JS, Kanbach DK, Kraus S. Artificial intelligence in healthcare institutions: A systematic literature review on influencing factors. Technol Soc. 2024;76:102443. doi:10.1016/j.techsoc.2023.102443.
- Lekkala S, Avula R, Gurijala P. Next-Gen firewalls: Enhancing cloud security with generative AI. J Artif Intell Cloud Comput. 2024;3(4):1-9. doi:10.47363/JAICC/2024(3)404.
- Al-Hammuri K, Gebali F, Kanan A. ZTCloudGuard: Zero Trust context-aware access management framework to avoid medical errors in the era of generative AI and cloud-based health information ecosystems. AI. 2024;5(3):1111-1131. doi:10.3390/ai5030055.
- Pfeifer B, Sirocchi C, Bloice MD, Kreuzthaler M, Urschler M. Federated unsupervised random forest for privacy-preserving patient stratification. Bioinformatics. 2024;40(Suppl 2):ii198-ii207. doi:10.1093/bioinformatics/btae382.
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: Challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60. doi:10.1109/MSP.2020.2975749.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. In: Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS); 2017. p. 4768-4777.
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-1144. doi:10.1145/2939672.2939778.
- Ortigossa ES, Gonçalves T, Nonato LG. Explainable artificial intelligence (XAI)—From theory to methods and applications. IEEE Access. 2024;12:80799-80846. doi:10.1109/ACCESS.2024.3409843.
- Chaddad A, et al. Explainable, domain-adaptive, and federated artificial intelligence in medicine. IEEE/CAA J Autom Sin. 2023;10(4):859-876. doi:10.1109/JAS.2023.123123.
- Albshaier L, Almarri S, Albuali A. Federated learning for cloud and edge security: A systematic review of challenges and AI opportunities. Electronics. 2025;14(5):1019. doi:10.3390/electronics14051019.
- Vani MS, Sudhakar RV, Mahendar A, et al. Personalized health monitoring using explainable AI: Bridging trust in predictive healthcare. Sci Rep. 2025;15:31892. doi:10.1038/s41598-025-15867-z.
- Zakhmi K, et al. Evolving Zero Trust architectures for AI-driven cyber threats in healthcare and other high-risk data environments: A systematic review. Cureus. 2025;17(6):e85446. doi:10.7759/cureus.85446.
- Selvaperumal D, et al. Artificial intelligence-enabled zero-trust cyber security framework for smart healthcare infrastructure. Int J Artif Intell Mach Learn. 2026;6(2 Suppl):204-217. doi:10.51483/IJAIML.6.2s.2026.204-217.
- Abbas SR, Seol H, Abbas Z, Lee SW. Exploring the role of artificial intelligence in smart healthcare: A capability and function-oriented review. Healthcare (Basel). 2025;13(14):1642. doi:10.3390/healthcare13141642.
- Al-Nafjan A, et al. Artificial intelligence in predictive healthcare: A systematic review. J Clin Med. 2025;14(19):6752. doi:10.3390/jcm14196752.
- Qureshi SS, et al. Advanced AI-driven intrusion detection for securing cloud-based industrial IoT. Egypt Inform J. 2025;30:100644. doi:10.1016/j.eij.2025.100644.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 785-794. doi:10.1145/2939672.2939785.
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. In: Proceedings of the 8th IEEE International Conference on Data Mining; 2008. p. 413-422. doi:10.1109/ICDM.2008.17.
- Abadi M, Agarwal A, Barham P, Brevdo E, Chen Z, Citro C, et al. TensorFlow: A system for large-scale machine learning. In: Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI); 2016. p. 265-283.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.