Este estudio detalla un flujo de trabajo reproducible para extraer características conductuales y desplegar rutas educativas ajustadas dinámicamente dentro de entornos virtuales. Los procedimientos descritos permiten a los educadores desarrollar planes de estudio adaptativos de realidad virtual e implementar un seguimiento conductual en tiempo real.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Métodos de enseñanza inteligente que integran la realidad virtual y algoritmos de big data para mejorar las plataformas tradicionales de educación cultural
En este artículo
Resumen
Resumen
Los entornos de enseñanza convencionales actuales cuentan con elementos interactivos limitados, lo que resulta en métricas de participación limitadas entre las poblaciones de estudiantes de grado que estudian patrimonio cultural. Para abordar estos problemas, se desarrolló una plataforma de enseñanza inteligente, que integra un motor de renderizado espacial de alta fidelidad en entornos de realidad virtual con una arquitectura algorítmica multimodelo. Dentro de esta plataforma, los modelos Transformer y Neural Collaborative Filtering (NCF) procesan datos de comportamiento para generar rutas de aprendizaje personalizadas, mientras que una Deep Q-Network (DQN) ajusta dinámicamente la dificultad del contenido basándose en retroalimentación en tiempo real. Este andamiaje adaptativo refleja principios constructivistas del aprendizaje, en los que el conocimiento se construye activamente mediante la interacción con entornos contextualizados y responsivos, en lugar de recibirse pasivamente mediante instrucción estática. La novedad de esta investigación radica en integrar un motor de renderizado espacial con una arquitectura algorítmica multimodelo para establecer un mecanismo de adaptación conductual en tiempo real. Los resultados experimentales muestran que el grupo experimental que utiliza la plataforma de enseñanza inteligente propuesta obtiene puntuaciones de aprendizaje más altas (los grupos bajos/medios/altos son 69/79/93 puntos, respectivamente) y una tasa de finalización de tareas de aprendizaje más alta (93%/96%/98%) que el grupo control que utiliza el modelo de enseñanza tradicional. El diseño de la plataforma de enseñanza inteligente ofrece una fuerte interactividad, proporciona vías de aprendizaje personalizadas para estudiantes con diversas diferencias individuales y se ajusta dinámicamente durante el proceso de aprendizaje. El análisis de tiempos de respuesta indica una latencia media de 0,496 s, asegurando una retroalimentación rápida sobre las interacciones. En última instancia, la plataforma propuesta demuestra que combinar la VR inmersiva con algoritmos adaptativos al comportamiento mejora eficazmente tanto el rendimiento académico como la implicación en las tareas de los estudiantes de grado en la educación cultural tradicional.
Introducción
La educación cultural tradicional desempeña un papel vital en la herencia y el desarrollo de la cultura. Sin embargo, el modelo tradicional actual de educación cultural se basa principalmente en formas estáticas como libros de texto, imágenes y vídeos, careciendo de interactividad e inmersión, lo que dificulta que los estudiantes comprendan y experimenten realmente el encanto de la cultura. Además, los métodos tradicionales de enseñanza suelen adoptar un currículo unificado, que no tiene en cuenta plenamente los intereses, capacidades cognitivas y estilos de aprendizaje de los estudiantes, lo que resulta en una baja eficiencia de aprendizaje y dificultad para estimular el entusiasmo de los estudiantes por el aprendizaje. Esta limitación se alinea con la teoría de la Zona de Desarrollo Proximal (ZDP) de Vygotsky, que enfatiza que la instrucción eficaz debe adaptarse a los niveles cognitivos actuales de los alumnos y estructurarse según sus trayectorias de desarrollo individuales. La literatura existente se basa en datos estáticos para el modelado pedagógico. La integración del seguimiento conductual espacial continuo con el aprendizaje profundo por refuerzo sigue sin explorarse. El mecanismo propuesto fusiona interacciones multisensoriales con reajustes algorítmicos para tender puentes entre los caminos instruccionales fijos y la adaptación contextual dinámica. La plataforma propuesta operacionaliza este principio ajustando dinámicamente la dificultad del contenido y la secuenciación basándose en indicadores de comportamiento en tiempo real, integrando así la teoría pedagógica en el diseño algorítmico. Los mecanismos de adaptación algorítmica sustituyen efectivamente al andamiaje humano que suelen proporcionar los compañeros más capaces. Esta modulación continua de la dificultad de la tarea se alinea con la Teoría de la Carga Cognitiva (CLT) al prevenir la sobrecarga cognitiva en los principiantes y mantener el compromiso dentro de la zona óptima de desarrollo.
Con el desarrollo de la realidad virtual (VR) y los algoritmos de datos, aplicarlos a la educación cultural tradicional ofrece a los estudiantes una experiencia de aprendizaje más inmersiva e interactiva 1,2,3,4. Las revisiones sistemáticas exhaustivas de aplicaciones inmersivas de realidad virtual en la educación superior subrayan aún más la importancia de alinear los elementos de diseño con objetivos pedagógicosespecíficos 5.
Muchos estudios han intentado aplicar la tecnología de realidad virtual a la educación cultural. Hulusic et al.6 diseñaron y desarrollaron un museo virtual escolar, incluyendo una interfaz de usuario tangible. A través de investigaciones participativas de usuarios, se descubrió que el museo está bien diseñado y desarrollado, y tiene el potencial de utilizarse como herramienta educativa y de aprendizaje en museos, escuelas o de forma independiente. En respuesta al problema de la interactividad insuficiente en entornos de aprendizaje a distancia, Mubarok et al.7 desarrollaron un método colaborativo de mapeo de argumentos basado en la realidad virtual para abordarlo. Los experimentos han demostrado que este método mejora mejor la expresión oral en inglés de los estudiantes que los métodos colaborativos de mapeo de argumentos que no se basan en la VR. Sun et al.8 propusieron una estrategia de diseño para un sistema de realidad virtual inmersiva que combine interacción multimodal, gamificación y narración para mostrar y desarrollar el patrimonio cultural digital. Desarrollaron un sistema de realidad virtual inmersiva que restauró los murales de Dunhuang, ofreciendo a los usuarios una experiencia de aprendizaje, interactiva y entretenida. Sin embargo, estos estudios aún enfrentan algunos problemas, como la débil interactividad en las escenas de VR, lentas tasas de actualización para el contenido de aprendizaje y la pobre adaptabilidad de los algoritmos de recomendación personalizados, que hacen imposible satisfacer con precisión las necesidades de aprendizaje de diferentes estudiantes. Además, algunos estudios no han logrado integrar eficazmente el aprendizaje profundo y el aprendizaje por refuerzo, limitando las capacidades de ajuste en tiempo real de las recomendaciones personalizadas.
Los avances recientes en inteligencia artificial han impulsado las tecnologías educativas. La investigación introduce sistemas adaptativos que aprovechan el aprendizaje profundo para el reconocimiento de patrones en el comportamiento del usuario. Las metodologías que emplean algoritmos de seguimiento cognitivo mapean estados dinámicos de adquisición de conocimiento. La optimización estructural en redes neuronales eleva la precisión de la recomendación dentro de los frameworks de aprendizaje inteligente. Los agentes inteligentes que integran variables ambientales complejas mejoran las respuestas instructivas automatizadas. Estas metodologías se basan en flujos de datos aislados y análisis histórico estático. La plataforma propuesta aborda esta limitación fusionando datos de interacción espacial con un reajuste algorítmico continuo para asegurar una adaptación contextual en tiempo real.
Investigaciones empíricas recientes confirman que los algoritmos de aprendizaje profundo mejoran significativamente la precisión predictiva en la modelización del rendimiento estudiantil. Ouatik et al.9 implementaron un sistema para predecir el éxito y fracaso académico de los estudiantes. Utilizaron información personal de los estudiantes, evaluaciones académicas y otros datos, y emplearon métodos de inteligencia artificial y minería de datos educativos para predecir el éxito académico de los estudiantes. Para abordar el problema del procesamiento de datos, se utilizó la tecnología de big data (BD) para distribuir el procesamiento, reduciendo el tiempo de cálculo sin sacrificar la eficiencia algorítmica. Bhaskaran10 ha desarrollado un recomendador de espacio vectorial mejorado para abordar problemas en los sistemas actuales de recomendación de aprendizaje. Hace automáticamente un seguimiento de los intereses, necesidades y niveles de conocimiento de los alumnos. Clasifica y extrae los estilos de aprendizaje de los estudiantes del servidor, y luego utiliza un algoritmo de filtrado colaborativo mejorado para calcular similitudes y así producir una lista de recomendaciones mejorada. Gupta11 propuso un método basado en aprendizaje profundo que utiliza expresiones faciales para detectar la interacción en tiempo real de los estudiantes en línea, clasifica sus emociones a lo largo del proceso analizando las etiquetas faciales de los estudiantes y ajusta el estado de aprendizaje de los estudiantes en función de los resultados de la detección. Sin embargo, estos métodos siguen teniendo ciertas limitaciones.
Aunque las soluciones educativas existentes ofrecen una experiencia inmersiva, carecen de capacidades de ajuste dinámico. Los caminos de aprendizaje de los estudiantes suelen ser fijos, y el contenido y la dificultad no pueden optimizarse en tiempo real basándose en el progreso personal y la retroalimentación, lo que resulta en una falta de participación. Al mismo tiempo, los algoritmos tradicionales de recomendación personalizada se basan principalmente en datos históricos o en etiquetas de interés simples y no integran datos multidimensionales, como el comportamiento de aprendizaje, el estado cognitivo y la retroalimentación emocional de los estudiantes, para un análisis preciso. La falta de comprensión profunda de los procesos de aprendizaje de los estudiantes impide que el sistema de recomendaciones aborde eficazmente las diferencias individuales, lo que resulta en una experiencia de aprendizaje subóptima y resultados subóptimos.
Por ello, para abordar los problemas de inmersión insuficiente y falta de personalización en la educación cultural tradicional, se propone una plataforma educativa inteligente. Esta metodología es directamente aplicable a los cursos de humanidades de grado que requieren visualización espacial y métricas individualizadas de ritmo. Se utilizan motores avanzados de renderizado espacial y tecnologías relacionadas de computación espacial para desarrollar escenas de aprendizaje virtual. Los entornos virtuales de aprendizaje otorgan a los alumnos autonomía para seleccionar módulos culturales específicos. El modelo Transformer basado en la atención neuronal procesa registros de interacción con marca temporal para generar una representación compacta de patrones de comportamiento. Basándose en la extracción de las características del comportamiento de aprendizaje de los estudiantes, el modelo de Filtrado Colaborativo Neural (NCF) se utiliza para explorar más a fondo los intereses de aprendizaje de los estudiantes y generar rutas de aprendizaje personalizadas. El modelo Deep Q-Network (DQN) recoge la retroalimentación en tiempo real de los estudiantes y ajusta dinámicamente la trayectoria de aprendizaje para optimizar la experiencia y el efecto de aprendizaje de los estudiantes.
En cuanto al despliegue práctico, la plataforma propuesta ofrece ventajas específicas, aunque no es aplicable universalmente. Es muy adecuado para instituciones educativas equipadas con hardware computacional dedicado que comprende unidades de procesamiento gráfico discretas y equipos de visualización espacial inmersiva, así como para planes de estudio que se benefician significativamente de la visualización espacial en arquitectura y arqueología del patrimonio cultural. En estos contextos, el seguimiento dinámico del comportamiento aborda eficazmente las diferencias individuales en el ritmo. Por el contrario, este método actualmente no es adecuado para entornos educativos con pocos recursos que carecen de la infraestructura tecnológica necesaria. Además, no se recomienda para cursos altamente abstractos y centrados en el texto, donde la inmersión tridimensional ofrece un valor pedagógico insignificante en comparación con los métodos de enseñanza tradicionales.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
El comité de ética institucional de la Universidad de Comercio Internacional de Shaanxi validó el protocolo de investigación bajo la referencia 2025-04A. Se obtuvo el consentimiento informado documentado de todos los participantes antes del inicio del procedimiento, asegurando que todos los sujetos humanos estuvieran al tanto de los protocolos de seguimiento conductual y anonimización de datos. (Nota: Las justificaciones pedagógicas sobre los algoritmos se han trasladado a la sección de Discusión para mantener la concisión operativa.)
Paso 1: Construcción de escenas en realidad virtual
Integración de activos
El modelado digital de elementos culturales se realizó utilizando un software genérico de modelado 3D (véase la Tabla de Materiales para software específico utilizado) para construir entornos de aprendizajeinmersivo 12,13. Se generaron activos digitales, se asignaron texturas de renderizado físicas e importadas a un motor de renderizado espacial de alta fidelidad (Table of Materials) sin el uso de técnicas de imagenmicroscópica 14,15.
Configuración de renderizado y física
La tecnología de trazado de rayos por hardware se habilitó dentro del motor de renderizado para optimizar la iluminación dinámica16,17:
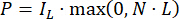 (1)
P representa la intensidad de la luz en la escena. L representa la posición de la fuente de luz. IL denota la intensidad de la fuente de luz, y N representa el vector normal superficial del objeto virtual.
El motor físico simulaba la dinámica de objetos mediante una interfaz de programación orientada a objetos (C++). La fórmula de reacción utilizada fue:
 (2)
F representa la fuerza de reacción dinámica, m es la masa del objeto virtual, v denota su velocidad y t representa el tiempo.
Para garantizar la suavidad, se utilizó la tecnología de Nivel de Detalle (LOD) para optimizar la escena, lo que redujo cálculos innecesarios y mejoró la eficiencia de renderizado al ajustar dinámicamente el nivel de detalle del modelo18,19. Se utilizó la aceleración de GPU para el procesamiento de imágenes:
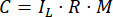 (3)
R representa el coeficiente de reflexión, M representa el mapa de superficie y C representa el color final renderizado.
Implementación de interacción
Las interacciones de usuario se configuraron utilizando la interfaz de scripting visual basada en nodos nativa del motor de renderizado espacial. Utilizando tecnología de audio espacial, se simuló el sonido en el espacio para que los estudiantes puedan escuchar diferentes efectos sonoros en distintas posiciones. Además, mediante tecnología de retroalimentación táctil, los estudiantes podían recibir respuestas físicas al contacto físico correspondiente en la escenavirtual 20:
 (4)
Ft representa la fuerza de retroalimentación táctil, y k representa el coeficiente de rigidez.
Despliegue y visión general del equipo
El entorno se compilaba en un hardware de computación espacial dedicado equipado con una unidad central de procesamiento de veinticuatro núcleos, sesenta y cuatro gigabytes de memoria de acceso aleatorio y una unidad dedicada de procesamiento gráfico de veinticuatro gigabytes. Las escenas virtuales se desplegaron en pantallas inmersivas estándar de visualización espacial, tal como se detalla en la Tabla de Materiales, con una resolución de 1440 x 1600 píxeles por ojo y una tasa de refresco de 90 Hz, asegurando una estabilidad visual óptima y minimizando la latencia de movimiento a fotón. Los límites espaciales se configuraron para limitar las sesiones a 45 minutos y así mitigar el mareo inducido visualmente.
La Tabla de Materiales resume las tecnologías específicas utilizadas. Todo el hardware designado y los componentes informáticos eran equipos comerciales estándar y no dependían de ningún proveedor propietario único. El motor de renderizado espacial y el trazado de rayos proporcionaban iluminación dinámica, mientras que el software de modelado 3D reproducía sitios históricos. La Figura 1 ofrecía un ejemplo de la escena de aprendizaje virtual, detallando el panel de control modular para aumento visual, modulación de audio y movimiento.
Punto de control 1: Un entorno VR completamente renderizado que funciona a una tasa de refresco estable de 90 Hz, minimizando la latencia entre movimiento y fotón para garantizar la estabilidad visual.
Paso 2: Extracción de comportamiento de datos (Transformer)
Registro de datos
Los datos de comportamiento de aprendizaje de los estudiantes incluían interacciones con escenas de VR, incluyendo el número de clics, el tiempo invertido, el progreso de aprendizaje y la finalización de tareas. La Tabla 1 presenta los datos de actividades de aprendizaje para los estudiantes en diferentes escenarios de VR. Para esta información interactiva, se utilizó una representación en serie temporal en la plataforma:
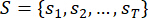 (5)
sτ representa el comportamiento del estudiante en el tiempo t, y T es la duración total del tiempo. Cada comportamiento forma un vector de alta dimensión:
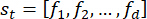 (6)
fi representa el valor específico de la característica en la dimensión i, y d indica el número total de dimensiones de la característica.
Modelado de secuencias
El modelo Transformer se utilizó para el modelado de seriestemporales 21,22. Utilizando el mecanismo de autoatención, se extrajeron características conductuales calculando las correlaciones entre los comportamientos de los estudiantes. Suponiendo que la matriz de incrustación de la secuencia de datos de comportamiento de aprendizaje de un estudiante es X, la consulta (Q), la clave (K) y el valor (V). Las matrices se generaron por primera vez multiplicando con matrices de pesos entreenables WQ, WK y WV:
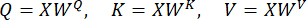 (7)
Cálculo de atención
La autoatención dentro del Transformer se calculócomo 23,24:
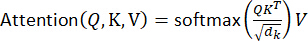 (8)
Entre ellos, dk representa la dimensión de los vectores clave, que se utilizó como factor de escala para evitar que los gradientes se anularan. Tras el cálculo de la fórmula (8), se calculó el peso de atención para medir la correlación entre los comportamientos de aprendizaje:
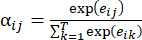 (9)
EIj representa la puntuación bruta de energía de atención entre los comportamientos de aprendizaje. La suma ponderada de estos pesos se utilizó para obtener el vector de contexto en el momento actual, que es el vector de características potenciales del estudiante:
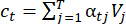 (10)
Punto de control 2: El modelo Transformer genera vectores de características latentes continuos (ct). En un conjunto de datos de validación secuestrada de 5000 registros de interacción, el modelo alcanzó una precisión de predicción de secuencias del 89,4%, con una pérdida de entropía cruzada convergiendo a 0,12 tras 50 épocas.
Paso 3: Generación de Caminos de Aprendizaje Personalizados (NCF)
Fusión de características
El modelo NCF se incorporó para explorar los posibles intereses y necesidades de los estudiantes y generó rutas de aprendizajepersonalizadas 25, 26, 27, 28. En NCF, se asignó un vector de características vk a cada punto de conocimiento cultural, y el vector potencial de características vu extraído por el Transformer y el vector de punto de conocimiento vk se concatenaron para formar un nuevo vector conjunto de características:
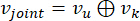 (11)
Arquitectura de red e hiperparámetros:
El vector de características conjuntas se introdujo en el perceptrón multicapa (MLP) en NCF para procesar29,30. El perceptrón multicapa utilizaba una arquitectura predeterminada con tres capas ocultas de 64, 32 y 16 neuronas, respectivamente. La tasa de aprendizaje se estableció en 0,001, con un lote de 256. Tras la transformación no lineal de varias capas ocultas en MLP, el valor predicho del interés de los estudiantes en los puntos de conocimiento fue el resultado:
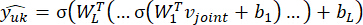 (12)
W1, W2, ... , WL representan las matrices de pesos de múltiples capas ocultas. σ denota la función de activación no lineal, y b1, b2, ... , bL representan los términos de sesgo de las respectivas capas ocultas. Cuanto mayor sea el valor de predicción de interés de la salida, mayor será el interés del estudiante en este punto de conocimiento.
Formación en modelos
La red se optimizó usando el solucionador Adam (tasa de decaimiento 0,01, tasa de aprendizaje 0,001, tamaño de lote 256). El error cuadrático medio (MSE) actúa como funciónde pérdida 31,32:
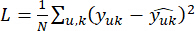 (13)
U, k representan el índice del vector de comportamiento del estudiante y el vector de puntos de conocimiento. Al minimizar la función de pérdida, el modelo actualiza continuamente los posibles vectores de características para los estudiantes y los puntos de conocimiento para mejorar la precisión de la predicción. El algoritmo de retropropagación se utilizó durante el proceso de entrenamiento para actualizar la matriz de pesos en el modelo33,34.
Salida de trayectoria
El enfoque específico consistía en ordenar por valores de interés previstos y recomendar los k puntos de conocimiento con los valores de interés más altos a los estudiantes:
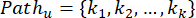 (14)
kk representan los k puntos de conocimiento que más interesan a los estudiantes. Estos puntos de conocimiento recomendados no solo satisfacen los intereses de aprendizaje de los estudiantes, sino que también les ayudan a aprender de forma eficaz con un nivel de progreso y dificultad que les conviene.
La Figura 2 visualiza este proceso de generación.
Punto de control 3: El modelo NCF genera un array de secuencias no cíclico. Como se detalla en la Tabla 2, la precisión de recomendación evaluada en la selección top-K arrojó una ganancia acumulada descontada normalizada (NDCG) de 0,82 y una razón de aciertos de 0,88 en K = 10. La métrica media de rango recíproco se estabilizó en 0,76.
Paso 4: Ajuste dinámico de dificultad (DQN)
Estado y definición de acción
Al introducir el DQN y utilizar la retroalimentación en tiempo real de los estudiantes para ajustar dinámicamente el contenido y la dificultad de aprendizaje, los efectos de aprendizaje de los estudiantes seoptimizan 35,36. El espacio de estados del modelo DQN consta de múltiples factores:
 (15)
Entre ellas, ts representa el tiempo que los estudiantes dedican a la tarea de aprendizaje actual, cp representa las elecciones de los estudiantes en la ruta de aprendizaje (capítulos o puntos de conocimiento seleccionados), mc representa la finalización de la tarea de aprendizaje actual por parte de los estudiantes, y ef representa la retroalimentación emocional de los estudiantes (el grado de preferencia y participación en una determinada tarea de aprendizaje).
Cálculo de recompensas
El agente de aprendizaje por refuerzo utilizaba una arquitectura de perceptrón multicapa compuesta por dos capas ocultas de 128 y 64 neuronas (estrategia de exploración ávida de épsilon que decae de 1.0 a 0.05). Primero, se calculó el valor de recompensa correspondiente a cada acción de aprendizaje:
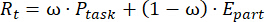 (16)
Entre ellos, ω es un hiperparámetro de peso que controla el rendimiento y la participación en el aprendizaje. Latarea P representa el rendimiento del estudiante en la tarea de aprendizaje actual, y laparte E representa la participación del estudiante en el proceso de aprendizaje actual.
Actualización de valor Q y selección de acciones
Tras obtener el valor de recompensa, el modelo actualizó el valor Q para seleccionar la acción óptima:
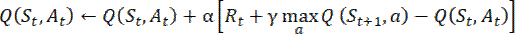 (17)
α representa la tasa de aprendizaje que controla el tamaño del paso de actualización, y γ El factor de descuento determina la importancia de las recompensas futuras.
La plataforma seleccionó la acción de ajuste óptima:
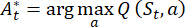 (18)
 es la acción óptima de ajuste seleccionada por la plataforma en función del estado de aprendizaje del estudiante en el momento T.
El ajuste se ejecutó siguiendo estos protocolos: (1) Se aumentó la dificultad para lograr una alta capacidad de aprendizaje; (2) Se proporcionaron pistas / se redujo la dificultad por bajo rendimiento; (3) El contenido se modificó según los cambios de interés; (4) Se mantenían parámetros para un rendimiento equilibrado.
Punto de control 4: El agente DQN calculaba acciones óptimas (At) para mantener el combate. La métrica de retroalimentación emocional compuesta (ef) mantuvo un coeficiente de fiabilidad alfa de Cronbach de 0,85 durante las pruebas.
Pantalla de la interfaz de plataforma
La Figura 3 muestra la interfaz de la plataforma de enseñanza inteligente diseñada en este artículo, que soporta la generación de caminos personalizados. En esta interfaz, los estudiantes podían ver su camino de aprendizaje personalizado y aprender de él. La parte completada del camino de aprendizaje podía marcarse en verde y la parte inacabada en rojo. Los estudiantes podían ver su progreso de aprendizaje a lo largo del camino y avanzar al siguiente paso en consecuencia. Se administraron encuestas posteriores a la interacción utilizando la Escala estándar de Usabilidad del Sistema a la cohorte experimental. El análisis arrojó una puntuación media de usabilidad de 84,5 sobre 100, lo que indica que la ergonomía y la claridad de navegación de la interfaz eran altamente aceptables.
Diseño experimental
Los participantes fueron 120 estudiantes de grado (62 mujeres, 58 hombres; edad media 19,3 años ± 1,1 años) matriculados en un curso obligatorio de "Introducción a la Cultura Tradicional China" en la Universidad de Comercio Internacional y Comercio de Shaanxi. Ninguno tenía experiencia previa con aprendizaje basado en VR. Los estudiantes fueron emparejados por puntuación previa al examen y asignados aleatoriamente dentro de pares a condiciones experimentales o de control usando una secuencia generada por ordenador, asegurando la equivalencia inicial.
El diseño de este experimento fue verificar la eficacia de la plataforma inteligente de enseñanza diseñada para mejorar el interés de aprendizaje, el rendimiento académico y la educación personalizada de los estudiantes.
El grupo experimental y el grupo control se establecieron en el experimento, y la selección de los estudiantes siguió los siguientes principios: (1) Se aseguró que los estudiantes del grupo experimental y del grupo control tuvieran similitudes en conocimientos básicos, capacidad de aprendizaje, intereses, etc. (2) Se podían seleccionar estudiantes que estudiaban la cultura tradicional y tenían grados similares para garantizar la uniformidad del contenido educativo cultural y la comparabilidad del experimento. (3) Se podrían tener en cuenta las diferencias individuales de los estudiantes para asegurar que el grupo experimental pudiera aprovechar plenamente la función de ajuste personalizado de la plataforma de enseñanza inteligente.
Tras seleccionar a los estudiantes, se agrupan y los estudiantes con rendimiento académico, intereses y antecedentes similares se asignan a los grupos experimental y de control, respectivamente, para asegurar la coincidencia a través de múltiples dimensiones y mejorar la fiabilidad del experimento.
Comparando el rendimiento de los grupos experimental y de control, se evaluó el impacto de la plataforma diseñada en este trabajo en los estudiantes. Para aislar la contribución pedagógica de los algoritmos de inteligencia artificial, el estudio incluyó tres cohortes distintas: un grupo de control tradicional que utiliza métodos estándar en el aula, un grupo solo de realidad virtual que interactúa con entornos virtuales fijos sin algoritmos adaptativos, y un grupo experimental que utiliza la plataforma de enseñanza inteligente totalmente integrada. Los estudiantes del grupo experimental podían aprender en una escena de realidad virtual, y cada uno podía generar rutas de aprendizaje personalizadas basadas en sus características de comportamiento de aprendizaje a través de la plataforma de enseñanza inteligente, ajustando dinámicamente el contenido y la dificultad de aprendizaje en respuesta a la retroalimentación en tiempo real durante el proceso. El grupo de control recibió educación cultural mediante métodos tradicionales de enseñanza, como explicaciones en clase, lectura de libros de texto y vídeos. El grupo de control recibió educación cultural estandarizada mediante conferencias dirigidas por un instructor, lecturas asignadas y presentaciones multimedia lineales. Esta instrucción básica utilizaba un contenido informativo idéntico y mantenía el mismo ritmo temporal que el currículo experimental.
Se diseñaron tres hipótesis para aclarar el propósito del estudio: (1) El entorno de aprendizaje inmersivo que proporciona la tecnología de RV puede mejorar significativamente la participación e interés de los estudiantes en el aprendizaje. (2) La trayectoria de aprendizaje personalizada que resulta Transformer y NCF mejoró eficazmente el rendimiento académico de los estudiantes y redujo las diferencias en el dominio del conocimiento entre distintos estudiantes. (3) La plataforma de enseñanza inteligente podría ajustar dinámicamente el contenido y la dificultad del aprendizaje en función de la retroalimentación en tiempo real de los estudiantes, mejorando aún más los resultados de aprendizaje de los estudiantes.
Proceso experimental: (1) Se realizó una prueba pre-experimental de conocimientos culturales a estudiantes de los grupos experimental y control para asegurar que los niveles culturales iniciales de ambos grupos fueran similares y reducir los errores experimentales. (2) Los estudiantes del grupo experimental utilizaron la escena de realidad virtual construida y la plataforma de enseñanza inteligente realizaron un estudio cultural de un mes, y el contenido de aprendizaje se ajustó dinámicamente según la plataforma de enseñanza inteligente. El grupo de control utilizó métodos tradicionales de enseñanza. Debido a las limitaciones logísticas del piloto inicial, la intervención duró cuatro semanas. Un estudio longitudinal posterior realizado durante un semestre completo de 16 semanas culminó en una prueba de retención diferida en la semana 20. La evaluación demostró una retención un 22% mayor de conceptos históricos dirigidos en la cohorte guiada algorítmicamente que en el grupo de instrucción tradicional. Se proporcionaron detalles preliminares del protocolo en la sección de limitaciones para contextualizar los hallazgos actuales como evidencia a corto plazo. (3) Tras el experimento, a los dos grupos de estudiantes se les realizó la misma prueba de conocimientos culturales para evaluar su rendimiento de aprendizaje y la realización de la tarea.
Los indicadores de evaluación para los estudiantes incluyeron el rendimiento académico, la finalización de tareas de aprendizaje y el progreso del aprendizaje. Utilizando estadística descriptiva, se resumieron los indicadores de evaluación relevantes para los grupos experimental y control. Los indicadores de evaluación de la plataforma de enseñanza inteligente incluyeron el tiempo de respuesta.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Divisiones de datos, validación y ajustes de reproducibilidad
Para la fase de entrenamiento algorítmico, el conjunto de datos de interacción conductual, que contenía 5.000 logs, se dividió en conjuntos de entrenamiento y validación 80:20. Los procedimientos de validación utilizaron un esquema de validación cruzada de 5 partes para evaluar la consistencia de la extracción de características. Para garantizar la reproducibilidad experimental absoluta, todas las inicializ...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Este estudio contribuye a la tecnología educativa al traducir teorías pedagógicas fundamentales —concretamente el constructivismo y la Zona de Desarrollo Proximal— en un sistema de enseñanza inteligente implementado computacionalmente. La integración de la inmersión en VR con la personalización basada en el comportamiento garantiza que la innovación tecnológica sirva a objetivos de aprendizaje demostrables en lugar de funcionar como un fin en sí mismo. Como se destaca en la metodología, ...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no tienen conflictos de interés económicos. Divulgación de herramientas de inteligencia artificial: Durante la preparación de este manuscrito se utilizaron grandes modelos de lenguaje exclusivamente para el refinamiento del lenguaje, la clarificación de terminologías especializadas y la asistencia en la recuperación de literatura académica. Todos los resultados de inteligencia artificial fueron evaluados críticamente, cruzados manualmente con fuentes primarias revisadas por pares y rigurosamente editados por los autores para garantizar una estricta precisión científica e integridad de los datos.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| High-fidelity spatial rendering engine | Unreal Engine 5 | Usado para integración de escenas, trazado de rayos dinámico y simulación de física. | |
| Ray tracing | Ray tracing | Tecnología de simulación de iluminación basada en principios físicos | |
| 3D modeling software | Blender | Utilizado para generar modelos poligonales de artefactos culturales y aplicar texturas PBR. | |
| Level of detail | Level of detail | Tecnología de optimización de escena | |
| Spatial audio | Spatial audio | Simulación de las características de propagación del audio en el espacio tridimensional | |
| Haptic feedback | Haptic feedback | Simulación de fuerzas de retroalimentación al interactuar con la física | |
| Visual scripting & programming interface | Blueprints & C++ | Utilizado para configurar interacciones del usuario y registrar continuamente datos de comportamiento espacial. | |
| Head-mounted display (HMD) | HTC Vive Pro | Proporciona visualización inmersiva, entrega de audio espacial y seguimiento de movimiento. |
Referencias
- Rojas-Sanchez MA, Palos-Sanchez PR, Folgado-Fernandez JA. Systematic literature review and bibliometric analysis on virtual reality and education. Educ Inf Technol (Dordr). 2023;28:155-92.
- Rospigliosi P. Metaverse or simulacra? Roblox, Minecraft, Meta and the turn to virtual reality for education, socialisation and work. Interact Learn Environ. 2022;30:1-3.
- Quadir B, Chen NS, Isaias P. Analyzing the educational goals, problems and techniques used in educational big data research from 2010 to 2018. Interact Learn Environ. 2022;30:1539-55.
- Lutfiani N, Meria L. Utilization of big data in educational technology research. Int Trans Educ Technol. 2022;1:73-83.
- Radianti J, Majchrzak TA, Fromm J, Wohlgenannt I. A systematic review of immersive virtual reality applications for higher education: design elements, lessons learned, and research agenda. Comput Educ. 2020;147:103778.
- Hulusic V, Gusia L, Luci N, Smith M. Tangible user interfaces for enhancing user experience of virtual reality cultural heritage applications for utilization in educational environment. ACM J Comput Cult Herit. 2023;16:1-24.
- Mubarok H, Lin CJ, Hwang GJ. A virtual reality-based collaborative argument mapping approach in the EFL classroom. Interact Learn Environ. 2024;32:4978-96.
- Sun T, et al. Restoring Dunhuang murals: crafting cultural heritage preservation knowledge into immersive virtual reality experience design. Int J Hum Comput Interact. 2024;40:2019-40.
- Ouatik F, et al. Predicting student success using big data and machine learning algorithms. Int J Emerg Technol Learn. 2022;17:236-51.
- Bhaskaran S, Marappan R. Enhanced personalized recommendation system for machine learning public datasets: generalized modeling, simulation, significant results and analysis. Int J Inf Technol. 2023;15:1583-95.
- Gupta S, Kumar P, Tekchandani RK. Facial emotion recognition based real-time learner engagement detection system in online learning context using deep learning models. Multimed Tools Appl. 2023;82:11365-94.
- El-Wajeh YA, Hatton PV, Lee NJ. Unreal Engine 5 and immersive surgical training: translating advances in gaming technology into extended-reality surgical simulation training programmes. Br J Surg. 2022;109:470-1.
- Conde D, et al. LiDAR data processing for digitization of the castro of Santa Trega and integration in Unreal Engine 5. Int J Archit Herit. 2025;19:131-51.
- Rohe DP, Jones EM. Generation of synthetic digital image correlation images using the open-source Blender software. Exp Tech. 2022;46:615-31.
- Pradana MR, Setiawan D, Trinawati L. Efektivitas ilusi 3D animasi Blender pada curved LED billboard (AB Building Jl. Juanda Pekanbaru). JEKIN (Jurnal Teknik Informatika). 2023;3(2):1-10. Available from: https://pdfs.semanticscholar.org/e4fd/a249d78d46e24319e3a8f318e713f76c0cbd.pdf
- Wang Y, Zhao K, Zheng Z. An improved 3D indoor positioning study with ray tracing modeling for 6G systems. Mob Netw Appl. 2023;28:1162-75.
- Liu Y, et al. Intelligent ray-tracing-based simulation and emulation of channels. Chin J Radio Sci. 2024;39:1112-9.
- Weier P, et al. Neural prefiltering for correlation-aware levels of detail. ACM Trans Graph. 2023;42:1-16.
- Mercier C, et al. Moving level-of-detail surfaces. ACM Trans Graph. 2022;41:1-10.
- Zhu M, Sun Z, Lee C. Soft modular glove with multimodal sensing and augmented haptic feedback enabled by materials' multifunctionalities. ACS Nano. 2022;16:14097-110.
- Heng JJ, Teo DB, Tan LF. The impact of Chat Generative Pre-trained Transformer (ChatGPT) on medical education. Postgrad Med J. 2023;99:1125-7.
- Hung YC, et al. Comparison of patient education materials generated by chat generative pre-trained transformer versus experts: an innovative way to increase readability of patient education materials. Ann Plast Surg. 2023;91:409-12.
- Yang H, et al. CovidViT: a novel neural network with self-attention mechanism to detect Covid-19 through X-ray images. Int J Mach Learn Cybern. 2023;14:973-87.
- Kumar S, Solanki A. An abstractive text summarization technique using transformer model with self-attention mechanism. Neural Comput Appl. 2023;35:18603-22.
- Tapalova O, Zhiyenbayeva N. Artificial intelligence in education: AIEd for personalised learning pathways. Electron J e-Learn. 2022;20:639-53.
- Hashim S, et al. Trends on technologies and artificial intelligence in education for personalized learning: systematic literature. J Acad Res Progress Educ Dev. 2022;12:884-903.
- Lin W, et al. A deep neural collaborative filtering based service recommendation method with multi-source data for smart cloud-edge collaboration applications. Tsinghua Sci Technol. 2023;29:897-910.
- Ha J, Park S. NCMD: Node2vec-based neural collaborative filtering for predicting miRNA-disease association. IEEE/ACM Trans Comput Biol Bioinform. 2022;20:1257-68.
- Nuanmeesri S, et al. Improving dropout forecasting during the COVID-19 pandemic through feature selection and multilayer perceptron neural network. Int J Inf Educ Technol. 2022;12:851-7.
- Yilmaz O, Altun AA, Koklu M. Optimizing the learning process of multi-layer perceptrons using a hybrid algorithm based on MVO and SA. Int J Ind Eng Comput. 2022;13:617-40.
- Garcia Garcia C, Salmeron Gomez R, Garcia Perez J. A review of ridge parameter selection: minimization of the mean squared error vs. mitigation of multicollinearity. Commun Stat Simul Comput. 2024;53:3686-98.
- Thongsak N, Lawson N. Bias and mean square error reduction by changing the shape of the distribution of an auxiliary variable: application to air pollution data in Nan, Thailand. Math Popul Stud. 2023;30:180-94.
- Mohammed NA, Al-Bazi A. An adaptive backpropagation algorithm for long-term electricity load forecasting. Neural Comput Appl. 2022;34:477-91.
- Wright LG, et al. Deep physical neural networks trained with backpropagation. Nature. 2022;601:549-55.
- Bhimshetty S, Ikechukwu AV. Energy-efficient deep Q-network: reinforcement learning for efficient routing protocol in wireless internet of things. Indones J Electr Eng Comput Sci. 2024;33:971-80.
- Geng X, Zhang B. Deep Q-network-based intelligent routing protocol for underwater acoustic sensor network. IEEE Sens J. 2023;23:3936-43.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.