Un marco multietapa anclado genéticamente que integra la aleatorización mendeliana, la transcriptómica tumoral y los análisis a nivel de célula individual priorizó a MAP1LC3A como un gen relacionado con la ferroptosis asociado a la susceptibilidad al glioblastoma y como candidato para validación experimental futura.
Artículo de investigación
Evidencia genética, transcriptómica y de célula única multietapa prioriza a MAP1LC3A entre los genes relacionados con la ferroptosis en el glioblastoma
34 visualizaciones
⸱
11 de septiembre de 2026
* These authors contributed equally
En este artículo
Resumen
Resumen
El glioblastoma (GBM) sigue siendo una malignidad altamente agresiva, y la contribución de los genes relacionados con la ferroptosis a la susceptibilidad de la enfermedad aún no se comprende completamente. Se aplicó un marco genéticamente anclado y multietapa para priorizar los genes relacionados con la ferroptosis asociados al GBM. De los 483 genes curados de FerrDb V2, 315 presentaron cis-eQTLs (loci cuantitativos de expresión candidatos en cis) en eQTLGen, 250 conservaron al menos tres instrumentos independientes tras el agrupamiento por desequilibrio de ligamiento, y 226 generaron estimaciones válidas de aleatorización mendeliana ponderadas por varianza inversa (IVW) utilizando un estudio de asociación del genoma completo para GBM que incluyó 6.183 casos y 18.169 controles. Treinta y cuatro genes cumplieron los criterios exploratorios de descubrimiento de P < 0,05 y una tasa de error tipo I de Benjamini–Hochberg (BH-FDR) < 0,20, con estimaciones concordantes en dirección de la aleatorización mendeliana bayesiana ponderada (BWMR). La aleatorización mendeliana en la etapa de replicación, utilizando cis-eQTLs de sangre total de GTEx V10, respaldó cuatro genes: ATG7, RPTOR, MAP1LC3A y CHMP6. La evaluación en tres cohortes transcriptómicas independientes de tumor–control demostró que MAP1LC3A estaba consistentemente subregulado en el tejido tumoral y mostró una estimación agrupada de efectos aleatorios significativa (cambio en el log₂ de expresión, −1,273; intervalo de confianza del 95 %, −1,625 a −0,920; tasa de error tipo I = 0,016), mientras que los otros tres genes carecían de apoyo estadístico comparable entre cohortes. Posteriormente, se realizó un análisis computacional de "knockout" virtual en una submuestra equilibrada por pacientes de 2.400 células malignas seleccionadas de 4.916 células elegibles procedentes de 20 tumores de GBM en adultos de tipo salvaje para IDH. En cinco ejecuciones independientes, se identificaron 3, 15, 4 y 7 genes descendientes robustos para ATG7, RPTOR, MAP1LC3A y CHMP6, respectivamente. Los conjuntos de consenso resultantes incluyeron 17 genes únicos, siendo RND3 compartido por los cuatro objetivos. El análisis de Gene Ontology indicó enriquecimiento en procesos de adhesión celular y de superficie celular, mientras que ninguna vía KEGG o Reactome permaneció significativa tras la corrección por múltiples comparaciones. En conjunto, estos hallazgos priorizan a MAP1LC3A para futuras investigaciones experimentales, al tiempo que distinguen la asociación genética, la concordancia en la expresión tumoral y la perturbación computacional de la evidencia definitiva de causalidad o mecanismo.
Introducción
El glioblastoma (GBM) sigue siendo un paradigma de malignidad refractaria al tratamiento. A pesar de la clasificación molecular cada vez más refinada y de la atención multidisciplinaria, las mejoras sostenibles en los resultados para los pacientes han sido limitadas1. En pacientes con aptitud médica, el tratamiento actual consiste en la resección quirúrgica máxima segura, seguida de radioterapia con temozolomida administrada de forma concurrente y adyuvante, un régimen establecido en un ensayo aleatorizado fundamental y mantenido en las guías clínicas contemporáneas1,2. Sin embargo, la infiltración difusa y la amplia heterogeneidad celular y molecular limitan el control sostenible de la enfermedad, y la mayoría de los pacientes finalmente experimentan progresión o recurrencia, para las cuales no existe un tratamiento estándar universalmente eficaz1,3. Esta persistente brecha entre los avances en la caracterización de la enfermedad y los resultados clínicos subraya la necesidad de identificar dependencias moleculares biológicamente relevantes que puedan orientar estrategias terapéuticas novedosas para el GBM.
La ferroptosis es una forma dependiente del hierro de muerte celular regulada, caracterizada por la peroxidación incontrolada de fosfolípidos y el fracaso de las defensas antioxidantes celulares, lo que la distingue mecanísticamente de la apoptosis y otros programas canónicos de muerte celular4,5. Este proceso es particularmente relevante en el caso del GBM, donde alteraciones genéticas y la plasticidad metabólica reconfiguran la homeostasis del hierro, el equilibrio redox y el metabolismo lipídico. Perfiles genómicos y lipidómicos integrados han demostrado que la eliminación de CDKN2A redistribuye ácidos grasos poliinsaturados oxidables, creando así una susceptibilidad a la ferroptosis dependiente del genotipo en modelos de GBM6. Asimismo, análisis emparejados de tumores primarios y recurrentes han identificado alteraciones asociadas a la recaída en GPX4, ACSL4 y otros reguladores de la ferroptosis7. También se ha demostrado que la modulación experimental de las vías de defensa contra la ferroptosis influye en la respuesta al temozolomida en células de GBM y modelos de xenoinjertos8. En conjunto, estos hallazgos identifican a la ferroptosis como una vulnerabilidad terapéutica biológicamente plausible en el GBM. Sin embargo, principalmente reflejan asociaciones con el estado tumoral o observaciones experimentales dependientes del contexto, y no establecen si la variación constitutiva en la expresión génica relacionada con la ferroptosis contribuye a la susceptibilidad hereditaria al GBM.
La mayoría de los estudios humanos que investigan la ferroptosis en glioma se han basado en análisis de expresión diferencial, modelado de supervivencia y subtipificación molecular utilizando conjuntos de datos de TCGA, CGGA y GEO9,10. Aunque estos estudios establecieron la relevancia pronóstica de los programas transcripcionales relacionados con la ferroptosis, su diseño observacional no puede determinar si la alteración en la expresión génica contribuye a la susceptibilidad del GBM o si, por el contrario, representa una consecuencia del desarrollo tumoral. Posteriormente, la aleatorización mendeliana a nivel del transcriptoma ha identificado genes regulados genéticamente y dependientes del tejido asociados con el riesgo de glioma, mientras que estudios más recientes basados en locus de rasgos cuantitativos de expresión (eQTL) y locus de rasgos cuantitativos de proteína (pQTL) han comenzado a priorizar posibles dianas terapéuticas para el GBM11,12. Sin embargo, las investigaciones previas generalmente han adoptado enfoques orientados al transcriptoma completo o centrados en dianas farmacológicas, en lugar de evaluar un conjunto preespecificado y exhaustivo de genes relacionados con la ferroptosis. Además, pocos estudios han integrado un gran estudio de asociación genómica amplia (GWAS) del GBM con una aleatorización mendeliana en etapa de replicación utilizando una fuente independiente de eQTL, seguido de una evaluación en múltiples cohortes transcriptómicas de tumor–control. Esta distinción es importante porque la regulación genética de la expresión génica varía considerablemente entre tejidos, y las asociaciones de eQTL derivadas de sangre no pueden asumirse como reflejo de los efectos reguladores dentro de tumores cerebrales11,13. Por lo tanto, se necesita un marco integrador que combine asociación genética, aleatorización mendeliana en etapa de replicación, transcriptómica tumoral transversal a cohortes y predicción funcional basada en células individuales derivadas de pacientes, para identificar genes relacionados con la ferroptosis que cuenten con evidencia convergente sobre su participación en el GBM.
Este estudio investigó si la expresión genéticamente regulada de genes relacionados con la ferroptosis se asocia con la susceptibilidad al GBM. Se combinaron análisis de aleatorización mendeliana en etapa de descubrimiento y en etapa de replicación con análisis de expresión génica en tres cohortes transcriptómicas independientes de tumores y controles. Los genes respaldados por ambas etapas de aleatorización mendeliana se evaluaron posteriormente en datos transcriptómicos de células individuales derivadas de pacientes, utilizando perturbación virtual para caracterizar las respuestas transcripcionales predichas en células malignas. En lugar de priorizar genes únicamente en función de firmas de expresión tumoral, este marco multietapa aprovechó primero la variación genética heredada y luego evaluó patrones de expresión relevantes para la enfermedad junto con perfiles computacionales de perturbación a nivel celular. La evidencia convergente resultante se utilizó para priorizar genes relacionados con la ferroptosis para futuras investigaciones experimentales en el GBM.
Protocolo
Este estudio obtuvo una exención de revisión ética por parte del Comité de Ética Médica del Primer Hospital Popular de Zhaoqing (número de referencia B2026-08-03). El estudio utilizó datos genéticos y transcriptómicos de nivel resumen, recopilados retrospectivamente y sin identificación, incluyendo datos de acceso controlado aprobados por los Comités de Acceso a Datos procedentes de EGAD00010001657 y conjuntos de datos obtenidos de GEO, eQTLGen y GTEx, de acuerdo con sus condiciones aplicables de acceso y uso. No se reclutaron nuevos participantes, no se recolectaron biospecímenes y no se accedió a datos a nivel de participante que pudieran identificarse. La aprobación ética y el consentimiento informado para los estudios originales fueron obtenidos por los generadores correspondientes de los datos, y los datos de acceso controlado se utilizaron de conformidad con el Acuerdo de Acceso a Datos aplicable.
Diseño del estudio
Este estudio empleó un marco multietapa para priorizar genes relacionados con la ferroptosis asociados a la susceptibilidad del glioblastoma (GBM) y evaluar sus efectos transcripcionales relevantes para la enfermedad (Figura 1). Primero, los genes relacionados con la ferroptosis, curados de FerrDb V2, se evaluaron mediante aleatorización mendeliana de dos muestras (MR) con datos de locus de rasgo cuantitativo de expresión en cis (cis-eQTL) y un amplio estudio de asociación del genoma completo (GWAS) para GBM. La MR ponderada por varianza inversa (IVW) sirvió como método principal de cribado, la aleatorización mendeliana bayesiana ponderada (BWMR) proporcionó una evaluación complementaria de la robustez, y se utilizó un conjunto de datos independiente de eQTL para la MR en la etapa de replicación. Segundo, los genes respaldados por los análisis genéticos se evaluaron en tres cohortes transcriptómicas independientes de tumor–control, seguidos de un metaanálisis entre cohortes. Tercero, se utilizaron datos transcriptómicos de células individuales derivados de pacientes para realizar una perturbación genética virtual en células malignas e identificar respuestas transcripcionales descendentes reproducibles. Estas respuestas se caracterizaron posteriormente mediante análisis de enriquecimiento funcional y análisis de redes compartidas. En conjunto, los análisis genéticos se diseñaron para identificar genes asociados a la susceptibilidad del GBM, mientras que los análisis transcriptómicos y de célula individual evaluaron la concordancia biológica y generaron hipótesis para validaciones experimentales posteriores.
Fuentes de datos
Los genes relacionados con la ferroptosis se obtuvieron de FerrDb V2, obteniéndose 483 genes humanos únicos con codificación proteica tras la armonización de los símbolos génicos y la eliminación de entradas duplicadas14. Se utilizaron estadísticas resumidas de cis-eQTL (loci cuantitativos de expresión en cis) de sangre total del Consorcio eQTLGen como conjunto de datos de exposición para la aleatorización mendeliana (MR) en la etapa de descubrimiento, mientras que los datos de cis-eQTL en sangre total de la versión V10 de GTEx sirvieron como conjunto de datos de exposición independiente para la MR en la etapa de replicación11,15. Las asociaciones con el resultado del glioblastoma (GBM) se obtuvieron de estadísticas resumidas de estudios de asociación del genoma completo (GWAS) con acceso controlado disponibles a través del European Genome-phenome Archive, que incluyen 6.183 casos y 18.169 controles de ascendencia europea16. La expresión tisular de los genes priorizados genéticamente se evaluó en tres cohortes independientes del Gene Expression Omnibus (GEO): GSE196533, que comprende 61 muestras de glioma grado 4 anotadas como GBM en los metadatos depositados y nueve muestras de cerebro no neoplásico; GSE4290, que incluye muestras de GBM y de cerebro no tumoral derivadas de epilepsia; y GSE116520, que contiene especímenes pareados del núcleo tumoral y peritumorales junto con controles no neoplásicos17,18,19. Se utilizaron datos de Smart-seq2 derivados de pacientes del conjunto GSE131928 para el análisis virtual de perturbación en células malignas20. Las características de los conjuntos de datos y sus respectivos roles analíticos se resumen en Tabla 1. Todos los análisis se realizaron utilizando conjuntos de datos previamente recolectados y desidentificados, para los cuales se había obtenido aprobación ética y consentimiento informado en los estudios originales.
Selección del instrumento genético y armonización de datos
Los instrumentos candidatos se restringieron a los loci de rasgos cuantitativos de expresión en cis (cis-eQTLs) asociados con la expresión génica a nivel de significancia genómica completa (P < 5 × 10⁻8). Las variantes se agruparon utilizando el panel de referencia europeo del Proyecto 1000 Genomas con un umbral de desequilibrio de ligamiento (LD) de r2 < 0,001 dentro de una ventana de 10.000 kb. Se excluyeron de los análisis primarios de aleatorización mendeliana (MR) los genes que conservaron menos de tres instrumentos independientes tras la agrupación. Dado el objetivo de cribado exploratorio, se estableció previamente un mínimo de tres instrumentos para conservar genes con apoyo escaso pero fuerte de cis-eQTLs, permitiendo al mismo tiempo la estimación mediante IVW con múltiples instrumentos. Este umbral se acompañó de una agrupación estricta por LD y filtrado por estadístico F; las estimaciones basadas únicamente en tres o cuatro instrumentos se interpretaron con cautela, y los análisis de sensibilidad se realizaron solo cuando metodológicamente era aplicable. La fuerza del instrumento se evaluó para cada variante mediante el estadístico F (F = β2/SE2), donde β y SE representan la estimación del efecto del cis-eQTL y su error estándar, respectivamente. Se excluyeron las variantes con F < 10 para minimizar el sesgo por instrumentos débiles21,22. Los conjuntos de datos de exposición y resultado se armonizaron alineando los alelos de efecto y las direcciones del efecto. Se excluyeron las variantes duplicadas, las variantes no disponibles en el conjunto de datos GWAS de GBM y las variantes con codificación alélica incompatible. Debido a que las frecuencias de los alelos de efecto no estaban disponibles para el GWAS de GBM, se eliminaron las variantes palindrómicas con orientación de cadena ambigua en lugar de inferirlas. Por la misma razón, no se realizó una prueba formal de direccionalidad de Steiger.
Los análisis de aleatorización mendeliana
Se evaluó la asociación entre la expresión génica predicha genéticamente y la susceptibilidad al GBM mediante aleatorización mendeliana de dos muestras (MR). En la etapa de descubrimiento, solo se incluyeron genes con al menos tres instrumentos independientes de locus cuantitativo de expresión cis (cis-eQTL), y el método ponderado por varianza inversa (IVW) se utilizó como enfoque analítico principal. Las estimaciones del efecto se informaron como razones de momios (OR) con intervalos de confianza del 95 % (IC) por cada unidad de aumento en la expresión génica predicha genéticamente. Para tener en cuenta las pruebas múltiples entre los genes evaluados, los valores P de IVW se ajustaron mediante el procedimiento de Benjamini–Hochberg23. Se conservaron como candidatos exploratorios los genes con P < 0,05 y una tasa de descubrimiento falso de Benjamini–Hochberg (BH-FDR) < 0,20. Se eligió este umbral de FDR relativamente permisivo para reducir la exclusión prematura de genes potencialmente relevantes durante la etapa de descubrimiento; por lo tanto, el estatus de candidato se interpretó junto con análisis posteriores, y no como evidencia confirmatoria. Posteriormente, se aplicó la aleatorización mendeliana ponderada bayesiana (BWMR) a los candidatos de la etapa de descubrimiento, utilizando los mismos instrumentos armonizados24. La concordancia entre los resultados de IVW y BWMR se evaluó según la significación estadística y la dirección del efecto. Siempre que el número de instrumentos disponibles lo permitió, se realizaron la prueba Q de Cochran, la prueba del intercepto MR-Egger, MR-PRESSO y análisis leave-one-out para evaluar la heterogeneidad, la pleiotropía horizontal, las variantes atípicas influyentes y el efecto de polimorfismos de nucleótido único (SNP) individuales22.
Se realizó la replicación en la etapa de validación mediante datos de eQTL cis en sangre total de GTEx V10. Se aplicó el método de la razón de Wald cuando solo estaba disponible un instrumento, mientras que se utilizó el método IVW para los genes con dos o más instrumentos. La replicación se definió por un valor de P < 0,05, BH-FDR < 0,20 y una dirección del efecto consistente con la estimación correspondiente en la etapa de descubrimiento. Dado que varias estimaciones de replicación de GTEx se basaron únicamente en uno o dos instrumentos, se interpretaron como evidencia de apoyo a la replicación, más que como evidencia independiente de causalidad.
Evaluación transcriptómica entre cohortes
Los cuatro genes priorizados mediante los análisis de aleatorización mendeliana (MR) en las etapas de descubrimiento y replicación se evaluaron en tres cohortes transcriptómicas independientes. Para GSE196533, los datos brutos de conteo de secuenciación de ARN se analizaron utilizando DESeq225. Se excluyeron los genes con conteos inferiores a 10 en todos los muestras excepto dos, mientras que los cuatro genes objetivo se conservaron independientemente del filtrado de expresión. Se evaluó la expresión diferencial entre 61 muestras de glioma grado 4 anotadas como GBM en los metadatos depositados y nueve muestras de cerebro no neoplásico.
Para GSE4290, se excluyeron cuatro muestras que carecían de un diagnóstico histopatológico explícito, quedando 77 muestras de GBM y 23 muestras de cerebro sin tumor. Las intensidades de la matriz procesadas se transformaron mediante log2, se normalizaron por cuantiles y se analizaron utilizando modelos lineales robustos de Bayes empírico implementados en limma26. Cuando múltiples sondas se asignaban al mismo gen, se seleccionó la sonda con la expresión media más alta en todas las muestras incluidas, independientemente de la significancia de la expresión diferencial.
GSE116520 incluyó especímenes apareados de núcleo tumoral y peritumorales de 17 pacientes, junto con ocho controles no neoplásicos. Los datos de expresión depositados, transformados logarítmicamente y normalizados por cuantiles, se analizaron utilizando limma. Las correlaciones intra-paciente entre muestras de núcleo tumoral y peritumorales se consideraron mediante bloqueo a nivel del paciente y la función duplicateCorrelation. La comparación entre núcleo tumoral y control fue la prespecificada para el metaanálisis entre cohortes, mientras que las comparaciones peritumorales y la tendencia ordenada control–peritumoral–núcleo tumoral se evaluaron por separado.
Los cambios específicos del estudio en el log2 de la razón de expresión y los errores estándar se agruparon utilizando un modelo de efectos aleatorios con verosimilitud máxima restringida y una inferencia de Hartung–Knapp, tal como se implementó en metafor. La heterogeneidad entre estudios se evaluó mediante el estadístico Q de Cochran y la I2. Los valores P agrupados para los cuatro genes diana se ajustaron utilizando el procedimiento de Benjamini–Hochberg. Se consideró un apoyo transcripcional sólido cuando la tasa de descubrimientos falsos (FDR) del metaanálisis fue < 0,05, hubo significancia del FDR a nivel de cohorte en al menos dos conjuntos de datos y la dirección de los efectos fue concordante en las tres cohortes.
Análisis virtual de eliminación a nivel de célula individual
Se utilizaron datos derivados de pacientes mediante Smart-seq2 del conjunto GSE131928 para evaluar los cuatro genes replicados por MR en células malignas. Las células malignas adultas se identificaron según las anotaciones proporcionadas en el estudio original, y se seleccionó aleatoriamente un número igual de células de cada paciente elegible para minimizar el desequilibrio en la representación de pacientes. Se realizó un silenciamiento virtual mediante scTenifoldKnk y se repitió en cinco ejecuciones independientes. Los genes con un valor de P ajustado por Benjamini–Hochberg < 0,05 en una ejecución individual se consideraron significativos. Los genes descendentes reproducidos en al menos tres de las cinco ejecuciones se definieron como el conjunto principal de consenso, mientras que para el análisis de sensibilidad se aplicó un criterio más estricto de cuatro de cinco. Estos resultados se interpretaron como predicciones computacionales de perturbación transcripcional, y no como evidencia de regulación molecular directa.
Enriquecimiento funcional y análisis de redes compartidas
Se realizó un análisis de enriquecimiento funcional utilizando genes diana específicos identificados de forma reproducible en al menos tres de cinco simulaciones virtuales de interrupción génica. El enriquecimiento de vías en Gene Ontology (GO), el Kyoto Encyclopedia of Genes and Genomes (KEGG) y Reactome se evaluó mediante pruebas hipergeométricas unilaterales, utilizando como conjunto génico de fondo los 1.004 genes incluidos en la inferencia de la red. Los valores de P se ajustaron por separado para cada base de datos de anotación utilizando el procedimiento de Benjamini–Hochberg, y se consideró estadísticamente significativo un valor de P ajustado < 0,05.
Se construyó una red bipartita para representar las relaciones entre los cuatro objetivos de eliminación génica y sus genes descendentes de consenso. Los genes asociados con múltiples objetivos se identificaron en función de su grado compartido, y se cuantificó el solapamiento entre los conjuntos de genes específicos de cada objetivo mediante recuentos de intersección y los índices de Jaccard. Las aristas de la red representan asociaciones entre perturbaciones computacionales reproducibles y no deben interpretarse como evidencia de interacciones moleculares directas.
Análisis estadístico y reproducibilidad
A menos que se indique lo contrario, las pruebas estadísticas fueron bilaterales, y los múltiples comparaciones se ajustaron mediante el procedimiento de Benjamini–Hochberg. Los criterios de significancia específicos para cada análisis se describen en las secciones correspondientes. Todos los análisis se realizaron utilizando R o Python. Los procedimientos aleatorizados utilizaron semillas predeterminadas, y el código analítico, las versiones del software y los ajustes detallados de parámetros se archivaron para garantizar la reproducibilidad. Todos los conjuntos de datos se habían recopilado previamente y se encontraban desidentificados; se obtuvo la aprobación ética y el consentimiento informado en los estudios originales.
Resultados
Selección de genes relacionados con la ferroptosis e instrumentos genéticos
Se obtuvo un total de 483 genes relacionados con la ferroptosis de FerrDb V2 (Figura 1). Entre estos, 315 genes coincidieron con el conjunto de datos eQTLGen y tenían al menos un locus candidato cis de rasgo cuantitativo de expresión (cis-eQTL). Después del agrupamiento por desequilibrio de ligamiento, 250 genes conservaron al menos tres instrumentos candidatos independientes. Tras la búsqueda del resultado-variante, la armonización de alelos y el control de calidad, 226 genes produjeron estimaciones válidas ponderadas por varianza inversa (IVW) y se incluyeron en el análisis de aleatorización mendeliana (MR) de la etapa de descubrimiento (Archivo Suplementario 1). Todos los 3.578 instrumentos conservados en el análisis de la etapa de descubrimiento tuvieron estadísticos F >10 (mínimo, 29,72; mediana, 70,76), lo que indica ausencia de sesgo por instrumentos débiles. Entre los 34 genes candidatos de la etapa de descubrimiento, el estadístico F mediano fue de 67,22, con un mínimo de 29,72.
La RM en fase de descubrimiento identifica genes relacionados con la ferroptosis asociados a la susceptibilidad al GBM
Entre los 226 genes que produjeron estimaciones válidas de IVW, 34 cumplieron con los criterios predeterminados de la etapa de descubrimiento de IVW P < 0,05 y tasa de error de descubrimiento falso de Benjamini-Hochberg (BH-FDR) < 0,20, compuestos por 19 asociaciones inversas y 15 asociaciones positivas con la susceptibilidad al GBM (Figura 2A). La evidencia estadística más fuerte se observó para RPTOR (OR = 0,809, IC del 95 % 0,737–0,887; P = 7,02 × 10⁻6; BH-FDR = 0,0012) y PLA2G6 (OR = 1,568, IC del 95 % 1,281–1,920; P = 1,08 × 10⁻5; BH-FDR = 0,0012). Las estimaciones de la aleatorización mendeliana ponderada bayesiana (BWMR) fueron nominalmente significativas y concordantes en dirección con las estimaciones de IVW para los 34 genes candidatos (Figura 2A). Las pruebas del intercepto MR-Egger no mostraron evidencia de pleiotropía horizontal direccional. La prueba Q de Cochran detectó heterogeneidad únicamente para MAP1LC3A (P = 0,043), mientras que las pruebas globales MR-PRESSO no identificaron distorsión significativa por valores atípicos entre los 33 genes evaluables. No se pudo realizar MR-PRESSO para SLC7A11 porque solo había disponibles tres instrumentos (Archivo Suplementario 1). Los análisis específicos por gen con exclusión secuencial, los gráficos de comparación de métodos y los gráficos en embudo para los cuatro genes posteriormente replicados se presentan en la Figura Suplementaria 1. Los 34 candidatos de la etapa de descubrimiento se evaluaron posteriormente utilizando un conjunto de datos independiente de eQTL. De estos, 26 tenían instrumentos suficientes para la MR en la etapa de replicación, y cuatro cumplieron con los criterios predeterminados de replicación.
La replicación independiente por MR respalda a cuatro candidatos identificados en la etapa de descubrimiento
De los 34 candidatos en la etapa de descubrimiento, 26 tenían al menos un instrumento cis-eQTL elegible en sangre total de GTEx V10 y se incluyeron en el análisis de MR en la etapa de replicación. Trece genes estaban representados por un solo instrumento y se analizaron utilizando la razón de Wald, mientras que los 13 genes restantes tenían dos o más instrumentos y se analizaron utilizando IVW. Cuatro genes cumplieron los criterios preespecificados de replicación de P < 0,05, BH-FDR < 0,20 y una dirección del efecto concordante con la estimación de la etapa de descubrimiento (Figura 2B; Archivo Suplementario 1).
Una mayor expresión predicha genéticamente de ATG7 (OR = 0,523, IC del 95 % = 0,330–0,831; P = 0,0061; BH-FDR = 0,0976), RPTOR (OR = 0,718, IC del 95 % = 0,563–0,915; P = 0,0075; BH-FDR = 0,0976) y MAP1LC3A (OR = 0,830, IC del 95 % = 0,717–0,959; P = 0,0117; BH-FDR = 0,1012) se asoció con una menor susceptibilidad al GBM. En contraste, una mayor expresión predicha genéticamente de CHMP6 se asoció con una mayor susceptibilidad (OR = 1,378, IC del 95 % = 1,032–1,838; P = 0,0295; BH-FDR = 0,1916). Las direcciones del efecto para los cuatro genes fueron consistentes con las observadas en el análisis de descubrimiento. No se detectó heterogeneidad significativa entre los genes para los cuales se pudo calcular la Q de Cochran (Archivo Suplementario 1). Dado que la mayoría de las estimaciones de replicación se basaron en solo uno o dos instrumentos, las pruebas formales de pleiotropía horizontal y distorsión por valores atípicos fueron aplicables solo a un subconjunto limitado de genes (Archivo Suplementario 1). Los gráficos diagnósticos correspondientes para MAP1LC3A, RPTOR y CHMP6 se proporcionan en la Figura Suplementaria 2. ATG7 no fue elegible para análisis diagnósticos con múltiples instrumentos porque su estimación de replicación se derivó de una razón Wald de un solo instrumento.
La evaluación transcriptómica entre cohortes prioriza MAP1LC3A
Los cuatro genes respaldados por ambos análisis de MR en las etapas de descubrimiento y replicación se evaluaron en tres cohortes transcriptómicas independientes que representan diferentes plataformas de expresión (Figura 3; Tabla 2; Figura Suplementaria 3; Archivo Suplementario 1). La expresión de MAP1LC3A se redujo consistentemente en tejido tumoral en las tres cohortes: GSE196533 (log₂FC = −1.553, FDR a nivel del transcriptoma = 3.21 × 10⁻8), GSE4290 (log₂FC = −1.243, FDR = 3.55 × 10⁻12) y GSE116520, núcleo tumoral versus control no neoplásico (log₂FC = −1.204, FDR = 9.78 × 10⁻8). En GSE116520, la expresión de MAP1LC3A también fue menor en el tejido peritumoral que en los controles no neoplásicos (log₂FC = −1.056, FDR = 2.85 × 10⁻6), con una tendencia decreciente significativa desde el control hasta el tejido peritumoral y luego al núcleo tumoral (coeficiente de tendencia = −0.531, FDR = 8.59 × 10⁻6).
El metaanálisis de efectos aleatorios confirmó una expresión significativamente menor de MAP1LC3A en el tejido tumoral (FC log₂ agrupada = −1,273, IC del 95% de −1,625 a −0,920; P de Hartung–Knapp = 0,0041; BH-FDR = 0,016), sin evidencia de heterogeneidad entre estudios (I2 = 0%; Archivo Suplementario 1). La expresión de RPTOR fue consistentemente menor en las tres cohortes y alcanzó significancia a nivel del transcriptoma en GSE4290, aunque su estimación agrupada no fue estadísticamente significativa (FC log₂ = −0,258, IC del 95% de −0,655 a 0,139; BH-FDR = 0,196; I2 = 42,3%). La expresión de CHMP6 fue consistentemente mayor en el tejido tumoral y alcanzó significancia en GSE4290, mientras que la estimación agrupada permaneció no significativa (FC log₂ = 0,150, IC del 95% de −0,130 a 0,431; BH-FDR = 0,196; I2 = 52,0%). ATG7 mostró diferencias pequeñas e inconsistentes en dirección entre cohortes y ninguna asociación agrupada significativa (FC log₂ = 0,036, IC del 95% de −0,073 a 0,146; BH-FDR = 0,291; I2 = 0%). Por lo tanto, entre los cuatro genes replicados por MR, MAP1LC3A mostró la evidencia más fuerte y consistente de expresión diferencial asociada al tumor.
La eliminación virtual a nivel de célula individual revela perturbaciones transcripcionales específicas del blanco y reproducibles
Los cuatro genes replicados por MR se evaluaron en 4.916 células malignas elegibles procedentes de 20 tumores de GBM de tipo salvaje para IDH en adultos del conjunto GSE131928. ATG7, RPTOR, MAP1LC3A y CHMP6 se detectaron en el 42,78 %, 45,89 %, 46,89 % y 31,90 % de las células malignas elegibles, respectivamente, lo que respalda su inclusión en el análisis de eliminación virtual (Supplementary Figure 4; Supplementary File 1). Para minimizar el desequilibrio en la representación de pacientes, se seleccionaron aleatoriamente 120 células de cada tumor, obteniéndose un conjunto de datos equilibrado por paciente compuesto por 2.400 células malignas. Cada gen objetivo se evaluó en cinco ejecuciones independientes, lo que dio lugar a 20 análisis de eliminación virtual.
Utilizando el criterio preespecificado de BH-FDR < 0,05 en al menos tres de cinco ejecuciones, el knockout virtual identificó tres genes descendientes robustos para ATG7, 15 para RPTOR, cuatro para MAP1LC3A y siete para CHMP6 (Figura 4A; Figura suplementaria 5). El conjunto consenso de RPTOR comprendió RND3, NKAIN4, CHI3L1, CDKN1A, BCAN, PDGFRA, OLIG1, LHFPL3, ENO2, HILPDA, LGALS3, ANXA1, CNTN1, NAMPT y SCRG1. El conjunto consenso de MAP1LC3A incluyó RND3, CD24, BCAN y S100B, mientras que los conjuntos consenso de ATG7 y CHMP6 contenían tres y siete genes, respectivamente. Aplicar el criterio de significancia más estricto en al menos cuatro de cinco ejecuciones redujo los conjuntos consenso a dos genes asociados a ATG7, nueve genes asociados a RPTOR, un gen asociado a MAP1LC3A y cuatro genes asociados a CHMP6. En conjunto, estos análisis identificaron perturbaciones transcripcionales reproducibles y específicas del blanco dentro de la red reguladora inferida de células malignas.
Los análisis de enriquecimiento funcional y de redes compartidas identifican respuestas convergentes relacionadas con la adhesión
Los cuatro conjuntos de consenso específicos para los objetivos comprendieron 17 genes descendentes únicos. El análisis de red identificó a RND3 como el único gen compartido por los cuatro knockout virtuales, mientras que BCAN, CD24 y NKAIN4 fueron compartidos cada uno por tres de los cuatro knockout virtuales. CHI3L1, LHFPL3 y PDGFRA fueron compartidos por dos objetivos, mientras que los diez genes restantes fueron específicos de un objetivo (Figura 4B,C). La mayor superposición par absoluta ocurrió entre RPTOR y CHMP6, que compartieron seis genes descendentes. Según la similitud de Jaccard, la mayor superposición proporcional se observó entre ATG7 y CHMP6 (índice de Jaccard = 0.429), seguida por RPTOR–CHMP6 y MAP1LC3A–CHMP6 (ambos 0.375).
El análisis de Ontología Genética del conjunto consenso de 17 genes agrupados identificó diez términos significativamente enriquecidos tras la corrección de Benjamini–Hochberg (Figura 4D; Figura Suplementaria 6). Los términos enriquecidos en procesos biológicos incluyeron adhesión celular (BH-FDR = 0.0028), regulación positiva de la proliferación de poblaciones celulares (BH-FDR = 0.0028), respuesta inflamatoria (BH-FDR = 0.0139), regulación positiva de la cascada ERK1/ERK2 (BH-FDR = 0.0165) y adhesión célula-célula (BH-FDR = 0.0196). Los términos significativos de componente celular incluyeron superficie celular, región extracelular, membrana plasmática y matriz extracelular, mientras que unión a carbohidratos fue el único término de función molecular significativamente enriquecido. La adhesión celular permaneció significativamente enriquecida cuando el análisis se restringió a genes compartidos por al menos dos dianas y cuando se aplicó el criterio consenso más estricto de cuatro de cinco corridas. Ninguna vía KEGG ni Reactome permaneció significativa tras la corrección BH.
El enriquecimiento específico del blanco fue más extenso para RPTOR, cuyo conjunto consenso de 15 genes se enriqueció en cuatro términos de proceso biológico y cuatro términos de componente celular (Figura Suplementaria 7). El conjunto consenso de MAP1LC3A se enriqueció en adhesión celular (BH-FDR = 8,74 × 10⁻4) y desarrollo del sistema nervioso central (BH-FDR = 0,0364), mientras que el conjunto consenso de CHMP6 se enriqueció en adhesión celular (BH-FDR = 0,0075). Ningún término de Ontología Genética alcanzó un BH-FDR < 0,05 para el conjunto consenso de tres genes de ATG7.
DISPONIBILIDAD DE LOS DATOS:
Los conjuntos de datos transcriptómicos públicos están disponibles en GEO bajo los números de acceso GSE196533, GSE4290, GSE116520 y GSE131928. Las estadísticas resumidas sobre el resultado del GBM se han depositado con acceso controlado en el Archivo Europeo de Genoma-Fenoma (EGA), conjunto de datos EGAD00010001657 (https://ega-archive.org/datasets/EGAD00010001657). El acceso es administrado por el Comité de Acceso a Datos responsable y requiere una solicitud aprobada y un Acuerdo de Acceso a Datos. Según el acuerdo aplicable, los autores no están autorizados a redistribuir los archivos ni a depositarlos en un repositorio público. Los datos resumidos de eQTL están disponibles a través del Consorcio eQTLGen y de GTEx, según sus respectivas condiciones de acceso y uso. Los guiones de análisis que respaldan este estudio se proporcionan como Archivo de Código Suplementario 1 y Archivo de Código Suplementario 2.
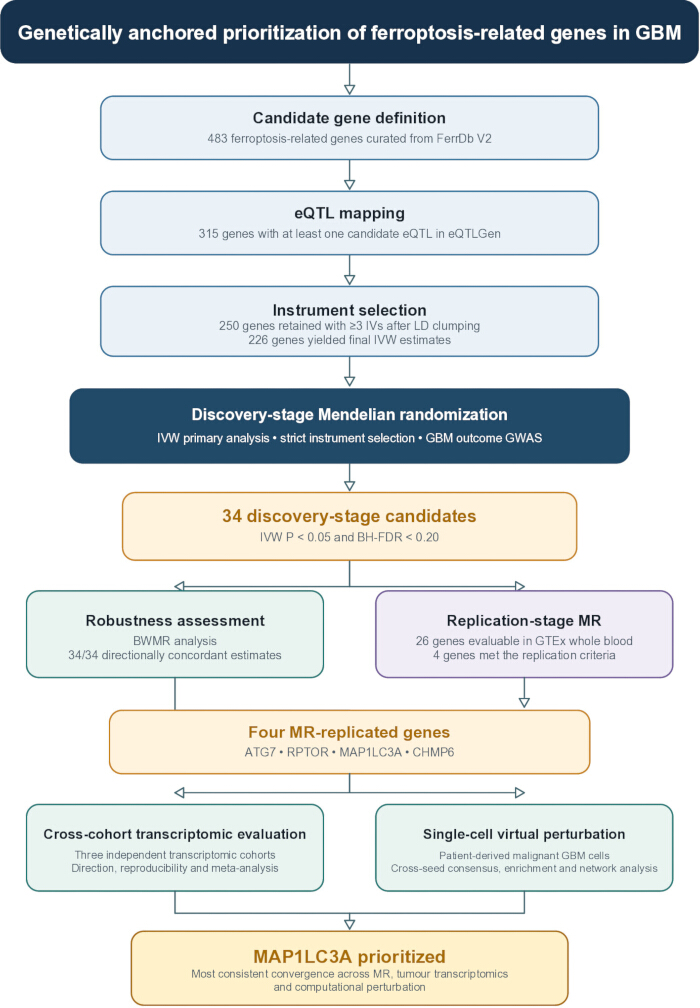
Figura 1: Diseño del estudio y marco de integración de evidencias para la priorización genéticamente anclada de genes relacionados con la ferroptosis en glioblastoma. Los genes relacionados con la ferroptosis, curados a partir de FerrDb V2, se mapearon en eQTLGen, se analizaron para identificar instrumentos independientes de locus cuantitativo de rasgo de expresión cis (cis-eQTL) y se evaluaron mediante aleatorización mendeliana (MR) en la etapa de descubrimiento. De los 483 genes curados, 315 tenían al menos un cis-eQTL candidato, 250 conservaron al menos tres instrumentos independientes tras el agrupamiento por desequilibrio de ligamiento (LD), y 226 produjeron estimaciones válidas ponderadas por varianza inversa (IVW) tras la búsqueda del resultado por variante y la armonización de alelos. Treinta y cuatro genes cumplieron los criterios de la etapa de descubrimiento, tras lo cual se utilizó la aleatorización mendeliana ponderada bayesiana (BWMR) para evaluar la robustez. Posteriormente, se evaluaron 26 genes en la etapa de replicación mediante MR utilizando cis-eQTLs de sangre total de GTEx V10. Cuatro genes (ATG7, RPTOR, MAP1LC3A y CHMP6) cumplieron los criterios de replicación y se evaluaron adicionalmente en tres cohortes transcriptómicas independientes y mediante perturbación virtual en células malignas derivadas de pacientes. La integración de estos análisis complementarios priorizó MAP1LC3A para investigaciones posteriores. BWMR = aleatorización mendeliana ponderada bayesiana; eQTL = locus cuantitativo de rasgo de expresión; IVW = ponderado por varianza inversa; LD = desequilibrio de ligamiento; MR = aleatorización mendeliana. Haga clic aquí para ver una versión ampliada de esta figura.
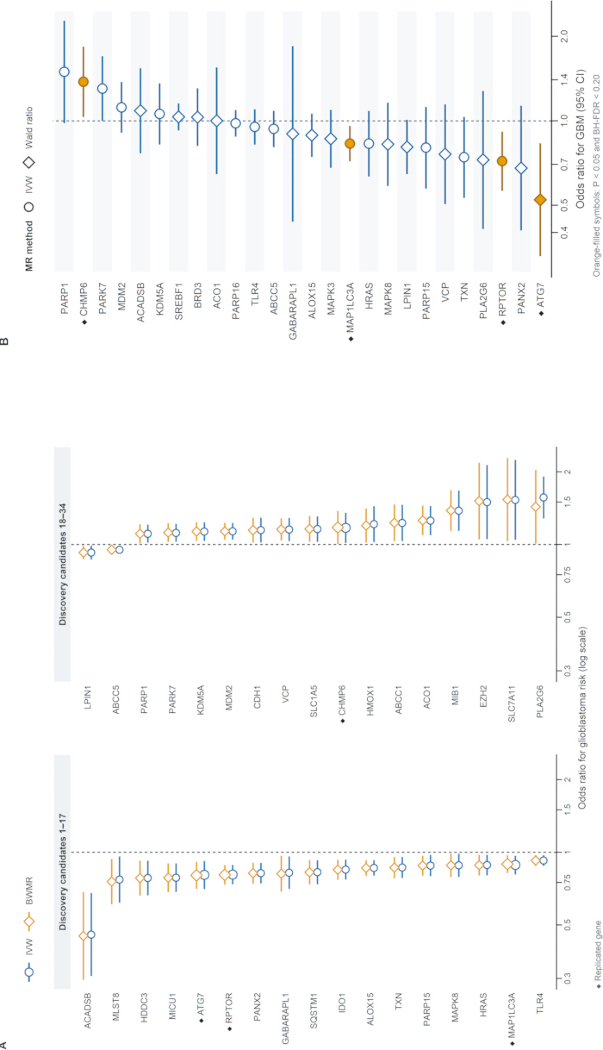
Figura 2: Robustez en la etapa de descubrimiento y replicación independiente de los efectos de genes relacionados con la ferroptosis predichos genéticamente sobre el riesgo de glioblastoma. (A) Gráficos forestales emparejados que comparan las estimaciones ponderadas por varianza inversa (IVW) y las estimaciones de aleatorización mendeliana ponderadas bayesianas (BWMR) para los 34 genes que cumplieron con los criterios de la etapa de descubrimiento: IVW P < 0,05 y tasa de error de descubrimiento falso de Benjamini–Hochberg (BH-FDR) < 0,20. Los cuadrados antes de los nombres de los genes indican aquellos que posteriormente fueron respaldados en el análisis de replicación independiente. El triángulo identifica a LPIN1, para el cual las estimaciones IVW y BWMR mostraron direcciones de efecto discordantes. (B) Gráfico forestal de los 26 genes evaluados en el conjunto de datos de replicación. Se muestran estimaciones IVW para genes con al menos dos instrumentos, mientras que se muestran estimaciones de razón Wald para genes con un solo instrumento. Los símbolos rellenos de naranja identifican a ATG7, RPTOR, MAP1LC3A y CHMP6, que cumplieron con los criterios de replicación (P < 0,05 y BH-FDR < 0,20). Los puntos y líneas horizontales representan las razones de momios (OR) e intervalos de confianza del 95% (IC), respectivamente; la línea vertical punteada indica OR = 1. Las OR se muestran en escala logarítmica. GBM = glioblastoma. Haga clic aquí para ver una versión más grande de esta figura.
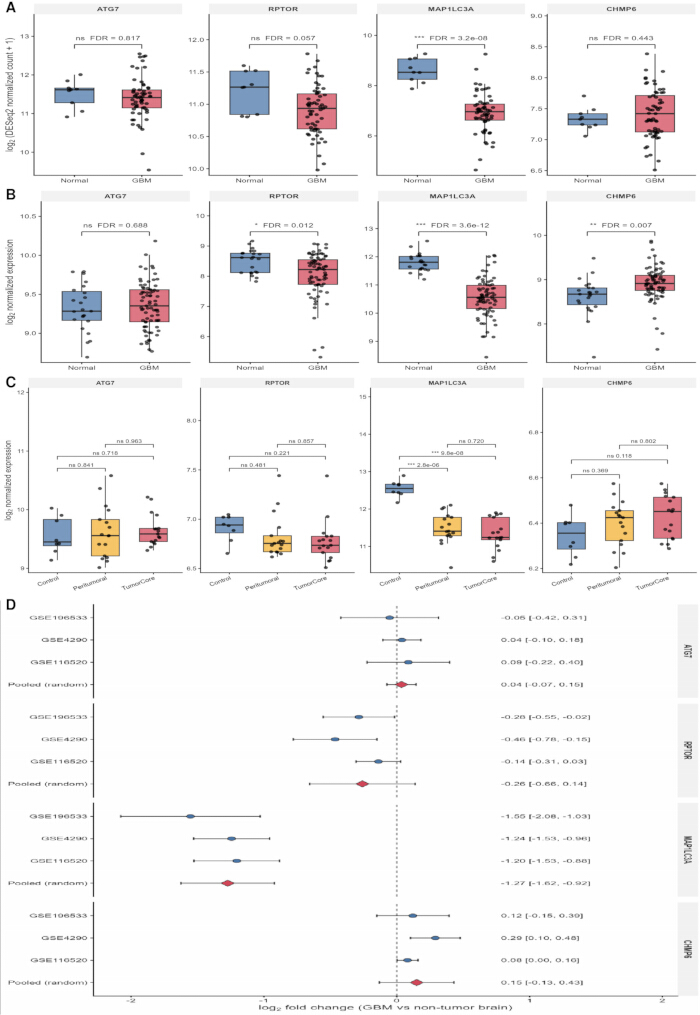
Figura 3: Evaluación transcriptómica cruzada de cohortes de los cuatro genes replicados por MR. Expresión de ATG7, RPTOR, MAP1LC3A y CHMP6 en GSE196533 (61 especímenes de glioma grado 4 anotados como GBM en los metadatos depositados y nueve especímenes de cerebro no neoplásico); (A) GSE4290 (77 GBM y 23 especímenes de cerebro sin tumor); (B) y GSE116520 (17 especímenes del núcleo tumoral, 17 especímenes peritumorales emparejados por paciente y ocho especímenes de control no neoplásicos); (C) Las cajas indican la mediana y el rango intercuartílico (RIC), los bigotes se extienden hasta 1,5 × RIC, y los puntos representan muestras individuales. (D) Cambios específicos del estudio en el log₂ y metaanálisis de efectos aleatorios que comparan tejido tumoral o del núcleo tumoral con tejido cerebral no neoplásico. Los puntos y las líneas horizontales indican estimaciones específicas del estudio e intervalos de confianza del 95 %, mientras que los rombos representan estimaciones agrupadas de máxima verosimilitud restringida con inferencia de Hartung–Knapp. Los valores positivos indican una expresión mayor en el tejido tumoral. FDR = tasa de falsos descubrimientos; GBM = glioblastoma; MR = aleatorización mendeliana. Haga clic aquí para ver una versión más grande de esta figura.
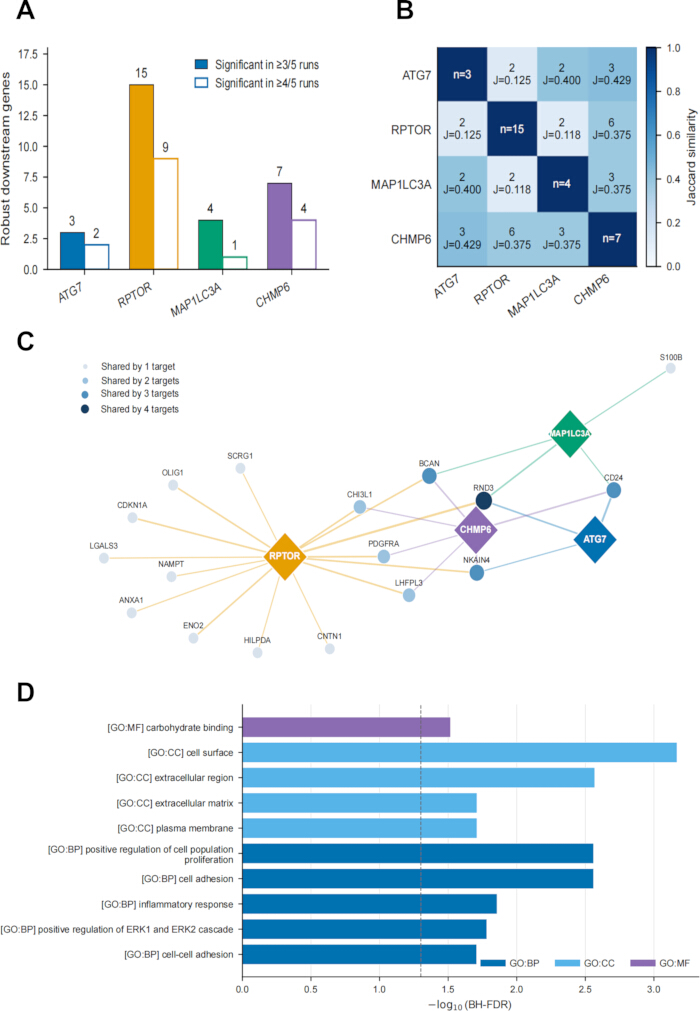
Figura 4: Consenso cruzado y convergencia funcional de los silenciamientos virtuales a nivel de célula individual en células de glioblastoma maligno. (A) Número de genes descendientes robustos identificados para cada blanco utilizando el criterio preespecificado de significancia en al menos tres de cinco ejecuciones y el criterio más estricto de sensibilidad en cuatro de cinco ejecuciones. (B) Superposición por pares de genes descendientes robustos; las celdas indican los recuentos de superposición y los coeficientes de similitud de Jaccard. (C) Red bipartita que conecta los cuatro blancos de silenciamiento virtual (diamantes) con los genes descendientes robustos (círculos). Los colores de las líneas indican el blanco perturbado, mientras que el tamaño del círculo y la intensidad del color indican el número de blancos que comparten cada respuesta descendiente. Las líneas representan asociaciones entre perturbaciones computacionales reproducibles, no interacciones moleculares directas. (D) Enriquecimiento significativo en Ontología Genética (Gene Ontology) del conjunto consenso agrupado de 17 genes. La longitud de las barras representa −log10(BH-FDR); la línea punteada indica el umbral de significancia (BH-FDR = 0,05); los colores indican proceso biológico (BP), componente celular (CC) y función molecular (MF). El análisis de enriquecimiento funcional utilizó el fondo de la red reguladora balanceada por pacientes compuesta por 1.004 genes. Ninguna vía KEGG ni Reactome permaneció significativa tras la corrección de Benjamini–Hochberg. Abreviaturas: BH-FDR = tasa de falsos descubrimientos de Benjamini–Hochberg; BP = proceso biológico; CC = componente celular; GO = Ontología Genética; KEGG = Enciclopedia de Kioto de Genes y Genomas; MF = función molecular. Haga clic aquí para ver una versión más grande de esta figura.
Tabla 1: Resumen de las fuentes de datos y sus funciones analíticas en el estudio. Los conteos de muestras representan las observaciones incluidas en los análisis presentes. BH-FDR = tasa de descubrimientos falsos de Benjamini-Hochberg; cis-eQTL = locus cuantitativo de rasgo de expresión en cis; EGA = Archivo Europeo de Genoma-Fenoma; GBM = glioblastoma; GTEx = Expresión Genotipo-Tejido; GWAS = estudio de asociación del genoma completo; IV = variable instrumental; MR = aleatorización mendeliana; RNA-seq = secuenciación de RNA. Haga clic aquí para descargar esta tabla.
Tabla 2: Evidencia transcriptómica entre cohortes para los cuatro genes replicados por MR. Los valores representan cambios en el índice log₂ para tejido de GBM o del núcleo tumoral en relación con tejido cerebral no neoplásico. Las estimaciones agrupadas se obtuvieron mediante modelos de efectos aleatorios con máxima verosimilitud restringida y con inferencia de Hartung–Knapp. CI = intervalo de confianza; FDR = tasa de descubrimientos falsos. Haga clic aquí para descargar esta tabla.
Figura suplementaria 1: Análisis de sensibilidad en la etapa de descubrimiento mediante aleatorización mendeliana para los cuatro genes replicados. MAP1LC3A, ATG7, RPTOR y CHMP6 se presentan cada uno de la siguiente manera: (A) análisis de exclusión secuencial; (B) gráfico de dispersión comparativo entre métodos; y (C) gráfico en embudo.Haga clic aquí para descargar este archivo.
Figura suplementaria 2: Gráficos diagnósticos de aleatorización mendeliana por etapa de replicación para los tres genes replicados con múltiples instrumentos. MAP1LC3A, RPTOR y CHMP6 se presentan cada uno de la siguiente manera: (A) gráfico de dispersión de comparación de métodos; y (B) gráfico en embudo. ATG7 se estimó utilizando una razón Wald de un solo instrumento y, por lo tanto, no fue elegible para gráficos diagnósticos de múltiples instrumentos.Haga clic aquí para descargar este archivo.
Figura suplementaria 3: Análisis de componentes principales de las tres cohortes transcriptómicas independientes. (A) Cohorte de secuenciación de ARN GSE196533. (B) Cohorte Affymetrix GPL570 GSE4290. (C) Cohorte Illumina GPL10558 GSE116520. El análisis de componentes principales se realizó utilizando los 500 genes o sondas con la mayor varianza dentro de cada cohorte. Cada punto representa una muestra biológica; los colores indican los grupos de tejidos; y las etiquetas de los ejes indican la varianza explicada por cada componente principal.Haga clic aquí para descargar este archivo.
Figura suplementaria 4: Detectabilidad de los cuatro genes replicados por MR en células malignas de GBM adulto. (A) Tasas generales de detección de ATG7, RPTOR, MAP1LC3A y CHMP6 entre 4.916 células malignas procedentes de 20 tumores de GBM de tipo salvaje para IDH en adultos en GSE131928/SCP393.B) Tasas de detección a nivel del paciente para los mismos genes. El color indica el porcentaje de células malignas con TPM > 0.Haga clic aquí para descargar este archivo.
Figura suplementaria 5: Reproducibilidad del cruzamiento de semillas en las señales descendentes de eliminación virtual. (A) Número de genes descendentes significativos según BH-FDR identificados en cinco ejecuciones independientes para cada blanco. Los puntos representan semillas aleatorias y las barras horizontales indican las medianas. (B) Genes descendentes significativos en al menos tres de las cinco ejecuciones. El eje x muestra el número de ejecuciones significativas, los colores identifican el blanco perturbado y el tamaño de los puntos representa la estadística Z mediana de scTenifoldKnk. El gen blanco en sí fue excluido.Haga clic aquí para descargar este archivo.
Figura suplementaria 6: Análisis de sensibilidad de enriquecimiento agrupado, compartido y con umbral estricto. Enriquecimiento funcional de (A) el consenso agrupado definido por significancia en al menos tres de cinco ejecuciones; (B) genes compartidos por al menos dos objetivos según el criterio de tres de cinco; (C) el consenso agrupado estricto definido por significancia en al menos cuatro de cinco ejecuciones; y (D) genes compartidos por al menos dos objetivos según el criterio de cuatro de cinco. El eje x muestra −log₁₀(P nominal), el tamaño de los puntos refleja el recuento de superposición, y los colores indican la base de datos de anotaciones. Los puntos rellenos alcanzaron BH-FDR < 0,05, mientras que los puntos vacíos denotan términos exploratorios con P nominal < 0,05. Se utilizó como fondo una red reguladora de 1.004 genes.Haga clic aquí para descargar este archivo.
Figura suplementaria 7: Enriquecimiento funcional específico del blanco de respuestas robustas de silenciamiento virtual Enriquecimiento de genes descendentes robustos tras el corte virtual de (AATG7 (BRPTOR; (C) MAP1LC3A; y (D) CHMP6. El eje x muestra −log₁₀(nominal P), el tamaño del punto refleja el recuento de superposición, y los colores indican GO: BP, GO: CC, GO: MF, KEGG o Reactome. Los puntos rellenos alcanzaron BH-FDR < 0,05, mientras que los puntos abiertos indican términos exploratorios con valores nominales P < 0.05. Los 1.004 genes que componen la red reguladora equilibrada del paciente sirvieron como fondo de enriquecimiento.Haga clic aquí para descargar este archivo.
Archivo suplementario 1: Tablas suplementarias que respaldan la priorización multietapa de genes relacionados con la ferroptosis asociados a la susceptibilidad del glioblastoma. Este archivo suplementario contiene todas las tablas suplementarias que respaldan los análisis genéticos, transcriptómicos y de célula individual. Incluye la selección y cribado de genes relacionados con la ferroptosis e instrumentos genéticos; resultados completos de la aleatorización mendeliana en las etapas de descubrimiento y replicación junto con análisis de sensibilidad, incluyendo evaluaciones de heterogeneidad, pleiotropía horizontal y MR-PRESSO; características de las cohortes, análisis de expresión diferencial y metaanálisis entre cohortes de genes priorizados genéticamente; así como los análisis de eliminación virtual en células individuales, evaluaciones de reproducibilidad, análisis de enriquecimiento funcional y resultados de redes compartidas.Haga clic aquí para descargar este archivo.
Archivo de código suplementario 1: Secuencias de comandos en R y Python utilizadas para el análisis de aleatorización mendeliana, transcriptómico, de eliminación virtual en células individuales, de enriquecimiento funcional y de redes descritos en este estudio.Haga clic aquí para descargar este archivo.
Archivo de código suplementario 2: Scripts de análisis complementarios, rutinas de graficación y utilidades de flujo de trabajo utilizadas para generar los resultados del estudio, las figuras y los productos suplementarios.Haga clic aquí para descargar este archivo.
Discusión
Este estudio integró asociación genética, aleatorización mendeliana (MR) en etapa de replicación, transcriptómica tumoral y modelado de células individuales derivadas de pacientes para priorizar genes relacionados con la ferroptosis asociados a la susceptibilidad del glioblastoma (GBM). El tamizado de 483 genes curados frente a un estudio de asociación del genoma completo (GWAS) de GBM, que incluyó 6.183 casos y 18.169 controles, identificó 34 candidatos en la etapa de descubrimiento, cuatro de los cuales—ATG7, RPTOR, MAP1LC3A y CHMP6—fueron respaldados en el análisis de replicación mediante un recurso independiente de locus de rasgo cuantitativo de expresión (eQTL). La evidencia se volvió progresivamente más selectiva más allá de los análisis genéticos. MAP1LC3A mostró una regulación descendente constante en tres cohortes tumorales independientes y permaneció significativo en el metaanálisis cruzado de cohortes. Este patrón de expresión tumoral complementó la asociación protectora observada en los análisis de MR, aunque ambos enfoques abordan aspectos distintos de la biología de la enfermedad. RPTOR y CHMP6 mostraron evidencia transcriptómica con dirección consistente pero menos concluyente, mientras que ATG7 careció de respaldo reproducible a nivel tisular. La eliminación virtual reveló además respuestas transcripcionales específicas del blanco, pero parcialmente superpuestas, en células malignas. En conjunto, estas capas analíticas sucesivas refinaron los hallazgos iniciales de MR al distinguir candidatos con distintos grados de respaldo relevante para la enfermedad, destacándose MAP1LC3A como el candidato más sólido en general.
Gran parte de las evidencias humanas existentes que vinculan la ferroptosis con el glioma se han obtenido a partir de estudios de expresión tumoral. Análisis de TCGA, CGGA y otras cohortes públicas han identificado repetidamente firmas relacionadas con la ferroptosis asociadas con la supervivencia, el grado tumoral, las características moleculares y las características inmunitarias9,27. Aunque estos estudios establecieron la relevancia clínica de los programas transcripcionales relacionados con la ferroptosis, los perfiles de expresión obtenidos de tumores establecidos no pueden distinguir entre genes asociados con la susceptibilidad y cambios transcripcionales que surgen durante la progresión tumoral o que reflejan diferencias en la composición celular. Los análisis genéticos proporcionan una perspectiva complementaria. Robinson y colegas integraron datos de GWAS de glioma con conjuntos de datos de eQTL de cerebro y sangre total mediante MR y colocalización, priorizando genes de susceptibilidad putativos con efectos dependientes del tejido y demostrando una concordancia limitada entre las estimaciones derivadas de sangre y cerebro11. Más recientemente, un estudio integrador basado en MR mediante eQTL y pQTL combinó evidencia genética con análisis de expresión diferencial y colocalización para priorizar GPX7 y CXCL10 para una evaluación adicional en GBM12. En contraste, el presente estudio comenzó con un conjunto de genes predefinido relacionado con la ferroptosis y evaluó candidatos priorizados genéticamente mediante MR en etapa de replicación, transcriptómica tumoral y perturbación computacional resuelta a nivel celular. La refinación progresiva desde 34 asociaciones en la etapa de descubrimiento hasta cuatro genes replicados, y finalmente hasta MAP1LC3A como el único gen que mostró expresión diferencial estadísticamente significativa entre cohortes, ilustra el valor discriminatorio de integrar múltiples enfoques analíticos complementarios. Es importante destacar que los análisis transcriptómicos no tenían como objetivo validar los instrumentos genéticos derivados de sangre, sino determinar si los genes priorizados genéticamente también exhibían patrones de expresión reproducibles y relevantes para la enfermedad.
MAP1LC3A es de especial interés porque los hallazgos actuales amplían su caracterización previa como marcador asociado al tumor y pronóstico. Un estudio bioinformático previo con múltiples cohortes incorporó MAP1LC3A en una firma de seis genes relacionada con la supervivencia y recurrencia del GBM, y también informó de una metilación alterada de MAP1LC3A, aunque su contribución a la susceptibilidad de la enfermedad permanecía sin resolver28. Aquí, una expresión genéticamente predicha más alta de MAP1LC3A se asoció consistentemente con una menor susceptibilidad al GBM en ambas etapas de MR. Además, MAP1LC3A se encontró reprimido de forma reproducible en tres cohortes tumorales independientes a pesar de las diferencias en plataformas de expresión, composiciones de muestras y metodologías analíticas, y la estimación del metaanálisis agrupado no mostró heterogeneidad detectable entre estudios. Aunque estos hallazgos no establecen que la reducción en la expresión de MAP1LC3A inicie el GBM, proporcionan evidencia más sólida sobre la relación del gen con la susceptibilidad a la enfermedad que los análisis de expresión diferencial en tumores por sí solos. MAP1LC3A codifica isoformas LC3A dentro de la familia proteica mamífera ATG8. Bai y colaboradores demostraron que la variante 1 de LC3A sufre conjugación con fosfatidiletanolamina para generar LC3A-II y se localiza en autofagosomas durante la autofagia inducida29. También se ha demostrado que el recambio autofágico de ferritina influye en la sensibilidad a la ferroptosis en células de GBM, incluyendo condiciones de privación de cisteína y en modelos dependientes de ALDH1A330,31. Sin embargo, estos estudios examinaron principalmente LC3-II total o LC3B, más que MAP1LC3A específicamente. En los actuales análisis a nivel de célula individual, la perturbación virtual de MAP1LC3A produjo respuestas descendentes reproducibles, enriquecidas en procesos relacionados con la adhesión celular. En conjunto, estas observaciones identifican a MAP1LC3A como un candidato específico para investigar cómo se interrelacionan en el GBM la regulación asociada a la autofagia, la susceptibilidad a la ferroptosis y el comportamiento de las células malignas.
Los genes restantes replicados por MR recibieron niveles variables de respaldo en los análisis posteriores. Una expresión de RPTOR genéticamente predicha más alta se asoció con una menor susceptibilidad al GBM en ambas etapas de MR, y su expresión fue consistentemente más baja en los tres cohortes de tumores, aunque la estimación agrupada no alcanzó significancia estadística. La eliminación virtual de RPTOR produjo el conjunto más amplio de cambios transcriptómicos reproductibles en la expresión génica, con enriquecimiento en vías relacionadas con la señalización de ERK, respuestas inflamatorias, proliferación celular y adhesión celular. Aunque estos hallazgos son coherentes con el papel establecido de RPTOR como andamio de mTORC1, la magnitud de la respuesta transcripcional no debe interpretarse como evidencia de un efecto causal más fuerte32. CHMP6 mostró asimismo asociaciones concordantes en ambas etapas de MR, con una expresión genéticamente predicha más alta asociada a una mayor susceptibilidad al GBM. Aunque la expresión de CHMP6 estuvo consistentemente elevada en los tres cohortes de tumores, el intervalo de confianza agrupado incluyó el valor nulo y la heterogeneidad entre estudios fue moderada. Evidencia experimental que demuestra que la reparación de membranas mediada por CHMP6 y el complejo ESCRT-III suprime la muerte celular ferroptótica proporciona un contexto mecanicista plausible, aunque estos hallazgos se obtuvieron fuera de modelos de GBM33. En contraste, ATG7 mostró una asociación genética protectora replicada, pero sin un patrón reproductible de expresión en tumores. La eliminación virtual identificó únicamente tres genes descendentes robustos, y ninguna categoría funcional permaneció significativa tras la corrección por múltiples pruebas. Estudios experimentales previos han implicado la autofagia dependiente de ATG7 en la adaptación del GBM y en la respuesta al tratamiento34,35, pero estas observaciones no resuelven el respaldo cruzado relativamente débil observado aquí. Por consiguiente, RPTOR, CHMP6 y ATG7 permanecen como candidatos secundarios plausibles, mientras que MAP1LC3A mostró la mayor convergencia entre los análisis genéticos, transcriptómicos y de perturbación computacional.
Los análisis de perturbación virtual no identificaron una única vía descendente compartida por los cuatro genes prioritarios. En cambio, las respuestas transcripcionales reproducibles mostraron solo una superposición parcial, con RND3 como el único gen descendente compartido por las cuatro redes específicas para cada diana. La convergencia funcional más clara implicó procesos de adhesión celular y procesos extracelulares o de la superficie celular, y el enriquecimiento en adhesión celular se mantuvo significativo bajo el criterio más estricto de cruce entre semillas. Ninguna vía de KEGG ni de Reactome se mantuvo significativa tras la corrección por pruebas múltiples. Esta observación es notable porque, aunque los genes candidatos se seleccionaron a partir de un conjunto curado de genes relacionados con la ferroptosis, sus efectos descendentes predichos en células malignas de GBM no estuvieron dominados por vías canónicas de ferroptosis. Más bien, su contribución a la susceptibilidad del GBM podría implicar procesos celulares más amplios dentro de los cuales opera la maquinaria relacionada con la ferroptosis. Los análisis presentes no establecen un mecanismo molecular compartido ni identifican a RND3 como un mediador causal. En cambio, destacan un número limitado de programas en células malignas, particularmente aquellos relacionados con la adhesión celular, que merecen futuras investigaciones experimentales.
Este estudio debe interpretarse como un marco de priorización por etapas, y no como una asignación definitiva de genes causales. Ninguna capa analítica individual se consideró concluyente; en cambio, las asociaciones identificadas en la etapa de descubrimiento se evaluaron sucesivamente mediante BWMR, un recurso independiente de eQTL, tres cohortes transcriptómicas y un modelo computacional de regulación en células malignas derivadas de pacientes. Deben reconocerse varias limitaciones. Primero, el umbral de descubrimiento BH-FDR de < 0,20 se estableció para la selección de candidatos y no para inferencia confirmatoria, y solo 26 de los 34 candidatos identificados en la etapa de descubrimiento pudieron evaluarse en la replicación. Segundo, varios genes estuvieron representados por relativamente pocos instrumentos genéticos, y no se realizaron análisis formales de potencia a nivel gen; por consiguiente, las asociaciones débiles o nulas deben interpretarse con cautela. El umbral de elegibilidad de tres instrumentos aumentó la cobertura genética, pero limitó el rango y la estabilidad de los análisis de sensibilidad para los genes representados únicamente por tres o cuatro variantes. Aunque todos los instrumentos conservados en la etapa de descubrimiento superaron el umbral convencional F > 10 y los candidatos se evaluaron adicionalmente mediante BWMR y replicación independiente, estas medidas de seguridad no compensan completamente la escasez de instrumentos; por lo tanto, estas estimaciones deben considerarse exploratorias. Tercero, ambos recursos de eQTL se derivaron de sangre total y podrían no reflejar con precisión los efectos reguladores específicos del cerebro o del tumor. Cuarto, las estadísticas resumidas del GWAS de GBM disponibles carecían de la información necesaria para realizar pruebas de direccionalidad de Steiger y análisis formales de colocalización. En consecuencia, aún no se sabe si las señales de asociación de eQTL y GBM en cada locus provienen del mismo variant causal o de variantes distintos en desequilibrio de ligamiento. Aunque BWMR está diseñado para manejar la pleiotropía horizontal generalizada y los instrumentos atípicos, la concordancia entre IVW y BWMR no puede descartar la pleiotropía residual ni sustituir a los análisis formales de colocalización. Además, las cohortes transcriptómicas evaluaron tumores ya establecidos y no la susceptibilidad a la enfermedad, y una de las cohortes consistió en muestras de glioma grado 4 y no exclusivamente en GBM de tipo salvaje para IDH. Finalmente, los análisis de célula única se limitaron a células malignas de un único conjunto de datos y modelaron computacionalmente la perturbación reguladora en lugar de hacerlo experimentalmente; no evaluaron células no malignas dentro del microambiente tumoral ni reprodujeron directamente la perturbación génica in vitro o in vivo. Por consiguiente, las variantes causales subyacentes, los mecanismos específicos por tipo celular y las consecuencias biológicas aún deben establecerse.
Entre los cuatro genes replicados, MAP1LC3A mostró el respaldo más consistente en los análisis genéticos, transcriptómicos y de célula individual. RPTOR, CHMP6 y ATG7 conservaron evidencia de los análisis de MR en dos etapas, pero mostraron un respaldo menos consistente en los análisis transcriptómicos y de perturbación posteriores. Por lo tanto, MAP1LC3A debe considerarse un candidato prioritario para investigaciones futuras, más que un gen causal establecido o un objetivo terapéutico. Los estudios futuros deberían determinar primero si las señales de eQTL y de asociación con GBM se colocalizan, utilizando conjuntos completos de datos a nivel del locus junto con recursos reguladores específicos del cerebro o del tumor. Posteriormente, estudios de perturbación bidireccional en modelos de GBM derivados de pacientes podrían examinar la sensibilidad a la ferroptosis, la peroxidación lipídica, la supervivencia celular y los programas transcripcionales relacionados con la adhesión identificados mediante los análisis computacionales. Dichos experimentos serán necesarios para distinguir los efectos sobre la susceptibilidad heredada a la enfermedad de aquellos que influyen en el comportamiento de las células tumorales ya establecidas, y para probar directamente las asociaciones convergentes identificadas en este estudio.
Divulgaciones
Los autores declaran que no tienen intereses en conflicto.
Agradecimientos
Los autores agradecen al equipo de Genómica del Cáncer del Instituto de Investigación del Cáncer por proporcionar acceso a las estadísticas resumidas del estudio de asociación del genoma completo (GWAS) de glioma a través del Archivo Europeo de Genoma-Fenoma (conjunto de datos EGAD00010001657). La generación original de estos datos fue financiada por Cancer Research UK, incluyendo el Fondo Bobby Moore, el Wellcome Trust y el DJ Fielding Medical Research Trust (C1298/A8362).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| BWMR | Paquete R | BWMR | Randomización mendeliana bayesiana ponderada |
| DESeq2 | Bioconductor | Versión 1.46.0 | Análisis de expresión diferencial de secuenciación de ARN |
| FerrDb V2 | FerrDb | Versión 2 | Fuente de 483 genes relacionados con la ferroptosis curados |
| Microarreglo masivo de glioblastoma | NCBI Gene Expression Omnibus | GSE4290 | Cohorte de evaluación transcriptómica |
| Estadísticas resumidas de GWAS de glioblastoma | Archivo Europeo de Genoma-Fenoma | EGAD00010001657 | Datos de resultado con acceso controlado; 6.183 casos y 18.169 controles |
| Secuenciación de ARN de una sola célula Smart-seq2 de glioblastoma | NCBI Gene Expression Omnibus | GSE131928 | Análisis de eliminación virtual en células malignas |
| Secuenciación masiva de ARN de glioma grado 4 | NCBI Gene Expression Omnibus | GSE196533 | Cohorte de evaluación transcriptómica |
| Estadísticas resumidas de cis-eQTL de sangre entera de GTEx | Proyecto Genotipo-Expresión Tisular | GTEx V10 | Datos de exposición en etapa de replicación |
| limma | Bioconductor | Versión 3.62.2 | Análisis de expresión diferencial de microarreglos |
| metafor | Paquete R | Versión 4.8-0 | Metanálisis de efectos aleatorios |
| R | Foundation R para la Computación Estadística | Versión 4.4.2 | Ambiente de computación estadística |
| scTenifoldKnk | Paquete R | Versión 1.0.3 | Análisis de eliminación virtual a nivel de célula individual |
| Microarreglo masivo de zona central del tumor y tejido peritumoral | NCBI Gene Expression Omnibus | GSE116520 | Cohorte de evaluación transcriptómica |
| TwoSampleMR | Paquete R | Versión 0.6.29 | Randomización mendeliana de dos muestras |
| Estadísticas resumidas de cis-eQTL de sangre entera | Consortium eQTLGen | eQTLGen | Datos de exposición en etapa de descubrimiento |
Referencias
- Weller M, et al. EANO guidelines on the diagnosis and treatment of diffuse gliomas of adulthood. Nat Rev Clin Oncol. 2021;18:170-186.
- Stupp R, et al. Radiotherapy plus concomitant and adjuvant temozolomide for glioblastoma. N Engl J Med. 2005;352:987-996.
- McBain C, et al. Treatment options for progression or recurrence of glioblastoma: a network meta-analysis. Cochrane Database Syst Rev. 2021;5:CD013579.
- Dixon SJ, et al. Ferroptosis: an iron-dependent form of nonapoptotic cell death. Cell. 2012;149:1060-1072.
- Stockwell BR, et al. Ferroptosis: A regulated cell death nexus linking metabolism, redox biology, and disease. Cell. 2017;171:273-285.
- Minami JK, et al. CDKN2A deletion remodels lipid metabolism, priming glioblastoma for ferroptosis. Cancer Cell. 2023;41:1048-1060.e1049.
- Kram H, et al. Glioblastoma relapses show increased markers of vulnerability to ferroptosis. Front Oncol. 2022;12:841418.
- Miao Z, et al. A targetable PRR11-DHODH axis drives ferroptosis- and temozolomide-resistance in glioblastoma. Redox Biol. 2024;73:103220.
- Liu HJ, et al. Ferroptosis-related gene signature predicts glioma cell death and glioma patient progression. Front Cell Dev Biol. 2020;8:538.
- Dong J, et al. Ferroptosis-related gene contributes to immunity, stemness, and predicts prognosis in glioblastoma multiforme. Front Neurol. 2022;13:829926.
- Robinson JW, et al. Transcriptome-wide Mendelian randomization study prioritizing novel tissue-dependent genes for glioma susceptibility. Sci Rep. 2021;11:2329.
- Zhang H, Wang Z, Qiao X, Wu J, Cheng C. Investigating potential drug targets for the treatment of glioblastoma: a Mendelian randomization study. BMC Cancer. 2025;25:654.
- GTEx Consortium. The GTEx Consortium atlas of genetic regulatory effects across human tissues. Science. 2020;369:1318-1330.
- Zhou N, et al. FerrDb V2: update of the manually curated database of ferroptosis regulators and ferroptosis-disease associations. Nucleic Acids Res. 2023;51:D571-D582.
- Võsa U, et al. Large-scale cis- and trans-eQTL analyses identify thousands of genetic loci and polygenic scores that regulate blood gene expression. Nat Genet. 2021;53:1300-1310.
- Melin BS, et al. Genome-wide association study of glioma subtypes identifies specific differences in genetic susceptibility to glioblastoma and non-glioblastoma tumors. Nat Genet. 2017;49:789-794.
- Zeng C, et al. Dissection of transcriptomic and epigenetic heterogeneity of grade 4 gliomas: implications for prognosis. Acta Neuropathol Commun. 2023;11:133.
- Sun L, et al. Neuronal and glioma-derived stem cell factor induces angiogenesis within the brain. Cancer Cell. 2006;9:287-300.
- Kruthika BS, et al. Transcriptome profiling reveals PDZ binding kinase as a novel biomarker in peritumoral brain zone of glioblastoma. J Neurooncol. 2019;141:315-325.
- Neftel C, et al. An integrative model of cellular states, plasticity, and genetics for glioblastoma. Cell. 2019;178:835-849.e821.
- Burgess S, Thompson SG. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40:755-764.
- Papadimitriou N, et al. Physical activity and risks of breast and colorectal cancer: a Mendelian randomisation analysis. Nat Commun. 2020;11:597.
- Song W, et al. Causal relationship between gut microbiota and lung squamous cell carcinoma: a bidirectional two-sample Mendelian randomization study. Postgrad Med J. 2025;101:526-534.
- Zhao J, et al. Bayesian weighted Mendelian randomization for causal inference based on summary statistics. Bioinformatics. 2020;36:1501-1508.
- Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 2014;15:550.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43:e47.
- Yun D, et al. A novel prognostic signature based on glioma essential ferroptosis-related genes predicts clinical outcomes and indicates treatment in glioma. Front Oncol. 2022;12:897702.
- Li R, et al. Identification of candidate genes associated with prognosis in glioblastoma. Front Mol Neurosci. 2022;15:913328.
- Bai H, Inoue J, Kawano T, Inazawa J. A transcriptional variant of the LC3A gene is involved in autophagy and frequently inactivated in human cancers. Oncogene. 2012;31:4397-4408.
- Hayashima K, Kimura I, Katoh H. Role of ferritinophagy in cystine deprivation-induced cell death in glioblastoma cells. Biochem Biophys Res Commun. 2021;539:56-63.
- Wu Y, et al. ALDH1-mediated autophagy sensitizes glioblastoma cells to ferroptosis. Cells. 2022;11:4015.
- Carriere A, et al. ERK1/2 phosphorylate Raptor to promote Ras-dependent activation of mTOR complex 1 (mTORC1). J Biol Chem. 2011;286:567-577.
- Dai E, Meng L, Kang R, Wang X, Tang D. ESCRT-III-dependent membrane repair blocks ferroptosis. Biochem Biophys Res Commun. 2020;522:415-421.
- Comincini S, et al. microRNA-17 regulates the expression of ATG7 and modulates the autophagy process, improving the sensitivity to temozolomide and low-dose ionizing radiation treatments in human glioblastoma cells. Cancer Biol Ther. 2013;14:574-586.
- Wang L, et al. Autophagy mediates glucose starvation-induced glioblastoma cell quiescence and chemoresistance through coordinating cell metabolism, cell cycle, and survival. Cell Death Dis. 2018;9:213.