El marco propuesto MSCNN-LSTM integra la extracción de características espaciales multiescala con la modelización de secuencias temporales para el reconocimiento de acciones en videos deportivos, capturando características espaciales detalladas y patrones de movimiento temporales, al tiempo que logra un rendimiento competitivo en la clasificación de conjuntos de datos de referencia de acciones deportivas.
Artículo de investigación
Reconocimiento de acciones en vídeos deportivos mediante redes convolucionales multiescala con modelado temporal basado en memoria a largo plazo y corto plazo (LSTM)
En este artículo
Resumen
Resumen
El reconocimiento de acciones en videos deportivos sigue siendo un desafío debido a la complejidad de las dinámicas de movimiento, la oclusión y la alta variabilidad intraclase. Aunque los enfoques actuales basados en aprendizaje profundo, incluidos CNN-BiLSTM y modelos basados en transferencia de aprendizaje, han demostrado ser efectivos en el reconocimiento de actividades humanas, su rendimiento puede verse limitado en escenarios deportivos con movimientos rápidos y diversos. Muchos métodos existentes dependen de filtros convolucionales de una sola escala, que podrían no captar eficazmente tanto las características de movimiento detalladas como las generales de forma simultánea. Para abordar esta limitación, este estudio propone una red neuronal convolucional de múltiples escalas (MSCNN, por sus siglas en inglés) integrada con una red de memoria a corto y largo plazo (LSTM, por sus siglas en inglés) para el reconocimiento de acciones en videos deportivos. La MSCNN extrae representaciones espaciales en múltiples campos receptivos mediante núcleos convolucionales en paralelo, lo que permite aprender características de movimiento detalladas y contextuales. Estas características son posteriormente procesadas por la LSTM para capturar dependencias temporales y la continuidad del movimiento a través de cuadros consecutivos. Se realizó una evaluación experimental en los conjuntos de datos de referencia UCF11, UCF Sports y JHMDB. El modelo propuesto MSCNN-LSTM alcanzó precisiones de clasificación del 98,3 %, 95,4 % y 81,7 %, respectivamente, superando a los enfoques comparativos evaluados en este estudio. Un estudio de ablación demostró además la contribución de la extracción de características multiescala y del modelado temporal al rendimiento general. Estos hallazgos demuestran el potencial del marco propuesto para combinar información espacial y temporal en el reconocimiento de acciones en videos deportivos.
Introducción
El reconocimiento de actividades humanas tiene amplias aplicaciones en diversos dominios del mundo real, incluyendo vigilancia inteligente, detección de anomalías, recuperación audiovisual basada en acciones y monitoreo de pacientes en el ámbito sanitario1,2. El reconocimiento de acciones, particularmente en secuencias de video provenientes de sistemas de vigilancia y plataformas de redes sociales, tiene un potencial significativo para la detección de anomalías y la comprensión de eventos3. Las acciones humanas se identifican en el análisis de video mediante la observación de diferentes partes del cuerpo, como las manos y las piernas. A diferencia de las imágenes estáticas, un solo fotograma a menudo no es suficiente para representar una acción4. Por ejemplo, la postura inicial de actividades como jugar fútbol y saltar la cuerda puede parecer similar en un único fotograma. Las diferencias entre estas acciones se vuelven evidentes cuando se observan a través de una secuencia de fotogramas que capturan los patrones de movimiento y las interacciones del cuerpo humano con su entorno5,6,7. Las abreviaturas utilizadas a lo largo de este manuscrito se resumen en Tabla 1 para mejorar la legibilidad y garantizar la coherencia en la terminología.
| Abreviatura | Forma completa |
| AI | Inteligencia Artificial |
| AUC | Área bajo la curva |
| BiLSTM | Memoria a corto y largo plazo bidireccional |
| CNN | Red neuronal convolucional |
| CUDA | Arquitectura unificada de dispositivos de procesamiento |
| F1-score | Media armónica de precisión y recuperación |
| GPU | Unidad de procesamiento gráfico |
| HAR | Reconocimiento de actividades humanas |
| JHMDB | Base de datos de movimiento humano conjunto |
| LSTM | Memoria a corto y largo plazo |
| mAP-T | Precisión media temporal |
| MCC | Coeficiente de correlación de Matthews |
| MSCNN | Red neuronal convolucional multiescala |
| ROC | Característica operativa del receptor |
| TSI | Índice de estabilidad temporal |
| UCF | Universidad de Florida Central |
| VRAM | Memoria de acceso aleatorio de video |
Tabla 1: Lista de abreviaturas utilizadas en el manuscrito. Abreviaturas y acrónimos comunes empleados a lo largo del estudio y sus formas completas correspondientes.
La clasificación rápida y precisa de videos deportivos es importante para una amplia gama de aplicaciones8,9,10, incluyendo análisis deportivo, detección de eventos, recuperación basada en contenido y sistemas de recomendación11,12,13. Con el rápido crecimiento del contenido de video relacionado con los deportes, las limitaciones de los marcos analíticos anteriores se han vuelto cada vez más evidentes14. En consecuencia, existe una creciente demanda de enfoques robustos capaces de abordar la complejidad y la naturaleza dinámica de las actividades deportivas. Los métodos tradicionales de clasificación de videos deportivos han dependido en gran medida de descriptores elaborados manualmente, como el flujo óptico y el histograma de gradientes orientados (HOG), para caracterizar los patrones de movimiento y las actividades en videos deportivos15.
Las ConvNets, que han logrado un éxito notable en la clasificación de imágenes estáticas, también se han aplicado al análisis de videos. Sin embargo, el reconocimiento de acciones sigue siendo más difícil porque los videos contienen información espacio-temporal dinámica. Los enfoques actuales basados en aprendizaje profundo generalmente se pueden clasificar en tres grupos: redes de dos flujos16, redes convolucionales 3D y arquitecturas computacionalmente eficientes. Para aprender información temporal a partir del flujo óptico, las redes de dos flujos emplean una ConvNet adicional17,18, aunque este enfoque es computacionalmente costoso. Mientras que arquitecturas convolucionales 3D como C3D, I3D y R3D pueden modelar información temporal directamente, aumentan considerablemente el número de parámetros, lo que hace que la optimización sea más difícil. Los métodos computacionalmente eficientes intentan reducir la complejidad del modelo explorando operaciones 3D descompuestas.
Además, dado que las CNN pueden extraer características espaciales locales y las LSTM pueden capturar información contextual temporal, los modelos híbridos pueden aprender eficazmente patrones de movimiento espacio-temporales a partir de entradas de sensores. Estudios recientes que combinan arquitecturas de CNN y redes neuronales recurrentes han producido resultados alentadores18,19,20. Sin embargo, debido a que las LSTM comprimen la información durante el procesamiento de secuencias, el ruido introducido durante la extracción de características puede afectar el rendimiento del reconocimiento. Para abordar este problema, varios estudios han incorporado mecanismos de atención21,22. Los mecanismos de atención permiten al modelo centrarse en las características más relevantes para la tarea de reconocimiento, mejorando así el rendimiento de clasificación.
Aunque los modelos profundos bidireccionales LSTM combinados con la extracción de características basada en CNN han logrado resultados prometedores para el reconocimiento de actividades humanas, aún persisten varios desafíos al extender estos marcos al reconocimiento de acciones en videos deportivos. En primer lugar, las arquitecturas CNN-LSTM existentes suelen emplear extracción de características convolucionales de una sola escala, lo que puede limitar su capacidad para capturar acciones que ocurren en múltiples resoluciones espaciales y temporales, como el movimiento simultáneo de jugadores y objetos en escenas deportivas. Las redes convolucionales multi-escala, incluidas las CNN 3D23 y las CNN de dos flujos, han demostrado la importancia de captar pistas espaciales y de movimiento a diferentes escalas, aunque este concepto sigue siendo menos explorado en sistemas híbridos basados en LSTM. En segundo lugar, la mayoría de los modelos CNN-BiLSTM anteriores24 se centran principalmente en dependencias temporales a corto plazo, mientras que la continuidad del movimiento a largo alcance y las interacciones entre objetos comunes en deportes de equipo podrían no representarse adecuadamente. Muchos enfoques basados en transferencia de aprendizaje, como MobileNetV2 y ResNet, dependen de características de fotogramas estáticos y no aprovechan completamente los mecanismos de atención temporal ni la fusión adaptativa de características multi-escala25. Además, la mayoría de los modelos existentes se han evaluado principalmente en conjuntos de datos de referencia como UCF11 y JHMDB. Conjuntos de datos más recientes específicos para deportes que capturan patrones complejos de movimiento de cámara y actividad, como SoccerNet y FineGym, siguen estando poco explorados. Estas limitaciones destacan la necesidad de un marco de extracción de características convolucionales multi-escala integrado con módulos de memoria temporal, como redes LSTM o BiLSTM, para captar mejor tanto representaciones espaciales finas como dependencias temporales a largo alcance en el reconocimiento de acciones en videos deportivos.
Además, las CNN pueden extraer características espaciales locales, mientras que las LSTM pueden modelar el contexto temporal. Por lo tanto, las arquitecturas híbridas CNN-RNN han mostrado un rendimiento prometedor en el reconocimiento de actividades humanas26,27. Estudios recientes han ampliado los marcos convencionales CNN-LSTM mediante la incorporación de estrategias complementarias de aprendizaje para mejorar el reconocimiento de actividades humanas. Por ejemplo, se han introducido mecanismos de atención para resaltar características relevantes para la tarea y suprimir representaciones menos informativas, mejorando así el rendimiento del reconocimiento28. Otros enfoques han adoptado el aprendizaje multitarea para optimizar conjuntamente las tareas de reconocimiento de acciones y segmentación temporal, mejorando la eficiencia del aprendizaje y la representación de características29. A pesar de estos avances, los métodos existentes aún pueden tener una capacidad limitada para distinguir acciones visualmente similares, ya que las características espaciales y temporales finamente detalladas no siempre se capturan de manera efectiva. Tabla 2 resume las fortalezas y limitaciones de los enfoques existentes30.
| Referencia / Año | Método utilizado | Conjunto(s) de datos | Métricas de rendimiento | Puntos fuertes clave | Limitaciones |
| Hassan et al. (2024)1 | KFDI (Imagen Dinámica de Fotogramas Clave) | UCF11 | Precisión: 85,3% | Selección eficiente de fotogramas clave y representación mejorada de imágenes dinámicas. | Sensible a errores en la selección de fotogramas; modelado temporal limitado. |
| Zhou et al. (2023)24 | CNN con dilatación + BiLSTM + Bloque residual | UCF11, UCF Sports | Precisión: UCF11: 89% y UCF Sports: 92,2% | Integra aprendizaje espacial y temporal; captura información a múltiples escalas. | Requiere mucho cálculo; riesgo de sobreajuste en conjuntos de datos pequeños. |
| Ullah et al. (2025)34 | Características locales–globales + QSVM | UCF11 | Precisión: 82,6% | Combina características diseñadas manualmente y características profundas para un reconocimiento robusto. | Requiere ajuste manual; escalabilidad limitada. |
| Shin et al. (2025)25 | ViT-ReT (Transformador de Visión + Transformador Recurrente) | UCF11, UCF50, UCF101 y JHMDB | Precisión: UCF11: 97,73%; UCF50: 98,81%; UCF101: 98,46%; JHMDB: 83,38% | Captura dependencias espaciales y temporales a largo alcance. | Alto costo computacional y grandes necesidades de datos. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Precisión: 85,1% | Aprendizaje espaciotemporal de características de extremo a extremo. | Altos requisitos de memoria y GPU. |
| Karuppannan et al. (2024)35 | Autoencoder profundo + CNN | UCF11 | Precisión: 96,2% | Aprende representaciones compactas de características. | Modelado temporal a largo plazo limitado. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF Sports, JHMDB, UCF101 y HMDB51 | Precisión: KTH: 97,67%; UCF Sports: 95,00%; JHMDB: 73,13%; UCF101: 92,97%; HMDB51: 69,74% | Aprendizaje temporal efectivo basado en profundidad. | Requiere estimación precisa de profundidad y preprocesamiento extenso. |
Tabla 2: Comparación de los métodos existentes de aprendizaje profundo para el reconocimiento de acciones en videos deportivos. Resumen de enfoques representativos de aprendizaje profundo, incluyendo conjuntos de datos, características metodológicas, ventajas y limitaciones, destacando las brechas de investigación abordadas por el marco propuesto MSCNN-LSTM.
Se ha propuesto un marco para la animación facial impulsada por sincronización de audio, que combina un modelo de denoising facial (FDM) con un modelo de difusión latente de lo local a lo global (LG-LDM) para generar animaciones faciales expresivas emocionalmente. Se empleó un autoencoder variacional cuantizado por vectores centrado en emociones (EVQ-VAE) para reconstruir la geometría facial tridimensional detallada y las variaciones sutiles de expresión31. Asimismo, se ha desarrollado un marco de agarre robótico consciente de oclusiones que utiliza visión estéreo binocular para realizar segmentación del objetivo, localización, inferencia de oclusión y estimación de poses de agarre múltiples en condiciones de oclusión32. Además, se ha introducido un marco en dos etapas para la extracción del terreno a partir de nubes de puntos, utilizando proyección en cuadrícula y división adaptativa de contenedores, en el que se emplearon probabilidades de elevación y curvatura para refinar los límites entre terreno y obstáculos tras una extracción inicial mediante análisis de características basado en cuadrícula33.
A pesar de los avances significativos en el reconocimiento de acciones basado en aprendizaje profundo, los métodos existentes aún tienen dificultades para manejar la alta variabilidad y complejidad de los videos deportivos, incluyendo movimientos rápidos, desplazamientos de cámara e interacciones entre múltiples jugadores. Muchos modelos tradicionales basados en CNN o LSTM operan a una única escala espacial y, por lo tanto, pueden tener dificultades para capturar de manera efectiva tanto los patrones de movimiento locales como los globales. Además, mantener la coherencia temporal en secuencias de larga duración o acciones superpuestas sigue siendo un desafío. Aunque los métodos de aprendizaje por transferencia han mejorado la extracción de características, su adaptación a conjuntos de datos específicos de deportes sigue siendo relativamente poco explorada.
Este estudio tiene como objetivo desarrollar y evaluar un marco Multi-Scale Convolutional Neural Network–Long Short-Term Memory (MSCNN-LSTM) para el reconocimiento de acciones en videos deportivos, integrando la extracción de características espaciales multiescala con modelado temporal basado en LSTM, con el fin de capturar tanto características espaciales detalladas como dependencias temporales a largo plazo. El marco propuesto emplea núcleos convolucionales complementarios y fusión de características en múltiples niveles para mejorar la representación de acciones deportivas complejas en condiciones desafiantes. Su desempeño fue evaluado en los conjuntos de datos de referencia UCF11, UCF Sports y JHMDB utilizando precisión, exactitud, recuperación, puntuación F1, precisión media promedio en el tiempo (mAP-T), índice de estabilidad temporal (TSI), coeficiente kappa de Cohen (κ), coeficiente de correlación de Matthews (MCC) y área bajo la curva ROC (AUC). Los resultados experimentales demostraron un desempeño competitivo en comparación con los métodos evaluados en este estudio, destacando el potencial del marco para el análisis deportivo, el monitoreo del rendimiento de atletas, la detección automatizada de eventos y la comprensión de videos deportivos.
Protocolo
Este estudio empleó un marco de aprendizaje profundo en dos etapas para el reconocimiento de acciones en videos deportivos que integra una red neuronal convolucional multiescala (MSCNN) con una red de memoria a corto y largo plazo (LSTM). Se utilizaron conjuntos de datos de referencia disponibles públicamente, específicamente UCF11, UCF Sports y JHMDB, para el desarrollo y evaluación del modelo. No se recopilaron nuevos datos de participantes humanos, ni se accedió ni procesó información personalmente identificable. Dado que el estudio implicó el análisis secundario de conjuntos de datos públicos y anonimizados y no involucró participación humana directa, no se requirió aprobación ética institucional ni consentimiento informado.
El flujo de trabajo consistió en muestreo de fotogramas y normalización temporal, seguido de la extracción de características mediante el módulo MSCNN. Las características extraídas se procesaron posteriormente utilizando una red LSTM para modelado temporal y luego se enviaron a una capa de clasificación multiclase. Finalmente, el modelo se entrenó y evaluó utilizando los conjuntos de datos de referencia seleccionados. Figura 1 ilustra la arquitectura general del marco propuesto.
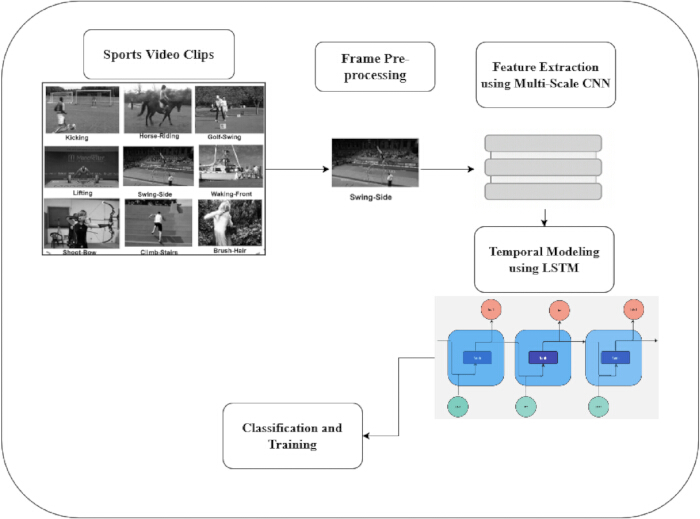
Figura 1: Marco propuesto MSCNN-LSTM para el reconocimiento de acciones en videos deportivos. Flujo de trabajo general que ilustra el preprocesamiento de video, la extracción de características espaciales multiescala, el aprendizaje de secuencias temporales y la clasificación de acciones. Haga clic aquí para ver una versión más grande de esta figura.
Figura 1 ilustra el flujo de trabajo del marco propuesto para el reconocimiento de acciones en videos deportivos basado en una arquitectura híbrida MSCNN-LSTM. El proceso comienza con clips de video deportivos que contienen diversas acciones atléticas, incluyendo patear, montar a caballo y realizar golpes de golf. Los videos originales se descompusieron en cuadros individuales durante la etapa de preprocesamiento, en la cual los cuadros se recortan, estandarizan y preparan para la entrada al modelo. Los cuadros preprocesados se introdujeron luego en el módulo MSCNN para la extracción de características. La arquitectura convolucional multiescala captura características espaciales en diferentes campos receptivos, permitiendo la extracción de información local y contextual de los cuadros del video deportivo. Los vectores de características extraídos fueron posteriormente procesados por la red LSTM para modelar las dependencias temporales y la evolución del movimiento a través de cuadros consecutivos. Finalmente, el módulo de clasificación y entrenamiento utilizó las representaciones espacio-temporales aprendidas para predecir la categoría de acción de cada clip de video. El marco propuesto comprendió cuatro pasos secuenciales, comenzando con la recolección de datos y el preprocesamiento utilizando los conjuntos de datos de referencia UCF11 (YouTube Actions), UCF Sports y JHMDB. Cada video deportivo se convirtió en una secuencia de cuadros, que fueron redimensionados, normalizados y aumentados mediante rotación, inversión y recorte para mejorar la robustez frente a variaciones ambientales. Los cuadros preprocesados fueron posteriormente procesados por la Red Neuronal Convolucional Multiescala (MSCNN) propuesta, en la cual ramas convolucionales paralelas con núcleos de 3 × 3, 5 × 5 y 7 × 7 extrajeron características espaciales locales y contextuales complementarias. Estas características multiescala se concatenaron y refinaron utilizando normalización por lotes y agrupación máxima (max pooling) para generar representaciones compactas de características. Las características resultantes a nivel de cuadro se proporcionaron posteriormente a una red de Memoria a Corto y Largo Plazo (LSTM) para modelar las dependencias temporales entre cuadros consecutivos. Las salidas finales de la LSTM se aplanaron y se transmitieron a través de capas completamente conectadas con activación ReLU, seguidas por un clasificador Softmax para predecir la categoría de acción. La red se entrenó utilizando el optimizador Adam con una función de pérdida de entropía cruzada y regularización por abandono (dropout) para reducir el sobreajuste. El rendimiento del modelo se evaluó finalmente en los conjuntos de datos de referencia UCF11, UCF Sports y JHMDB utilizando precisión, exactitud, recuperación y puntuación F1.
1. Recolección y preprocesamiento de datos
En este estudio se utilizaron tres conjuntos de datos de referencia disponibles públicamente para deportes y acciones humanas. Estos conjuntos de datos contienen imágenes reales de deportes con movimiento de cámara, puntos de vista y complejidad de fondo variables. Específicamente, el estudio utilizó UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), que contiene 11 categorías de acciones recopiladas a partir de 1.168 videos de YouTube grabados aproximadamente por 25 individuos, con múltiples muestras por acción. La Base de Datos de Movimiento Humano con Anotaciones Conjuntas (JHMDB)34,35 contiene 21 clases de acciones y 928 videos anotados. El conjunto de datos UCF Sports comprende 10 clases de acciones y 150 secuencias de video capturadas a partir de fuentes de transmisión con una resolución de 720 × 480 píxeles (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
En conjunto, estos conjuntos de datos abarcan deportes individuales y colectivos y ofrecen variación en duración temporal y escala visual para evaluar el marco propuesto de reconocimiento de acciones MSCNN-LSTM. Como parte del proceso de evaluación de la calidad de los datos, los conjuntos de datos UCF11, UCF Sports y JHMDB fueron examinados en busca de videos dañados, archivos duplicados y fragmentos con anotaciones incompletas. No se identificaron muestras que cumplieran con estos criterios de exclusión; por lo tanto, todos los videos disponibles se conservaron para el análisis posterior. Luego, los conjuntos de datos se dividieron en subconjuntos de entrenamiento (70 %), validación (15 %) y prueba (15 %) utilizando una estrategia consistente de división aleatoria. Figura 2 presenta imágenes representativas utilizadas para el entrenamiento y la evaluación.
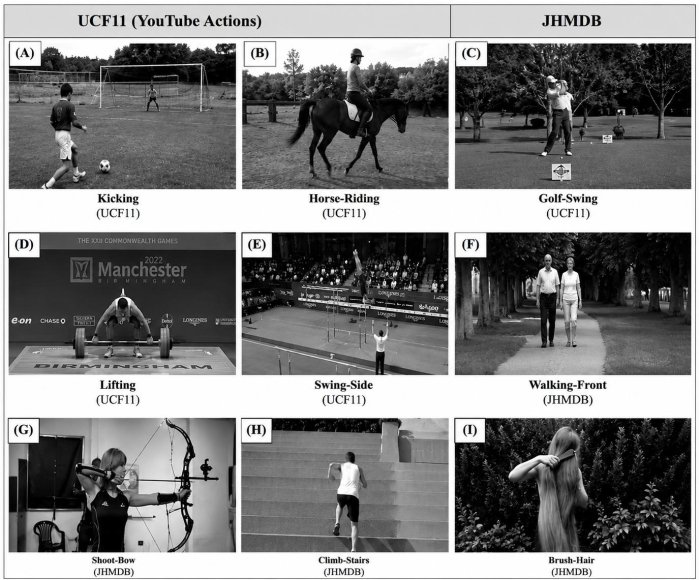
Figura 2: Cuadros representativos de conjuntos de datos de reconocimiento de acciones deportivas de referencia. Los paneles (A–D) muestran ejemplos del conjunto de datos UCF11 (YouTube Actions), los paneles (E–H) del conjunto de datos UCF Sports y los paneles (I–L) del conjunto de datos JHMDB. Los cuadros ilustran variaciones en clases de acciones, puntos de vista, fondos, condiciones de iluminación y complejidad del movimiento. Haga clic aquí para ver una versión más grande de esta figura.
El modelo propuesto de reconocimiento de acciones fue evaluado en los conjuntos de datos de referencia UCF11, UCF Sports y JHMDB, como se resume en la Tabla 3. Estos conjuntos de datos representan patrones de movimiento diversos y condiciones ambientales desafiantes. El conjunto de datos UCF11 (Acciones de YouTube) contiene acciones deportivas de 11 clases adquiridas bajo condiciones variables de iluminación, punto de vista y fondo. El conjunto de datos UCF Sports comprende 150 videos de deportes de campo procedentes de emisiones profesionales, con secuencias de movimiento realistas. El conjunto de datos JHMDB proporciona anotaciones detalladas de movimiento humano para 21 categorías de acciones finamente diferenciadas y sirve como conjunto de datos de referencia para el reconocimiento espaciotemporal de acciones. En conjunto, estos conjuntos de datos se utilizaron para evaluar el rendimiento del modelo en escenarios de deportes y acciones humanas. La red fue entrenada utilizando el optimizador Adam durante 100 épocas con un tamaño de lote de 32, una tasa de aprendizaje inicial de 0.001 y una función de pérdida de entropía cruzada. Se seleccionó el modelo con la menor pérdida de validación para la evaluación final. Todos los experimentos utilizaron una semilla aleatoria fija de 42. Se aplicaron detención temprana y reducción de la tasa de aprendizaje en meseta para mejorar la convergencia, y se utilizó recorte de gradientes con un umbral de 5.0 durante el entrenamiento del LSTM para prevenir gradientes explosivos. El modelo propuesto MSCNN-LSTM contenía aproximadamente 15 millones de parámetros entrenables. La configuración de hardware y software utilizada para la implementación se resume en la Tabla 4. Dado que las distribuciones de clases estaban suficientemente equilibradas, no se aplicaron procedimientos adicionales de ponderación por clases ni remuestreo. Los modelos comparadores se implementaron utilizando los hiperparámetros reportados en sus estudios originales, con configuraciones de entrenamiento armonizadas cuando fue factible. Los valores de rendimiento se reportaron como la media ± desviación estándar de cinco ejecuciones independientes con diferentes inicializaciones aleatorias. Las diferencias entre el modelo propuesto y los modelos comparadores se evaluaron mediante pruebas t pareadas con un umbral de significancia de p < 0.05.
| Conjunto de datos | N.º de clases | N.º de vídeos | Resolución (px) | Origen | Descripción |
| UCF11 (YouTube Actions) | 11 | 1168 | Variable (≈ 320×240) | University of Central Florida | Incluye 11 acciones humanas de deportes (por ejemplo, lanzamiento de baloncesto, saltos de trampolín, swing de golf, malabares con fútbol). Los vídeos se recopilaron de YouTube con gran variación en iluminación, punto de vista y fondo. |
| UCF Sports | 10 | 150 | 720×480 | UCF Sports Action Dataset | Contiene actividades deportivas como saltos de trampolín, equitación, swing de golf, carrera y levantamiento de pesas, grabadas a partir de imágenes reales de televisión (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | Max Planck Institute for Intelligent Systems | Incluye actividades cotidianas y deportivas como atrapar, saltar, cepillarse el cabello, disparar y correr, con anotaciones articulares para el análisis de movimiento y postura. |
Tabla 3: Características de los conjuntos de datos de referencia utilizados para entrenamiento y evaluación. Resumen de los conjuntos de datos UCF11, UCF Sports y JHMDB, que incluye el número de clases de acciones, muestras de video, características del conjunto de datos y sus roles en el entrenamiento, validación y prueba del modelo.
| Parámetros utilizados | Descripción |
| Lenguaje de programación | Python 3.8.18 [4] |
| Framework de aprendizaje profundo | TensorFlow 2.15.0 [1] |
| Acelerador GPU | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| CPU | Intel Core i9 @ 3.5 GHz × 16 núcleos |
| Sistema operativo | Windows 11 |
| Memoria (RAM) | 64 GB DDR4 |
| Optimizador | Adam (tasa de aprendizaje = 0.001) |
| Tamaño del lote | 32 |
| Número de épocas | 100 |
| Funciones de activación | ReLU (capas CNN), Softmax (capa de salida) |
| Tasa de abandono (dropout) | 0.5 |
Tabla 4: Configuración del entorno de simulación y de los hiperparámetros del modelo MSCNN-LSTM propuesto. Especificaciones de hardware, entorno de software, ajustes del optimizador, tasa de aprendizaje, tamaño de lote, número de épocas, dimensiones de entrada y otros hiperparámetros utilizados durante el entrenamiento y la evaluación del modelo.
2. Preprocesamiento
Antes del entrenamiento, cada video en bruto se convirtió en una secuencia de cuadros ordenada en el tiempo y luego se normalizó, muestreó temporalmente y aumentó. Cada video de entrada V se convirtió primero en una secuencia de cuadros y se representó como un tensor 4D V ∈ RT×H×W×C, donde T es el número de cuadros, H × W i denota el índice del cuadro, y C denota el número de canales de color (3 para RGB). La canalización de preprocesamiento consistió en la extracción de cuadros, el redimensionamiento espacial seguido del recorte central o aleatorio a una resolución fija (H′, W′), la normalización de la intensidad por píxel y la ampliación opcional de los datos, incluyendo inversión aleatoria, escalado y variación aleatoria del color, antes de la extracción de características. Concretamente, la normalización de la intensidad se implementó como normalización por puntuación estándar según se muestra en la ecuación (1).
 (1)
donde μ, σ son las medias y desviaciones estándar de los canales calculadas sobre el conjunto de entrenamiento, o como escalado min-máx según la ecuación (2).
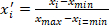 (2)
Después de la normalización, cada cuadro se representó como F̃t ∈ RH′×W′×C′ y el tensor de video resultante se representó como V′ ∈ RT×H′×W′×C. En un frontend convolucional multi-escala, se obtienen varios mapas de características espaciales con campos receptivos diferentes mediante la aplicación de varias convoluciones 2D (o 3D para las primeras convoluciones espacio-temporales) con distintos tamaños de núcleo; luego se generó una representación de características temporales para cada cuadro o clip de video corto, que se envió al módulo LSTM. El artículo original aplica MobileNetV2 y luego Deep BiLSTM para la modelización temporal; la misma tubería de preprocesamiento descrita es completamente compatible con un reemplazo basado en convolución multi-escala más LSTM.
3. Muestreo y normalización temporal
Dado que las duraciones de los videos T varían entre y dentro de los conjuntos de datos, se muestrean o remuestrean temporalmente los fotogramas de forma uniforme para proporcionar al modelo de convolución multiescala + LSTM una longitud de entrada fija N en términos de fotogramas o fragmentos cortos. Los índices de fotogramas uniformes pueden calcularse según la ecuación (3),
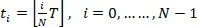 (3)
por lo tanto, la secuencia de fotogramas muestreados es Vs = {F̃t0, …, F̃tN−1}. Cuando se requiere una fidelidad temporal más precisa, realizamos una interpolación temporal lineal: para cualquier tiempo fraccional remuestreado τ ∈ [0, T−1] calculado según la ecuación (4).
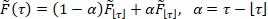 (4)
de modo que la secuencia remuestreada Vs tenga exactamente N fotogramas y conserve un movimiento suave. Alternativamente, el muestreo mediante clips cortos y contiguos (longitud de ventana temporal w con paso s) produce un conjunto de tensores de clips donde cada clip Cj ∈ RT×H′×W′×C y j = 0, …, ⌊(T − w)/s⌋. Para la normalización temporal dentro de la red, un agrupamiento temporal simple a múltiples escalas es efectivo: dada una secuencia de características temporales X = {x1, …, xN} generada por convoluciones de múltiples escalas, aplique las características agrupadas como se indica en la ecuación (5).
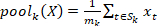 (5)
donde Sk es el soporte temporal para la escala k (por ejemplo, Sk puede ser bloques no superpuestos o índices dilatados) y mk = |Sk|.
Antes de la extracción de características, todos los videos se redimensionaron a 224 × 224 píxeles y se muestrearon a 25 fotogramas por segundo. Cada experimento utilizó una longitud de secuencia constante de 32 fotogramas. Entre las técnicas de aumento de datos se incluyeron el recorte aleatorio (escala = 0,8–1,0), la rotación aleatoria (±15°), el volteo horizontal aleatorio (probabilidad = 0,5) y la modificación del brillo (±20%). Se utilizaron los valores promedio de ImageNet [0,485, 0,456, 0,406] y las desviaciones estándar [0,229, 0,224, 0,225] para estandarizar los valores de los píxeles. Para cada secuencia de video, se utilizó una selección uniforme de fotogramas para el muestreo temporal. Las películas más largas se recortaron o muestrearon uniformemente para mantener una longitud de secuencia consistente, mientras que los videos con menos de 32 fotogramas se rellenaron con ceros. Durante todo el entrenamiento y la evaluación, estos parámetros se utilizaron de forma constante.
4. Extracción de características utilizando MSCNN
Se empleó una red neuronal convolucional multiescala (MSCNN) para mejorar la representación espacial de las acciones en videos deportivos. Las redes neuronales convolucionales convencionales que dependen de un único tamaño de kernel pueden tener una capacidad limitada para capturar características a múltiples escalas espaciales. Debido a que algunas acciones deportivas presentan características visuales similares, puede ser difícil para una arquitectura convolucional de una sola escala capturar simultáneamente características locales y globales. Para abordar esta limitación, el marco propuesto utiliza kernels convolucionales de diferentes tamaños para realizar la extracción multiescala de características y la fusión de características.
En la arquitectura de red propuesta, se utilizaron núcleos de convolución de 1 × 1 para organizar la información a través de los canales y reducir la dimensionalidad de los mapas de características de entrada. Además, estas capas aumentan la capacidad expresiva de la red mediante la introducción de transformaciones de características adicionales y representaciones no lineales. Los núcleos de convolución de diferentes tamaños permiten la extracción de información espacial a múltiples escalas. Se realiza una normalización secuencial tras la fusión ponderada de características multiescala para mejorar la estabilidad del entrenamiento. Con el fin de mitigar los problemas de desvanecimiento y explosión del gradiente durante el entrenamiento de redes profundas, la arquitectura sugerida utiliza conexiones residuales y modelado temporal basado en LSTM.
El diseño multi-escala mejora la capacidad de la red para capturar características a diferentes resoluciones espaciales y potencia la capacidad de representación de características. Además, el núcleo convolucional convencional de N × N se descompone en operaciones convolucionales de N × 1 y 1 × N. Las convoluciones de N × 1 y 1 × N empleadas en el módulo MSCNN están diseñadas para capturar características espaciales direccionales y multi-escala complementarias a partir de cuadros individuales del video. Estas operaciones convolucionales mejoran la representación de características espaciales al extraer patrones a diferentes escalas de campo receptivo. Las relaciones temporales entre cuadros consecutivos son posteriormente modeladas por el módulo LSTM, que procesa la secuencia de características extraídas por el MSCNN para aprender dependencias temporales a largo plazo en el reconocimiento de acciones.
Cada video deportivo V = {F1, F2, …, FT} se descompone en T fotogramas. Para codificar las variaciones espaciales, por ejemplo, la postura de los jugadores, el desenfoque por movimiento y la trayectoria del balón, ramas convolucionales a tres escalas diferentes operan s ∈ {1, 2, 3}, correspondientes a tamaños de núcleo 3 × 3, 5 × 5 y 7 × 7. Cada rama extrae mapas de características según la ecuación (6):
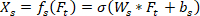 (6)
Donde Ws y bs son los pesos y sesgos de la convolución a la escala s, y σ es la activación ReLU. La capa de fusión multiescala agrega características como en la ecuación (7):
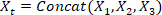 (7)
Este tensor de características fusionadas incorpora tanto señales de movimiento finas como información contextual de áreas amplias, como actividades grupales. Figura 3 ilustra únicamente el módulo de extracción de características MSCNN. La capa LSTM (256 unidades ocultas), la capa densa (128 neuronas) y la capa de dropout (0,5) utilizadas para modelado temporal y clasificación se presentan por separado en la Figura 4.
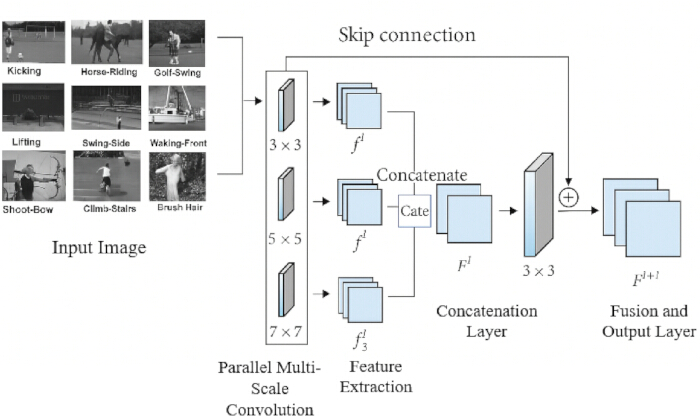
Figura 3: Módulo propuesto de extracción de características de la red neuronal convolucional multi-escala (MSCNN). Tres ramas convolucionales paralelas con tamaños de núcleo de 3 × 3, 5 × 5 y 7 × 7 extraen características espaciales multi-escala complementarias, que se fusionan antes de la modelización temporal mediante la red LSTM. Haga clic aquí para ver una versión más grande de esta figura.
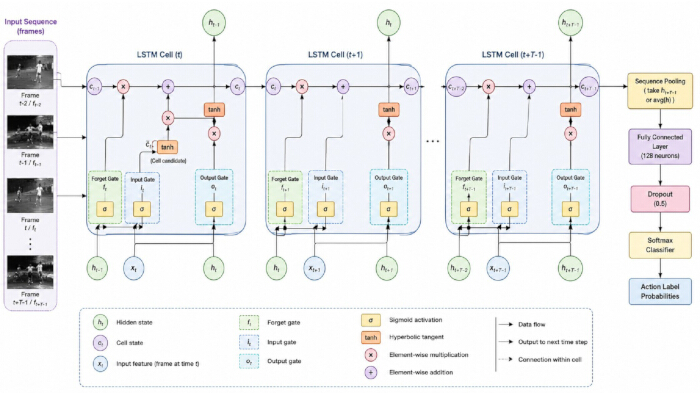
Figura 4: Arquitectura LSTM propuesta para el reconocimiento de acciones en videos deportivos. El módulo LSTM modela las dependencias temporales mediante operaciones de puertas de entrada, olvido y salida a través de cuadros de video consecutivos. Haga clic aquí para ver una versión más grande de esta figura.
Figura 3 ilustra el módulo propuesto de extracción de características mediante una Red Neuronal Convolucional Multiescala (MSCNN, por sus siglas en inglés) para el reconocimiento de acciones en videos deportivos. Los fotogramas de video de entrada se procesaron en paralelo a través de tres ramas convolucionales con tamaños de núcleo de 3 × 3, 5 × 5 y 7 × 7, cada una conteniendo 64 filtros para capturar características espaciales finas y gruesas complementarias. Las salidas se refinaron mediante normalización por lotes, activación ReLU y agrupación máxima de 2 × 2, luego se concatenaron y fusionaron mediante una convolución de 1 × 1 con 128 filtros. Una conexión residual de salto preservó la información espacial de bajo nivel y mejoró el flujo de gradientes. Los mapas de características fusionados se aplanaron y se transmitieron a una capa LSTM con 256 unidades ocultas para modelado temporal, seguida por una capa completamente conectada con 128 neuronas, activación ReLU y una tasa de abandono (dropout) de 0,5 antes de la clasificación final mediante una capa Softmax. Los mapas de características multiescala (f1l, f2l y f3l) se concatenaron para formar la representación fusionada (Fl), que se refinó adicionalmente mediante una convolución de 3 × 3 para generar el mapa de características de salida para la capa subsiguiente. Esta arquitectura jerárquica permitió el aprendizaje de características espaciales complementarias en múltiples campos receptivos, mejorando el rendimiento en el reconocimiento de acciones deportivas.
5. Modelado temporal utilizando LSTM
Con el fin de modelar la evolución basada en el tiempo a lo largo de los bordes del video, la secuencia de características agregadas se proporcionó al sistema LSTM para capturar las dependencias dinámicas y la continuidad del movimiento. Para cada video de entrada, primero extraímos características CNN multiescala por cuadro. Sean los cuadros del video I1, …, IT. Para cada cuadro t y cada escala s, el codificador convolucional multiescala produce un vector de características ft(s) ∈ Rd. Luego se fusionan las escalas en un único descriptor de cuadro mediante proyección + concatenación o suma ponderada, como se muestra en la ecuación (8):
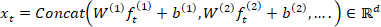 (8)
Luego, introduzca la secuencia {xt}tT=1 en una LSTM para modelar la dinámica temporal. En la notación estándar de LSTM, en el tiempo t las puertas y los estados se definen en las ecuaciones (9) a (13):
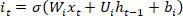 (9)
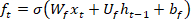 (10)
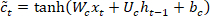 (11)
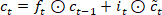 (12)
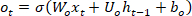 (13)
Aquí σ es la activación sigmoide, ⊙ es la multiplicación elemento a elemento. Aunque se pueden utilizar arquitecturas LSTM bidireccionales para capturar el contexto temporal pasado y futuro, el marco propuesto emplea un LSTM estándar para modelar las dependencias temporales a través de los fotogramas secuenciales del video. Esta elección de diseño es coherente con la arquitectura MSCNN-LSTM presentada en este estudio. Después de procesar el clip, se obtuvo una representación del clip (por ejemplo, último estado oculto o agrupamiento temporal): z = Poolt(vt).
Figura 4 ilustra el flujo de trabajo de la arquitectura LSTM propuesta para el reconocimiento de acciones deportivas. La red recibió una secuencia de fotogramas de video o características extraídas por una CNN y las procesó en pasos de tiempo sucesivos (t−2, t−1 y t). Cada celda LSTM constaba de una puerta de entrada, una puerta de olvido y una puerta de salida, que regulaban el flujo de información a través de la red. La puerta de entrada incorporaba nueva información al estado de la celda, la puerta de olvido descartaba información temporal irrelevante y la puerta de salida generaba el estado oculto que se propagaba al siguiente paso de tiempo. El estado de la celda preservaba dependencias temporales a largo plazo, mientras que el estado oculto capturaba información temporal a corto plazo. Tras el procesamiento secuencial, las salidas del LSTM se agruparon para generar una representación de características temporales, que se transmitió a una capa completamente conectada y a un clasificador Softmax para predecir la acción deportiva correspondiente. La red se entrenó utilizando el optimizador Adam durante 100 épocas con un tamaño de lote de 32, una tasa de aprendizaje inicial de 0,001 y una función de pérdida de entropía cruzada. Se seleccionó el modelo con la menor pérdida de validación para la evaluación final. Para garantizar la reproducibilidad, todos los experimentos se realizaron utilizando una semilla aleatoria fija de 42. Se emplearon la detención temprana y la reducción de la tasa de aprendizaje en meseta para mejorar la convergencia, y se aplicó recorte de gradientes con un umbral de 5,0 durante el entrenamiento del LSTM para evitar gradientes explosivos. El modelo MSCNN-LSTM propuesto contenía aproximadamente 15 millones de parámetros entrenables.
Las puntuaciones finales de la clase y la probabilidad utilizan una capa lineal + softmax como en la Ec. (14):
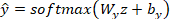 (14)
Entrene minimizando la pérdida de entropía cruzada sobre los clips etiquetados según la ecuación (15):
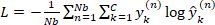 (15)
donde Nb es el tamaño del lote, C el número de clases, y y(n) es la verdad fundamental codificada en one-hot. Se aplica regularización (dropout en las salidas de xt/LSTM, decaimiento de pesos) y recorte de gradientes para ayudar a la estabilidad en secuencias largas de deportes.
Resultados
El modelo propuesto MSCNN-LSTM fue entrenado y evaluado en los conjuntos de datos UCF11 (YouTube Actions), UCF Sports y JHMDB, que incluían diversas acciones deportivas, puntos de vista y patrones de movimiento. Dado que las distribuciones de clases estaban suficientemente equilibradas, no se aplicaron procedimientos adicionales de ponderación por clases ni de remuestreo. Los modelos comparadores se implementaron utilizando los hiperparámetros reportados en sus estudios originales, con configuraciones de entrenamiento armonizadas cuando fue factible. Los resultados se presentaron como la media ± desviación estándar de cinco ejecuciones independientes con diferentes inicializaciones aleatorias. Las diferencias entre el modelo propuesto y los modelos comparadores se evaluaron mediante pruebas t pareadas con un umbral de significancia de p < 0,05.
Figura 5 compara la precisión de clasificación entre los tres conjuntos de datos. El modelo MSCNN-LSTM alcanzó la precisión más alta, llegando al 98,3 % en UCF11, al 95,4 % en UCF Sports y al 81,7 % en JHMDB. Estos valores superaron a los obtenidos por los modelos Dilated CNN–BiLSTM, Two-Stream LSTM y ViT-ReT. La menor precisión en JHMDB reflejó la mayor dificultad para reconocer acciones finamente detalladas en videos de menor resolución.
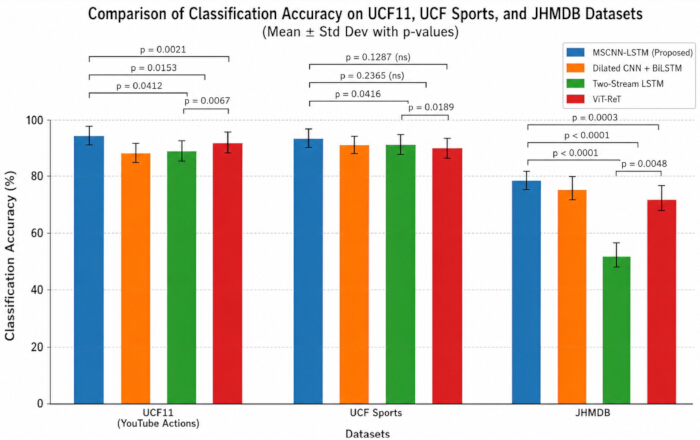
Figura 5: Comparación de la precisión de clasificación (%) de diferentes modelos de aprendizaje profundo en conjuntos de datos de videos deportivos. Precisión de clasificación de MSCNN-LSTM, ViT-ReT, Two-Stream LSTM y Dilated CNN + BiLSTM en los conjuntos de datos UCF11, UCF Sports y JHMDB. Los resultados se presentan como media ± DE de cinco ejecuciones independientes (n = 5). Las barras de error representan una desviación estándar. La significancia estadística se evaluó mediante pruebas t pareadas de dos colas (p < 0,05). Haga clic aquí para ver una versión más grande de esta figura.
El modelo propuesto también alcanzó la mayor precisión en todos los conjuntos de datos, con valores de aproximadamente 96 % en UCF11, 93 % en UCF Sports y 78 % en JHMDB (Figura 6). Los valores de recuperación fueron aproximadamente 95 %, 94 % y 77 %, respectivamente (Figura 7), mientras que los puntajes F1 correspondientes fueron aproximadamente 95,5 %, 93,5 % y 77,5 % (Figura 8). Estos hallazgos indicaron que el modelo mantuvo un equilibrio favorable entre identificar correctamente las clases de acciones y limitar las predicciones falsas positivas.
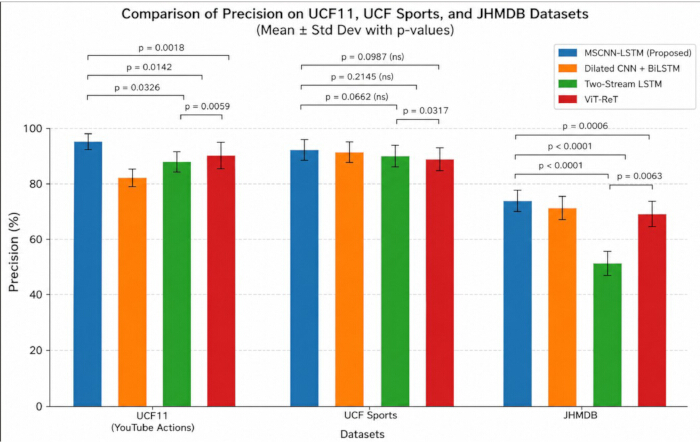
Figura 6: Comparación de la precisión (%) de diferentes modelos de aprendizaje profundo en conjuntos de datos de videos deportivos. Los valores de precisión se reportan como media ± DE de cinco ejecuciones independientes (n = 5). Las barras de error representan una desviación estándar. La significancia estadística se evaluó mediante pruebas t pareadas de dos colas (p < 0,05). Haga clic aquí para ver una versión más grande de esta figura.
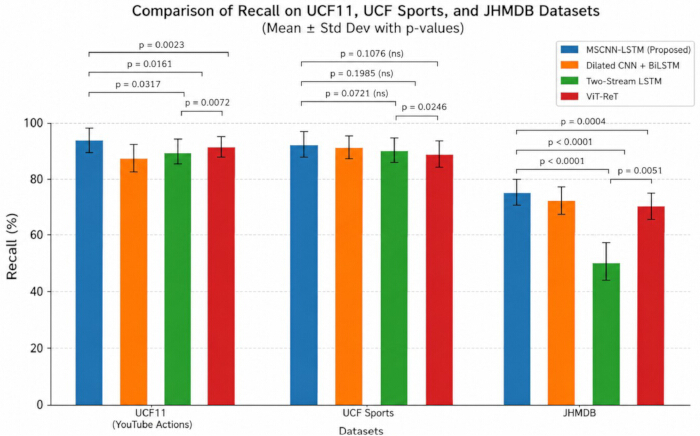
Figura 7: Comparación del porcentaje de recuperación (%) de diferentes modelos de aprendizaje profundo en conjuntos de datos de videos deportivos. Los valores de recuperación se reportan como media ± DE de cinco ejecuciones independientes (n = 5). Las barras de error representan una desviación estándar. La significancia estadística se evaluó mediante pruebas t pareadas de dos colas (p < 0,05). Haga clic aquí para ver una versión más grande de esta figura.
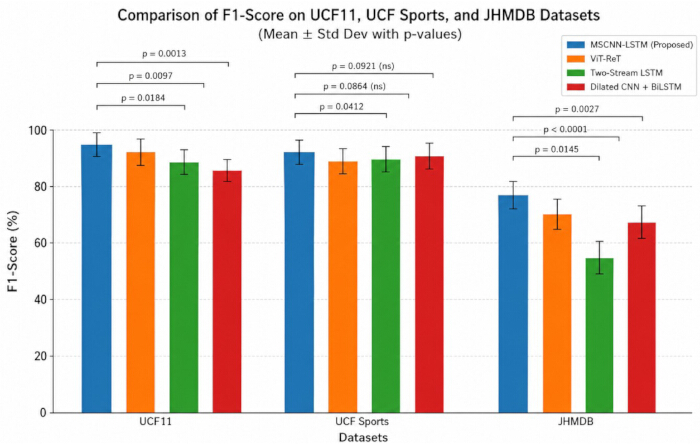
Figura 8: Comparación del puntaje F1 (%) de diferentes modelos de aprendizaje profundo en conjuntos de datos de videos deportivos. Los puntajes F1 se reportan como media ± DE de cinco ejecuciones independientes (n = 5). Las barras de error representan una desviación estándar. La significancia estadística se evaluó mediante pruebas t pareadas de dos colas (p < 0,05). Haga clic aquí para ver una versión más grande de esta figura.
Tabla 5 presenta los resultados del coeficiente kappa de Cohen y del coeficiente de correlación de Matthews. En UCF11, el modelo propuesto alcanzó κ = 0,96 y MCC = 0,96, en comparación con valores de κ/MCC de 0,92/0,92 para ViT-ReT, 0,90/0,90 para Two-Stream LSTM y 0,87/0,87 para Dilated CNN–BiLSTM. En UCF Sports, el MSCNN-LSTM alcanzó κ = 0,95 y MCC = 0,94, superando los valores correspondientes obtenidos por ViT-ReT (0,90/0,90), Two-Stream LSTM (0,88/0,89) y Dilated CNN–BiLSTM (0,84/0,85). En JHMDB, el modelo propuesto alcanzó κ = 0,83 y MCC = 0,84, en comparación con 0,74/0,75 para ViT-ReT, 0,70/0,71 para Two-Stream LSTM y 0,71/0,72 para Dilated CNN–BiLSTM. Estos resultados mostraron un mayor acuerdo entre las etiquetas predichas y las etiquetas reales para el modelo propuesto.
| Modelo | Conjunto de datos | Kappa de Cohen (κ) | Coeficiente de Correlación de Matthews (MCC) |
| CNN dilatada + BiLSTM [4] | UCF11 (Acciones de YouTube) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| LSTM de dos flujos [38] | UCF11 (Acciones de YouTube) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Transformador de Visión + Transformador Recurrente) [6] | UCF11 (Acciones de YouTube) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| MSCNN–LSTM propuesto | UCF11 (Acciones de YouTube) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
Tabla 5: Comparación del coeficiente kappa de Cohen (κ) y el coeficiente de correlación de Matthews (MCC) en diferentes modelos de aprendizaje profundo. Comparación del rendimiento de MSCNN-LSTM, ViT-ReT, Two-Stream LSTM y Dilated CNN + BiLSTM en los conjuntos de datos UCF11, UCF Sports y JHMDB. Valores más altos indican un mayor acuerdo entre las etiquetas predichas y reales, así como una mayor fiabilidad en la clasificación. Los valores se reportan como media ± DE de cinco ejecuciones independientes (n = 5).
Figura 9 presenta las curvas de característica operativa del receptor. La MSCNN-LSTM propuesta alcanzó valores de AUC de 0,975 en UCF11, 0,961 en UCF Sports y 0,937 en JHMDB. Los valores de AUC consistentemente altos indicaron una fuerte discriminación entre clases de acciones en conjuntos de datos de diferente complejidad.
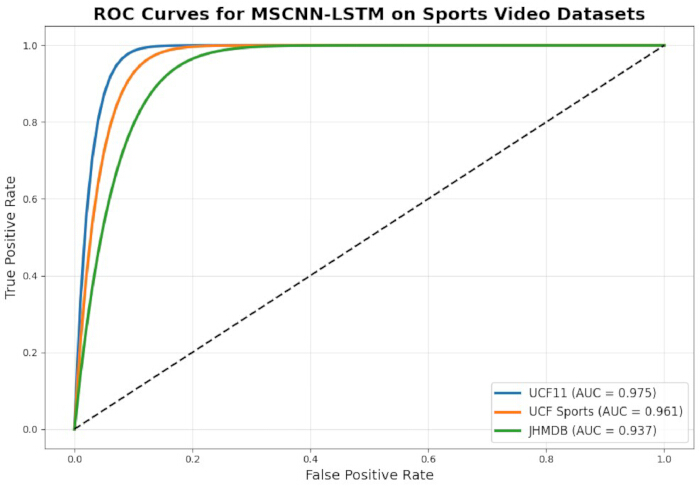
Figura 9: Curvas de característica operativa del receptor (ROC) del modelo propuesto MSCNN-LSTM. Curvas ROC para los conjuntos de datos UCF11, UCF Sports y JHMDB que ilustran el equilibrio entre la tasa de verdaderos positivos y la tasa de falsos positivos. El área bajo la curva (AUC) resume el rendimiento discriminativo del modelo a través de diferentes umbrales de clasificación. Haga clic aquí para ver una versión más grande de esta figura.
Los resultados de rendimiento temporal se resumen en la Tabla 6. En UCF11, el modelo propuesto alcanzó un mAP-T del 98,3 %, una precisión a nivel de fotograma del 96,5 % y un TSI de 0,95. En UCF Sports, los valores correspondientes fueron del 95,4 %, 94,0 % y 0,93. En JHMDB, el modelo alcanzó un mAP-T del 81,7 %, una precisión a nivel de fotograma del 78,9 % y un TSI de 0,88 (Tabla 7). Estos valores fueron superiores a los obtenidos por los modelos comparadores e indicaron una mayor coherencia temporal y estabilidad en las predicciones en secuencias de acciones tanto cortas como largas.
| Método | Conjunto de datos | mAP-T (%) | Precisión a nivel de cuadro (%) | Índice de Estabilidad Temporal (TSI) |
| CNN dilatada + BiLSTM4 | UCF11 (Acciones de YouTube) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCF Sports | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| LSTM de dos flujos38 | UCF11 (Acciones de YouTube) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCF Sports | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Transformador de visión + Transformador recurrente)6 | UCF11 (Acciones de YouTube) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCF Sports | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (Acciones de YouTube) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCF Sports | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
Tabla 6: Comparación de métricas de rendimiento temporal para el reconocimiento de acciones en videos deportivos. Resultados experimentales de la precisión media sobre segmentos temporales (mAP-T), la exactitud a nivel de fotograma y el Índice de Estabilidad Temporal (TSI) para diferentes modelos de aprendizaje profundo en los conjuntos de datos de referencia. Los valores se reportan como media ± DE a partir de cinco ejecuciones independientes (n = 5).
| Configuración | CNN multiescala (MSCNN) | LSTM | Precisión (%) | Puntuación F1 (%) | mAP-T (%) |
| Línea base solo CNN | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| Solo MSCNN | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| MSCNN-LSTM propuesto | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
Tabla 7: Estudio de ablación del marco propuesto MSCNN-LSTM. Contribución al rendimiento de los componentes MSCNN y LSTM bajo condiciones idénticas de entrenamiento y evaluación. Los valores se reportan como media ± DE provenientes de cinco ejecuciones independientes (n = 5).
Figura 10, Figura 11, Figura 12 presentan las matrices de confusión normalizadas por filas para UCF11, UCF Sports y JHMDB, respectivamente. Las tres matrices mostraron una clara dominancia diagonal, lo que indica que la mayoría de las clases de acciones se identificaron correctamente. Se produjeron errores limitados fuera de la diagonal, principalmente entre acciones con características visuales o de movimiento similares. La matriz de JHMDB exhibió una confusión de clases comparativamente mayor, lo que es consistente con el menor rendimiento cuantitativo observado en este conjunto de datos más desafiante.
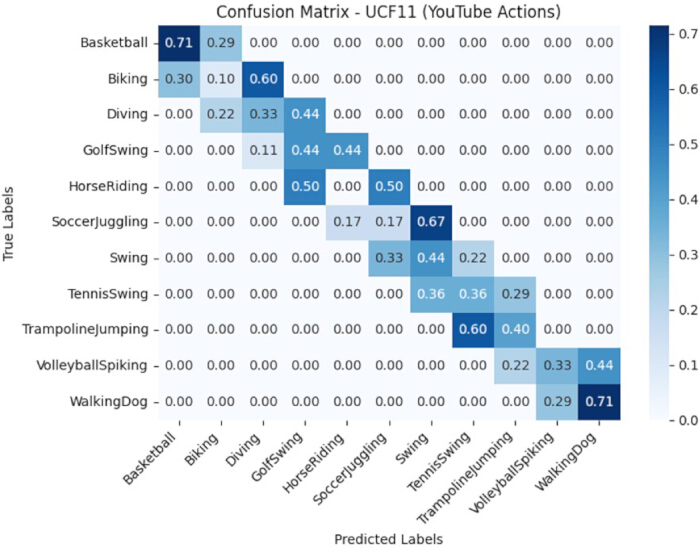
Figura 10: Matriz de confusión normalizada por fila del modelo propuesto MSCNN-LSTM en el conjunto de datos UCF11. Cada fila se normaliza a la unidad, y las entradas diagonales representan la recuperación específica por clase en lugar de la precisión general de clasificación, que se indica por separado. Haga clic aquí para ver una versión más grande de esta figura.
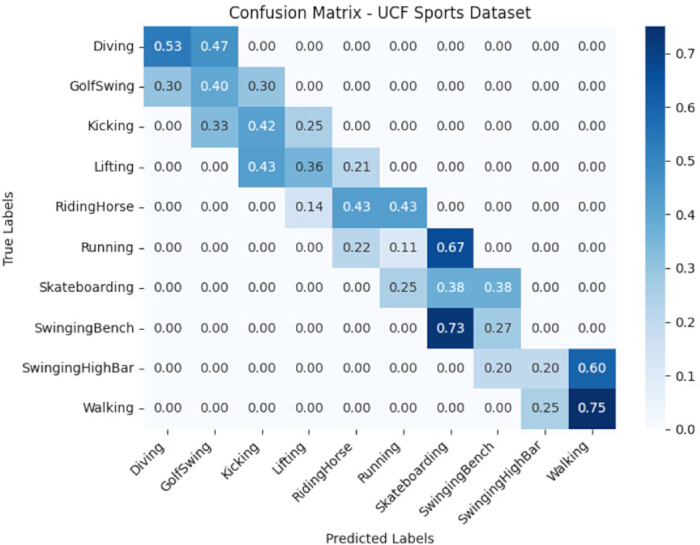
Figura 11: Matriz de confusión normalizada por fila del modelo propuesto MSCNN-LSTM en el conjunto de datos UCF Sports. Cada fila se normaliza a la unidad, y las entradas diagonales representan la recuperación específica por clase en lugar de la precisión general de clasificación, que se indica por separado. Haga clic aquí para ver una versión más grande de esta figura.
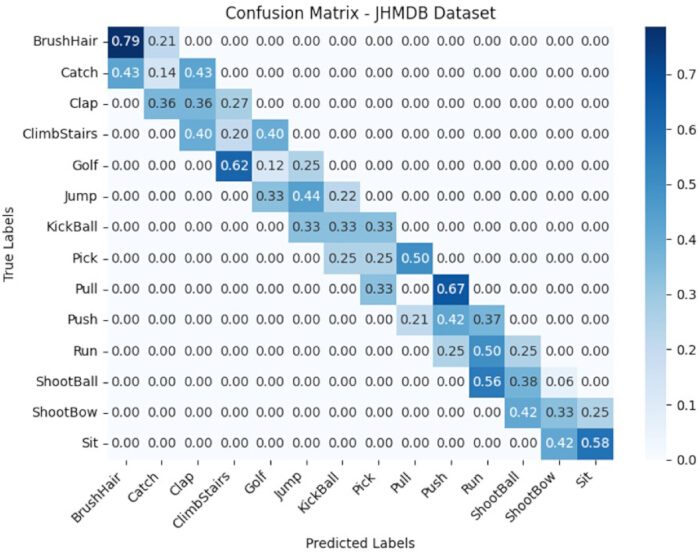
Figura 12: Matriz de confusión normalizada por fila del modelo propuesto MSCNN-LSTM en el conjunto de datos JHMDB. Cada fila se normaliza a la unidad, y las entradas diagonales representan la recuperación específica por clase en lugar de la precisión general de clasificación, que se informa por separado. Haga clic aquí para ver una versión más grande de esta figura.
En general, el marco propuesto MSCNN-LSTM superó de manera consistente a los modelos comparadores evaluados en las mediciones de clasificación, acuerdo, discriminación y estabilidad temporal. Los hallazgos respaldaron la hipótesis de que combinar la extracción multi-escala de características espaciales con modelado temporal basado en LSTM mejora el reconocimiento de acciones deportivas en conjuntos de datos con distinta complejidad de movimiento, calidad de imagen y condiciones de punto de vista.
DISPONIBILIDAD DE LOS DATOS:
Los conjuntos de datos analizados durante el presente estudio están disponibles públicamente en las siguientes fuentes: el conjunto de datos UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) y el conjunto de datos UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Para favorecer la reproducibilidad de este estudio, la canalización de preprocesamiento, la partición del conjunto de datos (generación de divisiones de entrenamiento/validación/prueba), los archivos de implementación, los archivos de configuración y la documentación de apoyo utilizados en los experimentos se han depositado en el repositorio Zenodo y están disponibles públicamente en https://doi.org/10.5281/zenodo.21020947.
Discusión
El marco propuesto MSCNN-LSTM superó consistentemente los enfoques evaluados en los conjuntos de datos de referencia UCF11, UCF Sports y JHMDB. Los métodos anteriores basados en arquitecturas Dilated CNN–BiLSTM, Vision Transformer y CNN 3D han demostrado un aprendizaje efectivo de características espacio-temporales, pero podrían estar limitados por una alta complejidad computacional, requisitos sustanciales de entrenamiento o una representación insuficiente de patrones de movimiento finos23,24,25. En contraste, el marco propuesto integró la extracción multi-escala de características espaciales con un modelado temporal basado en LSTM, permitiendo capturar tanto detalles locales del movimiento como dependencias temporales de largo alcance. Esta integración mejoró el reconocimiento de acciones deportivas complejas, redujo la confusión entre clases y aumentó la coherencia temporal, especialmente en el conjunto de datos más desafiante JHMDB. Estos hallazgos indican que el marco propuesto proporcionó una representación equilibrada de la información espacial y temporal en comparación con los enfoques basados en CNN, redes recurrentes y transformadores evaluados.
Desde una perspectiva teórica, el marco MSCNN-LSTM proporcionó un enfoque unificado para la fusión de características multiescala y el aprendizaje temporal secuencial36,37. El uso de campos receptivos jerárquicos permitió la extracción de información espacial a diferentes escalas, mientras que la LSTM modeló las dependencias entre cuadros de video consecutivos. Este diseño amplió la canalización convencional CNN-LSTM al preservar la información espacial local y contextual antes del modelado temporal. El rendimiento consistente en conjuntos de datos que contienen diversas clases de acciones, patrones de movimiento y puntos de vista de cámara respaldó aún más la robustez de la arquitectura propuesta.
Desde una perspectiva práctica, el marco mostró potencial para el análisis deportivo automatizado, la evaluación del rendimiento de los atletas, la detección de eventos y la comprensión de videos deportivos. Sin embargo, se requiere una validación adicional bajo condiciones operativas del mundo real antes de su implementación. Aunque la arquitectura logró un rendimiento de reconocimiento elevado, su idoneidad para dispositivos con recursos limitados o plataformas de análisis basadas en la nube debe confirmarse mediante una evaluación adicional del costo computacional, el tiempo de inferencia, los requisitos de memoria y el consumo de energía.
El estudio de ablación demostró las contribuciones complementarias de los componentes MSCNN y LSTM. La MSCNN mejoró la extracción de características espaciales mediante el aprendizaje de representaciones a múltiples escalas de campo receptivo, mientras que el LSTM potenció la modelización temporal al capturar dependencias de movimiento entre cuadros consecutivos. La configuración completa MSCNN-LSTM logró el mejor rendimiento, lo que indica que la extracción multi-escala de características espaciales y la modelización de secuencias temporales contribuyeron conjuntamente a la mejora observada en el reconocimiento de acciones.
En general, el marco propuesto MSCNN-LSTM combinó de manera efectiva el aprendizaje de representaciones espaciales y temporales para el reconocimiento de acciones en videos deportivos. La evaluación en los conjuntos de datos UCF11, UCF Sports y JHMDB mostró un rendimiento mejorado en comparación con los enfoques de aprendizaje profundo evaluados. Estos resultados respaldan la hipótesis de que la integración de características convolucionales multiescala con modelado temporal basado en LSTM mejora el reconocimiento de acciones deportivas complejas. Sin embargo, se requiere validación en conjuntos de datos más grandes, diversos y de dominios cruzados para establecer la generalización y la aplicabilidad en el mundo real.
Se deben considerar varias limitaciones. En primer lugar, la evaluación se limitó a conjuntos de datos de referencia disponibles públicamente y puede no representar completamente la diversidad y complejidad de los entornos deportivos del mundo real. En segundo lugar, aunque se utilizaron particiones fijas de entrenamiento, validación y prueba, no se pudo excluir por completo el sesgo del conjunto de datos ni la fuga involuntaria de datos. En tercer lugar, el rendimiento informado puede variar según la composición del conjunto de datos, la inicialización del modelo, los procedimientos de preprocesamiento y la configuración del entrenamiento. Además, los componentes de modelado convolucional y temporal multiescala aumentaron los requisitos computacionales, lo que podría afectar la implementación en dispositivos con recursos limitados. Asimismo, el marco no fue evaluado utilizando conjuntos de datos externos ni escenarios de producción en tiempo real.
Los modelos de video basados en transformadores han mostrado un rendimiento sólido en conjuntos de datos de gran escala para el reconocimiento de acciones, pero a menudo requieren recursos computacionales sustanciales y grandes volúmenes de datos de entrenamiento. El marco MSCNN-LSTM propuesto ofrece un enfoque alternativo mediante la combinación de la extracción de características espaciales multi-escala con modelado temporal recurrente. Futuros trabajos deberían investigar la validación cruzada entre conjuntos de datos, inferencia en tiempo real, optimización computacional, estimación de incertidumbre y arquitecturas híbridas que integren mecanismos de atención basados en transformadores con el marco propuesto de CNN-LSTM multi-escala38.
Divulgaciones
Los autores declaran que no tienen conflictos de intereses.
Agradecimientos
Esta investigación se realizó en el Centro de Tecnología de Inteligencia Artificial (CAIT), Facultad de Ciencias y Tecnología de la Información, Universiti Kebangsaan Malaysia. Los autores agradecen sinceramente el apoyo institucional y las instalaciones de investigación proporcionadas. Este trabajo no recibió financiación específica de ninguna agencia pública, comercial o sin fines de lucro.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| GPU GeForce RTX 3090 | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Utilizado para entrenamiento e inferencia de modelos de aprendizaje profundo |
| Procesador Intel Core i9 | Intel Corporation | 16 núcleos, 3,5 GHz | Utilizado para preprocesamiento y cálculo de datos |
| Memoria del sistema | Generic | 64 GB de RAM DDR4 | Soporta procesamiento de video a gran escala |
| Lenguaje de programación Python | Python Software Foundation | Versión 3.8.18 | Lenguaje de programación principal para la implementación |
| TensorFlow | Versión 2.15 | Entorno de aprendizaje profundo utilizado para el desarrollo del modelo | |
| Sistema operativo | Microsoft Corporation | Windows 11 | Desarrollo del modelo y experimentación |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | Aceleración de GPU para el entrenamiento del modelo |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Biblioteca de aceleración para redes neuronales profundas |
| OpenCV | Open Source | Versión 4.8.1 | Extracción y preprocesamiento de fotogramas de video |
| NumPy | Open Source | Versión 1.24.4 | Cálculo numérico y procesamiento de matrices |
| Scikit-learn | Open Source | Versión 1.3.2 | Evaluación del rendimiento y análisis estadístico |
| Matplotlib | Open Source | Versión 3.7.5 | Visualización de resultados experimentales |
| Conjunto de datos UCF11 | University of Central Florida | Conjunto de datos público | Conjunto de datos de referencia para reconocimiento de acciones deportivas |
| Conjunto de datos UCF Sports | University of Central Florida | Conjunto de datos público | Conjunto de datos de referencia para reconocimiento de acciones deportivas |
| Conjunto de datos JHMDB | Max Planck Institute for Informatics | Conjunto de datos público | Conjunto de datos de referencia para reconocimiento de movimiento y acciones humanas |
Referencias
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543