Este estudio propone un algoritmo que acopla estrechamente las características visuales jerárquicas capturadas por un codificador jerárquico de transformador de ventana desplazada con la profundidad previa de la caja delimitadora 3D Manhattan generada por detección de segmentos de línea, logrando así una reconstrucción semántica de alta precisión de escenas interiores complejas.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Un método de análisis semántico para imágenes de escenas interiores basado en conocimientos previos sobre la estructura de edificios
En este artículo
Resumen
Resumen
Para abordar las discontinuidades de predicción semántica y las distorsiones físicas de los límites causadas por la oclusión de muebles en escenas interiores complejas, este artículo propone un método de análisis semántico que aprovecha los priors de estructura de edificios. El esquema utiliza un codificador jerárquico de transformador de ventana desplazada para extraer características visuales multiescala y combina un algoritmo de detección de segmentos de línea con consistencia en dirección de gradiente para construir una caja delimitadora 3D Manhattan. Esta caja delimitadora se transforma en un campo de distancia con signo (SDF) antes de codificar contornos geométricos discretos en un campo de potencial físico continuo. Un mecanismo de atención cruzada guiado por la estructura fuerza a que las señales visuales se alineen con los límites geométricos ortogonales 3D reales, restaurando la continuidad de las características en las áreas ocluidas. Un grafo de adyacencia espacial construido a partir de nodos superpíxeles impulsa una Red Convolucional de Grafos (GCN) para agregar características, asegurando la consistencia semántica macroscópica dentro del plano físico portador de carga. Una combinación de pérdida de entropía cruzada a nivel de píxel y una pérdida de consistencia estructural diseñada a medida refuerza las restricciones, penalizando las predicciones fuera de límites. Experimentos realizados en múltiples corridas independientes muestran que la intersección media sobre unión (mIoU) alcanza el 68,7% con una desviación estándar del 0,2%, y la puntuación F1 del límite estructural alcanza el 76,4% con una desviación estándar del 0,3%, confirmando el rendimiento robusto de los módulos propuestos. Con un tamaño de nodo de imagen único de 256, el tiempo medio de inferencia se mantuvo en 61 ms.
Introducción
El análisis semántico de imágenes de escenas interiores ocupa una posición central en la cognición espacial tridimensional y en las tareas de razonamiento espacialinteligente 1,2. La extracción de características visuales en entornos físicos reales suele verse gravemente obstaculizada por disposiciones espacialescomplejas 3. Resolver la discontinuidad semántica y la distorsión física de los límites de la estructura de la cimentación del edificio causada por la oclusión de muebles a gran escala es importante para la investigación en cogniciónespacial 4,5. Eliminar con precisión la interferencia de objetos desordenados y restaurar la continuidad física de la misma pared y suelo determinará directamente la precisión de la reconstrucción tridimensional de escenas y el análisis lógico espacialglobal 6. La discontinuidad semántica causada por la oclusión de mobiliario a gran escala y el efecto de reparación estructural de la guía previal propuesta para edificios se ilustran en la Figura 1, donde la entrada ocluida rojo verde azul (RGB) en la Tabla 1A, la distorsión base de la máscara en la Figura 1B y el resultado de reparación previa de la estructura en la Figura 1C se comparan bajo la misma condición de escena interior.
Para cumplir con los requisitos de precisión del razonamiento lógico espacial, las redes visuales actuales impulsadas por píxeles se enfrentan a múltiples obstáculos al tratar con entornos interiorescomplejos 7,8. Los espacios interiores suelen estar llenos de mobiliario denso y mobiliario desordenado, lo que provoca una pérdida significativa de señales de límite visual a bajo nivel en lasimágenes 9. Los mecanismos convencionales de extracción de características dependen en exceso de respuestas locales bidimensionales de color y textura, careciendo de una comprensión macroscópica de las rígidas leyes ortogonales de estructuras tridimensionales hechaspor el hombre 10. Esta limitación del campo receptivo local hace que la propagación de características se interrumpa fácilmente, dificultando la extensión de la topología global a través de lasoclusiones 11. Actualmente, existe una necesidad urgente de resolver el problema central de las discontinuidades en la predicción semántica y las graves distorsiones de los límites físicos causadas por la oclusión einterferencia 12.
Para abordar fallos estructurales en los cimientos de los edificios causados por la oclusión y la interferencia, la comunidad académica ha desarrollado una variedad de medidas de intervencióndirigidas 13. Las redes de agregación de características intermodales compensan eficazmente las deficiencias inherentes de una sola modalidad visual en la percepción espacial introduciendo mapas de profundidad o priors de texto para ayudar con imágenes rojo-verde-azul (RGB) 14,15. Los marcos de percepción de límites y selección adaptativa de contexto inyectan estrategias de mejora física de contornos en la etapa de decodificación de características, lo que mejora considerablemente el ajuste de bordes de los resultados de predicción en escenascomplejas 16,17. Los modelos de inferencia basados en GCNs y mecanismos de interacción de características mejoran significativamente la suavidad de características y la consistencia macrosemántica en regiones homogéneas al construir conexiones a nivel denodo 18,19. Integrar priors estructurales explícitos de Manhattan en la tubería de extracción de características visuales impone límites de consistencia geométrica, lo que aborda los desafíos de discontinuidad de características causados por una oclusión extensa de objetos en primerplano 20.
Para abordar el desafío central de fallos de predicción semántica y distorsiones severas de los límites físicos asociados a la infraestructura de construcción, se propone un marco de análisis semántico basado en un mecanismo de acoplamiento de lazo cerrado que incorpora priors arquitectónicos. Este marco trasciende las canaletas de ingeniería ingenuas al establecer una alineación bidireccional de mapeo entre campos geométricos continuos de potencial y variedades de características visuales discretas, formando una sinergia no trivial que corrige errores de oclusión mediante leyes estructurales. Este esquema se basa en una red de columna vertebral visual multiescala y un algoritmo de detección de segmentos de línea basado en la estimación del punto de fuga, para adquirir características de apariencia local y priors ortogonales de aristas que representan la caja delimitadora 3D de Manhattan en paralelo, y luego transformarlos en una SDF. El algoritmo emplea un mecanismo de atención cruzada guiado por la estructura, empleando características visuales como vectores de consulta y tratando las características SDF como claves y valores para cálculos de producto escalar, forzando así que la señal visual se alinee con el límite geométrico 3D real en el espacio de características. Un grafo de adyacencia espacial construido a partir de nodos superpíxeles y características de borde de coplanaridad espacial se introduce en un GCN para realizar la agregación de características entre nodos y el paso de mensajes. El proceso de optimización de parámetros de extremo a extremo emplea conjuntamente entropía cruzada a nivel de píxel y una función de pérdida de consistencia estructural personalizada, que limita y penaliza estrictamente a los píxeles predichos que cruzan el límite edificio-prior. La cadena completa de análisis semántico se resume en la Figura 2, que vincula la entrada de imágenes RGB, la extracción geométrica de prior, el alineamiento de atención cruzada, el razonamiento de grafos superpíxeles y la decodificación de máscaras semánticas dentro de una arquitectura unificada.
Las primeras redes de análisis sintáctico de escenas dependían de operaciones convolucionales para capturar texturas de apariencia local, pero debido a limitaciones en los campos receptivos locales, mostraban una coherencia semántica insuficiente de objetivos a granescala 21,22. Estudios previos han aplicado el módulo de autoatención de la arquitectura visual Transformer para extraer información contextual global y construir características de asociación de píxeles a largadistancia 23,24. Las estrategias de agregación de características multi-vista multimodal extraen los rasgos geométricos espaciales tridimensionales de la escena fusionando nubes de puntos en el mapa de profundidad y entradas de comandosde texto 25,26. Los mecanismos híbridos de atención para fusión de características dirigidos a dominios específicos han madurado gradualmente. Al construir puentes de interacción de características, han reducido significativamente la pérdida de energía y la escasez de características en la transmisión multiescala de señales visuales, y han mejorado la robustez del análisis sintáctico de estructuras complejas. Los diseños de codificadores de vanguardia integran e inferen conjuntamente detalles espaciales en el dominio de alta frecuencia junto con características globales y locales, reforzando la capacidad de la red para distinguir categorías semánticas de grano fino con alta similitud y mejorando la precisión del análisis eninteriores 27,28. Los avances recientes en arquitecturas de segmentación semántica proporcionan referencias valiosas para optimizar la eficiencia computacional y la percepción espacial. Los modelos diseñados para predicción densa y agregación contextual a escala múltiple extraen características geométricas de grano fino de fondos complejos. Las estrategias de desacoplamiento de características y fusión sinérgica abordan la ambigüedad semántica en las regiones límite. Mecanismos de atención ligeros y módulos de agregación con puertas optimizan la distribución de parámetros, acelerando así la inferencia mientras se preservan los detalles estructurales locales. La implementación de estos diseños arquitectónicos eficientes ofrece una guía teórica para reducir la sobrecarga computacional de las operaciones de inferencia topológica no euclidianas en el análisis de escenas interiores.
Se utilizan los previos de estructura de edificios y la estimación de disposición 3D para corregir errores de análisis visuallocal 29. Estudios previos han extraído características geométricas ortogonales y paralelas de edificios interiores como restricciones de inferencia para reducir el sesgo de predicción de redes causado por fondos interioressaturados 30,31. Los esquemas existentes utilizan algoritmos de detección de segmentos de línea y técnicas de análisis puntual de ablación de imágenes para generar cajas delimitadoras Manhattan 3D que mapeen los límites físicos de las habitaciones y ayuden en la localización de las características visualessubyacentes 32. La arquitectura conjunta del módulo de conciencia de límites y el contexto multiescala incrustan implícitamente información estructural previa en el proceso de decodificación de características de alta dimensión, obligando a la red a producir máscaras semánticas que coincidan estrechamente con los contornos físicos reales, mejorando efectivamente la irregularidad y el desenfoque de los bordes de losobjetos 33. Se han explorado ampliamente diseños de funciones de pérdida semi-supervisadas o débilmente supervisadas con propiedades de realce de fronteras. Apoyándose en fórmulas matemáticas rigurosas para castigar comportamientos independientes de clasificación de píxeles que violan las reglas topológicas espaciales, la suavidad geométrica y la integridad estructural del resultado final de segmentación están garantizadas desde la fuente de optimización degradientes 34.
Algunos estudios han utilizado redes neuronales de grafos para realizar agregación multidominio de características visuales y razonamiento sobre relaciones topológicas en un espacio de altadimensión 35. El algoritmo de segmentación de superpíxeles preagrega bloques de píxeles adyacentes con características similares de respuesta de color y textura en nodos conectados independientes. El algoritmo de segmentación superpíxel comprime la redundancia computacional de la estructura del grafo a nivel de imagen y preserva la topología geométrica básica de la imagen36. El GCN, construido sobre el vector de características nodales de alta dimensión, y la matriz de adyacencia que representa la proximidad espacial impulsa la transmisión direccional eficiente y la fusión interactiva de información visual multiescala a lo largo del grafo físico conectado en el dominioespacial 37,38. La aplicación del módulo de mejora temporal de información y el mecanismo híbrido de salto multiescala suprime el suavizado excesivo y homogeneización de las características del nodo generadas en el proceso de paso profundo de mensajesmulticapa 39. La tecnología de transformación wavelet de grafo multiescala y la estrategia de optimización de aprendizaje de elementos pseudo-etiquetados optimizan el mecanismo antiruido de fondo de la fórmula de actualización de características de nodos, de modo que características con los mismos atributos semánticos mantengan un modo de respuesta cooperativa en topología de redcompleja 40. El mecanismo de razonamiento basado en grafos asigna cuadrículas de píxeles regulares a espacios topológicos no euclidianos para realizar cálculos de agregación de características de estructuras irregulares de edificios y componentesinteriores 41.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Se prepararon conjuntos de datos de escenas RGB interiores y sus anotaciones semánticas antes del entrenamiento en red. El conjunto de datos 3D para interiores a gran escala y el conjunto de datos de escenas interiores RGB-D (véase la Tabla de Materiales) se obtuvieron de sus repositorios oficiales. Se conservaron las escenas de adquisición interiores que contenían oclusión de mobiliario, variación de iluminación, interrupción de límites de muros y complejos diseños espaciales para coincidir con el escenario de análisis objetivo. Las etiquetas semánticas se convirtieron en máscaras de anotación PNG de canal único indexadas, y todas las imágenes RGB y máscaras semánticas se redimensionaron a 512 × 512 píxeles. Durante el entrenamiento se aplicó aumento de datos en línea, con giros horizontales aleatorios con probabilidad de 0,5, escalado aleatorio de brillo entre 0,8 y 1,2, y rotación aleatoria entre −10° y +10° para ampliar la distribución estructural. Los canales RGB se normalizaron con valores medios de 0,485, 0,456 y 0,406 y valores de desviación estándar de 0,229, 0,224 y 0,225. La prueba 3D a gran escala en interiores siguió la división oficial de lanzamiento utilizada en este estudio, con 1201 escenas de entrenamiento y 312 escenas de validación para el desarrollo y validación del modelo. El benchmark RGB-D de escenas interiores siguió el protocolo oficial de evaluación, con 795 imágenes de entrenamiento y 654 imágenes de prueba. No se aplicó ninguna división adicional basada en porcentaje a estos dos referentes públicos.
Se inicializó una red de columna vertebral visual jerárquica de transformadores de ventana desplazada (véase la Tabla de Materiales) como la red troncal del codificador de transformadores de ventana móvil. El tamaño de la incrustación del parche estaba configurado como 4 x 4 píxeles. Las dimensiones de incrustación de las cuatro etapas jerárquicas se establecieron en 128, 256, 512 y 1024, y el número de bloques transformadores en las cuatro etapas se fijó en 2, 2, 18 y 2. El tamaño de la ventana de atención local se estableció en 7 x 7, y el número de cabezas de atención en 4, 8, 16 y 32 para las cuatro etapas jerárquicas. Se usaron funciones de activación continua no lineales dentro de todas las capas de perceptrón multicapa. El muestreo espacial se realizó mediante operaciones de fusión de parches con un paso de 2 tras cada etapa jerárquica. La arquitectura de la red central y los hiperparámetros del módulo de inferencia convolucional se resumieron en la Tabla 1.
A continuación, se realizó la extracción de características de autoatención con ventana desplazada en los mapas de características de entrada. Cada mapa de características se dividía en ventanas locales no solapadas con dimensiones espaciales de 7 × 7. La atención regular de ventana y la atención de ventana desplazada se alternaban entre bloques adyacentes de transformadores de ventana desplazada. La distancia de desplazamiento cíclico se estableció en 3 píxeles y se aplicó codificación de sesgo posicional relativo dentro de cada ventana de atención local. Las características visuales locales se agregaron mediante autoatención multi-cabeza para generar representaciones jerárquicas y a escala múltiple.
Los previos estructurales de Manhattan se extrajeron de imágenes RGB interiores. Los segmentos estructurales de los bordes se detectaron mediante un algoritmo de detección de segmentos de línea de gradiente-dirección-consistencia. Las direcciones estructurales dominantes se agruparon mediante un algoritmo de consenso aleatorio de muestra (RANSAC) (véase la Tabla de Materiales) basado en la estimación del punto de fuga. Se reconstruyeron tres direcciones Manhattan mutuamente ortogonales para generar la representación Manhattan 3D de la caja delimitadora. El límite estructural reconstruido se convirtió en un mapa SDF calculando la distancia euclidiana mínima desde cada píxel hasta el segmento de línea límite más cercano.
Se generaron características de atención cruzada guiadas por estructuras después de que se obtuvieran las características visuales y los previos de SDF. La variedad de características visuales se mapeó al tensor de consulta Q a través de la matriz de transformación lineal W subelemento Q de la tapa de doble acuñación R, a la matriz de formación W, subelemento Q de la tapa de doble acuñación R, a la matriz 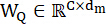 de formación. El campo de distancias continuas previa se mapeó al tensor clave K y al tensor de valor V a través de las matrices
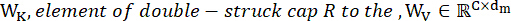 de transformación , y la dimensión del modelo se estableció en 512. La modulación multi-cabeza dividió el espacio de proyección en 8 subespacios independientes, con cada cabeza con una dimensión de 64. La disposición espacial previa proyectaba coordenadas discretas de píxeles en un campo de potencial continuo y generaba la matriz de afinidad estructural S como un sesgo espacial aditivo explícito para modular la matriz de similitud del producto escalar. El tensor de características visuales se utilizó como fuente de consulta porque el análisis semántico requiere que cada ubicación visual recupere activamente evidencia estructuralmente consistente del espacio geométrico a priori. El prior SDF se utilizó como fuente clave y de valor porque almacena la distancia continua de límite y las pistas estructurales interior-exterior derivadas del diseño Manhattan. El término producto escalar medía la compatibilidad entre la apariencia semántica y el prior geométrico, mientras que el término estructural aditivo λS desplazaba los pesos de atención hacia píxeles en el mismo plano físico o cerca del mismo contorno arquitectónico. El coeficiente λ representaba la confianza en el prior estructural extraído y controlaba hasta qué punto se incorporaban restricciones ortogonales rígidas en la distribución de atención. Esta formulación redujo la difusión transfronteriza causada por la oclusión del mobiliario y mantuvo la relajación adaptativa en diseños no Manhattan. La distribución de la atención guiada por la estructura se calculó según la Ecuación 1.
Ecuación 1: 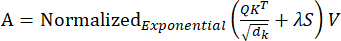
donde A denota la matriz de agregación de atención guiada por estructuras, Q denota el tensor de consulta generado a partir de características visuales, K denota el tensor clave generado a partir de características previas SDF, V denota el tensor de valores generado a partir de representaciones a priori estructurales, dk denota la dimensión de características del tensor clave, λ denota el coeficiente de ponderación estructural adaptativo utilizado para identificar la confianza geométrica de regiones locales y relajar restricciones ortogonales rígidas en espacios no Manhattan y S denota la matriz de afinidad SDF. La división por dk estabilizó la escala de los logits de atención y evitó que las grandes dimensiones de las características produjeran pesos de atención sobreconcentrados. La función exponencial normalizada (véase la Tabla de Materiales) transformaba las puntuaciones de similitud moduladas en una distribución espacial normalizada, permitiendo que cada píxel agregara información estructural previa basada en la consistencia semántica y geométrica. Este diseño explica por qué la apariencia visual y los priors de límite arquitectónico se fusionan a nivel de atención en lugar de por concatenación directa de características.
El grafo de topología de superpíxeles se construyó a partir del mapa de características alineado con la estructura. El mapa de características se segmentó utilizando un algoritmo de generación de regiones espaciales. El número de superpíxeles se estableció en 256, el coeficiente de compacidad en 10, el coeficiente de suavizado gaussiano en 1,0 y el número de iteración en 10. Las restricciones de proximidad espacial se impusieron estableciendo el peso métrico de distancia a una relación constante de 1,0 respecto a la distancia entre el espacio de color de características durante el agrupamiento, manteniendo así una generación uniforme de nodos a través de límites de denso desorden. Los píxeles con respuestas semánticas homogéneas se agregaron en nodos superpíxeles. Las aristas de grafos se construyeron según relaciones de adyacencia espacial, fuerza de afinidad SDF y restricciones de consistencia geométrica coplanar. El proceso de construcción de la matriz de afinidad estructural y la conectividad topológica se muestra en la Figura 3, que muestra cómo la guía SDF se transformó en relaciones espaciales a nivel de grafo.
La formulación de grafos se introdujo para convertir el razonamiento denso píxel a píxel en razonamiento espacial nodo a nodo sobre regiones estructurales homogéneas. Cada nodo superpíxel representaba una región local con respuesta semántica y continuidad espacial similares, mientras que cada arista representaba un camino fiable para la transmisión de características sujeto a las restricciones de adyacencia, afinidad de campo de distancia y consistencia coplanar. Este diseño redujo la influencia de píxeles aislados y ruidosos y permitió que regiones ocluidas de paredes, suelos y techos recibieran mensajes de nodos físicamente adyacentes. Por tanto, la construcción de aristas servía como un puente matemático entre la guía SDF continua y el razonamiento discreto de grafos no euclidianos.
Se configuró una red de razonamiento convolucional de grafos de tres capas con dimensiones ocultas de características 512, 256 y 128. La capa convolucional de grafos realizaba suavizado de características sobre la estructura del grafo basado en las relaciones espaciales de los nodos. La adyacencia de auto-bucle mantuvo el estado original de cada nodo durante el paso de mensajes, evitando que las características de una pequeña región estructural fueran borradas por las grandes regiones circundantes. La normalización simétrica escaló los elementos de la matriz de adyacencia mediante el producto de las raíces cuadradas inversas de los grados de los nodos, de modo que nodos de alto y bajo grado contribuyeron bajo magnitudes numéricas comparables durante la propagación. La propagación por avance de avance realizó una agregación espacial localizada, en la que cada estado de nodo absorbió características de alta dimensión de grupos coplanares adyacentes antes de aplicar la función de rectificación no lineal elemento por elemento. Esta formulación hacía que la capa de convolución de grafos aproximara la difusión semántica a lo largo de planos interiores físicamente significativos en lugar de suavizar sin restricciones los límites de objetos no relacionados. Las características de los nodos del grafo se evaluaron según la Ecuación 2.
Ecuación 2: 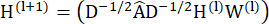
La proyección desde características densas de píxeles hasta nodos superpíxeles, el paso de mensajes de convolución de grafos y la retroproyección de coordenadas se presentan en la Figura 4, aclarando el camino de agregación de características desde cuadrículas de imagen regulares hasta una topología no euclidiana y de vuelta a una representación semántica densa. La proyección desde características densas de píxeles en la Figura 4A a nodos superpíxeles en la Figura 4B, el paso de mensajes de convolución de grafo en la Figura 4C y la retroproyección de coordenadas en la Figura 4D aclaran el camino de agregación de características desde las cuadrículas de imagen regulares hasta una topología no euclidiana y de nuevo a una representación semántica densa.
donde H(l) denota el tensor de características del nodo de la capa de convolución del grafo l-ésimo, Â denota la matriz de adyacencia con conexiones de auto-lazo, D denota la matriz de grados correspondiente a la matriz de adyacencia, W(l) denota la matriz de pesos aprendible de la capa de convolución del grafo l-ésimo, y σ denota la función de activación de la Unidad Lineal Rectificada. El término ÂH(l) agregaba características de nodos superpíxeles adyacentes, mientras que D−1/2 y D−1/2 equilibraban la contribución de nodos con diferentes densidades de conexión. La matriz aprendible W(l) proyectaba características agregadas en un nuevo espacio semántico, permitiendo que la capa de grafos distinga la consistencia estructural de la cercanía espacial ordinaria. La activación no lineal preservó la diferencia en las respuestas entre regiones coplanares y no coplanares tras la agregación de características.
Las características de segmentación semántica se decodificaban tras el razonamiento de grafos. El decodificador se construyó utilizando tres etapas de upsampling bilineal de interpolación y operaciones de fusión de conexión por salto entre capas. Las características superficiales del codificador espacial se concatenaron con características semánticas de alto nivel mediante fusión canal a canal. La resolución de las características se restauró al tamaño original de la imagen, y el mapa final de predicción semántica de probabilidad se generó mediante una capa de convolución 1 × 1.
La red completa de análisis semántico se entrenó usando un optimizador de desintegración de pesos desacoplado (véase la Tabla de Materiales). La tasa de aprendizaje inicial se estableció en 0,0001, el coeficiente de decaimiento en peso en 0,01 y el tamaño del lote en 8 para ambos benchmarks públicos. La tasa de decaimiento del primer momento se estableció en 0,9, la tasa de decaimiento del segundo momento en 0,999 y el coeficiente numérico de estabilidad épsilon en 1 × 10⁻8. La pérdida de validación se monitorizaba al final de cada época, y los puntos de control se guardaban cuando aumentaba el mIoU en el conjunto de validación. La red fue entrenada durante 300 épocas utilizando una estrategia de decaimiento de la tasa de aprendizaje polinómica con una potencia de decaimiento de 0,9. Se realizaron cinco entrenamientos independientes utilizando diferentes inicializaciones de semillas aleatorias para establecer una línea base de evaluación estadísticamente rigurosa. La red se optimizó conjuntamente mediante pérdida de entropía cruzada a nivel de píxel y pérdida de consistencia estructural. Todos los experimentos se realizaron en una plataforma informática equipada con hardware de computación paralela de alta memoria, y la información detallada del hardware se reportó en la Tabla de Materiales.
La optimización conjunta imponía la alineación geométrica de los límites calculando la magnitud del gradiente espacial del tensor de probabilidad de clase. La pérdida de consistencia estructural se utilizó como regularizador, multiplicando la norma de los gradientes de predicción espacial por los valores continuos de SDF. La lógica matemática era que los cambios semánticos de categorías debían concentrarse cerca de los contornos arquitectónicos reales, donde la SDF se aproximaba a cero, mientras que los interiores planos de paredes, suelos y techos debían mantener respuestas semánticas suaves. Cuando un gran gradiente de predicción aparecía lejos de un límite estructural, el término del campo de distancia aumentaba la penalización y desalentaba las transiciones semánticas falsas dentro de un plano físico homogéneo. Cuando aparecía un gradiente de predicción cerca de un contorno de distancia cero, la penalización seguía siendo limitada y preservaba transiciones legítimas de clase a lo largo de los límites arquitectónicos. Las regiones de transición semántica se restringieron a alinearse con los contornos de distancia cero de la SDF, según la Ecuación 3.
Ecuación 3: 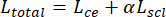
donde Ltotal denota la función objetivo de optimización final, Lce denota la pérdida cruzada de entropía a nivel de píxel, Lscl denota la pérdida de penalización por consistencia estructural y α denota el coeficiente de ponderación de pérdida estructural. El término de entropía cruzada proporcionaba supervisión semántica a nivel de píxel mediante máscaras de anotación, mientras que el término de consistencia estructural imponía regularización geométrica usando priors arquitectónicos. El coeficiente de ponderación α reconocimiento equilibrado de categorías y alineación de fronteras, evitando que la optimización sobreajuste tanto la precisión local de la etiqueta como los contornos estructurales rígidos. Este objetivo conjunto vinculaba semántica visual, consistencia física de los límites y parámetros de red entreenables dentro de un objetivo de optimización unificado.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Montaje experimental
Este estudio utilizó dos conjuntos de datos estándar de análisis de escenas interiores, un conjunto de datos 3D para interiores a gran escala y un conjunto de datos RGB-D para escenas interiores, para evaluar el rendimiento y ajustar el modelo. El conjunto de datos 3D para interiores a gran escala contiene escenas complejas de espacio físico escaneadas de forma realista y vistas RGB de alta resolución, proporcionando etiqu...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
El algoritmo de este artículo acopla estrechamente las características visuales jerárquicas capturadas por un codificador jerárquico de transformador de ventana desplazada con la profundidad previa de la caja delimitadora 3D Manhattan generada por detección de segmentos de línea, logrando así una reconstrucción semántica de alta precisión de escenas interiores complejas. Un mecanismo de atención cruzada guiado por la estructura fuerza la señal visual a alinearse con el verdadero límite g...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no tienen conflictos de interés económicos.
Agradecimientos
Financiación: Programa clave de Investigación y Desarrollo de Shaanxi (Programa nº 2024CY2-GJHX-76).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Referencias
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.