Este protocolo describe la implementación de una plataforma web interoperable que integra datos clínicos basados en FHIR con generación aumentada por recuperación y modelos grandes de lenguaje multiagente para apoyar la toma de decisiones clínicas. El flujo de trabajo permite la implementación reproducible, la integración estandarizada de datos y la evaluación del análisis de datos médicos asistido por inteligencia artificial (AI).
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Plataforma web interoperable basada en modelos de lenguaje extensos para el análisis de datos médicos: un protocolo para el soporte de decisiones clínicas
En este artículo
Resumen
Resumen
La toma de decisiones clínicas frecuentemente se ve obstaculizada por registros electrónicos de salud fragmentados y una interoperabilidad limitada entre sistemas heterogéneos de información sanitaria. Este artículo presenta un protocolo paso a paso para implementar una plataforma web interoperable que integra datos clínicos mediante el estándar Fast Healthcare Interoperability Resources (FHIR), junto con Generación Aumentada por Recuperación (RAG), Modelos de Lenguaje de Gran Tamaño (LLMs) y un marco de razonamiento clínico multiagente para apoyar el análisis de datos médicos y la asistencia en la toma de decisiones clínicas. El protocolo describe el flujo de trabajo completo, incluyendo la configuración del entorno computacional, el preprocesamiento de conjuntos de datos clínicos, la integración de datos basada en FHIR, la construcción de una base de datos vectorial, la configuración de recuperación, la ingeniería de indicaciones (prompt engineering), la orquestación multiagente y la evaluación del sistema. Los resultados representativos demuestran la capacidad de la plataforma para generar respuestas clínicamente relevantes y coherentes en el contexto, mejorando al mismo tiempo la interoperabilidad semántica entre fuentes de datos heterogéneas. El rendimiento del sistema se evaluó utilizando métricas cuantitativas y semánticas complementarias, incluyendo BLEU, ROUGE, BERTScore y similitud del coseno. Se realizó una evaluación cualitativa utilizando conjuntos de datos de referencia sanitarios de acceso público y completamente anonimizados para evaluar la reproducibilidad del flujo de trabajo metodológico propuesto. La arquitectura propuesta combina la interoperabilidad sanitaria estandarizada con modelos de lenguaje mejorados por recuperación para mejorar el razonamiento contextual, reducir las alucinaciones y apoyar flujos de trabajo clínicos asistidos por inteligencia artificial reproducibles. Este protocolo proporciona un marco escalable y reproducible para investigadores y desarrolladores que buscan implementar sistemas sanitarios inteligentes, interoperables y respetuosos con la privacidad, destinados a la asistencia en la toma de decisiones clínicas, el análisis de datos médicos y futuras investigaciones traslacionales.
Introducción
La información de salud se genera rutinariamente en hospitales, centros de diagnóstico, laboratorios y clínicas ambulatorias, y a menudo permanece distribuida entre sistemas de información heterogéneos. Esta fragmentación limita la interoperabilidad y restringe el acceso oportuno a historiales clínicos completos, creando desafíos persistentes para la atención clínica, la integración de datos y la gestión sanitaria1,2,3,4.
Las consecuencias de esta fragmentación resultan particularmente evidentes en los flujos de trabajo clínicos que dependen del acceso oportuno a la información del paciente. Cuando los profesionales de la salud no pueden recuperar historiales médicos completos e integrados, la evaluación clínica se vuelve más difícil, lo que aumenta el riesgo de toma de decisiones incompleta y reduce la eficiencia en la prestación de la atención, especialmente en entornos de emergencia5,6.
Los recientes avances en inteligencia artificial (IA), particularmente en modelos lingüísticos grandes (LLM), han ampliado el rango de enfoques computacionales disponibles para aplicaciones en salud. Estos modelos se han investigado en tareas como asistencia diagnóstica, triaje clínico y apoyo en la toma de decisiones. Por ejemplo, Jahan et al.5 evaluaron el uso de LLM en tareas biomédicas, mientras que Taylor et al.7 investigaron modelos ajustados para la detección digital de salud mental, reportando resultados alentadores en entornos clínicos especializados.
La aplicación de los modelos de lenguaje grande también se ha expandido a dominios clínicos más especializados. Song et al. 49 exploraron su uso en el diagnóstico de neumoconiosis, mientras que Chien et al.8 aplicaron estos modelos para analizar patrones de carga de trabajo entre cuidadores informales. En oftalmología, Xue et al.9 propusieron un sistema de preguntas y respuestas para el diagnóstico de glaucoma, mientras que Tan et al.3 y Wu et al.10 informaron sobre el uso de modelos de lenguaje grande en sistemas diagnósticos híbridos y consultas de medicina tradicional china.
El uso de los modelos de lenguaje de gran tamaño no se limita a aplicaciones clínicas directas. Zhang et al.11 investigaron su aplicación en el reconocimiento de emociones en escenarios de salud mental, mientras que Sarzaeim et al.12 exploraron sistemas de vigilancia inteligente que también podrían contribuir a análisis relacionados con la salud pública. Estos estudios ilustran la amplia aplicabilidad de los enfoques basados en modelos de lenguaje de gran tamaño en diversos ámbitos relacionados con la atención sanitaria.
Aunque los modelos de lenguaje grandes (LLM) han ampliado las posibilidades para aplicaciones en el ámbito sanitario, su integración en entornos clínicos sigue asociada a importantes desafíos técnicos, organizativos y regulatorios. La implementación práctica requiere una infraestructura computacional adecuada, una gobernanza eficaz de los datos y el cumplimiento de marcos regulatorios como el Reglamento General de Protección de Datos (GDPR) y la Ley Brasileña de Protección de Datos Generales (LGPD). Estos marcos establecen requisitos para el procesamiento seguro y ético de información sanitaria sensible, abordando al mismo tiempo cuestiones relacionadas con la privacidad, la fiabilidad y el sesgo algorítmico en los sistemas sanitarios asistidos por inteligencia artificial13,14 .
La interoperabilidad entre fuentes heterogéneas de datos sanitarios, incluidos los registros electrónicos de salud (EHR), sistemas de imágenes médicas y dispositivos del Internet de las Cosas (IoT), sigue representando un desafío técnico importante para la implementación de soluciones sanitarias asistidas por inteligencia artificial. En este contexto, los marcos estandarizados de interoperabilidad como HL7 FHIR proporcionan un mecanismo estructurado para intercambiar información clínica entre diferentes sistemas, preservando al mismo tiempo la coherencia semántica y apoyando la integración escalable.
Este trabajo presenta una plataforma web interoperable que integra modelos de lenguaje grandes con estándares de interoperabilidad en salud para apoyar el análisis de datos médicos en entornos clínicos heterogéneos. La arquitectura propuesta combina la integración de datos basada en HL7 FHIR con generación aumentada por recuperación (RAG) y un marco de procesamiento multiagente para proporcionar un análisis asistido por inteligencia artificial sensible al contexto, manteniendo alineación con los requisitos aplicables de protección de datos, incluida la Ley General de Protección de Datos de Brasil (LGPD).
Este protocolo describe una arquitectura interoperable para integrar datos clínicos heterogéneos utilizando estándares establecidos de interoperabilidad en atención médica. También detalla la implementación de una canalización de procesamiento multiagente basada en modelos de lenguaje grandes y pequeños (LLMs y SLMs), junto con un marco de evaluación que combina métricas cuantitativas y análisis cualitativos para evaluar el comportamiento de la plataforma propuesta.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio no implicó la reclutación de participantes humanos, el acceso a registros de pacientes identificables ni experimentos con animales. El protocolo se desarrolló y evaluó exclusivamente utilizando conjuntos de datos disponibles públicamente y completamente anonimizados para la validación metodológica. No se accedió ni procesó ninguna información personal de salud. Por lo tanto, no se requirió la aprobación de una Junta de Revisión Institucional (IRB) ni de un Comité de Ética en Investigación. El protocolo se desarrolló de acuerdo con los principios aplicables de protección de datos, incluida la Ley General de Protección de Datos de Brasil (LGPD), para apoyar aplicaciones futuras que involucren datos clínicos.
Selección y preprocesamiento del conjunto de datos
El protocolo propuesto se evaluó utilizando conjuntos de datos clínicos de acceso público y completamente anonimizados, que incluyen registros electrónicos de salud estructurados (EHR), datos de respuestas a preguntas clínicas y conjuntos de datos de imágenes médicas para la validación metodológica. Antes de su integración en la plataforma, los conjuntos de datos pasaron por procedimientos estandarizados de preprocesamiento, incluyendo la normalización de datos, eliminación de registros inconsistentes o incompletos, mapeo a recursos HL7 FHIR, limpieza del texto, segmentación en fragmentos de recuperación y generación de incrustaciones para indexación vectorial. Estos pasos de preprocesamiento garantizaron la coherencia semántica entre fuentes de datos heterogéneas, facilitando la interoperabilidad y permitiendo la reproducibilidad del flujo de trabajo propuesto, al tiempo que se mantenía el cumplimiento con los principios aplicables de privacidad de datos.
Los conjuntos de datos se obtuvieron de repositorios de referencia públicos comúnmente utilizados en la investigación de inteligencia artificial y salud digital. Se seleccionaron para representar información clínica heterogénea, incluyendo registros electrónicos de salud (EHR) estructurados, narrativas clínicas no estructuradas, tareas de respuesta a preguntas clínicas y metadatos de imágenes médicas. En lugar de evaluar una cohorte clínica específica, el protocolo se centra en demostrar un flujo de trabajo de implementación reproducible que puede adaptarse a diferentes conjuntos de datos de atención médica. La diversidad de estos conjuntos de datos de referencia permite validar la canalización de interoperabilidad, la generación aumentada por recuperación (RAG) y el marco de razonamiento multiagente a través de múltiples modalidades de datos clínicos.
Configuración del entorno experimental
El entorno experimental se configuró para evaluar la plataforma interoperable bajo condiciones controladas y reproducibles. La arquitectura comprende módulos de ingesta de datos, capas de interoperabilidad, modelos lingüísticos grandes (LLMs) y componentes de evaluación organizados en una única canalización de procesamiento para el análisis de datos médicos. Figura 1 ilustra el flujo de trabajo completo, desde la ingesta de datos clínicos hasta la generación de resultados diagnósticos.
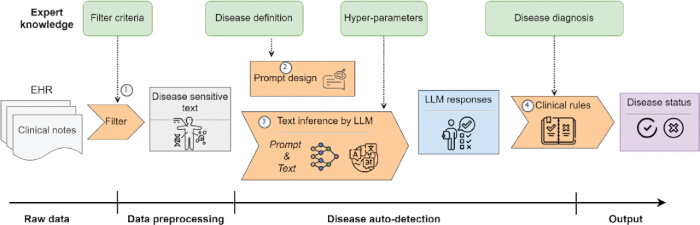
Figura 1: Flujo general del sistema que ilustra la tubería de procesamiento desde los datos clínicos brutos hasta la salida del estado de la enfermedad. El proceso comienza con la ingesta de Registros Electrónicos de Salud (EHR), seguida de filtrado y preprocesamiento de datos para extraer información sensible a enfermedades. Una etapa de diseño de indicaciones estructuradas integra conocimiento experto, definiciones de enfermedades e hiperparámetros, permitiendo una interacción eficaz con el Modelo de Lenguaje de Gran Tamaño (LLM). El LLM realiza inferencia de texto para generar respuestas contextualizadas, que posteriormente se evalúan mediante reglas clínicas para determinar el estado final de la enfermedad. El flujo de trabajo destaca la integración del preprocesamiento de datos, la formulación basada en conocimiento y la inferencia basada en inteligencia artificial para apoyar la toma de decisiones clínicas. Haga clic aquí para ver una versión más grande de esta figura.
Arquitectura de interoperabilidad en atención médica
La infraestructura de backend adopta una arquitectura modular basada en API RESTful para apoyar la comunicación entre los componentes de la plataforma (Figura 2). Esta arquitectura acomoda información clínica heterogénea, incluyendo registros electrónicos de salud (EHR) estructurados, notas médicas y metadatos derivados de sistemas de imágenes médicas. Dado que estos datos provienen de múltiples fuentes y formatos, la interoperabilidad se logra mediante modelos de datos estandarizados, particularmente el marco Fast Healthcare Interoperability Resources (FHIR)15,16,17.. La adopción de FHIR facilita el intercambio de información estructurada al tiempo que preserva la escalabilidad y flexibilidad en entornos clínicos distribuidos. También se incorporaron mecanismos de comunicación basados en HL7 para facilitar la integración con sistemas clínicos heredados, que aún se utilizan ampliamente en instituciones sanitarias16,17.
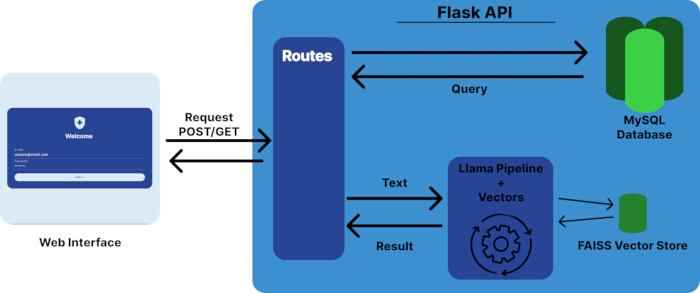
Figura 2: Arquitectura del sistema de la plataforma interoperable propuesta. La interfaz web se comunica con el backend mediante una API Flask utilizando solicitudes HTTP POST/GET. La API gestiona el enrutamiento, el procesamiento de consultas y la interacción con fuentes de datos estructurados y no estructurados. Una base de datos MySQL almacena datos clínicos estructurados, mientras que un almacén vectorial basado en FAISS permite búsquedas de similitud para operaciones de recuperación. La canalización basada en LLaMA procesa entradas de texto y genera respuestas utilizando representaciones vectoriales, posibilitando la generación aumentada por recuperación (Retrieval-Augmented Generation, RAG). La arquitectura destaca la integración de servicios web, gestión de bases de datos, recuperación vectorial e inferencia de modelos de lenguaje grandes en un sistema unificado. Haga clic aquí para ver una versión ampliada de esta figura.
Configuración del flujo de trabajo multiagente
La arquitectura multiagente se organiza en agentes funcionales especializados, responsables de etapas distintas del flujo de trabajo. Un agente de preprocesamiento realiza la normalización de datos y la asignación FHIR, seguido por un agente de recuperación encargado de la búsqueda semántica dentro de la base de datos vectorial. Un agente de razonamiento integra el contexto recuperado con el LLM para generar respuestas, mientras que un agente de validación verifica la coherencia y el formato de la salida antes de que se devuelva la respuesta final. La coordinación entre agentes sigue una estrategia de orquestación secuencial en la que la salida de cada agente sirve como entrada para la etapa siguiente, asegurando una implementación reproducible y modular.
Integración de datos clínicos
La capa de integración de datos agrega información de múltiples fuentes clínicas y la prepara para el procesamiento posterior. El preprocesamiento incluye la normalización de datos, la tokenización y el alineamiento de entidades para mejorar la coherencia semántica entre conjuntos de datos heterogéneos. Dado que la información clínica varía en estructura y calidad, estas operaciones ayudan a reducir el ruido y facilitan la interacción con modelos de inteligencia artificial. También se aplicaron estrategias de mapeo estructurado para armonizar diferentes formatos de datos y mantener la compatibilidad con la canalización de procesamiento, como se ilustra en Figura 315,16,17.
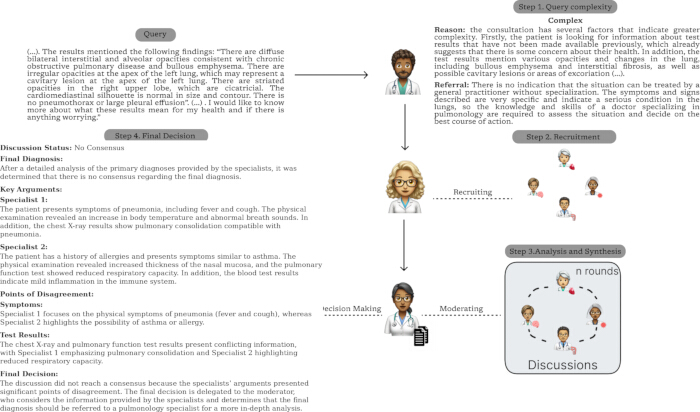
Figura 3: Ejemplo detallado del proceso de razonamiento clínico multiagente. La figura ilustra cómo se analiza una consulta clínica mediante múltiples etapas, incluyendo la evaluación de complejidad, el reclutamiento de especialistas, la discusión colaborativa y la toma final de decisiones. Este proceso demuestra la capacidad del sistema para adaptar dinámicamente las estrategias de razonamiento según la complejidad de la consulta, mejorando tanto la eficiencia como la precisión diagnóstica en escenarios de apoyo a la toma de decisiones clínicas. Haga clic aquí para ver una versión más grande de esta figura.
Configurar la canalización de generación aumentada por recuperación
Se incorpora la generación aumentada por recuperación (Retrieval-Augmented Generation, RAG) para proporcionar un análisis consciente del contexto, combinando la recuperación de información con las capacidades generativas de los modelos grandes de lenguaje. Las consultas del usuario se convierten en representaciones vectoriales mediante modelos de incrustación y se comparan con la base de datos vectorial utilizando una búsqueda semántica por similitud para recuperar los pasajes contextuales más relevantes. Los documentos recuperados se combinan luego con la consulta original antes de la inferencia por parte del modelo grande de lenguaje (LLM). Esta estrategia ayuda a proporcionar información contextual durante la generación de respuestas y se ha asociado con una mayor consistencia factual y una reducción de las alucinaciones en aplicaciones intensivas en conocimiento, incluida la atención sanitaria18,19. Figura 1 y Figura 3 ilustran el flujo de trabajo general de recuperación y el proceso de razonamiento correspondiente.
Para cada solicitud del usuario, el prompt final se construye dinámicamente combinando la consulta original con los pasajes contextuales más relevantes recuperados de la base de datos vectorial. La información recuperada se incorpora como evidencia contextual antes de la inferencia, lo que permite que el modelo de lenguaje genere respuestas basadas en el conocimiento sanitario recuperado, preservando la coherencia semántica y reduciendo las generaciones infundadas.
Ingeniería de indicaciones y razonamiento multiagente
El protocolo incorpora estrategias de estimulación estructurada para mejorar la interpretación contextual durante la generación de respuestas. Estas técnicas de estimulación, junto con mecanismos de inferencia avanzados, ayudan a guiar el proceso de razonamiento en escenarios clínicos complejos y son coherentes con los avances recientes reportados en la literatura20.
La arquitectura incluye un marco multiagente compuesto por módulos especializados que realizan funciones distintas dentro de la tubería de procesamiento, incluyendo validación de datos, filtrado de contexto, apoyo al razonamiento clínico y verificación de resultados. La organización modular permite que las tareas se ejecuten secuencialmente o en paralelo, lo que proporciona flexibilidad para diferentes requisitos de procesamiento (Figura 4). Distribuir estas actividades entre múltiples agentes reduce la dependencia de un único modelo de lenguaje y favorece un flujo de trabajo de procesamiento más robusto. Esta estrategia arquitectónica es coherente con los avances recientes en inteligencia artificial distribuida y diseño de sistemas inteligentes21,22.
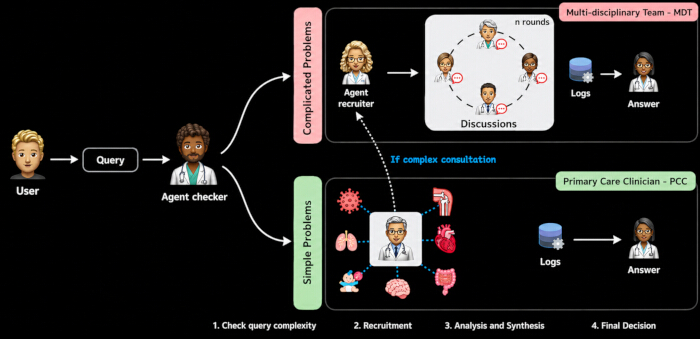
Figura 4: Marco de decisión multiagente para el razonamiento clínico. El proceso comienza con una consulta del usuario, que es evaluada por un agente verificador encargado de determinar la complejidad de la consulta. En los casos complejos, el sistema recluta dinámicamente un equipo multidisciplinario (MDT) compuesto por agentes especializados, que llevan a cabo rondas iterativas de discusión para analizar el problema y sintetizar conocimientos antes de producir una decisión final. En los casos más simples, la consulta es gestionada por un agente de clínica primaria (PCC), lo que permite generar respuestas más rápidamente. Esta arquitectura adaptable equilibra eficiencia y profundidad analítica, mejorando la calidad de las decisiones y la escalabilidad del sistema en aplicaciones sanitarias. Haga clic aquí para ver una versión ampliada de esta figura.
Evaluación del rendimiento
El rendimiento del sistema se evaluó utilizando métricas complementarias que capturan tanto la calidad lingüística como la consistencia semántica de las salidas generadas. Se aplicó BLEU para medir la similitud sintáctica basada en la superposición de n-gramas23, mientras que ROUGE evaluó la recuperación y la cobertura del contenido, particularmente en tareas de resumen y extracción de información24. La similitud semántica se evaluó con BERTScore, que utiliza incrustaciones contextuales derivadas de modelos basados en transformadores para comparar los textos generados y los de referencia25. Los análisis adicionales incluyeron la perplejidad y la similitud del coseno para examinar la confianza del modelo y la coherencia semántica, respectivamente26,27.
Las métricas de evaluación seleccionadas ofrecen perspectivas complementarias sobre el rendimiento del sistema al combinar análisis léxicos y semánticos. Esta combinación es particularmente relevante en aplicaciones de atención médica, donde la interpretación contextual es tan importante como la similitud léxica. La plataforma fue evaluada en un entorno computacional controlado que permite tanto el despliegue en la nube como local. La ejecución local de los modelos lingüísticos grandes (LLM) se incluyó como una opción para cumplir con los requisitos de privacidad de los datos y reducir la dependencia de servicios externos al procesar información clínica sensible. Esta estrategia de despliegue es compatible con los marcos de protección de datos y puede adaptarse a diferentes entornos operativos4.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
El rendimiento del sistema se evaluó utilizando métricas cuantitativas complementarias junto con un análisis cualitativo para examinar tanto la precisión lingüística como la coherencia semántica de las salidas generadas. Esta estrategia de evaluación combina medidas léxicas y semánticas para proporcionar una caracterización más amplia del comportamiento del modelo en tareas de generación de lenguaje relacionadas con la atención sanitaria.
Tabla 1 presenta los resultados cuanti...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
La evaluación presentada en este estudio representa una validación metodológica realizada utilizando conjuntos de datos de referencia en salud disponibles públicamente y completamente anonimizados. No se llevó a cabo ninguna validación clínica prospectiva que involucrara a profesionales de la salud ni reclutamiento de pacientes, ya que el objetivo de este trabajo es demostrar un protocolo de implementación reproducible y no su eficacia clínica.
Los hallazgos de este estudio sugieren que combin...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no tienen intereses financieros competitivos ni relaciones personales que pudieran haber influido en el trabajo reportado en este manuscrito. Las herramientas de inteligencia artificial generativa (AI) se utilizaron exclusivamente para ayudar con la edición del lenguaje, la corrección gramatical y las mejoras en la legibilidad del manuscrito. Todo el contenido científico, el diseño del estudio, la metodología, el análisis de datos, la interpretación de los resultados y las decisiones editoriales fueron desarrollados, verificados y aprobados por los autores, quienes asumen la responsabilidad total sobre el contenido de este manuscrito.
Agradecimientos
Los autores desean agradecer al Laboratorio de Sistemas Embebidos y Distribuidos (LESC), de la Universidad Federal de Ceará (UFC), por proporcionar el entorno de investigación y las discusiones técnicas que apoyaron el desarrollo de este trabajo. Los autores también agradecen a los desarrolladores y mantenedores del software de código abierto, los estándares de interoperabilidad y los conjuntos de datos de acceso público utilizados a lo largo de este estudio.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | Base de datos vectorial utilizada para la búsqueda de similitud en la canalización de Generación Aumentada por Recuperación (RAG). |
| Estándar FHIR | HL7 International | Release 4 (R4) | Estándar de interoperabilidad sanitaria adoptado para el intercambio estructurado de datos clínicos. |
| Flask | Pallets Projects | Version 3.0.3 | Framework web de Python utilizado para implementar la API backend RESTful. |
| Estándar HL7 | HL7 International | Version 2.x | Protocolo de mensajería heredado utilizado para la interoperabilidad con sistemas de información hospitalarios. |
| API REST HTTP | Implementación personalizada | N/A | Capa de comunicación RESTful entre el frontend, backend, base de datos y servicios de inteligencia artificial. |
| LangChain | LangChain Inc. | Version 0.3.x | Framework utilizado para integrar modelos de lenguaje grandes (LLM), ingeniería de indicaciones y flujos de trabajo de Generación Aumentada por Recuperación. |
| LangGraph | LangChain Inc. | Version 0.2.x | Framework utilizado para coordinar el flujo de trabajo de razonamiento clínico multiagente. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | Modelo de lenguaje grande empleado para razonamiento clínico y generación de lenguaje natural. |
| MySQL Community Server | Oracle Corporation | Version 8.0 | Base de datos relacional utilizada para almacenar datos clínicos estructurados. |
| Ollama | Ollama Inc. | Version 0.9.x | Motor de inferencia local utilizado para ejecutar modelos de lenguaje grandes preservando la privacidad del paciente. |
| Python | Python Software Foundation | Version 3.11 | Lenguaje de programación utilizado para implementar la plataforma completa. |
| PyTorch | Linux Foundation | Version 2.4 | Framework de aprendizaje profundo utilizado para la inferencia de modelos de lenguaje grandes. |
| Canalización de Generación Aumentada por Recuperación (RAG) | Implementación personalizada | N/A | Framework de inteligencia artificial que combina recuperación semántica con inferencia de modelos de lenguaje grandes para la generación de respuestas con contexto. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Modelo de incrustación utilizado para generar representaciones vectoriales densas para la recuperación semántica de documentos. |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | Sistema operativo utilizado para el desarrollo y la evaluación experimental. |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | Entorno de desarrollo integrado utilizado para la implementación y depuración del software. |
Referencias
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.