Este estudio presenta un marco de dos etapas para la clasificación de cobertura terrestre hiperspectral y LiDAR, que utiliza la extracción de características mediante MetaFormer y la coincidencia bidireccional de flujos para la alineación cruzada de modalidades antes de la fusión. La evaluación en tres conjuntos de datos públicos de referencia demuestra un rendimiento competitivo en la clasificación bajo protocolos fijos de referencia.
Artículo de investigación
Aprendizaje continuo de campos vectoriales cross-modales para la clasificación de la cobertura terrestre mediante imágenes hiperespectrales y LiDAR
En este artículo
Resumen
Resumen
La clasificación multimodal de sensores remotos desempeña un papel importante en aplicaciones como la cartografía urbana y el monitoreo ambiental. Sin embargo, las distribuciones heterogéneas de características entre las modalidades de detección pueden provocar desalineación de características e inconsistencia semántica, lo que limita la eficacia de la fusión multimodal. Los enfoques existentes de fusión multimodal, incluidos métodos basados en convoluciones, grafos, atención, contraste, transporte y secuencias, pueden aprovechar información complementaria, pero podrían no alinear adecuadamente las distribuciones de características específicas de cada modalidad. Este estudio propone FlowErs, un marco de clasificación multimodal en dos etapas que aborda este desafío mediante la coincidencia de flujos multimodales. La hipótesis de trabajo es que reducir las discrepancias entre distribuciones de características emparejadas antes de la fusión de características mejora la clasificación de cobertura terrestre bajo protocolos de referencia fijos. En la primera etapa, codificadores MetaFormer específicos de cada modalidad extraen representaciones jerárquicas a partir de datos de imágenes hiperespectrales (HSI) y de detección y alcance por luz (LiDAR). A continuación, un módulo de coincidencia de flujos multimodales aprende campos de velocidad condicionados al tiempo para transportar las distribuciones de características emparejadas hacia una representación latente compartida, utilizando un objetivo bidireccional de error cuadrático medio. En la segunda etapa, se reutiliza el módulo de alineación previamente entrenado para alinear las representaciones multimodales antes de que una cabeza de fusión ligera realice la clasificación píxel a píxel. La evaluación en tres conjuntos de datos de referencia públicos demostró una precisión general máxima (OA) del 97,56 % bajo divisiones fijas de referencia. El desempeño varió entre las clases individuales de cobertura terrestre, y en el estudio se analizan las limitaciones específicas por clase y la influencia del desequilibrio de clases en las métricas agregadas. La evaluación actual se limita a experimentos con divisiones fijas, sin análisis estadístico de ejecuciones repetidas ni caracterización computacional. En trabajos futuros se investigará la robustez estadística, la eficiencia computacional y la generalización entre regiones.
Introducción
La clasificación precisa del uso y cobertura de la tierra (LULC) mediante imágenes de sensores remotos es esencial para una amplia gama de aplicaciones del mundo real, incluyendo el desarrollo urbano, la vigilancia ambiental, la gestión de desastres y el desarrollo sostenible1. En los últimos años, se ha incrementado considerablemente la disponibilidad de datos de teledetección multimodal, incluyendo imágenes hiperspectrales (HSI), detección y alcance de luz (LiDAR) y radar de apertura sintética (SAR). Este mayor acceso ha ampliado sustancialmente las capacidades de la teledetección para la clasificación detallada de cobertura terrestre2. Estas modalidades de detección capturan características distintas pero complementarias de la superficie terrestre. Las HSI proporcionan información espectral rica para caracterizar la composición de materiales, mientras que el LiDAR ofrece información precisa sobre estructura y elevación3. La integración de estas fuentes de datos heterogéneos puede generar representaciones de características más discriminativas, tolerantes al ruido y semánticamente completas que cualquiera de las modalidades por separado4.
Sin embargo, la explotación efectiva de datos multimodales sigue siendo un desafío persistente5. Una dificultad principal surge de la heterogeneidad inherente de las modalidades de detección, que difieren en resolución espacial, características de ruido, distribuciones estadísticas y semántica de características6. Por ejemplo, el mismo objeto de cobertura terrestre puede representarse como una firma espectral de alta dimensión en HSI y como estructuras geométricas dispersas en LiDAR7. En consecuencia, las características específicas de cada modalidad a menudo residen en variedades de características diferentes, lo que hace que la fusión directa de características sea ineficaz o potencialmente engañosa. Además, muchos enfoques existentes de fusión multimodal, incluidos los basados en convolución, atención y transformadores, asumen implícitamente que las características extraídas de diferentes sensores ya están alineadas espacial y semánticamente8. Sin embargo, este supuesto a menudo no es válido en aplicaciones prácticas. La simple concatenación de características o la fusión píxel a píxel no pueden capturar adecuadamente las discrepancias entre modalidades, lo que puede resultar en una optimización inestable y un rendimiento de generalización reducido. Además, aunque los métodos de fusión basados en atención mejoran la interacción de características, pueden ofrecer una modelización limitada de las dependencias cruzadas a largo alcance necesarias para la clasificación de cobertura terrestre a gran escala o alta resolución9. En consecuencia, el alineamiento efectivo de representaciones de características heterogéneas sigue siendo un desafío importante en la teledetección multimodal, ya que los incrustados incompatibles pueden limitar la integración de información complementaria.
Para abordar este desafío, la alineación cruzada de modalidades se formula como un problema de transporte condicional de características. La coincidencia de flujos proporciona un marco matemáticamente fundamentado para aprender aplicaciones continuas e invertibles entre distribuciones de características heterogéneas10. Transporta una distribución hacia otra mediante un campo de velocidad dependiente del tiempo, parametrizado por una ecuación diferencial ordinaria (ODE), promoviendo así transformaciones continuas entre variedades de características11. A diferencia de los modelos basados en difusión, que dependen de perturbaciones estocásticas de ruido o de coincidencia implícita de distribuciones mediante entrenamiento adversarial, la coincidencia de flujos aprende transformaciones deterministas y biyectivas entre espacios estructurados de características12. Estas características hacen que la coincidencia de flujos sea especialmente adecuada para la teledetección multimodal, donde la HSI, el LiDAR y el SAR representan cada uno variedades de características de alta dimensión que capturan propiedades complementarias de la superficie terrestre13. Por consiguiente, la coincidencia de flujos ofrece un enfoque riguroso para establecer correspondencia cruzada de modalidades mediante el transporte continuo de características, al tiempo que promueve la consistencia geométrica durante la alineación de características. Bajo supuestos adecuados de regularidad, un flujo ODE puede proporcionar una aplicación invertible; sin embargo, en el presente estudio no se evaluó empíricamente la invertibilidad exacta ni la interpretabilidad física. La hipótesis de trabajo es que reducir las discrepancias entre distribuciones de características emparejadas antes de la fusión de características mejora la clasificación agregada de cobertura terrestre bajo divisiones fijas de referencia.
Motivado por estas consideraciones, el marco propuesto, FlowErs, incorpora una etapa de alineación basada en flujos dentro de una arquitectura de dos etapas. En la primera etapa, se entrena una red de flujos bidireccional para alinear las variedades de características de cada modalidad. Específicamente, los modelos básicos MetaFormer específicos de cada modalidad extraen incrustaciones jerárquicas de características, y se optimiza un objetivo de coincidencia de flujos para transportar muestras entre distribuciones de características específicas de cada modalidad. Este proceso proporciona una transformación suave e invertible entre espacios de características, favoreciendo que las representaciones pertenecientes a la misma clase semántica se alineen más estrechamente dentro de un dominio latente compartido. En la segunda etapa, el alineador de flujos previamente entrenado se mantiene fijo, y las nuevas entradas multimodales se transforman antes de ser fusionadas por un clasificador ligero. Esta estrategia de entrenamiento desacoplada separa el alineamiento geométrico de la clasificación semántica, permitiendo que ambas etapas optimicen objetivos complementarios. El módulo de alineación tiene como finalidad reducir las discrepancias en las distribuciones de características antes de la fusión de características, aunque no se afirma una garantía demostrada de preservación de volumen. Además, FlowErs proporciona una formulación explícita de transporte de características para la fusión multimodal, aunque en el presente estudio no se evaluó por separado la robustez frente a errores de registro.
Las principales contribuciones de este estudio se resumen a continuación. Se presenta FlowErs como un marco en dos etapas para la clasificación multimodal de cobertura terrestre. En el marco propuesto, primero se extraen características específicas de cada modalidad mediante codificadores MetaFormer y luego se alinean a través de un módulo basado en flujos antes de la fusión ligera de características. Este diseño desacoplado permite una optimización eficiente al tiempo que mantiene flexibilidad entre diferentes modalidades de sensado. Además, este estudio investiga la coincidencia condicional de flujos como mecanismo de transporte de características para el alineamiento cruzado por pares en la teledetección multimodal. El módulo de flujo bidireccional predice objetivos de velocidad opuestos para representaciones de características emparejadas antes de la fusión, proporcionando así una estrategia explícita de alineamiento previa a la integración multimodal. Asimismo, se evalúa el marco propuesto en tres conjuntos de datos públicos de referencia, alcanzando una precisión general máxima (OA) del 97,56 % bajo las particiones fijas proporcionadas. También se documentan explícitamente las limitaciones a nivel de clase y el alcance de la evaluación actual.
Avances recientes en la coincidencia de flujos (flow matching) han establecido este enfoque como un potente marco para modelado generativo que unifica modelos basados en difusión, energía y transporte. A diferencia de los modelos de difusión, que simulan trayectorias estocásticas, la coincidencia de flujos aprende una EDO determinista que transporta una distribución previa simple, como ruido gaussiano, hacia la distribución de datos objetivo mediante un campo de velocidad aprendible15. Esta formulación relaciona directamente la estimación del score con la evolución de la densidad, lo que resulta en trayectorias de probabilidad más suaves y una dinámica de entrenamiento más estable. Una ventaja clave de la coincidencia de flujos es su formulación determinista y computacionalmente eficiente. Los modelos de flujo rectificado16 simplifican aún más las trayectorias de transporte hasta convertirlas en caminos casi rectos, mejorando la estabilidad numérica y permitiendo la generación de muestras de alta calidad con relativamente pocos pasos de integración. Estudios posteriores, incluidos los modelos de consistencia17, han incorporado objetivos inspirados en la difusión en marcos compactos basados en flujos para lograr una calidad de muestra comparable o mejorada con inferencia eficiente. Además, el entrenamiento basado en flujos puede aprovechar estructuras previamente entrenadas de difusión, facilitando el uso de priores generativos a gran escala mientras se reducen los costos de muestreo. Estudios recientes han extendido la coincidencia de flujos a una amplia gama de aplicaciones. Por ejemplo, Hu et al.18 investigaron estructuras tipo transformador y manipulaciones en el espacio latente para edición de imágenes controlable y componible mediante coincidencia de flujos. Otras aplicaciones incluyen síntesis de imágenes19, diagnóstico de fallas en rodamientos20 y soldadura robótica multitrayecto y multijunta21. En conjunto, estos estudios demuestran que la coincidencia de flujos es aplicable más allá de la síntesis de imágenes de alta resolución y condicional, a la vez que proporciona una base teórica sólida con potencial para la generalización de dominios. Al aprender mapas de transporte continuos y deterministas, la coincidencia de flujos ofrece un equilibrio entre eficiencia, controlabilidad y fidelidad generativa. Su formulación basada en EDO ofrece una perspectiva unificada del modelado generativo moderno y proporciona una base teórica para aplicaciones que involucran representación multimodal de datos y alineación de características.
La clasificación multimodal de sensores remotos busca superar las limitaciones de las modalidades individuales de detección mediante la integración de información complementaria procedente de HSI, imágenes multiespectrales, LiDAR y SAR. Los enfoques de fusión temprana dependían de características diseñadas manualmente o algoritmos basados en núcleos, como las máquinas de vectores de soporte (SVM), pero estaban limitados por la alta dimensionalidad y la interacción insuficiente entre modalidades22. Los avances en el aprendizaje profundo han permitido estrategias de fusión estructuradas, incluyendo fusión temprana, intermedia y tardía, siendo la fusión a nivel de características una solución práctica que equilibra la integración de información y la complejidad computacional23. Las redes neuronales convolucionales (CNN) capturan eficazmente la información espacial-espectral local, mientras que las arquitecturas basadas en Transformers modelan dependencias de largo alcance a un costo computacional mayor24. En consecuencia, las arquitecturas híbridas CNN–Transformer se han vuelto cada vez más populares porque combinan las fortalezas complementarias de ambos enfoques. Ejemplos representativos incluyen métodos de fusión a escala adyacente que mejoran la información contextual mediante interacciones entre escalas25 y marcos multiescalares que combinan características superficiales de CNN con representaciones profundas de Transformers utilizando mecanismos de atención adaptativa26. En conjunto, estos estudios destacan la importancia de una interacción eficaz entre escalas y modalidades para reducir la redundancia de características y mejorar la representación semántica.
Recientemente, también se han explorado estrategias complementarias para el aprendizaje multimodal. Por ejemplo, los métodos de representación de bajo rango, como el marco guiado por la curva de Ebbinghaus, reducen el sobreajuste al preservar la estructura de la variedad mientras suprimen la información redundante27. En paralelo, se ha investigado el aprendizaje multimodal distribuido para abordar las limitaciones de privacidad y comunicación en aplicaciones prácticas. Por ejemplo, FedFusion proyecta características superficiales en subespacios de bajo rango para permitir el aprendizaje multimodal federado28. En conjunto, estos estudios ilustran tres direcciones de investigación complementarias: arquitecturas híbridas CNN–Transformador para equilibrar la modelización de características locales y globales, aprendizaje de bajo rango para reducir redundancia y ruido, y aprendizaje distribuido para una implementación escalable y respetuosa con la privacidad. Sin embargo, aún persisten desafíos importantes, incluyendo el desequilibrio entre modalidades, la disponibilidad limitada de datos etiquetados y el compromiso entre la compresión del modelo y la precisión de clasificación. Estos desafíos han motivado una investigación continua en marcos ligeros y generalizables para la fusión multimodal. Enfoques recientes de alineación multimodal también han incorporado atención cruzada, aprendizaje contrastivo, fusión basada en grafos, adaptación de dominio y estrategias de coincidencia de distribuciones. En contraste, FlowErs formula la alineación multimodal como un transporte de características emparejadas y condicionado al tiempo, y se presenta como una estrategia de alineación complementaria, no como un reemplazo universal para los enfoques existentes.
Protocolo
En este estudio se utilizaron exclusivamente conjuntos de datos de referencia de acceso público (Houston2013, Augsburg y MUUFL) para la clasificación de cobertura terrestre mediante teledetección. No se incluyeron participantes humanos, experimentos con animales ni muestras biológicas recién recolectadas. Por lo tanto, no se requirió aprobación ética institucional.
Resumen del estudio
El marco propuesto FlowErs realiza la clasificación multimodal de cobertura terrestre mediante una estrategia de aprendizaje en dos etapas. Su flujo de trabajo general se ilustra en la Figura 1A–C. El marco consta de tres componentes principales: (i) codificadores basados en MetaFormer que extraen representaciones jerárquicas de características a partir de modalidades sensoras heterogéneas, (ii) un módulo de coincidencia de flujos multimodal (MFM) que alinea explícitamente las distribuciones de características entre modalidades, y (iii) una cabeza de clasificación ligera que predice categorías de cobertura terrestre a partir de las representaciones de características fusionadas. El flujo de trabajo general primero extrae características específicas de cada modalidad, luego alinea estas características dentro de un espacio latente compartido mediante la coincidencia de flujos condicional, y finalmente realiza la clasificación de cobertura terrestre a nivel de píxel utilizando las representaciones multimodales alineadas.
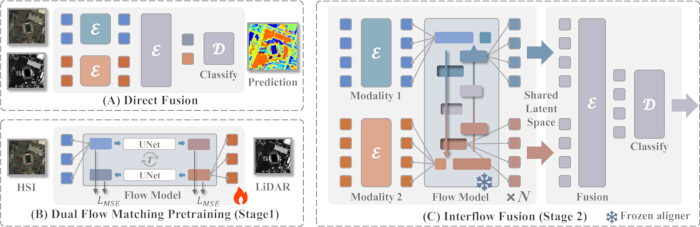
Figura 1: Descripción general del marco FlowErs propuesto para la clasificación multimodal de cobertura terrestre. (A) Fusión convencional directa de características, en la cual las características específicas de cada modalidad extraídas de imágenes hiperspectrales (HSI) y datos de detección y alcance de luz (LiDAR) se concatenan directamente antes de la clasificación. (B) Etapa 1: Preentrenamiento bidireccional mediante coincidencia de flujos multimodales. Una U-Net condicionada por tiempo aprende el transporte continuo bidireccional entre representaciones de características específicas de cada modalidad mediante una función de pérdida de error cuadrático medio para alinear distribuciones heterogéneas de características. (C) Etapa 2: Fusión mediante flujo intercambiado. El módulo preentrenado de coincidencia de flujos se mantiene fijo y se reutiliza para alinear las representaciones de características específicas de cada modalidad antes de la fusión ligera de características y la clasificación de cobertura terrestre a nivel de píxel. E, codificador; D, decodificador; T, incrustación temporal; , función de pérdida de error cuadrático medio; S, representación latente compartida. Haga clic aquí para ver una versión más grande de esta figura.
El marco propuesto separa el alineamiento de características de la clasificación semántica mediante una estrategia de entrenamiento en dos etapas. Durante la primera etapa, el módulo MFM se entrena para aprender el transporte bidireccional de características entre variedades de características específicas de cada modalidad. Durante la segunda etapa, el módulo de alineamiento de flujos previamente entrenado se congela y se reutiliza para alinear las representaciones de características multimodales antes de la fusión ligera de características y la clasificación. Este diseño desacoplado permite que el módulo de alineamiento y la red de clasificación optimicen objetivos complementarios, a la vez que reducen las discrepancias en la distribución de características antes de la fusión multimodal.
Resumen teórico
La coincidencia de flujos es un paradigma reciente de modelado generativo que aprende una transformación determinista continua entre dos distribuciones de probabilidad. A diferencia de los modelos basados en difusión, que introducen estocasticidad mediante perturbaciones de ruido, la coincidencia de flujos parametriza directamente un campo de velocidad aprendible que transporta continuamente una distribución de probabilidad hacia otra. Esta formulación de transporte continuo permite el alineamiento de características mediante una EDO, permitiendo que representaciones de características emparejadas provenientes de diferentes modalidades sensoriales evolucionen a lo largo de una trayectoria compartida antes de la fusión de características. En el presente estudio, se adopta la coincidencia de flujos condicional para aprender el transporte bidireccional de características entre incrustaciones específicas de la modalidad extraídas por los codificadores MetaFormer. El modelo se entrena utilizando un objetivo de coincidencia de flujos condicional que minimiza la discrepancia entre los campos de velocidad predichos y los objetivos a través de representaciones de características interpoladas. La formulación matemática completa, la derivación teórica, las ecuaciones gobernantes y el objetivo de entrenamiento se proporcionan en Supplementary File 1.
Formulación del problema
La clasificación de cobertura terrestre a partir de datos de teledetección multimodal implica aprender representaciones semánticas a partir de modalidades de detección heterogéneas, como HSI y LiDAR. Estas modalidades presentan características de detección distintas. HSI adquiere información espectral rica con cientos de canales ( ), mientras que LiDAR proporciona información estructural detallada con relativamente pocos canales (
 ). Este desequilibrio entre riqueza espectral y escasez estructural crea una brecha de dominio considerable en las distribuciones de características, lo que hace que la fusión directa de características sea subóptima y potencialmente inestable.
Formalmente, dada una pareja de entradas multimodales, 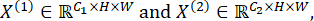 el objetivo consiste en predecir un mapa semántico a nivel de píxel de acuerdo con la Ecuation 1:
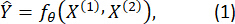
Aquí, 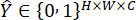 es el tensor de etiquetas codificado en one-hot, C denota el número total de categorías de cobertura terrestre, y θ representa todos los parámetros entrenables del modelo. El conjunto de datos Houston2013 tiene un tamaño de imagen de 349 × 1905 píxeles con 144 bandas hiperspectrales (HSI) y 1 banda LiDAR. El conjunto de datos Augsburg tiene un tamaño de imagen de 1152 × 480 píxeles con 224 bandas HSI y 1 banda LiDAR. El conjunto de datos MUUFL tiene un tamaño de imagen de 325 × 220 píxeles con 64 bandas HSI y 2 bandas LiDAR. Para todos los conjuntos de datos, los fragmentos de imagen de entrada se redimensionaron a 32 × 32 píxeles antes del entrenamiento.
Los enfoques multimodales convencionales fusionan características específicas de cada modalidad mediante la concatenación o mecanismos de atención, suponiendo implícitamente que las diferentes modalidades residen en un espacio de características compatible. Sin embargo, esta suposición rara vez se cumple en los datos de teledetección, ya que las distribuciones estadísticas específicas de cada modalidad y sus características espaciales y espectrales difieren sustancialmente.
Para vincular explícitamente esta discrepancia, se introduce un módulo de coincidencia de flujo,  . El módulo se parametriza mediante
 y aprende transformaciones continuas bidireccionales entre variedades de características específicas de cada modalidad. Específicamente (Ecuación 2),
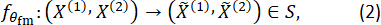
Aquí, S denota el espacio latente compartido en el que las representaciones de características específicas de cada modalidad están alineadas geométricamente. Posteriormente, las representaciones de características alineadas se fusionan y clasifican según la ecuación 3 de la siguiente manera:
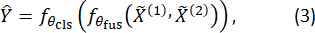
Aquí,  y
 denotan los módulos de fusión de características y clasificación, respectivamente. Esta formulación define el marco general de FlowErs. En lugar de depender únicamente de la fusión estadística implícita de características, el marco propuesto introduce un mecanismo explícito de alineación basado en flujos que transporta continuamente las representaciones de características específicas de cada modalidad a un espacio latente compartido antes de la fusión de características multimodales y la predicción semántica.
Codificador MetaFormer
FlowErs realiza alineación de características multimodal mediante codificadores ligeros específicos para cada modalidad, que aprenden representaciones de características informativas y geométricamente consistentes a partir de cada modalidad sensorial. Como se ilustra en la Figura 2, cada modalidad es procesada por un codificador independiente basado en la arquitectura MetaFormer. MetaFormer generaliza el diseño fundamental del Transformer al separar la mezcla de tokens de la transformación de canales, sin calcular explícitamente la autoatención. Este diseño permite un procesamiento eficiente de HSI de alta dimensión, a la vez que se mantiene adaptable a modalidades con pocos canales, como LiDAR.
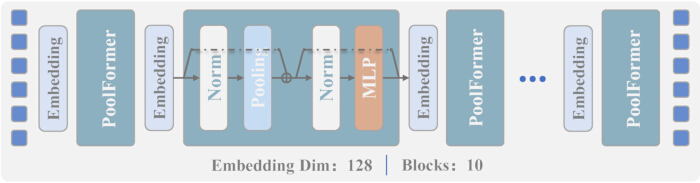
Figura 2: Arquitectura del codificador MetaFormer específico por modalidad utilizado en el marco propuesto FlowErs. El codificador transforma entradas específicas de cada modalidad en representaciones jerárquicas de características mediante la repetición de incrustaciones y bloques PoolFormer. Cada bloque PoolFormer consta de normalización, mezcla de tokens basada en agrupación, adición residual, normalización y un perceptrón multicapa (MLP). Las representaciones jerárquicas de características resultantes se envían al módulo multimodal de coincidencia de flujo para la alineación de características entre modalidades. Norm, normalización; MLP, perceptrón multicapa. Haga clic aquí para ver una versión más grande de esta figura.
Para cada modalidad  , el codificador MetaFormer
 , transforma la entrada
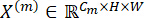 en una jerarquía de representaciones de características latentes (Equation 4):
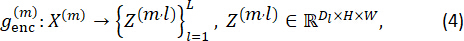
Aquí, L denota el número total de etapas del codificador, y Dl denota la dimensión del incrustado en la etapa l. El codificador MetaFormer consta de tres etapas (N = 3) con dimensiones de incrustado de 64, 128 y 256, respectivamente. Los números correspondientes de bloques PoolFormer en cada etapa son 2, 6 y 2, siguiendo la arquitectura jerárquica progresiva descrita en el manuscrito.
Cada codificador comienza con una convolución de 1 × 1 que proyecta los canales de entrada en un espacio de incrustación común (Ecuación 5):
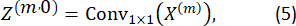
Después de esta capa de proyección hay L bloques MetaFormer apilados. Cada bloque consta de dos operaciones residuales: (i) mezcla de tokens mediante agrupación espacial para agregar información contextual y (ii) transformación de canales mediante un perceptrón multicapa (MLP) para refinar las representaciones de características espectro-espaciales. Estas operaciones se expresan mediante las ecuaciones 6 y 7 de la siguiente manera:
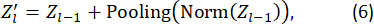

Aquí, Pooling(·) denota la agregación de contexto espacial basada en agrupamiento promedio y MLP(·) denota una red convolucional de alimentación directa de dos capas que incorpora activación GELU y regularización por abandono (dropout).
El codificador sigue una arquitectura jerárquica en la que la dimensión del embedding aumenta progresivamente a través de etapas sucesivas (por ejemplo, 64  128 256). Este diseño progresivo permite que las capas más profundas codifiquen información espacial-espectral cada vez más rica, al tiempo que mejora la capacidad representacional de las características aprendidas. La implementación utiliza un kernel de agrupación de 3 × 3, una dimensión oculta de MLP de 128 y una tasa de abandono (dropout) de 0,1. Todas las capas convolucionales dentro del codificador MetaFormer utilizan kernels de 1 × 1 con un paso (stride) de 1 y sin relleno (padding). El operador de agrupación utiliza un agrupamiento promedio de 3 × 3 con un paso de 1 y un relleno de 1. Se utiliza normalización por lotes (BatchNorm2d) en todo el codificador. El MLP tiene una dimensión oculta de 128, emplea la función de activación GELU y utiliza una tasa de abandono de 0,1. Las tres etapas del codificador contienen 2, 6 y 2 bloques PoolFormer, respectivamente, y estas configuraciones arquitectónicas se aplican de forma consistente en todas las etapas.
En comparación con los codificadores basados en Transformer, el codificador MetaFormer elimina el costo computacional cuadrático asociado con la autoatención, al tiempo que reduce el sesgo específico a la modalidad durante la extracción de características. Su mezclador de tokens basado en agrupación agrega eficientemente el contexto espacial local, mientras que el alineamiento entre modalidades se realiza posteriormente mediante el módulo de coincidencia de flujo. En consecuencia, las representaciones de características de nivel más alto producidas por el codificador proporcionan entradas semánticamente informativas y geométricamente consistentes para el alineamiento de características multimodales.
Correspondencia de Flujo Multimodal
El desafío principal tras la extracción de características es la alineación de representaciones de características heterogéneas procedentes de distintas modalidades sensoriales que residen en variedades de características diferentes. La concatenación directa de  y
 a menudo tiene un rendimiento deficiente debido a distribuciones de características inconsistentes y sesgos específicos de cada modalidad. FlowErs aborda explícitamente este desafío mediante la introducción de un módulo MFM que aprende transformaciones continuas y bidireccionales entre los dos espacios de características, como se ilustra conceptualmente en Figura 1B.
Sea 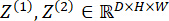 la representación de características extraída por los codificadores MetaFormer. Se define un campo de flujo continuo parametrizado por el tiempo de interpolación
 utilizando la Ecuación 8 de la siguiente manera:
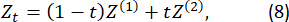
Aquí, t = 0 corresponde a la modalidad fuente y t = 1 corresponde a la modalidad objetivo.
El modelo de coincidencia de flujo, , se implementa como una U-Net condicionada al tiempo que predice el campo de velocidad instantáneo que rige la transformación a lo largo de esta trayectoria de interpolación. Cada predictor de flujo consta de tres bloques de submuestreo (64 128 256 512) y tres bloques correspondientes de sobremuestreo (512 256 128 64) que utilizan convoluciones de 3 × 3, normalización por lotes y activación mediante unidad lineal rectificada (ReLU). Las incrustaciones intermedias de tiempo tienen dimensiones de 128, 256, 512, 256 y 128, respectivamente. La incrustación de tiempo utiliza una codificación posicional sinusoidal fija. La integración de la EDO se realiza mediante el método de Euler hacia adelante con un tamaño de paso fijo. Durante el entrenamiento, el número de pasos de integración se estableció en 6, mientras que durante la inferencia se utilizaron de forma predeterminada 5 pasos de integración. El número real de iteraciones del bucle de integración se calcula como 
El campo de velocidad predicho viene dado por la Ecuación 9 de la siguiente manera:
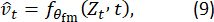
Aquí,  denota la velocidad instantánea predicha. El modelo aprende a aproximar el desplazamiento
 animando así a transformaciones continuas entre espacios de características específicos de cada modalidad. El objetivo de entrenamiento se formula como una pérdida bidireccional de error cuadrático medio (MSE) condicionada al tiempo, como sigue (Equation 10):
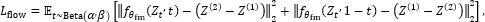 (10)
El muestreo de t a partir de la distribución Beta especificada expone al modelo a estados intermedios de interpolación, pero no establece una consistencia cíclica exacta. A diferencia de los métodos de alineación basados en difusión, la formulación propuesta de coincidencia de flujos es determinista, no requiere muestreo estocástico durante la inferencia y puede entrenarse utilizando datos tanto etiquetados como no etiquetados.
Un modelo de flujo entrenado sirve posteriormente como un operador de alineación determinista que proyecta representaciones de características específicas de cada modalidad en un espacio latente compartido S. Las representaciones alineadas se obtienen de la siguiente manera (Ecuación 11):
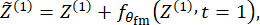
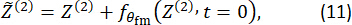
Aquí,  y
 denotan las representaciones de características alineadas. El alineamiento basado en flujo se aplica a las representaciones de características intermedias de las dos primeras etapas del codificador (Etapas 1 y 2), con dimensiones de incrustación de 64 y 128, respectivamente. Las características del codificador de nivel más alto (Etapa 3, dimensión de incrustación 256) no son procesadas por el módulo de coincidencia de flujo. En cambio, estas características se concatenan directamente y se envían al clasificador para la predicción multimodal.
Este mecanismo de alineación bidireccional transporta progresivamente representaciones de características específicas de cada modalidad hacia un espacio latente compartido mediante un campo de flujo continuo. En consecuencia, y se alinean más estrechamente antes de la fusión de características multimodales, proporcionando representaciones de características semánticamente consistentes y geométricamente compatibles para la clasificación posterior.
Secuencia de entrenamiento
FlowErs aprovecha datos etiquetados y no etiquetados al mismo tiempo que mantiene una alineación transmodal estable mediante una estrategia de entrenamiento en dos etapas, como se ilustra en la Figura 1(B,C). Durante la primera etapa, se aprende un módulo de alineación invariante a la modalidad mediante coincidencia de flujos no supervisada. Durante la segunda etapa, se realiza una clasificación supervisada utilizando las representaciones latentes alineadas, reutilizando al mismo tiempo el módulo de alineación de flujos previamente entrenado.
Fase 1: Preentrenamiento de flujo no supervisado
Dadas pares de imágenes multimodales,  se extraen representaciones específicas de la modalidad,
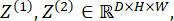 , utilizando los codificadores MetaFormer. Las representaciones intermedias de características se generan mediante la interpolación definida en la Ecuación 8, donde
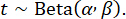 . El módulo de coincidencia de flujo,
 , se optimiza minimizando el objetivo bidireccional condicionado al tiempo definido en la Ecuación 10, sin utilizar etiquetas de clase. Durante esta etapa, solo se actualizan los parámetros de coincidencia de flujo,
 , lo que permite al modelo aprender correspondencias conscientes de la geometría a partir de muestras etiquetadas y no etiquetadas antes de la clasificación supervisada. La etapa 1 (preentrenamiento mediante coincidencia de flujo) se realizó utilizando el optimizador AdamW con una tasa de aprendizaje de 1 × 10⁻4, una disminución de peso de 1 × 10⁻2 y un programa de enfriamiento cosenoidal para la tasa de aprendizaje. Se utilizaron tamaños de lote de 16 para los conjuntos de datos Houston2013 y Trento, mientras que se usaron tamaños de lote de 32 para los conjuntos de datos Augsburg y MUUFL. El módulo de coincidencia de flujo se preentrenó durante 2.000 épocas utilizando muestras etiquetadas y no etiquetadas. La semilla aleatoria se fijó en 3407. Todos los experimentos se realizaron utilizando PyTorch en una única GPU NVIDIA A100 (80 GB de memoria).
Fase 2: Clasificación supervisada con un alineador compartido
El módulo preentrenado de coincidencia de flujo se reutiliza durante el entrenamiento supervisado y se aplica a las dos primeras etapas del codificador en lugar de a todos los niveles de características. Las representaciones de características alineadas se fusionan posteriormente mediante la cabeza de clasificación para generar predicciones a nivel de píxel. La optimización supervisada minimiza la pérdida de entropía cruzada enmascarada (Ecuación 12):
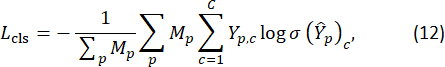
Aquí, M denota la máscara de etiquetas, Y denota las etiquetas reales codificadas en formato one-hot, y σ(·) denota la función softmax. Durante la Etapa 2 (entrenamiento supervisado), el módulo preentrenado de coincidencia de flujos permaneció completamente congelado y actuó como un operador fijo de alineación multimodal. Sus pesos preentrenados se cargaron al inicio de la Etapa 2 y no se actualizaron durante el entrenamiento supervisado. Únicamente se optimizaron los parámetros del codificador MetaFormer y del clasificador. El entrenamiento supervisado se realizó utilizando el optimizador AdamW con tasas de aprendizaje específicas para cada conjunto de datos: 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) y 1 × 10⁻5 (Trento). La disminución de peso (weight decay) se estableció en 1 × 10⁻2 para todos los conjuntos de datos excepto para MUUFL, para el cual se utilizó un valor de 5 × 10⁻2. Se emplearon tamaños de lote de 16 o 32 según el conjunto de datos. Los modelos se entrenaron durante 100 épocas (Houston2013 y MUUFL), 200 épocas (Augsburg) y 20 épocas (Trento) utilizando un programa de tasa de aprendizaje con enfriamiento cosenoidal (cosine annealing). Se utilizó CrossEntropyLoss con reducción por media como función de pérdida. No se aplicó detención temprana; en su lugar, se seleccionó como modelo final el punto de control que alcanzó la mayor precisión general (OA) en el conjunto de prueba. El flujo completo de implementación del procedimiento de entrenamiento en dos etapas se resume en Archivo Suplementario S1 (Algoritmo S1).
Esta estrategia de entrenamiento desacoplado separa el alineamiento geométrico de la discriminación semántica. En la Etapa 1, el modelo aprende mapeos bidireccionales de características continuas utilizando el objetivo de coincidencia de flujo. En la Etapa 2, el módulo de alineamiento preentrenado proporciona una operación común de transporte de características antes de la fusión de características multimodales, mientras que la red de clasificación aprende representaciones discriminativas por clases a partir del espacio latente alineado. Reutilizar el alineador preentrenado promueve un alineamiento de características consistente antes de la fusión, pero no se presenta como una garantía independiente de una mejor generalización.
Conjuntos de datos experimentales
El marco propuesto se evaluó utilizando tres conjuntos de datos de referencia multimodales de teledetección representativos: Houston201329, Augsburg30 y MUUFL31.
El conjunto de datos Houston2013 fue publicado como parte del Concurso de Fusión de Datos IEEE GRSS. Representa un paisaje urbano diverso en Houston, EE. UU., y contiene 15 clases de cobertura del suelo, incluyendo zonas residenciales, carreteras, vegetación y cuerpos de agua. El conjunto de datos incluye imágenes espectrales hiperespectrales (HSI) con 144 bandas espectrales que abarcan el espectro visible hasta el infrarrojo cercano, junto con un modelo digital de superficie (DSM) derivado de LiDAR de una sola banda, con una resolución espacial de 2,5 m. Las texturas urbanas complejas y la variabilidad espectral sustancial dentro de las clases hacen que este conjunto de datos sea un reto para la clasificación precisa de la cobertura del suelo.
El conjunto de datos de Augsburgo se adquirió sobre una zona urbana densamente construida en Alemania. Comprende imágenes hiperspectrales con 224 bandas espectrales que cubren el rango de longitud de onda de 400 a 1000 nm, junto con datos de elevación LiDAR co-registrados. El conjunto de datos contiene 17 clases anotadas de cobertura del suelo, incluyendo estructuras edificadas, suelo desnudo, asfalto, vegetación y sombra, con una resolución espacial de 2 m. En comparación con Houston2013, Augsburgo presenta correlaciones espectrales más fuertes junto con una mayor diversidad de clases, lo que proporciona un punto de referencia desafiante para evaluar el alineamiento de características cruzadas y la generalización.
El conjunto de datos MUUFL Gulfport fue recopilado sobre un campus universitario y representa un entorno semirrural que contiene vegetación abundante junto con pequeñas estructuras artificiales. El conjunto de datos incluye imágenes hiperespectrales denoizadas de 64 bandas junto con mediciones LiDAR de doble banda que consisten en información de elevación e intensidad. Contiene 11 clases de cobertura terrestre y presenta detalles espaciales finos, píxeles mixtos y condiciones variables de iluminación, lo que lo hace especialmente adecuado para evaluar la fusión de características multimodales en la clasificación de objetos pequeños.
En conjunto, estos tres conjuntos de datos de referencia abarcan una variación considerable en resolución espacial (1–2,5 m), dimensionalidad espectral (64–224 bandas), complejidad de la escena y composición del uso del suelo. En consecuencia, proporcionan una base diversa para evaluar la eficacia y la generalización de los métodos multimodales de clasificación del uso del suelo. Las características principales de los conjuntos de datos se resumen en Tabla 1. Las particiones de entrenamiento/prueba para los tres conjuntos de datos corresponden a las divisiones oficiales de referencia proporcionadas por los proveedores originales de los datos. Específicamente, el conjunto de datos Houston2013 utiliza la partición oficial del Concurso de Fusión de Datos IEEE GRSS 2013, que comprende 2.832 muestras de entrenamiento y 12.197 muestras de prueba. El conjunto de datos Augsburg utiliza las anotaciones oficiales mask_train y mask_test, produciendo 4.538 muestras de entrenamiento y 47.896 muestras de prueba. El conjunto de datos MUUFL utiliza la partición oficial train_test_gt.mat, que contiene 28.645 muestras de entrenamiento y 24.283 muestras de prueba. Para cada conjunto de datos, se extrajo un parche de imagen de 32 × 32 píxeles centrado en cada píxel etiquetado como una muestra individual de entrenamiento o prueba. No se realizó ninguna división adicional de los datos ni remuestreo.
| Propiedad | Houston2013 | Augsburg | MUUFL |
| Tamaño de la imagen HSI (píxeles) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Tamaño de la imagen LiDAR (píxeles) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Bandas espectrales HSI | 144 | 224 | 64 |
| Bandas LiDAR | 1 | 1 | 2 |
| Rango de longitud de onda HSI | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| Rango de longitud de onda LiDAR | No aplicable | No aplicable | No aplicable |
| Resolución espacial (HSI) | 2.5 m | 2.0 m | 0.54 m × 1.00 m |
| Resolución espacial (LiDAR) | 2.5 m | 2.0 m | 0.60 m × 0.78 m |
| Número de clases de cobertura terrestre | 15 | 17 | 11 |
Tabla 1: Características de los tres conjuntos de datos de referencia de teledetección multimodal utilizados para la evaluación. La tabla resume las dimensiones de las imágenes, las características espectrales, las resoluciones espaciales y el número de clases de cobertura terrestre para los conjuntos de datos de referencia Houston2013, Augsburg y MUUFL utilizados para evaluar el marco propuesto FlowErs.
Detalles de implementación
El marco FlowErs se implementó en PyTorch y se entrenó y evaluó utilizando una unidad de procesamiento gráfico (GPU) con 80 GB de memoria. El entrenamiento se realizó durante 100 épocas con un tamaño de lote de 16. Se utilizó el optimizador AdamW con una tasa de aprendizaje inicial de 1 × 10⁻⁴ y una disminución de peso de 1 × 10⁻². Se empleó un programador de tasa de aprendizaje con recocido cosenoidal para actualizar la tasa de aprendizaje durante todo el entrenamiento. Se aplicó una tasa de abandono (dropout) de 0,1 para mejorar la generalización del modelo y reducir el sobreajuste. Se utilizó la función de pérdida de entropía cruzada para la optimización supervisada. Para garantizar la reproducibilidad, todos los experimentos se inicializaron utilizando una semilla aleatoria fija de 3407. Se utilizaron las particiones de entrenamiento/prueba proporcionadas sin crear una división adicional de validación. Cada fragmento de entrada se redimensionó a 32 × 32 píxeles antes del entrenamiento. No se aplicó aumento de datos, corrección explícita de registro de imágenes ni normalización adicional del cargador de datos. Los píxeles asociados con etiquetas negativas se excluyeron del cálculo de la pérdida supervisada. No se evaluó por separado el manejo de píxeles faltantes o ruidosos.
Métricas de evaluación
Se utilizaron tres métricas de evaluación ampliamente adoptadas para evaluar el rendimiento de la clasificación: OA, Precisión Promedio (AA) y el coeficiente Kappa (k). OA mide la proporción de muestras clasificadas correctamente entre todas las muestras, AA representa la precisión media de clasificación en todas las clases de cobertura terrestre, y el coeficiente Kappa cuantifica el acuerdo entre las clasificaciones predichas y de referencia después de tener en cuenta el acuerdo por azar. Valores más altos de las tres métricas indican un mejor rendimiento de clasificación. Todos los valores reportados en Tablas 2–6 son estimaciones puntuales fijas obtenidas utilizando la semilla aleatoria 3407. No se reportan intervalos de confianza, pruebas de significancia estadística ni valores p.
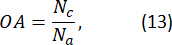
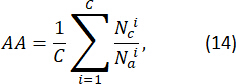
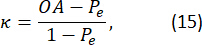
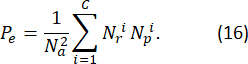
Aquí, Nc y Na indican el número total de muestras clasificadas correctamente y el número total de muestras evaluadas, respectivamente.  y
 indican el número de muestras clasificadas correctamente y el número total de muestras para la clase i-ésima, respectivamente. En el cálculo del coeficiente Kappa, Pe indica la probabilidad de acuerdo debida al azar, y
 y
 indican los conteos de muestras de referencia y predichas para la clase i-ésima, respectivamente.
Resultados
El flujo de trabajo general de evaluación del marco propuesto FlowErs se ilustra en la Figura 1, que resume la estrategia de clasificación multimodal en dos etapas. El proceso de extracción de características específico por modalidad basado en el codificador MetaFormer se muestra en la Figura 2, y las características principales de los tres conjuntos de datos de referencia utilizados para la evaluación se resumen en la Tabla 1. Posteriormente, el rendimiento de clasificación se evaluó en los conjuntos de datos de referencia MUUFL, Houston2013 y Augsburg utilizando la OA, la AA y el coeficiente Kappa (κ) definidos en la sección de Protocolo.
Comparación con otros métodos
Se incluyeron varias redes de clasificación multimodal de referencia para proporcionar una comparación integral del marco propuesto. DFINet32 integra información hiperspectral y multiespectral mediante un módulo de atención cruzada por profundidad para mejorar la interacción de características a través de múltiples objetivos de pérdida. DSHFNet33 introduce una estrategia de fusión jerárquica dinámica que combina progresivamente representaciones de escala fina y escala gruesa. MDL-Middle34 emplea una estrategia de fusión de características en capas intermedias para equilibrar la información proveniente de múltiples modalidades de sensores. CMCL35 trata los datos de HSI y LiDAR como vistas complementarias de la misma escena y aplica aprendizaje contrastivo junto con un ajuste fino dual para mejorar la alineación de características. Two-Branch36 utiliza una arquitectura convolucional de doble camino que procesa independientemente cada modalidad antes de la fusión de características. ExViT37 realiza el procesamiento de fragmentos multimodales mediante ramas Transformer en paralelo con módulos de atención cruzada entre modalidades. DSymFuse38 extiende la arquitectura Transformer de doble rama mediante una fusión jerárquica de características locales y globales. CTPMSN39 combina arquitecturas convolucionales y Transformer con alineación de indicaciones textuales y visuales para mejorar la coherencia semántica y la discriminación de clases. Los valores de comparación se obtuvieron de las publicaciones citadas o de sus protocolos de evaluación reportados, y no fueron generados utilizando una implementación unificada ni un marco experimental común. Por lo tanto, estas comparaciones deben interpretarse como comparaciones descriptivas de referencia y no como evaluaciones controladas directas.
Conjunto de datos MUUFL
Los resultados de clasificación obtenidos para el conjunto de datos MUUFL Gulfport se resumen en la Tabla 2, y se presentan mapas de clasificación representativos en la Figura 3A–J. En la división fija del conjunto de referencia reportada, el marco propuesto alcanzó una OA del 95,24 % y un coeficiente Kappa del 93,69 %, frente al 93,99 % y 92,03 %, respectivamente, de CTPMSN. El rendimiento por clase varió entre las categorías de cobertura del suelo. En comparación con CTPMSN, el marco propuesto logró mayores precisiones de clasificación para las clases Árboles, Mayormente Césped y Superficie Mixta, con aumentos del 2,73 %, 3,16 % y 1,86 %, respectivamente. En contraste, la clase Bordillo Amarillo siguió siendo difícil debido al número limitado de muestras disponibles, y su precisión reportada fue inferior a la de varios métodos comparativos. Por consiguiente, la mejora observada en el rendimiento agregado no debe interpretarse como una indicación de un desempeño superior en cada clase individual de cobertura del suelo. La comparación cualitativa en la Figura 3A–I muestra los mapas de clasificación generados por los métodos evaluados, mientras que la Figura 3J presenta el mapa de referencia correspondiente, ilustrando la distribución espacial de las clases de cobertura del suelo en todo el conjunto de datos MUUFL Gulfport.
| Clase | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Árboles | 89.2 | 74.91 | 87.31 | 84.86 | 91.32 | 92.64 | 91.24 | 95.55 | 98.28 |
| Principalmente césped | 72.98 | 84.63 | 76.38 | 86.54 | 80.65 | 77.48 | 79.57 | 88.92 | 92.08 |
| Superficie mixta | 69.22 | 34.77 | 68.33 | 54.75 | 67.92 | 82.07 | 82.23 | 87.92 | 89.78 |
| Tierra/arena | 76.68 | 87.06 | 78.74 | 84.45 | 78.32 | 93.74 | 89.17 | 97.27 | 93.55 |
| Camino | 86.68 | 81.09 | 83.76 | 86.25 | 84.34 | 90.35 | 85.6 | 94.52 | 95.94 |
| Agua | 100 | 99.25 | 88.52 | 98.53 | 100 | 99.38 | 100 | 100 | 97.56 |
| Sombra | 83.29 | 90.65 | 92.12 | 97.72 | 84.89 | 91.47 | 91 | 95.98 | 90.54 |
| Edificio | 93.26 | 90.22 | 89.69 | 97.54 | 93.76 | 89.27 | 96.29 | 96.29 | 98.26 |
| Acera | 57.34 | 53.09 | 77.06 | 77.98 | 71.32 | 73.54 | 79.62 | 88.07 | 79.61 |
| Banqueta amarilla | 84.28 | 1.03 | 96.75 | 80.62 | 81.41 | 93.72 | 91.57 | 97.37 | 48.91 |
| Paneles de tela | 97.92 | 92.79 | 99.41 | 98.41 | 99.21 | 99.41 | 100 | 99.41 | 93.13 |
| Precisión general (OA) | 83.87 | 74.29 | 83.54 | 82.45 | 85.61 | 89.94 | 88.78 | 93.99 | 95.24 |
| Precisión promedio (AA) | 82.76 | 73.23 | 84.37 | 85.9 | 85.1 | 90.12 | 89.54 | 94.68 | 88.88 |
| Coeficiente Kappa (κ × 100) | 79.82 | 67.92 | 78.84 | 78.37 | 81.22 | 85.37 | 85.37 | 92.03 | 93.69 |
Tabla 2: Rendimiento de clasificación (%) de diferentes métodos en el conjunto de datos de referencia MUUFL. Rendimiento de clasificación por clase junto con la precisión general (OA), precisión promedio (AA) y coeficiente Kappa (κ) obtenidos por el marco propuesto FlowErs y los métodos competidores en el conjunto de datos de referencia MUUFL.
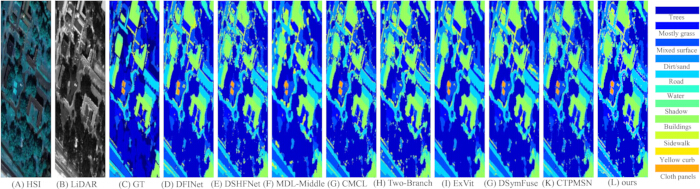
Figura 3: Resultados representativos de clasificación de cobertura terrestre para el conjunto de datos de referencia MUUFL. (A) Imagen hiperespectral (HSI). (B) Imagen de detección y alcance por luz (LiDAR). (C) Mapa de referencia de terreno real (GT). (D–L) Mapas de clasificación generados por DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN y el marco propuesto FlowErs, respectivamente. La leyenda de colores identifica las clases de cobertura terrestre representadas en cada mapa de clasificación.Haga clic aquí para ver una versión más grande de esta figura.
conjunto de datos Houston2013
Los resultados de clasificación obtenidos para el conjunto de datos Houston2013 se presentan en la Tabla 3, y los mapas representativos de clasificación se muestran en la Figura 4A–J. En la división fija del conjunto de referencia reportada, el marco propuesto alcanzó una OA del 97,56 % y un coeficiente Kappa del 97,39 %. En comparación con los resultados reportados de CTPMSN, el marco propuesto demostró una OA aproximadamente 3,8 puntos porcentuales más alta. También se observaron mejoras en las clases Residencial y Carretera, con aumentos reportados de aproximadamente 2,4 y 0,5 puntos porcentuales, respectivamente. Sin embargo, la clase Comercial siguió siendo comparativamente difícil y mostró una precisión de clasificación más baja que varios métodos competidores, lo que podría reflejar similitudes espectrales y espaciales con otras categorías urbanas de cobertura del suelo. En general, los resultados agregados indican un mejor desempeño de clasificación en este conjunto de referencia, aunque demostrando que el rendimiento varió entre las clases individuales. La comparación cualitativa en la Figura 4A–I muestra los mapas de clasificación generados por los métodos evaluados, mientras que la Figura 4J presenta el mapa de referencia correspondiente de referencia, que ilustra la distribución espacial de las clases de cobertura del suelo a lo largo del conjunto de datos Houston2013.
| Clase | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Hierba sana | 82.39 | 85.58 | 83.1 | 82.91 | 80.31 | 81.67 | 80.06 | 96.96 | 100 |
| Hierba estresada | 100 | 94.65 | 85.06 | 95.68 | 92.44 | 100 | 78.67 | 94.27 | 96.94 |
| Hierba sintética | 100 | 98.12 | 99.6 | 94.93 | 99.23 | 99.01 | 99.41 | 99.41 | 99.84 |
| Árbol | 100 | 93.09 | 91.57 | 93.37 | 98.75 | 98.96 | 95.55 | 96.21 | 99.6 |
| Suelo | 98.76 | 99.91 | 98.86 | 99.43 | 99.2 | 99.91 | 98.67 | 99.43 | 100 |
| Agua | 94.5 | 93.1 | 100 | 97.3 | 95.32 | 100 | 95.8 | 100 | 97.6 |
| Residencial | 87.5 | 66.65 | 97.64 | 92.58 | 90.87 | 93.28 | 87.22 | 86.86 | 99.29 |
| Comercial | 91.53 | 76.29 | 88.13 | 87.96 | 95.31 | 89.27 | 85.85 | 94.61 | 84.07 |
| Carretera | 84.19 | 36.29 | 85.93 | 80.76 | 82.63 | 89.42 | 93.29 | 88.07 | 92.73 |
| Autopista | 69.32 | 89 | 74.42 | 57.41 | 66.69 | 71.33 | 67.95 | 81.66 | 99.74 |
| Ferrocarril | 96.76 | 94.78 | 84.54 | 79.57 | 93.44 | 92.88 | 79.13 | 97.7 | 99.72 |
| Estacionamiento 1 | 83.27 | 88.39 | 95.39 | 52.83 | 85.67 | 89.63 | 91.07 | 93.28 | 95.42 |
| Estacionamiento 2 | 85.36 | 96.46 | 87.37 | 92.42 | 86.17 | 89.47 | 84.21 | 95.09 | 99.18 |
| Cancha de tenis | 100 | 97.3 | 95.14 | 83.04 | 98.72 | 97.89 | 100 | 100 | 99.72 |
| Pista de atletismo | 99.21 | 100 | 100 | 97.02 | 100 | 97.97 | 100 | 100 | 99.83 |
| Precisión general (OA) | 91.21 | 85.02 | 89.55 | 83.87 | 90.01 | 91.57 | 87.57 | 93.74 | 97.56 |
| Precisión promedio (AA) | 92.42 | 87.55 | 91.05 | 85.76 | 90.98 | 92.32 | 89.09 | 94.9 | 97.58 |
| Coeficiente Kappa (κ × 100) | 91.09 | 83.59 | 87.59 | 82.76 | 89.1 | 90.85 | 85.29 | 93.21 | 97.39 |
Tabla 3: Rendimiento de clasificación (%) de diferentes métodos en el conjunto de datos de referencia Houston2013. Rendimiento de clasificación por clase junto con la precisión general (OA), precisión promedio (AA) y coeficiente Kappa (κ) obtenidos por el marco propuesto FlowErs y los métodos competidores en el conjunto de datos de referencia Houston2013.
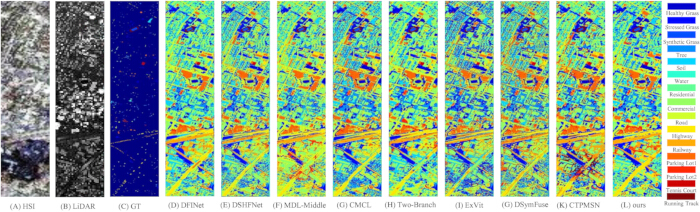
Figura 4: Resultados representativos de clasificación de cobertura terrestre para el conjunto de datos de referencia Houston2013. (A) Imagen hiperespectral (HSI). (B) Imagen de detección de luz y alcance (LiDAR). (C) Mapa de referencia de terreno real (GT). (D–L) Mapas de clasificación generados por DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN y el marco propuesto FlowErs, respectivamente. La leyenda de colores identifica las clases de cobertura terrestre representadas en cada mapa de clasificación. Haga clic aquí para ver una versión más grande de esta figura.
Conjunto de datos de Augsburgo
Los resultados de clasificación obtenidos para el conjunto de datos de Augsburg se resumen en la Tabla 4, y se presentan mapas de clasificación representativos en la Figura 5A–J. Este conjunto de datos se caracteriza por una variación sustancial dentro de las clases y una estructura de fondo compleja. En la división fija del conjunto de pruebas reportada, el marco propuesto alcanzó una OA de 97.56% y una AA de 89.21%. En comparación con los métodos de referencia enumerados, el marco propuesto reportó precisiones de clasificación más altas para las clases Industrial y Comercial en aproximadamente 14 y 45 puntos porcentuales, respectivamente. La diferencia entre OA y AA indica que el rendimiento general se vio influenciado por la frecuencia de las clases, mientras que AA refleja el rendimiento promedio en todas las clases. Por lo tanto, la OA reportada debe interpretarse junto con los resultados por clase, ya que el rendimiento de la clasificación varió entre las distintas categorías de cobertura del suelo. La comparación cualitativa en la Figura 5A–I muestra los mapas de clasificación producidos por los métodos evaluados, mientras que la Figura 5J presenta el mapa de referencia correspondiente de referencia, que ilustra la distribución espacial de las clases de cobertura del suelo a lo largo del conjunto de datos de Augsburg.
| Clase | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Árboles | 96.41 | 98.21 | 91.72 | 94.27 | 95.85 | 93.64 | 90.58 | 93.36 | 99.57 |
| Residencial | 96.88 | 42.08 | 95.19 | 69.84 | 92.75 | 97.71 | 96.32 | 97.37 | 98.97 |
| Industrial | 58.2 | 47.29 | 62.61 | 35.22 | 72.66 | 65.82 | 72.45 | 64.6 | 86.41 |
| Plantas bajas | 92.22 | 51.75 | 87.76 | 80.27 | 88.9 | 84.88 | 89.65 | 96.72 | 99.58 |
| Huertos | 55.87 | 95.94 | 50.86 | 89.33 | 72.86 | 46.85 | 62.91 | 58.69 | 91.22 |
| Comercial | 10.98 | 50.91 | 24.24 | 45.59 | 20.32 | 24.49 | 17.22 | 29.73 | 74.3 |
| Agua | 22.87 | 67.78 | 29.04 | 54.87 | 36.82 | 24.49 | 13.27 | 15.53 | 74.39 |
| Precisión general (OA) | 88.78 | 56.59 | 87.74 | 75.94 | 87.29 | 87.72 | 88.35 | 91.56 | 97.56 |
| Precisión promedio (AA) | 62.29 | 65.47 | 63.06 | 67.61 | 67.78 | 62.56 | 63.2 | 65.14 | 89.21 |
| Coeficiente Kappa (κ × 100) | 84.32 | 46.78 | 82.69 | 67.83 | 82.58 | 82.49 | 83.36 | 87.88 | 96.48 |
Tabla 4: Rendimiento de clasificación (%) de diferentes métodos en el conjunto de datos de referencia de Augsburg. Rendimiento de clasificación por clase junto con la precisión general (OA), precisión promedio (AA) y coeficiente Kappa (κ) obtenidos por el marco FlowErs propuesto y los métodos competidores en el conjunto de datos de referencia de Augsburg.
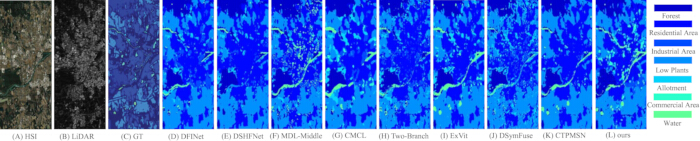
Figura 5: Resultados representativos de clasificación de cobertura terrestre para el conjunto de datos de referencia de Augsburgo. (A) Imagen hiperespectral (HSI). (B) Imagen de detección y alcance por luz (LiDAR). (C) Mapa de referencia de terreno (GT). (D–L) Mapas de clasificación generados por DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN y el marco propuesto FlowErs, respectivamente. La leyenda de colores identifica las clases de cobertura terrestre representadas en cada mapa de clasificación. Haga clic aquí para ver una versión más grande de esta figura.
Para facilitar una comparación visual más detallada de regiones difíciles, se presentan en la Figura 6 vistas ampliadas de regiones de interés representativas de los conjuntos de datos MUUFL, Houston2013 y Augsburg. Estas vistas ampliadas resaltan los límites de los objetos y las estructuras espaciales a escala fina que son menos evidentes en los mapas de clasificación de toda la escena mostrados en las Figuras 3–5, proporcionando evidencia cualitativa adicional del rendimiento de la clasificación en los tres conjuntos de datos de referencia.
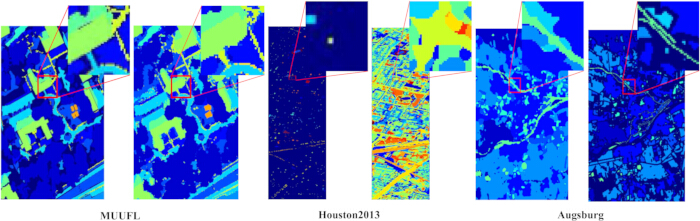
Figura 6: Vistas ampliadas de regiones representativas de interés (ROIs) de los conjuntos de datos MUUFL, Houston2013 y Augsburg. Las regiones representativas de interés (ROIs) de los conjuntos de datos MUUFL, Houston2013 y Augsburg se ampliaron para facilitar la comparación visual de los detalles finos de la clasificación. Las cajas rojas indican las regiones seleccionadas, y las vistas ampliadas correspondientes resaltan los límites de los objetos, las estructuras pequeñas y otras áreas complejas que son difíciles de apreciar en los mapas completos de clasificación mostrados en las Figuras 3–5. Estas vistas ampliadas proporcionan una evaluación cualitativa adicional de los resultados de clasificación. Haga clic aquí para ver una versión más grande de esta figura.
Estudio de ablación
Efecto del módulo de coincidencia de flujo multimodal:
Para evaluar la contribución del módulo MFM, se realizaron experimentos de ablación utilizando tres configuraciones del modelo: el marco completo FlowErs (Línea base), un modelo sin el módulo MFM (sin MFM) y un modelo simplificado que emplea alineación de flujo unidireccional (Flujo único). Los resultados cuantitativos correspondientes se resumen en Tabla 5.
| Método | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| Línea base | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| sin MFM | 92.87 | 86.02 | 91.05 | 95.31 | 95.28 | 94.97 | 95.12 | 87.06 | 93.98 |
| Flujo único | 94.38 | 87.43 | 92.72 | 96.58 | 96.47 | 96.22 | 96.47 | 88.36 | 95.47 |
Tabla 5: Estudio de ablación del marco FlowErs propuesto en los conjuntos de datos de referencia MUUFL, Houston2013 y Augsburg. Se informa el rendimiento de clasificación para el modelo completo (Línea base) y dos variantes de ablación utilizando la precisión general (OA), la precisión promedio (AA) y el coeficiente Kappa (κ).
En comparación con el modelo de referencia, la eliminación del módulo MFM dio como resultado valores más bajos de OA, AA y Kappa en los tres conjuntos de datos de referencia. La configuración de flujo único produjo un rendimiento intermedio entre el modelo completo y el modelo sin MFM, lo que indica que la alineación unidireccional de características conservó parte de la mejora de rendimiento observada, aunque no alcanzó el rendimiento conjunto de la implementación bidireccional. Estas observaciones sugieren que el módulo de alineación de flujo bidireccional contribuyó al rendimiento informado bajo las condiciones de evaluación de referencia. Las diferencias informadas representan estimaciones puntuales de división fija obtenidas utilizando una única semilla aleatoria y, por lo tanto, deben interpretarse de forma descriptiva y no como evidencia de significancia estadística.
Entre los tres conjuntos de datos de referencia, las diferencias agregadas más grandes en el rendimiento entre el modelo de referencia y los modelos de ablación se observaron en el conjunto de datos MUUFL, mientras que diferencias comparativamente menores se observaron en el conjunto de datos Houston2013. Se observaron mejoras tanto en la OA como en la AA para el modelo completo en comparación con las configuraciones de ablación, lo que indica un rendimiento agregado de clasificación más alto junto con un mejor rendimiento promedio por clase bajo los divisiones de evaluación utilizadas. Estos hallazgos son coherentes con la hipótesis del estudio de que el alineamiento de características antes de la fusión multimodal podría mejorar el rendimiento de clasificación; sin embargo, no se realizaron experimentos repetidos ni análisis estadísticos en el presente estudio.
Efecto del número de pasos de integración de flujo:
Para evaluar más a fondo la influencia del número de pasos de integración de flujo dentro del módulo MFM, se varió el número de pasos de integración de 2 a 10. Los resultados de clasificación correspondientes se resumen en la Tabla 6. El parámetro del paso de integración controla la discretización del proceso continuo de transporte de características durante la alineación multimodal, donde valores más pequeños representan una discretización más gruesa y valores más grandes representan una discretización más fina. Como se muestra en la Tabla 6, las estimaciones más altas del punto fijo de división en las métricas evaluadas se obtuvieron cuando el número de pasos de integración fue de 6. El rendimiento mejoró generalmente a medida que el número de pasos de integración aumentó de 2 a 6, tras lo cual el rendimiento informado permaneció relativamente estable o disminuyó ligeramente en los tres conjuntos de datos de referencia. Estas observaciones indican que la configuración nominal de seis pasos de integración proporcionó el rendimiento agregado más alto bajo las condiciones de referencia evaluadas. Dado que los resultados informados se basan en una única semilla aleatoria y divisiones fijas de referencia, estas diferencias deben interpretarse de forma descriptiva y no como evidencia de diferencias de rendimiento estadísticamente significativas.
| Pasos de integración de flujo | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| 2 | 92.37 | 84.63 | 90.12 | 95.73 | 96.12 | 95.64 | 94.86 | 85.73 | 92.76 |
| 3 | 93.58 | 85.47 | 90.98 | 96.32 | 96.48 | 96.01 | 95.61 | 86.48 | 93.51 |
| 4 | 94.31 | 86.51 | 91.76 | 96.88 | 96.92 | 96.57 | 96.18 | 87.34 | 94.12 |
| 5 | 94.92 | 87.62 | 92.54 | 97.18 | 97.22 | 97.05 | 96.89 | 88.02 | 95.07 |
| 6 | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| 7 | 95.12 | 88.56 | 93.5 | 97.49 | 97.44 | 97.31 | 97.34 | 88.84 | 96.21 |
| 8 | 94.95 | 88.22 | 93.2 | 97.31 | 97.29 | 97.17 | 96.98 | 88.46 | 95.82 |
| 9 | 94.63 | 87.75 | 92.85 | 97.09 | 97.03 | 96.88 | 96.45 | 87.92 | 95.28 |
| 10 | 94.21 | 86.97 | 92.18 | 96.77 | 96.81 | 96.61 | 95.87 | 87.03 | 94.61 |
Tabla 6: Efecto del número de pasos de integración de flujo en el rendimiento de clasificación para los conjuntos de datos de referencia MUUFL, Houston2013 y Augsburg. El rendimiento de clasificación se reporta como precisión general (OA), precisión promedio (AA) y coeficiente Kappa (κ) para diferentes números de pasos de integración de flujo. Seis pasos de integración corresponden a la configuración utilizada en el marco final de FlowErs.
Entre los conjuntos de datos evaluados, el conjunto de datos MUUFL mostró la mayor variación en el rendimiento a medida que cambiaba el número de pasos de integración, mientras que el conjunto de datos Houston2013 presentó cambios comparativamente menores y alcanzó su rendimiento más alto reportado en seis pasos de integración. El conjunto de datos Augsburg demostró una tendencia similar con una variación de rendimiento relativamente modesta a través de diferentes configuraciones de pasos. En conjunto, estas observaciones sugieren que un número moderado de pasos de integración proporcionó el rendimiento de clasificación más alto reportado para los conjuntos de datos evaluados. El presente análisis no incluye experimentos repetidos, estimaciones de incertidumbre, perfilado computacional, robustez ante modalidades faltantes o entradas ruidosas, ni generalización cruzada entre regiones, y por lo tanto no se extraen conclusiones respecto a estos aspectos.
La evaluación en los tres conjuntos de datos de referencia mostró un rendimiento competitivo de clasificación agregada bajo las divisiones fijas reportadas, con una OA máxima del 97,56 %. Los experimentos de ablación mostraron que la configuración completa de coincidencia de flujo bidireccional logró consistentemente un rendimiento agregado más alto que los modelos correspondientes de ablación en todos los conjuntos de datos evaluados. Los análisis por clase indicaron que el rendimiento de clasificación varió entre las categorías de cobertura terrestre, siendo las clases minoritarias y las categorías espectralmente similares relativamente más difíciles y contribuyendo a la diferencia observada entre OA y AA en conjuntos de datos desequilibrados. La evaluación actual se basa en estimaciones puntuales con divisiones fijas obtenidas usando una única semilla aleatoria y no incluye estimaciones de incertidumbre de ejecuciones repetidas, pruebas de significancia estadística, análisis computacional, sensibilidad al desalineamiento espacial, robustez ante modalidades faltantes o ruidosas, ni generalización cruzada entre regiones. Estos aspectos requieren una investigación adicional en estudios futuros.
Disponibilidad de datos:
Los conjuntos de datos de referencia públicos utilizados en este estudio están disponibles a través de sus proveedores originales. Los materiales de implementación, mapas de predicción y resultados de evaluación están disponibles públicamente en el repositorio Zenodo en https://doi.org/10.5281/zenodo.21395701.
Archivo Suplementario 1: Formulación matemática y algoritmo de entrenamiento del marco FlowErs. Este archivo suplementario proporciona la formulación matemática completa subyacente al marco FlowErs propuesto, incluyendo la formulación de flujo continuo (Ecuaciones S1–S2), la ecuación de flujo de probabilidad (Ecuación S3), la trayectoria óptima de flujo (Ecuaciones S4–S5), el objetivo de entrenamiento condicional por coincidencia de flujos (Ecuación S6) y las propiedades teóricas asociadas. El archivo también incluye el Algoritmo S1, que resume el flujo de trabajo completo de entrenamiento en dos etapas, compuesto por un preentrenamiento no supervisado por coincidencia de flujos seguido de una clasificación multimodal supervisada.
Discusión
El presente estudio presenta FlowErs, un marco multimodal de teledetección que separa la alineación de características cruzadas de la clasificación semántica mediante una estrategia de aprendizaje en dos etapas. En lugar de fusionar directamente características específicas de modalidades heterogéneas, el marco propuesto primero alinea las representaciones de características utilizando la coincidencia condicional de flujos antes de la fusión multimodal y la clasificación. Este diseño aborda el desafío persistente de las distribuciones heterogéneas de características entre HSI y LiDAR, donde las diferencias en los mecanismos de detección suelen limitar la eficacia de las estrategias convencionales de fusión basadas en concatenación o atención23,26,35,36,37,38,39. Al formular la alineación multimodal como un transporte continuo de características, FlowErs extiende los avances recientes en la coincidencia de flujos desde el modelado generativo hacia el aprendizaje de representaciones multimodales en teledetección15,16,17,18,19,20,21. Bajo las condiciones de referencia evaluadas, el marco propuesto logró un rendimiento competitivo en la clasificación agregada en los conjuntos de datos Houston2013, Augsburg y MUUFL, mientras que el estudio de ablación complementario respaldó adicionalmente la contribución del módulo de alineación de flujos bidireccionales al rendimiento reportado en divisiones fijas.
Los hallazgos descritos sugieren que el alineamiento explícito de características antes de la fusión multimodal podría mejorar la compatibilidad de las representaciones de características heterogéneas extraídas a partir de diferentes modalidades sensoras. Los métodos previos de teledetección multimodal se han basado principalmente en redes convolucionales, arquitecturas basadas en transformadores, mecanismos de atención, aprendizaje contrastivo o fusión guiada por indicaciones para fortalecer la interacción de características23,26,35,36,37,38,39. Aunque estos enfoques han demostrado un buen desempeño en clasificación, la mayoría asume que los embeddings específicos de cada modalidad pueden fusionarse directamente tras la extracción de características. En contraste, FlowErs introduce una etapa intermedia de alineamiento geométrico que transporta continuamente las características específicas de cada modalidad hacia un espacio latente compartido antes de la clasificación. La evaluación por clases demuestra que las mejoras agregadas en el desempeño no se distribuyeron uniformemente entre todas las categorías de cobertura terrestre. Por ejemplo, varias clases minoritarias y categorías urbanas espectroscópicamente similares siguieron siendo relativamente difíciles de clasificar, y la diferencia observada entre OA y AA, particularmente para el conjunto de datos de Augsburg, refleja la influencia del desequilibrio de clases junto con el desempeño variable a nivel de clase. Por consiguiente, las métricas agregadas informadas deben interpretarse junto con los resultados por clases, y no como evidencia de mejoras uniformes en todas las categorías.
Los experimentos de ablación respaldan aún más el diseño propuesto. La eliminación del módulo de coincidencia de flujos multimodal redujo el rendimiento agregado de clasificación en los tres conjuntos de datos de referencia, mientras que la variante de flujo unidireccional tuvo un desempeño consistentemente intermedio entre el modelo completo y el modelo sin alineación de flujo. Estas observaciones son coherentes con la hipótesis de trabajo de que el transporte bidireccional de características podría mejorar la correspondencia entre modalidades antes de la fusión de características bajo las condiciones de evaluación de los conjuntos de referencia. De manera similar, el análisis de integración del flujo demostró que la discretización intermedia de la trayectoria de transporte aprendida produjo el rendimiento agregado más alto, con seis pasos de integración representando el punto de funcionamiento nominal en la implementación actual. Las mejoras en el rendimiento se volvieron marginales o disminuyeron ligeramente con pasos adicionales de integración, lo que sugiere que una discretización cada vez más fina podría ofrecer rendimientos decrecientes bajo las condiciones experimentales evaluadas. Si este punto de funcionamiento se generaliza a otros conjuntos de datos, modalidades sensoriales o arquitecturas de red sigue por investigarse.
Se deben considerar varias limitaciones al interpretar los resultados presentes. En primer lugar, la evaluación se limitó a tres conjuntos de datos de referencia disponibles públicamente, utilizando particiones fijas de entrenamiento/prueba y una única semilla aleatoria. En consecuencia, no se evaluó la incertidumbre de ejecuciones repetidas, los intervalos de confianza, las pruebas de significancia estadística ni la variabilidad entre ejecuciones. En segundo lugar, los métodos de comparación se tomaron directamente de sus respectivas publicaciones en lugar de ser reimplementados dentro de un marco experimental común; por lo tanto, las comparaciones reportadas deben interpretarse de forma descriptiva y no como reproducciones controladas directas. En tercer lugar, no se investigó la robustez frente a modalidades faltantes, observaciones ruidosas, mala registración espacial y generalización entre regiones. Además, aunque el ajuste de flujo proporciona un marco teórico para el transporte continuo y potencialmente invertible de características15,16,17, en el presente estudio no se verificó empíricamente la invertibilidad exacta, la preservación de la topología ni la interpretabilidad física de las transformaciones aprendidas. Las características computacionales, incluyendo el tiempo de inferencia, el consumo de memoria y la complejidad en operaciones de punto flotante, tampoco fueron perfiladas por separado.
Las aproximaciones alternativas para estudiar la alineación multimodal continúan evolucionando. Estudios recientes han explorado el aprendizaje contrastivo, la fusión basada en grafos, el aprendizaje de representaciones de rango bajo, el aprendizaje multimodal guiado por indicaciones (prompt), el aprendizaje federado y arquitecturas híbridas convolucionales–Transformer para mejorar la integración de características multimodales23,26,27,28,35,36,37,38,39. Estas estrategias siguen siendo complementarias en lugar de mutuamente excluyentes, y trabajos futuros podrían investigar combinaciones de transporte explícito de características basado en flujos con estos paradigmas de alineación existentes. Más allá de la clasificación de cobertura del suelo, la alineación continua de características también podría aplicarse a tareas relacionadas de teledetección multimodal, incluyendo segmentación semántica, detección de cambios, reconocimiento de objetos, monitoreo ambiental, evaluación de desastres, agricultura de precisión y cartografía urbana, donde las modalidades de detección complementarias están disponibles en grado creciente2,3,4,5,6,7,8,9,23.
Las investigaciones futuras deben evaluar el marco propuesto bajo condiciones experimentales más diversas, incorporando análisis estadísticos de ejecuciones repetidas, perfilado computacional, robustez ante modalidades faltantes o ruidosas, sensibilidad a errores de registro espacial y evaluación de transferencia entre regiones. Estudios adicionales que examinen parametrizaciones alternativas del flujo, diferentes arquitecturas de codificadores y conjuntos de datos de referencia multimodales más grandes aclararían aún más la generalización y aplicabilidad práctica de la metodología propuesta. En conjunto, los resultados actuales indican que el alineamiento explícito de características mediante coincidencia condicional de flujos representa una estrategia complementaria prometedora para la clasificación multimodal en teledetección, al tiempo que destacan varias oportunidades para un mayor desarrollo metodológico y una evaluación integral.
Divulgaciones
Conflicto de intereses:
Los autores declaran que no tienen conflictos de intereses.
Agradecimientos
This work was financially supported by the Scientific Research Fund Project of Shaanxi A&F University (Grant No. ZK25-38) and the Education Department of Shaanxi Province (Grant No. 24JK0734).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| optimizador AdamW | Fundación PyTorch | Incluido en PyTorch | Utilizado para la optimización del modelo. Se utilizó PyTorch 2.5.0. |
| Conjunto de datos de referencia de Augsburgo | Hu J et al. (Datos Científicos del Sistema Terrestre, 2022); Tecnología de Teledetección, LMU Múnich | https://doi.org/10.5281/zenodo.7185498 | Conjunto de datos de referencia multimodal de teledetección pública utilizado para la evaluación de modelos. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | Utilizado para el entrenamiento y la inferencia de modelos acelerados por GPU. |
| Unidad de procesamiento gráfico (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | Utilizado para el entrenamiento y la evaluación del modelo. |
| conjunto de datos de referencia Houston2013 | Concurso de Fusión de Datos de la Sociedad IEEE de Ciencias de la Tierra y Teledetección | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Conjunto de datos de referencia público de imágenes hiperspectrales y LiDAR utilizado para la evaluación de modelos. |
| Conjunto de datos de referencia MUUFL Gulfport | Universidad de Florida (Gader P et al., Informe Técnico REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Conjunto de datos de referencia de imágenes hiperspectrales públicas y LiDAR utilizado para la evaluación del modelo. |
| Sistema operativo | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | Entorno computacional utilizado para el desarrollo, entrenamiento y evaluación del modelo. |
| PyTorch | Fundación PyTorch | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | Marco de aprendizaje profundo utilizado para implementar, entrenar y evaluar el modelo FlowErs. |
| Python | Fundación Python Software | Python 3.11; https://www.python.org/downloads/release/python-3110/ | Lenguaje de programación utilizado para implementar y ejecutar el flujo de trabajo computacional. |
Referencias
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.