Este protocolo describe una metodología estructurada de diseño de servicios para diagnosticar problemas complejos en procesos de aplicación y consulta de servicios públicos de bajo riesgo. El enfoque integra el mapeo de partes interesadas, el mapeo de recorridos, el diseño conjunto y la creación de prototipos de baja fidelidad, junto con la evaluación simulada basada en tareas del comportamiento del usuario, la toma de decisiones y la usabilidad de los materiales del servicio antes de su implementación.
Artículo de método
Un protocolo de visualización de diseño de servicios sistémicos para problemas complejos en procesos de consulta y aplicación de servicios públicos de bajo riesgo
21 visualizaciones
⸱
11 de septiembre de 2026
En este artículo
Resumen
Resumen
Los problemas complejos de servicios públicos con características similares a los problemas intratables, incluydos múltiples actores, información fragmentada, límites de responsabilidad poco claros y la ausencia de una solución única y aceptada universalmente, son difíciles de estructurar en entornos administrativos rutinarios. Este artículo presenta un protocolo sistemático de visualización de diseño de servicios para aplicaciones y procesos de consulta de bajo riesgo en servicios públicos, definidos como servicios administrativos que no determinan tratamientos médicos, estatus legal, elegibilidad financiera, protección de menores, consecuencias disciplinarias u otras decisiones de alta responsabilidad que afecten derechos. El protocolo integra el mapeo de partes interesadas, el mapeo del recorrido del servicio público, el diseño conjunto Double Diamond y la prueba de prototipos de baja fidelidad, con el fin de traducir desafíos administrativos fragmentados en conceptos de servicio accionables y co-diseñados, y evaluarlos mediante tareas simuladas. En una vía representativa de aplicación administrativa de bajo riesgo, la prueba con tareas simuladas realizada con 28 participantes (112 registros de tareas basales y 112 registros posteriores al prototipo) mostró tiempos más cortos de finalización de tareas (178,4 ± 49,6 s–121,7 ± 38,2 s), menos errores (1,86 ± 0,91–0,79 ± 0,63 errores por tarea) y mayor éxito en las tareas (62,5 %–82,1 %) tras la exposición a los materiales generados mediante el protocolo. Estos hallazgos representan evidencia de usabilidad basada en tareas, ya que la secuencia fija antes/después podría incluir efectos de aprendizaje. Este protocolo reproducible ofrece un enfoque estructurado y basado en visualización para diagnosticar problemas complejos de servicios públicos y prototipar soluciones en entornos de servicios públicos de bajo riesgo.
Introducción
Las organizaciones de servicio público enfrentan cada vez más desafíos complejos que desafían simples ajustes administrativos. Estos problemas se caracterizan por la participación de múltiples actores, responsabilidades fragmentadas, acceso desigual a la información y tensiones entre procedimientos administrativos estandarizados y necesidades diversas de los usuarios. En lugar de afirmar que tales problemas pueden resolverse mediante una fórmula completamente reproducible, este protocolo los trata como problemas de servicio acotados y de bajo riesgo, con características similares a los problemas «wicked» (intratables), que pueden estructurarse, visualizarse y explorarse mediante pasos de facilitación reproducibles1,2. En la prestación rutinaria de servicios públicos, estos problemas se manifiestan como fallos operacionales: los ciudadanos tienen dificultades para identificar los materiales requeridos, el personal de primera línea enfrenta consultas repetitivas y los administradores aplican reglas que no son fácilmente visibles para los usuarios finales.
Para abordar estas complejidades, la innovación en servicios públicos ha pasado de reformas internas de eficiencia hacia enfoques participativos centrados en el usuario. La investigación actual indica que la co-creación y la coproducción permiten que ciudadanos, profesionales y organizaciones contribuyan de forma colaborativa a la innovación del servicio3,4,5. Sin embargo, este cambio participativo introduce un desafío metodológico. Aunque diversas partes interesadas pueden estar de acuerdo en que un servicio es ineficiente, rara vez alcanzan un consenso sobre dónde ocurre la falla estructural, quiénes se ven más afectados o qué intervenciones específicas son necesarias.
Este protocolo está destinado a investigadores de diseño de servicios, investigadores de administración pública, equipos de mejora de servicios municipales o universitarios y facilitadores capacitados que requieran un enfoque repetible para traducir quejas de múltiples actores en materiales diagnósticos visuales antes de la implementación. Es más adecuado para aplicaciones de bajo riesgo, como servicios de consulta, registro, verificación de estado y seguimiento, en los que los usuarios deben interpretar requisitos, preparar materiales, avanzar a través de múltiples etapas del servicio y coordinarse con varios actores. No debe utilizarse como método principal para la toma de decisiones en emergencias, transacciones altamente estandarizadas con procedimientos establecidos de un solo paso, resolución legal, tratamiento médico, protección de menores, decisiones sobre estatus migratorio, determinaciones de ayuda financiera, procesos disciplinarios, ni en ningún entorno que requiera acceso a expedientes de casos identificables.
En comparación con el análisis independiente de partes interesadas, el mapeo de recorridos o los talleres participativos, el flujo de trabajo propuesto vincula el mapeo de actores, desgloses específicos de servicios por etapa, la formulación conjunta de desafíos y la prueba simulada de prototipos dentro de una única secuencia auditada. Esta integración ayuda a prevenir que los equipos pasen directamente de una insatisfacción generalizada a ideas de solución sin antes identificar quiénes se ven afectados, dónde ocurre la falla y qué materiales pueden probarse de forma segura. Asimismo, revisiones recientes sobre diseño conjunto en el sector público y la salud pública destacan la necesidad de procesos transparentes, facilitación explícita y evaluación cuidadosa de la participación y las dinámicas de poder4,6,7,8,9.
El diseño de servicios ofrece un marco práctico para abordar este desafío mediante métodos visuales, participativos y orientados al prototipado6,8,10. En lugar de tratar los fallos del servicio como déficits políticos abstractos, el diseño de servicios examina las interacciones entre usuarios, personal, puntos de contacto y procesos internos. Por consiguiente, la co-creación se propone cada vez más dentro de la administración pública como un medio para involucrar a los ciudadanos en la definición de problemas complejos4,7,11. Sin embargo, las iniciativas de co-creación a menudo resultan insuficientes cuando carecen de un mecanismo estructurado para traducir las experiencias subjetivas de las partes interesadas en materiales de servicios públicos comprobables, o cuando no gestionan explícitamente las diferencias de poder entre los participantes.
Una transición metodológica rigurosa requiere la integración secuencial de herramientas analíticas específicas. El mapeo de interesados sirve como línea base diagnóstica al aclarar la participación de los actores, su influencia, dependencias y asimetrías de información12. Luego, el mapeo de recorridos se utiliza para identificar puntos críticos específicos y ambigüedades en la responsabilidad a lo largo de las etapas secuenciales del servicio13. Posteriormente, el marco Double Diamond proporciona una ruta estructurada para convertir estas interrupciones mapeadas en desafíos de diseño accionables, separando la exploración divergente del problema del desarrollo convergente de soluciones7,8,14. Finalmente, la prueba de prototipos de baja fidelidad permite evaluar de forma segura conceptos co-diseñados antes de su implementación, un paso esencial en los servicios públicos, donde cambios prematuros pueden interrumpir el acceso de los ciudadanos o aumentar las cargas administrativas15,16.
A pesar de la creciente orientación metodológica sobre estas herramientas, la reproducibilidad sigue siendo una limitación crítica en la literatura sobre co-diseño de servicios públicos6,7,8,17. Muchos estudios describen los talleres de diseño en términos generales, ocultando los pasos analíticos precisos necesarios para su réplica independiente. Un método riguroso debería establecer etapas fijas, asignaciones definidas de tiempo, reglas estandarizadas de puntuación, productos visuales consistentes y criterios de decisión transparentes. Además, debería distinguir claramente la evaluación de la usabilidad en etapas iniciales y basada en tareas, de afirmaciones más amplias sobre el desempeño real del organismo en el mundo práctico.
Este artículo presenta un protocolo sistemático de visualización de diseño de servicios desarrollado para estructurar problemas complejos con múltiples actores en la innovación de servicios públicos de bajo riesgo4,6,16,17. Diseñado específicamente para procesos de aplicación y consultoría en servicios públicos, el protocolo integra secuencialmente el mapeo de partes interesadas, el mapeo de recorridos, un taller de Doble Diamante y la prueba de prototipos. El objetivo general es proporcionar a investigadores y profesionales un enfoque altamente reproducible, paso a paso, para pasar de quejas fragmentadas sobre un servicio a un diagnóstico visual, una definición objetiva del problema y la verificación empírica de conceptos de servicio co-diseñados.
Protocolo
La aplicación representativa descrita en este artículo fue aprobada por el Comité de Ética en Protección de la Investigación con Seres Humanos de la Universidad de la Ciudad de Macao, Macao, China (Número de aprobación: 2600AL2401; válida del 10 de enero de 2026 al 10 de enero de 2028). Se obtuvo el consentimiento informado por escrito o electrónico de todos los participantes antes de su participación. El protocolo no implicó intervenciones médicas, poblaciones vulnerables, engaño, muestras biológicas, datos financieros privados, evaluación del desempeño individual ni acceso a registros administrativos oficiales. Las herramientas de investigación utilizadas para el protocolo se enumeran en la Tabla de Materiales.
1. Reclutamiento de participantes y definición del contexto
- Seleccione una aplicación de servicio público de bajo riesgo y su proceso de consulta para evaluar, como una vía administrativa municipal, universitaria o comunitaria que requiera búsqueda de información, aclaración de elegibilidad, preparación de documentos, presentación de la solicitud, tramitación, notificación y apoyo de seguimiento.
- Excluya contextos que impliquen tratamiento médico, gestión de casos legales, estatus migratorio, protección de menores, determinación de ayuda económica, procedimientos disciplinarios, decisiones de emergencia o registros administrativos oficiales.
- Considere un problema de servicio público adecuado para este protocolo cuando presente al menos tres características complejas o similares a problemas intratables: participación de múltiples grupos de interesados, límites de responsabilidad poco claros, fallos repetidos en la coordinación entre actores, información del servicio incompleta o inconsistente, y ausencia de una solución única acordada.
NOTA: No presente el protocolo como una solución a un problema completamente intratable. Preséntelo como una forma de estructurar un problema de servicio público acotado y de bajo riesgo para su diagnóstico, co-diseño y prueba simulada. - Reclute entre 80 y 120 participantes para la etapa del cuestionario, basándose en su familiaridad con el uso, la prestación, la coordinación o la gestión de servicios públicos.
- Utilice este tamaño muestral como una meta práctica de planificación para respaldar perfiles estables de interesados descriptivos en varios grupos de roles, manteniéndolo factible para un estudio de diseño de servicios no interventivo.
- Seleccione participantes que representen todos los roles principales de interesados involucrados en el proceso del servicio público.
- Forme un subgrupo de entre 20 y 30 participantes para que participen en las etapas del taller de co-diseño y pruebas de prototipos.
- Forme 4 a 6 grupos mixtos por roles, manteniendo cada grupo lo suficientemente pequeño como para fomentar una participación activa.
- Asegúrese de que cada grupo mixto incluya al menos tres categorías de interesados, como ciudadanos, personal de primera línea, trabajadores comunitarios o administradores.
- Separar a ciudadanos y proveedores de servicios durante las discusiones iniciales de mapeo de interesados si se prevén desequilibrios de poder.
- Realice una síntesis de roles mixtos tras las discusiones iniciales. Durante la síntesis de roles mixtos, utilice turnos estructurados, escritura silenciosa de ideas, presentación anónima de tarjetas y votación anónima con puntos para evitar que administradores o personal profesional dominen las contribuciones de los ciudadanos.
- Preste especial atención al reclutamiento de participantes, preparación de roles y condiciones que permitan a los usuarios aportar ideas en lugar de limitarse a responder a problemas definidos por expertos7,9,18.
- Instruya a todos los participantes para que no revelen nombres identificables, números de identidad, direcciones domiciliarias, números de teléfono, identificadores de casos, historiales médicos, registros legales, registros de ingresos ni archivos de desempeño institucional.
- Asigne códigos de participante no identificables (por ejemplo, P001 y P002).
- Capacite a todos los facilitadores antes de la recolección de datos utilizando el mismo guion de facilitación, tarjetas de ejemplo de puntos críticos, rúbrica de desafíos de diseño y ejemplos de calificación de prototipos.
- PASO CRÍTICO: Calibre a los facilitadores pidiéndoles que clasifiquen de forma independiente al menos cinco puntos críticos de ejemplo y cinco borradores de enunciados "¿Cómo podríamos?".
NOTA: Los facilitadores deben alcanzar al menos un 80 % de acuerdo en decisiones de inclusión, agrupación y revisión antes de continuar. - Discuta las discrepancias hasta que los facilitadores alcancen al menos un 80 % de acuerdo en decisiones de inclusión, agrupación y revisión.
- Utilice al menos dos facilitadores siempre que sea posible: un facilitador principal para guiar la discusión y un observador para registrar tiempos, equilibrio de participación y desviaciones del protocolo.
- Si varios facilitadores dirigen grupos paralelos, realice una revisión de 15 a 20 minutos después de cada etapa principal y documente cualquier diferencia en indicaciones o reglas de interpretación en la hoja de auditoría.
PRECAUCIÓN: Tras completar el reclutamiento de participantes, el consentimiento, la capacitación de facilitadores y la preparación de materiales, los investigadores pueden hacer una pausa antes de comenzar la Etapa 1. Reanuden solo tras confirmar que todos los participantes tienen códigos asignados y que todas las hojas de trabajo carecen de información identificable.
2. Preparación de los materiales del protocolo
- Prepare los materiales del protocolo antes de su implementación.
- Prepare la hoja informativa para los participantes, el cuestionario anónimo basado en roles, la hoja de trabajo para la cartografía de interesados, la hoja de calificación de interesados de cinco puntos, la plantilla para el mapeo del recorrido del servicio público, las tarjetas de puntos críticos, la plantilla de desafío de diseño, las tarjetas de soluciones, la hoja de selección de prototipos, la rúbrica de calibración para el facilitador, las hojas de tareas simuladas, la lista de verificación de equivalencia de conjuntos de tareas, la rúbrica de puntuación de prototipos, la hoja de codificación, las notas de sintaxis o flujo de trabajo para el análisis y la lista de verificación de desidentificación.
- Asigne a cada material específico del estudio un identificador interno estable y un número de versión.
- Organice la plantilla de mapeo del recorrido en siete etapas predeterminadas: búsqueda de información, aclaración de elegibilidad o requisitos, preparación de documentos, presentación de la solicitud, procesamiento interdepartamental, notificación del resultado y apoyo posterior.
- Adapte los nombres de las etapas únicamente después de documentar en qué se diferencia el servicio seleccionado del camino administrativo predeterminado de bajo riesgo.
- Mantenga la misma secuencia de puntos de contacto, actores responsables, insumos de información, productos, puntos críticos y consecuencias posteriores.
- Diseñe escenarios simulados de servicios públicos para las hojas de tareas del prototipo sin incluir datos reales personales, administrativos o de agencias.
- Consulte la Tabla 1 para conocer las etapas, las asignaciones de tiempo, los materiales y los productos predeterminados necesarios para el protocolo.
- Consulte la Tabla 2 para conocer los elementos de recolección de datos, las reglas de puntuación, los umbrales de validez y los controles de protección de datos.
- Utilice métodos de diseño de servicios para hacer visibles, discutibles y comprobables los problemas complejos de los servicios públicos19.
Tabla 1: Etapas del protocolo, tiempos, materiales requeridos y resultados predefinidos. El flujo de trabajo del protocolo incluye las actividades principales, los participantes, la asignación estimada de tiempo, los materiales necesarios y los resultados esperados para cada etapa.Haga clic aquí para descargar esta tabla.
Tabla 2: Métricas de recopilación de datos, métodos, criterios de exclusión y controles de protección de datos. Las métricas recopiladas en cada etapa del protocolo, los métodos correspondientes de recopilación de datos, los criterios de exclusión predefinidos y las medidas implementadas para proteger la confidencialidad de los participantes y la integridad de los datos.Haga clic aquí para descargar esta tabla.
3. Etapa 1: Mapeo de partes interesadas
- Instruya a los participantes a utilizar la hoja de trabajo de mapeo de partes interesadas para que, de forma individual, enumeren de cinco a ocho actores involucrados en el proceso de servicio público seleccionado.
- Asigne de 25 a 35 minutos para la etapa de mapeo de partes interesadas.
- Consulte la Figura 1 para conocer el flujo general del protocolo de visualización.
- Oriente a los participantes para que califiquen a cada actor listado en cuatro dimensiones utilizando una escala anclada de cinco puntos (1 = muy bajo; 5 = muy alto): influencia en el resultado del servicio, dependencia de otros actores, acceso a la información del servicio y presión de coordinación.
- Proporcione ejemplos escritos antes de que los participantes completen las calificaciones.
- Defina una influencia alta como la de un actor cuya decisión, demora o interpretación afecta sustancialmente el resultado del servicio.
- Defina una dependencia alta como la de un actor que no puede completar el proceso del servicio sin información, confirmación o acción de otros actores.
- Calcule la puntuación media para cada grupo de partes interesadas en cada dimensión.
- Señale como brecha de percepción una discrepancia de dos puntos o más entre grupos de partes interesadas en la misma dimensión, ya que representa un cambio de al menos el 40 % en la escala de cinco puntos y es lo suficientemente grande como para sustentar una discusión en el taller, más allá de un simple ruido menor en las calificaciones.
- Lleve cada brecha de percepción identificada a la discusión del taller.
- Utilice los resultados del mapeo de partes interesadas para hacer visibles los roles de los actores, sus dependencias, influencias y asimetrías de información antes de iniciar el rediseño20.
- Elabore un perfil de relación entre actores que incluya categorías de partes interesadas, puntuaciones medias por dimensión y brechas de percepción señaladas.
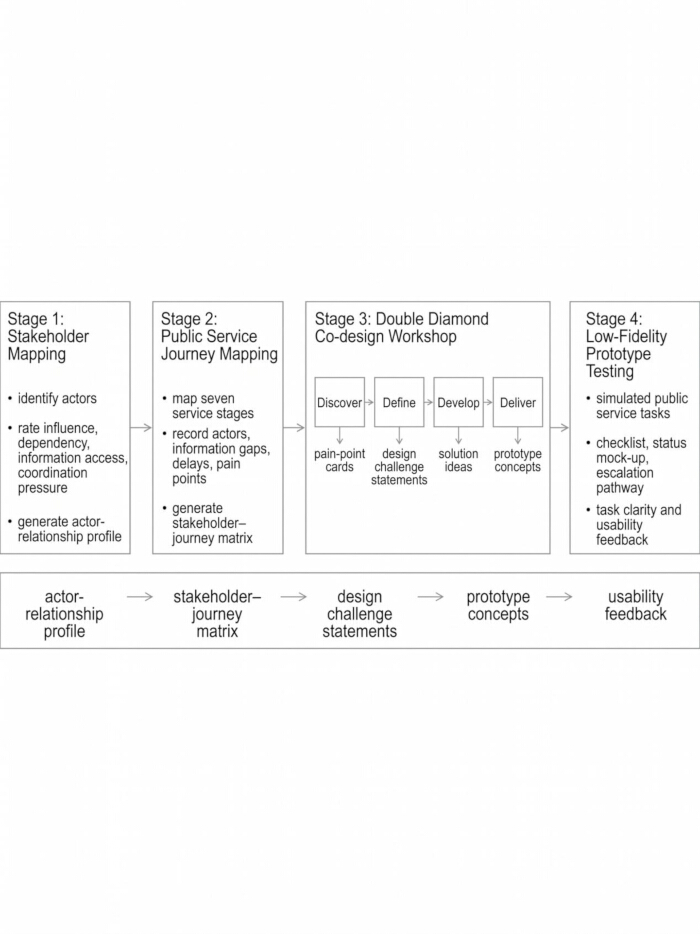
Figura 1: Flujo de trabajo general del protocolo de visualización del diseño de servicios públicos. El flujo de trabajo consta de cuatro etapas interconectadas: mapeo de interesados, mapeo del recorrido del servicio público, co-diseño Double Diamond y pruebas de prototipos. Los resultados incluyen perfiles de actores y relaciones, matrices de interesados y recorridos, enunciados de desafíos de diseño, conceptos de prototipos y retroalimentación preliminar sobre usabilidad. Se destacan las fases Discover (Descubrir), Define (Definir), Develop (Desarrollar) y Deliver (Entregar) del marco Double Diamond para ilustrar la transición desde la exploración divergente hasta el desarrollo convergente de soluciones. Haga clic aquí para ver una versión ampliada de esta figura.
4. Etapa 2: Mapeo del recorrido del servicio público
- Guíe al subgrupo del taller para mapear el proceso de servicio de siete etapas.
- Asigne de 45 a 60 minutos para esta etapa.
- Indique a los participantes que registren el actor principal, la información de entrada, la información de salida, el canal de comunicación, el retraso típico, el punto crítico, la gravedad y la consecuencia posterior para cada etapa.
- Pida a los participantes que califiquen la gravedad de cada punto de dolor en una escala de cinco puntos (1 = inconveniente menor; 5 = fallo grave que probablemente afecte el acceso al servicio, desencadene una queja formal o cause una escalada importante).
- PASO CRÍTICO: Combine los puntos críticos solo cuando se refieran a la misma etapa del proceso, impliquen el mismo tipo de brecha informativa o ambigüedad de responsabilidad, y produzcan una consecuencia posterior similar.
- Mantenga los puntos de dolor informados por un solo participante en el archivo de codificación original. No priorice estos puntos de dolor a menos que reciban una puntuación de gravedad de 4 o 5.
- Genere una matriz integrada de recorrido de partes interesadas (Figura 2) para visualizar la presencia de puntos críticos (P), brechas de información (I), ambigüedad en la responsabilidad (R) y oportunidades de rediseño (O) en las celdas de la matriz.
- Utilice la elaboración de mapas de recorrido para localizar fallos en el servicio a lo largo de puntos de contacto secuenciales, en lugar de tratar la insatisfacción o demora como un resultado único y agregado21.
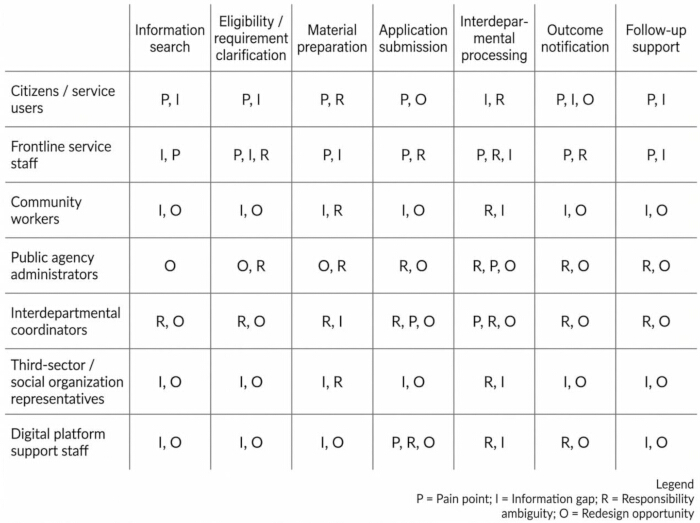
Figura 2: Matriz integrada de recorrido de partes interesadas para la visualización de problemas en servicios públicos. La matriz organiza siete etapas del servicio público en el eje horizontal y los principales grupos de partes interesadas en el eje vertical. Cada celda indica la presencia de problemas específicos en el servicio, denotados por las siguientes abreviaturas: P = punto crítico; I = laguna informativa; R = ambigüedad en responsabilidades; O = oportunidad de rediseño. La matriz sirve como un puente visual entre el mapeo de partes interesadas y el diseño conjunto, al vincular los roles de las partes interesadas con los problemas específicos de cada etapa del servicio. Haga clic aquí para ver una versión ampliada de esta figura.
5. Etapa 3: Taller de co-diseño Doble Diamante
- Realice el taller de co-diseño Double Diamond en una sesión de 2,5 a 3 horas.
- Adopte el marco metodológico Double Diamond para separar la exploración divergente de la toma convergente de decisiones7,8,14.
- Asegúrese de que ciudadanos, proveedores de primera línea, administradores y organizaciones asociadas participen en la co-creación o co-diseño, en lugar de depender únicamente de reformas internas dirigidas por expertos4,22.
- Lleve a cabo la fase de Descubrimiento (30–40 min).
- Instruya a los participantes para que revisen la matriz de recorrido de las partes interesadas y agreguen tarjetas de puntos críticos que falten.
- Asegúrese de que cada tarjeta válida de punto crítico registre la etapa del recorrido, el actor afectado, la falla del servicio, la brecha de información o ambigüedad de responsabilidad, y la consecuencia a largo plazo.
- Lleve a cabo la fase de Definición (40–50 min).
- Pida a cada participante que seleccione en silencio las tres tarjetas de puntos críticos que mejor representen fallas del servicio de alta severidad y transversales a varios actores.
- Utilice votación anónima con puntos o clasificación escrita antes de la discusión abierta para reducir los efectos de estatus y desequilibrios de poder.
- Agrupe las tarjetas seleccionadas según la etapa del recorrido, el actor afectado, la brecha de información o ambigüedad de responsabilidad, y la consecuencia a largo plazo.
- Pida al facilitador que lea en voz alta cada grupo y confirme que los participantes coincidan en que las tarjetas describen la misma falla del servicio.
- Convierta cada grupo en un único enunciado de desafío de diseño del tipo "¿Cómo podríamos?"
- Asegúrese de que cada enunciado de desafío de diseño especifique al actor afectado, la etapa problemática del recorrido, la falla del servicio y la dirección deseada de mejora.
- Evalúe cada desafío de diseño mediante una rúbrica de cuatro ítems que valore la especificidad, la claridad del actor, la vinculación con evidencia mapeada y la viabilidad para pruebas con prototipos de baja fidelidad.
- Revise cualquier enunciado que omita al actor, combine múltiples fallas no relacionadas, proponga una solución prematuramente o no pueda probarse usando materiales simulados del servicio.
- Registre el borrador original, la razón de la revisión y el enunciado final validado en la hoja de auditoría.
PRECAUCIÓN: Los investigadores pueden hacer una pausa tras aprobar los enunciados finales de los desafíos de diseño y reanudar cuando se hayan preparado las tarjetas de soluciones y las hojas de selección de prototipos. - Lleve a cabo la fase de Desarrollo (50–60 min).
- Instruya a los participantes para que generen ideas de mejora del servicio para cada desafío de diseño y las registren en tarjetas de solución.
- Excluya ideas que requieran datos reales de casos, registros individuales de elegibilidad, cambios importantes en leyes o políticas, o archivos administrativos identificables.
- Lleve a cabo la fase de Entrega (30–40 min).
- Pida a los participantes que califiquen cada idea de solución en una escala de cinco puntos según el impacto esperado en el servicio, la viabilidad de implementación, el acuerdo entre las partes interesadas y la adecuación para pruebas con tareas simuladas.
NOTA: Seleccione conceptos de prototipo con una puntuación media de al menos 4,0 tanto en viabilidad como en capacidad de prueba. Este umbral es necesario para garantizar que los prototipos sean viables para pruebas con tareas simuladas sin cuellos de botella en la implementación.
6. Etapa 4: Prueba de prototipo de baja fidelidad
- Desarrolle prototipos de baja fidelidad para los conceptos priorizados.
- Prepare tres formatos de prototipo: una lista de verificación de requisitos del servicio, una maqueta de seguimiento del estado del servicio y una vía de seguimiento o escalación.
- PASO CRÍTICO: Cree dos conjuntos de tareas emparejados antes de la prueba. Asegúrese de que los conjuntos de tareas estén equilibrados en cuanto a pasos de decisión, longitud de lectura, campos requeridos, complejidad del escenario y tiempo esperado de finalización.
- Empareje los conjuntos de tareas según el número de pasos de decisión, longitud de lectura, campos requeridos, complejidad del escenario y tiempo esperado de finalización.
- Realice una prueba piloto con los conjuntos de tareas emparejados utilizando tres a cinco usuarios no incluidos en el estudio.
- Revise los conjuntos de tareas si el tiempo medio de finalización difiere en más del 10 %.
- Administre tareas simuladas de servicios públicos para evaluar los prototipos.
- Siempre que sea posible, utilice un diseño contrabalanceado o con grupo control para distinguir la familiaridad con la tarea de la exposición al prototipo.
- Si todos los participantes completan las tareas basales antes de las tareas posteriores al prototipo, registre esto como un riesgo potencial de efecto de aprendizaje en las secciones Protocolo, Resultados y Discusión.
- Proporcione a cada participante cuatro escenarios de tareas basales antes de la exposición al prototipo.
- Después de la exposición al prototipo, proporcione cuatro escenarios de tareas comparables, pero no idénticos.
- Establezca un tiempo máximo de 5 min para cada tarea.
- Lea instrucciones idénticas para cada tarea a todos los participantes.
- No proporcione pistas durante la realización de la tarea. Limite las aclaraciones únicamente a preguntas de procedimiento.
- Mida el tiempo de finalización de la tarea en segundos, desde la presentación de la tarea hasta la respuesta final.
- Registre la tarea como incompleta, asigne un tiempo de finalización de 300 s y codifique el éxito de la tarea como 0 si un participante no completa la tarea dentro de los 5 min.
- Codifique una tarea como exitosa solo cuando el participante seleccione la respuesta correcta o complete todos los pasos de decisión requeridos dentro del límite de tiempo.
- Calcule el número de errores contabilizando los pasos de decisión omitidos, incorrectos o innecesarios.
- Mida la claridad percibida por el participante inmediatamente después de cada tarea utilizando una escala de cinco puntos (1 = muy poco claro; 5 = muy claro).
- Después de completar todas las tareas, solicite a los participantes que evalúen la usabilidad del prototipo y su intención de adopción.
NOTA: La prueba de prototipos evalúa la claridad y usabilidad basadas en tareas de los materiales generados por el protocolo, y no las mejoras en el desempeño del servicio público23.
7. Análisis de datos y control de calidad
- Excluya las respuestas del cuestionario completadas en menos de 3 min, las respuestas con más del 20 % de valores faltantes, respuestas idénticas en todos los ítems de la escala Likert o respuestas que contengan información inconsistente sobre el rol.
- Resuma los datos del cuestionario utilizando medias y desviaciones estándar para variables continuas, y frecuencias y porcentajes para variables categóricas.
- Codifique los datos de los interesados y del mapeo del recorrido utilizando la hoja de codificación estructurada. Dos investigadores deben codificar independientemente al menos el 20 % del material antes de una discusión de consenso, y luego informar el porcentaje de acuerdo y kappa de Cohen o un estadístico de fiabilidad equivalente.
- Analice las salidas del taller contando las tarjetas válidas de puntos críticos, los grupos de problemas, las declaraciones de desafíos de diseño, las ideas de solución, las calificaciones de viabilidad y los conceptos de prototipo preseleccionados.
- Calcule la puntuación de usabilidad del prototipo específica del protocolo a partir de cinco ítems de cinco puntos: claridad de los requisitos, visibilidad del estado, claridad del siguiente paso, facilidad para completar la tarea y confianza en el uso del material. Transforme la puntuación bruta (que varía de 5 a 25) a una escala de 0-100 utilizando la fórmula:
usabilidad score = (raw score - 5) / 20 x 10017 - Analice los datos de prueba del prototipo para extraer indicadores de claridad y usabilidad basados en tareas. Utilice IBM SPSS Statistics (Analizar > Comparar medias > Prueba T para muestras relacionadas; Analizar > Pruebas no paramétricas > Muestras relacionadas; Analizar > Estadísticos descriptivos > Tablas de contingencia > Estadísticos > McNemar) o comandos equivalentes en R (t.test(..., paired = TRUE), wilcox.test(..., paired = TRUE) y mcnemar.test()) para exportar el estadístico de prueba, el valor P exacto, el intervalo de confianza del 95 % cuando esté disponible y el tamaño del efecto.
- Interprete los valores P descriptivamente con un alfa predefinido de 0,05 y enfatice la dirección, magnitud y consistencia del efecto a través de los indicadores24.
- Agregue los registros repetidos de tareas al nivel del participante o utilice un modelo apropiado de medidas repetidas si se analizan simultáneamente cuatro tareas por condición.
NOTA: No trate todos los registros de tareas como estadísticamente independientes a menos que esta suposición esté explícitamente justificada. - PASO CRÍTICO: Documente todas las decisiones relacionadas con la limpieza de datos, codificación, emparejamiento de conjuntos de tareas y análisis estadístico en una hoja de auditoría para mantener la reproducibilidad. Asegúrese de que todos los datos desidentificados se almacenen en archivos protegidos con contraseña a los que solo el equipo de investigación pueda acceder.
Resultados
Inclusión de participantes y viabilidad del protocolo
El protocolo se implementó con éxito, obteniendo 100 respuestas válidas a los cuestionarios (una tasa de finalización del 89,3 %) y un subgrupo dedicado de 28 participantes que completaron las etapas del taller y de pruebas del prototipo. Los participantes seleccionados representaron a siete categorías de partes interesadas involucradas en el proceso del servicio público: ciudadanos o usuarios del servicio (n = 32), personal de primera línea del servicio (n = 18), trabajadores comunitarios (n = 14), administradores de agencias públicas (n = 12), coordinadores interdepartamentales (n = 8), representantes del tercer sector (n = 10) y personal de apoyo a plataformas digitales (n = 6).
Los 28 participantes del taller se dividieron en cinco grupos mixtos por roles, y cada grupo incluyó al menos tres categorías de interesados. Todos los grupos completaron la elaboración de mapas de interesados, mapas de recorrido, el proceso de co-diseño Double Diamond y la prueba de prototipos, produciendo perfiles de actores y relaciones, matrices de interesados y recorridos, enunciados de desafíos de diseño validados, conceptos de prototipos y registros simulados de pruebas de tareas (Tabla 3). Las etapas estructuradas de mapeo requirieron menos intervenciones del facilitador que las fases de definición del problema.
Tabla 3: Inclusión de participantes, composición de partes interesadas y etapas de implementación del protocolo. Reclutamiento e inclusión de participantes, composición de los grupos de partes interesadas, participación en los talleres, finalización del protocolo y los resultados de implementación a través de las cuatro etapas del protocolo. Haga clic aquí para descargar esta tabla.
Resultados de visualización: mapeo de interesados y recorridos
La etapa de mapeo de interesados identificó nueve categorías de actores, siete de las cuales aparecieron de forma consistente en todos los grupos y conformaron el eje vertical de la matriz de recorrido de interesados. Los administradores de agencias públicas obtuvieron las puntuaciones medias más altas en influencia, mientras que los ciudadanos obtuvieron las puntuaciones más altas en dependencia y las más bajas en acceso a la información. Se identificaron nueve brechas de percepción, definidas como discrepancias en las valoraciones de dos puntos o más. La brecha más grande se produjo en el acceso percibido a la información entre ciudadanos y administradores.
La etapa de mapeo del recorrido generó 126 declaraciones brutas de puntos críticos. Tras una combinación estructurada según la etapa del recorrido y la consecuencia posterior, se conservaron 38 fallos de servicio únicos, de los cuales 12 cumplieron con los criterios predefinidos de priorización (frecuencia ≥10 % o gravedad ≥4,0). La mayoría de los fallos priorizados ocurrieron durante la preparación de materiales, la aclaración de elegibilidad y el procesamiento interdepartamental. Estos hallazgos se sintetizaron en la matriz integrada de recorrido de partes interesadas (Figura 2).
Transformación de co-diseño y generación de prototipos
Durante el taller de co-diseño Double Diamond, los participantes generaron 94 tarjetas válidas de puntos críticos, que se agruparon en 14 áreas problemáticas. De las 17 declaraciones iniciales del reto de diseño, seis requirieron revisiones porque carecían de una dirección clara de mejora, definían al actor afectado de forma demasiado amplia o proponían una solución antes de definir claramente el problema. Tras una revisión basada en una rúbrica, se mantuvieron 11 declaraciones del reto de diseño.
Durante la fase de Desarrollo, los participantes generaron 32 ideas de mejora del servicio. La aplicación de los umbrales predefinidos de viabilidad y capacidad de prueba (puntuaciones ≥4,0) redujo estas ideas a seis conceptos preseleccionados. Se seleccionaron tres conceptos de prototipos de baja fidelidad para pruebas basadas en tareas: una lista de verificación de requisitos del servicio en una sola página, un prototipo de seguimiento del estado del servicio y una vía de escalación definida (Figura 3). Los resultados numéricos de todas las etapas de visualización y co-diseño se resumen en la Tabla 4.
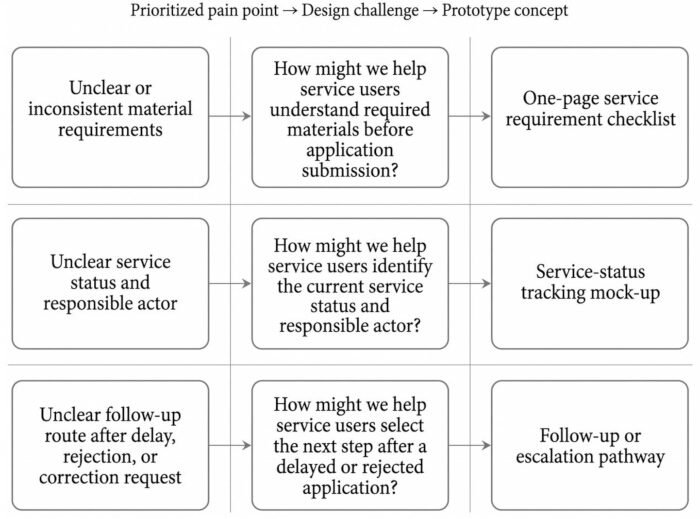
Figura 3: Ruta de transformación de puntos críticos a prototipo. La figura ilustra tres rutas de transformación desde los puntos críticos priorizados hasta los enunciados de desafíos de diseño y los conceptos de prototipos de baja fidelidad. Los enunciados de desafíos de diseño se presentan utilizando el formato «¿Cómo podríamos?», una técnica de diseño colaborativo utilizada para plantear problemas como oportunidades abiertas para la generación de soluciones. Los ejemplos mostrados incluyen: (1) requisitos de materiales poco claros o inconsistentes convertidos en una lista de verificación de requisitos del servicio en una página; (2) estado del servicio poco claro y falta de identificación del responsable, transformados en un modelo simulado para el seguimiento del estado del servicio; y (3) rutas de seguimiento poco claras tras retrasos, rechazos o solicitudes de corrección, convertidas en una ruta de seguimiento o escalación. Haga clic aquí para ver una versión ampliada de esta figura.
Tabla 4: Resultados generados por el protocolo y resultados cuantitativos de las pruebas basadas en tareas. Las salidas generadas en cada etapa del protocolo, junto con los resultados cuantitativos de la evaluación simulada basada en tareas del prototipo, incluyen indicadores de usabilidad y rendimiento. Haga clic aquí para descargar esta tabla.
Resultados de la prueba del prototipo basada en tareas
El protocolo generó 224 registros simulados de tareas provenientes de 28 participantes, compuestos por 112 registros de tareas basales y 112 registros posteriores al prototipo. Los materiales generados mediante el protocolo se asociaron con un mejor desempeño durante las tareas simuladas. Realizamos un análisis de muestras apareadas a nivel del participante (n = 28) para tener en cuenta las correlaciones intra-individuales a lo largo de tareas repetidas. El tiempo medio de finalización de la tarea disminuyó significativamente de 178,4 ± 35,8 s en la línea basal a 121,7 ± 28,4 s tras el prototipo (diferencia media = −56,7 s; IC del 95 %, −68,3 – −45,1 s; Cohen’s dz = −1,92; prueba t apareada, P < 0,001). De manera similar, el número medio de errores por participante se redujo de 1,86 ± 0,61 a 0,79 ± 0,44 (diferencia media = −1,07 errores; IC del 95 %, −1,27 – −0,87; Cohen’s dz = −2,05; prueba t apareada, P < 0,001). Las tasas de éxito en las tareas se analizaron mediante una prueba de rangos con signo de Wilcoxon sobre las proporciones de éxito a nivel del participante, mostrando una mejora significativa (Z = −4,12, P < 0,001). Las calificaciones medias de claridad también mejoraron significativamente a nivel del participante, aumentando de 3,1 ± 0,5 a 4,2 ± 0,4 (diferencia media = 1,10 puntos; IC del 95 %, 0,94 a 1,26; Cohen’s dz = 2,71; prueba t apareada, P < 0,001).
La tasa general de éxito en la tarea aumentó del 62,5 % (70/112 registros de tareas) en la línea base al 82,1 % (92/112 registros de tareas) tras la exposición al prototipo, lo que representa un incremento de 19,6 puntos porcentuales (IC del 95 %, de 8,2 a 31,1 puntos porcentuales; comparación de dos proporciones, P = 0,001). Dado que los conteos agregados indican 22 registros de tareas exitosas adicionales tras la exposición al prototipo, todas las tablas de discordancia pareadas factibles produjeron un resultado exacto de sensibilidad de McNemar inferior a P < 0,01, lo que respalda la misma conclusión direccional y evita la reconstrucción de pares discordantes a nivel individual no disponibles.
Los resultados autoinformados por los participantes fueron coherentes con estos hallazgos operativos. Las puntuaciones medias de claridad aumentaron de 3,1 ± 0,7 a 4,2 ± 0,5 en la escala de cinco puntos (n = 112 registros de tareas por condición; diferencia media = 1,10 puntos; IC del 95 %, de 0,94 a 1,26; diferencia media estandarizada a nivel resumido = 1,81; P a nivel resumido < 0,001). Los materiales finales obtuvieron una puntuación de usabilidad específica del protocolo de 78,4 ± 9,6 y una puntuación de intención de adopción de 4,1 ± 0,6 (Figura 4). Estas puntuaciones de usabilidad se calcularon a partir de los cinco ítems específicos del estudio del protocolo, en lugar de a partir de la Escala Estándar de Usabilidad del Sistema (SUS). Los comentarios abiertos respaldaron estos hallazgos: 21 de 28 participantes informaron una mayor claridad visual de la matriz de recorrido de las partes interesadas, 17 de 28 informaron roles de actores más claros, 19 de 28 informaron etapas de servicio más claras, y 20 de 28 confirmaron la usabilidad práctica de los materiales del prototipo.
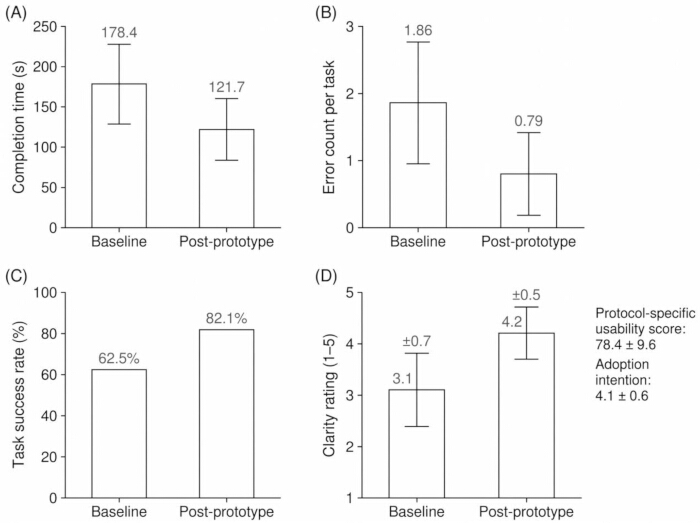
Figura 4: Resultados de claridad y usabilidad basados en tareas tras la exposición al prototipo. (A) Tiempo medio de finalización de la tarea (s). (B) Número medio de errores por tarea. (C) Tasa de éxito en la tarea (%). (D) Claridad valorada por los participantes (escala de 1 a 5). Otras métricas en el panel (D) incluyen la puntuación de usabilidad específica del protocolo y la intención de adopción. Las barras representan las medias a nivel de participante, y las barras de error indican la desviación estándar (SD). Las comparaciones entre las condiciones basal y posterior al prototipo se realizaron a nivel de participante y fueron estadísticamente significativas (P < 0,001) para el tiempo de finalización, el número de errores, la claridad y la tasa de éxito en la tarea. Haga clic aquí para ver una versión más grande de esta figura.
Discusión
Este protocolo proporciona un método sistemático y reproducible para estructurar problemas complejos en entornos de servicios públicos de bajo riesgo. Al integrar secuencialmente el mapeo de partes interesadas, el mapeo de recorridos, el diseño conjunto Double Diamond y la prueba de prototipos de baja fidelidad, el método traduce quejas fragmentadas de múltiples actores en intervenciones de servicio comprobables, manteniendo al mismo tiempo una distinción clara entre la evidencia de usabilidad simulada y el desempeño administrativo real. Los resultados representativos demuestran que los desafíos en los servicios públicos rara vez están aislados en un solo paso del procedimiento; por el contrario, se distribuyen entre los usuarios, el personal de primera línea y los administradores de oficinas centrales. Una contribución clave de este protocolo es su capacidad para hacer visibles estas dependencias entre múltiples actores y las asimetrías informativas antes de que comience el desarrollo de soluciones.
Un componente central de este protocolo es la matriz de recorrido de las partes interesadas. En los servicios públicos multiautor, las partes interesadas frecuentemente tienen diferentes interpretaciones sobre dónde se originan los fallos del servicio. La matriz funciona como un objeto límite, un artefacto tangible que es adaptable a través de diferentes límites conceptuales manteniendo al mismo tiempo una identidad común entre los grupos de participantes, facilitando así el consenso entre roles y el diseño colaborativo25,26. Al traducir la insatisfacción difusa del usuario en eventos observables y específicos de cada etapa, la matriz reduce el riesgo de una formulación vaga del problema y ayuda a prevenir que los participantes del taller recurran a ajustes administrativos familiares pero ineficaces.
La aplicación estructurada del marco Double Diamond facilita una transición controlada desde la exploración del problema hasta la reconfiguración práctica del servicio. Los resultados indican que pasar de quejas generales a desafíos de diseño específicos del tipo «¿Cómo podríamos?» suele ser la fase más exigente del proceso, que requiere una facilitación activa, criterios explícitos de selección y revisiones documentadas. Sin estas limitaciones estructurales (especificar el actor afectado, la etapa del recorrido, la falla del servicio y la mejora prevista), las sesiones de co-diseño podrían generar soluciones genéricas que no aborden las fallas del servicio identificadas. La vinculación directa entre un punto crítico prioritario (por ejemplo, requisitos de materiales poco claros) y su prototipo correspondiente (por ejemplo, una lista de verificación de una página) ilustra la validez generativa del protocolo.
Es importante distinguir los resultados de pruebas de prototipos basados en tareas, generados por este protocolo, de las afirmaciones sobre mejoras organizacionales reales. Las reducciones observadas en el tiempo de finalización de tareas y en las tasas de error indican que los materiales co-diseñados son claros y utilizables bajo condiciones simuladas. Sin embargo, la prototipación en etapas iniciales en el sector público tiene principalmente como objetivo apoyar el aprendizaje y la mitigación de riesgos antes de la implementación16,27. La secuencia fija de pruebas antes/después utilizada en la aplicación representativa también podría introducir efectos de familiaridad con la tarea o de aprendizaje, ya que los participantes realizaron las tareas de línea base antes que las tareas posteriores al prototipo. Las implementaciones futuras deben utilizar órdenes de tareas contrabalanceadas, grupos control emparejados o modelos de medidas repetidas para distinguir los efectos del prototipo de los efectos del aprendizaje.
Solucionar problemas comunes de fallos en el protocolo es esencial para la reproducibilidad. Si el mapeo de interesados produce solo etiquetas genéricas de actores, los facilitadores deben pedir a los participantes que especifiquen la decisión, la información o la dependencia de coordinación asociada a cada actor. Si los mapas de recorrido se convierten en listas de quejas, los facilitadores deben devolver cada tarjeta a una etapa específica del recorrido, al actor afectado, la brecha de información y la consecuencia posterior.
Se espera una modificación del protocolo cuando el flujo de trabajo se traslade a diferentes entornos de servicios públicos. Para los servicios administrativos universitarios, las etiquetas de las etapas pueden enfatizar los procesos de registro, apelaciones y apoyo. Para la reorganización de las vías de atención ambulatoria en el sector salud, deben ampliarse las salvaguardas éticas y las aprobaciones de gobernanza clínica. Para la coordinación de servicios sociales, los requisitos de protección de datos entre agencias pueden exigir controles más estrictos de desidentificación y derivación. Las diferencias culturales, administrativas y gubernamentales también pueden influir en la libertad con que los participantes critican los procedimientos, en la forma en que se distribuye la autoridad dentro de grupos mixtos, y en si se requiere votación anónima o mapeo separado entre usuarios y proveedores.
Se deben considerar varias limitaciones al aplicar este método. En primer lugar, el protocolo está diseñado específicamente para servicios consultivos y administrativos de bajo riesgo. Aplicarlo en entornos de alto riesgo, como intervenciones médicas o decisiones legales, requeriría salvaguardias éticas considerablemente reforzadas, experiencia específica en el dominio y protocolos de protección de datos. En segundo lugar, aunque separar los grupos de usuarios y proveedores durante la etapa inicial de mapeo puede reducir la supresión de comentarios negativos, las desigualdades de poder inherentes aún podrían influir en la dinámica colaborativa durante la síntesis con roles combinados. En tercer lugar, el éxito de la fase Definir sigue dependiendo de la experiencia del facilitador. Por lo tanto, grupos de investigación independientes deben utilizar formación estandarizada para facilitadores, ejercicios de calibración, listas de verificación de observación y revisiones posteriores a la sesión antes de comparar resultados entre diferentes contextos.
En conclusión, este protocolo sistemático de visualización proporciona un enfoque estructurado y limitado éticamente para diagnosticar y prototipar soluciones a problemas complejos de servicios públicos. Impulsa la innovación en servicios públicos más allá de las discusiones políticas abstractas al ofrecer un kit de herramientas reproducible que une la reforma dirigida por expertos con el diseño centrado en el usuario. Las investigaciones futuras deben aplicar este protocolo a dominios adicionales de servicios públicos, incluyendo servicios digitales municipales, servicios administrativos universitarios, apoyo educativo, rediseño de trayectorias ambulatorias en salud y coordinación de servicios sociales. Los estudios futuros también deben evaluar cómo se desempeñan los prototipos desarrollados en talleres controlados tras su implementación en flujos de trabajo administrativos rutinarios.
Divulgaciones
Los autores declaran que no tienen intereses en competencia.
Agradecimientos
Los autores agradecen a todos los participantes, incluidos ciudadanos, personal de primera línea de servicios y administradores de agencias públicas, por su participación en los cuestionarios, talleres de co-diseño y sesiones de pruebas de prototipos. Sus contribuciones y perspectivas sobre las experiencias de servicios públicos con múltiples actores respaldaron el desarrollo de este protocolo sistemático de visualización de diseño de servicios.
Los autores también agradecen el apoyo institucional y académico brindado por la Facultad de Innovación y Diseño, Universidad Ciudad de Macao; la Facultad de Arte y Diseño, Universidad de Shenzhen; y la Facultad de Arte y Diseño, Universidad Guangdong Baiyun. Esta investigación no recibió ninguna subvención específica de ninguna agencia financiadora en los sectores público, comercial o sin fines de lucro.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Sintaxis de análisis o notas del flujo de trabajo | Equipo de investigación | PSD-VP-S17 v1.1 | Documentar el flujo de trabajo en SPSS o R equivalente para comparaciones pareadas, pruebas de Wilcoxon, comprobaciones de sensibilidad de McNemar, tamaños del efecto, intervalos de confianza y resultados de informes. |
| Cuestionario anónimo basado en roles | Equipo de investigación | PSD-VP-S02 v1.1 | Recopilar información sobre el rol de los interesados y sus percepciones iniciales sobre el proceso de servicio público seleccionado. |
| Lista de verificación de desidentificación | Equipo de investigación | PSD-VP-S14 v1.1 | Asegurar que no se recojan ni divulguen nombres de participantes, números de identificación, direcciones, identificadores de casos ni registros administrativos. |
| Plantilla de desafío de diseño | Equipo de investigación | PSD-VP-S07 v1.1 | Convertir los puntos críticos agrupados en enunciados estructurados y comprobables del tipo «¿Cómo podríamos?». |
| Rúbrica de calibración del facilitador | Equipo de investigación | PSD-VP-S15 v1.1 | Normalizar la preparación del facilitador, la codificación de ejemplos, la revisión de enunciados de desafíos y la coherencia entre facilitadores. |
| Ficha de calificación de interesados con escala de cinco puntos | Equipo de investigación | PSD-VP-S04 v1.1 | Calificar la influencia de cada interesado, su dependencia, acceso a la información y presión de coordinación. |
| IBM SPSS Statistics | IBM Corporation | Version 26.0 or later | Realizar análisis descriptivos, pruebas t pareadas, pruebas de rangos con signo de Wilcoxon y pruebas de McNemar para los resultados de pruebas de prototipos. |
| Materiales de prototipo de baja fidelidad | Equipo de investigación | PSD-VP-S10 v1.1 | Desarrollar y probar materiales de servicio en etapas iniciales, incluyendo una lista de verificación de requisitos, maqueta del estado del servicio y vía de seguimiento. |
| Microsoft Excel | Microsoft Corporation | Microsoft 365 or equivalent | Organizar los datos del cuestionario, calcular estadísticas descriptivas, gestionar hojas de codificación y preparar tablas resumen. |
| Tarjetas de puntos críticos | Equipo de investigación | PSD-VP-S06 v1.1 | Registrar fallos en el servicio, brechas de información, ambigüedad en responsabilidades, actores afectados y consecuencias posteriores. |
| Ficha informativa para participantes | Equipo de investigación | PSD-VP-S01 v1.1 | Explicar el propósito del estudio, los procedimientos, los derechos de los participantes y los requisitos de consentimiento antes de la participación. |
| Almacenamiento de datos con contraseña | Sistema informático institucional o del equipo de investigación | Acceso restringido al equipo de investigación | Almacenar de forma segura datos del cuestionario desidentificados, resultados de talleres, archivos de codificación y registros de pruebas de tareas. |
| Rúbrica de evaluación de prototipos | Equipo de investigación | PSD-VP-S12 v1.1 | Evaluar la claridad del prototipo, usabilidad, éxito en la tarea, número de errores e intención de adopción. |
| Ficha de selección de prototipos | Equipo de investigación | PSD-VP-S09 v1.1 | Seleccionar conceptos de prototipos que cumplan con umbrales predefinidos de viabilidad y capacidad de prueba. |
| Plantilla de mapeo de recorrido del servicio público | Equipo de investigación | PSD-VP-S05 v1.1 | Mapear el proceso de servicio público a lo largo de la búsqueda de información, aclaración de requisitos, preparación de materiales, presentación, tramitación, notificación y apoyo de seguimiento. |
| Fichas de tareas simuladas | Equipo de investigación | PSD-VP-S11 v1.1 | Evaluar la finalización de tareas, precisión en decisiones y claridad antes y después de la exposición al prototipo. |
| Tarjetas de soluciones | Equipo de investigación | PSD-VP-S08 v1.1 | Documentar ideas de mejora del servicio generadas durante el taller de co-diseño Double Diamond. |
| Hoja de trabajo de mapeo de interesados | Equipo de investigación | PSD-VP-S03 v1.1 | Identificar de 5 a 8 actores involucrados en el proceso de servicio público y visualizar sus roles y dependencias. |
| Hoja de codificación estructurada | Equipo de investigación | PSD-VP-S13 v1.1 | Codificar datos de mapeo de interesados, resultados de mapeo de recorridos, agrupaciones de puntos críticos y resultados de talleres. |
| Lista de verificación de equivalencia de conjuntos de tareas | Equipo de investigación | PSD-VP-S16 v1.1 | Documentar la coincidencia entre tareas basales y posteriores al prototipo según pasos de decisión, longitud de lectura, campos requeridos, complejidad y tiempo de finalización en prueba piloto. |
Referencias
- Rittel HWJ, Webber MM. Dilemmas in a general theory of planning. Policy Sci. 1973;4(2):155-69.
- Suoheimo M, Vasques R, Rytilahti P. Deep diving into service design problems: Visualizing the iceberg model of design problems through a literature review on the relation and role of service design with wicked problems. Des J. 2021;24(2):231-51.
- Voorberg WH, Bekkers V, Tummers LG. A systematic review of co-creation and co-production: Embarking on the social innovation journey. Public Manag Rev. 2015;17(9):1333-57.
- Schwoerer K, Keppeler F, Mussagulova A, Puello S. CO-DESIGN-ing a more context-based, pluralistic, and participatory future for public administration. Public Adm. 2022;100(1):72-97.
- Edelmann N, Mergel I. Co-production of digital public services in Austrian public administrations. Adm Sci. 2021;11(1):https://doi.org/10.3390/admsci11010022
- Blomkamp E. Systemic design practice for participatory policymaking. Policy Des Pract. 2022;5(1):12-31.
- Vargas C, et al. Exploring co-design: A systematic review of concepts, processes, models, and frameworks used in public health research. J Public Health. 2025;47(4):https://doi.org/10.1093/pubmed/fdaf084
- Wacnik P, Daly SR, Verma A. Participatory design: A systematic review and insights for future practice. Des Sci. 2025;11:https://doi.org/10.1017/dsj.2025.10009
- Udoewa V. An introduction to radical participatory design: Decolonising participatory design processes. Des Sci. 2022;8:https://doi.org/10.1017/dsj.2022.24
- Stickdorn M, Schneider J. This is service design thinking: Basics, tools, cases. BIS Publishers; Amsterdam; 2011. https://www.wiley.com/en-us/This+is+Service+Design+Thinking%3A+Basics%2C+Tools%2C+Cases-p-9781118156308
- Blomkamp E. The promise of co-design for public policy. Aust J Public Adm. 2018;77(4):729-43.
- Bryson JM. What to do when stakeholders matter: Stakeholder identification and analysis techniques. Public Manag Rev. 2004;6(1):21-53.
- Folstad A, Kvale K. Customer journeys: A systematic literature review. J Serv Theory Pract. 2018;28(2):196-227.
- Design C. Eleven lessons: Managing design in eleven global brands. Design Council; London; 2007. https://www.idi-design.ie/content/files/ElevenLessons_Design_Council_2.pdf
- Steen M, Manschot M, De Koning N. Benefits of co-design in service design projects. Int J Des. 2011;5(2):53-60.
- Not E, et al. Designing a digital environment to support the co-production of public services: Balancing multiple requirements and governance concepts. Digit Gov: Res Pract. 2024;5(3):https://doi.org/10.1145/3603632
- Excellence UGCfPS. Design thinking for public service excellence. UNDP Global Centre for Public Service Excellence; Singapore; 2014. https://www.undp.org/publications/designthinking-public-service-excellence
- Osborne SP. The new public governance? Public Manag Rev. 2006;8(3):377-87.
- Hartley J. Innovation in governance and public services: Past and present. Public Money Manage. 2005;25(1):27-34.
- Freeman RE. Strategic management: A stakeholder approach. Pitman; Boston; 1984.
- Stickdorn M, Hormess ME, Lawrence A, Schneider J. This is service design doing: Applying service design thinking in the real world. O'Reilly Media; Sebastopol; 2018. https://www.thisisservicedesigndoing.com/
- Bovaird T. Beyond engagement and participation: User and community coproduction of public services. Public Adm Rev. 2007;67(5):846-60.
- Donetto S, Pierri P, Tsianakas V, Robert G. Experience-based co-design and healthcare improvement: Realizing participatory design in the public sector. Des J. 2015;18(2):227-48.
- Tomczak M, Tomczak E. The need to report effect size estimates revisited: An overview of some recommended measures of effect size. Trends Sport Sci. 2014;21(1):19-25.
- Sanders EBN, Stappers PJ. Co-creation and the new landscapes of design. CoDesign. 2008;4(1):5-18.
- Star SL, Griesemer JR. Institutional ecology, 'translations' and boundary objects: Amateurs and professionals in Berkeley's Museum of Vertebrate Zoology, 1907-39. Soc Stud Sci. 1989;19(3):387-420.
- Liedtka J. Why design thinking works. Harv Bus Rev. 2018;96(5):72-9.