Este estudio integra transcriptómica pediátrica pública de neumonía, secuenciación de ARN a nivel de célula individual en pulmón de ratón, cribado de compuestos derivados de Paeonia, acoplamiento molecular y simulaciones de dinámica molecular para identificar dianas inflamatorias asociadas a neutrófilos e interacciones predichas de catequinas para su validación futura.
Artículo de investigación
Efectos de la catequina derivada de Paeonia sobre la inflamación asociada a neutrófilos en la neumonía
En este artículo
Resumen
Resumen
La neumonía en niños frecuentemente se acompaña de respuestas inflamatorias excesivas y disregulación inmunitaria, lo que puede conducir a resultados clínicos graves. La catequina ha demostrado actividad antiinflamatoria en múltiples contextos de enfermedad, pero su papel y sus mecanismos moleculares en la neumonía permanecen poco claros. Se analizaron datos públicos de secuenciación de ARN en masa provenientes de neumonía pediátrica (GSE261482) y datos públicos de secuenciación de ARN unicelular de pulmón de ratón procedentes de un modelo experimental de neumonía (GSE295484), utilizando análisis de red de coexpresión génica ponderada, análisis de expresión diferencial, anotación de tipos celulares y análisis de enriquecimiento de conjuntos de genes. Las interacciones entre la catequina y proteínas seleccionadas se evaluaron mediante simulaciones de acoplamiento molecular y dinámica molecular. Se identificó un módulo génico clave asociado con rasgos relacionados con la neumonía, y se seleccionaron 18 genes candidatos, enriquecidos principalmente en vías inflamatorias e inmunitarias. El análisis unicelular mostró que estos genes estaban predominantemente enriquecidos en neutrófilos y macrófagos alveolares, con proporciones aumentadas de neutrófilos en condiciones inflamatorias. MMP9, PYGL y GADD45A fueron seleccionados como genes candidatos. Las simulaciones de acoplamiento y dinámica molecular respaldaron interacciones estables predichas entre la catequina y estas proteínas seleccionadas. La catequina podría estar asociada con vías inflamatorias relacionadas con la neumonía mediante la modulación de vías asociadas a neutrófilos e interacciones con proteínas inmunitarias clave. Este estudio proporciona una visión a nivel de sistema sobre la acción de la catequina en la neumonía y destaca posibles dianas para validación experimental adicional.
Introducción
La neumonía es una enfermedad respiratoria común y potencialmente grave en niños, causada principalmente por agentes infecciosos como Mycoplasma pneumoniae. Representa un componente importante de la neumonía adquirida en la comunidad y se asocia con una morbilidad significativa debido a respuestas inflamatorias excesivas y una desregulación inmunitaria1,2. Cada vez hay más evidencia que sugiere que las citocinas inflamatorias, incluyendo el factor de necrosis tumoral-α (TNF-α) y la interleucina-6 (IL-6), desempeñan un papel fundamental en la progresión de la enfermedad al promover el reclutamiento de células inmunitarias, el daño tisular y la disfunción pulmonar3. A pesar de los avances en la terapia antimicrobiana, los mecanismos moleculares que impulsan la inflamación en la neumonía pediátrica aún no se comprenden por completo4.
Los flavonoides han atraído una atención considerable debido a sus propiedades antiinflamatorias y antioxidantes5. La catequina, un polifenol que ocurre naturalmente y que se encuentra ampliamente en el té y en alimentos de origen vegetal, se ha reportado que atenúa el estrés oxidativo y las respuestas inflamatorias en diversos modelos de enfermedades6. Estudios previos han demostrado que la catequina puede suprimir cascadas de señalización proinflamatorias, incluidas las vías MAPK y NF-κB, y regular la expresión de citoquinas, aliviando así la inflamación y la disfunción metabólica7. Sin embargo, la mayoría de los estudios existentes se centran en enfermedades metabólicas o cardiovasculares, mientras que el papel de la catequina en enfermedades inflamatorias respiratorias, particularmente en la neumonía, permanece poco explorado. Además, los blancos moleculares y los mecanismos subyacentes a la protección mediada por catequina en la neumonía siguen siendo poco claros.
Este estudio tuvo como objetivo investigar los posibles mecanismos moleculares de la catequina en la neumonía. Se planteó la hipótesis de que la catequina podría atenuar las respuestas inflamatorias mediante la interacción con proteínas clave y vías de señalización implicadas en la regulación inmune. Para probar esta hipótesis, se integraron análisis de farmacología de redes, acoplamiento molecular, simulación de dinámica molecular y secuenciación de ARN a nivel de célula individual para identificar sistemáticamente genes candidatos y evaluar sus interacciones con la catequina. Además, se analizó la distribución de células inmunitarias y los patrones de expresión génica para explorar el papel de los neutrófilos y los macrófagos en la progresión de la enfermedad.
Los resultados mostraron una unión predicha estable entre la catequina y proteínas seleccionadas, incluyendo PYGL, MMP9 y GADD45A, y mantuvieron la estabilidad estructural durante las simulaciones de dinámica molecular. Además, el análisis a nivel de célula individual reveló alteraciones significativas en las proporciones de células inmunitarias, particularmente neutrófilos, bajo condiciones inflamatorias. Estos hallazgos sugieren que la catequina podría estar asociada con mecanismos antiinflamatorios que implican la función de células inmunitarias y vías de señalización clave. Este estudio proporciona una visión a nivel de sistemas de los posibles mecanismos asociados con la catequina en la neumonía y respalda la validación adicional de la catequina como un compuesto candidato para la investigación de enfermedades respiratorias inflamatorias.
Protocolo
Este estudio implicó un análisis secundario de conjuntos de datos disponibles públicamente y desidentificados procedentes de la base de datos Gene Expression Omnibus. No se reclutaron, recolectaron o generaron nuevos participantes humanos, experimentos con animales ni muestras clínicas para este estudio. La aprobación ética y el consentimiento informado para los conjuntos de datos originales fueron responsabilidad de los estudios originales que generaron los datos. Por lo tanto, no se requirió una aprobación adicional por parte del comité de ética para el presente análisis secundario.
Recolección y preprocesamiento de datos
Los datos de secuenciación de ARN en masa (RNA-seq) se obtuvieron del conjunto de datos del Gene Expression Omnibus (GEO) GSE2614828. La matriz de expresión utilizada en este estudio contenía 177 muestras de sangre total, incluyendo 139 muestras de neumonía pediátrica y 38 muestras de controles sanos. Los metadatos disponibles incluían sexo, clasificación etiológica, tubo de recolección, lote y condición de la enfermedad. Las muestras de neumonía se anotaron como bacteriana definitiva (DB), viral definitiva (DV), bacteriana probable (PB), viral probable (PV) o desconocida (U), según la anotación del conjunto de datos original.
Los datos de secuenciación de ARN de una sola célula (scRNA-seq) se obtuvieron del conjunto de datos GEO GSE2954849, derivado de tejidos pulmonares de ratones C57BL/6 de tipo silvestre en un modelo experimental de neumonía. El conjunto de datos incluyó ratones neonatos (PND05) y ratones juveniles (PND12) expuestos al aire ambiente, PBS o E. coli, y recolectados a las 48 h o 96 h posteriores a la aspiración.
Análisis de red de coexpresión génica ponderada (WGCNA)
Para la construcción de la red de coexpresión, primero se filtró la matriz de expresión para eliminar los genes con baja expresión. Tras la eliminación de los genes de baja expresión, se evaluó la variabilidad mediante la desviación absoluta mediana (MAD). Los 5.000 genes con los valores más altos de MAD se utilizaron posteriormente para el análisis de red de coexpresión génica ponderada (WGCNA) en R. Se aplicó una potencia de umbralización suave de 15 porque cumplía con el criterio de topología libre de escala de R2> 0,8. Este umbral se utilizó para construir la matriz de adyacencia ponderada, que posteriormente se transformó en una matriz de superposición topológica (TOM). A continuación, se detectaron módulos génicos a partir del árbol de agrupamiento jerárquico basado en TOM. Para identificar los módulos relacionados con rasgos asociados a la neumonía, se calcularon los eigengenes de los módulos y se analizó su correlación con el estado de la enfermedad y su etiología.
Análisis de expresión diferencial
Se compararon los grupos de neumonía y control sano mediante el paquete limma de R para identificar genes diferencialmente expresados. Se realizó la corrección por múltiples pruebas utilizando el método de Benjamini-Hochberg. Los genes se consideraron diferencialmente expresados solo cuando se cumplían ambos umbrales: |cambio en el log2 de la razón| > 1 y valor p ajustado < 0,05.
Identificación de Paeoniacompuestos activos derivados y predicción de dianas
Para identificar sistemáticamente los compuestos bioactivos en Paeonia y sus posibles dianas biológicas, se empleó una estrategia de integración multi-bases de datos para garantizar confiabilidad y exhaustividad, siguiendo marcos establecidos de farmacología de redes. Primero, los compuestos activos de Paeonia fueron recuperados de la Base de Datos de Farmacología de Sistemas de Medicina Tradicional China (TCMSP, https://tcmsp-e.com) y otras bases de datos públicas, incluyendo ETCM y fuentes de la literatura. Los compuestos fueron seleccionados en función de parámetros farmacocinéticos, incluyendo biodisponibilidad oral (OB ≥ 30 %) y similitud con fármacos (DL ≥ 0,18), con el fin de identificar ingredientes bioactivos candidatos.
Los posibles blancos proteicos se predijeron mediante enfoques complementarios basados en ligandos. Se utilizó SwissTargetPrediction (http://www.swisstargetprediction.ch) para identificar los blancos humanos más probables, mediante la comparación de las estructuras de los compuestos con ligandos de actividad conocida, y solo se conservaron las predicciones con una probabilidad ≥ 0,1. Para ampliar la cobertura de blancos, también se empleó el Similarity Ensemble Approach (SEA, http://sea.bkslab.org) para analizar posibles interacciones fuera del blanco en familias de proteínas, incluyendo aquellas interacciones no captadas por predicciones canónicas de blancos. Para complementar aún más la predicción basada en ligandos, se utilizó el servidor PharmMapper (http://lilab.ecust.edu.cn/pharmmapper/) para realizar una asignación inversa de farmacóforos frente a una base de datos completa de proteínas humanas, seleccionándose los blancos con puntuaciones de ajuste normalizadas ≥ 0,7. Además, se recopilaron interacciones compuesto-blanco validadas experimentalmente a partir de bases de datos públicas, incluyendo DrugBank y BindingDB, para mejorar la fiabilidad de la identificación de blancos. Todos los blancos predichos se estandarizaron posteriormente a símbolos génicos oficiales utilizando la base de datos UniProt (https://www.uniprot.org), restringiendo el organismo a "Homo sapiens". Se eliminaron las entradas duplicadas para garantizar la precisión de los datos. El conjunto integrado de blancos se definió como la unión de todos los blancos predichos y validados para Paeonia, representando así la base molecular potencial de sus efectos farmacológicos. Dado que la catequina fue identificada como uno de los compuestos activos derivados de Paeonia y tiene una actividad antiinflamatoria bien documentada, se seleccionó como compuesto representativo para las simulaciones posteriores de acoplamiento molecular y dinámica molecular.
Análisis de enriquecimiento funcional
El enriquecimiento funcional se evaluó para los procesos biológicos de Gene Ontology (GO) y las vías de Kyoto Encyclopedia of Genes and Genomes (KEGG) utilizando el paquete clusterProfiler en R. Se conservaron los términos enriquecidos cuando la tasa de descubrimientos falsos (FDR) era < 0,05.
Análisis de secuenciación de ARN a nivel de célula individual y análisis posterior
Los datos de secuenciación de ARN a nivel de célula individual se procesaron en Seurat. Se utilizó la matriz GSE295484 procesada para el análisis posterior, sin aplicar ningún filtro adicional a nivel celular tras su importación. La matriz procesada contenía 90.883 células y 26.511 genes. Los gráficos de control de calidad utilizaron umbrales de referencia de 200 y 8.000 genes detectados por célula y 1,4 % de lecturas mitocondriales. Los datos se normalizaron, escalaron y sometieron a un análisis de componentes principales (PCA). Luego se realizó la agrupación celular, y se empleó la aproximación de variedad uniforme y proyección (UMAP) para visualizar las poblaciones celulares en un espacio reducido dimensionalmente. Las identidades celulares se asignaron según los genes marcadores canónicos. Los genes marcadores se identificaron utilizando FindAllMarkers con only.pos = TRUE, min.pct = 0,25 y logfc.threshold = 0,25.
Para evaluar la actividad de conjuntos de genes candidatos a nivel de célula individual, se realizó un análisis AUCell utilizando el paquete R AUCell. Las células se puntuaron según la expresión de firmas génicas predefinidas, y los patrones de enriquecimiento se visualizaron en gráficos UMAP. Para GSE295484, se calcularon las proporciones de poblaciones de células inmunitarias, incluyendo macrófagos alveolares y neutrófilos, en los grupos de aire ambiente, PBS y E. coli a las 48 h y 96 h posteriores a la aspiración. Las diferencias entre los grupos se evaluaron utilizando pruebas estadísticas no paramétricas. Los genes marcadores de neutrófilos se identificaron a partir del conjunto de datos de célula única y se intersectaron con genes candidatos previamente identificados para obtener los genes clave asociados a neutrófilos para análisis posteriores.
Acoplamiento molecular
El acoplamiento molecular se realizó utilizando AutoDock Vina, con la preparación del receptor y del ligando llevada a cabo mediante AutoDock Tools. Las estructuras cristalinas de las proteínas diana se obtuvieron del Protein Data Bank (PDB), incluyendo GADD45A (ID de PDB: 2KG4), MMP9 (ID de PDB: 6ESM) y PYGL (ID de PDB: 3DDS). Las estructuras proteicas se procesaron antes del acoplamiento eliminando moléculas de agua y ligandos co-cristalizados. Luego se añadieron átomos de hidrógeno polares y se asignaron cargas de Gasteiger.
La estructura tridimensional de la catequina se obtuvo de PubChem y se preparó en AutoDock Tools. Luego, se utilizó AutoDock Vina para acoplar la catequina con cada proteína diana y evaluar la afinidad de unión predicha y el patrón de interacción. Los parámetros de la caja de rejilla para el acoplamiento fueron los siguientes: GADD45A-catequina, center_x = 0.131, center_y = -0.002, center_z = -0.018, size_x = 47.25, size_y = 47.25, size_z = 47.25; MMP9-catequina, center_x = -0.434, center_y = 43.036, center_z = 14.868, size_x = 47.25, size_y = 47.25, size_z = 47.25; PYGL-catequina, center_x = 88.408, center_y = -80.795, center_z = 105.959, size_x = 100.45, size_y = 100.45, size_z = 100.45.
Simulación de dinámica molecular
Se utilizó el campo de fuerza AMBER14SB para los componentes proteicos. Los parámetros del ligando se generaron con el campo de fuerza GAFF2 mediante sobtop_1.0 (dev3.1), y se asignaron cargas RESP. Se empleó agua TIP3P para solvatar cada complejo proteína-ligando en una caja de simulación cúbica. La adición de iones Na⁺ y Cl⁻ ayudó a neutralizar el sistema y alcanzar una concentración iónica de 0.15 M. El método de malla de Ewald para partículas (PME) se utilizó para las interacciones electrostáticas de largo alcance con un corte de 1 nm. Se aplicaron restricciones de enlace utilizando el algoritmo LINCS. Para eliminar los choques estéricos, se realizó una minimización de energía mediante los métodos de descenso más pronunciado y gradiente conjugado.
Después de la equilibración, se realizaron simulaciones de dinámica molecular (MD) de producción en condiciones NPT a 310 K y 1 bar, controladas por el termostato de Nosé–Hoover y el barostato de Parrinello–Rahman. Cada simulación se ejecutó durante 100 ns con un paso de tiempo de 2 fs.
Análisis estadístico
Todos los análisis estadísticos se realizaron utilizando el software R. Los análisis de correlación se llevaron a cabo mediante los métodos de Pearson o Spearman, según correspondiera. Las comparaciones entre grupos se realizaron utilizando pruebas no paramétricas, incluida la prueba de Kruskal-Wallis. Se consideró estadísticamente significativo un valor de p < 0,05.
Resultados
Identificación de un módulo génico clave asociado con la neumonía pediátrica mediante WGCNA
Para identificar módulos génicos asociados con la neumonía pediátrica, se realizó un análisis de WGCNA con datos transcriptómicos de sangre total procedentes de pacientes con neumonía y controles sanos. El análisis de agrupamiento de muestras no reveló valores atípicos evidentes, lo que indica una buena calidad de los datos para el análisis posterior (Figura 1A). El ACP demostró además una clara tendencia de separación entre los grupos con neumonía y los sanos, lo que sugiere perfiles transcriptómicos distintos entre las condiciones (Figura 1B). Para construir una red libre de escala, los genes se ordenaron según la desviación absoluta mediana, se seleccionaron los 5.000 genes superiores para la construcción de la red y la potencia de umbralización suave se estableció en 15 según el criterio del índice de ajuste de topología libre de escala (R2 > 0,8), manteniendo al mismo tiempo una conectividad media relativamente baja (Figura 1C). Con este umbral, el agrupamiento jerárquico identificó múltiples módulos génicos con patrones de expresión distintos (Figura 1D). El análisis de la relación entre módulos y rasgos reveló que varios módulos estaban significativamente correlacionados con fenotipos clínicos. En particular, el módulo azul mostró una fuerte correlación con el estado de la enfermedad (neumonía frente a sano) y con la clasificación etiológica, lo que sugiere su posible papel en la progresión de la enfermedad y en la respuesta del huésped (Figura 1E).
Además, el análisis de diagrama de dispersión de la pertenencia al módulo frente a la significancia del gen dentro del módulo azul mostró una fuerte correlación positiva (cor = 0.6, p = 2.1e−35), lo que indica que los genes altamente conectados dentro del módulo también estaban fuertemente asociados con el rasgo clínico (Figura 1F).
Asociación del módulo azul con la etiología de la neumonía bacteriana
Para investigar más a fondo las diferencias en la expresión génica según las distintas etiologías de la neumonía, se realizó un análisis de WGCNA utilizando múltiples clasificaciones clínicas, incluyendo los grupos control (C), bacteriana definitiva (DB), viral definitiva (DV), bacteriana probable (PB), viral probable (PV) y desconocida (U). El análisis de la relación entre módulos y rasgos reveló que varios módulos presentaron correlaciones significativas con subtipos etiológicos específicos. En particular, el módulo azul mostró la correlación positiva más fuerte con el grupo DB, lo que sugiere su posible participación en las respuestas del huésped específicas a la infección bacteriana (Figura 2A).
El dendrograma de agrupamiento genético y la asignación de módulos correspondiente confirmaron aún más la solidez de la construcción de módulos y la clara separación de los grupos de genes (Figura 2B). Dentro del módulo azul, el análisis de la pertenencia al módulo frente a la significancia génica mostró una correlación positiva significativa (cor = 0,41, p = 7,8e−14), lo que sugiere que los genes altamente conectados dentro de este módulo también estaban fuertemente asociados con el rasgo etiológico (Figura 2C).
Además, la comparación de la expresión de los eigengenes del módulo entre diferentes grupos etiológicos reveló diferencias significativas en el módulo azul (prueba de Kruskal-Wallis, p = 1.5e−13). Específicamente, el módulo azul mostró una expresión elevada en los grupos con neumonía bacteriana, particularmente en el subgrupo DB, en comparación con otras categorías etiológicas (Figura 2D).
Dieciocho genes candidatos relacionados con compuestos derivados de Paeonia asociados con neumonía pediátrica identificados mediante análisis integrado
Para identificar genes candidatos asociados con neumonía pediátrica y posibles dianas relacionadas con Paeonia, primero se realizó un análisis de expresión diferencial entre pacientes con neumonía y controles sanos. Con estos criterios, se identificaron 1.110 genes con expresión diferencial (DEG) entre muestras de neumonía y controles sanos, incluyendo 524 genes regulados positivamente y 586 regulados negativamente. Los 524 DEG regulados positivamente se proporcionan en la Tabla Suplementaria S1 (véase también la Figura 3A). Para refinar aún más los genes clave, los DEG relacionados con la neumonía se superpusieron con genes asociados al fenotipo DB y con dianas predichas de Paeonia. Este análisis integrado arrojó 18 genes superpuestos, lo que sugiere sus posibles funciones en la progresión de la enfermedad y en respuestas asociadas con Paeonia (Figura 3B).
Se construyó una red de interacciones compuesto-diana para visualizar las relaciones entre los componentes activos de Paeonia y los genes candidatos identificados, lo que reveló una amplia conectividad entre compuestos y dianas (Tabla Suplementaria S2 y Figura 3C). Para explorar las funciones biológicas de estos 18 genes, se realizaron análisis de enriquecimiento funcional. El enriquecimiento del proceso biológico en GO asoció principalmente los genes candidatos a funciones inmunitarias e inflamatorias, incluyendo la regulación de la respuesta inflamatoria, la respuesta a hormonas peptídicas, la regulación positiva del metabolismo de especies reactivas de oxígeno y la regulación de la señalización mediada por interferón tipo II (Figura 3D). El análisis KEGG mostró además que los genes estaban enriquecidos en vías relacionadas con la inflamación y la inmunidad, tales como las vías de señalización de IL-17 y NF-κB, así como en vías metabólicas y endocrinas, incluyendo la señalización del glucagón y la biosíntesis de hormonas esteroides (Figura 3D).
Enriquecimiento de genes candidatos en neutrófilos y macrófagos alveolares en el análisis transcriptómico unicelular
Para investigar la distribución celular de los genes candidatos en un contexto experimental de neumonía, se analizó el conjunto de datos de secuenciación de ARN unicelular (scRNA-seq) de pulmón de ratón GSE295484. Se realizó un análisis de control de calidad para evaluar la fiabilidad de los datos. Las distribuciones del número de genes detectados, los recuentos de UMI y los porcentajes de genes mitocondriales y ribosomales indicaron datos unicelulares de alta calidad general en la matriz procesada (Figura 4A). Los gráficos de dispersión mostraron los umbrales de referencia para la detección de genes y el contenido mitocondrial utilizados en la visualización del control de calidad (Figura 4B).
Después de la normalización y la reducción de dimensionalidad, las células se agruparon y visualizaron mediante UMAP. Se identificaron poblaciones celulares distintas, incluyendo neutrófilos, macrófagos alveolares, monocitos, células epiteliales y otros tipos celulares inmunitarios y estromales, lo que demuestra la heterogeneidad celular del microentorno pulmonar durante la neumonía (Figura 4C). Para evaluar la actividad de los 18 genes candidatos a nivel individual de célula única, se realizó un análisis AUCell. Los resultados mostraron que la firma génica estaba predominantemente enriquecida en neutrófilos y macrófagos alveolares, como lo indica la mayor puntuación AUC en estas poblaciones celulares (Figura 4D).
Genes inflamatorios asociados con compuestos derivados de Paeonia en un modelo de neumonía bacteriana en ratón
Para investigar más a fondo la dinámica de las células inmunitarias en el modelo experimental de neumonía en ratón, se analizó la proporción de macrófagos alveolares y neutrófilos en los grupos expuestos al aire ambiente, PBS y E. coli a las 48 h y 96 h posteriores a la aspiración. A las 48 h, los macrófagos alveolares mostraron una disminución notable durante la infección por E. coli en comparación con las condiciones de aire y PBS, mientras que los neutrófilos exhibieron un aumento sustancial en su proporción celular (Figura 5A). Se observó una tendencia similar a las 96 h, con proporciones de neutrófilos que permanecieron elevadas en respuesta a la estimulación con E. coli, mientras que los macrófagos alveolares mostraron niveles comparativamente más bajos. Estos resultados indican una expansión prominente de los neutrófilos durante la infección bacteriana. Para explorar las características funcionales de los neutrófilos, se identificaron genes marcadores de neutrófilos y se realizó un análisis de enriquecimiento funcional. El enriquecimiento mediante KEGG asoció los genes marcadores de neutrófilos con señales inflamatorias, incluyendo las vías de TNF, MAPK y receptores de lectina tipo C (Figura 5B). Los términos GO de procesos biológicos también se concentraron en funciones de respuesta inmunitaria, como la migración de leucocitos, la adhesión célula-célula entre leucocitos, la regulación positiva de la respuesta de defensa y la respuesta a moléculas de origen bacteriano (Figura 5B). Para identificar los genes clave que vinculan la actividad de los neutrófilos, la neumonía y los blancos de Paeonia, se intersectaron los genes marcadores de neutrófilos con los 18 genes candidatos identificados previamente. Este análisis arrojó tres genes superpuestos: MMP9, PYGL y GADD45A (Tabla Suplementaria S3 y Figura 5C). Finalmente, la visualización de la expresión génica a nivel de célula individual mostró que estos tres genes se expresan predominantemente en poblaciones de neutrófilos (Figura 5D), lo que respalda aún más sus posibles funciones en respuestas inflamatorias mediadas por neutrófilos.
Afinidad de unión predicha de la catequina con proteínas seleccionadas en el acoplamiento molecular
Para evaluar aún más las posibles interacciones entre catequina y proteínas, se realizó un análisis de acoplamiento molecular entre las proteínas seleccionadas (MMP9, PYGL y GADD45A) y la catequina, un compuesto activo derivado de Paeonia. Las estructuras cristalinas de GADD45A, MMP9 y PYGL se obtuvieron del Protein Data Bank, y la estructura tridimensional de la catequina se recuperó de la base de datos PubChem. Los resultados del acoplamiento sugirieron que la catequina podría unirse a sitios de las tres proteínas seleccionadas, con energías de unión de −6,3 kcal/mol para GADD45A, −7,6 kcal/mol para MMP9 y −8,0 kcal/mol para PYGL (Figura 6). Entre estas proteínas seleccionadas, la catequina mostró la mayor afinidad de unión predicha con PYGL, seguida por MMP9 y GADD45A, lo que sugiere una posible interacción preferencial con una proteína relacionada con el metabolismo.
A nivel molecular, la catequina formó múltiples enlaces de hidrógeno e interacciones hidrofóbicas con residuos aminoacídicos clave en cada proteína. En GADD45A, la catequina interactuó con residuos como GLN33 y TRP135. En MMP9, se observaron enlaces de hidrógeno estables con residuos incluyendo GLN227, TYR248 y HIS236. De manera similar, en PYGL, la catequina formó múltiples enlaces de hidrógeno con residuos como LYS554 y ASN631, contribuyendo a la estabilidad del enlace. Además de los enlaces de hidrógeno, el análisis de interacciones reveló fuerzas de van der Waals e interacciones relacionadas con π, lo que indica un patrón de unión multimodal que mejora la estabilidad de los complejos predichos entre ligando y proteína. En conjunto, estos resultados sugieren que la catequina puede formar complejos predichos estables con MMP9, PYGL y GADD45A. Sin embargo, la relevancia terapéutica de estas interacciones requiere una validación experimental adicional.
Interacciones estables predichas entre la catequina y proteínas seleccionadas
Basándose en las conformaciones de acoplamiento obtenidas mediante el acoplamiento molecular, se realizaron simulaciones de dinámica molecular de 100 ns para evaluar más a fondo la estabilidad de los complejos catequina-proteína. El análisis de RMSD mostró que los tres complejos proteína-ligando alcanzaron el equilibrio durante el período de simulación. Entre ellos, los complejos PYGL–catequina y MMP9–catequina presentaron fluctuaciones de RMSD relativamente estables, mientras que el complejo GADD45A–catequina mostró fluctuaciones ligeramente más altas, aunque se mantuvieron dentro de un rango aceptable (Figura 7A). El análisis de Rg indicó que todos los complejos mantuvieron una compactación estructural estable a lo largo de la simulación, con variaciones mínimas en el tiempo (Figura 7B). De manera similar, el análisis de SASA demostró niveles de exposición estables para todos los complejos, lo que respalda adicionalmente su estabilidad estructural (Figura 7C). El análisis de enlaces de hidrógeno reveló interacciones persistentes entre la catequina y las proteínas seleccionadas. El complejo PYGL–catequina mantuvo un mayor número de enlaces de hidrógeno a lo largo del tiempo en comparación con MMP9 y GADD45A, lo que sugiere interacciones de unión más fuertes y estables (Figura 7D).
La flexibilidad a nivel de residuos se evaluó mediante el RMSF. Los resultados mostraron que la mayoría de los residuos presentaron baja fluctuación, con solo unas pocas regiones que mostraron mayor flexibilidad, lo que indica que la unión del ligando no indujo una inestabilidad estructural importante en las proteínas (Figura 7E). En conjunto, estos hallazgos sugieren que la catequina forma complejos predichos estables con MMP9, PYGL y GADD45A, observándose la mayor estabilidad en la interacción entre PYGL y catequina. Estos resultados respaldan interacciones predichas estables entre la catequina y las proteínas seleccionadas, proporcionando evidencia computacional para una posterior validación experimental.
Disponibilidad de datos:
En este estudio se analizaron conjuntos de datos disponibles públicamente. El conjunto de datos de RNA-seq masivo está disponible en el Gene Expression Omnibus (GEO) bajo el número de acceso GSE261482 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482), y el conjunto de datos de scRNA-seq de pulmón de ratón está disponible bajo el número de acceso GSE295484 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484). Las salidas procesadas utilizadas en el artículo se proporcionan como Tabla Suplementaria S1, Tabla Suplementaria S2 y Tabla Suplementaria S3.
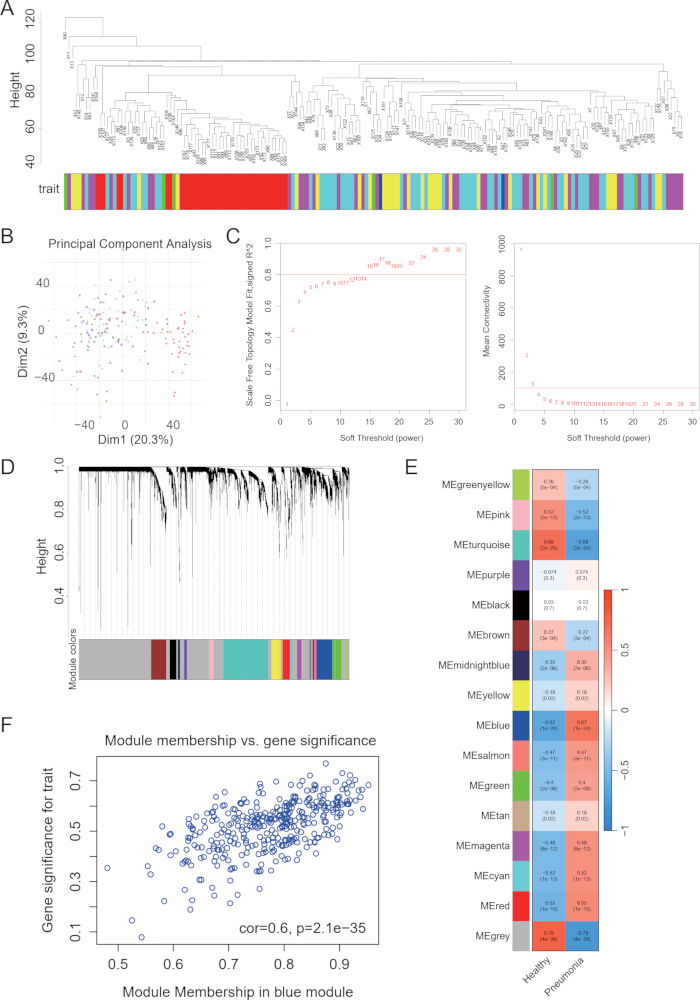
Figura 1. Construcción de WGCNA e identificación de módulos asociados a la enfermedad (A) Se realizó la agrupación de muestras a partir de los perfiles de expresión génica, y las anotaciones de los rasgos correspondientes se muestran debajo del dendrograma. (B) El análisis de componentes principales muestra la distribución de las muestras a lo largo de los dos primeros componentes principales. (C) La potencia de umbralización suave se evaluó utilizando el índice de ajuste de topología libre de escala y la conectividad media. (D) Los genes se agruparon según la superposición topológica, y las asignaciones de módulos se indican mediante colores. (E) Las correlaciones de los eigengenes de los módulos con los rasgos clínicos se muestran como un mapa de calor. (F) Se muestra la relación entre la pertenencia al módulo y la significancia génica para los genes del módulo azul. Haga clic aquí para ver una versión más grande de esta figura.
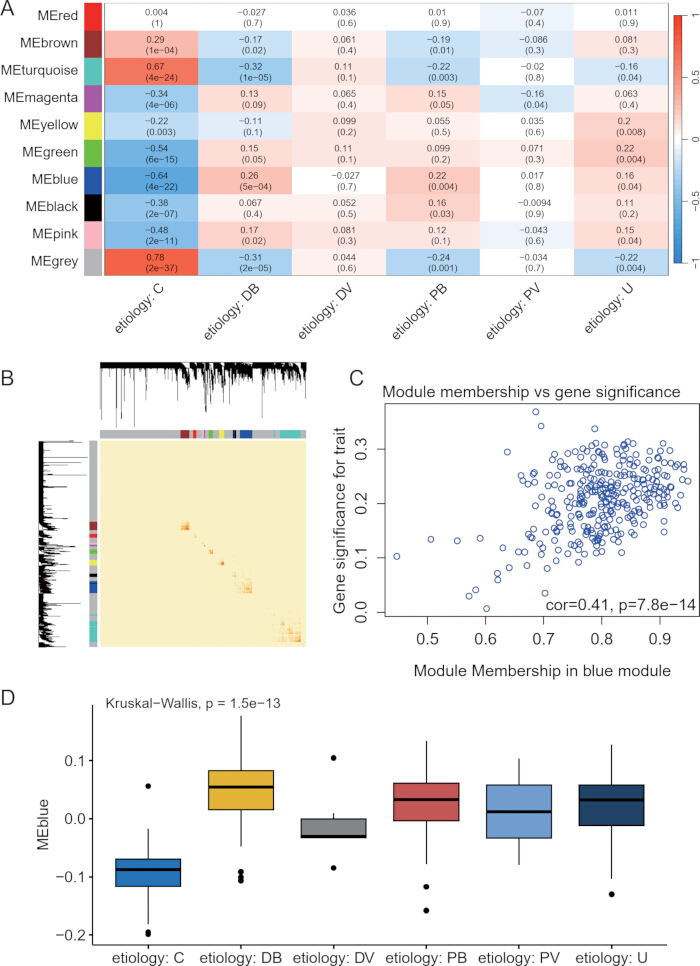
Figura 2. Análisis WGCNA basado en la etiología de la neumonía. (A) Se muestran las correlaciones de los eigengenes modulares para los grupos de etiología, incluyendo control, bacteriano definitivo, viral definitivo, bacteriano probable, viral probable y desconocido. (B) Los módulos de genes se asignaron a partir del dendrograma de agrupamiento basado en la superposición topológica. (C) Se grafican la pertenencia al módulo y la significancia del gen para el módulo azul. (D) Se compara la expresión del eigengene del módulo azul entre los grupos de etiología. Abreviaturas: WGCNA = análisis de red de coexpresión génica ponderada; C = control; DB = bacteriano definitivo; DV = viral definitivo; PB = bacteriano probable; PV = viral probable; U = desconocido. Haga clic aquí para ver una versión más grande de esta figura.
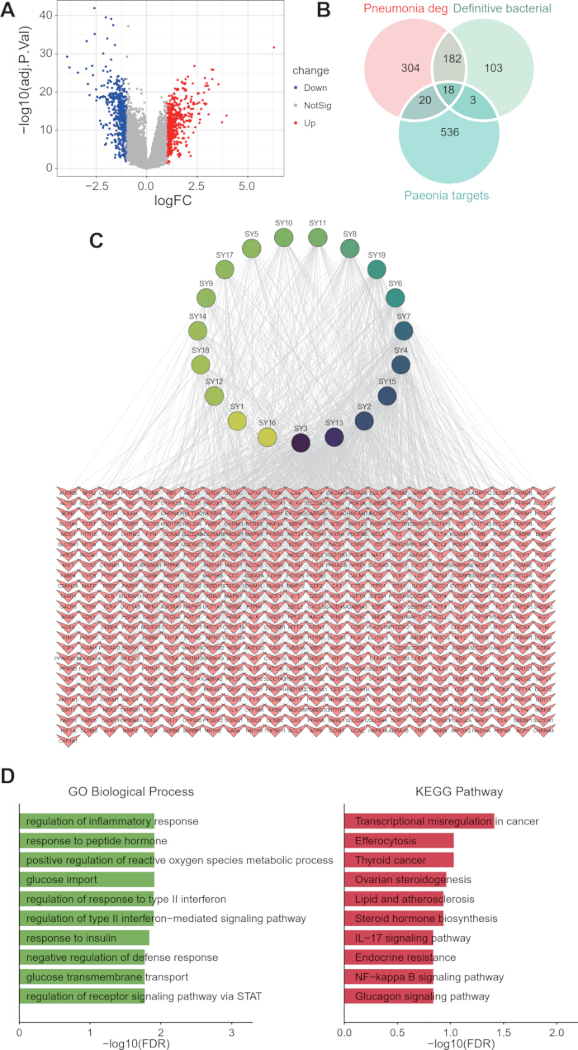
Figura 3. Identificación y análisis funcional de genes candidatos. (A) Gráfico de dispersión que muestra los genes diferencialmente expresados entre muestras de neumonía y controles. (B) Diagrama de Venn que muestra la superposición entre los genes diferencialmente expresados en neumonía, los genes relacionados con bacterias definitivos y los genes diana de Paeonia. (C) Red de interacción compuesto-diana entre los componentes activos de Paeonia y los genes candidatos. (D) Gráficos de barras que muestran el enriquecimiento de procesos biológicos de la Ontología Genética (izquierda) y el enriquecimiento de vías KEGG (derecha) para los genes superpuestos. Haga clic aquí para ver una versión más grande de esta figura.
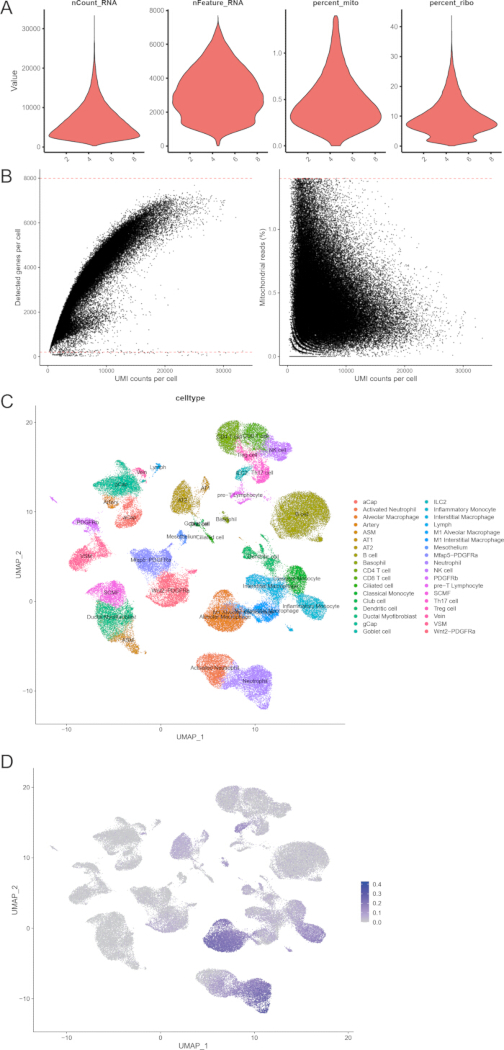
Figura 4. Análisis transcriptómico de célula individual de la neumonía. (A) Los gráficos de violín resumen las métricas de control de calidad, incluyendo nCount_RNA, nFeature_RNA, porcentaje de genes mitocondriales y porcentaje de genes ribosomales. (B) Gráficos de dispersión que muestran las relaciones entre los conteos de UMI, los genes detectados por célula y el porcentaje de genes mitocondriales. (C) Visualización UMAP de los grupos celulares anotados por tipos celulares. (D) Gráfico UMAP que muestra las puntuaciones AUCell para la firma génica candidata en células individuales. Haga clic aquí para ver una versión más grande de esta figura.
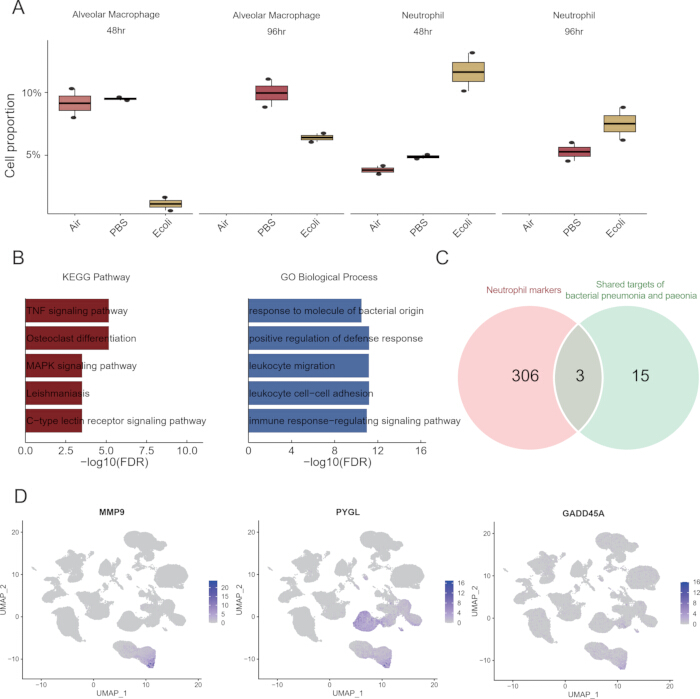
Figura 5. Dinámica de neutrófilos e identificación de genes clave. (A) Diagramas de caja que muestran las proporciones celulares de macrófagos alveolares y neutrófilos bajo diferentes condiciones (aire, PBS y E. coli) a las 48 h y 96 h. (B) Gráficos de barras que muestran el enriquecimiento de vías KEGG (izquierda) y el enriquecimiento de procesos biológicos GO (derecha) para los genes marcadores de neutrófilos. (C) Diagrama de Venn que muestra la superposición entre los genes marcadores de neutrófilos y los blancos comunes de la neumonía bacteriana y Paeonia. (D) Gráficos UMAP que muestran los patrones de expresión de MMP9, PYGL y GADD45A en las poblaciones celulares. Haga clic aquí para ver una versión más grande de esta figura.
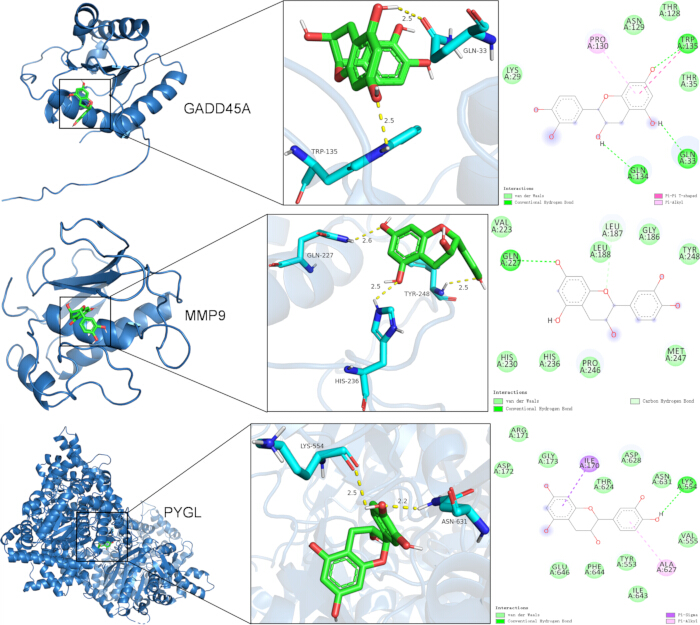
Figura 6. Acoplamiento molecular de la catequina con proteínas seleccionadas. Estructuras tridimensionales de complejos proteína-ligando que muestran la unión de la catequina a GADD45A (arriba), MMP9 (en medio) y PYGL (abajo). Los paneles ampliados muestran las regiones de unión y los contactos con residuos aminoácidos clave. Los diagramas bidimensionales presentan los enlaces de hidrógeno y otras interacciones entre la catequina y las proteínas seleccionadas. Haga clic aquí para ver una versión más grande de esta figura.
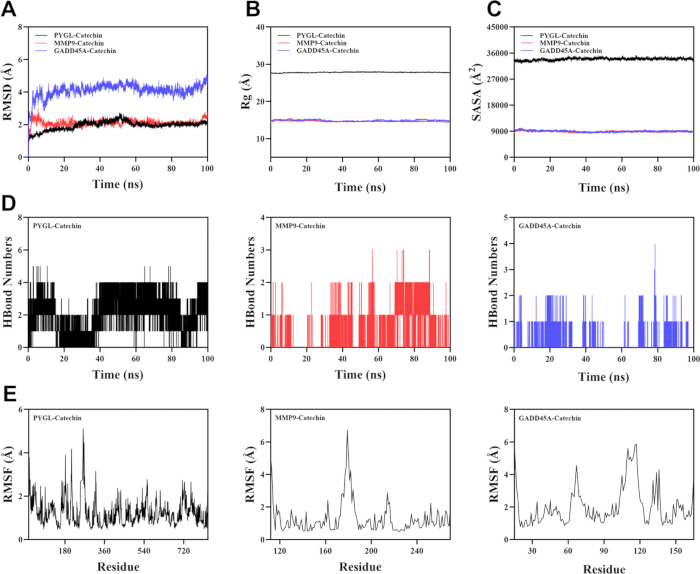
Figura 7. Simulaciones de dinámica molecular de complejos proteína–ligando. (A) Desviación cuadrática media de los complejos durante la simulación. (B) Cambios en el radio de giro a lo largo del tiempo. (C) Área de superficie accesible al disolvente durante la simulación. (D) Número de enlaces de hidrógeno entre la catequina y las proteínas diana a lo largo del tiempo. (E) Fluctuación cuadrática media de los residuos proteicos en cada complejo. Abreviaturas: RMSD = desviación cuadrática media; Rg = radio de giro; SASA = área de superficie accesible al disolvente; RMSF = fluctuación cuadrática media. Haga clic aquí para ver una versión más grande de esta figura.
Tabla suplementaria S1. Genes diferencialmente expresados regulados hacia arriba en neumonía pediátrica frente a muestras de controles sanos, que incluye símbolos de genes, cambios en el log2 de las razones, valores P, valores P ajustados y estadísticas limma relacionadas. Haga clic aquí para descargar este archivo.
Tabla suplementaria S2. Tabla de interacciones compuesto-diana de Paeonia utilizada para el análisis de redes, que incluye identificadores de compuestos, nombres de compuestos y genes diana asociados. Haga clic aquí para descargar este archivo.
Tabla suplementaria S3. Tabla de genes marcadores de célula individual procedente de GSE295484, que incluye valores P, cambios logarítmicos promedio en base 2, porcentajes de expresión, valores P ajustados, anotaciones de grupos celulares y símbolos de genes. Haga clic aquí para descargar este archivo.
Discusión
La neumonía es una causa importante de enfermedad y muerte en lactantes y niños pequeños a nivel mundial, lo que representa una carga sustancial para la salud pública1. La patogénesis de la neumonía pediátrica es compleja y comprende múltiples procesos interconectados, incluyendo respuestas inflamatorias excesivas, estrés oxidativo y la desregulación de las vías inmunitarias y metabólicas2,10,11. Estudios previos han sugerido que la activación descontrolada de células inmunitarias innatas, particularmente neutrófilos y macrófagos, contribuye al daño del tejido pulmonar mediante la liberación de citocinas proinflamatorias, enzimas proteolíticas y especies reactivas de oxígeno (ROS)12. A pesar de los avances en terapias antimicrobianas y de soporte, las estrategias eficaces dirigidas a estos mecanismos moleculares subyacentes siguen siendo limitadas. Por lo tanto, identificar nuevos agentes terapéuticos capaces de modular la inflamación y restablecer la homeostasis inmunitaria es de gran importancia.
Los fitoquímicos, especialmente las catequinas, han atraído una atención creciente debido a sus propiedades antiinflamatorias, antioxidantes e inmunomoduladoras bien documentadas13,14,15. Sin embargo, los mecanismos moleculares precisos mediante los cuales la catequina ejerce sus efectos protectores en la neumonía siguen siendo en gran parte desconocidos. Este estudio exploró sistemáticamente los posibles mecanismos asociados con la catequina en la neumonía pediátrica utilizando un enfoque integrador que combina transcriptómica, secuenciación de ARN a nivel de célula individual, acoplamiento molecular y simulaciones de dinámica molecular.
De acuerdo con la hipótesis inicial, los resultados demostraron que el módulo azul identificado mediante WGCNA se asoció significativamente tanto con el estado de la enfermedad como con la clasificación etiológica, lo que sugiere que este módulo representa un programa transcripcional central implicado en la neumonía pediátrica. La integración adicional del análisis de expresión diferencial y la predicción de dianas de Paeonia reveló 18 genes superpuestos, que se enriquecieron en vías relacionadas con la inmunidad, incluyendo la respuesta inflamatoria, el metabolismo de especies reactivas de oxígeno y la señalización del interferón tipo II16,17. Estos hallazgos respaldan aún más la idea de que las respuestas inmunitarias desreguladas y el estrés oxidativo son factores centrales en la progresión de la enfermedad.
El análisis de secuenciación de ARN a nivel de célula individual reveló además que el conjunto de genes candidatos estaba predominantemente enriquecido en neutrófilos y macrófagos alveolares, destacando el papel central de las células inmunitarias innatas en la progresión de la neumonía. Las proporciones de neutrófilos aumentaron significativamente bajo la estimulación con E. coli, particularmente a las 48 h y 96 h, lo que indica una activación sostenida durante la inflamación aguda, lo cual es coherente con su doble función en la eliminación de patógenos y el daño tisular mediado por factores inflamatorios y ERO18. Un análisis adicional identificó tres genes clave—MMP9, PYGL y GADD45A—como posibles vínculos entre las respuestas inmunitarias, la regulación metabólica y el estrés celular. Si bien MMP9 participa en la remodelación de la matriz extracelular y la infiltración inflamatoria19, y GADD45A regula las respuestas al estrés y la inmunidad, PYGL sugiere un papel del reprogramación metabólica en la activación inmunitaria20,21. Las simulaciones de acoplamiento molecular y dinámica molecular predijeron una unión estable de la catequina a estas proteínas seleccionadas, respaldada por energías de unión favorables y perfiles estables de RMSD, Rg y SASA, junto con enlaces de hidrógeno persistentes y valores bajos de RMSF. Estos hallazgos sugieren que la catequina podría estar asociada con estos blancos inflamatorios y metabólicos, aunque se requiere validación experimental adicional para confirmar sus efectos reguladores directos22.
Además de sus efectos antiinflamatorios, la catequina también puede ejercer funciones protectoras al modular el estrés oxidativo y el equilibrio metabólico. El enriquecimiento de vías relacionadas con las ERO sugiere que la catequina podría aliviar el daño oxidativo al aumentar la capacidad antioxidante, lo cual es consistente con informes previos sobre las propiedades antioxidantes de las catequinas. Además, la participación de enzimas metabólicas como PYGL resalta un posible papel de la catequina en la regulación de la inmunometabolismo, un concepto emergente en las enfermedades inflamatorias.
Se deben reconocer varias limitaciones de este estudio. En primer lugar, este estudio se basó principalmente en conjuntos de datos transcriptómicos disponibles públicamente y en análisis computacionales, y los mecanismos predichos aún no han sido validados experimentalmente. Aunque los estudios de acoplamiento molecular y las simulaciones de dinámica molecular sugirieron interacciones estables entre la catequina y las proteínas diana candidatas, estos hallazgos no demuestran inhibición funcional, activación ni eficacia terapéutica. Se requieren ensayos bioquímicos adicionales, experimentos celulares y estudios in vivo para validar los efectos reguladores de la catequina sobre MMP9, PYGL y GADD45A y para determinar su relevancia terapéutica en la neumonía. En segundo lugar, la información clínica disponible para el conjunto de datos de neumonía pediátrica fue limitada. El conjunto de datos GSE261482 proporcionó datos transcriptómicos de sangre total de pacientes pediátricos con neumonía y controles sanos, junto con metadatos que incluyen sexo, clasificación etiológica, tubo de recolección, lote y estado de la enfermedad.
Sin embargo, las variables clínicas detalladas, incluida la edad individual, la gravedad de la neumonía, el estado de tratamiento en el momento del muestreo y otra información sobre la evolución de la enfermedad, no estaban completamente disponibles en los metadatos de GEO utilizados en este estudio. Por lo tanto, no fue posible realizar análisis estratificados adicionales según la gravedad clínica, la etapa de tratamiento o el subgrupo de edad. En tercer lugar, los conjuntos de datos de RNA-seq masivo y de RNA-seq a nivel de una sola célula se derivaron de contextos biológicos diferentes. GSE261482 se generó a partir de muestras de sangre total de pacientes pediátricos, mientras que GSE295484 se generó a partir de tejidos pulmonares de ratones C57BL/6 de tipo salvaje en un modelo experimental de neumonía. Por consiguiente, los resultados de una sola célula deben interpretarse como evidencia de contexto celular de apoyo para las poblaciones de células inflamatorias y la distribución de genes candidatos, más que como una validación directa en la neumonía pediátrica humana. Además, el modelo de neumonía inducida por E. coli en ratones no representa completamente las etiologías heterogéneas de la neumonía pediátrica, incluidas las causas bacterianas, virales, probablemente bacterianas, probablemente virales y desconocidas.
Finalmente, la selección de MMP9, PYGL y GADD45A se basó en una exploración bioinformática integradora y en su relevancia biológica conocida, pero sus funciones precisas en la inflamación asociada a neutrófilos y en la regulación mediada por catequinas aún deben confirmarse. Se necesitan estudios futuros que utilicen cohortes clínicas pediátricas, conjuntos de datos de célula única humanos, ensayos funcionales específicos para dianas y modelos experimentales de neumonía para validar estos hallazgos y aclarar el potencial traslacional de la catequina.
En resumen, este estudio sugiere que la catequina podría estar asociada con respuestas inflamatorias relacionadas con neutrófilos y con genes seleccionados implicados en la regulación inmunitaria, el estrés oxidativo y las vías metabólicas en la neumonía. Mediante un análisis integrador de secuenciación de ARN masivo, secuenciación de ARN a nivel de una sola célula, acoplamiento molecular y simulaciones de dinámica molecular, este estudio identificó un módulo de genes asociado con la enfermedad y seleccionó MMP9, PYGL y GADD45A para los análisis de acoplamiento y simulación con catequina. El enriquecimiento de los genes candidatos en neutrófilos y macrófagos alveolares, junto con las interacciones predichas estables observadas entre la catequina y las proteínas seleccionadas, respalda un mecanismo potencial que requiere validación experimental adicional. En conjunto, estos hallazgos ofrecen una perspectiva a nivel de sistemas sobre posibles mecanismos asociados con la catequina en la neumonía, aunque se necesitan más estudios experimentales y clínicos para validar estas observaciones y aclarar su relevancia terapéutica.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| campo de fuerza AMBER14SB Tipo: Campo de fuerza | Campo de fuerza proteico para simulaciones de dinámica molecular | ||
| paquete R AUCell Tipo: Paquete R | Puntuación de actividad de conjuntos de genes a nivel de célula individual | ||
| AutoDock Tools Tipo: Software | Preparación de receptores y ligandos | ||
| AutoDock Vina Tipo: Software | Acoplamiento molecular | ||
| BindingDB Tipo: Base de datos | BindingDB | Interacciones compuesto-diana validadas experimentalmente; URL/versión no proporcionada en el manuscrito | |
| paquete R clusterProfiler Tipo: Paquete R | Análisis de enriquecimiento GO y KEGG | ||
| DrugBank Tipo: Base de datos | DrugBank | Interacciones compuesto-diana validadas experimentalmente; URL/versión no proporcionada en el manuscrito | |
| base de datos ETCM Tipo: Base de datos | ETCM | Selección de compuestos activos de Paeonia; URL/versión no proporcionada en el manuscrito | |
| campo de fuerza GAFF2 Tipo: Campo de fuerza | Campo de fuerza para ligandos en simulaciones de dinámica molecular | ||
| GROMACS 2022 Tipo: Software | GROMACS | Simulación de dinámica molecular | |
| GSE261482 Tipo: Conjunto de datos público de RNA-seq masivo | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482 | Datos de expresión en sangre total de neumonía pediátrica y controles sanos |
| GSE295484 Tipo: Conjunto de datos público de scRNA-seq | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484 | Datos de secuenciación de ARN de célula única de pulmón de ratón obtenidos de un modelo experimental de neumonía |
| paquete R limma Tipo: Paquete R | Análisis de expresión diferencial | ||
| Servidor PharmMapper Tipo: Base de datos/herramienta | PharmMapper | http://lilab.ecust.edu.cn/pharmmapper/ | Mapeo inverso de farmacóforos |
| Protein Data Bank (PDB) Tipo: Base de datos | Protein Data Bank | Estructuras proteicas para GADD45A (2KG4), MMP9 (6ESM) y PYGL (3DDS) | |
| base de datos PubChem Tipo: Base de datos | PubChem | Estructura tridimensional de la catequina | |
| software R Tipo: Software | R Project | Análisis estadísticos | |
| paquete R Seurat Tipo: Paquete R | Control de calidad, normalización, agrupamiento, visualización UMAP y anotación celular en secuenciación de ARN de célula única | ||
| Similarity Ensemble Approach (SEA) Tipo: Base de datos/herramienta | SEA | http://sea.bkslab.org | Predicción de interacciones potenciales fuera del blanco |
| sobtop_1.0 (dev3.1) Tipo: Software | Generación de parámetros para ligandos | ||
| SwissTargetPrediction Tipo: Base de datos/herramienta | SwissTargetPrediction | http://www.swisstargetprediction.ch | Predicción de dianas de compuestos |
| modelo de agua TIP3P Tipo: Modelo de agua | Solvatación de complejos proteína-ligando | ||
| Traditional Chinese Medicine Systems Pharmacology Database (TCMSP) Tipo: Base de datos | TCMSP | https://tcmsp-e.com | Selección de compuestos activos de Paeonia |
| base de datos UniProt Tipo: Base de datos | UniProt | https://www.uniprot.org | Normalización de símbolos génicos |
| paquete R WGCNA Tipo: Paquete R | Análisis de red de coexpresión génica ponderada |
Referencias
- Chen L, Chen Y, Huang J, Zhang J. LncRNA LINC00707 serves as a sponge of miR-382-5p to alleviate lipopolysaccharide (LPS)-induced WI-38 cell injury through upregulating NKAP in infantile pneumonia. Autoimmunity. 2022;55(5):328-38.
- Li S et al. miRNA-302e attenuates inflammation in infantile pneumonia through the RelA/BRD4/NF-κB signaling pathway. Int J Mol Med. 2019;44(1):47-56.
- Kennedy II DE et al. Contribution of Puma to inflammatory resolution during early pneumococcal pneumonia. Front Cell Infect Microbiol. 2022;12:886901.
- Wang C et al. Suppressing neutrophil itaconate production attenuates Mycoplasma pneumoniae pneumonia. PLoS Pathog. 2024;20(11):e1012614.
- Shen N et al. Plant flavonoids: classification, distribution, biosynthesis, and antioxidant activity. Food Chem. 2022;383:132531.
- Peng X, McClements DJ, Liu X, Liu F. EGCG-based nanoparticles: synthesis, properties, and applications. Crit Rev Food Sci Nutr. 2025;65(12):2177-98.
- Li T et al. Synergistic anti-inflammatory effects of quercetin and catechin via inhibiting activation of TLR4-MyD88-mediated NF-κB and MAPK signaling pathways. Phytother Res. 2019;33(3):756-67.
- Viz-Lasheras S et al. A diagnostic host-specific transcriptome response for Mycoplasma pneumoniae pneumonia to guide pediatric patient treatment. Nat Commun. 2025;16(1):673.
- Michki SN et al. Age-dependent immune responses and resident cell dynamics in young mice following pneumonia. iScience. 2026;29(1):114219.
- Jin M et al. Catechin-functionalized cationic lipopolymer based multicomponent nanomicelles for lung-targeting delivery. Adv Mater. 2024;36(17):e2302985.
- Shin-Ya M et al. Effects of tea, catechins and catechin derivatives on Omicron subvariants of SARS-CoV-2. Sci Rep. 2023;13(1):16577.
- Zheng Q, Li J, Yang L. Systematic investigation of catechin/cyclodextrin encapsulated polymeric nanospheres for the treatment and nursing care of pediatric pneumonia-causing human pathogens. Microb Pathog. 2025;205:107524.
- Zhang Y et al. Anti-inflammatory effect of chlorogenic acid in Klebsiella pneumoniae-induced pneumonia by inactivating the p38MAPK pathway. Int J Med Microbiol. 2023;313(2):151576.
- Gleeson K, Reynolds HY. Life-threatening pneumonia. Clin Chest Med. 1994;15(3):581-602.
- Ross SM. Resveratrol: the anti-inflammatory effects of a phytochemical compound on pneumonia, respiratory syncytial virus, and severe acute respiratory syndrome (SARS-CoV-2). Holist Nurs Pract. 2023;37(2):110-2.
- Hu H et al. Hybrid biomimetic membrane coated particles-mediated bacterial ferroptosis for acute MRSA pneumonia. ACS Nano. 2023;17(12):11692-712.
- Dong L et al. A ROS-responsive nanoprodrug-engineered phage biotherapy for precision treatment of multidrug-resistant Gram-negative bacterial pneumonia. J Control Release. 2025;382:113708.
- Wiegman CH et al. Oxidative stress in ozone-induced chronic lung inflammation and emphysema: a facet of chronic obstructive pulmonary disease. Front Immunol. 2020;11:1957.
- Jiang T et al. Dual role of Baimao-Longdan-Congrong-Fang in inhibiting Staphylococcus aureus virulence factors and regulating TNF-α/TNFR1/NF-κB/MMP9 axis. Phytomedicine. 2025;139:156477.
- Zhang H et al. The attenuated Mycoplasma bovis strain promotes apoptosis of bovine macrophages by upregulation of CHOP expression. Front Microbiol. 2022;13:925209.
- Borella R et al. Metabolic reprograming shapes neutrophil functions in severe COVID-19. Eur J Immunol. 2022;52(3):484-502.
- Xu Y et al. Exosomal miR-155-5p drives widespread macrophage M1 polarization in hypervirulent Klebsiella pneumoniae-induced acute lung injury via the MSK1/p38-MAPK axis. Cell Mol Biol Lett. 2023;28(1):92.