Este protocolo de ciencias del comportamiento y evaluación psicológica estandariza la administración de cuestionarios en línea, la puntuación, el cribado de la calidad de los datos y el análisis reproducible para evaluar la adicción a internet y las dificultades en la regulación emocional entre estudiantes universitarios.
Artículo de método
Un protocolo de cuestionario estandarizado para la evaluación de la adicción a Internet y la regulación emocional en estudiantes universitarios
En este artículo
Resumen
Resumen
El uso de internet está profundamente integrado en la vida universitaria, pero el uso problemático de internet no puede evaluarse adecuadamente únicamente por el tiempo de exposición. Evidencia sugiere que los patrones inadecuados o compulsivos de uso de internet están asociados con dificultades en la regulación emocional, aunque las inconsistencias en el orden de los cuestionarios, criterios de elegibilidad, umbrales de cribado, procedimientos de puntuación y reporte analítico continúan limitando la comparabilidad entre estudios. Este artículo metodológico presenta un protocolo estandarizado de cuestionarios para estudios de ciencias del comportamiento y evaluación psicológica que examinan la adicción a internet y la dificultad en la regulación emocional entre estudiantes universitarios. El flujo de trabajo incluye una secuencia fija de cuestionarios, criterios de elegibilidad predefinidos, configuraciones obligatorias de respuestas, umbrales de tiempo de finalización basados en pruebas piloto, cribado secuencial de calidad de datos, puntuación estandarizada del test de adicción a internet y de la escala de 16 ítems de dificultades en la regulación emocional, y análisis descriptivos, correlacionales y de regresión multivariable reproducibles. El protocolo también especifica el archivo de respuestas crudas, registros de cribado, archivos README/manual de códigos y el conjunto final de datos listo para el análisis. Se presenta una implementación representativa para demostrar la ejecución del protocolo, más no para validar los instrumentos ni establecer prevalencias. En dicha implementación, se invitó a 520 estudiantes y se recibieron 480 cuestionarios. Tras la exclusión secuencial de envíos duplicados, respuestas aceleradas, verificaciones de atención fallidas, respuestas con patrones sistemáticos, inconsistencias lógicas y datos centrales faltantes, se conservaron 452 cuestionarios válidos. La demostración analítica predefinida examinó la asociación entre la puntuación total del test de adicción a internet y la puntuación total de la escala de dificultades en la regulación emocional. La muestra conservada mostró una puntuación media total de 51,94 en el test de adicción a internet y una puntuación media total de 35,95 en la escala de dificultades en la regulación emocional. La dificultad en la regulación emocional aumentó a través de los grupos de severidad de adicción a internet, y la asociación permaneció evidente tras el ajuste por covariables demográficas y conductuales. Este protocolo proporciona un flujo de trabajo transparente que puede repetirse, auditarse y adaptarse para futuros estudios transversales, de medidas repetidas o longitudinales en poblaciones universitarias.
Introducción
El uso de internet se ha convertido en una parte habitual de la vida universitaria, incluyendo el trabajo académico, la comunicación social, el entretenimiento, la búsqueda de información y la regulación emocional. Por esta razón, el comportamiento de los estudiantes en internet no debería interpretarse simplemente como exposición a la pantalla o tiempo en línea. Evidencias previas mostraron que el uso problemático de internet ya era observable en poblaciones juveniles y universitarias antes de que el entorno actual basado en plataformas móviles se volviera altamente saturado1. Estudios más recientes realizados en universidades indican además que el uso problemático de internet es lo suficientemente común como para requerir una evaluación sistemática en lugar de una descripción informal2.
Los estudiantes universitarios representan una población particularmente relevante para la evaluación estandarizada porque la presión académica, la transición social, la vida independiente y la autonomía creciente suelen ocurrir en la misma etapa de desarrollo. Estas exigencias se gestionan frecuentemente mediante los mismos dispositivos y plataformas digitales que también pueden volverse difíciles de regular. Una revisión metaanalítica mostró que el uso problemático de internet entre estudiantes se asocia con múltiples resultados relacionados con la salud mental, lo que respalda su interpretación como una preocupación conductual y psicológica más amplia, y no como un problema limitado al uso de la tecnología3. El estrés percibido también se ha relacionado con patrones de adicción a internet entre estudiantes universitarios, lo que sugiere que las presiones emocionales y contextuales deben considerarse al diseñar estudios basados en cuestionarios en este campo4.
El presente protocolo utiliza el término «adicción a internet» cuando se refiere específicamente al constructo medido por la prueba de adicción a internet y sus categorías establecidas de puntuación. El término más amplio «uso problemático de internet» se emplea al discutir la literatura más extensa sobre comportamientos relacionados con internet que son desadaptativos, excesivos o que afectan funcionalmente. «Uso compulsivo de internet» se utiliza únicamente cuando la literatura citada enfatiza la pérdida de control, los impulsos o el uso repetitivo a pesar de las consecuencias negativas. Por lo tanto, estos términos están relacionados, pero no se consideran completamente intercambiables. Cuando el protocolo se implementa con la Prueba de Adicción a Internet, se mantiene el término «adicción a internet» como terminología específica del instrumento; cuando se utilizan instrumentos alternativos o revisados, la terminología debe ajustarse a las etiquetas del constructo y a las suposiciones diagnósticas del instrumento seleccionado.
La regulación emocional proporciona un punto de entrada psicológico plausible para comprender por qué algunos estudiantes pasan de un uso frecuente del internet a un uso inadecuado del mismo. Un estudio prospectivo de un año mostró que la dificultad en la regulación emocional estaba relacionada tanto con la aparición posterior como con la remisión de la adicción al internet entre estudiantes universitarios5. Este hallazgo es importante para el diseño de protocolos porque la regulación emocional no es simplemente un correlato adicional; podría influir en la forma en que los estudiantes utilizan el internet para evitar, reducir o manejar el malestar. Al mismo tiempo, el funcionamiento social sigue siendo relevante. El uso problemático del internet se ha asociado con las habilidades sociales entre estudiantes universitarios, lo que indica que los factores interpersonales y emocionales deben evaluarse junto con las variables relacionadas con el uso digital6. Durante el período de la COVID-19, el uso problemático del internet también coexistió con dificultades psicológicas más amplias entre estudiantes universitarios chinos, lo que respalda aún más la necesidad de evaluaciones estructuradas en entornos universitarios7.
Un desafío adicional es que el comportamiento digital es heterogéneo. Los estudiantes pueden utilizar plataformas digitales para estudiar, mantener contacto social, entretenerse, buscar información sobre salud o aliviar temporalmente sus emociones, y no todo uso frecuente es perjudicial. Una revisión sistemática sobre el uso digital relacionado con la salud mental en estudiantes universitarios mostró que la interacción digital puede cumplir múltiples funciones psicológicas8. Por lo tanto, el campo necesita procedimientos que distingan el uso frecuente ordinario del uso problemático o desregulado. Evidencia reciente sobre el uso problemático del teléfono inteligente en estudiantes universitarios sugiere asimismo que el riesgo depende del patrón conductual, la función y el contexto, y no solo de la duración9. Por esta razón, el presente protocolo combina la duración del uso de internet, el uso durante la noche, la actividad en línea principal y una puntuación estandarizada de síntomas, en lugar de basarse en un único indicador de exposición.
La medición es otra fuente importante de inconsistencia. La prueba de adicción a internet sigue siendo uno de los instrumentos más utilizados para evaluar los síntomas de adicción a internet, pero su dimensionalidad y su interpretación han variado según el contexto. Evidencia psicométrica sistemática indica que el instrumento ha sido ampliamente utilizado, aunque continúan surgiendo preguntas sobre la estructura factorial y la interpretación de la puntuación10. Se han reportado preocupaciones similares en muestras de estudiantes universitarios, donde el uso generalizado de la escala no resolvió por completo la incertidumbre acerca del constructo que se mide11. Estudios de validación en poblaciones universitarias de habla hispana y peruana también muestran que el instrumento puede funcionar adecuadamente, pero que su comportamiento psicométrico debe considerarse dentro de la población objetivo en la que se aplica12,13.
Por lo tanto, el protocolo está diseñado para ser estable en el flujo de trabajo, pero adaptable en la selección de instrumentos. La prueba de adicción a Internet se utiliza aquí debido a su uso histórico, a los umbrales disponibles y a su comparabilidad con investigaciones previas en estudiantes universitarios. Sin embargo, el protocolo no exige que la prueba de adicción a Internet permanezca como el instrumento preferido indefinidamente. Si los marcos diagnósticos evolucionan o si nuevos instrumentos resultan más apropiados para una población específica, se puede mantener el mismo flujo de trabajo reemplazando el módulo específico de la escala, el rango de puntuaciones, los umbrales de gravedad, las entradas del código de códigos y la documentación README. Cualquier reemplazo de este tipo debe realizarse antes de comenzar la recolección formal de datos y debe reportarse como una modificación del protocolo, y no como un cambio analítico ad hoc.
El problema metodológico abordado por este artículo no es simplemente que los estudios sobre adicción a internet y regulación emocional lleguen a conclusiones diferentes. Más bien, muchos estudios difieren en cuanto al orden de los cuestionarios, los criterios de elegibilidad, la configuración de la plataforma de encuestas, el manejo de respuestas duplicadas, los procedimientos de verificación de atención, los umbrales de tiempo de finalización, las reglas para datos faltantes, la verificación de puntuaciones y la presentación de archivos listos para el análisis. Estas diferencias dificultan la comparación, reproducción e inclusión de los resultados en futuras síntesis de evidencia. El presente protocolo responde a esta brecha al establecer de forma fija la secuencia de aplicación, la lógica de cribado, la estructura de puntuación y la ruta analítica, de manera que pueda repetirse, auditarse y modificarse de forma transparente. Por lo tanto, su contribución es orientada al protocolo: proporciona un flujo de trabajo reproducible para estudios observacionales en ciencias del comportamiento y evaluaciones psicológicas en poblaciones universitarias, en lugar de proponer un nuevo constructo psicológico o presentar un estudio de prevalencia como resultado principal.
Protocolo
El estudio, titulado «Un protocolo estandarizado de cuestionario para la evaluación de la adicción a internet y la regulación emocional en estudiantes universitarios», fue revisado y aprobado por el Comité de Ética y Académico de la Universidad de Economía y Negocios de Zhengzhou bajo el número de aprobación 20260113004 antes del inicio del reclutamiento de participantes14. El estudio utilizó un diseño transversal con cuestionario en línea anónimo que incluyó a estudiantes universitarios de tiempo completo de entre 18 y 24 años de edad, y se llevó a cabo de acuerdo con los requisitos éticos institucionales y la Declaración de Helsinki. Se obtuvo el consentimiento informado electrónico antes del acceso al cuestionario. Los participantes recibieron una hoja informativa electrónica que describía los objetivos del estudio, los procedimientos, la naturaleza voluntaria de la participación y las medidas de protección de datos, y tuvieron la libertad de retirarse en cualquier momento sin penalización. No se recopiló ninguna información personal directamente identificable en el archivo principal de la encuesta, incluyendo nombre, número de identificación estudiantil, dirección exacta, número de teléfono, correo electrónico personal o cuenta de redes sociales. Los identificadores generados por la plataforma se utilizaron únicamente para la detección de respuestas duplicadas y se eliminaron antes del análisis del conjunto de datos. Todos los datos se almacenaron de forma segura y se analizaron en forma desidentificada. Este flujo de trabajo del cuestionario no fue registrado prospectivamente antes del reclutamiento de participantes. Sin embargo, todos los componentes principales del protocolo, incluyendo la versión bloqueada del cuestionario, el archivo README/manual de códigos, el registro de cribado, las reglas de puntuación, la sintaxis de análisis y los archivos del flujo de trabajo listos para el análisis, fueron archivados y se proporcionan como materiales complementarios del flujo de trabajo para apoyar la reproducibilidad y la auditabilidad.
Los identificadores generados por la plataforma y los identificadores técnicos limitados por dispositivo o cuenta se utilizaron únicamente para la detección de respuestas duplicadas y se eliminaron del conjunto de datos analíticos anónimo final. Las variables principales y las reglas de puntuación se resumen en la Tabla 1, y el diccionario completo de variables se proporciona en la Tabla Suplementaria 1. Los archivos del cuestionario, el libro de códigos, el registro de cribado, el plan de resultados y los materiales del flujo de trabajo listos para el análisis se incluyen en el Archivo Suplementario 1.
| Dominio | Variable | Codificación/Puntuación | Papel en el protocolo |
| Idoneidad | Edad | Años; rango de idoneidad 18–24 | Variable de idoneidad y covariable |
| Demografía | Sexo | 1 = masculino; 2 = femenino; 3 = prefiero no decirlo | Variable descriptiva y covariable en regresión |
| Demografía | Año académico | 1 = primer año; 2 = segundo año; 3 = tercer año; 4 = cuarto año o superior; 5 = posgrado | Variable descriptiva |
| Demografía | Categoría de disciplina | 1 = humanidades y ciencias sociales; 2 = ciencias e ingeniería; 3 = negocios y administración; 4 = artes y diseño; 5 = otra | Variable descriptiva |
| Demografía | Tipo de residencia | 1 = residencia universitaria; 2 = alquiler fuera del campus; 3 = vivienda familiar; 4 = otra | Variable descriptiva |
| Demografía | Gastos mensuales de manutención | 1 = <1.000 CNY; 2 = 1.000–1.999 CNY; 3 = 2.000–2.999 CNY; 4 = ≥3.000 CNY | Variable descriptiva |
| Comportamiento de uso de internet | Uso de internet entre semana | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Covariable conductual |
| Comportamiento de uso de internet | Uso de internet los fines de semana | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Covariable conductual |
| Comportamiento de uso de internet | Actividad en línea principal | 1 = estudio; 2 = redes sociales; 3 = juegos; 4 = entretenimiento/vídeo; 5 = compras; 6 = uso mixto; 7 = otra | Variable descriptiva |
| Comportamiento de uso de internet | Dispositivo principal de acceso | 1 = teléfono inteligente; 2 = tableta; 3 = portátil/ordenador de sobremesa; 4 = dispositivos mixtos | Variable descriptiva |
| Comportamiento de uso de internet | Uso nocturno después de las 23:00 | 1 = nunca; 2 = menos de una vez por semana; 3 = 1–2 noches/semana; 4 = 3–5 noches/semana; 5 = casi todas las noches | Covariable conductual y variable de cribado por coherencia lógica |
| Escala principal | Puntuación total del IAT | Suma de 20 ítems; cada ítem puntuado de 1 a 5; rango total 20–100 | Variable independiente principal |
| Escala principal | Grupo de gravedad del IAT | 20–39 = uso normal; 40–69 = uso problemático; 70–100 = uso problemático grave | Variable de agrupación |
| Escala principal | Puntuación total del DERS-16 | Suma de 16 ítems tras la inversión obligatoria de puntuación; rango total 16–80 | Variable dependiente principal |
| Escala principal | Subescalas del DERS-16 | Calculadas según la clave de puntuación fija del DERS-16 | Resultados descriptivos de regulación emocional |
| Covariable | Duración del sueño | 1 = <6 h; 2 = 6–6,9 h; 3 = 7–7,9 h; 4 = ≥8 h | Variable de ajuste |
| Covariable | Actividad física semanal | 0 = ninguna; 1 = 1–2 sesiones; 2 = 3–4 sesiones; 3 = ≥5 sesiones | Variable de ajuste |
| Covariable | Estrés académico | 1 = bajo; 2 = moderado; 3 = alto | Variable de ajuste |
| Control de calidad | Comprobación de atención | 1 = aprobado; 0 = suspendido | Criterio de exclusión |
| Control de calidad | Tiempo de finalización | Duración de la finalización en segundos | Variable de cribado basada en el tiempo |
| Control de calidad | Número de respuestas en cadena larga | Longitud máxima de respuestas idénticas consecutivas en los 36 ítems puntuados de la escala | Variable de cribado por patrón de respuestas |
| Control de calidad | Desviación estándar intra-individual | Desviación estándar intra-individual en los 36 ítems puntuados de la escala | Variable de cribado por respuestas invariantes |
| Control de calidad | Indicador de coherencia lógica | 0 = sin inconsistencia; 1 = inconsistencia detectada | Variable de cribado por coherencia lógica |
Tabla 1: Variables principales, estructura de codificación y reglas de puntuación utilizadas en el protocolo estandarizado del cuestionario. Esta tabla resume las variables principales de elegibilidad, demográficas, de uso de internet, escalas, covariables y de control de calidad empleadas en el flujo de trabajo principal. Incluye los valores de codificación, rangos de puntuación, reglas de puntuación y funciones de las variables principales utilizadas para la administración del cuestionario, selección, puntuación y análisis. Abreviaturas: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Haga clic aquí para descargar esta tabla.
1. Configuración de la población de estudio, estructura del cuestionario y flujo de la encuesta
- Defina la población objetivo y la muestra válida
- Reclute estudiantes universitarios y de posgrado a tiempo completo, de entre 18 y 24 años de edad, que puedan completar el cuestionario de forma independiente en un teléfono móvil o computadora. Registre la versión del cuestionario en el idioma correspondiente y utilice versiones de escalas que hayan sido validadas o adecuadamente adaptadas para la población estudiantil objetivo.
- Documente cualquier modificación relacionada con accesibilidad o idioma antes de la recolección de datos, cuando se incluyan estudiantes internacionales, estudiantes con discapacidades o grupos estudiantiles multilingües.
- Restrinja la participación a una respuesta completada por participante. Utilice la función de restricción por dispositivo, cuenta, cookie o enlace autenticado de la plataforma de encuestas, cuando esté disponible.
NOTA: Cuando la misma cuenta de participante genere respuestas desde múltiples dispositivos, identifique y concilie esos registros durante el cribado de duplicados utilizando el identificador limitado por cuenta, la marca de tiempo, el estado del cuestionario y la similitud en los patrones de respuesta. - Establezca un tamaño mínimo de muestra válida final de 450 cuestionarios y continúe con el reclutamiento hasta que el conjunto de datos limpio permanezca por encima de este umbral tras el cribado.
NOTA: Cuando el uso problemático grave de internet u otro subgrupo pequeño sea el objetivo principal del análisis, establezca una meta de reclutamiento mayor antes de comenzar la recolección de datos. - Registre el número de personas invitadas, el número de respuestas recibidas, el número excluido en cada paso predefinido de cribado y el número final retenido, para que posteriormente se pueda resumir el flujo de participantes en la Figura 1.
- Construya el cuestionario en un orden fijo
- Organice el cuestionario en la siguiente secuencia: consentimiento informado, información demográfica, comportamiento de uso de internet, prueba de adicción a internet, escala abreviada de dificultades en la regulación emocional, duración del sueño, actividad física semanal y estrés académico percibido. Mantenga este orden sin cambios para todos los participantes. No aleatorice el orden de las escalas principales.
- Registre edad, sexo, año académico, categoría de disciplina, tipo de residencia y gastos mensuales de manutención utilizando categorías de respuesta cerradas. Marque todos los ítems demográficos como obligatorios.
NOTA: Para el sexo, incluya masculino, femenino y prefiero no decirlo. Mantenga la categoría "prefiero no decirlo" en los análisis descriptivos. En los análisis de regresión, codifique el sexo utilizando variables indicadoras con masculino como categoría de referencia, incluyendo indicadores separados para femenino y prefiero no decirlo. No elimine participantes únicamente por seleccionar "prefiero no decirlo". - Registre la duración del uso de internet en días de semana, duración del uso de internet en fines de semana, actividad en línea principal, dispositivo principal de acceso y uso de internet nocturno después de las 23:00. Codifique el uso nocturno como 1 = nunca, 2 = menos de una vez por semana, 3 = 1–2 noches por semana, 4 = 3–5 noches por semana y 5 = casi todas las noches.
- Registre el período académico durante el cual se administra el cuestionario. En la implementación representativa, la encuesta se aplicó durante un semestre regular de enseñanza, fuera de las semanas de exámenes finales, específicamente durante las semanas 6–7 del semestre.
- Administre y puntúe los instrumentos principales
- Administre la prueba de adicción a internet de 20 ítems como una escala obligatoria y puntúe cada ítem de 1 a 5. Sume los 20 ítems para obtener una puntuación total que varíe de 20 a 100, luego clasifique 20–39 como uso normal, 40–69 como uso problemático y 70–100 como uso problemático grave15.
- Utilice el término "adicción a internet" al informar los puntajes y grupos de severidad basados en la IAT. Utilice "uso problemático de internet" únicamente cuando se refiera a la literatura más amplia o a constructos no basados en la IAT.
- Administre inmediatamente después la escala abreviada de 16 ítems de dificultades en la regulación emocional y puntúe cada ítem de 1 a 5. Invierta la codificación de los ítems 1, 6 y 8 antes de la suma, luego calcule una puntuación total que varíe de 16 a 80, donde puntuaciones más altas indican mayor dificultad en la regulación emocional16.
- Genere cinco puntuaciones de subescalas para no aceptación, metas, impulso, estrategias y claridad, tras verificar la inversión de la codificación.
- Vuelva a verificar la dirección de codificación de todos los ítems invertidos antes de calcular las puntuaciones totales y de subescala. Utilice la misma clave de puntuación DERS-16 para cada participante y documente dicha clave en el README/manual de códigos.
- Cuando se utilice un instrumento revisado o alternativo de adicción a internet, reemplace el módulo específico de la escala antes de comenzar la recolección de datos y actualice los nombres de los ítems, rango de puntuación, umbrales de severidad, sintaxis de puntuación, README/manual de códigos, capturas de pantalla del cuestionario y Tabla de Materiales.
- Agregue covariables y un ítem de control de atención
- Registre la duración del sueño como <6 h, 6–6,9 h, 7–7,9 h y ≥8 h. Registre la frecuencia semanal de actividad física como 0, 1–2, 3–4 y ≥5 sesiones. Registre el estrés académico percibido como bajo, moderado o alto. Defina una sesión de actividad física como ≥20 min de actividad moderada o vigorosa.
- Inserte un ítem de control de atención con respuesta dirigida en la sección de comportamiento y requiera que el participante seleccione una opción de respuesta específica. El ítem utilizado en la implementación representativa fue: “Para confirmar que está leyendo con atención, seleccione ‘3 = a veces’ para este ítem”. Marque para exclusión cualquier cuestionario que no pase este ítem durante la limpieza17.
PASO CRÍTICO: No cambie el redactado del ítem, los puntos de respuesta, el orden de la escala, los umbrales de exclusión, la configuración de la plataforma de encuestas, las reglas de codificación ni las reglas de análisis estadístico después de que comience formalmente la recolección de datos.
NOTA: Resuma las variables principales, valores de codificación, rangos de puntuación y reglas de puntuación en la Tabla 1. Proporcione el diccionario completo de variables, campos de estado de archivo, indicadores de cribado, campos de identificadores técnicos, variables de seguimiento de conjuntos de datos, nombres de archivos y versiones de software en la Tabla Suplementaria 1 y en el README/manual de códigos.
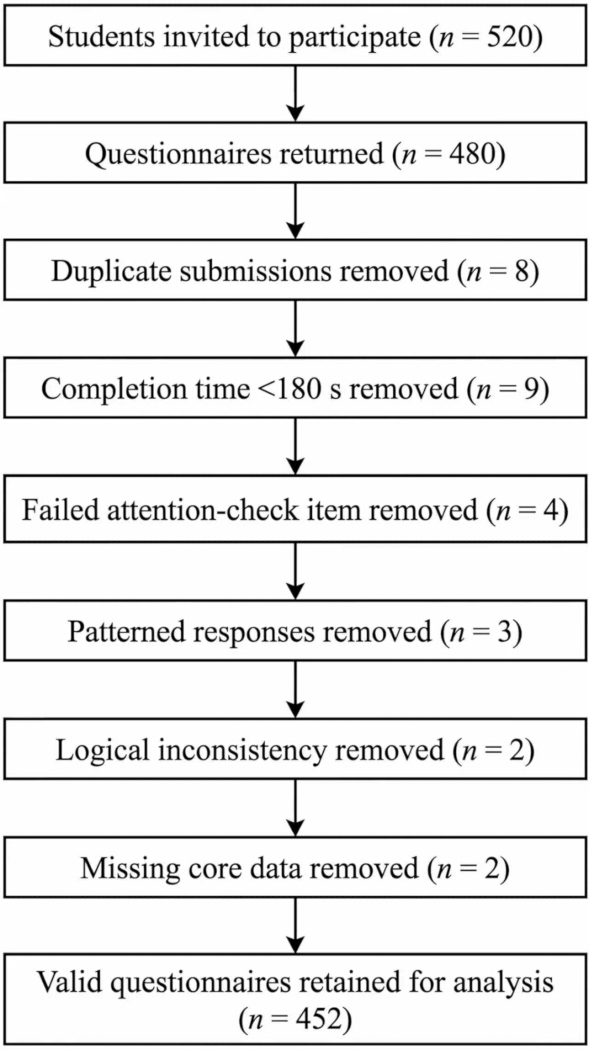
Figura 1: Flujo del cuestionario para reclutamiento, cribado, exclusión y retención analítica final. Este diagrama de flujo muestra la progresión desde los estudiantes invitados hasta los cuestionarios devueltos, pasando por cribados secuenciales de calidad de los datos y exclusión según criterios preespecificados, hasta la retención final de cuestionarios válidos para el análisis. La figura presenta el número de estudiantes invitados, cuestionarios devueltos, registros excluidos en cada paso de cribado y la muestra analítica final. Haga clic aquí para ver una versión más grande de esta figura.
2. Realizar una prueba piloto del cuestionario y bloquear la versión final para el campo
- Realice una prueba piloto del cuestionario completo
- Aplique el cuestionario completo a 20–30 estudiantes que cumplan con los criterios formales de inclusión, pero que no se incluyan en el conjunto de datos final.
- Registre el tiempo de completitud y la retroalimentación escrita sobre claridad, carga de respuesta, acceso técnico, orden de los ítems, comprensión de las comprobaciones de atención y cualquier ambigüedad en las opciones de respuesta demográficas o conductuales.
- Registre el tamaño de la muestra piloto, el tiempo mediano de completitud, el rango intercuartílico, el tiempo mínimo y máximo de completitud, y todos los cambios en el redactado realizados tras la prueba piloto.
- En la implementación representativa, la prueba piloto incluyó a 25 estudiantes, el tiempo mediano de completitud fue de 540 s y el tiempo esperado de completitud se estableció en 6–8 min.
- Revise el redactado ambiguo, significados duplicados, opciones de respuesta poco claras o problemas de visualización del software identificados durante la prueba piloto, y luego fije la versión final del cuestionario antes de su lanzamiento formal.
NOTA: Si el estudio incluye estudiantes multilingües, adultos mayores, adolescentes o estudiantes con discapacidades, realice pruebas cognitivas adicionales o pruebas piloto en subgrupos antes del lanzamiento formal.
- Establezca los ajustes operativos y las reglas de exportación
- Cree un nuevo proyecto de encuesta en la plataforma de encuestas en línea seleccionada. Ingrese la página de consentimiento como la primera página y configure el ítem de consentimiento como un ítem de bifurcación obligatorio.
- Configure la encuesta de modo que los participantes que no den su consentimiento salgan automáticamente sin ver el cuerpo del cuestionario.
- Incorpore todos los ítems demográficos, de uso de internet, IAT, DERS-16, covariables y comprobaciones de atención utilizando el redactado y los anclajes de respuesta fijados. Establezca todos los ítems principales como obligatorios.
- Active el registro automático de la hora de inicio, hora de finalización, duración de la completitud, estado de la respuesta y el identificador de respuesta generado por la plataforma.
- Habilite los controles de una respuesta por participante cuando estén disponibles, incluyendo enlaces de encuesta autenticados, restricción por dispositivo, prevención de repeticiones basada en cookies, prevención de repeticiones basada en cuentas o configuraciones de revisión de respuestas duplicadas. Registre los controles habilitados en el archivo README/manual de códigos.
- Desactive la recopilación de identificadores directos innecesarios. Si la plataforma registra la dirección IP por defecto, desactive el almacenamiento de IP o sustitúyala por un campo no identificativo para detección de duplicados, cuando lo permita la política institucional.
NOTA: Cuando se conserven temporalmente direcciones IP o metadatos del dispositivo para detección de duplicados, almacénelos únicamente en el archivo crudo cifrado, restrinja el acceso al analista del estudio y elimínelos antes de generar el conjunto de datos analítico final. - Especifique si se permite pausar y reanudar. En este protocolo, no se habilita una función formal de guardar y regresar en diferentes sesiones. Los participantes solo pueden pausar dentro de la misma sesión del navegador abierta, y el tiempo registrado de completitud incluye todo el tiempo transcurrido.
- Exporte el archivo de respuestas crudas en formatos de hoja de cálculo y de valores separados por comas al cerrar la encuesta18. También exporte un archivo de encuesta a documento o una copia en PDF/A que contenga el redactado final del cuestionario, el orden de los ítems, configuraciones de bifurcación, configuraciones de ítems obligatorios y estructura de codificación. Guarde estos archivos con nombres controlados por versión.
- Calcule el tiempo mediano de completitud de la prueba piloto y establezca el umbral mínimo de completitud válida en aproximadamente un tercio de ese valor. Fije el umbral final inferior en 180 s y aplíquelo uniformemente durante el cribado formal.
- Dado que este umbral se deriva de la muestra piloto, vuelva a establecerlo cuando el protocolo se implemente en una población sustancialmente diferente, plataforma, versión de idioma o entorno institucional.
NOTA: Archive las capturas de pantalla finales del cuestionario, la exportación final del cuestionario, el archivo README/manual de códigos, el registro de la prueba piloto, el redactado de las comprobaciones de atención, la plantilla del registro de cribado, los ajustes de exportación y la sintaxis estadística como archivos complementarios o de auditoría.
3. Publicar el cuestionario y conservar el conjunto de datos original
- Reclutar participantes mediante canales fijos
- Distribuir una invitación estandarizada a través de grupos de comunicación estudiantil, canales de clase o listas de correo institucionales durante un período fijo de recolección de 14 días.
- Indicar en la invitación y en la página de consentimiento el propósito del estudio, el tiempo esperado de finalización de 6 a 8 minutos, el manejo anónimo de los datos, la participación voluntaria y la ausencia de penalización o recompensa académica por no participar.
- Mostrar la página de consentimiento antes de que aparezca cualquier ítem del cuestionario y exigir un acuerdo activo antes del acceso. No permitir el acceso al cuerpo del cuestionario sin una respuesta afirmativa de consentimiento.
- Indicar en la página de consentimiento que los participantes pueden interrumpir el proceso antes de la entrega final y que las respuestas incompletas no se utilizarán en el análisis final.
- Utilizar la misma versión bloqueada del cuestionario en todos los canales de reclutamiento. Si se usan varios canales de reclutamiento, registrar el canal únicamente cuando esté previamente especificado como una variable del estudio.
- Conservar el archivo original de respuestas
- Mantener todos los registros recibidos, incluidas las respuestas incompletas y aquellas excluidas posteriormente, en el archivo de exportación original. Exportar el conjunto completo de datos inmediatamente después del cierre de la encuesta y almacenarlo como raw_returns_YYYYMMDD.csv y raw_returns_YYYYMMDD.xlsx.
- Conservar en el archivo original la hora de envío, la duración de la finalización, el estado de la respuesta, el identificador de respuesta generado por la plataforma y el identificador técnico limitado por dispositivo o cuenta. No sobrescribir estos campos durante limpiezas posteriores.
- Guardar una copia de solo lectura del conjunto de datos original antes de comenzar el filtrado. Almacenar el archivo original, el registro de filtrado y el conjunto de datos analítico final en carpetas separadas. Restringir el acceso al archivo original que contiene identificadores técnicos únicamente al personal del estudio autorizado.
ADVERTENCIA: No recopilar información directamente identificable, como nombre completo, número de identificación estudiantil, dirección exacta de residencia estudiantil, número de teléfono personal, dirección de correo electrónico personal o cuenta de redes sociales, en el archivo principal de la encuesta.
NOTA: Pausar el flujo de trabajo tras la exportación original, guardar una copia de solo lectura del conjunto de datos original y reiniciar el proceso de limpieza únicamente a partir de esa copia preservada.
4. Revisar los cuestionarios devueltos y generar el conjunto de datos analítico final
- Aplicar la secuencia de cribado en un orden fijo
- Ordenar todos los registros devueltos por identificador limitado por dispositivo, identificador limitado por cuenta (cuando esté disponible), marca de tiempo, estado del cuestionario y similitud de respuestas. Identificar primero los envíos duplicados. Conservar el registro completo más temprano cuando dos o más envíos provengan del mismo participante dentro del mismo ciclo de recolección.
- Si se detectan múltiples envíos desde la misma cuenta autenticada pero desde dispositivos diferentes, tratarlos como envíos duplicados del mismo participante. Conservar el registro completo más temprano y excluir los registros completos posteriores. Si el registro más temprano está incompleto y un registro posterior es completo, conservar el registro completo más temprano.
- Eliminar los registros con tiempo de finalización <180 s, revisar los registros finalizados entre 180 y 240 s, y eliminar los registros que no pasen el elemento de control de atención de respuesta dirigida en cuarto lugar. Documentar el número eliminado en cada paso en screening_log_v1.xlsx19.
- Para los registros finalizados entre 180 y 240 s, realizar una revisión manual utilizando el resultado del control de atención, la bandera de respuestas en cadena larga, la desviación estándar intra-individuo y la bandera de consistencia lógica.
- Conservar un registro de velocidad dudosa solo cuando no esté presente ninguna otra bandera de calidad de datos. Registrar cada decisión sobre velocidad dudosa en el registro de cribado.
- Eliminar registros con patrones, inconsistencias o incompletos
- Eliminar todos los cuestionarios que muestren respuestas en cadena larga, definidas como 18 o más respuestas idénticas consecutivas en los 36 ítems puntuados de la escala, o una desviación estándar intra-individuo ≤0,25 en esos ítems.
- Eliminar cualquier cuestionario que muestre combinaciones conductuales imposibles. Definir "la categoría de respuesta más alta en casi todos los ítems de la prueba de adicción a internet" como una puntuación de 5 en al menos 18 de los 20 ítems del IAT.
NOTA: La regla de inconsistencia lógica se activa cuando un encuestado informa tanto el uso de internet en días laborables como en fines de semana en la categoría de menor duración (<2 h por día), uso de internet nocturno codificado como "casi todas las noches" y una puntuación de 5 en al menos 18 de los 20 ítems del IAT. Aplicar esta regla solo después de completar el cribado de duplicados, tiempo de finalización, control de atención y respuestas con patrones. - Eliminar todos los cuestionarios con valores faltantes en cualquier ítem del IAT, cualquier ítem del DERS-16 o cualquier covariable predefinida.
NOTA: Esta regla de caso completo se utiliza porque la encuesta en línea emplea ítems centrales obligatorios y porque el modelo de regresión representativo requiere un conjunto fijo de covariables. Cuando los datos faltantes en covariables superen el 5%, utilizar un método predefinido alternativo para datos faltantes, como la imputación múltiple. - Asignar un ID de estudio anónimo a cada registro conservado y guardar el archivo restante como analytic_dataset_v1.csv y analytic_dataset_v1.xlsx.
- Eliminar del conjunto de datos analítico final los identificadores de respuesta generados por la plataforma, identificadores limitados por dispositivo, identificadores limitados por cuenta, direcciones IP (si se conservaron durante el cribado), marcas de tiempo y notas de revisión en texto libre. Conservar únicamente el ID de estudio anónimo y las variables de análisis.
PASO CRÍTICO: Aplicar la secuencia de cribado en el mismo orden a cada registro y no volver a incluir casos previamente excluidos en etapas posteriores. Asignar como razón principal de exclusión el primer criterio de exclusión activado y registrar las banderas secundarias únicamente como notas en el registro de cribado.
NOTA: Resumir los recuentos finales de exclusiones por motivo en Tabla 2, y mantener esos recuentos idénticos al flujo de participantes reportado posteriormente en Figura 1.
| Orden de cribado | Ítem de cribado | Regla operativa | Acción de cribado | Regla de documentación |
| Paso 1 | Preservación de exportación bruta | Exportar todos los registros devueltos inmediatamente después del cierre de la encuesta y guardarlos como raw_returns_YYYYMMDD.csv y raw_returns_YYYYMMDD.xlsx | Conservar una copia de solo lectura antes de iniciar cualquier limpieza | Archivar en la carpeta de datos brutos |
| Paso 2 | Verificación de consentimiento y acceso | Identificar registros sin consentimiento informado electrónico activo antes del acceso al cuestionario | Excluir del flujo de trabajo analítico los registros sin consentimiento | Registrar en screening_log_v1.xlsx los registros excluidos o inaccesibles cuando se conservan en la exportación de la plataforma |
| Paso 3 | Cribado de duplicados | Identificar registros que comparten el mismo identificador limitado por dispositivo o identificador limitado por cuenta dentro del mismo ciclo de recolección y que coincidan en sexo, edad, curso académico y al menos un 80 % de respuestas idénticas en el cuestionario | Conservar el registro completo más temprano y excluir todos los duplicados posteriores | Registrar en screening_log_v1.xlsx el número excluido y los valores de raw_record_id afectados; asignar primary exclusion_reason = 1 |
| Paso 4 | Reconciliación de duplicados por múltiples dispositivos | Identificar múltiples envíos completos del mismo participante autenticado desde diferentes dispositivos | Tratar estos registros como envíos duplicados; conservar el registro completo más temprano | Registrar en screening_log_v1.xlsx el identificador limitado por cuenta y el raw_record_id conservado; asignar a los registros posteriores primary exclusion_reason = 1 |
| Paso 5 | Cribado por tiempo de finalización | Identificar todos los cuestionarios con un tiempo de finalización <180 s | Excluir automáticamente todos esos registros | Registrar el número excluido en screening_log_v1.xlsx; asignar primary exclusion_reason = 2 |
| Paso 6 | Revisión de velocidad límite | Identificar todos los cuestionarios con un tiempo de finalización entre 180 y 240 s | Revisar manualmente cada registro utilizando indicadores de atención, cadenas largas, desviación estándar intra-sujeto y lógica; conservar solo si no hay ninguna bandera adicional presente | Registrar cada caso como retained_after_manual_review = 1 o excluded_after_manual_review = 1 en screening_log_v1.xlsx |
| Paso 7 | Cribado por verificación de atención | Identificar todos los registros que no superan el ítem de verificación de atención con respuesta dirigida | Excluir todos los registros reprobados que no hayan sido excluidos previamente en un paso anterior | Registrar el número excluido en screening_log_v1.xlsx; asignar primary exclusion_reason = 3 |
| Paso 8 | Cribado por patrón de respuestas | Identificar registros con 18 o más respuestas idénticas consecutivas entre los 36 ítems de escala puntuados, o con desviación estándar intra-sujeto ≤0,25 en esos ítems | Excluir todos esos registros que no hayan sido excluidos previamente en un paso anterior | Registrar el número excluido en screening_log_v1.xlsx; asignar primary exclusion_reason = 4 |
| Paso 9 | Cribado por consistencia lógica | Identificar registros que muestren la combinación imposible previamente especificada: weekday_internet_use y weekend_internet_use codificados ambos como <2 h, late_night_use codificado como casi todas las noches, y una puntuación de 5 en al menos 18 de los 20 ítems del IAT | Excluir todos esos registros que no hayan sido excluidos previamente en un paso anterior | Registrar el número excluido y la nota de revisión en screening_log_v1.xlsx; asignar primary exclusion_reason = 5 |
| Paso 10 | Cribado por ausencia en datos clave | Identificar registros con algún valor faltante en IAT_1–IAT_20, DERS_1–DERS_16, edad, sexo, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity o academic_stress; la opción «prefiero no decirlo» para sexo se considera una respuesta válida, no como dato faltante | Excluir todos esos registros que no hayan sido excluidos previamente en un paso anterior | Registrar el número excluido en screening_log_v1.xlsx; asignar primary exclusion_reason = 6 |
| Paso 11 | Asignación de exclusión principal | Identificar registros que cumplan con más de un criterio de exclusión | Asignar como razón principal de exclusión el primer criterio activado en la secuencia de cribado previamente especificada | Registrar las banderas secundarias únicamente en las notas de revisión; no asignar múltiples razones principales |
| Paso 12 | Eliminación de identificadores técnicos | Identificar en el archivo limpio los identificadores de respuesta generados por la plataforma, identificadores limitados por dispositivo, identificadores limitados por cuenta, marcas de tiempo y cualquier metadato técnico temporalmente conservado | Eliminar estos campos del conjunto de datos analítico final después de completar el cribado | Documentar la eliminación en screening_log_v1.xlsx |
| Paso 13 | Conservación final | Conservar todos los registros que superen todos los pasos previos de cribado | Asignar un identificador de estudio anónimo a cada registro conservado | Guardar como analytic_dataset_v1.csv y analytic_dataset_v1.xlsx |
| Paso 14 | Resumen del cribado | Contar el número eliminado en cada paso y el número final conservado | Resumir los conteos finales para su inclusión en el manuscrito | Mantener los conteos en la Tabla 2 idénticos a los del Gráfico 1 |
| Paso 15 | Preservación del historial de auditoría | Conservar el archivo bruto, el registro de cribado y el conjunto de datos analítico final como archivos separados | No sobrescribir, fusionar ni editar manualmente los archivos fuente archivados | Almacenarlos por separado en las carpetas de datos brutos, cribado y analíticos |
Tabla 2: Secuencia preespecificada de cribado, umbrales de exclusión, acciones de cribado y reglas de documentación para la limpieza del cuestionario. Esta tabla resume el orden fijo de cribado utilizado para limpiar los cuestionarios devueltos, incluyendo verificaciones de consentimiento y acceso, cribado de duplicados, reconciliación de múltiples dispositivos, cribado del tiempo de completitud, revisión de velocidad límite, fracaso en las comprobaciones de atención, respuestas estructuradas, inconsistencias lógicas, omisiones centrales, eliminación de identificadores técnicos, retención final y preservación del historial de auditoría. Abreviaturas: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Haga clic aquí para descargar esta tabla.
5. Calificar variables, verificar la confiabilidad y preparar el archivo listo para el análisis
- Generar puntuaciones totales, puntuaciones de subescalas y variables categóricas derivadas
- Sumar las puntuaciones de los 20 ítems del IAT para generar la puntuación total de adicción a internet, luego almacenar tanto la puntuación continua como la clasificación de gravedad de tres niveles en el archivo listo para el análisis.
- Recodificar los ítems 1, 6 y 8 del DERS-16, calcular la puntuación total y las cinco puntuaciones de subescala, y agregar todas las variables derivadas al mismo conjunto de datos a nivel de participante.
- Realizar una verificación de rango antes del cálculo de las puntuaciones. Confirmar que todos los valores de los ítems del IAT y del DERS-16 estén entre 1 y 5, que todos los valores recodificados estén entre 1 y 5, que las puntuaciones totales del IAT estén entre 20 y 100, y que las puntuaciones totales del DERS-16 estén entre 16 y 80. Registrar la salida de la verificación de rango en el registro de puntuación.
- Recodificar covariables en categorías analíticas fijas
- Recodificar la duración del uso de internet entre semana y durante el fin de semana como <2 h, 2–3,9 h, 4–5,9 h y ≥6 h. Recodificar el uso de internet nocturno como nunca, <1 noche/semana, 1–2 noches/semana, 3–5 noches/semana y casi todas las noches.
- Recodificar la duración del sueño, la frecuencia de actividad física y el estrés académico percibido utilizando las reglas de categorización previamente establecidas en la Sección 1.4 y almacenar los valores recodificados bajo nombres de variables fijos en el mismo conjunto de datos.
- Recodificar el sexo para la regresión utilizando dos variables indicadoras: mujer frente a hombre y prefiero no decirlo frente a hombre. Reportar la codificación en la nota al pie de la tabla y en el archivo README/manual de códigos.
- Verificar la integridad del cálculo de puntuaciones y la consistencia interna
- Calcular el alfa de Cronbach para la puntuación total del IAT y la puntuación total del DERS-16 antes del análisis inferencial. Volver a verificar la codificación de los ítems, la recodificación inversa y los rangos imposibles de los ítems si alguno de los valores alfa es <0,7020. Reportar los valores del alfa de Cronbach en la sección Resultados Representativos.
- Calcular las correlaciones ítem-total o los valores de alfa-si-el-ítem-se-elimina si alguna de las escalas muestra una consistencia interna inesperadamente baja. No eliminar ítems de la escala del análisis principal a menos que se haya previsto su eliminación o el estudio esté explícitamente diseñado como un estudio de validación psicométrica.
- Guardar el conjunto de datos final listo para el análisis junto con un archivo README que enumere los nombres de las variables, las reglas de codificación, los umbrales de exclusión, los nombres de los archivos, las versiones del software, la versión del cuestionario, la sintaxis de puntuación, la especificación del modelo de regresión y los procedimientos necesarios para regenerar el mismo conjunto de datos.
6. Analice los datos y conserve los resultados reproducibles
- Generar estadísticas descriptivas y comparaciones entre grupos
- Presentar las variables continuas como media ± desviación estándar y las variables categóricas como frecuencia y porcentaje. Resumir las características demográficas, el comportamiento de uso de internet y las puntuaciones de las escalas utilizando la estructura de resultados predefinida.
- Indicar el tamaño de la muestra utilizado en cada análisis. Utilizar la muestra analítica retenida como denominador, a menos que una tabla indique claramente lo contrario.
- Comparar las puntuaciones totales y de las subescalas del DERS-16 entre los tres grupos de gravedad del IAT y emplear pruebas bilaterales con α = 0,05 para los análisis principales. Reportar tamaños del efecto estandarizados cuando sea apropiado.
NOTA: Para las comparaciones entre grupos, reportar η2 o η2 parcial para el análisis de varianza, o un tamaño del efecto no paramétrico equivalente si se utiliza una prueba no paramétrica. Interpretar con cautela las comparaciones del subgrupo con uso problemático grave cuando este subgrupo sea pequeño. - Calcular la correlación de Pearson entre la puntuación total del IAT y la puntuación total del DERS-16 cuando ambas variables presenten un comportamiento distribucional aceptable; de lo contrario, utilizar la correlación de Spearman como análisis de sensibilidad. Reportar n, r o ρ, intervalo de confianza del 95 % si lo genera el software estadístico, valor p e interpretación de la magnitud.
- Ajustar el modelo de regresión ajustado y archivar los resultados
- Utilizar la puntuación total del DERS-16 como variable dependiente y la puntuación total del IAT como variable independiente principal. Incluir edad, sexo, uso de internet entre semana, uso de internet durante el fin de semana, duración del sueño, actividad física y estrés académico percibido como covariables. Este modelo constituye la demostración analítica predefinida del flujo de trabajo estandarizado.
- Antes de interpretar el modelo de regresión ajustado, evaluar los supuestos de regresión y la estabilidad del modelo. Examinar las gráficas de residuos frente a valores ajustados para verificar linealidad y homocedasticidad, revisar una gráfica Q-Q o una prueba de normalidad para la distribución de los residuos, y calcular los factores de inflación de la varianza para evaluar la multicolinealidad.
- Reportar estos diagnósticos en la sección de Resultados Representativos o en la salida del análisis suplementario.
- Si se detecta heterocedasticidad en los residuos, reportar errores estándar robustos frente a heterocedasticidad como análisis de sensibilidad.
- Si existen observaciones influyentes, indicar si el coeficiente principal para la puntuación total del IAT permanece esencialmente sin cambios tras los diagnósticos de influencia. No eliminar observaciones influyentes a menos que se cumpla una regla preespecificada de calidad de datos.
- Reportar los coeficientes no estandarizados, errores estándar, coeficientes estandarizados, valores p, R2 del modelo, R2 ajustado, estadístico F del modelo y rango de VIF para el modelo ajustado. Incluir el tamaño de la muestra en el título de la tabla o en una nota al pie.
- Si se prueban interacciones, efectos de subgrupos o vías de mediación, especificar dichos análisis antes de la recolección de datos o etiquetarlos como exploratorios. El protocolo principal no requiere pruebas de interacción a menos que las diferencias entre subgrupos sean un objetivo predefinido del estudio.
- Guardar toda la sintaxis estadística, tablas de resultados, gráficas de residuos, resultados de VIF, resultados de fiabilidad y figuras generadas con nombres de archivo bajo control de versiones. Regenerar todos los resultados reportables directamente a partir de analytic_dataset_v1, y no a partir de archivos editados manualmente.
NOTA: Mantener el texto del protocolo centrado en la replicación del flujo de trabajo. Presentar las estadísticas representativas detalladas, figuras de subgrupos, diagnósticos de regresión, evaluación de multicolinealidad y resultados del modelo en la sección de Resultados Representativos.
Resultados
Flujo del estudio y retención analítica final
Los resultados demuestran la ejecución del flujo de trabajo estandarizado del cuestionario, y no una validación independiente de la prueba de adicción a Internet ni del DERS-16. Durante el período de 14 días, se invitó a participar a 520 estudiantes universitarios y se devolvieron 480 cuestionarios. La selección se realizó en el orden preestablecido. Primero, se eliminaron 8 envíos duplicados, seguidos por 9 cuestionarios con un tiempo de completitud inferior a 180 s, 4 cuestionarios que no superaron el ítem de control de atención de respuesta dirigida, 3 cuestionarios que mostraban respuestas en patrón, 2 cuestionarios con inconsistencia lógica y 2 cuestionarios con datos básicos faltantes. Tras completar toda la secuencia de selección, se conservaron 452 cuestionarios válidos en el conjunto final de datos analíticos. La tasa final de retención fue del 94,2 % entre los cuestionarios devueltos y del 86,9 % entre los estudiantes invitados. El flujo del cuestionario desde la invitación hasta la retención analítica final se presenta en Figura 1.
Características de los participantes
La muestra analítica final incluyó 452 estudiantes, con una edad media de 20,41 ± 1,58 años. Las estudiantes mujeres constituyeron la proporción mayor de la muestra, con 279 estudiantes mujeres, 167 estudiantes hombres y 6 estudiantes que eligieron «prefiero no decirlo». Los participantes procedían de todos los años académicos y de múltiples disciplinas, siendo los estudiantes de segundo y tercer año los que representaban las proporciones más grandes. La mayoría de los encuestados vivían en residencias universitarias, y los gastos mensuales de manutención se concentraron en las categorías de 1.000–1.999 y 2.000–2.999. La muestra retenida también mostró una exposición sustancial a internet como rutina. En días laborables, la distribución se centró principalmente en las categorías de 2–3,9 h y 4–5,9 h, mientras que el uso los fines de semana aumentó, con 322 de 452 estudiantes que reportaron al menos 4 h diarias. El acceso mediante teléfonos inteligentes fue el modo dominante. Las actividades en línea primarias más frecuentes fueron las redes sociales, el entretenimiento/videos y el uso relacionado con estudios. El uso nocturno después de las 23:00 era común, con 228 de 452 estudiantes que reportaron uso nocturno al menos tres noches por semana. La duración del sueño se concentró entre 6 y 7,9 h, la actividad física se presentó más frecuentemente en la categoría de 1–2 sesiones por semana, y la respuesta modal fue estrés académico moderado. El perfil demográfico y conductual de la muestra retenida se muestra en Tabla 3.
| Característica | Categoría | n | % |
| Sexo | Varón | 167 | 36,9 |
| Mujer | 279 | 61,7 | |
| Preferiría no decirlo | 6 | 1,3 | |
| Año académico | Primer año | 88 | 19,5 |
| Segundo año | 124 | 27,4 | |
| Tercer año | 131 | 29 | |
| Cuarto año o superior | 79 | 17,5 | |
| Posgrado | 30 | 6,6 | |
| Categoría de disciplina | Humanidades y ciencias sociales | 118 | 26,1 |
| Ciencia e ingeniería | 96 | 21,2 | |
| Negocios y administración | 104 | 23 | |
| Artes y diseño | 82 | 18,1 | |
| Otro | 52 | 11,5 | |
| Tipo de residencia | Residencia universitaria en el campus | 301 | 66,6 |
| Alquiler fuera del campus | 79 | 17,5 | |
| Casa familiar | 58 | 12,8 | |
| Otro | 14 | 3,1 | |
| Gastos mensuales de manutención, CNY | <1.000 | 61 | 13,5 |
| 1.000–1.999 | 176 | 38,9 | |
| 2.000–2.999 | 149 | 33 | |
| ≥3.000 | 66 | 14,6 | |
| Uso de internet entre semana | <2 h | 52 | 11,5 |
| 2–3,9 h | 157 | 34,7 | |
| 4–5,9 h | 166 | 36,7 | |
| ≥6 h | 77 | 17 | |
| <2 h | 29 | 6,4 | |
| 2–3,9 h | 101 | 22,3 | |
| 4–5,9 h | 178 | 39,4 | |
| ≥6 h | 144 | 31,9 | |
| Actividad en línea principal | Estudio | 74 | 16,4 |
| Redes sociales | 126 | 27,9 | |
| Juegos | 61 | 13,5 | |
| Entretenimiento/vídeo | 102 | 22,6 | |
| Compras | 28 | 6,2 | |
| Uso mixto | 47 | 10,4 | |
| Otro | 14 | 3,1 | |
| Dispositivo principal de acceso | Teléfono inteligente | 323 | 71,5 |
| Tableta | 18 | 4 | |
| Portátil/ordenador de sobremesa | 67 | 14,8 | |
| Dispositivos mixtos | 44 | 9,7 | |
| Uso nocturno después de las 23:00 | Nunca | 48 | 10,6 |
| Menos de una vez por semana | 57 | 12,6 | |
| 1–2 noches/semana | 119 | 26,3 | |
| 3–5 noches/semana | 141 | 31,2 | |
| Casi todas las noches | 87 | 19,2 | |
| Duración del sueño | <6 h | 83 | 18,4 |
| 6–6,9 h | 146 | 32,3 | |
| 7–7,9 h | 157 | 34,7 | |
| ≥8 h | 66 | 14,6 | |
| Actividad física semanal | Ninguna | 91 | 20,1 |
| 1–2 sesiones | 176 | 38,9 | |
| 3–4 sesiones | 128 | 28,3 | |
| ≥5 sesiones | 57 | 12,6 | |
| Estrés académico | Bajo | 73 | 16,2 |
| Moderado | 241 | 53,3 | |
| Alto | 138 | 30,5 | |
| Edad, años | Media ± DE | 20,41 ± 1,58 | — |
Tabla 3: Características demográficas y conductuales basales de la muestra retenida. Esta tabla presenta el perfil demográfico y las características del uso de internet de la muestra final retenida tras el cribado preespecificado. Las variables incluyen sexo, año académico, categoría de disciplina, tipo de residencia, gastos mensuales de manutención, uso de internet entre semana y durante el fin de semana, actividad en línea principal, dispositivo principal de acceso, uso nocturno después de las 23:00, duración del sueño, actividad física semanal, estrés académico y edad. Abreviaturas: CNY = yuan chino; SD = desviación estándar. Haga clic aquí para descargar esta tabla.
Gravedad de la adicción a internet, resultados en la regulación emocional y fiabilidad
En la muestra completa retenida (n = 452), la puntuación media total en la prueba de adicción a Internet fue de 51,94 ± 16,58. Según los umbrales de gravedad preestablecidos, 200 encuestados fueron clasificados como usuarios normales, 239 como usuarios problemáticos y 13 como usuarios con problemas graves, lo que convierte al grupo de uso problemático en el subgrupo más grande. La puntuación media total en el DERS-16 en la muestra retenida fue de 35,95 ± 8,89. La prueba de adicción a Internet mostró una consistencia interna aceptable, con un alfa de Cronbach de 0,91, y el DERS-16 también mostró una consistencia interna aceptable, con un alfa de Cronbach de 0,88. Al examinar las puntuaciones totales del DERS-16 en los tres grupos de gravedad del IAT, el grupo de uso normal tuvo la media más baja, el grupo de uso problemático tuvo una media más alta y el grupo de uso problemático grave tuvo la media más alta. La comparación entre grupos para la puntuación total del DERS-16 fue estadísticamente significativa en la muestra retenida (n = 452; F = 72,80, p < 0,001; η2 = 0,245). El mismo patrón direccional fue evidente en los resúmenes de las subescalas del DERS-16. Debido a que el subgrupo de uso problemático grave era pequeño (n = 13), los valores de este subgrupo se presentan como parte del patrón distribucional general, más que como base para inferencias detalladas sobre el subgrupo grave. La gravedad de la adicción a Internet y los resultados en regulación emocional se resumen en Tabla 4.
| Medida | Uso normal | Uso problemático | Uso problemático grave | Total |
| n = 200 | n = 239 | n = 13 | n = 452 | |
| Puntuación total del IAT | 34,20 ± 3,90 | 65,33 ± 6,90 | 78,70 ± 6,20 | 51,94 ± 16,58 |
| Puntuación total del DERS-16 | 31,20 ± 7,10 | 39,24 ± 8,30 | 48,50 ± 9,60 | 35,95 ± 8,89 |
| No aceptación del DERS-16 | 5,90 ± 1,90 | 7,29 ± 2,10 | 8,90 ± 2,40 | 6,72 ± 2,16 |
| Metas del DERS-16 | 6,20 ± 1,80 | 7,82 ± 2,00 | 9,10 ± 2,30 | 7,14 ± 2,09 |
| Impulso del DERS-16 | 5,80 ± 1,70 | 7,72 ± 2,10 | 9,40 ± 2,50 | 6,92 ± 2,19 |
| Estrategias del DERS-16 | 9,60 ± 2,90 | 12,29 ± 3,30 | 15,10 ± 3,80 | 11,18 ± 3,44 |
| Claridad del DERS-16 | 3,70 ± 1,30 | 4,18 ± 1,40 | 5,00 ± 1,60 | 3,99 ± 1,41 |
| Alfa de Cronbach del IAT | — | — | — | 0,91 |
| Alfa de Cronbach del DERS-16 | — | — | — | 0,88 |
| Comparación grupal total del DERS-16 | — | — | — | F = 72,80; p < 0,001; η² = 0,245 |
| Correlación de Pearson entre la puntuación total del IAT y la puntuación total del DERS-16 | — | — | — | n = 452; r = 0,524; IC del 95 %: 0,45–0,59; p < 0,001 |
Tabla 4: Grupos de gravedad de la adicción a internet, resultados de regulación emocional, fiabilidad y correlación en la muestra analítica final. Esta tabla presenta las puntuaciones totales del IAT, las puntuaciones totales del DERS-16 y los valores de los subescalas del DERS-16 en los grupos de uso normal, uso problemático y uso problemático severo. También incluye las medias totales de la muestra, los valores alfa de Cronbach para el IAT y el DERS-16, la comparación entre grupos de la puntuación total del DERS-16 y la correlación de Pearson entre la puntuación total del IAT y la puntuación total del DERS-16. Abreviaturas: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale; CI = intervalo de confianza; SD = desviación estándar. Haga clic aquí para descargar esta tabla.
Asociación entre la adicción a internet y la regulación emocional
Se evaluó la asociación predefinida con puntuación continua entre la puntuación total del IAT y la puntuación total del DERS-16 en la muestra analítica retenida (n = 452). La correlación de Pearson entre la puntuación total del IAT y la puntuación total del DERS-16 fue positiva y de magnitud moderada (r = 0.524, IC del 95 %: 0,45–0,59, p < 0,001). Por lo tanto, los estudiantes con puntuaciones totales más altas en el IAT tendieron a reportar una mayor dificultad general en la regulación emocional. Este resultado fue coherente con la distribución por grupos de gravedad y no dependió únicamente de la clasificación categórica del IAT, como se muestra en Tabla 4.
Análisis de regresión multivariable
El modelo de regresión ajustado incluyó la muestra analítica retenida (n = 452). Se introdujo la puntuación total del DERS-16 como variable dependiente y la puntuación total del IAT como la variable independiente principal. La edad, el sexo, el uso de internet entre semana, el uso de internet durante el fin de semana, la duración del sueño, la actividad física semanal y el estrés académico se incluyeron como covariables en el mismo modelo. El sexo se introdujo mediante una codificación prespecificada de variables indicadoras, tomando como categoría de referencia a los hombres y con indicadores separados para mujeres y preferir no decir. Tras el ajuste, la puntuación total del IAT siguió asociada positivamente con la puntuación total del DERS-16 (B = 0.21, SE = 0.02, β = 0.39, p < 0.001). Entre las covariables, el estrés académico mostró una asociación positiva con la puntuación total del DERS-16 (B = 2.36, β = 0.23, p < 0.001), mientras que la duración del sueño (B = -1.12, β = -0.13, p < 0.001) y la actividad física semanal (B = -0.84, β = -0.10, p = 0.003) mostraron asociaciones negativas con la puntuación total del DERS-16. El uso de internet entre semana conservó un coeficiente positivo menor tras el ajuste (B = 0.71, β = 0.09, p = 0.015), mientras que el uso de internet durante el fin de semana no permaneció estadísticamente robusto en el modelo ajustado (B = 0.49, β = 0.07, p = 0.071). La edad y ambos indicadores de sexo no fueron predictores independientes significativos bajo la misma especificación. El modelo explicó el 39,8 % de la varianza en la puntuación total del DERS-16, con un R2 ajustado de 0,386, y el modelo global fue estadísticamente significativo, F(9, 442) = 32,47, p < 0,001. No se observó multicolinealidad, con factores de inflación de varianza comprendidos entre 1,03 y 1,42. Los diagnósticos de los residuos no mostraron violaciones importantes de linealidad ni de homocedasticidad en la inspección de residuos frente a valores ajustados. El gráfico Q-Q de los residuos no mostró desviaciones sustanciales respecto a la normalidad aproximada. La prueba de Breusch-Pagan no fue estadísticamente significativa, p = 0,214. La distancia máxima de Cook fue de 0,18, y ninguna observación superó una distancia de Cook de 0,50. El modelo de regresión ajustado se reporta en Tabla 5.
| Predicción | B | EE | β | t | p | VIF |
| Constante | 18.42 | 2.11 | — | 8.73 | <0.001 | — |
| Puntuación total del IAT | 0.21 | 0.02 | 0.39 | 9.84 | <0.001 | 1.42 |
| Edad | 0.18 | 0.11 | 0.03 | 1.64 | 0.102 | 1.08 |
| Sexo, mujer frente a hombre | 0.62 | 0.54 | 0.04 | 1.15 | 0.252 | 1.05 |
| Sexo, prefiero no decirlo frente a hombre | 0.28 | 1.89 | 0.01 | 0.15 | 0.882 | 1.03 |
| Uso de internet entre semana | 0.71 | 0.29 | 0.09 | 2.45 | 0.015 | 1.36 |
| Uso de internet los fines de semana | 0.49 | 0.27 | 0.07 | 1.81 | 0.071 | 1.31 |
| Duración del sueño | -1.12 | 0.31 | -0.13 | -3.61 | <0.001 | 1.18 |
| Actividad física semanal | -0.84 | 0.28 | -0.1 | -3 | 0.003 | 1.12 |
| Estrés académico | 2.36 | 0.39 | 0.23 | 6.05 | <0.001 | 1.27 |
Tabla 5: Regresión lineal multivariable de la puntuación total del DERS-16 sobre la puntuación total del IAT y variables de confusión en la muestra analítica final. Esta tabla presenta el modelo de regresión ajustado con la puntuación total del DERS-16 como variable dependiente y la puntuación total del IAT como variable independiente principal. Se incluyeron como variables de confusión: edad, sexo, uso de internet en días laborables, uso de internet los fines de semana, duración del sueño, actividad física semanal y estrés académico. La tabla también informa los coeficientes estandarizados, los factores de inflación de la varianza y los diagnósticos del modelo. Abreviaturas: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale; VIF = variance inflation factor. Haga clic aquí para descargar esta tabla.
Tabla suplementaria 1: Diccionario completo de variables, presencia de archivos, estructura de codificación y campos de gestión de datos utilizados en el flujo de trabajo del cuestionario estandarizado. Esta tabla suplementaria proporciona el diccionario completo de variables para el protocolo, incluyendo variables de ética y consentimiento, variables del entorno de la encuesta, variables demográficas, variables de uso de internet, indicadores de control de calidad, ítems de escalas, puntuaciones derivadas, covariables, campos de identificación técnica, variables de seguimiento de conjuntos de datos, información sobre el estado de los archivos y reglas de codificación. Abreviaturas: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale.Haga clic aquí para descargar este archivo.
Archivo complementario 1: Materiales complementarios del flujo de trabajo del cuestionario. Este archivo complementario contiene los archivos del cuestionario, el libro de códigos, el registro de cribado, el plan de resultados y los materiales del flujo de trabajo listos para el análisis, utilizados para reproducir el flujo de trabajo estandarizado de administración del cuestionario, cribado, puntuación y análisis.Haga clic aquí para descargar este archivo.
Discusión
La principal contribución de este artículo es el flujo de trabajo del cuestionario estandarizado, más que la asociación representativa observada entre la adicción a internet y la dificultad para regular las emociones. La implementación mostró que una secuencia fija de consentimiento electrónico, ítems demográficos, comportamiento de uso de internet, puntuación del IAT, puntuación del DERS-16, recopilación de covariables, cribado secuencial de la calidad de los datos y análisis de regresión reproducible puede ejecutarse en una muestra de estudiantes universitarios. Este énfasis procedimental es importante porque el uso problemático de internet a menudo se asocia con la desregulación emocional en la literatura, pero procedimientos inconsistentes de administración y limpieza de datos pueden dificultar la comparación de hallazgos entre estudios21. Por lo tanto, el flujo de trabajo actual favorece la comparabilidad al hacer explícitos el orden de las mediciones, las reglas de exclusión, los pasos de puntuación y las salidas analíticas antes de comenzar la interpretación.
Varios pasos del procedimiento son especialmente críticos para la reproducibilidad. Primero, se debe completar el consentimiento electrónico antes del acceso al cuestionario, y los identificadores técnicos utilizados para la detección de duplicados deben separarse del conjunto de datos analítico final anonimizado. Segundo, la revisión para detectar duplicados debe realizarse antes de la evaluación del tiempo de finalización, la revisión de las preguntas de control de atención, el cribado de respuestas con patrones sistemáticos, la revisión de coherencia lógica y las comprobaciones de datos faltantes, ya que cambiar este orden puede alterar la muestra final retenida. Tercero, los procedimientos de puntuación del IAT y del DERS-16 deben fijarse antes de la recolección de datos, incluyendo la codificación inversa y la clasificación por gravedad. Estos pasos reducen la variación evitable en la investigación mediante encuestas en línea y son coherentes con preocupaciones más amplias de que los hallazgos sobre adicción a internet puedan verse afectados por el estrés, el autocontrol y la ansiedad, así como por diferencias en el procedimiento de medición22.
El protocolo también requiere varias comprobaciones de solución de problemas durante su implementación. Si la plataforma de encuestas no puede restringir envíos repetidos, el cribado de duplicados debe basarse en una combinación de identificadores limitados por cuenta, identificadores limitados por dispositivo, marcas de tiempo, estado del cuestionario y similitud en los patrones de respuesta. Si muchos registros caen dentro del rango de velocidad límite, se debe revisar conjuntamente el resultado de las preguntas de atención, el número de respuestas con cadenas largas, la desviación estándar intra-individuo y la bandera de consistencia lógica, en lugar de utilizar únicamente el tiempo de finalización. Si el alfa de Cronbach es inesperadamente bajo, se deben verificar la codificación de los ítems, la codificación inversa y los rangos de puntuación antes de tomar cualquier decisión a nivel de ítem. Estos procedimientos son particularmente relevantes porque los comportamientos relacionados con internet y los teléfonos inteligentes están asociados con procesos de sueño y regulación emocional, por lo que un cribado descuidado o una codificación errónea podrían ser una fuente potencial de inferencias distorsionadas23.
Los umbrales de exclusión utilizados en la implementación representativa deben considerarse estandarizados dentro de este flujo de trabajo, pero no fijos universalmente para todas las poblaciones futuras. El umbral inferior de tiempo de finalización de 180 s se derivó de pruebas piloto y debe volver a calibrarse cuando el protocolo se aplique a adultos mayores, adolescentes, encuestados multilingües, cuestionarios adaptados para accesibilidad o plataformas con formatos de presentación diferentes. La regla de inconsistencia lógica y los criterios de respuestas patrón también podrían requerir ajustes cuando varíen la longitud de la escala, el orden de los ítems o los puntos de respuesta. Asimismo, el pequeño subgrupo con uso problemático severo en la implementación representativa indica que los estudios diseñados para comparaciones entre subgrupos deben incrementar las metas de reclutamiento o utilizar muestreo estratificado antes de la recolección de datos. Esta flexibilidad es importante porque las variables conductuales y de estilo de vida, incluida la actividad física, pueden interactuar con la atención, la rumiación y la autorregulación de formas que varían entre grupos de estudiantes24.
Se deben considerar varias limitaciones al aplicar este protocolo. El flujo de trabajo utiliza instrumentos de autorreporte, por lo que los errores de recuerdo, el sesgo de deseabilidad social y la varianza común por método pueden influir en las mediciones tanto de la exposición como del resultado. Estos riesgos pueden reducirse, pero no eliminarse, mediante el uso de un lenguaje neutral, un orden fijo del cuestionario, verificaciones de atención, covariables preespecificadas y una presentación transparente de los datos faltantes y exclusiones. En estudios futuros también podría incorporarse mediciones objetivas del comportamiento digital, como registros del tiempo de uso de la pantalla del teléfono inteligente, historiales de uso de aplicaciones o resúmenes del uso basados en plataformas, con el fin de fortalecer la validez del constructo. Sin embargo, estas incorporaciones requieren un lenguaje específico para el consentimiento, salvaguardas de privacidad, procedimientos de minimización de datos y reglas de vinculación. Por lo tanto, deberían añadirse como extensiones planificadas del protocolo en lugar de modificaciones informales al flujo de trabajo del cuestionario25.
El protocolo es adaptable, pero no debe transferirse mecánicamente a todos los entornos. En poblaciones no universitarias, puede ser necesario revisar los criterios de elegibilidad, los canales de reclutamiento, los ítems relacionados con el estrés académico y las categorías de uso de internet. En estudios internacionales multicéntricos, se debe documentar previamente la traducción, la adaptación cultural, la equivalencia de plataformas, el manejo de zonas horarias, las normas de protección de datos y la supervisión a nivel de sitio antes de agrupar los datos. Si el IAT se sustituye por una medida más reciente o específica para la población, aún puede mantenerse el flujo de trabajo, pero se deben actualizar el rango de puntuación, los umbrales de gravedad, el código, la sintaxis, Tabla de Materiales y el diccionario de variables complementarias antes de la recolección de datos. Esta distinción entre la duración del uso de internet y el uso desregulado es importante, porque el tiempo en línea por sí solo puede no captar el mismo constructo que el uso problemático o compulsivo26.
Finalmente, la implementación representativa fue transversal y no debe interpretarse como evidencia de una dirección temporal. La asociación observada entre la puntuación total del IAT y la puntuación total del DERS-16 demuestra cómo funciona la vía analítica, no si la dificultad en la regulación emocional causa un uso problemático de internet o si el uso problemático de internet empeora la regulación emocional con el tiempo. Se han reportado patrones transversales similares en otros entornos universitarios, pero se necesitan aplicaciones longitudinales o con medidas repetidas para examinar la direccionalidad y el cambio27. El valor del presente protocolo radica en que proporciona un flujo de trabajo estable y de línea base para futuros estudios. Al estandarizar el consentimiento, la aplicación de cuestionarios, la selección, la puntuación, las verificaciones de fiabilidad, los diagnósticos del modelo, el archivo de archivos y la documentación complementaria, el protocolo puede respaldar estudios transversales más reproducibles y puede ampliarse a diseños longitudinales o de intervención cuando las preguntas temporales se conviertan en el objetivo principal28. La inclusión de un libro de códigos, un registro de selección, un plan de resultados y materiales de flujo de trabajo listos para el análisis también es coherente con los principios de documentación de software y flujos de trabajo científicos orientados al FAIR29 y con las recomendaciones más amplias de ciencia abierta para informes transparentes y reproducibles30.
Divulgaciones
El autor no tiene nada que revelar.
Agradecimientos
Este trabajo fue apoyado por el Proyecto de Ciencia Blanda de la Provincia de Henan 2025, «Investigación sobre el Impacto y la Ruta de Optimización de los Cambios en la Población Escolar sobre el Desarrollo de Alta Calidad de la Educación Superior Privada en la Provincia de Henan» (Número de Proyecto 252400410490), y por el Proyecto del Fondo de Investigación Doctoral de la Universidad de Economía y Negocios de Zhengzhou 2025, «Investigación sobre el Mecanismo de Formación y el Mecanismo de Orientación de la Opinión Pública del Comportamiento en Clúster en Red de los Estudiantes Universitarios». El autor agradece a la Universidad de Economía y Negocios de Zhengzhou por el apoyo institucional.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Conjunto de datos listo para el análisis | Documento interno específico del estudio | analytic_dataset_v1.csv y analytic_dataset_v1.xlsx | Conjunto de datos anónimo final utilizado para todos los análisis descriptivos, de fiabilidad, de correlación y de regresión que deben informarse |
| Sintaxis de análisis | Documento interno específico del estudio | analysis_syntax_v1.R o archivo de script equivalente | Utilizado para reproducir la verificación de puntuaciones, comprobaciones de fiabilidad, estadísticas descriptivas, análisis de correlación, modelado de regresión, cálculo de VIF y resultados diagnósticos |
| Redacción del ítem de control de atención | Documento interno específico del estudio | attention_check_v1.txt | Redacción fijada del ítem de control de atención de respuesta dirigida utilizado durante la administración del cuestionario |
| Cuestionario DERS-16 | Fuente original de la escala o versión autorizada/adaptada del cuestionario | Escalafón corto DERS-16 de 16 ítems para Dificultades en la Regulación Emocional | Utilizado para evaluar la dificultad en la regulación emocional; el cálculo de puntuaciones sigue la clave de puntuación DERS-16 fijada y documentada en el código |
| Folleto informativo electrónico y página de consentimiento | Documento interno específico del estudio | consent_form_v1.pdf o página de consentimiento de la plataforma | Utilizado para proporcionar información sobre el estudio y obtener el consentimiento informado electrónico antes del acceso al cuestionario |
| Hoja con convención de nomenclatura de archivos | Documento interno específico del estudio | file_naming_convention_v1.xlsx | Utilizado para estandarizar los nombres de los archivos crudos, limpios, analíticos, registros de cribado, código y resultados |
| Capturas de pantalla finales del cuestionario | Documento interno específico del estudio | questionnaire_screenshots_v1.pdf | Utilizado para documentar la presentación fijada de la encuesta, el orden de los ítems, los puntos de respuesta y la configuración de ítems obligatorios |
| Entorno de desarrollo integrado | Posit | RStudio Desktop | Utilizado para gestionar scripts, registros y flujos de trabajo de análisis reproducibles |
| Cuestionario del Test de Adicción a Internet | Fuente original de la escala o versión autorizada/adaptada del cuestionario | Test de Adicción a Internet de 20 ítems | Utilizado para evaluar los síntomas de adicción a internet y clasificar el uso normal, el uso problemático y el uso problemático grave |
| Plataforma de encuestas en línea | Qualtrics | Plataforma XM; cuenta institucional o con licencia | Utilizada para construir el cuestionario, exigir ítems obligatorios, gestionar el acceso basado en consentimiento, restringir envíos repetidos cuando sea posible y exportar los datos de respuestas |
| Paquete estadístico opcional con menú | IBM | SPSS Statistics | Utilizado cuando se requiere un flujo de trabajo de análisis basado en interfaz gráfica para estadísticas descriptivas, comprobaciones de fiabilidad o análisis de regresión |
| Archivo README o código | Documento interno específico del estudio | README_v1.txt o codebook_v1.xlsx | Utilizado para documentar nombres de variables, reglas de codificación, rangos de puntuación, reglas de inversión de codificación, umbrales de exclusión, nombres de archivos y versiones de software |
| Copia de archivo de solo lectura | Formato de documento portátil | PDF/A o PDF de archivo aprobado por la institución | Utilizado para preservar el instrumento de encuesta fijado, la página de consentimiento y los documentos de apoyo al protocolo |
| Libro de registro de cribado | Documento interno específico del estudio | screening_log_v1.xlsx | Utilizado para documentar cribado de duplicados, cribado por tiempo de finalización, fallos en el control de atención, respuestas patrones, inconsistencias lógicas, datos faltantes, decisiones de revisión manual y conteos finales retenidos |
| Software de hojas de cálculo | Microsoft | Formato de libro de Microsoft Excel (.xlsx) | Utilizado para registros de cribado, diccionario de variables, registros de revisión manual y preparación de libros de trabajo suplementarios |
| Entorno de computación estadística | Foundation R / CRAN | R 4.5.3 | Utilizado para verificación de puntuaciones, estadísticas descriptivas, comprobaciones de fiabilidad, análisis de correlación, análisis de regresión, cálculo de VIF y resultados diagnósticos |
| Archivo Suplementario 1 | Archivo suplementario específico del estudio | Supplementary File 1.xlsx | Contiene materiales del flujo de trabajo del cuestionario, código, registro de cribado, plan de resultados y materiales del flujo de trabajo listos para el análisis |
| Tabla Suplementaria S1 | Tabla suplementaria específica del estudio | Supplementary Table S1 | Proporciona el diccionario completo de variables, presencia de archivos, estructura de codificación, campos de identificadores técnicos, variables de cribado y campos de seguimiento del conjunto de datos |
| Documento de exportación de encuesta | Qualtrics | Exportación de encuesta a Word o exportación a PDF | Utilizado para archivar la redacción final del cuestionario, el orden de los ítems, la configuración de ramificación, la configuración de ítems obligatorios y la codificación de respuestas |
| Formato de exportación de encuesta | Qualtrics | Exportación CSV | Utilizado para la preservación de respuestas crudas y la exportación de datos listos para el análisis |
Referencias
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.