Este protocolo demuestra un flujo de trabajo estructurado y verificable para procesar datos anónimos de cuestionarios sobre el bienestar de estudiantes universitarios, desde la exportación inicial y el filtrado de respuestas hasta la puntuación de escalas, comprobación de fiabilidad, diagnósticos de regresión, verificación de fuentes de figuras y salidas analíticas listas para su visualización.
Artículo de método
Un flujo de trabajo estructurado para el cribado, la calificación y la visualización de datos de cuestionarios sobre el bienestar de estudiantes universitarios
En este artículo
Resumen
Resumen
Los estudios basados en cuestionarios se utilizan ampliamente para examinar el bienestar estudiantil, pero la ruta procedural desde las respuestas crudas hasta variables analizables, tablas estadísticas y salidas visuales a menudo queda insuficientemente documentada. Este protocolo demuestra un flujo de trabajo estructurado y verificable para procesar datos anónimos de cuestionarios sobre el bienestar de estudiantes universitarios, recolectados mediante múltiples secciones con escalas tipo Likert. El flujo de trabajo comienza con la aprobación ética, la documentación del consentimiento, la configuración del cuestionario y la exportación de datos crudos, y continúa con la revisión de respuestas, evaluación de respuestas duplicadas, manejo de datos faltantes, codificación de ítems, puntuación inversa, evaluación de confiabilidad, análisis descriptivo, análisis de correlación, comparación contrastiva entre grupos, modelado de regresión, verificación diagnóstica y preparación de fuentes para visualizaciones. El cuestionario de ejemplo utiliza secciones de escalas documentadas en fuentes originales y adaptadas al estudio, basadas en las Escalas de Depresión Ansiedad y Estrés-21, la Escala de Procrastinación de Tuckman, la Escala de Sentido Psicológico de Pertenencia Escolar, literatura sobre medición del pensamiento de orden superior y documentación de escalas de bienestar subjetivo. Emoción negativa, procrastinación académica, sentido de pertenencia escolar, pensamiento de orden superior y bienestar subjetivo se utilizan como variables a nivel de escala para mostrar cómo las respuestas a nivel de ítem pueden convertirse en salidas analíticas rastreables. Los resultados representativos incluyen una tabla de flujo de cribado, resumen demográfico, estadísticas descriptivas y de verificación de rangos, estimaciones de consistencia interna, una matriz de correlación, resultados de comparaciones contrastivas, coeficientes de regresión, diagnósticos de residuos e influencia, y archivos fuente para figuras. El protocolo hace hincapié en reglas de decisión preespecificadas, un mapa de escalas vinculado, un registro de cribado previo al análisis, verificación de puntuación inversa y verificación de fuentes numéricas para las figuras. En lugar de proponer una nueva escala psicométrica, validar un modelo de medición o establecer relaciones causales, este método proporciona un procedimiento práctico y verificable para investigadores que necesitan cribar, puntuar, analizar y visualizar datos de cuestionarios sobre el bienestar de estudiantes universitarios. El flujo de trabajo puede adaptarse a estudios similares basados en cuestionarios, siempre que el mapa de escalas, la aprobación ética, las reglas de puntuación, los umbrales de cribado de respuestas y los archivos fuente para visualizaciones se definan antes del análisis.
Introducción
El bienestar subjetivo es un resultado importante en la investigación estudiantil porque refleja cómo los estudiantes evalúan sus vidas, experiencias emocionales, relaciones sociales y funcionamiento diario dentro de los entornos de aprendizaje. En la educación superior, el bienestar del estudiante es multidimensional y no se limita únicamente a la satisfacción con la vida o al malestar psicológico1. Por lo tanto, los datos obtenidos mediante cuestionarios siguen siendo útiles cuando los investigadores necesitan examinar experiencias emocionales, conductuales, sociales, cognitivas y relacionadas con el bienestar dentro del mismo marco analítico.
El valor de los datos de un cuestionario depende no solo de los constructos seleccionados, sino también de la forma en que las respuestas originales se convierten en variables analíticas. Muchos estudios informan puntajes de escalas, matrices de correlación, comparaciones entre grupos o modelos de regresión sin mostrar las decisiones intermedias que conectan los registros originales con las tablas y figuras finales. Las respuestas faltantes pueden manejarse de forma inconsistente, los ítems invertidos pueden codificarse incorrectamente, los envíos duplicados pueden permanecer en el conjunto de datos y las respuestas descuidadas pueden tratarse como observaciones válidas. Por lo tanto, las decisiones sobre datos faltantes deben planificarse, documentarse y reportarse, en lugar de considerarse un paso oculto a posteriori2. Los datos de cuestionarios en línea también requieren reglas explícitas de calidad de respuesta, ya que responder con excesiva rapidez, marcar la misma opción en todas las preguntas, dar respuestas inconsistentes y otros patrones de bajo esfuerzo pueden distorsionar las estadísticas descriptivas, las estimaciones de fiabilidad y las asociaciones observadas3.
La novedad de este protocolo radica en su historial de auditoría vinculado, que va desde la exportación bruta del cuestionario hasta los resultados estadísticos y visuales finales. En concreto, el flujo de trabajo incorpora un mapa completado de escalas, un registro de revisión previo al análisis, un punto de control para puntuaciones invertidas, un registro de verificación de puntuación, verificación de la fuente numérica de las figuras y un rastro de auditoría que enlaza cada tabla o figura con su archivo fuente. Esto diferencia el método de las prácticas estándar de limpieza de encuestas, puntuación de escalas, pruebas de fiabilidad o visualización. En lugar de afirmar simplemente que los datos del cuestionario fueron limpiados y analizados, el protocolo especifica qué archivo está bloqueado, qué archivo se revisa, qué reglas se aplican, qué puntuaciones de escala se generan y qué tabla numérica verificada se utiliza para crear cada resultado visual.
El flujo de trabajo se demuestra mediante datos anónimos de un cuestionario aplicado a estudiantes universitarios que incluye cinco variables de escala: emoción negativa, procrastinación académica, sentido de pertenencia escolar, pensamiento de orden superior y bienestar subjetivo. Estos constructos fueron seleccionados para proporcionar ejemplos de índole emocional, conductual, contextual escolar, cognitiva y orientados a resultados dentro de un flujo de trabajo estructurado y verificable. Se ha relacionado la procrastinación académica con dificultades posteriores de salud mental en estudiantes universitarios, incluyendo resultados asociados a depresión, ansiedad y estrés4. El sentido de pertenencia escolar y el bienestar subjetivo también están estrechamente relacionados entre poblaciones estudiantiles, lo que respalda la inclusión de medidas relacionadas con el sentido de pertenencia y el bienestar dentro del mismo marco de procesamiento de cuestionarios5. Sin embargo, en este protocolo, estos constructos se utilizan para demostrar el flujo de trabajo, y no para establecer un modelo psicológico causal.
Una característica central del protocolo es la separación entre las decisiones de procesamiento de datos y la interpretación sustantiva. El mapa de escala se prepara antes del análisis, los criterios de calidad de respuesta se fijan antes de la puntuación de la escala, la verificación del recodificado inverso se completa antes de las pruebas estadísticas y las figuras se generan únicamente después de verificar sus tablas numéricas de origen. Esta secuencia es importante porque las escalas de respuesta tipo Likert requieren una alineación cuidadosa entre la redacción de los ítems, los puntos de anclaje de respuesta, la dirección de puntuación y el tratamiento estadístico6. El protocolo también prioriza la complejidad del modelo tras una preprocesamiento transparente y la verificación de la puntuación. Los modelos predictivos o multivariables pueden ser útiles en investigaciones estudiantiles7, y los resúmenes gráficos pueden mejorar la interpretación cuando permanecen vinculados a matrices numéricas verificadas8, pero ambos dependen de una preparación transparente de las variables de entrada. Por esta razón, el flujo de trabajo utiliza el análisis de correlación, la comparación contrastiva entre grupos, la modelización de regresión, la verificación diagnóstica y la visualización como módulos de ejemplo, y no como afirmaciones sustantivas obligatorias.
Este protocolo está destinado a investigadores que necesitan un flujo de trabajo práctico para el procesamiento de cuestionarios con datos anónimos sobre el bienestar estudiantil. Es adecuado cuando las respuestas a nivel de ítem del cuestionario se exportan desde una plataforma en línea, se deben calcular variables a nivel de escala a partir de ítems de tipo Likert, y el objetivo es producir resultados descriptivos, correlacionales, de comparación entre grupos, regresionales, diagnósticos y listos para visualización. No está diseñado para establecer relaciones causales, validar escalas nuevas, reemplazar el análisis factorial confirmatorio, sustituir las pruebas de invariancia de medición, ni para suplir los modelos de respuesta al ítem o de variables latentes. Su contribución es de tipo procedimental: hace visible, repetible y verificable el camino desde los registros del cuestionario hasta las tablas y figuras reportadas. Este enfoque es coherente con las preocupaciones actuales sobre la calidad de los datos de encuestas en línea9, la verificación de regresiones e influencias10, y los flujos de trabajo de análisis basados en cuestionarios auditables11.
Protocolo
Este estudio que involucró a participantes humanos fue revisado y aprobado por el Comité de Ética del Colegio de Aeronáutica, Universidad Abierta de Guizhou (Número de aprobación: GZOU-EDU-2024-015). El comité determinó que el estudio cumplía con los requisitos para obtener una exención ética porque utilizó procedimientos de cuestionario anónimos y voluntarios, y no representaba más que un riesgo mínimo para los participantes. Todos los participantes proporcionaron su consentimiento informado electrónico antes de completar el cuestionario y podían dejar de responder en cualquier momento sin penalización. Dado que varios ítems abordaban emociones negativas, estrés, soledad, desamparo, insatisfacción o experiencias relacionadas con el bienestar, la página de consentimiento y la página final del cuestionario incluían información de contacto del investigador y de la institución para los participantes que experimentaran malestar. El conjunto de datos utilizado en este protocolo fue anonimizado antes del cribado, puntuación, análisis y visualización. El cuestionario completo se proporciona como Archivo Suplementario 1.
1. Preparar el cuestionario, los materiales éticos y los documentos del flujo de trabajo
- Defina la población elegible, el entorno del estudio, los constructos del cuestionario y los productos analíticos planeados antes de programar el cuestionario.
- Elabore una solicitud de ética que incluya la población objetivo, el canal de reclutamiento, el contenido del cuestionario, el tiempo estimado de cumplimentación, la protección del anonimato, el almacenamiento de datos, el procedimiento de retirada, la información de apoyo al participante y los análisis previstos.
- Guarde el documento de aprobación o exención ética, el texto del consentimiento, el texto de reclutamiento, la versión del cuestionario, la información de apoyo al participante y el flujo de trabajo planeado en la carpeta del proyecto antes de comenzar la recolección de datos.
- Defina la población objetivo como estudiantes universitarios de tiempo completo con al menos 18 años de edad, actualmente matriculados en educación superior, capaces de comprender el cuestionario y de otorgar consentimiento informado.
- Defina los criterios de exclusión antes del reclutamiento. Excluya a los encuestados que rechacen el consentimiento, que no cumplan con la definición de población objetivo, que envíen respuestas duplicadas, que superen el umbral de datos faltantes o que cumplan con los criterios combinados de respuesta inválida descritos en el paso 1.4.
- Coloque la declaración de consentimiento informado al inicio del cuestionario. Indique el propósito del estudio, la naturaleza voluntaria de la participación, el tiempo aproximado de cumplimentación de 12 minutos, la protección del anonimato, el derecho a retirarse, el plan de uso de los datos, la información de contacto del investigador y la información de contacto para apoyo.
- No recoja información directamente identificable, incluyendo números de identificación estudiantil, números de identificación nacional, números de teléfono móvil, direcciones de correo electrónico personales, direcciones de residencias estudiantiles u otros identificadores personales.
- Organice el cuestionario en el siguiente orden: consentimiento informado, información demográfica, ítems sobre emociones negativas, ítems sobre procrastinación académica, ítems sobre pertenencia escolar, ítems sobre pensamiento de orden superior y ítems sobre bienestar subjetivo.
- Seleccione los instrumentos originales antes de programar el cuestionario. En este protocolo, la emoción negativa se evaluó mediante la Escala de Depresión Ansiedad y Estrés de 21 ítems (DASS-21), la procrastinación académica mediante la Escala de Procrastinación de Tuckman de 16 ítems, la pertenencia escolar mediante la Escala de Sentido Psicológico de Pertenencia Escolar de 18 ítems, el pensamiento de orden superior mediante un conjunto de 20 ítems adaptado de la literatura publicada sobre medición del pensamiento de orden superior, y el bienestar subjetivo mediante una escala de 20 ítems de bienestar subjetivo para investigaciones con estudiantes universitarios12,13,14,15,16.
- Prepare un mapa de escalas bloqueado antes de programar el cuestionario. Incluya el nombre del constructo, el nombre original de la escala, la cita original, la versión del idioma, el estado de permiso o autorización, el procedimiento de traducción o adaptación, el código del ítem, el enunciado del ítem, el rango de respuesta, los anclajes de respuesta, la dirección de puntuación, el estado de ítems invertidos, la variable final a nivel de escala y la regla de puntuación.
- Describa un conjunto de ítems como una escala validada únicamente cuando se documenten el instrumento original, la cita, las evidencias de validación y el estado de adaptación o traducción. Identifique cualquier conjunto de ítems desarrollado por el autor o específico del estudio en Tabla 1 y Archivo Suplementario 1.
- Bloquee el marco de medición antes de la recolección de datos. Para instrumentos traducidos o adaptados, complete la traducción, revisión, reconciliación y prueba piloto antes de iniciar el reclutamiento.
- Prepare un paquete de auditoría del flujo de trabajo que incluya el archivo bloqueado del cuestionario, el mapa de escalas, la lista de verificación para la exportación de datos brutos, el registro de cribado, el registro de verificación de puntuación, el registro de análisis, la plantilla de tabla de fuentes de figuras y el archivo de sintaxis o script de análisis.
- Utilice nombres de archivo con versión para todos los artefactos del flujo de trabajo.
- Defina las columnas requeridas para cada archivo de auditoría.
- El registro de cribado incluye ID del registro, criterio de cribado, estado de marcado, estado de exclusión, motivo de exclusión, fecha de decisión e iniciales del revisor.
- El mapa de escalas incluye nombre del constructo, fuente de la escala, código del ítem, enunciado del ítem, rango de respuesta, anclajes de respuesta, estado de inversión de puntuación, nombre final de la variable, regla de puntuación y estado de permiso o adaptación.
- El registro de verificación de puntuación incluye código del ítem, rango de valores original, rango de valores recodificados, fórmula de inversión de puntuación, resultado de verificación de rango, estado de discrepancia, corrección realizada y fecha de corrección.
- La tabla de fuentes de figuras incluye número de figura, número de panel, tabla de origen, variables representadas, estadístico mostrado, tamaño de la muestra y estado de verificación.
- Defina el flujo de trabajo analítico antes de programar el cuestionario: administración de la encuesta, exportación de datos brutos, cribado de respuestas, puntuación de escalas, evaluación de fiabilidad, análisis descriptivo, análisis de correlación, comparación entre grupos alto y bajo, modelado de regresión, pruebas diagnósticas y preparación de visualizaciones17.
- Estructure el protocolo en torno a decisiones, operaciones y productos de verificación, en lugar de rutas de menú de software.
- Proporcione recursos del flujo de trabajo cuando lo permitan las políticas institucionales y editoriales, incluyendo el archivo del cuestionario, el mapa de escalas, la plantilla del registro de cribado, la plantilla del registro de puntuación, el archivo de sintaxis o script de análisis y las tablas de fuentes de figuras.
NOTA: Figura 1 muestra la ruta desde la preparación del cuestionario hasta la exportación de datos brutos, el cribado de respuestas, la puntuación de escalas, el análisis estadístico, las pruebas diagnósticas y la salida de visualización. Tabla 1 informa el instrumento fuente, el número de ítems, el rango de respuesta, el marco de puntuación, la regla de inversión de puntuación, el estado de permiso o adaptación y la variable final a nivel de escala para cada constructo.
2. Configurar y distribuir el cuestionario
- Confirme que la plataforma del cuestionario admita el control mediante consentimiento, elementos obligatorios, revisión de envíos duplicados, captura de marcas de tiempo y registro de la duración de las respuestas.
- Cree el cuestionario utilizando la plataforma de encuestas en línea que aparece en la Tabla de materiales. Programe el cuestionario según el mapa de escalas bloqueado.
- Compare el cuestionario programado con el mapa de escalas bloqueado, ítem por ítem, antes de publicar el enlace de la encuesta. Registre cualquier corrección en el registro del estudio.
- Establezca el ítem de consentimiento informado como el primer ítem obligatorio. Detenga automáticamente el cuestionario cuando un participante seleccione “No acepto participar”.
- Programe las secciones de escalas demográficas y psicológicas según el orden fijado en el paso 1.8. Utilice códigos de ítems que coincidan con el mapa de escalas.
- Establezca los ítems de las escalas psicológicas como obligatorios únicamente cuando lo permita la aprobación o exención ética y cuando los participantes puedan retirarse sin penalización. Si no se permiten respuestas obligatorias, registre la regla para datos faltantes antes de la recolección de datos.
- Muestre los anclajes de respuesta antes de cada sección de escala y mantenga los anclajes consistentes dentro de cada escala18.
- Desactive los envíos repetidos cuando la plataforma de la encuesta ofrezca esta función. Mantenga cualquier identificador anónimo del dispositivo, navegador, plataforma o envío necesario para la revisión de respuestas duplicadas.
- Habilite el registro automático de la hora de envío y de la duración de la finalización.
- Establezca el período de apertura del cuestionario en 7 días calendario, o utilice la ventana de recolección aprobada por el comité de ética.
- Envíe el enlace del cuestionario a través del canal institucional de reclutamiento aprobado. Proporcione las mismas instrucciones escritas a todos los participantes.
- Cierre el cuestionario una vez finalizada la ventana de recolección previamente especificada.
NOTA: Mantenga en el registro del estudio el texto del reclutamiento, el enlace del cuestionario, las fechas de apertura y cierre, la configuración de la plataforma, el texto del consentimiento, la versión final del cuestionario y la configuración de exportación de la plataforma.
3. Exportar y asegurar los datos brutos
- Exporte las respuestas completadas del cuestionario como un archivo de hoja de cálculo inmediatamente después de que finalice el período de recolección.
- Guarde el primer archivo exportado como el conjunto de datos brutos bloqueado. No edite este archivo.
- Cree una copia de trabajo para la selección, puntuación y análisis. Asigne al archivo un nombre que incluya la fecha, el número de versión y el identificador del proyecto.
- Verifique que el archivo exportado contenga una fila por encuestado y una columna por variable demográfica, ítem del cuestionario, variable de marca de tiempo, variable de plataforma o campo derivado de la plataforma.
- Guarde el conjunto de datos brutos bloqueado, la copia de trabajo, el mapa de escalas, el archivo del cuestionario, el registro del estudio, el registro de selección, el registro de verificación de puntuación, el registro de análisis, las tablas de origen de figuras y el archivo de sintaxis o script en una carpeta del proyecto protegida con contraseña.
- Verifique que el conjunto de datos no contenga información directamente identificable. Elimine cualquier campo identificable inesperado de la copia de trabajo antes del análisis y registre el nombre del campo, la razón de la eliminación, la fecha de eliminación y las iniciales del revisor responsable en el registro del estudio.
- Revise la posibilidad de identificación indirecta antes de compartir o publicar datos a nivel de participante. Examine las categorías demográficas pequeñas generadas por combinaciones de sexo, edad, nivel académico, categoría de institución y categoría de especialidad académica. Si una categoría contiene menos de cinco encuestados, combine categorías, suprima la categoría o proporcione únicamente datos agregados.
- Registre el estado de disponibilidad de los datos en el registro del estudio, indicando si los datos a nivel de participante están disponibles, restringidos por requisitos éticos o de privacidad, o sustituidos por un conjunto de datos agregado del flujo de trabajo.
- Cree un registro de selección antes de la limpieza de datos. Registre el tamaño muestral bruto, el criterio de selección, el número de registros marcados, el número de registros eliminados, el número de registros conservados, la razón de exclusión, la fecha de la decisión y las iniciales del revisor.
- Cree un archivo de seguimiento de análisis antes del análisis estadístico. Registre el nombre del software, la versión del software, el sistema operativo, los nombres de los archivos, la versión de los datos, la versión del script o sintaxis y la fecha de cada ejecución del análisis.
NOTA: Utilice el conjunto de datos brutos bloqueado únicamente para verificación. Realice toda la selección, puntuación y análisis utilizando la copia de trabajo.
4. Evaluar las respuestas y construir el conjunto de datos analítico
- Aplique reglas preestablecidas de exclusión y control de calidad antes de calcular cualquier puntaje a nivel de escala.
- Aplique las reglas de cribado a la copia de trabajo en este orden: estado de consentimiento, elegibilidad, envíos duplicados, datos faltantes, duración de la respuesta, respuestas en línea recta, valores fuera de rango e indicadores combinados de calidad de respuesta.
- Después de cada operación de cribado, registre el número de registros marcados, eliminados y conservados en el registro de cribado. No sobrescriba versiones anteriores del archivo de trabajo.
- Elimine todos los registros en los que el ítem de consentimiento informado esté marcado como “No” o quede sin responder.
- Elimine todos los registros que no cumplan con los criterios de inclusión definidos en el Paso 1.4.
- Revise la presencia de envíos duplicados utilizando identificadores anónimos de respuesta, hora de envío, indicadores de envío duplicado de la plataforma y patrones de respuesta repetidos.
- Conservar el primer envío completo cuando se detecten entradas duplicadas, a menos que exista una razón documentada que justifique conservar una respuesta completa posterior.
- Corrija todas las reglas de calidad de respuesta antes de calcular los puntajes de las escalas. Tabla 2 resume los umbrales de exclusión, umbrales de marcado, la justificación, el respaldo bibliográfico y el plan de análisis de sensibilidad utilizados en el flujo de trabajo.
- Revise la presencia de datos faltantes. Elimine a un encuestado si faltan más del 20 % de todos los ítems de la escala. Reemplace un ítem aislado faltante con la puntuación media del encuestado para la misma escala solo si al menos el 80 % de esa escala ha sido completado. No impute variables demográficas a menos que la variable no se utilice en ningún análisis.
- Registre el número de encuestados excluidos por tener más del 20 % de ítems faltantes en las escalas y el número que recibió imputación de la media dentro de la escala. En el conjunto de datos actual, 4 encuestados fueron excluidos por tener más del 20 % de ítems faltantes en las escalas, y 21 encuestados recibieron imputación de la media dentro de la escala para 37 ítems faltantes aislados.
- Revise la duración de la respuesta. Marque las respuestas completadas en menos de 180 s. Trate este valor como una alerta de velocidad, no como una regla automática de exclusión.
- Revise la presencia de respuestas en línea recta. Marque una respuesta si se selecciona la misma opción en más del 90 % de todos los ítems de escala Likert. Trate este valor como una alerta de patrón de respuesta, no como una regla automática de exclusión.
- Revise otros indicadores de bajo esfuerzo, incluyendo evidencia de envíos duplicados, marcas de tiempo imposibles, cadenas de respuestas repetidas en envíos separados o conflictos entre metadatos de la plataforma y contenido del cuestionario.
- Elimine una respuesta marcada solo cuando al menos dos indicadores de control de calidad sugieran una respuesta inválida, como un tiempo de finalización extremadamente corto combinado con respuestas en línea recta, evidencia de envío duplicado o metadatos de plataforma imposibles19.
- Registre todos los registros marcados, incluso cuando se conserven. En el conjunto de datos actual, 19 respuestas fueron marcadas por duración de finalización < 180 s, 8 respuestas fueron marcadas por >90 % de respuestas en línea recta, y 13 registros fueron excluidos porque cumplieron con dos o más indicadores de calidad de respuesta.
- Revise la presencia de valores fuera de rango. Confirme que los ítems de emoción negativa estén dentro del rango 1–4, los ítems de procrastinación académica, pertenencia escolar y pensamiento de orden superior estén dentro del rango 1–5, y los ítems de bienestar subjetivo estén dentro del rango 1–6.
- Corrija un valor solo cuando la exportación original muestre claramente un error de formato. No modifique puntajes psicológicos válidos solo porque parezcan inusualmente altos o bajos.
- Genere una tabla de flujo de cribado que informe los cuestionarios enviados, exclusiones por consentimiento y elegibilidad, exclusiones por duplicados, exclusiones por datos faltantes, alertas de calidad de respuesta, exclusiones combinadas por control de calidad, imputaciones de ítems aislados, casos analíticos conservados y tamaño final de la muestra analítica.
- Complete la tabla de flujo de cribado utilizando el registro de cribado bloqueado y conserve un registro auditado exportado de las decisiones de cribado. En el conjunto de datos actual, el flujo de cribado fue el siguiente: cuestionarios enviados, n = 448; exclusiones por consentimiento o elegibilidad, n = 6; envíos duplicados eliminados, n = 5; registros excluidos por >20 % de ítems faltantes en escalas, n = 4; registros excluidos por dos o más indicadores de calidad de respuesta, n = 13; conjunto de datos analítico final, n = 420.
- Guarde los registros conservados como el conjunto de datos analítico. Utilice un nuevo nombre de archivo con versión y conserve el registro de cribado junto con el conjunto de datos analítico.
NOTA: Conservar puntajes extremos válidos a menos que exista un problema documentado de calidad de respuesta.
5. Calificar las escalas psicológicas
- Convierta las respuestas a nivel de ítem en variables a nivel de escala solo después de completar el examen de las respuestas y haber guardado el conjunto de datos analítico.
- Codifique todos los ítems de tipo Likert según los puntos de respuesta del cuestionario bloqueado y las reglas de puntuación del mapa de la escala.
- Mantenga las variables originales de los ítems sin cambios. Cree variables derivadas separadas para los ítems recodificados o invertidos en su puntuación.
- Calcule la puntuación de cada escala según el mapa de escala bloqueado y el instrumento fuente correspondiente o el manual de puntuación.
- Invierta la puntuación de los ítems designados de bienestar subjetivo antes de calcular la puntuación de bienestar subjetivo. Para la escala de respuesta de 1 a 6, calcule cada ítem invertido como 7 menos la puntuación original y agregue _R al nombre de la variable derivada.
- Utilice las variables con puntuación invertida, no las variables originales, al calcular el bienestar subjetivo.
- Calcule la puntuación de cada escala como la media de sus ítems retenidos: emoción negativa, procrastinación académica, pertenencia escolar, pensamiento de orden superior y bienestar subjetivo.
- Asigne a las variables finales a nivel de escala los nombres Emoción negativa, Procrastinación académica, Pertenencia escolar, Pensamiento de orden superior y Bienestar subjetivo.
- Verifique el valor mínimo y máximo de cada variable a nivel de escala frente a su rango teórico de respuesta. Vuelva a revisar la codificación, la inversión de puntuación y el manejo de valores perdidos si alguna puntuación queda fuera del rango esperado.
- Verifique la dirección de cada escala frente al mapa de escala antes del análisis inferencial. Las puntuaciones más altas deben reflejar la dirección prevista del constructo.
- Realice una auditoría de inversión de puntuación antes del análisis. Recalcule los ítems con puntuación invertida para un subconjunto aleatorio de registros o para todos los ítems con puntuación invertida cuando sea factible, y registre el resultado de la auditoría en el registro de verificación de puntuación.
- Si se detecta un error en la puntuación, corrija la variable derivada, regenere la puntuación de escala afectada, actualice el registro de verificación de puntuación y vuelva a ejecutar todos los análisis posteriores y tablas fuente de figuras basadas en el conjunto de datos analítico corregido.
NOTA: Trate la inversión de puntuación y la verificación de rango como puntos de control obligatorios antes del análisis de correlación, comparación de grupos, modelado de regresión o visualización.
6. Evaluar la consistencia interna y las propiedades descriptivas
- Calcule la consistencia interna, las correlaciones corregidas entre cada ítem y el total, y las estadísticas descriptivas para cada escala utilizando las variables de ítems definidas en el mapa de escala bloqueado.
- Registre el alfa de Cronbach, el número de ítems, el tamaño válido de la muestra, las correlaciones corregidas entre cada ítem y el total, y los valores de alfa-si-se-elimina-el-ítem para cada escala.
- Utilice un alfa de Cronbach de 0,70 como umbral mínimo aceptable de fiabilidad para este flujo de trabajo. Antes de eliminar cualquier ítem, revise la redacción del ítem, la dirección de la puntuación, la inversión de puntuación, la alineación con el constructo y la documentación del instrumento original20.
- Calcule el omega de McDonald como una estimación complementaria de la fiabilidad cuando el entorno de análisis lo permita. Informe del omega junto con el alfa de Cronbach cuando ambas estimaciones conduzcan a interpretaciones diferentes de la fiabilidad.
- Revise cualquier ítem que presente una correlación corregida ítem-total negativa o muy baja antes de considerar su eliminación. Trate esto inicialmente como un posible problema de codificación, inversión de puntuación o alineación con el constructo.
- No elimine un ítem únicamente para aumentar el alfa de Cronbach. La eliminación de un ítem debe justificarse mediante el manual de puntuación, la redacción del ítem, la correlación corregida ítem-total, la adecuación conceptual y la verificación documentada de la puntuación.
- Calcule las estadísticas descriptivas para las cinco variables a nivel de escala, incluyendo media, desviación estándar, mínimo, máximo, asimetría y curtosis.
- Revise la concentración en extremos anotando la proporción de participantes con las puntuaciones mínima y máxima posibles en cada escala.
- Registre las estimaciones de fiabilidad, los diagnósticos ítem-total, las estadísticas descriptivas y cualquier decisión relacionada con la puntuación en el registro de análisis.
NOTA: El alfa de Cronbach se utiliza como una verificación de fiabilidad, no como un procedimiento completo de validación psicométrica. Cuando se requiera una evaluación formal de la medición, complemente este flujo de trabajo con el omega de McDonald, análisis factorial confirmatorio, pruebas de invariancia de medición, modelado de respuesta al ítem u otros métodos basados en variables latentes.
7. Realizar el análisis de correlación
- Utilice las cinco variables verificadas a nivel de escala: emoción negativa, procrastinación académica, pertenencia escolar, pensamiento de orden superior y bienestar subjetivo.
- Antes de calcular las correlaciones de Pearson, inspeccione las distribuciones y los diagramas de dispersión bivariados para cada par de variables a nivel de escala.
- Evalúe si las variables muestran una variación de puntuación aproximadamente continua, asimetría severa, relaciones no lineales o patrones influyentes de valores atípicos.
- Calcule los coeficientes de correlación de Pearson y los valores p bilaterales para todos los pares de variables a nivel de escala cuando las suposiciones sean aceptables para el análisis descriptivo de asociación.
- Registre el coeficiente de correlación, pvalor p, tamaño de la muestra y dirección de la asociación para cada par de variables.
- Informe los coeficientes de correlación con tres decimales.
- Compare la dirección de cada coeficiente con el mapa de la escala. Vuelva a verificar la puntuación de los ítems si un coeficiente contradice la dirección prevista del constructo.
- Guarde la matriz de correlación verificada como la tabla fuente numérica para el mapa de calor de correlación en la sección de Resultados Representativos.
- Cuando las distribuciones están claramente sesgadas, se requiere una escala ordinal de sensibilidad o los diagramas de dispersión sugieren asociaciones monótonas pero no lineales, repita el análisis utilizando la correlación de Spearman y compare la dirección y la magnitud relativa de las asociaciones.
- Registre si los resultados de Pearson y Spearman llevaron a la misma interpretación sustantiva.
NOTA: Utilice el análisis de correlación tanto como una verificación descriptiva de asociación como una auditoría de la dirección de los puntajes.
8. Crear grupos de bienestar subjetivo alto y bajo
- Utilice el conjunto de datos analítico limpio y puntuado. No regrese al archivo original para la construcción de grupos.
- Utilice la puntuación continua de bienestar subjetivo como resultado principal para la modelización por regresión. Use la agrupación alta-baja únicamente para la comparación contrastiva de perfiles.
- Ordene a los encuestados según la puntuación de bienestar subjetivo de mayor a menor.
- Aplique la regla prespecificada del 27 % para grupos extremos con el fin de definir los grupos de alto y bajo bienestar subjetivo. Documente la justificación de este umbral en Tabla 2 y en el registro de análisis.
- Asigne a los encuestados del 27 % superior al grupo de alto bienestar subjetivo y a los del 27 % inferior al grupo de bajo bienestar subjetivo.
- Mantenga al 46 % central en el conjunto de datos analítico completo para estadísticas descriptivas, análisis de correlación, comparación por sexo y modelización por regresión, pero excluya estos casos de la comparación alta-baja.
- Cree una variable de agrupación denominada Grupo de bienestar subjetivo. Codifique al grupo superior como Alto, al inferior como Bajo y al resto de encuestados como Medio.
- Verifique que los grupos alto y bajo contengan el número previsto de casos. Si existen puntuaciones empatadas en el límite del 27 %, aplique la regla prespecificada para resolver empates y registre la decisión en el registro de análisis.
- Realice una comprobación de sensibilidad cuando el límite del 27 % genere una pertenencia inestable a los grupos debido a puntuaciones empatadas o un tamaño muestral pequeño. Utilice una regla alternativa prespecificada, como la agrupación por terciles, y señale si la interpretación permanece inalterada.
NOTA: La agrupación alta-baja es un procedimiento descriptivo de contraste. No debe sustituir a la puntuación continua de bienestar subjetivo en el modelo principal de regresión.
9. Comparar los grupos de bienestar subjetivo alto y bajo
- Filtre el conjunto de datos analítico para conservar únicamente a los encuestados clasificados como Alto o Bajo en la variable de agrupación de bienestar subjetivo.
- Compare los grupos alto y bajo en emoción negativa, procrastinación académica, sentido de pertenencia escolar y pensamiento de orden superior.
- Antes de la comparación entre grupos, inspeccione las distribuciones específicas de cada grupo, los tamaños muestrales y la igualdad de varianzas para cada variable.
- Utilice una muestra independiente t-prueba cuando las suposiciones de distribución y varianza sean aceptables. Utilice la de Welch t-prueba cuando no se cumple el supuesto de igualdad de varianzas.
- Registrar las medias de los grupos, desviaciones estándar, diferencias de medias, t-valores, grados de libertad, p-valores e intervalos de confianza del 95 %.
- Calcule el valor d de Cohen para cada diferencia entre grupos e interprete el tamaño del efecto junto con el valor p.
- Inspeccione si la dirección de cada diferencia entre grupos es coherente con las definiciones del constructo y con la matriz de correlación.
- Guarde la tabla verificada de comparación entre grupos como la fuente numérica para cualquier visualización de comparación entre grupos.
- Informe este análisis como un contraste entre perfiles extremos de bienestar subjetivo.
NOTA: No interprete la comparación alta-baja como evidencia causal.
10. Examinar las diferencias sexuales
- Elimine el filtro de grupo alto-bajo y regrese al conjunto de datos analíticos completo.
- Utilice el sexo como una variable descriptiva de agrupamiento en lugar de como una exposición causal.
- Compare a los participantes femeninos y masculinos en cuanto a emociones negativas, procrastinación académica, sentido de pertenencia escolar, pensamiento de orden superior y bienestar subjetivo.
- Antes de realizar la comparación, revise los tamaños muestrales específicos por grupo, la presencia de datos faltantes, las distribuciones y la igualdad de varianzas.
- Utilice una prueba t para muestras independientes cuando los supuestos sean aceptables. Utilice la prueba t de Welch cuando no se cumpla el supuesto de igualdad de varianzas.
- Registre las medias por grupo, desviaciones estándar, diferencias de medias, valores t, grados de libertad, valores p, intervalos de confianza del 95 % y valores de d de Cohen.
- Interprete las diferencias por sexo de forma descriptiva y reporte los tamaños del efecto junto con los valores p.
- No utilice los resultados de la comparación por sexo para justificar exclusiones a posteriori, modificaciones de escalas o interpretaciones causales.
NOTA: Las comparaciones por sexo se incluyen como verificaciones descriptivas de subgrupos dentro de este flujo de trabajo transversal basado en cuestionarios.
11. Estimar el modelo de regresión
- Utilice el bienestar subjetivo como la variable dependiente.
- Utilice la emoción negativa, la procrastinación académica, la pertenencia escolar y el pensamiento de orden superior como predictores simultáneos a nivel de escala21.
- Utilice las variables continuas a nivel de escala creadas durante la puntuación de las escalas. No sustituya la puntuación continua del bienestar subjetivo por la variable categórica de grupos altos-bajos.
- Ajuste el modelo principal mediante regresión lineal múltiple con entrada simultánea.
- Registre los coeficientes no estandarizados, los coeficientes estandarizados, los errores estándar, los valores t, los valores p, los intervalos de confianza del 95%, R2, R2 ajustado, la tolerancia y el factor de inflación de la varianza.
- Utilice valores del factor de inflación de la varianza inferiores a 5,00 como umbral para la ausencia de multicolinealidad severa.
- Revise gráficos de dispersión bivariados, gráficos parciales de regresión o gráficos de componente más residuo para evaluar si las asociaciones entre los predictores y el bienestar subjetivo son aproximadamente lineales.
- Evalue la independencia de los residuos utilizando el estadístico de Durbin-Watson.
- Evalue la normalidad de los residuos mediante un gráfico Q-Q de residuos y una prueba formal de normalidad cuando sea apropiado para el tamaño de la muestra.
- Evalue la homocedasticidad utilizando un gráfico de residuos estandarizados frente a valores predichos estandarizados.
- Guarde los residuos estandarizados, los valores predichos estandarizados, los valores de apalancamiento y la distancia de Cook para la verificación diagnóstica.
- Estime un modelo suplementario ajustado que incluya los cuatro predictores psicológicos y las variables demográficas reportadas en la descripción de la muestra, incluyendo sexo, edad, nivel académico, categoría de institución y categoría de especialidad académica, cuando estas variables estén disponibles y tengan una distribución adecuada.
- Compare el modelo principal con el modelo suplementario ajustado. Registre si la dirección, magnitud e interpretación estadística de los cuatro predictores psicológicos permanecen estables tras el ajuste demográfico.
- Guarde los coeficientes estandarizados verificados y los intervalos de confianza del 95% del modelo principal como tabla numérica fuente para el gráfico de coeficientes en la sección de Resultados Representativos22.
NOTA: Interprete los coeficientes de regresión como asociaciones condicionales, no como efectos causales. El modelo ajustado por variables demográficas se utiliza en un análisis de sensibilidad para evaluar si las conclusiones del procedimiento permanecen estables tras tener en cuenta las variables contextuales disponibles.
12. Diagnosticar el modelo de regresión
- Inspeccione los residuos estandarizados del modelo de regresión ajustado. Marque los casos con residuos estandarizados absolutos mayores que 3,00.
- Revise los valores de apalancamiento y la distancia de Cook para identificar observaciones influyentes.
- Señale las observaciones con una distancia de Cook mayor que 4/n como potencialmente influyentes, donde n es el tamaño de la muestra analítica. Considere una distancia de Cook mayor que 1,00 como un umbral de referencia de influencia severa, y no como el único criterio de cribado.
- Examine la gráfica de residuos frente a valores predichos para detectar no linealidad, varianza desigual y agrupaciones inusuales.
- Revise la gráfica cuantil-cuantil (Q-Q) de los residuos y el resultado de la prueba de normalidad de los residuos. Registre si la evaluación de normalidad respalda el uso del modelo lineal para el análisis descriptivo de asociación.
- Registre el estadístico de Durbin-Watson y determine si la independencia de los residuos es aceptable.
- Revise todos los casos marcados en comparación con el registro de cribado, el registro de verificación de puntuaciones y los criterios de elegibilidad.
- Mantenga los casos marcados cuando representen observaciones válidas y no reflejen errores de entrada de datos, errores de puntuación, envíos duplicados, violaciones de elegibilidad o problemas documentados de calidad de respuesta.
- Corrija o elimine un caso marcado únicamente cuando el historial de auditoría identifique un error documentado en el procedimiento, elegibilidad, codificación, puntuación o entrada de datos.
- Vuelva a ejecutar el modelo de regresión tras cualquier corrección documentada y compare los coeficientes, los intervalos de confianza, R2, R2 ajustado y los resultados diagnósticos con el modelo original.
- Realice una verificación de sensibilidad a la influencia ajustando nuevamente el modelo tras excluir los casos con distancia de Cook mayor que 4/n. Informe si cambia la interpretación sustantiva.
- Registre la decisión diagnóstica final en el registro de análisis, incluyendo el número de casos marcados por residuos estandarizados, el número marcado por distancia de Cook mayor que 4/n, la distancia máxima de Cook, el estadístico de Durbin-Watson y la conclusión de las comprobaciones de normalidad y linealidad.
NOTA: No elimine casos influyentes únicamente para mejorar el ajuste del modelo. La eliminación o corrección debe basarse en una justificación documentada en el historial de auditoría.
Resultados
Conjunto de datos analíticos generado tras el cribado de respuestas
El flujo de trabajo de cribado de respuestas generó un conjunto de datos analíticos compuesto por 420 registros anónimos de estudiantes procedentes de 448 cuestionarios enviados. El registro de cribado documentó cada punto de decisión. Se eliminaron seis registros porque no se cumplieron los requisitos de consentimiento o elegibilidad, se descartaron cinco envíos duplicados, se excluyeron cuatro registros por tener más del 20 % de los ítems de las escalas sin responder y se excluyeron 13 registros por cumplir dos o más indicadores de calidad de respuesta. Diecinueve respuestas fueron marcadas por una duración de cumplimentación <180 s, ocho respuestas fueron marcadas por presentar respuestas en línea recta en >90 % de los ítems, y a 21 encuestados se les imputó la media dentro de la escala para 37 ítems ausentes aislados. El conjunto de datos analíticos final no contenía información directamente identificable de los participantes, ningún caso conservado superaba el umbral de exclusión por datos faltantes y todas las respuestas a los ítems conservadas se encontraban dentro de los rangos de respuesta predefinidos. El flujo de cribado se resume en Tabla 3.
La muestra retenida incluyó 275 encuestadas mujeres y 145 encuestados hombres, representando el 65,5 % y el 34,5 % del conjunto de datos analítico, respectivamente. La edad media fue de 20,1 ± 1,2 años. Los encuestados se distribuyeron en cuatro niveles académicos de pregrado, siendo los años 1 a 4 responsables del 27,1 %, 27,4 %, 25,5 % y 20,0 % de la muestra. El conjunto de datos también incluyó tres categorías institucionales y cinco categorías de especialidad académica. Ninguna celda demográfica publicada contenía menos de cinco encuestados tras la revisión de las categorías. Las características demográficas del conjunto de datos analítico se resumen en la tabla 4.
Construcción de la escala, verificación del rango y ejemplos de flujo de trabajo subóptimo
Después del codificado de los ítems y la puntuación inversa, se calcularon cinco variables a nivel de escala: emoción negativa, procrastinación académica, sentido de pertenencia escolar, pensamiento de orden superior y bienestar subjetivo. Cada puntuación permaneció dentro de su rango teórico de respuesta. Las puntuaciones de emoción negativa oscilaron entre 1,048 y 3,143 en una escala de 1 a 4. La procrastinación académica, el sentido de pertenencia escolar y el pensamiento de orden superior variaron entre 1,312 y 4,250, 2,333 y 4,444, y 2,350 y 4,850, respectivamente, en sus escalas de 1 a 5. El bienestar subjetivo osciló entre 2,000 y 5,300 en una escala de 1 a 6. La verificación de la puntuación inversa no identificó discrepancias entre las variables derivadas con puntuación inversa y la regla de puntuación fijada en el conjunto de datos analítico final. Estas comprobaciones confirmaron que el codificado de ítems, la puntuación inversa, el manejo de ítems faltantes y la agregación de puntuaciones se completaron sin errores detectables de rango.
El flujo de trabajo también generó ejemplos subóptimos de auditoría que ilustran cómo se detectan errores o resultados cuestionables antes del análisis final. Durante una ejecución de auditoría, se detectó un valor invertido incorrecto de bienestar subjetivo porque el registro de verificación de puntuación comparó el valor original, la fórmula esperada «puntuación invertida = 7 - puntuación original», el valor derivado y el rango final de la escala. Se corrigió la variable derivada, se regeneró la puntuación de bienestar subjetivo y se volvieron a ejecutar todos los resultados posteriores de estadísticas descriptivas, correlaciones, comparaciones, regresiones, diagnósticos y figuras. En otro archivo de trabajo intermedio, se identificó un valor de ítem fuera de rango durante la verificación de rango y se rastreó hasta el manejo de la hoja de cálculo, y no hasta la exportación bruta bloqueada. Se corrigió y documentó la copia de trabajo sin alterar ninguna respuesta extrema válida. También se revisó una advertencia de fiabilidad cuando un ítem mostró una correlación ítem-total corregida más baja que otros ítems de la misma escala; dado que la redacción del ítem, la dirección de la puntuación y la alineación del constructo eran correctas, se mantuvo el ítem. Se identificó una discrepancia en una visualización preliminar cuando una figura no coincidía con su tabla numérica verificada; la figura se regeneró a partir de la tabla verificada y se actualizó el registro de origen de la figura. Estos ejemplos demuestran que el flujo de trabajo no solo genera resultados exitosos, sino que también detecta errores de codificación, problemas de rango, advertencias de fiabilidad, discrepancias entre figuras y sus fuentes, y cuestiones relacionadas con la calidad de las respuestas mediante el historial de auditoría.
Propiedades descriptivas y consistencia interna
Las cinco variables a nivel de escala mostraron variación utilizable. La puntuación media de emoción negativa fue de 2,099 ± 0,391, y la puntuación media de procrastinación académica fue de 2,639 ± 0,484. La pertenencia escolar y el pensamiento de orden superior presentaron valores medios moderadamente altos, de 3,343 ± 0,390 y 3,627 ± 0,418, respectivamente. La puntuación media de bienestar subjetivo fue de 3,784 ± 0,543. Ninguna escala mostró un patrón evidente de piso o techo, y la proporción de encuestados en el mínimo o máximo teórico fue inferior al 2,0% en cada escala.
La consistencia interna fue aceptable para las cinco escalas. Los valores del alfa de Cronbach oscilaron entre 0,834 y 0,899, superando el umbral predeterminado de 0,70. La emoción negativa mostró la mayor consistencia interna, con un alfa de Cronbach de 0,899, seguida del bienestar subjetivo con 0,895. Los valores de omega de McDonald variaron entre 0,842 y 0,906, y las estimaciones de omega no modificaron la interpretación de la fiabilidad. La revisión de las correlaciones ítem-total corregidas no identificó ningún ítem que requiriera eliminación. Las estadísticas descriptivas y las estimaciones de fiabilidad se presentan en Tabla 5.
Estructura de correlación entre variables a nivel de escala
La matriz de correlación se utilizó como una medida descriptiva de asociación y como verificación de la dirección de la puntuación. Antes de calcular las correlaciones de Pearson, se examinaron las distribuciones de las escalas y los diagramas de dispersión bivariados. Ninguna variable mostró asimetría o curtosis severas, y ningún gráfico bivariado mostró un patrón no lineal fuerte que invalidara el análisis descriptivo de la correlación de Pearson. El bienestar subjetivo se correlacionó negativamente con la emoción negativa (r = -0.496) y la procrastinación académica (r = -0.294), y positivamente con la pertenencia escolar (r = 0.481) y el pensamiento de orden superior (r = 0.386). Las asociaciones restantes siguieron la misma lógica de puntuación: la emoción negativa se asoció positivamente con la procrastinación académica (r = 0.270) y negativamente con la pertenencia escolar (r = -0.346) y el pensamiento de orden superior (r = -0.205); la procrastinación académica se asoció negativamente con la pertenencia escolar (r = -0.222) y el pensamiento de orden superior (r = -0.134); y la pertenencia escolar se asoció positivamente con el pensamiento de orden superior (r = 0.310). La matriz completa de correlación de Pearson se presenta en Tabla 6.
Una verificación de sensibilidad de Spearman produjo la misma interpretación direccional para todos los pares de variables. Las correlaciones de Spearman entre el bienestar subjetivo y los cuatro predictores fueron ρ = -0,502 para la emoción negativa, ρ = -0,301 para la procrastinación académica, ρ = 0,477 para la pertenencia escolar y ρ = 0,392 para el pensamiento de orden superior. Se utilizó la matriz de Pearson verificada como tabla fuente numérica para la visualización. Figura 2A presenta el mapa de calor completo de las correlaciones entre las cinco variables a nivel de escala. Figura 2B muestra las cuatro correlaciones con el bienestar subjetivo.
Demostración contrastiva utilizando grupos con bienestar subjetivo alto y bajo
La regla del 27 % se utilizó como una demostración metodológica contrastiva y no como una clasificación sustantiva de perfiles reales de bienestar. Esta regla generó dos grupos de tamaño igual: 113 encuestados en el grupo de alto bienestar subjetivo y 113 en el grupo de bajo bienestar subjetivo. Los 194 encuestados intermedios se mantuvieron en el conjunto de datos analítico completo, pero se excluyeron de esta comparación contrastiva. Ningún empate en los límites alteró la asignación a los grupos.
Este módulo mostró que el flujo de trabajo podía generar una variable de agrupamiento preespecificada, filtrar el conjunto de datos analítico, calcular estadísticas descriptivas específicas de cada grupo, realizar comparaciones entre grupos adecuadas según los supuestos estadísticos y exportar una tabla fuente verificada para su visualización. El grupo con alta bienestar subjetivo mostró menor emoción negativa que el grupo con bajo bienestar subjetivo (1,864 ± 0,358 frente a 2,335 ± 0,343; diferencia media = -0,472) y menor procrastinación académica (2,455 ± 0,476 frente a 2,801 ± 0,483; diferencia media = -0,346). La pertenencia escolar y el pensamiento de orden superior fueron mayores en el grupo con alto bienestar subjetivo, con diferencias medias de 0,454 y 0,351, respectivamente. Las cuatro comparaciones fueron significativas (p < 0,001), con valores de d de Cohen de -1,346 para emoción negativa, -0,722 para procrastinación académica, 1,279 para pertenencia escolar y 0,860 para pensamiento de orden superior. Se utilizó la prueba t de Welch cuando no se cumplió el supuesto de igualdad de varianzas; de lo contrario, se mantuvo la prueba t estándar para muestras independientes. Estos resultados no deben interpretarse como evidencia de que los predictores seleccionados definen perfiles reales de bienestar estudiantil en el mundo real, ya que los grupos se crearon a partir de la variable resultado y luego se compararon en variables correlacionadas. La comparación entre los grupos alto y bajo se resume en Tabla 7.
Comparación descriptiva por sexo
El sexo se examinó como una variable descriptiva de agrupamiento. Los participantes femeninos presentaron una puntuación media ligeramente mayor en emoción negativa que los participantes masculinos (2,129 ± 0,380 frente a 2,042 ± 0,407). Esta diferencia fue estadísticamente significativa, pero pequeña en magnitud (p = 0,033; d de Cohen d = 0,224). La procrastinación académica, la pertenencia escolar, el pensamiento de orden superior y el bienestar subjetivo no mostraron diferencias significativas según el sexo. Las medias de bienestar subjetivo fueron casi idénticas entre las respuestas de mujeres y hombres (3,781 ± 0,521 frente a 3,789 ± 0,583; p = 0,887; d de Cohen d = -0,015). La prueba de Welch tlas comprobaciones de sensibilidad de la prueba no alteraron la interpretación de los resultados de comparación por sexo. Los resultados de las diferencias por sexo se presentan en Tabla 8.
Modelo de regresión como ejemplo de generación de modelos y verificación diagnóstica
Se utilizó el modelo de regresión lineal múltiple como ejemplo para generar, diagnosticar y verificar un modelo a partir de datos de cuestionarios puntuados. El bienestar subjetivo se introdujo como variable dependiente, mientras que la emoción negativa, la procrastinación académica, la pertenencia escolar y el pensamiento de orden superior se introdujeron simultáneamente como predictores a nivel de escala. El objetivo de este módulo fue demostrar la extracción de coeficientes, las comprobaciones de multicolinealidad, el diagnóstico de residuos, la evaluación de influencia, el análisis de sensibilidad ajustado por variables demográficas, y la preparación de figuras y código fuente.
El modelo explicó una proporción moderada de la varianza en el bienestar subjetivo, con R2 = 0.411 y R2 ajustado = 0.406. La emoción negativa mostró el coeficiente estandarizado más bajo (B = -0.450, β estandarizado = -0.324). La procrastinación académica también mostró un coeficiente negativo (B = -0.130, β estandarizado = -0.116). La pertenencia escolar y el pensamiento de orden superior mostraron coeficientes estandarizados positivos de β = 0.275 y β = 0.218, respectivamente. Los cuatro predictores fueron estadísticamente significativos en el modelo ajustado: emoción negativa, pertenencia escolar y pensamiento de orden superior con p < 0.001, y procrastinación académica con p = 0.004. No se indicó multicolinealidad, ya que todos los valores del factor de inflación de la varianza fueron inferiores a 1.24. Estas salidas de regresión son resultados representativos de verificación del modelo, no una explicación psicológica definitiva del bienestar estudiantil. Tabla 9 proporciona la salida completa de regresión.
Se estimó un modelo suplementario ajustado por variables demográficas mediante la adición de sexo, edad, nivel académico, categoría de institución y categoría de especialidad académica a los cuatro predictores psicológicos. El modelo ajustado explicó una proporción similar de varianza, con R2 = 0.427 y R2 ajustado = 0.414. La dirección y la interpretación estadística de los cuatro predictores psicológicos permanecieron sin cambios tras el ajuste demográfico. El modelo de sensibilidad ajustado por variables demográficas se resume en la Tabla 10. La Figura 3A muestra los coeficientes estandarizados y los intervalos de confianza del 95 % para los cuatro predictores. La Figura 3B presenta la representación diagnóstica basada en los valores predichos estandarizados, los residuos estandarizados y la distancia de Cook.
Diagnósticos de regresión y retención del modelo
Los diagnósticos de regresión no indicaron que el modelo ajustado estuviera determinado por un único registro influyente. Los gráficos bivariados y de regresión parcial no mostraron no linealidad marcada. El gráfico de residuos frente a valores predichos no reveló heterocedasticidad grave ni agrupamiento inusual. El estadístico de Durbin-Watson fue de 1.93, lo que respalda una independencia aceptable de los residuos. El gráfico Q-Q de los residuos no mostró desviaciones graves respecto a la normalidad. Una prueba formal de normalidad de los residuos resultó estadísticamente significativa, W = 0.992, p = 0.031, pero el gráfico Q-Q y el tamaño de la muestra apoyaron la retención del modelo lineal para el análisis descriptivo de asociación.
Dos registros presentaron residuos estandarizados absolutos mayores que 3,00. Ningún registro tuvo una distancia de Cook mayor que 1,00. Utilizando el umbral más sensible de la distancia de Cook >4/n, donde n = 420 y 4/n = 0,0095, se identificaron 17 registros como potencialmente influyentes. La mayor distancia de Cook fue 0,037. Los casos con residuos e influencia marcados fueron revisados en comparación con el registro de cribado, el registro de verificación de puntuaciones y los criterios de elegibilidad. Ninguno mostró evidencia de errores en la entrada de datos, puntuaciones incorrectas, respuestas duplicadas, incumplimiento de los criterios de elegibilidad ni problemas documentados de calidad de respuestas; por lo tanto, estos casos se mantuvieron en el modelo final. Una verificación de sensibilidad a la influencia, excluyendo los casos con distancia de Cook >4/n, produjo la misma interpretación del flujo de trabajo que el modelo principal. El cambio absoluto máximo en los coeficientes estandarizados fue de 0,026, y el ajustado R2 cambió de 0,406 a 0,405. Los resultados diagnósticos y de sensibilidad se resumen en Tabla 11.
Verificación interna del flujo de trabajo analítico
El flujo de trabajo se repitió a partir del conjunto de datos analíticos limpio y puntuado, utilizando las mismas reglas de puntuación, umbrales de decisión y archivo de trazado del análisis. Se repitieron el análisis de consistencia interna, estadísticas descriptivas, análisis de correlación, comparaciones entre grupos alto-bajo, comparaciones por sexo, modelado de regresión, verificación diagnóstica y preparación de las fuentes para la visualización. Las salidas repetidas coincidieron con las estadísticas descriptivas originales, la matriz de correlación, los valores de comparación entre grupos, los coeficientes de regresión, los resultados diagnósticos y los archivos fuente para visualización. Esto confirmó la estabilidad computacional del flujo de trabajo analítico cuando se aplicó al mismo conjunto de datos analíticos bloqueado. Esta verificación no constituye una reproducibilidad procedural independiente, la cual requeriría que un analista independiente aplicara todo el flujo de trabajo a partir de la exportación bruta bloqueada y obtuviera las mismas salidas documentadas.
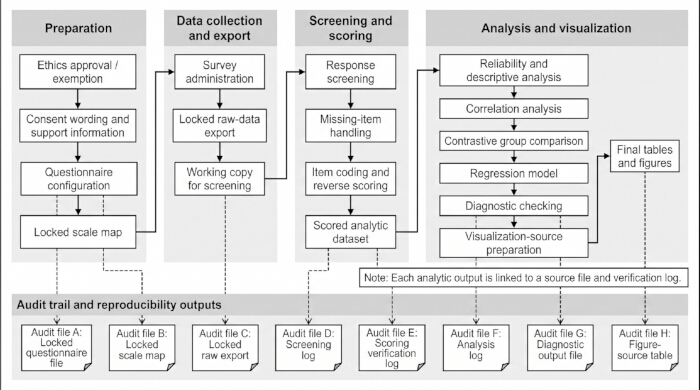
Figura 1: Flujo de trabajo para el procesamiento de datos subjetivos sobre bienestar basados en cuestionarios. El esquema muestra la secuencia del protocolo y los principales productos de auditoría, incluyendo la preparación ética, la configuración del cuestionario, la administración de la encuesta, la exportación de datos brutos, el mapa de escalas, el registro de cribado, el conjunto de datos analíticos puntuados, las tablas de análisis verificadas, los diagnósticos de regresión, los archivos fuente de figuras y las salidas de visualización. Haga clic aquí para ver una versión más grande de esta figura.
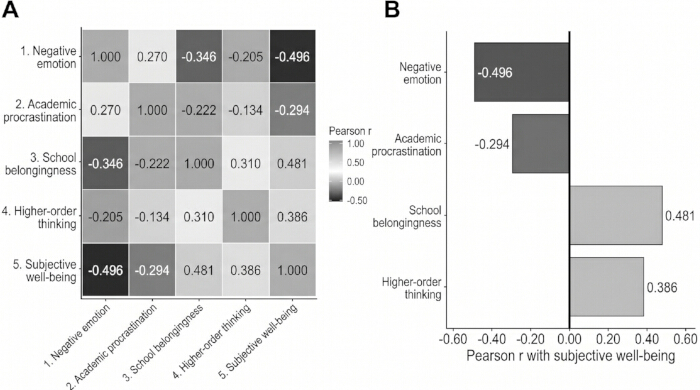
Figura 2: Estructura de correlación entre las variables a nivel de escala. (A) Mapa de calor de correlación de Pearson generado a partir de la matriz de correlación verificada en la Tabla 6. (B) Perfil de correlación centrado en el bienestar subjetivo, generado a partir de la misma tabla fuente verificada. Se muestran las cinco variables a nivel de escala: emoción negativa, procrastinación académica, pertenencia escolar, pensamiento de orden superior y bienestar subjetivo. Haga clic aquí para ver una versión más grande de esta figura.
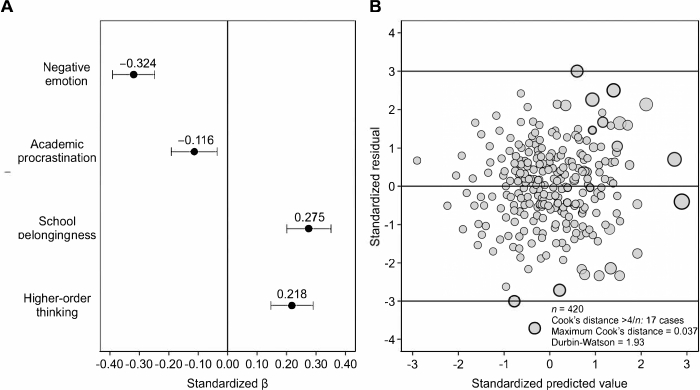
Figura 3: Visualización de coeficientes de regresión y diagnósticos. (A) Coeficientes de regresión estandarizados e intervalos de confianza del 95 % generados a partir del resultado principal de regresión en Tabla 9. (B) Representación gráfica del diagnóstico de regresión generada a partir de los valores predichos estandarizados, los residuos estandarizados y los valores de la distancia de Cook resumidos en Tabla 11. Valores mayores de la distancia de Cook indican observaciones con mayor influencia potencial sobre el modelo ajustado. Haga clic aquí para ver una versión más grande de esta figura.
Tabla 1: Estructura del cuestionario y marco de puntuación de la escala. Esta tabla resume el marco de medición, que incluye el nombre del constructo, el instrumento de origen, la cita de origen, el estado de adaptación o documentación, el número de ítems, el rango de respuestas, la dirección de la puntuación, el requisito de inversión de puntuación, el método de puntuación, la variable final a nivel de escala y el rol en el protocolo. Haga clic aquí para descargar esta tabla.
Tabla 2: Criterios de cribado de respuestas y decisiones analíticas. Esta tabla enumera los criterios preespecificados para el cribado del consentimiento, el cribado de elegibilidad, la revisión de respuestas duplicadas, el manejo de datos faltantes, la detección de duración de respuesta sospechosa, la identificación de respuestas en línea recta, los rangos válidos de respuestas, la evaluación de fiabilidad, la clasificación en grupos alto-bajo, los diagnósticos de regresión y las comprobaciones de sensibilidad. Haga clic aquí para descargar esta tabla.
Tabla 3: Flujo de cribado desde los cuestionarios enviados hasta el conjunto de datos analítico final. Esta tabla informa el número de cuestionarios enviados, registros marcados, registros eliminados, registros conservados y fuentes de verificación en cada paso del cribado. La duración de la finalización y las respuestas en línea recta se consideraron indicadores de calidad de respuesta en lugar de criterios de exclusión automáticos. Haga clic aquí para descargar esta tabla.
Tabla 4: Características demográficas del conjunto de datos analítico. Esta tabla resume los registros estudiantiles anonimizados conservados tras el cribado de respuestas, incluyendo sexo, edad, año de pregrado, categoría de la institución y categoría de la especialidad académica. Las celdas demográficas fueron revisadas para evaluar el riesgo de identificación indirecta antes de su presentación. Haga clic aquí para descargar esta tabla.
Tabla 5: Estadísticas descriptivas, verificación de rango y consistencia interna de las cinco variables a nivel de escala. Esta tabla presenta el número de ítem, rango teórico, rango observado, media, desviación estándar, alfa de Cronbach, omega de McDonald y concentración en extremos inferior y superior para las variables emoción negativa, procrastinación académica, pertenencia escolar, pensamiento de orden superior y bienestar subjetivo. Haga clic aquí para descargar esta tabla.
Tabla 6: Matriz de correlación de Pearson de variables a nivel de escala. Esta tabla presenta los coeficientes de correlación de Pearson entre emoción negativa, procrastinación académica, pertenencia escolar, pensamiento de orden superior y bienestar subjetivo. La matriz se utilizó como resultado descriptivo de asociaciones y como paso de verificación de la dirección de los puntajes. Haga clic aquí para descargar esta tabla.
Tabla 7: Comparación contrastiva entre grupos con bienestar subjetivo alto y bajo. Esta tabla compara la emoción negativa, la procrastinación académica, la pertenencia escolar y el pensamiento de orden superior entre los encuestados que se encuentran en el 27% superior y en el 27% inferior de las puntuaciones de bienestar subjetivo. La comparación muestra el flujo de trabajo de agrupamiento y comparación, más que una clasificación sustantiva de perfiles de bienestar. Haga clic aquí para descargar esta tabla.
Tabla 8: Comparación descriptiva por sexo. Esta tabla presenta comparaciones descriptivas de la emoción negativa, la procrastinación académica, la pertenencia escolar, el pensamiento de orden superior y el bienestar subjetivo según el sexo. El sexo se trató como una variable descriptiva de agrupamiento. Haga clic aquí para descargar esta tabla.
Tabla 9: Modelo principal de regresión lineal múltiple que predice el bienestar subjetivo. Esta tabla presenta el modelo de regresión principal en el que el bienestar subjetivo fue la variable dependiente, y las emociones negativas, la procrastinación académica, la pertenencia escolar y el pensamiento de orden superior se introdujeron simultáneamente como predictores a nivel de escala. Se incluyen los valores de error estándar, intervalo de confianza y factor de inflación de la varianza. Haga clic aquí para descargar esta tabla.
Tabla 10: Modelo de sensibilidad de regresión ajustado por variables demográficas que predice el bienestar subjetivo. Esta tabla muestra los cuatro predictores psicológicos tras el ajuste por sexo, edad, año de estudios de pregrado, categoría de la institución y categoría de la especialidad académica. Las variables demográficas categóricas se introdujeron utilizando codificación dummy. Se incluyen los valores de error estándar, intervalo de confianza y factor de inflación de la varianza. Haga clic aquí para descargar esta tabla.
Tabla 11: Diagnósticos de regresión y comprobaciones de sensibilidad de influencia. Esta tabla resume los resultados de los diagnósticos del modelo, los residuos y la influencia, incluyendo residuos estandarizados, distancia de Cook > 1,00, distancia de Cook > 4/n, distancia máxima de Cook, estadístico de Durbin-Watson, gráfico cuantil-cuantil (Q-Q) de los residuos, prueba de normalidad de los residuos, gráfico de residuos frente a valores predichos, comprobación de linealidad y análisis de sensibilidad de influencia. Haga clic aquí para descargar esta tabla.
Archivo suplementario 1: Estructura del cuestionario, procedencia de la escala y documentación de puntuación. Este archivo suplementario proporciona el orden de administración del cuestionario, el texto del consentimiento informado, las variables demográficas, la documentación del instrumento de origen, los códigos de los ítems, los puntos de anclaje de las respuestas, la información sobre adaptación y estado de documentación, la dirección de puntuación, las reglas de inversión de puntuación, la construcción final de las variables a nivel de escala, las reglas para el manejo de ítems faltantes, los campos de vinculación de calidad de respuesta, las reglas de verificación de rango y los vínculos de referencia para los cinco constructos del cuestionario. Funciona como suplemento del cuestionario/libro de códigos para documentar la programación, puntuación y verificación de las escalas en el flujo de trabajo. Haga clic aquí para descargar este archivo.
Discusión
Este protocolo estandariza un proceso común pero a menudo poco reportado en estudios de bienestar basados en cuestionarios: el paso de los registros brutos de respuestas a datos filtrados, variables de escala puntuadas, resultados estadísticos y archivos listos para su visualización. Su contribución no consiste en desarrollar una nueva teoría del bienestar subjetivo ni en proponer un modelo causal. Por el contrario, el flujo de trabajo proporciona una ruta verificable para la configuración del cuestionario, el filtrado de respuestas, la puntuación de escalas, la comprobación de fiabilidad, el análisis descriptivo, el análisis de asociaciones, los diagnósticos de regresión y la verificación de las fuentes de las figuras. Esta distinción es importante porque la verificabilidad en la investigación basada en cuestionarios depende de decisiones procedimentales que a menudo se toman antes de comenzar la interpretación estadística, incluyendo qué registros se conservan, cómo se manejan los ítems faltantes, cómo se procesan los ítems invertidos y cómo se vinculan las tablas numéricas fuente con las salidas visuales. Hacer explícitas estas decisiones reduce las prácticas cuestionables de medición en la investigación basada en escalas23 y favorece una cultura investigadora más transparente24.
Una característica central del protocolo es el uso de artefactos concretos de auditoría en lugar de descripciones verbales exclusivamente. El flujo de trabajo revisado vincula cada constructo con su instrumento fuente, rango de ítems, puntos de anclaje de respuesta, dirección de puntuación, regla de inversión de puntuación, variable final a nivel de escala, y la información sobre adaptación o estado de documentación. La trazabilidad incluye el archivo bloqueado del cuestionario, el mapa de escalas bloqueado, la exportación cruda bloqueada, el registro de cribado, el registro de verificación de puntuación, el registro de análisis, el archivo de resultados diagnósticos y la tabla de fuentes de figuras. Estos archivos aclaran qué versión del cuestionario se aplicó, qué registros se excluyeron o conservaron, cómo se generaron las puntuaciones y qué tabla verificada se utilizó para crear cada figura. Cuando no sea posible compartir públicamente los datos a nivel de participante, un conjunto de datos sintético con la misma estructura de variables y registros completos de cribado y puntuación puede permitir a los lectores probar el flujo de trabajo computacional sin acceder a registros identificables o indirectamente identificables. Esta estructura basada en artefactos es coherente con el principio FAIR de que las salidas de investigación reutilizables requieren una procedencia, estructura y condiciones de acceso claras25.
Los resultados representativos deben interpretarse como productos del flujo de trabajo, no como evidencia sustantiva sobre los determinantes psicológicos del bienestar estudiantil. La comparación entre alto y bajo bienestar subjetivo se incluyó para demostrar cómo puede implementarse, verificarse y reportarse una regla de agrupamiento preespecificada; no debe interpretarse como una clasificación realista de perfiles de bienestar. De forma similar, el modelo de regresión muestra cómo pueden modelarse datos puntuados de cuestionarios, evaluarse la multicolinealidad, analizarse mediante diagnósticos de residuos e influencia, y vincularse a una tabla verificada de fuentes de figuras. Sin embargo, esto no establece que la emoción negativa, la procrastinación académica, la pertenencia escolar o el pensamiento de orden superior determinen causalmente el bienestar subjetivo. Dado que todas las variables principales se recopilaron mediante el mismo cuestionario de autorreporte en un único momento, no pueden descartarse el sesgo del método común, los efectos del estilo de respuesta ni el contexto compartido de medición26.
Este flujo de trabajo tampoco sustituye la validación psicométrica completa. El alfa de Cronbach, omega de McDonald, verificaciones del rango observado, revisión ítem-total y verificación de puntuación inversa son pasos útiles de control de calidad para un flujo de trabajo de puntuación auditado, pero no establecen validez factorial, invariancia de medición, propiedades de respuesta de los ítems ni comparabilidad entre grupos. Los estudios que utilicen el cuestionario para pruebas sustantivas de teorías deberían realizar análisis factorial confirmatorio, pruebas de invariancia de medición entre grupos demográficos o institucionales relevantes, y controles adicionales de validez cuando sea apropiado27. Por lo tanto, el presente protocolo debe entenderse como un marco auditado para el procesamiento y reporte de datos, no como un estudio de validación completo para los constructos incluidos.
El flujo de trabajo se demostró en una muestra de un estudiante universitario, utilizando datos de cuestionarios autorreportados recopilados en un único momento, sin validación externa. No se debe asumir su portabilidad a otras poblaciones, disciplinas, instituciones, idiomas y contextos culturales. Si se reutiliza el flujo de trabajo en otro contexto, se debe reconstruir el mapa de la escala en lugar de copiarlo mecánicamente. Los investigadores deben revisar el origen de los ítems, el estado de traducción o adaptación, la dependencia cultural y contextual de los ítems de bienestar, los anclajes de respuesta, las reglas de puntuación inversa, la interpretación de las puntuaciones y los requisitos éticos locales. Los procedimientos de traducción y adaptación requieren documentación explícita en lugar de cambios informales en la redacción28, y la interpretación de las puntuaciones de pruebas educativas y psicológicas debe permanecer vinculada a la evidencia respecto al uso y población previstos29.
En la práctica, el protocolo es más útil como un marco auditado para el procesamiento y reporte de datos en investigaciones sobre bienestar basadas en cuestionarios. Ayuda a los investigadores a hacer visibles las decisiones sobre limpieza, puntuación, diagnósticos y visualización antes de que comience la interpretación. Las aplicaciones futuras deberían probar el flujo de trabajo en muestras independientes, diferentes entornos institucionales, diseños longitudinales y equipos de analistas replicados de forma independiente. La validación externa, las reglas de decisión preregistradas, los conjuntos de datos sintéticos compartidos, los registros de cribado/puntuación de ejemplo completados y la replicación por analistas independientes fortalecerían aún más la portabilidad y credibilidad del flujo de trabajo.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Agradecimientos
Los autores agradecen a los estudiantes universitarios que participaron en la encuesta por su apoyo durante la recolección de datos. Los autores también agradecen a los instructores pertinentes y a los asistentes de investigación por su ayuda en la distribución de los cuestionarios, la organización de los datos, la verificación de los resultados y la elaboración de tablas y figuras. Este trabajo no recibió financiamiento específico.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| paquete R broom | CRAN | paquete R | Utilizado para convertir salidas de regresión en tablas estructuradas de coeficientes y resúmenes del modelo. |
| paquete R car | CRAN | paquete R | Utilizado para la verificación del factor de inflación de la varianza y el apoyo al diagnóstico de regresión. |
| documentación original de las Escalas de Depresión, Ansiedad y Estrés-21 | Fundación de Psicología de Australia | Lovibond y Lovibond, 1995 | Documentación original para la sección de emociones negativas. El flujo de trabajo utilizó redacción adaptada al estudio, alineada con evaluaciones recientes del estado emocional negativo. |
| paquete R dplyr | CRAN | paquete R | Utilizado para filtrado de datos, recodificación, agrupación, resúmenes del flujo de cribado y preparación de tablas analíticas. |
| paquete R ggplot2 | CRAN | paquete R | Utilizado para generar el mapa de calor de correlación, el gráfico de correlación del bienestar subjetivo, el gráfico de coeficientes de regresión y la visualización diagnóstica. |
| documentación original para la medición del pensamiento de orden superior | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Documentación original para la sección de pensamiento de orden superior. El flujo de trabajo utilizó un conjunto de ítems adaptado al estudio, alineado con el pensamiento analítico, evaluativo, reflexivo, integrador y basado en evidencia. |
| IBM SPSS Statistics | IBM Corp. | Versión 29.0.2.0 | Utilizado para estadísticas descriptivas, alfa de Cronbach’s, correlación de Pearson, pruebas t para muestras independientes y de Welch’s, regresión lineal múltiple, estadístico de Durbin-Watson, residuos estandarizados, valores de apalancamiento, distancia de Cook’s y factores de inflación de la varianza. |
| paquete R psych | CRAN | paquete R | Utilizado para resúmenes psicométricos, verificación del alfa de Cronbach’s y omega de McDonald’s. |
| documentación original de la Escala de Sentido Psicológico de Pertenencia Escolar | Wiley | Psychol Sch. 1993;30(1):79-90 | Documentación original para la sección de pertenencia escolar. El flujo de trabajo utilizó redacción adaptada al estudio, alineada con la aceptación percibida, conexión, apoyo y sentido de pertenencia en el entorno escolar. |
| entorno estadístico R | Fundación R para la Computación Estadística | Versión 4.4.2 | Utilizado para verificación analítica secundaria, omega de McDonald’s, comprobaciones de sensibilidad de Spearman, preparación de salidas de regresión, preparación de salidas diagnósticas y preparación de visualizaciones. |
| paquete R readxl | CRAN | paquete R | Utilizado para importar exportaciones de cuestionarios en hojas de cálculo al flujo de trabajo de verificación en R. |
| documentación original de la Escala de Bienestar Subjetivo para Ciudadanos Chinos | Scientific & Academic Publishing | DOI: 10.5923/j.ijap.20190905.01 | Documentación original para la sección de bienestar subjetivo. El flujo de trabajo utilizó redacción adaptada al estudio e ítems con puntuación inversa, alineados con satisfacción vital, sentido, apoyo, progreso, insatisfacción, desamparo y experiencias de bienestar relacionadas con el estrés. |
| Archivo Suplementario 1: Estructura del cuestionario y documentación de escalas | Autores | Archivo Suplementario 1 | Proporciona la estructura del cuestionario aplicado, orden de los constructos, procedencia de las escalas, códigos de los ítems, anclas de respuesta, dirección de puntuación, reglas de puntuación inversa, construcción de puntuaciones a nivel de escala e información sobre el estado de la documentación. |
| documentación original de la Escala de Procrastinación de Tuckman | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Documentación original para la sección de procrastinación académica. El flujo de trabajo utilizó redacción adaptada al estudio, alineada con el retraso académico y el comportamiento de posposición de tareas. |
| plataforma en línea de cuestionarios Wenjuanxing | Changsha Ranxing Information Technology Co., Ltd. | plataforma basada en web | Utilizada para el consentimiento electrónico, programación del cuestionario, recolección de respuestas a ítems, captura de marcas de tiempo, registro de la duración de la finalización, revisión de envíos duplicados y exportación de respuestas en bruto. |
Referencias
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.