Este estudio presenta un marco de colaboración ciberfísica para la Industria 5.0 habilitado por inteligencia artificial interpretable, que utiliza una red neuronal convolucional-transformer y SHAP para la detección acústica de anomalías industriales en el conjunto de datos MIMII. La integración de computación en el borde (edge-computing) respalda un mantenimiento predictivo interpretable y centrado en el ser humano.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Colaboración ciberfísica apoyada por IA explicable para la fabricación sostenible en la Industria 5.0
En este artículo
Resumen
Resumen
En este estudio, presentamos un enfoque innovador para la fabricación sostenible de piezas industriales mediante un sistema de colaboración ciberfísica basado en inteligencia artificial explicable (XAI) para la Industria 5.0. Se ha encontrado que los sistemas ciberfísicos humanos (CPHS) actuales integran la inteligencia artificial solo en cierta medida y, a menudo, carecen de explicabilidad. En consecuencia, existe la necesidad de mejorar su escalabilidad y flexibilidad, en línea con los principios de la Industria 5.0: resiliencia, viabilidad a largo plazo y enfoque centrado en el ser humano. Para abordar estas limitaciones, introducimos una arquitectura que integra el aprendizaje profundo y la inteligencia artificial explicable en el ecosistema del sistema ciberfísico (CPS) para permitir una toma de decisiones inteligente y explicable. Específicamente, utilizamos el conjunto de datos Malfunctioning Industrial Machine Investigation and Inspection (MIMII) para la detección de fallas en máquinas a partir de señales acústicas. Las señales de audio se someten a una transformación espectral para generar imágenes espectrograma, que luego son procesadas por una red neuronal convolucional (CNN) para la extracción de características espaciales y por un codificador transformador para las características temporales. Para mejorar la transparencia y facilitar la cooperación con el ser humano en el bucle, el enfoque basado en explicaciones aditivas de Shapley (SHAP) ayuda a los operadores a comprender el proceso de toma de decisiones del sistema resaltando las características de entrada que influyen en las predicciones del modelo. Además, el marco se aplica en un sistema ciberfísico basado en computación en el borde (edge computing) para lograr baja latencia y bajo consumo de energía, a la vez que proporciona respuestas oportunas, contribuyendo así a garantizar un entorno de producción sostenible. Los resultados experimentales muestran que la arquitectura propuesta CNN-Transformador alcanza una precisión del 98,5 % y supera a los sistemas CPHS existentes manteniendo baja latencia. El uso de inteligencia artificial explicable en este tipo de sistema de colaboración ciberfísica aumenta considerablemente la confianza del operador y posibilita una colaboración fluida entre humanos y máquinas.
Introducción
La transición desde la Industria 4.0, que enfatizaba la tecnología, la mecanización y la comunicación, hacia el nuevo modelo de Industria 5.0, que combina el avance tecnológico con la adaptabilidad, el desarrollo sostenible y el enfoque centrado en el ser humano, ha influido en la evolución dinámica de los sistemas industriales.1,2. La Comisión Europea define la Industria 5.0 como un paradigma centrado no solo en la productividad y la eficiencia, sino también en tres pilares: la orientación al ser humano, la sostenibilidad y la resiliencia. Es importante señalar que investigaciones recientes han destacado el papel de los sistemas de inteligencia artificial, la cooperación humano-máquina y la fabricación sostenible como los principales impulsores de los entornos de la Industria 5.03,4. Los métodos tradicionales de mantenimiento ya no son suficientes en este entorno industrial en evolución. Para posibilitar la resiliencia en contextos complejos e inestables, el mantenimiento debe evolucionar hacia una forma más adaptable y sistémica5Desde 2011, la Industria 4.0 ha sido el modelo dominante para la transformación industrial en Europa, fomentando la transformación digital de las empresas para mejorar sus operaciones y maximizar los recursos disponibles.4. Por lo tanto, es imperativo aumentar la eficiencia sin eliminar la mano de obra humana en la producción, al mismo tiempo que se protege la salud y la seguridad de los trabajadores. Debido a esto, las empresas y los académicos han comenzado a definir los principios del paradigma de la Industria 5.05,6,7, en parte motivado por la noción japonesa de Sociedad 5.08,9,10,11. A pesar del mayor énfasis reciente en el mantenimiento sostenible en la literatura, la mayoría de las evaluaciones sistemáticas existentes siguen siendo fragmentadas o específicas de un dominio, y carecen de un marco integral que integre resiliencia, sostenibilidad e inteligencia artificial. Por ejemplo, los autores examinan prácticas de mantenimiento sostenible para sistemas o estrategias específicas, incluyendo el mantenimiento productivo total sostenible (STPM), mientras que otros investigadores hablan de incorporar temas de sostenibilidad en las técnicas de mantenimiento12,13,14. Autor realizó una evaluación exhaustiva de los criterios de adopción de la sostenibilidad y destacó los factores tecnológicos que permiten a la fabricación tener un impacto sostenible positivo15. Sin embargo, dentro del paradigma de la Industria 5.0, la sostenibilidad, la resiliencia y la toma de decisiones basada en inteligencia artificial no están plenamente integradas en ninguno de estos trabajos. Como resultado, los métodos de mantenimiento suelen abordar la sostenibilidad de forma separada. SHAP destaca entre otras técnicas de inteligencia artificial explicable (XAI) debido a su método teóricamente sólido de atribución de características16,17,18.
La toma de decisiones basada en datos es posibilitada por la inteligencia artificial, pero los modelos precisos a menudo requieren grandes cantidades de datos. Las técnicas convencionales de aprendizaje automático (ML), como los árboles de decisión, la regresión logística y la regresión lineal, con frecuencia tienen un rendimiento deficiente en situaciones altamente no lineales porque suponen distribuciones de datos relativamente simples19. Al aprender representaciones complejas de características a partir de grandes conjuntos de datos, las redes neuronales profundas (DNN) superan estas limitaciones20. Según estudios, las redes más profundas suelen tener un mejor desempeño que las estructuras superficiales en tareas complejas de toma de decisiones21, pero su creciente profundidad y complejidad de parámetros hacen que el modelo sea menos interpretable22.
Un sistema ciberfísico (CPS) es una tecnología habilitadora crucial para la fabricación en la Industria 5.0 porque combina inteligencia distribuida, computadoras embebidas, procesos físicos y comunicación. Para permitir operaciones industriales flexibles, inteligentes y en tiempo real, los CPS modernos están integrando rápidamente computación de borde, inteligencia artificial de borde y el Internet de las cosas verde (G-IoT)23,24. La sostenibilidad y la resiliencia han sido destacadas en estudios recientes sobre Mantenimiento 4.0 y mantenimiento inteligente. Aunque trabajos anteriores han examinado la importancia de la tecnología del Mantenimiento 4.0 en la fabricación sostenible y han propuesto marcos de modelado para el mantenimiento sostenible, estudios bibliométricos y sistemáticos han evaluado tecnologías de mantenimiento inteligente25,26,27,28. Investigaciones adicionales han analizado la integración del mantenimiento sostenible en entornos de la Industria 4.0 y sistemas de producción orientados a la sostenibilidad29,30,31,32. El concepto del Operador 4.033, los marcos centrados en el ser humano para la Industria 5.034 y las perspectivas socioeconómicas35 han recibido una atención significativa en relación con el mantenimiento centrado en el ser humano. Además, avances en mantenimiento digital36, mantenimiento predictivo y prescriptivo37,38 y estrategias de mantenimiento sostenible39,40 han sido enfatizados en estudios recientes. A pesar de estos avances, la investigación sigue dispersa, y pocos estudios ofrecen un paradigma coherente que integre inteligencia artificial explicable, sostenibilidad, resiliencia y cooperación ciberfísica centrada en el ser humano. Los sistemas ciberfísicos (CPS) no han alcanzado autonomía completa a pesar de su creciente implementación, y el paradigma de la Industria 5.0 no la favorece. Por el contrario, la Industria 5.0 pone mayor énfasis en la supervisión, cooperación y toma de decisiones humanas. Al incorporar el pensamiento y la cooperación humanos en los procesos ciberfísicos, sistemas ciber-humanos como los sistemas ciberfísicos con participación humana (HiLCPS)41, los sistemas ciberfísicos centrados en el ser humano (HCPS)42,43 y los sistemas ciberfísicos humanos (CPHS)44 amplían los CPS tradicionales. Esta integración mejora la adaptabilidad, transparencia, seguridad y resiliencia al permitir la colaboración en tiempo real entre sistemas inteligentes y operadores humanos45,46.
La detección industrial de anomalías de audio se ha visto ampliamente mejorada gracias a nuevas arquitecturas, como el Transformador de Visión (ViT), el Transformador de Espectrograma de Audio (AST), el Conformer y el aprendizaje auto-supervisado; sin embargo, su integración con sistemas ciberfísicos explicables para la Industria 5.0 sigue siendo limitada. Sin integrar explicabilidad, despliegue en el borde (edge) y apoyo a la toma de decisiones con participación humana en un único marco, la investigación actual se centra principalmente en la precisión de clasificación o en la interpretabilidad basada en XAI a posteriori. Este estudio propone una arquitectura novedosa de colaboración ciberfísica habilitada por inteligencia artificial explicable (XAI) que combina redes neuronales convolucionales y transformadores, computación en el borde, modelado de dependencias temporales, explicabilidad basada en SHAP, aprendizaje de características espaciales y apoyo a decisiones centrado en el ser humano, con el fin de posibilitar una fabricación sostenible en la Industria 5.0 y superar estas limitaciones.
Por lo tanto, persiste un déficit sustancial de investigación. Las técnicas actuales de detección acústica de anomalías basadas en CNN/Transformador favorecen el rendimiento de clasificación, pero carecen de cooperación ciberfísica y explicabilidad. Si bien los marcos de la Industria 5.0 ofrecen modelos conceptuales centrados en el ser humano que no integran el aprendizaje profundo explicable, la inteligencia periférica y la toma de decisiones asistida por operadores en un solo sistema, las técnicas de mantenimiento predictivo basadas en XAI aumentan la transparencia, pero operan de forma independiente de las arquitecturas CPHS. Por consiguiente, aún falta un único sistema ciberfísico humano de la Industria 5.0 que integre la detección precisa de anomalías auditivas, la explicabilidad basada en SHAP, la implementación habilitada en el borde y la cooperación con el ser humano en el bucle.
Este artículo propone un nuevo paradigma colaborativo ciberfísico basado en inteligencia artificial explicable que combina CNN y Transformador para la Industria 5.0, con el fin de superar estas limitaciones. La arquitectura sugerida integra en un único marco CPHS la implementación en computación de borde, la extracción de características espaciales basada en CNN, el aprendizaje de dependencias temporales basado en Transformador, la explicabilidad basada en SHAP y el apoyo a la toma de decisiones con participación humana. A diferencia de los métodos actuales, que abordan estos elementos de forma independiente, el marco propuesto ofrece una solución integrada que mejora simultáneamente el rendimiento en la detección de anomalías, la transparencia del modelo, la eficiencia operativa y la colaboración centrada en el ser humano para la fabricación sostenible.
El objetivo principal de este estudio es crear un sistema ciberfísico humano habilitado para inteligencia artificial explicable (CPHS) para la fabricación sostenible de la Industria 5.0, combinando la explicabilidad basada en SHAP, computación en el borde y soporte de decisiones con participación humana, junto con un enfoque híbrido basado en CNN-Transformer para la detección acústica de anomalías. En particular, el marco propuesto tiene como finalidad mejorar la precisión en la detección de anomalías, proporcionar predicciones claras y comprensibles, facilitar una implementación eficiente en el borde y fomentar la toma de decisiones cooperativa entre sistemas inteligentes y operadores humanos. Al lograr simultáneamente un alto rendimiento en la detección, explicabilidad, operación con baja latencia y colaboración ciberfísica centrada en el ser humano, esta arquitectura integrada aborda las limitaciones de los actuales marcos de detección acústica de anomalías, mantenimiento predictivo basado en XAI y sistemas CPHS.
La arquitectura propuesta presenta un sistema ciberfísico humano unificado habilitado para inteligencia artificial explicable (CPHS) para la Industria 5.0, en contraste con las técnicas actuales de detección de anomalías acústicas, que se centran principalmente en la precisión de clasificación. Dentro de una única arquitectura, combina la extracción de características espaciales basada en CNN, modelado temporal basado en Transformadores, explicabilidad basada en SHAP, computación en el borde y soporte de decisión con participación humana. La arquitectura sugerida aborda problemas clave de transparencia, asistencia al operador y cooperación ciberfísica mediante la fusión de detección precisa de anomalías con toma de decisiones comprensible y despliegue en tiempo real en el borde. La principal contribución científica de este trabajo es la integración a nivel de sistema, que distingue al enfoque propuesto de investigaciones previas que se centran únicamente en la detección de anomalías, la inteligencia artificial explicable o los marcos de la Industria 5.0.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
La metodología propuesta utiliza un enfoque basado en sistemas de un sistema ciberfísico humano (CPHS) de Industria 5.0 que combina aprendizaje profundo explicativo con un marco de colaboración ciberfísica habilitado por computación en el borde para apoyar procesos de fabricación sostenibles. En primer lugar, el problema se aborda reconociendo ciertas limitaciones de las soluciones actuales de CPHS, como la falta de inteligencia impulsada por IA, explicabilidad y colaboración centrada en el ser humano. Para abordar estos desafíos, la solución propuesta aprovecha el conjunto de datos MIMII para el monitoreo del estado de máquinas industriales mediante el procesamiento de señales acústicas.
El marco propuesto comienza alimentando los espectrogramas generados a un modelo de CNN que extrae características espaciales mediante el reconocimiento de patrones de frecuencia significativos asociados con diferentes condiciones de la máquina. Las características espaciales extraídas se convertirán en secuencias y se introducirán en un módulo codificador transformador para capturar dependencias temporales mediante la autoatención. La representación de características transformada se transmite posteriormente a un módulo clasificador completamente conectado para clasificar los estados de la máquina como normales o anormales. Además, para garantizar transparencia y facilitar la toma de decisiones centrada en el ser humano, se emplea el enfoque de explicabilidad SHAP para explicar las predicciones seleccionando regiones significativas en el dominio tiempo-frecuencia en la salida del modelo. El modelo diseñado se implementará en un entorno de CPS habilitado para edge computing, permitiendo inferencias en tiempo real con baja latencia computacional y bajo consumo energético. Asimismo, se integrará un esquema con participación humana para permitir que los operadores validen los resultados utilizando la explicabilidad. El rendimiento se valida mediante exactitud, precisión, exhaustividad y puntuación F1, así como otras métricas a nivel de sistema, como latencia y eficiencia energética.
El marco propuesto es un mecanismo de CPHS impulsado por XAI para la fabricación sostenible en el contexto de la Industria 5.0, y su flujo de trabajo se presenta como una canalización que va desde la adquisición de datos hasta la toma de decisiones inteligentes y la ejecución, como se muestra en la Figura 1. En la etapa inicial del procedimiento de adquisición de datos, se recopilan señales de sonido procedentes de máquinas industriales, como motores, bombas y rodamientos, utilizando conjuntos de datos como MIMII. Las señales de datos así obtenidas se envían a la siguiente etapa, denominada preprocesamiento de datos, donde se someten a filtrado, normalización y segmentación. Finalmente, las señales de datos segmentadas se convierten en un espectrograma mediante la transformada de Fourier de corta duración (STFT) en la capa de representación de características.
Luego, la capa del modelo de IA utiliza las imágenes del espectrograma para extraer características mediante el módulo CNN, identificando patrones espaciales y anomalías. A continuación, las características extraídas se reorganizan y se introducen en el codificador transformador, que aprende las dependencias temporales y las relaciones de largo alcance mediante mecanismos de autoatención. Los vectores de características resultantes se clasifican como normales o anormales utilizando la capa de clasificación. Para garantizar la transparencia en el proceso de predicción, la capa de explicabilidad utiliza SHAP para resaltar las regiones significativas en el dominio tiempo-frecuencia del espectrograma.
Además, existe un proceso con intervención humana en el que los operadores interpretan y proporcionan retroalimentación sobre los resultados del modelo. En la capa de implementación, el modelo se ejecuta en una infraestructura CPHS basada en el edge, lo que garantiza una inferencia rápida y un bajo consumo de energía, mientras que opcionalmente se puede interconectar con sistemas en la nube para requisitos de almacenamiento o análisis avanzados. En conjunto, el marco garantiza una detección precisa de fallas, explicabilidad y un funcionamiento eficiente en tiempo real, acorde con los requisitos de la Industria 5.0.
Definición del problema y análisis de requisitos
Los sistemas ciberfísicos humanos (CPHS) en entornos de Industria 5.0 prometen inteligencia, sostenibilidad y enfoque centrado en el ser humano. Sin embargo, los marcos contemporáneos para construir CPHS se ven obstaculizados por la falta de capacidades avanzadas habilitadas por inteligencia artificial, explicabilidad y un apoyo adecuado para la colaboración humano-máquina. De hecho, los CPHS convencionales se basan en modelos basados en reglas o modelos no interpretables, lo que dificulta la adaptación a condiciones industriales cambiantes y limita la confianza de los operadores en la automatización. Además, los CPHS convencionales no pueden analizar eficazmente datos altamente sofisticados, como las señales acústicas industriales que contienen componentes espaciales (es decir, frecuencia) y dependientes del tiempo, los cuales son importantes para el mantenimiento predictivo. Por lo tanto, es necesario crear un marco capaz de detectar anomalías en máquinas con alta precisión, proporcionar explicaciones y operar en el borde (edge), posibilitando así los sistemas ciberfísicos.
Aquí, x(t) es la señal acústica de entrada, S(f,t) es la representación del espectrograma de la señal,  es la etiqueta y θ es el conjunto de parámetros de la arquitectura CNN-Transformer. Los símbolos utilizados en las ecuaciones siguientes se introducen justo después de su primera aparición para preservar la corrección matemática.
Desde un punto de vista matemático, la tarea puede formalizarse como un problema de aprendizaje supervisado. Sea la señal acústica industrial representada por x(t). La STFT de x(t) se calcula según la fórmula:
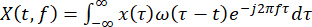 (1)
donde ω(.) es la función de ventana y f es la frecuencia. El espectrograma generado 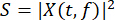 sirve como entrada para el algoritmo de aprendizaje profundo. El objetivo es entrenar la función de mapeo
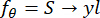 (2)
donde es la etiqueta de clase (normal o anormal), y donde S es la entrada del espectrograma, y es la etiqueta de salida predicha y θ es el conjunto de parámetros aprendibles de la arquitectura CNN-Transformer. El problema de optimización se formula como la minimización de la pérdida de clasificación:
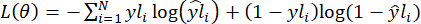 (3)
sujeto a las restricciones de latencia mínima  , eficiencia energética
 y capacidad de interpretación, en la que la explicación ∅(SHAP) captura la importancia de las características en el proceso de predicción,
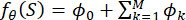 (4)
donde  es la contribución de cada característica individual. De acuerdo con lo anterior, los requisitos de diseño incluyen los siguientes: (i) detección confiable de anomalías basada en aprendizaje profundo híbrido, (ii) salidas interpretables para la intervención humana, y (iii) implementación en un marco de CPS con capacidades mejoradas en el borde.
Adquisición y preprocesamiento del conjunto de datos
A este respecto, para evaluar el marco CPHS propuesto basado en IA explicable, se ha seleccionado el conjunto de datos MIMII13. Este conjunto de datos es un referente ampliamente utilizado para detectar anomalías en maquinaria industrial mediante señales acústicas. Esta base de datos contiene grabaciones sonoras de diversas máquinas, como rieles deslizantes, ventiladores, bombas y válvulas, en condiciones de funcionamiento tanto normales como defectuosas. Para cada máquina, las grabaciones varían según diferentes configuraciones y entornos de ruido. Esto lo hace adecuado para entrenar y evaluar modelos bajo condiciones industriales en tiempo real.
Aunque el conjunto de datos MIMII se utiliza ampliamente en estudios de detección de anomalías no supervisados que dependen únicamente de muestras normales durante el entrenamiento, incluye anotaciones explícitas tanto de estados normales como anómalos de las máquinas. El problema se plantea como una tarea supervisada de clasificación binaria para evaluar la capacidad de la arquitectura propuesta de CNN-Transformador basada en IA explicable para distinguir entre estados sanos y defectuosos de las máquinas. Específicamente, se utilizan las etiquetas oficiales de MIMII, asignando la etiqueta de clase 0 a las muestras normales y la etiqueta de clase 1 a las muestras anómalas.
Tabla 1 muestra los detalles de la descripción del conjunto de datos. Aproximadamente 12.000 grabaciones de señales acústicas se consideran en la presente investigación, incluyendo operaciones de maquinaria tanto normales como defectuosas. Según los requisitos, todas las grabaciones en este estudio se han capturado a 16 kHz y tienen una duración de 10 s. Aunque el conjunto de datos contiene aproximadamente 12.000 grabaciones, se seleccionó únicamente un subconjunto equilibrado por clases de 2.000 grabaciones para visualizar la matriz de confusión. Todas las métricas de rendimiento informadas se calcularon utilizando el conjunto de prueba completo (aproximadamente 2.400 grabaciones). Además, las muestras de entrenamiento y prueba se separan en una proporción de 80:20 para el entrenamiento del modelo. Esta base de datos es especialmente adecuada para aplicaciones de la Industria 5.0 porque incluye condiciones de ruido en tiempo real. La distribución de grabaciones utilizada en este estudio se proporciona en Tabla 2. A partir de este conjunto de datos, se seleccionaron aproximadamente 12.000 grabaciones que cubren todos los tipos de máquinas y condiciones de relación señal-ruido (SNR) para experimentos de clasificación binaria supervisada utilizando una división entrenamiento/prueba de 80:20, que muestra los tipos industriales de máquinas, los identificadores correspondientes de las máquinas, los números totales de grabaciones acústicas normales y anómalas, las condiciones de SNR y la partición entrenamiento/prueba empleada para la clasificación binaria supervisada.
El experimento se realizó utilizando el conjunto de datos MIMII (Malfunctioning Industrial Machine Investigation and Inspection) versión 1.0, que comprende cuatro tipos de máquinas industriales: ventiladores, bombas, válvulas y rieles deslizantes. Los datos se recopilaron de diferentes identificadores de máquinas (ID00-ID06, según el tipo de máquina) y condiciones. La base de datos MIMII comprende datos adquiridos con relaciones señal-ruido (SNR) de −6 dB, 0 dB y +6 dB. Los datos normales corresponden al estado saludable de la máquina industrial, mientras que los datos anómalos corresponden a un estado anómalo. Las clases se etiquetaron según la anotación de la base de datos, con los datos normales etiquetados como clase 0 y los datos anómalos etiquetados como clase 1.
Se requería un procedimiento de evaluación imparcial en el que la división entre conjuntos de entrenamiento y prueba se realizara a nivel de la grabación de audio original, antes de cualquier división, aumento o creación de espectrogramas. Como resultado, segmentos de audio de la misma grabación no podían aparecer tanto en el conjunto de entrenamiento como en el de prueba. Para el experimento de evaluación, se utilizaron grabaciones con diferentes relaciones señal-ruido (−6 dB, 0 dB y +6 dB), lo que permitió evaluar el marco propuesto bajo diversas condiciones industriales.
Para evitar fugas de datos, la división entre entrenamiento y prueba se realizó utilizando el archivo de audio original como base, antes de cualquier segmentación o generación de espectrogramas. Los segmentos provenientes de la misma grabación de audio de 10 s se asignaron exclusivamente al conjunto de entrenamiento o al conjunto de prueba, sin que ningún segmento estuviera presente en ambos conjuntos. Posteriormente, los espectrogramas se generaron y aumentaron por separado para cada conjunto de datos. De este modo, se evita el problema de la fuga de datos, evitando así una evaluación excesivamente optimista del rendimiento.
Preprocesamiento del conjunto de datos
Las señales acústicas no procesadas del conjunto de datos MIMII se procesan posteriormente para mejorar la calidad de la señal y permitir una extracción eficaz de características. La señal de entrada se denota mediante x(t), donde t es el tiempo. El primer proceso es el filtrado de ruido, mediante el cual se eliminan los ruidos de fondo utilizando una función de filtrado tal que:
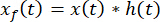 (5)
donde ∗ representa el proceso de convolución y h(t) es la respuesta al impulso del filtro. Este proceso mejora la claridad de la señal acústica y minimiza los efectos del ruido, que suele ser prevalente en entornos industriales. Se utiliza la normalización de la señal para asegurar que las amplitudes de todas las señales de audio sean comparables antes de introducirlas en el modelo de aprendizaje profundo. La señal normalizada, denotada como xn(t), se calcula mediante:
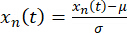 (6)
donde μ y σ son el valor medio y la desviación estándar de la señal de entrada, respectivamente. Todos los señales de entrada tienen garantizados valores medios cero y varianzas unitarias gracias a este procedimiento. Finalmente, para su procesamiento, la señal de entrada normalizada se divide en múltiples fragmentos pequeños. Dado que la longitud de la señal completa es T, esta se descompone en N tramas solapadas, cada una con una longitud L, mediante una función de ventana deslizante:
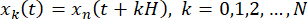 (7)
donde H es el tamaño del salto. El espectrograma puede definirse mediante la fórmula siguiente:
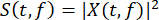 (8)
Los espectrogramas obtenidos de esta manera se introducen en el marco basado en CNN-transformador para extraer características espaciales y temporales que permitan una detección exitosa de anomalías. Figura 2 muestra la canalización de preprocesamiento.
Figura 2 ilustra una tubería de preprocesamiento vertical que puede emplearse para datos acústicos adquiridos en la industria. En primer lugar, las señales de audio en bruto se extraen del conjunto de datos MIMII y se introducen en la etapa de eliminación de ruido para reducir el ruido. A continuación, se normaliza la señal para eliminar inconsistencias de amplitud, asegurando que la señal sea coherente. Posteriormente, la señal se divide en secciones más pequeñas y solapadas. Tras la segmentación, se aplicarán transformaciones STFT a los datos para convertir las señales en el dominio del tiempo en señales en el dominio tiempo-frecuencia. Luego, se calcula el espectro de potencia como parte de la generación del espectrograma de la señal. Los espectrogramas preprocesados serán así la salida generada en el proceso y se utilizarán en el modelo propuesto de CNN-transformador.
Generación del espectrograma
Después de la normalización y segmentación de los datos, las señales acústicas se convierten en una representación en el dominio tiempo-frecuencia mediante la Transformada de Fourier de Tiempo Corto (STFT). El espectrograma resultante proporciona una representación gráfica de los cambios en la composición de frecuencia a lo largo del período de análisis. En entornos industriales, las fallas de las máquinas suelen manifestarse como patrones de frecuencia, lo que hace que los espectrogramas sean más útiles para detectar anomalías en las máquinas.
Por lo tanto, los datos procesados resultantes se convierten en imágenes de espectrogramas para distinguir entre instancias normales y anormales dentro de las máquinas. Los datos de audio se convertirán en múltiples espectrogramas para permitir que el modelo de aprendizaje analice los componentes de frecuencia locales y los cambios temporales dentro del proceso de la máquina. Estas imágenes se utilizan como datos de entrada para el modelo CNN-transformador, donde la CNN maneja los patrones espaciales (de frecuencia) mientras que los Transformadores manejan las relaciones temporales.
Algoritmo 1: Generación de espectrogramas a partir de señales acústicas
Entrada: señal de audio cruda x(t)
Resultado: Espectrograma S(t, f)
Paso 1: Cargar la señal de audio x(t)
Paso 2: Aplicar filtrado de ruido
Paso 3: Normalizar la señal xn(t)
Paso 4: Segmentar la señal en tramas:
para k = 1 hasta N hacer
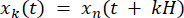
fin para
Paso 5: Aplicar una función de ventana w(t) a cada segmento
Paso 6: Calcular la TFST:
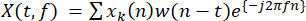 (9)
Paso 7: Calcular la magnitud:
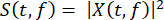 (10)
Paso 8: Almacenar el espectrograma S(t, f)
Paso 9: Devolver el conjunto de datos del espectrograma
El proceso de generación de espectrogramas comienza con la adquisición de la señal de audio original, seguido de pasos de preprocesamiento como la reducción de ruido y la normalización de la señal para garantizar la integridad y calidad de la señal. A continuación, el audio normalizado se divide en múltiples ventanas solapadas para capturar las características temporales de períodos tanto largos como cortos. Para evitar fugas espectrales, cada segmento se multiplica por una función de ventana antes de pasar por la transformada de Fourier de corta duración. Posteriormente, la señal transformada se representa como una función de valores complejos en el dominio de la frecuencia, y sus magnitudes se elevan al cuadrado. De este modo, la energía de las frecuencias a lo largo del tiempo dado queda representada por los espectrogramas. Finalmente, estos se almacenan como datos similares a imágenes y se introducen en la red neuronal para su entrenamiento.
Extracción de características espaciales mediante CNN
Después del proceso de creación de espectrogramas, las imágenes de salida en el dominio tiempo-frecuencia se toman como entradas y se introducen en una red neuronal convolucional (CNN). Suponiendo que el espectrograma de entrada es  , donde H es el dominio de frecuencia y W es el dominio de tiempo. El propósito de utilizar la CNN aquí es aprender características espaciales discriminativas a partir del espectrograma de entrada. Estas características espaciales discriminativas ayudarán a diferenciar entre el comportamiento normal y anormal de la máquina en un entorno industrial.
Una operación básica realizada por la red neuronal convolucional (CNN) es la convolución. La convolución con un filtro dado  se define como:
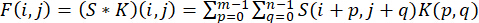 (11)
La operación descrita anteriormente permite que la red neuronal identifique características espaciales locales, como bordes, frecuencias y contenido armónico, en el espectrograma. Esto se realiza mediante múltiples operaciones de filtrado que generan diversas representaciones de características, produciendo varios mapas de características. A la convolución le sigue una función de activación no lineal, como se muestra a continuación:
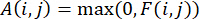 (12)
Esta no linealidad permite a la red captar y representar relaciones complejas entre variables. La siguiente etapa en una red neuronal convolucional implica la aplicación de operaciones de agrupación. La técnica común de agrupación máxima se expresa matemáticamente como sigue:
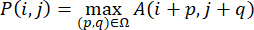 (13)
donde Ω se refiere a la ventana de agrupación. La agrupación ayuda a lograr invariancia ante traslaciones y conservar únicamente la información relevante, descartando la redundancia. Desde variables de bajo nivel, como frecuencias, hasta comportamientos complejos de máquinas, se pueden extraer características de alto nivel de forma jerárquica utilizando una red neuronal convolucional. En consecuencia, los mapas de características se pueden utilizar para representar la salida final de la red:
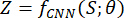 (14)
donde representa los parámetros aprendibles de la CNN. Los mapas de características contienen información espacial rica y se transforman en secuencias para servir como entradas al codificador transformador en la siguiente fase. El proceso de extracción de características espaciales descrito anteriormente es crucial para permitir que el modelo detecte anomalías mínimas en señales acústicas industriales.
Figura 3 demuestra cómo se extraen horizontalmente características espaciales de la entrada del espectrograma utilizando un modelo CNN. Comienza con el espectrograma de entrada, que codifica las propiedades de frecuencia-temporal de la señal de audio en forma pictórica. El espectrograma de entrada luego pasa por una capa convolucional, en la cual varios tipos de filtros extraen características espaciales como bandas de frecuencia, bordes y texturas, produciendo así mapas de características. Posteriormente, los mapas de características extraídos pasan por una función de activación no lineal, la unidad lineal rectificada (ReLU), lo que permite a la red neuronal detectar dependencias en los datos de entrada. A continuación, los mapas de características pasan por una capa de agrupación (pooling), donde se reduce el tamaño del mapa conservando sus características más importantes. Este proceso de capas convolucionales, de activación y de agrupación se repite varias veces, creando una jerarquía de representación de características que comienza con características simples y evoluciona hacia otras más sofisticadas relacionadas con las operaciones de la máquina.
Modelado temporal mediante un codificador transformer
Una vez que se han extraído las características espaciales mediante la CNN, el siguiente paso consiste en derivar mapas de características de alto nivel que capturen los patrones basados en frecuencia aprendidos a partir del espectrograma. Los mapas de características resultantes se aplanan y reorganizan luego en secuencias para capturar la información temporal en la señal acústica. Suponiendo que los mapas de características están representados por 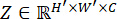 , donde H', W', y C son la altura, el ancho y los canales, respectivamente, se deriva la siguiente secuencia:
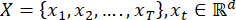 (15)
donde T representa la longitud de la secuencia, y d es la dimensión de la característica. El Transformer utiliza entonces la secuencia anterior para modelar dependencias a largo plazo mediante un mecanismo de autoatención. A diferencia de los modelos recurrentes convencionales, el modelo Transformer procesa cada elemento de la secuencia en paralelo y utiliza pesos de atención para determinar la relevancia relativa de cada parte. El funcionamiento del mecanismo de atención consiste en utilizar vectores de Consulta Q, Clave K y Valor V generados para cada entrada xt de acuerdo con:
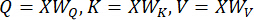 (16)
donde WQ, WK, WV son pesos entrenables. Las similitudes entre los elementos se determinan mediante:
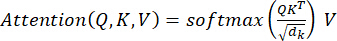 (17)
dk es la dimensión importante de los vectores. Este procedimiento facilita que el modelo aprenda dependencias de pasos temporales distantes en la señal y se enfoque únicamente en los segmentos temporales pertinentes. Para aumentar la capacidad de aprendizaje de la red, se utiliza la atención multi-cabeza, que se refiere al proceso mediante el cual varias cabezas de atención aprenden de la entrada en paralelo:
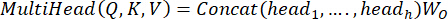 (18)
Cada cabezal atiende a características distintas de la secuencia de entrada temporal. Esto va seguido de redes neuronales de alimentación directa y conexiones residuales:
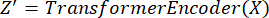 (19)
La secuencia codificada resultante captura tanto las características espaciales como temporales de la entrada. Esta secuencia se envía a la capa clasificadora para detectar anomalías.
Figura 4 muestra el proceso general de modelado temporal mediante un codificador transformer sobre características extraídas de la CNN. En primer lugar, se utilizan los mapas de características extraídos de la CNN, que contienen información espacial del espectrograma. Los mapas de características se aplanan en una secuencia, en la que cada elemento corresponde a una marca de tiempo. A continuación, la secuencia pasa por una transformación lineal que proyecta los datos en vectores de una dimensión específica. Dado que los modelos transformer carecen de la capacidad para capturar dependencias temporales, también se añade una codificación posicional a los vectores de incrustación para preservar la estructura temporal de la secuencia. Finalmente, la secuencia pasa a través de un codificador transformer, compuesto por una pila de múltiples capas, en el que se emplea un mecanismo de autoatención multi-cabeza para permitir que el modelo aprenda las conexiones entre las marcas de tiempo en la secuencia. La red neuronal de alimentación directa mejora aún más estas incrustaciones, mientras que las conexiones residuales garantizan una propagación eficiente de los gradientes. El proceso se repite a través de las capas del codificador transformer apiladas, las cuales capturan interacciones temporales progresivamente más complejas. Al final, las incrustaciones de la secuencia se combinan en una representación de longitud fija mediante agrupación (por ejemplo, agrupación promedio o el token de clasificación (CLS)), obteniendo así una representación global de características temporales.
Capa de clasificación
Después de la codificación temporal con el codificador transformador, las salidas serán una secuencia de vectores codificados, cada uno con características relacionadas tanto con los aspectos espaciales como temporales de la señal de entrada. El primer paso hacia la clasificación a partir de las salidas codificadas consiste en agrupar todas esas características en un único vector. Esto se logra aplicando agrupación promedio (mean pooling) a la secuencia de vectores de características o empleando el llamado «token de clasificación». Suponga que la salida del transformador es 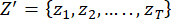 , donde cada
 . La característica agrupada h se calcula como:
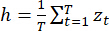 (20)
Luego, el vector de características agregado h representa la entrada de forma compacta y sirve como entrada del clasificador. La parte de clasificación comprende una o más capas densas, que transforman la representación aprendida al espacio de salida. Una capa densa implementa una transformación que se define de la siguiente manera:
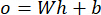 (21)
donde o es la salida (logits), b es el vector de sesgo y W es la matriz de pesos. Estos últimos son las puntuaciones de clase en una forma no normalizada. Para incorporar no linealidad en el modelo, a menudo se utilizan funciones de activación como ReLU. Finalmente, se aplica una función de activación softmax a los logits para obtener una probabilidad para cada clase:
 (22)
donde C representa el número de clases, (C = 2; normal y anormal). La predicción de clase se basará en el valor de probabilidad máximo. Durante el entrenamiento, los valores óptimos de los parámetros del modelo se obtienen minimizando la pérdida de entropía cruzada entre las etiquetas reales y las predichas, logrando así una clasificación precisa de los estados de la máquina. En resumen, la capa de clasificación cumple una función esencial al transformar las características temporales extraídas mediante la arquitectura Transformer en decisiones prácticas. A través de una adecuada discriminación entre estados de máquina sanos y defectuosos, la detección de anomalías y la toma inteligente de decisiones se vuelven posibles dentro del paradigma de la Industria 5.0.
Figura 5 muestra cómo funciona la capa de clasificación, que se encuentra después del codificador Transformer. El proceso comienza con la salida de la secuencia codificada, en la cual cada vector contiene información temporal aprendida a partir de la entrada. Estos vectores se combinan en un único vector, conocido como vector de características globales. El siguiente paso consiste en pasar el vector de características globales a través de varias capas densas de redes neuronales. En cada capa densa, se realizan operaciones de multiplicación matricial para crear combinaciones lineales de las entradas. Después, se puede aplicar una función de activación no lineal, como ReLU, para aumentar la flexibilidad en el aprendizaje de los límites de decisión. Al final de la última capa densa, existen puntuaciones logit para cada clase. Estas puntuaciones logit pueden utilizarse en la función Softmax para calcular puntuaciones de probabilidad para cada clase. Estas puntuaciones de probabilidad se emplean para determinar si la entrada pertenece a la Clase 0 (Normal) o a la Clase 1 (Anormal).
Explicabilidad mediante SHAP
Después de que el modelo clasifique las señales de entrada, se generan predicciones según si la máquina funciona normal o anormalmente. Sin embargo, dentro del entorno de la Industria 5.0, no es suficiente producir predicciones; el sistema también debe proporcionar transparencia e interpretabilidad para apoyar la toma de decisiones humanas. El siguiente marco utiliza SHAP, un modelo basado en la teoría de juegos que cuantifica la importancia de cada característica para determinar la predicción. Al hacerlo, SHAP asigna pesos a las características, lo que permite evaluar la importancia relativa de diferentes secciones de la entrada del espectrograma en la predicción general.
La formulación matemática de SHAP se basa en una descomposición del modelo f(x):
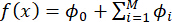 (23)
donde ∅0 es el valor de referencia (salida media del modelo), ∅i es el efecto de la i-ésima característica, y M es el número de características de entrada. Para los fines de este estudio, las características son los intervalos de tiempo-frecuencia del espectrograma. Los valores SHAP son positivos si contribuyen a la probabilidad del estado anormal y negativos en caso contrario. Esta formulación garantiza una explicación única y localmente consistente para cada predicción. El método SHAP puede aplicarse a un modelo entrenado de CNN-transformador para proporcionar una explicación basada en la importancia de las características. La representación visual mostrará los intervalos de tiempo-frecuencia más importantes en el espectrograma que afectan el proceso de toma de decisiones. Por ejemplo, un comportamiento anormal del equipo puede resultar en ciertas bandas de frecuencia de alta energía que el marco SHAP identifica como contribuyentes importantes al proceso de decisión.
Además, SHAP puede fomentar la cooperación entre personas y máquinas en un entorno ciberfísico. Esto se debe a que las predicciones pueden explicarse mediante visualizaciones intuitivas, lo que permite a los operadores y a los sistemas de toma de decisiones verificar las predicciones, analizar el problema y tomar las medidas adecuadas. Esto no solo aumenta la confianza, sino que también hace que los procesos de fabricación basados en inteligencia artificial sean confiables y responsables. Al integrar algoritmos de aprendizaje profundo que cumplen con los estándares de rendimiento actuales con SHAP, que proporciona explicabilidad, la arquitectura propuesta cumple con los requisitos de la Industria 5.0.
Algoritmo 2: Explicabilidad basada en SHAP para la predicción del modelo
Entrada: modelo entrenado f(x), espectrograma de entrada S
Resultado: valores SHAP  y mapa de explicación
Paso 1: Introduzca el espectrograma S en un modelo entrenado
Paso 2: Calcular la predicción: y = f(S)
Paso 3: Inicializar un explicador SHAP orientado al aprendizaje profundo
Paso 4: Calcular los valores SHAP:
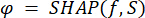
Paso 5: Para cada característica i en S:
Calcular la contribución 
Paso 6: Generar el mapa de explicación:
Resalte las regiones con alta 
Paso 7: Visualizar la importancia de las características (mapa de calor)
Paso 8: Devolver los valores SHAP y el mapa de explicación
El algoritmo de explicabilidad basado en SHAP comienza obteniendo una imagen del espectrograma preprocesada como entrada y alimentándola en la arquitectura entrenada de CNN-transformador para realizar predicciones (por ejemplo, condición normal o anormal de la máquina). Después de realizar predicciones utilizando la arquitectura entrenada, se emplea el método SHAP para interpretar el modelo. En particular, se calculan los valores SHAP (ϕ) para cada característica de entrada con el fin de determinar qué componentes tiempo-frecuencia de la entrada contribuyen más a la predicción. Para calcular estos valores, deben compararse las salidas del modelo para entradas con y sin ciertas características.
Después de calcular los valores SHAP para cada característica, su influencia sobre la predicción puede evaluarse mediante el signo y la magnitud del valor SHAP. Por ejemplo, las características con valores SHAP más altos tienen mayor probabilidad de influir en el resultado, y un signo positivo o negativo indica que la característica impulsa la predicción hacia la clase normal/anormal, respectivamente. En función de los resultados, puede elaborarse un mapa de explicación en forma de mapa de calor.
Por último, el algoritmo genera tanto los valores SHAP como las visualizaciones, lo que proporciona una idea clara de cómo los humanos pueden analizar la decisión del modelo. La técnica hace que el proceso sea más transparente y permite a los humanos participar en la toma de decisiones, garantizando así tanto las predicciones del algoritmo como su fiabilidad en la industria impulsada por inteligencia artificial. Se seleccionaron muestras de prueba representativas de instancias anómalas diagnosticadas con precisión en diversos tipos de máquinas para mejorar la fiabilidad del análisis de explicabilidad. Mientras que el análisis global de importancia de características SHAP se realizó agrupando los valores SHAP a través del conjunto de datos de prueba para identificar ubicaciones en el dominio tiempo-frecuencia consistentemente influyentes, se generaron explicaciones SHAP locales para estos casos representativos. Sin necesidad de anotaciones expertas, este análisis integrado local y global ofrece una interpretación confiable de las predicciones del modelo.
Integración de CPS habilitada para edge
Esta solución propuesta se utiliza dentro de los CPS habilitados para el edge computing, que tiene como objetivo lograr eficiencia, sostenibilidad y operaciones industriales en tiempo real. Una vez que el modelo ha sido entrenado, la red CNN-transformer se implementará mediante un enfoque de edge computing. La capa de edge computing en cuestión está cerca de los dispositivos industriales de Internet de las Cosas (IIoT), incluyendo sensores y maquinaria. En lugar de transmitir todos los datos recopilados a la nube, el dispositivo perimetral realiza inferencias sobre la señal acústica entrante sin transferirla previamente. Por lo tanto, el sistema puede detectar anomalías en la maquinaria casi instantáneamente y tomar las medidas necesarias antes de que la situación empeore. Otra ventaja de este enfoque habilitado para el edge computing es una menor latencia y mayor eficiencia, ya que los datos se analizan cerca del punto de generación. En otras palabras, a diferencia del enfoque en la nube, donde el tiempo de inferencia Tinf
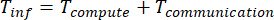 (24)
La latencia, en general, se reducirá considerablemente mediante una disminución en Tcommunication. Otro beneficio es la reducción del consumo de ancho de banda y de la energía consumida al transmitir datos de forma continua. Por lo tanto, este sistema es escalable y sostenible para plantas industriales grandes con numerosos dispositivos conectados. Además, el CPS permite la interacción con la capa física (máquinas), la IA (capa computacional) y la capa humana.
Colaboración con participación humana
Un componente clave del CPS sugerido para la Industria 5.0, que incluye operadores humanos activamente involucrados en el proceso de toma de decisiones junto con modelos de inteligencia artificial, es la colaboración con el humano en el bucle. Específicamente, según el marco diseñado, el sistema no se convierte en una caja negra autónoma, sino que permite a los operadores interactuar con él y observar resultados de predicciones explicables en forma de explicaciones SHAP. Las predicciones en cuestión se refieren a los resultados (normales/anormales), acompañados de visualizaciones de partes de los espectrogramas utilizados para generarlas.
Dicha interacción ayuda a los operadores a comprender mejor cómo se forma la predicción y qué factores contribuyen a ella. La participación humana implica verificar los resultados del sistema y permite a los operadores anularlos cuando sea necesario, basándose en su criterio profesional. La colaboración con los operadores humanos hace que el sistema sea más confiable, eficiente, seguro y fiable, ayudando a prevenir errores.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
El sistema de colaboración ciberfísica integrado con inteligencia artificial explicable presentado fue probado experimentalmente con aproximadamente 12 000 grabaciones de audio del conjunto de datos MIMII, que contiene condiciones normales y anormales de máquinas. El conjunto de datos de entrenamiento consistió en unos 9 600 registros, mientras que el conjunto de datos de prueba incluyó aproximadamente 2 400 muestras de audio. Según los resultados, el modelo sugerido basado en CNN-transformador alcanzó una precisión de c...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Los resultados experimentales demuestran que la arquitectura propuesta de CNN-transformador supera a los algoritmos individuales al integrar eficazmente el aprendizaje de características espaciales y temporales. Según el estudio de ablación, aunque la CNN extrae características discriminativas basadas en frecuencia de los espectrogramas, el codificador transformador mejora el rendimiento del modelo al capturar dependencias temporales de largo alcance en las señales acústicas. Además, la matriz de confusión muestra muy po...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Se utilizó una herramienta de inteligencia artificial (ChatGPT) únicamente para ayudar a editar el lenguaje y mejorar la gramática, claridad y legibilidad. Las herramientas de inteligencia artificial no se utilizaron para generar datos científicos, realizar experimentos, analizar resultados, interpretar hallazgos ni obtener conclusiones científicas. Todo el contenido científico, el análisis de datos, la interpretación y la versión final del manuscrito fueron revisados, verificados y aprobados independientemente por los autores, quienes asumen toda la responsabilidad sobre la exactitud e integridad del trabajo. Los autores no tienen conflictos de intereses que declarar.
Agradecimientos
FINANCIAMIENTO: Este trabajo fue apoyado por el Proyecto Clave sobre la Reforma de la Enseñanza Universitaria en la Provincia de Shaanxi (Número de Proyecto 23BG053); el Fondo de Investigación Científica para Talentos de Alto Nivel de la Universidad Politécnica de Shaanxi (Número de Proyecto BSJ-2023-08); y el Proyecto de Investigación Científica de la Universidad Politécnica de Shaanxi (Número de Proyecto 2024YKYB-006). Los autores agradecen sinceramente a la Universidad Politécnica de Shaanxi, Xianyang, China, y a la Universidad de Ingeniería del Tráfico de Xi’an, Xi’an, China, por proporcionar las instalaciones y el apoyo institucional que permitieron esta investigación.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Escala de Apoyo Social | Escala académica publicada; originalmente desarrollada por Park y revisada/ampliada por Kim | versión de 25 ítems; formato de respuesta tipo Likert de 5 puntos; sin número de catálogo comercial | Mide el apoyo social percibido entre docentes en formación de educación infantil en las dimensiones de Apoyo Emocional, Apoyo Informativo, Apoyo Material y Apoyo Evaluativo. Coeficiente general de Cronbach’s alfa = 0,96. |
| Escala de Autoeficacia del Docente | Escala académica publicada; desarrollada originalmente por Enochs y Riggs; versión adaptada al chino para estudios | versión de 25 ítems; formato de respuesta tipo Likert de 5 puntos; sin número de catálogo comercial | Evalúa la eficacia docente en el contexto chino de la formación inicial en educación infantil, en las dimensiones de Eficacia Percibida como Docente en General y Eficacia Percibida como Docente Personal. Coeficiente general de Cronbach’s alfa = 0,96. |
| Escala de Interacción entre Maestro y Niño | Escala académica publicada; desarrollada por Lee y revisada por el panel de expertos del estudio para su uso en China | versión de 30 ítems; formato de respuesta tipo Likert de 5 puntos; sin número de catálogo comercial | Evalúa la competencia autoreferida en la interacción entre docente y niño, en lugar de la calidad observada de la interacción en el aula. Incluye Interacción Emocional, Interacción Verbal e Interacción Conductual; alfa general de Cronbach’s alfa = 0.94. |
| Formulario de Información Demográfica | Equipo de investigación, colaboración entre la Universidad de Artes y Ciencias de Sichuan y la Universidad de Daegu | Sección personalizada del cuestionario del estudio; sin número de catálogo comercial | Se recopilaron las características de los participantes, incluyendo género, nivel educativo, categoría profesional, ubicación de la pasantía, duración de la pasantía, tipo de pasantía y tipo de jardín de infantes. |
| Información para el participante y guion del consentimiento informado | Equipo de investigación; aprobado por el Comité de Ética en Investigación de la Universidad de Daegu | Número de aprobación ética: XXX; registro de aprobación local para verificar | Utilizado antes de la distribución del cuestionario para explicar el propósito del estudio y el contenido de la encuesta, y obtener el consentimiento informado de los participantes, futuros docentes de educación infantil. |
| Paquete de cuestionario de encuesta piloto | Equipo de investigación y panel de expertos | Versión piloto utilizada en junio–5, 2024; sin número de catálogo comercial | Pilotó la claridad y adecuación de la Escala de Percepciones Profesionales, la Escala de Apoyo Social, la Escala de Autoeficacia Docente, la Escala de Interacción Docente-Niño y los ítems demográficos en 50 estudiantes de pedagogía en educación infantil. |
| Procedimiento de Revisión por Panel de Expertos | Equipo de investigación; panel de expertos compuesto por dos profesores de educación infantil, un director de prejardín, tres supervisores de prácticas y el equipo de investigación | Revisión de contenido basada en consenso; sin número de modelo comercial | Utilizado para revisar los ítems de la escala en cuanto a ambigüedad, adecuación, claridad semántica, pertinencia evolutiva y relevancia cultural antes de la encuesta formal. |
| Formularios impresos de cuestionarios en el lugar | Equipo de investigación; suministros para encuestas institucionales locales | Formularios de encuesta en papel; sin número de catálogo comercial | Utilizado para la administración del cuestionario en el lugar. En la muestra final, se obtuvieron 336 cuestionarios válidos en el lugar antes de combinarlos con los cuestionarios en línea. |
| Tencent | Aplicación móvil WeChat; la versión debe verificarse a partir del registro del dispositivo/aplicación utilizado durante junio–julio de 2024 | Utilizado como canal de distribución en línea para la administración del cuestionario; se recopilaron 27 cuestionarios completados a través de la vía en línea/WeChat. | |
| Procedimiento de reclutamiento por teléfono y en persona | Equipo de investigación | Procedimiento estandarizado de reclutamiento; sin número de catálogo comercial | Utilizado para contactar a instituciones/participantes, explicar el objetivo del estudio y el contenido de la encuesta, y apoyar el consentimiento informado antes de la administración del cuestionario. |
| SPSS Statistics | IBM | Versión 27.0 | Utilizado para estadísticas descriptivas, coeficientes de correlación de Pearson, alfa de Cronbach’análisis de fiabilidad alfa, comprobaciones de normalidad mediante asimetría y curtosis, y Harman’una prueba de un solo factor para el sesgo común por método |
| SPSS Amos | IBM | Versión 26.0 | Utilizado para el análisis factorial confirmatorio, la modelización de ecuaciones estructurales, la prueba de invariancia de medición en múltiples grupos, la prueba de bootstrap de efectos indirectos y la comparación de modelos alternativos. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel o versión de Excel instalada localmente; verifique la versión local exacta antes de la presentación | Recomendado/utilizado como entorno de trabajo para organizar los datos codificados de la encuesta, el diccionario de datos, las tablas suplementarias y la Tabla de Materiales de JoVE. La versión local exacta debe ser verificada por los autores. |
| Criterios de índices de ajuste en el modelado de ecuaciones estructurales | Guía metodológica publicada; referencias de Schreiber et al. y Kline citadas en el manuscrito | Sin número de catálogo comercial; criterios aplicados en el plan de análisis estadístico | Define e informa índices de ajuste del modelo, incluyendo el estadístico chi-cuadrado, chi-cuadrado dividido por los grados de libertad, Índice de Tucker-Lewis, Índice de Ajuste Comparativo, Índice Ajustado de Bondad de Ajuste, Índice de Ajuste Incremental, Raíz del Error Cuadrático Medio de Aproximación y Residuo Estándarizado de la Raíz del Cuadrado Medio. |
| Procedimiento de Prueba de Mediación con Bootstrap | SPSS Amos / plan de análisis estadístico del equipo de investigación | 5.000 muestras bootstrap; intervalos de confianza del 95 % corregidos para el sesgo | Utilizado para evaluar asociaciones indirectas mediante la eficacia del docente. Los efectos indirectos se consideraron significativos cuando el intervalo de confianza corregido para el sesgo al 95% no incluía el cero. |
| Procedimiento de Prueba de Invariancia de Medición | SPSS Amos / plan de análisis estadístico del equipo de investigación | Análisis factorial confirmatorio multigrupo ΔCFI &< .010 y ΔRMSEA &< .015 criterios | Utilizado para evaluar la invariancia configuracional, métrica y escalar según el género, tipo de programa, duración de la pasantía e institución antes de interpretar las estimaciones del SEM combinado. |
Referencias
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.